
TECH EXPLORER
기술 탐색
쏟아지는 오픈소스와 논문 가운데 코어닷투데이가 직접 열어 보고 돌려 본 것들. 읽기 전에 먼저 만져 보세요.
에이전트
6
MCP (Model Context Protocol)
에이전트와 도구 사이의 공용 규격 — 2026-07-28 개정으로 핸드셰이크와 세션을 지우고 웹처럼 라우팅·캐시되는 프로토콜이 됐다
Agent Skills (SKILL.md)
업무마다 에이전트를 새로 만들지 말고 절차·스크립트·서식·검수를 폴더 하나에 담아 범용 에이전트에게 건넨다 — 평소에는 이름과 설명 약 100토큰만 올라가는 업무 매뉴얼 규격
GLM-Legal
활성 18B짜리 가벼운 모델에 법률 중간학습과 수만 개 과제 환경 강화학습을 얹어 Harvey LAB 19.2% — 프런티어를 앞섰지만 다섯 건 중 네 건은 여전히 어딘가를 놓친다
The Agency (agency-agents)
성격·절차·산출물을 갖춘 AI 전문가 수백 명을 부서별 마크다운으로 — 멀티 에이전트 팀을 조립하는 오픈소스 부품 창고
코딩 에이전트 하니스 설계 연구
모델은 그대로 두고 하니스 부품 하나씩만 바꿔 본 176개 실험 — 맥락 관리·계획·행동 공간은 모델과 예산에 따라 효과가 뒤집힌다
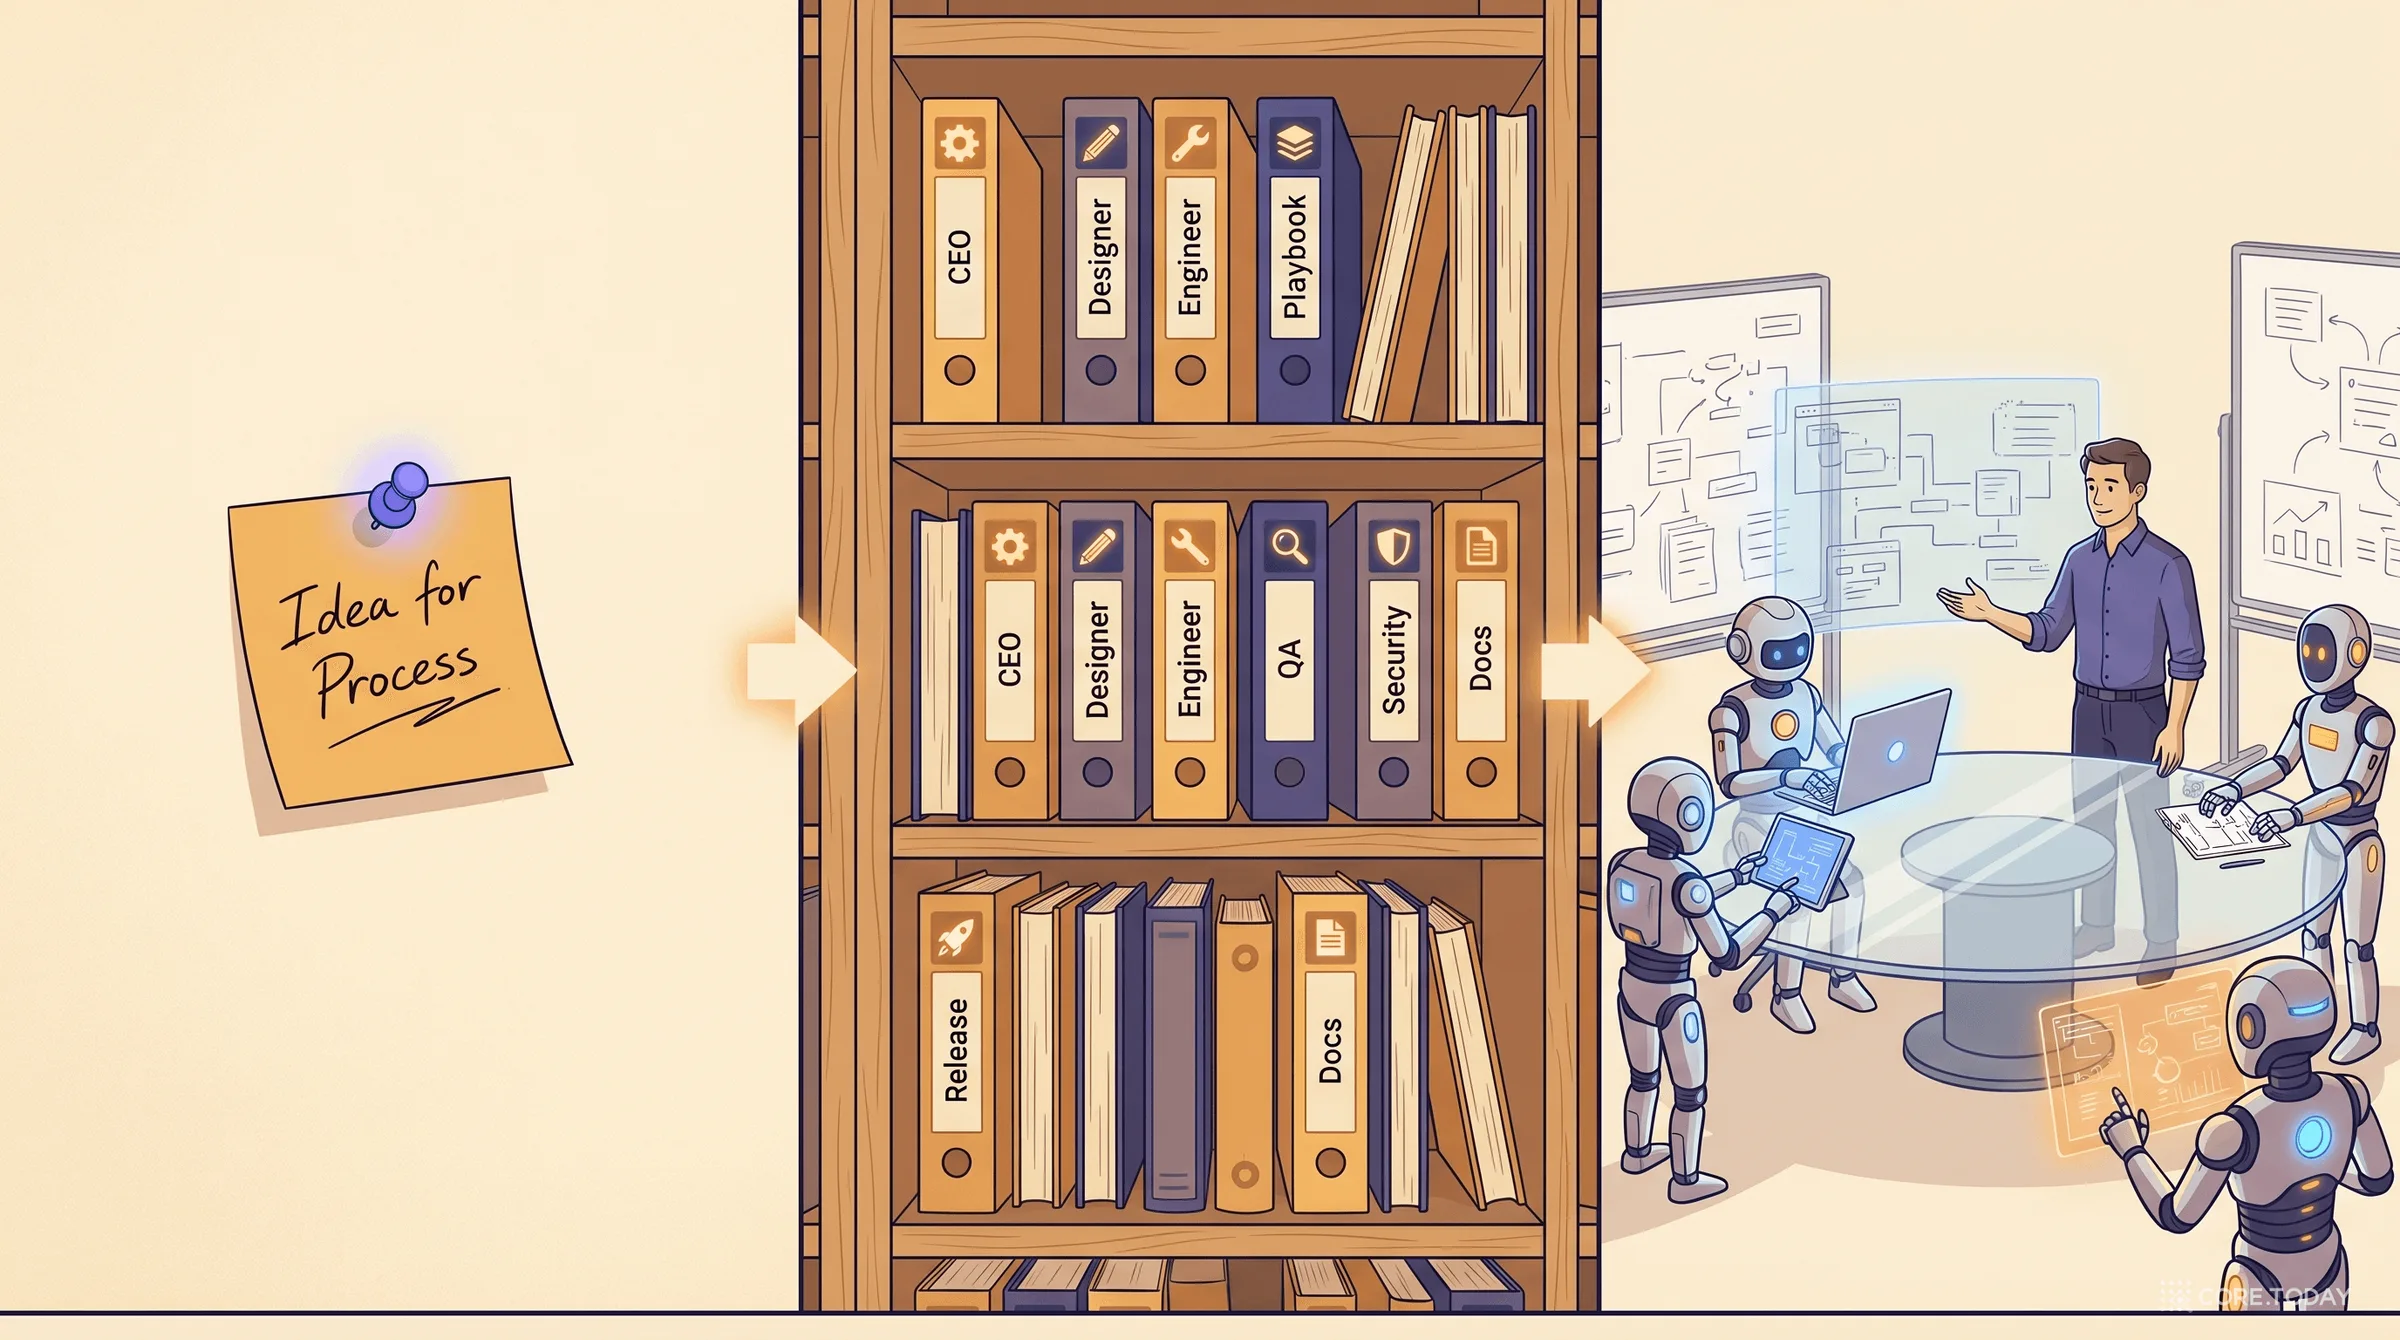
gstack
Claude Code를 '가상 엔지니어링 팀'으로 — CEO·엔지니어링 매니저·QA·보안 담당을 슬래시 커맨드 스킬로 묶은 Garry Tan의 작업 방식
에이전트 기억
15에이전트 계열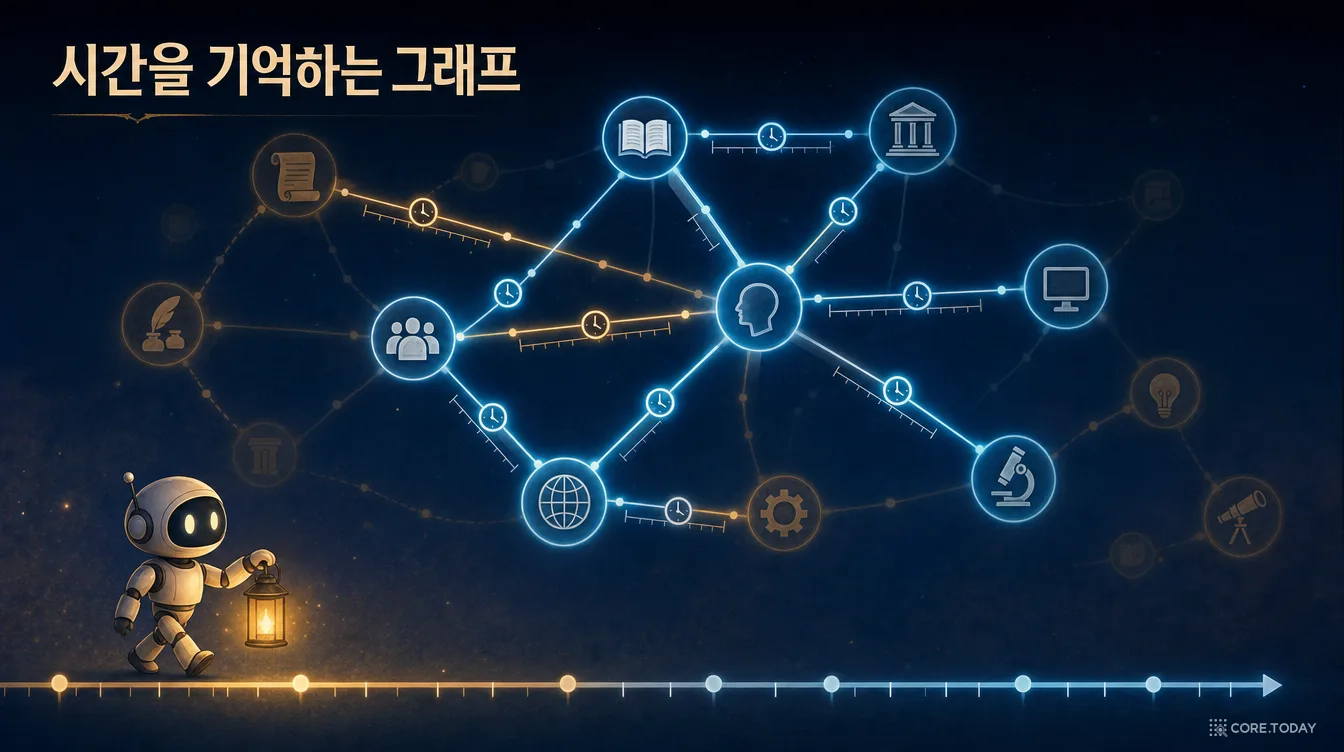
Graphiti
사실마다 유효기간을 적는 시간 지식 그래프 — 에이전트 기억이 '옛 사실'과 '지금 사실'을 구분하게 한다
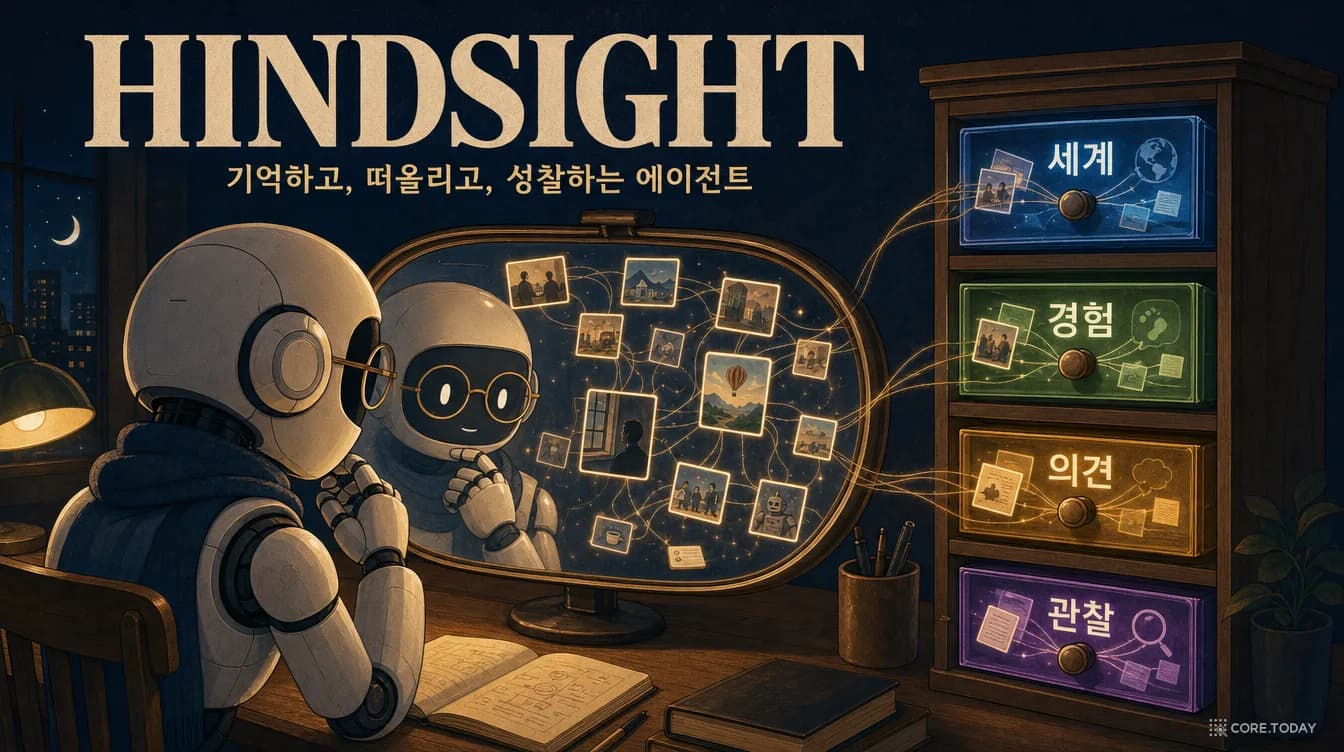
Hindsight
본 것과 믿는 것을 따로 적는 기억 엔진 — 원본 사실은 쌓고, 관찰만 근거와 함께 고쳐 쓴다
FEB-30
답이 맞았다고 기억이 맞는 건 아니다 — 문서가 들어올 때마다 기억 저장소를 열어 정답 상태와 대조하는 내재 평가 벤치마크
MemoryArena
기억을 '떠올렸나'가 아니라 '떠올린 것으로 다음에 무엇을 했나'로 채점하는 다중 세션 시험장 — 13가지 기억 방식 모두 과제 성공률 0.20 이하
MemStrata
포트는 8080이 됐는데 AI는 아직 8000이라고 한다 — 유사도 대신 (주어, 관계) 열쇠로 옛 값을 지우지 않고 퇴역시키는 시간 유효성 기억
SodaMem
모든 기억에 원문 영수증을 붙이고, 바뀐 사실은 지우지 않고 닫는 시간 그래프 기억 — 단, 92.8%를 낸 저장소에서 대체는 꺼져 있었다
StateMem
기억은 하는데 지금을 모르는 에이전트에게 상태 장부를 — 대체 표시·의존 그래프·재계산 안내로 '상태 표류'를 줄이고, 답변 프롬프트 하나짜리 래퍼로도 옮겨 쓴다
Supersede
메모장만 쥔 에이전트가 바뀐 사실을 얼마나 놓치는지 재고, 그 측정을 보상으로 바꿔 훈련하는 강화학습 환경
TOKI
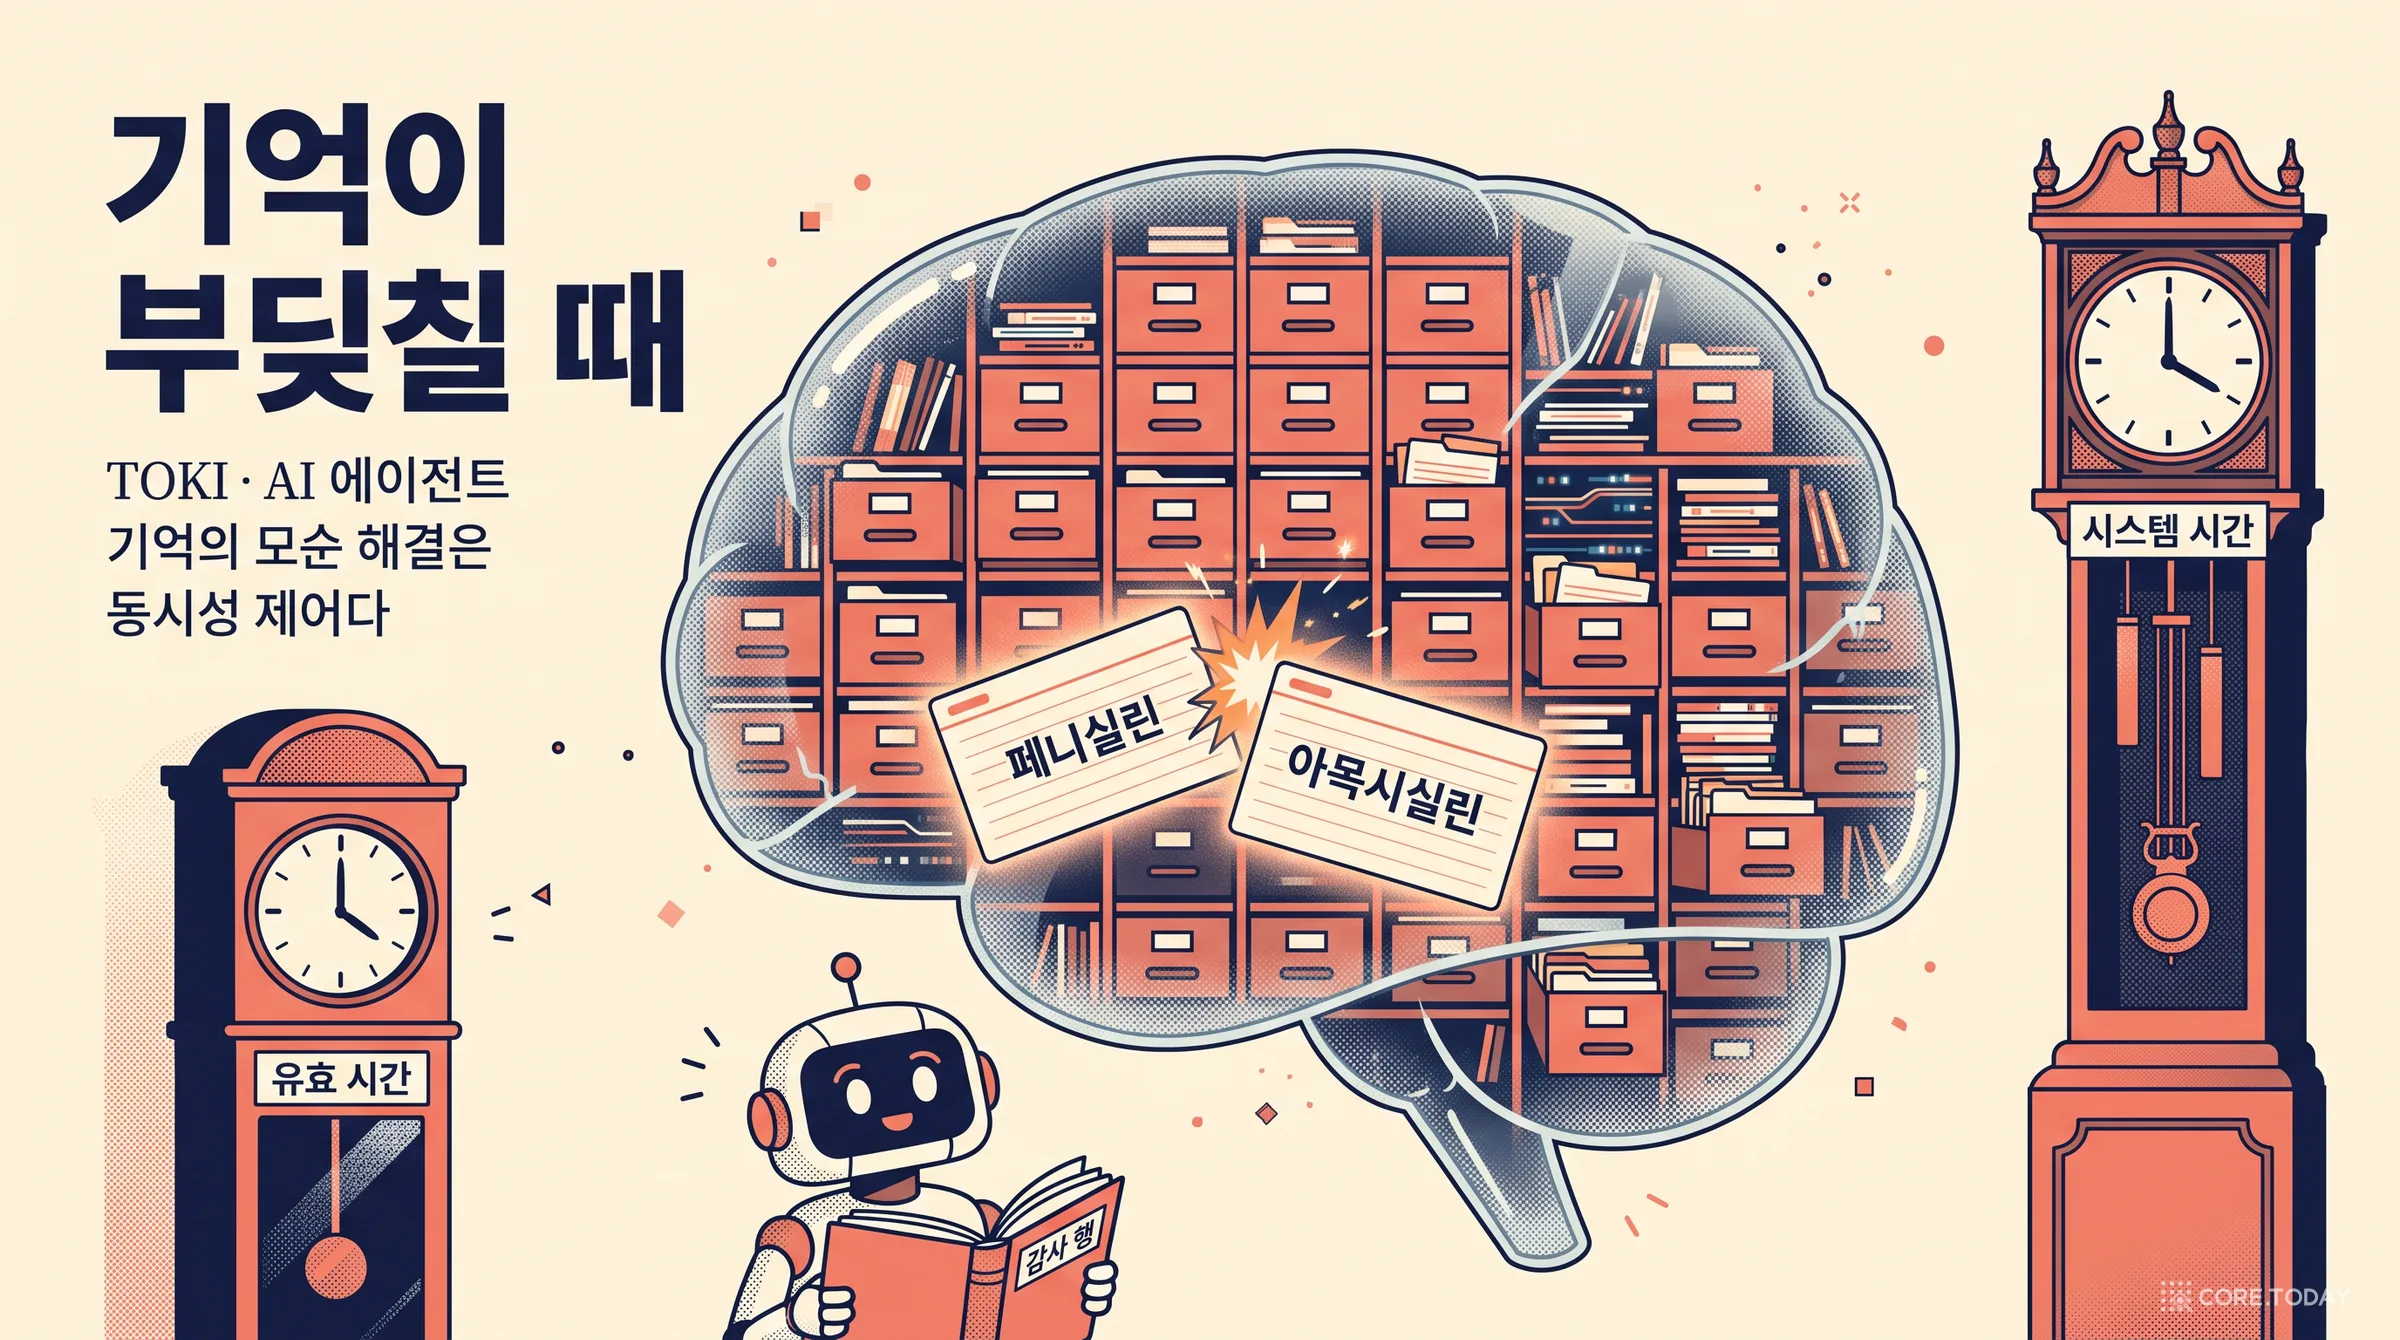
기억의 모순 해결은 '누가 더 똑똑한가'가 아니라 동시성 제어다 — 네 전략에 격리 수준 계약을 붙이고, 진 사실은 감사 행에, LLM 판정은 키로 장부에
JAM
기억은 미리 요약하지 말고 물어볼 때 짓는다 — 원본은 폴더에 두고 README 지도만 미리 그린 뒤, 작은 Researcher가 찾아 들어간다
Letta
기억을 git 저장소의 마크다운 파일로 둔다 — 에이전트가 자기 기억을 직접 고쳐 쓰고 커밋하는 MemGPT의 후신
Mem0
대화에서 사실을 뽑아 쌓는 가장 가벼운 기억 레이어 — 2026년 4월부터는 고치지 않고 추가만 한다
MemAgent
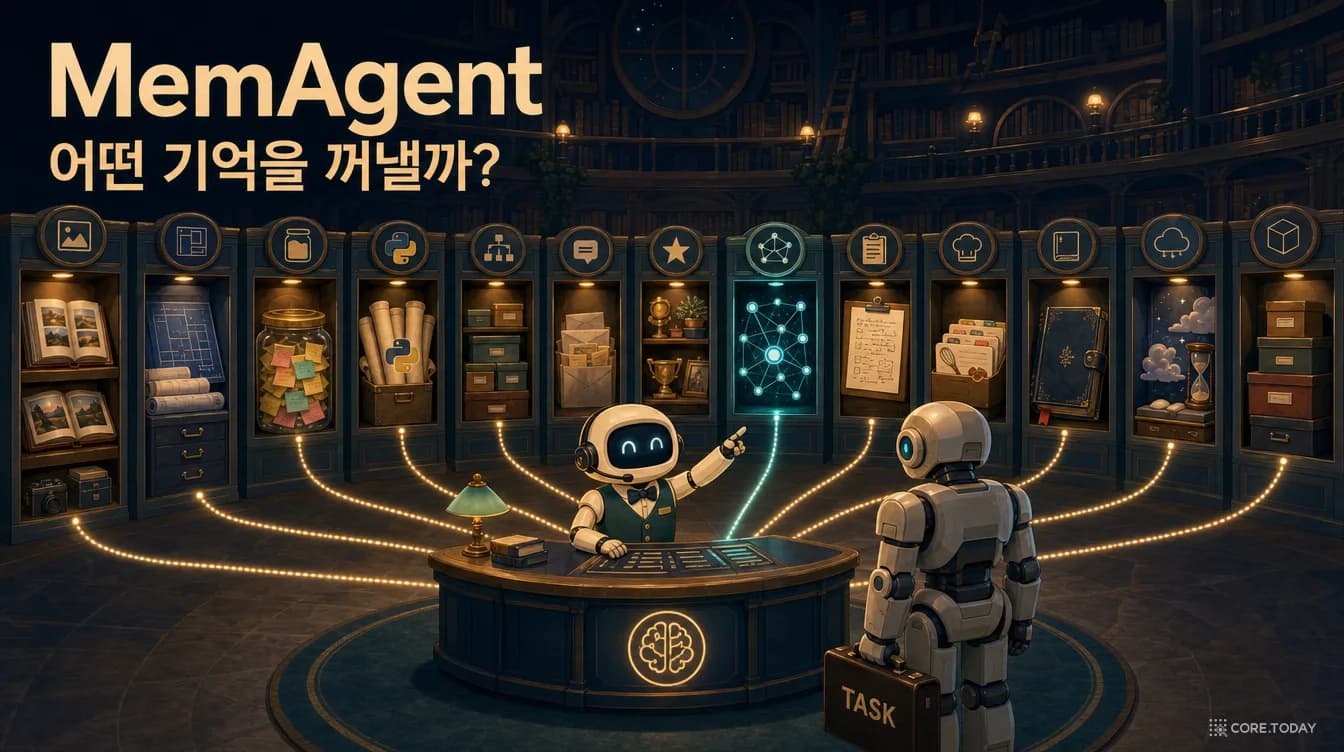
만능 기억은 없다 — 13가지 기억 방식 중 과제마다 꺼낼 곳과 넣을 곳을 고르는 4B 라우터
MemoType
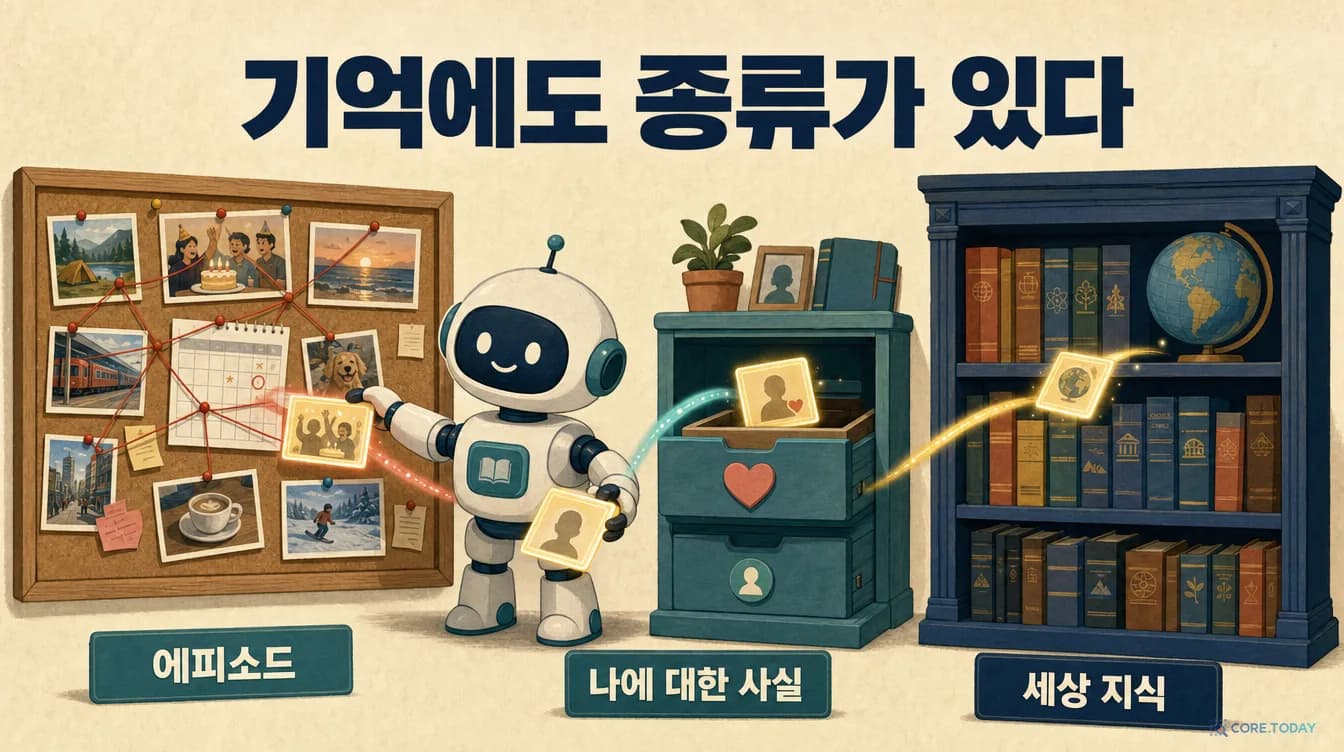
기억에도 종류가 있다 — 사건·개인 정보·일반 지식을 먼저 가르고, 종류마다 다른 방법으로 찾는다
검색 허용성
관련 있는 기억이 써도 되는 기억은 아니다 — 범위·정책·수명을 1/0/? 세 값으로 판정하고, 같은 재현율에서 비교하는 평가 프레임워크
프롬프트 최적화
5에이전트 계열
GEPA
점수 대신 실패 기록을 읽고 프롬프트를 고친다 — 반성과 파레토 선택으로 프롬프트를 진화시키는 최적화기
Combee
에이전트 수십 대의 회고를 플레이북 하나로 잃지 않고 모은다 — 병렬 프롬프트 학습의 '컨텍스트 과부하'를 푸는 확장 층
FlowBank
버리던 후보 워크플로를 은행처럼 모아 두고 문제마다 골라 보낸다 — 커버리지로 고르고 그래프 신경망으로 짝짓는 '미리 만들어 다시 쓰기'
LAWA
멀티에이전트 워크플로의 '가장 긴 줄'을 깎는다 — 시간을 절대 늘리지 않는 두 가지 그래프 편집과 실행 없이 채점하는 GNN 평가기
Squeeze Evolve
비싼 모델은 시작과 갈림길에만 — 검증기 없는 진화형 추론에서 묶음마다 모델을 골라 같은 정확도를 더 싸게 얻는다
검색·RAG
7검색 계열
에이전틱 검색 (Agentic Search)
검색 결과를 보고 다시 묻고, 문서를 열어 이동하고, 충분하면 멈춘다 — RAG가 파이프라인에서 에이전트로 바뀌는 방식
AEVS
트리플의 주어·관계·목적어마다 원문 글자 위치를 묶고, 본문에서 찾은 말로만 조합한 뒤 원문으로 되돌려 검증한다 — 점수보다 '어디서 왔는지 확인할 수 있다'를 사는 지식 그래프 추출
Docling
PDF·Office·스캔 문서를 구조를 잃지 않은 문서 객체로 바꾸는 파서 — RAG 파이프라인의 입구
GraphRAG
문서를 지식 그래프와 커뮤니티 요약으로 바꿔 '전체를 관통하는 질문'에 답한다 — 그래프 RAG의 원형
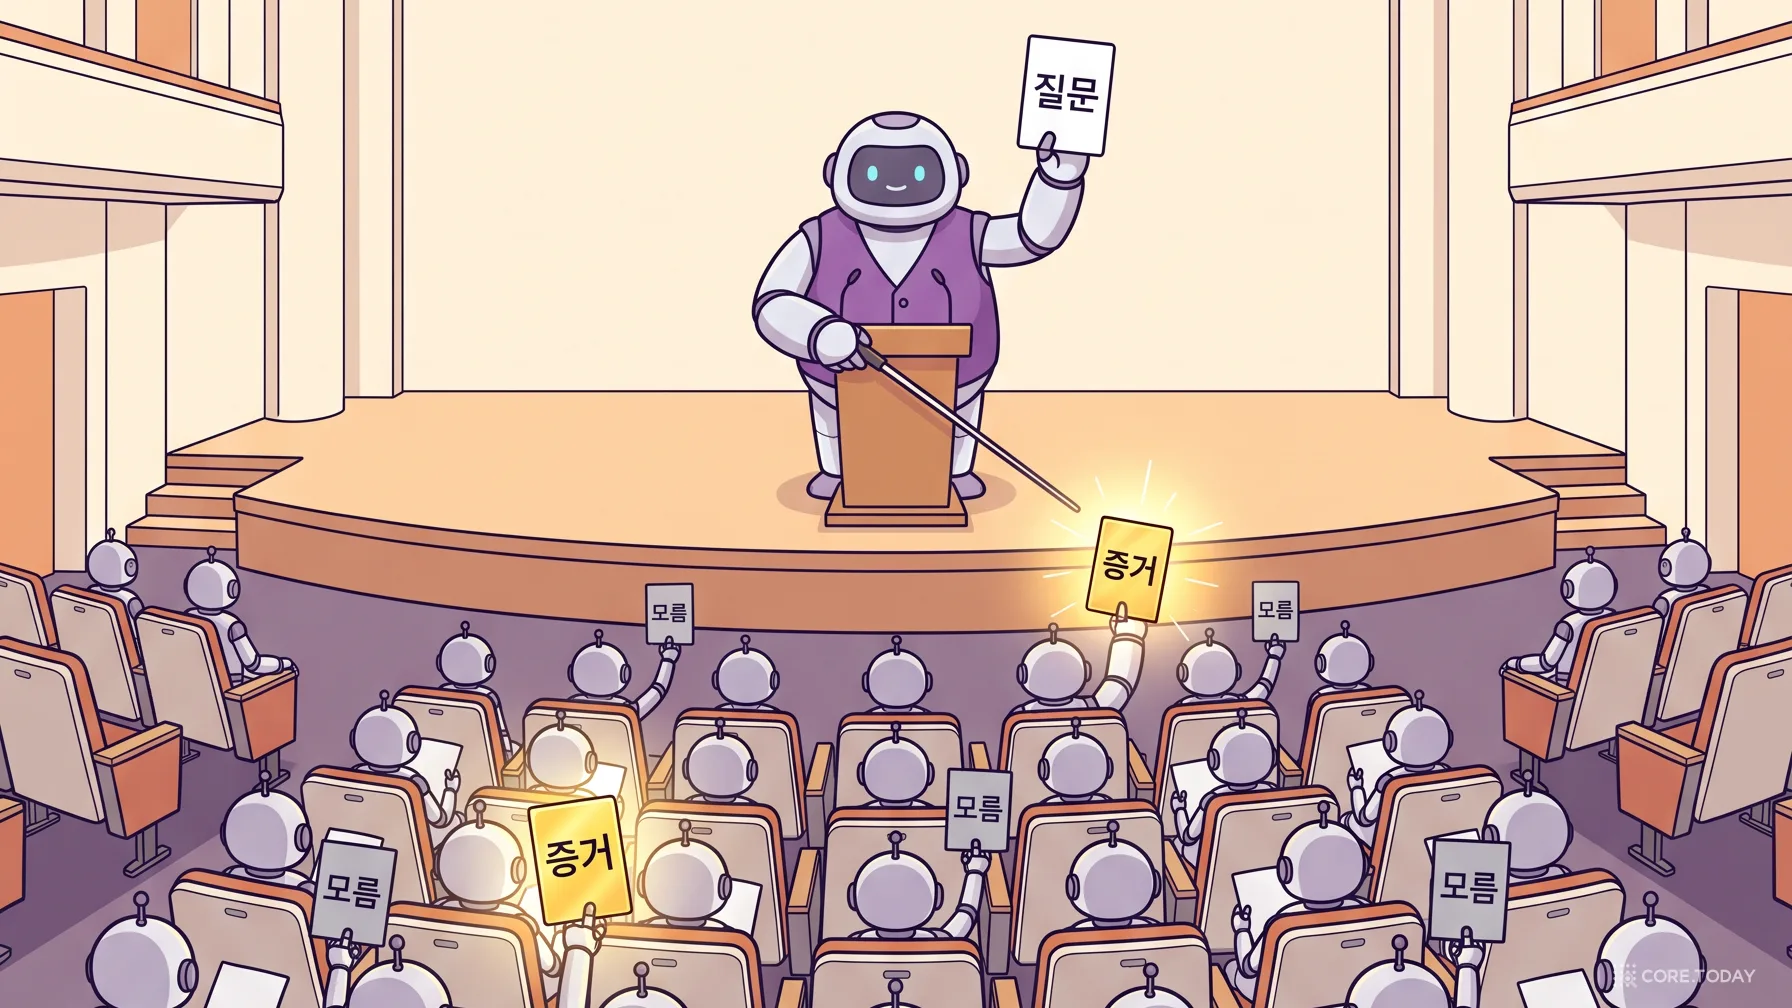
PARSER
읽기는 병렬로, 추론은 질문 순서대로 — 문서를 안 보는 리드 에이전트가 청크 담당 서브에이전트 수천 개를 지휘한다
충분한 컨텍스트 (Sufficient Context)
검색된 문서가 '관련 있는가'가 아니라 '이것만으로 답할 수 있는가'를 묻는다 — RAG 환각을 줄이는 Google의 판정 렌즈
turbopuffer
오브젝트 스토리지 위에 세운 서버리스 검색 엔진 — 벡터를 '주인'에서 '색인 하나'로 내리는 중
임베딩
3검색 계열
인프라·DB
6인프라 계열
FalkorDB
그래프를 희소 행렬로 메모리에 올려 Redis 키 하나에 담는 RedisGraph의 후계 — 작은 그래프 수천 개를 한 인스턴스에서 Cypher로
Tailscale · Headscale
공유기 뒤에 숨은 기기들을 WireGuard로 직접 잇는 메시 VPN — 전화번호부(조정 서버)만 내 서버로 옮기고 싶으면 헤드스케일
이중 시간 SQL (SQL:2011)
'언제 참이었나'와 '언제 알았나'를 두 기간으로 적는 SQL 표준 — PostgreSQL 18·19와 MariaDB에서 어디까지 되나
TigerBeetle
시간·디스크·네트워크를 전부 가짜로 만들고 씨앗 하나로 버그를 되살린다 — 결정론적 시뮬레이션 테스트로 검증하는 금융 원장 데이터베이스
vLLM
KV 캐시를 운영체제처럼 페이지로 나누고 빈자리를 매 스텝 채운다 — 2026년 GPU 위 LLM 서빙의 기본 엔진
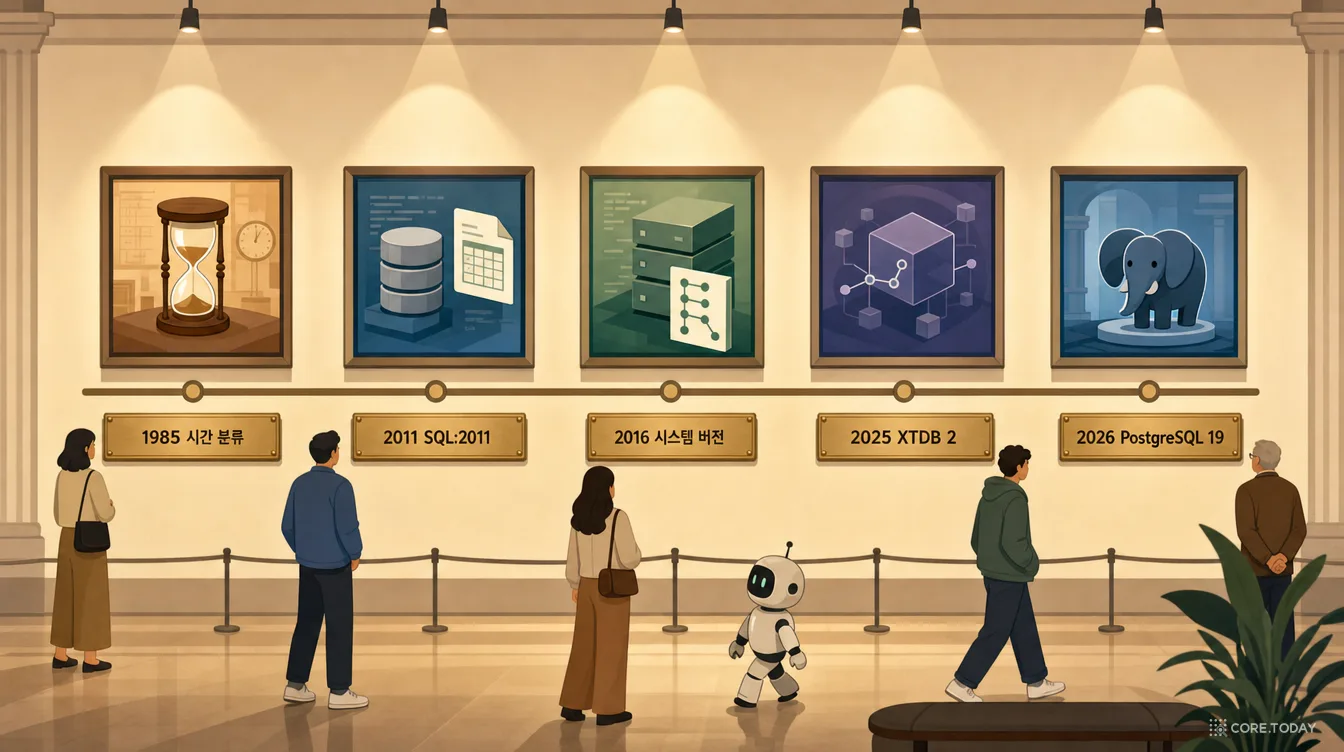
XTDB
모든 테이블이 처음부터 이중 시간인 SQL 데이터베이스 — 기록의 시계는 앞으로만 흐르고, 지난 사실은 지워지지 않고 닫힌다
로컬 AI
5인프라 계열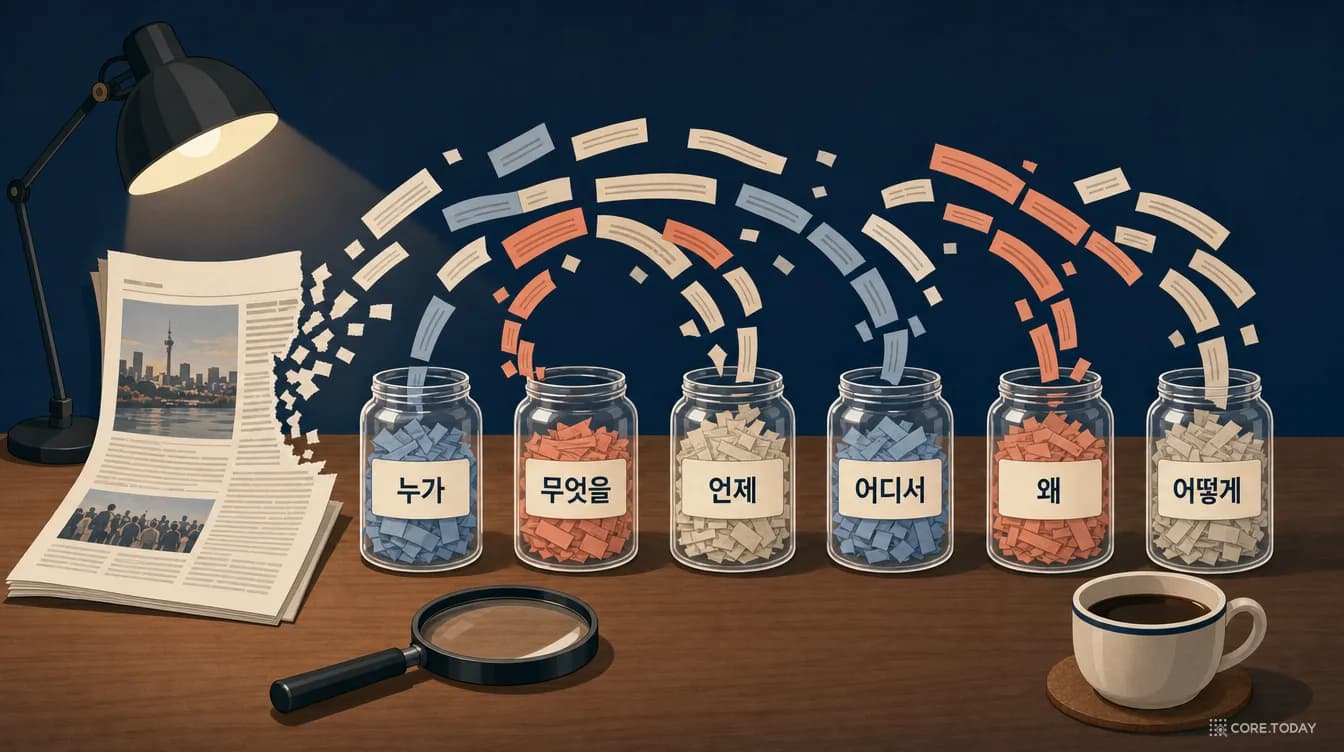
육하원칙 추출 (5W1H)
기사에서 누가·언제·어디서·무엇을·왜·어떻게를 꺼낸다 — 절반은 답을 찾는 일, 나머지 절반은 '없다'고 말하는 일
EAGER
사건 추출에 '여섯 명의 채점관'과 '문제지마다 다른 오답 보기'를 붙인 강화학습 — 7B 모델이 퓨샷 프런티어 LLM의 세 배 점수를 낸다
GLiNER2
뽑고 싶은 것의 이름을 글자로 적으면 원문에서 그 조각을 집어 오는 2억 개짜리 인코더 — 개체·분류·관계·레코드를 CPU에서 한 번에
로컬 판정 모델 (tev1·Nimble)
글자를 쓰지 않고 선택지 하나와 확률만 돌려주는 열린 가중치 모델 — Ollama의 /v1/systemone에서 Jev 자리를 로컬로 대신한다
Ollama
명령 한 줄로 오픈 모델을 내 컴퓨터에서 돌리는 로컬 실행기 — 채팅·임베딩에 이어 판정 모델까지 한 서버에서
과학 AI
5과학·교육 계열
Lean 형식 증명 — 페르마의 마지막 정리
Claude 에이전트들이 11일 동안 2만 9천여 개 정리를 쌓아 올린, 컴퓨터가 검증한 최초의 페르마 증명 — 새로운 것은 수학이 아니라 검증이다
JAX-PI
PINN이 왜 무너지는지에 대한 6년치 처방을 한 저장소에 모았다 — 손실 가중, 시간 인과 학습, PirateNet, 2차 최적화까지 JAX로
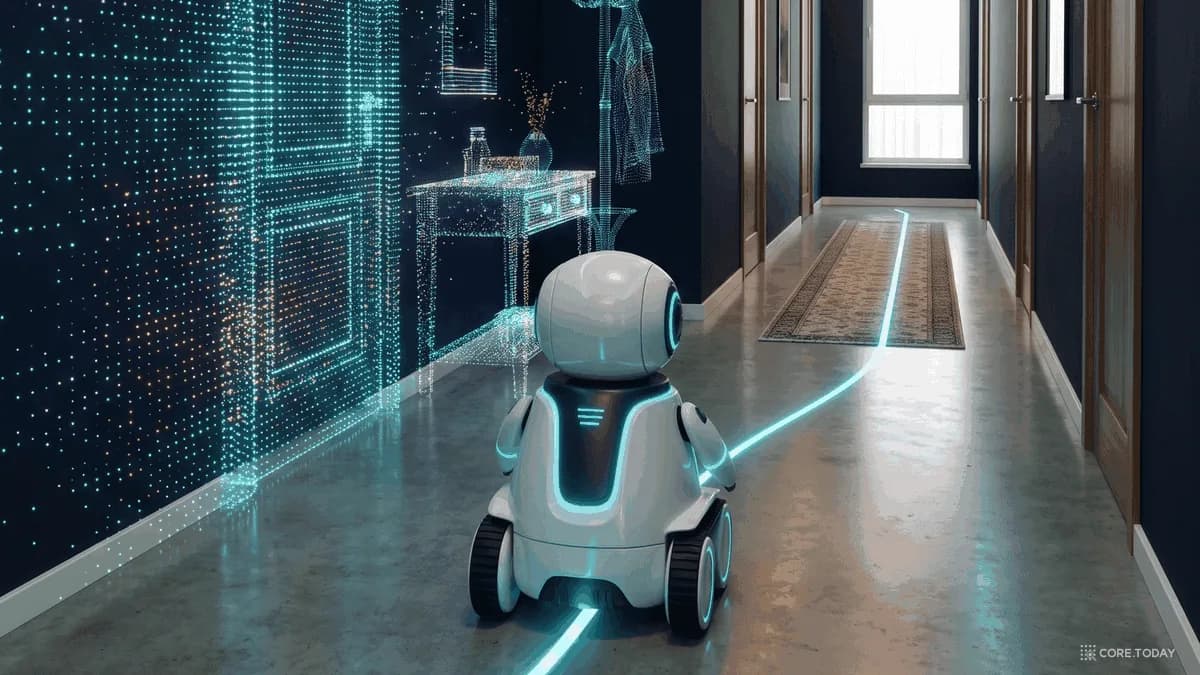
LingBot-Map
카메라 영상 한 편을 1만 프레임 넘게 20 FPS로 3차원 복원한다 — 무엇을 기억하고 무엇을 버릴지를 어텐션 마스크로 배운 스트리밍 모델
OpenAI math 저장소
미공개 내부 모델이 쓴 수학 원고 722편, 결과 계열 372개를 하룻밤에 공개한 저장소 — '검증됨'과 '이해됨' 사이의 거리를 재는 실물 자료
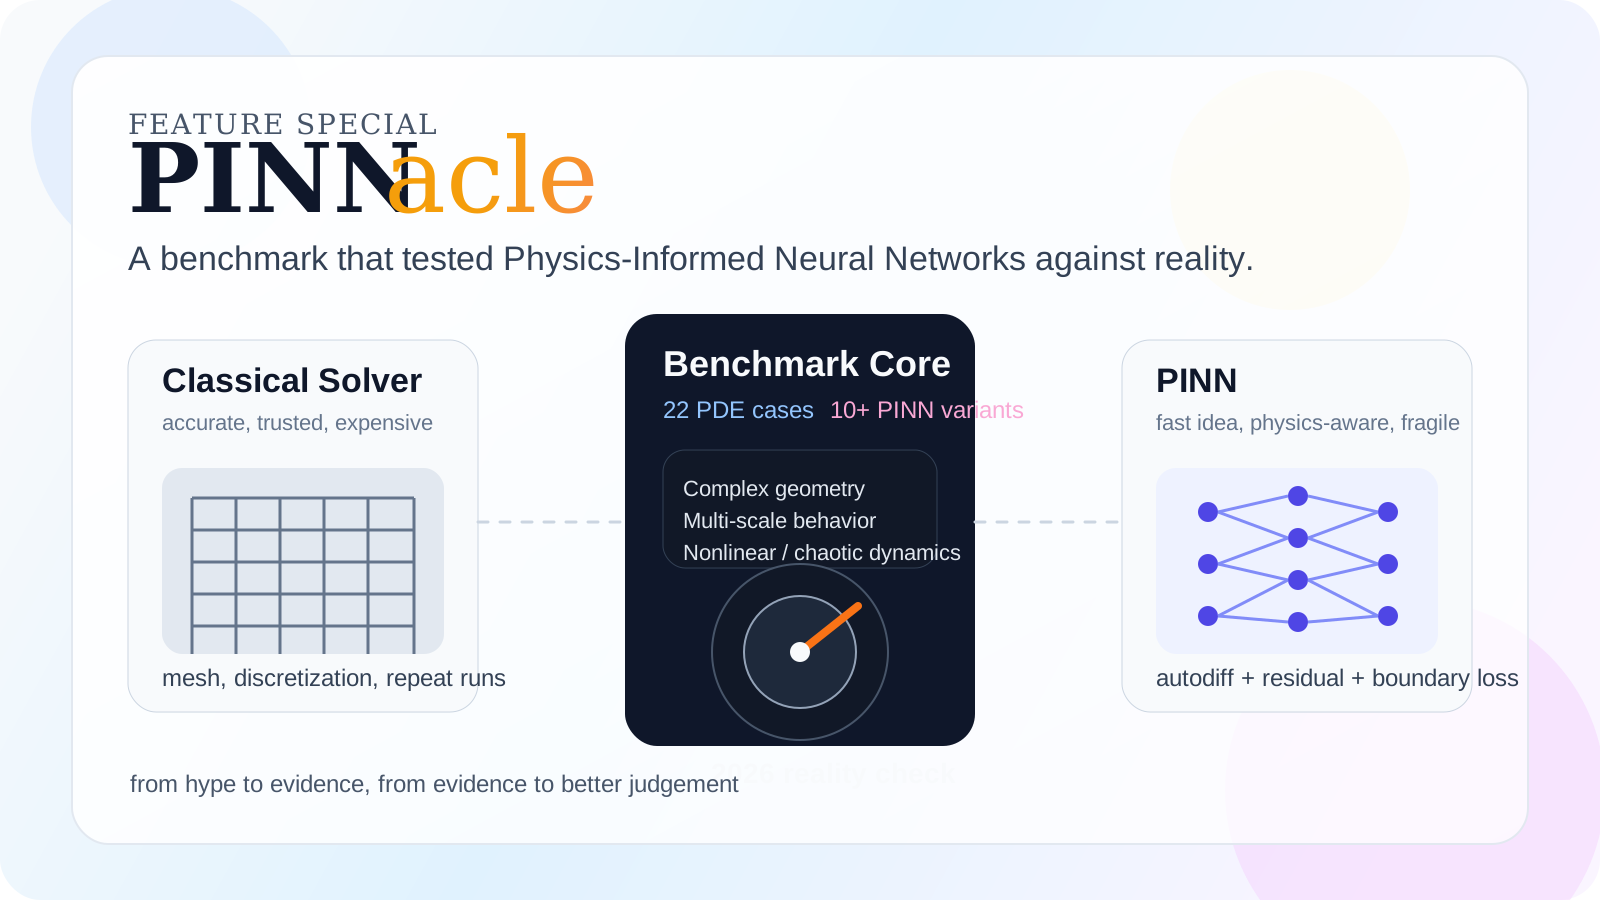
PINNacle
22개 PDE 위에 대표 PINN 변형 10여 개를 같은 규칙으로 세웠다 — vanilla PINN은 절반도 못 풀었고, 어떤 처방이 어떤 난제에 듣는지 지도가 생겼다
AI 교육
1과학·교육 계열
신뢰·안전
4신뢰 계열
LLM 확신도·보정
모델이 말한 '0.85'는 계기판 눈금이 아니라 다음에 올 법한 글자다 — 확신도를 측정으로 바꾸는 채점법과 기록 기반 규칙
Claimify
해석이 갈리면 뽑지 않는다 — 답변을 고르기·모호성 해소·분해 세 관문에 통과시켜 확인할 수 있는 주장만 남기는 추출기

C2PA
사진과 영상에 '누가, 언제, 무엇으로 만들고 고쳤는지'를 서명한 영수증을 붙이는 표준 — 쓸모는 크지만 증거로 쓰기엔 아직 균열이 많다
LLM 텍스트 워터마킹
단어를 초록과 빨강으로 나누고 초록 쪽을 살짝 밀어 준다 — 글자 하나 바꾸지 않고 '기계를 거친 글'에 통계 서명을 남기는 방법
평가·벤치마크
3신뢰 계열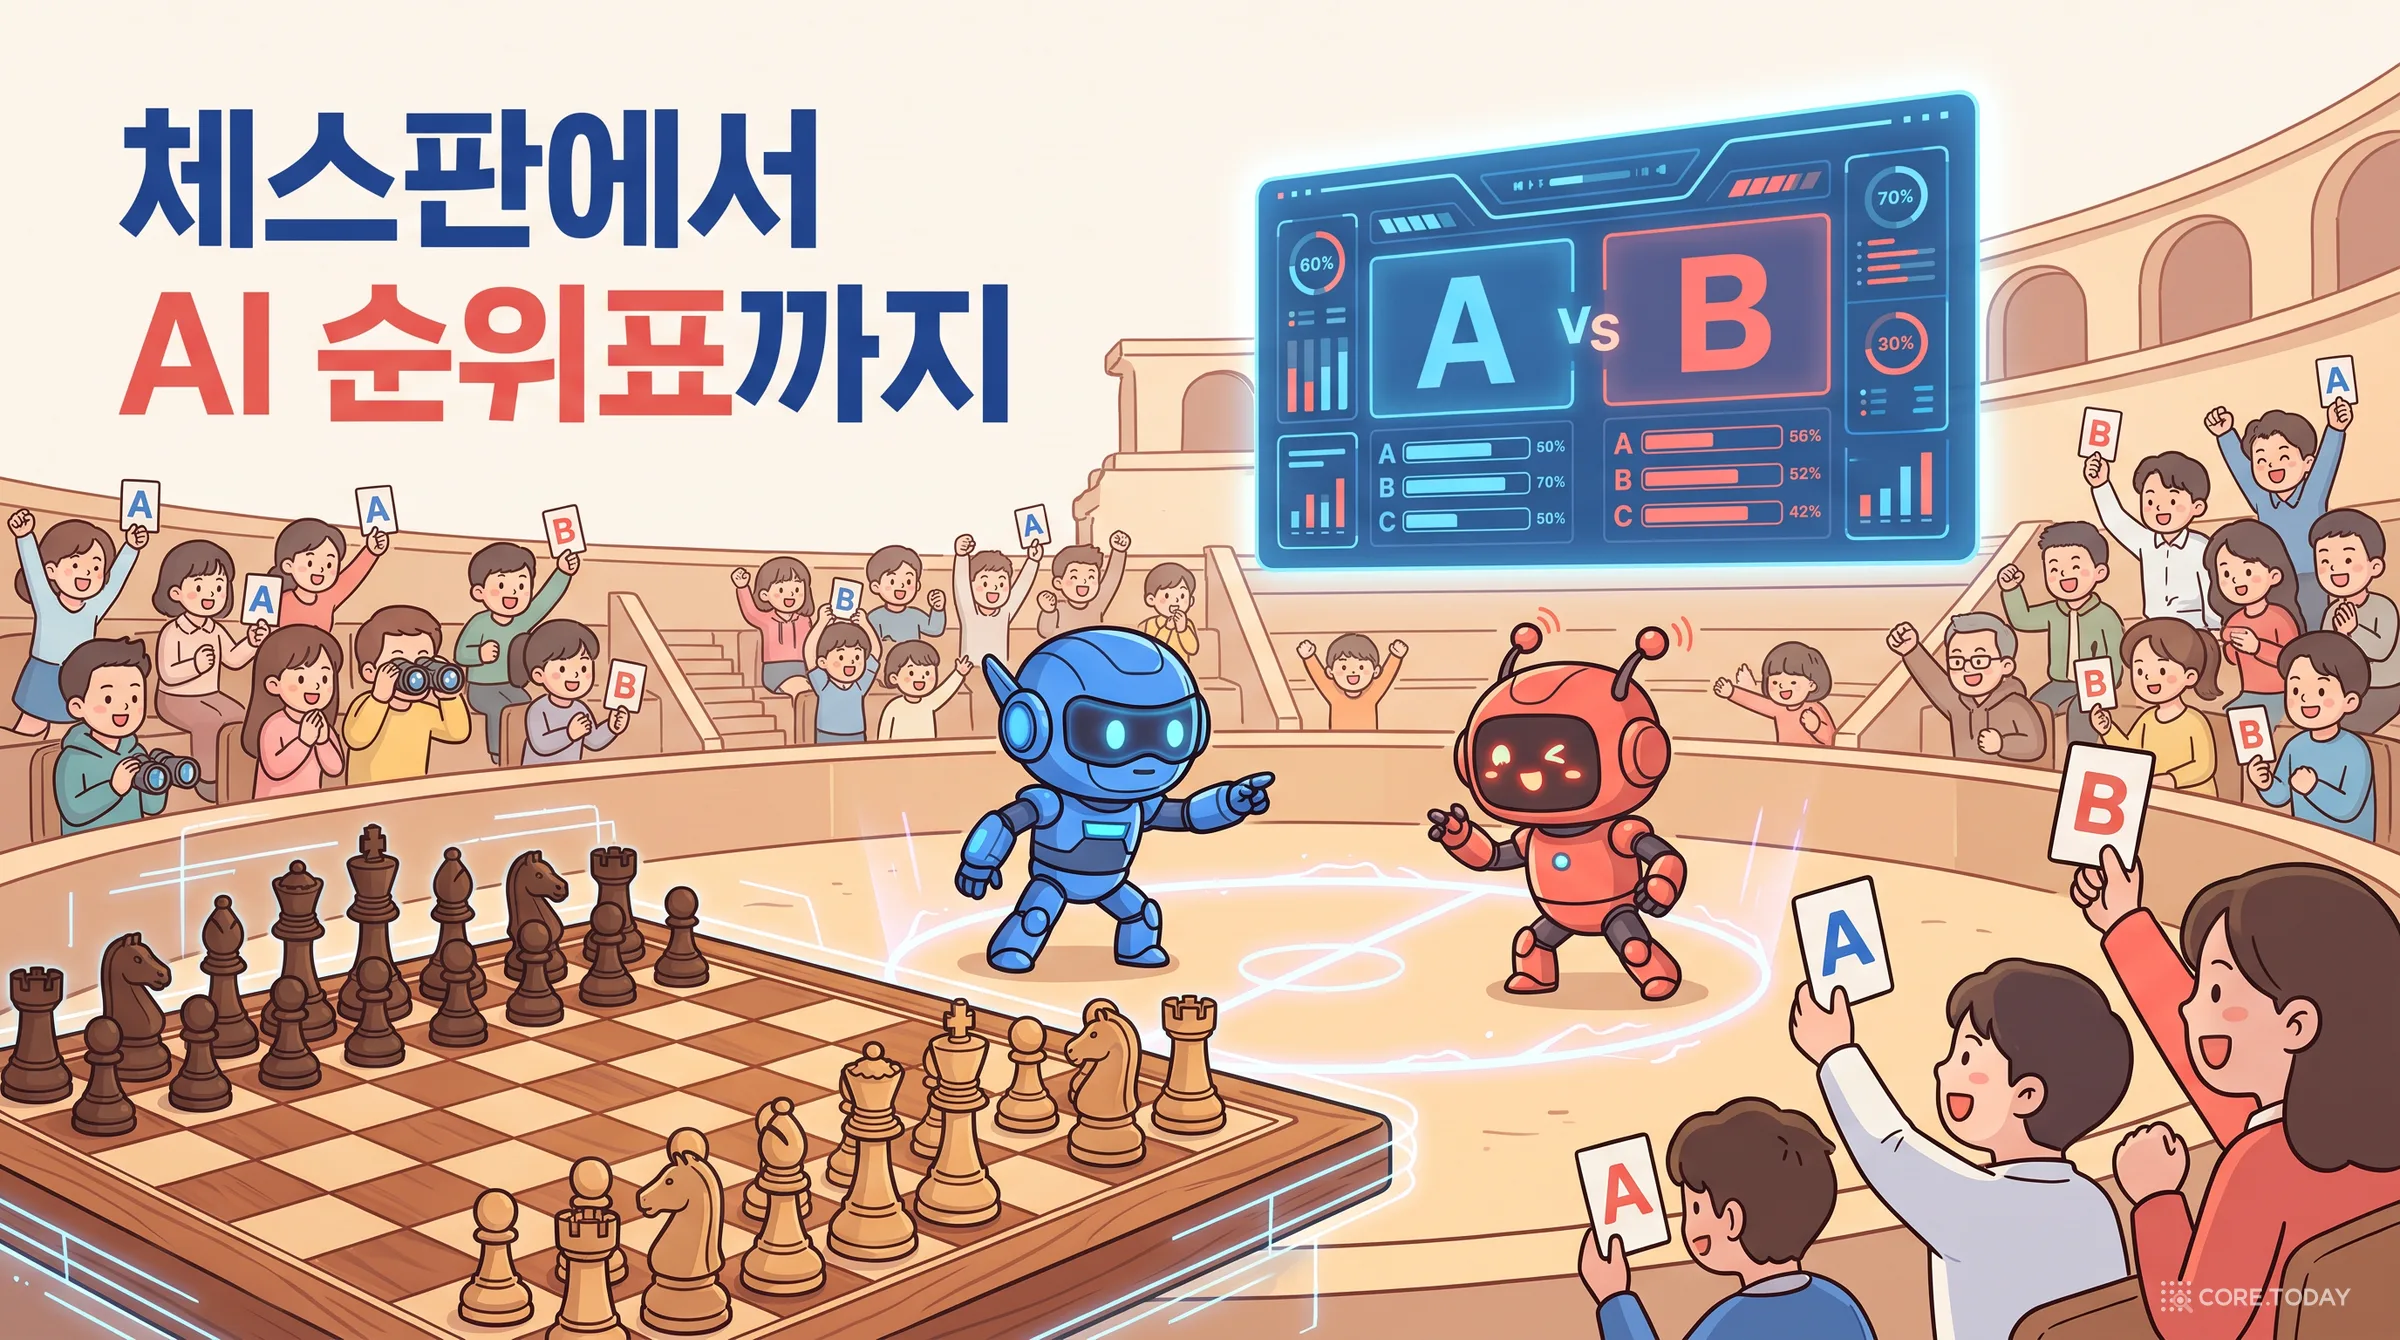
Chatbot Arena (LMArena)
이름을 가린 두 답 중 하나를 고른 수백만 표를 1952년 돼지고기 맛 비교의 수식으로 줄 세운 순위표 — 점수보다 신뢰구간과 스타일 보정을 먼저 봐야 한다
Gemini 4 Argon
지식 노동 표에서는 맨 앞, 터미널 코딩에서는 나란히 — 성적표의 줄마다 누가 쟀는지부터 확인해야 하는 구글의 새 최전선 모델
SlopCodeBench
테스트는 전부 통과하는데 한 달 뒤엔 아무도 못 고치는 코드 — 에이전트가 자기 코드를 이어받게 해서 '슬롭'이 쌓이는 속도를 재는 벤치마크