무엇인가
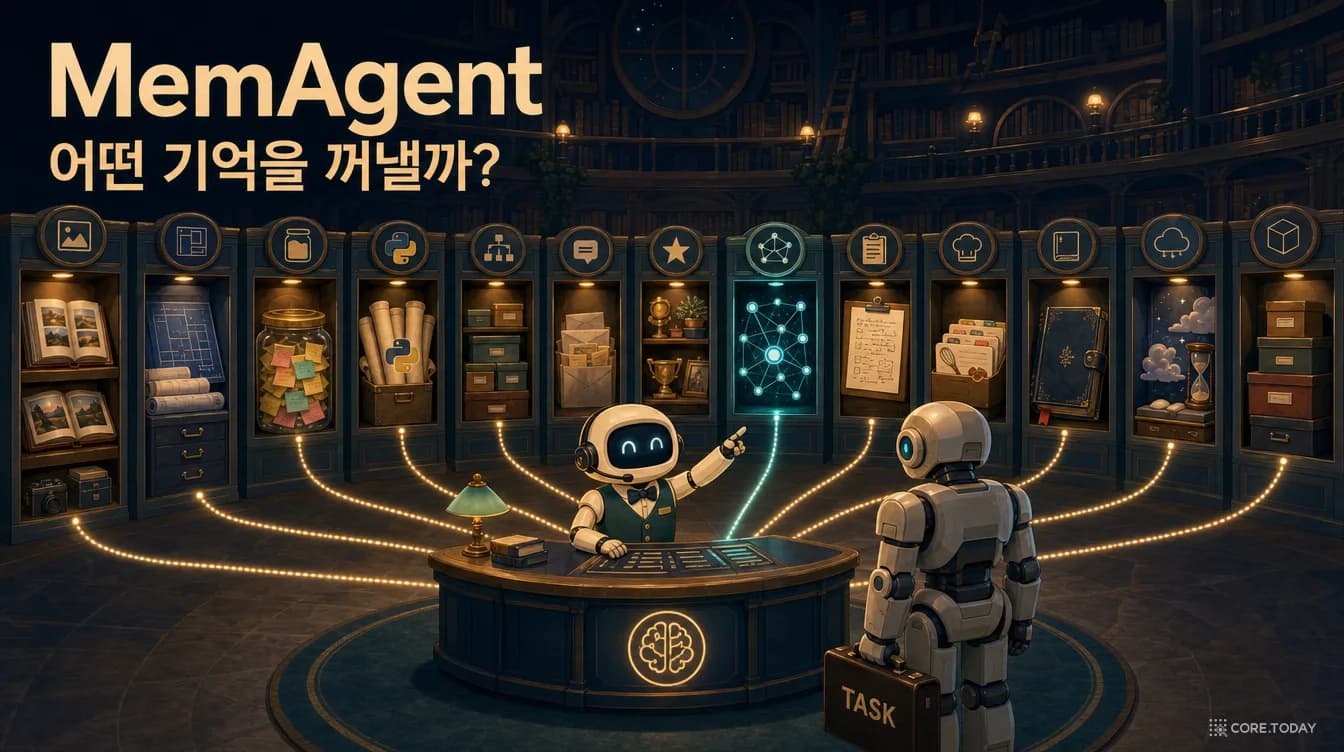
MemAgent는 칭화대·텐센트 연구진이 2026년 9월 26일 arXiv에 올린 「MemAgent: Learning to Manage Heterogeneous Memory Providers for LLM Agents」(arXiv 2609.32521)의 기억 라우터입니다. 더 좋은 기억 하나를 발명하는 대신, 이미 있는 여러 기억 방식 가운데 과제마다 어느 것을 쓸지 고르는 작은 모델을 학습시켰습니다.
출발점은 실험 하나입니다. 궤적 요약(Voyager·DILU), 실패에서 뽑은 통찰(ExpeL), 변수 자리를 비운 워크플로(AWM), 실행 가능한 함수(SkillWeaver) 등 13가지 기억을 같은 작업 에이전트(Flash-Searcher + GPT-5-mini)에 하나씩 꽂고 GAIA·WebWalkerQA·xBench-DeepSearch 세 시험을 치르게 했더니, 1위가 셋 다 달랐습니다(AWM, ExpeL, SkillWeaver). 그런데 "문제마다 맞힌 기억이 하나라도 있으면 정답"으로 치는 사후 오라클은 평균 89.6%로, 최고의 단일 기억(ExpeL 71.0%)보다 18%p 넘게 높았습니다. 논문은 여기서 기억을 이질적인 기억 제공자 위의 라우팅 문제로 다시 씁니다.
이름이 같은 다른 논문이 있습니다. 2025년 7월의 MemAgent(arXiv 2507.02259, ICLR 2026)는 긴 문서를 조각내 읽으며 고정 길이 메모를 덮어쓰는 '긴 문맥' 연구입니다. arXiv 번호로 구분하세요.
어떻게 동작하나
기억 에이전트(Qwen3.5-4B + LoRA)는 과제 하나의 생애 동안 세 번 결정합니다. 모든 기억 제공자는 retrieve와 store 두 동작만 가진 공통 인터페이스 뒤에 숨어 있습니다.
학습은 강화학습이 아닙니다. 훈련 과제 173개를 13개 기억으로 강제 라우팅해 모두 풀어 본 뒤(강제 탐색), 결정마다 세 가지 신호로 점수를 매깁니다. BEGIN은 정답 여부, BEGIN·IN은 LLM 심판의 활용·관련성 평가, END는 그 궤적이 나중에 실제로 꺼내져 성공에 쓰였는지(하류 재사용)입니다. 좋은 결정만 남겨 LoRA(r=16, 학습 파라미터 0.84%)로 지도 미세조정을 합니다.
| 방법 | GAIA | WebWalkerQA | xBench-DS | 평균 |
|---|---|---|---|---|
| 기억 없음 | 58.8 | 69.4 | 69.0 | 65.7 |
| ExpeL (최고 단일) | 61.8 | 77.1 | 74.0 | 71.0 |
| 무작위 라우팅 | 58.2 | 72.4 | 71.0 | 67.2 |
| All-Fuse (전부 꺼내 통합) | 63.6 | 75.3 | 74.0 | 71.0 |
| PromptRoute (학습 없이 프롬프트) | 65.5 | 71.2 | 76.0 | 70.9 |
| MemAgent | 69.7 | 79.4 | 78.0 | 75.7 |
| 오라클 (상한) | 87.3 | 89.4 | 92.0 | 89.6 |
라우팅 비용은 과제당 약 1.2초(수행 시간의 0.3% 미만)이고, 평균 스텝은 9.1에서 8.0으로 줄었습니다. 많이 넣는 것보다 맞는 것을 넣는 쪽이 일을 합니다.
빠른 시작
공개 저장소는 학습·평가 파이프라인 전체를 담고 있지만 학습된 라우터 가중치와 강제 탐색 데이터는 없습니다. 벤치마크 데이터도 직접 받아 data/에 넣어야 합니다.
git clone https://github.com/WalkerWorldPeace/MemAgent && cd MemAgent
conda create -n memagent python=3.10 && conda activate memagent
pip install -r requirements.txt
cp .env.example .env   # OPENAI_API_KEY, DEFAULT_MODEL, SERPER_API_KEY 등을 채운다
이후 단계는 README 순서대로 강제 탐색 → 결정별 보상 → 보상 필터 SFT 데이터 → LoRA SFT(GPU 8장 기준)입니다. 학습 인프라가 없다면 PromptRoute부터 보세요. 강제 탐색 로그에서 기억별 성공률·과제 유형별 규칙·대표 사례를 뽑은 지식베이스를 프롬프트에 넣고 큰 LLM에게 라우팅을 맡기는 방식으로, GPU 없이 학습한 라우터 GAIA 성능의 94%가 나왔습니다.
언제 쓰고, 언제 피하나
- 잘 맞는다: 과제 분포가 넓은 범용 리서치·검색 에이전트, 위키·런북·스크립트 저장소·장애 회고처럼 지식 저장소가 이미 여럿인 조직(공통
retrieve/store만 씌우고 라우터를 둔다), 같은 유형의 과제가 반복돼 탐색 데이터가 쌓이는 운영 환경. - 다른 방법을 먼저 본다: 기억 저장소가 한두 개뿐인 서비스(라우팅할 다양성이 없다), 개인 비서의 대화 기억(정확성·삭제권이 핵심), 과제의 정답 여부를 알 수 없는 도메인(이 학습법은 정답 신호가 있어야 돈다).
한계와 주의
- GAIA Level 1은 본 적 있는 문제다. 훈련 과제 53개가 평가에도 쓰였다. 처음 보는 L2+L3 112문항만 다시 세면 MemAgent 63.4% 대 최고 단일 59.8%로, 차이는 4문항이다.
- 표본이 작고 반복 실험이 없다. xBench-DS에서 SkillWeaver를 앞선 +1.0%p는 정확히 1문항이다. 시드 반복이나 신뢰구간이 없다.
- 오라클은 '선택의 가치 + 운'이다. 13번 중 한 번이라도 맞히면 정답이라는 계산은 재시도 효과(pass@k)를 품고 있다. 기억 없이 13번 돌린 대조군이 없다.
- 천장은 라우터 밖에 있다. GAIA에서 틀린 문제의 42%는 어떤 기억으로도 못 푸는 문제였다.
- 같은 GPT-5-mini가 작업 에이전트·학습 데이터 심판·정답 판정자를 겸한다. 기억 제공자 목록은 라우터 프롬프트에 하드코딩돼 있어, 기억을 더하거나 뺄 때 다시 학습해야 하는지 검증되지 않았다.
- 프로브 미리보기가 라우터 프롬프트에 그대로 들어가므로, 저장소에 심긴 주입 문구가 새 공격 경로가 될 수 있다.