무엇인가
Hindsight는 데이터 파이프라인 회사 Vectorize가 만든 오픈소스 에이전트 기억 엔진입니다. 2025년 12월 Vectorize·워싱턴포스트·버지니아공대 연구진이 낸 논문 「Hindsight is 20/20」(arXiv 2512.12818)이 출발점이고, 2026년 10월 13일 1.0이 나왔습니다. 저장소 별은 5만 개를 넘었습니다.
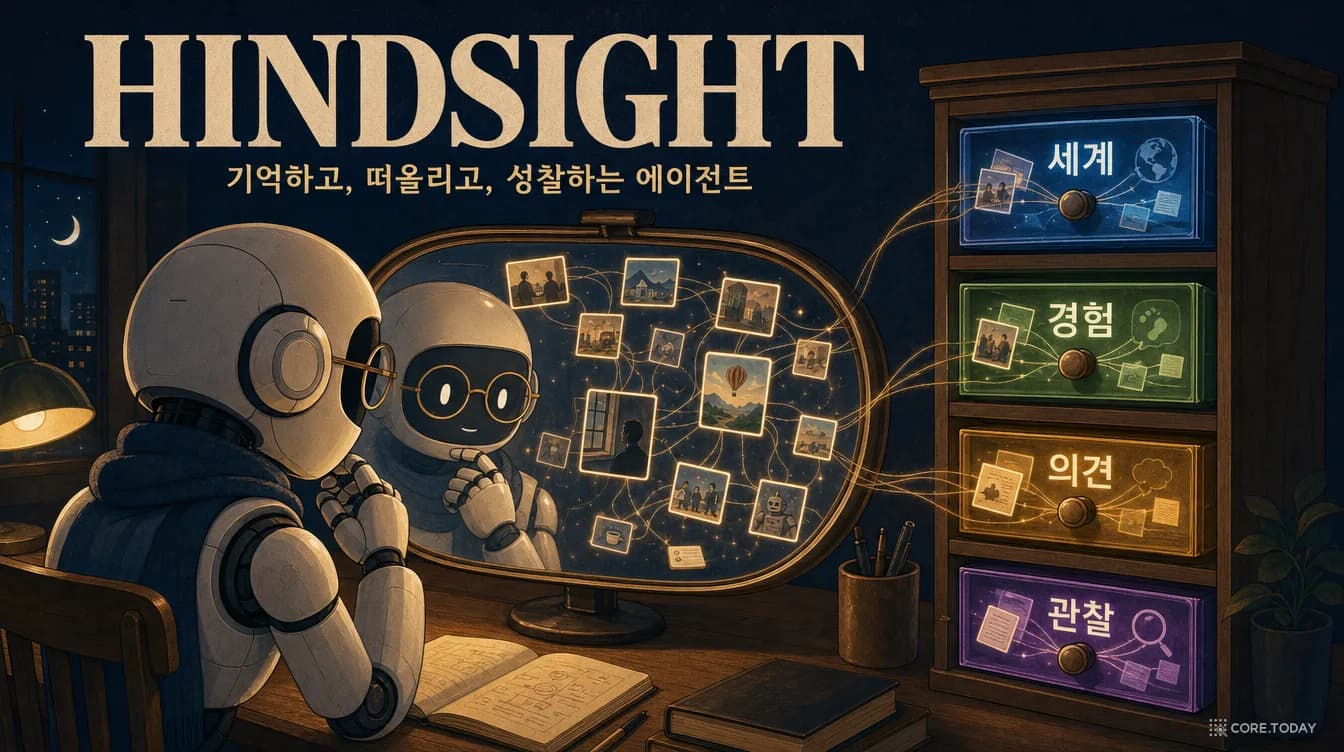
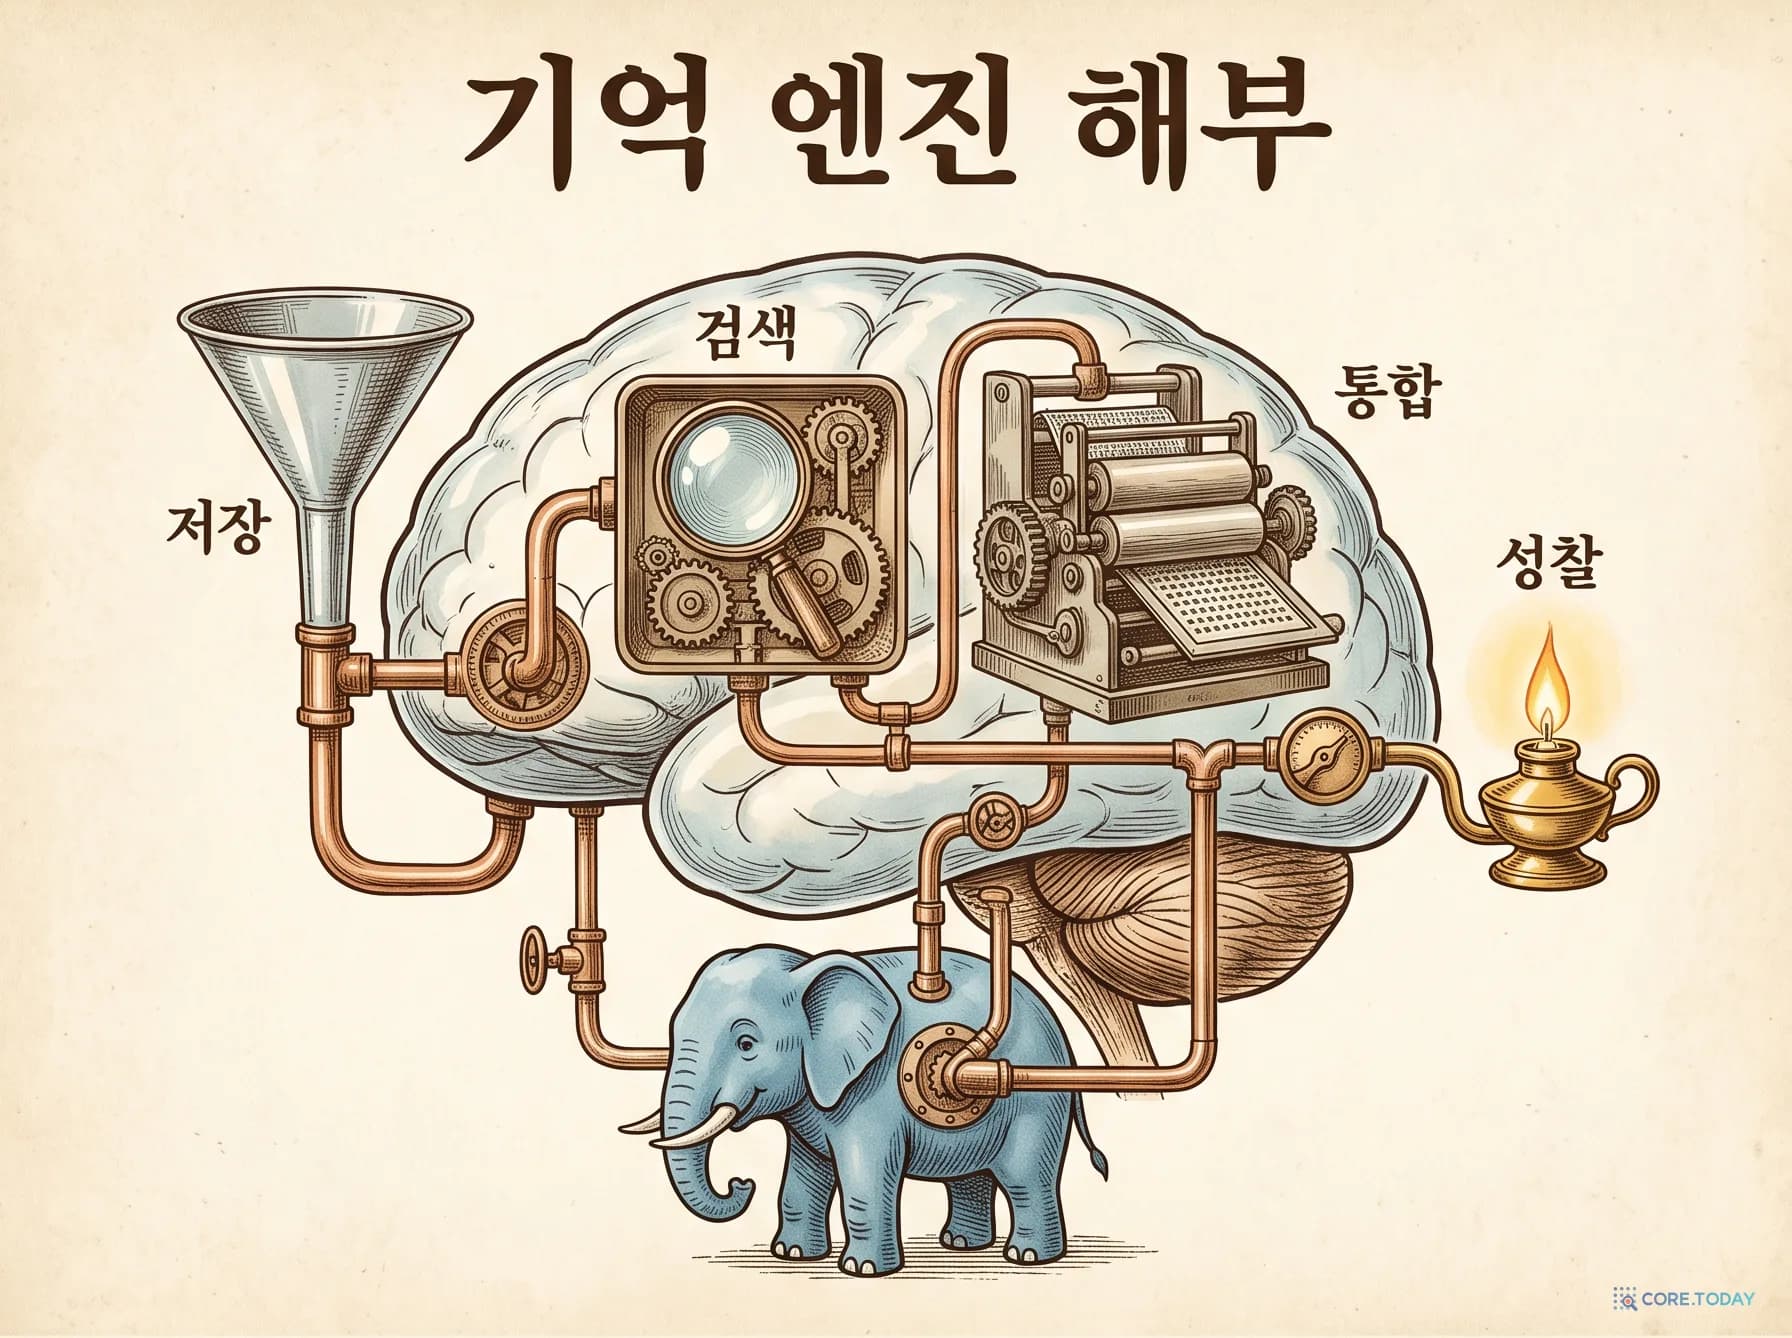
논문이 던진 질문은 하나입니다. "이 에이전트는 자기가 본 것과 자기가 믿는 것을 구분하는가?" 사용자가 한 말, 에이전트가 한 일, 에이전트가 추측한 것이 같은 무게로 벡터 창고에 섞이면, 추측이 사실의 옷을 입고 굳습니다. 그래서 Hindsight는 기억을 세계 사실·경험(증거)과 관찰(증거에서 만든 믿음)로 나눠 적고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로만 다룹니다.
논문에는 의견 네트워크와 확신도 숫자가 따로 있었지만, 2026년 1월 v0.4.0에서 의견은 관찰로 흡수됐습니다. 지금의 관찰은 확신도 대신 뒷받침하는 사실, 정확한 인용, 근거 개수를 들고 있습니다. "얼마나 믿나"가 아니라 "왜 믿나"를 설명하는 쪽으로 간 것입니다.
어떻게 동작하나
pg_trgm 글자 조각 유사도 + 공출현 + 시간 점수로 합친다.based_on)을 돌려준다. 은행마다 회의감·문자주의·공감 성향을 1~5로 준다.저장소는 PostgreSQL 하나입니다. 벡터·전문 검색·작업 큐(FOR UPDATE SKIP LOCKED)까지 Postgres 테이블로 돌리고, 은행 사이에는 Deficit Round Robin으로 작업을 공정하게 나눕니다. 논문 기준 같은 GPT-OSS-20B 모델의 LongMemEval 정확도가 대화를 통째로 넣었을 때 39.0%에서 Hindsight를 거치면 83.6%로 올랐습니다. 모델은 그대로 두고 기억 구조만 바꾼 비교라 논문에서 가장 단단한 숫자입니다.
빠른 시작
서버 없이 파이썬 안에서 띄우는 내장 모드가 가장 짧습니다(README).
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(
    llm_provider="openai",
    llm_model="gpt-5-mini",
    llm_api_key=os.environ["OPENAI_API_KEY"],
) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="minji", content="김민지는 판교의 게임 회사에서 백엔드 개발자로 일한다")
    results = client.recall(bank_id="minji", query="민지는 어디서 일하나?")
운영 환경은 Docker 이미지(ghcr.io/vectorize-io/hindsight)로 API 서버를 띄우고 pip install hindsight-client로 붙습니다. 서버 클라이언트에는 client.reflect(bank_id=..., query=...)가 있고, 은행마다 MCP 엔드포인트(/mcp/{bank_id}/)가 기본으로 열립니다. 기본 임베딩(bge-small-en-v1.5)과 재정렬 모델(ms-marco-MiniLM-L-6-v2)은 이름 그대로 영어 모델이니 한국어 서비스라면 다국어 모델로 먼저 바꿉니다.
코어닷투데이 실측
코어닷투데이는 2026년 10월 21일 기준 main 코드를 읽고, 엔티티 병합 함수를 위젯으로 옮겨 파이썬 원본과 같은 값을 내는지 대조했습니다. 질의 날짜 해석에 쓰는 dateparser도 직접 돌렸습니다(기준일 2026-10-21).
| 입력 | 측정값 | 결과 |
|---|---|---|
| '민지' 대 '김민지' | trigram 0.17, 문자열 비율 0.80 | 후보 문턱 0.3에 걸려 새 엔티티가 생김 |
| '서준 팀장' 대 '서준' | trigram 0.50 | 이름 점수 0.29, 공출현·시간이 0.31 이상 받쳐야 병합 |
| '김민지 님' 대 '김민지' | trigram 0.67 | 같은 날이면 병합 |
| "어제 회의에서 뭐라고 했어?" | dateparser | '어제'를 날짜로 잡음 |
| "지난주에", "3월에", "두 달 전" | dateparser | 날짜를 못 찾음 — 시간 갈래가 켜지지 않음 |
한국어는 성과 이름을 붙여 쓰기 때문에 글자 조각이 덜 겹칩니다. 엔티티 해석기를 고치기보다 은행 미션이나 추출 지시에 "사람은 성과 이름을 함께 적는다"를 넣는 편이 쌉니다. 질의 쪽 기간 표현은 한국어 규칙이 없으니 앞단에서 날짜 범위로 바꿔 넘기는 것이 안전합니다.
언제 쓰고, 언제 피하나
| 상황 | Hindsight가 잘 맞는다 | 다른 방법을 먼저 본다 |
|---|---|---|
| 세션 | 같은 사용자·저장소가 몇 주, 몇 달 반복해 돌아온다 | 대화가 몇 턴에 끝나고 다시 오지 않는다 |
| 운영 | Postgres 하나로 여러 사용자·에이전트를 동시에 받아야 한다 | 그래프 DB가 이미 있고 '언제부터 참이었나'를 질의해야 한다 |
| 감사 | "왜 그렇게 판단했나"를 근거 사실로 보여 줘야 한다 | 정해진 사내 문서를 찾는 일이다(기억이 아니라 RAG의 영역) |
| 비용 | 읽기가 잦고 쓰기는 적당하다 | 잡담까지 모두 넣는 쓰기 위주 서비스 |
한계와 주의
- 논문과 제품이 다르다. 의견 네트워크와 확신도 갱신 공식은 v0.4.0에서 사라졌고, 성향의 편향 강도 β도 제품 설정에 없다. 논문 벤치마크는 성향을 모두 3(중립)으로 두고 잰 것이라 성향·의견 쪽은 사실상 검증되지 않았다.
- 점수의 판사가 바뀐다. 2026년 벤치마크 사이트의 LongMemEval-S 94.6%는 답변 gemini-3.1-pro-preview, 채점 gemini-2.5-flash-lite로 잰 값이다. 논문(GPT-OSS-120B 채점)과 같은 시험이 아니다.
- 쓰기가 비싸다. Hindsight Cloud 가격표 기준 retain 100만 토큰당 10달러, recall 0.75달러로 쓰기가 13배 넘게 비싸다.
- 이름과 구현이 어긋나는 곳이 있다. 키워드 갈래의 'BM25'는 기본 백엔드에서 IDF가 없는
ts_rank_cd이고, 그래프 갈래는 확산 활성화가 아니라 1-hop 확장이며, 주석에 있는 MMR은 구현이 없다. - 잊는 법이 없다. 최신성·근거 수로 순위를 ±10%, ±5% 기울일 뿐 TTL이나 망각은 없다. 삭제 요구가 오면 원본 → 사실 → 관찰 → 지식 페이지까지 따라가 지워야 한다.
- 비밀 마스킹(Memory Defense)은 기본 꺼짐이고, 주민등록번호·휴대전화·사업자번호 패턴은 들어 있지 않다. 결정 모델 분류는 2026-10-21 기준 main에만 있었고 공급자 기본값이
none이다.