무엇인가
vLLM은 학습이 끝난 LLM을 실제 요청에 답하게 만드는 추론·서빙 엔진입니다. 2023년 UC 버클리 스카이 컴퓨팅 랩의 논문 「Efficient Memory Management for LLM Serving with PagedAttention」(SOSP 2023)에서 태어났고, 지금은 대부분의 관리형 서비스와 쿠버네티스 도구가 전제로 삼는 GPU 서빙의 기본값입니다. 2026년 10월 기준 엔진은 사실상 vLLM과 SGLang으로 모였고, 한때 표준이던 허깅페이스 TGI는 저장소가 보관 처리됐습니다.
넷플릭스는 처음 TensorRT-LLM으로 플랫폼을 지었다가 vLLM으로 갈아탔습니다. 이유는 최고 성능이 아니라 운영 적합성이었습니다. 컴파일 없이 커스텀 모델을 바로 올리고, 디코딩 로직에 확장 훅을 걸고, 실패와 중간 상태를 들여다보기 쉽다는 점입니다.
어떻게 동작하나
LLM은 토큰을 하나씩 이어 쓰고, 그때마다 앞 토큰들의 계산 결과(KV 캐시)를 다시 봅니다. 문장이 얼마나 길어질지 모르니 예전 시스템은 최대 길이만큼 메모리를 통째로 예약했고, 논문에 따르면 KV 캐시 메모리의 20~40%만 실제로 썼습니다.
/v1/chat/completions 형태를 그대로 받는다. 호스티드 모델로 만든 시제품을 자체 호스팅 모델로 옮길 때 base_url과 모델 이름만 바꾸면 된다.논문은 기존 시스템 대비 처리량 2~4배를 보고했습니다. 접두사 캐시와 쪼개 읽기는 기본으로 켜져 있고, 임베딩·리랭킹처럼 프리필만 하는 작업도 같은 엔진에서 돕니다. 릴리스는 약 2주 간격입니다(v0.30.0 9월 22일, v0.31.0 10월 5일, v0.32.0 10월 18일).
빠른 시작
공식 빠른 시작 문서의 예입니다. NVIDIA GPU 기준이고, 애플 실리콘은 vLLM-Metal을 따로 설치합니다.
uv pip install vllm --torch-backend=auto
vllm serve Qwen/Qwen2.5-1.5B-Instruct        # 기본 포트 8000

curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen2.5-1.5B-Instruct",
       "messages": [{"role": "user", "content": "Who won the world series in 2020?"}]}'
기본값은 운영값이 아닙니다. 엔진의 기본은 "들어오는 대로 다 받는다"이고, 벤치마크 최대 처리량에는 좋지만 서비스에서는 사고의 조건입니다.
| 설정 | 기본값 | 운영에서는 |
|---|---|---|
--max-num-seqs (동시 처리 수) | 80GB급 이상 GPU에서 1,024 | 속도 기준을 지키는 굿풋 시험으로 구한 값. 대개 수십 |
--max-num-queued-reqs (엔진 안 대기 한도) | 없음 (무제한) | 반드시 지정. 넘으면 거절한다 |
--max-model-len (문맥 상한) | 모델이 지원하는 최대 | 서비스가 실제로 쓰는 길이까지만 |
--gpu-memory-utilization | 0.92 | 한 GPU에 엔진을 둘 이상 띄우면 나눠서 지정 |
대시보드는 vllm:num_requests_waiting(밀리고 있나), vllm:num_requests_running, vllm:time_to_first_token_seconds, vllm:inter_token_latency_seconds, vllm:kv_cache_usage_perc, 접두사 캐시 적중률(vllm:prefix_cache_hits ÷ vllm:prefix_cache_queries) 여섯 개로 시작합니다.
언제 쓰고, 언제 피하나
| 상황 | vLLM을 직접 돌린다 | 다른 길을 먼저 본다 |
|---|---|---|
| 사용률 | GPU를 늘 채울 부하가 있다 (H100 시간당 4달러 대 100만 토큰당 0.6달러로 셈하면 사용률 약 62%가 본전) | 업무 시간에만 붐벼 평균 사용률 10~20% — 토큰 과금 API가 싸다 |
| 통제 | 미세조정 모델, 여러 LoRA, 제약 디코딩처럼 엔진 설정을 건드려야 한다 | 공개 모델을 그대로 쓴다 |
| 규모 | GPU 수 장 이상, 동시 요청이 많은 서비스 | 개발자 노트북·CPU·엣지 — llama.cpp·Ollama |
| 작업 | 접두사가 짧거나 보통인 대화·RAG | 접두사가 매우 긴 작업·초대형 모델은 SGLang도 함께 시험 |
한계와 주의
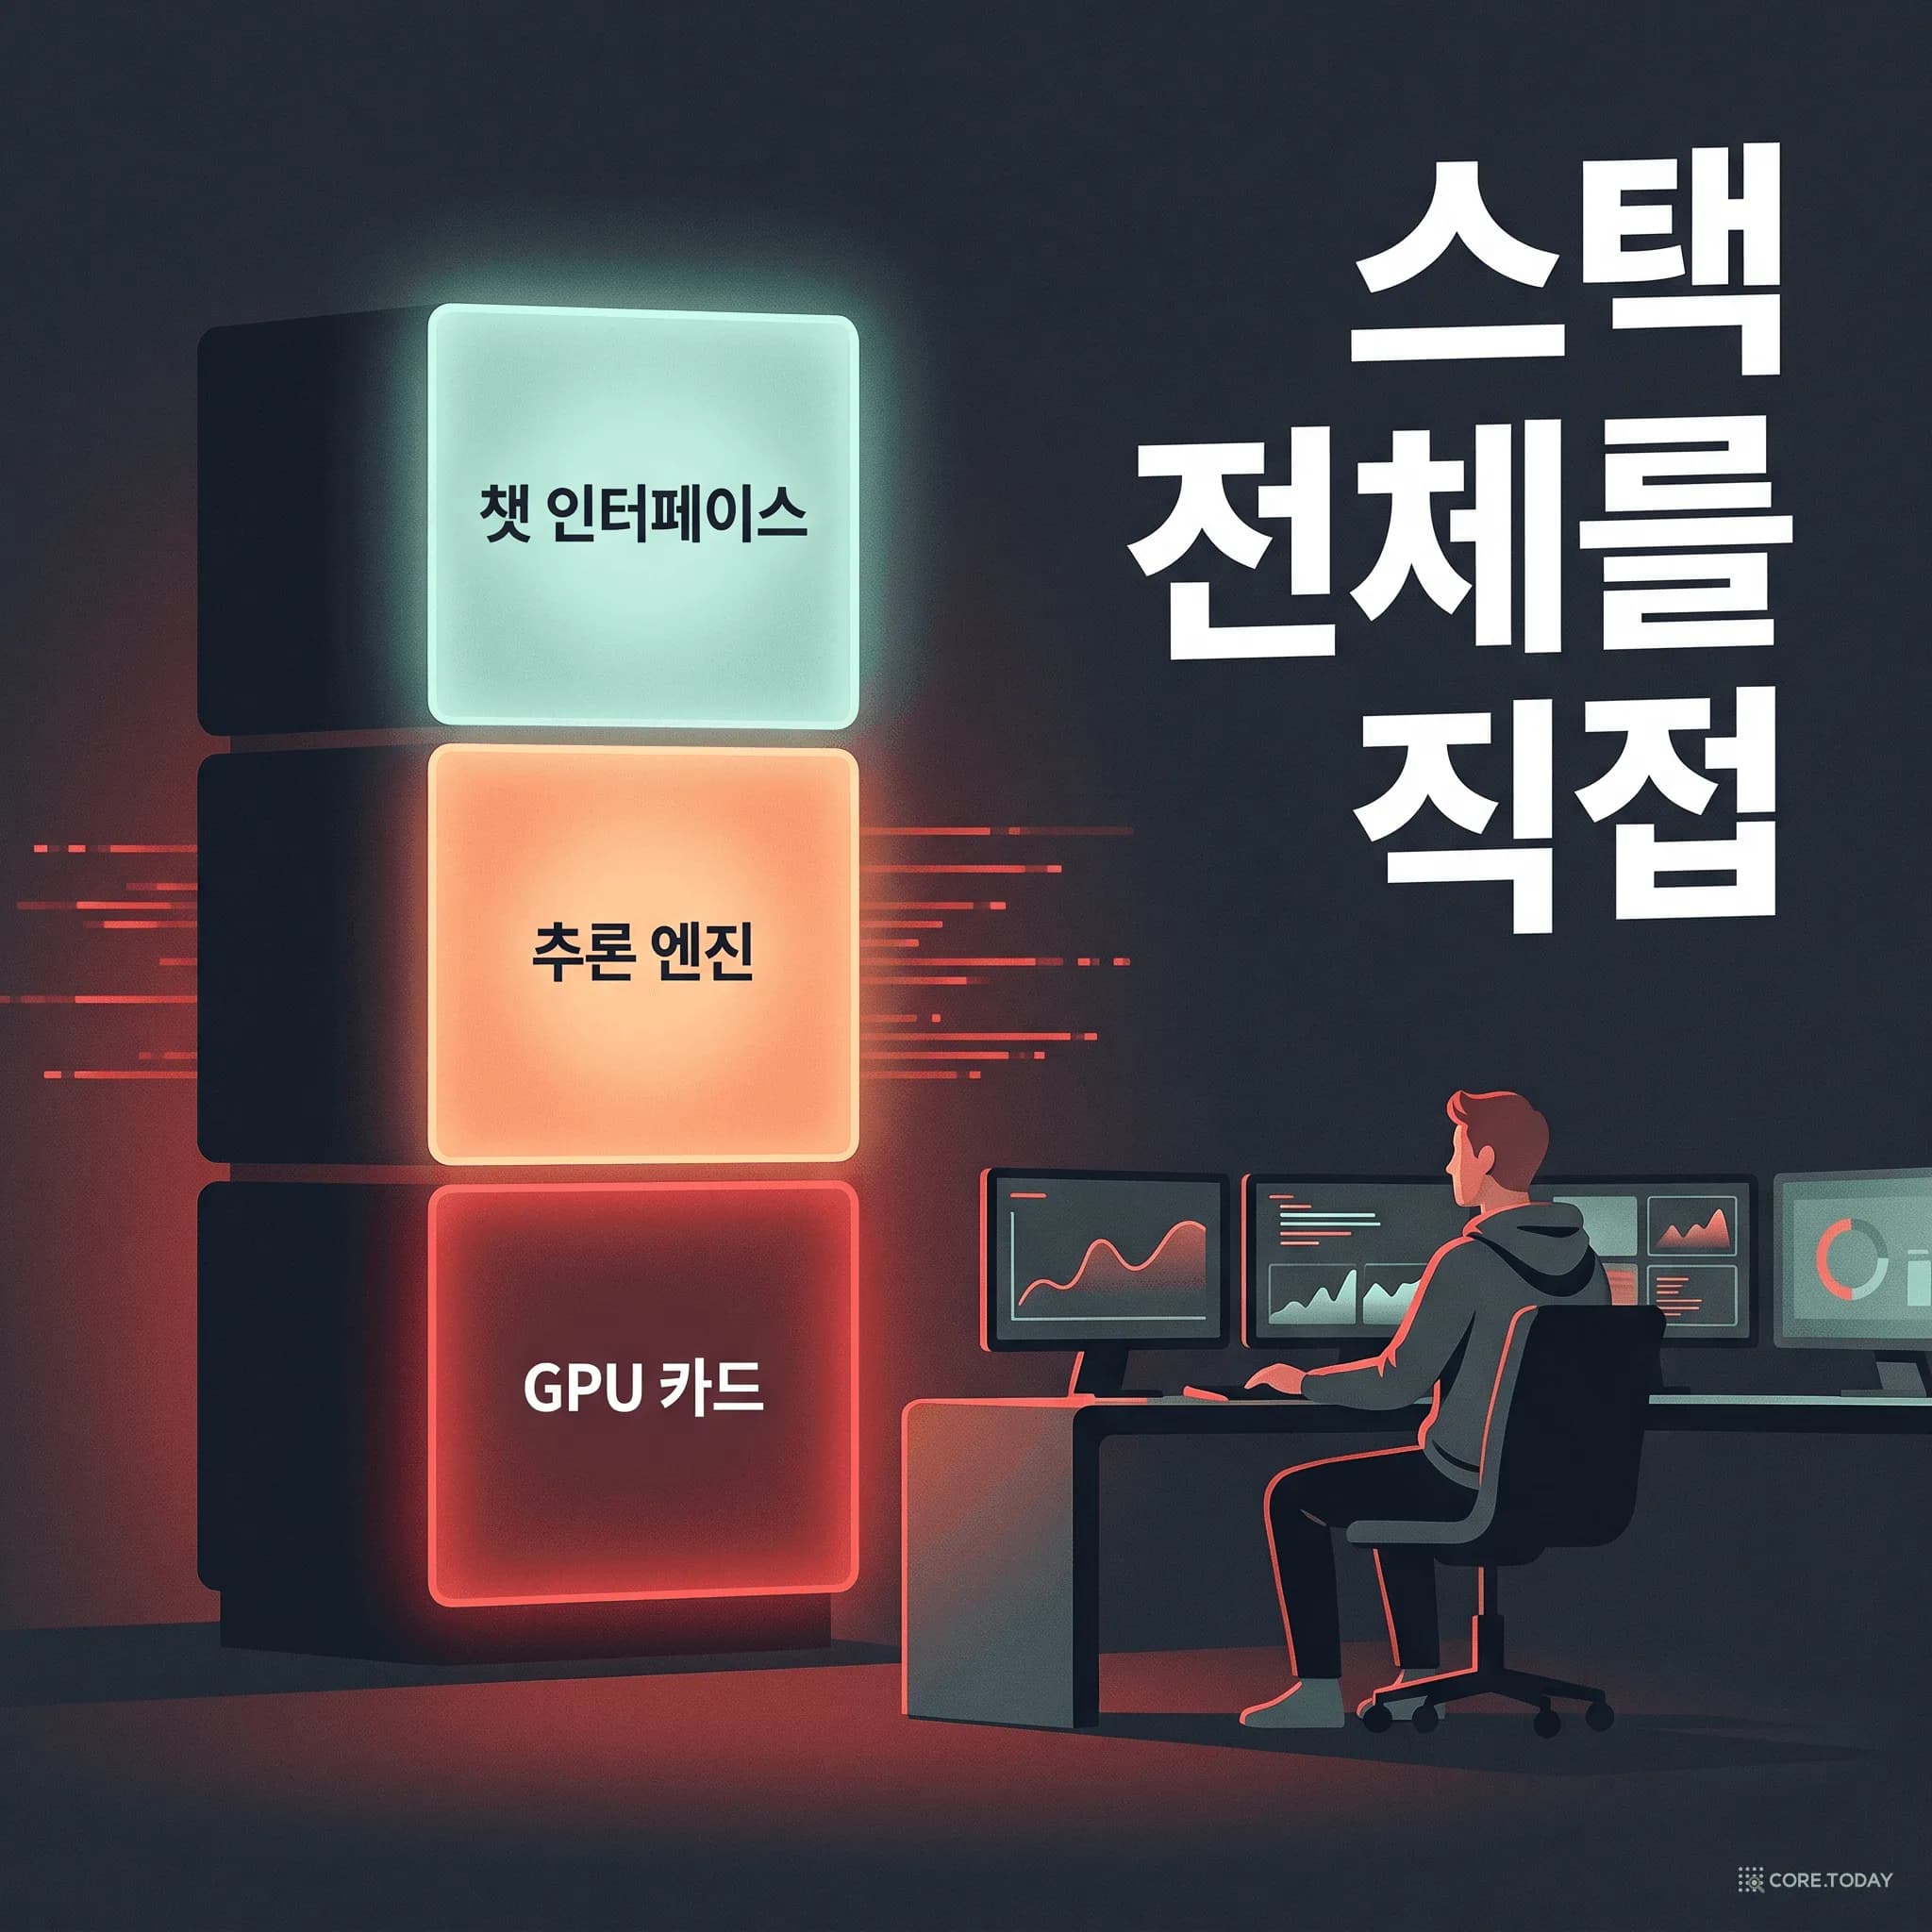
- 성능은 엔진 바깥에서 갈린다. 같은 H100 16장·Qwen3-32B에서 쿠버네티스 기본 방식으로 순서대로 나눈 구성은 첫 토큰 시간 p90이 154.1초, 캐시와 부하를 보고 나눈 구성은 0.9초였습니다(llm-d 저장소의 측정). 서버가 둘 이상이면 같은 대화를 같은 서버로 보내는 라우팅부터 손봅니다.
- 조용히 실패한다. KV 캐시가 바닥나면 엔진 안 대기열이 끝없이 자라고 첫 토큰 시간이 55초 안팎까지 늘어도 응답 코드는 200입니다(Akamai 실험). 상한과 바깥 대기열, 거절을 설계에 넣습니다.
- GPU 사용률로 자동 확장하지 않는다. 요청 하나로도 높게 찍힙니다. 진행 중 요청 수와 대기열을 씁니다. vLLM에 딸린 배포 템플릿은 CPU 사용률 80%를 확장 기준 기본값으로 두고 있으니 그대로 쓰지 않습니다.
- 버전을 고정한다. 넷플릭스는 Triton 25.09가 vLLM 0.11.2에서 제거된 모듈을 불러 배포가 통째로 멈춘 일을 겪었고, vLLM 프로젝트도 0.20.0 뒤 긴급 패치를 두 번 낸 뒤 매일 밤 모델·하드웨어 조합 17가지를 검증하기 시작했습니다.
- 구조화 출력 백엔드는 이름을 명시한다. 기본값
auto는 릴리스마다 동작이 바뀔 수 있다고 문서에 적혀 있습니다. 넷플릭스는 앞단에서response_format이 엔진에 닿기 전에 조용히 버려지는 문제도 겪었습니다.