무엇인가
에이전틱 검색은 검색에 관한 결정 — 무엇을 검색할지, 어디를 읽을지, 언제 멈출지 — 을 파이프라인 설계자가 아니라 모델이 질의마다 내리게 하는 방식입니다. 검색 알고리즘이 바뀐 것이 아닙니다. BM25도 벡터 검색도 그대로 있고, 바뀐 것은 누가 언제 결정하느냐입니다.
파이프라인 RAG는 한 방향으로만 흐릅니다. 질의 → top-k → 프롬프트 → 답. 첫 결과를 보고 나서야 다음에 무엇을 할지 알 수 있는 질문 — 두 문서 비교, 표와 각주, "별표 2 참조"를 따라가기, 첫 검색이 불충분한 경우 — 에서는 k를 늘려도 구조적으로 실패합니다.
2026년 상반기에 세 갈래 연구가 같은 방향을 가리켰습니다. 검색 도구를 모델에게 직접 주는 A-RAG(USTC, 2월), 문서를 링크된 위키로 컴파일하는 LLM-Wiki(Tencent WeChat, 5월), 인덱스 없이 셸로 코퍼스를 뒤지는 DCI(5월). 8월 20일 Mistral이 다섯 도구 구성으로 제품화했습니다.
어떻게 동작하나
핵심은 도구를 세트로, 해상도를 나눠서 주는 것입니다. A-RAG는 세 도구(keyword_search·semantic_search·chunk_read)를 줍니다. 두 검색 도구는 전문이 아니라 청크 ID와 짧은 스니펫만 돌려주고, 전문은 모델이 chunk_read로 요청할 때만 들어옵니다. 이미 읽은 청크를 다시 읽으려 하면 토큰을 쓰지 않습니다. 이 "점진적 공개" 덕에 도구가 늘었는데 토큰이 줄었습니다.
| 구성 (A-RAG 논문) | 도구 | 질문당 검색 토큰 |
|---|---|---|
| Naive RAG | 없음 — 한 번 검색 | 약 5,300 |
| A-RAG (Naive) | 임베딩 검색 하나, 전문 반환 | 22,000~56,000 |
| A-RAG (Full) | 키워드·의미 검색(스니펫) + 청크 읽기 | 2,700~7,700 |
Mistral의 다섯 도구는 search(코퍼스 전체, exclude_ids로 이미 본 청크 제외), open, navigate, read, grep(열린 문서 안)입니다. 인덱스는 "어느 문서가 유망한가"를, 에이전트는 "그 문서의 어느 페이지·표를 확인할지"를 맡습니다. 그러려면 인덱스가 청크의 오프셋(페이지·절)을 알아야 합니다.
빠른 시작
A-RAG 공식 저장소 README의 절차입니다(임베딩은 논문과 같은 Qwen3-Embedding-0.6B).
git clone https://github.com/Ayanami0730/arag.git && cd arag
uv sync --extra full
git clone https://huggingface.co/datasets/Ayanami0730/rag_test data --depth 1

uv run python scripts/build_index.py --chunks data/musique/chunks.json \
    --output data/musique/index --model Qwen/Qwen3-Embedding-0.6B --device cuda:0

export ARAG_API_KEY="your-api-key" ARAG_BASE_URL="https://api.openai.com/v1" ARAG_MODEL="gpt-5-mini"
uv run python scripts/batch_runner.py --config configs/example.yaml \
    --questions data/musique/questions.json --output results/musique --limit 10 --workers 5
Mistral 쪽은 로컬에서 코퍼스를 색인해 볼 수 있는 mistralai/search-starter-app(MIT, Vespa 인덱스 + MCP 서버)이 있습니다.
언제 쓰고, 언제 피하나
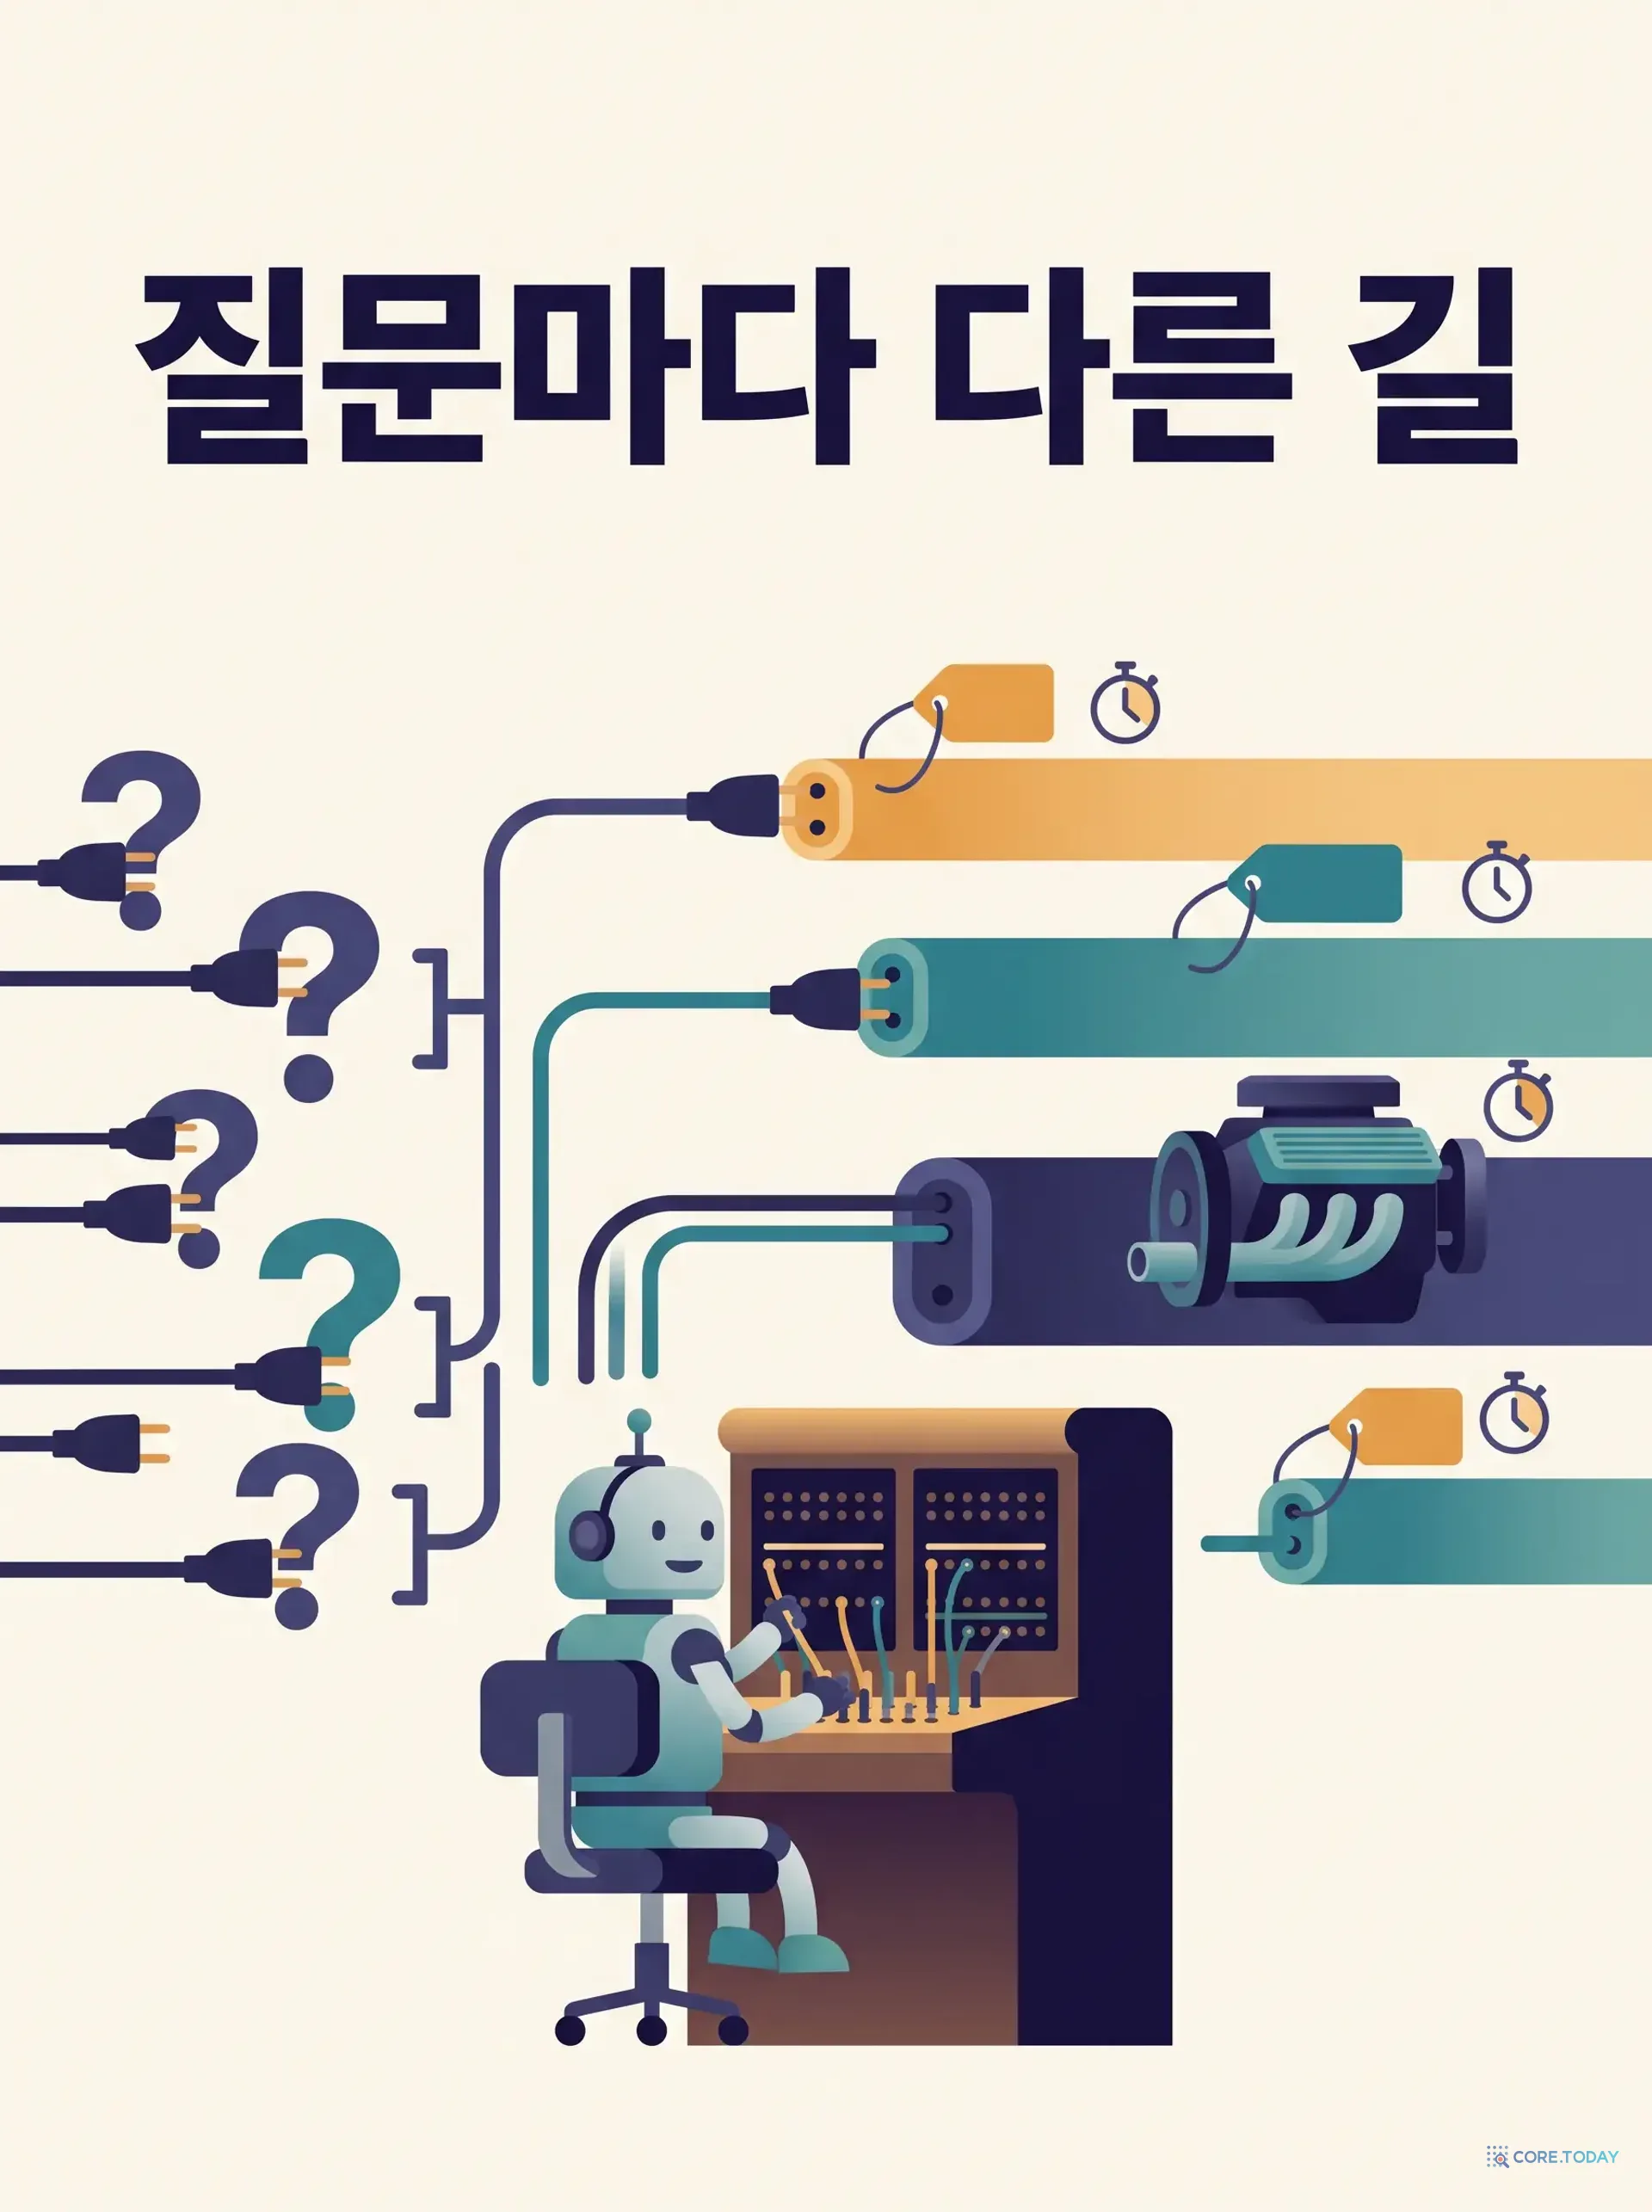
전체 질의에 켜지 않습니다. 모든 질의는 하이브리드 RAG로 먼저 가고, 충분성 판정이 실패하거나 라우터가 어려운 유형으로 분류한 질의만 에이전트 경로로 승격합니다.
| 질문의 성격 | 보낼 경로 | 도구 호출 |
|---|---|---|
| 직접 사실 조회, 위치가 예측 가능, 대량 반복 FAQ | 하이브리드 RAG (one-shot) | 검색 1회 |
| 긴 계약서·보고서의 특정 표·각주, 원문 확인이 필요한 수치 | 검색 + 열기 + 이동 + 읽기 | 3~8회 |
| 여러 문서 비교·합산 | 반복 검색 + 증거 집합 관리 | 문서별 반복 + 충분성 판정 |
| 사건·관계·다중 홉 | 그래프·구조화 RAG | 그래프 탐색·조인 |
| 스캔·표·도표 문서 | 멀티모달 문서 RAG | 페이지 찾은 뒤 그 페이지만 VLM |
Mistral 발표 기준 FinanceBench에서 one-shot 26.7%가 다시 검색만 할 수 있어도 +47.3~52.6pp 올랐고, 이동 도구를 더하면 정확도가 더 오르면서 토큰은 search-only 대비 23.9~33.7% 줄었습니다. 스캔 위주의 OfficeQA Pro에서 GLM-5.2는 6.3% → 51.9%였습니다. 실패 질의 중 비교·참조 따라가기 같은 유형이 10%도 안 되면 지금은 파이프라인 개선이 먼저입니다.
한계와 주의
- 충분성 판정과 스텝 예산이 도구보다 먼저다. "충분하면 멈춘다 / N스텝이면 합성한다 / 반복이면 포기한다" 세 규칙이 없으면 비용 상한이 없는 시스템이 된다. 승격 비율이 20%를 넘으면 스텝을 늘리기 전에 라우터를 조인다.
- 검색 도구 하나만 주는 것이 최악이다. 반복은 가능한데 해상도가 없어 매번 코퍼스를 통째로 들여온다.
- 모델이 도구를 잘 다뤄야 이득이 크다. A-RAG도 GPT-4o-mini 백본에서는 2Wiki에서 HippoRAG2에 졌다. 소형 오픈 모델로 온프레미스에서 돌린다면 이 조건부터 본다.
- grep만으로는 넓은 코퍼스를 못 고른다. DCI는 문서 10만 → 20만 건에서 13.6점 떨어지고 40만 건에서 37.5%로 무너졌다. 인덱스로 후보를 좁히고 그 안에서 고해상도 도구를 쓴다.
- Mistral 수치는 공급사 측 결과다. 자체 스택·하네스·두 모델·두 벤치마크. one-shot 기준값이 잘 튠된 하이브리드보다 낮게 잡혔을 수 있다.
- 공격 표면이 넓어진다. 읽은 문서의 문장이 다음 검색어를 정하므로, 오염된 문서가 검색 경로까지 조종할 수 있다. 관련성 점수와 출처 신뢰도를 분리한다.
- A-RAG 저장소는 README에 MIT를 표기하지만 GitHub가 인식하는 LICENSE 파일은 없다(2026-10 확인).