무엇인가
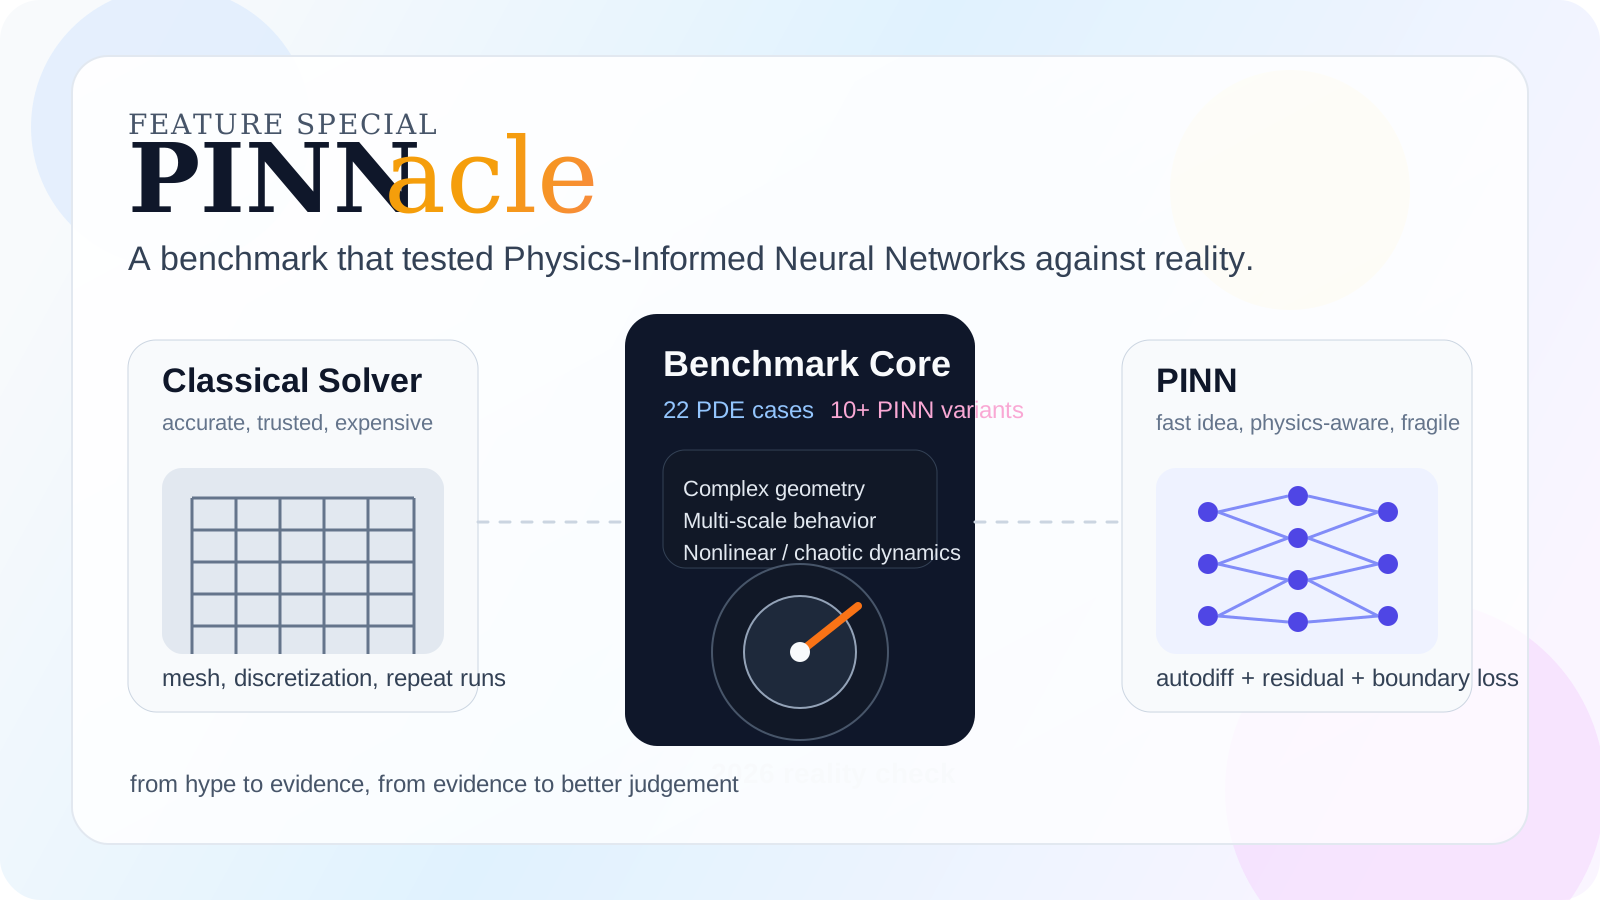
PINNacle은 물리 정보 신경망(PINN)을 위한 종합 벤치마크와 그 코드베이스입니다. 하오(Zhongkai Hao) 등이 2023년 arXiv에 공개했고 NeurIPS 2024에 채택됐습니다. 새 PINN 변형을 제안하는 논문이 아니라, 그때까지 나온 대표 변형들을 한자리에 세워 놓고 어디서 되고 어디서 무너지는지를 같은 규칙으로 잰 논문입니다.
2019년 라이시(Raissi) 등의 정식화 이후 PINN 변형은 쏟아졌지만, 대부분 자기에게 유리한 몇 개 예제로만 성능을 보였습니다. PINNacle은 그 그림을 현실형 난제 세트로 넓혔을 때 성적이 얼마나 흔들리는지를 처음으로 체계적으로 드러냈습니다.
어떻게 동작하나
논문은 세 덩어리입니다. 데이터셋(22개 PDE 케이스), 툴박스(대표 방법 구현), 평가(공통 지표, 주로 L2 상대 오차)입니다.
| 문제군 | 개수 | 대표 케이스 | 무엇을 시험하나 |
|---|---|---|---|
| Burgers | 2 | Burgers1d-C, Burgers2d-C | 비선형 수송, 충격파 |
| Poisson | 4 | Poisson2d-CG, Poisson3d-CG | 복잡 형상, 이질 계수, 3D |
| Heat | 4 | Heat2d-MS, Heat2d-LT | 다중 스케일, 장시간 적분 |
| Navier-Stokes | 3 | NS2d-C, NS2d-LT | 유체 난제 |
| Wave | 3 | Wave1d-C, Wave2d-MS | 2차 시간 미분, 진동 |
| 혼돈 | 2 | Gray-Scott, Kuramoto-Sivashinsky | 민감도, 혼돈 동역학 |
| 고차원 | 2 | PNd, HNd | 차원의 저주 |
| 역문제 | 2 | PInv, HInv | 계수 복원 |
비교 대상은 계열별로 묶입니다. vanilla PINN과 Adam+L-BFGS, 손실 재가중(PINN-LRA, PINN-NTK), 콜로케이션 재표집(RAR), 새 옵티마이저(MultiAdam), 새 손실(gPINN, hp-VPINN), 적응 활성함수(LAAF, GAAF), 영역 분할(FBPINN)입니다. 실험은 대부분 20,000 에폭, 학습률 0.001로 돌렸습니다.
핵심 결과는 한 줄입니다. L2 상대 오차 10% 이하를 성공으로 보면 vanilla PINN은 22개 중 10개만 풀었다.
| 난제 유형 | 논문 메시지 | 눈에 띈 방법 |
|---|---|---|
| 복잡 형상 | 재가중·재표집·적응 활성함수가 일부 개선 | Poisson2d-CG 재가중·재표집 1.43%, Heat2d-CG LAAF 2.39% |
| 다중 스케일 | 큰 구조와 미세 구조를 동시에 맞추기 어렵다 | PINN-NTK, 일부 영역 분할 |
| 비선형·혼돈 | 제대로 푸는 방법이 거의 없다 | Gray-Scott FBPINN 7.99% |
| 역문제 | 변분 정식화가 특히 강하다 | HInv vPINN 1.19% |
| 장시간·3D | Heat2d-LT, Poisson3d-CG는 모든 방법 실패 | HNd는 L-BFGS가 힌트 |
빠른 시작
git clone https://github.com/i207M/PINNacle.git --depth 1
cd PINNacle
pip install -r requirements.txt

# 기본 설정으로 전체 케이스 실행 (선택 인자: --name EXP_NAME --seed SEED --device DEVICE)
python benchmark.py
README는 Python 3.9 conda 환경을 예로 듭니다. 방법별 실행 옵션과 케이스 정의는 공식 문서 사이트(위 홈페이지)에 있습니다. 저장소 그림 resources/pinnacle.png가 데이터셋·툴박스·평가의 전체 구조를 보여 줍니다.
언제 쓰고, 언제 피하나
- 잘 맞는다: 새 PINN 기법을 제안하거나 고를 때 "몇 개 예제에서 좋았다"가 아니라 난제 유형별로 비교하고 싶을 때. 내 문제가 복잡 형상·다중 스케일·혼돈·고차원 중 어디에 가까운지 보고 어떤 계열의 처방부터 시도할지 정할 때.
- 다른 방법을 먼저 본다: 같은 PDE 가족을 많이 반복 추론해야 하면 신경 연산자(DeepONet·FNO), 고정밀 순방향 해가 필요하면 전통 솔버(FEM·FVM)가 기본이다. PINN은 희소 관측의 역문제·파라미터 식별에서 가장 설득력이 있다.
한계와 주의
- "PINN은 끝났다"로 읽으면 오독이다. 논문의 메시지는 문제 난이도와 방법 계열의 궁합을 보지 않고 vanilla PINN 하나로 다 하려는 사고가 위험하다는 쪽에 가깝다.
- 학습 레시피가 결과를 크게 좌우한다. 배치 크기는 클수록 대체로 좋았고, 에폭은 어느 지점 뒤 포화됐으며, 학습률은 문제마다 최적점이 달랐다(10-3·10-4·단계 감쇠가 비교적 안정).
- 수치 정밀도는 벤치마크 밖의 변수다. 2025년 「FP64 is All You Need」는 FP32에서 실패로 보이던 PINN이 FP64로 바꾸자 오차가 급락한 사례(예: convection 0.7640 → 0.0072)를 보였다. 실패 판정을 내리기 전에 dtype과 종료 조건을 먼저 확인한다.
- README의 실행 안내는 "20개 케이스"라고 적혀 있어 논문의 22개와 다르다. 무엇이 기본 실행에서 빠지는지는 문서에서 확인한다.
- README의 구현 목록에는 인과 학습(2022), PirateNet(2024), 2차 전처리(SOAP, 2025) 같은 처방이 없다. 이런 처방은 JAX-PI 같은 다른 구현에서 찾는다.