무엇인가
MemoryArena는 스탠퍼드·UCSD·UIUC·프린스턴 등의 연구진(교신 저자 Zexue He)이 2026년 2월 arXiv에 올리고 ICML 2026에 실린 에이전트 기억 벤치마크입니다(arXiv 2602.16313). LoCoMo·LongMemEval처럼 고정된 대화 기록을 읽힌 뒤 사실 하나를 묻는 대신, 뒤 세션의 과제가 앞 세션의 결정을 모르면 풀리지 않게 만들고 그 위에서 기억 방식들을 나란히 잽니다. 월요일에 산 카메라가 캐논이라는 사실을 떠올리는 것으로 끝나지 않고, 화요일 렌즈 진열대에서 EF 마운트가 아닌 렌즈를 걸러 내야 점수가 나옵니다.
시험장은 다섯 환경 701과제, 하위 과제 4,850개입니다. 묶음 웹 쇼핑 150(WebShop 기반, 앞에서 산 물건과 호환), 단체 여행 계획 270(TravelPlanner 기반, 앞 여행자의 확정 일정 참조), 점진 웹 검색 221(BrowseComp-Plus 기반, 기록이 12만 토큰 넘기도 함), 수학 40·물리 20 증명 사슬(앞 보조정리의 결과식 재사용)입니다. 과제당 평균 57번 행동하고 기록은 4만 토큰을 넘습니다. 결과는 한 문장입니다. 13가지 방식 모두 다섯 환경 평균 과제 성공률이 0.20 이하였고, 단체 여행은 전원 0이었습니다. 공저자 중에는 이 시험에서 고전한 MIRIX의 저자와 ReasoningBank의 1저자도 있습니다.
어떻게 동작하나
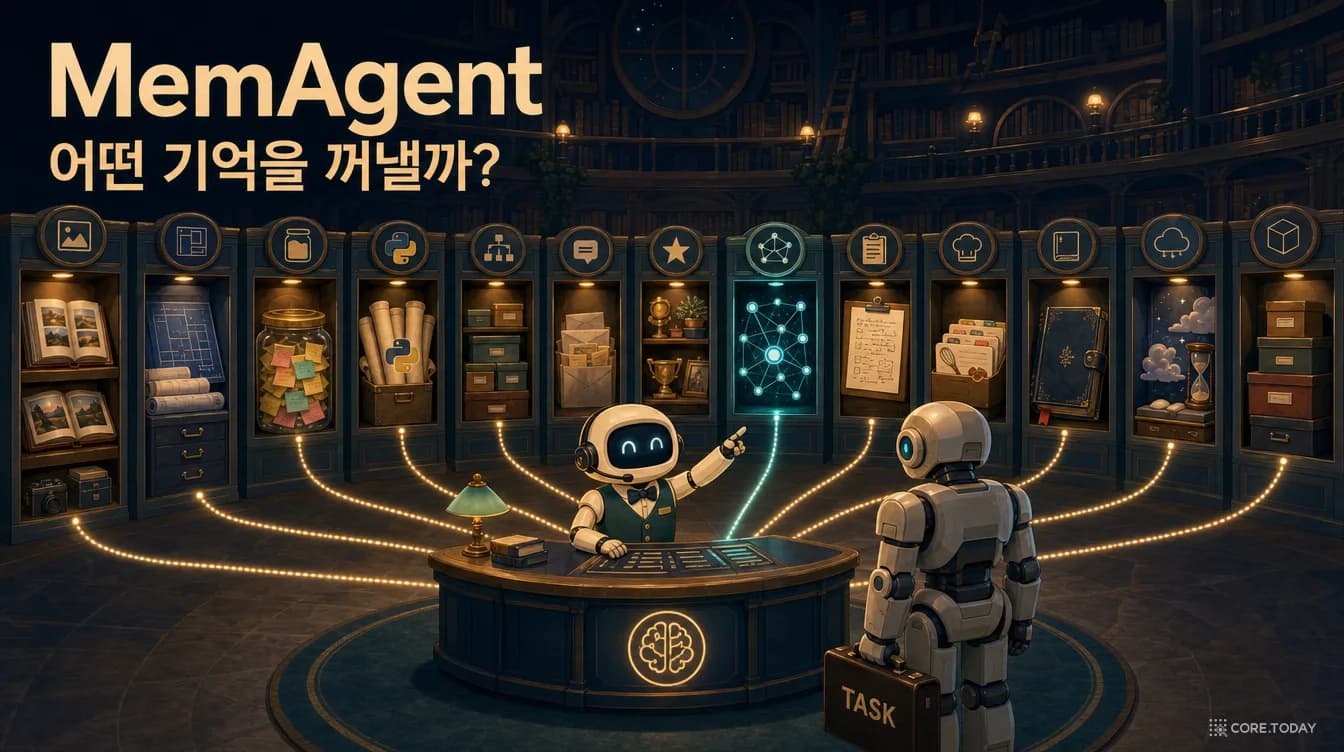
논문은 기억을 두 함수로 추상화한 기억-에이전트-환경 고리를 씁니다. 하위 과제를 시작할 때 기억에서 한 번 꺼내 <memory context> 블록으로 넣고(RETRIEVE), 그것을 조건으로 행동하고, 세션이 끝나면 관측·행동을 기억에 녹여 넣습니다(UPDATE). 기억은 에피소드 시작 때 비어 있고, 무엇을 남길지는 에이전트가 골라야 합니다.
하위 과제 시작 때 한 번
과제 에이전트 GPT-5.1-mini 고정
세션 기록 반영 → 다음 하위 과제
같은 인터페이스에 세 무리 13개 방식을 꽂았습니다. 롱컨텍스트(GPT-5.1-mini·GPT-4.1-mini·Gemini-3-Flash·Claude-Sonnet-4.5), 기억 에이전트(Letta·Mem0·Mem0-g·MIRIX·ReasoningBank), RAG(BM25·text-embedding-3-small·MemoRAG·GraphRAG)입니다. 롱컨텍스트의 나머지 세 줄은 과제 에이전트 자체를 바꾼 기준선이라, 기억 방식끼리의 공정한 비교는 GPT-5.1-mini 롱컨텍스트와 나머지 아홉 줄 사이입니다. 점수는 SR(과제 전체 성공), PS(하위 과제 통과 비율), 단체 여행 전용 sPS(제약 만족 비율)입니다. 논문 표·그림에서 나온 관찰은 이렇습니다.
- 부분은 하는데 전체를 못 합니다. GPT-5.1-mini 롱컨텍스트는 쇼핑 하위 과제 58%를 맞혔지만 완주는 1%였습니다(Claude-Sonnet-4.5는 79%와 12%). 0.58을 여섯 번 곱하면 약 3.8%입니다.
- 기억 장치를 붙이면 떨어지는 곳이 있습니다. 기억 에이전트를 붙이자 쇼핑 PS 0.58→평균 0.41, 여행 sPS 0.52→평균 0.24였습니다. 반대로 기록이 넘치는 점진 검색 SR은 롱컨텍스트 평균 0.04, 기억 에이전트 0.15, RAG 0.19였습니다. 정확한 값을 다시 써야 하면 덜 가공한 RAG가 요약형 기억보다 꾸준했고, 2D 그래프 기억이 1D보다 나은 점은 없었습니다.
- 기억은 느립니다. 하위 과제 하나에 롱컨텍스트 34~82초, RAG 90~107초, 기억 에이전트 99~133초(Letta 쇼핑 219초)였습니다.
- 깊어질수록 무너집니다(믿음 표류). 단체 여행에서 앞 제약을 맞혔다는 조건의 통과율이 의존 거리 L0 0.48 → L2 0.21 → L4 0.15로 단조 감소했습니다(부록 표 7, 정보가 모두 맥락에 있는 롱컨텍스트). 논문은 이상적인 기억을 과거 세션의 '충분 통계량'을 돌려주는 POMDP의 믿음 상태 추정기로 정의합니다.
과제 에이전트를 Claude Sonnet 4.6으로 바꾼 추가 실험(부록 표 5)에서는 여행 sPS 0.89, 수학 SR 0.37로 올랐지만 세 무리의 순서는 그대로였습니다.
빠른 시작
데이터는 Hugging Face에, 코드는 2026년 6월 '미리보기판'으로 공개됐습니다.
huggingface-cli download ZexueHe/memoryarena --repo-type dataset --local-dir memoryarena
아래 '회상 대 행동' 실측은 데이터만으로 재현됩니다. 단체 여행에서 앞서 합류한 여행자를 참조하는 요청만 고르고(참조 값과 정답이 매번 주어지는 기준 여행자 일정과 다른 경우로 한정), 같은 요청에 기억 형태를 바꿔 넣은 뒤 회상("Zoey의 3일차 점심은?")과 행동("Zoey의 3일차 점심보다 10% 이상 비싼 곳 하나")을 따로 채점합니다.
코어닷투데이 실측
2026년 10월, 공개 데이터와 로컬 qwen3.5:9b(생각 모드 끔, 온도 0, 한 번 실행)로 쟀습니다. 행동은 검색 도구 대신 도시의 식당·숙소 표를 펼쳐 주고 선택 하나만 하게 한 축소판이고, 기억 원문은 정답 일정입니다. 표본은 29과제의 참조 요청 115개입니다.
| 기억 형태 | 회상 | 행동 |
|---|---|---|
| 원문 장부 (앞 여행자 요청+확정 일정 전체) | 97.4% | 35.7% |
| 필요한 사실 한 줄 (오라클) | – | 31.3% |
| BM25 상위 5개 | 41.7% | 19.1% |
| 모델이 쓴 3줄 메모 | 0.0% | 5.2% |
| 기억 없음 | – | 2.6% |
- 기억해 내기와 기억으로 행동하기 사이가 61점 벌어졌습니다. 회상 97.4%(95% 구간 92.6~99.1%), 행동 35.7%(27.5~44.7%). 정답 사실을 쥐여 준 오라클도 31.3%(23.5~40.3%)로 구간이 겹쳐, 이 모델의 병목은 기억이 아니라 기억을 쓰는 추론이었습니다.
- JOIN은 쉽고 RELATION은 어려웠습니다. "Zoey와 같은 곳"(32개)은 회상·행동 모두 93.8%였고, "Zoey보다 10% 비싼 곳"(83개)은 회상 98.8%에 행동 13.3%, 오라클 6.0%였습니다. 단체 여행 요청 8,235개 중 42%가 RELATION입니다.
- 모델이 쓴 요약 메모는 결정을 버렸습니다. 취향과 경로만 적었고, 참조 대상의 식당·숙소 이름이 메모에 나온 경우는 요청 100여 개 중 6개였습니다.
- RAG의 성능은 검색이 정했습니다. BM25 회상 41.7%는 검색 적중률 42.2%와 거의 같았고, 회상에 실패하면 행동은 0/67이었습니다. 의존이 깊어지면 BM25 회상은 L1 67.3% → L2 33.3% → L3 이상 10.0%로 무너졌지만, 원문 장부 회상은 깊이와 무관하게 94~100%였습니다.
- 처음 계획한 '일정 전체 짜기'는 기억 이전에 무너졌습니다. 정답 일정을 기억으로 다 줘도 기억이 필요 없는 독립 요청조차 9B 15%, qwen3.8:27b 27%만 맞혔습니다.
공개 데이터를 세어 보니 하위 과제 합계 4,850개는 논문과 정확히 일치했고, 단체 여행 참조 요청 4,893개의 95.5%가 기준 여행자가 아닌 앞서 합류한 여행자를 가리켰습니다. 그 뒤 사람들의 일정은 기억에서만 찾을 수 있다는 뜻입니다.
언제 쓰고, 언제 피하나
| 상황 | 판단 |
|---|---|
| 회상 점수(LoCoMo 등)만 보고 기억 시스템을 고르려 할 때 | 이 방식대로 '앞 결정을 참조하는 다음 결정'을 자기 업무에서 뽑아 완주율로 잰다 |
| 기록이 맥락 창에 들어가고 정확한 값을 다시 써야 함 (주문·예약·일정) | 원문 장부가 기본. 요약형 기억은 상태 값을 버리기 쉽다 |
| 기록이 넘치거나 소음이 많음 (심층 검색·긴 유도) | 추린 기억이 낫다. 검색 적중률을 따로 잰다 |
| 세계가 바뀌는 상황(가격 변동·사용자 정정)의 기억 갱신 | 이 벤치마크는 재지 않는다 |
한계와 주의
- 숫자가 문서마다 엇갈립니다. 오라클 실험(부록 표 8)의 검색 개선이 최종본은 +0.05, OpenReview 반박문은 +0.54입니다. +0.54라면 검색 성공률이 열 배가 되어 "오라클을 줘도 낮다"는 결론과 어긋나는데, 어느 쪽이 오타인지 공개 자료로는 알 수 없습니다. 같은 표의 수학 원래 SR 0.26은 표 3의 0.21과 다르고, 과제 에이전트도 본문은 GPT-5-mini, 표 3 제목은 GPT-5.1-mini입니다.
- 'SR'의 정의가 환경마다 다릅니다. 검색과 수학·물리는 마지막 하위 과제만 맞히면 성공이라 점진 검색에서는 PS가 SR보다 낮습니다(Mem0: SR 0.24, PS 0.09).
- 어느 단계의 실패인지는 이 시험만으로 모릅니다. 기억을 끝에서 끝까지 한 덩어리로 재고, 일부 시스템은 내부가 닫혀 있습니다. 기억 장치가 손해 보는 이유로 든 '표현·훈련의 어긋남'은 심사에서 사후 가설로 지적됐고 저자들도 인과 주장이 아니라고 물러섰습니다. 기억 시스템은 기본 설정이고, 세션 사이에 세상은 변하지 않습니다.
- 수학 40·물리 20문제는 작습니다. 물리 SR 0.60과 0.50의 차이는 두 문제입니다.
- 공개 데이터에 흠이 있습니다. 쇼핑 150과제 중 93개는 1단계의 목표 줄("가장 비싼 것")과 선호 줄("평점 최고")이 어긋납니다. 사이트의 데이터 예시는 쇼핑과 검색이 뒤바뀌어 있습니다. 공식
eval.py는 두 문자열을 짧은 쪽 길이로 잘라 비교해 짧은 오답이 정답 앞부분과 같으면 통과시킵니다(위 실측은 더 엄격하게 쟀습니다). - 위 실측은 9B 모델 하나의 축소판입니다. 요점은 절대 점수가 아니라 같은 모델·같은 기억 안의 간격입니다. 메모는 한 가지 프롬프트의 결과이고, 요청 분류와 의존 거리는 정규식 근사입니다.