무엇인가
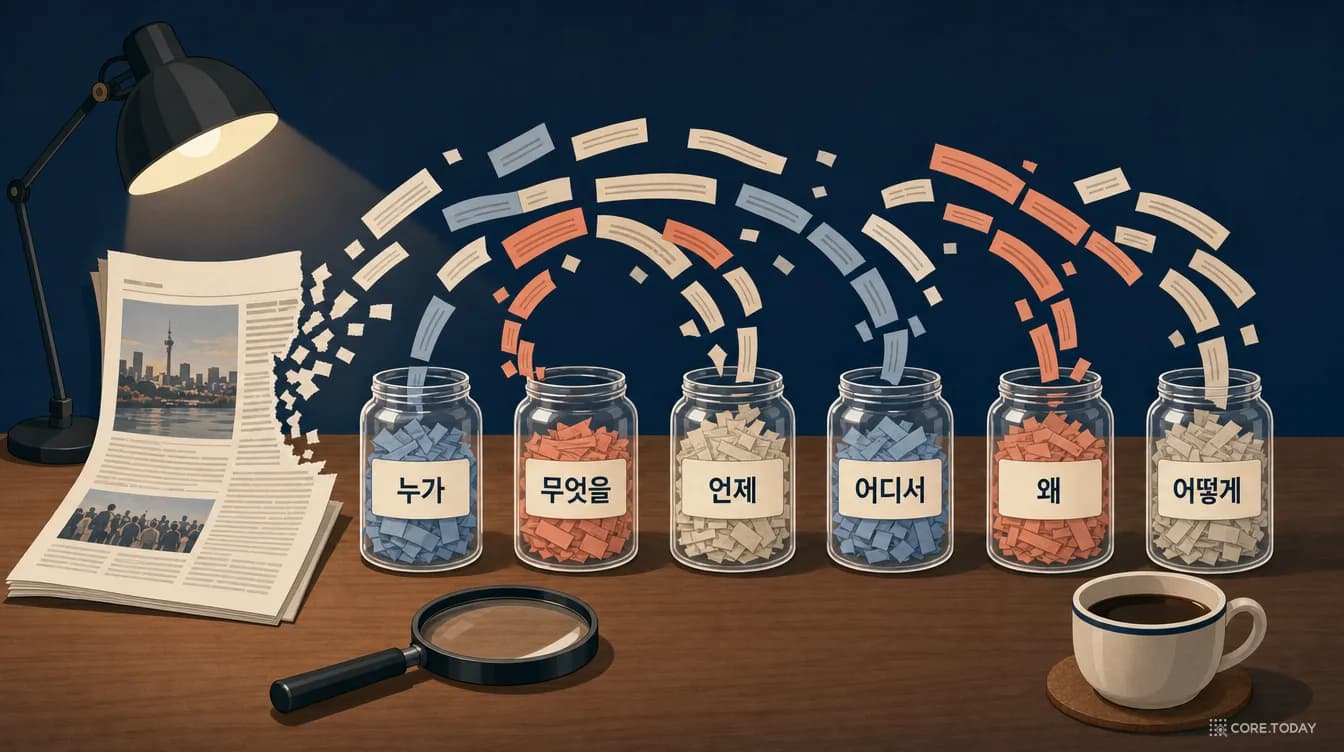
기자는 첫 문장에 여섯 질문의 답을 몰아넣고 덜 중요한 답은 아래로 내립니다(역피라미드). 육하원칙 추출은 그 여섯 답을 기계가 꺼내게 하는 일이고, 같은 사건 묶기·사실 추출·미디어 편향 분석의 첫 단계입니다.
출발점은 2019년 독일 콘스탄츠 대학의 Hamborg·Breitinger·Gipp이 낸 Giveme5W1H입니다. Stanford CoreNLP의 구문 분석·개체명·상호참조 위에 규칙과 위치 가중치를 쌓아 영어 기사에서 칸마다 후보를 뽑고 점수로 하나를 골랐습니다. BBC 기사 120건 평가에서 4W 평균 정밀도 0.82, 여섯 칸 평균 0.73이었고 '왜'는 0.28, '어떻게'는 0.42였습니다. 코드는 Apache-2.0으로 공개돼 있지만 영어 전용이고 2024년 10월 이후 커밋이 없습니다.
2026년의 한국어 기사에서는 손이 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 코어닷투데이는 같은 기사 72건에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌려, 어느 칸을 어느 손에 맡길지 정리했습니다.
어떻게 동작하나
어려움의 절반은 모델이 아니라 정의입니다. 한 기사에 사건이 여럿이고 '누가'는 문장마다 바뀌므로, Giveme5W1H처럼 헤드라인이 가리키는 주요 사건 하나를 기준으로 삼습니다.
| 칸 | 정의 | 자주 틀리는 지점 |
|---|---|---|
| 누가 | 주요 사건의 행위 주체. 기사 표기 그대로의 짧은 명사구 | 질문한 의원, 피해자를 주체로 고름 |
| 언제 | 송고 시각이 아니라 사건 시각 | "13일 밝혔다"의 발표일을 사건일로 봄 |
| 어디서 | 사건 장소. 데이트라인 "(광주=연합뉴스)"는 장소가 아님 | 기관명·나라를 장소로 지어냄 |
| 왜 · 어떻게 | 기사에 명시된 경우만. 추론 금지, 없으면 null | 배경 설명을 이유로 지어냄 |
그리고 빈칸입니다. 검수한 정답 72건에서 '왜'가 없는 기사가 61%, '어떻게'가 없는 기사가 63%, '어디서'가 없는 기사도 40%였습니다. 큰 모델은 빈칸을 지어내고 작은 모델은 있는 답도 비웁니다. 그래서 설계는 무엇을 꺼낼지보다 무엇을 비워 둘지에서 시작합니다.
빠른 시작
실측에서 효과가 컸던 정의서 문장입니다. 아래 라이브 실행도 같은 방향의 지시로 기사 문단을 구조화합니다.
영어 기사라면 원조 구현을 돌려 볼 수 있습니다. README 기준으로 pip3 install giveme5w1h와 giveme5w1h-corenlp install 뒤 CoreNLP 서버(giveme5w1h-corenlp)를 먼저 띄워야 합니다.
from Giveme5W1H.extractor.document import Document
from Giveme5W1H.extractor.extractor import MasterExtractor

extractor = MasterExtractor()
doc = Document.from_text(text, date_publish)
doc = extractor.parse(doc)
print(doc.get_top_answer('who').get_parts_as_text())
코어닷투데이 실측
2026년 10월 13일 연합뉴스 7개 섹션 60건과 네이버 뉴스 요약 데이터셋 12건, 합쳐 72건 432칸. 쓰기 모델 넷에는 글자 하나 다르지 않은 정의서를 줬습니다(글자 F1).
| 방법 | 평균 | '왜' | 기사당 |
|---|---|---|---|
| Gemini 3.8 Flash 쓰기 (사고 끔) | 0.86 | 0.73 | 3.6초 |
| Flash + Clef-Flash 27B 부재 검문 | 0.87 | 0.84 | 7초 |
| Flash · Flash-Lite · 9B 다수결 | 0.86 | 0.85 | 5초 (병렬) |
| Qwen3.5 9B 로컬 쓰기 | 0.69 | 0.67 | 5.1초 |
| 판정 모델이 후보 다섯 중 고르기 | 0.62~0.71 | 0.35~0.66 | — |
| KorQuAD 독해 모델 (KoELECTRA) | 0.18~0.30 | 0.10 | 질문 6개에 0.4초 |
- 독해 모델은 범용 질문에 무너졌습니다. "이 사건의 주체는?"에 '다소', '이미' 같은 부사를 잘라 왔습니다. KorQuAD는 본문 표현을 품은 구체적 질문용입니다.
- 고르기는 쓰기를 못 이겼습니다. 정답이 후보 안에 있는데도(상한 0.9 이상) 그랬고, 후보를 쓰기 모델 셋으로 줄이자 4B부터 클라우드까지 네 판정 모델이 모두 0.74 근처로 모였습니다.
- 부재는 선택지가 아니라 질문으로 묻습니다. 같은 Nimble이 "없음"을 선택지 하나로 끼우면 '왜' 0.35, "이유가 명시돼 있는가"를 noul로 따로 물으면 AUROC 0.85였습니다. 검문은 큰 모델의 과잉은 깎지만 작은 모델의 누락은 채우지 못했습니다.
- 채점을 바꿔도 순위는 그대로였습니다. 답 2,371개를 판사 여섯에게 다시 채점시키자 클라우드 판사·Jev의 순위는 글자 F1과 켄달 상관 0.96~0.98. Flash와 9B의 격차도 0.175에서 0.160으로 줄었을 뿐입니다. '언제'는 날짜 정규화 규칙만으로 9B가 0.77에서 0.83이 됐습니다.
- 증류는 실패했습니다. Flash 답 1,623개(라벨 비용 5.6달러)로 Qwen3 4B를 LoRA로 가르쳤더니 0.656으로, 학습 전(0.686)보다 낮았습니다. 학생은 판단보다 '여섯 칸을 다 채우는' 버릇을 먼저 배웠습니다.
언제 쓰고, 언제 피하나
| 제약 | 구성 |
|---|---|
| 반출 가능, 단순하게 | Flash 단독 + 로컬 판정 모델(Clef-Flash 또는 Nimble) 부재 검문 |
| 반출 가능, 로컬 GPU 없음 | Flash 단독. '왜'의 지어냄은 감수하고 근거 번호로 검수 |
| 반출 불가, 애플 실리콘 있음 | 로컬 쓰기 모델 + Nimble choice로 근거 문장. 증류 전에 같은 크기 최신 모델부터 정의서만으로 잰다 |
| 반출 불가, CPU만 | 독해 모델 단독은 쓰지 않는다. 4B라도 들인다 |
한계와 주의
- 정답 초안을 Gemini 3.8 Flash가 썼습니다. Claude가 432칸을 원문과 대조해 16칸을 고쳤지만, 사람 둘이 독립적으로 단 정답은 아닙니다. 다른 최상위 모델(Gemini 3.1 Pro)과 정답의 거리도 이 정도였으니 0.85를 넘는 차이는 표현 차이로 읽습니다.
- 72건은 작습니다. 칸별 점수의 95% 신뢰구간은 대략 ±0.08입니다.
- '왜'의 정답 자체가 흔들립니다. 판사들이 정답을 의심한 네 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 정의서를 바꾸면 '왜' 점수는 0.1 단위로 움직입니다.
- 채점 판사에게는 가족 편향이 있었습니다. Gemini 판사는 Gemini 답에, Qwen 계열 로컬 판사는 Qwen 답에 후했습니다. 평가 대상과 다른 가족의 판사 둘 이상의 중앙값을 씁니다.
- 로컬 27B 쓰기 모델은 Ollama MLX 러너가 긴 입력에서 멈춰 빠졌습니다. 연합뉴스 60건은 국정감사 기간의 하루치입니다.