무엇인가
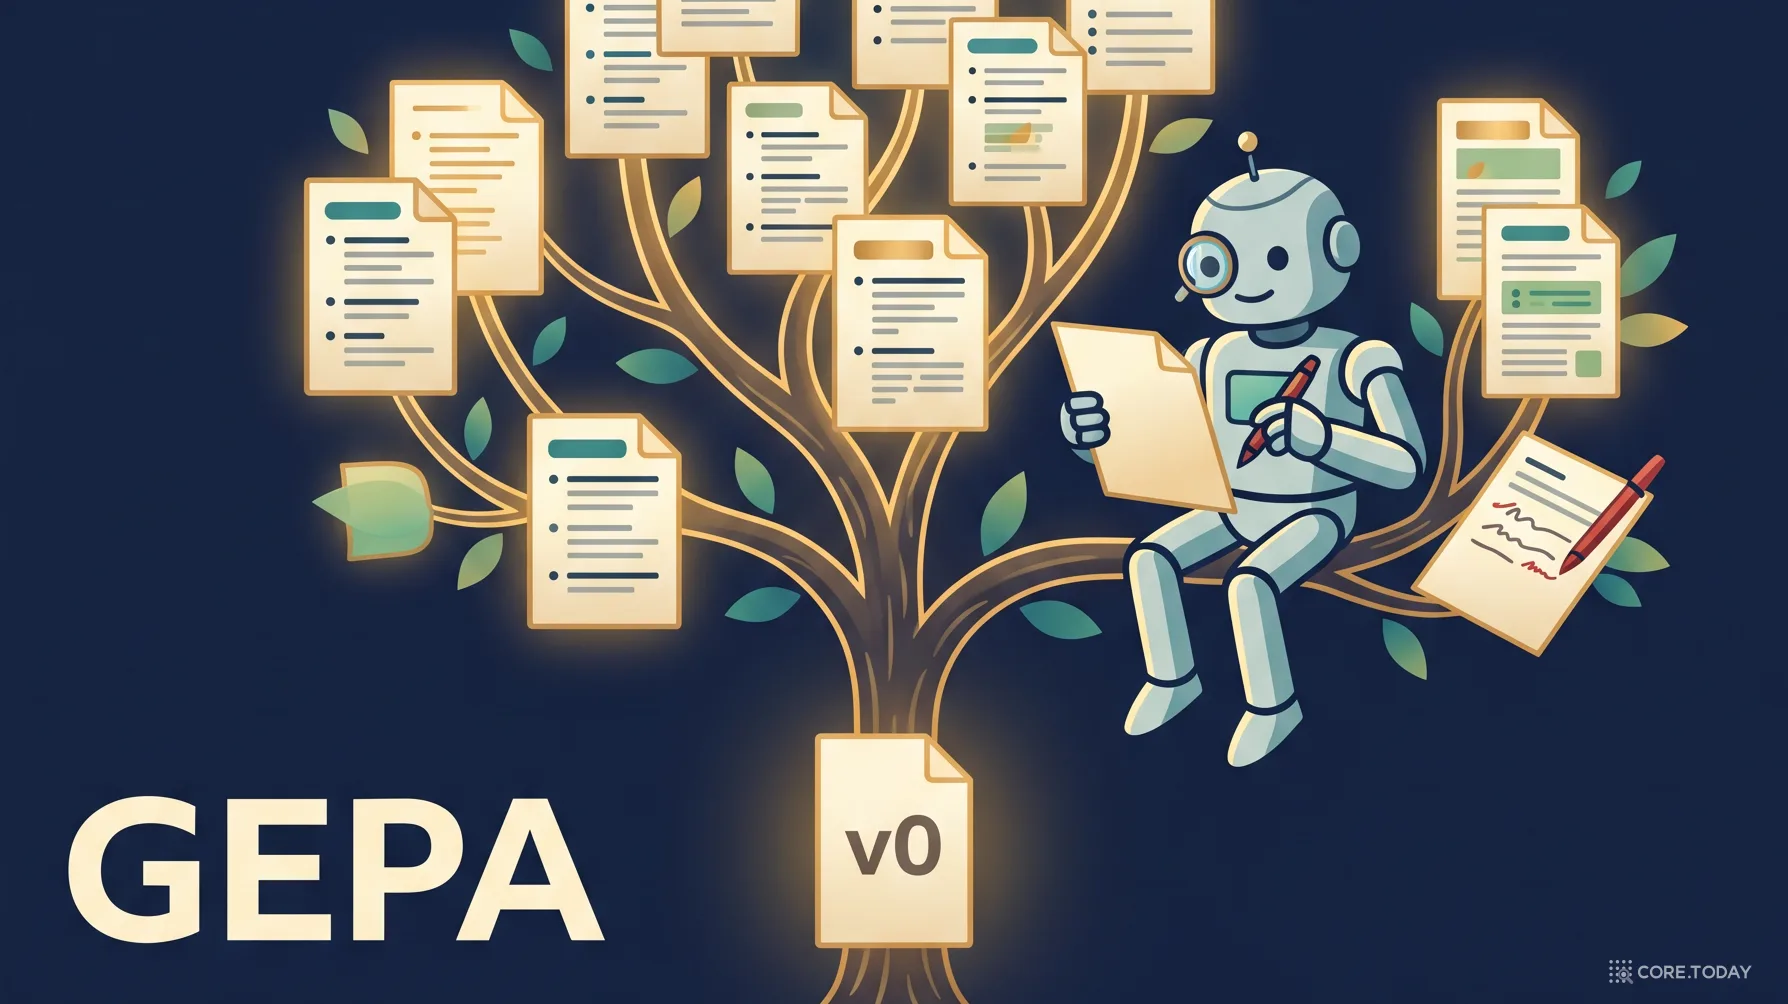
GEPA(Genetic-Pareto)는 언어 모델 시스템의 프롬프트를 자동으로 고치는 최적화기입니다. UC 버클리·스탠퍼드·MIT·데이터브릭스 연구자 17명이 2025년 7월 arXiv에 공개했고 ICLR 2026 구두 발표로 채택됐습니다.
강화학습은 시도 한 번에 점수 하나를 받습니다. 그런데 언어 모델이 일한 흔적은 전부 글입니다 — 생각 과정, 도구 호출, 컴파일러 오류 메시지까지. GEPA는 그 글을 다른 언어 모델에게 읽혀 "무엇이 잘못됐고 프롬프트를 어떻게 바꿔야 하는지" 반성하게 하고, 그 반성으로 프롬프트를 고칩니다.
어떻게 동작하나
1. 실행
현재 프롬프트로 학습 예시 몇 개를 돌리고 실행 기록(추론·도구 호출·출력)을 남긴다.
2. 피드백
피드백 함수가 점수와 함께 왜 그 점수인지를 글로 돌려준다. 예: "환불 기한이 빠짐".
3. 반성
반성 모델이 기록과 피드백을 읽고 모듈 하나의 프롬프트를 새로 쓴다.
4. 파레토 선택
평균 1등만 남기지 않고, 문항 하나라도 1등인 후보를 모두 살려 두고 그중에서 다음 부모를 고른다.
파레토 선택이 핵심입니다. 평균 점수만 보면 특정 유형의 문제를 잘 푸는 프롬프트가 일찍 버려지고, 탐색이 한 방향으로 쏠립니다. GEPA는 문항별 최고 후보를 남겨 서로 다른 강점을 가진 프롬프트들이 계속 경쟁하게 합니다. 두 후보의 장점을 합치는 병합(merge) 단계도 있습니다.
빠른 시작
DSPy 안에서 쓰는 것이 가장 짧습니다. 핵심은 점수만이 아니라 피드백 글을 함께 돌려주는 지표 함수입니다.
python
import dspy

class Answer(dspy.Signature):
    """고객 문의에 답한다."""
    question: str = dspy.InputField()
    answer: str = dspy.OutputField()

program = dspy.ChainOfThought(Answer)

def metric(example, pred, trace=None, pred_name=None, pred_trace=None):
    problems = []
    if example.needs_refund_window and "14일" not in pred.answer:
        problems.append("환불 기한(수령 후 14일)이 빠짐")
    score = 1.0 if not problems else 0.0
    feedback = "모든 기준 충족" if not problems else " / ".join(problems)
    return dspy.Prediction(score=score, feedback=feedback)

optimizer = dspy.GEPA(
    metric=metric,
    auto="light",  # 예산은 light부터
    reflection_lm=dspy.LM("openai/gpt-5", temperature=1.0, max_tokens=32000),
)
optimized = optimizer.compile(program, trainset=train, valset=val)
DSPy 없이 임의의 텍스트 구성요소(프롬프트, 코드, 설정)를 진화시키려면 독립 패키지 gepa의 gepa.optimize()에 어댑터를 붙입니다.
언제 쓰고, 언제 피하나
| 상황 | GEPA가 잘 맞는다 | 다른 방법을 먼저 본다 |
|---|---|---|
| 모델 접근 | API 모델만 쓸 수 있다 | 가중치를 고칠 수 있고 GPU가 넉넉하다 |
| 데이터 | 정답 달린 예시가 수십~수백 개 | 수만 개 이상 |
| 실패의 성격 | 규칙·절차·형식을 몰라서 틀린다 | 알아도 못 한다 — 긴 추론, 계산 실력 |
| 채점기 | 틀린 이유를 글로 말해 줄 수 있다 | 맞다·틀리다만 안다 |
한계와 주의
- 수치는 판본마다 다르다. 2025년 7월 v1은 네 과제에서 GRPO보다 평균 10% 높다고 했고, 2026년 2월 v2는 여섯 과제 평균 약 6점으로 정리했다. 인용할 때 판본을 밝힌다.
- '35배 적은 롤아웃'은 한 과제 이야기다. IFBench에서 678회 대 24,000회였고, 그때 향상은 2.73점이었다.
- 수학(AIME)에서는 강화학습이 이겼다. 지식·계산 실력이 부족한 문제는 프롬프트로 메우기 어렵다.
- 피드백에 정답을 통째로 넣으면 프롬프트가 답안지가 된다. 무엇이 빠졌는지만 일반화해서 말한다.
- 후속 연구(ACE)는 GEPA 계열 최적화가 프롬프트를 지나치게 짧게 다듬는 '간결성 편향'을 지적했다.