무엇인가
PARSER(Parallel Reading, Sequential Reasoning)는 홍콩중문대 연구진이 2026년 9월 arXiv에 공개한 긴 문서 멀티홉 질의응답용 에이전트 구조입니다. 출발점은 한 문장입니다. "긴 문서를 읽는 순서는 문서가 정하고, 질문을 추론하는 순서는 질문이 정한다."
100만 토큰 창을 가진 모델도 긴 문서 앞에서는 무너집니다. 논문 실험에서 Qwen3.5-4B는 HotpotQA 문서 전체를 넣었을 때 7K 토큰에서 80.5%, 896K 토큰에서 31.3%였습니다. MemAgent·ReMemR1 같은 순차 메모리 에이전트는 문서를 한 번, 순서대로 읽으며 메모리를 덮어씁니다. 그래서 두 번째 홉의 증거가 첫 번째 홉보다 앞에 나오면, 그 증거를 "아직 상관없어 보이는 문장"으로 버립니다.
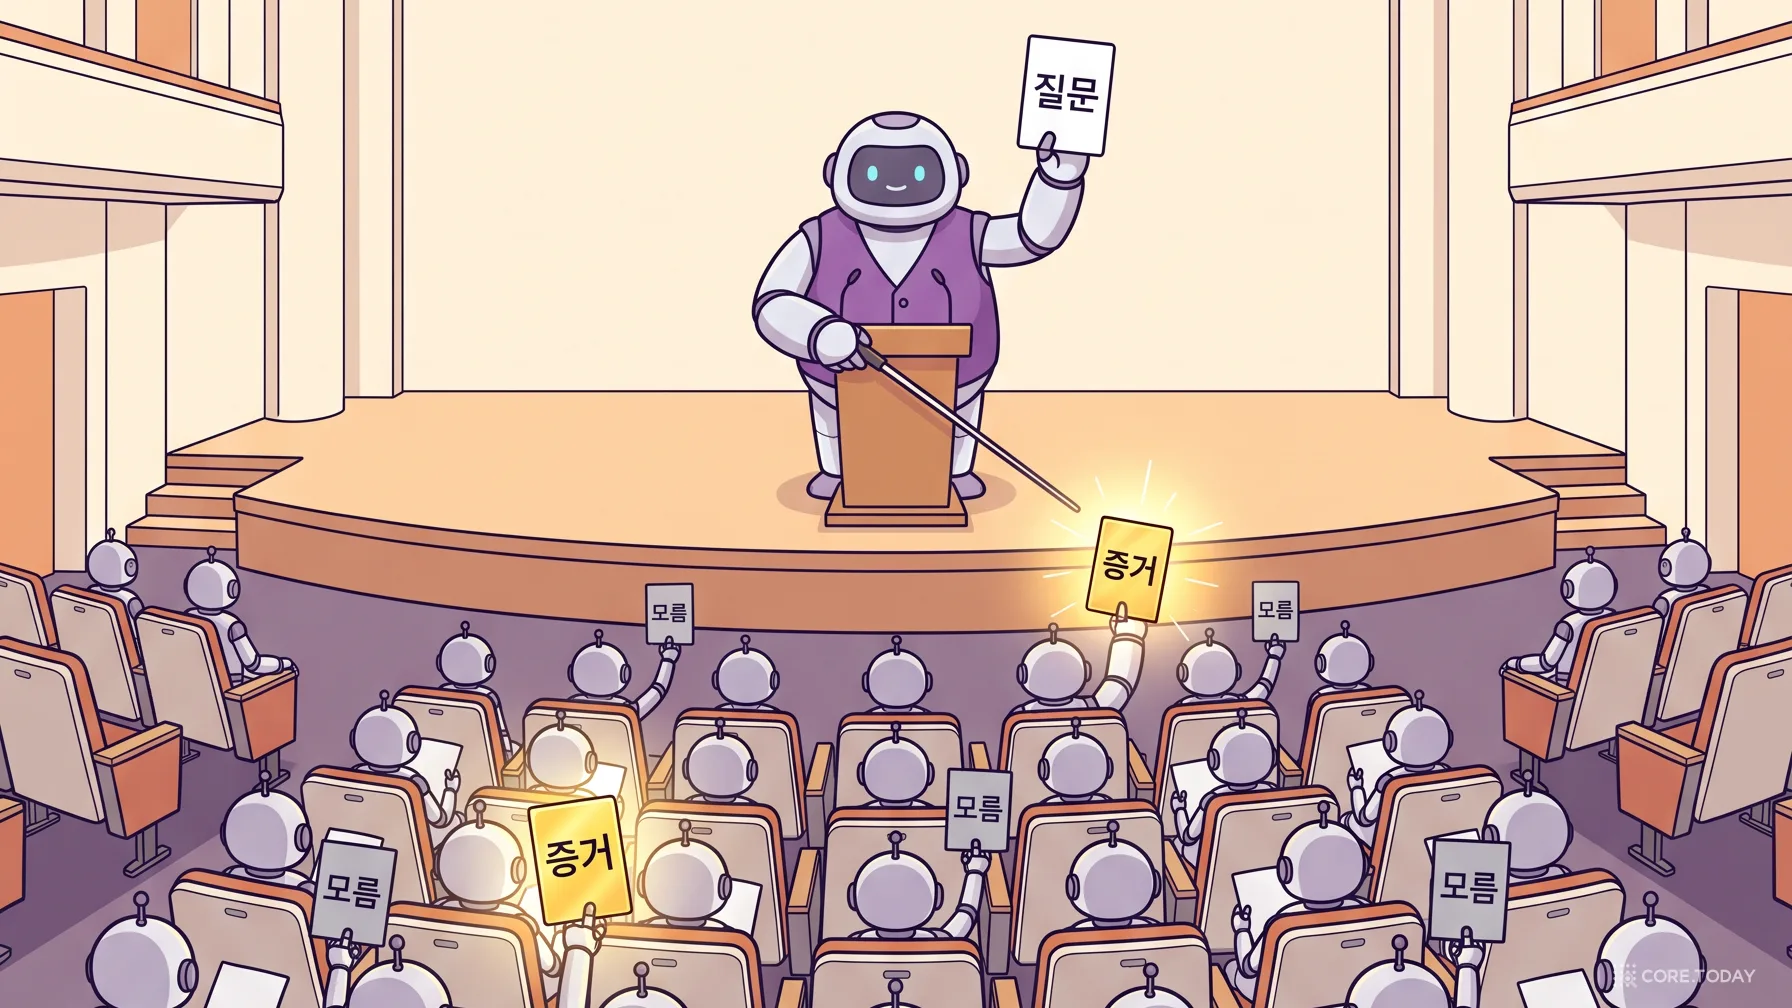
PARSER는 두 순서를 끊습니다. 모든 청크를 동시에 읽어 읽기 순서를 없애고, 추론만 질문이 요구하는 순서로 한 단계씩 갑니다.
어떻게 동작하나
query_agents(query) 도구를 부른다. 서로 독립인 질의는 한 턴에 묶어 보낸다.Unknown 한 마디만 낸다. Unknown은 리드에게 전달되지 않는다.학습은 리드 에이전트만 합니다. 보상은 최종 답이 정답과 일치하는가(0 또는 1) 하나이고, 최적화는 GRPO입니다. 서브에이전트가 돌려준 관찰 토큰은 손실에서 마스킹합니다. 아무도 가르치지 않았는데 리드는 서로 의존하지 않는 질의를 한 턴에 묶어 보내는 법을 배웠습니다(턴당 질의 수 1.06 → 1.62).
빠른 시작
공개된 것은 학습된 4B 리드 에이전트, 데이터셋, 학습·평가 코드입니다. README 기준으로 모델을 받고, 리드 체크포인트에 저장소의 채팅 템플릿을 덮어씁니다(원래 Qwen3.5 템플릿은 이전 턴의 생각 내용을 지우는데, 리드는 그것을 봐야 하기 때문입니다).
hf download inNexus/parser-qwen35-4b --local-dir parser-4b
cp chat_template.jinja parser-4b/chat_template.jinja
hf download inNexus/parser_dataset --repo-type dataset --local-dir data
리드가 내보내는 도구 호출과 서브에이전트의 응답은 이런 모양입니다(논문 부록 F의 실제 궤적).
{"name": "query_agents", "arguments": {"query": "Everything's Ducky film director"}}
{"name": "query_agents", "arguments": {"query": "Karthika film director"}}
{"agent_15": {"evidence": "Everything's Ducky is a 1961 comedy film directed by Don Taylor", "answer": "Don Taylor"}}
6,400문단 문서에서 이 질문을 PARSER는 3단계에 풀었고, MemAgent는 161단계를 돌고도 틀렸습니다. 학습 재현은 VERL + Megatron 비동기 RL, SGLang Router, NGINX가 필요하고 논문 기준 H100 16장으로 4B에 약 312시간이 들었습니다.
언제 쓰고, 언제 피하나
| 측정 (논문 v2) | PARSER | 비교 대상 |
|---|---|---|
| HotpotQA 896K 토큰 (4B) | 85.4% | 순차 메모리 최강 ReMemR1 73.4% |
| HotpotQA 평균 (9B 리드) | 86.8% | DeepSeek-V4-Pro 전체 입력 80.5% |
| 학습 안 한 2WikiMultiHopQA 평균 (4B) | 87.0% | MemAgent-4B 60.6% |
| 증거 순서를 뒤집었을 때 | 96.4% → 97.1% | MemAgent 66.5% → 23.3% |
| 단일 요청 지연 (896K) | 78초 | MemAgent 876초 (동시 요청 16~32개에서는 격차 1.7배) |
- 잘 맞는다: 문서가 수십만 토큰을 넘고, 증거가 흩어져 있고, 첫 질의로는 두 번째 단서를 모르는 질문 — 계약서 실사, 결재·인사 기록을 잇는 감사, 설정에서 라우트까지 따라가는 코드베이스 질문.
- 다른 방법을 먼저 본다: 수만 토큰 이하면 그냥 다 넣는 편이 낫다(짧은 문서에서는 전체 입력이 PARSER보다 높았다). 같은 문서에 질의가 반복되면 색인을 만드는 RAG가, 이름·식별자 같은 글자 그대로의 단서가 있으면 grep이 싸다.
한계와 주의
- 동명이인에 속는다. 서브에이전트는 리드가 지금까지 알아낸 것을 모르고, 리드는 서브에이전트가 어느 문단을 봤는지 모른다. "조지아의 엘레네 공주" 질문에서 러시아 대공녀 옐레나의 남편을 그대로 받아 틀렸다. 답 제출 전 검증 라운드나 확인된 사실을 질의에 실어 주는 방어가 필요하다.
- 총 계산량이 늘 수 있다. 출력 토큰은 MemAgent의 1% 아래지만, 매 라운드 모든 청크를 다시 읽는다. KV 캐시가 밀려나면 프리필이 약 K배(약 4배)가 된다. 속도 이점은 "GPU 메모리가 청크 캐시를 다 들고 있다"는 전제 위에 있다.
- 싸게 이긴다는 뜻은 아니다. 지연 측정에서 PARSER는 H100 한 장 + RTX 3090 한 장을 썼다.
- 합성 벤치마크, 너그러운 지표. 위키피디아 문단을 섞어 붙인 문서에 128개 질문을 길이별로 재사용했고, Sub_EM은 부분 문자열 일치를 정답으로 친다. Qwen3.5 한 계열에서만 검증됐다.
- 서브에이전트는 2B → 4B에서 78.3% → 84.6%로 오르고 9B에서는 84.8%로 거의 그대로였다. 비용 대부분인 서브에이전트는 작게 둬도 된다.
- 이름이 같은 다른 MemAgent 논문(이종 메모리 라우팅)이 있다. 여기서 비교 대상은 바이트댄스·칭화의 MemAgent(ICLR 2026)다.