무엇인가
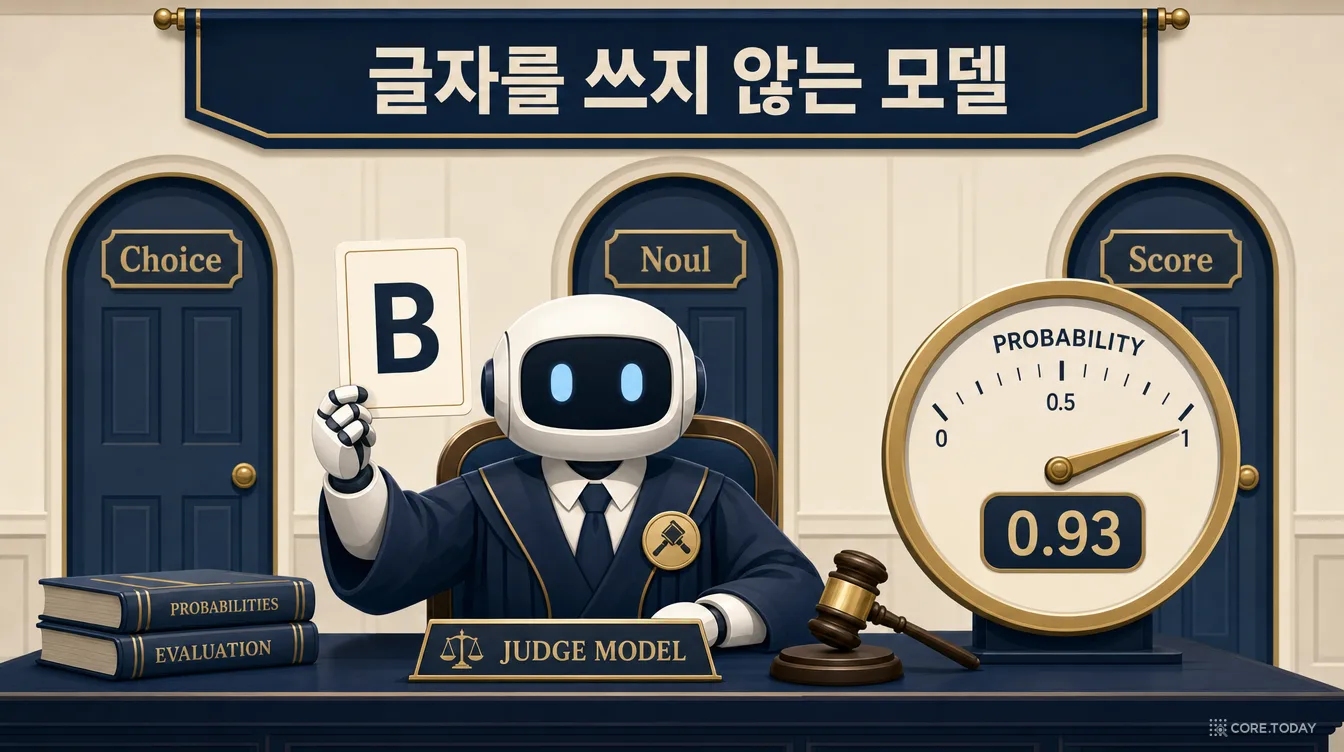
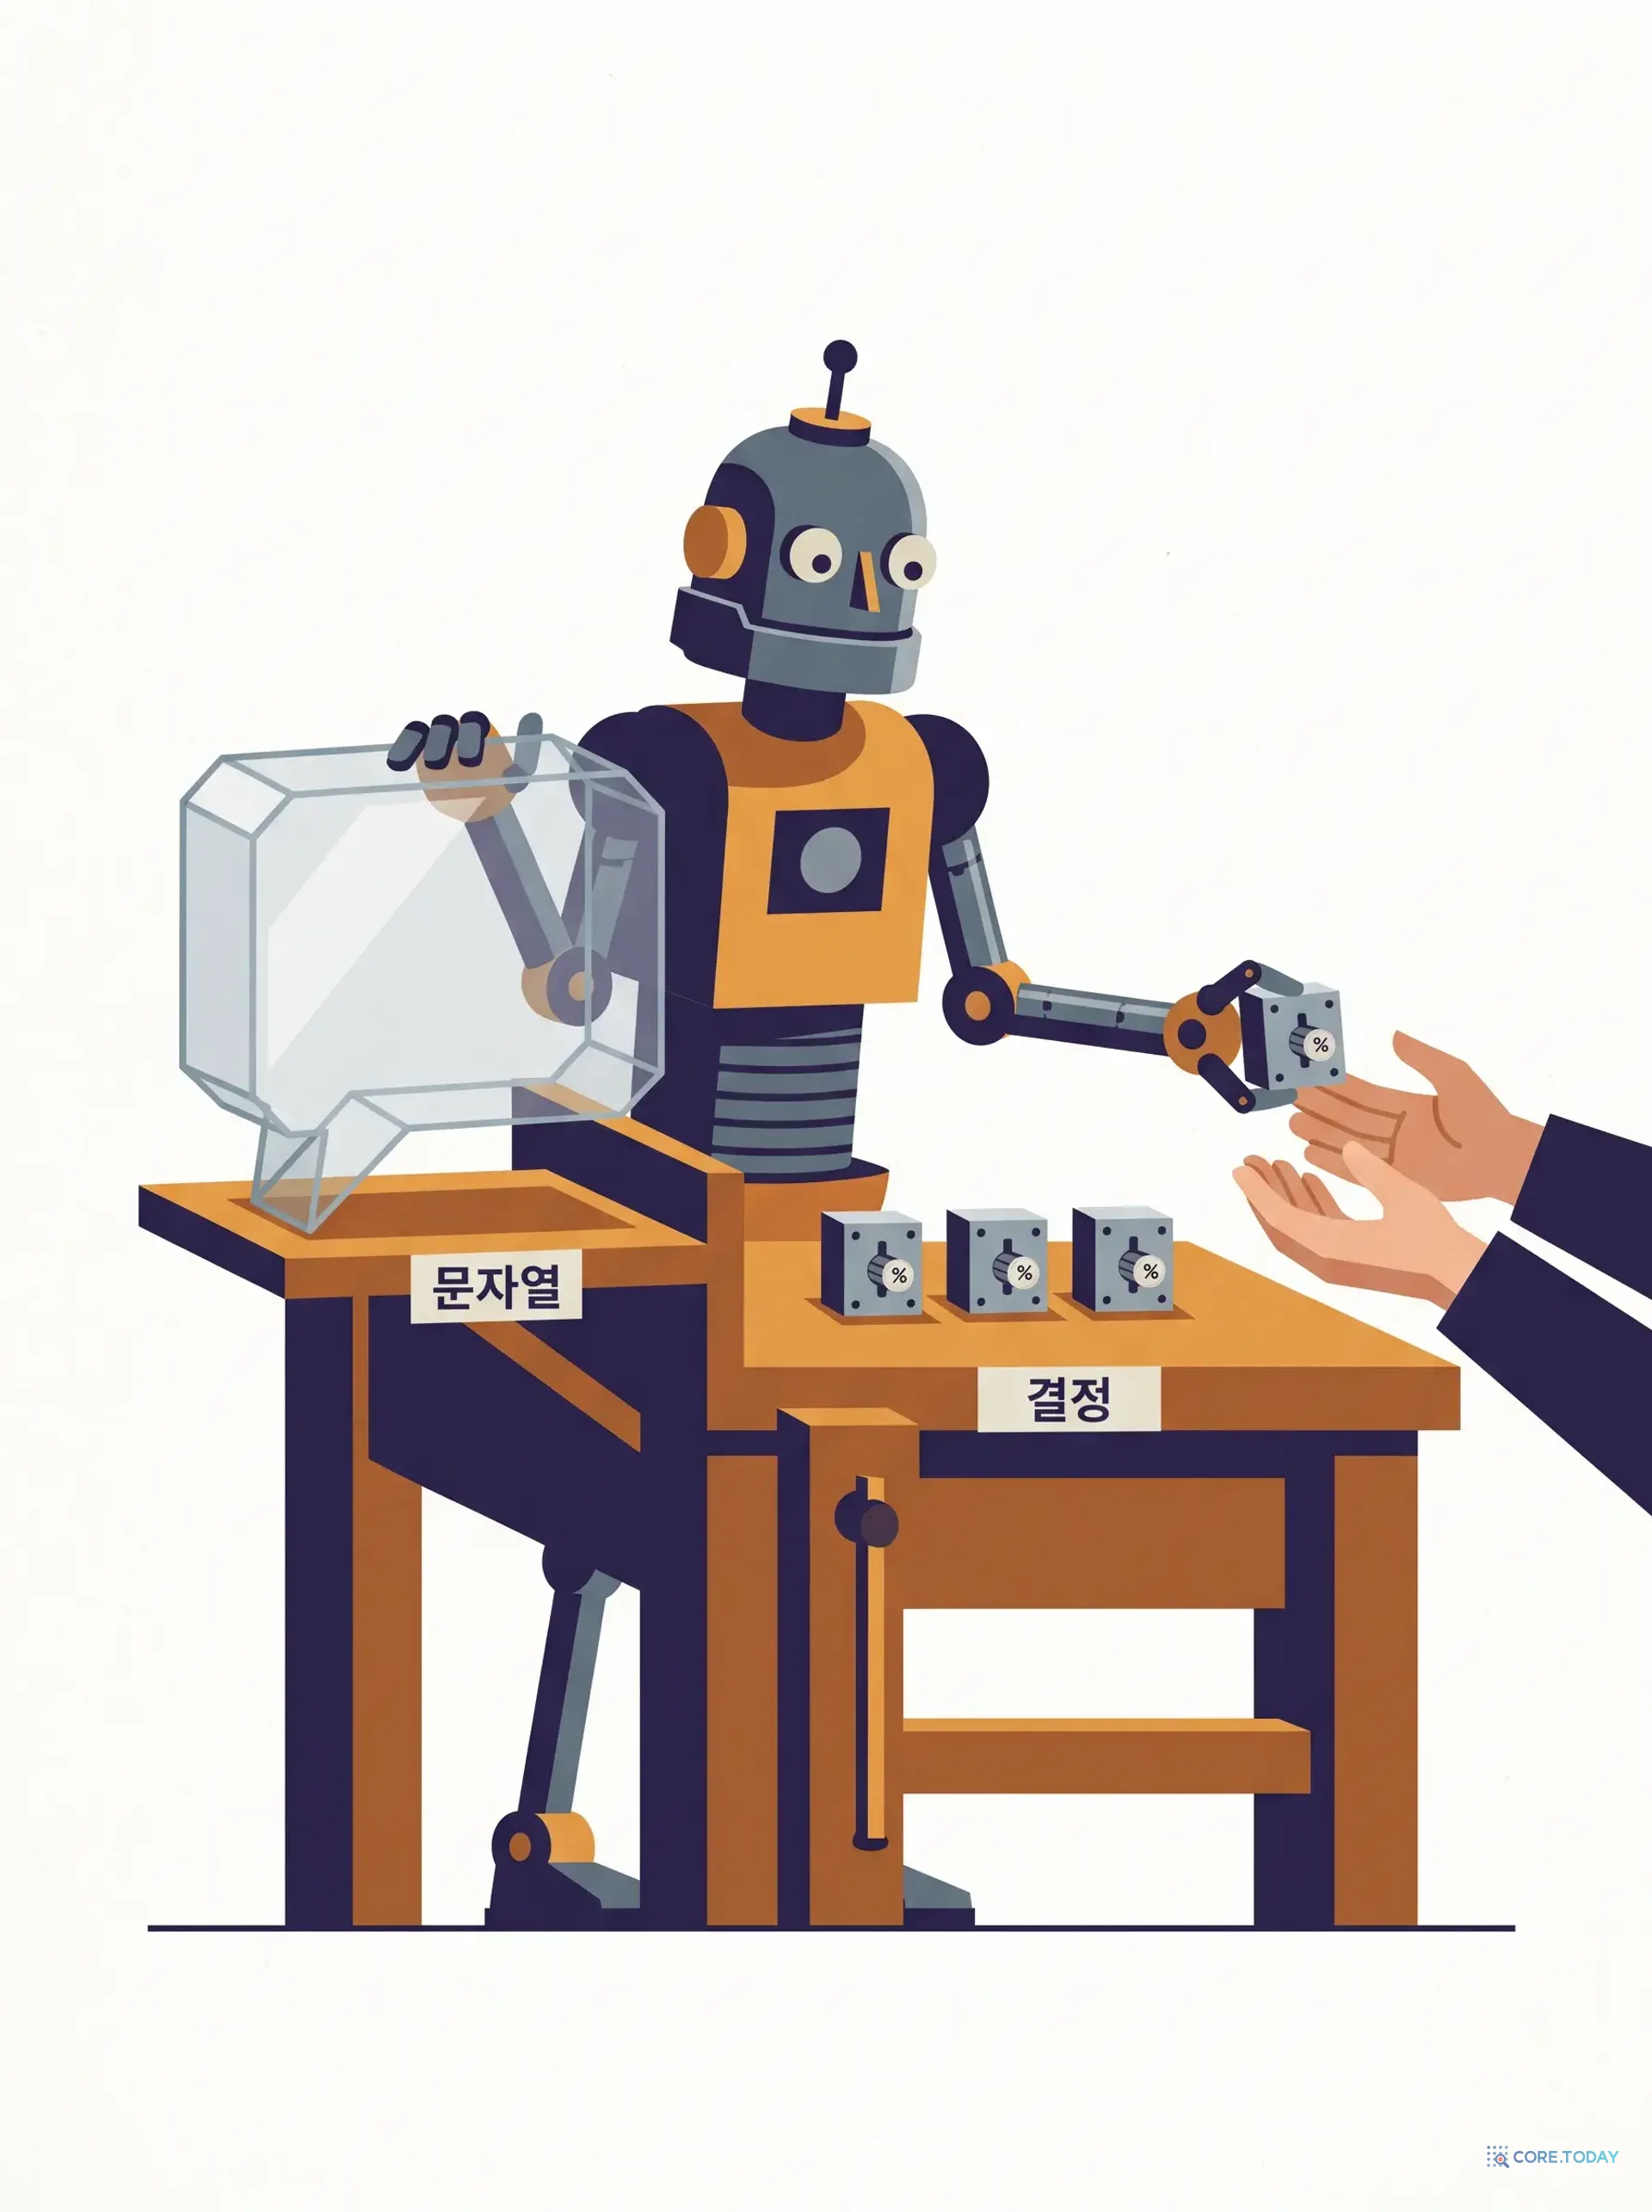
판정 모델(decision model)은 임베딩처럼 벡터를 내지도, 채팅처럼 문장을 쓰지도 않습니다. 상태(판정할 글)와 질문을 받아 선택지 하나와 각 선택지의 확률만 돌려줍니다. 2026년 9월 TypeSafe가 닫힌 API로 낸 Jev가 이 모양을 처음 내세웠고, 몇 주 사이에 열린 가중치 복제가 나왔습니다.
| 모델 | 만든 곳 | 뼈대 · 학습 | 공개 성적 (13개 데이터셋 평균) | Ollama 창 |
|---|---|---|---|---|
| tev1:0.8b | Together AI | Qwen3.5-0.8B · LoRA SFT 37,840예 | 63.5% | 2,048 |
| tev1:4b | Together AI | Qwen3.5-4B · LoRA SFT 37,840예, 약 17달러·25분 | 73.3% | 2,048 |
| nimble | Bespoke Labs | Qwen3.5-9B · LoRA, 사실 하나만 다른 대조 쌍 2,676개 | 74.8~75.7% | 8,192 |
| Jev 1.13 (API, 비교용) | TypeSafe | 비공개 | 76.0% | — |
Ollama는 2026년 9월 29일 새 엔드포인트 /v1/systemone과 새 능력 decision으로 이 모델들을 받아들였고, 요청·응답 모양은 Jev API를 그대로 따릅니다. 그래서 model 필드만 바꿔 원본과 복제품을 같은 코드로 비교할 수 있습니다. 데이터가 밖으로 나가지 않고 호출당 과금이 없다는 것이 로컬로 옮긴 이유입니다.
어떻게 동작하나
output_tokens는 0이다.형식이 깨지지 않고 파싱할 JSON이 없으며, 지연은 입력 길이에 비례하고 선택지 수에는 거의 무관합니다. 대신 설명을 쓰지 않고, 선택지 밖의 답을 내지 않고, 질문끼리 일관성을 맞추지 않습니다. TypeSafe는 이것을 카너먼의 빠른 직관에 빗대 '시스템 원'이라 부릅니다. 뼈대는 평범한 디코더 LLM이고 바뀐 것은 무엇을 출력으로 읽느냐이므로, LoRA 한 겹과 수천 개의 예시로 복제가 됐습니다.
빠른 시작
ollama pull nimble
curl http://localhost:11434/v1/systemone -d '{
  "model": "nimble",
  "state": "고객: 지난주에 주문한 노트북이 아직도 안 왔어요. 배송 조회도 안 되고요. 환불해 주세요.",
  "questions": {
    "route":   { "type": "choice", "instructions": "이 문의를 처리할 부서를 고르시오",
                 "criteria": { "shipping": "배송 문의", "refund": "환불/취소",
                               "tech": "기술 지원", "other": "기타" } },
    "angry":   { "type": "noul",  "instructions": "고객이 불만을 표현하고 있다" },
    "urgency": { "type": "score", "instructions": "긴급도",
                 "criteria": ["낮음", "보통", "높음"] }
  }
}'
코어닷투데이 실측에서 Nimble은 이 문의를 refund 0.829, shipping 0.163으로 읽었고 tev1 4B는 shipping 0.717로 반대로 읽었습니다. 둘 다 틀렸다고 할 수 없는 문의이고, 그래서 확률이 필요합니다. score의 criteria는 배열이어야 하고(객체면 400), confidence는 확률이 몰린 정도이지 정답일 확률이 아닙니다.
코어닷투데이 실측
2026년 10월 한국어 문서 660건·질문 85개·업무 과제 93문항으로 세 모델을 Jev 1.13과 같은 날, 같은 프롬프트로 붙였습니다.
| 자리 | Jev 1.13 | Nimble 9B | tev1 4B | tev1 0.8B |
|---|---|---|---|---|
| 리랭크, 열 장 한꺼번에 choice (출발 0.879) | 0.915 | 0.919 | 0.918 | 0.771 |
| 리랭크, 쌍별 noul · 짧은 한국어 지시 | 0.911 | 0.866 | 0.880 | 0.668 |
| 리랭크, 쌍별 noul · 참·거짓 기준 설명 붙임 | 0.930 | 0.907 | 0.913 | — |
| 업무 과제 7종 단순 평균 | 96.8% | 91.7% | 88.6% | 71.4% |
| "0.8 이상"이라 말한 쌍 중 실제 정답 | 62% | 25% | 42% | 13% |
| 호출 지연 중앙값 | 206~218ms (네트워크 포함) | 244~422ms | 120~240ms | 37~57ms |
- 고르는 과제(문의 라우팅·민원 배정)는 세 모델 모두 90% 이상이고 0.8B도 됩니다. 읽고 따지는 과제(환불 규정·인젝션·도구 호출 위험)는 크기를 탑니다. 0.8B는
rm -rf와DROP TABLE을 포함한 위험 호출 일곱 개 전부에 0.5 아래를 줬습니다. - 원본은 묻는 방식을 가리지 않고 복제품은 가립니다. 기준 설명(
criteria)은 복제품의 성능 조건입니다. - 확률 보정에서 가장 크게 갈립니다. 복제품의 학습에는 확률을 빈도에 맞추는 단계가 없습니다. 임계값으로 자동 처리와 사람 검토를 가르려면 자기 데이터 수백 건으로 온도를 맞춥니다.
- '없음'을 묻는 데 쓸모가 있었습니다. 육하원칙 실험에서 "기사에 이유가 명시돼 있는가"를 noul로 물으면 Nimble이 AUROC 0.85로 가렸습니다.
언제 쓰고, 언제 피하나
- 잘 맞는다: 데이터를 내보낼 수 없는 팀의 문의 라우팅·분류, 임베딩이 고른 상위 10개 재정렬, 규정 적용, 에이전트 도구 호출 앞의 회색 지대 검문. 라벨 없이 오늘 시작할 수 있고 기준이 바뀌면 설명 한 줄만 고칩니다.
- 다른 방법을 먼저 본다: 라벨이 수백 개 넘게 있으면 임베딩 이웃 투표가 나았습니다(5-NN 73% 대 판정 제로샷 58~61%). 수천 건에서 찾는 일은 임베딩의 몫이고, 반출이 허용되며 GPU가 없다면 Jev API가 가장 싼 심판입니다.
한계와 주의
- tev1은 실험적 모델이다. Together가 그렇게 표시했고 모델 카드는 한국어 등 비영어, 인젝션, 보정을 시험하지 않았다고 적습니다. 판정 모델을 고위험 결정의 유일한 검문으로 두지 않습니다.
- 창을 넘으면 자르지 않고 거부한다. tev1은 2,048토큰이라 후보 열 장의 요약을 110자로 줄여야 했습니다.
- 버전이 빠르게 바뀐다. Nimble 저장소는 이후 v2~v4와 27B 버전을 내고 선택지 상한도 늘렸습니다. Ollama의
nimble태그가 어느 체크포인트인지 확인하고 임계값은 다시 시험합니다. - 라이선스가 갈린다. Nimble 가중치는 Apache-2.0이고, tev1은 데이터 빌더·학습 코드가 MIT입니다. Nimble 저장소에는 2026-10-24 기준 라이선스 파일이 없습니다.
- 과제 7종은 10~16문항이라 큰 격차만 믿습니다. 지연은 맥 한 대에서 직렬로 잰 값입니다.