
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
[특집] 스스로 채점하는 기계 — MASS와 GEPA, 자기 개선 고리에서 '좋아졌다'는 말을 어디까지 믿을 것인가
2026년 10월 8일, 같은 날 arXiv에 올라온 두 논문이 같은 고리를 서로 다른 쪽에서 돌렸다. 버클리·사카나 AI의 MASS(arXiv 2610.12176)는 모델이 자기 복사본으로 팀을 꾸려 일하고, 스스로 채점하고, 잘된 기록으로 자기 가중치를 다시 학습하는 고리를 두 바퀴 돌려 연구형 벤치마크 넷에서 출력 토큰당 점수를 1.2~1.6배로 올렸다. 딥리서치 에이전트의 프롬프트를 GEPA로 고친 논문(arXiv 2610.12601)은 처음 보는 주제 500문항에서 인용 보상을 0.702에서 0.781로 올렸지만, 이긴 프롬프트의 절반이 외운 답안지였고 그 답안지는 점수를 한 푼도 벌지 못했다는 것을 함께 보였다. 이 글은 두 논문을 부록까지 읽고, 1965년 굿의 '지능 폭발'에서 알파고 제로와 다윈 괴델 머신까지 자기 개선의 계보를 따라간 뒤, 워크플로의 네 부품(역할·지시·계약·홉), 두 겹의 고리, 완주율이 올린 점수, 2.6배 부풀림을 만든 승자의 저주, 숫자 하나짜리 채점이 전이를 음수로 만든 실험을 위젯 7개와 삽화로 풀어 설명한다.
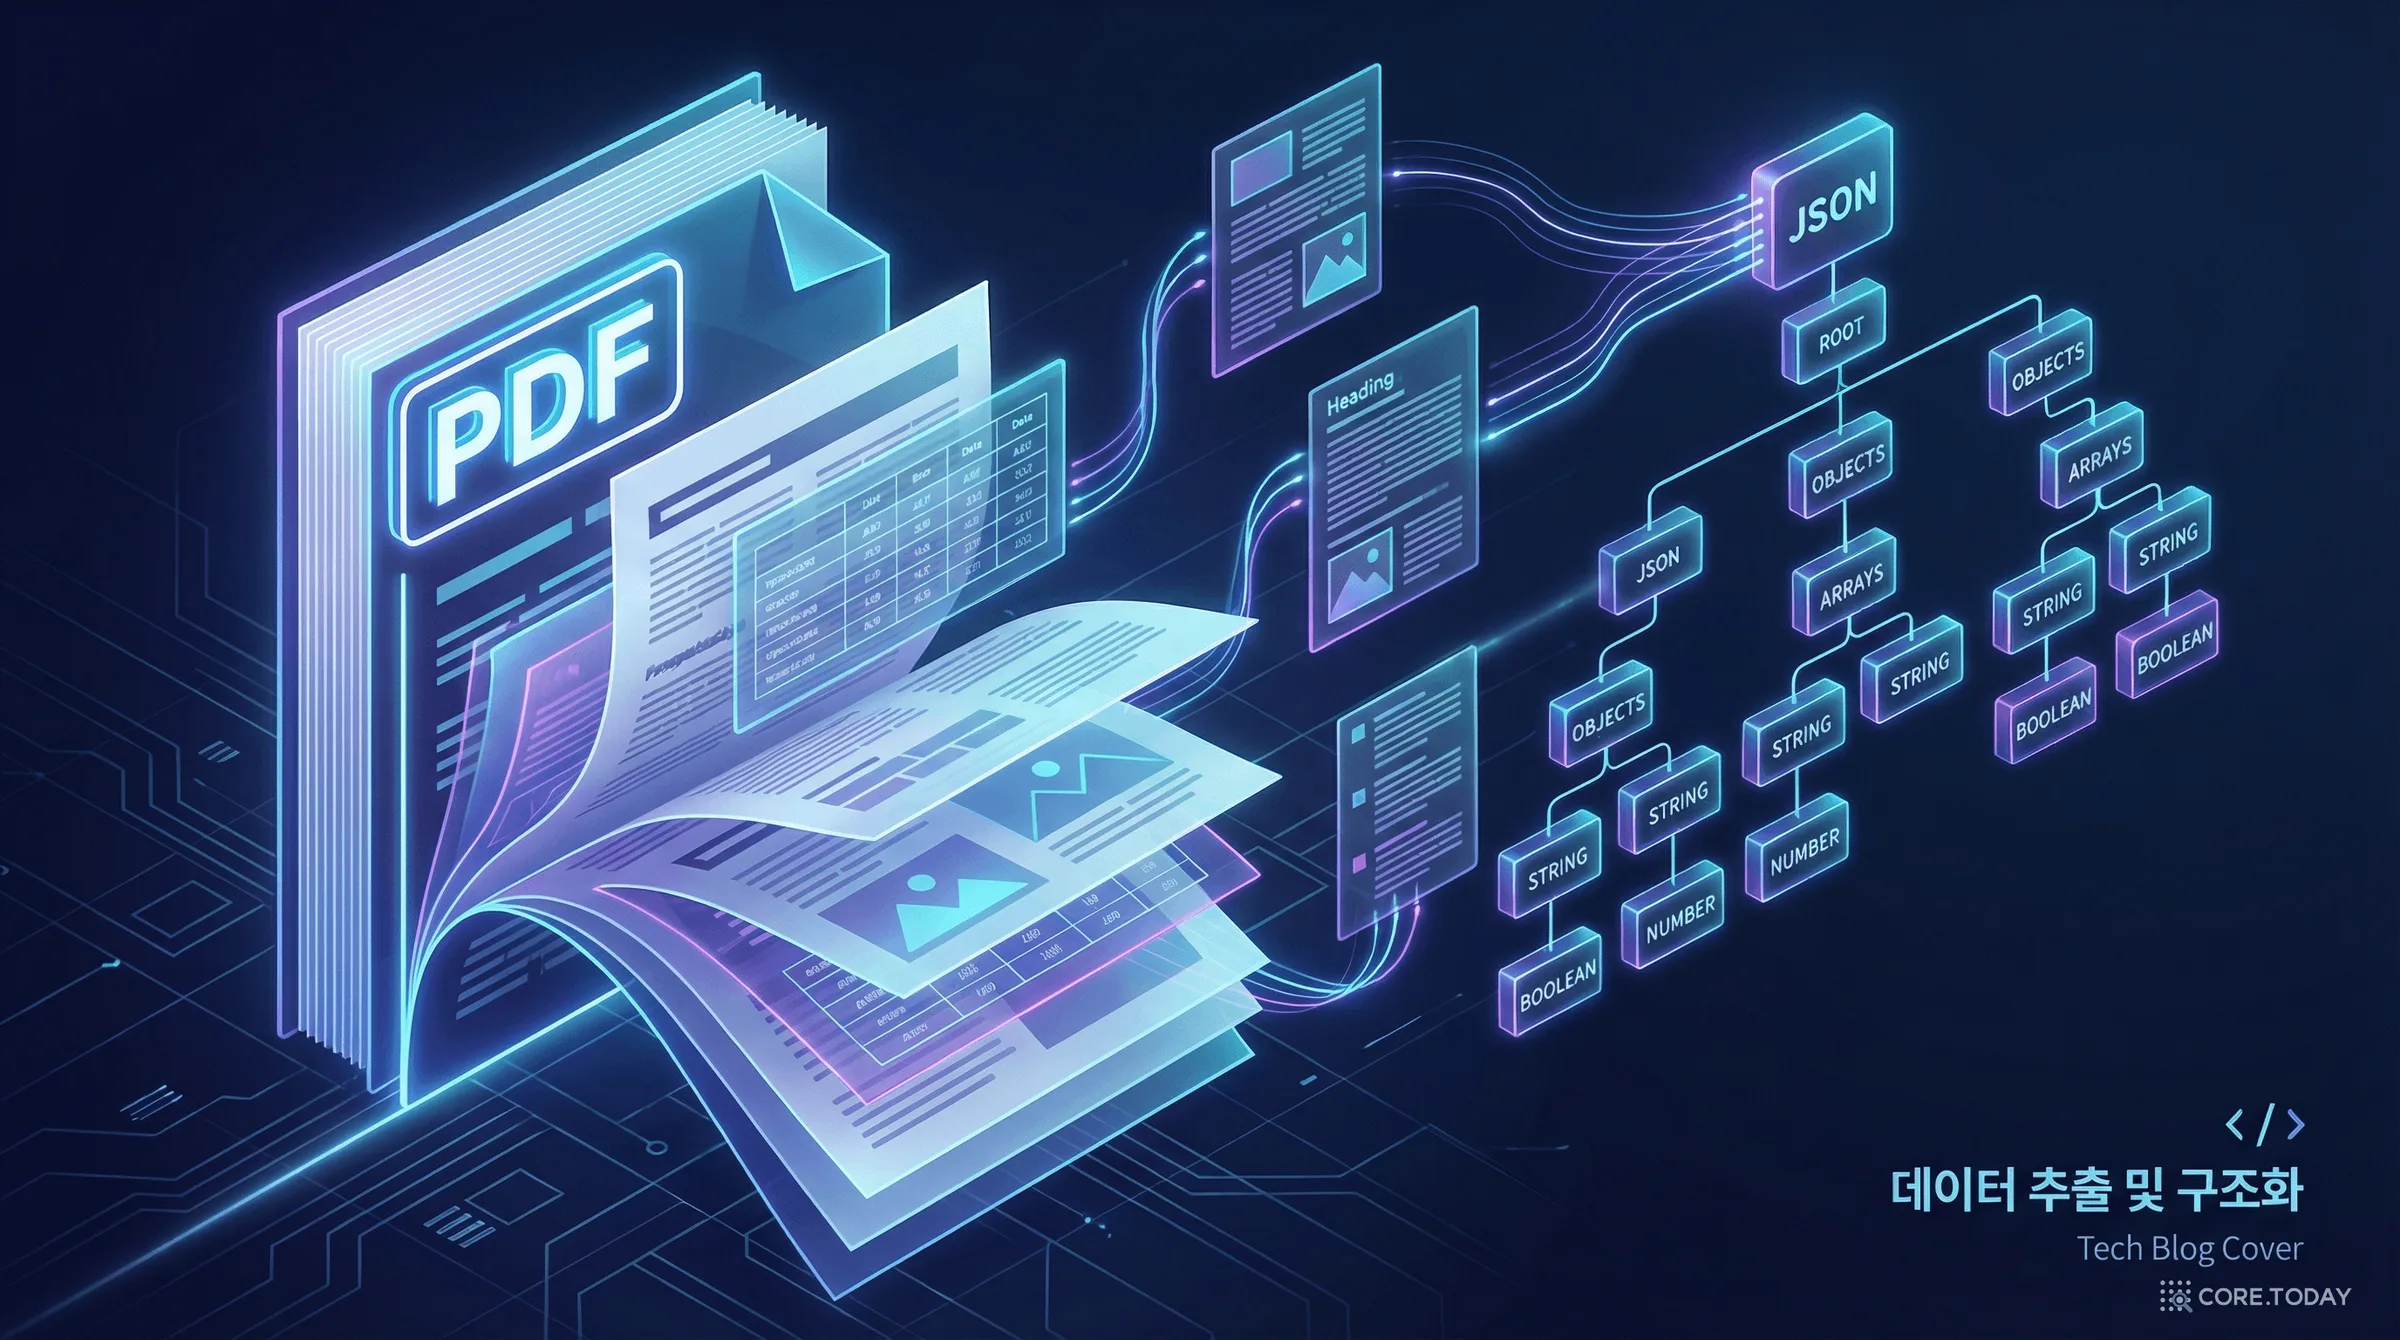
OpenDataLoader PDF 완전 해부: AI 시대, PDF 파싱의 새로운 표준
PDF는 30년 넘게 디지털 문서의 표준이었지만, AI에게는 최악의 데이터 형식이다. OpenDataLoader PDF는 이 문제를 어떻게 해결하는가? XY-Cut++ 알고리즘부터 하이브리드 아키텍처, 프롬프트 인젝션 방어까지 — 11,000개 이상의 GitHub 스타를 받은 오픈소스 프로젝트의 기술을 완전히 해부한다.
[특집] 하네스도 분업을 배운다 — Adaptive-GEPA, 요청을 나누는 법과 푸는 법을 한 번의 탐색으로 함께 진화시키기
하나의 AI 창구에는 성격이 다른 요청이 섞여 들어온다. 사실을 찾아야 하는 질문, 오래 생각해야 하는 수학 문제, 개인정보를 가려야 하는 부탁, 조건을 지켜 글을 고치는 일. 2026년 9월 30일 공개된 Adaptive-GEPA(arXiv 2609.38762)는 이 창구를 최적화하는 세 번째 길을 제안한다. 프로그램 하나를 통째로 다듬지도, 과제별로 미리 나눠 따로 다듬지도 않고, 요청을 나누는 라우터와 전문가 프로그램 묶음을 한 번의 탐색에서 함께 진화시킨다. 라우터의 지시문, 전문가마다 붙는 한 줄 설명, 프로그램 코드가 모두 사람이 읽는 글이고 실패 기록을 읽은 반성 모델이 그중 하나를 골라 고친다. 서로 다른 갈래를 합칠 때는 슬롯 번호가 아니라 ‘실제로 처리한 요청’의 겹침으로 전문가를 짝짓는다. Qwen3-8B 실험에서 네 과제 평균은 52.6에서 70.6으로 올랐고(프로그램 하나 진화 62.5, GRPO 54.0), 과제 이름을 한 번도 받지 않은 라우터가 시험 요청 651건을 과제 구분과 똑같이 나눴다. 이 글은 논문을 부록까지 읽고, 1991년 전문가 혼합에서 2025년 GEPA까지의 계보, 후보 하나의 구조, 다섯 가지 편집, 발자국 정렬 병합, 결과 표와 탐색 기록을 차례로 푼다. 시드 하나, 같은 프로그램을 다시 채점해도 2점씩 흔들리는 검증 점수, 세지 않은 계산량 같은 한계도 숫자로 짚었다. 한국어 요청 64건으로 논문의 ‘설명·라우터 편집’ 현상을 로컬 모델에서 다시 확인한 실측을 덧붙였다. 인터랙티브 6개, 일러스트 14장, 논문 그림 9장.
RAG 완전 이해: LLM은 왜 거짓말을 하고, 검색은 어떻게 이를 바로잡는가
1000권을 외운 천재가 왜 어제 환율을 틀리는지, 그리고 '답하기 전에 먼저 찾아봐'라는 단순한 아이디어가 어떻게 AI의 가장 중요한 아키텍처 패턴이 되었는지를 논문과 사례로 풀어본다.
ALL POSTS
모든 포스트
[특집] 스키마 없이 9억 노드 — AutoSchemaKG 깊이 읽기: 사건 노드, 개념화, ATLAS, 그리고 초록의 숫자가 표에서 뜻하는 것
지식 그래프는 40년 동안 분류표(스키마)를 사람이 먼저 그리고 그 칸에 사실을 채우는 방식으로 만들어졌습니다. ACL 2026에 실린 AutoSchemaKG(홍콩과기대·화웨이)는 순서를 뒤집어, LLM으로 개체와 '사건'을 먼저 뽑고 뽑힌 것마다 개념 꼬리표를 붙여 스키마를 끌어냅니다. 문서 5천만 건에서 노드 13.6억·엣지 86억짜리 그래프 ATLAS가 나왔고 GPU 78,400시간이 들었습니다. 이 글은 Cyc·Freebase·OpenIE·허스트 패턴으로 이어지는 역사부터 논문의 세 아이디어를 풀고, 표를 한 줄씩 다시 읽습니다. 사건 노드는 문단 정보의 89%를 지켰지만(개체 트리플은 35%), '12~18% 향상'은 BM25 대비였고 같은 검색기의 원본 그래프와는 비기거나 졌으며, 개념 노드가 보탠 점수는 1점 안팎, '92% 정렬'은 정답률이 아니라 BERTScore였습니다. 코어닷투데이가 한국어 위키백과 25문단에 같은 프롬프트를 돌린 실측과, 저장소 이슈·IBM의 재현·저자들의 후속 논문까지 함께 정리했습니다.
[특집] 설계도를 찾는 기계 — Archon과 AFlow, LLM을 '어떻게 엮을지'를 사람 대신 탐색이 정하기 시작했을 때
2024년 가을, 3주 간격으로 두 논문이 같은 질문에 서로 다른 답을 냈다. LLM을 여러 번, 여러 개 불러 엮으면 성능이 오른다는 건 다들 안다. 그런데 무엇을 몇 번 부르고 어떤 순서로 엮을지는 누가 정하는가. 스탠퍼드의 Archon(arXiv 2409.15254, ICML 2025)은 구조를 '여섯 개의 다이얼'로 줄이고 신경망 구조 탐색에서 쓰던 베이즈 최적화로 9,576가지 조합을 뒤졌다. DeepWisdom·홍콩과기대(광저우)의 AFlow(arXiv 2410.10762, ICLR 2025 구두 발표)는 구조를 '파이썬 코드'로 두고 LLM이 한 번에 한 군데씩 고치게 하면서 그 시도들을 나무로 기억했다. 이 글은 두 논문을 부록까지 읽고, 왜 한 번만 묻지 않게 됐는지(1785년 콩도르세, 1907년 골턴의 소, 2022년 자기 일관성)에서 시작해 여섯 부품과 깔때기 구조, 9,576가지 공간과 기대 향상, 노드·오퍼레이터·엣지, 선택·확장·평가·역전파 네 단계를 차례로 푼다. 본문과 부록, 공개 코드 사이에 엇갈리는 숫자(비평가 11.5점 대 3.1점, 선택 확률의 α·λ 세 벌)도 짚었다. 그리고 2년이 지난 2026년 11월의 눈으로 다시 본다. 단순 다수결이 자동 설계를 이긴다는 반론, 같은 모델을 여러 번 부르는 편이 섞는 것보다 낫다는 Self-MoA, 모델 안으로 들어간 병렬 추론, 그럼에도 남은 것. 인터랙티브 6개, 일러스트 14장, 논문 그림 15장.
검색에서 재구성으로 — '누가 그렇게 말했는지' 기억하는 AI, CogMem과 PEC²F 기억 그래프
"지나는 준호가 잘린 게 회사 실수래"라는 말을 들은 AI가 몇 주 뒤 "준호는 회사 실수로 잘렸어요"라고 답한다면, 기억은 있었지만 출처를 잃은 것입니다. 칭화대 선전 국제대학원의 CogMem(arXiv 2610.11314)은 대화 기억을 사람·사건·개념·주장·사실 다섯 종류의 노드로 나누고, 남의 의견은 '누가, 누구에 대해' 한 말인지가 붙은 주장 노드로 따로 보관합니다. 질문이 오면 규칙 기반 제어기가 닻 내리기·교집합·시공간 탐색·원문 확인 네 연산자를 골라 답을 다시 짓습니다. 바틀릿의 '재구성 기억'과 툴빙의 일화·의미 기억, 출처 감시 이론, 샐리-앤 실험, 상보적 학습 이론에서 이 설계가 어디서 왔는지 따라갔습니다. 논문 표를 원 논문들과 대조해 보니 기준선 숫자 상당수가 GAM·LightMem 논문의 표를 그대로 옮긴 것이었고, LongMemEval의 'Qwen2.5-14B' 열은 실제로는 Qwen3-30B 결과였습니다. 한국어로 직접 재 보니 논문식 문장 쌍은 유사도 0.824에도 오귀속이 0건이었지만, 실제 대화 저장 형식에서는 최대 48%가 남의 의견을 집어 왔습니다. 인터랙티브 7개.
[특집] 요약도 실력이다 — 컨텍스트 압축을 강화학습 안으로 들여온 CompactionRL 완전 해설
코딩 에이전트가 몇 시간째 일하다 보면 컨텍스트 창이 가득 찹니다. 그때 하네스는 지금까지의 대화를 요약으로 접고 새 창에서 일을 이어 가게 합니다. 이것이 컨텍스트 압축(compaction)입니다. 그런데 이 요약은 지금까지 훈련 밖에 있었습니다. 모델은 요약에서 이어 가는 연습을 한 적이 없고, 요약을 잘 쓴다고 보상을 받은 적도 없습니다. 칭화대와 Z.AI의 2026년 7월 논문 CompactionRL은 압축을 강화학습 롤아웃 안에 넣고, 요약 토큰과 실행 토큰을 같은 최종 보상으로 함께 훈련합니다. 이를 위해 세 가지 장치를 씁니다. 조원을 기다리지 않는 단일 롤아웃 PPO, 짧은 요약이 손실을 독차지하지 않게 하는 토큰 단위 손실, 그리고 잘린 구간 너머로 보상의 거리를 되살리는 구간 넘는 GAE입니다. 106B 모델에서 SWE-bench Verified 66.4%, Terminal-Bench 2.0 26.2%로, 추론 때만 압축한 기준 모델보다 6.6점·4.9점 높습니다. 요약 모델만 바꿔도 6.5점이 움직인다는 실험, 요약을 훈련하면 요약이 길어진다는 관찰, 그리고 이 이득이 압축을 켰을 때만 나온다는 한계까지 표와 그림을 하나씩 읽습니다. 직접 돌려 보는 위젯 일곱 개를 함께 실었습니다.
먼저 정리하고, 그다음 따라간다 — 기억이 바뀌면 '읽을 기록'도 바뀐다: Contract Memory Compiler 특집
회의가 A실에서 B실로 옮겨졌다는 사실을 AI가 잘 기억해도, 층수를 물으면 여전히 A실의 2층 기록을 읽을 수 있습니다. 갱신은 값만 바꾸는 게 아니라 '다음에 읽어야 할 기록'을 바꾸기 때문입니다. 2026년 9월 arXiv에 올라온 Contract Memory Compiler는 질문 전에 관계를 최신 값으로 정리하고, 질문 속 이름에서 출발해 그 정리된 그래프를 따라가 원문 기록을 건네는 방식으로 FactConsolidation 다중 홉 정확도를 78.25%까지 올렸습니다. 같은 추출과 같은 답 모델에서 순서만 뒤집으면 21.50%입니다. 메모리 네트워크부터 MQuAKE·MemoryAgentBench까지의 역사, 다섯 단계의 작동 원리, 대조군 하나하나의 의미를 짚고, 공개 데이터와 로컬 4B 모델로 논문 결과를 다시 재 보았습니다.
[특집] 기억의 기억 — 바뀐 사실은 지우지 말고 '밀어내라'. AI 에이전트 기억 MoM·P-Mem 완전 해설
AI 비서에게 "5K 기록은 27:12"라고 말하고, 몇 달 뒤 "25:50으로 깼다!"고 자랑했다. 그런데 "내 최고 기록이 뭐였지?"라고 묻자 27:12라고 답한다. 싱가포르국립대의 2026년 9월 논문 「MoM: Memory of Memory」는 이 실패의 뿌리를 두 질문으로 정리한다. 현재 값을 언제 정하는가(들어올 때냐, 물을 때냐), 그리고 밀려난 값을 남기는가(남기느냐, 지우느냐)다. RAG 같은 아카이브는 물을 때 정하고 다 남긴다. 그래서 낡은 값이 다시 끼어든다. Mem0 같은 CRUD 기억은 들어올 때 정하지만 지운다. 그래서 잘못 고친 값을 되돌릴 수 없다. 논문은 비어 있던 칸, 즉 '들어올 때 확정하되 밀려난 값은 출처로 남긴다'를 고른다. 그 구현인 P-Mem은 수락·이의·기각·철회·해결·지지의 여섯 연산으로 버전을 옮기고, 간선을 따라 되돌린다. 결과는 정직하다. 정확도는 가장 강한 검색 기억과 비슷하지만(52.6% 대 50.8%), 읽는 토큰은 약 4분의 1이다. 낡은 답은 19.4%에서 10.9%로 줄었다. 수정이 여덟 번 쌓이면 물을 때 다시 꿰는 방식은 25%로 무너지지만 쓸 때 확정한 칸은 100%를 지킨다. 착오를 철회하면 100%를 되살리는데 CRUD는 0%다. 회계 장부의 역분개와 등기부의 '말소사항'부터 시간 데이터베이스, 이벤트 소싱, 2026년의 ChatGPT 'Dreaming'까지 이 생각의 계보를 따라가고, 논문의 그림과 표를 하나씩 읽는다. 논문의 실험 세 가지는 한국어로 다시 만들어 로컬 Qwen 4B로 직접 돌렸다. 수정이 여덟 번 쌓이자 질문 때 다시 꿰는 방식은 22.5%, 쓸 때 확정은 100%였고, 9B로 키워도 25%였다. 철회 복구는 보존 여부 하나로 100% 대 0%로 갈렸다. 다만 4B 주석기가 여섯 연산을 완벽히 고른 것은 예시를 넣은 지시문 덕분이었다. 예시를 빼자 '해결' 연산을 40건 중 1건만 골랐다. 인터랙티브 위젯 7개.
질문 하나로 연대기를 짓는 법 — TimelineAgent로 읽는 '질문 중심 문서 횡단 타임라인'
기사 서른 건을 주고 '스티브 잡스 연대기'를 만들라고 하면, 기계는 '월요일'이 며칠인지, '그'가 누구인지, '할 것이다'가 일어난 일인지부터 막힙니다. EMNLP 2026에 실린 TimelineAgent는 이 일을 여섯 단계로 쪼개고, 단계마다 필요한 원자 기술만 골라 쥐여 주는 규약을 더해 같은 모델의 한 번에 묻기보다 두 배 이상 높은 점수를 냈습니다. 편년체·기전체·기사본말체에서 SemEval-2015까지 연표 기술의 역사, 논문의 구조와 표·그림, 그리고 코어닷투데이가 공개 데이터와 공식 채점기로 로컬 9B 모델에서 직접 재현한 결과를 함께 정리합니다.
[특집] '얼마나'가 아니라 '어디에' — 생각·구조·시간, 추론 예산을 나눠 쓰는 세 논문 (Gambit·MaAS·LAWA)
같은 문제를 512번 풀게 하고 다수결을 냈는데 오답이 나왔다. 2026년 여름 프린스턴의 Gambit 논문은 이 장면에서 출발해 질문을 바꾼다. 계산을 얼마나 더 쓸지가 아니라 어디에 쓸지다. 이 글은 같은 질문에 서로 다른 단위로 답한 세 논문을 함께 읽는다. Gambit(arXiv 2608.08020)은 한 문제 안에서 GPU 메모리 칸을 유망한 풀이에 몰아주고, MaAS(arXiv 2502.04180, ICML 2025 구두 발표)는 질문마다 에이전트 팀의 크기를 다르게 뽑고, LAWA(arXiv 2610.14481, NeurIPS 2026)는 되풀이되는 질의의 가장 긴 줄을 깎는다. 1976년 음성 인식에서 태어난 빔 탐색이 왜 번역에서 밀려났다가 '생각 단위'로 돌아왔는지, 신경망 구조 탐색의 슈퍼넷이 에이전트로 건너오며 무엇이 바뀌었는지를 따라간 뒤, 세 논문을 부록과 표까지 검산한다. 헤드라인의 +3.3%는 30문항 중 한 문제이고, '엄격히 우세'는 15칸 중 11칸이며, MaAS 표의 토큰 수와 달러는 서로 맞지 않는다. 모의실험과 계산기 다섯 개, 논문 그림 열두 장을 함께 싣는다.
작은 모델, 큰 벤치마크 — K-LegalDeID로 읽는 BIO와 CRF의 귀환, 109만 건의 데이터, 그리고 0.99 뒤의 0.94
판결문 비실명화에 대한 두 번째 답이 2026년 3월 EACL에 나왔습니다. 고려대 연구진의 K-LegalDeID는 앞선 Thunder-DeID와 거의 모든 선택이 반대입니다. 라벨은 729개가 아니라 11개, 모델은 처음부터 사전학습한 15억 파라미터가 아니라 공개된 KLUE-BERT 1억 1천만에 CRF 층 하나, 데이터는 판결문 6,700건이 아니라 채팅·판결문·공개 데이터를 합친 109만 문장입니다. 그리고 엄격한 개체 단위 F1 0.9923을 보고합니다. 이 글은 1995년의 BIO 표기와 2001년의 CRF가 왜 2026년에 다시 쓰이는지부터 풀고, 39개 법 분야 2,000건의 새 데이터와 주석자 일치도 0.7352, 여섯 가지 채점 방식을 그림·표·위젯으로 따라갑니다. 숫자를 뜯어 보면 0.9923은 채팅이 대부분인 시험지의 점수이고, 새로 만든 판결문만으로는 0.94~0.97이며, 다른 연구실의 정답지로 채점하면 0.37로 떨어집니다. 코어닷투데이는 공개된 KLUE-BERT 어휘로 이름 2,000개에 조사를 붙여 직접 토큰화해, 경계가 맞아떨어지는 비율 97.3%와 ‘신한은행’이 한 토큰이 되는 문제를 확인했습니다.