무엇인가
MemoType은 홍콩시립대와 화웨이 노아의 방주 연구소가 2026년 10월 8일 arXiv에 올린 NeurIPS 2026 채택 논문 「Memory Type Varies: Empowering LLM Agents for Long-Term Memory with Diverse Strategies」(arXiv 2610.11573)의 장기 기억 검색 프레임워크입니다.
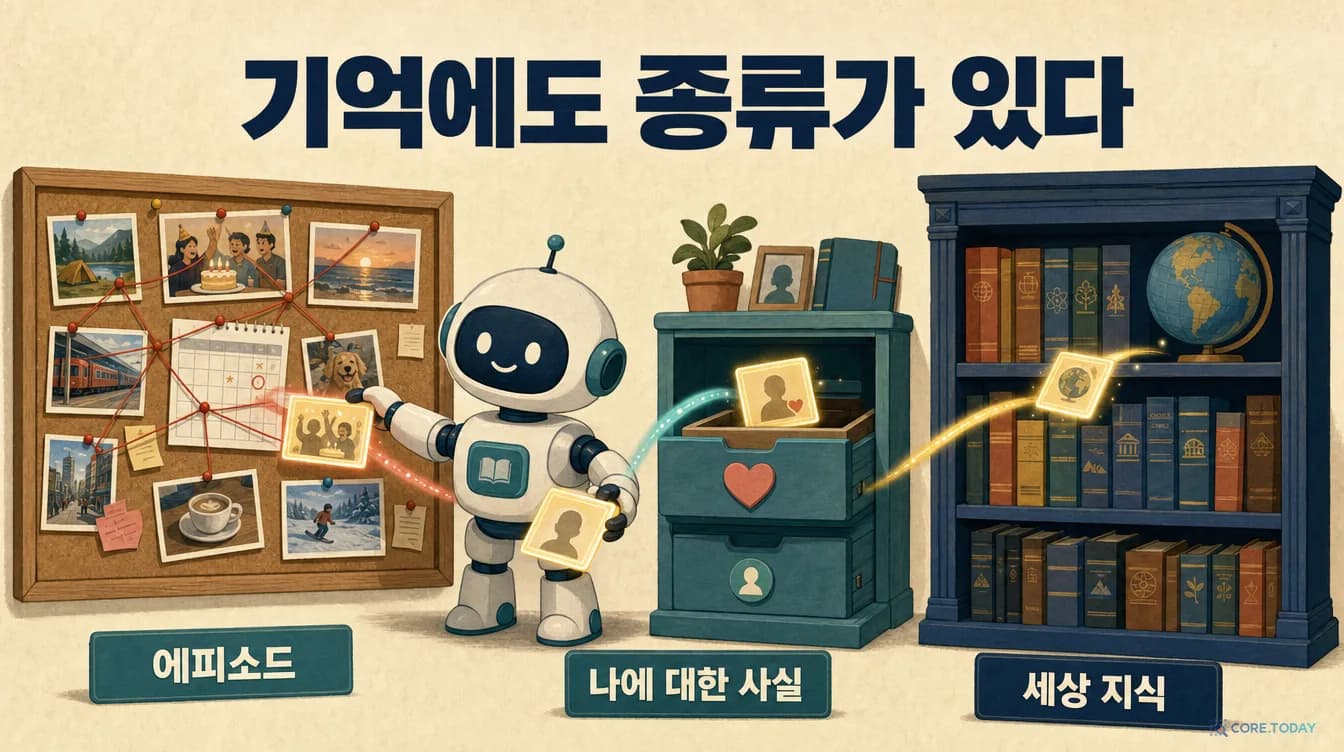
진단은 한 문장입니다. 지금까지의 AI 메모리는 모든 기억을 같은 방식으로 찾았다. "지난달 조지랑 태산 다녀왔어"(사건), "나는 뉴욕대에서 수학을 전공했다"(나에 대한 사실), "물은 100도에서 끓는다"(세상 지식)는 생김새가 다른데, 하나의 임베딩과 코사인 유사도로 똑같이 찾았습니다. 그래서 "4주 전에 조지는 어디 갔었지?"에 '지난달'과 '4주 전'을 잇지 못하고, "내 전공이 뭐지?" 같은 짧은 질문은 긴 기억과 어긋납니다.
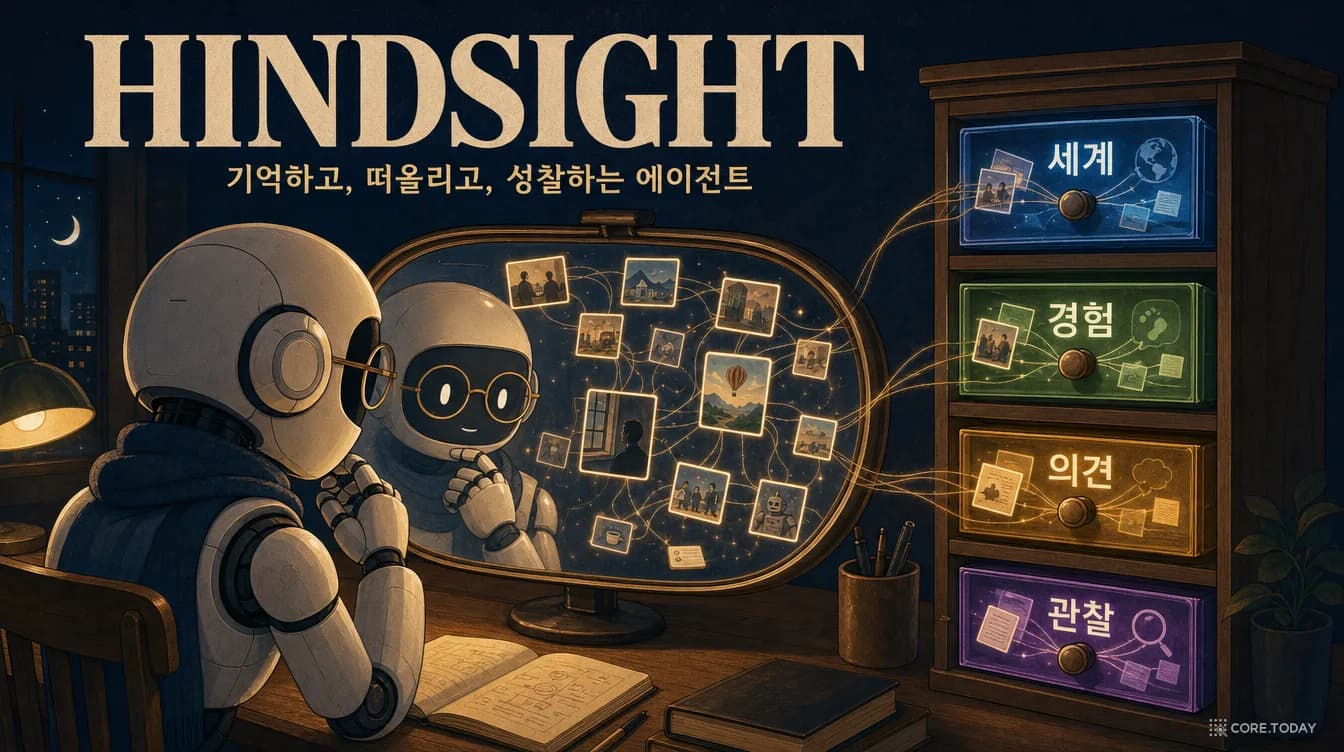
MemoType은 1972년 심리학자 털빙의 일화 기억·의미 기억 구분을 대화 AI에 맞게 셋으로 다시 나눕니다. 에피소드 기억(EM), 개인 의미 기억(PM), 일반 의미 기억(GM). LongMemEval-S에서 일화 기억은 12.35%뿐이고, 임베딩을 펼쳐 보니 의미 기억 안에서 개인 내용과 일반 지식이 두 덩어리로 갈라졌기 때문입니다. 기억을 '저장 칸'이 아니라 '찾는 법'의 단위로 쓴다는 점이 MIRIX·Hindsight 같은 다른 종류 구분과 다릅니다.
어떻게 동작하나
타입 필터만 켜도 Recall@1이 4~7포인트 오릅니다(LongMemEval-S 43.40 → 50.21). 기억을 모두 같은 방식으로 보강한 최고 단일 전략보다 타입별 전략이 데이터셋마다 5.1~5.7포인트 높았고, 데이터셋마다 최고 단일 전략이 달랐습니다. 150만 토큰짜리 LongMemEval-M에서는 Recall@1 48.09로 2위(31.91)보다 16.18포인트 높았습니다. 기억 더미가 클수록 서랍부터 고르는 일의 가치가 커집니다.
빠른 시작
공개 저장소에는 코드·프롬프트·TriMEM CSV가 있지만 학습된 라우터 가중치는 없어 라우터부터 학습합니다(README).
conda env create -f environment.yml && conda activate memotype
# experiment/async_llm.py 에 API_KEY, BASE_URL을 먼저 적는다
DATA=locomo   # locomo, longmemeval_s, longmemeval_m, perltqa
ADAPTER=model/qwen3-1.7b
accelerate launch --num_processes 2 --mixed_precision bf16 experiment/0-router_training.py
python experiment/1-memory_route.py  --data DATA−−adapterDATA --adapter DATA−−adapterADAPTER
python experiment/2-construct_emb.py --data $DATA --retriever contriever
python experiment/2-query_route.py   --data DATA−−adapterDATA --adapter DATA−−adapterADAPTER
python experiment/3-retrieve.py      --data $DATA --retriever contriever
python experiment/4-generate.py      --data $DATA --retriever contriever
전체를 도입하지 않아도 가져다 쓸 수 있는 것이 있습니다. 저장할 때 "어제·지난달"을 대화 날짜 기준 절대 날짜로 바꿔 붙이기, 개인 정보가 담긴 턴에 "답할 수 있는 질문" 3~5개를 함께 색인하기, 답변 전에 쓴 기억 번호를 인용시키기입니다.
비용 — 필요한 것만 구조화한다
| 방법 (LongMemEval-M 기억 구축) | 구축 비용 | 구조화 대상 |
|---|---|---|
| A-Mem | 936.90달러 (LLM 487만 회) | 모든 턴을 노트·링크로 |
| HippoRAG2 (외삽 추정) | 548.98달러 | 모든 턴을 개체·관계로 |
| MemoType | 3.77달러 (LLM 5만 2천 회) | 로컬 라우터로 분류한 뒤 에피소드 턴(2.2%)만 |
A-Mem의 248분의 1, HippoRAG2의 146분의 1입니다. 차이는 기법이 아니라 선택에서 나옵니다. 사용자↔어시스턴트 대화는 대부분 지식 설명이라 사건이 드뭅니다. 반대로 사건이 80.9%인 PerLTQA에서는 격차가 줄어, MemoType의 비용이 HippoRAG2의 절반, A-Mem의 3분의 1 이하 수준입니다.
언제 쓰고, 언제 피하나
- 잘 맞는다: 일정·여행(EM), 취향·건강·가족(PM), 대화 중 오간 지식(GM)이 섞이는 개인 비서·컴패니언, 문의 이력과 고객 프로필과 정책이 한 로그에 섞이는 고객 상담, 증상 시작 시점이 중요한 문진, "저번 주에 틀린 유형"을 찾는 교육 튜터. 상대 시간 표현이 많고 주어를 자주 생략하는 한국어 대화에 에피소드 전략이 특히 맞는다.
- 다른 방법을 먼저 본다: 전체 이력이 컨텍스트 창에 다 들어가는 짧은 대화, 사내 위키 같은 문서 검색, 코딩·자동화 에이전트의 절차·경험 기억(세 범주 밖), 응답 지연에 극도로 민감한 실시간 서비스.
한계와 주의
- 질문 시점 비용과 지연이 보고되지 않았다. 가상 기억 5개 생성, 사건 요소 추출, 가지치기, 답변까지 질문 하나에 LLM을 최소 3~4번 부른다. 비용표는 쓰기 쪽만 보여 준다.
- 부품이 오래됐다. 모든 실험이 Contriever와 gpt-4o-mini다. 최신 임베딩에서 이득이 얼마나 남는지는 알 수 없다.
- 정리 3.3은 동기 부여 이상은 아니다. "단일 전략에는 천장이 있다"는 정리는 무작위 질문-문서 쌍의 평균 유사도에 대한 것이지 정답 문서의 순위에 대한 것이 아니다.
- 라우터가 틀리면 정답 서랍이 닫힌다. 필터를 켜면 LongMemEval-S Recall@10이 94.26에서 92.34로 조금 떨어진다. 개인 의미 기억 판별(82.65%)은 GPT-4o-mini 프롬프트(87.18%)보다 낮다.
- 기억의 수명을 다루지 않는다. 무엇을 찾을지만 말할 뿐 무엇을 고치고 버릴지는 말하지 않는다. 개인 의미 기억은 시간에 따라 가장 잘 바뀌는 범주다.
- TriMEM은 영어 데이터라 한국어 서비스는 라우터를 다시 학습해야 한다(BERT급 분류기로도 검색 성능이 크게 떨어지지 않았다). README는 MIT라고 적지만 저장소에 LICENSE 파일이 없고, 표마다 숫자가 조금씩 어긋나는 곳이 있다.