
Experience is everything.
신뢰하는 파트너
AI가 만드는 살아 있는 경험. 행사장에서, 교실에서, 국회에서, 공장에서—모든 현장을 경험의 무대로 바꿉니다.
보는 행사를 경험하는 행사로—AI 아르스 키오스크
정답 대신 선택하는 경험—토닥북
하나의 모델로 문서의 모든 것을—Core.OCR
AI가 맥락을 기억하는 의정지원 시스템
물리 법칙과 AI가 융합된 부식 검사
감정과 취향을 향기로—Hyscent AI 조향
플랫폼 솔루션 AI를 만드는 팀을 위한 기반—모델 API부터 배포 인프라까지.
모든 AI 모델을 API 하나로—Console
이미지 · 영상 · 음성 · LLM 330개 이상의 모델을 키 하나, 원화 크레딧 하나로 호출합니다.
기관의 GPU를 모두의 배포 플랫폼으로—Deploy
기관 서버에 설치하고, git push 한 번으로 GPU가 붙은 서비스 주소를 엽니다.
모든 현장을
경험의 무대로
행사장, 교실, 국회, 공장—어디든 코어닷투데이의 AI가 닿는 곳에서 사람들은 기술이 아닌 경험을 만납니다.
모두를 위한 AI 놀이터
이미지 · 영상 · 오디오 생성 모델 176개를 계정 하나, 크레딧 하나로. 카드 등록 없이 매월 300 크레딧으로 시작하세요.
경험을 만드는 기술 역량
AI는 무대 뒤에, 경험은 무대 위에—보이지 않는 기술이 살아 있는 가치를 만듭니다.
기술은 숨기고 경험만 보여주다
복잡한 알고리즘은 무대 뒤에, 매끄러운 경험은 무대 위에—코어닷투데이가 만드는 AI의 방식입니다.
경험하는 행사
단순히 보는 행사를 관람객이 직접 참여하는 다감각 몰입 경험으로 전환합니다. AI가 얼굴을 분석하고, 나만의 캐릭터와 포토카드, 향수까지 즉석 제작합니다.
선택하는 독서
아이의 선택이 이야기가 되는 의사결정 기반 독서. 수동 시청을 넘어 능동적 판단과 경험을 제공합니다.
어디로 갈까요?
질문하는 AI 비서
단순 키워드 검색을 넘어 과거 발언을 기억하고 맥락을 이해하는 AI 비서 경험을 제공합니다.
직관적 산업 관제
물리 법칙과 AI를 융합한 고도의 기술을, 현장 엔지니어에게는 한눈에 보이는 위험 지도 대시보드로 제공합니다.
고객의 막연한 상상을
현실로 빚어내는 수고로움
그것이 코어닷투데이의 존재 이유입니다.
보이지 않는 복잡한 알고리즘과 수고로움—데이터 정제, 물리 법칙 융합, 안전 체계 구축—은 무대 뒤에 감춰두고, 무대 위 고객에게는 오직 매끄럽고 감동적인 경험만을 선사합니다.
모든 산업에 경험을 입히다
코어닷투데이의 AI 경험 솔루션은 행사, 교육, 공공, 제조 등 다양한 산업 현장에 맞춤 적용됩니다. 어떤 분야든 사용자 경험 중심으로 재설계합니다.
신뢰하는 고객사
다양한 산업의 리더들과 함께합니다
코어닷투데이의 AI 키오스크를 도입한 후, 행사 참관객의 체류 시간이 3배로 늘었습니다. 관람객들이 직접 참여하며 즐기는 모습이 인상적이었습니다.
토닥북은 우리 아이가 스스로 생각하고 선택하게 만들었습니다. 영상만 보던 아이가 이제 이야기 속에서 직접 결정을 내리며 독서를 즐깁니다.
Sharp-PINN 덕분에 현장 엔지니어들이 복잡한 데이터 해석 없이도 즉각적인 의사결정이 가능해졌습니다. 위험 지도 하나로 전체 상황이 보입니다.
인사이트
최근 인사이트
코어닷투데이가 직접 실험하고 정리한 AI 기술 이야기를 기술 블로그에 공개합니다.
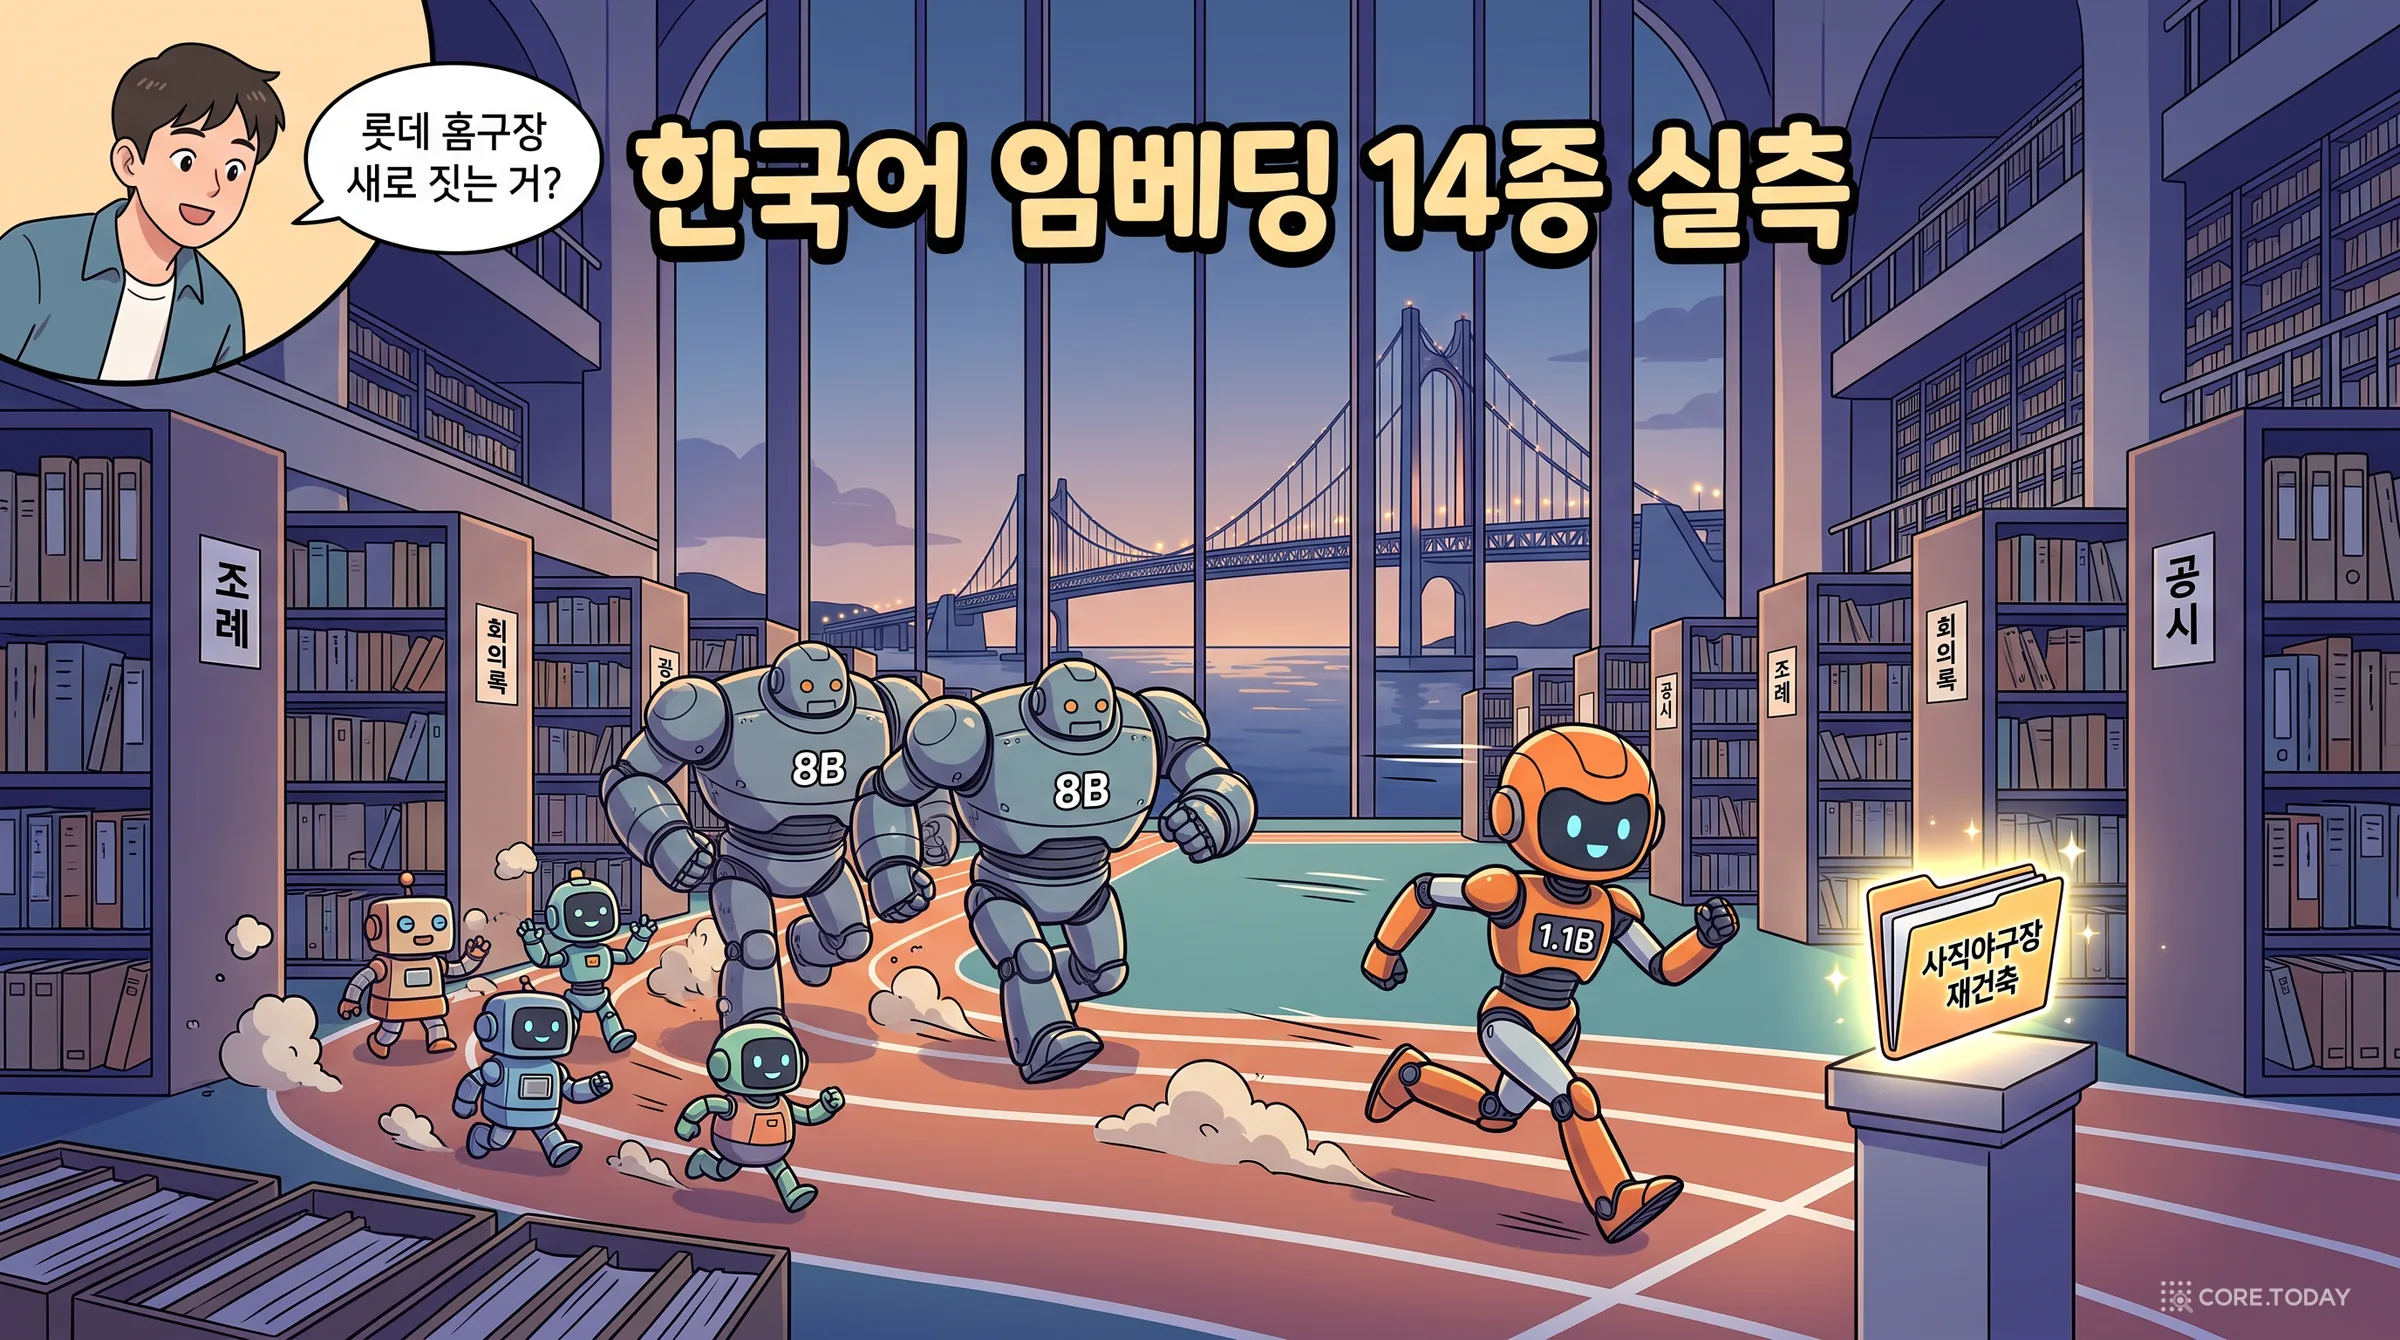
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
‘299억’을 고른 재정렬기 — 재정렬기 15종·로컬 LLM·질의 고쳐 쓰기로 정한 사실탐색기 검색 설계
1편에서 고른 임베딩 KURE-v3 위에 무엇을 더 얹어야 할지 정하려고, 재정렬기 15종과 로컬 LLM 두 개, 질의 고쳐 쓰기, 문단에 제목 붙이기를 같은 부산 시험지로 쟀습니다. 재정렬기는 근거·술어 찾기를 올렸지만 주어 찾기는 대부분 깎았습니다. 작은 재정렬기는 '순천만 박람회 경제적 효과'에 대상 이름 대신 '299억'을 골랐습니다. 지시문 한 줄이 이 어긋남을 고쳤고, 값 가르기까지 거의 완벽하게 만들었습니다. 근거 찾기의 가장 큰 개선은 재정렬이 아니라 제목 붙이기였고, '기록에 없음'은 어떤 점수로도 잘 걸러지지 않았습니다. 프로덕트에 무엇을 넣을지 설치 환경별로 정리했습니다.
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
경험을 함께 만들어 볼까요?
행사, 교육, 공공, 산업—어떤 현장이든 코어닷투데이의 AI가 살아 있는 경험으로 바꿔 드립니다.