무엇인가
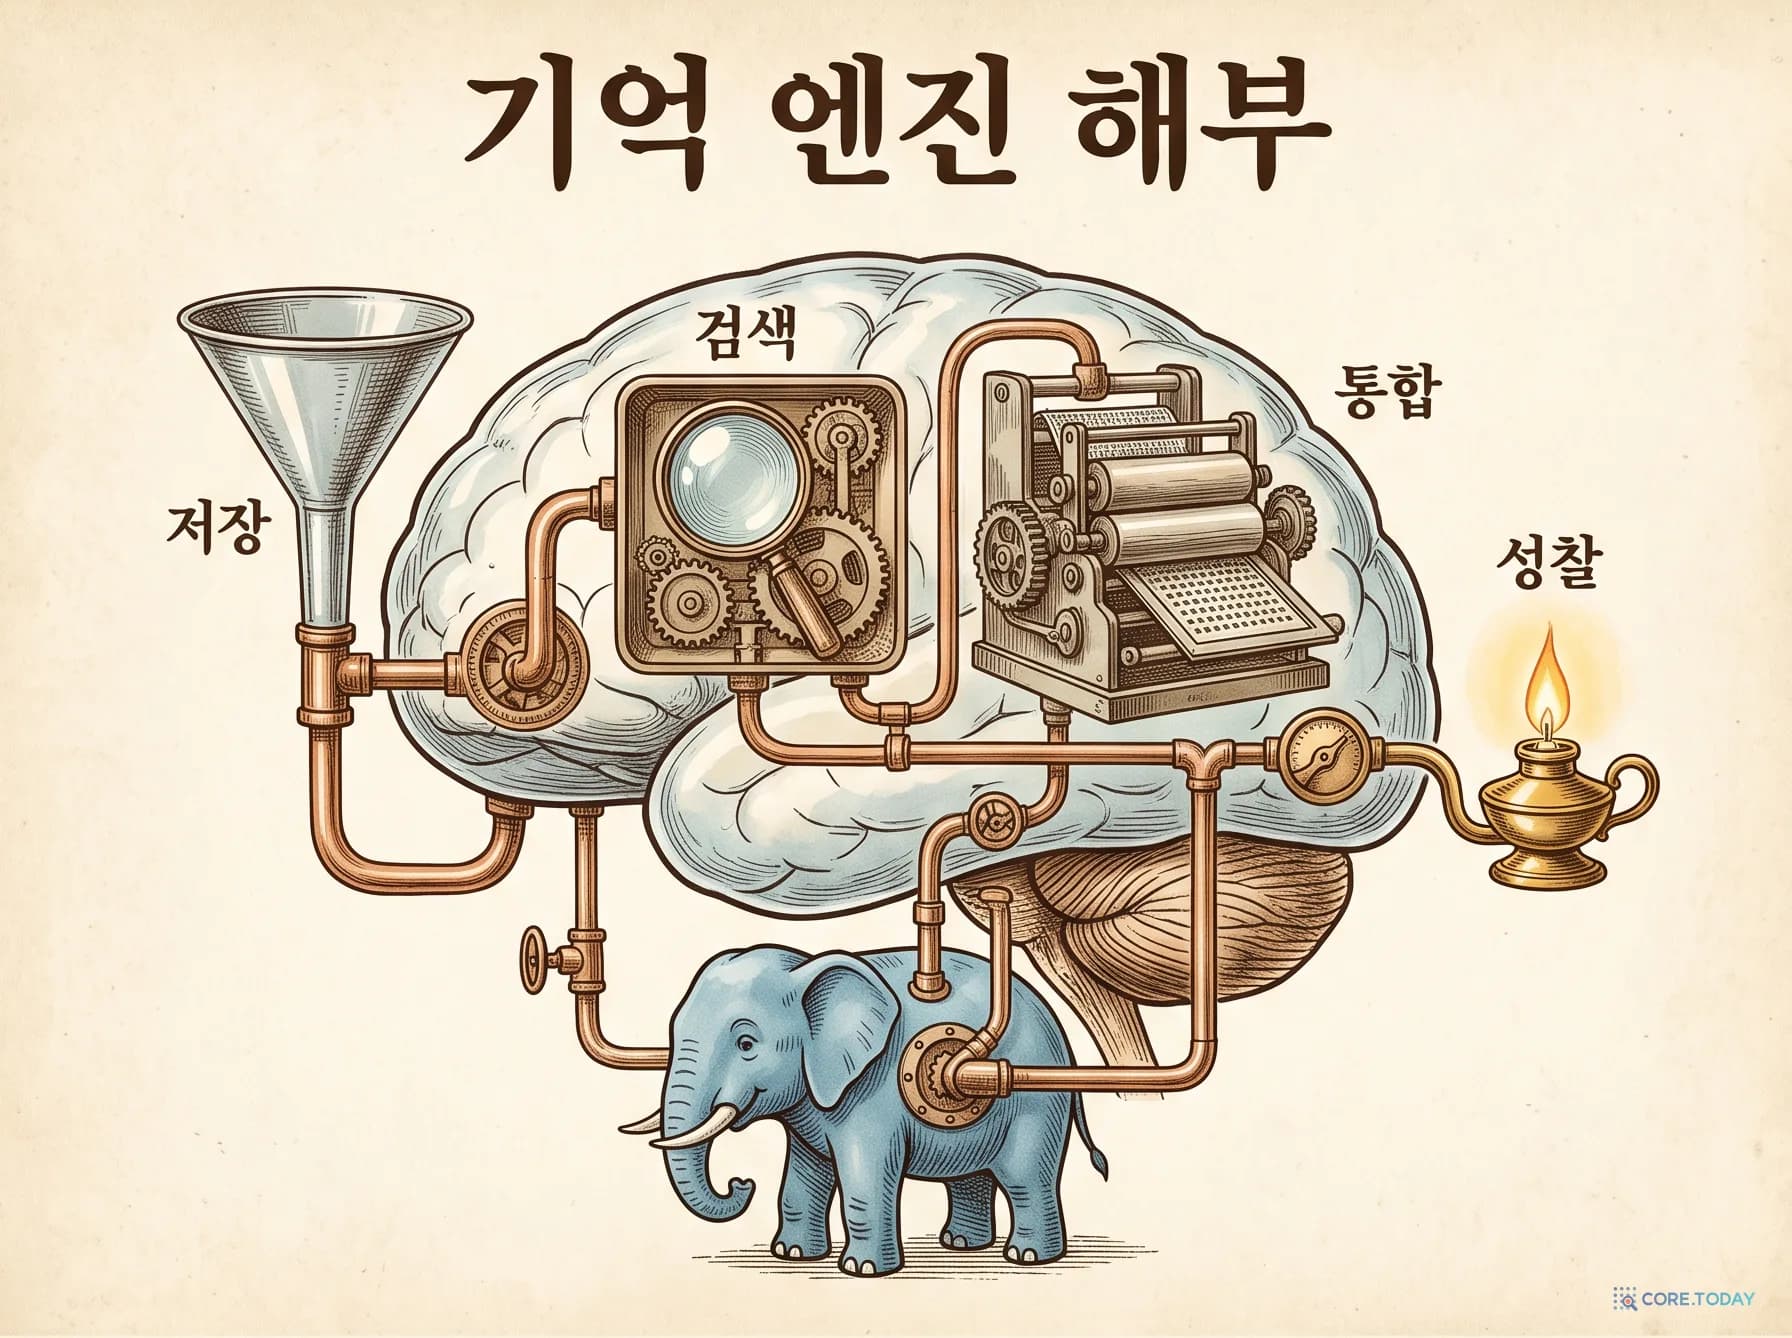
Letta는 2023년 10월 UC 버클리의 MemGPT 논문(arXiv 2310.08560)에서 나온 회사이자 프레임워크입니다. MemGPT는 LLM을 운영체제처럼 다루자고 했습니다. 컨텍스트 창은 RAM, 외부 저장소는 디스크로 보고, 모델이 함수 호출로 자기 기억을 직접 옮기고 고칩니다. 다른 기억 엔진이 서버 파이프라인으로 사실을 뽑는 것과 달리, Letta에서는 에이전트 자신이 기억을 씁니다.
2026년에 Letta는 그 '작업 맥락'을 git으로 버전 관리되는 마크다운 파일 묶음으로 바꿨습니다(2026년 2월 「Context Repositories」, 지금의 MemFS). 파이썬으로 된 V1 API 서버는 은퇴해 저장소의 archive 브랜치로 옮겨졌고, 현재 소스는 TypeScript로 된 letta-code입니다. 터미널 UI, 앱 서버, Slack·Telegram 채널, 웹(chat.letta.com)까지 한 하네스에서 돕니다.
어떻게 동작하나
.md 파일은 전부 시스템 프롬프트에 들어간다. 하위 폴더는 필요할 때 Memory(path) 도구로 읽는다.git commit을 한다. 크기 제한은 pre-commit 훅이 건다(깊이 2, 파일당 20,000자, 핵심 기억 합계 65,536자). 고친 내용은 다음에 프롬프트를 다시 조립할 때 반영된다.모순이 들어오면 Letta는 사람이 위키를 관리하듯 문서를 고치고, 이력은 버전 관리에 맡깁니다. 옛 기억은 git 이력에만 남습니다. "지금 어디 다녀?"에는 유리하지만 "작년 이맘때는?"을 기억 검색으로 묻기는 어렵습니다. Letta 연구진의 2025년 4월 「Sleep-time Compute」(arXiv 2504.13171)는 쉬는 시간에 맥락을 미리 곱씹어 두면 질문 시점 계산을 약 5배 줄인다고 보고했고, 지금 letta-code의 '드리밍(/sleeptime)'이 그 계보입니다.
빠른 시작
npm install -g @letta-ai/letta-code   # 또는 uv tool install letta
cd my-project
letta                                  # 터미널 UI. 처음 실행 때 클라우드/로컬을 고른다
letta --new-agent --personality tutorial
기억은 슬래시 명령으로 다룹니다. /palace로 기억을 보고, /memory-repository set git@github.com:...로 MemFS를 내 GitHub 저장소에 동기화하고, /sleeptime으로 주기적 드리밍을 켭니다. 자기 모델 키는 /connect로 붙입니다.
참고 실측 — Letta식 파일 기억
Letta 자체를 돌린 실험은 아닙니다. 코어닷투데이는 같은 고객 10명의 한국어 상담 24마디를 같은 모델(gemini-3.5-flash-lite)로 파일 기억 네 방식과 시간 그래프(Graphiti 0.30.2)에 기억시키고 질문 210개를 던졌습니다. '부분 편집'은 Letta의 memory_replace·Anthropic 메모리 도구처럼 편집 명령만 내는 방식입니다.
| 기억 | 전체 정확도 | 과거 시점 질문 | 쓰기 비용(1,000마디당) |
|---|---|---|---|
| 파일 · 그대로 기록 (LLM 0회) | 95.2% | 96.3% | 0달러 |
| 파일 · 다시 쓰기 (이력 남김) | 91.9% | 98.8% | 0.93달러 |
| 파일 · 부분 편집 | 84.3% | 88.7% | 0.33달러 |
| 그래프 · 엣지 전체 | 81.4% | 83.8% | 2.31달러 |
| 파일 · 현재만 | 47.6% | 21.2% | 0.47달러 |
파일이 이긴 이유는 형식이 아니라 옛 값을 기간과 함께 남겼느냐였습니다. 150마디로 늘리자 부분 편집은 작은 사실을 하나도 놓치지 않았지만 '언제' 질문이 66.7%로 약했고, 다시 쓰기 파일의 쓰기 비용은 그래프의 두 배 가까이 됐습니다. 날짜를 과거로 소급한 위조 메일에는 파일 세 방식이 모두 10/10 속았습니다. 출처가 외부 이메일이라고 스스로 적어 놓고도 주소를 고쳤습니다. 다만 고객 단위로 묶어 다시 계산하면 1·2위의 3.3점 차이는 95% 구간이 0을 포함합니다. 믿을 수 있는 것은 이력을 남긴 쪽과 버린 쪽의 47점 차이입니다.
언제 쓰고, 언제 피하나
| 상황 | Letta식 파일 기억 | 다른 설계를 본다 |
|---|---|---|
| 누가 쓰나 | 코딩 에이전트처럼 에이전트가 스스로 규칙을 배워야 한다 | 서버가 정해진 규칙으로 사실을 추출해야 한다 |
| 규모 | 한 사람·한 프로젝트, 사실 수백 개 이하 | 사실 수천 개 이상, 여러 사용자가 공유 |
| 사람의 개입 | 사람이 기억을 읽고 고치고 git으로 되돌린다 | 사람이 기억을 볼 일이 없다 |
| 시간 질의 | "지금 무엇이 참인가" | "그때는 무엇이 참이었나"를 기계가 질의해야 한다 |
한계와 주의
- 한글 검색이 약하다. 로컬 BM25에는 한자·가나용 부분 문자열 규칙은 있지만 한글은 없어서, 코드대로라면 "메모리"로 검색해도 "메모리를"이 든 메시지는 걸리지 않는다.
- 날짜는 검사되지 않는다. 파일의 날짜는 모델이 적은 글자일 뿐 필드가 아니다. 통째로 다시 쓰는 방식은 형식을 모델이 고르고, 그 형식이 무엇을 남길지 정한다.
- 클라우드 기능은 코드로 확인할 수 없다. 클라우드 모드의 하이브리드 검색·서버 측 압축·성찰은 서버 코드가 공개되지 않았다.
- 문서와 코드가 어긋난 곳이 있다. letta-code의
rrf_score는 RRF가 아니라 일치한 검색어 비율이고, 보관된 V1 서버의 블록 글자 제한은 표시만 하고 강제하지 않았다. - 2025년 'LoCoMo 74.0%'를 과신하지 않는다. 파일 하나에 grep뿐 아니라 의미 검색 도구도 함께 준 결과이고, 대화를 통째로 넣은 기준선과의 차이 1.1점은 벤치마크의 잡음 안에 있다.
- 외부 문서에서 온 변경은 지시문이 아니라 쓰기 함수에서 막아야 한다. 파일을 고치는 LLM은 출처를 보고 쓰기를 거부하지 않았다.