무엇인가
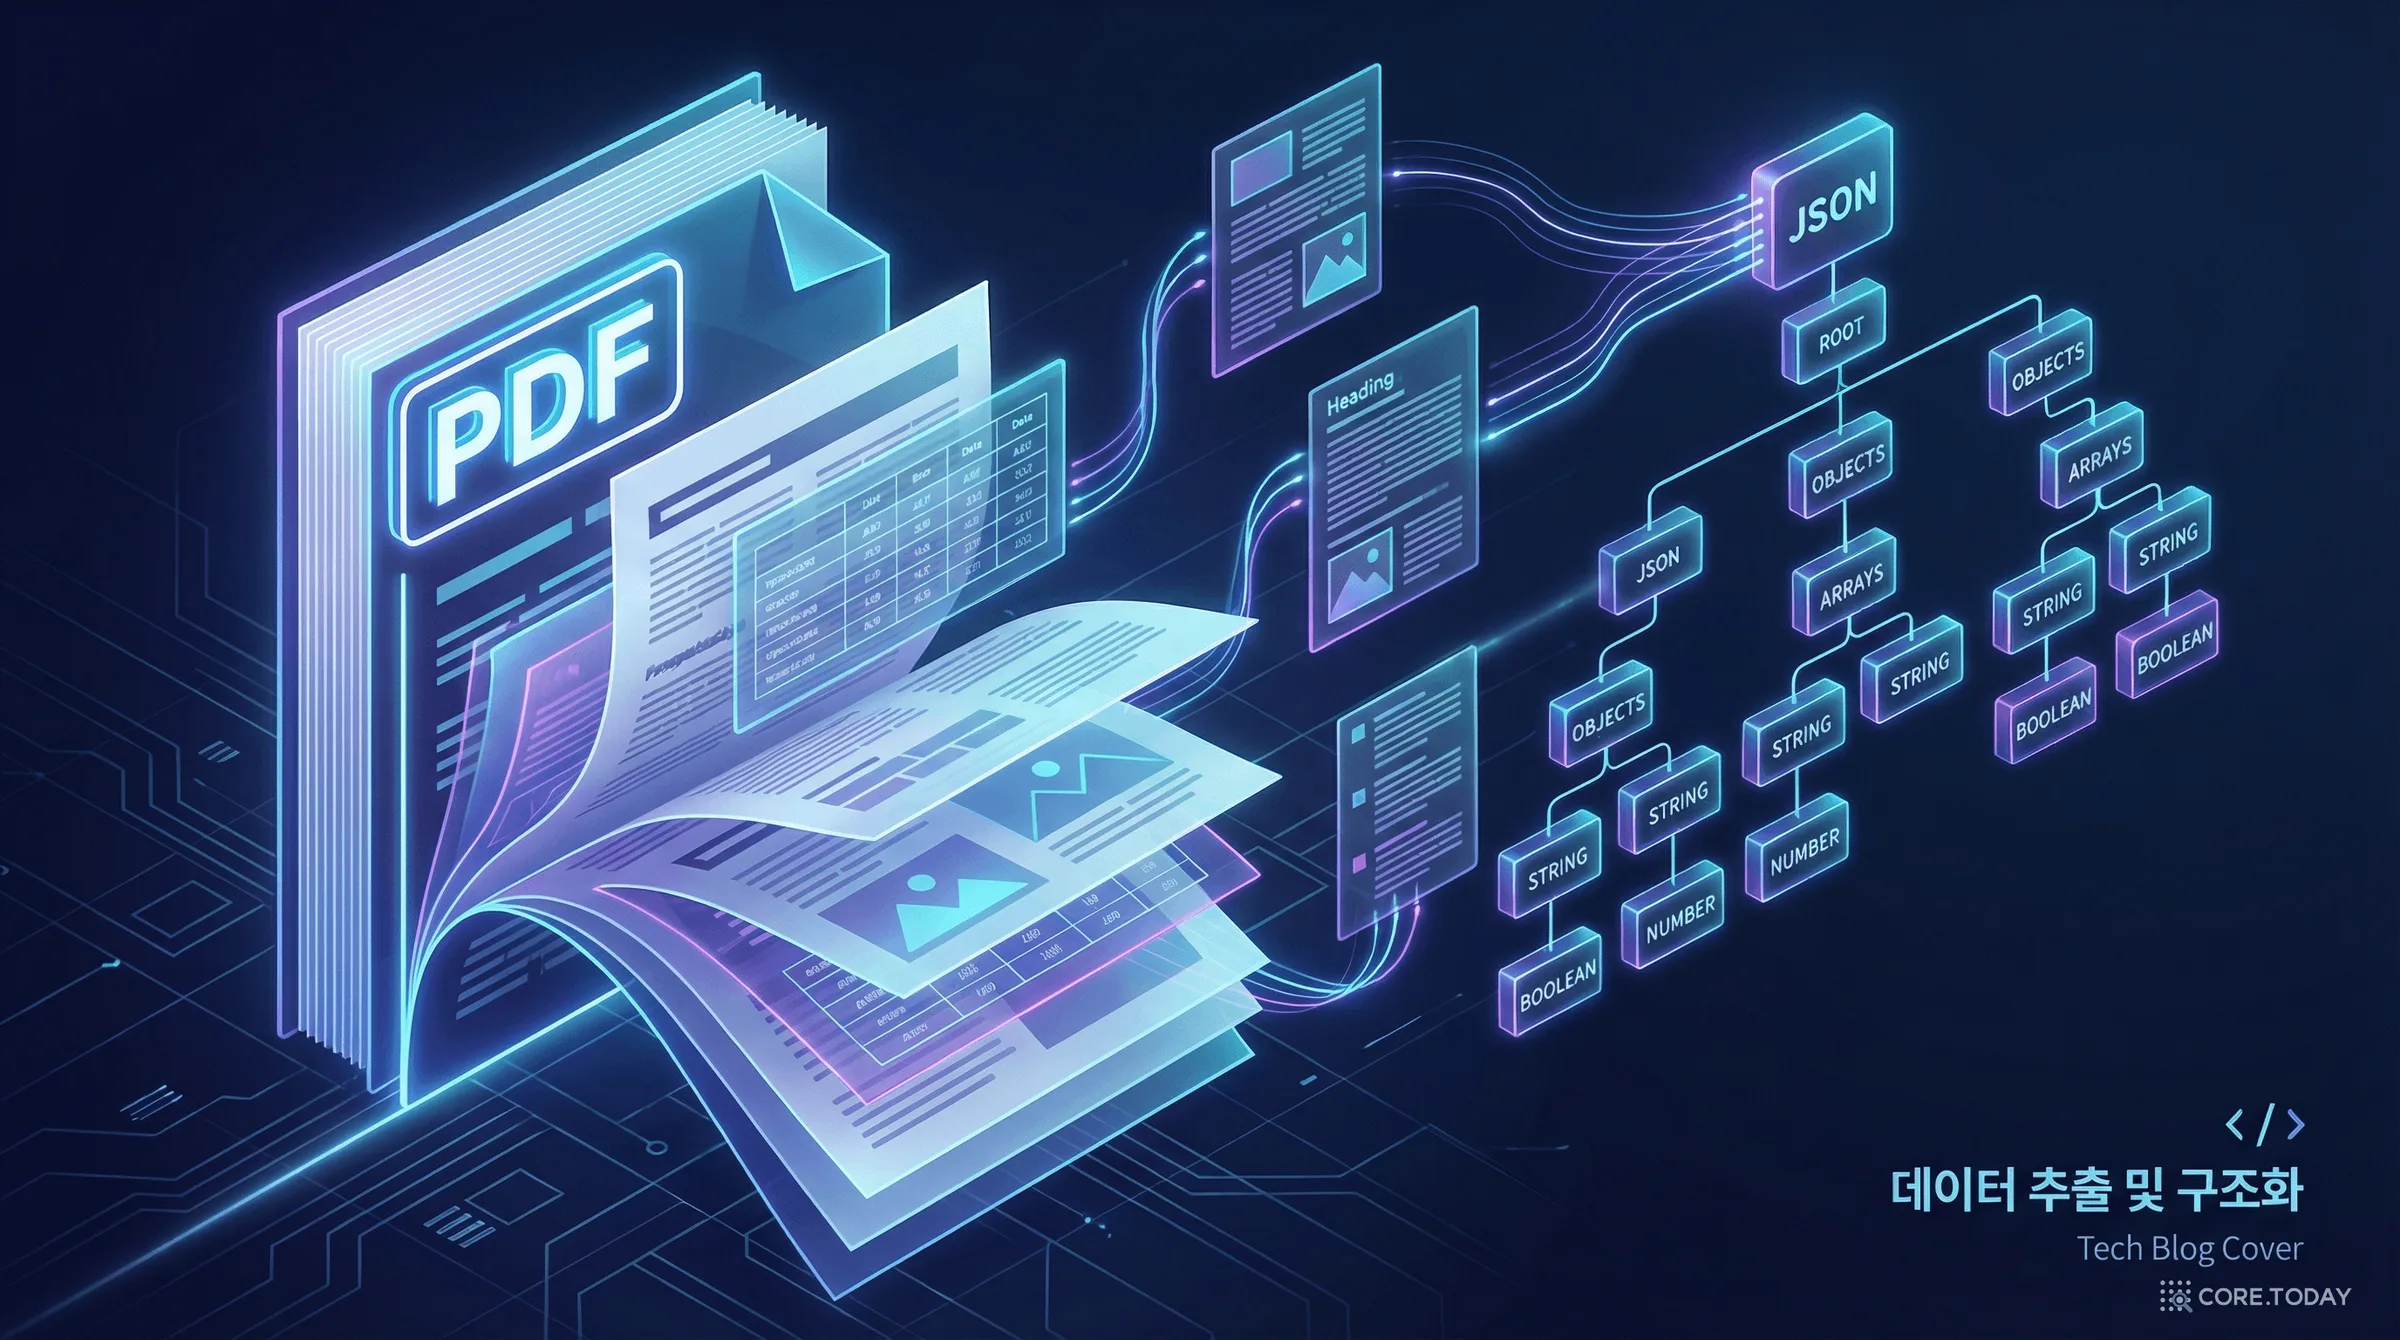
Docling은 IBM Research 취리히의 AI for knowledge 팀이 시작해 LF AI & Data 재단에 기증한 문서 변환 라이브러리입니다. PDF, DOCX·PPTX·XLSX, HTML, EPUB, Apple Pages, 이메일(EML·MSG), 이미지, LaTeX, 오디오까지 받아 하나의 표현 형식 DoclingDocument로 바꿉니다.
RAG에서 파서는 가장 아래층입니다. 표가 텍스트로 추출되지 않았으면 표에 대한 질문은 어떤 임베딩으로도 못 찾고, 스캔 첨부에 OCR이 돌지 않았으면 그 문서는 없는 것과 같습니다. 코어닷투데이가 2026년 RAG 특집에서 정리한 판단은 "자체 파이프라인의 기본 파서로 강력 추천"이었습니다.
핵심은 출력이 청크가 아니라는 점입니다. Docling의 산출물은 어느 페이지의 어느 좌표에 어떤 유형의 요소가 어떤 부모 아래 있는지를 담은 문서 객체이고, 청크는 그 객체에서 파생됩니다. 무손실 JSON과 RAG용 청크가 별도 출력인 이유입니다.
어떻게 동작하나
HierarchicalChunker·HybridChunker)로 절 제목 메타데이터가 붙은 청크를 만든다.운영 형태도 여럿입니다. 민감 데이터·폐쇄망용 로컬 실행, API 서버(docling-serve), 에이전트에 붙이는 MCP 서버(docling-mcp), LangChain·LlamaIndex·Crew AI·Haystack 연동이 있습니다. LightRAG의 멀티모달 파싱(RAG-Anything)과 OpenDataLoader PDF의 AI 백엔드(docling-fast)도 Docling을 씁니다.
빠른 시작
README의 Python 예시에 공식 문서의 HybridChunker 사용법을 이었습니다.
from docling.document_converter import DocumentConverter
from docling.chunking import HybridChunker

doc = DocumentConverter().convert("https://arxiv.org/pdf/2408.09869").document
print(doc.export_to_markdown())          # 사람이 읽는 출력

chunker = HybridChunker()                # 문서 계층을 따라 나누고, 토큰 창에 맞춰 쪼개고 합친다
for chunk in chunker.chunk(dl_doc=doc):
    text_for_embedding = chunker.contextualize(chunk=chunk)  # 절 제목 등 메타데이터를 붙인 문자열
    print(text_for_embedding[:200])
명령줄에서는 docling <파일 또는 URL> 한 줄이면 현재 디렉터리에 .md가 생깁니다. VLM 파이프라인은 docling --pipeline vlm --vlm-model granite_docling <URL>입니다.
언제 쓰고, 언제 피하나
| 상황 | Docling이 잘 맞는다 | 다른 방법을 먼저 본다 |
|---|---|---|
| 문서 종류 | PDF·Office·스캔·이메일이 섞인 사내 문서 | 처음부터 깨끗한 HTML·Markdown만 있다 |
| 보안 | 외부 API로 문서를 보낼 수 없다 | 관리형 문서 AI를 써도 된다 |
| 후속 작업 | 원문 하이라이트, 절 단위 재청킹, 시각 인덱스 연결이 필요하다 | 본문 텍스트만 한 번 뽑으면 끝난다 |
| 속도 | 페이지당 1초 안팎이면 충분하다 | 텍스트 위주 PDF를 대량으로 아주 빠르게 처리해야 한다 |
OpenDataLoader 팀의 공개 벤치마크(PDF 200개)에서 Docling은 종합 0.88로 OpenDataLoader 하이브리드(0.90) 다음이었고, 읽기 순서 0.90·표 구조 0.89·제목 계층 0.80, 페이지당 0.73초였습니다. 경쟁 도구 팀이 운영하는 벤치마크라는 점을 감안해 읽습니다.
한계와 주의
- 마크다운으로 바로 뽑아 청킹하지 않는다. 그 순간 페이지·좌표·부모 요소·표 셀 구조를 버린다. 나중에 재청킹이나 멀티모달 연결이 필요하면 전체를 다시 파싱해야 한다. 원문·페이지 이미지·JSON·청크 네 층을 모두 남긴다.
- 파서는 검색 실패 원인 다섯 가지 중 하나만 고친다. 잘못된 청크 경계, 절 제목·약어 누락, 동의어 불일치, 최신 버전 미선택은 청킹·인덱스 표현·메타데이터 층의 일이다.
- 모델 라이선스는 따로 확인한다. 코드는 MIT지만 README는 개별 모델 사용 시 원 패키지의 모델 라이선스를 따르라고 적는다.
- 변경이 잦다. Python 3.9 지원은 2.70.0에서 끊겼고, 2026-10 기준 PyPI 최신은 2.142.1이다. 운영에서는 버전을 고정한다.
- HWP·HWPX는 Docling 지원 형식 목록에 없다. 한글 문서가 많다면 변환 경로를 따로 준비한다.