무엇인가
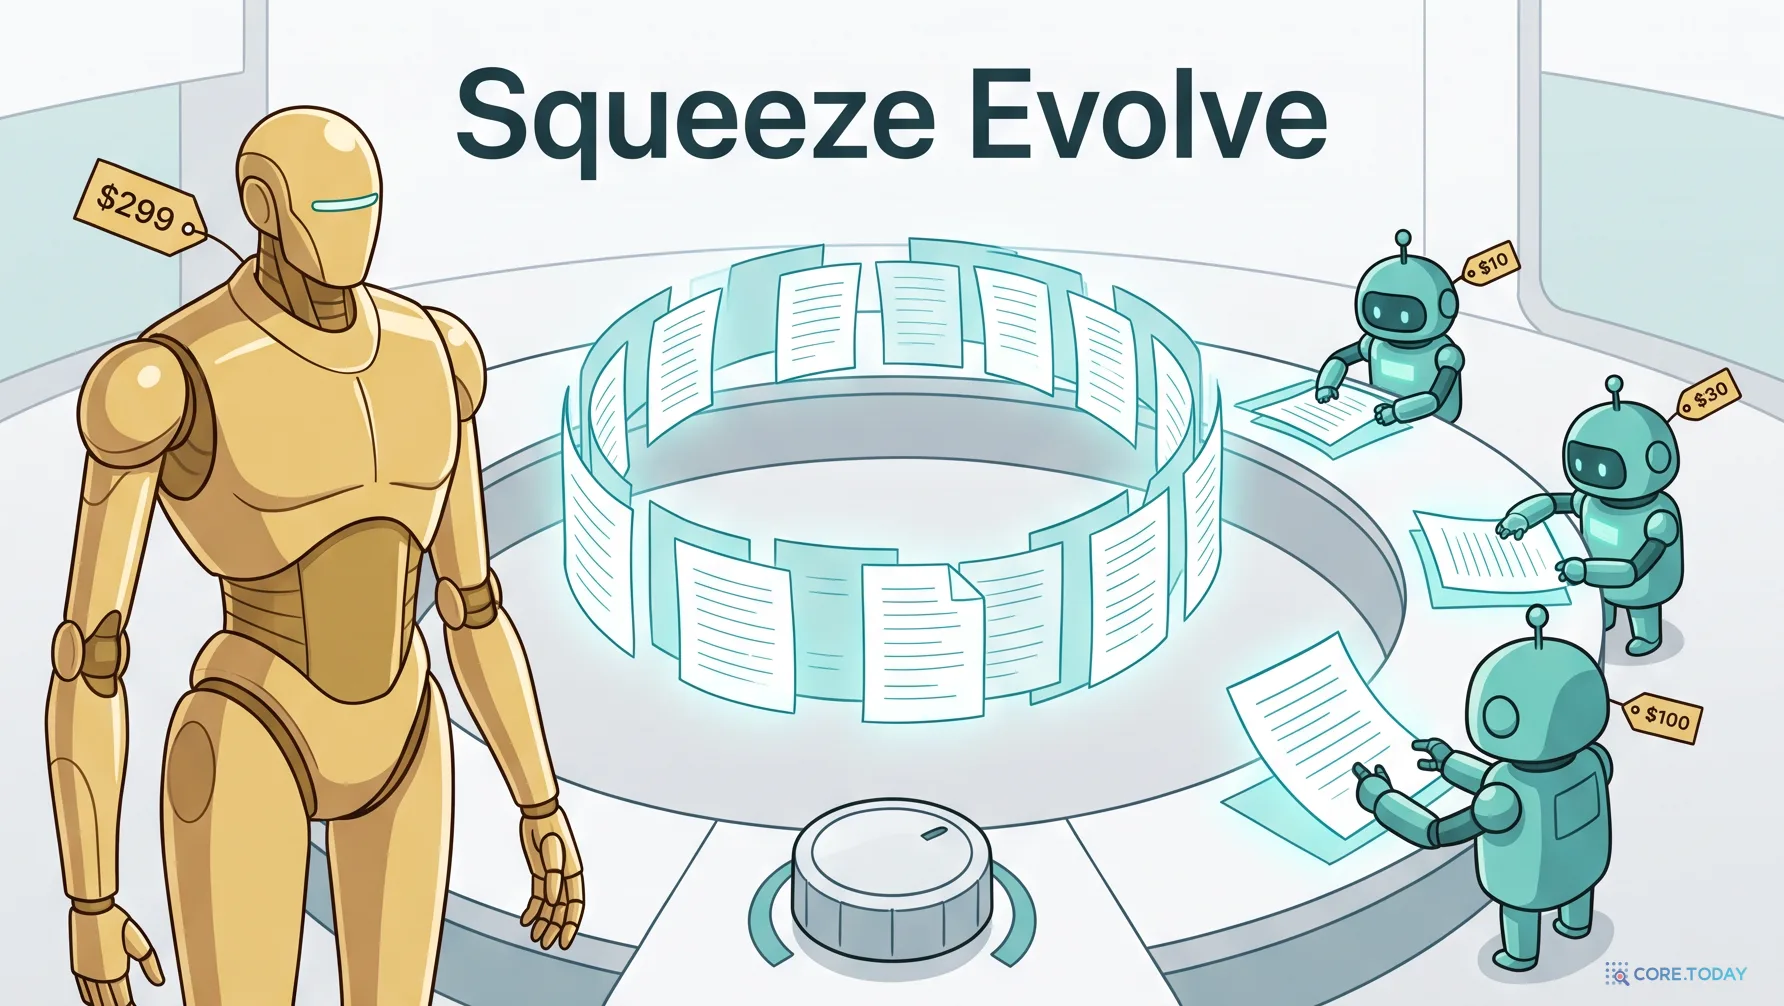
Squeeze Evolve는 검증기 없는 진화형 추론을 여러 모델로 나눠 돌리는 오케스트레이션 틀입니다. UC 버클리·Together AI·스탠퍼드 등 연구자 19명(트리 다오, 제임스 저우 포함)이 2026년 4월 arXiv에 공개했고 COLM 2026에 채택됐습니다. 코드는 Apache 2.0입니다.
후보 답 여러 개를 만들고, 몇 개씩 묶어 모델에게 "이 풀이들을 읽고 더 나은 풀이 하나를 써라"를 여러 세대 반복하는 RSA(재귀 자기 집계) 같은 방법은 성능을 올리지만 한 번 답할 때의 500~700배 토큰을 씁니다. Squeeze Evolve는 질문을 바꿉니다. 더 쓰는 법이 아니라 정해진 능력을 가장 싸게 얻는 법입니다. 답은 비싼 모델을 '한계 효용이 가장 큰 곳'에만 쓰는 것입니다.
어떻게 동작하나
설계는 논문 4장의 네 가지 발견에서 나옵니다. ① 같은 모델로만 돌리면 세대가 갈수록 후보가 닮아 가고 정답이 사라진다(다양성 붕괴). ② 강한 모델이 첫 후보를 만들 때가 반대 배치보다 낫다(AIME 2025에서 88% 대 65%). ③ 묶음이 이미 정답 쪽으로 기울어 있으면 약한 모델도 잘 합친다. ④ 모델이 글을 쓰며 이미 낸 토큰 로그 확률이 묶음의 난이도를 알려 준다.
조절 손잡이는 p 하나입니다. p를 올리면 비싼 모델 비율과 정확도·비용이 함께 오르고, p=0이면 재조합 전부를 싼 모델이 맡아 비싼 모델은 0세대에만 쓰입니다. 문턱을 문제마다 백분위수로 잡기 때문에 문제 난이도와 상관없이 비용을 예측할 수 있습니다.
빠른 시작
Claude Code 플러그인이 가장 짧습니다. 강한 모델로 후보를 뽑은 뒤 답의 다양성으로 묶음을 나눠 합의는 무료 선택, 낮음은 Haiku, 중간은 Sonnet, 높음은 Opus로 보내고 라우팅 기록과 함께 종합 답을 돌려줍니다. 별도 API 키 없이 사용자의 Claude 세션을 씁니다.
/plugin marketplace add squeeze-evolve/squeeze-evolve
/plugin install squeeze-evolve@squeeze-evolve
/squeeze-evolve:ask <질문>
자기 모델로 벤치마크를 돌리려면 저장소를 vLLM 서브모듈과 함께 받아 설치하고, YAML 설정(모델은 싼 것부터 비싼 순서, 문턱은 모델 수−1개)으로 실행합니다.
git clone --recurse-submodules https://github.com/squeeze-evolve/squeeze-evolve.git
cd squeeze-evolve
pip install -e ".[dev]"

squeeze-evolve-client \
  --config benchmarks/aime25/configs/example.yaml \
  --input data/aime25/test.parquet \
  --n-problems 5
교차 모델 확신도를 쓰려면 저장소의 vLLM 포크(확신도 통계를 GPU 안에서 누적해 숫자 하나만 돌려주는 경로)가 필요합니다. 기본 vLLM은 요청 하나에 약 13MB의 로그 확률 텐서를 돌려주고, Qwen3-235B에서는 메모리 부족으로 멈췄습니다. NVIDIA Dynamo에도 dynamo.squeeze_evolve 구성 요소로 들어갔지만 Dynamo 문서는 실험적 구성 요소로 표시합니다.
코어닷투데이 실측
논문의 원 채우기 결과(정사각형에 원 26개, 반지름 합 최대화)에서 진화가 찾아낸 프로그램 구조가 얼마나 그럴듯한지 보려고, 같은 설계를 파이썬으로 직접 짜서 시드 24개로 돌렸습니다. 무작위·육각 격자 초기 배치 → 중심을 고정하면 LP로 최적 반지름 → 중심 1~3개를 흔드는 담금질 → SLSQP 동시 최적화입니다.
| 결과 | 반지름 합 | 비고 |
|---|---|---|
| 무작위 중심 + LP 반지름 (출발점) | 1.3886 | 코어닷투데이 계산 |
| 담금질 + SLSQP, 최고 시드 | 2.6311 | 대부분의 시드는 2.61~2.63 국소 최적해에서 멈춤 |
| Squeeze Evolve (논문 표 7) | 2.635896 | GPT-OSS-120B + 20B, 진화 중 실행 없음 |
| ShinkaEvolve (논문 표 7) | 2.635982 | 진화 중 실행·채점 |
같은 구조로도 마지막 0.005가 남았습니다. 원 몇 개의 자리를 통째로 바꾸는 조합적 이동이 필요한 이 구간이 문제의 진짜 난이도이고, 방법들이 겨루는 곳이 소수 넷째 자리라는 뜻입니다.
언제 쓰고, 언제 피하나
| 상황 | 잘 맞는다 | 다른 방법을 먼저 본다 |
|---|---|---|
| 검증 | 정답 확인이 비싸거나 불가능하다 | 싸게 채점할 수 있다 — 검증기 기반 탐색(AlphaEvolve류)이 먼저다 |
| 이미 진화형 추론을 쓴다 | RSA를 비싼 모델로만 돌리고 있다 | 단발 추론으로 충분하다 — 진화는 토큰을 수백 배 쓴다 |
| 모델 구성 | 맹점이 서로 다른 강·약 모델 쌍이 있다 | 같은 계열이라 같은 곳에서 틀린다 |
| 답의 형태 | 수학·객관식·격자처럼 최종 답을 뽑아 비교할 수 있다 | 보고서처럼 '같은 답'을 정의하기 어렵다(확신도만 남는다) |
대표 결과는 같은 오픈 계열 쌍에서 1.4~2.0배, 오픈+폐쇄 혼합에서 1.5~1.8배 절감이었습니다(논문 표 4). ARC-AGI-2 공개 평가에서는 Gemini 3.1 Pro로 97.5%·과제당 7.74달러를 보고해, 같은 모델의 RSA(93.3%·28.85달러)보다 3.7배 쌌습니다.
한계와 주의
- "비싼 모델을 이겼다"는 통계적으로 구별되지 않는다. COLM 저자 답변의 윌콕슨 검정에서 비싼 모델 대비 차이는 모두 유의하지 않았다. 정직한 결론은 "통계적으로 구별되지 않으면서 1.6~1.7배 싸다"이다.
- ARC-AGI-2 97.5%는 공개 세트의 자체 보고치다. 비공개 세트로 검증되지 않았고, 이 실험은 확신도 라우팅이 아니라 답 다양성과 단일 모델(Gemini 3.1 Pro)로 돌았다. 2026년 가을에는 단일 모델들이 진화 없이 같은 점수를 1달러 안쪽에 낸다.
- p는 가격표가 붙은 다이얼이다. p=0은 가장 싸지만 과제에 따라 1.5~6%p를 잃었고, 크기 차이가 큰 쌍(Qwen3 30B→235B)은 HMMT25에서 4.7%p 낮았다.
- 확신에 찬 오답에는 속수무책이다. 모든 후보가 같은 오답을 확신하면 그 묶음은 다수결로 넘어가 아무도 다시 보지 않는다.
- 공개 코드의 다양성 라우팅 방향을 확인한다. 2026-10-24 기준
assign_routes는 적합도가 낮을수록 비싼 모델로 보내는데, 다양성 D는 클수록 어렵다.fitness: diversity를 그대로 쓰면 합의된 묶음이 비싼 모델로 가는 역방향 라우팅이 된다(저장소의 Claude Code 플러그인은 방향을 바로잡았다고 주석에 적혀 있다). - 원 채우기의 '검증기 없는 발견'은 진화 과정 이야기다. 최종 보고 단계에서는 뽑은 프로그램들을 실행해 최고 점수를 골랐다.