무엇인가
FEB-30은 AWS와 루마니아 클루지나포카 공과대학 연구진이 2026년 10월 15일 arXiv에 올린 「Beyond Downstream QA: Rethinking How We Evaluate Agent Memory」(arXiv 2610.22209)의 에이전트 기억 내재 평가 벤치마크입니다. LoCoMo·LongMemEval부터 2026년의 MemoryAgentBench·MEME까지 기억 벤치마크는 모두 '질문하고 답을 채점'하는 외재 평가였습니다. FEB-30은 문서가 하나 들어올 때마다 기억 저장소를 직접 열어 그 시점의 정답 상태와 비교합니다. 이름은 2월 30일, 최근 벤치마크들이 다가갔지만 넘지 못한 문턱이라는 뜻입니다.
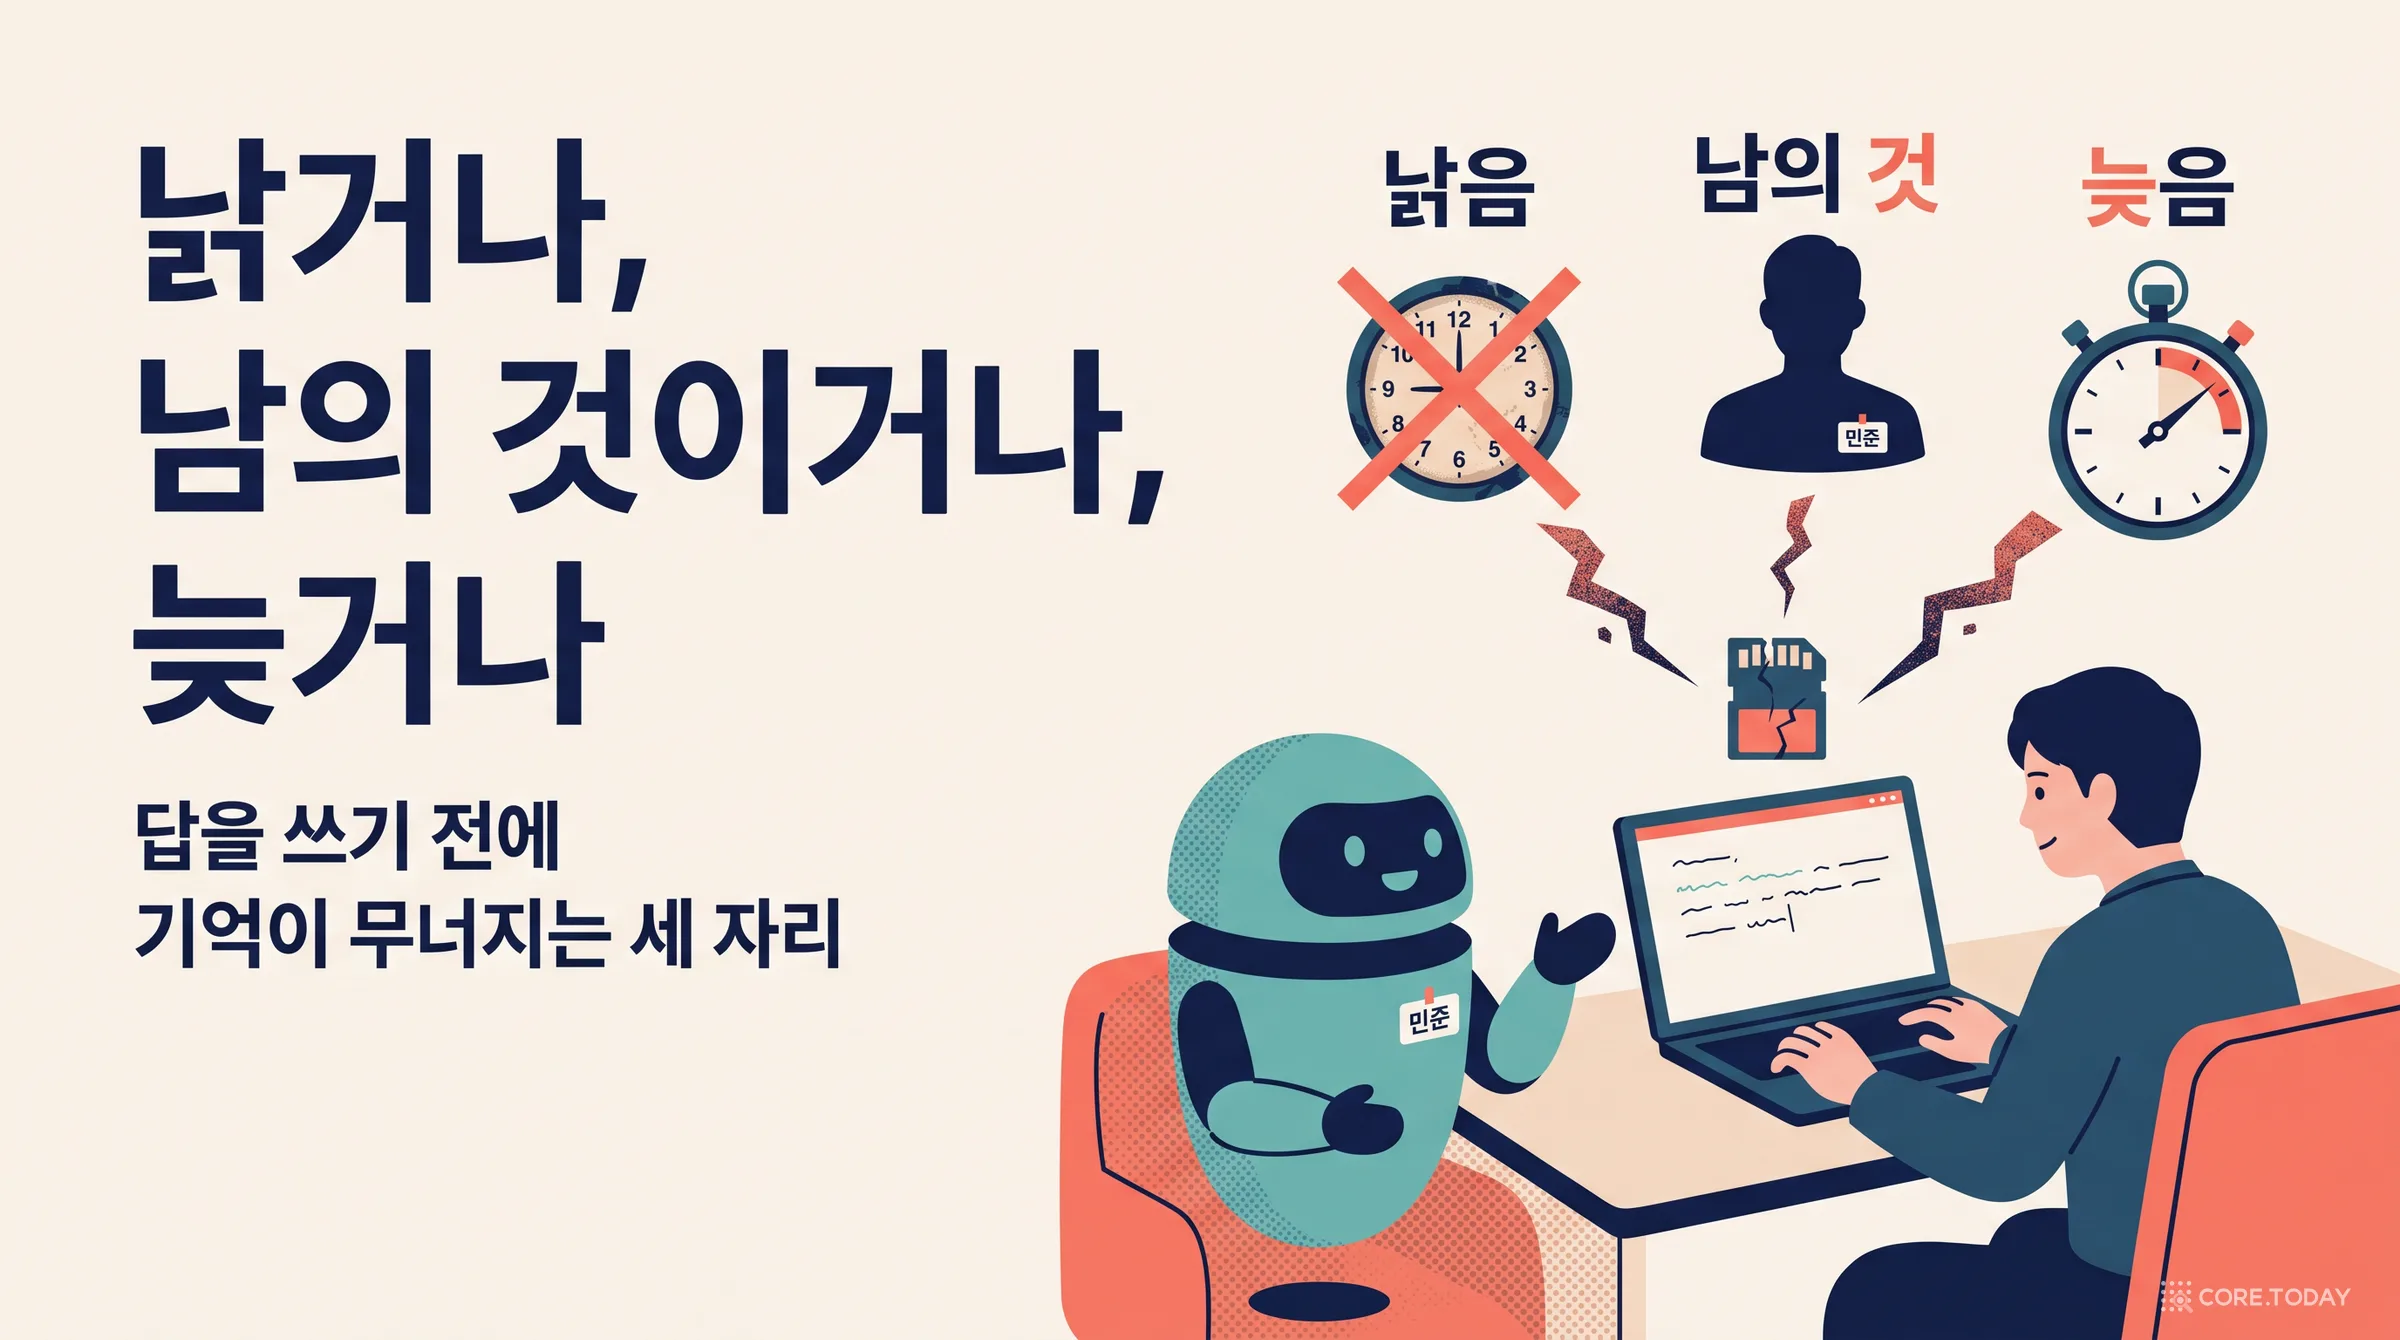
외재 점수만으로는 두 실패가 안 보인다는 것이 논문의 주장입니다. 거짓 양성(LLM 보상)은 저장소가 낡았는데 강한 답변 모델이 날짜를 보고 메워 답이 맞는 경우, 거짓 음성(검색 병목)은 저장소는 맞는데 질문 표현이 달라 검색이 못 꺼내는 경우입니다. 뿌리는 1993년 갈리어스·스파크 존스의 내재·외재 평가 구분이고, 2016년 RepEval 워크숍이 "내재 점수는 실전을 예측하지 못한다"고 보인 교훈도 함께 읽어야 합니다.
어떻게 동작하나
정답을 문서에서 뽑지 않고 정답 궤적을 먼저 쓰고 거기서 문서를 생성합니다(RIKER의 역발상 패러다임). 궤적의 상태마다 claims(그때까지 저장소에 있어야 할 전체 상태, 채점용)와 docClaims(그 문서에 새로 담긴 정보, 생성용)를 나눠, 앞서 배운 것을 스스로 들고 있어야 통과하게 했습니다.
| 구성 | 내용 (논문 보고) |
|---|---|
| 궤적 | 30개. 분야 C1 LLM 보상 · C2 검색 병목 · C3 연산 분류 · C4 종합 · C5 시간 순서 · C6 여러 작성자, 난이도 L1·L2·L3 각 10개 |
| 문서 | 147건(상태 문서 127 + C2 방해 문서 20). 5개 회사 생성 모델 6개를 돌려쓰고, 심사 모델 3개 만장일치. 사람 검토에서 11%가 내용 수정, 28%가 껍데기 제거 필요 |
| 시험 대상 | 추출 → 임베딩 → 분류 → 종합 시스템 하나. 관찰마다 생성·강화·갱신·대체·무시를 LLM이 고르고, 강화는 확신도 +0.1, 옛 날짜 관찰은 시간 경비가 강화로 강등 |
| 내재 채점 | 상태마다 정답 주장의 덮음률. 임베딩 유사도 0.8 초과 사실만 LLM 판정관이 YES·PARTIAL·NO로 확인. 궤적 평균이 내재 점수 |
| 진단 지표 | 갱신 탐지 재현율, 거짓 갱신률, 연산 분류 정확도, 사실 개수, 확신도 오차 |
| 외재 채점과 괴리 | 궤적당 진단 질문으로 답을 채점. 둘의 평균 절대 괴리(MAD)와 15점 넘게 벌어진 비율. 판정 Claude Haiku 4.5, 답변 Amazon Nova Pro, 온도 0, 11회 반복 |
논문 결과는 이렇습니다. 내재·외재의 평균 괴리 0.168 ± 0.025, 44%의 궤적이 15점 넘게 벌어졌고, 50% 통과 기준의 일치도는 κ = 0.118(피어슨 r = 0.423)이었습니다. 내재가 평균 +0.118 높아 거짓 음성 쪽이 흔했습니다. 연산 분류 정확도는 20.1%(L1 33.8 → L3 10.1%), 거짓 갱신률 22.2%, 갱신 탐지 재현율 73.6%. 외재 점수는 분야를 가리지 않고 42~55%로 납작했지만 내재는 C1 82.2%부터 C6 41.5%까지 갈렸습니다. 시스템·말뭉치·백본을 바꾼 네 구성에서도 괴리는 남았고, 백본을 올리자 κ는 0.035로 더 떨어졌습니다.
빠른 시작
FEB-30 데이터는 내려받을 수 없지만 방법은 바로 따라 할 수 있습니다. 우리 업무에서 사실이 변하는 이야기를 골라 상태별 정답을 먼저 씁니다. 논문 부록 A.1의 궤적을 한국어로 옮기면 이런 모양입니다.
{
  "id": "c5-linear", "category": "C5", "difficulty": "L1",
  "extrinsicQA": ["가람상사 데이터베이스 이전을 설명하라: 원래 무엇이고, 어디로 가며, 일정과 진행 상황은?"],
  "states": [
    { "index": 0, "timestamp": "2025-01-15", "action": "create",
      "claims": ["사내 서버에서 PostgreSQL 14 운영", "운영 DB 약 3TB"] },
    { "index": 1, "timestamp": "2025-03-20", "action": "update",
      "claims": ["사내 서버에서 PostgreSQL 14 운영", "운영 DB 약 3TB", "Aurora와 AlloyDB 검토 중"],
      "docClaims": ["Aurora와 AlloyDB 검토 중", "2분기 개념 검증 계획"] }
  ]
}
그다음 docClaims로 문서를 만들어 하나씩 넣고, 넣을 때마다 저장소를 엽니다. 채점은 ① 있어야 할 사실이 있나(덮음률)와 ② 없어야 할 낡은 사실이 없나를 함께 보고, ③ 외재 질문은 사실 하나씩 묻는 여러 개로 나누고, ④ 같은 저장소를 판정 방식만 바꿔 다시 매겨 자를 검증합니다.
코어닷투데이 실측
2026년 10월, 논문의 방법으로 한국어 미니 FEB를 만들어 로컬에서 돌렸습니다. 여섯 분야 × 2 = 궤적 12개, 문서 41건(상태 37 + 방해 4), 기대 주장 77개, 단일 질문 33개. 문서는 Claude Code(Opus 5.5)가 정답 궤적을 보고 썼고, 나머지는 로컬 Ollama입니다. 추출·종합 qwen3.5:9b, 임베딩 bge-m3, 답변·판정 qwen3.8:27b, 검색 BM25(글자 두 개 단위) 0.3 + 밀집 0.7, 온도 0, 궤적마다 1회. 종합 단계만 바꿔 A(논문 프롬프트 그대로), B(갱신 편향 세 줄 삭제), C(분류 없이 쌓는 추가 전용)를 비교했습니다.
| 지표 | A 논문 프롬프트 | B 세 줄 삭제 | C 추가 전용 |
|---|---|---|---|
| 내재·전체 (사실을 판정관에 전부) | 91.7 | 89.8 | 89.2 |
| 내재·0.8 (논문식) | 20.5 | 18.8 | 59.1 |
| 외재·복합 (논문식) | 79.2 | 70.8 | 62.5 |
| 외재·단일 | 79.4 | 75.9 | 69.7 |
| 원문 통째 (기억 없음) | 83.3 | 83.3 | 83.3 |
| 궤적당 사실 수 / 평균 길이 | 1.8개 / 219자 | 1.8개 / 212자 | 8.9개 / 42자 |
| 끝까지 남은 낡은 사실 | 4개 | 3개 | 4개 |
- 같은 저장소가 판정 방식만 바꿔 100점과 25점. A는 새 관찰을 기존 사실 하나에 이어 붙여 219자 덩어리를 만들었고, 가람상사 DB 이전 궤적은 판정관이 전부 보면 100점, 0.8 필터를 거치면 25점이었습니다. YES 쌍의 평균 유사도는 A 0.705(0.8 초과 15%), C 0.822(64%)여서 논문식 내재 점수에서는 순위가 뒤집혀 C가 A의 세 배였습니다.
- 덮음률은 옛 요금을 보지 못했습니다. C의 한빛물류 궤적은 내재 75점이었지만 "지금 요금제는?"에 옛 값 "스탠다드, 월 120만 원"으로 답해 외재 0점이었습니다. A는 같은 낡은 사실을 남긴 채 답은 맞혔고 내재도 100점이었습니다. 이 LLM 보상을 잡은 것은 덮음률이 아니라 코어닷투데이가 더한 '낡은 사실 수'였습니다.
- 서랍에 다 있는데 못 답한 경우도 있었습니다. 옛값과 새 소식을 한 문장에 이어 붙인 사실에서 '3명'을 읽고 틀리거나(정답 2명), 정리되지 않은 충돌 앞에서 "I don't have that information"이라고 답했습니다(내재 100, 외재 0).
- 세 줄을 지워도 9B는 '갱신'만 했습니다. 강화 상태의 관찰(A 14개, B 15개) 중 강화로 분류된 것은 둘 다 0개, 대체 상태 17개 중 대체는 1개. 갱신 편향은 프롬프트보다 모델 쪽에 있었습니다. 분류 정확도 56%도 상태 25개 중 13개가 '갱신' 정답이라 무조건 갱신해도 나오는 숫자입니다.
- 질문을 잘게 나누면 두 채점이 가까워졌습니다. 내재·전체와의 상관은 복합 질문 A 0.69, B 0.31, C 0.21에서 단일 질문 0.78, 0.60, 0.39로, 평균 괴리는 17.7·27.3·33.0에서 13.4·17.4·24.1점으로 줄었습니다. 판정관은 "TLS 인증서 만료"를 정답 "인증서 만료"보다 자세하다며 네 번 모두 PARTIAL로 줬습니다.
- 기억 시스템 셋 다 원문 통째(83.3)를 넘지 못했습니다. 문서 몇 건짜리 궤적에서 기억은 정보를 보태기보다 덜 망치는 쪽을 재게 됩니다.
언제 쓰고, 언제 피하나
| 상황 | 쓰는 법 |
|---|---|
| 추출 프롬프트·백본 교체 전후 회귀 시험 | 골든 궤적을 다시 돌려 저장소 상태·사실 개수를 비교. 질문 점수는 그대로인데 사실이 두 배면 기억이 쪼개지는 중 |
| 질문 점수가 떨어졌을 때 고장 위치 찾기 | 추출·종합·갱신·검색 중 어디인지 상태별 덮음률과 진단 지표로 가른다 |
| 업무 기억의 감사("그때 무엇을 참으로 믿었나") | 상태별 채점 형태를 그대로 쓴다 |
| 내재 점수 하나로 제품 순위 매기기 | 피한다. 내재 지표도 검증받아야 할 대리 지표다(논문 r = 0.42) |
| Mem0식 추가 전용 저장소 | 분류 지표가 정의되지 않고 덮음률이 가장 후해진다. 읽기 시점 상태를 따로 정의해야 한다 |
한계와 주의
- C1은 설계와 결과가 반대입니다. 표 1은 C1을 "기억은 틀렸지만 답은 맞는" 분야라 하는데 C1 다섯 궤적 모두 내재가 외재 이상이었고, 부록 표 11은 C1을 "기억은 맞는데 질의응답이 과소평가"한다고 설명합니다. 외재가 내재를 앞선 궤적은 30개 중 셋뿐이고 모두 L3, C1은 없었습니다. 실험이 보인 것은 대부분 거짓 음성입니다.
- 외재 자가 거칩니다. 외재 점수 30개 중 16개가 11번 내내 정확히 50.0 ± 0.0(매번 PARTIAL)이고, 45.5 ± 14.4·54.5 ± 14.4까지 더하면 22개가 11번 중 10번 이상 PARTIAL입니다. 코어닷투데이 모의실험에서 논문식(질문 1개 × 사실 4개 × 3단계)은 r ≈ 0.31, κ ≈ 0.10, 단일 질문 8개는 r ≈ 0.54, κ ≈ 0.38이었습니다. κ = 0.118의 상당 부분은 채점 해상도일 수 있습니다.
- 덮음률은 재현율만 봅니다. 낡은 사실이 남아도 점수에 흔적이 없고, 내재 채점도 유사도 0.8 필터라는 검색을 거칩니다. 표 4의 놓침률 71.4%와 내재 60.6%가 맞지 않고(내재 100인데 놓침 11%인 궤적도 있음), C5는 갱신 탐지 90.6%·거짓 갱신 0%인데 분류 정확도 0.4%입니다. 계산 정의가 공개되지 않았습니다.
- 분류 20%의 일부는 프롬프트가 부추겼습니다. 시험 대상의 종합 프롬프트(부록 B.2)에 "생성보다 갱신을 선호하라", "애매하면 update를 써라"가 있습니다. 다만 코어닷투데이 실측에서는 이 줄을 지워도 결과가 같아, '원인'이 아니라 '부추김' 정도로 읽습니다.
- 재현할 수 없습니다. 논문이 적은 저장소
github.com/amazon-science/feb-30-benchmark는 2026년 10월 25일 기준 404이고, 시험 대상의 '최상위 LLM'과 생성·심사 모델 이름도 없습니다. 동반 서베이는 미공개이고, MemoryAgentBench·LongMemEval-V2의 역량은 원 논문과 다르게 인용됐습니다. - 범위가 좁습니다. 궤적 30개, 시험 대상 시스템 하나, 영어, 기술·비즈니스 운영 한 영역입니다. 일화·절차 기억은 다루지 않습니다. 위 한국어 실측도 궤적 12개 × 1회라 통계가 아니라 사례로 읽어야 합니다.