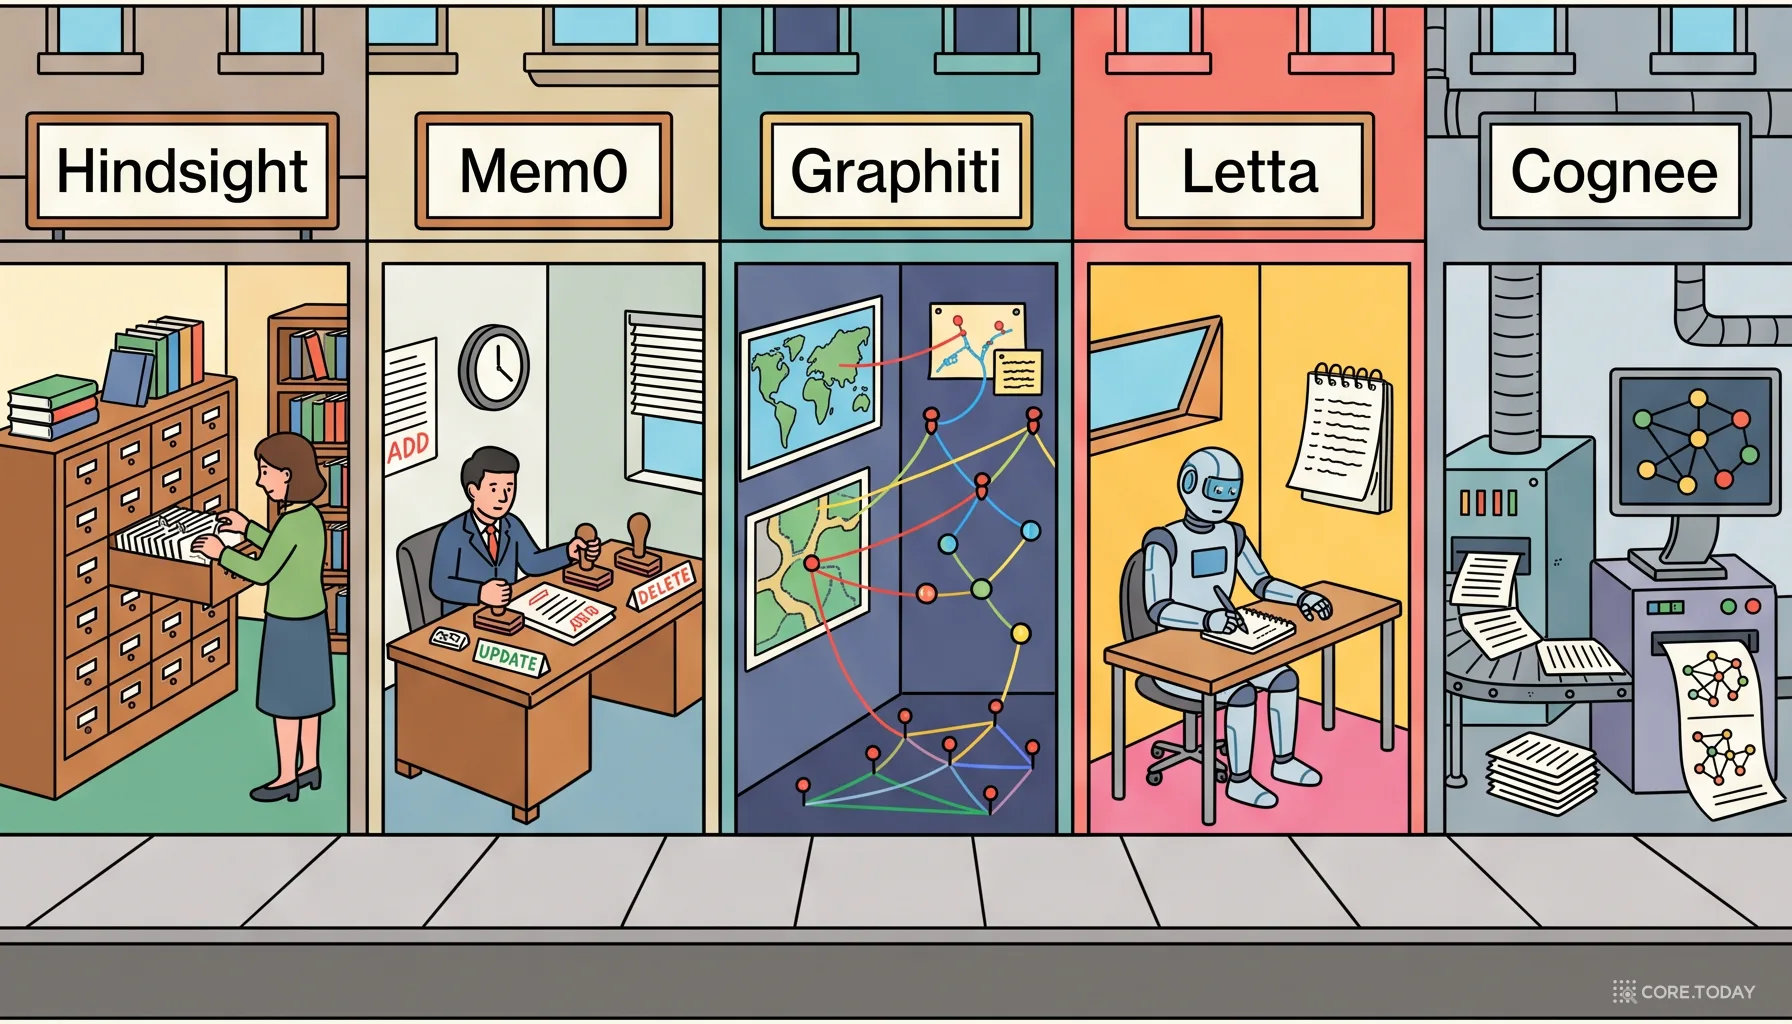
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
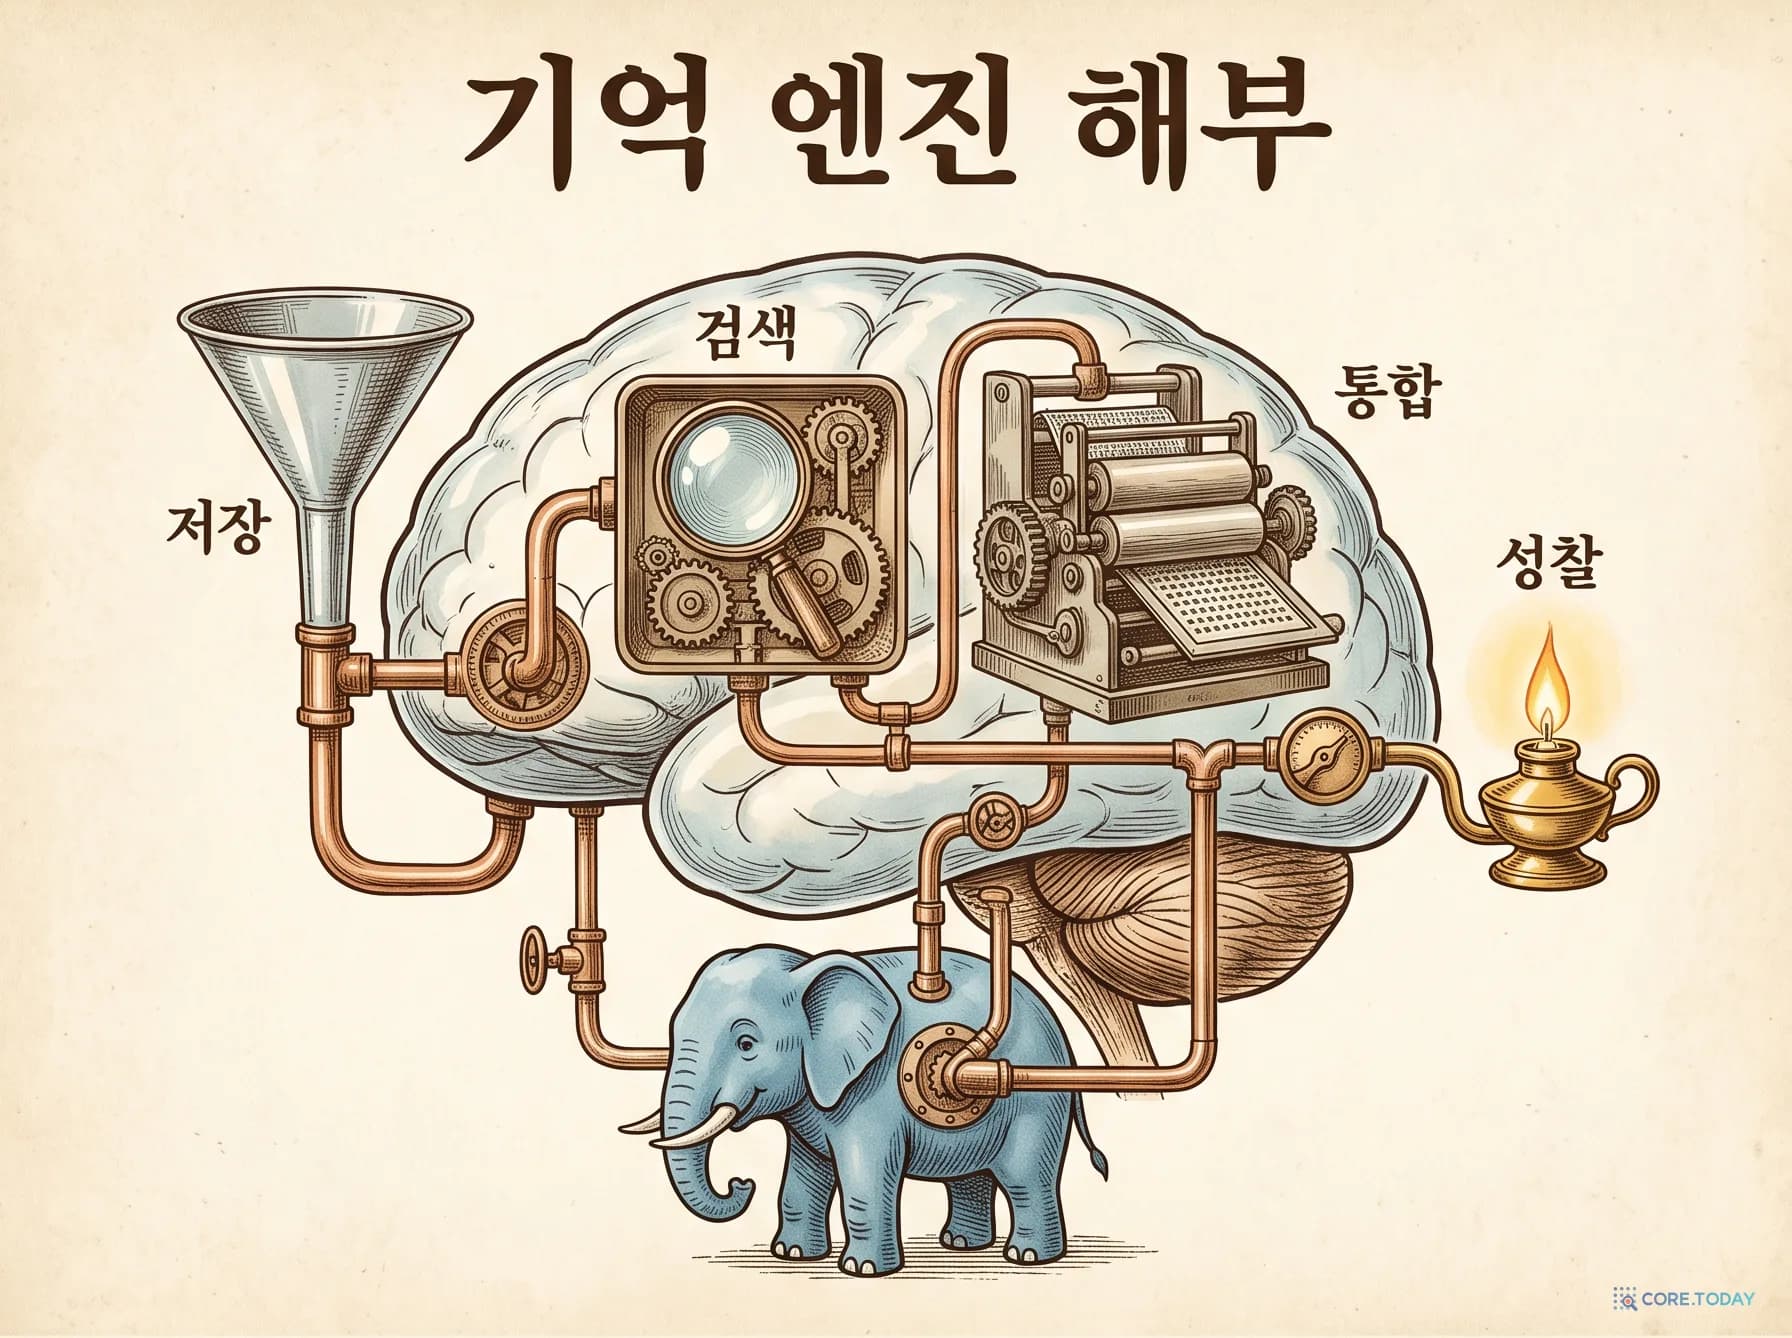
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
에이전트 메모리 시장은 숫자로 말한다. Hindsight는 LongMemEval-S 94.6%, Mem0은 94.4%를 내세운다. 둘 다 "업계 최고"라고 쓴다. 그런데 두 숫자는 같은 시험지에서 나온 것이 아니다. Mem0의 README는 스스로 "관리형 플랫폼의 점수이며, 오픈소스 SDK에는 없는 독점 최적화가 포함돼 있다"고 각주를 단다. 코어닷투데이가 메모리 벤치마크 비판 특집에서 짚었듯, 채점 프롬프트 하나만 바꿔도 점수가 수십 점 움직인다.
그래서 이번에는 성적표 대신 엔진룸을 열었다. 2026년 10월 21일 기준 각 저장소의 main 브랜치를 내려받아 저장(retain)·검색(recall)·통합(consolidation)·성찰(reflect) 경로를 함수 단위로 따라갔다. 기준이 된 것은 Vectorize의 Hindsight다. 별 52,258개, MIT 라이선스, 10월 13일에 1.0이 나왔다. 코어닷투데이는 열흘 전 Hindsight 논문 해설을 썼다. 이번 글은 그 속편이 아니라 해부 실습이다. 논문이 "무엇을 하겠다"고 한 것과 코드가 "실제로 무엇을 하는지"를 맞대 본다.
같은 칼로 네 엔진을 더 갈랐다.
Mem0 (별 67,577, Apache-2.0, Python 2.2.1) — 가장 많이 쓰이는 기억 레이어
Graphiti (별 32,108, Apache-2.0, 0.31.2) — Zep의 시간 지식 그래프 엔진
Letta (구 MemGPT, 별 25,216) — 에이전트가 스스로 기억을 고쳐 쓰는 설계
Cognee — 문서를 지식 그래프로 만드는 파이프라인
해부하고 나니 다섯 엔진이 공유하는 뼈대가 보였다. 그리고 광고 문구와 코드가 어긋나는 지점이 생각보다 많았다. 미리 결론을 적어 둔다.
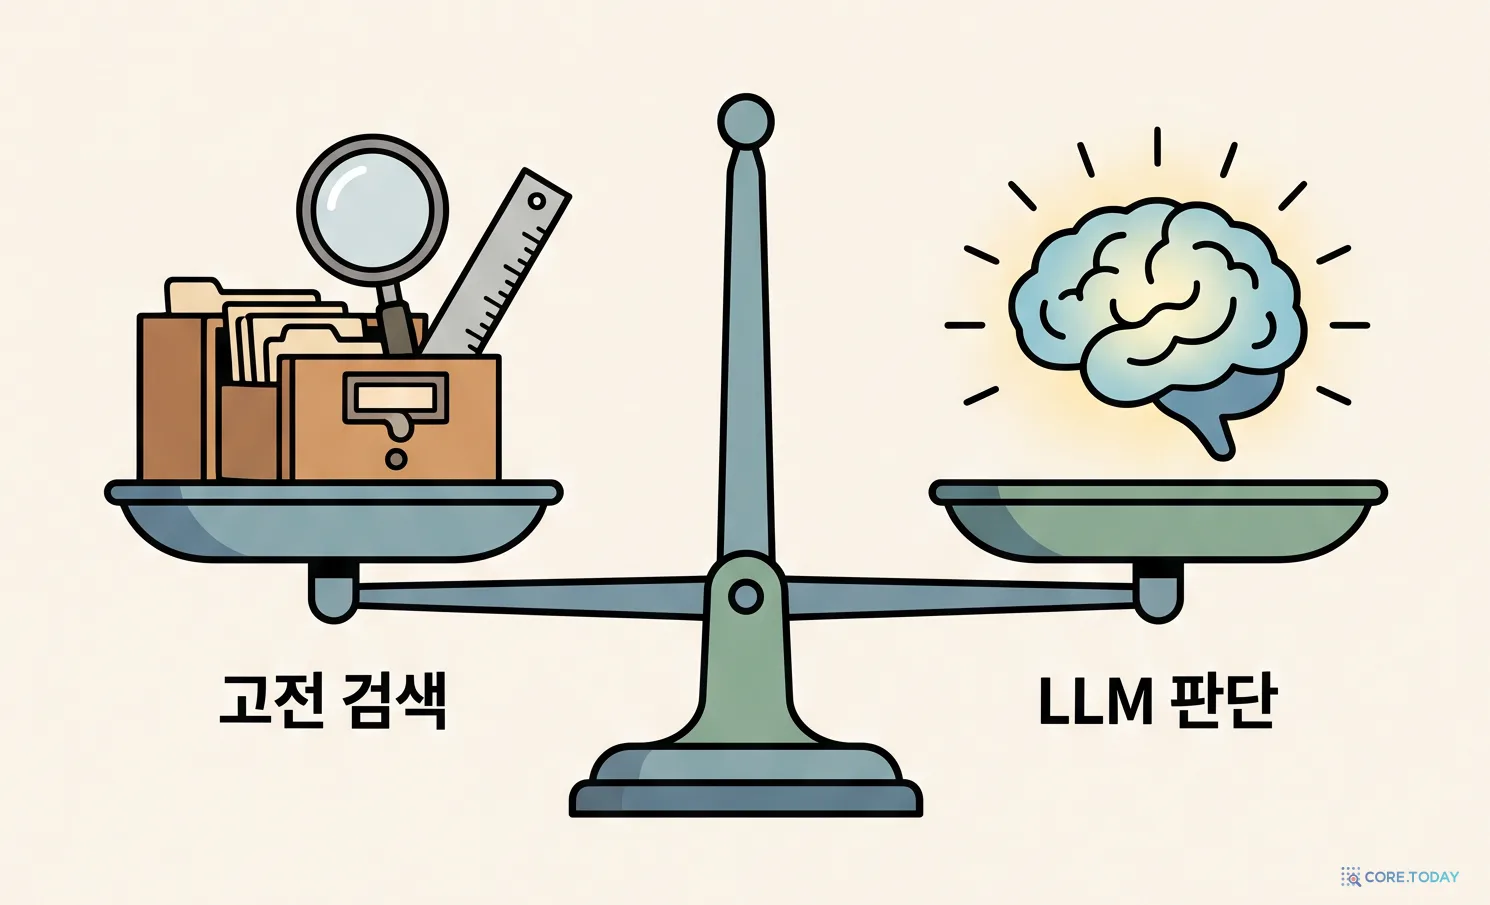
똑똑한 부분은 생각보다 고전적이다. Hindsight에서 LLM이 개입하는 곳은 사실 추출, 관찰 통합, 성찰 답변 셋뿐이다. 엔티티 병합은 글자 조각(trigram) 비교, 검색 융합은 1990년대 정보 검색의 RRF, 작업 분배는 네트워크 스케줄링의 Deficit Round Robin이다. 검색 한 번에 LLM 호출은 0번이다.
세부 상수 하나가 성격을 바꾼다. 같은 '순위 융합'이라도 Hindsight는 상수 k=60을, Graphiti는 k=1을 쓴다. 이 숫자 하나로 "여러 검색에서 고르게 나온 기억"을 믿을지 "한 검색의 1등"을 믿을지가 갈린다.
2026년의 새 부품은 '결정 모델'이다. 글을 쓰는 LLM 앞에, 객관식 판단만 1초 안에 내리는 작은 모델을 세운다. Hindsight와 Graphiti 둘 다 10월에 이 경로를 넣었다.
다섯 엔진 모두 '잊는 법'을 구현하지 않았다. 망각 곡선, TTL, 중요도 점수는 어디에도 없다. 오래된 기억은 지우는 대신 흐리게 만들거나, 무효 표시를 하거나, 덮어쓴다.
한국어는 곳곳에서 조용히 미끄러진다. '김민지'와 '민지'는 Hindsight에서 한 사람으로 합쳐지지 않는다. Graphiti의 퍼지 매칭은 한글을 지우고 시작하고, Mem0의 엔티티 추출은 영어 spaCy 모델에 고정돼 있다.
이 글의 수치는 별도 표기가 없으면 코드의 기본값이다. 대부분 환경변수나 은행(bank) 설정으로 바꿀 수 있다. 코드는 읽기만 했고 실행해서 검증하지는 않았다. 예외는 위젯이다. 위젯은 해당 함수를 TypeScript로 옮겨 원본 Python과 같은 값을 내는지 대조했다.
1. 해부 지도 — 네 개의 기관과 두 개의 계통
해부학 교과서는 기관(organ)과 계통(system)을 나눠 설명한다. 기억 엔진도 그렇게 보면 편하다. 기관은 기억을 다루는 네 단계다. 계통은 그 기관들을 떠받치는 배관(작업 큐)과 면역(비밀정보 방어)이다.
저장 Retain 대화 → 사실·엔티티·링크
→
통합 Consolidation 사실 → 관찰 (백그라운드)
검색 Recall 질문 → 근거 묶음
→
성찰 Reflect 근거 → 답변·지식 페이지
Hindsight를 기준으로 각 기관에서 누가 일하는지 먼저 정리한다. 이 표가 글 전체의 지도다.
눈여겨볼 점은 검색이다. "AI 메모리"라고 하면 검색할 때도 LLM이 머리를 굴릴 것 같지만, Hindsight의 기본 검색은 LLM을 한 번도 부르지 않는다. 임베딩 모델(BAAI/bge-small-en-v1.5, 384차원)과 크로스인코더(ms-marco-MiniLM-L-6-v2)는 로컬에서 돌고, 나머지는 SQL과 산술이다. LLM 비용은 쓰기 쪽에 몰려 있다. 기억은 쓸 때 비싸고 읽을 때 싸다. 다른 엔진도 대체로 같은 방향이다. Mem0 검색은 LLM 0회, Graphiti의 기본 search()도 0회다.
기술 스택도 의외로 수수하다. API 서버는 FastAPI와 asyncpg, 저장소는 PostgreSQL 하나다. 벡터는 pgvector HNSW, 전문 검색은 Postgres tsvector, 작업 큐도 Postgres 테이블이다. Redis도 Kafka도 Neo4j도 없다. 그래프 탐색도 별도 그래프 DB 없이 링크 테이블과 CTE(공통 테이블 식)로 한다. 엔터프라이즈용 객체 스토리지 엔진(Memlake)은 오픈소스에 포함되지 않는다.
2. 저장(Retain) — 대화를 사실로, 이름을 엔티티로
2-1. 3,000자 청크와 "6개월 뒤에도 쓸모 있을까?"
저장 파이프라인은 여섯 단계다.
청킹기본 3,000자. JSON 대화는 턴 경계, JSONL은 줄 단위, 일반 텍스트는 문단 → 줄 → 문장 → 쉼표 → 공백 순으로 자른다. 겹침(overlap)은 없다.
사실 추출청크마다 LLM 1회, temperature 0.1, 구조화 출력. what·when·where·who·why와 엔티티, 인과 관계를 JSON으로 받는다.
임베딩사실 문장에 날짜와 엔티티 꼬리를 붙여 임베딩한다. 저장되는 문장에는 꼬리가 붙지 않는다.
1단계쓰기 트랜잭션 밖에서 엔티티 해석과 의미 이웃 탐색(ANN)을 한다.
2단계사실·엔티티·링크를 한 트랜잭션으로 기록한다.
통계커밋 후 엔티티 언급 수·마지막 본 날짜를 갱신한다. 행 잠금을 짧게 유지하려는 분리다.
추출 프롬프트에는 실무자가 눈여겨볼 규칙이 여럿 있다. 상대 날짜("어제", "지난주")는 대화 날짜 기준의 절대 날짜로 바꾼다. 대명사는 풀어 쓴다("Emily (user's roommate)"). 원문 언어는 유지한다. 그리고 선별 기준은 한 문장이다. "6개월 뒤에도 쓸모 있을까?" 인사, 맞장구, 화면에 지금 떠 있는 내용은 여기서 걸러진다.
방어 장치도 촘촘하다. LLM 출력이 너무 길어 잘리면 청크를 가운데 ±20% 안의 문장 경계에서 반으로 나눠 다시 시도한다. 최소 500자까지 내려간다. 응답 중 파싱에 성공한 사실이 80% 미만이면 틀린 키를 알려 주며 다시 묻는다. 인과 관계는 caused_by 하나뿐이고, 사실 하나당 최대 2개, 자기보다 앞에 나온 사실만 가리킬 수 있다. 순환 참조를 구조적으로 막는 방법이다.
작은 요령도 있다. 같은 청크에서 나온 사실 i에는 시각에 i × 0.01초를 더해 순서를 보존한다. 은행의 미션(이 기억이 무엇을 위해 존재하는가)은 시스템 프롬프트가 아니라 사용자 메시지에 넣는다. 시스템 프롬프트를 고정해 두면 프롬프트 캐시가 깨지지 않기 때문이다.
2-2. 임베딩에만 붙이는 꼬리표
사실 "민지는 한라산에 올랐다"를 임베딩할 때 실제 입력은 이렇다.
text
민지는 한라산에 올랐다 (happened in 2026-06-14) [민지, 한라산]
검색할 때 "6월에 민지가 간 산"처럼 날짜나 이름이 섞인 질문이 와도 벡터가 가까워지도록 하는 장치다. 저장되는 본문과 크로스인코더가 보는 문장에는 꼬리가 없다. 같은 정보를 두 번 넣어 점수가 부풀지 않게 한 분리다.
같은 문서를 다시 넣으면 청크별 SHA-256 해시로 바뀐 청크만 다시 추출한다(델타 retain). 같은 문서에 쌓인 append 요청은 작업을 집어 갈 때 최대 16개까지 하나로 접는다. 긴 대화 로그에 메시지가 한 줄씩 붙을 때마다 LLM을 부르지 않으려는 장치다.
2-3. 엔티티 해석 — 임베딩을 쓰지 않는다
Hindsight의 엔티티 해석은 이 글에서 가장 고전적이면서 가장 공들인 부분이다. 새로 들어온 이름(언급)을 은행에 이미 있는 이름(후보)과 비교해, 같은 대상이면 기존 엔티티에 붙이고 아니면 새로 만든다. 임베딩은 쓰지 않는다. 순서는 이렇다.
후보 탐색. Postgres 확장 pg_trgm의 % 연산자로 trigram 유사도 0.3 이상인 이름을 이름당 최대 200개 가져온다.
단어·숫자 호환성. 서로에게 없는 숫자가 하나씩 있으면 다른 엔티티다. 여러 단어로 된 이름은 짧은 쪽의 모든 단어가 긴 쪽 단어와 같거나, 접두어이거나, 문자열 유사도 0.6 이상이어야 한다.
첫 항은 이름 자체의 유사도다(Python difflib.SequenceMatcher). 둘째 항은 공출현이다. n은 같은 사실에 함께 나온 다른 엔티티 수, 합은 그중 후보와도 함께 나온 적 있는 엔티티에 대해 구한다. 여기에 1/√d를 곱한다. d는 그 엔티티가 은행 전체에서 함께 나온 엔티티 수다. '회사'나 '나'처럼 아무 데나 등장하는 엔티티는 증거로서 가치가 낮으니 깎는다. 셋째 항은 시간이다. 후보를 마지막으로 본 날과 7일 넘게 떨어져 있으면 0점이다.
trigram이 뭔지부터 짚자. 단어 앞에 공백 둘, 뒤에 공백 하나를 붙이고 세 글자씩 미끄러지며 자른 조각이다. "room"은 ␣␣r, ␣ro, roo, oom, om␣ 다섯 조각이 된다. 두 이름의 조각 집합이 얼마나 겹치는지(자카드 지수)가 trigram 유사도다. Hindsight는 Postgres의 결과와 바이트 단위로 같은 순수 Python 구현(engine/trigram.py)을 따로 갖고 있다. 같은 배치 안의 새 이름끼리 묶을 때 DB 연결을 잡지 않기 위해서다.
"John Smith"와 "Jane Smith". trigram 0.47, 문자열 비율 0.80이다. 성이 같고 같은 회사 사람들과 함께 나오면 한 사람으로 합쳐졌다. 그래서 단어별 대조가 생겼다. john/jane의 비율은 0.50이라 단어 기준선 0.6을 넘지 못한다.
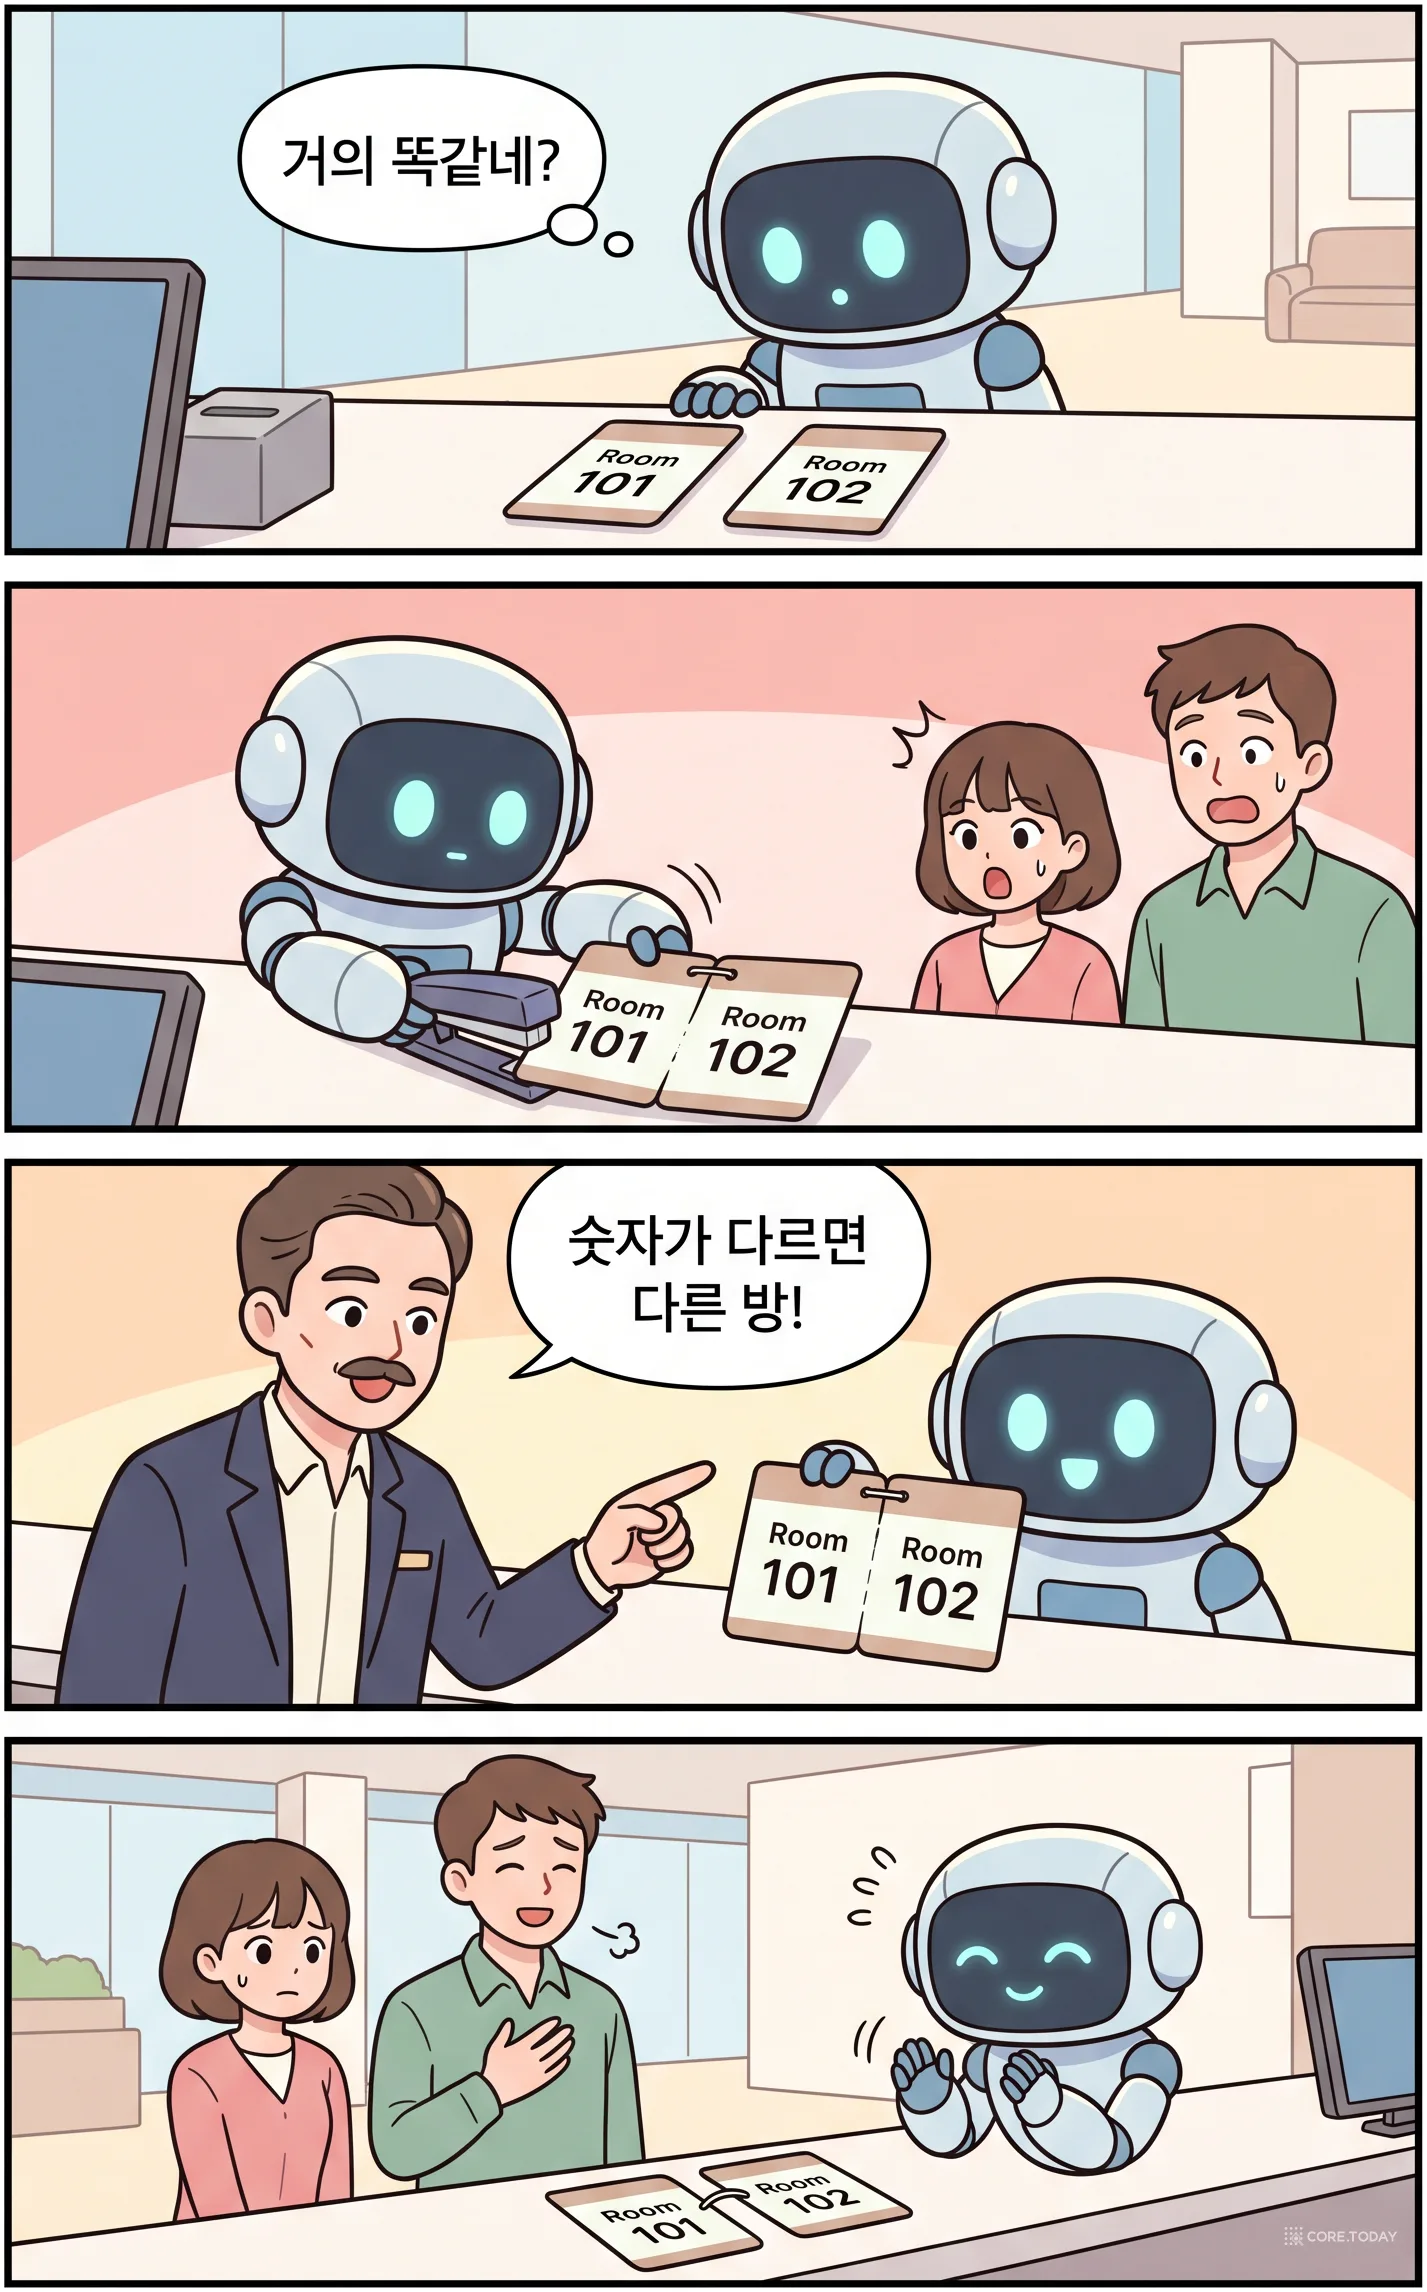
"Room 101"과 "Room 102". 101/102의 문자열 비율은 0.67로 단어 기준선을 넘는다. 그래서 숫자 규칙이 따로 생겼다. 다만 처음 만든 "숫자가 정확히 같아야 한다" 규칙은 "Q3 earnings"와 "Q3 2024 earnings"까지 갈라놓았다. 지금은 한쪽 숫자가 다른 쪽의 부분집합이면 통과시킨다.
"Tigran"과 "Iran". 문자열 비율은 0.80으로 "Alice"/"Alice Chen"(0.67)보다 높다. 짧은 이름에서는 우연히 겹친 글자가 비율을 부풀린다. 그래서 후보 문턱을 trigram(0.20)으로 걸었다(#3751).
0.6000000000000001. 이름 0.4 + 시간 0.2는 부동소수점으로 0.6000000000000001이 되어 병합되고, 이름 0.3 + 공출현 0.3은 정확히 0.6이 되어 엄격한 >에서 탈락했다. 그래서 지금은 소수 여섯째 자리에서 반올림한 뒤 >=로 비교한다.
2-4. 한국어 이름은 왜 미끄러지는가
위젯의 세 번째 사례가 한국어 사용자에게 가장 중요하다. '김민지'와 '민지'는 문자열 비율로는 0.8로 아주 가깝다. 그러나 trigram은 단어 단위로 만든다. 한국어는 성과 이름을 붙여 쓰기 때문에 '김민지'는 통째로 한 단어다. 두 이름이 공유하는 조각은 민지␣ 하나뿐이고 유사도는 0.17이다. 후보 문턱 0.3에 걸려 점수 계산까지 가지 못한다. 같은 대화, 같은 날이어도 '민지'라는 엔티티가 새로 생긴다.
몇 쌍을 더 재 봤다(Python 원본과 위젯 결과가 같다).
언급
후보
trigram
문자열 비율
결과
민지
김민지
0.17
0.80
후보 탈락 → 새 엔티티
삼성
삼성전자
0.33
0.67
문턱 통과, 이름 점수 0.33 → 공출현·시간이 0.27 이상 필요
코어닷
코어닷투데이
0.38
0.67
위와 같음
서준 팀장
서준
0.50
0.57
이름 점수 0.29 → 공출현·시간이 0.31 이상 필요
김민지 님
김민지
0.67
0.75
이름 점수 0.38 → 같은 날이면 병합
띄어쓰기가 있으면 단어가 통째로 겹쳐 trigram이 오르고, 붙여 쓰면 떨어진다. 영어권 이름의 "성 + 이름" 구조를 전제로 다듬은 규칙이 한국어에서는 다르게 동작하는 셈이다. 다만 첫 관문이 하나 더 있다. 사실 추출 LLM이 대명사와 호칭을 풀어 쓰도록 지시받기 때문에, 대화에서 "민지"라고만 불러도 LLM이 맥락을 보고 "김민지"로 적어 줄 수 있다. 한국어 서비스라면 추출 프롬프트나 은행 미션에 "사람은 성과 이름을 함께 적는다" 같은 규칙을 넣는 편이 엔티티 해석기를 고치는 것보다 싸다.
다른 엔진은 어떨까. Graphiti는 정확한 이름 일치 → 엔트로피 게이트 → MinHash/LSH(문자 3-gram, 순열 32개, 밴드 4) 후 자카드 0.9 이상이면 병합, 나머지는 LLM에 묻는 구조다. 그런데 퍼지 비교용 정규화 함수가 [^a-z0-9' ]을 지운다. 영문 소문자·숫자·아포스트로피를 뺀 모든 글자가 사라진다. 한글 이름은 빈 문자열이 되고 엔트로피가 0이 되어 퍼지 경로가 아예 꺼진다. 한국어 엔티티는 정확히 같거나 LLM이 판정하거나 둘 중 하나다. Mem0은 2026년 4월부터 spaCy 영어 모델(en_core_web_sm)로 엔티티를 뽑고, 정규화 문자열이 같거나 임베딩 코사인 0.95 이상일 때만 합친다. Letta와 LangMem에는 엔티티 해석 자체가 없다.
2-5. 네 종류의 실 — 링크
사실끼리는 네 종류의 링크로 이어진다. 검색의 그래프 갈래가 이 실을 따라간다.
링크
만드는 방법
가중치
시간
같은 종류의 사실 중 시간상 앞뒤 이웃. 배치 안에서는 날짜순 정렬 후 다음 20개만 본다
max(0.3, 1 − Δ시간/24), 사실당 최대 20개
의미
DB 쪽은 HNSW 근사 최근접 이웃, 배치 안은 numpy 블록 행렬곱(256행 단위)
코사인 0.7 이상, 상위 50개
인과
LLM이 뽑은 caused_by 중 검증을 통과한 것
1.0
엔티티
저장하지 않는다. 검색할 때 엔티티-사실 매핑 테이블에서 즉석으로 계산한다
—
엔티티 링크를 저장하지 않는 이유는 단순하다. '민지'가 등장한 사실이 1,000개면 링크는 50만 개가 된다. 매핑 테이블 하나로 같은 질문에 답할 수 있으니 굳이 펼쳐 둘 필요가 없다.
작은 불일치도 하나 있다. 배치 안에서 시간 링크를 만들 때는 24시간이 넘으면 멈춘다. 그런데 DB에 이미 있는 이웃을 찾는 쿼리에는 이 컷오프가 없다. 그래서 몇 달 떨어진 이웃도 하한 0.3으로 이어진다. 버그라기보다 "가장 가까운 이웃은 멀어도 이어 둔다"는 설계로 읽을 수도 있지만, 문서에는 설명이 없다.
2-6. 다른 엔진의 저장 경로 — 하나는 줄였고, 하나는 늘렸고, 하나는 맡겼다
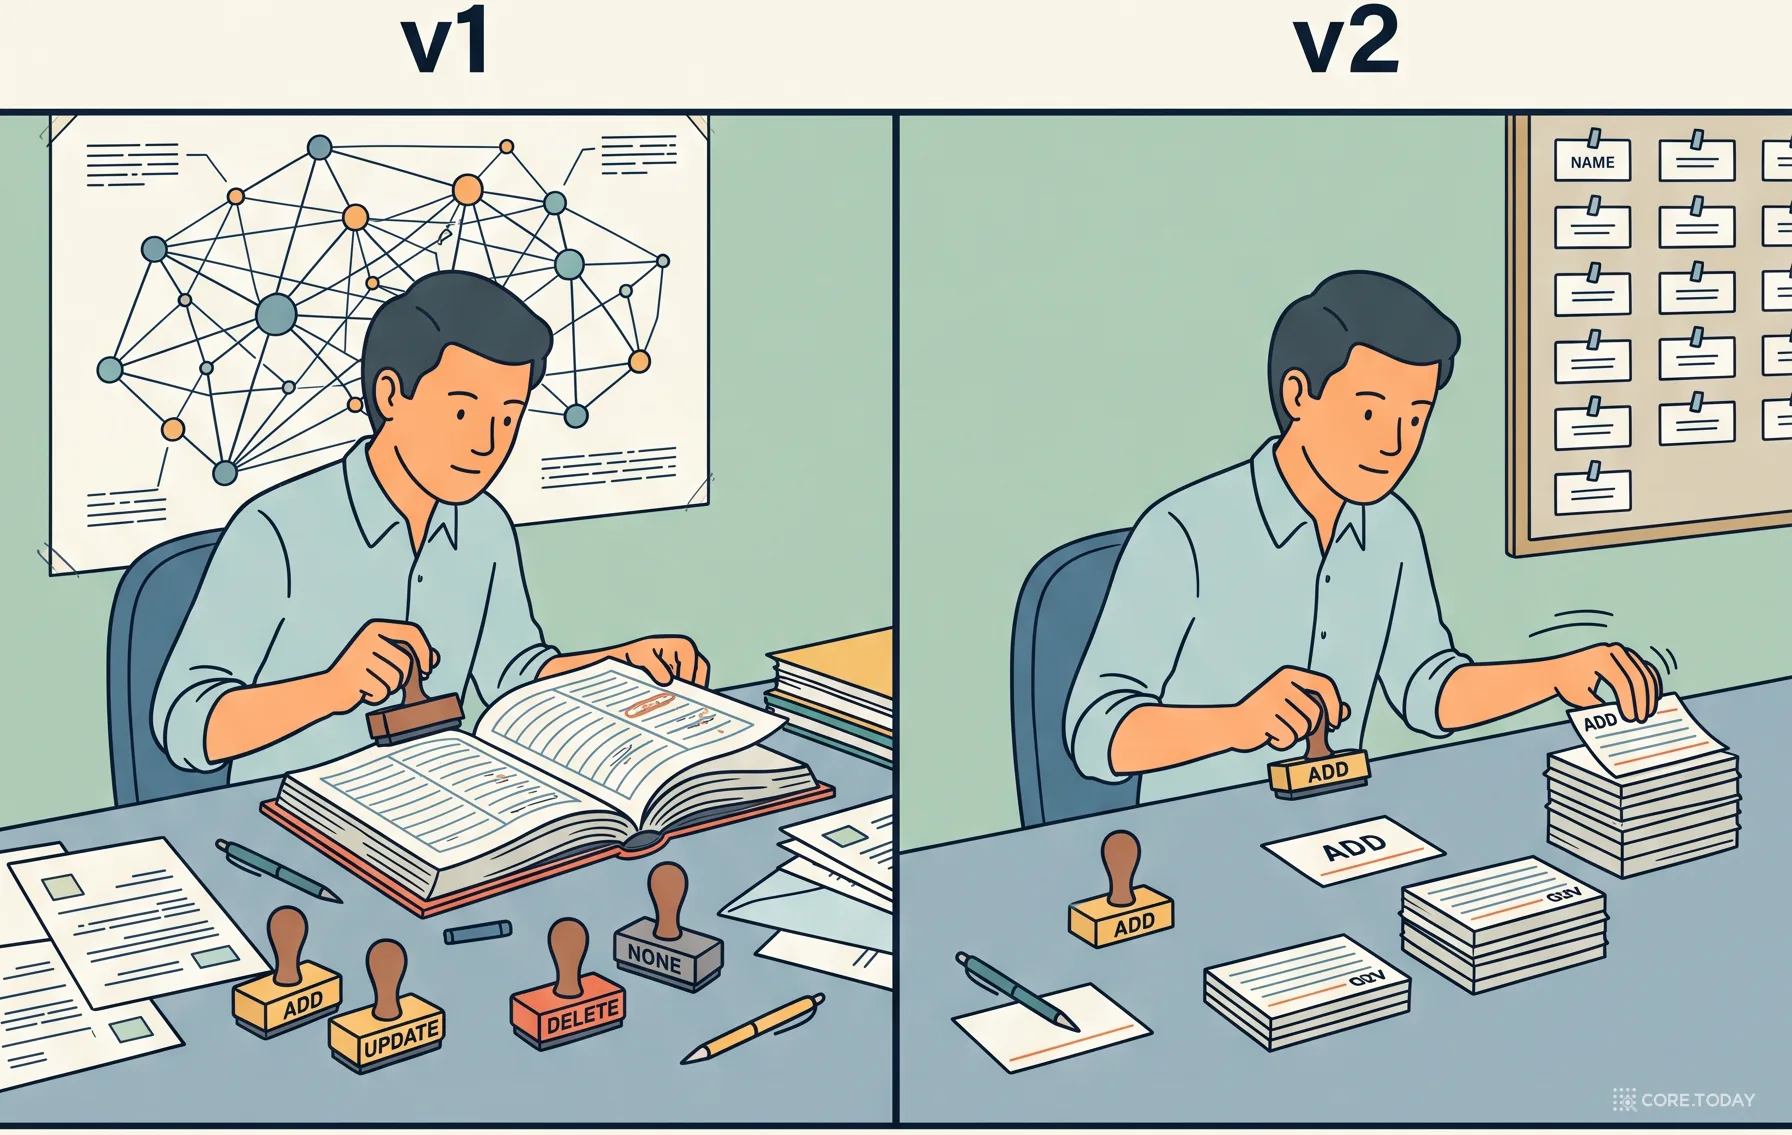
Mem0은 2026년 4월 14일(v2.0.0)에 쓰기 경로를 갈아엎었다. 2025년 논문(arXiv 2504.19413)이 설명한 구조는 2단계였다. LLM이 사실을 뽑고, 사실마다 기존 기억 5개를 찾아 다시 LLM에게 ADD·UPDATE·DELETE·NONE 중 하나를 고르게 했다. 그래프를 켜면 엔티티 추출, 관계 추출, 모순 관계 삭제 판단이 더해져 add() 한 번에 LLM이 5번 불렸다.
지금은 LLM 1회, 그것도 추가만 한다. 프롬프트 첫 줄이 "Your sole operation is ADD"다. 대화 전체를 한 덩어리로 임베딩해 기존 기억 10개를 찾고, 그 UUID를 "0", "1", … 같은 정수로 바꿔 보여 준다(LLM이 UUID를 잘못 베껴 쓰는 것을 막는 요령이다). 모순은 UPDATE 대신 "아몬드 우유에서 귀리 우유 라테로 바꿨다"처럼 전환을 서술하는 새 기억으로 처리하라고 지시한다. 프롬프트는 "애매하면 추출하라. 중복은 하류의 중복 제거 시스템이 처리한다"고 말한다. 그런데 실제 하류의 중복 제거는 앞서 찾은 10개와 MD5 해시가 정확히 같을 때만 건너뛰는 것이다. 한 글자만 달라도 중복으로 쌓인다. Neo4j·Memgraph·Kuzu·AGE 그래프 드라이버 약 4,000줄은 오픈소스에서 삭제됐다. 코어닷투데이가 4월 초에 쓴 Mem0 + Kuzu 가이드의 그래프 기능은 지금의 오픈소스에는 없다.
Graphiti는 반대로 쓰기에서 LLM을 많이 쓴다. 빈 그래프에 첫 에피소드를 넣으면 2회(엔티티 추출, 사실 추출)지만, 그래프가 찬 뒤에는 새 사실마다 "기존 사실과 중복인가, 모순인가"를 LLM에 묻는다. 새 사실 5개짜리 에피소드면 대략 8~14회다. 매번 직전 에피소드 10개를 원문 그대로 프롬프트에 넣으니 토큰도 많이 든다. 대신 얻는 것이 이중 시간(bi-temporal) 모델이다. 모순된 옛 사실은 지우지 않고 invalid_at과 expired_at을 찍어 이력으로 남긴다. 흥미롭게도 무효화의 최종 판정은 LLM이 아니라 날짜 비교가 내린다. LLM이 모순이라고 해도 두 사실 중 하나라도 날짜가 없으면 아무것도 무효화되지 않는다.
Letta는 저장을 에이전트에게 맡긴다. 추출 파이프라인이 없다. 2026년 8월 15일 Letta는 Python 서버 저장소를 보관 처리했고, 지금의 Letta(letta-code, TypeScript)에서 기억은 Markdown 파일이 든 git 저장소다. 루트의 .md 파일은 전부 시스템 프롬프트에 들어가고, 하위 폴더는 필요할 때 Memory(path) 도구로 읽는다. 쓰기 전용 도구는 없다. 에이전트가 일반 편집 도구로 파일을 고치고 git commit을 한다. 크기 제한은 git pre-commit 훅이 건다(깊이 2, 파일당 20,000자, 핵심 기억 합계 65,536자). 그리고 프롬프트가 분명히 말한다. "기억을 고쳐도 이번 턴의 행동은 바뀌지 않는다." 커밋된 내용은 다음에 프롬프트를 다시 조립할 때 반영된다. 코어닷투데이가 파일 vs 그래프 기억 실험에서 본 "원문 파일이 그래프보다 정확했다"는 결과와 같은 방향의 선택이다.
키워드 갈래의 'BM25'는 이름일 뿐이다. 기본 백엔드는 Postgres의 ts_rank_cd(cover density)인데, 이 함수는 단어가 얼마나 드문지(IDF)를 보지 않는다. 대신 질의 토큰이 많을 때 Postgres 통계(pg_stats)로 문서 빈도가 낮은 토큰부터 16개를 고른다. IDF가 하던 일을 입구에서 일부 대신하는 셈이다. 진짜 BM25가 필요하면 ParadeDB pg_search, VectorChord-BM25, PGroonga 같은 백엔드로 바꿀 수 있다. Mem0의 pgvector 어댑터도 똑같이 ts_rank_cd를 쓰면서 BM25라고 부른다. 업계에서 'BM25'가 '키워드 검색'의 대명사가 된 흔적이다.
공유 엔티티가 1개면 0.46, 2개면 0.76, 4개면 0.96이다. tanh가 포화시키므로 '나'처럼 수많은 사실에 등장하는 엔티티가 점수를 독식하지 못한다. 논문은 그래프 검색을 확산 활성화(spreading activation)로 설명했다. 코드의 그래프 갈래는 씨앗에서 한 걸음만 나간다. 여러 걸음 퍼지는 확산은 시간 갈래에 있다.
propagated=parent×wlink×boost×0.7
boost는 원인·결과 링크면 2.0, 가능하게 함·막음 링크면 1.5다. 이웃의 점수는 자기 날짜의 근접도와 전파된 점수 중 큰 값이고, 0.2를 넘어야 다음 확산의 출발점이 된다. "지난달 그 장애 때문에 뭘 바꿨지?"처럼 기간과 인과가 섞인 질문에서, 기간 안의 사건에서 출발해 인과 링크를 따라 기간 밖의 후속 조치까지 닿게 하는 장치다.
3-2. 한국어 날짜 표현은 시간 갈래에 닿지 못한다
시간 갈래는 질의에서 기간을 뽑아야 작동한다. Hindsight는 먼저 규칙 테이블로 뽑는다. "couple days ago"는 [−3일, −1일], "few weeks ago"는 [−5주, −2주], "Month YYYY"는 그 달 전체다. 규칙은 영어·스페인어·이탈리아어·프랑스어·독일어·러시아어 표현을 다루고, 중국어는 별도 파일에 더 큰 규칙 세트가 있다. 한국어 규칙은 없다. 규칙이 실패하면 dateparser 라이브러리로 넘어간다.
Hindsight가 쓰는 dateparser를 직접 돌려 봤다(기준일 2026-10-21, 언어 자동 감지).
질의
dateparser가 찾은 날짜
어제 회의에서 뭐라고 했어?
'어제' → 2026-10-20
지난주에 민지가 뭐 했지?
없음
3월에 간 여행
없음
2025년 여름 휴가
없음
두 달 전 이직
없음
上个月做了什么 (중국어: 지난달 뭐 했지)
'上个月' → 2026-09-21
last week what did Minji do?
'do' → 2026-10-15 (엉뚱한 단어를 날짜로 잡음)
이 표는 dateparser 단독 결과다. Hindsight는 여기에 자체 점수(숫자 +100, 월 이름 +50, 상대어 +50, 요일 +30)를 매겨 'do' 같은 과잉 매칭을 걸러 내는 층을 더 얹는다. 영어 'last week'는 규칙 테이블이 먼저 잡으니 dateparser까지 가지도 않는다. 한국어는 그 규칙 층이 없으니 dateparser의 성적이 곧 한국어 성적이다. 저장 쪽은 문제가 덜하다. 사실 추출 LLM이 "지난주"를 절대 날짜로 바꿔 적기 때문이다. 문제는 질의 쪽이다. "지난주에 뭐 했지?"라고 물으면 시간 갈래가 켜지지 않고, 나머지 세 갈래가 '지난주'라는 단어의 의미와 키워드로만 찾는다.
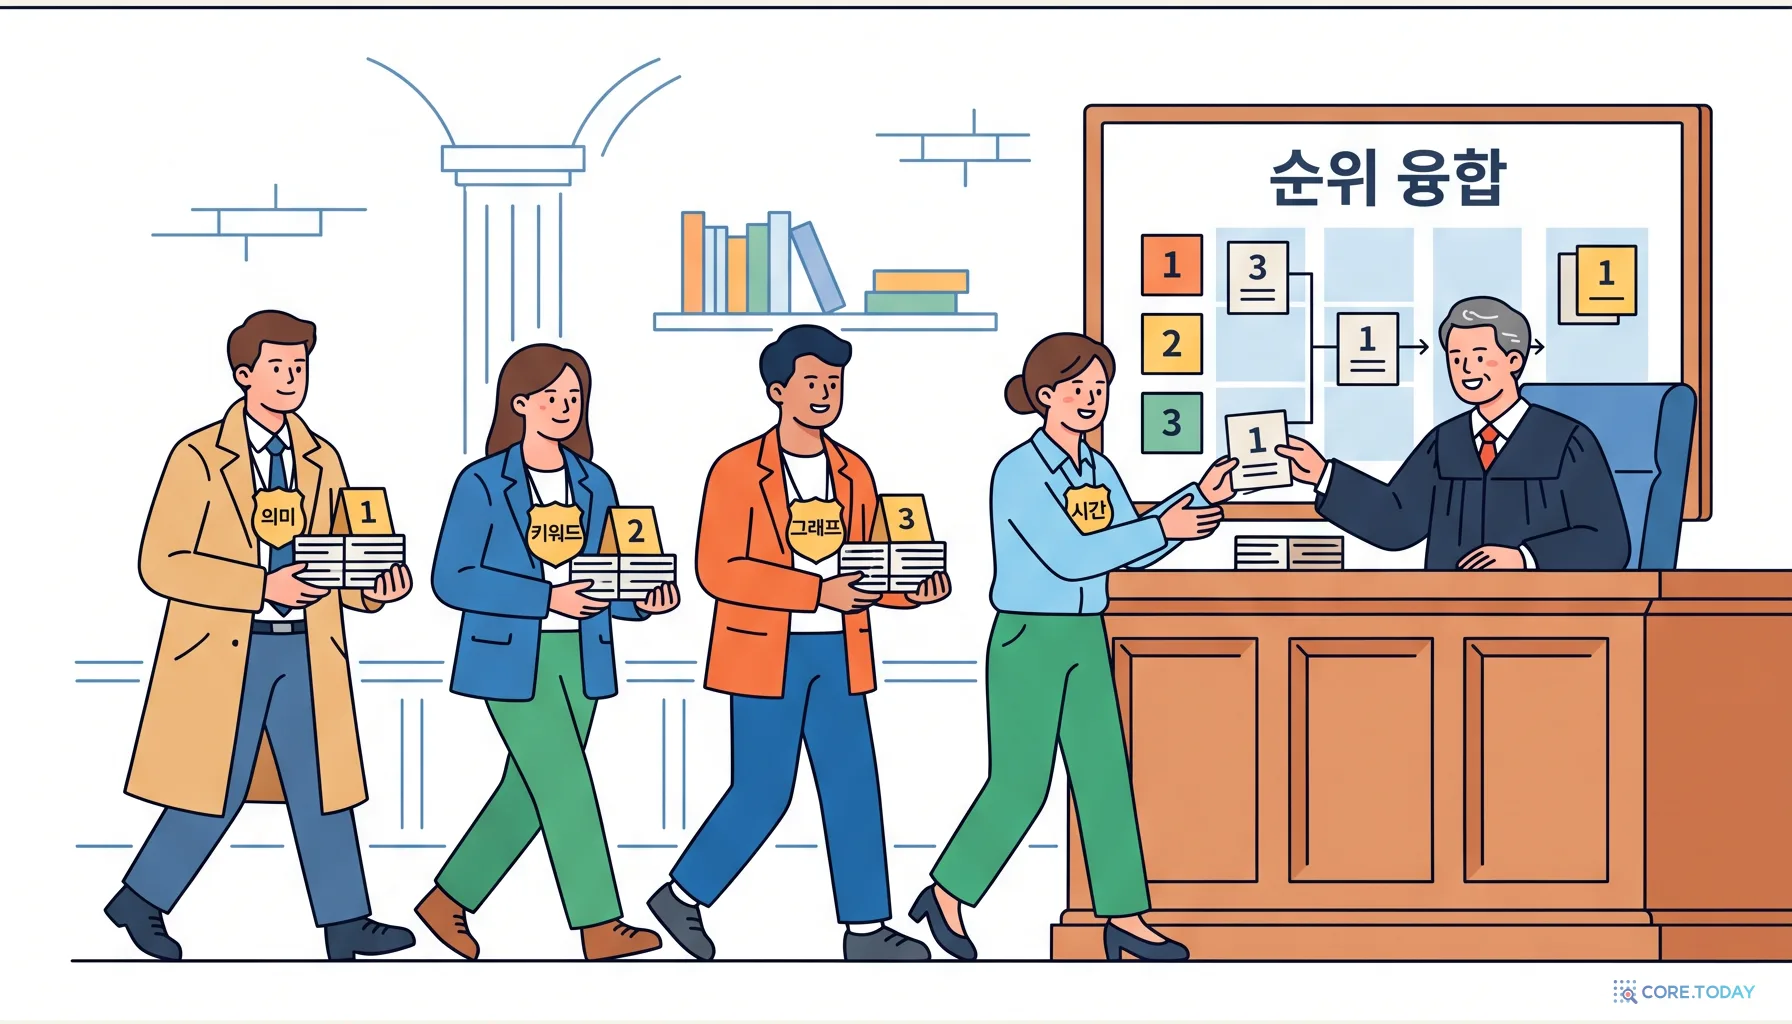
3-3. 역순위 융합 — 점수가 아니라 등수로 섞는다
네 갈래의 점수는 단위가 다르다. 코사인 0.7과 ts_rank_cd 0.03과 그래프 점수 1.8을 그냥 더할 수는 없다. 그래서 점수를 버리고 등수만 쓴다. 역순위 융합(Reciprocal Rank Fusion, RRF)은 2009년 Cormack 등이 제안한 방법이다.
RRF(d)=갈래i∑k+ranki(d)1
목록에 없으면 0을 더한다. 벌점은 없다. 상수 k가 성격을 정한다. k가 크면 1등과 10등의 몫 차이가 작아져 여러 목록에 고르게 나온 문서가 이긴다. k가 작으면 한 목록의 1등이 큰 몫을 가져간다. Hindsight는 원 논문의 권장값 k=60을 쓰고, 융합 결과에서 상위 300개를 다음 단계로 넘긴다.
이 숫자가 엔진마다 다르다는 사실이 이번 해부의 수확 중 하나다.
엔진
합치는 방법
상수
Hindsight
네 갈래 RRF
k = 60
Graphiti
BM25 + 코사인(+ BFS) RRF
k = 1 (1등 1.0, 2등 0.5, 3등 0.33)
Cognee
청크 본문 벡터 + 청크 요약 벡터, 두 목록 RRF
k = max(30, min(60, 20 + 2·top_k)) → 기본 40
Letta V1 (보관)
Turbopuffer 백엔드일 때만 벡터 + BM25 RRF
k = 60, 가중치 0.5·0.5
Mem0
RRF가 아니다. 의미 후보에 정규화한 키워드·엔티티 점수를 더하고 나눈다
분모 = 1 + (키워드 점수 있음) + 0.5·(엔티티 부스트 있음)
MemOS
합치지 않는다. 결과를 합집합으로 모아 크로스인코더에 넘긴다
—
Mem0의 방식에는 숨은 효과가 둘 있다. 첫째, 후보는 의미 검색 결과(최대 top_k × 4 또는 60개)에서만 나온다. 키워드 점수와 엔티티 점수는 그 안에서 순서를 바꿀 뿐 새 후보를 데려오지 못한다. 게다가 기본 문턱 0.1이 의미 점수에 먼저 걸린다. 임베딩이 놓친 오류 코드·제품 번호는 키워드로 정확히 일치해도 결과에 나오지 않는다. 둘째, 분모가 결과 집합 전체에서 한 번 정해진다. 후보 하나에만 키워드 점수가 있어도 모든 후보의 분모가 2가 된다. 같은 기억의 점수가 다른 후보 사정에 따라 오르내리니, 반환된 점수를 절대 문턱으로 쓰기 어렵다.
3-4. 심판 — 크로스인코더와 세 개의 가중치
RRF 상위 300개는 크로스인코더가 다시 매긴다. 질문과 후보 문장을 함께 넣어 관련도를 직접 계산하는 모델이다. 문서 앞에는 날짜를 붙인다([Date: June 05, 2022 (2022-06-05)] 본문). 기본 모델은 로컬 MiniLM이지만 Cohere, TEI, FlashRank, ZeroEntropy, Jina-MLX(애플 실리콘 전용), Google, Alibaba 등 열 가지가 넘는 재정렬기를 지원하고, 실패 시 다음 재정렬기로 넘어가는 체인도 만들 수 있다. 점수가 [0, 1] 밖이면 시그모이드로 정규화한다.
r은 최신성(기본 선형: 오늘 1.0에서 365일 뒤 바닥 0.1까지), t는 질의 기간과의 근접도(기간 표현이 없으면 0.5), p는 근거 수 정규화 값 clamp(0.5 + ln n / 10)이다. 배율의 폭은 각각 ±10%, ±10%, ±5%뿐이다.
세 배율을 모두 최대로 몰아도 약 1.27배, 최소로 몰면 약 0.79배다. 크로스인코더 점수 차이가 크면 2년 묵은 기억도 1위를 지킨다. 이것은 결함이 아니라 의도로 보인다. "관련 없는데 최신인 기억"이 "관련 있는데 오래된 기억"을 밀어내면 안 된다. 그렇다면 "삼성에 다닌다"와 "지난주 카카오로 이직했다"의 충돌은 누가 푸는가. 다음 절의 통합 단계가 푼다. 검색은 순위를 조금 기울일 뿐이고, 모순 해소는 기억 자체를 고쳐 쓰는 쪽이 맡는다.
마지막은 토큰 예산이다. 상위 thinking_budget × 2개를 순서대로 넣되, 안 들어가는 항목은 건너뛰고 다음 항목을 계속 시도한다(그리디). 하나도 안 들어가면 1위 하나는 돌려준다. 토큰은 o200k_base 인코딩으로 센다. 크로스인코더 대신 '결정 모델'을 설정하면 후보마다 "이 질문에 도움이 되는가"를 묻는 재정렬로 바뀌는데, 이때는 세 배율도 건너뛴다. 이 경로는 10월 15일 main에 들어왔고 아직 정식 릴리스에는 없다.
3-5. 다른 엔진의 검색에서 본 것들
Graphiti. 기본 search()는 BM25(Neo4j Lucene)와 코사인 두 갈래를 RRF k=1로 합치고 LLM을 부르지 않는다. search_()의 기본 레시피는 엣지·노드·에피소드·커뮤니티 네 범위에 BFS(깊이 3)를 더하고 크로스인코더로 재정렬한다. 크로스인코더는 gpt-4.1-mini에 후보마다 1토큰짜리 True/False 질문을 던지고 그 확률을 점수로 쓰는 방식이라, 한 질의에 최대 130번 가까운 호출이 생길 수 있다. 그 밖에 코드에서 본 점은 다섯 가지다.
Neo4j에서 코사인 검색은 벡터 인덱스 없이 모든 엣지를 훑는다.
MMR은 표준(선택한 집합 기준으로 하나씩 고르는 탐욕 방식)이 아니라 한 번에 벌점을 매긴다. 레시피 하나는 λ=1이라 다양성 항이 0이 된다.
node_distance 재정렬은 주석에는 '최단 경로'라고 적혀 있지만 실제로는 1-hop 직접 연결 여부만 본다.
기본 검색은 무효화된 과거 사실도 그대로 돌려준다. "지금 참인 것"만 보려면 호출자가 날짜 필터를 넣어야 한다.
search(num_results=50)가 모듈 전역 레시피 객체의 limit을 덮어쓴다. 같은 객체를 쓰기 경로도 쓰기 때문에, 검색 한 번이 이후 모든 add_episode의 중복·모순 후보 수를 바꾼다.
Cognee. 1.6.5의 기본 검색은 지식 그래프 검색이 아니라 HYBRID_COMPLETION이다. 청크 본문 벡터와 청크 요약 벡터 두 목록을 RRF(k=40)로 합치고, 엔티티 벡터 상위 10개에서 1-hop 이웃을 붙인 뒤 LLM이 답한다. 키워드 갈래와 재정렬기는 없다. 그래프 검색(GRAPH_COMPLETION)은 '무차별 트리플 탐색'이다. 노드·엣지에 벡터 거리를 입히고, 벡터 검색에 안 걸린 요소는 벌점 6.5를 준 뒤, 엣지마다 양 끝 노드와 자신의 거리 합이 가장 작은 k개를 고른다.
Letta. 로컬 모드의 대화 검색은 JSONL 파일을 전부 읽어 메모리에서 BM25(k1=1.2, b=0.75)를 계산한다. 인덱스도 임베딩도 재정렬기도 없다. 한자·히라가나·가타카나는 부분 문자열 규칙이 있지만 한글은 없어서, 한글 단어는 토큰이 정확히 같을 때만 맞는다. 코드대로라면 "메모리"로 검색해도 "메모리를"이 든 메시지는 걸리지 않는다. 클라우드 모드의 하이브리드 검색은 서버 코드가 공개되지 않아 확인할 수 없었다.
MemOS. 기본 fast 검색은 작업 기억 전체와 벡터 검색 결과를 합집합으로 모은 뒤 크로스인코더(bge-reranker-v2-m3)로 다시 매기고, 관련도 0.45 미만을 버리고, MMR(λ=0.8)로 중복을 걸러 낸다. 이번에 본 엔진 중 MMR을 제대로 기본으로 켠 곳은 MemOS뿐이다. Hindsight 코드에는 docstring에 "MMR λ=0.5"라고 적혀 있지만 구현은 없다.
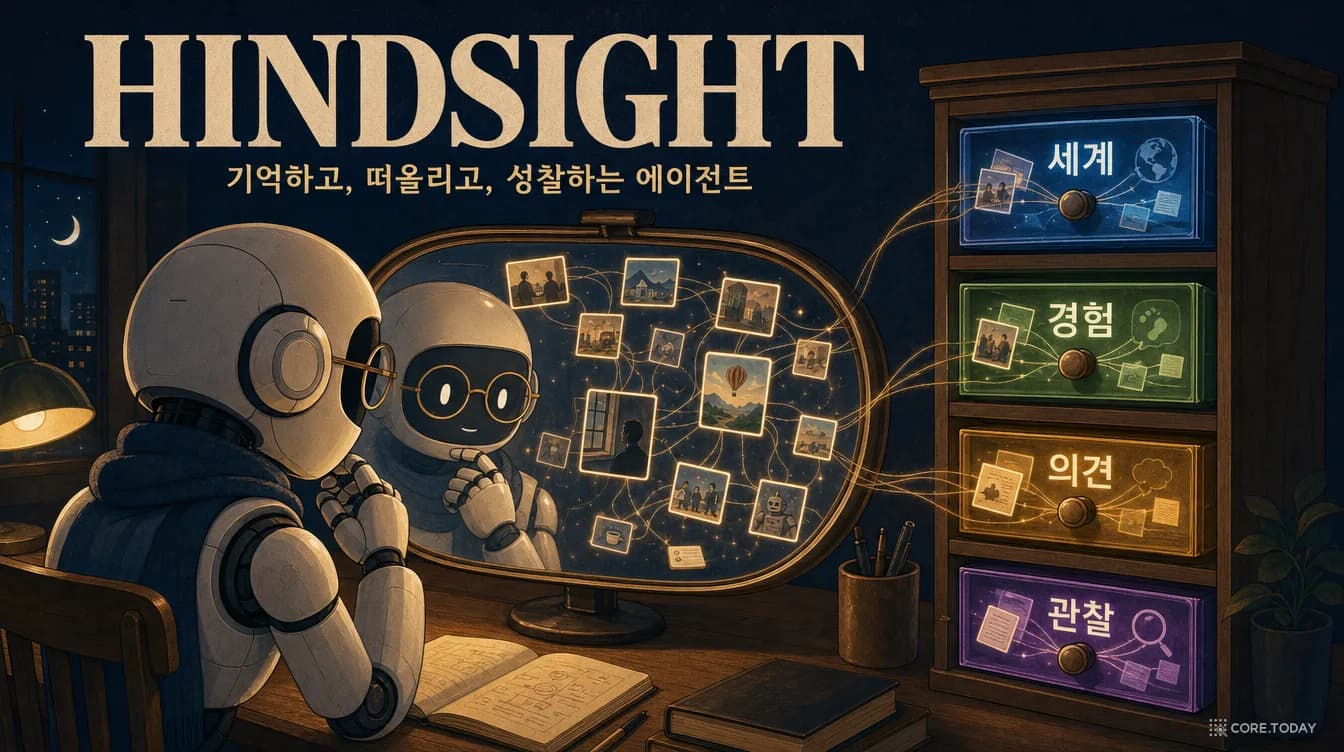
Hindsight의 기억은 두 층이다. 아래층의 사실은 대화에서 추출한 원자료로, 쌓이기만 한다. 위층의 관찰은 여러 사실을 엔티티 중심으로 합성한 요약이다. 관찰은 고쳐 쓴다. 통합은 백그라운드에서 아직 통합되지 않은 사실을 오래된 순서로 가져와 관찰을 만들고 고치는 작업이다. 논문의 '의견(opinion) 네트워크'는 2026년 1월 v0.4.0에서 이 관찰 층으로 흡수됐다.
처리량 상수는 이렇다. 한 번에 50개, 한 라운드에 100개를 처리하고, LLM 호출 하나에 사실 8개를 묶는다. 서로 다른 태그 그룹 4개까지 동시에 처리하고, 한 그룹 안의 배치는 차례로 돈다. 큰 그룹이 작은 그룹을 굶기지 않게 그룹마다 상한을 두고, 락은 정렬된 순서로 잡아 교착을 피한다.
배치 하나는 여섯 단계를 거친다.
관련 관찰 검색사실마다 관찰만 recall한다. 크로스인코더 대신 갈래를 번갈아 뽑는 interleave를 쓴다. 거의 같은 '쌍둥이' 관찰이 크로스인코더와 RRF에서는 서로를 밀어내 묻혔기 때문이다.
결정 모델 분류쉬운 사실은 LLM 전에 처리한다. 아래 4-2에서 다룬다.
LLM 통합남은 사실만 보내 생성·갱신·삭제 목록을 받는다. 스키마를 동적으로 만들어 근거 사실 ID를 이번 배치의 ID로만 제한한다.
사후 보정LLM이 잘못 베낀 UUID는 앞 13자로 맞춘다. 같은 관찰에 대한 갱신 두 건은 합치고, 갱신과 삭제가 겹치면 갱신이 이긴다.
의미 중복 제거새로 만들거나 바뀐 관찰에 코사인 0.97 이상인 이웃(상위 5개 중)이 있으면 LLM이 합칠지 둘지 정한다. 숫자·엔티티·부정·조건 중 하나라도 다르면 둔다.
원자적 커밋임베딩과 LLM 작업은 DB 연결 없이 끝내고, 모든 변경과 통합 완료 표시를 한 트랜잭션으로 쓴다.
시스템 프롬프트에는 처리 규칙 12개가 있다. 새로 만들기보다 기존 관찰 갱신을 우선한다. 산술은 하지 않는다(LLM이 "3회 방문"을 더하다 틀리는 것을 막는다). 최신성은 언급 시각(mentioned_at) 기준이다. 그리고 규칙 10번은 "더 오래된 소식이 더 새로운 믿음을 고쳐 쓰지 못한다"이다.
실패 처리도 꼼꼼하다. 실패한 배치는 반으로 쪼개 다시 시도하고 사실 1개까지 내려간다. 그래도 실패한 사실에만 consolidation_failed_at을 찍는다. 재시도 대기는 min(2ⁿ⁻¹, 8)초다. 레이트리밋과 401/403은 바로 올리고, JSON 파싱 오류는 바로 실패 처리한다. LLM이 답에서 빠뜨린 사실은 최대 두 번 더 묻는다.
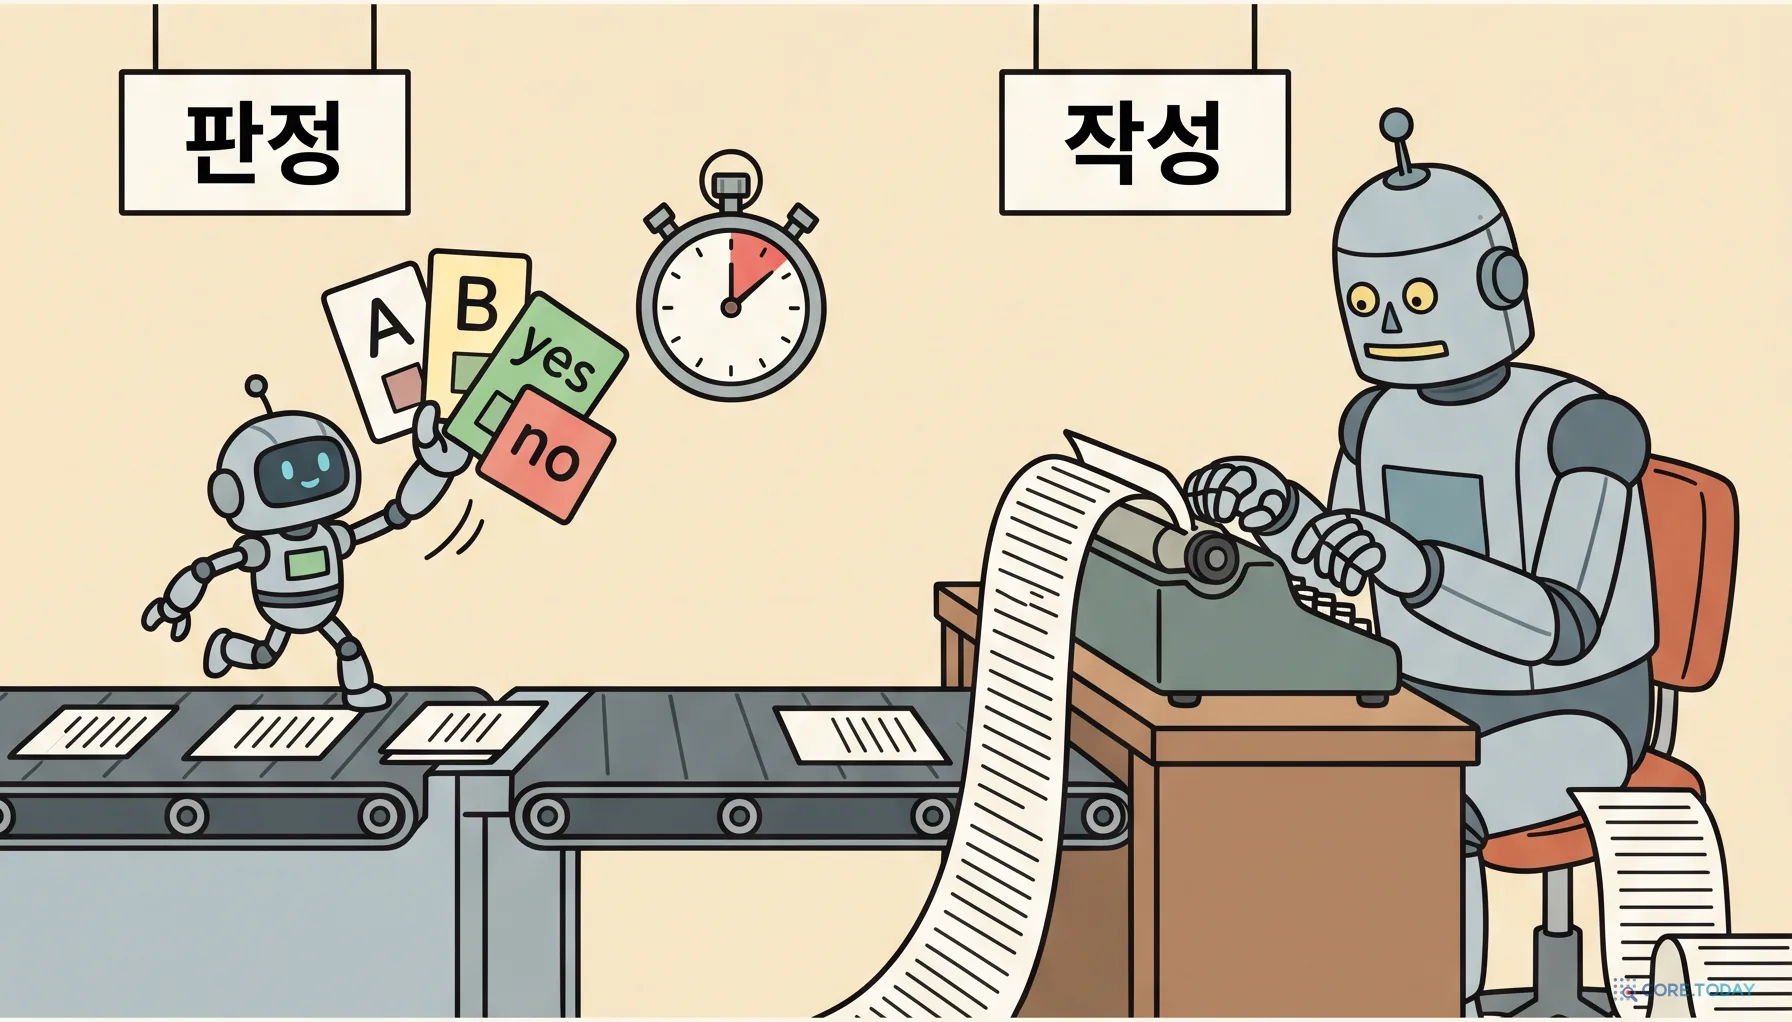
10월 16일 Hindsight main에 들어온 분류(triage) 단계는 2026년 기억 엔진의 방향을 잘 보여 준다. 코드 주석의 논리는 이렇다. 은행에 들어오는 사실 대부분은 세 가지 쉬운 경우 중 하나다. 관찰이 이미 말하는 것을 다시 말하거나, 어떤 관찰에도 없는 새 내용이거나, 잡담이다. 셋 다 글을 쓸 필요가 없다. 근거로 붙이거나, 문장 그대로 새 관찰로 만들거나, 버리면 된다. 그러니 글을 쓰는 LLM 대신 객관식 질문에만 답하는 결정 모델에 맡긴다.
결정 모델은 텍스트를 생성하지 않는다. 상태(state)와 질문 목록을 받아 고르기(choice)·점수(score)·예/아니오(noul)로만 답한다. Hindsight는 TypeSafe의 Jev, Cloudflare Workers AI의 Clef, OpenAI Decisions API 세 가지를 지원한다. 코어닷투데이는 판정 모델 연작에서 Jev와 로컬 판정 모델을 한국어로 비교한 적이 있다. 그 '판정 모델'이 기억 엔진의 부품으로 들어온 셈이다. Graphiti도 중복·모순 판정용 Jev 클라이언트를 갖추고 있다(중복 문턱 0.7, 모순 문턱 0.8).
사실 하나와 관련 관찰 최대 10개를 보여 주고 묻는 질문은 이렇다.
질문
답
쓰임
relation
restates / new / changes / chatter
사실의 성격
match
후보 중 하나
어느 관찰에 관한 이야기인가 (후보가 2개 이상일 때)
covers_oN
yes / no
restates 판정을 확인
touches_oN
yes / no
하나라도 yes면 LLM으로 넘긴다
keep_as
as_stated / reworded / not_wanted
은행에 고유 미션이 있을 때만
이 설계에서 가장 배울 만한 부분은 신뢰도 문턱을 없앤 이유다. 처음에는 답마다 0.8~0.95의 확신도 문턱을 두었다. 그러자 0.3~0.7 사이로 조심스럽게 답하는 모델은 아무것도 결정하지 못했고, 모델과 질문마다 문턱을 다시 맞춰야 했다. 지금은 가장 확률이 높은 답만 쓰고, 대신 답끼리 맞는지 교차 검사한다. 관계를 '새것'이라고 고르면서 어떤 관찰에 대해서는 '고쳐 써야 한다'고 답했다면, 어느 쪽도 믿지 않고 LLM에 넘긴다. 확신도 숫자 하나에 기대는 대신 질문을 여러 각도로 던져 자기모순을 잡는 방법이다. 문서는 같은 통과율에서 통합 LLM 호출이 약 40% 줄었다고 적는다.
단서가 둘 있다. 결정 모델 공급자의 기본값이 none이라, 설정하지 않으면 이 분류는 돌지 않는다. 그리고 결정 모델 스택 전체가 10월 13일의 1.0.0 릴리스 이후 main에 들어온 것이라 아직 정식 버전에 없다.
4-3. 다른 엔진은 모순을 어떻게 다루나
엔진
모순이 들어오면
옛 기억은
Hindsight
통합 LLM이 관찰 문장을 고쳐 쓴다. 근거 사실은 그대로 남는다
사실 층에 남는다. 관찰 층은 최신 상태
Mem0 (v2)
고치지 않는다. "A에서 B로 바꿨다"는 새 기억을 추가하라고 프롬프트로 지시한다
그대로 남는다. 둘 다 검색된다
Graphiti
엣지마다 LLM이 중복·모순을 판정하고, 날짜 비교로 옛 엣지에 무효 시각을 찍는다
삭제하지 않고 이력으로 남긴다. 기본 검색에도 나온다
Letta
25스텝마다 성찰 서브에이전트가 별도 git 브랜치에서 파일을 고쳐 쓰고 흡수한 줄은 지운 뒤 병합한다
git 이력에만 남는다
Cognee
기본 경로에는 없다. review_conflicts(기본 꺼짐)를 켜면 LLM이 사실 충돌을 검토한다
마지막에 쓴 설명이 앞의 설명을 덮어쓴다
MemOS
재구성기(기본 꺼짐)가 코사인 0.8 이상 쌍마다 LLM으로 모순·중복을 판정해 병합하거나 오래된 쪽을 지운다
병합 시 원본은 보관 상태로 남는다
같은 문제를 여섯 가지로 푼다. Hindsight와 Graphiti는 '증거는 남기고 결론만 고친다'는 점에서 닮았고, Letta는 사람이 위키를 관리하듯 '문서를 고치고 이력은 버전 관리에 맡긴다'. Mem0은 모순 해소를 포기하는 대신 쓰기 비용을 LLM 1회로 줄였다. 어느 쪽이 맞는지는 질문의 성격에 달렸다. "지금 어디 다녀?"에는 Hindsight·Letta가 유리하고, "작년 이맘때는 어디 다녔지?"에는 이력을 지우지 않는 Graphiti·Mem0이 유리하다.
Letta의 성찰 지침에는 기억 관리 전반에 쓸 만한 문장이 있다. "여러 규칙이 같은 원인을 공유하면, 그 모두를 설명하는 하나의 원칙으로 바꾸고 흡수된 줄은 지워라. 좁은 규칙이 계속 늘어나는 것은 실패의 신호다." 여기서 통합은 요약이 아니라 일반화다.
reflect는 기억을 근거로 답을 쓰는 에이전트 루프다. 도구 루프는 최대 10회, 컨텍스트는 10만 토큰이다. 흥미로운 것은 도구를 쓰는 순서를 강제한다는 점이다. 처음 몇 턴은 정해진 도구만 부를 수 있다. 멘탈 모델(사용자가 정의한 요약 문서) → 관찰 → 원본 사실(recall) 순서다. 그 뒤에야 자유 턴이 된다. 최신 멘탈 모델이 이미 답을 갖고 있으면 강제 단계를 일찍 풀어 준다. 그리고 recall도 하기 전에 "답 없음"으로 끝내려 하면 한 번 거절하고 recall을 시킨다. 요약만 보고 "그런 기록은 없습니다"라고 답하는 실패를 막는 장치다.
10월 21일에도 이 루프가 바뀌었다. 예전에는 자유 턴에서 모델이 답을 써 놓고 버려지는 일이 있었다. 이제 자유 턴은 반드시 도구를 불러야 하고, 답을 찾았는지를 answer_ready 도구로 신호한 뒤, 마무리 단계에서 답을 한 번만 쓴다. 같은 날 들어온 다른 커밋은 이 글의 독자에게 흥미로울 것이다. Claude Opus 5.5와 Sonnet 5.5는 특정 도구를 강제로 지정하는 tool_choice를 거부한다. 그래서 reflect는 이 모델들에서 auto로 물러나고, 사다리 순서는 프롬프트로만 강제된다. 모델 공급자의 API 정책 하나가 기억 엔진의 제어 구조를 바꾼 사례다.
기본 설정에서 reflect 한 번은 보통 LLM 4회다(관찰 검색 → recall → answer_ready → 마무리 답변). 멘탈 모델이 있으면 5회, 최대 10턴과 마무리가 상한이다. 컨텍스트가 넘치면 오래된 도구 결과부터 비우고, 그래도 넘치면 맵리듀스로 넘어간다. 청크마다 출처와 날짜가 달린 주장을 뽑고, 마지막에 한 번 합친다.
5-2. 성격 다이얼은 숫자가 아니라 문장으로
은행에는 성향(disposition) 세 가지를 1~5로 줄 수 있다. 회의성(skepticism), 문자 그대로 읽기(literalism), 공감(empathy)이다. 셋 다 3(중립)이면 숫자만 넣고, 그렇지 않으면 설명 문장으로 풀어 넣는다. 코드 주석에 적힌 이유는 "숫자만 주면 약한 모델이 무시했다"이다. 논문의 성향 공간에 있던 편향 강도 β는 제품에서 사라졌다.
지침(directive)은 우선순위 내림차순, 생성 시각 내림차순으로 정렬해 태그 범위로 적용한다. 지침이 있으면 답변 도구에 directive_compliance 필드가 필수가 된다. 시스템 프롬프트의 시간 규칙도 눈여겨볼 만하다. "가장 최근에 언급된 것이 이긴다. 단, 이유가 명시된 결정은 이유 없는 나중 변경보다 오래간다." "회의 결과 B안으로 가기로 했다(비용 때문에)" 뒤에 "그냥 A안 할까?"라는 혼잣말이 와도 B안을 유지하라는 뜻이다.
5-3. 지식 페이지 — 문서를 다시 쓰지 않고 편집 명령만 낸다
8월 v0.9.0에 들어온 지식 페이지(Knowledge Pages)는 기억에서 자동으로 갱신되는 문서다. 설계가 깔끔하다.
기준 문서가 있고 원천 질의가 그대로면 증분(delta) 모드, 아니면 전체 모드로 간다.
DB 시각으로 기준점을 잡아, 갱신 도중 들어온 사실은 다음 회차로 미룬다.
마지막으로 본 기억 시각(워터마크) 이후의 새 관찰만 읽는다. 읽을 게 없으면 reflect를 건너뛴다.
LLM은 문서를 다시 쓰지 않는다. 블록·섹션 ID를 지정해 append, insert, replace, remove 같은 편집 명령만 낸다. 모르는 ID를 가리키는 명령은 버리고, 손대지 않은 블록은 바이트 그대로 남긴다.
인용한 사실이 삭제됐으면 그 내용을 걷어내는 'unsay' 패스를 돌린다.
LLM에게 문서 전체를 다시 쓰게 하면 매번 문체가 흔들리고 멀쩡한 문장이 사라진다. ID 기반 편집 명령은 그 흔들림을 구조적으로 막는다. 10월 19일에는 여기에도 결정 모델 문턱이 들어왔다. 새 기억마다 "이것이 이 페이지를 바꿀 수 있는가"를 먼저 묻고, 남은 것만 증분 LLM 호출 한 번에 넘긴다. 문서에 따르면 기억 20개짜리 갱신이 LLM 3회에서 1회로 줄었다.
retain, 통합, 지식 페이지 갱신은 모두 백그라운드 작업이다. Hindsight는 이 작업을 외부 브로커 없이 Postgres 테이블(async_operations) 하나로 돌린다. 워커는 500ms마다 폴링하고 슬롯은 10개다. 작업을 집어 가는 쿼리의 핵심은 한 줄이다.
sql
SELECT o.operation_id, o.operation_type, o.task_payload, o.retry_count, o.bank_id
FROM async_operations o
WHERE o.status ='pending'AND (o.next_retry_at ISNULLOR o.next_retry_at <= NOW())
ORDERBY o.created_at
LIMIT $1FORUPDATESKIP LOCKED
FOR UPDATE는 고른 행을 잠그고, SKIP LOCKED는 다른 워커가 이미 잠근 행을 기다리지 않고 건너뛴다. 워커 여러 대가 같은 테이블을 동시에 훑어도 같은 작업을 두 번 집지 않는다. Postgres 9.5(2016)부터 있는 기능으로, 큐가 필요할 때 Redis나 RabbitMQ를 추가하기 전에 먼저 떠올릴 만한 도구다.
6-2. 대량 업로드 한 건이 다른 사용자를 굶기지 않게
FIFO 큐의 고질병은 굶주림이다. 한 사용자가 문서 1,000건을 올리면 뒤에 온 사용자의 문서 한 건은 1,000건이 다 빠질 때까지 기다린다. Hindsight는 두 층의 공정성을 둔다. 먼저 테넌트(스키마)를 순환하며 풀마다 1건씩 주고 남은 슬롯을 채운다. 그리고 공유 풀 안에서 은행끼리는 Deficit Round Robin을 쓴다.
DRR은 1995년 Shreedhar와 Varghese가 네트워크 라우터에서 패킷 크기가 다른 흐름들에 대역폭을 공정하게 나누려고 만든 알고리즘이다. Hindsight에서는 모든 작업이 슬롯 하나를 쓰므로 '적자(deficit)' 계산은 늘 0이 되고 순환만 남는다. 코드 주석의 설명이 명쾌하다. "bank_id > $1이 곧 순환이다." 은행 ID 공간 위의 커서를 인덱스 탐색으로 한 칸씩 밀면 된다. 폴링마다 커서 다음 은행에서 1건, 나머지 빈 슬롯은 FIFO로 채운다. 두 단계를 한 SQL 문으로 묶어 왕복을 늘리지 않았다. 5만 건이 대기 중일 때 측정값은 0.10ms(그냥 FIFO는 0.02ms)다.
통합 작업은 은행당 하나만 돈다. 흔히 이런 직렬화에는 Postgres advisory lock을 쓴다. Hindsight는 일부러 금지했다. PgBouncer 같은 커넥션 풀러 뒤에서는 세션이 여러 클라이언트에 돌려 쓰이므로 세션 단위 잠금을 믿을 수 없기 때문이다. 대신 "처리 중인 동료가 없고, 더 오래된 대기 동료가 없을 때만 집는다"는 SQL 조건으로 직렬화한다.
재시도 정책은 작업마다 다르다.
대상
정책
일반 작업
60초 간격, 최대 3회
통합
min(5·2ⁿ, 1,800)초, 횟수 제한 없음
저장소 역압(backpressure)
120초 연기
append 경합 패배
2·2ⁿ⁻¹초(최대 300초)에 0.5~1.5배 지터 → 실제 상한 약 450초
작업별 최대 실행 시간은 retain 1시간, reflect 5분이다. 통합의 2시간은 총 실행 시간이 아니라 유휴 시간 제한이다. 배치를 하나 커밋할 때마다 다시 잰다. 300초마다 '백로그는 있는데 대기 작업이 없는 은행'을 찾아 통합을 다시 넣는다.
6-3. 다른 엔진에는 큐가 없다
Graphiti 코어는 큐가 없다. add_episode docstring은 "에피소드는 하나씩 순서대로 추가하고 기다려라. 필요하면 Celery 같은 작업 큐를 써라"라고 말한다. MCP 서버는 그룹마다 메모리 안의 asyncio.Queue를 두고, REST 서버는 전역 큐 하나와 워커 하나를 둔다. 둘 다 프로세스가 재시작되면 대기 작업이 사라진다. 코드대로라면 REST 서버 워커는 작업 하나가 예외를 던지면 루프 자체가 끝난다(실행해서 확인하지는 않았다). Mem0은 add()를 호출한 스레드에서 동기로 실행한다. AsyncMemory도 대부분 동기 코드를 스레드로 감싼 것이다. Letta V1의 수면 시간 에이전트는 fire-and-forget 비동기 작업이었고, letta-code의 성찰은 서브에이전트와 git worktree로 격리한다. MemOS는 프로세스 안 스케줄러가 기본이고 Redis 큐는 선택 사항이다.
기억 엔진을 운영 환경에 올릴 때 가장 먼저 부딪히는 것은 알고리즘이 아니라 이 배관이다. 사용자 100명이 동시에 긴 대화를 넣는 순간, 큐가 영속적인지와 공정한지가 체감 품질을 정한다.
기억 엔진은 대화를 영구히 저장한다. 사용자가 무심코 붙여 넣은 API 키나 카드 번호도 사실로 추출돼 몇 달 뒤 검색 결과로 돌아올 수 있다. Hindsight의 Memory Defense는 retain 요청이 추출 LLM에 닿기 전에 정규식 46개를 돌려 비밀처럼 생긴 문자열을 [REDACTED:종류]로 바꾼다. 은행별로 켜는 기능이고 기본은 꺼져 있다.
순서가 중요하다.sk-ant-(Anthropic)와 sk-proj-(OpenAI 프로젝트 키)를 일반 sk-보다 먼저 검사한다. 일반 패턴이 먼저 먹으면 종류가 틀리게 기록된다.
카드 번호는 Luhn 검사를 통과해야 한다. 숫자 개수만 보던 시절에는 타임스탬프와 포트 목록이 카드로 지워졌다. 같은 숫자만 반복되는 자리 채움 값(0000…)은 Luhn을 통과해도 버리고, UUID 안의 숫자 덩어리도 예외로 둔다.
한중일 문장 속 비밀. Python re의 \b는 유니코드 기준이라 한글·한자도 단어 문자로 본다. "凭证为sk_test_…"(자격 증명은 sk_test_…)처럼 붙여 쓰면 '为'와 's' 사이에 경계가 없어 키가 통과했다. 지금은 ASCII 문자 기준의 lookaround를 쓰고, 테스트가 \b 사용 자체를 막는다.
정책은 allow / redact / block. 모든 항목이 막히면 API가 422를 돌려준다. allow가 아닌 결정마다 웹훅과 감사 로그가 남는데, 감사 로그에는 원문 대신 길이를 반영한 지문만 남긴다.
한국에서 쓸 때는 위젯의 첫 예시가 핵심이다. 주민등록번호(6-7자리), 휴대전화 번호(3-4-4), 사업자등록번호(3-2-5), 계좌번호, 이메일은 모두 그대로 기억에 들어간다. 미국 사회보장번호(3-2-4)는 지운다. 코드 주석이 스스로 "미국 중심 기본값, 배포마다 조정할 수 있음"이라고 적어 두었다. 문맥에 기대야 하는 키(Cohere, Mistral)도 정규식으로는 잡지 않으니 detect-secrets나 trufflehog 같은 문맥 인식 스캐너를 위에 얹으라고 권한다.
다른 엔진에는 이런 장치가 없다. Graphiti의 입력 정리 함수는 제로폭·제어 문자만 지운다. Mem0의 '민감 필드' 목록은 설정 객체를 복사할 때 API 키를 지우는 용도이지 기억 내용을 가리는 기능이 아니다. 오히려 Mem0 추출 프롬프트는 건강·정서 상태까지 추출하라고 지시한다. 관련해 두 가지를 더 적어 둔다. Mem0과 Graphiti는 PostHog 텔레메트리가 기본으로 켜져 있다(환경변수로 끈다). Mem0은 GitHub의 원격 공지 설정을 1시간마다 받아 와서 '플랫폼 안내' 메시지를 50:50 A/B로 띄우는 장치를 갖고 있다. 지금은 모든 메시지가 꺼져 있다. 사내망에서 쓴다면 둘 다 확인할 일이다.
기억 오염 공격도 같은 계통의 문제다. 코어닷투데이의 기억 오염 특집에서 본 것처럼, 악의적인 문서 한 장이 사실로 추출되면 이후 모든 답변에 스며든다. 비밀 마스킹은 나가는 정보를 막는 장치이고, 오염 방어는 들어오는 정보를 의심하는 장치다. 둘 다 '기억하기 전'에 해야 한다.
사람의 기억 연구는 망각에서 시작했다. 1885년 에빙하우스의 망각 곡선이 그 출발점이다. 그런데 이번에 본 다섯 엔진 중 어느 것도 망각을 구현하지 않았다. TTL도, 중요도 점수도, 예약된 삭제도 없다.
Hindsight: 검색할 때 최신성과 근거 수로 ±10%, ±5% 가중할 뿐이다. 사실은 쌓이고 관찰은 고쳐 쓴다.
Mem0: expiration_date는 검색에서 숨기기만 하고 지우지 않는다. 감쇠(decay) 파라미터를 넘기면 "오픈소스 SDK에서는 지원하지 않는다"는 오류가 난다. 플랫폼 기능이다.
Graphiti: 모순된 사실에 무효 시각을 찍을 뿐 남긴다. 명시적으로 에피소드를 지우면 그 에피소드만 근거인 엣지를 지우지만, 그 에피소드가 무효화했던 다른 엣지를 되살리지는 않는다.
Letta: 컨텍스트에서 밀려나거나(요약), 에이전트가 스스로 지운다. git 이력이 백업이다.
Cognee: 그래프 사실에는 감쇠가 없다. 세션 캐시만 7일 뒤 만료된다. 유일한 감쇠 공식(사용자 선호도, 턴당 0.02)은 개인화 기능과 함께 기본으로 꺼져 있다.
예외는 MemOS다. 기억 종류마다 용량 상한(라이브러리 기본: 작업 기억 20, 장기 기억 1,500, 사용자 기억 480)을 두고, 80%에 이르면 갱신 시각이 가장 오래된 노드부터 지운다. 다만 서버의 기본 설정은 장기·사용자 기억 상한을 100만으로 잡아 두어서, 실제로 잘리는 것은 작업 기억 20개뿐이다.
왜 아무도 잊지 않을까. 세 가지 이유를 짐작할 수 있다. 첫째, 벤치마크가 망각을 벌하지 않는다. LongMemEval과 LoCoMo는 "기억하는가"를 묻지 "적절히 잊는가"를 묻지 않는다. 둘째, 저장 비용이 싸다. 사실 하나는 수백 바이트이고 Postgres는 수억 행을 견딘다. 셋째, 잘못 잊는 비용이 잘못 기억하는 비용보다 커 보인다. 사용자가 "지난번에 말했잖아"라고 할 때의 실망은 즉각적이다. 오래된 기억이 답을 흐리는 피해는 조용히 쌓인다.
그러나 망각이 없다는 것은 '삭제할 권리'가 수작업이라는 뜻이기도 하다. 개인정보 보호법이 보장하는 삭제 요구가 들어오면, 원본 문서를 지운 뒤 그 문서에서 나온 사실, 그 사실을 근거로 한 관찰, 그 관찰을 인용한 지식 페이지까지 따라가 지워야 한다. Hindsight의 'unsay' 패스는 그 사슬의 끝부분을 자동화한 몇 안 되는 장치다.
8-2. 문서와 코드가 어긋나는 곳
해부하다 보면 주석과 코드가 서로 다른 말을 하는 곳이 나온다. 대부분 사소하지만, 문서만 보고 설계를 판단하면 틀린다는 증거로 모아 둔다.
엔진
문서·주석
코드
Hindsight
"MMR λ=0.5로 다양성 적용"
MMR 구현 없음
Hindsight
"spaCy로 엔티티 추출"
spaCy를 쓰지 않는다. 미사용 변수 _nlp = None만 남았다. 엔티티는 LLM이 뽑는다
Hindsight
사고 예산 high = 600
1000
Hindsight
저장 문장 = what | when | where | who | why
where가 들어가지 않는다
Hindsight
Oracle 인덱스 이름 …_hnsw
실제로는 IVF 계열 NEIGHBOR PARTITIONS
Mem0
"기억은 linked_memory_ids로 연결된다" (changelog)
LLM이 낸 linked_memory_ids를 저장하지 않는다
Mem0
프롬프트: 최근 메시지 최대 20개, 관찰 날짜 기준 상대 시간 변환
10개만 넘긴다. 오픈소스에서 timestamp가 막혀 관찰 날짜는 늘 오늘이다
Mem0
README LoCoMo 92.5, LongMemEval 94.4
changelog는 91.6 / 93.4. README 스스로 플랫폼 점수(top-200 검색)라고 밝힌다. 오픈소스 기본 top_k는 20
Graphiti
README: 동시성 기본 10
코어 20 (MCP 서버만 10)
Graphiti
node_distance: "중심 노드까지 최단 경로"
1-hop 직접 연결 여부만
Graphiti
청킹 모듈 826줄
어디에서도 import하지 않는다
Letta V1
블록 chars_limit, archival 검색 기본 10개, conversation_search는 하이브리드
제한은 표시만 하고 강제하지 않는다. 기본 5개. 기본은 ILIKE 부분 문자열 검색이고 날짜 필터는 무시된다
letta-code
rrf_score
RRF가 아니라 일치한 검색어 비율
Cognee
예전 문서: 기본 검색은 GRAPH_COMPLETION
1.6.5 기본은 HYBRID_COMPLETION
Cognee
피드백 가중치로 스스로 개선
구현은 다 있지만 순위 영향 기본값이 0.0
MemOS
텍스트·활성화·파라미터 세 종류 기억
파라미터(LoRA) 기억은 "아직 쓰지 말라"는 자리 표시 파일
MemOS
주석: 다양성 벌점은 유사도 0.80 초과부터, 후보 5배로 늘림
코드: 0.9 초과, 3배
이 표를 비난으로 읽을 필요는 없다. 모두 활발하게 개발 중인 저장소이고, 주석이 코드를 못 따라가는 것은 빠르게 움직인다는 뜻이기도 하다. Hindsight는 1.0 이후 8일 동안 커밋 221개가 쌓였다. 다만 "문서에 MMR이 있다", "그래프 메모리 내장"이라는 문장만 보고 엔진을 고르면 안 된다는 교훈은 분명하다.
자기 편집형Letta에이전트가 기억 파일을 직접 고친다. 서버는 저장·조립·성찰 일정만 맡는다
도구 묶음형LangMemLangGraph 저장소 위에 추출·검색 도구를 얹는다. 엔진이라기보다 부품
파이프라인형 안에서도 무게중심이 다르다. Hindsight는 검색에 공을 들였다(네 갈래, 융합, 재정렬, 토큰 예산). Graphiti는 쓰기에 공을 들였다(사실마다 중복·모순 판정, 이중 시간). Mem0은 2026년에 양쪽 모두를 덜어 내 가장 가볍고 싼 쪽으로 갔다. Cognee는 문서를 그래프로 바꾸는 일이 중심이고, 대화 기억보다 지식 베이스에 가깝다. MemOS는 작업 기억과 장기 기억을 나누고 용량을 관리하는, 이름 그대로 '운영체제'의 비유를 따른다.
쓰기 비용을 정리하면 이렇다(기본 설정, 코드 경로에서 센 값).
Mem0 (add 1회)
LLM 1
Hindsight (청크 1개)
LLM 1 + 통합
MemOS (창 1개)
LLM 1
Cognee (청크 1개)
LLM 2
Graphiti (새 사실 5개)
LLM 8~14
바의 길이는 최댓값 14를 기준으로 한 비율이다. Hindsight의 '+ 통합'은 백그라운드에서 사실 8개당 약 1회가 더 붙는다는 뜻이다. Letta는 기억을 쓰는 일이 에이전트 루프의 도구 호출 자체라서 같은 잣대로 잴 수 없다.
10. 2026년의 지형 — 세 가지 흐름
10-1. 생성 모델과 판정 모델의 분업
이번 해부에서 가장 새로운 부품은 결정 모델이었다. Hindsight는 10월 중순 한 주 동안 결정 모델을 네 곳에 넣었다. 검색 재정렬, 통합 분류, 성찰의 증거 충분성 판단("답할 수 없음 / 일부 / 완전"), 지식 페이지 갱신 문턱이다. Graphiti도 중복·모순 판정에 Jev를 쓸 수 있다. 공급자 쪽에서는 OpenAI가 Decisions API를, Cloudflare가 Workers AI의 Clef를 내놓았다.
공통 논리는 이것이다. 기억 엔진이 내리는 판단 대부분은 글쓰기가 아니라 분류다. "이 사실은 새것인가", "이 후보는 질문에 도움이 되는가", "이 증거로 답할 수 있는가". 이런 판단에 대화형 LLM을 쓰면 느리고 비싸고, 확률을 직접 주지 않으니 문턱을 정하기 어렵다. 판정 모델은 1초 안에, 선택지별 확률과 함께 답한다. LLM은 관찰 문장을 고쳐 쓰거나 최종 답을 쓰는 일에만 남긴다. 코어닷투데이가 임베딩과 판정 모델은 언제 무엇을에서 정리한 역할 분담이 기억 엔진 안에서 그대로 재현되고 있다.
10-2. 열린 핵심, 닫힌 상위 기능
두 번째 흐름은 오픈소스 경계의 이동이다. 이번에 본 엔진 대부분이 핵심은 열어 두고, 그 위의 기능 일부를 관리형 플랫폼으로 옮겼다.
엔진
오픈소스에 있는 것
플랫폼·엔터프라이즈로 간 것
Mem0
추가 전용 추출, 하이브리드 점수, 엔티티 링크
그래프 메모리, 시간 질의(timestamp, reference_date), 감쇠, 벤치마크 점수를 낸 최적화
Hindsight
Postgres·Oracle 엔진 전체
객체 스토리지 엔진 Memlake ("1억 개 기억, p99 100ms 미만")
Letta
letta-code 클라이언트, 로컬 백엔드(실험적)
클라우드의 하이브리드 검색·서버 측 압축·성찰
MemOS
트리 기억, 재구성기, 스케줄러
기억 버전 관리 파이프라인(훅 선언만 공개)
Cognee
파이프라인 전체, GLiNER 데모 추출기
운영 등급 GLiNER 추출기
비난할 일은 아니다. 오픈소스 회사가 수익을 내는 흔한 방식이다. 다만 README의 성능 수치와 기능 목록이 어느 쪽 기준인지는 반드시 확인해야 한다. Mem0 README의 LongMemEval 94.4는 플랫폼 점수이고, 오픈소스에서는 시간 질의 파라미터를 넘기면 오류가 난다.
10-3. 1년 사이에 바뀐 뼈대
세 번째 흐름은 속도다. 2026년 한 해 동안 다섯 엔진 중 넷이 뼈대를 바꿨다.
2026-01Hindsight v0.4.0 — 논문의 의견 네트워크를 관찰로 흡수하고 멘탈 모델을 도입했다.
2026-04Mem0 v2.0.0 — LLM 2회 파이프라인을 추가 전용 1회로 바꾸고, 그래프 드라이버 약 4,000줄을 오픈소스에서 지웠다.
2026-08Letta — Python 서버를 보관 처리하고, git 기반 Markdown 기억(MemFS)을 쓰는 letta-code로 옮겼다. Hindsight v0.9.0이 지식 페이지를 냈다.
2026-10-16Cognee 1.6.5 — 공개 API의 중심이 remember / recall / improve / forget이 됐고, memify는 폐기 예정 경고를 낸다. 기본 검색도 그래프 검색에서 하이브리드로 바뀌어 있다.
2026-10-13Hindsight 1.0.0 — API 안정성을 약속했다. 그 뒤 8일 동안 main에 결정 모델 스택이 들어왔다.
그사이 Graphiti는 Kuzu 드라이버를 폐기 예정으로 표시했다. 상위 Kuzu 프로젝트가 더는 관리되지 않기 때문이다. Cognee는 Kuzu 계열 포크인 Ladybug를 기본 그래프 DB로 쓴다. 이 속도는 실무자에게 두 가지를 요구한다. 하나는 버전 고정이다. 같은 엔진이라도 6개월 전 튜토리얼의 코드는 지금 동작하지 않을 수 있다. 다른 하나는 기억 데이터의 이식성이다. Mem0 v1에서 그래프를 썼다면 v2로 올리는 순간 그 그래프는 오픈소스에서 읽을 수 없다. 원본 대화를 엔진 바깥에 따로 보관해 두면 엔진을 바꿀 때 다시 넣으면 된다. Letta가 기억을 사람이 읽을 수 있는 Markdown과 git으로 옮긴 것도 이런 이식성을 고려한 선택으로 읽힌다.
11. 한국어로 쓴다면 — 엔진별 점검표
해부하면서 한국어에서 조용히 미끄러지는 지점을 모아 두었다. 대부분 설정이나 프롬프트로 피할 수 있다.
①
임베딩 모델부터 바꾼다
Hindsight의 기본 로컬 임베딩은 BAAI/bge-small-en-v1.5, 이름 그대로 영어 모델이다. ONNX 경로의 기본인 multilingual-e5-small이나 다국어 모델로 바꾼다. 코어닷투데이의 한국어 임베딩 9종 실측이 고를 때 참고가 된다. MemOS의 기본 nomic-embed-text도 확인 대상이다.
②
이름은 추출 단계에서 표준화한다
Hindsight에서 '민지'와 '김민지'는 trigram 문턱에 걸려 합쳐지지 않는다. Graphiti의 퍼지 매칭은 한글을 지운다. 엔티티 해석기를 고치기보다 추출 프롬프트(은행 미션)에 "사람은 성과 이름을 함께, 회사는 공식 명칭으로 적는다"를 넣는 편이 싸다.
③
질의의 기간 표현은 앞단에서 푼다
Hindsight의 기간 규칙에는 한국어가 없고, dateparser는 '어제' 정도만 잡는다. "지난주", "3월에", "두 달 전"을 날짜 범위로 바꾸는 작은 전처리기를 질의 앞에 두거나, 기간을 API 파라미터로 직접 넘긴다.
④
한국형 비밀 패턴을 더한다
Memory Defense를 켜고, 주민등록번호·휴대전화·사업자번호·계좌번호 패턴을 추가한다. 다른 엔진에는 마스킹 자체가 없으니 retain 앞단에 직접 둔다.
⑤
키워드 검색의 형태소를 확인한다
Postgres의 'simple' 사전과 Letta의 로컬 BM25는 조사를 떼지 않는다. "메모리를"과 "메모리"가 다른 토큰이다. 한국어 키워드 검색이 중요하면 PGroonga(Hindsight 지원)나 형태소 분석을 거친 별도 열을 쓴다.
Graphiti 한국어 실측에서 코어닷투데이는 Graphiti가 한국어 대화에서도 쓸 만한 그래프를 만든다는 것을 확인했다. 이번 해부는 그 결과의 이면을 보여 준다. 한국어에서 잘 동작하는 부분은 대부분 LLM이 맡은 단계이고, 결정론적 단계(퍼지 매칭, 날짜 규칙, 정규식)는 영어를 전제로 만들어져 한국어에서 꺼지거나 헛돈다. LLM이 그 빈틈을 메우는 동안 비용은 늘어난다.
12. 어떤 엔진을 언제 — 실무 가이드
상황
먼저 볼 엔진
이유
Postgres 하나로 운영하고 싶다, 여러 사용자·여러 에이전트가 동시에 쓴다
Hindsight
영속 큐와 공정 분배, 검색에 LLM 0회, 비밀 마스킹
가장 싸고 단순한 개인화 기억이 필요하다
Mem0
add 1회 LLM, search 0회. 대신 모순 해소와 중복 제거는 기대하지 말 것
"언제부터 언제까지 참이었나"가 중요하다(계약, 인사, 의료 이력)
Graphiti
이중 시간과 무효화 이력. 기본 검색이 무효 사실도 돌려주니 필터를 꼭 건다
코딩 에이전트처럼 에이전트가 스스로 규칙을 배워야 한다
Letta
기억이 사람이 읽고 고칠 수 있는 Markdown이고 git으로 되돌릴 수 있다
사내 문서를 지식 그래프로 만들어 질문하고 싶다
Cognee
문서 → 그래프 파이프라인이 중심. 대화 기억보다 지식 베이스에 가깝다
작업 기억 용량을 엄격히 관리해야 한다
MemOS
유일하게 용량 기반 삭제가 있다
엔진을 고른 뒤에 할 일도 적어 둔다.
기본값을 그대로 믿지 않는다. 임베딩 모델, 재정렬기, 결정 모델, 비밀 마스킹이 모두 '꺼져 있거나 영어용'일 수 있다.
원본을 엔진 밖에 남긴다. 엔진의 뼈대가 1년에 한 번씩 바뀌는 시기다.
자기 데이터로 잰다. 공개 벤치마크 점수는 채점 모델·검색 예산·플랫폼 최적화가 제각각이다. 내 대화 100개와 질문 50개로 만든 작은 평가가 README의 숫자보다 정확하다.
삭제 경로를 미리 그린다. 망각이 없으니, 삭제 요청이 왔을 때 원본 → 사실 → 관찰 → 요약 문서까지 지우는 절차를 운영 문서에 적어 둔다.
맺으며 — 기억은 검색이고, 검색은 오래된 기술이다
에이전트 메모리를 '새로운 AI 능력'으로 소개하는 글이 많다. 해부해 보면 그 안은 반세기 정보 검색 연구의 부품 창고다. trigram 비교는 1980년대 철자 교정, 역순위 융합은 2009년 SIGIR, Deficit Round Robin은 1995년 라우터, SKIP LOCKED는 2016년 Postgres에서 왔다. LLM은 그 부품들 사이에서 사실을 뽑고, 관찰을 고쳐 쓰고, 마지막 답을 쓴다. 그리고 2026년 가을, 그 LLM 앞에 객관식 판정만 하는 작은 모델이 한 명 더 섰다.
좋은 기억 엔진을 가르는 것은 결국 숫자 몇 개다. k=60인가 1인가. 문턱이 0.3인가 0.6인가. 신뢰도 문턱을 둘 것인가, 답끼리의 일치를 볼 것인가. 이 숫자들은 하나같이 사고에서 나왔다. 두 사람이 한 사람으로 합쳐졌고, 두 방이 한 방이 됐고, 사람과 나라가 하나가 됐다. Hindsight 코드의 주석들은 그 사고 기록이다. 이 글이 코드를 열어 본 이유도 거기에 있다. 벤치마크 점수는 결과만 말해 주지만, 주석은 엔진이 무엇을 겪으며 지금 모양이 됐는지를 말해 준다.
아직 아무도 풀지 않은 문제도 분명해졌다. 잊는 법이다. 다섯 엔진은 기억을 흐리게 하거나, 무효 표시를 하거나, 덮어쓸 뿐 지우지 않는다. 사람의 기억에서 망각은 결함이 아니라 기능이다. 에이전트의 기억이 1년, 5년 쌓였을 때 무엇을 놓아야 하는지는 다음 세대 엔진의 숙제로 남아 있다.
참고문헌
해부한 저장소 (2026-10-21 기준 main)
vectorize-io/hindsight — commit 48bd16e82, v1.0.0(2026-10-13) 이후 221커밋. 주요 파일: hindsight-api-slim/hindsight_api/engine/memories/pg/entity_resolver.py, engine/trigram.py, engine/search/reranking.py, engine/search/fusion.py, engine/consolidation/triage.py, engine/db/ops_postgresql.py, extensions/memory_defense.py, engine/temporal_periods.py