지도와 심판 — 임베딩과 판정 모델, 언제 무엇을 쓰나: 업무 12가지와 조합 실측 (로컬 모델 실측 3편)
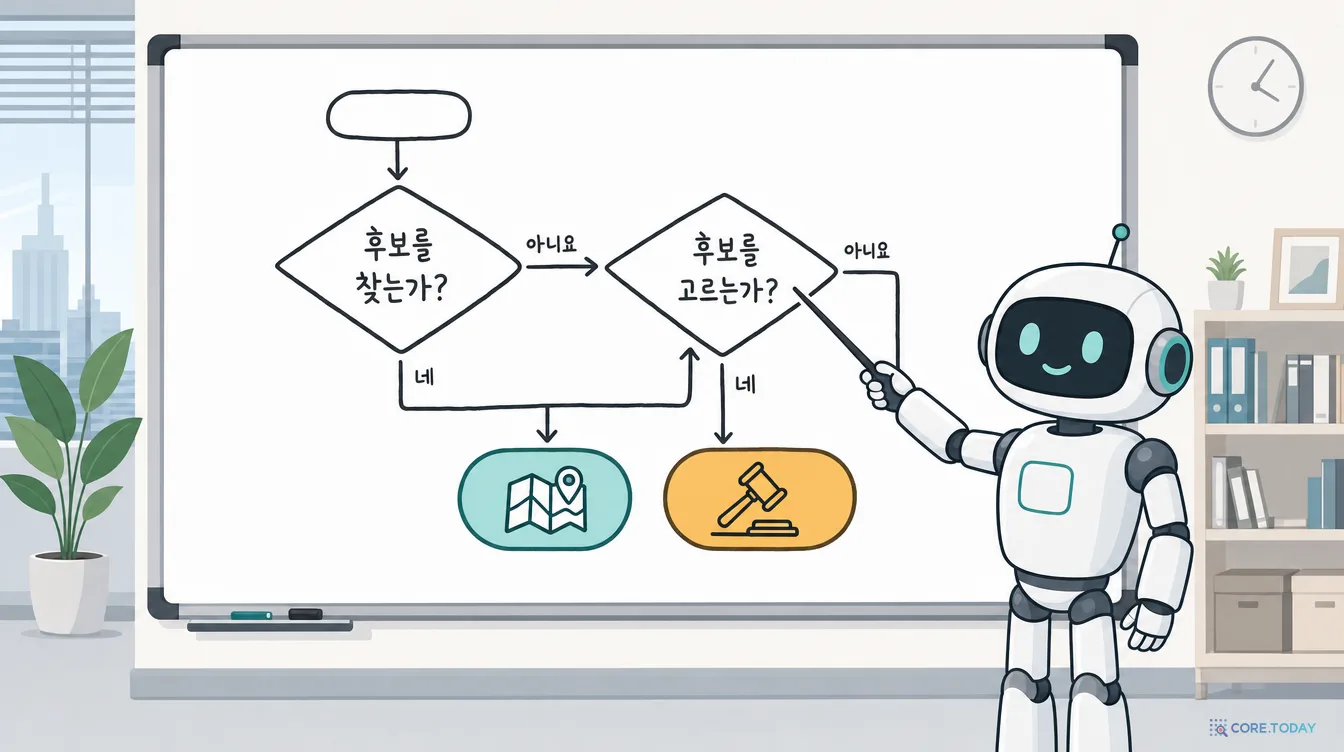
1편에서 임베딩 모델 아홉 개를, 2편에서 판정 모델 세 개를 같은 맥에서 한국어로 쟀습니다. 3편은 그 둘을 한 자리에 놓고 묻습니다. 어느 일에 어느 쪽을 쓰나. 임베딩은 지도입니다. 수백만 건 중 어디를 볼지 알려 주고, 좌표를 저장해 두고 재사용합니다. 판정 모델은 심판입니다. 눈앞의 후보 몇 개 중 무엇이 맞는지, 규정에 비춰 되는지 안 되는지를 확률과 함께 말합니다. 이 글은 네 가지 질문으로 두 자리를 가르는 진단표, 고객 문의 라우팅·환불 규정·감성 점수·인젝션 탐지·도구 호출 가드·민원 배정·LLM 라우팅 일곱 업무의 실측(판정 모델 세 개 대 임베딩 유사도 대 27B 채팅 모델), 코어닷투데이가 실제로 만나는 업무 열두 가지의 추천 조합·예시·함정, 그리고 '작은 임베딩 + 판정 모델이 큰 임베딩을 따라잡는가'를 1편의 모델 다섯으로 확인한 조합 실험을 담았습니다. 마지막은 메모리·지연·비용·데이터 반출을 한 표로 놓은 운영 체크리스트입니다. 인터랙티브 4개와 삽화 6장.
1편의 임베딩 모델 아홉 개와 2편의 판정 모델 세 개는 같은 맥의 같은 ollama list에 나란히 있습니다. 그런데 하는 일이 전혀 다릅니다.
임베딩 = 지도문장 → 좌표(벡터)수백만 건 중 어디를 볼지. 좌표는 저장해 재사용. 비교·군집·추천 가능. 설명도 확률도 없음
판정 모델 = 심판상태 + 질문 → 선택지 하나 + 확률눈앞의 후보 2~26개 중 무엇이 맞는지. 규정을 읽고 따짐. 저장할 출력 없음. 한 번에 한 상태
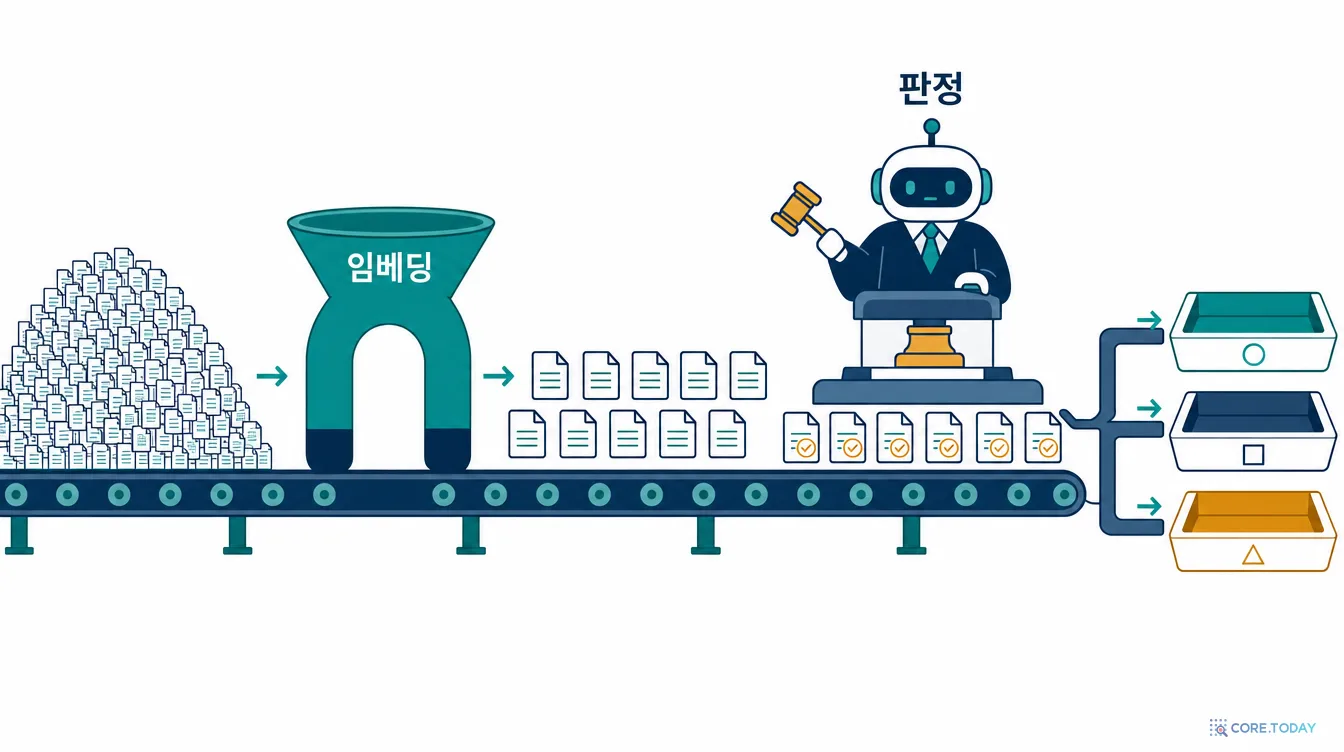
임베딩은 좌표를 만듭니다. 문서 100만 건을 한 번 좌표로 바꿔 두면 질문이 올 때마다 질문의 좌표만 새로 구해 가까운 것을 찾습니다. 좌표는 재사용되고, 두 문서가 비슷한지도 좌표로 잽니다. 그러나 좌표는 "왜 비슷한지"도 "규정에 맞는지"도 모릅니다. "14일 이내 미개봉"과 "20일 된 미개봉"은 좌표로는 거의 같은 자리입니다.
판정 모델은 결정을 만듭니다. 상태 하나와 질문 몇 개를 받아 선택지 중 하나를 확률과 함께 고릅니다. 규정을 읽고, 부정을 읽고, 조건을 따집니다. 그러나 후보가 수천 건이면 시작조차 못 합니다. 한 호출에 선택지 26개, 창은 2K~8K 토큰입니다. 저장해 둘 출력도 없어서 같은 문서를 다음에 또 읽어야 합니다.
그래서 둘은 경쟁자가 아니라 파이프라인의 다른 자리입니다. 검색 스택 6편에서 "지도와 심판을 비교하는 것"이라고 썼던 바로 그 구분이고, 이 글은 그 구분을 업무 열두 가지로 펼칩니다. 다른 점은 심판이 이제 로컬에서 돈다는 것입니다.
첫째, 답은 어디서 오나. 수천 건 이상에서 찾아야 하면 임베딩이 먼저입니다. 다른 길이 없습니다. 눈앞의 후보 몇 개 중 고르거나, 문장 하나에 예/아니오를 매기는 일이면 판정 모델의 자리입니다. 둘 다라면 — 많은 것 중 찾아서 몇 개 중 고른다면 — 임베딩 다음에 판정 모델입니다.
둘째, 판단 기준은 무엇인가. "비슷한 것"이면 임베딩으로 끝납니다. "규정에 비춰"라면 판정 모델입니다. 유사도는 규정을 못 읽습니다. "사람이 붙인 라벨이 수백 개 있다"면 임베딩 이웃 투표가 판정 모델 제로샷보다 낫습니다(2편 6부: 73% 대 58~61%). 라벨이 없으면 판정 모델이 임베딩 제로샷보다 훨씬 낫습니다(58~61% 대 31~45%).
셋째, 기준이 얼마나 자주 바뀌나. 새 카테고리, 새 규정, 새 부서가 자주 생기면 판정 모델이 쌉니다. 질문의 설명 한 줄만 바꾸면 되고 재학습도 재색인도 없습니다. 임베딩 k-NN은 새 라벨의 예시를 모아야 하고, 임베딩 모델을 바꾸면 전체를 다시 색인해야 합니다.
넷째, 결과에 무엇이 필요한가. 순위·목록이면 임베딩. 확률·확신도 — "이건 자동 처리, 저건 사람 검토"를 가르는 숫자 — 가 필요하면 판정 모델. 저장해 두고 재사용할 좌표(중복 탐지·군집·추천)가 필요하면 임베딩뿐입니다. 판정 모델은 재사용할 출력이 없습니다.
2편 8부의 한국어 과제 7종(문항 93개)에 임베딩 쪽 방법과 채팅 LLM을 더해 한 표에 놓았습니다. 임베딩은 선택지 설명문을 임베딩해 가장 가까운 것을 고르는 제로샷이라 choice 과제만 할 수 있습니다. noul과 score를 임베딩으로 흉내 낼 자연스러운 방법은 없습니다. 그것 자체가 첫 번째 결론입니다.
과제
판정 · tev1 4B
판정 · Nimble 9B
임베딩 · BGE-M3 유사도
임베딩 · EG2 유사도
채팅 · Qwen3.8 27B
고객 문의 라우팅 (6지선다)
100%
94%
63%
63%
94%
공공 민원 배정 (6지선다)
100%
100%
64%
79%
100%
LLM 라우팅 (2지선다)
90%
100%
90%
100%
100%
환불 규정 적용 (noul)
83%
92%
불가
불가
100%
인젝션 탐지 (noul)
75%
83%
불가
불가
92%
도구 호출 위험 (noul)
79%
93%
불가
불가
100%
리뷰 만족도 (5등급 score)
93%
80%
불가
불가
100%
호출 지연 중앙값
120~240ms
244~422ms
22~28ms
40~43ms
317~391ms
확률 출력
있음
있음
없음
없음
없음
적재 메모리
4.4GB
9.3GB
1.2GB
1.3GB
18GB
임베딩 유사도는 6지선다에서 63~79%, 판정 모델은 94~100%. 설명문 유사도는 "환불은 됐는데 배송비 3,000원은 왜 안 돌려주나요?"를 배송 부서로 보냅니다. '배송비'라는 단어가 '배송'과 가깝기 때문입니다. 판정 모델은 환불 부서로 보냅니다. 문장이 묻는 것이 환불의 범위이기 때문입니다. 2지선다(LLM 라우팅)에서는 임베딩도 90~100%였습니다. 선택지가 둘이고 기준이 "짧고 단순한가"처럼 표면에 드러나면 좌표 거리로도 됩니다.
noul과 score는 판정 모델과 채팅 모델만 할 수 있고, 둘 중 판정 모델이 운영에 유리합니다. 27B 채팅 모델은 정확도에서 가장 높았지만(92~100%) 18GB 메모리, 파싱 코드, 확률 없음을 치릅니다. Nimble은 규정 적용 92%, 도구 위험 93%를 9GB에서 확률과 함께 냅니다. 둘의 정확도 차이 0~8%포인트가 운영 비용 차이보다 큰지는 업무마다 다르고, 그 저울질이 아래 시나리오의 내용입니다.
tev1 4B와 Nimble 9B는 과제에 따라 갈립니다. 고르는 과제는 4B가 같거나 낫고(100% 대 94%, 만족도 93% 대 80%), 읽고 따지는 과제는 9B가 낫습니다(규정 92% 대 83%, 도구 위험 93% 대 79%). 메모리가 넉넉하면 Nimble, 4GB 안에서 라우팅·등급 매기기만 한다면 tev1 4B. 0.8B는 2편에서 본 대로 고르는 과제에만 씁니다.
3부. 업무 열두 가지: 추천 조합, 예시, 함정
위젯의 열두 시나리오 중 여섯을 본문에서 더 풀어 씁니다. 코어닷투데이가 실제로 만나는 일들이고, 숫자는 1·2편과 이 글 2부의 실측입니다.
사내 문서 검색·RAG → 임베딩 다음에 판정
규정집·회의록·공고문 수만 건에서 답을 찾는 일입니다. 후보를 찾는 1차는 임베딩만 할 수 있습니다. EmbeddingGemma 300M(1편 2위, 620MB)이나 Qwen3-Embedding 4B에 BM25를 RRF로 합칩니다. 2차는 상위 10개를 Nimble에게 한꺼번에 choice로 고르게 합니다(2편 5부: 0.879 → 0.919). 그다음 LLM이 답을 씁니다.
1차 · 임베딩 + BM25
"청년 일자리 사업 신청 기한" → 후보 10건. 여기서 정답이 빠지면 끝. Recall@10부터 재십시오(1편 모델들은 0.86~0.98).
2차 · Nimble choice
열 건을 선택지 a~j로. "질문에 가장 잘 답하는 문서" → 확률로 재정렬. 질문당 1회, 1.6초.
3차 · 생성
상위 3건을 LLM에 넣어 답 생성. 답이 문서에 근거하는지는 다시 Nimble noul로 검문(아래 환각 검문).
함정: 기준 설명 없이 짧게 묻는 쌍별 noul은 로컬 모델에서 1차를 올리지 못했습니다(2편 5부). 한꺼번에 묻거나, 쌍별이라면 참·거짓의 기준을 한 줄씩 적어 주십시오(4편: 0.866 → 0.907). tev1을 쓴다면 후보를 110자 안팎으로 잘라 2,048토큰에 맞춰야 합니다.
선택지가 여섯 개 안팎이고 기준을 말로 쓸 수 있습니다. tev1 4B로 100%, Nimble로 94%(2부). 라벨 데이터 없이 오늘 시작할 수 있고, 새 부서가 생기면 설명 한 줄만 보탭니다. confidence로 자동 처리와 사람 검토를 가릅니다. "같은 날 19,900원이 두 번 결제됐습니다"처럼 분명한 문의는 확률이 한곳에 몰려 자동 처리되고, "결제 페이지에서 카드 인증 창이 안 떠요"처럼 결제와 기술 지원 사이에 걸치는 문의(Nimble이 유일하게 틀린 문항)는 확률이 갈려 사람에게 갑니다.
함정: 라벨 수천 건이 이미 있고 부서 체계가 몇 년째 그대로라면 임베딩 5-NN이 더 싸고 비슷할 수 있습니다(2편 6부). 둘 다 재 보고 고르십시오. 한 가지 더. 판정 모델이 고른 부서를 그대로 믿지 말고 처음 한 달은 사람이 전수 확인하며 선택지 설명을 다듬는 기간으로 쓰십시오. 설명 한 줄이 정확도를 10%포인트 바꿉니다.
LLM 에이전트가 셸·DB·메일을 실행하기 전에 한 번 묻습니다. "이 호출이 되돌리기 어려운 피해를 일으킬 수 있는가?" Nimble은 14개 호출에서 93%(Brier 0.04). rm -rf(0.88), DROP TABLE(0.82), 전체 고객 메일 발송(0.78), curl … | sh(0.95), S3 재귀 삭제(0.93)를 잡았고, 놓친 것은 WHERE 절 없는 UPDATE(0.38) 하나였습니다. 0.8B는 50%로, 위험한 호출 일곱 개 전부에 0.5 아래를 줬습니다. 매 호출 앞에 서야 하므로 지연이 중요하고(Nimble 244ms), 확률이 있어야 "0.5 이상은 승인 대기"가 가능합니다.
함정: 판정 모델을 유일한 가드로 두지 마십시오. 2편의 tev1 모델 카드가 그대로 말합니다. "틀릴 수 있다. 고위험 결정의 유일한 검문이 되게 하지 마라." 고위험 명령은 정규식 규칙으로 이중 차단하고, 판정 모델은 규칙이 못 잡는 회색 지대를 맡깁니다.
규정 적용·자격 심사 → 판정 모델, state를 {규정, 요청}으로
환불·보조금·대출처럼 조건을 따져 승인하는 일입니다. 규정 네 조항과 요청을 상태의 다른 키로 넣고 noul 하나를 묻습니다. Nimble 92%, tev1 4B 83%, 0.8B 42%. 틀린 자리가 교훈적입니다. "3주 전에 샀는데 미개봉"은 14일을 넘겨 불가인데 0.8B는 정확히 0.5를 줬고, "구매 10일, 미개봉"처럼 분명히 가능한 요청에도 0.32를 줬습니다. 조항을 읽지 못하는 것입니다. 4B와 9B가 함께 흔들린 문항은 "설치가 안 되는 소프트웨어 라이선스"였습니다. 디지털 상품 불가 조항과 하자 조항이 충돌하는 자리라 4B는 0.78, 9B는 0.5를 줬습니다. 조항이 충돌하는 문항은 사람에게 가야 하고, 확률이 그것을 알려 줍니다.
함정: 규정이 길면 tev1의 2,048토큰 창을 넘깁니다. Nimble(8K)을 쓰고, 그래도 넘치면 관련 조항만 넣으십시오. 고액 결정은 확률이 높아도 사람이 최종 승인합니다.
중복 문의 묶기·관련 글 추천 → 임베딩만
"비슷한가"는 좌표 거리로 재는 일이고, 좌표는 한 번 만들어 저장합니다. 민원 1만 건을 묶으려면 임베딩은 1만 번, 판정 모델은 쌍마다 물어야 하니 5천만 번입니다. 추천도 같습니다. 질의가 문장이 아니라 문서 자체이고 후보가 전체 코퍼스입니다. 판정 모델의 자리가 아닙니다. BGE-M3나 Arctic 2.0 벡터로 코사인 0.85 이상을 묶고, 경계 사례(0.75~0.85)만 Nimble noul("같은 내용의 문의인가")로 확인하면 두 도구가 제자리에 섭니다.
함정: 임베딩은 '아니다'·'빼고'를 못 읽습니다(9편). "환불 말고 교환"과 "환불 요청"이 가깝게 묶입니다. 그 경계가 바로 판정 모델이 설 자리입니다.
뉴스·공고 모니터링 → 임베딩으로 넉넉히, 판정으로 좁게
"우리 지역·우리 분야와 관련 있는가"를 매일 수천 건에서 거릅니다. 1차는 양이 많으니 임베딩으로 상위 50~100건, 2차는 기준이 미묘하니 Nimble noul로 "울산 지역 AI 사업과 직접 관련 있는가"를 묻습니다. "경남 창원 스마트공장 지원"은 임베딩에게는 가까운 문서지만 판정 모델에게는 울산이 아닙니다. 기준이 바뀌면 질문만 바꿉니다.
함정: 임베딩이 1차에서 떨어뜨린 것은 판정 모델이 볼 기회가 없습니다. 1차는 넉넉하게 잡고 2차에서 좁히십시오. 2편 7부에서 본 대로 noul의 확률은 과신 경향이 있으니 임계값(0.7)은 자기 데이터 100건으로 맞춥니다.
1편의 결론 하나는 "8B 임베딩이 1위"였고, 2편의 결론 하나는 "Nimble이 열 장 중 답을 잘 고른다"였습니다. 둘을 합치면 질문이 하나 생깁니다. 작은 임베딩 모델 + 판정 모델이 큰 임베딩 모델 하나를 따라잡는가. 1편의 임베딩 모델 다섯이 각각 고른 상위 10개를 Nimble이 두 방식(쌍별 noul, 한꺼번에 choice)으로 다시 정렬했습니다.
1차 임베딩
1차만
+ Nimble 쌍별
+ Nimble 한꺼번에
천장 (Recall@10)
1차 모델 용량·질의 지연
Qwen3-Embedding 8B
0.879
0.866
0.919
0.965
4.7GB · 115ms
EmbeddingGemma 300M
0.852
0.892
0.916
0.976
0.6GB · 22ms
BGE-M3
0.830
0.883
0.907
0.953
1.2GB · 24ms
Qwen3-Embedding 0.6B
0.785
0.860
0.889
0.929
0.6GB · 27ms
EmbeddingGemma 2 440M
0.765
0.831
0.867
0.894
0.7GB · 29ms
첫째, 300M 임베딩 + Nimble = 8B 임베딩 + Nimble. EmbeddingGemma 300M에 Nimble을 한꺼번에 방식으로 붙이면 0.916, Qwen3-8B에 붙이면 0.919. 0.003 차이는 잡음입니다. 1차 모델의 용량은 8분의 1, 질의 지연은 5분의 1입니다. 심판이 좋으면 지도는 "정답을 열 장 안에 넣는" 일만 하면 되고, 그 일은 300M도 합니다(천장 0.976, 오히려 8B보다 높습니다).
둘째, 쌍별 noul이 작은 1차에서는 작동합니다. 2편에서 Qwen3-8B의 상위 10개를 쌍별로 재정렬하면 0.879 → 0.866으로 오히려 내려갔습니다. 그런데 EmbeddingGemma 300M의 상위 10개에서는 0.852 → 0.892, BGE-M3는 0.830 → 0.883, Qwen3-0.6B는 0.785 → 0.860으로 올랐습니다. 큰 임베딩 모델이 고른 열 장은 이미 다 비슷비슷해서 "관련 있는가"로는 못 가르고, 작은 모델이 고른 열 장에는 분명히 틀린 것이 섞여 있어서 걸러 낼 것이 있습니다. 6편에서 Jev가 약한 1차(RRF 0.794, BM25 0.616)를 크게 복구한 것과 같은 모양입니다. 심판은 지도가 서툴수록 할 일이 많습니다. 원본 Jev를 같은 자리에 세우면 더 올라갑니다(300M + Jev 한꺼번에 0.931, 4편).
셋째, 천장은 1차가 정합니다. EmbeddingGemma 2 440M은 Nimble을 붙여도 0.867에서 멈춥니다. 상위 10개 안에 정답이 있는 비율이 0.894라 열 질문 중 하나는 심판이 볼 기회조차 없습니다. 조합을 설계할 때 1차 모델을 고르는 기준은 nDCG가 아니라 Recall@10(또는 @20)입니다. 그 숫자가 높은 작은 모델이 nDCG가 높은 큰 모델보다 좋은 1차입니다.
?
질문
8B 임베딩(4.7GB, 115ms)을 써야 하나, 300M(0.6GB, 22ms)으로 되나.
→
실측
300M + Nimble 한꺼번에 0.916, 8B + Nimble 0.919, 8B 단독 0.879. 300M의 Recall@10은 0.976으로 다섯 중 최고.
✓
결론
심판(9GB)을 둘 수 있다면 지도는 300M으로 충분하다. 메모리 총합 10GB, 질의당 1.7초. 심판을 못 두면 8B 단독 0.879가 상한이다.
비용을 적어 둡니다. 300M + Nimble 한꺼번에 구성에서 질문 하나의 지연은 임베딩 22ms + Nimble 1.6초입니다. 1.6초는 상태에 열 장(평균 1,160토큰)을 읽는 시간입니다. 후보를 다섯 장으로 줄이면 절반이 되고, 상위 3개만 LLM에 넘기는 RAG라면 다섯 장으로도 충분한 경우가 많습니다. 쌍별 방식은 열 번 호출이지만 한 번에 130토큰이라 병렬로 보내면 비슷한 시간에 끝납니다.
5부. 운영 체크리스트: 메모리, 지연, 비용, 데이터
항목
임베딩 (EmbeddingGemma 300M 기준)
판정 모델 (Nimble 9B 기준)
채팅 LLM (Qwen3.8 27B 기준)
Jev API (4편 직접 실측)
적재 메모리
0.6GB (8B는 12GB)
9.3GB (tev1 4B는 4.4GB)
18GB
0
호출 지연 (중앙값)
22ms
250~420ms (열 장 읽기 1.6초)
320~390ms (p95 최대 4초)
218ms (네트워크 포함)
출력
벡터 (저장·재사용)
선택지 + 확률
문자열 (파싱 필요)
선택지 + 확률
호출당 비용
0
0
0
0.00004달러 (하루 1만 건이면 월 11달러)
데이터 반출
없음
없음
없음
있음 (ZDR은 엔터프라이즈)
기준이 바뀌면
라벨 재수집 또는 전체 재색인
질문·선택지 텍스트 수정
프롬프트 수정
질문·선택지 텍스트 수정
한국어 실측 (이 시리즈)
검색 0.852, 분류 5-NN 73%
리랭크 0.919, 규정 92%, 도구 위험 93%
과제 7종 92~100%
리랭크 0.930, 과제 7종 97%, 분류 61%
못 하는 것
부정·규정·확률
후보 생성, 설명, 26개 초과 선택지, 질문 간 일관성
확률, 형식 보장
로컬 실행
표를 읽는 법은 이렇습니다. 메모리 예산이 10GB 안이면 EmbeddingGemma 300M + Nimble(또는 tev1 4B)로 지도와 심판을 다 갖출 수 있습니다. 4GB 안이면 300M + tev1 4B. 라우팅·등급 매기기만 한다면 그 조합으로 충분하고, 규정 적용·도구 가드가 들어가면 Nimble이 필요합니다. 27B 채팅 모델은 정확도의 상한을 알려 주는 기준선으로 두고, 판정 모델이 그 기준선에서 얼마나 떨어지는지를 자기 데이터로 재서 메모리 절반·확률 출력·형식 보장과 맞바꿀지 결정합니다.
시작하는 팀을 위한 열 가지
1
자기 문서로 질문 100~200개를 먼저 만듭니다. 이 시리즈의 모든 결론은 85문항에서 나왔고, 여러분의 문서에서는 순위가 바뀔 수 있습니다.
2
임베딩은 EmbeddingGemma 300M으로 시작하고 접두어를 모델 카드대로 붙입니다. Recall@10을 먼저 보고, 0.95 아래면 BM25를 RRF로 합칩니다.
3
상위 10개는 판정 모델에게 한꺼번에 choice로 고르게 합니다. 쌍별 noul은 1차가 약할 때만 씁니다.
4
분류는 라벨이 500개 넘게 있으면 임베딩 5-NN과 판정 제로샷을 둘 다 재 보고, 없으면 판정 제로샷으로 시작합니다.
5
선택지 설명을 한 줄씩 정성껏 씁니다. 설명이 곧 모델입니다. 처음 한 달은 사람이 전수 확인하며 설명을 고칩니다.
6
'none'·'기타' 선택지를 넣습니다. 어느 것도 맞지 않을 때 모델이 억지로 고르지 않게.
7
확률 임계값은 자기 데이터로 정합니다. 0.8은 80%가 아닙니다(2편 7부). 100건으로 온도 하나를 맞추면 보정이 눈에 띄게 좋아집니다.
8
상태를 JSON 객체로 나눠 줍니다. {규정, 요청}처럼 역할이 다른 텍스트를 한 문자열에 섞지 않습니다.
9
tev1은 2,048토큰, Nimble은 8,192토큰입니다. 넘치면 자르지 않고 400을 돌려줍니다. 길이를 코드에서 먼저 재십시오.
10
판정 모델을 유일한 가드로 두지 않습니다. 규칙(정규식·화이트리스트)이 먼저, 판정 모델은 회색 지대, 고위험은 사람.
6부. 한계와 다음
문항이 적습니다. 과제 7종은 10~16문항, 검색은 85문항. 큰 격차만 믿으십시오.
임베딩 쪽의 분류 방법을 두 가지만 썼습니다. 설명문 유사도와 5-NN. 라벨 몇 개로 로지스틱 회귀를 얹는 전통적 방법은 재지 않았고, 그것이 판정 제로샷을 이길 가능성은 충분합니다.
채팅 LLM은 27B 하나만 비교했습니다. 같은 크기의 채팅 모델(Qwen3.5 9B)에 글자만 답하게 하면 Nimble과 얼마나 다른지가 다음 숙제입니다. 판정 모델의 가치는 '같은 크기의 채팅 모델 대비'에서 가려집니다.
조합 실험은 Nimble 하나로만 했습니다. tev1 4B를 작은 1차에 붙이면 메모리 5GB 조합이 되는데, 그 수치는 재지 않았습니다.
Clef(27B 판정)는 설치하지 않았습니다. 이미지 입력이 필요한 자리는 이 시리즈가 비워 둔 칸입니다.
지연은 한 대의 맥에서 직렬로 잰 값입니다. 병렬 호출과 상태 캐시 재사용은 실제 서비스에서 숫자를 크게 바꿉니다.
세 편을 한 줄로 줄이면 이렇습니다. 지도는 작아도 되고, 심판은 로컬에 둘 수 있게 됐고, 둘의 자리를 나누는 것이 모델을 키우는 것보다 큰 차이를 만든다.