메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
2026년 가을, 에이전트 기억 업계의 점수판은 이렇습니다. LoCoMo에서 Zep 94.7, Mem0 92.5, EverMemOS 92.3, Backboard 90. LongMemEval에서 Mastra 94.87, Mem0 94.4, Zep 90.2. 1년 반 전 Mem0 논문의 표에서 1등이 68점대였으니, 기억 기술이 그사이 눈부시게 발전한 것처럼 보입니다.
그런데 같은 표를 조금만 넓게 펼치면 이상한 숫자가 나옵니다. Zep 한 제품의 LoCoMo 점수가 누가 쟀느냐에 따라 58.44에서 94.7까지 흩어져 있습니다. Mem0가 잰 Zep은 58.44와 65.99, Zep이 잰 Zep은 75.14와 94.7, 제3의 회사들이 잰 Zep은 59.22, 79.09, 81.06, 85.22입니다. 2026년 4월에는 한 감사 프로젝트가 LoCoMo 정답지의 6.4%가 틀렸다고 발표했습니다. 정답지가 틀리면 만점은 100점이 아니라 93.6점 근처가 됩니다. 그런데 몇몇 시스템은 그보다 높은 점수를 발표했습니다.
이 연재도 같은 함정 위에 서 있었습니다. 지난 편에서는 원문을 그대로 쌓은 파일이 95.2%로 Graphiti(81.4%)를 이겼습니다. 하지만 그 숫자는 우리가 만든 한국어 고객 10명, 질문 210개, 우리가 고른 채점 모델에서 나왔습니다. 질문 두 개가 모호해서 모든 시스템이 함께 틀린 일도 있었습니다.
그래서 이번에는 벤치마크를 시험대에 올렸습니다. LoCoMo와 LongMemEval을 내려받아, 기억 시스템 없이 대화 전체를 통째로 넣는 기준선을 2024년식 모델과 2026년식 모델로 다시 돌리고, 일부러 틀린 답 4,700개를 2025년·2026년의 채점 프롬프트들에 넣고, 정답지 1,540개를 대화 원문과 하나하나 대조했습니다. 결과를 먼저 요약합니다.
기억 시스템 없이도 2025년의 기억 시스템들을 넘었습니다. Mem0 논문의 '대화 통째로 넣기' 기준선을 그대로 재현하니 74.0%(논문 72.90%)였고, 답변 모델만 2026년 저가 모델(gemini-3.1-flash-lite)로 바꾸니 LoCoMo 80.7%(1,540문항 2.51달러), LongMemEval 81.6%였습니다. 2025년 Mem0 66.88, Zep 75.14(LoCoMo), Zep 71.2(LongMemEval)보다 높습니다.
같은 답에 채점 프롬프트만 바꾸면 26점이 움직였습니다(55.8%~81.4%). 같은 프롬프트에 채점 모델만 바꿔도 12점(62.1%~74.0%)이 움직였습니다.
채점기는 찍기를 통과시킵니다. 정답과 오답을 나란히 적은 답을 Mem0의 2025년 채점 프롬프트는 71~76%, 2026년 채점 프롬프트는 100% 정답 처리했습니다. 8~13일 틀린 날짜도 2026년 프롬프트는 68개 모두 통과시켰습니다. 대화를 아예 안 보고 답해도 25.9%를 받았습니다.
정답지의 7%가 틀렸거나 모호했습니다(Claude Sonnet 5.5 감사 + 사람 재확인). 추론·상식 질문은 30%였습니다. 독립 감사(Penfield Labs)와 같은 곳을 짚었습니다.
LoCoMo는 대화 10개에 몰려 있어 95% 구간이 ±3.1점입니다. 발표된 '최고 성능' 경쟁의 상당수(0.3~1.6점 차이)는 잡음 안입니다. 이 연재 4편의 1·2위 차이(3.3점)도 그랬습니다.
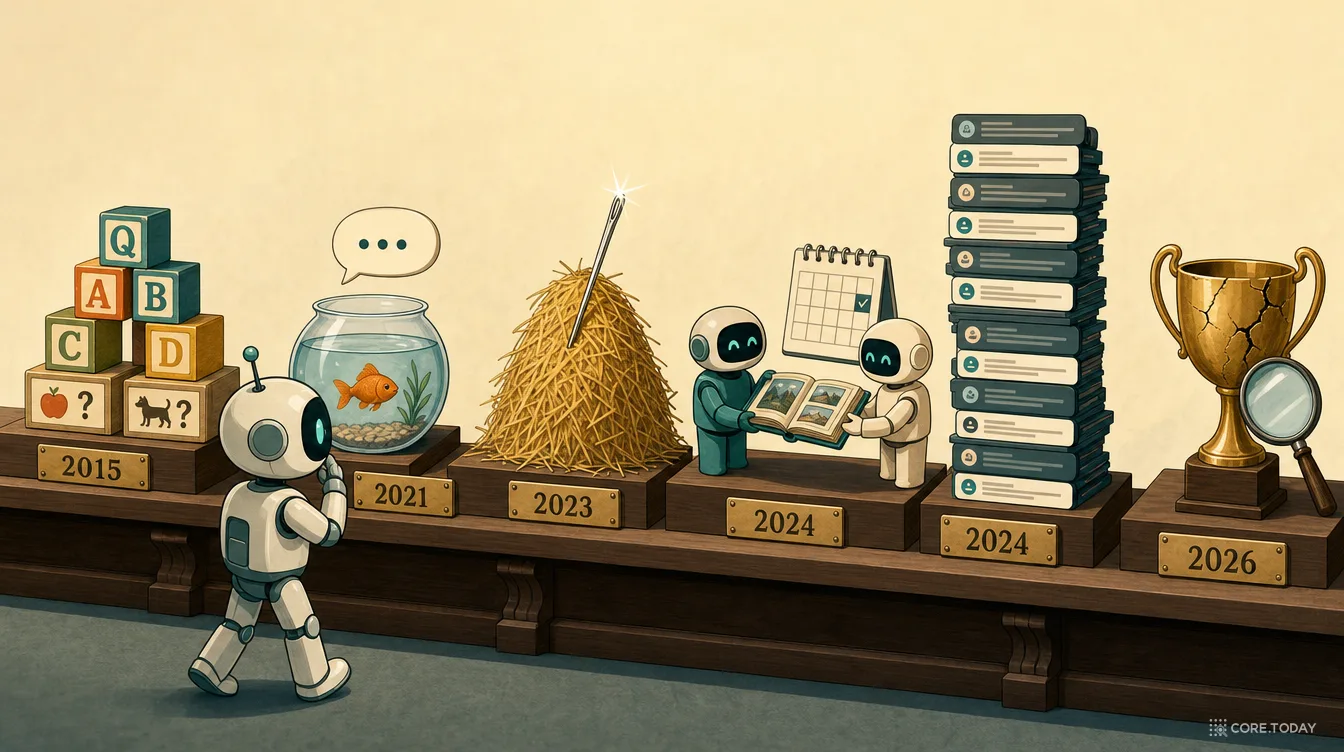
기계의 기억을 시험하는 일은 처음부터 '만든 문제'로 시작했습니다. 2014년 페이스북 AI 연구소의 메모리 네트워크(Memory Networks)는 읽고 쓰는 장기 기억을 가진 신경망을 제안했고, 이듬해 같은 팀이 그 시험지로 bAbI를 내놓았습니다. 텍스트 어드벤처 게임 같은 시뮬레이션에서 자동 생성한 20가지 과제("존이 부엌에 갔다. 사과는 어디 있나?")였고, 과제마다 정확도 95%를 넘기면 '통과'로 쳤습니다. 이 95%라는 기준에 논문은 각주를 달았습니다. "95%라는 선택(과 학습 예제 1,000개)은 임의적이다." 분야의 첫 기억 시험부터 합격선은 관례였습니다.
2021년 7월의 MSC(「금붕어 기억을 넘어서」, Beyond Goldfish Memory)는 사람 둘이 몇 시간 또는 며칠 간격으로 다섯 번 대화한 데이터를 만들었습니다. 실제로 며칠을 기다린 것은 아니고 '1~7시간 또는 1~7일 뒤'라는 설정만 붙였습니다. 제목의 금붕어에도 각주가 있습니다. "구어적 표현으로 썼다. 금붕어에게 장기 기억이 있다는 증거는 Agranoff 외(1965)를 보라."
첫 기억 벤치마크는 '기억 없음'에 졌다
2023년 10월 MemGPT는 MSC 대화마다 LLM으로 질문 하나를 만들어 DMR(Deep Memory Retrieval)이라는 과제를 정의했습니다. MemGPT는 GPT-4 Turbo로 93.4%를 냈습니다. 그런데 15개월 뒤 Zep 논문이 같은 과제에 기억 장치 없이 대화 전체를 맥락에 넣은 기준선을 돌려 보니 gpt-4-turbo로 94.4%, gpt-4o-mini로 98.0%가 나왔습니다. 대화 하나가 60마디 정도라 요즘 모델의 맥락 창에 다 들어갔기 때문입니다. 첫 에이전트 기억 벤치마크는 그렇게 '기억 안 함'에게 졌습니다.
건초더미 속 바늘, 그리고 한 문장
2023년 11월 그렉 캄라트(Greg Kamradt)의 건초더미 속 바늘(Needle-in-a-Haystack) 시험이 화제가 됐습니다. 폴 그레이엄의 에세이 더미 속 아무 위치에 "샌프란시스코에서 가장 좋은 일은 샌드위치를 먹으며 돌로레스 공원에 앉는 것"이라는 문장 하나를 심고 찾게 했습니다. GPT-4-128K는 7만 3천 토큰을 넘으면서 회상이 떨어졌고, 한 번 돌리는 데 API 비용이 약 200달러 들었습니다. Claude 2.1의 점수는 27%였습니다.
2주 뒤 Anthropic이 답을 냈습니다. 모델의 응답 앞에 "맥락에서 가장 관련 있는 문장은 다음과 같습니다:" 한 줄을 붙이자 점수가 27%에서 98%로 올랐습니다. Claude가 바늘을 못 찾은 게 아니라, 문맥에 어울리지 않는 문장이라며 답하기를 주저했던 것입니다. 2023년 가장 유명한 장기 맥락 그래프는 기억이 아니라 답할 의향을 재고 있었습니다. 이 일화는 이 글 내내 다시 나옵니다. 점수는 시험지와 채점 방식과 프롬프트의 곱입니다.
LoCoMo와 LongMemEval, 그리고 'J 점수'
2024년 2월 스냅·UNC의 LoCoMo와 2024년 10월 UCLA·텐센트의 LongMemEval이 나오면서 에이전트 기억은 비로소 '긴 대화'를 시험지로 갖게 됐습니다. 두 벤치마크는 다음 장에서 자세히 뜯어봅니다.
여기서 기억해 둘 사실 하나가 있습니다. LoCoMo 원 논문에는 LLM 채점이 없었습니다. 원 논문은 정답과 답의 단어 겹침(토큰 F1)으로 채점했습니다. 지금 모두가 인용하는 'LLM 판정 정확도', 이른바 J 점수는 2025년 4월 Mem0 논문이 도입한 것이고, 그때 쓴 채점 프롬프트가 Zep, Memobase, EverMemOS의 평가 코드에 거의 그대로 복사됐습니다. 그 프롬프트에는 이런 문장이 있습니다. "너그럽게 채점하라. 정답과 같은 주제를 건드리기만 하면 정답으로 쳐라." 이 문장이 이 글의 두 번째 주인공입니다.
다른 분야는 이미 겪은 일
정답지가 틀리고, 점수가 포화되고, 시험지가 학습 데이터로 새는 일은 메모리 벤치마크만의 문제가 아닙니다.
사건
무엇이 드러났나
시기
Northcutt 외, 「테스트 셋의 만연한 라벨 오류」
널리 쓰는 테스트 셋 10개의 정답 라벨 평균 3.3% 이상이 틀림(ImageNet 검증 셋은 6% 이상). 오류 비율이 조금만 달라져도 ResNet-18이 ResNet-50을 이기는 등 순위가 뒤집힘
2021년 3월
MMLU-Redux, 「MMLU는 끝났나?」
MMLU 문항의 6.49%에 오류, 바이러스학 과목은 57%
2024년 6월
SWE-bench Verified
출시 때 엔지니어 93명이 1,699문항을 검토해 500문항만 남겼지만, 2026년 2월 OpenAI가 어려운 문항 138개를 다시 감사하니 59.4%에 결함. 모든 최신 모델이 정답 패치를 외워 재현할 수 있었고, OpenAI는 점수 발표를 중단
2024년 8월 → 2026년 2월
리더보드 착시(Leaderboard Illusion)
챗봇 아레나에서 메타가 라마 4 출시 전 비공개 변형 27개를 시험하고 가장 좋은 것만 공개. 숫자 하나하나는 사실이어도 '고른 공개'가 점수를 부풀림
2025년 4월
경제학자 찰스 굿하트(1975)의 관찰을 인류학자 메릴린 스트래선(1997)이 이렇게 다시 썼습니다. "측정이 목표가 되면, 그것은 더 이상 좋은 측정이 아니다." 에이전트 기억은 2025년부터 투자와 마케팅이 몰린 분야가 됐고, LoCoMo와 LongMemEval은 그 목표가 됐습니다.
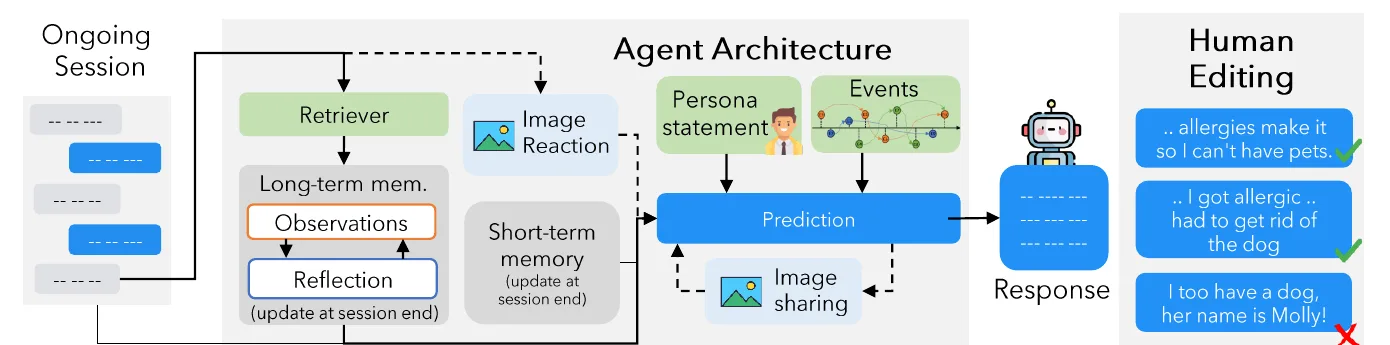
LoCoMo 논문(arXiv 2402.17753) 그림 3. 대화를 만드는 파이프라인입니다.
LoCoMo의 대화는 사람이 나눈 것이 아닙니다. 위 그림이 생성 과정입니다. MSC의 짧은 인물 설명을 gpt-3.5-turbo가 긴 페르소나로 늘리고, 그 인물에게 6~12개월에 걸친 사건 그래프(최대 25개, 원인-결과로 연결)를 줍니다. 그다음 두 LLM 에이전트가 그림 왼쪽의 기억 모듈(관찰을 모으고 세션이 끝날 때 반성하는 장기 기억, 세션 요약인 단기 기억)을 달고 세션마다 그사이 일어난 사건을 이야기하며 대화합니다. 사진도 주고받습니다. 공유할 사진은 웹 검색으로 찾고, 받은 쪽은 BLIP-2가 붙인 캡션을 봅니다. 마지막으로 사람이 대화를 고칩니다. 그림 오른쪽처럼 "알레르기 때문에 반려동물을 못 키운다"던 인물이 "나도 강아지가 있어, 이름은 몰리야"라고 말하면 지웁니다. 사람 편집자는 대화 마디의 약 15%를 고치고 사진의 약 19%를 빼거나 바꿨습니다.
논문은 대화 50개, 질문 7,512개를 설명하지만 공개된 것은 대화 10개, 질문 1,986개입니다. 저장소 README는 "가장 긴 대화를 남기고 비공개 LLM을 싸게 평가하기 위해" 일부를 골랐다고 적었습니다. 대화 하나는 369~689마디, 세션 19~32개입니다. 질문은 다섯 종류입니다.
데이터 파일의 번호
실제 종류
문항 수
예
1
여러 군데를 모아야 하는 질문(multi-hop)
282
팀이 책을 읽은 작가들은?
2
시간 질문(temporal)
321
멜라니는 언제 다쳤나?
3
추론·상식 질문(open-domain)
96
캐럴라인은 어떤 분야로 진학할 것 같나?
4
한 군데에 답이 있는 질문(single-hop)
841
존 사촌의 개 이름은?
5
속임 질문(adversarial)
446
대화에 없는 일을 물음
여기서 두 가지가 꼬여 있습니다.
첫째, 5번 속임 질문 446개 중 444개에는 정답 필드가 없습니다.adversarial_answer(함정 답)만 있습니다. 그래서 Mem0, Zep, EverMemOS 모두 5번을 빼고 1,540문항으로 채점합니다. 데이터의 22%가 아무도 채점하지 않는 질문입니다.
둘째, 파일의 번호와 논문의 나열 순서가 다릅니다. 논문 4.1절은 (1) 단일, (2) 다중, (3) 시간, (4) 상식, (5) 속임 순으로 설명하지만, 파일의 번호는 위 표와 같습니다(원 저장소의 평가 코드와 이슈 #6·#29, Mem0의 2026년 코드가 이 대응을 확인합니다). 이 차이 때문에 Mem0 논문의 범주별 표는 네 열 중 세 열의 이름이 틀렸습니다. 이번 조사에서 리서치 담당이 네 열 이름을 번호에 대응시키는 24가지 경우를 모두 계산했더니, 문항 수로 가중 평균했을 때 논문의 '전체' 점수 여섯 개를 0.01 이내로 재현하는 대응은 하나뿐이었습니다. Mem0 논문의 '단일(Single Hop)' 열은 실제로는 다중 질문, '다중(Multi-Hop)' 열은 상식 질문, '상식(Open Domain)' 열은 단일 질문입니다. 이 표는 Memobase, MIRIX, MemMachine, Hindsight, Backboard의 비교표에 그대로 옮겨졌습니다. Zep의 README도 2025년 7월 '범주 대응 수정' 커밋 뒤에도 두 열이 바뀌어 있습니다. 그래서 2026년의 여러 비교표에서는 같은 열 제목 아래 서로 다른 범주의 숫자가 나란히 있습니다.
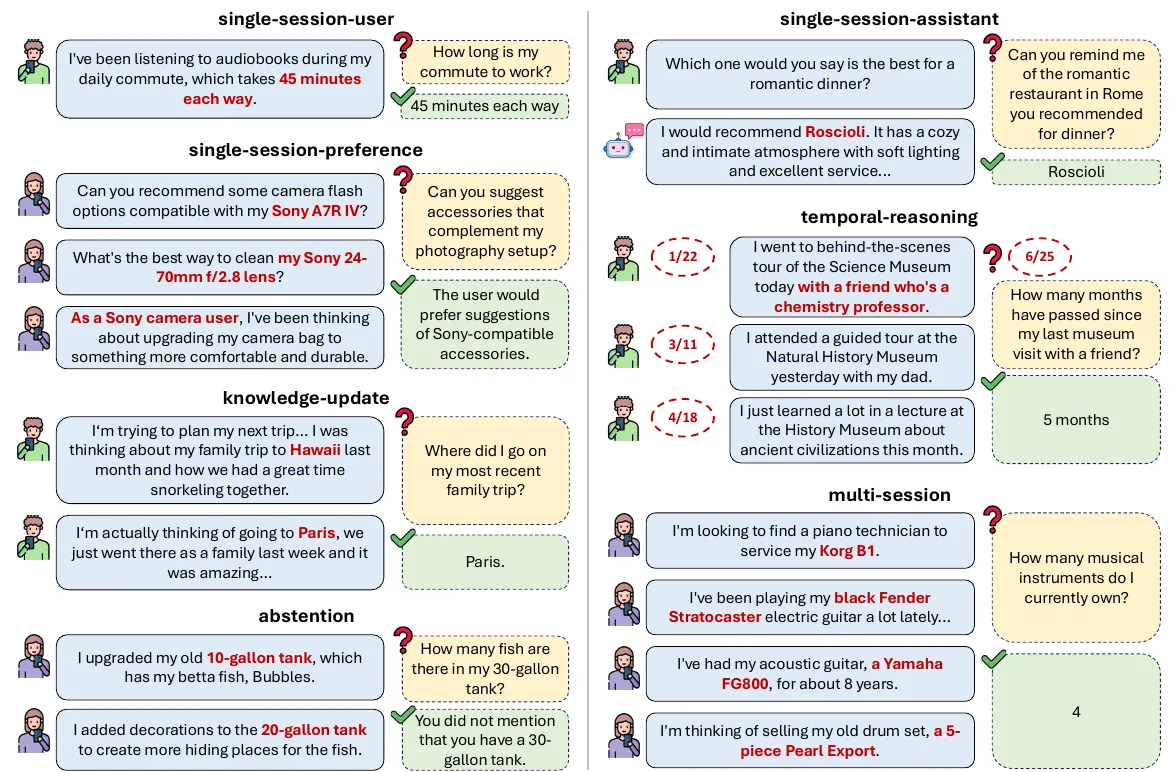
LongMemEval은 LoCoMo의 약점을 겨냥해 만들었습니다. 위 그림의 일곱 유형이 다섯 능력(정보 추출, 여러 세션 추론, 지식 갱신, 시간 추론, 기권)을 나눠 잽니다. 지식 갱신 예를 보면, 사용자가 "지난달 하와이 가족 여행"을 말한 뒤 다른 세션에서 "지난주 가족끼리 파리에 다녀왔다"고 말합니다. "가장 최근 가족 여행지는?"의 정답은 파리입니다. 기권 예는 10갤런·20갤런 수조 이야기만 있는데 "30갤런 수조에 물고기가 몇 마리냐"고 묻습니다. 정답은 "그런 수조는 말한 적 없다"입니다. 500문항 중 30개가 기권 문항입니다.
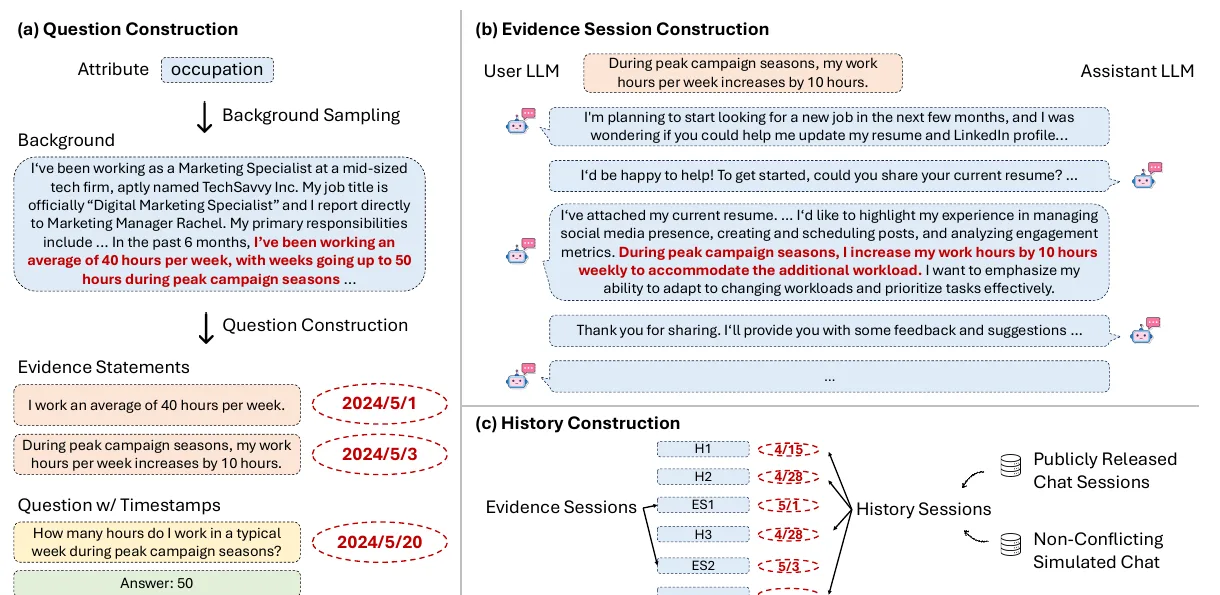
LongMemEval 논문 그림 2. 질문 만들기 → 증거 세션 시뮬레이션 → 건초더미 조립.
만드는 방식이 그림 2입니다. (a) 사용자 속성 164가지 중 하나(예: 직업)로 배경 문단을 만들고, 사람이 질문과 증거 문장을 다듬습니다. (b) 증거는 대놓고 말하지 않습니다. 사용자 역할 LLM이 이력서 상담을 받으며 "성수기에는 주 10시간 더 일한다"를 슬쩍 흘립니다. 세션의 약 70%는 사람이 고쳤습니다. (c) 이 증거 세션을 다른 대화들 사이에 날짜와 함께 섞습니다. 섞는 대화는 ShareGPT 25%, UltraChat 25%, 모순 없게 만든 시뮬레이션 대화 50%입니다. 논문 스스로 이 구성을 "건초더미 속 바늘과 비슷하다"고 설명합니다. 표준판 LongMemEval_S는 질문마다 세션 약 48개, 약 11만 5천 토큰입니다.
채점은 GPT-4o가 질문 유형별 프롬프트로 합니다. 시간 질문 프롬프트에는 "날짜 수의 하루 차이는 감점하지 말라", 지식 갱신 프롬프트에는 "옛 정보를 함께 말해도 갱신된 답이 있으면 정답"이라는 규칙이 있습니다. 논문은 이 채점이 "사람 전문가와 97% 넘게 일치한다"고 썼는데, 그 검증은 유형별 30문항, 두 모델의 평범한 답으로 한 것입니다.
그리고 2025년 9월 시험지가 바뀌었습니다. 저자들은 "정답을 방해하는 잡음 세션을 정리했다"며 longmemeval_s_cleaned를 내고 원래 파일을 대체했습니다. 이번에 두 파일을 비교해 보니 질문과 정답은 그대로지만 500문항 중 454문항의 건초더미가 바뀌었고(질문당 평균 2.5세션 교체), 그 전후의 점수는 같은 시험지 점수가 아닙니다. 질문 시각이 마지막 세션보다 앞서는 문항도 원본 77개, 정리본 76개 있었습니다. 모두 같은 날 몇 시간 앞이고, 관리자는 의도한 것이 아니라고 답했습니다.
3. 점수판의 뒷면: 같은 제품, 다른 점수
벤치마크 숫자가 흔들리는 이유는 대개 사기가 아니라 조건입니다. 누가 돌렸나, 답하는 모델은 무엇이었나, 채점은 어떤 모델이 어떤 프롬프트로 했나, 어떤 문항을 뺐나, 평균을 어떻게 냈나. 이 다섯 가지 중 하나만 달라도 점수가 10점 넘게 움직입니다. 2025~2026년 공개 자료에서 확인한 사례들입니다.
81.6(gpt-4o, 2025) · 58.4(MemOS 논문) · 현재 홈페이지 "97%"
97%는 검색 지표(Recall@20)인데 다른 회사들의 LLM 채점 정확도 표에 나란히 놓임
Mastra · LongMemEval
94.87(gpt-5-mini)
여섯 유형 점수의 단순 평균(유형별 문항 수 30~133개 무시). 500문항을 똑같이 세면 93.6%. gpt-4o로는 84.8%
Google Vertex Memory Bank · LongMemEval
약 70(원 논문) → 42.4(Redis 재측정)
Redis가 2026년 9월 여러 제품을 같은 gpt-4o와 공식 채점기로 다시 돌린 결과. "발표치와 +3점에서 −28점까지 달랐다"
가장 극적인 것은 채점 프롬프트입니다. Mem0의 2025년 채점 프롬프트도 "너그럽게"였지만, 2026년 4월 Mem0가 92.5%와 94.4%를 발표하며 공개한 새 벤치마크 저장소(mem0ai/memory-benchmarks)의 LoCoMo 채점 프롬프트는 훨씬 더 나갑니다.
같은 저장소의 LongMemEval 채점 프롬프트에는 "너는 너무 빨리 '아니오'라고 하는 경향이 있다. 애매하면 '예' 쪽으로 기울어라", "정답을 포함하는 범위는 정답", "'최근'은 6년 전까지"라는 문장이 있고, "Suica 카드", "TripIt 앱"처럼 특정 문항을 겨냥한 듯한 예외 규칙도 들어 있습니다. 공식 채점 프롬프트의 "필요한 정보의 일부만 담으면 '아니오'" 규칙과는 반대 방향입니다. 리서치 결과 Mem0의 LoCoMo 결과 파일에서 후보 여러 개를 나열한 답 148개 중 147개가 정답으로 처리됐습니다. 예를 들어 정답이 "2023년 5월 7일"인 질문에 "- 2023년 5월 7일 / - 2023년 6월 26일"이라고 답한 것도 정답이었습니다.
공정하게 말하면, Mem0는 같은 발표 글에 이렇게 적었습니다. "LoCoMo와 LongMemEval 같은 작은 벤치마크는 공격적인 검색 전략, 더 큰 맥락 창, 최신 모델로 크게 끌어올릴 수 있다. 그것이 기억 시스템 자체가 좋아졌다는 뜻은 아니다." 점수를 낸 회사도 그 점수가 무엇을 재는지 알고 있습니다. 문제는 그 단서가 점수판에는 실리지 않는다는 것입니다.
4. 실험 설계: 기억 시스템을 빼고 시험지만 재기
이번 실험의 목표는 어떤 기억 시스템이 더 좋은지가 아닙니다. 시험지와 채점이 무엇을 재는지입니다. 그래서 기억 시스템을 하나도 쓰지 않았습니다. 네 가지를 쟀습니다.
실험 1 · 기준선대화 전체를 통째로 넣고 답하게 했습니다. LoCoMo는 Mem0의 2025년 평가 코드(커밋 aae5989)의 '전체 맥락' 프롬프트를 그대로 썼고, LongMemEval은 공식 생성 코드의 프롬프트(세션 JSON + '단계별로 답하라')를 썼습니다. 답변 모델은 2024~2025년 논문들이 쓴 gpt-4o-mini와 2026년의 저가 모델 gemini-3.1-flash-lite입니다. 대화를 아예 주지 않는 '맨손' 기준선도 돌렸습니다
실험 2 · 채점LoCoMo 1,540문항마다 일부러 틀린 답을 만들었습니다. 같은 주제의 다른 사실(구체적 오답), 주제만 건드리는 두루뭉술한 답(애매한 오답), 정답과 오답을 나란히 적은 답(양다리), 8~13일 어긋난 날짜(근접 날짜)입니다. 이것을 Mem0 2025 채점, 엄격한 채점, LongMemEval 공식 채점, Mem0 2026 채점 프롬프트에 넣었습니다. 채점 모델은 gemini-3.1-flash-lite로 고정하고, 채점 모델의 영향을 보려고 gpt-4o-mini와 claude-haiku-4.5로도 일부를 다시 쟀습니다
실험 3 · 정답지LoCoMo 정답 1,540개를 Claude Sonnet 5.5에게 대화 원문 전체(세션 날짜, 사진 캡션 포함)와 함께 주고 '정답 / 사소한 부정확 / 틀림 / 모호함'으로 판정하게 했습니다. '틀림' 판정은 사람이 표본을 다시 확인했습니다
실험 4 · 통계위 결과로 신뢰구간, 대화 단위 군집 부트스트랩, 검출 가능한 최소 차이를 계산했습니다
모든 호출은 회사 LLM 게이트웨이(api.core.today)를 거쳤고 온도 0으로 한 번씩 돌렸습니다. 원래 계획은 2024~2025년 논문들과 똑같이 OpenAI 모델(gpt-4o-mini 답변·채점, GPT-4o 공식 채점)로 모두 재는 것이었는데, 실험 도중 게이트웨이의 OpenAI 상류 크레딧이 바닥났습니다. 그래서 그 전에 끝난 OpenAI 결과(LoCoMo 기준선 재현, 일부 채점)는 그대로 쓰고, 나머지 채점은 gemini-3.1-flash-lite로, LongMemEval 공식 채점은 claude-haiku-4.5로 바꿨습니다. 기준을 바꾼 곳은 표마다 적었습니다. 게이트웨이 키 하나에 분당 200만 토큰 한도가 있어 전체 실험에 반나절이 걸렸고, 비용은 맺음말에 적었습니다.
LoCoMo: 2024년 기준선은 재현됐고, 2026년 저가 모델은 2025년의 모든 기억 시스템을 넘었다
먼저 Mem0 논문의 '전체 맥락' 기준선을 그대로 재현했습니다. 같은 프롬프트("가장 짧게 답하라"), 같은 답변 모델(gpt-4o-mini), 같은 채점(gpt-4o-mini + '너그럽게' 프롬프트)입니다. 결과는 74.0%로, 논문의 72.90%와 1점 남짓 차이였습니다(OpenAI 크레딧이 바닥나기 전 1,381문항 기준). 대화 하나가 1만 6천~2만 6천 토큰이라 gpt-4o-mini의 맥락 창에 다 들어가고, 1,540문항을 돌리는 데 5.86달러가 들었습니다.
같은 프롬프트에 답변 모델만 2026년의 저가 모델 gemini-3.1-flash-lite로 바꿨습니다. 대화를 프롬프트 앞에 두어 문항끼리 캐시를 공유하게 했더니 1,540문항 전체에 2.51달러가 들었습니다.
LoCoMo 1,540문항
Mem0 2025 채점
Mem0 2026 채점
엄격한 채점
토큰 F1
맨손 · gpt-4o-mini(대화 안 줌)
25.9%
—
11.6%
15.5
통째로 · gpt-4o-mini(2024)
70.3% 원조 gpt-4o-mini 채점 74.0%
81.4%
56.4%
40.4
통째로 · gemini-3.1-flash-lite(2026)
80.7%
88.1%
60.5%
57.7
채점 모델은 표시가 없으면 gemini-3.1-flash-lite입니다. 답변 프롬프트는 Mem0 평가 코드의 전체 맥락 프롬프트 그대로이며, 생각을 늘어놓게 하는 단계별 프롬프트를 쓰지 않았습니다.
2025년 발표된 기억 시스템들의 LoCoMo 점수는 Mem0 66.88, Mem0 그래프판 68.44, Letta 파일 시스템 74.0, Zep 75.14였습니다. 기억 시스템을 하나도 쓰지 않은 2026년의 저가 모델이 같은 채점 프롬프트로 80.7%를 냈습니다. 답변 모델이 달라 직접 비교는 아니지만, 이것이 요점입니다. LoCoMo 점수의 상당 부분은 기억 시스템이 아니라 답하는 모델이 만듭니다. Penfield 감사도 gpt-4.1-mini에 단계별 답변 프롬프트를 주고 대화를 통째로 넣어 92.62%를 냈고, 이는 EverMemOS의 92.32%보다 높았습니다. 2026년 90점대 주장 중 Mem0(gpt-5)와 Zep(gpt-5.4)은 최상위 모델로 답한 점수입니다.
그렇다고 기억 시스템이 쓸모없다는 뜻은 아닙니다. LoCoMo의 대화는 2만 토큰 남짓이라 통째로 넣기가 가능할 뿐입니다. 실제 서비스처럼 대화가 수백만 토큰(LongMemEval_M이 약 150만 토큰)으로 길어지면 통째로 넣기는 맥락 창을 넘거나, 비싸지고 느려집니다. 문제는 2만 토큰짜리 시험으로 수백만 토큰짜리 기억을 재고 있다는 데 있습니다. 시험이 너무 쉬워서 기억 시스템을 쓰지 않는 쪽이 이깁니다.
LongMemEval: 11만 토큰을 통째로
LongMemEval_S는 질문마다 약 11만 토큰의 건초더미가 따로 있어 LoCoMo보다 훨씬 무겁습니다. 공식 생성 프롬프트(세션을 날짜순 JSON으로 넣고 "단계별로 답하라")로 gemini-3.1-flash-lite에 500문항 전체를 통째로 넣었습니다. 5,900만 토큰을 읽는 데 14.95달러가 들었습니다. 채점은 공식 유형별 프롬프트를 그대로 쓰되, OpenAI 크레딧 소진으로 GPT-4o 대신 claude-haiku-4.5가 했습니다.
LongMemEval_S 500문항
점수
조건
전체 맥락 gpt-4o (Zep 논문, 2025)
60.2%
원본 데이터 · 공식 GPT-4o 채점
Zep (2025)
71.2%
gpt-4o 답 · 공식 채점
Supermemory (2025)
81.6%
gpt-4o 답 · GPT-4o 채점
전체 맥락 gemini-3.1-flash-lite (이번)
81.6%
정리본 · 공식 프롬프트를 claude-haiku-4.5가 채점 · 95% 구간 ±3.4점
Mastra OM (gpt-4o)
84.2%
유형 평균
Zep (2026) · Mem0 v3 · Mastra OM(gpt-5-mini)
90.2 · 94.4 · 94.87%
gpt-5급 답, 채점 조건 제각각
2025년 Zep 논문이 기억 시스템의 필요를 보여 준 근거는 "11만 토큰을 통째로 넣은 gpt-4o는 60.2%, Zep은 71.2%"였습니다. 2026년의 저가 모델은 같은 11만 토큰을 통째로 넣고 81.6%를 냈습니다. 시험지가 정리본으로 바뀌었고 채점 모델이 달라 엄밀히 같은 비교는 아니지만, 1년 반 사이에 '통째로 넣기'의 바닥이 20점 넘게 올라왔다는 것은 분명합니다. 기억 시스템의 발표 점수는 이 올라온 바닥과 같은 답변 모델로 비교해야 의미가 있습니다.
유형별로 보면 기억 시스템이 존재 이유로 내세우는 곳이 여전히 약점입니다. 한 세션 안의 사실(사용자 97.1%, 어시스턴트 98.2%)은 거의 다 맞혔지만 여러 세션을 모아야 하는 질문 75.2%, 지식 갱신 75.6%, 시간 추론 80.5%, 선호 63.3%였습니다. 지식 갱신에서 틀린 답을 보면 이 연재가 다섯 편 내내 다룬 문제가 그대로 나옵니다. "웰스파고에서 사전 승인받은 금액은?"에 모델은 이렇게 답했습니다. "35만 달러입니다. (나중 세션에서 40만 달러를 언급했지만, 자세한 재무 계획에 쓴 숫자는 35만 달러였습니다.)" 새 값을 봤는데도 옛 값을 골랐습니다. 대화를 통째로 넣어도 '어느 것이 지금 유효한가'는 저절로 풀리지 않습니다.
'기권' 문항(말한 적 없는 것을 물음) 30개 중에서는 66.7%만 "그런 말은 없었다"고 답했습니다. 나머지는 비슷한 다른 사실을 끌어와 답을 지어냈습니다.
같은 답에 채점 방식만 바꾸면 점수가 얼마나 움직일까요. 앞 장의 gpt-4o-mini 답 1,540개를 채점 프롬프트 네 가지로 다시 매겼습니다. 채점 모델은 gemini-3.1-flash-lite 하나로 고정하고 프롬프트만 바꿨습니다(원래 Mem0가 쓴 gpt-4o-mini로 끝까지 재려 했으나 실험 도중 게이트웨이의 OpenAI 상류 크레딧이 바닥났습니다. 그 전에 끝난 1,381문항의 gpt-4o-mini 채점은 74.0%였습니다).
Mem0 2026 채점
81.4%
Mem0 2025 채점
70.3%
엄격한 채점
56.4%
LongMemEval식 채점
55.8%
토큰 F1(원 논문)
40.4
같은 gpt-4o-mini 답 1,540개. 채점 모델은 모두 gemini-3.1-flash-lite, 토큰 F1은 LoCoMo 원 논문 방식.
답은 하나도 바뀌지 않았는데 점수가 55.8%에서 81.4%까지, 26점 움직였습니다. 이 폭은 Mem0 논문의 Mem0(66.88)와 2026년 Mem0 v3(92.5)의 차이와 비슷합니다. 너그러운 채점은 통과하고 엄격한 채점에서 떨어진 답 214개를 들여다보면 대부분 노골적인 오답이 아니라 덜 정확한 답입니다. "에번은 언제 직장을 잃었나"에 정답지는 '2023년 10월 말', 모델은 "지난달"이라고 답했습니다(언제 기준의 지난달인지 없음). "멜라니의 아이들이 좋아하는 것"에 정답지는 '공룡, 자연', 모델은 "자연, 동물, 가족과 보내는 시간"이라고 답했습니다(공룡이 빠짐). "마리아가 계획한 모금 행사"에 정답지는 '칠리 요리 대회, 링 던지기', 모델은 링 던지기 하나만 댔습니다. 어디까지를 맞았다고 볼지는 결국 정해야 하는 문제이고, 그 결정이 점수의 4분의 1을 좌우합니다.
일부러 틀린 답은 얼마나 통과하나
이번에는 정답을 알고 일부러 틀리게 쓴 답을 넣었습니다. 이 답들은 모두 0%에 가까워야 정상입니다.
답의 종류(예)
Mem0 2026
Mem0 2025
LongMemEval식
엄격
구체적 오답 — 정답 '용기(Brave)'에 '파이트 송(Fight Song)'
15.0%
3.0%
0.1%
0.5%
애매한 오답 — '용기를 북돋는 노래'
45.4%
11.6%
0.5%
0.4%
양다리 답 — '- 브레이브 - 파이트 송'
100%
76.4%
15.8%
1.6%
근접 날짜 — 정답 '5월 7일'에 '5월 19일'(68문항)
100%
0%
0%
0%
맨손 — 대화를 아예 안 보고 답함
—
25.9%
10.4%
11.6%
LoCoMo 1,540문항, 채점 모델 gemini-3.1-flash-lite. 오답은 gpt-4.1이 정답을 보고 일부러 만들었습니다. 원조 gpt-4o-mini 채점으로 끝까지 잰 칸: 구체적 오답 4.3%, 양다리 답 71.2%(시간 질문만 보면 86.6%).
네 가지가 보입니다.
첫째, 후보를 여럿 대면 통과합니다. 정답과 오답을 나란히 적은 답을 Mem0 2025 프롬프트는 76.4%, 원조 gpt-4o-mini 채점은 71.2% 통과시켰습니다. 시간 질문에서는 86.6%입니다. "같은 주제를 건드리면 정답"이라는 규칙에서 후보 중 하나가 정답이면 주제는 언제나 같기 때문입니다. Mem0 2026 프롬프트는 "정답 항목을 하나라도 포함하면 정답"이라고 명시하므로 1,540개 전부가 통과했습니다. 리서치에서 Mem0의 2026년 결과 파일에 후보 나열형 답이 148개 있었고 그중 147개가 정답 처리된 것과 같은 현상입니다. 시스템이 확신이 없을 때 후보를 다 늘어놓는 습관만 들여도 점수가 오릅니다.
둘째, 날짜 허용 범위가 시간 질문을 무력화합니다. 정답과 8~13일 어긋난 날짜 68개를 Mem0 2026 프롬프트는 모두 정답으로 처리했습니다. "14일 이내면 정답"이라는 규칙 그대로입니다. 다른 세 프롬프트는 하나도 통과시키지 않았습니다. 그런데 LoCoMo 시간 질문의 정답은 "5월 7일", "5월 25일 전 일요일"처럼 하루 단위입니다. 이 규칙 아래에서는 '지난주 토요일'을 '지지난주 토요일'로 기억하는 시스템과 정확히 기억하는 시스템이 같은 점수를 받습니다. 이 연재 1편의 주제였던 '사실이 언제 바뀌었나'를 재는 능력이 채점에서 지워집니다.
셋째, 애매한 답에 대한 관용은 채점 모델에 따라 크게 다릅니다. Penfield 감사는 원조 gpt-4o-mini 채점이 애매한 오답을 62.81% 통과시킨다고 보고했습니다. 같은 Mem0 2025 프롬프트를 gemini-3.1-flash-lite에 주니 11.6%였습니다(애매한 답의 문구는 서로 다릅니다). claude-haiku-4.5에 주니 4.7%였습니다. 양다리 답도 Gemini 76.4%, 원조 gpt-4o-mini 71.2%, Haiku 45.6%로 갈렸고, 진짜 답의 점수도 gpt-4o-mini 74.0%, Gemini 70.3%, Haiku 62.1%로 같은 프롬프트, 같은 답에 채점 모델만 바꿔 12점이 움직였습니다. 프롬프트만이 아니라 채점 모델의 성향도 점수의 일부라는 뜻입니다. 2026년의 주요 발표들은 채점 모델이 gpt-4o-mini, GPT-4.1, gpt-5, gpt-5.4, GPT-OSS-120B로 모두 다릅니다.
넷째, 대화를 안 봐도 4분의 1을 맞힙니다. 대화를 아예 주지 않고 질문만 준 gpt-4o-mini의 답을 Mem0 2025 프롬프트로 채점하면 25.9%였습니다. "오드리가 가장 좋아하는 고기는?"에 '닭고기', "데버라와 졸린은 리우데자네이루에 가 봤나?"에 '예', "멜라니가 새로 산 신발은 어디에 쓰나?"에 '달리기'. 대화 없이 찍어도 맞는 문항이 적지 않습니다. 여기에 너그러운 채점이 "졸린은 몇 살?"(정답지 '학생이니 아마 서른 이하')에 "25살"처럼 그럴듯한 추측까지 받아 줍니다. 엄격한 채점에서는 11.6%로 줄어듭니다. 기억 시스템 점수의 바닥은 0이 아니라 이 맨손 점수입니다.
정리하면, 채점 프롬프트는 중립적인 도구가 아니라 무엇을 기억이라고 부를지에 대한 정의입니다. "주제만 맞으면 된다"는 정의 아래서는 '대략 기억하는 시스템'과 '정확히 기억하는 시스템'이 구별되지 않고, "하나라도 맞으면 된다"는 정의 아래서는 '찍는 시스템'이 이깁니다. LongMemEval의 공식 프롬프트("필요한 정보의 일부만 담으면 아니오")와 이번에 쓴 엄격한 프롬프트는 이런 답을 대부분 걸러냈습니다. 너그러운 프롬프트가 처음 쓰인 이유는 짐작할 수 있습니다. 시스템의 답이 정답지보다 길고 표현이 달라 토큰 F1이 너무 가혹했기 때문입니다(MemGPT가 같은 이유로 ROUGE로 바꿨습니다). 하지만 그 해법이 너무 멀리 갔습니다.
LoCoMo 정답 1,540개를 Claude Sonnet 5.5에게 대화 원문 전체(세션 날짜, 사진 캡션, 발화 번호 포함)와 함께 보여 주고 하나씩 판정하게 했습니다. 대화 하나를 프롬프트 캐시에 올려 두고 질문만 바꿔 묻는 방식이라 1,540문항에 18.2달러가 들었습니다.
범주(파일 번호)
문항
맞음
사소한 부정확
모호함
틀림
틀림+모호함
한 군데(4)
841
786
21
15
19
4.0%
여러 군데(1)
282
216
47
10
9
6.7%
시간(2)
321
280
15
10
16
8.1%
추론·상식(3)
96
62
5
21
8
30.2%
전체
1,540
1,344
88
56
52
7.0%
감사 모델의 '틀림' 판정 52개 중 24개를 사람이 대화 원문을 직접 읽고 다시 확인했습니다. 결과는 세 갈래였습니다.
확실히 틀린 정답지 13개. 말한 사람이 바뀐 것(데이브가 사진을 시작했는데 정답지는 캘빈, 존의 공부법을 팀의 공부법으로), 날짜 계산이 틀린 것('지난 금요일'을 대화 당일로, 2024년 일을 2023년으로), 기간 계산이 틀린 것(7월 11일~20일 캐나다 여행이 '19일'), 그리고 대화 어디에도 없는 내용입니다. 네이트가 좋아하는 책 시리즈의 주제는 정답지에 '드래곤'인데, 대화에는 "모험, 마법, 멋진 인물"뿐이고 '드래곤'은 사진을 웹에서 찾을 때 쓴 내부 검색어(fantasy novels dragon cover series)에만 있습니다. 게임방 조명이 '빨강·보라'라는 정답은 사진 원본에만 있고, 시스템이 받는 캡션은 "컴퓨터와 게임 의자가 있는 게임방"입니다. Penfield 감사가 짚은 대로, 어떤 기억 시스템도 그 검색어나 원본 사진을 받지 않습니다.
설계상 채점할 수 없는 문항 8개. 대부분 추론·상식(3번) 질문입니다. "알레르기로 보아 조애나에게 있을 법한 기저 질환은?"의 정답은 '천식', "오드리와 앤드루가 사는 주는?"의 정답은 '미네소타', "어느 국립공원을 말하는 걸까?"의 정답은 '보야저스 국립공원'입니다. 대화에는 단서가 거의 없습니다. 출제자가 사진이나 설정에서 추론한 답이라, 맞는 추론을 해도 정답지와 다를 수 있습니다. 표에서 3번 범주의 '틀림+모호함'이 30%인 이유입니다.
감사 모델의 오판 1개, 모호함 2개. 감사 모델도 틀립니다. "팀이 가 본 곳"에서 '캘리포니아'를 근거 없다고 했지만, 팀은 "캘리포니아에서 만난 팬"이라고 말했습니다.
이 결과는 Penfield Labs의 2026년 4월 감사(dial481/locomo-audit, Claude Opus 4.6 + 사람 검토)와 독립적으로 비슷한 곳을 가리킵니다. 그들이 점수에 영향을 주는 오류로 꼽은 99개 중 84개를 우리 감사도 '틀림·모호함·사소한 부정확'으로 판정했고, 우리의 '틀림' 52개 중 40개가 그들의 목록에 있었습니다. 두 감사를 합쳐 보면 LoCoMo 정답지의 3~6%는 틀렸고, 추가로 3~4%는 정답이 하나로 정해지지 않습니다.
그럼 이 오류가 점수에 어떤 영향을 줄까요. 앞 장의 gpt-4o-mini 답을 다시 보면, 정답지가 틀린 52문항에서도 채점기가 '정답'을 준 경우가 Mem0 2025 채점에서 17개, Mem0 2026 채점에서 31개였습니다. 틀린 정답지와 일치하는 답에 점수를 주거나, 맞는 답을 너그럽게 틀린 정답지와 같다고 봐 준 것입니다. 예를 들어 "존이 스튜디오를 여는 데 얼마나 걸렸나"에 모델은 대화 날짜를 계산해 "1월 20일부터 6월 20일, 5개월"이라고 맞게 답했는데, 정답지는 '6개월'이었고, Mem0 2026 채점은 "기간은 50% 이내면 정답"이라는 규칙으로 이를 정답 처리했습니다. 이번에는 맞는 답이 점수를 받았지만, 같은 규칙은 틀린 답에도 똑같이 작동합니다.
정답지가 틀리거나 모호한 108문항을 빼고 다시 계산하면 같은 답의 점수가 모든 채점 방식에서 2~3점 오릅니다(Mem0 2025 채점 기준 70.3% → 72.9%). 순위를 바꿀 만한 크기는 아니지만, 90점대 초반의 점수 차이를 다투는 지금은 이 2~3점이 '최고 성능'을 가르는 폭과 같습니다.
마지막은 통계입니다. LoCoMo 1,540문항이면 많아 보이지만, 이 문항들은 대화 10개에서 나왔습니다. 같은 대화의 문항들은 함께 쉽거나 함께 어렵습니다. 실제로 같은 gpt-4o-mini 답(Mem0 2025 프롬프트 채점)의 정확도가 대화별로 62.8%(conv-42)에서 78.0%(conv-44)까지 15점 넘게 차이 났습니다.
그래서 문항이 아니라 대화를 단위로 다시 뽑는 부트스트랩(10개 대화에서 복원 추출 4,000번)으로 신뢰구간을 쟀습니다. 문항이 독립이라고 보면 95% 구간이 ±2.3점이지만, 대화 단위로 재면 ±3.1점(67.2~73.3%)입니다. 분산이 약 1.9배 커집니다(설계 효과 1.88). Anthropic의 에번 밀러가 2024년 「평가에 오차 막대를 달자」에서 권한 방식 그대로이고, 그 논문은 DROP 벤치마크에서 이 배수가 3.05였다고 보고했습니다.
범주별로 나누면 더 넓어집니다. 문항이 96개뿐인 추론·상식 범주는 ±9.7점, 시간 범주(321개)는 ±5.4점입니다. 2026년 비교표들이 소수점 둘째 자리까지 적는 범주별 점수 대부분이 이 구간 안에서 움직입니다. 밀러의 식으로 두 시스템을 같은 문항에서 비교할 때(정오 상관 0.5 가정) 검출할 수 있는 최소 차이를 계산하면, LoCoMo 전체는 약 4.5점(대화 단위 묶음 반영), LongMemEval 500문항은 약 4~6점입니다. 발표된 '최고 성능' 경쟁의 상당수, 예를 들어 Mem0 그래프판과 Mem0의 1.56점, Letta 파일 시스템과 전체 맥락의 1.1점, EverMemOS와 감사 측 전체 맥락 기준선의 0.3점은 이 선 아래에 있습니다.
여기에 앞 장의 두 잡음원이 더해집니다. 채점 프롬프트(같은 답에 26점), 채점 모델(같은 프롬프트에 12점)입니다. 한 번 돌린 점수 하나로 순위를 매기기에는 저울이 너무 무딥니다.
9. 이 연재도 예외가 아니다
남의 점수만 의심하면 공정하지 않습니다. 이 연재 네 편의 실측을 같은 잣대로 다시 봅니다.
잣대
이 연재가 한 것
약점
데이터
한국어 고객 상담 10명 × 24마디를 직접 설계(이사·이직·약 변경·요금제 변경)
우리가 만든 시험지에서 우리가 1등을 정했습니다. 그래프에 불리한 '그만뒀다'류 표현, 파일에 유리한 짧은 대화가 결과에 영향을 줬을 수 있습니다
문항 수
210문항(고객 10명 × 같은 질문 21개)
같은 질문 21개를 고객 10명에게 반복한 구조라, 질문 하나가 어려우면 열 번 함께 틀립니다. 질문 단위로 묶어 다시 계산하니 분산이 2~4배 커졌고(설계 효과 2.2~4.1), 4편의 1·2위 차이(원문 파일 95.2% 대 다시 쓰기 파일 91.9%, 3.3점)의 95% 구간은 −1.4~+9.0점으로 0을 포함했습니다. 통계적으로 가릴 수 없는 차이였습니다
채점
gemini-3.5-flash가 답하고 같은 모델이 채점
답하는 모델과 채점 모델이 같았습니다. 채점 프롬프트도 우리가 썼습니다
모호한 질문
두 문항이 모호해 모든 시스템이 함께 틀림
그 두 문항을 빼도 순위는 같았지만, 만점이 100이 아니었다는 뜻입니다
반복
한 번 실행
Graphiti의 판정 흔들림(1편에서 측정)을 생각하면 여러 번 돌린 평균을 내야 했습니다
그래서 4편의 결론은 이렇게 읽어야 합니다. "원문 파일이 Graphiti보다 낫다"가 아니라, "대화 수백 마디 규모에서는, 이력을 날짜와 함께 남긴 쪽이 이력을 버린 쪽을 크게 이긴다(95.2% 대 47.6%, 47점 차이)". 47점 차이는 어떤 잡음 계산으로도 살아남습니다. 3점 차이는 그렇지 않습니다. 벤치마크를 의심한다는 것은 숫자를 버리라는 뜻이 아니라, 어느 크기의 차이까지 믿을지 정하라는 뜻입니다.
LoCoMo와 LongMemEval의 한계가 알려지면서 새 벤치마크가 쏟아졌습니다. 각자가 고치려는 문제와, 순위가 어떻게 바뀌었는지를 정리했습니다.
벤치마크
고치려는 문제
무엇을 보여줬나
MemoryAgentBench(2025-07)
LoCoMo(약 9천 토큰)는 "더 이상 요즘 모델을 시험하지 못한다". 10만~144만 토큰, 대화가 차례로 들어옴
Mem0 21.1, Zep 24.0 대 gpt-4o-mini 장기 맥락 42.2, BM25 41.5. 기억 시스템이 자기 바탕 모델보다 낮음
BEAM(2025-10, ICLR 2026)
짧은 세션을 이어 붙인 대화는 주제가 뚝뚝 끊김. 100만·1천만 토큰의 일관된 대화
100만 토큰 맥락 모델이 100만에서 0.19~0.26, 모순 해결은 모두 0.053 이하
HaluMem(2025-11)
최종 답만 보면 어느 단계에서 틀렸는지 모름. 추출·갱신·질의를 단계별로 채점
추출 회상률이 대부분 60% 미만. 긴 설정에서 Mem0의 갱신 정확도 25.50 → 1.45(저자 일부가 1위 시스템 MemOS와 같은 조직)
MemoryArena(2026-02)
LoCoMo에서 거의 포화된 에이전트가 실제 과제에서는 못함. 서로 얽힌 에이전트 과제 701개
모든 시스템 성공률 0.20 이하. Mem0 0.13 < BM25 0.17. 단체 여행 계획은 전원 0
LoCoMo-Plus(2026-02)
표면 사실 회상이 아니라 '말하지 않은 제약'을 기억하는지
최고가 gemini-2.5-pro 전체 맥락 26.06%. 같은 시스템들이 LoCoMo에서는 57~60
LongMemEval-V2(2026-05)
사용자 대화가 아니라 에이전트가 환경에서 겪은 경험을 기억하는지. 건초더미 최대 1억 1,500만 토큰
궤적을 파일로 두고 코딩 에이전트가 탐색하는 방식 72.5% 대 가장 강한 RAG 48.5%
DynamicMem(2026-06)
한 시점 점수만 봄. 15개월치 활동을 5개 시점에서 재기
이력이 길어질수록 정확도 하락(MemoryOS −14.2점). 실패의 93% 이상이 검색 단계
EvalMem(2026-09)
오답이 '저장 안 함·못 찾음·못 씀' 중 무엇인지 모름
순위 뒤집힘: EverMemOS는 LoCoMo 3위, LongMemEval 1위, 새 벤치마크 4위. "모든 설정에서 앞서는 시스템은 없다"
공통된 방향이 보입니다. 더 길게(통째로 넣기를 못 하게), 더 동적으로(사실이 바뀌고 시점마다 잼), 단계별로(어디서 틀렸는지), 과제로(질문에 답하기가 아니라 일을 해내기). 그리고 채점 쪽에서는 MemBench처럼 아예 객관식으로 바꿔 LLM 채점을 없애거나, DynamicMem처럼 채점 판정 756건을 사람이 감사(일치율 96.3%)하는 쪽으로 가고 있습니다.
이 연재의 1~4편이 했던 것도 결국 같은 방향이었습니다. 한국어로, 바뀌는 사실로, 시점별 질문으로, 그리고 저장 단계(엣지가 닫혔나)를 따로 쟀습니다. 다만 규모가 작았습니다.
다섯 편을 관통하는 교훈은 하나입니다. 기억은 '무엇을'보다 '언제'와 '누가 그렇게 말했나'가 어렵습니다. 사실을 저장하는 것은 이제 쉽습니다. 어려운 것은 그 사실이 언제부터 언제까지 참이었는지, 어떤 출처가 그렇게 말했는지, 그리고 그 판단을 누가 채점하는지입니다. 기억 시스템의 점수가 94점이든 75점이든, 그 숫자를 만든 시험지와 채점기와 표본을 함께 읽지 않으면 그 숫자는 마케팅입니다.
다음에 'LoCoMo 9X%'라는 발표를 보면, 이 글의 점검표 열 문항을 떠올려 주세요. 그리고 가능하면, 내 서비스의 대화로 작은 시험지를 직접 만들어 보세요. 이 연재가 다섯 번 한 일이 그것입니다.
이번 실험 비용은 약 60달러였습니다. 가장 큰 항목은 정답지 감사(Claude Sonnet 5.5, 18.2달러)와 LongMemEval 500문항 통째로 읽기(gemini-3.1-flash-lite, 15.2달러)였고, LoCoMo 1,540문항 통째로 읽기는 gpt-4o-mini 5.86달러, gemini-3.1-flash-lite 2.51달러였습니다. 코드와 결과(답변·채점·감사 판정 전체)는 위젯 데이터로 함께 공개합니다.
참고 자료
벤치마크·원 논문
Weston et al., "Towards AI-Complete Question Answering: A Set of Prerequisite Toy Tasks(bAbI)", arXiv 1502.05698
Evan Miller, "Adding Error Bars to Evals", arXiv 2411.00640, Card et al., "With Little Power Comes Great Responsibility", arXiv 2010.06595
Zheng et al., "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena", arXiv 2306.05685, Thakur et al., "Judging the Judges", arXiv 2406.12624, Dubois et al., "Length-Controlled AlpacaEval", arXiv 2404.04475, Zhao et al., "One Token to Fool LLM-as-a-Judge", arXiv 2507.08794
Strathern, "'Improving ratings': audit in the British University system", European Review 5(3), 1997