Graphiti시간 지식 그래프에이전트 메모리실측벤치마크엣지 무효화Neo4jbge-m3한국어 검색BM25cjk 분석기도커Zep이슈 1728
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
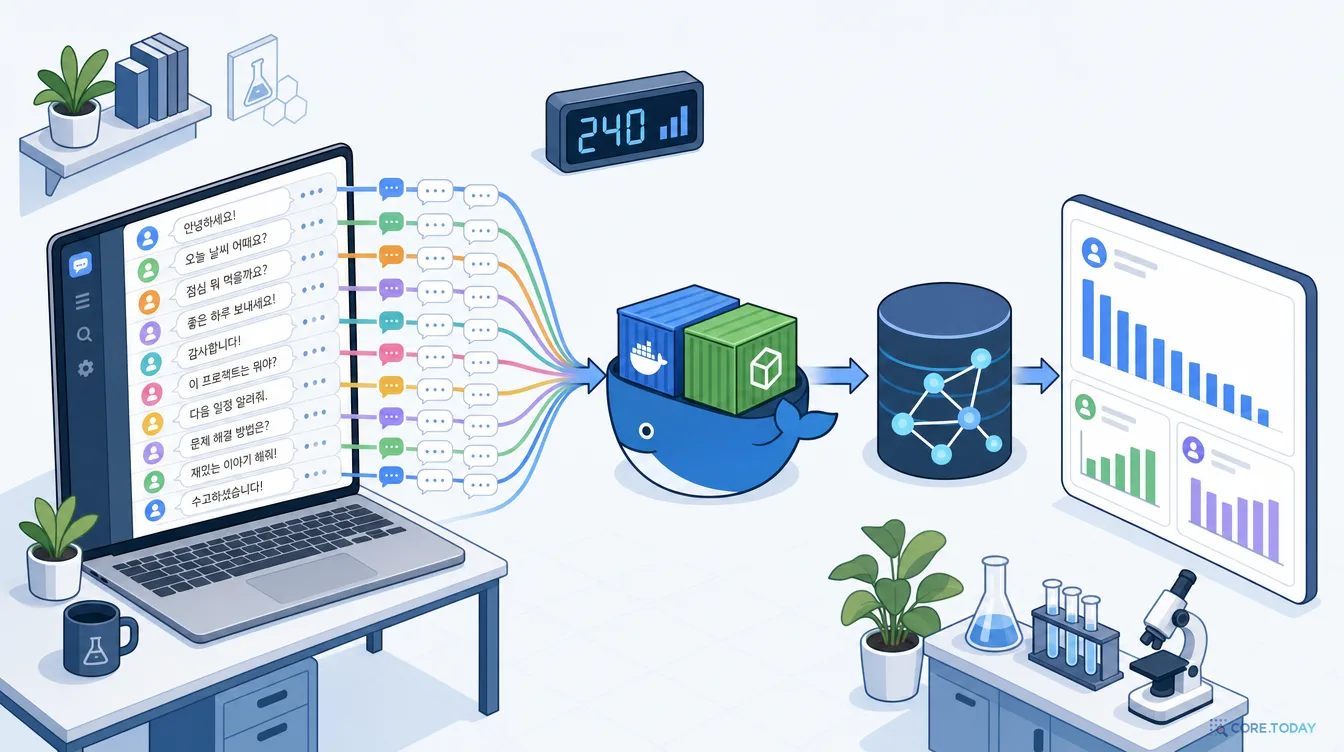
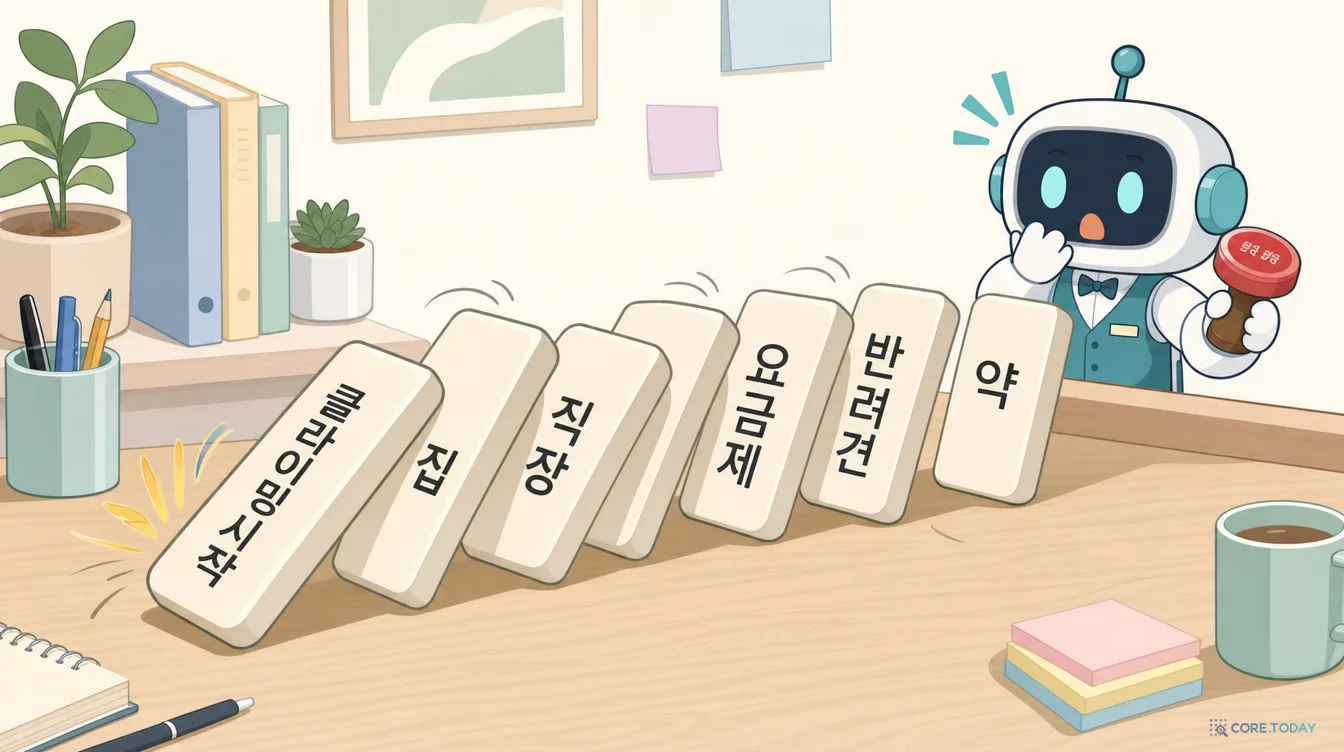
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
지난 글에서 Graphiti의 시간 그래프를 코드 한 줄 한 줄까지 따라 읽었습니다. 사실마다 두 개의 시계를 달고, 새 사실이 옛 사실과 부딪히면 지우지 않고 기간을 닫는다는 설계는 깔끔했습니다. 그런데 읽으면서 걸리는 곳이 몇 군데 있었습니다.
모순 후보를 그래프 전체에서 찾는다(이슈 #1728). 관련 없는 사실이 서로를 닫을 수 있다.
미래형 문장을 잡는 안전망이 영어 정규식이다. 한국어 사실에는 작동하지 않는다.
키워드 검색 인덱스가 한국어 조사를 떼지 못하는 기본 분석기로 만들어진다.
코드를 읽고 “그럴 것 같다”고 쓰는 것과, 실제로 넣어 보고 “이만큼 그렇다”고 쓰는 것은 다른 일입니다. 그래서 이번에는 도커 위에 Graphiti를 그대로 띄우고, 한국어 상담 기록을 넣어 직접 재 봤습니다. 질문은 하나입니다.
옛 사실은 정말, 제때, 제대로 닫히는가?
먼저 결론부터 요약합니다.
1
판정 모델이 품질을 정한다
Graphiti는 모순·중복 판정을 ‘작은 모델’(기본값 gpt-4.1-nano)에게 맡깁니다. 이 상태에서는 끝까지 참이어야 할 사실의 15~28%가 잘못 닫혔습니다. 판정만 gpt-4.1-mini로 바꾸자 두 번의 실행 모두 0건이 됐고, 시점별 정확도는 71~72%에서 80~82%로 올랐습니다. 비용 증가는 1천 건당 0.5달러 정도입니다.
2
그래도 바뀐 사실의 40%는 안 닫힌다
“마포에 산다”와 “분당으로 이사했다”가 나란히 ‘유효’로 남는 일이 판정 모델과 상관없이 흔했습니다. 이슈 #1728을 고치려는 PR #1729는 잘못 닫힘을 없앴지만, 대신 변경 반영률을 20~45%로 떨어뜨렸습니다. 한쪽을 막으면 다른 쪽이 새는 시소입니다.
3
한국어 키워드 검색은 분석기 하나로 두 배
기본 분석기에서 한국어 질문 80개 중 43개가 빈 결과였습니다(적중 23.7%). 인덱스 분석기를 cjk로 바꾸자 빈 결과가 0이 되고 적중이 58.8%로 올랐습니다. 다만 의미 검색을 섞은 혼합 검색은 처음부터 80% 안팎이라, 키워드 검색의 몫은 이름·고유명사 질의입니다.
이 글의 실험 코드와 숫자는 2026년 10월 10일, graphiti-core 0.30.2 기준입니다.
즉 “이 새 사실이 저 옛 사실을 끝내는가”라는, 시간 그래프에서 가장 중요한 결정을 기본 설정에서는 gpt-4.1-nano가 내립니다. Graphiti 0.30.2의 기본 큰 모델은 gpt-5.5지만, 작은 모델 기본값은 gpt-4.1-nano 그대로입니다. 그래서 실험은 판정 모델을 바꾸는 축을 중심에 놓았습니다.
넣은 데이터: 가상의 고객 10명, 1년치 상담 240마디
실제 상담 기록에는 정답이 없습니다. 무엇이 언제 바뀌었는지 모르면 채점을 할 수 없으니, 정답을 알고 있는 대화를 만들었습니다. 고객 10명이 각자 약 10개월 동안 24번 말을 겁니다. 이름·동네·회사·약·반려동물·취미는 사람마다 다르지만, 사건의 구조는 모두 같습니다. 그래야 설정끼리 비교할 수 있습니다.
사건 유형
예 (박서연)
정답 동작
변경 (5회)
“지난주 월요일부터 요금제를 프로로 바꿨어요.” “지난달 15일에 성남 분당으로 이사했어요.”
옛 사실을 정확한 날짜로 닫고 새 사실을 연다
추가 (6회)
“강아지 콩이도 새로 데려왔어요.” “주말에는 작은 온라인 꽃집도 하고 있어요.”
아무것도 닫지 않는다 (고양이 보리, 직장은 그대로)
그만둠 (2회)
“러닝은 무릎 때문에 그만뒀어요.”
그 사실만 닫는다
늦게 도착한 옛이야기
“서울 마포구 오기 전엔 2019년부터 대전에 살았어요.”
지금 거주지를 닫지 않는다. 옛 거주지는 마포 이전에 끝난 사실
미래 계획
“다음 달 말에 한빛소프트 그만두려고요.”
지금 직장을 닫지 않는다. 계획 사실의 시작은 말한 날
반복·잡담 (6회)
“한빛소프트 일이 요즘 바빠요.” “오늘 날씨가 정말 춥네요.”
아무것도 바꾸지 않는다
상대 날짜(“지난주 월요일”, “3일 전”, “이번 달 1일”, “지난달 15일”)는 말한 시각에서 정답 날짜를 계산해 두었습니다. 같은 대화를 영어로 옮긴 판본도 만들어 언어의 영향을 따로 봤습니다.
어떻게 채점했나
그래프에는 “박서연 lives in 서울 마포구” 같은 자유 문장이 남습니다. 이 문장이 정답 사실 중 무엇에 해당하는지는 gpt-4.1에게 대응시켰고, 무작위로 뽑은 40개를 사람이 다시 확인했습니다(오분류 0건). 그다음 두 가지를 쟀습니다.
시점별 정확도: 대화 기간 동안 7일 간격으로 시점을 찍고, 각 시점마다 “그래프는 이 사실을 참이라고 보는가”(어떤 엣지가 그 시점을 valid_at~invalid_at 안에 품는가)와 “실제로 참이었나”를 비교합니다. 정답이 바뀌는 날 앞뒤 3일(날짜가 흐린 “이번 주에 끊었어요”는 7일)은 뺐습니다. 지난 글의 이중 시간 평면에서 ‘지금 아는 바로는, 그때 무엇이 참이었나’를 묻는 질의를 자동으로 수백 번 던지는 셈입니다.
마지막 시점 판정: 대화가 끝난 시점에 사실마다 ‘제대로 유효’, ‘제대로 닫힘’, ‘잘못 닫힘’(아직 참인데 닫힘), ‘못 닫음’(바뀌었는데 열림), ‘추출 누락’으로 분류합니다.
실행은 모두 8번, 에피소드 1,920건입니다. 같은 설정을 두 번씩 돌린 것도 있는데, LLM 기반 파이프라인이 실행마다 얼마나 흔들리는지 보기 위해서입니다.
실행
언어
추출(큰 모델)
판정(작은 모델)
비고
R1, R1b
한국어
gpt-4.1-mini
gpt-4.1-nano
작은 모델 기본값, 두 번 실행
R2
영어
gpt-4.1-mini
gpt-4.1-nano
같은 대화의 영어판
R3, R3b
한국어
gpt-4.1-mini
gpt-4.1-mini
판정만 키움, 두 번 실행
R4
한국어
gpt-4.1-mini
gpt-4.1-nano
PR #1729 적용
R5
한국어
gpt-4.1-mini
gpt-4.1-mini
PR #1729 적용
R6
한국어
gpt-5.5
gpt-4.1-nano
Graphiti 0.30.2 기본 모델 조합
2. 첫 장면: 클라이밍 한 마디가 여섯 사실을 닫다
본 실험 전에 고객 한 명(박서연)으로 시험 삼아 돌린 결과부터 보겠습니다. 설정은 Graphiti 기본 작은 모델(gpt-4.1-nano)입니다. 24마디를 넣는 데 590초, 한 마디에 약 25초가 걸렸습니다.
2025년 6월 15일, 박서연 님이 이렇게 말합니다.
박서연: 요즘은 클라이밍도 시작했어요.
새 취미가 하나 늘었을 뿐입니다. 그런데 이 마디를 처리한 뒤의 그래프를 보면, 다음 여섯 사실의 invalid_at에 똑같이 2025-06-15가 찍혀 있었습니다.
닫힌 사실 (그래프 문장 그대로)
실제로는
박서연 lives in 서울 마포구.
공교롭게 실제 이사일(6월 15일)과 같다. 하지만 이사 소식은 한 달 뒤(7월 15일)에야 들어왔다. 이 시점의 시스템은 근거 없이 닫았다
지난 글 8부에서 소개한 이슈 #1728의 증상 그대로입니다. 모순 후보를 같은 사람의 그래프 전체에서 의미가 비슷한 엣지로 찾고, 판정 모델이 “같은 사람에 대한 다른 이야기”를 모순으로 짚자, 날짜 규칙이 기계적으로 기간을 닫았습니다. 닫힌 날짜가 모두 클라이밍 사실의 valid_at과 같다는 점이 단서입니다. 지난 글 3.5절의 규칙 ④ 그대로 “새 사실이 시작된 날”에 옛 사실을 끝낸 것입니다.
이 그래프에 “서연 님 지금 어디 살아요?”라고 물으면 어떻게 될까요? 6월 15일 이후에는 열린 거주지 사실이 하나도 없습니다. 7월에 분당으로 이사했다는 말이 들어오기 전까지, 그래프는 서연 님이 아무 데도 살지 않는다고 말합니다.
한 명으로 본 장면이 우연인지 확인하려고 본 실험을 돌렸습니다. 아래에서 실제 실험 그래프를 한 마디씩 되감아 볼 수 있습니다. 같은 고객의 같은 대화가 판정 모델과 PR 적용 여부에 따라 얼마나 다른 기억으로 남는지 보세요. 오태윤 님의 기본값(nano) 그래프에서는 여섯 번째 마디(복용 중인 약 이야기)와 열네 번째 마디(새 취미 이야기)가 각각 여러 사실을 한꺼번에 닫습니다.
3. 결과: 여덟 번의 실행
여덟 번의 실행을 지표별로 나란히 놓았습니다. 각 실행은 고객 10명 × 24마디 = 240건입니다.
실행
시점별 정확도
참인 사실 보존율
변경 반영률
닫힌 엣지
1천 건당 비용
R1 한국어 · 판정 nano
71.1%
85.1%
45.0%
35.4%
$2.14
R1b 같은 설정 반복
72.1%
72.1%
70.0%
46.5%
$2.15
R2 영어 · 판정 nano
71.2%
70.8%
75.4%
49.8%
$2.11
R3 한국어 · 판정 mini
80.4%
100%
58.3%
28.9%
$2.65
R3b 같은 설정 반복
82.0%
100%
63.3%
31.9%
$2.66
R4 판정 nano + PR #1729
75.9%
98.6%
20.0%
19.9%
$2.14
R5 판정 mini + PR #1729
78.8%
100%
45.0%
24.9%
$2.67
R6 추출 gpt-5.5 · 판정 nano
63.4%
91.7%
31.0%
24.7%
$26.18
‘참인 사실 보존율’은 끝까지 참이어야 할 사실 70개(새 거주지·새 직장·반려동물 둘·직장 밖 역할·부업·두 번째 취미 × 10명) 가운데 마지막에 유효로 남은 비율, ‘변경 반영률’은 바뀌어 닫혀야 할 사실 60개(이전 거주지·이전 직장·베이직·프로·약 둘 × 10명) 가운데 제대로 닫힌 비율입니다. 추출이 아예 안 된 사실은 두 비율에서 뺐습니다.
표를 읽는 법부터 짚겠습니다. 두 비율은 서로 당기는 관계입니다. 많이 닫을수록 변경 반영률은 오르지만 보존율은 떨어지고, 적게 닫을수록 그 반대입니다. 그래서 둘을 함께 담는 시점별 정확도가 종합 점수 역할을 합니다.
가장 큰 차이는 판정 모델에서 나왔습니다. 추출 모델(gpt-4.1-mini)은 그대로 두고 작은 모델만 nano에서 mini로 바꿨더니,
잘못 닫힘이 사라졌습니다. 끝까지 참이어야 할 사실 70개 중 10~19개가 닫히던 것이, 두 번의 실행 모두 0개가 됐습니다. 반려동물, 직장 밖 역할, 부업이 엉뚱하게 끝나는 일이 없어졌습니다.
닫힌 엣지 비율이 35~47%에서 29~32%로 내려왔습니다. 이슈 #1728의 운영 그래프가 41%였으니, nano 판정의 그래프는 그 보고와 같은 수준이었습니다.
시점별 정확도가 71~72%에서 80~82%로 올랐습니다.
비용은 1천 건당 2.14달러에서 2.65달러로 0.5달러 늘었습니다. 판정은 짧은 프롬프트라 큰 모델 비용에 비하면 작습니다.
또 하나 눈여겨볼 것은 흔들림입니다. 같은 nano 설정을 두 번 돌린 R1과 R1b는 보존율이 85.1%와 72.1%, 변경 반영률이 45.0%와 70.0%로 크게 달랐습니다. nano 판정은 실행마다 “어느 쪽으로 틀릴지”가 바뀝니다. 반면 mini 판정의 R3과 R3b는 보존율 100%로 같았고 변경 반영률도 58.3%와 63.3%로 가까웠습니다. 운영에서 예측 가능성은 정확도만큼 중요합니다.
이 결과에서 바로 쓸 수 있는 권고가 나옵니다. Graphiti를 쓴다면 small_model을 기본값으로 두지 마세요. 작은 모델이 하는 일이 ‘작은 일’이 아닙니다.
판정을 mini로 키워도 바뀐 사실의 37~42%는 끝까지 닫히지 않았습니다. 마지막 시점의 박서연 님 그래프에는 이런 사실이 동시에 ‘유효’로 남아 있었습니다.
R3 · 박서연 · 대화가 끝난 시점에 ‘유효’인 사실 일부
박서연 lives in 서울 마포구 (2025-01-05 ~ 열림) 박서연 moved to 성남 분당 on June 15, 2025. (2025-06-15 ~ 열림) 박서연 changed her subscription plan to the 프로 요금제 … (2025-02-24 ~ 열림) 박서연은 2025년 9월 10일에 요금제를 엔터프라이즈 요금제로 올렸다. (2025-09-10 ~ 열림)
왜 이럴까요? 두 사실을 나란히 놓으면 이유가 보입니다.
옛 사실
새 사실
무엇이 다른가
LIVES_IN 박서연 → 서울 마포구
LIVES_IN 박서연 → 성남 분당 (“moved to”)
끝 엔티티가 다르다. 사람에게 거주지가 하나뿐이라는 규칙은 그래프에 없다
USES_PLAN 박서연 → 베이직 요금제
SWITCHED_TO_PLAN 박서연 → 프로 요금제
관계 이름도, 끝 엔티티도 다르다
WORKS_AT 정하은 → 오름디자인
WORKS_AT 정하은 → 가람출판사
관계 이름이 같아도 판정 모델이 모순으로 짚지 않으면 닫히지 않는다
사람에게 “집은 한 곳”, “요금제는 하나”, “주 직장은 하나”라는 상식이 있지만, 언어 모델이 매번 그 상식을 떠올려 판정해 주지는 않습니다. 이 상식을 그래프에 규칙으로 적어 두는 방법이 지난 글에서 소개한 사용자 정의 엣지 타입(온톨로지)입니다. 이번 실험은 Graphiti의 기본 동작(온톨로지 없음)을 쟀고, 온톨로지를 넣었을 때 얼마나 나아지는지는 다음 실험 과제로 남겼습니다.
이슈 #1728을 고치려는 PR #1729(2026년 10월 10일 현재 미병합)는 모순 후보를 이렇게 좁힙니다. 같은 두 엔티티를 잇는 엣지이거나, 한쪽 끝을 같은 자리에 공유하면서 관계 이름이 같은 엣지만 닫을 수 있다. 0.30.2에 그대로 패치해 돌린 결과는 예상한 시소였습니다.
잘못 닫힘: nano 판정에서 10~19개 → 1개, mini 판정에서는 원래 0개 → 0개.
변경 반영률: nano 판정에서 45~70% → 20%, mini 판정에서 58~63% → 45%.
바로 앞 표가 이유입니다. “마포에 산다”와 “분당으로 이사했다”는 끝 엔티티가 달라 첫째 조건에 걸리지 않고, 관계 이름이 매번 미묘하게 달라(LIVES_IN / MOVED_TO, USES_PLAN / SWITCHED_TO_PLAN) 둘째 조건에도 걸리지 않습니다. 언어 모델이 관계 이름을 자유롭게 짓는 한, 이름이 같아야 닫는 규칙은 진짜 변경까지 막아 버립니다. PR #1729는 “잘못 닫는 것”보다 “못 닫는 것”이 낫다는 선택이고, 두 실패 중 무엇이 더 해로운지는 서비스마다 다릅니다. 상담 기록이라면 지난 요금제로 청구하는 쪽이, 의료라면 끊은 약을 복용 중으로 보는 쪽이 각각 더 위험할 수 있습니다.
3.4 기본값 gpt-5.5: 열두 배 비싸고, 덜 뽑는다
Graphiti 0.30.2의 기본 큰 모델인 gpt-5.5로 추출을 맡기면(판정은 기본값 nano) 어떨까요. 결과는 의외였습니다.
비용은 1천 건당 26.18달러로 mini의 약 12배였습니다.
시점별 정확도는 63.4%로 여덟 번 중 가장 낮았습니다. 추출 누락이 34건으로 다른 실행(9~17건)의 두세 배였고, 취미와 부업 같은 사실을 거의 뽑지 않았습니다. 판정이 nano이니 변경 반영률도 31%에 그쳤습니다.
대신 언어 지시는 완벽하게 따랐습니다. 한국어로 말하면 사실 문장도 100% 한국어로 남았습니다. gpt-4.1-mini는 같은 지시를 받고도 사실의 70% 이상을 영어 서술(“박서연 lives in …”)로 남겼습니다.
큰 모델이 더 꼼꼼하게 뽑을 거라는 기대와 반대로, 추론을 끈(reasoning='none', Graphiti가 gpt-5.5에 자동으로 거는 설정) gpt-5.5는 더 보수적으로 뽑았습니다. 이 실험의 범위에서는 추출 모델을 키우는 것보다 판정 모델을 키우는 것이 훨씬 싸고 효과적이었습니다.
3.5 미래의 계획: 날짜는 맞게, 직장은 일찍
지난 글에서 걱정한 대목입니다. “다음 달 말에 그만두려고요”의 시작 날짜는 프롬프트 지시대로 말한 날로 잘 들어갔습니다(gpt-4.1-mini 추출, 10명 중 7~9명). 영어 정규식 안전망이 작동하지 않는 한국어에서도 프롬프트만으로 대부분 지켜졌다는 뜻입니다. 예외는 gpt-5.5였습니다. 10명 중 2명의 계획 사실이 미래의 퇴사일을 시작 날짜로 받았는데, 두 문장 모두 한국어(“박서연은 다음 달 말에 한빛소프트를 그만두려고 한다.”)라서 영어 정규식이 손댈 수 없는 경우였습니다.
더 큰 문제는 계획이 지금 직장을 미리 닫는 일이었습니다. mini 판정의 세 실행(R3·R3b·R5)에서 “다음 달 말에 그만두려고요”를 처리하면서 직장 사실을 닫은 경우가 6~8건이었습니다. 실제 이직은 한 달 뒤인데, 그래프는 계획을 말한 날 이미 퇴사한 것으로 기록합니다. 흥미롭게도 판정이 더 똑똑한(mini) 쪽에서 더 자주 일어났습니다. nano는 이 둘을 아예 연결하지 못했고, mini는 연결은 했지만 “계획”과 “사실”을 구분하지 못한 것입니다.
3.6 한국어 대 영어: 차이는 흔들림 안에 있었다
같은 대화를 영어로 넣은 R2는 시점별 정확도 71.2%로 한국어 R1(71.1%)·R1b(72.1%)와 같았습니다. 보존율과 반영률은 R1b와 비슷했고, R1과 R1b 사이의 차이가 언어 차이보다 컸습니다. 이 실험 규모에서 언어 자체의 차이는 실행 간 흔들림을 넘지 않았습니다.
언어가 분명히 갈린 곳은 따로 있었습니다.
“지난주 월요일”: 한국어에서는 프로 요금제 시작일이 10명 중 8명 정확했는데, 영어 “starting last Monday”는 1명만 맞았습니다(중앙값 7일 차이). 영어의 “last Monday”는 ‘가장 최근의 월요일’로도 읽히는 말이라, 모델이 틀렸다기보다 말 자체가 모호합니다. 한국어의 “지난주 월요일”이 더 정확한 표현이었던 셈입니다.
사실 문장의 언어: 위에서 본 대로 gpt-4.1-mini는 한국어 대화를 대부분 영어 서술로 저장합니다. 이것은 다음 절의 검색에 직접 영향을 줍니다.
3.7 늦게 도착한 옛이야기와 빠진 취미
마지막으로 모든 설정에서 공통으로 나타난 두 가지입니다.
옛이야기의 끝 날짜. “서울 마포구 오기 전엔 2019년부터 대전에 살았어요”는 정답으로는 마포 이전(2025년 1월 이전)에 끝난 사실입니다. 그런데 그래프는 대부분 이 사실을 말한 날까지 유효로 기록했습니다(예: 2019-01-01 ~ 2025-07-15). 그 결과 이 사실의 시점별 정확도는 모든 설정에서 10~44%에 그쳤습니다. “2025년 3월에 서연 님은 어디 살았나?”라고 물으면 대전과 마포가 함께 나옵니다. “~ 오기 전엔”이라는 상대적 끝을 날짜로 바꾸려면 다른 사실(마포 거주 시작)을 참조해야 하는데, 논문 부록에 실린 시간 추출 프롬프트부터 “관련 사건에서 날짜를 추론하지 말라”고 지시합니다. 의도된 보수성이 만든 공백입니다.
활동형 사실의 누락. “취미로 러닝을 하고 있어요”는 10명 중 9~10명에서 사실로 남지 않았습니다. 엔티티 추출 프롬프트가 “관계나 행동은 노드로 만들지 말라”고 지시해서, 러닝·요가 같은 활동 명사가 엔티티가 되지 못하기 때문으로 보입니다. 반면 “요즘은 클라이밍도 시작했어요”처럼 변화로 말한 두 번째 취미는 gpt-4.1-mini 추출에서 대부분 잡혔습니다(gpt-5.5는 이것도 놓쳤습니다). 같은 정보라도 말하는 방식에 따라 기억되거나 사라집니다.
기억을 잘 닫아도 꺼내지 못하면 소용이 없습니다. 지난 글에서 Graphiti의 키워드(BM25) 인덱스가 한국어 조사를 떼지 못하는 기본 분석기로 만들어진다고 썼는데, 실제로 확인해 보니 그대로였습니다. Neo4j에 만들어진 인덱스 네 개(edge_name_and_fact 등)의 분석기는 모두 standard-no-stop-words였습니다. Neo4j가 기본 제공하는 분석기 목록에는 한국어 형태소 분석기(nori)가 없고, 한·중·일 문자를 두 글자씩 자르는cjk 분석기가 있습니다.
R1 그래프(한국어)에 고객마다 질문 8개, 모두 80개를 던지고 상위 5개 안에 정답 사실이 들어오는지 쟀습니다. 질문은 “박서연은 지금 어디 살아요?”, “서연 님 요즘 회사 어디 다녀요?”, “누리랩스로 이직한 사람”처럼 조사와 존칭을 섞었습니다.
한국어 · 키워드 · 기본 분석기
23.7%
한국어 · 키워드 · cjk 분석기
58.8%
영어 · 키워드 · 기본 분석기
52.5%
한국어 · 의미(코사인)
83.8%
한국어 · 혼합(키워드+의미) · 기본
82.5%
한국어 · 혼합 · cjk
80.0%
상위 5개 적중률(recall@5), 질문 80개. 막대 길이는 100% 기준.
기본 분석기에서는 80개 중 43개가 아예 빈 결과였습니다. 이유는 두 겹입니다. 첫째, “박서연은”, “서연 님”, “다녀요?”가 모두 통째로 한 토큰이라 사실 문장의 “박서연”과 맞지 않습니다. 둘째, 3.4절에서 본 대로 사실 문장의 70% 이상이 영어 서술(“lives in”, “works at”)이라 한국어 질문과 겹치는 낱말 자체가 이름과 고유명사뿐입니다.
cjk로 인덱스만 다시 만들자 빈 결과가 0이 되고 적중률이 58.8%로 두 배 넘게 올랐습니다. 바꾸는 방법은 Cypher 두 줄입니다(그래프 수집이 돌고 있지 않을 때 하세요. 수집 중의 중복·모순 후보 검색도 이 인덱스를 씁니다).
cypher
DROP INDEX edge_name_and_fact;
CREATE FULLTEXT INDEX edge_name_and_fact FOR ()-[e:RELATES_TO]-()
  ON EACH [e.name, e.fact, e.group_id]
  OPTIONS {indexConfig: {`fulltext.analyzer`: 'cjk'}};
다만 결론을 과장하면 안 됩니다. 혼합 검색은 분석기와 상관없이 80% 안팎이었습니다. 의미 검색(bge-m3)이 한국어 질문과 영어 사실 문장 사이를 이미 잘 이어 주기 때문입니다. 키워드 검색이 진짜 필요한 곳은 제품 코드, 약 이름, 회사 이름처럼 글자가 정확히 같아야 하는 질의이고, 그런 질의라면 cjk 분석기로 바꾸는 것이 거의 공짜에 가까운 개선입니다. 바이그램은 형태소 분석보다 거칠어서 엉뚱한 두 글자 일치도 함께 올라오므로, 혼합 검색에서는 오히려 1~2개 질문이 밀려났습니다.
5. 비용과 속도
에피소드 한 건을 그래프에 넣을 때 무엇이 드는지 정리했습니다(R1 기준, 240건 평균).
단계 (프롬프트)
모델
호출 / 240건
입력 토큰 / 240건
엔티티 추출 extract_nodes.extract_message
큰 모델
240
58만 5천
사실 추출 extract_edges.edge
큰 모델
240
49만
엔티티 중복 판정 dedupe_nodes.nodes
작은 모델
133
21만 9천
사실 중복·모순 판정 dedupe_edges.resolve_edge
작은 모델
183
16만 9천
에피소드당 LLM 호출 약 3.3회, 입력 토큰 약 6천 개. 2024년 이슈(#186)에서 “메시지당 12초”, 2025년 이슈(#467)에서 “짧은 대화 40개에 0.8달러”가 보고됐는데, 2026년 0.30.2는 그보다 훨씬 가벼워졌습니다. 0.29에서 날짜 판정을 별도 단계로 떼고, 중복 판정 앞에 고전적인 문자열 비교를 둔 영향으로 보입니다.
처리 시간은 에피소드당 중앙값 12~14초. 한 사용자의 메시지는 순서대로 넣어야 하지만(앞 사실을 보고 뒤 사실을 닫으니까) 사용자끼리는 병렬로 넣을 수 있어, 10명을 동시에 넣은 240건이 4분 반~5분에 끝났습니다.
비용은 판정 모델보다 추출 모델이 좌우합니다. 입력 토큰의 4분의 3이 큰 모델 몫이라, 판정을 nano에서 mini로 키워도 1천 건당 0.5달러 남짓 늘 뿐입니다. 반대로 큰 모델을 gpt-5.5로 바꾸면 12배가 됩니다.
한 가지 덧붙이면, 처음에 colima 가상 머신을 4코어로 띄웠을 때는 로컬 임베딩(bge-m3)이 병목이 되어 30개 흐름이 동시에 몰리자 5분 동안 한 건도 끝나지 않았습니다. 코어를 14개로 늘리고 Ollama의 동시 처리 수를 8로 올리자 임베딩 64개가 1.7초에 끝났습니다. 로컬 임베딩을 쓴다면 이 부분부터 확인하세요.
6. 실무 권고
실측에서 바로 나온 것만 적습니다.
1. 작은 모델
small_model을 기본값(gpt-4.1-nano)으로 두지 않는다. 모순·중복 판정이 이 모델 몫이다. 이번 실험에서는 mini로 바꾸는 것만으로 잘못 닫힘이 0이 됐고, 비용은 1천 건당 0.5달러 늘었다.
2. 큰 모델
큰 모델을 키우는 것보다 작은 모델을 키우는 편이 싸고 효과가 크다. gpt-5.5(추론 끔)는 12배 비싸고 추출 누락이 늘었다. 대신 사실을 원문 언어로 남기는 데는 확실히 나았다.
3. 지표
닫힌 엣지 비율을 늘 본다. 이번 실험에서 판정이 건강할 때 29~32%, 과잉일 때 35~50%였다. 갑자기 늘면 판정 모델이나 프롬프트가 바뀌지 않았는지 확인한다.
4. 못 닫음
거주지·요금제·주 직장처럼 ‘하나만 유효한’ 관계는 사용자 정의 엣지 타입으로 정의하고, 필요하면 앱에서 같은 타입의 옛 엣지를 닫는 후처리를 둔다. 기본 동작만으로는 바뀐 사실의 37~42%가 열린 채 남았다.
5. PR #1729
병합되면 잘못 닫힘은 줄지만 변경 반영도 크게 준다(이번 실험 20~45%). 4번의 엣지 타입 정의와 함께 써야 관계 이름이 맞아 제 효과를 낸다.
6. 한국어 검색
BM25 인덱스를 cjk 분석기로 다시 만든다. 이름·고유명사 질의의 빈 결과가 사라진다. 혼합 검색을 기본으로 쓰면 영향은 작다.
7. 계획과 옛이야기
“~하려고요” 같은 계획이 지금 사실을 닫는 경우가 판정이 좋을수록 더 잦았다. 계획을 별도 엣지 타입으로 두거나, 계획 사실이 들어올 때의 무효화를 앱에서 검토한다. “~ 전엔”으로 시작하는 옛이야기는 끝 날짜가 말한 날로 잘못 들어가기 쉽다.
8. 시계 하나는 실제 시각
expired_at(기록의 시간)은 언제나 수집을 실행한 실제 시각이다. 지난 기록을 한꺼번에 넣으면 1년치 대화의 ‘알게 된 시점’이 모두 수집한 날 하루로 뭉친다. 감사용 질의가 필요하면 원래 메시지 시각을 따로 보관한다.
8번은 실험하다 알게 된 것입니다. 이번 실험의 엣지는 2025년의 대화를 2026년 10월 10일에 넣었기 때문에, created_at과 expired_at이 모두 2026-10-10이었습니다. 세상의 시간(valid_at·invalid_at)은 대화 속 날짜를 따라가지만, 기록의 시간은 실제로 기록한 날을 따릅니다. 이중 시간 모델의 정의상 맞는 동작이지만, “2025년 3월에 상담원 화면에는 무엇이 떠 있었나”를 재현하려는 사람에게는 함정입니다. 지난 글 7부에서 reference_time에 실제 메시지 시각을 넣으라고 한 이유가 세상의 시간 쪽이라면, 이것은 기록의 시간 쪽의 주의점입니다.
7. 이 실험의 한계
합성 데이터입니다. 고객 10명이 모두 같은 사건 구조를 따르고, 한 마디에 한 가지 정보만 담았습니다. 실제 상담은 한 메시지에 여러 사실이 섞이고, 상담원 발화도 끼어듭니다.
표본이 작습니다. 설정당 240건, 반복은 두 설정에서 두 번씩뿐입니다. nano 판정의 흔들림을 보면 한 번의 실행으로 결론을 내리면 위험합니다. 이 글의 수치는 방향을 보는 데 쓰고, 소수점 차이에 의미를 두지 마세요.
채점에 언어 모델을 썼습니다. 엣지를 정답 사실에 대응시키는 일은 gpt-4.1이 했고, 40개 표본 검토에서 오류는 없었지만 전수 검토는 아닙니다.
한 가지 DB, 한 가지 버전입니다. Neo4j 5.26, graphiti-core 0.30.2만 쟀습니다. FalkorDB나 Zep 관리형 서비스(자체 그래프 엔진 Konig, 별도 검색 계층)에서는 결과가 다를 수 있습니다. 특히 Zep 서비스는 2025년 말 이후 중복 판정 앞단을 고전적 기법으로 바꿨다고 밝혔습니다.
온톨로지 없이 쟀습니다. 사용자 정의 엔티티·엣지 타입을 넣으면 못 닫음 문제가 크게 달라질 수 있습니다. 이것은 다음 실험입니다.
마무리: 시간 그래프의 시계는 판정자가 돌린다
지난 글은 “사실에 유효기간을 적는다”는 아이디어가 얼마나 잘 설계됐는지를 봤습니다. 이번 실측은 그 유효기간을 누가 적는지를 보여 줍니다. 두 개의 시계와 날짜 규칙은 코드가 정확하게 돌리지만, “이 둘이 부딪히는가”라는 판단은 언어 모델 한 번의 호출에 달려 있고, 기본 설정은 그 판단을 가장 작은 모델에게 맡깁니다.
다행히 처방은 단순했습니다. 판정자를 한 단계 키우면 엉뚱한 사실을 닫는 일이 사라집니다. 어려운 것은 반대쪽, 사람에게는 당연한 “집은 하나”라는 상식을 그래프가 스스로 떠올리게 하는 일입니다. 그 상식을 규칙으로 적어 주는 온톨로지가 다음 실험의 주제입니다.