GraphitiZep시간 지식 그래프Temporal Knowledge Graph이중 시간 모델Bitemporal에이전트 메모리엣지 무효화GraphRAGMem0LongMemEvalRAG
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
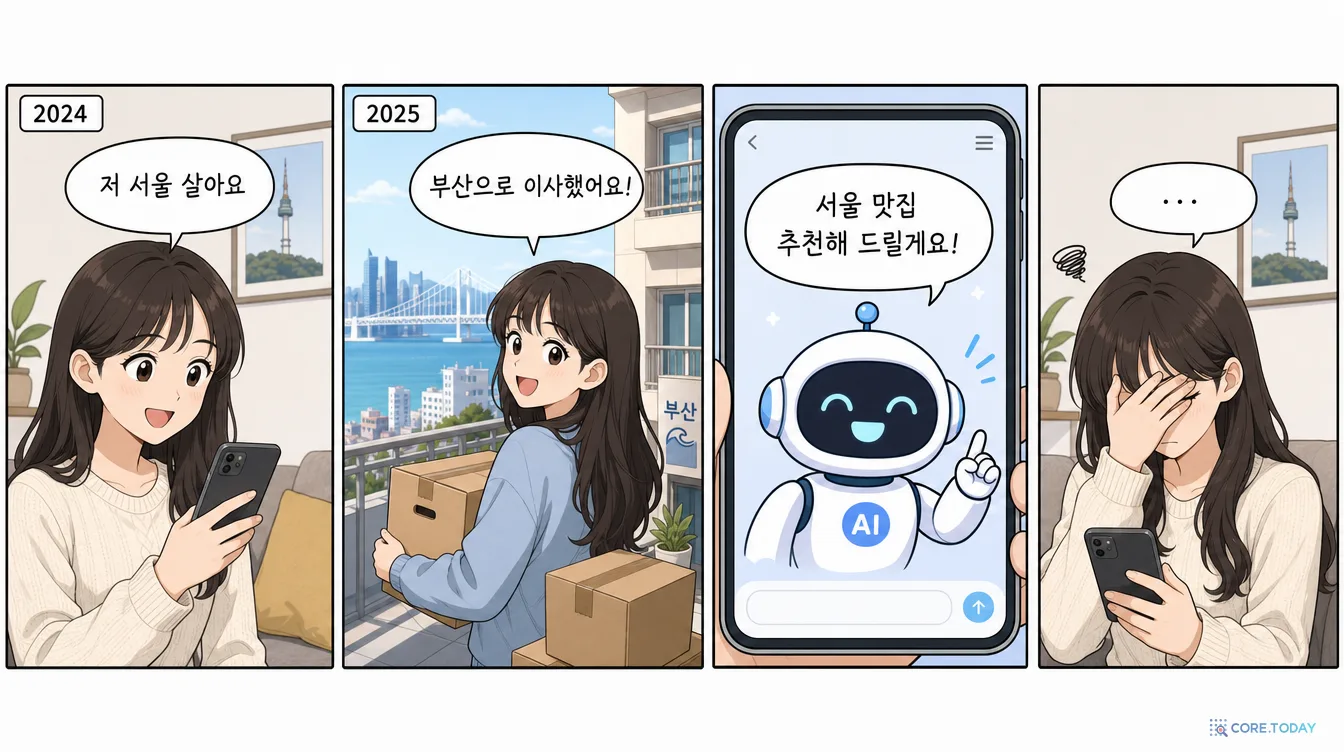
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
작년 봄, 서연 님은 비서 에이전트에게 “저 데이터팀이에요”라고 말했습니다. 가을에는 “ML팀으로 옮겼어요”라고 했고요. 그런데 올해 비서가 회의 자료를 정리하면서 이렇게 씁니다. “데이터팀 박서연 님께 공유드립니다.”
이 비서는 기억력이 나쁜 게 아닙니다. 두 문장을 모두 기억합니다. 문제는 두 문장 가운데 어느 쪽이 지금 참인지 모른다는 데 있습니다. 사람에게는 너무 당연해서 문제라고 여기지도 않는 일입니다. “예전엔 데이터팀이었고 지금은 ML팀”이라는 감각, 즉 사실마다 유효기간이 있다는 감각이 기계의 기억에는 기본으로 들어 있지 않습니다.
이 글은 그 감각을 기계에게 붙여 주려는 오픈소스 프레임워크 Graphiti를 다룹니다. Graphiti는 에이전트 메모리 회사 Zep이 만든 핵심 엔진입니다. 2025년 1월 논문 「Zep: A Temporal Knowledge Graph Architecture for Agent Memory」(arXiv 2501.13956)로 공개됐고, 2026년 10월 현재 GitHub 별 3만 1천 개를 넘긴 저장소(getzep/graphiti, 최신 v0.30.2)입니다.
Graphiti가 하는 일을 한 문장으로 줄이면 이렇습니다.
사실을 지우지 않는다. 대신 사실마다 ‘언제부터 언제까지 참이었는지’와 ‘언제 알게 됐는지’를 적는다.
간단해 보이는 이 원칙에는 40년쯤 된 데이터베이스 이론, 사람의 기억에 대한 심리학, 그리고 언어 모델이 저지르는 실수를 막는 꽤 섬세한 규칙들이 얽혀 있습니다. 이 글은 그 실타래를 처음부터 풀어 봅니다.
?
이 글이 답하려는 질문
기계의 기억에 시간이 왜 필요한가? 데이터베이스는 이 문제를 언제부터 어떻게 풀어 왔나? Graphiti의 ‘네 개의 타임스탬프’는 각각 무엇인가? 옛 사실은 정확히 어떤 규칙으로 닫히나? 2026년의 다른 기억 설계와 비교하면 어디에 맞고 어디에 안 맞나?
→
이 글의 방식
논문을 읽고, 실제 코드(v0.30.2)의 분기를 그대로 옮긴 인터랙티브로 따라갑니다. 예시는 모두 한국어 대화로 바꿨고, 한국어로 쓸 때 생기는 함정도 따로 짚습니다.
✓
먼저 읽으면 좋은 글
논문 전체의 구조와 벤치마크는 Zep 논문 해부에서, Zep 제품군(Konig·Context Lake·MCP)의 관계는 Zep 생태계 지도에서 다뤘습니다. 이 글은 그중 ‘시간’ 한 가지만 깊게 팝니다.
잠깐 — 같은 이름, 다른 논문
arXiv에서 “Graphiti”를 찾으면 2504.03182가 먼저 나오기도 합니다. 「Graphiti: Bridging Graph and Relational Database Queries」(He, Fang, Dillig, Wang, 2025년 4월)는 Cypher 그래프 질의와 SQL 질의가 같은 결과를 내는지 자동으로 증명하는 프로그래밍 언어 연구 도구로, 이 글의 Graphiti와는 이름만 같습니다. 에이전트 메모리 Graphiti의 논문은 2501.13956(Rasmussen 외, Zep AI)입니다.
1부. 사실은 상하는 음식이다
냉장고에 날짜를 적는 이유
냉장고에 반찬을 넣을 때 통에 날짜를 적어 두는 집이 많습니다. 반찬이 상해서가 아니라, 언제 넣었는지 모르면 먹어도 되는지 판단할 수 없기 때문입니다.
사실도 그렇습니다. “지훈은 카카오에서 일한다”는 2023년에는 참이었고 2026년 3월부터는 거짓입니다. 문장 자체는 그대로인데 참·거짓이 시간에 따라 바뀝니다. 논리학에서는 이런 사실을 유동 사실(fluent)이라고 부릅니다. 반대로 “앨런 튜링은 1912년 6월 23일에 태어났다”처럼 한 번 참이면 영원히 참인 사실도 있습니다.
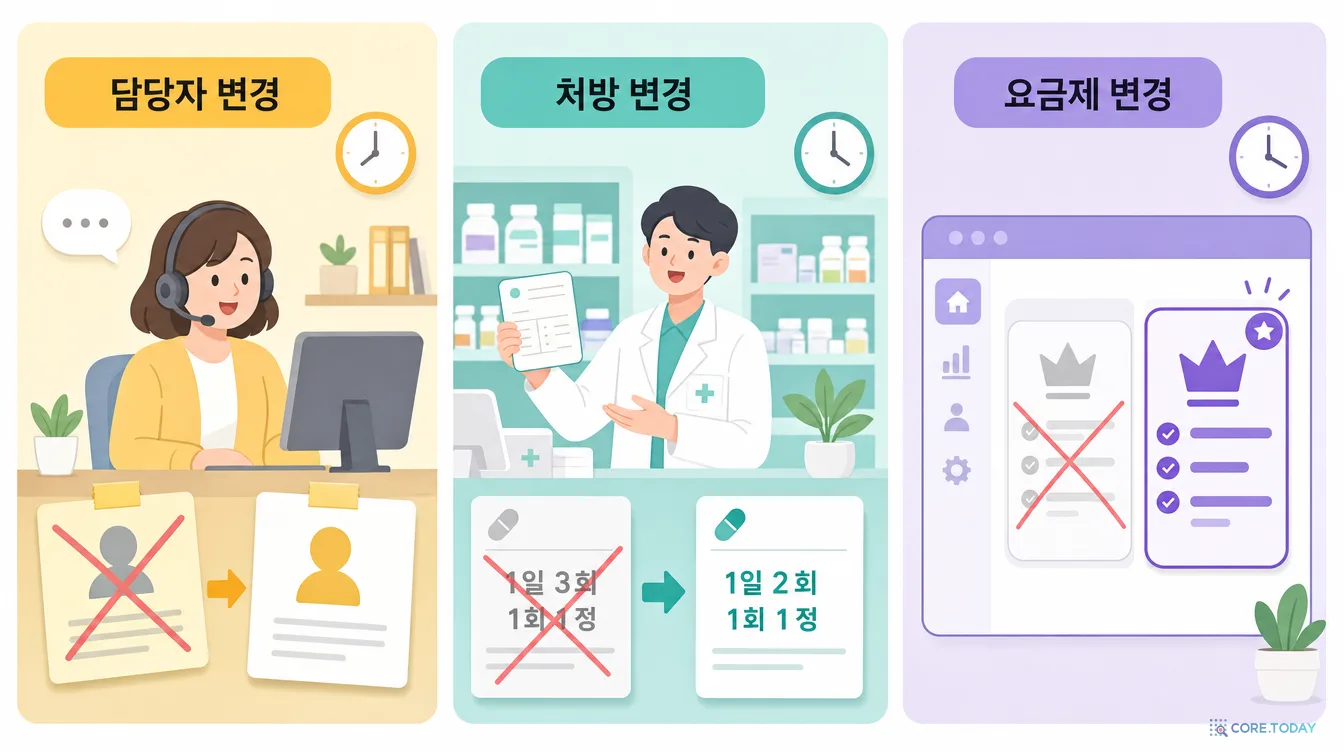
문제는 에이전트가 듣는 정보 대부분이 앞쪽, 즉 상하는 쪽이라는 점입니다. 사는 곳, 다니는 회사, 쓰는 요금제, 먹는 약, 좋아하는 브랜드, 담당자, 재고, 가격, 일정이 다 그렇습니다.
표의 마지막 열을 보면 질문이 두 종류로 나뉩니다. “지금 무엇이 참인가”와 “그때 무엇이 참이었나(또는 그때 우리는 무엇을 알고 있었나)”입니다. 앞의 질문만 필요하다면 옛 값을 지우고 새 값을 덮어쓰면 됩니다. 뒤의 질문에도 답하려면 지워서는 안 됩니다. 그렇다고 그냥 쌓아 두기만 하면 앞의 질문에 엉뚱한 답이 나옵니다.
덮어쓸 것인가, 쌓을 것인가
기억 장치를 만드는 쪽은 오래전부터 이 딜레마를 겪었습니다.
덮어쓰기: 칸마다 최신 값 하나만 둡니다. 지금을 묻는 질문에는 빠르고 정확하지만, 과거는 흔적 없이 사라집니다.
쌓기: 들은 말을 전부 보관합니다. 아무것도 잃지 않지만, 꺼낼 때 서로 모순되는 조각이 함께 나옵니다. 어느 쪽이 나중 말인지는 꺼낸 쪽이 알아서 판단해야 합니다.
요약하기: 쌓인 말을 주기적으로 짧게 다시 씁니다. 최신 상태는 잘 담지만, 다시 쓸 때마다 지나간 상태와 날짜가 깎여 나갑니다.
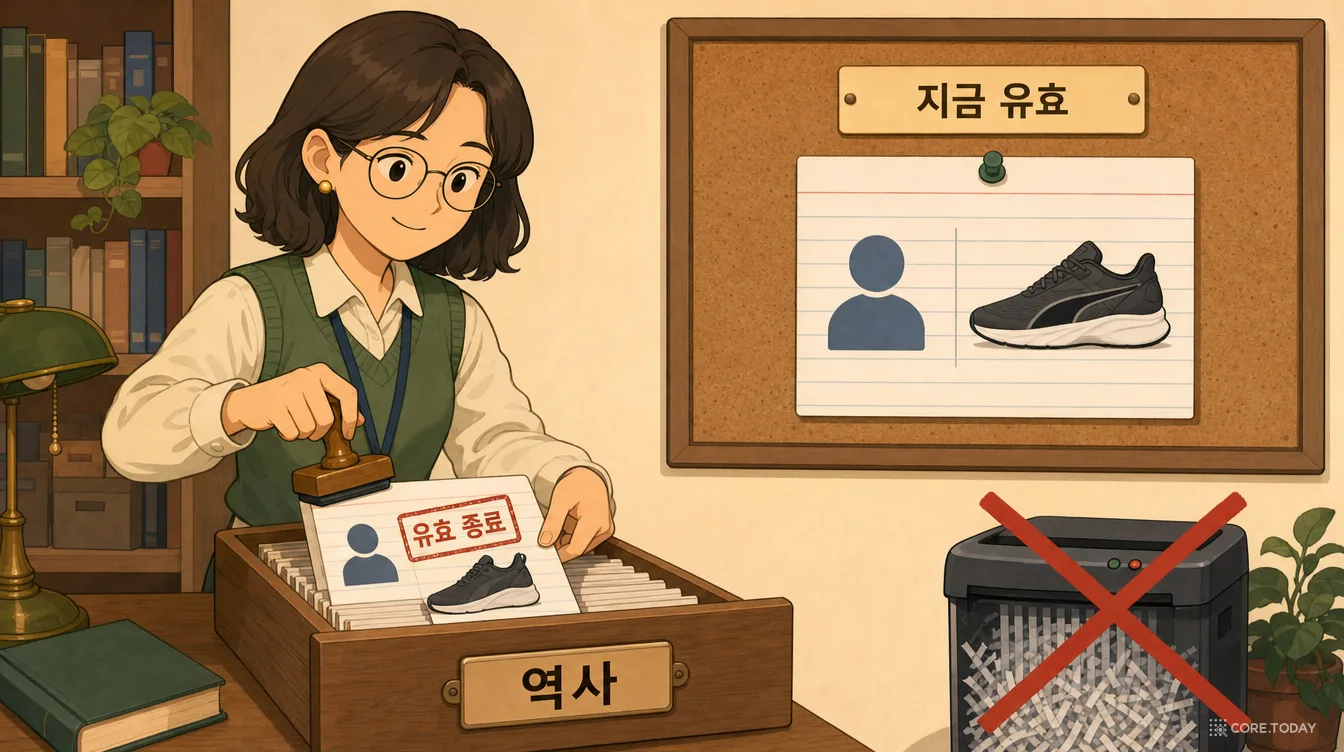
Graphiti의 답은 네 번째 길입니다. 쌓되, 사실마다 기간을 적는다. 새 사실이 옛 사실과 부딪히면 옛 사실을 지우지 않고 끝 날짜를 채워 “닫습니다”. 아래 인터랙티브에서 같은 다섯 마디 대화를 다섯 가지 방식으로 기억했을 때 무엇이 달라지는지 확인해 보세요.
두 가지를 짚어 두겠습니다. 첫째, 대화가 짧을 때는 통째로 넣는 쪽이 가장 정확합니다. Zep 논문도 이 점을 숨기지 않습니다(5부에서 다룹니다). 기억 장치가 값을 하는 건 대화가 쌓여 통째로 넣을 수 없게 된 다음입니다. 둘째, 시간 그래프도 계산까지 해 주지는 않습니다. “ML팀에 온 지 얼마나 됐나”를 계산하는 건 여전히 답하는 언어 모델입니다. 시간 그래프는 그 계산에 필요한 날짜를 잃어버리지 않게 할 뿐입니다.
2부. 시간을 다뤄 온 40년 — 데이터베이스가 먼저 겪은 문제
Graphiti의 핵심 아이디어는 새것이 아닙니다. 논문 스스로도 “이중 시간 모델을 LLM 기반 지식 그래프에 적용한 것이 새롭다”고 말합니다. 앞쪽의 이중 시간 모델 자체는 1980년대 데이터베이스 연구자들이 만든 것입니다. 이 계보를 알면 Graphiti가 무엇을 물려받았고 무엇을 새로 더했는지가 또렷해집니다.
1983년, 제임스 앨런(James Allen)은 「시간 구간에 대한 지식 유지」(CACM)에서 두 구간 사이에 가능한 관계를 13가지로 정리했습니다. ‘앞선다’, ‘맞닿는다’, ‘겹친다’, ‘안에 든다’, ‘같이 시작한다’, ‘같이 끝난다’, ‘같다’의 일곱 가지와 그 역관계 여섯 가지입니다. “분당에 산 기간은 판교에 산 기간과 맞닿는다”, “카페 알바 기간은 지금 직장 기간보다 앞선다”처럼, 시간 추론은 결국 구간 사이의 관계를 따지는 일이라는 생각의 출발점입니다. Graphiti의 겹침 검사(3.5절 규칙 ④)도 이 관계 가운데 ‘앞선다·맞닿는다’면 모순이 아니라고 보는 셈입니다.
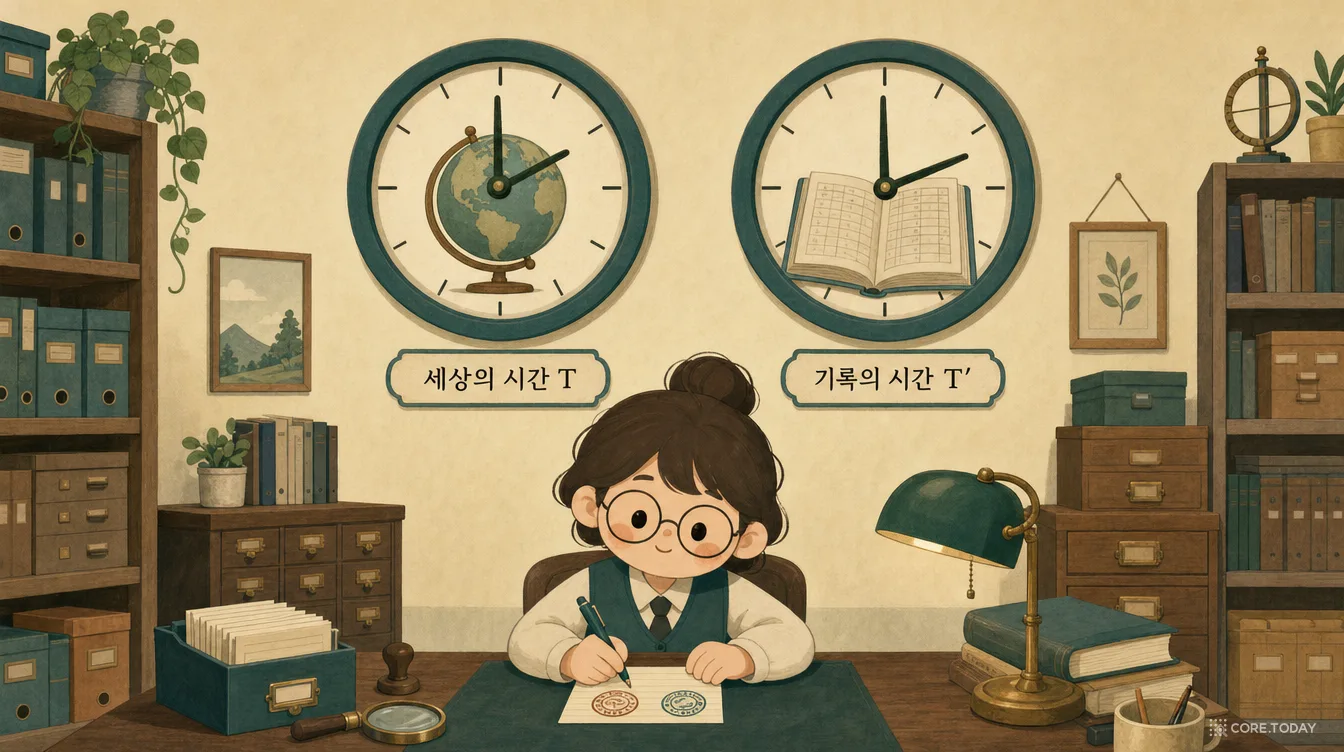
1985~1986년, 리처드 스노드그래스(Richard Snodgrass)와 Ilsoo Ahn은 SIGMOD 논문 「데이터베이스 속 시간의 분류」(1985)와 IEEE Computer 논문 「시간 데이터베이스」(1986)에서 결정적인 구분을 내놓습니다(용어는 1986년 논문에서 지금의 이름으로 자리 잡았습니다). 데이터베이스가 다루는 시간에는 유효 시간(valid time)과 트랜잭션 시간(transaction time)이 있고, 둘은 서로 독립이라는 것입니다. 유효 시간은 현실에서 그 사실이 참이었던 기간, 트랜잭션 시간은 데이터베이스에 그 사실이 기록돼 있던 기간입니다. 둘 다 지원하는 데이터베이스를 이중 시간(bitemporal) 데이터베이스라고 부릅니다. Graphiti의 T와 T′가 정확히 이 두 축입니다.
1983
앨런의 구간 대수 — 두 시간 구간 사이의 관계 13가지. 시간 추론의 문법
1985~86
스노드그래스·안 — 유효 시간과 트랜잭션 시간은 독립. ‘이중 시간’ 데이터베이스의 탄생
1995
TSQL2 — 시간 개념을 넣은 SQL 확장 제안. 연구 성과를 한 언어로 정리(674쪽짜리 책)
2011
SQL:2011 표준 — 시스템 버전 테이블(트랜잭션 시간)과 애플리케이션 기간 테이블(유효 시간). 둘 다 쓰면 이중 시간 테이블
2012
구글 지식 그래프 “문자열이 아니라 사물을”. 같은 해 위키데이터 출범, 사실마다 시작·종료 시점 한정자(P580·P582)
2013
YAGO2 — 사실에 시간과 장소를 붙인 지식 베이스(주어·술어·목적어 + 시간·장소)
2017~21
시간 지식 그래프 학습 — Know-Evolve, TTransE, HyTE, RE-NET. 뉴스 사건 데이터(ICEWS·GDELT)로 미래 관계 예측
2020
RAG(Lewis 외) — 언어 모델에 외부 문서 검색을 붙이다. 초록부터 ‘세상 지식 갱신’을 열린 문제로 꼽음
2023
생성 에이전트(Park 외)의 기억 흐름, MemGPT(Packer 외)의 계층 기억 — LLM에게 장기 기억을
2024
GraphRAG(마이크로소프트), AriGraph, LightRAG, HippoRAG — LLM이 뽑은 지식 그래프로 검색. 8월 Graphiti v0.1.0 공개
2025
Zep 논문(1월) — 이중 시간 모델 + LLM 지식 그래프 + 에이전트 기억. 4월 Mem0 논문, 메모리 벤치마크 논쟁
2026
ChatGPT ‘Dreaming’(6월)이 “시간이 지나도 최신으로”를 목표로 명시, Mem0가 덮어쓰기를 버리고 ‘추가만’으로 전환, Zep이 기억 오염 방어 논리로 이중 시간을 내세움
은행과 보험이 먼저 알았던 것
이중 시간 모델이 실무에서 오래 쓰인 곳은 돈이 걸린 시스템입니다. 마틴 파울러의 글 「Bitemporal History」(2021)는 급여 예시를 듭니다. 2월 15일부터 오른 월급을 회사가 3월 15일에야 알게 됐다면, 3월 1일에 지급한 2월분 급여는 당시로서는 맞게 계산한 것이지만 지금 보면 틀린 것입니다. 소급 정산을 하려면 “당시 무엇을 알고 있었나”와 “실제로는 어땠나”를 둘 다 알아야 합니다. 파울러는 워크숍 참가자들이 ‘유효/트랜잭션’이라는 말을 어려워해서 ‘실제(actual) 시간’과 ‘기록(record) 시간’으로 바꿔 부른다고 썼습니다. 이 글이 ‘세상의 시간’과 ‘기록의 시간’이라고 부르는 것도 같은 이유입니다.
데이터베이스 제품도 이 생각을 받아들였습니다. Datomic은 트랜잭션 시간을 기본으로 저장해 “그 시점의 데이터베이스”를 그대로 꺼내 볼 수 있게 했고(asOf), XTDB는 두 축을 모두 기본으로 갖춰 FOR VALID_TIME AS OF와 FOR SYSTEM_TIME AS OF를 따로 물을 수 있게 했습니다. XTDB 문서는 감사(audit)에는 기록 시간 기준 질의를 쓰라고 권합니다. 3부의 인터랙티브에서 “3월 10일 청구서는 왜 Basic이었나”를 물은 것이 바로 이 질의입니다.
지식 그래프가 시간을 만났을 때
지식 그래프 쪽에서도 시간은 오래된 숙제였습니다. 위키데이터는 “버락 오바마 — 직위 — 미국 대통령”이라는 진술에 시작 시점(P580)과 종료 시점(P582)을 한정자로 붙여, 같은 진술이 언제 참이었는지 적습니다. YAGO2(2013)는 4억 4,700만 개 사실을 담으면서, 주어·술어·목적어에 시간과 장소를 더한 SPOTL 모델로 사실을 시공간 위에 놓았습니다.
2017년 무렵부터는 기계학습 연구자들이 시간 지식 그래프 임베딩을 연구했습니다. Know-Evolve, TTransE, HyTE, RE-NET 같은 모델은 국제 분쟁 뉴스에서 뽑은 사건 데이터(ICEWS, GDELT)로 “다음 달 A국과 B국 사이에 어떤 사건이 일어날까”를 예측합니다. 이 계열에게 시간은 예측에 쓰는 특징값이었습니다.
Graphiti는 이 두 갈래 가운데 데이터베이스 쪽에 더 가깝습니다. 시간으로 무엇을 예측하지 않습니다. 대신 장부를 정확히 적습니다. 다른 점은 장부의 재료입니다. SQL:2011의 이중 시간 테이블에는 사람이 정리한 깔끔한 행이 들어가지만, Graphiti에는 언어 모델이 사람의 말에서 뽑아낸 사실이 들어갑니다. “지난주”를 날짜로 풀고, “그만뒀어요”가 무엇을 끝냈는지 알아내고, 두 문장이 모순인지 판단하는 일이 모두 언어 모델의 몫입니다. 40년 된 장부 방식에 언어 모델이라는 서기를 붙인 것, 이것이 Graphiti의 새로움입니다.
RAG(2020)는 정적인 문서 더미를 검색합니다. 문서가 바뀌면 색인을 다시 만들어야 합니다.
생성 에이전트(2023)는 기억마다 ‘최근성’ 점수를 매겨 오래된 기억이 덜 떠오르게 했습니다. 시간을 다루지만, ‘오래됨’과 ‘더는 참이 아님’을 구분하지는 않습니다. 10년 된 생일 정보는 오래됐어도 여전히 참입니다.
MemGPT(2023)는 운영체제의 메모리 계층을 흉내 내 컨텍스트 안팎으로 기억을 옮깁니다. 무엇이 최신인지는 에이전트가 스스로 편집하며 관리합니다.
GraphRAG(2024)는 문서에서 엔티티 그래프를 뽑고 커뮤니티 요약을 미리 만들어, “이 문서 더미 전체의 주제는?” 같은 전역 질문에 답합니다. 문서가 한 번에 들어오는 상황을 가정합니다.
Graphiti(2024~)는 GraphRAG의 그래프와 커뮤니티를 가져오되, 데이터가 조금씩 계속 들어오고 사실이 바뀌는 상황에 맞게 다시 설계했습니다. 그 중심에 이중 시간이 있습니다.
Graphiti의 README는 GraphRAG와의 차이를 표 하나로 정리합니다. 시간 처리 행은 GraphRAG가 “기본적인 타임스탬프 추적”, Graphiti가 “자동 사실 무효화를 갖춘 명시적 이중 시간 추적”입니다. 모순 처리 행은 GraphRAG가 “LLM 요약 판단”, Graphiti가 “시간 기록을 보존한 자동 무효화”입니다. 물론 회사가 직접 만든 비교표이고, 두 도구는 겨냥하는 문제가 다릅니다(6부).
3부. Graphiti 해부 — 시간을 담는 그릇
이제 Graphiti 안으로 들어가 보겠습니다. 순서는 그릇(그래프의 세 층) → 시계(네 개의 타임스탬프) → 손(수집 파이프라인) → 규칙(옛 사실을 닫는 법)입니다.
3.1 세 층짜리 건물: 원문, 사실, 무리
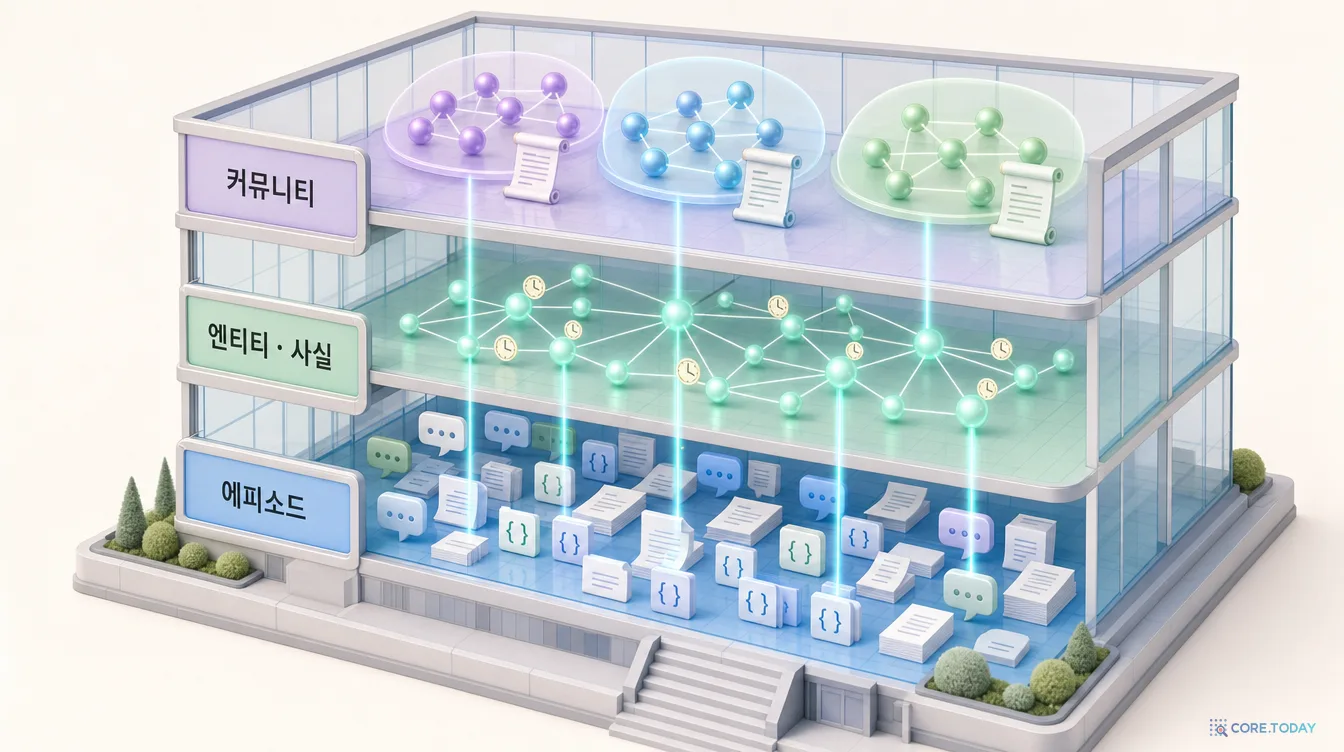
논문은 Graphiti의 그래프를 G=(N,E,ϕ)로 적습니다. 노드 집합, 엣지 집합, 그리고 엣지가 어느 두 노드를 잇는지 알려 주는 함수입니다. 수식은 이게 전부이고, 중요한 건 이 그래프가 세 층으로 나뉜다는 점입니다.
3층 · 커뮤니티 𝒢c 강하게 연결된 엔티티 무리와 그 요약. “지훈의 직장 생활”, “서연의 식생활” 같은 큰 그림
2층 · 엔티티와 사실 𝒢s 노드 = 사람·회사·장소·개념 (이름 + 요약) 엣지 = 두 엔티티 사이의 사실 + 네 개의 타임스탬프
1층 · 에피소드 𝒢e 들어온 원문 그대로: 메시지·텍스트·JSON. 고치지도 지우지도 않는 ‘무손실’ 보관소
1층 에피소드는 들어온 데이터 그대로입니다. 대화 메시지 한 마디, 문서 한 단락, 주문 시스템이 보낸 JSON 한 덩어리가 각각 에피소드 하나입니다. 에피소드에는 기준 시각 tref가 붙습니다. 메시지라면 보낸 시각입니다. 이 값이 뒤에서 “지난주”, “2주 뒤” 같은 말을 실제 날짜로 바꾸는 기준점이 됩니다.
2층 엔티티와 사실은 에피소드에서 뽑아낸 지식입니다. 노드는 사람·회사·제품 같은 대상이고, 엣지는 그 사이의 관계입니다. 엣지 하나에는 WORKS_AT 같은 짧은 관계 이름과 “지훈은 네이버에서 일한다” 같은 사실 문장(fact), 그리고 시간 정보가 함께 들어 있습니다. 모든 엣지는 자기가 어느 에피소드에서 나왔는지 기억합니다(episodes 목록). 그래서 “그거 언제 누가 한 말이야?”라고 물으면 원문으로 되돌아갈 수 있습니다.
3층 커뮤니티는 서로 촘촘히 연결된 엔티티 무리와 그 요약입니다. 마이크로소프트 GraphRAG에서 가져온 생각이지만, 만드는 방법이 다릅니다(3.7절).
이 설계는 심리학의 오래된 구분을 그대로 닮았습니다. 1972년 엔델 털빙(Endel Tulving)은 사람의 장기 기억을 일화 기억(언제 어디서 무슨 일이 있었나)과 의미 기억(세상에 대해 아는 것)으로 나눴습니다. “지난 화요일 점심에 서연이 채식을 시작했다고 말했다”는 일화이고, “서연은 채식을 한다”는 의미입니다. Graphiti의 1층은 일화 기억, 2층은 의미 기억에 해당합니다. 논문도 이 대응을 명시하고, 일화와 의미를 나눈 그래프는 AriGraph(2024)에서 먼저 시도됐다고 밝힙니다.
T, 세상의 시간(사건의 시간): 그 사실이 실제로 참이었던 기간입니다. 지훈이 네이버에서 일한 기간, 운동화가 품절이었던 기간입니다.
T′, 기록의 시간(트랜잭션 시간): 시스템이 그 사실을 언제 알게 됐고 언제 닫았는지입니다. 데이터베이스에 행이 들어간 시각입니다.
두 시계는 자주 어긋납니다. 고객은 3월 1일에 요금제를 바꾸고 3월 15일에야 알려 줍니다. 그 2주 동안 세상은 이미 바뀌었는데 시스템은 몰랐습니다. 이 어긋남을 기록해 두지 않으면 “3월 10일에 에이전트는 왜 Basic 요금으로 계산했나?”라는 감사 질문에 답할 수 없습니다.
두 축 위에 시각이 두 개씩, 그래서 엣지마다 네 개의 타임스탬프가 붙습니다.
필드 (코드 이름)
시간축
뜻
예: “지훈은 카카오에서 일한다”
valid_at (논문 t_valid)
T 세상
사실이 참이 되기 시작한 때
2022-04-01 (입사일)
invalid_at (논문 t_invalid)
T 세상
사실이 더는 참이 아니게 된 때. 비어 있으면 ‘아직 참’
2026-03-02 (네이버 첫 출근일)
created_at (논문 t′_created)
T′ 기록
시스템이 이 사실을 처음 기록한 때
2022-04-03 (그 말을 들은 날)
expired_at (논문 t′_expired)
T′ 기록
시스템이 이 사실의 끝을 기록한 때
2026-03-05 (이직 소식을 들은 날)
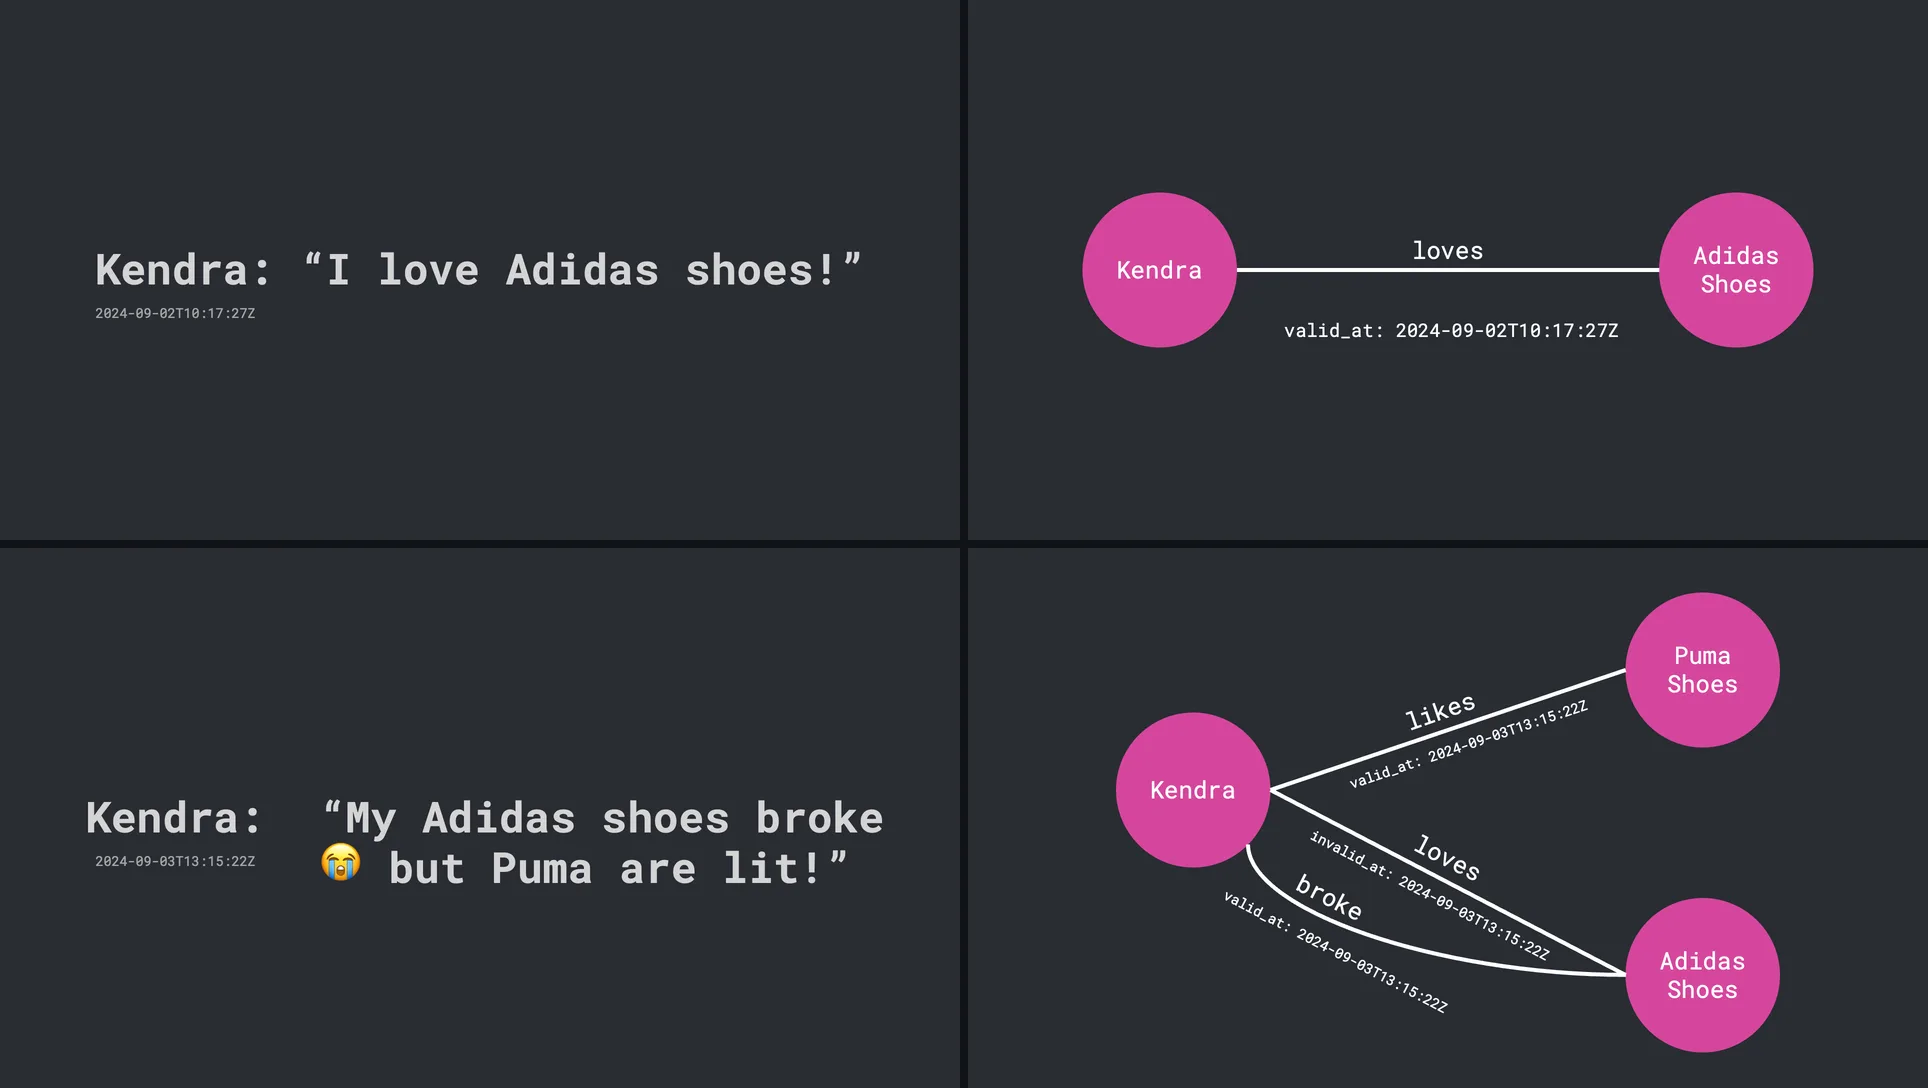
README의 그림이 이 개념을 가장 짧게 보여 줍니다. 켄드라가 “아디다스 신발 너무 좋아!”라고 말하면 loves 엣지가 생기고 valid_at이 찍힙니다. 다음 날 “아디다스 신발 망가졌어. 근데 푸마 최고!”라고 말하면 새 엣지 두 개(broke, likes)가 생기고, 옛 loves 엣지는 지워지는 대신 invalid_at을 받습니다.
출처: getzep/graphiti README의 graphiti-graph-intro.gif에서 네 프레임을 골라 배치. Apache-2.0.
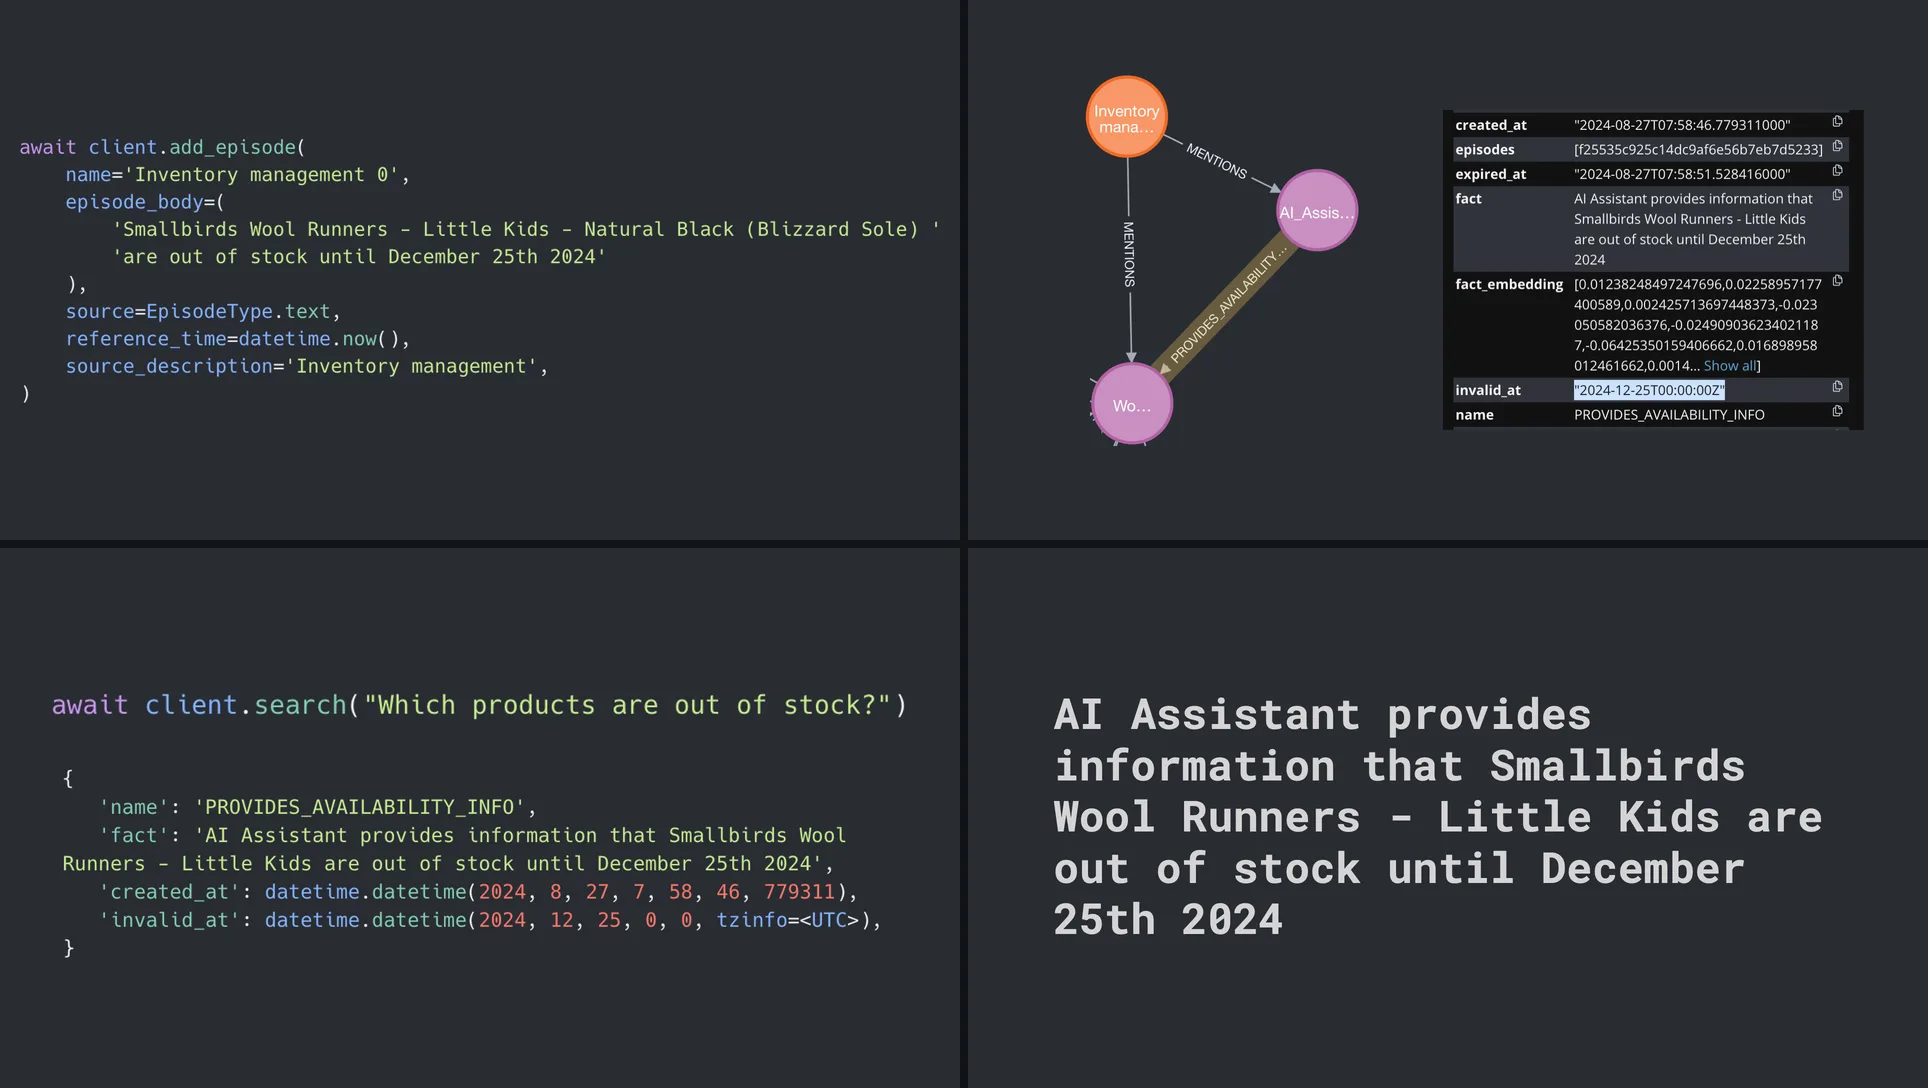
두 번째 README 그림은 구조화된 업무 데이터 쪽 예시입니다. 재고 시스템이 “스몰버즈 울 러너는 2024년 12월 25일까지 품절”이라는 텍스트 에피소드를 넣으면, 엣지의 invalid_at에 미래 날짜 2024-12-25가 들어갑니다. 지금은 참이지만 끝나는 날이 정해진 사실입니다. 눈여겨볼 곳은 오른쪽 위 속성 창입니다. created_at이 07:58:46인데 expired_at이 07:58:51로, 불과 5초 뒤에 찍혀 있습니다. 끝 날짜를 이미 아는 사실은 들어오는 순간 ‘끝이 기록된 사실’로 처리되기 때문입니다(3.6절의 규칙 ②). 즉 Graphiti에서 expired_at은 “더는 믿지 않는다”가 아니라 “끝 날짜를 확정해 기록했다”에 가깝습니다.
출처: getzep/graphiti README의 graphiti-intro-slides-stock-2.gif에서 네 프레임을 골라 배치. Apache-2.0.
두 시계를 함께 쓰면 질문이 두 차원으로 늘어납니다. 가로축에 세상의 시간, 세로축에 기록의 시간을 두면 사실 하나가 평면 위의 영역이 됩니다. 아래 인터랙티브에서 “언제의 시스템이 언제의 사실을” 믿었는지 직접 찍어 보세요. 특히 두 번째와 세 번째 버튼을 번갈아 누르면, 같은 3월 10일에 대한 답이 묻는 시점에 따라 달라지는 걸 볼 수 있습니다.
계단 모양을 기억해 두면 좋습니다. 끝을 모르던 시기에는 사실이 오른쪽(미래)으로 열려 있다가, 끝을 알게 된 순간부터 닫힌 구간이 됩니다. 은행·보험 시스템이 수십 년 동안 그려 온 그림이 이것이고(2부), Graphiti는 이 그림을 언어 모델이 읽은 대화 위에 그립니다.
3.3 ‘지난주’를 날짜로 바꾸기
사람은 날짜를 숫자로 말하지 않습니다. “지난주에 이사했어요”, “2주 뒤에 출장 가요”, “작년 여름부터”라고 말합니다. Graphiti는 에피소드의 기준 시각 tref를 언어 모델에게 함께 주고, 이런 상대 표현을 ISO 8601 날짜로 풀게 합니다. 논문 부록에 실린 시간 추출 프롬프트의 규칙을 옮기면 이렇습니다.
규칙 1
사실 자체에 관한 날짜만 뽑는다. 문장에 날짜가 있어도 그 관계의 시작·끝과 무관하면 무시한다.
규칙 2
현재형 문장(“네이버에 다녀요”)이면 기준 시각을 valid_at으로 쓴다.
규칙 3
“10년 전”, “2분 전” 같은 상대 표현은 기준 시각에서 계산한다.
규칙 4
날짜만 있고 시각이 없으면 자정(00:00:00), 연도만 있으면 1월 1일 자정으로 둔다.
규칙 5
관련 사건에서 날짜를 추론하지 않는다. 직접 언급된 날짜만 쓴다. 정보가 없으면 비워 둔다.
2026년의 코드는 여기에 한 가지를 더했습니다. 미래의 계획과 약속입니다. “다음 달 말에 퇴사할 거예요”를 듣고 valid_at을 다음 달 말로 적으면, 그 사실은 아직 참이 아닌 것이 됩니다. 그런데 우리가 기록하고 싶은 건 “퇴사”가 아니라 “퇴사할 계획이 있다”이고, 이건 말한 그날부터 참입니다. 그래서 현재 프롬프트는 계획·약속·예정·마감은 valid_at을 말한 날로 두고, 미래 날짜는 사실 문장 안에 남기라고 지시합니다. “금요일까지 보고서를 끝내겠다” 같은 느슨한 마감은 invalid_at이 아닙니다. 반면 “12월 25일까지 품절”처럼 계속되던 상태가 그날 끝나는 경우에만 미래 날짜를 invalid_at에 씁니다.
여기에 코드 쪽 안전망(normalize_future_temporal_bounds)이 하나 더 있습니다. 사실 문장에서 will, plans to, scheduled to, by 같은 표현을 정규식으로 찾아 언어 모델의 실수를 한 번 더 바로잡습니다. 그런데 이 정규식은 영어 표현만 찾습니다. Graphiti는 기본적으로 “원문과 같은 언어로 추출하라”고 지시하므로, 한국어로 대화하면 사실 문장도 한국어로 뽑히고, 이 안전망은 작동하지 않습니다. 한국어 서비스라면 프롬프트 지시가 유일한 방어선이라는 뜻입니다. 기준 시각을 메시지가 실제로 오간 시각으로 정확히 넣는 일(reference_time)이 그래서 더 중요합니다.
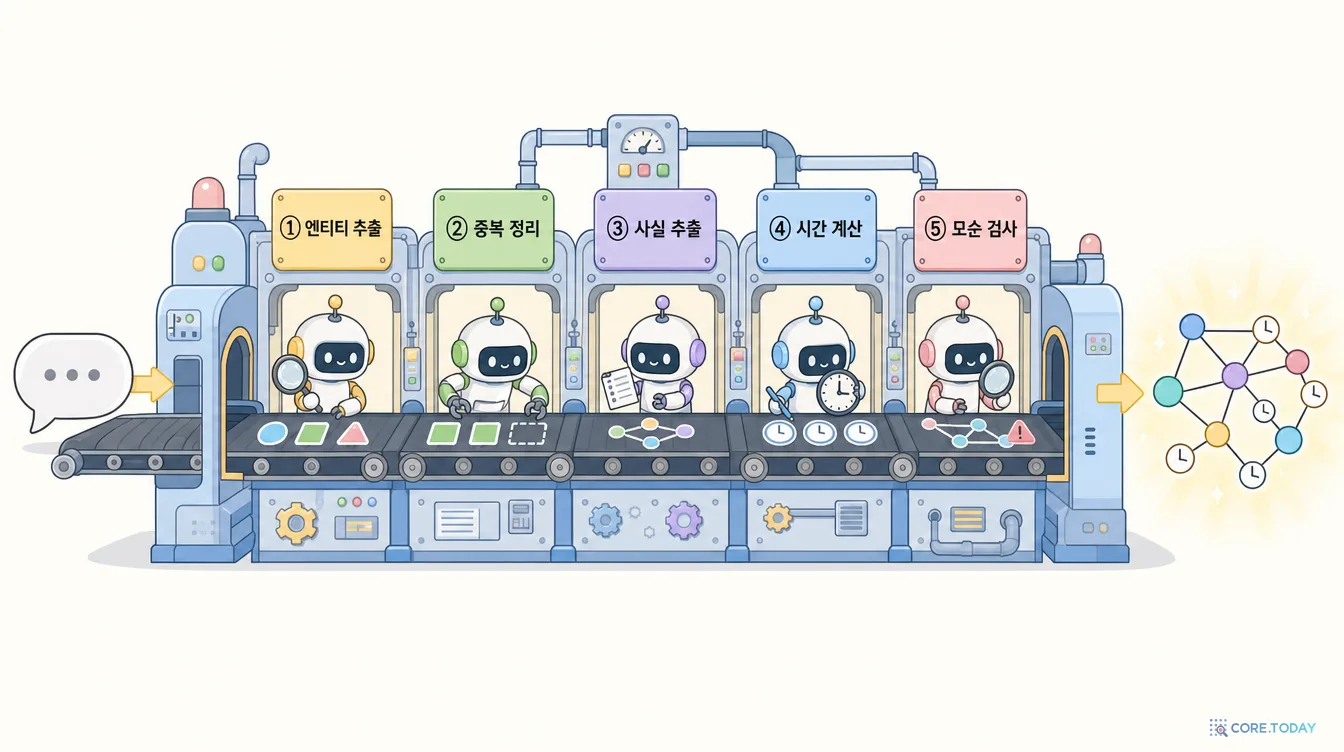
add_episode()를 한 번 부르면 안에서 다음 일이 차례로 일어납니다. 논문 2.2절과 현재 코드를 함께 보며 정리했습니다.
① 엔티티 추출
현재 메시지와 직전 메시지 4개(대화 두 턴)를 함께 읽고 등장하는 대상을 뽑는다. 말한 사람은 항상 첫 엔티티. 날짜는 노드로 만들지 않는다(엣지에 붙일 것이므로). 논문은 Reflexion식 자기 점검으로 빠뜨린 엔티티를 한 번 더 찾는다고 적었다.
② 엔티티 정리
뽑은 이름을 임베딩(논문 실험은 1024차원 BGE-m3)해 비슷한 기존 노드를 찾고, 이름·요약 전문 검색으로 후보를 더한 뒤, 언어 모델이 “같은 대상인가”를 판정한다. ‘지훈’, ‘김지훈 님’, ‘지훈 씨’가 한 노드로 합쳐진다.
③ 사실 추출·중복 제거
엔티티 쌍 사이의 관계를 사실 문장으로 뽑는다. 중복 검사는 같은 두 엔티티 사이의 엣지만 대상으로 해서, 비슷하지만 다른 사람 사이의 사실이 섞이는 일을 막고 계산량도 줄인다.
④ 시간 추출
기준 시각에 비춰 valid_at·invalid_at을 정한다(3.3절).
⑤ 모순 검사·무효화
언어 모델이 의미가 가까운 기존 사실 중 새 사실과 모순되는 것을 고르고, 코드가 날짜를 비교해 누구의 기간을 닫을지 정한다(3.5절).
그래프에 쓰는 일은 언어 모델이 만든 질의가 아니라 미리 정해 둔 Cypher 질의로 합니다. 논문은 “스키마를 일정하게 유지하고 환각을 줄이기 위해” 그렇게 했다고 밝힙니다. 언어 모델은 무엇을 쓸지만 정하고, 어떻게 쓸지는 코드가 정합니다. 3.5절의 무효화 규칙도 같은 철학입니다.
이 파이프라인에서 비용이 보입니다. 에피소드 한 건에 언어 모델 호출이 여러 번 들어갑니다(추출, 정리, 사실 추출, 시간, 모순 판정, 요약 갱신). 그래서 README는 기본 동시 실행 수(SEMAPHORE_LIMIT)를 10으로 낮게 잡고, 구조화 출력(Structured Output)을 지원하는 모델을 쓰라고 강조합니다. 작은 모델은 출력 형식이 틀려 수집이 실패하는 일이 잦다고 경고합니다.
새 사실이 들어왔을 때 옛 사실과 부딪히면 무슨 일이 일어날까요? 논문은 이렇게 적습니다.
시스템은 언어 모델로 새 엣지와 의미가 가까운 기존 엣지를 비교해 모순을 찾는다. 시간적으로 겹치는 모순을 찾으면, 영향받은 엣지의 t_invalid를 새 엣지의 t_valid로 설정해 무효화한다. (논문 2.2.3절)
핵심은 역할 분담입니다. “이 둘은 모순인가?”라는 판단은 언어 모델이 합니다. 그 판단을 받아 누구의 기간을 어디서 닫을지는 코드가 날짜만 보고 기계적으로 정합니다. 현재 코드(edge_operations.py의 _apply_temporal_invalidation과 resolve_edge_contradictions)를 풀어 쓰면 규칙은 넷입니다.
규칙 ① 미래형 정규화
계획·약속 문장이면 valid_at을 말한 날로 당기고, 느슨한 마감은 invalid_at에서 뺀다.
규칙 ② 끝이 있는 사실
새 사실이 처음부터 invalid_at을 갖고 오면, 들어오는 즉시 expired_at을 찍어 ‘역사’로 저장한다.
규칙 ③ 늦게 도착한 옛이야기
모순 후보 가운데 새 사실보다 늦게 시작한 것이 있으면, 닫히는 쪽은 새 사실이다. 새 사실의 invalid_at = 그 후보의 valid_at.
규칙 ④ 겹침 검사 후 닫기
후보마다 두 기간이 겹치는지 본다. 겹치지 않으면 모순이 아니므로 그대로 둔다. 겹치고 후보가 더 일찍 시작했으면 후보를 닫는다: invalid_at = 새 사실의 valid_at, expired_at = 지금.
규칙 ③이 재미있습니다. 논문은 “트랜잭션 시간 T′를 따라 새 정보를 우선한다”고 썼습니다. 그런데 현재 코드가 실제로 비교하는 것은 들은 순서(T′)가 아니라 사실이 시작된 시점(T)입니다. “판교 오기 전엔 2023년부터 분당에 살았어요”를 나중에 들었다고 해서 판교 사실을 닫으면 안 되기 때문입니다. 나중에 들은 말이 아니라, 나중에 시작된 사실이 이깁니다. 규칙 ④의 겹침 검사는 언어 모델이 잘못 짚은 모순을 걸러 내는 안전장치이기도 합니다. 대학 시절 아르바이트 이야기를 언어 모델이 “지금 직장과 모순”이라고 판정해도, 두 기간이 겹치지 않으니 지금 직장은 닫히지 않습니다.
아래 실험실에서 다섯 상황을 바꿔 가며 어느 분기가 실행되는지 보세요.
이 규칙들이 다루지 못하는 경우도 분명히 있습니다. 언어 모델이 모순을 놓치면(예: “요즘 재택이에요”와 “판교 사무실로 출근해요”를 모순으로 보지 않으면) 두 사실이 모두 ‘유효’로 남습니다. 반대로 둘 다 참일 수 있는 사실을 모순으로 짚으면, 겹침 검사를 통과한 경우 멀쩡한 사실이 닫힙니다. “고양이를 키운다”와 “강아지를 키운다”는 둘 다 참일 수 있습니다. 무효화의 품질은 결국 모순 판정의 품질에 달려 있고, 이것은 프롬프트와 모델이 결정합니다. 반대로 사실을 지우지 않는 설계이기에, 잘못 닫힌 사실도 원문 에피소드와 함께 남아 있어 나중에 되돌릴 수 있습니다.
3.6 커뮤니티: 큰 그림을 조금씩 고쳐 그리기
마지막 층은 커뮤니티입니다. GraphRAG(마이크로소프트, 2024)는 그래프 전체에 라이덴(Leiden) 알고리즘을 돌려 무리를 나누고 무리마다 요약을 만듭니다. 문서 더미가 한 번 들어와 고정되는 상황에는 잘 맞지만, 대화처럼 매 순간 조금씩 바뀌는 그래프에서는 매번 전체를 다시 나누기가 부담스럽습니다.
Graphiti는 레이블 전파(label propagation)를 씁니다. 새 엔티티가 들어오면 이웃 노드들이 속한 커뮤니티를 보고 가장 많은 이웃이 속한 무리에 합류시킨 뒤 그 무리의 요약만 고칩니다. 레이블 전파의 한 걸음만 실행하는 셈입니다. 이렇게 조금씩 고치면 지연과 비용이 크게 줄지만, 시간이 지나면 처음부터 전부 다시 나눴을 때와 결과가 조금씩 달라집니다. 그래서 논문은 주기적인 전체 재계산이 여전히 필요하다고 적습니다. 커뮤니티 이름에는 핵심어를 넣고 임베딩해서, 검색 때 “지훈의 직장 생활” 같은 무리를 통째로 찾을 수 있게 합니다.
4부. 꺼내 쓰기 — 시간이 붙은 사실을 찾는 법
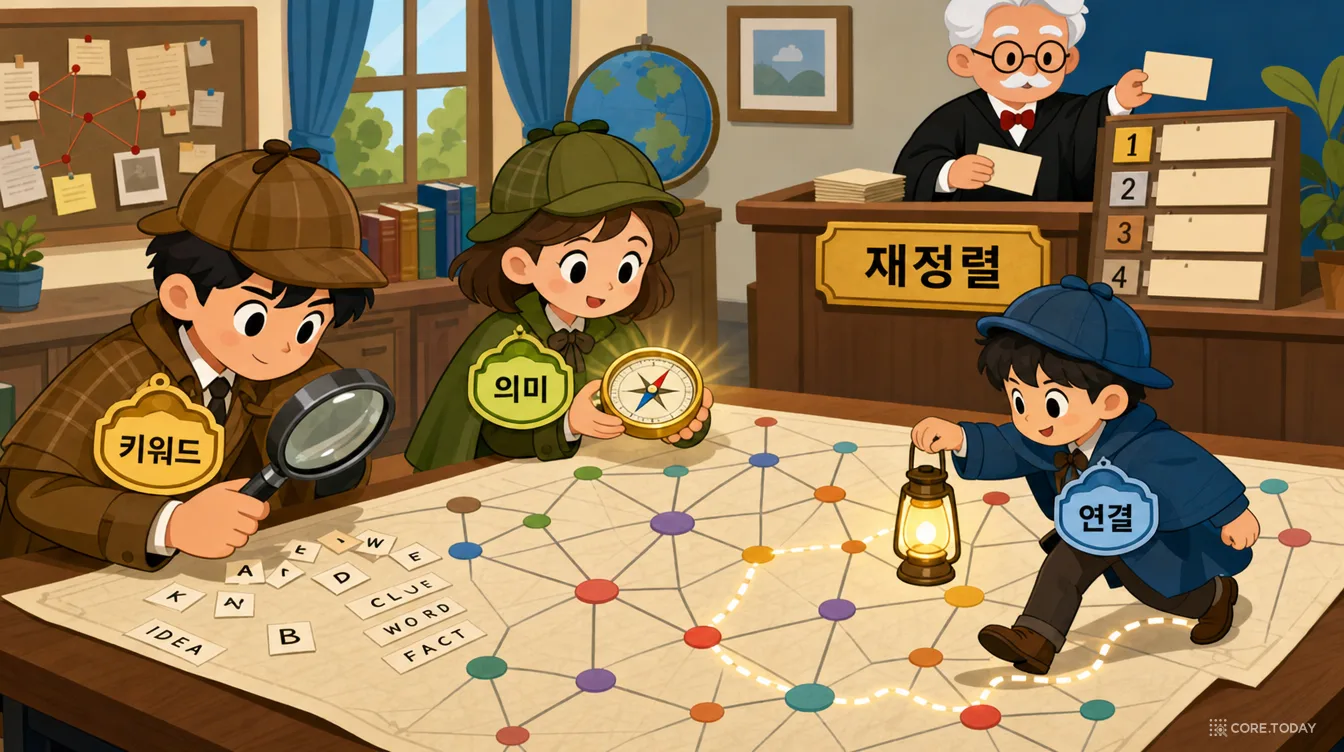
잘 쌓는 것만큼 잘 꺼내는 것이 중요합니다. 논문은 검색을 함수 하나로 정의합니다. 질문 문자열 α를 받아 컨텍스트 문자열 β를 돌려주는 f(α)=χ(ρ(ϕ(α)))입니다. 세 글자가 세 단계입니다.
키워드(BM25): 질문과 같은 낱말이 들어 있는 사실을 찾습니다. 1970년대부터 다듬어진 고전적인 정보 검색입니다. 이름, 제품 코드, 고유명사에 강합니다.
의미(코사인 유사도): 질문과 사실을 각각 임베딩해 뜻이 가까운 것을 찾습니다. “회사”로 물어도 “네이버에서 일한다”를 찾습니다.
연결(너비 우선 탐색, BFS): 질문이 아니라 출발 노드에서 시작해 몇 걸음 안의 사실을 모읍니다. 출발점을 최근 에피소드에 나온 노드로 잡으면 “요즘 무슨 얘기를 하던 사람인지”가 따라옵니다.
논문은 셋의 차이를 이렇게 정리합니다. 키워드 검색은 낱말의 닮음, 의미 검색은 뜻의 닮음, 그래프 탐색은 맥락의 닮음을 잡는다. 그래프에서 가까운 노드는 비슷한 대화 맥락에 함께 등장했다는 뜻이기 때문입니다. 검색 대상도 층마다 다릅니다. 엣지는 사실 문장, 엔티티는 이름, 커뮤니티는 핵심어를 담은 이름을 검색합니다.
ρ 재정렬: 넓게 모은 것을 정밀하게
검색은 재현율(놓치지 않기)을, 재정렬은 정밀도(정확한 것을 위로)를 맡습니다. Graphiti가 제공하는 재정렬기는 다섯 가지입니다.
재정렬기
하는 일
어울리는 상황
RRF (순위 역수 융합)
여러 검색 결과의 순위만 보고 합친다. 각 목록에서 k번째면 1/k점(코드의 기본 상수는 1)
기본값. 점수 척도가 다른 검색을 합칠 때
MMR (최대 한계 관련성)
관련 있으면서 서로 겹치지 않는 결과를 고른다
비슷한 사실이 여러 번 나올 때
에피소드 언급 수
대화에서 자주 언급된 엔티티·사실을 위로
“자주 하는 얘기”가 중요한 개인 비서
노드 거리
지정한 중심 노드에서 그래프상 가까운 것을 위로
특정 사용자·고객 중심의 질문
크로스 인코더
질문과 후보를 함께 넣어 모델이 관련도를 직접 매긴다
정확도가 가장 중요하고 비용을 감수할 때
χ 조립: 기간을 붙여 건넨다
마지막 단계가 시간 그래프다운 부분입니다. 찾은 엣지마다 사실 문장과 함께 유효 기간을 붙여 문자열로 만듭니다. 논문에 실린 템플릿은 이렇습니다.
text
FACTS and ENTITIES represent relevant context to the current conversation.
These are the most relevant facts and their valid date ranges.
If the fact is about an event, the event takes place during this time.
format: FACT (Date range: from - to)
<FACTS>
{facts}
</FACTS>
These are the most relevant entities
ENTITY_NAME: entity summary
<ENTITIES>
{entities}
</ENTITIES>
여기서 중요한 설계 선택이 하나 드러납니다. 기본 검색은 끝난 사실을 걸러 내지 않습니다. “지훈은 카카오에서 일했다 (2022-04-01 - 2026-03-02)”와 “지훈은 네이버에서 일한다 (2026-03-02 - present)”를 둘 다 건네고, 어느 쪽이 지금인지는 답하는 모델이 기간을 읽고 판단합니다. 덕분에 “예전엔 어디 다녔지?”에도 답할 수 있지만, 기간을 제대로 읽지 못하는 작은 모델은 헷갈릴 수 있습니다. 필요하면 SearchFilters로 valid_at·invalid_at·created_at·expired_at 조건을 걸어 검색 단계에서 거를 수 있습니다.
인터랙티브의 첫 질문에서 키워드 검색이 아무것도 못 찾은 것은 한국어 사용자에게 실제로 중요한 문제입니다. Graphiti는 Neo4j 전문 인덱스를 분석기 지정 없이 만들고, 기본 분석기는 한국어 조사를 떼지 않습니다. “지훈은”, “지훈의”, “지훈이”가 모두 다른 토큰입니다. 한국어로 운영한다면 형태소 분석기(nori 등)를 쓰는 인덱스로 바꾸거나, 의미 검색과 그래프 탐색의 비중을 키우는 편이 낫습니다. 이 블로그의 한국어 검색 스택 시리즈가 이 문제를 따로 다룹니다.
5부. 숫자로 보기 — 시간 문제에서 실제로 나아졌나
논문의 실험은 두 벤치마크로 이뤄졌습니다. 전체 수치와 해석은 Zep 논문 해부에서 자세히 다뤘으니, 여기서는 시간과 관련된 부분만 골라 읽겠습니다.
DMR: 너무 쉬운 시험
첫 번째는 MemGPT 팀이 만든 DMR(Deep Memory Retrieval)입니다. 대화 500개, 대화마다 세션 5개, 세션마다 메시지 최대 12개입니다.
기억 방식
답하는 모델
정확도
재귀 요약 (MemGPT 논문 보고치)
gpt-4-turbo
35.3%
대화 요약
gpt-4-turbo
78.6%
MemGPT (MemGPT 논문 보고치)
gpt-4-turbo
93.4%
전체 대화 넣기
gpt-4-turbo
94.4%
Zep
gpt-4-turbo
94.8%
대화 요약
gpt-4o-mini
88.0%
전체 대화 넣기
gpt-4o-mini
98.0%
Zep
gpt-4o-mini
98.2%
출처: Zep 논문 Table 1.
Zep이 MemGPT를 이겼다는 것이 초록의 첫 문장이지만, 논문 스스로 이 결과를 깎아 말합니다. 대화 하나가 60개 메시지뿐이라 요즘 모델의 컨텍스트에 통째로 들어갑니다. 전체 대화를 넣은 기준선이 이미 94.4%, 98.0%입니다. 질문도 단일 사실을 묻는 것뿐이고, “편하게 마시는 음료”처럼 대화에 그렇게 표현된 적 없는 말로 묻는 모호한 문항도 많다고 지적합니다. 1부의 인터랙티브에서 본 그대로입니다. 짧은 대화에서는 통째로 넣기가 이깁니다.
LongMemEval: 길어지면 이야기가 달라진다
두 번째는 LongMemEval(Wu 외, 2024)입니다. 대화 하나가 평균 약 11만 5천 토큰으로 길고, 질문이 여섯 유형으로 나뉩니다. 그중 두 유형이 이 글의 주제와 직접 맞닿아 있습니다.
temporal-reasoning(시간 추론): “A를 한 건 B를 하기 전이었나?”, “그 일로부터 몇 주 지났나?”
knowledge-update(지식 갱신): 대화 중에 바뀐 정보를 최신 값으로 답하는지
기억 방식
모델
정확도
응답 지연
평균 컨텍스트
전체 대화
gpt-4o-mini
55.4%
31.3초
115k 토큰
Zep
gpt-4o-mini
63.8%
3.20초
1.6k 토큰
전체 대화
gpt-4o
60.2%
28.9초
115k 토큰
Zep
gpt-4o
71.2%
2.58초
1.6k 토큰
출처: Zep 논문 Table 2. 실험은 2024년 12월~2025년 1월, 보스턴의 가정용 회선에서 AWS us-west-2의 Zep 서비스로 접속해 측정. 지연에는 Zep 쪽에만 네트워크 왕복이 더해졌다.
컨텍스트가 115k에서 1.6k 토큰으로 약 70분의 1로 줄면서 정확도는 오르고 응답 시간은 약 90% 줄었습니다. 시간 관련 유형만 떼어 보면 이렇습니다(gpt-4o 기준).
시간 추론 · 전체 대화
45.1%
시간 추론 · Zep
62.4%
지식 갱신 · 전체 대화
78.2%
지식 갱신 · Zep
83.3%
어시스턴트 발화 회상 · 전체 대화
94.6%
어시스턴트 발화 회상 · Zep
80.4%
출처: Zep 논문 Table 3 (gpt-4o). 막대 길이는 100% 만점 기준.
질문 유형
gpt-4o-mini 전체→Zep
gpt-4o 전체→Zep
single-session-preference (선호)
30.0% → 53.3%
20.0% → 56.7%
temporal-reasoning (시간 추론)
36.5% → 54.1%
45.1% → 62.4%
multi-session (여러 세션 종합)
40.6% → 47.4%
44.3% → 57.9%
knowledge-update (지식 갱신)
76.9% → 74.4%
78.2% → 83.3%
single-session-user (사용자 발화)
81.4% → 92.9%
81.4% → 92.9%
single-session-assistant (어시스턴트 발화)
81.8% → 75.0%
94.6% → 80.4%
출처: Zep 논문 Table 3.
이 표에서 읽을 것이 셋 있습니다.
시간 추론은 두 모델 모두에서 크게 올랐습니다(17~18%p). 사실마다 기간이 붙어 오니, 11만 토큰 사이에 흩어진 날짜를 모델이 직접 찾아 맞출 필요가 없어진 덕입니다.
지식 갱신은 모델에 따라 갈렸습니다. gpt-4o는 올랐고 gpt-4o-mini는 오히려 내려갔습니다. 4부에서 본 대로 Graphiti는 옛 사실과 새 사실을 기간과 함께 둘 다 건넵니다. 기간을 읽고 최신 쪽을 고르는 일은 답하는 모델 몫인데, 작은 모델이 이 일을 덜 잘한 것입니다. 논문도 “덜 유능한 모델이 Zep의 시간 데이터를 이해하도록 하는 개발이 더 필요하다”고 적었습니다.
어시스턴트가 한 말을 되묻는 질문은 떨어졌습니다(gpt-4o 기준 14%p). 그래프는 주로 사용자에 관한 사실을 뽑기 때문에, “아까 네가 추천한 책 제목이 뭐였지?” 같은 질문의 재료는 사실로 남지 않기 쉽습니다. 원문 에피소드는 남아 있지만 이 실험의 검색은 사실과 엔티티만 꺼냈습니다.
숫자를 읽을 때의 주의
이 결과는 Zep 팀이 자기 제품을 잰 것입니다. 경쟁사 Mem0는 2025년 4월 논문(arXiv 2504.19413)에서 LoCoMo 벤치마크로 Zep을 65.99점(Mem0 그래프판 68.44점)으로 쟀고, Zep은 5월 6일 “설정이 잘못됐다”며 84%라는 반박 글을 냈습니다. 그런데 이틀 뒤 Mem0 CTO가 Zep의 계산에서 분모와 분자의 문항 범위가 다르다는 오류를 짚었고, Zep은 5월 12일 오류를 인정하고 75.14%(10회 평균)로 고쳤습니다. 서로가 서로를 잰 숫자이고, 메모리 벤치마크는 아직 설정에 따라 순위가 뒤집히는 단계라는 점을 기억해 둘 만합니다. 2026년 Zep 연구 페이지는 gpt-5.4로 LongMemEval 90.2%를 내세우지만, 이것도 회사가 직접 잰 값입니다.
실험은 2024년 말의 모델(gpt-4o, gpt-4o-mini)로 했습니다. 2026년의 모델은 컨텍스트가 훨씬 길고 긴 문맥을 더 잘 읽습니다. “통째로 넣기”의 기준선이 그만큼 올라왔다는 뜻입니다. 반면 지연과 비용 차이(28.9초 대 2.58초, 115k 대 1.6k 토큰)는 컨텍스트가 길어질수록 오히려 더 커집니다.
LongMemEval은 대화 기억 시험입니다. Graphiti의 또 다른 장점인 대화와 업무 데이터(JSON)를 한 그래프에 섞는 능력은 이 시험으로 측정되지 않았고, 논문도 이 점을 한계로 꼽습니다.
6부. 2026년의 지도 — 모두가 ‘시간’으로 모여든다
Zep 논문이 나온 지 1년 9개월이 지났습니다. 그사이 흥미로운 일이 벌어졌습니다. 서로 다른 길을 가던 기억 시스템들이 “옛 사실을 지우지 말고, 언제의 사실인지 적어라”라는 결론으로 모여들고 있습니다.
덮어쓰기를 버린 Mem0
가장 상징적인 변화는 Mem0입니다. 2025년 Mem0의 기억 갱신은 새 정보가 들어오면 언어 모델이 기존 기억에 대해 ADD·UPDATE·DELETE 중 하나를 고르는 방식이었습니다. 그런데 2026년 4월 Mem0는 새 알고리즘을 소개하며 이 단계를 버렸다고 밝힙니다. 이유는 “덮어쓰기가 때때로 핵심 정보를 지웠기 때문”이고, 이제는 추가만(ADD-only) 하며 “정보가 바뀌면 새 사실이 옛 사실 옆에 나란히 산다”고 설명합니다. 예시로 든 것도 뉴욕에서 샌프란시스코로의 이사입니다.
Graphiti와 Mem0는 이제 같은 전제(지우지 않는다)에서 다른 길을 갑니다. Graphiti는 쓸 때 모순을 판정해 기간을 닫고, Mem0는 쓸 때는 쌓기만 하고 어느 쪽이 최신인지를 꺼낼 때 가립니다. 쓰기 비용과 읽기 정확도를 어디서 치를지의 차이입니다. Mem0가 공개한 BEAM 벤치마크(최대 1천만 토큰) 결과에서 1천만 토큰 구간의 시간 추론 점수가 16.3점에 그친 것은, 꺼낼 때 가리는 방식이 아주 긴 기록에서 얼마나 어려운지 보여 줍니다. 물론 이것도 회사가 직접 잰 숫자입니다.
‘최신으로 머물기’를 목표로 적은 ChatGPT
OpenAI는 2026년 6월 ChatGPT 기억을 개편한 ‘Dreaming’을 소개하면서, 저장된 기억이 “시간이 지나면 낡는 경향이 있다”고 스스로 인정했습니다. 평가 목표 가운데 하나가 “시간이 지나도 최신으로 머물기(Stay current over time)”이고, “7월에 싱가포르에 갈 예정”을 여행이 끝난 뒤 “2026년 7월에 싱가포르에 다녀왔다”로 고쳐 쓰는 예를 듭니다. Graphiti 식으로 말하면 계획 사실을 닫고 경험 사실을 여는 일입니다. 수억 명의 사용자를 가진 제품이 같은 문제를 같은 말로 부르기 시작했다는 점이 의미 있습니다.
시간은 보안 문제이기도 하다
Zep은 2026년 9월 「에이전트 기억 오염 방어」에서 새로운 각도를 꺼냅니다. 많은 기억 시스템이 “더 최근 것이 이긴다”로 모순을 해결하는데, 공격자가 사건 날짜를 일부러 늦게 적은 주장을 넣으면 진짜 사실을 밀어낼 수 있다는 것입니다. 방어책은 두 시각을 따로 남기는 것, 즉 출처가 주장한 사건 시각과 애플리케이션이 그 기록을 받아들인 시각을 구분하는 것입니다. 이중 시간 모델이 감사와 정확도를 넘어 보안 장치로도 쓰인다는 주장입니다. 실제로 2024년에는 프롬프트 주입으로 ChatGPT 기억에 악성 지시를 심어 이후의 모든 대화를 빼돌리는 공격(SpAIware)이 시연된 적이 있습니다. 기억이 오래 남을수록, 잘못 들어간 기억도 오래 남습니다.
Graphiti 자신도 바뀌었다
2025~2026년 Graphiti 저장소의 변화 가운데 이 글의 주제와 맞닿은 것만 추리면 이렇습니다.
시기
버전
변화
2025-02
v0.7.0
Pydantic으로 사용자 정의 엔티티 타입(정해 둔 온톨로지). 논문이 결론에서 제안한 방향
2025-06
v0.12.0
사용자 정의 엣지 타입, 그래프 DB 추상화
2025-09
v0.19.0
Amazon Neptune(AWS 기여)·Kuzu 드라이버
2025-10
MCP 1.0
Graphiti MCP 서버 1.0. Claude·Cursor 같은 도구가 시간 그래프를 기억으로 쓰게 됨
2025-11
—
중복 판정에 MinHash·LSH 같은 고전 기법을 앞단에 두고 LLM은 보조로(수집 비용 절감)
2026-01
v0.26.0
‘사가(saga)’: 에피소드를 이야기 단위로 묶어 요약
2026-04
v0.29.0
valid_at·invalid_at 결정을 별도 단계로 분리, 엔티티·엣지 한 번에 추출(선택), fact_triple 에피소드 타입
2026-09
v0.30.x
README가 ‘시간 컨텍스트 그래프(temporal context graph)’로 표현을 바꿈. Kuzu는 상류 프로젝트 중단으로 지원 중단 예고
출처: getzep/graphiti 릴리스 노트, Zep 블로그. 별 수는 2026년 10월 10일 기준 3만 1,591개(2025년 11월 2만 개 돌파).
Zep 제품 쪽에서는 2025년 4월 셀프 호스팅용 Community Edition을 중단하고 오픈소스 역량을 Graphiti에 모았으며, 2026년 8월에는 그래프 DB까지 직접 만든 Konig를 발표했습니다. 이 흐름은 Zep 생태계 지도와 FalkorDB·Memgraph 글에서 다뤘습니다.
그래서 어디에 맞나
기억 설계 여섯 가지를 ‘사실이 바뀔 때 어떻게 다루나’ 중심으로 나란히 놓았습니다. 상황을 바꿔 가며 보세요.
정리하면 시간 그래프가 빛나는 조건은 세 가지가 겹칠 때입니다. ① 사람·계정·조직처럼 같은 대상에 대한 사실이 계속 바뀌고, ② ‘지금’뿐 아니라 ‘그때’도 물어야 하며, ③ 수집 비용을 감당할 만큼 각 사실의 가치가 높을 때입니다. 고객 지원, 영업, 의료 상담, 사내 비서, 감사가 필요한 업무가 여기에 들어갑니다. 반대로 문서가 거의 바뀌지 않는 Q&A, 비용이 최우선인 대규모 소비자 챗봇, 한 세션 안에서 끝나는 대화에는 과한 도구일 수 있습니다.
7부. 직접 써 보기 — 코드와 체크리스트
최소 예제: 기준 시각을 정확히 넣는 것부터
Graphiti를 쓸 때 가장 흔한 실수는 reference_time에 지금 시각(41)을 넣는 것입니다. README의 예제도 그렇게 되어 있지만, 이것은 실시간 대화를 바로 넣을 때만 맞습니다. 지난 상담 기록을 한꺼번에 넣는다면 메시지가 실제로 오간 시각을 넣어야 “지난주”가 올바른 날짜로 풀립니다. 이 값이 틀리면 그 위의 모든 시간 정보가 함께 틀립니다.
python
from datetime import datetime, timezone
from graphiti_core import Graphiti
from graphiti_core.nodes import EpisodeType

graphiti = Graphiti("bolt://localhost:7687", "neo4j", "password")
await graphiti.build_indices_and_constraints()

# 과거 상담 기록을 넣을 때: 메시지가 오간 실제 시각을 reference_time으로
history = [
    ("2026-03-05T09:12:00+09:00", "지훈: 저 이번 주 월요일부터 네이버로 출근해요."),
    ("2026-04-02T14:30:00+09:00", "지훈: 판교 오기 전엔 2023년부터 분당에 살았어요."),
]
for ts, text in history:
    await graphiti.add_episode(
        name=f"상담 {ts}",
        episode_body=text,
        source=EpisodeType.message,
        source_description="고객 상담 채팅",
        reference_time=datetime.fromisoformat(ts),
        group_id="customer-jihun",  # 사람(고객)마다 그래프를 나눈다
    )
‘지금’과 ‘그때’를 나눠 묻기
기본 검색은 끝난 사실도 기간과 함께 돌려줍니다(4부). 질문의 성격에 따라 필터를 거는 편이 작은 모델에게 친절합니다. SearchFilters의 날짜 조건은 바깥 목록이 OR, 안쪽 목록이 AND입니다.
python
from graphiti_core.search.search_filters import (
    SearchFilters, DateFilter, ComparisonOperator as Op,
)

# 1) 지금 유효한 사실만: invalid_at이 비어 있는 엣지
now_only = SearchFilters(
    invalid_at=[[DateFilter(comparison_operator=Op.is_null)]],
)

# 2) 2025-06-01 시점에 참이던 사실: valid_at <= T 이고 (invalid_at > T 또는 비어 있음)
T = datetime(2025, 6, 1, tzinfo=timezone.utc)
as_of_T = SearchFilters(
    valid_at=[[DateFilter(date=T, comparison_operator=Op.less_than_equal)]],
    invalid_at=[
        [DateFilter(date=T, comparison_operator=Op.greater_than)],
        [DateFilter(comparison_operator=Op.is_null)],
    ],
)

edges = await graphiti.search("지훈 씨 어디 살아?", group_ids=["customer-jihun"], search_filter=as_of_T)
for e in edges:
    print(e.fact, e.valid_at, e.invalid_at)
“그때 시스템이 무엇을 알고 있었나”를 재현하려면 여기에 created_at <= T′ 조건을 더하고, expired_at이 T′ 이후인 엣지는 ‘그때는 끝을 몰랐던 사실’로 해석하면 됩니다. 다만 Graphiti는 엣지를 제자리에서 고쳐 쓰므로, 끝 날짜가 여러 번 바뀐 경우의 중간 상태까지 남지는 않습니다. 법적 감사 수준의 완전한 이력이 필요하면 원문 에피소드를 함께 보관하고 재처리할 수 있게 두거나, 정형 데이터는 SQL:2011·XTDB 같은 이중 시간 DB에 따로 두는 편이 안전합니다.
도입 전 체크리스트
1. 필요성
같은 대상에 대한 사실이 실제로 자주 바뀌는가? ‘그때’를 묻는 질문이 실제로 있는가? 둘 다 아니면 벡터 RAG나 내장 기억으로 충분하다.
2. 기준 시각
모든 에피소드에 실제 발생 시각을 넣는다. 시간대(타임존)를 명시한다. 일괄 적재 때 datetime.now()를 쓰지 않는다.
3. 그래프 나누기
group_id로 사용자·고객·프로젝트마다 그래프를 나눈다. 남의 사실이 모순 후보로 끌려오는 일을 줄인다.
4. 모델
구조화 출력을 지원하는 모델을 쓴다. 모순 판정에 너무 작은 모델을 쓰지 않는다(아래 한계 참고). 한국어라면 한국어 추출 품질을 직접 확인한다.
5. 온톨로지
자주 쓰는 관계(소속, 거주, 요금제, 복용 약)는 Pydantic 엔티티·엣지 타입으로 미리 정한다. 무엇이 무엇을 대체하는지가 분명해진다.
6. 한국어 검색
BM25 인덱스가 조사를 떼지 못하는 점을 감안해 형태소 분석기 인덱스를 검토한다. 미래형 정규식 안전망은 영어 전용임을 기억한다.
7. 비용·속도
에피소드당 LLM 호출 수와 지연을 실측한다. 보고된 사례로 메시지당 약 12초(2024), 짧은 대화 40개에 약 0.8달러(2025, 기본 OpenAI 모델)가 있다. SEMAPHORE_LIMIT로 동시성을 조절한다.
8. 검토 루프
닫힌 사실(invalid_at이 찍힌 엣지)의 비율을 지표로 본다. 갑자기 늘면 모순 판정이 과잉인지 표본을 뽑아 사람이 검토한다.
8부. 한계 — 양쪽으로 틀릴 수 있다
시간 그래프는 마법이 아닙니다. 실패는 두 방향으로 일어납니다.
모순을 놓치는 쪽. 언어 모델이 두 사실의 모순을 알아채지 못하면 둘 다 ‘유효’로 남습니다. 2026년 이슈 가운데에는 작은 비추론 모델로 모순 판정을 돌렸더니 진짜 모순을 거의 잡지 못했다는 보고가 있습니다. 이때 시간 그래프는 날짜가 붙은 벡터 RAG와 크게 다르지 않게 됩니다.
멀쩡한 사실을 닫는 쪽. 2026년 8월 Graphiti 저장소에 올라온 이슈 #1728은 반대 방향의 실패를 보고합니다. 한 운영 그래프에서 사실 약 3,950개 가운데 1,616개(41%)에 invalid_at이 찍혀 있었고, 손으로 4개를 검토하니 3개가 잘못 닫힌 것이었습니다. “어떤 사람이 회사에서 일한다”가 “같은 사람이 그 회사의 코드 저장소 조직을 관리한다”에 의해 닫히는 식입니다. 직함이 하나 더 생겼을 뿐인데 옛 직장이 끝난 것으로 기록된 셈입니다.
보고자가 짚은 원인은 이렇습니다. 예전 코드는 무효화 후보를 새 엣지와 끝점을 공유하는 엣지로 제한했는데, 여러 그래프 DB를 지원하려고 검색 경로를 일반화하는 리팩터링(#906)에서 그 제한이 빠졌습니다. 그래서 지금은 같은 그룹 안의 의미가 비슷한 아무 엣지나 후보가 됩니다. 게다가 후보는 어느 엔티티를 잇는지 정보 없이 사실 문장만으로 언어 모델에게 전달됩니다. 3.5절의 날짜 규칙은 “누가 먼저 시작했나”만 볼 뿐 “같은 대상에 관한 사실인가”는 보지 않습니다. 이 글을 쓰는 2026년 10월 10일 기준, 현재 main 코드에서도 후보 검색은 필터 없이 그룹 전체를 대상으로 하고, 수정 PR 두 건(#1729, #1772)은 아직 열려 있습니다.
이 사례는 시간 그래프의 강점과 약점을 동시에 보여 줍니다. 잘못 닫힌 사실도 지워지지 않았기 때문에 41%라는 숫자를 셀 수 있었고, 원문 에피소드로 되돌아가 고칠 수 있습니다. 덮어쓰기 방식이었다면 무엇을 잃었는지조차 몰랐을 것입니다. 하지만 검색이 닫힌 사실의 순위를 낮추면 사용자에게는 사실상 잊힌 것과 같습니다. 7부 체크리스트 8번처럼 닫힌 사실의 비율을 지표로 보는 이유입니다.
그 밖의 한계도 정리해 둡니다.
수집 비용과 지연: 에피소드마다 언어 모델을 여러 번 부릅니다. 실시간으로 넣은 정보가 바로 검색되지 않을 수 있습니다(Mem0 논문은 Zep에 넣은 직후의 검색이 자주 실패하고 몇 시간 뒤에 나아졌다고 보고했습니다).
어시스턴트 발화: 그래프는 사용자에 관한 사실 중심이라, “네가 아까 뭐라고 했지?”류 질문은 약합니다(5부).
잊힐 권리: “지우지 않는다”는 원칙은 개인정보 삭제 요청과 정면으로 부딪힙니다. 사실을 닫는 것과 지우는 것은 다르며, 삭제 요청에는 원문 에피소드와 파생 사실을 함께 지우는 별도 절차가 필요합니다.
벤치마크: 현재의 기억 벤치마크는 대부분 몇만~십여만 토큰짜리 대화이고, 업무 데이터와 대화를 섞은 상황이나 몇 년에 걸친 기록은 아직 잘 재지 못합니다. LoCoMo 정답지 자체에 오류가 많다는 독립 감사(2026년 4월)도 있습니다.
마무리: 잊지 않는 것이 아니라, 언제였는지 아는 것
처음의 서연 님 이야기로 돌아가 보겠습니다. 비서가 “데이터팀 박서연 님”이라고 쓴 것은 기억이 모자라서가 아니라, 기억에 날짜가 없어서였습니다. 사람의 기억도 완벽하지 않지만, 우리는 적어도 “그건 예전 얘기고”라고 말할 줄 압니다.
Graphiti가 한 일을 다시 요약하면 이렇습니다.
1
물려받은 것
1980년대 데이터베이스 연구의 이중 시간 모델(세상의 시간 + 기록의 시간), GraphRAG의 엔티티 그래프와 커뮤니티, 심리학의 일화·의미 기억 구분
2
새로 더한 것
언어 모델을 ‘서기’로 써서 사람의 말에서 사실과 기간을 뽑고, 모순 판정은 모델이, 기간을 닫는 일은 날짜 규칙이 하도록 역할을 나눈 것. 데이터가 계속 들어와도 전체를 다시 계산하지 않는 증분 설계
3
남은 숙제
모순 판정의 정확도(양방향 오류), 수집 비용, 한국어 같은 비영어 처리, 잊힐 권리와의 조화, 더 현실적인 벤치마크
2026년에 기억 시스템들이 같은 결론으로 모여드는 걸 보면, “사실에 유효기간을 적는다”는 생각은 특정 제품의 기능이라기보다 에이전트 기억의 기본 문법이 되어 가는 것 같습니다. 에이전트가 사람 곁에서 몇 달, 몇 년을 함께 보내게 될수록, 중요한 건 더 많이 기억하는 일이 아니라 무엇이 언제의 기억인지 아는 일일 것입니다.
참고 자료
논문
Rasmussen, P. 외 (2025). Zep: A Temporal Knowledge Graph Architecture for Agent Memory. arXiv:2501.13956
(동명의 다른 논문) He, Y., Fang, R., Dillig, I., Wang, Y. (2025). Graphiti: Bridging Graph and Relational Database Queries. arXiv:2504.03182
Allen, J. F. (1983). Maintaining Knowledge about Temporal Intervals. Communications of the ACM 26(11)
Snodgrass, R., Ahn, I. (1985). A Taxonomy of Time in Databases. SIGMOD '85 / (1986) Temporal Databases. IEEE Computer 19(9)
Kulkarni, K., Michels, J.-E. (2012). Temporal Features in SQL:2011. SIGMOD Record 41(3)
Hoffart, J. 외 (2013). YAGO2: A Spatially and Temporally Enhanced Knowledge Base from Wikipedia. Artificial Intelligence 194
Tulving, E. (1972). Episodic and Semantic Memory. Organization of Memory
Lewis, P. 외 (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401
Park, J. S. 외 (2023). Generative Agents: Interactive Simulacra of Human Behavior. arXiv:2304.03442
Packer, C. 외 (2023). MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560
Edge, D. 외 (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130
Anokhin, P. 외 (2024). AriGraph: Learning Knowledge Graph World Models with Episodic Memory for LLM Agents
Wu, D. 외 (2024). LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. arXiv:2410.10813 (ICLR 2025)
Maharana, A. 외 (2024). Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo). arXiv:2402.17753
Chhikara, P. 외 (2025). Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. arXiv:2504.19413
Dhingra, B. 외 (2022). Time-Aware Language Models as Temporal Knowledge Bases. TACL
Zep: “Lies, Damn Lies, & Statistics: Is Mem0 Really SOTA in Agent Memory?” (2025-05), “Graphiti hits 20k stars” (2025-11), “Defending Agent Memory Against Poisoning” (2026-09), “Why we built a graph database service” (2026-08)
Mem0: “The token-efficient memory algorithm” (2026-04)
OpenAI: “Dreaming: Better memory for a more helpful ChatGPT” (2026-06)