한국어 임베딩OllamaQwen3-EmbeddingBGE-M3Nomic EmbedSnowflake Arctic EmbedEmbeddingGemmaEmbeddingGemma 2벡터 검색RAGnDCG마트료시카접두어토크나이저MLX실측 벤치마크로컬 모델 실측튜토리얼
맥 한 대에 임베딩 모델 아홉 개 — Qwen3·BGE-M3·Nomic·Arctic·EmbeddingGemma 1·2를 한국어로 다시 재다 (로컬 모델 실측 1편)
10월 1일 다섯 모델을 쟀던 글 뒤로 열흘 사이에 많은 것이 바뀌었습니다. 구글이 EmbeddingGemma 2를 냈고, Ollama 0.40이 애플 실리콘에서 MLX 러너를 기본으로 켰고, 같은 맥에 올라 있는 임베딩 모델이 아홉 개가 됐습니다. 이 글은 그 아홉 개 — Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic Embed v2 MoE, Snowflake Arctic Embed 2.0, EmbeddingGemma 300M, EmbeddingGemma 2 740M·440M — 를 코어닷투데이 문서 660건과 한국어 질문 85개로 같은 조건에서 다시 쟀습니다. 모델마다 '무엇을 하려고 만든 모델인지'를 뼈대(인코더·디코더·온디바이스) 기준으로 쉽게 풀고, 결과에서 가장 놀라운 한 줄 — 308M짜리 1세대 EmbeddingGemma가 4B 모델과 같은 점수를 냈고 2세대는 그보다 낮았다 — 이 왜 나왔는지, 접두어 한 줄이 0.08을 바꾸는 이유, 같은 문서를 토크나이저가 얼마나 다르게 쪼개는지, 벡터를 256차원으로 잘라도 되는지를 실제 값으로 보여 줍니다. 인터랙티브 7개와 삽화 6장. 2편은 글자를 쓰지 않는 판정 모델 tev1·Nimble, 3편은 두 종류를 언제 어떻게 쓰나입니다.
10월 1일에 쓴 글에서 임베딩 모델 다섯 개를 우리 문서로 쟀습니다. 결론은 "Qwen3-Embedding 8B가 1위, 4B가 균형점, BGE-M3가 가성비"였습니다. 그 뒤 열흘 동안 세 가지가 바뀌었습니다.
첫째, 10월 6일 구글 딥마인드가 EmbeddingGemma 2를 냈습니다. 텍스트·이미지·오디오를 한 공간에 놓는 740M 모델이고, 텍스트만 쓰면 270M입니다. 특집으로 뜯어본 글에서 "한국어 성능은 공개되지 않았다"고 적었는데, 이제 직접 잴 수 있게 됐습니다.
둘째, Ollama 0.40이 애플 실리콘에서 MLX 러너를 기본으로 켰습니다. 같은 ollama pull 명령으로 받아도 어떤 모델은 llama.cpp에서, 어떤 모델은 MLX에서 돕니다. EmbeddingGemma 2가 바로 MLX로 도는 첫 임베딩 모델입니다. 양자화 방식도 다릅니다(nvfp4).
셋째, 같은 맥에 아홉 개의 임베딩 모델이 올라 있게 됐습니다. 다섯 개를 쟀던 조건을 그대로 두고 네 개를 더했습니다(글 중간에 EmbeddingGemma 2의 텍스트 전용 270M 태그 하나를 확인용으로 더 받았습니다). 아래 명령 한 줄이 이 글의 출발점입니다.
이 글은 로컬 모델 실측 3부작의 1편입니다. 1편은 임베딩 모델 아홉 개, 2편은 같은 맥에 함께 올라 있던 낯선 모델 둘 — 글자를 쓰지 않고 확률만 돌려주는 판정 모델 tev1과 nimble — 을, 3편은 두 종류를 언제 무엇에 쓰는지를 다룹니다. 세 편 모두 같은 코퍼스, 같은 질문, 같은 맥입니다.
0부. 3분 복습: 임베딩, 코사인, nDCG
임베딩 모델은 문장을 받아 숫자 목록 하나(벡터)를 돌려줍니다. 768개든 4,096개든 그 숫자들이 문장의 좌표입니다. 뜻이 비슷한 문장은 가까운 좌표에 놓이도록 학습됐습니다. 검색은 질문의 좌표와 문서들의 좌표 사이 각도(코사인 유사도)를 재서 가까운 순서로 늘어놓는 일입니다. 색인은 문서 좌표를 미리 계산해 두는 일이고, 질의는 질문 하나의 좌표만 새로 구하는 일입니다.
그래서 임베딩 모델을 고를 때 보는 숫자는 넷입니다. 좌표가 얼마나 좋은가(검색 품질), 문서를 얼마나 빨리 좌표로 바꾸나(색인 처리량), 질문 하나를 얼마나 빨리 바꾸나(질의 지연), 좌표가 몇 개의 숫자로 돼 있나(차원, 곧 저장 비용). 이 글은 넷을 전부 잽니다.
검색 품질의 지표는 nDCG@10입니다. "상위 10개 안에 정답이 있는가, 있다면 얼마나 위쪽인가"를 0과 1 사이로 누른 값입니다. 정답이 1등이면 1, 2등이면 0.63, 10등 안에 없으면 0입니다. 질문 85개의 평균을 씁니다. 더 자세한 복습은 1편의 1부에 있습니다.
1부. 아홉 모델, 세 계열
같은 "임베딩 모델"이라도 뼈대가 다릅니다. 뼈대를 알면 결과가 왜 그렇게 나왔는지 절반은 설명됩니다.
인코더(BERT) 계열BGE-M3 · Arctic Embed 2.0 · Nomic v2 MoE문장을 양방향으로 한 번에 읽는 독해 전문가. 0.5B 안팎, 빠르고, 긴 문서(8K)를 받는다
디코더(LLM) 계열Qwen3-Embedding 0.6B · 4B · 8B글을 쓰던 LLM을 임베딩용으로 재훈련. 크고 느리지만 질문의 뜻을 가장 잘 읽는다
온디바이스 Gemma 계열EmbeddingGemma 300M · EmbeddingGemma 2 740M/440M폰에 넣으려고 만든 소형 모델. 접두어 템플릿이 모델의 일부다
인코더 계열: 독해 전문가
BERT 이후의 인코더는 문장 전체를 한꺼번에 보며 각 단어가 앞뒤 단어를 모두 참고합니다(양방향). 글을 쓰지 않으니 생성 능력이 없고, 그만큼 작고 빠릅니다. 2024년 1월 BAAI의 BGE-M3가 이 계열의 기준점이 됐습니다. XLM-RoBERTa large(568M)를 밀어 올려 100개 넘는 언어, 8,192토큰, 그리고 밀집·희소·다중벡터 세 출력을 한 모델에서 내는 "M3"(Multi-Linguality, Multi-Functionality, Multi-Granularity)를 구현했습니다. Ollama에서는 밀집 벡터만 나옵니다.
Snowflake Arctic Embed 2.0(2024년 12월)은 BGE-M3와 같은 뼈대를 씁니다. 모델 카드의 기반 모델이 bge-m3-retromae, 즉 BGE-M3를 만들기 전 단계의 사전학습 체크포인트입니다. 스노우플레이크는 여기에 자기들 데이터와 마트료시카 학습을 얹어 "다국어를 더하면서 영어 품질을 잃지 않는" 모델을 목표로 했습니다. 질의에만 query: 접두어를 붙입니다. Apache 2.0.
Nomic Embed Text v2 MoE(2025년 2월)는 인코더에 전문가 혼합(MoE)을 넣은 첫 임베딩 모델입니다. 전체 475M 중 호출마다 305M만 계산하므로 아홉 모델 가운데 가장 빠릅니다. 대신 컨텍스트가 512토큰이라 긴 문서는 반드시 잘라야 하고, search_query:·search_document: 접두어가 필수입니다(모델 카드가 접두어 없이는 쓰지 말라고 못 박습니다).
디코더 계열: 글 쓰던 모델의 전직
Qwen3-Embedding(2025년 6월)은 LLM인 Qwen3를 임베딩용으로 다시 학습한 모델입니다. 마지막 토큰의 은닉 상태를 벡터로 씁니다. 0.6B·4B·8B 세 크기, 1,024·2,560·4,096차원, 32K 컨텍스트, 119개 언어, 마트료시카 지원, Apache 2.0. 다국어 MTEB에서 8B가 70.58점으로 공개 모델 1위에 올랐습니다. 질의 앞에 영어 지시문(Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery: )을 붙이는 것이 권장 사용법입니다. 큰 만큼 느리고, 4,096차원은 저장 비용이 BGE-M3의 4배입니다.
Gemma 계열: 폰에 넣으려고 만든 모델
EmbeddingGemma(2025년 9월)는 Gemma 3 308M을 바탕으로 한 텍스트 임베딩 모델입니다. 768차원이고 512·256·128로 잘라 쓸 수 있으며(마트료시카), 컨텍스트는 2,048토큰입니다. 핵심은 접두어 템플릿입니다. 질의는 task: search result | query: , 문서는 title: none | text: 로 시작해야 합니다. 학습할 때 늘 이 템플릿을 봤기 때문에, 빼면 다른 모델이 됩니다.
EmbeddingGemma 2(2026년 10월 6일)는 텍스트 코어 270M에 비전 인코더 170M, 오디오 인코더 300M을 선택해 붙이는 모듈 구조입니다. Ollama의 embeddinggemma-2:latest가 740M(텍스트+이미지+오디오), :440m이 텍스트+이미지, :270m이 텍스트 전용입니다. 768차원, 8K 컨텍스트, Apache 2.0. 템플릿은 1세대와 같습니다. 그리고 이 글의 실측에서 MLX 러너에 nvfp4 양자화로 도는 유일한 모델입니다.
표에서 하나만 미리 보십시오. 세 계열의 파라미터 수는 0.3B에서 7.6B까지 25배 차이가 납니다. 점수도 25배 차이가 날까요.
2부. 실험 설계: 1편과 같게, 모델만 더
코퍼스는 코어닷투데이 블로그 글 596건과 뉴스 64건, 합쳐 660건의 제목과 요약입니다(평균 273자). 1편의 589건에서 열흘 사이 블로그가 71건 늘었습니다. 질문은 1편과 똑같은 85개입니다. 사람이 정답 문서의 핵심어를 일부러 피해서 쓴 22개, 로컬 27B 모델이 "핵심 명사를 베끼지 말고" 바꿔 쓴 45개, 제목의 고유명사를 그대로 쓴 키워드 질문 18개. 정답이 여럿인 질문이 4개 있습니다.
1편과 다른 점이 하나 있습니다. 1편에서는 BM25와 하이브리드(RRF)까지 쟀지만 이 글은 임베딩 모델끼리의 비교에 집중합니다. BM25·RRF·리랭커 이야기는 2편 하이브리드 검색에 그대로 있습니다.
3부. 성적표: 1위는 그대로, 2위가 이변
위젯의 기본 설정(모델별 최선 설정, 전체 85문항, nDCG@10)으로 읽으면 이렇습니다.
Qwen3-Embedding-8B (지시문)
0.879
EmbeddingGemma 300M (접두어)
0.852
Qwen3-Embedding-4B (지시문)
0.850
Arctic Embed 2.0 (query:)
0.834
BGE-M3
0.830
Nomic Embed v2 MoE
0.796
Qwen3-Embedding-0.6B
0.785
EmbeddingGemma 2 740M·440M (접두어)
0.765
첫째, 1위는 그대로입니다. Qwen3-Embedding 8B가 0.879로 가장 높습니다. 1편의 0.889에서 0.01 내려간 것은 코퍼스가 71건 늘어 헷갈릴 문서가 많아졌기 때문이고, 다른 모델도 비슷하게 내려갔습니다. 정답이 1등인 비율 79%, 상위 10개 안에 드는 비율 96%. 열 번 중 아홉 번 넘게 첫 화면 안에 정답이 있습니다.
둘째, 2위가 이변입니다. 308M짜리 1세대 EmbeddingGemma가 0.852로 4B 모델(0.850)과 같은 점수를 냈습니다. 파라미터는 13분의 1, 파일은 620MB, 문서 처리량은 8배, 질의 지연은 4분의 1입니다. 이 모델은 1편에 없었습니다. 있었다면 결론이 달라졌을 것입니다.
셋째, Arctic Embed 2.0은 BGE-M3와 같은 뼈대답게 같은 자리에 섰습니다. 접두어를 붙인 Arctic이 0.834, BGE-M3가 0.830. 0.004 차이는 잡음입니다. 그러나 접두어를 빼면 Arctic은 0.792로 떨어집니다. 뼈대가 같아도 학습 레시피가 다르면 사용법이 달라집니다.
넷째, EmbeddingGemma 2는 1세대보다 낮았습니다. 접두어를 붙여도 0.765, 빼면 0.708. 740M과 440M의 점수가 소수점 넷째 자리까지 같은데, 이것은 오류가 아닙니다. 두 태그의 텍스트 코어(270M)가 같고 440M은 비전 인코더만 뺀 것이라, 텍스트만 넣으면 같은 벡터가 나옵니다. 이미지를 쓰지 않는다면 440M을 받을 이유가 없고, 텍스트만 쓴다면 270M이면 됩니다. 확인 삼아 embeddinggemma-2:270m(378MB)도 돌려 봤더니 역시 0.7646으로 같았습니다. 세 태그는 텍스트 검색에서 같은 모델입니다.
왜 2세대가 1세대보다 낮은가는 이 글이 완전히 답하지 못하는 질문입니다. 가능한 설명은 셋입니다. ① 텍스트 코어가 308M에서 270M으로 줄고 다섯 가지 입력을 한 공간에 맞추느라 텍스트 한 가지의 정밀도가 양보됐을 수 있습니다. ② Ollama의 2세대 태그는 nvfp4 양자화를 MLX 러너에서 돌립니다. 1세대는 BF16입니다. 4비트 부동소수점은 한국어처럼 토큰이 잘게 쪼개지는 언어에서 더 아플 수 있습니다. ③ 구글의 다국어 MTEB 점수는 2세대(61.36)가 1세대(61.15)보다 높지만, 그 평균에서 한국어는 작은 조각입니다. 셋 중 무엇이 얼마인지는 전체 정밀도 체크포인트를 같은 코퍼스로 재 봐야 가려집니다. 이 글은 "Ollama에서 받은 그대로 쓰면 이렇다"까지만 말합니다.
?
의문
같은 회사의 후속 모델이 전작보다 한국어 검색 점수가 0.09 낮다. 740M과 440M은 점수가 똑같다.
→
확인한 것
텍스트 코어가 같으니 두 태그의 벡터가 같은 것은 정상. 2세대만 nvfp4·MLX로 돈다. 접두어를 빼면 둘 다 더 떨어진다.
✓
실무 결론
텍스트 검색만 할 거면 1세대(300M). 이미지·음성까지 한 공간에 놓을 거면 2세대. 둘을 한 인덱스에 섞을 수는 없다.
4부. 크기 대 품질 대 속도
가로축(파라미터 수)을 로그로 놓고 세로축에 점수를 찍으면 그림이 분명해집니다. 0.3B에서 0.6B로 가도, 0.6B에서 4B로 가도 점수는 조금씩만 오르고, 4B에서 8B로 가면 0.03 오릅니다. 크기 25배에 점수 0.09. 반면 0.3B 안에서도 접두어와 학습 레시피에 따라 0.08이 갈립니다(EmbeddingGemma 접두어 유무). 크기는 점수를 약속하지 않고, 사용법은 점수를 좌우합니다.
660건이라 몇 분이지만 100만 건이면 8B는 사흘, 300M 모델은 5시간입니다. 그리고 8B의 벡터는 4,096차원이라 저장도 5배 큽니다(float32 기준 문서당 16KB 대 3KB). 한 번 색인하고 오래 쓰는 코퍼스라면 사흘은 치를 만한 비용이지만, 매일 수만 건이 새로 들어오는 코퍼스라면 처리량이 곧 운영 비용입니다.
EmbeddingGemma 2가 MLX에서 도는데 llama.cpp의 1세대보다 느린 점도 적어 둡니다. 모델이 2.4배 크니(740M 대 308M) 당연한 면이 있고, Ollama 0.40의 MLX 임베딩 경로가 아직 첫 버전이라는 면도 있습니다. 러너 간 공정한 속도 비교는 이 글의 범위 밖입니다.
접두어(prefix)는 모델에게 "지금 들어오는 글이 질문인지 문서인지"를 알려 주는 짧은 머리말입니다. E5(2022)가 query:·passage:로 시작한 관습이고, 구글 계열은 task: search result | query: 처럼 과제 이름까지 넣은 템플릿을 씁니다. 왜 필요한가. 질문 "파리의 인구는?"과 문서 "파리는 인구 210만의 프랑스 수도다"는 글자로는 다르지만 짝이어야 합니다. 같은 모델이 둘을 다르게 인코딩하려면 역할을 알아야 합니다.
실측에서 접두어의 효과는 모델마다 전혀 달랐습니다.
EmbeddingGemma 1세대: +0.082 (0.770 → 0.852). 접두어가 곧 모델의 일부입니다. 빼면 BGE-M3 아래로, 붙이면 4B 수준으로 갑니다. 사람 질문 22개만 보면 0.630 → 0.805로 더 극적입니다.
EmbeddingGemma 2세대: +0.057 (0.708 → 0.765). 같은 방향, 조금 작은 폭.
Arctic Embed 2.0: +0.042 (0.792 → 0.834). query: 한 단어가 BGE-M3와의 자리를 바꿉니다.
Qwen3 8B·4B: +0.013·+0.008. 있으면 좋은 정도. 그런데 사람 질문 22개만 보면 8B는 지시문이 없는 쪽이 0.829로 더 높습니다(있으면 0.790). 전체 평균을 올린 것은 LLM 바꿔쓰기 45개였습니다.
Qwen3 0.6B: −0.010. 지시문이 오히려 해롭습니다. 1편과 같은 결과입니다. 작은 모델은 긴 영어 지시문을 소화하지 못하는 것으로 보입니다.
규칙은 하나입니다. 문서를 색인할 때 쓴 규칙을 질의 때도 똑같이 쓰고, 모델 카드가 정한 템플릿은 글자 하나까지 지키십시오.title: none | text: 에서 공백 하나를 빼도 다른 토큰이 됩니다.
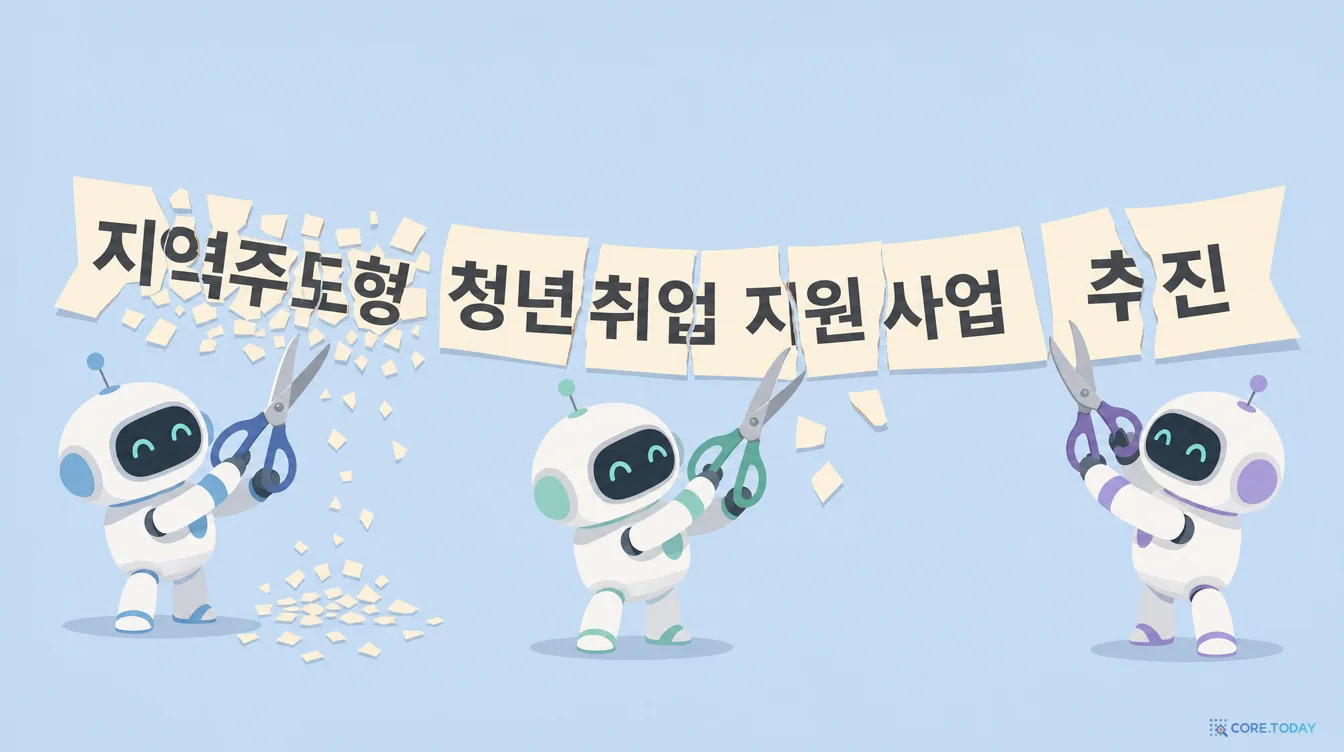
모델은 글자를 보지 않고 토큰을 봅니다. 토크나이저가 한국어를 얼마나 잘게 쪼개느냐가 컨텍스트 창을 얼마나 빨리 채우는지, 그리고 한 토큰에 얼마나 많은 뜻이 실리는지를 정합니다. 같은 문장 하나를 넣어 봤습니다.
토크나이저 계열
모델
42자 문장 → 토큰
문서 1건 평균 (273자)
XLM-R SentencePiece (250K 어휘)
BGE-M3 · Arctic 2.0 · Nomic v2
23
145~150
Gemma (262K 어휘)
EmbeddingGemma 1 · 2
29
154 (+접두어 6)
Qwen3 (151K 어휘)
Qwen3-Embedding 0.6B · 4B · 8B
34
185
실험 문장은 "지역주도형 청년취업 지원사업 추진으로 울산 청년 300명이 일자리를 얻었다."입니다. XLM-R 계열은 23토큰, Gemma는 29, Qwen3는 34. 같은 문서를 Qwen3는 XLM-R보다 27% 더 잘게 봅니다. 두 가지 뜻이 있습니다. 긴 문서를 넣을 때 Qwen3의 32K 창은 XLM-R 계열의 8K 창보다 넓지만, 한국어로는 그 격차가 겉보기만큼 크지 않습니다. 그리고 Qwen3가 1위를 한 것은 한국어를 더 효율적으로 쪼개서가 아니라, 잘게 쪼갠 조각들을 더 큰 모델이 더 잘 조립했기 때문입니다. 자세한 토크나이저 이야기는 BM25는 한국어를 어떻게 쪼개나에 있습니다.
7부. 질문 유형별로 보면 다른 그림
평균은 세 종류의 질문을 섞은 값입니다. 유형별로 나누면 모델의 성격이 드러납니다.
모델 (최선 설정)
사람 바꿔쓰기 22
LLM 바꿔쓰기 45
키워드 18
Qwen3-8B
0.790
0.874
1.000
EmbeddingGemma 300M
0.805
0.816
1.000
Arctic 2.0
0.807
0.789
0.980
Qwen3-4B
0.779
0.825
1.000
Nomic v2
0.791
0.725
0.980
BGE-M3
0.773
0.791
1.000
EmbeddingGemma 2
0.695
0.705
1.000
Qwen3-0.6B
0.641
0.768
1.000
키워드 질문은 모두가 맞힙니다. "Headlamp Freelens k9s 비교"처럼 제목의 고유명사를 그대로 쓰면 0.3B 모델도 만점입니다. 이런 질문이 대부분인 서비스(제품명·코드명·사람 이름으로 찾는 사내 검색)라면 모델 크기는 거의 무의미하고, 사실 BM25로도 충분합니다.
차이는 사람이 일부러 다른 말로 쓴 22개에서 납니다. "우리말 문서 검색에서 문장을 벡터 하나로 뭉개지 않고 토큰마다 비교하는 방식"에는 'KURE'도 'late interaction'도 없습니다. 여기서 Qwen3-0.6B는 0.641, EmbeddingGemma 2는 0.695로 무너지고, 8B와 EmbeddingGemma 1세대, Arctic이 0.79~0.81로 버팁니다. 흥미롭게도 사람 질문에서는 8B가 1등이 아닙니다. Arctic(0.807)과 EmbeddingGemma 1(0.805)이 근소하게 앞섭니다. 8B의 평균 1위는 LLM 바꿔쓰기 45개(0.874)가 만든 것입니다. LLM이 만든 질문은 LLM 계열 모델이 잘 읽는다는, 어쩌면 당연한 편향이 숨어 있습니다.
Nomic은 사람 질문(0.791)보다 LLM 질문(0.725)에서 약합니다. 다른 모델과 반대 방향입니다. 512토큰 창과 MoE 라우팅이 긴 서술형 질문에서 불리한 것으로 보이지만, 45문항으로 단정할 수는 없습니다.
위젯에서 '엇갈림'을 누르면 모델 간 점수 차가 0.6 이상인 질문만 남습니다. 그 열 몇 개를 읽어 보면 어떤 표현이 어떤 모델을 넘어뜨리는지가 숫자보다 분명하게 보입니다.
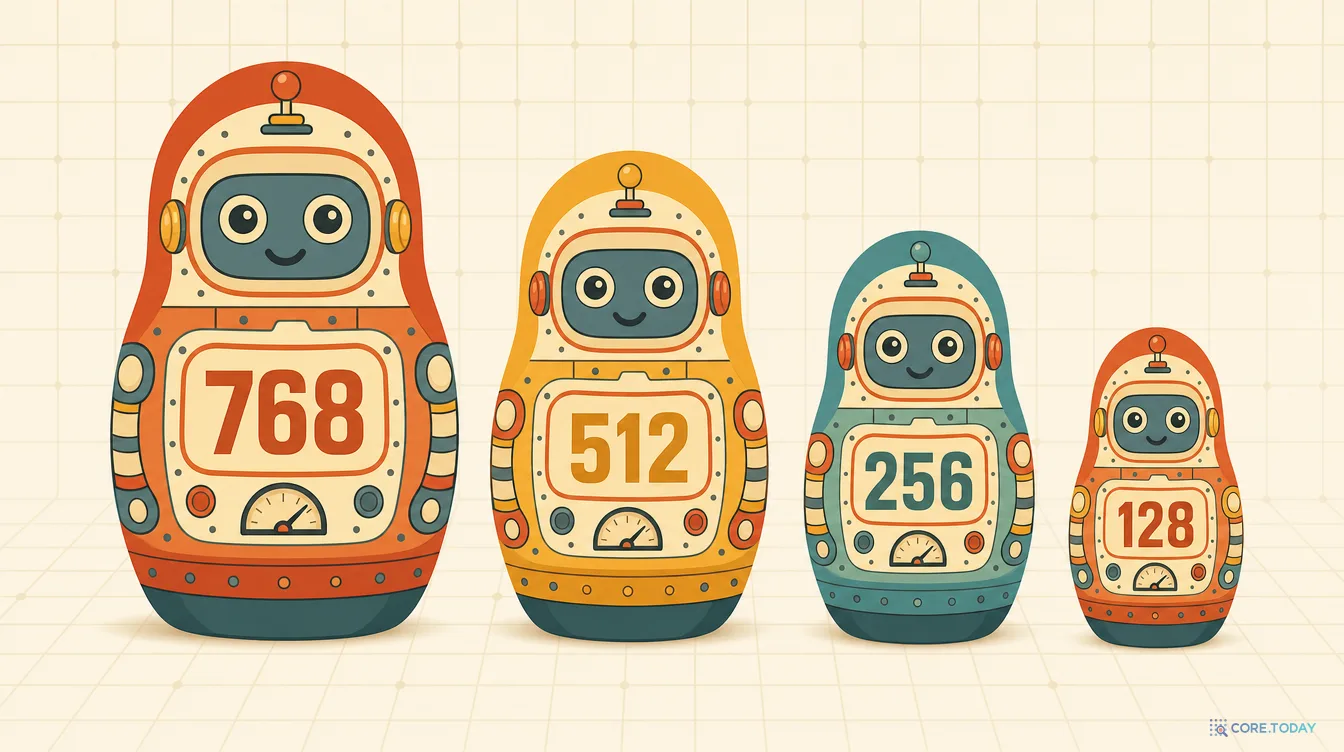
마트료시카 표현 학습(MRL)을 거친 모델은 벡터의 앞쪽 차원에 중요한 정보를 몰아 넣도록 학습됐습니다. 그래서 4,096차원 벡터의 앞 1,024개만 남기고 잘라도(그리고 다시 정규화하면) 품질이 천천히 떨어집니다. 저장 비용을 4분의 1로 줄이는 가장 싼 방법입니다. 아홉 모델 중 BGE-M3와 Nomic v2(256까지), Arctic(256까지), Qwen3, EmbeddingGemma 1·2(128까지)가 MRL을 지원합니다.
실측은 두 방식으로 했습니다. 저장해 둔 전체 벡터를 로컬에서 자른 값과, Ollama /api/embed의 dimensions 옵션으로 서버가 자른 값. 둘이 소수점 넷째 자리까지 같았습니다. Ollama의 dimensions는 앞쪽 절단 + 재정규화 그 이상도 이하도 아니라는 뜻이고, 이미 저장한 벡터가 있다면 다시 임베딩하지 않고 잘라 써도 됩니다.
Qwen3-4B는 2,560 → 256으로 10분의 1로 줄여도 0.850 → 0.833입니다. 1,024(0.845)와 512(0.846)는 사실상 손실이 없습니다. 저장 공간을 5분의 1로 줄이고 0.005를 내는 거래입니다.
EmbeddingGemma 1은 768 → 256에서 0.852 → 0.785. 0.07의 손실로, 큰 모델보다 가파릅니다. 작은 모델은 차원 하나하나에 실린 정보가 많아서 자르면 더 아픕니다.
128차원은 모두 아픕니다. Qwen3-4B 0.755, EmbeddingGemma 1 0.712, EmbeddingGemma 2 0.603. 128은 벡터 수천만 건의 1차 후보 생성에만 쓰고, 상위 후보는 전체 차원으로 다시 재는 2단계 구성이 맞습니다(3편 마트료시카의 적응형 검색).
9부. 공개 벤치마크와 왜 다른가
모델
MTEB 다국어 v2 (평균)
이 글 nDCG@10
순위 (공개 → 이 글)
Qwen3-Embedding-8B
70.58
0.879
1 → 1
Qwen3-Embedding-4B
69.45
0.850
2 → 3
Qwen3-Embedding-0.6B
64.33
0.785
3 → 7
EmbeddingGemma 2 (740M)
61.36
0.765
4 → 8
EmbeddingGemma (300M)
61.15
0.852
5 → 2
공개 점수가 있는 다섯 모델만 놓고 보면 순위가 꽤 다릅니다. 0.6B는 공개 순위 3위인데 이 글에서 7위이고, EmbeddingGemma 1세대는 공개 5위인데 이 글에서 2위입니다. 이유는 셋입니다.
첫째, MTEB 다국어 평균에서 한국어는 작은 조각입니다. 100개 넘는 언어와 검색·분류·군집·재순위 과제를 평균한 숫자는 "이 모델이 전반적으로 얼마나 좋은가"를 말하지 "한국어 공고문 검색에서 얼마나 좋은가"를 말하지 않습니다. 둘째, 이 글의 문서는 짧고(273자) 질문은 바꿔쓰기라 어휘 일치보다 의미 이해를, 긴 문맥 처리보다 짧은 문장의 밀도를 봅니다. 셋째, 양자화입니다. 공개 점수는 전체 정밀도이고 이 글은 Ollama가 배포한 양자화본(Q4_K_M, F16, BF16, nvfp4)입니다.
한국어 공개 벤치마크로는 KURE가 있고, RAG 특집 7편에서 Qwen3-8B의 9과제 평균이 0.783, 한국어 특화 late-interaction 모델 KURE-v2가 0.816임을 확인했습니다. 그 글의 결론 — "구조가 자리를 만들고, 한국어 학습 데이터가 점수를 만든다" — 은 이 글의 결론과 같은 방향입니다. 순위표는 방향을 알려 주고, 답은 여러분의 문서가 줍니다.
10부. 그래서 무엇을 고르나
위젯은 규칙 기반 추천이고, 아래는 그 규칙의 근거입니다.
기본값 · EmbeddingGemma 300M
620MB, CPU에서도 돌고, 접두어만 지키면 4B와 같은 점수. 이 글이 바꾼 가장 큰 결론입니다. 2,048토큰 창과 Gemma 약관(상업 이용 가능, 금지 용도 조항 있음)만 확인하면 대부분의 한국어 사내 검색에 첫 선택.
품질 우선 · Qwen3-Embedding 4B → 8B
GPU가 있고 질의 지연 100ms를 받아들일 수 있으면 4B. 8B는 0.03을 더 얻는 대신 색인 처리량이 절반, 저장이 1.6배. 1,024차원으로 잘라 쓰면 저장 부담은 사라집니다.
긴 문서 · Arctic Embed 2.0 또는 BGE-M3
8K 창. 둘은 같은 뼈대이고 점수도 같습니다. Apache 2.0이 필요하면 Arctic(query: 접두어 필수), MIT가 편하면 BGE-M3(접두어 없음). 256차원 절단은 Arctic이 더 잘 버팁니다.
처리량 우선 · Nomic v2 MoE
초당 59건으로 가장 빠르고 256차원까지 자를 수 있지만, 512토큰 창과 서술형 질문 약세를 감수해야 합니다. 짧은 문서 수천만 건의 1차 후보 생성용.
이미지·음성 · EmbeddingGemma 2
사진으로 문서를, 음성 메모로 글을 찾아야 한다면 유일한 로컬 선택지. 텍스트 검색 품질은 1세대보다 낮으니, 텍스트 인덱스를 따로 둘지 결정해야 합니다.
어떤 모델을 고르든 세 가지는 같습니다. 접두어를 모델 카드대로 붙일 것, 벡터 하나로 끝내지 말고 BM25와 합칠 것(2편), 상위 10개를 리랭커로 다시 고를 것. 마지막 자리에 무엇을 세울지가 다음 글의 주제입니다. 같은 맥에 올라 있던 낯선 모델 둘, tev1과 nimble은 임베딩이 아니라 글자를 쓰지 않는 판정 모델이었습니다.
11부. 이 실험의 한계
질문이 85개, 문서가 660건입니다. 0.02 안팎의 차이는 잡음입니다. 이 글이 자신 있게 말하는 것은 큰 격차(EmbeddingGemma 1 대 2, 접두어 유무, 128차원 절단)뿐입니다.
문서가 짧습니다. 제목+요약 273자. 보고서·회의록처럼 수천 토큰짜리 문서에서는 2K 창 모델(EmbeddingGemma 1)과 512 창 모델(Nomic)의 순위가 달라질 것입니다.
LLM 바꿔쓰기 45문항은 Qwen 계열 LLM이 만들었습니다. 7부에서 본 대로 Qwen3 임베딩에 유리한 편향이 있을 수 있습니다.
양자화본끼리의 비교입니다. 특히 EmbeddingGemma 2의 nvfp4·MLX 경로는 Ollama 0.40에서 처음 열린 것이라, 전체 정밀도 체크포인트와 같은 결과가 나온다고 보장할 수 없습니다.
속도는 한 대의 맥에서 잰 값입니다. 러너(llama.cpp·MLX)와 배치 크기에 따라 달라지고, NVIDIA GPU에서는 큰 모델의 처리량 격차가 줄어듭니다.
하이브리드(BM25+RRF)와 리랭커는 이 글에서 다시 재지 않았습니다. 1편·2편의 결론을 그대로 전제합니다.
부록: 실험 재현 방법
모델별 접두어 규칙 (Python, 표준 라이브러리 + numpy)
python
import json, urllib.request
import numpy as np
defembed(model, texts, dimensions=None):
body = {"model": model, "input": texts, "keep_alive": "15m", "truncate": True}
if dimensions:
body["dimensions"] = dimensions # MRL 절단 (앞쪽 차원 + 재정규화)
req = urllib.request.Request("http://localhost:11434/api/embed",
data=json.dumps(body).encode(), headers={"Content-Type": "application/json"})
return json.load(urllib.request.urlopen(req))["embeddings"]
QI = ("Instruct: Given a web search query, retrieve relevant passages ""that answer the query\nQuery: ")
PREFIX = { # (질의 접두어, 문서 접두어)"qwen3-embedding:8b": (QI, ""),
"qwen3-embedding:4b": (QI, ""),
"qwen3-embedding:0.6b": ("", ""), # 0.6B는 지시문 없는 쪽이 나았다"bge-m3": ("", ""),
"snowflake-arctic-embed2": ("query: ", ""),
"nomic-embed-text-v2-moe": ("search_query: ", "search_document: "),
"embeddinggemma": ("task: search result | query: ", "title: none | text: "),
"embeddinggemma-2": ("task: search result | query: ", "title: none | text: "),
}
defnorm(a):
a = np.asarray(a, dtype=np.float64)
return a / np.linalg.norm(a, axis=1, keepdims=True)
model = "embeddinggemma"
qp, dp = PREFIX[model]
D = norm(embed(model, [dp + d for d in docs])) # 32건씩 나눠 보내는 편이 안전
Q = norm(embed(model, [qp + q for q in queries]))
sim = Q @ D.T # (질문 수 × 문서 수) 코사인 행렬
top10 = np.argsort(-sim, axis=1)[:, :10]
평가(nDCG@10·MRR·Recall@k)는 수십 줄짜리 직접 구현이고, 1편의 부록과 같습니다. 모델은 ollama pull 아홉 번이면 전부 받아지고, 아홉 모델의 전체 실험은 M1 Ultra에서 15분 안에 끝납니다(그중 10분이 Qwen3 4B·8B의 문서 색인입니다).