기억이 부딪칠 때 — AI 에이전트 기억의 모순 해결은 왜 '동시성 제어'인가, TOKI 논문 완전 해설
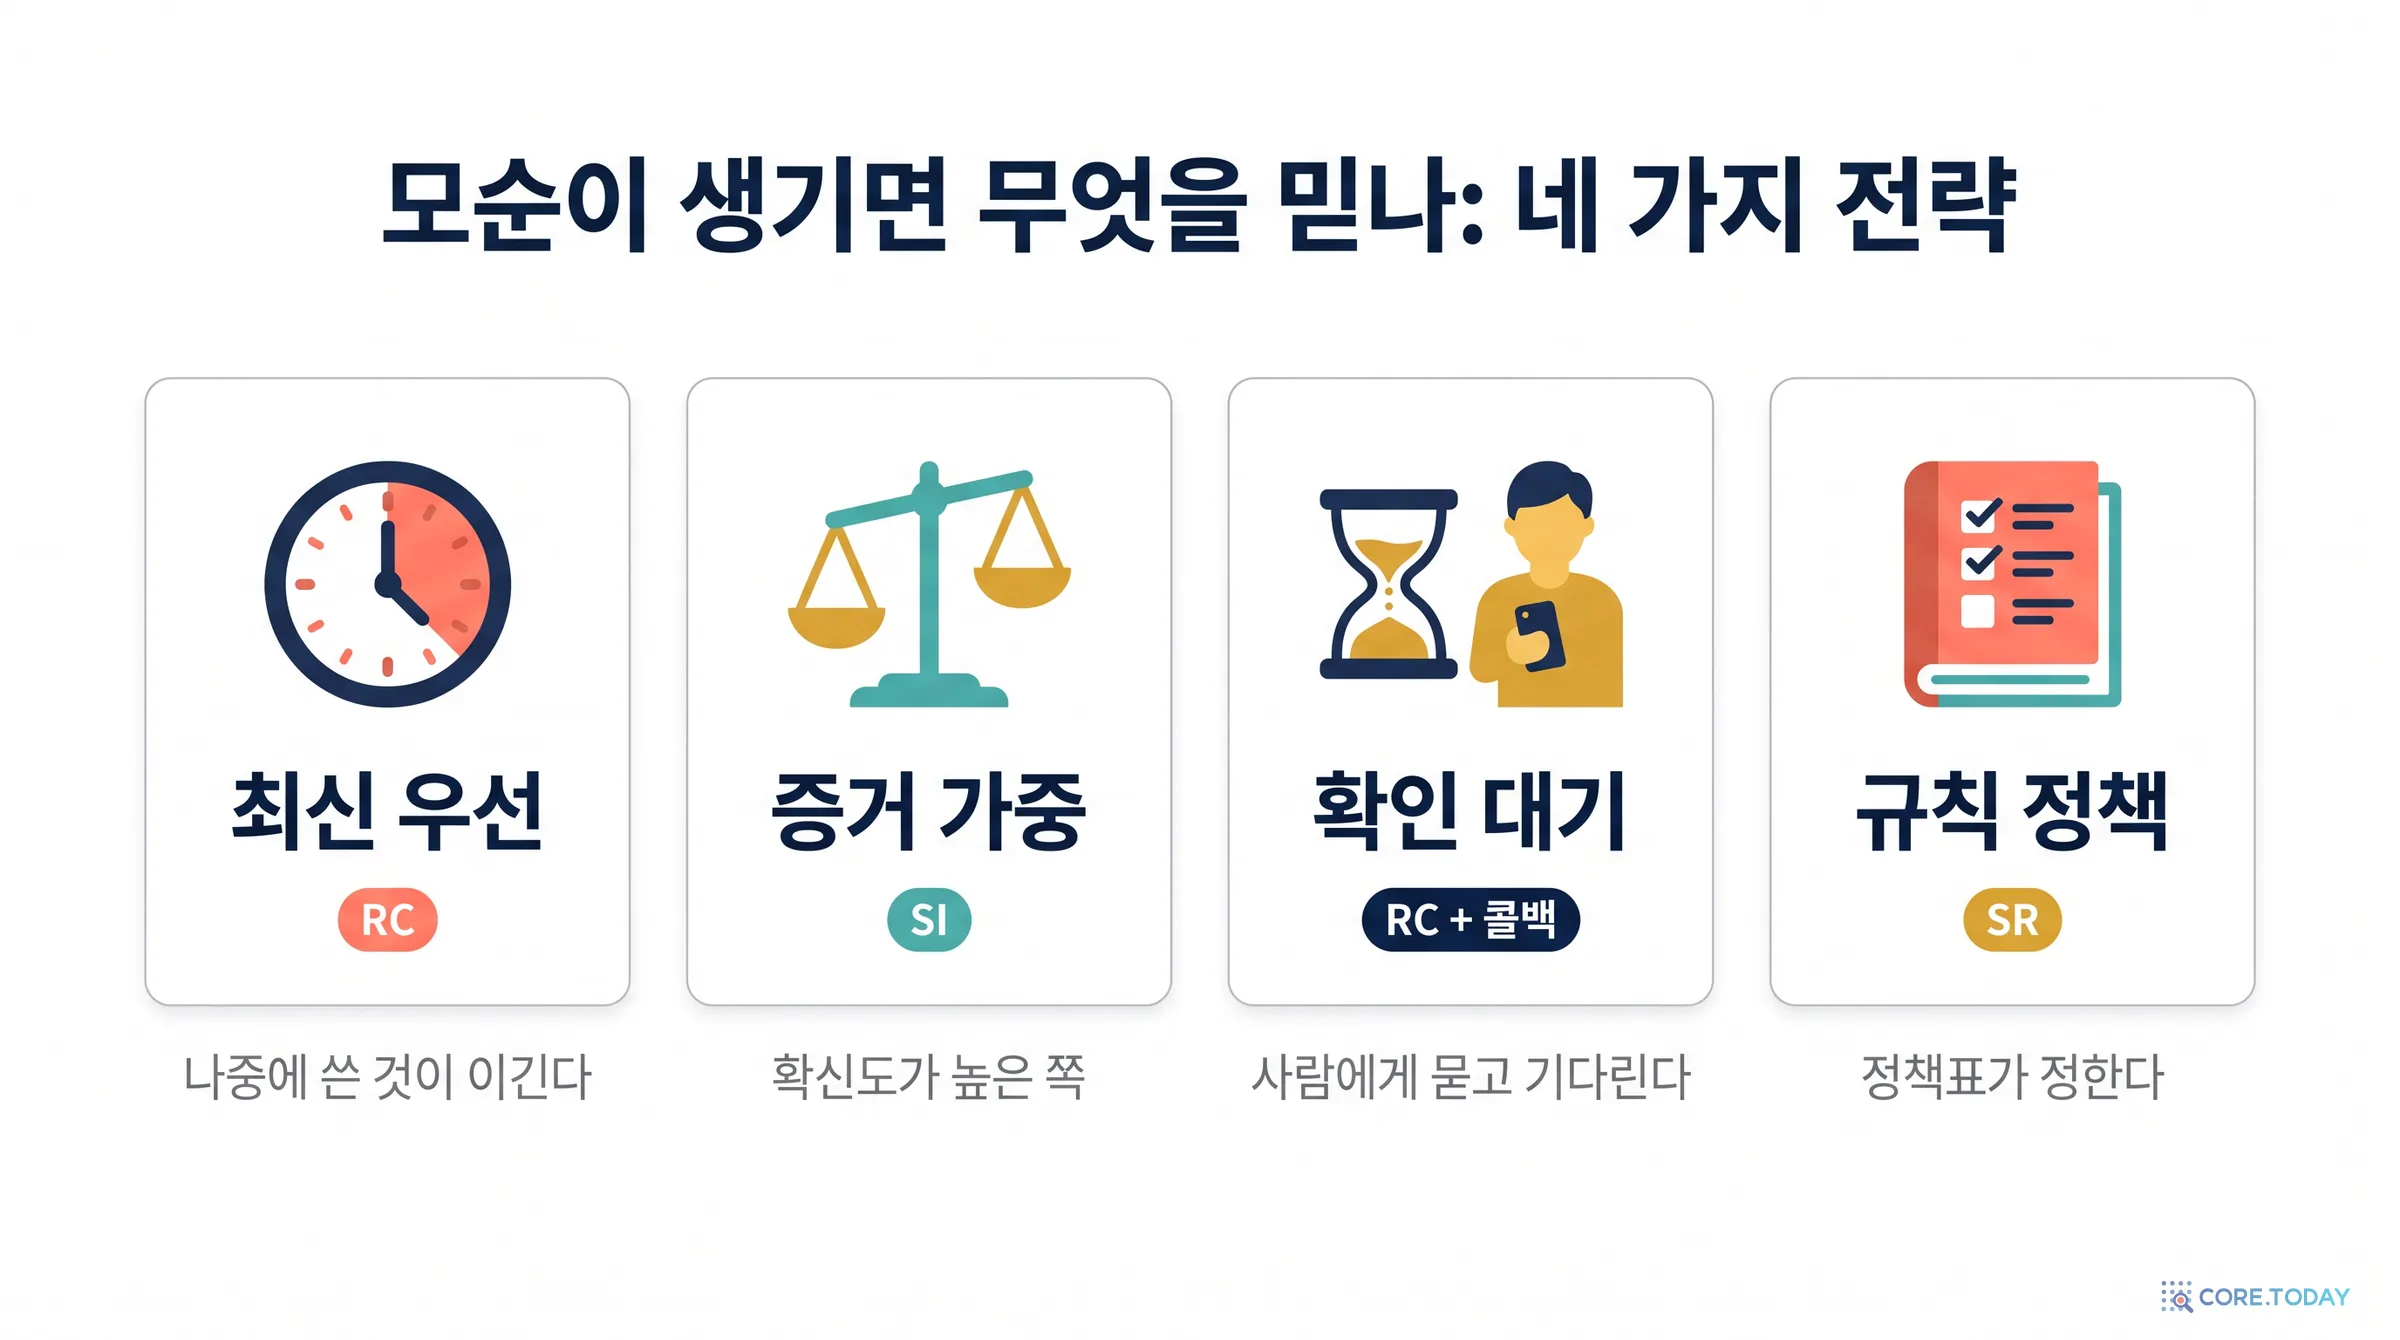
에이전트의 기억에 '담당자는 박 과장'과 '담당자는 이 대리'가 함께 들어오면 누가 이기나. 홍콩과기대의 TOKI 논문(arXiv 2606.06240)은 이 질문이 사실 50년 된 데이터베이스 문제, 즉 동시성 제어라고 말한다. 최신 우선·증거 가중·확인 대기·규칙 정책이라는 네 가지 생산 전략을 격리 수준이 붙은 연산자로 다시 쓰고, 진 사실을 지우지 않는 '감사 행'과 LLM 판정을 키로 기록하는 '판정 로그'로 세 가지 새 이상(판정 재현 불일치·믿음 표류 스큐·감사 소거)을 막는다. 이중 시간 데이터베이스, 베렌슨의 격리 수준 비판, 출처 반가환이라는 세 뿌리부터 정리 다섯 개의 쉬운 풀이, 여덟 시스템 판정표의 칸별 무게까지 읽었다. PostgreSQL 17에서 두 에이전트의 동시 쓰기를 격리 수준별로 50번씩 돌리고, 로컬 4B 모델을 판정자로 같은 모순을 반복해 물어 판정이 얼마나 뒤집히는지 직접 쟀다 — 온도 0에서도 두 기록의 제시 순서만 바꾸면 36쌍 중 13쌍에서 승자가 바뀌었다. 논문이 밝힌 코드 저장소가 404라는 점, 판정표 일부 칸이 지금 코드와 맞지 않는다는 점도 짚었다. 인터랙티브 위젯 6개.
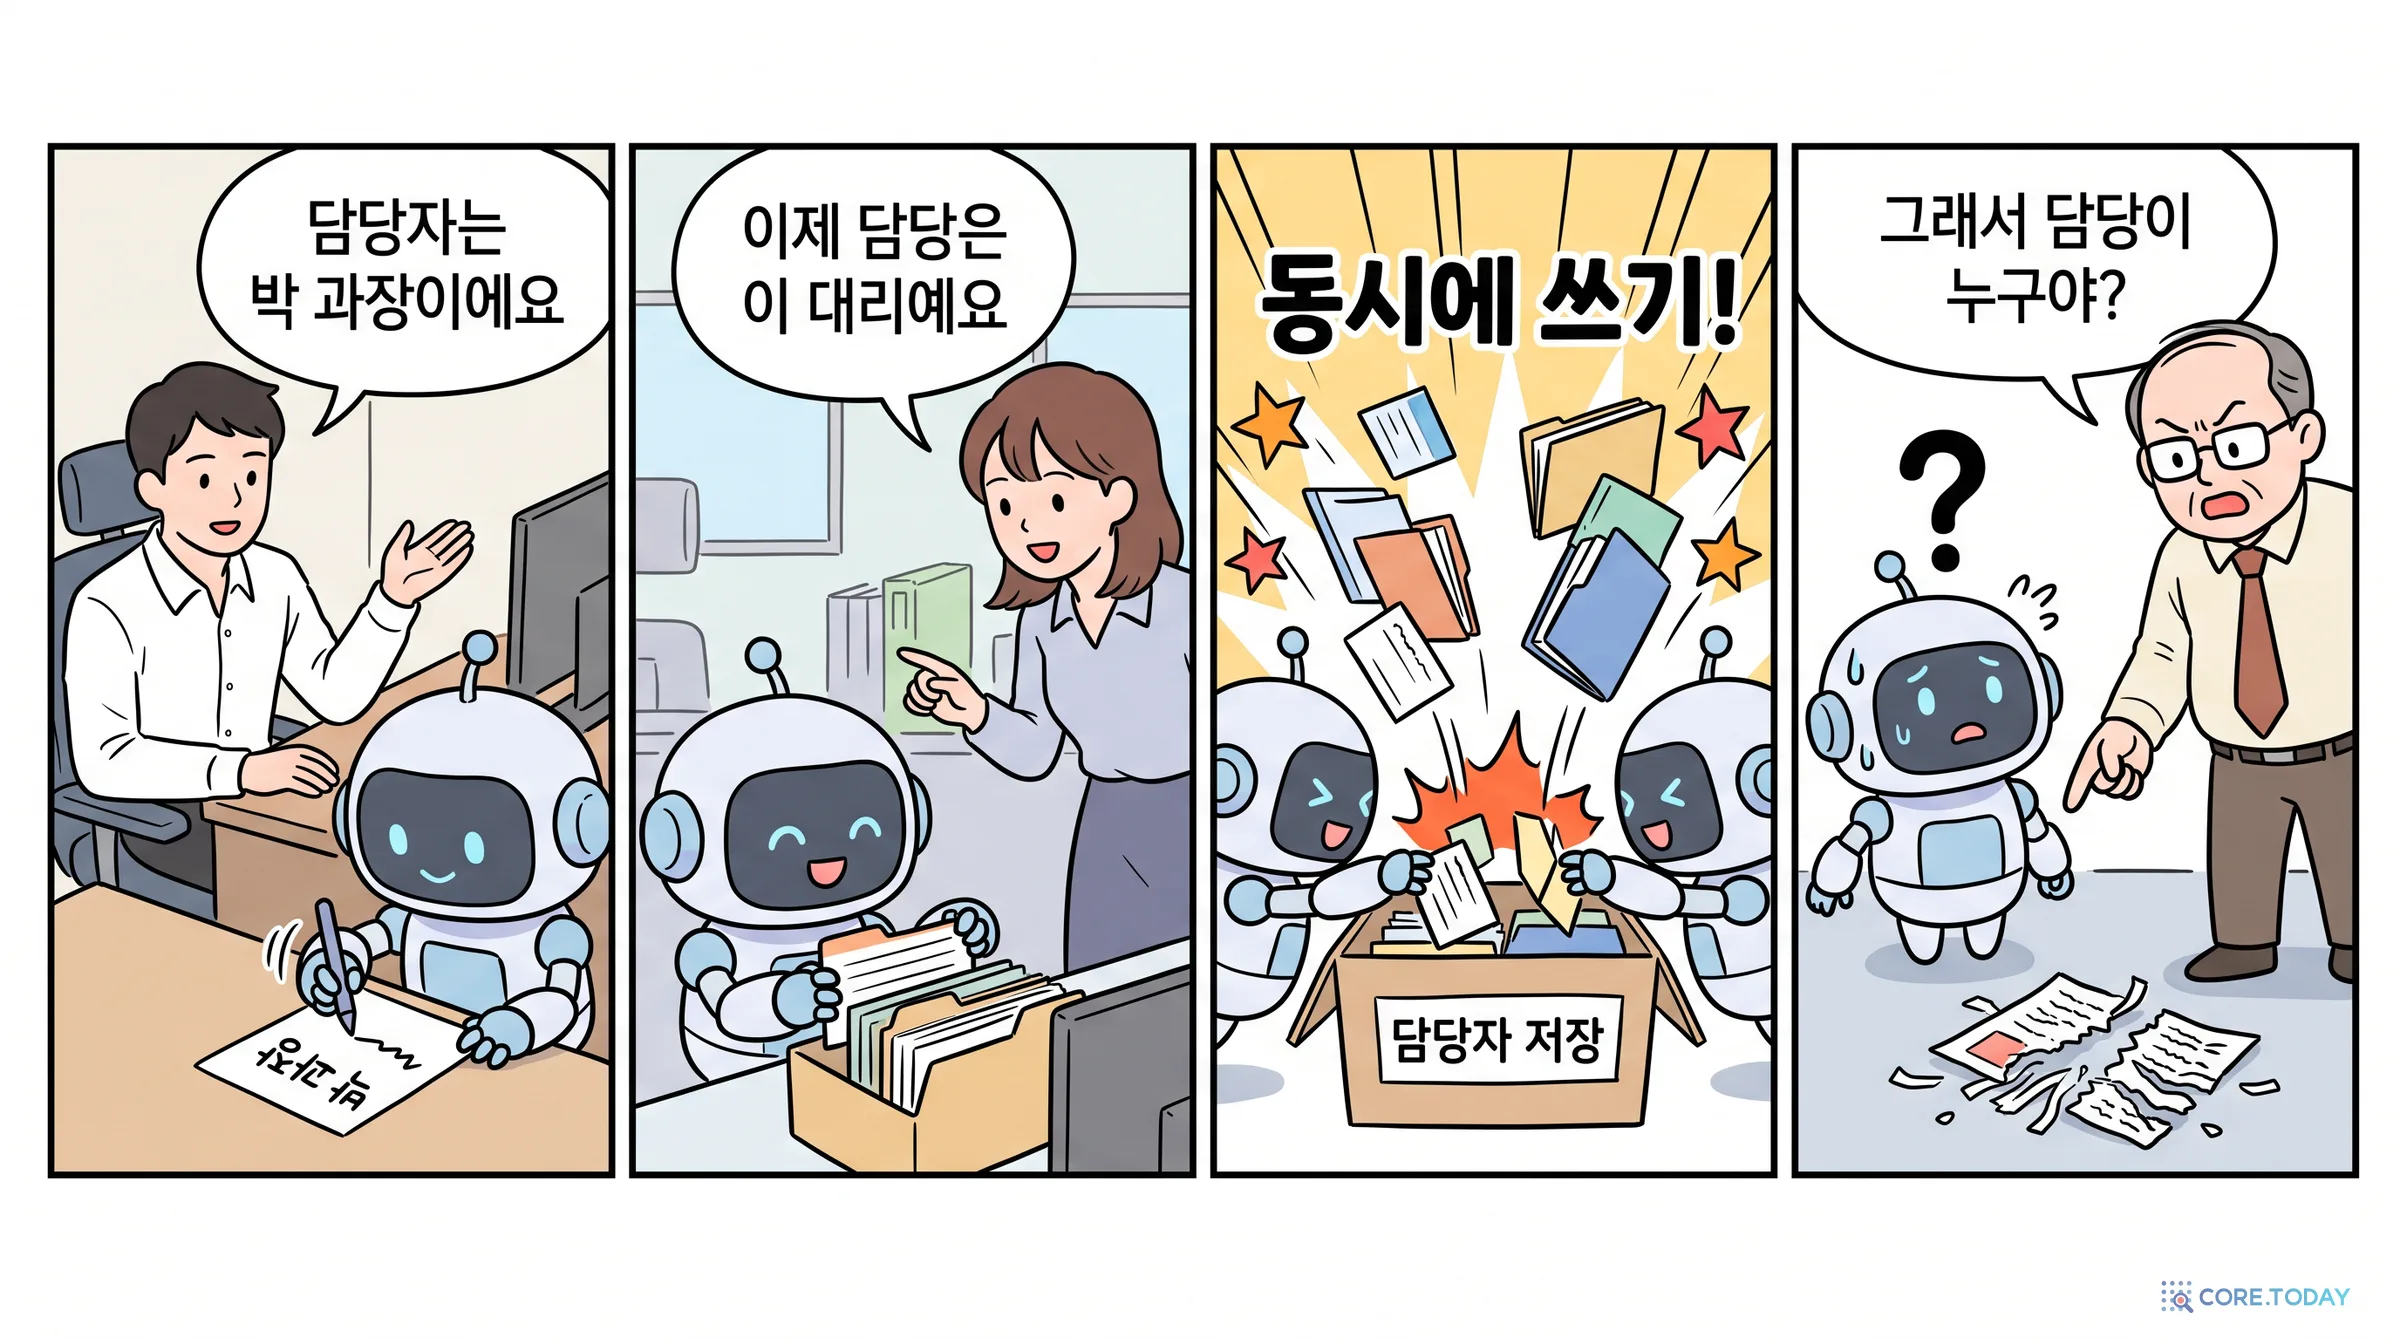
월요일, 영업팀 김 대리가 회사의 AI 비서에게 말합니다. "거래처 A 담당자는 박 과장님이에요." 비서는 기억에 적습니다. 목요일, 다른 팀원이 다른 채널에서 같은 비서에게 말합니다. "A사 담당이 이 대리님으로 바뀌었대요." 그런데 하필 그 순간, 비서의 다른 인스턴스가 지난주 회의록을 정리하며 "A사 담당자: 박 과장"을 다시 확인해 기억에 쓰고 있었습니다. 다음 주 월요일 팀장이 묻습니다. "그래서 A사 담당이 누구야?"
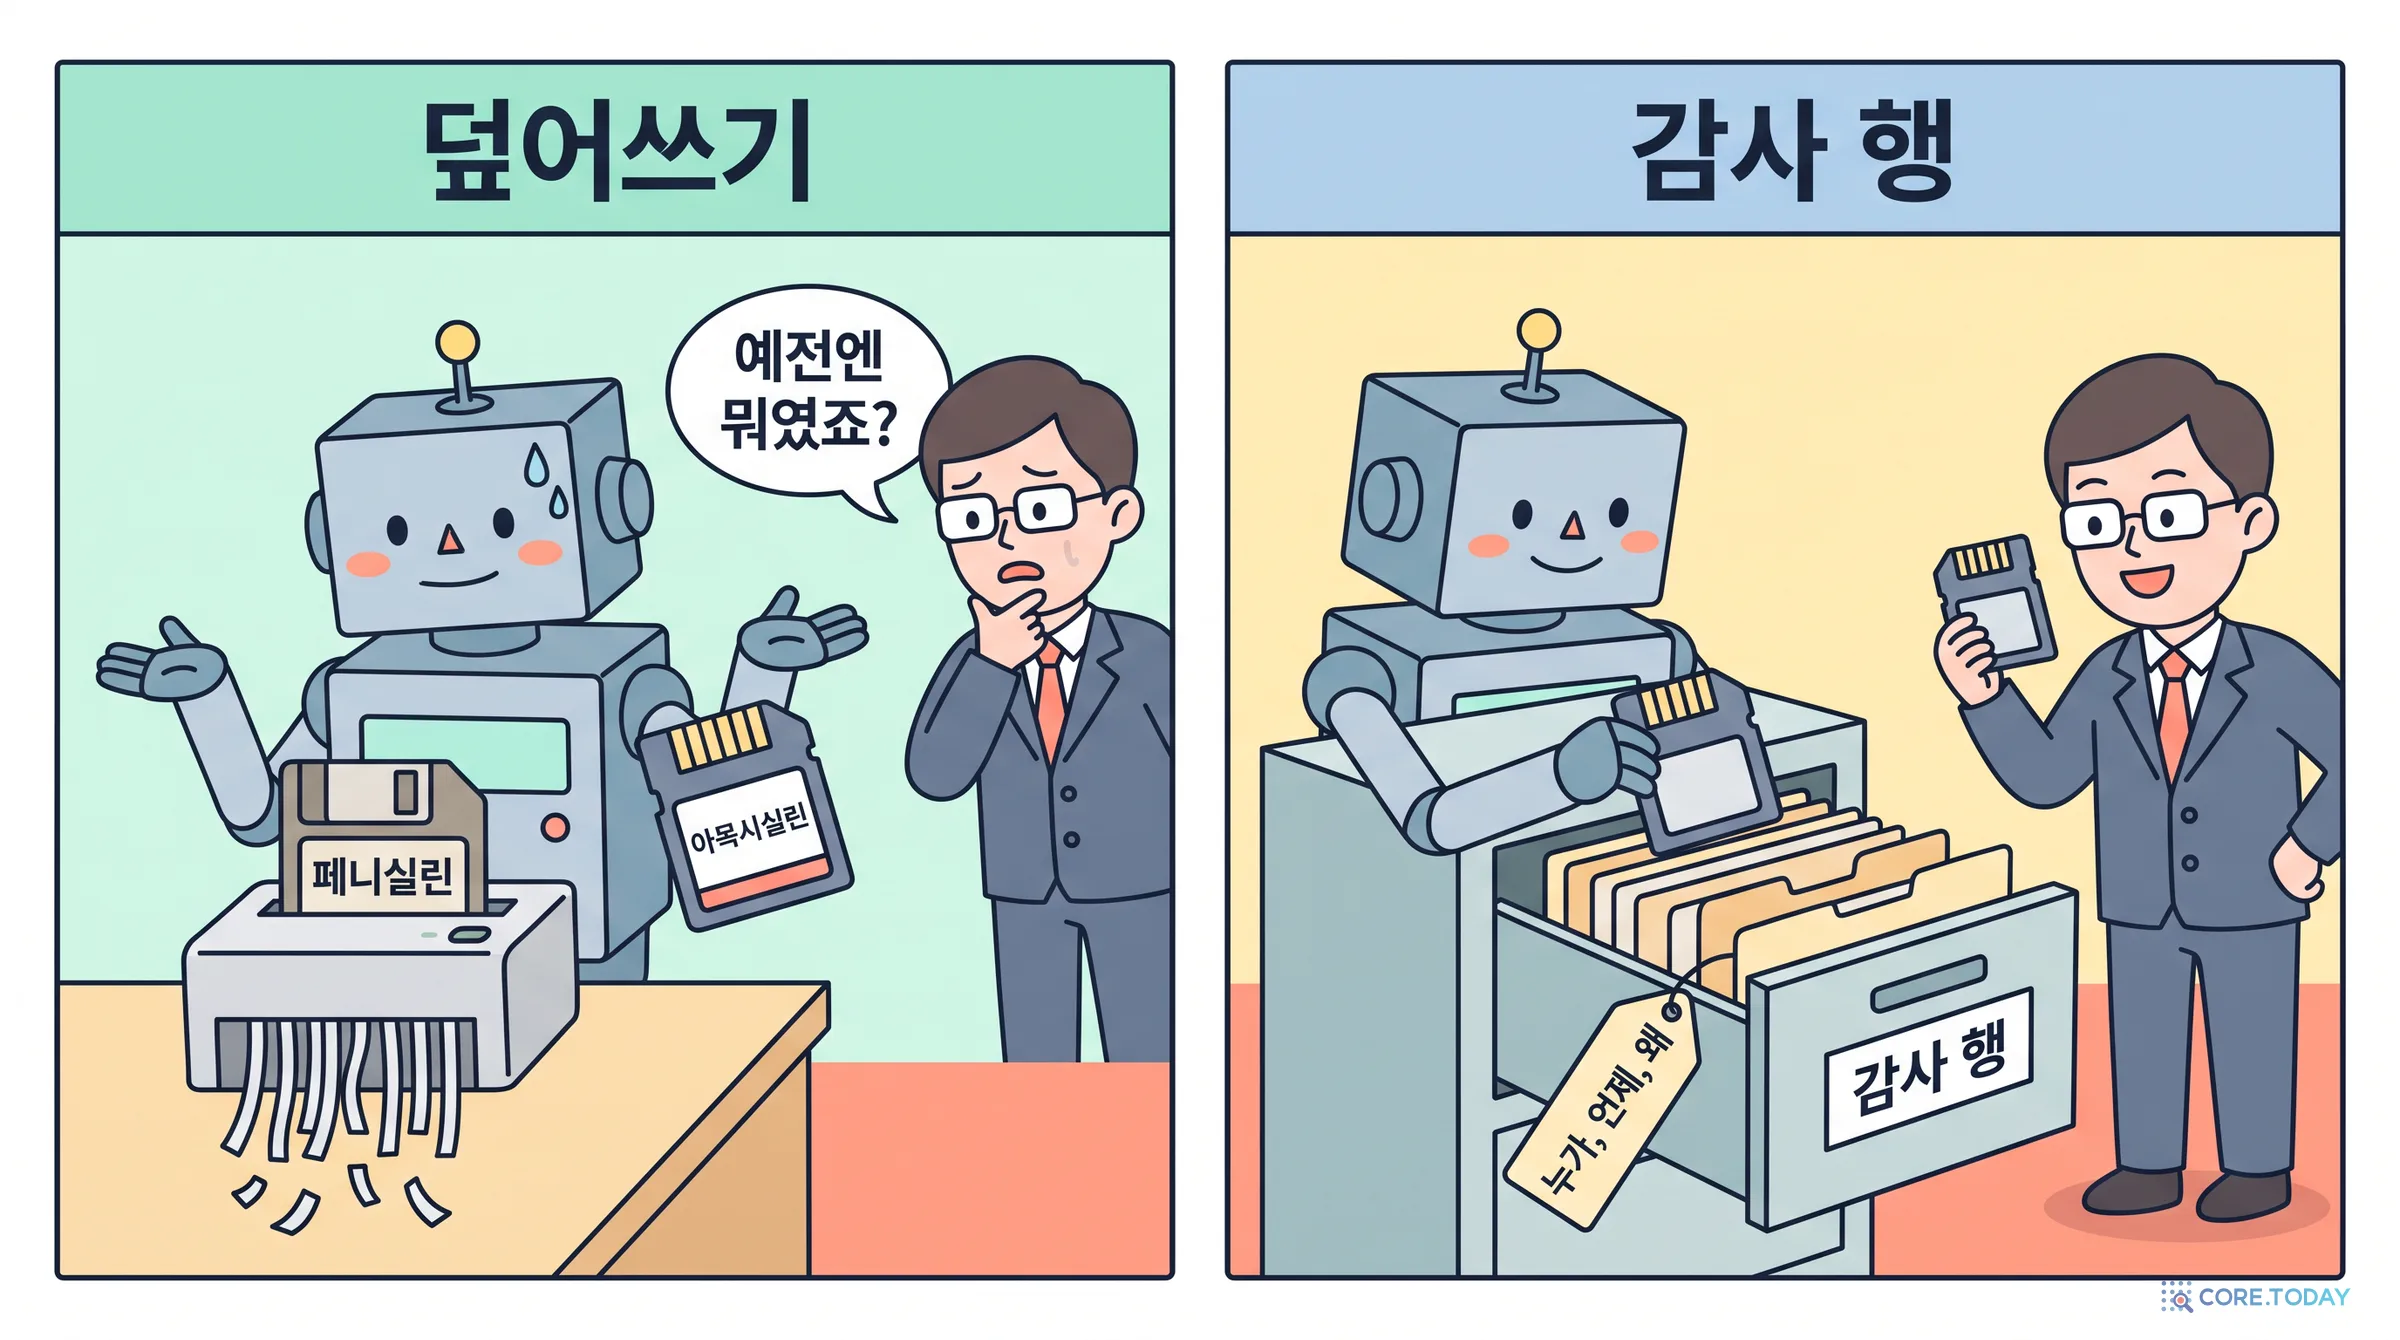
답은 세 가지 중 하나입니다. 운이 좋으면 "이 대리"입니다. 운이 나쁘면 "박 과장"입니다. 더 나쁘면 비서가 둘 다 현재 값으로 들고 있다가 그때그때 다르게 답합니다. 그리고 가장 나쁜 경우는, 어느 쪽이 맞는지와 별개로 "왜 그렇게 판단했는지, 예전엔 뭐라고 알고 있었는지"를 아무도 되짚을 수 없는 상태입니다. 박 과장이라는 기록이 덮어쓰기로 사라졌기 때문입니다.
이건 상상 속 시나리오가 아닙니다. 2026년의 에이전트 기억 엔진들 — mem0, Graphiti(Zep), Letta, MIRIX — 은 모두 대화나 문서에서 사실을 뽑아 저장하고, 새 사실이 옛 사실과 부딪치면 어떻게든 하나를 고릅니다. 고르는 방법은 엔진마다 다르지만, 고른 방법이 어떤 조건에서만 안전한지 밝힌 엔진은 없습니다.
2026년 6월 4일 arXiv에 올라온 「TOKI: A Bitemporal Operator Algebra for Contradiction Resolution in LLM-Agent Persistent Memory」(홍콩과기대 왕쯔밍, arXiv 2606.06240)는 이 공백을 정면으로 겨눕니다. 논문의 주장은 한 문장입니다.
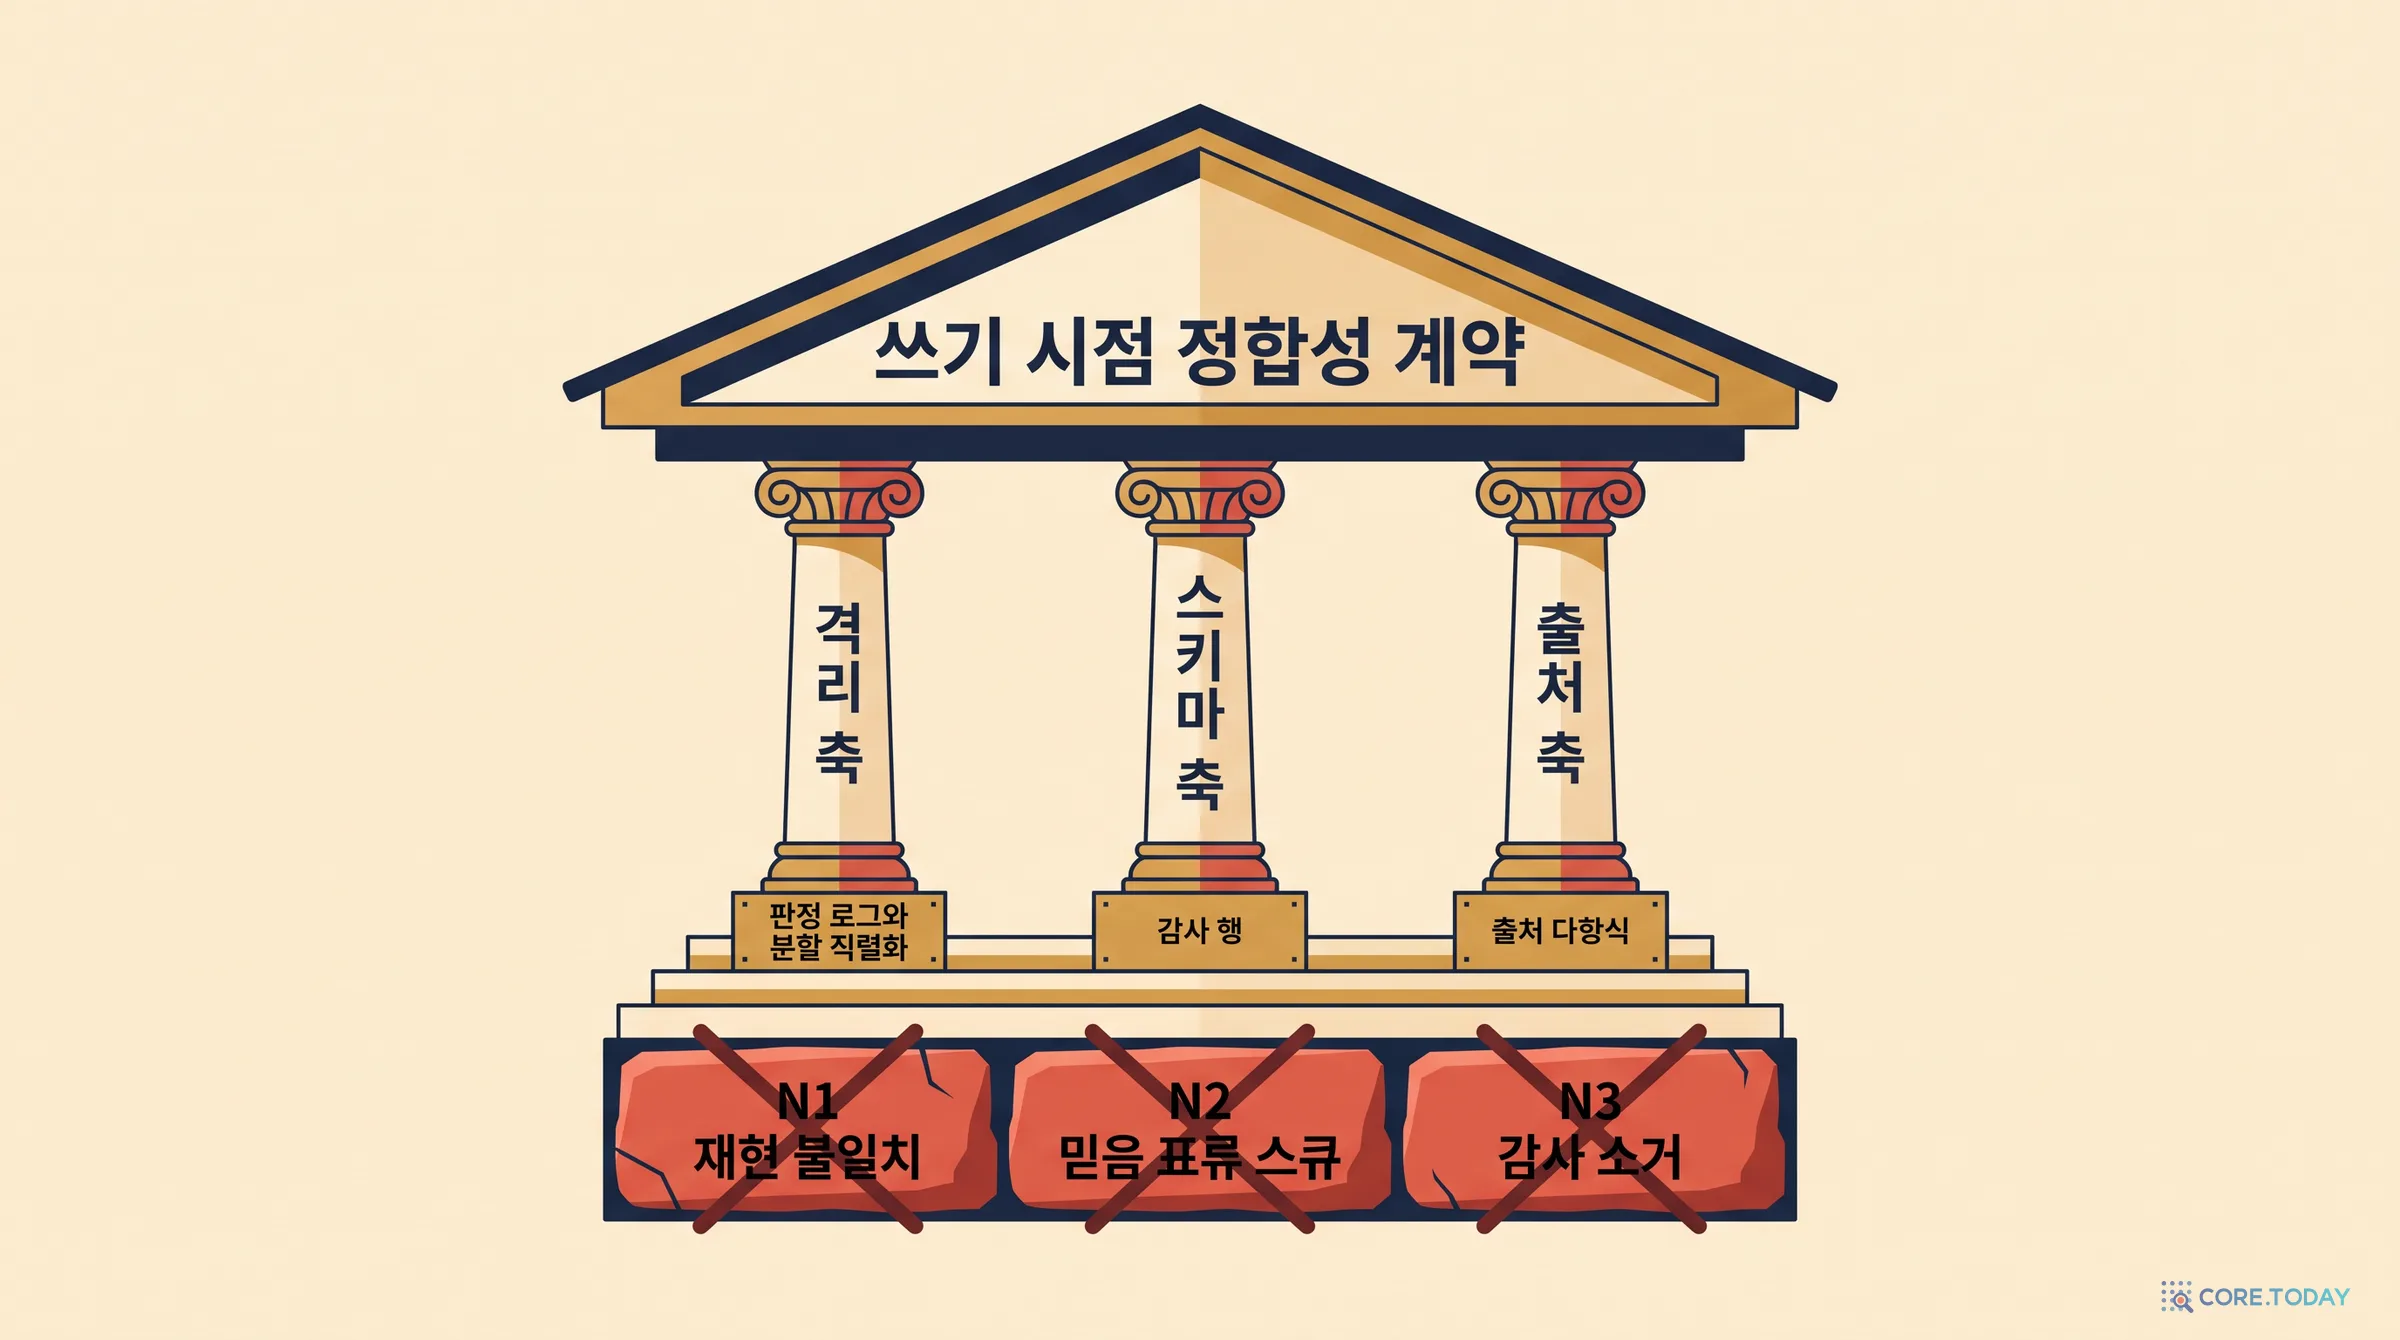
기억의 모순 해결은 쓰기 시점의 동시성 제어(concurrency control)다.
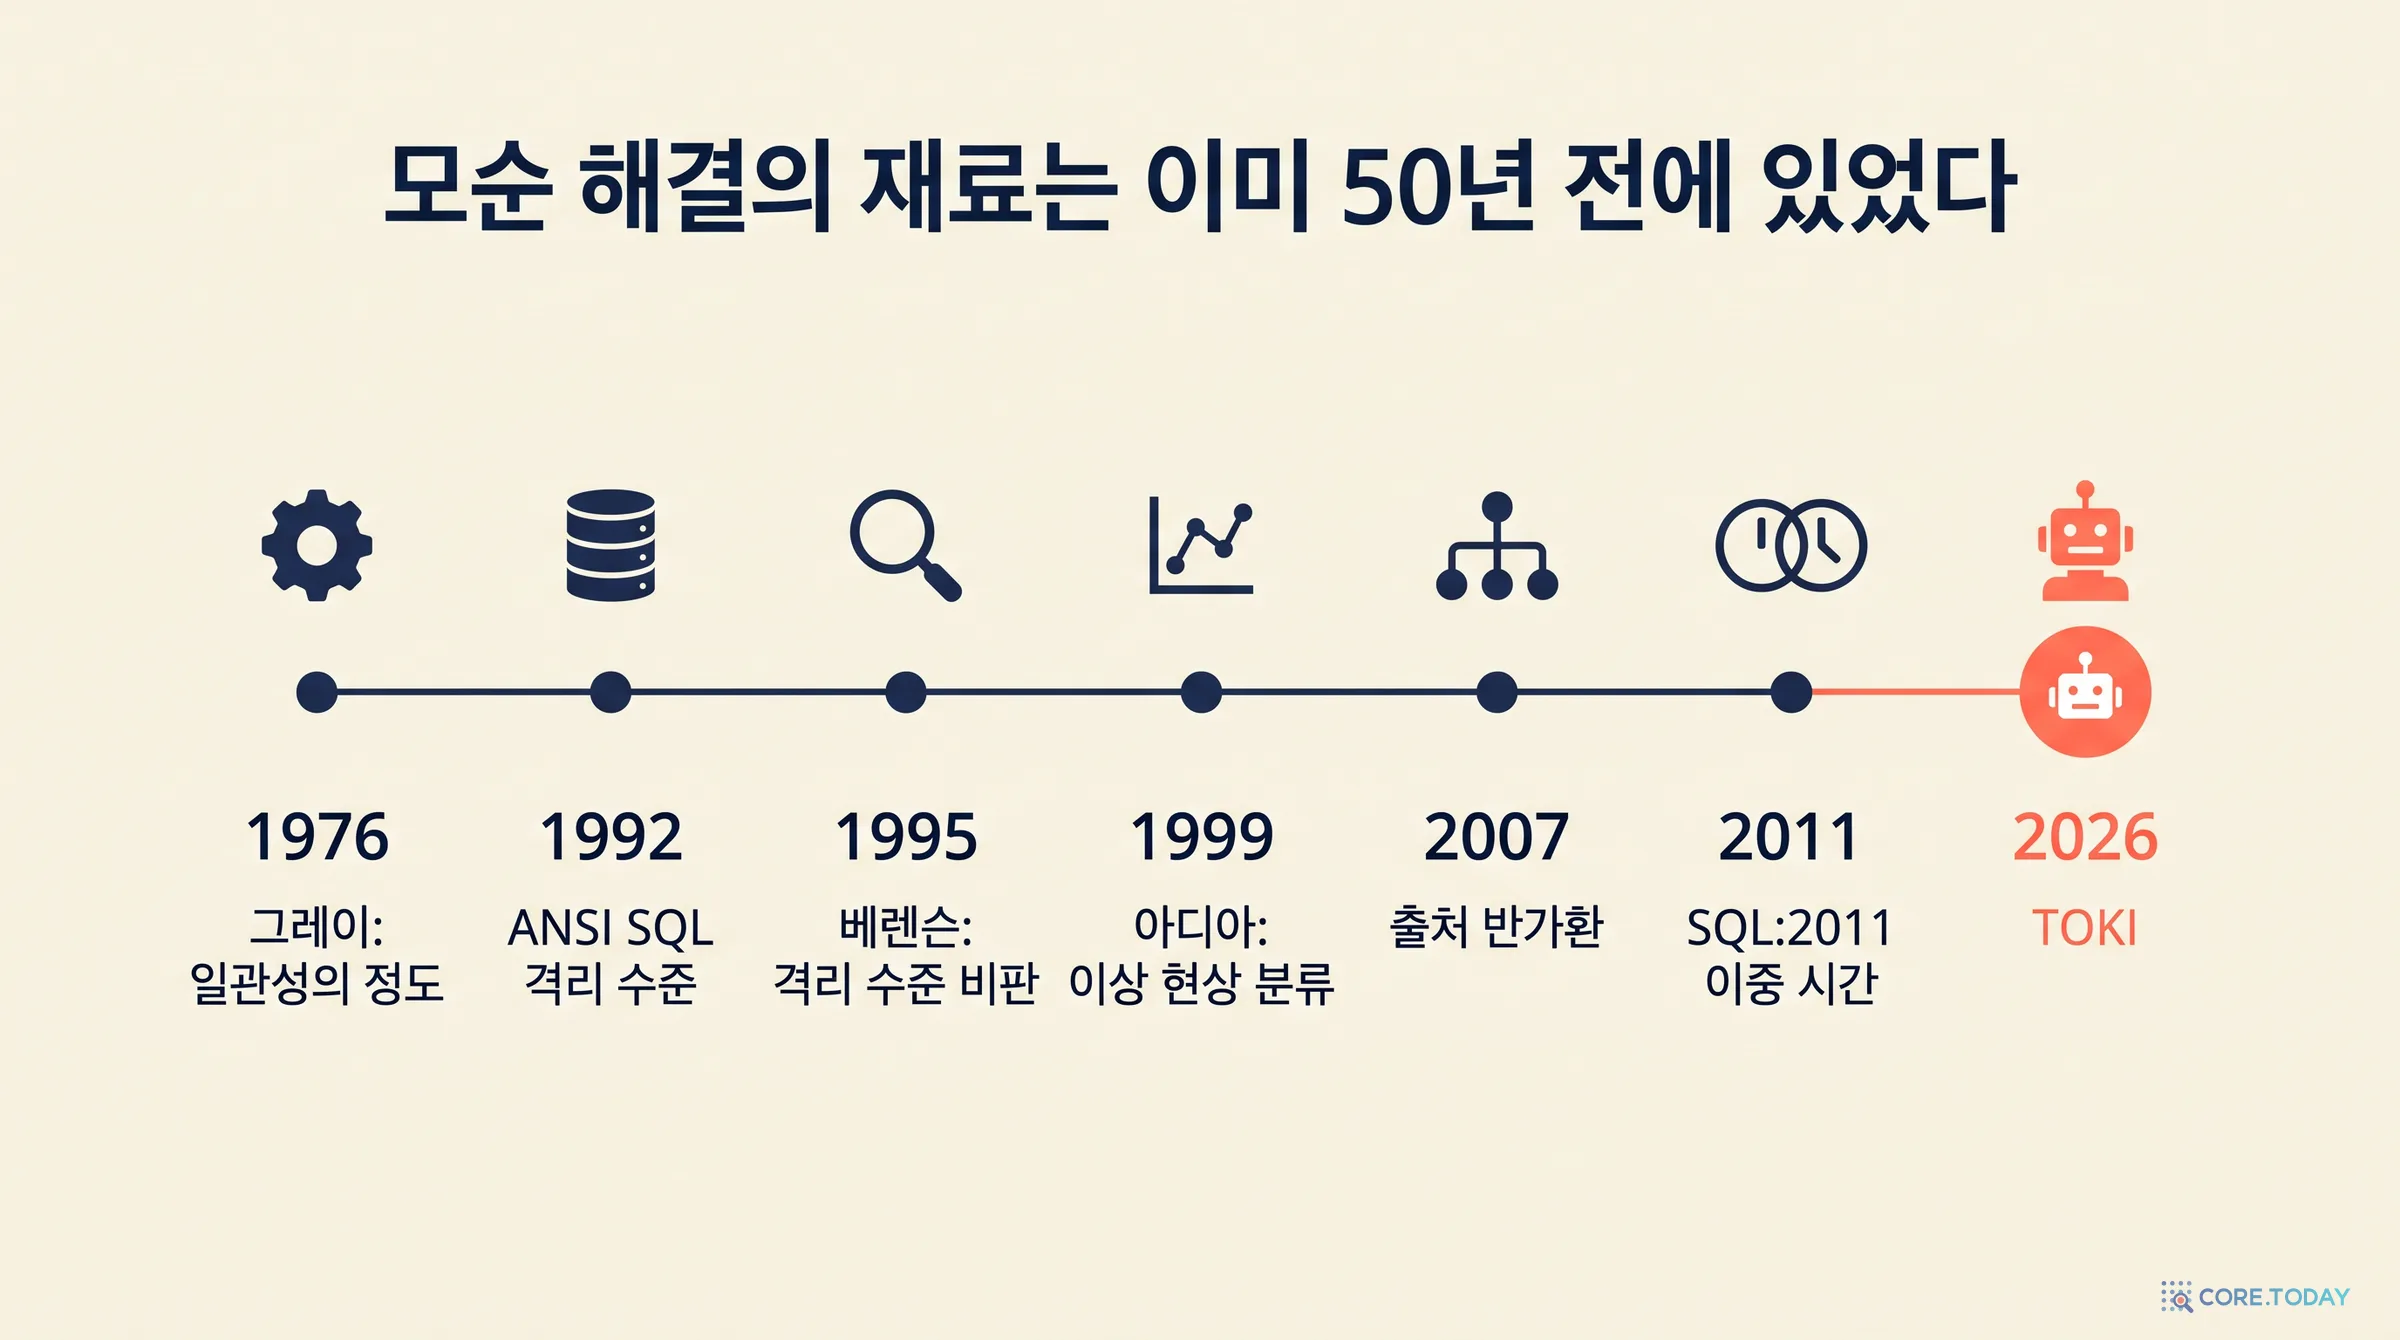
데이터베이스 분야는 이 문제를 이미 50년 동안 풀어 왔습니다. 두 사람이 같은 계좌를 동시에 고칠 때 무엇이 잘못될 수 있는지(격리 수준), 사실이 언제 참이었고 언제 기록됐는지(이중 시간), 어떤 결론이 어떤 근거에서 나왔는지(출처)를 다루는 이론이 다 있습니다. TOKI는 이 세 가지를 LLM 에이전트의 기억 쓰기 경로로 옮겨 오고, 고전 이론에는 없던 LLM 판정자라는 새 참여자 때문에 생기는 이상 세 가지에 이름을 붙입니다.
이 글은 논문을 처음부터 끝까지 읽고 다음 순서로 풀어 씁니다.
에이전트 기억이 왜 '쓰기가 많은 데이터베이스'이고, 생산 시스템이 쓰는 네 가지 모순 해결 전략은 무엇인가
TOKI가 빌려 온 세 개의 뿌리: 두 개의 시계(이중 시간 데이터베이스), 격리 수준 50년사, 출처 반가환
TOKI의 본체: 사실 한 줄의 해부, 이중 행 스키마, 네 연산자, 그리고 세 가지 새 이상(N1·N2·N3)
정리 다섯 개를 수식 없이 읽기, 여덟 시스템 판정표를 칸별로 읽기
코어닷투데이 실측: PostgreSQL 17에서 두 에이전트 동시 쓰기 재현, 로컬 4B 판정자의 재현 불일치 측정(A·B 순서만 바꿔도 36쌍 중 13쌍에서 승자가 바뀐다)
비판적으로 읽기, 그리고 2026년에 이 논문이 갖는 의미와 실무 점검표
코어닷투데이는 지난 한 달 동안 에이전트 기억을 여러 각도에서 다뤘습니다. Graphiti의 시간 그래프, 이중 시간 SQL 실습, 기억 오염, 기억 엔진 코드 해부, 상태 표류. TOKI는 그 조각들을 '트랜잭션'이라는 하나의 틀로 묶는 논문이라, 이전 글들을 읽은 분께는 퍼즐의 마지막 조각처럼 느껴질 겁니다. 처음 읽는 분도 따라올 수 있게 바닥부터 설명하겠습니다.
1. 기억은 '쓰기가 많은 데이터베이스'다
1-1. 검색이 아니라 쓰기가 문제다
에이전트 기억에 관한 논의는 오랫동안 읽기에 쏠려 있었습니다. 어떤 기억을 꺼낼까(검색), 몇 개를 넣을까(문맥 예산), 어떻게 순위를 매길까(재정렬). LoCoMo·LongMemEval 같은 벤치마크도 결국 "질문에 맞는 기억을 꺼내 정답을 냈나"를 잽니다. 코어닷투데이가 메모리 벤치마크를 다시 채점했을 때도 핵심 변수는 검색과 채점 방식이었습니다.
TOKI는 시선을 반대쪽으로 돌립니다. 에이전트가 대화할 때마다 기억은 쓰입니다. 사용자의 이사, 이직, 취향 변화, 프로젝트 일정 변경, 서버 포트 변경 — 모든 믿음의 갱신은 "버전이 붙은 쓰기"입니다. 논문 서론의 첫 문장이 이것입니다.
에이전트의 영속 기억은 쓰기가 많은 데이터 관리 기반이다. 모든 믿음 갱신은 버전이 붙은 쓰기이며, 유효 시간·시스템 시간·출처 표시, 그리고 암묵적인 격리 수준을 지닌다.
마지막 단어가 중요합니다. 암묵적인 격리 수준. 어떤 엔진도 "우리 모순 해결은 이런 동시 실행 조건을 가정한다"고 말하지 않지만, 실제로는 모두 무언가를 가정하고 있다는 뜻입니다.
1-2. 같은 열쇠, 다른 값: '모순'의 정확한 정의
TOKI는 기억 속 사실 하나를 (주어, 술어, 목적어) 세 쌍으로 봅니다. "(앨리스, 복용약, 페니실린)", "(거래처 A, 담당자, 박 과장)", "(API 서버, 포트, 8080)". 그리고 두 사실이 모순인 조건을 세 가지로 정의합니다.
주어와 술어가 같다 — 같은 '열쇠'(key)에 대한 이야기다.
목적어가 다르다 — 값이 다르다.
유효 기간이 한 순간이라도 겹친다 — 같은 시점에 둘 다 참일 수는 없다.
세 번째 조건이 영리합니다. "앨리스는 3월까지 페니실린, 4월부터 아목시실린"은 모순이 아닙니다. 기간이 겹치지 않으니 둘 다 참입니다. 모순은 같은 시점에 대해 다른 말을 할 때만 생깁니다. 시간 구간 사이의 관계를 따질 때 논문은 1983년 제임스 앨런의 13가지 구간 관계(before, meets, overlaps, during…)를 씁니다. 13가지 중 공유하는 순간이 없는 넷(앞, 뒤, 맞닿음 두 가지)을 빼면 나머지 9가지가 모순이 성립하는 경우입니다.
1-3. 생산 시스템의 네 가지 답
같은 열쇠에 다른 값이 들어오면 무엇을 믿을까. 논문은 실제로 배포된 시스템들이 쓰는 방법이 결국 넷이라고 정리합니다.
네 번째 열이 이 논문의 출발점입니다. 각 전략은 맞게 동작하기 위해 동시 실행에 관한 전제를 깔고 있는데, 그 전제를 아무도 적어 두지 않았습니다. 예를 들어 최신 우선은 "두 에이전트가 같은 값을 거의 동시에 고치는 일은 없다"고 믿습니다. 사람 한 명과 비서 하나가 대화하던 시절에는 대체로 맞는 믿음이었습니다. 하지만 2026년의 에이전트는 여러 개가 병렬로 돌고, 백그라운드에서 문서를 정리하고, 다른 에이전트의 출력을 읽어 기억을 고칩니다. 게다가 에이전트는 읽고 나서 쓰기 전까지 LLM을 부르느라 수 초를 씁니다. 일반 웹 서비스에서 읽기와 쓰기 사이의 틈이 수 밀리초라면, 에이전트 기억에서는 그 틈이 수천 배 넓습니다. 동시성 문제가 드물 수가 없습니다.
아래 위젯에서 같은 모순을 네 전략으로 풀어 보세요. 사례를 바꾸면 전략마다 승자가 달라지고, 각 전략이 가정하는 격리 수준과 그보다 약할 때 새어 나오는 이상이 함께 표시됩니다.
2. 첫 번째 뿌리: 두 개의 시계
2-1. "언제 참이었나"와 "언제 알았나"는 다르다
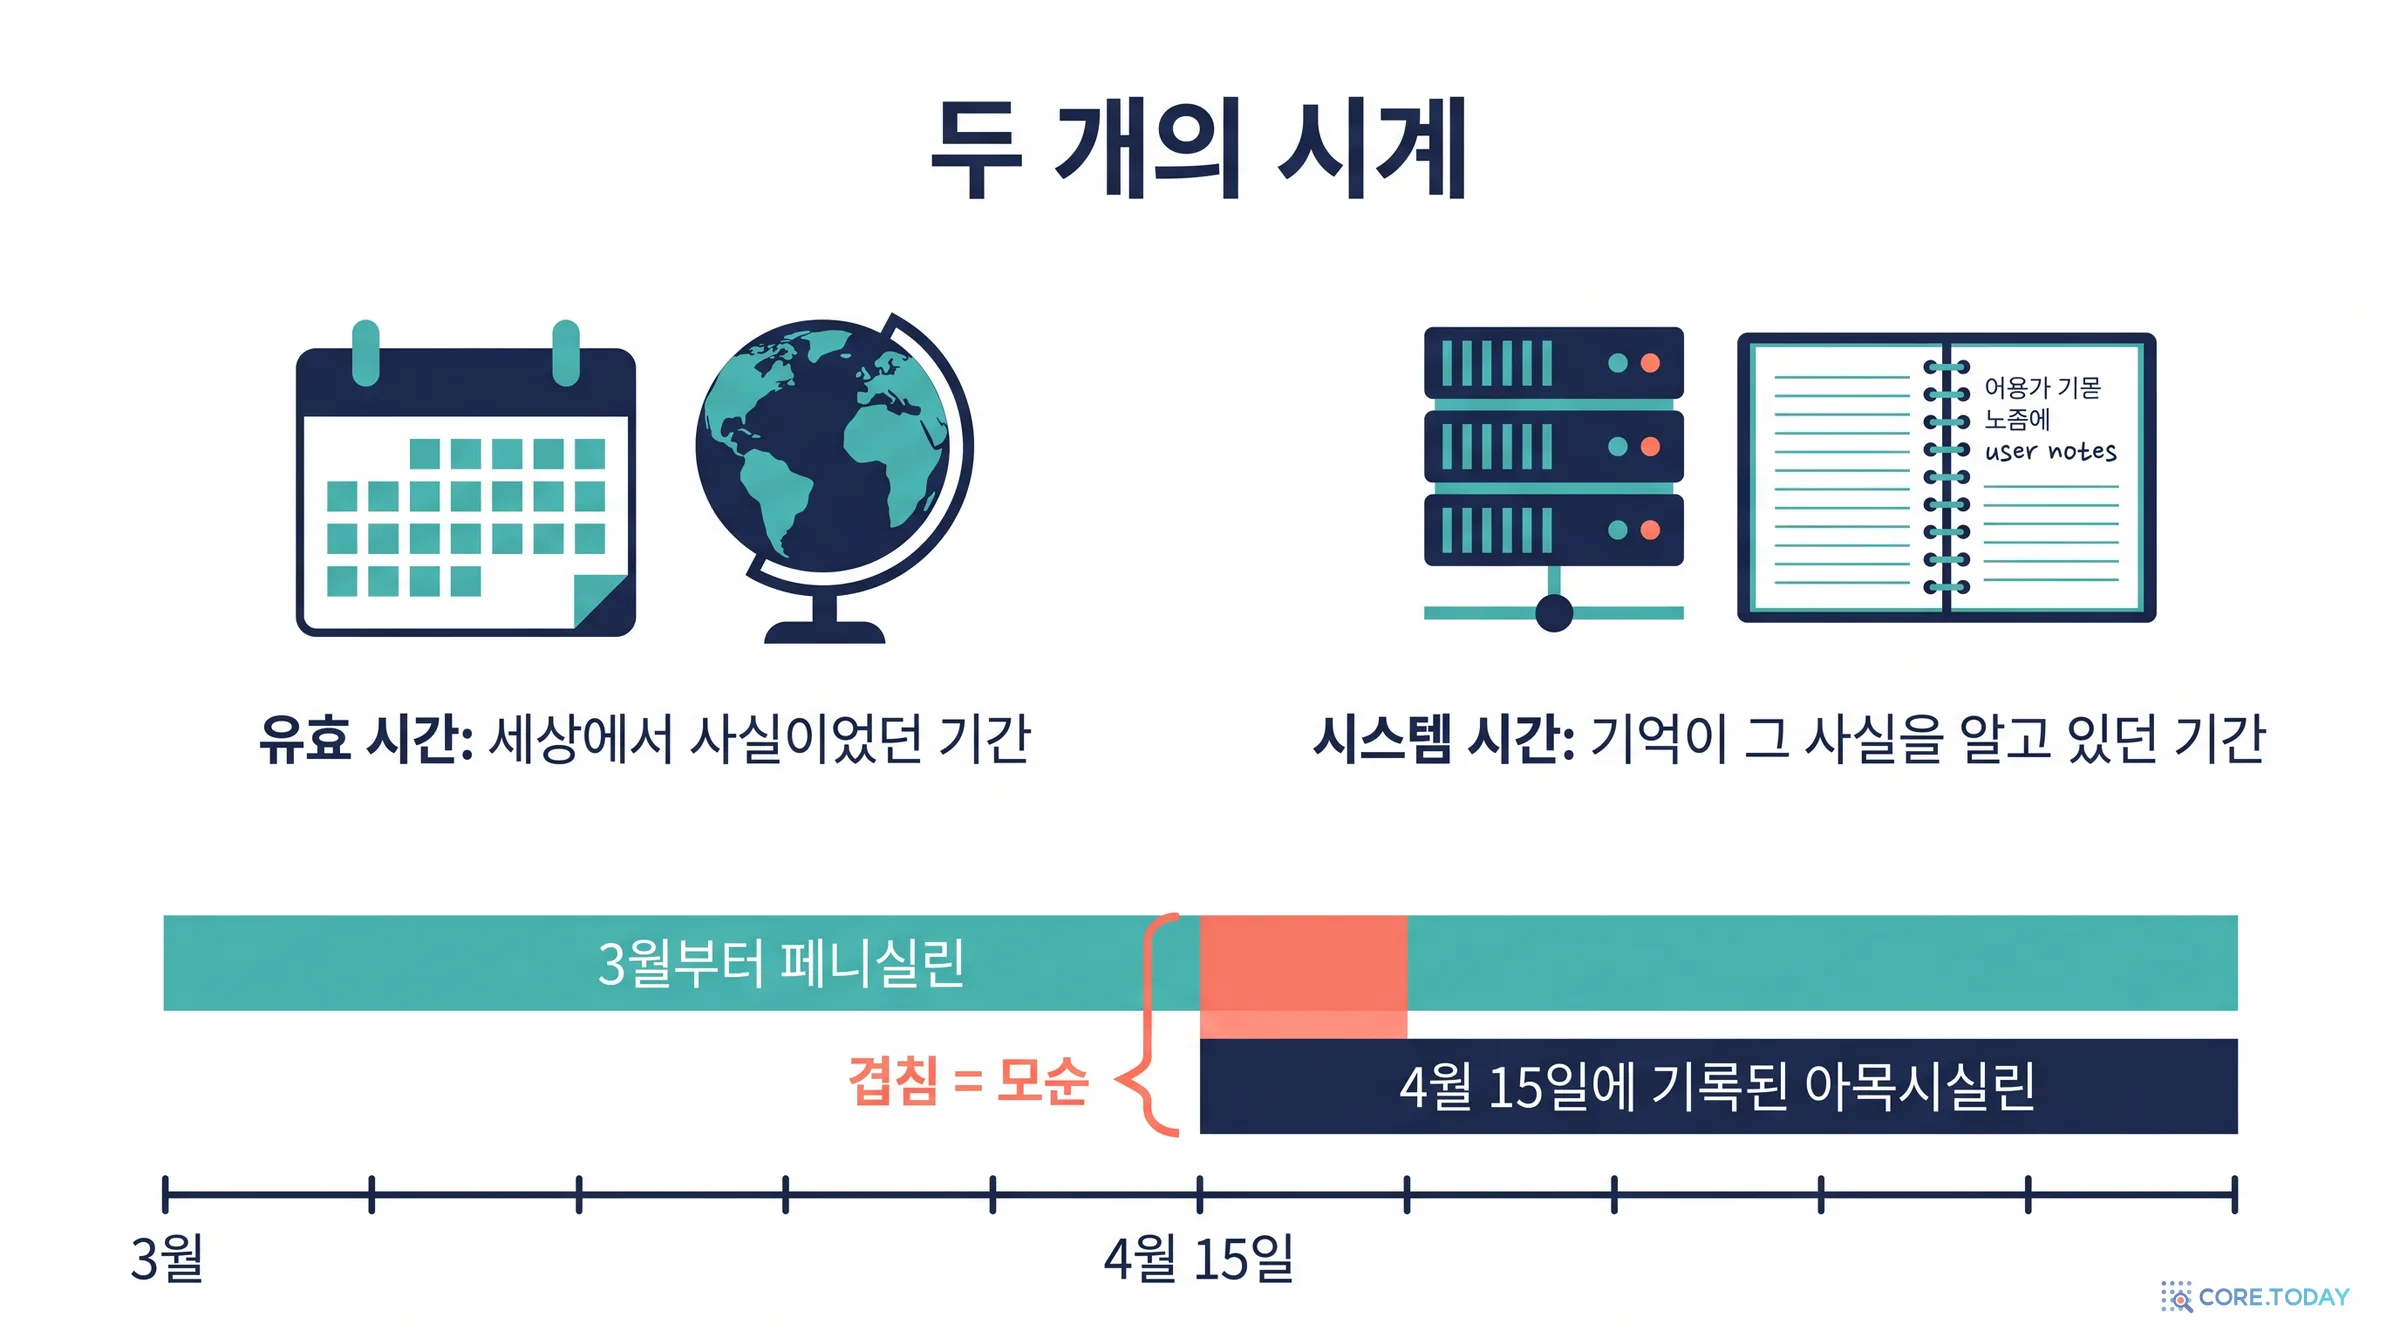
TOKI의 이름 앞에 붙은 'Bitemporal(이중 시간)'은 데이터베이스 연구에서 40년 된 개념입니다. 1985년 리처드 스노드그래스와 일순 안(Ilsoo Ahn)은 SIGMOD 논문 「데이터베이스 속 시간의 분류」에서 시간을 두 종류로 나눴습니다.
유효 시간(valid time): 그 사실이 세상에서 참이던 기간. "앨리스는 3월 1일부터 페니실린을 먹었다."
거래 시간·시스템 시간(transaction/system time): 데이터베이스가 그 사실을 알고 있던 기간. "우리는 3월 1일에 그렇게 기록했고, 4월 15일까지 그렇게 믿었다."
둘을 모두 기록하면 '이중 시간'입니다. 둘이 왜 따로 있어야 하는지는 보험·회계·의료처럼 소급이 흔한 분야에서 금방 드러납니다. 6월에 "3월 급여는 사실 10% 인상분이 반영됐어야 했다"는 사실이 밝혀지면, 3월(유효 시간)의 값이 바뀌지만 그 사실을 안 건 6월(시스템 시간)입니다. 4월에 발행한 급여 명세서가 틀렸다고 책망할 수는 없습니다 — 그때는 그렇게 알았으니까요. 감사관이 묻는 질문은 늘 둘 중 하나입니다. "그때 진실은 무엇이었나?"(유효 시간)와 "그때 우리는 무엇을 근거로 판단했나?"(시스템 시간).
스노드그래스는 1994년 TSQL2라는 시간 질의 언어 명세를 주도했고, 1995년 책으로 냈습니다. 표준 SQL에 들어가기까지는 오래 걸렸습니다. SQL:2011(ISO/IEC 9075:2011, 2011년 12월)이 되어서야 PERIOD FOR(응용 시간 기간), 시스템 버전 테이블(SYSTEM_TIME), 과거 시점 질의(FOR SYSTEM_TIME AS OF), 기간 일부만 고치는 FOR PORTION OF가 표준이 됐습니다. IBM Db2(2010~2012), 오라클(Flashback은 2001년, 기간은 2013년), SQL Server 2016(시스템 시간만), MariaDB 10.3~10.4가 차례로 지원했습니다.
PostgreSQL은 가장 늦었습니다. 2025년 9월에 나온 PostgreSQL 18이 겹치지 않는 기간 키(WITHOUT OVERLAPS)와 기간 외래 키를 들였고, 19 개발판에 UPDATE … FOR PORTION OF가 2026년 4월 커밋됐다가 9월 15일에 되돌려졌습니다. 되돌린 이유가 이 글의 주제와 정확히 겹칩니다. READ COMMITTED 격리 수준에서 동시 수정이 유실될 수 있다는 지적이었습니다. 이중 시간 갱신조차 동시성 제어 없이는 안전하지 않다는 것을 PostgreSQL 커뮤니티가 직접 보여 준 셈입니다. 코어닷투데이는 이중 시간 SQL 실습 글에서 이 유실을 직접 재현한 적이 있습니다.
에이전트 기억 쪽에서 이중 시간을 처음 본격적으로 들인 것은 Zep의 Graphiti였습니다. Graphiti의 간선(사실)은 valid_at·invalid_at(유효 시간)과 created_at·expired_at(시스템 시간)을 함께 지닙니다. 새 사실이 옛 사실과 모순되면 옛 간선을 지우지 않고 invalid_at을 찍어 둡니다. 2026년 1월의 TSM 논문(arXiv 2601.07468)은 대화가 오간 시간과 사건이 일어난 시간을 분리하는 것만으로 LongMemEval·LoCoMo에서 최대 12.2%포인트를 올렸다고 보고했습니다. 대부분의 기억 엔진이 이 두 축을 하나로 뭉개고 있다는 방증입니다.
2-3. 직접 만져 보기: 변경인가, 정정인가
두 시계를 따로 두면 기억이 답할 수 있는 질문이 달라집니다. 아래 위젯은 논문의 예(앨리스의 복용약)를 이중 시간 격자에 그린 것입니다. 가로축이 유효 시간, 세로축이 시스템 시간이고, 각 사실은 두 기간의 곱인 직사각형입니다. 질의는 격자 위의 한 점입니다.
여기서 꼭 해 볼 것이 있습니다. 4월 15일의 '아목시실린' 기록이 처방이 바뀐 것(변경)인지, 3월 기록이 애초에 틀린 것(정정)인지를 바꿔 보세요. 같은 기록이라도 뜻에 따라 정답이 다릅니다. 변경이라면 "3월 20일에 앨리스가 먹던 약"은 여전히 페니실린이어야 하고, 정정이라면 아목시실린이어야 합니다.
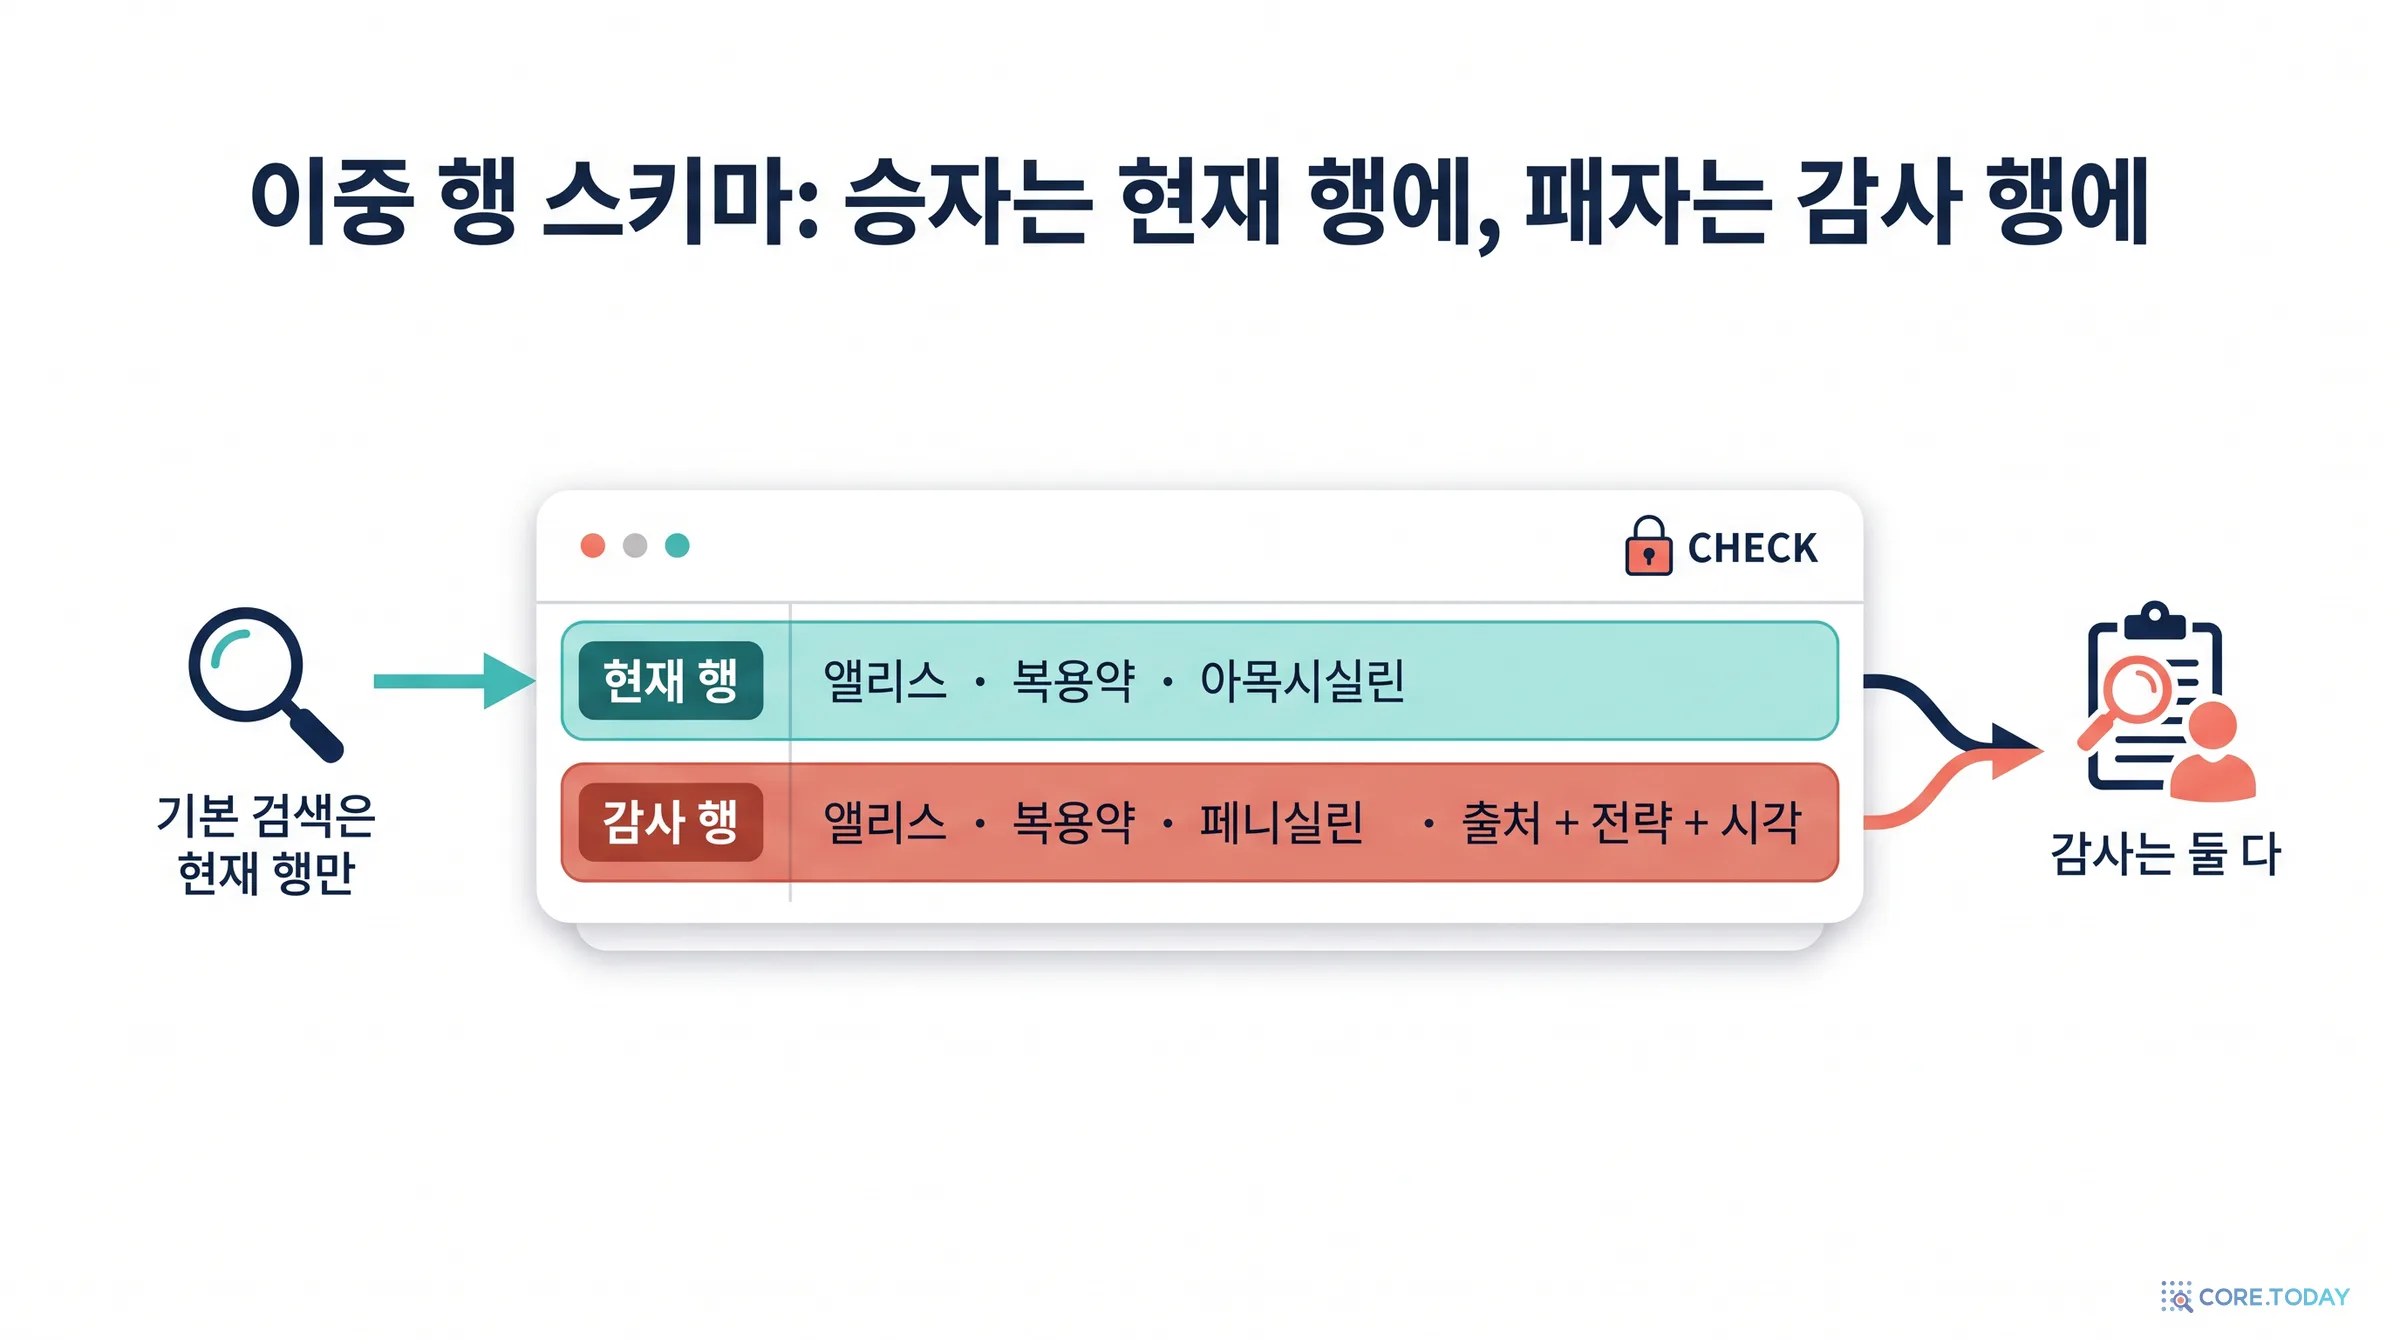
위젯에서 'TOKI 이중 행'과 '변경'을 고르고, 유효 시점을 3월에, 기억 시점을 6월에 두면 기본 검색이 비어 있는 것을 볼 수 있습니다. 이것은 이 글 뒤쪽 비판에서 다시 다룰 TOKI의 설계 선택입니다. TOKI의 쓰기 경로는 모순이 생기면 진 쪽 행 전체의 시스템 시간을 닫고 감사 행으로 보냅니다. 승자 독식입니다. 정정이라면 그게 맞지만, 변경이라면 SQL:2011의 FOR PORTION OF처럼 유효 시간을 잘라 앞부분을 살리는 쪽이 맞습니다. 어쨌든 TOKI는 진 쪽을 감사 행에 남기므로 정보는 사라지지 않습니다. 기본 검색에서 안 보일 뿐입니다.
3. 두 번째 뿌리: 격리 수준 50년사
3-1. 은행 계좌에서 시작된 이야기
두 번째 재료는 트랜잭션 격리 수준입니다. 여러 사람이 같은 데이터를 동시에 고칠 때 무엇이 잘못될 수 있고, 데이터베이스가 그중 무엇을 막아 주는지를 정한 약속입니다.
출발점은 1976년 IBM의 짐 그레이 등이 쓴 「잠금의 단위와 일관성의 정도」입니다. 완벽한 고립(모든 트랜잭션이 하나씩 차례로 실행된 것과 같은 결과, 즉 직렬화 가능성)은 비싸니, 조금 느슨한 '정도'(degree)를 몇 단계로 두자는 생각이었습니다. 1992년 ANSI SQL 표준은 이것을 네 단계 격리 수준 — READ UNCOMMITTED, READ COMMITTED, REPEATABLE READ, SERIALIZABLE — 로 정하고, 각 수준이 막아야 할 현상(phenomena) 세 가지(더러운 읽기, 흐린 읽기, 팬텀)로 정의했습니다.
3-2. 1995년, "그 정의는 틀렸다"
3년 뒤 마이크로소프트 리서치의 할 베렌슨, 필 번스타인, 짐 그레이, 짐 멜턴, 엘리자베스·패트릭 오닐이 「ANSI SQL 격리 수준 비판」(SIGMOD 1995)을 냅니다. 이 논문이 TOKI의 직계 조상입니다. 요지는 ANSI의 현상 목록이 너무 짧아서, 실제 데이터베이스가 일으키는 이상을 다 담지 못한다는 것이었습니다. 베렌슨 등은 이상을 다시 셌습니다.
기호
이름
한 줄 설명
TOKI가 막는 데 필요한 수준
P0
더러운 쓰기
남이 아직 커밋하지 않은 값을 덮어쓴다
RC
P1
더러운 읽기
남이 커밋하지 않은 값을 읽었는데, 그 트랜잭션이 취소된다
RC
P2
흐린 읽기
같은 행을 두 번 읽었더니 값이 다르다
SI
P3
팬텀
같은 조건으로 두 번 조회했더니 행 집합이 다르다
SR
P4
갱신 손실
둘이 같은 값을 읽고 각자 고쳐 쓰면, 먼저 쓴 쪽이 사라진다
SI
A5A
읽기 스큐
서로 묶인 두 값을 서로 다른 시점의 상태로 읽는다
SI
A5B
쓰기 스큐
둘이 같은 조건을 읽고 서로 다른 행을 고쳐, 합치면 조건이 깨진다
SR
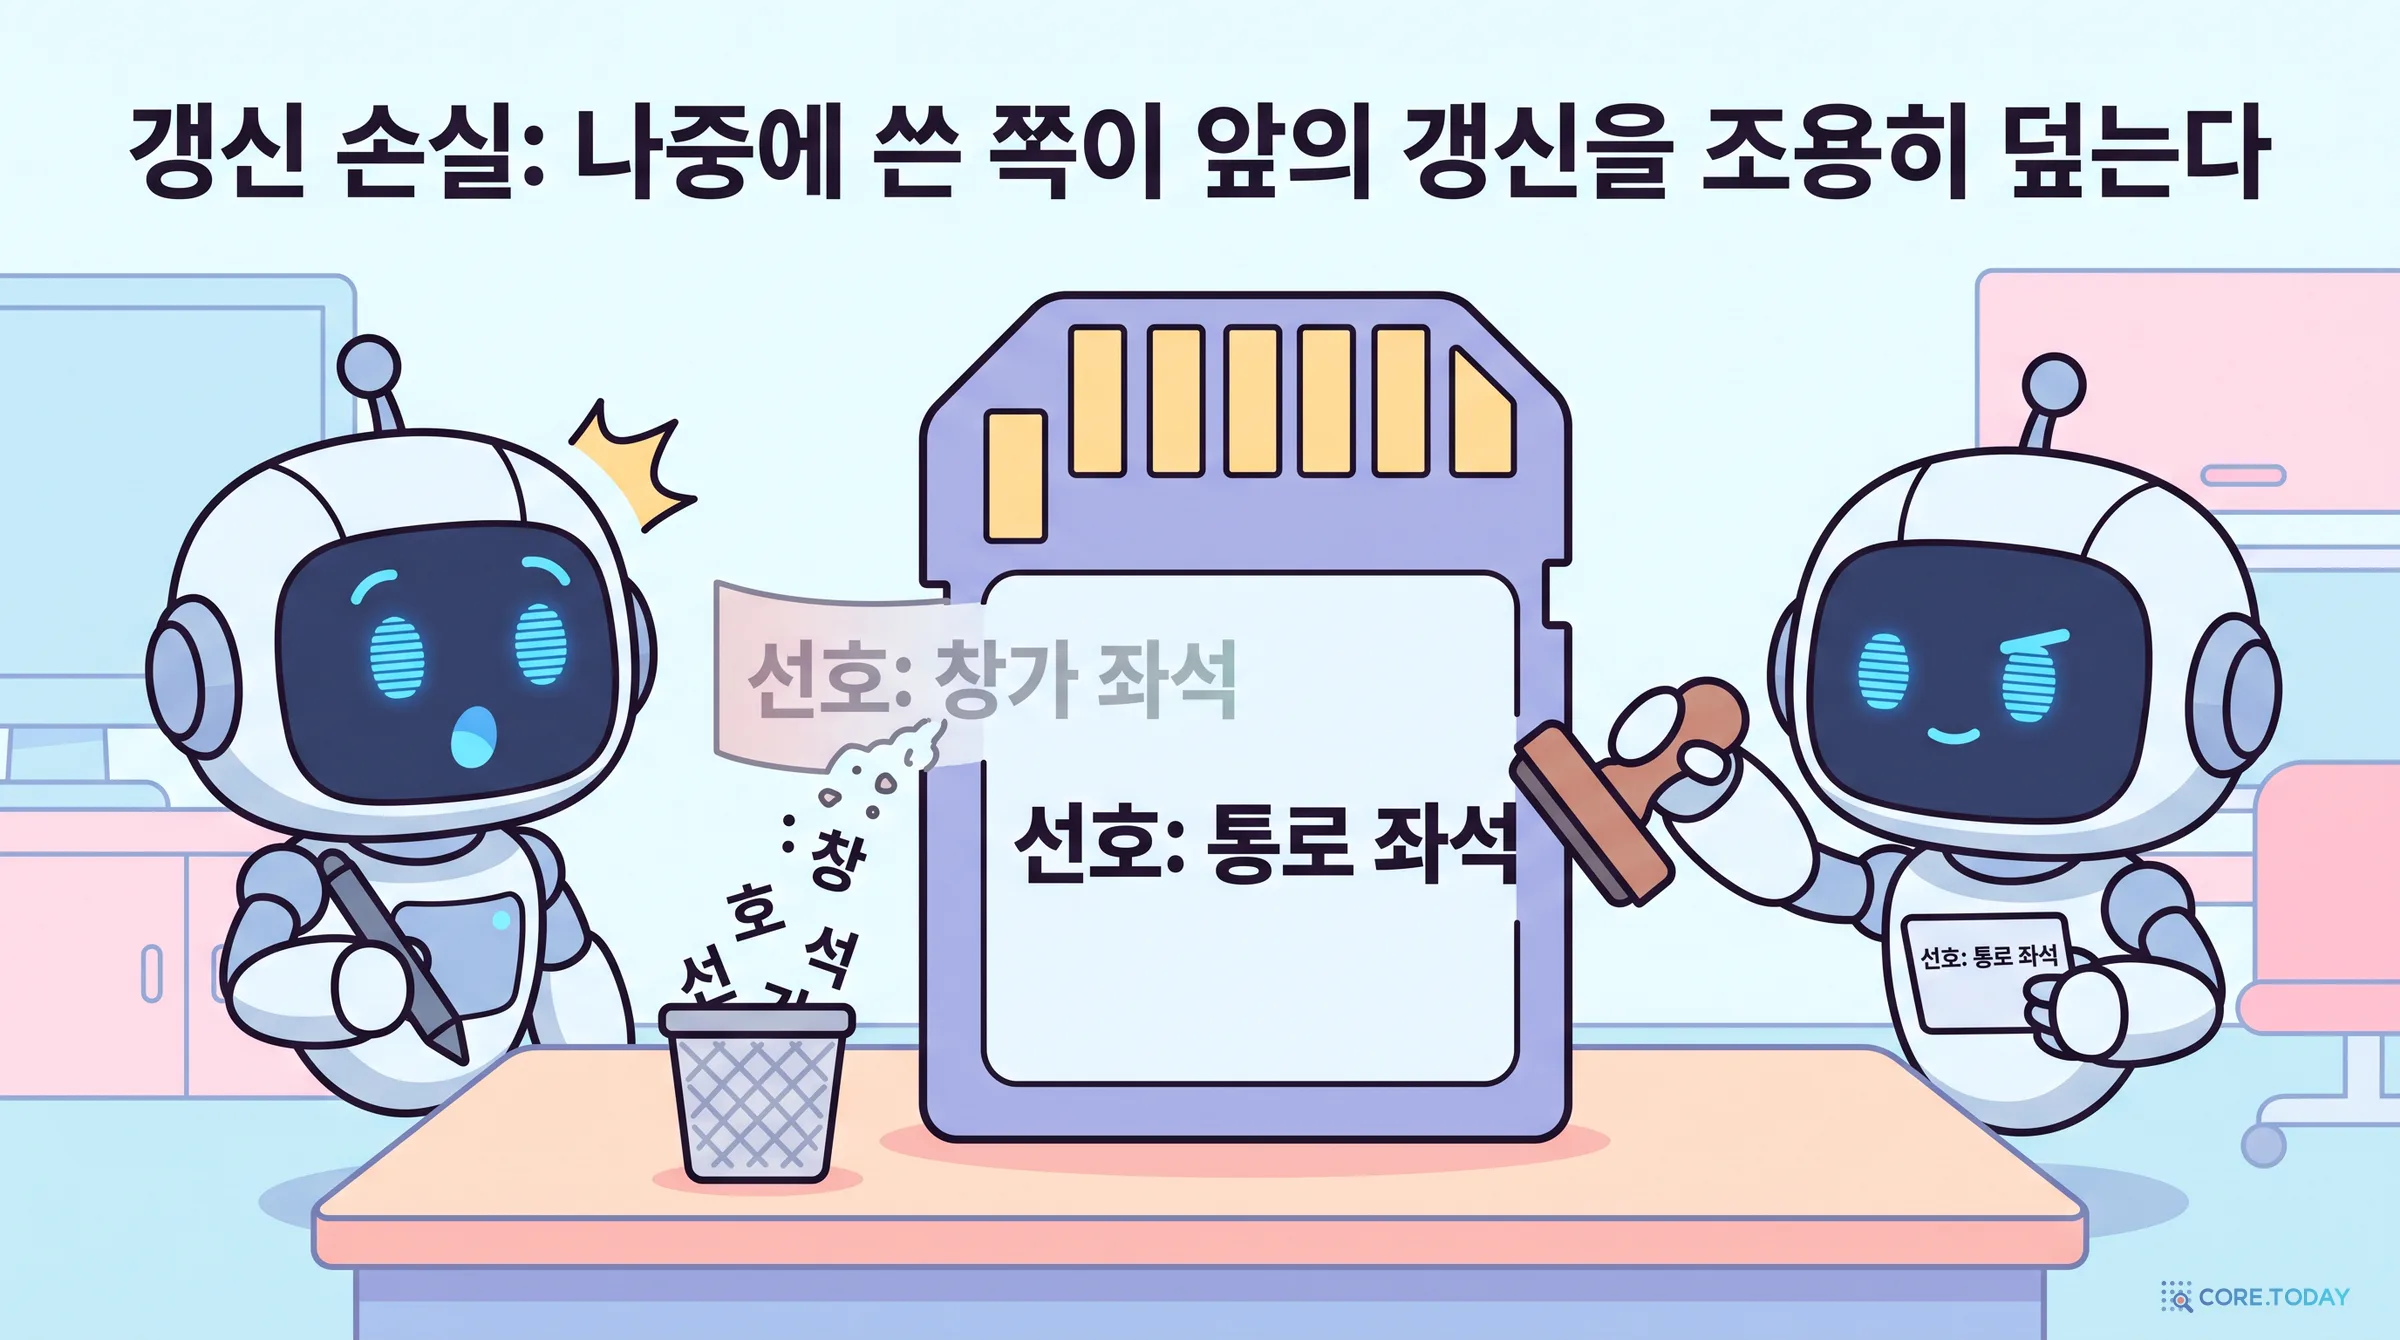
RC는 읽기 커밋(Read Committed), SI는 스냅숏 격리(Snapshot Isolation), SR은 직렬화(Serializable)입니다. 스냅숏 격리도 베렌슨 등이 이 논문에서 처음 정식으로 정의한 수준입니다. 트랜잭션이 시작 순간의 데이터 '사진'을 보고 일하며, 같은 행을 동시에 고친 두 트랜잭션 중 하나는 실패시킵니다. 그래서 갱신 손실(P4)은 막지만, 서로 다른 행을 고친 경우는 못 막습니다. 그게 쓰기 스큐(A5B)입니다.
갱신 손실은 그림으로 보면 바로 이해됩니다. 두 에이전트가 같은 기억 카드를 읽고, 각자 고친 다음 차례로 씁니다. 늦게 쓴 쪽이 이깁니다. 먼저 쓴 쪽의 갱신은 오류 메시지 하나 없이 사라집니다.
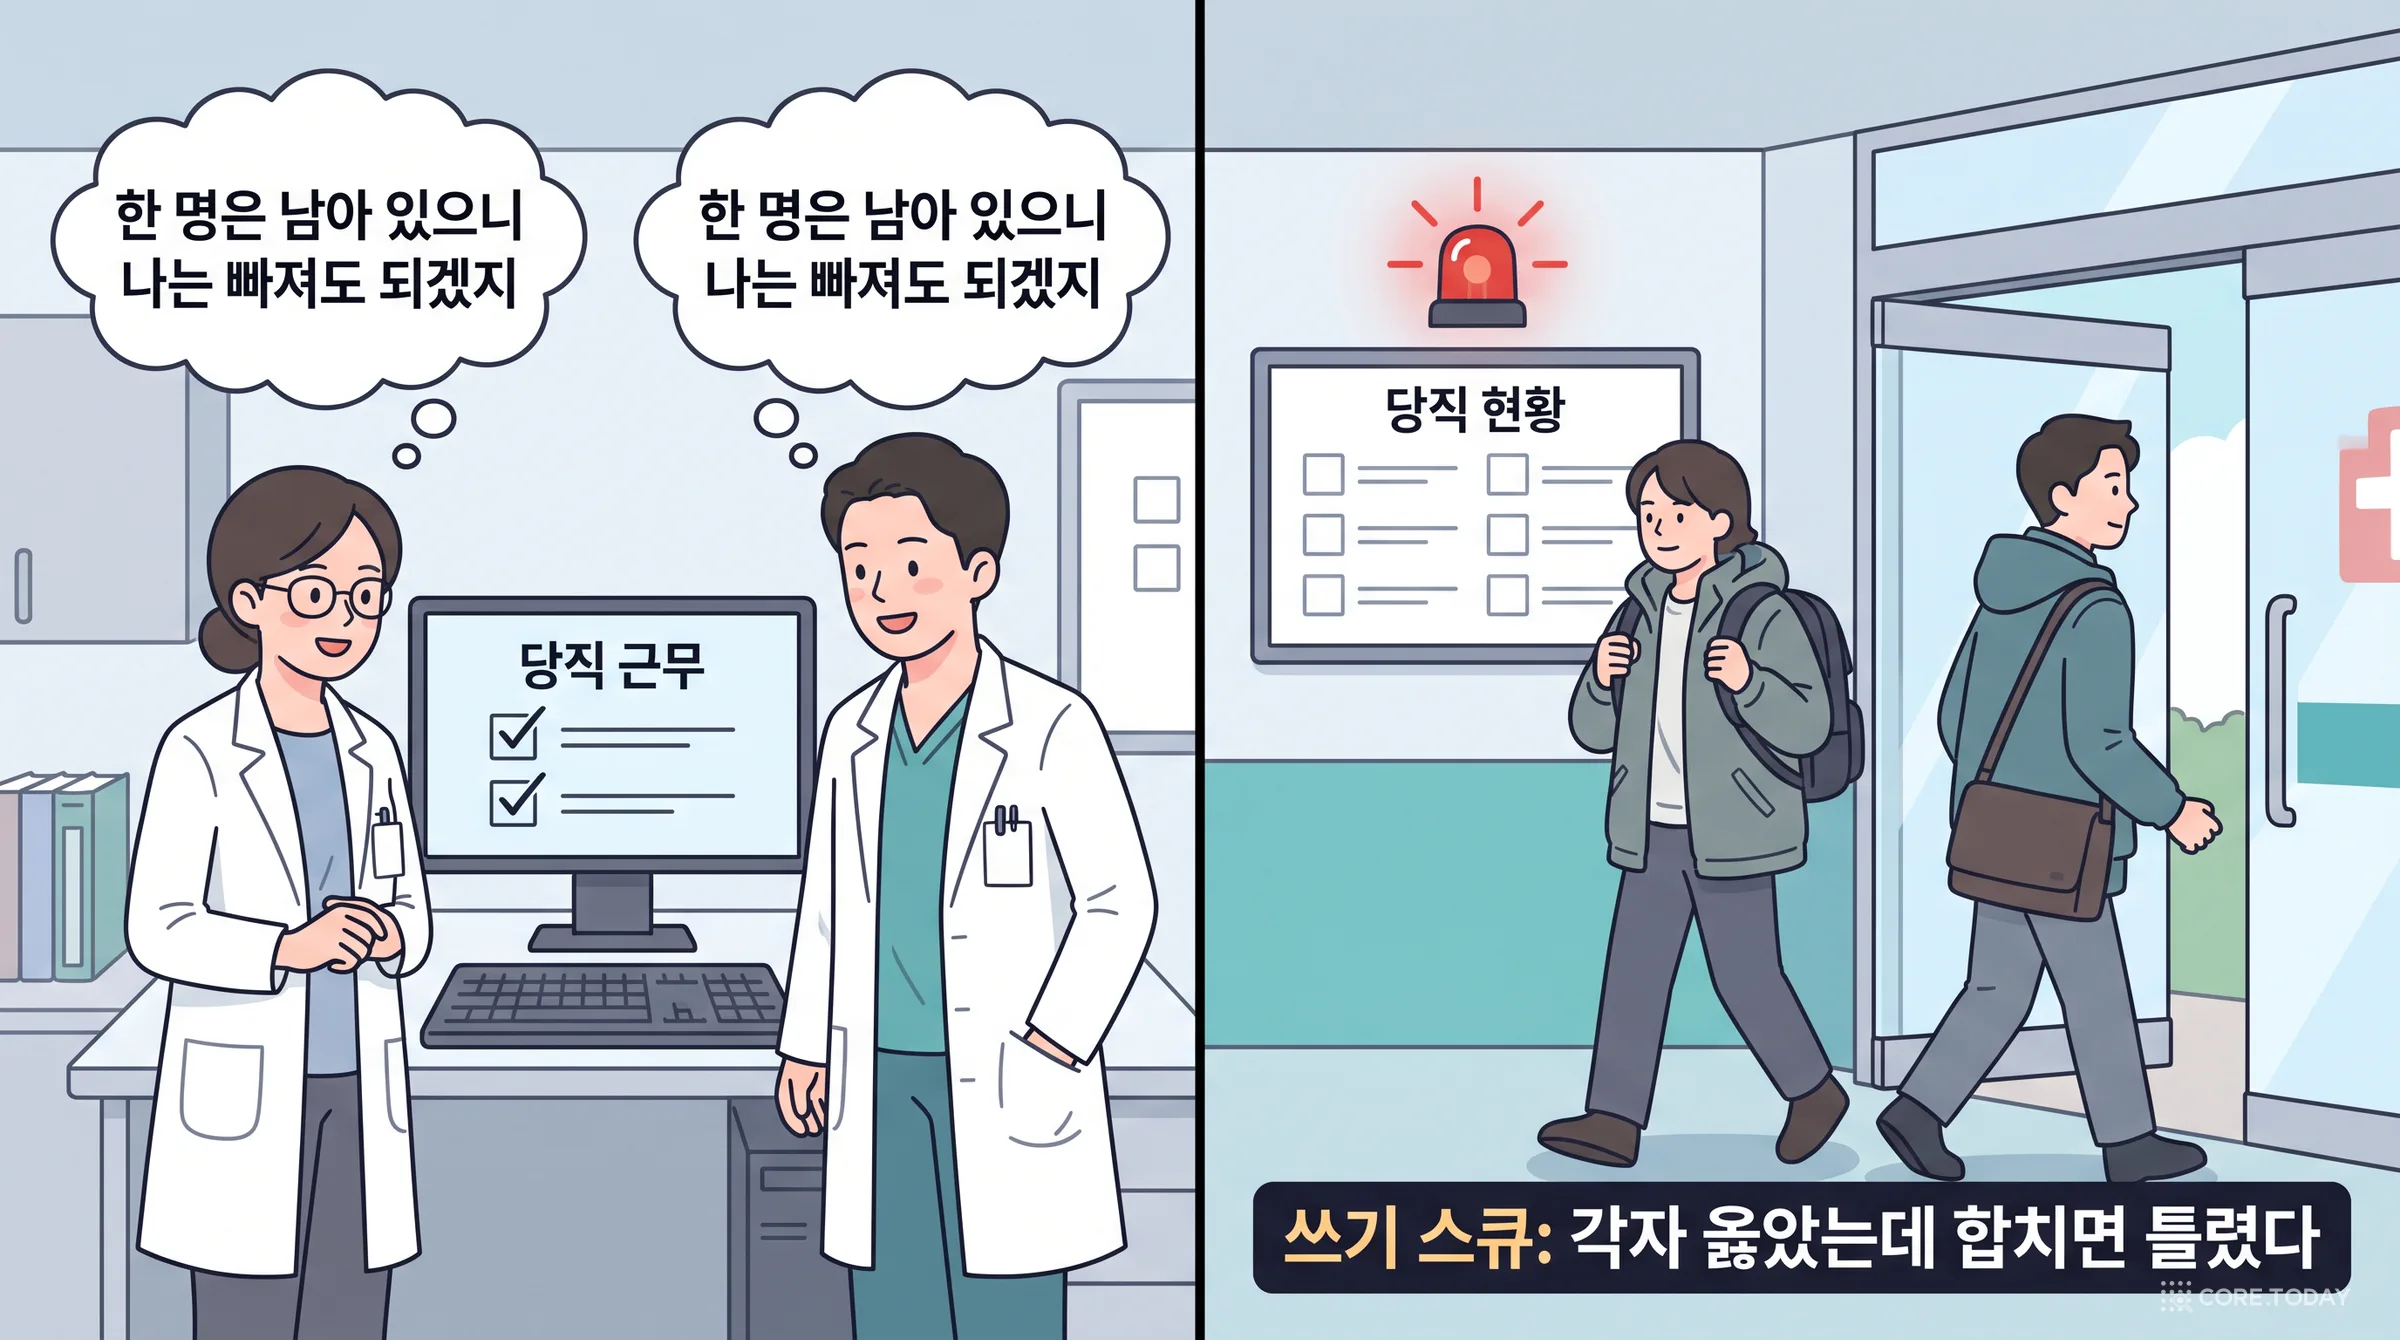
쓰기 스큐를 가장 유명하게 만든 예는 2008년 마이클 케이힐, 우베 뢰엄, 앨런 페케테의 SIGMOD 논문에 나오는 당직 의사 이야기입니다(마틴 클레프만의 『데이터 중심 애플리케이션 설계』가 이 예를 대중화했지만, 원래 출처는 케이힐 등입니다). 병원 규칙은 "당직에는 최소 한 명이 남아 있어야 한다"입니다. 앨리스와 밥이 동시에 몸이 안 좋아 당직을 빼려고 합니다. 각자 당직표를 보니 두 명이 있습니다. "한 명은 남으니까 나는 빠져도 되겠지." 둘 다 자기 행만 고쳤고, 둘 다 커밋됩니다. 당직표는 빕니다.
각자는 자기가 본 사진 안에서 옳았습니다. 합치면 틀립니다. 스냅숏 격리는 두 트랜잭션이 같은 행을 고친 경우만 충돌로 보기 때문에 이것을 막지 못합니다. 이것을 막으려면 "누가 무엇을 읽었는지"까지 추적해야 합니다. 케이힐 등은 바로 그 방법 — 직렬화 가능 스냅숏 격리(SSI) — 을 같은 논문에서 제안했고, PostgreSQL은 2011년 9.1판에서 SSI를 SERIALIZABLE의 구현으로 채택했습니다(포츠·그리트너, VLDB 2012, 스냅숏 격리 대비 성능 비용 7% 미만). 오라클의 'SERIALIZABLE'은 지금도 실제로는 스냅숏 격리입니다.
3-4. 이론이 아니었던 사고들
이 이상들은 교과서 속 이야기가 아닙니다.
플렉스코인(2014년 3월 2일): 비트코인 거래소 플렉스코인에서 공격자가 계정 간 송금 요청을 수천 건 동시에 보내, 잔액 확인과 차감 사이의 틈을 파고들었습니다. 896 BTC가 빠져나갔고 거래소는 문을 닫았습니다. 확인한 뒤 행동하는(check-then-act) 전형적인 갱신 손실입니다.
ACIDRain(SIGMOD 2017): 스탠퍼드의 토드 와르샤프스키와 피터 베일리스는 오픈소스 쇼핑몰 프로그램 12개를 분석해 동시성 공격 22개를 찾았습니다. 이 프로그램들을 쓰는 웹사이트는 약 200만 개, 전체 전자상거래 사이트의 절반이 넘었습니다. 22개 모두 기본 격리 수준에서 통했고, 그중 17개는 가장 강한 격리 수준에서도 통했습니다. 애플리케이션이 트랜잭션 경계를 잘못 그었기 때문입니다.
젭슨(Jepsen): 분산 시스템 검증가 카일 킹스버리의 젭슨 분석은 PostgreSQL 12.3의 SERIALIZABLE에서 실제 이상(G2-item)을 찾아 2020년 8월 수정판을 끌어냈고, 2023년 12월에는 MySQL 8.0.34의 REPEATABLE READ가 갱신 손실을 허용하며 스냅숏 격리조차 만족하지 않는다는 것을 보였습니다.
교훈은 둘입니다. 첫째, 데이터베이스가 내세우는 격리 수준과 실제 동작이 다를 수 있습니다. 둘째, 데이터베이스가 완벽해도 애플리케이션이 읽기와 쓰기를 한 트랜잭션으로 묶지 않으면 소용없습니다. 에이전트 기억 엔진은 대부분 두 번째 경우입니다. 기억을 읽고, LLM을 부르고, 결과를 쓰는 과정이 한 트랜잭션이 아닙니다.
3-5. 아디아의 일반화
1999년 MIT의 아툴 아디아는 박사 논문에서 이상을 잠금이 아니라 의존 그래프(누가 누구의 쓰기를 읽고 덮었나)의 순환으로 다시 정의했습니다. 이렇게 하면 잠금을 쓰든 다중 버전을 쓰든 같은 잣대로 격리 수준을 판정할 수 있습니다. TOKI의 정리 1이 "어떤 격리 수준이 어떤 이상을 막는가"를 판정할 때 쓰는 잣대가 이 베렌슨–아디아 체계입니다.
4. 세 번째 뿌리: 출처 반가환
4-1. "그 답은 어디서 왔나"
세 번째 재료는 데이터 출처(provenance)입니다. 질의 결과의 각 줄이 원본의 어느 줄들에서 나왔는지를 추적하는 연구입니다. 2000년 스탠퍼드의 추이·위덤이 데이터 웨어하우스의 '계보'(lineage)를, 2001년 부네먼·칸나·탄이 '왜(why) 출처'와 '어디서(where) 출처'를 정식화했습니다.
4-2. 2007년, 출처를 다항식으로
2007년 펜실베이니아 대학의 토드 그린, 그리고리오스 카르보나라키스, 발 타넨은 「출처 반가환(Provenance Semirings)」(PODS 2007)에서 놀랍도록 우아한 일반화를 내놓았습니다. 원본의 각 줄에 변수(x₁, x₂, …)를 붙이고, 질의가 줄들을 함께 쓰면 곱하고(조인), 다른 길로 같은 결과를 얻으면 더하면(합집합·투영) 됩니다. 결과의 각 줄에는 다항식이 붙습니다.
예를 들어 "앨리스의 약은 아목시실린"이라는 결론에 x₂·x₃ + x₄가 붙어 있다면, 이 결론은 두 길로 나왔습니다. 환자 앱 입력(x₂)과 약국 기록(x₃)을 맞춰 봐서, 그리고 보호자 전화(x₄)만으로. 이 다항식 하나에서 다른 모든 출처 정보를 계산할 수 있습니다. x₂가 오염됐다면 x₂ = 0을 대입하면 됩니다(x₄가 남으니 결론은 유지). 신뢰도를 알고 싶으면 변수에 확률을 대입합니다. 근거가 있기만 하면 되는지 알고 싶으면 모든 변수에 '참'을 대입합니다. 이 체계를 수학적으로는 교환 반가환(commutative semiring) — 더하기와 곱하기가 있되 빼기는 없는 대수 — 위의 'K-관계'라고 부릅니다. 이 논문은 10년 뒤인 2017년 PODS '시간의 시험상'을 받았습니다.
TOKI가 출처를 가져오는 이유는 단순합니다. 모순에서 진 사실을 나중에 되살리고, 진 쪽의 근거가 무엇이었는지 설명하려면 출처가 붙어 있어야 합니다. 감사 행이 들고 있는 것이 바로 '승자 출처 + 패자 출처'라는 다항식입니다. 그리고 반가환의 '자연 순서'(a ⪯ b ⇔ 어떤 c가 있어 a + c = b)에서 p_패자 ⪯ p_승자 + p_패자는 항상 성립합니다. 진 쪽의 출처가 감사 행 안에 늘 포함되어 있다는 뜻이고, 이 한 줄이 TOKI 정리 2(감사 소거 방지)의 증명 전부입니다.
아래 위젯은 이 다항식을 어떤 '운반체'로 적느냐에 따라 감사 행이 무엇을 되살릴 수 있는지 보여 줍니다. 7절의 정리 3과 명제 1이 바로 이 이야기입니다.
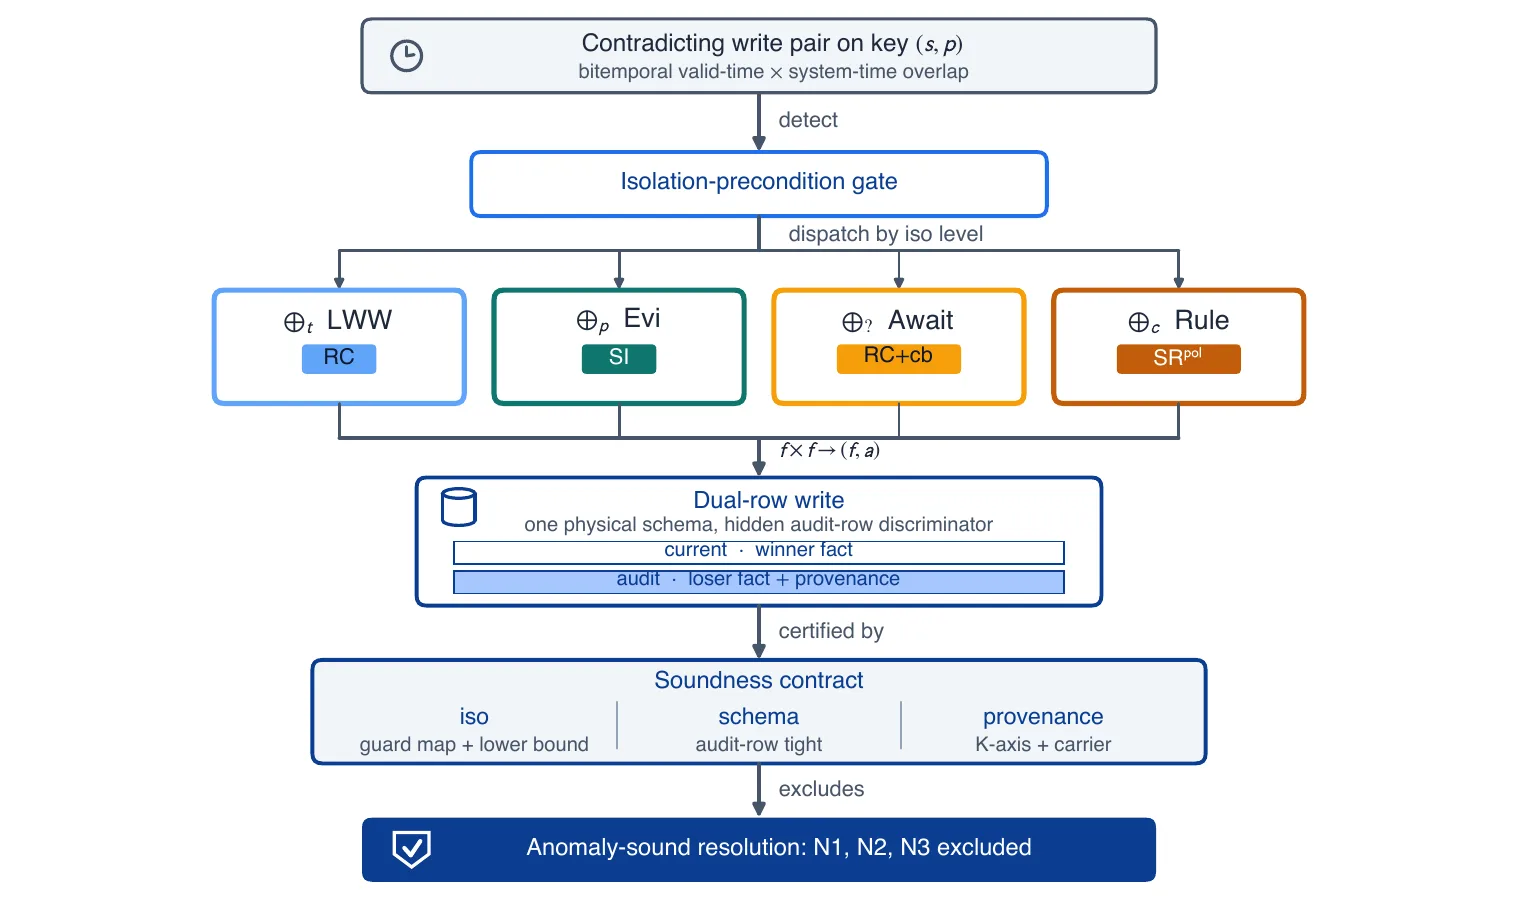
위에서 아래로 읽으면 이렇습니다. ① 같은 (주어, 술어) 키에서 유효 기간이 겹치는 두 사실이 감지되면, ② '격리 전제 관문'이 그 사실에 붙은 전략 표시를 보고 네 연산자 중 하나로 보냅니다. 각 연산자는 자기가 필요로 하는 격리 수준에서만 실행됩니다. ③ 연산자는 승자를 현재 행에, 패자를 출처와 함께 감사 행에 씁니다. ④ 이 전체가 세 축(격리·스키마·출처)의 건전성 정리로 보증되어, ⑤ 세 가지 새 이상이 배제됩니다.
5-2. 사실 한 줄의 해부
TOKI는 에이전트의 모든 사실을 하나의 표에 담습니다. 사용자에게 보이는 열이 11개, 숨은 열이 하나입니다(논문 표 2).
#
열
뜻
어디서 왔나
1
fact_id
사실 식별자 (7번과 함께 기본 키)
—
2~4
subject · predicate · object
주어 · 술어 · 목적어(내용)
지식 그래프의 세 쌍
5~6
valid_from · valid_to
유효 시간 기간
SQL:2011 응용 시간
7~8
system_time_start · end
시스템 시간 기간
SQL:2011 시스템 시간
9
provenance_id
출처 다항식
K-관계 출처(2007)
10
confidence
확신도 0~1
TOKI 확장
11
resolution_strategy_id
어떤 연산자가 이 행을 만들었나(⊕t·⊕p·⊕?·⊕c)
TOKI 확장
12
row_kind
current 또는 audit (CHECK 제약으로 둘 중 하나만)
숨은 구분자, N3 방어의 핵심
12번 열이 핵심입니다. 물리적으로는 한 표이지만, row_kind가 표를 '현재 조각'과 '감사 조각'으로 나눕니다. 기본 검색은 row_kind = current만 보므로, 감사 행을 아무리 쌓아도 기존 질의의 답은 하나도 바뀌지 않습니다. 논문은 이것을 "보수적 확장"이라 부르고 명제 5로 증명합니다(구분자 필터가 기존 열 위의 모든 관계 대수 질의와 교환된다). 감사관은 별도의 감사 조각으로 진 사실들을 봅니다.
네 전략은 모두 같은 꼴(시그니처)을 가집니다. 사실 × 사실 → (사실, 감사). 모순인 두 사실을 받아, 승자 하나와 감사 기록 하나를 돌려줍니다. 다른 것은 세 가지뿐입니다 — 승자를 고르는 기준, 필요한 격리 수준, 그리고 행에 찍는 전략 표시(논문 표 1).
연산자
승자 선택
격리 전제
전제가 약하면
⊕t 최신 우선
(시스템 시각, id)가 큰 쪽
RC 읽기 커밋
P4 갱신 손실
⊕p 증거 가중
(확신도, 시각, id)가 큰 쪽
SI 스냅숏 격리
A5B 쓰기 스큐
⊕? 확인 대기
도착한 콜백이 고른 쪽
RC + 콜백
콜백 경계
⊕c 규칙 정책
정책 행이 고른 쪽
정책 표에 SR
P3 팬텀
여기서 '격리 전제'는 이렇게 읽습니다. 최신 우선은 시스템 시각만 비교하므로 남의 커밋된 값만 보면(RC) 승자 선택 자체는 틀리지 않습니다. 그러나 RC는 갱신 손실을 막지 못하므로, 그 위험은 알려진 대가로 표에 적혀 있습니다. 증거 가중은 같은 분할의 여러 확신도를 한 시점의 사진으로 읽어야 하므로 SI가 필요하고, SI도 막지 못하는 쓰기 스큐가 대가로 남습니다. 규칙 정책은 '활성 규칙' 집합을 조건으로 조회하므로 그 사이에 규칙이 추가되는 팬텀을 막으려면 정책 표만큼은 SR로 묶어야 합니다.
중요한 것은 이 표가 "이 전략이 나쁘다"는 판정이 아니라는 점입니다. 각 전략이 어디까지 안전한지의 계약서입니다. 최신 우선을 쓰겠다면 "우리는 RC를 가정하고 갱신 손실을 감수한다"고 적으라는 것입니다. 그러면 운영자가 그 대가를 알고 고를 수 있습니다.
5-4. 쓰기 경로: 알고리즘 1
논문의 알고리즘 1은 새 사실 하나가 들어올 때의 쓰기 경로입니다. 순서대로 풀면 다음과 같습니다.
1같은 (주어, 술어) 분할에서 시스템 시간이 열려 있는 현재 행들을 연다.
2같은 값이 이미 있고 기간이 겹치면 '중복 확인'으로 보고 아무것도 새로 쓰지 않는다(출처만 합친다).
3모순인 현재 행이 없으면 새 사실을 현재 행으로 넣고 끝. 둘 이상이면 오류를 낸다 — 이진 연산자는 기존 사실 하나만 상대한다(추측하지 않는다).
4새 사실의 전략 표시로 연산자를 고른다: ⊕t는 RC, ⊕p는 SI, ⊕?는 RC+콜백, ⊕c는 정책 표 SR. 모르는 표시는 조용히 기본값으로 가지 않고 오류.
5⊕?·⊕c라면 판정(콜백·정책)을 받아 연산자 커밋보다 먼저 판정 로그에 키와 함께 기록한다(가설 H1).
6연산자가 승자·패자를 정하고, 출처를 합친다(p_승 + p_패). 기존 행이 졌으면 그 행의 시스템 시간을 닫고 승자를 새 현재 행으로 넣는다.
참조 구현은 별도 이중 시간 기능이 없는 평범한 관계형 엔진(DuckDB) 위에 파이썬 약 2,700줄로 이것을 구현했다고 밝힙니다. SQL:2011의 AS OF도 직접 짰습니다. 네 개의 시간 열과 구분자에 거는 필터 하나로 현재 값 검색, 감사 재생, 둘 다 보기 세 모드를 낸다고 합니다.
5단계의 '판정을 연산자 커밋보다 먼저 키와 함께 기록'이 이 논문에서 가장 새로운 부분입니다. 왜 필요한지 보려면, 고전 이론에는 없던 참여자 — LLM 판정자 — 를 들여다봐야 합니다.
6. LLM 판정자가 들어오면서 생긴 세 가지 새 이상
6-1. 고전 알파벳에는 '판사'가 없다
베렌슨–아디아의 이상들은 사람이 짠 트랜잭션을 위한 언어입니다. 그 언어의 '알파벳'은 다섯 글자 — 시작, 읽기, 쓰기, 커밋, 취소 — 뿐입니다. 그런데 에이전트 기억의 쓰기 경로에는 하나가 더 있습니다. "이 두 사실 중 무엇이 맞나?"를 판정하는 LLM 호출입니다. mem0의 옛 방식은 LLM에게 ADD·UPDATE·DELETE·NONE 중 하나를 고르게 했고, Graphiti는 LLM에게 새 간선과 모순되는 옛 간선을 찾게 합니다.
LLM 판정은 데이터베이스 입장에서 기묘한 연산입니다. 읽기처럼 무언가를 보고, 쓰기처럼 결과를 남기지만, 같은 입력에 다른 답을 낼 수 있습니다. 온도가 0이 아니면 표본 추출이 다르고, 온도가 0이어도 GPU 연산 순서나 배치 구성, API 쪽 모델 교체에 따라 답이 흔들립니다. 그래서 TOKI는 알파벳에 두 글자를 더합니다.
j(R, θ) — 판정 호출. R은 판정자가 읽은 사실들, θ는 '디코더 묶음'(프롬프트, 시드, 모델 버전, 온도, 도구 출력 해시)입니다.
cb(R, h, k) — 외부 콜백. 요청 해시 h에 대해 k번째 후보를 승자로 돌려주는 사람·도구의 답입니다.
이 일곱 글자 알파벳에서, 고전 알파벳으로는 이름조차 붙일 수 없던 이상 세 가지가 보입니다.
6-2. N1 — 판정 재현 불일치
같은 모순을 다시 판정했더니 다른 승자가 나오는 것입니다. 언제 다시 판정하나요? 생각보다 자주입니다. 쓰기 도중 프로세스가 죽어 재시작할 때, 기억을 다른 서버로 옮겨 로그를 재생할 때, 검색 단계에서 모순을 다시 정리할 때, 두 에이전트가 같은 모순을 각자 발견했을 때.
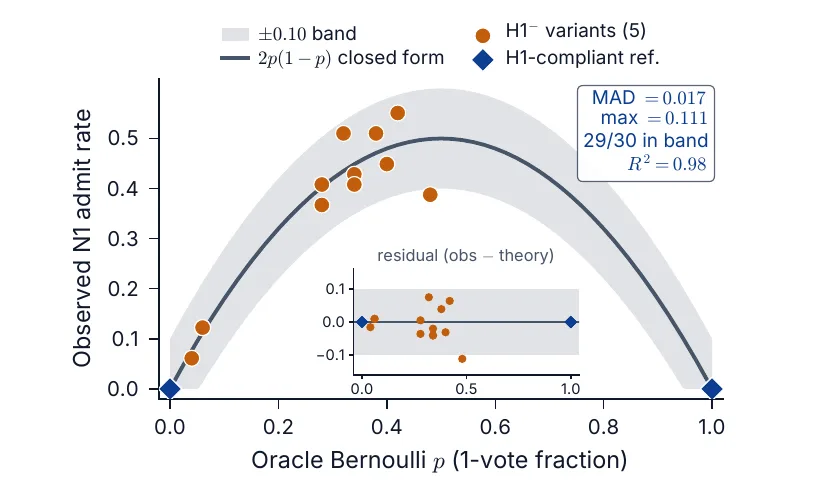
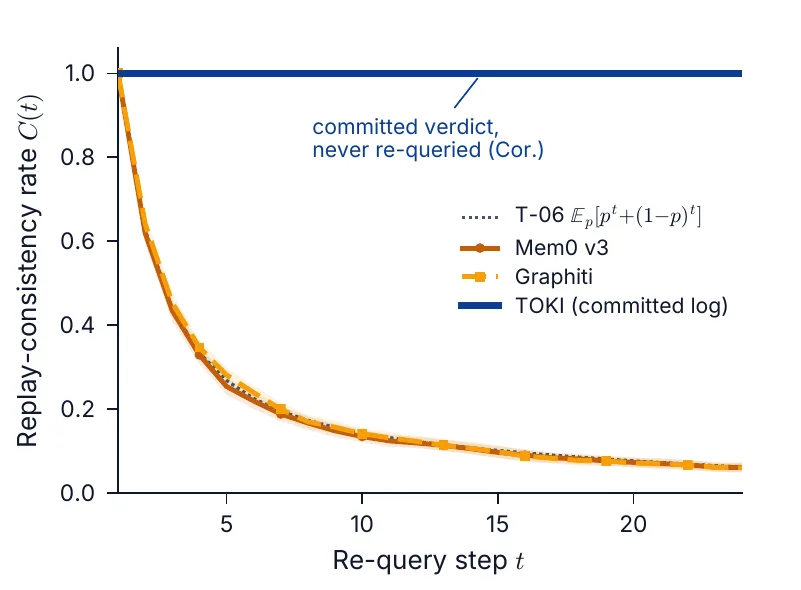
확률로 보면 간단합니다. 어떤 모순에 대해 판정자가 확률 p로 A를, 1−p로 B를 고른다고 합시다. 두 번 물었을 때 답이 갈릴 확률은 2p(1−p) 입니다. p = 0.5(판정자가 반반으로 헷갈리는 모순)면 50%, p = 0.9여도 18%입니다. t번 물어서 모두 같은 답이 나올 확률은 pᵗ + (1−p)ᵗ이고, 이것은 t가 커질수록 빠르게 0에 가까워집니다. 판정을 다시 할 때마다 기억이 흔들린다는 뜻입니다.
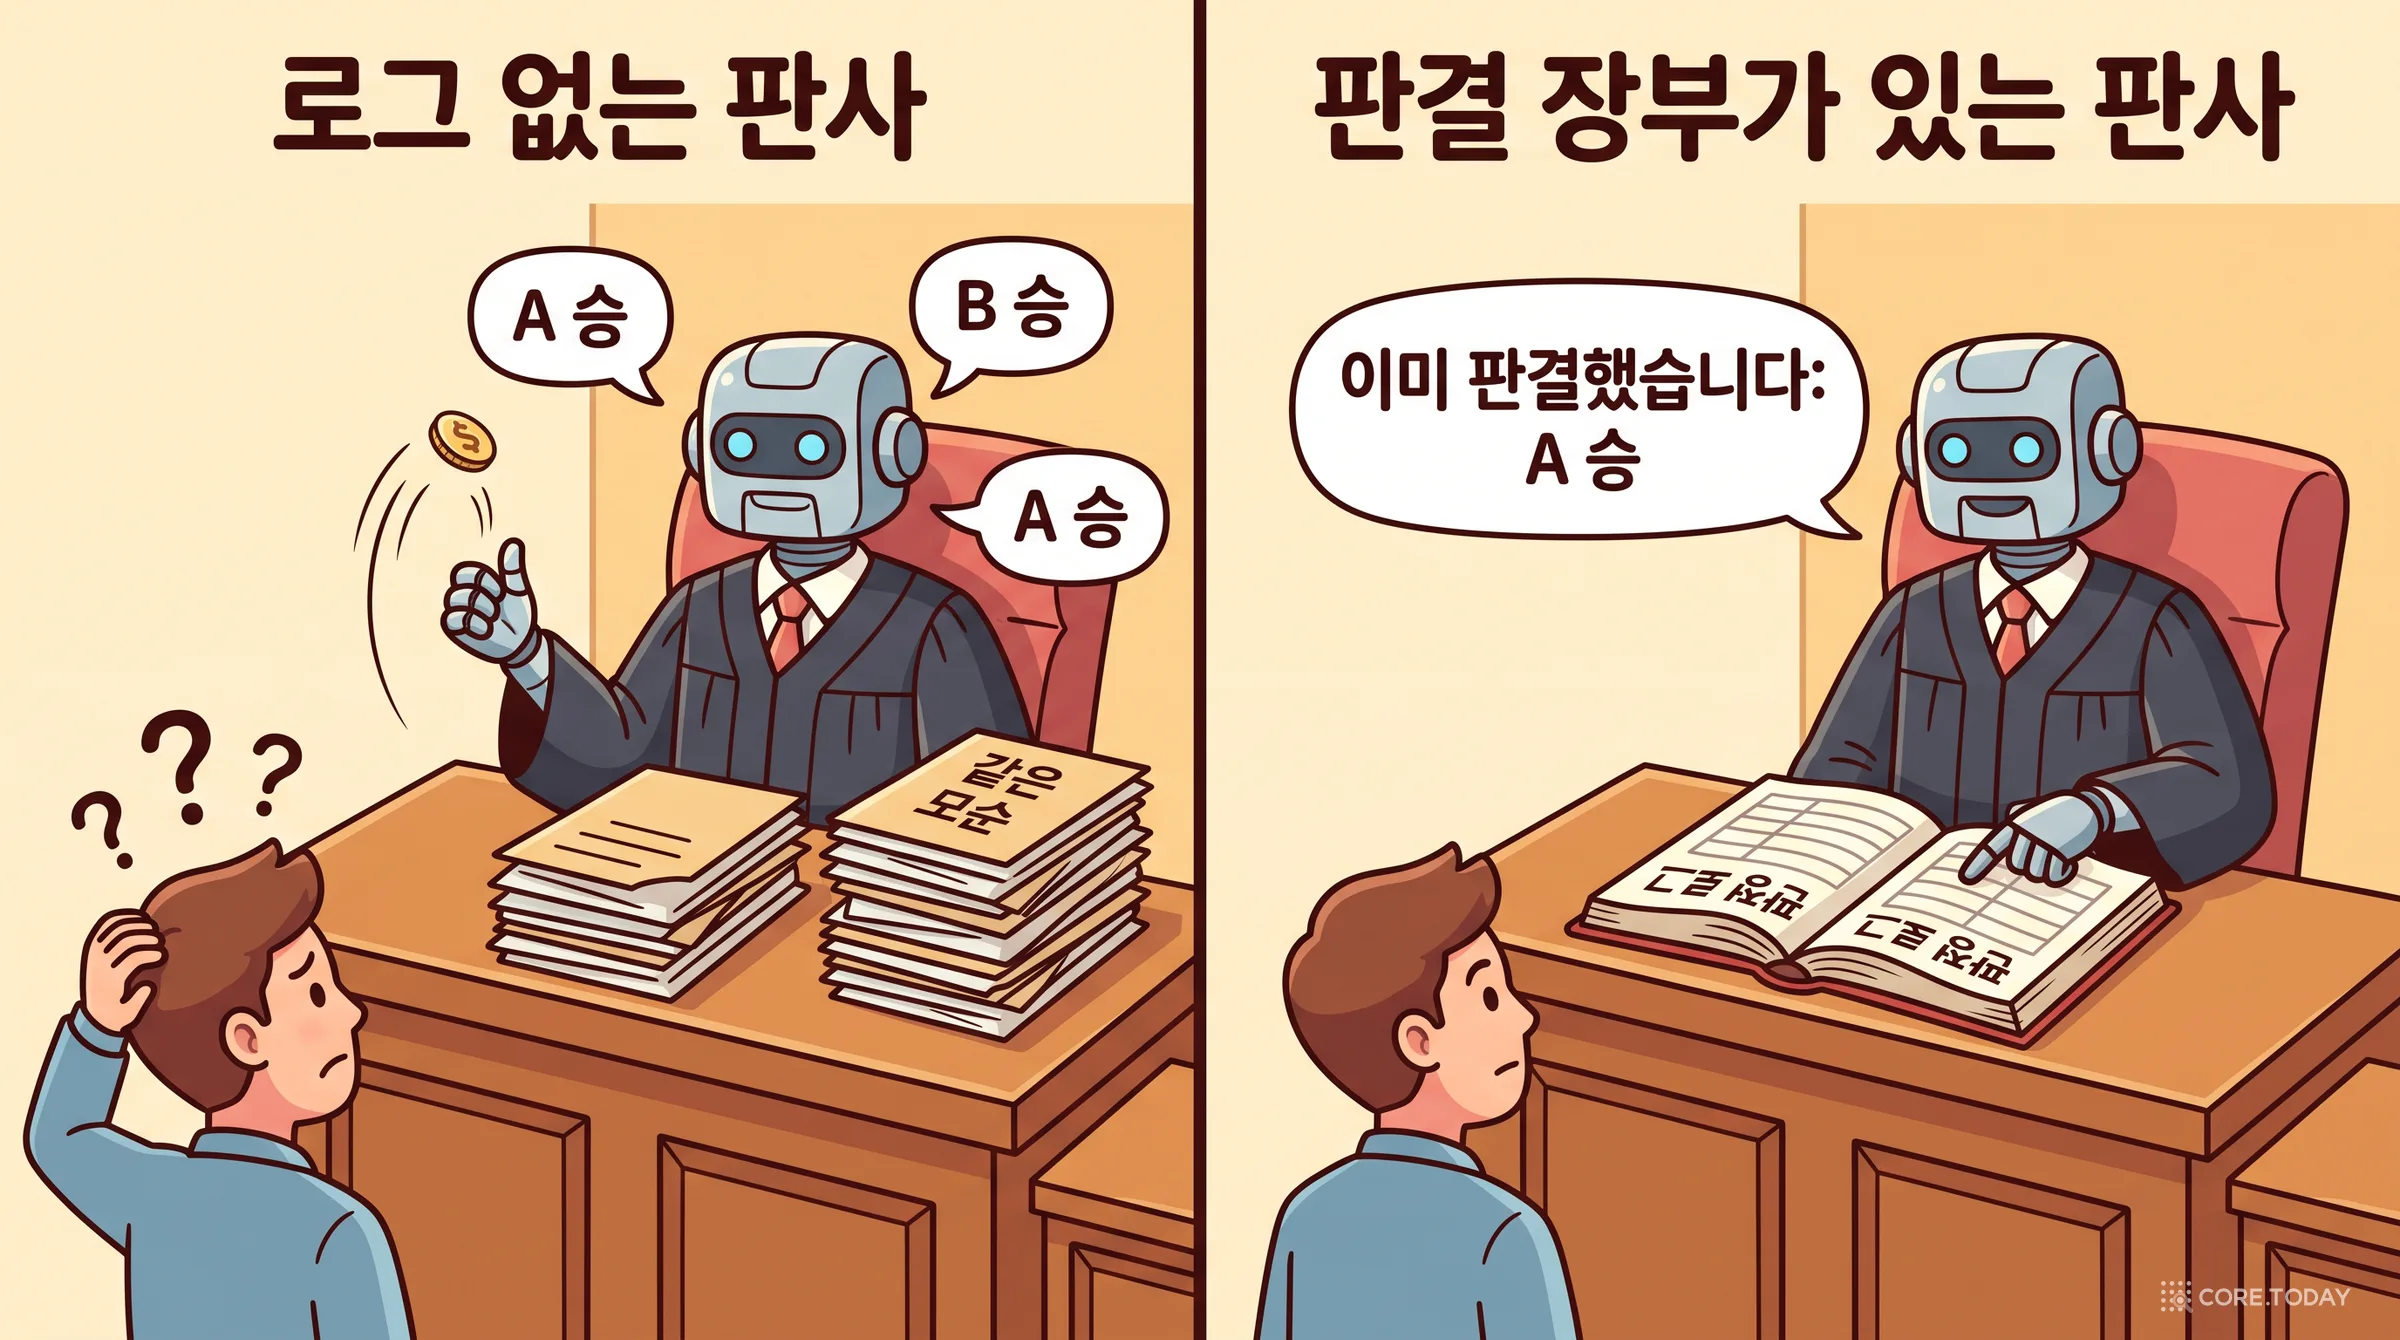
TOKI의 처방은 법원과 같습니다. 판결은 장부에 적고, 같은 사건이 다시 오면 장부를 읽는다. 판정 결과를 (R, θ)를 키로 하는 판정 로그에 연산자 커밋보다 먼저 기록하고, 두 번째부터는 판정자를 부르지 않고 로그를 읽습니다. 이것이 알고리즘 1의 5단계였습니다.
여기서 논문의 가장 영리한 한 수가 나옵니다. 보조정리 1(알파벳 다리) 은 판정 호출 j(R, θ)를 이렇게 바꿔 읽습니다 — 첫 호출은 판정 로그의 (R, θ) 행에 대한 '없으면 넣기' 쓰기로, 이후 호출은 그 행에 대한 읽기로. 그러면 N1은 고전 이상 두 개로 환원됩니다. 같은 행을 다시 읽었더니 값이 다름(P2 흐린 읽기, SI가 막음), 그리고 첫 기록 때 두 트랜잭션이 동시에 '없네' 하고 각자 넣음(P3 팬텀, SR이 막음). 새 괴물처럼 보이던 N1이 50년 된 이상의 옷을 입는 순간, 50년 된 방어(판정 로그에 SR, 또는 유일 키 제약·선형화 가능한 키-값 저장소)를 그대로 가져다 쓸 수 있습니다.
6-3. N2 — 믿음 표류 스큐
증거 가중(⊕p)은 같은 (주어, 술어) 분할에 있는 여러 사실의 확신도를 읽고 승자를 정합니다. 그 사이 다른 에이전트가 같은 분할의 다른 행의 확신도를 고치면, 두 트랜잭션은 서로 다른 행을 썼기 때문에 스냅숏 격리 아래에서 둘 다 커밋됩니다. 결론(믿음 캐시)과 그 근거(확신도들)가 어긋납니다. 3절의 당직 의사와 같은 모양, 즉 쓰기 스큐를 (주어, 술어) 분할 위로 옮긴 것입니다(따름정리 1). 방어도 같습니다. 그 분할을 직렬화 수준으로 묶습니다.
이름이 '표류'인 이유는 이 어긋남이 한 번에 크게 터지지 않고 조금씩 쌓이기 때문입니다. 확신도 갱신이 잦은 기억 — 사용자의 취향, 진행 중인 프로젝트 상태 — 에서 믿음이 근거와 조용히 멀어집니다. 코어닷투데이가 상태 표류에서 다룬 "기억은 하는데 지금을 모른다"와 결이 닿는 현상입니다.
6-4. N3 — 감사 소거
덮어쓴 사실을 되살릴 수 없는 것입니다. 진 사실을 지우거나 덮어쓰면, 나중에 "예전엔 뭐라고 알고 있었지?", "왜 그렇게 판단했지?", "그 근거가 오염된 출처였다면 무엇을 다시 봐야 하지?"에 답할 수 없습니다.
N3는 격리 수준과 무관합니다. 아무리 직렬화를 해도 덮어쓰면 사라집니다. 그래서 TOKI는 이것을 스키마 축의 문제로 따로 뗍니다. 방어는 이중 행 스키마, 즉 감사 행입니다. 그리고 감사 행이 진 쪽의 근거를 정확히 얼마나 자세히 기억하는지는 세 번째 축, 출처 축이 정합니다.
7. 정리 다섯 개를 수식 없이 읽기
논문의 수학은 '세 개의 직교하는 축'으로 정리됩니다. 서로 독립인 세 질문입니다 — 누가 이기는가가 흔들리지 않나(격리 축), 진 쪽이 남는가(스키마 축), 남은 것이 얼마나 자세한가(출처 축).
격리 수준 L이 이상 집합 Φ를 막는다 ⇔ L이 Φ의 '경비 수준' 이상이다. 양방향이라, 한 단계 약하면 반드시 뚫리는 일정이 있다
자물쇠 등급표: 이 등급 이상이면 이 도둑은 못 들어오고, 한 등급 아래면 반드시 들어올 수 있다
보조정리 1 판정·콜백 알파벳 다리
격리
판정 호출을 '판정 로그 행 읽기/쓰기'로 바꿔 읽으면 N1·N2가 고전 이상으로 환원된다
새 범죄를 기존 형법 조문에 대응시키기
정리 2 감사 소거의 스키마 승격
스키마
감사 행 스키마에서는 모든 패자의 출처가 어떤 감사 행에 포함된다. 기본 스키마에서는 그렇지 않은 일정이 반드시 있다
파쇄기 대신 보관함: 보관함이 있으면 항상 찾을 수 있다
명제 1 K-공허성과 K-하중
출처
출처 운반체(불리언·다중선형·다중차수)를 바꿔도 격리 판정은 똑같다. 운반체가 의미 있는 곳은 감사 행 복원뿐이다
영수증 종류는 도둑을 막는 데 무관하지만, 환불 때는 중요하다
정리 3 운반체 복원 가능성
출처
같은 기록을 여러 번 쓴 결론에서 한 건만 철회했을 때 다항식만으로 복원 가능 ⇔ 그 변수의 차수가 2 이상. 다중차수만 이걸 한다
“몇 번 썼는지” 적힌 영수증만 부분 환불을 계산할 수 있다
정리 4 합성 건전성
격리·스키마
연산자를 여러 개 이어 붙인 파이프라인은 각 단계 격리 수준의 최댓값(격자의 상한)을 요구하고, 한 단계라도 감사 행이 필요하면 전체가 감사 행 모드다
쇠사슬은 가장 강한 고리가 아니라 모든 고리를 합친 조건으로 묶인다
명제 2 n개 모순 집합
출처
최신 우선·증거 가중은 n개 사실이 한꺼번에 부딪쳐도 처리 순서와 무관하게 같은 승자와 같은 합친 출처를 낸다
토너먼트 대진을 어떻게 짜도 최강자가 우승한다(전순서이므로)
정리 5 N1 하한 — 판정 로그는 필요하다
격리
판정자가 조금이라도 비결정적이면, 판정 로그를 키로 기록하지 않는 시스템은 반드시 N1을 허용하는 실행이 있다
장부 없는 법원은 언젠가 같은 사건에 다른 판결을 낸다
이 중 논문이 "날카로운 결과"라고 부르는 것은 정리 5와 그 짝(따름정리 4)입니다. 정리 5는 필요성을, 따름정리 2는 충분성을 말하므로, 둘을 합치면 "관계형 일정 모형 안에서, N1을 막는다 ⇔ 판정 로그를 키로 기록하고 그 로그를 직렬화로 읽는다"가 됩니다. 판정 로그 말고 다른 영리한 방법은 없다는 뜻입니다(유일 키 제약, 선형화 가능한 키-값 저장소, 내용 주소 판정 캐시는 같은 계약을 다른 수단으로 구현한 것이라 같은 범주입니다).
정리 5의 증명은 놀랄 만큼 짧습니다. 판정자가 서로 다른 내부 상태 ω₁, ω₂에서 다른 답을 내는 입력이 하나라도 있다고 합시다(온도가 0이 아닌 LLM이라면 당연히 있습니다). 로그가 없는 시스템은 재실행 때 판정자를 다시 부를 수밖에 없고, 한 번은 ω₁, 한 번은 ω₂에 걸리면 끝입니다. 이 단순함이 이 결과의 힘입니다. "우리 판정자는 거의 결정적이에요"라는 말은 방어가 되지 못합니다. 하한은 '거의'를 용서하지 않습니다.
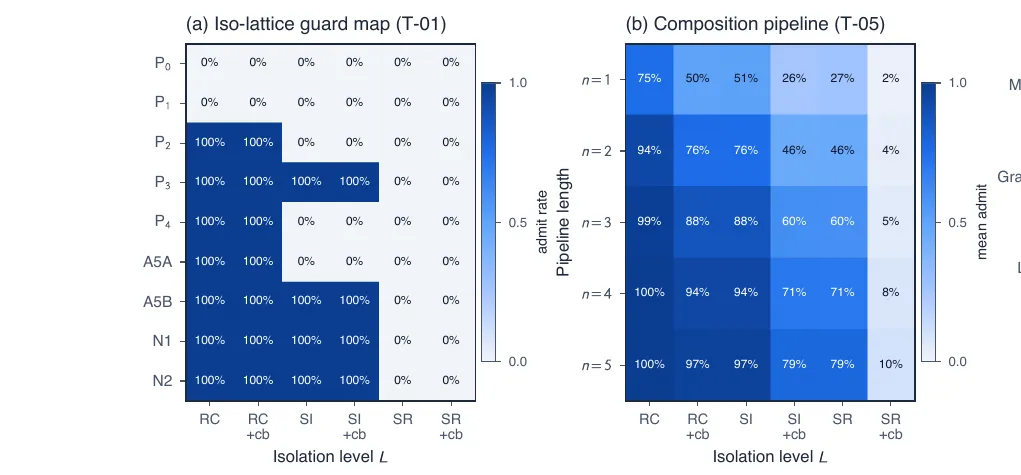
정리 4의 '상한'도 실무에 바로 쓰입니다. 대부분의 기억 엔진은 수집 → 중복 제거 → 증거 가중 → 정책 확인처럼 여러 단계를 잇습니다. 각 단계가 각자 안전해도 파이프라인 전체가 안전하려면 가장 까다로운 단계의 격리 수준으로 전체를 묶어야 합니다. 논문 그림 4(b)는 파이프라인 길이를 1에서 5로 늘렸을 때 이상 허용률이 RC에서 75% → 100%로 치솟고, 상한인 'SR + 콜백'에서만 2~10%로 바닥에 깔린다는 것을 보여 줍니다.
8. 실험 읽기: 무엇을 보였고, 무엇을 보이지 않았나
8-1. 여덟 시스템 판정표
논문의 경험적 핵심은 표 4입니다. 기억 시스템 6개(mem0 v2·v3, Graphiti, Letta, Zep, MIRIX), 엔진 계층 비교 대상 1개(WorldDB), 그리고 TOKI를 세 이상에 대해 판정했습니다. 각 시스템을 두 번 읽었습니다. T(transcribed)는 공개된 모순 처리 논리를 코드 줄 번호까지 인용하며 옮겨 적은 것, I(imported)는 실제 코드의 모순 처리 진입점을 결정론적 판정 스텁으로 돌린 것입니다.
결론은 이렇게 요약됩니다.
감사 소거(N3)는 거의 보편적입니다. 출처 경로가 문서화된 기억 시스템 다섯 개가 모두 허용했습니다(MIRIX는 보류).
판정 재현 불일치(N1) 는 쓰기 경로나 검색 경로에서 LLM 판정을 시드 고정 없이 부르는 mem0 v3·Graphiti·MIRIX에서 나왔습니다.
믿음 표류 스큐(N2) 는 분할을 스냅숏 격리로 읽는 mem0 v3·Letta·Zep·MIRIX에서 나왔습니다.
WorldDB는 세 이상을 모두 배제했는데, 판정자를 쓰기 경로에서 아예 뺐기 때문입니다(내용 주소 방식의 불변 노드 + 질의 시점의 결정론적 처리). 쓰기 때 증거 가중 판정이 필요한 배포에는 해당하지 않는 해법입니다.
TOKI만이 판정자를 쓰기 경로에 둔 채 세 이상을 모두 배제했습니다.
위젯에서 칸을 눌러 보면 칸마다 무게가 다르다는 것도 보입니다. 이 부분은 10절에서 따로 다룹니다.
8-2. 정리를 격자로 확인하기
정리마다 '예측된 0/1 경계'를 전수 실험으로 확인한 것이 4.5절입니다. 그림 4(a)는 정리 1의 확인입니다. 이상 9가지(고전 7 + N1·N2) × 격리 수준 6가지(RC·SI·SR 각각 콜백 유무) = 54칸에서, 경비 수준 이상인 32칸은 모두 0%, 그 아래 22칸은 모두 100%였습니다.
그림 출처: Wang, TOKI (arXiv 2606.06240v1), Figure 4 (a)(b).
N1과 N2의 줄을 보세요. 스냅숏 격리(SI)까지는 100% 뚫리고 직렬화(SR)에서야 0%가 됩니다. N1이 SR을 요구하는 이유는 앞에서 본 대로, 판정 로그의 첫 기록이 팬텀(P3)이기 때문입니다. 두 트랜잭션이 동시에 "이 판정은 아직 없네"를 보고 각자 다른 판정을 넣을 수 있으니까요. 이 격자들은 논문이 직접 만든 일정 생성기 위의 전수 시험이라, 정리를 '검산'하는 의미이지 실제 시스템에서의 발생 빈도를 잰 것은 아닙니다.
8-3. 판정자를 실제 LLM으로: 2p(1−p)는 맞았다
정리 5가 현실의 LLM에서도 성립하는지는 그림 5와 6이 보여 줍니다. 논문은 최신 모델(frontier LLM)을 온도 1.0, 추론 접두를 붙여 판정자로 쓰고, 판정 로그를 지킨 참조 구현과 로그가 없는 변형 다섯 개(네 기준 시스템 흉내 + TOKI에서 로그를 뺀 것)를 비교했습니다.
그림 출처: Wang, TOKI (arXiv 2606.06240v1), Figure 6. p가 0 또는 1인 결정적 칸(30칸 중 17칸)은 정의상 일관되므로 이 곡선에서 제외됐습니다.
8-4. "LoCoMo +0.86"과 "−0.49"의 정확한 뜻
초록에 나오는 두 숫자는 오해하기 쉽습니다.
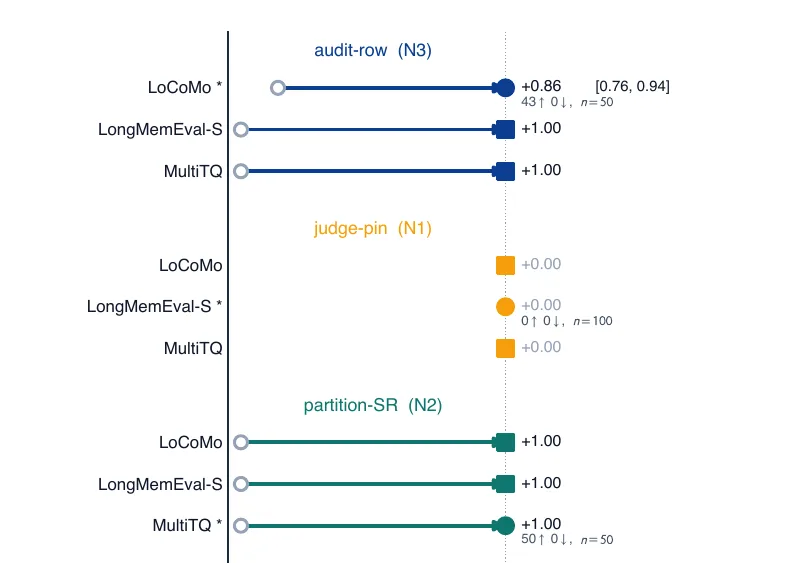
+0.86은 LoCoMo 전체 정확도가 86%포인트 올랐다는 뜻이 아닙니다. LoCoMo에서 뽑은 50문항짜리 조각에서 감사 행 방어를 켠 쪽과 끈 쪽을 짝지어 비교한 값으로, 43문항이 좋아지고 0문항이 나빠졌습니다(쌍체 부트스트랩 95% 신뢰구간 0.76~0.94). 그림에서 읽으면 정답률이 약 0.14에서 1.00으로 움직입니다. 부록이 적은 측정량의 이름은 paired_accuracy_delta_audited_current_vs_stale, 즉 '감사를 거친 현재 값 대 낡은 값'의 비교입니다. 다만 이 50문항을 어떻게 골랐는지는 논문에 자세히 나오지 않고 저장소도 열리지 않아, 조각의 성격은 확인할 수 없습니다. 같은 그림의 다른 칸들은 더 조심해서 읽어야 합니다. 대상이 아닌 벤치마크의 대조군은 10문항에 인위적으로 만든 어긋남을 넣은 것이라 +1.00으로 포화됐고, 판정 고정(N1)은 이 실험 표면에 판정 재생 표가 없어 +0.00으로 나왔습니다. 논문도 이 그림을 '메커니즘 부하 시험'이라 부르며 효용 우위를 주장하지 않고, "칸별 차이는 무기억 기준선 대비 여유를 재는 것이 아니다"라고 금지 결론까지 적어 둡니다.
그림 출처: Wang, TOKI (arXiv 2606.06240v1), Figure 2. 별표()는 각 방어의 주 대상 칸입니다.*
−0.49는 TOKI의 기억 계층을 빼고 같은 시스템을 돌렸을 때, 판정 가능한 LoCoMo 질문 1,444개(단일 홉·시간·개방형 사실)에서 정답률이 0.540에서 0.048로 떨어졌다는 뜻입니다. 기억이 있는 시스템과 없는 시스템의 비교이므로, 큰 차이가 나는 것이 자연스럽습니다. 이것은 TOKI가 다른 기억 시스템보다 낫다는 증거가 아니라, 'TOKI의 기억 계층이 실제로 기억 역할을 한다'는 기본 확인입니다. 이 묶음은 채점이 어려운 추측형 문항과 정답이 비어 있는 적대적 문항을 뺀 '답할 수 있는' 문항만 모은 것이기도 합니다.
다른 기억 시스템과의 직접 비교는 어땠을까요. LoCoMo의 대화 하나씩을 쓴 50문항 조각들에서 mem0 v3 대비 −0.04(0.02 대 0.06), Graphiti 대비 −0.08(0.04 대 0.12), Zep 대비 +0.02(0.06 대 0.04)였고, 세 신뢰구간 모두 0을 포함했습니다. 괄호 안 정확도가 보여 주듯 모든 시스템이 이 조각에서 12% 이하이고, 차이는 문항 몇 개입니다. 사전 등록한 검정력이 0.42에 불과했다는 것도 논문이 스스로 밝힙니다. 결론은 "이 규모로는 구별되지 않는다"입니다. TOKI의 기여는 정확도가 아니라 계약이라는 것이 논문의 일관된 입장입니다.
8-5. 비용
단일 프로세스 기준으로, 기억 크기를 0에서 10만 개 사실까지 늘려도 모순 해결 지연은 중앙값 3.88~4.15ms, p99는 18.2ms 아래였습니다. 동시 작성자 수에 대해서는 평균 지연이 작성자 수의 0.86제곱으로 늘었습니다(R² 0.992). 다만 직렬화에는 대가가 있습니다. 부록의 PostgreSQL 17.6 SERIALIZABLE 시험에서 쓰기 36건 중 동시 작성자 2명일 때 18건, 4명일 때 11건만 커밋됐고 나머지는 직렬화 실패로 되돌려졌습니다. 직렬화는 이상을 막는 대신 재시도를 요구합니다. 분산 환경에 대한 주장은 없습니다.
9. 코어닷투데이 실측: 이상은 정말 새어 나오나
논문이 밝힌 코드 저장소(github.com/ZenAlexa/toki-bitemporal-memory)는 2026년 10월 31일 현재 404입니다. 그래서 TOKI의 구현을 돌려 보는 대신, 논문의 두 핵심 주장을 우리 손으로 확인했습니다. ① 격리 수준이 약하면 기억 쓰기에서 정말 이상이 새어 나오는가. ② LLM 판정자는 같은 모순에 정말 다른 답을 내는가. 둘 다 크레딧이 들지 않는 로컬 환경(도커의 PostgreSQL 17, 로컬 Ollama)에서 했습니다.
9-1. PostgreSQL 17에서 두 에이전트 동시 쓰기
기억 표 하나(주어, 술어, 목적어, 확신도, 근거 횟수, 시스템 시간 시작·끝)를 만들고, 두 연결이 같은 순간에 읽은 뒤(배리어) 50ms 쉬고 쓰도록 강제했습니다. 50ms는 실제 에이전트가 읽기와 쓰기 사이에 LLM을 부르는 수 초에 비하면 오히려 짧은 틈입니다. 시나리오는 셋입니다.
갱신 손실: 두 에이전트가 각자 새 근거를 확인하고 근거 횟수를 1 → 2로 올린다(정답은 3).
이중 대체: 두 에이전트가 각자 다른 새 약(아목시실린, 세팔렉신)으로 기존 페니실린 행을 대체한다.
정리 에이전트의 쓰기 스큐: 현재 값이 둘(모순 상태)일 때, 두 정리 에이전트가 각자 "하나는 남으니" 서로 다른 쪽을 은퇴시킨다.
격리 수준마다 50번씩 돌린 결과입니다.
격리 수준 (PostgreSQL 이름)
갱신 손실
이중 대체
쓰기 스큐
RC (READ COMMITTED, 기본값)
50/50 발생
50/50 발생 — 현재 값 2개
50/50 발생 — 현재 값 0개
SI (REPEATABLE READ)
50/50 한쪽 중단
50/50 한쪽 중단
50/50 발생 — 현재 값 0개
SR (SERIALIZABLE)
50/50 한쪽 중단
50/50 한쪽 중단
50/50 한쪽 중단
이론이 말한 그대로입니다. 가장 흔한 기본값인 READ COMMITTED에서는 세 이상이 모두 오류 메시지 하나 없이 새어 나옵니다. 이중 대체는 특히 고약합니다. 두 에이전트 모두 "기존 행을 닫고 새 행을 넣었다"고 믿지만, 두 번째 에이전트의 '닫기'는 이미 닫힌 행을 다시 찾지 못해 0행을 고치고 지나갑니다. 결과는 현재 값이 둘인 기억 — 모순을 풀려던 두 쓰기가 새 모순을 만든 겁니다. 스냅숏 격리(REPEATABLE READ)는 같은 행을 건드린 앞의 둘은 막지만, 서로 다른 행을 고친 쓰기 스큐는 통과시켜 기억이 앨리스의 약을 통째로 잊게 합니다. SERIALIZABLE만 셋을 모두 막고, 그 대가로 한쪽을 직렬화 실패(SQLSTATE 40001)로 되돌립니다. 되돌려진 쪽은 다시 시도해야 합니다.
아래 위젯에서 각 시나리오를 한 단계씩 진행해 볼 수 있습니다.
이 실험이 말해 주는 실무적 사실이 하나 더 있습니다. 대부분의 에이전트 기억 엔진은 벡터 저장소나 그래프 데이터베이스 위에서 돌고, "읽기 → LLM 호출 → 쓰기"가 한 트랜잭션으로 묶여 있지도 않습니다. 그런 구조에서는 위 표의 RC 줄보다도 나쁩니다. 격리 수준을 올리는 것 이전에, 모순 해결의 읽기와 쓰기를 한 트랜잭션 경계 안에 넣는 것이 첫걸음입니다.
9-2. 로컬 판정자는 같은 모순에 같은 답을 하나
두 번째 실험은 N1입니다. 회사 업무에서 흔히 생기는 한국어 모순 36쌍을 만들었습니다. "인사 발령 공문으로 부서가 바뀐" 분명한 갱신 8쌍, "동료가 전한 말 vs 본인 발언" 같은 애매한 경우 12쌍, 근거가 대등한 경우 10쌍, "약관 vs 상담원 안내" 같은 규칙 충돌 6쌍입니다. 로컬에서 돌린 Qwen3-4B-Instruct-2507(MLX)에게 "지금 기억에 현재 값으로 남길 쪽은 A인가 B인가"를 물었습니다. 각 쌍을 원래 순서와 A·B를 뒤바꾼 순서로 제시하고, 답 자리의 토큰 확률을 직접 읽어 온도 1.0 표본 20개와 온도 0의 답(가장 확률 높은 토큰)을 얻었습니다. 처음에는 Ollama의 qwen3.5:9b로 시작했지만, 같은 모델을 다른 작업이 공유하고 있어 호출 한 번에 5분씩 걸려 4B로 바꿨습니다.
결과는 세 가지입니다.
측정
결과
뜻
판정이 흔들리는 칸 (0.05 < p < 0.95)
72칸 중 19칸
4분의 1은 판정자 자신도 확신하지 못한다. 19칸 중 13칸이 근거 대등, 4칸이 애매한 경우다
연속 두 판정 불일치율 (온도 1.0)
7.97% (예측 2p(1−p) 9.21%)
재시작·재생 열두 번 중 한 번꼴로 승자가 바뀐다
t번 재질의가 모두 같을 확률 (흔들리는 19칸 평균)
2번 68.5% → 5번 35.9% → 10번 18.0% → 24번 4.5%
논문 그림 6의 감쇠와 같은 모양
온도 0인데 A·B 순서만 바꿔 승자가 바뀐 쌍
36쌍 중 13쌍 (36%)
가장 결정적인 설정에서도 판결은 프롬프트 모양에 따라 갈린다
첫째와 둘째는 논문의 정리 5를 그대로 확인합니다. 우리는 판정자의 확률 p를 직접 읽었으므로, 표본 불일치율이 2p(1−p)에 가까운 것 자체는 당연합니다. 실측의 의미는 p가 어디에 분포하는가에 있습니다. 분명한 갱신(인사 발령 공문, 본인의 이사 통보)에서는 판정자가 거의 언제나 새 기록을 골랐지만(16칸 중 15칸), 근거가 대등한 쌍에서는 새 기록을 고른 비율이 절반(20칸 중 10칸)이었고, 판정자가 흔들리는 곳은 정확히 사람도 판단하기 어려운 곳이고, 그런 모순일수록 다시 물을 때마다 기억이 뒤집힙니다. 규칙 충돌은 흔들리지 않았지만 일관되게 옳지도 않았습니다. 새 기록을 고른 칸이 12칸 중 3칸인데, 약관·취업규칙을 지킨 것은 맞지만 같은 태도로 2026년 식약처 고시보다 2024년 내부 지침을 골랐고, 반대로 사내 보안 규정보다는 기사로 전해진 NIST 권고를 골랐습니다. 권위의 순서를 판정자에게 맡기면 안 되고, 규칙 정책(⊕c)이 따로 있어야 하는 이유입니다.
셋째가 이 실험에서 가장 중요한 발견입니다. 온도를 0으로 두면 판정자는 결정적이 됩니다. 같은 프롬프트에는 늘 같은 답을 합니다. 그런데 두 기록을 프롬프트에 넣는 순서만 바꾸면, 36쌍 중 13쌍에서 승자가 바뀌었습니다. "김민수의 소속 부서: 마케팅팀(3월 인사 시스템) vs 전략기획팀(9월 인사 발령 공문)"처럼 분명한 쌍조차, 새 기록을 B 자리에 두면 확률 1.00으로 새 기록을 골랐지만 A 자리에 두면 0.18에 그쳤습니다. 출장지(일정표의 도쿄 vs 메신저의 '아마 오사카')는 어느 기록이든 B 자리에 놓인 쪽을 99% 이상 골랐습니다. 승자가 뒤집힌 쌍은 곧 내용이 아니라 자리를 고른 쌍입니다. 어느 자리를 고르는지는 쌍마다 달라(A 6쌍, B 7쌍), 고정된 자리 편향으로 보정해 없앨 수도 없습니다.
이것이 판정 로그 설계에 주는 함의는 분명합니다. TOKI의 판정 로그 키는 (읽은 집합 R, 디코더 묶음 θ)이고 θ에는 프롬프트가 들어갑니다. 에이전트 A는 [옛 기록, 새 기록] 순서로, 에이전트 B는 [새 기록, 옛 기록] 순서로 같은 모순을 판정하면, 두 판정은 다른 키가 되어 로그가 서로를 보호하지 못합니다. 온도를 0으로 내리는 것은 N1의 해결책이 아니며, 판정 로그도 키와 프롬프트를 함께 정규화(사실 id 순 정렬, 순서 없는 집합 키)해야 제 역할을 합니다.
논문 부록에도 같은 방향의 자료가 있습니다. 엄격·관대 프롬프트 두 가지와 온도 0·0.7을 교차한 실험에서 claude-haiku-4-5의 PARTIAL 묶음 75문항 중 46문항이 불안정했는데, 그중 42문항은 프롬프트 때문에 갈렸고, 온도만으로 갈린 문항은 0개, 둘 다인 문항이 4개였습니다(표 8). 판정을 흔드는 주된 힘은 난수가 아니라 프롬프트입니다.
10. 비판적으로 읽기
TOKI는 중요한 질문을 정확한 언어로 던진 논문입니다. 그러나 읽는 사람이 알아야 할 한계와 의문도 분명합니다.
10-1. 재현할 수 없는 재현 패키지
논문은 부록 A에 '주장–증거 지도', 부록 F에 재현 실행서를 두고, 모든 숫자에 make repro-… 명령과 CSV 파일 경로를 붙였습니다. 형식만 보면 재현성의 모범입니다. 그러나 정작 그 저장소가 404이고, 부록 D가 고정했다는 기준 시스템의 커밋 해시들(mem0 a623caf, Graphiti c427615, Letta bb52a89, Zep faf2ace)도 전체 해시로 찾아봐도 지금 GitHub에서 조회되지 않습니다. mem0의 해시는 표 15(a623caf)와 본문(a623cfa…)이 서로 다르기도 합니다. 판정표의 'Wire' 칸이 실제로 무엇을 돌린 결과인지 독자가 확인할 방법이 현재로서는 없습니다.
10-2. 판정표의 칸마다 무게가 다르다
판정표는 이 논문의 가장 강한 주장("모든 기준 시스템이 적어도 하나를 허용")을 받치지만, 칸을 하나씩 열어 보면 성격이 제각각입니다.
N3는 '사라짐'이 아니라 '필드 이름'을 검사했습니다. 감사 소거라는 이름은 사실이 없어진다는 인상을 줍니다. 그런데 표 16을 보면 Graphiti의 실행 칸은 EntityEdge.model_fields에 superseded_by·replaces·replaced_by_uuid 같은 필드가 있는지를 보고, Letta의 실행 칸은 BlockHistory의 열이 그 필드 집합과 겹치는지를 봅니다. 값이 지워졌는지를 관찰한 것이 아닙니다. 실제로 옛 값은 대부분 남아 있습니다.
mem0: 현재 기본 경로(2026년 4월 패키지 2.0.0에 들어온 'V3' 파이프라인)는 ADD만 합니다. 새 사실은 옛 사실 옆에 쌓이고, 명시적 update·delete는 SQLite history 표에 이전 값을 남깁니다.
Graphiti: 모순된 옛 간선을 지우지 않고 invalid_at과 expired_at을 찍어 남깁니다. 무효화는 논문 설명("검색 때 무효화")과 달리 쓰기 때(add_episode 안의 resolve_extracted_edges) 일어납니다. 대체한 간선의 uuid는 호출 중에만 메모리에 있고 저장되지 않습니다.
Letta: 논문 스스로 BlockHistory가 Bob → Carol 체크포인트를 순서대로 지닌다고 적습니다. 대체 관계가 순서로만 암시된다는 것이 판정 사유입니다.
세 경우 모두 없는 것은 값이 아니라 대체 관계와 출처 다항식입니다. 감사에 필요한 것이 그것이라는 논문의 주장은 타당하지만, '소거'는 강한 이름입니다.
정작 지우는 시스템은 보류됐습니다. 현재 MIRIX 코드는 semantic_memory_update에서 옛 항목을 hard delete합니다. 논문은 외부 벤치마크(MMA-Bench)를 옮겨 적었다는 이유로 이 칸을 비워 뒀습니다.
같은 이유, 다른 판정. Graphiti와 Letta의 실행 칸 N2는 "확신도 분할 필드가 없어 술어가 정의되지 않는다"며 보류입니다(표 17). 그런데 Zep의 실행 칸은 간선에 관련도·검색 점수만 있고 확신도 분할 경계가 없다는 점을 들어 N2를 '허용'으로 적습니다. 또 Letta의 T 칸은 "블록 이력의 확신도 갱신이 분할을 SI로 읽는다"고 하는데, I 칸은 그 블록 이력에 확신도 필드가 없다고 합니다. Claim 열은 사람이 baselines.py에 선언한 구조 모형(partition_isolation="SI" 등)에서 나온다는 점도 기억해야 합니다.
Zep은 두 제품을 읽었습니다. T 칸은 legacy/의 Go 커뮤니티판으로, Zep 스스로 지원 종료를 밝힌 판입니다. I 칸은 Zep Cloud API의 서비스 경계입니다. 커뮤니티판도 실제 처리는 Graphiti HTTP 서비스에 넘기므로, Zep과 Graphiti는 독립된 두 표본이 아닙니다.
N1의 실행 증거는 없습니다. 기준 시스템의 I 칸은 재현성을 위해 결정론적 판정 스텁을 쓰므로 N1을 관찰할 수 없어 전부 보류입니다. 판정표의 N1 '허용'은 코드를 옮겨 적은 T 칸에서 왔습니다. 그림 4(c)·부록 B.2에서 Letta·Zep '흉내' 변형이 N1을 0.167~0.204로 허용했다는 결과도 판정자를 붙인 가상의 변형으로, 판정표에서 두 시스템의 N1은 '해당 없음'입니다.
정리하면 판정표의 결론은 "이 시스템들이 틀렸다"보다 "이 시스템들은 무엇을 보장하는지 말하지 않는다" 로 읽는 것이 정확합니다. 그리고 그것이 논문이 실제로 주장하는 바이기도 합니다.
10-3. 인용 숫자 하나가 원문에 없다
서론의 "BeliefShift는 일곱 모델 계열에서 세션을 넘나드는 모순의 최대 42%를 해결하지 못한 채 둔다"는 문장은 동기의 첫 근거입니다. 그러나 BeliefShift 논문(arXiv 2603.23848)에는 '42%'라는 숫자가 없습니다. 가장 가까운 것은 LLaMA-3 8B + RAG의 모순 해결률 지표(CRR) 0.58이고, 1 − 0.58 = 0.42로 계산한 것으로 보입니다. 그런데 CRR은 사람이 매긴 부분 점수의 평균이지 '해결 못 한 모순의 비율'이 아닙니다. 큰 흐름에는 영향이 없지만, 꼼꼼히 인용할 때는 조심해야 할 대목입니다.
10-4. 승자 독식: 변경과 정정을 구분하지 않는다
2절 위젯에서 본 대로, TOKI의 쓰기 경로는 진 쪽 행 전체를 현재 조각에서 뺍니다. "처방이 4월 10일에 바뀌었다"(변경)와 "3월 기록이 오기였다"(정정)를 같은 연산으로 처리하는 셈입니다. 감사 행에 정보가 남으니 잃는 것은 없지만, "3월 20일에 앨리스가 먹던 약"이라는 평범한 질문이 기본 검색에서 비게 됩니다. 이중 시간 모형의 진짜 힘은 변경(유효 시간의 새 구간)과 정정(시스템 시간의 수정)을 구분하는 데 있는데, TOKI는 시간 축을 '모순 감지'에만 쓰고 '해결'에는 쓰지 않습니다. 실제 시스템이라면 연산자 앞에 "이것은 변경인가 정정인가"를 묻는 단계가 필요합니다.
10-5. 판정 로그는 '일관되게' 만들 뿐 '옳게' 만들지 않는다
판정 로그는 같은 키로 다시 물으면 같은 답을 돌려줍니다. 첫 판정이 틀렸다면 일관되게 틀립니다. 이것은 결함이 아니라 설계 의도(재현 가능성)이지만, 실무에서는 "판정을 다시 해야 할 때"를 따로 정해야 합니다. 모델을 바꿨을 때, 새 근거가 들어왔을 때, 사람이 이의를 제기했을 때. 논문도 모델 교체와 프롬프트 변경은 디코더 묶음 θ 자체를 바꾸므로 격리 격자 밖이며 별도의 '판정 프롬프트 민감도 보조정리'로 다룬다고 밝힙니다.
그리고 9-2절의 실측이 보여 주듯, 키가 바뀌는 일은 생각보다 쉽게 일어납니다. 두 사실을 프롬프트에 넣는 순서만 바꿔도 프롬프트가 달라지므로 다른 키가 되고, 판정자는 처음 보는 사건처럼 새로 판결합니다. 논문의 n항 선택 경로가 '순서와 무관한 집합 키'를 쓰는 이유가 이것인데, 실제로 구현할 때는 키뿐 아니라 프롬프트 자체도 정규화(사실을 id 순으로 정렬해 제시)해야 합니다.
10-6. 직렬화의 비용과 범위
정리들은 '관계형 일정 모형' 안에서 성립하고, 실험은 단일 프로세스입니다. 부록의 PostgreSQL SERIALIZABLE 시험에서 동시 작성자 4명이면 쓰기 36건 중 11건만 커밋됐습니다. 직렬화 실패를 재시도하는 비용, 그리고 벡터 저장소·그래프 데이터베이스처럼 SERIALIZABLE을 아예 제공하지 않는 저장소에서 이 계약을 어떻게 구현할지는 열려 있습니다. 논문은 분산 환경을 명시적으로 범위 밖에 둡니다.
10-7. 문서의 결
43쪽 중 본문은 12쪽이고, 나머지 31쪽이 부록입니다. 부록 A의 표에는 '심사자 위험'(reviewer risk) 열이 있어 각 주장에 예상되는 반박과 그 방어를 미리 적어 두었고, 'ADR-0017' 같은 내부 설계 결정 기록 번호가 본문에 그대로 나옵니다. 석사 과정 학생 한 명의 단독 저작으로서 놀라운 분량이지만, 읽는 쪽에서는 핵심 주장과 방어 문장이 섞여 있어 소화하기 어렵습니다. 정리의 증명들도 상당수가 '증명 스케치' 수준이고 전체 증명은 '정리 파일'(저장소)에 있다고 하는데, 그 저장소가 지금 열리지 않습니다.
10-8. 그럼에도: 후속 연구들이 받아 들였다
한편 TOKI는 넉 달 사이 적어도 여덟 편의 후속 arXiv 논문에 인용됐습니다. 그중 MemTX는 TOKI를 기준선으로 다시 구현해 비교했고, '인식론적 타이핑'(Epistemic Typing) 논문은 TOKI를 "가장 가까운 형제 연구 — 이론 우선, 수정되지 않은 엔진 위에 얹은 계층"으로 소개합니다. 에이전트 기억을 데이터베이스의 언어로 말하는 흐름이 생겼고, TOKI가 그 흐름의 초기 기준점 노릇을 하고 있다는 뜻입니다.
11. 2026년에 이 논문이 말하는 것
11-1. 기억을 '여럿이' 쓰는 시대
2024년의 에이전트 기억은 대체로 한 사용자와 한 비서의 일기장이었습니다. 쓰는 사람이 사실상 하나였으니 동시성은 문제가 아니었습니다. 2026년의 풍경은 다릅니다. 코딩 에이전트는 하위 에이전트 여러 개를 병렬로 돌리고, 사내 비서는 여러 직원의 대화를 같은 조직 기억에 모으며, 백그라운드 '정리 에이전트'가 밤새 기억을 통합하고 요약합니다. 기억은 공유 자원이 됐습니다.
공유 자원에 여럿이 쓰면 동시성 제어가 필요하다는 것은 1970년대에 이미 배운 교훈입니다. TOKI가 하는 일은 그 교훈을 에이전트 기억에 다시 적용하라고, 그리고 LLM 판정자라는 새 참여자를 위한 규칙(판정 로그)을 하나 더하라고 요구하는 것입니다.
11-2. 기록하라는 규제, 지우라는 규제
감사 행은 규제 환경과도 맞물립니다. EU 인공지능법 제12조는 고위험 AI 시스템이 "사건을 자동으로 기록(로그)할 수 있어야 한다"고 정하고, 제19조는 공급자가 그 로그를 최소 6개월 보관하도록 합니다(2026년 7월의 '디지털 옴니버스' 개정으로 부속서 III 고위험 의무의 적용은 2027년 12월로 미뤄졌습니다). 한국의 「인공지능 발전과 신뢰 기반 조성 등에 관한 기본법」도 2026년 1월 22일 시행됐고, 고영향 AI 사업자에게 문서화와 기록 관리 의무를 지웁니다. "왜 그렇게 판단했나"를 나중에 설명할 수 있는 기억 — 진 사실과 그 근거, 판정 기록이 남는 기억 — 은 이런 요구에 대한 기술적 답의 일부입니다.
반대 방향의 압력도 있습니다. GDPR 제17조의 삭제권(잊힐 권리), 한국 개인정보보호법의 목적 달성 후 파기 의무는 "지우라"고 합니다. 감사 행은 "남기라"고 합니다. 논문도 이 긴장을 열린 문제로 꼽습니다(부록 G.7: 사용자에 묶인 쓰기 토큰으로 출처 다항식을 나눠, 삭제 연산자 ⊕⊥를 네 연산자와 합성 가능하게 만들 수 있는가). 출처 다항식이 있으면 "이 사용자에게서 온 근거"를 정확히 찾아 지울 수 있다는 점에서, 출처는 기록과 삭제 양쪽 모두의 도구이기도 합니다.
11-3. 기억 오염과 출처
코어닷투데이는 기억 오염을 다루며 날짜 하나로 기억이 바뀌는 공격을 재현한 적이 있습니다. 2026년 5월의 '잠복 기억 오염'(Sleeper Memory Poisoning, arXiv 2605.15338)은 오염된 기억이 일단 검색되면 이후 공격자가 의도한 행동이 60~89%의 경우 실행된다고 보고했습니다. TOKI는 정상적인 쓰기의 정합성을 다루고 악의적 주입은 범위 밖이라고 선을 긋지만, 둘은 맞물립니다. 오염이 발견된 날 해야 할 일은 "그 출처에서 온 모든 결론을 다시 계산하라"이고, 그러려면 결론마다 출처 다항식이 붙어 있어야 하며, 오염된 쓰기에 밀려난 진짜 사실이 감사 행에 남아 있어야 합니다. 4절의 위젯에서 환자 앱 입력(x₂)을 철회해 본 것이 바로 그 작업입니다.
11-4. 사실탐색기의 경험
코어닷투데이의 사실탐색기 v2는 공적 기록에서 "지금 참인 것"을 유지하는 시스템이고, 그 중심에 권위 기반 대체(AGS) — 더 권위 있는 최신 기록이 옛 기록을 대체하되, 옛 기록은 지우지 않고 대체 관계와 근거를 남긴다 — 가 있습니다. TOKI의 언어로 말하면 사실탐색기의 대체는 규칙 정책(⊕c) 에 가깝고, 대체된 기록은 감사 행으로 남습니다. 직접 만들어 보며 배운 것도 TOKI의 주장과 겹칩니다. 판정 모델의 결과는 반드시 캐시(TOKI의 판정 로그)에 키로 남겨야 했습니다. 그러지 않으면 재실행할 때마다 묶음이 달라져 회귀 시험이 무의미해졌습니다. 그리고 새 기록이 세상의 변화인지 옛 기록의 오류인지는 판정 모델에 맡기기보다 문서의 성격을 보고 따로 판단하는 편이 안정적이었습니다. 10-4절의 비판은 이 경험에서 나온 것입니다.
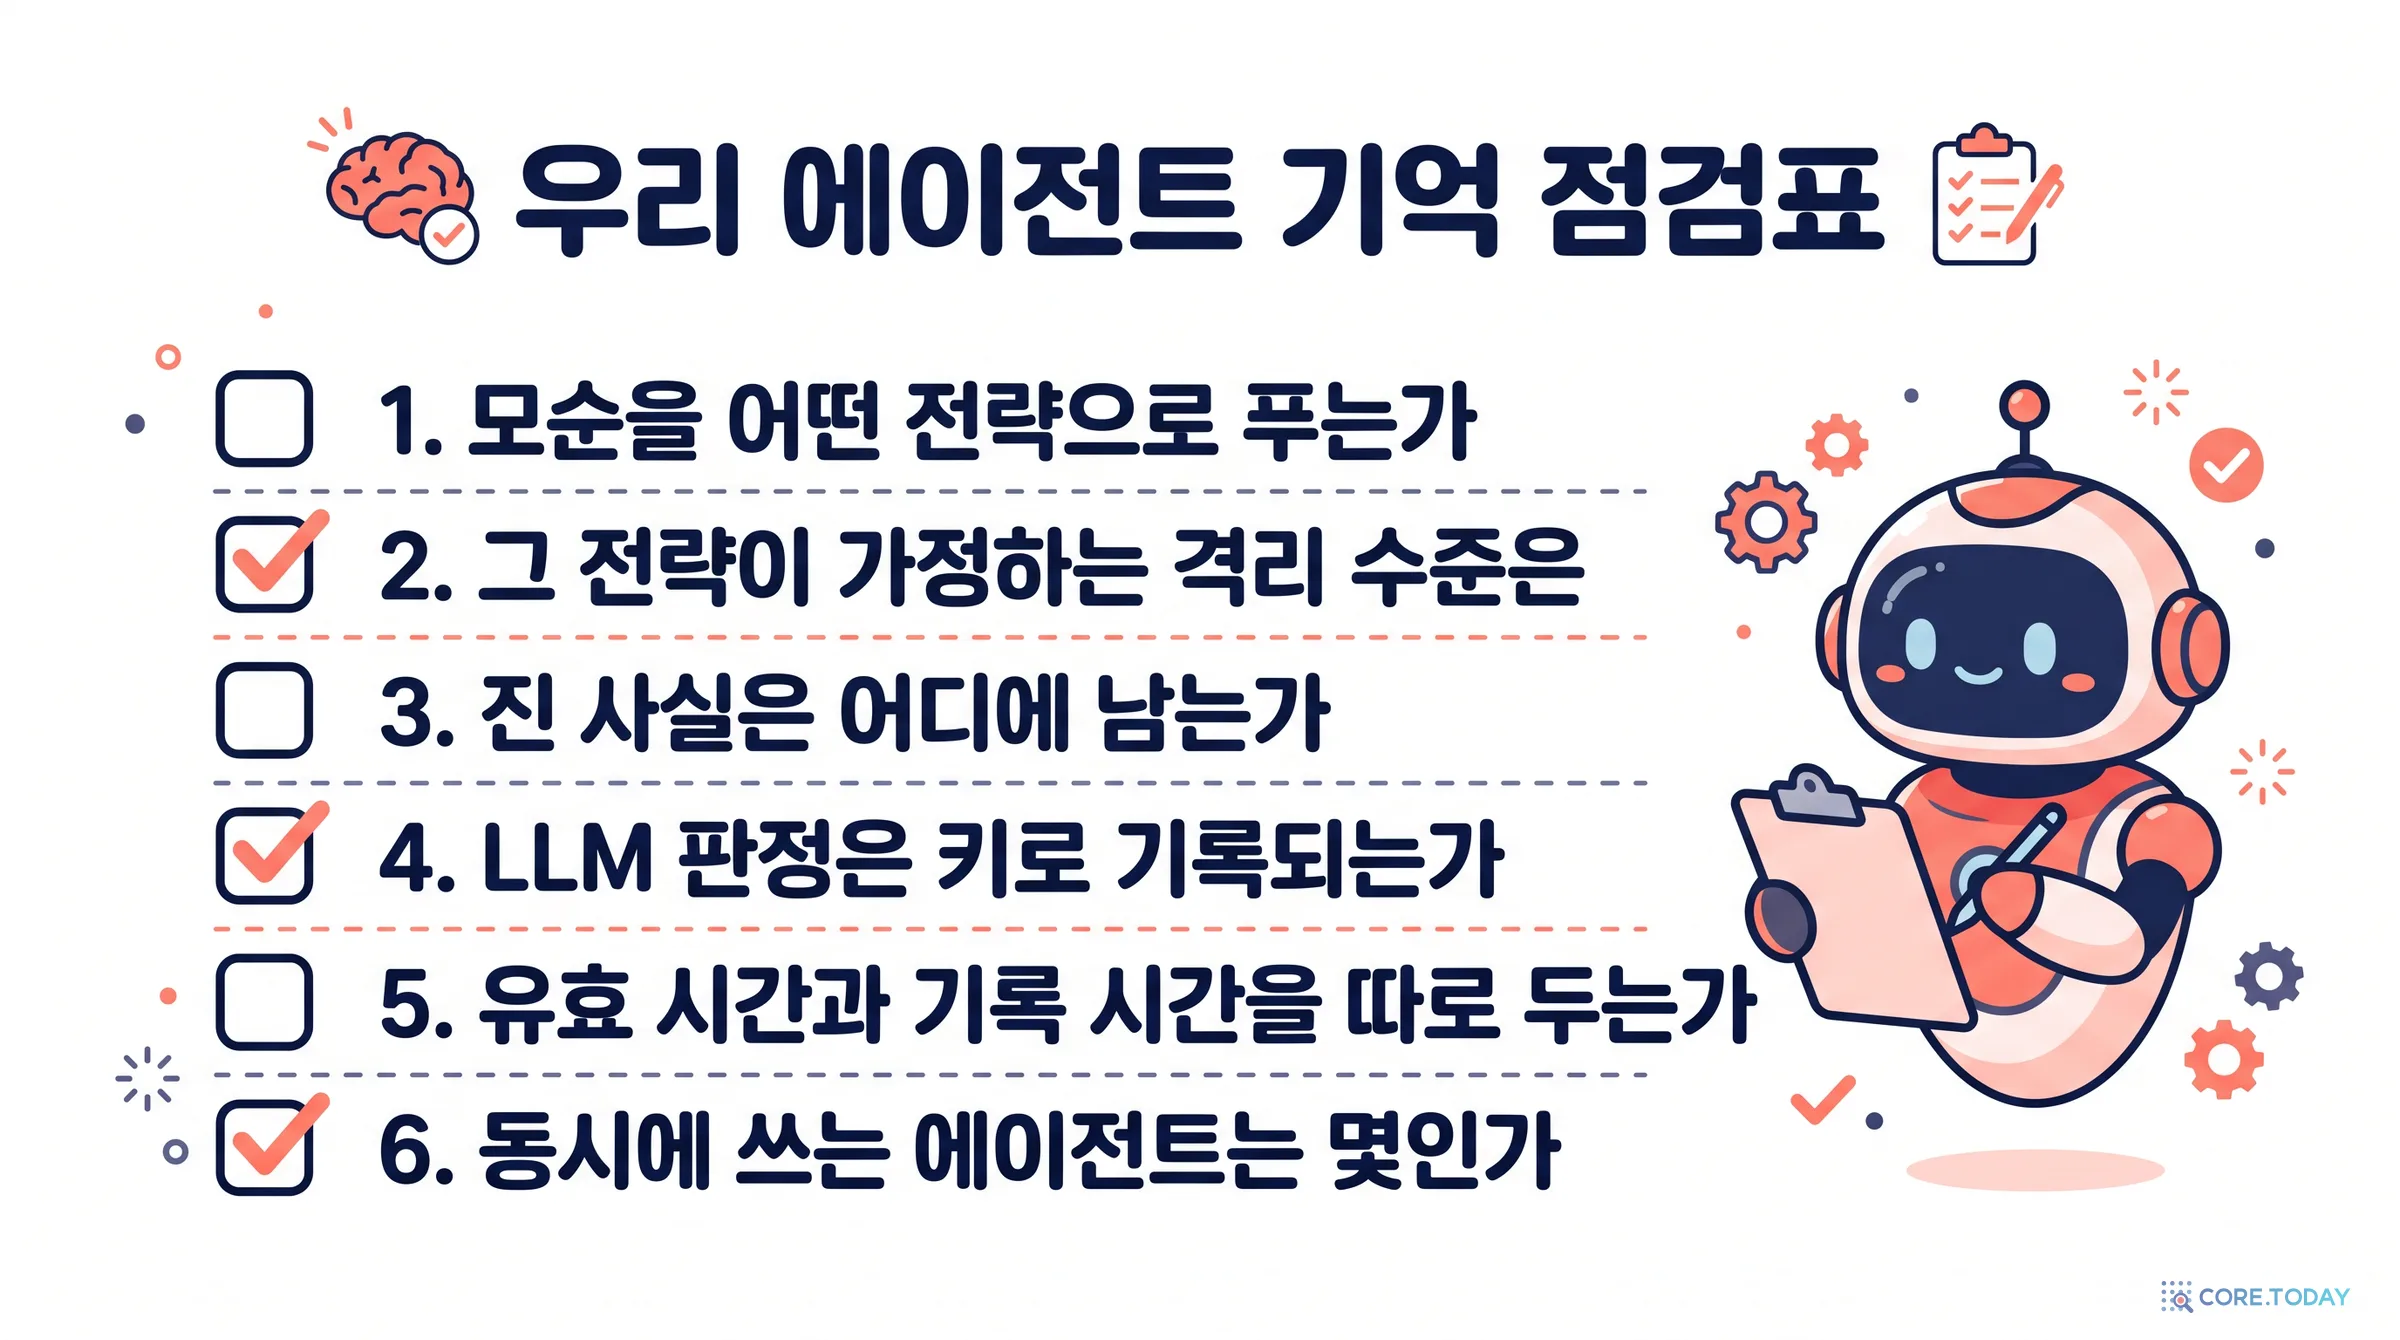
모순 해결 전략을 이름으로 적는다. 최신 우선인가, 증거 가중인가, 확인 대기인가, 규칙인가. 섞어 쓴다면 어떤 술어(주소, 담당자, 약, 설정값)에 어떤 전략을 쓰는지 표로 둔다.
그 전략이 가정하는 격리 수준을 적고, 저장소가 실제로 그것을 주는지 확인한다. 증거 가중을 쓰면서 분할을 직렬화하지 않으면 믿음 표류가 열려 있다. 벡터 저장소처럼 트랜잭션이 없는 저장소라면 키별 잠금이나 조건부 쓰기(비교 후 교체)로 최소한 같은 키의 쓰기를 직렬화한다.
모순 해결의 읽기와 쓰기를 한 트랜잭션에 넣는다. "읽고 → LLM 부르고 → 쓰기"가 따로 놀면 RC보다도 약하다. 쓰기 때 '영향받은 행 수'를 확인하고, 0이면 다시 읽는다(9-1절의 이중 대체).
진 사실은 지우지 말고 은퇴시킨다. 현재 조각과 감사 조각을 나누고, 감사 행에 대체한 사실의 id, 전략, 시각, 근거(출처)를 남긴다. 기본 검색은 현재 조각만 본다.
LLM 판정은 키로 기록한다. 키에는 판정 대상 사실들의 id 집합(순서 무관), 모델 버전, 프롬프트 버전, 온도, 시드를 넣는다. 프롬프트에 사실을 넣는 순서도 정규화한다. 재시작·재생 때는 판정자를 다시 부르지 않고 로그를 읽는다. 다시 판정할 조건(새 근거, 모델 교체, 사람의 이의)은 따로 정한다.
유효 시간과 기록 시간을 따로 둔다. 그리고 새 사실이 '변경'인지 '정정'인지를 구분해, 변경이면 유효 시간을 자르고 정정이면 대체한다.
출처는 최소한 '어떤 출처들이'(다중선형) 수준으로 남긴다. 오염된 출처를 철회해야 하는 날을 대비해서다. 같은 근거가 여러 번 쓰이는 시스템이라면 '몇 번'까지(다중차수) 남긴다.
동시에 쓰는 주체의 수를 센다. 사람 한 명과 비서 하나라면 최신 우선으로 충분할 수 있다. 하위 에이전트·정리 에이전트·여러 채널이 같은 기억을 쓴다면, 위 항목들은 선택이 아니다.
마무리: 새 문제처럼 보이는 오래된 문제
TOKI가 남기는 가장 큰 통찰은 정리 하나가 아니라 관점의 이동입니다. 에이전트 기억의 모순은 "LLM이 더 똑똑해지면 풀릴 문제"처럼 보입니다. 더 좋은 판정자, 더 긴 문맥, 더 정교한 프롬프트. 그러나 판정자가 아무리 똑똑해도, 두 에이전트가 같은 순간에 서로 다른 행을 고치면 기억은 앨리스의 약을 잊습니다. 판정자가 아무리 정확해도, 다시 물을 때마다 조금씩 흔들리면 기억은 일관되지 않습니다. 판정이 아무리 옳아도, 진 쪽을 지우면 왜 그렇게 판단했는지 설명할 수 없습니다. 이것들은 지능의 문제가 아니라 쓰기의 문제이고, 쓰기의 문제에는 50년 된 답이 있습니다.
논문 자체는 거칠고, 지금은 재현도 할 수 없으며, 판정표의 일부 칸은 현재 코드와 맞지 않습니다. 정확도에서 다른 시스템을 이긴다는 주장도 하지 않습니다. 그래도 이 논문이 내놓은 계약의 언어 — 이 전략은 이 격리 수준을 가정하고, 이 이상을 감수하며, 진 쪽을 여기 남긴다 — 는 앞으로 에이전트 기억을 만들고 고르는 모든 사람이 써먹을 수 있는 도구입니다. 기억 엔진의 문서에 "우리는 RC를 가정하고 갱신 손실을 감수한다"는 한 줄이 들어가는 날, 에이전트 기억은 데이터베이스가 걸어온 길을 한 단계 따라잡게 될 것입니다.
참고 자료
논문 본체
Ziming Wang, "TOKI: A Bitemporal Operator Algebra for Contradiction Resolution in LLM-Agent Persistent Memory", arXiv 2606.06240v1, 2026-06-04. https://arxiv.org/abs/2606.06240 (본문의 그림 1·2·4·5·6은 이 논문에서 인용)
이중 시간
R. Snodgrass, I. Ahn, "A Taxonomy of Time in Databases", SIGMOD 1985.
R. Snodgrass (ed.), The TSQL2 Temporal Query Language, Kluwer, 1995.
R. Snodgrass, Developing Time-Oriented Database Applications in SQL, Morgan Kaufmann, 2000.
K. Kulkarni, J.-E. Michels, "Temporal Features in SQL:2011", SIGMOD Record 41(3), 2012.
J. F. Allen, "Maintaining Knowledge about Temporal Intervals", CACM 26(11), 1983.
격리 수준과 동시성
J. Gray, R. Lorie, G. Putzolu, I. Traiger, "Granularity of Locks and Degrees of Consistency in a Shared Data Base", 1976.
H. Berenson, P. Bernstein, J. Gray, J. Melton, E. O'Neil, P. O'Neil, "A Critique of ANSI SQL Isolation Levels", SIGMOD 1995.
A. Adya, "Weak Consistency: A Generalized Theory and Optimistic Implementations for Distributed Transactions", MIT PhD thesis, 1999.
M. Cahill, U. Röhm, A. Fekete, "Serializable Isolation for Snapshot Databases", SIGMOD 2008.
D. Ports, K. Grittner, "Serializable Snapshot Isolation in PostgreSQL", PVLDB 5(12), 2012.
T. Warszawski, P. Bailis, "ACIDRain: Concurrency-Related Attacks on Database-Backed Web Applications", SIGMOD 2017.