에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.
코어닷투데이2026-10-0757분
들어가며 — 기억이 쏟아지는 해
2026년의 AI 비서들은 더 이상 "매일 아침 기억이 리셋되는 신입사원"이 아니다. ChatGPT는 지난 대화를 참조하고, Claude는 프로젝트별 기억을 쌓으며, Microsoft 365 Copilot은 "Copilot Memory"라는 이름으로 사용자의 선호를 기억한다. OpenAI Agents SDK 쿡북에는 "장기 기억 노트로 상태 관리하기"가 정식 예제로 올라왔고, Google의 Agent Development Kit은 아예 Memory를 1급 모듈로 둔다.
개발자 쪽은 더 요란하다. Mem0, Zep, Letta, MemOS, MemoryOS, A-MEM, LightMem, SimpleMem, Cognee, MemTree, MemoChat, MemAgent, MEM1… 2023년 말 MemGPT가 "LLM을 운영체제처럼 다루자"고 제안한 뒤 3년 만에, 에이전트에게 기억을 달아 주겠다는 라이브러리가 수십 개로 불어났다. 각자 "LoCoMo에서 X% 향상", "토큰 90% 절감"을 외치는데, 숫자를 나란히 놓고 보면 이상한 점이 하나 있다. 같은 벤치마크에서 서로 다른 시스템이 전부 1등이다. 백본 모델이 다르고, 평가 코드가 다르고, 데이터셋 버전이 다르기 때문이다.
이 특집이 다루는 논문은 바로 이 혼란에 자를 들이댄다. 상하이교통대학교 Wei Zhou·Xuanhe Zhou 팀과 칭화대 Guoliang Li, MemOS를 만든 MemTensor가 함께 쓴 "Are We Ready For An Agent-Native Memory System?"(arXiv:2606.24775, 2026년 6월)이다. 제목부터 도발적이다. "에이전트 네이티브 메모리 시스템, 우리는 준비됐나?" 결론을 미리 말하면 아직 아니다. 하지만 왜 아닌지를 이렇게 체계적으로 보여 준 연구는 처음이다.
?
문제
기존 평가는 F1·BLEU 같은 최종 점수만 보고 메모리 시스템을 '블랙박스'로 취급했다. 비용, 모듈 간 트레이드오프, 사실이 바뀔 때의 견고성은 측정조차 안 됐다.
!
접근
메모리를 데이터 관리 시스템으로 보고 네 모듈(표현·저장 / 추출 / 검색·라우팅 / 유지보수)로 분해. 12개 시스템 + 2개 기준선을 5개 워크로드·11개 데이터셋에서 같은 러너로 돌리고, 한 모듈씩 바꾸는 통제 실험까지 수행.
→
발견
만능 구조는 없다. 효과는 "기억 구조가 워크로드의 병목과 맞느냐"로 결정된다. 추상화는 층마다 정보를 버리고, 국소 유지보수가 전역 재구성보다 싸며, 더 큰 LLM은 잘못된 기억을 고쳐 주지 못한다.
이 글은 논문을 순서대로 옮기지 않는다. 먼저 왜 "기억"이라는 개념이 필요해졌는지부터 역사로 짚고, 논문이 제안한 해부도를 익힌 뒤, 다섯 가지 연구 질문의 실험 결과를 인터랙티브 위젯으로 직접 만져 보고, 마지막으로 2026년 현장에서 어떤 기억 구조를 골라야 하는지까지 간다. 우리 블로그의 앞선 글들 — AI는 어떻게 기억하는가, Zep 논문 해부, Cognee 완전 가이드, Context Rot와 컨텍스트 엔지니어링 — 이 각각 한 시스템이나 한 개념을 다뤘다면, 이번 특집은 그 전부를 한 저울에 올린 결산이다.
1. 기억이 데이터베이스가 되기까지 — 짧은 역사
1.1 컨텍스트 창이라는 칠판 (2020~2022)
GPT-3가 나왔을 때 LLM의 "기억"은 컨텍스트 창 하나였다. 2,048토큰짜리 칠판. 대화가 길어지면 앞부분을 지우고, 다음 세션이 열리면 칠판은 깨끗하다. 모델의 가중치에 세상 지식은 들어 있지만 당신에 대한 지식은 어디에도 없다.
이 시절 해법은 소박했다. 지난 대화를 요약해 다음 프롬프트 앞에 붙이기(요약 버퍼), 최근 N턴만 유지하기(슬라이딩 윈도), 둘을 섞기. LangChain 초기 버전의 ConversationSummaryBufferMemory 같은 이름이 이 시대의 유물이다. 기억은 프롬프트의 일부였지 시스템이 아니었다.
1.2 RAG, 읽기 전용 기억 (2020~2023)
2020년 Lewis 등이 제안한 RAG(Retrieval-Augmented Generation)는 바깥의 문서 더미에서 질문과 비슷한 조각을 찾아 프롬프트에 끼워 넣는다. 벡터 데이터베이스 붐이 뒤따랐고, 2023년에는 "RAG = 기업 AI의 표준 아키텍처"가 됐다.
그런데 RAG는 읽기 전용이다. 문서는 고정돼 있고, 질문마다 상태 없이 검색한다. 사용자가 "나 부산으로 이사했어"라고 말해도 RAG의 코퍼스는 바뀌지 않는다. 쓰기, 갱신, 삭제, 모순 해결 — 데이터베이스라면 당연한 기능이 RAG에는 없다. 논문은 이 차이를 2장에서 명시한다. "RAG는 상태 없는 읽기 전용 검색 프리미티브이고, 에이전트 메모리는 지속적이고 갱신 가능한 인프라로서 표현·저장·검색·유지보수의 전 생애주기를 다룬다."
1.3 "LLM을 운영체제처럼" — MemoryBank와 MemGPT (2023)
2023년에 두 갈래가 열렸다. 하나는 MemoryBank(Zhong 등, AAAI 2024)로, 경험을 타임스탬프 찍힌 스트림에 쌓고 주기적으로 LLM이 "반성(reflection)"을 써서 다시 스트림에 넣는다. 에빙하우스 망각 곡선까지 흉내 냈다. 다른 하나는 MemGPT(Packer 등, 2023년 10월)로, 운영체제의 가상 메모리에서 아이디어를 가져왔다. 컨텍스트 창은 RAM, 외부 저장소는 디스크. LLM이 스스로 core_memory_replace, archival_memory_search 같은 함수를 호출해 기억을 옮긴다. MemGPT는 뒤에 Letta라는 회사와 프레임워크가 됐다.
같은 해 MemoChat(Lu 등)은 대화를 주제별 JSON 메모로 접어 LLM이 주제를 골라 꺼내게 했다. 세 시스템 모두 "기억을 어떻게 구조화하고 누가 관리하는가"를 처음으로 설계 문제로 다뤘다.
1.4 폭발의 해 (2025)
2025년은 메모리 시스템의 캄브리아기였다.
1월
Zep — 시간 인식 지식 그래프(Graphiti). 사실에 valid_from / valid_to를 붙여 "언제 참이었나"를 저장. 자체 논문에서 LongMemEval 기준 전체 컨텍스트 주입 대비 정확도 최대 18.5% 향상, 응답 지연 90% 감소를 보고.
2월
A-MEM — 제텔카스텐(카드 상자) 방식. 새 노트가 들어오면 기존 노트와 링크를 걸고, 기존 노트의 설명을 '진화'시킨다.
4월
Mem0 — "프로덕션 준비된" 메모리. 대화에서 사실을 뽑아 벡터로 저장하고, 충돌하면 LLM 툴콜로 UPDATE/DELETE. 그래프 변종 Mem0ᵍ 동시 공개. LoCoMo에서 OpenAI 메모리 대비 26% 향상, 토큰 90% 절감 주장. 같은 달 ICLR에서 MemTree(잎은 원문, 조상은 요약인 동적 트리)가 발표됐다.
7월
MemOS — "기억 운영체제". 텍스트·활성화(KV 캐시)·파라미터 메모리를 MemCube라는 단일 객체로 묶는다. MemAgent — 고정 길이 메모를 RL로 덮어쓰는 정책 학습.
가을
MemoryOS(EMNLP) — OS 페이지 교체처럼 '열(heat)'이 식은 세그먼트 퇴출. LightMem(10월) — 엔트로피로 쓸모없는 토큰을 걸러 가볍게 쌓기.
2026년 1월
SimpleMem — 질의를 LLM이 먼저 계획하고 벡터·BM25·SQL을 함께 때리는 하이브리드. 그리고 6월, 이 모든 것을 한 저울에 올린 이번 논문.
문제는 이 폭발이 파편화를 낳았다는 점이다. 논문 서론은 네 가지 결함을 짚는다. ① MemoChat·MemTree·LightMem 같은 대표 시스템이 기존 평가에 아예 빠져 있었다. ② 평가는 F1·BLEU 같은 최종 점수 하나에 의존해, 근거를 제대로 찾았는지·바뀐 사실에 견디는지·세션이 쌓여도 버티는지를 따로 재지 않았다. ③ 인덱스 구축 시간, 질의 지연 같은 운영 비용을 거의 측정하지 않았다. ④ 시스템을 통째로 비교해, 어느 부품이 성적을 만드는지 알 수 없었다.
2. 기억은 RAG도, 컨텍스트 엔지니어링도, 전통 DB도 아니다
논문 2장은 짧지만 개념 정리의 핵심이다. 세 가지 이웃 개념과 선을 긋는다.
구분
RAG
컨텍스트 엔지니어링
전통 데이터베이스
에이전트 메모리 시스템
상태
없음(읽기 전용)
매 턴 재구성
지속
지속 + 에이전트 전용
쓰기·갱신
코퍼스 고정
창 안만 다룸
스키마 기반 덮어쓰기
불확실·부분·모순된 관찰을 시간에 걸쳐 흡수
질의 방식
의미 유사도
프롬프트 선택
정확한 술어(WHERE)
자연어·부분 맥락·잠재 의도 → 근사 매칭 + LLM 유도
생애주기
없음
없음
트랜잭션
표현 → 저장 → 검색 → 통합·망각
접근 패턴
단일
단일
OLTP / OLAP
장문 합성·일화 회상·사실 조회·시간 추론·스트리밍 갱신이 한 워크로드에 섞임
세 번째 줄을 눈여겨보자. 전통 DB의 질의는 WHERE city = '부산'처럼 술어다. 에이전트의 질의는 "내가 요즘 사는 데 근처 맛집"처럼 의도다. '요즘'은 시간 조건이고, '사는 데'는 엔티티 조회이며, '근처'는 공간 추론이다. 하나의 자연어 문장이 세 종류의 데이터베이스 연산을 요구한다. 그래서 논문은 "실용 시스템은 의미 검색, 구조 필터링, 토폴로지 순회를 한 아키텍처 안에서 섞는 하이브리드 실행이 필요하다"고 쓴다. 이 문장이 뒤의 모든 실험 결과를 예고한다.
논문은 기억의 종류도 정리한다. 시간 축으로는 세션 안의 단기 기억과 세션을 넘는 장기 기억, 기능 축으로는 구체적 사건(일화), 추상화된 사실(의미), 재사용 가능한 행동 전략(절차), 그리고 사용자 선호. 앞선 글에서 인지과학의 네 기억을 다뤘으니 여기선 넘어간다. 중요한 건 다음 정의다.
에이전트 메모리 시스템 = ⟨ℛ, 𝒮, 𝒬, 𝒰⟩. 표현·저장(ℛ), 추출(𝒮), 검색·라우팅(𝒬), 유지보수(𝒰) 네 모듈의 튜플이며, 각 모듈이 기억 생애주기의 한 단계를 담당한다.
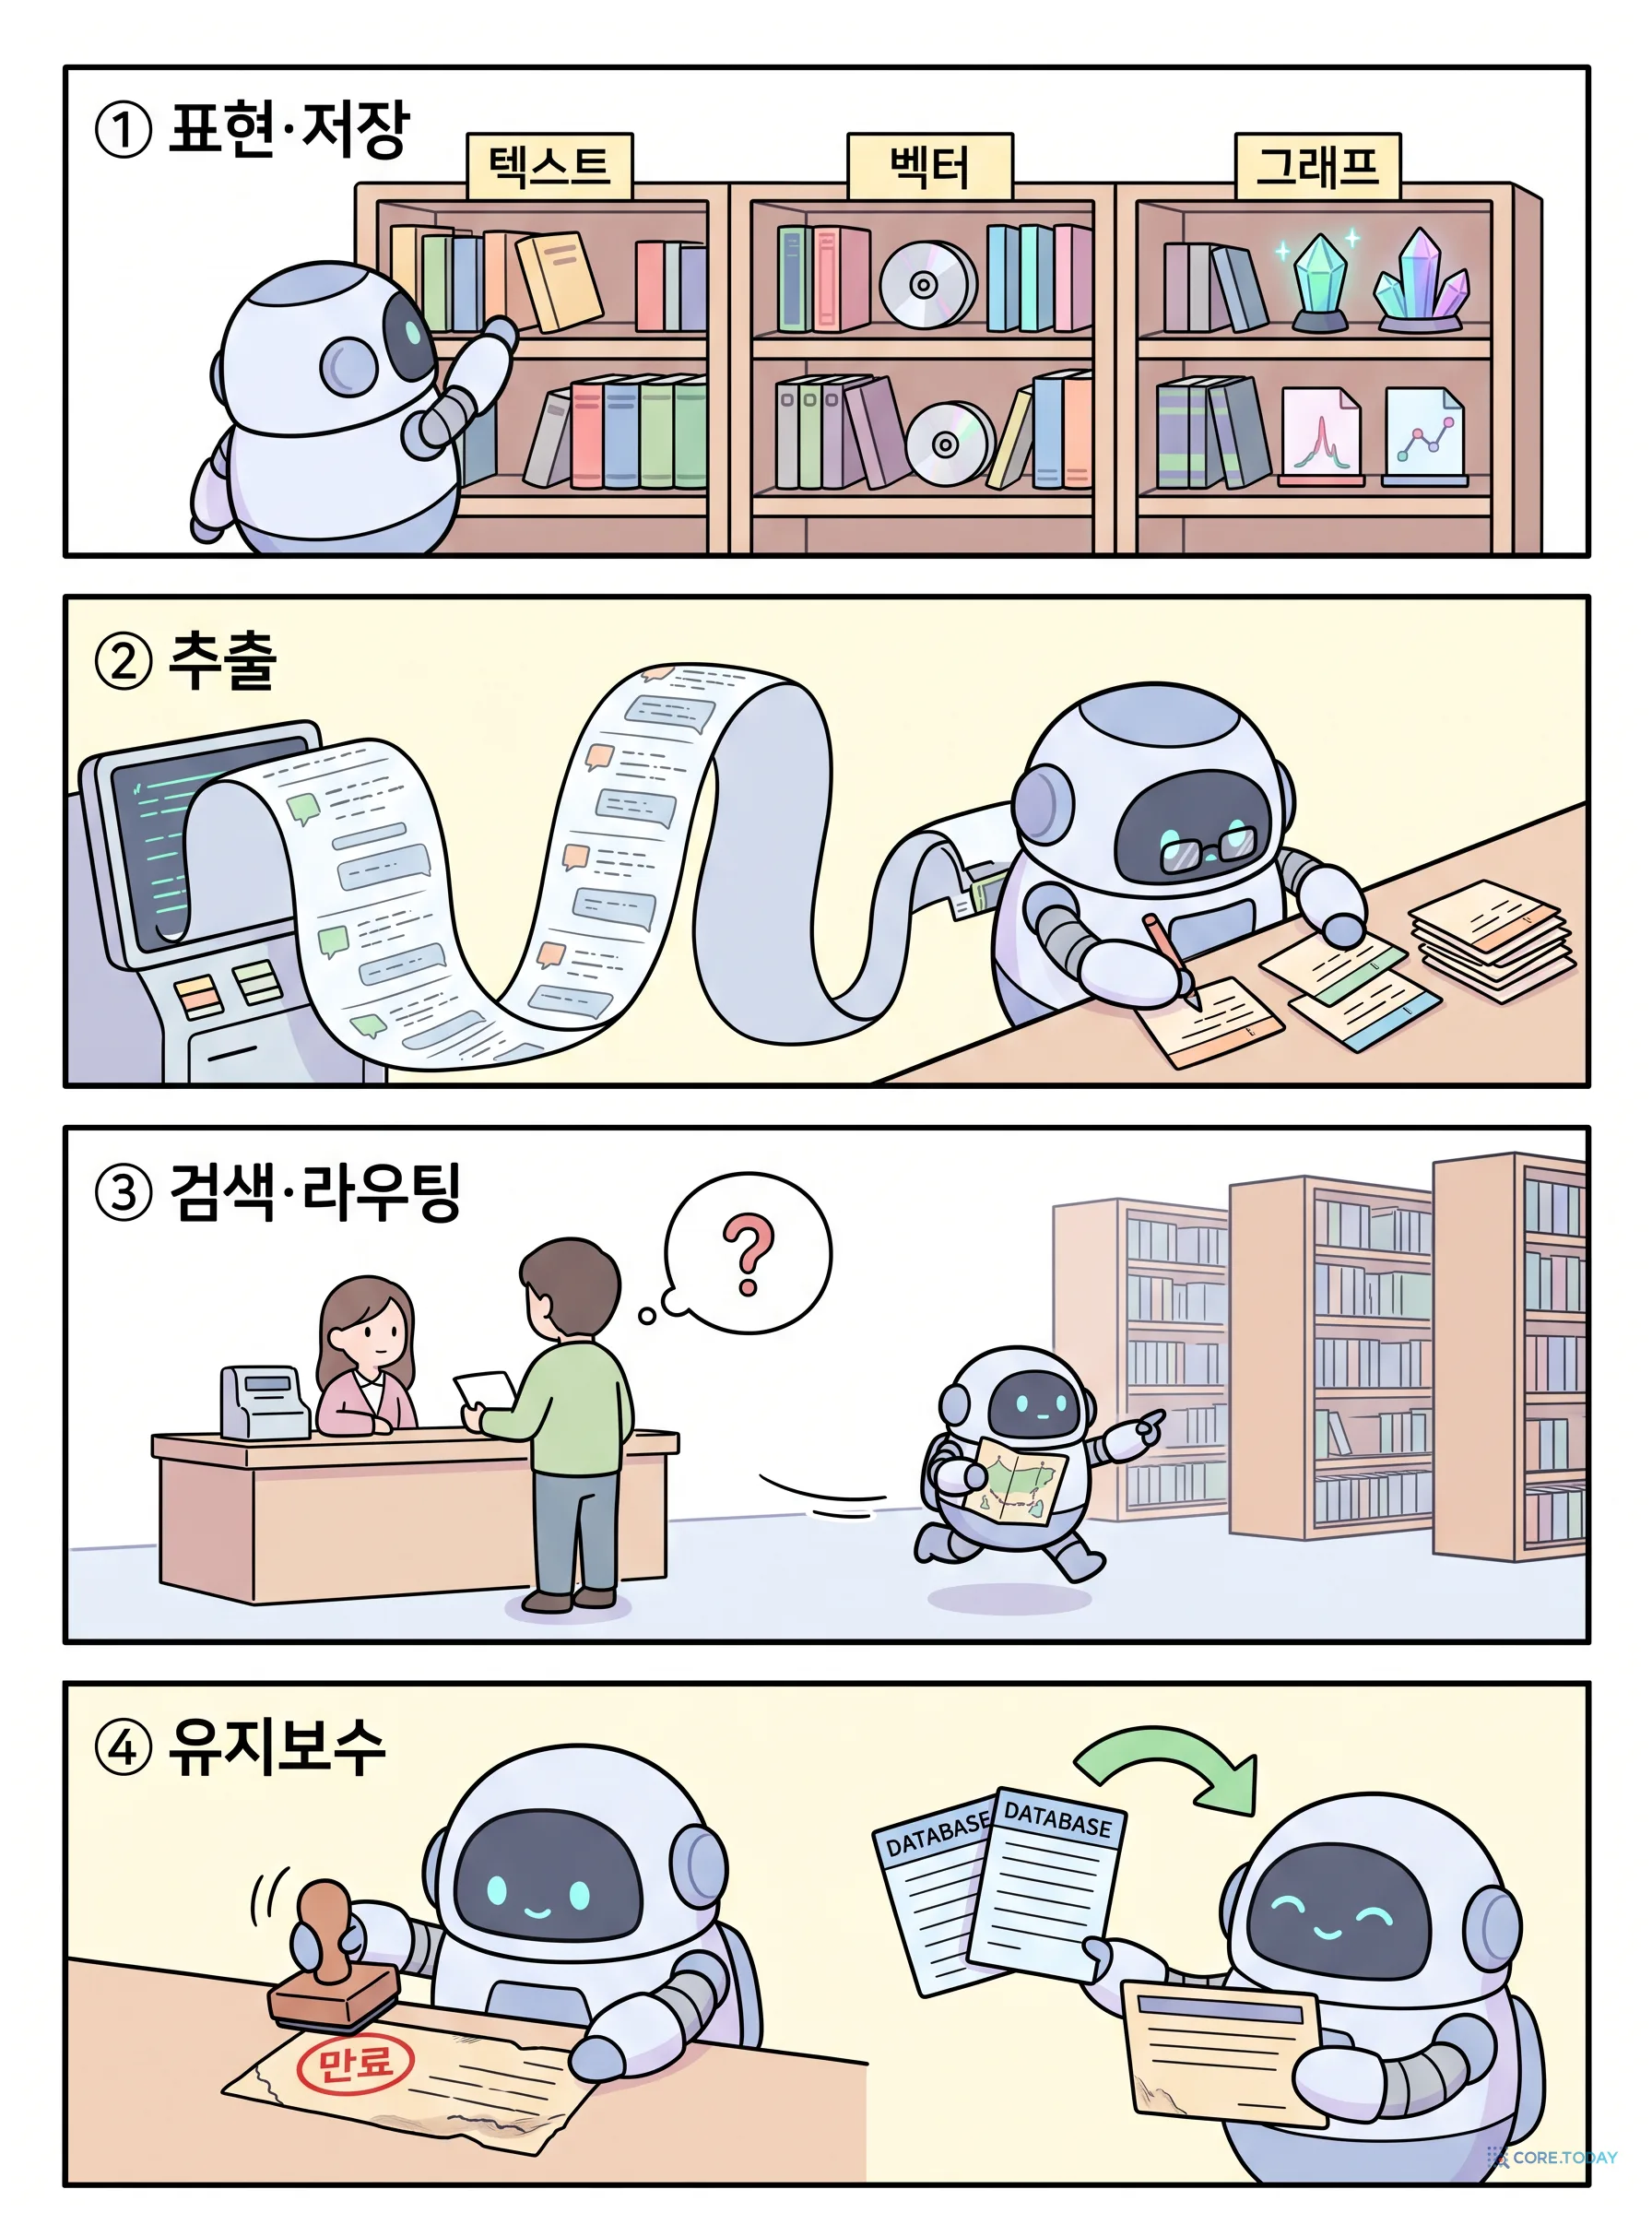
도서관에 비유하면 명확하다. 표현·저장은 책의 형태(원문 두루마리인가, 색인 카드인가, 관계도인가)와 서고의 종류다. 추출은 사서가 긴 대화를 읽고 카드를 쓰는 일이다. 검색·라우팅은 안내 데스크에서 어느 서고를 어떤 순서로 뒤질지 정하는 일이고, 유지보수는 낡은 카드에 만료 도장을 찍고 중복 카드를 합치는 일이다.
논문 3장은 이 네 모듈 각각에 대해 기존 시스템이 택한 방식을 분류했다(논문 Table 1). 아래 위젯에서 모듈을 눌러 선택지와 장단점을 보고, 실제 시스템을 골라 네 모듈이 어떤 조합인지 확인해 보자.
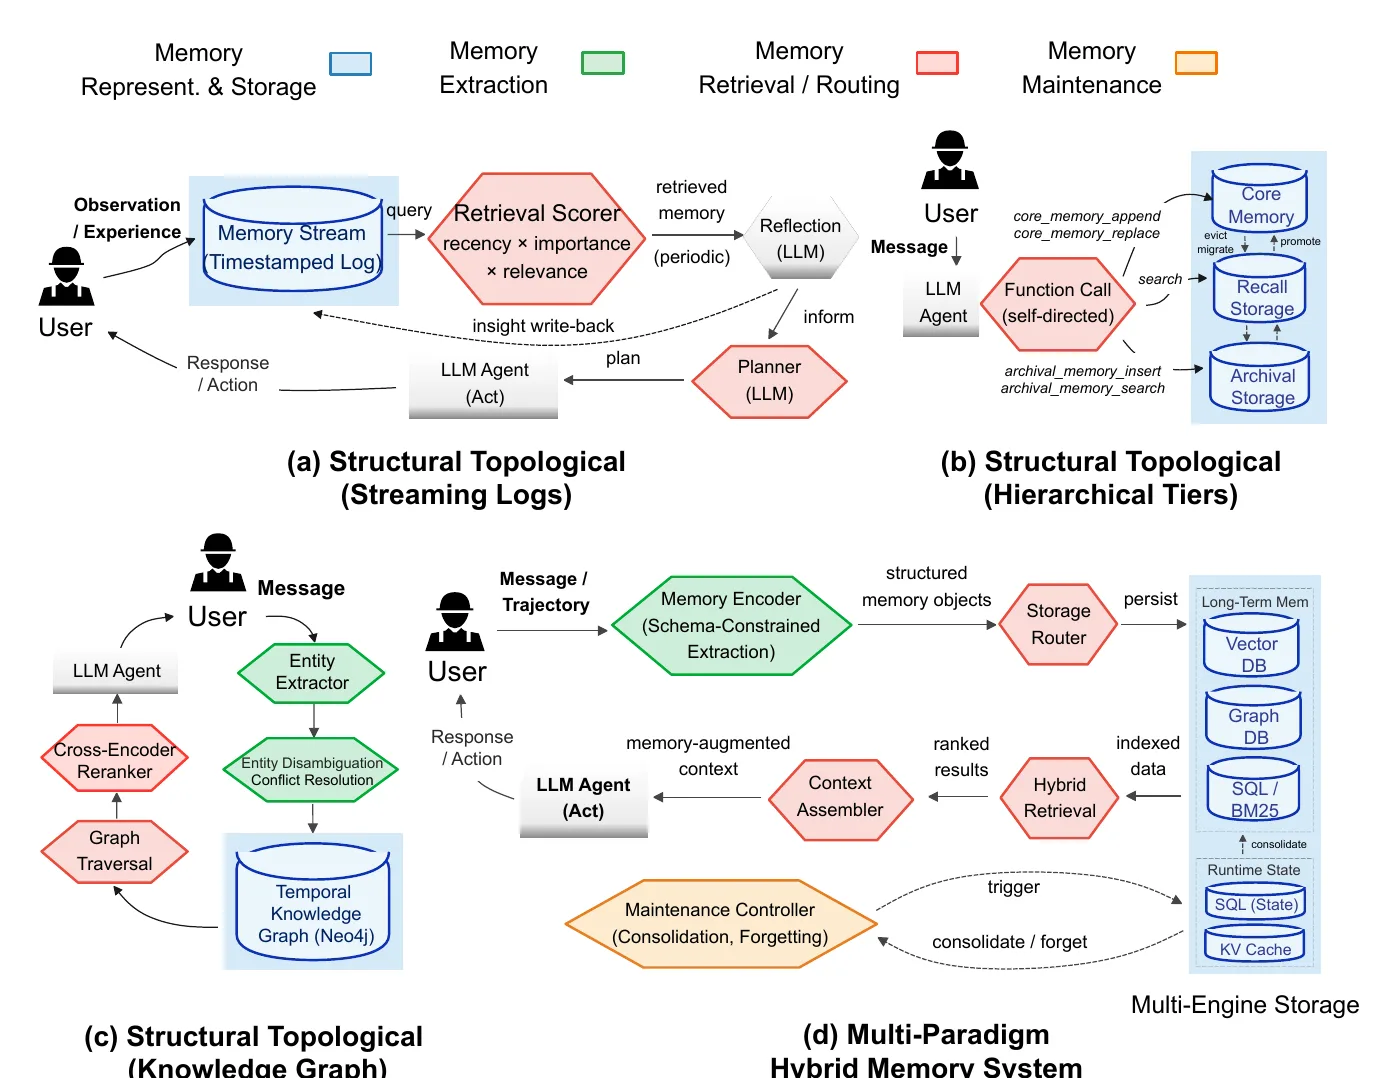
논문 Figure 1. (a) 스트리밍 로그형(MemoryBank), (b) 계층 티어형(MemGPT), (c) 지식 그래프형(Zep·Mem0ᵍ), (d) 다중 패러다임 하이브리드(A-MEM 등). 색은 네 모듈을 뜻한다 — 파랑: 표현·저장, 초록: 추출, 빨강: 검색·라우팅, 주황: 유지보수. 출처: Zhou et al., arXiv:2606.24775.
몇 가지만 짚어 둔다.
표현에는 세 층위가 있다. 평평한 토큰 시퀀스(사람이 읽는 사실 문장이든 벡터든), 그래프·트리 토폴로지, 그리고 원문+타임스탬프+라벨+임베딩+링크를 한 객체에 담는 복합 컨테이너. 아래로 갈수록 표현력이 커지지만 만들고 고치는 비용도 커진다.
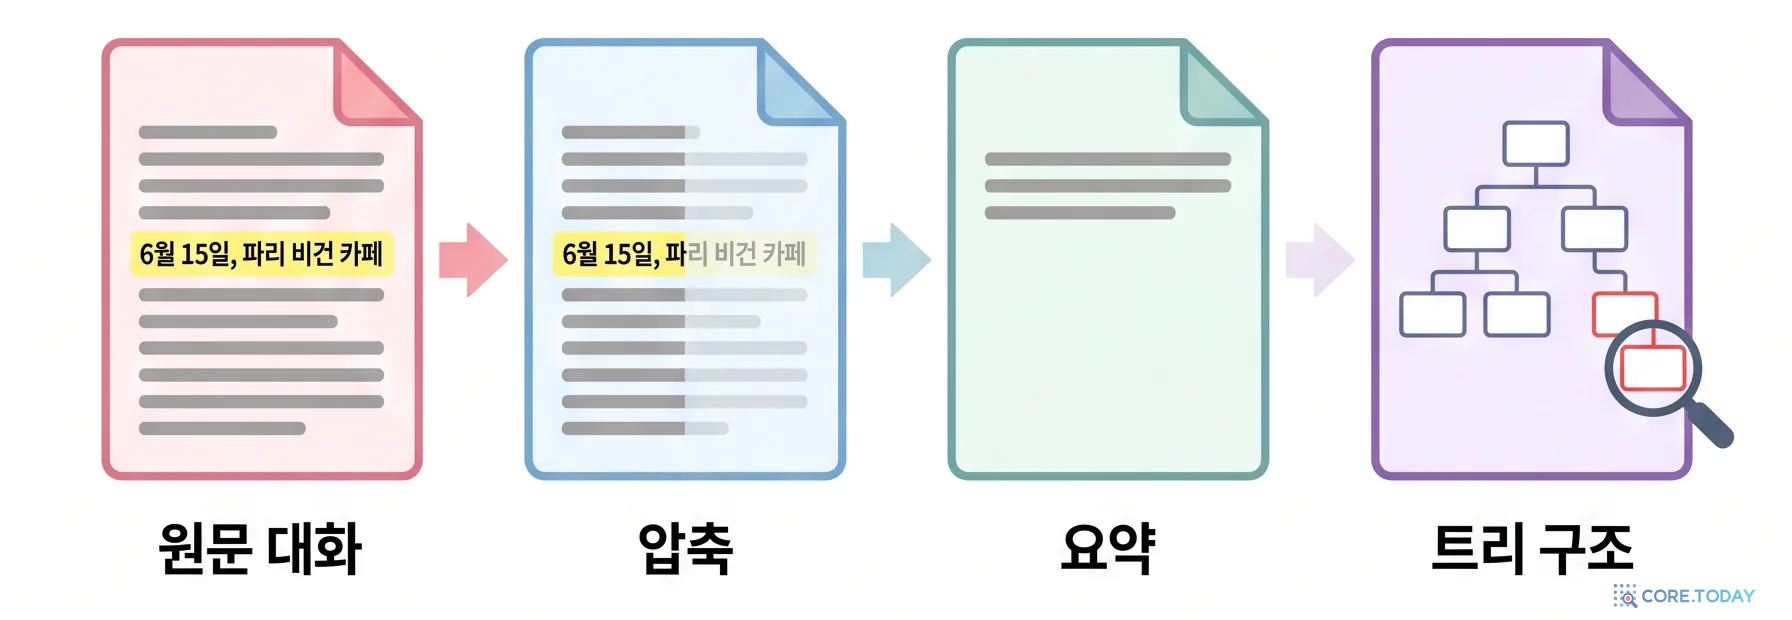
추출은 "얼마나 버릴 것인가"의 선택이다. 원문을 그대로 두면 아무것도 안 버리지만 길이 한도에 걸린다. 스키마 없이 사실만 뽑으면 검색 단위는 작아지지만 뽑히지 않은 세부는 영영 사라진다. 스키마에 맞춰 뽑으면 시간·관계 질의가 가능해지지만 틀 밖의 정보는 왜곡된다. 이 선택이 5장에서 가장 극적인 숫자를 만든다.
검색은 다섯 갈래다. 어텐션(외부 DB 없음), 벡터 KNN, 그래프 순회, LLM이 직접 계획·함수 호출하는 에이전트 라우팅, 그리고 여러 엔진을 순차·병렬로 섞는 하이브리드. Zep은 코사인 검색·BM25·BFS를 동시에 돌려 RRF와 크로스인코더로 재정렬하고, MemoryOS는 Boolean 필터로 먼저 좁힌 뒤 의미 검색을 한다.
유지보수는 네 가지다. 지우지 않고 유효 기간을 찍는 다중 버전(Zep, Cognee, MemOS), FIFO나 '열(heat)' 점수로 물리적으로 지우는 용량 기반 퇴출(MemAgent, Letta, MemoryOS), LLM이 합치거나 CRUD를 내리는 의미 통합(Mem0, MemTree, SimpleMem, A-MEM), 그리고 모델 가중치를 백그라운드에서 갱신하는 파라미터 최적화(MemoRAG). 이 중 무엇을 기본값으로 둘 것인가가 5장의 마지막 질문이다.
4. 실험실 — 같은 저울, 같은 러너
평가의 공정성이 이 논문의 존재 이유이므로 설정을 꼼꼼히 보자.
워크로드
무엇을 재나
지표
쓰인 연구 질문
LoCoMo
아주 긴 다중 턴 대화(수십 세션)에서 일화·시간·개방형·단일 홉 질문. 질문마다 '근거 발화'가 표시돼 있어 검색 자체를 채점할 수 있다
EM, Answer F1, Recall@K
RQ1·2·3·4·5, 5장 전부
LongMemEval
여러 세션에 흩어진 개인 사실을 다시 잇고, 바뀐 사실(Knowledge Update)과 시간 순서(Temporal Reasoning)를 추론. MemoryAgentBench 판본
LifelongAgentBench의 데이터베이스 조작 과제. 앞선 UPDATE·INSERT 결과를 기억해야 다음 명령이 맞는다
EM, 작업 성공률(최종 테이블 상태)
RQ1
LongBench
짧음·중간·긺 세 구간의 긴 문서 QA. 입력 길이에 따른 견고성
정확도
RQ4·5
MemBench
단순 회상·잡음·지식 갱신·고수준 추론·다중 세션 추천 슬라이스
—
테스트베드 포함(본문 그림에는 미등장)
대상은 12개 메모리 시스템(MemoChat, Mem0, MemAgent, MemTree, Zep, Cognee, LightMem, SimpleMem, MemOS, MemoryOS, A-MEM, Letta)과 두 기준선(Long Context = 대화 전체를 프롬프트에 넣기, Embedding RAG = 청크를 임베딩해 유사한 것만 넣기)이다. 백본 LLM은 시스템 간에 통일했다. 논문 본문은 주 실험의 백본 이름을 따로 적지 않지만, Figure 7의 수치가 백본 비교 실험(Figure 9)의 Qwen3-8B 막대와 일치하므로 주 실험은 Qwen3-8B로 돌린 것으로 보인다(견고성 실험에서는 DeepSeek-Chat·GPT-5.4-mini·GPT-5.4까지 4종). 그리고 같은 러너가 구축 시간과 질의 시간을 함께 기록해 비용을 비교할 수 있게 했다.
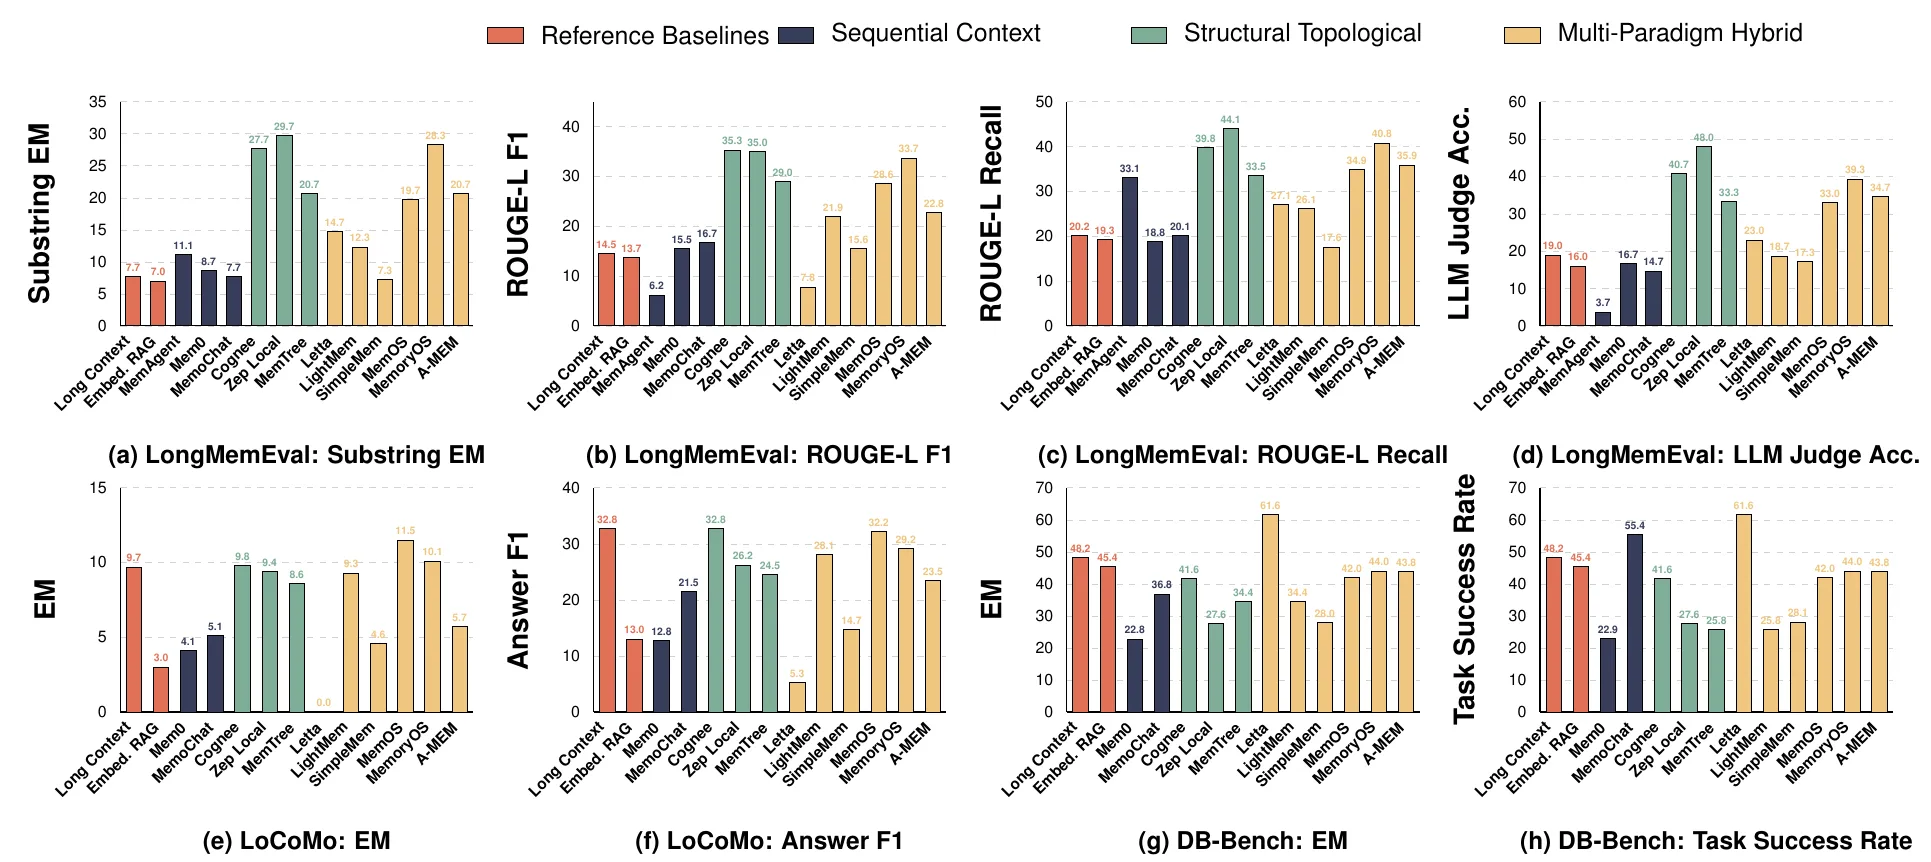
공개 테스트베드 OpenDataBox/MemoryData의 README에 실린 주요 결과 요약. 네 패러다임(기준선·순차 컨텍스트·구조적 토폴로지·다중 패러다임 하이브리드)으로 색을 나눴다. 출처: github.com/OpenDataBox/MemoryData.
테스트베드는 공개돼 있다. main.py 하나에 메서드 YAML과 데이터셋 YAML을 넘기면 22개 프리셋(논문의 12개 외에 GraphRAG, HippoRAG, RAPTOR, EverOS, Self-RAG, MemoRAG, BM25 RAG 등 포함)을 4개 벤치마크 패밀리에서 돌릴 수 있다. 결과는 results/outputs/<모델>/<데이터셋>/…_results.json으로 떨어진다. 자기 워크로드를 넣어 보고 싶은 팀에게 이 저장소 자체가 논문의 가장 실용적인 산출물일 수 있다.
다섯 가지 연구 질문(RQ)은 이렇다.
RQ1 효과 — 메모리가 워크로드별로 실제로 성적을 올리나?
RQ2 검색 충실도 — 답에 필요한 근거를 얼마나 정확히 꺼내 오나?
RQ3 갱신 견고성 — 사실이 바뀐 뒤에도 맞게 답하나? 백본을 바꿔도 그대로인가?
RQ4 장기 안정성 — 컨텍스트가 길어지고 근거가 멀어져도 버티나?
RQ5 운영 비용 — 그 성적에 몇 초, 얼마를 내야 하나?
5. RQ1 — 만능 챔피언은 없다
첫 번째 결과이자 논문의 제목에 가장 가까운 답이다. 아래 위젯에서 벤치마크와 지표를 바꿔 보라. 1위가 계속 바뀐다.
세 워크로드의 챔피언이 전부 다르다.
LongMemEval(여러 세션에 흩어진 사실 잇기)에서는 구조를 가진 시스템이 이긴다. Zep이 LLM Judge 정확도 48.0, Cognee가 ROUGE-L F1 35.3. 벡터만 쓰는 Mem0(16.7)나 Long Context(19.0)는 절반 이하다.
LoCoMo(긴 대화에서 정확한 세부 짚기)에서는 하이브리드 단계적 필터가 이긴다. MemOS가 EM 11.5로 1위. 그런데 Answer F1에서는 Long Context와 Cognee가 32.8로 공동 1위다.
DB-Bench(연쇄된 데이터베이스 조작)에서는 원문 흔적을 보존하는 쪽이 이긴다. Long Context EM 48.2, MemoChat 작업 성공률 55.4, 그리고 LoCoMo에서 0점에 가까웠던 Letta가 61.6으로 1위다.
Letta의 사례가 특히 재미있다. LoCoMo EM 0.0, Answer F1 5.3으로 꼴찌인 시스템이 DB-Bench에서는 최고다. 이유는 설계에 있다. Letta(MemGPT)는 LLM이 스스로 함수를 호출해 기억을 옮기는 절차적 시스템이다. "앞서 어떤 명령을 실행했는가"처럼 중간 상태와 실행 순서가 중요한 과제에서는 이 구조가 빛나지만, 대화 속 날짜 하나를 정확히 찾는 과제에서는 요약·이동 과정에서 세부가 유실된다.
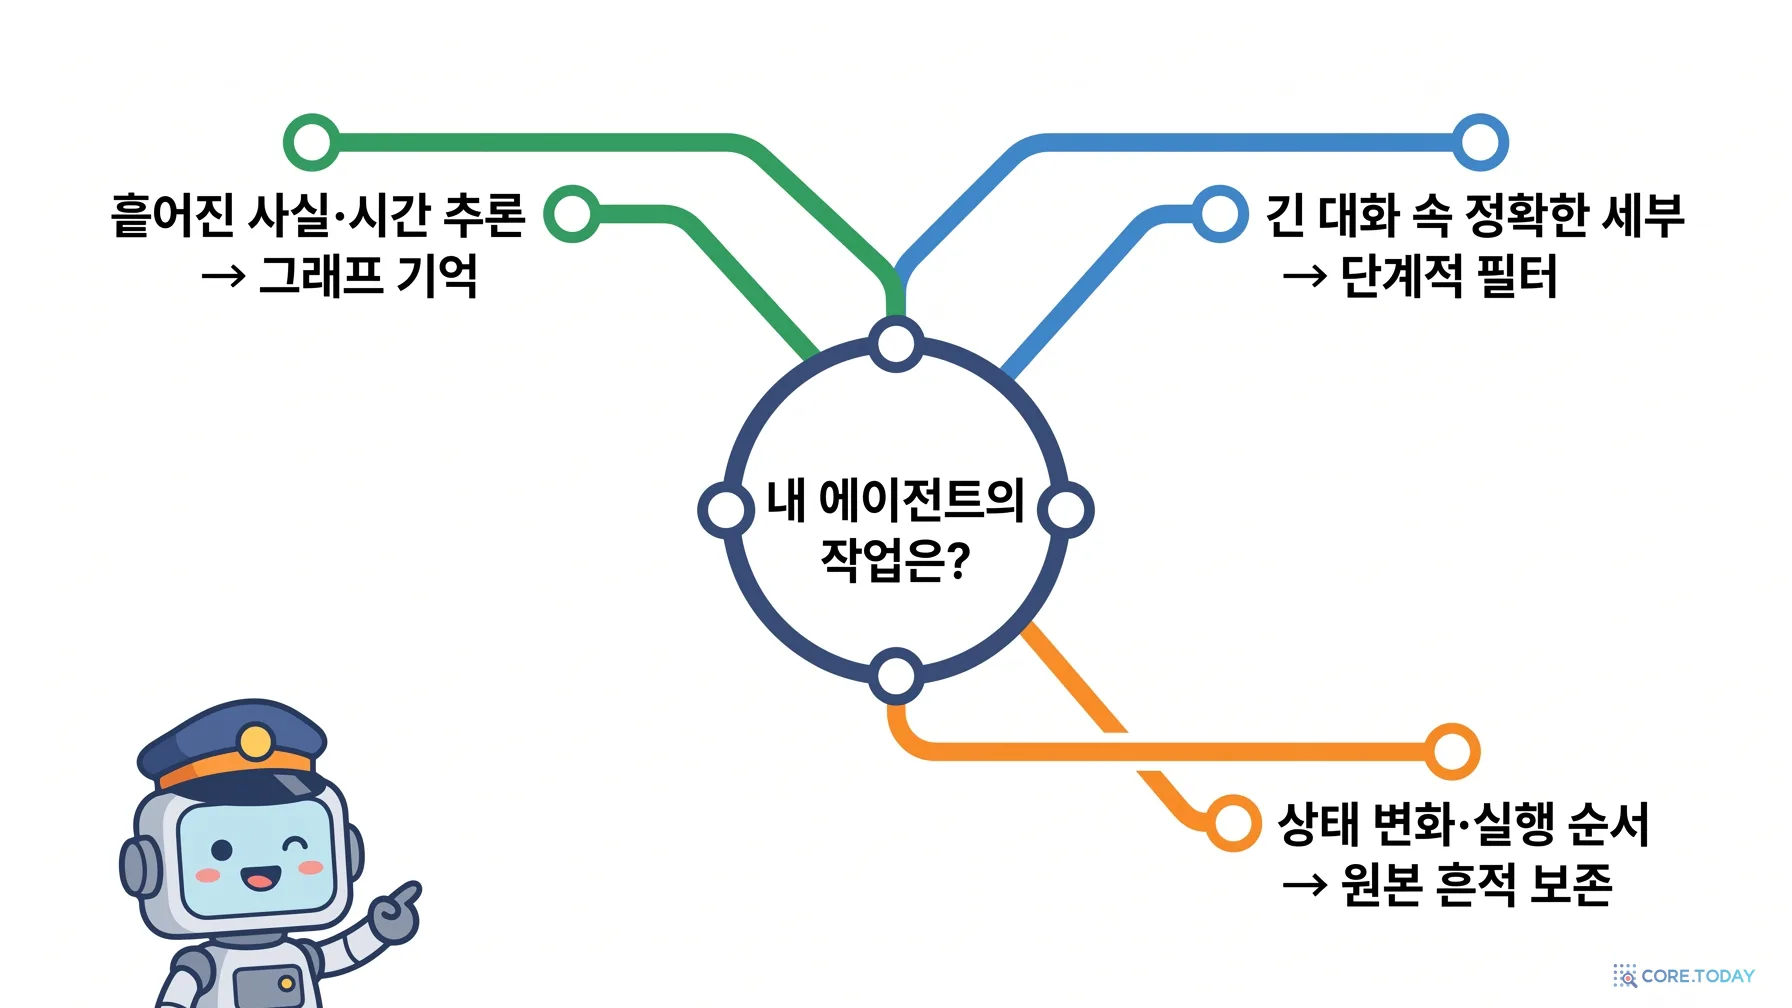
논문은 이를 Finding 1 (워크로드 정렬 기억)으로 정리한다. 세 가지 병목에 세 가지 처방이 대응한다.
흩어진 사실·사건 순서 LongMemEval
→
관계·시간 인식 검색 Zep, Cognee
길지만 일관된 대화 속 정확한 세부 LoCoMo
→
요약 우선 → 세부 좁히기 MemOS, MemoryOS
중간 상태 변화·실행 순서 DB-Bench
→
원본 흔적 보존 Long Context, MemoChat
5.1 곁다리 발견: Exact Match는 언제 믿을 수 있나
같은 그림에서 논문은 지표 자체에 대한 경고도 뽑는다(O2). LoCoMo처럼 답이 짧고 정규형이 있는 과제(장소 이름, 물건 속성)에서는 EM이 의미 있다. 하지만 LongMemEval처럼 여러 세션의 사실을 종합해 서술해야 하는 과제에서는 정답과 표현이 다를 수 있어 ROUGE-L이나 LLM Judge가 더 변별력이 있다. DB-Bench는 더 극단적이다. Long Context가 EM 1위인데, MemoChat은 EM이 더 낮으면서 작업 성공률은 훨씬 높다. 출력 문자열이 정답과 같은지(EM)와 실제로 테이블 상태가 맞는지(성공률)는 다른 질문이다. 메모리 논문들이 흔히 내세우는 "F1 X% 향상"을 읽을 때 그 과제에 F1이 맞는 자인지부터 물어야 한다는 뜻이다.
최종 답이 틀렸을 때 원인은 둘 중 하나다. 근거를 못 찾았거나, 찾았는데 LLM이 잘못 썼거나. 둘을 분리하려면 검색 단계 자체를 채점해야 한다. LoCoMo는 질문마다 "이 답의 근거는 어느 발화인가"가 표시돼 있어 이게 가능하다. 논문은 상위 K개 안에 근거가 들어왔는지(Recall@K)를 재고, 근거가 몇 세션 전에 있었는지에 따라 성적을 나눴다.
결과는 "검색"에 대한 통념을 흔든다.
첫째, K=1 챔피언과 K=10 챔피언이 다르다. 질의를 LLM이 먼저 계획하는 SimpleMem은 Recall@1에서 39.0으로 1위다. 딱 하나를 집어 오는 데 강하다. 하지만 K=10에서는 A-MEM 85.9, MemTree 80.5가 앞선다. 노트끼리 링크를 걸거나(A-MEM) 잎-조상 계층을 두는(MemTree) 구조가 관련 증거 묶음을 함께 끌어온다. 논문은 이를 "강한 기억 검색은 top-1 랭킹 문제가 아니라 증거 완성 문제"라고 쓴다. 실제 질문의 근거는 보통 하나가 아니다. "내 반려동물 이름들을 다 말해 봐"는 세 세션의 세 발화가 필요하다.
둘째, 벡터 유사도는 '최근'에 편향된다. Embedding RAG는 근거가 5세션 안에 있을 때 95%를 찾지만, 6~10세션이면 18%, 그 뒤로는 사실상 0이다. 반면 A-MEM은 26~31세션 전 근거도 90% 이상 찾는다. 임베딩 공간에서 질문과 "비슷한" 발화는 보통 최근 맥락과 겹치는 발화이고, 오래전 발화는 어휘가 달라 멀어진다. 구조(링크·계층·시간)는 이 거리를 잇는 다리다.
Finding 2 (증거 중심 조직): 조기 발견(early localization)과 증거 조립(evidence assembly)은 별개의 설계 목표다. 평평한 유사도 검색은 짧은 거리에서만 쓸 만하고, 흩어지거나 먼 근거에는 명시적 구조가 필요하다.
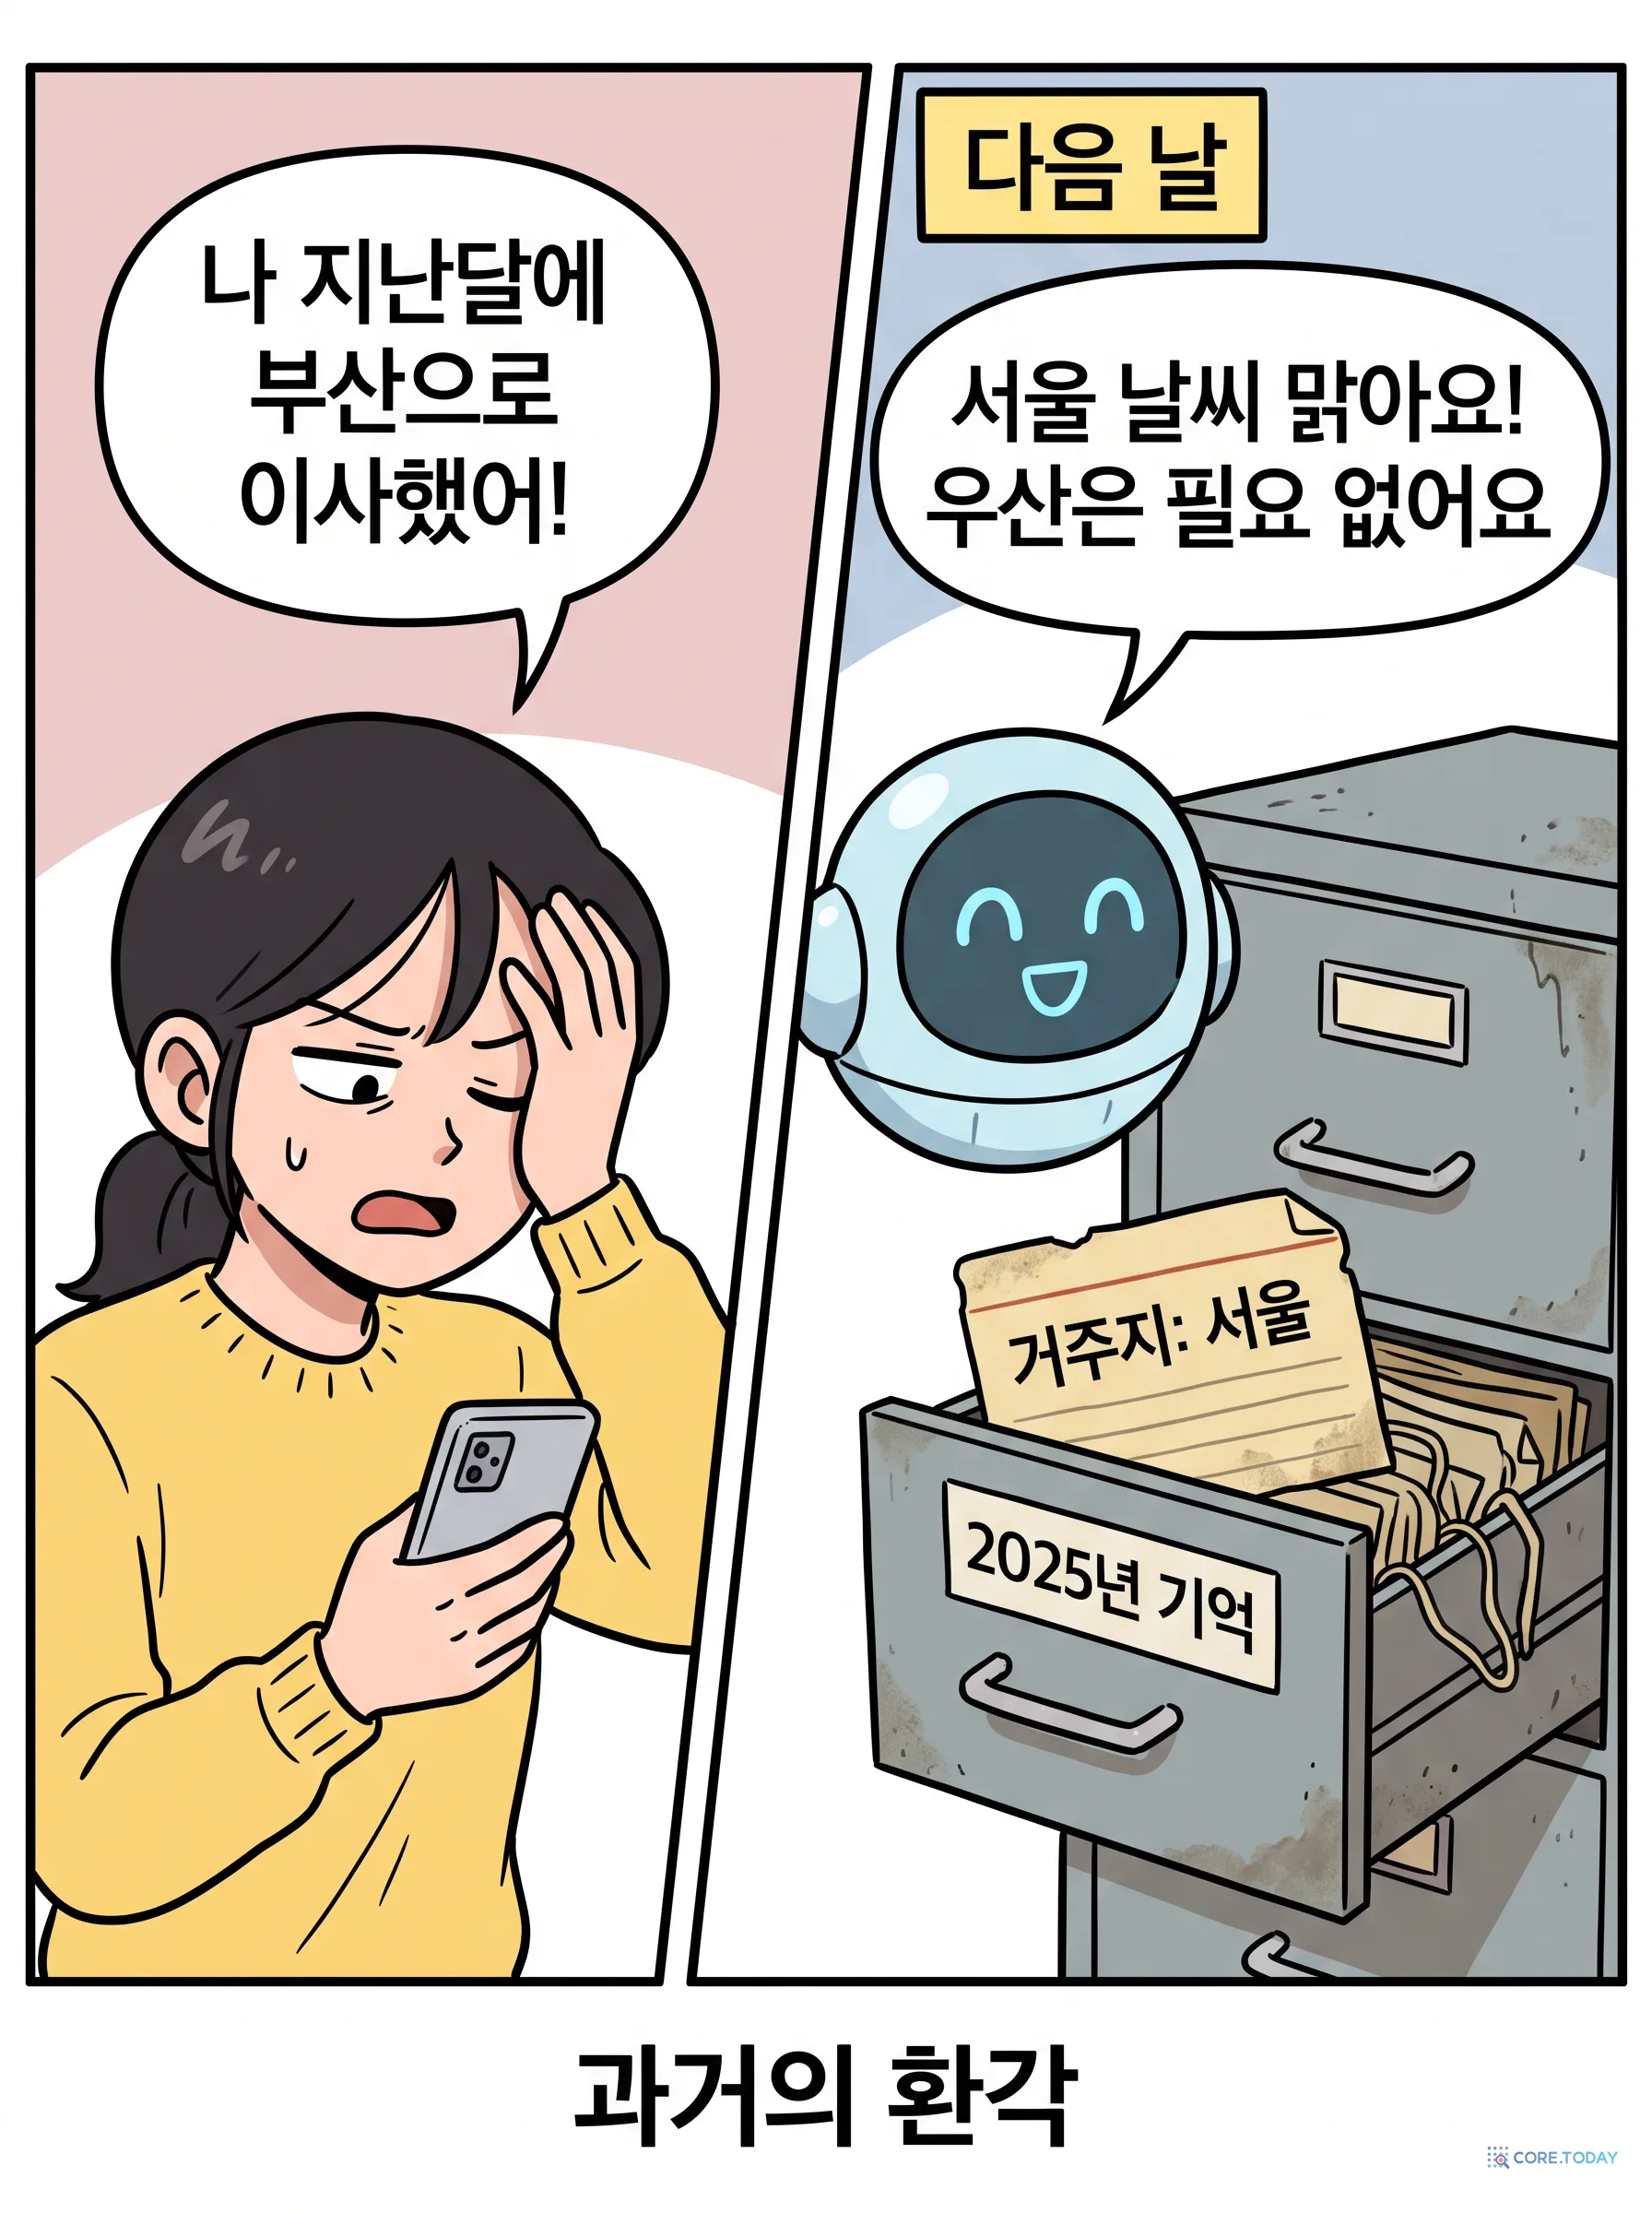
이 논문에서 가장 기억에 남을 표현은 "과거의 환각(hallucinations of the past)"이다. 보통 환각은 모델이 없는 사실을 지어내는 것을 뜻한다. 그런데 기억 시스템이 있는 에이전트는 다른 종류의 환각을 일으킨다. 한때 참이었지만 지금은 거짓인 사실을 자신 있게 말하는 것. 지난달에 부산으로 이사했다고 말했는데 오늘 "서울 날씨 맑아요"라고 인사하는 비서. 기억이 없어서가 아니라 기억이 낡아서 생기는 오류다.
논문은 LongMemEval의 "지식 갱신"·"시간 추론" 슬라이스와 LoCoMo의 시간 질문으로 메모리 시스템 11개와 기준선 2개를 따로 채점했다(Table 2).
세 가지가 보인다.
직접적인 사실 갱신("전엔 X였는데 이제 Y")에는 그래프 계열이 압도적이다. Zep 44.4, Cognee 37.8, MemoryOS 35.6. 옛 관계를 지우지 않고 무효화하는 다중 버전 유지보수가 효과를 낸다. 반면 사실을 뽑아 벡터로 쌓는 Mem0는 15.6, 시간순 우선 규칙만 있는 SimpleMem은 6.7이다. 벡터 공간에서 "서울 산다"와 "부산 산다"는 거의 같은 점이고, 어느 쪽이 최신인지 가릴 구조가 없다.
시간 추론("그 일 몇 주 뒤에 뭘 샀지")은 전반적으로 어렵다. 1위 Cognee가 18.7이고, 대화를 통째로 넣는 Long Context(12.0)가 여러 메모리 시스템과 비슷하거나 낫다. 요약·추출 과정에서 시간 단서가 파괴된다는 신호다.
현재 유효한 상태를 정확히 짚는 LoCoMo 시간 질문에서는 MemOS(EM 8.9)와 Cognee(F1 28.1)가 앞선다. 하이브리드 필터가 "지금"을 먼저 좁혀 준다.
말로만 들으면 추상적이니 직접 돌려 보자. 아래 시뮬레이터는 논문의 실험이 아니라, 논문이 분류한 네 가지 전략이 같은 대화 기록에 어떻게 다르게 반응하는지를 각본대로 보여 주는 교육용 장치다. 지민이라는 사용자가 넉 달 동안 네 번 대화했고 그 사이 이사를 했다.
시뮬레이터에서 가장 주목할 칸은 "사실 추출 + CRUD"의 "이사 오기 전엔 어디 살았지?"다. 현재 상태를 맞히려고 UPDATE로 덮어쓴 순간 과거가 사라진다. 현재는 맞고 과거는 틀리는 시스템과, 현재도 과거도 맞지만 100배 느린 시스템(시간 그래프) 사이에서 무엇을 고를지는 어떤 질문이 많이 들어오는지에 달려 있다.
7.1 더 똑똑한 모델이 해결해 주지 않을까?
자연스러운 반론이 있다. "GPT-5.4처럼 더 강한 모델을 쓰면 옛 사실과 새 사실쯤은 알아서 가려 주지 않나?" 논문은 백본을 Qwen3-8B, DeepSeek-Chat, GPT-5.4-mini, GPT-5.4로 바꿔 가며 같은 실험을 했다(Figure 9). 결과: 절대 점수는 오르지만 순위는 거의 그대로다. MemOS는 네 백본에서 Answer F1 32.2 → 41.2 → 38.6 → 41.2로 줄곧 1위였고, Embedding RAG는 날짜 기반 최신 상태 질문에서 네 백본 모두 틀렸다. 유일한 순위 변동은 A-MEM이 MemTree를 큰 모델에서 앞지른 것뿐이다.
Finding 3 (시간 갱신 충실도): 갱신 뒤의 올바른 행동은 모델 용량이 아니라 파이프라인 설계 문제다. ① 수정 가능성을 표현 단계에 내장해 나중 사실이 같은 엔티티에 묶이게 하고(Zep·Cognee), ② 질의 시점 선택성을 워크로드에 맞추며(MemOS·MemoryOS), ③ LLM 스케일링은 근거를 찾은 뒤 표현을 다듬는 데 쓰라. 더 큰 모델에게 낡은 기억을 가려 달라고 맡기는 건 비싼 도박이다.
8. RQ4 — 긴 지평선에서 무엇이 무너지나
메모리 시스템의 존재 이유는 "오래 가는 것"이다. 논문은 세 가지 방식으로 지평선을 늘렸다. LongBench로 입력 길이를, LongMemEval로 누적 세션 수를, LoCoMo로 근거까지의 거리를.
시스템
LongBench 짧음 → 중간 (정확도)
LoCoMo 근거 거리 1–5 → 26–31 (Answer F1)
판정
Long Context
42.6 → 19.0
높음 → 급락
큰 프롬프트는 방해물도 함께 쌓는다
Embedding RAG
40 → 20 (근사)
37.1 → 7.4
근거가 멀어지면 사실상 실패
SimpleMem
35.2 → 34.9
중간 유지
다중 뷰 필터가 방해물을 걸러 냄
Cognee · MemOS · MemoryOS
—
모든 구간에서 상위 유지
관계·시간·계층이 먼 사실을 붙잡음
A-MEM
37 → 35.5, 긺에서 16.5 (근사)
상위
중간까지 견고, 아주 긴 입력에서는 약화
Long Context의 추락이 교훈적이다. 100만 토큰 창의 시대에 "그냥 다 넣으면 되지 않나"는 가장 흔한 반론인데, LongBench에서 입력이 '짧음'에서 '중간'으로만 늘어도 정확도가 42.6에서 19.0으로 반토막 난다. 우리가 Context Rot 특집에서 다룬 현상 그대로다. 입력이 길어지면 정답 근거와 함께 방해물(distractor)이 쌓이고, 어텐션은 그 사이에서 길을 잃는다.
흥미로운 건 LoCoMo의 시간 질문에서 원문 긴 컨텍스트가 여전히 대부분의 메모리 시스템을 이긴다는 점이다(논문 요약 ❹). 의미 기반 통합이 시간 순서라는 단서를 파괴하기 때문이다. "A가 있고 나서 B"라는 정보는 두 발화의 순서에 들어 있는데, 요약하거나 사실로 쪼개는 순간 순서가 사라진다.
Finding 4 (지평선 구조화 기억): 지평선이 길어질수록 문제는 "더 많이 저장하기"에서 "어떤 추상화를 고를 것인가"로 옮겨 간다. 방해물이 많으면 다중 뷰 필터(SimpleMem), 근거가 멀면 관계 인덱스(Cognee·Zep), 세션을 먼저 찾고 세부를 좁혀야 하면 거친→세밀 요약(MemOS·MemoryOS).
여기서부터가 데이터베이스 연구자의 시선이 빛나는 대목이다. 논문은 같은 러너로 기억 구축 시간 + 질의 시간을 재고, 이를 LoCoMo·LongMemEval 6개 지표의 정규화 평균(효용)과 함께 그렸다.
프런티어를 읽어 보자.
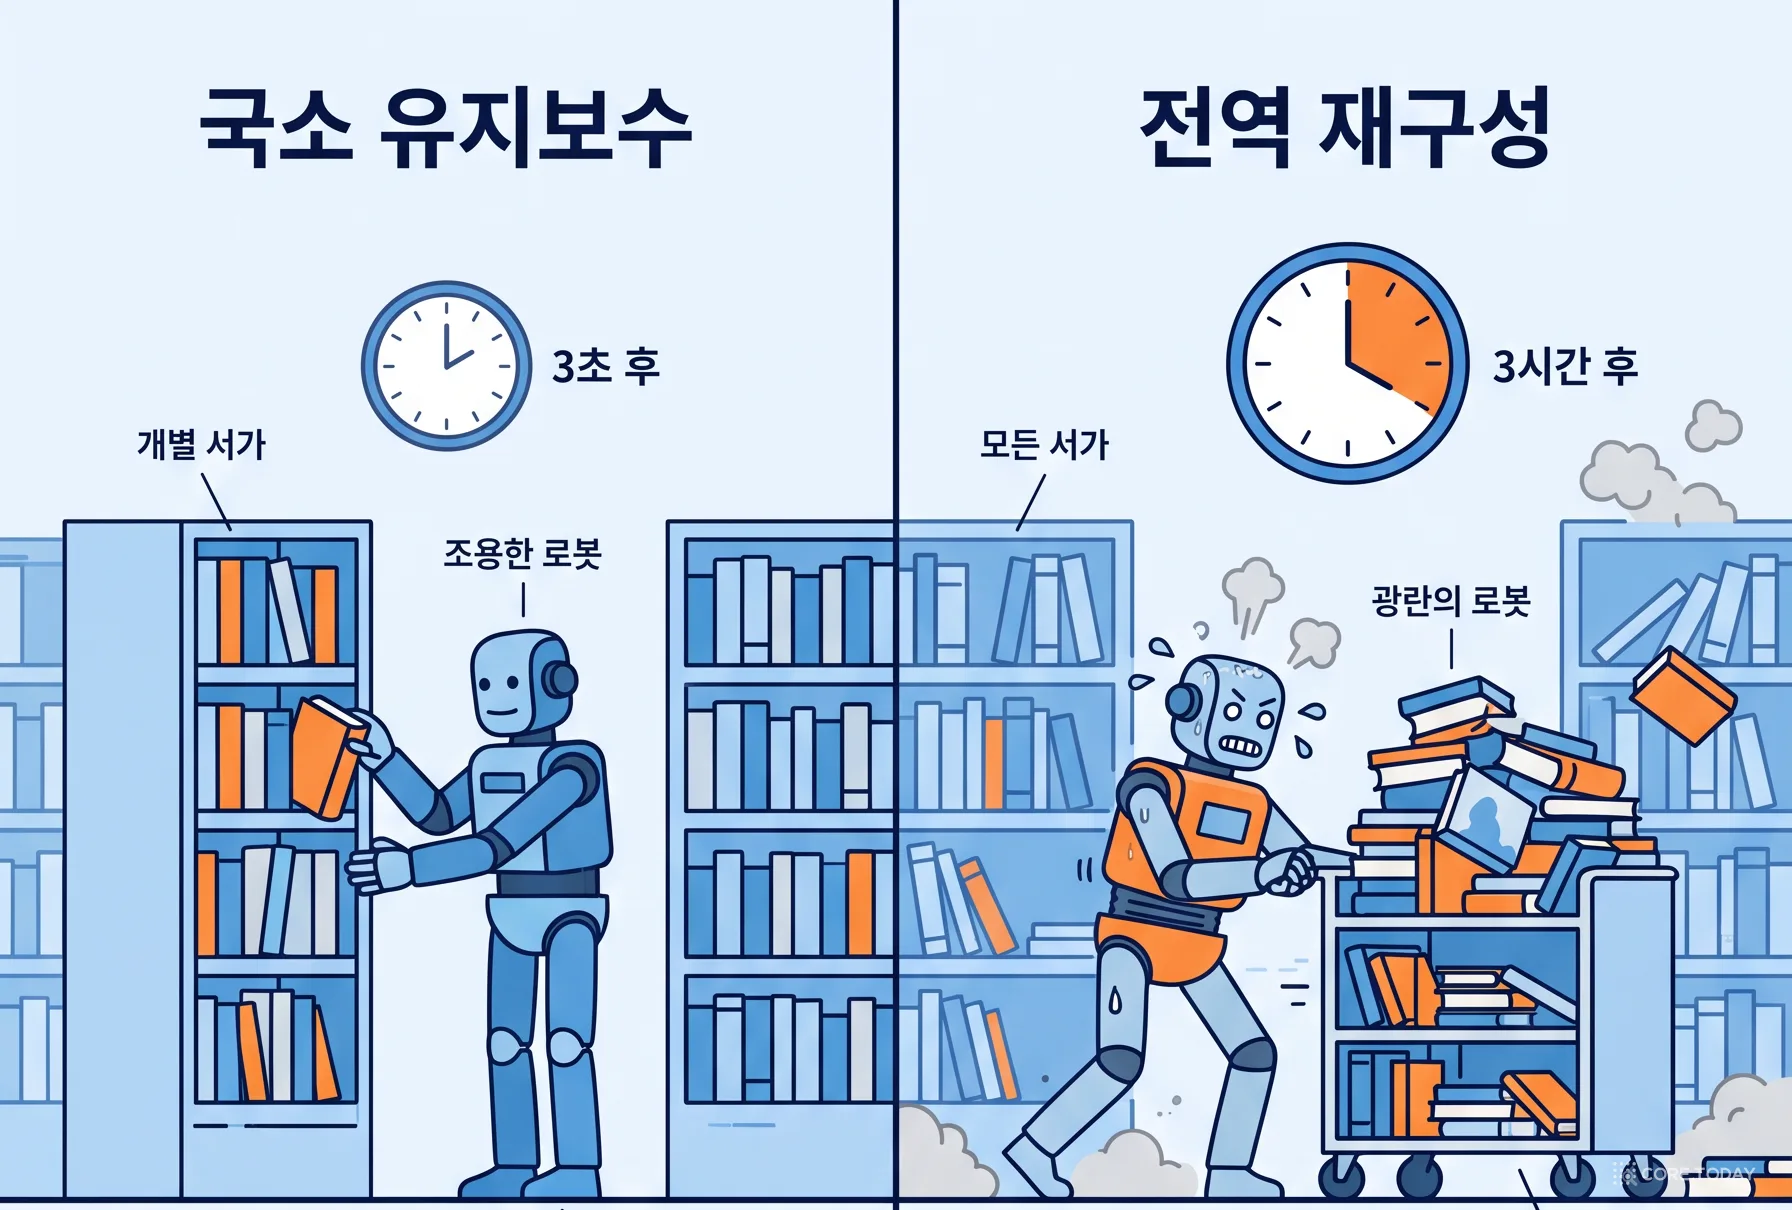
싸고 쓸 만한 구역에는 LightMem(질의당 3.67초, 효용 48.3)과 MemTree(15.9초, 63.5)가 있다. 둘 다 쓰기 한 번이 저장소 일부에만 퍼진다. LightMem은 세그먼트 단위로 압축하고 제한된 하이브리드 검색을 하며, MemTree는 새 잎이 들어오면 그 경로의 조상만 다시 요약한다.
비싸지만 정확한 구역에는 MemoryOS(28.6초, 82.0), Cognee(116.5초, 84 이상), Zep(155.1초, 84 이상)이 있다. 그래프 전체를 통합하거나 여러 저장소를 동기화하거나 메모리 전체를 다시 쓰는 시스템들이다.
비싸고 쓸모없는 구역에 Mem0(35.9초, 21.4)가 있다는 점이 뼈아프다. 사실 추출마다 LLM을 부르고 충돌 판단에 또 부르는데, 그렇게 얻은 기억의 효용이 Embedding RAG와 비슷하다.
긴 입력(LongBench)에서는 격차가 수백 배로 벌어진다. LightMem 17.3초, MemTree 116.7초인 반면 Mem0 374초, MemoChat 460초, MemoryOS 490초, A-MEM 552초, 그리고 Zep Local은 질의당 2,867초다. 문서 하나를 넣을 때마다 지식 그래프 전체가 흔들리기 때문이다.
Finding 5 (운영 스케일링 규칙): 효율은 구조의 유무가 아니라 유지보수의 범위가 결정한다. ① 국소 갱신·검색이 최고의 비용-효용 균형을 준다. ② 풍부한 조직은 유지보수가 광범위한 재계산을 피할 때만 이득이다. ③ 긴 컨텍스트 워크로드에서는 메모리 전체 조정이 지배적 비용이 된다. 데이터베이스로 치면 "전체 테이블 재색인 vs 증분 인덱스 갱신"의 차이이고, 결론도 같다.
4장이 "어떤 시스템이 어디서 이기나"였다면 5장은 "왜 이기나"다. 같은 시스템에서 한 모듈만 바꾼 변형을 만들어 비교했다. 아래 실험실에서 M1~M4를 돌아보자.
네 가지 교훈이 나온다. 하나하나가 실무에서 바로 쓸 수 있는 규칙이다.
10.1 M1 — 추상화는 층마다 정보를 버린다
LightMem에서 사용자 발화를 원문으로 두면 네 지표 모두 최고다(LoCoMo EM 24.2 / F1 38.9, LongMemEval Substring EM 26.0 / ROUGE-L 31.4). 군더더기만 제거한 압축은 LoCoMo 추론은 거의 지키지만(38.6) LongMemEval의 정확한 세부 회수를 절반 이하로 떨어뜨린다(10.7). LLM 요약은 둘 다 무너진다(8.5 / 15.6). 논문의 예시가 선명하다 — 러시아 애니메이션 제목 "Nu, pogodi!"는 요약을 거치면 돌아오지 않는다. 그리고 MemTree를 더 깊게 만들어도 개선은 1점 안팎이다. 계층은 '찾아가기'를 돕지만 표현 단계에서 사라진 정보를 되살리지는 못한다.
Mem0의 벡터 저장소를 그래프로 바꿔도(Mem0ᵍ) 거의 달라지지 않는다는 결과도 같은 맥락이다. 병목은 저장소가 아니라 그 앞의 추출에 있다.
10.2 M2 — 늦게 걸러라 (Late Filtering)
이 논문에서 가장 극적인 숫자가 여기 있다. MemOS의 Fast Memorize(가볍게 저장)와 Fine Memorize(LLM이 정밀하게 사실 추출)를 비교하면, 정밀 추출은 LongMemEval 사실 회수에서 소폭 앞서지만(22.3 vs 20.7) LoCoMo 다중 홉 추론을 40.8에서 5.0으로 붕괴시킨다. 나중에 조합해야 비로소 의미가 생기는 세부를 쓰기 시점에 "중요하지 않다"고 버린 탓이다.
같은 방향의 결과가 둘 더 있다. MemoChat에서 LLM이 주제를 잘게 쪼개는 것보다 휴리스틱으로 굵게 묶는 쪽이 LongMemEval에서 낫고(10.7 vs 7.3), LightMem에서 사용자 발화만이 아니라 어시스턴트 답까지 저장하면 LoCoMo가 오른다(25.5 vs 24.2). 어시스턴트의 답에는 사용자가 흘린 날짜나 다듬어진 표현이 남아 있기 때문이다.
Finding 7: 추출은 쓰기 시점에 맥락을 보존해야 한다. 걸러내는 일은 읽기 시점(검색)에 맡겨라. "쓰기 시점 추출(write-time extraction)"이라는 Mem0류의 핵심 설계가 정면으로 도전받는 대목이다.
10.3 M3 — 계획은 좋고, 반성은 과잉이다
검색 쪽 결과는 상대적으로 온건하다. A-MEM에서 벡터·키워드 융합을 균형으로 두는 게 키워드 쪽으로 기울이는 것보다 낫고(F1 24.6 vs 23.0), SimpleMem에서 LLM이 질의를 먼저 계획하는 단계는 모든 지표를 올린다(F1 18.7 → 20.7, Recall 86.4 → 90.6). 그런데 계획 위에 반성(reflection) 단계를 얹으면 오히려 소폭 떨어진다(20.0 / 88.6).
Finding 8: 검색 품질은 복잡함이 아니라 겨냥한 구조에서 온다. 경로가 이미 정해졌다면 추가 숙고는 지연만 늘린다. "에이전트에게 생각할 시간을 더 주면 좋아진다"는 통념이 검색 라우팅에서는 통하지 않는다.
10.4 M4 — 보수적 통합이 기본값이다
MemoryOS에서 주제 유사도 임계값을 높여 더 까다롭게 합치는 설정(Conservative-Merge)이 기본값보다 소폭 낫고(F1 23.5 vs 23.2), 단기 버퍼를 키워 백엔드 쓰기를 미루는 설정(Delayed-Flush)은 20.6으로 떨어진다. 논문은 지연 플러시를 "기만적 트레이드오프"라고 부른다. 표면적으로는 더 많은 원문이 버퍼에 살아 있어 커버리지가 넓어 보이지만, 질문 시점에 증거가 턴 사이에 흩어져 있어 실제로는 답을 만들지 못한다. MemoChat에서 창마다 단일 주제로 뭉뚱그리는 것도 손해다(16.2 vs 16.6). 드물지만 유용한 단서가 사라진다.
Finding 9: 유지보수는 균형 잡힌 갱신 체제에서 가장 잘 작동한다. 보수적으로 통합하되 미루지 말고, 너무 굵게 요약하지 마라.
ChatGPT의 메모리는 대화에서 사실을 뽑아 저장하고 사용자가 보고 지울 수 있는, 전형적인 스키마 없는 사실 추출 + 툴 주도 CRUD 계열이다. 논문의 분류로는 Mem0와 같은 칸이다. 그렇다면 같은 약점 — 바뀐 사실에 약하고, 과거 상태를 잃는다 — 을 공유할 가능성이 크다.
Claude Code의 CLAUDE.md와 자동 메모리 디렉터리는 흥미롭게도 원문 보존 + 사용자(또는 에이전트)가 직접 쓰는 파일이다. 추출을 LLM이 자동으로 하지 않고, 파일 단위로 읽는다. 논문의 언어로는 "Late Filtering"에 가깝다 — 쓸 때 걸러내지 않고 읽을 때 고른다.
Letta, Zep, Mem0, MemOS는 각자 논문 Table 1의 한 행이다. 이 논문이 각 시스템의 약점을 수치로 보여 줬다는 점에서, 벤더 자료만으로 고르던 시대는 끝났다.
11.2 실무 선택 가이드
논문의 Finding 1·3·4·5를 네 가지 질문으로 압축했다. 정답지가 아니라 출발점이다.
여기에 코어닷이 현장에서 덧붙이는 규칙 몇 가지.
먼저 질문 로그를 분류하라. 들어오는 질문의 몇 %가 "최근 사실", 몇 %가 "흩어진 사실", 몇 %가 "바뀐 사실", 몇 %가 "실행 상태"인지 세어 보면 구조가 거의 정해진다. 논문의 메시지가 "병목에 맞춰라"이니, 병목을 재는 게 1단계다.
원문을 버리지 마라. M1·M2의 결과는 명확하다. 어떤 추출을 하든 원문은 별도 저장소(S3든 파일이든)에 남기고, 추출물은 인덱스로만 취급하라. 추출이 틀렸을 때 다시 뽑을 수 있어야 한다.
바뀌는 사실에는 유효 기간을 붙여라. 그래프까지 가지 않아도 된다. 사실 레코드에 valid_from·valid_to·superseded_by 세 칸만 두고 덮어쓰지 않으면, "과거의 환각"의 절반은 사라진다. 이건 데이터베이스 세계가 수십 년 전에 "시간 테이블(temporal table)"로 해결한 문제다.
지연 예산을 먼저 정하라. Zep·Cognee의 정확도는 질의당 100초 이상의 값이다. 챗봇 응답은 못 기다리지만, 야간 배치로 기억을 구축하고 질의는 캐시에서 하는 구조라면 감당할 수 있다. 구축 시간과 질의 시간을 따로 재라.
벤치마크를 돌려라. 공개 테스트베드가 있다. 자기 대화 로그 100건으로 LoCoMo 형식의 질문을 만들어 두 세 시스템을 돌리는 데 하루면 된다. 벤더가 낸 숫자 대신 자기 숫자를 가져라.
11.3 코어닷의 관점
우리는 여러 제품에서 사용자·조직 단위의 상태를 LLM 호출과 함께 다룬다. 이 논문을 읽고 가장 크게 바뀐 생각은 "메모리는 기능이 아니라 데이터 모델"이라는 것이다. 어떤 메모리 라이브러리를 붙일지보다, 우리 도메인의 사실이 얼마나 자주 바뀌고, 얼마나 멀리서 다시 필요해지며, 틀렸을 때 얼마나 비싼지를 먼저 적어야 한다. 그 답에 따라 어떤 팀은 원문 로그 + 좋은 검색이면 충분하고, 어떤 팀은 시간 그래프가 필요하다. 논문이 준 건 정답이 아니라 질문의 목록이고, 그게 더 값지다.
12. 그래서, 준비됐나?
논문의 답은 "아직"이다. 결론부가 짧아서 아쉽지만, 여섯 가지 핵심 발견을 다시 묶으면 "에이전트 네이티브 메모리"가 갖춰야 할 조건이 거꾸로 보인다.
논문의 발견
현재 시스템의 한계
에이전트 네이티브 메모리가 갖춰야 할 것
❶ 만능 구조 없음
한 가지 표현에 모든 질문을 맞춤
워크로드별로 표현·검색 경로를 고르는 적응형 라우팅
❷ 검색은 증거 완성 문제
top-1 유사도에 최적화
근거 묶음을 모으는 링크·계층·시간 인덱스
❸ 과거의 환각
덮어쓰기 또는 무한 추가
사실의 유효 기간과 버전이 1급 개념
❹ 통합이 시간 단서를 파괴
요약이 순서를 지움
원문 흔적을 유지하며 시간 순서를 보존하는 저장
❺ 구조의 비용이 효용에 비례하지 않음
쓰기마다 전역 재구성
증분·국소 유지보수, 구축/질의 비용 분리 계측
❻ 추상화 층마다 정보 손실
쓰기 시점 공격적 추출
늦게 걸러라 — 보존 우선, 선택은 읽기 시점에
12.1 한계와 반론
이 논문도 완벽하지 않다. 읽으면서 들었던 의문을 적어 둔다.
저자 구성. MemTensor는 MemOS를 만든 회사이고, MemOS는 여러 지표에서 "프런티어에 가장 가까운" 시스템으로 서술된다. 테스트베드가 공개돼 있어 재현은 가능하지만, 이 점은 알고 읽는 게 좋다.
Letta의 LoCoMo 0점. EM 0.0은 성능이 아니라 통합 문제(출력 형식, 타임아웃)일 가능성이 있다. 논문이 이를 설명하지 않는다. "같은 러너"의 공정성은 각 시스템이 의도대로 설정됐는지에 달려 있고, 12개 외부 시스템을 전부 최적으로 맞추기는 어렵다.
벤치마크 편향. LoCoMo와 LongMemEval은 결국 "개인 비서 대화"다. 코딩 에이전트의 작업 기억, 다중 에이전트의 공유 기억, 멀티모달 기억은 다루지 않는다. DB-Bench가 유일한 비대화 과제이고 그 결과가 가장 달랐다는 점은, 대화 밖 워크로드에서는 결론이 또 달라질 수 있음을 시사한다.
작은 백본, 낮은 절대 점수. 주 실험 수치는 Qwen3-8B 막대와 일치한다. LoCoMo EM이 10 안팎, LongMemEval LLM Judge가 최고 48인 것은 메모리 구조만이 아니라 답을 쓰는 모델의 한계이기도 하다. 논문은 백본을 키워도 순위가 유지된다고 보였지만 비교 대상은 다섯 개 구성뿐이라, 전체 순위가 큰 모델에서도 그대로인지는 열려 있다.
"에이전트 네이티브"의 정의. 제목이 던진 개념을 논문 본문이 적극적으로 정의하지 않는다. 위 표의 오른쪽 열은 논문의 발견에서 우리가 거꾸로 추론한 것이지 저자의 문장이 아니다.
그림과 본문의 수치 차이. 논문 Figure 7의 DB-Bench에서 Letta가 61.6으로 가장 높은데, 본문은 MemoChat 55.4를 "가장 강한" 사례로 든다. 아마 "전체 워크로드를 커버한 시스템 중"이라는 단서가 생략된 듯하다. 이 글의 위젯은 그림의 숫자를 그대로 썼다.
12.2 마무리
2023년에 MemGPT가 "LLM을 운영체제처럼"이라고 했을 때, 많은 사람이 멋진 은유라고 생각했다. 3년 뒤 이 논문은 그 은유를 문자 그대로 받아들였다. 운영체제의 메모리 관리에는 페이지 교체 정책이 있고, 데이터베이스에는 인덱스·버전·트랜잭션이 있다. 그것들은 벤치마크 점수 하나로 평가되지 않는다. 처리량, 지연, 일관성, 복구 가능성으로 평가된다. 에이전트 메모리도 이제 그 자리에 왔다.
가장 좋은 기억 시스템은 가장 많이 기억하는 시스템이 아니다. 무엇이 바뀌었는지 알고, 무엇을 버려도 되는지 알며, 그 판단에 얼마가 드는지 아는 시스템이다. 논문의 제목에 답하자면 — 아직 준비되지 않았다. 하지만 이제 무엇을 준비해야 하는지는 안다.