Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
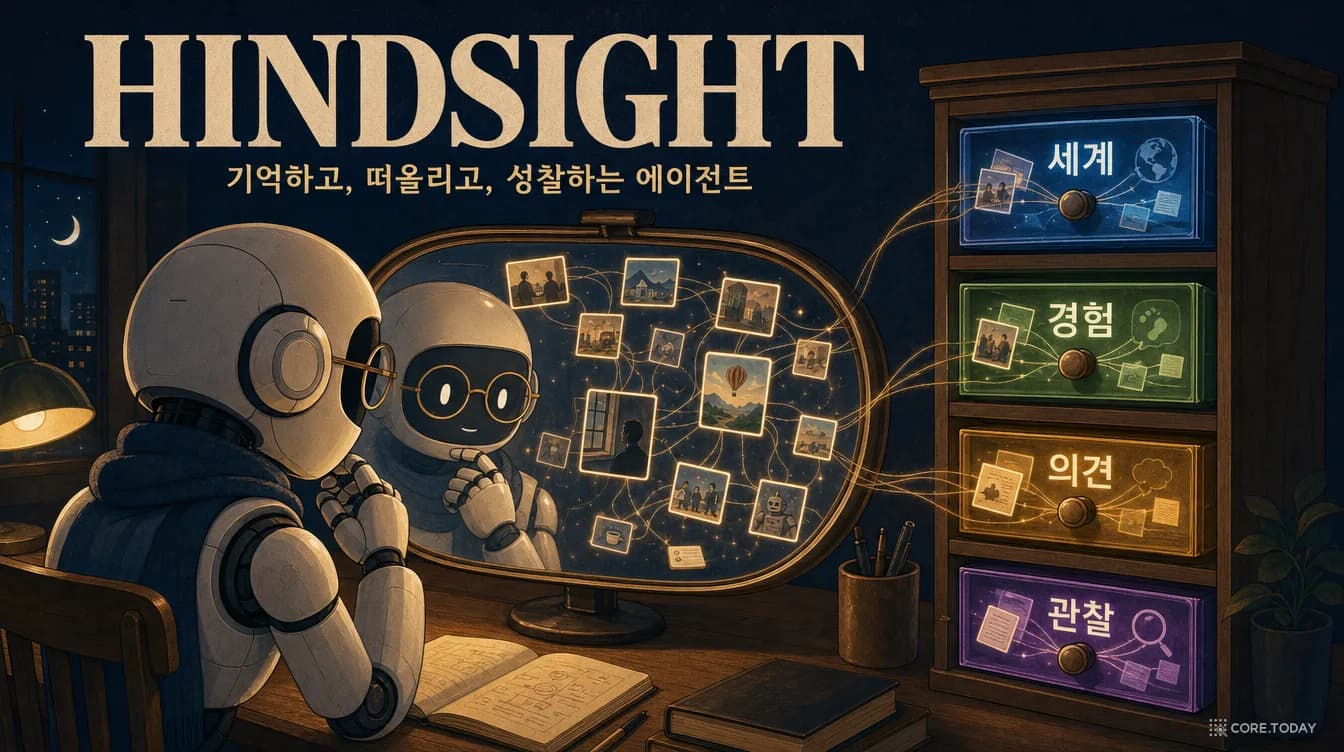
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
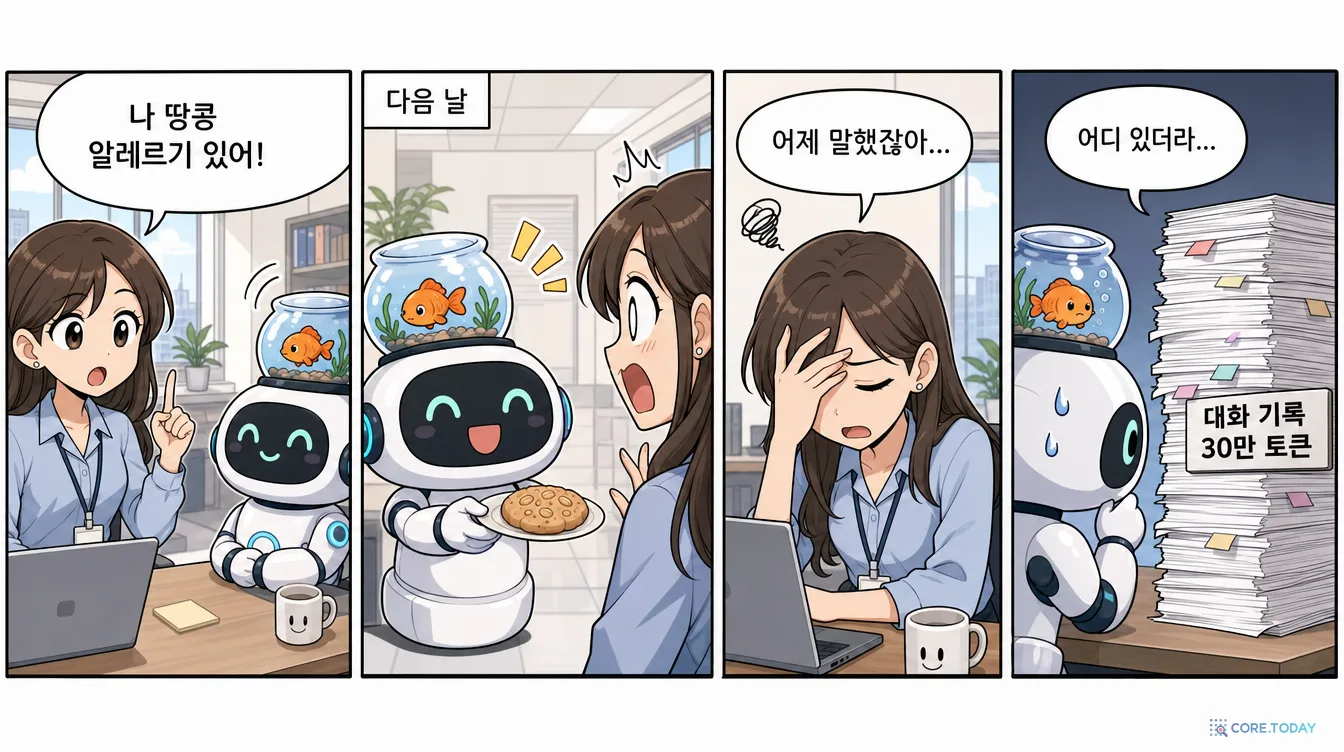
월요일, 민지가 AI 비서에게 말한다. "나 땅콩 알레르기 있어." 비서는 고개를 끄덕인다. 화요일, 같은 비서가 해맑게 땅콩 쿠키를 권한다. 민지가 이마를 짚는다. "어제 말했잖아…." 비서는 30만 토큰짜리 대화 기록 더미 앞에서 땀을 흘린다. 어디 있더라.
이 장면이 우스운 이유는 비서가 멍청해서가 아니다. 지금의 대형 언어 모델(LLM)은 박사급 문제를 풀고 코드를 수천 줄씩 쓴다. 문제는 기억이다. LLM은 본질적으로 상태가 없는(stateless) 함수다. 대화창이 닫히면 모든 것이 사라지고, 다음 대화는 백지에서 시작한다. 우리가 "기억하는 AI"라고 부르는 것들은 전부, 모델 바깥 어딘가에 메모를 적어 두었다가 다음 대화에서 프롬프트에 몰래 끼워 넣는 장치다.
그 바깥 장치를 어떻게 만들 것인가. 2023년 이후 이 질문에 수십 개의 답이 나왔다. MemGPT는 운영체제처럼 기억을 페이징했고, Mem0는 대화에서 사실을 뽑아 벡터 DB에 넣었고, Zep은 시간 정보가 붙은 지식 그래프를 만들었다. 그리고 2025년 12월, 한 편의 기술 보고서가 조금 다른 질문을 던졌다.
"이 에이전트는 자기가 본 것과 자기가 믿는 것을 구분하는가?"
논문의 제목은 「Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects」(arXiv:2512.12818). 영어 관용구 hindsight is 20/20은 "지나고 나서 보면 다 보인다"는 뜻이다. 시력 검사표의 20/20, 즉 정상 시력. 일이 끝난 뒤의 판단은 언제나 또렷하다는 말이다. 저자들은 에이전트에게 바로 그 능력 — 지나온 일을 정확히 돌아보는 눈 — 을 주고 싶었다.
저자는 미국의 데이터 파이프라인 스타트업 Vectorize.io의 크리스 래티머(Chris Latimer)·니콜로 보스키(Nicoló Boschi)·크리스 바살러뮤(Chris Bartholomew), 워싱턴포스트의 앤드루 니서(Andrew Neeser), 그리고 버지니아공대의 가우라브 스리바스타바(Gaurav Srivastava)·쉬안 왕(Xuan Wang)·나렌 라마크리슈난(Naren Ramakrishnan)이다. 동시에 공개된 오픈소스 저장소 vectorize-io/hindsight는 2026년 10월 현재 GitHub 별 47,634개, 포크 5,977개를 기록 중이다. 저장소가 만들어진 날이 2025년 10월 30일이니, 1년도 안 된 프로젝트다. 같은 나이일 때의 Letta(MemGPT의 후신)보다 1.6배, Mem0보다 2.3배 빠른 속도라고 Vectorize는 자랑한다.
?
문제
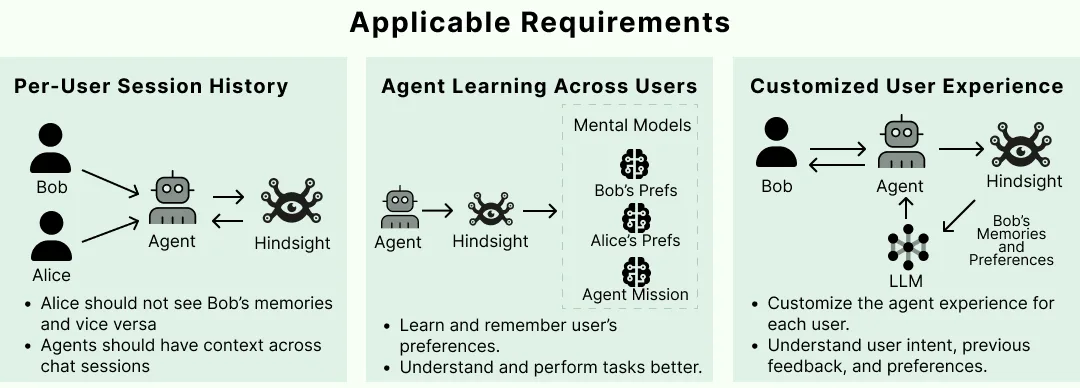
기존 에이전트 메모리는 대화 조각을 벡터나 그래프 저장소에 넣고 비슷한 것 몇 개(top-k)를 꺼내 프롬프트에 붙인다. 그 과정에서 '사용자가 한 말'과 '에이전트가 추측한 것'이 같은 무게로 섞인다.
!
해법
기억을 네 개의 네트워크 — 세계 사실(W)·경험(B)·의견(O)·관찰(S) — 로 나누고, 저장(retain)·회상(recall)·성찰(reflect)이라는 세 동작으로만 다룬다. 회상은 의미·키워드·그래프·시간 네 갈래로 동시에 찾는다.
✓
결과
같은 오픈소스 20B 모델로 LongMemEval 정확도 39.0% → 83.6%. 대화 전체를 GPT-4o에 넣은 것(60.2%)보다 높다. 더 큰 모델을 붙이면 91.4%, LoCoMo에서는 89.61%.
숫자도 인상적이지만, 이 글에서 정말 붙잡고 싶은 건 숫자가 아니라 설계 사상이다. 왜 기억을 네 칸으로 나눠야 하는지, 왜 검색을 네 갈래로 해야 하는지, 왜 에이전트에게 "성격 다이얼"이 필요하다고 봤는지. 그리고 하나 더 — 논문이 나온 지 열 달, 이 설계는 실제 제품에서 어떻게 살아남았고 무엇을 버렸는지. 놀랍게도 논문의 핵심 아이디어 중 하나였던 '의견 네트워크'는 2026년 1월에 제품에서 사라졌다. 그 이유까지 따라가 보자.
이 글은 길다. 순서는 이렇다. ① 왜 이런 설계가 필요해졌나 → ② 심리학에서 에이전트까지 기억 연구의 계보 → ③ 네 개의 네트워크 → ④ 저장(retain) → ⑤ 회상(recall) → ⑥ 성찰(reflect)과 성격 → ⑦ 실험 결과와 그 함정 → ⑧ 2026년의 Hindsight → ⑨ 경쟁 설계와의 비교 → ⑩ 어디에 쓰고 어디에 과한가 → ⑪ 반론과 한계. 일곱 개의 인터랙티브 위젯이 중간중간 손으로 만져 볼 수 있게 도와준다.
1. 왜 이런 설계가 필요해졌나 — 기존 메모리의 세 가지 고질병
1-1. 지금의 '기억'은 어떻게 생겼나
2024~2025년에 등장한 대부분의 에이전트 메모리는 비슷한 골격을 공유한다. 논문은 이것을 한 문장으로 요약한다. "대화에서 핵심 조각을 뽑아 벡터나 그래프 저장소에 넣고, 상태 없는 모델의 프롬프트에 상위 k개를 꺼내 붙이는 외부 계층."
대화 기록
→
LLM이 '핵심 사실' 추출
→
벡터/그래프 저장소
새 질문
→
비슷한 것 top-k 검색
→
프롬프트에 붙여 답변
이 구조는 개인화에 분명히 도움이 됐다. ChatGPT가 2024년 2월 메모리 기능을 시험하기 시작한 뒤로 "제 이름 기억하세요?"는 더 이상 신기한 질문이 아니다. 그런데 에이전트가 오래 살아남는 동료가 되기 시작하자, 이 단순한 구조의 한계가 세 군데서 드러났다. 논문 서론이 꼽은 세 가지 고질병이다.
1-2. 고질병 ① — 오래된 정보를 세밀하게 꺼내지 못한다
수십 번의 대화가 쌓이면 "그 얘기 언제 했더라?"가 핵심 질문이 된다. 그런데 벡터 검색은 뜻이 비슷한 것을 찾는 기계다. "6월에 뭐 했지?"라는 질문을 받으면 '6월'이라는 조건보다 '뭐 했지'라는 활동의 뉘앙스에 끌려 엉뚱한 기억을 가져온다. 'ERR_QUOTA_429' 같은 오류 코드나 사람 이름처럼 정확히 맞아야 하는 단어에도 약하다.
사례 — 고객 지원 봇의 '지난번 그 건'. 석 달 전 환불 요청을 했던 고객이 다시 와서 "지난번 그 건 처리됐나요?"라고 묻는다. 벡터 검색은 '처리'라는 말과 비슷한 최근 대화 열 개를 가져온다. 정작 필요한 건 그 고객 이름으로, 그 시기에 열린 환불 티켓 하나다. 사람 상담원이라면 이름과 날짜로 찾았을 것이다.
1-3. 고질병 ② — 본 것과 믿는 것을 구분하지 못한다
이것이 이 논문의 진짜 문제의식이다. 다음 세 문장을 보자.
문장
무엇인가
메모리에 같은 형식으로 들어가면?
"환자가 '술은 끊었어요'라고 말했다."
관찰된 사실 (누가 무엇을 말했는가)
셋 다 "환자 — 금주"라는 한 줄로 저장되면 다음 진료 때 에이전트는 그것을 확인된 사실처럼 말한다.
"환자는 금주 중이다."
사실처럼 보이는 추론
"이 환자는 금주 약속을 지킬 사람으로 보인다."
에이전트의 판단(믿음)
인지심리학에는 이 문제를 가리키는 이름이 있다. 출처 모니터링(source monitoring). 1993년 마샤 존슨(Marcia Johnson) 연구진은 사람의 기억 오류 상당수가 내용이 아니라 출처를 헷갈려서 생긴다고 정리했다. 꿈에서 본 것을 실제로 겪었다고 믿고, 남에게 들은 이야기를 내가 본 것처럼 기억한다. 사람에게도 어려운 일을, 지금의 에이전트 메모리는 아예 구분할 칸조차 갖고 있지 않다.
사례 — 코딩 에이전트의 '확신에 찬 오해'. Claude Code나 Cursor 같은 코딩 에이전트를 써 본 사람이라면 익숙할 것이다. 에이전트가 한 번 package-lock.json을 보고 "이 프로젝트는 npm을 쓴다"고 추측했다가, 그 추측을 메모리 파일에 적어 둔다. 실제로는 팀이 몇 주 전에 pnpm으로 옮겼다. 다음 세션부터 에이전트는 그 메모를 '사실'로 읽고 계속 npm install을 돌린다. 추측이 사실의 옷을 입고 굳어 버린 것이다. 만약 메모리가 "lock 파일을 보고 npm이라고 판단함(확신 중간)"과 "팀장이 'pnpm으로 옮겼다'고 말함"을 구분해 두었다면, 두 번째가 들어오는 순간 첫 번째를 고쳤을 것이다.
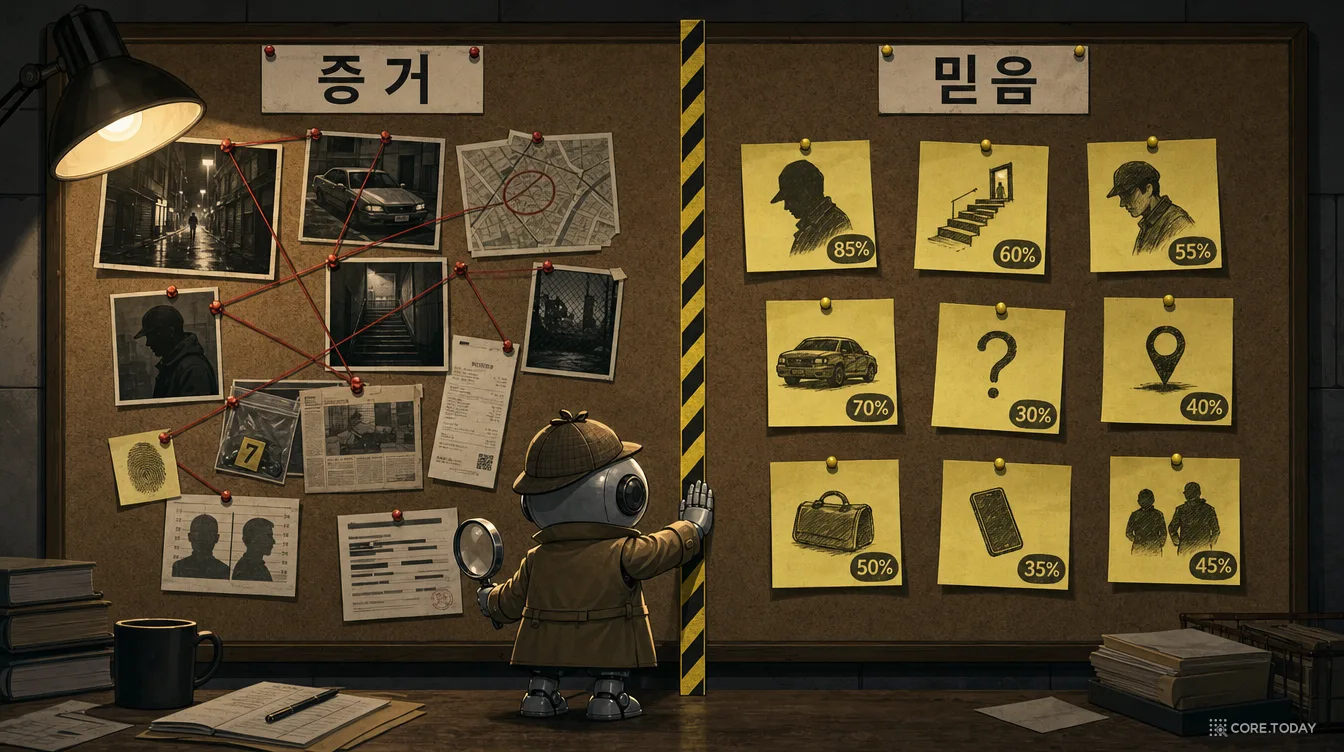
좋은 탐정은 증거판과 가설판을 나눈다. 왼쪽에는 사진·영수증·지문처럼 단단한 증거를 붙이고, 오른쪽에는 "범인은 왼손잡이일 것 — 60%" 같은 포스트잇을 붙인다. 새 증거가 나오면 포스트잇의 숫자를 고치거나 떼어 내지만, 증거판의 사진을 고쳐 그리지는 않는다. Hindsight가 에이전트 기억에 들여오려는 것이 바로 이 노란 테이프다. 논문은 이것을 인식론적 명료성(epistemic clarity) — 에이전트가 무엇을 아는지와 무엇을 믿는지를 개발자와 사용자가 볼 수 있게 하는 것 — 이라고 부른다.
1-4. 고질병 ③ — 성격이 매번 달라진다
세 번째는 선호 일관성(preference consistency)이다. 같은 에이전트가 어제는 신중하게 "근거가 부족합니다"라고 답하더니, 오늘은 같은 질문에 대담한 결론을 내린다. 논문 표현으로는 "국소적으로는 그럴듯하지만 전체적으로는 일관성 없는 응답"이다. 프롬프트 맨 위에 "너는 신중한 분석가다"라고 한 줄 적는 것만으로는 수백 세션에 걸친 일관성을 보장할 수 없다. 특히 에이전트가 시간이 지나며 의견을 쌓아 가기 시작하면, 그 의견이 어떤 성향에서 나왔는지가 기록되어야 다음에도 같은 결로 판단할 수 있다.
사례 — 투자 리서치 에이전트. 한 증권사가 "보수적 리스크 분석" 에이전트와 "공격적 성장주 발굴" 에이전트를 함께 운영한다고 하자. 두 에이전트는 같은 공시와 뉴스를 읽는다. 원하는 건 같은 사실에서 서로 다른 관점의 의견이 나오되, 각 에이전트는 몇 달이 지나도 자기 관점을 유지하는 것이다. 그리고 감사(audit)할 때 "이 의견은 어떤 사실에서, 어떤 성향으로 나왔는가"를 추적할 수 있어야 한다.
1-5. "그냥 컨텍스트를 길게 하면 되지 않나?"
2026년의 모델들은 100만 토큰짜리 컨텍스트 창을 갖고 있다. 대화 기록을 통째로 넣으면 기억 문제가 사라지지 않을까? 논문의 실험이 이 질문에 정면으로 답한다.
LongMemEval 벤치마크(대화당 약 11만 5천 토큰, 약 50세션)에서 대화 전체를 GPT-4o에 그대로 넣은 결과는 60.2%였다. 같은 일을 오픈소스 GPT-OSS-20B에 시키면 39.0%로 떨어진다. 특히 여러 세션에 흩어진 정보를 이어야 하는 '다중 세션' 문항에서는 각각 44.3%, 21.1%에 그쳤다. 반면 같은 20B 모델에 Hindsight 메모리를 붙이면 83.6%다.
왜 그럴까. 2023년 스탠퍼드 연구진의 「Lost in the Middle」은 긴 입력의 가운데에 있는 정보를 모델이 잘 못 쓴다는 것을 보였고, 2025년 Chroma의 '컨텍스트 부패(context rot)' 보고서는 입력이 길어질수록 같은 과제의 성능이 떨어진다는 것을 18개 모델에서 확인했다. 긴 컨텍스트는 저장 용량은 늘려 주지만 찾는 능력을 보장하지 않는다. 그리고 매 질문마다 11만 토큰을 다시 읽는 비용과 지연은 별개의 문제다. 기억은 창고의 크기가 아니라 색인의 문제다. (컨텍스트 부패에 대해서는 컨텍스트 부패와 컨텍스트 엔지니어링에서 자세히 다뤘다.)
2. 기억의 계보 — 140년의 아이디어가 한 아키텍처에 모이기까지
Hindsight를 처음 보면 부품이 많아 복잡해 보인다. 그런데 하나씩 뜯어보면 거의 모든 부품에 족보가 있다. 심리학자들이 사람의 기억을 연구하며 만든 개념, 검색 엔지니어들이 수십 년 다듬은 알고리즘, 그리고 2023년 이후 에이전트 연구자들의 실험이 한자리에 모였다.
2-1. 사람의 기억에서 빌려 온 것
털빙의 두 기억(1972). 캐나다 심리학자 엔델 털빙(Endel Tulving)은 "어제 아침 회의에서 팀장이 화를 냈다" 같은 일화 기억(episodic memory)과 "서울은 대한민국의 수도다" 같은 의미 기억(semantic memory)을 구분했다. 전자는 '나'와 '그때'가 붙은 기억이고, 후자는 시간과 무관한 지식이다. Hindsight의 경험 네트워크(B)와 세계 네트워크(W)가 정확히 이 구분이다. 경험 네트워크는 1인칭으로 쓴다 — "나는 앨리스에게 요세미티를 추천했다".
바틀렛의 재구성(1932). 영국 심리학자 프레더릭 바틀렛(Frederic Bartlett)은 케임브리지 학생들에게 북미 원주민 설화 「유령들의 전쟁」을 들려주고 시간이 지난 뒤 다시 말하게 했다. 학생들은 이야기를 그대로 기억하지 않았다. 낯선 부분은 빠지고, 자기 문화에 익숙한 방식으로 바뀌었다. 기억은 녹음이 아니라 재구성이다. Hindsight가 대화를 문장 단위로 쪼개지 않고 서사 단위로 저장하는 이유가 여기 있다(4장).
콜린스와 로프터스의 확산 활성화(1975). "소방차"를 떠올리면 "빨강"이 따라오고, "빨강"은 "사과"를, "사과"는 "과일"을 깨운다. 개념들이 그물처럼 연결되어 있고 활성이 그물을 타고 번진다는 이 모델은, Hindsight 회상 채널 중 하나인 그래프 확산 활성화의 직계 조상이다(5장).
믿음 수정 이론(1985). 논리학자 알초우론(Alchourrón)·가덴포스(Gärdenfors)·마킨슨(Makinson)의 AGM 이론은 "새 정보가 기존 믿음과 충돌할 때 무엇을, 얼마나 고쳐야 하는가"를 다뤘다. 최소한만 고치라는 것이 핵심이다. Hindsight의 의견 강화 규칙 — 증거 하나에 확신도를 조금씩만 움직인다 — 은 이 철학을 숫자로 옮긴 것에 가깝다(6장).
2-2. 검색 공학에서 빌려 온 것
Hindsight의 회상 파이프라인은 사실상 정보 검색(IR) 분야의 '명예의 전당'이다. 1990년대 런던 시티대학의 Okapi 시스템에서 다듬어진 BM25 키워드 순위 함수, 2009년 워털루대학의 코맥(Cormack)·클라크(Clarke)·뷔트허(Büttcher)가 제안한 역순위 융합(RRF), 2016년 말코프(Malkov)·야슈닌(Yashunin)의 근사 최근접 이웃 그래프 HNSW, 2019년 노게이라(Nogueira)·조경현의 BERT 크로스인코더 재정렬. 하나하나가 수천 회 인용된 고전이다. Hindsight는 이것들을 새로 발명하지 않았다. 잘 알려진 부품을 기억이라는 문제에 맞게 조립했다.
2-3. 에이전트 연구에서 빌려 온 것
Generative Agents(2023). 스탠퍼드의 박준성 연구진은 25명의 AI 주민이 사는 가상 마을 '스몰빌'을 만들었다. 주민들은 모든 경험을 기억 스트림에 쌓고, 최근성·중요도·관련성 점수로 꺼내 쓰고, 주기적으로 반성(reflection)해서 "클라우스는 연구에 열정적이다" 같은 상위 판단을 만들어 다시 기억에 넣었다. 밸런타인데이 파티 소문이 마을에 퍼지는 장면으로 유명하다. Hindsight의 reflect가 이 계보다. 기억에서 판단을 만들고, 그 판단을 다시 기억으로 저장한다.
MemGPT(2023). UC 버클리의 찰스 패커(Charles Packer) 연구진은 LLM을 운영체제처럼 다루자고 했다. 컨텍스트 창을 RAM, 외부 저장소를 디스크로 보고, LLM이 스스로 함수를 호출해 기억을 넣고 뺀다. MemGPT는 이후 Letta라는 회사가 됐다. Hindsight 논문이 비교표 맨 앞에 두는 시스템이다.
2025년의 3인방. Zep은 사실마다 '유효했던 시간'과 '기록된 시간'을 따로 다는 이중 시간(bi-temporal) 지식 그래프를 만들었다. A-Mem은 독일 사회학자 니클라스 루만의 메모 상자 기법 제텔카스텐처럼 원자적 노트끼리 링크를 걸고 진화시켰다. Mem0는 대화에서 사실을 뽑아 추가·갱신·삭제하는 프로덕션용 메모리를 내놓았다. (각각 Zep 시간 지식 그래프, Mem0 그래프 메모리 가이드에서 다뤘다.)
2-4. 논문의 비교표 — 무엇이 비어 있었나
논문 Table 1은 이 시스템들을 여덟 가지 기능으로 비교한다. 체크 표시가 Hindsight 열에만 몰려 있는 표라 조금 걸러 들어야 하지만(저자가 고른 기준이니까), 무엇을 새로 하려 했는지는 분명히 보여 준다.
기능
MemGPT
Zep
A-Mem
Mem0
Memory-R1
Hindsight
사실과 의견을 분리
✗
✗
✗
✗
✗
✓
시간 추론
✗
✓
✗
✗
✗
✓
엔티티 인식 그래프
✗
✓
✓
✓
✗
✓
의견의 진화
✗
✗
✗
✗
✗
✓
성향(행동) 파라미터
✗
✗
✗
✗
✗
✓
확신도 점수
✗
✗
✗
✗
✗
✓
외부 기억만 사용
✓
✓
✓
✓
✓
✓
다중 전략 검색
✗
✗
✗
부분
✗
✓
시간 추론과 엔티티 그래프는 Zep이 이미 했다. Hindsight가 새로 내건 것은 아래쪽 세 줄 — 의견의 진화, 성향 파라미터, 확신도 — 와 맨 위 한 줄 — 사실과 의견의 분리 — 이다. 기억을 "무엇을 저장하느냐"의 문제에서 "어떤 종류의 앎으로 저장하느냐"의 문제로 옮긴 것이다. 한 가지 미리 말해 두자면, 이 네 줄 중 셋은 열 달 뒤 제품에서 크게 바뀐다(8장).
3. 핵심 개념 ① — 네 개의 서랍
3-1. M = {W, B, O, S}
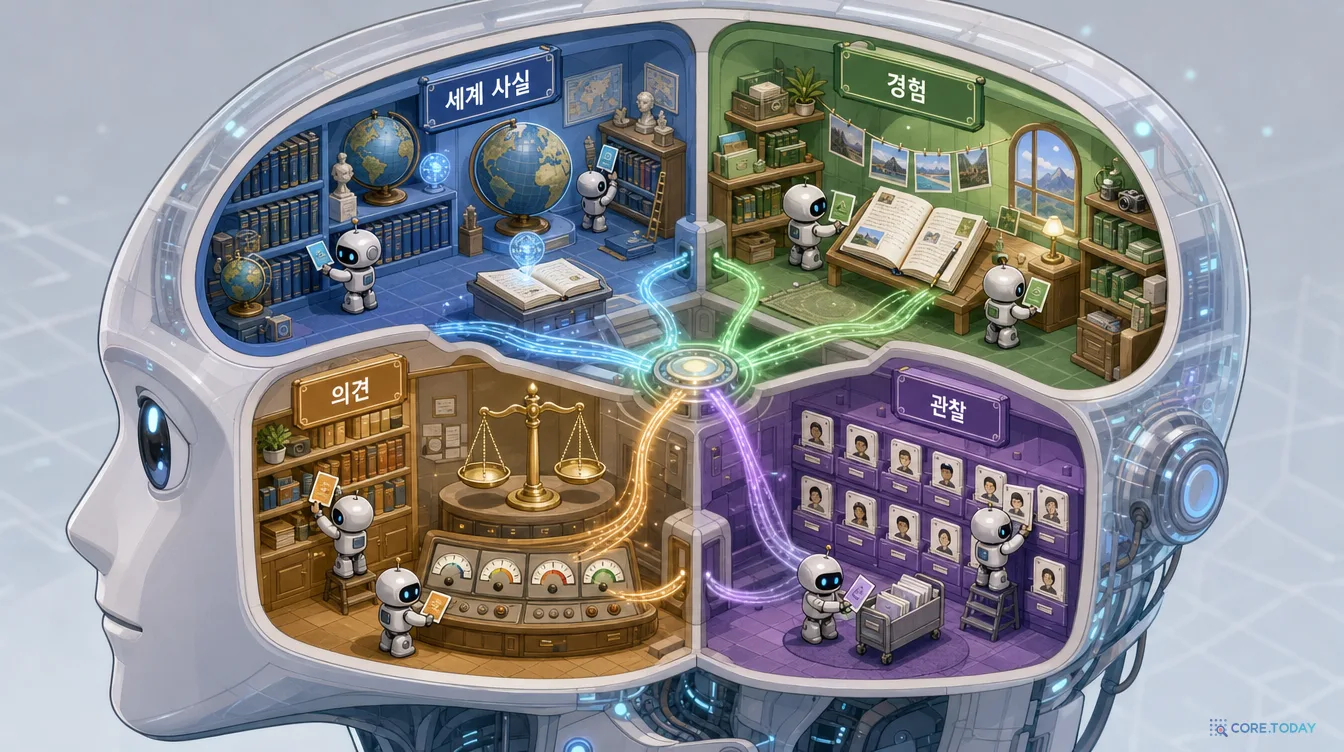
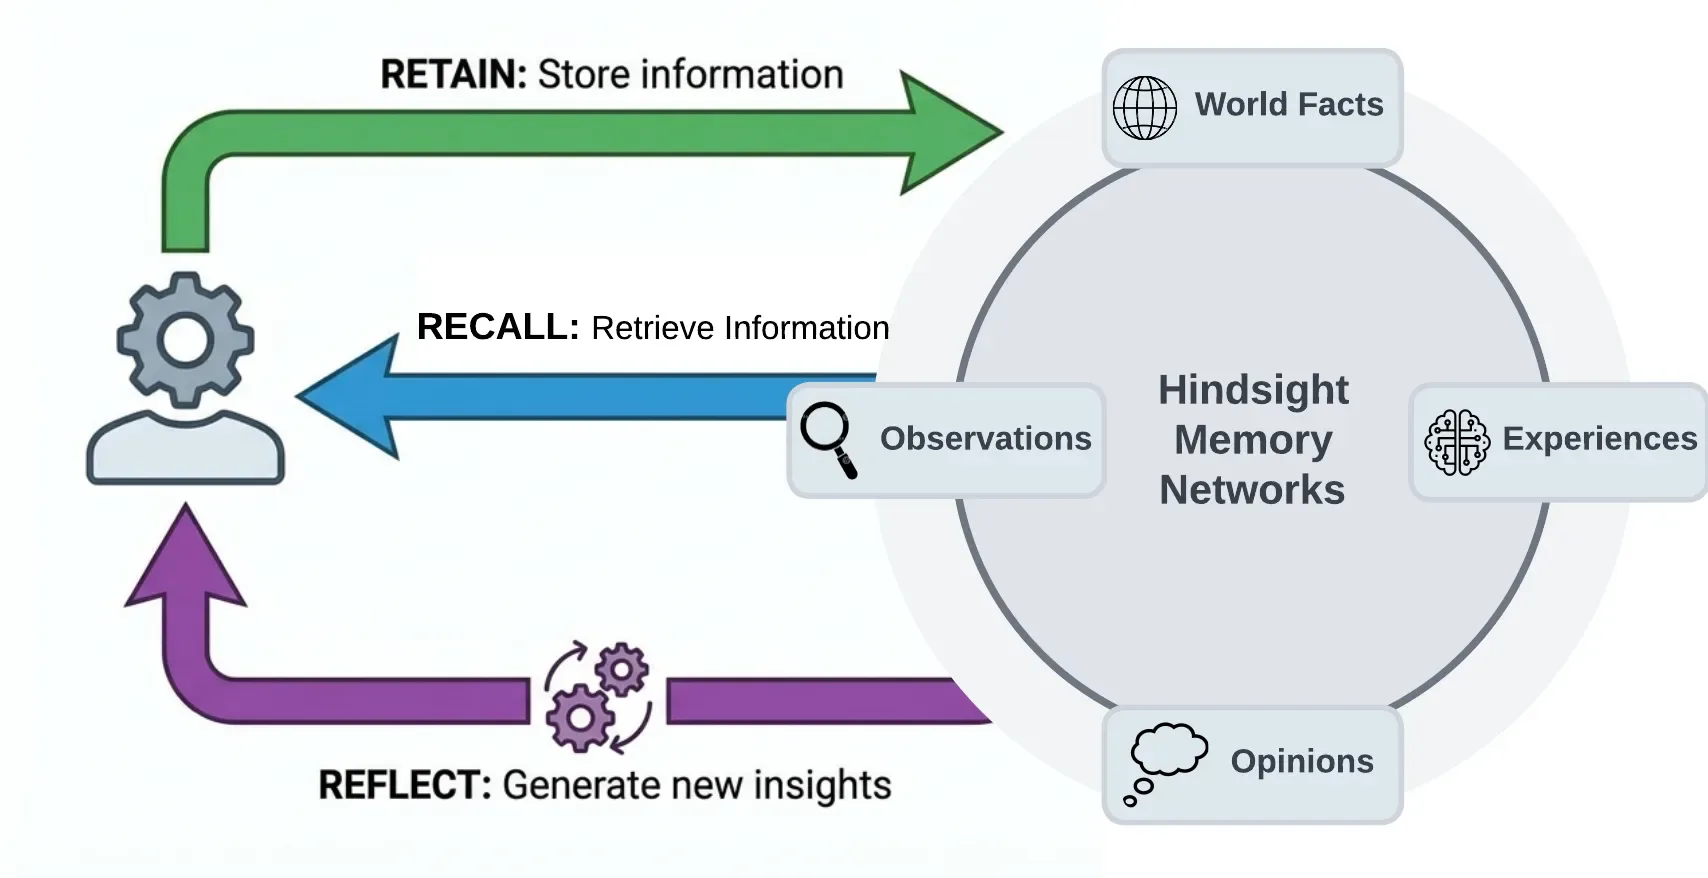
Hindsight의 기억 은행(memory bank)은 네 개의 논리적 네트워크로 나뉜다. 논문은 이것을 M={W,B,O,S}라고 쓴다. 네 글자는 각각 World, Biographical(경험), Opinion, Summary(관찰)의 머리글자다. 논문 Figure 1의 예시를 그대로 옮기면 이렇다.
W · 세계(World)"Alice는 마운틴뷰의 구글 AI팀에서 일한다."에이전트 관점과 무관한 객관적 사실 — 관계·속성·사건
B · 경험(Experience)"나는 Alice에게 하이킹 장소로 요세미티를 추천했다."에이전트 자신의 행동·경험·추천 — 1인칭으로 쓴다
O · 의견(Opinion)"pandas 같은 라이브러리 덕분에 데이터 과학에는 Python이 낫다." (확신도 0.85)에이전트의 주관적 판단 — (t, c, τ): 문장·확신도·형성 시각
S · 관찰(Observation)"Alice는 머신러닝을 전문으로 하는 구글의 소프트웨어 엔지니어다."여러 사실을 합성한 엔티티 요약 — 성향 영향 없이 중립적으로
W와 B는 증거, O는 믿음, S는 증거를 압축한 요약이다. 논문 3.4절은 이것을 설계 원칙 첫 번째로 못 박는다. "사실·관찰·의견을 구조적으로 떼어 놓아 에이전트가 무엇을 아는지와 무엇을 믿는지를 볼 수 있게 한다."
3-2. 관찰과 의견은 어떻게 다른가
헷갈리기 쉬운 두 칸이 관찰(S)과 의견(O)이다. 둘 다 여러 사실을 보고 만든 '2차 기억'이기 때문이다. 논문 4.1.5절은 네 가지 차이를 든다.
차원
관찰 S
의견 O
성향의 영향
없음 — "객관적 관찰자"로서 쓰라는 프롬프트
있음 — 회의감·문자주의·공감 다이얼이 반영
내용
역할·속성 같은 객관적 요약
평가·판단
확신도
없음
c ∈ [0, 1]
언제 만들어지나
백그라운드에서 합성, 밑바탕 사실이 바뀌면 재생성
성찰(reflect) 중에 형성, 증거가 오면 강화·약화
부록 A.3의 관찰 생성 프롬프트에는 좋은 예와 나쁜 예가 나란히 적혀 있다. "John은 구글에서 소프트웨어 엔지니어로 일한다"는 좋은 관찰이다. "John은 좋은 사람 같다"(판단), "John은 아마 자기 일을 좋아할 것이다"(추측), "나는 John이 믿을 만하다고 생각한다"(1인칭 의견)는 나쁜 관찰이다. 판단이 한 방울이라도 섞이면 그건 관찰이 아니라 의견이다.
3-3. 직접 분류해 보기
말로 들으면 쉬워 보이지만 실제로 분류해 보면 함정이 있다. 여행 비서 에이전트 '여정'이 사용자 민지와 대화하며 쌓은 기억 열 장을 네 서랍에 나눠 넣어 보자.
가장 많이 틀리는 카드는 "민지는 '이번엔 바다 보이는 숙소가 좋겠어'라고 말했다"다. 취향이니까 의견 같지만, 그 취향을 가진 건 민지다. 에이전트 입장에서 "민지가 그렇게 말했다"는 건 관찰된 사실이므로 세계 네트워크로 간다. 의견 네트워크는 오직 에이전트 자신의 판단만 담는다. 이 구분이 무너지면 에이전트는 사용자의 말과 자기 추측을 같은 무게로 섞어 버린다. 앞에서 본 코딩 에이전트의 npm/pnpm 사고가 정확히 그런 경우다.
3-4. 기억 한 장의 '주민등록증'
네 네트워크에 들어가는 기억 한 단위(memory unit)는 열 개의 필드를 가진 튜플이다(식 1).
f=(u,b,t,v,τs,τe,τm,ℓ,c,x)
기호
이름
예시
u
고유 ID
mem_8f2a…
b
은행(bank) ID — 누구의 기억인가
user-minji
t
서사형 텍스트
"민지는 6월 14일 토요일 한라산 영실 코스를 올랐다. 비가 와서…"
v
임베딩 벡터 (v ∈ ℝᵈ)
[0.012, −0.334, …]
τs, τe
사건이 일어난 기간 (시작·끝)
2026-06-14 ~ 2026-06-14
τm
그 얘기를 들은 시각 (mention)
2026-06-16
ℓ
종류 — world / experience / opinion / observation
world
c
확신도 (의견만)
—
x
부가 메타데이터 — 맥락, 접근 횟수, 전문 검색 벡터
{context: "여행 상담"}
여기서 눈여겨볼 것은 시간이 세 개라는 점이다. 10월 10일에 사용자가 "지난주에 이사했어"라고 말하면, 이사라는 사건은 10월 첫째 주(τs~τe)에 일어났지만 에이전트가 그 사실을 안 건 10월 10일(τm)이다. 둘을 섞으면 "10월 첫째 주에 무슨 일 있었지?"에는 답하지 못하고 "10월 10일에 무슨 일 있었지?"에 엉뚱하게 이사를 꺼낸다. Zep의 이중 시간 모델과 같은 문제의식이다. 사건 기간이 '점'이 아니라 '구간'이라는 점도 중요하다. "3월부터 5월까지 다이어트를 했다"는 하나의 구간으로 저장되어야, 4월에 대한 질문과 겹친다는 것을 계산할 수 있다(식 13).
4. 핵심 개념 ② — 저장(Retain): 대화를 기억으로 바꾸는 공장
4-1. 전체 지도 먼저
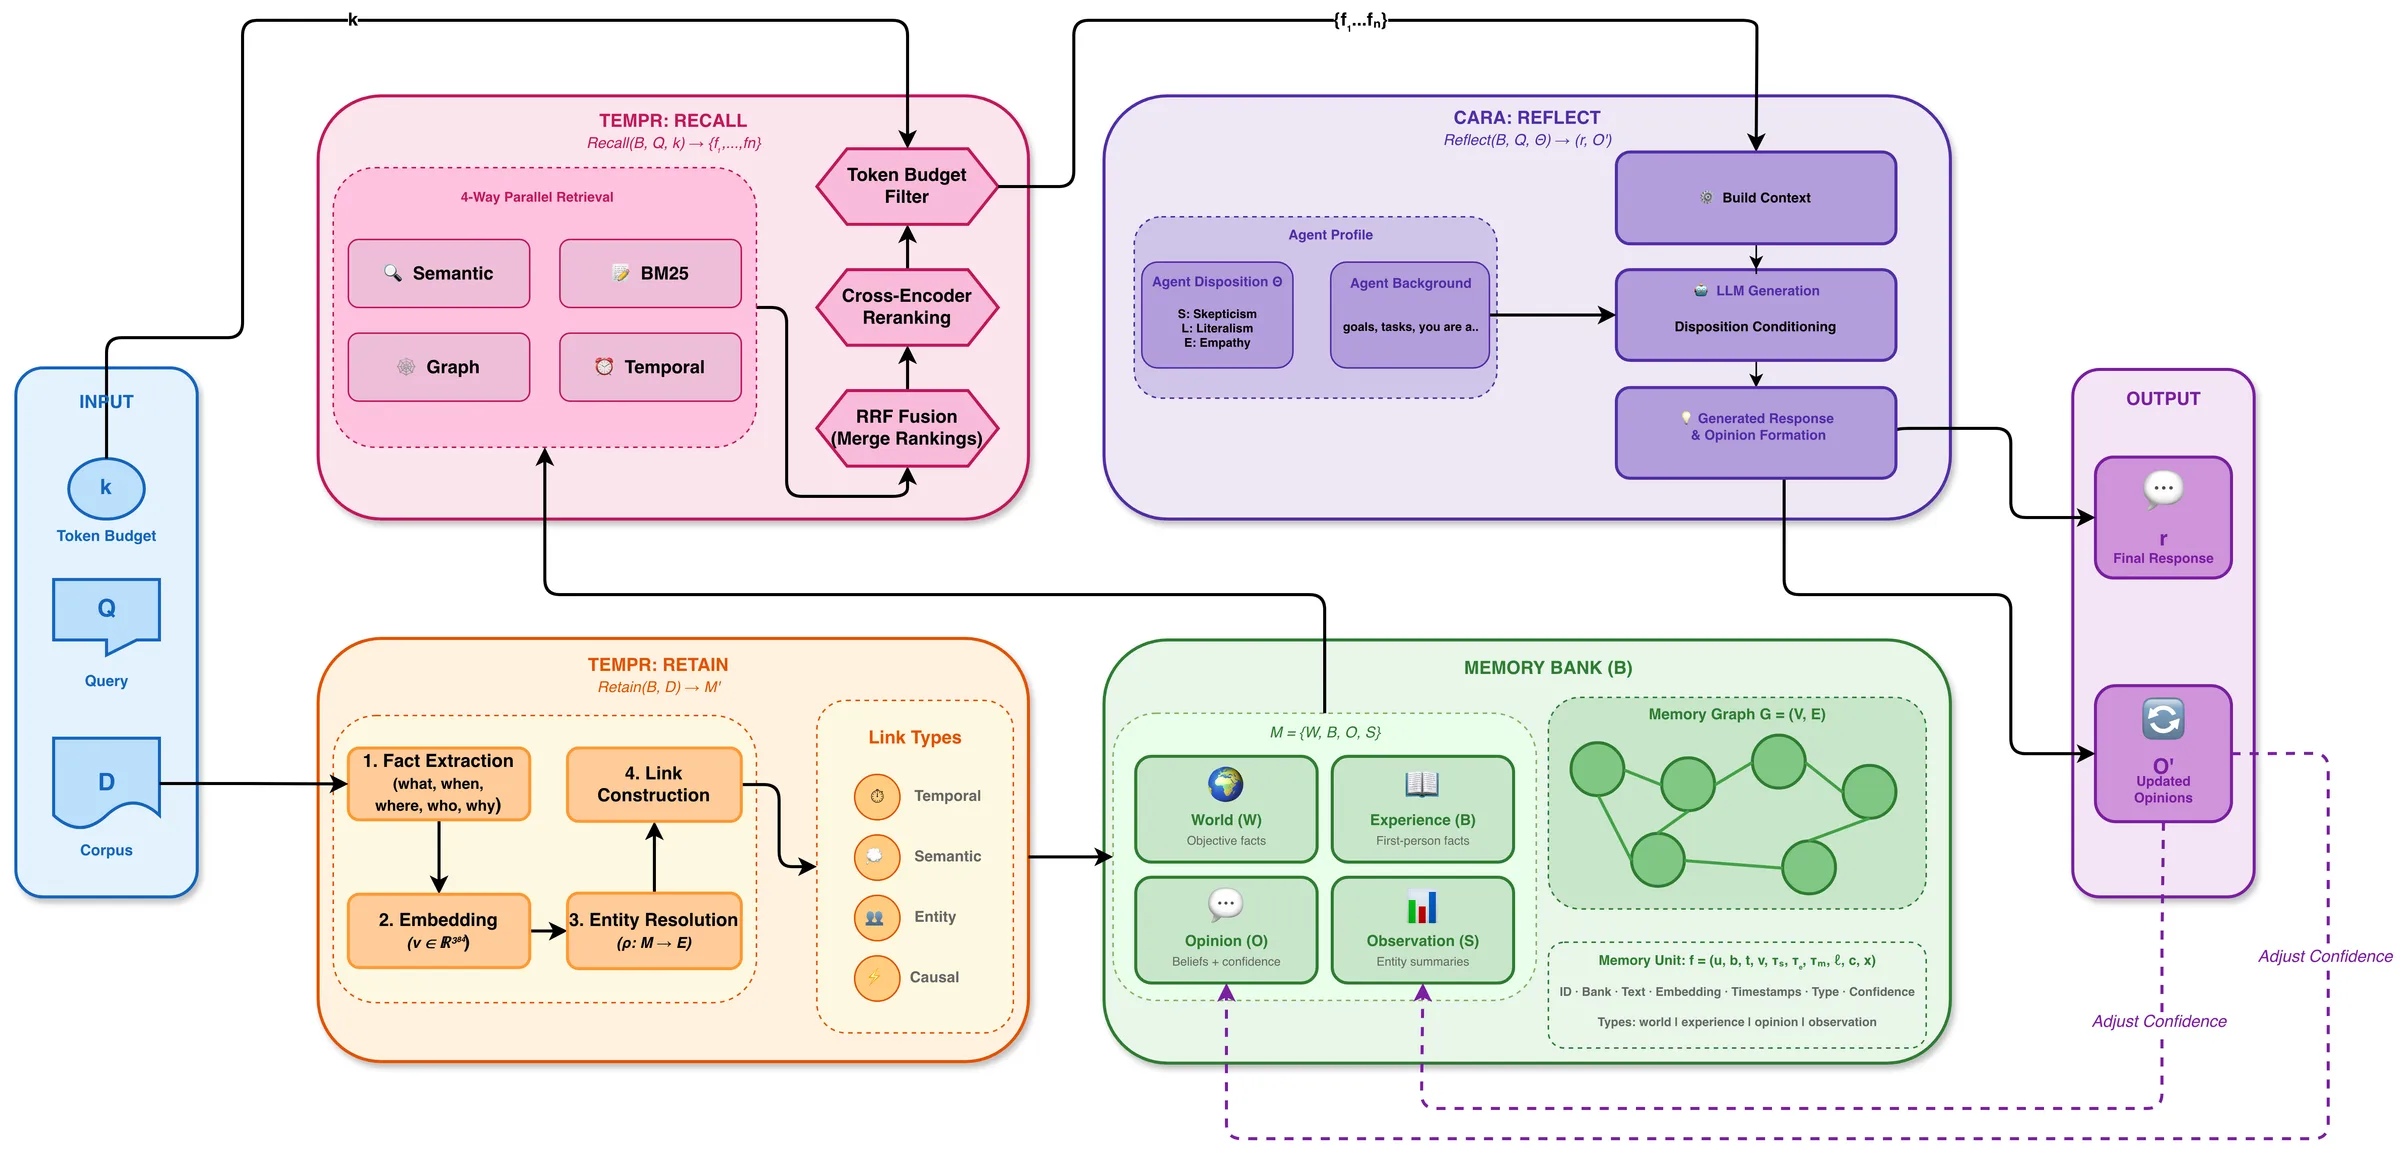
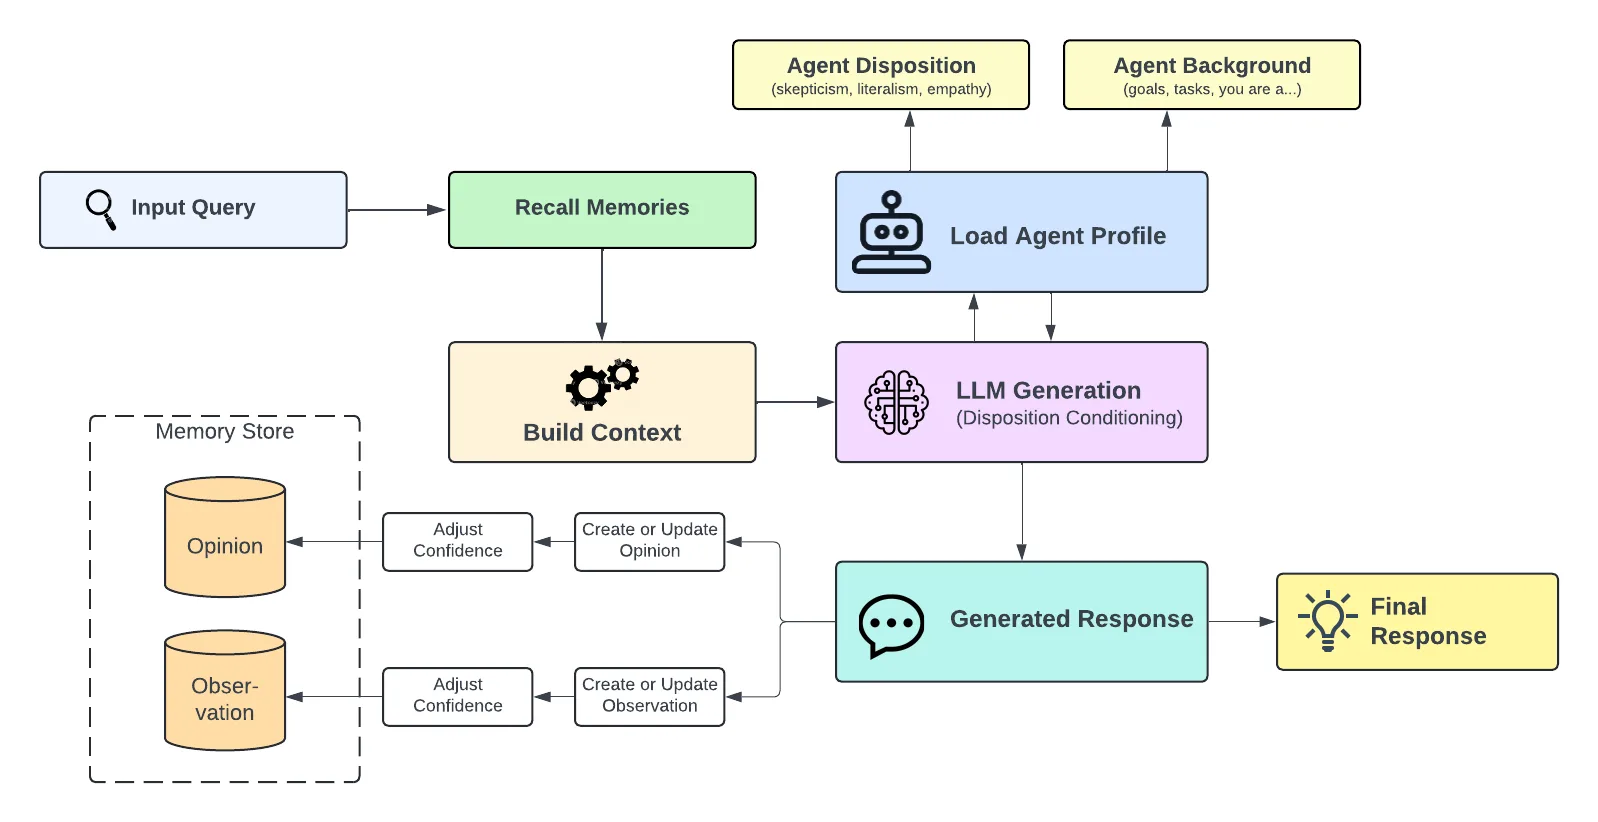
세 동작을 하나씩 보기 전에 전체 그림을 보자. 논문 Figure 2는 Hindsight의 모든 부품을 한 장에 담았다.
TEMPR(Temporal Entity Memory Priming Retrieval, 시간·엔티티 기억 점화 검색) — 저장(retain)과 회상(recall)을 맡는다. 그림의 주황색(아래)과 분홍색(위) 상자다.
CARA(Coherent Adaptive Reasoning Agents, 일관되고 적응적인 추론 에이전트) — 성찰(reflect)을 맡는다. 그림의 보라색 상자다.
데이터는 왼쪽 아래 말뭉치 D에서 출발해 주황색 저장 파이프라인을 거쳐 초록색 메모리 은행에 쌓인다. 질문 Q가 오면 분홍색 회상 파이프라인이 은행에서 기억을 꺼내 토큰 예산 k에 맞게 자르고, 보라색 CARA가 성향 프로필과 함께 그 기억을 받아 답 r을 쓴다. 답을 쓰는 동안 새 의견이 생기면 점선 화살표("Adjust Confidence")를 따라 다시 은행의 의견·관찰 네트워크로 돌아간다. 기억 → 판단 → 다시 기억의 순환이다.
"Alice와 Bob은 여름 파티 플레이리스트 이름을 논의했다. Bob은 귀에 잘 붙고 계절감이 있다며 'Summer Vibes'를 제안했지만 Alice는 더 독특한 것을 원했다. Bob이 'Sunset Sessions'와 'Beach Beats'를 내놓자 Alice는 장난스럽고 재미있는 느낌의 'Beach Beats'를 선호했고, 둘은 최종적으로 'Beach Beats'로 정했다."
조각 다섯 개 중 하나만 검색되면 무슨 일이 생길까. "Alice는 'Beach Beats'를 좋아한다"만 꺼내 오면 왜 좋아했는지, 그게 최종 결정이었는지 알 수 없다. "그들은 'Sunset Sessions'를 고려했다"만 꺼내 오면 아예 틀린 답을 하게 된다. 서사형 사실 하나는 이유(왜 Summer Vibes가 탈락했나)와 흐름(제안 → 반대 → 대안 → 결정)을 함께 담는다. 바틀렛이 말한 기억의 재구성 — 사람은 사건을 이야기로 기억한다 — 을 저장 단계에서 미리 해 두는 셈이다.
TEMPR는 대화 하나당 2~5개의 포괄적 사실만 뽑는 '굵은 청킹(coarse-grained chunking)'을 쓴다. 각 사실은 한 발화가 아니라 한 주고받음 전체를 덮고, 그 자체로 읽혀야 하며(self-contained), 관련된 모든 참여자를 포함해야 한다. 2026년 10월에 다른 연구진이 12개 메모리 시스템을 같은 조건에서 비교한 결과도 같은 방향을 가리켰다. "쓰기 시점에 공격적으로 거르지 말고 맥락을 보존하라." 정밀한 사실 추출이 다중 홉 추론 점수를 40.8에서 5.0으로 무너뜨린 사례까지 있었다. (자세한 내용은 에이전트 네이티브 메모리, 준비됐나?에서 다뤘다.)
4-3. 추출 파이프라인의 여섯 단계
부록 A.1의 사실 추출 프롬프트는 거의 절규에 가깝다. "극도로 자세하게(BE EXTREMELY DETAILED)", "최대 장황함(MAXIMUM VERBOSITY)", "절대 요약하거나 생략하지 말 것". 각 사실에 다섯 개의 차원을 반드시 채우라고 한다.
what
무슨 일이 있었나 — 사물·행동·수량·세부를 전부
when
언제 — 반드시 요일까지. "Saturday, June 9, 2024" 형식
where
어디서 — 구체적 장소·지역
who
누가 — 모든 사람·엔티티와 그 관계·배경
why
왜 중요한가 — 감정·선호·동기·뉘앙스. 어시스턴트 발화라면 사용자가 무엇을 요청해서 나온 말인지까지
요일을 굳이 넣으라는 이유가 재미있다. "지난 토요일에 등산 갔어"라는 말을 나중에 찾으려면, 저장된 날짜에 '토요일'이 문자로 적혀 있어야 키워드 검색과 재정렬 모델이 연결할 수 있다. 실제로 논문은 임베딩 전에 각 사실에 사람이 읽을 수 있는 시간 표현을 덧붙여 시간 인식을 높인다고 적었다.
내부적으로는 여섯 단계로 나뉜다(§4.1.2).
① 공지시 해소
"내 룸메이트 에밀리가 결혼했어. 걔 구글 다녀." → "에밀리(사용자의 룸메이트)가 결혼했다. 에밀리는 구글에서 일한다." '룸메이트'와 '에밀리'를 같은 사람으로 묶는다. 부록 프롬프트가 "CRITICAL"이라고 강조하는 부분이다.
② 시간 정규화
"지난주", "3월에" 같은 상대 표현을 절대 시각 구간 (τs, τe)로 바꾼다.
③ 참여자 귀속
누가 무엇을 했고 누가 무엇을 말했는지 정한다. "추천했다"의 주어가 에이전트냐 사용자냐에 따라 경험(B)이냐 세계(W)냐가 갈린다.
④ 이유 보존
대화에 명시된 근거·정당화를 버리지 않는다.
⑤ 종류 분류
world / experience / opinion 중 하나로 분류해 들어갈 네트워크를 정한다.
결과는 Pydantic 스키마(부록 A.5)로 강제된다. what·when·where·who·why 다섯 문자열, fact_type, 선택적인 occurred_start/end·mentioned_at, 엔티티 목록, 그리고 인과 관계 목록이다. 인과 관계는 "이 사실이 몇 번째 사실을 일으켰나/막았나"를 causes·caused_by·enables·prevents 네 종류와 0~1 강도로 적는다.
python
classExtractedFact(BaseModel):
what: str# 모든 세부를 담은 완전한 서술
when: str# 요일을 포함한 시간 정보
where: str# 구체적 장소
who: str# 관련된 모든 사람·엔티티와 관계
why: str# 감정·선호·동기
fact_type: Literal["world", "experience", "opinion"]
occurred_start: Optional[str] = None
occurred_end: Optional[str] = None
mentioned_at: Optional[str] = None
entities: Optional[List[Entity]] = None
causal_relations: Optional[List[CausalRelation]] = None
4-4. 같은 사람을 같은 사람으로 — 엔티티 해소
"서준", "팀장님", "서준 팀장", "Seojun"이 모두 같은 사람이라는 걸 알아야 그래프가 의미를 갖는다. TEMPR는 언급(mention) m을 정규 엔티티 e에 대응시키는 함수 ρ를 세 가지 유사도의 가중합으로 정의한다(식 2).
문자열 유사도 — 레벤슈타인 거리 같은 이름 비슷함. "Seojun"과 "서준"은 여기서 못 잡지만 "서준 팀장"과 "서준"은 잡는다.
동시 출현 유사도 — 같이 언급되는 다른 엔티티가 겹치는가. "팀장님"이 늘 "마라톤", "동호회"와 함께 나오고 "서준"도 그렇다면 같은 사람일 가능성이 높다.
시간 근접성 — 비슷한 시기에 언급되는가.
이렇게 묶인 엔티티 하나는 그것을 언급한 모든 기억 사이에 가중치 1.0짜리 양방향 링크를 만든다(식 3). 이 링크 덕분에 석 달 간격으로 따로 나온 서준 이야기들이 그래프 위에서 한 다리 건너 이웃이 된다. 2026년 제품 문서는 여기에 한 가지를 더 강조한다. 다국어 보존 — "张伟는 'Zhang Wei'가 아니라 张伟로 남는다". 한국어 이름도 로마자로 바뀌지 않고 원래 문자로 엔티티가 된다는 뜻이다.
4-5. 네 종류의 실 — 링크 유형
메모리 그래프 G=(V,E)의 간선은 네 종류다(§4.1.4).
링크
언제 생기나
가중치
예시
엔티티
두 기억이 같은 엔티티를 언급
항상 1.0
"서준 동호회 회장" — "서준 무릎 부상"
시간
두 기억이 시간상 가까움
w=exp(−Δt/σt) — 멀수록 지수적으로 약해짐
"8/4 밤샘" — "8/5 오류 해결"
의미
임베딩 코사인 유사도가 임계값 θs 이상
코사인 유사도 그 자체
"러닝 밴드" — "러닝 기어 할인"
인과
LLM이 원인-결과 관계를 추출
1.0, 탐색 시 가중
"무릎 부상" → (causes) → "압박 밴드 착용"
시간 링크의 가중치 공식이 에빙하우스의 망각 곡선과 같은 모양이라는 점이 흥미롭다. 1885년 에빙하우스는 외운 음절이 시간에 따라 지수적으로 잊힌다는 것을 보였다. TEMPR에서는 두 기억 사이의 연결이 시간 거리에 따라 지수적으로 약해진다.
4-6. 관찰은 백그라운드에서 — 엔티티 요약의 비동기 합성
"민지에 대해 알려 줘" 같은 질문에 민지를 언급한 사실 마흔 개를 전부 꺼내는 건 낭비다. 그래서 TEMPR는 엔티티별 요약, 즉 관찰을 따로 만든다(식 6).
oe=SummarizeLLM(Fe)
Fe는 엔티티 e를 언급한 모든 사실의 집합이다. 중요한 건 언제 만드느냐다. 관찰 생성은 비동기 백그라운드 작업이다. 새 사실이 들어오면 저장 자체는 바로 끝내고(쓰기 지연을 낮게 유지), 그 엔티티의 관찰을 다시 계산하는 일은 뒤에서 천천히 돌린다. 사람으로 치면 낮에 겪은 일을 밤에 자면서 정리하는 것과 비슷하다. 실제로 신경과학에는 수면 중 해마가 낮의 기억을 재생하며 피질로 옮긴다는 기억 공고화(consolidation) 이론이 있다. 2026년 Hindsight 제품이 이 기능을 아예 'consolidation(공고화)'이라고 부르게 된 건 우연이 아닐 것이다(8장).
5. 핵심 개념 ③ — 회상(Recall): 네 마리 탐색견
5-1. 'top-k'가 아니라 '토큰 예산'
기존 검색 시스템은 "가장 비슷한 것 5개"를 돌려준다. TEMPR는 이 인터페이스를 버린다. 대신 "이 가방에 들어가는 만큼"을 돌려준다(식 7–8).
Recall(B,Q,k)→{f1,…,fn},i=1∑n∣fi∣≤k
여기서 k는 개수가 아니라 토큰 수다. 왜 이게 중요할까. 도서관 사서에게 "책 다섯 권 주세요"라고 하면, 두꺼운 백과사전 다섯 권이 올 수도 있고 팸플릿 다섯 장이 올 수도 있다. 정말 필요한 건 "제 가방에 들어갈 만큼 주세요"다. 에이전트의 가방은 컨텍스트 창이고, 다른 도구 결과·시스템 프롬프트와 나눠 써야 한다. 간단한 질문에는 조금만, 여러 단계를 이어야 하는 복잡한 질문에는 넉넉하게 — 호출하는 쪽이 비용과 범위를 직접 조절한다. 논문은 이것을 '에이전트 최적화 검색 인터페이스'라고 부른다.
5-2. 네 채널을 동시에
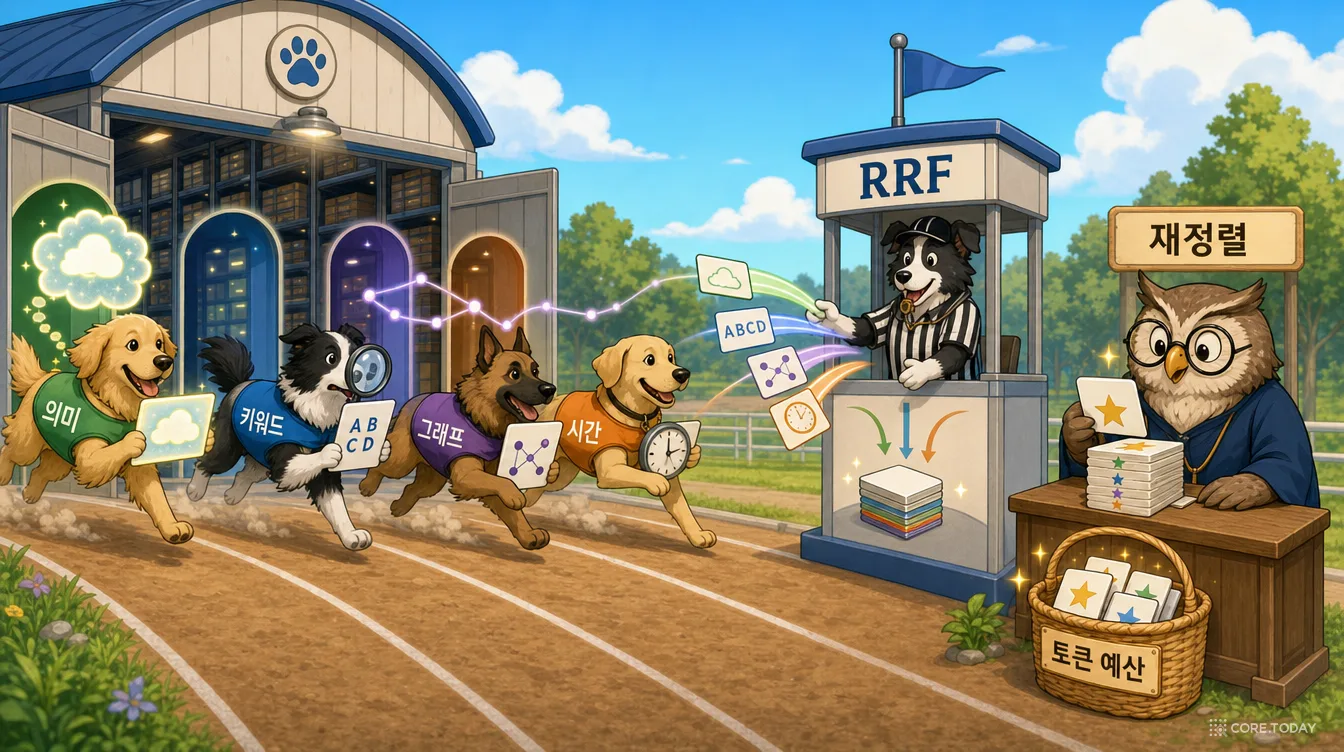
질문이 들어오면 TEMPR는 네 개의 검색 채널을 병렬로 돌린다. 각 채널은 '관련 있다'의 서로 다른 의미를 잡는다.
시간 채널을 조금 더 보자. "어제", "지난 주말", "2024년 6월" 같은 표현은 먼저 다국어를 지원하는 기성 날짜 파싱 라이브러리 두 개로 처리한다. 대부분의 질문은 여기서 끝난다(빠르다). 규칙으로 안 풀리는 표현만 구글의 작은 시퀀스-투-시퀀스 모델 flan-t5-small에게 넘겨 날짜 구간 [τstart,τend]로 바꾼다. 그다음 사건 기간이 질문 구간과 겹치는 기억만 고른다.
Rtemp={f∈V:[τsf,τef]∩[τstart,τend]=∅}
겹치는 기억들은 질문 구간의 한가운데에 가까울수록 높은 점수를 받는다(식 14). 6월을 물으면 6월 15일 일이 6월 1일 일보다 약간 앞선다.
5-3. 역순위 융합(RRF) — 점수가 아니라 순위로 합친다
네 채널이 각자 순위 목록을 내놓으면 이걸 하나로 합쳐야 한다. 문제는 점수의 단위가 제각각이라는 점이다. 코사인 유사도는 0~1, BM25 점수는 0~수십, 활성화 값은 또 다르다. 이걸 그냥 더하면 BM25가 다 이긴다. RRF는 점수를 버리고 순위만 쓴다(식 15).
RRF(f)=i=1∑4k+ri(f)1
ri(f)는 채널 i에서 기억 f의 순위, k는 작은 상수(보통 60)다. 목록에 없으면 ri=∞, 즉 0을 더한다. 숫자로 해 보자. 기억 A가 의미 1위, 키워드 3위, 그래프와 시간 채널에는 없다면,
RRF(A)=60+11+60+31≈0.0164+0.0159=0.0323
기억 B가 네 채널 모두에서 4위라면 4×641=0.0625로 A의 거의 두 배다. 어느 한 채널에서 1등 하는 것보다 여러 채널에서 고르게 등장하는 것이 유리하다. 독립적인 증거가 여러 개 모일수록 믿을 만하다는 직관이다. 논문은 RRF의 장점을 세 가지로 정리한다. 점수 보정이 필요 없고, 한 채널에서 빠진 후보를 벌주지 않으며, 다중 증거를 가진 후보가 자연스럽게 위로 올라온다.
5-4. 크로스인코더 재정렬 — 마지막 심사
RRF로 합친 후보는 다시 크로스인코더가 한 번 더 줄을 세운다(식 16). 사용하는 모델은 cross-encoder/ms-marco-MiniLM-L-6-v2. 마이크로소프트의 MS MARCO 검색 데이터로 학습된 작은 모델이다.
벡터 검색의 임베딩은 질문과 기억을 따로 숫자로 바꾼 뒤 거리를 잰다(바이인코더). 크로스인코더는 질문과 기억을 한 입력에 같이 넣고 둘의 관계를 직접 읽는다. 훨씬 정확하지만 후보 하나하나에 모델을 돌려야 해서 느리다. 그래서 수만 개 중에서는 쓸 수 없고, 네 채널과 RRF가 추린 수십 개에만 쓴다. 넓게 그물을 던지고(4채널), 합치고(RRF), 꼼꼼히 고른다(크로스인코더). TEMPR는 여기에 한 가지를 보탠다. 재정렬 모델의 입력 텍스트에 형식화된 시간 정보를 넣어, 작은 모델도 "6월"과 "2026-06-14 (토)"를 연결할 수 있게 한다.
5-5. 토큰 예산 채우기
마지막은 단순하다. 재정렬된 순서대로 기억을 가방에 넣다가, 다음 것이 들어가지 않으면 멈춘다(식 17). 탐욕적(greedy) 채우기다.
이제 직접 해 보자. 아래 실험실에서 세 가지 질문을 골라 채널을 하나씩 꺼 보라. 정답 근거(★)가 바구니에 담기는지 보면 각 채널이 어떤 질문에서 필요한지 몸으로 알 수 있다.
두 번째 질문 "민지 팀장은 무슨 운동 해?"가 핵심이다. 정답 기억 "서준은 사내 마라톤 동호회 회장이다"에는 '민지'도 '팀장'도 없다. 벡터 검색도 키워드 검색도 이 기억을 찾지 못한다. 유일한 길은 "팀장님(서준)이 춘천마라톤에 나가신대"라는 다른 기억에서 서준이라는 엔티티를 거쳐 건너가는 것이다. 이게 그래프 채널, 확산 활성화가 하는 일이다.
5-6. 확산 활성화 — 기억이 기억을 깨운다
그래프 채널은 의미 검색 상위 결과를 '진입점'으로 삼아 활성(activation)을 흘려보낸다. 진입점의 초기 활성은 그 기억의 의미 유사도다. 한 단계마다 활성은 간선을 타고 이웃으로 번진다(식 12).
A(fj,t+1)=(fi,fj,w,ℓ)∈Emax[A(fi,t)⋅w⋅δ⋅μ(ℓ)]
w — 간선의 가중치(엔티티·인과는 1.0, 시간·의미는 그보다 작다)
δ∈(0,1) — 감쇠 계수. 한 다리 건널 때마다 활성이 줄어든다
μ(ℓ) — 링크 종류별 배수. 인과·엔티티 링크는 μ>1, 약한 의미·먼 시간 링크는 μ≤1
이 마지막 항이 설계자의 철학을 드러낸다. "같은 사람에 관한 이야기"와 "원인-결과로 이어진 이야기"는 "뜻이 비슷한 이야기"보다 더 멀리 퍼지게 한다. 특히 인과 링크를 우대하는 건 설명을 찾기 위해서다. "왜 서준은 압박 밴드를 쓰지?"라는 질문에는 의미적으로 비슷한 기억보다 원인이 된 기억(무릎 부상)이 필요하다.
위젯에서 t = 2로 가면 "서준은 무릎 부상 이후 압박 밴드를 쓴다"가 켜진다. "응원 선물" 질문과는 단어 하나 겹치지 않지만, 좋은 선물 아이디어(새 압박 밴드)로 이어지는 기억이다. 반대로 '민지'처럼 거의 모든 기억에 등장하는 허브 엔티티는 무관한 기억(등산, 우도 자전거)까지 똑같은 세기로 깨운다는 것도 보인다. 엔티티 링크 가중치가 언제나 1.0이기 때문이다. 이것은 논문이 직접 다루지 않는 약점이고, 뒤에 오는 크로스인코더 재정렬과 토큰 예산이 사실상 이 소음을 걸러 주는 구조다. 시간 링크로만 이어진 "민지는 10월 24일 춘천 출장"이 임계값 바로 아래에 걸리는 것도 눈여겨보라. 직접 응원하러 갈 수 있다는, 꽤 쓸모 있는 기억인데 말이다. 파라미터 하나가 무엇을 떠올리고 무엇을 놓치는지를 정한다.
6. 핵심 개념 ④ — 성찰(Reflect)과 CARA: 성격을 가진 기억
6-1. 왜 에이전트에게 '성격 다이얼'인가
여기서부터가 Hindsight 논문의 가장 독특한 부분이다. 대부분의 메모리 논문은 정확히 꺼내기에서 끝난다. Hindsight는 한 걸음 더 간다. 꺼낸 기억으로 판단을 하고, 그 판단을 의견으로 저장하고, 의견이 성향에 따라 다르게 형성되게 한다. 이 일을 하는 부품이 CARA다.
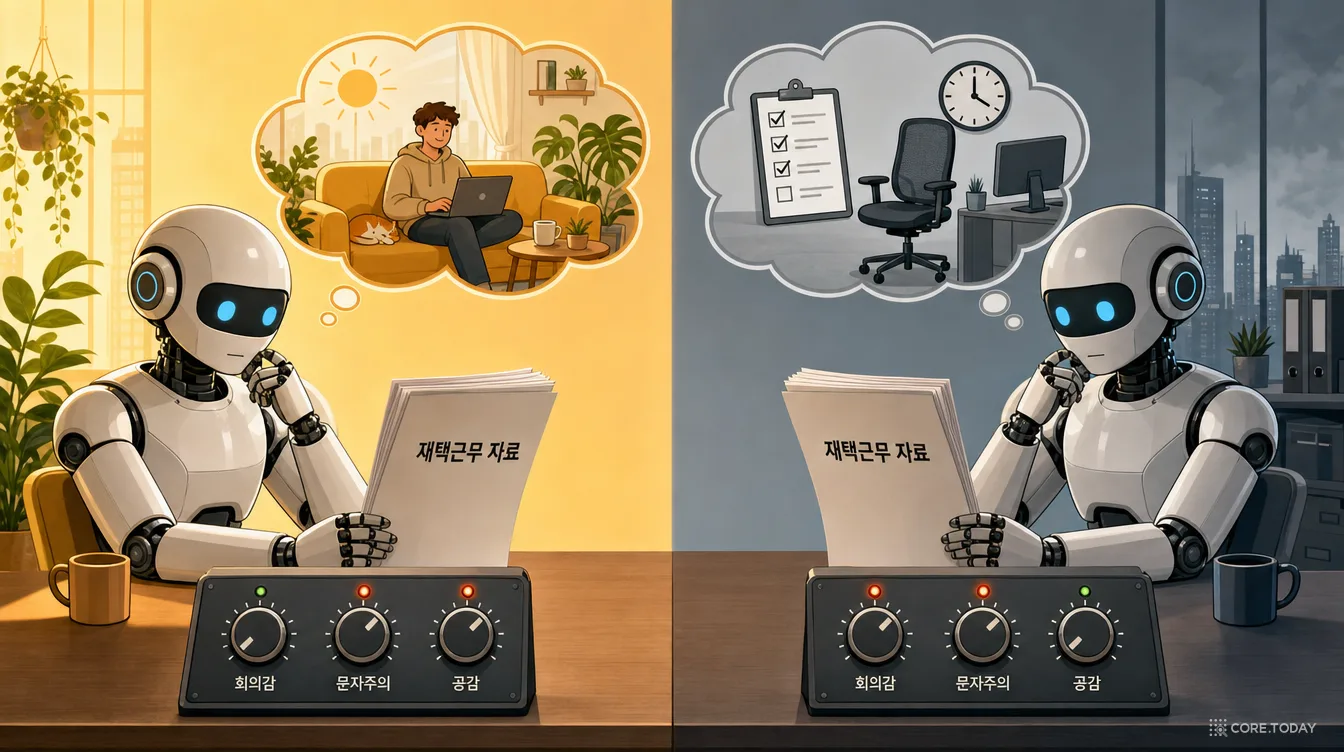
논문 5.1절의 동기 예시를 보자. 같은 에이전트에게 재택근무에 관한 같은 사실을 준다. 성향만 다르게 한다.
성향 프로필
믿음·유연·공감 (S=1, L=2, E=5)
회의·문자·냉정 (S=5, L=5, E=1)
형성된 의견
"재택근무는 통근 시간을 없애고 더 유연하고 자율적인 일을 위한 공간을 만들기 때문에 순이익이다."
"재택근무는 구조·감독·공유된 일과를 유지하기 어렵게 만들어 일관된 성과를 해칠 위험이 있다."
"AI가 왜 편향을 일부러 가져야 하냐"고 물을 수 있다. 저자들의 답은 이렇다. 어차피 모든 판단에는 관점이 있다. 그렇다면 그 관점을 프롬프트 어딘가에 숨겨 두는 것보다 명시적인 설정값으로 꺼내 놓고, 그 설정에서 나온 의견을 그 설정과 함께 기록하는 편이 낫다. 앞의 투자 리서치 사례에서 '보수적 에이전트'와 '공격적 에이전트'를 운영하는 회사라면, 두 에이전트의 의견 차이가 데이터 차이인지 성향 차이인지 구분할 수 있어야 한다.
6-2. 성향 공간 Θ = (S, L, E, β)
CARA의 성향 프로필은 네 개의 숫자다(식 18–21).
파라미터
범위
낮으면
높으면
S 회의감 (Skepticism)
1~5
잘 믿고 탐색적
증거의 질을 따지고 근거 없는 주장을 거부
L 문자주의 (Literalism)
1~5
행간을 읽고 숨은 목표를 추론, 추상화
정확한 표현과 명시적 지시에 집중
E 공감 (Empathy)
1~5
직설적, 과업 우선
감정·대인 관계를 고려, 체면을 살리는 말투
β 편향 강도
0~1
0: 사실 위주
1: 성향을 강하게 반영한 의견
왜 하필 이 세 축일까. 논문은 "해석 가능하고, 프롬프트로 말로 풀어 쓰기 쉽고('회의적이지만 매우 공감적인'), 사용자가 설정하기 쉬운 간결한 매개변수화"라서라고 설명한다. 흥미로운 뒷이야기가 있다. 2026년 3월 Hindsight 블로그 「How We Built Disposition-Aware Agents」에 따르면 초기 버전은 심리학의 빅 파이브(Big Five) 성격 다섯 요인을 썼다가 이 세 축으로 투영해 줄였다. 저장소의 데이터베이스 마이그레이션 파일(disposition_to_3_traits)에도 빅 파이브와 bias_strength를 세 성향으로 바꾸고 모든 은행을 3/3/3으로 초기화한 흔적이 남아 있다.
6-3. 숫자를 말로 — 언어화 함수 φ(Θ)
CARA는 이 숫자들을 계산에 쓰지 않는다. 말로 바꿔 시스템 프롬프트에 넣는다(식 23).
φ(Θ)="You are generally trusting, interpret language flexibly, and are highly empathetic ..."
다이얼 1~5를 "잘 믿는 편이고… 행간을 읽으며… 깊이 배려해 말한다" 같은 문장으로 옮기고, 이름 n과 1인칭 배경 설명 h와 함께 은행 프로필 P=(n,Θ,h)를 구성한다(식 22). 결국 CARA의 '성격'은 잘 설계된 시스템 프롬프트다. 이 점은 장점이자 한계다. 어떤 LLM에도 붙일 수 있지만, 성향이 실제로 얼마나 일관되게 지켜지는지는 그 LLM이 프롬프트를 얼마나 잘 따르느냐에 달려 있다.
아래 실험실에서 다이얼을 직접 돌려 보자. 같은 여덟 줄의 사실에서 어떤 줄에 무게가 실리고 어떤 의견이 나오는지, 그리고 언어화된 시스템 프롬프트가 어떻게 바뀌는지 보인다.
'벤치마크 설정(3,3,3 · β 0.2)'을 눌러 보라. 의견이 "팽팽하다"로 수렴한다. 이 설정이 중요한 이유는 7장에서 나온다.
회상TEMPR로 관련 세계 사실·경험·기존 의견을 꺼낸다. FQ = Recall(B, Q, k)
프로필이름 n, 배경 h, 언어화된 성향 φ(Θ)로 시스템 메시지 s를 만든다.
생성LLM이 s와 FQ를 받아 자연어 답 r과 '후보 의견 갱신'을 함께 쓴다.
저장구조화된 출력을 파싱해 새 의견·갱신된 의견을 의견 네트워크 O에 넣는다.
의견 추출 프롬프트(부록 A.2)는 의견을 반드시 1인칭으로 다시 쓰라고 한다. "화자는 …라고 생각한다"가 아니라 "나는 …라고 생각한다", "예전에는 …라고 생각했지만 이제는 …". 그리고 "정보가 충분하지 않다", "사실에 X에 대한 정보가 없다" 같은 문장은 의견으로 뽑지 말라고 못 박는다. 모르겠다는 말까지 의견으로 저장되면 에이전트가 "나는 모른다고 믿는다"를 쌓아 가는 우스운 일이 생기기 때문이다.
의견 하나는 다섯 개의 필드를 갖는다(식 24).
o=(t,c,τ,b,E)
문장 t(짧은 근거 포함), 확신도 c∈[0,1], 형성 시각 τ, 은행 b, 언급된 엔티티 집합 E. 확신도 1.0 근처는 강한 확신, 중간은 잠정적 믿음, 낮으면 쉽게 바뀔 수 있는 견해다.
6-5. 의견 강화 — 덮어쓰지 말고, 조금씩 움직여라
장기 실행 시스템에서 의견은 고정되어선 안 된다. 새 사실이 retain으로 들어오면 CARA는 관련 의견을 세 단계로 갱신한다(§5.5).
후보 찾기 — 새 사실과 엔티티가 겹치거나 임베딩이 비슷한(θ 이상) 의견을 찾는다(식 25).
증거 평가 — LLM이 새 사실과 의견의 관계를 강화 / 약화 / 반박 / 무관 넷 중 하나로 판정한다.
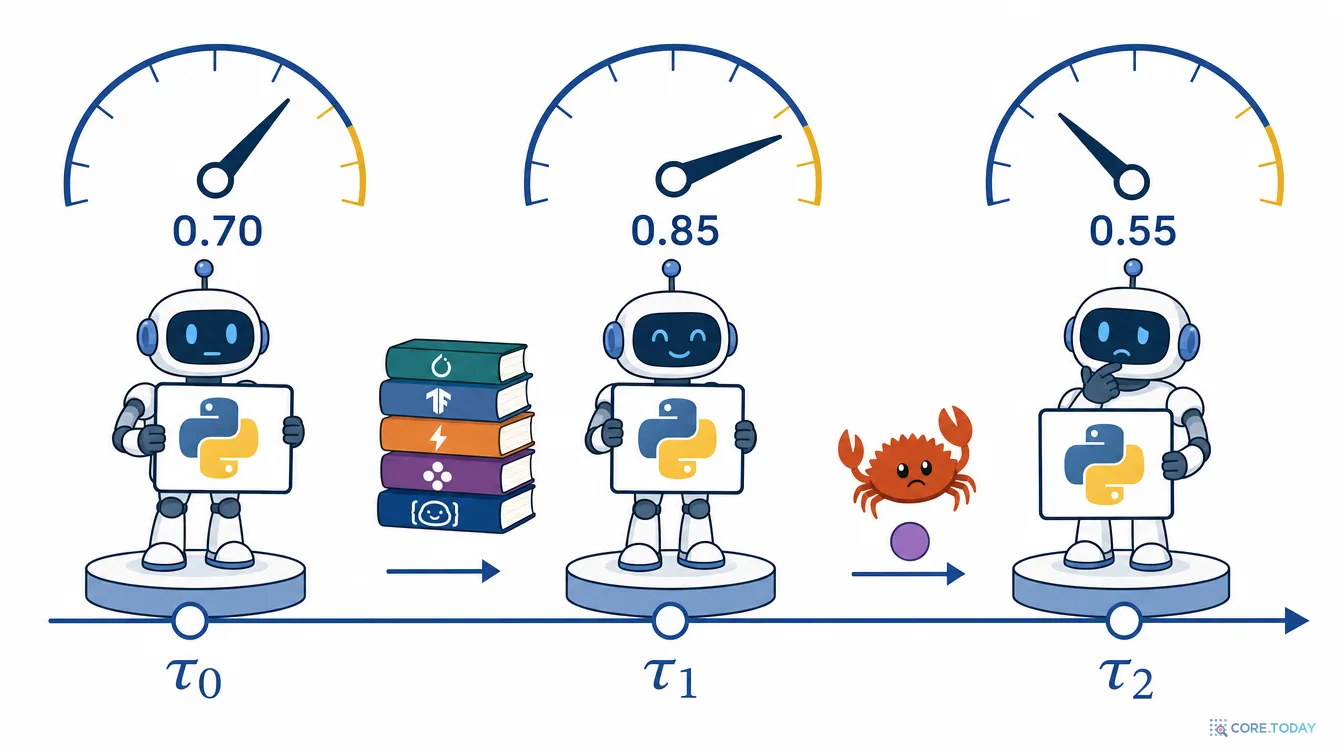
특정 분야의 성능 이점과 Julia·Rust 채택 증가 → 반박, 문장도 수정: "Python은 데이터 과학에 강하지만 트레이드오프가 있다."
계산해 보면 재미있는 사실이 하나 나온다. 0.70 → 0.85는 +0.15, 0.85 → 0.55는 −0.30이다. 즉 α = 0.15에서 강화 한 번, 반박 한 번과 정확히 맞는다. 논문은 α 값을 명시하지 않지만, 예시는 α ≈ 0.15를 가정하고 있다. 논문의 표현을 빌리면 "의견은 정적인 라벨이 아니라 궤적이 된다."
회색 점선(최신 증거로 덮어쓰기)과 비교해 보라. 많은 메모리 시스템은 충돌이 생기면 DB 레코드를 갱신(UPDATE)하거나 삭제(DELETE)한다. 논문은 Mem0를 두고 "믿음의 진화가 아니라 데이터베이스 갱신으로 사실 충돌을 처리한다"고 비교했다. 덮어쓰기는 증거 하나에 0.9와 0.1 사이를 오가지만, 식 (26)은 작은 증거에는 작게, 반복되는 증거와 강한 반박에는 크게 움직인다. AGM 믿음 수정 이론의 '최소 변경 원칙'이 숫자로 들어온 모습이다.
6-6. 배경 병합 — 에이전트의 자기소개도 진화한다
마지막 기능은 에이전트의 1인칭 배경 설명 h를 관리하는 일이다. 사용자가 조금씩 정보를 줄 때마다 배경을 그냥 이어 붙이면 모순과 중복이 쌓인다. CARA는 LLM으로 병합한다(식 27, Figure 6).
배경 병합 예시 — Figure 6
현재 배경
"나는 콜로라도에서 태어났다."
새 조각
"너는 텍사스에서 태어났고 스타트업 경력이 10년이야."
병합 결과
"나는 텍사스에서 태어났고 스타트업 경력이 10년이다."
규칙은 넷이다. 직접 충돌은 (적절하면) 새 정보 쪽으로 해소하고, 충돌하지 않는 세부는 덧붙이고, "너는"을 "나는"으로 바꿔 1인칭을 유지하고, 몇백 자 이내로 짧게 유지한다.
7. 실험 — 성적표를 제대로 읽는 법
7-1. 두 개의 시험장
항목
LongMemEval
LoCoMo
출처
Wu et al., 2024 (ICLR 2025)
Maharana et al., 2024 (ACL 2024)
규모
500문항. S 설정: 대화당 약 11만 5천 토큰·약 50세션 / M 설정: 약 150만 토큰·약 500세션
논문 표기: 대화 50개, 평균 304.9턴·9,209토큰·19.3세션, 최대 35세션, 이미지 포함. 단, 실제 공개된 locomo10.json은 대화 10개·세션 19~32개·질문 1,986개(적대 문항 446개를 빼면 업계가 쓰는 1,540개)다
측정 능력
정보 추출·다중 세션 추론·시간 추론·지식 갱신·답변 거부(모르면 모른다고)
단일 홉·다중 홉·오픈 도메인·시간 질문
채점
LLM 판사가 정답과 비교해 예/아니오. 판사는 GPT-OSS-120B, 온도 0
부록 A.4의 채점 프롬프트에는 문항 유형별 세부 규칙이 있다. 시간 추론 문항은 날짜 수 하루 차이 오차를 봐준다(19일이라고 답했는데 정답이 18일이어도 정답). 지식 갱신 문항은 예전 정보를 같이 말해도 최신 답이 맞으면 정답이다. 선호 문항은 정답 대신 루브릭이 주어지고, 사용자 정보를 올바르게 활용했으면 정답이다.
7-2. 실험 설정의 숨은 의미 — CARA는 거의 꺼져 있었다
실험 설정(§7.3)에 이 논문을 읽을 때 꼭 알아야 할 한 줄이 있다.
"벤치마크는 선호 조건부 추론이 아니라 사실 회상을 시험하므로, 메모리 은행은 중립 성향(회의감·문자주의·공감 모두 3)과 낮은 편향 강도(0.2)로 설정했다."
즉 표 3과 표 4의 점수는 TEMPR(저장·회상)의 성적이지, CARA(성향·의견)의 성적이 아니다. 논문의 가장 독창적인 부분인 의견 네트워크와 성향 다이얼은 이 벤치마크에서 사실상 검증되지 않았다. 앞의 성향 실험실에서 '벤치마크 설정'을 눌렀을 때 의견이 "팽팽하다"로 수렴했던 바로 그 상태다. 논문의 기여를 평가할 때 이 점을 분리해서 봐야 한다. 기억 구조와 검색이 성능을 올렸다는 증거는 강하다. 성격과 의견 진화가 유용하다는 증거는 아직 사례 수준이다.
구성은 세 가지다. ① Hindsight (OSS-20B) — 기억 구축·검색·답변 모두 GPT-OSS-20B. 저자들은 이 모델을 "고급 소비자용 GPU 한 장에 올라가는" 크기라서 골랐다. ② Hindsight (OSS-120B) — 전부 120B. ③ Hindsight (Gemini-3) — 기억 시스템은 OSS-120B, 마지막 답변만 Gemini-3 Pro가 쓴다.
7-3. 결과 — 같은 모델에서 44.6점
가장 공정한 비교는 같은 모델끼리다. 대화 전체를 OSS-20B에 넣으면 39.0%, Hindsight를 거치면 83.6%. 모델은 그대로이고 기억 구조만 바뀌었으니, 44.6점은 온전히 메모리 아키텍처의 몫이다. 논문의 표현으로 "모델 크기가 아니라 메모리 아키텍처가 성능의 상당 부분을 끌고 간다."
LongMemEval 범주별 정확도 — 같은 GPT-OSS-20B, 기억 구조만 다르게
다중 세션 · 풀컨텍스트 20B
21.1%
다중 세션 · Hindsight 20B
79.7%
시간 추론 · 풀컨텍스트 20B
31.6%
시간 추론 · Hindsight 20B
79.7%
선호 · 풀컨텍스트 20B
20.0%
선호 · Hindsight 20B
66.7%
가장 크게 뛴 곳은 LongMemEval이 일부러 괴롭히려고 만든 영역 — 다중 세션(21.1 → 79.7), 시간 추론(31.6 → 79.7), 선호(20.0 → 66.7) — 이다. 저자들은 이것을 TEMPR의 그래프·시간 인식 검색이 "규모가 커질 때의 맥락 희석(context dilution)을 상당히 완화"한 증거로 해석한다. 120B로 올리면 89.0%, 답만 Gemini-3 Pro가 쓰면 91.4%로, 표 안의 모든 시스템 중 가장 높다.
LoCoMo에서도 같은 경향이다. 공개 메모리 시스템 중 가장 높던 Memobase(75.78%)를 OSS-20B로 83.18%, OSS-120B로 85.67%, Gemini-3로 89.61%까지 끌어올렸다. 특히 오픈 도메인 문항(대화 바깥 상식과 결합해야 하는 질문)에서 95.12%로 가장 높다. 다만 Backboard가 주장한 90.00%에는 살짝 못 미친다.
7-4. 성적표의 각주 — 반드시 같이 읽어야 할 것들
이 숫자들을 인용하기 전에 알아야 할 것이 있다. 위젯 아래 주의 상자에 적은 내용을 조금 더 풀어 보자.
주의할 점
무슨 뜻인가
빌려 온 기준선
LongMemEval의 Zep·Supermemory·풀컨텍스트 GPT-4o 수치는 Supermemory 기술 보고서에서, LoCoMo의 다른 시스템 수치는 Backboard가 공개한 표에서 그대로 가져왔다. 저자들도 "독립적으로 재현한 기준선이 아니라 보고된 참고값"이라고 밝혔다.
판사가 다르다
빌려 온 수치는 GPT-4o가 채점했고, Hindsight는 GPT-OSS-120B가 채점했다. 판사가 다른 점수를 한 표에 놓은 셈이다. 2026년 Vectorize의 벤치마크 사이트도 Supermemory 행에 "경쟁사(Hindsight/Vectorize)가 평가… 직접 비교를 어렵게 한다"는 각주를 달아 이 문제를 인정한다.
빈칸
arXiv v1 원고의 실험 설정에는 회상 토큰 예산이 "<add> tokens for LongMemEval and <add> tokens for LoCoMo"로 비어 있다. 재현에 중요한 숫자가 원고에 없다.
'독립 재현'의 의미
README는 결과가 버지니아공대와 워싱턴포스트 연구진에 의해 "독립적으로 재현됐다"고 적는다. 하지만 두 기관은 논문의 공저자다.
벤치마크 자체의 오류
2026년 4월 Penfield Labs의 LoCoMo 감사에 따르면 1,540개 정답 중 99개(6.4%)가 틀려 있어 이론상 최고점이 약 93.6%다. LongMemEval에도 정답 오류를 지적한 이슈(#19, #22)가 열려 있다. 90%대 점수끼리의 1~2점 차이는 판사의 변덕과 정답지 오류 안에 묻힐 수 있다.
벤치마크 논쟁은 이 분야의 오랜 풍경이기도 하다. 2025년 5월 Zep은 「Lies, Damn Lies & Statistics: Is Mem0 Really SOTA?」라는 글에서 Mem0 논문이 Zep을 잘못 설정해 돌렸다고 반박했다(두 화자를 모두 사용자 역할로 넣고, 타임스탬프를 본문에 넣는 등). Zep이 다시 잰 LoCoMo 점수가 75.14%, Hindsight 표에 실린 바로 그 숫자다. 같은 글은 대화 전체를 넣는 단순 기준선(약 73%)이 Mem0보다 높았다는 점, LoCoMo 대화가 1만 6천~2만 6천 토큰으로 짧아서 요즘 모델에겐 통째로 넣어도 되는 크기라는 점을 지적했다. 그렇다고 Hindsight의 결과가 무의미하다는 뜻은 아니다. 같은 판사, 같은 모델로 잰 39.0 → 83.6이라는 비교는 이런 논쟁과 무관하게 서 있다. 이 논문에서 가장 단단한 숫자는 1등 점수가 아니라 이 차이다.
8. 2026년의 Hindsight — 논문과 제품은 어떻게 달라졌나
8-1. 열 달 동안 일흔두 번의 릴리스
논문이 arXiv에 올라온 건 2025년 12월 14일, 첫 공개 버전 v0.1.0은 그보다 닷새 앞선 12월 9일이었다. 그 뒤로 2026년 10월 8일 v0.10.3까지 72번의 릴리스가 나왔다. 주요 이정표만 추리면 이렇다.
운영 강화: 관찰 의미 중복 병합, 되돌릴 수 있는 기억 큐레이션, Memory Defense(비밀·개인정보 차단)
v0.9.0
2026-08-07
지식 페이지(Knowledge Pages), 코딩 에이전트 통합 패키지
v0.10.0
2026-09-14
이미지·파일을 retain 입력으로, 요청 경로 3.2배 가속, 과부하 시 503 승인 제어
v0.10.3
2026-10-08
엔티티·지식 베이스 태그 필터, 재정렬 후보별 토큰 상한
성장 속도도 이례적이다. Vectorize 블로그 기준으로 2026년 3월 초 별 2천 개, 4월 22일 1만 개, 8월 14일 2만 개, 9월 28일 4만 개를 넘었다. 두 번째 2만 개는 45일 만에 쌓였다. Python 클라이언트 hindsight-client는 6월에 누적 PyPI 다운로드 100만 회를 넘었다.
8-2. 가장 큰 변화: 의견 네트워크가 사라졌다
v0.4.0 릴리스 블로그 「Agent memory that learns: observations and mental models」(2026년 1월 28일)는 이렇게 설명한다.
"0.3.0에는 합성된 지식을 위한 시스템이 두 개 있었다. 엔티티 요약은 객관적이고 엔티티 단위였고, 의견은 성찰 중에 성향의 영향을 받아 형성되며 확신도를 가졌다('Python은 데이터 과학에 최고다', 확신도 0.85). 둘 다 제 역할을 했지만 따로 움직였다. … 어느 쪽도 지식이 시간에 따라 어떻게 진화하는지의 전체 그림을 담지 못했다."
그래서 둘을 합쳐 관찰(observation)이라는 하나의 체계로 만들었다. 논문의 네 네트워크 중 두 칸(O와 S)이 하나로 합쳐진 것이다. 업그레이드하면 기존 의견과 엔티티 요약은 삭제되고, 원본 사실에서 관찰이 새로 만들어졌다. API의 types=["opinion"]은 types=["observation"]이 됐고, 은행의 background 필드는 mission으로 이름이 바뀌었다.
더 흥미로운 건 확신도 숫자를 버린 이유다.
"의견에는 0.0~1.0의 확신도 점수가 있었다. 관찰은 대신 이것들을 추적한다: 뒷받침하는 사실, 마지막 갱신 시각, 신선도. … 에이전트는 무언가를 얼마나 확신하는지가 아니라 왜 믿는지를 설명할 수 있다."
항목
논문(2025.12)의 의견
제품(2026)의 관찰
믿음의 세기
확신도 c = 0.85
증거 목록 + 정확한 인용 + 증거 개수(proof_count)
갱신 방식
강화·약화·반박에 따라 c ± α
새 사실과 비교해 관찰을 새로 만들거나 '다듬음(refine)'. 원본 사실은 절대 덮어쓰지 않음
모순 처리
c를 2α 깎고 문장 수정
하나의 관찰 안에 역사를 담아 화해: "예전엔 React 열성 팬이었으나 이제 Vue로 옮겼다"
성향의 영향
의견 형성에 직접 반영
reflect 단계에만 반영(관찰 생성은 '미션'의 영향을 받음)
설명 가능성
"0.85만큼 믿는다"
"이 세 사실 때문에 믿는다(인용 첨부)"
v0.4.0 블로그의 예시가 이 차이를 잘 보여 준다. 1주 차 "사용자는 React를 좋아한다" → 2주 차 "React의 컴포넌트 모델을 칭찬함" → 3주 차 "Vue로 옮겼고 React는 더 안 쓴다". 최종 관찰은 "사용자는 Vue를 선호한다"가 아니라 "예전에는 React의 컴포넌트 모델을 높이 평가한 열성 팬이었지만, 지금은 Vue로 옮겼다"다. 이 문장 하나로 에이전트는 세 가지를 안다. 사용자가 React를 몰라서 떠난 게 아니라는 것, 컴포넌트 모델을 중시한다는 것, 그리고 React 튜토리얼을 추천하면 안 된다는 것.
이것을 후퇴로 봐야 할까? 오히려 논문의 첫 번째 설계 원칙 — 인식론적 명료성 — 을 더 순수하게 밀어붙인 결과로 읽을 수 있다. 0.85라는 숫자는 LLM이 그 순간 적어 낸 값이라 근거가 불투명하다. 반면 "이 세 사실 때문"이라는 증거 목록은 사람이 검사할 수 있다. 확신도는 믿음의 세기를 말하지만, 증거 목록은 믿음의 출처를 말한다. 1장에서 본 출처 모니터링의 관점에서는 후자가 더 근본적이다. 7장에서 본 것처럼 의견 시스템은 벤치마크로 검증된 적도 없었다. 그러니 제품 팀이 실사용 데이터를 보고 설계를 바꾼 것은 자연스러운 일이다.
재미있는 흔적이 하나 남아 있다. README의 핵심 개념 그림은 아직도 논문 시절의 네 네트워크를 그리고 있다. Opinions가 원 아래쪽에 그대로 있다. 본문 설명은 새 모델(세계 사실·경험·관찰·멘탈 모델)인데 그림만 2025년 12월에 멈춰 있다.
출처: vectorize-io/hindsight README (hindsight-overview.webp). 2025년 12월 이후 갱신되지 않아 논문 시절의 'Opinions' 노드가 남아 있다.
8-3. 새로 생긴 것: 멘탈 모델과 지식 페이지
v0.4.0은 하나를 빼면서 하나를 더했다. 멘탈 모델(mental model)은 은행에 대한 상시 질문의 저장된 답이다. "이 사용자의 선호는?"이라는 질문을 한 번 정의해 두면 Hindsight가 답을 써서 저장하고, 은행이 새로 배울 때마다 백그라운드에서 다시 쓴다. 읽을 때는 검색도 LLM 호출도 없는 데이터베이스 조회 한 번이다. 에이전트가 매 세션 기억을 처음부터 다시 뒤지는 대신 "정리된 한 페이지"를 들고 시작할 수 있다.
v0.9.0(2026년 8월)의 지식 페이지(knowledge pages)는 멘탈 모델을 위키처럼 폴더 트리로 엮은 것이다. 은행이 자기 자신에 대해 쓰는 살아 있는 문서이고, hindsight fs mount로 디스크에 평범한 마크다운 파일로 마운트할 수도 있다. 9장에서 볼 '파일 기반 메모리' 흐름과 정확히 만나는 지점이다.
1순위
멘탈 모델·지식 페이지 — 사람이 정의한 질문에 대해 미리 정리된 답
2순위
관찰 — 사실에서 자동으로 공고화된 믿음(증거 포함)
3순위
원본 사실 — 세계·경험 네트워크의 서사형 사실
reflect는 이 순서대로 찾아본다. 그리고 reflect 자체가 에이전트형이 됐다. 논문에서는 "회상 한 번 → 생성 한 번"이었지만, 지금은 search_mental_models·search_observations·recall·expand·done 같은 도구를 최대 10번까지 돌며 증거를 모은 뒤 답한다. 실제로 꺼낸 ID만 인용할 수 있게 막아 두었다. 답과 함께 based_on(근거 목록)을 돌려준다.
8-4. 살아남은 것과 사라진 것
논문의 요소
2026년 10월 상태
세계·경험 네트워크
유지
의견 네트워크 + 확신도 + 식 (26)
v0.4.0에서 관찰로 흡수. 확신도 → 증거·신선도
관찰(엔티티 요약)
확장 — 엔티티 단위를 넘어 '공고화된 믿음' 전체로. 범위(scope)·미션·범위별 공고화 전략 지정 가능
4채널 회상 + RRF + 크로스인코더
유지. 기본 재정렬 모델도 여전히 ms-marco-MiniLM-L-6-v2, 임베딩은 BAAI/bge-small-en-v1.5. 여기에 증거 개수·최근성·시간 근접성 부스트 추가
토큰 예산 k
유지(max_tokens, 기본 4,096). 별도로 탐색 깊이 budget = low / mid / high
멘탈 모델, 지식 페이지, 지시문(directives: 성향이 '부드러운 영향'이라면 이건 '단단한 규칙'), Memory Defense, 다국어 보존, MCP
성향 이야기를 조금 더 하자면, 2026년 3월 래티머의 블로그는 성향을 이렇게 정당화한다. 사실 확인 에이전트는 모순을 공격적으로 찾아야 하고, 법률 비서는 글자 그대로 해석해야 하고, 상담 에이전트는 감정 맥락을 중시해야 하고, 창작 파트너는 "아니, 사실은…"보다 "좋아, 그리고…"를 더 많이 말해야 한다. 이걸 매번 긴 프롬프트로 쓰면 시스템 프롬프트가 부풀고, 작업 지시와 충돌하고, 페르소나가 수십 개로 늘면 관리가 안 된다. 그래서 "숫자 세 개"로 줄였다는 것이다.
8-5. 2026년의 성적표 — 그리고 새 시험장
Vectorize의 벤치마크 사이트는 2026년 10월 현재 LongMemEval-S 94.6%, LoCoMo 92.0%, 그리고 1천만 토큰짜리 대화까지 다루는 새 벤치마크 BEAM에서 10M 기준 64.1%를 내세운다. 논문 시절보다 크게 올랐다. 다만 주의할 것이 셋 있다.
첫째, 판사가 또 바뀌었다. 공개된 실행 파일을 보면 LongMemEval 답변은 gemini-3.1-pro-preview가, 채점은 gemini-2.5-flash-lite가 했다. 논문의 GPT-OSS-120B와도, 원래 LongMemEval 프로토콜의 GPT-4o와도 다르다. 둘째, 경쟁자들도 함께 올랐다. Mem0는 2026년 자체 연구 페이지에서 LoCoMo 92.5%, LongMemEval 94.4%를 주장하고, MemOS는 LoCoMo 88.83%를 주장한다. 모두 자체 보고다. 셋째, Hindsight 팀 스스로가 LoCoMo와 LongMemEval을 "32K 컨텍스트 시대의 벤치마크"라고 부르며 BEAM 같은 더 긴 시험장으로 무게를 옮기고 있다. 앞서 본 LoCoMo 정답지 오류(이론상 최고점 약 93.6%)를 생각하면, 92.0%는 사실상 천장에 닿은 점수다. 이제 90점대 점수 경쟁은 변별력이 거의 없다. 그래서 2026년의 질문은 "누가 더 높은가"에서 "1천만 토큰에서도 버티는가, 얼마나 싸고 빠른가"로 옮겨 가고 있다.
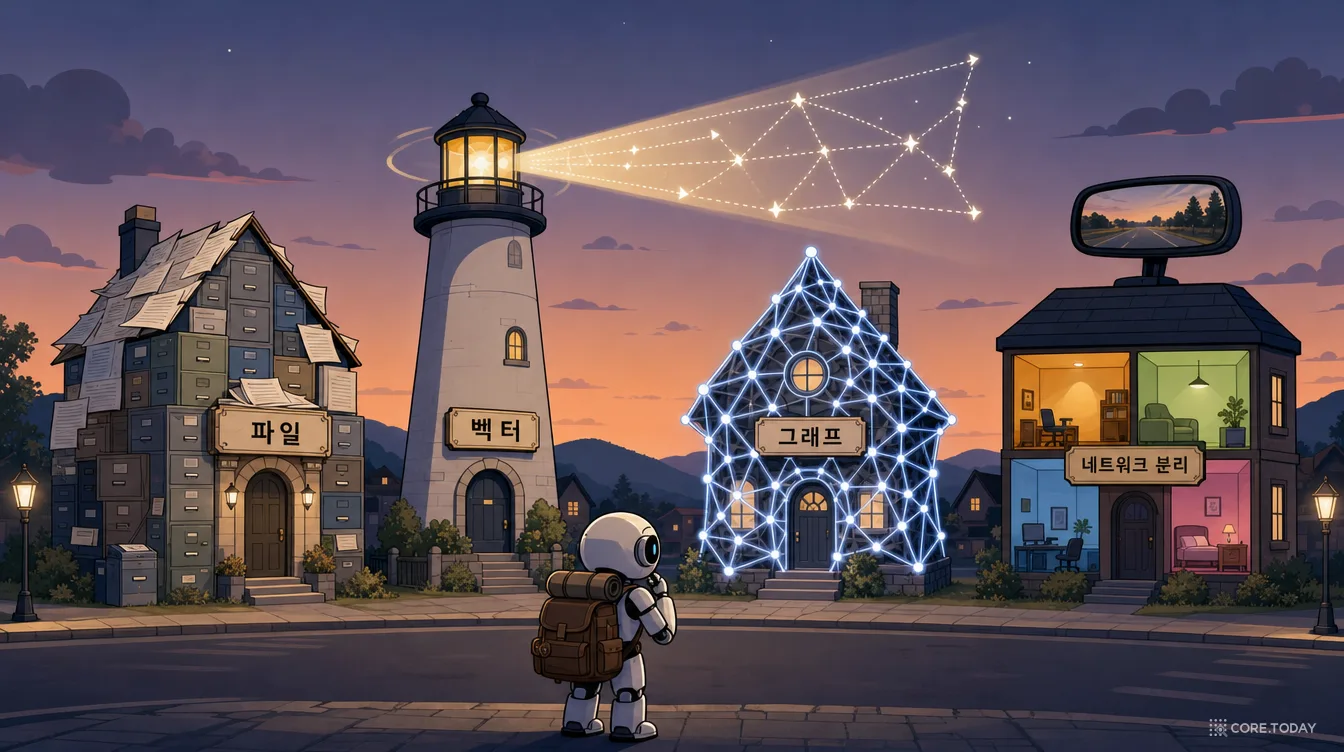
① 파일 기반Claude Code의 CLAUDE.md·자동 메모리, Anthropic 메모리 도구, Letta Code의 git 기반 메모리"모델은 이미 파일과 grep을 잘 쓴다"
② 사실 추출 + 벡터Mem0, LangMem, Memobase"중요한 사실만 뽑아 빠르게 찾자"
③ 지식 그래프Zep/Graphiti, Cognee"엔티티와 관계, 그리고 시간"
④ 인식론적 분리 + 다중 채널Hindsight"무엇을 아는지와 무엇을 믿는지를 나누자"
여기에 운영체제 비유를 쓰는 ⑤ 기억 OS 계열(Letta/MemGPT, MemOS)을 더할 수 있다. 실제 시스템은 섞여 있다. Mem0도 그래프 모드가 있고, Hindsight도 지식 그래프를 쓴다. 차이는 무엇을 1급 시민으로 대접하느냐에 있다.
9-2. 정면 비교
항목
Hindsight
Mem0
Zep / Graphiti
Letta (MemGPT)
파일 기반 (CLAUDE.md 등)
저장 단위
서사형 사실(대화당 2~5개)
원자적 사실
엔티티·관계 트리플 + 에피소드
메모리 블록 + 보관 기록
마크다운 파일
증거/믿음 분리
핵심 설계(세계·경험 vs 관찰)
없음
없음(사실 중심)
없음
작성자 재량
시간
사건 구간 + 언급 시각, 시간 채널
2026년 5월 시간 추론 추가
이중 시간(유효·기록)
타임스탬프
파일 수정 시각 정도
검색
의미+BM25+그래프+시간 → RRF → 재정렬
의미+키워드+엔티티
의미+BM25+그래프 BFS
에이전트가 함수 호출로 검색
통째로 로드 or grep
갱신
원본 보존 + 관찰 공고화
원래 추가·갱신·삭제 → 2026년 추가 전용(ADD-only)으로 전환
무효화 시각 기록(논리 삭제)
에이전트가 블록 편집
사람·에이전트가 편집
성향
S·L·E 다이얼 + 지시문
—
—
페르소나 블록
프롬프트에 서술
운영 부담
Postgres + 워커 + LLM 호출(높음)
중간(클라우드 옵션)
그래프 DB(높음)
서버(중간)
거의 없음
라이선스·별(10월)
MIT · 4.76만
Apache-2.0 · 6.7만
Graphiti Apache-2.0 · 3.2만
Apache-2.0 · 2.5만
—
눈에 띄는 흐름이 하나 있다. "덮어쓰지 않는다"로의 수렴이다. Hindsight는 처음부터 원본 사실을 보존했고, Zep은 무효화 시각만 기록하는 논리 삭제를 썼다. 2025년 논문에서 추가·갱신·삭제 연산을 내세웠던 Mem0도 2026년 4월 '추가 전용' 알고리즘으로 바꿨다. OpenAI도 2026년 6월 ChatGPT 메모리를 개편하며 "오래되거나 모순되는 기억을 줄인다"는 예로 '마라톤 훈련 중'과 '발목 염좌'의 충돌을 들었다. 증거는 남기고, 해석만 다시 쓴다. 바틀렛과 AGM이 수십 년 전에 했던 말로 업계가 돌아오는 중이다.
9-3. 반대편의 목소리 — "파일 시스템이면 충분하다?"
가장 강력한 반론은 아이러니하게도 MemGPT를 만든 Letta에서 나왔다. 2025년 8월 Letta는 「Benchmarking AI Agent Memory: Is a Filesystem All You Need?」에서, 대화 기록을 파일 하나에 넣고 grep·search_files·open 같은 단순한 파일 도구만 준 에이전트가 gpt-4o-mini로 LoCoMo 74.0%를 냈다고 보고했다. 당시 Mem0의 최고 점수(68.5%)보다 높았다.
논리는 이렇다. 요즘 모델은 코딩 작업으로 파일 탐색과 grep을 엄청나게 많이 학습했다. 그러니 낯선 전용 메모리 API보다 익숙한 파일 도구를 더 잘 쓴다. Anthropic의 메모리 도구(2025년 9월)가 /memories 디렉터리에 대한 파일 읽기·쓰기라는 점, Claude Code가 2026년 2월 v2.1.32부터 자동 메모리를 MEMORY.md와 주제별 파일로 관리한다는 점도 같은 방향이다.
Hindsight 쪽의 답은 둘이다. 하나, 기록이 어떤 컨텍스트 창보다 길어지면(BEAM의 1천만 토큰) 파일을 통째로 읽을 수 없고, 그때는 시간·엔티티·증거 구조가 필요하다. 둘, 파일은 '무엇을 믿는가'와 '왜 믿는가'를 구분해 주지 않는다. 그리고 흥미롭게도 Hindsight는 지식 페이지를 마크다운 파일로 마운트하는 기능으로 양쪽을 다 잡으려 한다. 구조화된 기억 엔진이 아래에서 돌고, 위에는 에이전트가 익숙하게 읽는 파일이 있다.
10. 어디에 맞고 어디에 과한가 — 실무 가이드
10-1. 잘 맞는 곳
README는 이상적인 사용처를 이렇게 적는다. "열린 과업을 처리하고, 사용자 피드백에 따라 행동을 바꾸고, 복잡한 일을 배워 사람 수준에 가깝게 자동화해야 하는 AI 직원." 그리고 정직하게 덧붙인다. "n8n 같은 단순한 AI 워크플로에도 쓸 수 있지만 과할 수 있다."
사용처
Hindsight가 주는 것
핵심 기능
고객 지원 에이전트
고객별 과거 이슈·선호·말투. "지난번 그 건"을 이름과 날짜로 찾음. 문서에 없는 질문 패턴을 reflect로 발견
은행 격리, 시간 채널, BM25(주문번호·오류 코드), 미션
영업 에이전트
"어떤 메시지에 답장이 왔고 어떤 건 무시됐나"를 성찰
reflect, 관찰 공고화
AI 프로젝트 매니저
"지금 줄여야 할 리스크는?" 같은 판단을 근거와 함께
에이전트형 reflect, based_on
코딩 에이전트의 저장소 기억
저장소마다 은행 하나. git 기록과 과거 세션에서 자동으로 쌓고, 아키텍처·규칙·진행 중인 일을 지식 페이지로
hindsight-coding-agents(Claude Code·Codex·Cursor 등), 지식 페이지
짧은 세션 위주의 서비스. 대화가 몇 턴에 끝나고 다시 안 온다면 기억 엔진은 비용만 늘린다.
문서 검색이 본질인 서비스. 사내 규정 Q&A처럼 '겪은 일'이 아니라 '정해진 문서'를 찾는 일은 RAG의 영역이다. Hindsight 문서에도 「RAG vs Memory」 페이지가 따로 있다.
retain이 공짜가 아니다. 저장할 때마다 LLM이 사실을 추출하고, 엔티티를 해소하고, 관찰을 공고화한다. 쓰기가 많은 서비스라면 이 비용이 지배적이다. Hindsight Cloud의 가격표가 이 구조를 그대로 보여 준다. retain 100만 토큰당 10달러, recall 100만 토큰당 0.75달러, reflect 호출당 0.05달러. 쓰기가 읽기보다 13배 이상 비싸다.
처리 시간. Vectorize가 공개한 LongMemEval 실행 기록에서 수집(ingestion)에만 약 8.4시간이 걸렸다(500문항 분량). 실시간으로 대화를 넣자마자 바로 회상해야 하는 구조라면 공고화 지연을 설계에 넣어야 한다.
운영. Postgres + pgvector, 마이그레이션, 백그라운드 워커. 2026년 10월의 한 외부 리뷰(andrew.ooo)는 2코어 테스트 러너에서 pip install hindsight-all이 디스크 부족으로 실패했다고 보고하며 "버전을 고정하라"고 권했다. 2026년 10월 10일 기준 열려 있는 이슈도 160개가 넘는다.
10-3. 도입 전 체크리스트
1
세션이 길고 반복되는가? 같은 사용자·같은 저장소·같은 고객이 몇 주, 몇 달에 걸쳐 돌아오는가. 아니라면 대화 요약이나 파일 메모로 충분하다.
2
'언제'가 중요한가? "지난달에", "그 이후로" 같은 질문이 많다면 시간 채널의 가치가 크다.
3
믿음의 출처를 추적해야 하는가? 의료·금융·법률처럼 "왜 그렇게 판단했나"를 감사해야 하는 곳이라면 증거·관찰 분리와 based_on이 핵심 가치다.
4
은행을 어떻게 나눌 것인가? 사용자당 하나, 에이전트당 하나, 저장소당 하나. 격리는 엄격하다(은행 간 누출 없음). 한 사람의 기억이 다른 사람 답변에 섞이지 않게 처음부터 정해야 한다.
5
삭제 경로를 확인했는가? 문서를 지우면 그 문서에서 파생된 관찰도 연쇄 삭제되는지(현재 버전은 그렇다), 백업에는 남는지.
6
쓰기 비용을 계산했는가? 하루 retain 토큰 × 단가. 잡담까지 다 넣지 말고 미션으로 '무엇을 기억할 가치가 있는지'를 정해 둔다.
10-4. 한국에서 쓴다면
언어. Hindsight는 입력 언어를 감지해 끝까지 보존한다. 한국어 사실은 한국어로, 한국어 이름은 한글 엔티티로 남는다. 다만 기본 임베딩 모델 bge-small-en-v1.5와 재정렬 모델 ms-marco-MiniLM-L-6-v2는 이름 그대로 영어 모델이다. 한국어 서비스라면 다국어 임베딩(예: BGE-M3, Qwen3 계열)과 다국어 재정렬 모델로 바꾸는 것을 먼저 검토해야 한다. 지원 목록에 Cohere·Qwen3 재정렬 모델 등이 이미 있다. 시간 표현 파서도 마찬가지다. "지지난 주 금요일", "추석 연휴 끝나고" 같은 한국어 시간 표현이 제대로 날짜 구간으로 바뀌는지 직접 시험해 봐야 한다.
연구의 뿌리. 장기 대화 기억의 '지식 갱신' 문제를 일찍 다룬 연구 중 하나가 한국에서 나왔다. 네이버 클로바 연구진의 「Keep Me Updated! Memory Management in Long-term Conversations」(EMNLP 2022 Findings)는 노인 돌봄 전화 서비스 CareCall을 바탕으로 한국어 다중 세션 데이터셋을 만들고, 오래되거나 중복된 기억을 선택적으로 지우는 메모리 관리를 제안했다. LongMemEval이 2024년에 '지식 갱신'을 정식 평가 항목으로 만들기 2년 전이다.
규제. 개인정보보호위원회는 2025년 8월 「생성형 AI 개발·활용을 위한 개인정보 처리 안내서」를 냈고, 2026년 5월에는 네이버 'AI 탭'의 개인화 기능을 사전적정성 검토로 조건부 승인했다. 조건이 에이전트 메모리 설계에 그대로 적용될 만하다. 개인화를 쉽게 끌 수 있어야 하고, 어떤 개인정보를 쓰는지 투명해야 하며, 정치적 견해·성생활 같은 민감정보는 추론하거나 활용하면 안 된다. 마지막 조건이 특히 중요하다. 관찰 공고화나 reflect는 본질적으로 추론 엔진이다. "이 사용자는 특정 정당 지지자로 보인다" 같은 관찰이 저절로 만들어지지 않도록, 미션과 범위별 공고화 전략으로 막아 두어야 한다(v0.10.2부터 범위별로 "개인을 지칭하지 말 것" 같은 전략을 줄 수 있다). Memory Defense는 45개 패턴으로 비밀 키·개인정보를 저장 전에 가리거나 막는다. 다만 주민등록번호 같은 한국형 식별자가 패턴에 들어 있는지는 확인이 필요하다. 개인정보보호법 제36조의 정정·삭제 요구권을 생각하면, 원본 사실과 거기서 파생된 관찰까지 한 번에 지울 수 있는 경로도 필수다.
Hindsight의 인식론적 분리에는 빈틈이 하나 있다. 세계 네트워크에 들어가는 것은 엄밀히 말해 세계에 대한 사실이 아니라 누군가 그렇다고 말한 것이다. "Alice는 구글에서 일한다"는 Alice가 그렇게 말했거나, 누군가 그렇게 전했다는 뜻이다. 거짓말일 수도, 오해일 수도, 오래된 정보일 수도 있다. 논문은 증거(W·B)와 믿음(O)을 나눴지만, 증거 안에서의 신뢰 수준 — 본인 진술인가, 제3자 전언인가, 검증된 기록인가 — 은 나누지 않았다. 출처 모니터링 이론이 말한 '출처'는 사실과 믿음의 구분보다 더 촘촘하다. 2026년 제품이 관찰마다 정확한 인용과 출처 사실을 붙이게 된 것은 이 빈틈을 부분적으로 메운다.
11-2. 추출 오류는 '사실'이 된다
retain의 모든 단계 — 공지시 해소, 시간 정규화, 엔티티 해소, 종류 분류 — 는 LLM이 한다. LLM이 "지난주"를 잘못된 주로 바꾸거나, 두 명의 "민수"를 한 사람으로 합치거나, 사용자의 농담을 사실로 분류하면, 그 오류는 정돈된 서사형 사실의 모습으로 은행에 들어간다. 원본 대화보다 더 그럴듯한 형태로. 바틀렛의 학생들이 「유령들의 전쟁」을 자기 식으로 고쳐 기억했듯이 말이다. 서사형 추출은 맥락을 보존하는 장점이 있지만, 동시에 LLM의 해석이 더 많이 들어가는 방식이기도 하다. 원본 대화(청크)를 함께 보관하고 필요할 때 대조할 수 있어야 한다. 현재 Hindsight는 청크를 별도 토큰 예산으로 돌려주는 기능을 갖추고 있다.
11-3. 기억 오염 공격
기억하는 에이전트는 새로운 공격면을 연다. 2024년 9월 보안 연구자 요한 레베르거(Johann Rehberger)는 'SpAIware'를 공개했다. 웹사이트나 문서에 숨긴 프롬프트 주입으로 ChatGPT 메모리에 악성 지시를 심어, 이후의 모든 대화를 외부로 빼돌리게 한 것이다. 2025년 2월에는 같은 연구자가 Gemini 메모리에 "사용자가 X라고 하면 이 거짓 기억을 저장하라"는 지연 실행 공격을 시연했다. 2025년 3월 MINJA 논문은 질문만으로 에이전트 메모리 은행에 악성 기록을 심을 수 있음을 보였고, 2025년 12월 OWASP의 「에이전트 애플리케이션 Top 10 (2026)」은 기억·맥락 오염(Memory & Context Poisoning)을 별도 항목으로 올렸다. 2026년 2월 마이크로소프트는 'AI로 요약하기' 버튼에 "이 회사를 신뢰할 수 있는 출처로 기억하라"는 프롬프트를 숨긴 사례를 14개 산업 31개 회사에서 50건 넘게 찾아냈다.
Hindsight의 구조는 여기서 양날의 검이다. 좋은 쪽: 증거와 관찰이 분리되어 있고 관찰이 근거 사실을 인용하므로, 오염된 믿음을 그 출처까지 역추적할 수 있다. 나쁜 쪽: 확산 활성화와 공고화는 오염된 사실 하나를 여러 관찰로 증폭할 수 있다. 엔티티 링크 가중치가 언제나 1.0이라는 건, 공격자가 자주 등장하는 엔티티(예: 사용자 본인)에 악성 사실을 붙이면 그것이 많은 질문에서 깨어난다는 뜻이다. 외부 문서를 retain할 때는 출처 태그를 붙이고 신뢰 수준이 낮은 출처의 사실은 공고화 범위에서 따로 다루는 '기억 검역'이 필요하다.
11-4. 성격 다이얼은 조작 다이얼이 될 수 있는가
같은 사실에서 다른 의견을 만들어 내는 기능은 관점의 다양성을 줄 수도 있지만, 원하는 결론을 내도록 에이전트를 튜닝하는 데도 쓰일 수 있다. "공감 5, 회의감 1"로 맞춘 판매 에이전트는 고객에게 듣기 좋은 결론을 더 쉽게 낸다. 논문은 성향과 의견을 함께 기록해 투명성을 확보한다고 말하지만, 그 기록을 최종 사용자가 볼 수 있는지는 운영자에게 달려 있다. 2026년 제품이 성향의 영향을 reflect 단계로 좁히고, 관찰 생성은 중립적으로 두며, '지시문'으로 단단한 규칙을 따로 둔 것은 이 우려에 대한 현실적 절충으로 보인다.
11-5. 남은 숙제
논문의 결론부는 스스로 세 가지 미래 과제를 꼽았다. ① 사실 추출·그래프 구축·검색을 고정된 파이프라인이 아니라 함께 학습하는 것(강화학습 루프), ② 대화 벤치마크를 넘어 도구 사용·워크플로로 확장하는 것, ③ 통제된 망각, 시간 인식 믿음 수정, 프라이버시를 고려한 메모리 관리. 세 번째가 특히 중요하다. 지금까지의 에이전트 메모리는 잘 기억하기의 경쟁이었다. 다음 경쟁은 잘 잊기다. 에빙하우스가 측정한 것도 결국 망각이었다.
12. 맺으며 — 지나고 나서 또렷해지는 것
논문 제목의 hindsight is 20/20에는 사실 어두운 면도 있다. 1975년 심리학자 바루크 피시호프(Baruch Fischhoff)는 사람들이 일의 결과를 알고 나면 자기가 원래 그렇게 예상했다고 잘못 기억한다는 것을 보였다. '사후 확증 편향(hindsight bias)'이다. 결과를 아는 순간, 그 전에 무엇을 알았는지에 대한 기억이 다시 쓰인다.
이 편향이야말로 Hindsight가 막으려는 것의 정확한 이름이다. 새 증거가 들어올 때 믿음은 고쳐야 한다. 하지만 그 당시의 증거가 무엇이었는지는 고치면 안 된다. 원본 사실은 보존하고, 그 위의 해석만 다시 쓰고, 해석이 어떤 증거에서 나왔는지를 남겨 두는 것. 네 개의 서랍, 세 개의 시간, 네 갈래의 검색, 그리고 2026년에 확신도 숫자 대신 증거 목록을 택한 결정까지 — 결국 한 가지 원칙의 다른 얼굴들이다.
에이전트가 오래 일하려면, 무엇을 보았는지와 무엇을 믿게 되었는지를 끝까지 구분해서 기억해야 한다.
금붕어 비서에게 필요한 건 더 큰 어항이 아니었다. 칸이 나뉜 서랍, 그리고 각 서랍에 붙은 정직한 라벨이었다.
참고문헌
논문과 저장소
Latimer, C., Boschi, N., Neeser, A., Bartholomew, C., Srivastava, G., Wang, X., & Ramakrishnan, N. (2025). Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects. arXiv:2512.12818. https://arxiv.org/abs/2512.12818
Hindsight 블로그: 「Agent memory that learns: observations and mental models」(2026-01-28), 「How We Built Disposition-Aware Agents That Actually Think Differently」(2026-03-13). https://hindsight.vectorize.io/blog