SodaMem에이전트 메모리장기 기억시간 지식 그래프출처대체LongMemEval연결 밀도하이브리드 검색자기 채점Mem0ZepGraphiti
[특집] 영수증 있는 기억 — SodaMem으로 읽는 AI 에이전트의 '지금 참인 것': 출처·시간·대체, 그리고 92.8%의 뒷면
AI 비서가 '매운 음식 좋아하시죠?'라며 위염 환자에게 마라탕을 권한다면, 기억을 못 해서가 아니라 무엇이 지금 참인지 몰라서입니다. 2026년 8월 공개된 SodaMem은 대화에서 뽑은 사실마다 원문 영수증(출처 조각)을 붙이고, 네 개의 시계로 시간을 적고, 바뀐 사실은 지우지 않고 닫습니다. 그래프·BM25·임베딩 세 터널에서 함께 걸린 증거를 위로 올리고, 플래너가 모은 증거로 리더가 인용을 달아 답합니다. LongMemEval-S에서 92.8%, 문항당 0.16센트라는 숫자도 냈습니다. 바틀릿의 재구성 기억과 파치올리의 장부에서 시작해 이중 시간 데이터베이스, 진리 유지 시스템, BM25와 RRF, MemGPT·Mem0·Zep으로 이어지는 계보를 따라가며 논문의 개념을 하나씩 풀었습니다. 코어닷투데이는 공개된 답안 500개를 다른 모델로 다시 채점했고(88.6%, 직접 판정하면 약 90%), 같은 검색 결과를 작은 모델에 읽혔고, 코드를 열어 논문과 다른 세 곳을 찾았습니다. 92.8%를 낸 저장소는 대체를 '관찰만' 하는 모드였고, 공개 코드의 BM25는 한글을 한 글자도 토큰으로 만들지 못합니다. 작은 모델로 같은 시나리오를 넣어 보니 옛 주소는 닫히지 않았고, 영어 대화에서는 위염 환자에게 매운 김치찌개를 권했습니다. 인터랙티브 7개.
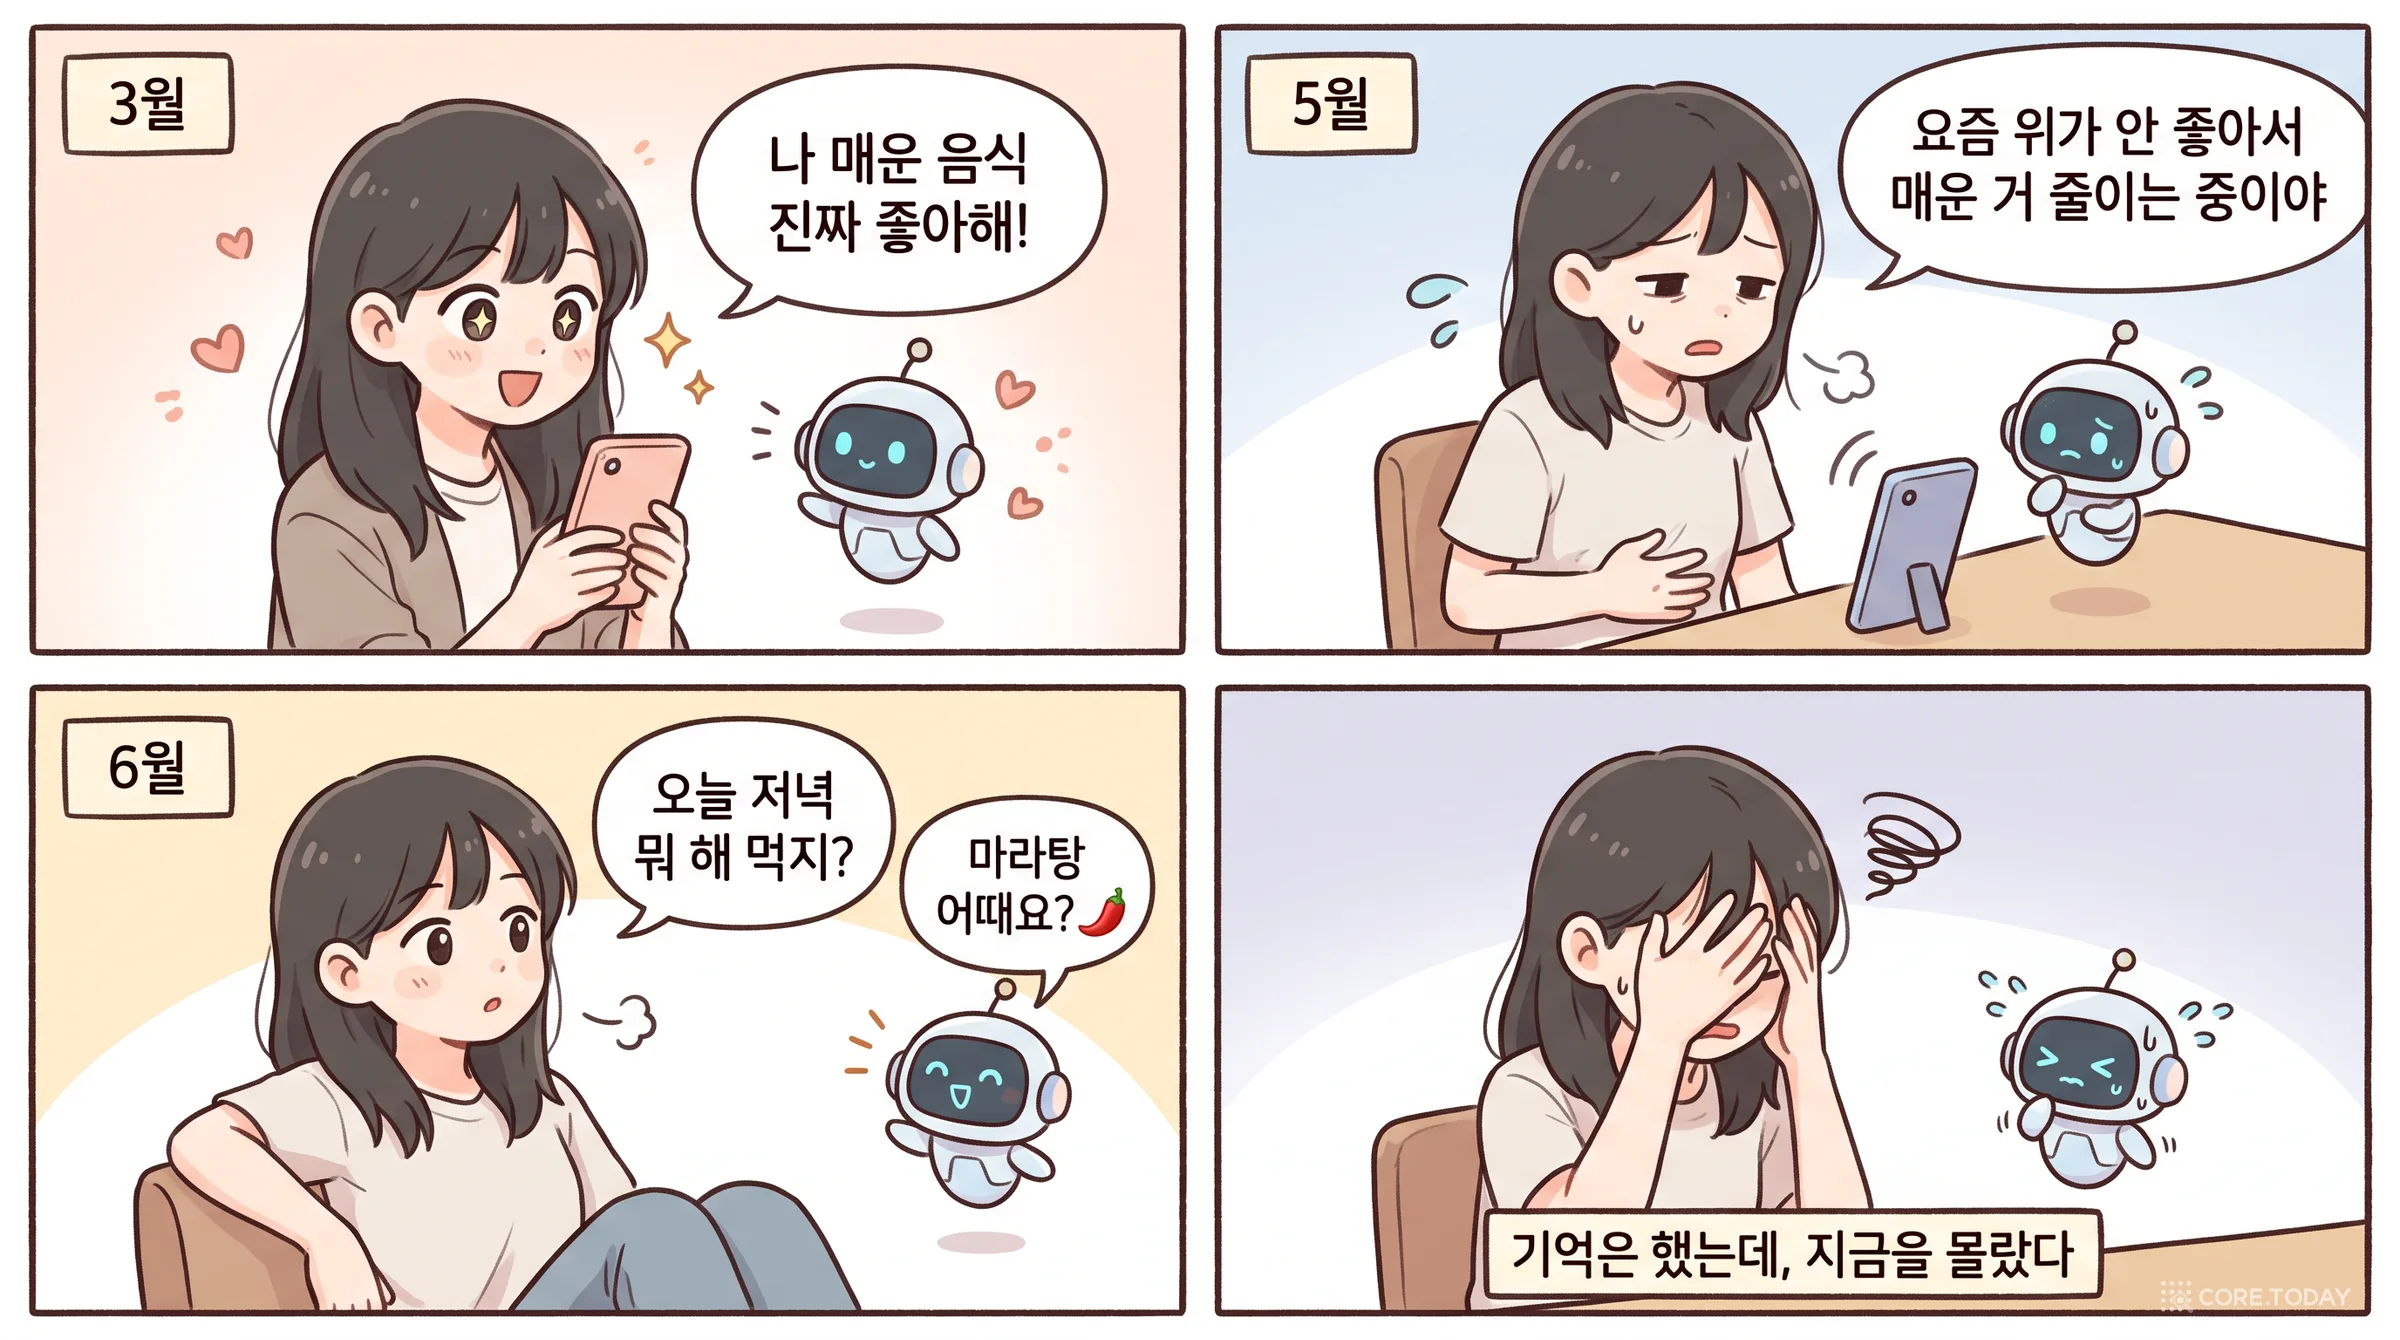
3월에 지은 씨는 AI 비서에게 "나 매운 음식 진짜 좋아해, 마라탕은 일주일에 두 번은 먹어"라고 말했습니다. 5월에는 "요즘 위염 때문에 매운 거 줄이는 중이야"라고 했습니다. 6월의 어느 저녁 "오늘 저녁 뭐 해 먹지?"라고 묻자 비서는 밝게 답합니다. "마라탕 어때요?"
비서가 잊은 것은 하나도 없습니다. 오히려 너무 잘 기억했습니다. 3월의 말도 5월의 말도 다 갖고 있었습니다. 다만 둘 중 어느 쪽이 지금 참인지를 몰랐습니다. 지은 씨가 "내가 매운 거 싫어한다고 언제 그랬어?"라고 따지면 비서는 더 곤란해집니다. 그런 말은 한 적이 없고("줄이는 중"이라고 했을 뿐입니다), 비서가 그 기억을 어디서 가져왔는지 보여 줄 방법도 없습니다.
2026년 8월 8일 arXiv에 올라온 「SodaMem: Evidence-Grounded Temporal Graph Memory for LLM Agents」(arXiv 2608.08055)는 이 장면에서 출발합니다. 논문 첫 문장이 이렇습니다.
몇 주에 걸쳐 사용자를 돕는 LLM 에이전트는 한때 말해진 것이 아니라 지금 참인 것을 기억해야 한다.
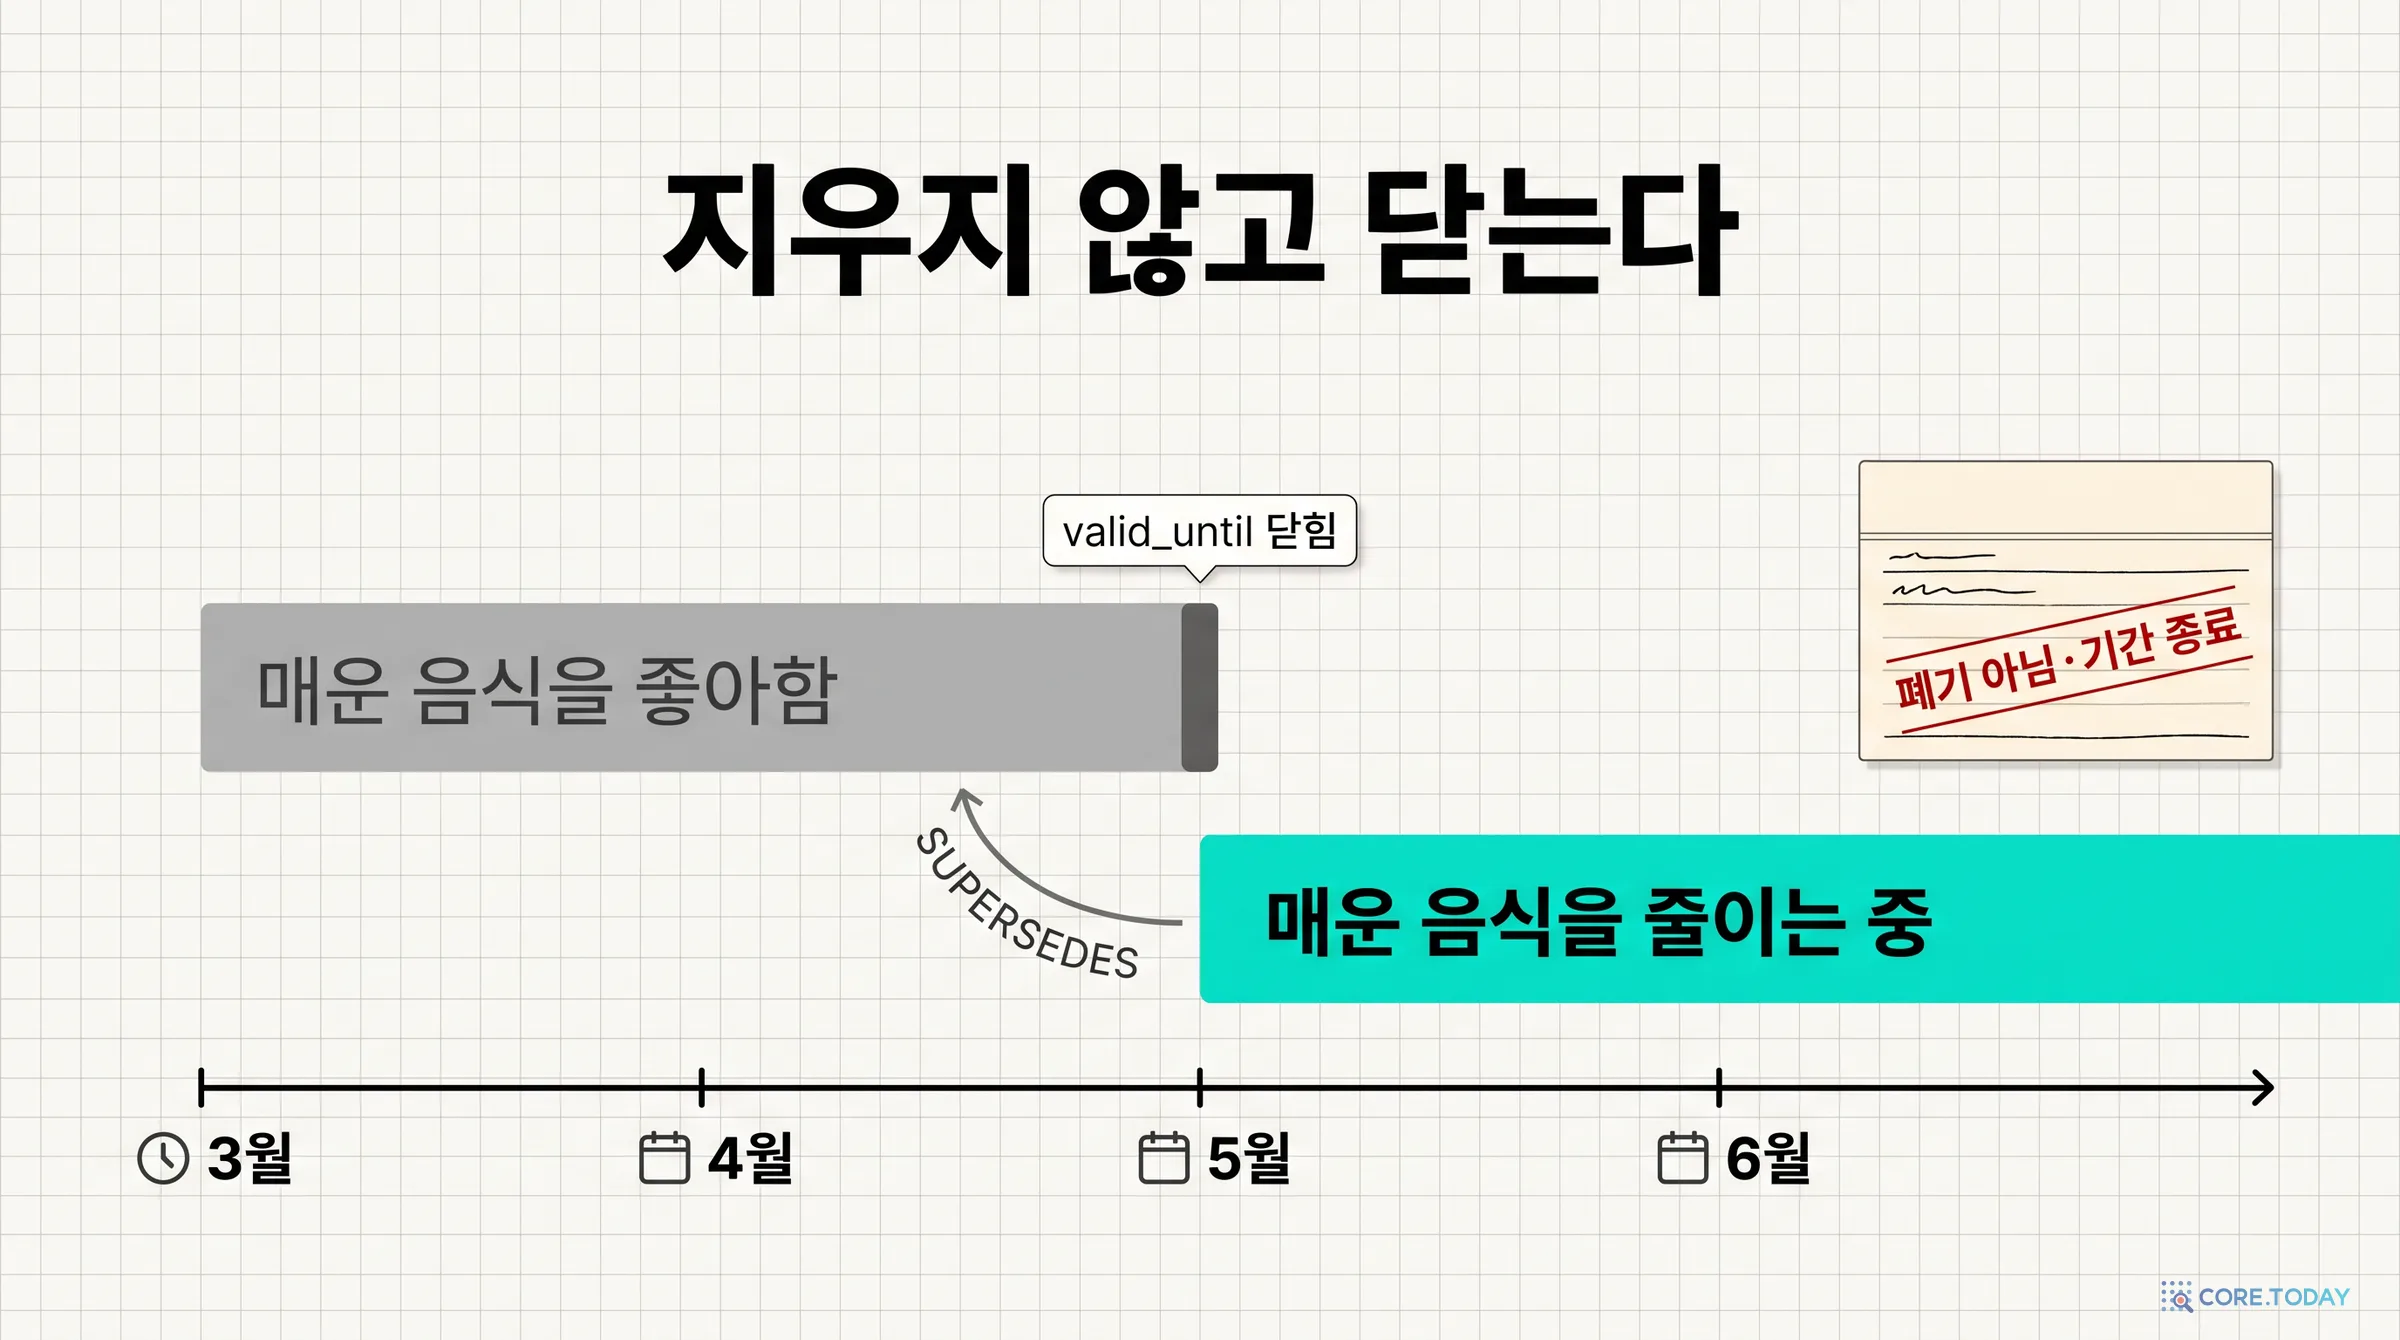
해법도 한 문장으로 요약됩니다. 기억을 일기장이나 벡터 더미가 아니라 영수증이 붙은 사실 카드의 시간 그래프로 만들자는 것입니다. 사실마다 원문 조각을 출처로 반드시 달고(출처), 일어난 때·참이었던 때·말한 때를 따로 적고(시간), 사실이 바뀌면 옛 카드를 찢지 않고 유효기간을 닫는 것입니다(대체). 그리고 답할 때는 증거부터 모은 다음 인용을 달아 씁니다.
숫자도 함께 냈습니다. 장기 대화 기억 벤치마크 LongMemEval-S 500문항에서 92.8%를 맞혔고, 답 하나에 평균 0.161센트(약 1.8만 토큰)를 썼습니다. 저자들은 "Opus·GPT-4o급 고득점 시스템보다 문항당 비용이 10~40배 싸다"고 적었습니다. GitHub 저장소(SodaMem/SodaMem, 아파치 2.0)는 논문보다 하루 먼저 공개됐고, 2026년 10월 말 현재 별은 200개 남짓입니다.
이 글은 논문을 처음부터 끝까지 풀어 읽습니다. 어려운 말은 나올 때마다 풀겠습니다. 순서는 이렇습니다.
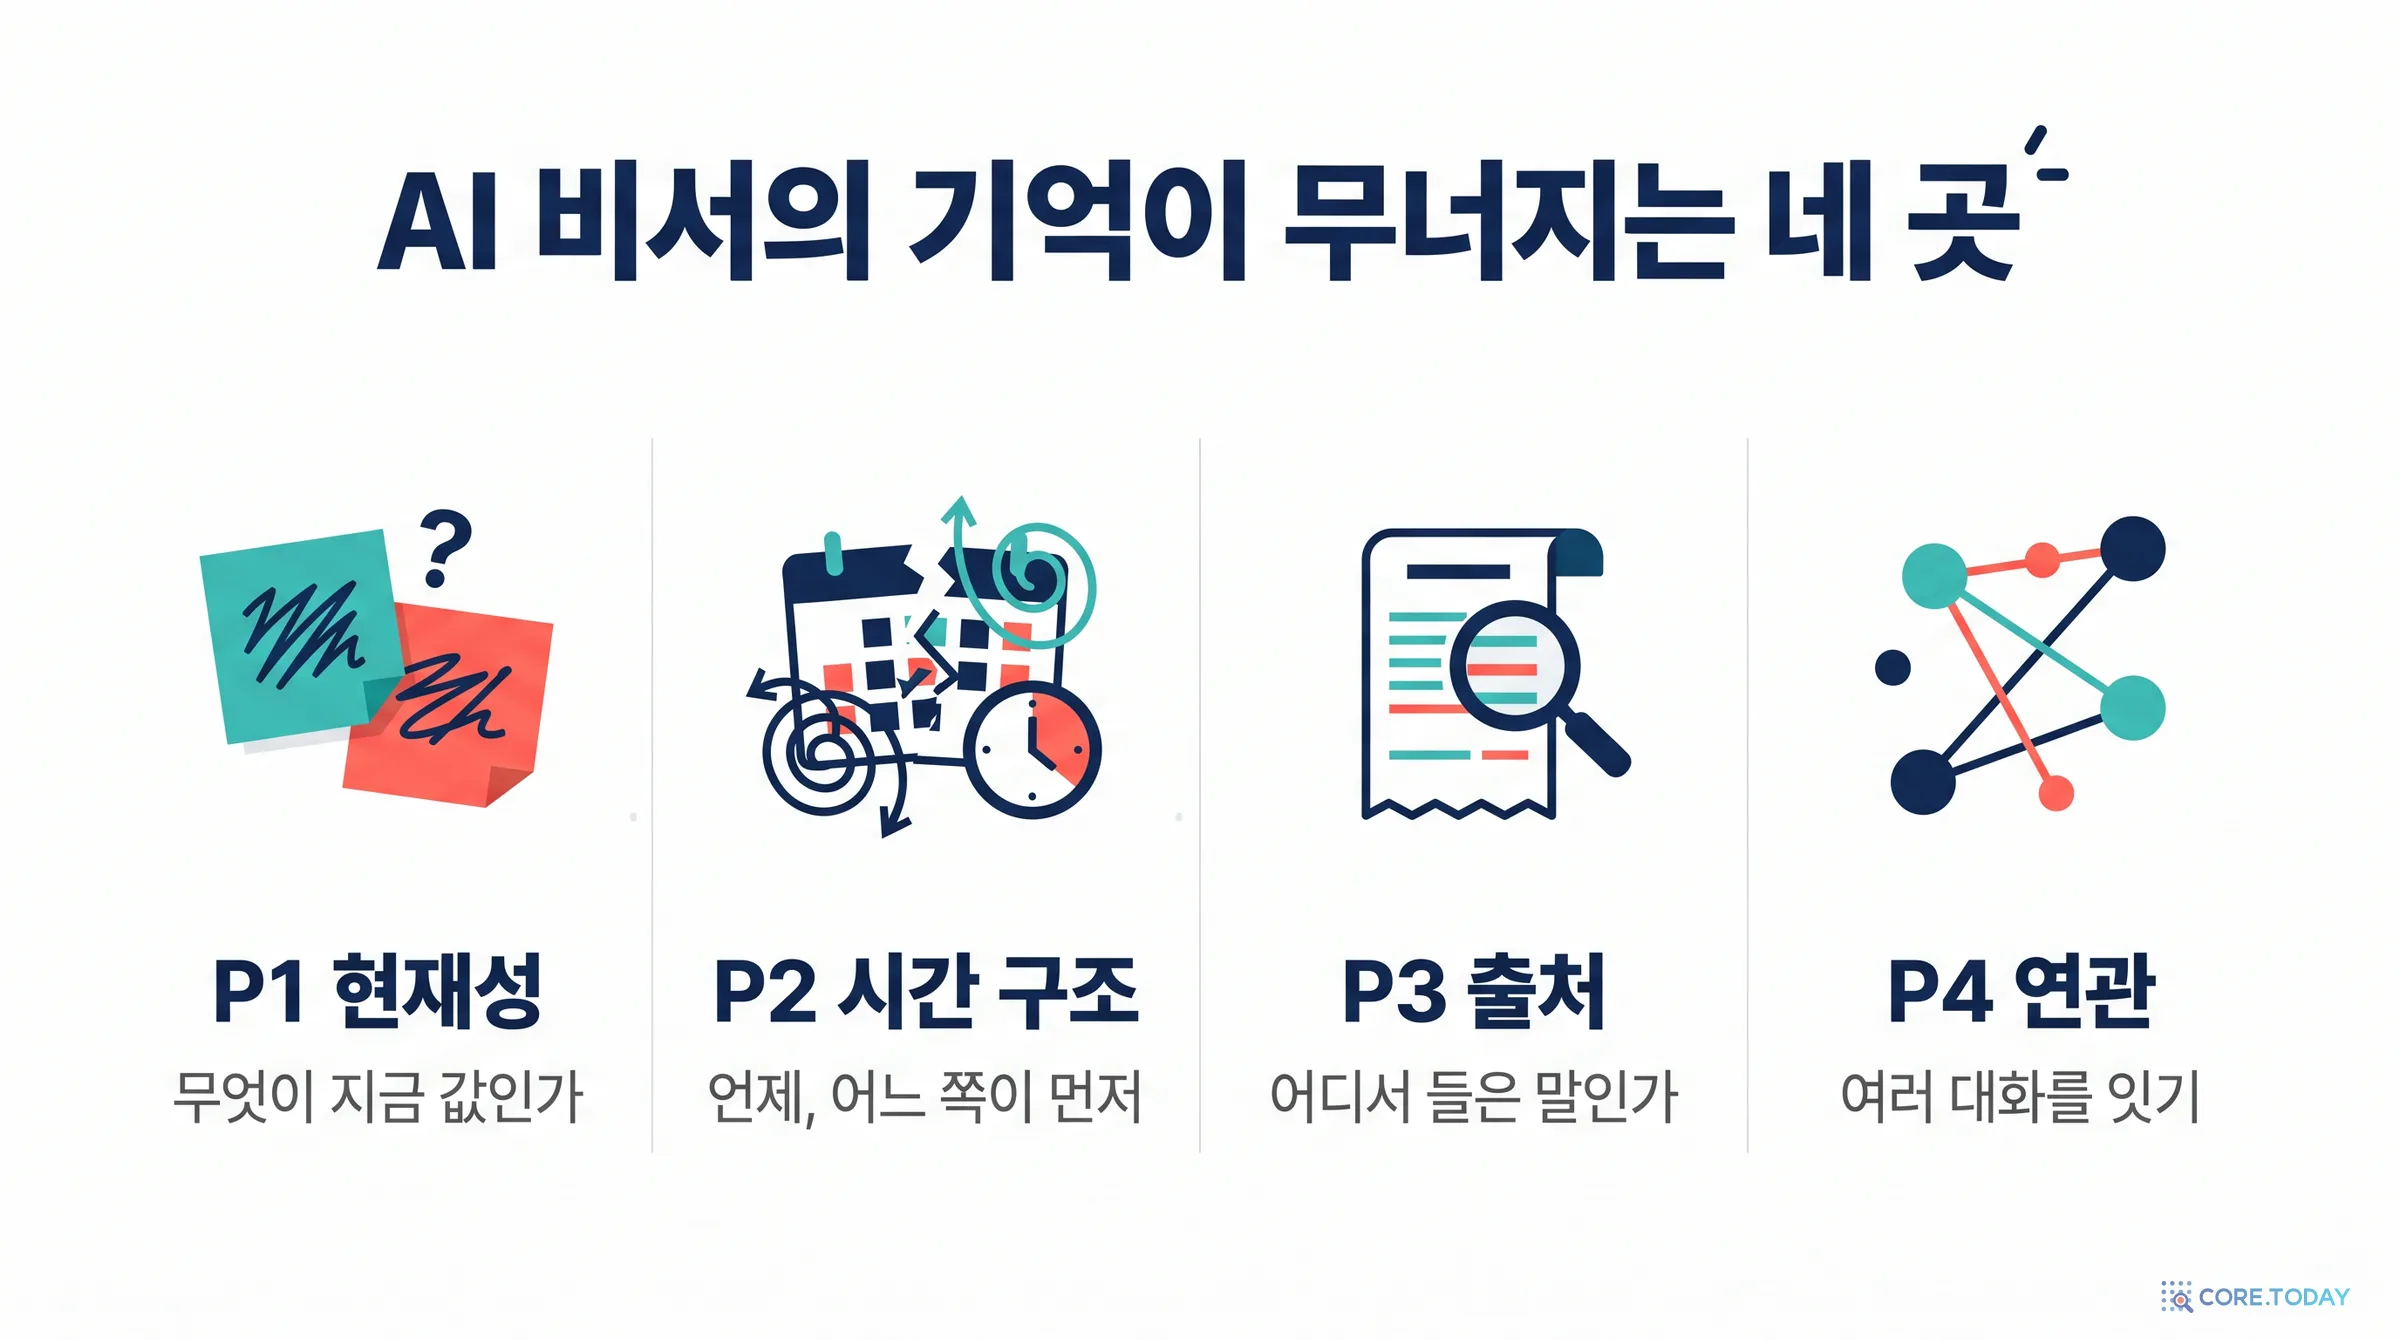
AI 비서의 기억이 무너지는 네 곳(논문의 P1~P4)을 장면으로 봅니다.
이 생각들이 어디서 왔는지, 1932년 심리학 실험부터 2026년 벤치마크 경쟁까지 계보를 따라갑니다.
SodaMem의 부품을 하나씩 엽니다. 사실 카드(FactEvent), 출처 검사, 대체, 세 터널 검색과 연결 밀도, 부드러운 시간 창, 플래너–리더입니다.
결과 표와 비용–정확도 그림을 읽습니다.
코어닷투데이 실측입니다. 공개된 답안 500개를 다른 모델로 다시 채점하고, 같은 검색 결과를 다른 리더에게 읽히고, 공개 코드를 열어 논문과 맞춰 보고, 한국어 대화를 직접 넣어 봤습니다.
한계와 반론을 짚고, 2026년에 이 기술이 어디에 쓰이는지, 지금 바로 쓸 수 있는 점검표로 마무리합니다.
?
문제
에이전트의 기억은 '찾기'는 잘하게 됐지만, 바뀐 사실 중 무엇이 지금 값인지, 언제 일어난 일인지, 어디서 들은 말인지를 잘 답하지 못한다.
!
SodaMem의 답
출처 조각이 반드시 붙은 사실 카드, 네 개의 시간축, 지우지 않고 닫는 대체, 세 터널의 연결 밀도 검색, 증거를 먼저 모으는 플래너–리더.
✓
코어닷투데이가 다시 재 보니
다른 모델로 다시 채점하면 88.6%, 엇갈린 문항을 직접 판정하면 약 90%. 92.8%를 낸 저장소는 대체를 적용하지 않은 '관찰만' 모드였고, 대체 규칙은 추출 모델이 지은 술어 이름에 기대고 있었다. 설계는 좋은데, 숫자와 설계 사이에는 틈이 있다.
1. 기억이 무너지는 네 곳
논문 서론은 이 분야의 질문이 바뀌었다고 말합니다. 예전에는 "모델이 대화 기록이라는 건초더미에서 바늘을 찾을 수 있나?"를 물었다면, 이제는 "에이전트가 사용자에 대한 일관되고 고칠 수 있는 모델을 유지하고, 그것을 맞는 조건에서 쓰는가?"를 묻는다는 것입니다. 그리고 마크다운 일기나 평평한 RAG(질문과 비슷한 조각을 찾아 붙이는 검색 증강 생성)가 매일 쓰는 비서에서 부딪히는 실패를 네 가지로 나눕니다.
P1 현재성과 충돌. 선호는 뒤집힙니다. 덧붙이기만 하는 로그는 "어느 값이 지금 값인가?"를 순서 없는 조각을 읽는 LLM에게 떠넘깁니다. 논문은 여기서 2026년 연구 두 편을 인용합니다. 하나는 Reddy와 Challaram의 「신선도 추적을 LLM에게 맡기지 마라」(arXiv 2606.01435)로, 버전 번호 같은 결정론적 표시가 LLM의 자유로운 판단보다 낫다는 결과를 냈습니다. 다른 하나는 STALE(arXiv 2605.06527)입니다. 나중 정보 때문에 옛 기억이 말없이 무효가 되는 '암묵적 충돌' 400개 시나리오, 1,200개 질문을 만들었는데, 가장 잘한 모델도 55.2%에 그쳤습니다.
P2 시간 구조. "가장 최근에", "두 달 전에", "어느 쪽이 먼저?" 같은 질문은 비교할 수 있는 시간선이 없으면 무너집니다. "지난주에 산 책"의 '지난주'는 말한 날을 알아야 계산됩니다.
P3 출처. 사람이 기억을 믿으려면 그 기억이 어느 대화의 어느 말에서 나왔는지 볼 수 있어야 합니다. 요약은 손실 압축이고, 벡터 검색의 적중은 왜 걸렸는지 설명하지 않습니다.
P4 연관. "지금 사는 동네에서 고양이 사료 살 데 있어?"에 답하려면 '사는 곳'과 '고양이'라는 서로 다른 대화의 사실을 이어야 합니다. 코사인 유사도로 가까운 것만으로는 부족합니다. 비슷하지만 다른 시기의 기억이 섞여 들어오는 '맥락 붕괴'(RaMem, arXiv 2606.22844의 용어)도 피해야 합니다.
아래 위젯에서 같은 대화 일곱 마디를 세 방식으로 기억시켰을 때 네 질문에 어떻게 답하는지 눌러 보세요.
P2 칸에서 날짜를 붙여 원문을 쌓은 일기가 꽤 잘한다는 점은 일부러 남겨 두었습니다. 코어닷투데이가 2026년 10월에 같은 고객 열 명의 상담을 파일과 그래프에 기억시켜 본 실험(「파일이냐 그래프냐」)에서도, 날짜와 함께 원문을 그대로 쌓은 파일이 95.2%로 Graphiti(81.4%)를 이겼습니다. 꼴찌는 현재 상태만 남긴 파일(47.6%)이었습니다. 이긴 이유는 형식이 아니라 "옛 값을 기간과 함께 남겼느냐"였습니다. SodaMem이 말하는 출처·시간·대체도 결국 그 질문에 대한 답입니다. 마크다운 일기는 논문 표현으로 "강력한 단순함의 기준선"이고, SodaMem은 그 기준선이 약한 곳(현재성·순서·출처·연관)을 구조로 메우려는 시도입니다.
2. 이 생각들은 어디서 왔나 — 기억·장부·시계·검색의 90년
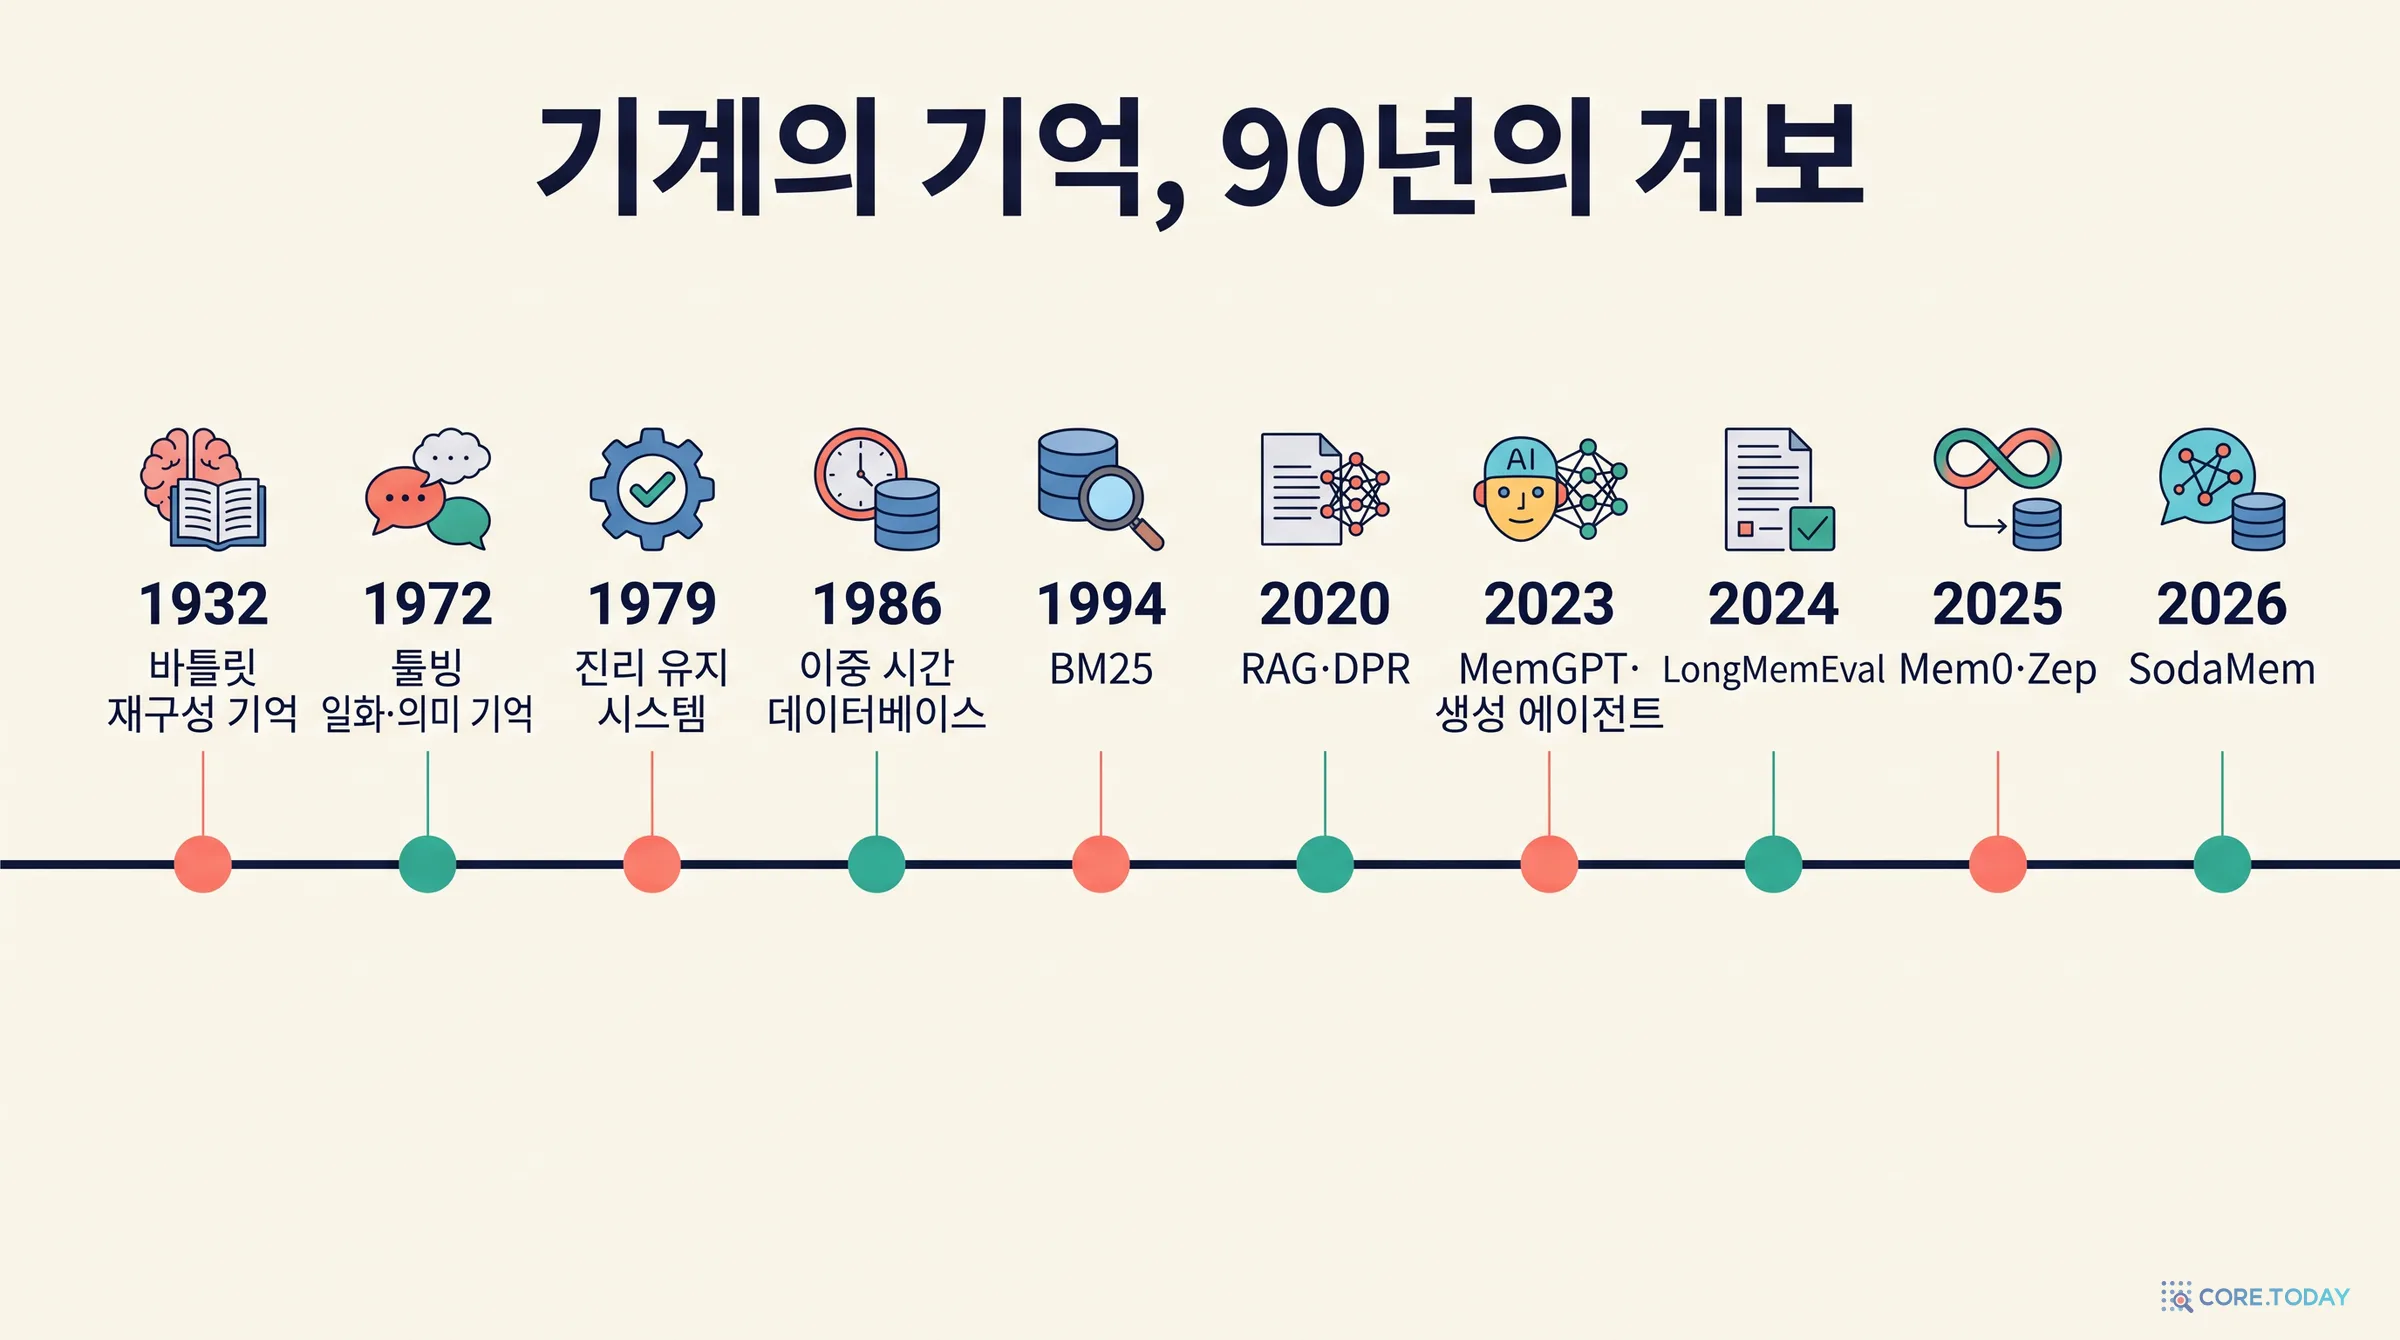
SodaMem은 새 개념을 발명했다기보다, 서로 다른 분야에서 오래 다듬어진 생각 다섯 가지를 한 상자에 담았습니다. 사람의 기억은 재구성된다는 심리학, 모든 기록에는 출처가 있어야 한다는 회계와 데이터베이스의 전통, 시간을 두 번 적는 시간 데이터베이스, 믿음을 고치는 논리, 그리고 정보 검색입니다. 하나씩 짧게 따라가 보겠습니다.
1932년 케임브리지의 심리학자 프레더릭 바틀릿은 『기억하기(Remembering)』에서 영국 학생들에게 아메리카 원주민 설화 「유령들의 전쟁」을 읽히고, 시간을 두고 여러 번 다시 말하게 했습니다. 이야기는 말할 때마다 짧아졌고, 낯선 대목은 학생들에게 익숙한 문화의 틀로 바뀌었습니다. 바틀릿의 결론은 기억이 녹음기처럼 재생되는 것이 아니라 그때그때 재구성된다는 것이었습니다. 앞에서 본 '줄이는 중'이 '싫어함'으로 바뀌는 요약의 손실과 똑같은 현상입니다.
1972년 엔델 툴빙은 기억을 일화 기억(언제 어디서 무슨 일이 있었나)과 의미 기억(세상에 대한 일반 지식)으로 나눴습니다. 에이전트 기억 논문들이 지금도 쓰는 구분입니다. SodaMem의 사실 카드에 '일어난 사건(past_event)'과 '현재 상태(current_state)'라는 양상이 따로 있는 것도 이 구분의 후손입니다.
날짜에 대한 기억은 특히 믿을 수 없습니다. 1964년 미국 통계학자 존 네터와 조지프 왁스버그는 가계 지출 면접 조사에서 사람들이 실제보다 최근에 있었던 일처럼 기억하는 경향을 측정했고, 이를 망원경 효과(telescoping)라고 불렀습니다. 석 달 전 일을 "두 달 전쯤"이라고 말하는 것입니다. 1974년 엘리자베스 로프터스와 존 파머는 교통사고 영상을 보여 준 뒤 "차가 '부딪쳤을' 때"와 "차가 '박살 났을' 때"로 질문만 바꿔도 사람들이 추정하는 속도와 깨진 유리를 봤다는 기억이 달라진다는 것을 보였습니다. 질문이 기억을 바꿉니다.
SodaMem의 '부드러운 시간 창' 원칙은 이 전통을 그대로 받습니다. 논문은 "사용자는 기간을 잘못 기억한다(석 달 전 사실을 '두 달 전'이라고 말한다). 엄격한 시간 필터는 맞는 증거를 떨어뜨린다"고 씁니다. 6장에서 위젯으로 확인합니다.
2-2. 장부와 영수증 — 출처의 전통 (1494~2013)
1494년 루카 파치올리는 『산술·기하·비율 및 비례 총람』에서 복식부기를 체계적으로 정리했습니다. 모든 거래는 두 번 적히고, 모든 기록은 원 증빙(전표·영수증)으로 거슬러 올라갈 수 있어야 합니다. 회계 감사는 장부의 숫자에서 영수증까지 거꾸로 따라가는 일입니다.
데이터베이스 연구는 이것을 데이터 계보(provenance)라고 불렀습니다. 2001년 피터 부네만, 산지브 칸나, 왕치우 탄의 논문 「왜와 어디서」(ICDT 2001)는 질의 결과의 한 줄이 원본 데이터의 어디서 왔고 왜 거기 있는지를 형식적으로 구분했습니다. 2013년 W3C는 출처를 기계가 읽을 수 있게 적는 표준 PROV를 권고안으로 냈습니다. 위키백과의 '출처 필요' 꼬리표도 같은 정신입니다. 출처 없는 문장은 일단 의심합니다.
SodaMem의 첫 번째 원칙 "출처 조각 없이는 오래 남을 주장을 저장하지 않는다"는 이 전통을 에이전트 기억에 들여온 것입니다. 저장소 README의 표현이 재미있습니다. "모든 기억은 영수증을 갖고 다닌다(Every memory carries its receipt)."
2-3. 시간을 두 번 적는다 — 시간 데이터베이스 (1983~2011)
1983년 제임스 앨런은 「시간 구간에 대한 지식 유지」(CACM)에서 두 시간 구간 사이에 가능한 관계 13가지(앞섬·만남·겹침·포함…)를 정리했습니다. '어느 쪽이 먼저?'를 기계가 따지는 기초입니다. 1985~1986년 리처드 스노드그래스와 일수 안(Ilsoo Ahn)은 데이터베이스의 시간을 유효 시간(현실에서 참이었던 기간)과 거래 시간(데이터베이스에 기록된 때)으로 나누는 분류를 내놓았습니다. 두 시간을 모두 적는 '이중 시간(bitemporal)' 모델은 2011년 SQL 표준에 들어갔습니다.
이중 시간 모델의 핵심 습관은 지우지 않고 닫는다입니다. 주소가 바뀌면 옛 주소 행을 지우지 않고 "여기까지 유효했다"는 끝 시각을 적습니다. 그래야 "3월에는 어디 살았지?"에도 답할 수 있습니다. 코어닷투데이는 이 계보를 「기억에 유효기간을 적다 — Graphiti 시간 그래프」와 「시간을 기억하는 SQL」에서 자세히 다뤘습니다. SodaMem은 이 두 시계를 넷으로 늘립니다(4장).
2-4. 믿음을 고치는 법 — 진리 유지와 믿음 수정 (1979~1985)
1979년 MIT의 존 도일은 진리 유지 시스템(TMS)을 발표했습니다. 추론 엔진이 믿는 사실마다 "무엇 때문에 믿는가"라는 근거를 달아 두고, 근거가 무너지면 그 위에 선 믿음을 함께 거둬들이는 장치입니다. 1985년 카를로스 알초우론, 피터 게르덴포르스, 데이비드 메이킨슨은 새 정보가 기존 믿음과 충돌할 때 믿음 집합을 어떻게 고쳐야 합리적인지를 공리로 정리했습니다(세 사람의 머리글자를 딴 AGM 이론). "최소한만 바꿔라", "새 정보는 받아들여라" 같은 원칙입니다.
SodaMem의 SUPERSEDES(대체)·CONTRADICTS(모순)·UPDATES(갱신) 엣지는 이 질문의 실용적인 답입니다. 새 사실이 옛 사실과 같은 '슬롯'(같은 주어와 같은 술어)에서 경쟁하면 옛 사실을 닫습니다. 다만 TMS처럼 "그 사실에 기대고 있던 다른 결론"까지 따라가 고치지는 않습니다. 그 일을 한 것이 같은 해 8월에 나온 StateMem이고, 코어닷투데이는 「기억은 하는데 지금을 모른다」에서 1969년 프레임 문제부터 그 계보를 따로 정리했습니다.
2-5. 찾는 기술 — BM25, 밀집 검색, 순위 융합 (1994~2020)
정보 검색의 고전 BM25는 1994년 TREC-3 대회에서 스티븐 로버트슨 연구진의 Okapi 시스템으로 다듬어졌습니다. 질문의 단어가 문서에 몇 번, 얼마나 드물게 나오는지로 점수를 매깁니다. 정확한 단어(이름, 숫자, 고유명사)에 강하고, 뜻은 같은데 말이 다르면 놓칩니다.
2020년에는 두 흐름이 겹쳤습니다. 블라디미르 카르푸힌 연구진의 DPR(밀집 문단 검색, EMNLP 2020)은 질문과 문서를 같은 벡터 공간에 넣어 뜻이 가까운 것을 찾았고, 패트릭 루이스 연구진의 RAG(NeurIPS 2020)는 찾은 문서를 생성 모델에 붙여 답하게 했습니다. 임베딩 검색은 바꿔 말한 표현에 강하지만, 비슷한 다른 일을 끌어오는 약점이 있습니다.
두 검색을 합치는 법도 오래된 주제입니다. 2009년 고든 코맥 연구진은 각 검색기의 등수만 써서 합치는 RRF(역순위 융합, SIGIR 2009)를 제안했습니다. 등수 r에 1/(60+r)을 주고 더하는 단순한 식인데, 이후 하이브리드 검색의 기본값이 됐습니다. SodaMem은 RRF 대신 터널마다 '질량'을 손으로 정해 더하는 쪽을 택했고, 공개 코드는 그 질량을 noisy-OR로 합칩니다. noisy-OR은 1988년 주디아 펄이 『지능 시스템의 확률적 추론』에서 정리한 모형으로, "여러 원인이 각자 독립적으로 결과를 일으킬 확률"을 합칩니다. 6장에서 계산기로 비교합니다.
2-6. LLM이 기억을 갖기까지 (2023~2025)
2023년 봄 스탠퍼드의 박준성 연구진은 「생성 에이전트」(UIST 2023)에서 가상 마을 주민 25명에게 '기억 흐름'을 줬습니다. 모든 관찰을 시간 순서로 쌓고, 최신성·중요도·관련성 점수로 꺼내고, 주기적으로 '성찰'을 써 넣었습니다. 같은 해 가을 버클리의 찰스 패커 연구진은 MemGPT에서 운영체제의 가상 메모리처럼 LLM의 문맥을 '주기억'과 '외부 저장소'로 나누고 모델이 직접 넣고 빼게 했습니다. 왕쥔 중 연구진의 MemoryBank는 에빙하우스 망각 곡선을 빌려 오래된 기억을 흐리게 했습니다.
평가도 생겼습니다. 2024년 LoCoMo(ACL 2024)는 수십 세션짜리 긴 대화에서 사실 회상·시간 추론·다중 홉 질문을 냈고, 같은 해 10월 공개된 LongMemEval(ICLR 2025)은 대화 기록 약 11.5만 토큰(세션 수십 개)에 질문 500개를 붙여 정보 추출·다중 세션 추론·지식 갱신·시간 추론·기권을 따로 쟀습니다. 지식 갱신 문항은 바로 "예전 값과 바뀐 값이 둘 다 있을 때 지금 값을 말하는가"입니다. SodaMem이 92.8%를 낸 것이 이 벤치마크입니다.
2025년에는 제품이 쏟아졌습니다. Mem0(arXiv 2504.19413)는 대화에서 사실을 뽑아 ADD·UPDATE·DELETE로 관리하는 API를 내놓았고, Zep(arXiv 2501.13956)과 그 엔진 Graphiti는 엣지마다 유효 기간을 달고 옛 엣지를 무효화하는 시간 지식 그래프를 만들었습니다. A-Mem은 노트끼리 서로 링크하는 제텔카스텐 방식을, HippoRAG는 해마의 색인 이론을 빌린 그래프 검색을 내놓았습니다. 2025년 말 Hindsight(arXiv 2512.12818)는 저장·회상·성찰을 나눈 엔진으로 LongMemEval 91.4%를 보고했습니다. 코어닷투데이는 「에이전트 기억 엔진 해부」에서 이 엔진들의 코드를 나란히 열어 봤습니다.
2-7. 2026년 — 점수 경쟁, 그리고 비용
2026년 들어 LongMemEval 점수는 90점대로 몰렸습니다. 2월 Mastra는 '관찰 기억'으로 GPT-5-mini 리더를 써서 94.87%를 냈고, 같은 방법이 GPT-4o 리더에서는 84.23%였습니다. 4월 Mem0 연구팀은 94.4%를, 3월 개인 개발자 조던 매캔의 agentmemory V4는 Claude Opus 4.6으로 96.2%를 보고했습니다. 이 숫자들이 무엇을 재는지는 코어닷투데이가 「메모리 벤치마크 점수, 믿어도 되나」에서 직접 다시 채점하며 따져 봤습니다. 같은 답안에 채점 프롬프트만 바꿔도 점수가 26점 움직였습니다.
그래서 2026년의 질문은 두 갈래가 됐습니다. 하나는 "점수 말고 무엇이 좋아졌나"입니다. 현재성, 출처, 감사 가능성처럼 점수 하나에 담기지 않는 성질입니다. 다른 하나는 "얼마에"입니다. 리더를 Opus로 바꾸면 점수가 오르지만 비용은 수십 배가 됩니다. SodaMem은 두 질문에 동시에 답하겠다고 나선 논문입니다. 구조로는 출처·시간·대체를, 숫자로는 '싼 모델(deepseek-v4-flash)로 90점대'를 내세웁니다.
왼쪽 열이 넣기(Ingest)입니다. 여러 세션의 대화가 들어오면 LLM 추출기가 '사실 카드' 후보를 뽑고, 출처 검사를 통과한 것만 남기고, 원하면 "지난주" 같은 상대 날짜를 절대 날짜로 바꿉니다. 가운데가 쌓기(Store)입니다. 사실 카드가 노드, 대체·모순·갱신·파생 관계가 엣지가 되고, 같은 내용에 BM25 색인과 벡터 색인을 함께 겁니다. 오른쪽이 답하기(Answer)입니다. 하이브리드 검색으로 증거 더미를 만들고, 플래너가 메모리 도구를 몇 번 더 불러 증거를 보태고, 별도의 리더가 인용을 달아 최종 답을 씁니다.
논문은 이를 세 줄의 식으로 씁니다. 사용자 u의 대화 기록을 H, 질문을 q라 하면
Mu=Ingest(Hu),E=Retrieve(q,Mu),a=Read(q,E)
입니다. 기억(M)을 만들고, 질문에 맞는 증거(E)를 고르고, 증거만 보고 답(a)을 씁니다. 목표는 채점자가 정답과 같다고 판정할 '증거에 근거한 답'입니다. 논문의 정의 0.2는 이 말을 엄격하게 씁니다. 답의 주요 주장마다 꺼내 온 증거가 뒷받침해야 하고, 그 증거는 비어 있지 않은 출처를 가져야 하고, 인용은 바로 그 기록을 가리켜야 합니다.
설계 원칙은 여섯 개입니다.
1증거 먼저 — 출처 조각 없이는 오래 남을 주장을 저장하지 않는다.
2시간을 드러내 적기 — 말한 때, 일어난 때, 유효 기간을 따로 적고, 질문은 '시간 창 + 정렬 방향'으로 푼다.
3고칠 수 있는 현재성 — 대체와 모순을 일급 관계로 두고, 무효가 된 사실은 답의 후보에서 뺀다.
4넓게 여러 신호로 찾기 — 터널마다 검색 머리를 여러 개 두고 각자 확장한 뒤 합친다.
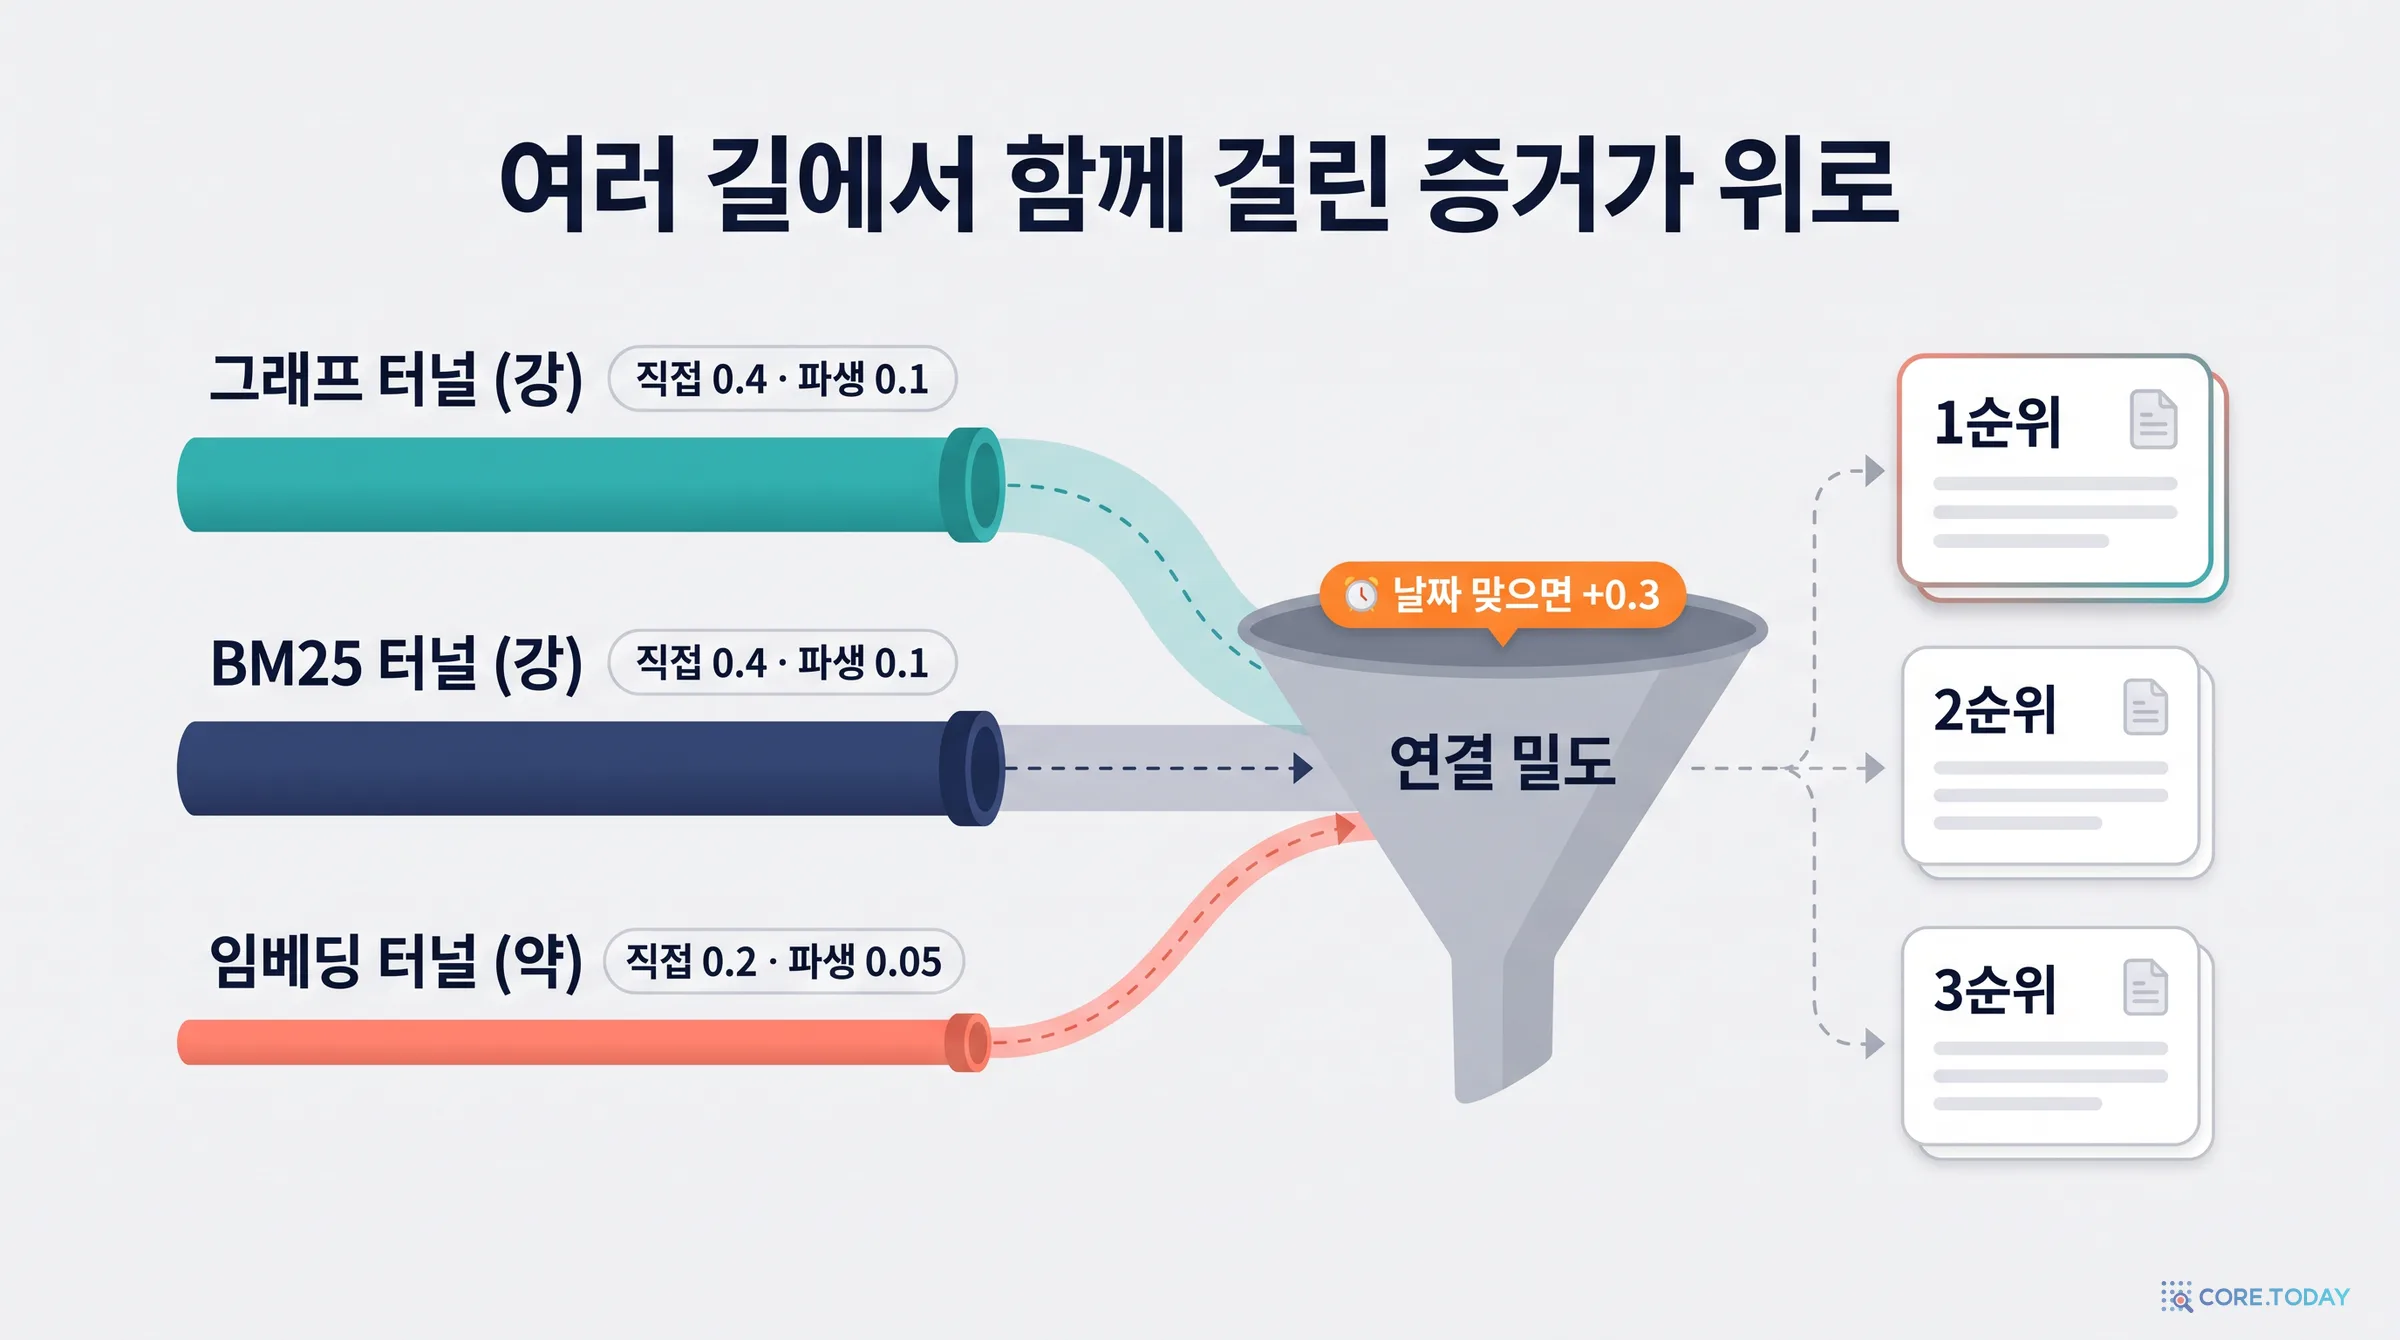
5연결 밀도로 순위 — 여러 길에서 함께 걸린 증거를 위로, 시간은 가산점으로, 거의 같은 것은 합친다.
6도구를 쓰는 답변 — 플래너가 모으고, 리더가 읽는다.
이제 부품을 하나씩 엽니다.
4. 사실 카드(FactEvent)와 출처 영수증
4-1. 일곱 칸짜리 카드
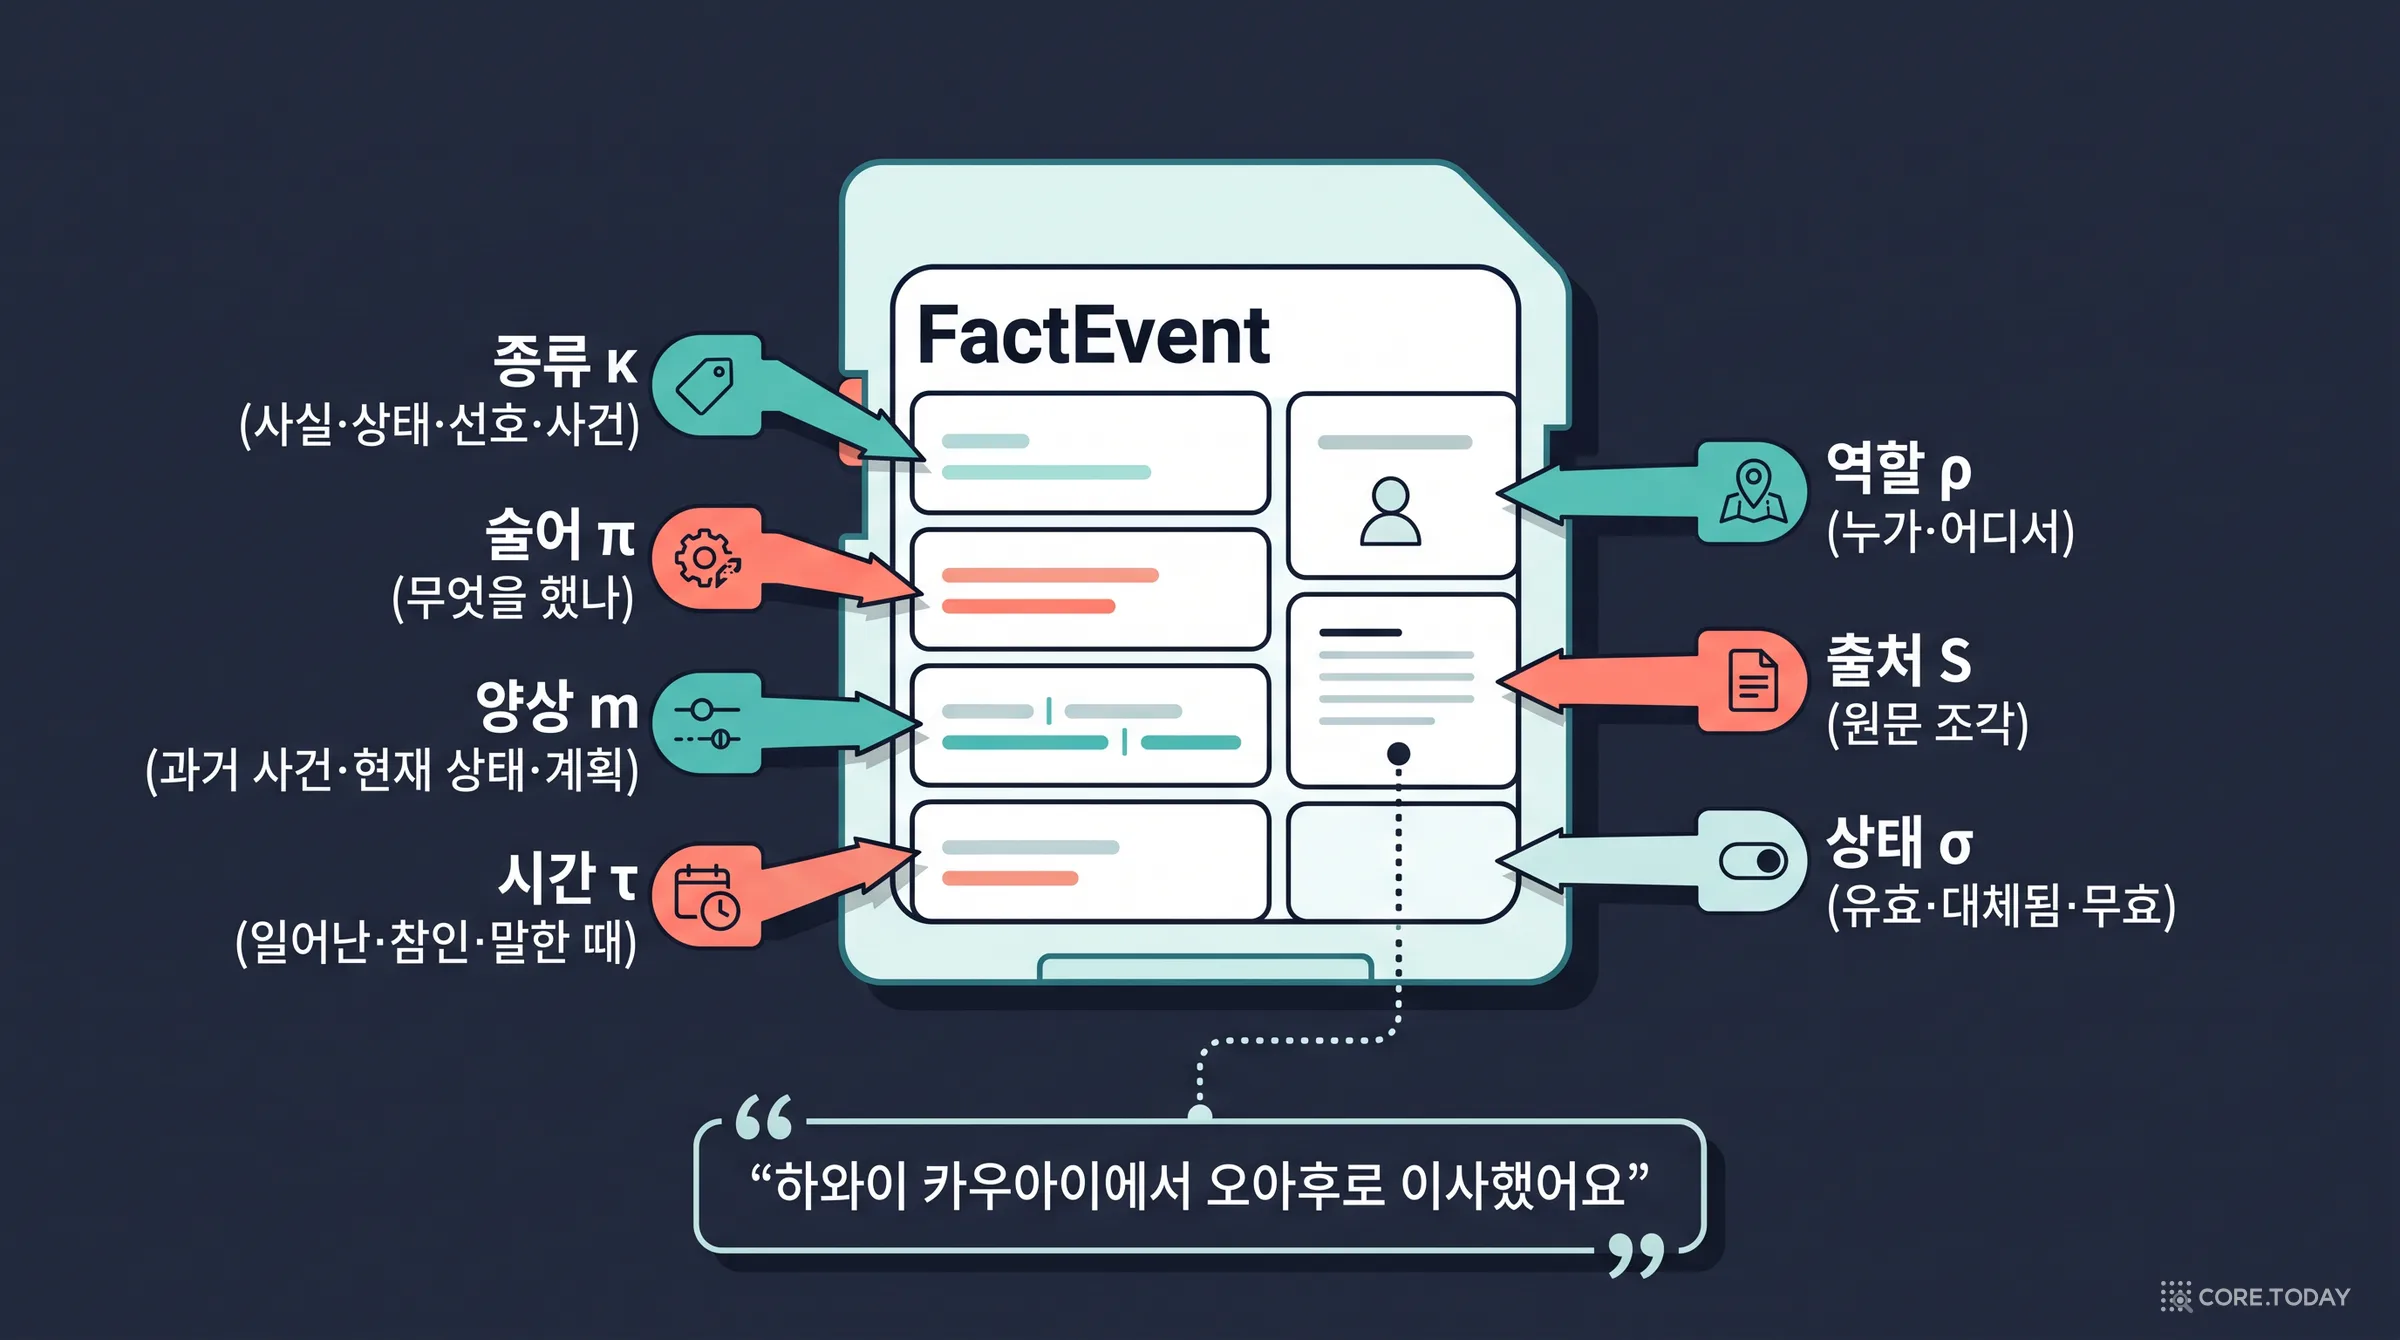
SodaMem 기억의 단위는 FactEvent(사실·사건 카드)입니다. 논문 정의 0.1은 이것을 일곱 개 칸의 묶음으로 씁니다.
종류 κ(kind): 사실(fact), 상태(state), 선호(preference), 사건(event), 프로필 같은 분류입니다.
술어 π(predicate): "무엇이 어떻다"를 짧은 영어 식별자로 씁니다. 예를 들어 user_lives_in_oahu.
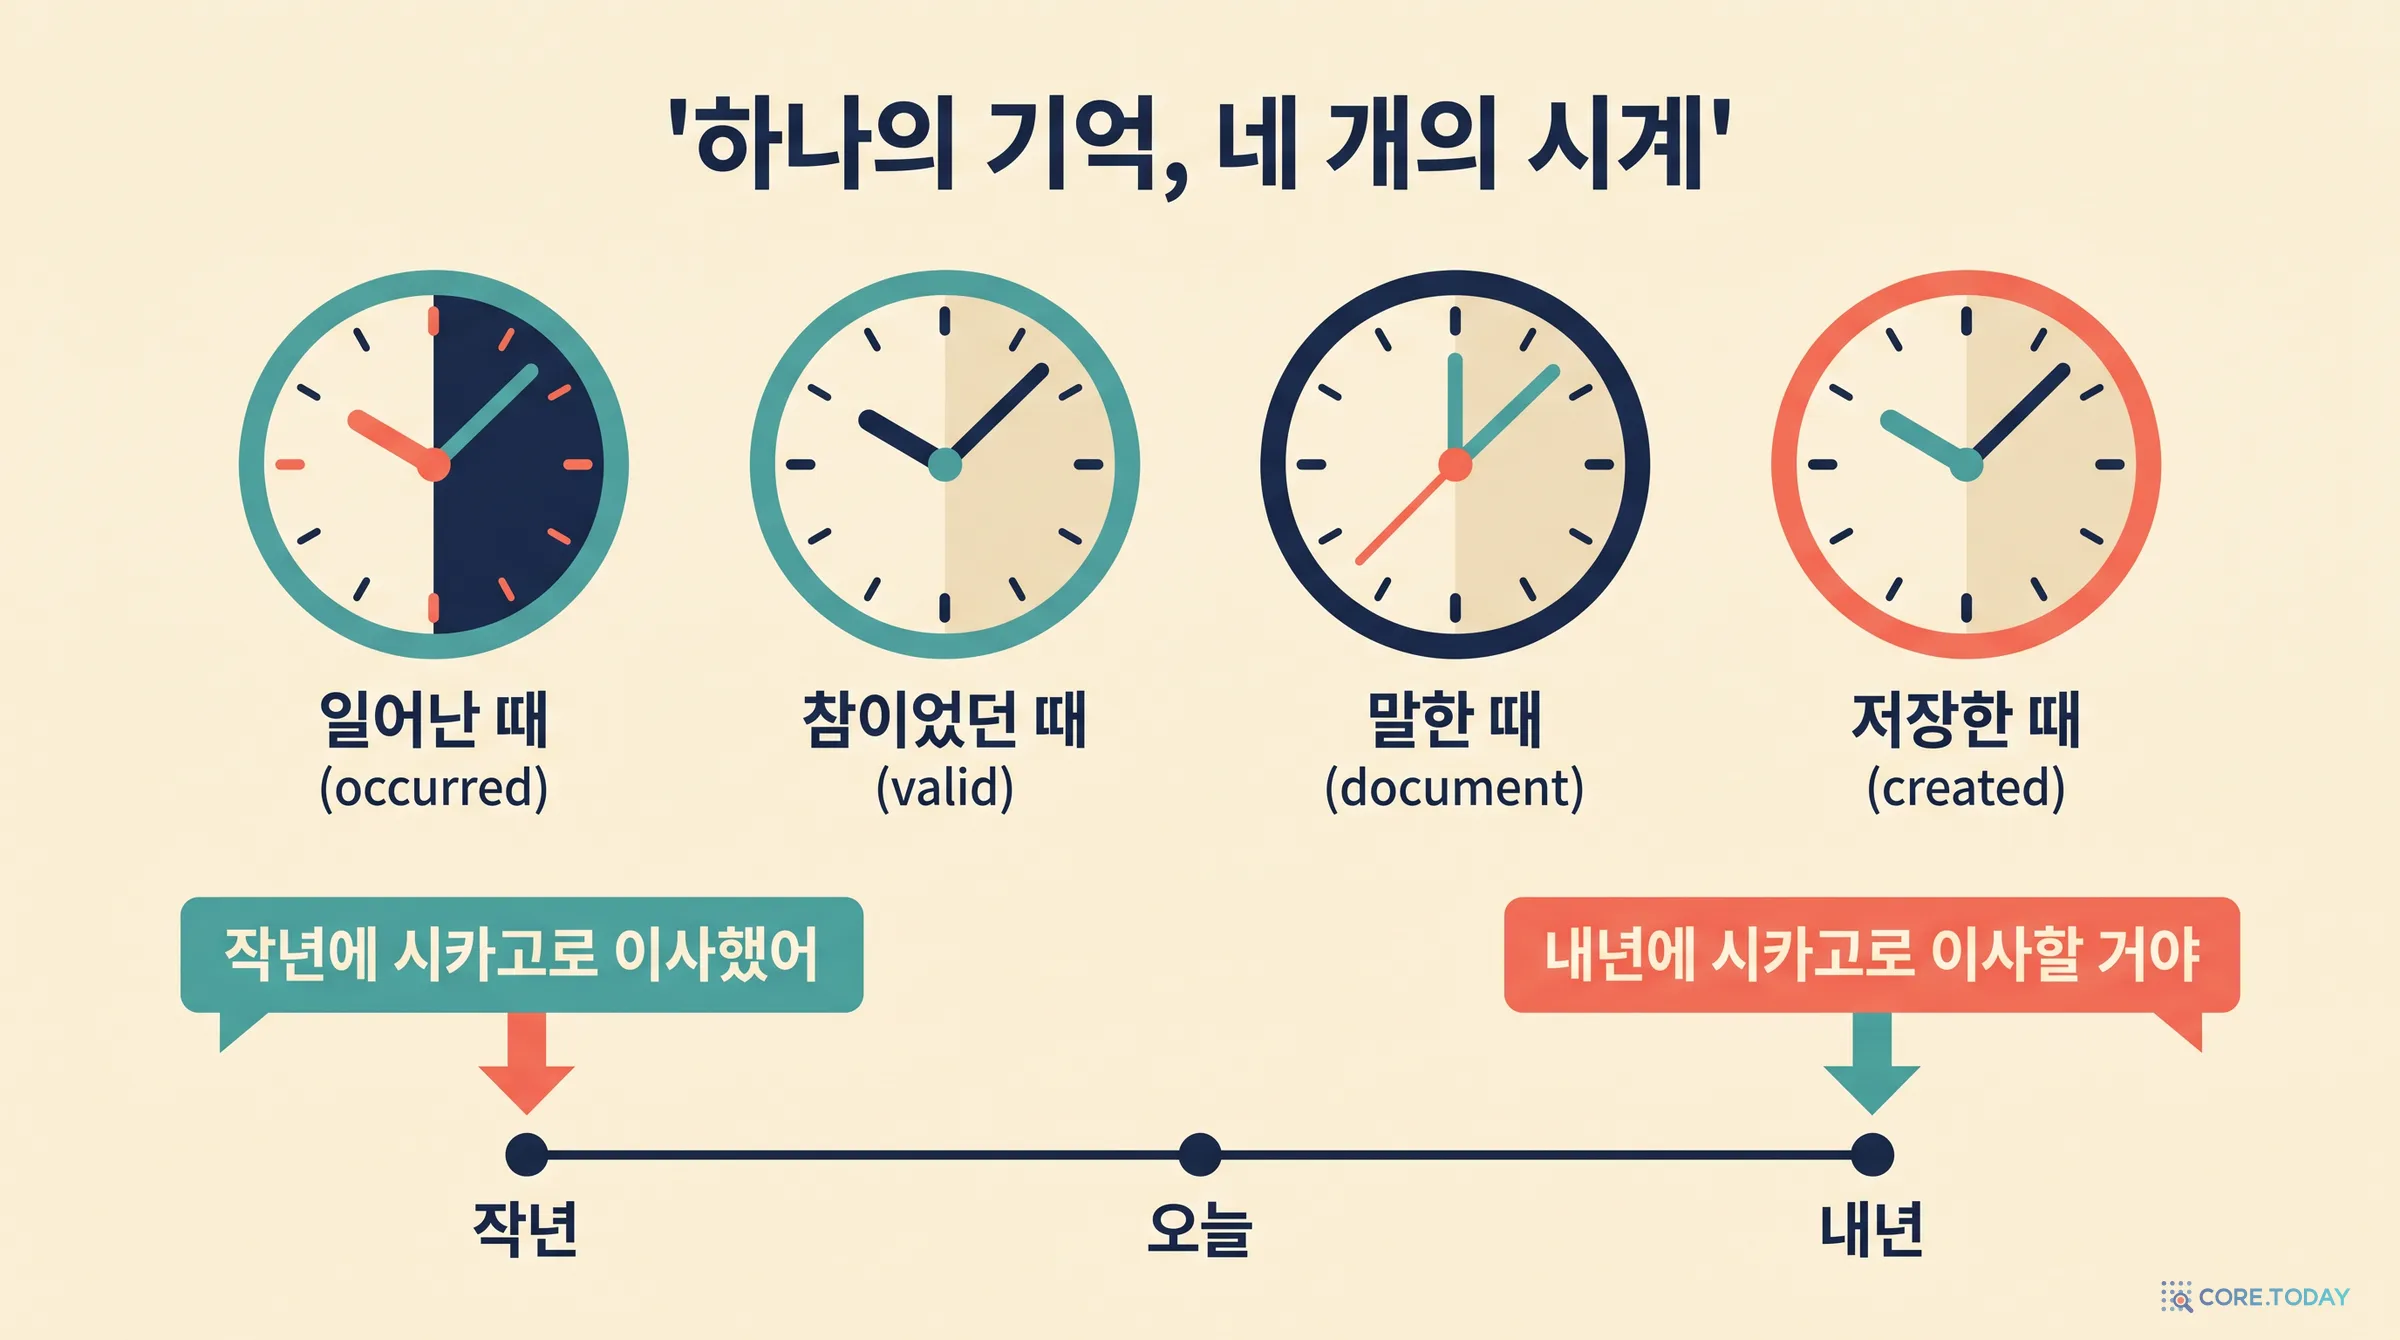
양상 m(modality): 이 문장이 지난 사건인지, 지금 상태인지, 앞으로의 계획인지, 비서의 조언인지, 바깥 정보인지를 가립니다. "작년에 시카고로 이사했어"와 "내년에 시카고로 이사할 거야"는 술어가 같아도 양상이 다릅니다.
시간 τ: 아래에서 따로 봅니다.
역할 ρ(roles): 누가, 무엇을, 어디서. 엔터티 그래프의 연결 고리가 됩니다.
출처 S(source spans): 이 카드를 낳은 원문 조각(MessagePiece) 목록입니다. 비어 있으면 안 됩니다.
상태 σ(status): 유효(active), 대체됨(superseded), 무효(invalid).
공개된 검색 결과 8,427행을 세어 보면 실제로 어떤 카드가 쌓이는지 보입니다. 질문 500개에 대해 꺼내 온 증거의 양상은 지난 사건 2,318행, 현재 상태 1,929행, 선호 1,475행, 비서의 조언 1,311행, 바깥 정보 755행, 앞으로의 계획 399행, 의도 222행이었습니다. 원문 대화 한 턴을 통째로 가져온 행(raw_turn)도 1,891행(22%)이나 됩니다. 카드만으로는 부족할 때를 대비해 원문 턴도 검색 단위로 남겨 둔 것입니다.
지난 사건
2,318
현재 상태
1,929
선호
1,475
비서의 조언
1,311
바깥 정보
755
앞으로의 계획
399
의도
222
4-2. 하나의 기억, 네 개의 시계
Graphiti 글에서 본 이중 시간 모델은 시계가 둘이었습니다. SodaMem 저장소 README는 넷을 적습니다.
논문 본문은 이를 말한 때(세션 시각), 일어난 때, 유효 기간의 세 축으로 설명하고, 저장한 때는 운영용으로 따로 둡니다. 네 시계가 왜 필요한지는 위 예에서 바로 보입니다. "작년에 이사했어"와 "내년에 이사할 거야"는 같은 날 말해도 일어난 때가 2년 차이 나고, 하나는 지난 사건이고 하나는 계획입니다. 시계가 하나뿐이면 둘을 구분할 수 없습니다.
말한 때는 '닻' 역할도 합니다. 추출 단계에서 "지난주 화요일"이라는 표현이 나오면 그 세션의 날짜를 기준으로 절대 날짜를 계산합니다(논문 식 4의 시간선 정리 T). 계산할 수 없으면 '미해결'로 표시하고 지어내지 않습니다.
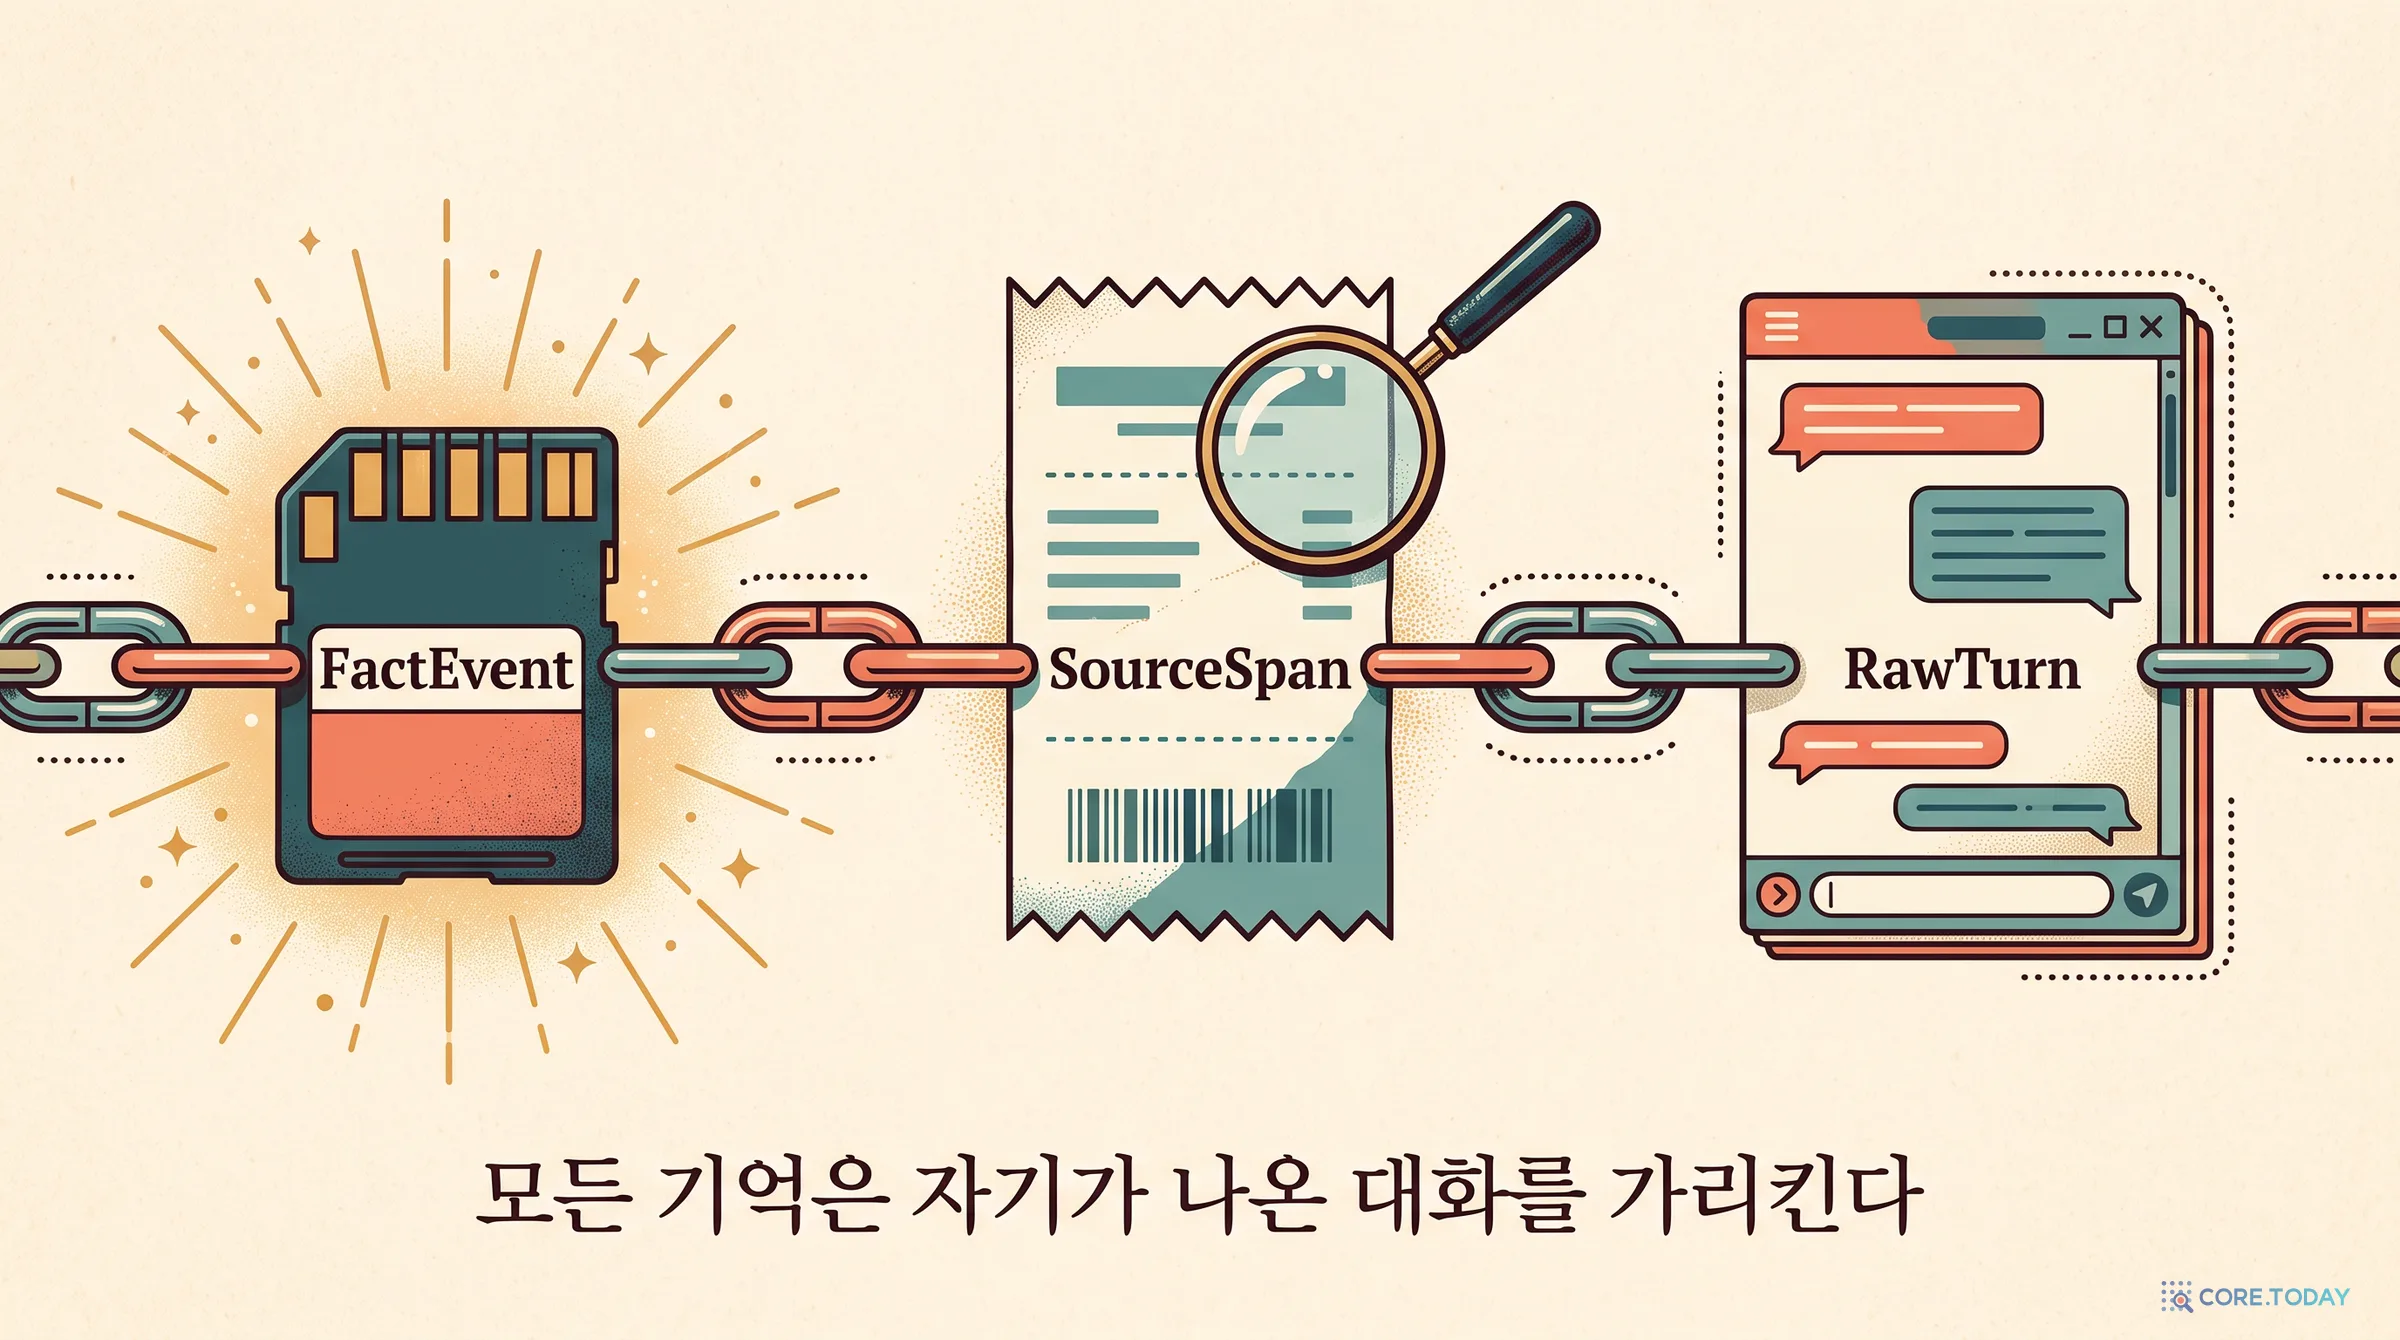
SodaMem의 증거 사슬은 FactEvent → SourceSpan → RawTurn입니다. 사실 카드는 원문 조각을 가리키고, 원문 조각은 대화의 몇 번째 세션 몇 번째 턴인지를 가리킵니다. README의 말대로 이것은 유사도 점수가 아니라 데이터베이스의 외래 키 사슬입니다. 그래서 "왜 나를 그렇게 생각해?"라는 질문에 원문을 그대로 보여 줄 수 있습니다.
논문은 추출 단계에 출처 강제 조건을 겁니다. LLM이 내놓은 후보가 가리키는 조각이 실제 원문 턴에 없으면 버립니다(알고리즘 1의 SpansValid). 공개 코드를 열어 보면 이 검사는 두 단계입니다.
LLM이 댄 조각 번호가 이 세션에 실제로 있으면 통과합니다.
번호가 틀렸으면 LLM이 함께 준 인용문(support_text)으로 출처를 되찾습니다. 인용문이 6자보다 짧으면 버립니다. 정확히 한 조각 안에 글자 그대로 들어 있으면 그 조각으로 복구합니다. 두 조각 이상에 들어 있으면 "모호하면 추측하지 않는다"며 버립니다. 글자 그대로 일치하는 조각이 없으면 단어 토큰이 80% 이상 겹치는 조각을 찾고, 없으면 버립니다.
이 규칙은 LLM 추출기의 가장 흔한 사고인 지어낸 일반화를 막습니다. "줄이는 중"을 "싫어한다"로 바꿔 적은 카드는 출처를 되찾지 못해 기억에 들어오지 못합니다. 대가도 있습니다. 원문에 충실하게 말을 바꿔 쓴 정상적인 사실도 같이 버려질 수 있습니다. 코드 주석에는 "LLM은 자주 의역하므로 인용문의 겹침이 0.8보다 낮아 사실이 버려진다"는 메모가 남아 있습니다.
그리고 한국어에서는 이 대가가 훨씬 커집니다. 80% 겹침을 재는 토큰 정규식이 영문 소문자와 숫자([a-z0-9])만 토큰으로 잡기 때문입니다. 한국어 인용문은 토큰이 0개라 "비교할 토큰 3개 미만"으로 곧장 버려집니다. 아래 위젯에서 직접 확인해 보세요.
출처 강제는 사실 카드 하나하나에 '증거능력'을 요구하는 셈입니다. 코어닷투데이가 「맞는 기억, 틀린 맥락」에서 다룬 '검색 허용성'이 꺼낸 기억을 써도 되는지를 묻는다면, SodaMem의 출처 강제는 그보다 앞에서 저장해도 되는지를 묻습니다.
5. 지우지 않고 닫는다 — 대체(supersession)
5-1. 정의
논문 정의 0.3은 이렇습니다. 새 사실이 옛 사실과 같은 주어–술어 슬롯에서 경쟁하면(또는 '갱신' 패턴과 맞으면) 새 사실이 옛 사실을 대체합니다. 그러면 옛 사실의 상태는 '대체됨'이 되고, 옛 사실의 유효 기간 끝(valid_until)은 새 사실이 효력을 갖는 시각으로 닫힙니다.
핵심은 지우지 않는다는 데 있습니다. README는 이를 "정정은 추가만 한다(ADD-only)"고 씁니다. 새 버전을 하나 더 쓰고 SUPERSEDES 엣지를 걸 뿐, 옛 카드를 제자리에서 고치지 않습니다. 닫힌 카드는 '지금' 질문의 후보에서 빠지지만 이력으로 남아 "전에는 어땠지?", "언제부터 바뀌었지?"에 답합니다. 무엇이 언제 왜 대체됐는지는 이벤트 로그(/v1/events)에 남습니다. "왜 X를 잊었지?"에도 답이 있다는 뜻입니다.
5-2. '같은 슬롯'을 어떻게 알아보나 — 코드의 규칙
정의는 간단하지만 "같은 슬롯"을 판정하는 일은 까다롭습니다. 공개 코드(maintainer.py)는 사고 사례에서 배운 규칙을 겹겹이 쌓아 두었습니다.
갱신 같은 말인가. 상태(state)·현재 상태 카드는 새 값이 오면 늘 갱신으로 봅니다. 선호 카드는 갱신 표지가 있을 때만 갱신으로 봅니다. 표지는 now·currently·actually·instead·moved·changed·started·stopped·recently 같은 영어 단어 목록이고, 인용문과 술어에서 찾습니다. 그냥 다시 말한 선호는 대체하지 않습니다. 한국어의 '요즘', '이제', '사실은'은 이 목록에 없습니다.
슬롯이 같은가. 정규화한 술어가 같거나, 술어가 달라도 사건 유형이 같고(‘기타’ 같은 포괄 유형은 제외) 값이 아닌 역할(장소·회사·물건)이 똑같아야 합니다. 시간·수량·금액처럼 바뀌는 게 당연한 역할은 비교에서 뺍니다.
누가 말했나. 비서가 한 말만으로 된 사실은 사용자가 한 말에서 나온 사실을 대체하지 못합니다. 비서가 "매운 음식 좋아하시죠?"라고 맞장구친 것이 사용자의 "줄이는 중"을 뒤집으면 안 되기 때문입니다.
무엇이 더 새것인가. 순서는 실제 사건·유효 시각이 먼저이고, 그다음이 말한 때입니다. 동점이면 내용 해시로 정해서, 같은 기록을 어떤 순서로 다시 넣어도 같은 결과가 나오게 합니다.
비교를 위해 다른 시스템을 나란히 놓아 보면 이렇습니다.
방식
사실이 바뀌면
옛 값
"지금 값" 판단은 누가
마크다운 일기·평평한 RAG
새 줄을 덧붙임
그대로 유효
매번 읽는 LLM
Mem0 (2025년판)
LLM이 ADD·UPDATE·DELETE 선택
고쳐 쓰거나 지움
쓰는 시점의 LLM
Zep·Graphiti
LLM이 모순 엣지를 찾아 무효화
유효 기간을 닫고 남김
쓰는 시점의 LLM + 시간 규칙
SodaMem
슬롯 규칙으로 SUPERSEDES 엣지
valid_until을 닫고 남김
쓰는 시점의 결정론적 규칙
Mem0은 2026년 4월 연구 버전에서 UPDATE·DELETE를 버리고 추가 위주로 돌아섰습니다(코어닷투데이의 엔진 해부 글 참고). 업계 전체가 "지우지 말고 닫거나 쌓아라" 쪽으로 움직이는 중이고, SodaMem은 그 흐름에서 판단을 LLM이 아닌 규칙에 맡기는 쪽에 섭니다. Reddy와 Challaram의 논문이 주장한 "신선도는 LLM에게 묻지 말고 결정론적으로"와 같은 방향입니다. 참고로 이 논문은 2026년 8월 2일 v2에서 제목을 「에이전트 기억을 위한 믿을 만한 검색 후 조립」으로 바꿨고, LongMemEval 확인 실험에서는 의미 있는 차이를 보이지 못했습니다(45문항 중 26 대 29, p=0.45).
5-3. 직접 바꿔 보기
아래 위젯에서 세 가지 슬롯(매운 음식·사는 곳·출근)의 기록에 네 가지 기억 방식을 적용해 보세요. 중간에 비서의 맞장구, 앞날의 계획, 이름은 같지만 다른 슬롯의 말(‘주말마다 망원동 부모님 댁에 가’)이 끼어 있습니다. 마지막 '관찰만' 단추는 이 글 9장에서 다룰 이야기의 예고편입니다.
6. 세 터널로 찾고, 연결 밀도로 줄 세우기
6-1. 질문을 먼저 쪼갠다
질문이 들어오면 SodaMem은 그것을 네 가지로 쪼갭니다. 엔터티 언급(‘두부’, ‘정자동’), 어휘 열쇠(BM25에 넣을 단어), 임베딩 질의, 그리고 시간 의도 (W, δ)입니다. W는 시간 창, δ는 '가까운 것부터' 또는 '먼 것부터'의 정렬 방향입니다. 시간 단서가 없으면 창은 비우고 가까운 것부터 봅니다. "최근에", "몇 달 전에" 같은 흐릿한 말은 넓은 창으로 풀어 정밀도보다 재현율을 택하고, 단서가 없으면 창을 지어내지 않습니다.
그래프·엔터티 터널(강). 질문에서 찾은 엔터티나 사실을 '검색 머리(head)'로 삼아, 의미 엣지나 관계 엣지를 따라 한 칸(또는 제한된 몇 칸) 넓힙니다.
BM25 터널(강). 사실 카드, 원문 조각, 원문 턴에서 단어로 찾습니다. 조각이 걸리면 이웃 조각과 그 조각이 속한 원문 턴 전체를 붙이고, 원문 턴이 걸리면 앞뒤 두 턴씩(±2)을 붙여 지역 맥락을 줍니다.
임베딩 터널(약). 벡터로 가까운 것을 찾습니다. 확장 방식은 BM25와 같지만, "비슷한데 다른 일"을 끌어올 수 있어서 기본 질량을 낮게 줍니다.
터널마다 검색 머리는 최대 10개이고, 머리마다 따로 넓힌 다음 유효성·관련성·시간 점수를 매겨 상위 K개만 남깁니다. 저장은 SQLite 한 파일에 하고, 벡터는 MiniLM급 작은 임베딩 모델(기본 설치는 90MB짜리 ONNX MiniLM)로 만듭니다. README가 "검색에는 LLM 호출이 0번"이라고 강조하는 이유가 여기 있습니다. 같은 저장소에 같은 질문을 넣으면 늘 같은 결과가 나옵니다.
입니다. 시간 보너스 β는 기본 0.3이고, 합쳐진 증거 하나에 한 번만 붙습니다. 정렬은 conf 순서로 하고, 동점이면 정렬 방향 δ로 가립니다. 거의 같은 증거는 ID가 같거나 임베딩 유사도가 θ(예 0.8) 이상이면 하나로 합칩니다.
이 방식의 직관은 독립된 증인이 여럿이면 믿을 만하다입니다. 이름 '두부'가 BM25로도, '고양이' 엔터티의 그래프 확장으로도, 임베딩으로도 걸린 카드는 셋 중 하나에만 걸린 카드보다 위로 갑니다. 반대로 임베딩 하나로만 걸린 '친구네 강아지 이름은 콩이'는 비슷해 보여도 아래로 갑니다.
공개 코드는 논문 식과 두 군데가 다릅니다. 첫째, 질량을 단순히 더하지 않고 noisy-OR(1 − ∏(1 − w))로 합칩니다. 같은 머리가 같은 증거에 여러 번 걸리면 가장 큰 질량 하나만 남깁니다. 둘째, 거의 같은 증거를 합치는 기준이 임베딩 유사도가 아니라 사건 지문입니다. 관계·주어·객체 엔터티·날짜 구간·양상·긍정/부정·수량이 모두 같을 때만 합칩니다. 코드에서 0.8이라는 숫자는 앞에서 본 출처 복구의 단어 겹침 기준으로 쓰입니다. 계산기로 세 가지 합치기 방식을 비교해 보세요.
왜 RRF가 아니라 손으로 정한 질량일까요? RRF는 터널별 등수만 보므로 강한 터널과 약한 터널이 같은 발언권을 갖습니다. SodaMem은 "임베딩은 비슷한데 틀린 일화를 가져온다"는 경험을 질량 차이(0.4 대 0.2)로 박아 둔 것입니다. 공개 코드의 설정 파일에 RRF 상수 60이 남아 있지만, 기본 검색 경로('fusion')는 질량 방식을 씁니다.
6-4. 시간은 문이 아니라 가산점
이 장에서 가장 사람 냄새 나는 원칙이 '부드러운 시간'입니다. 2장에서 본 망원경 효과처럼 사람은 날짜를 틀리게 기억합니다. "두 달 전에 산 러닝화"가 실제로는 석 달 전일 수 있습니다. 시간 창을 거르는 문으로 쓰면 창 밖의 정답은 리더에게 닿지도 못합니다. 그래서 SodaMem은 창과의 일치를 순위의 가산점으로만 씁니다. 논문이 딱딱하게 거르는 조건은 둘뿐입니다. 상태가 무효·대체됨인 사실, 그리고 유효 기간이 알려져 있는데 질문의 창과 어긋나는 사실입니다. 일어난 때가 창과 안 맞는다는 이유만으로 연결 밀도가 높은 후보를 떨어뜨리지는 않습니다.
위젯의 '공개 코드' 단추가 보여 주듯, 실제 코드의 융합 단계는 질문 속 날짜 문자열(‘2026-07’, ‘July 2026’, ‘2026’)만 시간 창으로 읽습니다. 논문에서 말한 '흐릿한 말을 넓은 창으로'는 융합 단계에 들어가 있지 않습니다. 코드 주석에 따르면, 질문을 풀어 창과 정렬 방향을 만드는 파서는 호출하는 곳이 없는 죽은 코드였고 8월 초 정리 과정에서 지워졌습니다. 그런 질문은 다음 장의 플래너가 타임라인·기간 계산 도구로 따로 풉니다.
검색 한 번으로 끝나지 않는 질문이 있습니다. "올해 결혼식에 몇 번 갔지?"처럼 여러 세션에 흩어진 항목을 세야 하는 질문, "이직하고 이사까지 며칠 걸렸지?"처럼 계산이 필요한 질문입니다. 그래서 SodaMem은 답하기를 둘로 나눕니다.
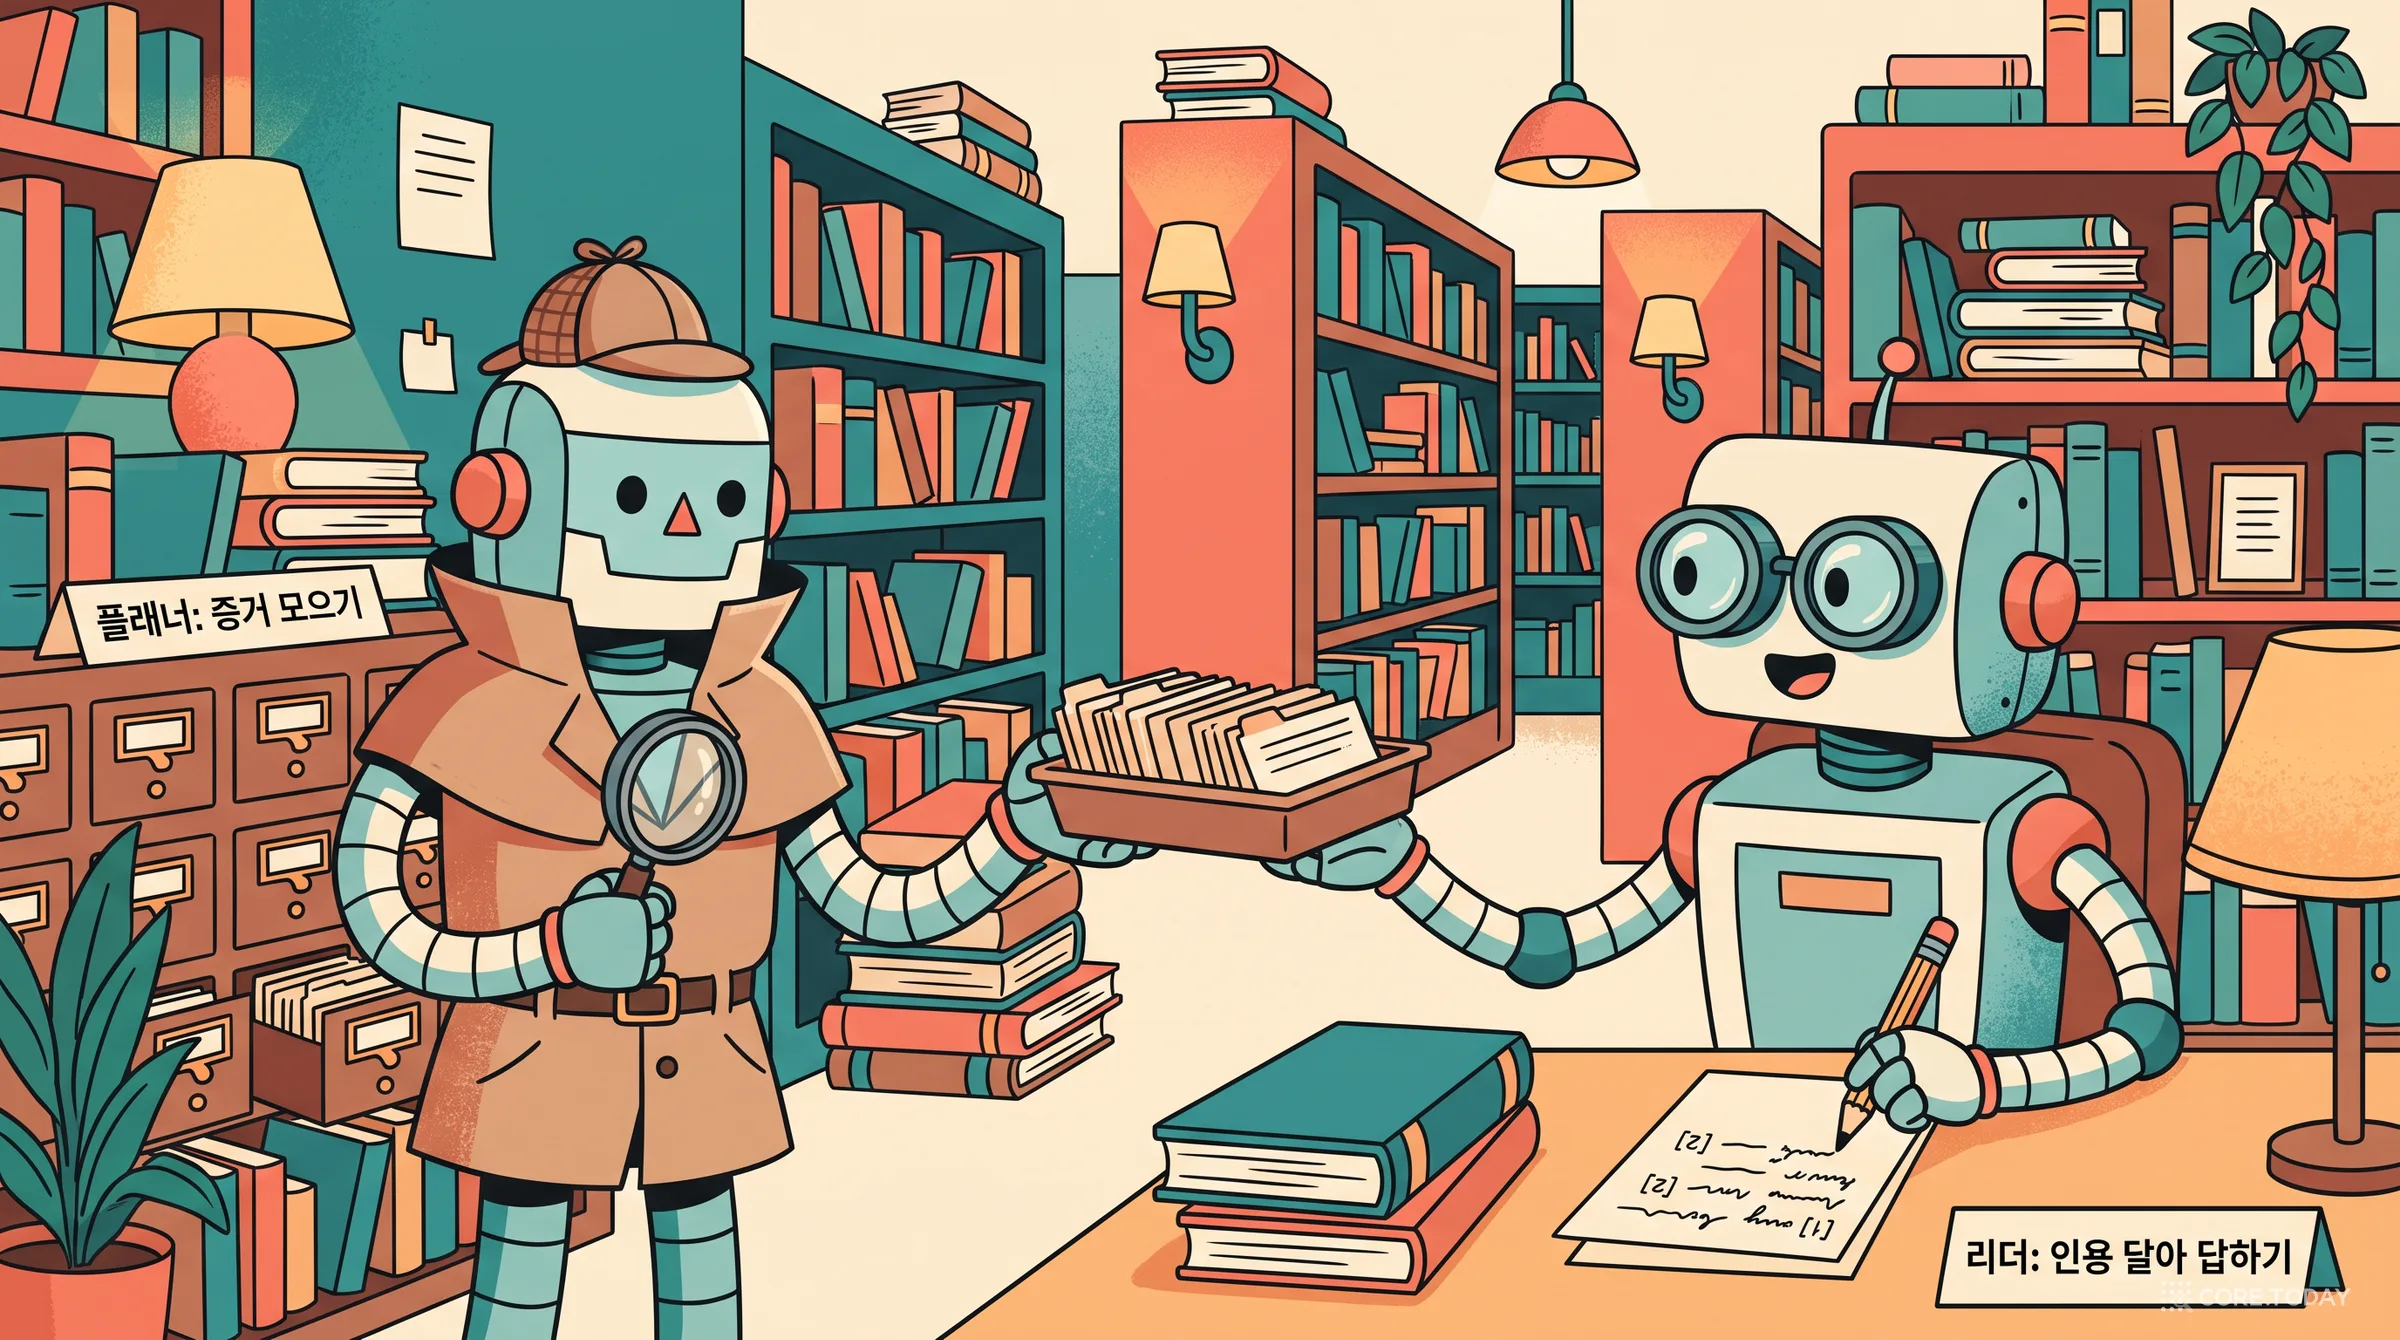
플래너는 LLM입니다. 연결 밀도로 만든 증거 더미를 보고, 단계 예산 안에서 메모리 도구를 더 부를지 멈출지 정합니다(알고리즘 3). 도구는 검색(search), 카드 열어 보기(inspect), 세션 통째로 펼치기(session expand), 엔터티의 시간선 보기(timeline), 세기(count), 계산(compute)입니다. 논문은 이를 '고리 안의 기억(memory in the loop)'이라고 부릅니다. 한 번에 기억을 쏟아붓는 대신 작은 검색을 여러 번 반복한다는 뜻입니다.
리더는 별도의 프롬프트입니다. 플래너가 고른 증거 ID만 보고 사용자에게 보일 답을 쓰며, 인용을 반드시 답니다. 논문은 둘을 나눈 이유를 "인용 규율을 도구 정책과 분리하기 위해"라고 씁니다. 증거를 찾는 일과 근거를 대며 쓰는 일은 서로 다른 기술이라는 판단입니다.
공개된 답안 500개의 기록을 세어 보면 플래너가 실제로 어떻게 일했는지 보입니다.
항목
값
읽는 법
플래너 단계 수
2단계 150문항, 3단계 125, 4단계 95, 5단계 70, 6단계 이상 60
절반 이상이 3단계 안에 끝남
검색(search)
500문항 모두
모든 질문의 첫 단계
증거 세기(count)
165문항
"몇 번", "몇 개" 질문
원문 검색(search_raw)
128문항
사실 카드로 부족할 때 원문으로
세션 펼치기(inspect_session)
127문항
앞뒤 맥락이 필요할 때
시간선 보기(timeline)
62문항
한 엔터티의 이력
기간 계산(calculate_duration)
44문항
"며칠", "몇 주"
문항당 토큰
평균 18,348 · 중앙값 14,640 · 상위 10% 32,398 이상 · 최대 99,870
긴 꼬리가 평균을 끌어올림
문항당 시간
평균 18.5초 · 최대 62초
대화형 비서로 쓰기엔 아직 느림
하나 더 눈여겨볼 것은 리더 프롬프트입니다. 공개 코드의 리더 지침 첫머리는 이렇습니다. "같은 사용자 속성에 대해서는, 가정·부정·앞날의 계획이 아닌 한, 가장 최근의 직접적인 사용자 발화를 우선하라. 맞는 증거가 없다고 해서 0이라고 단정하지 마라." 쓰는 시점의 대체가 없어도 읽는 쪽에서 '지금 값'을 고르겠다는 안전장치입니다. 이 문장이 실제로 얼마나 일하는지는 9장에서 재 봅니다.
8. 결과 읽기 — 표 1과 그림 2
8-1. 실험 조건
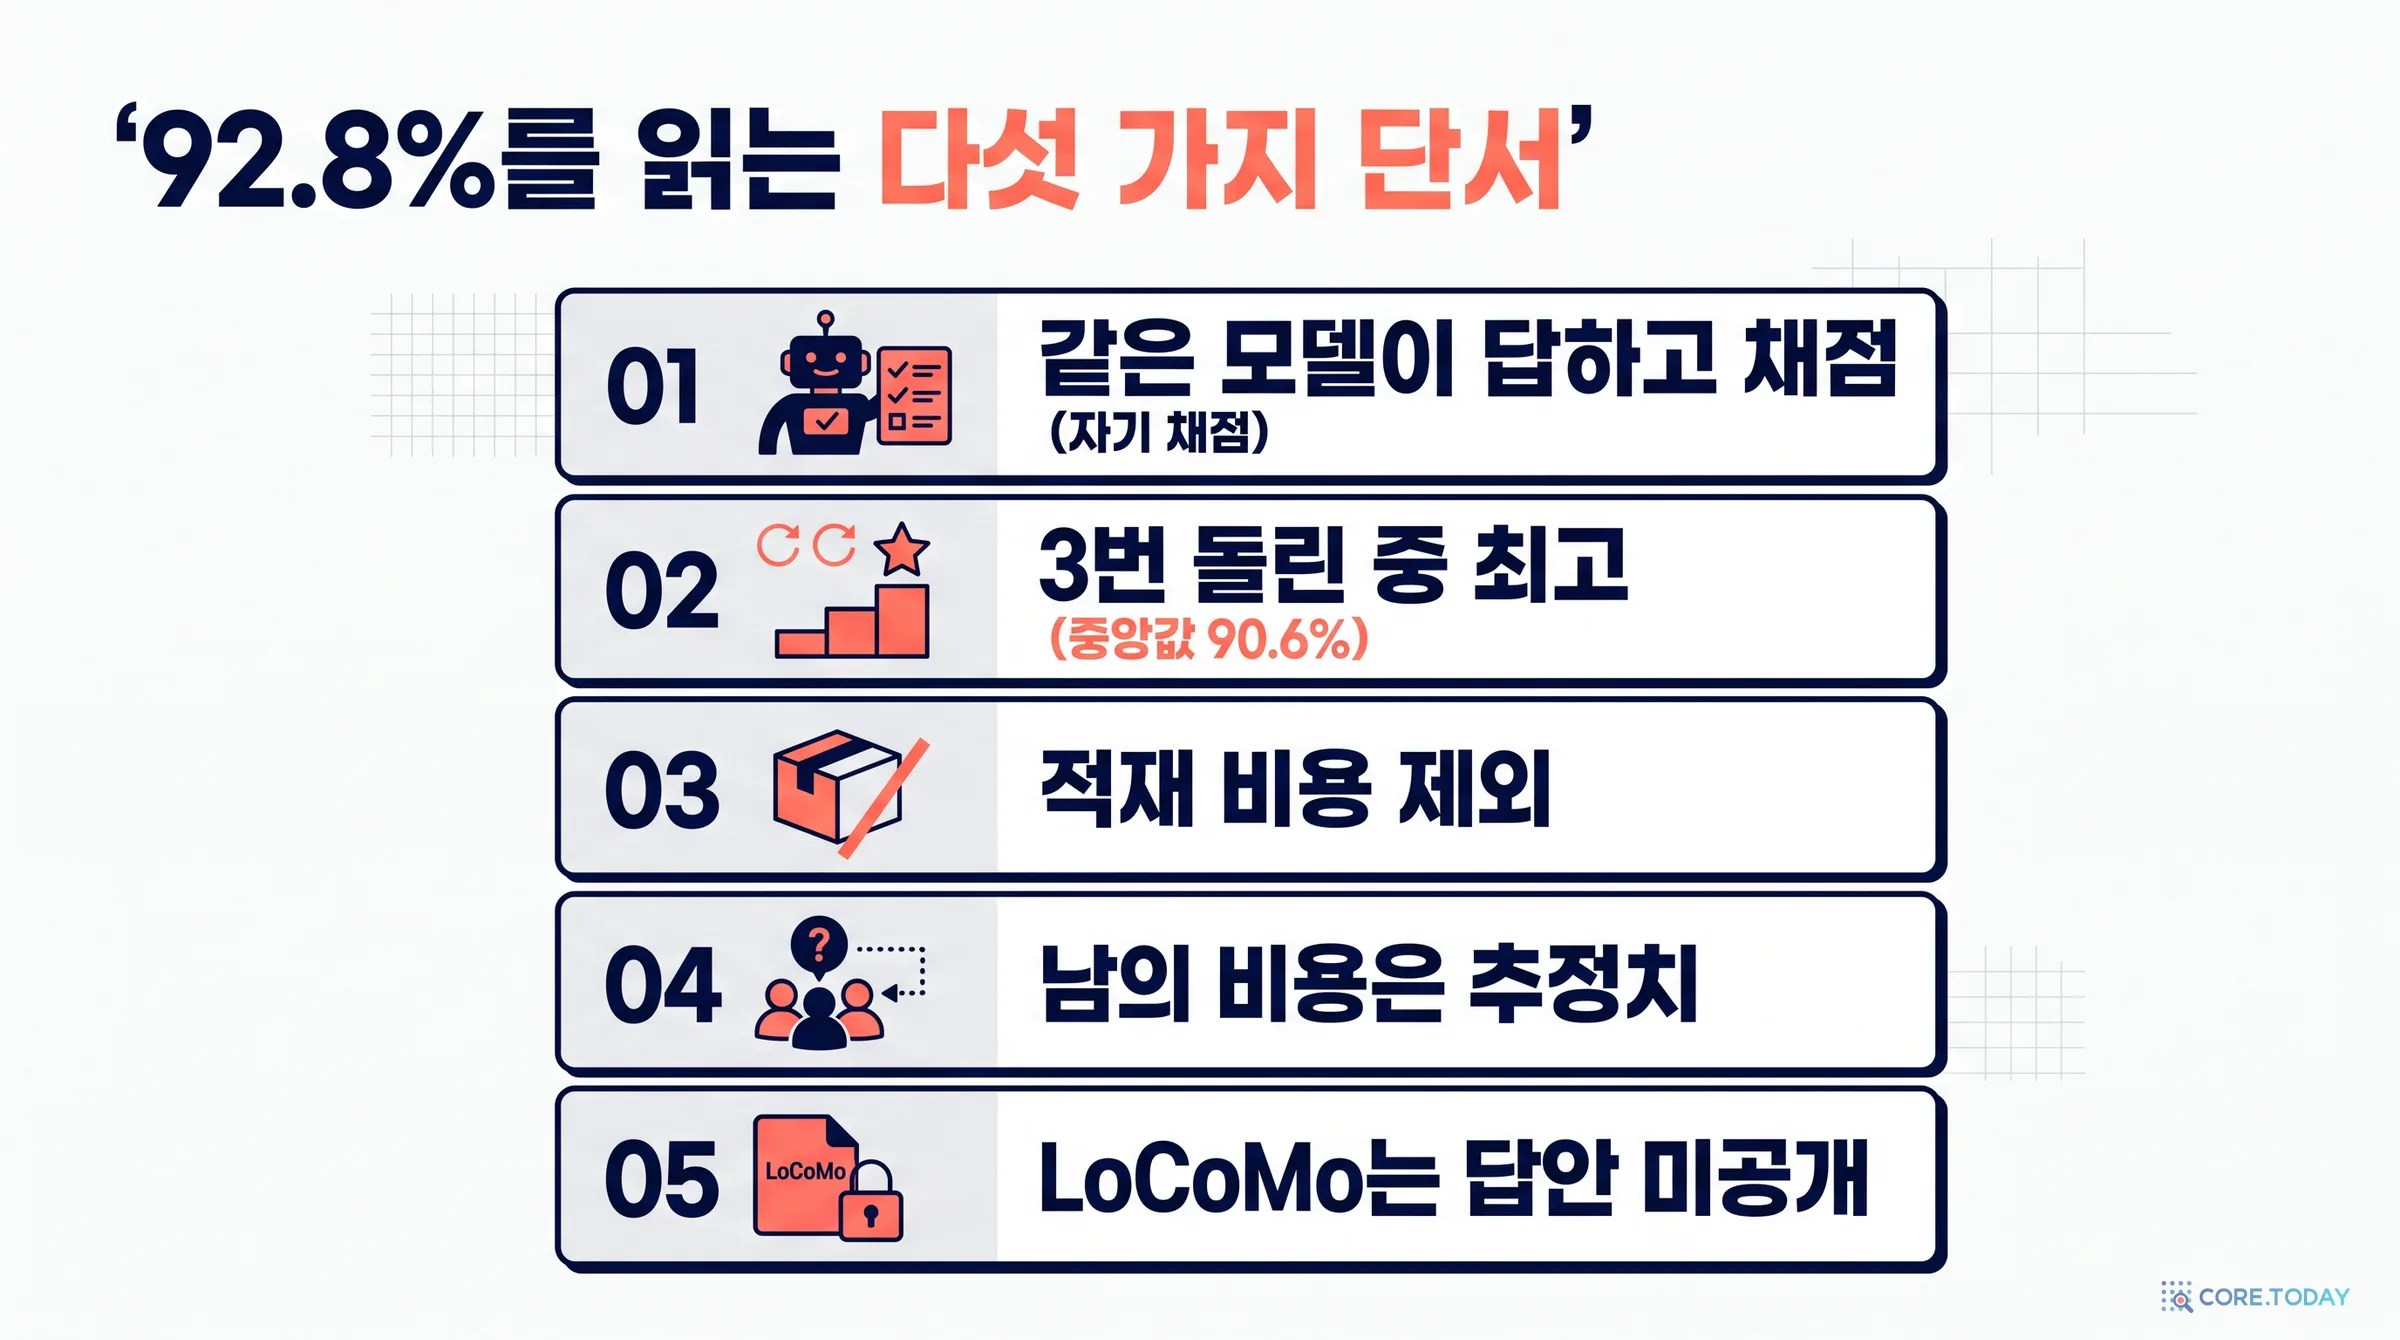
SodaMem의 실험은 하나의 '기록 저장소(store of record)' 설정으로 돌린 것입니다. 사용자 500명분 저장소에 사실 카드 235,840장이 들어 있고(사용자당 약 472장), 플래너·리더·채점자가 모두 deepseek-v4-flash입니다. 채점 프롬프트는 LongMemEval 공식 evaluate_qa.py의 문항 유형별 템플릿을 그대로 썼습니다. 결과는 500문항 중 464개, 92.8%입니다. 다만 논문은 이것이 세 번 돌린 것 중 최고이고 중앙값은 90.6%라고 밝힙니다. 저장소의 사양 문서(issue-24)에는 기준 점수가 "453/500 (90.6%), 3회의 중앙값, 범위 [453, 464], 표준편차 6.35"로 적혀 있습니다. 최솟값과 중앙값이 둘 다 453이니, 세 번의 점수는 453·453·464였다는 계산이 나옵니다(이 조합의 표본 표준편차가 정확히 6.35입니다). 세 번 중 두 번은 90.6%였고, 한 번이 92.8%였습니다.
비용은 플래너와 리더가 쓴 토큰만 셉니다. 적재(사실 추출)와 채점 비용은 빠집니다. deepseek-v4-flash 정가(입력 캐시 미스 100만 토큰당 0.14달러, 캐시 적중 0.0028달러, 출력 0.28달러)로 계산하면 평균 0.00161달러, 중앙값 0.00111달러입니다. 코어닷투데이가 공개 답안의 토큰 기록으로 다시 계산해도 소수점 다섯째 자리까지 같았습니다(입력의 53%가 캐시 적중).
8-2. 표 1 — 21개 시스템의 비용과 정확도
논문 표 1은 공개된 시스템 중 문항당 API 비용을 추정할 수 있는 것을 정확도 순으로 늘어놓습니다. 위쪽 몇 줄만 옮기면 이렇습니다.
시스템
리더 모델
정확도
1,000문항당 비용
코어닷투데이가 확인한 조건
agentmemory V4
Claude Opus 4.6
96.2%
$60 (추정)
채점 GPT-4o, 같은 500문항으로 46번 조정
Mem0 (2026 연구)
관리형
94.4%
$22 (추정)
리더·채점 미공개, 하네스 기본값 GPT-4o
SodaMem
deepseek-v4-flash
92.8%
$1.61 (측정)
자기 채점, 3회 중 최고
Cersei 전체 문맥
Gemini 2.5 Flash
87.6%
$33 (측정)
기억 시스템이 아닌 기준선, 유형별 평균(기권 제외)
Cersei Embed
Gemini 2.5 Flash
86.6%
$1.84 (측정)
유형별 평균(기권 제외)
AgentOS
GPT-4o·GPT-5-mini
85.6%
$7.7 (측정)
유형별로 리더 교체
장문맥 GPT-5-mini
GPT-5-mini
82.4%
$29.3 (측정)
기억 없이 전체 문맥
Zep (평가셋)
GPT-4o-mini
63.8%
$0.36 (추정)
제3자 평가, 답변 단계 하한
MemoryBank
GPT-4o-mini
21.0%
$2.21 (추정)
제3자 재현
'측정'은 저자들이 직접 잰 달러이고, '추정'은 공개된 토큰 수에 2026년 정가를 곱했거나, 기억에서 꺼낸 문맥 길이에 출력 200토큰을 더해 답변 단계의 하한으로 잡은 값입니다. 저자들도 이 비용들이 "밀리달러 단위 순위가 아니라 자릿수 비교"라고 적었습니다.
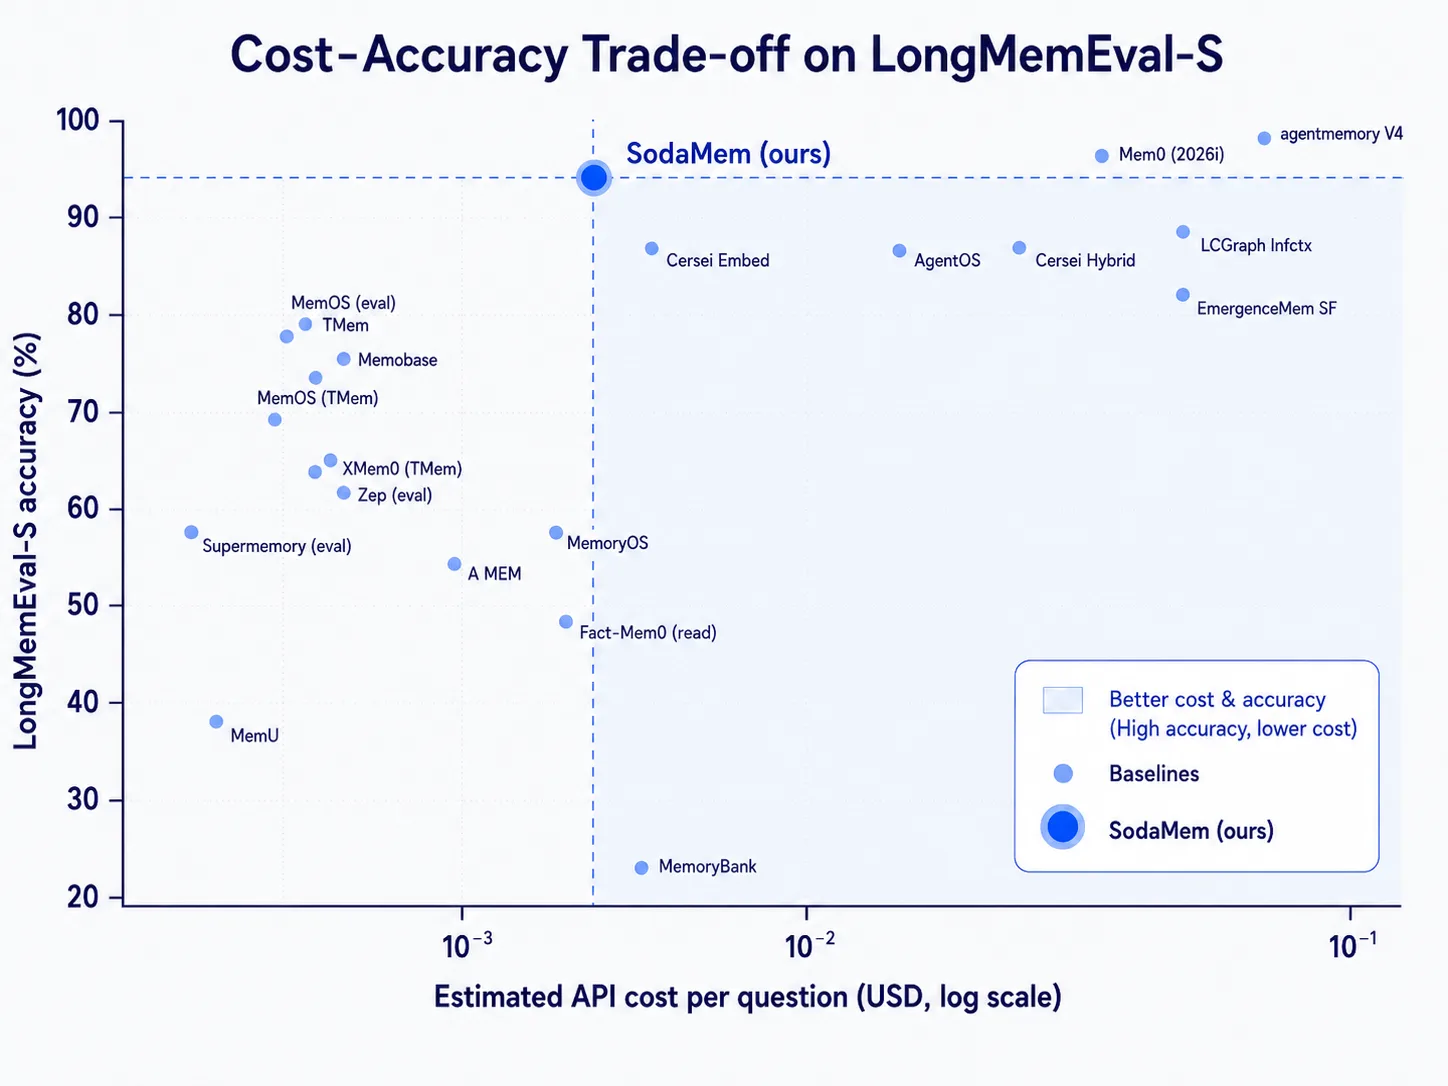
그림 2는 표 1을 로그 축 산점도로 그린 것입니다. SodaMem 점에서 그은 두 점선의 오른쪽 아래, 즉 SodaMem보다 비싸면서 덜 정확한 영역이 칠해져 있습니다. 경제학에서 말하는 '지배(dominance)'입니다. 이 영역에 든 점은 어떤 기준으로 봐도 SodaMem보다 나을 수 없습니다. 평균 비용 기준으로 Cersei 세 가지, AgentOS, 장문맥 GPT-5-mini, EmergenceMem, MemoryBank가 들어가고, 중앙값 기준으로는 MemoryOS와 Fact-Mem0까지 들어갑니다. SodaMem보다 점수가 높은 둘(agentmemory V4, Mem0 2026)은 문항당 0.06달러, 0.022달러로 한 자릿수 이상 오른쪽에 있습니다. 논문이 "Flash급 지출로 최고 수준 근처의 정확도"라고 말하는 근거가 이 그림입니다.
그런데 그림을 자세히 보면 이상한 곳이 몇 군데 있습니다. 표 1에는 없는 이름이 보입니다(‘TMem’은 TiMem, ‘XMem0 (TMem)’은 Mem0 (TiMem 재현), ‘LCGraph Infctx’는 아마 장문맥 GPT-5-mini, ‘Mem0 (2026i)’, ‘A MEM’). 점의 높이도 표와 다릅니다. SodaMem 별은 92.8%가 아니라 약 94% 높이에 찍혀 있고, agentmemory V4와 Mem0도 표보다 2점가량 높게 찍혀 있습니다. 범례는 칠한 영역을 "더 나은 비용·정확도"라고 부르는데, 본문은 같은 영역을 "SodaMem이 지배하는(더 나쁜) 영역"이라고 설명합니다. PDF에서 그림을 꺼내 보면 데이터로 그린 벡터 차트가 아니라 1448×1086 래스터 이미지입니다. 그림 1도 같은 결의 이미지입니다. 저자들이 그림을 어떻게 만들었는지는 알 수 없지만, 그림 2는 표 1을 대신하는 근거로 쓰면 안 됩니다. 아래 위젯은 표 1의 숫자로 점을 다시 찍은 것입니다.
위젯에서 '+ 적재 하한'을 눌러 보세요. LongMemEval-S의 대화 기록 약 11.5만 토큰을 같은 Flash 단가로 한 번 읽기만 해도 문항당 약 1.6센트가 듭니다. 실제 추출은 1,200토큰 창마다 5천 자 남짓한 추출 프롬프트를 붙이고 사실마다 JSON을 쓰므로 이보다 비쌉니다. 즉 벤치마크 조건(기록 하나에 질문 하나)에서는 적재가 답변보다 최소 열 배 비쌉니다. 실제 서비스에서는 한 번 적재한 기억으로 수백 번 답하므로 이 비용이 나뉘지만, '문항당 0.16센트'를 그대로 서비스 원가로 읽으면 안 됩니다. 반대로 장문맥 기준선(Cersei 전체 문맥, 장문맥 GPT-5-mini)은 매 질문마다 기록 전체를 읽는 비용이 이미 들어 있습니다. 적재를 뺀 기억 시스템과 적재가 필요 없는 장문맥을 같은 축에 놓으면 기억 시스템 쪽이 유리해 보입니다.
8-4. 유형별로 보면
논문은 유형별 점수를 싣지 않았지만, 공개 답안에는 문항 유형과 채점 결과가 다 있습니다. 세어 보면 이렇습니다.
한 세션 · 선호 (30)
100%
한 세션 · 사용자 (70)
98.6%
한 세션 · 비서 (56)
98.2%
지식 갱신 (78)
97.4%
시간 추론 (133)
94.7%
다중 세션 (133)
81.2%
(DeepSeek 자기 채점 기준. 기권 문항 30개는 각 유형에 섞여 있습니다.)
약점은 분명합니다. 여러 세션에 흩어진 항목을 세거나 더하는 다중 세션 문항이 81.2%로 가장 낮습니다. "지난달에 디너파티 몇 번 갔지?"(정답 3, 답 2), "올해 결혼식 몇 번 갔지?"(정답 3, 답 4) 같은 문제입니다. 증거 세기 도구를 165번이나 불렀지만, 하나를 빠뜨리거나 하나를 더 세는 실수가 남았습니다. 반대로 지식 갱신은 97.4%로 매우 높습니다. 그런데 이 높은 점수가 무엇 덕분인지가 다음 장의 주제입니다.
9. 코어닷투데이 실측 — 공개된 장부를 다시 맞춰 보다
SodaMem 저장소의 가장 큰 미덕은 답안 500개(sodamem_lme_judged.json)와 검색 결과 8,427행(sodamem_lme_retrieved_context.json)을 통째로 공개했다는 것입니다. README는 "아무 채점자로나 다시 채점하고, 검색 결과를 당신의 리더에게 줘 보라"고 말합니다. 그대로 했습니다. 실험은 전부 로컬 머신과 사내 GPU(A100)에서 Qwen 모델로 돌렸고, 유료 API는 쓰지 않았습니다.
9-1. 채점자를 바꾸면 — 92.8%에서 약 90%로
답안은 그대로 두고 채점자만 바꿨습니다. LongMemEval 공식 템플릿을 한 글자도 고치지 않고 Qwen 3.8 27B와 Qwen 3.5 9B에게 채점시켰습니다.
채점자
정답 수
정확도
DeepSeek v4 Flash (자기 채점, 논문)
464
92.8%
Qwen 3.8 27B
443
88.6%
Qwen 3.5 9B
444
88.8%
엇갈린 문항을 사람이 판정
448~450
89.6~90.0%
크기가 세 배 다른 두 Qwen 모델의 점수가 거의 같고, DeepSeek만 20문항 후합니다. 엇갈린 방향도 한쪽뿐입니다. DeepSeek와 Qwen 27B는 500문항 중 479개에서 같은 판정을 내렸고, 나머지 21개는 전부 DeepSeek가 정답, Qwen이 오답이라고 본 문항이었습니다. 반대 방향은 하나도 없습니다.
모델끼리 다수결로 정할 일이 아니어서 21문항을 하나씩 읽었습니다. 14개는 DeepSeek가 틀렸습니다. 답이 실제로 틀렸는데 정답 처리한 것입니다. 5개는 Qwen이 지나치게 엄격했습니다. 2개는 사람이 봐도 애매했습니다(위젯의 '엇갈린 21문항' 탭에서 모두 볼 수 있습니다). 공정을 위해 두 모델이 모두 오답으로 본 36문항도 전부 읽었는데, 이쪽은 정답이 숨어 있지 않았습니다.
DeepSeek가 정답 처리한 틀린 답 14개 중 9개가 시간 추론입니다. 몇 가지만 옮깁니다.
자기 채점이 통과시킨 오답들
"유럽 혼자 여행과 가족 로드트립, 뭐가 먼저?" → 정답 가족 로드트립, 답안 "유럽 혼자 여행"
"두 달 전 박물관에 친구와 갔나?" → 정답 아니요, 답안 "예"
"북클럽 가입 후 모임까지 얼마나?" → 정답 2주, 답안 "약 1주"
"스탠드업을 본 지 얼마 만에 오픈 마이크에?" → 정답 2개월, 답안 "약 5개월"
"사별 지지 모임에 몇 번?" → 정답 5번, 답안 "5 + 3 = 8번"
왜 이런 일이 생겼을까요. 공식 템플릿에는 "답이 정답과 같거나 정답에 이르는 중간 단계를 모두 담고 있으면 yes"라는 문장이 있습니다. SodaMem 리더는 단계별 풀이를 길게 쓰는 편이고(평균 855자), 모델이 자기 말투로 쓴 긴 풀이는 같은 모델에게 그럴듯해 보입니다. 표본은 작지만, 잘못 통과한 14개 답안의 길이 중앙값은 1,067자로 두 채점자가 모두 맞다고 한 답안(672자)보다 1.6배 깁니다. 코어닷투데이가 벤치마크 비판 글에서 본 "채점 프롬프트 하나로 26점이 움직인다"는 현상이 이번에는 채점 모델 쪽에서 나타났습니다.
유형별로 보면 사람 판정을 반영했을 때 시간 추론이 94.7%에서 88.0%로 가장 크게 내려가고, 나머지는 크게 변하지 않습니다. 약 90%는 저자들이 밝힌 3회 중앙값 90.6%와 비슷합니다. 저자들의 말대로 "자기 채점 고리는 느슨"했고, 고리를 조이면 90점 언저리입니다. 싼 모델로 90점이면 여전히 인상적인 결과입니다. 다만 Mem0 2026(94.4%)이나 agentmemory V4(96.2%)처럼 GPT-4o로 채점한 숫자와 비교하려면 이쪽도 독립 채점자를 써야 합니다.
9-2. 리더를 바꾸면 — 같은 증거, 71%
README는 "리더를 바꾸면 점수가 움직인다"고 적었습니다. 공개된 검색 결과를 Qwen 3.5 9B에게 읽히고, 질문 날짜와 SodaMem 리더 지침 첫 문단을 함께 줬습니다. 채점은 Qwen 27B로 통일했습니다.
유형 (문항 수)
SodaMem 답안
같은 증거를 9B가 읽음
한 세션 · 비서 (56)
98.2%
98.2%
한 세션 · 사용자 (70)
97.1%
91.4%
지식 갱신 (78)
94.9%
79.5%
시간 추론 (133)
86.5%
59.4%
다중 세션 (133)
77.4%
59.4%
한 세션 · 선호 (30)
93.3%
56.7%
전체 (500)
88.6%
71.2%
17점이 빠졌습니다. 공정하게 읽어야 합니다. 9B가 작은 모델인 것 말고도 불리한 조건이 셋 있습니다. 공개된 검색 결과에는 플래너의 세기·기간 계산 도구가 돌려준 값이 없고, 증거 행의 절반(4,278행)에는 날짜가 없으며, 코어닷투데이가 "간결하게 답하라"고 지시해 선호 문항처럼 풍부한 답이 필요한 곳에서 손해를 봤습니다. 그래서 이 숫자는 "9B는 DeepSeek보다 17점 못하다"가 아닙니다. 이 실험이 말하는 바는 한 질문의 정답률은 기억 저장소 혼자 내는 것이 아니라는 것입니다. 한 세션 문항처럼 증거가 한두 줄이면 작은 모델도 잘 읽습니다(98%). 여러 줄을 세고 날짜를 비교해야 할 때 점수가 무너지고, 그 부분을 메우는 것은 리더의 크기와 플래너의 도구입니다.
9-3. 논문과 코드가 다른 곳
코드를 읽으며 논문의 서술과 다른 곳을 표시했습니다. 논문이 틀렸다기보다, 논문은 설계도이고 코드는 8월 초에 크게 정리된 실물이라서 생긴 차이로 보입니다. 저장소의 코드 주석이 이 차이를 숨기지 않고 적어 둔 덕분에 찾을 수 있었습니다.
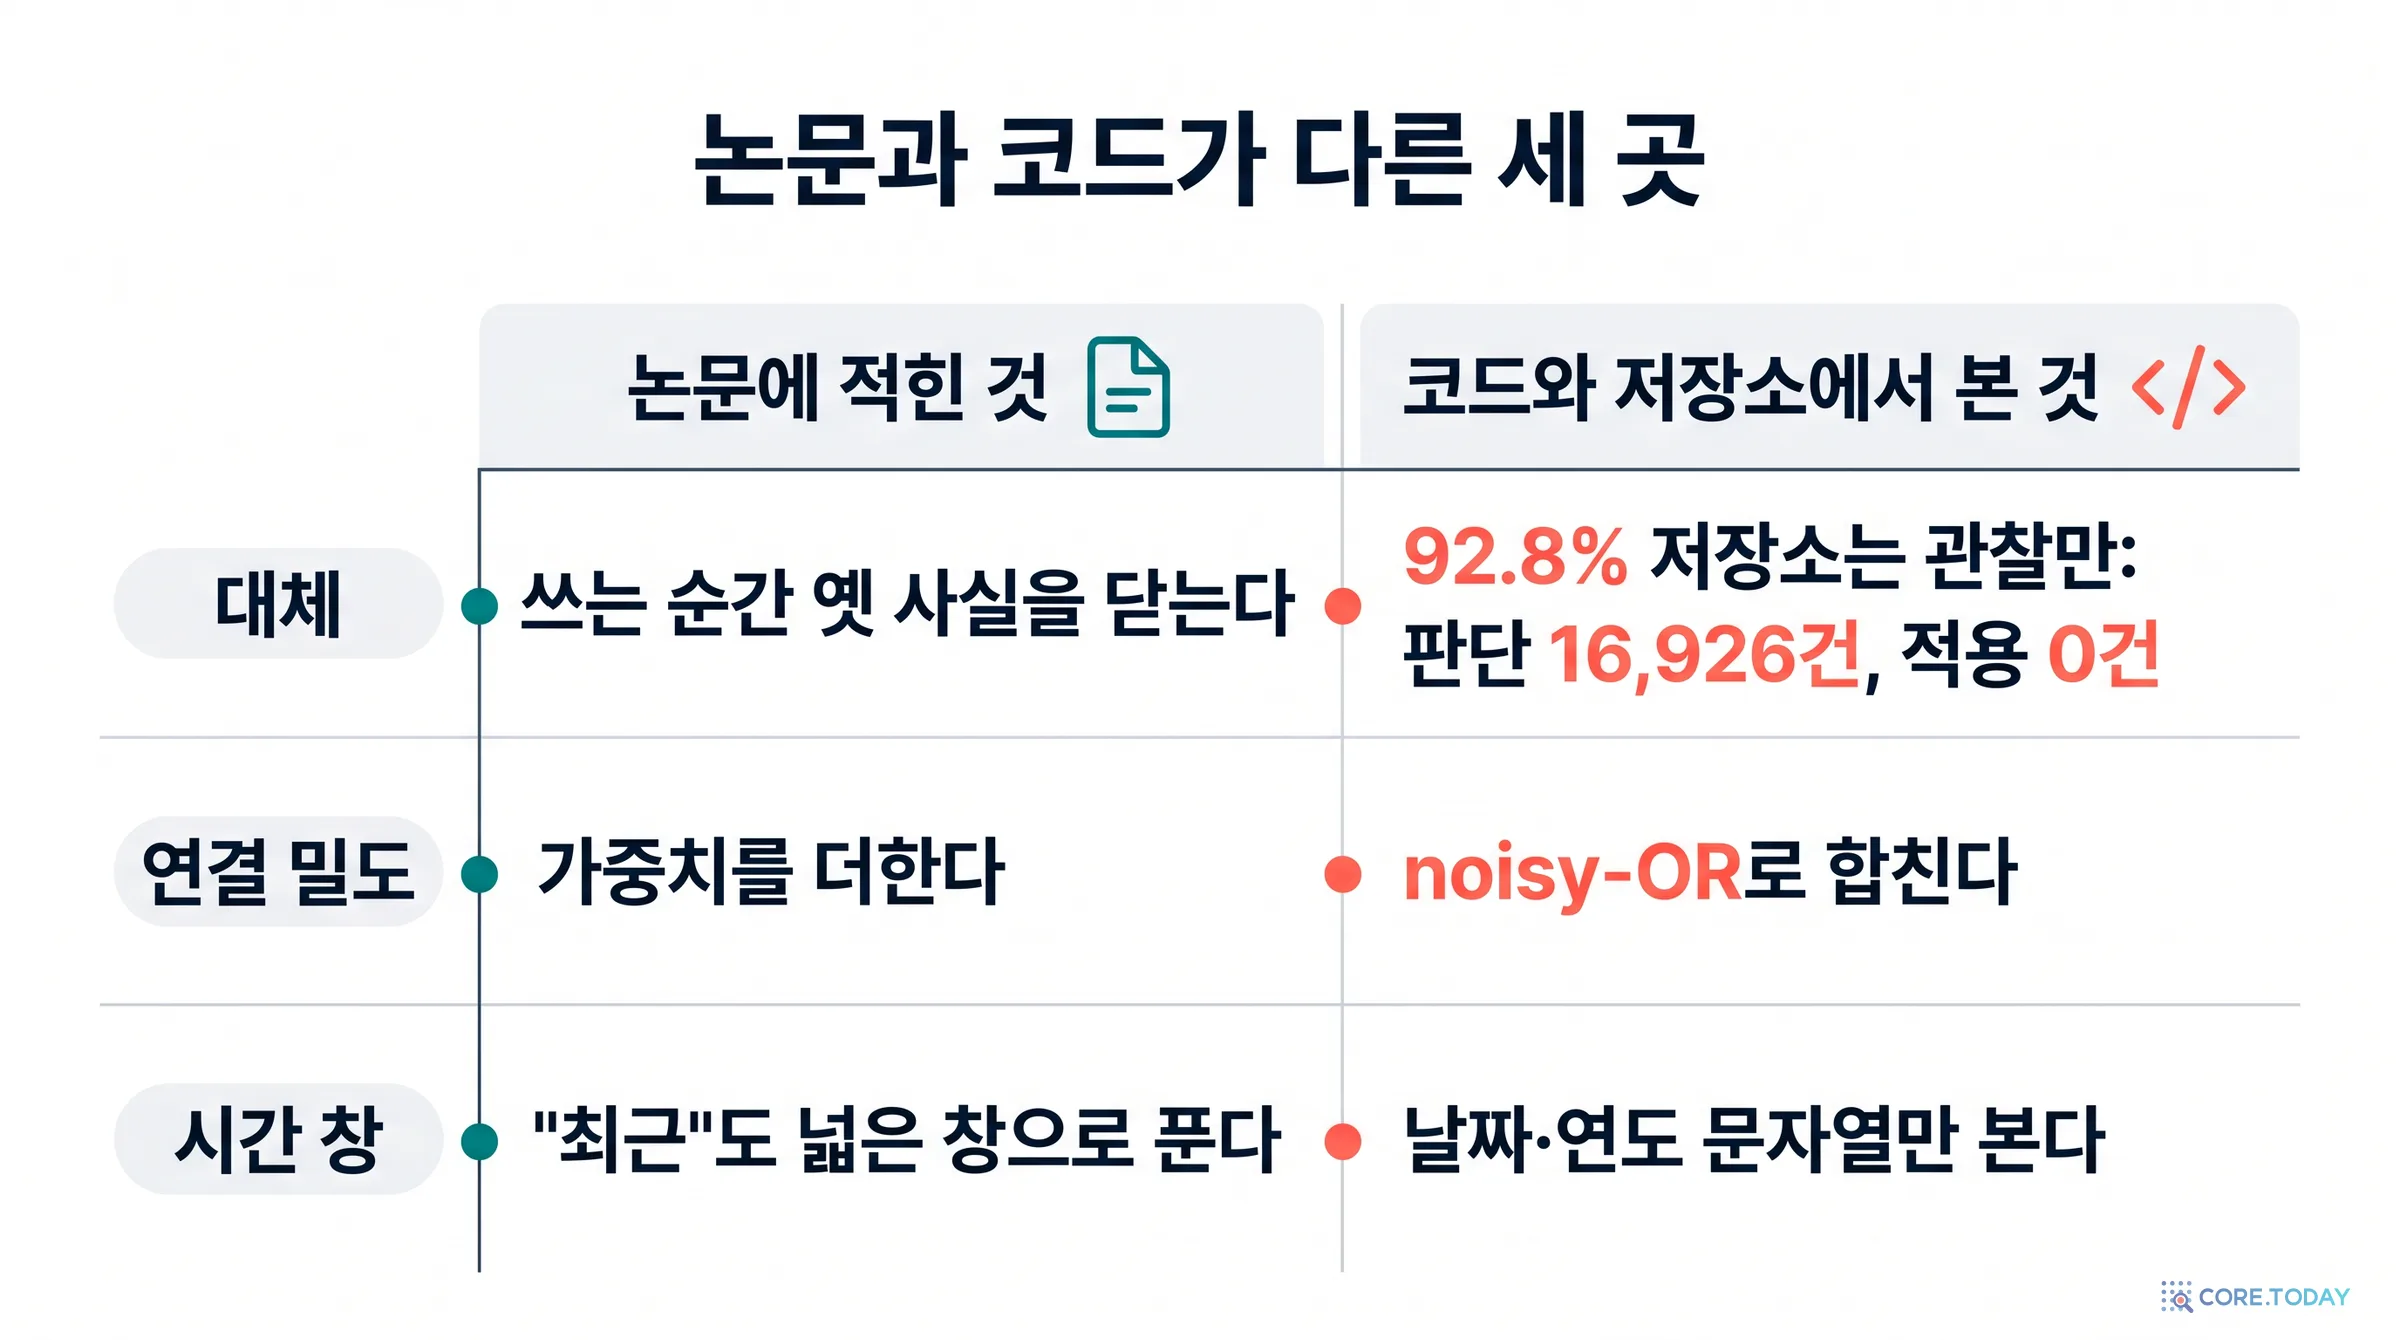
가장 큰 차이: 92.8%를 낸 저장소에서는 대체가 꺼져 있었습니다. 저장소 이름 longmemeval_s_500_Hobs_entitysubj의 'obs'는 관찰만(observe-only)이라는 뜻입니다. 코드의 플래그 supersede_observe_only가 켜진 상태로 만들어진 저장소는 대체 판단을 계산해 로그에 남기기만 하고, 실제로 옛 사실을 닫지 않습니다. 테스트 코드 주석은 구체적인 숫자까지 적어 두었습니다. "고정된 S500 저장소에는 supersede_observed 기록이 16,926건 있는데, 그것을 보여 줄 SUPERSEDES 엣지는 0건이다." 공개된 검색 결과가 이를 뒷받침합니다. 8,427행의 상태는 전부 active이고, valid_until이 채워진 행은 6개뿐입니다. CHANGELOG에는 이렇게 적혀 있습니다. "자동 대체는 이전에 기본값이 관찰만인 플래그 뒤에 있었고, 어떤 HTTP·MCP 배포도 그것을 바꿀 수 없었다. 그래서 어떤 배포도 아무것도 대체한 적이 없다." 8월 6일에 이 플래그는 지워졌고 대체는 무조건 적용으로 바뀌었습니다. 논문이 나오기 이틀 전입니다.
정리하면 지식 갱신 97.4%는 쓰는 시점의 대체로 낸 점수가 아닙니다. 옛 값과 새 값이 모두 유효한 채로 리더에게 갔고, 어느 쪽이 지금 값인지는 리더가 정했습니다. 앞서 본 사별 모임(5+3=8)이나 인터넷 속도(최신 발화를 따라 1Gbps, 정답 500Mbps)처럼 그 판단이 빗나간 사례도 있습니다.
그렇다면 공은 7장의 그 문장, "가장 최근의 직접적인 사용자 발화를 우선하라"에 있을까요? 코어닷투데이도 처음에는 그렇게 짐작했습니다. 그래서 재 봤습니다. 지식 갱신 78문항을 9B 리더에게 다시 읽히면서 그 문장 하나만 지웠습니다. 결과는 62개 대 62개, 맞고 틀린 문항까지 하나도 다르지 않았습니다. 답안 문구는 78개 중 58개가 달라졌으니 프롬프트는 분명히 바뀌었는데, 판정은 그대로였습니다.
짐작이 틀렸습니다. 날짜가 보이면 모델은 시키지 않아도 새 값을 고릅니다. 코어닷투데이의 파일 vs 그래프 실험에서 원문에 날짜만 붙인 파일이 잘한 이유와 같습니다. 그러니 이 결과가 가리키는 쪽은 "그 문장이 대체를 대신했다"가 아니라 "LongMemEval의 지식 갱신 문항은 쓰는 시점의 대체도, 특별한 지침도 없이 풀리는 구조"라는 것입니다. 이 벤치마크로는 SodaMem이 내세우는 대체의 효과를 잴 수 없습니다. 다만 9B 리더로 잰 값이고, 문항당 16.9행으로 줄어든 공개 검색 결과 위에서 잰 것이므로 DeepSeek 리더에서도 같은지는 알 수 없습니다.
연결 밀도는 합이 아니라 noisy-OR입니다. 6장에서 본 대로 식 (5)는 단순 합이지만 코드는 1 − ∏(1 − w)입니다. 순위가 크게 바뀌는 차이는 아니지만, 논문의 식을 그대로 구현하면 저장소와 다른 결과가 나옵니다.
시간 창은 날짜 문자열만 읽습니다. 정의 0.4의 (W, δ) 파서는 호출되지 않는 코드였고 8월에 지워졌습니다. 융합 단계에서는 ISO 날짜, 'May 2026', 네 자리 연도만 창이 됩니다. 정렬 방향 δ도 융합 코드에서는 쓰이지 않습니다.
시점 질의는 아직 없습니다. 유효 기간을 적어 두는 이유 중 하나는 "3월에는 어디 살았지?"에 답하는 것이지만, 공개 코드의 search(as_of=…)는 "아직 구현되지 않았다"며 오류를 냅니다. 조용히 무시하지 않고 오류를 내는 점은 좋습니다.
9-4. 한국어를 넣어 보면
논문의 시나리오를 그대로 흉내 낸 짧은 대화를 SodaMem에 넣었습니다. 사용자 한 명, 세션 여섯 개, 망원동 거주·매운 음식 선호·판교 출근에서 시작해 위염, 이사, 고양이 입양, 퇴사로 이어지는 12턴입니다. 같은 내용을 한국어와 영어로 각각 만들어, 공개 코드(v0.1.1) 기본 설정으로 추출·플래너·리더를 모두 Qwen 3.5 9B로 돌렸습니다. 벤치마크가 아니라 부품이 어떻게 움직이는지 들여다보는 작은 시험입니다. 논문의 추출 모델과 다르고, 언어마다 한 번씩만 돌렸습니다.
확인한 것
한국어
영어
만들어진 사실 카드
9장
11장
BM25 토큰 (첫 발화)
0개 (6개 세션 모두 빈 목록)
정상 (i, live, mangwon-dong…)
옛 주소 '망원동'이 닫혔나
아니오, 정자동과 함께 유효
아니오, 정자동과 함께 유효
옛 선호 '매운 음식'이 닫혔나
아니오
아니오
새 사실 '줄이는 중'의 상태
같은 세션의 다른 사실에 대체되어 닫힘
유효
'신분당선 출근'이 닫혔나
예, 6월 15일 (이사 사실에 대체됨)
예, 6월 15일 (이사 사실에 대체됨)
검색만 한 맥락(LLM 0회)의 저녁 질문 1순위
"마라탕 좋아하시는군요!" (비서 발화)
"I eat malatang twice a week."
끝단 답 5문항 (플래너+리더)
5개 모두 맞음
4개 맞음, 저녁 메뉴 틀림
문항당 답변 시간(9B, A100)
약 100~134초
약 83~112초
세 가지가 눈에 띕니다.
첫째, 영어에서 논문의 첫 예시가 실패했습니다. "What should I cook for dinner tonight?"에 비서는 매운 김치찌개와 고추장 비빔밥을 권하며 "매운맛을 높게 유지하면서 메뉴를 바꿔 보라"고 답했습니다. 논문 서론이 해결했다고 말한 바로 그 장면, 위염으로 매운 걸 줄이는 사람에게 매운 음식을 권하는 실패입니다.
둘째, 대체는 언어보다 술어 이름에 달려 있었습니다. 망원동이 닫히지 않은 이유는 한국어든 영어든 같습니다. 추출 모델이 옛 사실에는 live_in_mangwon_dong, 새 사실에는 live_in_bundang_jungdong_station이나 live_in이라는 술어를 지었습니다. 술어에 값이 섞여 들어가니 '같은 슬롯'으로 보이지 않습니다. 매운 음식도 love_spicy_food와 cutting_down_on_spicy_food_due_to_gastritis로 갈립니다. 반대로 사건 유형이 같게 붙은 상태 사실끼리는 슬롯이 다른데도 대체가 일어납니다. '신분당선 출근'이 이사 사실에 닫힌 것은 둘 다 사건 유형이 travel로 붙었기 때문이고, '줄이는 중'은 같은 세션의 '의사 권고'와 함께 health로 묶여 자기 짝에게 닫혔습니다. 이 저장소의 대체는 결정론적 규칙이지만, 그 규칙의 입력인 술어와 사건 유형은 LLM이 지은 이름입니다. "신선도를 LLM에게 맡기지 않는다"는 약속은 절반만 지켜집니다. 논문의 추출 모델(DeepSeek)이었다면 이름을 더 잘 지었을 수 있습니다. 16,926건의 대체 판단이 어떤 품질인지는 공개된 자료로 알 수 없습니다.
셋째, 한국어는 5문항을 다 맞혔습니다. 기록이 12턴뿐이어서 임베딩과 원문 턴 검색, 플래너의 세션 펼치기만으로 필요한 문장이 다 리더에게 닿았고, 리더가 날짜를 보고 최신 값을 골랐습니다. BM25 터널이 통째로 비어 있어도 작은 기록에서는 티가 나지 않습니다. 다만 기록이 커지면 이야기가 달라질 것입니다. '두부' 같은 고유명사를 정확히 찾는 어휘 터널이 없고, 질량 체계에서 강한 터널 하나가 빠지는 셈이기 때문입니다. CHANGELOG의 "CJK(중국어·일본어·한국어) 토큰화 지원"은 실제로는 한자 범위(U+4E00–9FFF)만 다룹니다. 일본어도 가나는 버리고 한자만 남습니다.
공개 코드의 BM25 토크나이저에 넣어 본 결과
"나 이사했어. 이제 분당 정자동 살아." → [ ]
"고양이 이름을 두부로 지었어." → [ ]
"2026년 5월에 GPT-5 샀어" → [2026, 5, gpt-5, gpt] (숫자와 영문만 남음)
"I moved. I now live in Jeongja-dong." → [i, moved, i, now, live, in, jeongja-dong, jeongja, dong]
"我搬家了,现在住在盆唐。" → [我, 搬, 家, …, 搬家, 现在, 住在, 盆唐] (19개)
"引っ越しました。今は盆唐に住んでいます。" → [引, 越, 今, 盆, 唐, 住, …] (가나는 빠짐)
BM25 토큰 생성은 조용히 실패합니다. 오류도 경고도 없고, 문서가 전부 빈 토큰이면 BM25 객체를 만들지 않고 넘어갑니다. 벤치마크에 없는 언어에서 기억 시스템을 쓸 때 가장 먼저 확인해야 할 종류의 일입니다. 다음 절의 점검표에 넣어 두었습니다.
저자들이 밝힌 것. 이 논문은 기록 저장소 설정 하나를 Flash 자기 채점으로 잰 결과이고, 모든 비교 시스템을 같은 하네스로 다시 돌린 것이 아닙니다. 다른 시스템의 비용은 공개된 토큰 수나 저자들이 밝힌 달러로 재구성한 것이라 자릿수 비교로만 읽어야 합니다. 적재 비용과 시간선 정리의 소거 실험은 후속 연구로 미뤘습니다. 남은 오답, 특히 자기 채점 아래의 시간 추론 오답은 적재 단계의 시간선 정리와 독립 재채점을 해야 할 이유라고 적었습니다.
코어닷투데이가 더 찾은 것.
자기 채점은 순서·기간 문제에서 후했다. 9-1에서 본 대로, DeepSeek가 정답 처리한 문항 중 14개는 직접 읽어 봐도 틀린 답이었고 그중 9개가 시간 추론이었습니다. 다른 채점 모델과 사람의 판정을 거치면 점수는 약 90%입니다. 저자들의 중앙값 90.6%와 거의 같습니다.
최고 점수는 세 번 중 한 번이었다. 세 번의 점수는 453·453·464였습니다. 논문 초록과 README의 92.8%는 그중 위쪽 끝입니다.
대체는 벤치마크에서 꺼져 있었다. 92.8% 저장소는 대체 판단을 기록만 하는 '관찰만' 모드로 만들어졌습니다. 논문이 P1(현재성)의 해법으로 내세운 메커니즘이 숫자에는 기여하지 않았습니다. 논문에는 "제품 기본값은 대체를 쓰고, 관찰만 하는 고정 저장소는 실험 축"이라는 한 줄이 있지만, 결과 표의 저장소가 바로 그 고정 저장소라는 점은 저장소 코드의 주석을 읽어야 알 수 있습니다.
소거 실험이 없다. 출처 강제, 시간선 정리, 세 터널, 연결 밀도, 플래너 중 무엇이 몇 점을 냈는지 알 수 없습니다. 코어닷투데이가 해 본 작은 소거(리더 지침 한 문장 지우기)에서는 지식 갱신 점수가 전혀 움직이지 않았습니다. 무엇이 점수를 냈는지는 여전히 모릅니다. 자동 심사 서비스 Pith의 AI 심사도 같은 점을 지적했습니다. 소거 없이는 "최전선 근처"라는 위치가 결과가 아니라 바람이라는 것입니다.
그림 2는 표와 맞지 않는다. 표 1에 없는 이름(TMem, XMem0, LCGraph Infctx), 표보다 1~2점 높게 찍힌 점들, 칠한 영역의 의미를 거꾸로 적은 범례가 있습니다.
비교 대상의 성격이 섞여 있다. Cersei 전체 문맥(87.6%)은 기억 시스템이 아니라 대화 전체를 넣은 기준선이고, Cersei와 Mastra는 유형별 평균(macro)을 보고합니다. agentmemory V4는 같은 500문항으로 46번 조정한 이력이 있고, 채점은 GPT-4o입니다. 채점 모델이 시스템마다 다르므로, 2~3점 차이는 채점 모델의 성격 차이 안에 들어갑니다.
LoCoMo 86.88%는 검증할 수 없다. 저장소 README가 스스로 밝히듯 LoCoMo는 문항별 답안·검색 문맥을 공개하지 않았고, 원본이 아닌 'LoCoMo 정제판'을 썼으며(적대적 범주 5의 446문항이 답할 수 있는 문항으로 고쳐져 있어 제외), 공개 이력에 없는 출시 전 빌드로 쟀습니다.
재현이 어려워지고 있다. 결과를 낸 빌드는 공개 이력(v0.1.0부터) 이전의 것입니다. 저장소에는 '프로토콜 v1.0 (468/500)'과 '유형 지정 답변 스키마'를 넣었다가 PR #8로 되돌린 흔적도 있습니다. 2026년 10월 말 현재 deepseek-v4-flash는 퇴역해 V4.1-Flash로 연결되고 단가는 2~4배 올랐습니다. 같은 설정을 지금 돌리면 다른 모델로, 더 비싸게 돕니다.
결정론적 규칙의 입력은 LLM이 짓는다. 9-4에서 본 대로 슬롯 판정은 추출 모델이 지은 술어·사건 유형에 달려 있습니다. 작은 모델에서는 옛 주소가 닫히지 않고, 새 사실이 자기 짝에게 닫혔습니다. 논문의 추출 모델로는 어떤지, 대체 판단 16,926건의 정밀도는 얼마인지 공개된 자료로는 알 수 없습니다.
영어 밖에서는 부품이 빠진다. 공개 코드의 BM25와 출처 복구는 한글을 토큰으로 만들지 못하고, 선호의 갱신 표지는 영어 단어 목록입니다.
그래도 칭찬할 점. 이 목록의 절반 이상은 저자들이 공개한 자료로 찾은 것입니다. 답안 500개와 검색 결과 8,427행을 모두 공개하고 "아무 채점자로나 다시 채점해 보라"고 한 것, README에 "리더와 채점자가 같은 모델이라 자기 채점 고리는 느슨하다", "리더 등급이 대부분의 구조 차이보다 점수를 더 움직인다"고 적은 것, 코드 주석과 커밋 메시지에서 스스로의 실수를 낱낱이 기록한 것은 2026년 에이전트 기억 분야에서 보기 드문 투명성입니다. "숫자 대신 답안을 보라"는 태도는 논문보다 저장소가 더 잘 지켰습니다.
반론도 있습니다. 대체가 꺼진 저장소로 97.4%가 나왔다면 "대체는 필요 없는 것 아니냐"는 반론입니다. 그렇게 읽기는 이릅니다. LongMemEval의 지식 갱신 문항은 대개 옛 값과 새 값이 한두 번씩 나오는 단순한 구조이고, 채점 템플릿은 "옛 정보를 함께 말해도 갱신된 답이 맞으면 정답"으로 칩니다. 9-3에서 본 대로 리더가 지침 없이도 최신 값을 고르는 조건입니다. 같은 슬롯이 수십 번 바뀌거나, 비서의 맞장구·계획·다른 슬롯의 말이 섞이거나, 수천 개 사실 중에서 골라야 하는 실제 서비스에서는 쓰는 시점의 대체가 더 중요해질 것입니다. 다만 그 주장은 이 논문의 숫자가 아니라 다른 실험으로 보여야 합니다. STALE의 최고 55.2%가 그 실험이 아직 필요하다는 신호입니다.
2024~2025년 ChatGPT, Gemini, Claude가 차례로 대화 기억 기능을 넣었고, 2026년에는 코딩 에이전트까지 프로젝트 기억(CLAUDE.md, AGENTS.md 같은 파일)을 기본으로 씁니다. SodaMem도 MCP 서버, LangGraph·CrewAI·OpenAI Agents SDK 어댑터, TypeScript SDK, Claude Code·Cursor용 설치 명령을 함께 내놓았습니다. 기억 계층이 모델 바깥의 '부품'으로 팔리는 시대입니다.
이때 출처·시간·대체가 왜 중요한지 사례로 보면 분명해집니다.
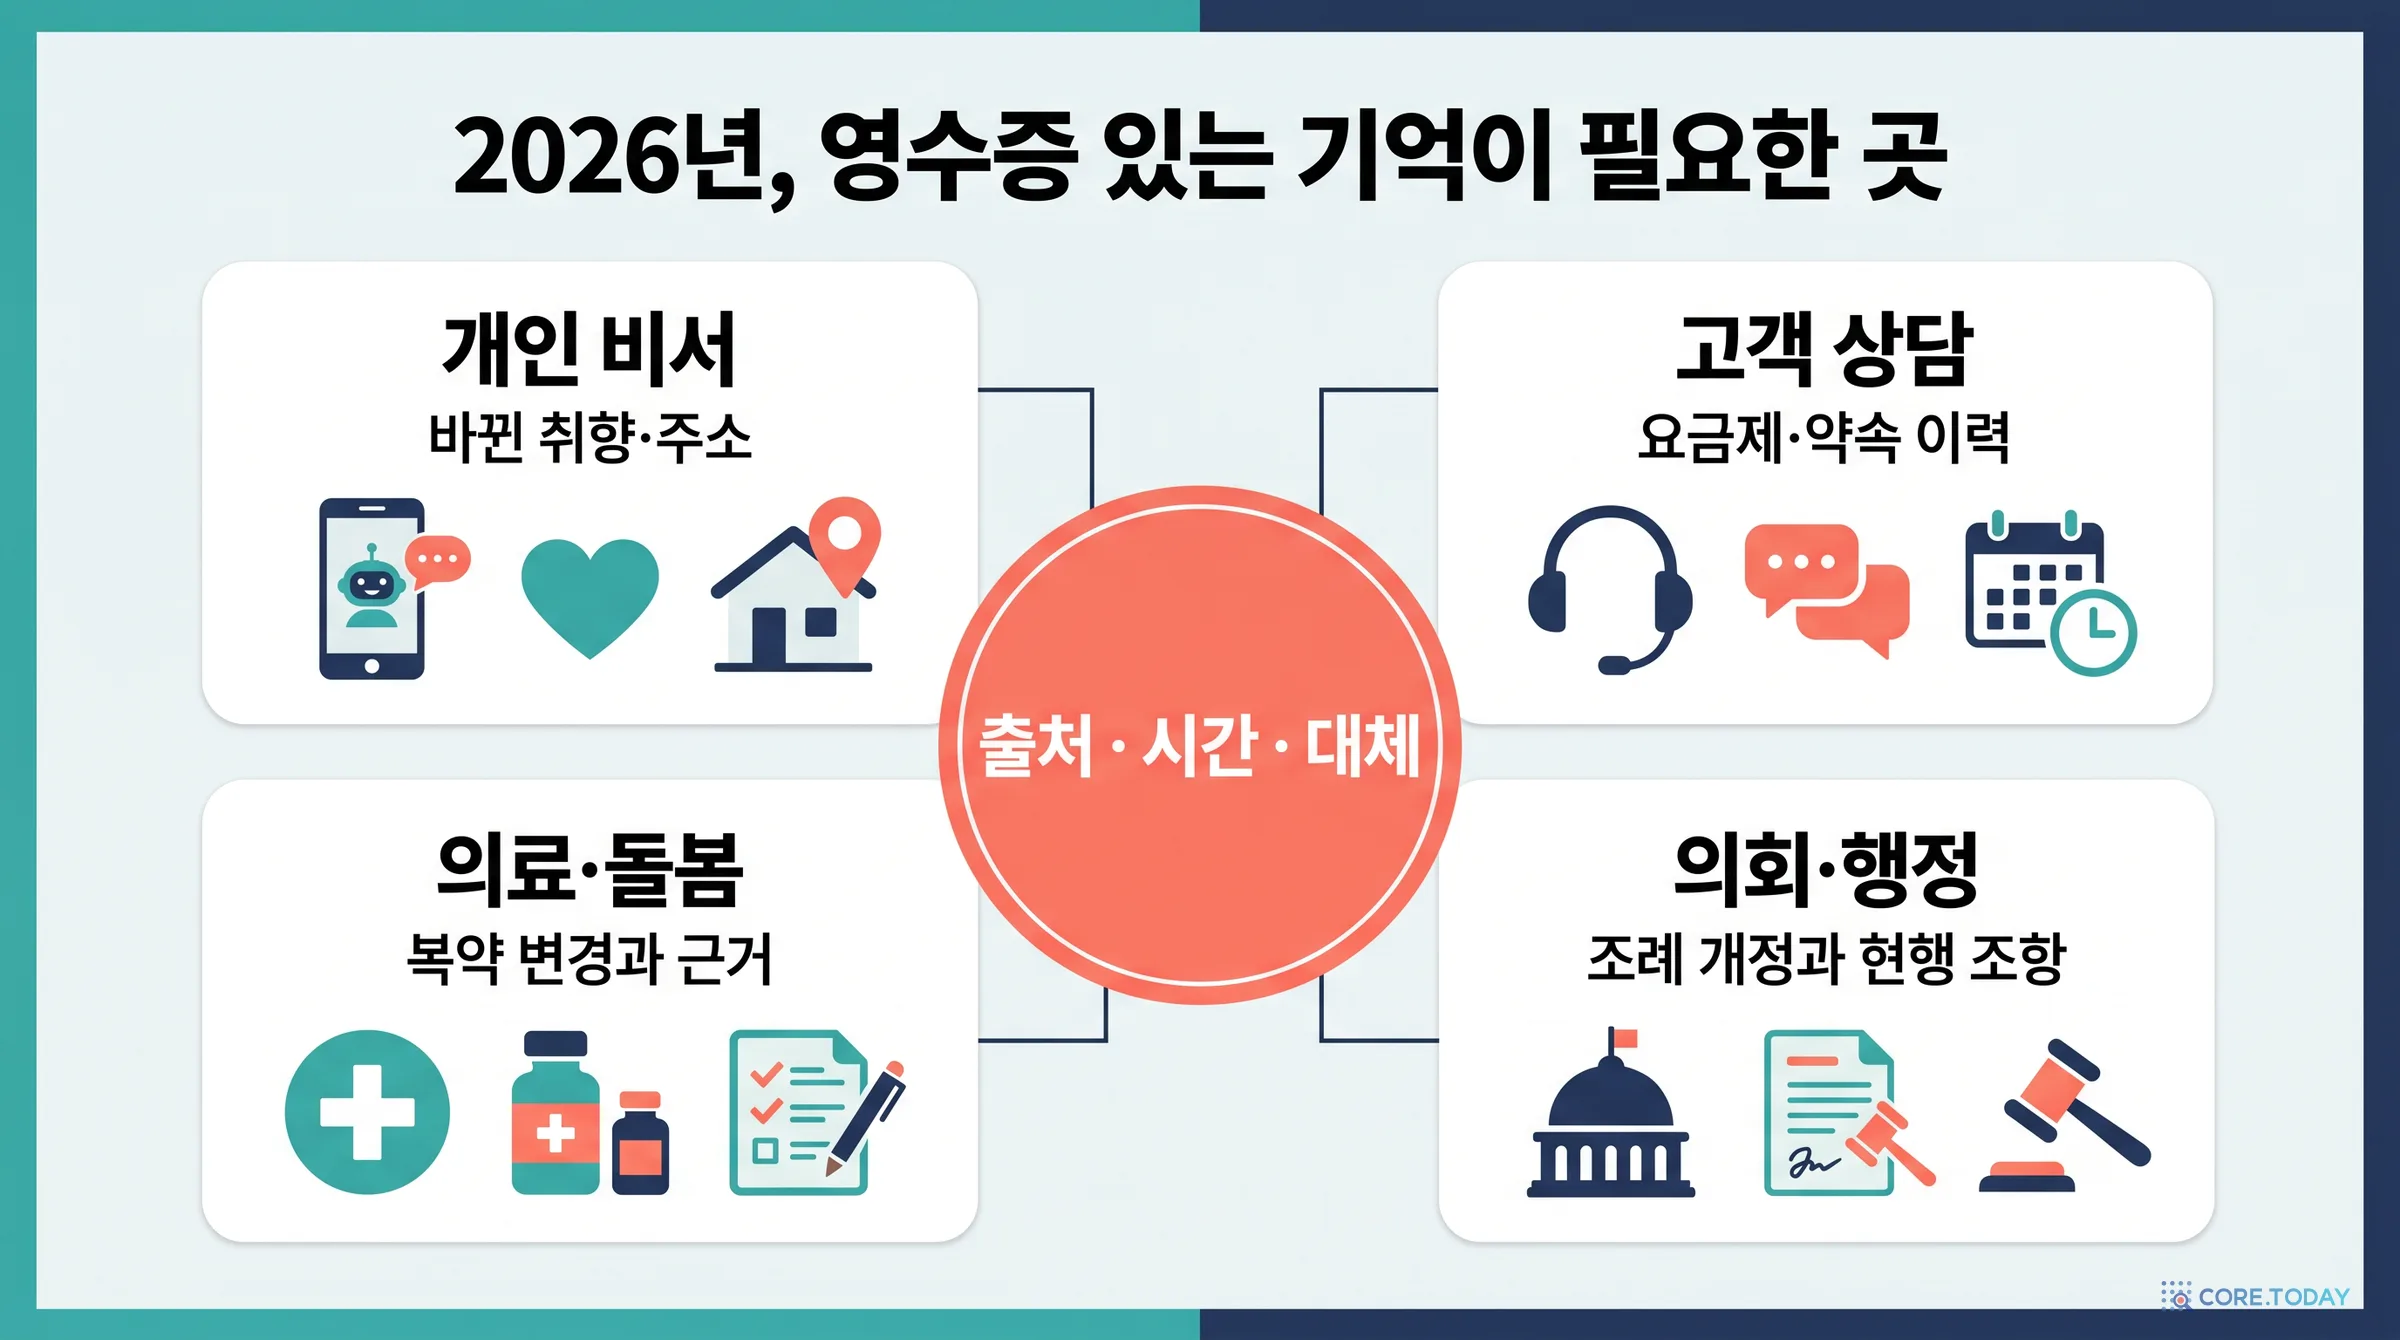
개인 비서. 이사, 이직, 식단 변화, 반려동물. 바뀐 값을 모르는 비서는 친절할수록 더 곤란합니다. "왜 그렇게 생각해?"에 원문으로 답할 수 있어야 사용자가 기억을 고칠 수 있습니다.
고객 상담. "지난달에 요금제 바꿨잖아요"라는 고객에게 옛 요금제로 청구서를 설명하면 민원이 됩니다. 상담원이 한 약속(‘다음 달부터 할인’)은 계획이지 현재 상태가 아닙니다. 비서의 말과 고객의 말을 구분하는 SodaMem의 규칙(비서의 말은 사용자의 사실을 대체하지 못한다)이 그대로 쓰입니다.
의료·돌봄. 복약은 대체의 연속입니다. 용량이 바뀌고, 약이 끊기고, 다시 시작됩니다. "언제부터 이 용량이었나"와 "누가 그렇게 말했나"를 답하지 못하는 기억은 돌봄 현장에서 쓸 수 없습니다.
의회·행정. 조례는 개정되고, 개정 전 조항은 '그때는 참'이었던 사실로 남아야 합니다. 코어닷투데이가 만든 사실탐색기 v2는 공적 기록에서 '지금 참인 것'을 권위 기반 대체(AGS)로 유지하고, 근거를 대거나 기권합니다. SodaMem이 대화 기억에서 한 일을 공적 기록에서 하는 셈입니다. 두 시스템이 같은 결론에 이른 지점이 있습니다. 대체 판단은 LLM의 자유 판단보다 결정론적 규칙이 낫고, 출처 없는 사실은 들이지 않는 편이 낫습니다. 다른 지점도 있습니다. 사실탐색기는 '누구의 말이 더 권위 있는가'(공포문 > 회의록 > 보도)를 대체 순서에 넣는데, SodaMem은 시간 순서와 화자(사용자 > 비서)만 봅니다.
11-2. 규제가 출처를 요구한다
한국 개인정보 보호법은 정보주체에게 자기 정보의 열람(제35조)과 정정·삭제(제36조)를 요구할 권리를 줍니다. 2026년 1월 22일 시행된 인공지능 기본법은 고영향 인공지능에 설명과 기록 관리 의무를 지웁니다. 유럽연합의 GDPR 제15조(열람권)와 AI 법도 같은 방향입니다. "AI가 나에 대해 무엇을 기억하고, 그걸 어디서 알았나"에 답하려면 기억마다 출처가 있어야 하고, "그건 옛날 얘기야"라는 정정에 답하려면 대체가 있어야 하고, "지워 줘"에 답하려면 무엇에서 무엇이 파생됐는지 알아야 합니다. SodaMem의 이벤트 로그(/v1/events)가 모든 추가·대체·삭제를 이유와 함께 남기는 것은 이런 요구에 맞는 설계입니다.
11-3. 한국어 서비스라면
9-4의 결과는 SodaMem만의 문제가 아닙니다. 영어권에서 만든 기억 엔진의 '결정론적 부품'(토크나이저, 정규식, 갱신 표지, 날짜 파서)은 대부분 영어를 전제로 합니다. LLM이 하는 부분은 한국어도 잘 돌지만, 그 LLM의 판단을 걸러 주는 규칙들이 한국어 앞에서 조용히 꺼집니다. 한국어로 쓰려면 적어도 네 군데를 고쳐야 합니다. BM25 토크나이저(형태소 분석기나 글자 n-gram), 출처 복구의 겹침 계산, 갱신 표지 목록('요즘·이제·사실은·바꿨어·옮겼어·그만뒀어'), '지난주·그저께·작년 이맘때' 같은 상대 날짜 표현입니다. 임베딩 모델도 한국어 성능을 따로 봐야 합니다. 코어닷투데이의 한국어 임베딩 14종 실측에서는 같은 문서에서 모델에 따라 정답률 차이가 컸습니다.
12. 오늘 바로 쓸 수 있는 점검표
에이전트에 장기 기억을 붙이고 있다면, SodaMem을 쓰든 안 쓰든 아래 열 가지를 확인해 보세요.
출처기억 한 건마다 원문(세션·턴)으로 거슬러 갈 수 있나? 요약만 남기고 원문을 버리고 있지 않나?
출처추출 모델이 원문에 없는 일반화('싫어한다')를 만들 때 그것을 걸러 내는 장치가 있나?
시간'말한 때'와 '일어난 때'를 따로 적나? '지난주'를 세션 날짜 기준으로 풀어 두나?
시간시간 조건을 거르는 문으로 쓰고 있지 않나? 사용자는 날짜를 틀리게 기억한다.
대체값이 바뀌면 옛 값을 지우나, 닫나? '전에는 어땠지?'에 답할 수 있나?
대체비서의 맞장구, 앞날의 계획, 이름만 같은 다른 슬롯이 현재 값을 덮지 않나?
대체대체 기능이 실제로 켜져 있나? 설정 기본값과 실제 배포 경로가 같은지 확인했나? (SodaMem도 8월 초까지는 꺼져 있었다)
검색한국어 기록에서 어휘 검색이 실제로 토큰을 만들고 있나? 빈 토큰 목록을 조용히 넘기고 있지 않나?
평가답한 모델과 채점한 모델이 같지 않나? 다른 채점자와 사람의 표본 검토를 거쳤나? 여러 번 돌린 중앙값을 보고 있나?
비용비용에 적재(추출)와 재적재가 들어 있나? 질문 하나당이 아니라 사용자 하나당 한 달 비용으로 계산했나?
맺으며 — 장부를 펼쳐 보이는 기억
SodaMem의 설계는 단단합니다. 출처 없는 사실은 들이지 않고, 시간을 네 개의 시계로 적고, 바뀐 사실은 지우지 않고 닫고, 여러 길에서 함께 걸린 증거를 믿고, 증거를 모은 다음에 쓴다. 회계사와 사서와 데이터베이스 설계자가 수백 년에 걸쳐 배운 습관을 에이전트의 기억에 옮겨 심었습니다.
그런데 이 글에서 다시 잰 숫자는 그 설계와 조금 다른 이야기를 합니다. 92.8%는 다른 채점자 아래서 약 90%가 되고, 그 점수를 낸 저장소에서는 대체가 꺼져 있었으며, 지식 갱신 문항은 대체 없이도 풀렸습니다. 작은 모델로 돌려 보니 대체 규칙은 추출 모델이 지은 이름에 흔들렸습니다. 설계가 틀렸다는 뜻이 아닙니다. 설계가 맞다는 증거가 아직 이 논문 안에 없다는 뜻입니다.
역설적으로 그 사실을 알아낼 수 있었던 것은 SodaMem이 자기 장부를 펼쳐 보였기 때문입니다. 답안 500개, 근거 8,427행, 스스로의 실수를 적은 코드 주석. 영수증 있는 기억을 주장하는 시스템이 자기 벤치마크에도 영수증을 붙여 둔 셈입니다. 2026년의 에이전트 기억에 필요한 것은 더 높은 점수보다 이런 장부일지도 모릅니다. 사용자가 "왜 그렇게 생각해?"라고 물을 때, 그리고 독자가 "그 숫자는 어디서 나왔어?"라고 물을 때 둘 다 원문을 펼쳐 보일 수 있는 기억입니다.
Pith. SodaMem 자동 심사(심사 모델 deepseek-v4-flash), 2026-08-12.
벤치마크와 비교 시스템
Wu et al. "LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory." arXiv 2410.10813, ICLR 2025. 채점 스크립트 src/evaluation/evaluate_qa.py.
Maharana et al. "Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo)." ACL 2024.
Chao et al. "STALE: Can LLM Agents Know When Their Memories Are No Longer Valid?" arXiv 2605.06527, 2026.
Reddy, Challaram. "Don't Ask the LLM to Track Freshness" (v1) → "Reliable Post-Retrieval Assembly for Agent Memory" (v2, 2026-08-02). arXiv 2606.01435.
Yang et al. "RaMem: Contextual Reinstatement for Long-Term Agentic Memory." arXiv 2606.22844, 2026.
Chhikara et al. "Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory." arXiv 2504.19413, 2025. Mem0 연구 블로그(2026).
Rasmussen et al. "Zep: A Temporal Knowledge Graph Architecture for Agent Memory." arXiv 2501.13956, 2025.
Hindsight: Retain–Recall–Reflect Memory for Agents. arXiv 2512.12818, 2025.
Mastra. "Observational Memory: 95% on LongMemEval." 2026-02.
McCann. agentmemory V4 기술 보고서(GitHub), 2026. / Pacifio. Cersei 메모리 벤치마크 문서, 2026. / Framers Lab. AgentOS 벤치마크, 2026.
"Beyond the Context Window: A Cost-Performance Analysis of Fact-Based Memory vs. Long-Context LLMs." arXiv 2603.04814, 2026.
Li et al. "TiMem." arXiv 2601.02845, 2026. / Liu et al. "SimpleMem." arXiv 2601.02553, 2026.
Packer et al. "MemGPT: Towards LLMs as Operating Systems." 2023. / Park et al. "Generative Agents." UIST 2023. / Zhong et al. "MemoryBank." 2023.
DeepSeek API 문서: V4 출시 공지(2026-04-24), 가격 페이지.
계보
Bartlett, F. C. Remembering. 1932. / Tulving, E. "Episodic and Semantic Memory." 1972.
Neter, J., Waksberg, J. "A Study of Response Errors in Expenditures Data from Household Interviews." JASA, 1964.
Loftus, E., Palmer, J. "Reconstruction of Automobile Destruction." 1974.
Pacioli, L. Summa de arithmetica, geometria, proportioni et proportionalita. 1494.
Buneman, Khanna, Tan. "Why and Where: A Characterization of Data Provenance." ICDT 2001. / W3C PROV, 2013.
Allen, J. "Maintaining Knowledge about Temporal Intervals." CACM, 1983. / Snodgrass, R., Ahn, I. "A Taxonomy of Time in Databases." SIGMOD 1985.
Doyle, J. "A Truth Maintenance System." Artificial Intelligence, 1979. / Alchourrón, Gärdenfors, Makinson. "On the Logic of Theory Change." JSL, 1985.
Robertson et al. "Okapi at TREC-3." 1994. / Karpukhin et al. "Dense Passage Retrieval." EMNLP 2020. / Lewis et al. "Retrieval-Augmented Generation." NeurIPS 2020.
Cormack, Clarke, Büttcher. "Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods." SIGIR 2009. / Pearl, J. Probabilistic Reasoning in Intelligent Systems. 1988.