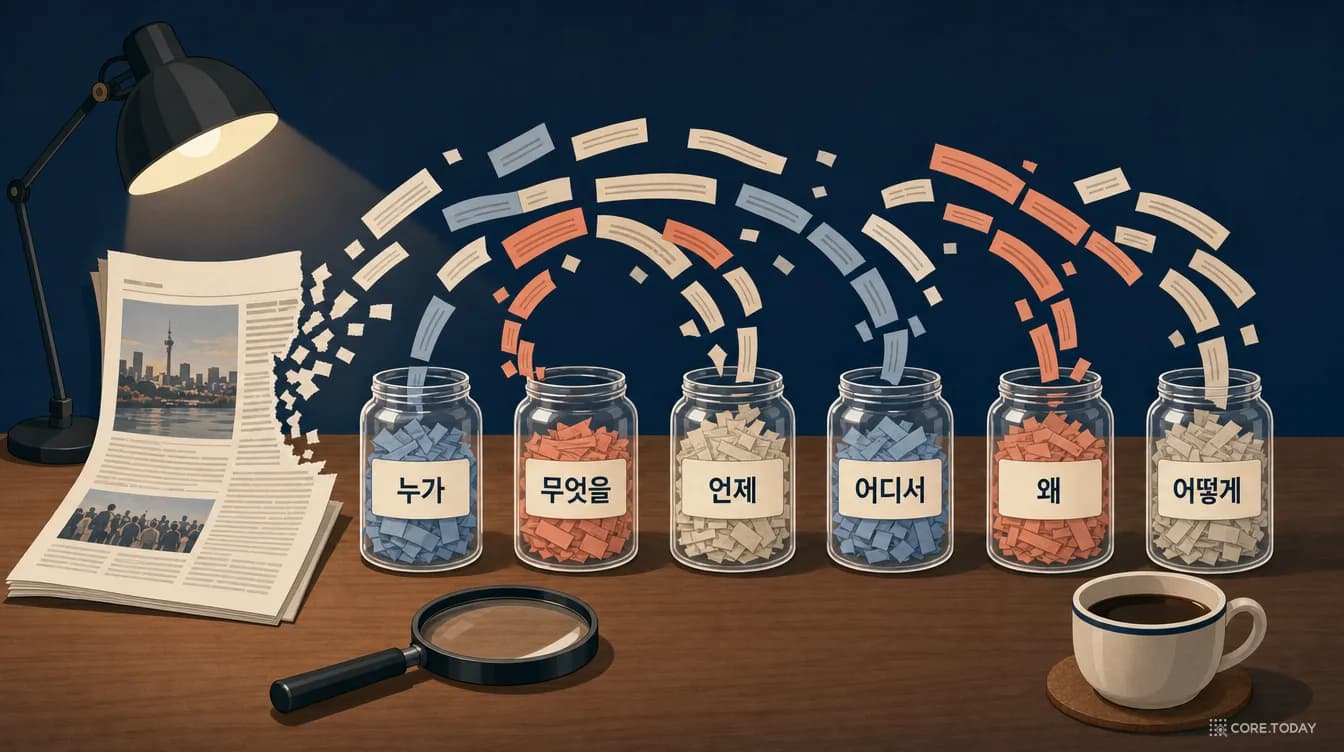
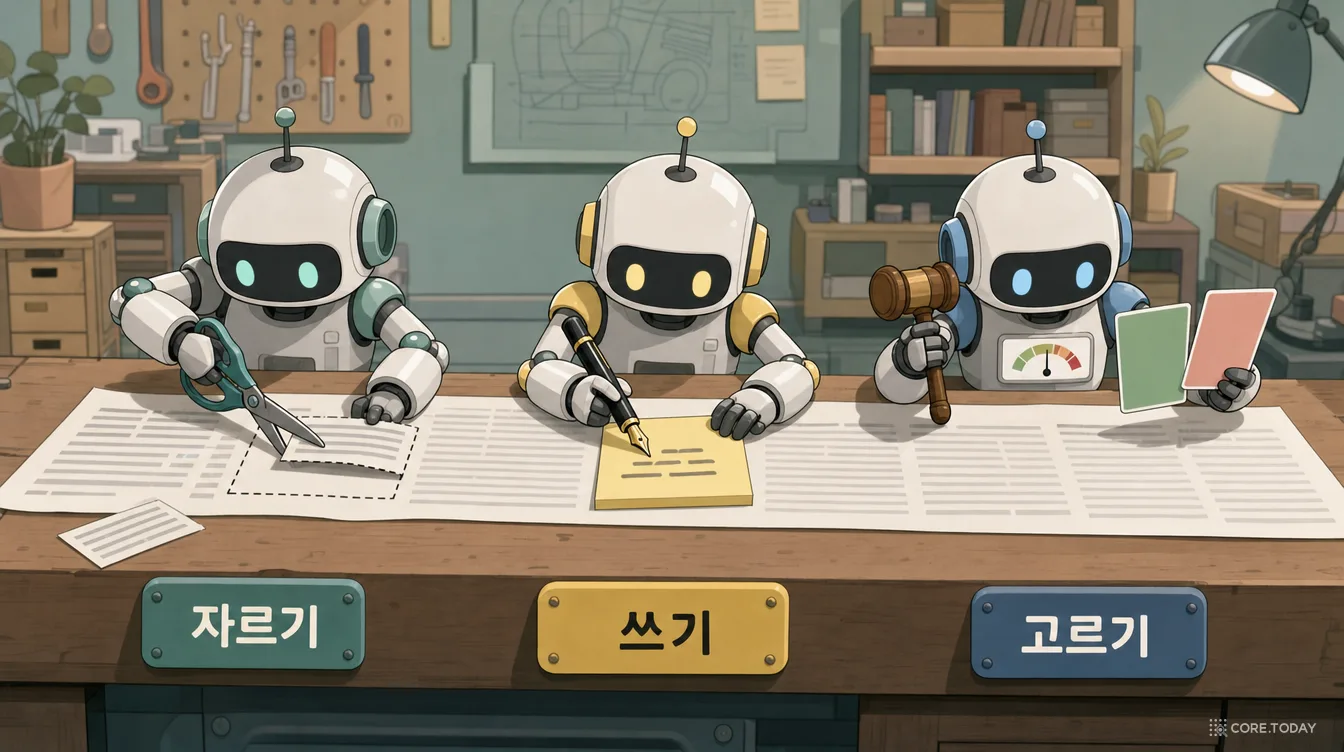
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
"(인천=연합뉴스) 13일 인천 남동구 구월동 대형 상업시설에서 50대 남성이 흉기를 마구 휘둘러 이용객 8명이 다쳤다."
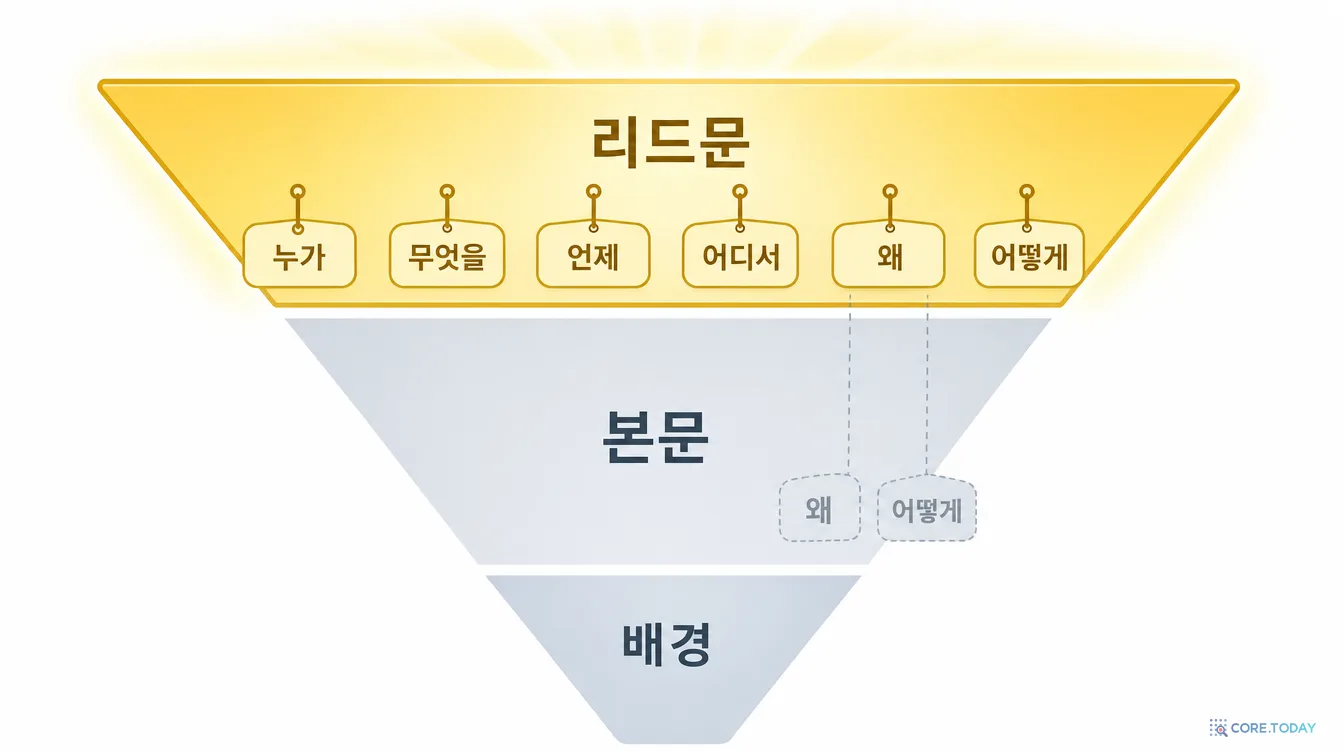
이 한 문장에 언제(13일), 어디서(인천 남동구 구월동 대형 상업시설), 누가(50대 남성), 무엇을(흉기를 휘둘러 8명이 다쳤다)이 들어 있습니다. 왜는 없고, 어떻게는 열 번째 문장에 가서야 나옵니다("양쪽 손에 흉기를 쥔 채 흰색 테이프로 묶어 고정한 상태로"). 기자는 이렇게 씁니다. 가장 중요한 답을 첫 문장에 몰아넣고, 덜 중요한 답은 아래로 내리는 역피라미드. 2,000년 전 로마의 수사학 교본에서 시작된 여섯 질문이 지금도 기사의 뼈대입니다.
이 블로그는 2026년 4월에 Giveme5W1H를 다뤘습니다. 2019년 독일 콘스탄츠 대학 팀이 만든 그 시스템은 구문 분석기와 개체명 인식기와 규칙 수십 개를 엮어 영어 기사에서 여섯 답을 꺼냈고, 평균 정확도는 0.7 근처였습니다. 그 글의 마지막 장은 "LLM 시대에 이 설계가 어떤 의미인가"로 끝났습니다. 이번 글은 그 질문의 실전편입니다. 2026년 10월, 한국어 기사에서 육하원칙을 꺼내려면 무엇으로 어떻게 해야 하는가. 추측이 아니라 같은 기사 72건에 같은 정의서를 주고 스무 가지가 넘는 조합을 직접 돌린 결과로 답합니다.
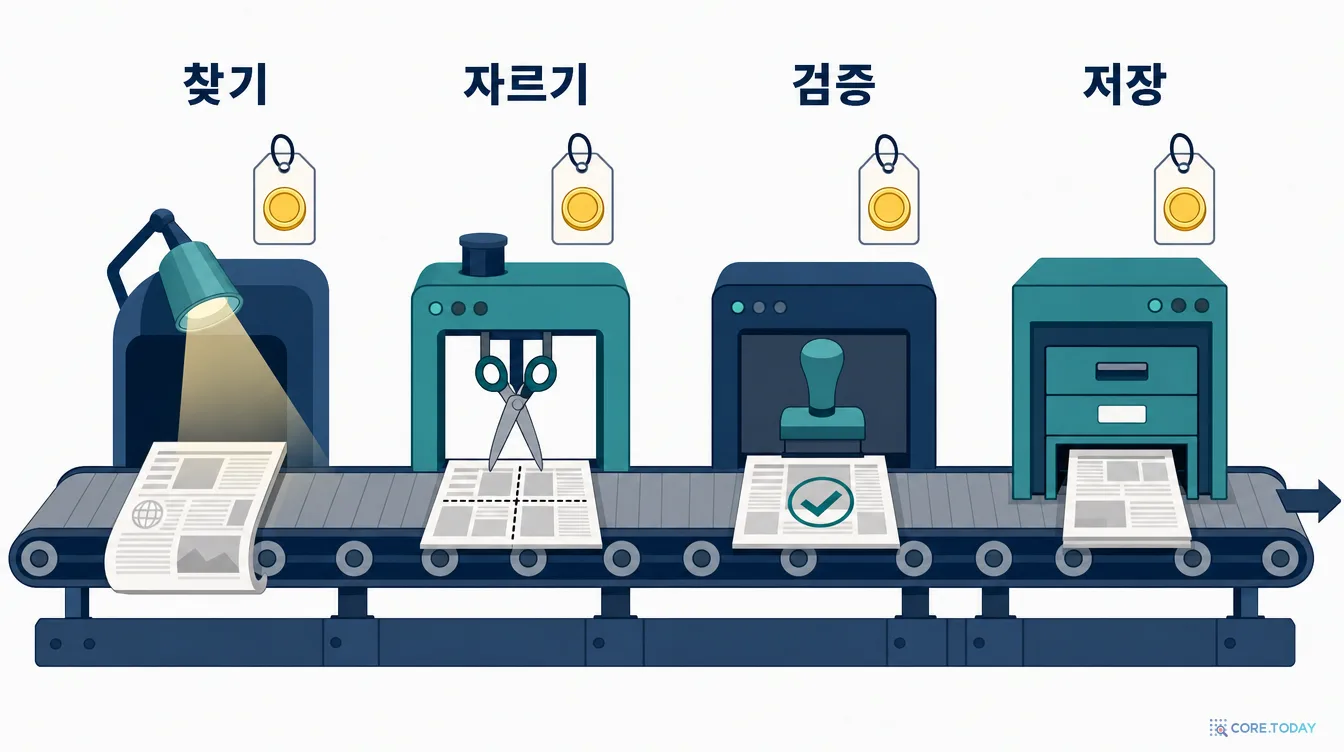
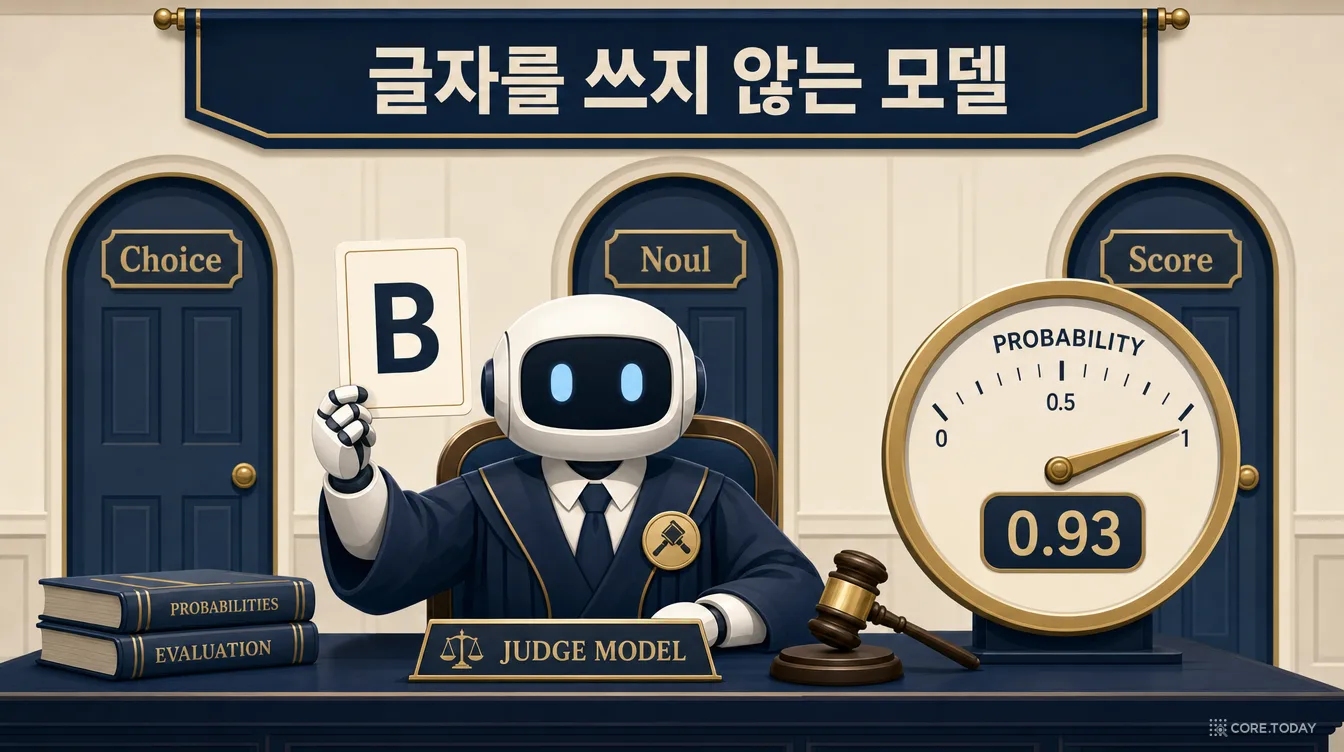
재료는 이 시리즈에서 이미 써 본 것들입니다. 임베딩 9종, 판정 모델 tev1·Nimble, Jev, 그리고 이번에 새로 들어온 클라우드플레어의 Clef, 한국어 독해(MRC) 모델 KoELECTRA, 로컬 채팅 모델 Qwen3.5 4B·9B, 클라우드의 Gemini 3.8 Flash·3.5 Flash-Lite. 각각이 할 수 있는 일이 다릅니다. 독해 모델은 자르기만 합니다. 채팅 모델은 쓰기를 합니다. 판정 모델은 고르기만 합니다. 임베딩은 찾기만 합니다. 이 넷을 어떻게 이어 붙이느냐가 이 글의 설계도입니다.
1부. 문제를 종이에 적기: 주요 사건 하나, 여섯 칸, '없음' 허용
육하원칙 추출이 어려운 첫 번째 이유는 모델이 아니라 정의입니다. 한 기사에는 사건이 여러 개 들어 있고, '누가'는 문장마다 바뀝니다. 국정감사 기사라면 질문한 의원, 답한 장관, 기사가 다루는 사고의 가해자가 모두 '누가' 후보입니다. 그래서 이 글은 Giveme5W1H의 정의를 빌려 헤드라인이 가리키는 주요 사건 하나를 기준으로 삼았습니다.
칸
정의 (정의서에 적은 그대로)
자주 틀리는 지점
누가
주요 사건의 행위 주체(사람·기관·단체). 기사 표기 그대로의 짧은 명사구
기자 이름, 질문한 의원, 피해자를 주체로 고름
무엇을
주체가 한 행위 또는 일어난 일. 서술어를 포함한 짧은 구
제목을 통째로 복사하거나 기사 전체를 요약함
언제
사건 시점의 표현. 송고 시각이 아니라 사건 시각
"13일 밝혔다"의 13일을 사건 시각으로 봄, 행사 예정일과 발표일을 섞음
어디서
사건 장소. 데이트라인 "(광주=연합뉴스)"는 장소가 아님
데이트라인을 장소로 봄, 기관명을 장소로 봄
왜
원인·이유·동기가 기사에 명시된 경우만. 추론 금지
"의원 질의에 답했다"의 질의를 이유로 봄, 배경 설명을 이유로 지어냄
어떻게
방법·수단·방식이 명시된 경우만
장소나 행사명("국무회의에서")을 방법으로 봄
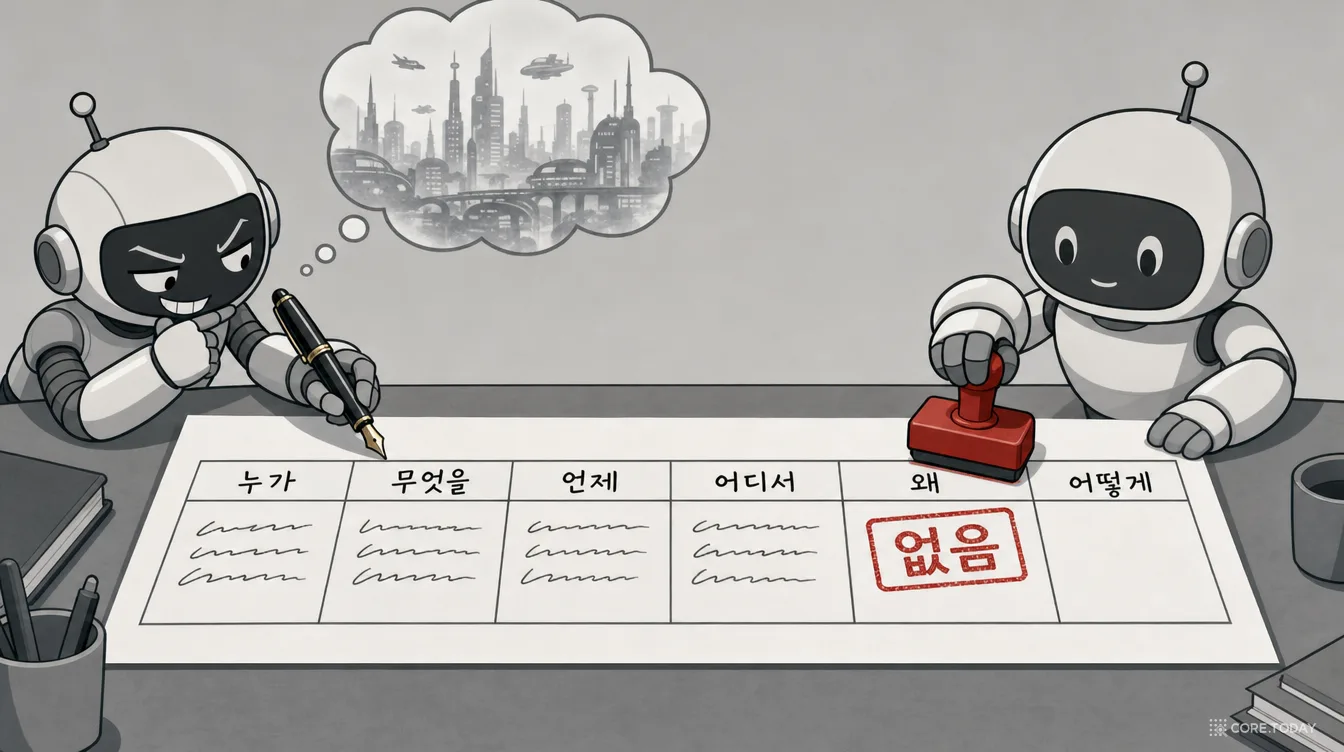
두 번째 이유는 빈칸입니다. 역피라미드의 꼭대기에는 누가·무엇을·언제·어디서가 거의 항상 있지만, 왜와 어떻게는 아래로 내려가거나 아예 없습니다. 검수를 끝낸 정답 72건에서 '왜'가 없는 기사가 61%, '어떻게'가 없는 기사가 63%, '어디서'가 없는 기사도 40%였습니다. 즉 이 과제의 절반은 "답을 찾는 일"이고 나머지 절반은 "없다고 말하는 일"입니다. 모델은 후자를 못 합니다. 빈칸을 보면 채우고 싶어 하기 때문입니다.
세 번째는 채점입니다. "흉기를 마구 휘둘러 이용객 8명이 다쳤다"와 "흉기를 휘둘러 8명이 다침"은 같은 답입니다. 이 글은 세 가지 자로 잽니다.
글자 F1: 공백·구두점·조사를 떼고 정답과 겹치는 글자의 비율. KorQuAD의 방식을 글자 단위로 쓴 것입니다. '무엇을'처럼 표현이 자유로운 칸에서는 0.6도 꽤 맞은 답입니다.
포함 일치: 한쪽이 다른 쪽을 품으면 1. "13일"과 "13일 오후 1시 40분께"는 포함 일치 1, 글자 F1 0.4입니다.
'없음' 정확도: 정답이 null인 칸을 null로 둔 비율. 왜·어떻게에서 가장 중요한 숫자입니다.
방법의 계보: 다섯 세대가 같은 질문에 답해 왔다
육하원칙 추출은 새 문제가 아닙니다. 방법이 바뀔 때마다 "무엇을 사람이 정하고 무엇을 기계가 정하는가"가 바뀌었을 뿐입니다.
세대
방식
육하원칙과의 연결
한국어에서의 문제
규칙·구문 (~2019)
Giveme5W1H: 구문 분석 + 개체명 + 리드문 위치 가중치
칸마다 후보를 뽑고 점수를 매겨 하나를 고름
영어 파서·규칙에 묶여 있어 그대로 옮길 수 없음
의미역 결정 (SRL)
서술어마다 행위자·대상·시간·장소·원인·방법 논항을 붙임
PropBank의 ARG0·ARG1·ARGM-TMP·LOC·CAU·MNR이 거의 여섯 칸과 일대일
공개 한국어 SRL 모델이 드물고, 주요 사건의 서술어를 고르는 문제는 남음
기계 독해 (2019~)
KorQuAD로 학습한 모델에 질문 하나당 구간 하나
"누가 ~했나?"를 여섯 번 물음
질문이 구체적이어야 함. 범용 질문에는 약함 (3부)
LLM 쓰기 (2023~)
정의서 + JSON 출력
여섯 칸을 한 번에 씀
빈칸을 지어냄, 송고일과 사건일 혼동 (3부)
판정 모델 (2026)
선택지 중 고르기·참일 확률
근거 문장 짚기, 후보 고르기, 부재 판정
쓰지 못함. 무엇에 붙일지가 관건 (4~6부)
이 글은 아래 네 세대를 같은 기사에 나란히 놓습니다. 의미역 결정은 쓸 만한 공개 한국어 모델을 찾지 못해 빠졌습니다.
2부. 재료: 기사 72건과 자원 열 가지
기사는 두 묶음입니다. 하나는 2026년 10월 13일 연합뉴스 RSS에서 사회·정치·경제·국제·문화·스포츠·지역 일곱 섹션을 돌며 뽑은 60건(섹션당 6~12건, 본문 400~1,500자, 인사·소식 모음과 자동 생성 기상 기사는 제외). 다른 하나는 2022년 7월 네이버 뉴스 요약 데이터셋에서 언론사가 겹치지 않게 고른 경제·IT 12건입니다. 전자는 "(인천=연합뉴스) 기자 = " 형식의 통신사 문체이고, 후자는 방송 원고와 신문 문체가 섞여 있어 형식에 대한 민감도를 볼 수 있습니다.
정답은 Gemini 3.8 Flash(사고 모드)가 정의서로 초안을 쓰고, 이 글을 쓴 Claude가 72건 432칸을 기사 원문과 대조해 16칸을 고친 것입니다. 고친 것은 대부분 '왜'였습니다. 초안은 "의원 질의에 답했다"의 질의를 이유로 적는 버릇이 있었고, 정의서대로 이유가 아니므로 null로 되돌렸습니다. 사람 둘이 독립적으로 단 정답이 아니라는 점, 그리고 정답 초안을 쓴 모델의 가족이 비교 대상에 들어 있다는 점은 이 글의 가장 큰 한계이며 결과를 읽을 때 계속 언급하겠습니다.
자원은 네 종류, 열 가지입니다.
손
자원
할 수 있는 일
어디서
자르기
KoELECTRA-base v3 (KorQuAD 미세조정, 110M)
질문을 주면 본문에서 구절 하나를 잘라 냄. 쓰지 못함
로컬 CPU, 질문 6개에 0.4초
찾기
EmbeddingGemma 300M (1편의 한국어 1위)
질문과 가장 가까운 문장을 찾음. 자르지 못함
로컬, 기사당 1초
쓰기
Qwen3.5 4B · 9B (사고 꺼짐, JSON 강제)
정의서를 읽고 여섯 칸을 씀
로컬, 기사당 5~7초
쓰기
Gemini 3.8 Flash (사고 꺼짐) · 3.5 Flash-Lite
같은 정의서로 씀
클라우드, 기사당 2~4초, 1만 건에 약 33달러 · 8.5달러
고르기
tev1 4B · Nimble 9B · Clef-Flash 27B · Jev 1.13
선택지 중 하나를 고르거나(choice) 참일 확률을 냄(noul). 쓰지 못함
로컬 셋 + 클라우드 하나(1만 건에 약 1.7달러)
Clef-Flash는 이 시리즈에 처음 나오는 이름입니다. 클라우드플레어가 2026년 10월에 낸 판정 모델로, Qwen3.8 27B를 바탕으로 하고 Ollama의 decision 기능으로 tev1·Nimble과 똑같은 요청을 받습니다. 쓰기 쪽의 로컬 27B(Qwen3.8 27B 채팅)는 이번에 빠졌습니다. 1,000토큰이 넘는 본문을 주면 Ollama의 MLX 실행기가 커널 스레드 한도를 넘겨 멈췄기 때문입니다(짧은 문장에서는 멀쩡했습니다). 그래서 로컬 쓰기는 Nimble의 바탕 모델인 Qwen3.5 9B와 tev1 4B의 바탕 모델인 Qwen3.5 4B가 맡았습니다. 판정 모델과 바탕 모델을 같은 기사에서 나란히 볼 수 있다는 점은 오히려 다행이었습니다.
쓰기 모델 넷에는 글자 하나 다르지 않은 같은 정의서를 주었고, 본문은 문장 번호를 붙여 넘겨 근거 번호도 함께 쓰게 했습니다. 판정 모델 넷에는 제목과 본문을 상태로 주고 질문만 바꿨습니다.
3부. 자르기와 쓰기: 독해 모델은 왜 무너졌고, 쓰기 모델은 어디서 갈렸나
점수표의 맨 아래 네 줄이 독해 모델입니다. 평균 F1 0.18~0.30. '누가'를 72건 중 49건 틀렸고, '언제'는 51건 틀렸습니다. 무엇을 잘라 왔는지 보면 이유가 보입니다. 가장 자주 나온 답은 "13일"(13번), 그다음이 "최소", "다소", "이미", "꾸준히", "어느덧", "급격히", "워낙" — 부사들입니다. KorQuAD로 학습한 독해 모델은 "임광현 국세청장은 누구의 지적에 반박했나?"처럼 본문의 표현을 그대로 품은 구체적 질문에 답하도록 훈련됐습니다. "이 기사의 주요 사건을 일으킨 주체는 누구인가?"는 그 모델에게 외국어입니다. 질문에 제목을 넣어 "'인천서 전자발찌 찬 50대 흉기난동…' 사건의 주체는 누구인가?"로 바꿔도('독해 + 제목 질문' 행) 평균이 0.02 오르는 데 그쳤습니다.
이 결과는 Giveme5W1H 글의 한 대목과 맞닿아 있습니다. 그 시스템이 구문 분석기와 개체명 인식기와 규칙을 열 겹 쌓은 이유가 바로 이것이었습니다. 범용 질문으로는 못 자른다. 2019년의 영어 시스템이 규칙으로 메운 자리를, 2026년의 한국어 110M 독해 모델도 혼자서는 못 메웁니다.
쓰기 모델 넷은 전혀 다른 그림입니다. 아래는 글자 F1입니다.
쓰기 모델
누가
무엇을
언제
어디서
왜
어떻게
평균
기사당
Gemini 3.8 Flash
0.90
0.85
0.94
0.94
0.73
0.80
0.86
3.6초
Gemini 3.5 Flash-Lite
0.84
0.69
0.90
0.75
0.70
0.71
0.77
1.8초
Qwen3.5 9B (로컬)
0.72
0.61
0.77
0.67
0.67
0.67
0.69
5.1초
Qwen3.5 4B (로컬)
0.75
0.59
0.72
0.61
0.62
0.63
0.65
6.6초
Flash가 1등인 것은 놀랍지 않습니다. 정답 초안을 같은 가족이 썼으니 표현이 닮을 수밖에 없고, 그 유리함은 글자 F1에 그대로 들어갑니다. 놀라운 것은 칸마다 격차의 모양이 다르다는 점입니다.
'언제'는 다 잘합니다. 4B도 0.72. 날짜 표현은 기사에서 모양이 정해져 있어 작은 모델도 집어냅니다. 9B가 틀린 15건을 하나씩 보면 세 종류입니다. 절반은 같은 날짜를 다르게 쓴 것입니다. 정답은 기사 표현 그대로 "이날"·"전날"인데 모델은 "13일"·"12일(현지시간)"로 풀어 썼습니다. 틀린 게 아니라 채점이 못 알아본 것입니다. 나머지 중 다섯 건 남짓이 발표일과 사건일의 혼동입니다. "지난달 28일 탄원서를 냈다"는 기사에서 "13일(취재일)"을, "26일 토론회를 연다"는 기사에서 "13일(발표일)"을 적었습니다. 나머지는 "내년 1월", "2028년까지"처럼 기사 속 다른 시점을 집은 경우입니다. Flash는 4건만 틀렸습니다.
'어디서'는 모델 크기가 가장 크게 갈립니다. Flash 0.94, Lite 0.75, 9B 0.67, 4B 0.61. 이유가 서로 다릅니다. Lite는 지어냈습니다(정답이 없는 29건 중 12건에 장소를 적음 — "스웨덴", "도쿄대", "수산발전기금"처럼 기관명이나 나라를 장소로). 4B는 포기했습니다(장소가 있는 43건 중 25건을 null로). 같은 0.6대라도 한쪽은 환각이고 한쪽은 결측입니다. 이 차이는 평균 점수에는 안 보이고 운영에서는 결정적입니다.
'왜'는 모두 0.7 아래이고, Flash가 유일하게 0.73입니다. 정답이 없는 기사 44건 중 Flash는 16건에 이유를 지어냈습니다. 반대로 4B는 한 건도 지어내지 않았지만 이유가 있는 28건 중 27건을 놓쳤습니다. 큰 모델은 대담하고 작은 모델은 소심합니다. 둘 다 그대로는 못 씁니다.
'무엇을'은 Lite가 유독 약합니다(0.69). Flash가 0.7 넘게 맞힌 13건을 Lite는 0.4 아래로 썼는데, 그 13건을 보면 Lite는 기사 전체를 요약했거나("기온이 급하강하고 내일 아침 대부분 지역 기온이 10도 이하에 그침") 두 번째 사건을 집었습니다("청문회 증인으로 불러달라고 요구했다" — 헤드라인 사건은 후보자 반대 입장). 리드문의 서술어 하나를 고르는 일은 생각보다 모델 크기를 탑니다.
기사별 탐색기는 '인천 흉기난동' 기사로 열립니다. 이 한 건에 이 글의 주제가 거의 다 들어 있습니다.
'어떻게': 정답은 열 번째 문장의 "양쪽 손에 흉기를 쥔 채 흰색 테이프로 묶어 고정한 상태로"입니다. 네 쓰기 모델 모두 그 문장을 찾아냈습니다. 다만 Flash만 그 구절에서 멈췄고, 나머지 셋은 "해당 건물 1층에서 곧장 엘리베이터를 타고 지상 2층 식당가로 이동한 뒤"처럼 뒤에 오는 동선까지 통째로 붙였습니다. 찾는 능력보다 멈추는 능력이 모델을 가릅니다.
'누가': 정답은 리드문의 "50대 남성"인데 9B와 4B는 세 번째 문장의 "A(59)씨"를 적었습니다. 같은 사람입니다. 글자 F1은 이것을 0점으로 매깁니다. 문자열 채점이 동일 인물의 다른 표기를 못 알아본다는 한계이고, 8부에서 다시 다룹니다.
'왜': 정답은 '없음'입니다. 쓰기 모델 넷은 모두 비워 뒀습니다. 그런데 5부에서 볼 Nimble과 tev1은 다섯 후보 중에서 독해 모델이 잘라 온 "50대 남성이 흉기를 마구 휘둘러"를 '왜'로 골랐습니다.
4부. 찾기 먼저: 문장을 맞게 골라도 구절은 틀린다
독해 모델이 추상적 질문에 약하다면, 앞에서 문장을 골라 주면 어떨까요. 기사 전체가 아니라 답이 들어 있는 문장 하나만 주면 고를 구절의 후보가 확 줄어듭니다. 이것이 '찾기→자르기' 세 줄입니다. 찾는 손은 셋입니다.
임베딩: EmbeddingGemma 300M으로 문장마다 벡터를 만들고, "제목: 이 사건의 주체는 누구인가" 같은 질문 벡터와 가장 가까운 문장을 고릅니다.
tev1 4B·Nimble 9B: 문장 목록을 선택지로 주고 "제목이 가리키는 주요 사건에 대해 '누가'에 해당하는 정보가 들어 있는 문장은?"을 choice로 묻습니다. 판정 모델의 선택지는 한 질문에 24~26개가 상한이라, 문장이 그보다 많으면 두 문장씩 묶었습니다.
먼저 찾기 자체는 얼마나 맞았을까요. 고른 문장(또는 묶음)에 정답 근거 문장이 들어 있었던 비율입니다.
찾는 손
누가
무엇을
언제
어디서
왜
어떻게
EmbeddingGemma 300M
0.60
0.60
0.54
0.40
0.39
0.11
tev1 4B (choice)
0.76
0.49
0.74
0.56
0.54
0.33
Nimble 9B (choice)
0.71
0.45
0.89
0.88
0.58
0.44
판정 모델이 임베딩보다 확실히 잘 찾습니다. 특히 '언제'와 '어디서'에서 Nimble은 열에 아홉을 맞혔습니다. 이것은 1편과 3편에서 본 결론과 같습니다. 임베딩은 "주제가 비슷한 문장"을 찾고, 판정 모델은 "이 질문에 답하는 문장"을 찾습니다. '어떻게'를 묻는 질문 벡터에 가장 가까운 문장은 대개 '어떻게'라는 단어와 비슷한 분위기의 문장일 뿐, 방법이 적힌 문장이 아닙니다(0.11). 흥미로운 예외는 '무엇을'입니다. 임베딩이 판정 모델보다 낫습니다. '무엇을'은 거의 항상 리드문에 있고, 제목과 가장 닮은 문장이 리드문이기 때문입니다.
그런데 구절까지 가면 이 장점이 거의 사라집니다. 맞는 문장을 받은 독해 모델도 '누가'를 0.43~0.46, '무엇을'을 0.10~0.12로 잘랐습니다. 문장 하나 안에서도 "이 사건의 주체"라는 질문이 무엇을 가리키는지 모르는 것은 그대로이기 때문입니다. 자르는 손을 Qwen3.5 4B로 바꿔 "이 문장에서 '누가'에 해당하는 구절만 그대로 복사하라, 없으면 null"로 시키면 사정이 나아집니다. Nimble이 고른 문장에서 4B가 복사한 '언제'는 0.75로, 같은 4B가 기사 전체를 받고 쓴 것(0.72)보다 오히려 높습니다. '누가'도 0.70으로 쓰기(0.75)에 가깝습니다. 리드문 네 칸에서는 찾기→복사가 쓰기와 거의 맞먹습니다. 문제는 나머지 칸입니다. '무엇을' 0.35, '어디서' 0.46, '왜' 0.19, '어떻게' 0.11로, 4B 쓰기(0.59·0.61·0.62·0.63)에 한참 못 미칩니다.
이유는 두 가지입니다. 첫째, 찾기가 틀린 문장을 넘기면 자르기는 회복할 수 없습니다. 둘째, 더 결정적으로, 찾기는 '없음'을 모릅니다. "답이 들어 있는 문장은?"이라는 choice 질문에는 반드시 하나를 골라야 하니, '왜'가 없는 기사에서도 어떤 문장이 넘어가고 그 문장에서 무언가가 잘려 나옵니다. '왜' 칸의 '없음' 정확도가 찾기→자르기 다섯 줄 모두 0.38~0.39, 즉 정답이 비어 있는 칸을 하나도 비우지 못했습니다. 4B에게 "문장에 그 정보가 없으면 null"이라고 분명히 일렀는데도, 문장 하나를 손에 쥐여 주면 무언가를 복사해 왔습니다. 문장을 건넨 것 자체가 "여기 답이 있다"는 신호가 된 셈입니다.
그러니 이 구조의 쓸모는 추출이 아니라 근거입니다. 쓰기 모델이 낸 값 옆에 "이 값은 몇 번째 문장에서 왔다"를 띄워 사람이 검수하게 하려면, 9B 판정 모델의 choice가 기사당 몇 초에 근거 문장을 열에 일고여덟 번 맞게 짚어 줍니다. 추출은 쓰기에게, 짚기는 고르기에게 맡기는 편이 낫습니다.
5부. 고르기: 판정 모델은 후보 중 정답을 알아보는가
판정 모델은 쓰지 못합니다. 그러면 쓰기 모델들이 낸 답을 선택지로 주면 어떨까요. 다섯 생성기(독해·4B·9B·Flash-Lite·Flash)의 '누가' 답이 서로 다르면 그것을 A~E로, 그리고 "기사에 명시되어 있지 않음"을 N으로 주고 하나를 고르게 합니다. 생성기가 모두 같은 답을 냈으면 판정을 건너뜁니다. 이것이 점수표의 '고르기' 행들입니다.
결과는 기대와 반대였습니다. 이 실험의 핵심 숫자는 상한입니다. 후보 다섯 중 정답에 가장 가까운 것을 매번 골랐다면 '누가'는 0.97, '왜'는 0.97, '어떻게'는 0.94까지 갑니다. 정답은 거의 항상 후보 안에 있었습니다. 그런데 판정 모델이 실제로 고른 답은 그 상한에서 한참 아래였고, 대부분 칸에서 Flash 단독보다도 낮았습니다.
칸 (글자 F1)
후보 중 최선 (상한)
Flash 단독
Jev 고르기
Nimble 고르기
tev1 4B 고르기
Clef-Flash 고르기
누가
0.97
0.90
0.81
0.78
0.79
0.79
무엇을
0.90
0.85
0.66
0.67
0.64
0.65
언제
1.00
0.94
0.81
0.75
0.76
0.78
어디서
1.00
0.94
0.63
0.73
0.64
0.72
왜
0.97
0.73
0.51
0.35
0.55
0.66
어떻게
0.94
0.80
0.45
0.43
0.40
0.67
무엇을 골랐는지 세어 보면 이유가 보입니다. 판정 모델들은 Flash의 답과 Flash-Lite의 답을 거의 같은 비율로 골랐습니다. 두 답은 대개 표현만 조금 다른 같은 구절이고("흉기를 마구 휘둘러 이용객 8명이 다쳤다" 대 "흉기를 휘둘러 8명이 다침"), 판정 모델에게 둘은 똑같이 그럴듯합니다. 차이가 드러나는 것은 한쪽이 틀린 사건을 집었을 때인데, 그때도 판정 모델은 "기사에 나오는 말인가"는 보지만 "헤드라인 사건의 그것인가"는 잘 가리지 못합니다. 독해 모델의 엉뚱한 답("다소", "이미")조차 다섯 판정 중 몇십 번씩 뽑혔습니다. 후보를 쓰기 모델 셋(Flash·Lite·9B)으로 줄이자 Jev의 평균이 0.64에서 0.74로 올랐습니다. 나쁜 후보를 빼 주는 것만으로 나아진다는 것은, 판정 모델이 나쁜 후보를 스스로 걸러 내지 못한다는 뜻입니다. 더 눈에 띄는 것은 그다음입니다. 후보가 셋일 때 네 판정 모델의 평균이 모두 0.74 근처로 모였습니다.
판정 모델
후보 5 (독해·4B 포함)
후보 3 (쓰기 셋)
참고: Flash 단독
tev1 4B
0.63
0.74
0.86
Nimble 9B
0.62
0.74
0.86
Clef-Flash 27B
0.71
0.74
0.86
Jev 1.13 (클라우드)
0.64
0.74
0.86
4B와 27B와 클라우드 모델의 차이가 사라졌습니다. 후보 구성이 판정 모델의 크기보다 결과를 더 많이 정했다는 뜻이고, 동시에 어떤 판정 모델도 후보 중 가장 좋은 답(Flash)을 꾸준히 골라내지 못했다는 뜻입니다. 고르기는 쓰기를 이기지 못했습니다.
가장 나쁜 칸은 '왜'입니다. Nimble이 다섯 후보에서 고른 '왜'는 글자 F1 0.35로 4B 단독(0.62)보다도 낮습니다. 선택지에 N("기사에 없음")이 있었는데도 판정 모델은 지어낸 이유 중 하나를 골랐습니다. 선택지에 그럴듯한 문장이 넷 있고 "없음"이 하나 있으면, 판정 모델은 문장 쪽에 확률을 몰아줍니다.
그런데 같은 Nimble에게 질문을 따로 하면 이야기가 달라집니다. "기사에 주요 사건의 원인이나 이유가 명시되어 있는가?"를 noul(참일 확률)로 물으면, 실제로 이유가 있는 기사와 없는 기사를 AUROC 0.85로 가릅니다. 같은 모델, 같은 기사, 같은 지식인데 "없음"을 선택지 하나로 끼워 넣으면 0.35, 독립된 예/아니오 질문으로 물으면 0.85. 이것이 이 글에서 판정 모델에 관해 얻은 가장 실용적인 교훈입니다. 부재는 선택지가 아니라 질문으로 물어야 합니다.
4편에서 Jev는 확률 보정이 가장 좋은 모델이었는데, 여기서 부재를 가르는 순위 능력(AUROC)은 로컬의 Clef-Flash와 Nimble이 더 높았고, Jev의 부재 확률을 Flash 뒤에 검문으로 붙였을 때는 '왜' 점수가 오르지 않았습니다(임계값 0.3·0.5 모두 0.73). Flash가 이유를 지어낸 16건 중 11건에 Jev는 0.5 넘는 '있음' 확률을 줬고, 낮은 확률로 지운 몇 건만큼 진짜 이유도 함께 지웠습니다. 보정(0.8이라 말했을 때 실제로 80%가 맞는가)과 순위(있는 기사에 없는 기사보다 높은 점수를 주는가)는 다른 능력이고, 부재 검문에 필요한 것은 후자입니다. 임계값은 어차피 우리 데이터로 다시 정해야 하기 때문입니다.
6부. 엮기: 무엇을 붙이면 실제로 나아지나
고르기가 쓰기를 못 이긴다면, 판정 모델은 어디에 붙여야 할까요. 세 가지 엮기를 시험했습니다.
1
다수결: Flash · Flash-Lite · 9B
칸마다 셋 중 둘 이상이 같은 답(공백·조사 무시)을 냈으면 그 답, 아니면 Flash의 답. 판정 모델 없이 쓰기 모델 셋만으로 만든 앙상블입니다. '왜'가 0.73 → 0.85, '왜'의 '없음' 정확도가 0.78 → 0.89로 올랐습니다. 셋 중 둘이 비워 두면 Flash가 지어낸 이유가 지워지기 때문입니다. 대신 '누가'·'어디서'는 0.03~0.04 내려갑니다.
2
Flash + 로컬 판정 모델의 부재 검문
Flash가 쓴 '왜'·'어떻게'를, 판정 모델이 "기사에 명시돼 있는가"에 준 noul 확률이 0.3 아래면 null로 되돌립니다. 검문을 Nimble(9B)이 서면 '왜'가 0.73 → 0.79, Clef-Flash(27B)가 서면 0.84로 오릅니다. '어떻게'는 0.80 → 0.77·0.75로 조금 내려갑니다. 평균은 0.859 → 0.864·0.870. 로컬 판정 모델 하나로 클라우드 쓰기 모델의 환각을 걸러 낼 수 있습니다.
3
9B + 로컬 부재 검문 (로컬만)
같은 검문을 로컬 9B에 붙이면 거의 바뀌지 않았습니다(Nimble 검문 0.685 → 0.685, Clef-Flash 검문 0.688). 9B가 지어낸 '왜' 일곱 건 중 여섯 건에 Nimble은 0.59 이상의 '있음' 확률을 줬습니다. 9B는 기사에 이유처럼 보이는 문장이 있을 때만 지어냈고, 그런 기사는 Nimble에게도 이유가 있어 보였습니다. 더 큰 문제는 9B의 손실이 환각이 아니라 누락(장소 16건, 이유 12건, 방법 19건을 비움)이라는 점이고, 검문은 누락을 고치지 못합니다.
정리하면, 판정 모델은 쓰기 모델의 '과잉'을 깎는 데 쓸모가 있고 '부족'을 채우는 데는 쓸모가 없습니다. 과잉이 문제인 큰 클라우드 모델에는 검문이 효과가 있고, 부족이 문제인 작은 로컬 모델에는 효과가 없습니다. 작은 모델의 누락을 메우려면 더 큰 쓰기 모델을 쓰거나, 쓰기 모델 여럿의 합집합을 취한 뒤 검문으로 깎는 순서가 맞습니다.
판정 모델의 크기가 차이를 만든 곳이 하나 있습니다. '없음'을 말하는 능력입니다. 이 시리즈에 처음 나온 Clef-Flash(27B)는 다섯 후보 고르기에서 N("기사에 없음")을 89번 골랐습니다. Nimble(9B)의 33번, tev1 4B의 45번보다 훨씬 많고, 그만큼 '왜'(0.66)와 '어떻게'(0.67)에서 다른 로컬 판정 모델보다 0.1~0.3 높았습니다. 부재 질문의 AUROC도 '왜' 0.87, '어떻게' 0.81로 넷 중 가장 높았습니다. 그래서 검문을 Clef-Flash로 바꾸면 Flash의 '왜'가 0.73에서 0.84로 오릅니다. 다만 '어떻게'는 0.80에서 0.75로 내려가는데, 방법이 짧게 스치듯 적힌 기사("기자회견을 열어", "자료를 통해")에서 판정 모델이 '명시돼 있지 않다'고 보는 경우가 많았기 때문입니다. 72건에서 이것을 보고 "검문은 '왜'에만 건다"고 정하면 점수는 더 오르겠지만, 같은 데이터로 규칙을 고르고 채점하는 일이라 이 글에서는 권하지 않고 사실만 적어 둡니다.
7부. 설계도: 제약에 따라 고르는 일곱 구성
여기까지의 숫자를 운영 결정으로 바꾸면 이렇습니다. 기사 1만 건 기준 비용은 이 글에서 잰 토큰 수에 공개 단가를 곱한 추정입니다.
정의서도 설계의 일부입니다. 이 실험에서 효과가 컸던 정의서 문장 몇 개를 그대로 옮깁니다.
정의서에서 효과가 컸던 문장
기준 사건
기사의 헤드라인이 가리키는 주요 사건 하나를 기준으로 한다.
언제
송고 시각이 아니라 사건 시각. 데이트라인 "(광주=연합뉴스)"는 사건 장소가 아니다.
왜·어떻게
기사에 명시되어 있을 때만. 추론하지 말 것. 없으면 null.
근거
각 항목에 그 값이 들어 있는 본문 문장 번호(0부터)를 적는다.
정의서 바깥에서 기계적으로 해결할 수 있는 일도 있습니다. '언제'의 정규화입니다. "이날", "전날", "오는 19일"은 기사 날짜만 알면 규칙으로 절대 날짜가 됩니다. 이 단계를 모델에게 맡기면 9B가 "13일"과 "이날"을 오가며 흔들리지만, 추출은 기사 표현 그대로 받고 정규화는 코드로 하면 두 가지가 섞이지 않습니다. 데이터베이스에는 두 값을 모두 저장합니다.
마지막 줄, 근거 번호는 공짜 검증 장치입니다. 쓰기 모델이 낸 값이 그 번호의 문장에 글자 그대로 들어 있는지 문자열 비교만 해도 지어낸 값의 상당수가 걸립니다. 그 번호 자체가 틀렸다면, 4부의 판정 모델 choice로 다시 짚게 하면 됩니다.
8부. 한계: 이 숫자들을 어디까지 믿을 수 있나
정답 초안을 Gemini 3.8 Flash가 썼습니다. 사고 모드로 쓴 초안을 432칸 대조해 16칸을 고쳤지만, 고치지 않은 칸의 표현은 Flash의 말투 그대로입니다. 사고를 끈 같은 Flash가 쓰기 1등인 데에는 이 유리함이 섞여 있습니다. 대신 기준점이 하나 있습니다. 같은 정의서로 Gemini 3.1 Pro가 따로 쓴 초안 17건을 최종 정답과 맞춰 보면 글자 F1이 누가 0.88, 무엇을 0.81, 언제 0.99, 어디서 0.96, 왜 0.76, 어떻게 0.81이었습니다. 다른 최상위 모델과 정답 사이의 거리가 이 정도이니, 0.85를 넘는 차이는 모델 차이라기보다 표현 차이로 읽는 편이 안전합니다.
사람 둘이 독립적으로 단 정답이 아닙니다. 검수는 한 명(이 글을 쓴 Claude)이 했고, '왜'의 경계("의원 질의에 답했다"는 이유인가)처럼 사람끼리도 갈릴 판단을 한쪽으로 정했습니다. 정의서를 바꾸면 '왜' 점수는 0.1 단위로 움직입니다.
채점은 문자열입니다. "50대 남성"과 "A(59)씨", "이날"과 "13일"은 같은 대상이지만 글자 F1과 포함 일치는 모두 0점을 줍니다. 이 손해는 기사 표현을 그대로 옮기지 않고 풀어 쓰는 모델(특히 9B·4B)에 몰립니다. LLM 채점자를 쓰면 이 문제는 줄지만, 채점자가 또 하나의 모델 편향이 됩니다. 이 글은 재현 가능한 문자열 채점을 택했고, 그 대가로 작은 모델의 점수가 실제보다 조금 낮게 나왔을 수 있습니다.
72건은 작습니다. 칸별 점수의 95% 신뢰구간은 대략 ±0.08입니다. 0.05 안쪽의 순위는 뒤집힐 수 있다고 보고 읽어 주세요. 섹션별로 쪼개면 더 작아지므로 섹션별 점수는 싣지 않았습니다.
로컬 27B 쓰기 모델이 빠졌습니다. Ollama 0.40.3의 MLX 실행기가 1,000토큰 넘는 입력에서 커널 스레드 한도 오류로 멈췄습니다. 고쳐지면 '로컬 쓰기'의 상한이 9B보다 올라갈 것입니다.
판정 모델의 지시문은 한 가지뿐입니다.4편에서 본 것처럼 로컬 판정 모델은 기준 설명을 붙이면 크게 달라집니다. 이 글의 고르기 질문은 짧은 한국어 한 줄이었고, 기준 설명을 정교하게 쓰면 고르기 점수가 오를 여지가 있습니다.
지연은 한 대의 맥북에서 잰 직렬 값입니다. 여러 모델을 동시에 띄운 상태라 서로 메모리를 다퉜고, 클라우드는 병렬 호출로 처리량을 쉽게 늘릴 수 있습니다.
연합뉴스 60건은 하루치입니다. 국정감사 기간이라 '누가 국감에서 무엇을 밝혔다' 기사가 많았고, 이런 기사에서는 '왜'의 경계가 특히 흐립니다. 사건·사고 기사가 많은 날에는 '어떻게'가, 경제 기사가 많은 날에는 '언제'의 예정·발표 혼동이 더 두드러질 것입니다.
맺으며: 여섯 칸은 네 종류의 손이 나눠 든다
Giveme5W1H는 2019년에 여섯 칸을 하나의 파이프라인이 다 채우려 했습니다. 2026년의 한국어 기사로 다시 해 보니, 여섯 칸은 성격이 너무 달라 한 손에 맡기기 아깝습니다.
누가·언제·어디서·무엇을은 쓰기의 몫입니다. 리드문에 거의 다 있고, 9B 로컬 모델도 '언제'를 0.77로 씁니다. 클라우드를 쓸 수 있다면 사고를 끈 Flash 한 번으로 충분합니다.
왜·어떻게는 쓰기만으로는 위험합니다. 절반 이상이 기사에 없는데 큰 모델은 지어내고 작은 모델은 놓칩니다. 이 두 칸에는 '없다'고 말할 줄 아는 장치, 즉 여러 쓰기 모델의 다수결이나 판정 모델의 부재 검문이 붙어야 합니다.
근거 문장은 고르기의 몫입니다. 판정 모델의 choice는 쓰지 못하지만 "어느 문장에 있느냐"를 임베딩보다 잘 짚습니다.
독해 모델(KorQuAD) 은 혼자서는 이 과제를 못 합니다. 질문이 구체적일 때만 빛나는 도구이고, 육하원칙의 질문은 추상적입니다.
3편에서 "임베딩은 찾고, 판정 모델은 고르고, LLM은 쓴다"고 적었습니다. 육하원칙 추출은 그 세 동사가 한 과제 안에서 칸별로 나뉘는 드문 예입니다. 무엇을 꺼낼지보다 무엇을 비워 둘지를 먼저 설계하는 것, 그것이 이 실험이 남긴 가장 실용적인 교훈입니다.
출처
Felix Hamborg, Corinna Breitinger, Bela Gipp. "Giveme5W1H: A Universal System for Extracting Main Events from News Articles." INRA Workshop at RecSys 2019. arXiv:1909.02766 — 이 블로그의 해설
Seungyoung Lim, Myungji Kim, Jooyoul Lee. "KorQuAD1.0: Korean QA Dataset for Machine Reading Comprehension." arXiv:1909.07005