지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
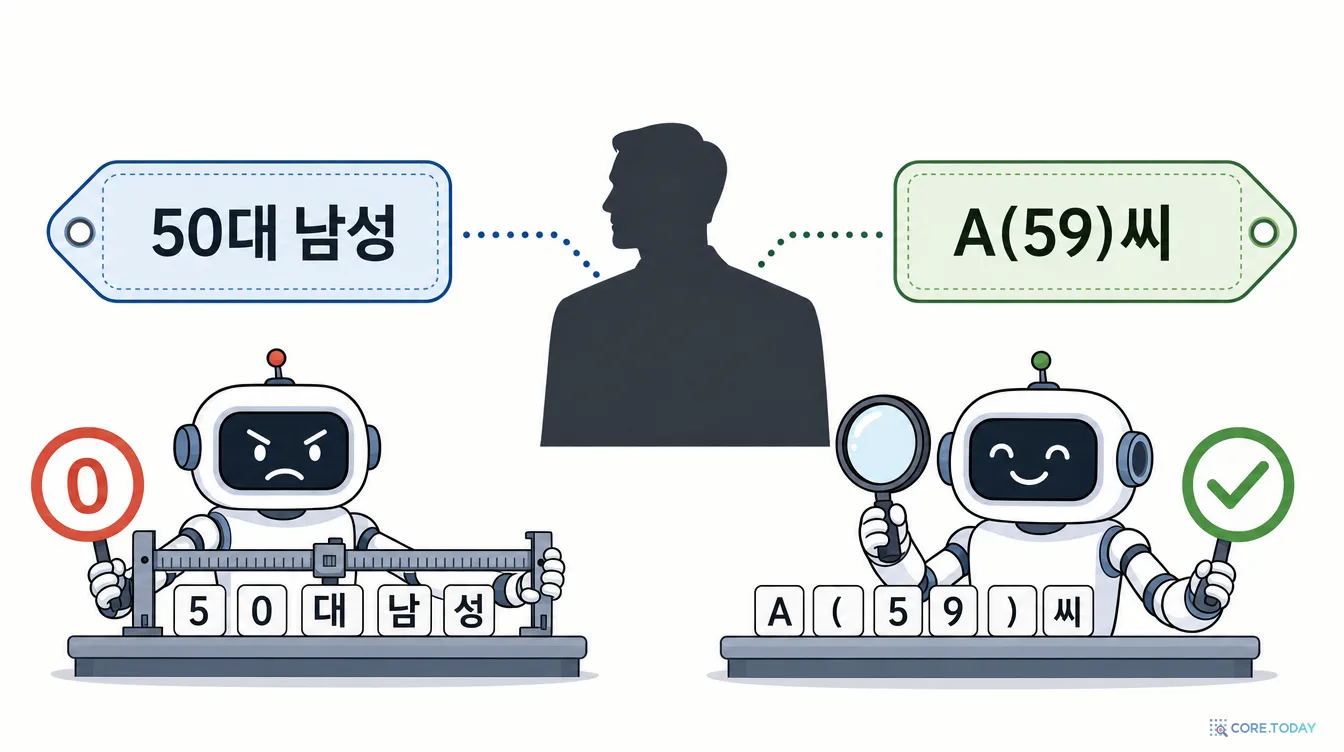
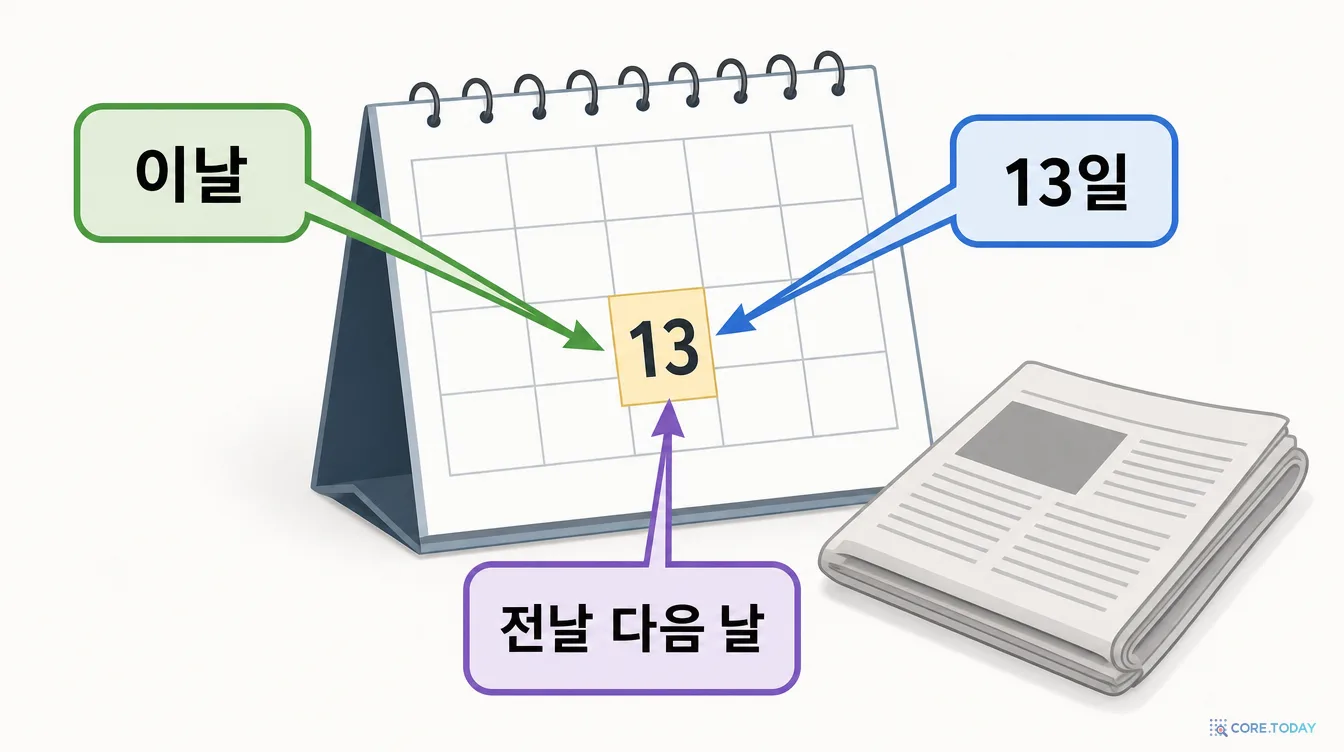
지난 글에서 인천 흉기난동 기사의 '누가'는 리드문의 "50대 남성"이었습니다. Qwen3.5 9B와 4B는 세 번째 문장의 "A(59)씨"를 적었습니다. 같은 사람입니다. 그런데 글자 F1은 이 답에 0점을 줬습니다. 겹치는 글자가 하나도 없기 때문입니다. 미국 놀이공원 사고 기사의 '언제'는 기사 표현 그대로 "이날 오후 4시"였고, 몇몇 모델은 "12일(현지시간)"이라 적었습니다. 이것도 같은 날입니다.
지난 글의 한계 절에 이 문제를 적어 두었습니다. "문자열 채점이 동일 대상의 다른 표기를 못 알아보며, 그 손해는 작은 모델에 몰렸을 수 있다." 그렇다면 질문은 둘입니다. 채점을 바꾸면 방법의 순위가 바뀌는가. 바뀐다면 지난 글의 결론, 예를 들어 "로컬 9B는 0.69, 클라우드 Flash는 0.86"이라는 격차가 자의 착시였다는 뜻이 됩니다. 그리고 무엇으로 채점해야 하는가. LLM에게 채점을 맡기면 표기 차이는 해결되지만, 채점자가 또 하나의 모델이 되어 자기 편향을 들여옵니다.
이 글은 지난 글의 24가지 방법이 낸 답을 하나도 바꾸지 않고, 채점만 아홉 가지로 다시 합니다. 결과를 먼저 말하면, 순위는 거의 바뀌지 않았고, 바뀐 것은 점수의 크기와 판사의 버릇이었습니다.
1부. 무엇을 다시 채점했나
지난 글의 24가지 방법은 기사 72건 × 여섯 칸 = 432칸에 답을 냈습니다. 같은 칸에서 여러 방법이 똑같은 답을 낸 경우를 하나로 합치면, 비어 있지 않은 서로 다른 답은 2,371개입니다. 한 칸에 평균 5.5개, 많게는 12개의 서로 다른 답이 있습니다. 이 2,371개를 아홉 가지로 채점했습니다.
종류
채점자
방식
비용·속도 (2,371개)
자
글자 F1
공백·구두점·조사를 뗀 뒤 겹치는 글자 비율 (지난 글의 기준)
0원, 즉시
자
포함 일치
한쪽이 다른 쪽을 품으면 1
0원, 즉시
자
글자 F1 + 날짜 정규화
'언제' 칸만 "이날·전날·지난 10일·12일(현지시간)"을 기사 날짜 기준 절대 날짜로 바꿔 비교
0원, 즉시
판사
Gemini 3.8 Flash
정답·기사·후보를 주고 맞음/부분/틀림 판정 (사고 꺼짐)
약 1.2달러, 칸당 2.7초
판사
Claude Sonnet 5.5
같은 프롬프트
약 3.6달러, 칸당 2.1초
판사
GPT-5.4 mini
같은 프롬프트 (추론 low)
약 0.8달러, 칸당 2.9초
판사
Qwen3.5 9B (로컬)
같은 프롬프트, Ollama
전기, 칸당 5초 남짓
판사
Jev 1.13
판정 모델. 후보마다 맞음/부분/틀림을 choice로
약 4센트, 칸당 0.2초
판사
Clef-Flash 27B (로컬)
Jev와 같은 choice 질문, Ollama decision
전기, 칸당 3초 남짓
판사에게는 칸 하나씩 줬습니다. 그 칸의 정답, 기사 원문(문장 번호), 그리고 그 칸에서 나온 서로 다른 후보 답 전부입니다. 후보끼리 비교하지 말고 정답과 기사에 비추어 하나씩 판정하라고 했습니다. 판정 기준은 이렇습니다.
판사에게 준 판정 기준 (요약)
맞음
정답과 같은 대상·사실을 가리킨다. 표현이 달라도 같은 것이면 맞다. 예: '50대 남성'과 'A(59)씨', '이날'과 '13일', '국회'와 '국회 보건복지위원회 국정감사'.
부분
정답의 일부만 담았거나, 정답을 담았지만 다른 정보를 크게 덧붙였다.
틀림
다른 대상·사건·시점이거나, 기사에 없는 내용이거나, 의미 없는 조각이다.
정답이 '없음'인 칸
값을 냈다면 원칙적으로 틀림. 단, 기사에 분명히 있어 정답이 틀렸다고 확신하면 맞음으로 하고 '정답 의심' 표시.
점수로 바꿀 때는 맞음 1, 부분 0.5, 틀림 0으로 셌습니다. 답이 비어 있는 칸은 채점자와 상관없이 정답도 비어 있으면 1, 아니면 0입니다.
기준점도 필요합니다. 판사들끼리 비교만 하면 누가 옳은지 알 수 없으니, 2,371개 중 234개를 층화 표본으로 뽑아 원문과 대조해 직접 판정했습니다. 칸마다 글자 F1 구간(1, 0.5 이상, 0.5 미만, 정답 없음)별로 정해진 수를 무작위로 뽑았고, 판정할 때는 어느 판사의 결과도 보지 않았습니다. 판정한 것은 이 글을 쓴 Claude입니다. 사람이 아니고, Claude 판사와 같은 가족이라는 점은 결과를 읽을 때 계속 감안해야 합니다. 234개 중 맞음 116, 부분 27, 틀림 84였고, 7개는 "후보가 맞고 정답이 오히려 의심스럽다"로 따로 표시했습니다.
24가지 방법을 채점자마다 따로 줄 세우고, 글자 F1 순위와 얼마나 같은지 켄달 순위 상관으로 쟀습니다. 1이면 순서가 똑같고, 0이면 무관합니다.
채점자
글자 F1 순위와의 상관
세 판사 중앙값과의 상관
글자 F1 + 날짜 정규화
1.00
0.99
포함 일치
0.98
0.96
Gemini 판사
0.98
0.99
Claude 판사
0.96
0.98
GPT 판사
0.96
0.98
Jev 판사
0.96
0.96
Qwen 9B 판사 (로컬)
0.88
0.87
Clef-Flash 판사 (로컬)
0.88
0.89
클라우드 판사 셋과 Jev는 글자 F1과 0.96~0.98로 같은 줄을 세웠습니다. 아홉 채점자 누구로 재도 맨 위 넷(Flash와, Flash에 검문·다수결을 붙인 셋)은 맨 위였고, 맨 아래 일곱(독해 모델과 찾기→자르기 계열)은 맨 아래였습니다. 지난 글의 결론 "클라우드 쓰기가 로컬 쓰기보다, 쓰기가 고르기보다, 고르기가 자르기보다 낫다"는 자를 바꿔도 그대로입니다.
움직인 것은 가운데입니다. 평균이 0.02~0.05 안에 몰려 있는 '후보 3 중 고르기' 네 줄과 로컬 쓰기 줄들이 채점자마다 한두 칸씩 자리를 바꿨습니다. 지난 글에서 "후보가 셋이면 판정 모델 넷이 모두 0.74 근처로 모였다"고 썼는데, 이번 결과는 그 넷 사이의 순서에는 의미가 없다는 것을 다시 확인해 줍니다. 판사마다 순서가 달랐습니다.
예외는 로컬 판사 둘입니다. Qwen 9B 판사와 Clef-Flash 판사는 글자 F1과의 상관이 0.88~0.88로 내려갔습니다. 이 둘로 재면 '후보 다섯 중 고르기'가 네다섯 계단씩 올라가고(Jev 15→11위, tev1 4B 16→12위), Flash-Lite는 5위에서 8위(Qwen 판사)·10위(Clef 판사)로 내려갔습니다.
줄은 그대로였지만 점수는 달라졌습니다. 세 판사(Gemini·Claude·GPT)의 중앙값으로 재면 쓰기 모델들은 모두 0.02~0.05 올랐고, 독해 모델 계열은 오히려 0.01~0.02 내려갔습니다.
방법
글자 F1
날짜 정규화
세 판사 중앙값
차이
Gemini 3.8 Flash 쓰기
0.860
0.859
0.883
+0.024
Gemini 3.5 Flash-Lite 쓰기
0.766
0.769
0.800
+0.034
Qwen3.5 9B 쓰기
0.685
0.694
0.723
+0.039
Qwen3.5 4B 쓰기
0.654
0.660
0.694
+0.040
KoELECTRA 독해
0.184
0.195
0.169
−0.015
작은 모델이 더 많이 되찾은 것은 맞습니다. 그러나 그 크기는 작습니다. Flash와 9B의 격차는 글자 F1로 0.175, 세 판사 중앙값으로 0.160입니다. 0.015만큼이 자의 착시였고, 나머지 0.16은 진짜 차이입니다. Flash와 4B의 격차도 0.205에서 0.189로 줄었을 뿐입니다. 지난 글의 "로컬 9B 0.69, 클라우드 0.86"은 판사로 재면 "0.72와 0.88"이 되고, 격차의 크기는 거의 그대로입니다.
점수가 어디서 돌아왔는지 칸별로 보면 더 분명합니다.
'무엇을'이 가장 많이 돌아왔습니다. 4B가 0.59에서 0.74로, 9B가 0.61에서 0.74로, Flash도 0.85에서 0.92로 올랐습니다. '무엇을'은 서술어를 포함한 구라 표현이 자유롭습니다. "'이재명 황제골프 특검법(안)'을 발의한다고 밝혔다"와 "'이재명 황제골프 특검법 (안)'을 발의한다"는 같은 답인데, 글자 F1은 꼬리 몇 글자 때문에 점수를 깎습니다.
'언제'는 규칙 몇 줄로 대부분 돌아옵니다. "이날"을 그 기사에서 앞서 나온 날짜로, "전날"을 그 하루 전으로, "지난 10일"을 지난달 또는 이달 10일로 바꾸는 정규화만으로 9B의 '언제'가 0.77에서 0.83으로 올랐습니다. 판사 중앙값(0.81)보다 오히려 높습니다. 같은 일을 하는 데 판사가 필요 없습니다.
'왜'·'어떻게'는 거의 그대로입니다. 이 칸의 점수는 대부분 '없음'을 맞혔느냐로 정해지고, 비어 있는 답은 어느 채점자에게나 같은 점수를 받기 때문입니다.
독해 모델의 조각은 더 깎였습니다. 글자 F1은 글자만 겹치면 부분 점수를 줍니다. 정답 "13일"에 "14일"을 낸 답이 0.67을, 정답 "고흥군 체육회"에 "체육회장 아내"를 낸 답이 0.5를 받았습니다. 둘 다 틀린 답이고, 세 판사 모두 틀림을 줬습니다. 글자 F1의 오차는 작은 모델을 깎는 쪽만이 아니라 엉뚱한 조각을 봐주는 쪽으로도 납니다.
줄이 같아도 칸 하나하나의 판정이 맞는지는 다른 문제입니다. 검수 표본 234개에서 각 채점자의 판정이 검수와 얼마나 같았는지 봤습니다. 문자열 점수는 0.8 이상을 맞음, 0.4 이상을 부분, 그 아래를 틀림으로 끊었습니다.
채점자
가중 카파
맞음/아님 일치율
검수보다 엄격
검수보다 관대
Gemini 판사
0.90
0.89
13%
1%
세 판사 중앙값
0.86
0.86
15%
0%
Claude 판사
0.83
0.81
20%
1%
GPT 판사
0.81
0.81
21%
1%
Jev 판사
0.81
0.77
23%
4%
Clef-Flash 판사 (로컬)
0.80
0.82
10%
11%
Qwen 9B 판사 (로컬)
0.73
0.80
19%
7%
글자 F1 + 날짜 정규화
0.73
0.77
7%
1%
글자 F1
0.69
0.76
8%
1%
포함 일치
0.61
0.77
18%
9%
세 가지가 보입니다.
문자열 자는 판사보다 확실히 검수와 덜 닮았습니다. 글자 F1의 가중 카파는 0.70, 날짜를 정규화해도 0.73입니다. 클라우드 판사는 0.81~0.90입니다. 순위는 같아도, 칸 단위로 "이 답이 맞았나"를 물으면 문자열은 열에 두세 번 다른 대답을 합니다.
모든 판사가 검수보다 엄격했습니다. 검수보다 반 단계 이상 낮게 매긴 비율이 13~23%이고, 높게 매긴 비율은 1~6%입니다. 판사들은 "국회 행정안전위원회"를 "국회 행정안전위원회의 경기남·북부경찰청 국정감사"의 맞는 답으로 보지 않고 부분으로 봤습니다. 판정 기준에 "'국회'와 '국회 보건복지위원회 국정감사'는 같은 대상"이라는 예를 넣었는데도 그랬습니다. 엄격함 자체가 나쁜 것은 아닙니다. 다만 판사의 절대 점수를 "정확도"로 읽으면 실제보다 낮게 읽게 됩니다.
Gemini 판사가 검수와 가장 닮았습니다(0.90). 그런데 이것을 "Gemini가 가장 좋은 판사"로 읽으면 안 됩니다. 이 데이터의 정답 초안을 Gemini 3.8 Flash가 썼고, 검수는 그 초안의 경계를 기준으로 했습니다. 정답과 같은 눈을 가진 판사가 정답과 같은 판정을 내리는 것은 당연합니다. 검수를 한 Claude와 같은 가족인 Claude 판사가 1등이 아니라는 점은, 적어도 검수자의 가족 편향이 결과를 지배하지는 않았다는 방증입니다.
판정이 갈린 칸을 하나씩 보면 어디서 갈리는지 보입니다. 클라우드 판사 셋과 Jev의 판정이 반 단계 이상 갈린 칸은 표본의 '왜' 40개 중 15개, '누가' 12개, '어디서' 11개였습니다. 판정 기준에 예로 넣은 바로 그 경우, 정답 "국회 보건복지위원회 국정감사"에 "국회"라고 쓴 답에도 Gemini·Claude 판사는 맞음을, GPT·Jev 판사는 부분을 줬습니다. 예시를 줘도 판사마다 받아들이는 정도가 다릅니다.
5부. 판사의 버릇
LLM 판사에 대해 가장 많이 거론되는 걱정은 자기 선호입니다. 자기와 같은 모델, 같은 가족이 쓴 답을 후하게 준다는 것입니다. 이 데이터는 그것을 재기에 좋은 구조입니다. 쓰기 모델 중 Gemini 가족(Flash·Flash-Lite)과 Qwen 가족(9B·4B)이 있고, 판사에도 Gemini와 Qwen 가족(Qwen 9B, 그리고 Qwen3.8 27B를 바탕으로 만든 Clef-Flash)이 있습니다.
같은 답을 두고, 한 판사가 다른 판사들의 평균보다 몇 점 후하게 줬는지를 답의 출신별로 쟀습니다. 비교 대상은 Gemini·Claude·GPT 판사 중 자신을 뺀 나머지입니다.
판사
Gemini가 쓴 답
Qwen이 쓴 답
독해 모델 조각
자기 가족 선호
Gemini 판사
+0.059
+0.023
+0.002
+0.036
Claude 판사
-0.051
-0.026
-0.007
해당 없음
GPT 판사
-0.008
+0.003
+0.004
해당 없음
Jev 판사
-0.064
-0.006
+0.014
해당 없음
Qwen 9B 판사 (로컬)
+0.047
+0.136
+0.052
+0.089
Clef-Flash 판사 (로컬)
+0.125
+0.188
+0.064
+0.063
Gemini 판사는 Gemini의 답에 다른 판사보다 0.06 후했고, Qwen의 답에는 0.02 후했습니다. 원래 다른 판사보다 조금 관대한 판사인데, 제 가족 앞에서 0.04가 더 관대해졌습니다.
Qwen 계열 판사 둘은 더 뚜렷했습니다. Qwen 9B 판사는 Qwen의 답에 다른 판사보다 +0.14, Gemini의 답에는 +0.05를 줬습니다. 제 가족 쪽으로 0.09만큼 기울었습니다. Clef-Flash는 모든 답에 관대한 판사인데(Gemini 답 +0.12), Qwen의 답에는 그보다 더 관대해 +0.19를 줬습니다.
Claude·GPT 판사는 어느 쪽도 감싸지 않았습니다. 두 가족 모두 이 데이터에 쓰기 모델이 없으니 감쌀 식구가 없습니다. 오히려 Claude 판사는 Gemini의 답에 다른 판사보다 0.05 엄격했습니다. Jev도 Gemini의 답에 0.06 엄격했습니다. Gemini·GPT 판사가 맞음을 줬는데 Jev만 부분을 준 Gemini 답 25개는 평균 41자로, Gemini 답 전체 평균 27자보다 길었고 16개가 '무엇을'이었습니다. Jev는 기사 문장을 길게 옮긴 답을 "다른 정보를 크게 덧붙였다"로 본 셈입니다.
0.04~0.09는 작아 보이지만, 지난 글에서 고르기 모델 넷의 차이가 0.01 안쪽이었다는 것을 떠올리면 순위를 뒤집기에 충분한 크기입니다. 다만 로컬 판사가 줄을 흔든 방식은 단순한 제 식구 감싸기와 달랐습니다. Qwen 9B 판사로 재면 Qwen 쓰기 모델의 순위는 오히려 내려갔고(9B 12→14위, 4B 14→17위), 독해 모델의 조각까지 후보로 섞인 '후보 다섯 중 고르기'가 올라갔습니다. 이 판사는 Qwen의 답에도 후했지만 독해 모델의 조각에도 다른 판사보다 0.05 후했습니다. 관대함의 방향이 출신 하나로 설명되지 않는다는 뜻이고, 그래서 로컬 판사로 줄을 세우면 예측하기 어려운 방향으로 줄이 바뀝니다. 그리고 다음 글에서 할 실험, Gemini가 쓴 답으로 로컬 모델을 가르치는 실험에서는 Gemini 판사로 채점하면 안 된다는 뜻이기도 합니다. 학생이 선생님 말투를 배울수록 Gemini 판사는 점수를 더 줄 것이기 때문입니다.
판정 기준에는 "정답이 틀렸다고 확신하면 표시하라"는 문장을 넣었습니다. 2,371개 중 Gemini 판사는 22개, Claude 판사는 17개, GPT 판사는 39개에 표시했습니다. 셋 중 둘 이상이 같은 답에 표시한 것은 10개였고, 모두 정답이 '없음'인 칸이었습니다. 칸으로 묶으면 네 칸입니다.
기사
칸
정답
판사들이 맞다고 본 답
근거 문장
코아시아 그룹 지배구조 개편
왜
없음
그룹사 전반 기업가치 제고를 위해
"탄탄한 지배구조를 기반으로 그룹사 전반 기업가치 제고를 위해 힘쓸 것"
충북도 민생경제 정책 수립
왜
없음
지역경제 전반에 활력을 불어넣는 게 최종 목표
"지원을 강화해 지역경제 전반에 활력을 불어넣는 게 최종 목표"
사우디, 후티 미사일 조사 착수
왜
없음
공항 공격으로 대형 인명피해가 나자
"대형 인명피해가 나자 방공 태세의 심각성을 자각한 것으로 보인다"
SR 탈선 사고 보상
어디서
없음
대전조차장역 인근
"대전조차장역 인근에서 일어난 탈선사고에 따른 승객 피해를 보상 중이다"
다시 읽어 보니 네 칸 모두 판사 쪽이 맞습니다. 지난 글의 정답은 "이유가 명시되어 있을 때만"이라는 정의를 엄격하게 적용해, 목적을 밝힌 문장("~을 위해 힘쓸 것", "~게 최종 목표")과 기자의 해석("~한 것으로 보인다")을 이유로 치지 않았습니다. 사건 장소도 "보상"이라는 행위의 장소가 아니라는 이유로 비웠습니다. 둘 다 정의서를 한쪽으로 읽은 결과입니다.
검수 표본에서 저도 7개 답에 "정답이 의심스럽다"는 표시를 했는데, 판사가 표시한 것과 겹친 것은 2개뿐입니다. 판사와 검수자가 의심하는 지점이 달랐다는 뜻이고, 정답 하나를 두 눈 이상으로 보는 것이 왜 필요한지 보여 줍니다.
이 발견은 지난 글의 숫자 하나를 고칩니다. 지난 글은 "Flash는 이유가 없는 기사의 36%(44건 중 16건)에 이유를 지어냈다"고 썼습니다. 판사들이 의심한 '왜' 세 칸을 '있음'으로 바꾸면 이유가 없는 기사는 41건, 그중 Flash가 지어낸 것은 14건(34%)입니다. 결론이 뒤집히지는 않지만, '왜'의 정답은 다른 칸보다 흔들리는 땅 위에 있습니다.
7부. 그래서 무엇으로 채점할까
이 실험을 추출 과제의 채점 지침으로 바꾸면 이렇습니다.
1
방법을 줄 세울 때는 문자열로 충분하다
글자 F1과 세 판사 중앙값의 순위 상관은 0.99였습니다. 공짜이고, 재현되고, 버릇이 없습니다. 방법 A와 B 중 무엇이 나은지 고르는 일이라면 판사를 부를 이유가 거의 없습니다. 단, 평균 차이가 0.02 안쪽인 방법끼리는 어떤 자로도 가르지 마세요.
2
'언제'는 판사가 아니라 규칙으로
기사 날짜와 본문의 앞선 날짜를 기준으로 "이날·전날·지난 N일·N일(현지시간)"을 절대 날짜로 바꾸는 규칙 40여 줄이 판사만큼 점수를 되찾았습니다. 저장할 때도 이 규칙을 그대로 쓰면 됩니다.
3
점수를 "정확도"로 말하려면 판사 여럿의 중앙값을
칸 단위 판정은 문자열보다 판사가 훨씬 정확합니다. 다만 판사 하나는 제 가족을 감싸고, 판사마다 엄격함이 다릅니다. 평가 대상과 다른 가족의 판사 둘 이상을 쓰고 중앙값을 취하세요. 이 실험에서 2,371개 답을 세 판사로 채점하는 데 든 돈은 약 5.6달러였습니다.
상황
추천 채점
피할 것
프롬프트·모델 A/B 비교
글자 F1 + 날짜 정규화
0.02 안쪽 차이로 결론 내기
"이 시스템은 몇 % 맞힌다"를 보고
평가 대상과 다른 가족의 클라우드 판사 2~3개 중앙값
평가 대상과 같은 가족의 판사 하나
Gemini 출력으로 학습한 모델 평가 (다음 글)
Claude·GPT 판사 + 글자 F1
Gemini 판사
로컬만 쓸 수 있는 환경
글자 F1 + 날짜 정규화. 로컬 판사는 표본 점검용으로만
로컬 판사로 순위 매기기
정답셋을 만들 때
판사 여럿에게 "정답 의심" 표시를 받아 다시 검수
한 사람·한 모델의 초안을 그대로 쓰기
8부. 한계
검수자는 사람이 아니라 이 글을 쓴 Claude입니다. 같은 기준으로 꼼꼼히 판정했지만, 사람 둘이 독립적으로 판정해 일치도를 잰 것은 아닙니다. 검수자와 같은 가족인 Claude 판사가 검수와의 일치에서 1등이 아니었다는 점이 가족 편향이 크지 않다는 방증이지만, 증명은 아닙니다.
표본은 234개입니다. 칸별로 40개 남짓이라 칸별 일치율의 오차는 ±0.1 안팎입니다.
판정 기준이 결과를 움직입니다. "국회"를 "국회 보건복지위원회 국정감사"의 맞는 답으로 볼지는 기준이 정하는 일이고, 판사마다 그 예시를 받아들이는 정도도 달랐습니다. 다른 기준을 쓰면 절대 점수는 달라집니다. 순위가 바뀔지는 이 실험이 말해 주지 않습니다.
판사는 칸 단위로 후보를 한꺼번에 봤습니다. 후보끼리 비교하지 말라고 했지만, 같은 칸의 다른 후보가 판정에 영향을 줬을 수 있습니다. 대신 이 방식이 후보를 하나씩 보내는 것보다 다섯 배쯤 쌉니다.
자기 선호는 두 가족에서만 쟀습니다. 쓰기 모델에 Claude·GPT가 없어 그 두 판사의 자기 선호는 잴 수 없었습니다.
맺으며: 자는 줄을 세우고, 판사는 칸을 읽는다
지난 글의 결론은 자를 바꿔도 살아남았습니다. 클라우드 Flash와 로컬 9B 사이 0.16의 격차는 진짜였고, 독해 모델이 이 과제에 맞지 않는다는 것도 진짜였습니다. 대신 이번에 새로 알게 된 것이 있습니다. 자가 깎은 점수는 '무엇을'에 몰려 있었고, '언제'의 손해는 규칙으로 되돌릴 수 있었으며, 판사는 제 가족을 조금씩 감쌌습니다. 그리고 정답이라는 것 자체가 '왜'에서는 판사보다 덜 믿을 만했습니다.
다음 글은 이 채점 지침을 들고 로컬 모델을 가르칩니다. Flash가 쓴 답 1,700개로 로컬 4B 모델을 가르쳐 0.16의 격차를 얼마나 줄일 수 있는지를, Gemini가 아닌 판사들로 잽니다.