사건 묶기이벤트 상호참조뉴스 클러스터링육하원칙5W1H사건 레코드시간장소블로킹JevOpenAI DecisionsGeminiEmbeddingGemmaQwen3-EmbeddingNimbleClefB-cubed한국어 NLP실측 벤치마크
같은 사건 묶기 2편 — 25개 언론사 하루치 2,766건, 시간·장소·사건 레코드는 어디까지 도와주는가
1편은 연합뉴스 하루치 603건에서 '육하원칙 칸 일치 규칙'이 같은 사건 쌍의 3분의 1도 못 찾는다고 끝났습니다. 그러면 육하원칙은 어떻게 써야 하고, 시간과 장소는 정말 도움이 될까요. 이번에는 통신사·방송·전국지·지역지 25곳의 2026년 10월 21일 기사 2,766건을 모아 후보 쌍 20,259개에 정답을 달고(LLM 판사 셋의 다수결과 직접 검수), 기사마다 Gemini로 '사건 레코드'(유형·행위·역할이 붙은 참여자·정규화된 날짜·시군구)를 뽑아 네 가지로 썼습니다. 후보를 찾는 블로킹 키로, 임베딩할 요약으로, 판정 모델의 입력으로, 그리고 '다를 수 없다'를 잘라내는 거부 조건으로. 결과는 선명하게 갈렸습니다. 참여자 이름 블로킹은 임베딩 이웃이 놓친 같은 사건 쌍 13.5%를 건졌고, 사건 요약 임베딩은 제목 임베딩보다 쌍 F1이 0.78에서 0.81로 올랐습니다. 그러나 시간·장소 거부 조건은 처음 설계대로면 같은 사건의 25%를 잘라 버렸고, 고친 뒤에도 좋은 판정 모델 위에서는 14쌍을 바로잡고 75쌍을 잘못 자르는 손해였습니다. 가장 잘 가른 것은 역시 판정 모델이었습니다. Jev 원문 입력 AUROC 0.982, 1편에 없던 OpenAI Decisions는 사건 레코드 입력에서 쌍 F1 0.848·묶음 F1 0.956으로 가장 높았습니다. 그리고 묶음을 가장 크게 망친 것은 모델이 아니라 '오늘의 8뉴스 예고' 같은 다이제스트 기사였습니다. 점수표·묶음 게시판·문턱값 탐색기·거부 조건 분해·원문 대 레코드·파이프라인 설계기 위젯 6개.
코어닷투데이는 1편에서 2026년 10월 13일 연합뉴스 기사 603건을 같은 사건끼리 묶어 봤습니다. 결론은 둘이었습니다. 같은 사건과 같은 이야기의 다른 사건을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 가장 자연스러워 보였던 방법, 즉 두 기사의 '누가·무엇을·어디서'가 같으면 같은 사건으로 보는 육하원칙 규칙은 같은 사건 쌍의 32%만 찾았습니다. 같은 사람이 "A(59)씨"와 "50대 남성"으로 불리고, 피해자 기사와 의인 기사의 '누가'가 서로 다르기 때문이었습니다.
그 글을 읽은 분들이 되물은 질문이 이 글의 출발점입니다. 그러면 육하원칙은 어떻게 써야 하는가. 그리고 시간과 장소, 즉 temporal·spatial 정보를 쓰면 더 나아지는가.
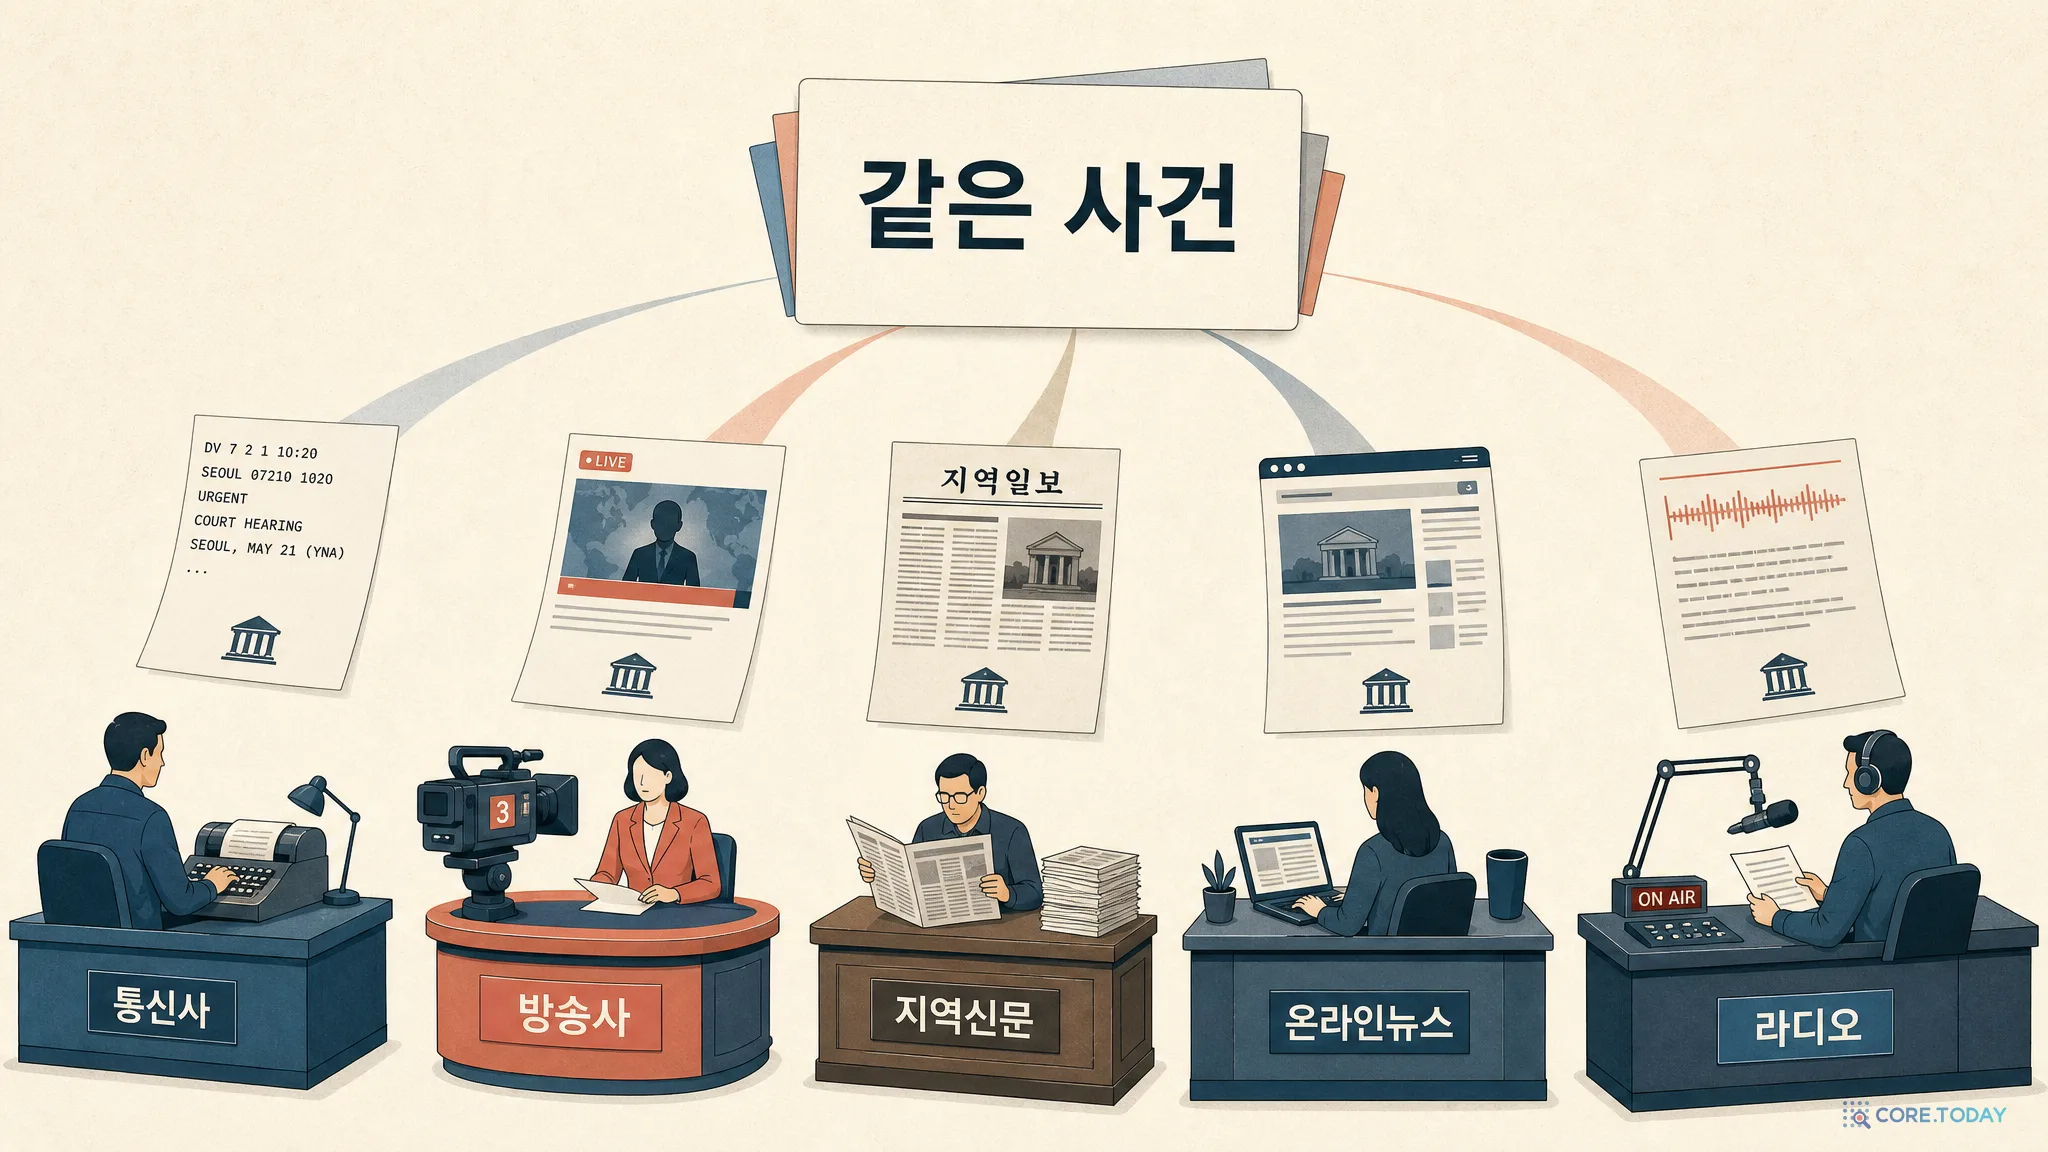
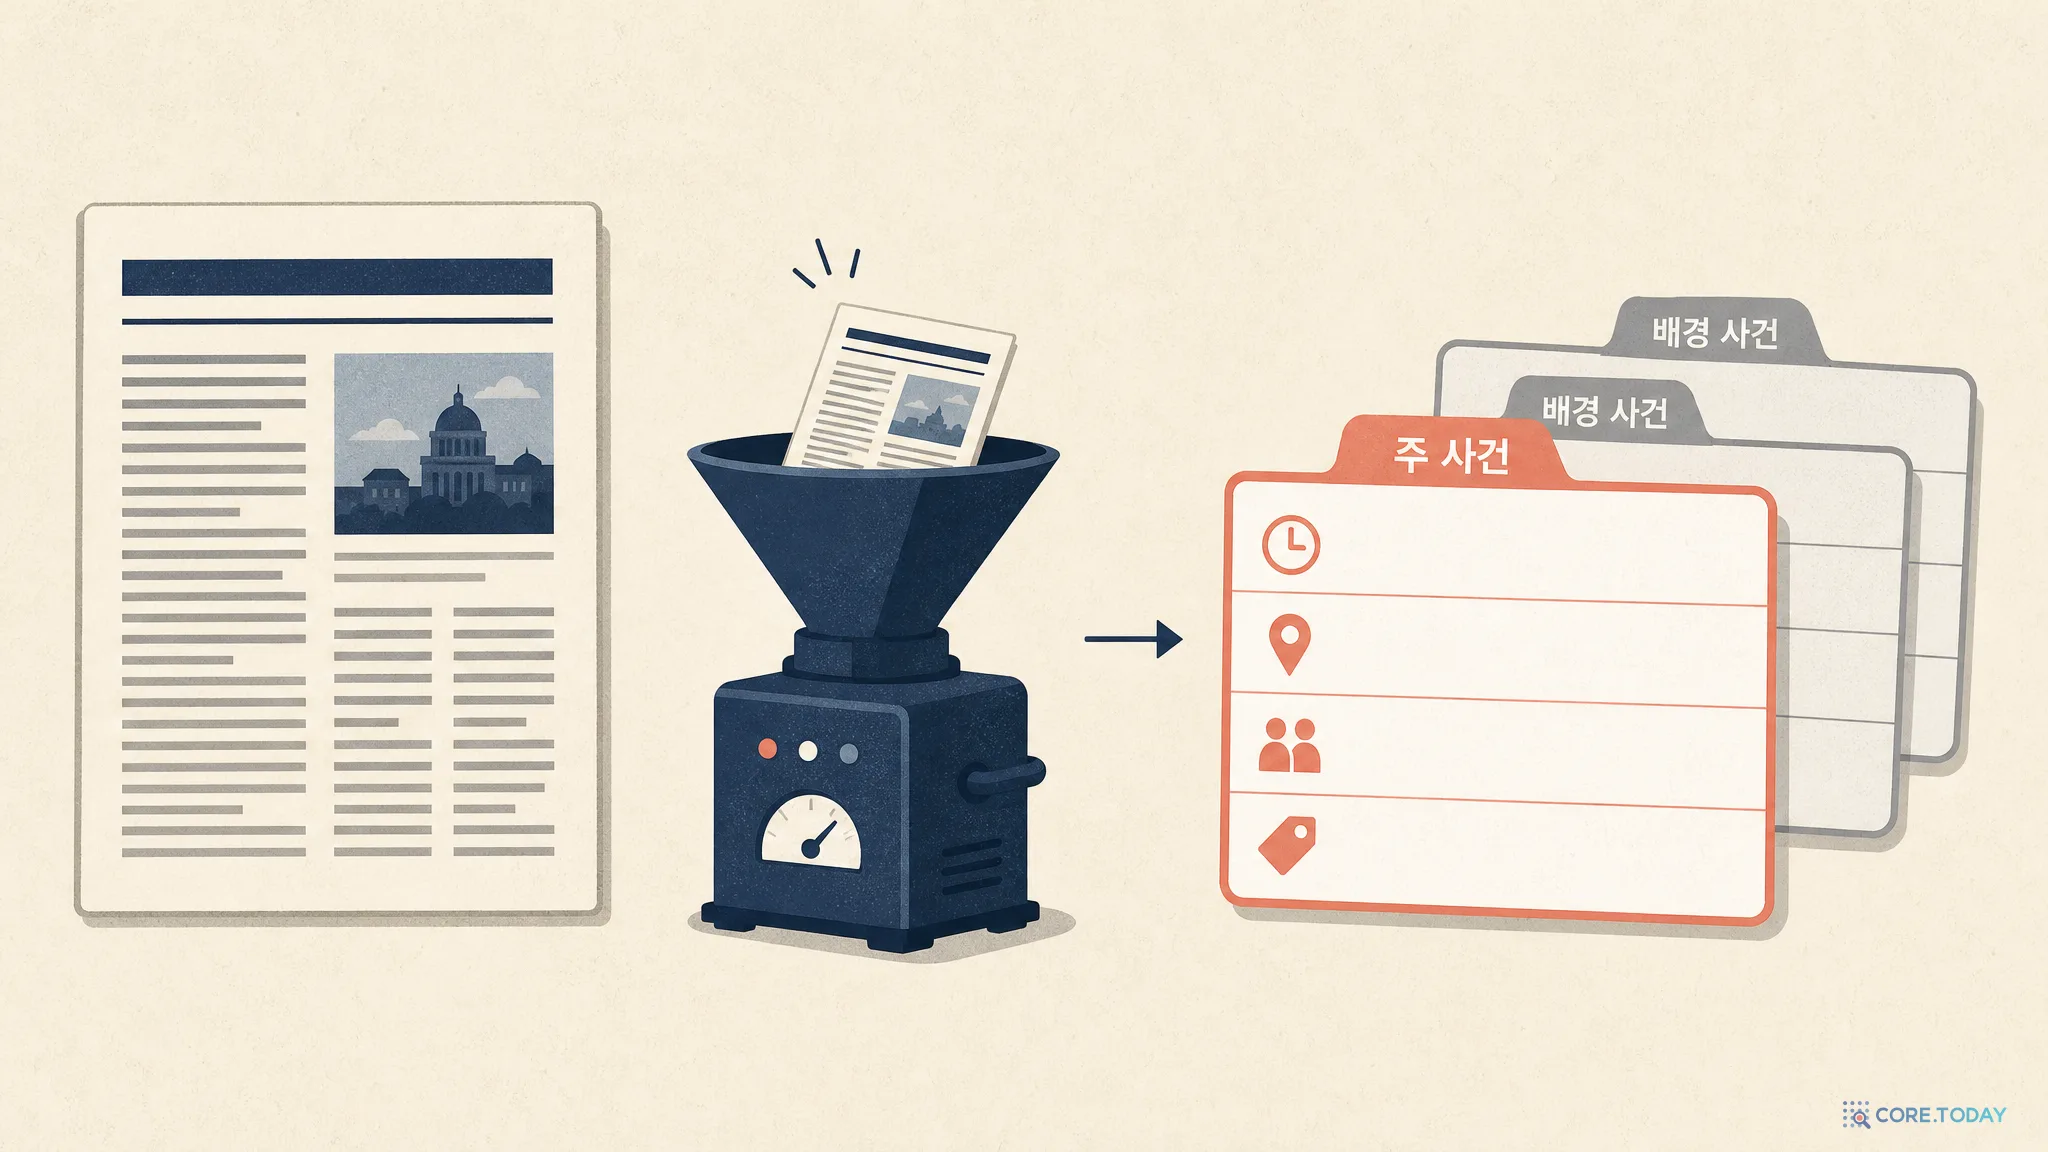
1편은 이 질문에 답할 수 없는 데이터였습니다. 한 언론사의 하루치라 시간이 변별력을 가질 수 없었고, '언제'는 규칙에 쓰지도 않았습니다. 그래서 이번에는 재료부터 바꿨습니다. 통신사·방송·전국지·지역지 25곳의 2026년 10월 21일 기사 2,766건입니다. 같은 사건을 다른 문체로 쓴 기사가 흔하고, 같은 날 다른 도시에서 같은 유형의 사건이 일어나며, 사건 시각과 보도 시각이 갈립니다. 그리고 육하원칙을 '칸 여섯 개'가 아니라 사건 레코드로 바꿔 뽑았습니다. 유형, 행위, 역할이 붙은 참여자 목록, 정규화된 날짜와 시각, 광역·시군구로 나눈 장소.
이 레코드를 네 자리에 넣어 봤습니다. 후보 쌍을 찾는 블로킹 키로, 임베딩할 요약문으로, 판정 모델에 주는 입력으로, 그리고 "이 둘은 같을 수 없다"를 잘라내는 거부 조건으로. 네 자리의 성적이 서로 달랐습니다.
1부. 재료: 25개 언론사의 하루
기사 2,766건
2026년 10월 21일 저녁, 접근 가능한 RSS를 모두 돌렸습니다. 연합뉴스 12개 섹션, 뉴시스 7개, SBS 4개, 경향신문 4개, 그리고 아시아경제·머니투데이·동아일보·한겨레·한국경제·서울신문·전자신문·노컷뉴스·오마이뉴스·세계일보·연합뉴스TV, 여기에 광주드림·전남일보·경북일보·대구일보·인천일보·강원도민일보·충청투데이·경남도민일보·울산제일일보·제주신문 등 지역지 열 곳입니다. 본문 300자 이상, 한글 비율 45% 이상인 기사만 남기고 같은 언론사의 같은 제목은 하나로 합쳤습니다.
숫자 하나가 문제의 성격을 바꿉니다. 1편에서는 기사의 84%가 그날 혼자였습니다. 언론사가 25곳이 되자 기사의 53%가 둘 이상의 기사가 있는 묶음에 속합니다. 유홍준 국립중앙박물관장 사퇴에 28건, 부산 북항 수로에 한 달 머문 상어 '부캉이'의 바다 복귀에 28건, 김여정 담화에 24건, KIA의 준플레이오프 승리에 26건이 달렸습니다. 422개 묶음 가운데 378개(90%)는 둘 이상의 언론사가 섞여 있습니다. 묶기가 예외가 아니라 일상이 됩니다.
정답 만들기: 판사 셋과 검수
후보 쌍은 세 경로의 합집합입니다. 제목과 첫 두 문장을 Qwen3-Embedding 8B와 EmbeddingGemma 300M으로 임베딩해 각각 가장 가까운 이웃 8개 중 유사도 0.5 이상, 사건 레코드의 참여자 이름을 공유하면서 사건 날짜가 양립하는 쌍, 그리고 사건 유형·시군구·날짜가 모두 같은 쌍. 합쳐서 20,629쌍입니다.
판정은 1편과 같은 세 갈래(같은 사건 / 같은 이야기, 다른 사건 / 다른 사건)로 하되 판사를 바꿨습니다. 기준 기사 하나에 후보를 최대 12개 붙여 한 번에 묻는 방식으로 Gemini 3.8 Flash(사고 모드)와 Claude Sonnet 5.5가 각각 판정했고, 1편에서 답 순서가 밀리던 GPT에게는 후보 번호를 키로 하는 JSON을 요구해 세 번째 판사(GPT-5.4)로 둘이 갈린 쌍에만 투입했습니다. 둘이 같은 답을 낸 쌍이 19,096쌍, 갈린 쌍이 1,533쌍이었고, 갈린 쌍은 셋의 다수결로 정했습니다. 셋이 모두 다른 답을 낸 쌍은 하나뿐이었습니다.
다수결로 정해진 쌍 중 '같은 사건'이 걸린 427쌍에서 36쌍을 뽑아 원문을 읽고 검수했습니다. 8쌍의 라벨을 바꿨습니다. 갈린 자리는 두 종류였습니다. 같은 경기의 다른 각도(김도영의 만루포 기사와 KIA의 시리즈 승리 기사)는 1편의 정의대로 같은 사건으로 되돌렸고, 사건과 그 사건에 대한 기관의 입장문(선관위 직원 사망 기사와 선관위의 유감 표명 기사)은 다른 사건으로 돌렸습니다. 같은 사건과 같은 이야기의 경계가 사람에게도 흐리다는 1편의 관찰은 그대로였고, 이 글의 정답도 그 흐림을 안고 있습니다.
정답을 만들다 발견한 함정 둘
정답 묶음을 눈으로 훑다가 이상한 묶음을 발견했습니다. 역삼동 연쇄방화 기사 20건 사이에 JTBC의 "발롱도르", "버섯 먹었다가 경로당 발칵"이 들어 있었습니다. 원인은 본문 추출이었습니다. JTBC 페이지는 자바스크립트로 본문을 그려서, 추출기가 19건 모두에 같은 기사(방화범 보도)의 본문을 돌려줬던 것입니다. 판사 셋은 같은 본문을 보고 '같은 사건'이라고 답했을 뿐입니다. JTBC 19건을 모두 뺐습니다.
둘째는 다이제스트 기사입니다. "[국감 말·말·말]", "◇내일의 경기", "오늘의 SBS 8뉴스 예고"처럼 그날의 사건 여럿을 한 기사에 나열한 글입니다. 이런 기사는 그날의 거의 모든 이야기와 '같은 이야기'이고, 판정 모델은 여기에 0.95 이상을 줍니다. 묶음 단계에서 이 기사 하나가 김여정 담화 24건과 추미애 경고 12건과 역삼동 방화 20건을 한 묶음으로 이어 붙였습니다. 제목 규칙으로 31건을 뺐습니다. 이 이야기는 5부에서 다시 합니다.
2부. 육하원칙을 쓰는 법을 바꾸다: 사건 레코드
1편의 규칙이 실패한 이유를 다시 적으면 셋입니다. 같은 사람을 다른 이름으로 부른다, 기사마다 주인공이 다르다, 익명 표기가 기사 사이에서 충돌한다. 셋 다 "칸 하나에 문자열 하나"라는 표현의 문제이지 육하원칙 자체의 문제가 아닙니다. 그래서 표현을 바꿨습니다.
기사마다 Gemini 3.8 Flash에게 JSON 스키마를 주고 사건 레코드를 뽑았습니다. 2,766건 모두 성공했고(JSON이 깨진 71건은 재시도), 기사당 입력 1,500토큰·출력 500토큰 안팎입니다.
칸
1편의 육하원칙
이번 사건 레코드
사건 수
기사당 하나
주 사건 하나(primary) + 배경 사건 최대 셋
무엇을
자유 문장
24종 유형(범죄발생·수사체포구속·재판선고·정책발표·행사축제공연·스포츠경기 …) + 동사구 한 토막
누가
이름 하나
참여자 목록. 역할(행위자·대상·발표주체·피의자·피해자·참여자·기관), 종류(사람·기관·기업·단체·익명개인), 익명 여부, 속성(나이·성별·직업)
언제
기사 표기 그대로
게재일 기준으로 환산한 날짜(YYYY-MM-DD)·시각(HH:MM)·해상도(time·day·week·month·unknown). 보도 시각이 아니라 사건 시각
어디서
기사 표기 그대로
광역(region1)·시군구(region2)·구체 장소(place)·특정 여부(specific). 국회·정부청사·온라인처럼 형식적인 장소는 specific=false
요약
사건 한 줄 요약
"누가 언제 어디서 무엇을 했다" 한 문장. 기사의 각도가 아니라 사건 자체를 쓰라고 지시
이 레코드를 네 자리에 썼습니다. 자리마다 성적이 다릅니다.
자리 1: 후보를 찾는 블로킹 키
같은 사건 쌍 2,918개 가운데 395쌍(13.5%)은 임베딩 이웃에는 없고 참여자 이름 블로킹으로만 후보에 들어왔습니다. 그중 361쌍이 다른 언론사 쌍입니다. 놓친 이유는 유사도가 낮아서가 아니었습니다. 이 395쌍의 Qwen3 8B 유사도 중앙값은 0.83이고 0.6 미만은 34쌍뿐입니다. 부캉이 묶음처럼 기사가 28건인 사건에서는 이웃 8개로 묶음 안의 모든 쌍을 덮을 수 없습니다. 묶음이 클수록 이웃 수 k가 모자라고, 이름이 같은 '부캉이'·'유홍준'·'김여정'이 그 구멍을 메웁니다. 이행성 덕분에 묶음 단계에서는 결국 같은 묶음에 들어오는 경우가 많지만, 쌍을 하나라도 더 확인하고 싶다면 임베딩 이웃과 이름 블로킹을 합집합으로 써야 합니다.
자리 2: 임베딩할 요약문
1편에서는 육하원칙의 '사건 한 줄 요약'을 임베딩해도 제목+리드보다 낫지 않았습니다. 이번에는 "기사의 각도가 아니라 사건 자체를 쓰라"고 지시한 요약을 Qwen3 8B로 임베딩했더니 쌍 F1이 0.779(제목+리드)에서 0.807로, 묶음 F1이 0.924에서 0.939로 올랐습니다. 잘못 합친 묶음도 76개에서 57개로 줄었습니다. 각도를 지운 요약은 임베딩에는 도움이 됩니다. 이 요약이 판정 모델에는 어떤 영향을 주는지는 4부에서 뒤집힙니다.
자리 3: 판정 모델의 입력
원문 대신 레코드를 주면 어떻게 되는지는 4부에서 따로 다룹니다. 미리 말하면 모델에 따라 갈렸습니다.
시간과 장소는 "같다"를 증명하기엔 약하고 "다르다"를 증명하기엔 강합니다. 같은 날 같은 시군구에서 일어난 두 사건은 얼마든지 다른 사건이지만, 날짜가 사흘 다르고 시군구가 다른 두 기사가 같은 사건일 수는 없습니다. 그래서 거부 조건으로 설계했습니다. 어떤 방법이 "같다"고 해도 시간·장소가 모순이면 자릅니다.
첫 설계는 같은 사건의 25%를 잘랐다
처음에는 셋을 모두 거부 조건으로 썼습니다. 사건 유형이 양립 불가, 사건 날짜가 다름, 장소가 다름. 부분 정답 7,403쌍으로 돌려 보니 같은 사건 쌍의 25%가 잘렸습니다. 원인을 하나씩 열어 보면 전부 추출의 문제였습니다.
시군구 칸에 설명문이 들어갔습니다. 같은 대구 엑스코 행사를 다룬 기사 다섯 건의 region2가 "북구일대(대구 엑스코 소재지)", "북구일원(엑스코)", "북구(추정불가시 대구시내생략가능/…)"처럼 제각각이었습니다. 심한 경우 200자짜리 자기 설명이 들어 있었습니다. 첫 "○○시|군|구" 토큰만 취하도록 정규화하니 대부분 사라졌습니다.
광역 표기가 갈렸습니다. "전남"과 "전라남도", "경남"과 "경상남도", "칼리닌그라드"와 "칼리닌그라드주". 약칭 표를 넣었습니다.
발표일과 사건일이 하루 어긋납니다. "우리금융, 1년간 34조 공급"을 한 기사는 "21일 밝혔다"로, 다른 기사는 "지난 20일"로 적습니다. 이재명 대통령의 '처벌 불원' 의사도 "전날"과 "21일"로 갈립니다. 같은 사건 쌍의 3.8%가 하루 차이였고 이틀 이상 차이는 1.5%였습니다. 날짜 거부는 이틀 이상 차이로 풀었습니다.
같은 사건이 다른 유형으로 보도됩니다. 선관위 직원 사망은 '사망부고'이면서 '의견논평'(특검 입장)이면서 '행정조치'(예방 연기)입니다. 유형 거부는 뺐습니다.
고친 거부 조건(날짜 이틀 이상 차이 또는 시군구 다름)은 같은 사건 2,918쌍 중 75쌍(2.6%)만 자르면서 다른 사건 2,836쌍과 같은 이야기 594쌍을 잘라 냈습니다.
그런데 판정 모델 위에서는 손해였다
문제는 그 2,836쌍과 594쌍이 대부분 판정 모델이 이미 걸러내는 쌍이라는 점입니다. Jev(원문 입력, 문턱값 0.87) 위에 거부 조건을 얹으면 판정이 "같다"고 한 같은 이야기 쌍 중 14쌍을 바로잡고, 판정이 맞게 "같다"고 한 같은 사건 쌍 75쌍을 잘못 자릅니다. 쌍 F1은 0.834에서 0.822로 내려갑니다. 임베딩 위에서도 마찬가지입니다. 요약 임베딩의 F1은 0.807에서 0.806으로 변화가 없고, 잘못 합친 묶음이 57개에서 50개로 주는 것이 전부입니다.
왜 이렇게 적게 돕는지는 거부 조건이 잡는 쌍의 정체를 보면 압니다. 거부가 잡은 다른 사건 2,836쌍은 "같은 유형, 다른 인스턴스"입니다. 다른 도시의 축제 개막, 다른 날의 국정감사, 다른 경기. 그런데 이 쌍들은 임베딩 유사도도 낮고 판정 모델도 0.1 이하를 줍니다. 거부가 필요 없는 쌍입니다. 반면 판정 모델이 틀리는 쌍은 "같은 날, 같은 곳, 같은 등장인물, 다른 행위"입니다. 제주 스토킹 살인 피의자의 퇴원과 구속(이틀 차이라 거부가 잡은 드문 예), 특검의 압수수색과 특검의 입장문, 발표와 그에 대한 반응. 시간과 장소가 같은 쌍이라 거부 조건이 손을 댈 수 없습니다.
한 가지 더. 같은 사건 쌍의 42%는 장소가 특정되지 않습니다. 정치·경제·국제·문화 기사의 '어디서'는 국회·세종·백악관·온라인이거나 아예 없습니다. 장소 거부는 사회·지역·스포츠 섹션에서만 일을 합니다.
그래서 결론은 이렇습니다. 시간·장소는 "같은 유형의 다른 인스턴스"를 가르고, 판정 모델은 "같은 이야기의 다른 사건"을 가릅니다. 두 오류는 다른 쌍에서 나고, 전자는 임베딩과 판정 모델이 이미 거의 다 처리하므로, 거부 조건이 추가로 얻는 것은 작습니다. 거부 조건의 값어치는 판정 모델이 없거나 약할 때, 그리고 묶음 단계에서 잘못 합친 묶음을 몇 개 줄일 때 나옵니다. 그 값어치의 상한은 모델이 아니라 추출기의 날짜·장소 정확도가 정합니다. 75쌍을 잘못 자른 것은 전부 발표일을 사건일로 적거나, 항소심 기사에 1심 날짜를 적거나, 아시안게임 사격장을 도요타시와 나고야시로 다르게 적은 추출 오류였습니다.
4부. 판정 모델: Jev, OpenAI Decisions, 그리고 로컬
1편에서 Jev는 AUROC 0.998로 다른 방법을 압도했지만 확률을 그대로 쓰면 안 됐습니다. 이번에는 판정 모델이 둘입니다. TypeSafe의 Jev(1.13.0)와, 2026년 10월에 공개 베타로 나온 OpenAI Decisions API(gpt-6-luna)입니다. 둘 다 채팅이 아니라 "이 상태에서 이 질문의 답은 참인가"에 확률 하나를 돌려주는 판정 API이고, 입력 토큰만 과금됩니다. 20,629쌍을 각각 두 번(원문 입력, 레코드 입력) 물었습니다. 같은 질문입니다. "기사A와 기사B는 같은 구체적 사건(같은 행위자가 같은 때에 한 같은 일)을 다루는가? 종합·후속·다른 각도·다른 언론사 보도도 같은 사건이면 참. 같은 큰 이야기의 다른 사건이면 거짓."
판정 모델 · 입력
AUROC
vs 같은 이야기
최적 문턱값
쌍 F1
묶음 F1
잘못 합친 묶음
Jev · 원문
0.982
0.944
0.87
0.834
0.949
29
Jev · 사건 레코드
0.977
0.930
0.77
0.817
0.954
26
OpenAI Decisions · 원문
0.976
0.928
0.92
0.838
0.953
43
OpenAI Decisions · 사건 레코드
0.977
0.937
0.77
0.848
0.956
37
Qwen3 8B · 사건 요약 임베딩
0.965
0.916
0.77
0.807
0.939
57
Qwen3 8B · 제목+리드 임베딩
0.961
0.905
0.76
0.779
0.924
76
EmbeddingGemma 300M
0.951
0.896
0.74
0.766
0.917
72
참여자 이름 겹침 규칙
0.869
0.812
0.36
0.628
0.862
101
순위는 남고 눈금은 바뀐다, 다시
Jev 원문 입력의 AUROC 0.982는 1편의 0.998보다 낮습니다. 다매체 데이터가 더 어렵습니다. 같은 언론사의 '(종합)' 재송고처럼 쉬운 쌍이 줄고, 다른 문체로 쓴 같은 사건과 같은 등장인물의 다른 사건이 늘었기 때문입니다. 그래도 순위를 매기는 능력은 임베딩(0.961~0.965)보다 분명히 높고, 특히 같은 이야기의 다른 사건을 가르는 AUROC(0.944 대 0.905~0.916)에서 차이가 납니다.
눈금은 1편과 또 다릅니다. Jev의 최적 문턱값은 1편의 0.9에서 0.87로, 확률 0.9 이상 구간의 실제 같은 사건 비율은 85%, 0.8 구간은 46%입니다. OpenAI Decisions는 원문 입력에서 더 과감해서 0.9 구간의 적중률이 78%, 0.8 구간이 27%였고, 문턱값을 0.92까지 올려야 했습니다. 레코드를 주면 85%와 58%로 얌전해집니다. 두 모델 모두 0.5는 틀린 자리입니다. 같은 이야기의 다른 사건에 0.5~0.9를 흔하게 주기 때문입니다.
원문을 줄까, 레코드를 줄까
여기서 모델에 따라 답이 갈렸습니다. Jev는 원문 입력이 쌍 F1 0.834로 레코드 입력 0.817보다 낫고, OpenAI Decisions는 레코드 입력이 0.848로 원문 0.838보다 낫습니다. 묶음 F1과 잘못 합친 묶음 수는 두 모델 모두 레코드 쪽이 조금 낫습니다(0.949→0.954, 0.953→0.956).
레코드 입력이 잃는 것은 각도입니다. 레코드는 기사의 각도를 지우고 사건 자체를 쓰라고 만든 것이라, LG 탈락 기사와 KIA 승리 기사의 레코드가 거의 같아집니다. 둘은 같은 경기이니 같은 사건이 맞지만, 전국체전 400m 계주 우승 기사와 그 경기에 뛴 다른 선수의 인터뷰 기사, 바이오 서밋 개최 기사와 그 서밋의 다른 세션 기사처럼 같은 행사의 다른 사건도 레코드가 비슷해져서 0.9 이상을 받습니다. 레코드 입력에서 같은 이야기의 다른 사건을 같다고 한 비율이 원문보다 높은 이유입니다(Jev 11%→15%).
레코드 입력이 얻는 것은 눈금입니다. 두 모델 모두 최적 문턱값이 0.77로 내려오고 확률이 덜 과감해집니다. 그리고 묶음 단계에서 실수가 덜 몰립니다.
LLM과 로컬 판정 모델
GPT-5.4 mini에게 채팅으로 같은 질문을 하면(임베딩 0.6 이상 5,906쌍) 쌍 F1이 레코드 입력 0.833, 원문 0.823으로 판정 모델과 비슷하지만, 답이 '같다/같은 이야기/다르다' 셋 중 하나라 문턱값을 움직일 수 없고 호출당 시간과 비용이 열 배 이상입니다. 정답 판사로 쓴 Gemini·Claude·GPT-5.4는 당연히 평가에서 뺐습니다.
로컬 판정 모델은 1편처럼 느려서 전체를 돌리지 못했습니다. 임베딩 0.6 이상인 쌍에서 무작위로 1,200쌍을 뽑아(같은 사건 506, 같은 이야기 533, 다른 사건 195로 전체보다 훨씬 어려운 표본) 같은 표본 위에서 모두 비교했습니다.
같은 표본 1,234쌍
AUROC
vs 같은 이야기
쌍 F1
Jev · 원문
0.945
0.924
0.851
OpenAI Decisions · 레코드
0.939
0.918
0.861
Jev · 레코드
0.933
0.909
0.849
OpenAI Decisions · 원문
0.928
0.902
0.860
Clef-Flash 27B · 레코드 (로컬)
0.927
0.902
0.837
Nimble 9B · 원문 (로컬)
0.906
0.873
0.826
Nimble 9B · 레코드 (로컬)
0.894
0.857
0.812
GPT-5.4 mini · 레코드 (채팅)
0.873
0.836
0.821
GPT-5.4 mini · 원문 (채팅)
0.845
0.804
0.811
1편에서 로컬 판정 모델은 "붙이지 말라"였는데, 이번에는 Clef-Flash 27B가 레코드 입력으로 AUROC 0.927까지 왔습니다. Jev 원문 입력과 0.02 차이이고, 같은 이야기를 가르는 AUROC(0.902)는 OpenAI Decisions 원문 입력과 같습니다. 1편의 Clef는 원문을 받았고 같은 이야기 대비 AUROC가 0.855에 확률이 과감했는데, 레코드를 주면 과제가 "두 사건 레코드가 같은가"라는 더 좁은 질문이 되어 로컬 모델도 따라옵니다. 다만 쌍당 2~3초라 하루 2만 쌍이면 열 시간이 넘습니다. 임베딩으로 후보를 2천 쌍 아래로 줄이면 쓸 수 있는 속도입니다.
쌍 판정을 이어 붙이면 묶음이 됩니다. 1편에서 본 대로 잘못 이은 쌍 하나가 묶음 둘을 합칩니다. 이번 데이터에서 그 피해를 가장 크게 낸 것은 판정 모델의 실수가 아니라 허브 기사였습니다.
다이제스트 하나가 묶음 넷을 잇는다
"오늘의 SBS 8뉴스 예고 (10월 21일)"는 그날 저녁 뉴스에 나올 사건 열 개를 한 문단씩 소개하는 기사입니다. Jev는 이 기사와 김여정 담화 기사에 0.96을, 추미애 경고 기사에 0.95를 줬습니다. OpenAI Decisions는 둘 다 1.00입니다. 틀린 판정이 아닙니다. 그 기사는 정말로 그 사건들을 다룹니다. 그러나 묶음 단계에서 이 기사 하나가 김여정 묶음 24건, 추미애 묶음 12건, 역삼동 방화 묶음 20건, 부캉이 묶음 28건을 사슬로 엮어 91건짜리(Jev), 121건짜리(Decisions) 묶음을 만들었습니다. 정답 묶음 7개와 11개가 섞인 묶음입니다.
제목 규칙으로 다이제스트 31건을 빼자 가장 큰 묶음이 30건과 36건으로 돌아왔습니다. 운영에서는 제목 규칙보다 나은 방법이 있습니다. 사건 레코드의 사건 수입니다. 보통 기사는 주 사건 하나에 배경 사건 한둘인데, 다이제스트는 유형이 제각각인 사건이 넷 이상 나옵니다. 묶기 전에 이런 기사를 빼거나, 빼지 않더라도 쌍을 이을 때 한쪽만 허브로 쓰지 않게 해야 합니다.
이행성을 끊는 값과 대가
허브를 뺀 뒤에도 잘못 합친 묶음은 남습니다(Jev 레코드 26개, Decisions 레코드 37개). 이것을 줄이는 방법으로 평균 연결을 시험했습니다. 두 묶음 사이의 후보 쌍 점수 평균이 문턱값 이상일 때만 합치는 방식입니다. 잘못 합친 묶음은 확실히 줍니다(Jev 레코드 0.8 기준 17개→12개, Jev 원문 0.8 기준 40개→23개). 대신 묶음 F1이 0.951에서 0.930으로 떨어집니다. 28건짜리 부캉이 묶음처럼 큰 정답 묶음은 안의 쌍 전부가 높은 점수를 받지 못하므로 둘셋으로 쪼개지기 때문입니다. "사건 데이터베이스에 중복 없이 쌓기"가 목적이면 평균 연결이 맞고, "같은 사건 보도를 한데 모아 보여 주기"가 목적이면 연결 요소가 맞습니다. 1편의 결론과 같습니다.
같은 이야기는 묶음의 속성이 아니라 묶음 사이의 관계다
정답을 만들며 가장 흐렸던 라벨은 '같은 이야기, 다른 사건'이었습니다. 1편에서도 표본 점검에서 열에 셋이 지나치게 넓었고, 이번에도 판사 셋이 가장 많이 갈린 라벨입니다(갈린 1,533쌍 중 1,196쌍이 '다른 사건'과 '같은 이야기' 사이). 흐린 이유는 그것이 묶음 하나의 속성이 아니라 묶음 사이의 관계이기 때문입니다. 선관위 직원 사망(묶음 A)과 특검의 입장문(묶음 B)과 선관위의 유감 표명(묶음 C)은 각각 같은 사건 묶음이고, 셋을 잇는 것이 이야기입니다.
그래서 설계는 두 층이 됩니다. 아래층은 같은 사건 묶음이고, 위층은 묶음을 잇는 이야기 스레드입니다. 같은 사건 판정에는 0.87 이상만 쓰고, 0.5~0.87 구간의 쌍은 버리지 않고 스레드 연결로 씁니다. 판정 모델이 같은 이야기의 다른 사건에 0.6~0.9를 주는 성질은 묶음에서는 결점이었지만 스레드에서는 바로 쓸 수 있는 신호입니다. 1편에서 "잘못 이은 쌍"이라고 부른 것이 두 층 설계에서는 이야기의 뼈대가 됩니다.
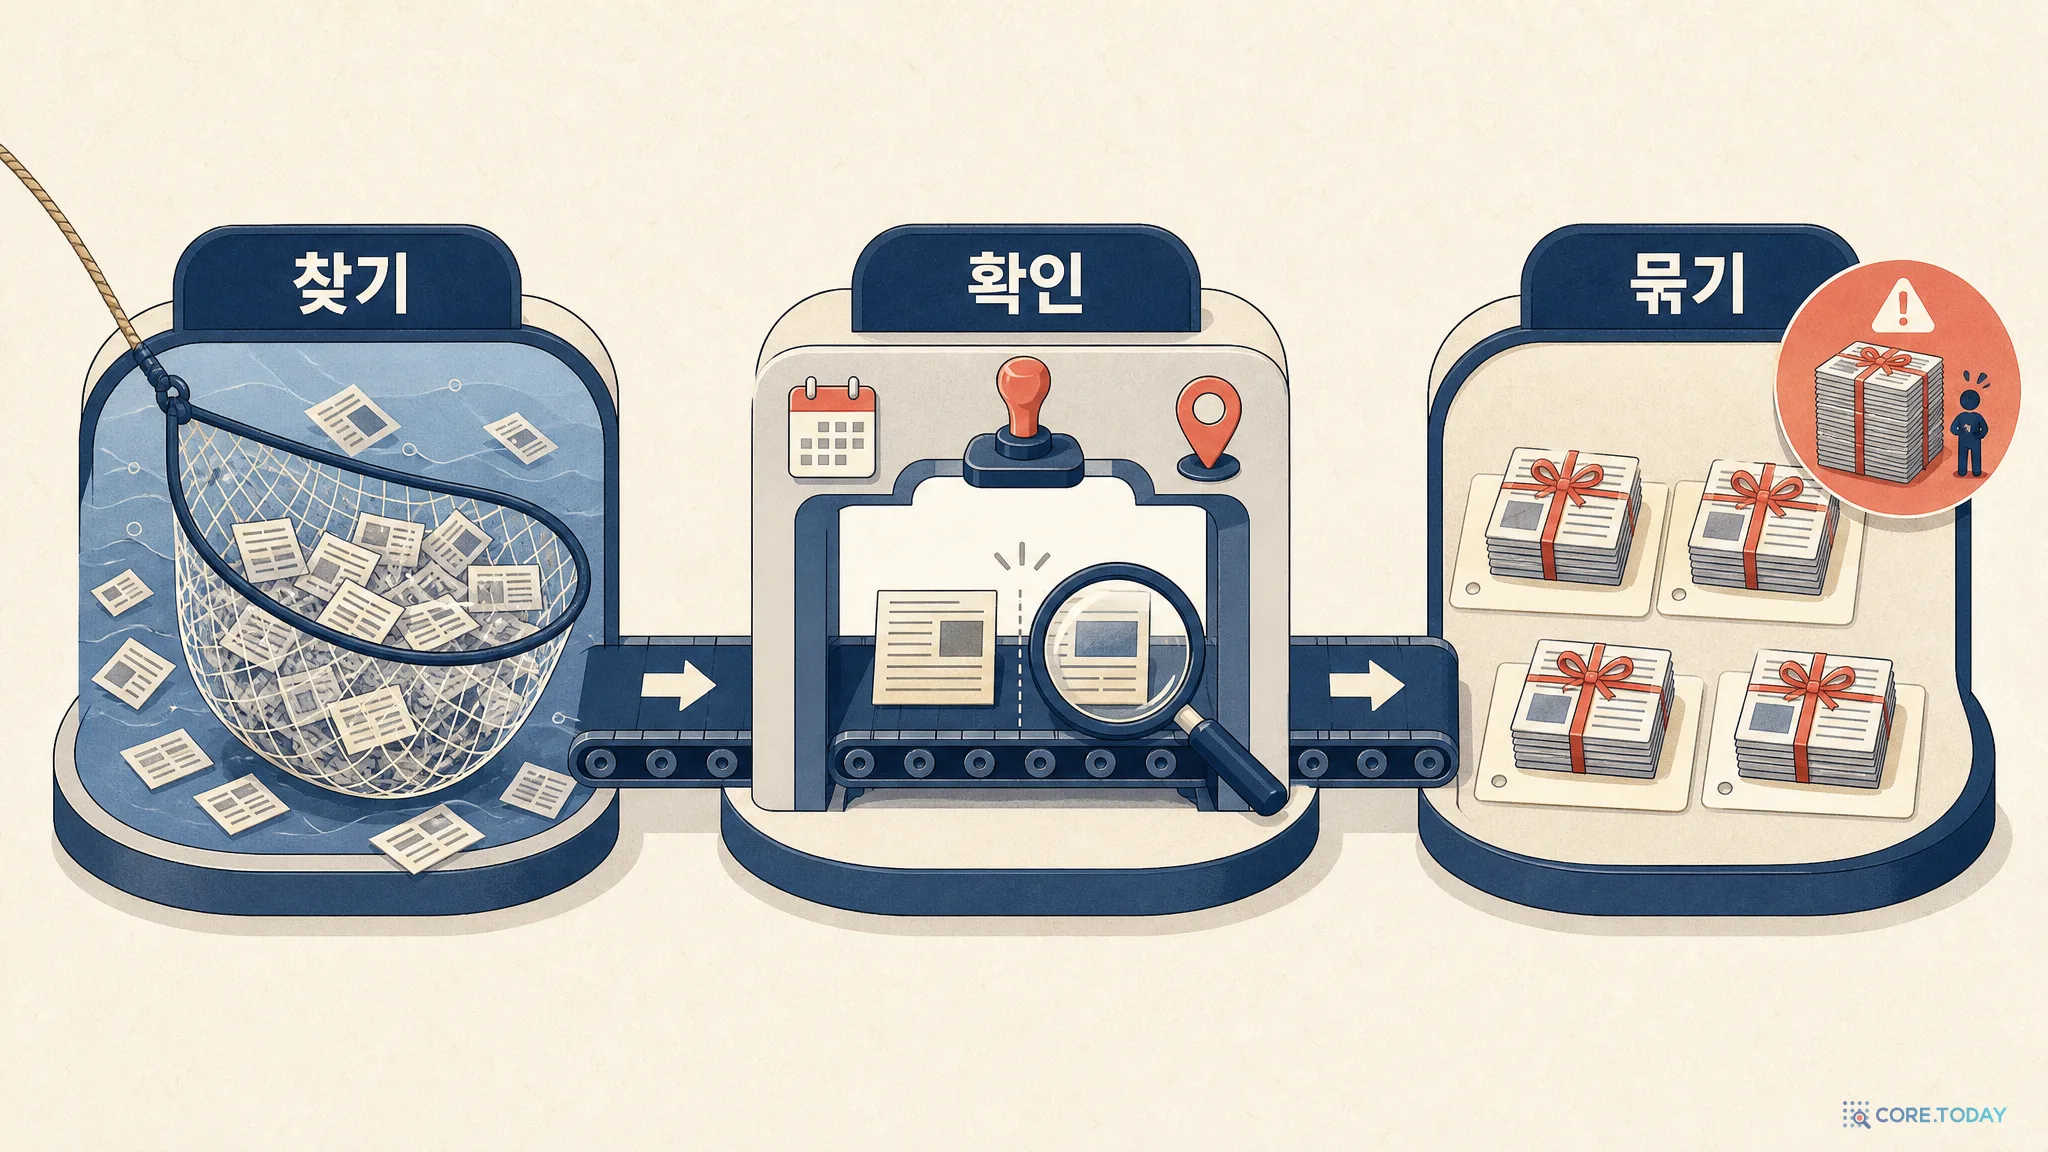
추출기사마다 사건 레코드를 한 번 뽑습니다. 주 사건과 배경 사건, 유형, 역할 붙은 참여자, 사건 날짜·시각·해상도, 광역·시군구·장소. 시군구는 첫 토큰만 취하고 광역은 약칭 표로 정규화합니다. 사건이 넷 이상이면 다이제스트로 표시해 허브가 되지 않게 합니다.
찾기제목+리드 임베딩 이웃과 참여자 이름 블로킹의 합집합을 후보로 삼습니다. 이름 블로킹이 임베딩 이웃이 놓친 같은 사건 쌍의 13.5%를 건집니다. 후보 중 임베딩 유사도 0.6 이상만 확인 단계로 보내면 같은 사건 쌍의 79.5%가 남고 후보는 20,629쌍에서 6,135쌍으로 줄어듭니다. 놓친 20.5%는 대부분 같은 묶음의 다른 기사를 통해 묶음에 들어옵니다.
확인판정 모델에게 "같은 구체적 사건인가"를 묻습니다. OpenAI Decisions라면 레코드 입력에 문턱값 0.8, Jev라면 원문 입력에 0.87 또는 레코드 입력에 0.77. 눈금은 자기 데이터 수십 쌍으로 반드시 다시 정합니다. 시간·장소 거부 조건은 판정이 0.97 미만일 때만 얹거나(소프트 거부), 묶음 단계의 안전장치로 남깁니다.
묶기확인된 쌍을 이어 묶음을 만듭니다. 중복 없이 쌓는 것이 목적이면 평균 연결, 모아 보여 주는 것이 목적이면 연결 요소. 묶음이 30건을 넘거나 섹션이 섞이면 사람에게 보냅니다. 0.5~0.87 구간의 쌍은 묶음 사이의 이야기 스레드로 씁니다. 육하원칙은 묶음 단위로 합칩니다. 참여자는 역할별 합집합, 날짜는 가장 이른 명시 값, 장소는 가장 구체적인 값.
제약
구성
쌍 F1 / 묶음 F1
가장 큰 묶음 / 잘못 합침
비용·시간 (하루 2,766건)
클라우드 판정 모델 (권장)
임베딩 0.6 + OpenAI Decisions 레코드 0.8
0.844 / 0.956
30 / 30
추출 2,766건 + 판정 6,135쌍, 1달러 안쪽, 수십 분
잘못 합침을 최소로
임베딩 0.6 + Jev 레코드 0.8 + 평균 연결
0.808 / 0.930
26 / 12
같음
클라우드 판정 모델, 원문만
임베딩 0.6 + Jev 원문 0.9
0.800 / 0.944
28 / 22
추출 생략 가능, 다이제스트 제목 규칙 필수
로컬만
임베딩 0.6 + Clef-Flash 27B 레코드
표본 AUROC 0.927
-
쌍당 4초, 후보를 2천 쌍 아래로
로컬, 판정 모델 없이
사건 요약 임베딩 하나, 문턱값 0.77
0.807 / 0.939
29 / 57
추출 비용만
피할 것
참여자 이름 겹침 규칙, 판정 확률 0.5, 다이제스트를 둔 채 연결 요소
0.628 / 0.862
91~121 / 101
1편의 설계도와 비교하면 세 가지가 더해졌습니다. 추출 단계가 맨 앞에 생겼고(블로킹 키·요약·판정 입력·거부 조건의 공급원), 다이제스트 제거가 묶기 앞에 생겼으며, 묶음 사이에 이야기 스레드 층이 생겼습니다. 시간·장소는 설계도의 한 칸이지만 주인공은 아닙니다.
7부. 한계
정답은 LLM 셋의 다수결과 표본 검수입니다. 사람 여럿이 독립적으로 라벨을 단 데이터가 아닙니다. 36쌍 검수에서 8쌍을 고쳤으니(22%) 다수결로 정해진 427쌍 중 90쌍 안팎이 더 흔들릴 수 있습니다. 같은 사건 쌍 2,918개 전체로 보면 3% 안쪽이지만, 특히 스포츠(같은 경기의 다른 각도)와 입장문(사건과 그에 대한 반응)에서 라벨 정의가 결과를 정합니다.
하루치입니다. 언론사는 25곳으로 늘었지만 시간은 여전히 하루라서, 날짜 거부 조건이 며칠에 걸친 후속 보도에서 어떻게 작동하는지는 보지 못했습니다. 사건 시각과 보도 시각을 분리해 둔 것은 그 경우를 위한 설계이지 실측이 아닙니다.
추출은 한 번, 한 모델입니다. 사건 레코드는 Gemini 3.8 Flash 한 번의 출력이고, 거부 조건의 오류 75쌍은 전부 여기서 났습니다. 두 모델로 뽑아 교차하거나 날짜·장소만 다시 묻는 식으로 줄일 여지가 있습니다.
로컬 판정 모델은 표본입니다. 1,200쌍에서의 AUROC 차이 0.02는 95% 신뢰구간 안에 들어갈 수 있습니다. Clef-Flash가 Jev와 같다는 뜻이 아니라, 1편에서 본 "로컬은 붙이지 말라"가 레코드 입력에서는 흔들린다는 뜻입니다.
본문 추출이 결과를 좌우합니다. JTBC는 아예 빠졌고, 한국경제·울산제일일보는 본문이 짧게 잡혔습니다. 통신사 문체(연합·뉴시스 1,560건, 56%)가 많아 다른 매체 조합에서는 수치가 달라집니다.
Gemini는 정답 판사라 평가에서 뺐고, GPT-5.4 mini는 정답 판사 GPT-5.4와 같은 계열입니다. mini의 점수는 그만큼 유리할 수 있습니다.
맺으며: 레코드는 네 자리 중 세 자리에서 일한다
1편의 질문은 "육하원칙으로 묶으면 되는가"였고 답은 "아니다"였습니다. 이번 질문은 "그러면 어떻게 쓰는가"였습니다. 답은 자리에 따라 다릅니다. 참여자 이름은 블로킹 키로 쓰면 임베딩이 놓친 13.5%를 건지고, 각도를 지운 요약은 임베딩하면 0.03이 오르며, 레코드를 판정 모델에 주면 눈금이 얌전해지고 묶음이 조금 깨끗해집니다. 세 자리에서 일합니다. 그러나 네 번째 자리, 시간·장소 거부 조건은 좋은 판정 모델 위에서는 바로잡는 것보다 잘못 자르는 것이 많았습니다. 시간과 장소가 가르는 "같은 유형의 다른 인스턴스"는 판정 모델이 이미 가르고, 판정 모델이 못 가르는 "같은 이야기의 다른 사건"은 시간과 장소가 같기 때문입니다.
그리고 묶음을 가장 크게 망친 것은 어느 모델도 아닌 '오늘의 8뉴스 예고' 한 건이었습니다. 묶기는 쌍의 문제가 아니라 그래프의 문제이고, 그래프에서는 허브 하나가 모델의 정확도 0.01보다 큽니다.
1편의 마지막 문장은 "임베딩은 그물을 치고, 판정 모델은 같은 일인지 확인한다"였습니다. 이번 글은 그 앞뒤에 한 문장씩 붙입니다. 레코드는 그물코를 메우고, 허브는 묶기 전에 걷어 낸다.
출처
Cosmin Adrian Bejan, Sanda Harabagiu. "Unsupervised Event Coreference Resolution with Rich Linguistic Features." ACL 2010 — ECB 데이터셋
Agata Cybulska, Piek Vossen. "Using a sledgehammer to crack a nut? Lexical diversity and event coreference resolution." LREC 2014 — ECB+ 데이터셋
Amit Bagga, Breck Baldwin. "Algorithms for Scoring Coreference Chains." LREC 1998 Workshop — B-cubed 평가
OpenAI. "Decisions API" 개발자 문서 (2026-10 공개 베타, gpt-6-luna)