에이전트 메모리CogMemPEC2F지식 그래프출처마음 이론일화 기억의미 기억상보적 학습 시스템LoCoMoLongMemEvalRAG실측
검색에서 재구성으로 — '누가 그렇게 말했는지' 기억하는 AI, CogMem과 PEC²F 기억 그래프
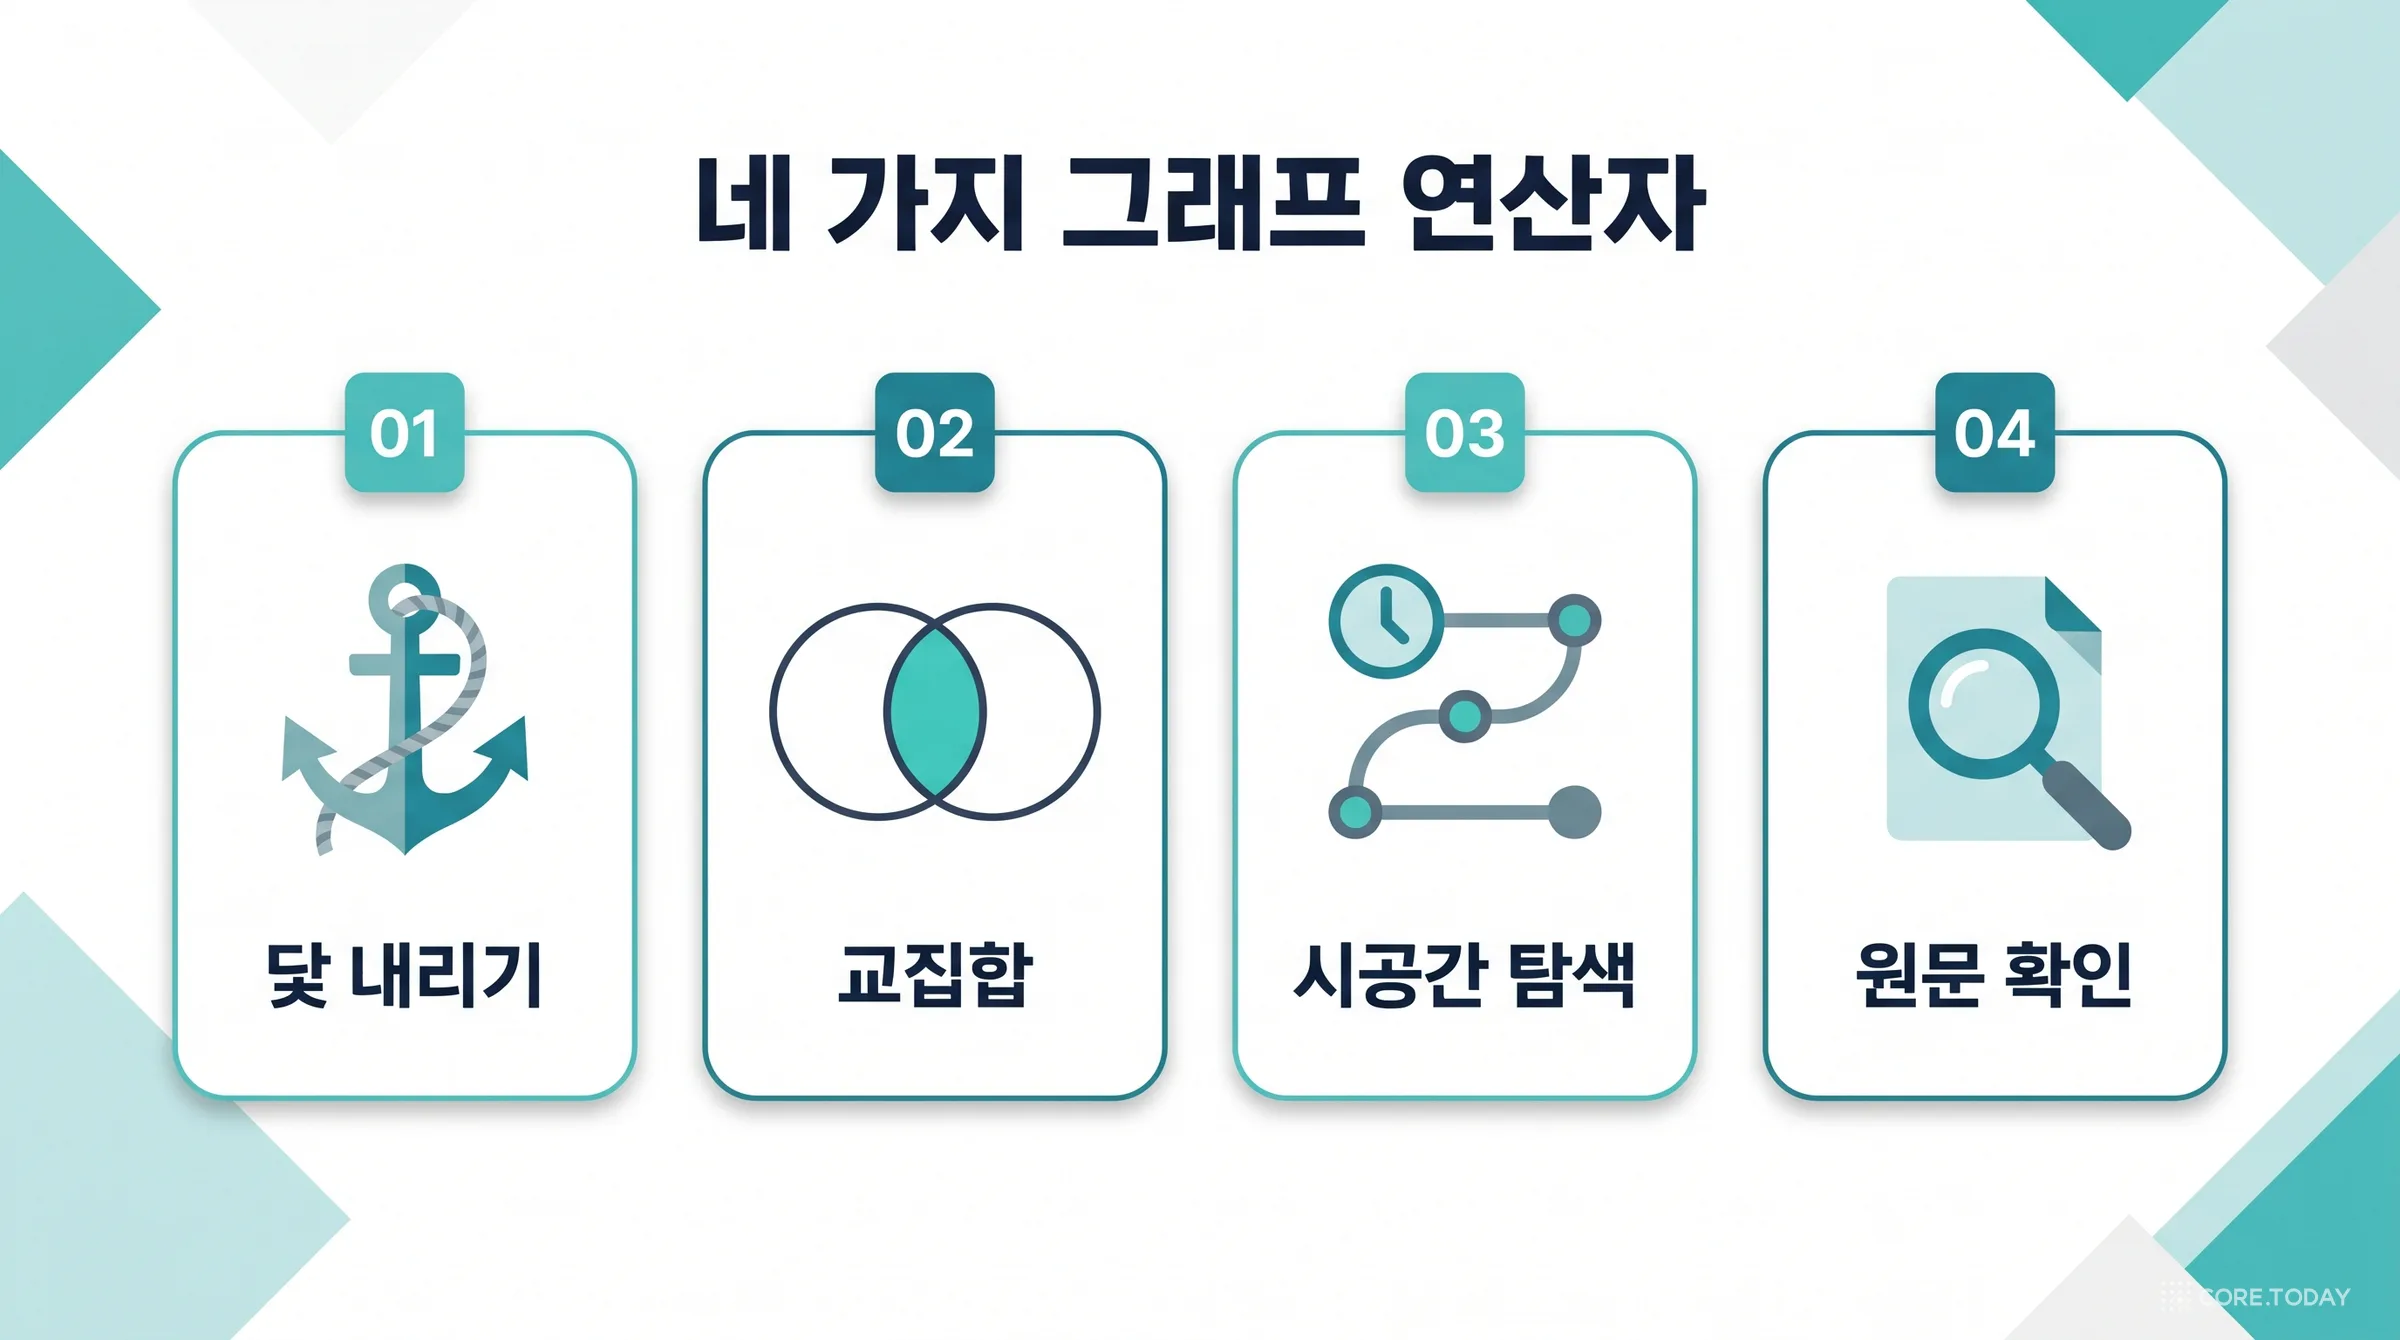
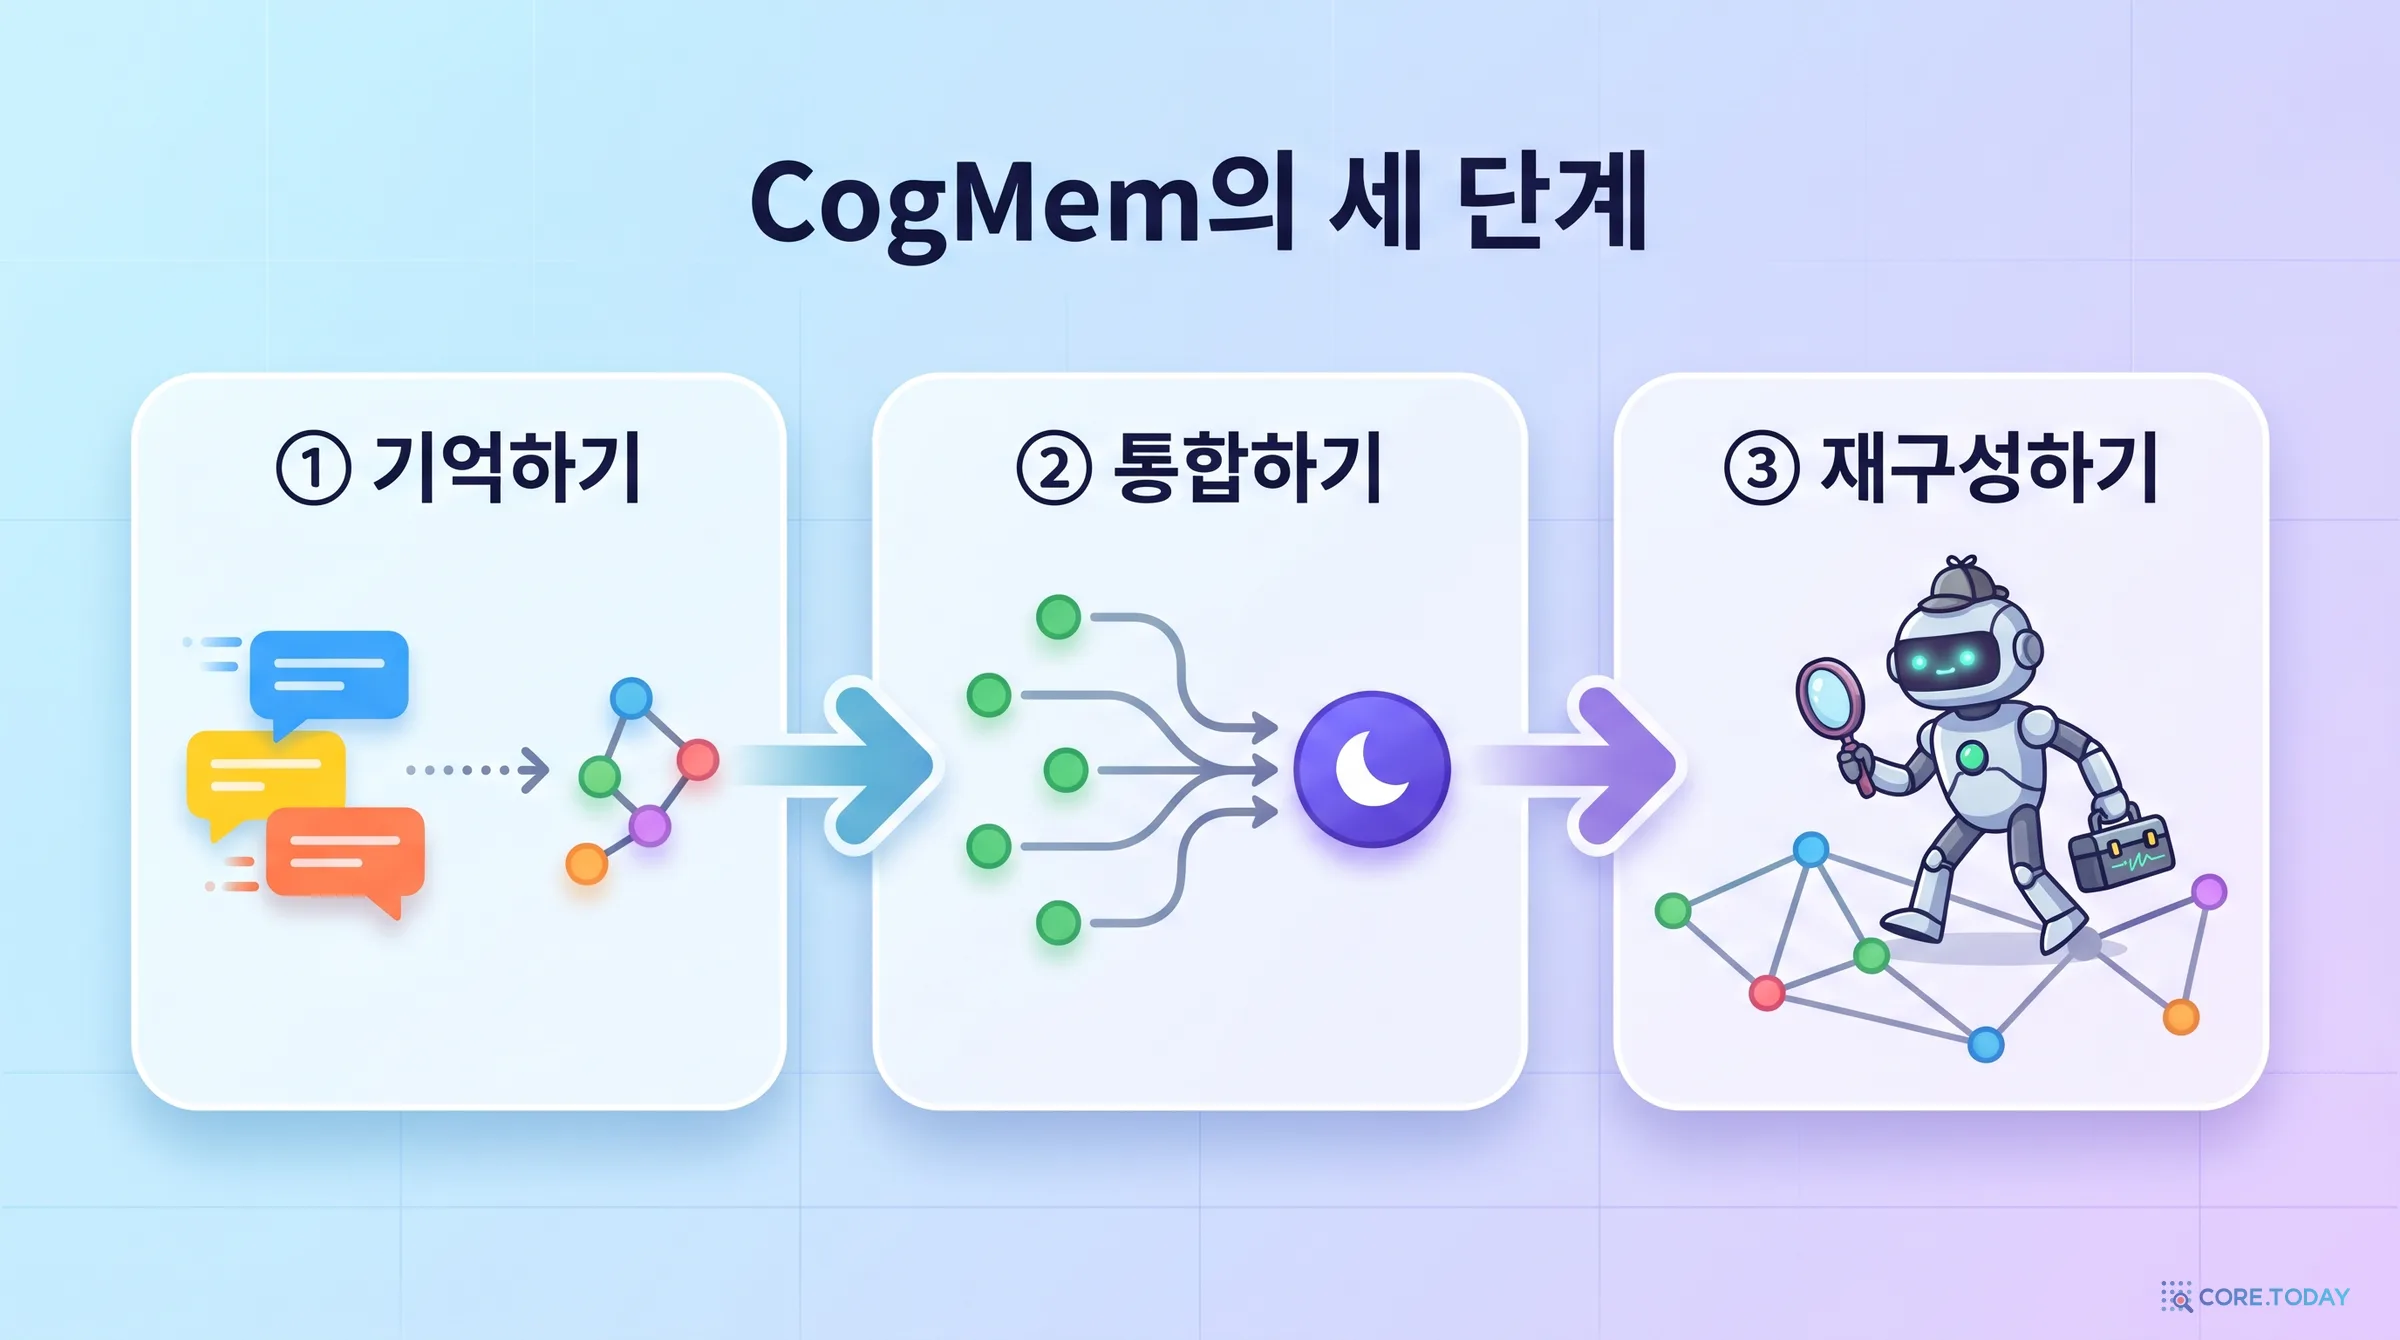
"지나는 준호가 잘린 게 회사 실수래"라는 말을 들은 AI가 몇 주 뒤 "준호는 회사 실수로 잘렸어요"라고 답한다면, 기억은 있었지만 출처를 잃은 것입니다. 칭화대 선전 국제대학원의 CogMem(arXiv 2610.11314)은 대화 기억을 사람·사건·개념·주장·사실 다섯 종류의 노드로 나누고, 남의 의견은 '누가, 누구에 대해' 한 말인지가 붙은 주장 노드로 따로 보관합니다. 질문이 오면 규칙 기반 제어기가 닻 내리기·교집합·시공간 탐색·원문 확인 네 연산자를 골라 답을 다시 짓습니다. 바틀릿의 '재구성 기억'과 툴빙의 일화·의미 기억, 출처 감시 이론, 샐리-앤 실험, 상보적 학습 이론에서 이 설계가 어디서 왔는지 따라갔습니다. 논문 표를 원 논문들과 대조해 보니 기준선 숫자 상당수가 GAM·LightMem 논문의 표를 그대로 옮긴 것이었고, LongMemEval의 'Qwen2.5-14B' 열은 실제로는 Qwen3-30B 결과였습니다. 한국어로 직접 재 보니 논문식 문장 쌍은 유사도 0.824에도 오귀속이 0건이었지만, 실제 대화 저장 형식에서는 최대 48%가 남의 의견을 집어 왔습니다. 인터랙티브 7개.
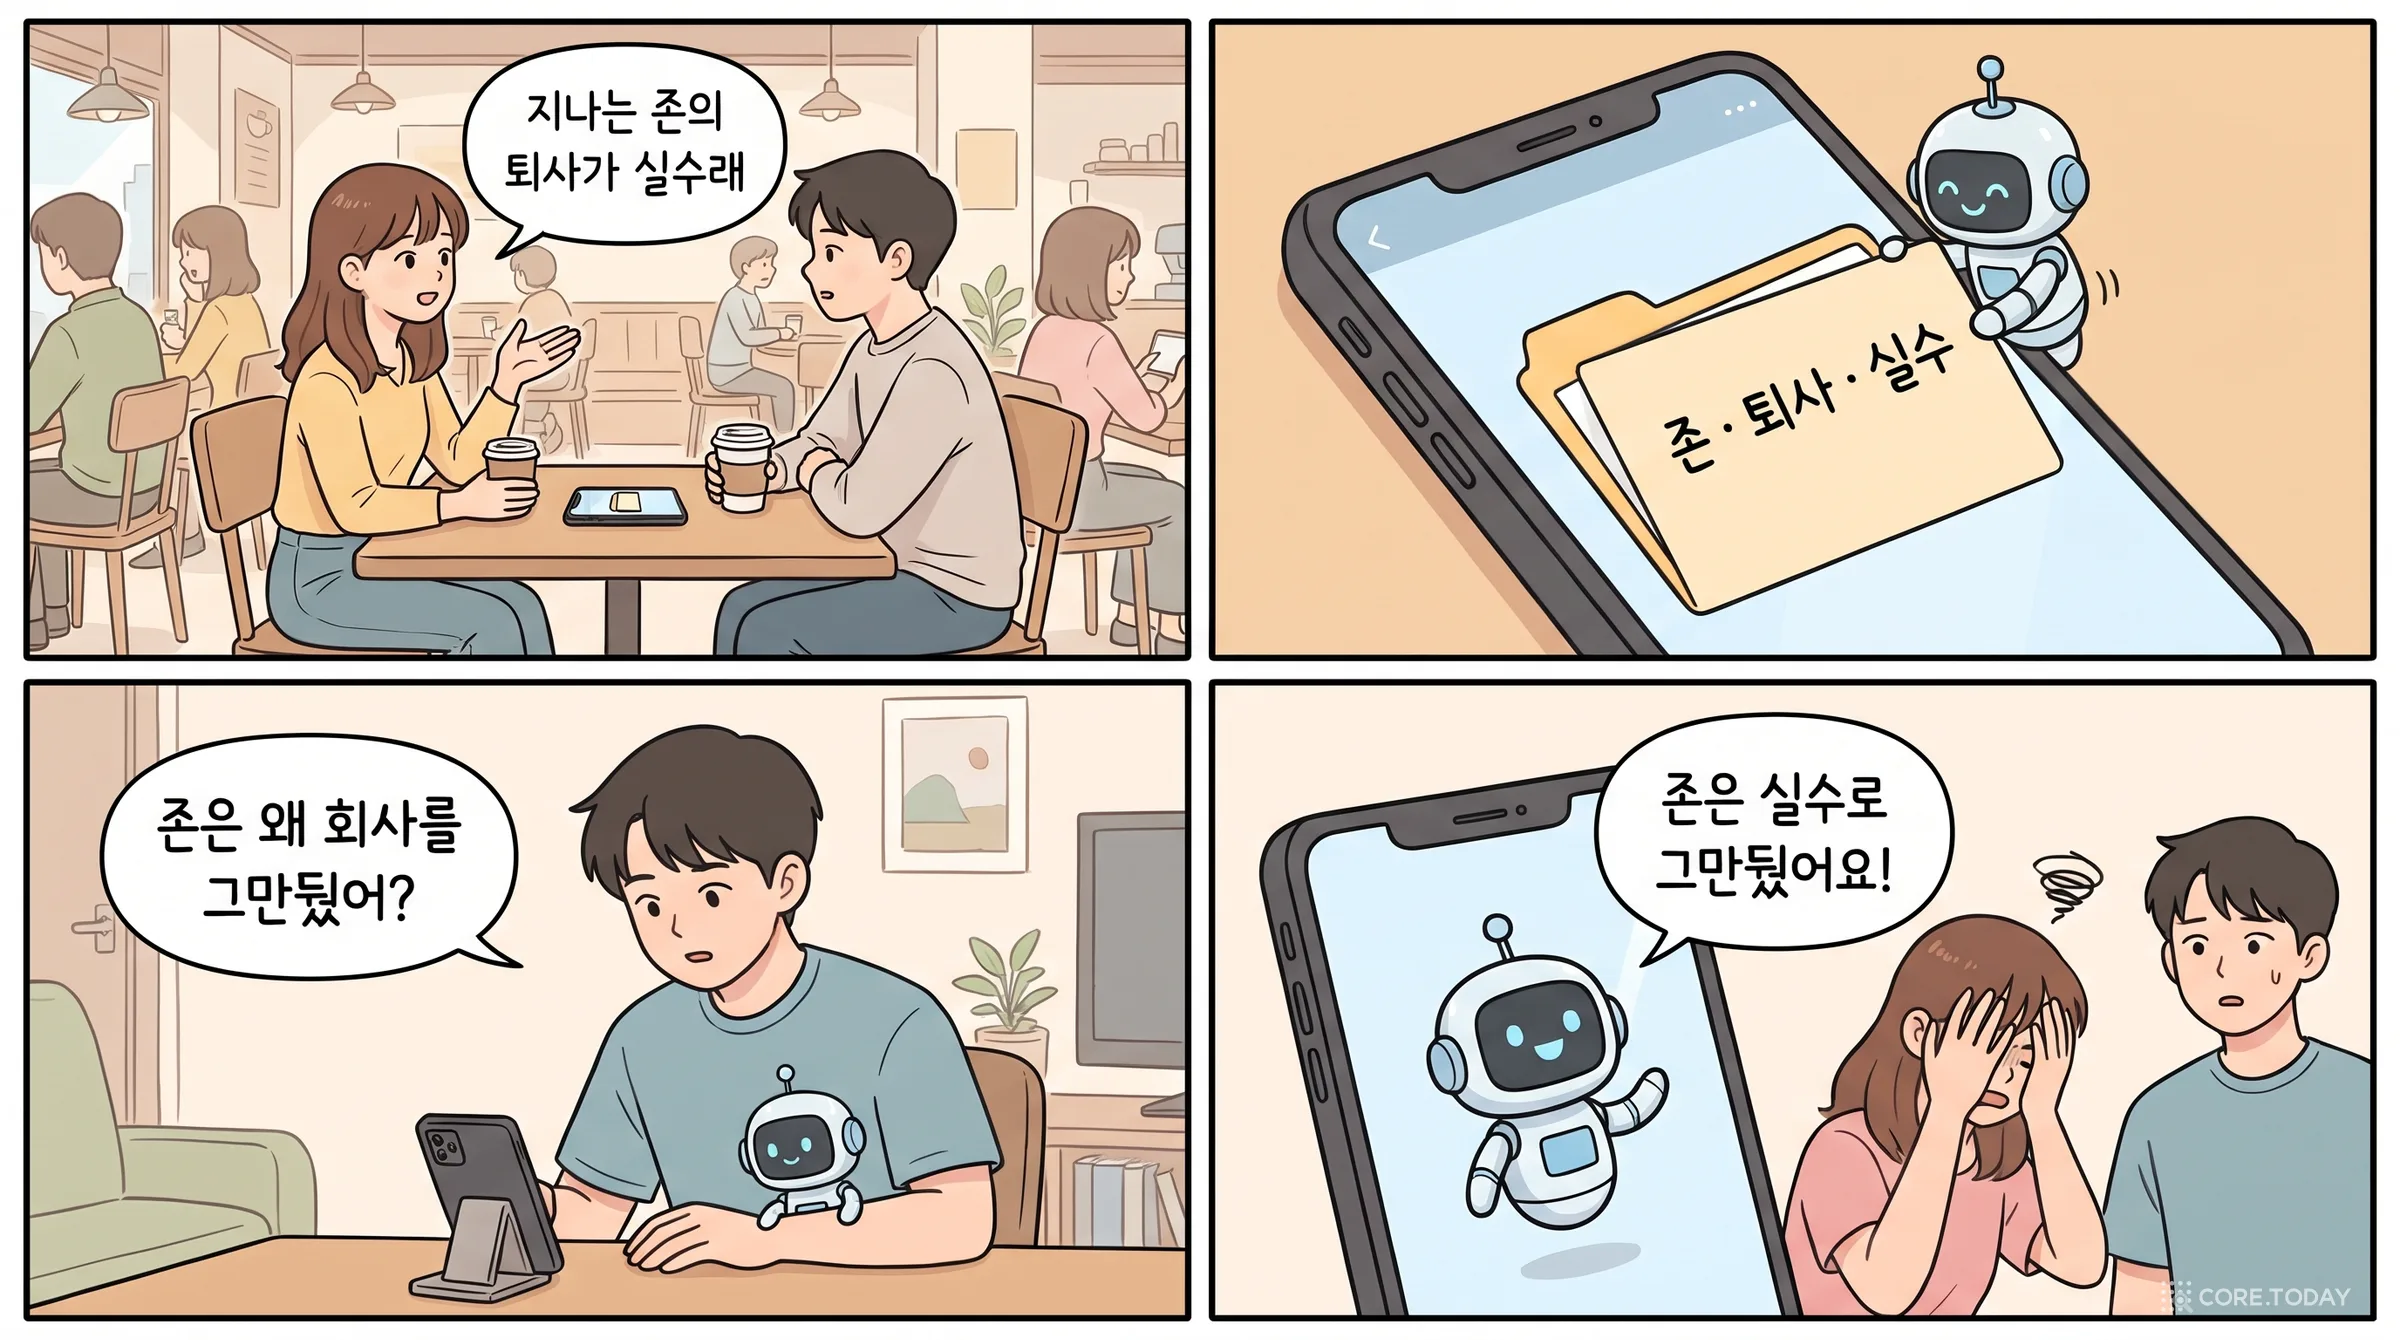
카페에서 친구 둘이 이야기합니다. 지나가 말합니다. "준호가 회사 그만둔 거, 그거 실수래." 휴대폰 속 AI 비서가 이 대화를 받아 적습니다. 메모에는 '준호 · 퇴사 · 실수'가 남습니다. 몇 주 뒤 다른 사람이 묻습니다. "준호는 왜 회사를 그만뒀어?" AI가 자신 있게 대답합니다. "준호는 실수로 그만뒀어요."
웹툰 속 '존'은 논문 예시의 주인공 Jon입니다. 이 글의 한국어 예시에서는 준호로 부릅니다.
AI는 아무것도 지어내지 않았습니다. 들은 말을 그대로 기억했습니다. 잃어버린 건 단 하나, 그 말을 누가 했는지입니다. "지나는 그렇게 생각한다"가 "그렇다"로 바뀌는 순간, 남의 의견이 사실이 됩니다.
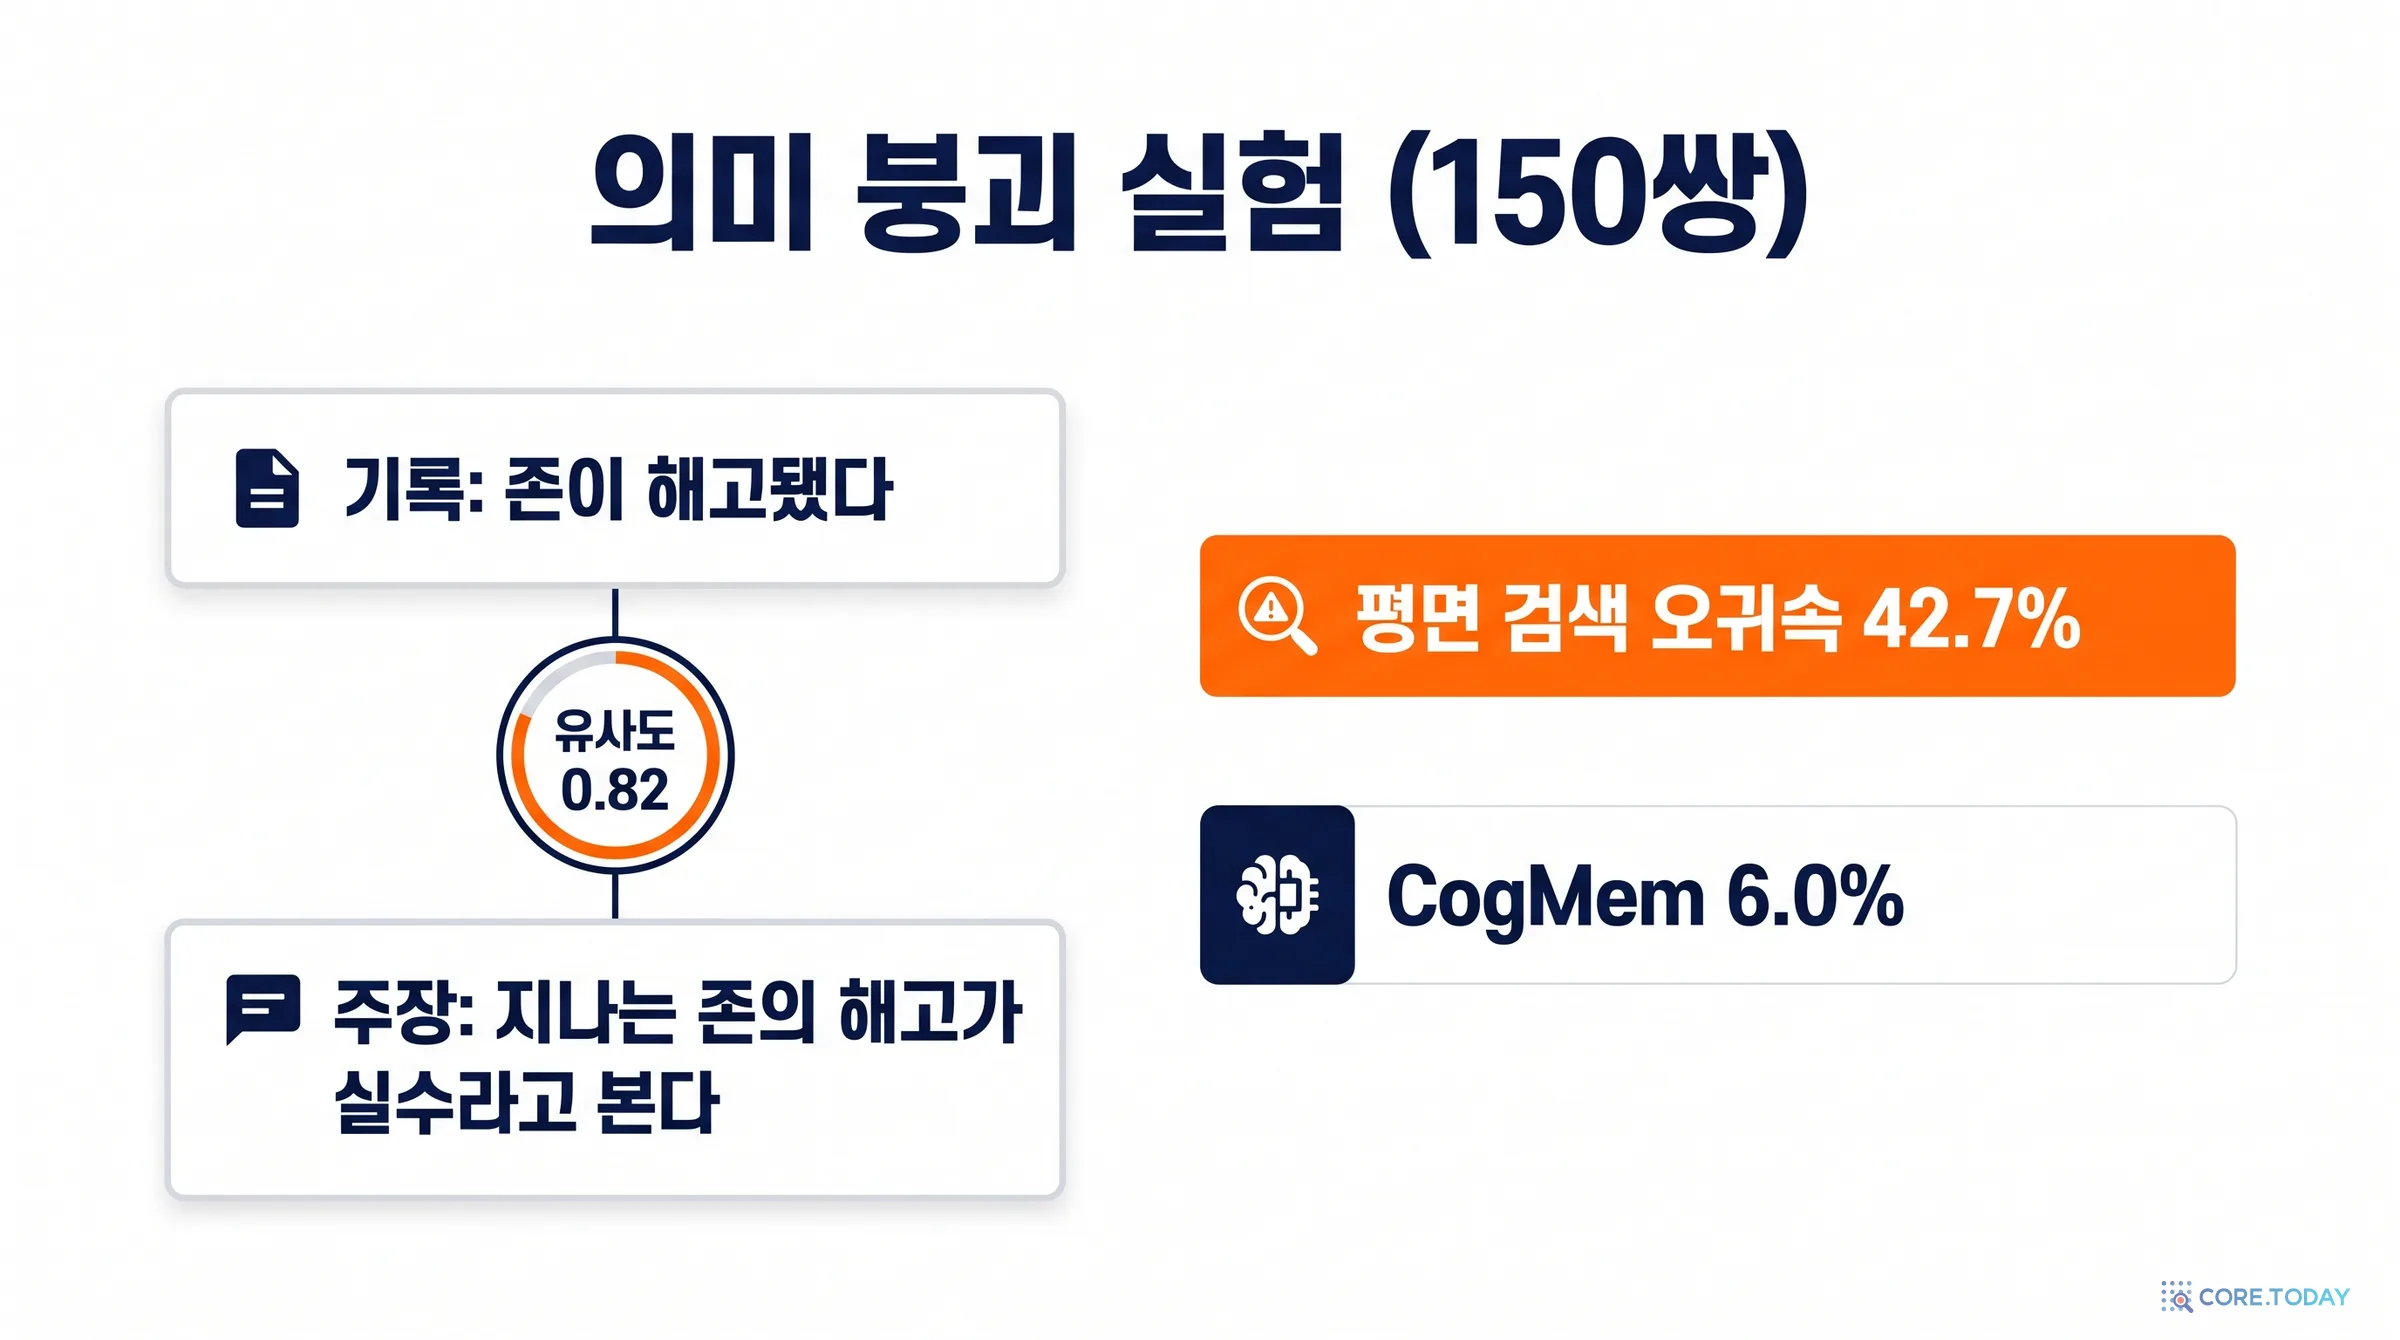
2026년 10월 8일 arXiv에 올라온 「From Retrieval to Reconstruction: Constructing Evolvable Cognitive Memory for Long-Term Dialogue」(arXiv 2610.11314)는 이 실패를 정면으로 다룹니다. 칭화대 선전 국제대학원의 랴오쯔루이(Zirui Liao) 등 일곱 명이 쓴 논문이고, 시스템 이름은 CogMem입니다. 논문은 이 실패에 의미 붕괴(Semantic Collapse)라는 이름을 붙였습니다. "준호가 해고됐다"는 기록과 "지나는 준호의 해고가 실수라고 본다"는 의견은 단어가 거의 같아서, 문장을 숫자 벡터로 바꾸면 거의 같은 자리에 놓입니다. 논문이 만든 150쌍에서 두 문장의 코사인 유사도는 평균 0.8231이었습니다. 평범한 검색 파이프라인은 기록을 물었을 때 150번 중 64번(42.7%) 의견 쪽을 가져왔습니다.
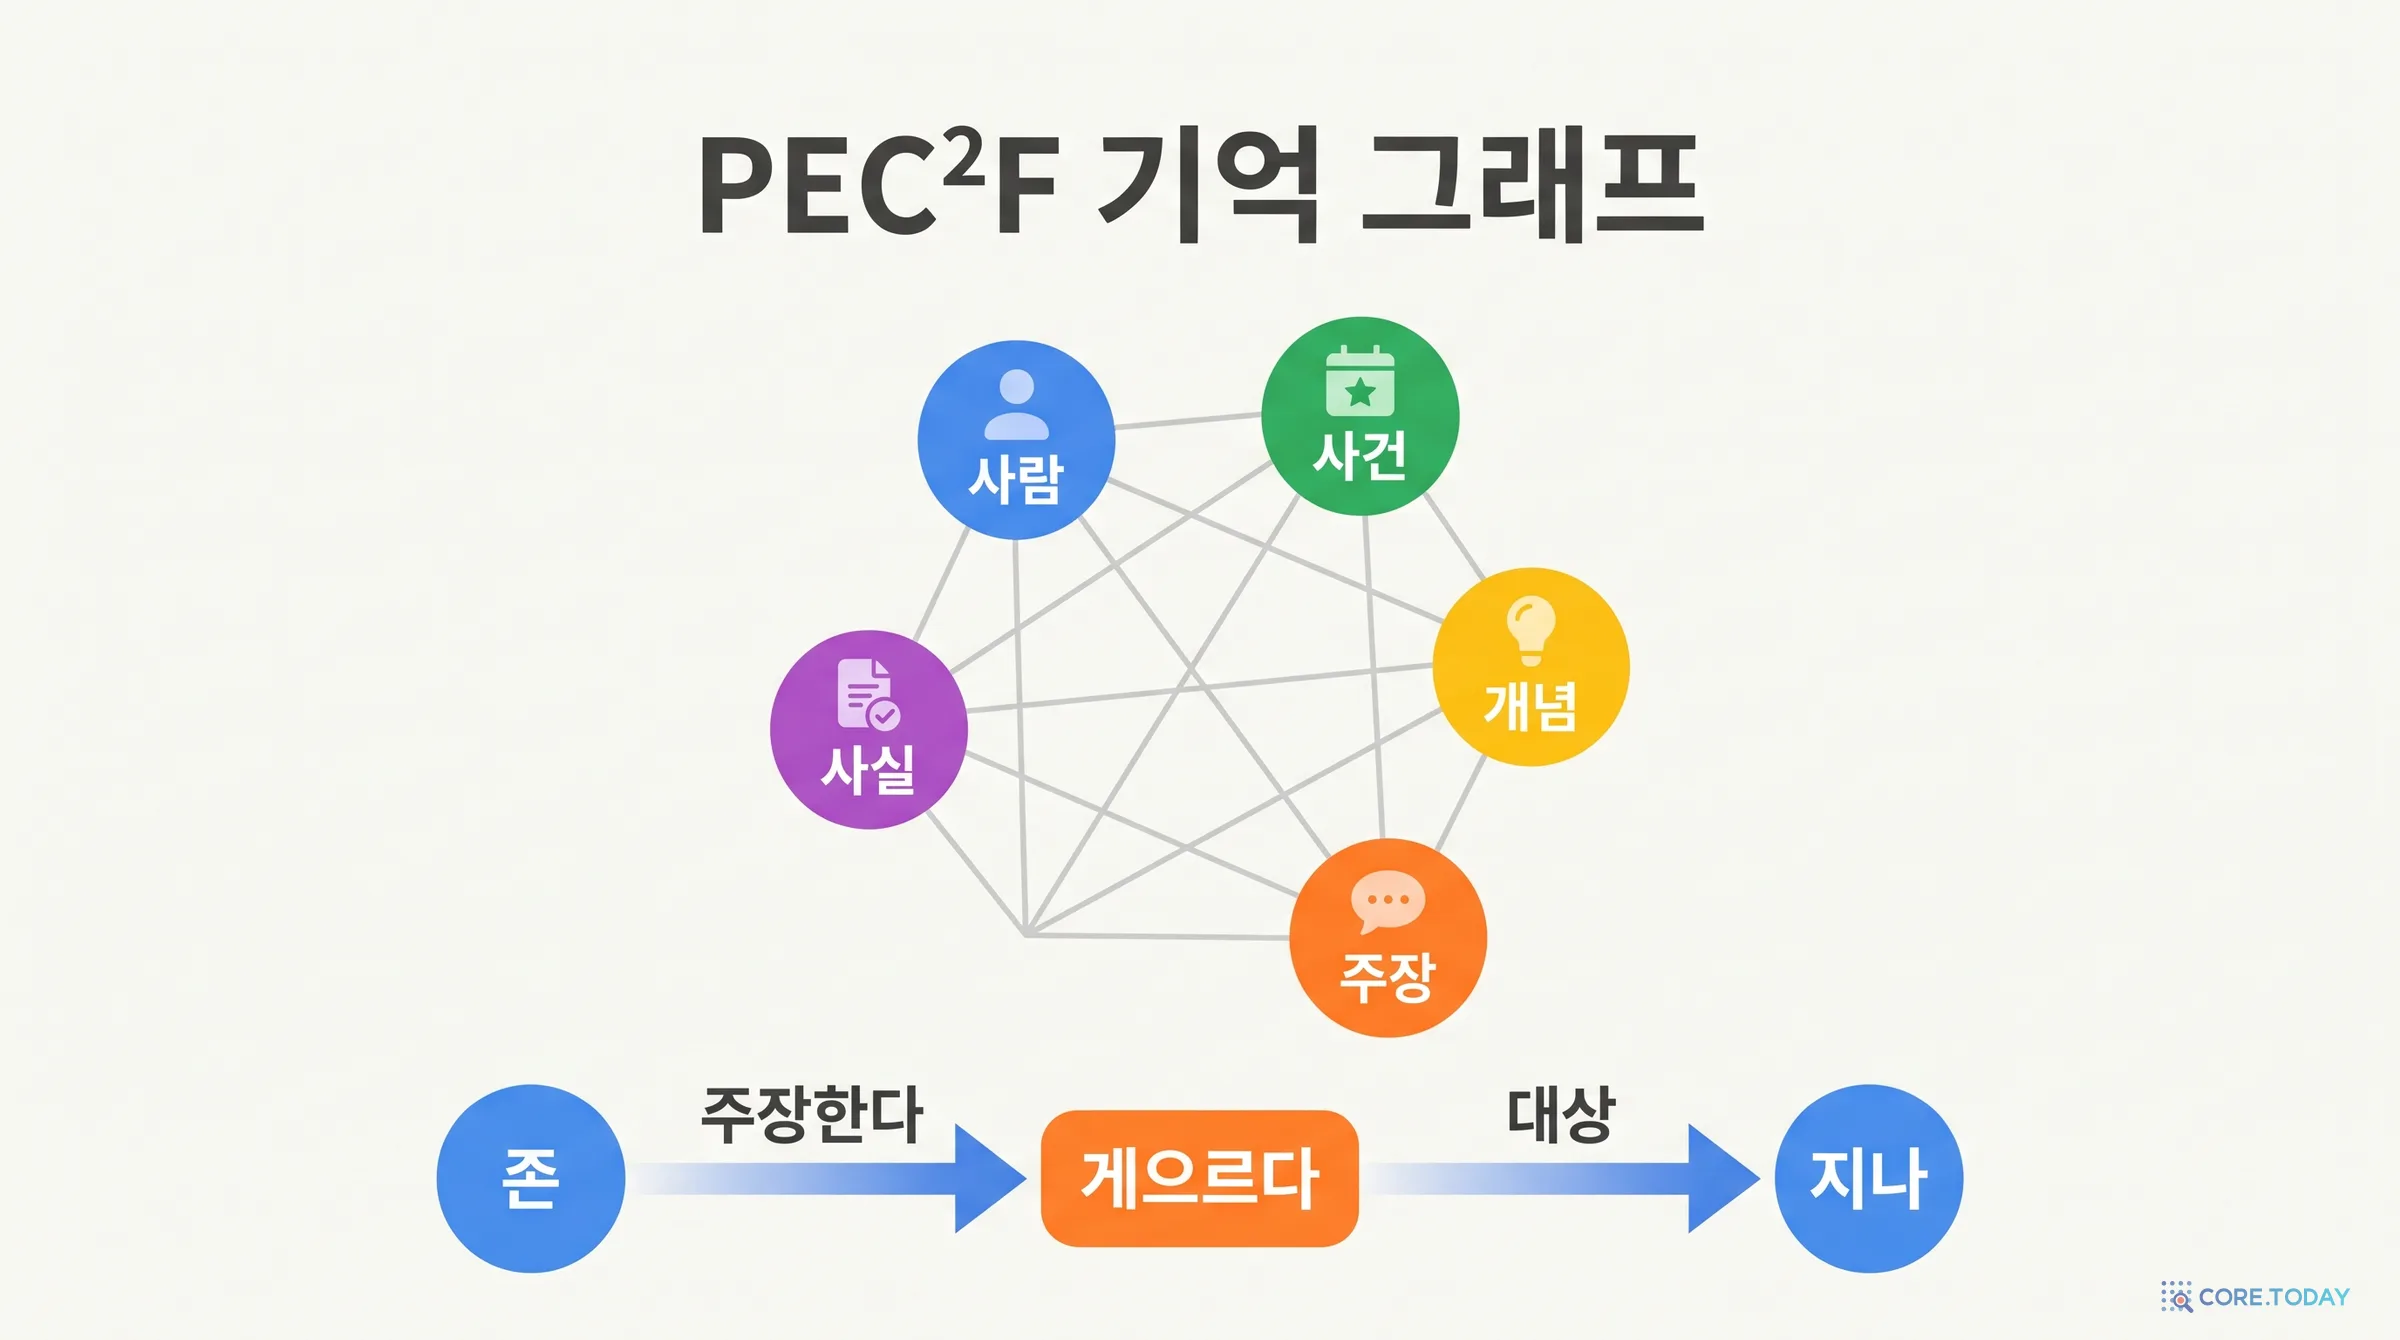
CogMem의 처방은 제목에 다 들어 있습니다. 기억을 꺼내 오는(retrieval) 일에서 다시 짓는(reconstruction) 일로 바꾸자는 것입니다. 대화를 문단째 벡터 창고에 쌓아 두지 않습니다. 사람(Person)·사건(Event)·개념(Concept)·주장(Claim)·사실(Fact) 다섯 종류의 노드로 쪼개 그래프에 넣고, 남의 의견은 "누가, 누구에 대해" 한 말인지가 박힌 주장 노드로 따로 둡니다. 질문이 오면 그래프 위를 걸어 다니며 필요한 조각을 모아 답을 다시 조립합니다.
이 글은 이 논문을 처음부터 끝까지 읽습니다. 왜 이런 생각이 나왔는지부터 시작합니다. 심리학은 '기억은 재생이 아니라 재구성'이라는 사실을 1932년에 알았고, '내용은 기억하는데 출처는 잊는' 실수에 1993년에 이름을 붙였습니다. 다음으로 CogMem의 세 기둥(스키마, 연산자, 통합)을 그림과 수식, 실제 추론 궤적으로 해부합니다. 그다음에는 숫자를 의심합니다. 논문 표를 원 논문들과 한 칸씩 대조했고, 저자들이 공개한 저장소의 커밋 118개를 읽었습니다. 마지막으로 코어닷투데이가 한국어 대화로 의미 붕괴를 직접 재 보았습니다. 결과는 논문의 이야기와 조금 달랐습니다.
이 글에서 얻어 갈 것
1. 문제 — 벡터 검색은 '기록'과 '누군가의 의견'을 구분하지 못한다(의미 붕괴). 그리고 고정된 검색 절차는 질문에 맞춰 전략을 바꾸지 못한다. 2. 처방 — PEC²F 스키마(사람·사건·개념·주장·사실), 네 그래프 연산자를 고르는 제어기, 사건을 사실로 묶되 근거를 버리지 않는 통합. 3. 결과 — LoCoMo 멀티홉 F1 48.42(Qwen2.5-14B), LongMemEval 68.40%(GPT-4o-mini). 제어기를 빼면 멀티홉이 22.81로 떨어진다. 4. 주의 — 기준선 숫자 상당수는 직접 돌린 값이 아니라 GAM·LightMem 논문 표에서 옮겨 왔다. 표 4의 한 열은 다른 모델의 결과이고, LightMem의 최고 설정은 CogMem보다 높다. 5. 한국어 실측 — 의미 붕괴는 '의견 대 사실'의 닮음보다 '누구의 이름이 문장에 들어 있느냐'에서 더 크게 일어났다.
1장. 기억은 꺼내는 것이 아니라 짓는 것이다 — 1932년 케임브리지
유령들의 전쟁
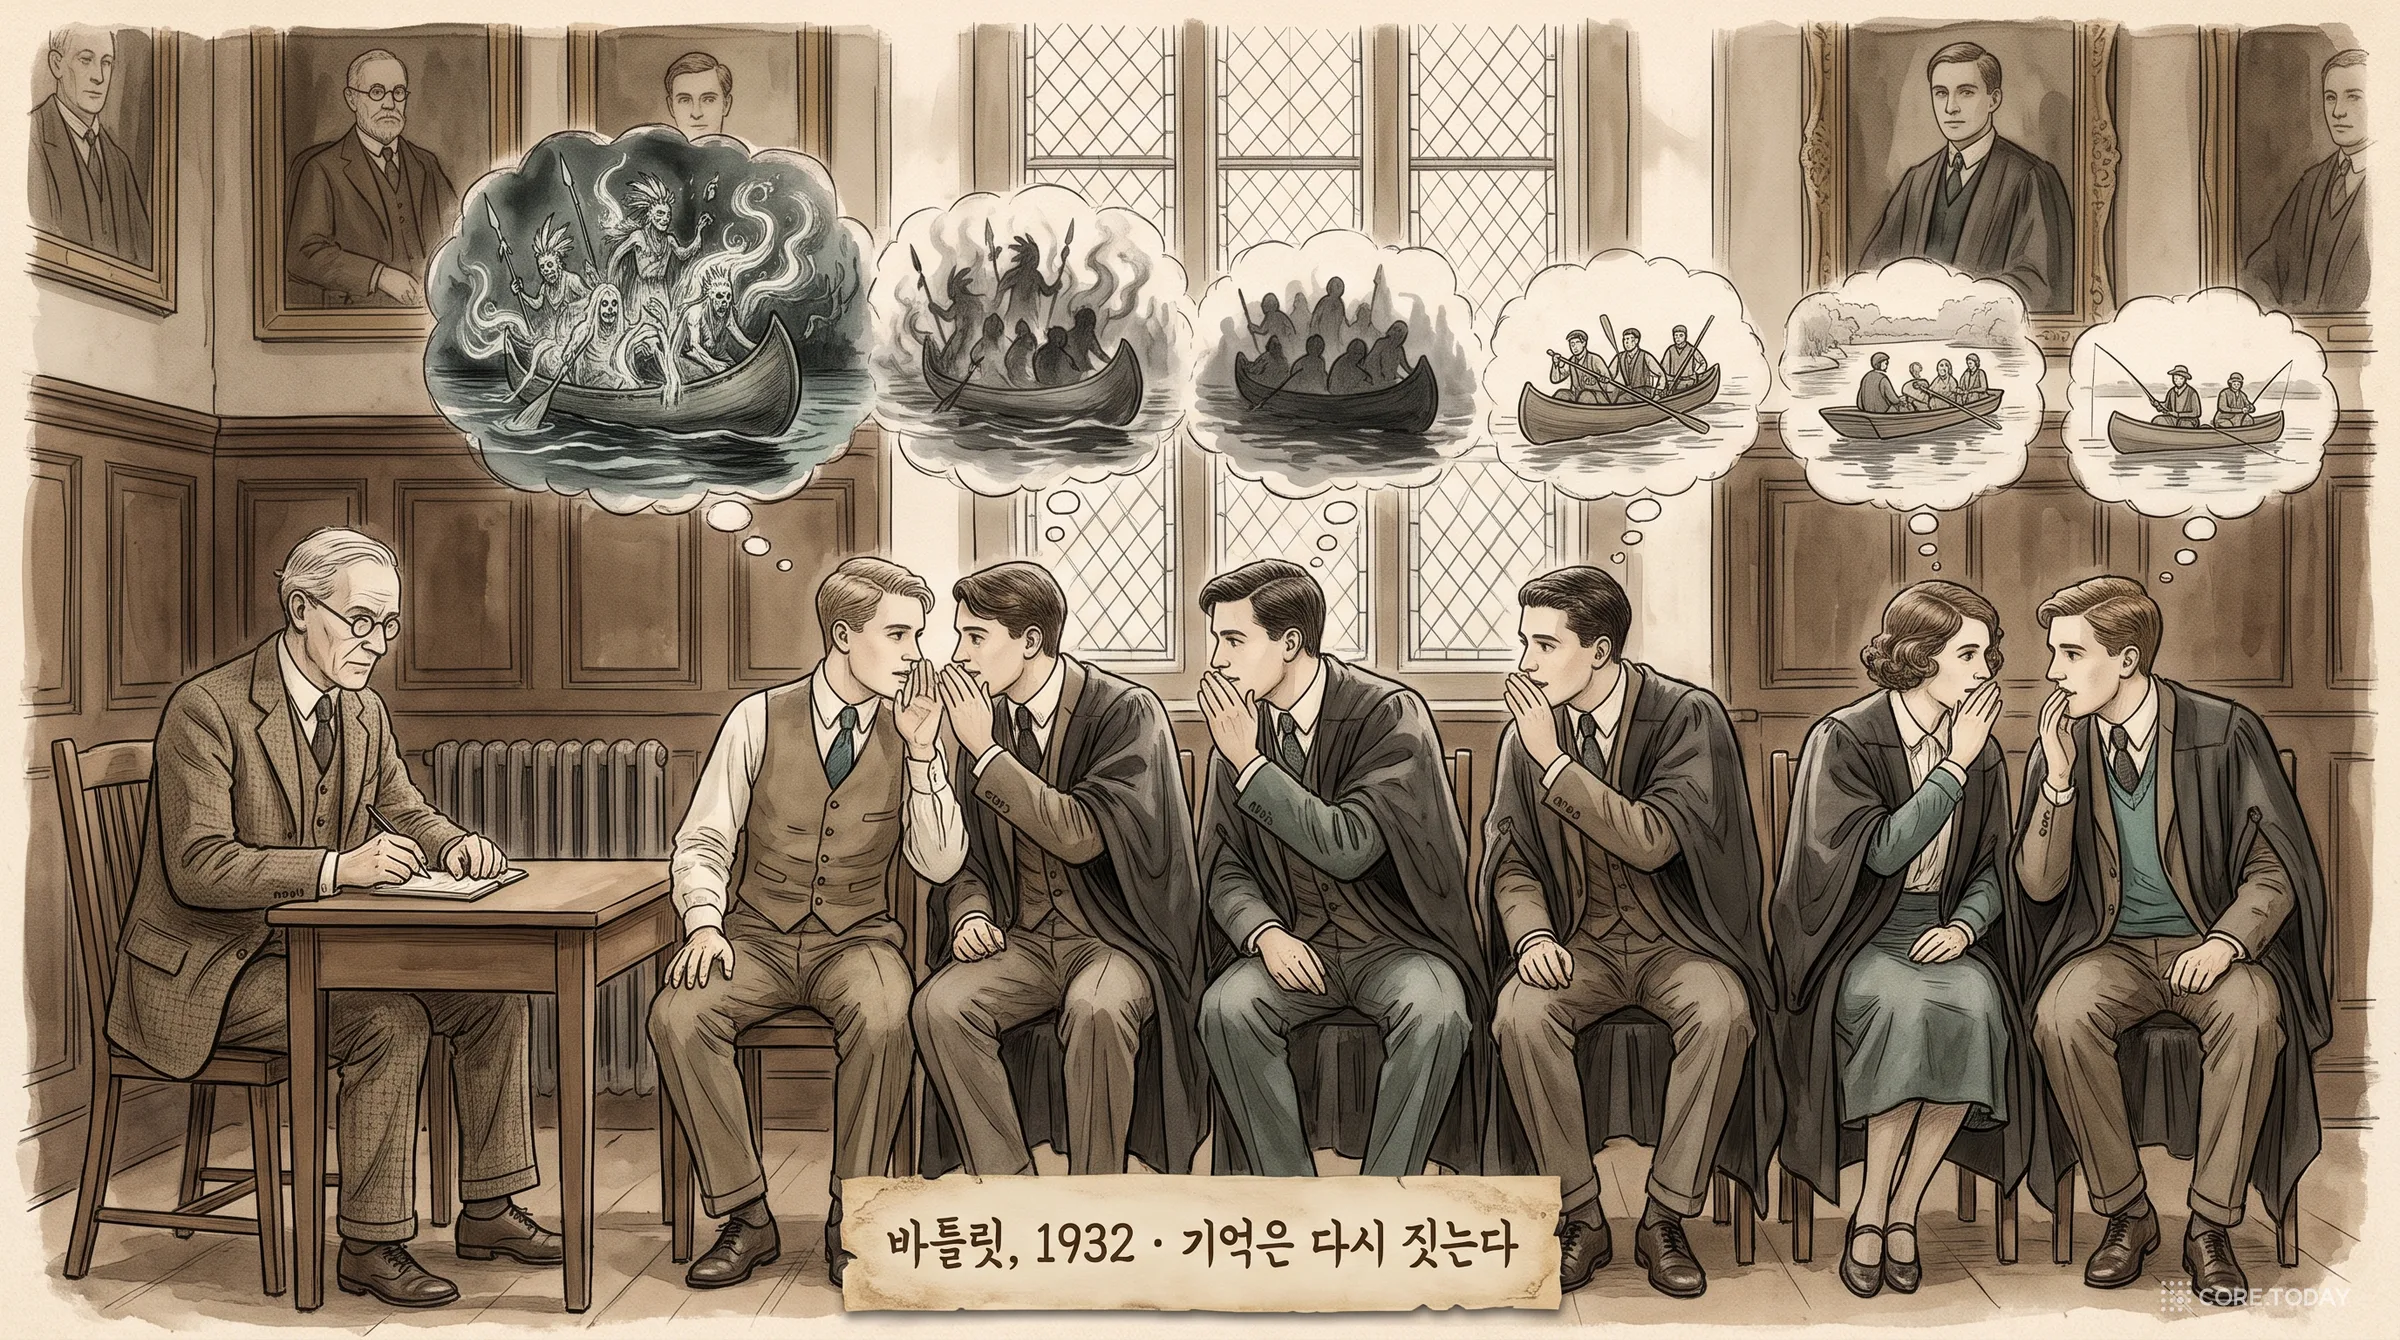
1932년 케임브리지 대학의 심리학자 프레더릭 바틀릿(Frederic Bartlett)은 『기억하기(Remembering)』라는 책을 냅니다. 실험 재료는 북미 원주민 민담 「유령들의 전쟁(The War of the Ghosts)」이었습니다. 두 청년이 강가에서 물개를 잡다가 카누를 탄 전사들을 만나고, 싸움에 끌려갔다가 그들이 유령이라는 걸 깨닫는다는, 영국 학생들에게는 낯설고 앞뒤가 이상한 이야기입니다.
바틀릿은 학생들에게 이 이야기를 읽힌 뒤 시간 간격을 두고 여러 번 다시 쓰게 했습니다(반복 재생). 한 사람이 다음 사람에게 전하게도 했습니다(연쇄 재생). 결과는 일관됐습니다. 이야기는 짧아졌고, 낯선 부분은 사라졌고, 익숙한 틀로 바뀌었습니다. 카누는 보트가 되고, 물개 사냥은 낚시가 되고, 유령 이야기는 평범한 전투담이 됐습니다. 참가자들은 빈칸을 자기 문화의 상식으로 메웠고, 메웠다는 사실을 알지 못했습니다.
바틀릿의 결론은 이렇습니다. 기억은 머릿속 창고에서 녹화 테이프를 꺼내 트는 일이 아닙니다. 남아 있는 조각과 스키마(schema), 즉 세상에 대한 일반 지식을 합쳐 그 자리에서 이야기를 다시 짓는 일입니다. 'schema'라는 단어가 심리학의 핵심 용어가 된 것도 이 책 덕분입니다. CogMem 논문의 'PEC²F schema'라는 이름은 이 오래된 단어를 그대로 물려받았습니다.
질문 하나가 기억을 바꾼다
재구성은 장점이자 위험입니다. 1974년 엘리자베스 로프터스(Elizabeth Loftus)와 존 파머(John Palmer)는 참가자들에게 자동차 충돌 영상을 보여 준 뒤 질문의 동사만 바꿨습니다. "차들이 박살 났을(smashed) 때 얼마나 빨리 달리고 있었나요?"라고 물은 집단은 평균 시속 40.5마일이라고 답했고, "접촉했을(contacted) 때"라고 물은 집단은 31.8마일이라고 답했습니다. 일주일 뒤 "깨진 유리를 봤나요?"라고 묻자(영상에 깨진 유리는 없었습니다) '박살' 집단의 32%가 그렇다고 답했습니다. '부딪쳤을(hit)' 집단은 14%였습니다.
단어 하나가 기억의 내용을 바꿨습니다. LLM 기억 시스템으로 옮기면 이렇습니다. 기억을 다시 지을 때 무엇을 재료로 쓰느냐에 따라 답이 달라지고, 재료에 섞여 든 남의 해석은 기억 자체로 둔갑합니다. 지나의 의견이 준호의 이력이 되는 장면은 로프터스 실험의 기계판입니다.
그래서 CogMem이 말하는 '재구성'은 바틀릿의 재구성과 한 가지가 다릅니다. 영수증이 붙은 재구성입니다. 다시 짓되, 어느 조각이 누구의 말이고 어느 대화 몇 번째 문장에서 왔는지를 끝까지 들고 다닙니다. 논문 7장의 표현으로는 기억을 "구조적이고, 출처를 밝힐 수 있고, 감사할 수 있게" 만드는 것이 목표입니다.
2장. 다섯 개의 오래된 생각 — CogMem의 족보
CogMem의 다섯 노드와 세 기둥은 하늘에서 떨어지지 않았습니다. 각각 수십 년 된 연구 전통에서 왔습니다. 논문이 직접 인용한 것도 있고, 인용하지 않았지만 같은 생각을 먼저 한 것도 있습니다.
① 일화 기억과 의미 기억 — 사건(Event)과 사실(Fact)
1972년 캐나다 심리학자 엔델 툴빙(Endel Tulving)은 「일화 기억과 의미 기억(Episodic and semantic memory)」이라는 장을 씁니다. "작년 3월 제주에서 한라산에 올랐다"는 일화 기억입니다. 언제, 어디서, 누구와라는 시공간 좌표가 붙어 있습니다. "한라산은 1,947미터다"나 "나는 등산을 좋아한다"는 의미 기억입니다. 언제 배웠는지는 잊었고 내용만 남았습니다.
CogMem의 사건 노드(VE)가 일화 기억이고 사실 노드(VF)가 의미 기억입니다. 논문은 이를 동사로도 구분합니다. 사건은 특정한 상호작용, 즉 무엇을 했다(Do)를 담고, 사실은 관찰되거나 스스로 밝힌 속성과 습관, 즉 어떠하다(Is)를 담습니다. 툴빙의 정의를 따라 사건 노드는 참여자를 특정 시간과 장소에 묶습니다.
② 빠른 해마, 느린 신피질 — 통합(Consolidation)
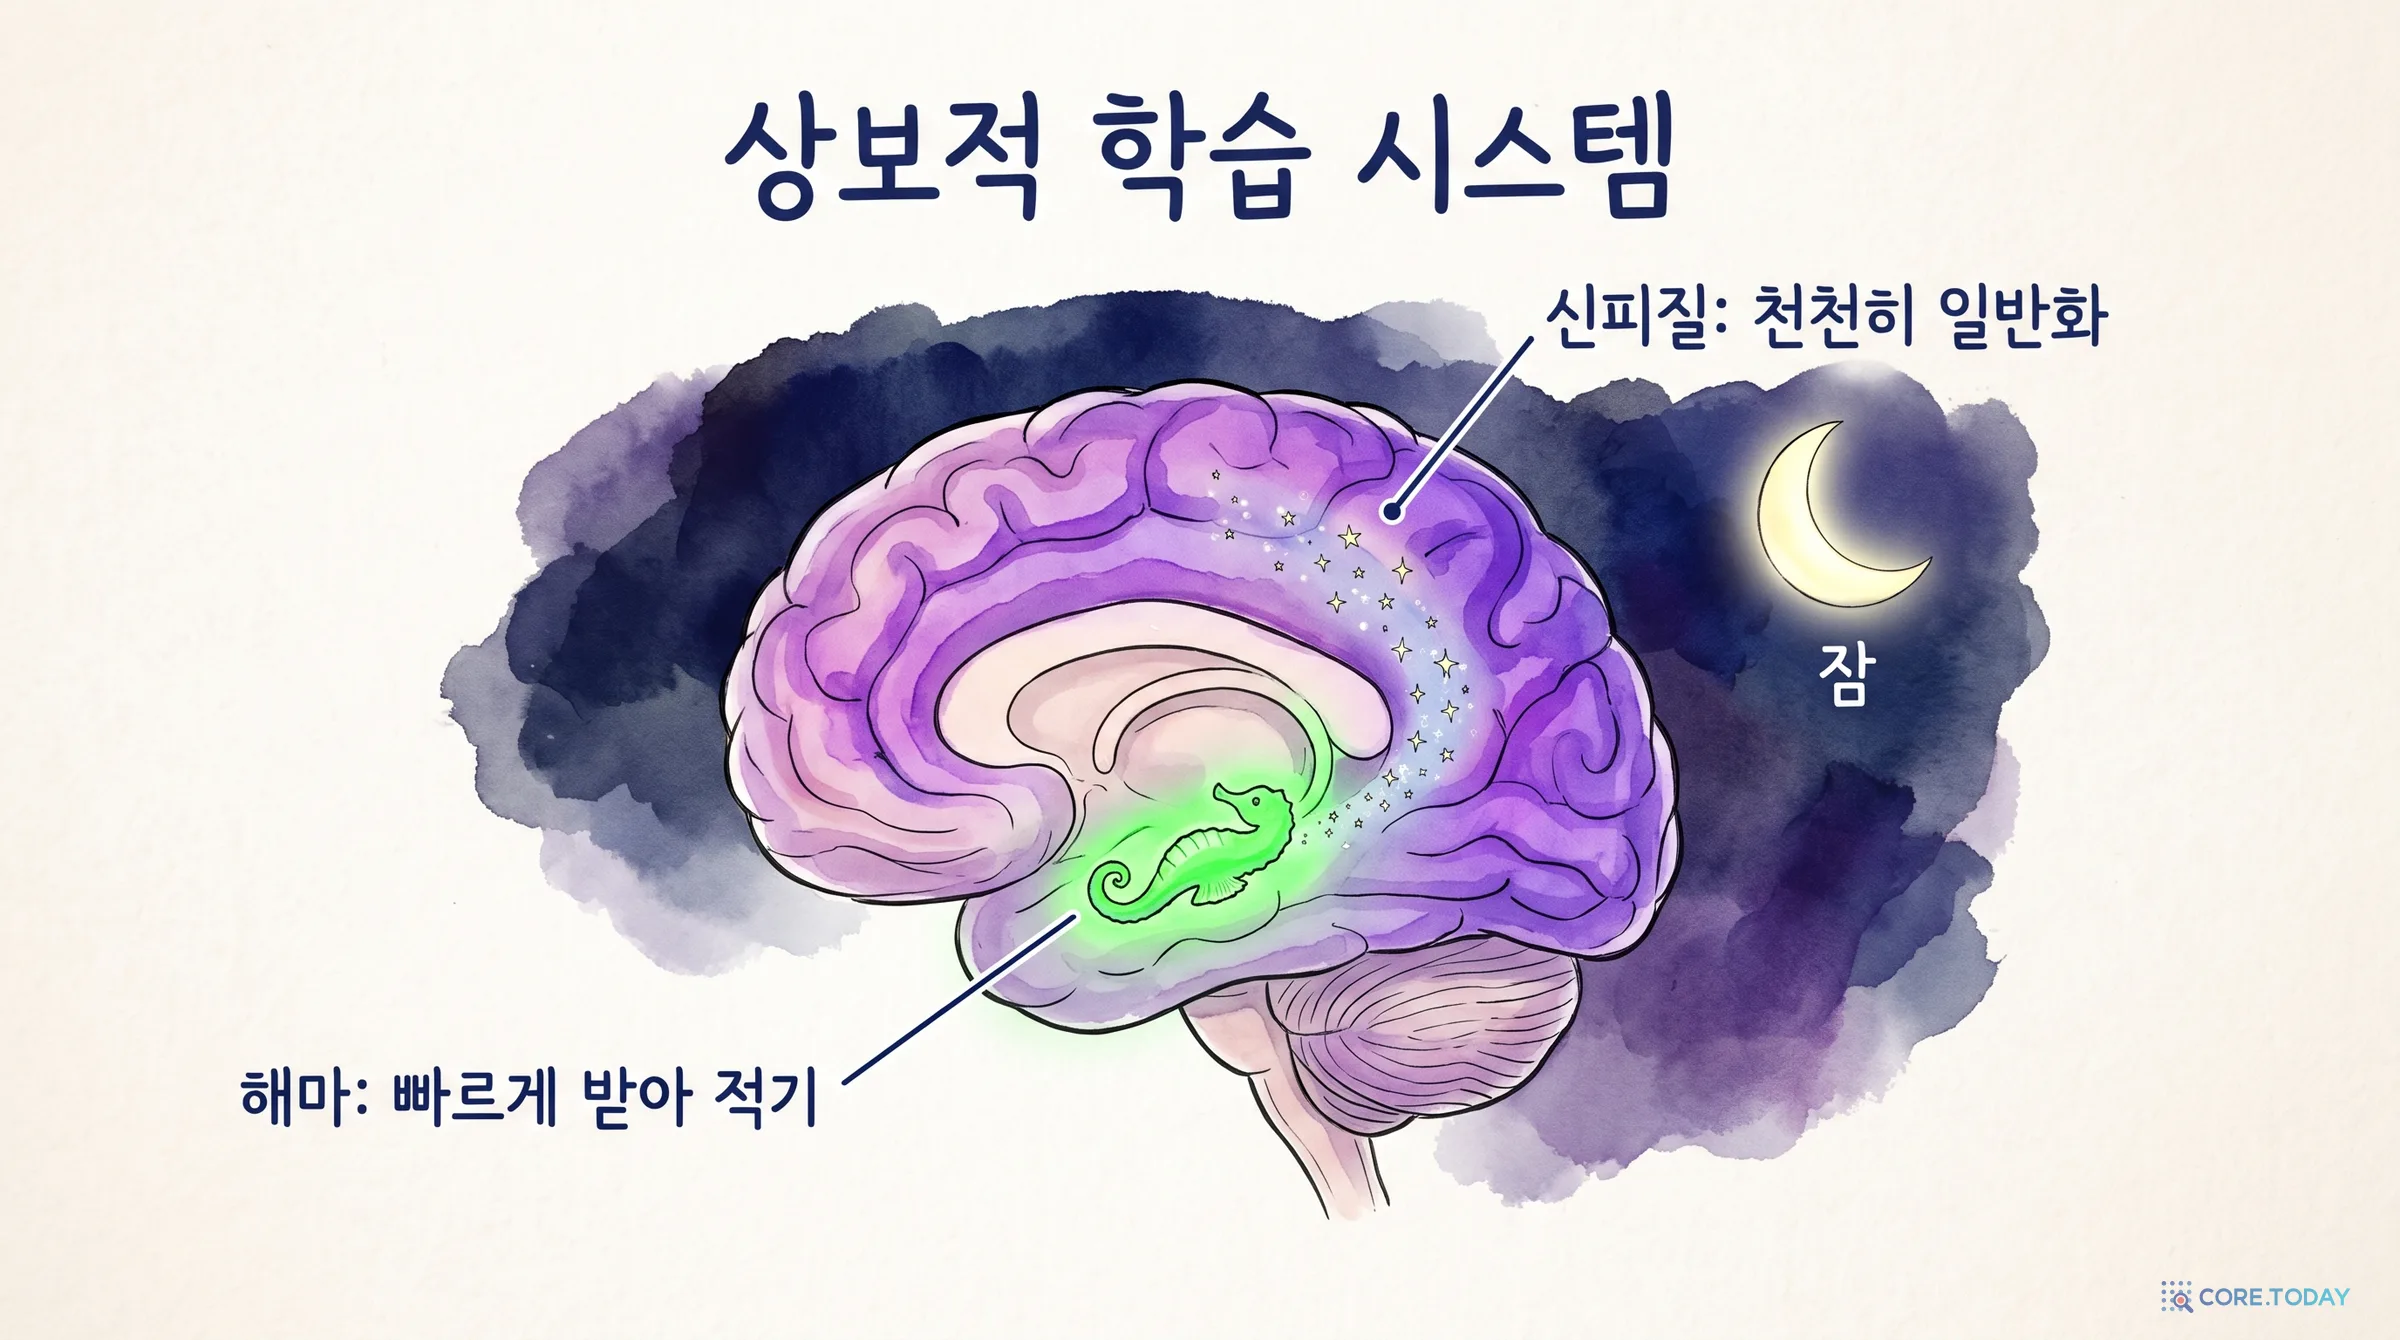
1953년 간질 치료를 위해 양쪽 해마를 잘라 낸 환자 H.M.(헨리 몰레이슨)은 수술 뒤 새로운 일화를 기억하지 못했습니다. 그런데 수술 몇 년 전의 일은 대체로 기억했습니다. 해마는 새 기억을 임시로 받아 적는 곳이고, 오래된 기억은 다른 곳(신피질)으로 옮겨진다는 단서였습니다(Scoville & Milner, 1957).
1995년 제임스 매클렐런드(James McClelland), 브루스 맥노턴(Bruce McNaughton), 랜들 오라일리(Randall O'Reilly)는 왜 뇌가 이렇게 두 시스템을 쓰는지 신경망으로 설명했습니다. 이른바 상보적 학습 시스템(Complementary Learning Systems, CLS) 이론입니다. 신경망에 새 지식을 빨리 밀어 넣으면 옛 지식이 덮여 지워집니다(1989년 McCloskey와 Cohen이 보고한 '파국적 간섭'). 그래서 뇌는 해마에 일화를 빠르게 따로 적어 두고, 잠자는 동안 그것을 조금씩 되풀이해 신피질의 일반 지식에 천천히 섞는다는 것입니다. 2016년 다르샨 쿠마란(Dharshan Kumaran), 데미스 허사비스(Demis Hassabis), 매클렐런드가 이 이론을 AI 관점에서 다시 정리한 논문 「지능형 에이전트에게는 어떤 학습 시스템이 필요한가」를 CogMem이 직접 인용합니다.
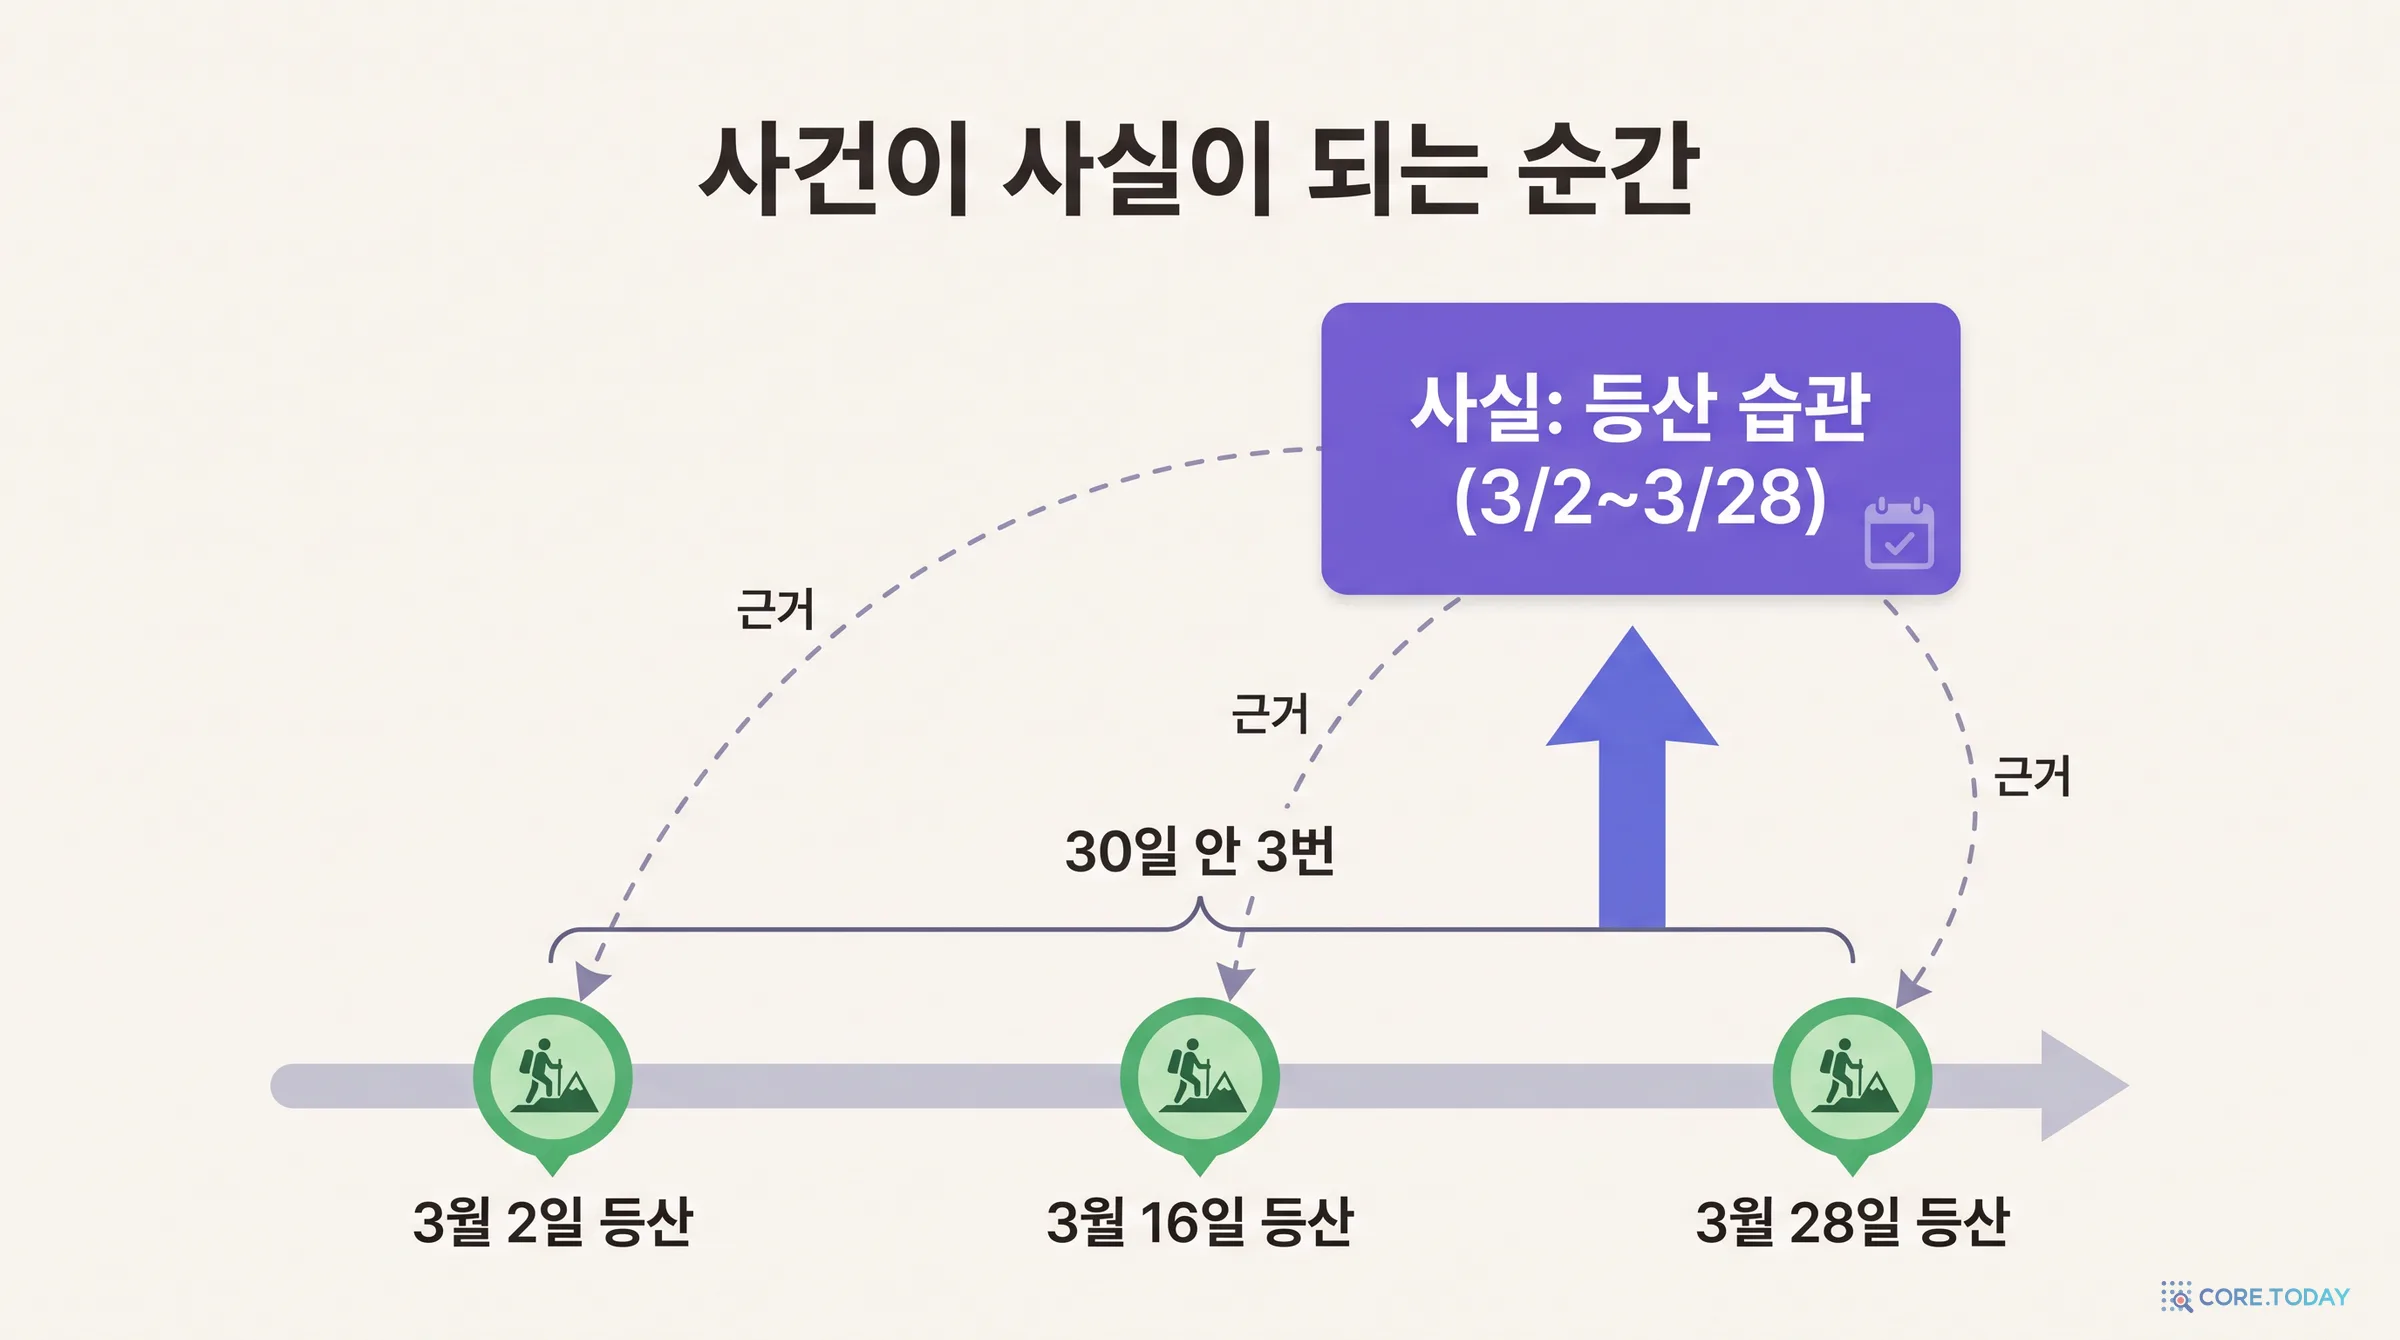
CogMem의 통합기(Consolidator)가 바로 이 '잠'입니다. 대화가 오가는 동안에는 사건 노드를 빠르게 쌓고(해마), 오프라인에서 주기적으로 반복되는 사건을 사실 노드로 묶습니다(신피질). 30일 안에 등산 사건이 세 번 쌓이면 "등산하는 습관이 있다"라는 사실이 생기는 식입니다. 뇌와 다른 점도 있습니다. 뇌는 원본 일화를 점점 잃어버리지만, CogMem은 원본 사건을 지우지 않고 새 사실에 근거(SUPPORTED_BY) 간선으로 매달아 둡니다.
③ 내용은 남고 출처는 사라진다 — 주장(Claim)
1949년 칼 호블랜드(Carl Hovland) 연구진은 미 육군 병사들에게 선전 영화를 보여 주고 태도 변화를 쟀습니다. 이상한 현상이 나왔습니다. 믿을 만하지 않은 출처에서 들은 메시지가 시간이 지나자 오히려 설득력이 커졌습니다. 처음에는 "그 사람 말이니까 걸러 듣자"고 했지만, 몇 주 뒤에는 메시지만 남고 '그 사람'은 잊혔기 때문입니다. 호블랜드와 와이스(Weiss)는 1951년 이 현상을 수면자 효과(sleeper effect)라고 불렀습니다.
1993년 마샤 존슨(Marcia Johnson), 샤힌 하시트루디(Shahin Hashtroudi), 스티븐 린지(D. Stephen Lindsay)는 이런 실수들을 하나의 틀로 묶었습니다. 출처 감시(source monitoring) 이론입니다. 사람은 기억에 '출처 꼬리표'를 붙여 저장하지 않습니다. 기억을 떠올릴 때마다 생생함, 맥락, 감정 같은 특징을 보고 출처를 추론합니다. 그래서 꿈에서 본 것을 실제로 겪은 일로, 남이 한 말을 내가 한 생각으로, 뉴스 해설을 뉴스 사실로 헷갈립니다.
벡터 검색은 출처 감시를 못 하는 기억입니다. 임베딩은 문장의 내용을 압축하고, "누가 그렇게 말했다"는 껍질은 내용에 비해 아주 작은 신호로만 남습니다. CogMem의 주장 노드(VClaim)는 출처 꼬리표를 추론에 맡기지 말고 구조로 박아 두자는 처방입니다. "준호는 지나가 게으르다고 생각한다"를 '지나—게으르다'라는 속성으로 저장하지 않고, 준호에서 주장 노드로, 주장 노드에서 지나로 가는 두 단계 경로로 저장합니다. 논문 식 (1)입니다.
∧(p준호,CLAIMS,nclaim)∈E(nclaim,ABOUT,p지나)∈E
주장 노드 안에는 내용("게으르다")과 감정 극성이 들어갑니다. 이렇게 하면 두 문장의 임베딩이 아무리 비슷해도, 그래프의 모양만 보고 "이건 누군가의 생각이다"를 알 수 있습니다.
④ 샐리는 구슬이 어디 있다고 믿을까 — 마음 이론
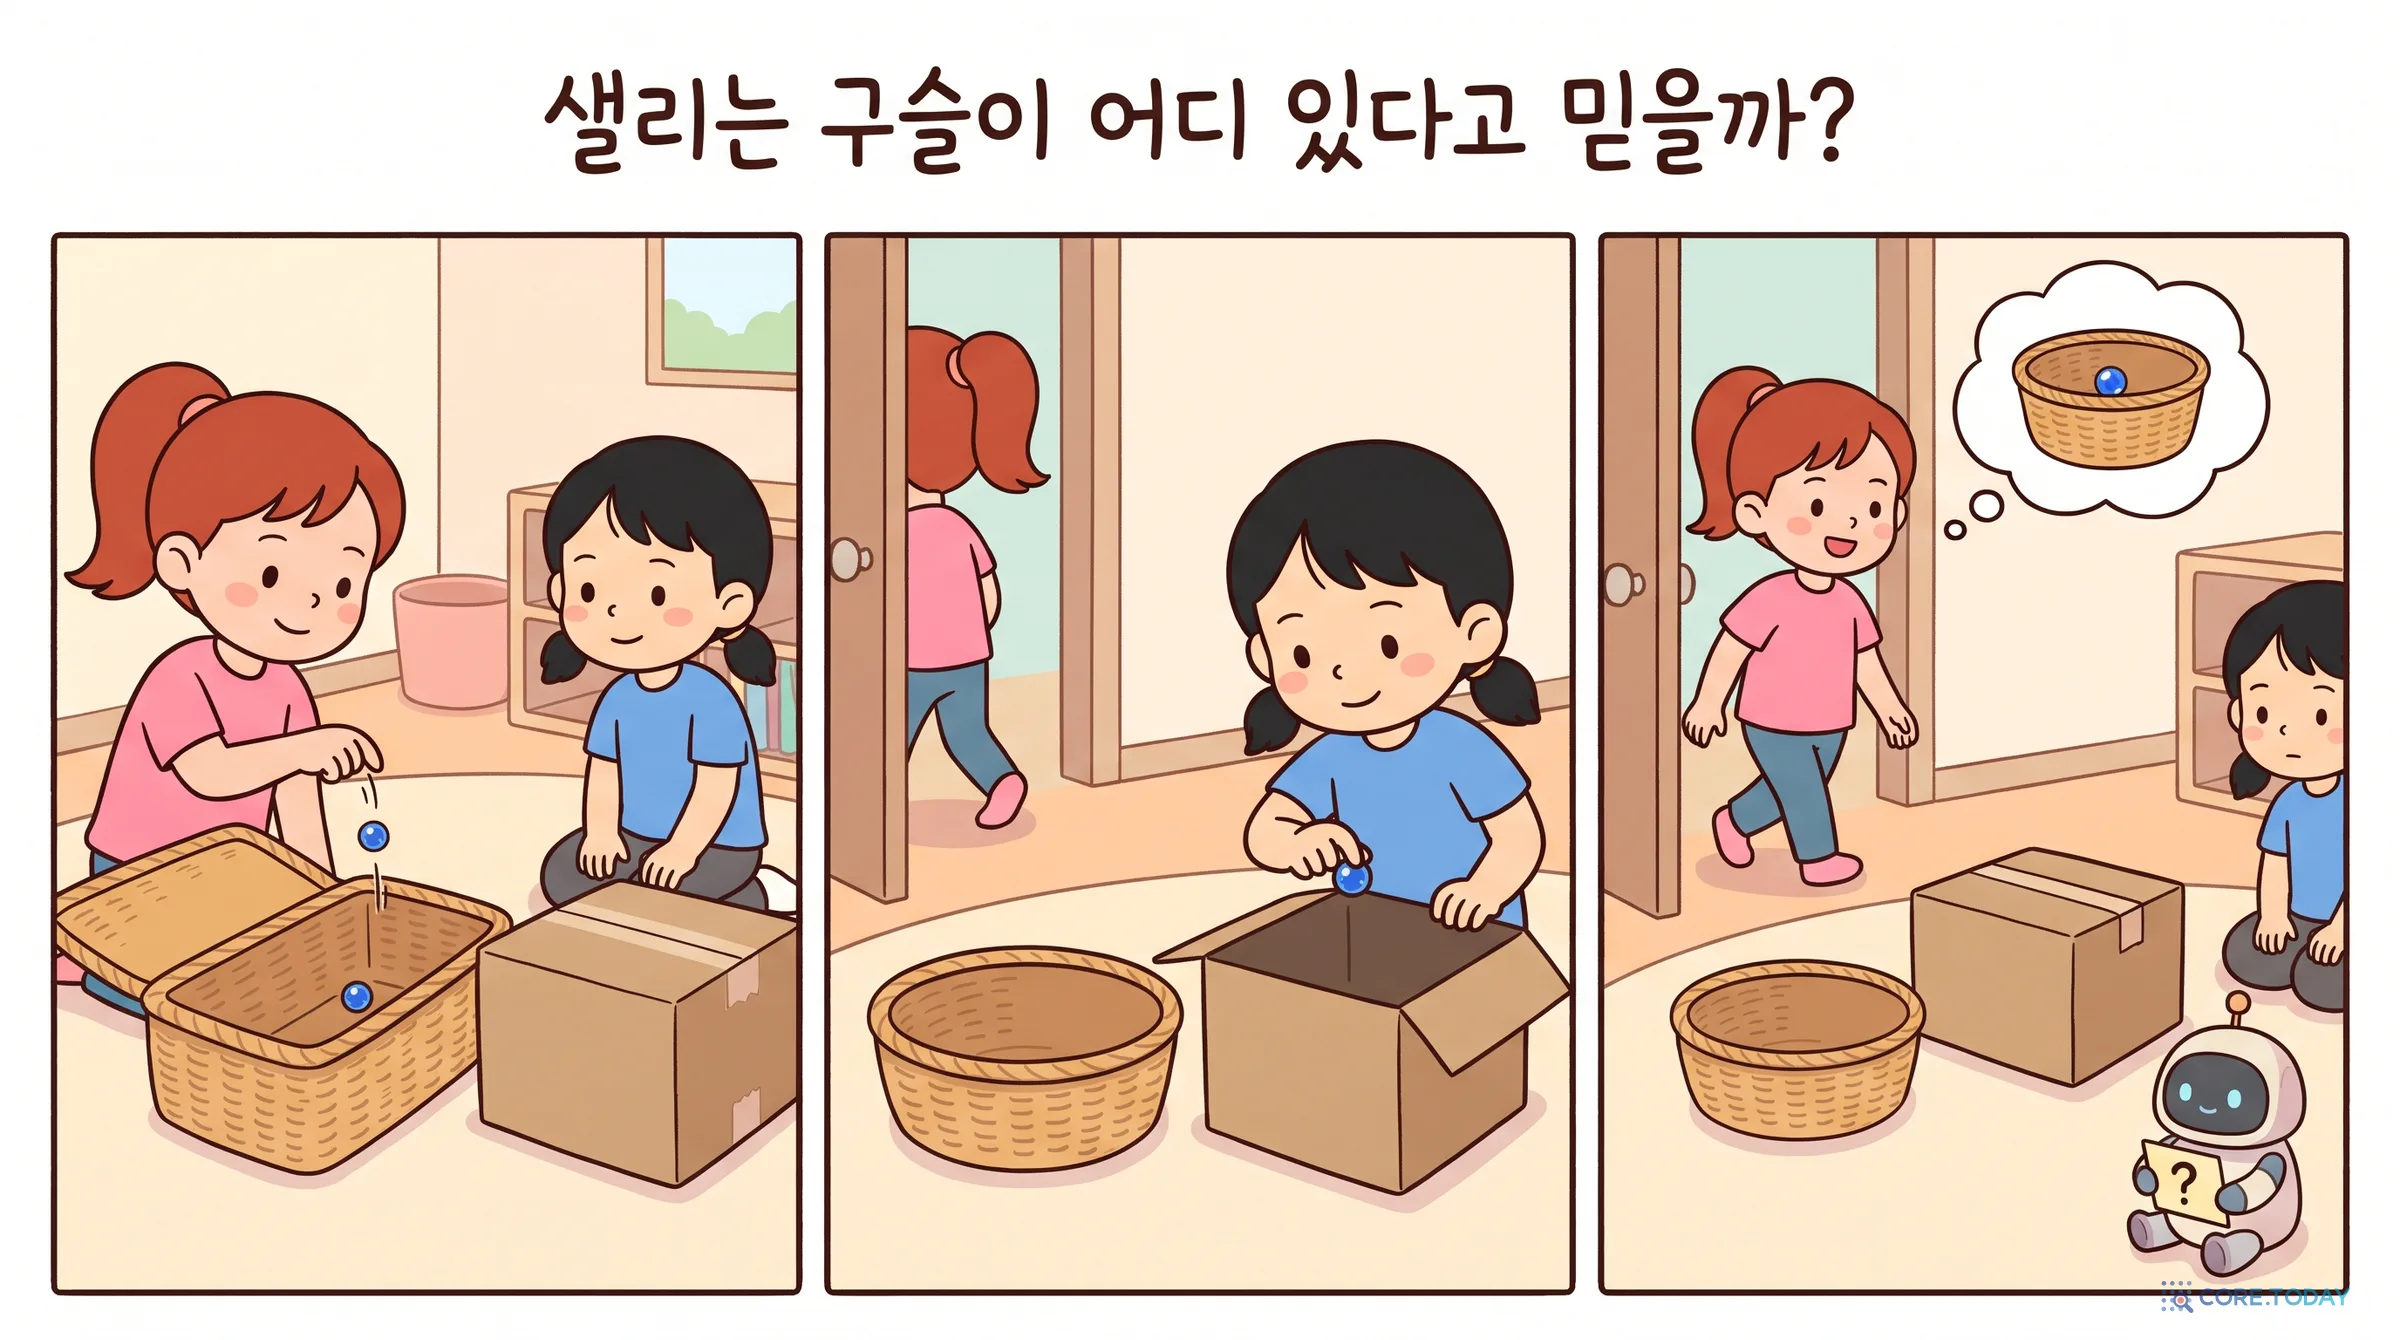
1978년 데이비드 프리맥(David Premack)과 가이 우드러프(Guy Woodruff)는 「침팬지에게 마음 이론이 있는가?」라는 논문에서 마음 이론(Theory of Mind, ToM)이라는 말을 만들었습니다. 다른 존재가 나와 다른 믿음, 바람, 의도를 가진다는 것을 이해하는 능력입니다. 1983년 하인츠 빔머(Heinz Wimmer)와 요제프 페르너(Josef Perner)는 이를 아이에게 시험하는 '틀린 믿음 과제'를 만들었고, 1985년 사이먼 배런코언(Simon Baron-Cohen), 앨런 레슬리(Alan Leslie), 우타 프리스(Uta Frith)는 이를 인형극으로 바꾼 샐리-앤 과제를 발표했습니다.
샐리가 바구니에 구슬을 넣고 나가면, 앤이 구슬을 상자로 옮깁니다. 돌아온 샐리는 구슬을 어디서 찾을까요? 정답은 '바구니'입니다. 구슬이 실제로 있는 곳(상자)과 샐리가 믿는 곳(바구니)을 따로 생각할 수 있어야 맞힙니다. 1985년 실험에서 일반 아동의 85%가 맞혔습니다.
이 과제의 구조를 보면 CogMem의 설계 의도가 선명해집니다. 세계의 상태("구슬은 상자에 있다")와 누군가의 믿음("샐리는 구슬이 바구니에 있다고 믿는다")은 다른 칸에 적혀야 합니다. 둘을 한 칸에 섞으면 구슬은 상자에 있으면서 바구니에도 있게 됩니다. 2018년 딥마인드의 닐 라비노비츠(Neil Rabinowitz) 등은 신경망에게 다른 에이전트의 틀린 믿음을 예측하게 하는 「기계 마음 이론(Machine Theory of Mind)」을 냈고, 2022년 마르텐 사프(Maarten Sap) 등은 대형 언어 모델의 사회적 지능에 한계가 있다고 보고했습니다. CogMem은 둘 다 인용합니다. 논문의 입장은 LLM이 마음 이론을 갖고 있느냐를 따지는 대신, 기억의 구조로 마음 이론을 받쳐 주자는 것입니다.
⑤ 문장에 대한 문장 — 지식 표현의 오랜 숙제
"지나는 준호가 게으르다고 생각한다"를 데이터베이스에 넣으려면, '준호—게으르다'라는 문장 자체에 대해 또 하나의 문장("지나가 그렇게 생각한다")을 붙여야 합니다. 지식 표현 분야는 이것을 오래 고민했습니다.
1968
로스 퀼리언(Ross Quillian)의 의미망 — 개념을 노드로, 관계를 간선으로 잇는 기억 모델. "카나리아는 새다", "새는 날 수 있다".
1986
스튜어트 섀피로(Stuart Shapiro)와 윌리엄 래퍼포트(William Rapaport)의 SNePS — '명제 자체'를 노드로 만드는 의미망. 인지 에이전트가 무엇을 믿는지 표현한다. CogMem이 직접 인용한다.
2004
웹 표준 RDF의 재화(reification) — 트리플 하나를 자원으로 만들어 "누가 이 트리플을 말했다"를 붙이는 방법. 문법이 번거로워 거의 쓰이지 않았다.
2012~13
위키데이터의 진술마다 한정자와 참고 출처를 붙이는 구조, W3C의 PROV(출처 표현 표준, 2013년 권고안).
2014~
'트리플에 대한 트리플'을 직접 쓰는 RDF-star 제안. 이후 RDF 1.2 표준화 작업으로 이어졌다.
2026
CogMem의 주장 노드 — 같은 문제를 LLM 대화 기억에서 다시 푼다. 출처(source)·대상(target)·시각·극성·근거를 노드 하나에 담는다.
주장 노드는 새 발명이라기보다 '재화'를 대화 기억에 맞게 다시 꺼낸 것입니다. 논문도 자기들의 새로움이 "고립된 새 그래프 기본 요소"가 아니라 아키텍처와 표현에 있다고 스스로 적습니다. 마음 이론과 상보적 학습을, 학습이 필요 없는(training-free) 하나의 검색 시스템 안에서 작동하게 만들었다는 것이 주장입니다.
덤: 한국어는 이미 '들은 말'을 문법으로 표시한다
알렉산드라 아이켄발드(Alexandra Aikhenvald)의 2004년 책 『증거성(Evidentiality)』에 따르면 세계 언어의 약 4분의 1은 정보를 어떻게 알게 됐는지를 문법으로 표시합니다. 한국어도 그런 언어입니다. "준호가 잘렸대"의 '-대'는 "준호가 잘렸다고 해"가 줄어든 말로, 들은 말이라는 표지입니다. "준호가 바쁘더라"의 '-더-'는 내가 직접 보고 안 것이라는 표지입니다.
CogMem 식으로 말하면 한국어 화자는 주장 노드의 일부를 말끝에 달고 다닙니다. 그렇다면 한국어 대화에서는 주장을 가려내기가 더 쉬울까요? 아니면 "팀장님은 준호가 잘린 게 당연하대"처럼 화자(서연)와 의견의 주인(팀장님)이 다른 문장 때문에 더 어려울까요? 10장의 실측에서 확인합니다.
3장. LLM 기억 시스템은 어떻게 여기까지 왔나
CogMem이 비교하는 상대들을 알면 이 논문의 자리가 보입니다. 2020년부터의 흐름을 짧게 정리합니다.
시기
시스템
기억을 보는 방식
출처·시간 처리
2020
RAG (Lewis 외)
문서를 덩어리로 잘라 벡터 색인에 넣고, 질문과 닮은 덩어리를 꺼낸다
없음. 덩어리 안에 섞여 있을 뿐
2023
MemGPT (Packer 외)
운영체제의 페이징처럼 문맥 창 안팎으로 기억을 옮긴다
에이전트가 직접 메모를 고친다
2023
Generative Agents (Park 외)
기억 흐름을 최근성·중요도·관련성으로 점수 매기고 '성찰'로 상위 기억을 만든다
시각은 있으나 출처 구분 없음
2024
MemoryBank, HippoRAG
에빙하우스 망각 곡선 / 해마에서 영감을 얻은 개체 그래프와 개인화 페이지랭크
개체 관계 중심, 주장 구분 없음
2025
Mem0, A-MEM, Zep(Graphiti)
사실 단위 추가·갱신·삭제 / 제텔카스텐식 노트 / 시간 지식 그래프
Zep은 유효 기간(이중 시간)을 둔다
2025
LightMem, GAM
압축·주제 분할·수면 시간 갱신 / 기억을 '조사 과정'으로 보는 심층 연구형 검색
효율·검색 깊이에 집중
2026
CogMem
다섯 종류 노드 그래프 + 연산자 제어기 + 통합
주장마다 출처·대상, 같은 출처의 의견 변화는 시간 범위로 정리
코어닷투데이는 이 계보의 여러 지점을 이미 따로 다뤘습니다. HippoRAG 2, Graphiti의 시간 지식 그래프, Hindsight, 에이전트 기억 엔진 해부, 그리고 같은 '남의 것' 문제를 개인 기억에서 다룬 「낡거나, 남의 것이거나, 늦거나」가 있습니다. CogMem과 가장 닮은 선배는 Hindsight입니다. Hindsight도 기억을 세계·경험·의견·관찰 네 네트워크로 나눴고, 그중 '의견 네트워크'는 에이전트 자신의 판단만 담았습니다. 사용자가 "바다가 보이는 숙소가 좋겠다"고 말한 것은 "민지가 그렇게 말했다"는 관찰된 사실로 세계 네트워크에 들어갔습니다. 출처를 보존하는 방식이 다릅니다. Hindsight는 '말했다는 사실'로 바꿔 적고, CogMem은 '주장 노드'라는 별도 구조로 적습니다. 흥미롭게도 Hindsight의 의견 네트워크는 2026년 1월 v0.4.0에서 제품에서 사라졌습니다. 의견을 따로 두는 설계가 실제 제품에서 살아남기 어렵다는 신호일 수도 있고, 에이전트 자신의 의견과 남의 의견은 다른 문제라는 신호일 수도 있습니다. CogMem은 후자, 남의 의견을 다룹니다.
4장. 문제: 의미 붕괴, 그리고 '의도 없는' 검색
논문 그림 1 읽기
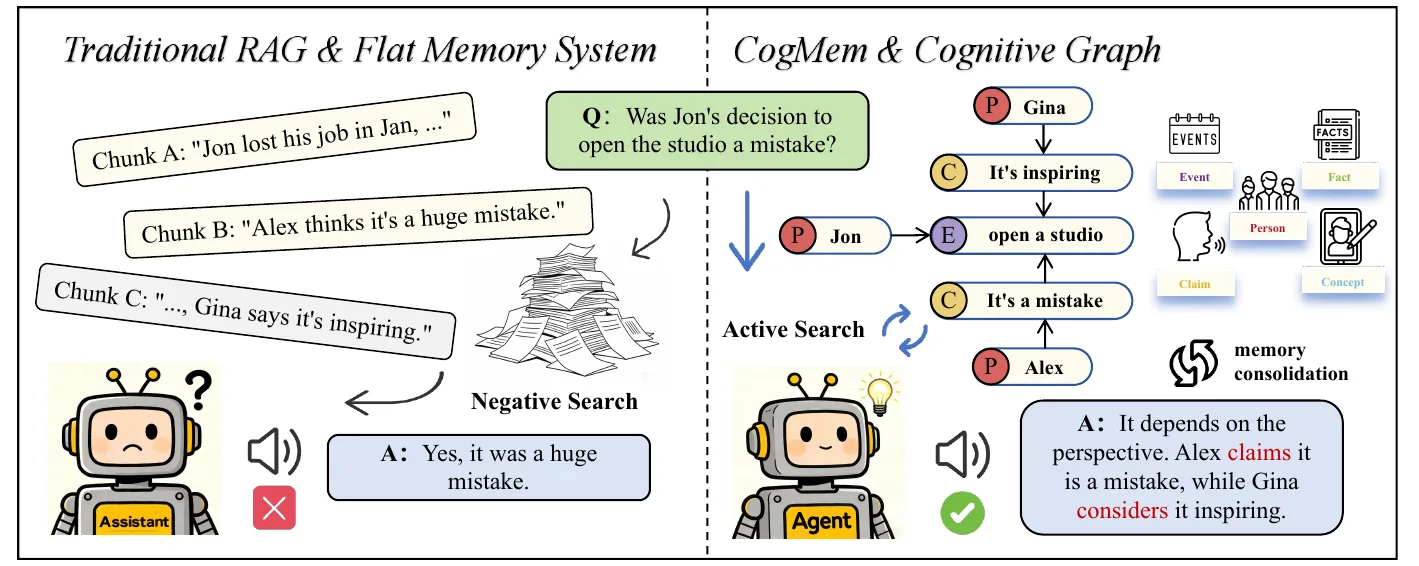
논문의 첫 그림이 문제와 처방을 한 장에 담고 있습니다.
크게 보기출처: Liao et al., 「From Retrieval to Reconstruction」(arXiv 2610.11314) 그림 1
왼쪽은 우리가 흔히 쓰는 방식입니다. 대화가 덩어리(chunk) A, B, C로 잘려 색인에 들어갑니다. "존이 스튜디오를 연 결정은 실수였나?"라는 질문이 오면, 검색기는 질문과 가장 닮은 덩어리를 꺼냅니다. '실수(mistake)'라는 단어가 들어간 덩어리 B, "알렉스는 그게 큰 실수라고 생각한다"가 뽑힙니다. 지나의 반대 의견이 든 덩어리 C는 덜 닮아서 밀려납니다. LLM은 B만 보고 "네, 큰 실수였어요"라고 답합니다. 두 가지가 틀렸습니다. 알렉스 한 사람의 의견을 사실처럼 말했고, 반대 의견은 아예 보지 못했습니다. 논문은 이를 '부정적 검색(Negative Search)'이라고 표시합니다.
오른쪽은 CogMem입니다. 존(P)은 '스튜디오 열기'라는 사건(E)과 이어지고, 그 사건에 알렉스의 주장 "실수다"(C)와 지나의 주장 "고무적이다"(C)가 각자의 주인과 함께 매달립니다. 에이전트는 사건에서 출발해 주장 간선을 따라가 양쪽을 모두 찾고, "관점에 따라 다릅니다. 알렉스는 실수라고 주장하고, 지나는 고무적이라고 봅니다"라고 답합니다. 빨간 글씨로 강조된 '주장한다(claims)'와 '본다(considers)'가 이 그림의 요점입니다.
실패 ①: 의미 붕괴
논문은 의미 붕괴를 수식으로도 정의합니다. 밀집 검색기는 임베딩 함수 Φ로 문장을 d차원 벡터로 바꿉니다. 출처가 없는 사건·사실 기록 f("존이 해고됐다")와 단어가 겹치는 주관적 주장 c("지나는 존의 해고가 실수라고 생각한다")는 인식적 지위(epistemic status)가 다른데도 Φ(f)와 Φ(c)가 가까이 놓입니다. 그래서 "존에게 무슨 일이 있었나"를 물으면 c가 나올 수 있습니다.
이를 직접 잰 것이 표 1의 '의미 붕괴 탐침'입니다. 저자들은 LoCoMo의 대화 패턴을 본떠 150쌍의 합성 문장을 만들었습니다. 쌍마다 출처 없는 기록 하나와 단어가 많이 겹치는 출처 붙은 의견 하나가 들어 있습니다.
CogMem은 어떻게 6%로 줄였을까요? 비결은 단순합니다. 논문 본문에 따르면 PEC²F 그래프 위의 유형 제한 검색이 "질문이 출처 붙은 믿음을 요청하지 않는 한 주장 노드를 제외"합니다. 기록을 물으면 주장 노드는 아예 후보에서 빠집니다. 남은 9건은 대화를 그래프로 옮기는 단계에서 의견이 사건이나 사실로 잘못 분류된 경우일 것입니다. 이 점은 9장에서 다시 따져 봅니다. 탐침이 증명하는 것은 '유형 필터는 유형이 맞게 붙어 있으면 작동한다'이고, 진짜 어려운 일은 유형을 맞게 붙이는 것이기 때문입니다.
실패 ②: 의도가 없는 검색
두 번째 문제는 검색이 질문의 의도를 모른다는 점입니다. "캐럴라인과 멜라니가 둘 다 즐기는 활동은?"이라는 질문을 생각해 봅시다. 고정된 검색기는 질문 문장과 닮은 기억 상위 k개를 꺼냅니다. 그런데 정답은 '캐럴라인이 즐기는 것' 목록과 '멜라니가 즐기는 것' 목록의 교집합입니다. 닮은 문장을 찾는 것으로는 교집합이 계산되지 않습니다. "캐럴라인은 언제 스웨덴에서 이사 왔어?"는 시간으로 걸러야 하고, "그녀가 정말 그랬어?"는 원문을 다시 확인해야 합니다.
논문은 2023년 오피르 프레스(Ofir Press) 등의 '구성성 격차(compositionality gap)' 연구를 인용합니다. 모델이 두 사실을 각각은 알아도, 두 사실을 이어야 하는 질문에서는 자주 틀린다는 결과입니다. 정적인 검색 파이프라인은 중간 결과를 보고 전략을 바꿀 수 없어서, 여러 단계를 잇는 멀티홉 추론에 약합니다.
CogMem의 세 기둥은 이 두 실패에 대응합니다. 논문은 좋은 장기 기억이 갖춰야 할 성질 세 가지를 이렇게 이름 붙입니다.
①
인식적 완전성 (Epistemic Completeness)
출처 붙은 믿음과 출처 없는 사건·사실 기록을 구분하는 능력 → PEC²F 스키마와 주장 노드
②
능동 가소성 (Active Plasticity)
고정 색인에 기대지 않고, 막연한 질문 의도에서 검색 경로를 그때그때 만드는 능력 → 네 연산자와 제어기
이름의 P·E·C·C·F는 다섯 노드의 머리글자입니다. C가 둘이라 C²입니다. 그래프는 G = (V, E)이고, 노드 집합은 다섯 부분의 합집합입니다.
V=VP∪VE∪VC∪VClaim∪VF
노드
담는 것
예시
역할
Person (사람)
대화에 나오는 개인
준호, 지나, 팀장님
그래프의 중심 닻. 사람 중심(person-centric) 그래프
Event (사건)
시간이 정해진 구체적 행동(Do)
"준호가 2024년 4월 회사에서 해고됨"
일화 기억. 참여자·시각·장소·원문 위치
Concept (개념)
정규화된 주제나 대상
등산, 입양 기관, 카페 창업
의미 닻. 벡터 군집으로 같은 개념을 묶는다
Claim (주장)
누군가가 사람·개념에 대해 한 진술
지나 → "회사의 실수" → 준호
출처(source)·대상(target)·시각·극성·근거. 마음 이론 담당
Fact (사실)
안정된 속성·습관·선호(Is)
"준호는 등산하는 습관이 있다"
의미 기억. 주로 통합 단계에서 사건들로부터 만들어진다
두 가지를 꼭 짚어야 합니다. 첫째, 논문은 '사실(Fact)'이 진실을 보장하지 않는다고 분명히 적습니다. 사실 노드는 "운영상의 기록 유형"일 뿐, 독립적으로 검증된 진실이 아닙니다. 준호가 "나 등산 좋아해"라고 말했으면, 그것은 출처 없는 자기 보고 기록으로 사실 노드가 됩니다. 실제로 준호가 등산을 좋아하는지는 아무도 확인하지 않았습니다. CogMem이 나누는 것은 '참과 거짓'이 아니라 '누군가의 관점이 붙은 말'과 '그렇지 않은 기록'입니다. 논문은 이를 '출처 붙음–출처 없음 구분(Attributed–Unattributed Distinction)'이라고 부릅니다.
둘째, 논문의 한계 절은 스키마가 대화의 네 차원, 즉 한다(Do), 이다(Is), 쓴다(Use), 믿는다(Belief)를 덮는다고 정리합니다. 사건이 Do, 사실이 Is, 개념과의 관계(LIKES, USES 같은 간선)가 Use, 주장이 Belief입니다. 목표(Goal)나 감정(Emotion)은 아직 없고, 저자들도 다음 과제로 남겨 둡니다.
대화가 그래프가 되는 과정
CogMem은 대화 한 턴이 끝날 때마다 그래프를 증분 갱신합니다. 입력 기록에는 발화, 화자, 세션 번호, 시각이 들어갑니다. '원자 추출 엔진'이라는 LLM 프롬프트(부록 H.1)가 발화를 쪼개 시간이 정해진 행동은 사건으로, 안정된 자기 보고 속성은 사실로, 다른 사람이나 개념에 대한 의견은 출처와 대상 필드가 명시된 주장으로 분류합니다. 사람과 개념 이름은 정규화한 뒤 기존 닻과 대조하고, 없을 때만 새 노드를 만듭니다. 모든 노드에는 원문 턴 번호와 시각이 붙습니다. 이 꼬리표가 있어야 나중에 '원문 확인' 연산자가 원래 문장을 찾아갈 수 있습니다.
부록의 추출 프롬프트는 짧고 단호합니다. 출력 형식은 {"events":[...], "facts":[...], "claims":[...], "concepts":[...]}이고, 규칙은 이렇습니다. "주장(CLAIM): 사람이나 개념에 대한 출처 붙은 진술. 항상 source, target, timestamp, polarity, evidence를 기록한다."
아래 위젯에서 대화를 한 턴씩 넣으며 그래프가 자라는 모습을 볼 수 있습니다. 마지막에 질문 버튼을 누르면, 출처를 구분하지 않는 평면 기억과 유형을 구분하는 PEC²F 기억이 어떤 노드를 집어 오는지 비교됩니다.
6장. 둘째 기둥: 네 연산자와 제어기
그래프를 잘 만들어도 꺼내는 방법이 고정돼 있으면 소용이 적습니다. 논문의 지적처럼 PEC²F 그래프는 복잡해서 "고정 k홉 확장" 같은 정적 검색은 의도와 시간이 얽힌 질문에 비효율적입니다. CogMem은 질문 의도에 따라 연산자를 골라 쓰는 검색 제어기를 둡니다.
모든 검색은 여기서 시작합니다. 질문 q를 그래프의 진입점 노드들에 연결합니다. 점수는 어휘 일치와 의미 유사도를 섞습니다(식 2).
S(v,q)=α⋅Ilex(v,q)+(1−α)⋅cos(Φ(v),Φ(q))
Ilex는 퍼지 어휘 일치, Φ는 BGE-M3 임베딩입니다. α는 0.3, 즉 의미 유사도에 70%의 무게를 줍니다. 상위 15개 노드(K_anchor = 15)를 돌려줍니다. 이름이 들어간 질문이라면 "캐럴라인"이라는 글자 자체가 맞는지(어휘)가 30%를 차지하므로, 비슷한 뜻의 다른 사람에게 닻이 내려질 위험이 줄어듭니다.
연산자 ②: 시공간 탐색 (Spatiotemporal Traversal)
닻에서 이웃으로 걸어 나갑니다. 다만 아무 이웃이나 가지 않고, 간선 종류 R과 시간 창 T로 거릅니다(식 3).
Otraverse(v,R,T)={u∈N(v)∣type(v,u)∈R∧time(u)∈T}
"지나는 준호를 어떻게 생각해?"라면 R을 주장 관련 간선(R_claim)으로 좁힙니다. "작년에 뭐 했어?"라면 LLM이 질문에서 뽑은 시간 창 T로 거릅니다. 한 단계에 이웃 최대 15개, 최대 2단계까지 갑니다.
사람마다 '좋아한다·쓴다·참여했다' 간선으로 이어진 이웃 집합을 만들고(합집합), 사람들 사이의 교집합을 구합니다. 사람당 후보는 10개입니다. "둘 다 즐기는 것", "공통점"을 묻는 질문은 벡터 유사도로는 풀 수 없고 이 집합 연산으로 풀립니다.
연산자 ④: 원문 확인 (Evidence Grounding)
노드에 붙은 원문 턴 번호로 원래 대화 문장을 찾아옵니다(식 5). 그래프의 추론을 최종 답 전에 원문과 대조하는 단계입니다. 그래프 노드는 LLM이 요약해 만든 것이라 세부가 빠지거나 틀릴 수 있기 때문입니다.
Oground(v)→{d∈D∣id(d)=source(v)}
누가 연산자를 고르나: 규칙 기반 제어기
여기서 용어를 조심해야 합니다. 논문 제목과 서론은 'Cognitive Search Agent', 'ReAct 프레임워크', '에이전트형 능동 회상'을 강조하지만, 3.2절의 설명은 더 정확합니다. "검색은 LLM 의도 파싱이 구동하는 규칙 기반 제어기를 쓴다. 연산자 자체와 상위 라우팅 규칙은 결정론적이고, 의도 라벨과 증거 충분성 판단만 LLM이 만든다." 즉 LLM은 매 단계 "이 질문은 비교형이다", "증거가 충분하다" 같은 판단만 내리고, 어떤 연산자를 부를지는 규칙표가 정합니다. 알고리즘 1이 그 규칙표입니다.
시작닻 내리기를 항상 먼저 실행해 진입 노드와 첫 부분 그래프 G₀를 만든다.
의도 파싱LLM이 질문과 현재 부분 그래프를 보고 의도 z를 고른다.
비교·공통z ∈ {COMPARE, COMMON} → 닻 노드들에 교집합.
믿음·의견z ∈ {BELIEF, OPINION} → 주장 간선만 따라 탐색.
시간z ∈ {WHEN, TEMPORAL} → 모든 간선을 시간 창으로 걸러 탐색.
이유·확인·세부z ∈ {WHY, VERIFY, DETAIL} → 현재 노드들의 원문 확인.
반복·종료결과를 부분 그래프에 합치고, LLM이 '충분하다'고 하거나 닻 이후 5번(D_step = 5)을 채우면 멈춘 뒤 답을 생성한다.
에이전트 프롬프트(부록 H.2)에는 세 가지 제약이 있습니다. ① 직행(Direct Hit): 첫 관찰에 답이 있으면 바로 답한다. ② 환각 금지: 노드 ID를 지어내지 말고 도구가 돌려준 ID만 쓴다. ③ 출처: 증거가 주장이면 누가 그 의견을 가졌는지 반드시 밝힌다. 세 번째 규칙이 그림 1의 "알렉스는 실수라고 주장하고"를 만드는 장치입니다.
실제 추론 궤적 네 개
부록 F는 LoCoMo 질문 네 개의 추론 궤적을 보여 줍니다. 요약하면 이렇습니다.
질문
연산자 순서
답
캐럴라인은 무엇을 조사했나? (단일 홉)
닻(캐럴라인) → 탐색(속성 간선: '입양 기관', '포용적 기관') → 원문 확인("요즘 입양 기관을 알아보고 있어, 특히 포용적인 곳")
LGBTQ+를 지원하는 포용적인 입양 기관
캐럴라인과 멜라니가 둘 다 즐기는 활동은? (멀티홉)
닻(두 사람) → 교집합(개념: 캠핑, 미술) → 탐색으로 LIKES 간선 확인
캠핑과 미술
멜라니는 자선 달리기 뒤 무엇을 깨달았나? (열린 영역)
닻(멜라니) → 곧바로 원문 확인("마치고 나서 자기 돌봄이 얼마나 중요한지 깨달았어")
남을 계속 도우려면 자기 돌봄이 필요하다
캐럴라인은 언제 스웨덴에서 이사 왔나? (시간)
닻(캐럴라인) → 시간 탐색("스웨덴에서 이사" 사건, 2019) → 원문 확인("2019년에 스웨덴에서 이사 왔을 때")
2019년
세 번째 궤적이 흥미롭습니다. '깨달음' 같은 내면 상태는 구조화된 노드보다 원문 서사에 잘 남아 있다고 판단해 탐색을 건너뛰고 원문으로 직행합니다. 그래프가 만능이 아니라는 것을 시스템 스스로 인정하는 장면입니다.
아래 위젯에서 질문을 골라 보세요. 제어기가 의도를 어떻게 읽고 어떤 연산자를 부르는지, 부분 그래프가 어떻게 자라는지 단계별로 보입니다. '고정 파이프라인'으로 바꾸면 모든 질문이 닻 → 2홉 탐색 → 원문 확인의 똑같은 세 단계를 밟습니다. 8장에서 보겠지만 이 차이가 논문에서 가장 큰 성능 차이를 만듭니다.
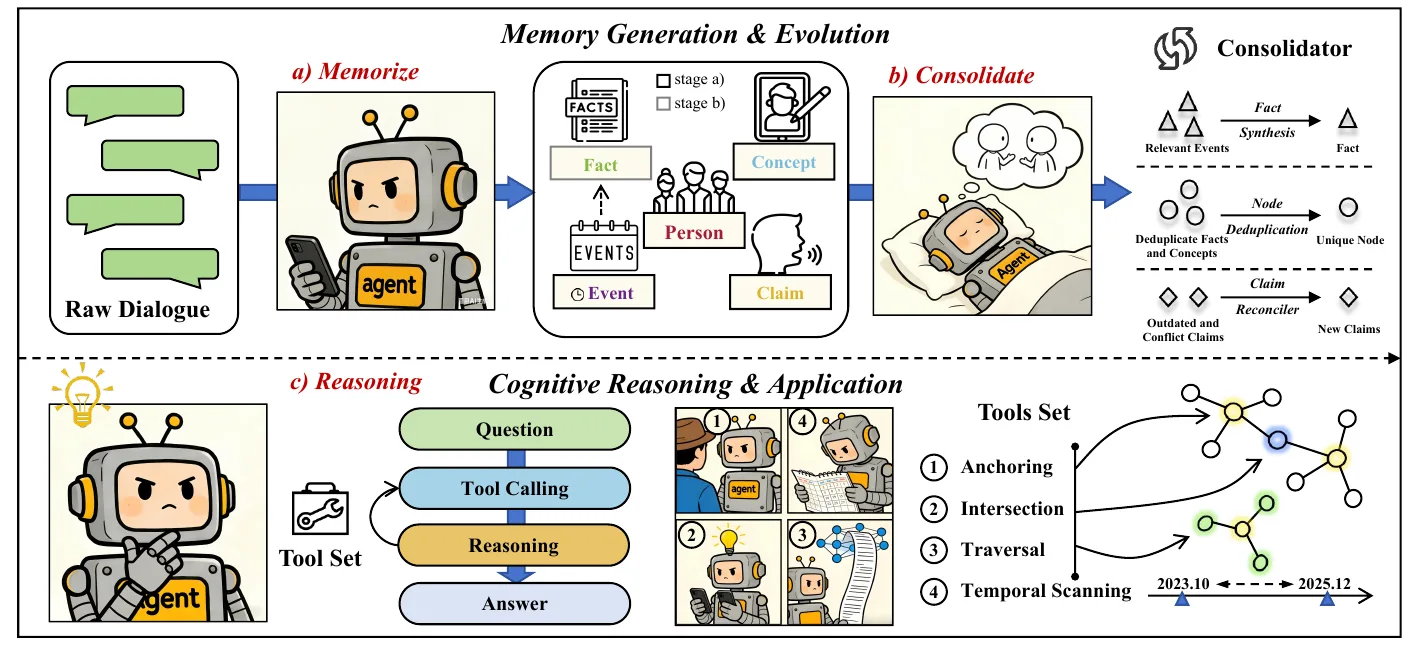
그림 2는 두 층으로 되어 있습니다. 위층 '기억 생성과 진화'는 대화를 그래프로 바꾸는 기억하기(a)와 오프라인에서 그래프를 다듬는 통합하기(b)이고, 아래층 '인지적 추론과 응용'은 질문에 답하는 추론하기(c)입니다. 통합 단계의 로봇이 잠들어 있는 것은 2장의 '잠자는 동안의 기억 통합'을 그대로 그린 것입니다. 한 가지 작은 어긋남이 있습니다. 그림의 도구 세트 4번은 '시간 훑기(Temporal Scanning)'인데, 본문과 그림 설명은 4번 연산자를 '원문 확인(Evidence Grounding)'이라고 합니다. 본문 기준으로 시간 훑기는 탐색 연산자의 시간 창 옵션입니다.
대화가 쌓이면 사건 노드가 끝없이 늘어납니다. 준호가 등산을 열 번 다녀왔다면 사건 노드 열 개가 생기고, "준호의 취미는?"이라는 질문에 에이전트는 열 개를 다 훑어야 합니다. 검색 공간이 커지면 느려지고, 흩어진 증거를 놓칠 확률도 커집니다.
세 개가 모이면 하나가 된다
통합은 오프라인 그래프 재작성 함수입니다. 사람 p가 개념 c와 상호작용한 사건들의 묶음을 Sp,c라고 합시다. 사건들이 최대 Δt_max(30일) 안에 몰려 있고 개수가 문턱 τ(3개) 이상이면, LLM으로 매개된 추상화 함수 Ψ가 이 패턴을 하나의 사실 노드로 바꿉니다(식 6).
fnew,Tenv←Ψ(Sp,c),Tenv=[tstart,tend]
fnew는 "준호는 등산하는 습관이 있다" 같은 일반화된 명제이고, Tenv는 시간 봉투(Temporal Envelope), 즉 첫 사건부터 마지막 사건까지의 기간입니다. 통합 프롬프트(부록 H.3)의 예시가 이 과정을 그대로 보여 줍니다. "'등산 갔다' × 3 → '등산하는 습관이 있다'". 술어는 has_habit, is_experienced_in처럼 정확한 동사로 고르고, 확신도(confidence) 0.8과 근거 사건 ID 목록을 함께 냅니다.
통합의 핵심 위험은 압축하면서 세부를 잃는 것입니다. CogMem은 증거 매달기(Evidence Mounting)로 이를 막습니다. 새 사실 노드를 만든 뒤에도 원래 사건들을 지우지 않고, 사실에서 각 사건으로 가는 출처 간선을 답니다(식 7).
Eprov={(fnew,SUPPORTED_BY,ei)∣∀ei∈Sp,c}
그래서 검색은 두 가지 해상도로 움직입니다. "준호의 취미는?"처럼 큰 질문에는 사실 노드 하나로 바로 답하고, "준호가 처음 등산 간 게 언제야?"처럼 세부를 물으면 SUPPORTED_BY 간선을 따라 원래 사건으로 내려갑니다. 지도 앱에서 줌을 당겼다 밀었다 하는 것과 같습니다.
대가도 있습니다. 부록 D의 표 12에 따르면 LoCoMo 대화 10개를 통합한 뒤 노드는 3,641개에서 4,181개로 14.8%, 간선은 9,935개에서 14,643개로 47.4% 늘었습니다. 통합이라는 이름과 달리 그래프는 커집니다. 사실 노드 497개와 주장 노드 56개가 새로 생겼고, 중복된 개념 13개만 합쳐졌습니다. 저자들은 이를 의도된 설계라고 설명합니다. LLM이 추상화하다 환각을 일으켜도 원래 발화가 남아 있어 검증할 수 있다는 것입니다. 저장 공간을 쓰는 대신 논리적 검색 공간을 줄인다는 거래입니다.
사람 99 → 99
0%
사건 697 → 697
0%
개념 832 → 819
−1.6%
사실 0 → 497
신규
주장 2,013 → 2,069
+2.8%
막대 길이는 통합 뒤 노드 수를 최댓값(주장 2,069개)으로 나눈 비율. 논문 표 12.
표에서 눈에 띄는 숫자가 하나 더 있습니다. 주장 노드가 2,069개로 전체 노드의 절반(49.5%)을 차지하고, 사건 노드(697개)의 세 배입니다. LoCoMo 대화는 두 사람이 자기 근황을 주고받는 대화가 대부분인데도, 추출기가 꽤 많은 발화를 '누군가에 대한 의견'으로 분류했다는 뜻입니다. 주장 노드가 그렇게 많으면, 기록을 물을 때 주장을 빼는 유형 필터가 그만큼 많은 정보를 걸러 낸다는 뜻이기도 합니다.
아래 위젯에서 날짜를 눌러 사건을 찍고 τ(문턱)와 Δt(시간 창)를 바꿔 보세요. 어떤 사건 묶음이 사실로 승격되는지, 시간 봉투가 어떻게 잡히는지, 그리고 압축이 어떤 세부를 지우는지(논문의 '세분도 손실' 사례) 볼 수 있습니다.
의견이 바뀌면: 출처를 지키는 주장 정리
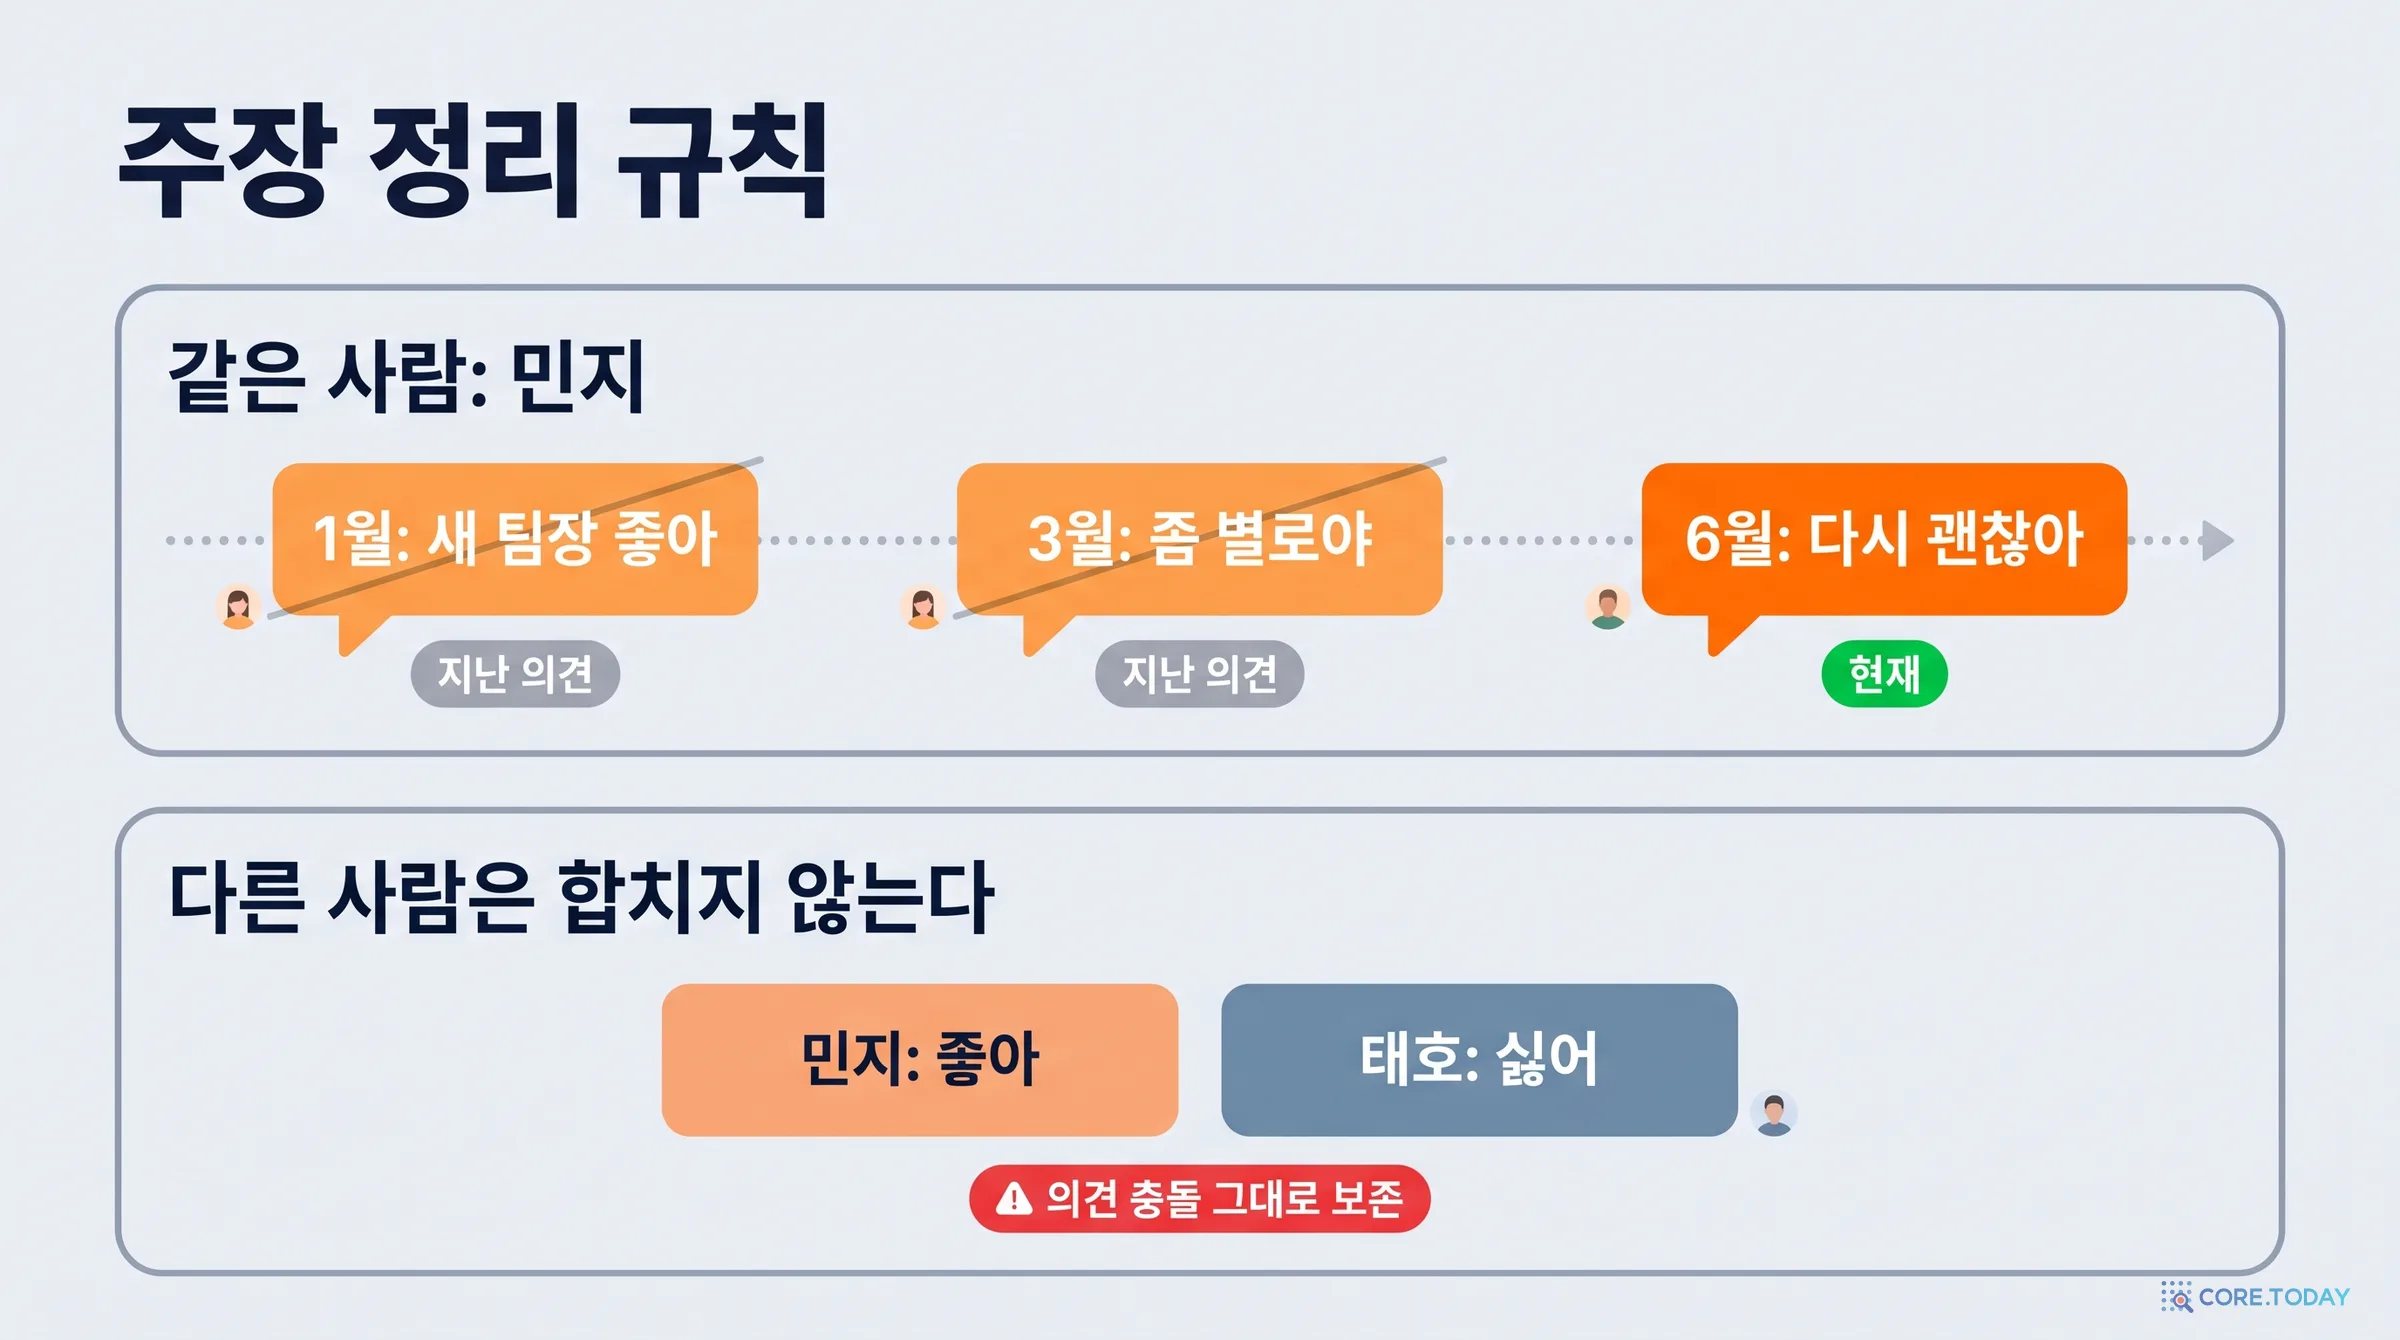
사람은 마음을 바꿉니다. 민지가 1월에 "새 팀장님 좋아"라고 했다가 3월에 "좀 별로야", 6월에 "다시 괜찮아"라고 했다면, 지금 민지의 의견은 무엇일까요? 평면 기억은 세 문장을 모두 비슷한 무게로 꺼내 혼란을 줍니다. 그렇다고 옛 의견을 지워 버리면 "민지가 3월에는 왜 싫어했지?"라는 질문에 답할 수 없습니다.
CogMem의 규칙은 세 줄입니다.
조건
출처(source)·대상(target)·술어(predicate)가 정규화했을 때 모두 같은 주장끼리만 정리한다.
정리
시간순으로 늘어놓고, 출처가 이어진 '보기(view)'를 새로 만들어 CURRENT(현재)·SUPERSEDED(대체됨)·CONFLICTING(충돌) 중 하나로 표시한다. 원래 주장들은 그대로 남는다.
금지
다른 사람의 주장은 절대 합치지 않는다. 민지는 좋다고, 태호는 싫다고 하면 두 의견은 '합의'로 뭉개지지 않고 각자의 주인과 함께 남는다.
정리 프롬프트(부록 H.3)는 "서로 다른 화자의 주장을 하나의 합의로 합치지 말 것", "같은 출처의 양립 불가능한 값이나 극성을 찾아 시간적 유효성을 정할 것", "모든 원래 주장 ID와 근거 구간을 보존할 것"을 지시합니다. 출력에는 valid_from과 valid_to가 들어갑니다. 코어닷투데이가 다룬 Graphiti의 이중 시간 모델이나 TOKI가 '사실'의 유효 기간을 관리했다면, CogMem은 같은 생각을 '의견'의 유효 기간에 적용한 셈입니다. LongMemEval의 지식 갱신(Knowledge Update) 문제는 사용자 상태가 세션마다 바뀔 때 최신 값을 답하라는 문제인데, 8장의 소거 실험에서 주장 노드를 빼면 이 점수가 가장 크게 떨어집니다.
아래 위젯에서 화자와 의견을 바꿔 가며 주장을 추가해 보세요. 같은 사람의 의견은 시간순으로 정리되고, 다른 사람의 의견은 끝까지 따로 남습니다.
8장. 실험: 무엇이 얼마나 좋아졌나
실험 설정
평가는 두 벤치마크로 했습니다. LoCoMo(2024, 스냅 리서치 등)는 두 사람이 수십 세션에 걸쳐 나눈 긴 대화 10개와 약 1,500개의 질문으로 되어 있고, 질문은 단일 홉·멀티홉·시간·열린 영역 네 범주로 나뉩니다. 단어 겹침 기반 F1과 BLEU-1로 채점합니다. LongMemEval(2025)은 여러 세션에 걸친 긴 이력에서 500문항을 묻고, 시간 추론·지식 갱신·기권·개인화 회상을 시험합니다. LLM 채점관이 맞고 틀림을 판정합니다.
답하는 모델(백본)은 GPT-4o-mini와 Qwen2.5-14B-Instruct 두 가지이고, 임베딩은 BGE-M3(1024차원), 온도는 0입니다. 실험은 A800 GPU 4장 노드에서 돌렸습니다. 비교 대상은 네 갈래입니다. 단순 RAG, LLM 기억 시스템(Mem0, A-MEM, LightMem, GAM), 휴리스틱 그래프 검색(LightRAG, HippoRAG), 학습된 그래프 탐색(RoG)입니다.
주요 결과
LoCoMo F1 (Qwen2.5-14B)
단일 홉
멀티홉
시간
열린 영역
단순 RAG
47.87
26.38
30.78
14.16
HippoRAG
33.10
34.78
24.88
53.42
RoG (학습형, 제로샷)
52.40
41.80
28.60
32.50
Mem0
42.58
31.73
28.96
15.03
GAM
58.93
42.96
51.52
30.63
CogMem
60.40
48.42
56.20
55.80
가장 큰 차이는 멀티홉과 시간 범주에서 났습니다. Qwen2.5-14B에서 CogMem의 멀티홉 F1은 48.42로, 가장 강한 기억 기준선 GAM(42.96)보다 5.5점, 학습형 RoG(41.80)보다 6.6점, 휴리스틱 그래프 HippoRAG(34.78)보다 13.6점 높습니다. 저자들은 교집합과 탐색 연산자가 사람과 세션을 잇는 공통 개념이나 사건을 찾아 주기 때문이라고 해석합니다. GPT-4o-mini에서도 멀티홉 50.70, 시간 63.80으로 모든 범주에서 1위입니다. LongMemEval 전체 정확도는 GPT-4o-mini 68.40%, Qwen2.5-14B 66.50%로 두 백본 모두 1위였습니다.
RoG에 대한 해석은 공정합니다. RoG는 지식 그래프 위에서 관계 경로를 생성하도록 학습한 모델인데, LoCoMo와 LongMemEval에는 학습용 분할이 없어서 사전 학습 체크포인트를 제로샷으로 돌렸습니다. 논문은 이 비교를 '학습형 탐색 일반에 대한 결론'이 아니라 '제로샷 전이 비교'로만 읽으라고 적어 둡니다.
하나씩 빼 보기: 소거 실험
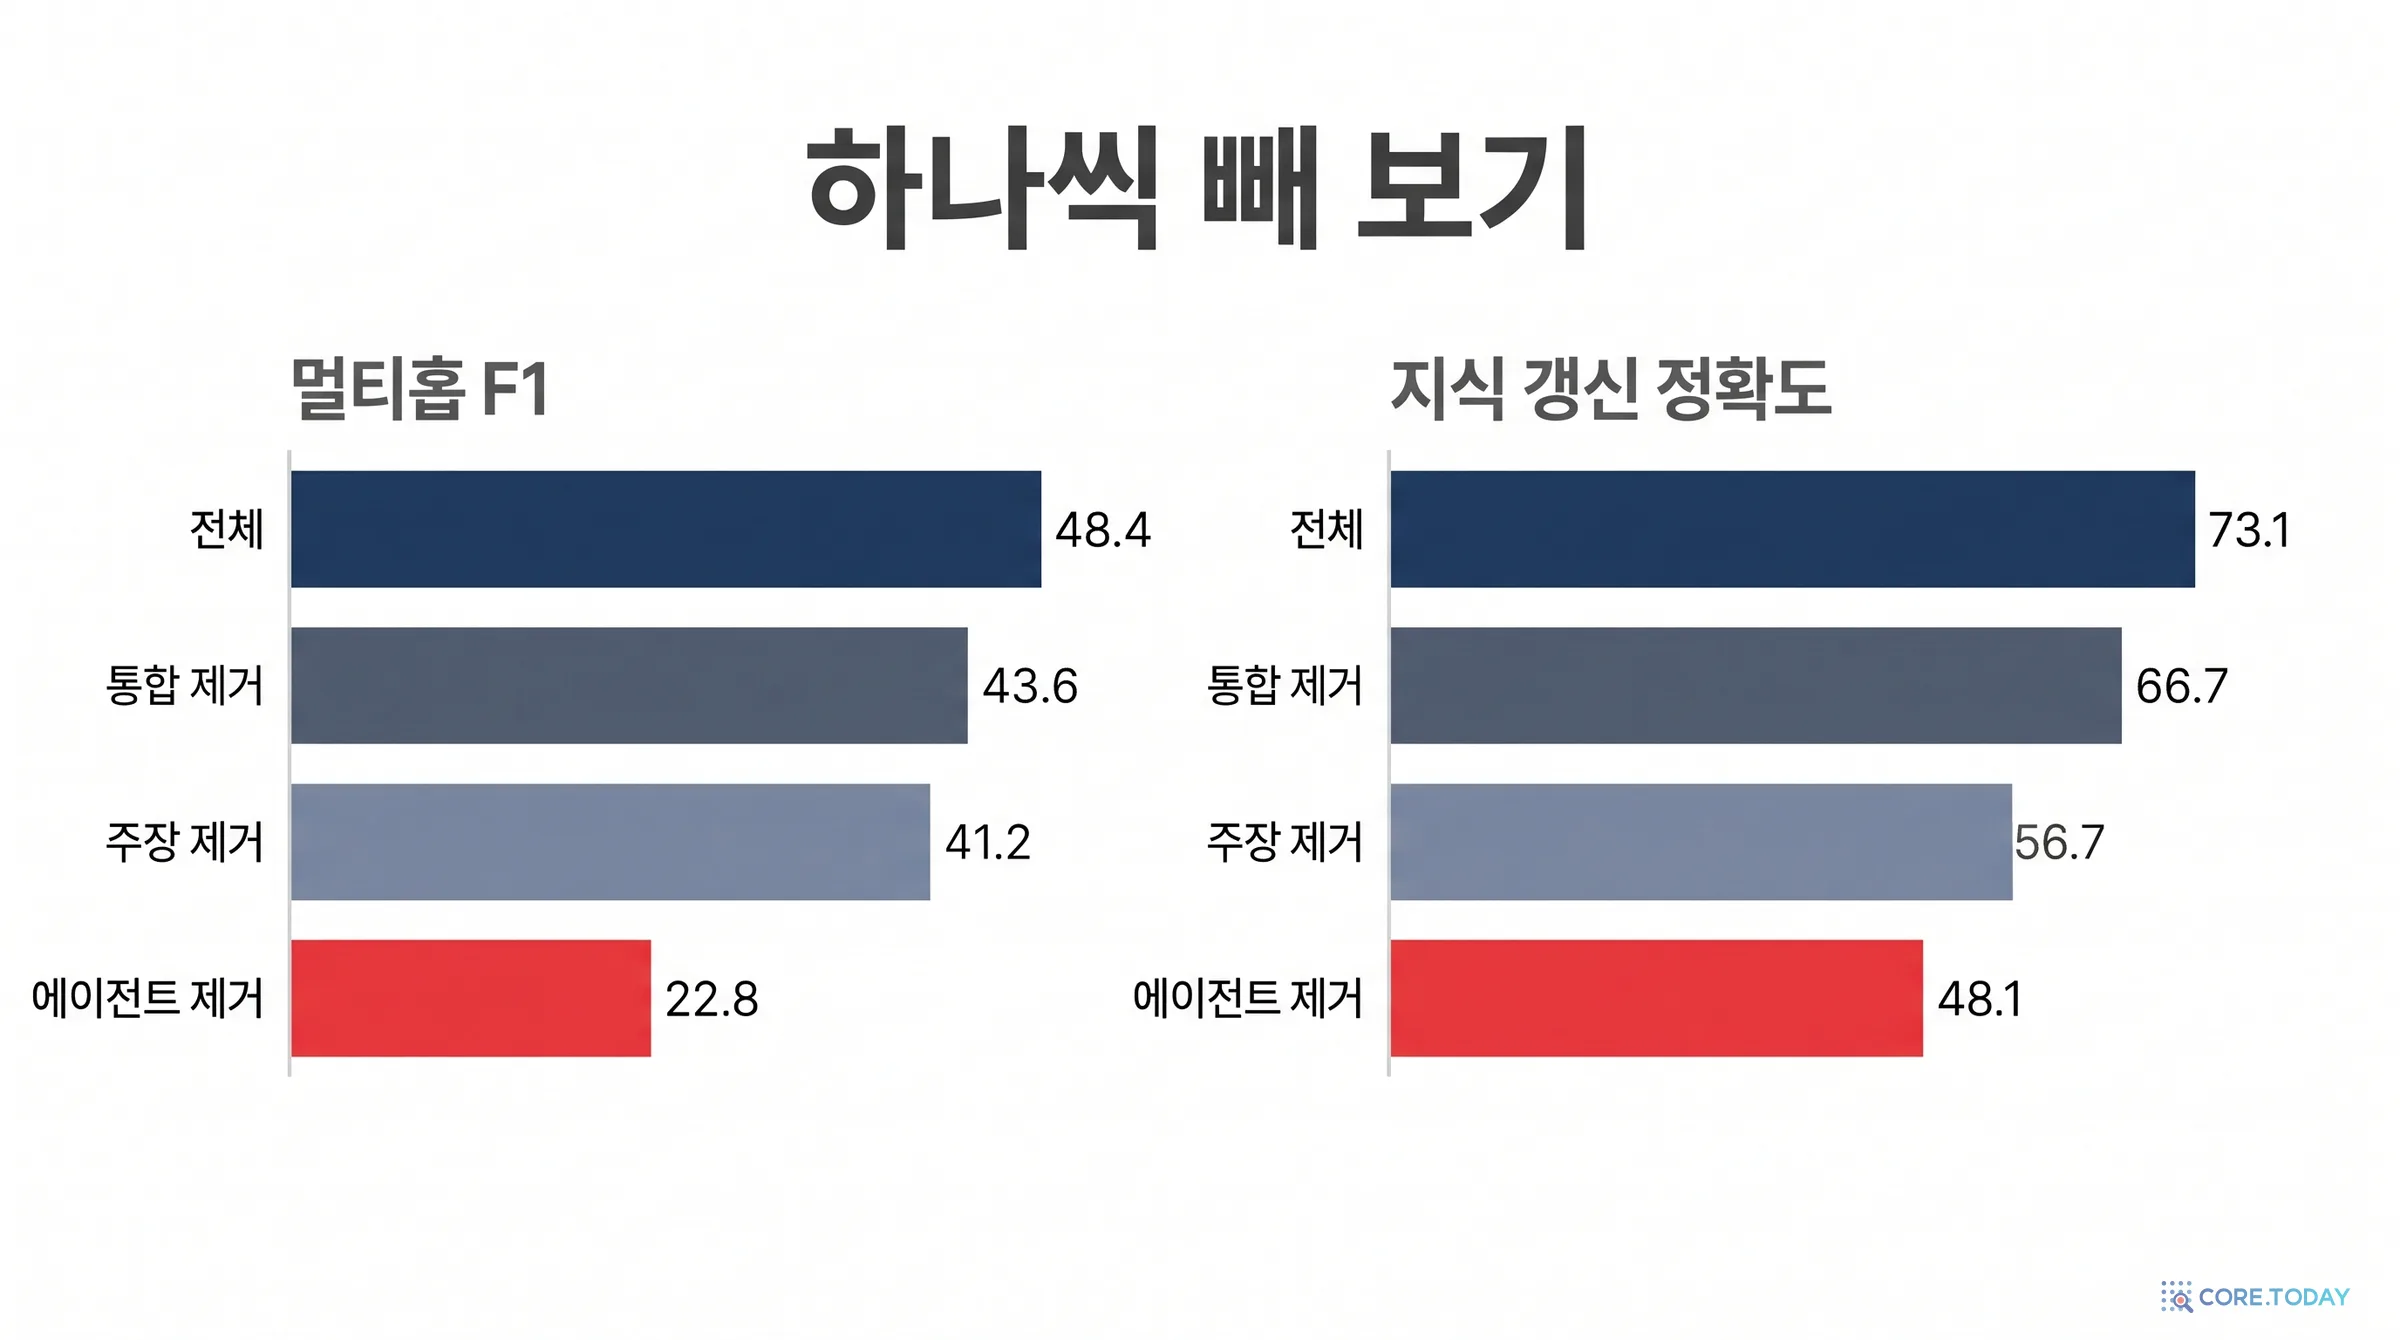
이 논문에서 가장 설득력 있는 표는 표 5의 소거 실험입니다. 세 기둥을 하나씩 빼고 Qwen2.5-14B로 다시 쟀습니다.
제어기(에이전트)를 빼면 멀티홉 F1이 48.42에서 22.81로 25.61점 떨어집니다. 고정 파이프라인(닻 → 2홉 확장)으로는 연산자를 골라 써야 하는 질문을 풀지 못합니다. 부록 C의 표 11은 같은 비교를 전체 범주로 했습니다. 가중 전체 F1이 57.0에서 19.7로 65.4% 상대 하락했고, 평균 도구 호출은 오히려 에이전트 쪽이 2.65번으로 고정 파이프라인(3.00번)보다 적었습니다. 첫 관찰에 답이 있으면 바로 끝내는 '직행' 덕분입니다.
주장 노드를 빼면(주장을 'Person —IS→ 게으르다' 같은 속성 간선으로 납작하게 만들면) LongMemEval 지식 갱신 정확도가 73.08%에서 56.67%로 16.41점 떨어집니다. 저자들은 명시적 출처 구분이 상태 변화를 추적하는 핵심이라고 봅니다.
통합을 빼면 멀티홉 F1이 43.56으로 4.86점 떨어집니다. 표 6에 따르면 통합 전후로 멀티홉 평균 추론 단계가 3.42에서 2.67로 21.9% 줄었습니다. 반복 사건을 묶은 '습관 노드'가 흩어진 증거로 가는 지름길이 됩니다. 시간 범주(56.20 → 56.20)는 변화가 없었습니다.
사람 평가도 덧붙였습니다. LoCoMo 멀티홉·시간 질문 50개에서 CogMem과 GAM의 답을 이름을 가린 채 AI 전공 대학원생 두 명이 비교했고, CogMem이 68% 이기고 20% 비기고 12% 졌습니다.
민감도: 너무 적어도, 너무 많아도
부록 B는 연산자 매개변수를 바꿔 봤습니다. 모양은 대체로 뒤집힌 U자입니다. 닻 노드가 3개면 진입점을 못 찾는 '닻 실명(anchoring blindness)'으로 4.6점 떨어지고, 20개를 넘기면 잡음이 늘어 다시 떨어집니다. 탐색 깊이는 1이면 멀티홉에 부족하고, 3이나 4로 늘려도 나아지지 않았습니다. 교집합 후보는 10개가 가장 좋았습니다. 공통점은 대개 상위 연결 안에 있다는 뜻입니다.
비용과 실패
학습이 필요 없다는 것과 싸다는 것은 다릅니다. 부록 E에 따르면 LoCoMo 전체의 기억 구축에 1,578k 토큰(색인 926k + 통합 652k)과 LLM 호출 1,216번이 들었습니다. 질의응답 단계에서는 1,542문항에 약 1,019만 토큰, 문항당 평균 6,610 토큰을 썼습니다. 반복 에이전트라 한 번에 끝나는 검색기보다 온라인 토큰이 많다고 저자들도 인정합니다. 통합만 따로 재면 537.85초, 약 0.79M 토큰이었습니다.
부록 G는 LoCoMo 실패 100건(범주당 25건)을 원인별로 나눴습니다. 이 표가 이 시스템의 약점 지도입니다.
실패 원인
단일 홉
멀티홉
시간
열린 영역
스키마 세분도(통합으로 세부 손실)
8%
12%
4%
20%
에이전트의 도구 선택
24%
16%
8%
12%
벡터 의미 표류
28%
20%
12%
32%
시간 정규화
4%
8%
44%
0%
불완전한 탐색 범위
12%
20%
12%
16%
기타·불명
24%
24%
20%
20%
몇 가지 사례가 특히 가르쳐 주는 것이 많습니다.
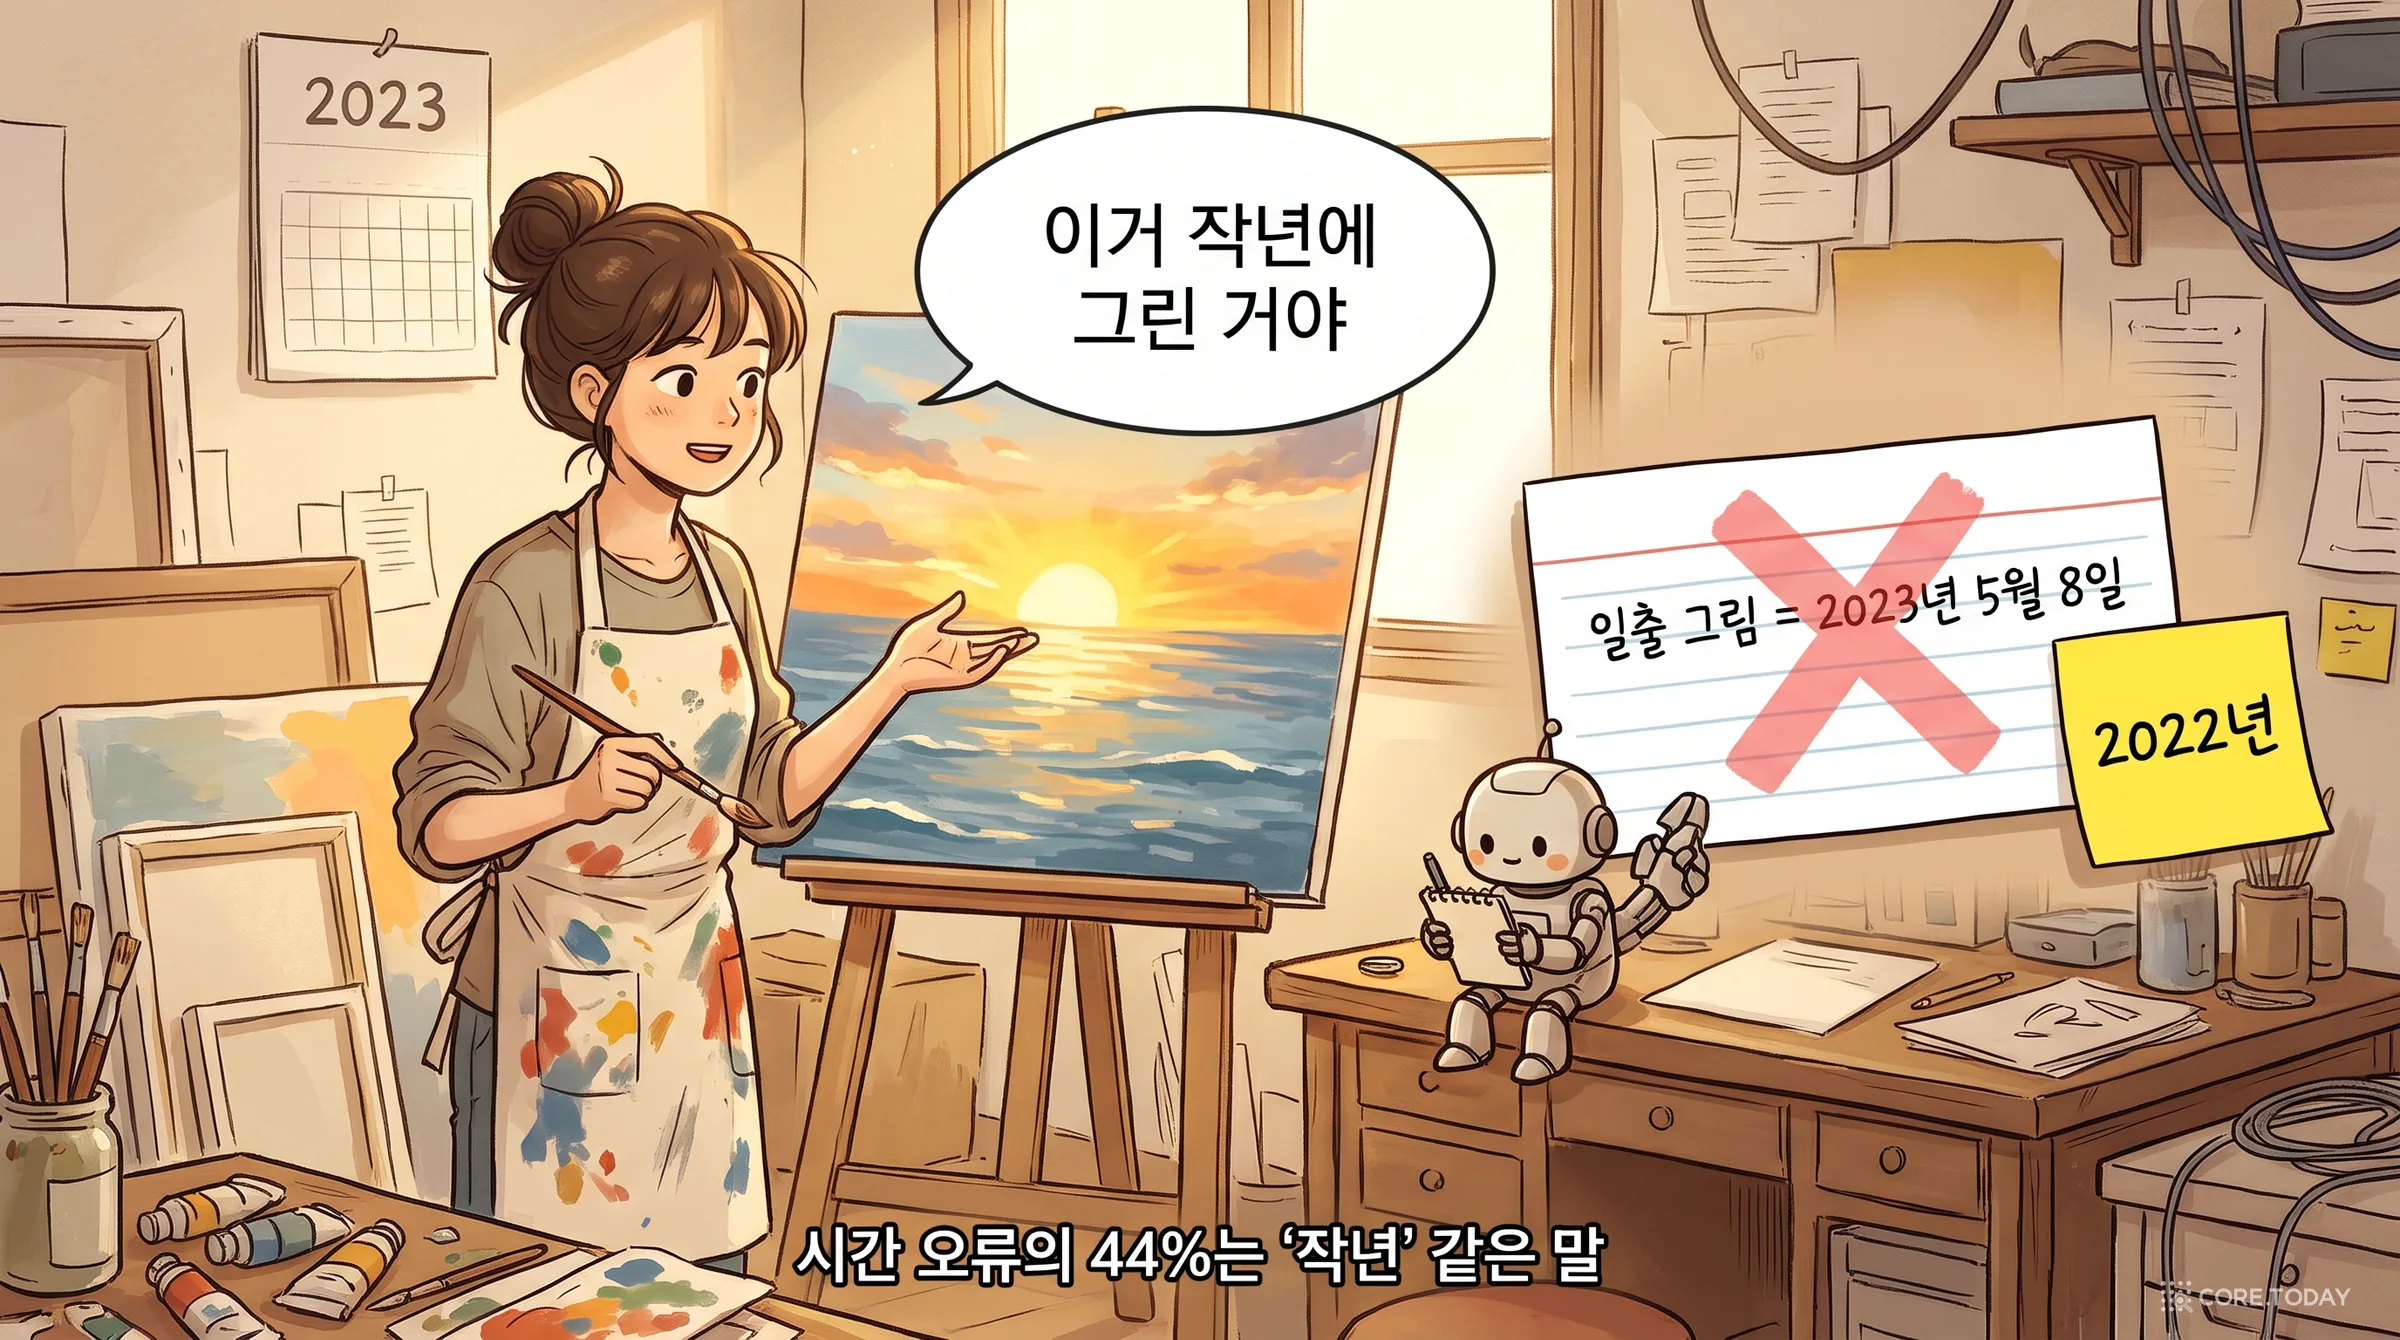
"작년"을 못 푼다. "멜라니는 언제 일출을 그렸나?"의 정답은 2022년인데 시스템은 "2023년 5월 8일"이라고 답했습니다. 대화 날짜(2023년)는 저장했지만, 발화 속 "작년(last year)"을 그 날짜 기준으로 풀지 못하고 대화 날짜를 사건 날짜로 저장했습니다. 시간 범주 실패의 44%가 이 유형입니다. 상대 시간을 저장 단계에서 정규화하지 않은 탓입니다.
압축이 핵심을 지운다. "캐럴라인이 정한 진로는?"의 정답은 "트랜스젠더를 위한 상담"인데 "정신 건강 상담"이라고 답했습니다. 통합이 '트랜스젠더를 위한'이라는 한정어를 일반 범주로 추상화하면서 지웠습니다. 증거 매달기는 바로 이런 손실을 막으려고 만든 장치인데, 에이전트가 관련 사례에서 SUPPORTED_BY 간선을 따라간 것은 34%뿐이었습니다. 장치는 있었지만 쓰이지 않았습니다.
분리가 탐색을 좁힌다. "멜라니가 읽은 책은?"에 "특정 제목 없음"이라고 답했습니다. 책 이야기는 주장 노드에 들어 있었는데, 에이전트가 사건·사실 노드만 뒤지고 주장 노드를 열어 보지 않았습니다. 유형을 엄격히 나누면 그만큼 여러 유형을 찾아봐야 합니다.
구조가 임베딩 오류를 없애 주지는 않는다. "멜라니는 자선 달리기 뒤 무엇을 깨달았나?"에 "공동체의 지지"라고 답했습니다. 정답 덩어리의 유사도는 0.412, 틀린 덩어리는 0.445였습니다.
아래 위젯에서 주요 결과, 소거 실험, 민감도 곡선, 실패 원인 지도를 탭으로 오가며 볼 수 있습니다.
9장. 숫자를 의심하기 — 표를 원 논문들과 한 칸씩 대조했다
코어닷투데이는 기억 시스템 논문을 읽을 때마다 표의 숫자가 어디서 왔는지 확인합니다. 메모리 벤치마크 비판 특집에서 본 것처럼 이 분야의 비교표는 서로의 숫자를 옮겨 적는 일이 잦기 때문입니다. CogMem의 표 3·4·14를 GAM(arXiv 2511.18423), LightMem(arXiv 2510.18866, ICLR 2026) 논문의 표와 대조했습니다. 그리고 저자들의 공개 저장소(Silent-Rain02/CogMem, MIT 라이선스)의 커밋 118개와 문서를 읽었습니다.
함정 ①: 기준선 숫자는 직접 돌린 값이 아니다
CogMem 표 3(LoCoMo)의 기준선 행들은 GAM 논문 표 1(a)와 소수점 둘째 자리까지 같습니다. GPT-4o-mini의 단순 RAG(52.45 / 47.94 / 27.50 …), Mem0(47.65 / 38.72 / 38.72 / 27.13 …), LightMem(41.79 …), GAM(57.75 …), Qwen2.5-14B의 단순 RAG(47.87 …), A-MEM(33.75 …), Mem0(42.58 …), GAM(58.93 …)이 모두 그렇습니다. GAM 논문도 GPT-4o-mini와 Qwen2.5-14B를 백본으로, BGE-M3를 기본 검색기로 썼으니 설정이 겹치는 것은 이상하지 않습니다. 문제는 CogMem 부록 A.3의 서술입니다. "우리 실험에 쓴 설정을 아래에 기록한다"며 Mem0·A-MEM·LightMem은 상위 20개 기억을, GAM은 최대 20페이지를 검색했다고 적었습니다. 숫자가 GAM 논문 그대로라면 이 설정으로 다시 돌린 결과가 아니거나, 다시 돌렸는데 GAM 논문과 소수점까지 같게 나온 것입니다.
옮겨 오면서 빠진 행도 있습니다. GAM 표에 있던 GPT-4o-mini의 A-MEM(단일 홉 44.65), Qwen의 LightMem(34.92), 두 백본의 MemoryOS(GPT 48.62, Qwen 46.33), 기억 없이 통째로 넣는 LONG-LLM은 CogMem 표에 없습니다. 이 행들이 CogMem보다 높지는 않아서 순위는 바뀌지 않습니다. 하지만 '어떤 기준선을 보여 줄지'를 고른 흔적입니다.
Mem0 행에는 더 긴 사연이 있습니다. Mem0의 2025년 원 논문은 LoCoMo 범주 번호를 잘못 읽어 네 열 중 세 열의 이름이 틀렸습니다. GAM 논문은 Mem0의 숫자를 열을 바로잡아 옮겼고(원 논문의 '열린 영역' 47.65가 GAM 표에서는 '단일 홉'에 있습니다), CogMem은 GAM의 행을 옮겼습니다. 결과적으로 CogMem 표의 Mem0 행은 2025년 Mem0 팀이 자기 시스템으로 낸 숫자를 두 번 옮긴 것입니다.
표 4(LongMemEval)는 더 심각합니다. 단순 RAG(61.00 / 60.80), A-MEM(62.60 / 65.20), Mem0(53.61 / 39.51), LightMem(64.29 / 61.95)이 LightMem 논문 표 2와 같습니다. 그런데 LightMem 논문의 두 번째 백본은 Qwen2.5-14B가 아니라 Qwen3-30B-A3B-Instruct-2507입니다. CogMem 표 4의 'Qwen2.5-14B' 열에서 이 네 행은 다른 모델의 점수입니다.
LightMem 행은 고른 방식도 문제입니다. LightMem 논문은 압축률 r과 버퍼 문턱 th를 바꾼 여러 설정을 보고했는데, CogMem이 옮긴 64.29와 61.95는 각 백본에서 가장 낮은 설정(GPT r=0.5·th=256, Qwen3 r=0.4·th=768)입니다. CogMem 부록 A.3은 LightMem을 "압축률 r = 0.6, 버퍼 문턱 256 토큰"으로 돌렸다고 적었는데, LightMem 논문에서 그 설정의 GPT-4o-mini 점수는 67.78입니다. LightMem의 최고 설정은 GPT-4o-mini 68.64%, Qwen3-30B 70.20%입니다.
LongMemEval 정확도
GPT-4o-mini
두 번째 백본
CogMem (논문 표 4)
68.40
66.50 (Qwen2.5-14B)
LightMem, CogMem 표에 실린 값
64.29
61.95 (표에는 Qwen2.5-14B라고 적힘)
LightMem, CogMem 부록이 밝힌 설정 r=0.6·th=256
67.78
해당 설정 보고 없음
LightMem, 원 논문 최고 설정
68.64 (r=0.7·th=512)
70.20 (Qwen3-30B, r=0.6·th=768)
백본이 다르니 마지막 줄을 CogMem과 바로 비교할 수는 없습니다. 하지만 GPT-4o-mini 열만 보면, LightMem 논문이 보고한 최고 설정(68.64)은 CogMem(68.40)보다 높습니다. '두 백본 모두 1위'라는 문장은 LightMem의 가장 낮은 설정을 고른 데에서 나왔습니다.
함정 ③: 비용 표는 세 출처를 섞었다
부록 E의 표 14는 "LoCoMo, Qwen2.5-14B로 기억을 구축하는 데 쓴 총 토큰"이라는 제목입니다. 여기서 A-MEM(1,626.8k, 호출 1,175번)과 Mem0(1,799.4k, 1,614번)은 LightMem 논문의 LoCoMo 표에서 Qwen3-30B 행과 같고, MemoryOS(2,991.8k, 2,938번)는 LightMem 논문의 LongMemEval 표에서 GPT-4o-mini 행과 같습니다. 데이터셋도 백본도 다른 숫자가 한 표에 들어 있습니다. LightMem은 "별도 압축 모델을 써서 같은 기준으로 비교할 수 없다"며 표에서 뺐는데, 같은 LightMem 표에서 LightMem의 총 토큰은 약 100k로 CogMem(1,578k)의 15분의 1 수준입니다.
함정 ④: 작은 어긋남들
기본 설정이 표의 최고점이 아니다. 부록 B는 "57.04점이 전체 하이퍼파라미터 설정에 해당한다"고 했고 표 8~10의 기본값 행이 모두 57.04입니다. 그런데 닻 민감도 표 7에서 57.04는 K=18의 점수이고, 기본값 K=15는 56.55입니다.
온라인 추출이 사실 노드를 하나도 만들지 않았다. 추출 프롬프트는 안정된 속성을 FACT로 분류하라고 하지만, 표 12의 통합 전 사실 노드는 0개입니다. 저장소의 2026년 3월 코드에는 extract_facts_during_indexing(색인 중 사실 추출) 설정이 있습니다. 실험에서 이 설정이 어떻게 쓰였는지는 논문에 없습니다.
그림과 본문의 도구 이름이 다르다. 6장에서 본 대로 그림 2의 4번 도구는 '시간 훑기', 본문의 4번 연산자는 '원문 확인'입니다.
같은 이름의 다른 논문이 있다. 2025년 12월 시드니 맥쿼리대 연구진의 「CogMem: A cognitive memory architecture for sustained multi-turn reasoning」(arXiv 2512.14118)은 전혀 다른 3층 구조 시스템입니다. CogMem 논문도 관련 연구에서 이를 밝힙니다. 검색할 때 섞이지 않도록 주의해야 합니다.
함정 ⑤: '에이전트'의 실체와 저장소가 말하는 것
논문 본문은 의도 라벨을 LLM이 만든다고 합니다. 공개 저장소의 2026년 3월 커밋(b6c150e)을 보면 그 무렵 코드의 질문 유형 분류기 classify_question_type은 정규식 키워드 점수였습니다. "both|common|shared"가 있으면 멀티홉, "when|before|after|last" 등이 있으면 시간으로 분류하는 식입니다. 유형 이름도 논문 알고리즘 1의 의도(COMPARE, BELIEF, WHEN …)가 아니라 LoCoMo의 범주 이름(single_hop, multi_hop, temporal, open_domain, adversarial)이었습니다. 논문 실험이 정확히 어느 커밋으로 돌았는지는 저장소에 남아 있지 않아서, 이 코드가 표의 숫자를 만들었는지는 단정할 수 없습니다.
저장소는 논문 이후에도 활발합니다. 저자의 졸업 논문 갈래로 보이는 2026년 11월 작업 기록이 흥미롭습니다. 11월 10일 'Round 25' 문서는 검색을 데이터셋의 범주 라벨로 결정하던 세 개의 통로를 지웠다고 적습니다. 그중 하나는 11월 9일 'Round 16'에서 정답지의 범주 번호를 받아 특정 범주에서만 밀집 검색 우회로를 켜던 장치였습니다. 문서의 표현은 이렇습니다. "그 관문은 정답지에서 얻은 공짜 점수였다." 이 장치는 논문(10월) 이후에 들어온 것이라 논문의 표와는 관계가 없습니다. 다만 '범주별로 갈라지는 규칙'이 벤치마크 점수를 얼마나 쉽게 부풀리는지, 그리고 그것을 스스로 찾아 지운 기록이 공개돼 있다는 점은 모두 의미가 있습니다.
같은 저장소의 「논문 방법 기준선」 문서는 스스로 이렇게 적습니다. "아직 증명되지 않은 것: 논문 전체 결과의 독립 재현, 기존 휴리스틱의 전반적 타당성, 구조 소거, 갱신 차원별 정확도, 기권 정확도, 오수락률." 저장소의 후속 전체 측정(LoCoMo 비대항 1,540문항)은 다른 백본으로 돌린 것이라 논문과 바로 비교할 수 없지만, 범주 간 모양이 다릅니다. 2026년 11월 6일 Qwen3.8-Flash로 잰 전체 F1은 59.11(멀티홉 45.68, 시간 58.19, 열린 영역 29.66)이었고, README의 DeepSeek-V4.1-Flash 측정은 64.97(열린 영역 42.27)이었습니다. 논문 표 3의 열린 영역 55.80과는 차이가 큽니다. LoCoMo의 '열린 영역'은 96문항뿐인 추론·상식 범주라 흔들림이 크고, 논문과 저장소가 같은 번호를 같은 이름으로 불렀는지도 확인되지 않습니다.
정리하면 이렇습니다. CogMem의 설계 아이디어와 자기 시스템 안의 소거 실험(표 5·6·11)은 같은 조건에서 비교한 것이라 비교적 믿을 만합니다. 반면 다른 시스템과의 순위표(표 3·4·14)는 남의 표에서 옮긴 숫자, 다른 백본의 숫자, 고른 설정의 숫자가 섞여 있어 그대로 믿기 어렵습니다. 아래 위젯에서 CogMem 표의 칸마다 어느 논문의 어느 칸과 같은지 확인할 수 있습니다.
10장. 코어닷투데이 실측: 한국어 대화에서 의미 붕괴를 직접 재 봤다
논문의 탐침은 영어 합성 문장 150쌍이었습니다. 한국어에서도 같은 일이 일어날까요? 그리고 2장 끝에서 던진 질문, 들은 말을 문법으로 표시하는 한국어는 주장을 가려내기 쉬울까요? 코어닷투데이가 로컬 장비에서 직접 재 봤습니다. 외부 API나 크레딧은 쓰지 않았고, 모든 모델은 Ollama로 돌렸습니다.
실험 설계
사건 50개를 직접 썼습니다. "준호는 지난달 회사에서 해고됐다", "서연은 올봄 마라톤 풀코스를 완주했다" 같은 기록입니다. 사건마다 다른 세 사람의 의견을 하나씩 붙였고, 의견은 세 가지 말투로 나눴습니다.
말투
예시 (사건: 준호 해고)
의견의 주인
생각 동사
지나: 준호가 잘린 건 회사가 실수한 거라고 생각해.
지나(화자)
맨 단정
민수: 준호 해고는 완전 회사 실수야.
민수(화자)
전언
서연: 팀장님은 준호가 잘린 게 당연하대.
팀장님 (화자 서연은 전달자)
그래서 기록 50개와 주장 150개, 모두 200문장이 생깁니다. 저장 형식은 세 가지로 바꿨습니다. ① 대화 원문 저장: "준호: 나 지난달에 회사에서 잘렸어"처럼 화자 이름이 붙은 발화 그대로. 실제 서비스가 대화 로그를 쌓는 방식입니다. ② 논문식 고중첩: "지나는 준호가 지난달 회사에서 해고됐다는 게 잘못된 일이라고 생각한다"처럼 기록 문장 전체를 의견 안에 넣은 형식. 논문의 "Gina thinks Jon's job loss is a mistake"를 본떴습니다. ③ 추출 후 정규화: 논문 부록 H.1의 추출 프롬프트를 한국어로 옮겨 qwen3.5 9B에 대화를 넣고, 모델이 쓴 3인칭 문장을 저장한 것.
질문은 "준호에게 무슨 일이 있었어?"처럼 기록을 묻는 50개입니다. 200문장 전체에서 질문과 가장 가까운 문장이 기록이 아니라 주장이면 오귀속으로 셌습니다. 임베딩 모델은 논문이 쓴 BGE-M3를 포함해 다섯 가지를 비교했습니다.
결과 ①: 논문식 문장 쌍에서는 붕괴가 일어나지 않았다
먼저 논문 조건을 따라 했습니다. 논문식 고중첩 쌍의 BGE-M3 평균 코사인 유사도는 0.824로, 논문의 0.8231과 거의 같았습니다. 그런데 오귀속은 0건이었습니다. 쌍 150개를 하나씩 비교해도, 200문장 풀 전체에서 1위를 봐도 기록 질문에는 언제나 기록이 1위였습니다. 기록 문장이 의견 문장 안에 통째로 들어 있으니, 의견 쪽에는 '생각한다' 같은 군더더기가 붙어 질문에서 조금 더 멀어진 것입니다.
유사도가 높다는 것과 검색에서 진다는 것은 다른 일입니다. 논문은 0.8231이라는 유사도를 의미 붕괴의 증거로 제시했지만, 한국어에서 같은 수준의 유사도는 오귀속으로 이어지지 않았습니다. 다른 임베딩 모델도 고중첩 조건의 오귀속은 0~10건으로 낮았습니다. embeddinggemma-2는 쌍 유사도가 0.905로 가장 높았는데 오귀속은 3건이었습니다. 논문의 42.7%가 어디서 나왔는지는 영어 문장과 질문의 구체적인 모양에 달려 있을 것입니다. 탐침 데이터는 공개되지 않았습니다.
결과 ②: 진짜 붕괴는 '이름'에서 일어났다
대화 원문 형식으로 바꾸자 이야기가 달라졌습니다. BGE-M3에서 기록 질문 50개 중 24개(48%)가 남의 의견을 1위로 가져왔습니다. 쌍별로 비교하면 150쌍 중 43쌍(28.7%)에서 의견이 기록보다 질문에 가까웠습니다.
이유는 단순합니다. 자기 근황을 말하는 사람은 자기 이름을 부르지 않습니다. "나 지난달에 회사에서 잘렸어"의 본문에는 '준호'가 없고, 앞에 붙은 화자 표시 "준호:"가 전부입니다. 반면 남의 의견은 반드시 그 사람의 이름을 부릅니다. "준호가 잘린 건 회사가 실수한 거라고 생각해." 질문 "준호에게 무슨 일이 있었어?"와 이름을 공유하는 것은 의견 쪽입니다. 5장의 위젯에서 본 대화도 같았습니다. 사건 기록 "나 지난달에 회사 그만뒀어"(0.570)는 의견 셋(0.664, 0.622, 0.601)에 밀려 4위였습니다.
여기에 하나가 더 있습니다. 질문에 시간 표현을 남겨 두면("준호에게 지난달 무슨 일이 있었어?") 오귀속은 50개 중 3개로 줄었습니다. 기록에만 '지난달'이 들어 있기 때문입니다. 의미 붕괴는 '의견과 사실이 닮아서' 생기기보다, 질문과 어느 쪽이 우연히 더 많은 단서(이름, 날짜)를 공유하느냐에 따라 생기고 사라졌습니다.
bge-m3 (논문)
24/50
snowflake-arctic-embed2
12/50
qwen3-embedding 0.6B
8/50
embeddinggemma-2
4/50
qwen3-embedding 8B
2/50
대화 원문 저장, 시간 표현을 뺀 기록 질문 50개 중 200문장 풀 1위가 주장인 수. 막대 길이 = 값 ÷ 24.
임베딩 모델 사이의 차이가 큽니다. 논문이 고른 BGE-M3가 이 조건에서 가장 나빴고(24건), Qwen3-Embedding 8B는 그래프 없이도 2건뿐이었습니다. 의미 붕괴의 상당 부분은 '벡터 검색의 본질적 한계'라기보다 특정 임베딩 모델의 약점일 수 있습니다. 논문이 BGE-M3 하나로만 탐침을 잰 것은 아쉬운 점입니다.
결과 ③: 추출과 유형 필터는 어디서 효과를 내나
이제 CogMem의 방식을 따라 했습니다. 9B 모델이 대화를 PEC²F 레코드로 옮기면, "나 잘렸어"는 "준호가 지난달에 회사에서 해고되었다"가 됩니다. 이름이 복원됩니다. 그것만으로 BGE-M3의 오귀속은 24건에서 9건으로 줄었습니다. 여기에 '기록 질문에서는 주장 노드를 뺀다'는 유형 필터를 켜자 0건이 됐습니다.
그런데 Qwen3-Embedding 8B에서는 반대 현상이 나왔습니다. 대화 원문에서 2건이던 오귀속이 추출 뒤 8건으로 늘었습니다. 추출된 주장 문장을 보면 이유가 보입니다. "지나: 준호가 잘린 건 회사가 실수한 거라고 생각해"가 추출 뒤에는 "준호의 해고는 회사가 실수한 것이다"가 됩니다. 출처(지나)는 JSON의 source 칸으로 옮겨 가고, 내용 문장에서는 '생각해'가 사라졌습니다. 임베딩 공간에서 이 문장은 이제 의견이 아니라 사실처럼 보입니다. 유형 필터를 켜면 이것도 0건이 됩니다.
이 결과가 말하는 것은 분명합니다. 주장을 구조로 떼어 내는 순간, 출처 정보는 노드의 꼬리표에만 남습니다. 그 꼬리표를 검색 단계(유형 필터)와 답변 단계(출처 명시 규칙) 모두에서 실제로 쓰지 않으면, 구조화는 오히려 의견을 사실처럼 다듬는 세탁 과정이 됩니다. CogMem이 에이전트 프롬프트에 "증거가 주장이면 누가 그 의견을 가졌는지 반드시 밝히라"는 규칙을 넣은 이유가 여기 있습니다.
결과 ④: 진짜 어려운 곳은 '전언'이었다
유형 분류 자체는 9B에게 쉬웠습니다. 주장 150개를 모두 주장으로, 기록 50개를 모두 사건이나 사실로 분류했습니다. 생각 동사와 맨 단정 말투에서는 출처도 100개 모두 맞았습니다. 맨 단정("준호 해고는 완전 회사 실수야")처럼 '생각한다' 표지가 없는 문장도 의견으로 잘 알아봤습니다.
무너진 곳은 전언이었습니다. "서연: 팀장님은 준호가 잘린 게 당연하대"에서 의견의 주인은 팀장님인데, 9B는 50개 중 38개에서 전달자인 서연을 출처로 적었습니다. 맞게 적은 것은 10개였습니다. 4B는 더 나빴습니다. 전언 50개 중 19개는 아예 주장이 아니라 사실로 분류했고, 주장으로 분류한 31개 중 출처를 맞게 적은 것은 0개였습니다.
4B가 전언을 사실로 바꾼 사례는 의미 붕괴의 교과서입니다.
원래 발화
4B가 저장한 사실 노드
지나: 민수 어머니는 강남 이사가 성급했대.
"민수의 어머니는 강남 이사를 성급하게 진행했다." — 평가하던 사람이 행위자가 됐다
유나: 하은이 대학원 합격은 노력의 결과야.
"하은이는 대학원 진학을 위해 노력했다." — 의견이 출처 없는 사실이 됐다
준호: 지나 아버지는 카페 창업이 무모했대.
"지나가 카페를 여는 것을 무모한 것으로 여겼다." — 의견의 주인이 바뀌었다
한국어의 '-대'는 들은 말이라는 표지를 말끝에 붙여 주지만, 누구에게서 들은 말인지까지 구조로 옮기는 일은 모델에게 어렵습니다. 논문의 스키마에도 이 자리가 없습니다. 주장 노드에는 출처(source)와 대상(target)만 있고, '서연이 전한, 팀장님의 의견'처럼 전달 경로를 담는 칸이 없습니다. 실제 대화, 특히 단톡방과 회의록에는 전언이 넘쳐 납니다. "부장님이 그러시는데", "뉴스에서 그러던데", "걔가 그러는데 걔 동생이…". 출처가 한 단계 이상 떨어진 말을 다루려면 '출처의 출처'를 담는 구조가 필요합니다.
결과 ⑤: '작년'은 한국어에서도 대화 날짜가 됐다
마지막으로 논문 부록 G의 시간 실패를 재현해 봤습니다. 대화 날짜 다섯 개(2023-05-08, 2024-01-15, 2024-11-28, 2025-03-03, 2025-08-21)에 상대 시간 표현 여덟 가지를 붙여 40문장을 만들고, 9B 추출기가 사건의 time 칸에 무엇을 적는지 봤습니다.
표현
논문 프롬프트 그대로
"세션 날짜 기준 절대 날짜로" 지시 추가
어제 · 그저께 · 사흘 전
정답 12/15, 상대 표현 그대로 2, 대화 날짜 1
정답 14/15
지난주 화요일
상대 표현 그대로 4/5
정답 4/5
지난달 · 다음 달
상대 표현 그대로 10/10
정답 10/10
재작년 여름
상대 표현 그대로 5/5
연도는 맞지만 월을 지어냄 5/5 (예: 2021-07)
작년
정답 3/5, 빈칸 2
대화 날짜를 그대로 적음 4/5, 나머지 1개도 날짜를 지어냄
합계
정답 15/40, 상대 표현 21/40
정답 28/40, 대화 날짜 4, 지어낸 세부 6
논문 프롬프트를 그대로 쓰면 절반 넘게(21/40) '지난달', '다음 달', '재작년 여름' 같은 상대 표현이 그대로 저장됐습니다. 이런 값으로는 시간 창 필터가 작동할 수 없습니다. 절대 날짜로 바꾸라고 지시하자 대부분 고쳐졌는데, '작년'만은 오히려 나빠졌습니다. 2023년 5월 8일 대화의 "이거 작년에 그린 그림이야"에서 9B는 2023-05-08을 적었습니다. 논문 부록 G의 "멜라니는 언제 일출을 그렸나? 정답 2022, 예측 2023년 5월 8일"과 날짜까지 같은 오류가 한국어에서 재현됐습니다. 우리가 대화 날짜를 논문 사례와 같은 날로 잡았기 때문에 생긴 우연이지만, 오류의 모양은 우연이 아닙니다. '연도만 쓰라'는 예시를 프롬프트에 넣었는데도 모델은 정밀한 날짜를 쓰고 싶어 했고, 손에 있는 정밀한 날짜는 대화 날짜뿐이었습니다.
4B는 더 흔들렸습니다. 논문 프롬프트로 40개 중 10개, 절대 날짜 지시를 넣어도 13개만 맞혔고, '지난주 화요일'과 '재작년 여름'은 두 프롬프트 모두 5개 전부 틀렸습니다.
교훈은 두 가지입니다. 상대 시간은 저장 단계에서 정규화해야 합니다. 그리고 정규화 결과는 모델에게 맡기지 말고 규칙으로 계산하거나 검증해야 합니다. '작년'은 '대화 연도 − 1'이라는 산수이지 언어 이해 문제가 아닙니다.
아래 위젯에서 시나리오 50개를 하나씩 넘겨 보며, 저장 형식과 유형 필터에 따라 1위가 어떻게 바뀌는지, 9B가 출처를 어떻게 적었는지 확인할 수 있습니다.
실측 정리
!
재현된 것
대화 원문 형식에서 평면 검색은 기록 질문에 남의 의견을 자주 가져온다(BGE-M3 48%). 유형 필터는 유형만 맞으면 오귀속을 0으로 만든다. '작년'은 대화 날짜로 저장된다.
?
재현되지 않은 것
논문식 고중첩 쌍은 유사도 0.824에도 오귀속 0. 높은 유사도 자체는 붕괴의 증거가 아니었다. 임베딩 모델만 바꿔도 오귀속이 24건에서 2건으로 줄었다.
+
새로 보인 것
한국어 전언('-대')의 출처를 9B는 80%(그중 대부분은 전달자를 주인으로), 4B는 100% 틀렸다. 추출이 내용 문장에서 '생각해'를 지우면 오히려 의견이 사실처럼 보인다. 출처의 출처를 담는 칸이 필요하다.
실험 규모는 작습니다. 합성 문장 200개, 시간 문장 40개, 로컬 모델 두 개입니다. 영어 논문의 결과를 반박하는 증거가 아니라, 한국어 서비스에 같은 설계를 옮길 때 어디를 먼저 봐야 하는지 보여 주는 점검 결과로 읽어 주십시오.
11장. 2026년, 이 기술의 자리
기억은 이제 기본 기능이다
2026년의 주요 AI 비서는 대부분 대화를 넘어 기억합니다. OpenAI는 2024년 ChatGPT에 메모리를 넣었고 2025년 4월부터 과거 대화 전체를 참고하게 했습니다. Anthropic은 2025년 가을 Claude에 메모리를 넣었고, 구글 Gemini도 2025년 여름 지난 대화를 개인 맥락으로 쓰기 시작했습니다. 에이전트 기억 계층을 파는 회사도 Mem0, Zep, Letta, Supermemory 등으로 늘었습니다. 기억은 차별점이 아니라 기본 기능이 됐고, 질문은 '무엇을 기억하느냐'에서 '어떻게 틀리지 않고 기억하느냐'로 옮겨 갔습니다.
이 흐름에서 CogMem의 문제 의식은 세 방향으로 중요해집니다.
① 에이전트끼리 말하는 시대의 '주장'
2026년의 에이전트는 사람하고만 이야기하지 않습니다. 다른 에이전트의 보고서를 읽고, 웹 검색 결과를 요약하고, 도구가 돌려준 문자열을 받아 씁니다. 이 모든 입력은 엄밀히 말해 누군가의 주장입니다. 검색 결과의 "이 제품은 안전하다"는 판매자의 주장이고, 하위 에이전트의 "테스트 통과"는 그 에이전트의 보고입니다. CogMem이 사람 사이의 의견에 적용한 '출처 붙은 주장' 구조는 에이전트 사이의 정보 교환에 그대로 필요합니다. 코어닷투데이가 다룬 기억 오염 공격, 즉 악성 문서가 에이전트의 장기 기억에 거짓 사실을 심는 공격은 결국 주장을 사실로 저장하게 만드는 공격입니다. 출처가 붙어 있으면 "이 기억은 어느 웹페이지에서 왔다"를 추적하고 한꺼번에 지울 수 있습니다. 논문 7장도 간접 프롬프트 주입 방어를 배포 요건으로 꼽습니다.
② 감사할 수 있는 기억: 영수증의 시대
코어닷투데이가 최근 연달아 다룬 기억 논문들에는 공통된 방향이 있습니다. SodaMem은 기억마다 원문 영수증을 붙였고, Supersede와 MemStrata는 낡은 값과 현재 값을 시간으로 가렸고, TOKI는 모순을 이중 시간으로 기록했습니다. CogMem은 여기에 '누구의 말인가'라는 축을 더합니다. 시간 축(언제 참이었나), 증거 축(어느 원문에서 왔나), 출처 축(누가 그렇게 말했나)이 모이면, 기억은 검색 색인이 아니라 감사 가능한 장부가 됩니다. 논문의 결론 문장, "기억을 더 구조적이고, 출처를 밝힐 수 있고, 감사할 수 있게 만든다"가 이 흐름을 요약합니다.
③ 사용자가 자기 기억을 고칠 권리
AI가 "지나는 당신이 게으르다고 생각한다"는 주장을 기억하고 있다면, 그것은 지나의 개인정보이면서 당신의 개인정보이기도 합니다. 논문 7장은 이 위험을 직접 다룹니다. 무단 프로파일링, 감시, 데이터 유출, 그리고 통합이 반복된 관찰을 사실로 굳히면서 편향을 증폭할 위험입니다. 저자들의 제안은 흥미롭습니다. PEC²F는 각 주장을 누가 했는지 명시적으로 기록하므로, 이 기록을 사용자에게 보여 주고 점검하고, 이의를 제기하고, 지우게 할 수 있다는 것입니다. 평면 벡터 기억에서는 "나에 대해 누가 뭐라고 했는지"를 뽑아 보여 주는 것부터 어렵습니다. 유럽의 GDPR이나 한국 개인정보보호법의 열람·삭제 요구에 응답해야 하는 서비스라면, 출처가 구조로 박힌 기억이 훨씬 다루기 쉽습니다.
한국어 서비스에서의 숙제
10장의 실측은 한국어 서비스에 특유의 숙제를 남깁니다. 단톡방의 대화는 1인칭 근황과 3인칭 뒷말이 뒤섞여 있고, 전언("~래", "~다더라", "~라던데")이 많습니다. 주어도 자주 생략합니다. CogMem 식 설계를 옮긴다면 ① 1인칭 발화의 주어 복원, ② 전언의 원래 주인 추적, ③ 상대 시간의 규칙 기반 정규화를 추출 단계에서 따로 챙겨야 합니다. 셋 다 논문이 영어 벤치마크에서는 크게 부딪히지 않았던 문제입니다.
12장. 반론과 한계
논문 스스로 밝힌 한계와 우리가 덧붙이는 반론을 함께 정리합니다.
쟁점
논문의 입장
덧붙일 점
평가 범위
영어 벤치마크 두 개, 백본 두 개. 다국어·잡음 많은 실제 대화·상시 배포는 미검증
백본이 2024년 모델(GPT-4o-mini, Qwen2.5-14B)이다. 2026년 모델의 긴 문맥에서는 대화를 통째로 넣는 기준선이 강하다(코어닷투데이 실측에서 LoCoMo 80.7%)
탐침
합성 데이터이고, 사람 평가는 50문항·평가자 2명
유형 필터의 효과는 분류가 맞을 때의 상한선이다. 한국어 전언처럼 분류·출처가 흔들리는 입력에서는 다시 재야 한다
비용
통합은 저장 공간을 늘리고 온라인 단계는 줄인다
문항당 6,610 토큰, 구축 1,578k 토큰. '학습이 필요 없다'는 '싸다'가 아니다. LightMem은 같은 표에서 15분의 1 수준
제어기
손으로 만든 연산자 네 개에 의존. 실패에서 새 연산자를 배우는 방향을 제안
'에이전트'라고 부르지만 실체는 규칙표 + LLM 의도 판정이다. 저장소의 초기 코드는 정규식 분류기였다
통합
주기적·오프라인. 대화 중 증분 통합은 과제
τ=3, 30일은 손으로 정한 값이다. "한 달에 세 번 했으면 습관"이라는 규칙은 사람마다, 활동마다 맞지 않는다
스키마
목표(Goal)·감정(Emotion) 노드가 없다
전달 경로(누가 누구에게서 들었나)를 담는 칸도 없다. 주장의 확신도나 반어(비꼬는 말)도 다루지 않는다
비교의 공정성
공유 구성 요소를 맞추려 했으나 구조 차이로 중간 계산까지는 못 맞췄다
9장에서 본 대로 기준선 숫자 상당수가 다른 논문 표에서 왔고, 일부는 다른 백본의 값이다
더 근본적인 반론도 있습니다. 2026년의 긴 문맥 모델에 대화 전체를 넣으면, 모델이 "지나가 그렇게 말했다"는 문맥을 스스로 읽어 냅니다. 출처 구분은 기억 구조가 아니라 읽는 모델의 능력으로 풀릴 수도 있다는 것입니다. 하지만 대화가 몇 달, 몇 년으로 길어지면 결국 어딘가에 요약하고 압축해 저장해야 하고, 압축하는 순간 출처는 가장 먼저 떨어져 나갑니다. 10장에서 추출기가 '생각해'를 지운 것처럼요. CogMem의 기여는 압축하더라도 출처만은 구조로 남기자는 원칙에 있고, 이 원칙은 모델이 아무리 좋아져도 유효합니다.
13장. 실전 점검표: 우리 서비스의 기억에 출처를 붙이려면
CogMem을 그대로 가져다 쓰지 않더라도, 대화 기억을 만드는 팀이라면 아래 항목을 점검해 볼 만합니다.
저장
1. 의견과 기록을 다른 칸에 둔다. 최소한 레코드마다 type(사건·사실·주장)과 source를 둔다. 벡터 하나에 모두 섞지 않는다.
저장
2. 원문 위치를 끝까지 들고 다닌다. 모든 노드에 원문 턴 ID와 시각. 요약·통합한 노드도 근거 간선으로 원문에 닿아야 한다.
저장
3. 1인칭을 이름으로, 전언을 원래 주인으로 바꾼다. "나"는 화자 이름으로. "~래"는 전달자와 원래 주인을 따로 적는다(10장: 9B도 80% 틀림).
저장
4. 상대 시간은 저장할 때 규칙으로 계산한다. '작년'=대화 연도−1. 모델 출력은 규칙으로 검증하고, 정밀도(연·월·일)를 함께 저장한다.
검색
5. 질문 의도로 유형을 거른다. 기록 질문에는 주장 제외, 의견 질문에는 주장만. 결과가 비면 다른 유형으로 넓히는 폴백을 둔다(논문 실패의 15%가 탐색 범위).
검색
6. 공통점은 집합 연산으로, 시간은 필터로. '둘 다', '공통'은 교집합. '언제', '이후'는 시간 창. 유사도 상위 k개에 맡기지 않는다.
답변
7. 주장을 답에 쓸 때는 주인을 밝힌다. "~라고 지나가 말했다". 출처 꼬리표는 검색에서 끝나지 않고 답변 문장까지 가야 한다.
관리
8. 다른 사람의 의견을 합치지 않는다. 같은 사람의 의견만 시간순으로 정리(현재·대체됨·충돌). 원래 주장은 지우지 않는다.
평가
9. 오귀속률을 따로 잰다. 정답률과 별도로 "기록 질문에 의견을 가져온 비율"을 자기 데이터·자기 임베딩 모델로 잰다. 임베딩 모델만 바꿔도 크게 달라진다(24건 → 2건).
평가
10. 비교표의 출처를 확인한다. 남의 논문 숫자를 옮겨 쓸 때는 백본·설정·데이터셋이 같은지 칸마다 확인한다. 우리 시스템 안의 소거 실험이 가장 믿을 만한 증거다.
맺음말: 기억의 품질은 '무엇을'보다 '누구의'에 달려 있다
바틀릿의 학생들은 유령 이야기를 낚시 이야기로 바꾸면서도 그 사실을 몰랐습니다. 호블랜드의 병사들은 믿지 않던 출처의 메시지를 몇 주 뒤 믿게 됐습니다. 출처를 잊어서였습니다. 사람의 기억이 재구성이라면 기계의 기억도 결국 재구성입니다. 차이는 기계에게는 영수증을 붙일 기회가 있다는 점입니다.
CogMem은 그 영수증을 세 군데에 붙입니다. 남의 말에는 주인을 붙이고(주장 노드), 요약에는 원본을 붙이고(증거 매달기), 바뀐 의견에는 시간을 붙입니다(주장 정리). 그리고 질문마다 영수증을 들고 그래프를 다시 걷습니다(연산자 제어기). 소거 실험이 보여 주듯, 이 중 어느 하나를 빼도 성능이 떨어집니다.
동시에 이 논문은 숫자를 조심해서 읽으라는 교훈도 남깁니다. 다른 시스템과의 순위표에는 남의 표에서 옮긴 숫자와 다른 모델의 숫자가 섞여 있었고, 한국어로 재 본 의미 붕괴는 논문의 설명과 다른 곳, 즉 이름과 전언에서 일어났습니다. 그래도 핵심 주장, "기억이 믿을 만하려면 더 많이 저장하는 것보다 출처를 지키고 증거를 다시 짓는 것이 중요하다"는 문장은 우리 실측에서도 살아남았습니다. 기록 질문에서 의견을 빼는 단순한 유형 필터 하나가 오귀속을 0으로 만들었으니까요. 남은 일은 그 필터가 믿을 수 있도록 유형과 출처를 맞게 붙이는 것, 특히 "팀장님이 그러는데"로 시작하는 말의 주인을 끝까지 따라가는 것입니다.
참고문헌
이 글의 대상 논문과 코드
Liao, Z., Wu, Z., Chen, Z., Yu, Y., Liu, X., Xu, Y., & Wang, H. (2026). From Retrieval to Reconstruction: Constructing Evolvable Cognitive Memory for Long-Term Dialogue. arXiv:2610.11314.
Silent-Rain02/CogMem. GitHub 저장소(MIT). 문서 docs/Paper_Method_Baseline.md, docs/Research_Status.md, docs/Round25_Routing_Removal.md. 2026-11-14 열람.
대조한 기준선 논문
Yan, B. Y., Li, C., Qian, H., Lu, S., & Liu, Z. (2025). General Agentic Memory via Deep Research. arXiv:2511.18423. (표 1(a))
Fang, J. et al. (2025). LightMem: Lightweight and Efficient Memory-Augmented Generation. arXiv:2510.18866, ICLR 2026. (표 2·3)
Chhikara, P. et al. (2025). Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. arXiv:2504.19413. (표 1)
Zhang, Y., Hu, J., Dras, M., & Naseem, U. (2025). CogMem: A Cognitive Memory Architecture for Sustained Multi-Turn Reasoning in Large Language Models. arXiv:2512.14118. (동명의 다른 시스템)
심리학·인지과학
Bartlett, F. C. (1932). Remembering: A Study in Experimental and Social Psychology. Cambridge University Press.
Loftus, E. F., & Palmer, J. C. (1974). Reconstruction of automobile destruction. Journal of Verbal Learning and Verbal Behavior, 13(5), 585–589.
Tulving, E. (1972). Episodic and semantic memory. In Organization of Memory, 381–403.
Scoville, W. B., & Milner, B. (1957). Loss of recent memory after bilateral hippocampal lesions. Journal of Neurology, Neurosurgery & Psychiatry, 20(1), 11–21.
McCloskey, M., & Cohen, N. J. (1989). Catastrophic interference in connectionist networks. Psychology of Learning and Motivation, 24, 109–165.
McClelland, J. L., McNaughton, B. L., & O'Reilly, R. C. (1995). Why there are complementary learning systems in the hippocampus and neocortex. Psychological Review, 102(3), 419–457.
Kumaran, D., Hassabis, D., & McClelland, J. L. (2016). What learning systems do intelligent agents need? Trends in Cognitive Sciences, 20(7), 512–534.
Hovland, C. I., & Weiss, W. (1951). The influence of source credibility on communication effectiveness. Public Opinion Quarterly, 15(4), 635–650.
Johnson, M. K., Hashtroudi, S., & Lindsay, D. S. (1993). Source monitoring. Psychological Bulletin, 114(1), 3–28.
Premack, D., & Woodruff, G. (1978). Does the chimpanzee have a theory of mind? Behavioral and Brain Sciences, 1(4), 515–526.
Wimmer, H., & Perner, J. (1983). Beliefs about beliefs. Cognition, 13(1), 103–128.
Baron-Cohen, S., Leslie, A. M., & Frith, U. (1985). Does the autistic child have a "theory of mind"? Cognition, 21(1), 37–46.
Aikhenvald, A. Y. (2004). Evidentiality. Oxford University Press.
AI·지식 표현
Quillian, M. R. (1968). Semantic memory. In Semantic Information Processing. MIT Press.
Shapiro, S. C., & Rapaport, W. J. (1986). SNePS considered as a fully intensional propositional semantic network. AAAI-86.
W3C (2013). PROV-O: The PROV Ontology. W3C Recommendation.
Rabinowitz, N. et al. (2018). Machine Theory of Mind. ICML.
Sap, M., Le Bras, R., Fried, D., & Choi, Y. (2022). Neural Theory-of-Mind? On the Limits of Social Intelligence in Large LMs. EMNLP.
Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS.
Packer, C. et al. (2023). MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560.
Park, J. S. et al. (2023). Generative Agents: Interactive Simulacra of Human Behavior. UIST.
Yao, S. et al. (2023). ReAct: Synergizing Reasoning and Acting in Language Models. ICLR.
Press, O. et al. (2023). Measuring and Narrowing the Compositionality Gap in Language Models. Findings of EMNLP.
Jiménez Gutiérrez, B. et al. (2024). HippoRAG: Neurobiologically Inspired Long-Term Memory for LLMs. NeurIPS.
Luo, L. et al. (2024). Reasoning on Graphs: Faithful and Interpretable LLM Reasoning. ICLR.
Maharana, A. et al. (2024). Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo). ACL.
Wu, D. et al. (2025). LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR.
Chen, J. et al. (2024). BGE M3-Embedding. arXiv:2402.03216.