포트는 8080이 됐는데 AI는 아직 8000이라고 한다 — 낡은 사실 오류와 '시간 유효성' 기억
RAG는 사실이 바뀌면 옛 값과 새 값을 둘 다 꺼내 오고, 어느 쪽이 지금 값인지 가릴 방법이 없습니다. 2026년 6월 arXiv에 올라온 MemStrata 논문은 이것을 '낡은 사실 오류'라 부르고, 유사도로는 바뀐 값을 가려낼 수 없다는 것(AUROC 0.59)부터 보인 뒤 (주어, 관계, 값) 열쇠로 옛 값을 지우지 않고 퇴역시키는 기억을 제안합니다. 1969년 프레임 문제부터 SQL:2011 시간 테이블까지 '바뀌는 세계를 기억하는 법'의 역사를 따라가고, 한국어 시나리오 30개로 논문의 핵심 주장을 로컬 모델에서 다시 재 보았습니다.
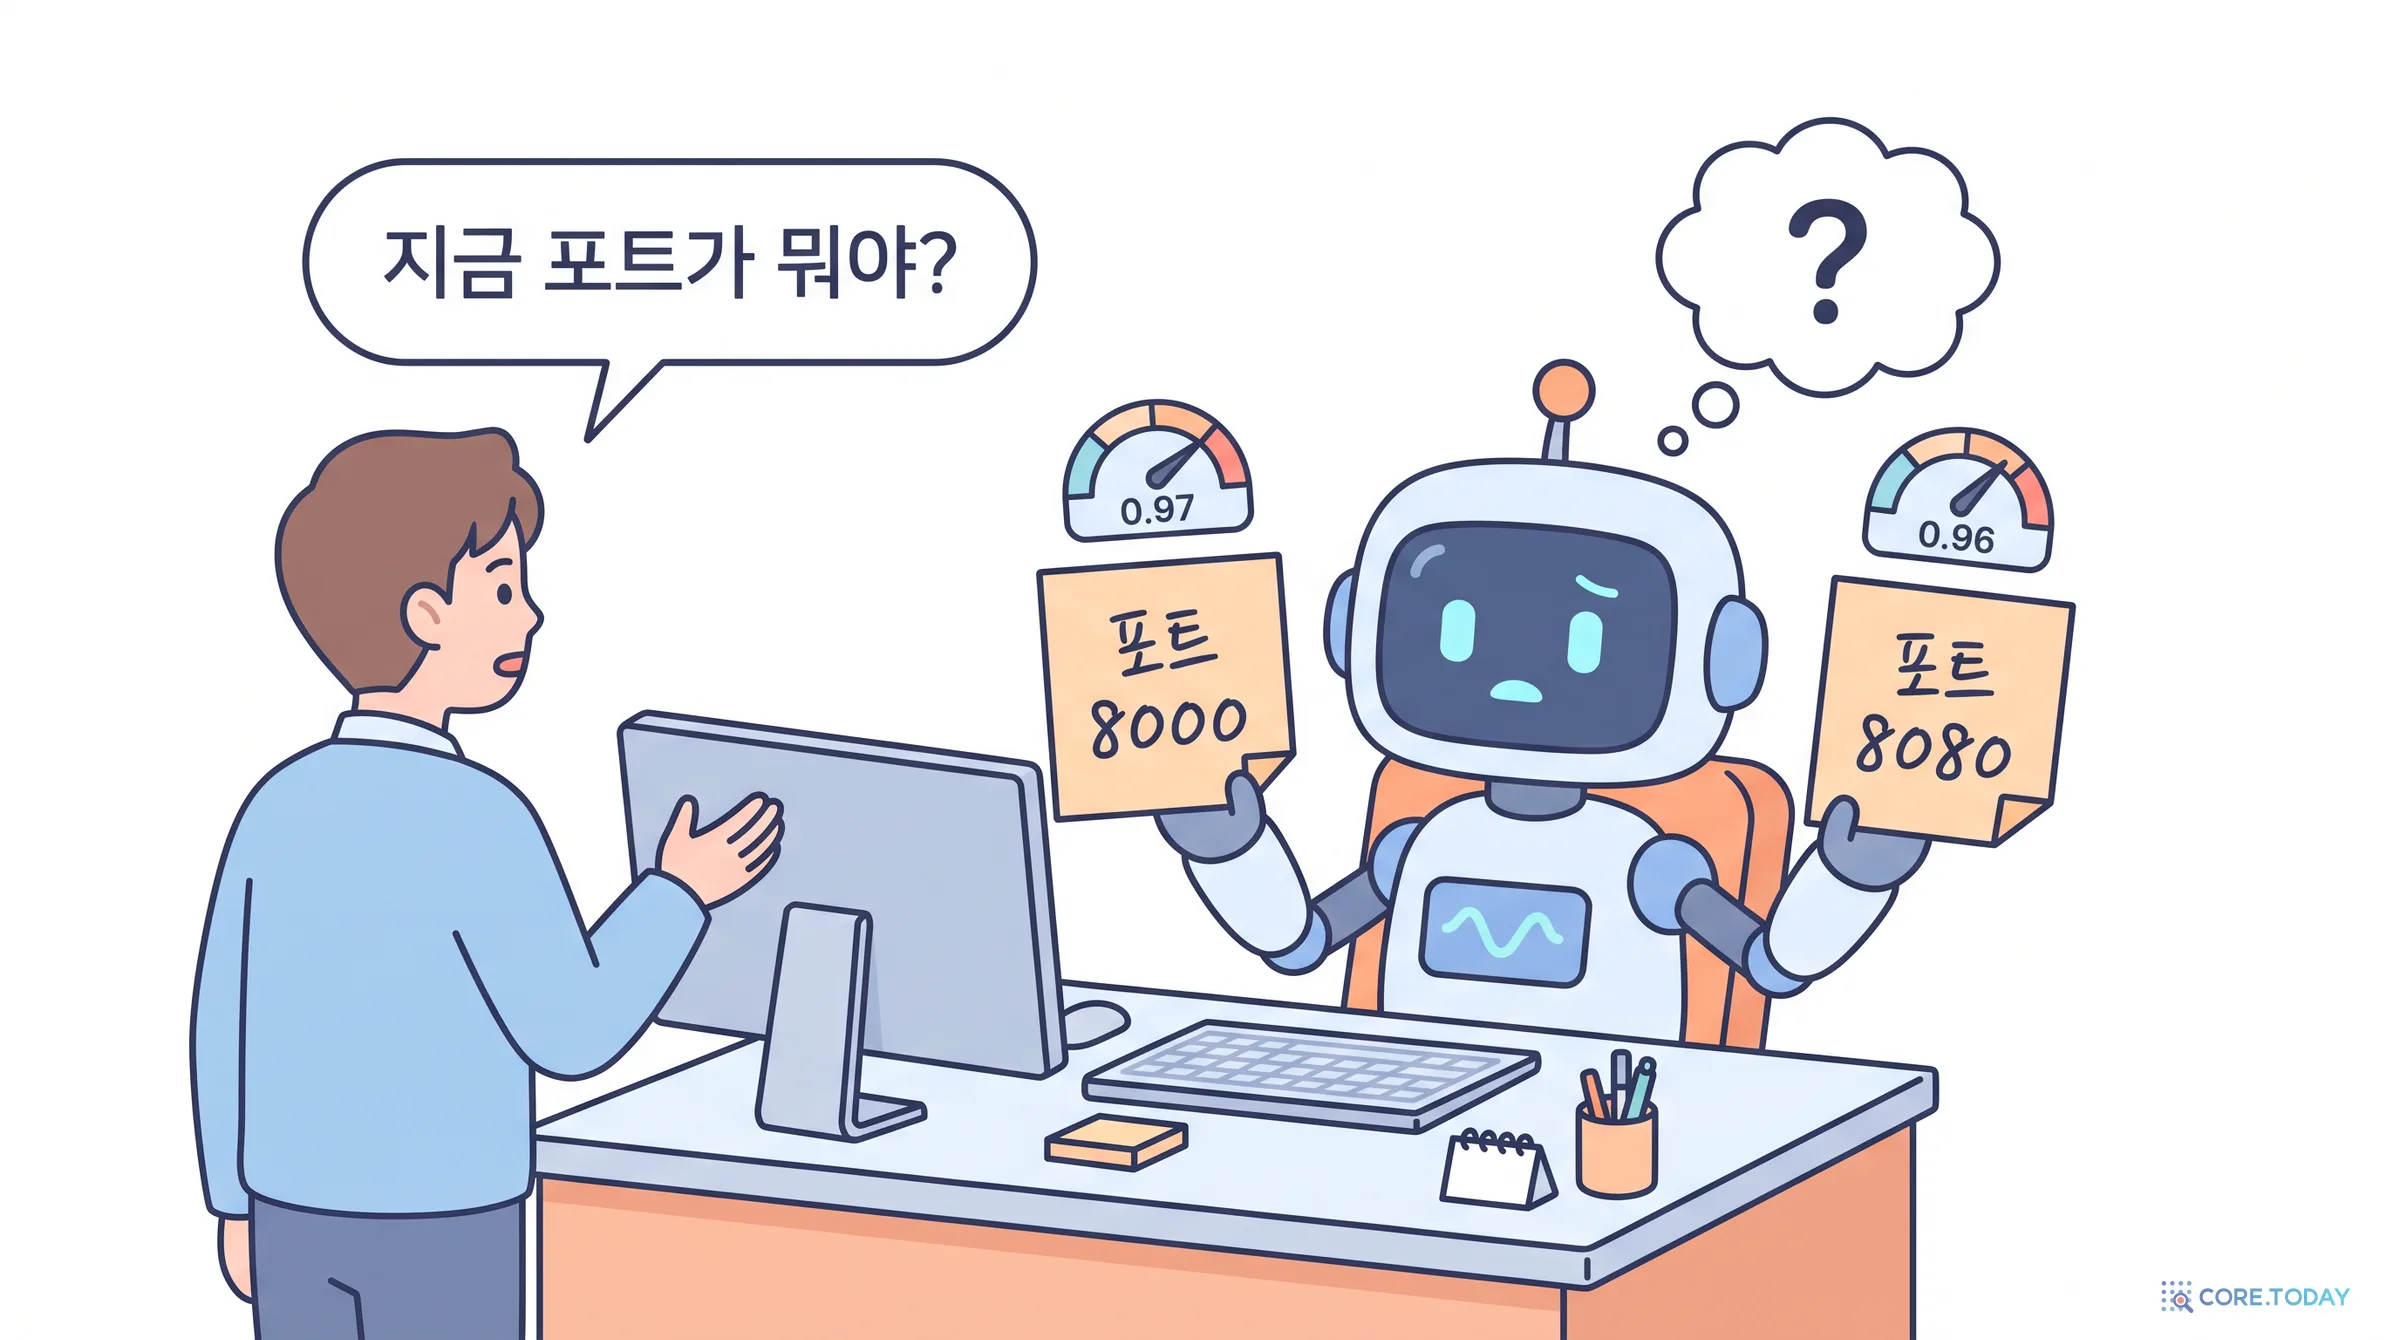
금요일 오후, 결제 서비스 팀이 포트를 8000에서 8080으로 옮겼습니다. 회의록에도 적었고, 사내 코딩 에이전트와의 대화에서도 "이제 8080이야"라고 말해 두었습니다. 월요일 아침 신입 개발자가 에이전트에게 묻습니다. "결제 서비스 로컬에서 띄우려면 몇 번 포트로 붙어야 해요?" 에이전트는 자신 있게 답합니다. "8000번입니다."
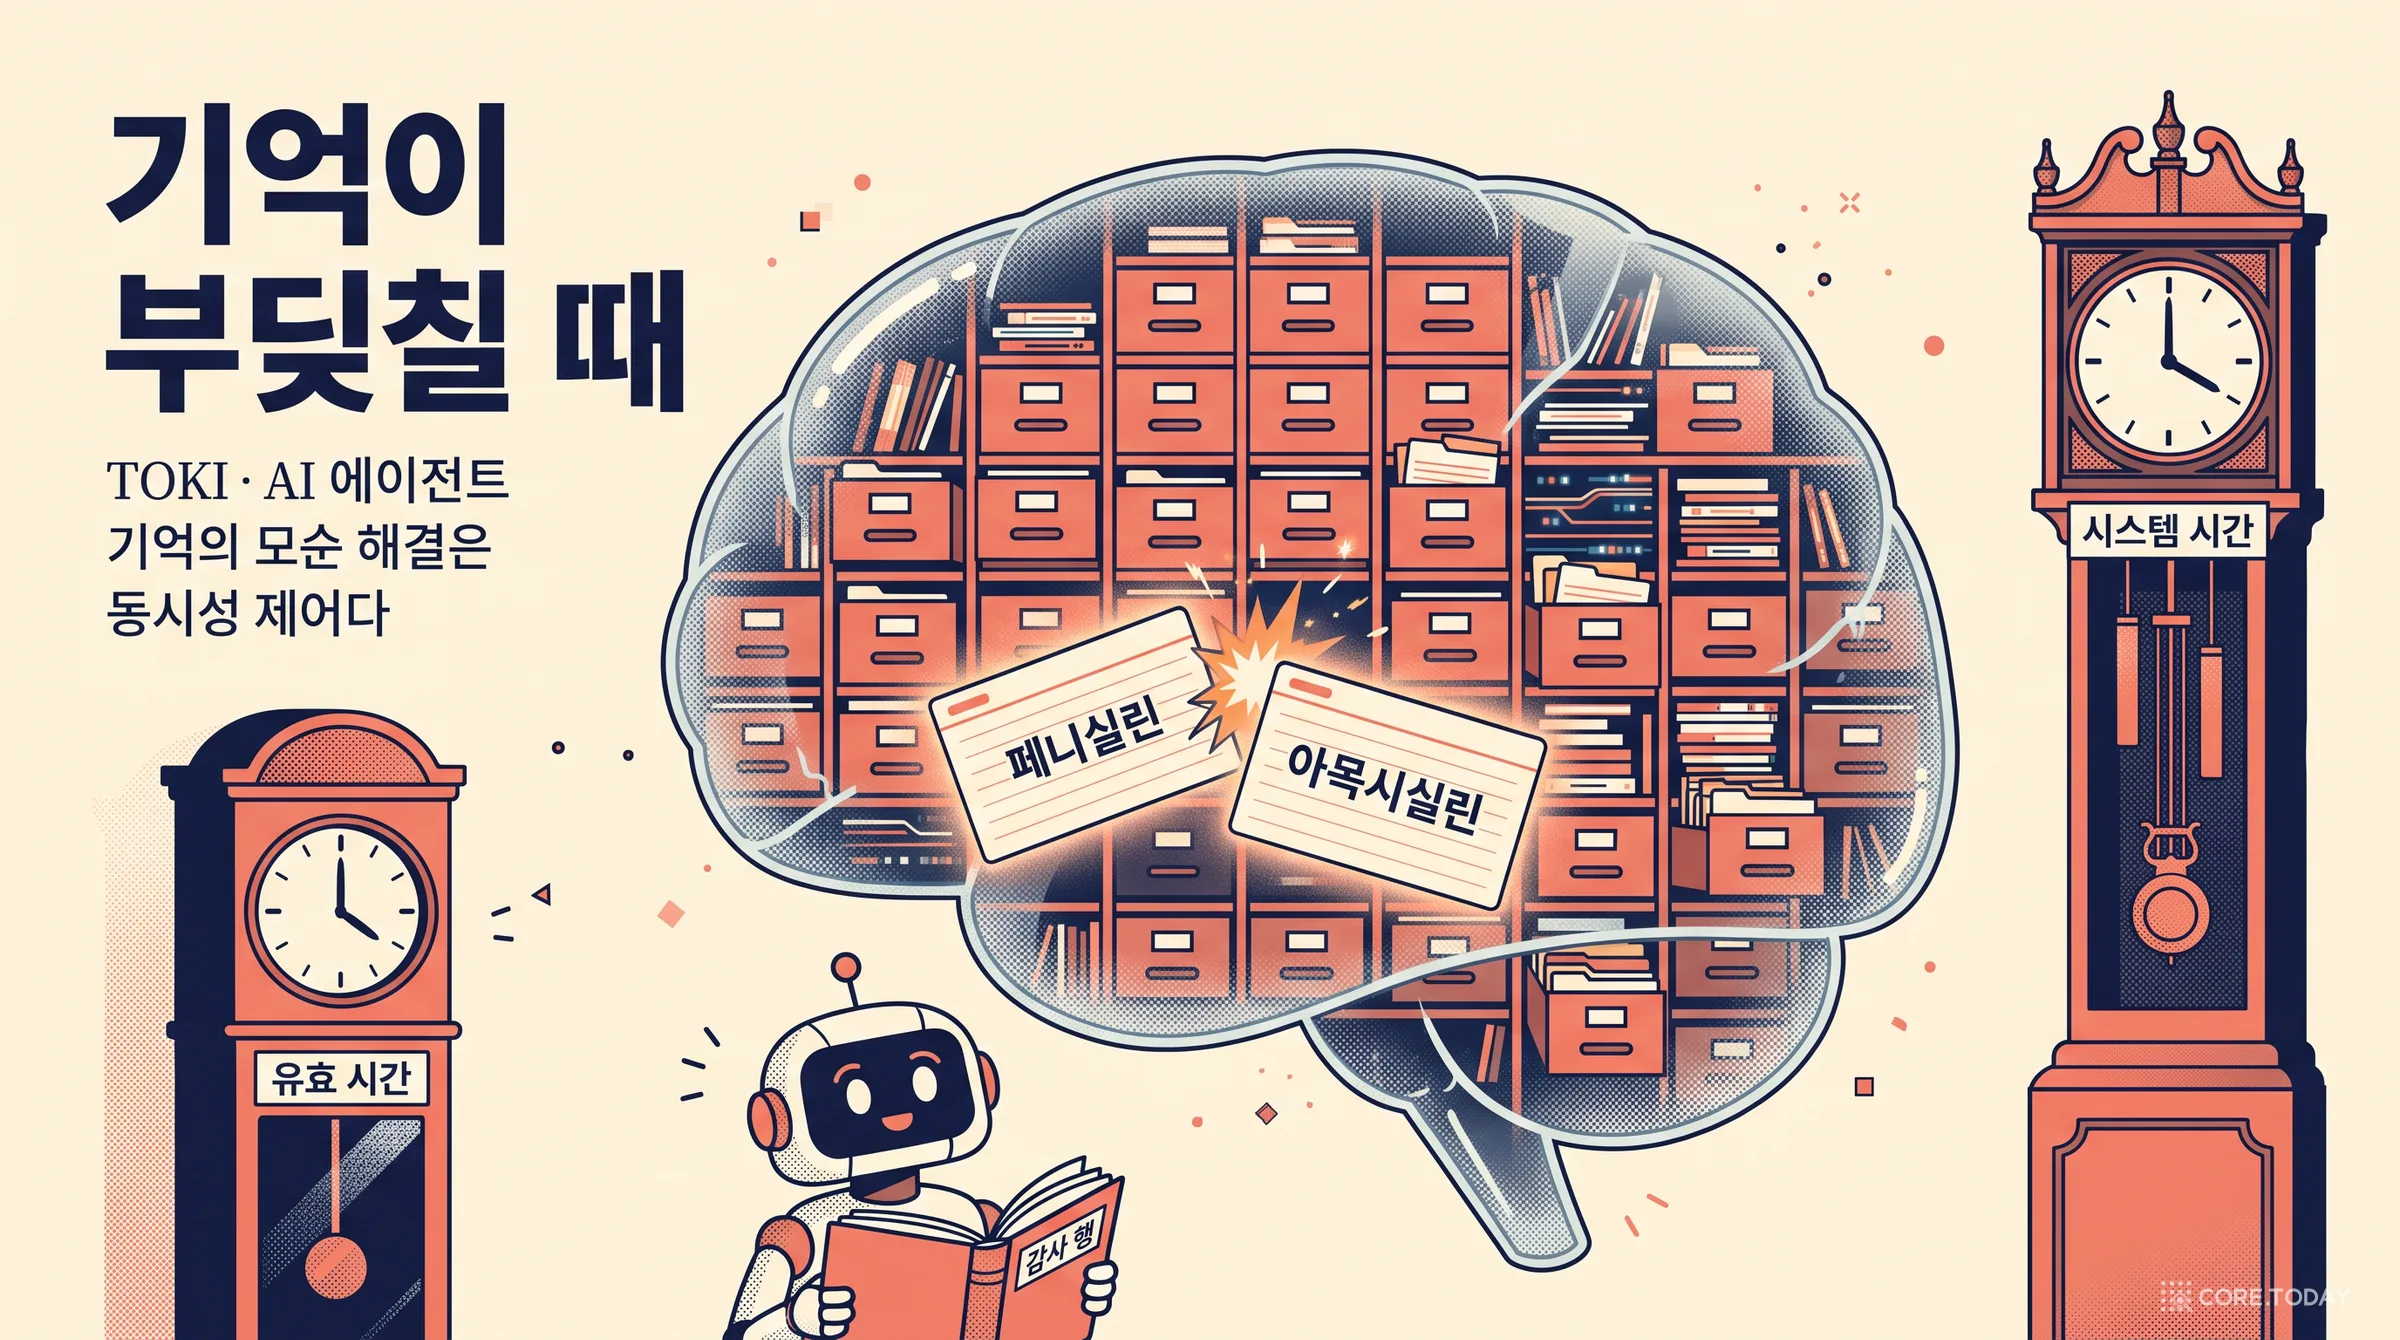
에이전트가 8080을 잊은 것은 아닙니다. 기억 저장소에는 "결제 서비스는 8000번 포트에서 요청을 받는다"와 "결제 서비스는 8080번 포트에서 요청을 받는다"가 둘 다 들어 있습니다. 질문과 비슷한 문장을 찾아오는 검색은 두 문장을 거의 같은 점수로 끌어올립니다. 두 문장은 숫자 하나만 다르니까요. 그다음은 운입니다. 모델이 "둘 중 뭐가 맞는지 모르겠다"며 답을 피하거나, 둘 중 하나를 골라 확신에 찬 목소리로 말합니다. 고른 것이 옛 값이면 신입은 오전 내내 연결 오류와 씨름합니다.
이 장면이 2026년 6월 25일 arXiv에 올라온 논문 「Temporal Validity in Retrieval Memory: Eliminating Stale-Fact Errors for AI Agents over Evolving Knowledge」(arXiv 2606.26511)의 출발점입니다. 저자는 MemStrata.dev의 Neeraj Yadav 한 사람이고, 표지에 "Draft v2"라고 적힌 21쪽짜리 초고입니다. 큰 연구소의 논문도 아니고 실험 규모도 작습니다. 그런데도 특집으로 다루는 이유는 이 논문이 에이전트 기억의 가장 흔한 실패 하나를 아주 또렷한 이름으로 부르기 때문입니다. 낡은 사실 오류(stale-fact error), 즉 이미 바뀐 사실의 옛 값을 지금 값처럼 내놓는 실패입니다.
논문의 주장은 세 문장으로 줄일 수 있습니다.
RAG에는 시간 개념이 없다. 사실이 바뀌면 옛 값과 새 값을 둘 다 찾아오고 어느 쪽이 지금 값인지 가릴 수 없다.
이 문제는 유사도를 더 잘 조율해서 풀리지 않는다. 바뀐 값은 같은 뜻의 다른 표현보다 오히려 원문과 더 비슷하기 때문이다.
그러니 바뀐 사실을 가려내는 일은 유사도가 아니라 구조로 해야 한다. 같은 (주어, 관계)에 다른 값이 들어오면 새것이 옛것을 대체하고, 옛것은 지우지 않고 기간을 닫아 원장에 남긴다.
코어닷투데이는 이 문제를 여러 번 다른 각도에서 다뤘습니다. 최신 기사는 대체로 맞지만 엇갈린 값은 끝내 남는다에서는 뉴스 2천 건 속 사실 1,831개가 어떻게 바뀌는지 따라갔고, Graphiti 시간 그래프와 이중 시간 SQL 실습에서는 '언제부터 언제까지 참이었나'를 저장하는 도구들을 직접 돌려 봤습니다. 사실탐색기 v2 설계는 아예 "지금 참인 것"을 유지하는 엔진을 만드는 이야기였습니다. 이번 논문은 같은 문제를 코드라는 가장 빨리 바뀌는 지식 위에서, 가장 단순한 장치로 공략합니다. 그래서 무엇이 되고 무엇이 아직 안 되는지가 선명하게 보입니다.
이 글은 다음 순서로 갑니다. 먼저 왜 유사도로는 바뀐 값을 못 가리는지 숫자로 확인하고(한국어로 직접 다시 쟀습니다), 1969년 인공지능의 '프레임 문제'부터 데이터베이스의 이중 시간, 에이전트 기억까지 이 문제가 걸어온 길을 훑습니다. 그다음 MemStrata의 쓰기 경로와 원장, 벤치마크 설계를 하나씩 뜯어보고, 논문 표를 직접 넘겨 보며 결과를 읽습니다. 마지막으로 한국어 시나리오 30개와 일부러 만든 함정 시나리오로 이 방식이 어디서 깨지는지 로컬 모델로 실측하고, 2026년 지금 이 기술이 어디에 필요한지 정리합니다.
검색 증강 생성(RAG)은 2020년 페이스북 AI 연구소의 Patrick Lewis 등이 NeurIPS에 발표한 논문에서 이름을 얻었습니다. 언어 모델이 모든 지식을 파라미터 안에 외우게 하는 대신, 문서를 잘게 잘라 벡터로 바꿔 두고 질문이 오면 비슷한 조각을 찾아 함께 읽게 하는 방식입니다. 이 설계의 큰 장점 하나는 지식을 갈아 끼울 수 있다는 점이었습니다. 모델을 다시 학습시키지 않아도 색인만 바꾸면 새 지식을 쓸 수 있습니다. 원 논문도 색인을 교체해 모델의 지식을 바꿀 수 있다는 점을 장점으로 꼽았습니다.
여기에 아이러니가 숨어 있습니다. '색인을 갈아 끼운다'는 약속은 누군가 낡은 문서를 빼고 새 문서를 넣어 줄 때만 지켜집니다. 에이전트 기억은 그렇게 돌아가지 않습니다. 대화가 쌓이고, 회의록이 쌓이고, 커밋 메시지가 쌓입니다. 아무도 옛 문장을 빼 주지 않습니다. 기억 저장소는 시간이 지날수록 같은 사실의 여러 버전이 나란히 쌓인 퇴적층이 됩니다. 논문 제목의 MemStrata(기억 지층)도 이 비유에서 왔을 것입니다.
검색은 '무엇에 관한 문장인가'만 본다
RAG의 검색은 질문 벡터와 문장 벡터의 코사인 유사도로 순위를 매깁니다. 코사인 유사도는 두 문장이 같은 이야기를 하는 정도를 잽니다. "결제 서비스 포트가 뭐야?"라는 질문과 가장 같은 이야기를 하는 문장은 당연히 포트에 관한 두 문장입니다. 8000이냐 8080이냐는 그 이야기의 '값'일 뿐, 이야기의 주제를 바꾸지 않습니다. 그래서 두 문장은 질문에 대해 사실상 같은 점수를 받습니다.
코어닷투데이의 한국어 실측(7부에서 자세히)에서 이 점수 차이를 직접 쟀습니다. BGE-M3 임베딩으로 30개 질문마다 옛 문장과 새 문장의 질문 유사도를 비교하면, 차이의 절댓값이 평균 0.01 안팎이었습니다. 상위 5개를 뽑으면 두 문장은 거의 언제나 함께 들어옵니다. 순위는 둘 중 누가 먼저 오느냐를 정하지만, 그 순서는 시간과 아무 관계가 없습니다.
모델은 두 가지 방식으로 실패한다
두 값을 함께 받은 언어 모델이 할 수 있는 일은 둘뿐입니다.
①
기권한다
"자료에 8000과 8080이 함께 있어 판단할 수 없습니다." 정직하지만 쓸모가 없습니다. 답할 수 있었던 질문을 버립니다.
②
하나를 고른다
문장 순서, 숫자 크기, 그럴듯함 같은 표면 단서로 고릅니다. 고른 값이 옛 값이면 확신에 찬 오답이 됩니다. 이것이 낡은 사실 오류입니다.
③
평가표는 ①을 숨긴다
기권을 허락한 평가에서는 RAG의 오답률이 낮아 보입니다. 모르겠다고 버틴 만큼 틀린 답이 줄기 때문입니다. 논문이 '답을 강제한 평가'를 따로 돌린 이유입니다.
논문은 이 두 번째 실패를 이렇게 정의합니다. 낡은 사실 오류율 = 값이 바뀐 사실을 묻는 질문 가운데 대체된(옛) 값으로 답한 비율. 단순해 보이지만 이 지표가 핵심입니다. 일반적인 '정답률'은 기권과 오답을 한 바구니에 넣지만, 낡은 사실 오류율은 "확신에 찬 옛 값"만 셉니다. 사람에게 가장 해로운 실패가 바로 그것입니다. "모르겠다"는 답은 다른 곳을 찾아보게 만들지만, "8000번입니다"는 그대로 실행됩니다.
코드가 가장 먼저 아프다
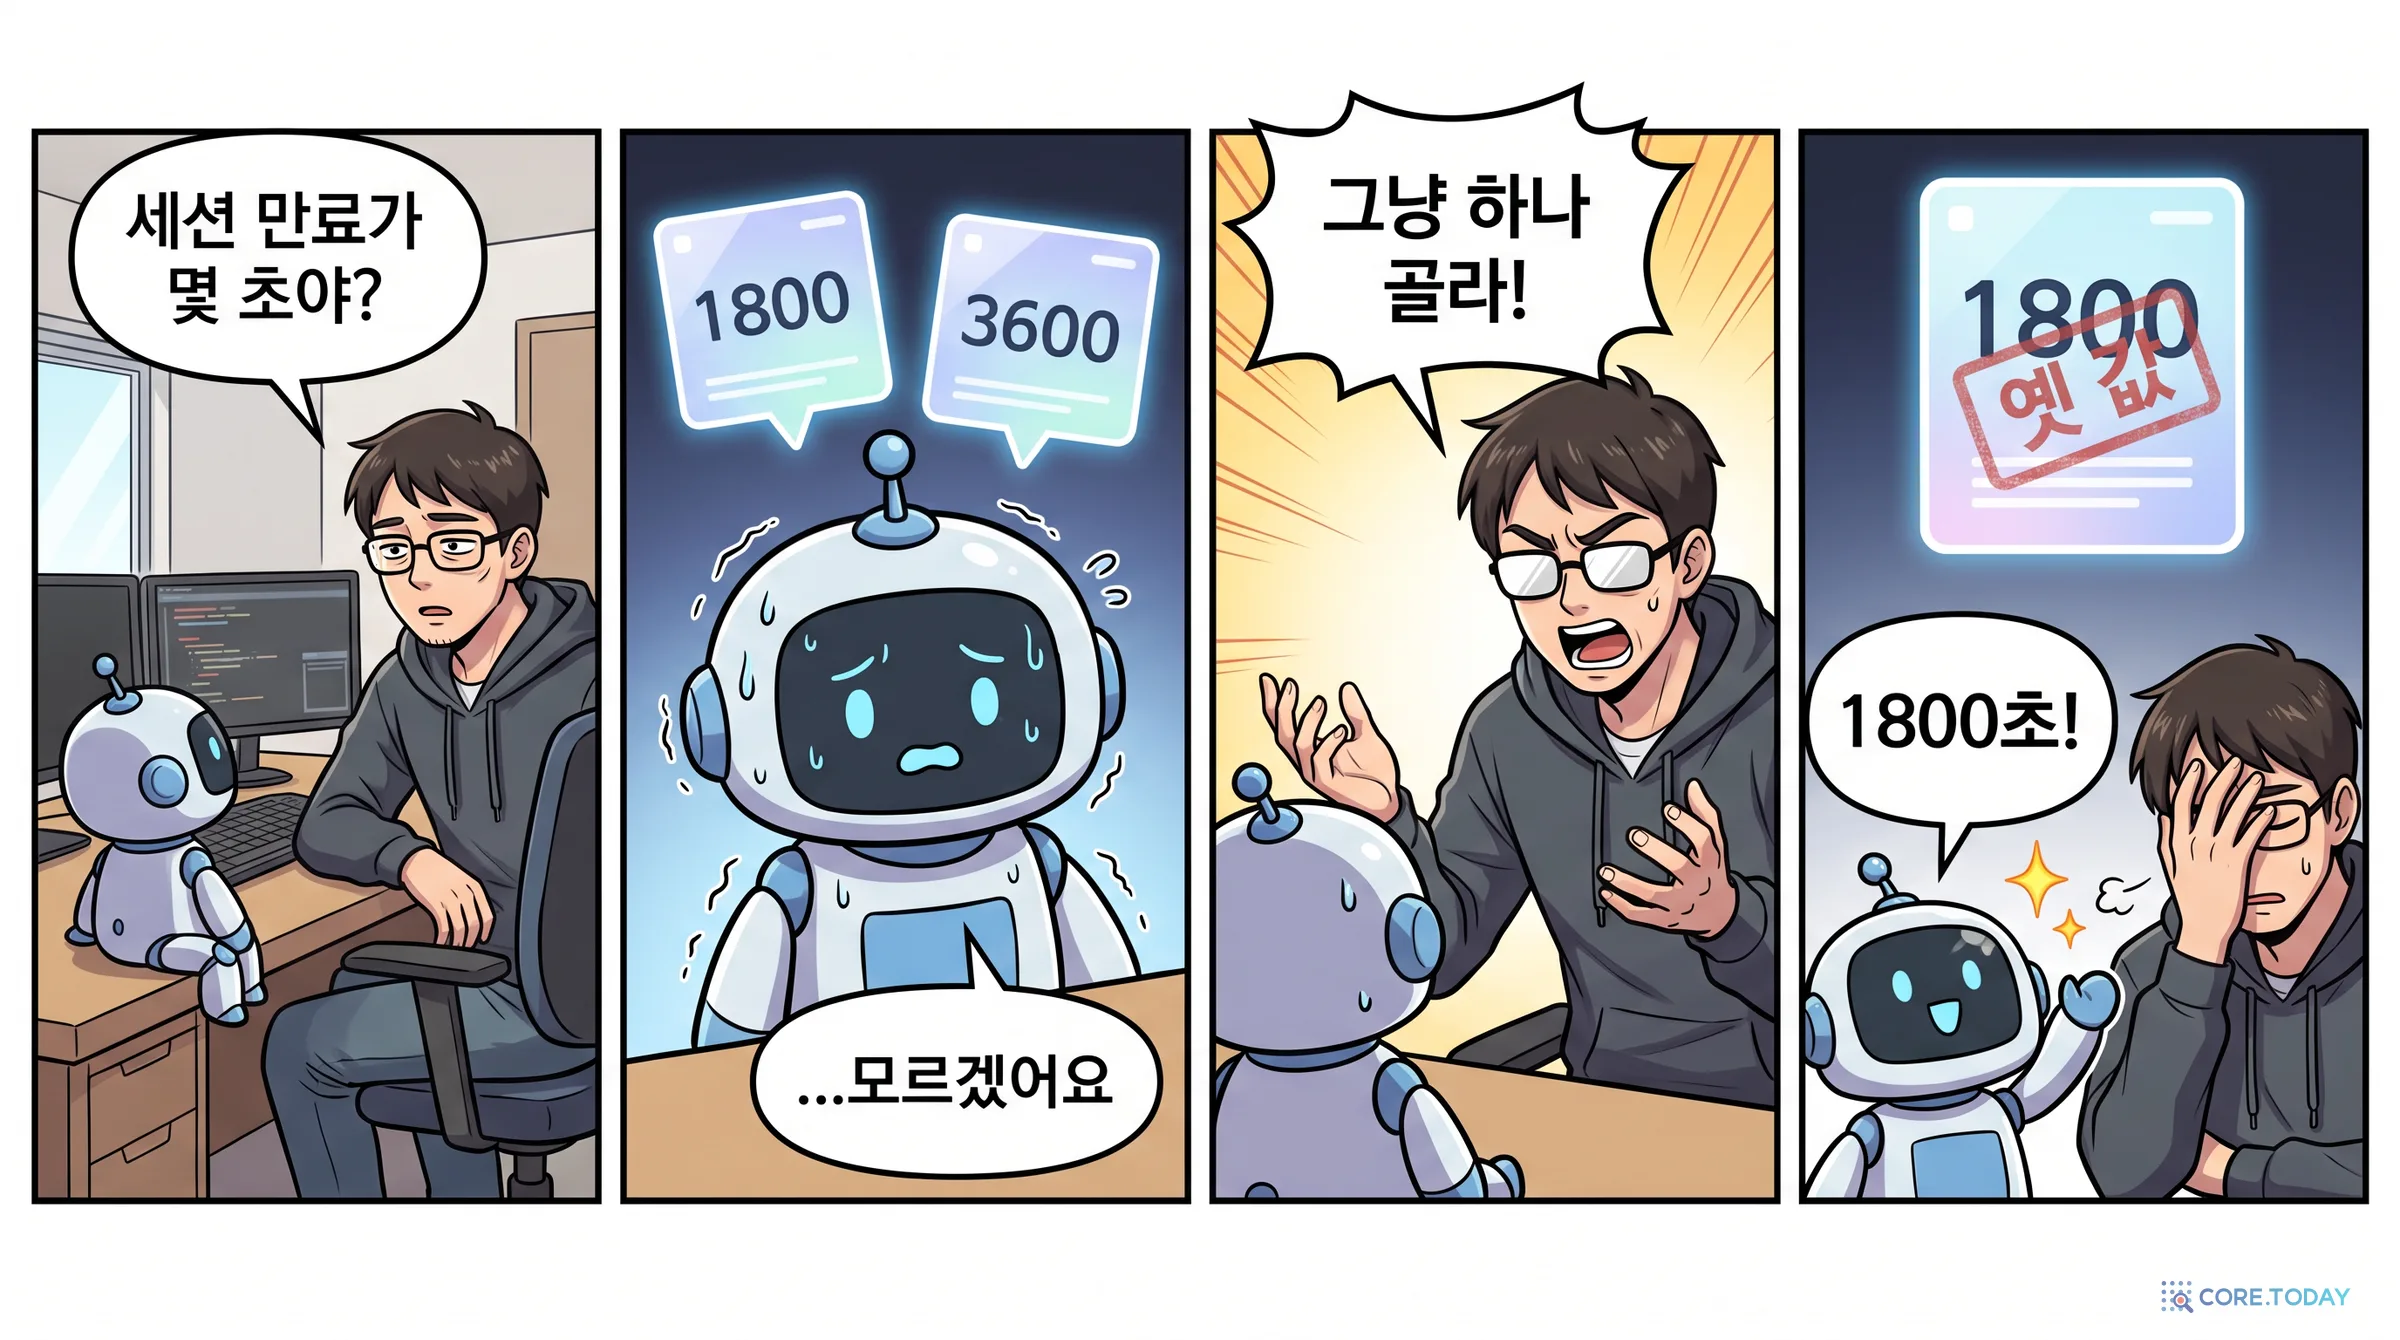
논문이 코드 지식을 첫 무대로 고른 이유도 여기에 있습니다. 코드에서는 사실이 끊임없이, 그리고 대화 밖에서 바뀝니다. 함수 이름이 바뀌고(get_user_by_id → fetch_user), 엔드포인트가 옮겨 가고(/api/v1/users → /api/v2/users), 설정 값이 오르내리고(세션 만료 1800초 → 3600초), 의존성 버전이 올라갑니다(numpy 1.24.0 → 1.26.4). 이런 변화는 커밋 한 줄로 일어나고 아무도 에이전트에게 "옛 기억을 지워"라고 말하지 않습니다. 논문은 이렇게 씁니다. "지난달의 포트 번호를 자신 있게 알려 주는 비서는 쓸모없는 것보다 나쁘다."
물론 코드만의 문제는 아닙니다. 회사 대표가 바뀌고, 고객센터 번호가 바뀌고, 조례가 개정되고, 진료 지침이 바뀝니다. 유효 기간이 있는 사실이라면 어디서든 같은 일이 생깁니다.
2부. 유사도로는 바뀐 값을 가려낼 수 없다
가장 먼저 떠오르는 해법
문제를 처음 본 엔지니어라면 거의 누구나 같은 해법을 떠올립니다. 쓸 때 걸러내자. 새 문장이 들어올 때 저장소에서 가장 비슷한 문장을 찾아, 이미 있는 사실을 되풀이하는 것(중복)이면 버리고, 기존 사실을 뒤집는 것(모순)이면 옛것을 갱신하고, 처음 보는 것(새 사실)이면 저장한다. 실제로 2024~2025년의 많은 에이전트 기억 시스템이 이런 식의 '추가·갱신·삭제·무시' 판정을 둡니다. 판정의 첫 관문은 대개 유사도 문턱입니다. "0.95 넘게 비슷하면 중복으로 본다" 같은 규칙입니다.
논문의 첫 번째 기여는 이 직관이 왜 실패하는지를 숫자로 보인 것입니다.
98쌍의 보정 실험
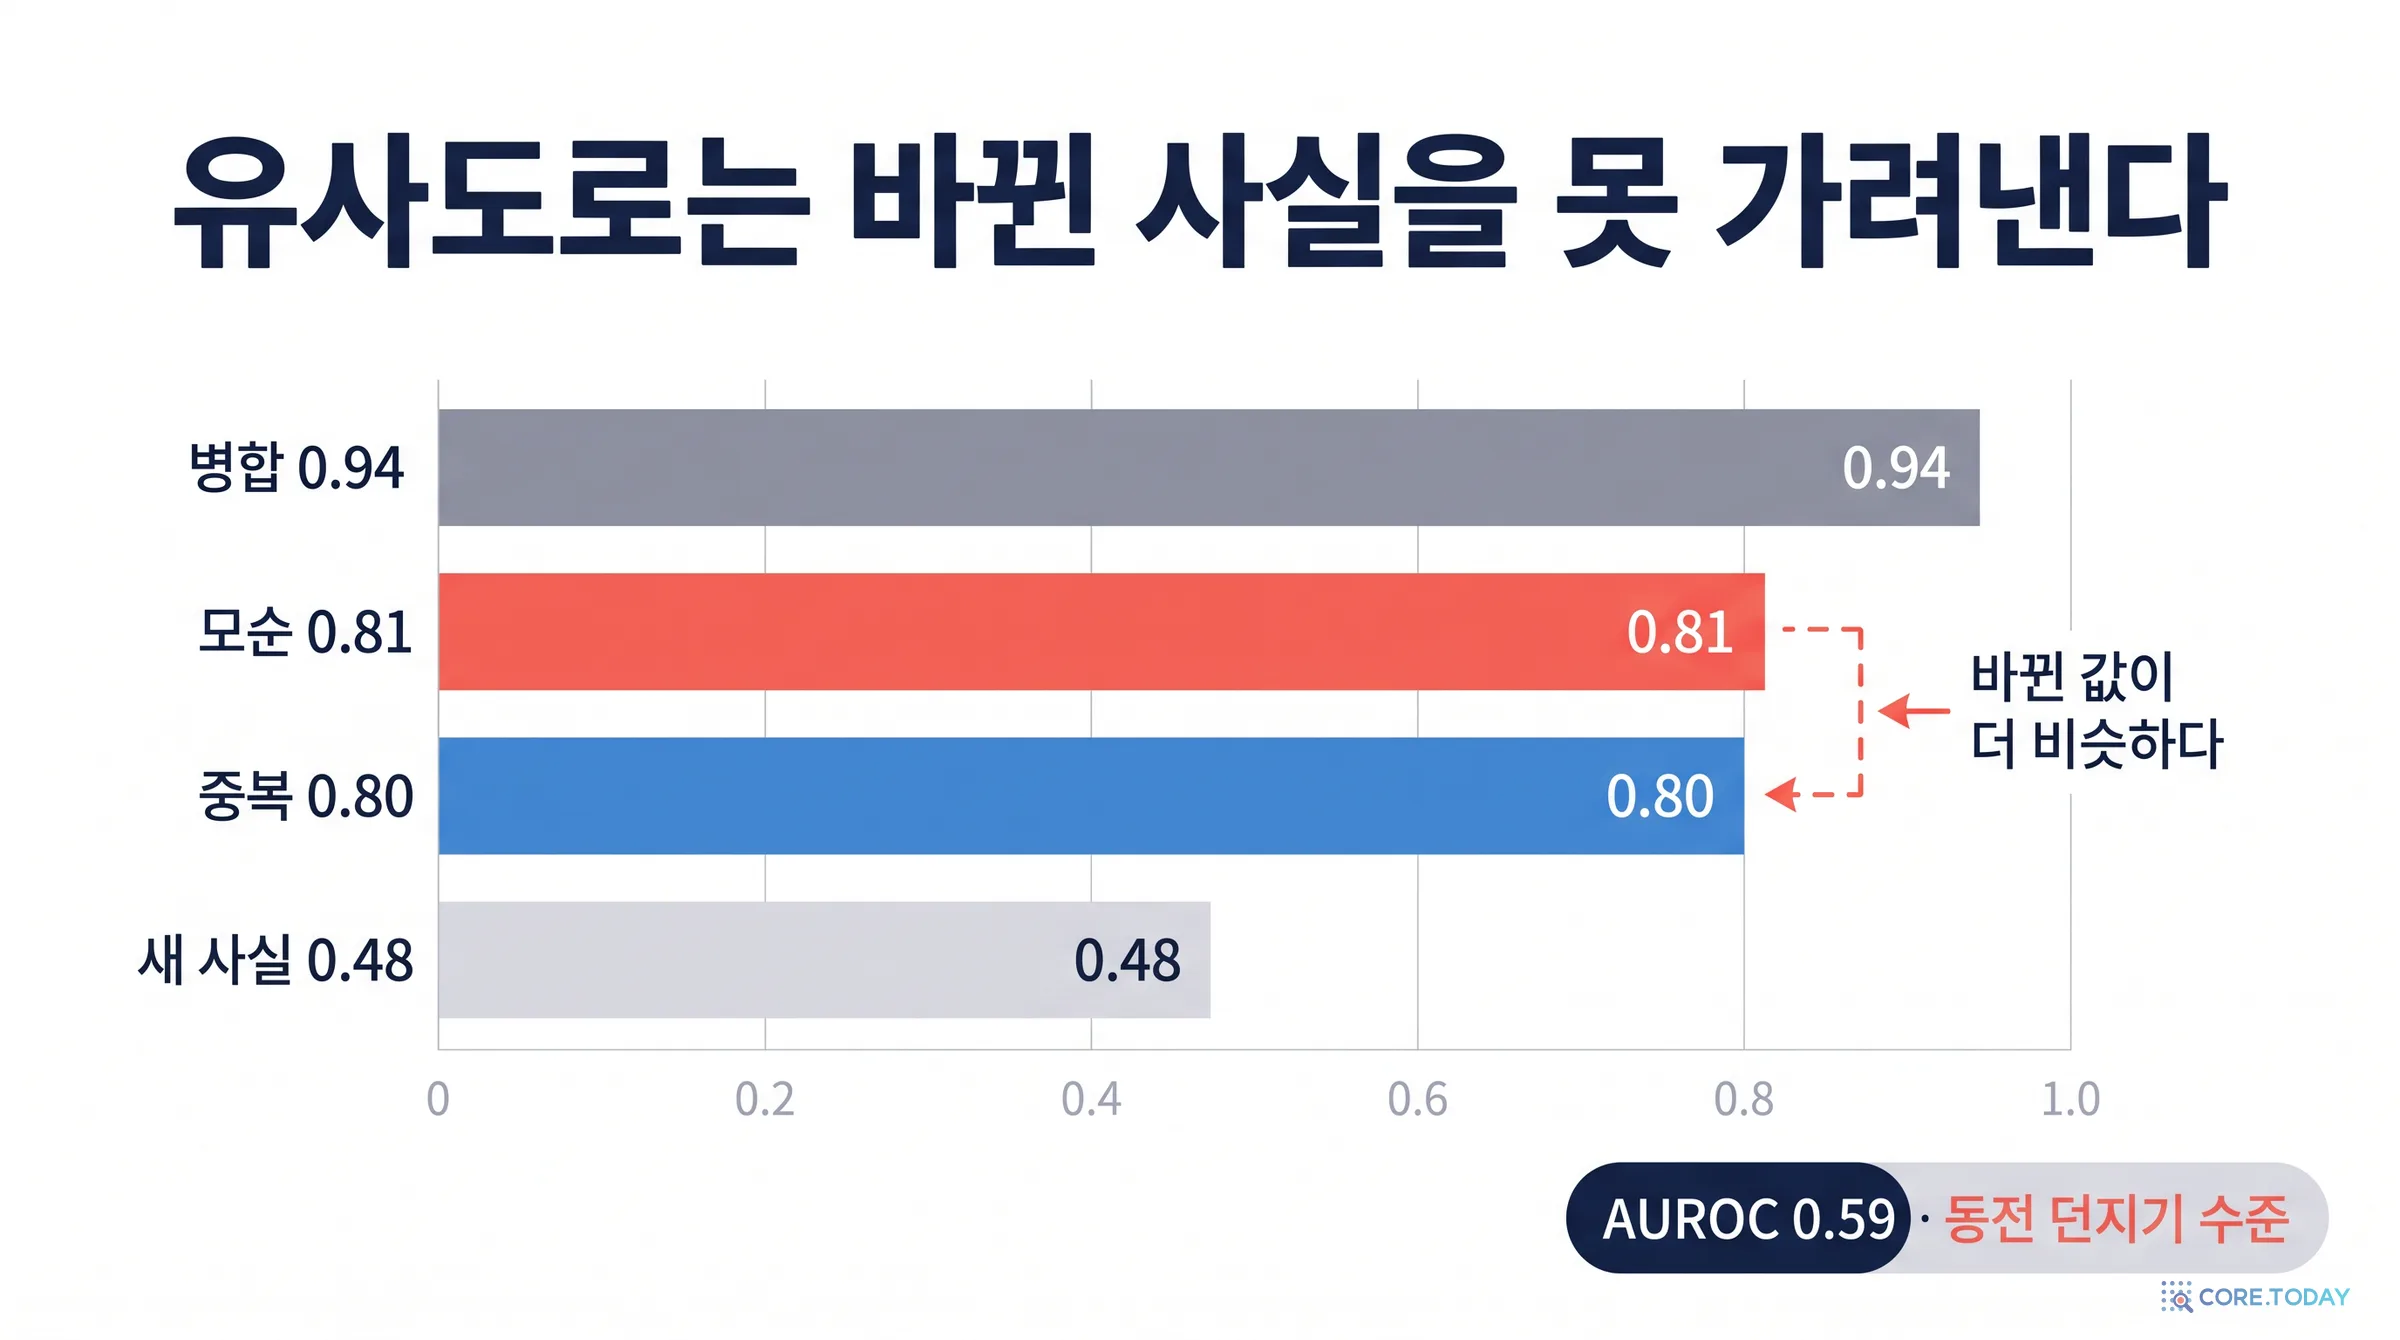
저자는 원래 사실과 네 종류의 후보 문장으로 이루어진 98쌍을 만들었습니다. 중복(같은 사실을 다르게 말함) 32쌍, 병합(세부를 덧붙임) 22쌍, 모순(값이 바뀜) 22쌍, 새 사실 22쌍입니다. 그리고 각 쌍의 코사인 유사도를 nomic-embed-text(768차원)로 쟀습니다.
눈여겨볼 곳은 가운데 두 줄입니다. 모순(0.812)이 중복(0.800)보다 원래 사실과 더 비슷합니다. 이유는 간단합니다. "포트는 8000이다"를 "포트는 8080이다"로 바꾸는 것은 토큰 하나를 바꾸는 가장 작은 편집입니다. 반면 같은 뜻을 다른 말로 하는 것("결제 서비스가 리슨하는 포트는 8000번이다")은 단어 여러 개를 바꿉니다. 임베딩은 문장 전체의 의미를 한 점으로 압축하는데, 숫자 하나는 그 의미에서 아주 작은 비중만 차지합니다. 값이 바뀌어도 '무엇에 관한 문장인가'는 그대로이니 벡터도 거의 그대로입니다.
이 분포에서 유사도 문턱 하나로 중복과 나머지를 가르는 성능을 AUROC로 재면 0.5926입니다. AUROC는 무작위로 뽑은 '진짜 중복' 쌍이 무작위로 뽑은 '다른' 쌍보다 높은 점수를 받을 확률이라, 0.5가 동전 던지기입니다. 0.59는 동전보다 조금 나은 수준입니다. 부록의 문턱 훑기 표를 보면 더 분명합니다. 문턱을 0.80에서 0.98까지 올려도 "중복이라고 판정한 것 중 진짜 중복"의 비율(정밀도)은 0.28에서 0.67까지밖에 오르지 않고, 그때 진짜 중복을 잡아내는 비율(재현율)은 0.31에 그칩니다. 자동으로 '중복이니 버린다'를 실행하려면 0.95 정도의 정밀도가 필요한데, 어떤 문턱에서도 거기에 닿지 않습니다.
이것이 왜 위험한지 뒤집어 생각해 보면 분명해집니다. 정밀도 0.67이란 '중복이니 버린다'고 판정한 문장 셋 중 하나가 사실은 모순, 즉 새 값이라는 뜻입니다. 유사도로 중복을 걸러내는 기억은 바뀐 사실의 새 값을 가장 먼저 버립니다. 고치려던 문제를 오히려 키웁니다.
한국어에서도 그럴까: 다섯 모델로 다시 재 보기
논문의 98쌍은 영어이고 데이터가 공개되어 있지 않습니다. 그래서 코어닷투데이는 한국어 사실 30개(코드 함수 이름 6, 설정 값 6, 의존성 버전 5, API 5, 회사·생활 사실 8)를 직접 만들어 같은 질문을 던졌습니다. 사실마다 원래 문장 하나와 네 문장을 붙였습니다.
원래결제 서비스는 8000번 포트에서 요청을 받는다.
중복결제 서비스가 리슨하는 포트는 8000번이다. (같은 값, 다른 표현)
모순결제 서비스는 8080번 포트에서 요청을 받는다. (같은 표현, 값만 바뀜 — 논문의 벤치마크 형식)
모순+표현결제 서비스가 리슨하는 포트는 8080번이다. (값도 표현도 바뀜)
새 사실결제 서비스는 쿠버네티스 위에서 돈다. (같은 주제, 다른 사실)
그리고 Ollama로 로컬에서 돌릴 수 있는 임베딩 모델 다섯 개로 원래 문장과 각 문장의 코사인을 쟀습니다. 결과는 논문보다 더 극적이었습니다.
임베딩 모델
중복 평균
모순 평균
모순+표현
AUROC (중복>모순)
모순이 더 비슷한 사실
BGE-M3
0.907
0.909
0.826
0.46
18 / 30
Nomic v2 MoE
0.875
0.880
0.767
0.47
20 / 30
EmbeddingGemma 300M
0.891
0.874
0.772
0.59
15 / 30
Qwen3 임베딩 0.6B
0.883
0.914
0.813
0.34
21 / 30
Qwen3 임베딩 8B
0.912
0.921
0.844
0.44
15 / 30
코어닷투데이 실측, 2026-10-31. 한국어 사실 30개, 지시문 접두사 없음. AUROC가 0.5보다 작으면 모순 쪽이 오히려 더 비슷하다는 뜻.
다섯 모델 중 네 모델에서 값만 바뀐 문장이 같은 뜻의 다른 표현보다 평균적으로 더 비슷했습니다. AUROC는 0.34에서 0.59 사이로, 가장 좋은 모델도 논문의 0.59와 같은 수준입니다. 큰 모델(Qwen3 8B)이라고 나아지지 않았습니다. 이것은 특정 모델의 결함이 아니라 '문장 하나를 벡터 하나로' 요약하는 방식 자체의 성질입니다. 임베딩은 주제를 재는 자이지 값을 재는 자가 아닙니다.
흥미로운 것은 세 번째 열입니다. 값과 표현이 함께 바뀐 모순은 유사도가 확 떨어집니다(0.77~0.84). 그러니 "0.9 이상이면 중복"이라는 규칙은 논문 형식의 모순(값만 바뀜)은 중복으로 오인해 버리고, 표현까지 바뀐 모순은 '새 사실'로 보고 옛 값 옆에 나란히 쌓습니다. 어느 쪽이든 옛 값이 살아남습니다. 아래 위젯에서 문턱을 직접 움직여 보세요.
그렇다면 LLM에게 판정을 맡기면?
다음으로 떠오르는 해법은 유사도로 후보를 뽑고 판정은 언어 모델에게 맡기는 것입니다. "이 새 문장은 기존 문장과 중복인가, 병합인가, 모순인가, 새 사실인가?" 논문의 비교 조건 중 '놀람 게이트(surprise gate)'가 바로 이것입니다. 유사도로 비슷한 기존 사실을 찾고, 3B 판정 모델이 네 가지 중 하나를 고릅니다.
결과는 좋지 않았습니다. 기권을 허락한 평가에서 게이트 조건은 RAG보다 답을 많이 했지만, 값이 바뀐 사실을 물었을 때 25~60%를 옛 값으로 답했습니다(코드 이름 바뀜 벤치마크에서 0.60). 판정 모델이 "모순"을 제대로 잡아내지 못해 옛 값이 그대로 남았거나, 비슷한 두 문장을 "병합"해 버렸기 때문입니다. 논문은 이를 "유사도 기반 대체는 낡은 사실을 적극적으로 흘린다"고 요약합니다.
결론은 이것입니다. 무엇이 무엇을 대체하는지는 유사도에 물어서는 안 된다. 두 문장이 같은 (주어, 관계)를 말하고 값만 다르다면, 그 둘이 얼마나 비슷한지와 상관없이 새것이 옛것을 대체해야 합니다. 이것은 확률적 판단이 아니라 구조의 규칙입니다.
MemStrata의 아이디어는 새롭지 않습니다. 논문도 그렇게 말합니다. "우리의 기여는 원장이라는 기본 장치가 아니라, 그것을 LLM 기억의 결정적 대체 규칙과 묶은 것이다." 바뀌는 세계를 어떻게 기억하느냐는 질문은 인공지능과 데이터베이스가 반세기 넘게 붙들어 온 질문입니다. 이 역사를 알면 MemStrata가 무엇을 가져왔고 무엇을 아직 안 가져왔는지가 보입니다.
1969년: 전화번호부와 프레임 문제
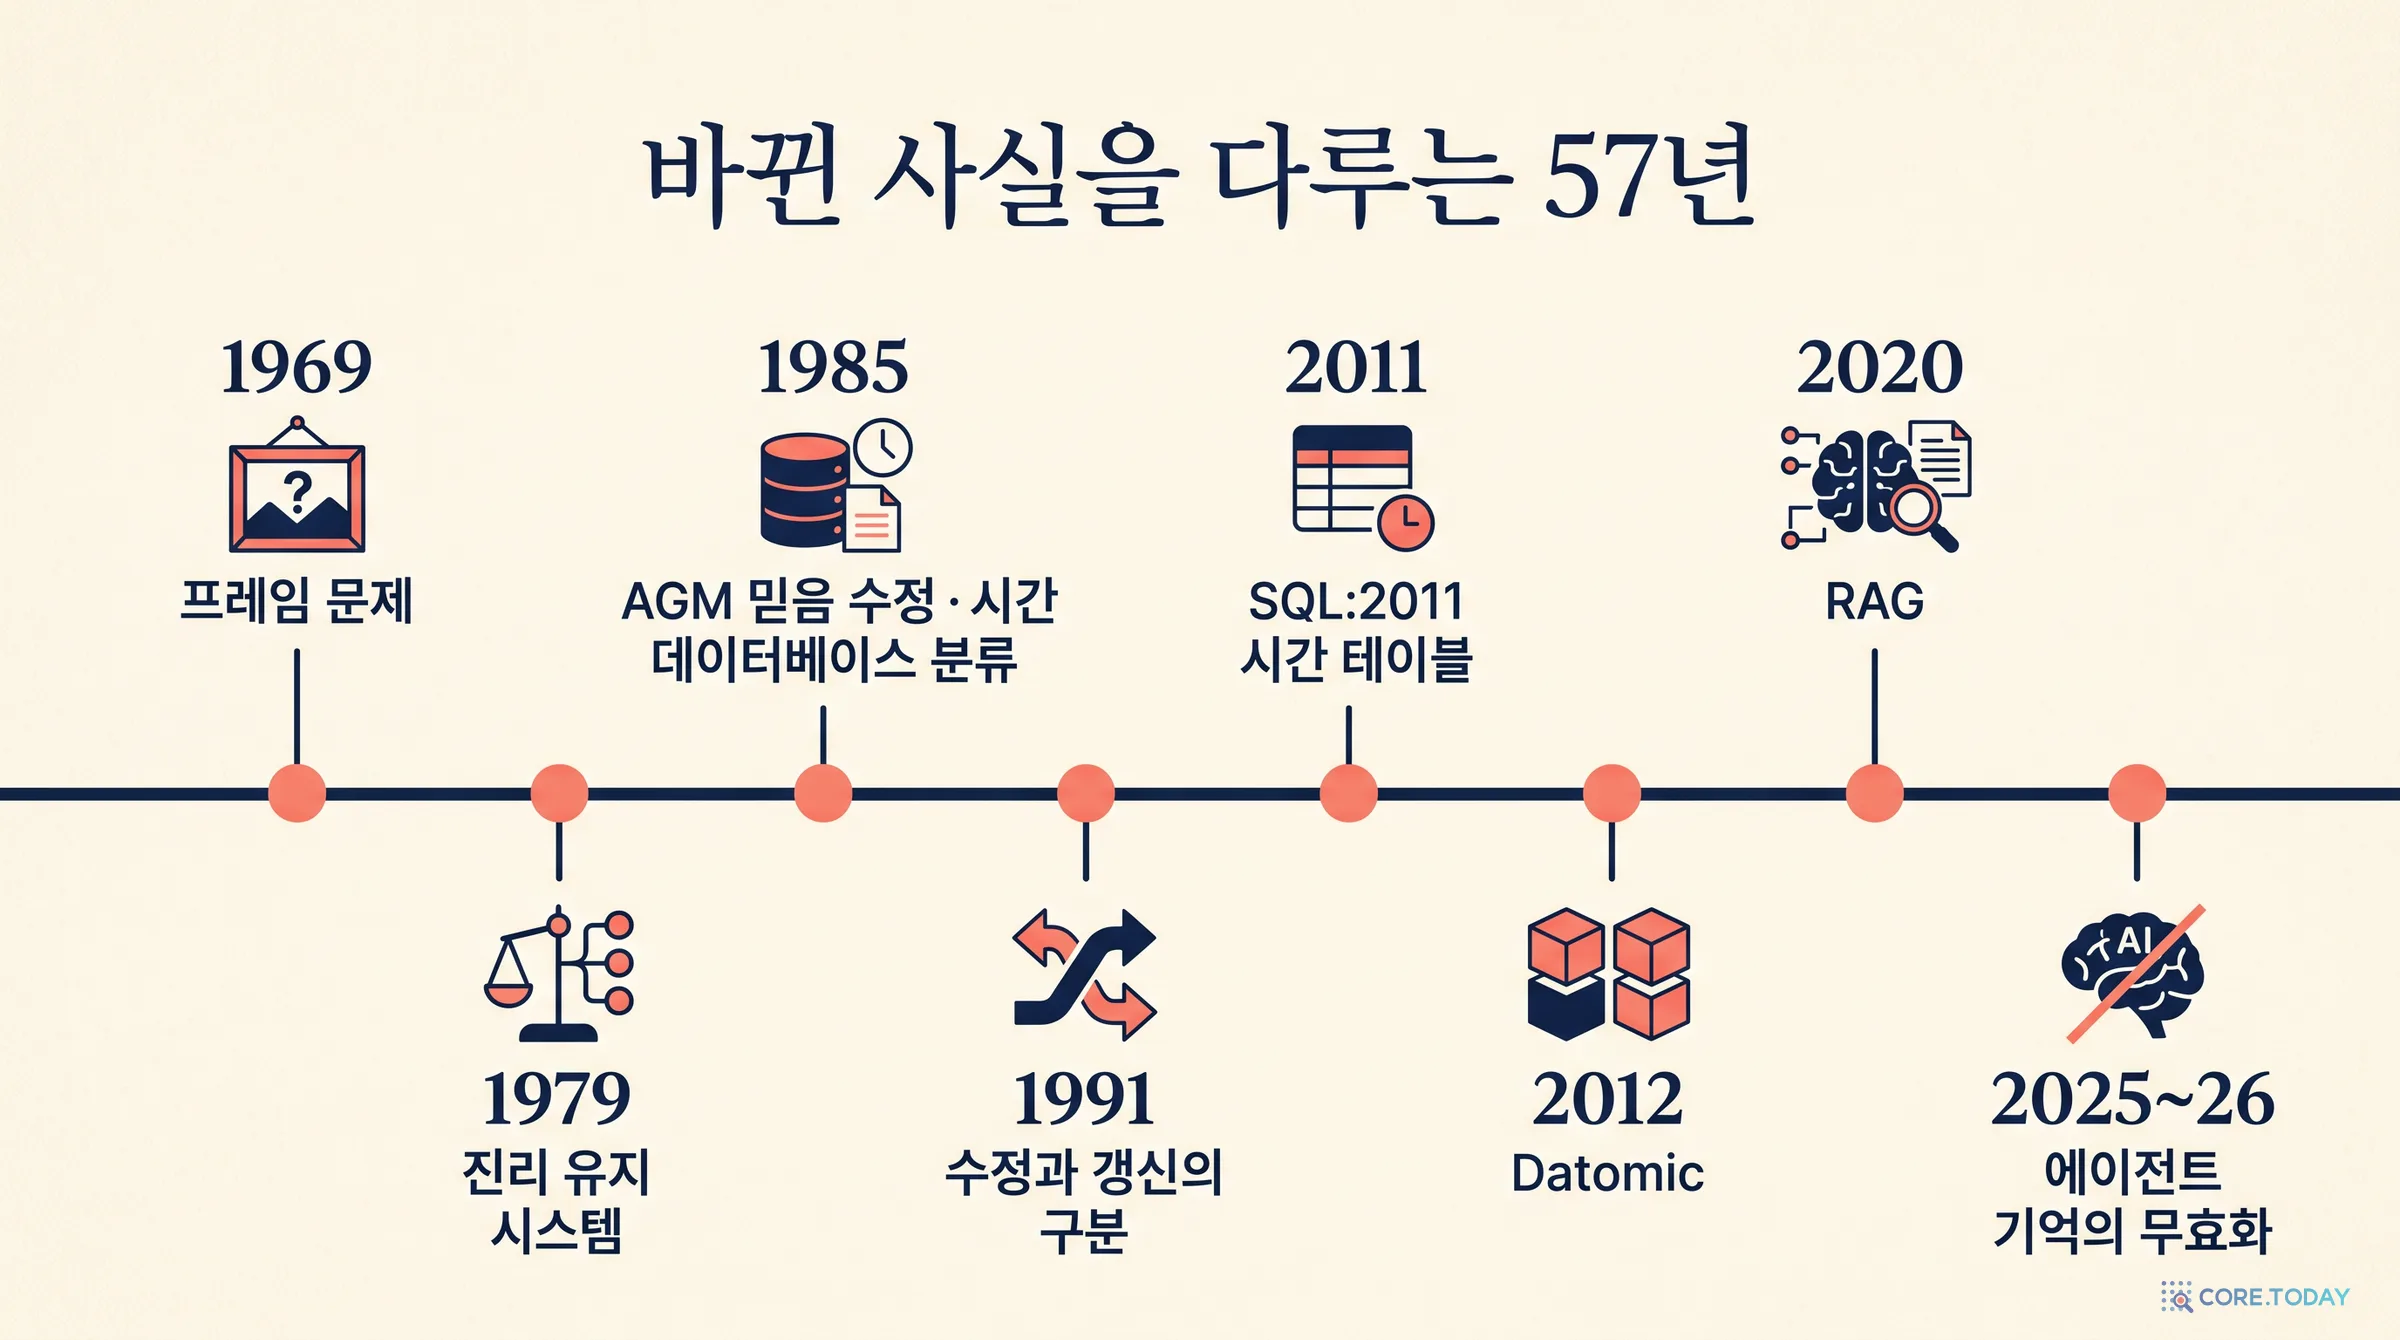
1969년 존 매카시와 패트릭 헤이스는 「인공지능의 관점에서 본 몇 가지 철학적 문제」라는 논문에서 세계를 '상황(situation)'의 연속으로, 시간에 따라 참거짓이 바뀌는 명제를 '플루언트(fluent)'로 표현했습니다. 예시는 블록 쌓기가 아니라 전화 걸기였습니다. 사람 p가 전화번호부에서 q의 번호를 찾아 전화를 거는 과정을 논리로 증명하려 하자 엉뚱한 곳에서 막혔습니다. 번호를 찾아보는 행동을 한 뒤에도 "p는 여전히 전화기를 갖고 있다"는 것을 증명할 수 없었던 것입니다. 행동이 바꾸지 않는 것까지 일일이 적어야 했고, 행동이 n개, 사실이 m개면 그런 조건이 n×m개 필요했습니다. 이것이 프레임 문제입니다.
이 논문에는 지금 읽으면 놀라운 대목이 있습니다. 전화가 실패할 수 있는 이유를 나열하면서 네 번째로 "전화 회사가 번호를 잘못 적었을 수 있다", 다섯 번째로 "q가 전화를 최근에야 놓았을 수 있다"를 꼽습니다. 앞의 것은 기록이 틀린 경우이고, 뒤의 것은 세계가 바뀌었는데 전화번호부가 따라가지 못한 경우, 곧 낡은 사실입니다. 이 둘을 구분해야 한다는 생각은 이름을 얻기까지 20년이 더 걸립니다.
1979년: 믿음에 이유를 붙여 두기
1979년 존 도일(Jon Doyle)은 MIT에서 진리 유지 시스템(TMS)을 발표했습니다. 아이디어는 믿음마다 '왜 그렇게 믿는지'의 근거를 붙여 두는 것입니다. 전제가 철회되면 그 전제에 기대던 믿음들이 연쇄적으로 OUT 상태가 됩니다. 이 방식의 뿌리는 1977년 스톨먼과 서스먼의 회로 분석 시스템에 있던 '의존성 기반 되짚기'입니다. 이 스톨먼이 나중에 GNU를 만든 바로 그 리처드 스톨먼입니다. 도일은 훗날 이름을 '이유 유지(reason maintenance)'로 바꿨습니다. 시스템이 추적하는 것은 진리가 아니라 이유이기 때문입니다.
MemStrata의 superseded_by 칸은 TMS의 근거 연결을 아주 가늘게 만든 것이라 볼 수 있습니다. "이 행은 저 행 때문에 퇴역했다"는 한 줄짜리 이유입니다.
1985년: 법전이 바뀔 때 무엇이 무효가 되나
1985년 6월, 알추론·게르덴포르스·마킨슨 세 사람이 이론 변경의 논리를 정리한 논문을 냈습니다. 세 사람의 머리글자를 딴 AGM 믿음 수정입니다. 믿음 집합에 대한 연산 세 가지를 정의했습니다. 확장(새 믿음을 그냥 더함), 축소(믿음 하나를 버림), 수정(새 믿음을 더하되 모순이 생기지 않게 필요한 것만 버림). 그리고 '최소 변경'을 원칙으로 세웠습니다. 바꿔야 하는 만큼만 바꾸라는 것입니다.
이 이론의 출발점이 흥미롭습니다. 아르헨티나의 법철학자 알추론과 논리학자 마킨슨은 원래 법전의 변화를 연구했습니다. 새 법이 제정되면 옛 조항 중 어느 것이 암묵적으로 폐지되는가? 낡은 사실을 어떻게 퇴역시킬지와 거의 같은 질문입니다.
같은 해 5월, 데이터베이스 쪽에서는 리처드 스노드그래스와 일수 안(Ilsoo Ahn)이 SIGMOD에 「데이터베이스 속 시간의 분류」를 발표했습니다. 이 논문은 두 시간을 갈라냈습니다. 유효 시간(valid time)은 사실이 현실에서 참이었던 기간이고, 기록 시간(transaction time)은 그 사실이 데이터베이스에 들어 있던 기간입니다. 논문의 예시는 이렇습니다. 평범한 데이터베이스는 "메리는 지난달부터 정교수로 승진했다"를 제대로 기록할 수 없고, "2년 전 메리의 직급은?"에도 답할 수 없습니다. 두 시간을 서로 독립된 축으로 보고 그 조합으로 데이터베이스 네 종류를 나눈 것이 이 논문의 기여입니다(두 용어 자체는 그 전부터 쓰이던 이름을 정리한 것입니다).
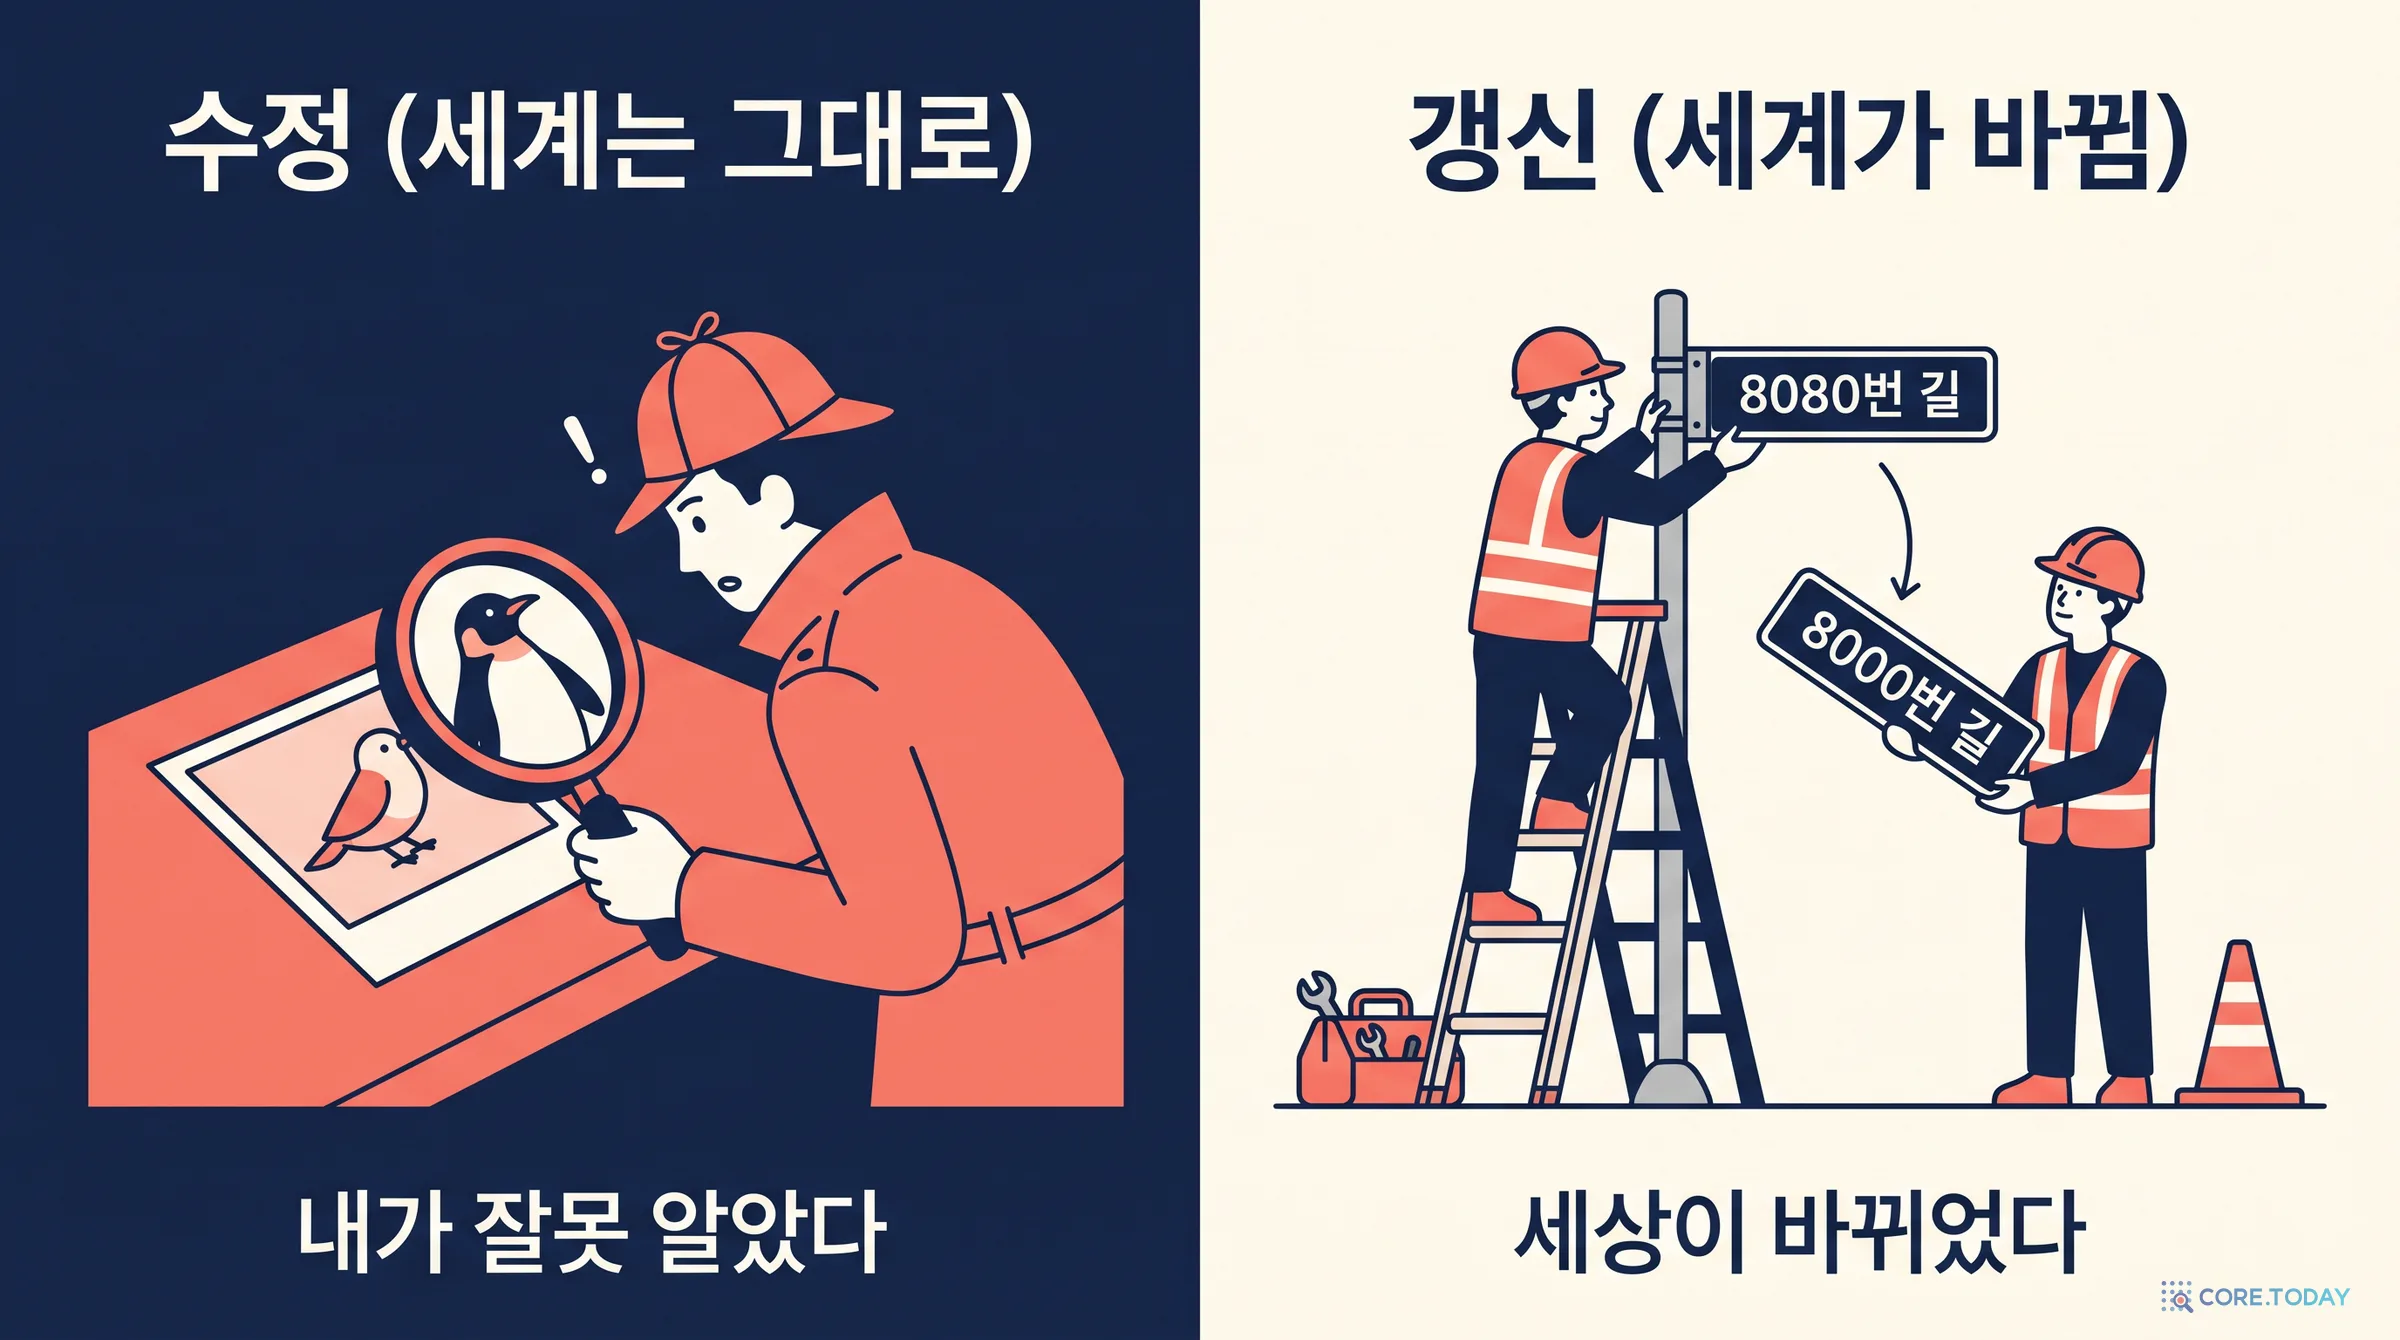
1991년 가쓰노와 멘델존은 AGM의 '수정'과 구별되는 갱신(update)을 분명히 했습니다. 수정은 세계는 그대로인데 내가 더 알게 되거나 틀린 것을 바로잡는 일입니다. 갱신은 세계 자체가 바뀐 일입니다. 철학 백과의 예가 깔끔합니다. 탁자 위에 책과 잡지 중 정확히 하나가 있다고 알고 있을 때, "탁자 위에 책이 있다"를 들으면(수정) 잡지는 없다고 결론 내려야 합니다. 그러나 "누가 탁자 위에 책을 올려놓았다"를 들으면(갱신) 잡지가 없다고 결론 내리면 안 됩니다.
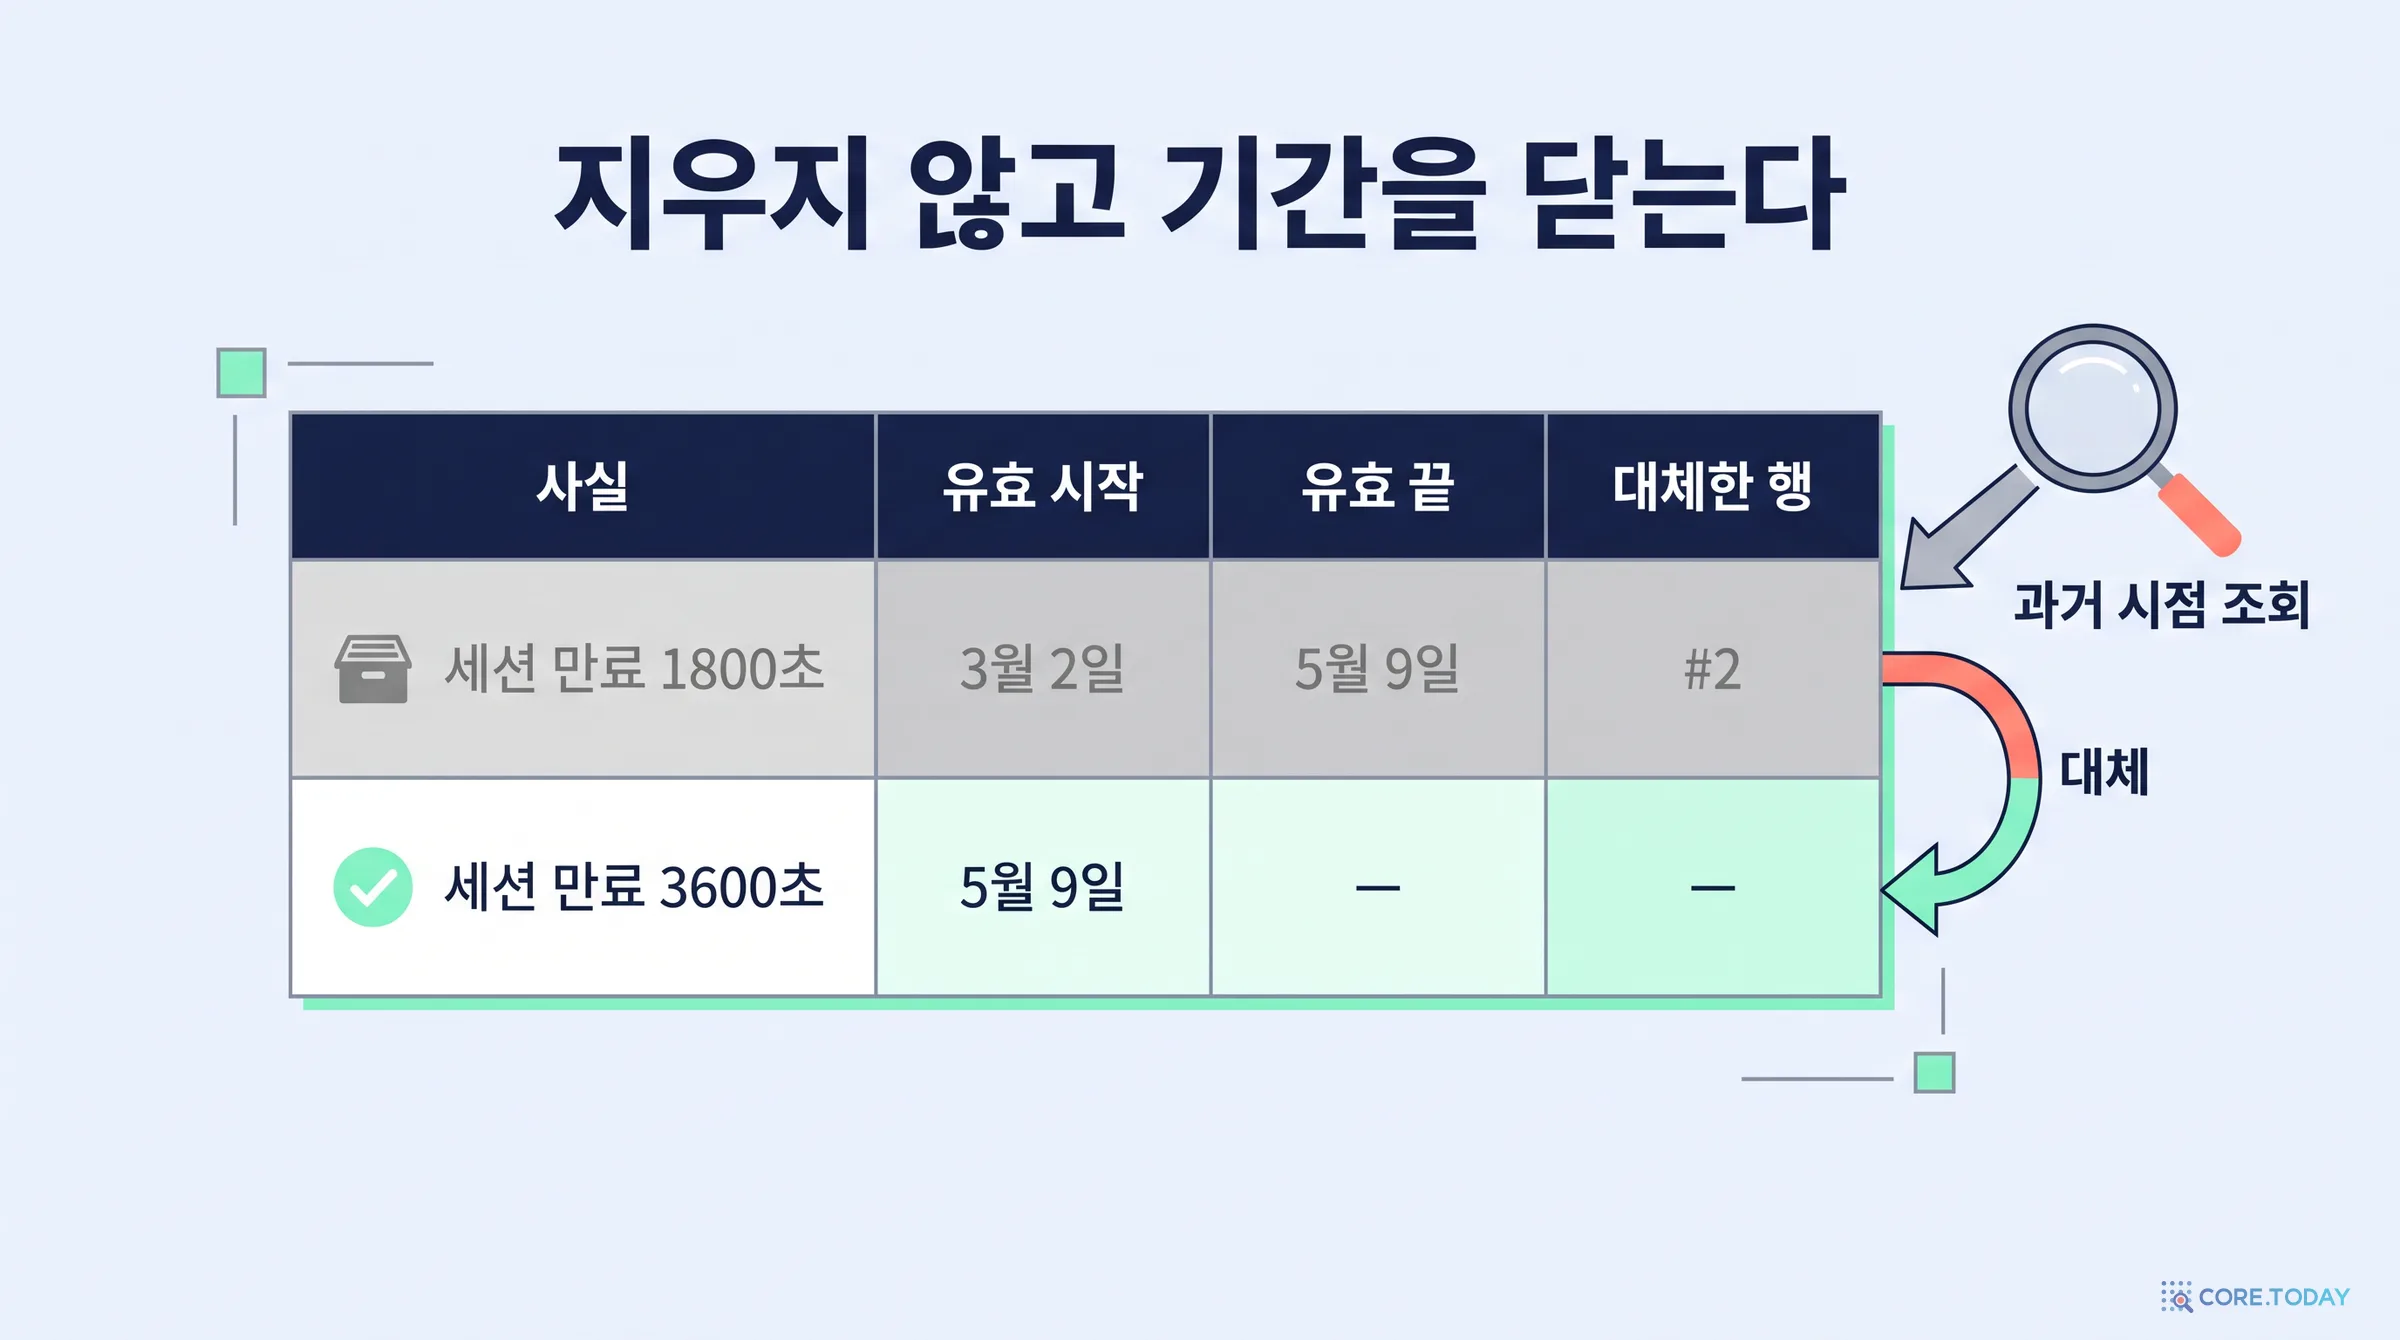
에이전트 기억에 이 구분은 결정적입니다. 포트가 8000에서 8080이 된 것은 갱신입니다. 8000은 틀린 적이 없습니다. 3월에는 참이었습니다. 그러니 지우면 안 되고 기간을 닫아야 합니다. 반면 회의록에 8800이라고 잘못 적었다가 8080으로 고친 것은 수정입니다. 8800은 한 번도 참이었던 적이 없으니 '틀린 기록'으로 남겨야 합니다. MemStrata의 대체 규칙은 둘을 구별하지 않습니다. 같은 열쇠에 다른 값이 오면 무조건 '퇴역'입니다. 이 차이가 언제 문제가 되는지는 원장 놀이터 위젯에서 직접 볼 수 있습니다.
2011~2012년: 표준과 제품이 된 이중 시간
데이터베이스 쪽의 표준화는 길고 험했습니다. 1993년 꾸려진 위원회가 1994년 TSQL2를 내놓았고 SQL3의 7부(SQL/Temporal)로 채택이 추진됐지만, 그 ISO 과제는 2001년 말 취소됐습니다. 시간 테이블은 SQL:2011에 와서야 다른 설계로 표준에 들어갔습니다. 응용 시간 기간(PERIOD FOR, FOR PORTION OF), 시스템 버전 테이블(WITH SYSTEM VERSIONING, FOR SYSTEM_TIME AS OF), 그리고 둘을 함께 쓰는 이중 시간 테이블입니다. IBM Db2 10(2012), SQL Server 2016(시스템 버전만), MariaDB 10.3~10.4(2018~2019)가 뒤따랐고, PostgreSQL은 18(2025)에서 기간 제약을 넣었습니다. 코어닷투데이는 이중 시간 SQL 실습에서 이 기능들을 도커로 직접 돌려 문서와 다른 동작들을 확인한 적이 있습니다.
2012년 3월에는 리치 히키가 Datomic을 발표했습니다. Datomic의 문서는 이렇게 씁니다. "제자리 갱신 데이터베이스가 삭제할 곳에서 Datomic은 새 철회(retraction)를 더한다." 주소가 바뀌면 옛 주소를 지우지 않고 "이 시점부터 더는 참이 아니다"라는 사실을 하나 더 쌓습니다. 히키는 이 설계를 설명하며 "회계사는 지우개를 쓰지 않는다"는 오래된 격언을 인용했습니다. 2019년 JUXT는 이중 시간을 기본으로 하는 Crux(지금의 XTDB)를 공개했습니다. 버전 관리 시스템도 같은 생각입니다. git revert는 옛 커밋을 지우지 않고 그것을 되돌리는 새 커밋을 쌓습니다. 마틴 파울러는 2005년 '이벤트 소싱'을 설명하며 버전 관리 시스템을 대표 예로 들었습니다.
위키데이터: 지금 값은 '순위'로 고른다
수많은 사람이 함께 고치는 지식 기반은 이 문제를 매일 겪습니다. 위키데이터는 문장마다 순위(선호·보통·폐기)와 시간 수식어(시작 시점 P580, 종료 시점 P582)를 둡니다. 2026년 10월 31일 현재 위키데이터의 대한민국(Q884) '국가원수' 항목을 보면, 이재명은 '선호' 순위에 시작 시점 2025-06-04가 붙어 있고, 윤석열은 '보통' 순위에 2022-05-10부터 2025-04-04까지로 기간이 닫혀 있습니다. 대통령이 없던 기간도 2025-04-04부터 06-03까지 '값 없음' 문장으로 따로 기록되어 있습니다.
여기서 두 가지를 배웁니다. 첫째, 옛 대통령은 지워지지도 '폐기'되지도 않습니다. 위키데이터 지침은 폐기 순위가 "올바른 과거 정보에는 적용되지 않는다"고 못 박습니다. 폐기는 틀렸던 정보(수정)에, 기간 닫기는 바뀐 정보(갱신)에 씁니다. 1991년의 구분이 그대로 살아 있습니다. 둘째, '지금 값'은 기간 닫기와 별도의 표시(선호 순위)로 고릅니다. 누가 지금 값을 정하는지가 데이터 안에 명시되어 있습니다.
2020년 이후: 색인 갈아 끼우기와 에이전트 기억
다시 RAG로 돌아오면, 2020년 원 논문의 4.5절 제목이 「색인 핫스왑(Index hot-swapping)」입니다. 저자들은 2016년 12월 위키백과로 만든 색인과 2018년 12월 색인을 준비하고, 그 사이 바뀐 세계 지도자 82명에 대해 "{직위}는 누구인가?"를 물었습니다. 시점이 맞는 색인을 쓰면 70%와 68%를 맞혔고, 엇갈린 색인을 쓰면 12%와 4%로 떨어졌습니다. 결론은 "비매개 기억을 갈아 끼우는 것만으로 RAG의 세계 지식을 갱신할 수 있다"였습니다.
이 실험을 꼼꼼히 보면 MemStrata가 겨냥하는 빈틈이 정확히 보입니다. 저자들은 색인을 통째로 바꿨습니다. 2016년의 페루 대통령과 2018년의 페루 대통령이 한 색인 안에 나란히 놓인 적이 한 번도 없습니다. 실제 시스템에서 문서는 조금씩 더해지고, 옛 문서는 새 문서 옆에 그대로 남습니다. '갈아 끼우면 된다'는 약속은 교체가 전면적이고 한 번에 일어난다는 가정 위에 서 있었습니다.
2023년 이후 에이전트 기억이 본격적으로 등장하면서 이 빈틈을 메우려는 시도가 이어졌습니다. MemGPT(지금의 Letta)는 운영체제처럼 기억을 계층으로 나눴고, Mem0의 2025년 논문은 새 기억이 들어올 때 LLM이 추가·갱신·삭제·무시 중 하나를 고르게 했습니다. Zep과 그 엔진 Graphiti는 2025년 초 이중 시간 지식 그래프를 내놓았습니다. LLM이 새 간선과 의미상 비슷한 옛 간선을 비교해 모순을 찾고, 모순이면 옛 간선의 유효 끝을 새 간선의 유효 시작으로 닫습니다. 코어닷투데이가 Graphiti 특집에서 코드로 확인했듯 마지막 단계(날짜 비교)는 결정적이지만, 무엇이 모순인지 찾는 첫 단계는 유사도 검색과 LLM 판단입니다. MemStrata의 AUROC 0.59 논증이 정면으로 겨누는 지점이 바로 여기입니다.
4부. MemStrata 해부: 열쇠, 원장, 그리고 '보관한 뒤 대체'
MemStrata는 에이전트와 언어 모델 사이에 놓이는 로컬 기억 계층입니다. 대화에서 사실을 뽑아 저장하고, 질문이 오면 토큰 예산에 맞춘 문맥 묶음을 만들어 줍니다. 논문이 평가한 부품은 넷입니다.
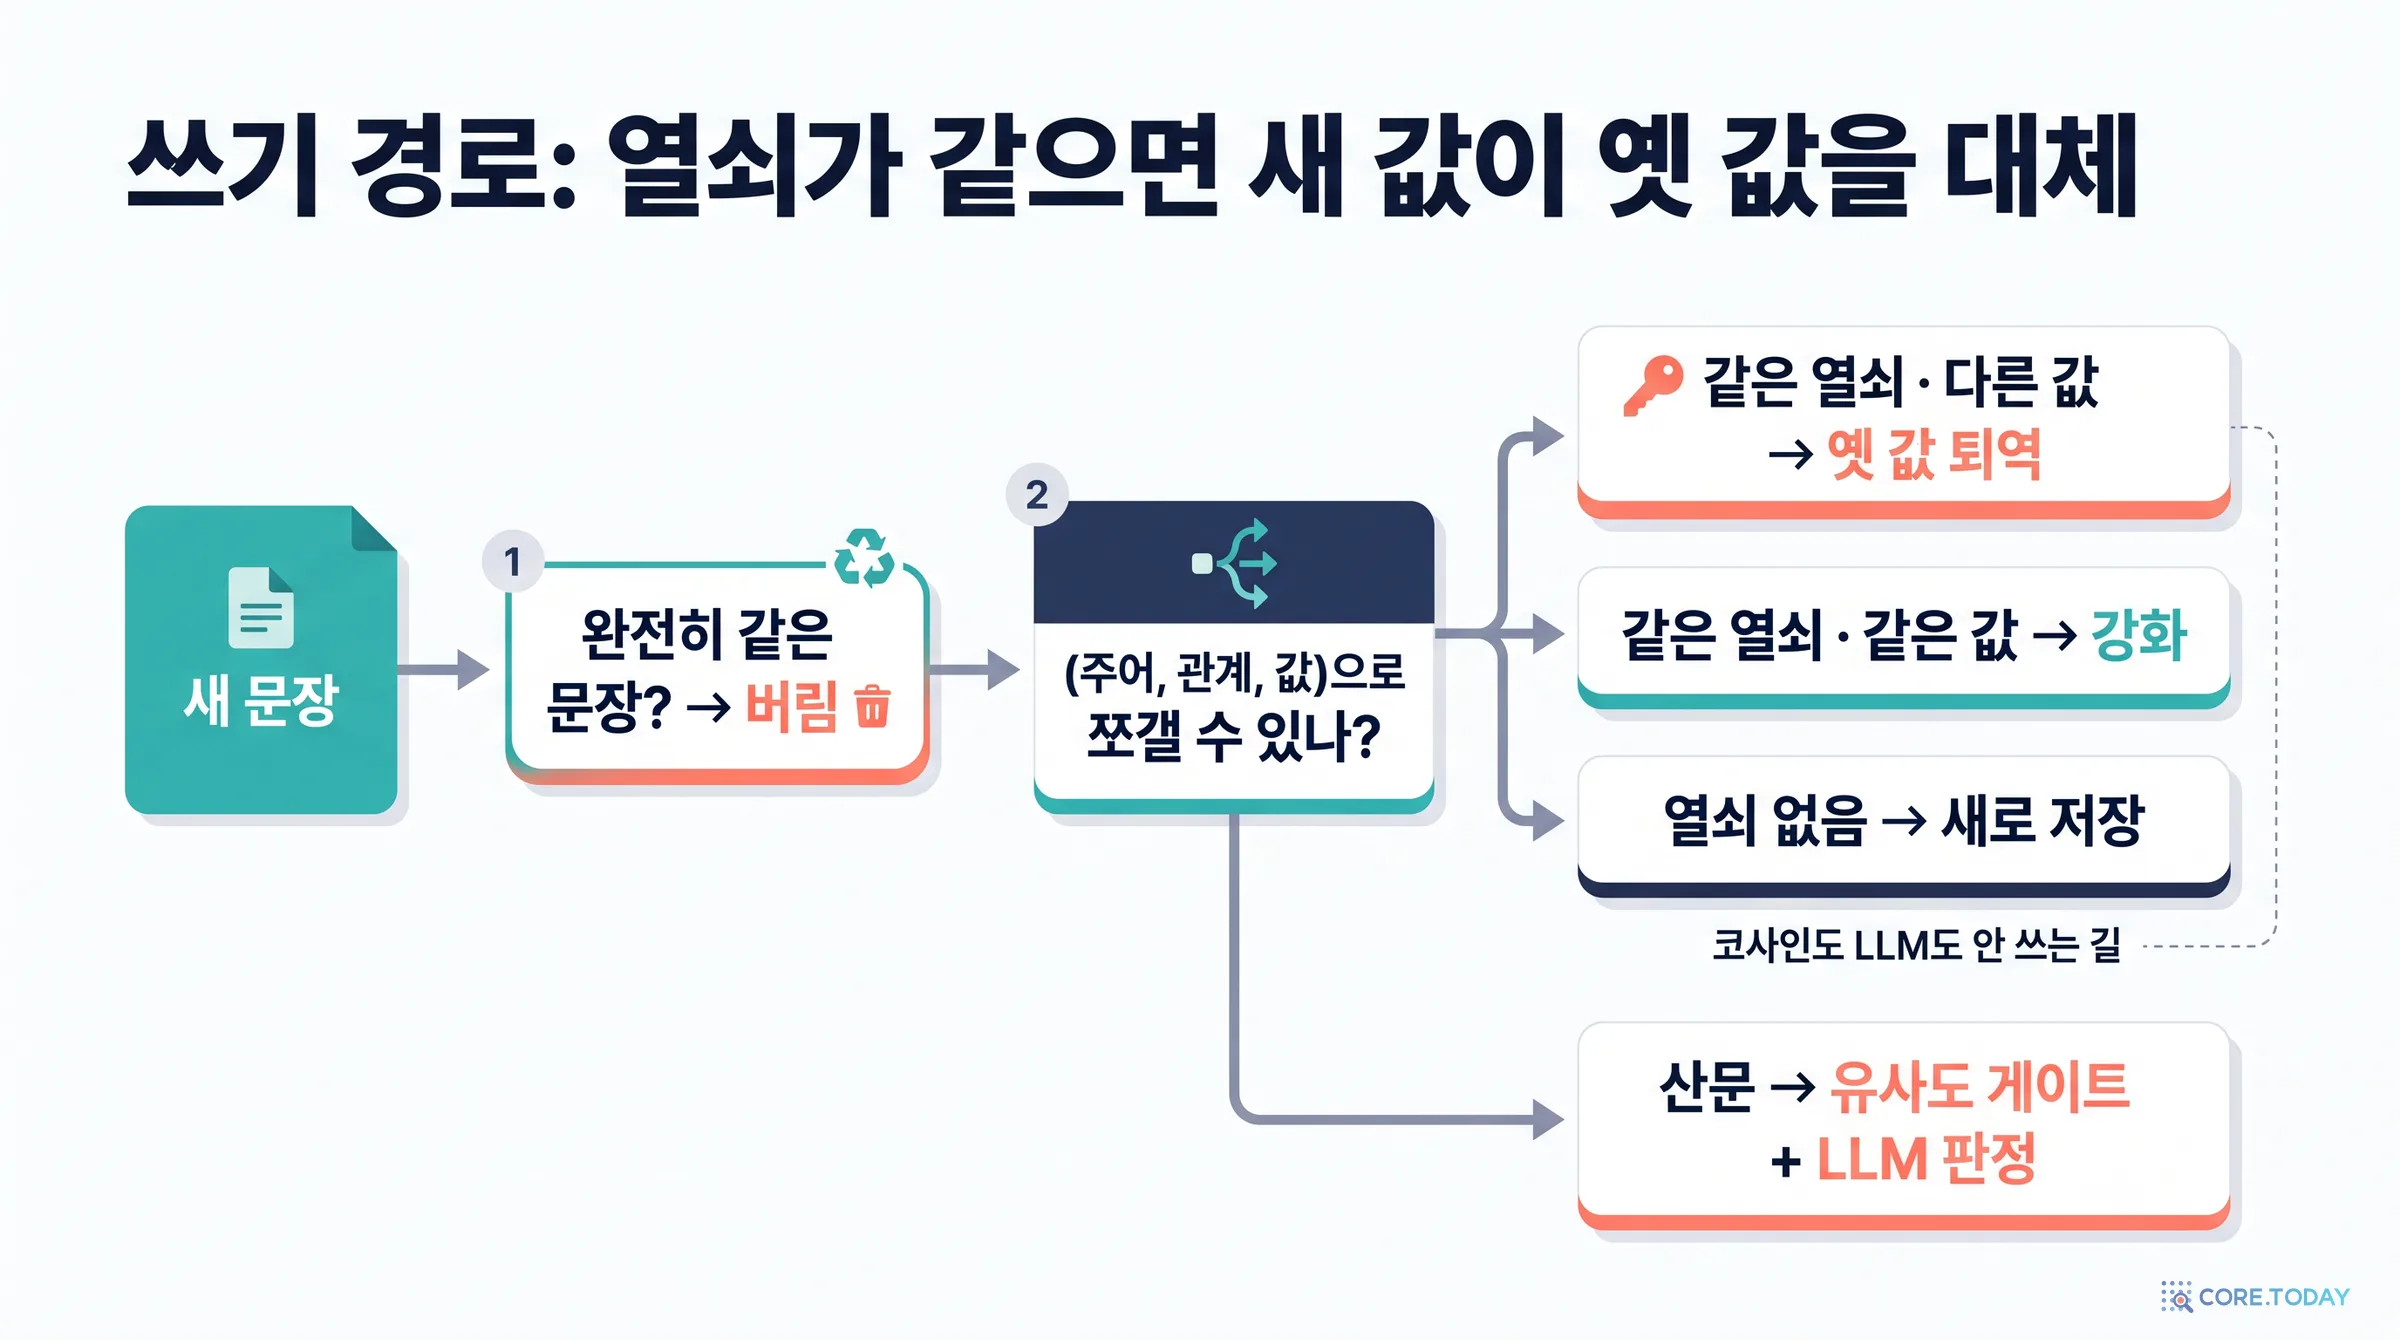
2단계결정적 단언 경로. 문장이 (주어, 관계, 값) 세 칸으로 깔끔하게 쪼개지고 값이 바뀔 수 있는 하나뿐이면, (주어, 관계)를 정규화해 '열쇠'로 삼습니다. 같은 열쇠의 활성 행이 있고 값이 다르면 옛 행의 기간을 닫고(valid_to 기록, superseded_by 연결) 새 행을 엽니다. 값이 같으면 중복으로 보고 강화합니다. 열쇠가 처음이면 새로 저장합니다. 코사인도, LLM 판정도 쓰지 않습니다.
3단계문장 게이트(예비 경로). 세 칸으로 안 쪼개지는 산문은 유사도와 LLM 판정으로 분류합니다. 이 경로는 완전 중복만 버리고, 모순이 아닌 비슷한 문장은 별개 사실로 남깁니다.
2단계에서 "LLM을 쓰지 않는다"는 말은 조심해서 읽어야 합니다. 문장을 세 칸으로 쪼개는 추출에는 LLM이 쓰입니다(부록 C.1의 extract_triple 프롬프트). LLM을 쓰지 않는 것은 그다음, 곧 '이 둘이 같은 사실의 두 버전인가'를 판정하는 단계입니다. 판정은 문자열 비교로 끝납니다. 열쇠가 같고 값이 다르면 대체, 그뿐입니다.
추출 프롬프트가 하는 일
그래서 이 방식의 성패는 추출 프롬프트에 달려 있습니다. 논문이 공개한 프롬프트의 핵심 규칙은 두 줄입니다.
extract_triple_v1.md의 핵심 규칙 (번역)
값(object)
옛 버전과 새 버전 사이에 달라질 값 하나. 이름·숫자·버전·경로·엔드포인트.
주어(subject)
그 값이 무엇에 속하는지. 값을 절대 포함하지 않는다. 값만 다른 두 문장은 반드시 같은 주어와 관계를 내야 한다.
식별자일 때
값이 함수·엔드포인트 이름이면 주어를 "~하는 함수"처럼 바꿔 쓴다. 예: "사용자 기록을 기본 키로 찾는 함수" / 이름은 / get_user_by_id
마지막 규칙이 영리합니다. "get_user_by_id 함수는 사용자를 찾는다"를 그대로 쪼개면 주어가 함수 이름이 되어 버립니다. 이름이 fetch_user로 바뀌면 주어가 달라지니 열쇠도 달라지고, 두 문장은 서로 다른 사실로 저장됩니다. 그래서 주어를 '하는 일'로 다시 쓰게 합니다. "사용자 기록을 기본 키로 찾는 함수"는 이름이 바뀌어도 그대로이니 열쇠가 유지됩니다. 사람 이름도 같습니다. "김정우 대표"가 아니라 "한빛상사의 대표이사"를 주어로 삼아야 대표가 바뀐 것을 잡아냅니다.
이 규칙은 동시에 이 방식의 가장 약한 고리이기도 합니다. 값만 다른 두 문장이 글자 하나 틀리지 않고 같은 주어를 내야 열쇠가 맞습니다. "사용자 기록을 기본 키로 찾는 함수"와 "기본 키로 사용자를 조회하는 함수"는 사람에게는 같은 주어지만 문자열 비교에는 다른 열쇠입니다. 이 문제는 7부 실측에서 숫자로 확인합니다.
퇴역한 사실은 지워지지 않습니다. 각 행은 valid_from(유효 시작), valid_to(유효 끝), superseded_by(나를 대체한 행)를 갖습니다. 검색은 지금 유효한 행만 봅니다. 퇴역한 행은 나중에 "3월 기준 세션 만료는?" 같은 과거 시점 질문에 쓰일 수 있습니다. 다만 논문은 이 과거 시점 조회를 구현은 하되 평가하지는 않았다고 밝힙니다.
여기서 논문이 '이중 시간(bi-temporal)'이라는 말을 쓰지만, 실제 평가에서 쓰는 시간은 하나뿐이라는 점을 짚어 둡니다. valid_from은 사실이 들어온 순서로 채워집니다. 스노드그래스의 용어로 말하면 기록 시간을 유효 시간의 대리값으로 쓴 것입니다. 한계 절에서 저자도 "기록 순서가 시간을 대신한다"고 인정하고, 실제 날짜를 끌어와 '그 시점 기준' 검색을 붙이는 일은 저장 구조가 아니라 다음 과제라고 씁니다. 두 시간을 구분하지 않으면 무슨 일이 생기는지 아래 놀이터에서 확인해 보세요. '늦게 도착한 옛 문서'를 고르면 기록 순서 규칙이 옛 값을 새 값으로 착각하는 장면이 나옵니다.
보관한 뒤 대체한다: 너무 많이 합치면 안 된다
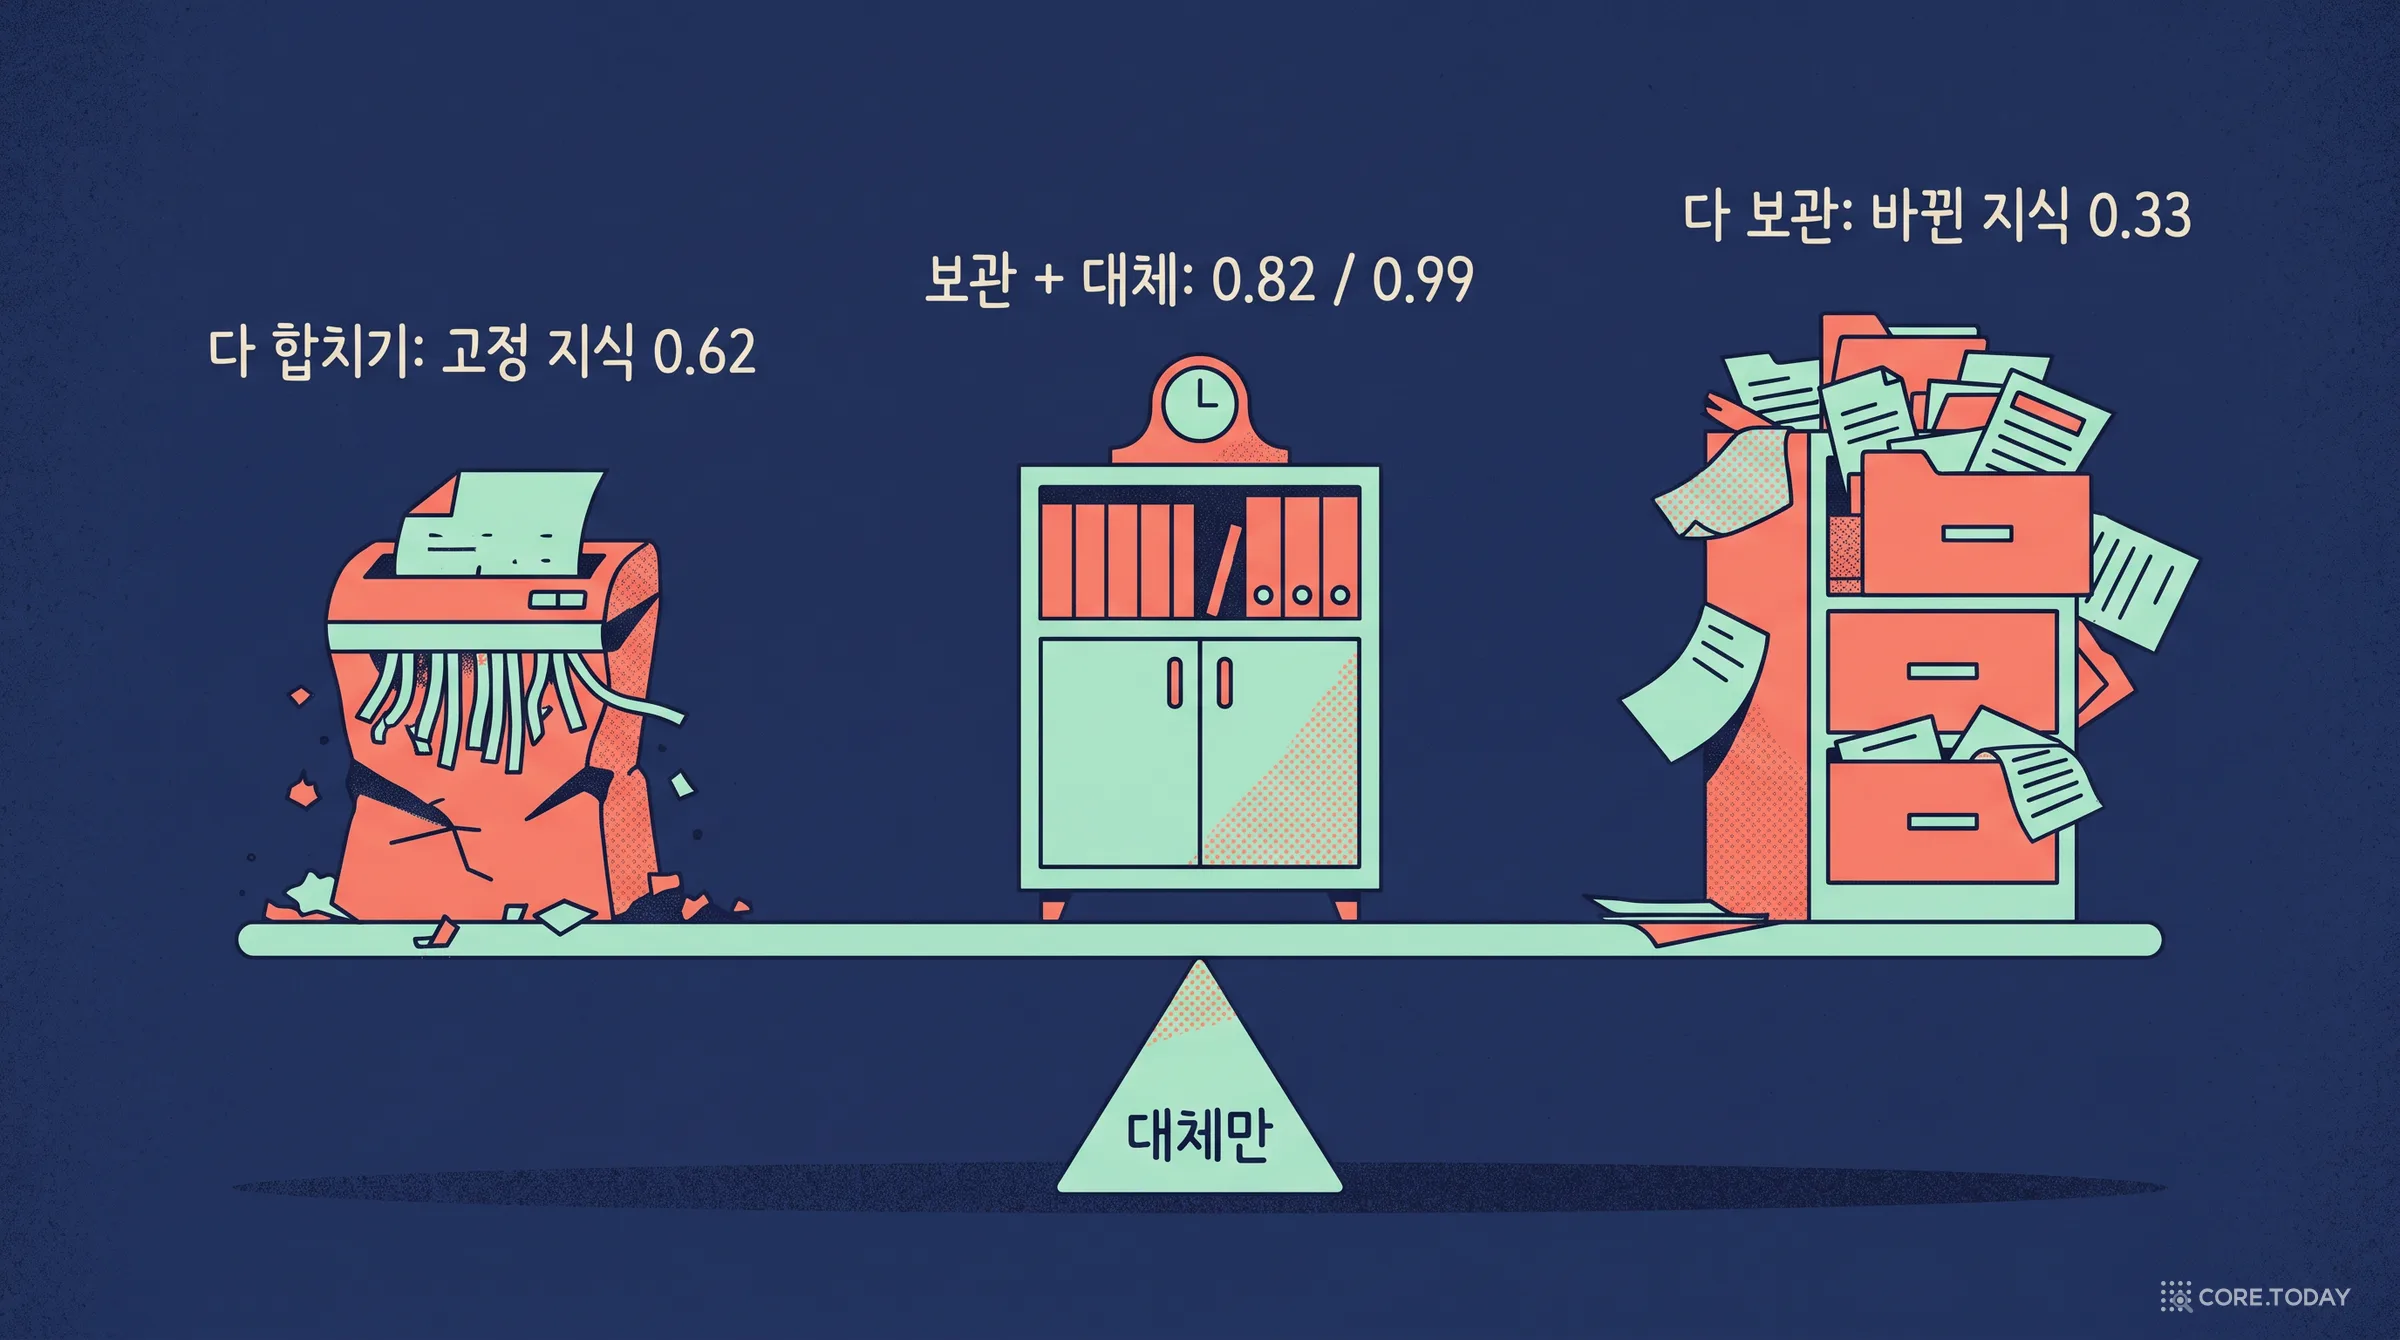
논문에서 가장 정직한 대목은 실패한 초기 설계를 숨기지 않은 부분입니다. 첫 버전은 기억이 무한정 커지는 것을 막으려고 쓰는 시점에 비슷한 사실들을 과감히 합쳤습니다. 그랬더니 고정 지식에서 RAG보다 나빠졌습니다. 프로젝트 사실 QA가 0.86에서 0.62로, 다회차 대화 회상이 0.30에서 0.13으로 떨어졌습니다. 합치는 과정에서 나중에 필요한 세부가 사라졌기 때문입니다.
그래서 최종 설계는 RAG처럼 다 보관합니다. 모순되지 않는 비슷한 사실은 별개로 남기고, 기억의 성장은 오직 한 축, 곧 같은 열쇠에 값이 바뀌는 축에서만 막습니다. 논문은 이를 "기억을 작게 만드는 게 아니라 낡은 사실을 퇴역시키는 것"이라고 정리합니다. 바뀐 지식 벤치마크에서 활성 사실 수가 약 48% 줄었지만, 그것은 목표가 아니라 결과입니다.
반대쪽 절제 실험도 있습니다. 대체 규칙을 아예 빼고 모든 턴을 보관하면, 바뀐 지식 네 벤치마크의 평균 정답률이 0.99에서 0.33으로 떨어져 단순 RAG(0.32)와 구별되지 않습니다. 더 나쁜 것은 지어낸 답이 늘어난다는 점입니다. 답한 문항당 지어낸 답의 비율이 0.04에서 0.25로 약 6배가 됐고, 설정 값 벤치마크에서는 0.56까지 올랐습니다. 옛 값과 새 값을 나란히 본 모델이 어느 쪽인지 모르겠으니 제3의 값을 만들어 낸 것입니다. 두 값의 공존은 단순히 정확도를 깎는 데서 그치지 않고 환각의 원천이 됩니다.
두 절제 실험이 설계를 양쪽에서 감쌉니다. 너무 합치면 고정 지식의 세부를 잃고, 대체가 없으면 바뀐 지식의 정확도와 안전을 잃습니다. 남는 결론은 하나입니다. 성능을 만든 것은 보관도, 압축도, 원문 묶기도 아닌 결정적 대체 하나라는 것입니다.
읽기 경로: 세 칸이 아니라 원문을 넣는다
읽을 때는 질문을 임베딩하고, 활성 사실과 단언 중에서 코사인 상위 k개를 고르고, 퇴역한 행을 거른 뒤 문맥으로 묶습니다. 작은 발견 하나가 있습니다. 세 칸으로 재구성한 짧은 문장("결제 서비스 포트 / 이다 / 8080")만 넣으면 답변 모델이 오히려 헷갈렸고, 원래 문장을 넣었더니 정확도가 돌아왔습니다(함수 이름 벤치마크 0.80→1.00, 다른 개선과 함께 측정). 열쇠는 판정용, 원문은 답변용으로 나눠 쓴 셈입니다.
읽기 경로에 LLM이 없으니 지연도 짧습니다. 논문의 측정으로 검색 지연은 약 2.1초로 단순 RAG와 같고, LLM 재정렬이나 검증을 붙인 조건은 16~18초입니다. 약 8배 차이입니다.
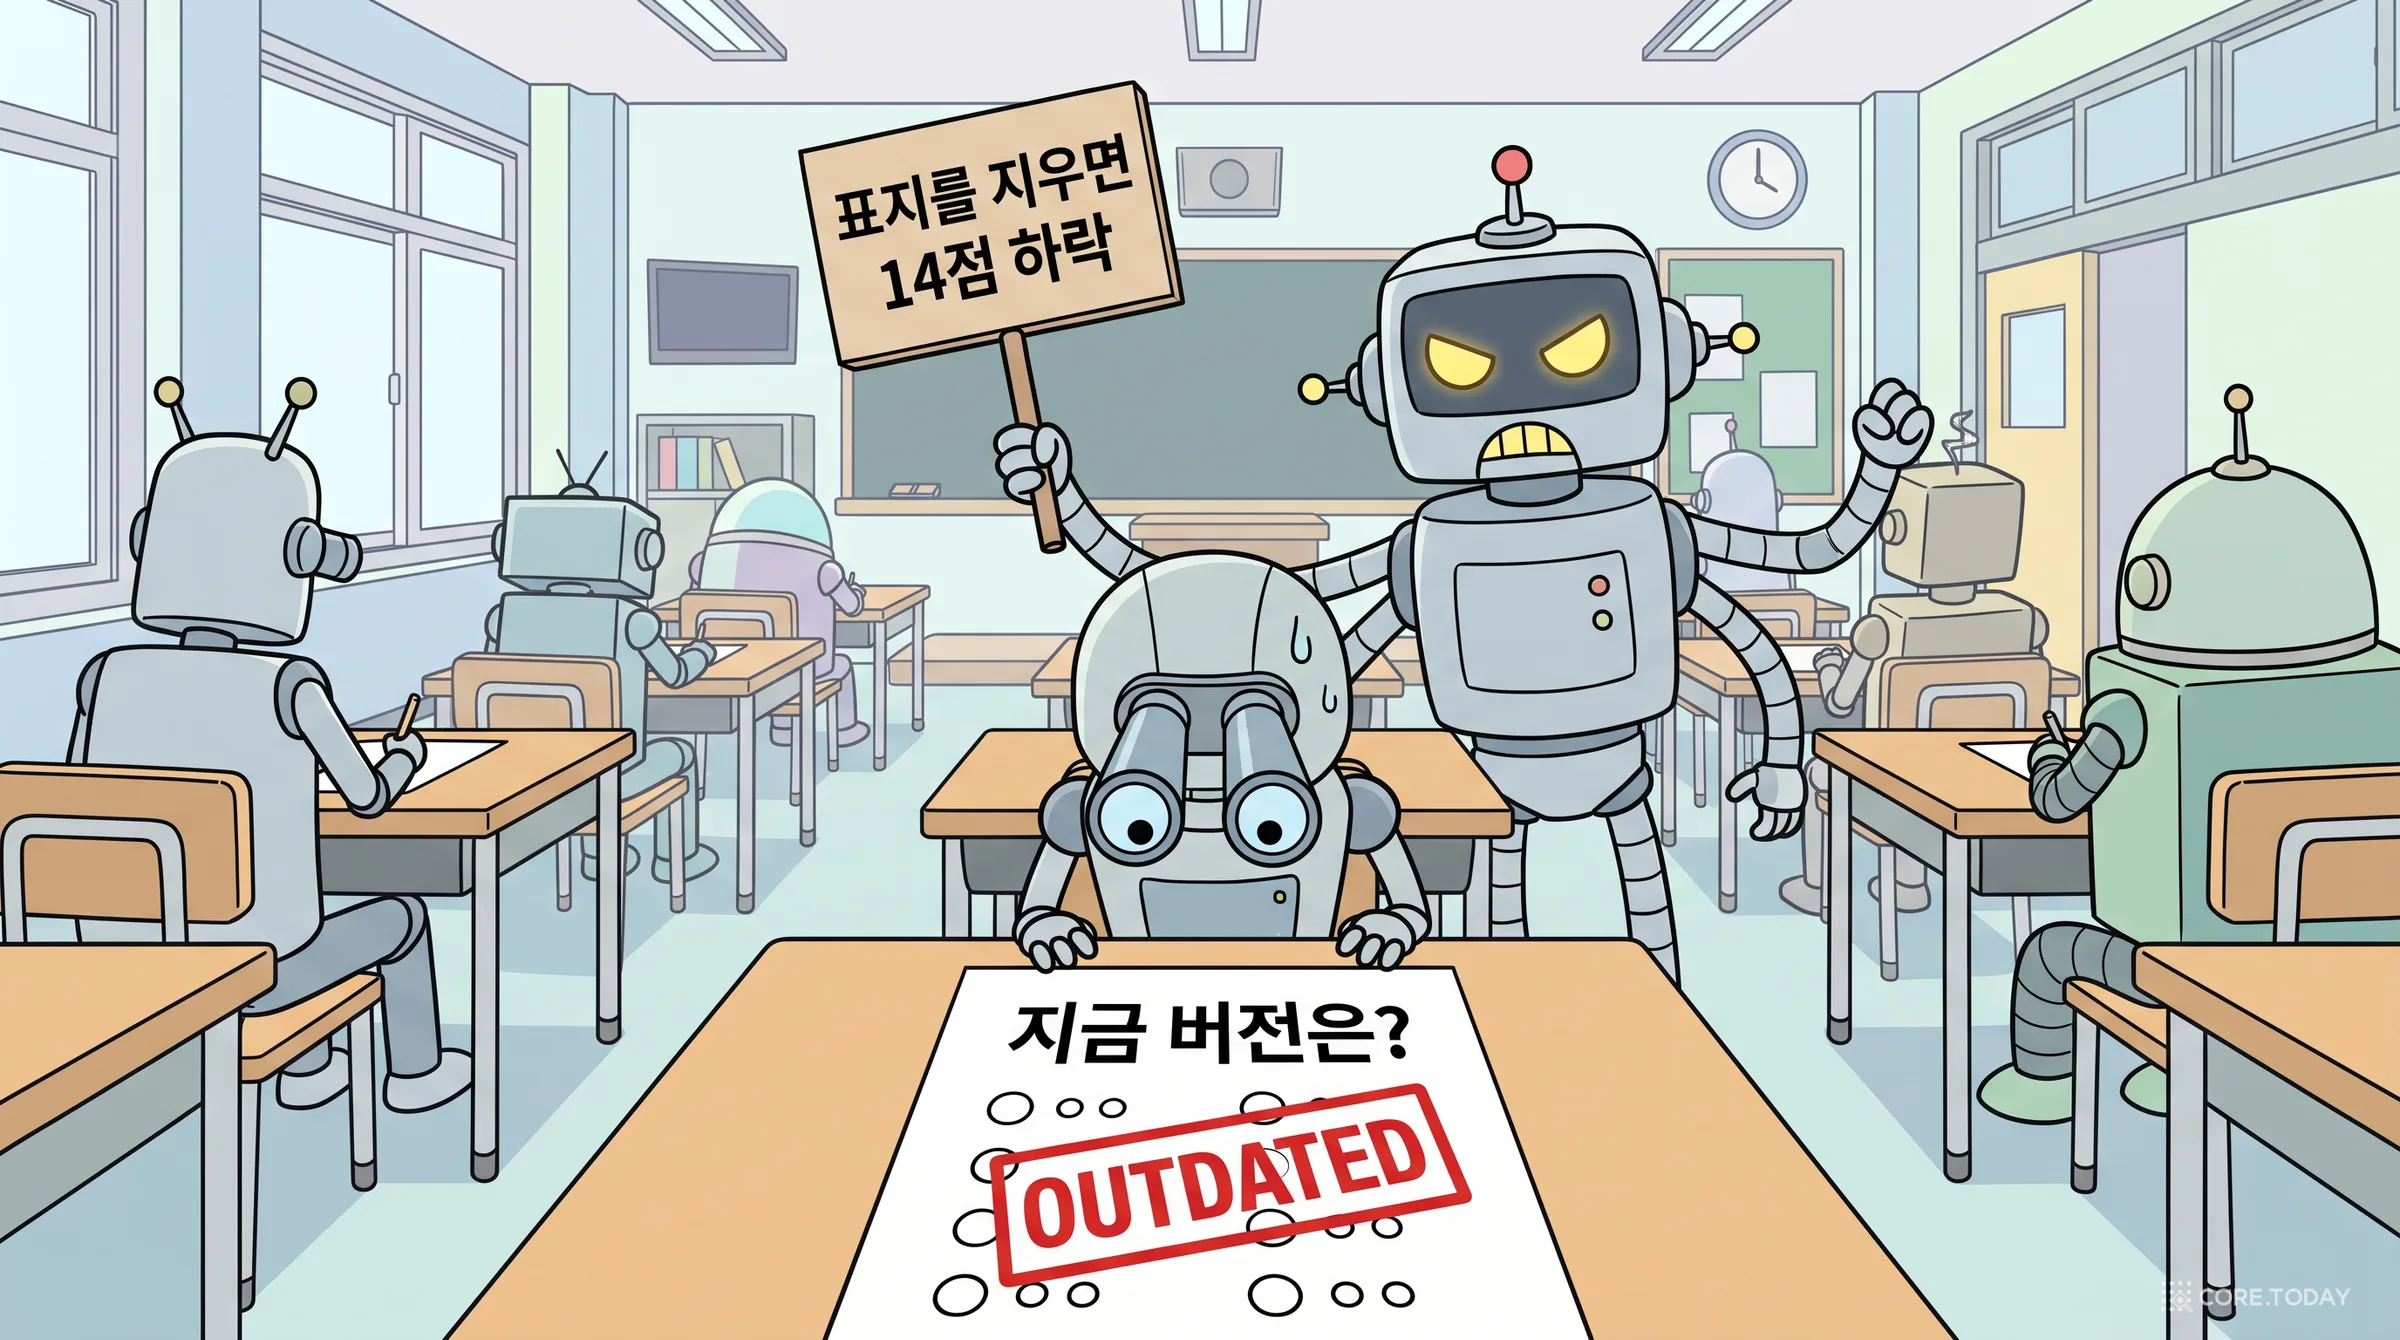
이 논문에서 가장 오래 남을 기여는 어쩌면 시스템이 아니라 평가 원칙일지 모릅니다. 저자는 바뀐 지식을 평가할 때 흔히 빠지는 함정을 지적합니다. 옛 문장에 '[OUTDATED]', '(legacy)', 'deprecated', '예전에는' 같은 표지가 하나라도 붙어 있으면, 검색 기반 비교 조건은 시간을 다루는 장치 없이도 표지를 읽고 답을 고를 수 있습니다. 시험지에 "이건 옛날 답"이라고 적혀 있는 셈입니다.
저자가 앞서 만든 벤치마크에는 이런 표지가 있었고, 그것을 지우자 LLM 재정렬 RAG의 정확도가 14점, 게이트 조건은 18점 떨어졌습니다. 시간 장치를 가진 MemStrata는 4점만 떨어졌습니다. 기존 평가가 '시간을 추적하는 능력'이 아니라 '표지를 읽는 능력'을 재고 있었던 것입니다.
그래서 이 논문의 네 벤치마크는 엄격한 표지 없음 불변식을 지킵니다. 옛 상태와 새 상태 문장은 바뀐 값 하나를 빼면 글자까지 같고, old·new·current·previous·deprecated·legacy·outdated 같은 단어와 그 동의어는 어디에도 나오지 않습니다. 이 규칙은 단위 테스트로 강제됩니다. 지금 값을 알려 주는 유일한 신호는 들어온 순서입니다.
벤치마크
옛 상태 (먼저 들어옴)
새 상태 (나중에 들어옴)
질문 → 정답
함수 이름 바뀜 (30)
get_user_by_id(uid) 함수는 users 테이블에서 기본 키로 사용자 기록을 찾는다
fetch_user(uid) 함수는 …(같음)
기본 키로 사용자 기록을 찾는 함수는? → fetch_user
설정 값 바뀜 (20)
config.py의 SESSION_TIMEOUT은 1800초
… 3600초
SESSION_TIMEOUT은 몇 초? → 3600
의존성 버전 (20)
requirements.txt에 numpy==1.24.0 고정
… numpy==1.26.4
numpy 버전은? → 1.26.4
API 바뀜 (20)
사용자 목록 엔드포인트는 GET /api/v1/users
… GET /api/v2/users
사용자 목록 경로는? → /api/v2/users
출처: 논문 부록 B.3~B.6의 예시를 번역. 괄호 안은 시나리오 수.
여기에 고정 지식 벤치마크 두 개가 더해집니다. 실제 프로젝트 사실(포트, 모델 이름, 설정 플래그, 결정 기록) 50문항과 LoCoMo 다회차 대화에서 뽑은 30문항입니다. 고정 벤치마크에는 모순이 없습니다. 바뀐 지식에서 이기는 대신 고정 지식에서 손해를 보지 않는지 확인하는 용도입니다.
표지 없음 불변식은 평가 설계로서 훌륭합니다. 코어닷투데이가 메모리 벤치마크 비판 특집에서 다뤘던 문제, 곧 벤치마크가 재려는 능력과 실제로 재는 능력이 어긋나는 문제를 정확히 겨냥합니다. 다만 같은 원칙을 끝까지 밀면 불편한 질문이 하나 생깁니다. 옛 문장과 새 문장이 값 하나만 빼고 글자까지 같다는 조건은, (주어, 관계) 열쇠를 뽑기에 가장 유리한 조건이기도 합니다. 이 점은 8부에서 다시 다룹니다.
실험 환경부터 봅니다. 모든 실험은 소비자용 하드웨어에서 로컬로, 온도 0·고정 시드·네트워크 차단(테스트로 강제)으로 돌았습니다. 답변 모델은 Qwen2.5-Coder-7B, 채점 모델은 그보다 작은 Qwen2.5-Coder-3B 두 개(정답 판정용과 지어냄 판정용을 따로), 임베딩은 nomic-embed-text입니다. 자기 답을 자기가 채점하지 않도록 역할마다 다른 모델 배정을 썼습니다. 비교 조건은 여덟 개입니다.
조건
쓸 때
읽을 때
역할
기억 없음
—
—
바닥선
단순 RAG
모든 턴 저장
코사인 상위 k
기본 비교군
RAG + LLM 재정렬
모든 턴 저장
LLM이 다시 줄 세움
'더 똑똑한 검색'
놀람 게이트
유사도+LLM 판정
코사인
유사도 기반 대체
게이트 + LLM 검증
유사도+LLM 판정
LLM 관련성 검사
'검증하면 낫지 않을까'
대체 + 과감한 병합
결정적 대체 + 병합
코사인
절제: 너무 합침
MemStrata
보관 + 결정적 대체
코사인 + 퇴역 거름
제안 방식
게이트 + 추론 필터
유사도+LLM 판정
추론 가능성 필터
중립
정답률: 두 개의 이야기
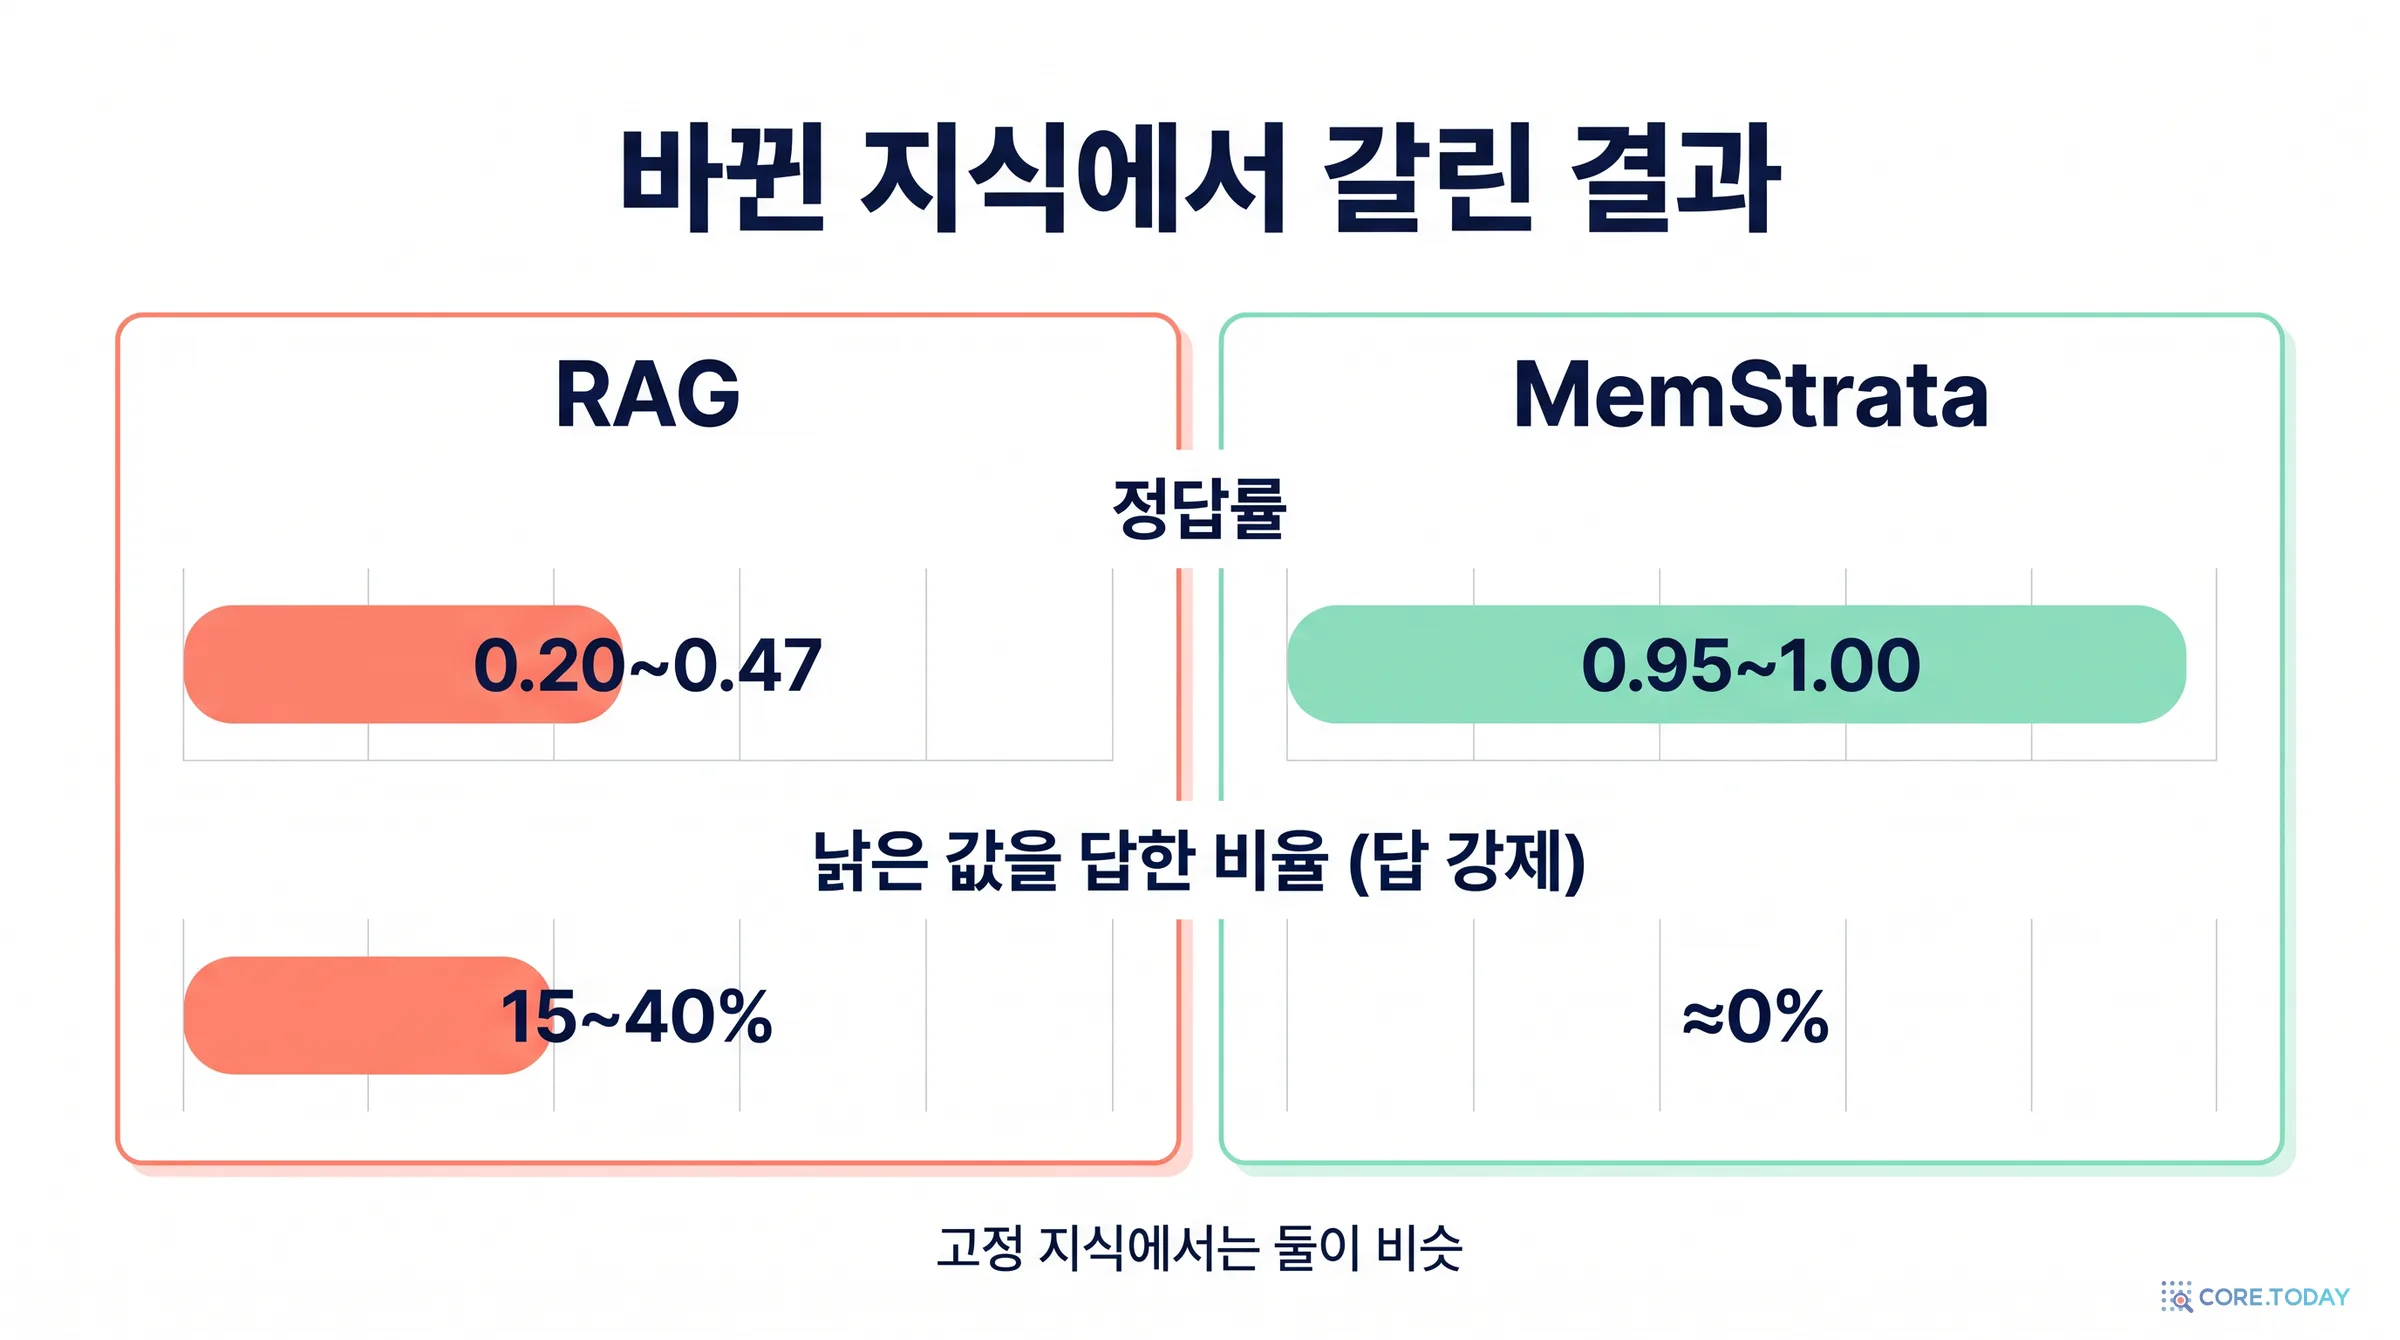
고정 지식에서 MemStrata는 RAG와 거의 같습니다(프로젝트 사실 0.82 대 0.86, 대화 0.30 대 0.30). 바뀐 지식 네 벤치마크에서는 0.95~1.00으로, RAG의 0.20~0.47을 2~5배 앞섭니다. LLM 검증을 붙인 조건은 오락가락하고 끝내 시간 계층의 정확도에 닿지 못하면서 지연만 8배입니다.
그런데 표를 넘겨 보면 RAG의 낮은 정답률에는 다른 사정도 섞여 있습니다. 설정 값 벤치마크에서 RAG는 20문항 중 6개에만 답했습니다. 나머지 14개는 "판단할 수 없다"며 기권했습니다. 정답률 0.25의 대부분은 틀린 답이 아니라 기권입니다. 그래서 논문은 기권을 금지한 보충 실험을 따로 돌렸습니다.
기권을 허락하면 RAG는 모르겠다고 버티며 실패를 숨깁니다. 답을 강제하면 15~40%를 옛 값으로 답합니다. 의존성 버전만 15%로 낮은데, 저자는 이를 "버전 숫자가 클수록 새것"이라는 운 좋은 표면 힌트 덕으로 봅니다. 모델이 시간을 추론한 것이 아니라 문자열을 보고 짐작한 것입니다. 실제로 버전은 내려가기도 합니다(되돌리기, 고정 하향). 이 힌트는 언제든 배신할 수 있습니다.
MemStrata는 두 조건 모두에서 거의 0%입니다. 옛 값이 검색 전에 저장소에서 빠지기 때문입니다. 모델이 옛 값을 볼 일이 없으니 고를 일도 없습니다. 저자가 "RAG가 구조상 피할 수 없는 실패"라고 부르는 이유입니다. RAG는 두 값을 다 찾아오고, 고를 장치가 없습니다.
게이트 조건(유사도 기반 대체)은 기권 허용 상태에서도 25~60%의 낡은 값 오답을 냈습니다. RAG보다 답을 많이 하지만 그만큼 옛 값을 흘립니다. 2부의 보정 실험이 예고한 그대로입니다. 유사도로 대체를 판정하면 바뀐 값을 중복으로 보고 버리거나, 옛 값을 남겨 둡니다.
아래 위젯에서 논문 부록의 원표를 직접 넘겨 볼 수 있습니다. '답한 문항 수' 탭을 꼭 눌러 보세요. 정답률이라는 숫자 하나가 얼마나 많은 것을 숨기는지 보입니다.
표 밖에서 읽어야 할 것
결과는 인상적이지만 몇 가지를 함께 기억해야 정확하게 읽힙니다. 벤치마크 문항이 20~30개라 0.05는 문항 하나입니다. '15%'는 20문항 중 3개입니다. 저자도 "순위표를 만들려는 게 아니라 메커니즘을 가르려는 규모"라고 씁니다. 그리고 바뀐 지식 벤치마크는 처음부터 이 방식이 가장 잘하도록 생긴 문제입니다. 문장 하나에 바뀌는 값 하나, 바뀐 값 말고는 글자까지 같은 두 문장. 이 조건이 풀리면 어떻게 되는지는 논문 안에도 단서가 있고, 저자의 후속 논문에도, 코어닷투데이의 실측에도 있습니다. 다음 부에서 차례로 봅니다.
7부. 코어닷투데이 실측: 한국어 30문항으로 다시 재 보기
논문의 데이터와 엔진은 공개되어 있지 않습니다(8부에서 다룹니다). 그래서 핵심 주장을 우리 손으로 다시 재 보기로 했습니다. 질문은 세 가지입니다. 한국어에서도 RAG는 옛 값을 내놓는가? 결정적 대체는 그것을 고치는가? 그리고 논문 벤치마크의 깨끗한 조건을 하나씩 풀면 어디서 깨지는가?
실험 설계
데이터한국어 사실 30개함수 이름 6 · 설정 값 6 · 의존성 5 · API 5 · 회사·생활 8, 표지 없음
저장 순서옛 값 30 + 같은 주제 새 사실 30 → 새 값 30옛 문장과 새 문장은 값만 다름(논문 형식)
검색BGE-M3 코사인 상위 5개Ollama, 로컬
답변·추출 모델qwen3.5:9b (온도 0, 생각 끔)추출 프롬프트는 논문 C.1을 한국어로 옮기되, 예시는 시험 문항과 겹치지 않게 새로 씀
채점문자열 대조 (LLM 채점 없음)새 값만 → 맞음, 옛 값만 → 낡은 값, 둘 다 → 둘 다, ‘모름’ → 기권
비교 조건은 다섯입니다. 단순 RAG를 기권 허용과 답 강제로 한 번씩, 그리고 논문에 없는 조건 하나를 더했습니다. RAG에 기록 순서만 붙인 것입니다. 검색된 문장마다 "[기록 37]"처럼 들어온 순번을 달고, 지시문에 "같은 대상에 값이 여럿이면 가장 나중에 기록된 값이 지금 값"이라는 한 문장을 더했습니다. 문장 속 표지가 아니라 시스템이 원래 아는 메타데이터라 표지 없음 불변식을 어기지 않습니다. 마지막 두 조건은 결정적 대체(MemStrata 방식)를 기권 허용과 답 강제로 돌린 것입니다.
결과 ①: 두 값이 함께 오면 9B 모델은 이렇게 답한다
먼저 검색 단계입니다. 30개 질문마다 옛 문장과 새 문장의 질문 유사도 차이는 평균 0.009, 가장 큰 경우도 0.04였습니다. 오히려 옛 문장이 더 높은 점수를 받은 경우가 21개였습니다. 두 문장은 30개 모두에서 상위 5개 안에 함께 들어왔습니다.
조건
새 값
옛 값
둘 다 말함
기권
단순 RAG · 기권 허용
1
0
11
18
단순 RAG · 답 강제
10
12
7
1
RAG + 기록 순서 표시 (논문에 없는 조건)
26
1
3
0
결정적 대체 · 기권 허용
25
1
4
0
결정적 대체 · 답 강제
26
1
3
0
코어닷투데이 실측, 2026-10-31. 30문항, qwen3.5:9b + BGE-M3.
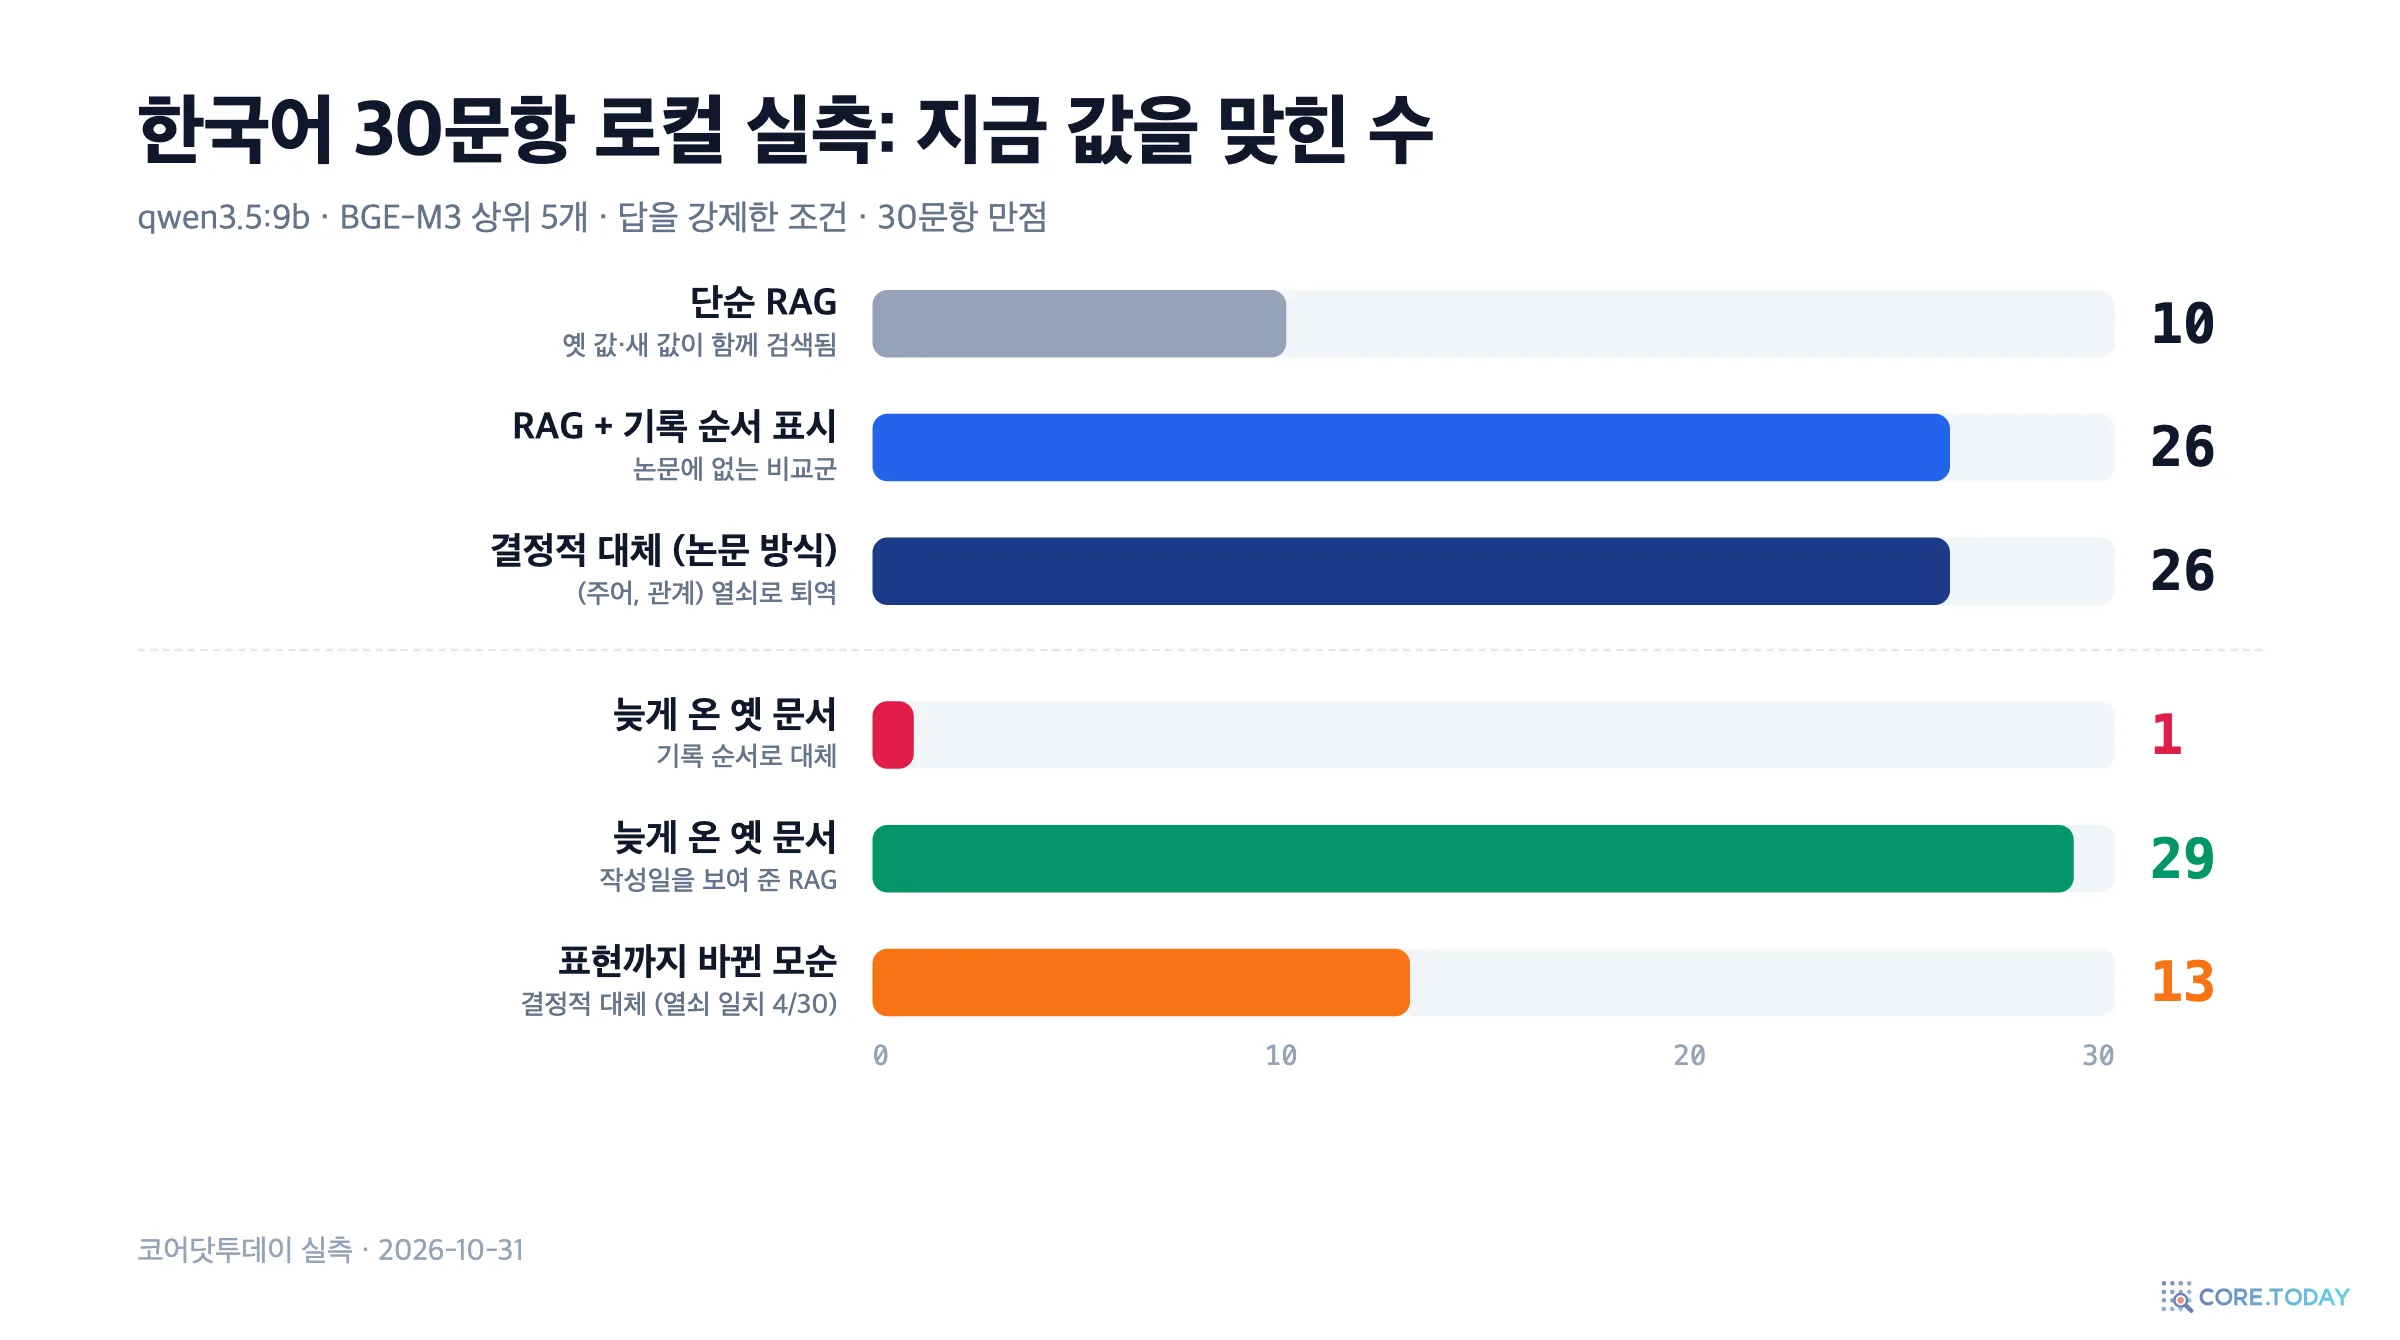
논문의 그림이 한국어에서도 그대로 나옵니다. 기권을 허락한 단순 RAG는 30문항 중 18개에 "모름"이라 답했고, 11개는 "8000, 8080"처럼 두 값을 다 늘어놓았습니다. 새 값 하나만 말한 것은 단 1개입니다. 답을 강제하자 12개(40%)를 옛 값으로 답했습니다. 논문이 보고한 15~40%의 상단입니다. 한빛상사 대표이사를 물으면 "김정우"(옛 대표), 본사 주소를 물으면 옛 주소, 무료 배송 기준을 물으면 "3만 원"(옛 기준)이었습니다. 하나만 고르라고 지시했는데도 7개는 끝까지 두 값을 함께 말했습니다. 사용자 입장에서는 이것도 답이 아닙니다.
결정적 대체는 26개를 맞혔고 옛 값은 1개였습니다. 논문의 '거의 0%'에 가깝습니다. 그런데 남은 4개의 실패가 흥미롭습니다. 30개 중 열쇠가 제대로 맞아 옛 값이 퇴역한 것은 25개였습니다. 값만 바뀐 같은 문장인데도 다섯 번 어긋났습니다. 네 번은 모델이 문장을 아예 세 칸으로 만들지 않았고(그중 하나가 논문 추출 프롬프트의 첫 예시를 그대로 번역한 get_user_by_id 문장입니다), 한 번은 "process_payment(amount) 함수는 토스페이먼츠 API로 결제를 청구한다"에서 값으로 함수 이름이 아니라 '토스페이먼츠 API'를 골랐습니다. 주어에 함수 이름이 들어가 버렸으니 이름이 바뀌면 열쇠도 바뀝니다. 논문이 경고한 바로 그 실수입니다.
그리고 가장 놀라운 줄은 가운데입니다. RAG에 기록 순서만 붙여 줘도 26개를 맞혔습니다. 결정적 대체와 같은 점수입니다. 같은 9B 모델이 "[기록 12] 결제 서비스는 8000번 포트…"와 "[기록 67] 결제 서비스는 8080번 포트…"를 보고 큰 번호를 고르는 일은 어렵지 않았습니다. 논문은 RAG가 "구조상" 이 실패를 피할 수 없다고 썼지만, 적어도 이 깨끗한 조건에서는 시간 정보 한 줄이 차이의 대부분을 메웠습니다. 결정적 대체가 남기는 장점은 따로 있습니다. 매 질문마다 모델의 추론에 기대지 않고, 퇴역한 값이 아예 문맥에 들어가지 않으며(8부의 Ground Truth First 결과를 떠올려 보세요), 같은 사실이 열 번 바뀌어도 상위 k개를 옛 버전들이 차지하지 않는다는 점입니다. 성능의 원천이 '대체'라기보다 '시간 정보를 쓴 것'에 더 가깝다는 것이 이 실측의 첫 번째 교훈입니다.
논문 벤치마크에는 세 가지 깨끗한 조건이 있습니다. 들어온 순서가 세상의 순서와 같고, 옛 문장과 새 문장의 표현이 같고, 문장마다 바뀌는 값이 하나뿐입니다. 이 조건을 하나씩 풀어 봤습니다.
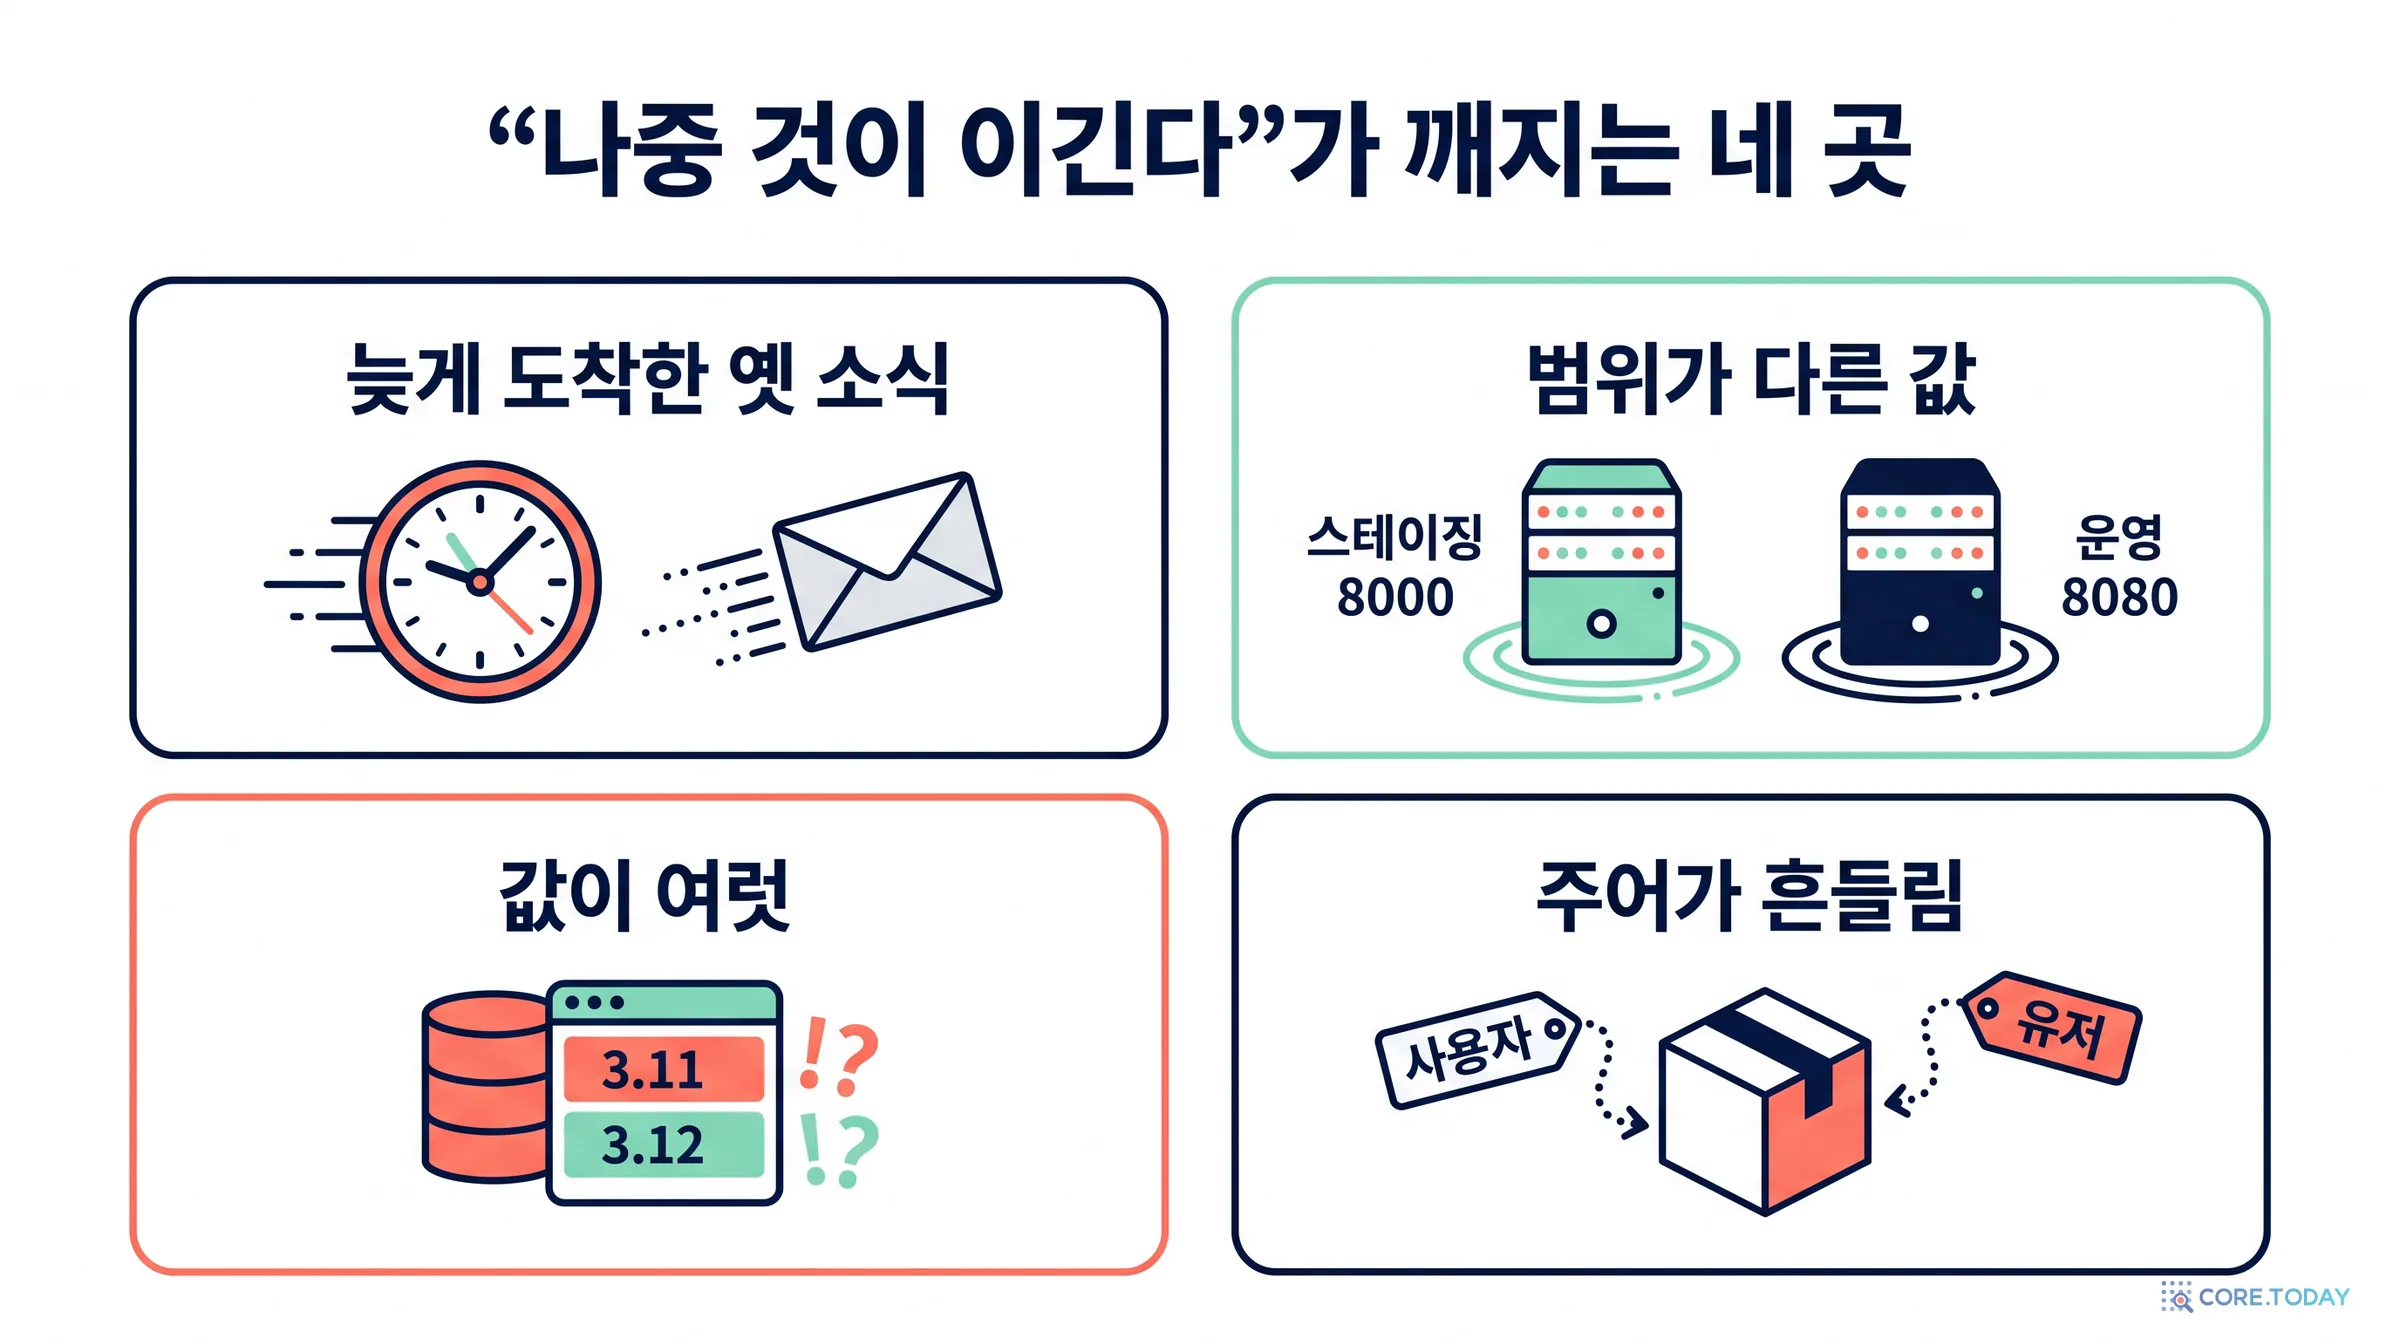
늦게 도착한 옛 문서. 새 값 30개를 먼저 넣고 옛 값 30개를 나중에 넣었습니다. 옛 위키를 이관하거나 지난 이슈를 한꺼번에 색인할 때 실제로 생기는 순서입니다. 들어온 순서로 대체하는 규칙은 30개 중 26개에서 옛 값으로 지금 값을 퇴역시켰습니다(맞힌 것 1개). RAG에 기록 순서를 붙인 조건도 같은 함정에 빠져 3개만 맞혔습니다. 해법은 시간의 출처를 바꾸는 것입니다. 각 문장에 문서 작성일(옛 값 3월 2일, 새 값 5월 9일)을 붙이고 "작성일이 가장 늦은 값이 지금 값"이라고 하자 RAG는 29개를 맞혔습니다. 결정적 대체도 비교 기준을 들어온 순서에서 작성일로 바꾸자 26개로 돌아왔습니다(남은 4개는 열쇠 추출 실패). 원장에 valid_from 칸이 있다는 것과, 그 칸을 세상 시각으로 채운다는 것은 전혀 다른 이야기입니다.
표현까지 바뀐 모순. 옛 값은 원래 문장으로, 새 값은 다른 표현으로 넣었습니다. "결제 서비스는 8000번 포트에서 요청을 받는다" 다음에 "결제 서비스가 리슨하는 포트는 8080번이다"가 오는 식입니다. 사람에게는 명백한 모순이지만 열쇠가 맞은 것은 30개 중 4개였습니다. 나머지 26개는 모델이 뽑은 주어 문자열이 달라("결제서비스|포트는" 대 "결제서비스가리슨하는포트|번호는") 새 사실로 저장됐고, 옛 값과 새 값이 RAG처럼 나란히 남았습니다. 답을 강제하자 17개를 옛 값으로 답했습니다. 논문이 '자가 틀렸다'며 격리한 산문 벤치마크(추출 44%)에서 일어난 일이 우리 데이터에서도 그대로 재현된 셈입니다.
범위가 다른 두 값. "스테이징 환경의 결제 서비스는 8000번", "운영 환경의 결제 서비스는 8080번"처럼 둘 다 참인 값 6쌍을 넣었습니다. 범위를 열쇠에서 빠뜨리면 하나가 다른 하나를 잘못 퇴역시킵니다. 다행히 잘못된 대체는 0건이었고 12문항을 모두 맞혔습니다. 다만 한 쌍에서 운영 쪽 열쇠가 '결제서비스|포트는'으로 뽑혀 '운영 환경'이 빠졌습니다. 나중에 범위 없이 "결제 서비스는 9000번 포트에서 요청을 받는다"는 문장이 들어오면 운영 값만 조용히 퇴역할 것입니다. 지금은 맞았지만 지뢰가 묻혀 있습니다.
한 문장에 값이 여럿. "이 라이브러리는 파이썬 3.10과 3.11을 지원한다"가 "3.11과 3.12를 지원한다"로 바뀌는 식의 6쌍입니다. 추출 프롬프트는 값이 여러 개인 문장은 세 칸으로 만들지 말라고 지시하므로 6개 모두 열쇠가 없었고, 결정적 대체는 단순 RAG와 똑같이 두 문장을 합쳐 "3.10, 3.11, 3.12"처럼 옛 값을 섞어 답했습니다. 논문 부록에는 값마다 세 칸을 따로 만드는 다중 값 추출기(C.2)가 있지만 본 평가에는 쓰이지 않았습니다. 그리고 "3.10과 3.11"에서 "3.11과 3.12"로 바뀐 것은 값 하나의 교체가 아니라 집합의 변화입니다. 3.11은 남고 3.10은 빠지고 3.12가 들어왔습니다. 세 칸 열쇠 하나로는 표현할 수 없는 바뀜입니다.
결국 모든 것은 쓰는 순간의 판정, 곧 "이 새 문장은 이미 있는 것의 중복인가, 모순인가, 새 사실인가"로 돌아옵니다. 아래 퀴즈에서 직접 문지기가 되어 보세요. 같은 문항을 유사도 규칙과 열쇠 규칙도 함께 풉니다. 사람에게는 쉬운 이 판정이 기계에게는 왜 어려운지, 그리고 두 규칙이 서로 다른 곳에서 틀린다는 것이 보일 것입니다.
실측이 말해 주는 것
①
문제는 진짜다
한국어에서도 두 값은 늘 함께 검색되고(유사도 차이 평균 0.009), 답을 강제한 9B 모델은 40%를 옛 값으로 답했다. 유사도는 바뀐 값을 가려내지 못한다(AUROC 0.34~0.59).
②
해법의 핵심은 '시간 정보'
결정적 대체(26/30)와 기록 순서를 붙인 RAG(26/30)가 같았다. 늦게 온 옛 문서에서는 둘 다 무너졌고(1·3/30), 작성일을 쓰자 둘 다 회복했다(29·26/30). 무엇이 '나중'인지가 규칙보다 먼저다.
③
병목은 열쇠 추출
같은 틀 25/30, 표현이 바뀌면 4/30, 값이 여럿이면 0/6. 대체 규칙은 결정적이지만, 그 규칙에 들어갈 열쇠를 만드는 것은 여전히 확률적인 언어 모델이다.
이 실측의 한계도 적어 둡니다. 30문항은 작고, 시나리오와 정답은 코어닷투데이가 직접 만들었습니다. 저장소에 사실이 90개뿐이라 두 값이 늘 상위 5개에 함께 들어왔는데, 수천 개가 쌓인 실제 저장소에서는 같은 사실의 여러 버전이 상위 k개를 다 차지하거나 새 값이 밀려나는 등 다른 모습이 나올 수 있습니다. 모델도 9B 하나만 썼습니다. 그래도 방향은 분명합니다. 논문의 문제 제기는 맞고, 해법의 무게중심은 논문이 강조한 '결정적 규칙'보다 그 앞단, 곧 열쇠를 어떻게 뽑고 시간을 어디서 가져오는가에 있습니다.
8부. 비판적으로 읽기: 이 논문이 말하지 않는 것
MemStrata 논문은 한계를 숨기지 않는 편입니다. 그래도 독자가 직접 짚어야 할 곳이 여럿 있습니다. 논문 자체, 저자의 후속 논문, 그리고 위의 실측을 함께 놓고 정리합니다.
① 추출 프롬프트의 예시가 곧 벤치마크 문항이다
부록 C.1의 추출 프롬프트에는 예시가 세 개 있습니다. 첫째가 "The function get_user_by_id(uid) looks up a user record by primary key in the users table.", 둘째가 "The SESSION_TIMEOUT setting is 1800 seconds in this project's config.toml."입니다. 그런데 부록 B.3의 함수 이름 벤치마크 첫 문항이 바로 그 get_user_by_id 문장이고, B.4 설정 값 벤치마크 첫 문항이 SESSION_TIMEOUT 1800초입니다. 프롬프트가 시험 문제의 모범 답안을 품고 있는 셈입니다. 같은 틀(값만 바뀐 같은 문장)의 나머지 문항에서도 추출이 쉬워지는 것은 당연합니다.
이것이 결과를 무효로 만들지는 않습니다. 대체 규칙 자체는 추출만 맞으면 결정적으로 동작하니까요. 다만 논문이 보고한 '깨끗한 대체 약 97%'는 이 조건에서 나온 숫자입니다. 코어닷투데이가 벤치마크 문항과 겹치지 않는 예시로 한국어 프롬프트를 만들어 9B 모델로 돌렸을 때는 같은 틀 30개 중 25개(83%)만 열쇠가 맞았습니다.
② 산문에서는 RAG에 진다: 격리된 벤치마크
논문 부록 B.8에는 '격리된 벤치마크'가 있습니다. 바뀐 사실을 자유로운 산문 안에 넣은 fair_contradiction입니다. 여기서는 추출기가 열쇠를 제대로 뽑은 비율이 약 44%에 그쳤고(값이 여럿인 문장, 문자열 변형), MemStrata는 0.62로 LLM 재정렬 RAG의 0.74보다 낮았습니다. 추출하지 못한 56%에서는 대체가 아예 작동하지 않기 때문입니다. 저자는 이 벤치마크를 "자가 틀렸다"며 본 결과에서 뺐습니다. 추출 품질을 재는 것이지 대체 메커니즘을 재는 게 아니라는 이유입니다.
논리적으로는 맞는 말입니다. 그러나 사용자가 겪는 것은 메커니즘이 아니라 시스템입니다. 실제 회의록과 대화는 산문입니다. 저자의 8월 후속 논문은 SWE-bench Lite/Verified 이슈 707개에서 깨끗한 단일 값 전환 130개를 골라 평가했는데(MemStrata 0.91, RAG 0.57~0.59), 같은 논문이 실제 수정 중 깨끗한 단일 값 전환은 약 18%뿐이라고 인정합니다. 나머지 82%의 변화는 이 방식의 정문으로 들어오지 않습니다.
③ '나중에 들어온 것'이 '나중에 참이 된 것'은 아니다
논문의 시간은 들어온 순서입니다. 7부의 실측처럼 옛 문서를 늦게 들여오면 기록 순서 대체는 옛 값을 새 값으로 올리고 진짜 새 값을 퇴역시킵니다. 이것은 가정의 문제가 아니라 흔한 운영 상황입니다. 위키 이관, 옛 이슈 일괄 색인, 백업 복원, 과거 메일함 연결이 모두 '늦게 도착한 옛 사실'을 만듭니다.
저자 자신이 10월 초에 낸 후속 논문 「옛 사실이 돌아올 때」가 이 약점을 정면으로 다룹니다. 같은 130개 전환에서 정체 기반 시간 기억은 98.5%였지만, 옛 문장을 글자 그대로 한 번 다시 읽히자 10.8%로 떨어지고 낡은 값 비율이 88.5%로 치솟았습니다. 옛 문장이 다시 들어오면 '같은 열쇠의 새 값'으로 보고 지금 값을 퇴역시키기 때문입니다. 퇴역한 값의 재활성화를 막는 장치를 넣으면 97.7%로 회복하지만, 그러면 정당한 되돌리기(버전을 일부러 내린 경우)를 알아챌 수 없게 됩니다. 변경의 출처 정보 없이는 '옛 문서를 다시 읽은 것'과 '정말로 되돌린 것'을 가를 방법이 없다는 것이 저자의 결론입니다.
④ 빠진 비교군: 시각을 붙인 RAG
논문은 RAG가 "시간 모델이 없어서 구조상 피할 수 없다"고 씁니다. 그런데 RAG 저장소에도 각 조각이 언제 들어왔는지는 기록되어 있습니다. 그 시각을 문맥에 함께 넣고 "나중 것이 지금 값"이라고 알려 주는 것은 거의 공짜입니다. 논문의 표지 없음 불변식은 문장 속 표지를 금지할 뿐, 시스템이 이미 아는 메타데이터까지 금지하지는 않습니다. 7부의 실측에서 이 단순한 비교군은 같은 9B 모델로 옛 값 오답을 30개 중 12개에서 1개로 줄였고, 결정적 대체와 같은 26개를 맞혔습니다. 공정한 비교라면 이 조건이 들어갔어야 합니다. 그래야 성능이 '결정적 대체'에서 왔는지 '시간 정보를 쓴 것' 자체에서 왔는지 가를 수 있습니다.
⑤ 작은 숫자와 표의 어긋남
바뀐 지식 벤치마크는 20~30문항이라 0.05가 문항 하나입니다. 신뢰구간은 넓습니다.
초록과 서론은 AUROC 0.59를 "모순과 중복을 가르는" 성능이라고 쓰지만, 5.1절은 "중복과 나머지를 가르는" 성능이라고 씁니다. 나머지에는 병합·새 사실이 섞여 있어 두 설명은 같은 숫자가 아닙니다.
'임베딩 바닥값 약 2.1초'는 질문 하나를 임베딩하는 데 쓰기에는 깁니다. 논문 환경에서의 측정값으로 읽어야지 일반적인 지연으로 옮기면 안 됩니다.
기억 크기 표에서 '기억 없음' 조건에 활성 사실이 47개, 16개로 찍혀 있는 등 정리가 덜 된 칸이 있습니다. PDF 첫 쪽에는 "이중 맹검 제출 전에 저자 정보를 지우고 모든 그림을 원본 파일에서 다시 만들 것"이라는 메모가 그대로 남아 있습니다.
⑥ 재현할 수 없다
논문 초록은 "하네스, 프롬프트, 데이터셋, 재현 가능한 평가 절차를 공개한다"고 쓰지만, 2026년 10월 31일 현재 arXiv에는 부속 파일이 없고 벤치마크와 하네스를 담은 공개 저장소도 찾을 수 없었습니다. 제품 엔진은 PyPI의 memstrata-coder 패키지로 배포되는데 라이선스가 독점(Proprietary)이고, 저자의 GitHub에는 "소스는 비공개"라고 적힌 바이너리 저장소가 있습니다. 해커뉴스에는 저자 계정이 올린 글 몇 개가 1~2점에 머물러 있고, 독립적인 재현이나 논평은 찾지 못했습니다. 논문 속 숫자를 바깥에서 검증할 길이 지금은 없습니다. 7부에서 한국어 데이터를 새로 만들어 핵심 주장만 따로 잰 이유입니다.
⑦ 퇴역한 값을 '보여 주면' 오히려 나빠진다
반대 방향의 증거도 있습니다. 2026년 7월의 「Ground Truth First」(arXiv 2607.21962)는 사실의 유효 기간을 먼저 정하는 기억을 평가하면서, 이중 시간 간선을 답변 모델에게 그대로 보여 주면 과거 지식 갱신 문항에서 81개 중 72개를 맞혀, 이력을 산문으로 녹여 보여 준 경우(79개)보다 나빴다고 보고합니다. 퇴역한 값이 답변 모델의 눈에 다시 들어가기 때문입니다. MemStrata가 읽기 경로에서 퇴역한 행을 거르는 것은 옳은 선택이고, 앞으로 '그 시점 기준' 질문을 지원할 때도 같은 원칙이 필요합니다. 원장은 남기되, 질문 시점에 유효하지 않은 값은 모델에게 보여 주지 않는 것입니다.
그래도 이 논문이 맞힌 것
비판을 늘어놓았지만 핵심 주장 세 가지는 7부의 한국어 실측에서도 살아남았습니다. 유사도는 바뀐 값을 가려내지 못하고(다섯 모델 AUROC 0.34~0.59), 두 값이 공존하면 모델은 기권하거나 옛 값을 고르거나 둘을 섞으며, 열쇠만 맞으면 결정적 대체는 그 실패를 깨끗이 없앱니다. 이 논문의 진짜 메시지는 "MemStrata가 최고"가 아니라 "바뀐 사실을 다루는 일은 검색의 문제가 아니라 쓰기의 문제"라는 데 있습니다. 그리고 그 쓰기의 성패는 대체 규칙보다 열쇠를 뽑는 추출에, 그리고 '무엇이 나중인가'를 정하는 시간 정보에 달려 있습니다.
2026년의 코딩 에이전트는 세션을 넘어 기억을 들고 다닙니다. 프로젝트 지침 파일, 자동 메모리, 대화 요약, MCP 기억 서버가 모두 '지난번에 알게 된 것'을 다음 세션에 넘겨줍니다. 그 기억 중 상당수가 이 논문이 다루는 종류입니다. 포트, 경로, 명령어, 함수 이름, 버전. 그리고 이것들은 코드베이스에서 가장 빨리 바뀌는 사실입니다.
언어 모델이 낡은 API를 쓰는 문제는 이미 잘 측정되어 있습니다. ICSE 2025에 실린 연구(「LLMs Meet Library Evolution」)는 일곱 개 모델에 파이썬 라이브러리 8개의 API 145쌍을 시험해, 폐기된 API를 쓰는 비율이 전체 25~38%, 주변 코드가 이미 낡았으면 70~90%, 주변 코드가 최신이어도 9~18%라고 보고했습니다. 2026년 4월의 「When LLMs Lag Behind」는 실제 API 변경 270건에서 모델이 만든 코드가 문서 없이 목표 환경에서 돌아간 비율이 42.55%, 구조화된 문서를 줘도 최대 66.36%였다고 씁니다. 모델 가중치에 박힌 지식이 낡는 문제와, 기억 저장소에 쌓인 지식이 낡는 문제는 같은 증상의 두 원인입니다. MemStrata가 다루는 것은 후자입니다. 가중치는 다시 학습해야 고치지만 기억은 쓰기 규칙으로 고칠 수 있습니다.
회사와 공공의 사실: 누가 '지금 값'을 정하나
조직의 사실도 바뀝니다. 대표이사, 담당자, 전화번호, 영업시간, 요금, 정책. 2024년 캐나다의 Moffatt 대 에어캐나다 사건은 자주 'AI가 낡은 정책을 안내한 사건'으로 소개되지만, 판결문을 보면 정확히는 같은 웹사이트의 두 출처가 서로 달랐던 사건입니다. 챗봇은 여행 후 90일 안에 유족 할인을 신청할 수 있다고 했고, 챗봇이 링크한 정책 페이지는 여행 후에는 적용되지 않는다고 했습니다. 재판부는 "챗봇이 스스로 책임지는 별개의 법적 주체라는 주장은 놀랍다"며 항공사에 812.02캐나다달러 배상을 명했습니다. 이것은 낡은 사실이라기보다 두 값 중 무엇이 권위를 갖는지 정한 규칙이 없었던 사건입니다. 그리고 바로 그 점에서 이 글의 주제와 닿아 있습니다. 두 값이 공존할 때 무엇이 이기는지 시스템이 정해 두지 않으면, 대가는 사용자가 치릅니다.
한국에서도 비슷한 긴장이 보입니다. 2026년 7월 헤럴드경제는 시민들이 생성형 AI의 답을 들고 공무원과 다투는 현장을 보도하며, "법령은 하루에도 많게는 수십 건씩 개정되기 때문에 민간 AI 업체가 최신성을 지속해서 유지하기 쉽지 않다"는 법제처 관계자의 말을 전했습니다. 공공 영역의 '지금 값'은 개정 순서가 아니라 시행일이 정합니다. 공포는 오늘 됐지만 시행은 6개월 뒤인 조항, 소급 적용되는 조항, 경과 규정이 붙은 조항. 들어온 순서로 대체하는 규칙은 여기서 바로 틀립니다. 코어닷투데이의 사실탐색기 v2가 '가장 최근 문서'가 아니라 '누가 확정했는가'를 기준으로 사실을 대체하고, 근거가 부족하면 기권하도록 설계한 것도 같은 이유입니다. 공포문과 회의록과 보도자료가 같은 사실에 대해 서로 다른 날짜에 서로 다른 값을 말할 때, 순서는 권위가 아닙니다.
에이전트 기억 제품들은 어디로 가고 있나
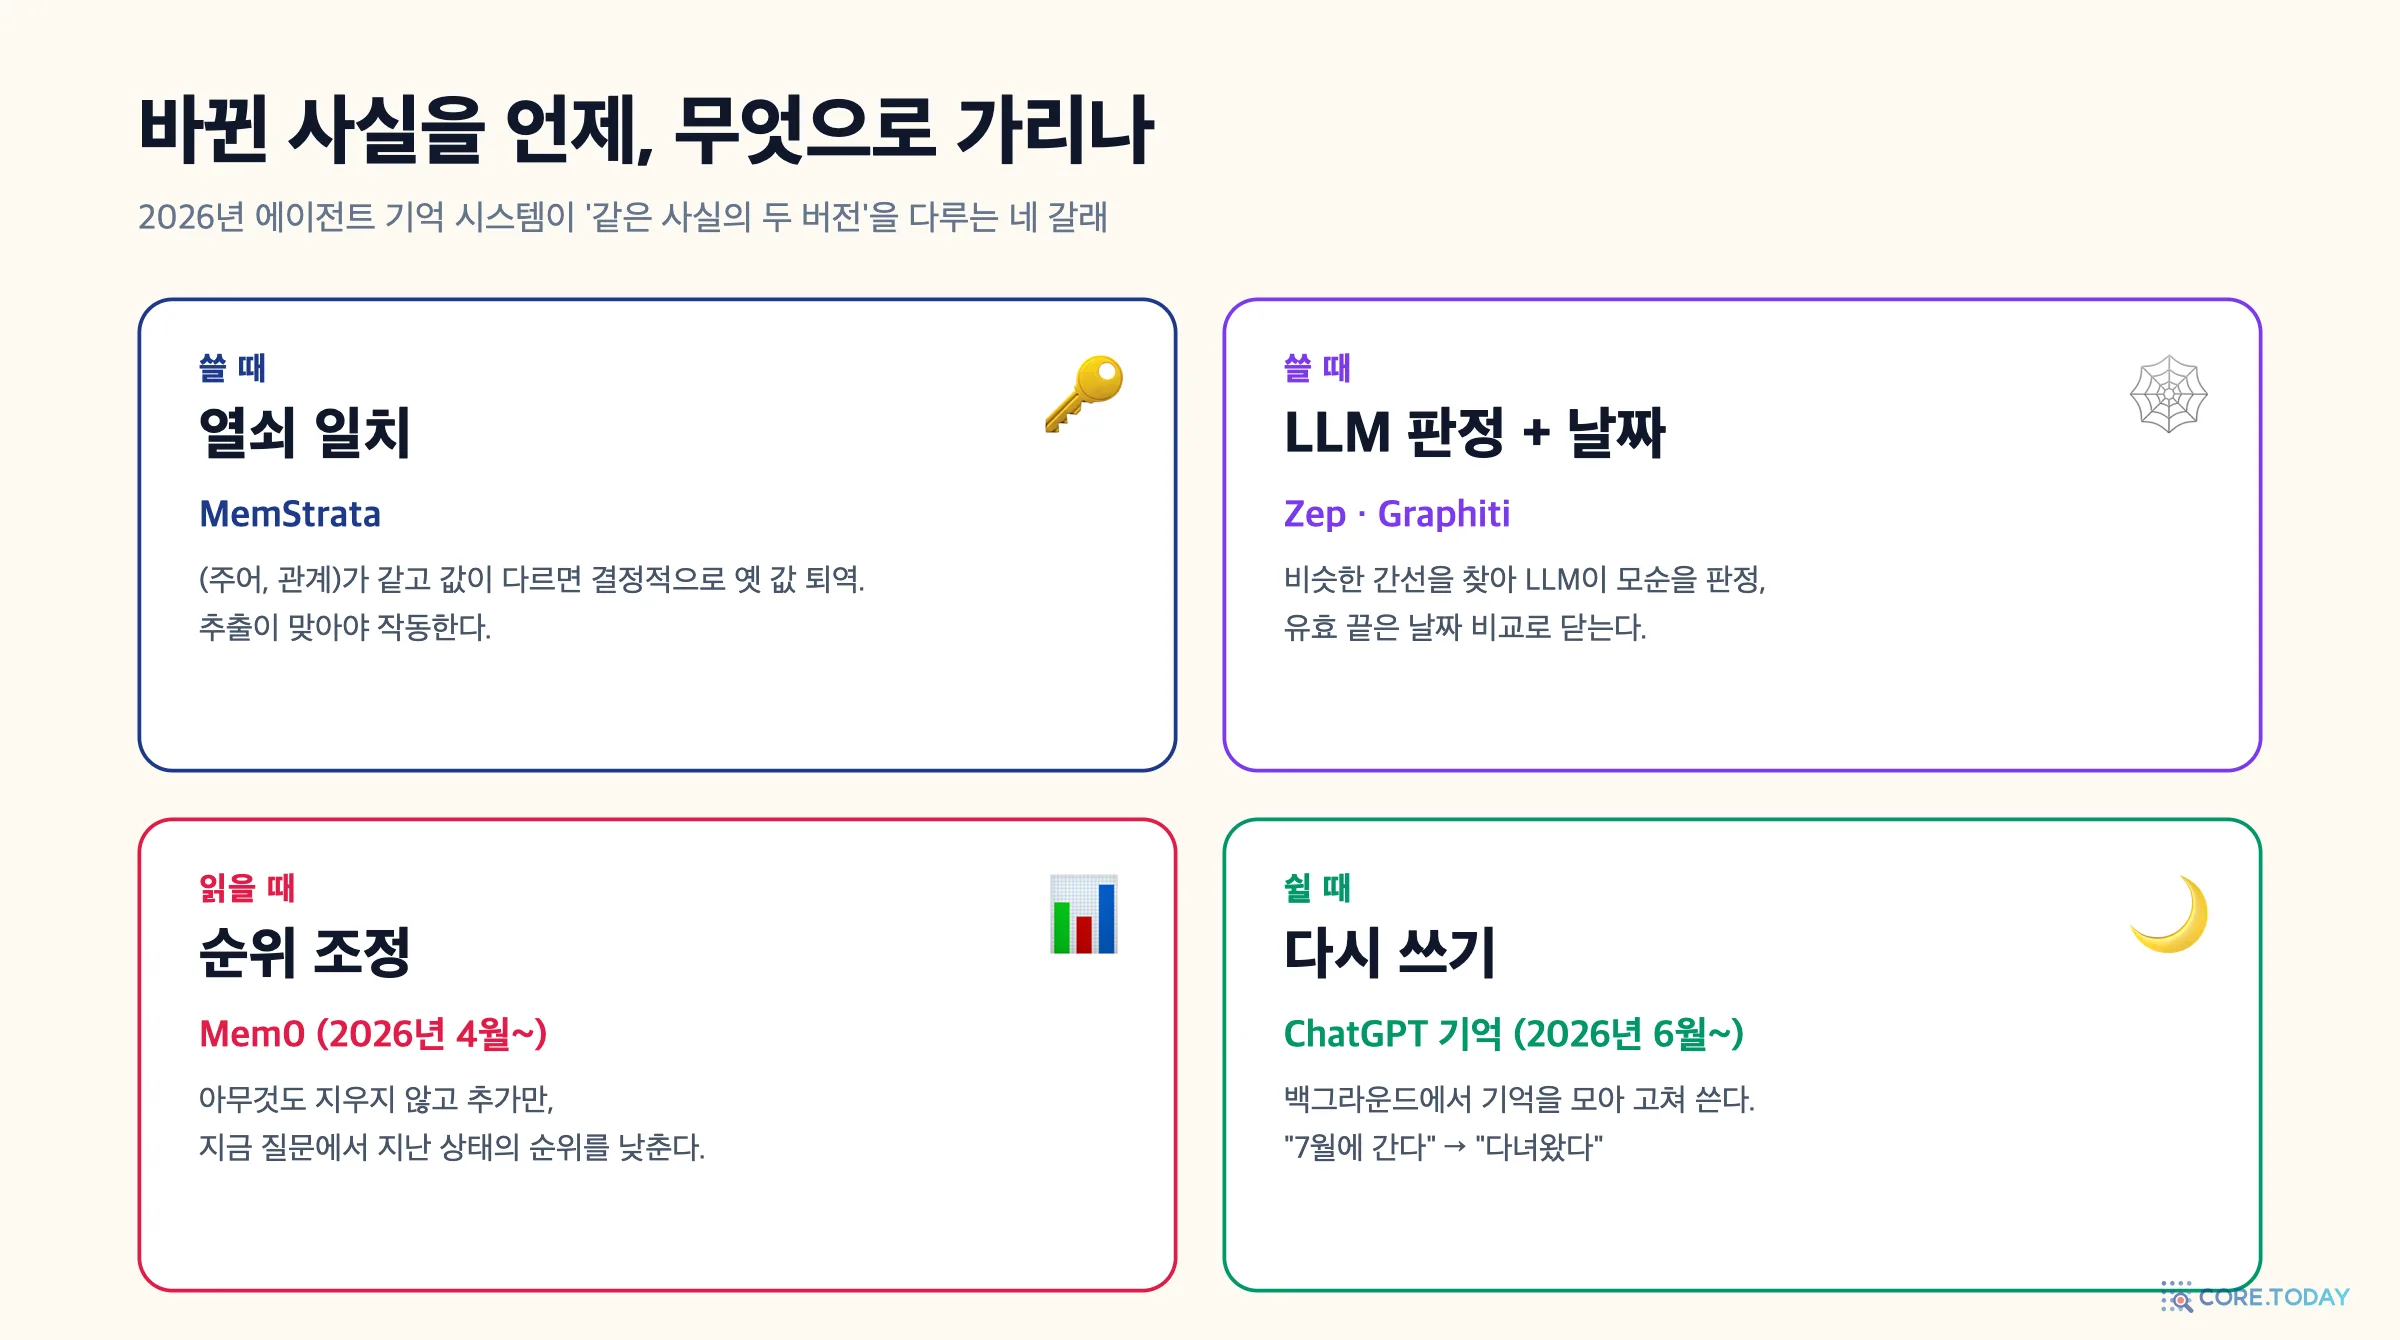
2026년의 주요 기억 제품을 이 논문의 질문, 곧 "바뀐 사실을 언제, 무엇으로 판정하는가"로 나눠 보면 방향이 흥미롭게 갈립니다.
시스템
판정 시점
무엇이 모순인지 찾는 법
옛 값의 처리
MemStrata (논문)
쓸 때
(주어, 관계) 열쇠 일치, 결정적
기간을 닫고 검색에서 제외
Zep / Graphiti
쓸 때
유사 간선 검색 + LLM이 모순 판정, 날짜 비교는 결정적
invalid_at으로 기간 닫음
Mem0 (2026년 4월 이후)
읽을 때
쓸 때는 판정하지 않음(추가 전용), 상태 열쇠·시간 서명으로 순위 조정
지우지 않고 event_end 표시, 지금 질문에서 순위를 낮춤
Supermemory
쓸 때
기억 사이 관계를 '갱신·확장·파생'으로 분류
isLatest로 지금 값 표시, 이력은 감사용으로 남김
Letta
에이전트가 편집할 때
에이전트 자신의 판단
git 기반 기억 파일, 편집마다 커밋
ChatGPT 기억 (2026년 6월 개편)
백그라운드 정리
모델이 여러 대화를 모아 다시 씀
시간이 지나면 고쳐 씀("7월에 간다"→"다녀왔다")
각 제품 문서·변경 기록 기준(2026-10-31 확인). Mem0는 2025년 논문의 추가·갱신·삭제·무시 방식에서 2026년 4월 추가 전용으로 바뀌었다.
가장 눈에 띄는 것은 Mem0의 방향 전환입니다. 2025년 논문에서는 LLM이 새 기억마다 추가·갱신·삭제를 판정했지만, 2026년 4월 새 알고리즘에서는 "아무것도 덮어쓰거나 지우지 않는" 추가 전용으로 바꾸고, 지금 값을 고르는 일을 검색 시점의 순위로 넘겼습니다. 5월에는 진행 중인 상태에 '상태 열쇠'를 두고 새 상태가 오면 옛 기억에 event_end를 찍는 시간 추론을 더했습니다. 쓰기 시점에 LLM 판정을 믿지 않게 됐다는 점에서는 MemStrata와 같은 진단이고, 그 해법을 읽기 시점으로 미뤘다는 점에서는 반대 방향입니다. 그리고 '상태 열쇠'는 결국 MemStrata의 (주어, 관계) 열쇠와 같은 생각입니다. 업계가 서로 다른 길로 같은 장치에 도착하고 있습니다.
연구 쪽 평가도 이 문제로 모이고 있습니다. LongMemEval(ICLR 2025)은 500문항 중 78문항을 '지식 갱신' 범주로 두었고, 저자들은 이 범주의 실패 상당수가 검색기가 새 값은 찾았는데 그것이 대체한 옛 값을 함께 찾지 못해서 생긴다고 분석했습니다. 바뀌었다는 사실 자체를 모르면 새 값도 확신을 갖고 쓰지 못한다는 뜻입니다. 2026년 5월의 STALE 벤치마크는 새 정보가 옛 기억을 직접 반박하지 않으면서도 거짓으로 만드는 '암묵적 충돌'을 다루는데, 가장 좋은 모델이 55.2%에 그쳤습니다. "이사했다"는 말에 "집 주소는 이제 ○○"가 따라오지 않는 경우입니다. 열쇠 일치로는 잡을 수 없는 바뀜입니다.
그래서 2026년의 역할은
이 논문이 2026년에 갖는 의미는 '정답을 냈다'가 아니라 질문을 옮겼다는 데 있습니다. 2023~2025년의 에이전트 기억 논의는 주로 "얼마나 많이, 얼마나 오래 기억하나"였습니다. 긴 대화 회상 벤치마크가 표준이었고, 성능은 회상률로 쟀습니다. MemStrata는 "기억이 많아질수록 무엇이 지금 참인지가 흐려진다"는, 회상의 반대편 문제를 가장 단순한 장치로 보여 줬습니다. 그리고 그 장치가 데이터베이스가 1985년에 이미 정리한 두 시간, 1991년에 정리된 수정과 갱신의 구분, 위키데이터가 매일 쓰는 순위 표시와 같은 계보에 있다는 것도요.
10부. 바뀌는 사실을 다루는 기억을 만들 때: 열 가지 점검표
논문과 실측, 그리고 반세기의 계보에서 건진 것을 실무 점검표로 정리합니다. 에이전트 기억을 직접 만들거나, 기억 제품을 고르거나, RAG 시스템을 운영하는 분이라면 하나씩 확인해 보세요.
1지우지 말고 기간을 닫는다. 바뀐 사실의 옛 값은 틀린 값이 아니라 '그때의 값'입니다. valid_to와 superseded_by를 남겨 두면 감사·되돌리기·과거 시점 질문이 모두 가능해집니다.
2퇴역한 값은 답변 모델에게 보여 주지 않는다. 원장에 남기는 것과 문맥에 넣는 것은 다릅니다. 퇴역한 행을 함께 보여 주면 오히려 낡은 값이 되살아납니다(Ground Truth First 72/81 대 79/81).
3무엇이 중복이고 무엇이 모순인지를 유사도에 묻지 않는다. 값만 바뀐 문장은 같은 뜻의 다른 표현보다 더 비슷합니다(한국어 다섯 모델 AUROC 0.34~0.59). '0.95 넘으면 중복' 규칙은 새 값부터 버립니다.
4열쇠에 범위를 강제한다. 환경(스테이징·운영), 지점, 회원 등급, 연도, 언어처럼 같은 주어를 여러 값으로 나누는 말은 열쇠에서 빠지면 안 됩니다. 추출 뒤 원문의 범위 단어가 열쇠에 남았는지 규칙으로 검사합니다.
5열쇠를 문자열이 아니라 정체로 맞춘다. "포트는"과 "포트 번호는"이 다른 열쇠가 되지 않도록 주어·관계를 통제 어휘나 엔티티 ID로 정규화합니다. 표현이 바뀌면 열쇠 일치가 30개 중 4개로 떨어졌습니다.
6값이 여럿인 문장은 쪼개고, 집합의 변화는 따로 다룬다. "3.10과 3.11 지원"→"3.11과 3.12 지원"은 값 교체가 아니라 원소의 추가·삭제입니다.
7시간은 '들어온 순서'가 아니라 '참이 된 시각'에서 가져온다. 문서 작성일, 커밋 시각, 시행일, 공고일. 기록 순서는 옛 문서가 늦게 들어오는 순간 정반대로 작동합니다(30개 중 26개 역전).
8'관측'과 '변경'을 구별한다. 옛 문장을 다시 읽은 것과 값을 정말로 되돌린 것은 같은 문자열 순서로 보입니다. 변경의 출처(커밋, 공지, 회의록)를 함께 저장해야 가를 수 있습니다(저자 후속 논문: 재읽기 한 번에 정확도 98.5%→10.8%).
9평가는 표지 없이, 답을 강제해서도 한다. '[OUTDATED]' 같은 표지는 점수를 14~18점 부풀리고, 기권 허용 평가는 낡은 값 오답을 기권 뒤에 숨깁니다. 기권률·둘 다 말한 비율·낡은 값 비율을 따로 봅니다.
10시각을 붙인 RAG를 비교군에 넣는다. 가장 싼 해법이 생각보다 강합니다(30개 중 26개). 새 기억 구조의 이득은 이 비교군을 넘어선 만큼만 진짜입니다.
그리고 한 가지 더. 들어온 순서도, 작성일도, 열쇠도 모두 '무엇이 지금 참인가'를 정하는 규칙이지 진실 자체가 아닙니다. 공문서와 회의록, 공식 발표와 익명 관계자가 서로 다른 값을 말할 때 무엇이 이기는지는 순서가 아니라 권위의 문제입니다. 규칙으로 정할 수 없는 경우를 알아보고 "아직 확정되지 않았습니다"라고 기권하는 능력도 기억의 일부입니다.
맺으며: 기억이 많아질수록 '지금'이 흐려진다
1969년 매카시와 헤이스가 전화번호부 앞에서 막혔을 때 그들이 마주한 것은, 세상이 바뀌는 방식을 기록하는 일이 세상을 기록하는 일보다 훨씬 어렵다는 사실이었습니다. 반세기 뒤의 에이전트 기억도 같은 벽 앞에 서 있습니다. 2023~2025년 우리는 에이전트가 '얼마나 많이' 기억하는지에 몰두했고, 그 결과 기억 저장소는 같은 사실의 여러 버전이 나란히 쌓인 지층이 됐습니다. 많이 기억할수록 무엇이 지금 참인지는 오히려 흐려집니다.
MemStrata 논문은 이 문제를 아주 작은 실험과 아주 단순한 규칙으로 보여 줬습니다. 유사도는 바뀐 값을 가려내지 못한다. 두 값이 함께 있으면 모델은 기권하거나 옛 값을 고른다. 같은 열쇠의 새 값이 옛 값을 결정적으로 퇴역시키면 그 실패가 사라진다. 코어닷투데이의 한국어 실측은 이 세 문장을 모두 확인했고, 동시에 그 규칙이 서 있는 땅이 생각보다 좁다는 것도 보여 줬습니다. 표현이 바뀌면 열쇠가 맞지 않고, 옛 문서가 늦게 오면 순서가 뒤집히고, 값이 여럿이면 열쇠 자체가 없습니다. 그리고 시간 정보 한 줄을 붙인 평범한 RAG가 같은 점수를 냈습니다.
그래서 이 논문에서 가져갈 것은 MemStrata라는 제품보다 하나의 질문입니다. "이 기억 시스템은 같은 사실의 두 버전을 만났을 때, 무엇을 근거로 하나를 퇴역시키는가?" 유사도라면 위험하고, 들어온 순서라면 늦게 온 옛 문서에 약하고, 열쇠라면 추출에 달려 있고, 작성일이나 시행일이라면 그 날짜를 어디서 가져오는지가 다음 질문이 됩니다. 이 질문에 답하지 못하는 기억 시스템은 월요일 아침마다 누군가에게 8000번 포트를 알려 줄 것입니다.
출처와 함께 읽을 글
이 글이 다룬 논문
Neeraj Yadav, 「Temporal Validity in Retrieval Memory: Eliminating Stale-Fact Errors for AI Agents over Evolving Knowledge」, arXiv 2606.26511 (2026-06-25, v1). arxiv.org/abs/2606.26511
같은 저자의 후속: 「Temporal Validity on Real Software Histories」, arXiv 2608.20685 (2026-08). 링크 · 「When Old Facts Return: Re-Reads, Reverts, and the Limits of Temporal Memory」, arXiv 2610.07715 (2026-10). 링크
MemStrata 제품 사이트 memstrata.dev (엔진은 비공개, PyPI memstrata-coder는 독점 라이선스)
역사와 이론
J. McCarthy, P. J. Hayes, 「Some Philosophical Problems from the Standpoint of Artificial Intelligence」, Machine Intelligence 4, 1969. PDF · 스탠퍼드 철학 백과 「The Frame Problem」 링크
J. Doyle, 「A Truth Maintenance System」, Artificial Intelligence 12(3), 1979, 231–272.
C. Alchourrón, P. Gärdenfors, D. Makinson, 「On the Logic of Theory Change」, Journal of Symbolic Logic 50(2), 1985. · 스탠퍼드 철학 백과 「Logic of Belief Revision」 링크
H. Katsuno, A. Mendelzon, 「On the Difference between Updating a Knowledge Base and Revising It」, KR'91, 1991.
R. Snodgrass, I. Ahn, 「A Taxonomy of Time in Databases」, ACM SIGMOD 1985. 기술 보고서 PDF
K. Kulkarni, J.-E. Michels, 「Temporal Features in SQL:2011」, SIGMOD Record 41(3), 2012. 링크
Datomic 문서 링크 · R. Hickey, 「The Datomic Information Model」, InfoQ 2013 링크
M. Fowler, 「Event Sourcing」(2005) 링크 · 「Bitemporal History」(2021) 링크