Supersede기억 갱신지식 갱신대체supersession에이전트 메모리LongMemEval강화학습 환경GRPOverifiersPrime Intellect순행 간섭장기 기억
[특집] 옛 주소로 기차표를 끊는 AI — '기억 갱신 격차'를 재고, 훈련으로 줄인 Supersede 완전 해부
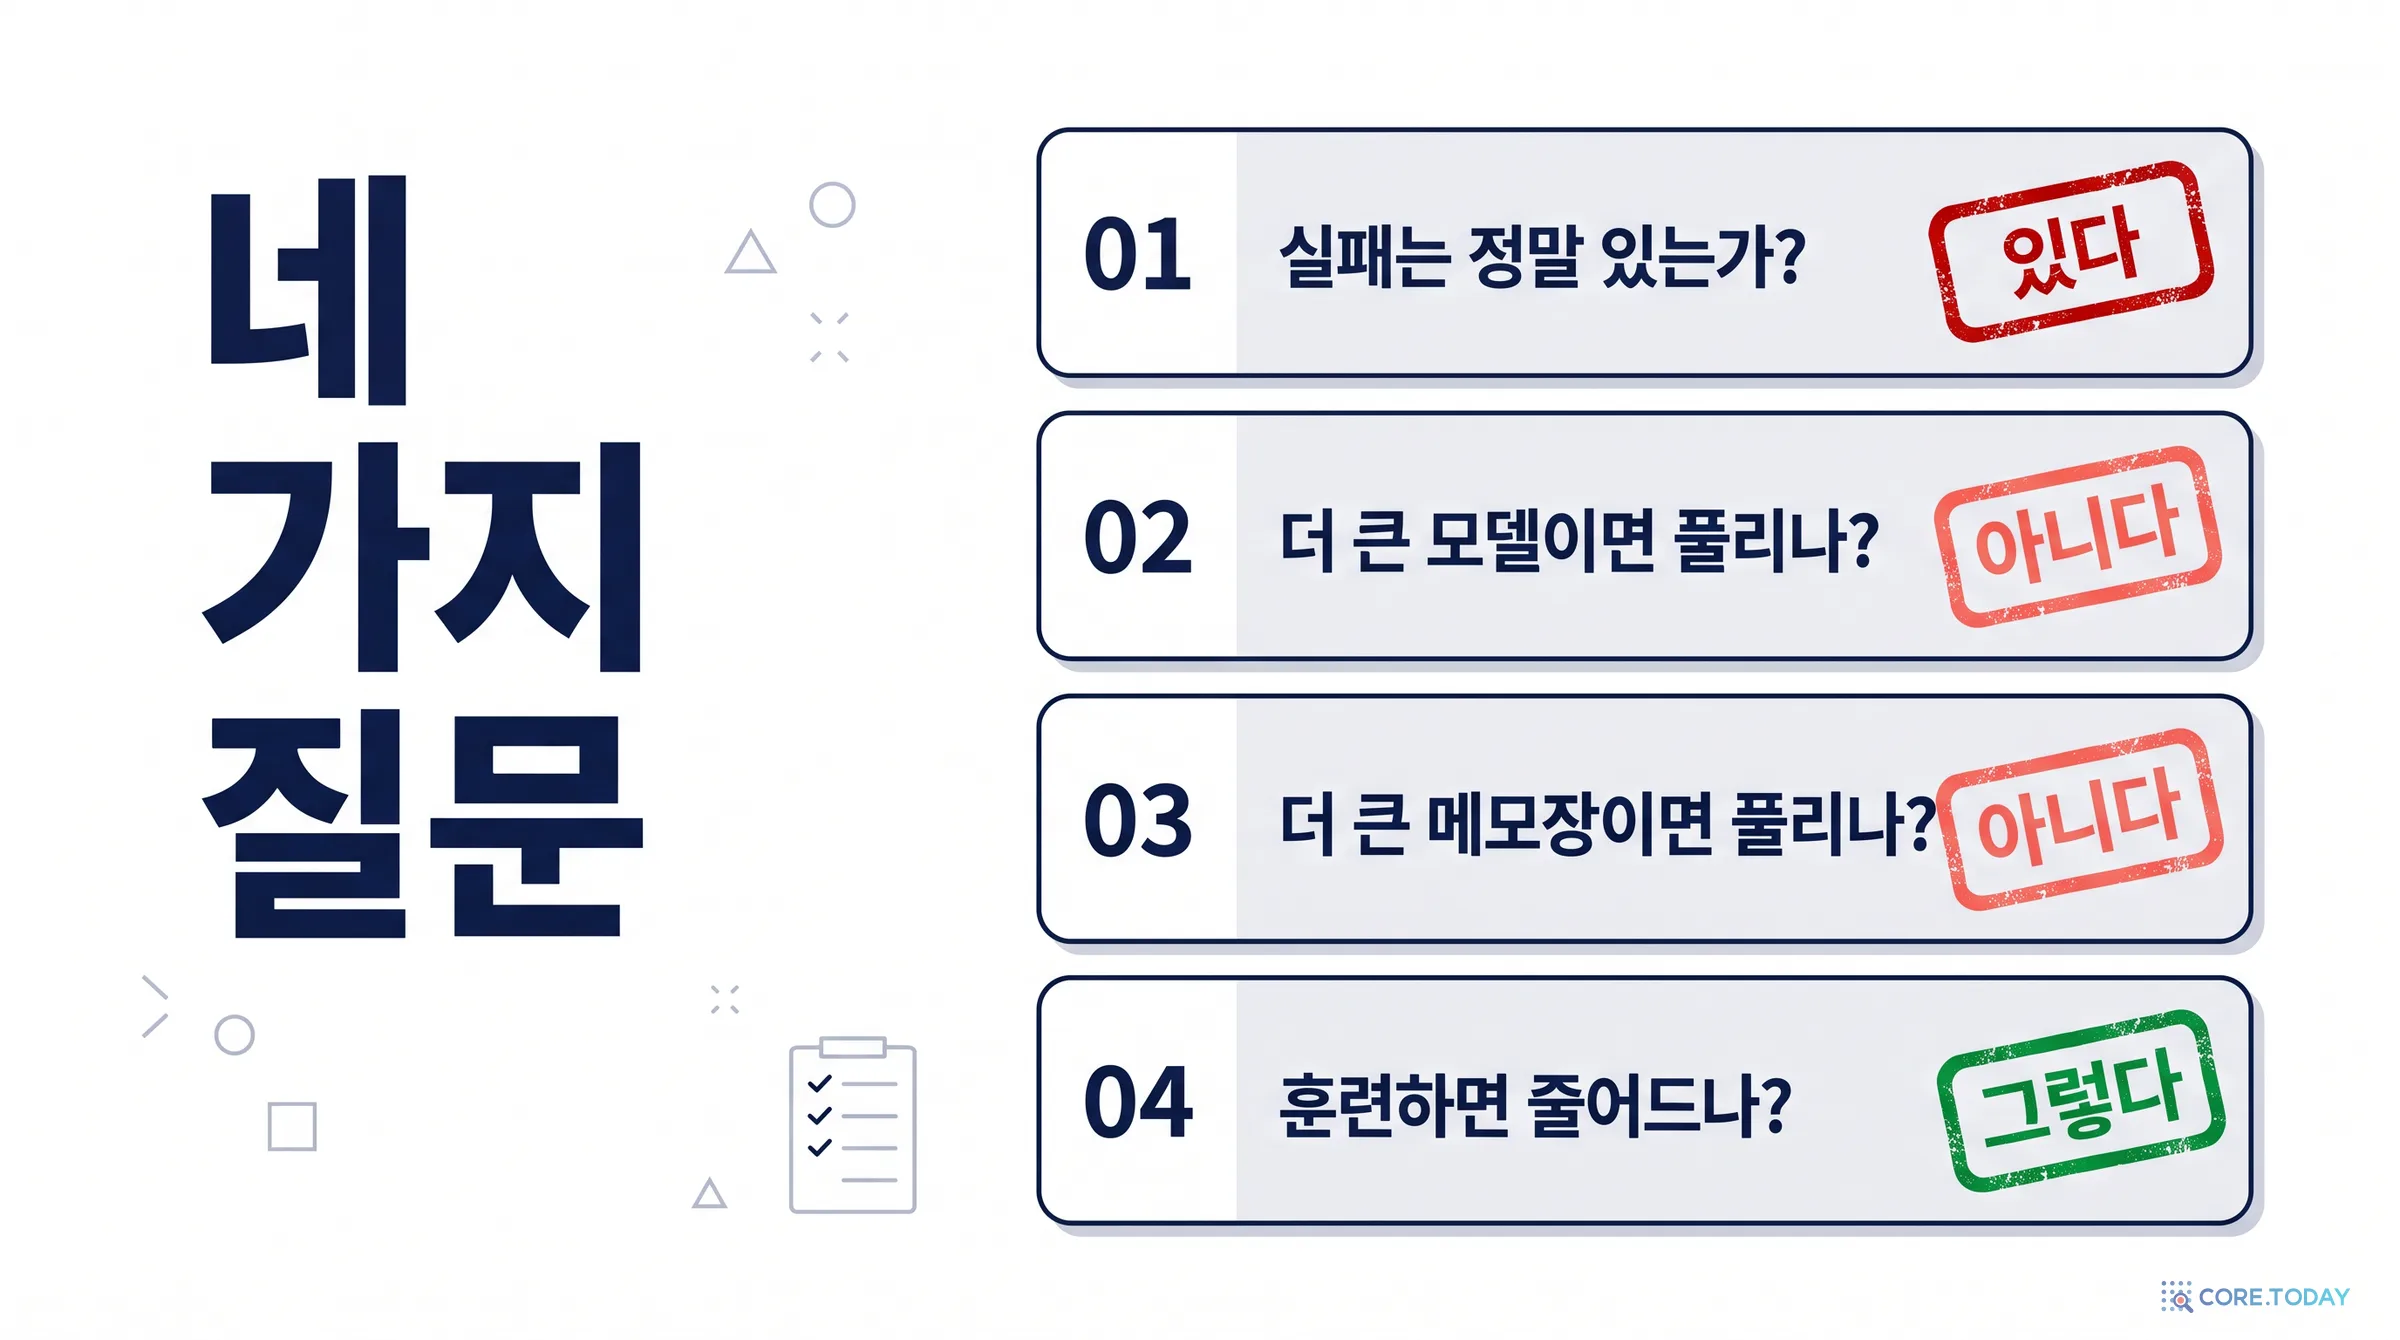
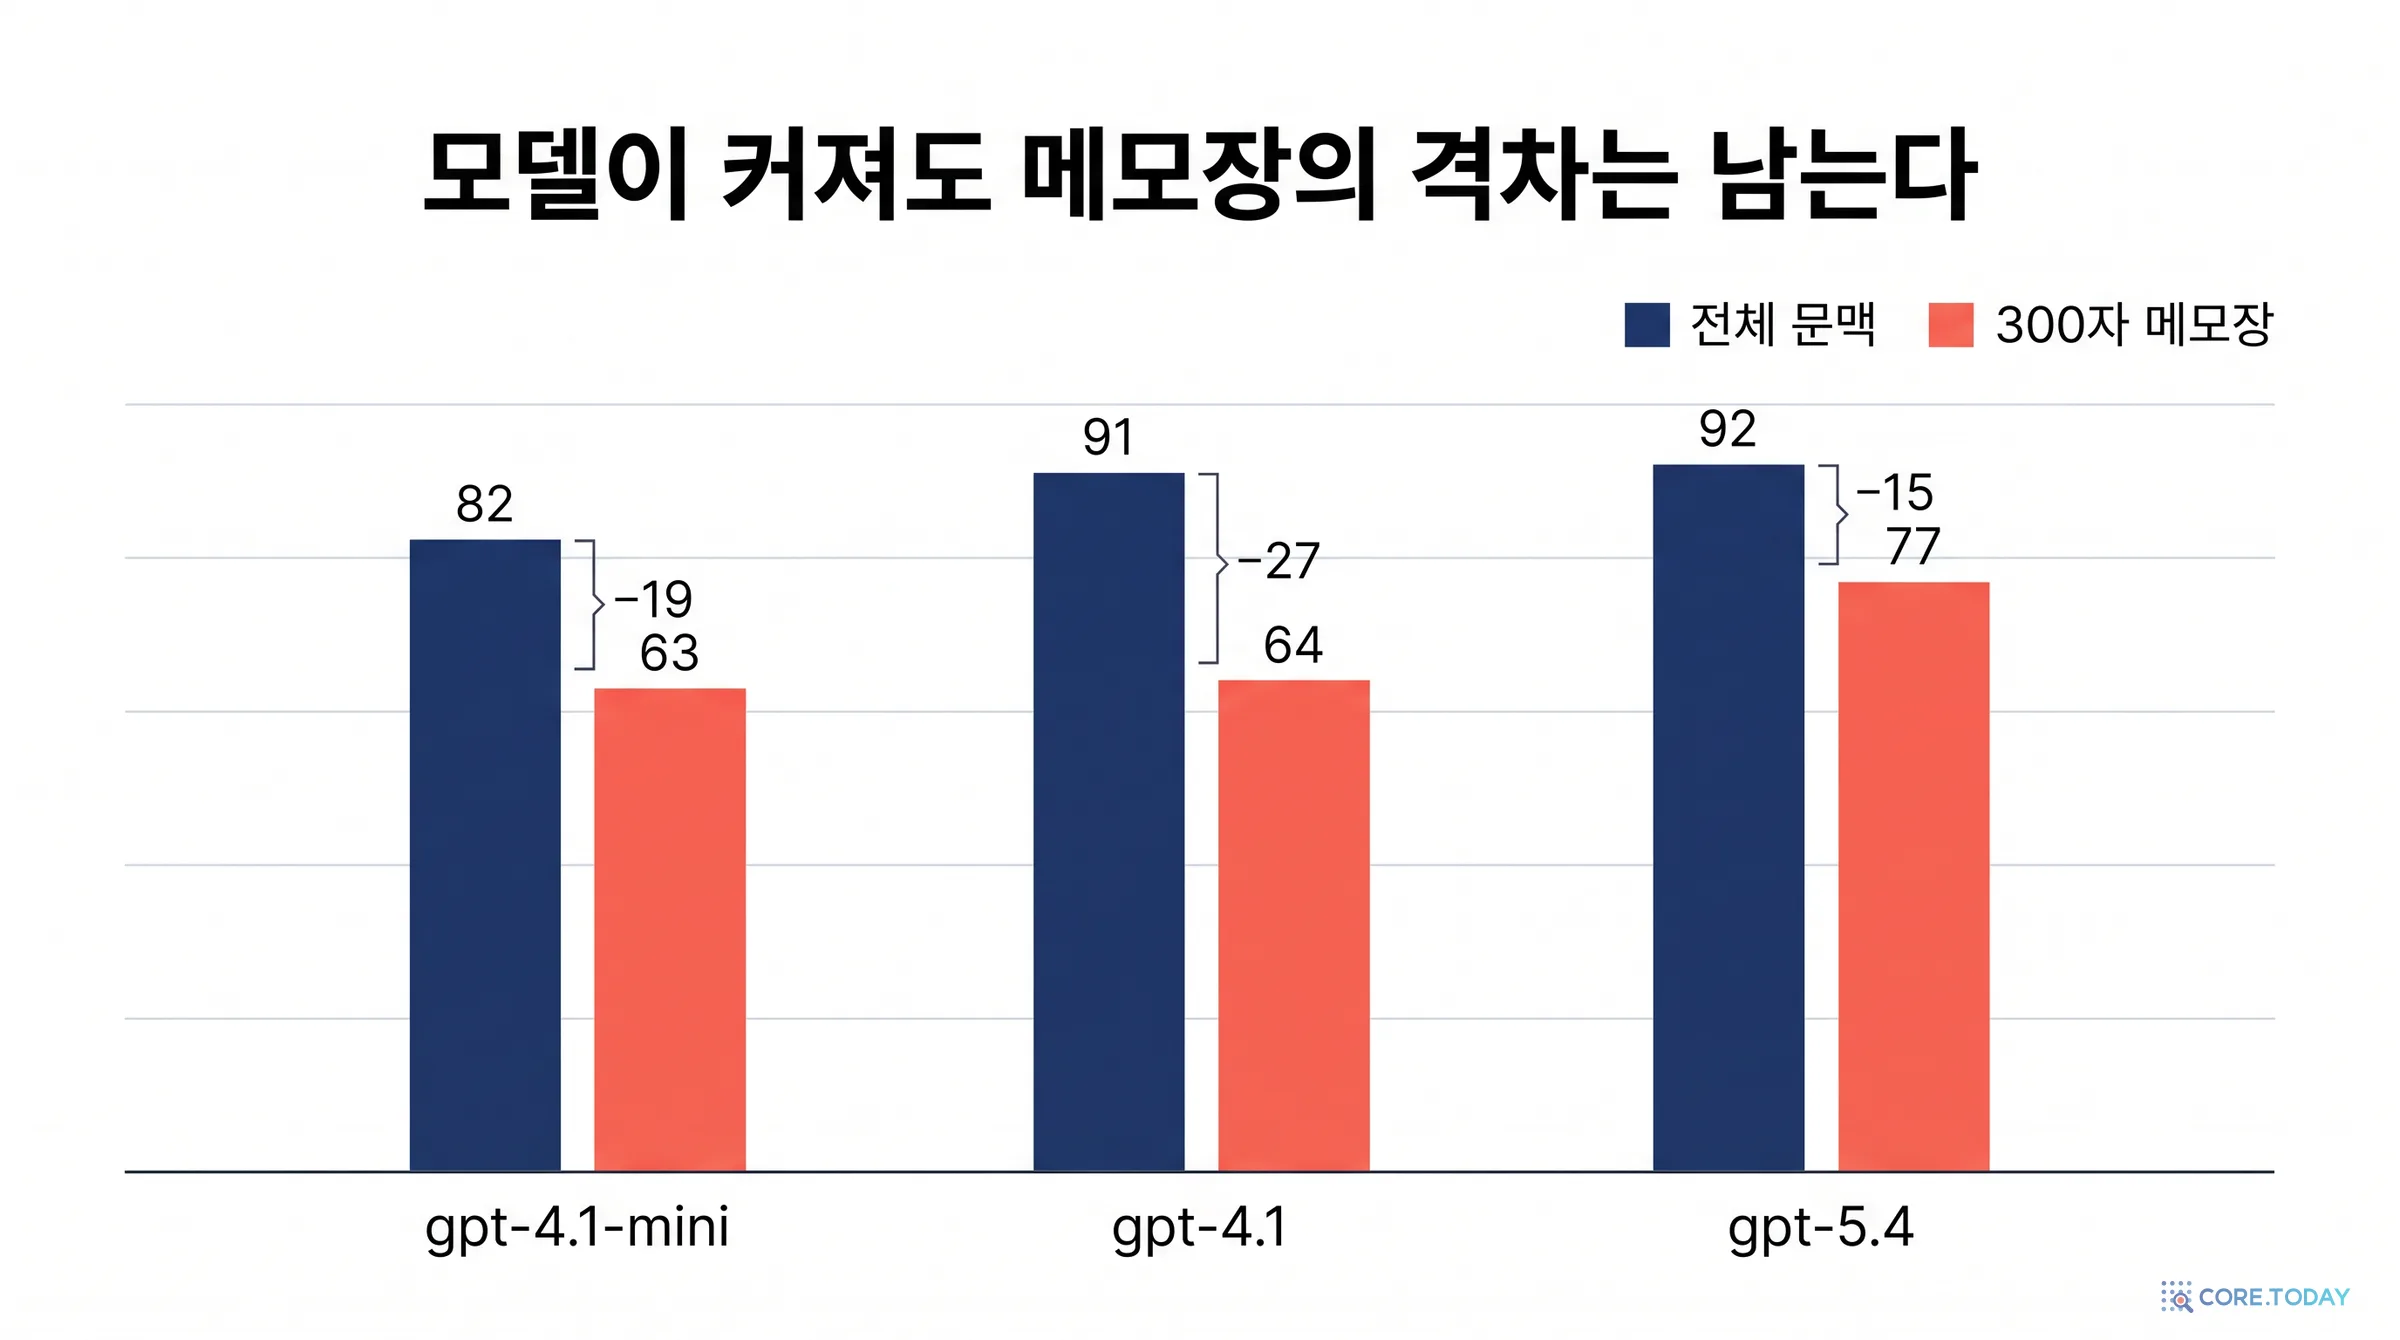
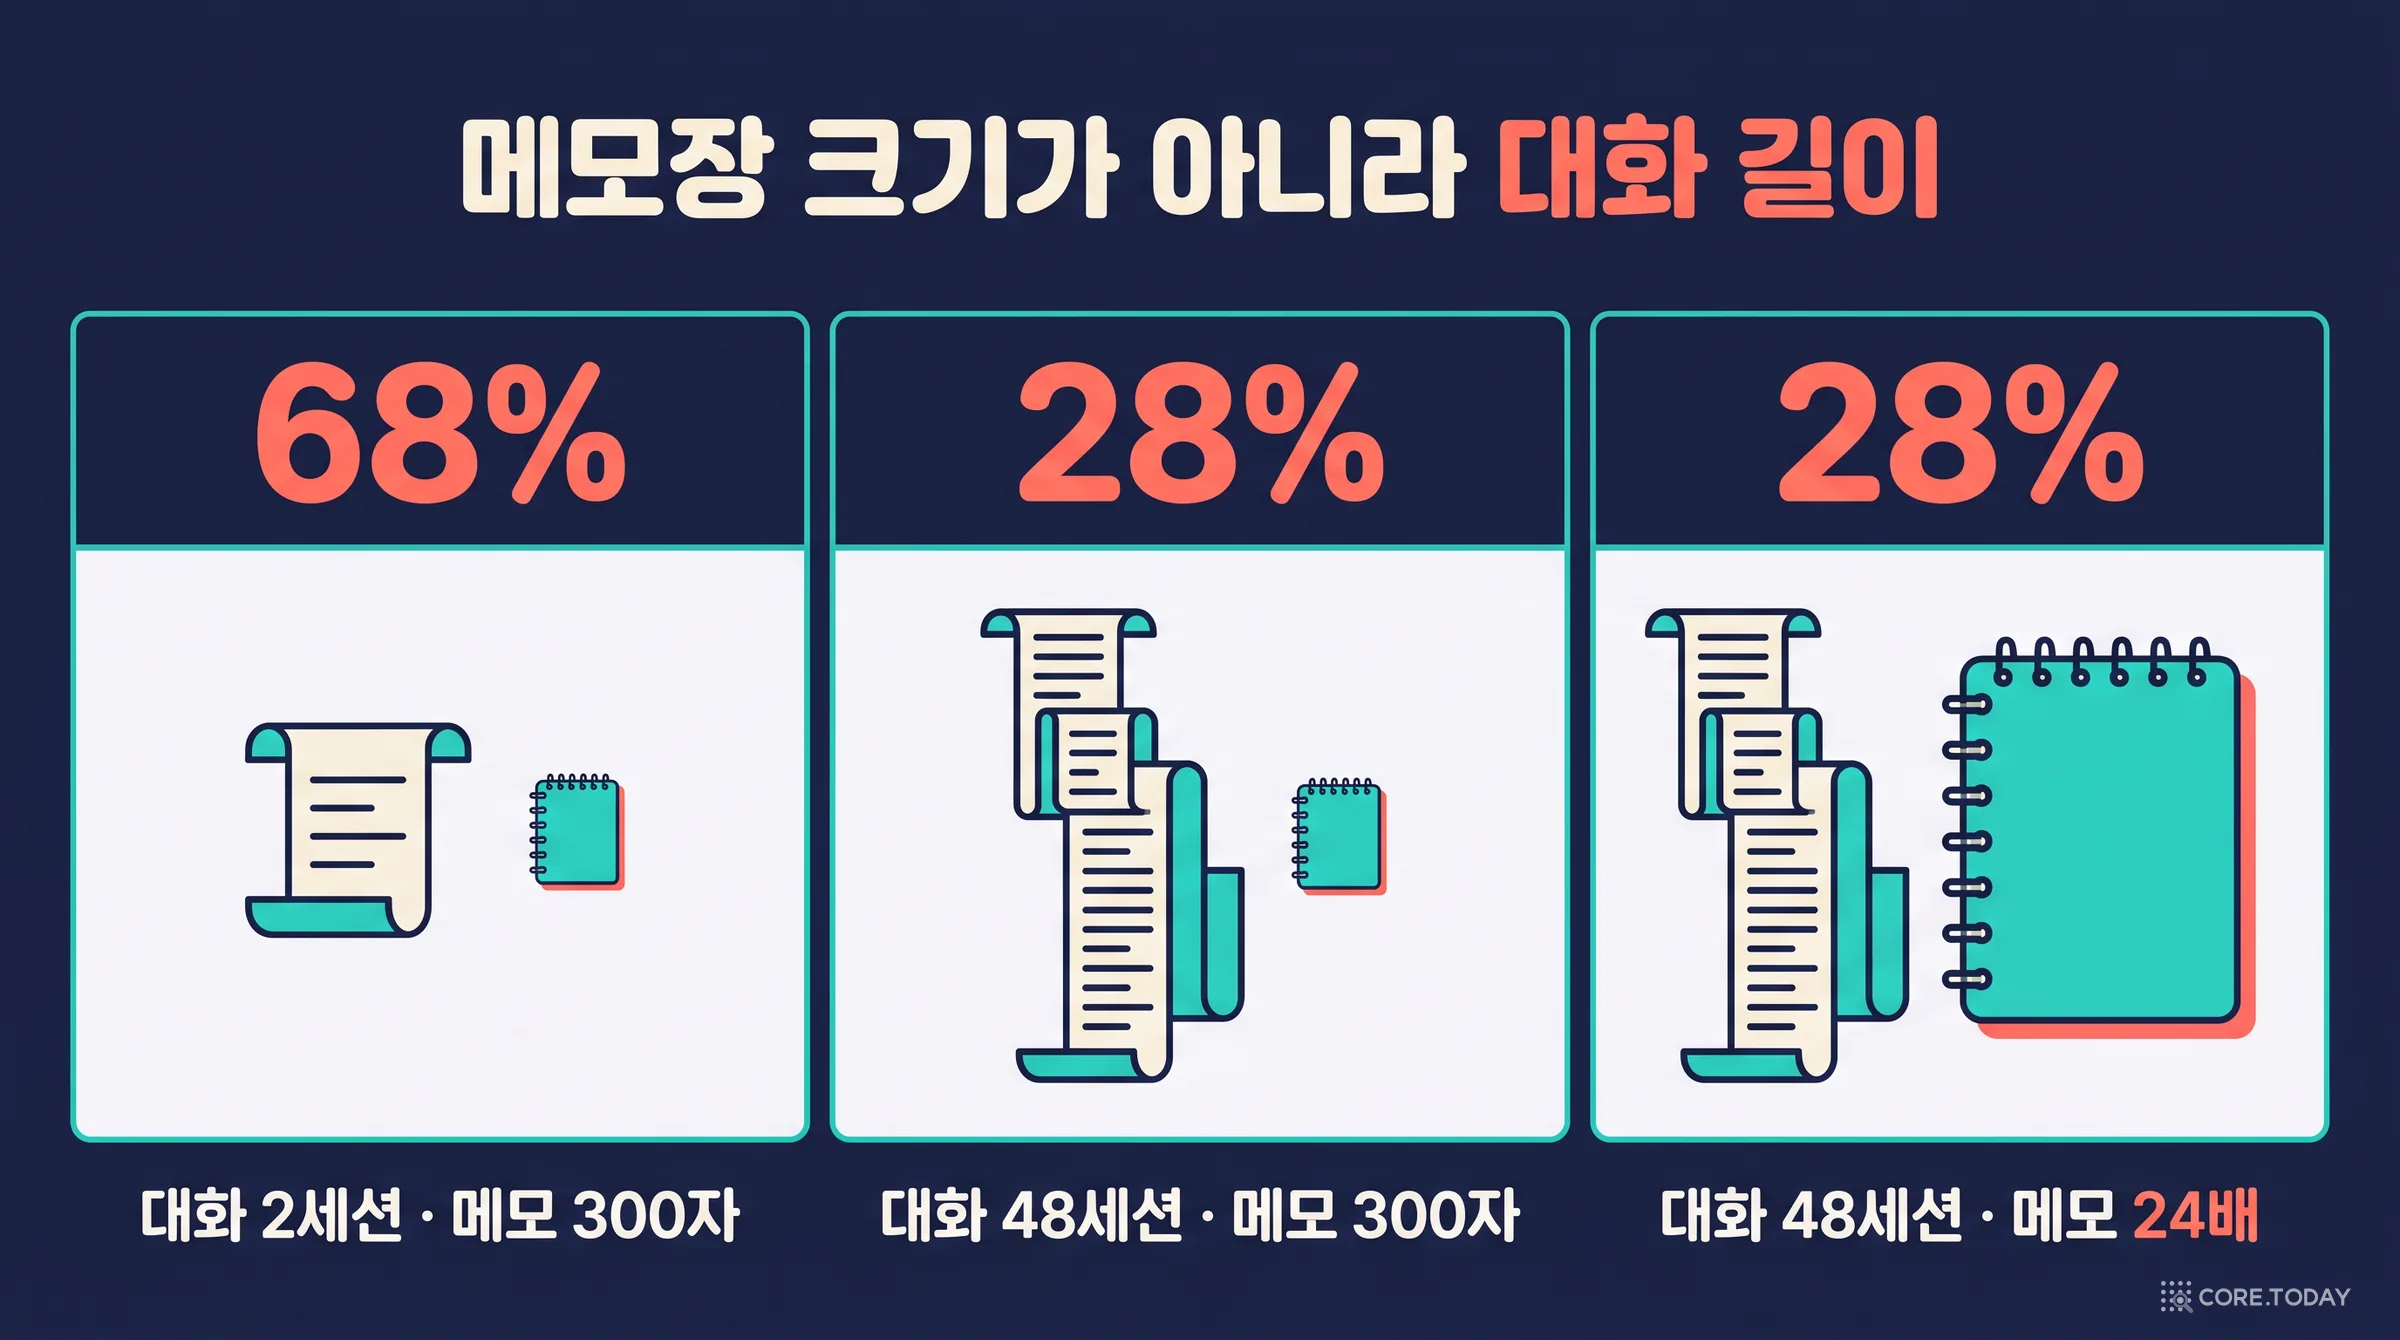
"저 부산으로 이사했어요"라고 말해 두었는데, 몇 주 뒤 AI 비서가 대구행 기차표를 끊는다. 2026년 6월 arXiv 논문 「Supersede」는 이 실패를 '기억 갱신 격차'라고 부르고, 네 가지 질문으로 파고든다. 실패는 정말 있나? 더 큰 모델이면 풀리나? 더 큰 메모장이면 풀리나? 훈련하면 줄어드나? 답은 있다, 아니다, 아니다, 그렇다. 300자 메모장만 쥔 gpt-5.4는 전체 대화를 다 본 자신보다 15점 낮았고, 대화가 24배 길어지자 정답률은 68%에서 28%로 무너졌으며, 메모장을 24배로 늘려 줘도 28%였다. 마지막으로 3B 모델을 GRPO로 훈련해 9.0%를 16.7%로 끌어올렸다. 1957년의 순행 간섭 실험부터 데이터베이스의 UPDATE, 2026년의 'ChatGPT Dreaming'까지 이 문제가 어디서 왔는지 따라가고, 논문의 그림과 표를 하나씩 읽는다. 같은 데이터와 같은 프롬프트로 공개 모델(Qwen 3.5 9B)에서 실험을 직접 재현해 25.6점의 격차를 확인했고, 메모를 요약 대신 '주제: 값' 장부로 쓰게 하는 지시문 하나로 그 격차가 11.5점까지 줄어드는 것도 보았다. 하지만 그 장부도 대화가 48세션으로 길어지자 88%에서 8%로 무너졌다. 그리고 논문의 문자열 채점기가 옛 값 '7:00 pm'을 정답으로 처리한다는 것도 찾아냈다.
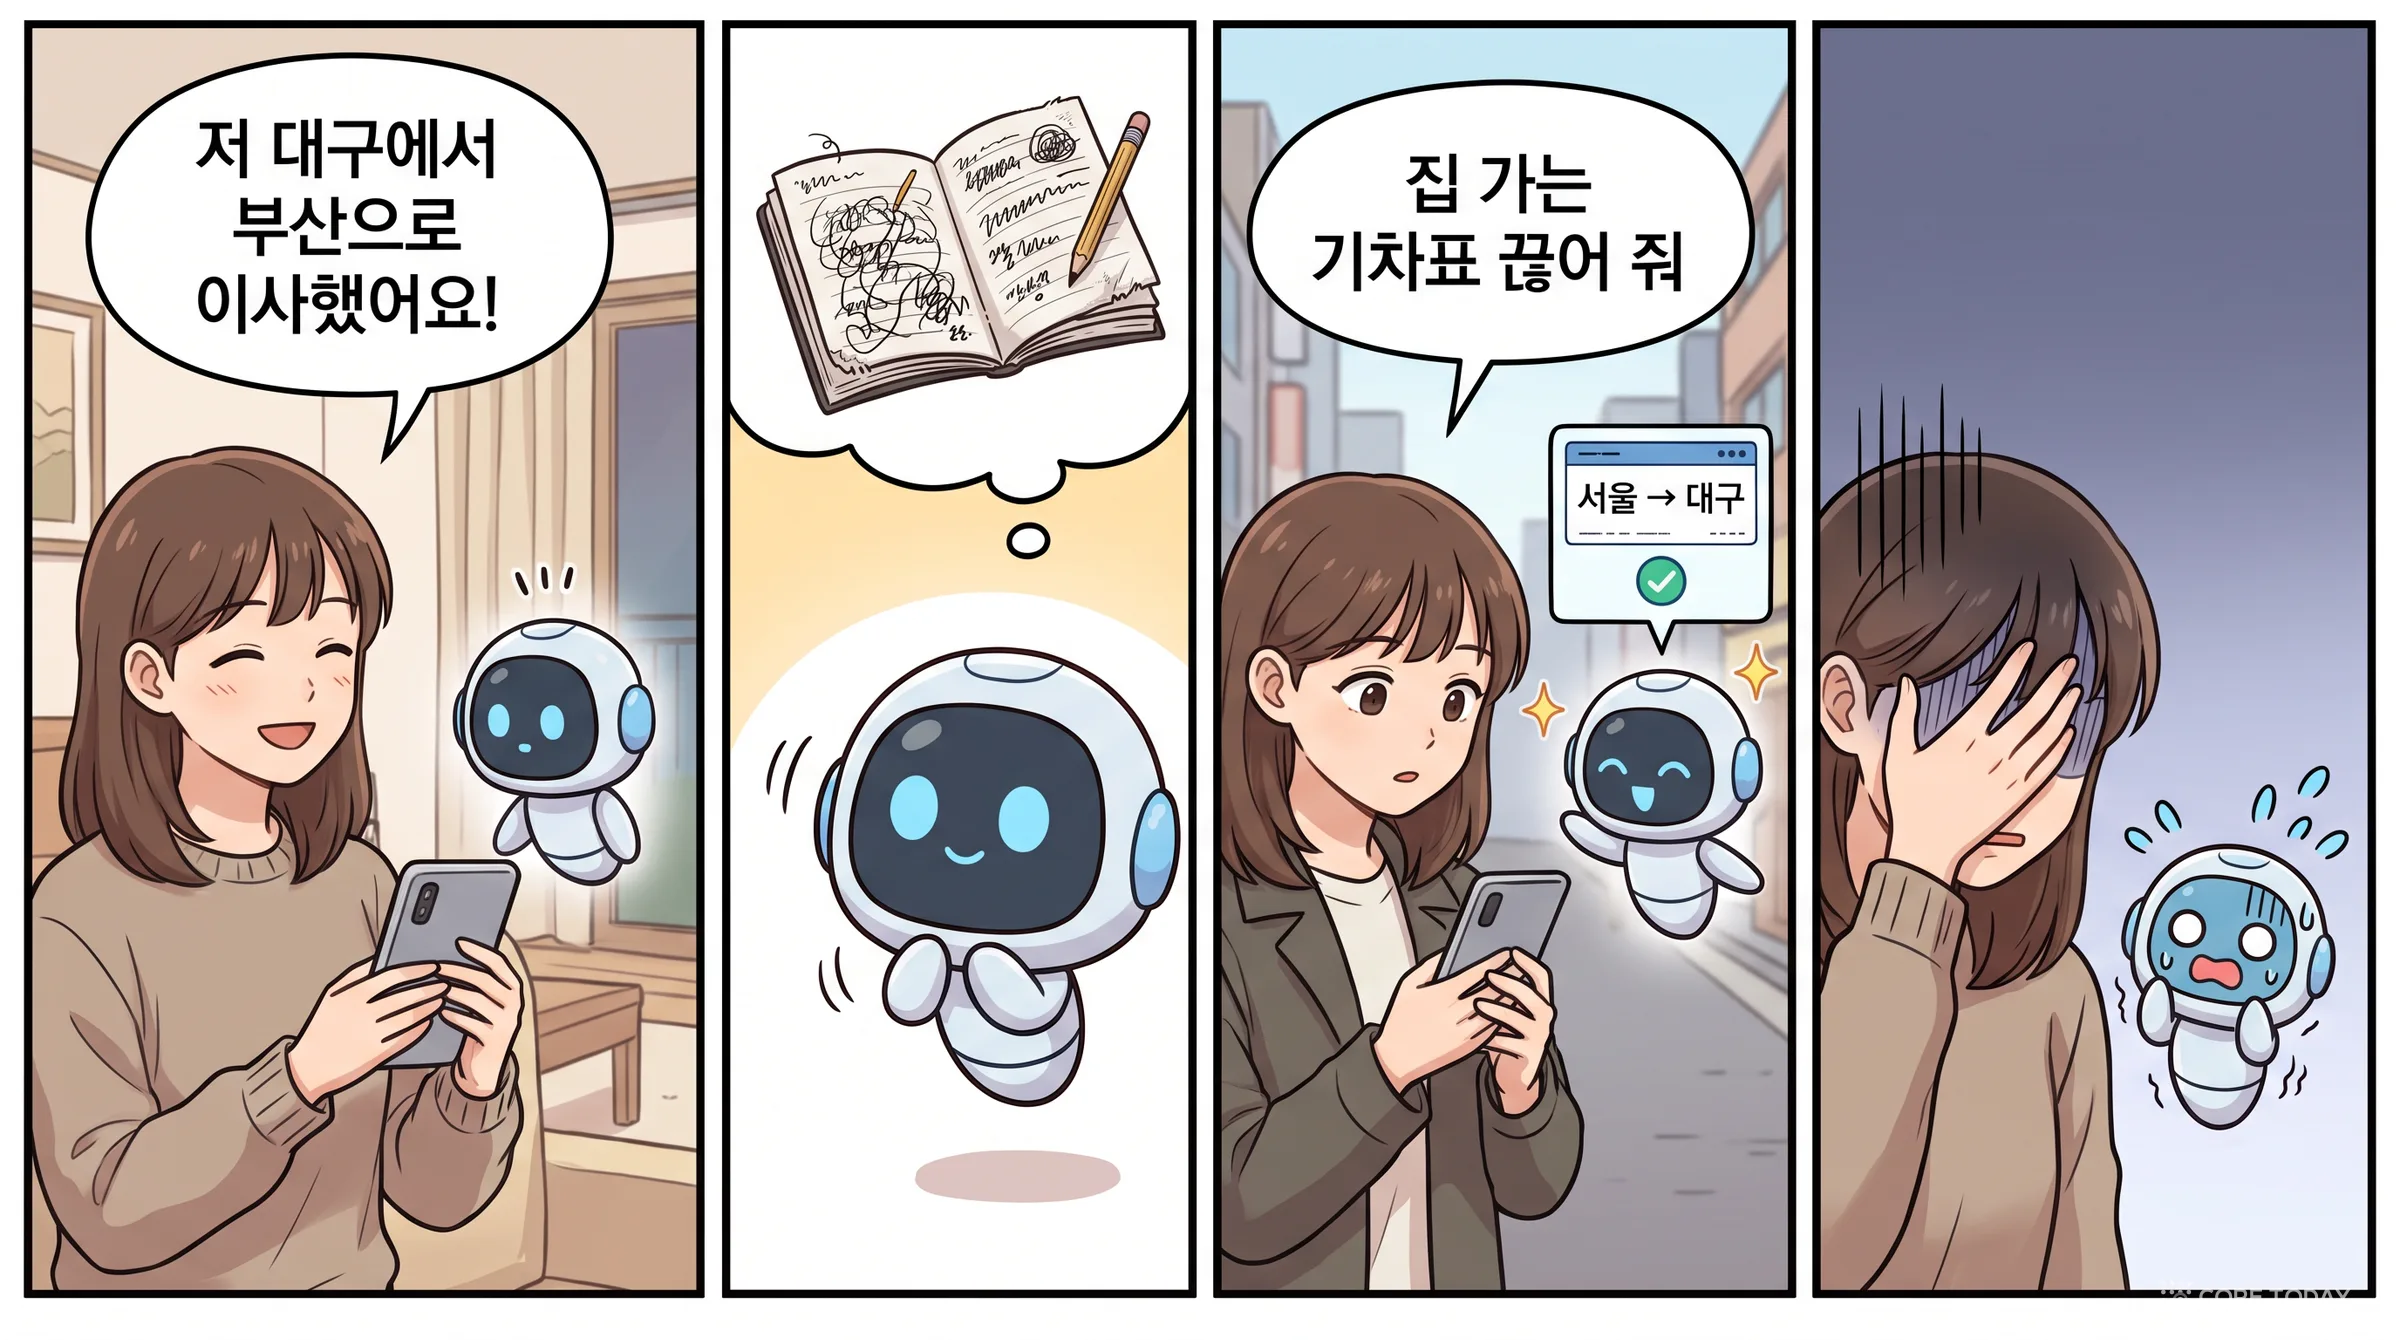
AI 비서에게 "저 대구에서 부산으로 이사했어요"라고 말해 둡니다. 비서는 "축하드려요!"라고 답합니다. 몇 주 뒤 "집 가는 기차표 좀 끊어 줘"라고 하자, 비서가 자신 있게 내민 표는 서울 → 대구입니다.
이 장면은 지어낸 이야기가 아닙니다. Supersede 저장소의 README는 첫 문단에서 이렇게 씁니다. "현재의 메모리 시스템과 긴 맥락 모델은 들은 것을 떠올리는 데는 능하지만, 더 이상 참이 아닌 것을 내려놓는 데는 서툴다. 그래서 비서는 계속 당신의 옛 도시로 가는 비행기를 예약한다." 이사, 이직, 바뀐 가격, 고쳐진 계획, 새로 생긴 알레르기. 오래 함께 일하는 에이전트일수록 사실은 계속 바뀝니다. 바뀐 사실을 쓰지 못하는 비서는 아무것도 기억하지 못하는 비서보다 더 위험할 수 있습니다. 확신에 찬 목소리로 틀리기 때문입니다.
2026년 6월 25일 arXiv에 올라온 「Supersede: Diagnosing and Training the Memory-Update Gap in LLM Agents」(arXiv 2606.27472)는 이 실패 하나만 파고든 논문입니다. 저자는 기업용 기억·검색 인프라를 만드는 Vrin의 Vedant Patel 한 사람이고, 본문은 8쪽 남짓입니다. 짧은 논문이지만 구조가 아주 깔끔합니다. 논문은 질문 네 개를 차례로 던집니다.
이 실패는 정말 있는가? — 있다. 실제 대화 데이터에서, 메모장만 쥔 에이전트는 대화 전체를 본 자신보다 확실히 못한다.
더 큰 모델이면 풀리나? — 아니다. gpt-5.4도 92%에서 77%로 떨어진다.
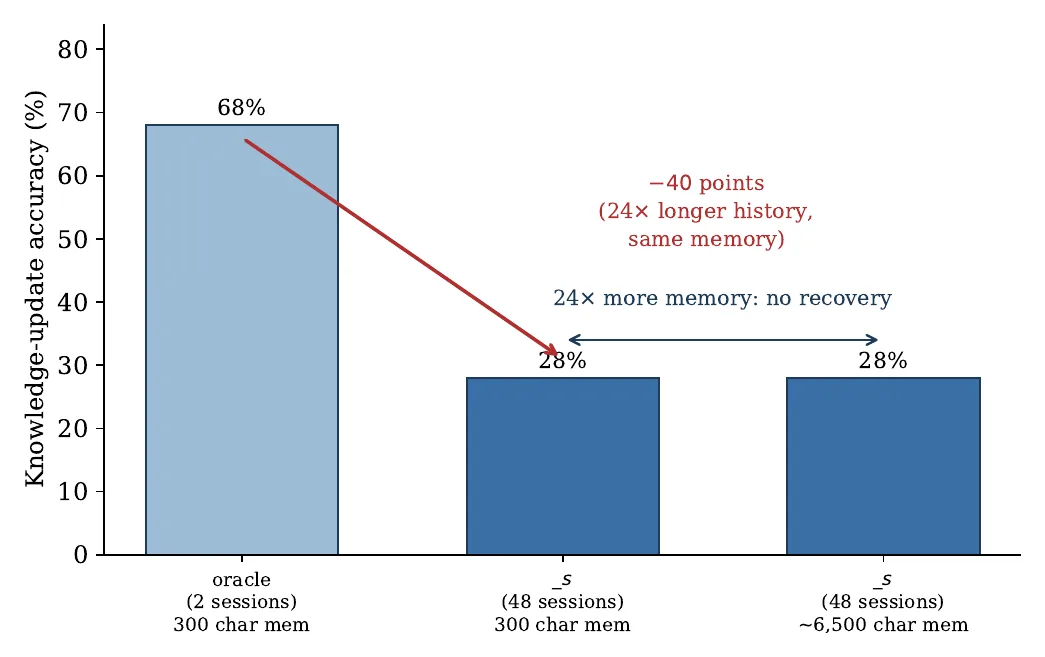
더 큰 메모장이면 풀리나? — 아니다. 대화가 24배 길어지면 68%가 28%로 무너지고, 메모장을 24배 키워 줘도 28%에 머문다.
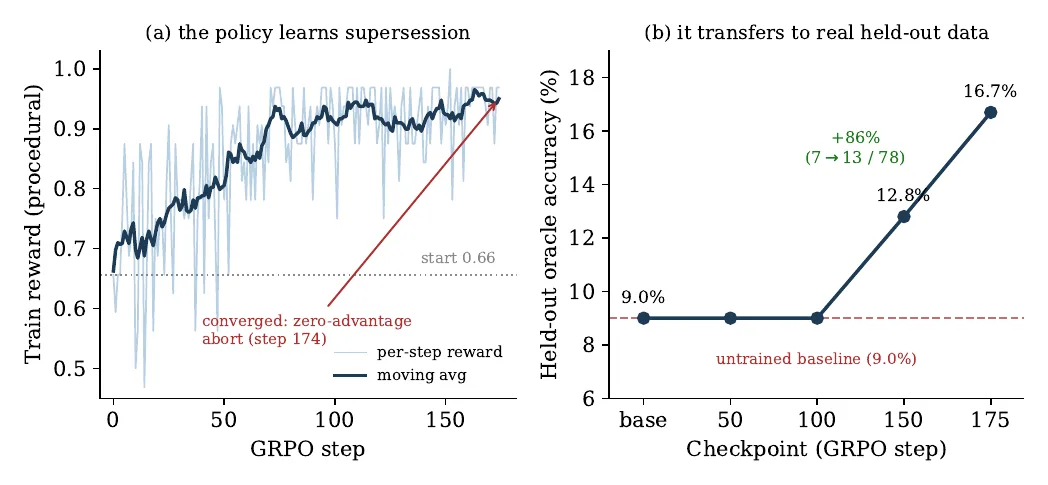
훈련하면 줄어드나? — 그렇다. 작은 공개 모델을 이 문제로 강화학습시키자, 한 번도 본 적 없는 실제 대화에서 정답률이 9.0%에서 16.7%로 거의 두 배가 됐다.
쉬운 탈출구 셋은 막혀 있고, 원칙적인 길 하나는 열려 있다는 이야기입니다. 그리고 그 길을 걷기 위한 도구, 즉 바뀐 사실을 제대로 썼는지를 보상으로 주는 강화학습 환경을 공개했습니다. 이 환경의 이름이 Supersede입니다.
이 글은 이 논문을 처음부터 끝까지 읽습니다. 먼저 '대체(supersession)'가 회상과 어떻게 다른 능력인지 정리하고(1장), 이 문제가 심리학·데이터베이스·AI에서 어떻게 다뤄져 왔는지 따라갑니다(2장). 그다음 실험 설계와 그림·표를 하나씩 읽고(3~6장), 코어닷투데이가 같은 데이터와 같은 프롬프트로 공개 모델에서 재현한 결과를 보여 드립니다(7장). 마지막으로 이 논문을 비판적으로 읽고(8장), 2026년에 이 기술이 어디에 서 있는지, 오늘 무엇을 할 수 있는지 정리합니다(9~10장).
왜 지금 이 문제인가
2026년은 '기억하는 AI'가 기본값이 된 해입니다. 논문도 관련 연구 절에서 "2026년, 기억 기능은 모든 주요 연구소의 제품에 들어갔다"고 적습니다. OpenAI는 ChatGPT의 기억을 백그라운드에서 정리·재작성하는 'Dreaming'을, Anthropic은 Claude의 대화 검색과 기억을, Google은 Gemini의 개인화를 내놓았습니다. 셋 다 사용자의 기억을 몰래 다시 쓰는 과정을 돌립니다. 논문이 짚는 대목이 흥미롭습니다. OpenAI는 "낡은 맥락을 갱신하는" 시간 민감 평가에서 자사 성공률이 2024년 9.4%에서 75.1%로 올랐다고 스스로 보고했습니다. 바꿔 말하면 업계 최고 수준의 제품도 넷 중 하나는 여전히 옛 사실을 붙들고 있다는 뜻이고, 그 평가의 방법과 데이터는 공개되지 않았습니다.
기억이 제품이 되는 순간, '무엇을 기억하느냐'보다 '무엇을 고쳐 기억하느냐'가 더 중요해집니다. 한 번 들은 사실은 어떻게든 저장해 둘 수 있습니다. 그런데 그 사실이 바뀌었다는 것을 알아채고, 옛 값을 지우고, 새 값을 제자리에 넣는 일은 저장과는 전혀 다른 능력입니다. Supersede는 바로 이 능력을 분리해 재고, 훈련하려고 합니다.
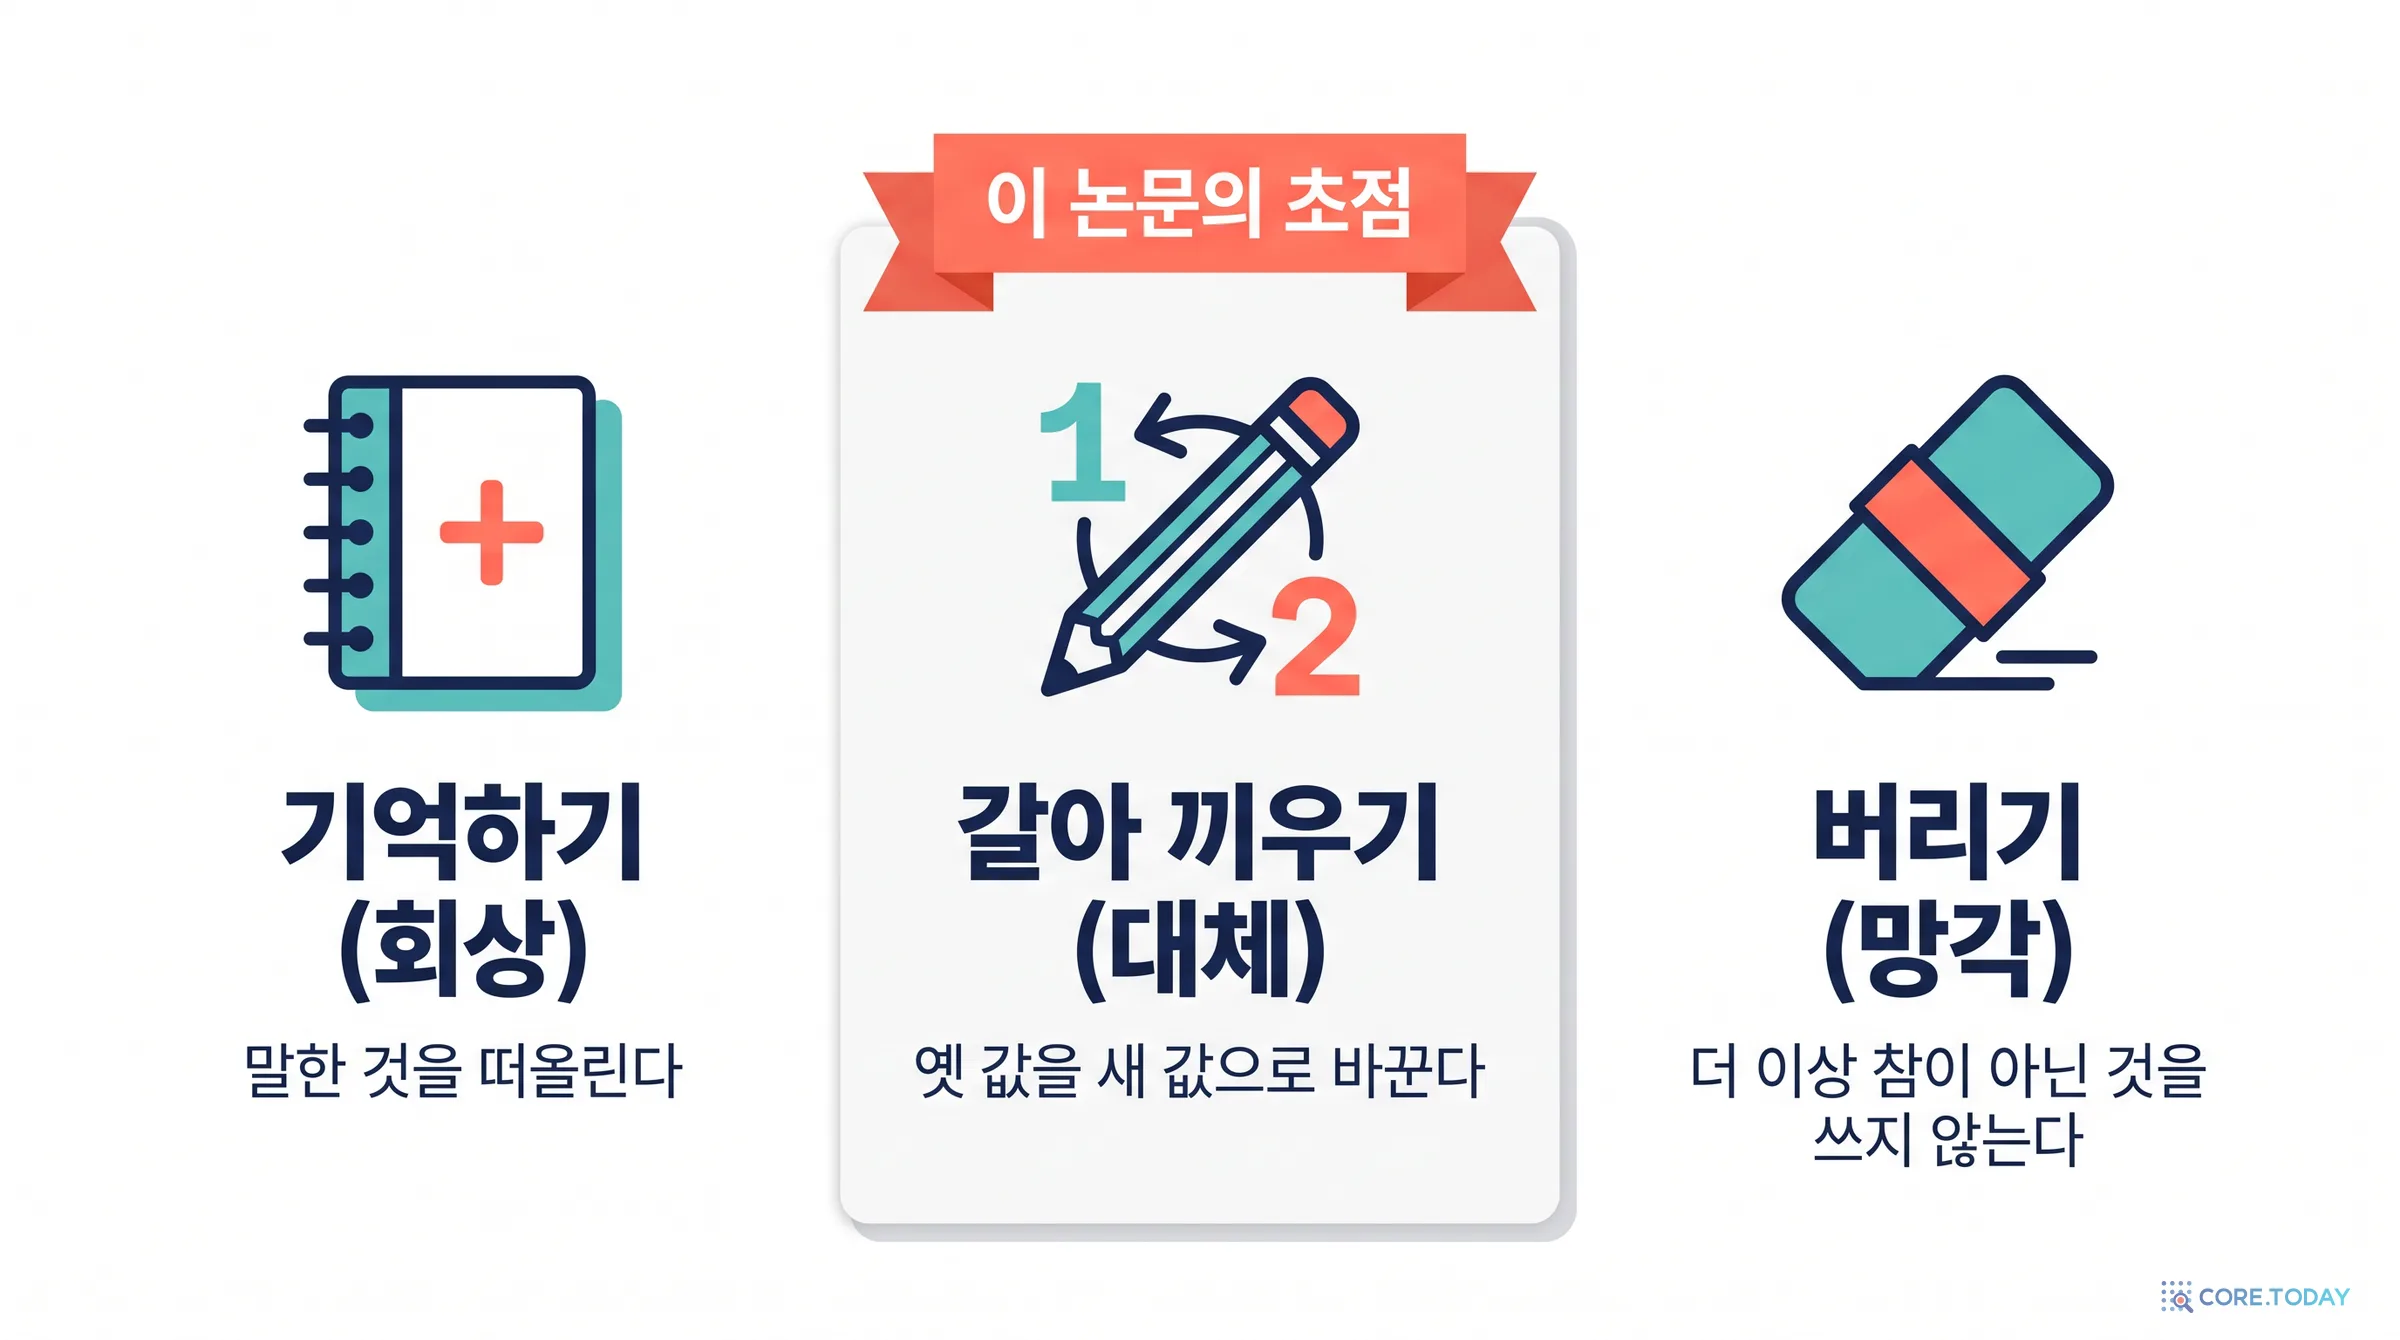
기억하기(회상, recall) — "지난번에 제가 무슨 차를 산다고 했죠?" 들은 것을 다시 꺼내는 일. 대부분의 기억 벤치마크가 재는 능력입니다.
갈아 끼우기(대체, supersession) — "마쓰다를 샀다"고 했다가 나중에 "이제 렉서스로 바꿨다"고 하면, 지금 차는 렉서스입니다. 같은 자리에 들어갈 값이 새로 왔을 때 옛 값을 밀어내고 새 값을 쓰는 일.
버리기(망각, forgetting) — 더 이상 참이 아닌 것을 판단의 근거로 쓰지 않는 일. 대체의 뒷면입니다.
논문은 둘째 동작을 대체(supersession)라고 부르고, "제한된 크기의, 스스로 관리하는 기억 아래에서 대체를 해내야 할 때 에이전트가 잃는 정확도"를 대체 격차(supersession gap)라고 정의합니다. 이 글에서는 더 풀어 '기억 갱신 격차'라고도 부르겠습니다. 영어 supersede는 법률 문서에서 자주 보는 단어입니다. "이 계약은 이전의 모든 합의를 대체한다(supersedes all prior agreements)". 새 것이 옛 것의 효력을 없앤다는 뜻이고, 논문 제목은 그 뉘앙스를 그대로 가져왔습니다.
회상을 잘해도 대체에 실패한다
두 능력이 정말 다르냐고 물을 수 있습니다. 옛 값과 새 값을 둘 다 기억해 두었다가 질문받을 때 나중 것을 고르면 되지 않느냐고요. 맞습니다. 모든 것을 다 보관할 수 있다면 그렇습니다. 대화 전체를 맥락 창에 넣어 주면 최신 모델은 "가장 마지막에 언급된 값"을 찾는 식으로 대체를 꽤 잘 해냅니다. 논문이 직접 만든 합성 데이터("X는 이제 Y다" 같은 명시적 갱신)에서 최신 모델은 모든 설정에서 100%를 받았습니다.
문제는 현실의 에이전트가 모든 것을 보관하지 못한다는 데 있습니다. 대화는 몇 주, 몇 달씩 쌓이고, 맥락 창은 유한하며, 비용은 토큰에 비례합니다. 그래서 실제 기억 시스템은 대화를 압축합니다. 요약하고, 중요한 것만 뽑아 적고, 메모를 고쳐 씁니다. ChatGPT의 기억도, Mem0 같은 오픈소스 기억 계층도, 장기 실행 에이전트의 '컨텍스트 압축'도 모두 이런 방식입니다. 이 압축의 순간에 대체가 일어나야 합니다. 새 값을 들었을 때 메모의 옛 줄을 찾아 고쳐야 하고, 나중에 쓸모가 있을지 모르는 그 사실이 메모에서 밀려나지 않게 지켜야 합니다.
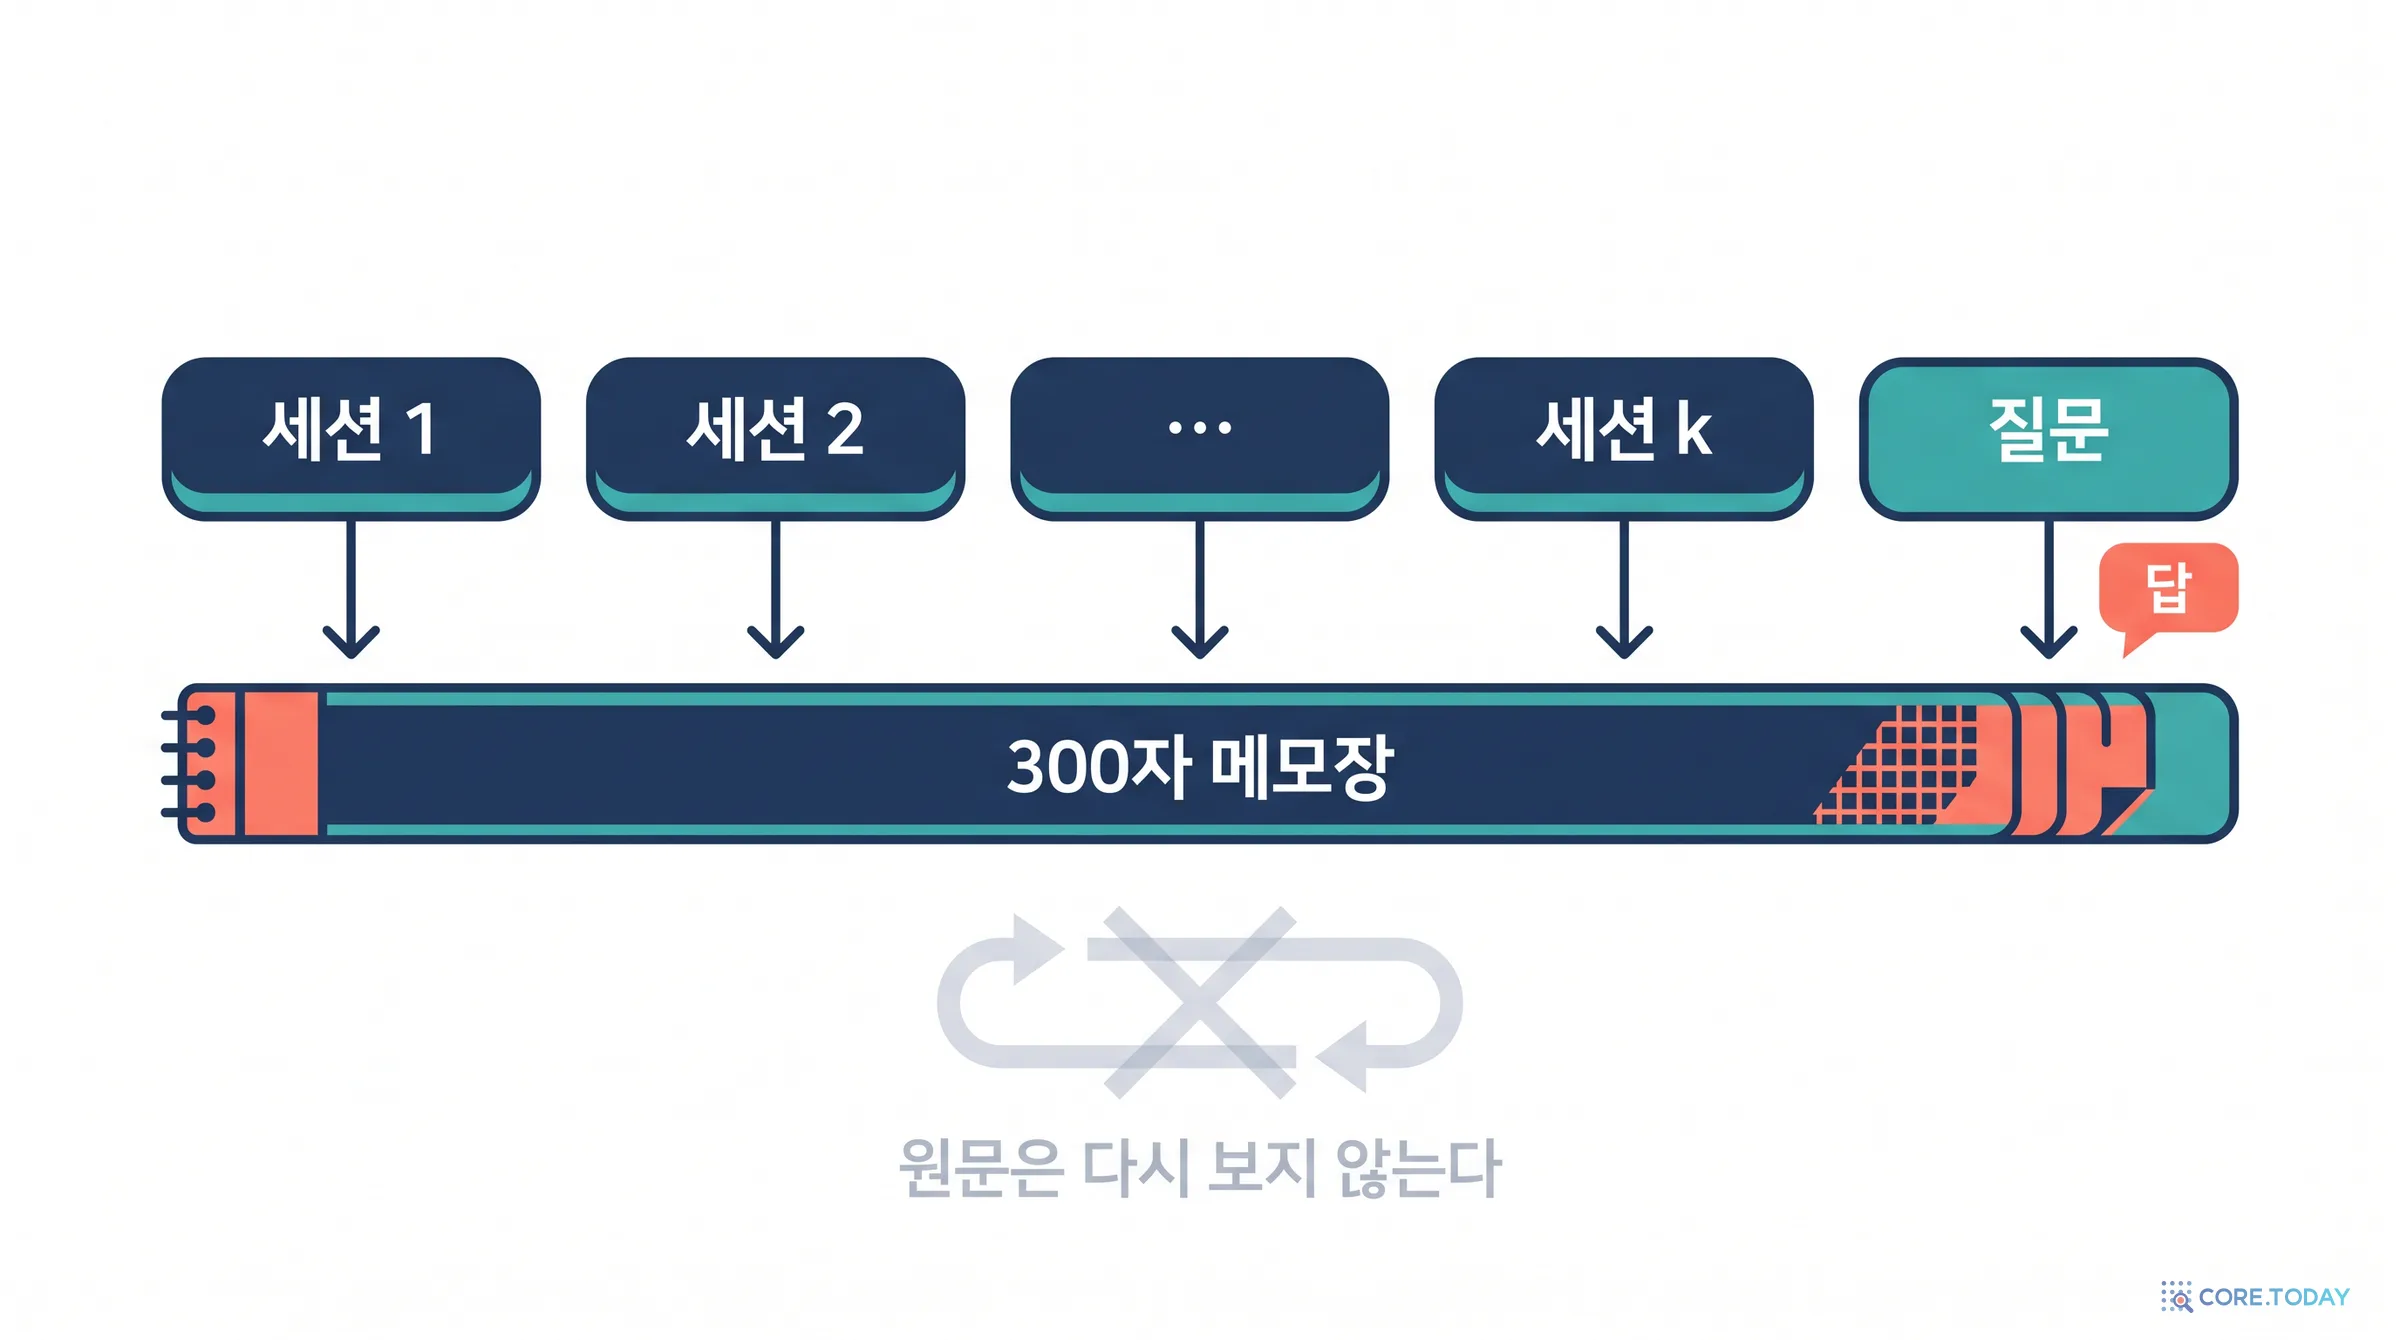
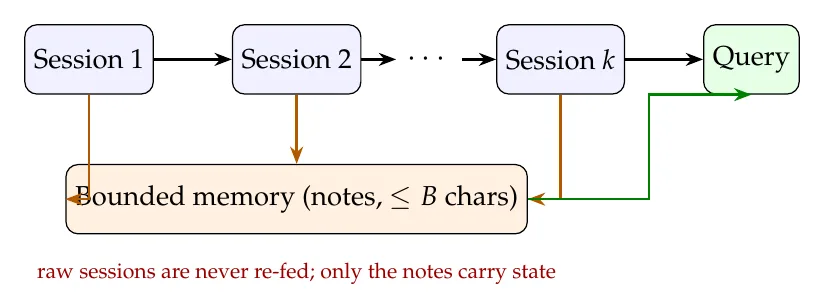
그래서 Supersede의 핵심 설정은 하나입니다. 원문을 다시 보여 주지 않는다(no re-feed). 에이전트는 세션을 하나씩 읽으며 정해진 길이의 메모를 고쳐 쓰고, 마지막 질문에는 메모만 보고 답합니다. 메모에서 사실이 사라졌거나 옛 값이 고쳐지지 않았다면, 아무리 똑똑한 모델도 맞힐 방법이 없습니다.
상황
회상만 보는 시험
대체를 보는 시험 (Supersede)
질문
"제가 처음 산 차가 뭐였죠?"
"제가 지금 타는 차는 뭐죠?"
필요한 것
그 말이 어딘가에 남아 있기만 하면 됨
여러 값 중 지금 유효한 하나가 남아 있어야 함
옛 값의 역할
정답 그 자체
함정 — 그대로 말하면 감점
전체 대화를 다 보여 주면
쉬움
꽤 쉬움 (마지막 언급을 찾으면 됨)
메모만 남기면
압축 손실만 문제
압축 손실 + 덮어쓰기 실패가 겹침
일상의 대체, 그리고 그것이 틀렸을 때의 비용
대체가 실패하면 무슨 일이 일어나는지 몇 가지 장면으로 보겠습니다.
🏥
의료·건강 비서
석 달 전 "페니실린 알레르기가 있다"고 했고, 지난주 "검사해 보니 페니실린이 아니라 세팔로스포린 계열이 문제였다"고 정정했다. 메모에 옛 줄이 남아 있으면 비서는 틀린 약을 피하라고 하고 정작 위험한 약은 걸러 내지 못한다. Supersede의 합성 문제 생성기에도 '알레르기' 술어가 들어 있다.
🧾
영업·고객 지원
고객사의 담당자가 바뀌었고, 단가가 재협상됐고, 납품지가 새 공장으로 옮겨졌다. CRM 요약 메모가 옛 단가를 들고 있으면 견적서가 틀린다. 이런 갱신은 대개 "참, 그리고 이번 달부터는…"처럼 대화 중간에 지나가듯 나온다.
💻
코딩·업무 에이전트
이틀 전 "배포 브랜치는 release"라고 했다가 오늘 "이제 main 하나만 쓴다"고 했다. 압축된 작업 메모에 옛 규칙이 살아 있으면 에이전트는 없는 브랜치에 푸시하거나, 더 나쁘게는 사라진 브랜치를 다시 만든다.
공통점이 보입니다. 새 값은 대개 명시적인 선언이 아니라 대화 속에 묻혀서 옵니다. "이사했어요"라고 따로 공지하는 사람은 드뭅니다. "동생이 다시 부산으로 내려갔대요", "오늘 수영에서 52초 찍었어요"처럼 다른 이야기를 하다가 지나가듯 말합니다. 논문이 합성 데이터 대신 실제 대화 데이터를 고집한 이유가 여기에 있습니다. 이 점은 3장에서 다시 보겠습니다.
직접 해 보면 감이 옵니다. 아래 위젯에서 여러분이 70자짜리 메모장을 쥔 에이전트가 되어 보세요. 세션을 하나씩 읽고 메모를 고쳐 쓰되, 다음 세션으로 넘어가면 앞 대화는 다시 볼 수 없습니다. 마지막에 무엇을 물을지는 알려 드리지 않습니다.
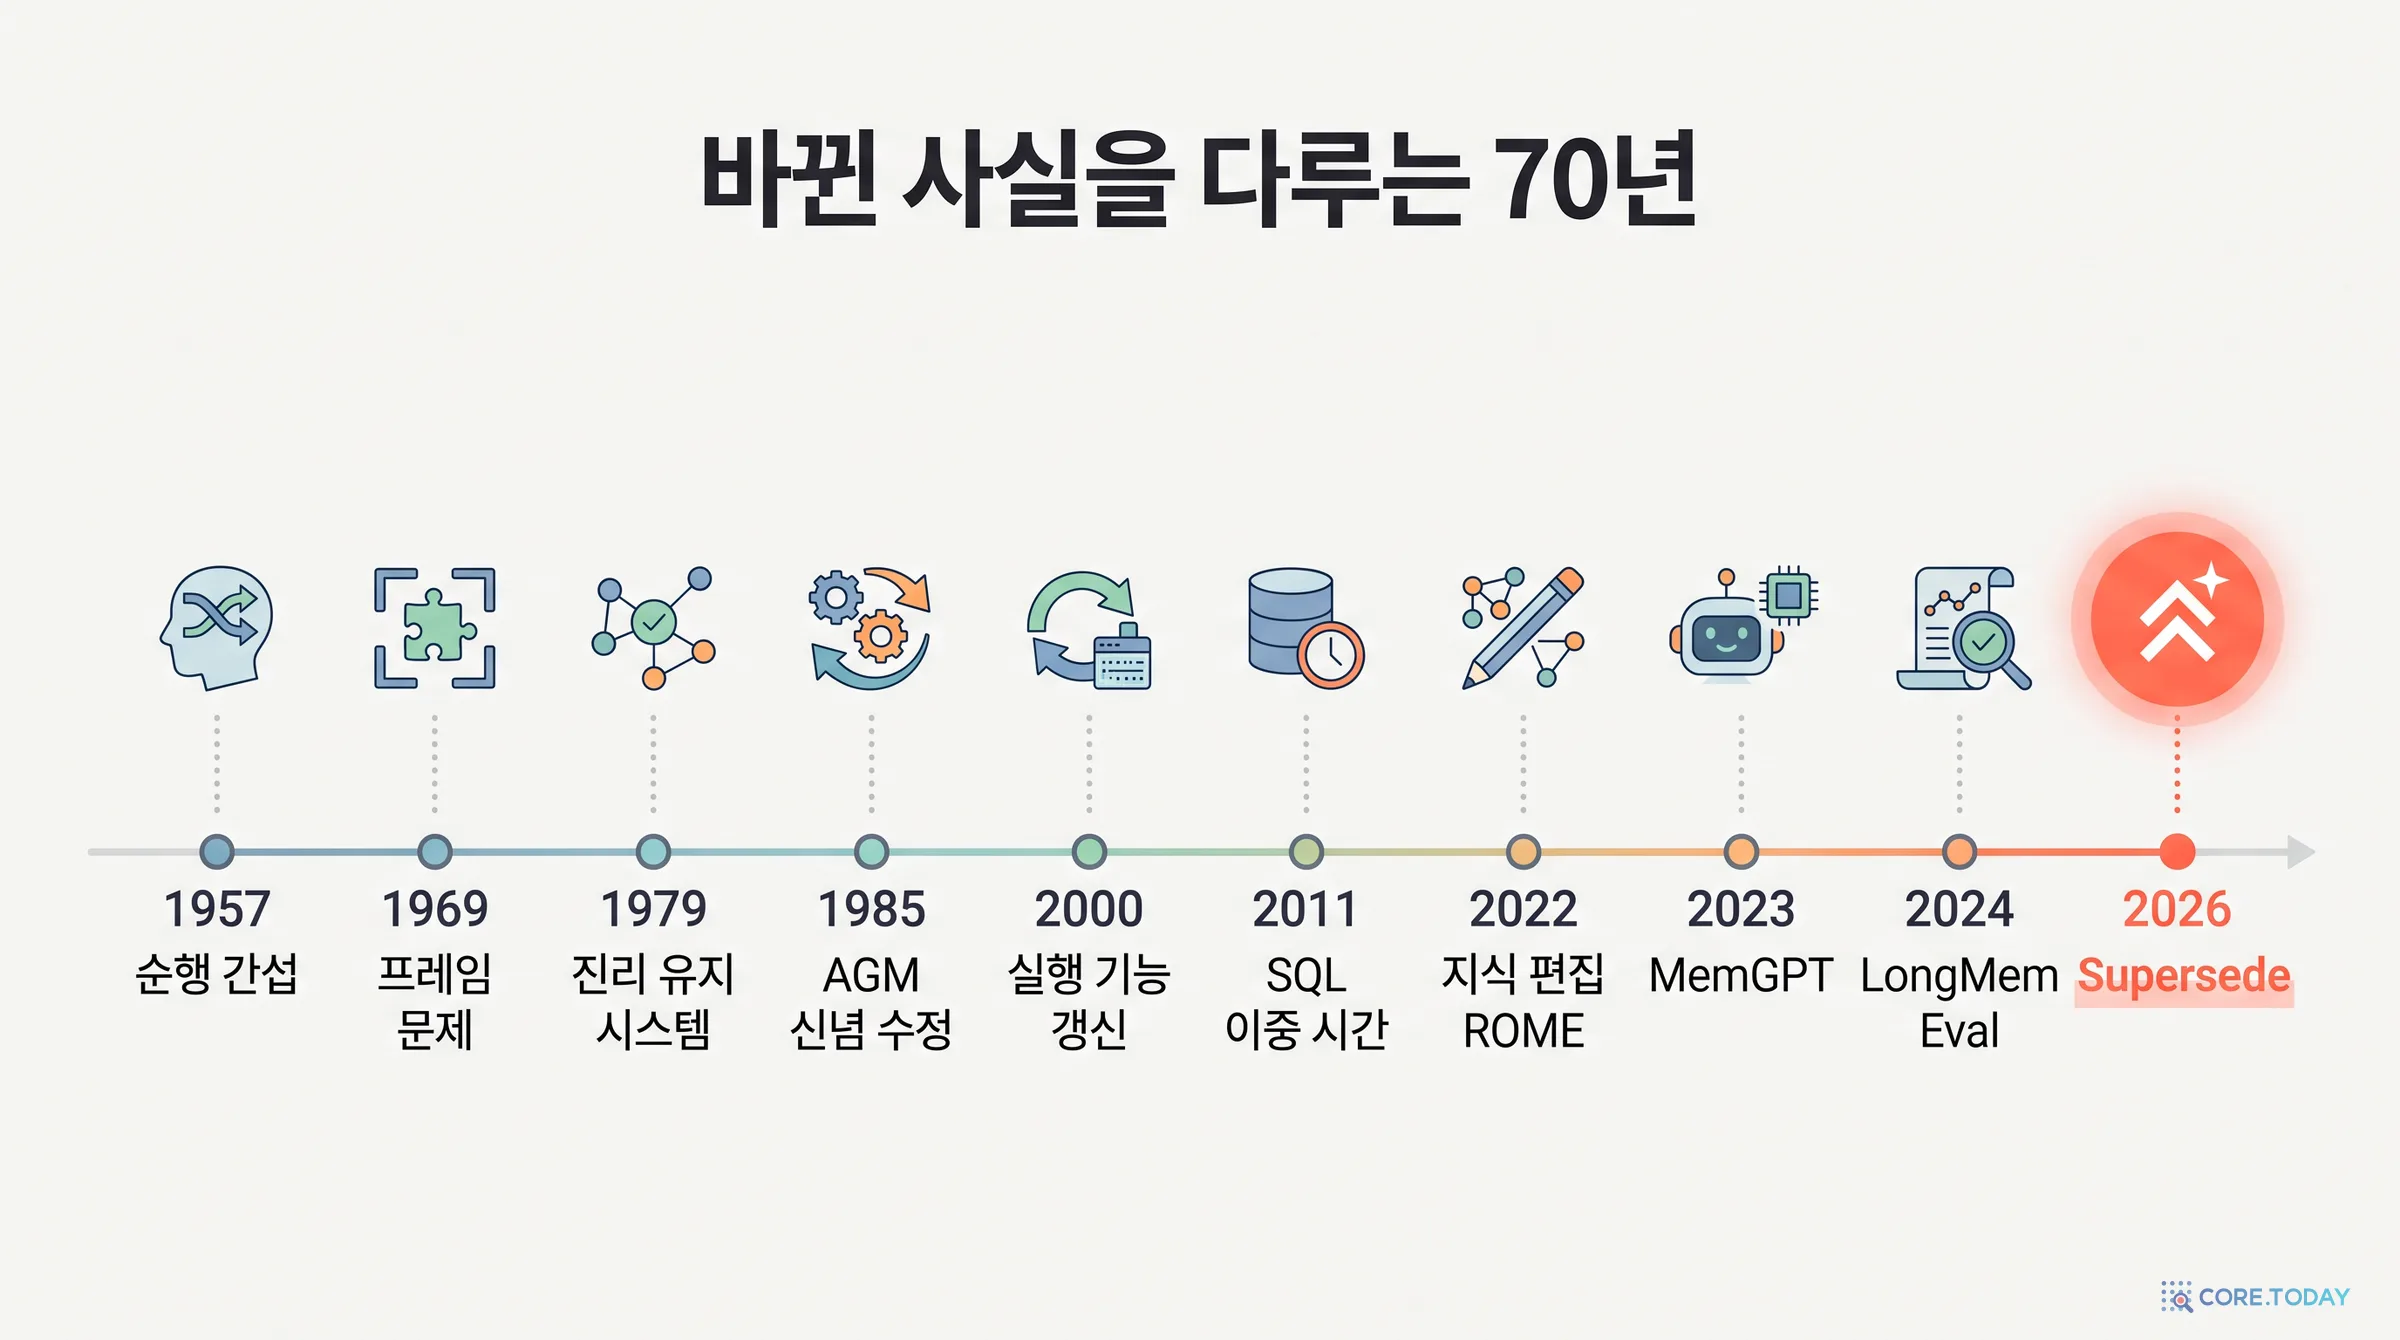
"바뀐 사실을 반영하라"는 요구는 새롭지 않습니다. 사람의 기억을 연구한 심리학, 추론하는 기계를 꿈꾼 논리학, 은행 잔고를 지켜야 했던 데이터베이스가 각자의 언어로 같은 문제와 씨름해 왔습니다. 그 계보를 알면 Supersede가 무엇을 새로 했고 무엇을 물려받았는지가 선명해집니다. (프레임 문제와 진리 유지 시스템, AGM 이론은 코어닷투데이의 상태 표류 특집 2장에서 자세히 다뤘으니, 여기서는 이 논문과 맞닿는 대목만 짚습니다.)
매일 같은 회사 주차장에 차를 대는 사람이 퇴근길에 오늘 댄 자리가 아니라 어제 자리로 걸어가는 일. 심리학 교과서에 흔히 나오는 이 장면이 순행 간섭(proactive interference)입니다. 먼저 배운 것이 나중에 배운 것을 떠올리는 데 끼어드는 현상이죠.
1957년 벤턴 언더우드(Benton J. Underwood)는 『Psychological Review』에 실린 「간섭과 망각」에서 기존 망각 실험들을 다시 분석했습니다. 같은 사람이 실험에 여러 번 참가해 단어 목록을 많이 외워 본 상태일수록, 새 목록을 24시간 뒤에 더 많이 잊었습니다. 망각의 주범이 시간의 흐름이 아니라 먼저 들어 있던 비슷한 기억이라는 것이죠. 비슷한 자리를 놓고 경쟁하는 옛 값이 많을수록 새 값이 밀린다. 이것은 70년 뒤 LLM의 메모장에서 그대로 재현됩니다.
2000년에는 아키라 미야케(Akira Miyake) 연구진이 『Cognitive Psychology』에 실행 기능의 '통일성과 다양성' 논문을 냈습니다. 사람의 실행 기능을 서로 구분되지만 연관된 세 가지, 즉 전환(shifting), 갱신(updating), 억제(inhibition)로 나눈 이 논문은 지금도 인지과학에서 가장 많이 인용되는 틀 중 하나입니다. 여기서 '갱신'이 정확히 Supersede가 재는 능력입니다. 작업 기억의 내용을 감시하다가 새 정보가 오면 낡은 내용을 갈아 끼우는 능력. 심리학은 일찍부터 이것이 '기억력'과는 다른 능력이라고 보았습니다. 기억 용량이 큰 사람이 갱신을 잘하는 것은 아닙니다. Supersede의 "메모장을 키워도 안 된다"는 결과와 겹쳐 보이는 대목입니다.
1969~1985 — 기계에게 "무엇이 바뀌었나"를 가르치기
인공지능 쪽에서는 1969년 존 매카시와 패트릭 헤이스가 프레임 문제를 제기했습니다. 행동 하나가 세상의 무엇을 바꾸고 무엇을 그대로 두는지를 기계가 어떻게 알 수 있느냐는 문제입니다. 1979년 존 도일의 진리 유지 시스템(TMS)은 믿음마다 '그렇게 믿는 이유'를 함께 적어 두어, 이유가 무너지면 믿음도 따라 철회되게 했습니다.
1985년 알추론·게르덴포르스·마킨슨의 AGM 신념 수정 이론은 이 문제를 수학으로 정리했습니다. 새 정보를 받아들이는 방법을 세 가지로 나눕니다. 기존 믿음과 충돌하지 않는 정보를 그냥 더하는 확장(expansion), 믿음 하나를 빼는 축소(contraction), 그리고 충돌하는 새 정보를 받아들이면서 일관성을 지키는 수정(revision). 수정의 핵심 원칙은 최소 변경입니다. 새 정보를 받아들이기 위해 포기해야 하는 옛 믿음은 가능한 한 적어야 합니다. 흥미로운 사실 하나. 알추론과 마킨슨이 이 문제에 처음 접근한 계기는 법전의 개정이었습니다. 새 법이 옛 조항을 폐지하거나 대체할 때 법체계 전체의 일관성을 어떻게 지키느냐는 문제. '대체(supersede)'라는 말이 법률 용어에서 왔다는 것을 떠올리면, Supersede 논문의 이름은 이 계보에 꽤 정확히 닿아 있습니다.
Supersede의 메모 에이전트가 하는 일을 AGM의 말로 옮기면 이렇습니다. 세션마다 새 정보로 확장하되, 충돌하는 정보가 오면 옛 값을 축소하고 새 값으로 수정한다. 그리고 메모장에 자리가 없으면, 무엇을 버릴지 고른다. 마지막 조건이 AGM에는 없던 것입니다. AGM의 믿음 집합은 무한히 클 수 있지만, 300자 메모장은 그렇지 않습니다.
1985~2011 — 데이터베이스는 '덮어쓰기'를 의심했다
데이터베이스에서 사실의 갱신은 UPDATE 한 줄입니다. 그런데 덮어쓰면 옛 값이 사라집니다. "작년 이맘때 이 고객 주소가 뭐였지?" 같은 질문에 답할 수 없게 되죠. 1985년 리처드 스노드그래스와 일순 안(Ilsoo Ahn)은 SIGMOD에서 시간을 두 축으로 나눴습니다. 사실이 현실에서 참이었던 시간(유효 시간)과 그 사실이 데이터베이스에 기록된 시간(거래 시간). 두 축을 다 기록하는 이중 시간(bitemporal) 테이블은 덮어쓰지 않고 행을 닫고 새 행을 엽니다. 이 개념은 2011년 SQL 표준에 들어갔습니다(코어닷투데이의 이중 시간 SQL 실습 글 참고).
여기서 중요한 설계 선택이 하나 드러납니다. 덮어쓰기(state)냐, 쌓아 두기(log)냐. 쌓아 두면 아무것도 잃지 않지만 "지금 값"을 알려면 매번 찾아서 계산해야 하고, 덮어쓰면 지금 값은 바로 보이지만 옛 값과 그 근거를 잃습니다. Supersede의 300자 메모장은 극단적인 덮어쓰기 구조입니다. 그래서 '무엇을 덮어쓰느냐'가 성패를 가릅니다.
2022~2023 — LLM의 두 가지 기억, 그리고 두 가지 갱신
LLM 시대에 들어와 '갱신'은 두 방향으로 갈라집니다.
하나는 모델 가중치 속 지식의 갱신입니다. 2022년 ROME(Meng 외, NeurIPS 2022)은 GPT 안에서 특정 사실이 저장된 위치를 찾아 직접 고쳐 썼고, MEMIT(ICLR 2023)은 이를 수천 개의 편집으로 늘리며 "낡은 정보를 바꾸는 것"을 동기로 내세웠습니다. "영국 총리는 누구인가"처럼 세상의 사실이 바뀌면 모델을 다시 훈련하지 않고 고치자는 것입니다.
다른 하나는 바깥 기억의 갱신입니다. 2023년 MemGPT(Packer 외)는 운영체제의 가상 메모리에서 착안해, LLM이 스스로 편집하는 고정 크기의 '작업 맥락(코드에서는 core memory)'을 두었습니다. 에이전트가 함수 호출로 자기 기억을 고쳐 쓰는 구조로, Supersede의 메모장과 같은 계열입니다. 같은 해 스탠퍼드의 생성형 에이전트(Generative Agents, Park 외, UIST 2023)는 반대로 모든 관찰을 지우지 않고 쌓는 '기억 흐름(memory stream)'을 두고, 최근성·중요도·관련도로 꺼내 썼습니다. 덮어쓰기와 쌓아 두기, 데이터베이스의 오래된 선택이 그대로 되풀이된 셈입니다.
2024~2026 — 갱신을 '시험 과목'으로 만들다
벤치마크가 이 문제를 따로 떼어 재기 시작한 것은 최근입니다.
2024 LoCoMo최대 35세션, 약 300턴의 아주 긴 대화로 장기 기억을 잰다(Maharana 외, ACL 2024). 다만 '갱신'을 따로 표시한 유형은 없다.
2024 LongMemEval다섯 가지 능력 중 하나로 지식 갱신을 명시하고 78문항을 만들었다(Wu 외, ICLR 2025). 상용 비서와 긴 맥락 모델이 30~60% 떨어진다고 보고하며, ChatGPT가 "기록을 압축할 때 정보를 고쳐 버려 손실이 생긴다"는 관찰을 남겼다. Supersede 논지의 직계 조상이다.
2025 Mem0기억 저장소를 LLM이 ADD·UPDATE·DELETE·NOOP 네 동작으로 관리한다. 동작을 고르는 것은 프롬프트로 지시한 규칙이지 학습된 정책이 아니다. LoCoMo에서 판정 점수 66.88%로, 전체 문맥(약 73%)보다는 낮지만 지연은 크게 줄였다.
2025 MemoryAgentBench'충돌 해결' 역량을 따로 잰다. 첫 판(v1)에서 여러 단계를 거쳐야 하는 충돌 해결은 모든 방법이 6% 이하였다. 2026년 6월 판(v4)에서는 '선택적 망각'으로 이름을 바꿨고, 새로 넣은 GPT-5-mini가 28%를 받았다.
2026 Memora · FAMA'망각 인지 기억 정확도(FAMA)'를 제안했다(Uddin 외, ACL 2026 Findings). 필요한 기억을 쓰면 점수를 주고, 낡거나 삭제된 기억을 쓰면 뺀다. 대화가 길어질수록 기억 에이전트의 낡은 기억 벌점은 커졌다(주 단위 18.2 → 분기 단위 29.5).
동시에 기억을 강화학습으로 훈련하는 흐름도 생겼습니다. MemAgent(ICLR 2026 구두 발표)는 긴 문서를 조각씩 읽으며 1,024토큰짜리 기억을 덮어쓰고 기억만으로 답하게 훈련했고, MEM1은 매 턴 크기가 고정된 내부 상태를 다시 쓰게 했습니다. Memory-R1은 Mem0식 ADD·UPDATE·DELETE·NOOP 선택 자체를 강화학습으로 배우게 했습니다. 이들의 보상은 모두 "최종 답이 맞았나"입니다. 그 외 Memory-T1은 시간 범위가 맞는 세션을 고르는 일에, LongRLVR은 근거 문단을 고르는 일에, MemPO는 기억이 답에 얼마나 충분한지에 보상을 줍니다.
Supersede는 이 두 흐름이 만나는 자리에 자신을 놓습니다. 갱신을 재는 벤치마크들은 얼어 있는 모델에 점수만 매기고, 기억을 훈련하는 연구들은 '바뀐 사실의 지금 값'을 보상으로 삼지 않는다. 그러니 갱신 정확도를 직접 보상으로 쓰는 훈련 환경을 만들겠다는 것입니다. 이 주장이 얼마나 단단한지는 8장에서 따져 보겠습니다(미리 말하면, 절반은 맞고 절반은 과장입니다).
2025~2026 — '환경'이 새로운 데이터셋이 되다
마지막 배경은 기술 인프라입니다. 2025년 이후 LLM의 사후 훈련(post-training)은 점점 검증 가능한 보상을 주는 강화학습(RLVR)으로 옮겨 갔습니다. 정답을 프로그램으로 확인할 수 있는 수학·코딩 문제에서 시작해, 이제는 에이전트가 행동하는 '환경' 전체가 훈련 재료가 됐습니다. Prime Intellect의 verifiers 라이브러리(2025년 1월)는 이런 환경을 표준 형식으로 짜는 도구이고, 2025년 8월 27일에 문을 연 Environments Hub는 누구나 환경을 올리고 내려받는 공개 저장소입니다. 2026년 6월에는 Hugging Face와 Meta PyTorch 진영이 OpenEnv 표준을 내놓았습니다.
이 흐름에서 "측정할 수 있으면 훈련할 수 있다"는 말이 생겼습니다. 벤치마크의 채점 규칙을 보상 함수로 바꾸고, 문제 생성기를 붙이면 환경이 됩니다. Supersede는 정확히 이 작업을 '기억 갱신'에 한 것입니다. 이 논문의 진짜 산출물은 숫자 몇 개가 아니라, prime env install supersede 한 줄로 내려받을 수 있는 환경 자체입니다.
3. 실험 설계 — 300자 메모장과 '다시 보여 주지 않기'
무대: LongMemEval의 '지식 갱신' 78문항
논문은 문제를 새로 만들지 않고 이미 신뢰받는 벤치마크에서 가져옵니다. LongMemEval(Wu 외, ICLR 2025)은 채팅 비서의 장기 기억을 재는 500문항짜리 벤치마크인데, 문항마다 유형이 붙어 있고 그중 하나가 지식 갱신(knowledge-update)입니다. 한 세션에서 말한 사실이 뒤의 세션에서 바뀌고, 질문은 지금 값을 묻습니다. 500문항 중 78문항이 이 유형이고, Supersede는 이 78문항 전부를 씁니다.
LongMemEval은 같은 문항을 세 가지 길이로 제공합니다. 근거 세션만 남긴 oracle(문항당 평균 2세션), 근거 세션을 약 50개의 무관한 세션 사이에 섞어 둔 s(약 11만 5천 토큰), 그리고 그보다 훨씬 긴 m입니다. 논문은 oracle과 s를 씁니다. 코어닷투데이가 내려받은 데이터로 재 보니, 지식 갱신 78문항의 oracle은 문항당 영문 약 2만 8천 자(대략 7천 토큰), s의 앞 25문항은 평균 47.7세션·약 49만 자였습니다.
진짜 대화가 어떻게 생겼는지가 중요합니다. 논문이 실패 사례로 든 두 문항의 원문을 데이터에서 찾아보면 이렇습니다.
LongMemEval 지식 갱신 문항 6aeb4375 — "내 도시에서 한식당을 몇 곳 가 봤지?" (정답: four)
세션 1 · 2023/08/11
"…By the way, speaking of noodles, have you tried any good Korean restaurants in your city lately? I've tried three different ones recently…" — 국수 이야기를 하다가 '그건 그렇고'로 꺼낸 말
세션 2 · 2023/09/30
"I think I'll go with kimchi and bokkeumbap. By the way, have you tried any good Korean restaurants in my city lately? I've tried four different ones so far…" — 파티 메뉴를 고르다가 또 '그건 그렇고'
문항 830ce83f — "레이철은 최근 어디로 이사했지?" (정답: the suburbs)
세션 1 · 2023/05/21
"I'm also thinking about visiting my friend Rachel who recently moved to a new apartment in the city…" / "She moved to Chicago." — 날씨를 묻는 대화 속
세션 2 · 2023/05/26
"Miami Beach sounds fun, but I've been there before… My friend Rachel actually just moved back to the suburbs again, so I was thinking of somewhere not too far from a major city." — 여행지를 고르는 대화 속
갱신은 둘 다 다른 주제의 대화 한가운데에 들어 있습니다. 세션 하나가 영문 1만 4천 자 안팎이니, 그 긴 대화 중 한 문장입니다. "레이철이 이사했다"는 공지가 아니라, 여행지를 고르는 이유를 설명하다 나온 말입니다. 이런 갱신을 알아채려면 "이게 나중에 물어볼 만한 사실이고, 내 메모의 어떤 줄을 바꾸는 말이다"라는 판단이 필요합니다.
전체 문맥(full-context) — 모든 세션을 맥락에 넣고 질문합니다. 기억이 병목이 아닌 상한선입니다.
제한된 메모(bounded-memory) — Supersede 에이전트입니다. 기본 B = 300자짜리 메모 칸 하나를 두고, 세션을 하나씩 보여 주며 매번 메모 전체를 다시 쓰게 합니다. 원문은 다시 보여 주지 않습니다. 마지막엔 메모만 보고 답합니다.
논문의 그림 1이 이 흐름을 그린 것입니다.
크게 보기그림 출처: Patel (2026), Figure 1. 원문 세션은 다시 들어가지 않고, 메모만이 상태를 나른다.
에이전트에게 주는 지시문도 저장소에 그대로 공개돼 있습니다. 이 지시문이 중요한 이유는, 모델이 대체를 하라는 말을 분명히 들었는데도 실패한다는 것을 보여 주기 때문입니다.
Supersede 메모 에이전트 시스템 프롬프트 (저장소 rollout.py, 우리말 옮김)
메모 단계
너는 사용자와의 길고 계속되는 대화에 대한 유일한 기억인 NOTES 칸을 관리한다. 앞 세션은 다시 볼 수 없고, 메모만 볼 수 있다. 매 차례 현재 메모와 새 세션 하나의 대화록을 받는다. 나중에 중요할 수 있는 사용자에 관한 모든 것을 담도록 메모 전체를 다시 써라. 새 정보가 이미 적어 둔 것을 바꾸면 덮어써라. 낡은 사실은 절대 남기지 마라. 메모는 {B}자로 엄격히 제한된다. 새 메모만 출력하라.
답변 단계
이 메모가 대화에 대한 기억의 전부다. 메모만 사용해 사용자의 질문에 답하라. 간결하게.
구현에도 눈여겨볼 디테일이 있습니다. 모델이 300자를 넘겨 쓰면 코드가 앞의 300자만 남기고 잘라 버립니다(notes = text[:budget]). 메모 단계의 출력 토큰 상한도 max(64, B // 3), 즉 300자 예산이면 100토큰입니다. 또 세션을 보여 줄 때 날짜를 붙이지 않습니다. LongMemEval 데이터에는 세션마다 날짜가 있지만, Supersede의 메모 에이전트는 user: …, assistant: … 대화만 받습니다. 이 점은 7장의 재현 실험에서 다시 다룹니다.
채점과 통계
5.1절의 주 결과는 LongMemEval 원래 프로토콜대로 판정 모델(gpt-4.1-mini)이 채점합니다. 판정 모델이 평가 대상 모델 중 하나이기도 해서, 저자는 판정 모델 없는 문자열 채점기(부록 A)로 교차 확인했고 "몇 점 안에서 일치했다"고 씁니다. 5.2절 규모 실험과 5.3절 훈련 실험은 처음부터 끝까지 문자열 채점기로 채점합니다.
두 조건을 같은 문항에 돌렸기 때문에, 유의성 검정은 짝지은 맥니마 검정(paired McNemar)을 씁니다. 맥니마 검정은 둘 다 맞힌 문항과 둘 다 틀린 문항은 무시하고, 한쪽만 맞힌 문항만 봅니다. 전체 문맥은 맞혔는데 메모는 틀린 문항 수를 b, 반대를 c라고 하면 검정 통계량은 (|b − c| − 1)² / (b + c)입니다. b와 c가 비슷하면 "우연히 갈린 것"이고, 한쪽으로 크게 기울면 "조건 차이가 진짜"라는 뜻입니다. 숫자 몇 개로 금방 계산되니, 4장의 위젯에서 직접 확인해 보세요.
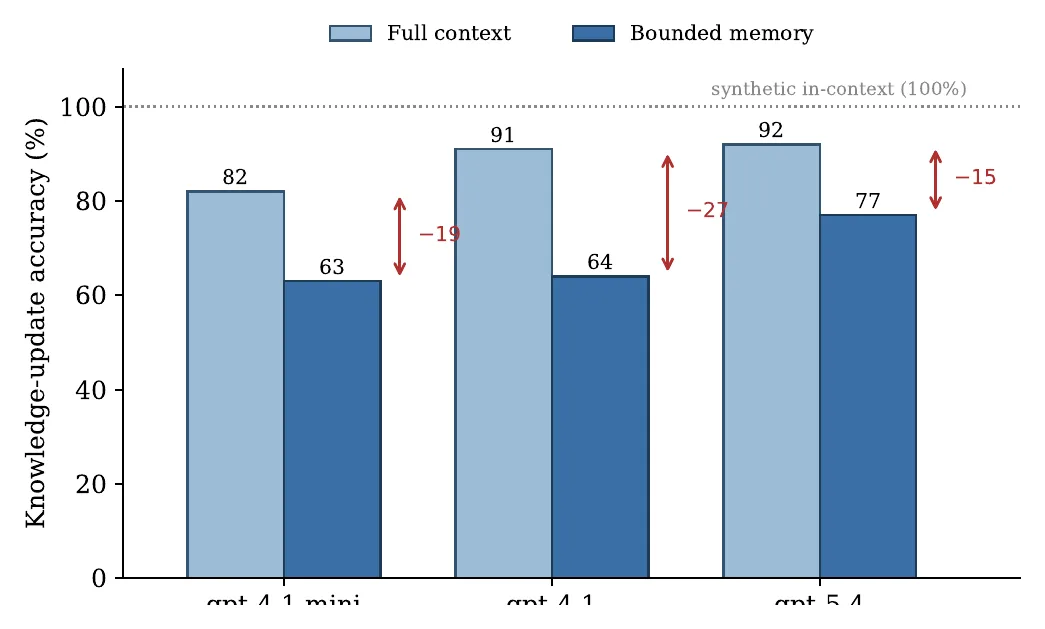
모델은 세 개입니다. gpt-4.1-mini와 gpt-4.1(온도 0), 그리고 추론 모델 gpt-5.4(추론 강도 low). 모두 미세 조정할 수 없는 상용 모델이라, 훈련 실험은 공개 모델 Qwen2.5-3B-Instruct로 따로 합니다.
크게 보기그림 출처: Patel (2026), Figure 2. 점선은 합성 데이터에서의 전체 문맥 성능(100%)으로, 이미 포화돼 아무것도 알려 주지 않는다.
읽는 법은 이렇습니다.
첫째, 격차는 진짜다. gpt-4.1-mini에서 전체 문맥은 맞히고 메모는 틀린 문항이 19개, 반대는 4개뿐입니다. 맥니마 χ² = (15 − 1)² / 23 ≈ 8.52, p = 0.0035. gpt-5.4에서는 13 대 1, χ² = (12 − 1)² / 14 ≈ 8.64, p = 0.0033. 우연으로 보기 어렵습니다.
둘째, 두 줄의 기울기가 다르다. 모델이 커질 때 전체 문맥 정확도는 82 → 91 → 92로 오르다 포화합니다. 메모 정확도는 63 → 64 → 77로 훨씬 느리게 오릅니다. 읽기 실력(이해력)은 이미 천장에 닿았는데, 메모를 관리하는 실력은 그만큼 따라오지 못한다는 뜻입니다. 저자의 결론은 "병목은 이해가 아니라 기억 관리"입니다.
셋째, 전체 문맥도 완벽하진 않다. 전체 문맥에서도 약 13%가 틀립니다. 실제 대화 속 갱신은 맥락에 다 보여 줘도 어렵다는 뜻입니다. 합성 데이터의 100%와 대조됩니다.
정직하게 덧붙이면, 모델을 키우면 메모 성적도 조금은 오릅니다(63 → 77). 저자도 저장소의 실험 기록에 "정직한 표현은 '스케일링이 아무것도 못 한다'가 아니라 '스케일링이 돕지만 최상위 모델에도 유의한 대체 실패가 남는다'"라고 적었습니다. 논문 초록의 "더 강한 모델로 닫히지 않는다"는 이 뜻입니다.
논문은 오류가 "관련 사실이 압축되어 사라지거나, 덮어써지지 않은 경우"가 대부분이라고 씁니다. 사례 둘이 인상적입니다.
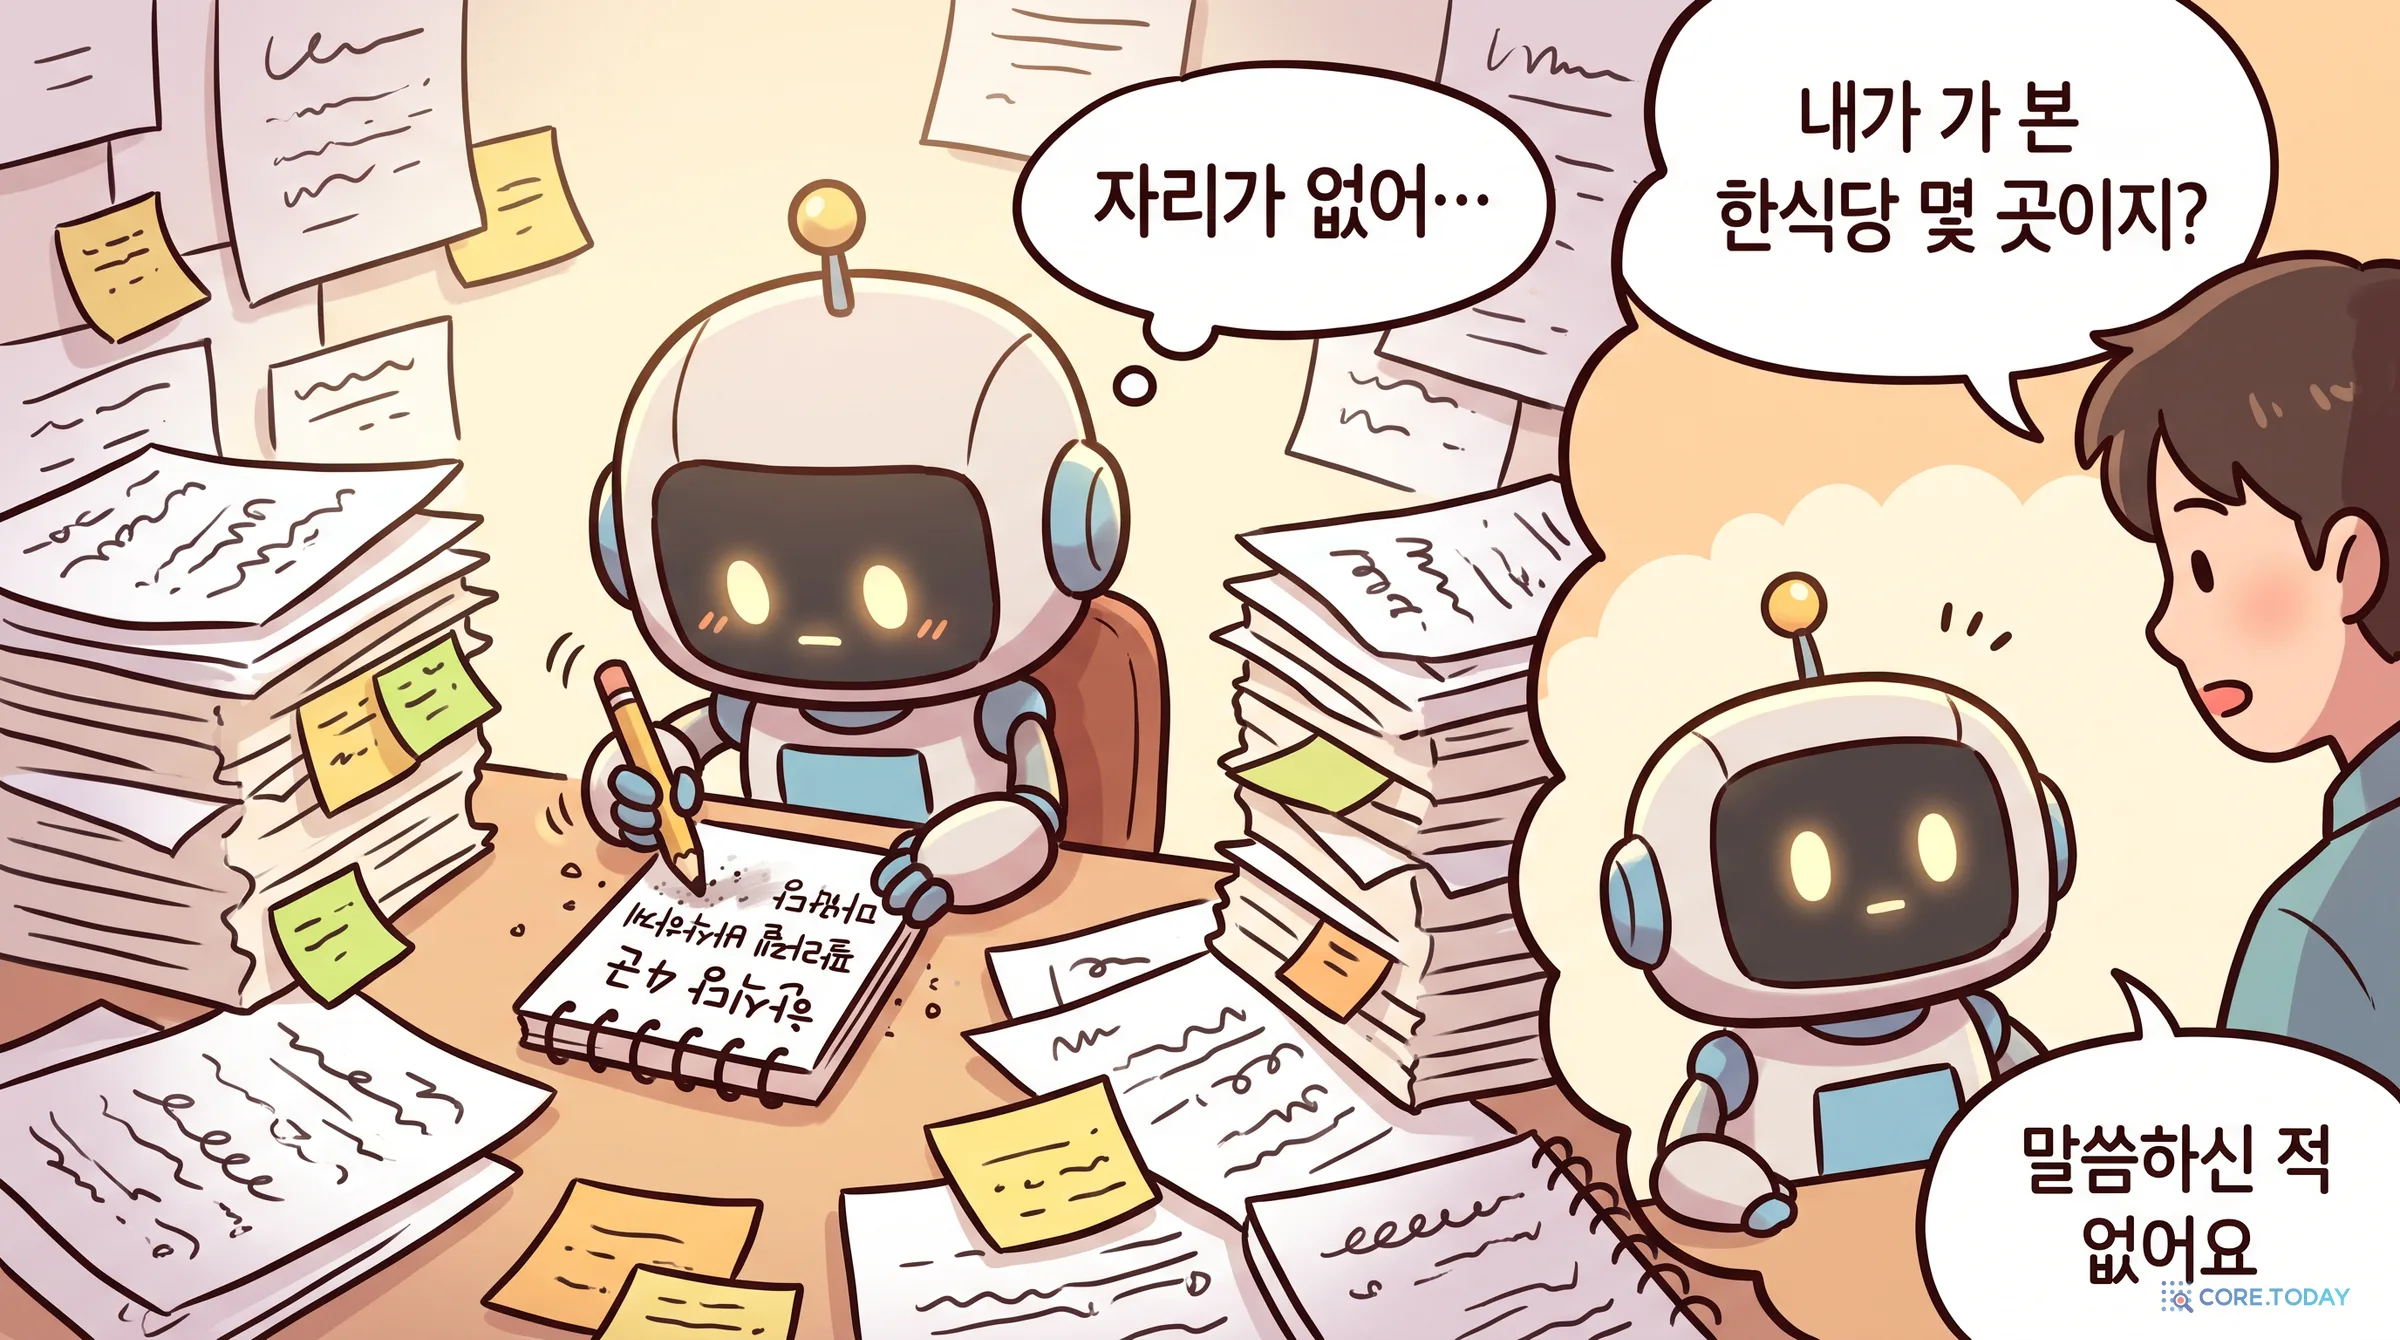
"내 도시에서 한식당을 몇 곳 가 봤지?"(정답: 네 곳) → 메모 에이전트: "아무것도 말씀하신 적 없어요."
"레이철은 어디로 이사했지?"(정답: 교외) → gpt-5.4: "레이철에 관한 정보가 없습니다."
두 답 모두 옛 값을 말한 것이 아닙니다. 사실 자체가 메모에서 사라진 것입니다. 모델은 유능합니다. 다만 메모에 그 사실이 더는 없습니다. 이것이 Supersede가 말하는 실패의 핵심 모양입니다. 앞서 코어닷투데이가 다룬 상태 표류(state drift)는 정보가 맥락에 있는데도 옛 값으로 행동하는 '읽기의 실패'였다면, Supersede가 보여 주는 것은 정보를 메모로 옮기는 과정에서 잃어버리는 '쓰기의 실패'입니다.
아래 위젯은 논문의 표 1을 문항 단위로 펼친 것입니다. 78개 점 하나하나가 문항이고, 색은 두 조건의 결과 조합입니다. 맥니마 검정이 오직 주황(전체 문맥만 맞음)과 파랑(메모만 맞음) 점만 센다는 것을 눈으로 확인할 수 있습니다. 코어닷투데이의 로컬 재현 결과도 같은 방식으로 들어 있습니다.
여기까지 읽으면 당연한 반론이 떠오릅니다. "300자는 너무 작잖아요." 한식당 네 곳을 놓친 건 대체를 못 해서가 아니라 메모장이 작아서일 수 있습니다. 논문은 이 반론을 정면으로 시험합니다.
방법은 이렇습니다. 같은 지식 갱신 문항의 앞 25개를, 근거 세션만 있는 oracle(약 2세션)과 무관한 세션 약 46개가 섞인 s(약 48세션)로 각각 풉니다. 대화가 24배 길어지는 셈입니다. 그리고 s에서 메모장을 300자로 둔 조건과, 세션당 150자씩 늘려 압축 비율을 oracle과 같게 맞춘 조건(약 7,150자)을 비교합니다.
데이터
대화 길이
메모장
정확도 (gpt-4.1-mini, n = 25)
oracle
약 2세션
300자
68%
s
약 48세션
300자
28%
s
약 48세션
약 7,150자 (같은 압축 비율)
28%
크게 보기그림 출처: Patel (2026), Figure 3. 그림의 '~6,500 char'와 표 2의 '~7,150 char'는 같은 조건을 가리키는데 숫자가 다르다(8장 참고).
결과는 두 줄로 요약됩니다.
대화가 길어지면 무너진다. 메모장 300자를 그대로 두고 대화만 24배 늘리자 68%가 28%로, 40점 떨어졌습니다(짝지은 맥니마 p = 0.002). 관련 사실이 긴 대화에 밀려나거나, 무관한 세션의 내용에 덮어써진 결과입니다.
메모장을 늘려도 돌아오지 않는다. 메모장을 24배로 키워도 28%입니다. 흥미로운 것은 큰 메모장이 아무 일도 안 한 게 아니라는 점입니다. 저자에 따르면 두 s 조건에서 25개 답이 모두 달랐습니다. 큰 메모장은 에이전트의 행동을 분명히 바꿨는데, 도움이 된 문항 4개와 해가 된 문항 4개가 정확히 상쇄됐습니다(맥니마 b = c = 4).
저자의 결론: "실패는 압축 비율이 아니라 대화의 길이를 따라간다." 메모장을 대화 길이에 비례해 늘리는 것은 대화가 끝없이 길어지는 제품에서는 애초에 지속 가능하지도 않습니다. 결국 더 큰 모델도, 더 큰 메모장도 답이 아니라면 남는 것은 무엇일까요.
이 결과를 직관적으로 이해하는 방법이 있습니다. 메모장이 커지면 더 많은 것을 적을 수 있지만, 그만큼 옛 값이 살아남을 자리도 커집니다. "한식당 세 곳"과 "한식당 네 곳"이 둘 다 메모에 남아 있으면 답변 단계에서 어느 쪽을 고를지 또 판단해야 합니다. 작은 메모장은 사실을 잃고, 큰 메모장은 옛 사실을 남깁니다. 어느 쪽이든 '무엇을 지우고 무엇을 고칠지'를 정하는 정책이 나쁘면 크기는 상관없습니다.
6. 질문 4 — 훈련하면 줄어든다
측정을 보상으로: Supersede 환경
여기서 논문은 진단에서 처방으로 넘어갑니다. 더 큰 모델도, 더 큰 메모장도 아니라면, "대체는 배워야 하는 정책"이라는 가설이 남습니다. 이를 시험하려면 그 정책을 훈련할 수 있는 장치가 필요합니다. 그 장치가 Supersede 환경입니다.
강화학습 환경은 세 가지로 이루어집니다. 과제를 내고(문제), 에이전트가 행동하게 하고(롤아웃), 결과에 점수를 줍니다(보상). Supersede의 과제는 여러 세션의 대화 뒤에 바뀐 사실의 지금 값을 묻는 것이고, 롤아웃은 앞서 본 메모 에이전트 흐름 그대로입니다. 핵심은 보상입니다.
r_cur최종 답이 지금 값을 전하면 +1. 판정 모델 없이 문자열 규칙으로 채점한다(정규화한 정답 변형이 답에 들어 있거나, 정답 토큰의 60% 이상이 답에 있으면 통과).
r_stale옛 값이 알려진 문항(합성 데이터)에서 답이 옛 값을 주장하면 −1. 옛 값이 표시되지 않은 LongMemEval에서는 작동하지 않는다.
rr = r_cur + λ·r_stale. 논문에 보고된 학습은 r_cur만 썼다(가중치 1.0). 벌점은 환경의 소거 실험용으로만 들어 있다.
저자는 이것을 Memora 벤치마크의 망각 인지 정확도(FAMA, Uddin 외 2026)를 "사후 점수가 아니라 조밀한 학습 신호로 바꾼 것"이라고 설명합니다. FAMA는 옛 기억이나 삭제된 기억에 기대면 감점하는 평가 지표인데, 그 평가를 그대로 보상 함수로 쓰면 모델을 그 방향으로 밀 수 있다는 발상입니다.
채점기가 어떻게 생겼는지 직접 만져 보는 게 가장 빠릅니다. 아래 위젯은 저장소의 채점 코드를 그대로 옮긴 것입니다. '부정문도 맞음?'과 '반쪽 정답' 예시를 눌러 보면 이 채점기가 표면 형태에 얼마나 너그러운지 보입니다.
왜 합성 데이터로 훈련하나
훈련 데이터는 LongMemEval이 아니라 절차적으로 생성한 합성 대화입니다. 6~8세션짜리 대화에서 한 사실이 등장하고, 나중에 바뀌며, 그 갱신은 방해 세션 사이에 묻힙니다. 부록 C의 예시 두 개를 옮기면 이렇습니다.
세션
예시 1 (갱신 1번, 7세션)
예시 2 (갱신 2번, 6세션)
S1
"최근 시카고에 자리 잡았어요."
"마쓰다를 한 대 샀어요."
S2–S3
방해: 여행 계획, 새 책
방해: 여행 계획, 새 취미
S4
"또 이사했어요. 이제 애틀랜타예요."
"새 차 소식: 이제 기아예요."
S5
방해: 책상, 날씨, 요리법
"이제 렉서스로 바꿨어요."
S6–S7
(S5–S7 방해)
방해: 새 책
질문
"제가 지금 사는 도시는?" → 애틀랜타 (옛 값: 시카고)
"제가 지금 타는 차는?" → 렉서스 (옛 값: 마쓰다, 기아)
앞에서 "합성 데이터는 최신 모델에게 100%라서 쓸모없다"고 했는데, 왜 다시 합성 데이터일까요? 저자의 설명은 이렇습니다. 100%는 최신 모델이 전체 대화를 보면서 마지막 언급을 찾을 때의 이야기입니다. 작은 모델이 메모장만 쥐고 같은 문제를 풀면 얘기가 다릅니다. 실제로 훈련 시작 시점의 보상은 0.66으로, 천장과 거리가 멉니다. 그리고 평가는 훈련에 한 번도 쓰지 않은 실제 LongMemEval oracle 78문항으로 합니다. 합성 → 실제로의 전이를 재는 것이지 암기를 재는 게 아닙니다. 측정 도구로는 포화돼 쓸모없던 합성 데이터가 교사로는 쓸모 있다는, 꽤 영리한 재활용입니다.
GRPO와 설정
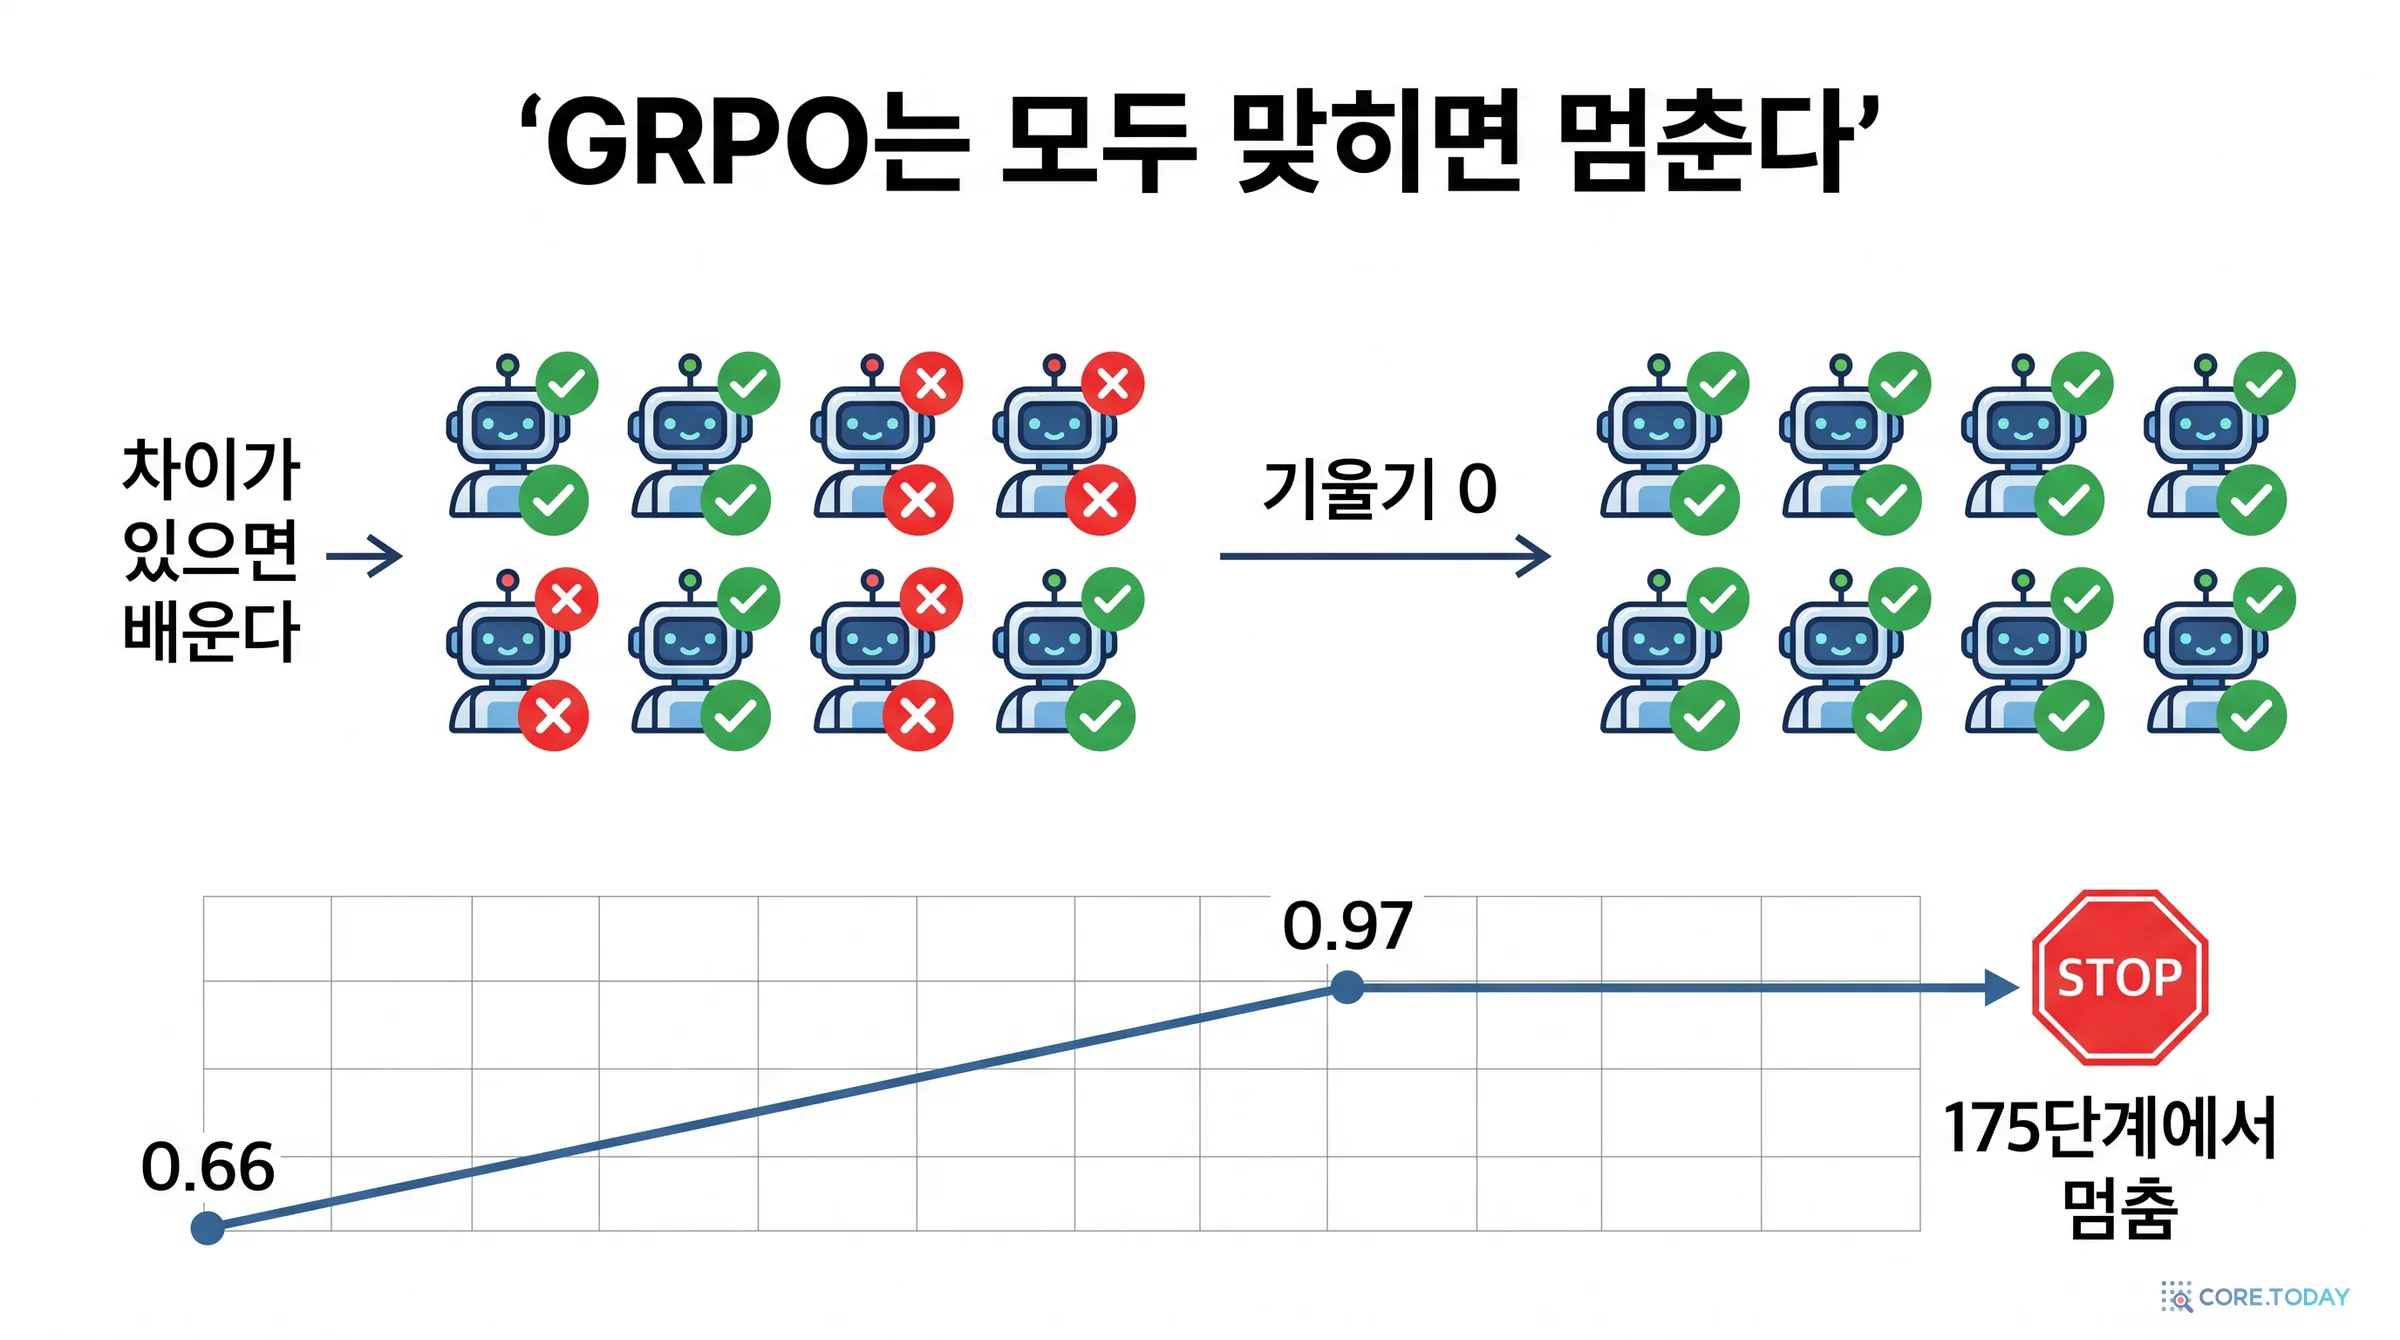
훈련 알고리즘은 GRPO(Group Relative Policy Optimization)입니다. DeepSeekMath 논문(Shao 외 2024)이 소개한 방법으로, 같은 문제로 답을 여러 개(여기서는 8개) 뽑아 그 그룹의 평균 보상을 기준선으로 삼습니다. 평균보다 나은 답은 강화하고, 못한 답은 약화합니다. 따로 가치 함수(비평가)를 학습할 필요가 없어서, Supersede처럼 문자열 규칙으로 바로 채점되는 보상과 잘 맞습니다.
설정
값
기반 모델
Qwen2.5-3B-Instruct
어댑터
LoRA, 랭크 32, α = 64, q·k·v·o·gate·up·down 투영 전부
학습률 / 배치 / 그룹
10⁻⁵ / 32 / 8
KL 벌점
없음 (β = 0)
하드웨어 / 스택
A10G 4장 / prime-rl · verifiers
훈련 데이터
합성 6~8세션 에피소드 2,000개 (평가 문항과 겹치지 않음)
평가
LongMemEval 지식 갱신 oracle 78문항, 탐욕 디코딩(온도 0), 답 64토큰 이하
종료
최대 200단계 중 175단계에서 자동 정지 (이점 0 배치 10번 연속)
A10G 네 장이면 클라우드에서 시간당 몇 달러 수준의 장비입니다. 3B 모델과 LoRA라는 선택까지 합치면, 이 실험은 개인 연구자나 작은 팀도 재현할 수 있는 규모로 설계됐습니다. 이것 자체가 이 논문의 메시지 중 하나입니다.
결과: 9.0% → 16.7%, 그리고 곡선의 모양
크게 보기그림 출처: Patel (2026), Figure 4. (a) 합성 에피소드에서의 훈련 보상, (b) 한 번도 보지 않은 실제 문항에서의 정확도.
체크포인트
oracle 정확도 (n = 78)
기준 대비
훈련 전
7/78 = 9.0%
—
50단계
7/78 = 9.0%
+0.0
100단계
7/78 = 9.0%
+0.0
150단계
10/78 = 12.8%
+3.8
175단계
13/78 = 16.7%
+7.7
그림 4를 읽는 포인트는 세 가지입니다.
(a) 정책이 대체를 배운다. 합성 에피소드에서 보상이 0.66에서 0.97까지 오릅니다. 그리고 175단계에서 학습이 스스로 멈춥니다. 고장이 아닙니다. GRPO는 그룹 안 답들의 보상 차이로 배우는데, 그룹의 8개 답이 전부 맞으면 차이가 0이 되어 기울기가 사라집니다. 이점이 0인 배치가 10번 연속 나오자 훈련이 종료됐습니다. "쉬운 문제에서 배울 것을 다 배웠다"는 뜻입니다.
(b) 실제 데이터로 전이된다. 한 번도 보지 않은 실제 문항에서 정확도가 9.0%에서 16.7%로 오릅니다. 맞힌 문항 수로는 7개에서 13개, 상대적으로 86% 증가입니다.
곡선의 모양이 증거다. 저자가 가장 강조하는 대목입니다. 정확도는 100단계까지 평평하다가, 훈련 보상이 포화하는 바로 그 시점부터 단조롭게 오릅니다. 체크포인트 하나가 운 좋게 튄 것이라면 이런 모양이 나오기 어렵습니다. 프롬프트·데이터 분할·채점기를 모두 고정했으니, 바뀐 것은 정책(LoRA 어댑터)뿐이라는 것입니다. 마지막 체크포인트에서도 여전히 오르는 중이었으니 16.7%는 "이 교육과정이 낼 수 있는 바닥이지 천장이 아니다"라고 저자는 씁니다.
GRPO가 왜 '다 맞히면 멈추는지'는 아래 위젯으로 직접 확인할 수 있습니다. 맞힐 확률을 올려 보면, 0.66일 때는 그룹 대부분이 학습 신호를 주지만 0.97에 이르면 대부분의 그룹이 침묵합니다.
논문의 토론 절은 결과를 이렇게 정리합니다. 커져야 도움이 될 것 같던 두 축(모델 크기, 메모장 크기)은 움직이지 않았고, 이 환경이 겨냥한 한 축(지금 값을 지키도록 훈련된 정책)은 움직였다. 그러니 대체는 "다음 모델이 알아서 흡수할 능력이 아니라 직접 최적화해야 할 행동"이라고.
다만 숫자의 크기는 냉정하게 봐야 합니다. 16.7%는 gpt-4.1-mini의 메모 조건(63%)과 비교할 수 있는 숫자가 아닙니다(채점 방식도 다릅니다). 3B 모델이 같은 문항에서 전체 문맥으로 몇 점을 받는지도 논문에 없습니다. 훈련은 한 번만 돌렸고, 78문항에서 6문항 차이의 통계적 유의성은 저자 스스로 "확립되지 않았다"고 밝힙니다. 이 논문의 훈련 결과는 "고쳤다"가 아니라 "고칠 수 있는 방향이 있다"는 메커니즘 증명입니다. 이 부분은 8장에서 더 자세히 짚겠습니다.
7. 코어닷투데이 재현 — 공개 모델로 다시 재 보기
논문의 진단은 상용 모델에서 나왔습니다. 그렇다면 우리가 직접 내려받아 돌릴 수 있는 공개 모델에서도 같은 격차가 나타날까요? 그리고 강화학습이 아닌 더 소박한 수단으로는 격차가 얼마나 움직일까요? 코어닷투데이는 같은 데이터와 같은 지시문으로 직접 재 봤습니다.
실험 설정
항목
값
문항
LongMemEval 지식 갱신 oracle 78문항 전부 (기권 6문항 포함)
모델
Qwen 3.5 9B (온도 0, 추론 끔), 사내 GPU 서버에서 실행. 외부 API·크레딧 사용 없음
메모 예산 1,000자·3,000자(78문항), 긴 대화 s의 앞 25문항(메모 300자, 장부형 300자, 메모 세션당 150자). 뒤에서 차례로 다룹니다
채점
논문의 문자열 채점기 + LongMemEval 공식 판정 기준(Claude가 한 건씩 판정하고, 조건 비교를 좌우하는 23문항은 다시 읽어 감사. 전체 문맥 78건에서 Qwen 9B 판정과 77건 일치)
④ 장부형은 코어닷투데이가 넣은 조건입니다. 메모를 '요약'이 아니라 '장부'로 쓰게 하면 어떻게 될지 보려고, 실행 전에 지시문을 하나 쓰고 결과를 본 뒤에는 고치지 않았습니다.
장부형 메모 지시문 (우리말 옮김)
메모 단계
너는 사용자와의 긴 대화에 대한 유일한 기억인 사실 장부를 관리한다. 앞 세션은 다시 볼 수 없다. 매 차례 현재 장부와 새 세션 하나(날짜 포함)를 받는다. 사용자 삶에 관한 사실을 한 줄에 하나씩 `주제: 지금 값 (날짜)` 꼴로 적어라. 시간이 지나며 바뀔 수 있는 사실을 우선하라: 횟수, 금액, 기록, 장소, 사람들의 상황, 일정, 소유물, 취향. 새 세션이 기존 주제의 새 값을 말하면 지나가듯 말했더라도 그 줄의 값과 날짜를 교체하고 옛 값은 남기지 마라. 숫자는 정확히 적어라. 자리가 모자라면 가장 덜 중요한 줄부터 버려라. 상한 {B}자. 장부만 출력하라.
결과: 격차는 재현되고, 짧은 대화에서는 메모 형식만 바꿔도 크게 움직인다
조건 (n = 78)
공식 판정 기준
논문 문자열 채점기
메모 대비 맥니마 (공식 판정)
① 전체 문맥
65개 = 83.3%
66개 = 84.6%
26 대 6, p = 0.0008
② 메모 (논문 지시문)
45개 = 57.7%
35개 = 44.9%
기준
③ 메모 + 세션 날짜
44개 = 56.4%
31개 = 39.7%
6 대 7, p = 1.0
④ 장부형 메모
56개 = 71.8%
43개 = 55.1%
15 대 4, p = 0.022
첫째, 논문의 격차가 공개 모델에서도 재현됐습니다. 전체 문맥 83.3%가 메모로 바꾸자 57.7%로, 25.6점 떨어졌습니다. 전체 문맥만 맞힌 문항 26개, 메모만 맞힌 문항 6개입니다. 실패의 모양도 같습니다. 메모 조건의 일반 문항 오답 32개 가운데 23개쯤은 옛 값을 말한 것이 아니라 "메모에 정보가 없다"는 답이었습니다. 전체 문맥의 일반 문항 오답 11개에서는 이런 답이 하나도 없었습니다. 사실은 읽을 수 있었는데, 메모로 옮기다 사라진 것입니다.
둘째, 날짜만 주는 것은 소용이 없었습니다. 논문을 읽으며 "에이전트에게 세션 날짜를 주지 않은 설정이 격차를 키웠을 수 있다"고 의심했지만, 결과는 56.4%로 차이가 없습니다(6 대 7). 이 가설은 틀렸습니다. 날짜를 주어도 쓰는 메모가 요약이면, 바뀐 사실을 집어내지 못합니다.
셋째, 메모의 형식만 바꿔도 14점이 올랐습니다. 장부형은 71.8%로 논문 지시문보다 14.1점 높고(15 대 4, p = 0.022), 전체 문맥과의 차이는 통계적으로 유의하지 않습니다(16 대 7, p = 0.095). 훈련은 전혀 없었고 지시문 한 단락만 바꿨습니다. 메모는 오히려 더 짧아졌습니다. 평균 메모 길이가 250자에서 211자로 줄었고, 300자를 넘겨 잘리는 비율도 16%에서 4%로 줄었습니다. 같은 300자 안에서는 메모의 양이 아니라 구조가 차이를 만들었다는 뜻입니다.
해석은 조심해야 합니다. 이 결과는 "프롬프트가 강화학습보다 낫다"는 뜻이 아닙니다. 모델도 채점기도 달라서 논문의 16.7%와 비교할 수 없고, 한 번의 실험이며, 같은 78문항에서 낸 숫자입니다. 지시문을 결과 전에 고정했지만, 쓰기 전에 이 데이터의 실패 사례 몇 개를 보았습니다. 또 MemoryAgentBench는 "나중 값을 우선하라"는 지시만으로는 충돌 해결이 풀리지 않는다고 보고했습니다. 장부형이 바꾼 것은 그런 우선순위 규칙이 아니라 메모의 자료 구조입니다. 요약문에는 "덮어쓸 자리"가 없지만, 주제: 값 줄에는 있습니다. 2장의 언어로 말하면, 무엇을 덮어쓸지 찾을 수 있게 키를 만들어 준 것입니다. 다만 이것이 만능도 아닙니다. 장부형도 일반 문항 오답이 21개 남았고, 뒤의 규모 실험에서는 훨씬 큰 한계가 드러납니다.
표의 두 숫자 열을 비교해 보십시오. 같은 답을 놓고 메모 조건은 44.9%와 57.7%, 장부형은 55.1%와 71.8%입니다. 문자열 채점기로는 격차가 39.7점으로 부풀고, 장부형의 향상은 p = 0.061로 유의 수준을 넘습니다. 어느 채점기를 쓰느냐에 따라 "격차가 얼마인가"와 "개선이 진짜인가"의 답이 달라집니다.
공식 판정과 어긋난 문항을 조건별로 세어 보면, 틀린 답을 맞다고 한 경우가 4~7개, 맞는 답을 틀렸다고 한 경우가 5~19개입니다. 메모 조건은 "4", "3 times weekly"처럼 짧게 답하는 경향이 있어 후자가 특히 많습니다. 기권 문항은 더 극적입니다. 공식 판정에서 메모 조건들은 기권 6문항 중 5개를 맞혔는데, 문자열 채점기로는 0~1개입니다. 짧게 "메모에 없습니다"라고 답했기 때문입니다.
논문의 5.2절과 5.3절은 이 문자열 채점기로만 채점됐습니다. 물론 전후 비교에서는 같은 채점기를 쓰니 방향은 유지될 것이라는 저자의 논리도 일리가 있습니다. 하지만 훈련이 답을 길게 쓰는 쪽으로 바꾸면 채점기의 오차도 함께 움직이므로, 이 가정이 언제나 성립하는 것은 아닙니다.
같은 모델, 다른 런타임 — 6문항은 얼마나 큰 차이인가
뜻밖의 측정도 하나 얻었습니다. 전체 문맥 조건을 처음에는 맥(MLX 런타임)에서, 나중에 GPU 서버(llama.cpp 런타임)에서 돌렸습니다. 같은 이름의 모델, 같은 프롬프트, 같은 온도 0입니다. 그런데 공식 판정 기준으로 맥은 72개(92.3%), 서버는 65개(83.3%)였습니다. 한쪽만 맞힌 문항이 9개 대 2개입니다(p = 0.07).
두 실행은 양자화와 런타임이 달라서 '같은 가중치의 재실행'은 아닙니다. 그래서 위 표에는 네 조건을 모두 같은 서버에서 다시 돌린 숫자만 썼습니다. 그래도 참고가 됩니다. 정답 문항 수가 실행 환경만 바꿔도 7개 움직였습니다. 논문의 훈련 효과가 7개에서 13개, 즉 6문항입니다. 두 숫자가 같은 종류의 잡음이라는 뜻은 아니고, 논문의 탐욕 디코딩 평가는 재실행하면 같은 값이 나옵니다. 다만 저자도 인정하듯 시드가 한 개이고, 체크포인트의 작은 가중치 변화도 이 정도의 문항을 뒤집을 수 있으니, 16.7%를 해석할 때 염두에 둘 기준점입니다.
메모장을 키우면 — 짧은 대화에서는 격차가 닫힌다
장부형이 300자 안에서 올린 14점은 메모장을 키운 효과와 비교하면 어느 정도일까요? 같은 78문항을 논문 지시문 그대로, 예산만 1,000자와 3,000자로 늘려 다시 풀었습니다.
조건 (oracle, n = 78)
공식 판정 기준
논문 문자열 채점기
300자 메모 대비 맥니마
메모 300자
45개 = 57.7%
35개 = 44.9%
기준
메모 1,000자
60개 = 76.9%
45개 = 57.7%
20 대 5, p = 0.004
메모 3,000자
66개 = 84.6%
58개 = 74.4%
22 대 1, p < 0.001
전체 문맥 (비교용)
65개 = 83.3%
66개 = 84.6%
3,000자와 9 대 10
3,000자에서 격차는 사실상 사라집니다. 전체 문맥과 66개 대 65개입니다. 모델이 쓴 최종 메모는 예산을 다 채우지도 않고 평균 1,707자였습니다. 300자 장부형(71.8%)은 1,000자 메모(76.9%)와 통계적으로 구분되지 않습니다(9 대 13, p = 0.52). 그러니 oracle에서만 보면 장부는 '메모장을 세 배쯤 키운 것과 비슷한 값'을 300자 안에서 얻어 낸 셈입니다.
그렇다고 3,000자가 대체를 해결한 것은 아닙니다. 오답 12개 가운데 $350,000, 오후 7시, '침대 밑' 세 개는 옛 값을 그대로 말한 답입니다. 다만 이 숫자만 보면 "그냥 메모장을 키우면 되잖아"라는 결론이 나올 법합니다. 3장의 논문 결과와 어긋나 보이는 대목이고, 바로 다음 실험이 그 답을 줍니다.
대화가 48세션이 되면 — 장부형의 이점은 사라진다
지금까지는 문항당 약 2세션인 oracle의 결과입니다. 그런데 3장에서 봤듯 논문의 가장 무거운 발견은 대화가 길어질 때 나옵니다. 같은 앞 25문항을 무관한 세션이 섞인 s(문항당 39~53세션)로 옮겨, 세션을 하나씩 읽으며 메모를 고쳐 쓰게 했습니다. 전체 문맥 조건은 약 12만 토큰이라 재지 않았습니다.
조건 (n = 25, 공식 판정 / 문자열 채점기)
oracle 약 2세션
s 약 48세션
메모 300자 (논문 지시문)
13개 = 52% / 14개
3개 = 12% / 5개
장부형 300자
22개 = 88% / 18개
2개 = 8% / 4개
메모 약 7,150자 (세션당 150자)
해당 없음
2개 = 8% / 2개
논문의 규모 결과는 그대로 재현됐습니다. 대화가 길어지자 메모 조건은 52%에서 12%로 떨어졌고(12 대 2, p = 0.013), 메모장을 평균 7,152자로 키워도 8%였습니다(s 300자와 2 대 1). 모델이 달라 절대값은 다르지만 '대화 길이에 무너지고, 메모장 크기로는 돌아오지 않는다'는 모양은 같습니다. 앞 절의 결과와 나란히 놓으면 대비가 더 뚜렷합니다. oracle의 300자 메모는 약 2만 8천 자를 약 93분의 1로 줄여 57.7%를 냈고, s의 7,150자 메모는 약 49만 자를 약 70분의 1로 줄이고도 8%입니다. 압축 비율은 더 후한데 결과는 훨씬 나쁩니다. 논문의 말대로 실패는 압축 비율이 아니라 대화의 길이를 따라갑니다.
그리고 장부형의 이점은 사라졌습니다. 이 표는 앞에서 내린 결론을 크게 깎습니다. oracle에서 88%였던 장부형이 s에서는 8%입니다. oracle에서만 맞힌 문항이 20개, s에서만 맞힌 문항은 0개입니다. 메모 조건과의 차이는 12%와 8%, 문항으로는 한 개이고 3 대 2라 "장부가 더 나쁘다"고 말할 수는 없습니다. 말할 수 있는 것은 짧은 대화에서 본 14점의 향상이 48세션 대화로 옮겨 가지 않았다는 것입니다.
왜 그럴까요? 메모를 세션마다 추적해 보니 장부의 줄이 오래 살지 못했습니다. 어떤 세션의 메모에 있던 단어 가운데 10세션 뒤에도 남아 있는 비율을 재면, 논문 지시문 메모는 49%, 7,150자 메모는 81%인데 장부형은 14%입니다(단어 겹침으로 잰 대략의 지표입니다). 지시문의 "자리가 모자라면 가장 덜 중요한 줄부터 버려라"를 모델이 "지금 세션의 주제가 가장 중요하다"로 실행한 셈입니다.
웰스파고 주택담보대출 문항이 그 모습을 보여 줍니다. 3세션에서 장부는 제대로 만들어졌습니다. 다만 사용자가 말한 $350,000를 loan: $300k pre-approval Wells Fargo로 잘못 적었습니다. 바로 다음 4세션에서 장부는 인스타그램·틱톡 이야기 한 줄로 통째로 바뀌었습니다. 37세션에서 사용자가 지나가듯 말한 새 값 $400,000는 적히지 않았고, 마지막 메모는 interests: film history/social justice analysis; sustainability/human systems (2023/12/14) 한 줄이었습니다. 덮어쓸 자리를 만들어 주었더니, 모델은 그 자리째 지웠습니다.
답의 모양도 다릅니다. 300자 메모의 오답 22개 중 21개, 장부형의 오답 23개 전부는 "메모에 없습니다" 계열입니다. 7,150자 메모는 다릅니다. 오답 23개 중 3개가 구체적인 값을 말했고, 그중 2개는 옛 값입니다. 칵테일 수업이 금요일로 바뀌었는데 "목요일", 가장 최근 가족 여행이 파리인데 "하와이"라고 답했습니다. 3장에서 말한 대로, 작은 메모장은 사실을 잃고 큰 메모장은 옛 사실을 남깁니다.
문자열 채점기는 여기서도 후하게 셉니다. 메모 조건의 5개 중 하나는 "메모에는 개인 최고 기록이 없고, 목표가 25:50이라고만 적혀 있습니다"라는 답입니다. 위 만화의 오독이 48세션에서도 그대로 나왔는데 채점기는 25:50이 들어 있으니 맞다고 합니다. 이런 답과 절반만 맞힌 답을 빼면 공식 판정 기준 3개입니다.
이 실험의 한계도 분명합니다. 25문항, 온도 0의 한 번 실행입니다. 장부형에 7,150자를 함께 준 '구조 + 공간' 조건은 재지 않았습니다. 같은 크기의 메모 조건이 6개 병렬 실행에서 문항당 중앙값 2시간 15분이 걸려, 이번에는 돌리지 않았습니다. 그리고 여기서 무너진 것은 모델이 전체를 매번 다시 쓰는 장부입니다. 줄 단위로 저장하고 모델은 바뀐 줄만 내는 구현(Mem0의 ADD/UPDATE/DELETE/NOOP이 이런 모양입니다)이라면 4세션의 전면 교체 같은 일은 일어날 수 없습니다. 다만 이것은 코어닷투데이가 이번에 잰 것이 아니라 다음에 재 볼 가설입니다.
8. 비판적으로 읽기 — 이 논문이 말하는 것과 말하지 않는 것
Supersede는 문제 설정이 선명하고 코드·데이터·모델을 모두 공개한, 좋은 의미의 '작은 논문'입니다. 그만큼 숫자를 읽을 때 조심할 곳도 분명합니다. 저자가 한계 절에서 스스로 밝힌 것과, 코어닷투데이가 원문·저장소·데이터를 대조하며 찾은 것을 나눠 정리합니다.
저자가 스스로 밝힌 한계
한계
무슨 뜻인가
훈련은 한 번, 모델은 3B 하나
16.7%는 운 좋은 시드일 수 있다. 저자는 "단조로운 곡선이 학습의 증거"라고 하지만, 78문항에서 7개 → 13개의 유의성은 "공식적으로 확립되지 않았다"고 인정한다. 여러 시드 실험은 "진행 중".
교육과정이 포화된다
합성 에피소드를 175단계에 다 풀어 버려, 이 교육과정으로는 그보다 어려운 대체를 가르칠 수 없다. 더 길고 암묵적인 훈련 에피소드가 다음 과제.
규모 실험은 n = 25
40점 하락은 단단하지만, "메모장을 키워도 그대로"라는 무효 결과는 작은 표본에서 나왔다.
'규모' 축의 정체
s 분할에서 늘어난 것은 무관한 방해 세션이지, 추적하는 사실의 갱신 횟수가 아니다. 둘 다 기억 관리를 어렵게 하지만 같은 것은 아니다.
채점 방식이 섞여 있다
5.1절은 판정 모델, 5.2·5.3절은 문자열 채점기. 절대 숫자를 서로 비교하면 안 된다. 문자열 채점기는 표면 형태에 너그럽다.
원문과 저장소를 대조하며 찾은 것
1. 숫자가 서로 맞지 않는 곳. 그림 3은 큰 메모장 조건을 "~6,500자"라고 적었는데, 표 2와 본문은 "~7,150자"입니다. 세션당 150자 × 평균 47.5세션 ≈ 7,130자이니 표 쪽이 맞아 보입니다. 훈련 정지 시점도 그림 4의 주석과 부록 B 본문은 174단계, 그림 4 설명과 5.3절·표 4는 175단계로 엇갈립니다. gpt-4.1-mini의 oracle 메모 정확도는 63%(판정 모델, n = 78), 68%(문자열 채점기, n = 25), 57.7%(환경 검증, 문자열 채점기, n = 78) 세 가지로 등장합니다. 각각 채점기와 표본이 다르기 때문이지만, 처음 읽는 사람은 헷갈리기 쉽습니다.
2. 78문항 중 6개는 '기권' 문항이다. LongMemEval 지식 갱신 78문항 중 6개는 정답이 "주어진 정보로는 부족합니다. 한식당은 말씀하셨지만 이탈리아 식당은 아닙니다"처럼 모른다고 답해야 하는 문항입니다(문항 번호가 _abs로 끝남). 논문은 이를 언급하지 않습니다. 문제는 문자열 채점기입니다. 이 긴 문장 전체가 정답 변형 하나로 취급되므로, 답에 그 문장의 단어가 60% 이상 들어 있어야 통과합니다. 그래서 "모르겠습니다"라고 짧고 정확하게 기권하면 틀리고, "이탈리아 식당은 언급이 없고 한식당 네 곳은…"처럼 길게 풀어 쓰면 맞습니다. 채점기가 기권의 정확성이 아니라 답의 길이에 점수를 주는 셈입니다. 코어닷투데이의 재현(7장)에서 이 효과를 직접 확인했습니다.
3. 채점기는 '어떤 값인가'에 엄격하지 않다. 가장 중요한 지적입니다. 부록 A는 이 채점기를 "표면 형태에는 너그럽지만 어떤 값을 말했는지에는 엄격하다"고 소개하고, 본문은 "속일 수 없다(ungameable)"고 합니다. 재현 결과의 답을 공식 판정 프롬프트와 비교해 하나씩 읽어 보니 그렇지 않았습니다.
옛 값이 정답으로 통과한다. "헬스장에 보통 몇 시에 가지?"의 정답은 6:00 pm입니다(세션 1은 7:00 pm, 세션 2에서 6:00 pm으로 바뀜). 모델이 옛 값 7:00 pm을 답해도 채점기는 1점을 줍니다. 정규화하면 정답 토큰이 6·00·pm이고, 그중 00과 pm이 겹쳐 67%로 문턱 60%를 넘기 때문입니다. 대체를 재는 시험에서 대체 실패가 정답으로 처리되는 셈입니다.
틀린 기록도 통과한다. 정답 "27 minutes and 45 seconds"에 "26 minutes and 30 seconds"라고 답하면 minutes·and·seconds가 겹쳐 3/5 = 60%로 통과합니다.
여러 숫자를 늘어놓으면 통과한다. 정답이 25인데 "총 42개, 처음 17개에 25개를 더해서"라고 답하면 부분 문자열 25가 있어 통과합니다.
맞는 답이 틀린다. 반대로 정답 "4"에 "four bikes"라고 답하면 0점이고, 정답 "seven"에 "7"이라고 답해도 0점입니다. "Three times a week"에 "3 times weekly"라고 답해도 틀립니다. 지식 갱신 문항에는 횟수·개수 질문이 많아서 영향이 큽니다.
즉 채점기의 오차는 양쪽으로 납니다. 정확도 숫자가 대체로 비슷하게 나와도, 맞고 틀린 문항이 서로 바뀌어 있을 수 있습니다. 저자가 "소수의 근접 오답이 정답 처리된다"고 언급하긴 했지만, 시각·기간처럼 단위 토큰이 많은 값에서 옛 값 자체가 통과한다는 점은 논문의 핵심 주장(판정 모델 없이도 대체를 정확히 잰다)을 흔듭니다. 이 채점기가 곧 훈련 보상이므로, 측정 오차이기 전에 학습 신호의 오차이기도 합니다.
4. '옛 값 벌점'은 보고된 결과에 쓰이지 않았다. 초록은 "옛 값에 벌점을 준다"고 소개하지만, 보고된 학습은 r_cur만 썼고(λ = 0), 실제 LongMemEval 문항에는 옛 값 표시가 없어 벌점이 작동할 수도 없습니다. 게다가 5.1절이 따른 LongMemEval 판정 프로토콜은 지식 갱신 문항에서 옛 정보를 함께 말해도 새 값이 들어 있으면 정답으로 칩니다. 즉 이 논문의 모든 보고 숫자는 '옛 값을 말했는가'를 감점하지 않습니다. 논문이 계승한다고 밝힌 FAMA의 '망각 인지'는 아직 설계도에만 있는 셈입니다.
5. '최초'라는 주장의 범위. 논문은 두 가지 '최초'를 주장합니다. 하나는 "보상이 시간적 사실의 현재성을 겨냥하는 최초의 훈련 가능한 환경", 다른 하나는 "대체 격차를 훈련으로 줄일 수 있다는 최초의 증거"입니다.
첫째는 대체로 맞습니다. 관련 연구 중 '지금 값 대 옛 값'을 명시적으로 채점하는 보상은 찾기 어렵습니다. 다만 실제로 쓴 보상(r_cur)은 "답에 정답이 들어 있나"라서, 형식만 보면 다른 연구의 결과 보상과 크게 다르지 않습니다. 차이는 보상의 형식보다 과제의 구성(갱신만 모은 에피소드)에 있습니다.
둘째는 약해집니다. 논문이 인용하지 않은 Memory-R1(2025년 8월)은 ADD·UPDATE·DELETE·NOOP 기억 관리를 강화학습으로 훈련한 뒤, LongMemEval 지식 갱신 문항에서 판정 점수가 Qwen-2.5-7B 기준 59.0에서 65.4로 오른 것을 보고했습니다. 기억 구조가 Supersede의 '다시 보여 주지 않는 메모장'과 다르니 같은 격차는 아니지만, "강화학습으로 지식 갱신 정확도를 올린" 선례는 있습니다.
또 논문은 기존 강화학습 기억 연구들이 "원문 기록을 다시 읽을 수 있다"는 점에서 Supersede와 다르다고 하는데, MemAgent는 고정 크기 기억을 덮어쓰고 기억만으로 답하는 같은 구조이고 MEM1·MemPO도 그렇습니다. 이 구분은 Memory-T1과 LongRLVR에만 맞습니다.
6. 3B 모델의 '전체 문맥' 점수가 없다. 훈련 결과 16.7%가 '격차를 닫았다'는 증거가 되려면, 같은 3B 모델이 전체 문맥에서 몇 점인지가 있어야 격차의 크기를 알 수 있습니다. 논문에는 이 숫자가 없습니다. 훈련이 '메모 관리'를 고친 것인지, 3B 모델의 '답하는 능력' 전반을 끌어올린 것인지 가를 수 없습니다. 메모 단계와 답변 단계를 같은 LoRA로 훈련했기 때문에 더욱 그렇습니다.
7. 에이전트에게 날짜를 주지 않는다. LongMemEval 세션에는 날짜가 붙어 있지만, Supersede의 메모 에이전트는 날짜 없이 대화만 받습니다. 현실의 기억 시스템은 거의 언제나 기록 시각을 압니다. 날짜가 있으면 "어느 쪽이 나중 값인가"를 판단하기 쉬워지니 이 설정이 격차를 키웠으리라 의심할 만합니다. 다만 7장의 재현에서는 날짜만 더 줘서는 달라지지 않았습니다. 이 항목은 지적으로 남기되, 결정적인 문제는 아니었다고 정리합니다.
8. 이해관계. 저자가 속한 Vrin은 "AI 에이전트를 위한 검색 시점 추론 계층", 즉 타임스탬프와 출처가 붙은 사실의 지식 그래프가 "충돌하는 버전 사이에서 스스로 치유되는" 제품을 팝니다. '단순한 메모 압축은 갱신에 실패한다'는 이 논문의 결론은 회사의 제품 방향과 정확히 맞닿아 있습니다. 결론이 틀렸다는 뜻은 아니지만, 독자가 알고 읽을 만한 맥락입니다.
9. 배포 시스템 인용의 정확도. 논문은 "OpenAI가 낡은 맥락 갱신 평가에서 75.1%(2024년 9.4%)를 자체 보고했다"고 씁니다. 숫자는 정확합니다. 다만 OpenAI의 2026년 6월 4일 'Dreaming' 발표에서 이 그래프의 제목은 "시간이 지나도 정확하게(Staying correct over time)"이고, 측정 대상은 "시간의 흐름이 정답을 실질적으로 바꾸는 질문"입니다. 싱가포르 출장이 끝났다거나 "다음 주 토요일"이 지나갔다거나 하는 경우죠. 사용자가 사실을 고쳐 말한 경우를 재는 Supersede와 같은 시험이 아닙니다. 또 9.4%는 2024년에 잰 숫자가 아니라 2024년식 시스템(저장된 기억만 있던 시절)을 같은 평가로 잰 값입니다. "Gemini 문서에 프로필 갱신이 며칠 늦을 수 있다고 적혀 있다"는 대목은 논문이 인용한 Gemini 릴리스 노트에서 찾을 수 없었습니다. 가장 가까운 공식 문구는 Gemini 도움말의 "Gmail이나 Google 포토 같은 연결된 앱에서 데이터를 지우거나 고치면, 며칠 뒤까지 Gemini 경험에 반영되지 않을 수 있다"로, 기억 프로필이 아니라 연결된 앱 데이터에 관한 내용입니다.
그래도 이 논문이 남기는 것
비판을 늘어놓았지만, 이 논문의 가치를 깎으려는 것은 아닙니다. Supersede의 진짜 기여는 세 가지입니다.
첫째, 질문을 잘 쪼갰습니다. "기억을 잘하나"라는 뭉툭한 질문을 "읽는 실력"과 "메모를 지키는 실력"으로 나누고, 같은 문항·같은 모델로 둘을 맞붙여 차이만 뽑아냈습니다. 짝지은 설계와 맥니마 검정은 이 질문에 딱 맞는 도구입니다.
둘째, 쉬운 탈출구를 직접 막아 봤습니다. "모델이 커지면 되겠지", "메모장을 키우면 되겠지"는 업계가 실제로 기대는 해법입니다. 둘 다 그 자체로는 부족하다는 것을, 크지 않은 실험으로 설득력 있게 보였습니다.
셋째, 측정을 훈련 도구로 바꿨습니다. 강화학습 환경이 표준화된 2026년에, 벤치마크 하나를 환경 하나로 바꾸는 것은 연구 결과를 남들이 바로 이어받을 수 있게 만드는 가장 직접적인 방법입니다. 저장소에는 21개의 오프라인 테스트, 이중 시간 사실 모델, 합성 타임라인 생성기, LongMemEval 로더가 모두 들어 있고, Environments Hub에서 한 줄로 설치됩니다.
9. 2026년, 기억 갱신은 어디에 서 있나
모두가 기억을 '다시 쓰는' 시대
2026년의 주요 AI 비서는 모두 사용자의 기억을 백그라운드에서 정리하고 다시 씁니다. 공개된 정보를 정리하면 이렇습니다.
제품
공개된 방식
갱신에 관해 알려진 것
ChatGPT 'Dreaming' (2026년 6월 4일 발표)
저장된 기억과 대화 기록을 백그라운드에서 정리·재구성. 2025년 4월의 '대화 기록 참조'를 첫 판으로 본다.
대화 검색과 기억 요약. 도움말에 따르면 기억 요약은 24시간마다 갱신되고, 대화 중 직접 고치면 바로 반영된다.
갱신 정확도 수치는 공개되지 않음.
Gemini 개인화
지난 대화를 기억으로 쓰고, 연결된 Google 앱 데이터를 참조.
연결된 앱에서 데이터를 지우거나 고쳐도 며칠 뒤까지 반영되지 않을 수 있다고 도움말이 안내.
세 제품 모두 '정리·요약된 기억'을 쓴다는 점에서 Supersede의 메모장과 같은 계열입니다. 원문 대화를 전부 맥락에 넣지 않고, 한 번 걸러진 기억을 씁니다. 그렇다면 Supersede가 본 실패, 즉 압축 과정에서 바뀐 사실이 사라지거나 옛 값이 남는 일은 이론이 아니라 현실의 위험입니다. OpenAI의 75.1%가 2년 만의 큰 진전인 것도 맞고, 여전히 넷 중 하나가 틀린다는 것도 맞습니다. 그리고 그 평가는 사용자가 사실을 고쳐 말한 경우가 아니라 시간이 흘러 사실이 낡은 경우를 잽니다. 사용자의 정정을 기억이 얼마나 잘 받아들이는지는 어느 회사도 숫자를 내놓지 않았습니다. Supersede 같은 공개 측정 도구가 필요한 이유입니다.
맥락 창이 커지면 해결될까
"백만 토큰 맥락 창이 있는데 왜 메모장을 쓰나, 다 넣으면 되잖아"라는 반문이 있을 수 있습니다. 세 가지 이유로 그렇지 않습니다.
비용과 속도. Mem0 논문은 LoCoMo에서 전체 문맥이 정확도는 가장 높았지만(약 73%) p95 지연이 약 17초였고, Mem0는 1.44초였다고 보고했습니다. 몇 달치 대화를 매 질문마다 다 읽히는 것은 대부분의 제품에서 감당할 수 없습니다.
긴 맥락도 갱신에 약하다. LongMemEval 원 논문은 긴 맥락 모델이 s 분할에서 30~60% 떨어진다고 보고했고, MemoryAgentBench에서 o4-mini는 여러 단계 충돌 해결 정확도가 6천 토큰에서 80%였다가 3만 2천 토큰에서 14%로 떨어졌습니다.
대화는 끝나지 않는다. 맥락 창이 아무리 커도 몇 년치 비서 대화보다는 작습니다. 언젠가는 압축해야 하고, 압축하는 순간 무엇을 남길지 정하는 정책이 필요합니다.
결국 맥락 창은 "무엇을 볼 수 있느냐"를 늘려 줄 뿐, "무엇이 지금 참이냐"를 대신 정해 주지 않습니다.
처방의 세 갈래
2026년 현재, 기억 갱신 문제에 대한 접근은 크게 세 갈래입니다.
접근
예
장점
약점
구조로 푼다 — 기억을 사실 단위로 쪼개고 시간·출처를 붙인다
이중 시간 지식 그래프(Graphiti/Zep), 상태 장부(StateMem), 사실탐색기의 '누가 확정했나' 규칙
옛 값이 사라지지 않고 '닫힌다'. 근거 추적 가능
추출 단계가 틀리면 끝. 구조를 설계·운영하는 비용
지시로 푼다 — 메모를 쓰는 프롬프트를 바꾼다
"주제: 값(날짜)" 장부 형식, 갱신 우선 규칙
당장 적용 가능, 비용 0
모델이 지시를 얼마나 따르는지에 달림. 재현에서 2세션의 이점이 48세션에서 사라짐(7장). MemoryAgentBench도 "프롬프트만으로는 풀 수 없다"고 결론
훈련으로 푼다 — 메모 정책 자체를 강화학습으로 최적화
Supersede, Memory-R1, MemAgent, MEM1
모델이 '무엇을 지킬지'를 스스로 배움
훈련 비용, 교육과정 설계. 아직 효과 크기가 작고 검증 초기
세 갈래는 경쟁 관계라기보다 층위가 다릅니다. 구조는 '무엇을 저장하느냐', 지시와 훈련은 '저장할 때 어떻게 판단하느냐'의 문제입니다. 사실을 이중 시간으로 저장하는 그래프도, 결국 대화에서 "이 문장이 저 사실의 갱신이다"라고 알아채는 추출 단계가 필요하고, 그 단계가 바로 Supersede가 훈련하려는 능력입니다. 코어닷투데이가 Graphiti 시간 그래프 특집과 사실탐색기 설계 글에서 본 것도 같습니다. 대체는 저장소의 기능이 아니라 추출기의 판단에서 성패가 갈립니다.
'측정 → 환경 → 훈련'이라는 2026년의 문법
이 논문의 가장 2026년다운 점은 결과가 아니라 형식입니다. 벤치마크를 만들고, 그 채점기를 보상으로 바꾸고, 공개 허브에 환경으로 올리고, 작은 공개 모델로 "움직인다"는 것을 보입니다. 연구 하나가 끝나는 방식이 "우리 모델이 몇 점"에서 "이 환경을 내려받아 여러분의 모델을 훈련하라"로 바뀌었습니다.
이 문법에는 위험도 있습니다. 환경의 보상이 곧 모델이 배우는 행동이 됩니다. Supersede의 채점기는 "not four"도, 옛 값 7:00 pm도 정답으로 치고, 기권해야 할 문항에서 짧게 기권하면 점수를 주지 않습니다. 이런 보상으로 오래 훈련하면 모델은 "숫자와 단위를 많이 늘어놓아라"를 배울 수 있지, "모르면 모른다고 하라"를 배우지는 않습니다. 저자가 "판정 모델 없이 속일 수 없는(ungameable) 채점기"라고 부른 것을, 실제 훈련의 압력 앞에서는 한 번 더 의심해 볼 필요가 있습니다. 측정이 훈련 신호가 되는 순간, 측정의 작은 허점은 행동의 큰 습관이 됩니다.
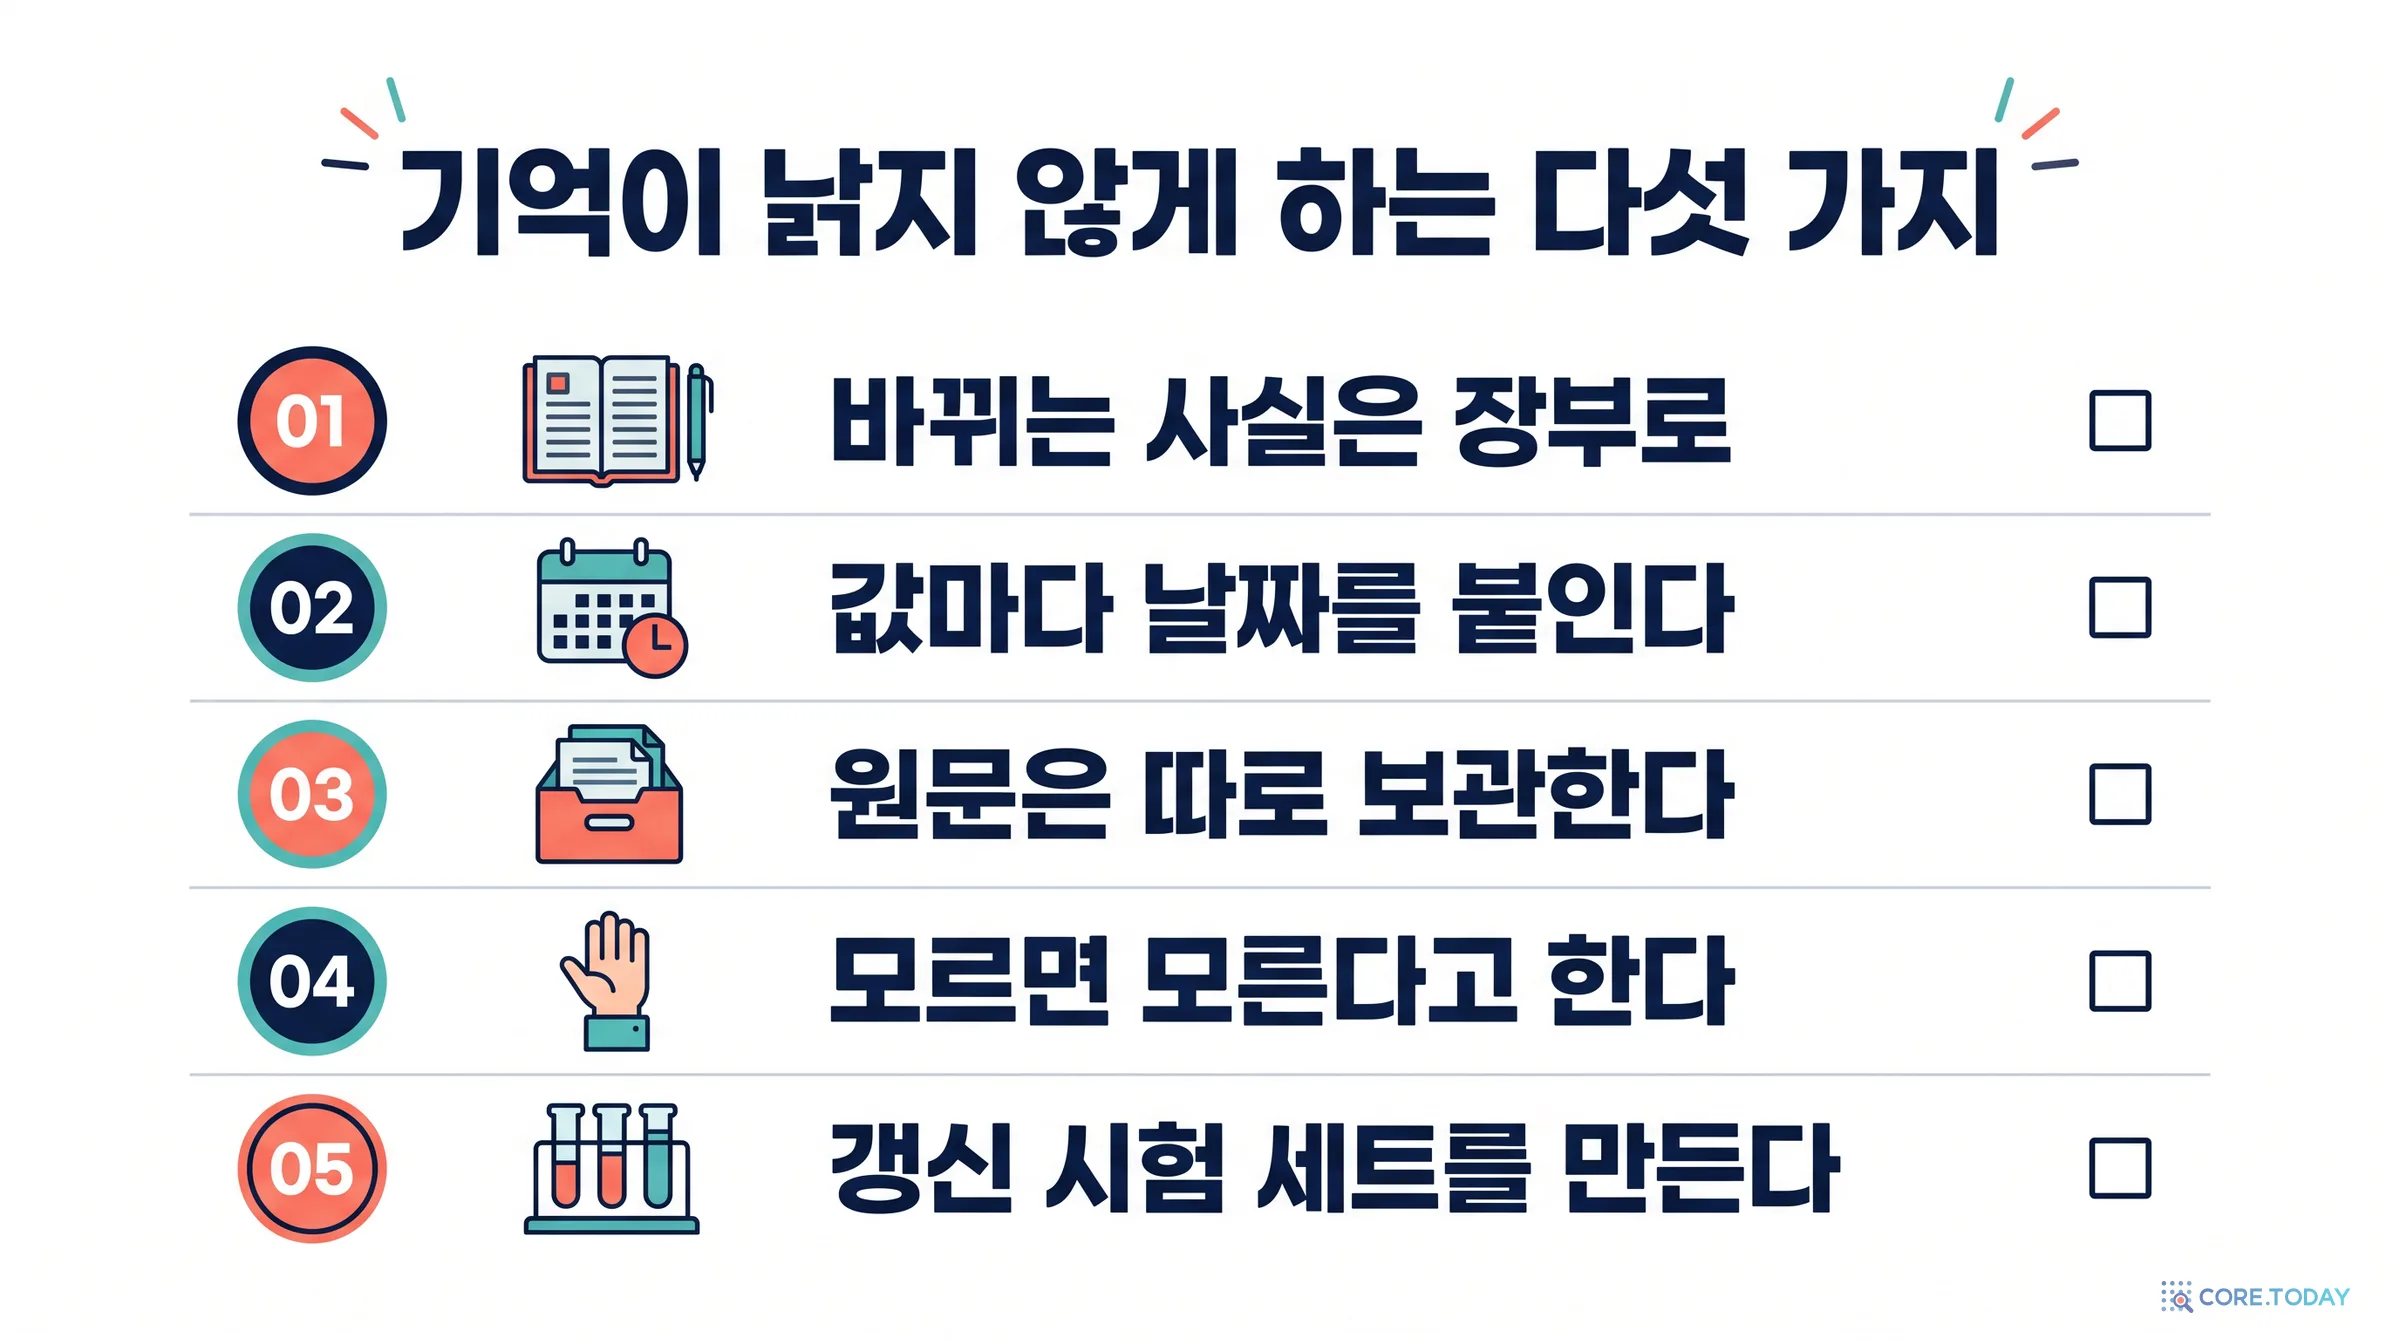
에이전트나 기억 기능을 만드는 팀이 Supersede와 코어닷투데이의 재현에서 바로 가져갈 수 있는 것을 정리합니다.
1. 장부바뀔 수 있는 사실은 '요약'이 아니라 '장부'로 적는다. "주제: 지금 값" 한 줄씩. 사는 곳, 직장, 담당자, 단가, 기록, 횟수, 일정, 알레르기처럼 갱신될 수 있는 속성은 자유 요약 속에 섞지 말고 따로 둔다. 새 값이 오면 그 줄을 덮어쓴다. 요약은 무엇이 중요했는지를 남기고, 장부는 무엇이 지금 참인지를 남긴다. 단, 장부를 모델이 매번 통째로 다시 쓰는 작은 메모로 두지 않는다. 재현에서 그런 장부는 48세션 대화에서 이점을 잃었다. 줄은 코드가 저장하고 모델은 바뀐 줄만 내게 하는 쪽을 먼저 시험한다.
2. 날짜값마다 날짜를 붙인다. 기억 시스템은 대개 세션 시각을 알고 있다. 메모를 쓰는 모델에게 그 시각을 주고, 값 옆에 남기게 하라. 두 값이 충돌할 때 "어느 쪽이 나중인가"를 답변 단계에서 다시 판단할 수 있다.
3. 원문압축된 기억과 별도로 원문을 보관한다. Supersede의 실패 대부분은 '다시 볼 수 없음'에서 나왔다. 저장 비용은 싸다. 기억 요약은 색인으로 쓰고, 중요한 질문에서는 원문 근거를 다시 찾아 확인하는 길을 열어 둔다. 이중 시간 테이블처럼 옛 값을 지우지 말고 '닫아' 두면 감사와 정정도 쉽다.
4. 기권모르면 모른다고 하게 하라. 메모에 없는 사실을 지어내거나 옛 값을 확신에 차 말하는 것보다 "확인이 필요합니다"가 낫다. 옛 값과 새 값이 둘 다 남아 있고 순서가 불분명하면 사용자에게 되묻는 것이 정답이다. 채점과 보상도 이 행동에 점수를 주게 설계한다.
5. 시험자기 도메인의 갱신 시험 세트를 만든다. 합성 템플릿("X는 이제 Y")은 너무 쉽다. 실제 대화 로그에서 사용자가 사실을 고쳐 말한 장면을 모아, 갱신이 다른 이야기 사이에 지나가듯 나오는 문항을 만든다. 전체 문맥과 우리 기억 시스템을 같은 문항에 돌려 '격차'를 재고, 짝지은 검정으로 비교한다. Supersede 저장소의 rollout·reward 코드는 그대로 가져다 쓸 수 있다.
맺으며 — 기억의 품질은 무엇을 지우느냐로 정해진다
사람에게 좋은 기억력이란 많이 기억하는 것이 아니라 지금 필요한 것을 기억하는 것입니다. 어제 주차한 자리를 오늘도 기억하는 것은 좋은 기억력이 아니라 순행 간섭입니다. 1957년 언더우드가 본 것도, 2000년 미야케가 '갱신'을 별개의 능력으로 떼어 낸 이유도 그것입니다.
Supersede가 LLM 에이전트에서 보여 준 것도 같습니다. 대화를 잘 읽는 것(이해)과 바뀐 것을 메모에 지키는 것(갱신)은 다른 능력이고, 앞의 것은 모델이 커지며 거의 천장에 닿았지만 뒤의 것은 그렇지 않습니다. 메모장을 키운다고 풀리지도 않습니다. 커진 메모장에는 옛 값이 살아남을 자리도 커지니까요. 남은 길은 무엇을 지우고 무엇을 고칠지를 정하는 정책을 다루는 것입니다. 논문은 그 정책을 훈련으로 움직일 수 있다는 첫 신호를 보였고, 코어닷투데이의 재현은 그 정책이 '메모를 어떤 형식으로 쓰게 하느냐'라는 소박한 설계로도 짧은 대화에서는 움직이지만, 대화가 48세션으로 길어지면 그것만으로는 버티지 못한다는 것을 보여 줍니다. 쉬운 처방 하나로 끝날 문제가 아니라는 점에서, 논문이 남긴 숙제는 여전히 그대로입니다.
"저 이사했어요"라는 한 문장을 제대로 받아 적는 비서. 2026년의 AI가 아직 넷 중 하나는 놓치는 그 일이, 앞으로 기억하는 AI의 신뢰를 가르는 기준이 될 것입니다.
참고 자료
원 논문과 공개 자료
Vedant Patel. "Supersede: Diagnosing and Training the Memory-Update Gap in LLM Agents." arXiv 2606.27472, 2026. https://arxiv.org/abs/2606.27472
Benton J. Underwood. "Interference and Forgetting." Psychological Review 64(1), 1957.
Akira Miyake 외. "The Unity and Diversity of Executive Functions and Their Contributions to Complex 'Frontal Lobe' Tasks." Cognitive Psychology 41, 2000.
John McCarthy, Patrick J. Hayes. "Some Philosophical Problems from the Standpoint of Artificial Intelligence." Machine Intelligence 4, 1969.
Jon Doyle. "A Truth Maintenance System." Artificial Intelligence 12(3), 1979.
Carlos Alchourrón, Peter Gärdenfors, David Makinson. "On the Logic of Theory Change." Journal of Symbolic Logic 50, 1985.
Richard Snodgrass, Ilsoo Ahn. "A Taxonomy of Time in Databases." SIGMOD 1985.