기억력 시험은 만점, 심부름은 낙제 — MemoryArena가 보여 준 에이전트 기억의 진짜 시험
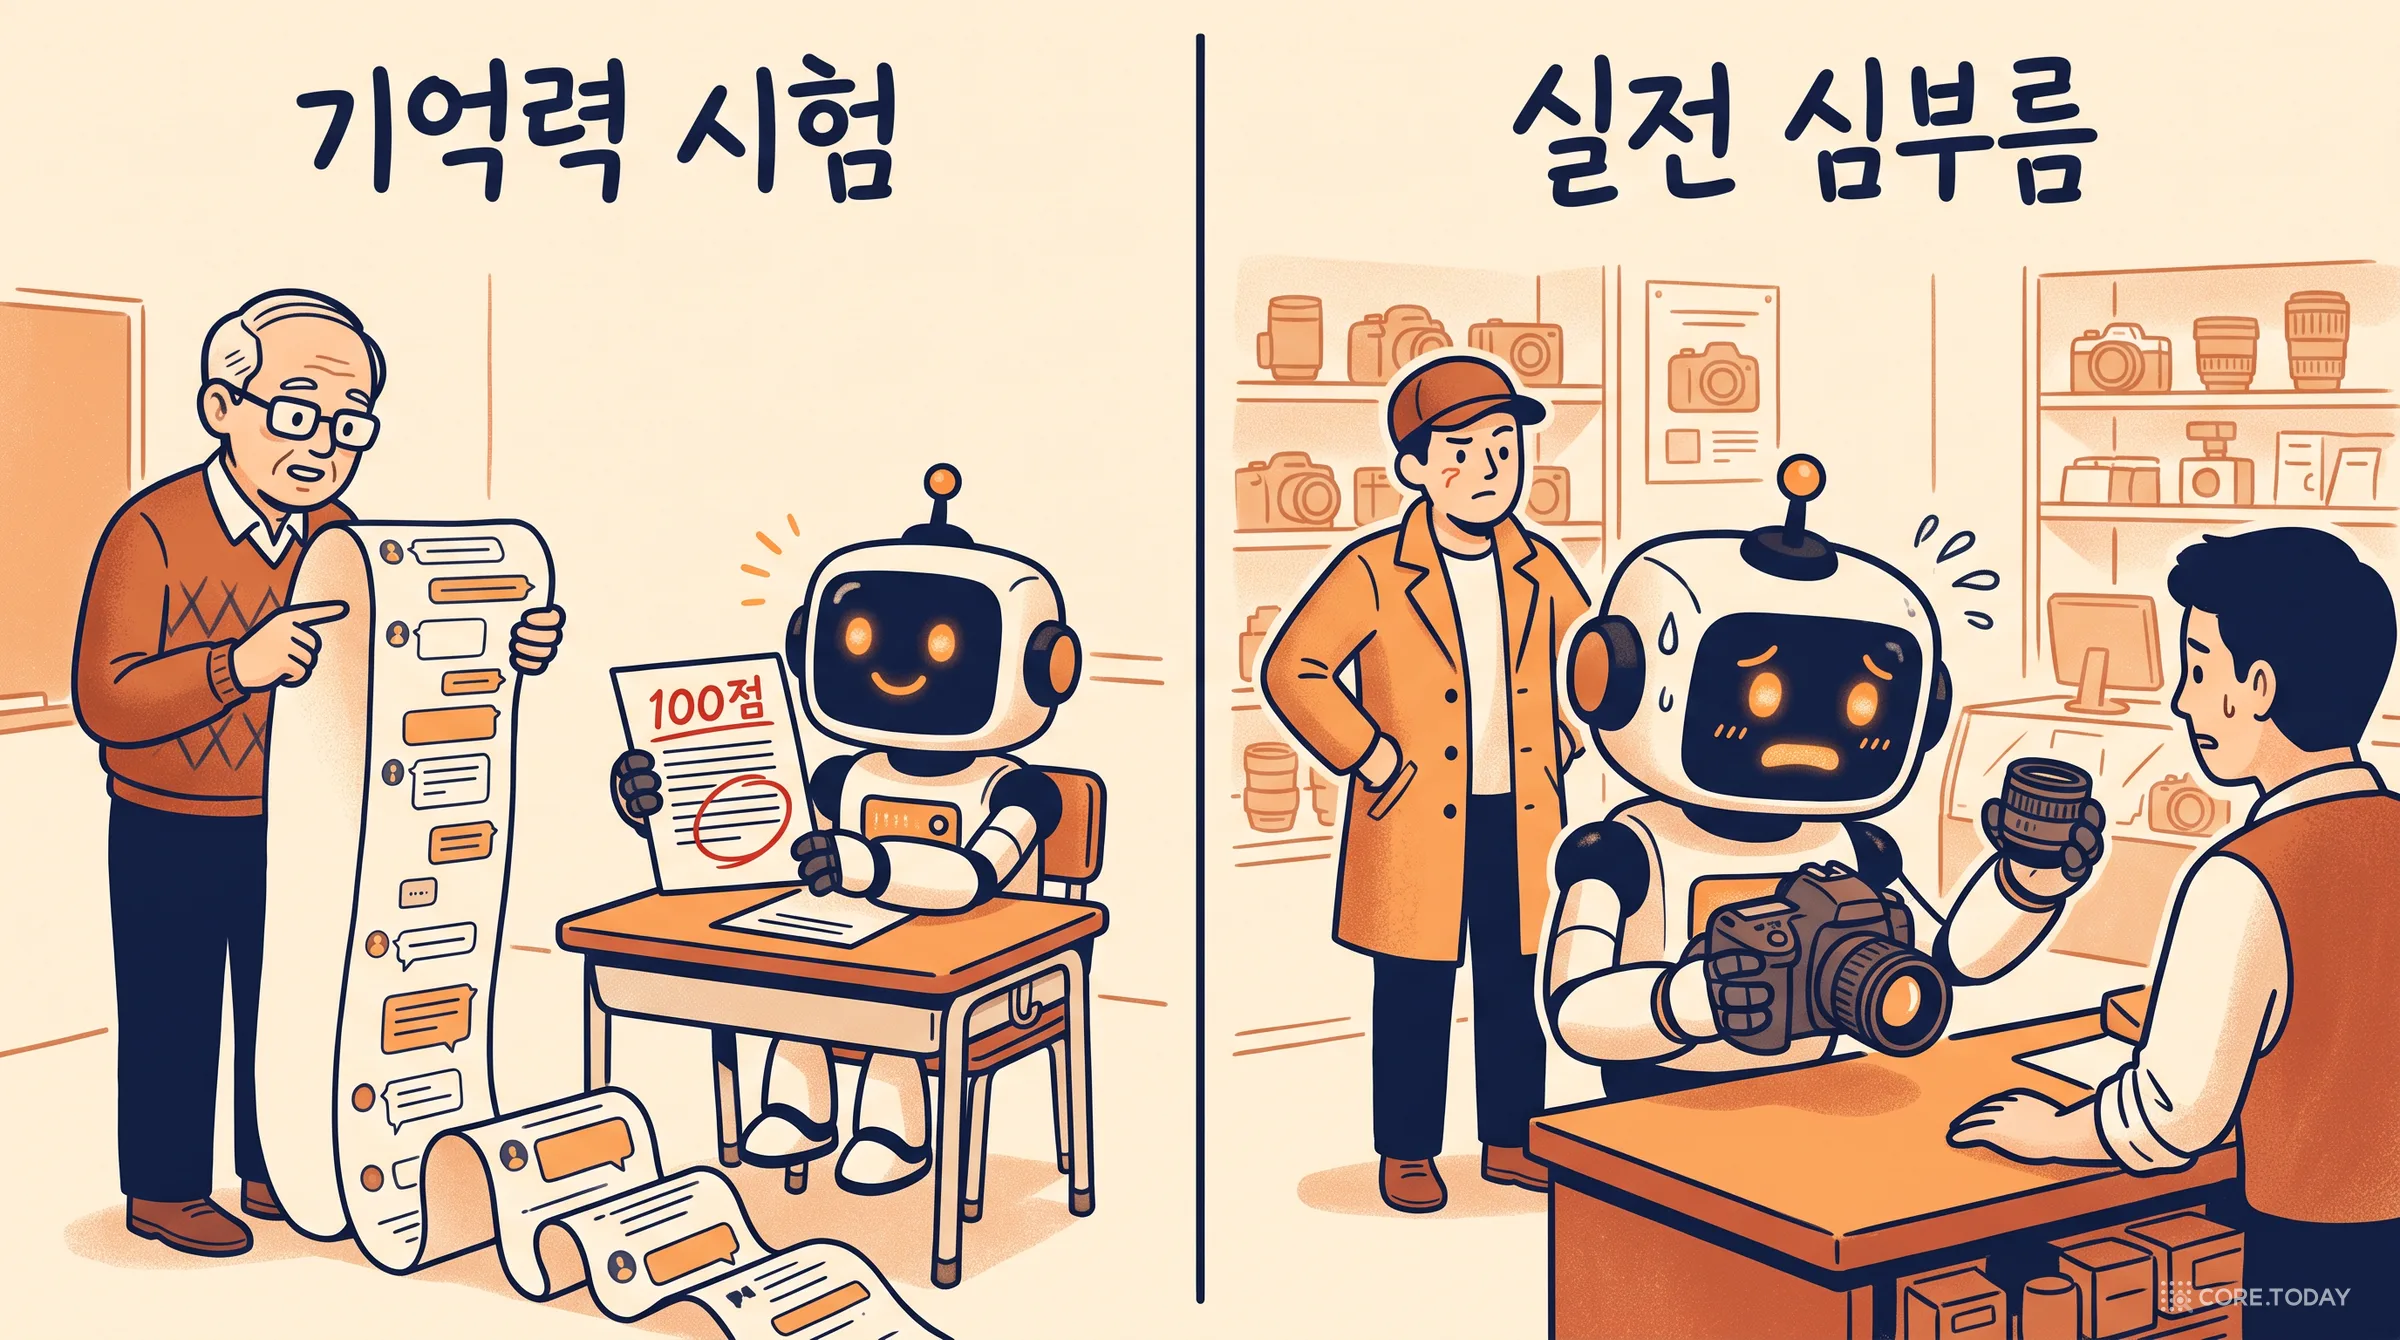
LoCoMo 같은 기억력 시험에서 90점대를 받는 에이전트가, 어제 산 카메라에 맞는 렌즈를 오늘 사 오는 심부름은 거의 못 합니다. ICML 2026 논문 MemoryArena는 기억을 '회상'이 아니라 '다음 행동'으로 채점합니다. 묶음 쇼핑·단체 여행·점진 검색·수학/물리 증명 사슬 701과제(하위 과제 4,850개)에서 롱컨텍스트·기억 에이전트·RAG 13가지 방식의 과제 성공률은 모두 0.20 이하였고, 단체 여행은 전원 0이었습니다. 기억 장치를 붙였다고 나아지지도 않았습니다. 왜 이런 시험이 필요해졌는지 1990년대 인지과학과 POMDP부터 건초더미 속 바늘, LoCoMo·LongMemEval까지 거슬러 올라가고, 네 경기장의 설계와 표·그림·부록 사례·공개 심사평을 하나씩 읽습니다. 공개 데이터로 '기억해 내기'와 '기억으로 행동하기'를 직접 갈라 재 보니, 같은 모델이 같은 기억으로 앞 여행자의 선택을 97% 떠올렸지만 그 선택을 기준 삼은 행동은 36%만 맞혔고, 필요한 사실을 정답으로 쥐여 줘도 31%였습니다. 모델이 직접 쓴 요약 메모는 취향만 적고 결정을 버려 회상 0%였습니다. 인터랙티브 5개.
이 글은 코어닷투데이 에이전트 기억 연재의 후속편입니다.메모리 벤치마크 점수, 믿어도 되나에서 LoCoMo·LongMemEval 점수를 직접 다시 채점하고, 마지막 절 「새 시험지들」에서 MemoryArena를 한 줄로 소개했습니다. 이번에는 그 한 줄을 한 편으로 펼칩니다.
0. 어제 산 카메라, 오늘 사는 렌즈
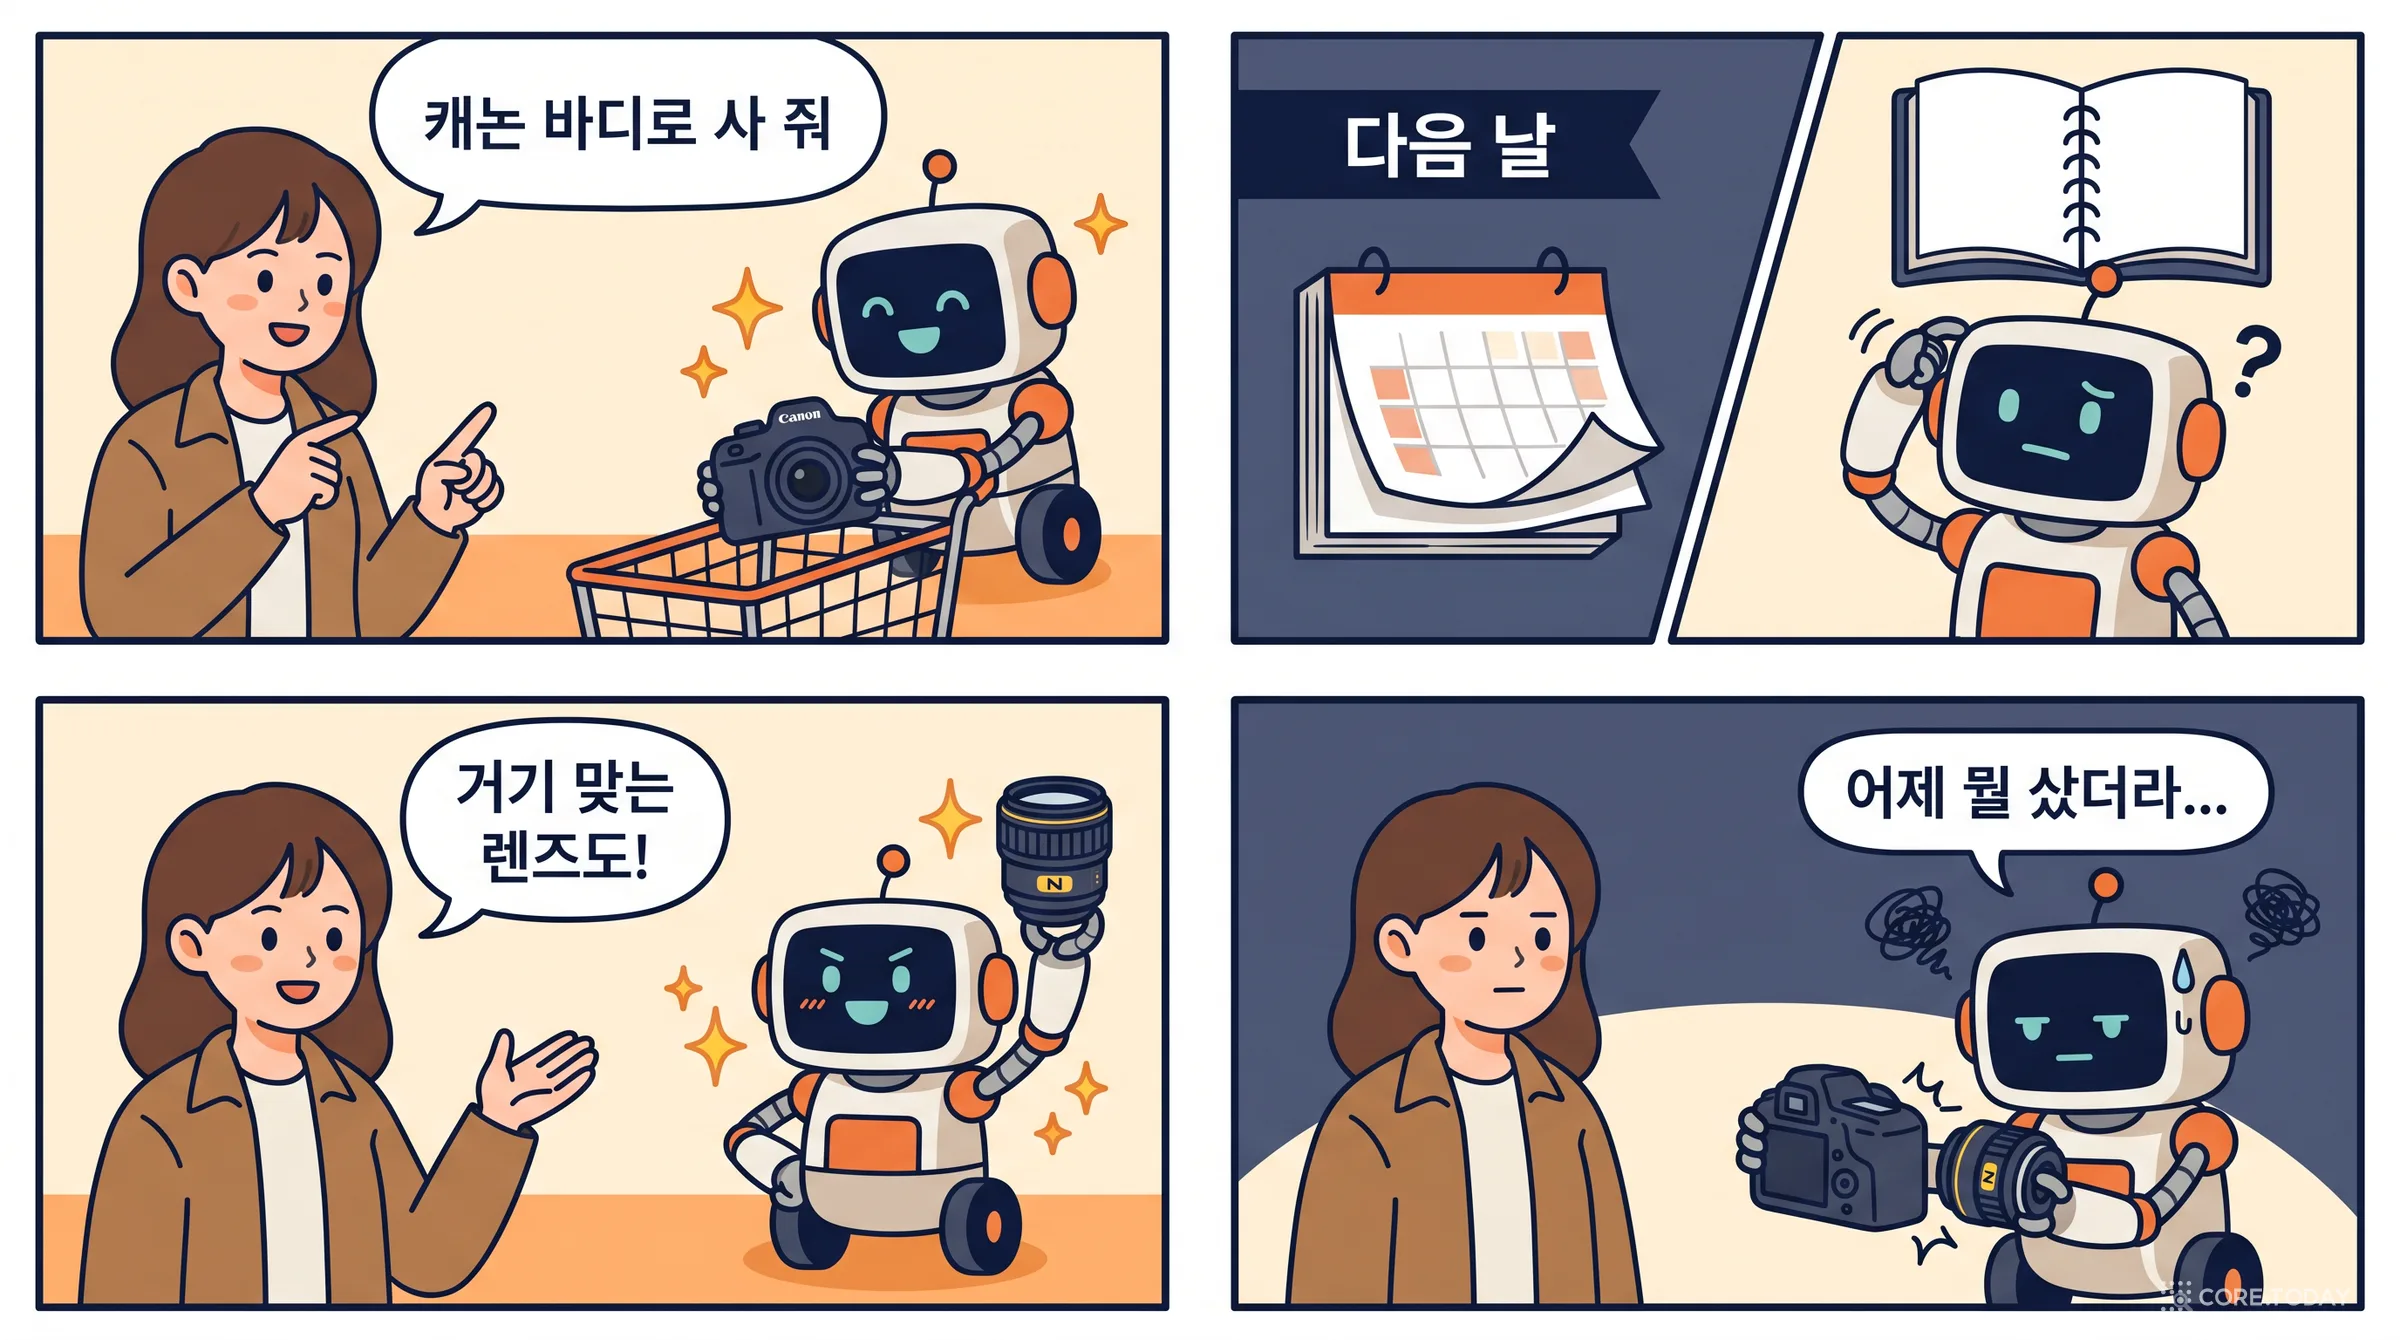
친구에게 심부름을 맡긴다고 해 봅시다. 월요일에는 "캐논 카메라 바디 하나 사 줘"라고 합니다. 친구는 가게 세 곳을 비교해 가장 싼 캐논 EOS Rebel을 사 옵니다. 화요일에는 "어제 산 카메라에 맞는 렌즈 중에 평점 제일 좋은 걸로"라고 합니다.
이 화요일 심부름에는 '어제 무엇을 샀는가'를 기억하는 일이 들어 있습니다. 그런데 기억만으로는 부족합니다. 캐논 바디라는 사실을 떠올린 다음, 그것이 EF 마운트라는 속성으로 이어지고, 진열대의 니콘 F 마운트 렌즈는 아무리 평점이 높아도 걸러 내야 합니다. 기억은 회상으로 끝나지 않고 다음 선택의 조건이 되어야 합니다.
2024~2025년에 나온 에이전트 기억 시스템들은 주로 첫 번째 능력, 즉 회상으로 채점을 받았습니다. 대화 수백 마디를 읽힌 뒤 "사용자가 키우는 개 이름은?"을 묻는 LoCoMo, 11만 토큰 대화 더미 속에서 사실을 찾게 하는 LongMemEval이 대표입니다. 코어닷투데이가 지난 실측에서 확인했듯, 2026년에는 기억 장치 없이 대화를 통째로 넣은 저가 모델도 LoCoMo에서 80%를 넘깁니다. 업체들은 90점대를 발표합니다. 시험이 거의 포화된 것입니다.
그러면 이 에이전트들은 화요일 심부름을 잘할까요? 2026년 2월 arXiv에 올라오고 같은 해 서울에서 열린 ICML 2026에 실린 논문 「MemoryArena: Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks」(스탠퍼드·UCSD·UIUC·프린스턴 등, 교신 저자 Zexue He)의 답은 "거의 못 한다"입니다.
이 논문이 만든 시험장은 네 곳입니다. 여섯 단계로 이어지는 묶음 쇼핑, 여행자가 한 명씩 합류하며 서로의 일정을 참조하는 단체 여행 계획, 조건이 하나씩 추가되는 점진 검색, 그리고 실제 논문의 보조정리 사슬을 따라가는 수학·물리 증명입니다. 701개 과제, 하위 과제 4,850개. 결과는 이렇습니다.
가장 잘한 방식(임베딩 RAG)
0.20
롱컨텍스트 GPT-5.1-mini
0.16
기억 에이전트 Mem0
0.13
단체 여행(13개 방식 전부)
0.00
다섯 환경 평균 과제 성공률(SR, 1.00 만점). 논문 표 3에서 옮겼습니다.
이 글은 세 가지를 합니다. 먼저 왜 이런 시험이 필요해졌는지를 인지과학과 강화학습, 그리고 지난 10년의 벤치마크 역사에서 찾습니다. 다음으로 논문의 설계와 표·그림·부록 사례를 하나씩 읽고, OpenReview에 공개된 심사평에서 나온 반론까지 따라갑니다. 마지막으로 공개 데이터를 내려받아 '기억해 내기'와 '기억으로 행동하기'를 직접 갈라 재 보고, 2026년에 이 개념이 어떤 의미인지 정리합니다.
1. 기억은 무엇을 위해 있나 — 이 질문의 짧은 역사
기억은 행동을 위해 있다
1997년 심리학자 아서 글렌버그는 학술지 『Behavioral and Brain Sciences』에 「기억은 무엇을 위해 있는가(What memory is for)」라는 논문을 냈습니다. 그때까지 심리학 실험실의 기억 연구는 대부분 단어 목록을 외우게 한 뒤 얼마나 떠올리는지를 쟀습니다. 글렌버그는 이 관점을 뒤집었습니다. 기억은 몸이 세상에서 행동하기 위해 진화했고, 따라서 기억을 이해하려면 그것이 어떤 행동을 가능하게 하는지를 봐야 한다는 주장입니다.
MemoryArena의 출발점이 정확히 이 생각입니다. 논문은 첫 문단에서 LLM 에이전트의 두 핵심 능력을 '기억(memorization)'과 '행동(action)'으로 나누고, 기존 평가가 둘 중 하나만 따로 본다고 지적합니다. 그리고 이렇게 주장합니다. "에이전트의 기억은 기억과 행동을 떼어 놓을 수 없는 하나로 보고 평가해야 한다."
강화학습은 이 문제를 '부분 관측'이라고 불렀다
사람의 심리학만이 아닙니다. 기계가 결정을 내리는 문제를 다루는 강화학습에는 이 상황을 가리키는 오래된 이름이 있습니다. 부분 관측 마르코프 결정 과정(POMDP)입니다. 1965년 아스트룀이 정식화했고, 1998년 케일블링·리트먼·캐서디의 논문으로 AI 계획 분야의 표준 틀이 되었습니다.
POMDP에서 행동하는 주체는 세상의 진짜 상태를 직접 보지 못합니다. 지금 눈앞의 관측만으로는 부족하고, 지난 관측들을 모아 "지금 세상은 아마 이런 상태일 것"이라는 믿음 상태(belief state)를 유지해야 합니다. 이 믿음 상태가 충분히 좋으면, 부분 관측 문제는 전부 관측되는 보통의 결정 문제처럼 풀 수 있습니다. 강화학습 쪽에서는 2015년 하우스크네히트와 스톤이 순환 신경망을 붙인 DRQN으로 화면 일부를 가린 아타리 게임을 풀며 '기억이 곧 믿음 상태 추정기'라는 생각을 실험으로 보였습니다.
MemoryArena는 논문 4.6절에서 스스로를 'POMDP 시험대'라고 부릅니다. 화요일의 에이전트는 "바디가 캐논이다"라는 상태를 지금 눈앞에서 관측하지 못합니다. 월요일 세션에서 본 것을 기억 장치에 남겼다가 꺼내야만 그 상태를 알 수 있습니다. 이 연결은 6절에서 다시 자세히 다룹니다.
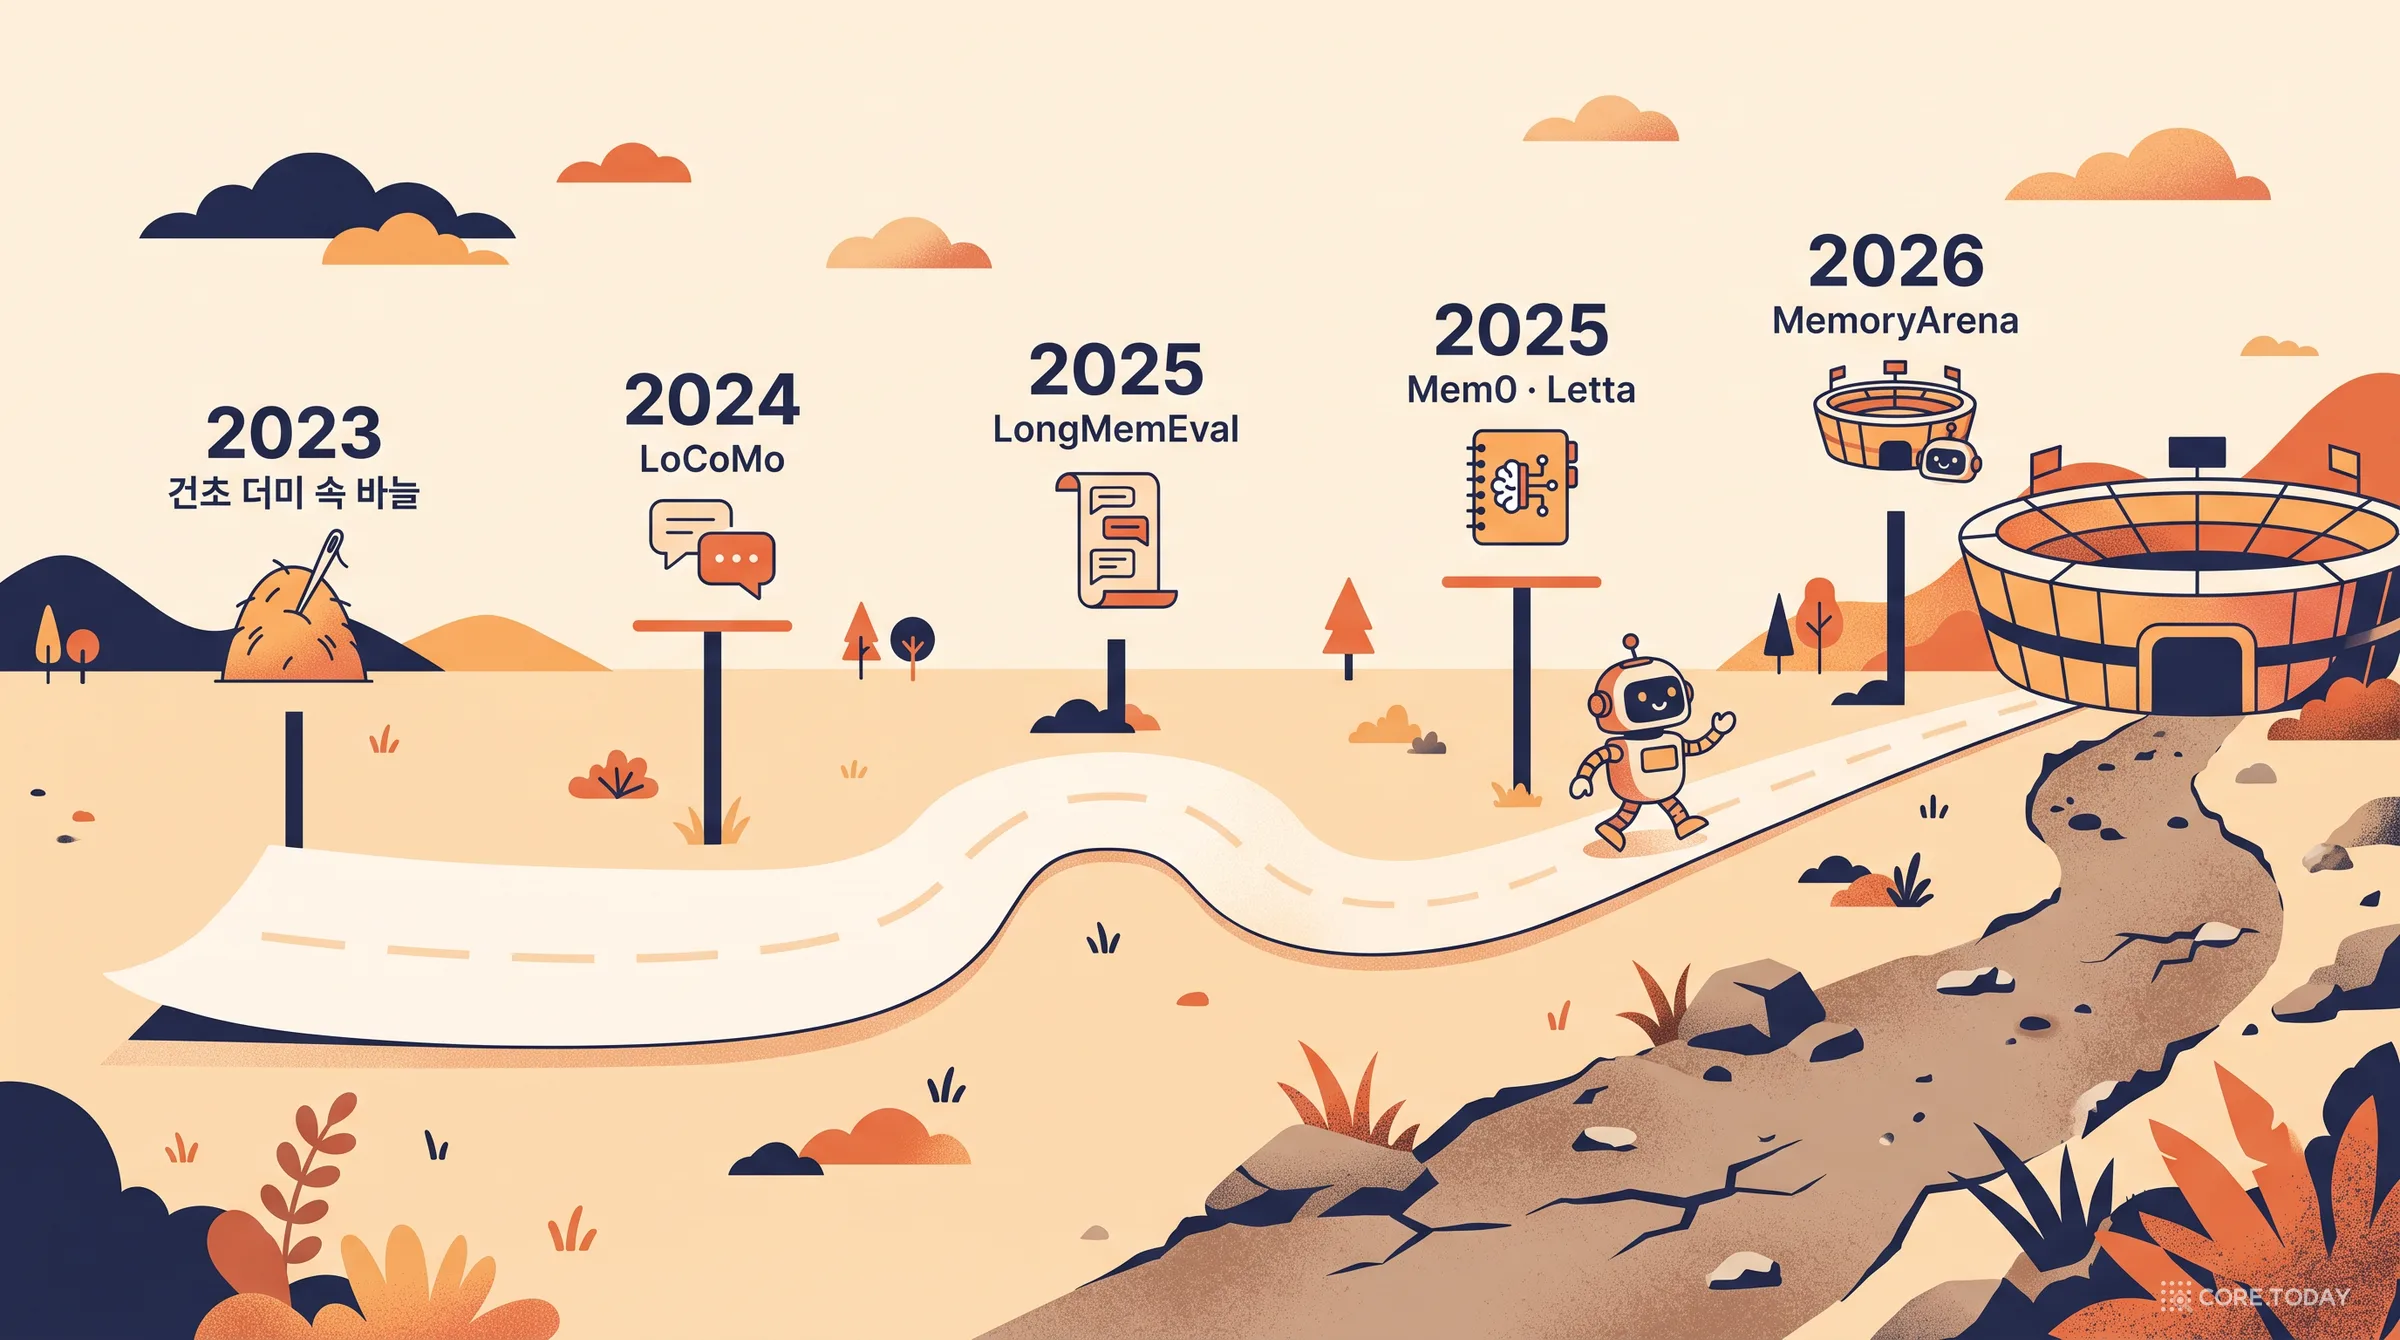
그림 속 연도는 각 이정표가 널리 알려진 해입니다. Letta의 전신 MemGPT 논문은 2023년 10월, Mem0 논문은 2025년 4월에 나왔습니다.
2015년 bAbI. 페이스북 AI 연구소가 "존은 부엌에 갔다. 존은 우유를 집었다. 우유는 어디 있나?" 같은 합성 문제 20종을 만들었습니다. 같은 팀의 메모리 네트워크(2014)를 시험하기 위한 것이었습니다.
2023년 '건초더미 속 바늘'(Needle in a Haystack). 그렉 캄라트가 긴 문서 아무 데나 엉뚱한 문장 하나를 숨기고 찾게 했습니다. 모델 회사들이 앞다퉈 "100만 토큰에서도 다 찾는다"는 초록색 격자를 발표했습니다. MemoryArena 논문도 이 시험을 Claude 3 발표문과 함께 인용합니다.
2024년 RULER·LongBench·∞Bench·BABILong. 바늘 찾기를 여러 바늘, 바늘 추적, 요약 같은 과제로 넓혔습니다. 엔비디아의 RULER는 "광고한 맥락 길이"와 "실제로 쓸 수 있는 길이"가 다르다는 것을 보였습니다.
2024년 LoCoMo. UNC·스냅의 연구진이 LLM 둘에게 페르소나를 주고 최대 35개 세션, 평균 300마디의 대화를 만들게 한 뒤 질문을 던졌습니다. 문서가 아니라 대화에서 기억을 재기 시작한 것입니다.
2025년 LongMemEval(ICLR 2025). 질문 500개를 약 40개 세션, 11만 5천 토큰짜리 대화 이력 속에 묻었습니다. 정보 추출, 여러 세션 추론, 시간 추론, 지식 갱신, 모르면 모른다고 하기의 다섯 능력을 따로 쟀고, 상용 비서들이 긴 대화에서 정확도가 약 30% 떨어진다고 보고했습니다.
2025년 MemoryAgentBench. MemoryArena의 공저자 위안저 후(Yuanzhe Hu)가 1저자인 연구로, 정보를 한 번에 주지 않고 여러 차례에 나눠 넣는 '점진적 다중 턴' 방식으로 기억을 쟀습니다.
이 시험들 덕분에 기억 기술은 빠르게 발전했습니다. MemGPT(2023)가 LLM에 운영체제처럼 '주 기억'과 '보조 기억'을 나눠 주었고, 이를 바탕으로 회사 Letta가 생겼습니다. Mem0(2025)은 대화에서 사실을 뽑아 저장하고 갱신하는 기억 층을, Zep/Graphiti(2025)는 시간이 붙은 지식 그래프를 내놓았습니다. MIRIX(2025)는 기억을 여섯 종류로 나눴고, 구글 클라우드 연구진의 ReasoningBank(2025)는 성공과 실패에서 '요령'을 뽑아 쌓았습니다. 코어닷투데이는 이 가운데 여럿을 기억 엔진 해부에서 코드로 열어 보았습니다.
그런데 이 시험들에는 공통점이 있습니다. 시험지가 고정된 글입니다. 대화든 문서든 미리 만들어 둔 이력을 읽히고, 사후에 질문 하나를 던져 답을 채점합니다. 에이전트가 무엇을 하든 이력은 바뀌지 않고, 기억한 것을 가지고 무엇을 하는지는 보지 않습니다.
반대편: 행동은 보지만 기억은 필요 없는 시험
반대편에는 행동을 재는 시험이 있습니다.
WebShop(2022, 프린스턴). 아마존 상품 118만 개로 만든 가상 쇼핑몰에서 "1달러 미만의 무향 데오도란트를 사라" 같은 지시를 수행합니다. MemoryArena의 묶음 쇼핑이 이 환경을 확장했습니다.
WebArena(2023), SWE-bench(2023). 실제 웹사이트 복제본이나 실제 깃허브 이슈에서 클릭하고 코드를 고칩니다.
TravelPlanner(ICML 2024, 푸단대·오하이오 주립대). 항공편·식당·숙소 데이터베이스를 검색해 예산과 조건에 맞는 여행 일정을 짭니다. 발표 당시 GPT-4가 최종 통과율 0.6%를 기록해 화제가 됐습니다. MemoryArena의 단체 여행이 이 데이터 위에 지어졌습니다.
BrowseComp(2025, OpenAI)와 BrowseComp-Plus(2025). 여러 조건을 동시에 만족하는 사람이나 사건을 웹에서 찾아내는 '심층 검색' 시험입니다. MemoryArena의 점진 검색이 BrowseComp-Plus의 830문항에서 출발했습니다.
이 시험들은 에이전트를 실제로 움직이게 하지만, 대부분 한 세션 안에서 끝납니다. 한 세션 안에서는 지금까지의 행동과 관측이 모두 맥락 창에 들어 있으므로, 별도의 장기 기억 없이도 풀 수 있습니다. 논문의 표현으로는 "맥락 창에 들어가는 한, 이전 상호작용 기록은 평평한 맥락으로 다뤄진다"는 것입니다.
그 사이의 빈칸
MemoryArena 논문 표 1은 이 두 계열을 다섯 가지 잣대로 나란히 놓습니다.
벤치마크
기억 방식 평가
에이전트 행동
환경 피드백
여러 세션
하위 과제끼리 의존
과제 수
평균 단계
LoCoMo
✓
✗
✗
✓
✗
7,512문항
해당 없음
LongMemEval
✓
✗
✗
✓
✗
500
해당 없음
MemoryAgentBench
✓
✗
✗
✓
✗
약 2천
해당 없음
WebArena
✗
✓
✓
✗
✗
812
13.3
WebShop
✗
✓
✓
✗
✗
200
7.3
Evo-Memory
✓
✓
✓
✓
✗
—
—
AgencyBench
✗
✓
✓
✓
✓
138
90
MemoryArena
✓
✓
✓
✓
✓
701
57
논문 표 1을 간추렸습니다(MemoryBench·VeriGUI 행 생략). Evo-Memory는 기존 단일 세션 과제를 순서대로 이어 붙였을 뿐 과제 사이 의존이 없고, AgencyBench는 의존은 있지만 기억 방식 자체를 비교하지 않습니다.
가장 가까운 선행 연구는 두 개입니다. Evo-Memory(2025)는 에이전트가 과제를 연달아 풀며 기억을 쌓게 했지만, 과제끼리는 독립이라 앞 과제를 몰라도 뒤 과제를 풀 수 있습니다. 쌓인 기억은 '요령'으로만 도움이 됩니다. AgencyBench(2026)는 하위 과제가 서로 의존하지만 단순한 추가·검색 도구 하나만 기억으로 주고 기억 방식 비교는 하지 않습니다. MemoryArena는 이 빈칸, 곧 "뒤 과제가 앞 과제를 모르면 풀리지 않게 만들고, 그 위에서 여러 기억 방식을 나란히 재는" 자리를 노렸습니다.
2. 기억-에이전트-환경 고리
한 세션의 에이전트
논문 3.2절은 개념을 수식 네 줄로 정리합니다. 먼저 기억 없는 보통의 에이전트입니다. 과제 s(예: 카메라 렌즈 사기)를 받은 에이전트는 매 단계 t마다 지금까지의 관측 o와 행동 a를 보고 다음 행동을 고릅니다.
ai,t∼πA(⋅∣si,oi,1:t−1,ai,1:t−1)
πA는 에이전트의 정책, 쉽게 말해 "이 상황에서 무엇을 할지 고르는 규칙"입니다. 한 세션 안에서는 지난 관측과 행동이 모두 맥락에 들어 있으므로 이것으로 충분합니다. 렌즈 검색 결과를 보고, 클릭하고, 상세 페이지를 보고, 구매합니다.
여러 세션으로 쪼개면
이제 큰 과제 하나가 하위 과제 s1→s2→⋯→sn으로 쪼개지고, 각 하위 과제가 따로따로의 세션에서 실행된다고 합시다. 월요일 세션이 끝나면 월요일의 관측·행동 기록은 다음 세션의 맥락에서 사라집니다. 그런데 화요일 과제는 월요일에 무엇을 샀는지 알아야 풀립니다. 여기서 세션을 건너 살아남는 저장소, 기억 M이 필요해집니다.
기억 시스템은 두 함수로 추상화됩니다. 매 행동 전에 지금 과제와 관련된 기억을 꺼내는 RETRIEVE,
mi,t=RETRIEVE(M,si,ai,1:t−1,oi,1:t−1)
꺼낸 기억까지 보고 행동을 고르는 기억 조건부 정책,
ai,t∼πA(⋅∣si,oi,1:t−1,ai,1:t−1,mi,t)
그리고 하위 과제가 끝나면 그 세션의 관측과 행동을 기억에 녹여 넣는 UPDATE입니다.
M←UPDATE(M,(oi,1:T,ai,1:T))
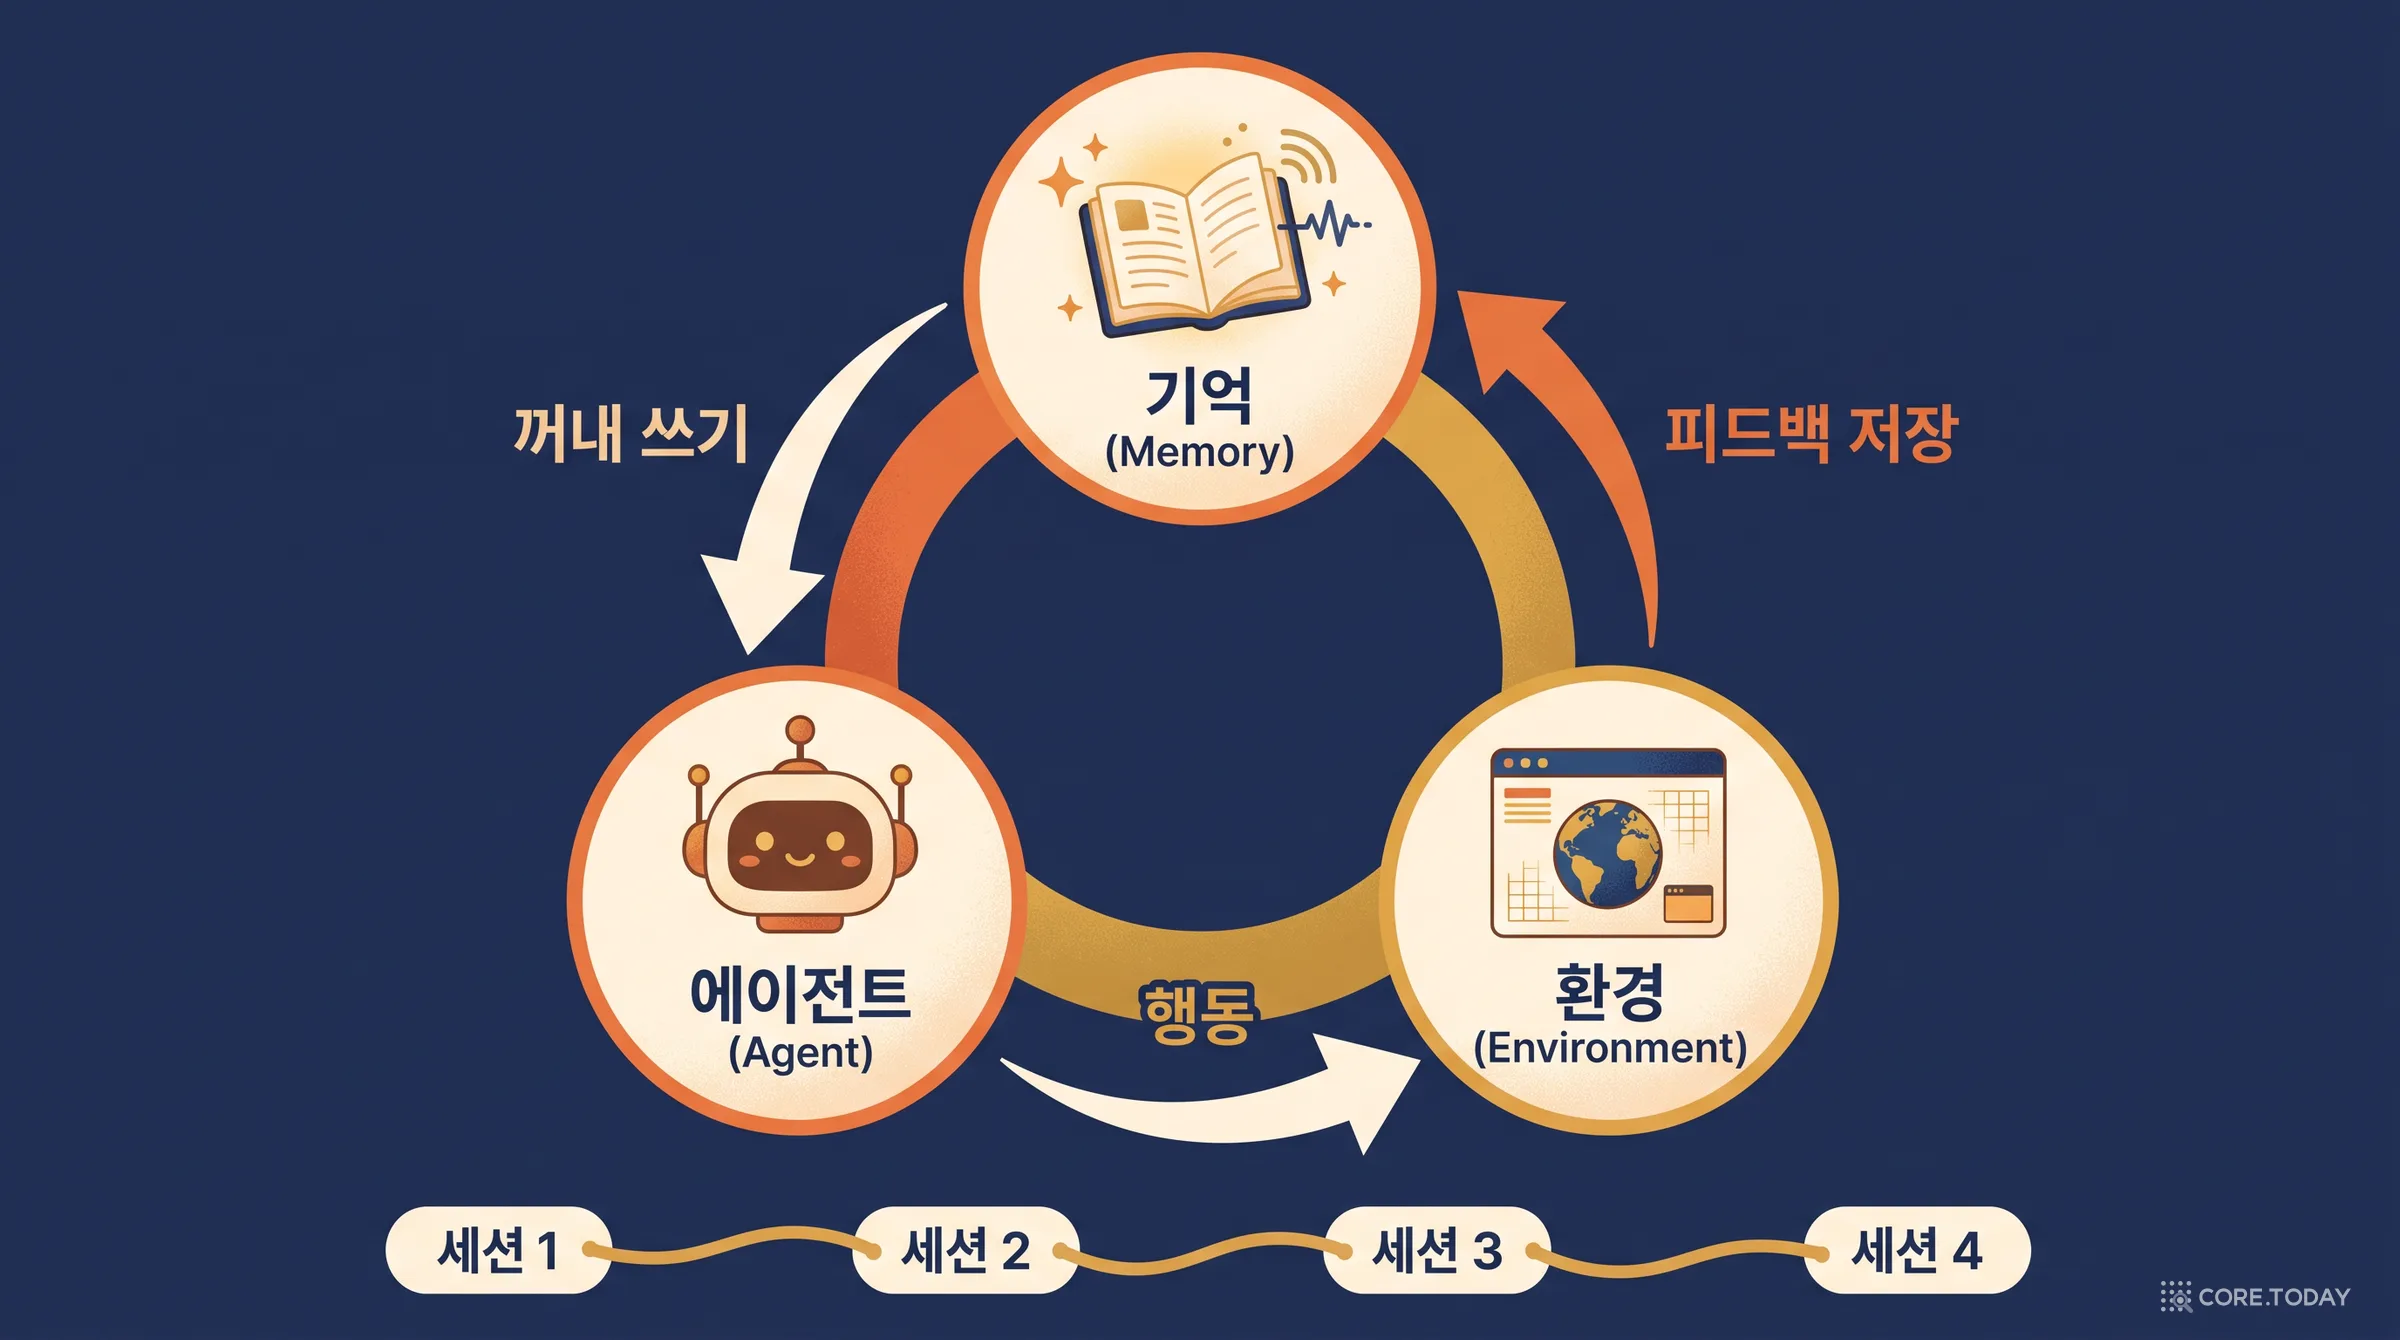
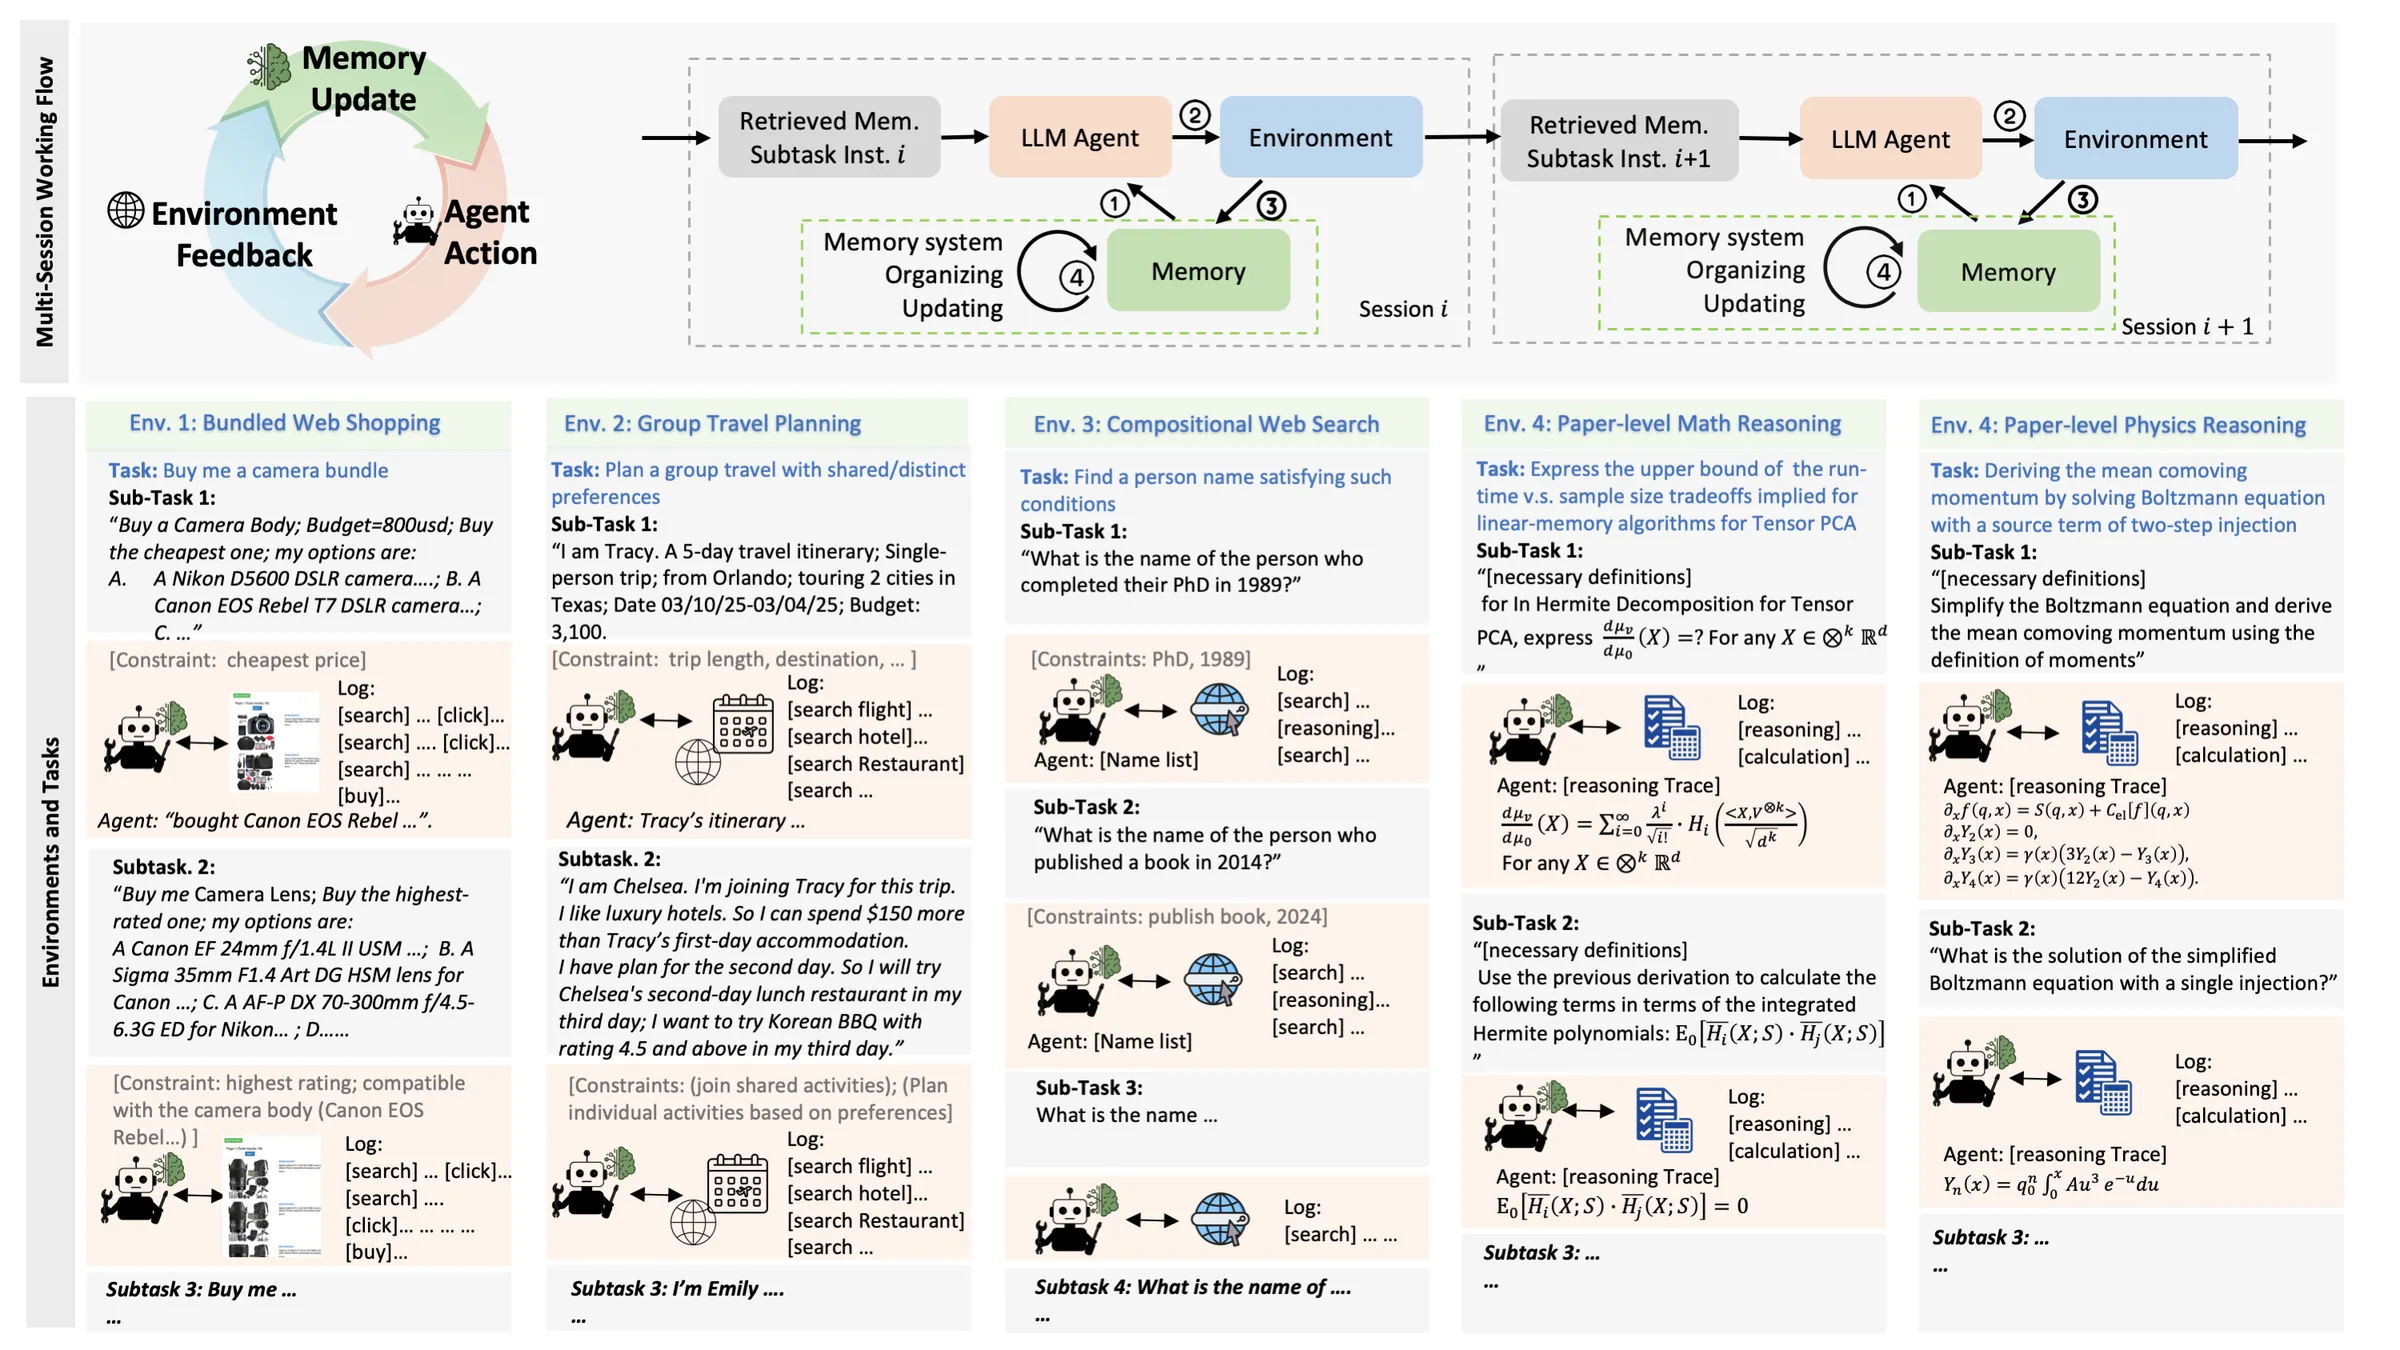
갱신된 기억은 다음 하위 과제 si+1로 넘어갑니다. 논문은 이 순환을 기억-에이전트-환경 고리(Memory-Agent-Environment Loop)라고 부릅니다. 행동이 환경의 피드백을 부르고, 피드백이 기억을 바꾸고, 기억이 다음 행동을 조건 짓습니다.
세 가지를 짚어 두겠습니다.
첫째, 기억 M은 무엇이든 될 수 있습니다. 지난 세션 기록을 통째로 이어 붙이는 긴 버퍼(롱컨텍스트)라면 RETRIEVE는 "전부 이어 붙여 주기", UPDATE는 "이번 세션 기록을 뒤에 붙이기"가 됩니다. 검색 증강(RAG)이라면 기록을 조각내 색인하고 비슷한 조각을 찾아 줍니다. Mem0나 Letta 같은 기억 에이전트라면 별도의 LLM이 기록을 읽고 무엇을 남길지 판단해 정리합니다. 같은 인터페이스에 서로 다른 기억을 꽂아 비교할 수 있다는 것이 이 틀의 장점입니다.
둘째, 기억은 처음에 비어 있습니다. 평가 에피소드가 시작될 때 M은 빈 상태로 초기화됩니다. 에이전트가 무엇을 남길지는 미리 정해져 있지 않고, 자기 행동과 환경 반응에서 직접 골라야 합니다. LoCoMo처럼 정해진 이력을 읽는 것과의 결정적 차이입니다.
셋째, 실험에서는 세션 시작 때 한 번만 꺼냅니다. 부록 B.1에 따르면 하위 과제 안의 행동들은 구조가 비슷하므로, 기억은 하위 과제를 시작할 때 한 번 꺼내 <memory context> 블록으로 프롬프트에 넣습니다. 비용을 줄이기 위한 선택이고, 행동 단위로 꺼내도록 바꿀 수도 있습니다.
MemoryArena 프로젝트 사이트의 개요 그림(논문 그림 1·2를 합친 판). 출처 memoryarena.github.io, CC BY-SA 4.0.
3. 네 개의 경기장
MemoryArena의 과제는 모두 사람이 손으로 다듬었습니다. 기계가 만든 초안을 사람이 검증하고, 뒤 하위 과제가 앞 하위 과제의 결과 없이는 풀리지 않도록 인과 순서를 강제했습니다. 논문 표 2와 공개 데이터(Hugging Face ZexueHe/memoryarena)의 규모는 다음과 같습니다.
환경
과제 수
과제당 하위 과제
평균 기록 길이
무엇을 기억해야 하나
묶음 웹 쇼핑
150
6
41.5k 토큰
앞에서 산 물건의 속성(호환성), 누적 지출
단체 여행 계획
270
5~9 (여행자 수)
40.6k 토큰
앞 여행자들의 확정 일정, 가격·평점
점진 웹 검색
221
2~16 (공개 데이터 4~16)
122.4k 토큰
지금까지 조건을 만족한 후보 목록
수학 증명 사슬
40
2~16
18.1k 토큰
앞 보조정리의 결과식
물리 증명 사슬
20
2~12
14.1k 토큰
앞 단계의 유도 결과
합계
701
평균 6.9 (총 4,850)
40k 토큰 이상
과제당 평균 57번의 행동
공개 데이터를 내려받아 세어 보니 하위 과제가 쇼핑 900·여행 1,869·검색 1,641·수학 354·물리 86개로 합계 4,850개, 논문과 정확히 일치했습니다.
경기장 1 — 묶음 웹 쇼핑: "앞에서 산 것과 맞는 것"
사람들은 관련 상품을 한 번에 다 사지 않습니다. 카메라를 사고 며칠 뒤 렌즈를, 또 며칠 뒤 가방을 삽니다. 뒤의 구매는 앞의 구매와 호환되어야 합니다.
연구진은 WebShop의 상품 데이터에서 가장 큰 다섯 분야(식료품, 뷰티·퍼스널케어, 전자제품, 홈 데코, 베이킹)만 남겼습니다. 상품 분류 경로의 끝에서 두 번째 단계까지 같은 상품끼리 묶으면 대략적인 호환 나무가 생깁니다. 예를 들어 "전자제품 > TV·비디오 > TV > TV 거치대"와 "전자제품 > TV·비디오 > TV > LED·LCD TV"는 같은 가지에 속합니다.
그다음 상품 설명에서 핵심 속성을 정규식으로 뽑아 수용-거부 지도를 만들었습니다. 75인치 TV는 70인치용 받침대를 받아들이지만 50인치용은 거부한다는 식의 상식 규칙입니다. 이 지도로 세션을 가로지르는 호환 사슬을 만들고, 사람이 모든 사슬을 직접 확인해 틀린 조합을 지웠습니다.
각 세션의 선택지는 다섯 개입니다. 정답 하나, 호환은 되지만 정답이 아닌 것 둘, 일부러 넣은 호환 불가 함정 둘. 정답을 하나로 정하기 위해 "평점 최고", "가장 비싼 것", "가장 싼 것" 중 하나의 선호 조건이 붙습니다. 부록 그림 4의 뷰티 예시를 보면 이렇습니다.
2단계 · 토너 고르기
호환 메모: 젤(Gel)은 수렴(Astringent)과 잘 맞는다. 폼(Foam)은 모공(Pore)과 잘 맞는다. 살리실산은 각질 제거와 잘 맞는다… 피할 것: 젤은 밀키(Milky)·장미(Rose)를 피한다. 살리실산은 수분(Hydrating)·무알코올을 피한다… 선호: 호환되는 것 중 평점 최고.
1단계에서 산 클렌저가 '젤'인지 '폼'인지를 기억하지 못하면, 2단계의 메모를 아무리 정확히 읽어도 답을 고를 수 없습니다. 하위 과제는 여섯 개, 총예산(예: 220달러)은 여섯 개 전체에 걸립니다. 예산은 앞 단계 지출을 기억해야만 지킬 수 있는 또 하나의 상태 변수입니다.
여행 하나를 처음 계획한 사람이 있고, 친구들이 한 명씩 합류한다고 해 봅시다. 기본적으로는 첫 사람의 일정을 함께 따르지만, 각자 바꾸고 싶은 칸이 있습니다. 논문은 TravelPlanner에서 혼자 여행하는 정답 일정 45개를 가져와 그 사람을 기준 여행자로 고정하고, 여행자를 5~8명씩 순서대로 추가해 270개의 단체 여행을 만들었습니다.
새 여행자의 요청은 세 종류입니다.
독립 요청 — "2일차 아침은 디저트·베이커리, 1인 67.6~80.4달러인 곳." 데이터베이스만 잘 검색하면 됩니다.
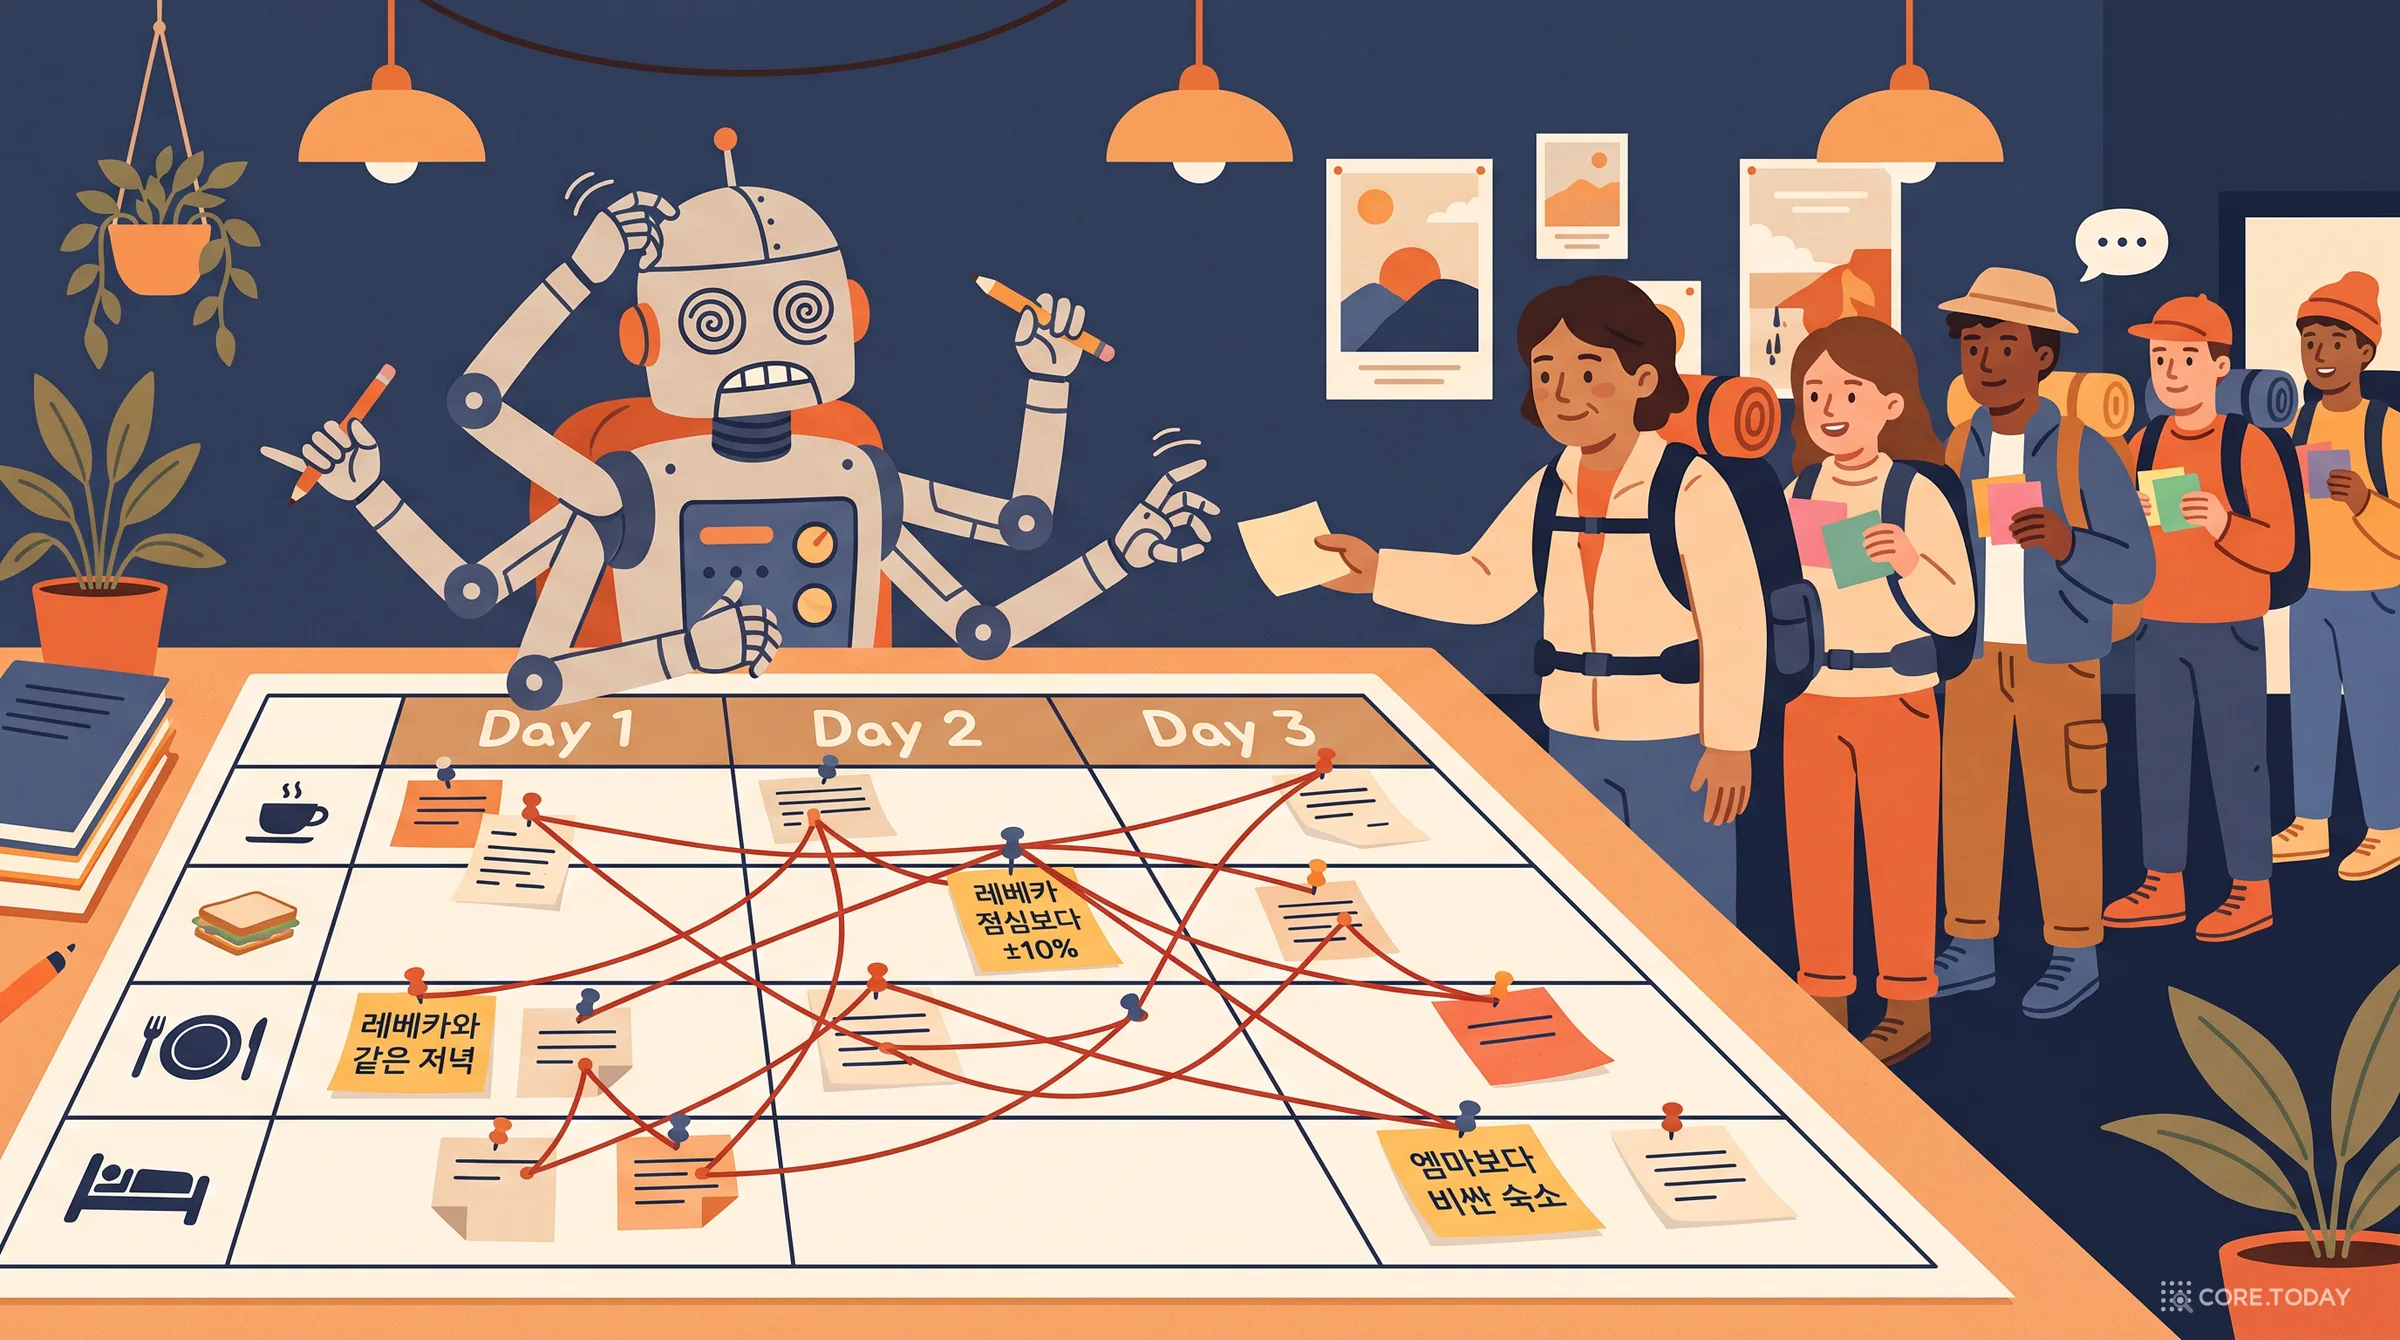
JOIN(합류) — "2일차 저녁은 레베카와 같이 먹고 싶어요." 레베카가 실제로 어디로 배정됐는지 기억해야 합니다.
RELATION(관계) — "레베카의 2일차 숙소보다 평점이 두 단계 이상 높은 곳." 레베카의 숙소 이름을 기억하고, 그 숙소의 평점까지 찾아 비교해야 합니다.
여행자는 앞의 누구든 참조할 수 있어서 의존 사슬이 최대 4단까지 이어집니다. 레베카의 저녁을 따라간 에릭의 저녁보다 10% 비싼 곳을 원하는 엠마의 숙소와 같은 곳에 묵고 싶은 바트… 하는 식입니다. 모든 조건은 데이터베이스 안에서 정답이 단 하나가 되도록 설계됐습니다.
코어닷투데이가 공개 데이터의 요청 문장을 직접 분류해 보았습니다(정규식 기반이라 근사치입니다).
L0 독립 요청
3,342
L1 앞 사람 1단 참조
2,889
L2 참조의 참조
1,255
L3
538
L4 이상
211
단체 여행 270과제의 요청 8,235개를 의존 거리로 나눈 분포(코어닷투데이 집계). 참조 요청 4,893개 중 95.5%가 기준 여행자가 아닌 '앞서 합류한 여행자'를 가리킵니다. 기준 여행자 일정은 매 세션 배경으로 주어지지만, 그 뒤 사람들의 일정은 기억에서만 찾을 수 있습니다.
절반이 넘는 요청(59%)이 다른 사람의 결정을 참조합니다. 여행자 한 명의 일정은 3·5·7일짜리 여행에서 아침·점심·저녁·관광·숙소·교통 칸 30개 안팎이고, 여행자마다 세션 하나가 할당되며 도구 호출은 최대 30번입니다. 에이전트는 항공편·식당·숙소·관광지·거리·도시 검색 도구 여섯 개로 데이터베이스를 뒤집니다.
직접 해 보면 감이 옵니다. 아래 게임에서 당신이 여행 계획 에이전트입니다. 세션이 닫힐 때마다 기록은 사라지고, 고른 메모 세 장만 다음 세션으로 넘어갑니다.
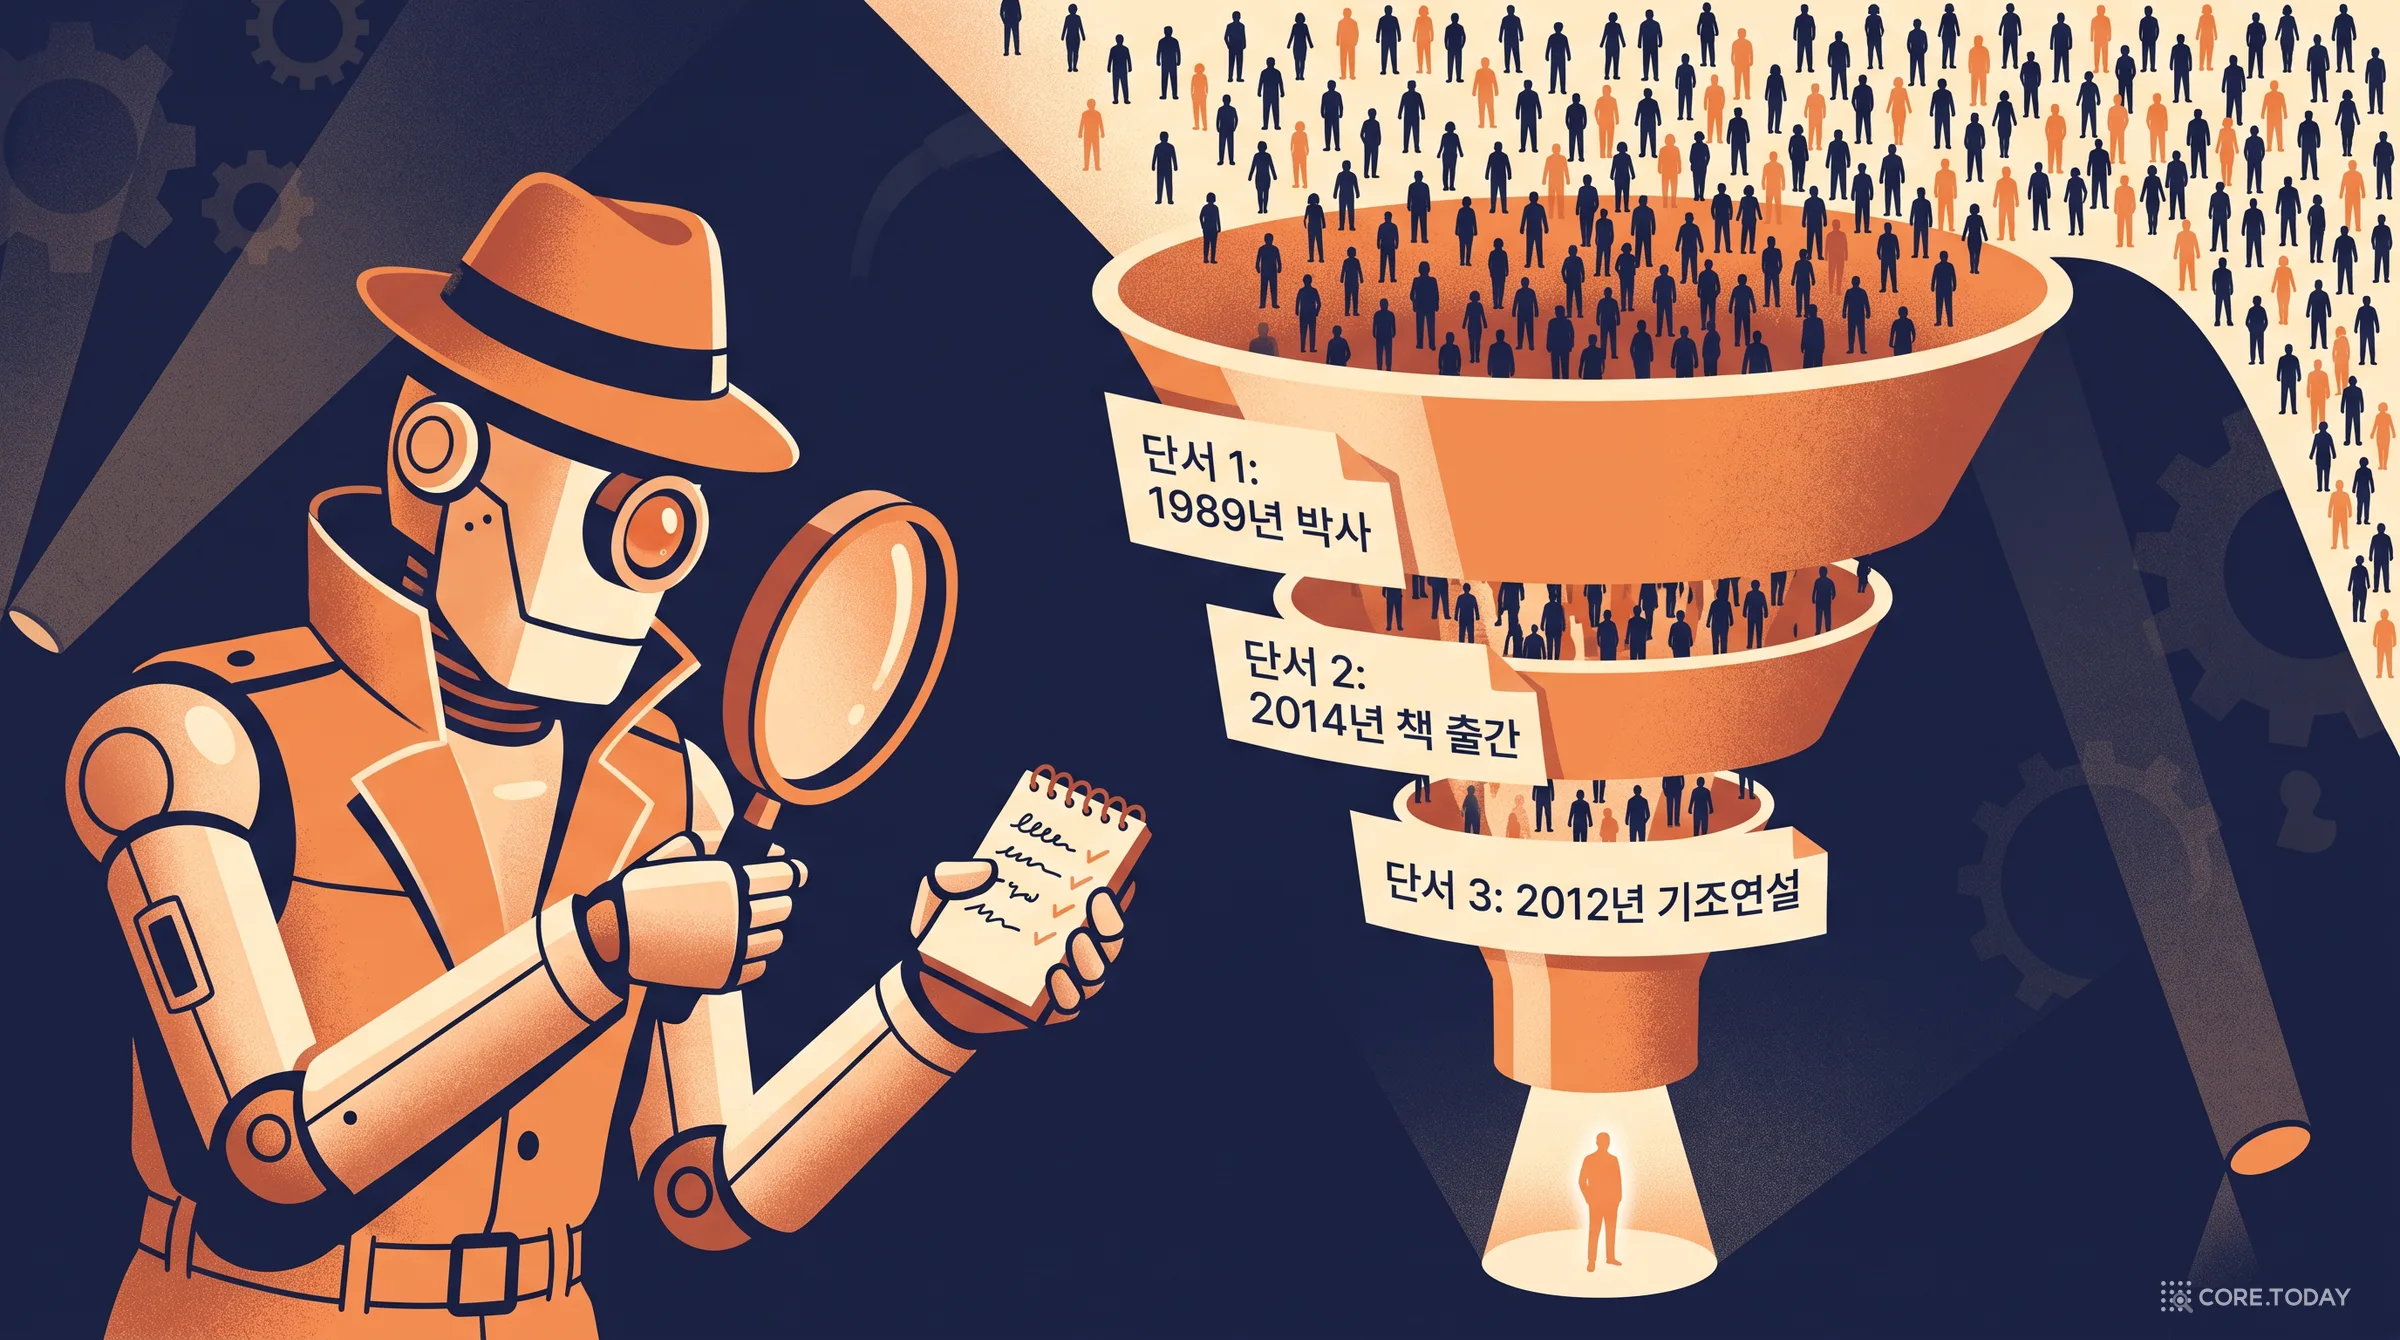
BrowseComp 계열 문제는 조건이 잔뜩 붙은 한 문장입니다. "학사와 대학원 학위를 다른 대학에서 받았고, 어떤 장소에 이름을 붙였으며, 2021년 7월까지 창립 10~40년 된 학회의 대회에 참가하기로 했고, 2020~2023년 논문의 2저자이며, 그 논문의 3저자는 2019년까지 브런즈윅에 살았고…"
실제 사용자는 이렇게 한꺼번에 묻지 않습니다. 대충 시작해서 조건을 하나씩 덧붙입니다. 논문은 BrowseComp-Plus의 830문항에서 출발해 두 단계로 걸렀습니다. 먼저 검색 도구를 가진 LLM 에이전트가 한 번에 풀어 버리는 문항을 뺐습니다. 기억이 필요 없는 문항이기 때문입니다. 남은 문항은 조건 하나씩을 더하는 하위 질문 묶음으로 쪼갰습니다. BrowseComp-Plus에서는 조건이 나란히 나열돼 있으므로, 사람이 쪼갠 결과를 다시 보고 앞 하위 질문의 정보만으로 각 하위 질문이 풀리는지 확인했습니다. 뒤 질문의 정보가 있어야 풀리는 하위 질문이 하나라도 있으면 묶음 전체를 버렸습니다. 그렇게 221문항이 남았습니다.
검색 대상은 BrowseComp-Plus의 고정 문서 모음이고, 검색기는 OpenAI 임베딩으로 상위 5개 문서를 앞 512토큰까지만 돌려줍니다. 각 하위 질문의 실행 기록이 12만 토큰을 넘을 수 있어, 네 환경 중 기록이 가장 깁니다. 마지막 하위 질문에서는 앞 하위 질문들의 기억과 함께 원래의 긴 질문 전체가 주어지고, 그 답의 정답 여부가 과제 성공을 결정합니다.
AIME 같은 경시 문제는 짧고 자기완결적입니다. 하지만 학습 이론이나 미분기하의 큰 정리는 정의와 보조정리 수십 개가 이어진 몇 쪽짜리 논증 위에 섭니다. 논문은 이 구조를 그대로 시험으로 옮겼습니다.
박사급 이론 수학·물리 전문가들이 긴 유도가 있는 실제 논문을 골라, 핵심 주장을 원 논문의 순서대로 중간 명제(보조정리·명제)들로 쪼갰습니다. 각 명제에 필요한 표기·정의·알고리즘을 배경으로 붙이고, 각 명제를 정답이 검증된 질문으로 바꿨습니다. 수학 40문제(순수수학·최적화·학습이론), 물리 20문제(고에너지 이론·현상론·격자, 응집물질 이론)입니다. 부록 그림 7의 예시는 여러 분포에 대한 학습(multi-distribution learning)에서 Hedge 알고리즘의 표본 복잡도를 다루는데, 4번 질문에 "(2번과 3번 질문의 답을 떠올릴 것)"이라는 주석이 달려 있습니다. 심사 반박문에 따르면 하위 과제 하나가 원 논문의 8쪽 분량 유도(55~63쪽)에 해당하기도 하고, 문제 하나를 만드는 데 박사급 전문가가 8~10시간을 썼습니다. 데이터 구축과 평가에 약 6만 달러가 들었다고 합니다.
이 환경의 기억은 쇼핑·여행과 성격이 다릅니다. 저장해야 할 것은 "캐논 바디" 같은 사실이 아니라 앞에서 유도한 식과 그 유도의 요령입니다. 논문이 "정리된 기술이 미래 실행에 영향을 주는" 과제라고 부르는 이유입니다.
4. 출전 선수와 채점 방식
세 무리, 열세 선수
과제 에이전트는 기본적으로 GPT-5.1-mini 하나로 고정하고(본문은 GPT-5-mini라고 적고 표 3 제목은 GPT-5.1-mini라고 적어 이름이 엇갈립니다), 여기에 기억 방식을 바꿔 끼웠습니다.
롱컨텍스트GPT-5.1-mini · GPT-4.1-mini · Gemini-3-Flash · Claude-Sonnet-4.5지난 세션 기록을 손대지 않고 프롬프트 앞에 이어 붙임
기억 에이전트Letta(MemGPT) · Mem0 · Mem0-g · MIRIX · ReasoningBank별도 LLM이 기록을 요약·정리·통합해 저장하고 꺼냄
RAGBM25 · text-embedding-3-small · MemoRAG · GraphRAG기록을 색인해 두고 비슷한 조각을 검색
롱컨텍스트 무리의 GPT-5.1-mini 외 세 줄은 다른 모델을 과제 에이전트로 쓴 기준선이라, 기억 방식끼리 공정하게 비교하려면 GPT-5.1-mini 롱컨텍스트와 나머지 아홉 줄을 견줘야 합니다.
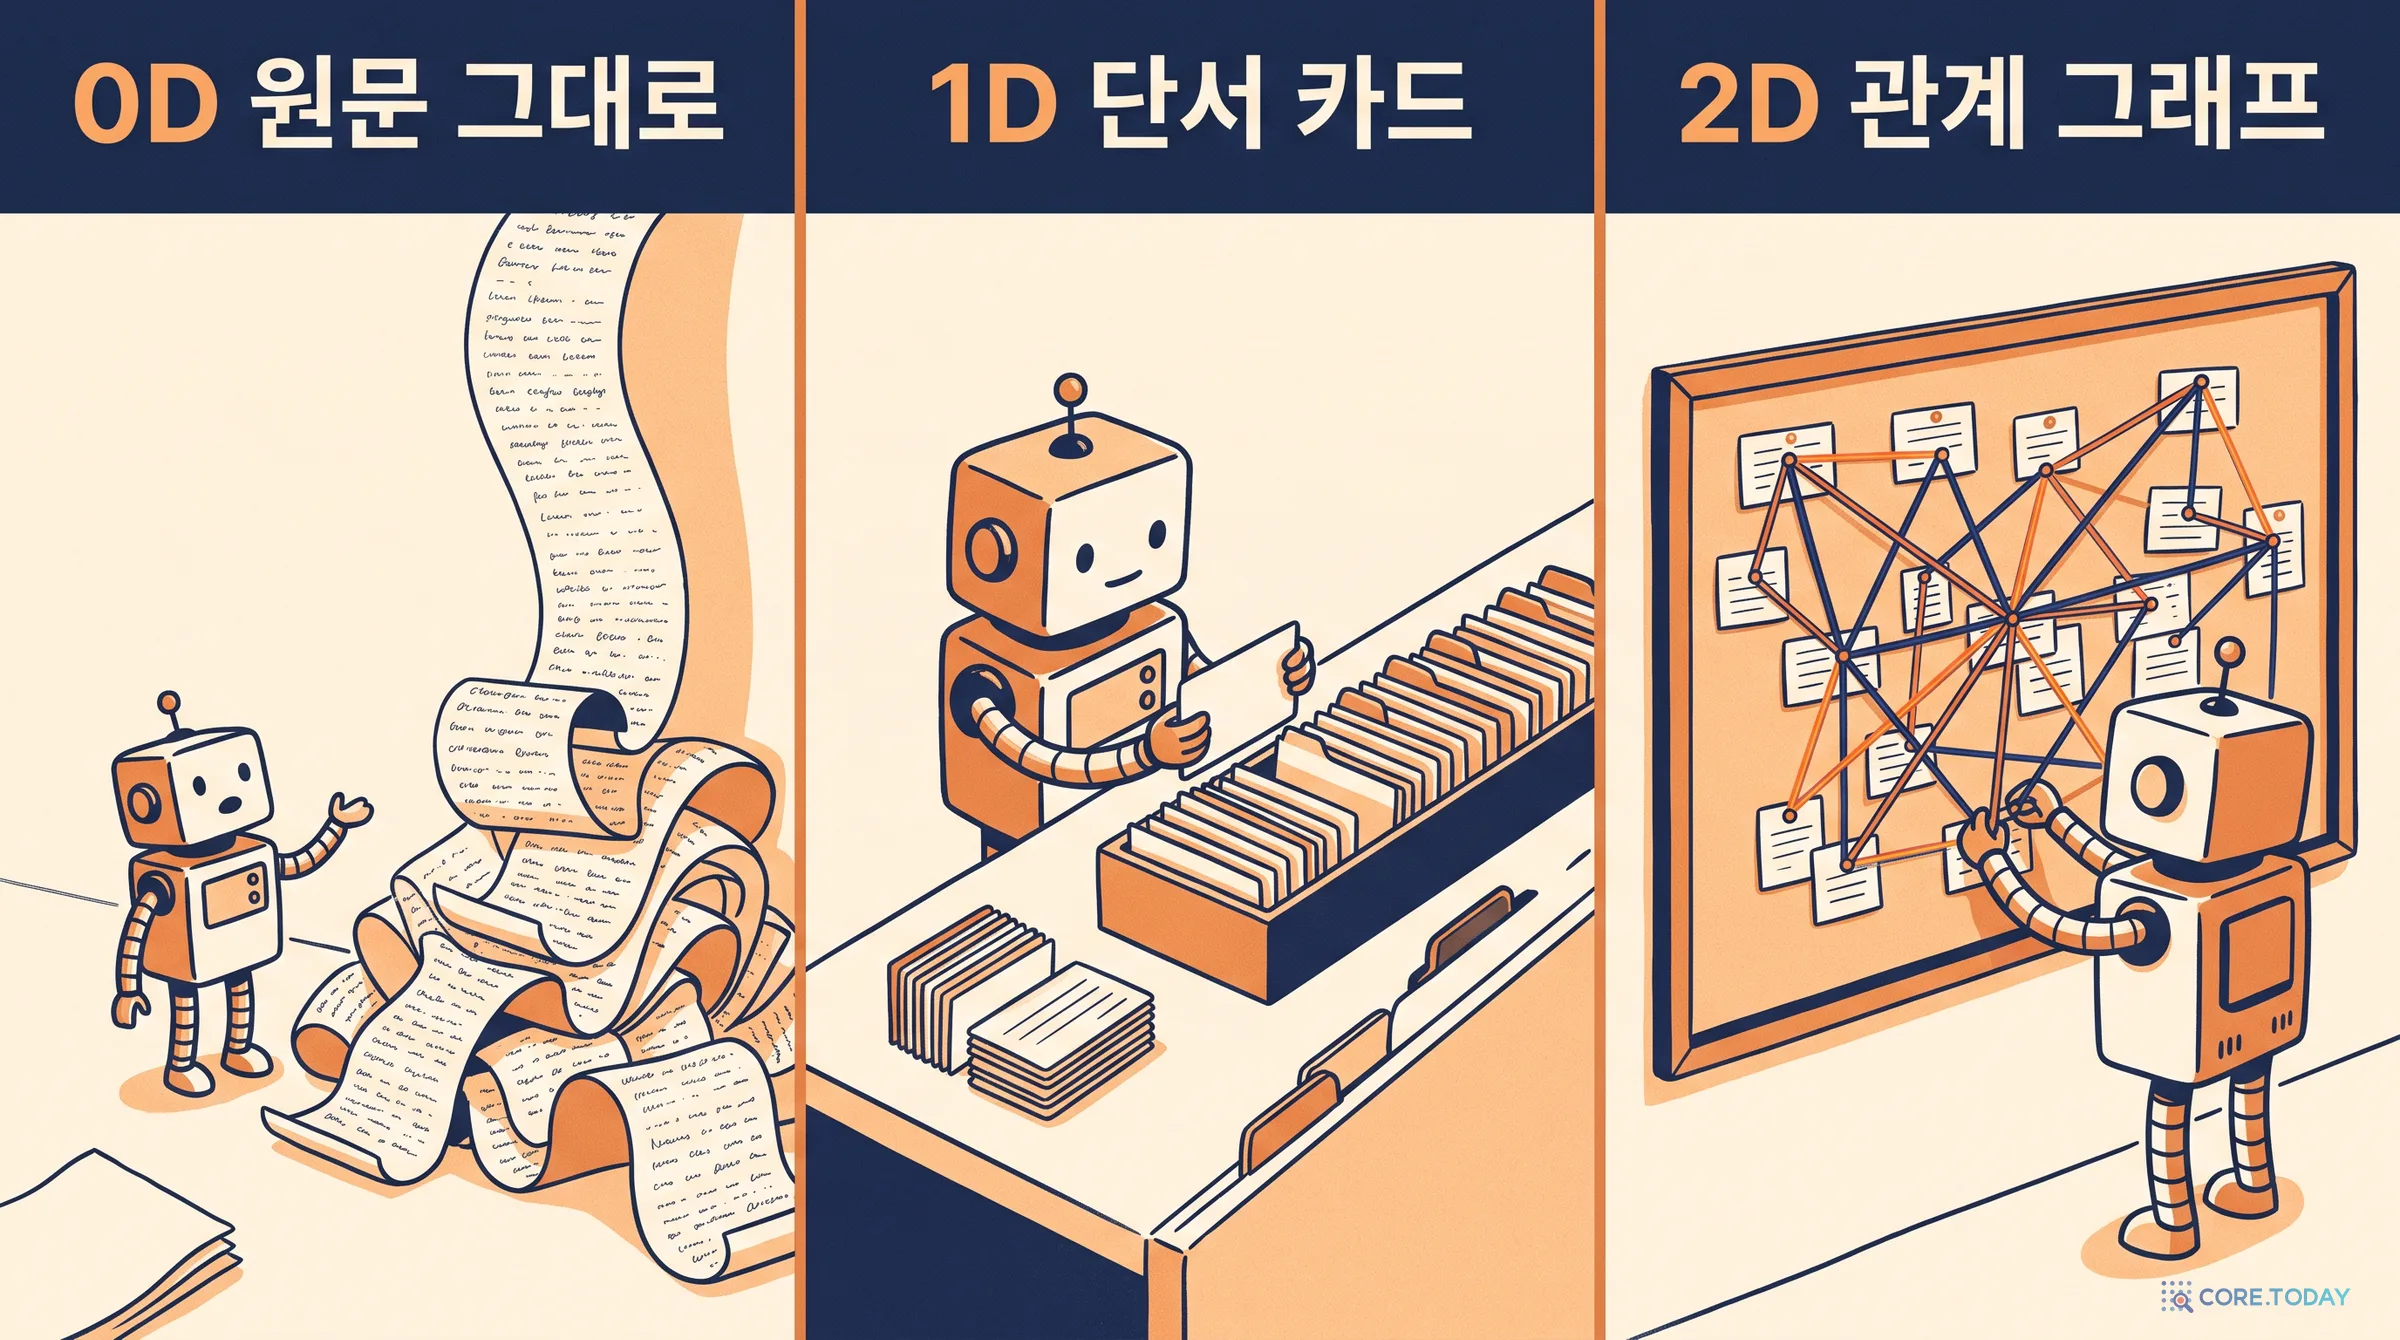
논문은 기억 에이전트 개관 논문(Hu 외, 2025)을 따라 기억의 구조를 세 차원으로 나눕니다.
0D — 가공 없음. 원문을 그대로 둡니다. 롱컨텍스트, BM25, 임베딩 RAG가 여기 속합니다.
1D — 평평한 기억. 학습되었거나 손으로 짠 규칙으로 정보를 정리·증류하지만, 저장 구조는 목록입니다. MemGPT, Mem0, ReasoningBank, MemoRAG.
2D — 구조화된 기억. 나무나 그래프 같은 관계 표현을 씁니다. MIRIX, Mem0-g(그래프판 Mem0), GraphRAG.
직관적으로는 차원이 높을수록 똑똑한 기억처럼 보입니다. 결과는 그렇지 않았습니다.
세 가지 점수
과제 성공률(SR) — 과제 전체를 다 풀었는가. 쇼핑과 여행은 마지막 묶음·일정이 모든 구성원을 만족해야 성공이고, 검색과 수학·물리는 마지막 하위 과제(최종 검색 질문, 주정리)를 맞히면 성공입니다.
진행 점수(PS) — 하위 과제 중 몇 개를 맞혔는가. 과제 Si의 하위 과제 수를 ∣Si∣, 통과한 수를 ∣sipass∣라 하면
PSSi=∣Si∣∣sipass∣,PS=N1∑i=1NPSSi
부분 진행 점수(sPS) — 단체 여행 전용입니다. 여행에서는 SR과 PS가 모든 방식에서 0에 가까워 비교가 안 되므로, 하위 과제(여행자 한 명) 안의 제약 Cj 중 만족한 비율로 부분 점수를 줍니다.
sPSSi=∣Si∣1∑j=1∣Si∣∣Cj∣∣Cjpass∣
sPS는 처음 제출본에는 문장으로만 있었는데, 심사위원 JwWp가 재현성 문제라고 지적해 최종본에 수식이 들어갔습니다.
5. 성적표 읽기
한눈에: 모두 낮다
논문 표 3의 핵심은 한 문장입니다. 모든 방식이 낮다. 다섯 환경 평균 성공률이 가장 높은 것이 임베딩 RAG의 0.20, 다음이 Gemini-3-Flash 롱컨텍스트의 0.19입니다. 단체 여행은 13개 방식 모두 성공률 0이고, 쇼핑도 Gemini·Claude 롱컨텍스트(0.12)를 빼면 0~0.01입니다. 이 숫자들은 LoCoMo에서 90점대를 받는다고 홍보되는 바로 그 시스템들의 것입니다.
성적표를 다섯 가지 관찰로 나눠 읽어 보겠습니다.
관찰 1 — 부분은 하는데 전체를 못 한다
거의 모든 방식에서 진행 점수(PS)가 성공률(SR)보다 훨씬 높습니다. GPT-5.1-mini 롱컨텍스트는 쇼핑에서 하위 과제 58%를 맞혔지만 여섯 개를 다 맞힌 과제는 1%뿐입니다. Claude-Sonnet-4.5는 79%를 맞히고 12%를 완주했습니다. 논문은 이를 "에이전트가 개별 하위 과제에서는 진전을 보이지만 그 부분 성공을 전체적으로 일관된 해답으로 통합하지 못한다"고 요약합니다.
이 차이는 곱셈에서 옵니다. 여섯 단계를 모두 맞혀야 성공이라면, 단계마다 58%씩 맞히는 에이전트의 완주 확률은 대략 0.58을 여섯 번 곱한 3.8%입니다. 실측 1%는 이보다도 낮은데, 앞 단계에서 잘못 산 물건이 예산과 호환 조건을 망가뜨려 뒤 단계까지 끌어내리기 때문으로 읽힙니다.
예외가 하나 있습니다. 점진 검색에서는 PS가 SR보다 낮습니다(Mem0: SR 0.24, PS 0.09). 중간 하위 질문의 답은 "1989년에 박사를 받은 사람들"처럼 목록이라 정확히 맞히기 어렵고, 마지막 질문에는 원래의 긴 질문 전체가 다시 주어지므로 중간을 틀려도 마지막을 맞힐 수 있기 때문입니다. 수학·물리도 마지막 주정리만 맞히면 성공으로 칩니다. 같은 'SR'이라도 환경마다 정의가 다르다는 점은 심사위원 HuFN도 지적했습니다.
관찰 2 — 기억 장치를 붙인다고 나아지지 않는다
같은 GPT-5.1-mini에 기억 에이전트를 붙이면 쇼핑 PS는 0.58에서 평균 0.41로, 여행 sPS는 0.52에서 평균 0.24로 떨어졌습니다. RAG도 쇼핑(0.54)과 여행(0.49)에서 롱컨텍스트보다 약간 낮습니다. 기억 장치가 정보를 잃는 것도 아닌데 왜 떨어질까요? 논문은 두 가지 어긋남(mismatch)을 듭니다.
표현의 어긋남. 롱컨텍스트 에이전트는 자기 행동이 시간 순서대로 적힌 일관된 원문을 읽습니다. 기억 시스템은 그 원문을 압축하고, 조각내고, 순서를 바꿔 돌려줍니다. LLM은 원문 맥락에서 배우는 데(맥락 내 학습) 익숙한데, 요약·재배열된 기억은 그 방식과 잘 맞지 않습니다.
훈련의 어긋남. 기억 시스템은 과제 에이전트와 함께 학습되지 않았습니다. 에이전트는 기억에 좋은 질문을 던지는 법도, 돌아온 기억을 추론에 엮는 법도 배운 적이 없습니다.
그래서 논문의 표현을 빌리면 "강한 롱컨텍스트 에이전트에 외부 기억을 짝지어도 1+1>2 효과가 안정적으로 나오지 않습니다." 다만 두 설명은 실험으로 따로 검증된 것이 아니라 결과를 보고 붙인 해석입니다. 심사위원 두 명(JwWp·ZqnJ)과 메타 리뷰가 이 점을 '사후 가설'이라고 지적했고, 저자들도 "인과 주장이 아니라 그럴듯한 설명"이라고 물러섰습니다.
관찰 3 — 기억이 이기는 곳은 따로 있다
반대로 점진 검색과 수학·물리에서는 외부 기억이 일관되게 나았습니다. 검색 SR은 롱컨텍스트 평균 0.04에서 기억 에이전트 평균 0.15, RAG 평균 0.19로 올랐습니다. 이유는 기록의 길이입니다. 점진 검색은 하위 질문 하나의 실행 기록이 12만 토큰을 넘을 수 있고, 수학·물리는 짧아도 매우 촘촘한 기호 추론이 이어집니다. 둘 다 원문을 통째로 넣으면 모델이 감당할 수 있는 추론 범위를 넘어서고, 논문의 표현으로 주의 포화(attention saturation)와 오류 누적이 일어납니다. 초반의 실수가 맥락에 그대로 남아 뒤 결정을 오염시킵니다. 외부 기억은 필요한 것만 추려 소음을 줄여 줍니다.
정리하면 이렇습니다. 기록이 맥락 창에 편히 들어가고 앞의 정확한 값을 다시 써야 하는 과제(쇼핑·여행)는 원문이 낫고, 기록이 넘치거나 소음이 많은 과제(검색·증명)는 추린 기억이 낫습니다. 같은 기억 장치가 환경에 따라 득도 되고 독도 됩니다. 코어닷투데이가 MemAgent 특집에서 다룬 "만능 기억은 없다"는 결론과 같은 이야기입니다.
관찰 4 — 정확한 재사용에는 덜 가공한 기억이 강하다
검색 증강(RAG)과 기억 에이전트를 견주면, 앞 하위 과제의 값을 그대로 다시 써야 하는 과제에서 RAG가 더 꾸준했습니다. 수학의 중간 결과식, 여행의 정확한 식당 이름과 시간대 같은 것입니다. 기억 에이전트는 정보를 요약·추상화하며 세부를 잃는 반면, RAG는 원문 조각을 그대로 돌려줍니다. 2D 구조 기억(MIRIX·Mem0-g·GraphRAG)도 1D보다 나은 점이 보이지 않았습니다.
흥미로운 사실 하나. MemoryArena의 공저자 중에는 이 시험에서 고전한 시스템의 저자들이 있습니다. MIRIX의 저자 왕위(Yu Wang)와 ReasoningBank의 1저자 오우양쓰루(Siru Ouyang)가 이 논문에 이름을 올렸습니다. 자기 시스템이 단순한 임베딩 검색에 지는 결과를 그대로 실은 셈입니다.
관찰 5 — 기억은 느리다, 그리고 복잡하다고 더 느린 것도 아니다
표 4는 하위 과제 하나를 끝내는 데 걸린 시간입니다. 롱컨텍스트가 평균 34~82초로 가장 빨랐고, RAG가 90~107초, 기억 에이전트가 99~133초로 가장 느렸습니다. Letta는 쇼핑 하위 과제 하나에 219초를 썼습니다. 그런데 2D 기억이라고 1D보다 느리지도, 0D라고 늘 빠르지도 않았습니다. 같은 구조끼리도 편차가 커서, 기억 구조의 복잡도로 지연 시간을 예측할 수 없다는 것이 논문의 결론입니다. 세션마다 기억을 반복해 불러야 하는 다중 세션 에이전트에서는 이 지연이 그대로 사용자 대기 시간이 됩니다.
더 센 모델로 바꾸면?
심사위원 두 명이 "과제 에이전트를 GPT-5.1-mini 하나로 고정한 결과를 일반화할 수 있느냐"고 물었고, 저자들은 반박 기간에 Claude Sonnet 4.6으로 다섯 방식을 다시 돌렸습니다(부록 표 5, 위 성적표에서 'Sonnet 4.6' 단추). 절대 점수는 조금 올랐습니다. 여행 sPS가 0.89, 수학 SR이 0.37입니다. 하지만 성공률은 여전히 낮고, 롱컨텍스트·기억 에이전트·RAG의 순서는 그대로였습니다. 저자들은 반박문에서 한 가지를 덧붙였습니다. 기억 장치가 별 도움이 안 되던 환경에서는 강한 모델일수록 롱컨텍스트와의 격차가 더 벌어지고, 도움이 되던 환경에서는 강한 모델일수록 그 이득이 줄었다는 것입니다. 모델이 강해질수록 '외부 기억'이 줄 수 있는 몫이 작아진다는 뜻으로 읽힙니다.
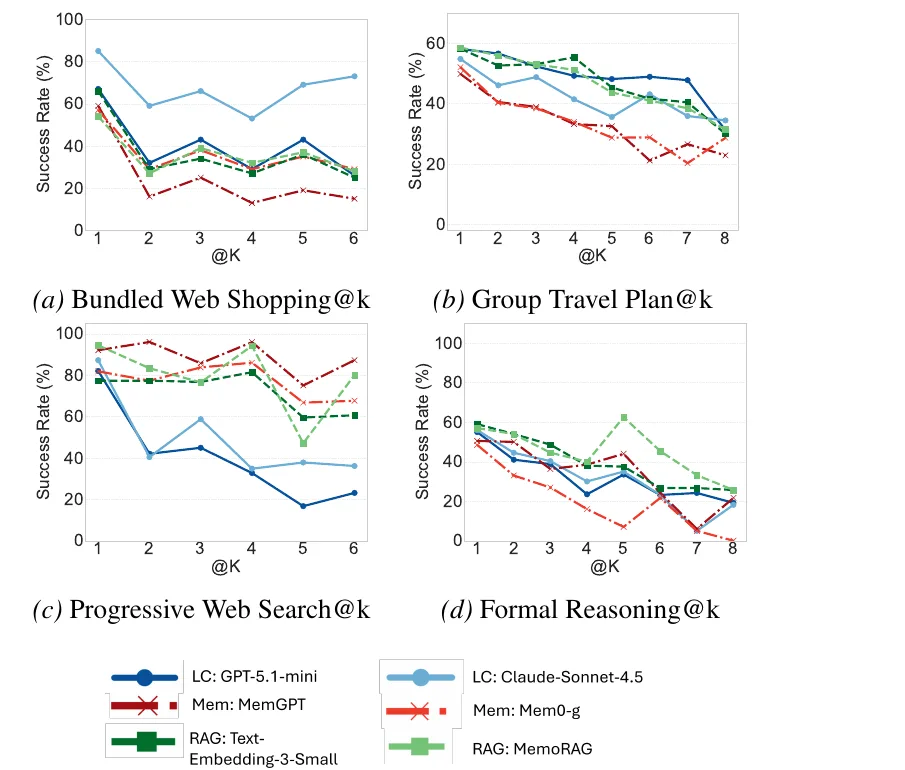
논문 그림 3. 가로축은 하위 과제 깊이 k, 세로축은 k번째 하위 과제의 성공률입니다. 출처 He 외(2026), arXiv 2602.16313(OpenReview 공개본 CC BY 4.0).
그림 3은 k번째 하위 과제의 성공률을 깊이별로 그렸습니다. 이 그림의 성공률은 '그 깊이의 하위 과제를 맞힌 비율'이라, 과제 전체를 다 풀어야 하는 표 3의 SR보다 훨씬 높게 나옵니다.
모든 방식이 깊이에 따라 떨어지고, 어떤 방식도 평평한 구간을 유지하지 못합니다. 떨어지는 모양은 환경마다 다릅니다.
쇼핑(a): 1단계는 55~85%인데 2단계에서 급락합니다. 1단계에는 앞 구매가 없어 호환 조건이 없고, 2단계부터 기억이 필요해지기 때문입니다. 흐린 하늘색 Claude-Sonnet-4.5 롱컨텍스트만 50~70%대를 지킵니다.
검색(c): 롱컨텍스트 두 줄(진한 파랑·하늘색)이 2단계부터 40%대로, 5단계에서 17%까지 떨어집니다. 반면 기억 에이전트(빨강)와 RAG(초록)는 대체로 60~96%를 유지합니다(MemoRAG만 5단계에서 47%로 한 번 꺼집니다). 기록이 12만 토큰을 넘는 환경에서 원문을 통째로 넣는 방식이 먼저 무너지는 장면입니다.
여행(b)·증명(d): 모든 방식이 비슷하게 꾸준히 내려갑니다. 증명에서는 MemoRAG만 5단계에서 62%로 튀어 오르고, Mem0-g는 8단계에서 0이 됩니다.
심사위원 JwWp는 이 그림의 가로축 '@K'가 무엇인지 적혀 있지 않다고 지적했고, 저자들은 "k번째 하위 과제의 깊이"라고 명시하겠다고 답했습니다.
의존 거리별 통과율 — 믿음 표류
부록 표 7은 더 날카로운 분석입니다. 단체 여행의 제약을 인과적 의존 거리(L0~L4)로 묶고, 앞 제약을 맞혔다는 조건에서 각 제약의 통과율을 쟀습니다. 롱컨텍스트 에이전트, 곧 앞 세션의 모든 정보를 손실 없이 가진 에이전트의 결과입니다.
L0 (참조 없음)
0.48
L1
0.29
L2
0.21
L3
0.18
L4
0.15
부록 표 7. 단체 여행, 롱컨텍스트 에이전트, 앞 제약을 맞혔을 때의 조건부 통과율(1.00 만점).
얕은 단계에서 0이 아니라는 것은 앞 세션의 정보를 얻기는 했다는 뜻입니다. 정보가 모두 맥락에 있으니 관측 실패도 아닙니다. 그런데도 의존이 깊어질수록 단조롭게 떨어집니다. 논문은 이를 믿음 표류(belief drift)라고 부릅니다. 에이전트가 머릿속에 그리는 '지금 상태'에 작은 오차가 생기고, 그 오차가 세션을 거치며 쌓여 결국 뒤 결정을 지배한다는 것입니다.
부록 사례 해부
평균 숫자 뒤에 어떤 실패가 있었을까요? 논문 부록 C.4에는 환경마다 두 개씩 사례가 실려 있습니다. 같은 장면에서 기억 방식마다 무엇을 꺼내 왔고 무엇을 했는지 나란히 놓았습니다.
사례들을 모으면 실패에 붙는 이름이 놀라울 만큼 다양합니다. 검색 실패(BM25가 '내가 산 사운드바'를 못 찾음), 맥락에 묻힘(2만 자 한가운데의 48달러), 압축 손실(요약 기억이 기준 여행자의 출발일을 버림), 잡음 오염(다른 과제의 기억 조각이 섞임), 요령만 기억(ReasoningBank가 사실 대신 일반 전략만 저장), 의미 표류(원래 질문을 놓치고 엉뚱한 배 이야기를 답함), 그리고 기억과 무관한 행동 습관(첫 후보를 바로 사는 충동구매).
특히 그림 14와 15는 서로를 비춥니다. 그림 14에서는 2,979자로 잘 압축한 Letta가 20,042자 원문을 가진 롱컨텍스트를 이겼고, 그림 15에서는 같은 계열의 MemGPT가 기준 여행자의 날짜와 출발지를 요약에서 빠뜨려 항공편을 2026년 3월 1일 뉴어크 출발로 검색했습니다. 원문의 날짜는 2022년 3월 16일, 출발지는 세인트피터즈버그였습니다. 압축은 소음을 줄이지만, 무엇이 나중에 필요할지 모르는 상태에서는 꼭 필요한 것을 버리기도 합니다.
세션을 가로질러 에이전트는 과제의 진짜 상태를 직접 보지 못합니다. 쇼핑 묶음의 숨은 사양, 단체 여행에서 계속 늘어나는 제약들, 뒤 하위 과제에 필요한 중간 결과가 그것입니다. 각 세션에서 에이전트가 보는 것은 이번 하위 과제 지시와 환경 피드백이라는 부분 관측뿐입니다. 외부 기억이 없으면 잘린 기록이나 모델 내부 지식에 기대야 하므로, 의사결정은 사실상 부분 관측이고 이력에 의존합니다.
이 관점은 두 단계로 이어집니다.
깊이에 따른 성능 저하 = 믿음 표류. 숨은 상태에 대한 에이전트의 추정에 작은 오차가 생기고, 세션을 거치며 쌓입니다(그림 3, 표 7).
외부 기억 = 믿음 상태 추정기. 이상적인 기억은 지금의 믿음 상태를 추론하는 데 필요한 정보, 곧 과거 세션의 충분 통계량을 빠짐없이, 그리고 그것만 돌려줍니다. 그런 기억이 있으면 에이전트는 모든 것이 보이는 보통의 결정 문제(MDP)처럼 행동할 수 있습니다. POMDP를 믿음 상태 위의 MDP로 바꿔 푸는 고전적 기법(belief-MDP reduction)과 같은 이야기입니다.
그런데 실측 성공률이 낮다는 것은, 지금의 기억 시스템들이 이 '충분 통계량'을 제공하지 못한다는 뜻입니다. 논문은 병목을 둘로 나눕니다.
기억 쪽 병목. 오늘의 기억 장치는 일반적인 회상, 압축, 의미 유사도 검색에 맞춰져 있습니다. 과제의 의존 구조를 따라 상태 변수를 보존하고 갱신하도록 만들어지지 않았습니다. "Rebecca의 3일차 점심 = 48달러, 평점 2.9" 같은 값은 의미상 질문과 비슷하지도 않고, 요약할 때 중요해 보이지도 않습니다.
에이전트 쪽 병목. 과제 에이전트는 기억에 질의하고, 돌아온 내용을 해석하고, 그것을 믿음 갱신의 단서로 엮도록 훈련받지 않았습니다. 기억을 덜 쓰거나 잘못 씁니다.
"정답 기억을 줘도" — 오라클 실험과 엇갈린 숫자
그렇다면 기억 쪽 병목만 없애면 어떻게 될까요? 심사위원 ZqnJ가 바로 이것을 물었습니다. "필요한 정보를 모두, 그리고 그것만 주는 오라클 기억을 주면 크게 좋아지는가? 좋아진다면 문제는 정보 추출과 검색이고, 아니라면 추론이다."
저자들은 오라클을 정의하기 어렵다고 답했습니다. 필요한 정보에는 사실뿐 아니라 이전 추론에서 얻은 기술과 경험 같은 절차 지식도 포함되는데, 그 최적의 형태는 사람도 검증할 수 없다는 것입니다. 그래도 근사를 시도했습니다. 앞 하위 과제의 정답 결과와 LLM이 정리한 짧은 작업 흐름을 롱컨텍스트 에이전트에 넣었습니다(검색 손실 없음). 최종본 부록 표 8의 결과입니다.
환경
원래 SR
오라클 기억 추가 시 변화
반박문(2026년 4월)의 같은 표
쇼핑
0.01
+0.016
+0.016
여행
0.00
+0.050
+0.050
검색
0.06
+0.05
+0.54
수학
0.26
+0.16
+0.16
모든 환경에서 올랐지만 성공률은 여전히 낮습니다. 논문은 "단순한 관측 실패 이상의 과제, 곧 질문과 기억 위에서 추론하는 문제가 남아 있다"고 결론짓습니다. 그런데 검색 칸의 숫자가 두 문서에서 다릅니다. OpenReview에 공개된 반박문에는 +0.54로 적혀 있고 "특히 원래 기록이 지나치게 긴 검색 과제에서" 개선이 컸다고 설명합니다. 최종본 표 8에는 +0.05입니다. +0.54가 맞다면 검색 성공률은 0.06에서 0.60으로 열 배가 되어, "오라클을 줘도 낮다"는 결론과 어긋납니다. 둘 중 하나는 오타일 텐데, 어느 쪽인지는 공개 자료만으로 알 수 없습니다. 수학의 '원래 SR 0.26'도 표 3의 GPT-5.1-mini 수학 SR(0.21)과 다릅니다. 검색처럼 기록이 아주 긴 환경에서는 '필요한 것만 주는 기억'의 효과가 클 수 있다는 점을 염두에 두고 읽는 편이 안전합니다.
반박문에는 표 8에 없는 숫자가 하나 더 있습니다. 쇼핑에서 MIRIX 기억에 앞 하위 과제의 정답 결과를 넣어 오류 전파를 끊어도 차이가 0.008에 그쳤다는 것입니다. 앞 세션의 실수가 뒤로 번지는 것(연쇄 오류)이 실패의 주원인은 아니라는 근거로 제시됐습니다.
8. 코어닷투데이 실측: 기억해 내기와 기억으로 행동하기를 갈라 보다
심사위원이 물었지만 답하지 못한 질문
심사위원 ZqnJ의 첫 질문은 이것이었습니다. "병목이 정보 획득에 있나, 기억 저장에 있나, 검색에 있나, 아니면 그 뒤의 추론에 있나?" 저자들은 기억 시스템들이 제각각이고 일부는 내부가 닫혀 있어 단계별로 쪼갤 수 없다고 답했습니다. 그 대신 MemoryArena는 기억을 끝에서 끝까지 한 덩어리로 잽니다.
공개 데이터가 있으니 작은 규모로나마 쪼개 볼 수 있습니다. 단체 여행의 요청 중 앞서 합류한 여행자를 참조하는 것만 골라, 같은 요청에 대해 두 가지를 따로 물었습니다.
회상 (LoCoMo식 질문)
기억에 따르면, Zoey는 3일차 점심으로 어디를 골랐나? 기억에 없으면 "unknown".
행동 (MemoryArena식 과제)
(그 도시의 식당 표 + 기준 여행자 일정 + 기억) 새 여행자의 요청 「1일차 저녁은 Zoey의 3일차 점심보다 10% 이상 비싸고 카페 메뉴가 있는 곳」을 만족하는 곳 하나를 골라라. 정답은 하나다.
실험 설계
데이터. 단체 여행 270과제 중 무작위 30과제(고정 시드)에서 과제마다 참조 요청 최대 4개를 뽑았습니다. 기억이 정말 필요한 요청만 남기려고, 참조하는 값과 정답이 모두 기준 여행자의 일정과 다른 경우로 한정했습니다(기준 일정은 매번 프롬프트에 들어가므로, 같으면 기억 없이도 맞힐 수 있습니다). 후보는 116개였습니다.
기억 형태 다섯 가지. ① 원문 장부: 앞 여행자들의 요청과 확정 일정 전체(0D, 롱컨텍스트형). ② 3줄 메모: 여행자마다 모델이 "나중에 참조될 만한 것"을 세 줄 이내로 직접 쓴 요약(1D, 추출형 기억). ③ BM25 검색: 일정을 여행자·날짜별 줄로, 요청을 문단으로 쪼개 색인하고 요청 문장으로 상위 5개를 검색(0D RAG). ④ 기억 없음. ⑤ 사실 한 줄: 필요한 값을 "Zoey의 3일차 점심은 Coco Bambu(1인 72달러, 평점 4.9, 해산물·BBQ)"처럼 정답으로 직접 줌(오라클, 행동에만).
모델. 로컬 qwen3.5:9b(생각 모드 끔, 온도 0). 실측 도중 작업 공간에 "사내 API 크레딧을 실험에 쓰지 말 것"이라는 기억 메모가 추가되어, 처음 계획한 게이트웨이 모델 대신 로컬 모델로 바꿨습니다(10절에서 다시 이야기합니다).
단순화. 행동 문제에서는 검색 도구 대신 그 도시의 식당·숙소 표를 미리 펼쳐 주고, 요청 한 문장에 대한 선택 하나만 하게 했습니다. 논문의 '30칸 일정 전체 짜기'보다 훨씬 쉬운 축소판입니다.
판정. 이름 부분이 정답과 같거나 거의 같을 때만 맞힘. 논문의 채점 코드(eval.py)는 두 문자열을 짧은 쪽 길이로 잘라 비슷하면 통과시키는데, 짧은 오답이 정답 이름의 앞부분과 같으면 통과하는 허점이 있어 더 엄격하게 쟀습니다.
처음 시도는 실패했다 — 그 자체로 하나의 결과
원래 계획은 논문처럼 여행자마다 일정 전체를 짜게 하는 것이었습니다. 시험 삼아 세 과제(여행자 17명, 요청 85개)를 여행 도시 전체의 식당·숙소 표와 함께 돌려 보니, 정답 일정을 기억으로 다 줘도 qwen3.5:9b는 기억이 필요 없는 독립 요청조차 15%만 맞혔습니다. 더 큰 qwen3.8:27b도 27%였습니다. 30개 남짓한 식당 표에서 "평점 3.4~3.6, 베이커리·해산물·피자"를 동시에 만족하는 한 곳을 고르는 일에서 이미 무너진 것입니다. 이 상태에서는 기억 방식의 차이가 추론 실패에 묻혀 보이지 않으므로, 요청 하나 단위로 쪼갠 지금의 설계로 바꿨습니다. 논문의 단체 여행이 13개 방식 모두 0점인 것이 "기억만의 문제"가 아니라는 방증이기도 합니다.
결과 1 — 기억해 내기는 거의 다 했다, 행동은 셋 중 하나
최종 표본은 29과제의 참조 요청 115개입니다(후보 116개 중 1개는 실행 오류로 빠졌습니다).
원문 장부 · 회상
97.4%
원문 장부 · 행동
35.7%
사실 한 줄(오라클) · 행동
31.3%
BM25 검색 · 회상
41.7%
BM25 검색 · 행동
19.1%
3줄 메모 · 회상
0.0%
3줄 메모 · 행동
5.2%
기억 없음 · 행동
2.6%
참조 요청 115개, 로컬 qwen3.5:9b, 한 번 실행. 95% 신뢰구간은 원문 회상 92.6~99.1%, 원문 행동 27.5~44.7%, 오라클 행동 23.5~40.3%입니다.
네 가지가 보입니다.
첫째, 원문 장부를 가진 모델은 "Zoey의 3일차 점심"을 97%의 확률로 정확히 떠올렸습니다. LoCoMo식으로 채점했다면 거의 만점입니다. 그런데 같은 기억으로 그 점심을 기준 삼아 식당을 고르는 행동은 36%만 맞혔습니다. 기억해 내는 능력과 기억으로 행동하는 능력 사이에 61점이 벌어져 있습니다. MemoryArena가 "LoCoMo에서 포화된 에이전트가 실제 과제에서는 못 한다"고 말한 바로 그 틈이, 하나의 모델과 하나의 기억 안에서 그대로 재현됩니다.
둘째, 필요한 사실을 정답으로 손에 쥐여 줘도(오라클) 행동은 31%였습니다. 원문 장부(36%)와 신뢰구간이 겹쳐 차이를 말할 수 없습니다. 이 모델에서는 병목이 기억이 아니라 기억을 쓰는 추론에 있다는 뜻입니다. 논문 부록의 오라클 실험(표 8)과 심사 반박문이 내린 결론, "관측 실패보다 추론이 더 큰 문제"와 같은 방향입니다.
셋째, 모델이 직접 쓴 3줄 메모는 회상 0%였습니다. "나중에 다른 여행자가 같이 하거나 비교할 수 있으니 기억할 것을 쓰라"고 지시했는데도, 모델은 "Layla는 피자·멕시칸·BBQ를 좋아하고 몬태나를 자동차로 여행한다"처럼 취향과 경로를 적었고, 정작 뒤에서 참조될 확정된 식당·숙소 이름은 거의 적지 않았습니다. 참조 대상의 이름이 그 과제의 메모 어딘가에라도 나온 경우는 요청 100여 개 중 6개뿐이었습니다. 요약은 '그 사람이 어떤 사람인가'를 남기고 '그 사람이 무엇을 골랐나'를 버렸습니다. 논문이 지적한 "일반적 회상·압축에 맞춰진 기억은 과제의 상태 변수를 보존하지 못한다"는 기억 쪽 병목이 가장 선명하게 드러난 장면입니다.
넷째, BM25 검색의 회상률 41.7%는 검색 적중률 42.2%와 거의 같았습니다. 필요한 일정 줄이 상위 5개에 들어오면 모델은 거의 다 읽어 냈고, 들어오지 않으면 행동 정확도가 0%였습니다(회상 성공 시 45.8%, 실패 시 0/67). RAG의 성능은 검색이 정합니다. 요청 문장은 앞 여행자들의 요청 문단과 단어가 많이 겹치고(같은 '가격대', '평점', '저녁'), 정작 필요한 일정 줄과는 사람 이름과 날짜 정도만 겹치기 때문입니다. 그림 13의 BM25 실패와 똑같은 구조입니다.
결과 2 — 같이 하기는 쉽고, 비교하기는 어렵다
요청 종류
개수
원문 회상
원문 행동
오라클 행동
BM25 회상 → 행동
JOIN — "Zoey와 같은 곳"
32
93.8%
93.8%
96.9%
56.2% → 56.2%
RELATION — "Zoey보다 10% 비싼 곳"
83
98.8%
13.3%
6.0%
36.1% → 4.8%
JOIN은 기억해 낸 이름을 그대로 옮겨 적으면 되므로 회상률이 곧 행동 정확도입니다. RELATION은 다릅니다. 기억해 낸 식당의 가격과 평점을 표에서 찾고, "10% 이내", "평점은 더 낮게" 같은 조건을 계산해, 30개 남짓한 후보 중 하나를 골라야 합니다. 기억은 99% 해냈지만 행동은 13%입니다. 필요한 값(가격·평점·요리)까지 한 줄로 손에 쥐여 줘도 6%였습니다. 9B 모델에게 이 비교 계산은 기억과 상관없이 어려운 일입니다. 논문의 단체 여행이 13개 방식 모두 성공률 0을 기록한 데에는, 요청의 42%(8,235개 중 3,493개)가 이런 RELATION이라는 사실이 크게 작용했을 것입니다.
결과 3 — 깊어질수록 무너지는 것은 검색이었다
의존 거리별로 나누면 원문 장부의 회상은 L1 93.9%, L2 100%, L3 이상 100%로 깊이와 상관없이 높았습니다. 반면 BM25의 회상은 L1 67.3% → L2 33.3% → L3 이상 10.0%로 곤두박질쳤습니다. 깊은 참조일수록 앞 여행자의 요청 문단에도 또 다른 사람의 이름과 조건이 얽혀 있어, 어휘가 겹치는 엉뚱한 문단이 상위를 차지하기 때문입니다. 원문 장부의 행동 정확도는 36.7% → 38.9% → 30.0%로 완만하게 내려갔습니다. 정답 기억을 넣었으므로 앞 세션의 실수가 번지는 효과는 없고, 순수하게 '깊은 참조를 다루는 어려움'만 남은 숫자입니다.
이 실측이 말하지 않는 것
작은 모델 하나입니다. 9B 로컬 모델의 절대 점수는 논문의 GPT-5.1-mini·Claude보다 낮을 것입니다. 이 실측의 요점은 절대 점수가 아니라 같은 모델·같은 기억 안에서 회상과 행동의 간격입니다.
축소판입니다. 검색 도구 없이 표를 펼쳐 주고 한 문장씩 물었습니다. 실제 에이전트는 여기에 검색 행동의 실수와 30칸 일정 관리가 더해집니다.
기억 원문은 정답 일정입니다. 앞 세션의 실수가 섞인 현실적인 기억이면 숫자는 더 낮아질 것입니다.
메모 방식은 한 가지 프롬프트입니다. "확정된 선택과 그 가격·평점을 반드시 적으라"고 지시했다면 메모 결과는 달랐을 것입니다. 바로 그것이 핵심입니다. 무엇을 남길지를 과제의 의존 구조에 맞춰 설계해야 기억이 쓸모 있어집니다.
한 번씩 실행했고, 판정은 이름 일치만 봤습니다. 요청 분류와 의존 거리 계산은 정규식이라 일부 오분류가 있을 수 있습니다.
9. 반론과 한계 — 공개 심사평이 짚은 것들
이 논문은 OpenReview에 심사평과 반박이 공개되어 있습니다(공저자 줄리언 매콜리의 홈페이지에도 PDF로 올라 있습니다). 심사위원 네 명의 최종 점수는 4·4·5·5, 결정은 일반 채택이었습니다. 심사평에서 나온 반론과 코어닷투데이가 데이터를 보며 발견한 점을 함께 정리합니다.
1. 기억을 잰 건가, 검색을 잰 건가. 심사위원 SaGB는 그림 13의 BM25 실패가 기억 관리가 아니라 검색 단계의 실패로 보인다며, 이 벤치마크가 "에이전트의 기억 관리보다 표준 검색 알고리즘의 취약함을 재는 것 아니냐"고 물었습니다. 저자들의 답은 "꺼낼 수 없는 기억은 쓸 수 없는 기억이므로 검색 실패도 기억 실패"이고, 검색이 없는 롱컨텍스트도 낮다는 것입니다. 둘 다 맞는 말이지만, 그렇다면 MemoryArena의 낮은 점수가 어느 단계의 실패인지는 이 벤치마크만으로는 알 수 없습니다. 저자들도 Mirix·Letta·Mem0-g의 내부가 공개되지 않아 검색 적중률이나 갱신 품질을 잴 수 없었다고 인정했습니다. 8절의 실측은 이 빈칸을 좁혀 보려는 시도였습니다.
2. 규모가 작은 영역. 쇼핑 150, 여행 270은 웹 에이전트 벤치마크로는 보통 규모지만 수학 40·물리 20은 작습니다. 저자들은 하위 과제로 세면 수학·물리가 440개(354+86)이고 각각이 논문 수준의 명제라고 답했지만, 심사위원 ZqnJ는 "그래도 문제 묶음은 60개"라고 다시 물었습니다. 물리 SR 0.60과 0.50의 차이는 20문제 중 두 문제 차이입니다.
3. 공정한 조율이 됐나. 기억 시스템마다 프롬프트와 하이퍼파라미터를 충분히 맞췄는지 불분명하다는 지적에, 저자들은 선행 연구의 프롬프트를 쓰고 기억 시스템은 원래 설정을 최소한만 바꿨다고 답했습니다. 거꾸로 말하면 기본 설정의 기억 시스템을 잰 것입니다. 단체 여행 전용으로 조율된 기억이라면 결과가 다를 수 있습니다.
4. 고정된 세상. 세션 사이에 세상은 변하지 않고 에이전트의 기록만 바뀝니다. 가격이 오르거나 식당이 문을 닫는 일, 3세션에서 사용자가 1세션의 사실을 정정하는 일은 없습니다. 오래된 기억과 새 기억을 구별하는 능력은 재지 않습니다. 사용자 한 명, 에이전트 하나라 여러 에이전트의 기억 공유도 범위 밖입니다.
5. 선행 연구와의 경계. 심사위원 JwWp는 긴 맥락 기억 벤치마크 BABILong이 관련 연구에서 빠졌다고 지적했고(저자들은 추가하겠다고 답함), ZqnJ는 Evo-Memory와의 개념적 경계가 선명하지 않다고 했습니다.
6. 데이터에서 직접 본 것. 공개 데이터를 읽으며 두 가지를 발견했습니다. 첫째, 묶음 쇼핑 150과제 중 93개(62%)는 1단계 지시가 서로 어긋납니다. 목표 줄에는 "가장 비싼 것을 사라", 바로 아래 선호 줄에는 "호환되는 것 중 평점 최고"라고 적힌 식입니다. 1단계에는 앞 구매가 없으니 선호 줄은 2단계 이후의 틀을 그대로 붙인 것으로 보입니다. 에이전트가 어느 줄을 따르느냐에 따라 1단계부터 정답이 갈릴 수 있습니다. 둘째, 프로젝트 사이트의 데이터 예시는 쇼핑과 검색의 예시가 서로 바뀌어 있습니다. 둘 다 결론을 흔들 문제는 아니지만, 이 벤치마크로 점수를 낼 때 알아 둘 만합니다.
7. 숫자의 엇갈림. 7절에서 본 오라클 실험의 검색 칸(+0.54 대 +0.05), 수학 원래 SR(0.26 대 0.21), 그리고 GPT-5-mini와 GPT-5.1-mini라는 모델 이름이 문서 안에서 엇갈립니다. 저자들은 데이터와 코드를 공개하겠다고 약속했고, 코드는 2026년 6월에 '미리보기판'으로 공개됐습니다(깃허브 ZexueHe/MemoryArena).
이런 한계에도 이 논문의 기여는 분명합니다. 심사위원 넷 모두가 "기억을 회상이 아니라 결정의 사전 정보(decision prior)로 재야 한다"는 문제의식에는 동의했습니다. 논문의 숫자 하나하나보다, 기억 평가의 단위를 '질문 하나'에서 '이어진 과제 전체'로 옮긴 것이 오래 남을 기여입니다.
2026년의 에이전트는 한 번의 대화로 끝나는 일보다 며칠, 몇 주에 걸친 일을 맡습니다. 코딩 에이전트는 어제 고친 모듈과 오늘 고칠 테스트를 이어서 다루고, 업무 비서는 지난주 고객 미팅에서 정한 조건을 이번 주 견적서에 반영해야 합니다. 2025~2026년 사이 주요 AI 비서들이 대화를 건너 기억하는 기능을 앞다퉈 내놓았고, 코딩 에이전트들은 CLAUDE.md·AGENTS.md 같은 기억 파일을 표준처럼 쓰게 됐습니다.
이런 일은 모두 MemoryArena의 구조를 하고 있습니다. 세션은 끊기고, 뒤 세션은 앞 세션의 결정에 의존하고, 무엇이 나중에 필요할지 미리 알 수 없습니다. 그래서 2026년에 중요한 질문은 "얼마나 많이 기억하나"가 아니라 "다음 세션에 무엇을 넘겨줘야 일이 이어지나"입니다.
이 글을 쓰는 동안 일어난 일
추상적인 이야기가 아닙니다. 이 글을 만드는 코딩 에이전트(Claude Code)도 세션을 건너 남기는 기억 메모를 씁니다. 코어닷투데이 블로그 작업용 메모가 70개쯤 쌓여 있는데, 들여다보면 MemoryArena가 말하는 상태 변수들입니다. "로컬 이미지 생성 API는 비율 설정을 무시한다(2026-10-07)", "이제 새 모델은 16:9를 지킨다(2026-10-24)" 같은 메모가 시간순으로 덧붙어 있습니다. 같은 사실이 갱신되는 것이고, 오래된 메모만 꺼내면 틀린 행동을 합니다(심사위원 SaGB가 '고정된 세상' 한계로 지적한 바로 그 문제입니다).
더 직접적인 사례도 있었습니다. 이 글의 실측을 준비하던 도중, 같은 작업 공간의 기억에 "사내 API 크레딧을 실험에 쓰지 말 것"이라는 새 메모가 추가됐습니다. 에이전트는 다음 행동을 고르기 전에 그 메모를 읽고 실험 모델을 사내 게이트웨이에서 로컬 모델로 바꿨습니다. 메모 한 줄이 세션 중간에 다음 행동의 조건이 된 것입니다. 기억이 회상이 아니라 행동을 위한 것이라는 글렌버그의 1997년 문장이, 이 글의 제작 과정에서 그대로 재현된 셈입니다.
기억 시스템의 설계 방향이 바뀐다
MemoryArena의 결과는 기억 시스템을 만드는 쪽에 몇 가지 방향을 줍니다. 논문 결론과 2026년의 흐름을 겹쳐 보면 이렇습니다.
회상에서 상태로
대화를 요약하는 기억에서, 과제의 상태 변수(누가·무엇을·얼마에·어떤 조건으로)를 장부처럼 유지하는 기억으로. 논문의 '충분 통계량'이 이것입니다.
따로에서 함께로
기억 시스템과 과제 에이전트를 따로 만들어 붙이는 대신 함께 최적화하기. 논문은 '훈련의 어긋남'을 지목했고, 반박문은 기억과 정책을 함께 학습한 SkillRL을 근거로 들었습니다.
한 가지에서 골라 쓰기로
원문이 이기는 환경과 추린 기억이 이기는 환경이 갈렸습니다. 과제의 기록 길이와 정확한 재사용 필요성에 따라 기억 방식을 고르거나 섞는 설계가 필요합니다.
점수에서 완주로
하위 과제 정답률(PS)이 아니라 과제 완주율(SR)과 의존 깊이별 감쇠를 보는 평가. 평균은 괜찮아도 완주는 거의 못 하는 시스템을 걸러 냅니다.
한국의 맥락
한국어 환경에서는 이 문제가 더 까다로울 수 있습니다. 8절에서 본 것처럼 단어가 겹쳐야 찾는 BM25 계열 검색은 '내가 산 물건의 속성'을 잘 못 찾는데, 한국어는 조사와 어미 변화로 같은 대상이 여러 형태로 적혀 어휘 일치 검색이 더 불리합니다. 코어닷투데이의 기억 오염 실측에서도 영어 문장만 막도록 짠 방어 규칙을 한국어 문장이 그대로 통과하는 장면을 보았습니다. 공공·금융처럼 앞 결정과 뒤 결정이 촘촘히 이어지는 한국 기업 업무에 에이전트를 들인다면, 한국어로 된 '다중 세션 의존 과제' 시험지가 따로 필요합니다.
11. 실무 점검표 — 우리 에이전트의 기억을 어떻게 잴까
MemoryArena와 이번 실측에서 뽑은, 에이전트 기억을 도입하거나 평가할 때의 점검표입니다.
회상 점수로 결정하지 않는다. LoCoMo·LongMemEval 같은 회상 점수는 필요조건일 뿐입니다. 우리 업무의 '앞 결정을 참조하는 다음 결정'을 몇 개 뽑아 직접 시험지를 만듭니다.
완주율을 따로 본다. 하위 과제 정답률이 80%여도 다섯 단계를 이어 붙이면 완주율은 약 33%입니다. 평균 대신 완주율과 의존 깊이별 감쇠를 봅니다.
무엇을 남길지 먼저 설계한다. 대화 전체가 아니라 뒤에서 참조될 상태 변수를 정의합니다. 이름만 남기지 말고 비교에 쓰일 속성(가격·평점·날짜·규격)을 함께 남깁니다.
'바탕 정보'를 요약에서 보호한다. 모든 세션이 공유하는 정보(기준 일정, 계약 조건, 사용자 프로필)는 요약 대상에서 빼고 고정 블록으로 매번 넣습니다. 그림 15의 MemGPT가 잃은 것이 이것입니다.
기록 길이에 따라 방식을 고른다. 맥락 창에 편히 들어가는 기록이면 원문이, 넘치거나 소음이 많으면 추린 기억이 낫습니다. 둘 다 시험해 봅니다.
검색 적중률을 따로 잰다. RAG를 쓴다면 "필요한 조각이 상위 k개 안에 들어왔나"를 행동 정확도와 분리해 잽니다. 어휘 검색은 상태 값을 잘 못 찾습니다.
기억을 줘도 못 쓰는 경우를 확인한다. 필요한 사실을 정답으로 직접 넣어 준 조건(오라클)과 비교해, 문제가 기억에 있는지 추론에 있는지 가릅니다.
지연 시간을 예산에 넣는다. 기억 에이전트는 하위 과제마다 1~2분이 더 걸릴 수 있습니다. 세션마다 반복되는 비용입니다.
기억의 유효기간을 둔다. 같은 사실이 갱신되면 옛 기억을 닫거나 날짜를 붙입니다. 코어닷투데이의 Graphiti 시간 그래프 특집이 이 문제를 다뤘습니다.
사례를 읽는다. 평균 점수만으로는 검색 실패, 압축 손실, 잡음 오염, 충동적 행동이 구별되지 않습니다. 실패 사례를 유형별로 분류해 봅니다.
맺으며: 기억은 시험이 아니라 다음 행동이다
MemoryArena는 기억에 관한 질문을 바꿨습니다. "에이전트가 무엇을 떠올리는가"에서 "떠올린 것으로 다음에 무엇을 하는가"로요. 그 질문 앞에서 2026년의 기억 시스템들은 아직 초보입니다. 하위 과제는 절반쯤 맞히지만 이어진 과제를 완주하는 일은 드물고, 기억 장치를 붙이면 오히려 떨어지는 곳도 있으며, 필요한 사실을 손에 쥐여 줘도 쓰지 못하는 경우가 많습니다.
이 결과는 비관이 아니라 방향입니다. 글렌버그가 1997년에 말했듯 기억은 행동을 위해 있고, 강화학습이 60년 전부터 말해 왔듯 좋은 기억은 '지금 상태를 아는 데 충분한 것'입니다. 에이전트 기억의 다음 단계는 더 많이 저장하는 것이 아니라, 다음 행동에 필요한 상태를 골라 넘기는 것입니다. 월요일에 산 카메라가 캐논이라는 사실과 그 마운트 규격을, 화요일의 렌즈 진열대 앞까지 가져가는 것 말입니다.
Glenberg, A. M. (1997). What memory is for. Behavioral and Brain Sciences, 20(1), 1–19.
Åström, K. J. (1965). Optimal control of Markov processes with incomplete state information. Journal of Mathematical Analysis and Applications, 10, 174–205.
Kaelbling, L. P., Littman, M. L., Cassandra, A. R. (1998). Planning and acting in partially observable stochastic domains. Artificial Intelligence, 101, 99–134.
Hausknecht, M., Stone, P. (2015). Deep Recurrent Q-Learning for Partially Observable MDPs. AAAI Fall Symposium. arXiv 1507.06527
기억 벤치마크
Weston, J. 외 (2015). Towards AI-Complete Question Answering: A Set of Prerequisite Toy Tasks (bAbI). arXiv 1502.05698
Kamradt, G. (2023). Needle In A Haystack — Pressure Testing LLMs. GitHub
Hsieh, C.-P. 외 (2024). RULER: What's the Real Context Size of Your Long-Context Language Models? arXiv 2404.06654
Maharana, A. 외 (2024). Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo). ACL 2024. arXiv 2402.17753
Wu, D. 외 (2025). LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR 2025. arXiv 2410.10813
Hu, Y., Wang, Y., McAuley, J. (2025). Evaluating Memory in LLM Agents via Incremental Multi-Turn Interactions (MemoryAgentBench). arXiv 2507.05257
Wei, T. 외 (2025). Evo-Memory: Benchmarking LLM Agent Test-time Learning with Self-Evolving Memory. arXiv 2511.20857
Li, K. 외 (2026). AgencyBench: Benchmarking the Frontiers of Autonomous Agents in 1M-Token Real-World Contexts. arXiv 2601.11044
행동 벤치마크
Yao, S. 외 (2022). WebShop: Towards Scalable Real-World Web Interaction with Grounded Language Agents. NeurIPS 2022. arXiv 2207.01206
Zhou, S. 외 (2024). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024. arXiv 2307.13854
Xie, J. 외 (2024). TravelPlanner: A Benchmark for Real-World Planning with Language Agents. ICML 2024. arXiv 2402.01622
Wei, J. 외 (2025). BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents. arXiv 2504.12516
Chen, Z. 외 (2025). BrowseComp-Plus: A More Fair and Transparent Evaluation Benchmark of Deep-Research Agent. arXiv 2508.06600
기억 시스템
Packer, C. 외 (2023). MemGPT: Towards LLMs as Operating Systems. arXiv 2310.08560
Chhikara, P. 외 (2025). Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. arXiv 2504.19413
Wang, Y., Chen, X. (2025). MIRIX: Multi-Agent Memory System for LLM-Based Agents. arXiv 2507.07957
Ouyang, S. 외 (2025). ReasoningBank: Scaling Agent Self-Evolving with Reasoning Memory. arXiv 2509.25140
Qian, H. 외 (2025). MemoRAG: Boosting Long Context Processing with Global Memory-Enhanced Retrieval Augmentation. WWW 2025.
Edge, D. 외 (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv 2404.16130
Liu, N. F. 외 (2024). Lost in the Middle: How Language Models Use Long Contexts. TACL, 12. arXiv 2307.03172
이미지: 표지와 삽화 13점은 코어닷투데이가 생성 모델로 만들었습니다. 논문 그림 3은 OpenReview 공개본(CC BY 4.0), 개요 그림은 프로젝트 사이트(CC BY-SA 4.0)에서 가져왔습니다. 표의 수치는 논문 본문·부록과 공개 반박문에서 옮겼고, 단체 여행 의존 거리 분포·쇼핑 지시 불일치·검색 적중률·기억 대 행동 실측은 코어닷투데이가 공개 데이터로 직접 계산했습니다.