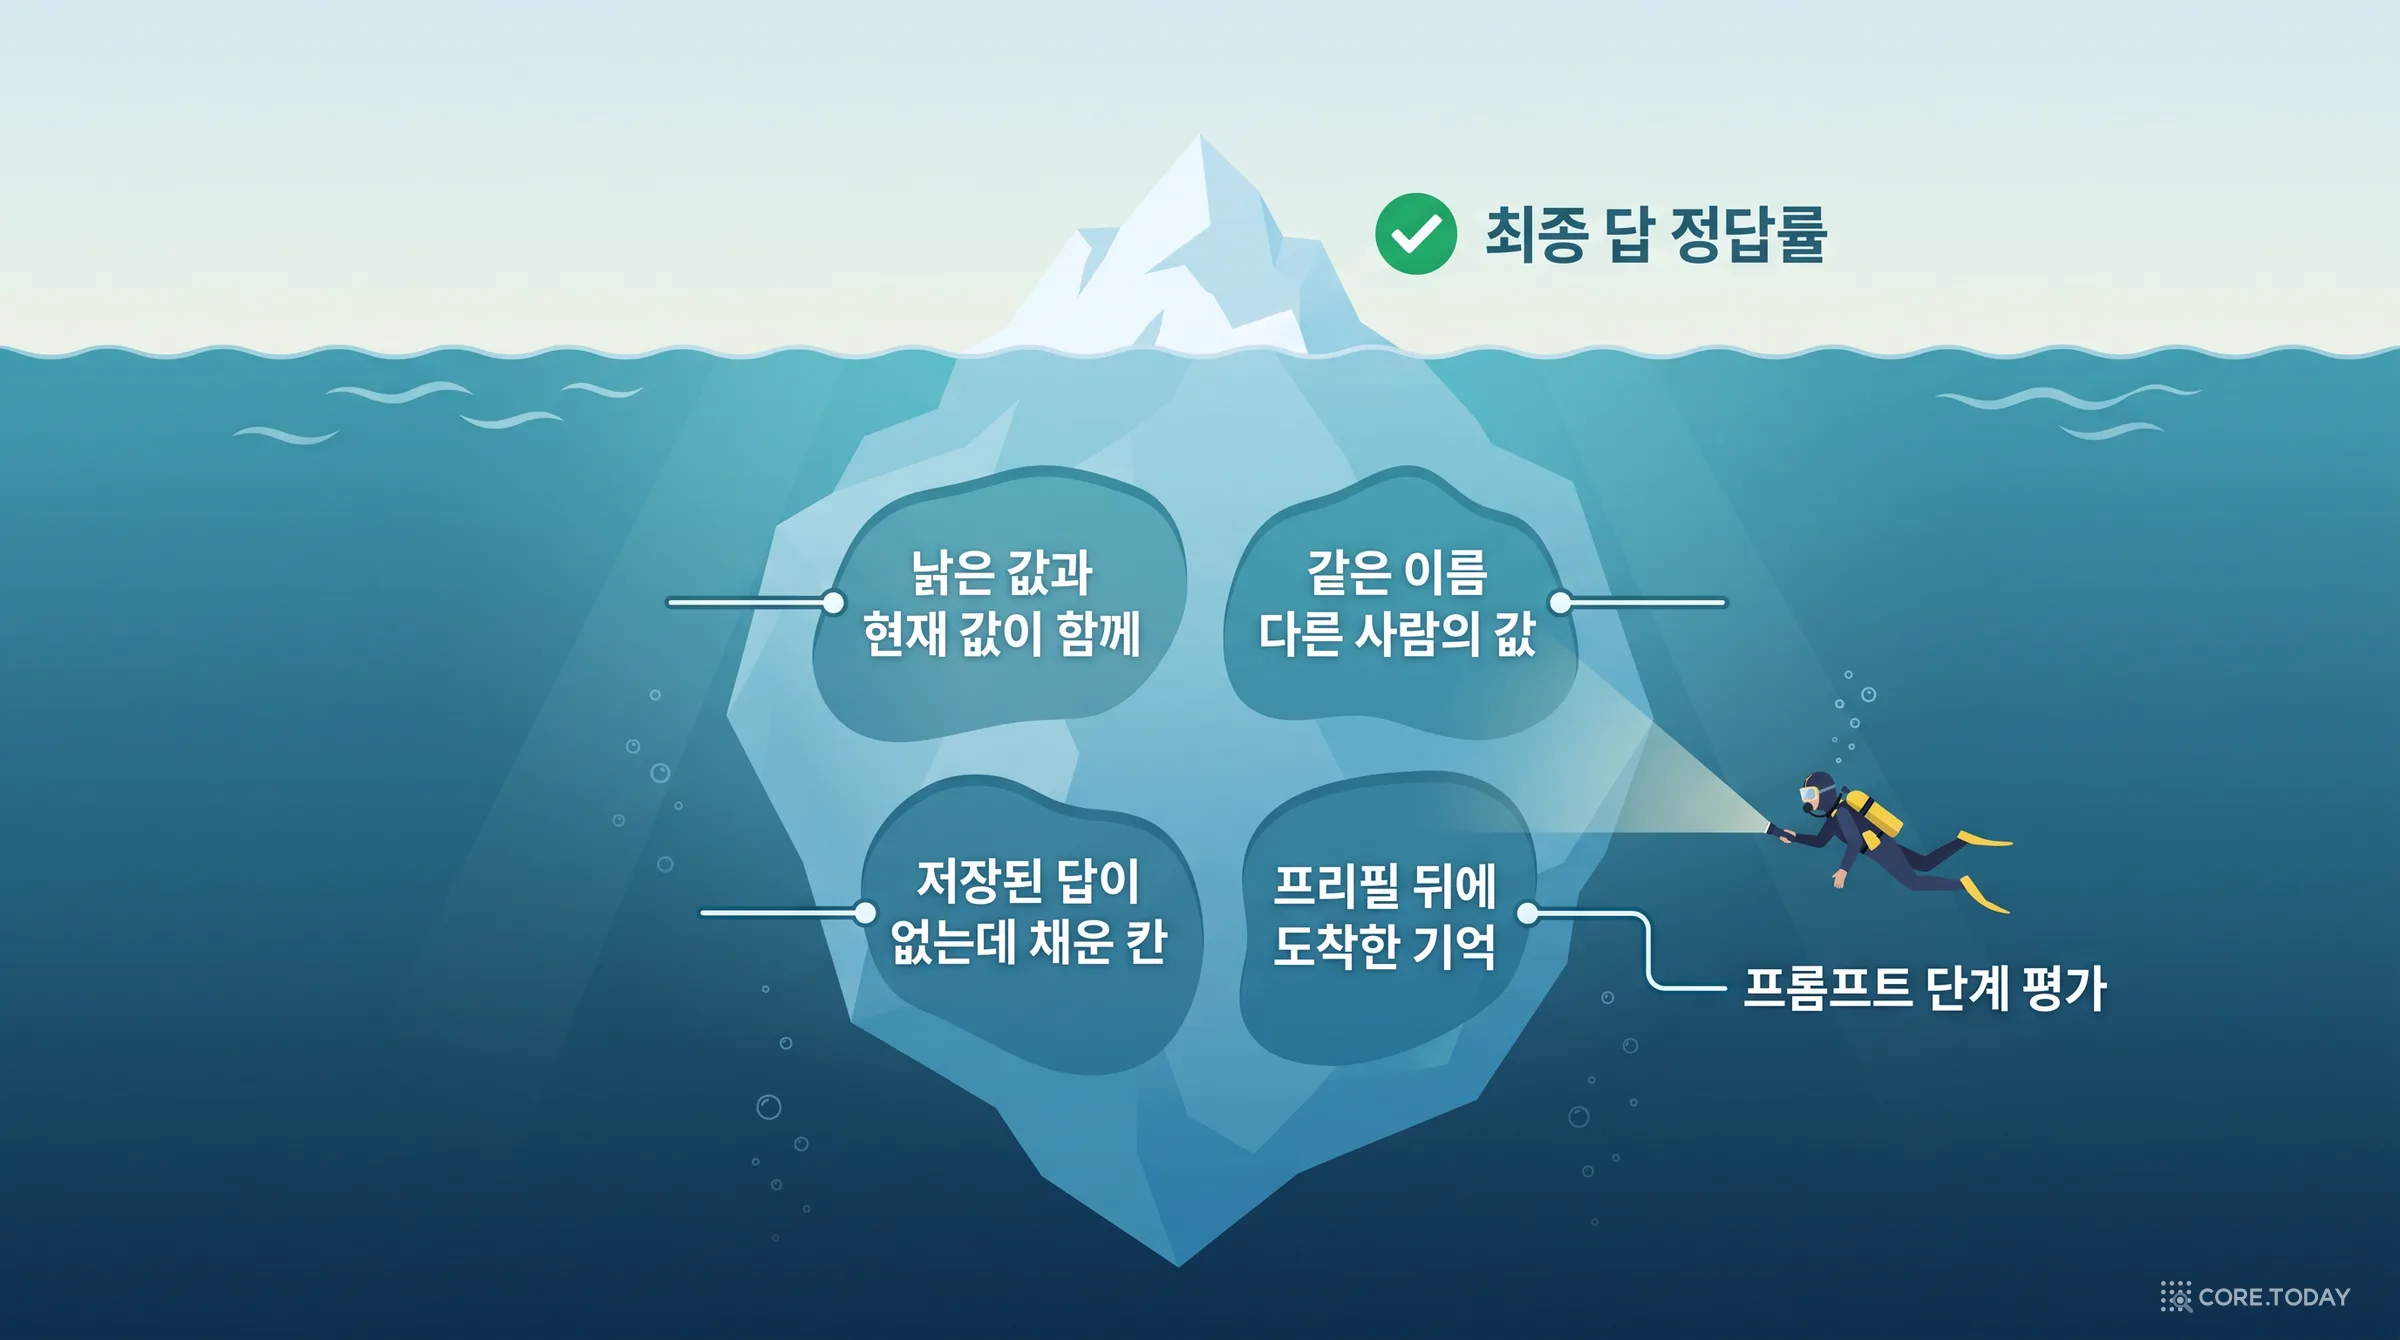
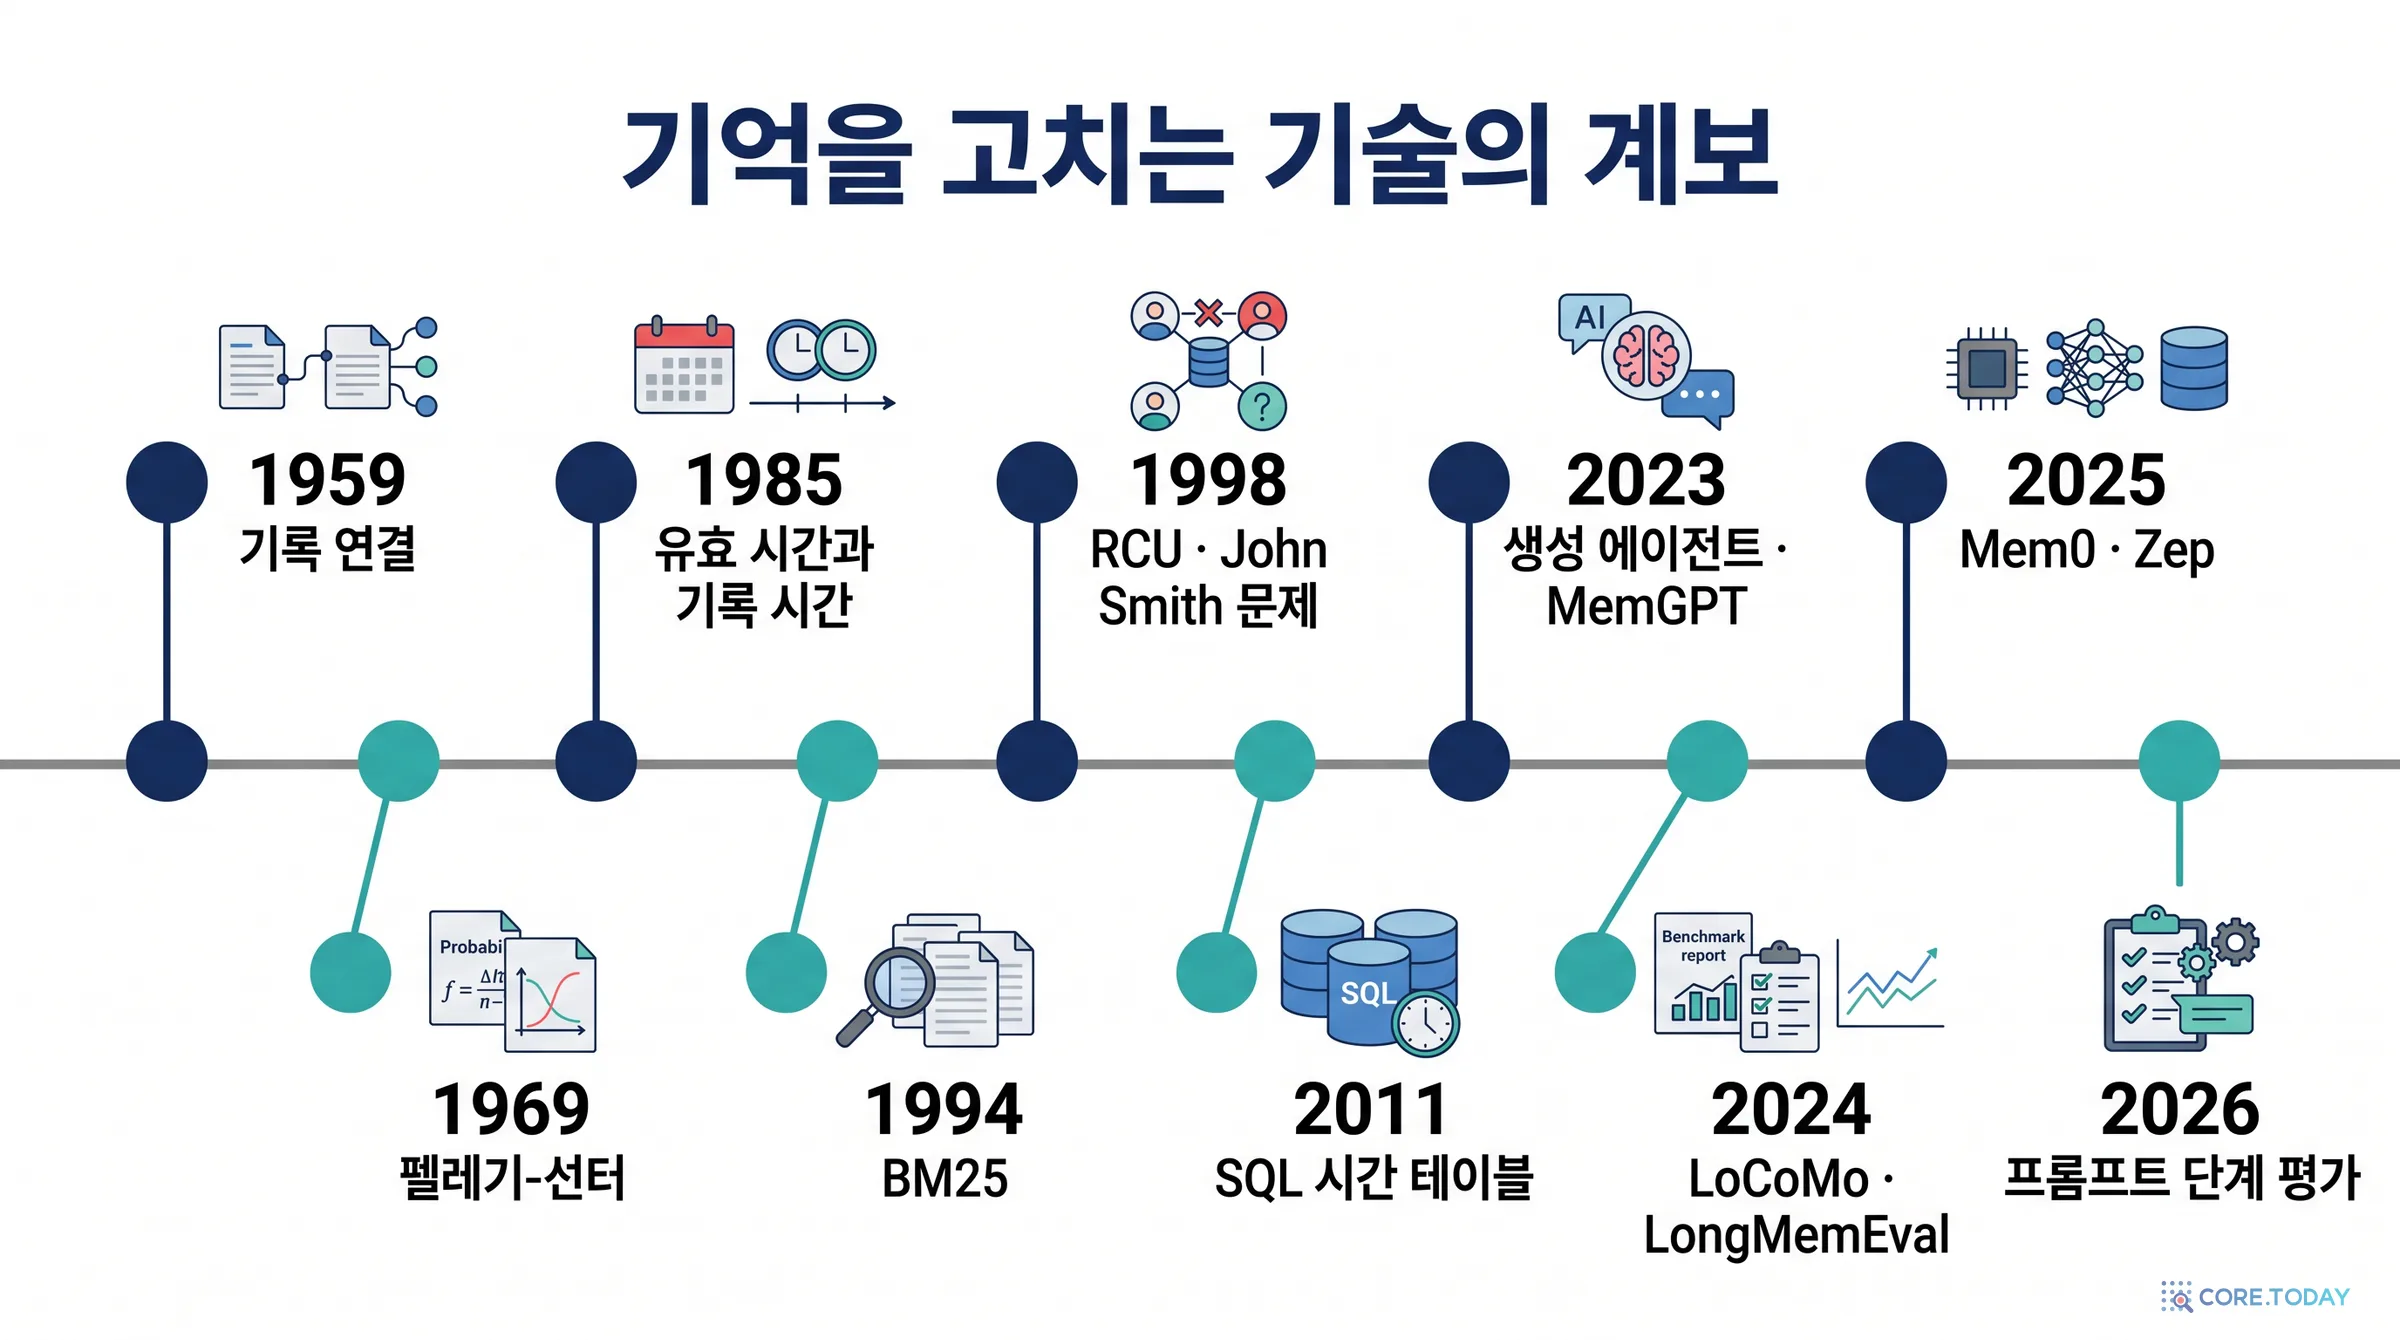
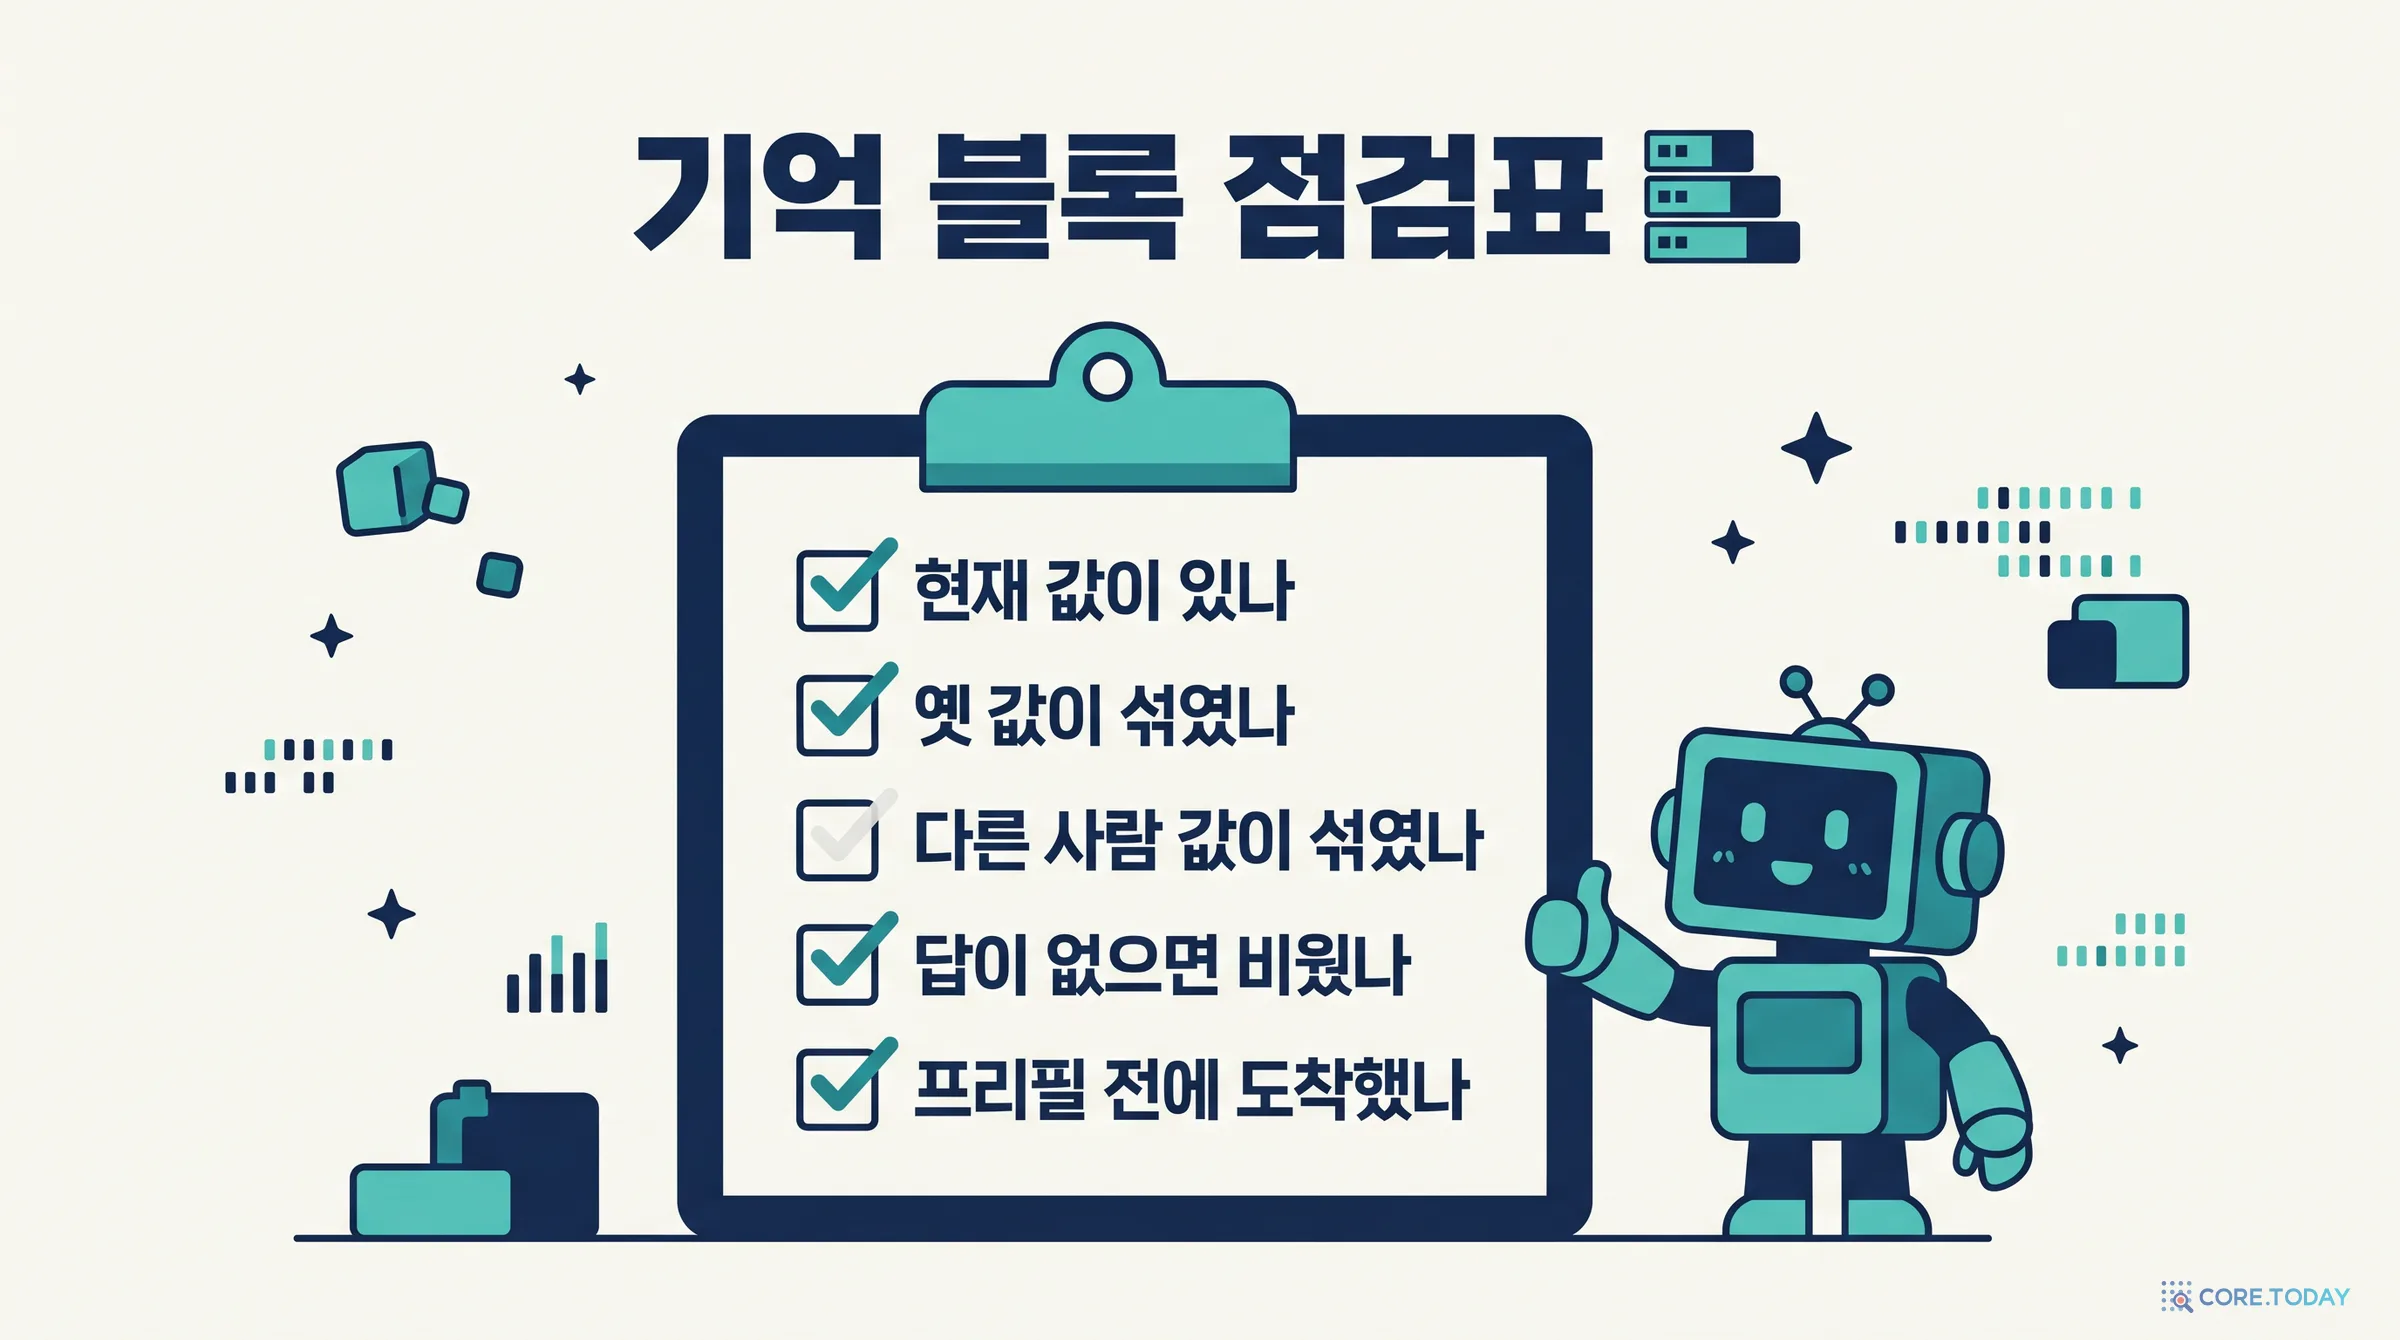
AI 비서의 기억은 보통 최종 답이 맞았는지로 채점한다. UC 버클리 연구진의 2026년 10월 논문 「Stale, Misattributed, or Late」는 채점 지점을 한 칸 앞으로 당겨, 모델에 들어가기 직전의 '기억 블록'이 낡은 값을 담았는지, 같은 이름의 다른 사람 값을 담았는지, 답이 없는데 무언가를 채웠는지, 프리필 전에 도착했는지를 따로 센다. 결론은 단순하다. 낡음은 검색이 아니라 쓰기의 문제이고, 진짜 어려운 일은 개정을 올바른 칸에 묶는 '키 붙이기'이며, 동명이인·기권·지연은 각각 다른 정보가 필요하다. 1959년 레코드 연결과 1985년 '유효 시간 대 기록 시간'에서 시작해 BM25·RCU·John Smith 문제를 거쳐 2026년 기억 제품까지 계보를 따라가고, 표와 그림을 하나씩 읽는다. 같은 실험을 한국어로 다시 만들어 로컬 Qwen 모델로 돌려 봤더니 저장소 구조에서 나오는 결과는 대부분 재현됐고, 'LLM 키 할당기가 규칙보다 나쁘다'는 모델 의존적인 결과는 재현되지 않았다.
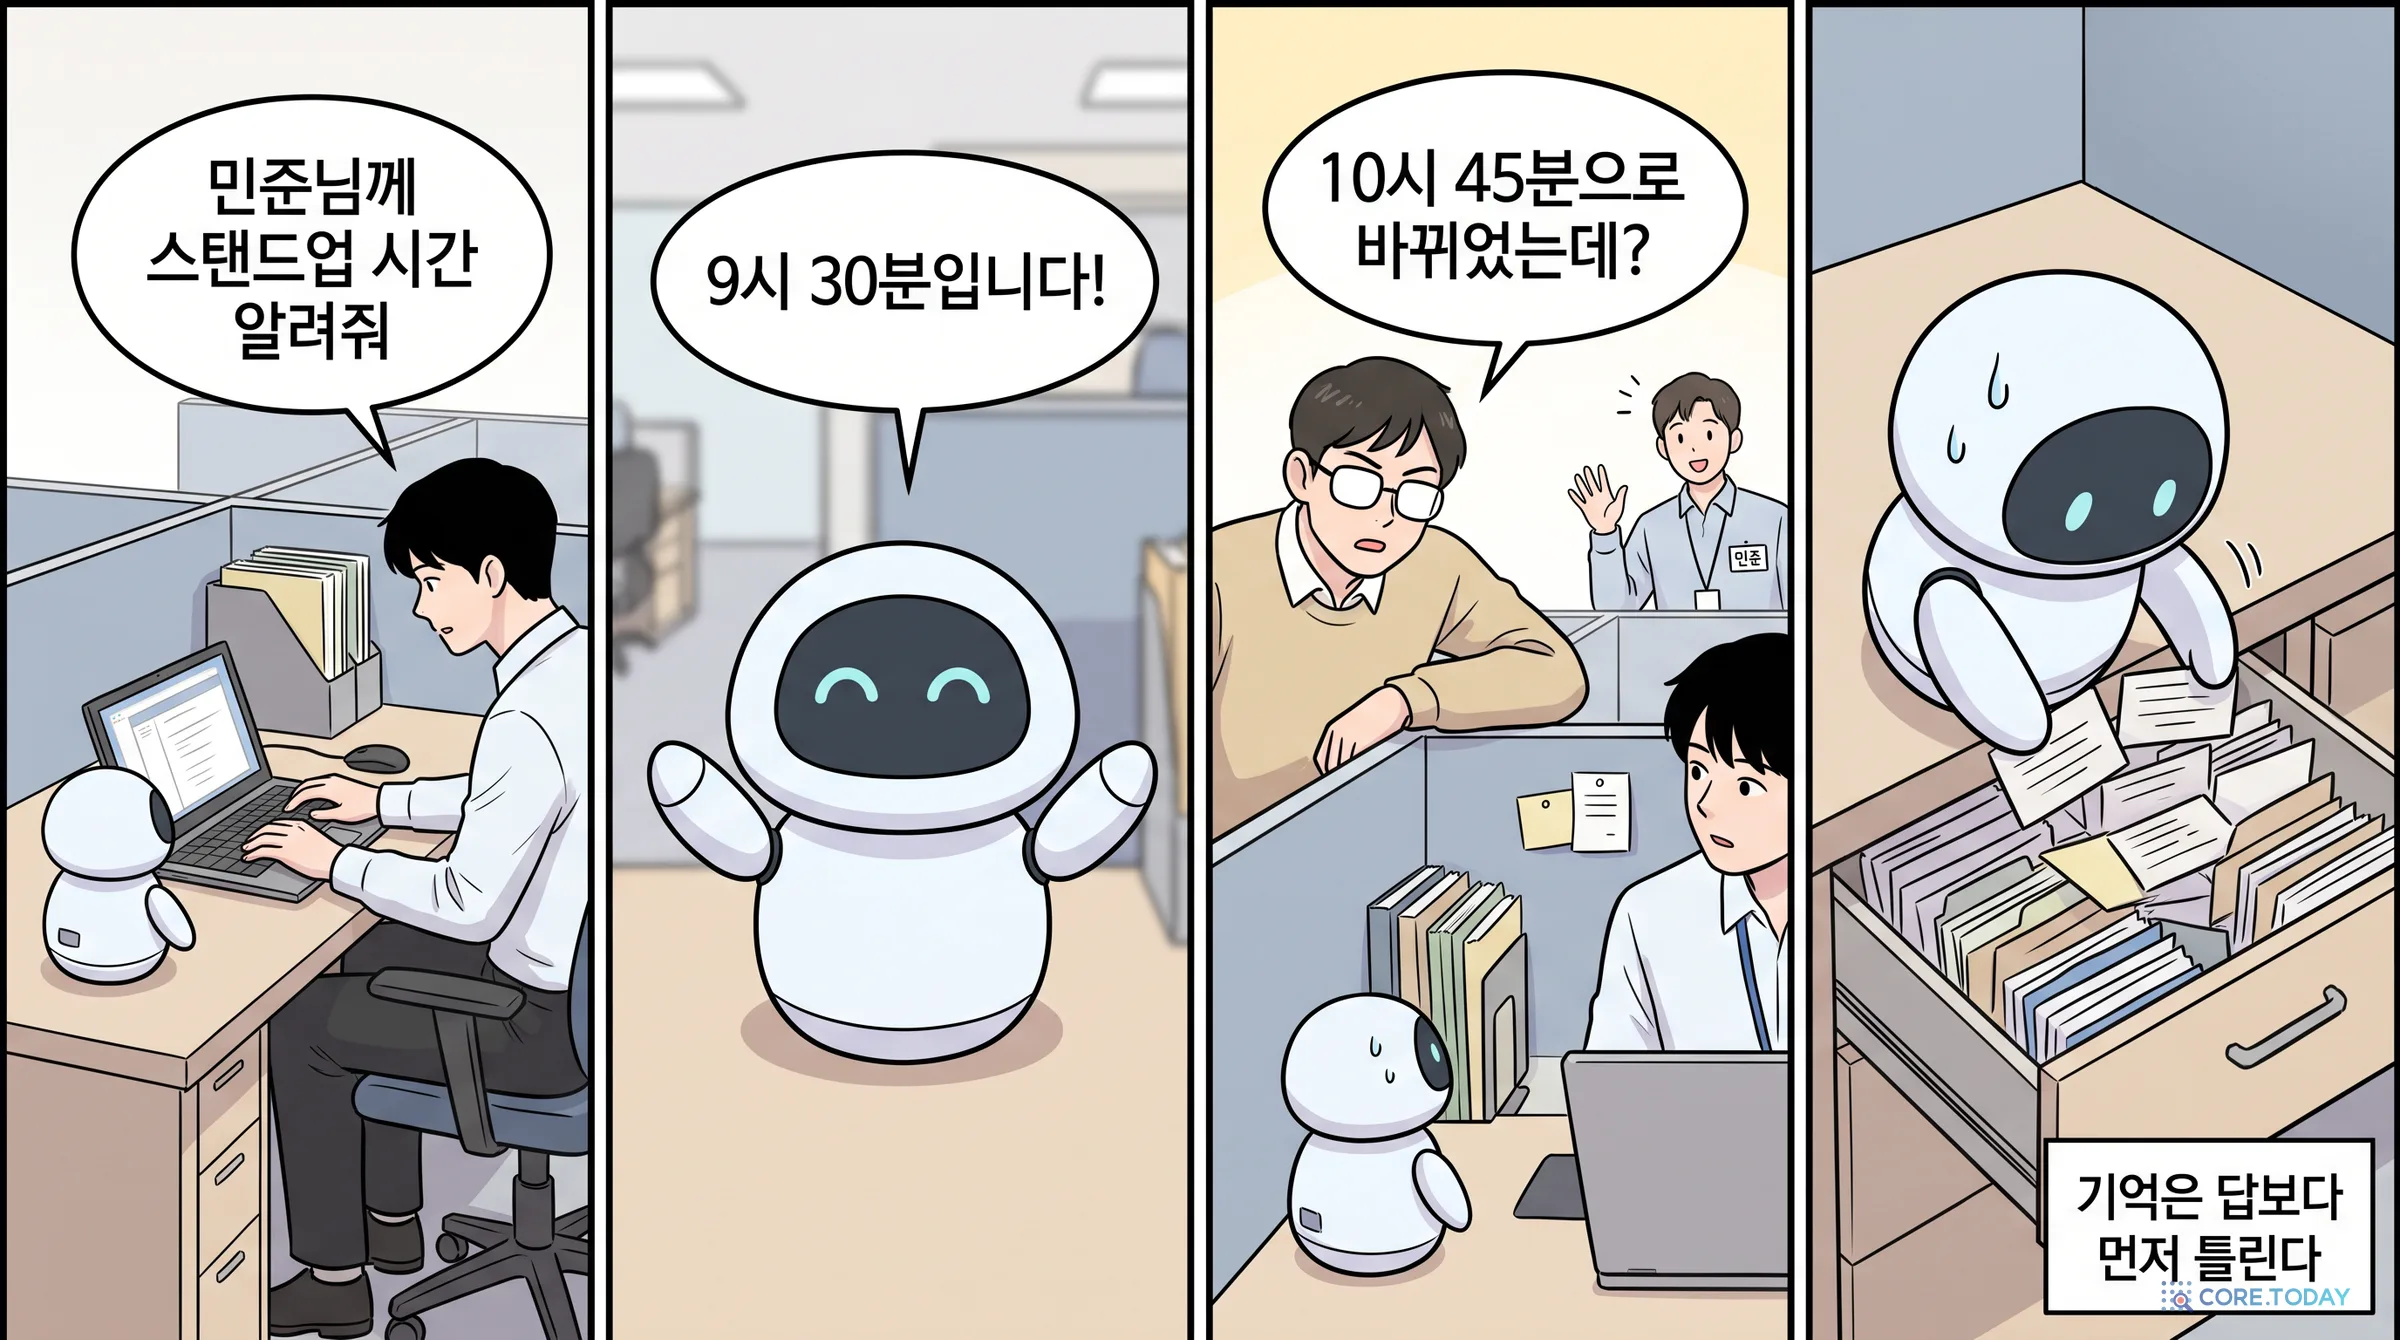
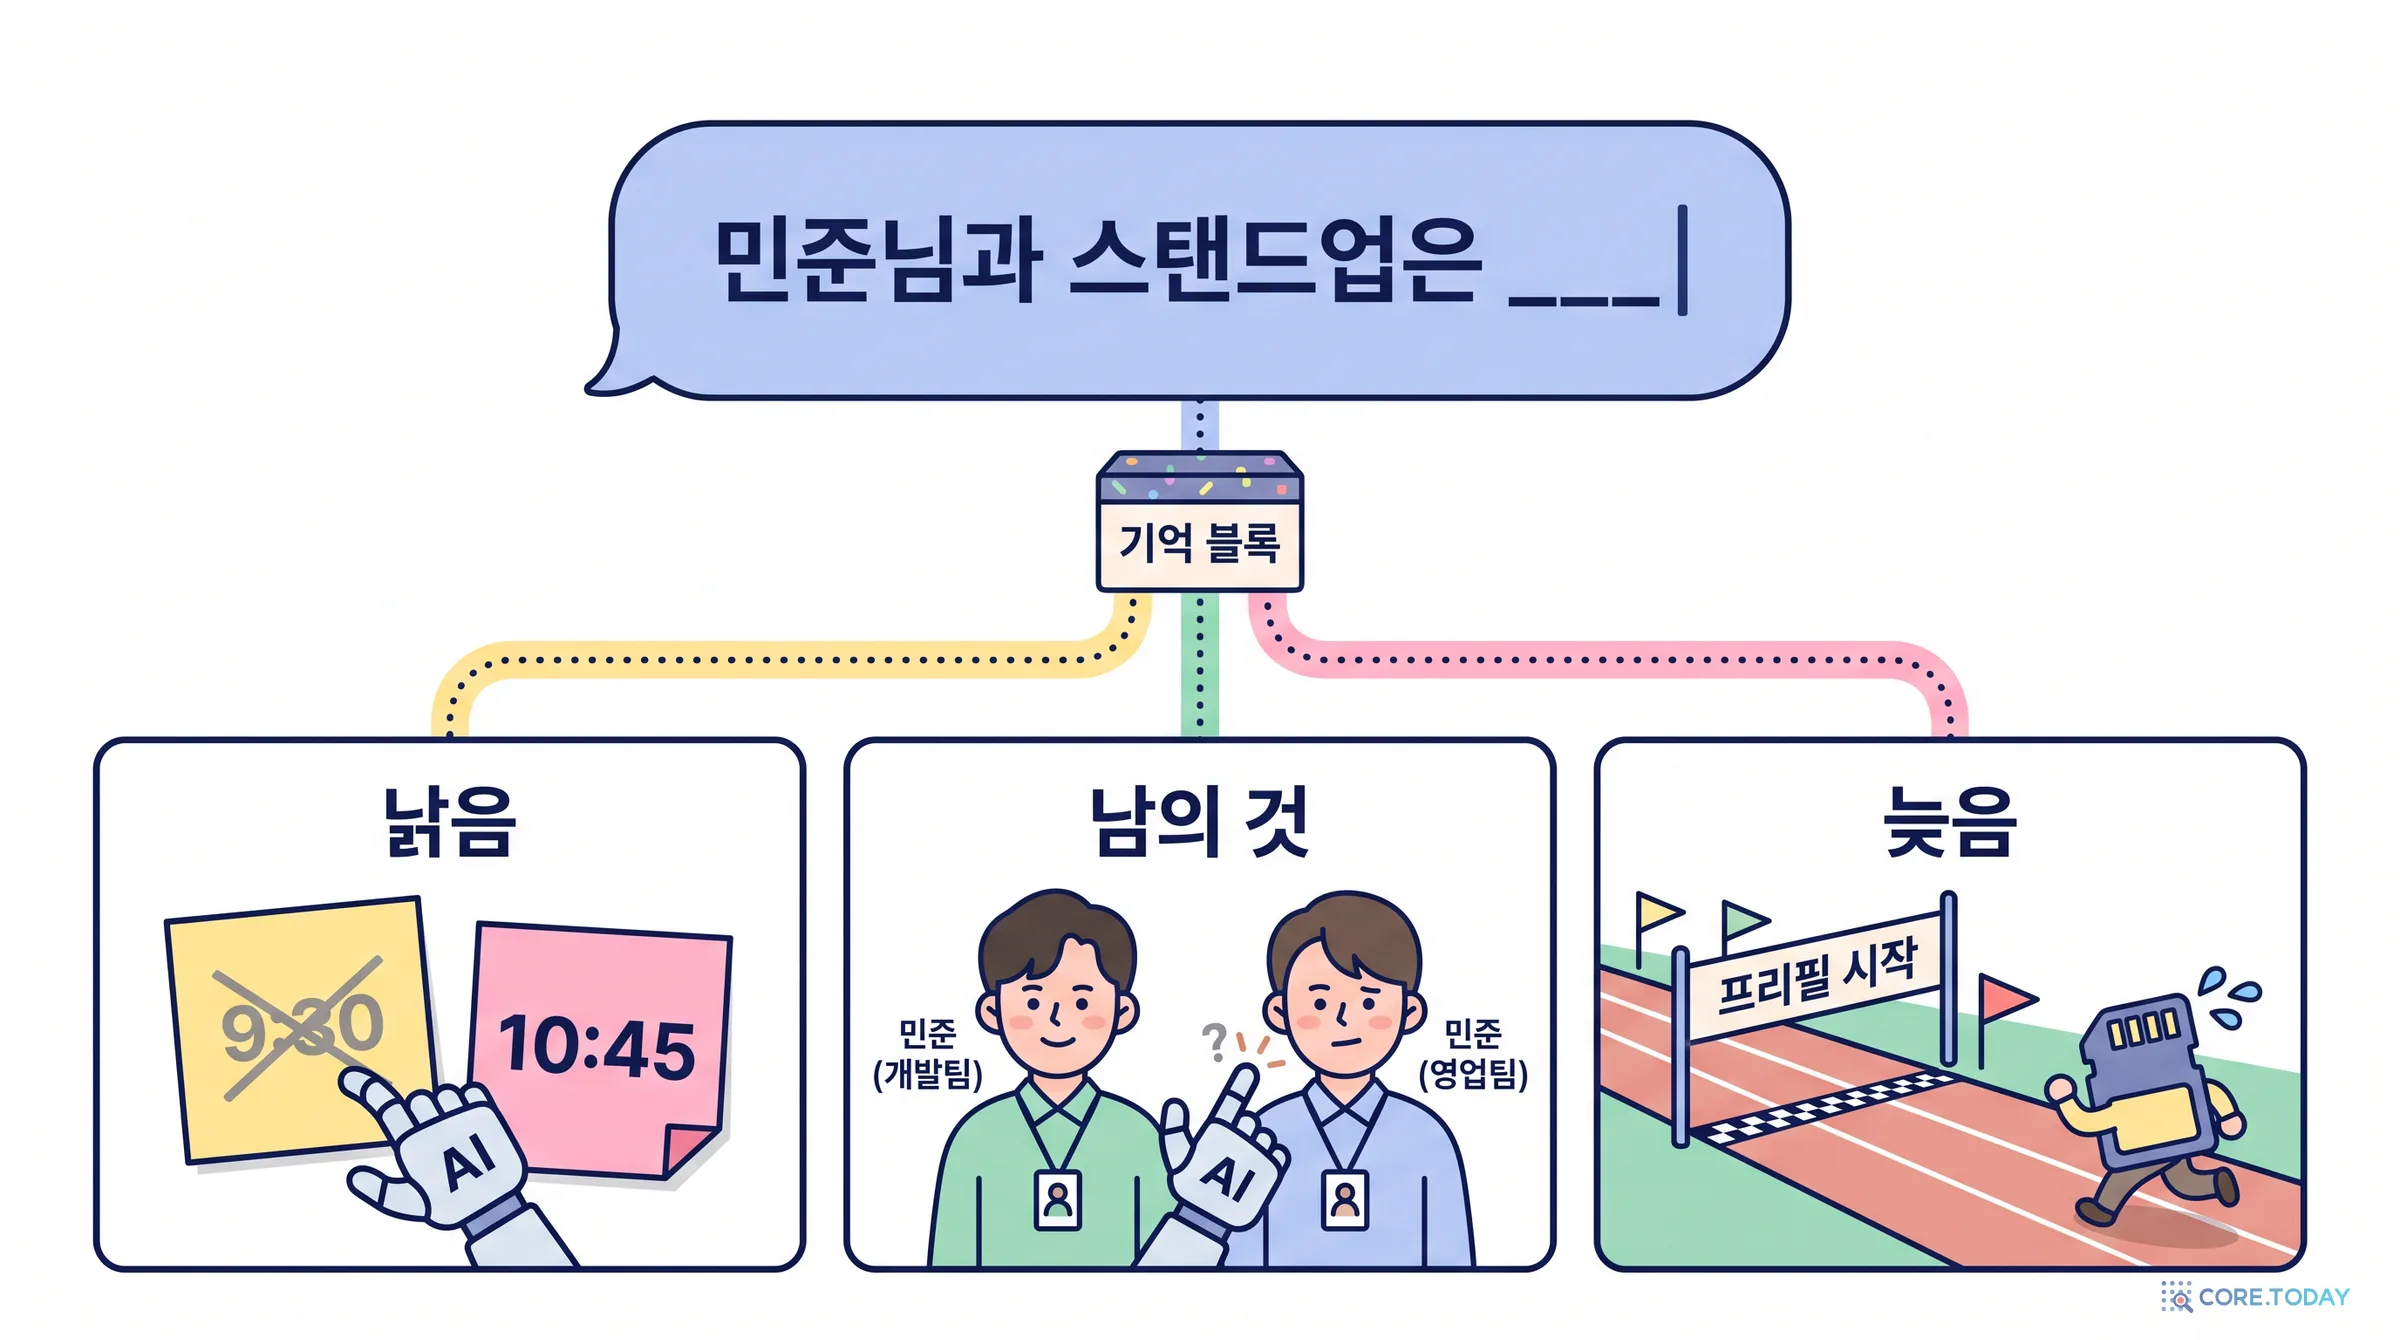
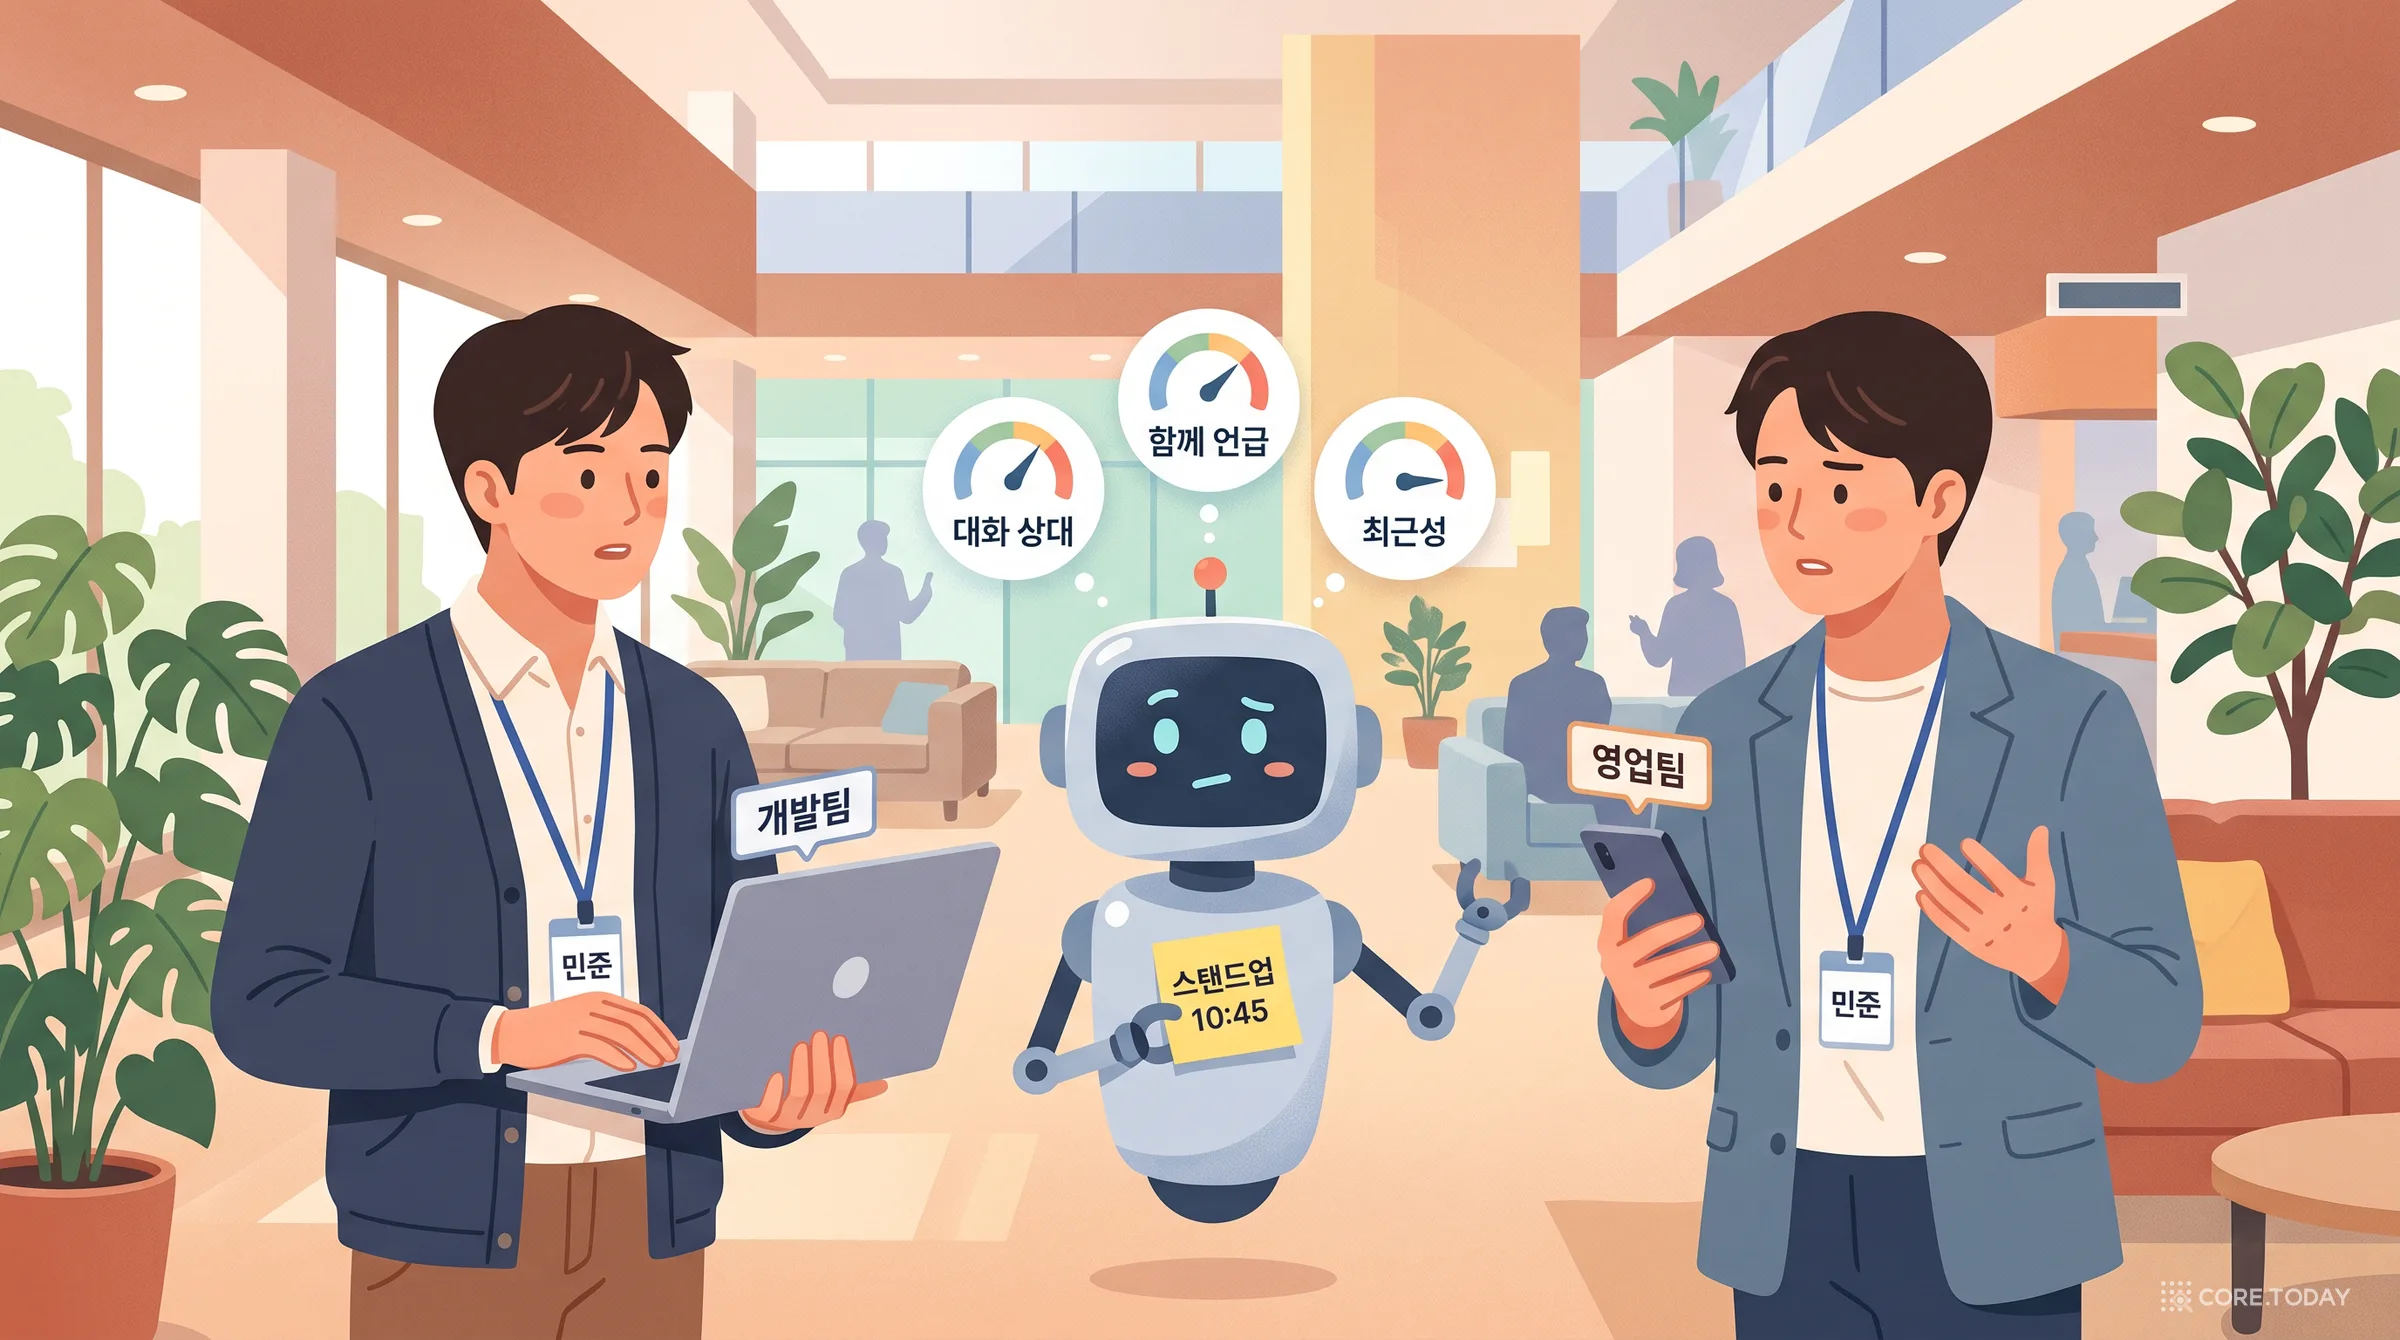
동료에게 메시지를 쓰고 있다고 해 봅시다. "민준님, 스탠드업은"까지 쳤는데 비서가 회색 글씨로 뒤를 이어 줍니다. "9시 30분에 뵐게요." 편리합니다. 문제는 스탠드업이 어제 10시 45분으로 바뀌었다는 것입니다. 아니면 9시 30분이 맞긴 한데 그건 영업팀 이민준의 스탠드업이고, 지금 메시지를 받는 사람은 개발팀 김민준일 수도 있습니다. 아니면 비서가 정확한 시간을 찾아내긴 했는데, 찾는 사이에 모델이 이미 글을 쓰기 시작해서 그 기억이 이번 문장에 끼지 못했을 수도 있습니다.
UC 버클리의 하오난 덩(Haonan Deng)과 하스 경영대학의 박 신차이스리(Park Sinchaisri)가 2026년 10월 7일 arXiv에 올린 논문 「Stale, Misattributed, or Late: Where Personal Memory Fails Before Generation」(arXiv:2610.10265)은 바로 이 세 장면에서 출발합니다. 제목이 곧 요약입니다. 개인 기억은 낡거나(stale), 남의 것이거나(misattributed), 늦어서(late) 실패하는데, 세 실패 모두 모델이 첫 단어를 쓰기 전에 일어납니다.
이 논문이 눈길을 끈 이유는 새 기억 엔진을 내놓아서가 아닙니다. 오히려 반대입니다. 저자들은 핵심 규칙 — 같은 항목의 새 값이 오면 옛 값을 닫는다 — 이 "우리의 기여가 아니다"라고 먼저 말합니다. 데이터베이스가 40년 전부터 해 온 일이고 Zep·Mem0 같은 기억 시스템도 이미 씁니다. 이 논문이 묻는 것은 그 다음입니다. 그 규칙의 전제가 깨지면 무엇을 잃는가, 그리고 규칙이 완벽하게 작동한 뒤에도 남는 오류는 무엇인가. 그것을 보려면 최종 답이 아니라 모델에 들어가는 기억 블록을 채점해야 한다는 것이 논문의 주장입니다. ICLR 2027에 익명으로 심사 중인 원고(OpenReview 제출 33770번)이고, 심사 페이지의 한 줄 요약은 이렇습니다. "정확한 검색만으로는 부족하다. 낡은 사실은 주로 쓰기 시점의 문제이고, 엉뚱한 사람 검색·기권·지연은 각각 다른 장치가 필요하다."
이 글은 논문을 처음부터 끝까지 읽되, 왜 이런 문제의식이 나왔는지부터 시작합니다. 낡은 값과 엉뚱한 사람의 값은 AI가 처음 겪는 문제가 아닙니다. 병원의 약 복용 기록, 신용 보고서, 항공 탑승 명단, 내비게이션 지도가 수십 년 동안 같은 문제로 사람을 다치게 했고, 데이터베이스와 통계학은 그 문제에 이름과 도구를 붙여 왔습니다. 그 계보를 따라간 뒤 논문의 정의·명제·표·그림을 하나씩 읽고, 코어닷투데이가 같은 실험을 한국어로 다시 만들어 로컬 모델로 돌려 본 결과를 보탭니다. 마지막에는 2026년의 기억 제품을 만드는 사람이 무엇을 재야 하는지 정리합니다.
중간중간 여섯 개의 위젯을 넣었습니다. 기억 블록을 직접 조립해 보고, 키 오류를 주입해 보고, 동명이인 사후확률을 계산해 보고, 마감 시간을 바꿔 보고, 키 할당기들을 비교하고, 마지막으로 내 시스템을 진단해 볼 수 있습니다.
논문이 말하는 개인 기억(personal memory)은 비서가 사용자와 주고받은 메시지·일정·약속에서 뽑아 둔 사실들입니다. 사용자가 새 요청을 보내면 기억 층(memory layer)이 그중 몇 줄을 골라 프롬프트 앞에 붙입니다. 논문은 이 덩어리를 기억 블록(memory block)이라고 부르고, 형식도 정해 둡니다. 맨 위에 [Relevant memory]라는 머리말이 있고, 한 줄에 사실 하나씩, 그 사실을 관찰한 날짜와 대화 상대를 괄호에 붙입니다.
text
[Relevant memory]
- (2025-06-11, to Alex Rivera) The standup with Alex Rivera is moved to room 16C.
이 블록이 망가지는 방식이 세 가지입니다.
고장
낡음 (stale)
남의 것 (misattributed)
늦음 (late)
블록에서 벌어지는 일
이미 대체된 옛 값이 들어간다
이름이 같은 다른 사람의 값이 들어간다
블록이 프리필 시작 뒤에 준비된다
스탠드업 예
10:45로 바뀌었는데 9:30이 함께 들어감
개발팀 김민준에게 쓰는데 영업팀 이민준의 시간이 들어감
정확한 10:45를 찾았지만 모델은 이미 쓰기 시작함
어디서 생기나
쓰기 시점 — 개정을 같은 칸에 묶지 못함
서빙 시점 — 요청이 가리키는 사람을 못 가림
서빙 경로 — 검색·인코딩·스케줄링 지연
고치는 데 필요한 정보
(엔티티, 슬롯) 키와 커밋 순서
누가 대화 상대인지, 누구와 함께 언급됐는지
마감 안에 끝나는 경로, 미리 만든 스냅숏
여기에 하나가 더 붙습니다. 저장소에 답이 아예 없을 때입니다. 김민준의 일당을 물었는데 저장된 적이 없다면, 올바른 기억 층은 빈 블록을 돌려줘야 합니다. 그런데 상위 k개를 뽑는 검색기는 언제나 k칸을 채웁니다. 일당이라는 단어가 들어간 줄은 이민준의 것밖에 없으니 그것이 들어갑니다. 논문은 이것을 기권(abstention) 실패로 따로 셉니다.
사람의 세계에서 이미 본 고장들
세 고장은 AI의 신종 질병이 아닙니다. 기록을 다루는 모든 시스템이 겪어 온 고전적인 사고입니다.
낡은 값. 2005년 캐나다의학협회지(CMAJ)에 실린 체계적 문헌고찰(Tam 외, 연구 22편)은 입원 환자의 10~67%가 처방약 복용 이력에 오류를 한 건 이상 갖고 있었다고 정리했습니다. 대부분은 빠진 약이었지만, 먹지 않는 약이 목록에 올라 있는 오류도 13~22%였습니다. 2022년 9월 미국 노스캐롤라이나에서는 한 운전자가 내비게이션 안내를 따라 2013년에 무너진 다리로 들어가 숨졌습니다. 유족의 소장에 따르면 주민들이 수년간 붕괴를 신고했고 2020년에는 지도 회사의 접수 확인 메일까지 있었습니다. 새 사실은 들어왔지만 옛 값이 닫히지 않은 것입니다. 2024년 2월 캐나다 브리티시컬럼비아주 민사분쟁심판소는 항공사 챗봇이 실제와 다른 유족 할인 규정을 안내한 사건(Moffatt v. Air Canada)에서, 챗봇이든 정적 웹페이지든 회사가 책임진다고 판단했습니다. 엄밀히 말하면 이 사건은 '낡은 값'보다 '틀린 값'에 가깝지만, 비서가 내놓은 정보의 책임이 누구에게 있는지는 분명히 보여 줍니다.
남의 것. 미국 연방거래위원회(FTC)가 2012년 신용 보고서 1,001명분을 조사했더니 26%가 잠재적 오류를 한 건 이상 찾았고, 5%는 대출·보험 조건이 나빠질 만한 오류였습니다. 대표적인 원인이 동명이인이나 부자(Jr./Sr.)의 기록이 한 파일에 섞이는 '혼합 파일(mixed file)'입니다. 2021년 미국 연방대법원의 TransUnion v. Ramirez 사건에서는 신용평가사가 이름만 대조해 테러·마약 제재 명단 인물과 이름이 같은 사람들에게 경고를 붙였고, 집단소송 원고는 8,185명이었습니다. 병원에서는 환자 오인이 같은 구조의 사고입니다. 미국 ECRI 연구소는 2013년 1월부터 2015년 8월까지 181개 기관에서 환자 확인 오류 7,613건을 모았는데 약 9%가 실제 위해로 이어졌습니다.
흔히 인용되는 2004년 테드 케네디 상원의원의 공항 탑승 제지 사건도 이 범주입니다. 다만 이야기에 반전이 있습니다. 그는 흔히 알려진 것처럼 '탑승 금지 명단(no-fly list)'에 올랐던 것이 아니라, 2008년 미국 교통보안청(TSA)의 정정에 따르면 추가 검색 대상 명단(selectee list)에 있던 다른 사람으로 오인됐습니다. 오귀속 사건은 이렇게 오귀속의 이야기 자체가 오귀속되기도 합니다.
늦음. 구글은 2009년 검색 결과에 일부러 지연을 넣는 실험을 했습니다. 400ms를 늦추자 첫 3주에 검색량이 0.44% 줄었고, 지연을 없앤 뒤에도 몇 주 동안 효과가 남았습니다. 흥미롭게도 LLM 대화는 이야기가 조금 다릅니다. 2026년 뉴욕대 연구진(arXiv:2604.06183)은 첫 토큰이 2초에 나온 답이 9초·20초짜리보다 덜 사려 깊다고 평가받았다고 보고했습니다. 사람이 느끼는 '느림'은 맥락에 따라 다릅니다. 하지만 이 논문이 말하는 늦음은 사람의 체감이 아니라 기계적인 마감입니다. 기억 블록은 프리필(prefill, 모델이 프롬프트 전체를 한 번에 읽어 내부 상태를 만드는 단계)이 시작되기 전에 완성돼야 합니다. 그 뒤에 도착한 블록은 아무리 정확해도 이번 응답에는 존재하지 않는 것과 같습니다.
AI 비서의 기억은 이제 기본값이다
이 문제가 2026년에 특히 중요해진 이유는 기억이 실험실 기능에서 제품의 기본값이 됐기 때문입니다. OpenAI는 2024년 2월 ChatGPT의 기억 기능을 시험 공개했고 2025년 4월에는 과거 대화 전체를 참고하는 기능을 더했습니다. 구글 Gemini는 2025년 8월 '개인 맥락(Personal Context)'을 기본으로 켰고, Anthropic은 2025년 9월 팀·기업 사용자부터 Claude에 기억을 넣은 뒤 10월 Pro·Max 사용자로 넓혔습니다. 오픈소스 쪽에서는 Mem0, Zep(Graphiti), Letta 같은 기억 엔진이 에이전트 개발의 표준 부품이 됐습니다.
기억이 기본값이 되면 기억의 오류도 기본값이 됩니다. 그리고 그 오류는 대부분 조용합니다. 모델이 틀린 답을 하면 사용자가 알아채지만, 블록에 옛 값과 새 값이 함께 들어간 채 모델이 운 좋게 새 값을 고르면 아무도 모릅니다. 다음 모델 버전에서, 프롬프트 한 줄을 바꾼 뒤에, 또는 하필 옛 값이 더 그럴듯하게 쓰인 날에 그 운이 다할 때까지는요.
LoCoMo(2024)나 LongMemEval(2024) 같은 대표적인 장기 기억 벤치마크는 질문을 던지고 모델의 최종 답이 정답과 맞는지를 봅니다. 코어닷투데이가 「메모리 벤치마크 점수, 믿어도 되나」에서 직접 다시 채점해 봤듯, 이 방식에는 채점 모델·채점 프롬프트에 따라 점수가 크게 흔들리는 문제가 있습니다. 이 논문이 짚는 문제는 그보다 더 근본적입니다. 최종 답 점수는 어느 부품이 틀렸는지 말해 주지 않습니다.
같은 "정답"이 서로 전혀 다른 블록에서 나올 수 있습니다.
블록 ①10:45만 들어 있다 → 모델이 10:45라고 씀 → 정답. 깨끗한 블록.
블록 ②9:00, 9:30, 10:45가 날짜와 함께 들어 있다 → 모델이 가장 최근 날짜를 골라 10:45 → 정답. 하지만 블록은 낡은 값 두 개를 담았다.
블록 ③김민준의 10:45와 이민준의 14:10이 함께 들어 있다 → 모델이 대화 상대 이름을 보고 10:45 → 정답. 하지만 블록은 남의 값을 담았다.
블록 ④정확한 10:45가 15ms 뒤에 도착 → 마감 10ms를 넘겨 모델은 기억 없이 씀 → 오답. 검색은 완벽했는데 점수는 0.
최종 답 채점은 ①·②·③을 똑같이 1점으로, ④를 검색 실패와 똑같이 0점으로 셉니다. ②와 ③은 지금은 괜찮지만 언제든 터질 지뢰입니다. 실제로 논문 부록 M에서 키에 5%의 잡음을 넣자 기억 블록의 18.3%에 낡은 값이 들어갔지만, 7B 모델은 그중 일부만 받아써서 최종 답에서는 4.2%만 낡은 값을 썼습니다. 3B 모델은 10.0%를 받아썼습니다. 블록의 오류율과 답의 오류율이 4배 이상 차이 나고, 그 차이는 모델에 따라 달라집니다. 모델이 대신 막아 주는 만큼은 평가에서 보이지 않습니다.
논문의 채점표: 다섯 개의 지표
논문 3절은 이것을 형식으로 씁니다. 수식이 나오지만 뜻은 간단합니다. 요청 t마다 기억 층이 고른 사실 집합을 S라고 하고, 사실 f마다 채점용 라벨 세 개를 붙입니다(기억 층은 이 라벨을 볼 수 없습니다).
R(f) — 요청한 슬롯의 값을 말하는가. 요청 속 이름과 표면형이 같은 사람이면 누구의 값이든 1.
I(f) — 의도한 바로 그 사람(엔티티)에 관한 사실인가.
V(f) — 그 값이 아직 현재 값인가.
세 라벨이 모두 1인 사실들이 정답 집합 G입니다. 그러면 지표는 이렇게 정의됩니다.
논문 식 (1)과 지표 — 쉬운 말로
현재 값 재현 C블록에 정답 사실이 하나라도 있으면 1
낡은 값 노출 Estale그 사람의 그 슬롯이지만 이미 대체된 값(R=1, I=1, V=0)이 한 줄이라도 있으면 1
오귀속 Eid같은 슬롯·같은 이름의 다른 사람 값(R=1, I=0)이 한 줄이라도 있으면 1
깨끗한 검색 Y답이 있을 때: C × (1 − Estale) × (1 − Eid). 답이 없을 때: 요청 슬롯 값을 하나도 넣지 않았으면 1
마감 내 깨끗함 Y(D)깨끗하고, 검색 시간 L이 마감 D 이하일 때만 1
세 가지 설계가 눈에 띕니다. 첫째, 노출 지표들은 서로 배타적이지 않습니다. 한 블록이 현재 값과 낡은 값과 남의 값을 동시에 담을 수 있고, 재현율만 보면 그 블록은 만점입니다. 논문은 현재 값과 낡은 값이 함께 든 경우를 따로 '공동 주입(co-injection)'으로 셉니다. 둘째, 답이 없는 요청을 따로 셉니다. 답이 없으면 재현율은 어떤 정책이든 0이므로, 올바르게 비운 정책과 엉뚱한 값을 채운 정책을 구별하려면 다른 정의가 필요합니다. 논문은 답 있는 경우와 없는 경우를 따로 보고하라고 강조하는데, 기권을 남발하면 후자는 좋아지고 전자는 나빠지기 때문입니다. 셋째, 시간이 점수 안에 들어갑니다. 마감을 넘긴 깨끗한 블록은 깨끗하지 않은 블록과 같은 0점입니다.
라벨을 정확히 붙일 수 있도록 벤치마크도 영리하게 설계했습니다. 통제 벤치마크의 값(시각·호실·날짜·금액)은 한 인스턴스 안에서 모두 고유합니다. "Dec 2"와 "Dec 24"가 섞이지 않게 토큰 경계까지 따집니다. 그러면 블록에 어떤 문자열이 있는지만 보고도 그 줄이 현재 값인지, 낡은 값인지, 남의 값인지 기계적으로 판정할 수 있습니다.
아래 위젯에서 직접 해 보세요. 11줄짜리 장난감 저장소에서 질의 다섯 개를 골라, 스위치를 켜고 끄며 블록이 어떻게 바뀌는지 보고, "최종 답만 채점했다면" 어떤 오류가 가려지는지 확인할 수 있습니다.
논문의 참고문헌은 짧지만, 그 안에는 데이터 관리의 반세기가 접혀 있습니다. 논문을 제대로 읽으려면 이 계보를 먼저 펼쳐 보는 편이 좋습니다. 논문의 거의 모든 장치에 조상이 있기 때문입니다.
1959~1969: '같은 사람인가'를 확률로 묻다 — 레코드 연결
1959년 10월, 캐나다의 하워드 뉴컴(Howard Newcombe)과 동료들은 『사이언스』에 「생체 기록의 자동 연결(Automatic linkage of vital records)」을 발표했습니다. 방사선이 인구에 미치는 영향을 연구하려면 출생 기록과 혼인 기록을 같은 가족끼리 이어야 했는데, 이름 철자는 제각각이고 공통 식별번호는 없었습니다. 그들은 Datatron 205라는 컴퓨터로 두 기록이 같은 사람일 확률을 계산했습니다.
10년 뒤인 1969년, 캐나다 통계청의 이반 펠레기(Ivan Fellegi)와 앨런 선터(Alan Sunter)가 이것을 이론으로 정리했습니다. 「레코드 연결의 이론」(JASA)의 핵심은 두 기록 쌍에 대해 우도비를 계산하고 임계값 두 개와 비교하는 것입니다. 위쪽 임계값을 넘으면 연결, 아래쪽보다 낮으면 비연결, 그 사이는 사람이 검토합니다. 왜 두 개일까요? 실수가 두 종류이고 대가가 다르기 때문입니다. 같은 사람을 놓치는 것(거짓 비연결)과 다른 사람을 합치는 것(거짓 연결)입니다.
이 글의 6장에서 만날 놓친 병합(missed merge)과 잘못된 병합(false merge)이 정확히 이 두 실수입니다. 2026년 기억 시스템에서 같은 슬롯의 개정을 다른 키로 붙이는 것은 거짓 비연결이고, 다른 슬롯을 같은 키로 묶는 것은 거짓 연결입니다. 그리고 펠레기와 선터가 알았던 것처럼, 두 실수는 다른 방향으로 해롭습니다.
1985: 세상의 시간과 기록의 시간 — 유효 시간 대 기록 시간
1985년 SIGMOD에서 리처드 스노드그래스(Richard Snodgrass)와 일수 안(Ilsoo Ahn)은 「데이터베이스의 시간 분류」를 발표했습니다. 그때까지 '등록 시각', '효력 발생 시각', '사건 시각' 같은 말이 제각각 쓰이던 것을 두 축으로 정리했습니다. 유효 시간(valid time)은 사실이 세상에서 참인 기간이고, 기록 시간(transaction time)은 그 사실이 데이터베이스에 들어 있던 기간입니다. 이 둘을 모두 갖는 테이블을 이중 시간(bitemporal) 테이블이라고 부릅니다. 스노드그래스는 1999년 크리스티안 옌센(Christian Jensen)과 함께 IEEE TKDE에 「시간 데이터 관리」라는 개관을 썼고, 이 논문이 인용하는 것이 바로 그 글입니다.
이 구분이 왜 중요한지는 논문의 정의 1에 나오는 한 문장에서 드러납니다. "활성 구간은 저장소의 상태를 기록할 뿐, 세상의 진실 시간이 아니다." 기억 시스템이 사실에 붙이는 '언제부터 언제까지'는 기록 시간입니다. 스탠드업이 세상에서 언제 바뀌었는지가 아니라, 기억 층이 그 변경을 언제 받아 적었는지입니다. 그래서 메시지가 늦게 도착하면, 기록 시간 규칙은 늦게 도착한 옛 값을 '최신'으로 만들어 버립니다. 6장에서 이 함정을 숫자로 봅니다.
현업에서는 같은 생각이 다른 이름으로 퍼졌습니다. 랄프 킴볼(Ralph Kimball)의 1996년 『데이터 웨어하우스 툴킷』 계열이 정리한 '천천히 변하는 차원(SCD)' 2형은 값이 바뀌면 옛 행을 덮어쓰지 않고 유효 시작·종료일과 '현재' 표시를 붙여 새 행을 추가합니다. 2011년 12월 채택된 SQL:2011 표준은 기록 시간을 시스템 버전 테이블(SYSTEM VERSIONING)로, 유효 시간을 응용 시간 기간(PERIOD FOR)으로 표준화했습니다. 코어닷투데이는 「시간을 기억하는 SQL」에서 이 기능을 PostgreSQL·MariaDB·XTDB로 직접 짜 봤고, 「기억에 유효기간을 적다」에서는 Graphiti가 같은 이중 시간 모델을 에이전트 기억에 옮긴 방식을 해부했습니다.
1994·2004: 단어를 세는 검색 — BM25와 BM25F
논문의 참조 기억 층 PFM은 임베딩을 쓰지 않습니다. 순위는 BM25F로 매깁니다. BM25는 1994년 11월 TREC-3에 참가한 시티 대학의 Okapi 팀(로버트슨, 워커 외)이 쓴 가중식으로 알려져 있습니다. 질의 단어가 문서에 몇 번 나오는지(많을수록 좋지만 체감), 그 단어가 전체 문서 중 얼마나 드문지(드물수록 좋음), 문서가 얼마나 긴지(길면 감점)를 곱해 더합니다. 2004년 로버트슨·사라고사·테일러가 CIKM에서 이것을 제목·본문 같은 여러 필드로 넓힌 것이 BM25F입니다. 필드마다 가중치를 달리 줘서 단어 빈도를 합친 뒤 BM25를 한 번 적용합니다.
PFM은 사실마다 필드 세 개 — 본문(가중치 1.0), 엔티티(2.5), 참여자(2.0) — 를 두고 BM25F를 계산합니다(부록 A 표 5). 30년 묵은 단어 세기가 2026년 논문의 기준 순위기라는 점이 이상해 보일 수 있지만, 5장에서 보듯 이 선택에는 이유가 있습니다.
1998: 두 개의 1998년 — RCU와 John Smith
1998년 10월, 시퀀트(Sequent, 이듬해 IBM에 인수)의 폴 매케니(Paul McKenney)와 존 슬링와인(John Slingwine)은 「읽기-복사-갱신(RCU)」을 발표했습니다. 읽는 쪽은 잠금 없이 현재 판본을 읽고, 쓰는 쪽은 새 판본을 복사본에 만든 뒤 포인터 하나만 바꿔 끼웁니다. 읽는 쪽은 절대 기다리지 않습니다. 이 기법은 2002년 10월 리눅스 커널 2.5.43에 들어가 지금은 커널 곳곳에 쓰입니다. 논문 부록 G의 '불변 스냅숏을 참조 하나로 발행한다'는 서빙 설계가 정확히 이 생각입니다. 요청 스레드는 기억을 정리하는 작업자의 잠금을 절대 잡지 않습니다.
같은 해 몬트리올의 ACL/COLING에서는 아밋 바가(Amit Bagga)와 브렉 볼드윈(Breck Baldwin)이 '문서 간 공지시(cross-document coreference)' 논문을 발표했습니다. 실험 데이터가 유명합니다. 1996~97년 『뉴욕 타임스』 기사 가운데 'John … Smith'가 나오는 197건을 모았더니, 그 안에 서로 다른 John Smith가 35명 있었습니다. 제너럴모터스 회장, UCLA 육상 코치, 탐험가, 영국 노동당 전 대표, 디즈니 「포카혼타스」의 주인공까지. 24명은 기사 한 건에만 나왔습니다. 당시 상용 개체명 인식기는 이들을 모두 같은 사람으로 묶었습니다. 이 논문은 지금도 널리 쓰이는 군집 평가 지표 B-CUBED를 처음 제안한 논문이기도 합니다.
28년 뒤, 이 논문이 LoCoMo에서 마주친 것이 세 명의 John입니다. 7장에서 봅니다.
1987: '차이가 없다'를 증명하는 법 — TOST
마지막 조상은 의외의 곳에 있습니다. 1987년 도널드 슈어만(Donald Schuirmann)은 제네릭 약이 원래 약과 '생물학적으로 동등한지'를 판정하는 방법으로 두 단측 검정(TOST)을 제안했습니다. 통계 검정에서 "차이가 유의하지 않다"는 "차이가 없다"는 뜻이 아닙니다. 표본이 적으면 무엇이든 유의하지 않으니까요. 동등성을 주장하려면 미리 정한 허용 범위(예: ±20%) 안에 차이가 있다는 것을 양쪽에서 각각 검정해야 합니다. 오늘날 미국 식품의약국의 생동성 판정 방법입니다.
이 논문은 "단순한 BM25가 PFM과 같다"고 주장하는데(이 글의 5장), 그때 이 도구를 씁니다. 실험 전에 허용 범위를 ±0.02로 못 박아 두고 TOST로 판정합니다. 기계학습 논문에서 드문 엄격함입니다.
2023~2026: LLM 기억의 시대
2023스탠퍼드의 생성 에이전트(Generative Agents)가 경험을 자연어 기억 흐름으로 저장하고 최근성·관련성·중요도로 꺼냈다. 버클리의 MemGPT는 LLM을 운영체제처럼 보고 기억을 계층 사이로 옮겼다.
2024ChatGPT 기억 시험 공개(2월). 장기 대화 벤치마크 LoCoMo(ACL 2024, 대화 10개·문항 1,986개)와 LongMemEval(ICLR 2025, 질문 500개 중 지식 갱신 78개·기권 30개)이 나왔다.
2025Zep(1월, 시간 지식 그래프 Graphiti)과 Mem0(4월)이 쓰기 시점에 모순을 판정해 옛 사실을 무효화하는 방식을 제품으로 내놨다. ChatGPT 과거 대화 참조(4월), Gemini 개인 맥락(8월), Claude 기억(9~10월).
2026'낡은 기억'이 독립된 연구 주제가 됐다. STALE(최고 모델도 55.2%), MemStrata(일반 RAG가 갱신된 사실 질문의 15~40%에서 옛 값을 냄), 이중 시간 연산자 대수 TOKI, 최종 답과 검색 맥락을 떼어 보는 MemTrace, 무효 기억 의존을 감점하는 Memora 벤치마크, 충돌 기억을 다루는 MemConflict.
2026년의 연구들은 대체로 같은 결론을 향합니다. MemStrata(Yadav, arXiv:2606.26511)는 바뀐 사실과 그냥 중복된 사실을 임베딩 코사인 유사도로 가르면 AUROC가 0.59에 불과하다고 보고합니다. 거의 동전 던지기입니다. "의미가 비슷하다"는 신호로는 "이게 저걸 대체했다"를 알 수 없다는 뜻입니다. TOKI(Wang, arXiv:2606.06240)는 제품들이 쓰는 갱신 규칙들 — 마지막에 쓴 쪽이 이김, 증거 가중 병합, 확인 대기 — 을 이중 시간 연산자 한 가족으로 정리하고, LLM 판정자를 쓰기 경로에 둔 시스템들이 재생 불일치나 감사 기록 소실 같은 문제를 허용한다고 지적합니다. MemTrace(Long 외, arXiv:2606.17328)는 실패한 경우를 뜯어 보니 증거가 없어서 틀린 경우보다 증거를 찾을 수 있었는데도 틀린 경우가 열 배 많았다고 보고합니다.
참고로 이 논문의 참고문헌에는 'Memora'가 두 번 나옵니다. 오기가 아닙니다. 2026년에는 같은 이름의 서로 다른 논문이 두 편 나왔습니다. 하나는 마이크로소프트 연구진의 기억 표현 방법(ICML 2026)이고, 다른 하나는 우딘 외의 망각 인식 벤치마크(ACL 2026 Findings)입니다. 동명이인 문제를 다루는 논문이 동명의 논문 두 편을 인용하는 셈입니다.
이 흐름 속에서 「Stale, Misattributed, or Late」의 자리는 분명합니다. 새 엔진을 만드는 대신, 이미 널리 쓰이는 규칙의 전제 조건을 하나씩 깨 보는 것입니다. 저자 구성도 흥미롭습니다. 공저자 신차이스리 교수의 본업은 정보검색이나 자연어처리가 아니라 운영관리와 행동과학 — 긱 노동자의 의사결정, 사람과 AI의 협업 — 입니다. 논문 곳곳에서 보이는 '사전 지정 동등성 마진', '군집 부트스트랩', '스케줄링 지연을 실제 서빙 경로에서 재라'는 태도는 시스템 논문보다 실험 설계 논문의 문법에 가깝습니다.
요청 시점 τ에서 '활성 뷰'는 a ≤ τ < b인 사실들입니다. 검색 정책은 활성 뷰만 볼 수도 있고, 구간을 무시하고 전체를 볼 수도 있습니다. 논문은 후자도 비교 대상으로 허용합니다. 그래야 "유효성 필터가 얼마나 기여하는가"를 깨끗하게 잴 수 있으니까요.
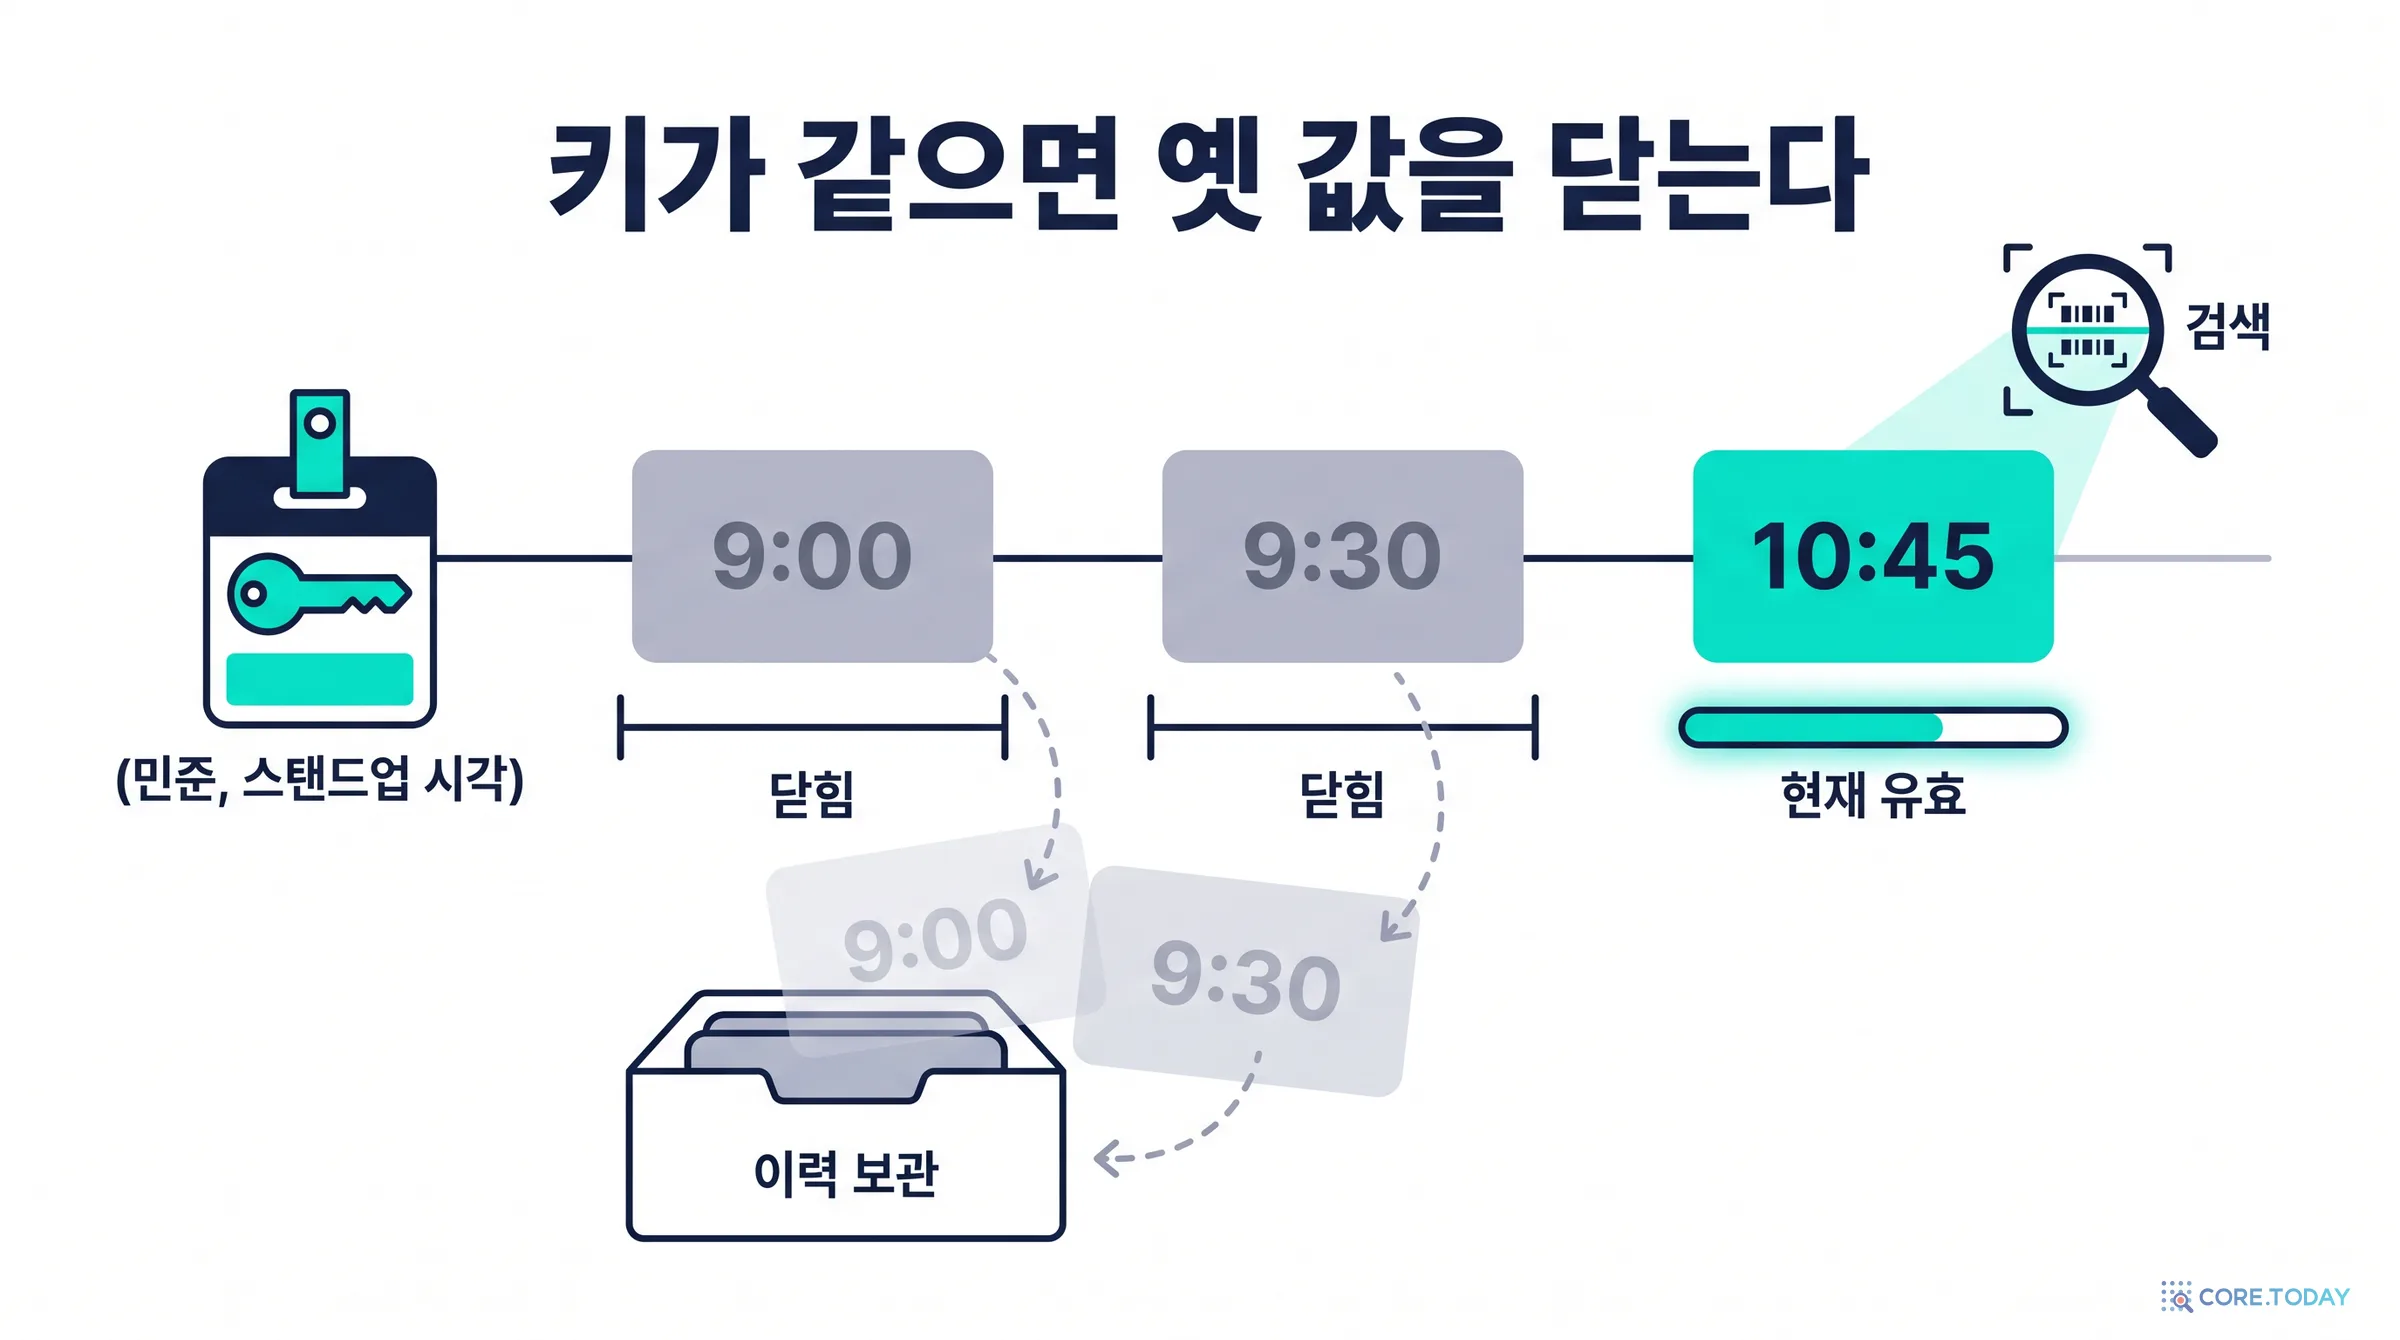
키 대체 규칙과 명제 1
규칙은 이렇습니다. 같은 키 κ를 가진 새 사실 f′가 시각 u에 커밋되면, f′의 구간을 [u, ∞)로 열고, 지금 활성인 이전 사실 f의 끝을 b = u로 닫습니다. f는 지워지지 않고 이력으로 남습니다. 커밋은 읽는 쪽에서 보기에 원자적입니다(반쯤 바뀐 상태를 아무도 보지 못합니다).
명제 1 (키당 활성 값은 최대 하나). 키 κ를 가진 갱신들이 위 규칙으로 하나씩 원자적으로 커밋되고 처음에 κ의 활성 사실이 최대 하나였다면, 읽는 쪽이 보는 모든 상태에서 κ의 활성 사실은 최대 하나다.
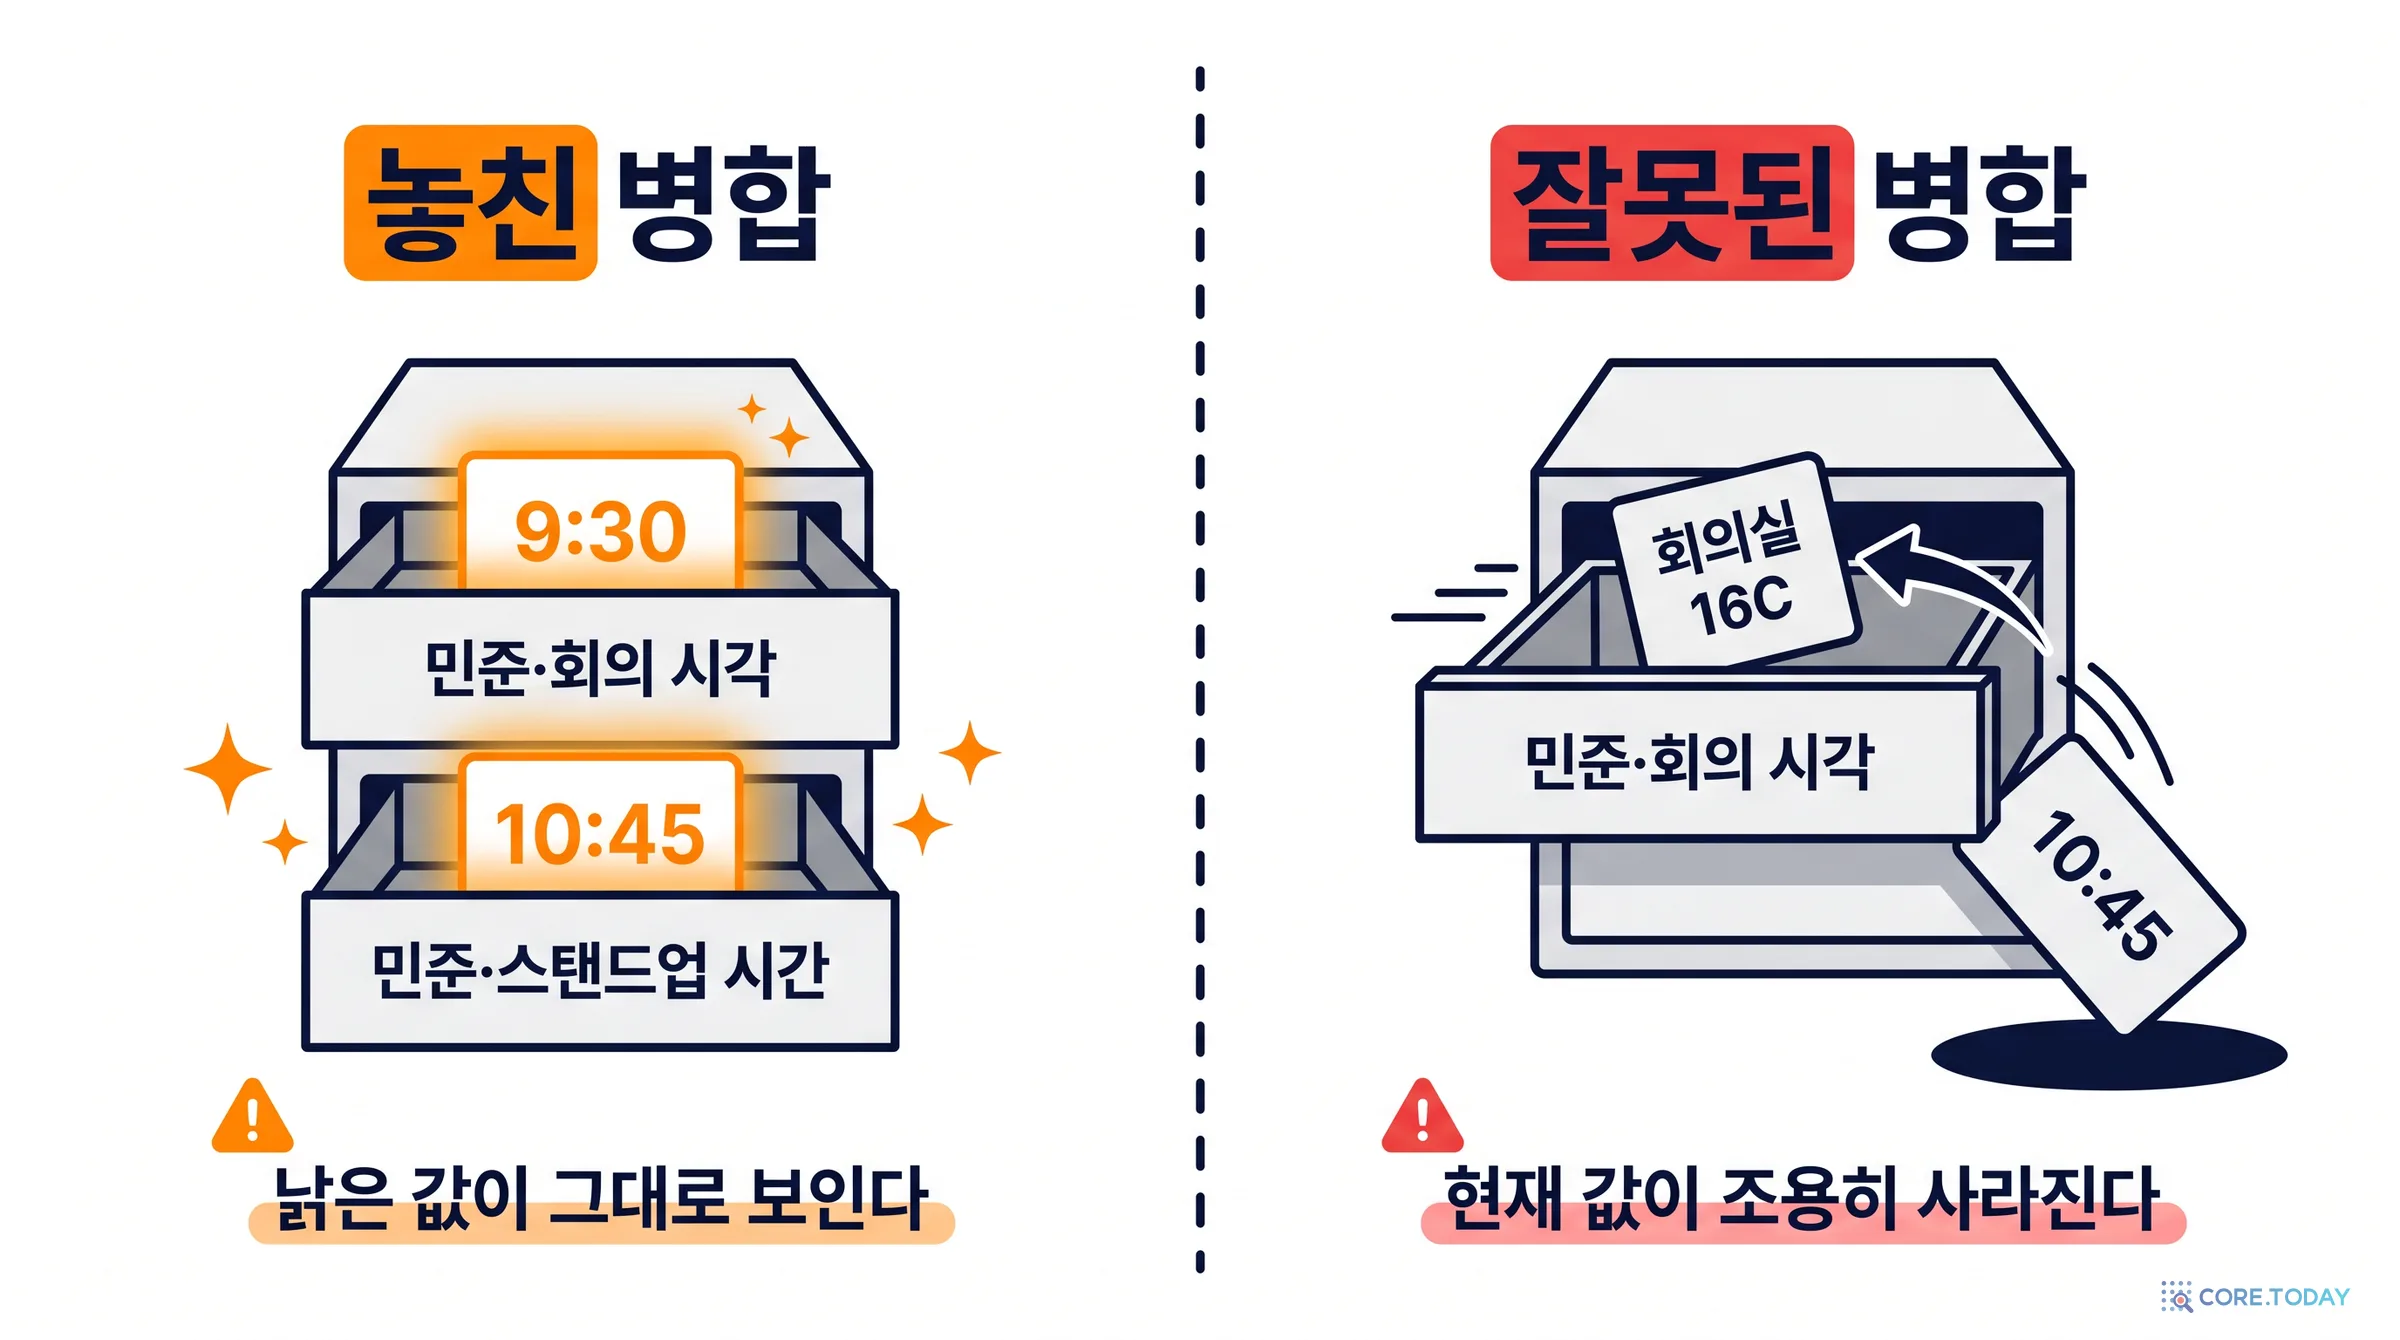
증명(부록 O)은 귀납법 몇 줄입니다. 중요한 것은 저자들이 이 명제에 붙인 경고입니다. "이것은 상태 불변식이지 정확성 보장이 아니다." 명제는 '하나만 살아 있다'를 보장할 뿐, '맞는 하나가 살아 있다'를 보장하지 않습니다. 세 가지 방식으로 틀린 하나가 살아남습니다.
①
순서가 뒤바뀐 도착
10:45 메시지가 먼저 오고 9:30 메시지가 나중에 도착하면, 규칙은 9:30으로 10:45를 닫는다. 불변식은 지켜졌고(활성 하나), 값은 틀렸다.
②
놓친 병합
추출기가 10:45 개정에 다른 키를 붙이면 9:30과 10:45가 서로 다른 키로 둘 다 살아 있다. 각 키에는 하나씩이니 불변식은 지켜졌다.
③
잘못된 병합
'회의실 16C' 개정에 '회의 시각' 키를 붙이면 멀쩡한 10:45가 닫힌다. 현재 값이 조용히 사라진다.
PFM에서 키는 추출기가 붙입니다. 통제 벤치마크에서는 규칙 추출기가 문장에 사전에 등록된 엔티티 이름, 슬롯 명사, 그 슬롯 타입의 값이 모두 있을 때만 키를 붙입니다. 키가 같은데 값도 같으면 '재관찰'(마지막 관찰 시각만 갱신), 값이 다르면 대체입니다. 키가 없는 사실은 같은 엔티티를 공유하는 활성 사실과 토큰 자카드 유사도가 0.8 이상이고 값 토큰이 같을 때만 흡수됩니다. 대체된 사실은 검색 색인에서 빠지지만 이력으로 남고, 가지치기는 각 키의 활성 사실을 절대 지우지 않습니다. 이 경로 어디에도 임베딩 모델이나 언어 모델이 돌지 않습니다.
통제 벤치마크
실험의 무대는 합성 벤치마크입니다. 인스턴스 하나에 개정 사슬(revision chain) 160개가 있습니다. 사슬마다 사람이나 프로젝트의 슬롯 하나(회의 시각, 회의실, 마감일, 출시일, 일당, 예산 한도 같은 것)에 대해 0~4번 개정이 일어납니다. 사이사이에 티켓 배정·배포 알림·장비 점검 같은 필러 메시지가 1,000개 섞입니다. 질의는 값 바로 앞에서 끊긴 미완성 메시지입니다("the standup with Alex is at"). 사람은 요청에서 이름(first name)으로만 불리기 때문에, 같은 이름을 가진 두 사람이 같은 슬롯 사슬을 가지면 자연스럽게 동명이인 경쟁자가 생깁니다. 인스턴스당 질의 240개 중 40~50개가 그런 모호한 질의입니다. 시드 5개로 1,200질의를 만듭니다.
표 1: 키가 낡음을 지운다
저장소
예산 B
현재 값 ↑
낡은 값 ↓
남의 값 ↓
공동 주입 ↓
깨끗함 ↑
키 있음
800자
0.998
0.000
0.121
0.000
0.877
키 없음
800자
0.950
0.703
0.004
0.701
0.247
키 있음
240자
0.869
0.000
0.000
0.000
0.869
키 없음
240자
0.823
0.446
0.000
0.438
0.385
두 저장소는 똑같은 사실 초안을 받습니다. 키 없는 저장소는 키를 무시할 뿐입니다. 결과는 극적입니다. 키 있는 저장소의 1,200개 블록 가운데 낡은 값이 든 것은 하나도 없습니다. 키 없는 저장소는 70.3%에 낡은 값이 들어갔고, 거의 전부(70.1%)가 현재 값 옆에 함께 들어갔습니다. 재현율만 보면 키 없는 저장소도 0.950으로 나쁘지 않아 보입니다. 이것이 2장에서 말한 '재현율이 가리는 오류'입니다.
몇 가지 정직한 단서가 붙습니다. 첫째, 0건은 '모집단 비율 0'이 아니라 95% 윌슨 상한 0.005라는 뜻입니다. 둘째, 이 벤치마크는 일부러 사슬의 80%를 개정했습니다. 현실에서는 대부분의 사실이 한 번도 안 바뀝니다. 그래서 저자들은 70%의 사실이 개정되지 않는 저장소를 가정해 다시 가중했는데(표 14), 키 있는 쪽은 0.877 그대로이고 키 없는 쪽은 0.603으로 올라갑니다. 격차는 줄지만 방향은 그대로입니다. 셋째, 예산을 240자로 줄이면 키 없는 저장소의 낡은 값 노출이 44.6%로 내려가는데, 이것은 개선이 아니라 블록이 작아 옛 값이 들어갈 자리가 줄어든 것일 뿐입니다. 현재 값 재현도 함께 떨어집니다.
남은 오류는 전부 동명이인이다
키 있는 저장소의 깨끗함이 1이 아니라 0.877인 이유는 남의 값(0.121) 때문입니다. 저자들은 이 145건을 하나하나 셌습니다. 145건 모두 모호한 질의 223개에서 나왔고, 그중 94건은 정답 사실이 1위에 있었는데 아래 칸에 같은 이름의 경쟁자가 끼어든 경우였습니다. 순위 1위만 보는 지표(MRR, Hit@1)는 이 블록들을 만점으로 셉니다. 논문의 요약은 이렇습니다. "신원은 1위 사실만이 아니라 블록 전체의 구성에 달려 있다."
5. 해부 ②: 순위기는 생각보다 중요하지 않았다
키 대체가 낡음을 지운다면, 그 다음 질문은 "그럼 검색기는 무엇이 좋은가"입니다. 2026년의 기본값은 임베딩 기반 밀집 검색이거나 BM25와 섞은 하이브리드입니다. 논문은 모든 검색기에 같은 저장소, 같은 선택 규칙(위에서부터 k=6줄, 800자까지), 같은 블록 형식을 주고 비교합니다.
방법
현재 값 ↑
낡은 값 ↓
남의 값 ↓
깨끗함 ↑ (95% 구간)
p50 지연
p99 지연
PFM
0.998
0.000
0.121
0.877 (0.850, 0.904)
0.25ms
0.69ms
BM25 + 유효성
0.891
0.000
0.120
0.774 (0.737, 0.809)
0.09ms
0.26ms
BM25 + 유효성 + Pt
1.000
0.000
0.128
0.873 (0.847, 0.896)
0.10ms
0.29ms
밀집 + 유효성 + Pt
1.000
0.000
0.164
0.836 (0.803, 0.868)
18.3ms
93.0ms
하이브리드 + 유효성 + Pt
1.000
0.000
0.157
0.843 (0.813, 0.872)
18.2ms
82.4ms
BM25 + Pt (유효성 없음)
0.997
0.802
0.007
0.195 (0.164, 0.227)
0.18ms
0.46ms
'+유효성'은 활성 사실만 검색한다는 뜻이고, '+Pt'는 대화 상대 이름을 질의와 사실 본문 양쪽에 붙인다는 뜻입니다. 표에서 읽을 것이 세 가지 있습니다.
첫째, 낡음을 가르는 것은 순위기가 아니라 유효성 필터입니다. 유효성 필터를 켠 모든 검색기의 낡은 값 노출은 0이고, 끈 검색기는 참여자 정보가 있어도 78~80%가 낡은 값을 봤습니다. 밀집 검색은 특히 흥미롭습니다. 현재 값은 거의 모든 질의에서 찾아내지만, 옛 판본도 함께 찾아냅니다. "스탠드업이 9:30으로 옮겨졌다"와 "스탠드업이 10:45로 옮겨졌다"는 의미상 거의 같은 문장이니까요. 앞에서 본 MemStrata의 AUROC 0.59와 같은 이야기입니다. 의미 유사도는 대체 관계를 모릅니다.
둘째, 저장소와 참여자 정보를 고정하면 단순한 BM25가 PFM과 같습니다. BM25+유효성+Pt는 0.873, PFM은 0.877입니다. 짝지은 차이는 0.005이고 90% 신뢰구간은 −0.008에서 0.019로, 미리 정한 ±0.02 범위 안에 들어갑니다(TOST p=0.038). 여기서 3장의 TOST가 쓰입니다. 순열 검정만 하면 p=0.55로 "유의한 차이 없음"이 나오는데, 저자들은 이것을 동등의 근거로 쓰지 않습니다. 유의하지 않은 것과 같은 것은 다르니까요. 대신 범위를 먼저 정하고 그 안에 있음을 보였습니다.
셋째, 밀집·하이브리드가 뒤지는 이유는 재현율이 아니라 남의 값입니다. 현재 값 재현은 1.000으로 똑같습니다. 그런데 남의 값 노출이 0.164·0.157로 어휘 검색(0.128)보다 높습니다. 임베딩 공간에서 '김민준의 스탠드업'과 '이민준의 스탠드업'은 너무 가깝습니다. 게다가 MiniLM 질의 인코딩에만 중앙값 약 18ms가 들어 10ms 마감을 거의 맞추지 못합니다(9장).
무엇이 순위를 결정했나: 지워 보기 실험
PFM에는 BM25F 말고도 장치가 많습니다. 최근성, 사용 빈도, 엔티티 그래프를 한 단계 따라가는 연상 항, 질의 단어 수 상한. 저자들은 이것을 하나씩 빼 보는 실험을 했습니다(표 13).
전체 PFM
0.877
엔티티 필드 뺌
0.884
그래프·사용·최근성 뺌
≈0.877
참여자 필드 뺌
0.842
참여자 질의어 뺌
0.811
참여자 정보 전부 뺌
0.756
키 뺌
0.247
측정 가능한 효과가 있는 순위 부품은 참여자 신호뿐이었습니다. 그래프와 사용 빈도 항은 1,200질의 중 단 하나의 결과도 바꾸지 않았습니다. 모호한 질의만 보면 참여자 정보를 모두 뺄 때 깨끗함이 0.341에서 0.130으로 무너집니다. 그리고 키를 빼면 나머지를 다 갖춰도 0.247입니다. 저자들은 조심스럽게 덧붙입니다. 이 0의 효과는 이 벤치마크에 국한된 것이고, 그 부품들이 쓸모없다는 증거는 아니라고요. 실제로 그래프 항은 7장에서 다른 역할로 다시 등장합니다.
이 장의 교훈을 한 줄로 줄이면 이렇습니다. 좋은 검색기를 고르는 것보다 저장소에 올바른 상태를 유지하고, 누구와 대화 중인지 검색기에 알려 주는 것이 훨씬 중요합니다. 코어닷투데이가 「에이전트 네이티브 메모리, 준비됐나?」에서 읽은 데이터베이스 관점의 비교 연구(이 논문도 인용합니다)가 "모든 시나리오를 지배하는 단일 구조는 없다"고 결론 내린 것과 같은 방향입니다.
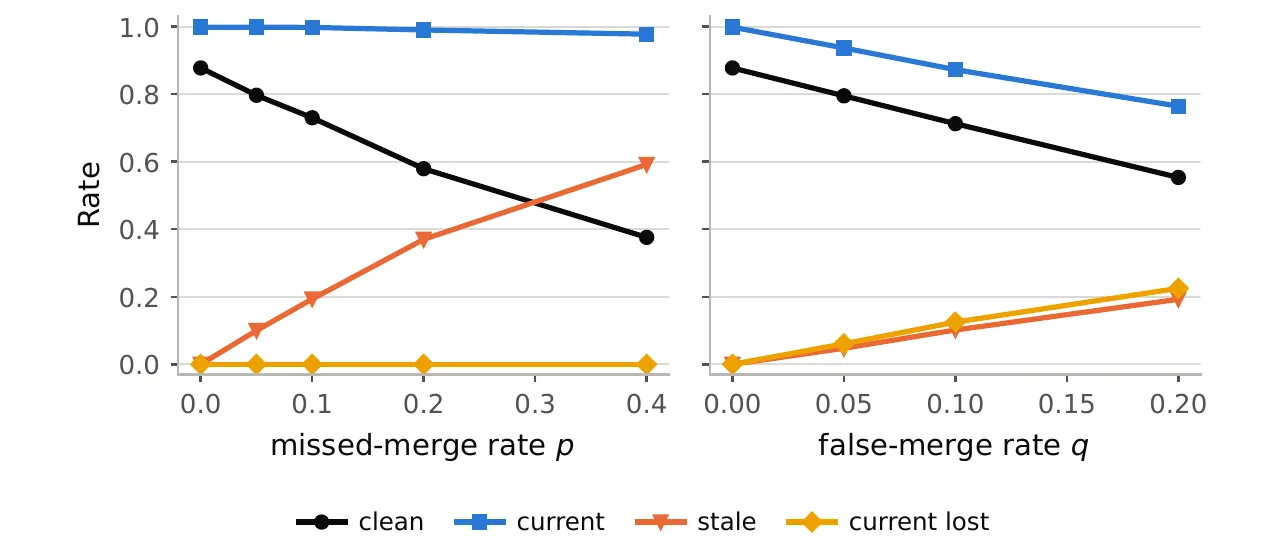
출처: Deng & Sinchaisri (2026), 그림 3. 키 있는 PFM에 키 오류를 주입한 결과(1,200질의).
두 그래프의 모양이 다릅니다. 이것이 이 장의 핵심입니다.
놓친 병합(왼쪽)은 낡은 값을 보이게 만듭니다. p=0.05면 낡은 값 노출 0.100, p=0.2면 0.370, p=0.4면 0.592로 키 없는 저장소(0.703)에 다가갑니다. 하지만 현재 값은 거의 그대로 있습니다(파랑). 블록을 들여다보면 문제가 보입니다.
잘못된 병합(오른쪽)은 현재 값을 지웁니다. q=0.05면 질의의 6.1%가 현재 값을 잃고, q=0.2면 22.5%가 잃으며 깨끗함은 0.553으로 떨어집니다. 노란 선 '현재 값 소실'은 블록에 아무것도 나타나지 않는 고장입니다. 사실이 활성 저장소에서 사라졌으니, 블록을 아무리 들여다봐도 그 자리에 무엇이 있어야 했는지 모릅니다.
잘못된 병합에서 낡은 값도 함께 오르는 이유도 재미있습니다. 엉뚱한 슬롯으로 들어간 개정은 제 슬롯의 옛 값을 닫지 못합니다. 그래서 한 번의 잘못된 병합이 두 칸을 동시에 망가뜨립니다. 남의 칸의 현재 값은 닫고, 자기 칸의 옛 값은 살려 둡니다.
키의 굵기와 도착 순서도 같은 비대칭을 만든다
부록 N은 같은 구조를 다른 각도에서 보여 줍니다.
키 입자(granularity). 한 사람이 스탠드업과 싱크 회의를 둘 다 갖고 있다면 키를 (엔티티, 슬롯)으로 잡을지 (엔티티, 슬롯, 명사)로 잡을지가 문제가 됩니다. 굵은 키는 두 회의를 하나로 합쳐 현재 값 재현을 0.500으로 떨어뜨립니다(하나가 다른 하나를 닫으니까요). 가는 키는 둘 다 지키지만, 키가 너무 가늘면 이번에는 같은 회의의 개정을 알아보지 못합니다. 키 없는 저장소는 이 조건에서 모든 질의에 낡은 값을 노출했습니다. 굵은 키는 지우고, 가는 키는 놓칩니다.
도착 순서. 사슬의 30%를 진술 순서와 다르게 도착시키면, 기록 시간 저장소의 깨끗함이 0.877에서 0.747로 0.130 떨어지고 낡은 값 노출이 0.156이 됩니다. 늦게 도착한 옛 값이 새 값을 닫기 때문입니다. 명제 1은 여전히 성립합니다 — 틀린 값 하나가 활성일 뿐입니다. 진술된 시각(메시지 안에 적힌 '언제')으로 정렬하면 원래 숫자가 정확히 돌아옵니다. 대신 이제는 메시지 속 날짜를 믿어야 합니다. 코어닷투데이가 「날짜 하나로 기억을 바꾼다」에서 실측했듯, 진술된 날짜를 믿는 시스템은 날짜를 위조하는 공격에 열립니다. 3장의 유효 시간과 기록 시간 구분이 여기서 실무의 선택이 됩니다.
규칙 추출기는 템플릿 문장에서는 완벽하지만, 사람들이 실제로 쓰는 문장은 템플릿이 아닙니다. 저자들은 qwen2:7b로 벤치마크 인스턴스 세 개의 사슬 메시지를 이름과 값을 보존한 채 다시 쓰게 했습니다. 1,268개 중 1,012개가 검사를 통과했고(나머지는 원래 템플릿 문장 유지), 모든 키 할당기가 같은 다시 쓴 말뭉치를 읽습니다. 다시 쓰는 모델이 자기 문장을 평가받는 일이 없도록 다시 쓰기 모델은 하나로 고정했습니다.
구성
키 정밀도 ↑
키 재현율 ↑
깨끗함 ↑
현재 값 소실 ↓
규칙 대비 Δ (95% 구간)
규칙 키
1.000
0.807
0.781
0.047
—
모델 키 llama3.2:3b
0.930
0.994
0.592
0.331
−0.189 (−0.241, −0.136)
모델 키 qwen2:7b
0.926
0.991
0.560
0.342
−0.221 (−0.273, −0.168)
모델 키 qwen2.5:7b
0.990
0.996
0.644
0.275
−0.136 (−0.186, −0.086)
모델 키 qwen2.5:14b
0.969
0.980
0.593
0.307
−0.188 (−0.240, −0.134)
Mem0식 모델 갱신 판정 (4종)
—
—
0.292~0.596
0.279~0.521
−0.471 ~ −0.167
키 없음
—
—
0.243
0.047
−0.537
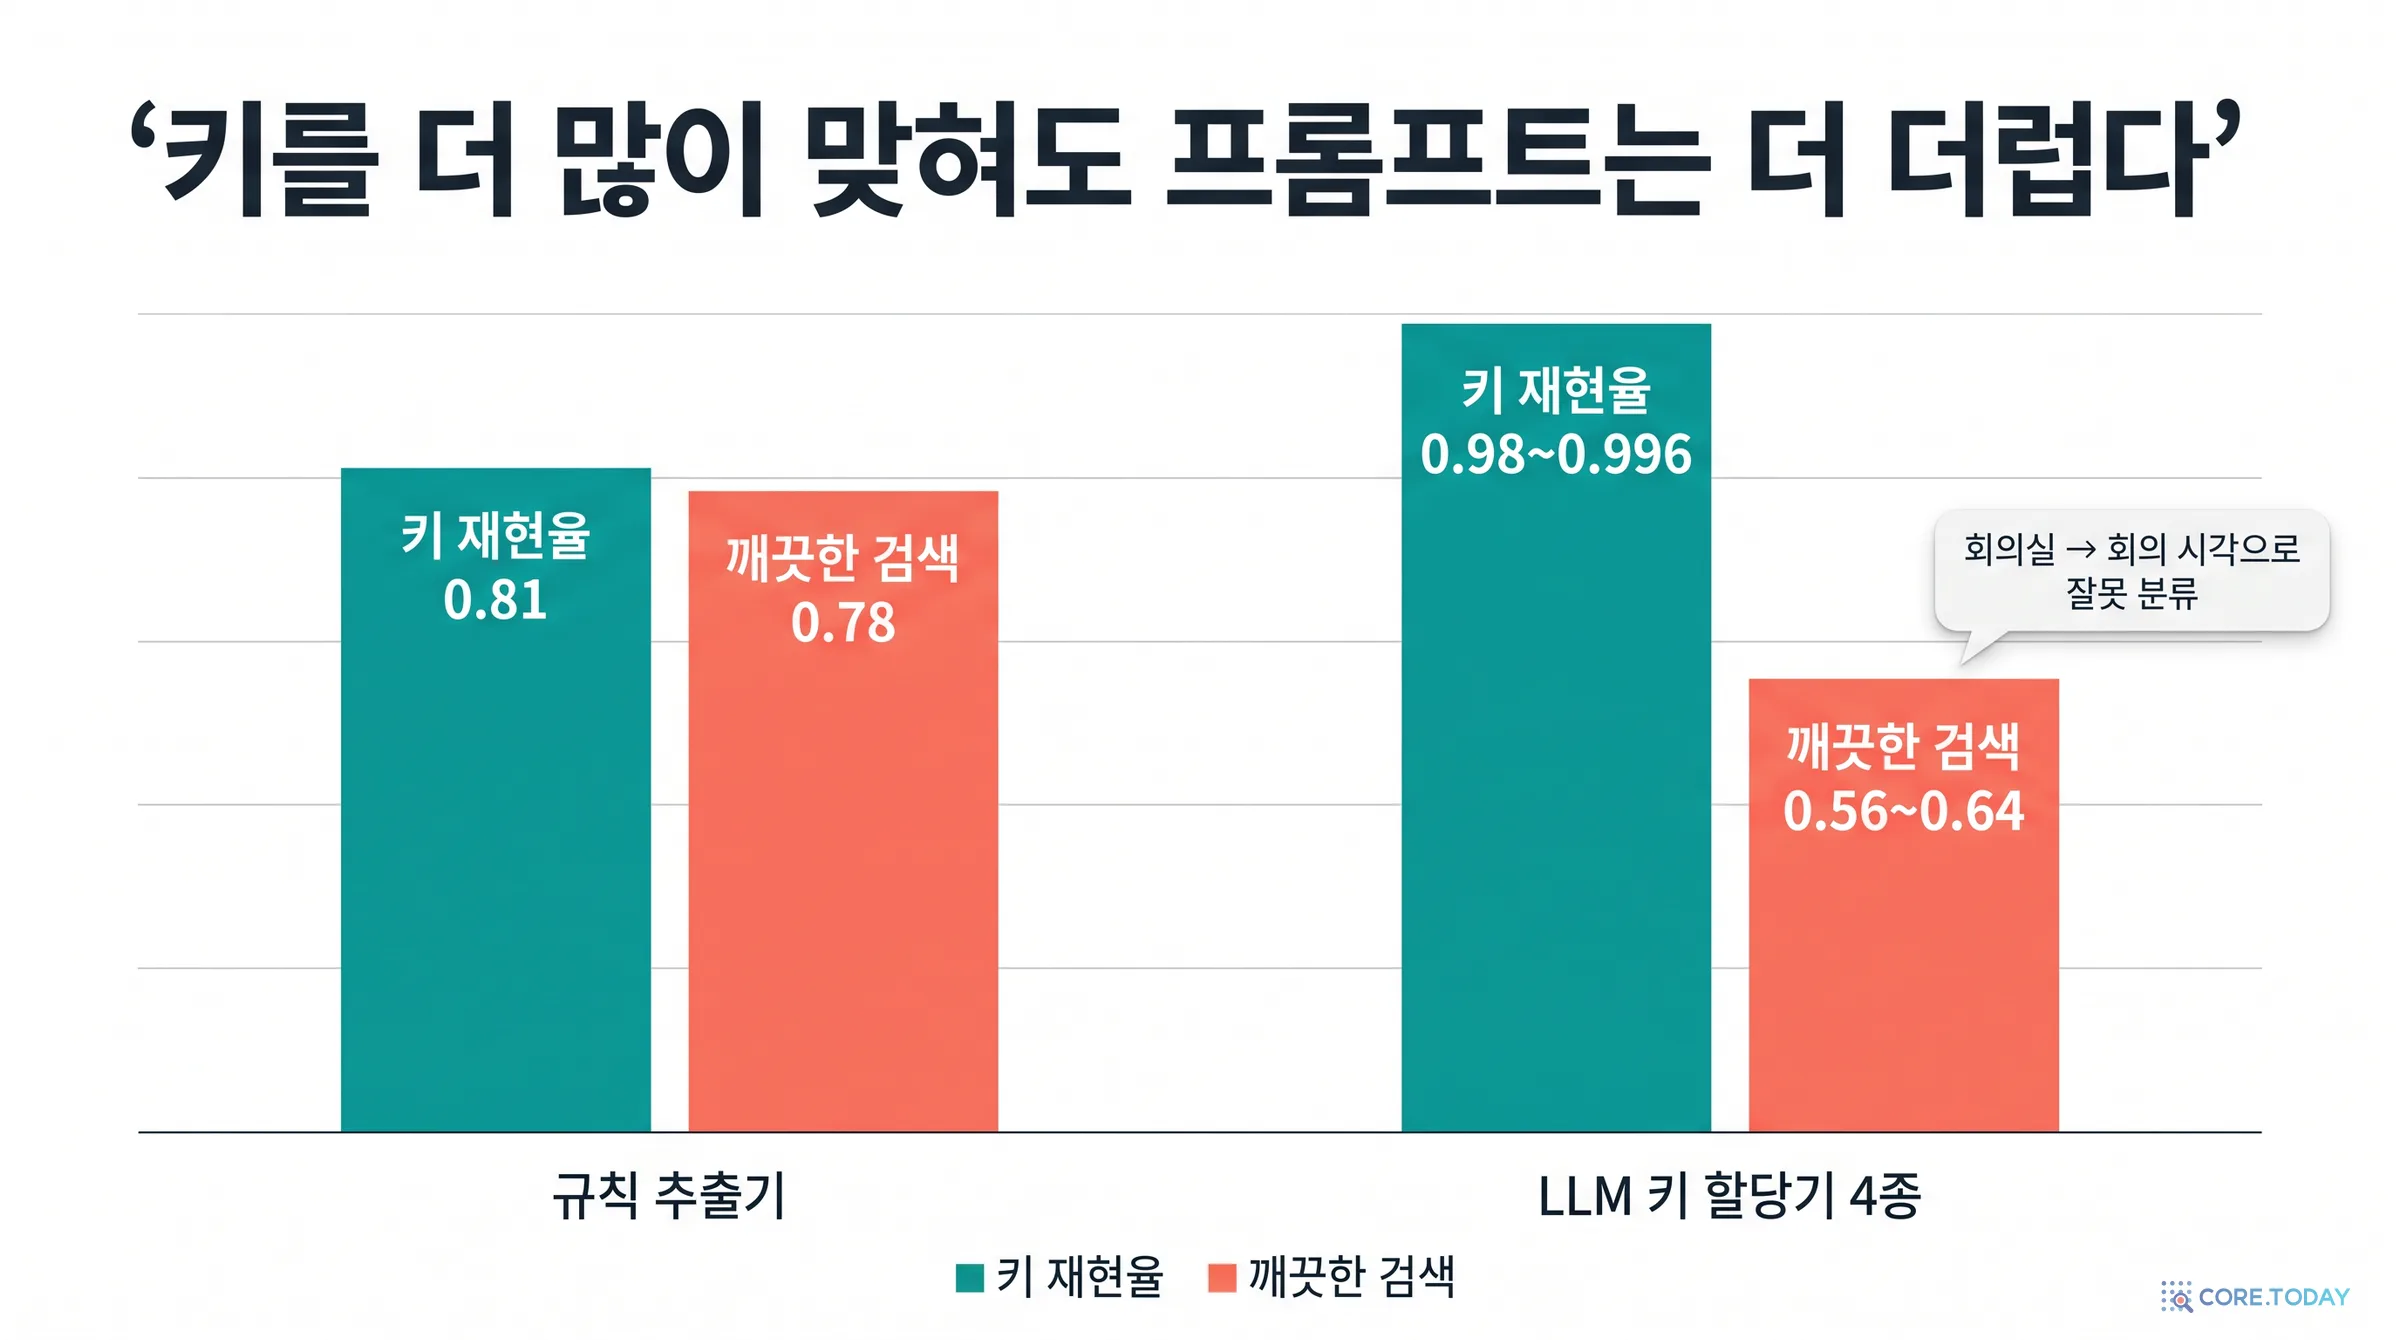
뒤집힌 결과입니다. 모델 키 할당기 네 개는 모두 키 재현율이 0.98 이상으로 규칙(0.807)보다 훨씬 높습니다. 그런데 깨끗한 검색은 모두 더 낮습니다(0.560~0.644 대 0.781). 차이의 신뢰구간은 전부 0을 포함하지 않습니다. 가장 좋은 qwen2.5:7b도 키 정밀도가 0.990인데 규칙보다 0.136 뒤집니다. 모델 크기도 순서를 정하지 못합니다. 14B가 같은 세대 7B보다 낮습니다.
오류 분류표(표 11)가 이유를 보여 줍니다.
키 할당기
맞음
놓침
엉뚱한 슬롯
엉뚱한 엔티티
가장 흔한 혼동
규칙
1,023
245
0
0
—
llama3.2:3b
1,173
7
88
0
회의실 → 회의 (76)
qwen2:7b
1,164
11
93
0
회의실 → 회의 (74)
qwen2.5:7b
1,250
5
13
0
마감일 → 회의 (12)
qwen2.5:14b
1,205
25
38
0
회의실 → 회의 (18)
규칙은 245개를 놓치지만 엉뚱한 슬롯에는 하나도 넣지 않습니다. 모델들은 5~25개만 놓치지만 13~93개를 엉뚱한 슬롯에 넣습니다. 그것도 늘 맞는 사람의 틀린 슬롯입니다(엉뚱한 엔티티는 0). 세 모델이 가장 많이 헷갈린 것이 회의실과 회의 시각인데, 이 벤치마크에서 두 슬롯이 같은 명사('스탠드업')를 공유하기 때문입니다. "the standup with Alex is in 16C"와 "the standup with Alex is at 10:45"의 차이는 전치사 하나입니다.
이제 6장 앞부분의 비대칭이 결정적이 됩니다. 놓친 키는 두 값을 모두 살려 블록에 보이게 합니다. 엉뚱한 슬롯의 키는 상관없는 현재 값을 닫아 조용히 지웁니다. 그래서 "이 설정에서는 슬롯 배정의 정밀도가 개정 재현율보다 중요하다"는 것이 논문의 결론입니다. 1969년 펠레기와 선터가 임계값을 두 개 둔 이유와 같습니다. 거짓 연결과 거짓 비연결의 대가가 다르면, 하나의 정확도 숫자로 줄여서는 안 됩니다.
Mem0식 경로 — 새 사실이 오면 가장 비슷한 활성 사실 다섯 개를 모델에게 보여 주고 추가·갱신·삭제를 판정하게 하는 방식 — 은 더 나빴습니다(0.292~0.596). 코어닷투데이가 「에이전트 기억 엔진 해부」에서 확인했듯 Mem0은 2026년 4월 v2.0에서 쓰기를 LLM 1회·추가 전용으로 바꿨으므로, 이 결과를 현재의 Mem0 제품에 그대로 대입할 수는 없습니다. 논문도 'Mem0 모양(Mem0-shaped)'이라고만 부릅니다. 하지만 '모델이 쓰기 경로에서 무엇을 닫을지 판정하는 구조'의 위험을 보여 주기에는 충분합니다.
슬롯 목록이 없을 때: LongMemEval
통제 벤치마크는 여섯 개의 슬롯 목록을 줍니다. 현실의 대화는 그런 목록을 주지 않습니다. 저자들은 LongMemEval의 지식 갱신 질문 78개 중, 이전 답과 이후 답이 원문 그대로 서로 다르게 존재하는 32개를 골라 '열린 키 발견'을 시험했습니다. 모델에게 턴마다 (엔티티, 속성, 값)을 뽑고 "같은 속성이 다시 나오면 같은 표현을 쓰라"고 지시합니다.
키 할당
둘 다 키 받음
그중 같은 키
병합 재현율
질문 간 잘못된 병합
낡은 값
깨끗함
상태 없음, qwen2:7b
0.438
0.000
0.000
0.042
0.688
0.219
+ 기존 키를 프롬프트에
0.500
0.125
0.062
0.294
0.594
0.250
+ 모델 판정 연결
0.438
0.071
0.031
0.143
0.719
0.188
+ 자카드 연결 θ=0.4
0.438
0.143
0.062
0.140
0.688
0.219
갱신 해소 없음
—
—
—
—
0.719
0.156
BM25 + 최근성 (키 없이)
—
—
—
—
0.688
0.250
결과는 냉정합니다. qwen2:7b는 1,198개 턴에 키를 붙였는데 정규화한 뒤에도 서로 다른 형태가 1,025가지였습니다. 32개 질문 중 한 개도 두 답 턴에 같은 키를 붙이지 못했습니다. 기존 키를 프롬프트에 보여 주면 병합 재현율이 0.062까지 오르지만, 서로 다른 질문의 키를 합치는 잘못된 병합도 0.042에서 0.294로 뛰어오릅니다. 모델 판정 연결과 자카드 연결도 같은 거래를 합니다. 어떤 변형도 병합 재현율 0.062를 넘지 못했고, 키 없이 BM25에 최근성만 더한 것(0.250)이 가장 나은 축에 듭니다.
단서가 있습니다. 32개 질문이라 낡은 값과 깨끗함의 구간이 ±0.16 정도로 넓어 팔(arm) 사이를 가르지 못합니다. 저자들도 그렇게 적었습니다. 그래도 병합 재현율 0.000~0.062라는 숫자는 구간을 따질 필요가 없을 만큼 작습니다. 이 부분집합에서 병목은 대체 규칙이 아니라 일관된 열린 키 발견 그 자체입니다. 아무리 좋은 규칙도 같은 칸에 같은 이름을 붙여 줄 사람이 없으면 작동할 수 없습니다.
세 항은 차례로 이렇게 읽습니다. ① 지금 대화 상대인가(가중치 1). ② 대화 상대와 기억 그래프에서 얼마나 자주 함께 언급됐나 — 대화 상대의 이웃 가중치 중 e가 차지하는 비율(가중치 1). ③ 얼마나 최근에 봤나 — 반감기 30일로 줄어드는 최근성(가중치 0.25). 온도 T=0.5로 소프트맥스를 취합니다. 검색은 확률이 가장 높은 엔티티의 사실과, 후보 누구에게도 해당하지 않는 사실만 남깁니다. 하드 참여자 필터는 이것의 극단적인 경우입니다. 대화 상대 본인의 사실만 남깁니다.
표 3: 필터와 사후확률의 거래
서빙 규칙
본 벤치 남의 값 ↓
본 벤치 깨끗함 ↑
제3자 재현 ↑
어려운 조각 깨끗함 ↑
답 없음 기권 ↑
없음
0.121
0.877
0.985
0.000
0.000
상대 점수 컷 @0.7
0.008
0.983
0.975
0.908
0.000
참여자 필터
0.000
0.998
0.020
1.000
0.000
신원 사후확률
0.032
0.967
0.985
1.000
0.000
+ 슬롯 게이트
0.032
0.967
0.985
1.000
1.000
마진 게이트
0.097
0.743
0.815
0.000
0.000
하드 참여자 필터는 본 벤치마크에서 남의 값을 완전히 없앱니다(0.998). 그런데 제3자에 관한 사실은 2.0%만 찾습니다. "박서연님, 김민준님 스탠드업이 몇 시였죠?"처럼 대화 상대가 아닌 사람 이야기를 하면 필터가 정답까지 버립니다. 사후확률은 남의 값을 12.1%에서 3.2%로 줄이면서(짝지은 차이 0.089, 구간 0.071~0.110) 제3자 재현율 98.5%를 지킵니다.
그래프 항이 여기서 역할을 찾습니다. 5장의 지워 보기 실험에서 그래프는 순위에 아무 영향이 없었습니다. 하지만 신원 해소에서는 대화 상대와 함께 이야기된 엔티티를 — 대화 상대 본인이 아니어도 — 후보로 살려 둡니다. 저자들의 정리는 실용적입니다. 대화 상대에 관한 사실만 필요하면 하드 필터, 제3자 이야기도 해야 하면 사후확률.
어려운 조각(hard slice)은 일부러 최악을 만든 것입니다. 같은 이름의 두 사람이 같은 슬롯·같은 명사·같은 템플릿·같은 날 도착한 사실을 갖습니다. 이때 아무 규칙이 없으면 모든 질의가 경쟁자의 값을 노출하고, 상대 점수 컷도 0.092를 남기지만, 필터와 사후확률은 모두 0으로 만듭니다.
공개 말뭉치는 더 가혹합니다. LoCoMo의 대화 열 개 가운데 세 개(conv-41 John과 Maria, conv-43 Tim과 John, conv-47 James와 John)에 John이라는 화자가 있습니다. 코어닷투데이가 공개 데이터 파일을 직접 세어 보니 conv-30에는 한 글자 다른 'Jon'도 있었습니다. 열 개 대화를 한 저장소(사실 13,435개, 질문 537개)에 넣고 이름이 겹치는 화자에 관한 질문 186개를 보면, 54.3%의 블록에 다른 대화의 사실이 섞였습니다. 출처로 판정하므로 값 라벨이 필요 없습니다.
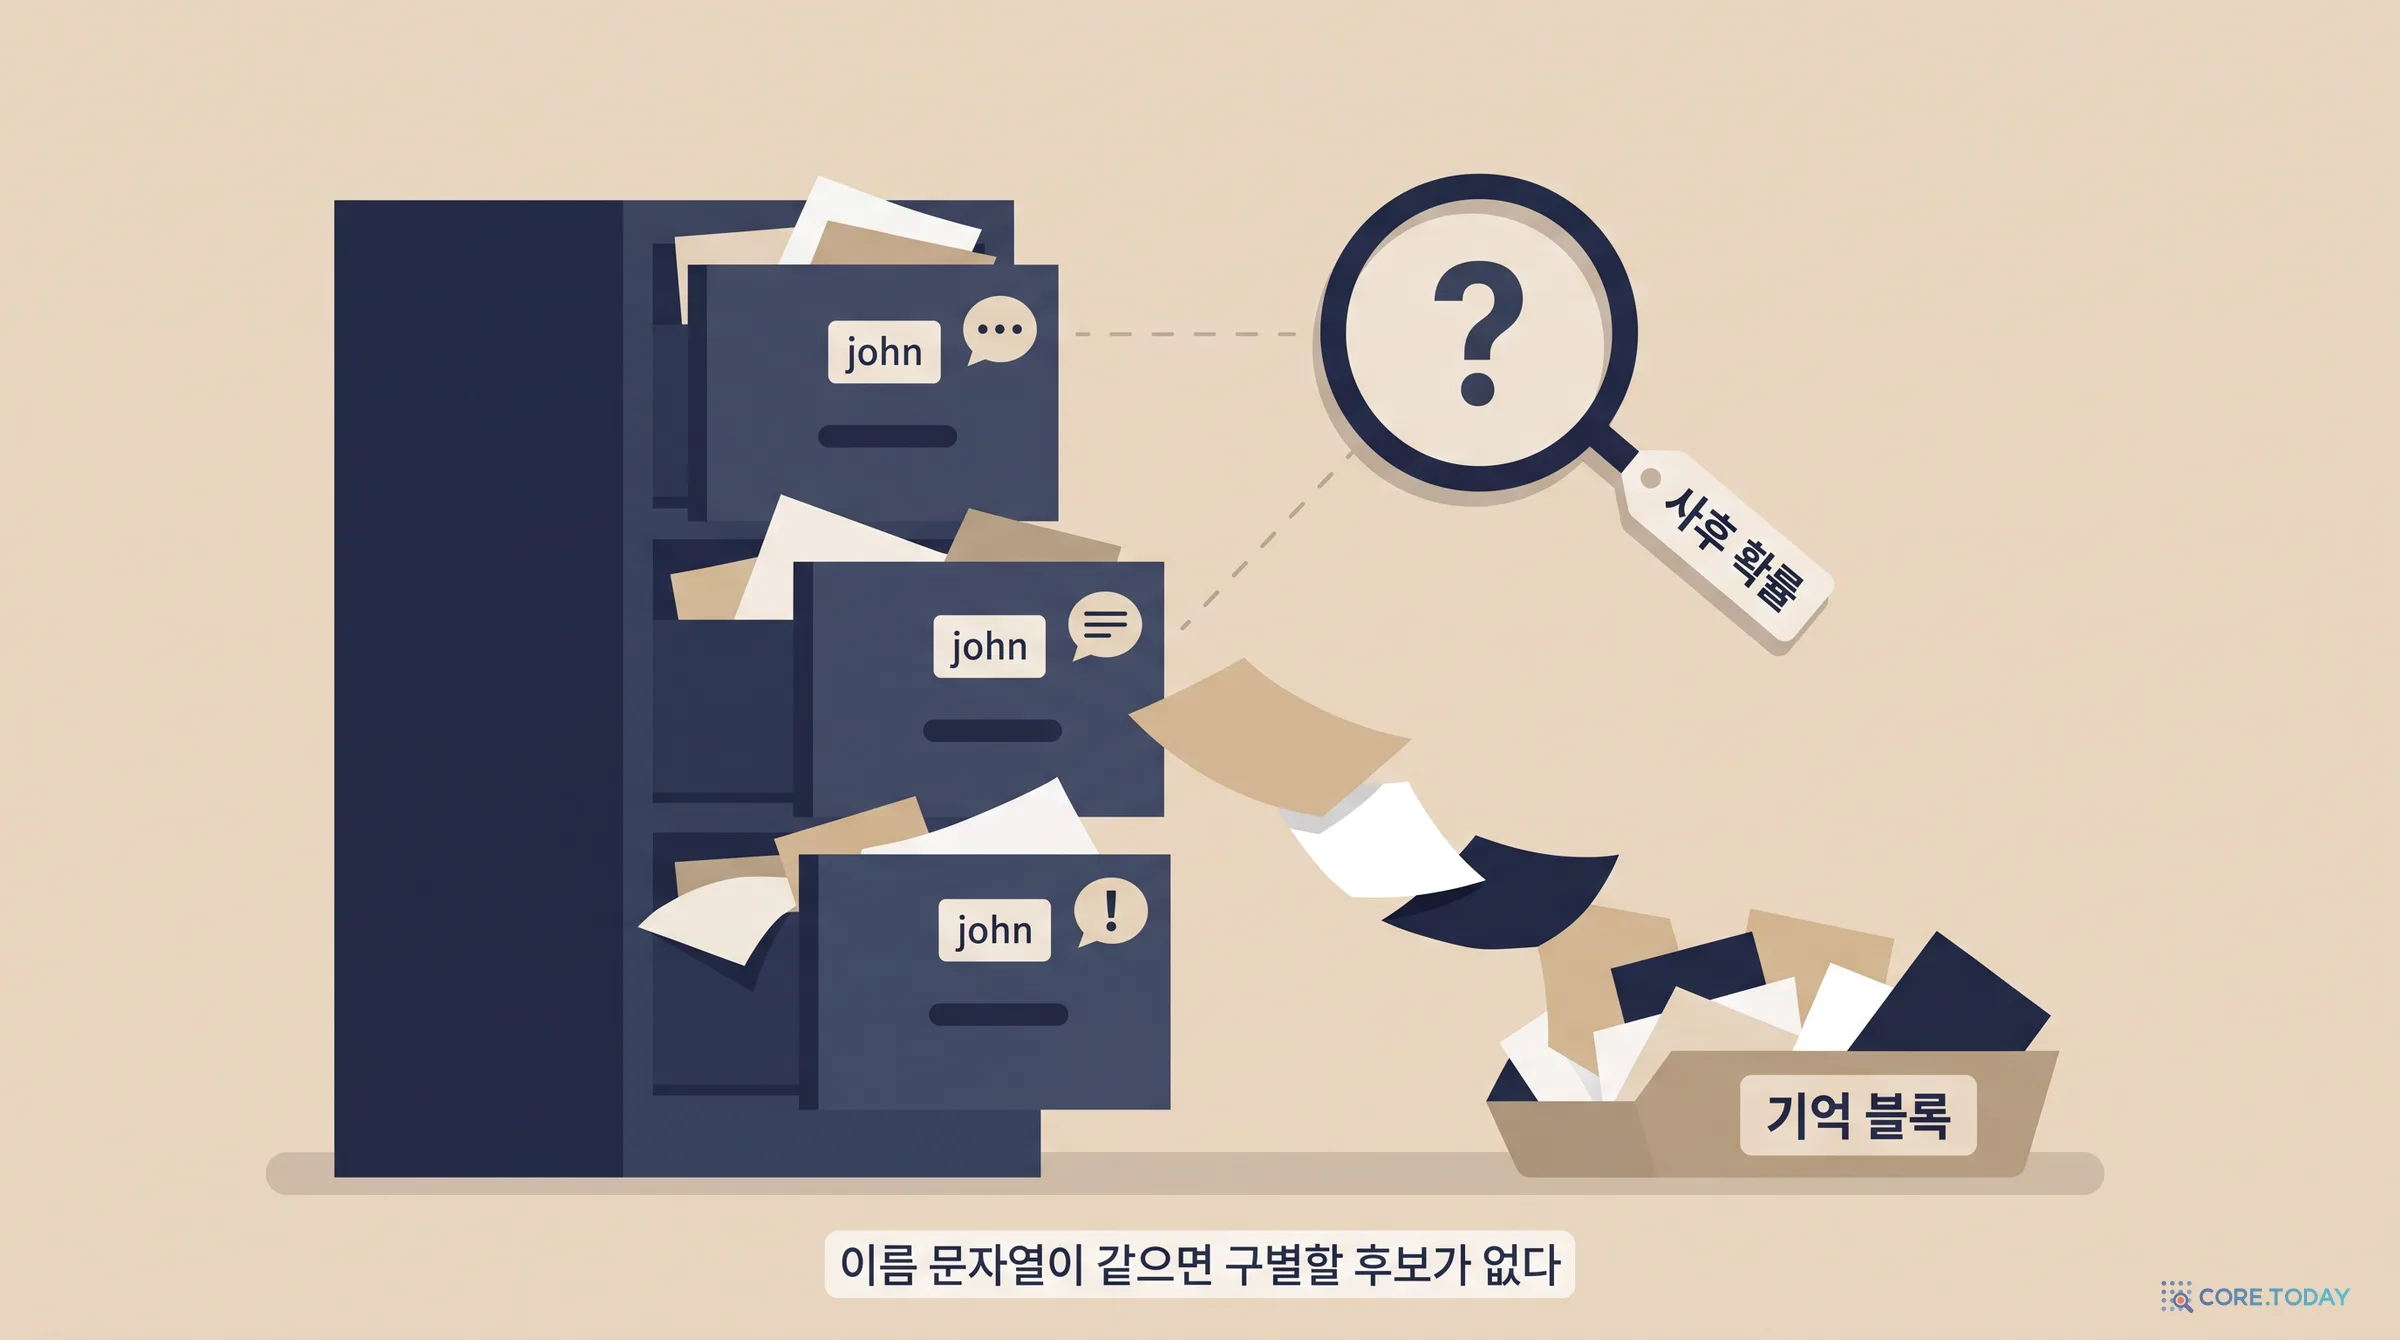
참여자 필터는 이것을 30.1%로 줄였습니다. LoCoMo의 질문이 화자 자신에 관한 것이라 재현율 손실도 없었습니다. 그런데 사후확률은 아무것도 하지 못했습니다. 이유는 간단하고도 근본적입니다. 두 John이 저장소에서 모두 똑같은 정규화 문자열 john이기 때문입니다. 식 (2)는 서로 다른 저장 엔티티 사이에서 고르는 장치인데, 후보가 하나뿐이면 고를 것이 없습니다. 그래프 친밀도로 대신해 보니 다른 대화 줄의 비율은 0.371에서 0.237로 줄었지만 이름이 겹치는 노출은 그대로였습니다.
1998년의 John Smith 35명과 같은 문제입니다. 동명이인 해소는 저장할 때 사람을 구별해서 적어 두었을 때만 가능합니다. 서빙 시점의 어떤 영리한 순위도 쓰기 시점에 합쳐진 사람을 다시 갈라 줄 수는 없습니다.
사생활의 문제이기도 하다
논문의 윤리 절은 오귀속을 정확도 문제로만 보지 않습니다. 한 관계에서 나온 사실이 같은 이름의 다른 사람에게 보내는 프롬프트에 들어가면 그것은 맥락을 넘는 노출입니다. 김민준과 나눈 연봉 이야기가 이민준에게 보내는 메시지 초안에 끼어드는 장면을 떠올려 보세요. 저자들은 분명히 선을 긋습니다. 이 논문의 신원 규칙은 순위 규칙이지 접근 제어 장치가 아니다. 사람 간 노출을 금지해야 하는 서비스라면 블록을 조립할 때 명시적인 정책으로 강제해야 합니다. 2023년 3월 ChatGPT가 캐시 클라이언트 버그로 다른 사용자의 대화 제목과 일부 결제 정보를 보여 준 사고, 2015년 크리스마스 스팀 상점이 캐시 설정 오류로 약 3만 4천 계정에 남의 페이지를 보여 준 사고는 '같은 열쇠로 남의 것을 꺼내는' 시스템 차원의 오귀속이었습니다.
저장소에 답이 없을 때 무엇이 일어나는지는 2장에서 예고했습니다. 논문의 어려운 조각에는 아무도 언급한 적 없는 회의실을 묻는 답 없는 요청 60개가 있습니다. 결과는 한 문장입니다. 게이트가 없는 모든 순위기, 유효성 필터, 신원 규칙이 60개 전부에 다른 사람의 같은 종류 값을 넣었습니다. 상위 k개 검색은 언제나 무언가를 돌려줍니다. 회의실을 물으면 누군가의 회의실이 들어갑니다.
논문은 두 가지 게이트를 비교합니다.
슬롯 게이트는 요청의 명사와 끝말로 어떤 슬롯을 묻는지 읽습니다. 명사가 분명하면(마감일, 출시일, 일당, 예산 한도) 명사로, 명사가 겹치면 끝말로 — "the standup with Alex is in"은 회의실, "… is at"은 시각. 그다음 블록에 그 슬롯을 말하는 사실이 있고 그 엔티티의 사후확률이 τ 이상일 때만 블록을 내보냅니다. 이 규칙은 본 벤치마크 1,200질의와 어려운 조각 180질의 모두에서 생성기의 슬롯과 정확히 일치했습니다.
마진 게이트는 슬롯 목록이 필요 없습니다. 1위 사실의 점수가 상위 후보 평균의 τ배 이상이고 요청의 내용어 3분의 1을 공유할 때만 내보냅니다.
슬롯 게이트는 답 없는 요청 60개를 모두 비우고 답 있는 요청은 0.2%만 비웠습니다. 마진 게이트는 답 없는 요청을 하나도 비우지 못하고 답 있는 요청의 15.8%를 비워 깨끗함을 0.134 깎았습니다. LoCoMo에서는 대화마다 저장소를 따로 만들고 다른 대화의 질문 1,800개를 던져 봤는데, 게이트 없는 순위기는 7.3%만 기권했습니다. 마진 게이트는 τ=1.5에서 답 없는 요청 95.0%를 잡았지만 답 있는 요청 73.9%도 비웠고, 현재 값 재현이 0.220에서 0.099로 떨어졌습니다. τ를 올리면 같은 거래선 위를 더 미끄러질 뿐입니다. LoCoMo에는 슬롯 목록이 없으니 슬롯 게이트는 시험할 수조차 없습니다.
요청 때 LLM에게 물으면 되지 않나
자연스러운 반론입니다. 낡음은 LLM이 날짜를 보고 걸러 내게 하고, 신원은 LLM에게 고르게 하고, 기권은 LLM에게 판정하게 하면 되지 않을까요. 부록 L(표 18)이 이 세 가지를 각각 규칙과 맞대결시켰습니다(qwen2:7b).
방법
낡은 값 ↓
남의 값 ↓
깨끗함 ↑
답 없음 기권 ↑
모델 호출 p50
BM25+Pt (유효성 없음)
0.800
0.006
0.196
0.000
—
LLM 시간 재정렬
0.381
0.008
0.302
0.000
653.6ms
키 있는 PFM
0.000
0.106
0.894
0.000
—
신원 사후확률
0.000
0.031
0.969
0.000
—
사후확률 + 슬롯 게이트
0.000
0.031
0.969
1.000
—
LLM 기권 판정
0.000
0.054
0.569
0.667
912.1ms
LLM 신원 해소
0.000
0.031
0.931
0.000
0.01ms (p99 1,967ms)
시간 재정렬은 낡은 값을 0.800에서 0.381로 줄이지만 지켜야 할 현재 값까지 버려 현재 값 재현이 0.998에서 0.454로 떨어집니다. 깨끗함은 0.302로 키 저장소(0.894)의 3분의 1이고, 0.25ms짜리 검색 뒤에 654ms를 더 씁니다. 논문의 표현대로 "쓰기 시점 대체가 주는 것의 절반도 되찾지 못하고 값은 두 번 치른다". 기권 판정은 답 없는 요청의 3분의 2만 비우면서, 다른 곳에서는 너무 쉽게 비워 깨끗함을 0.569로 떨어뜨렸습니다. 요청마다 912ms입니다. 셋 중 가장 나은 것은 신원 해소로, 모호한 언급에서만 호출되니 중앙값 비용은 거의 0이지만 99분위는 약 2초이고 깨끗함은 사후확률(0.969)보다 낮은 0.931입니다.
결론은 "LLM이 나쁘다"가 아닙니다. 구조화된 규칙이 성공하는 곳에서는 LLM 호출이 더 느리고 덜 정확했고, 스키마 없는 규칙이 실패하는 곳에서는 LLM 호출도 그 근본적인 모호성을 없애지 못했다는 것입니다. 정보가 없으면 더 똑똑한 판정자도 만들어 낼 수 없습니다.
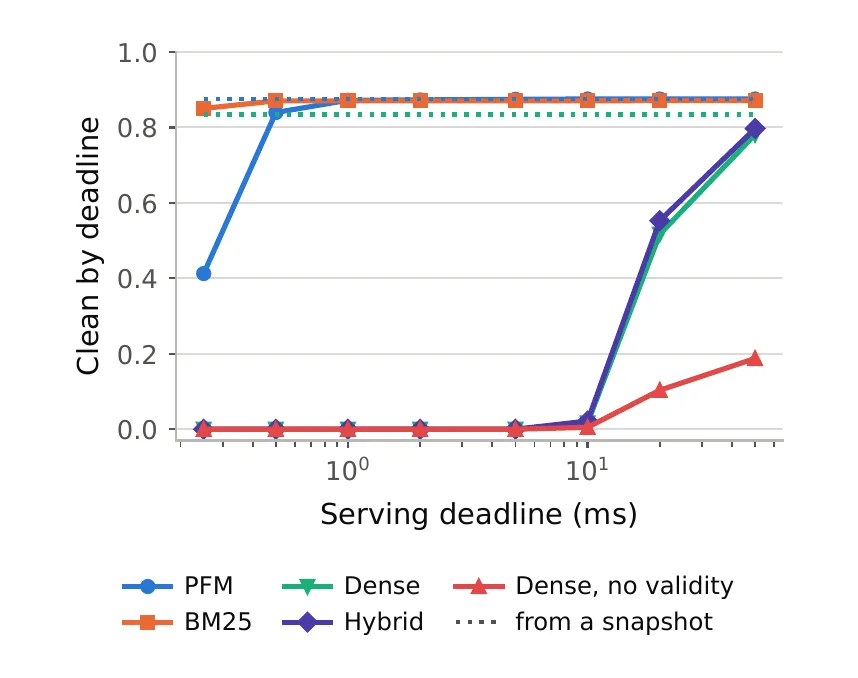
출처: Deng & Sinchaisri (2026), 그림 2. 시드 7, 모든 팔이 참여자 정보를 받고 활성 사실만 서빙(표시한 하나 제외). 실선은 요청 때 새로 검색, 점선은 최신 개정 이후 만든 스냅숏에서 읽기(약 1µs).
그림이 말하는 바는 세 가지입니다. 어휘 검색(PFM·BM25)은 1ms 위에서 모두 천장(약 0.87)에 붙습니다. 밀집과 하이브리드는 질의 인코딩 때문에 10ms 마감을 거의 넘지 못하고, 충분히 기다려도 남의 값 때문에 천장이 더 낮습니다. 유효성 없는 밀집 검색은 50ms를 줘도 0.19입니다. 늦음을 고쳐도 낡음은 그대로입니다.
스냅숏: 항상 제시간, 마지막 발행만큼만 신선
부록 G의 설계는 RCU를 닮았습니다. 백그라운드 작업자가 주기적으로 검색을 돌려 결과를 불변 스냅숏으로 만들고 참조 하나를 바꿔 끼워 발행합니다. 요청은 그 참조를 읽기만 합니다. '신선 모드'에서는 이미 돌고 있는 검색 작업자에게 요청을 넘기고 최대 ω만큼 기다렸다가, 시간을 넘기면 취소 플래그를 세우고 최신 스냅숏으로 물러섭니다. 요청 스레드는 저장소 잠금을 절대 잡지 않습니다.
명제 2 (기억으로 인한 대기의 상한). 스냅숏이 불변이고 참조 하나로 발행되며, 요청 스레드가 작업자의 잠금을 잡지 않고, 참조 읽기가 r 이내, 작업자 인계가 h 이내, 요청 스레드가 실행 가능해진 뒤 σ 이내에 실제로 돈다면 — 스냅숏 모드는 응답 경로에 최대 σ + r, 신선 모드는 최대 h + ω + σ + r만 더한다. 추출·색인 관리·그래프 갱신·가지치기가 얼마나 오래 걸리든 상관없이.
증명은 간단하지만, 저자들이 정말 공들인 부분은 상한에 들어가는 σ와 h를 실제 서빙 경로에서 재는 일이었습니다. 사실 2만 개짜리 저장소에 초당 최대 400개를 넣고 1초마다 가지치기를 하면서, 50ms마다 스냅숏을 발행하고 2,000개의 요청을 보냈습니다.
측정
GC 켬
GC 끔
뜻
스냅숏 참조 읽기 r (최대)
30µs
10µs
스냅숏 모드는 상한대로 작동
스케줄링 지연 σ (중앙값 / 99분위 / 최대)
2.1 / 28.5 / 34.8ms
1.8 / 10.6 / 16.0ms
상한이 기대는 실행 환경 값
잠깐 잠들기로 잰 대리값 (같은 순서)
1.0 / 8.5 / 32.2ms
—
99분위를 약 3배 과소평가
신선 모드 대기 (중앙값 / 99분위)
7.1 / 33.5ms
6.9 / 15.6ms
예산 ω = 5ms
스냅숏으로 물러선 비율
19.2%
11.7%
작업자 4개 풀 기준
곳곳에 실무의 교훈이 숨어 있습니다. 요청마다 파이썬 스레드를 새로 띄우면 Thread.start가 새 스레드가 돌 때까지 막혀서, 인터프리터 잠금 경합 아래 중앙값 3.0ms·최대 12.3ms가 듭니다. 의도한 대기 예산을 그것만으로 넘습니다. 그래서 작업자를 미리 띄워 두고 큐로 넘기면 인계 비용이 마이크로초 단위로 내려갑니다. 작업자를 하나만 두면 취소된 검색이 끝나기를 기다리는 머리 막힘(head-of-line blocking) 때문에 스냅숏 후퇴율이 12%에서 49%로 치솟아서 넷을 둡니다. 그리고 "잠깐 잠들었다 깨는 시간"으로 스케줄링 지연을 재면 99분위를 세 배쯤 과소평가합니다. 이 상한은 그 경로에서 잰 σ에만 의미가 있습니다.
스냅숏이 한 번만 뒤처져도
표 7은 스냅숏 모드의 대가를 보여 줍니다. 질의의 슬롯이 한 번 갱신되기 전에 만든 스냅숏으로 답하면, 개정된 질의는 100% 낡은 값을 보고 깨끗함은 0입니다. 개정이 없던 질의는 사실 자체가 아직 스냅숏에 없어 역시 0입니다. 두 번 뒤처지면 낡은 값이 62.6%, 깨끗함 0.6%입니다. 스냅숏은 늘 제시간에 오지만, 마지막 발행만큼만 신선합니다. 늦음을 피하려다 낡음을 사는 거래입니다.
저장소가 커지면
PFM의 검색 비용은 사실 개수가 아니라 질의가 훑는 가장 긴 게시 목록(posting list)에 따라 자랍니다. 표 9에 따르면 가비지 컬렉터에서 오래 사는 객체를 얼린(gc.freeze) 상태로 중앙값이 사실 1천 개에서 0.20ms, 2만 개에서 2.8ms, 10만 개에서 22.6ms입니다. 얼리지 않으면 10만 개에서 꼬리 지연이 159ms까지 튑니다. 모든 사실이 같은 단어를 공유하는 '좁은 어휘' 분포에서는 약 2만 개에서 밀집 검색(MiniLM 인코딩 + 정확한 전수 스캔)과 비용이 역전되고, 넓은 어휘에서는 5만 개 근처에서 만납니다. 저자들의 결론은 이렇습니다. 사실 수천 개짜리 개인 저장소는 두 교차점보다 한참 아래에 있습니다. 사용자가 읽은 모든 것을 저장하는 시스템이나, 사실들이 대부분의 단어를 공유하는 말뭉치는 그렇지 않습니다.
진짜 지연은 블록 자체가 만든다
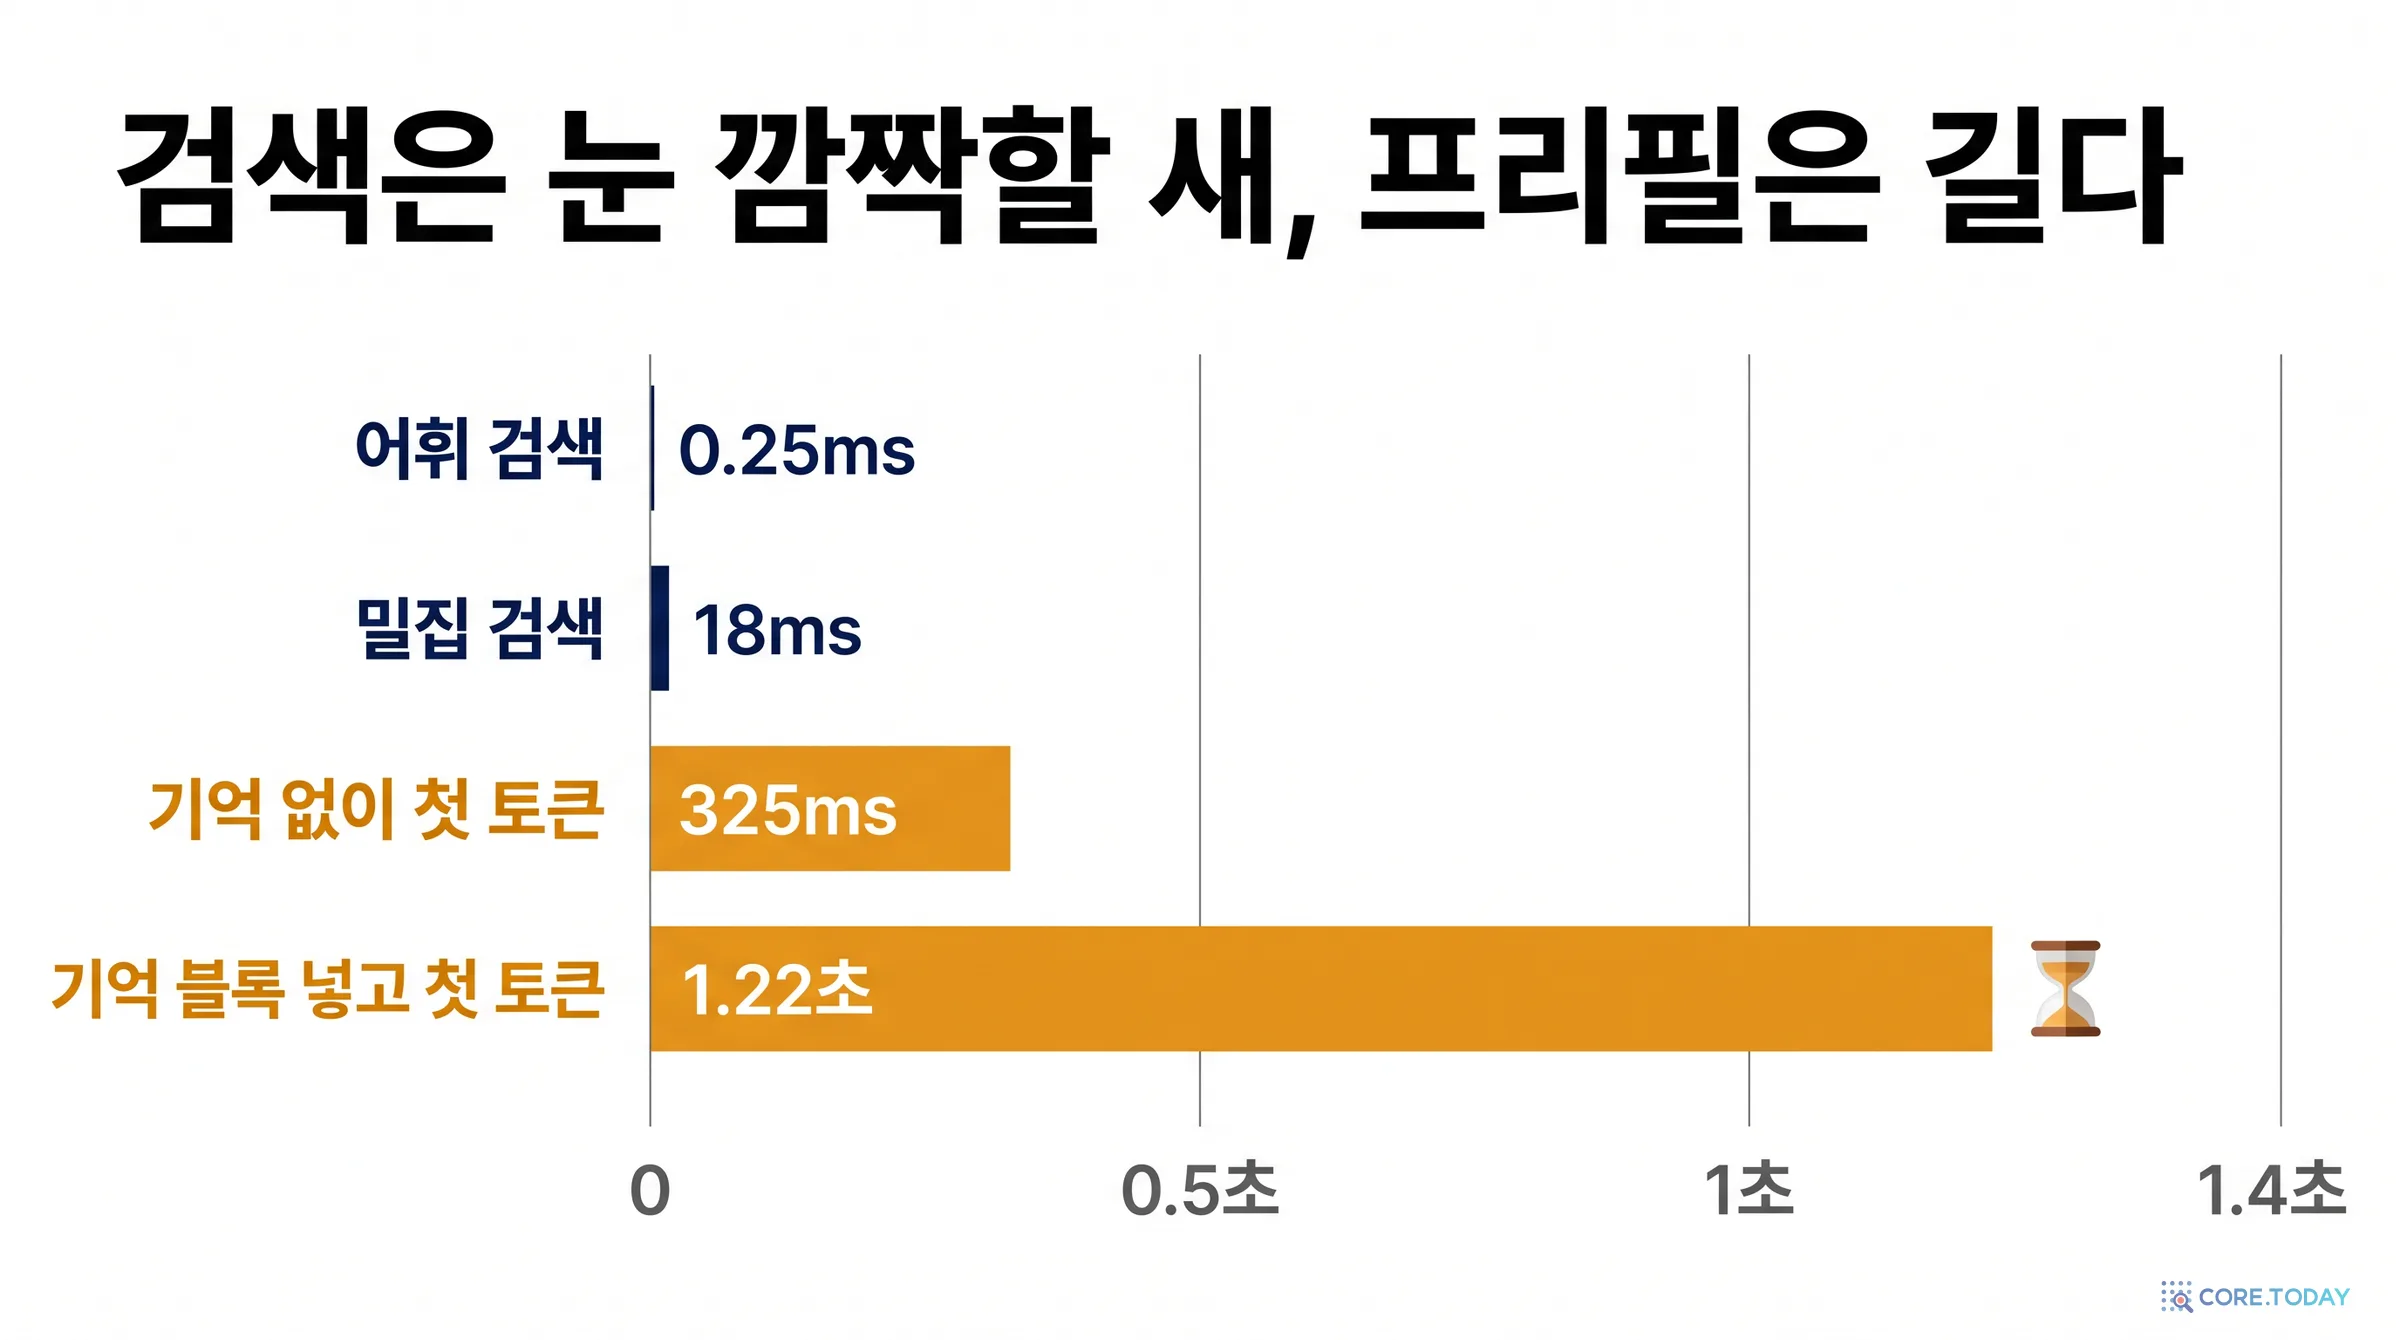
마지막 반전입니다. 검색이 0.25ms든 18ms든, 한 턴의 지연을 지배하는 것은 블록을 넣은 프리필입니다. qwen2:7b에서 첫 토큰까지의 중앙값은 기억 없이 325ms, 평균 472자짜리 블록을 넣으면 1.22초입니다. llama3.2:3b는 168ms에서 544ms. 블록을 만든 어휘 검색보다 대략 세 자릿수(천 배) 큰 비용입니다. 논문은 매 요청 맨 앞에 무작위 요청 번호를 넣어 서버가 프롬프트 접두부를 캐시하지 못하게 했으므로, 이 숫자는 매번 프리필을 처음부터 하는 최악의 경우입니다.
실무에서는 이 대목이 가장 쓸모 있을지 모릅니다. 블록이 짧을수록, 그리고 블록이 프롬프트에서 안 바뀌는 부분에 놓일수록 프리필 비용이 줄어듭니다. Anthropic이 2024년 프롬프트 캐싱을 발표하며 공개한 표에 따르면 10만 토큰짜리 캐시 프롬프트의 첫 토큰 시간이 11.5초에서 2.4초로 줄었습니다. 기억 블록은 요청마다 바뀌므로 통째로 캐시하기는 어렵지만, 블록의 크기와 위치가 검색 알고리즘보다 체감 속도에 더 큰 영향을 준다는 점은 기억해 둘 만합니다.
10. 블록의 오류는 답으로 번지는가
여기까지는 전부 블록 이야기였습니다. 마지막으로 확인할 것은 "그래서 블록이 더러우면 정말 답이 틀리나"입니다. 저자들은 시드 7의 240질의를 고정된 두 모델 — qwen2:7b와 llama3.2:3b, 둘 다 4비트·탐욕 디코딩 — 에 기억 조건별로 넣었습니다. 프롬프트는 "사용자가 {상대}에게 메시지를 쓰는 것을 돕고 있다. 미완성 메시지에 이어질 말만 써라" 형식이고, 판정은 완성문에 어떤 값이 들어 있는지로 다섯 가지(정답, 혼합, 낡음, 남의 것, 기타)를 가릅니다.
기억 조건 (qwen2:7b)
블록 낡은 값
정답 ↑
낡은 값 씀 ↓
남의 값 씀 ↓
첫 토큰 p50
기억 없음
—
0.000
0.004
0.000
325ms
PFM (키 있음)
0.000
0.929
0.000
0.013
1,229ms
PFM, 키 없음
0.642
0.704
0.188
0.000
1,236ms
BM25
0.692
0.629
0.254
0.004
1,365ms
BM25 + '최신 값을 써라' 지시
0.692
0.654
0.233
0.004
1,506ms
BM25 + 유효성
0.000
0.842
0.000
0.004
1,388ms
밀집 + 유효성
0.000
0.946
0.000
0.000
1,469ms
키 있는 기억에서 7B 모델은 92.9%가 현재 값을 썼고, 키 없는 저장소에서는 70.4%였습니다(짝지은 차이 0.225, 구간 0.161~0.296). 3B 모델은 91.2% 대 59.2%로 격차가 더 컸습니다(0.321). 키 없는 저장소에서 낡은 값이 든 프롬프트 154개 가운데 7B는 45번, 3B는 67번 낡은 값을 받아썼습니다. 작은 모델일수록 블록의 오류를 그대로 옮깁니다.
가장 흥미로운 줄은 '최신 값을 써라' 지시입니다. "기억 줄에는 날짜가 있다. 같은 것에 대해 두 줄이 다른 값을 주면 가장 최근 것을 써라"라는 문장을 넣었더니 BM25의 정답률이 0.629에서 0.654로 0.025 올랐습니다. 같은 BM25에 활성 사실만 검색하게 하면 0.842입니다. 프롬프트로 부탁하는 것은 저장소를 고치는 것의 일부도 되찾지 못했습니다. 날짜가 같은 블록 안에 버젓이 있는데도요.
부록 M은 망가진 블록에서 이 결론이 버티는지 봅니다(표 21). 결과는 고장의 종류에 따라 다릅니다.
키 잡음 · 블록 낡은 값
18.3%
키 잡음 · 7B가 받아씀
4.2%
키 잡음 · 3B가 받아씀
10.0%
순서 뒤섞임 · 블록 낡은 값
13.3%
순서 뒤섞임 · 7B가 받아씀
13.3%
키 잡음(p=q=0.05)에서는 블록의 18.3%에 낡은 값이 있었지만 7B는 4.2%만 받아썼습니다. 순서 뒤섞임에서는 블록의 13.3%에 낡은 값이 있었고 7B가 정확히 13.3%를 받아썼습니다. 차이는 블록의 구성에 있습니다. 키 잡음 블록에는 대개 현재 값과 낡은 값이 함께 있어 모델이 날짜를 보고 고를 기회가 있습니다. 순서가 뒤바뀐 블록에는 대개 낡은 값 하나만 있습니다 — 늦게 도착한 옛 값이 새 값을 닫았으니까요. 모델에게는 의심할 단서가 없습니다.
어려운 동명이인 조각에서는 아무 규칙 없이 블록이 모든 요청에 경쟁자의 값을 담았고, 두 모델은 30.6%·33.3%를 받아썼습니다. 사후확률을 켜면 답 있는 요청의 노출이 사라지지만 완성문 정답률은 움직이지 않았습니다. 남은 노출이 정확히 답 없는 요청에 몰려 있었고, 모델은 바로 그 요청들에서 틀렸기 때문입니다. 슬롯 게이트까지 켜야 7B는 100%, 3B는 97.2%가 맞았습니다(답 없는 요청에서 맞다는 것은 값을 말하지 않았다는 뜻입니다). 온도 0.7로 샘플링해도 키 유무의 격차는 0.229로 탐욕 디코딩(0.225)과 거의 같았습니다.
정리하면, 블록 수준의 오류는 생성으로 번집니다. 다만 번지는 비율은 모델 크기와 블록 구성에 따라 달라서, 최종 답만 보는 평가는 그 비율을 시스템의 성질로 착각하게 만듭니다.
11. 코어닷투데이 실측 — 한국어로 다시 만들어 돌려 봤다
논문의 코드는 익명 보충자료로만 제출돼 있어 바로 받아 볼 수 없습니다. 그래서 코어닷투데이는 부록 B의 벤치마크 설명을 따라 한국어판을 처음부터 다시 만들었습니다. 목표는 숫자를 맞추는 것이 아니라, 논문이 말하는 방향 — 낡음은 쓰기의 문제, 키 오류의 비대칭, 동명이인과 기권은 따로 — 이 한국어 문장과 다른 구현에서도 버티는지 보는 것입니다. 모든 모델 호출은 로컬(Ollama, Apple M1 Ultra)에서 돌렸습니다.
무엇을 만들었나
개정 사슬 160개사람 3슬롯 + 프로젝트 3슬롯스탠드업 시각·장소·일당 / 마감일·출시일·예산 한도, 사슬당 0~4번 개정, 일부는 '취소'로 끝남
동명이인 6쌍김민준·이민준, 박서연·최서연 …사슬 0~11은 같은 이름 쌍이 같은 슬롯을 갖도록 배치, 질의는 이름만("민준님,")
필러 812개배포·티켓·점검·라이선스봇이 보낸 업무 알림과 잡담, 체인에 안 나오는 이름 8개
질의 240개 × 시드 3개값 바로 앞에서 끊긴 미완성 메시지"민준님, 스탠드업 장소는" · 모호한 질의 38~48개/시드 · 답 없는 질의 35개(시드 합계)
검색기는 한글을 두 글자 조각(바이그램)으로 쪼갠 BM25이고, 'PFM-lite'는 여기에 엔티티 필드(가중치 2.5)와 참여자 필드(2.0)를 더한 BM25F입니다. 논문의 그래프·사용 빈도 항은 넣지 않았습니다(논문 지워 보기 실험에서 효과가 0이었습니다). 밀집 검색은 MiniLM 대신 다국어 임베딩 bge-m3를 썼습니다. 블록은 위에서부터 6줄·600자까지입니다. 라벨은 값 문자열이 아니라 출처(어느 사슬의 몇 번째 메시지인가)로 붙여서 정확합니다.
결과 ①: 표 1·2를 한국어로
구성 (질의 720개)
현재 값 ↑
낡은 값 ↓
남의 값 ↓
깨끗함 ↑
논문의 해당 값
PFM-lite, 키 있음
1.000
0.000
0.168
0.832
0.877
PFM-lite, 키 없음
0.975
0.700
0.039
0.274
0.247
BM25 + 유효성
0.879
0.000
0.175
0.704
0.774
BM25 + 유효성 + 참여자
1.000
0.000
0.174
0.826
0.873
밀집(bge-m3) + 유효성 + 참여자
0.986
0.000
0.164
0.825
0.836
BM25 + 참여자 (유효성 없음)
0.979
0.701
0.076
0.257
0.195
BM25 + 최근성 (유효성 없음)
0.992
0.682
0.086
0.272
0.193
밀집 + 참여자 (유효성 없음)
0.969
0.696
0.163
0.233
0.181
언어도, 토크나이저도, 임베딩 모델도, 값의 형식도 다른데 그림은 거의 그대로입니다. 키 없는 저장소의 낡은 값 노출은 70.0%로 논문의 70.3%와 거의 같고, 키를 넣으면 0이 됩니다. 어떤 순위기든 유효성 필터를 끄면 낡은 값이 70% 안팎으로 돌아옵니다. 최근성 가중을 곱해도 68.2%입니다. 옛 값을 뒤로 밀어 봐야 6줄짜리 블록 안에는 들어오기 때문입니다. BM25+유효성+참여자(0.826)와 PFM-lite(0.832)가 거의 같은 것도 논문과 같습니다.
한 군데는 다릅니다. 논문에서 밀집 검색은 남의 값 때문에 어휘 검색보다 뒤졌지만, 여기서는 bge-m3가 BM25와 사실상 같습니다(0.825 대 0.826). MiniLM보다 훨씬 큰 다국어 임베딩이고, 저장소의 사실 문장에 참여자 이름을 함께 넣어 임베딩했기 때문으로 보입니다. "밀집이 어휘보다 나쁘다"보다 "밀집으로 바꿔도 낡음과 남의 값 문제는 해결되지 않는다"가 더 안전한 일반화입니다.
결과 ②: 키 오류, 순서, 제3자
6장 위젯의 '한국어 재현' 버튼이 키 잡음 격자 전체입니다. 놓친 병합 p=0.4에서 낡은 값 노출이 0.414, 잘못된 병합 q=0.2에서 현재 값 소실이 0.175입니다. 기울기는 논문보다 조금 완만하지만 놓친 병합은 낡은 값을 보이게 하고 소실은 0, 잘못된 병합은 현재 값을 지운다는 비대칭이 그대로 나왔습니다.
조건 (시드 3개)
현재 값
낡은 값
깨끗함
논문
도착 순서대로
1.000
0.000
0.832
0.877
사슬 30% 순서 뒤섞임, 도착 순서로 처리
0.822
0.178
0.678
0.747
같은 조건, 진술 시각으로 처리
1.000
0.000
0.832
0.877
순서를 뒤섞으면 깨끗함이 0.154 떨어지고, 진술 시각으로 정렬하면 숫자가 정확히 돌아옵니다. 논문과 똑같은 모양입니다.
신원 규칙은 쉬운 조건과 어려운 조건에서 갈렸습니다. 대화 상대가 곧 주인공인 질의에서는 참여자 필터와 사후확률 모두 남의 값을 0으로 만들어 깨끗함 1.000을 냈습니다. 슬롯 게이트까지 켜면 답 없는 질의 35개를 모두 비웠고, 답 있는 질의 720개는 하나도 비우지 않았습니다. 게이트 없이는 35개 중 28개에 남의 값이 들어갔습니다.
어려운 쪽은 대화 상대를 무관한 사람으로 바꾼 제3자 질의(397개)입니다. 논문의 제3자 조각보다 일부러 불리하게, 대화 상대와 주인공이 아무 관련 없도록 무작위로 골랐습니다.
제3자 질의
현재 값
남의 값
깨끗함
이름 겹치는 126개의 깨끗함
규칙 없음
0.786
0.186
0.670
0.270
참여자 필터
0.000
0.000
0.000
0.000
동명이인 사후확률
0.700
0.126
0.700
0.429
참여자 필터의 재현율은 정말로 0입니다. 사후확률은 낫지만 이름이 겹치는 질의의 깨끗함이 0.429로 동전 던지기 근처입니다. 대화 상대 신호도, 공동 언급 신호도 없으니 최근성밖에 남지 않기 때문입니다. 식 (2)는 마법이 아니라 단서를 더하는 계산기입니다. 단서가 없으면 답도 없습니다.
결과 ③: 논문과 다르게 나온 곳 — LLM 키 할당
여기서 가장 흥미로운 차이가 나왔습니다. 논문처럼 qwen3.5:9b로 사슬 메시지 394개(시드 7)를 이름과 값을 보존해 다시 쓰게 했고, 342개가 검사를 통과했습니다. 세 모델에게 슬롯 목록을 주고 키를 붙이게 한 결과입니다. 논문은 한 번에 한 메시지씩 물었지만 호출 수를 줄이려고 20개씩 묶어 물었고, 같은 사슬 메시지가 한 묶음에 몰리지 않게 섞었습니다.
키 할당기 (질의 240개)
키 정밀도
키 재현율
엉뚱한 슬롯
깨끗함
낡은 값
소실
규칙(템플릿용)
1.000
0.381
0
0.438
0.525
0.000
규칙(공백 보정)
1.000
1.000
0
0.850
0.000
0.000
qwen3.5:4b
0.982
0.952
6
0.808
0.079
0.017
qwen3.5:9b
1.000
0.990
0
0.825
0.025
0.000
qwen3.8:27b
1.000
0.990
0
0.825
0.025
0.000
키 없음
—
—
—
0.321
0.671
0.000
논문의 반전은 재현되지 않았습니다. 9B와 27B는 엉뚱한 슬롯 배정이 한 건도 없었습니다. 두 사실이 눈에 띕니다. 첫째, 템플릿에 맞춰 짠 규칙은 처음에 재현율 0.381로 무너졌습니다. 원인은 어이없게도 띄어쓰기였습니다. 모델이 "27E호"를 "27E 호"로, "71만 원"을 "71 만 원"으로 다시 쓰자 정규식이 놓친 것입니다. 정규식을 공백에 너그럽게 고치자 394개를 모두 맞혔습니다. 물론 이 수정은 말뭉치를 본 뒤에 한 것이고, Qwen의 다시 쓰기가 슬롯 명사를 거의 보존했기 때문에 가능했습니다. 논문의 규칙도 다시 쓴 문장에서 재현율이 0.807로 떨어졌습니다. 둘째, 가장 작은 4B에서만 논문이 본 바로 그 혼동(회의실 → 회의 시각, 6건)이 나왔고 소실도 1.7% 생겼습니다.
그래서 논문이 틀렸다는 뜻일까요? 그렇게 읽을 수는 없습니다. 이 말뭉치의 다시 쓴 문장에는 대부분 '시간'이나 '장소'가 남아 있고, 값의 형식도 슬롯마다 다르며(10:45와 16C호), 모델도 논문보다 두 세대쯤 뒤입니다. 그렇다면 문장에서 슬롯 단서를 지우면 어떨까요? 현실의 메시지는 친절하지 않습니다. 마감일·출시일 메시지 55개를 "초롱 일정이 9월 1일로 변경됐습니다."처럼 바꿨습니다. 이 문장은 사람도 마감인지 출시인지 알 수 없습니다.
'일정' 문장 섞은 말뭉치
엉뚱한 슬롯
가장 흔한 혼동
현재 값
낡은 값
소실
깨끗함
규칙(공백 보정)
0
— (55개 모두 키 안 붙임)
1.000
0.154
0.000
0.700
qwen3.5:4b
38
출시일↔마감일 32건
0.942
0.150
0.058
0.713
qwen3.5:9b
33
마감일·출시일 → 일당 28건
1.000
0.163
0.000
0.692
qwen3.8:27b
26
출시일 → 마감일 26건
0.963
0.067
0.037
0.758
이제 논문이 말한 고장의 비대칭이 뚜렷해집니다. 규칙은 모르는 문장에서 손을 뗍니다. 낡은 값이 보이지만(0.154) 현재 값은 절대 잃지 않습니다. 모델은 모른다고 하지 않고 찍습니다. 4B는 동전을 던지듯 출시일과 마감일을 오갔고, 27B는 모든 '일정'을 마감일로 넣었습니다. 그 결과 현재 값 재현이 1.000에서 0.942·0.963으로 떨어졌습니다. 9B는 엉뚱하게 '일당'에 넣어 아무 값도 닫지 못한 덕에(프로젝트의 일당이라는 키는 없으니) 오히려 현재 값을 잃지 않았습니다. 깨끗함 숫자만 보면 27B가 가장 높고 규칙은 중간입니다. 논문처럼 "규칙이 이긴다"는 결론은 여전히 나오지 않습니다. 하지만 어떤 종류의 실패를 감수할 것인가는 완전히 다른 선택이라는 점은 분명히 보입니다. 낡은 값은 사용자가 알아챌 수 있고, 사라진 값은 아무도 모릅니다.
우리가 이 실험에서 얻은 교훈을 정리하면 이렇습니다. 슬롯 어휘가 분명하면 2026년의 중간 크기 모델은 키를 잘 붙입니다. 하지만 입력에 답이 없을 때 모델이 '없음'을 고르게 만드는 것은 별개의 문제입니다. 프롬프트에 '해당 없으면 없음'이라고 적어 뒀는데도 55개 중 '없음'을 고른 것은 4B 0개, 27B 0개, 9B 20개였습니다.
결과 ④: 슬롯 목록을 안 주면
LongMemEval 실험의 한국어 축소판도 돌렸습니다. 슬롯 목록 없이 qwen3.5:9b에게 "대상|속성"을 쓰게 합니다. 개정된 사슬 106개에서 마지막 두 메시지가 같은 키를 받았는지(논문의 병합 재현율에 해당)를 봅니다.
열린 키 할당
키 형태 수
병합 재현율
다른 사슬과 공유
낡은 값
깨끗함
상태 없음, 표현 그대로
281
0.340
0.000
0.567
0.425
상태 없음, '님'·'프로젝트' 정규화
232
0.462
0.004
0.446
0.525
저장된 키 보여 줌, 표현 그대로
183
0.764
0.011
0.233
0.675
저장된 키 보여 줌, 정규화
157
0.934
0.013
0.087
0.783
상태 없는 키 할당은 메시지 374개에 281가지 표현을 만들었습니다. 같은 사람의 같은 슬롯이 이민준|스탠드업시간, 이민준님|스탠드업시간으로 갈렸고, 정지호|일당이 정지호|일당기준이 되기도 했습니다. 심지어 스탠드업을 스타트업시간이라고 잘못 적은 키도 곳곳에 있었습니다. 한국어 이름 뒤에 붙는 '님' 하나가 병합을 깨뜨린다는 것은 영어 실험에는 없는 함정입니다.
그런데 저장된 키를 프롬프트에 보여 주자 결과가 크게 달라졌습니다. 병합 재현율이 0.764, 정규화하면 0.934까지 오르고 잘못된 병합은 1%대에 머물렀습니다. 논문에서는 같은 처치가 병합 재현율을 0.062로 올리는 동안 잘못된 병합이 0.294로 치솟았습니다. 이 차이를 과장하면 안 됩니다. 이 말뭉치는 사실상 여섯 종류의 속성만 있는 좁은 세계입니다. LongMemEval은 사람의 일상 전체를 다루고 턴마다 무엇이 '속성'인지부터 모호합니다. 우리 결과는 논문의 열린 영역 결론을 뒤집는 것이 아니라, 어려움이 말뭉치의 넓이에서 온다는 점을 보여 줍니다. 업무 메신저처럼 다루는 속성의 종류가 좁은 제품이라면, 기존 키를 보여 주고 이름 표현을 정규화하는 것만으로 꽤 멀리 갈 수 있습니다.
결과 ⑤: 블록의 오류는 답으로 번졌다
마지막으로 논문 부록 C의 프롬프트를 한국어로 옮겨 시드 7의 240질의를 두 모델에 넣었습니다. 매 요청 맨 앞에 무작위 번호를 붙여 접두부 캐시를 막은 것도, 값 포함 여부로 판정한 것도 논문과 같습니다. 모델이 시각을 "14 시 15 분"처럼 풀어 쓰는 경우는 정규화해서 판정했습니다. '최신 값' 지시는 "기억 줄에는 날짜가 있습니다. 같은 항목에 서로 다른 값이 있으면 가장 최근 값을 쓰세요."입니다.
기억 조건
블록 낡은 값
9B 정답
9B 낡은 값 씀
4B 정답
4B 낡은 값 씀
키 있는 저장소
0.000
0.933
0.000
0.912
0.000
키 없는 저장소
0.671
0.767
0.200
0.675
0.283
키 없는 저장소 + 최신 값 지시
0.671
0.812
0.167
0.692
0.279
방향이 논문과 같습니다. 낡은 값이 든 프롬프트 161개 가운데 9B는 48번, 4B는 73번 낡은 값을 받아썼습니다. 작은 모델일수록 더 그대로 옮기는 것도 같습니다. 키 저장소와 키 없는 저장소의 정답률 차이는 9B 0.166(95% 구간 0.106~0.228), 4B 0.236(0.172~0.303)입니다.
'최신 값을 써라' 지시도 비슷한 결과를 냈습니다. 9B에서는 0.046 올랐고(구간 0.004~0.088, 간신히 0을 벗어남), 4B에서는 0.016으로 구간이 0을 포함합니다. 어느 쪽이든 키를 넣어 얻는 이득의 일부에 그칩니다. 지시문을 넣어도 9B의 16.7%, 4B의 27.9%가 여전히 낡은 값을 썼습니다. 블록 안에 날짜가 버젓이 있는데도 그렇습니다.
한 가지는 논문이 강조하지 않은 흥미로운 대목입니다. 키 있는 저장소의 블록 240개 중 36개(15%)에는 같은 이름 다른 사람의 값이 들어 있었지만, 모델이 그것을 쓴 비율은 9B 0.4%, 4B 2.1%뿐이었습니다. 기억 줄마다 전체 이름과 대화 상대가 적혀 있으니 모델이 상당 부분 걸러 낸 것입니다. 2장에서 말한 '모델의 수습'이 숫자로 보이는 장면이고, 이 수습은 블록에 구별할 단서가 있을 때만 가능합니다. LoCoMo의 John처럼 저장소에서 이름이 합쳐지면 모델에게도 단서가 없습니다.
프리필도 재 봤습니다. 다른 작업이 함께 도는 기계에서 잰 값이라 절대값보다 비율을 보세요. 첫 토큰 준비에 쓴 프롬프트 처리 시간의 중앙값은 4B가 기억 없이 207ms, 약 300토큰짜리 프롬프트에서 415ms, 9B가 618ms와 1,744ms였습니다. 파이썬으로 짠 어휘 검색(중앙값 약 0.5ms)보다 수백 배에서 수천 배 큰 값입니다. 검색보다 블록이 지연을 지배한다는 논문의 결론은 그대로입니다.
재현의 정직한 한계
이 실측은 논문의 검증이 아니라 방향 점검입니다. 값 형식과 슬롯 구성은 코어닷투데이가 정했고, LLM 실험은 시드 하나(질의 240개, 깨끗함의 95% 구간 대략 ±4~5%p)입니다. 다시 쓰기 모델이 슬롯 명사를 잘 보존했고, 규칙은 말뭉치를 본 뒤에 고쳤으며, 키 할당은 20개씩 묶어 물었으므로 한 번에 하나씩 묻는 논문의 조건과 다릅니다. 지연 수치는 다른 작업이 함께 도는 기계에서 쟀습니다. 그래도 정리하면 이렇습니다.
논문의 주장
한국어 재현
키 대체가 낡은 값 노출을 없앤다
재현 (70.0% → 0)
순위기보다 유효성·참여자 정보가 중요하다
재현
놓친 병합과 잘못된 병합의 고장 방향이 다르다
재현
도착 순서 오류는 진술 시각으로 복구된다
재현 (숫자까지 일치)
참여자 필터는 제3자 사실을 버린다
재현 (재현율 0)
슬롯 게이트는 답 없는 요청을 비운다
재현 (35/35)
블록의 낡은 값이 생성으로 번지고, 작은 모델일수록 심하다
재현 (9B 48/161, 4B 73/161)
'최신 값을 써라' 지시는 저장소 수정을 대체하지 못한다
재현 (+0.046·+0.016 대 +0.166·+0.236)
검색보다 프리필이 지연을 지배한다
재현
밀집 검색은 남의 값 때문에 어휘 검색보다 낮다
재현 안 됨 (bge-m3는 동률)
LLM 키 할당기가 규칙보다 낮다
재현 안 됨 (9B·27B 오류 0, 슬롯 단서를 지워도 비슷)
기존 키를 보여 줘도 병합은 낮고 잘못된 병합이 늘어난다
재현 안 됨 (좁은 말뭉치에서 0.934, 잘못된 병합 1%대)
재현된 것은 대부분 저장소의 구조에서 나오는 결과이고, 재현되지 않은 것은 대부분 특정 모델의 능력에 달린 결과입니다. 전자는 모델이 좋아져도 사라지지 않습니다. 후자는 몇 달마다 다시 재야 합니다. 이 구분이 이번 재현에서 얻은 가장 큰 소득입니다.
12. 비판적으로 읽기 — 이 논문이 말하지 않는 것
좋은 논문은 한계 절이 성실합니다. 이 논문도 그렇습니다. 저자들이 직접 쓴 한계와, 코어닷투데이가 읽으며 덧붙이고 싶은 단서를 나눠 정리합니다.
저자들이 밝힌 한계
①
합성 벤치마크의 단순함
템플릿 계열이 작고, 값이 전역적으로 고유하며, 참여자 메타데이터가 정확하고, 슬롯 목록이 알려져 있다. 이 덕분에 블록 노출을 정확히 셀 수 있지만, 언어와 구조는 현실보다 쉽다.
②
공개 말뭉치는 선택적이다
LongMemEval은 열린 키 할당이 턴마다 모델 호출을 요구해 2,587턴만 썼고, 원문 그대로의 답 구간 조건 때문에 지식 갱신 78문항 중 32문항만 남았다. 바꿔 말한 답만 있는 질문은 빠졌다. LoCoMo에서는 어휘 문장 검색이 정답을 블록에 거의 못 넣어(현재 값 0.078) 재현율이 아니라 출처별 노출만 쟀다.
③
보장의 범위
명제 1은 갱신 불변식이지 의미적 정확성이 아니다. 낡음 결과는 개정을 올바른 슬롯·엔티티에 배정했다는 조건 위에 있다. 열린 영역 실험은 여러 그럴듯한 방법을 시험했지만, 일관된 키 발견을 위해 따로 학습한 시스템이나 더 풍부한 스키마의 해소기를 배제하지 않는다.
④
측정 환경
지연은 기계 한 대(Apple M2, 16GB)와 CPython 하나에서 쟀다. 응답 수준 실험은 작은 양자화 모델 둘과 문자열 포함 판정을 썼다. 어떤 실험도 실제 사용자의 이득을 재지 않았다.
코어닷투데이가 덧붙이는 단서
'같다'의 범위를 기억하자. BM25가 PFM과 같다는 결론은 ±0.02라는 사전 마진 안에서, 같은 활성 저장소와 같은 참여자 정보를 줬을 때의 이야기입니다. "BM25면 충분하다"로 읽으면 안 됩니다. 정확히는 "이 벤치마크에서 순위기 선택은 저장소 상태와 참여자 정보에 비해 사소했다"입니다. AgentIR(Yuan 외, arXiv:2605.25092)이 LoCoMo에서 BM25 단독이 가장 강했다고 보고한 것과 방향은 같지만, 문장 수준 사실·풍부한 패러프레이즈·긴 저장소에서는 다를 수 있습니다.
LLM 키 할당기의 패배는 '이 벤치마크의 슬롯 어휘' 위에 있다. 회의실과 회의 시각이 같은 명사를 공유하도록 만든 설계가 모델들의 주된 실패 지점이었습니다. 이것은 현실적인 함정이기도 하지만(사람들은 실제로 "스탠드업 16C로"라고 씁니다), 슬롯 정의를 더 분명히 하거나 슬롯마다 값 타입 검사를 붙이면 상당 부분 줄어들 수 있습니다. 모델들은 엉뚱한 엔티티로는 한 번도 보내지 않았습니다. 사람은 잘 구별하는데 칸을 헷갈립니다. 11장의 한국어 재현에서도 슬롯 단서가 분명하면 9B·27B의 슬롯 오류는 0건이었습니다. 그렇다면 "모델에게 키를 맡기지 말라"보다 "모델이 붙인 키의 슬롯 정밀도를 따로 재고, 값 타입이 슬롯과 맞지 않으면 거절하고, 단서가 없는 문장에는 '없음'을 고르게 하라"가 더 정확한 교훈입니다.
작은 모델만 썼다. 키 할당·응답 실험의 모델은 3B~14B이고 이전 세대입니다. 11장에서 본 대로 더 새로운 모델에서는 슬롯 혼동이 크게 줄었습니다. 하지만 큰 모델이라고 '같은 속성에 같은 이름을 붙이는' 열린 키 발견의 일관성 문제가 사라진다는 증거도 없습니다. 이것은 개별 판단의 정확도가 아니라 수천 번의 독립된 판단 사이의 일관성 문제이기 때문입니다.
은퇴는 삭제가 아니다. 논문의 윤리 절에서 가장 실무적인 문장은 이것입니다. 대체된 사실은 출처 보존을 위해 이력으로 남는데, 검색에서 내리는 것(retire)과 저장된 사실·그래프 연관을 지우는 것(delete)은 다르다. 논문의 참조 구현은 완전한 삭제를 구현하지 않으므로 삭제 요청을 충족한다고 해석하면 안 된다고 명시합니다. 실제 제품도 같은 구분 위에 있습니다. OpenAI 도움말에 따르면 ChatGPT의 저장 기억은 대화 기록과 따로 보관되어, 대화를 지워도 그 대화에서 생긴 기억은 남고 기억을 지워도 과거 대화 속 언급은 남습니다. 삭제된 기억 기록은 안전·디버깅 목적으로 최대 30일 보관됩니다. 유럽 GDPR 17조의 삭제권, 그리고 국내에서 2021년 4월 개인정보보호위원회가 이루다 개발사에 과징금·과태료 1억 330만 원을 부과하며 지적한 '파기해야 할 정보의 미파기'는 모두 이 구분을 법의 언어로 쓴 것입니다. 낡은 값을 검색에서 내리는 키 대체는 정확성 장치이지 잊힐 권리 장치가 아닙니다.
최종 답 평가를 버리자는 논문이 아니다. 결론의 마지막 문장이 이것을 분명히 합니다. "최종 답 정확도는 여전히 필요하지만, 그것만으로는 기억 시스템의 어느 부분이 실패했는지 알 수 없다." 블록 수준 지표는 최종 답 지표를 대체하는 것이 아니라 분해하는 도구입니다. 코어닷투데이가 「답은 맞았는데 서랍은 엉망」에서 다룬 FEB-30의 '내재 평가'와 「기억력 시험은 만점, 심부름은 낙제」의 MemoryArena가 각각 저장소 내부와 행동 결과를 보는 방향이라면, 이 논문은 그 사이 — 저장소에서 모델로 넘어가는 이음매 — 를 봅니다.
13. 2026년, 이 논문의 자리
2026년의 AI 제품에서 기억은 세 갈래로 퍼져 있습니다. 대화형 비서의 개인화 기억(ChatGPT·Claude·Gemini), 코딩 에이전트의 작업 기억(프로젝트 파일·규칙 파일), 그리고 기업용 에이전트의 고객·업무 기억. 셋 모두 같은 질문을 피할 수 없습니다. 지금 넣는 이 줄이 지금도 참인가, 이 사람에 관한 것인가, 답이 없을 때 비울 수 있는가, 제때 도착하는가.
이 논문이 주는 실무 메시지를 다섯 줄로 줄이면 이렇습니다.
쓰기낡음은 쓰기 시점에 해결한다. 검색 시점의 재정렬·지시문은 비싸고 덜 정확하다. (엔티티, 슬롯) 키와 활성 구간을 저장소에 둔다.
키키 품질을 따로 잰다. 재현율보다 슬롯 정밀도가 중요하다. 잘못된 병합은 블록에 보이지 않으므로 '현재 값 소실'을 별도 지표로 둔다. 도착 순서와 진술 시각 중 무엇을 믿을지 정한다.
신원사람은 쓸 때 고유 ID로 구별해 저장한다. 서빙에서는 대화 상대 신호를 검색에 넣고, 제3자 이야기가 필요하면 하드 필터 대신 사후확률을 쓴다. 사람 간 노출 금지는 순위가 아니라 정책으로 강제한다.
기권상위 k개는 항상 차 있다. 슬롯 목록이 있으면 슬롯 게이트, 없으면 기권을 별도 문제로 연구하고 답 있는 질의와 답 없는 질의를 나눠 보고한다.
시간서빙 경로에서 마감 내 깨끗함을 잰다. 검색보다 블록 크기와 프리필이 지연을 지배한다. 스냅숏은 제시간을 사고 신선함을 판다.
흥미로운 것은 이 다섯 줄 가운데 어느 것도 새 모델을 요구하지 않는다는 점입니다. 모두 데이터 관리의 문제입니다. 2023년 무렵 에이전트 기억 연구는 "더 똑똑한 검색"을 향해 달렸습니다. 임베딩, 그래프, 반성, LLM 재정렬. 2026년의 연구들 — STALE, MemStrata, TOKI, MemTrace, 그리고 이 논문 — 은 공통적으로 한 걸음 물러서서, 검색 이전에 저장소가 어떤 상태여야 하는지를 묻고 있습니다. 1985년 스노드그래스가 데이터베이스에 시간을 넣으며 했던 질문, 1969년 펠레기와 선터가 두 기록이 같은 사람인지 물으며 했던 질문으로 돌아가는 셈입니다.
코어닷투데이가 만드는 사실탐색기도 같은 결론에 도달했습니다. 공적 기록의 "지금 참인 것"을 유지하려면 검색을 잘하는 것보다 무엇이 무엇을 대체했는지를 쓰기 시점에 기록하는 것이 먼저였고, 그 대체를 판단할 때는 같은 칸인지(키)와 누구의 말인지(권위)를 따로 물어야 했습니다. 개인 기억과 공적 기록은 규모도 출처도 다르지만, 틀리는 방식은 놀랄 만큼 같습니다.
마지막으로, 내 시스템이 어디서 먼저 틀릴지 진단해 보세요. 처음 상태는 2026년에 흔한 구성으로 맞춰 두었습니다.
맺으며 — 기억은 답보다 먼저 틀린다
이 논문의 제목은 실패 목록이지만, 읽고 나면 한 문장의 태도가 남습니다. 모델이 무엇을 말했는지 보기 전에, 모델이 무엇을 보았는지 보라. 9:30과 10:45가 함께 든 블록에서 모델이 10:45를 골랐다면 그것은 기억 시스템의 성공이 아니라 모델의 수습입니다. 수습은 고맙지만 설계의 근거가 될 수는 없습니다.
다음에 AI 비서가 "민준님, 스탠드업은 9시 30분에 뵐게요"라고 이어 쓴다면, 그 9시 30분이 어디서 왔는지 물어볼 일입니다. 낡은 값이었는지, 다른 민준의 것이었는지, 아니면 맞는 값이 조금 늦게 도착했는지. 셋은 서로 다른 고장이고, 고치는 곳도 다릅니다.
참고문헌
대상 논문
Deng, H. & Sinchaisri, P. (2026). "Stale, Misattributed, or Late: Where Personal Memory Fails Before Generation." arXiv:2610.10265. arxiv.org/abs/2610.10265 · ICLR 2027 심사 중 OpenReview
인용된 기억 연구 (2023~2026)
Park, J. S. et al. (2023). "Generative Agents: Interactive Simulacra of Human Behavior." UIST 2023. arXiv:2304.03442
Packer, C. et al. (2023). "MemGPT: Towards LLMs as Operating Systems." arXiv:2310.08560
Maharana, A. et al. (2024). "Evaluating Very Long-Term Conversational Memory of LLM Agents" (LoCoMo). ACL 2024. arXiv:2402.17753
Wu, D. et al. (2024). "LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory." ICLR 2025. arXiv:2410.10813
Rasmussen, P. et al. (2025). "Zep: A Temporal Knowledge Graph Architecture for Agent Memory." arXiv:2501.13956
Chhikara, P. et al. (2025). "Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory." arXiv:2504.19413
Chao, H. et al. (2026). "STALE: Can LLM Agents Know When Their Memories Are No Longer Valid?" arXiv:2605.06527
Yadav, N. (2026). "Temporal Validity in Retrieval Memory: Eliminating Stale-Fact Errors for AI Agents over Evolving Knowledge" (MemStrata). arXiv:2606.26511
Wang, Z. (2026). "TOKI: A Bitemporal Operator Algebra for Contradiction Resolution in LLM-Agent Persistent Memory." arXiv:2606.06240
Long, X. et al. (2026). "MemTrace: Probing What Final Accuracy Misses in Long-Term Memory." arXiv:2606.17328
Tao, Z. et al. (2026). "MemConflict: Evaluating Long-Term Memory Systems under Memory Conflicts." arXiv:2605.20926
Uddin, M. N. et al. (2026). "From Recall to Forgetting: Benchmarking Long-Term Memory for Personalized Agents" (Memora 벤치마크). ACL 2026 Findings. arXiv:2604.20006
Xia, M. et al. (2026). "Memora: A Harmonic Memory Representation Balancing Abstraction and Specificity." ICML 2026. arXiv:2602.03315
Banerjee, P. et al. (2026). "APEX-MEM: Agentic Semi-Structured Memory with Temporal Reasoning for Long-Term Conversational AI." ACL 2026. arXiv:2604.14362
Su, M. et al. (2026). "Beyond Dialogue Time: Temporal Semantic Memory for Personalized LLM Agents." arXiv:2601.07468
Zhou, W. et al. (2026). "Are We Ready for an Agent-Native Memory System?" arXiv:2606.24775
Yuan, A. et al. (2026). "AgentIR: A Workload-Adaptive Cascade Retrieval Substrate for Long-Term Conversational Memory." arXiv:2605.25092
계보
Newcombe, H. B. et al. (1959). "Automatic Linkage of Vital Records." Science 130(3381):954–959.
Fellegi, I. P. & Sunter, A. B. (1969). "A Theory for Record Linkage." JASA 64(328):1183–1210.
Snodgrass, R. & Ahn, I. (1985). "A Taxonomy of Time in Databases." SIGMOD 1985.
Jensen, C. S. & Snodgrass, R. T. (1999). "Temporal Data Management." IEEE TKDE 11(1):36–44.
Kulkarni, K. & Michels, J.-E. (2012). "Temporal Features in SQL:2011." SIGMOD Record 41(3).
Robertson, S. E. et al. (1994). "Okapi at TREC-3." TREC-3.
Robertson, S., Zaragoza, H. & Taylor, M. (2004). "Simple BM25 Extension to Multiple Weighted Fields." CIKM 2004.
McKenney, P. E. & Slingwine, J. D. (1998). "Read-Copy Update: Using Execution History to Solve Concurrency Problems." PDCS 1998.
Bagga, A. & Baldwin, B. (1998). "Entity-Based Cross-Document Coreferencing Using the Vector Space Model." ACL/COLING 1998.
Schuirmann, D. J. (1987). "A Comparison of the Two One-Sided Tests Procedure and the Power Approach for Assessing the Equivalence of Average Bioavailability." J. Pharmacokinetics and Biopharmaceutics 15(6):657–680.
사례·제품
Tam, V. C. et al. (2005). "Frequency, type and clinical importance of medication history errors at admission to hospital." CMAJ 173(5):510–515.
FTC (2013). 신용 보고서 정확성 연구 의회 보고 관련 진술(FACT Act §319).
TransUnion LLC v. Ramirez, 594 U.S. 413 (2021).
Moffatt v. Air Canada, 2024 BCCRT 149.
ECRI Institute PSO (2016). Patient Identification Deep Dive.