Memory of MemoryMoMP-MemProvenant Memory출처 그래프provenance에이전트 메모리지식 갱신supersession철회이중 시간Mem0GraphitiLongMemEvalMemoryAgentBenchALFWorld등기부이벤트 소싱
[특집] 기억의 기억 — 바뀐 사실은 지우지 말고 '밀어내라'. AI 에이전트 기억 MoM·P-Mem 완전 해설
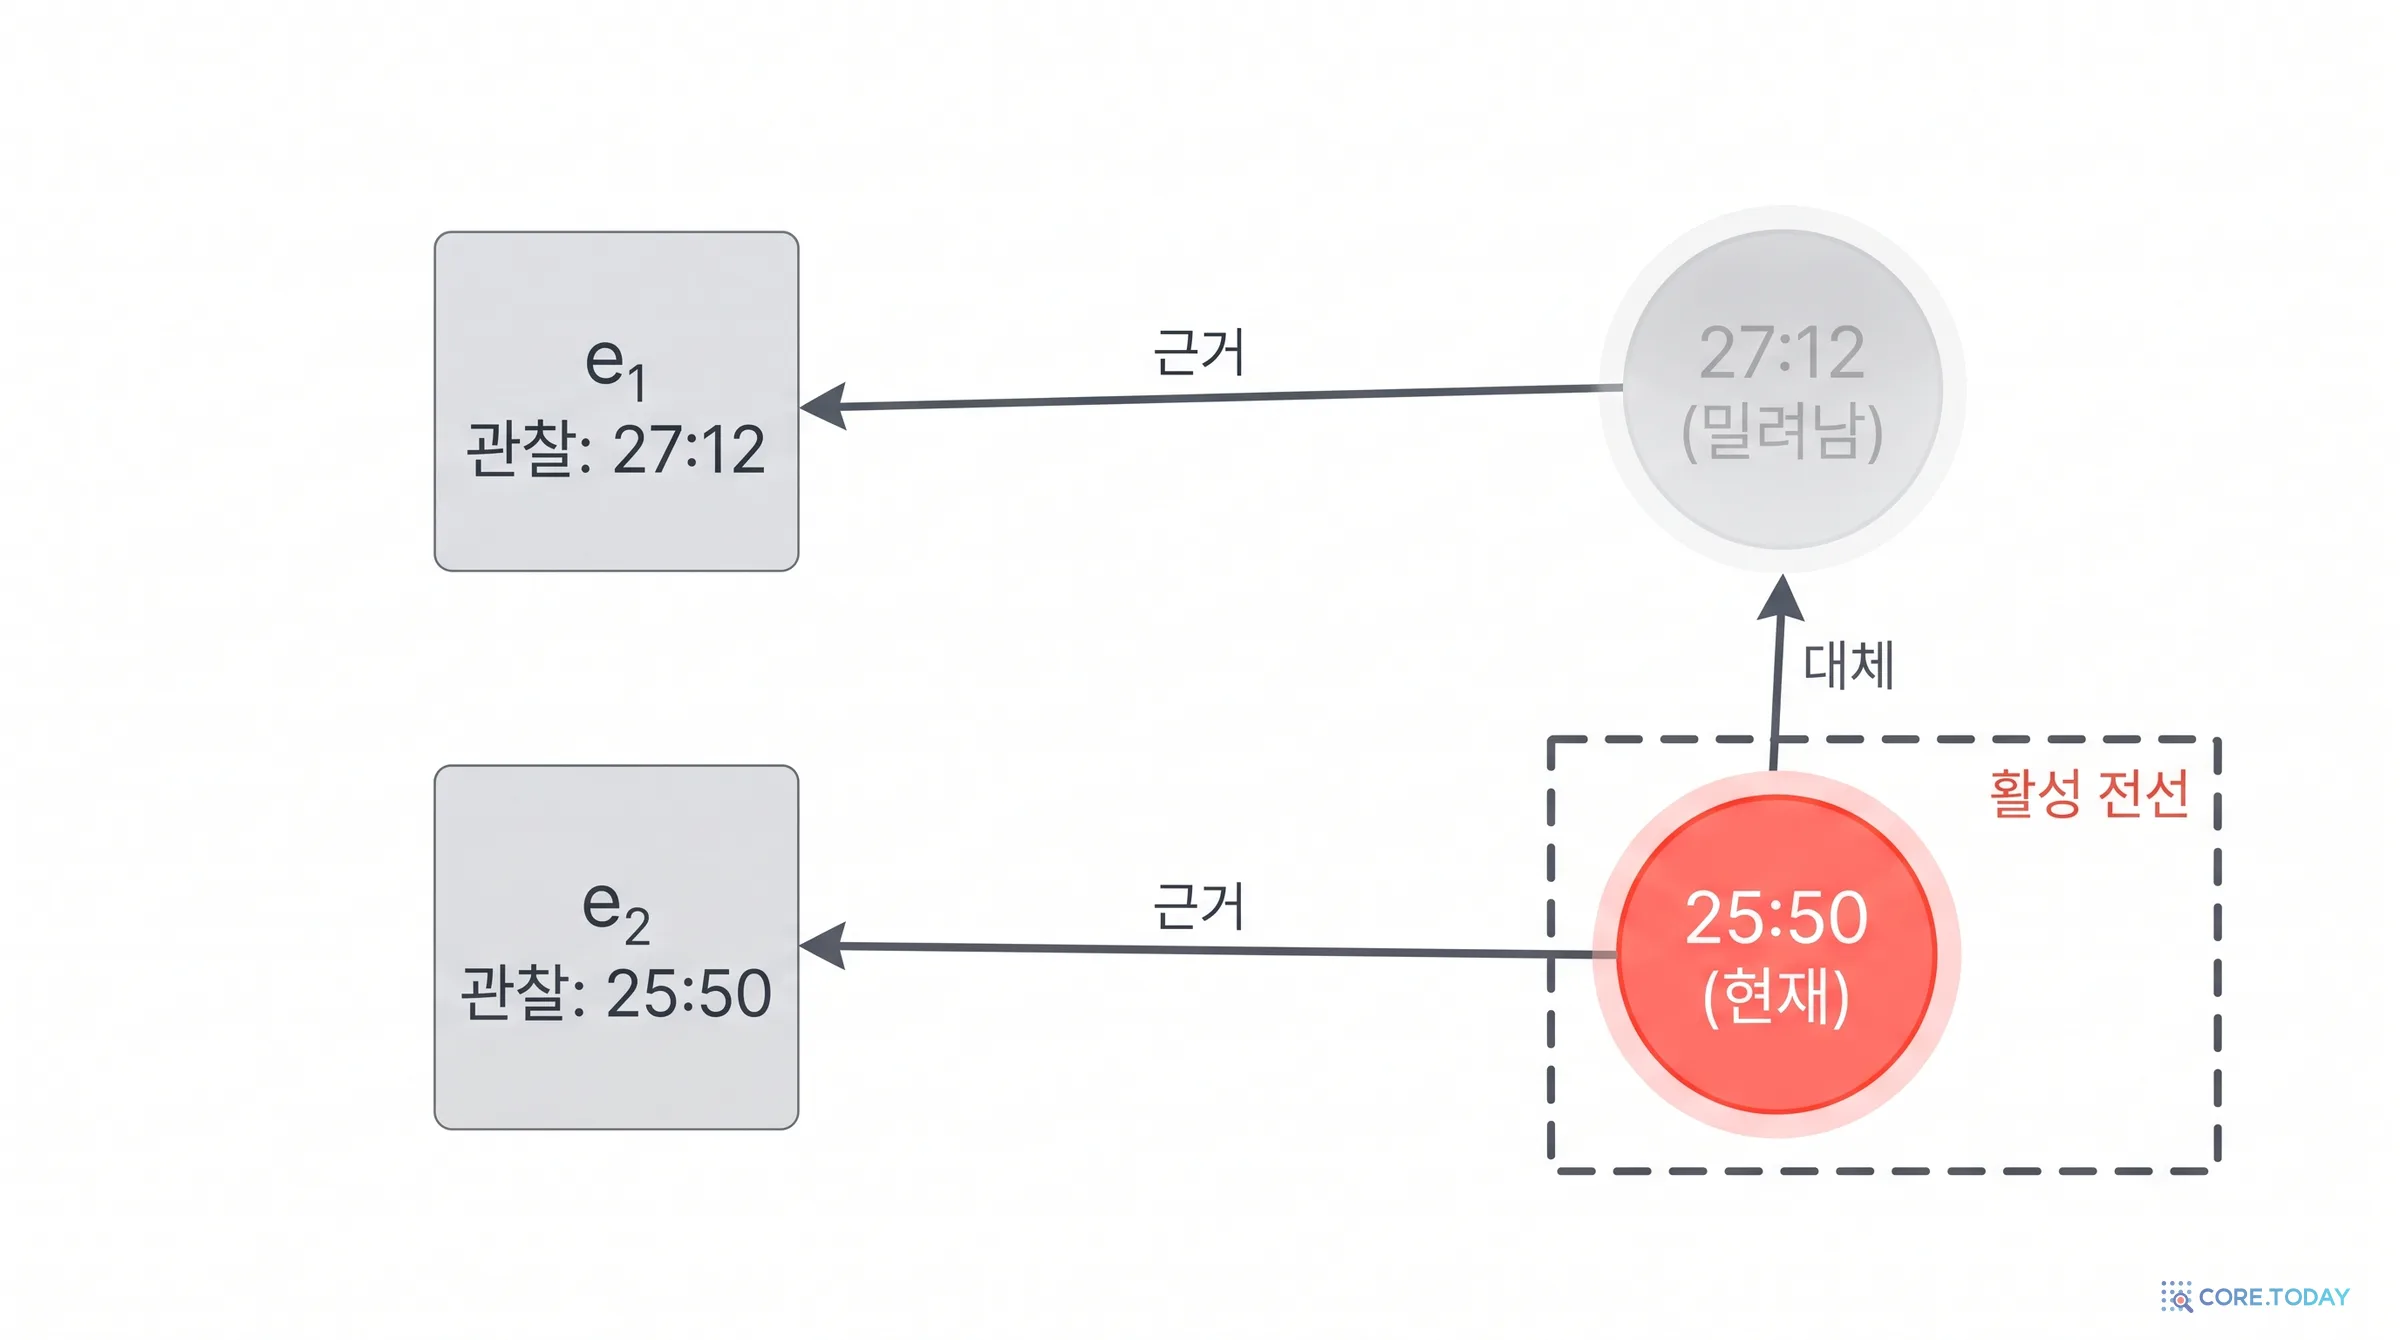
AI 비서에게 "5K 기록은 27:12"라고 말하고, 몇 달 뒤 "25:50으로 깼다!"고 자랑했다. 그런데 "내 최고 기록이 뭐였지?"라고 묻자 27:12라고 답한다. 싱가포르국립대의 2026년 9월 논문 「MoM: Memory of Memory」는 이 실패의 뿌리를 두 질문으로 정리한다. 현재 값을 언제 정하는가(들어올 때냐, 물을 때냐), 그리고 밀려난 값을 남기는가(남기느냐, 지우느냐)다. RAG 같은 아카이브는 물을 때 정하고 다 남긴다. 그래서 낡은 값이 다시 끼어든다. Mem0 같은 CRUD 기억은 들어올 때 정하지만 지운다. 그래서 잘못 고친 값을 되돌릴 수 없다. 논문은 비어 있던 칸, 즉 '들어올 때 확정하되 밀려난 값은 출처로 남긴다'를 고른다. 그 구현인 P-Mem은 수락·이의·기각·철회·해결·지지의 여섯 연산으로 버전을 옮기고, 간선을 따라 되돌린다. 결과는 정직하다. 정확도는 가장 강한 검색 기억과 비슷하지만(52.6% 대 50.8%), 읽는 토큰은 약 4분의 1이다. 낡은 답은 19.4%에서 10.9%로 줄었다. 수정이 여덟 번 쌓이면 물을 때 다시 꿰는 방식은 25%로 무너지지만 쓸 때 확정한 칸은 100%를 지킨다. 착오를 철회하면 100%를 되살리는데 CRUD는 0%다. 회계 장부의 역분개와 등기부의 '말소사항'부터 시간 데이터베이스, 이벤트 소싱, 2026년의 ChatGPT 'Dreaming'까지 이 생각의 계보를 따라가고, 논문의 그림과 표를 하나씩 읽는다. 논문의 실험 세 가지는 한국어로 다시 만들어 로컬 Qwen 4B로 직접 돌렸다. 수정이 여덟 번 쌓이자 질문 때 다시 꿰는 방식은 22.5%, 쓸 때 확정은 100%였고, 9B로 키워도 25%였다. 철회 복구는 보존 여부 하나로 100% 대 0%로 갈렸다. 다만 4B 주석기가 여섯 연산을 완벽히 고른 것은 예시를 넣은 지시문 덕분이었다. 예시를 빼자 '해결' 연산을 40건 중 1건만 골랐다. 인터랙티브 위젯 7개.
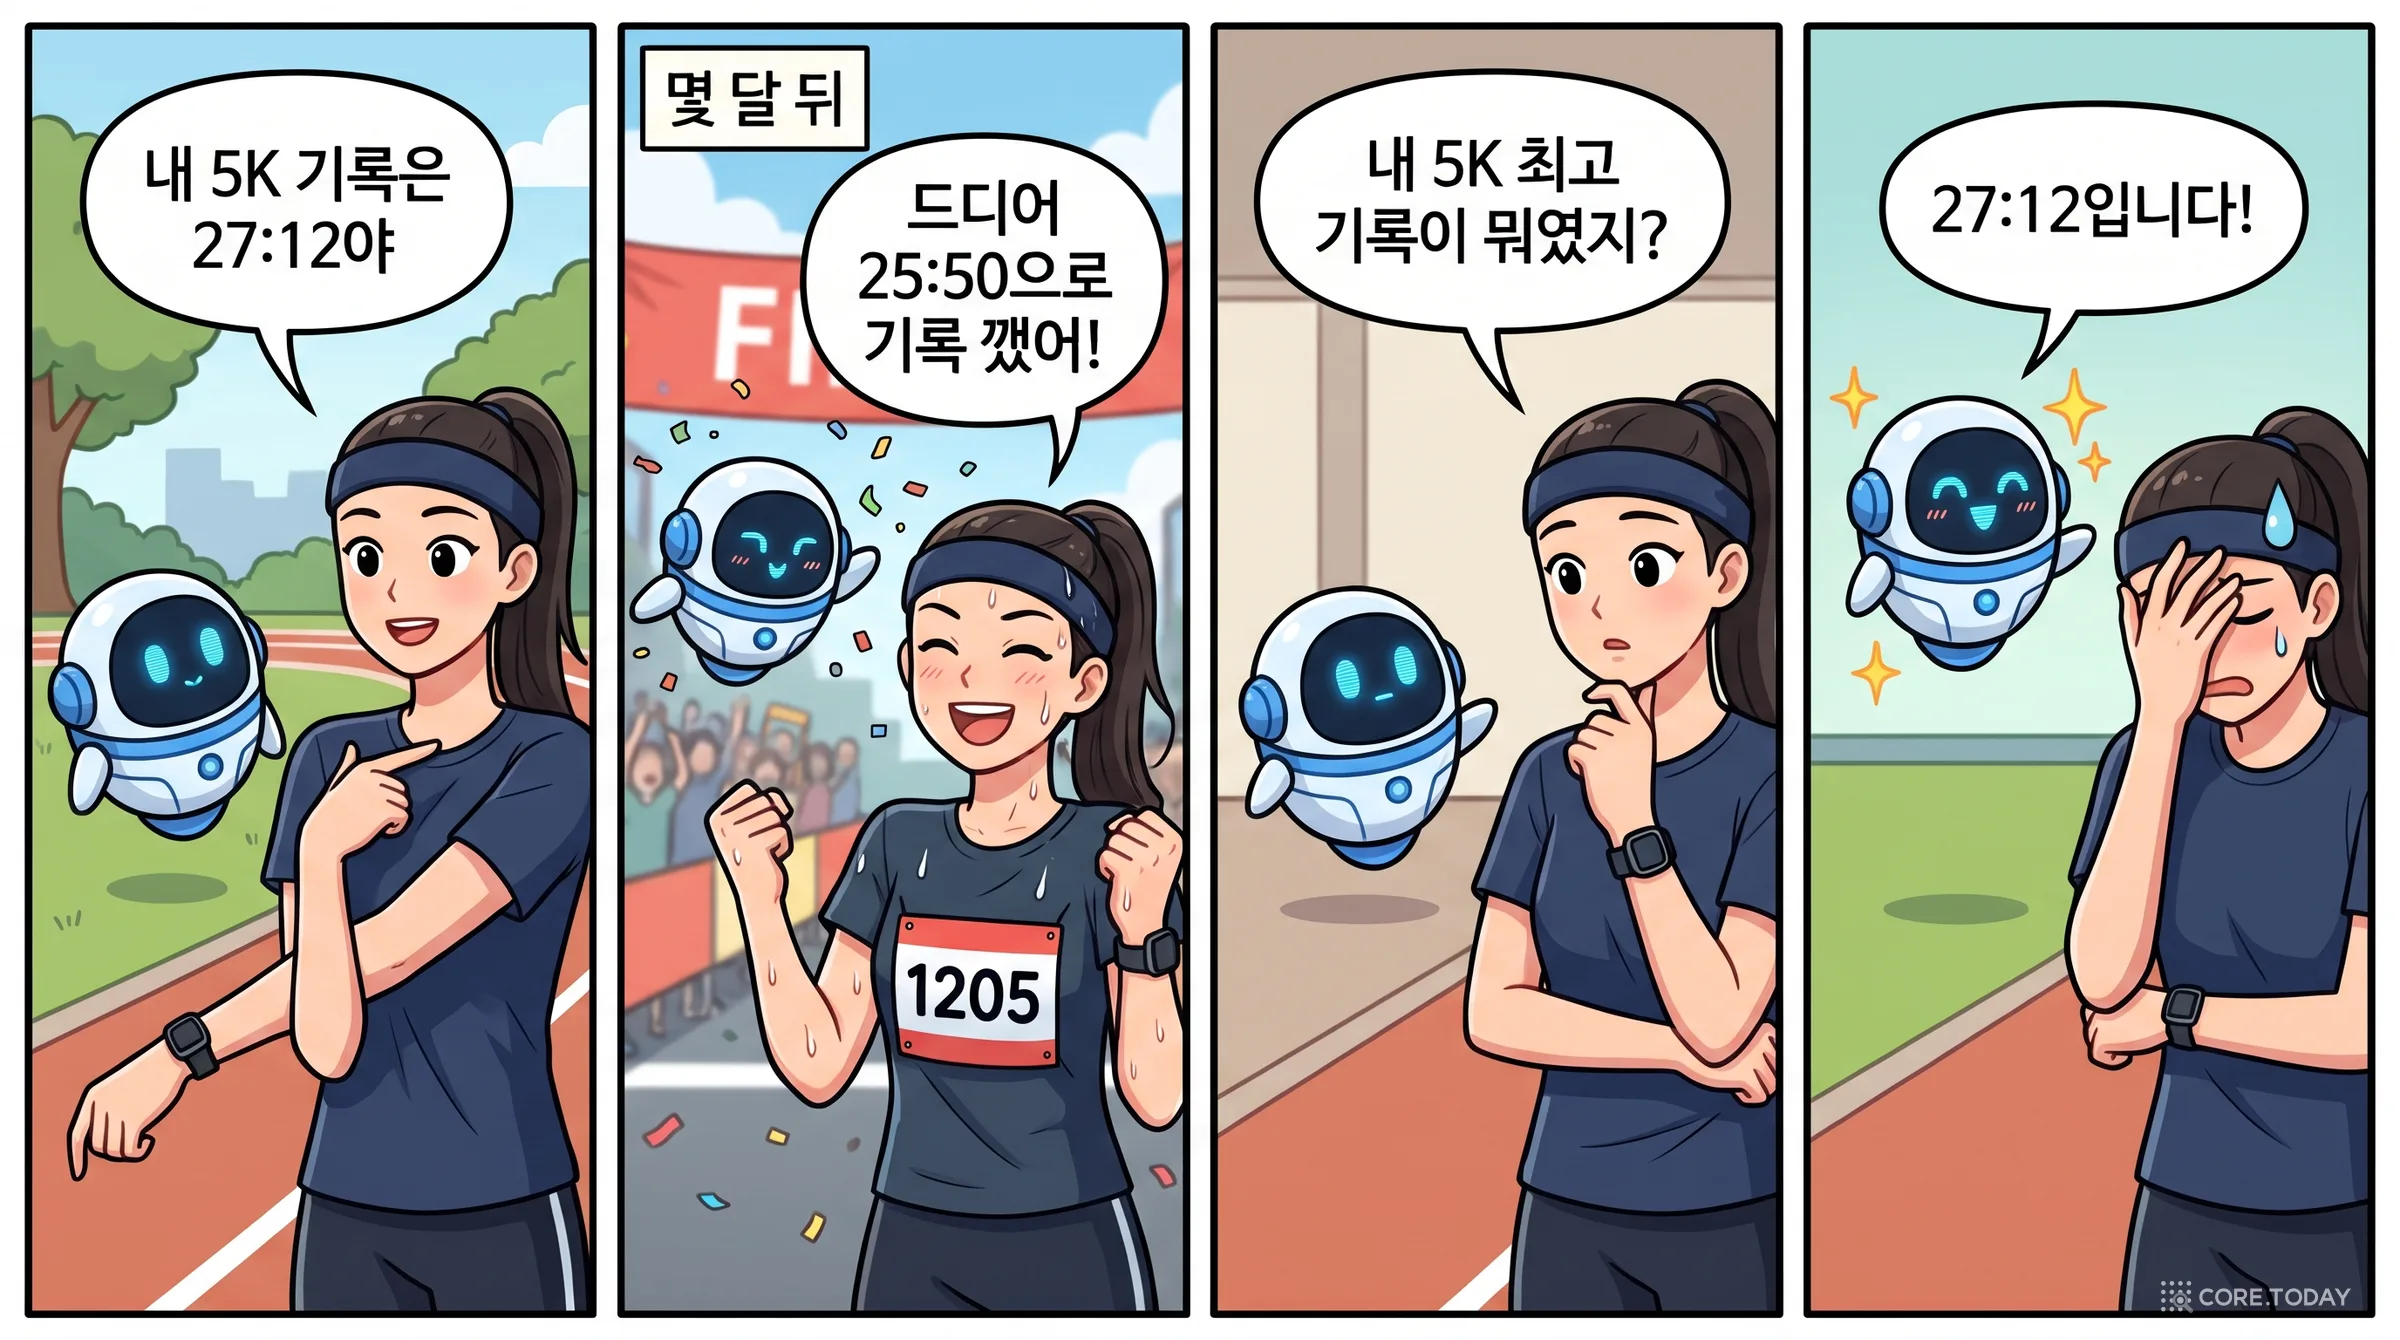
달리기를 시작한 지 반년 된 지수 씨는 AI 비서와 훈련 일지를 함께 씁니다. 3월에 이렇게 말했습니다. "이번 주말에 5K를 27:12에 뛰었어." 비서는 기억합니다. 7월, 마라톤 준비 이야기를 한참 하다가 지나가듯 덧붙입니다. "아 참, 드디어 PB 깼다, 25:50!" 비서는 이것도 기억합니다. 그리고 9월, 대회 참가 신청서를 쓰다가 묻습니다. "내 5K 최고 기록이 뭐였지?"
비서가 25:50을 잊은 것은 아닙니다. 둘 다 잘 저장되어 있습니다. 문제는 질문이 들어왔을 때 일어납니다. "5K 최고 기록"이라는 질문과 더 닮은 문장은 값을 또박또박 평서문으로 말한 3월의 문장입니다. 7월의 문장은 마라톤 이야기 사이에 끼어 지나가듯 말했을 뿐입니다. 검색은 3월 문장을 위로 올리고, 비서는 그 문장을 성실하게 읽습니다. 충실하게, 낡은 값을 보고합니다.
이 장면은 싱가포르국립대(NUS) 친보원(Bowen Qin)과 루야오(Yao Lu)가 2026년 9월 7일 arXiv에 올린 논문 「MoM: Memory of Memory」(arXiv 2609.25054)의 첫 그림입니다. 논문의 첫 문장이 이 글 전체의 주제입니다.
오래 일하는 LLM 에이전트에게 기억의 질문은 '무엇이 한때 기록되었나'가 아니라 '지금 무엇이 참인가'다.
저장의 문제가 아니라는 것이 핵심입니다. 논문은 이것을 증거의 지위(evidential status) 문제라고 부릅니다. 어느 값이 지금 값인지, 그 값이 무엇을 대체했는지, 왜 아직도 믿을 만한지를 기억이 스스로 알고 있어야 한다는 뜻입니다. 기억이 내용뿐 아니라 자기 항목의 출처·상태·역사까지 기억해야 한다는 것, 그래서 제목이 '기억의 기억'입니다.
?
문제
대부분의 에이전트 기억은 모든 대화를 저장해 두고, 질문이 올 때마다 기록을 검색해 '지금'을 다시 조립합니다. 그래서 낡은 값이 검색으로 되살아나고, 같은 갈등이 질문마다 다시 재판됩니다. 반대로 들어올 때 바로 고쳐 쓰는 기억은 옛 값을 지워 버려서, 잘못 고치면 되돌릴 수 없습니다.
→
제안
들어올 때 현재 값을 확정하되, 밀려난 값은 지우지 않고 '출처'로 남깁니다. 값과 관찰을 노드로, '대체·대안·근거·철회'를 간선으로 하는 출처 그래프(P-Mem)가 그 구현입니다. 에이전트는 그래프의 맨 앞줄, 즉 활성 전선(active frontier)만 읽습니다.
✓
결과
정확도는 가장 강한 검색 기억과 비슷하고(52.6% 대 50.8%), 읽는 토큰은 약 4분의 1입니다. 결정적 차이는 유효성입니다. 낡은 답이 19.4%→10.9%로 줄고, 수정이 여덟 번 쌓여도 100%를 지키며(물을 때 다시 꿰는 방식은 25%), 착오를 철회하면 100% 되살립니다(CRUD는 0%).
이 글의 순서는 이렇습니다. 먼저 공책 비유로 논문의 설계 공간을 잡습니다(1장). 이어 이 생각이 어디서 왔는지 따라갑니다. 회계 장부, 실험 노트, 등기부, 데이터베이스, 그리고 LLM 기억의 짧은 역사입니다(2장). 그다음 P-Mem의 구조를 그림과 표로 해부하고(3장), 실험 여섯 가지를 차례로 읽습니다(4장). 코어닷투데이가 논문의 세 실험을 한국어로 다시 만들어 로컬 모델로 돌린 결과를 보여 드리고(5장), 논문을 비판적으로 읽은 뒤(6장), 2026년에 이 기술이 어디에 서 있는지 정리합니다(7장).
1. 바뀐 사실 앞에서, 공책은 두 가지를 정해야 한다
논문이 제안하는 사고 실험은 아주 단순합니다. 기억을 공책이라고 생각하고, 사실이 바뀌었을 때 공책이 무엇을 하는지 물어보세요. 결정적인 선택은 두 가지뿐입니다.
현재 값을 언제 정하나. 새 소식이 도착할 때 정하는가(on arrival), 아니면 누가 물어볼 때까지 미루는가(query time)?
아카이브 — 긴 문맥, RAG·노트형, 가치 인식 검색(MemRL), 계층화(MemGPT·MemoryOS)
질문 때
남김, 강등 안 함
낡은 값이 다시 들어옴. 갈등을 질문마다 다시 재판하고, 판결이 일관되지 않을 때도 있음
CRUD 기억 — Mem0형 기억 은행
도착 때
지움(덮어쓰기·삭제)
잘못 고치면 되돌릴 수 없음. "예전엔 뭐였지?"에 답 못 함
이중 시간 KG — Zep·Graphiti
도착 때
남김(유효 구간)
타임스탬프로 중재. 열린 갈등도, 되돌리기도 없음
MoM (이 논문)
도착 때
출처로 남김
남은 약점: 다시 들여다보기 전까지는 틀린 채로 있음
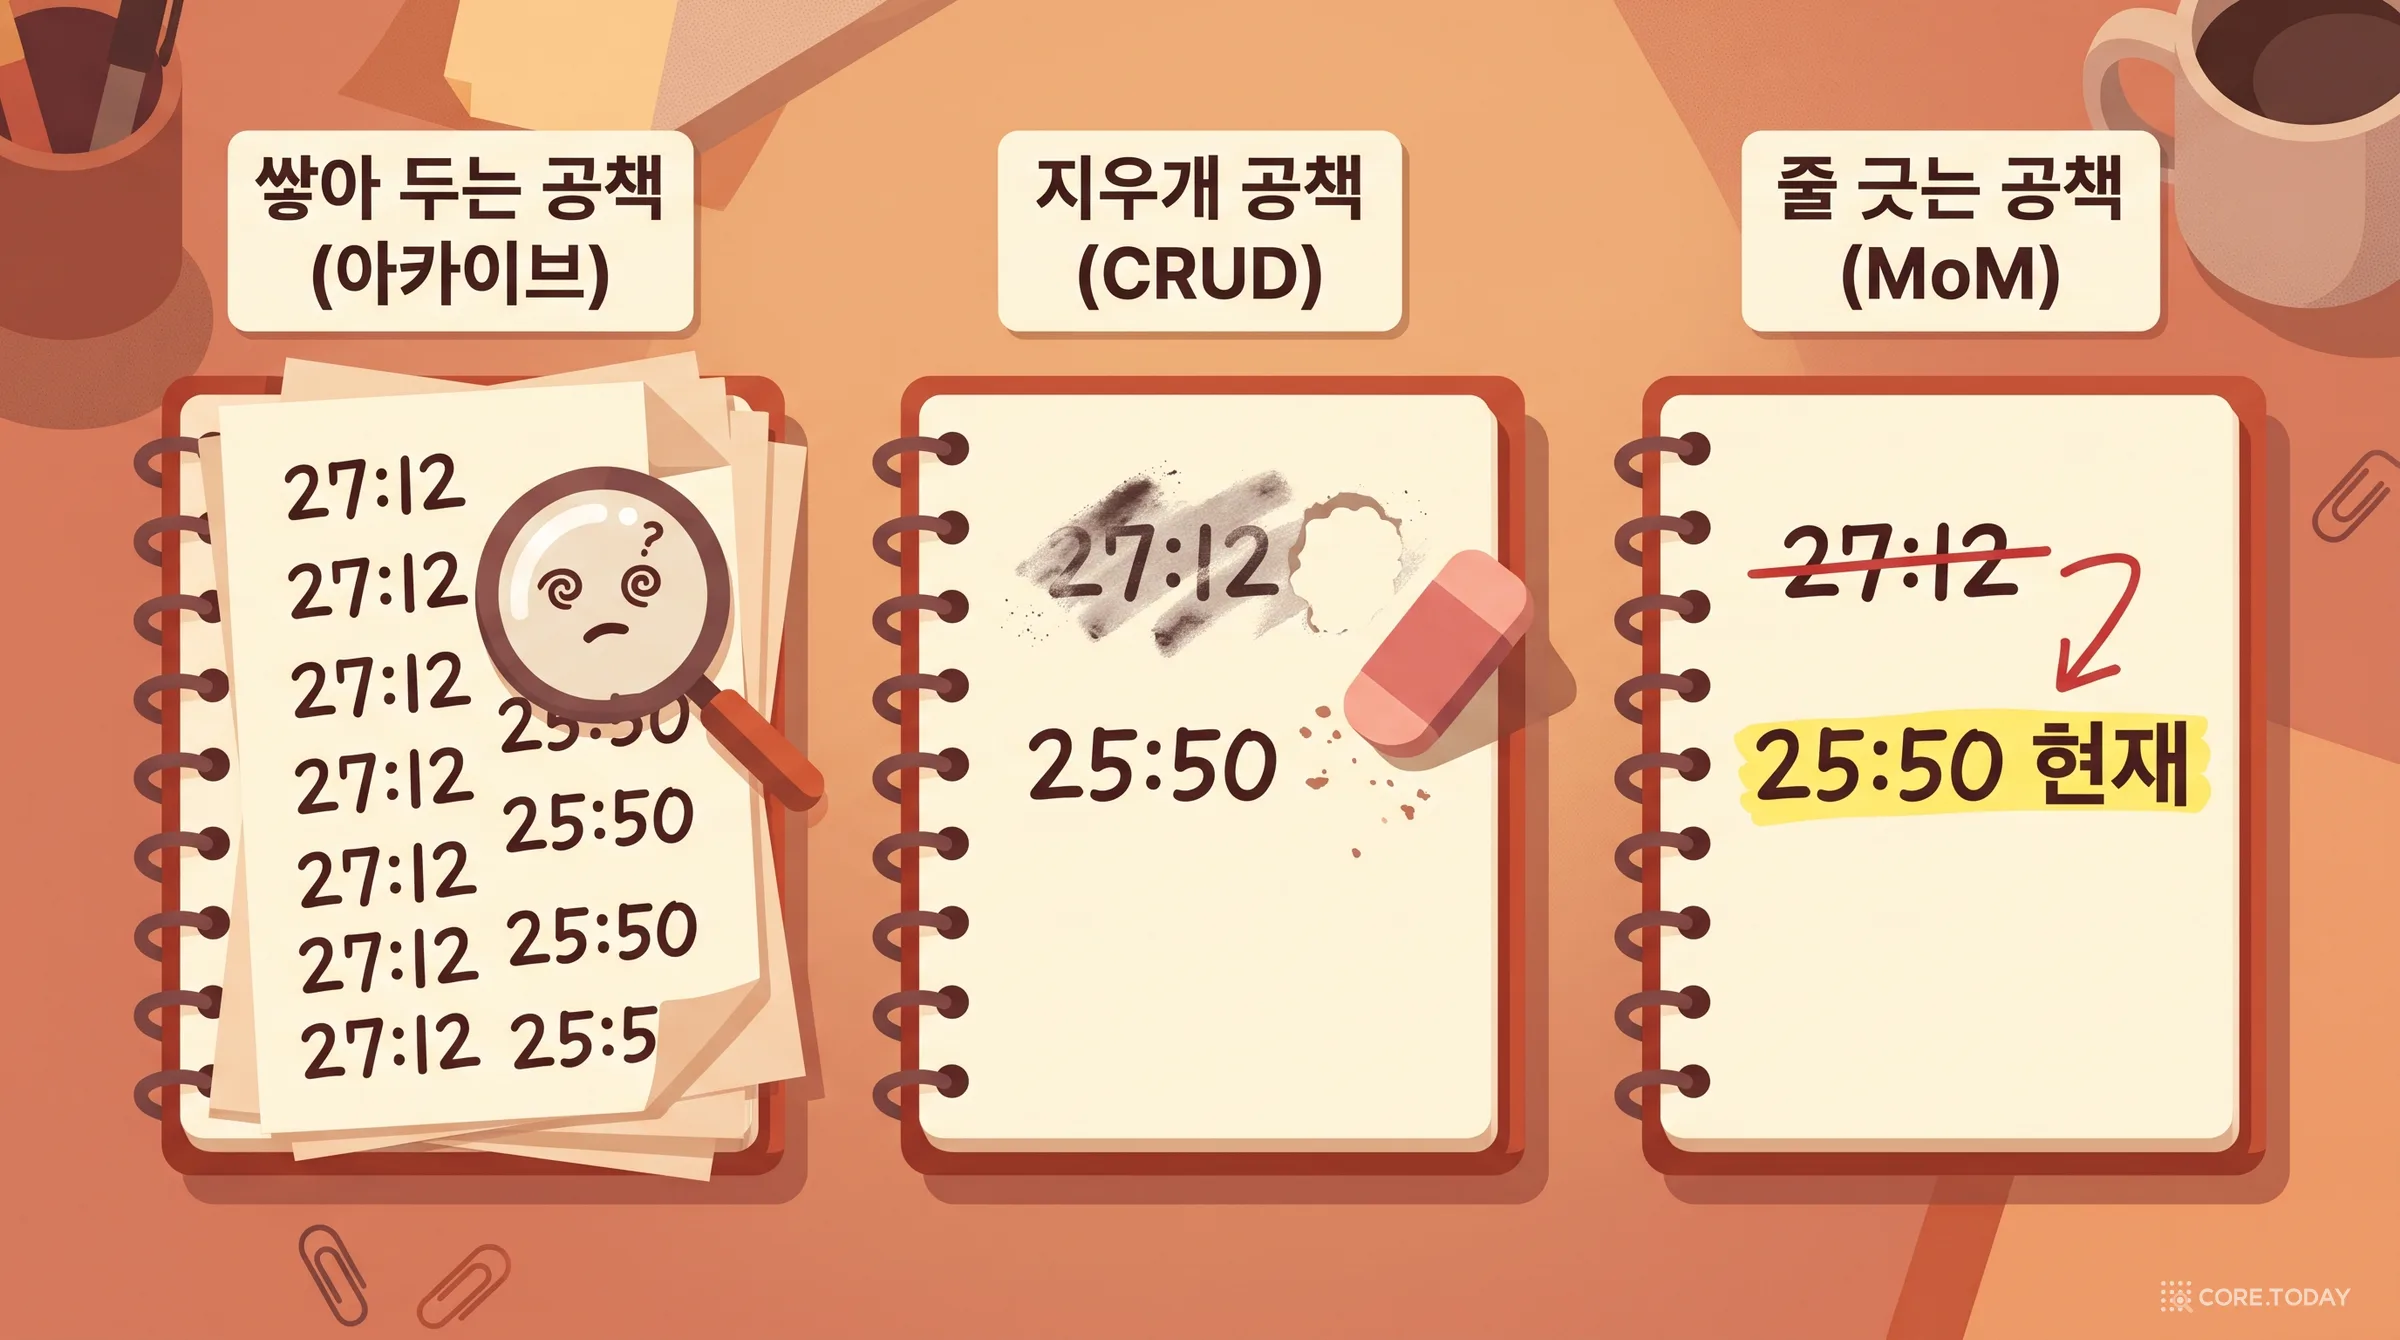
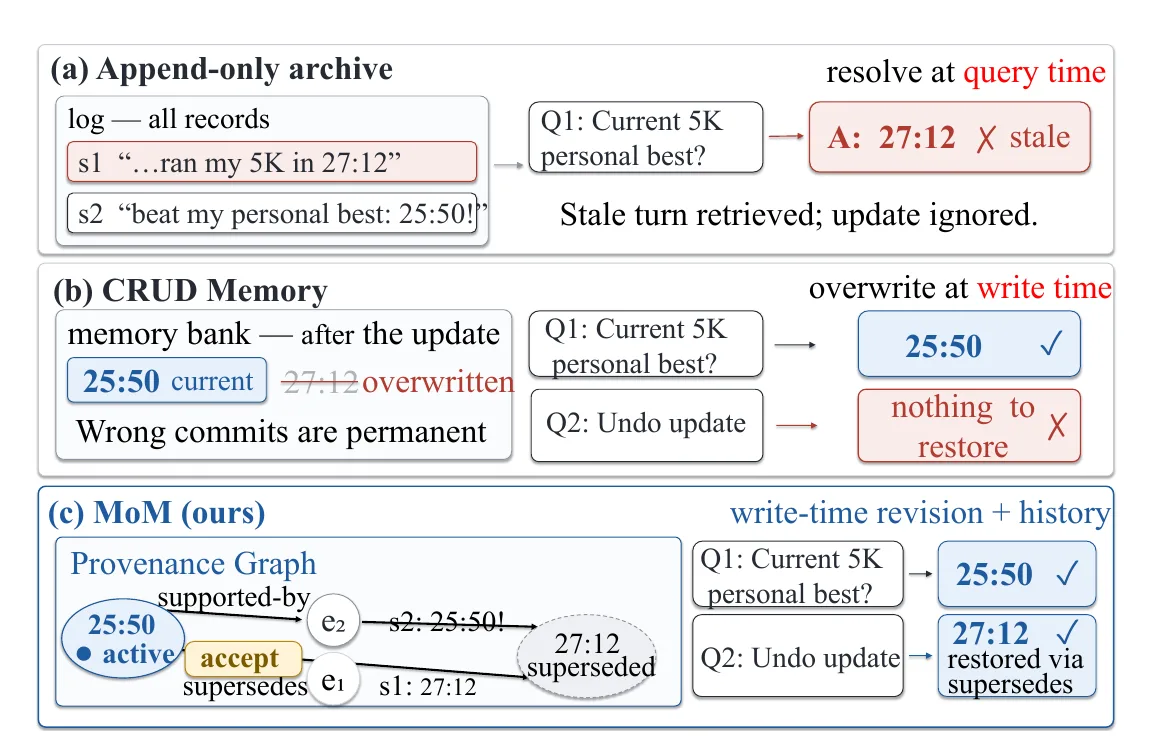
아카이브는 "질문 때 정하고, 다 남긴다"입니다. 모든 기록이 똑같이 '활성' 상태로 남아 있으니 무엇이 낡았는지 표시가 없고, 27:12는 계속 떠오릅니다. 질문이 올 때마다 같은 갈등을 다시 판결하는데, 그 판결이 매번 같다는 보장도 없습니다.
CRUD 기억은 "도착 때 정하고, 지운다"입니다. Mem0가 대표적입니다. 새 사실이 오면 LLM이 추가(ADD)·갱신(UPDATE)·삭제(DELETE)를 골라 기억 은행을 고칩니다. 읽기는 싸고 정확합니다. 그런데 잘못 고쳤다면? 옛 값은 이미 없습니다.
이중 시간 지식 그래프(Zep의 Graphiti)는 표 1에서 MoM과 같은 모서리에 있습니다. 도착 때 정하고, 밀려난 사실은 '유효 구간이 닫힌 간선'으로 남깁니다. 논문은 이 가까운 친척과 자신을 이렇게 구분합니다. 이중 시간 KG는 타임스탬프로 중재합니다. 그래서 "아직 결론 나지 않은 갈등"을 상태로 들고 있지 못하고, 한 번 내린 커밋을 다시 여는 연산도 없습니다(4장에서 이 차이가 숫자로 드러납니다).
MoM이 원하는 것은 비어 있던 조합입니다. 도착 때 현재 값을 확정해 키 하나에 값 하나인 간결한 현재 상태를 유지합니다. 그래서 에이전트는 질문마다 답을 조립하는 대신 답을 읽습니다. 동시에 밀려난 값은 전부 출처와 함께 보관합니다. 어디서 왔는지, 무엇을 대체했는지를 함께 남깁니다.
아래 위젯에서 같은 세 문장을 네 공책에 흘려 보내 보세요. 세 번째 사건(철회)에서 네 공책의 운명이 갈립니다.
출처: Qin & Lu (2026), 그림 1. (a) 아카이브는 낡은 값을 반환하고, (b) CRUD는 잘못된 갱신을 되돌리지 못하며, (c) MoM은 현재 값을 읽고 철회 시 앞 값을 복원한다.
남기는 것만으로는 부족하다 — 간선이 필요한 이유
여기서 질문이 하나 생깁니다. 아카이브도 옛 값을 남기고, 이중 시간 KG도 남깁니다. 그러면 MoM의 차별점은 '남긴다'가 아니라 무엇일까요? 논문은 예산 사례로 답합니다.
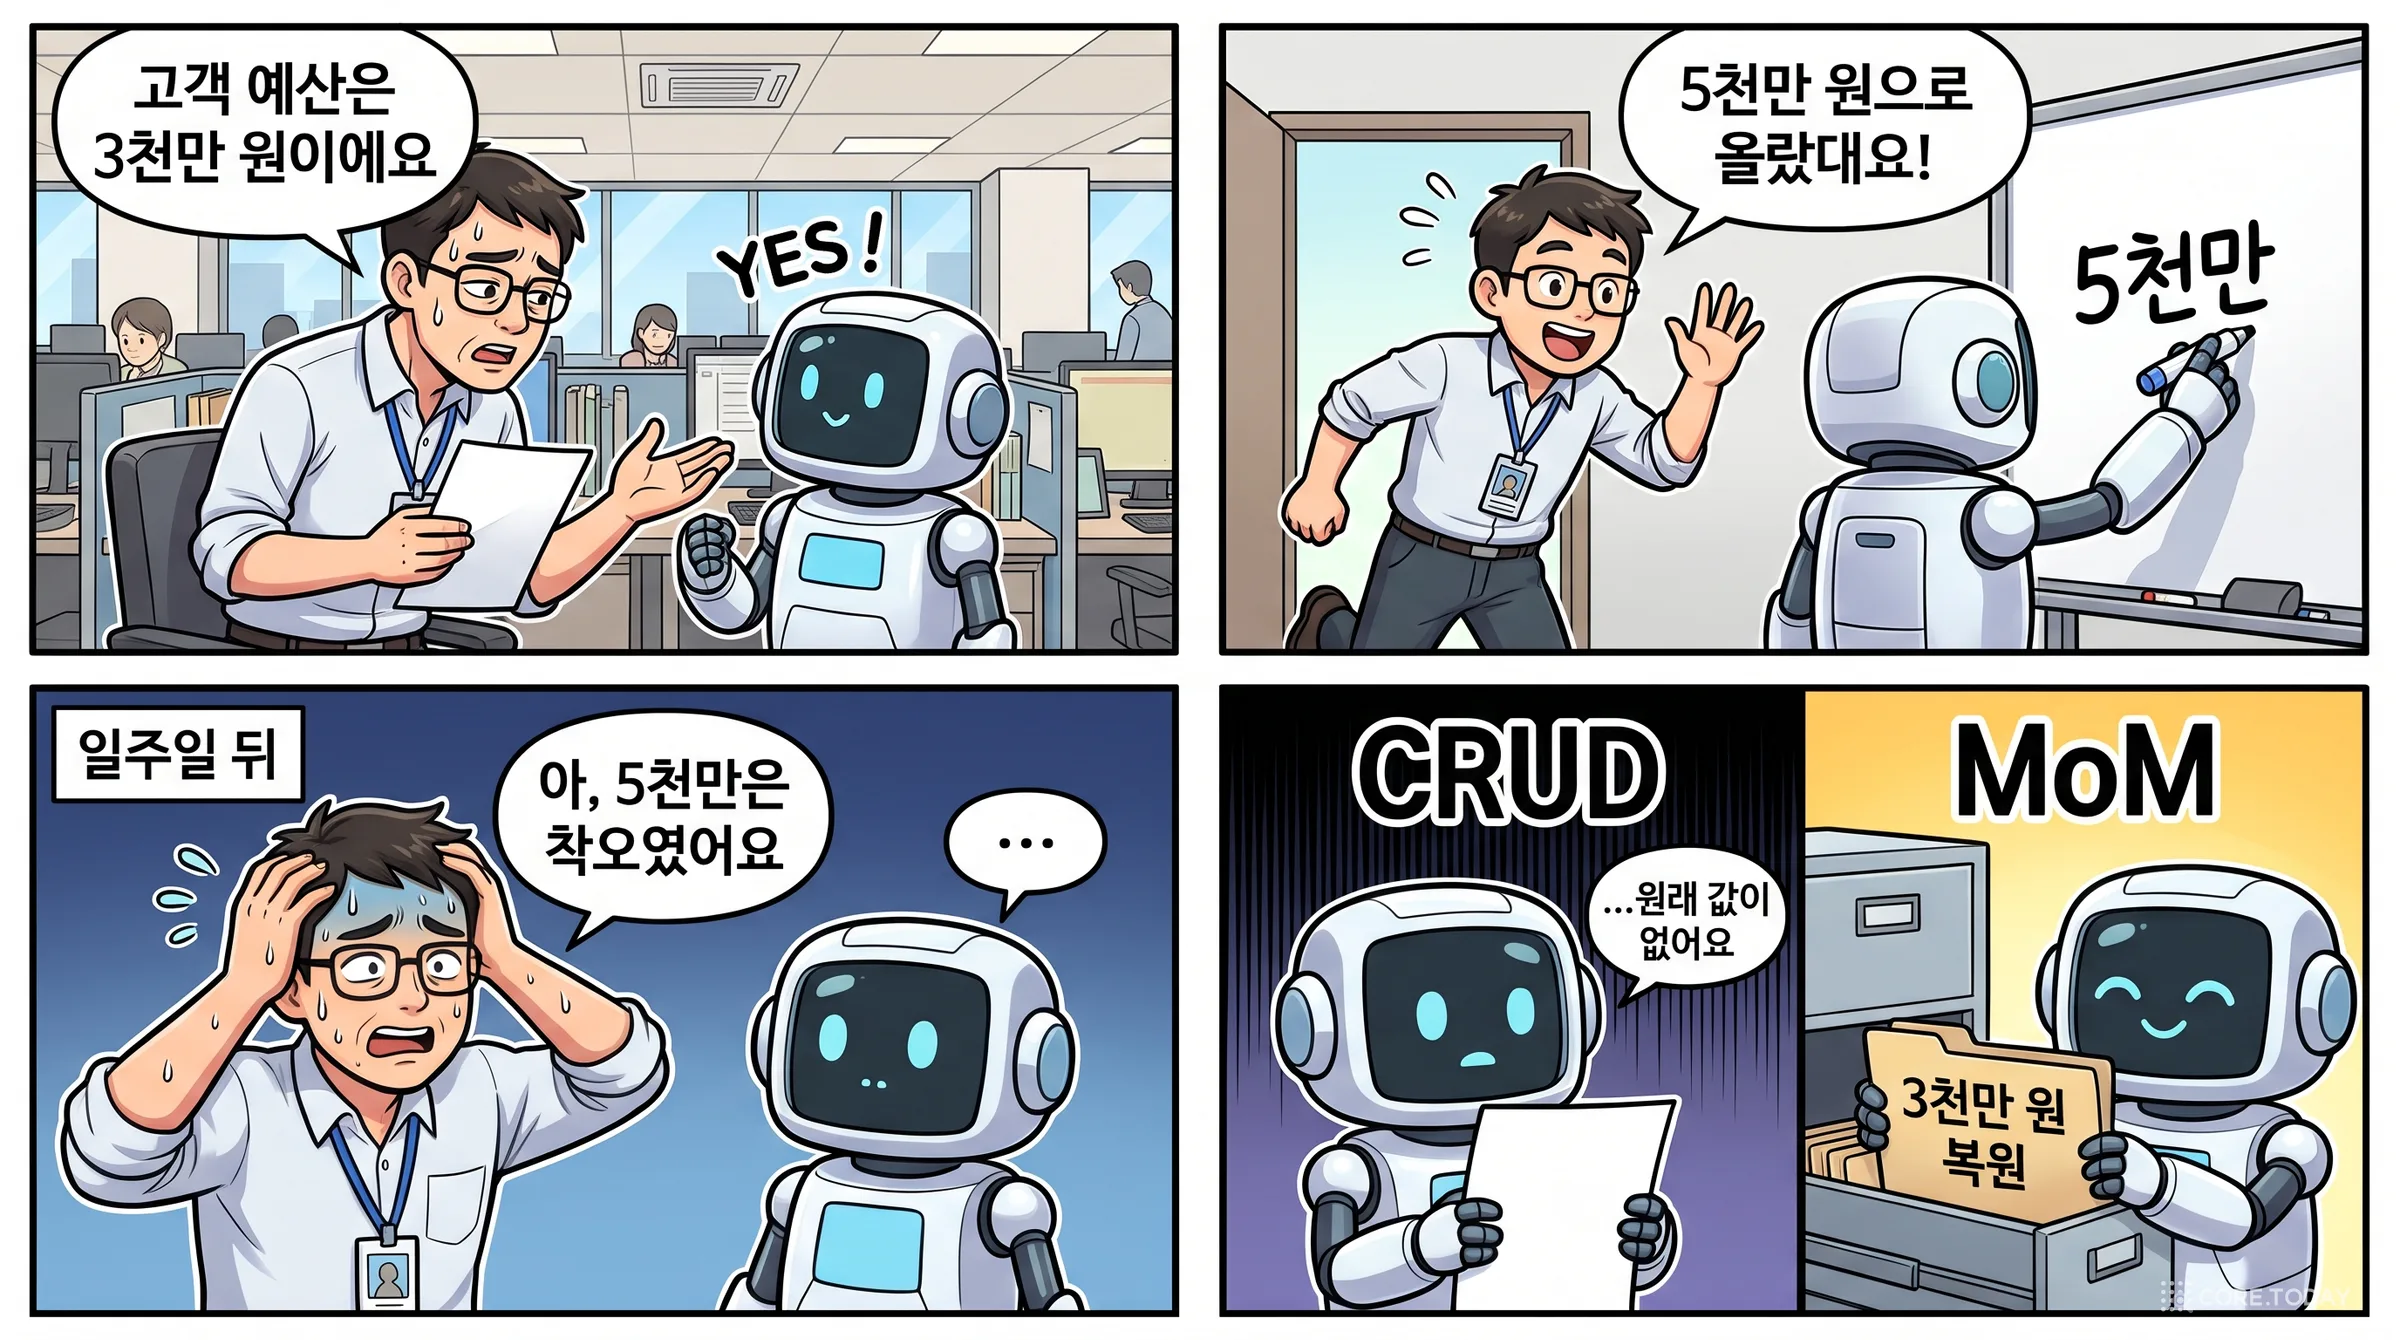
기억에 고객 예산이 3천만 원으로 들어 있습니다. "5천만 원으로 올랐대요"라는 말을 듣고 5천만 원을 현재 값으로 올립니다. 일주일 뒤 사용자가 "아, 5천만은 착오였어요"라고 철회합니다. 3천만 원을 되살리려면 "5천만 원이 3천만 원을 대체했다"는 기록된 간선이 필요합니다. CRUD는 3천만 원을 이미 버렸습니다. 평평한 아카이브는 3천만 원을 어딘가에 갖고 있지만, 그것이 5천만 원이 대체한 바로 그 값이라는 것을 알아볼 방법이 없습니다. 결국 문장 더미에서 다시 추리해야 합니다.
그러니 MoM의 핵심은 값 그 자체보다 값 사이의 관계입니다. 이 값이 저 값을 대체했다, 이 값과 저 값은 서로 경쟁하는 대안이다, 이 값은 저 관찰에서 근거를 얻었다. 논문의 표현으로는 "남겨 둔 값들만이 아니라 이 관계들이 있어야 잘못된 커밋을 되돌리고, 갈등을 열린 채로 두고, 값을 정당화할 수 있습니다."
2. 이 생각은 어디서 왔나 — 지우지 않고 바로잡는 500년
'바뀐 사실을 지우지 말고 밀어낸다'는 생각은 AI 연구자가 처음 한 것이 아닙니다. 논문도 스스로 "출처(provenance)와 시간 데이터베이스가 바로 이 일을 하려고 만들어졌다"며 그 중심 개념을 빌려 왔다고 밝힙니다. 사람들은 기록이 틀렸을 때 어떻게 해 왔을까요?
장부: 틀린 줄을 지우지 않고, 바로잡는 줄을 더한다
1494년 루카 파치올리가 『산술, 기하, 비율 및 비례 총람(Summa)』에 복식부기를 정리한 이래, 회계에는 오래된 불문율이 있습니다. 장부에서 틀린 기재를 지우지 않는다. 잘못 적은 분개가 있으면 그것을 정확히 상쇄하는 반대 분개(역분개)를 새로 적고, 그다음 올바른 분개를 다시 적습니다. 장부의 잔액은 언제나 '지금 참인 값'을 보여 주지만, 장부를 넘겨 보면 무엇이 언제 왜 고쳐졌는지가 고스란히 남아 있습니다. 회계 감사가 가능한 이유가 바로 이것입니다.
실험 노트도 같습니다. 미국 식품의약국(FDA)의 비임상시험관리기준(GLP, 21 CFR 58.130)은 원자료를 고칠 때 "원래 기재를 가리지 않게, 바꾼 이유를 적고, 날짜와 서명을 남겨야 한다"고 정합니다. 그래서 연구실에서는 틀린 숫자를 수정액으로 지우지 않고, 한 줄을 긋고 옆에 고친 값과 이유, 날짜, 이니셜을 씁니다. MoM의 언어로 바꾸면 이렇습니다. 틀린 값은 'superseded'나 'contradicted'로 강등되고, 고친 값이 'active'가 되며, 둘 사이에 '대체' 간선과 '근거'가 붙습니다.
등기부: '현재 유효사항'과 '말소사항 포함'
한국 독자에게 가장 친숙한 예는 아마 부동산 등기부일 것입니다. 집을 사거나 전세 계약을 할 때 떼어 보는 등기사항전부증명서에는 발급 옵션이 둘 있습니다. '현재 유효사항' 증명서는 지금 효력이 있는 등기만 보여 줍니다. '말소사항 포함' 증명서는 이미 말소된 등기까지 전부 보여 줍니다. 말소된 근저당은 빨간 줄이 그어진 채로 그대로 읽힙니다. 과거 소유자가 누구였는지, 어떤 근저당이 언제 설정됐다가 풀렸는지 같은 이력을 볼 때는 말소사항 포함본을 뗍니다.
이 두 증명서가 MoM의 두 가지 읽기와 정확히 겹칩니다. '현재 유효사항'은 에이전트가 기본으로 읽는 활성 전선입니다. '말소사항 포함'은 필요할 때 펼치는 출처와 이력입니다. 등기소는 말소된 등기를 지우지 않습니다. 강등할 뿐입니다. 그리고 말소된 등기에는 언제, 어떤 원인으로 말소됐는지가 함께 적힙니다. 수십 년 된 행정 제도가 이미 '기억의 기억'을 하고 있는 셈입니다.
데이터베이스: UPDATE의 원죄, 그리고 세 갈래의 해법
컴퓨터가 기록을 맡으면서 이 오래된 지혜가 잠시 잊혔습니다. 관계형 데이터베이스의 UPDATE는 옛 값을 그 자리에서 덮어씁니다. 디스크가 비싸던 시절에는 합리적인 선택이었습니다. 하지만 1980년대부터 데이터베이스 연구자들은 "언제 무엇이 참이었나"를 잃어버리는 비용을 깨닫기 시작했고, 해법은 세 갈래로 자랐습니다.
① 시간 데이터베이스. 리처드 스노드그래스와 크리스티안 옌센 등은 사실마다 '세상에서 참이었던 기간(유효 시간)'과 '데이터베이스가 그것을 알고 있던 기간(거래 시간)'을 따로 붙이는 이중 시간(bitemporal) 모델을 체계화했습니다. 논문이 인용하는 옌센·스노드그래스의 1999년 개관 「Temporal Data Management」가 그 정리이고, 이 생각은 2011년 SQL 표준(SQL:2011)의 시간 테이블로 들어갔습니다. 코어닷투데이는 이중 시간 SQL을 PostgreSQL·MariaDB·XTDB에서 직접 실습한 글에서 이 기능을 다뤘습니다.
② 데이터 출처(provenance). 피터 부너먼, 산지브 칸나, 왕치유 탄은 2001년 논문 「Why and Where」에서 질의 결과의 출처를 두 종류로 나눴습니다. 이 값이 왜 결과에 들어왔나(어떤 입력 튜플들이 근거인가), 그리고 어디서 복사되어 왔나입니다. 이 흐름은 2013년 W3C의 출처 표준 PROV-DM으로 이어집니다. PROV는 개체(entity)·활동(activity)·행위자(agent)와 그 사이의 관계(wasDerivedFrom, wasRevisionOf, wasInvalidatedBy 등)로 '이 데이터가 어떻게 만들어졌나'를 기록하는 공통 언어입니다. 코어닷투데이는 PROV-O 해설에서 이 어휘를 자세히 다뤘습니다. P-Mem의 '근거(supported-by)'와 '대체(supersedes)' 간선은 PROV의 파생·개정 관계와 같은 족보입니다.
③ 이벤트 소싱. 2005년 무렵 마틴 파울러가 정리한 이벤트 소싱은 "상태를 저장하지 말고, 상태를 바꾼 사건들을 순서대로 저장하라"는 설계 패턴입니다. 현재 상태는 사건 로그를 재생해서 얻는 파생물입니다. 파울러는 같은 시기에 잘못된 사건을 바로잡는 '소급 사건(Retroactive Event)' 패턴도 정리했는데, 처방이 놀랍도록 P-Mem과 닮았습니다. 원래 사건을 되돌리고, 그것을 거부됨(rejected)으로 표시한 뒤, 바로잡는 사건을 처리하라. P-Mem의 REJECT 연산이 바로 이것입니다. 깃(Git) 역시 같은 철학입니다. 커밋은 지워지지 않고, git revert는 되돌리는 커밋을 하나 더 쌓습니다.
1494파치올리 『총람』, 복식부기 정리. 틀린 기재는 지우지 않고 반대 분개로 바로잡는 관행
1978미국 FDA GLP 규정. 원자료 수정은 원래 기재를 가리지 않게, 이유·날짜·서명과 함께
1980~90년대시간 데이터베이스 연구. 유효 시간과 거래 시간을 나눈 이중 시간 모델(옌센·스노드그래스 1999 개관)
2001부너먼 외 「Why and Where」, 데이터 출처의 두 갈래 정의
2005파울러의 이벤트 소싱·소급 사건 패턴. 같은 해 깃(Git) 등장
2011 · 2013SQL:2011 시간 테이블 표준화 · W3C PROV-DM 출처 표준
2023LLM 에이전트 기억의 시작. Generative Agents의 기억 흐름, MemGPT의 계층형 기억
2024ChatGPT 기억 기능(2월). LoCoMo·LongMemEval 벤치마크가 '지식 갱신'을 별도 범주로 평가
2025Mem0(쓸 때 추가·갱신·삭제), Zep·Graphiti(이중 시간 KG), ChatGPT '대화 기록 참조'(4월), Claude 기억(9~10월)
2026ChatGPT 'Dreaming'(6월), MemoryArena·Supersede 등 갱신 실패 연구 급증, 그리고 MoM(9월)
LLM 기억의 짧은 역사: 검색에서 시작해, 갱신에서 막히다
LLM 에이전트의 기억은 2023년에 본격적으로 시작됐습니다. 스탠퍼드의 'Generative Agents'는 가상 마을 주민 25명에게 '기억 흐름(memory stream)'을 주었습니다. 모든 관찰을 시간순으로 쌓고, 최근성·중요도·관련성 점수로 꺼내 쓰는 방식입니다. 같은 해 버클리의 MemGPT는 운영체제의 가상 메모리처럼 문맥 창(주기억)과 외부 저장소(보조기억)를 오가는 계층형 기억을 제안했습니다. 둘 다 무엇을 문맥에 넣을지 정하는 배치(placement) 의 문제를 풀었습니다. 어느 값이 지금 참인지는 다루지 않았습니다. 표 1이 이들을 '아카이브'에 넣는 이유입니다.
벤치마크가 이 공백을 드러냈습니다. 2024년의 LoCoMo, 그리고 2025년 ICLR에 실린 LongMemEval은 긴 대화 기억을 평가하면서 지식 갱신(knowledge update) 을 별도 범주로 두었습니다. 대화 중에 사용자가 바꾼 정보를 나중에 묻는 문항입니다. 장기 기억 평가의 무게중심이 '잘 떠올리나'에서 '바뀐 것을 반영하나'로 옮겨 간 것입니다. 코어닷투데이는 LoCoMo·LongMemEval 해설과 MemoryArena 특집에서 이 흐름을 다뤘습니다.
2025년에는 쓰기 쪽 해법이 나왔습니다. Mem0는 대화에서 사실을 뽑아 쓸 때 바로 ADD·UPDATE·DELETE를 결정합니다. 논문은 이것을 "옳은 방향, 그러나 덮어쓴다"고 평가합니다. Zep의 Graphiti는 사실을 시간 지식 그래프의 간선으로 저장하고, 새 사실과 충돌하는 옛 간선을 지우지 않고 '무효화(invalidate)'합니다. Graphiti 시간 그래프 특집에서 자세히 다뤘습니다. 이 둘이 표 1의 CRUD 모서리와 이중 시간 KG 모서리입니다.
그리고 2026년, 갱신 실패 자체를 정면으로 겨눈 연구가 쏟아졌습니다. 코어닷투데이만 해도 이사한 뒤에도 옛 주소로 기차표를 끊는 Supersede, 옛 사실이 남아 있는 MemStrata, 기억 모순을 동시성 제어로 본 TOKI, 낡고·남의 것이고·늦은 기억을 다룬 개인 기억 특집을 연달아 해설했습니다. MoM은 이 흐름에서 한 발 물러나 설계 공간 전체를 두 축으로 정리하고, 비어 있던 칸을 채웁니다.
왜 데이터베이스 해법을 그대로 가져올 수 없나
그렇다면 질문이 남습니다. "옛 값을 남기되 대체됐다고 표시한다"는 데이터베이스의 정답이 이미 있는데, 왜 에이전트 기억은 그것을 그냥 쓰지 않을까요? 논문은 고전적 출처·시간 데이터베이스가 전제하는 세 가지 가정이 에이전트 환경에서 모두 깨진다고 답합니다.
고전 데이터베이스의 가정
에이전트에서 깨지는 방식
P-Mem의 대응 장치
키는 고정된 스키마가 정한다
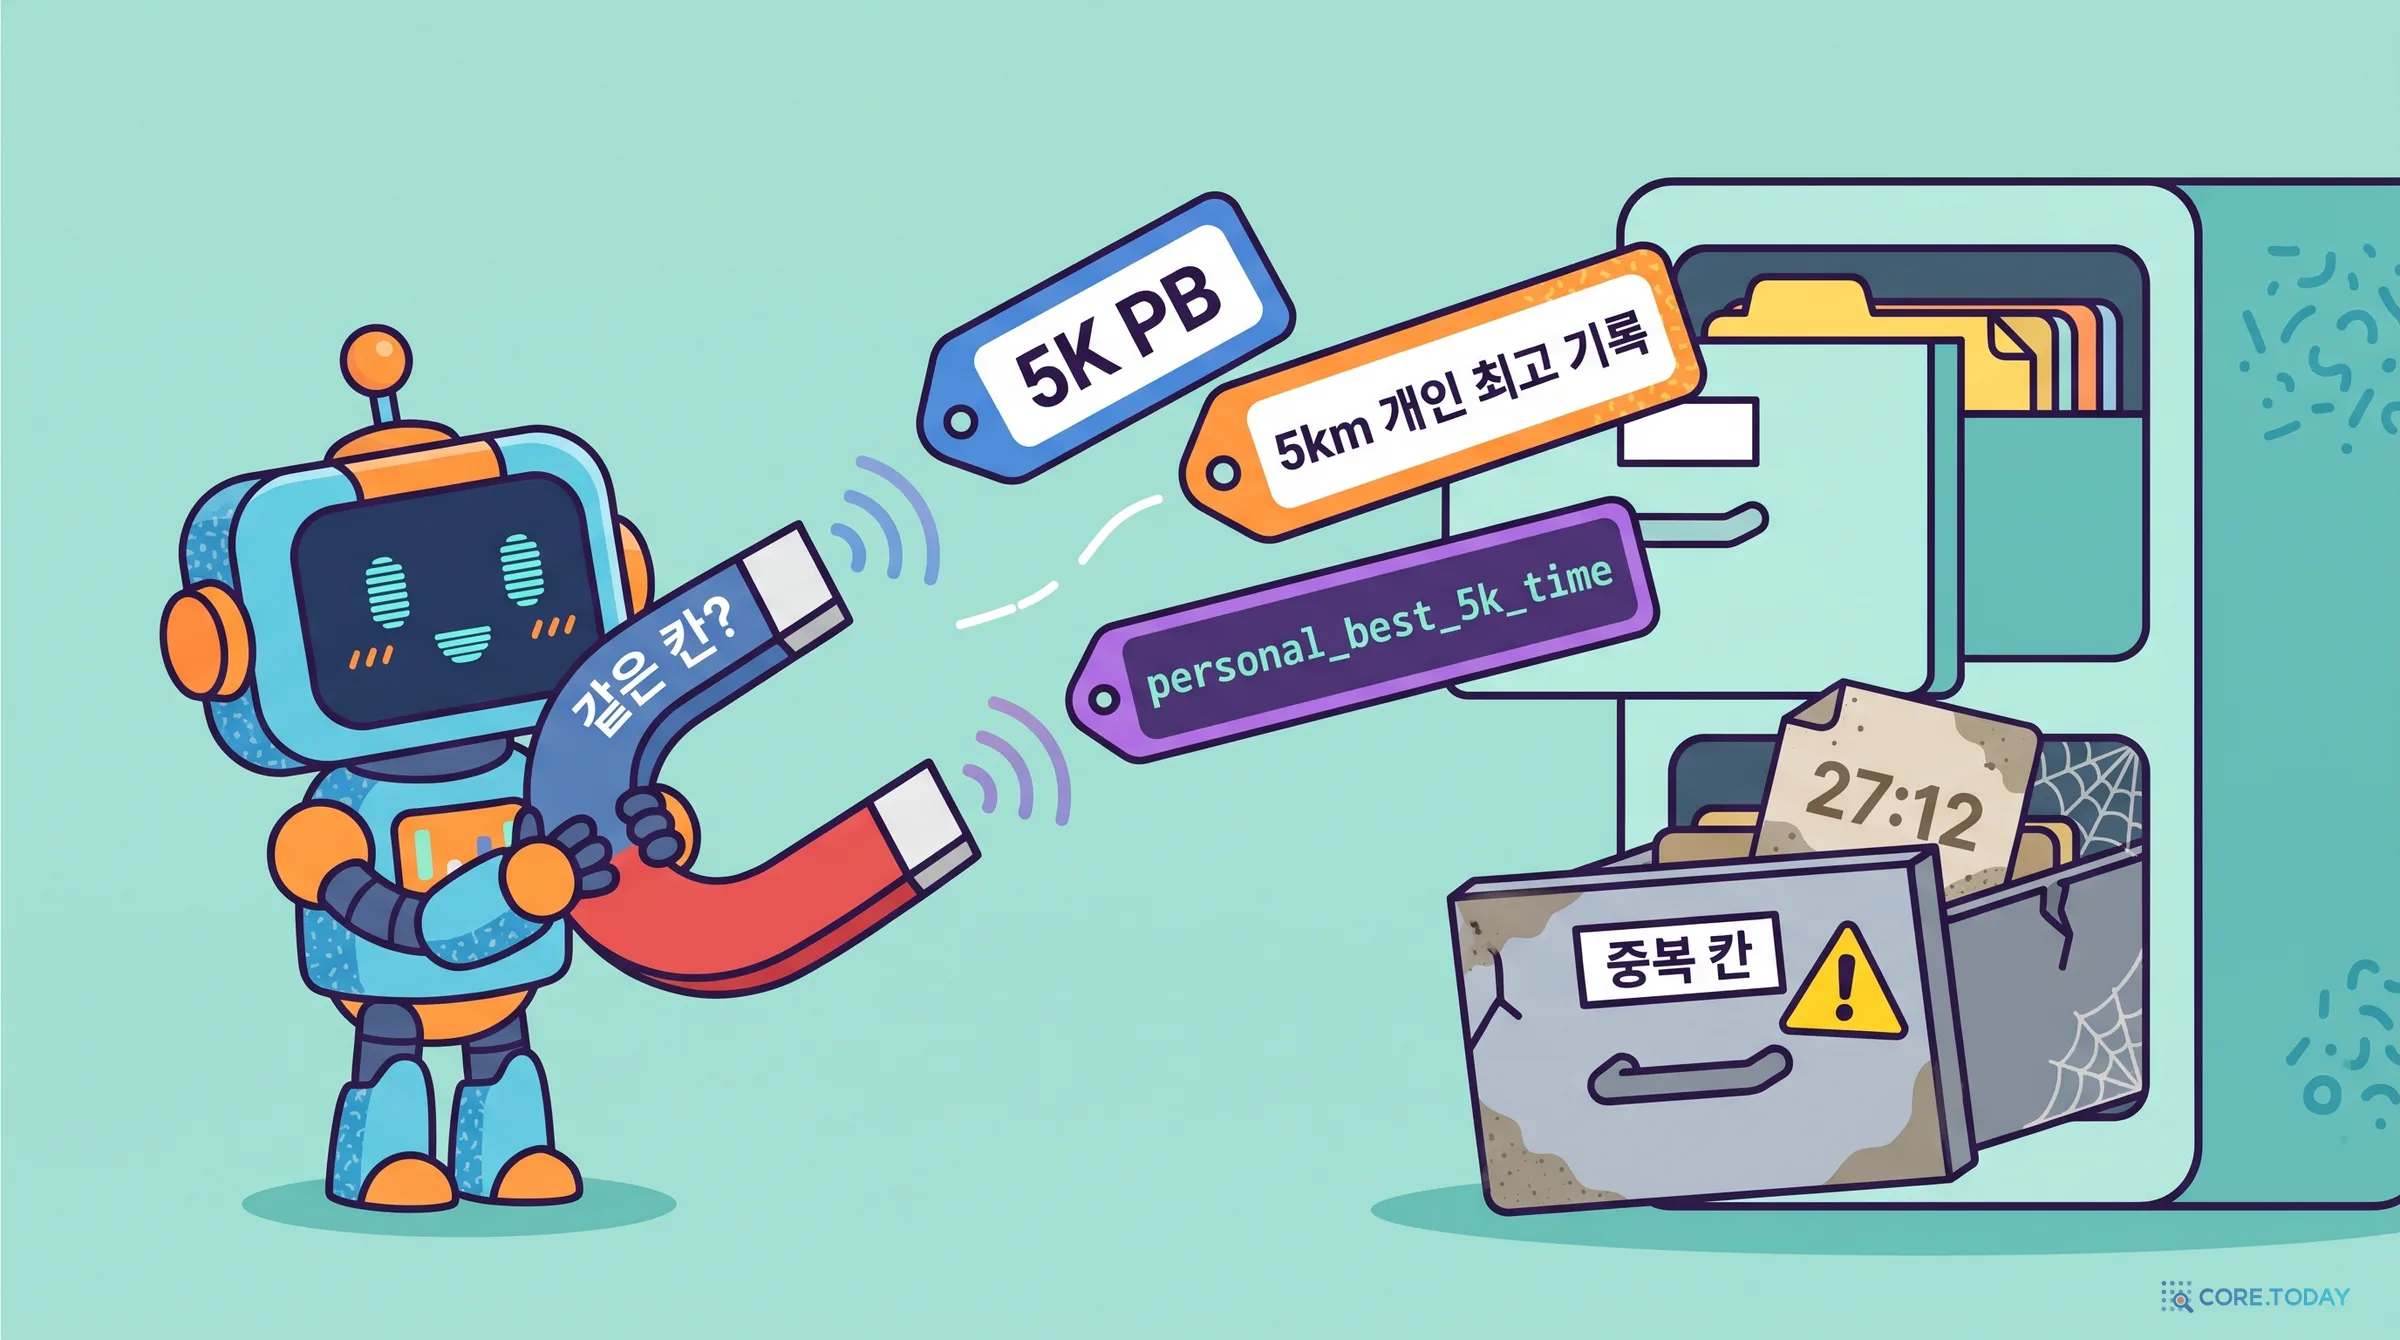
키를 언어에서 추론한다. 같은 속성이 '5K PB', '5km 개인 최고 기록'처럼 여러 모양으로 나온다
부드러운 키 정체성 (임베딩 일치 + 가벼운 확인)
쓰는 쪽은 정확한 트랜잭션이다
쓰는 쪽이 틀릴 수 있는 LLM이다. 읽을 때 현재 값을 다시 계산할 수도 없다
도착 순서로 쓸 때 대체를 확정
읽는 쪽은 저장소 전체를 훑을 수 있다
읽는 쪽은 문맥 예산이 있다
공개 모드가 있는 결정적 물질화 (현재 값 먼저, 근거는 요청 시)
그리고 이 셋을 묶는 원칙이 보존입니다. 아무것도 지우지 않으니 잘못 커밋한 값은 '대체' 간선 위에 강등된 노드로 남고, 나중에 철회가 오면 실패하는 대신 되살아납니다. 논문의 새로움은 '보존' 자체가 아니라 에이전트에 맞춘 조합에 있습니다. 언어에서 추론한 부드러운 키, 틀릴 수 있는 LLM의 연산 선택, 일급 시민으로서의 갈등 상태, 활성 전선에서 읽는 간결한 출처 공개가 그 조합입니다.
3. P-Mem 해부 — 출처 그래프 하나와 연산 여섯 개
논문은 MoM이라는 원칙을 P-Mem(Provenant Memory, 출처를 지닌 기억) 이라는 시스템으로 구현합니다. 차근차근 뜯어보겠습니다.
t번째 과제 qt가 오면, 기억 시스템이 지금까지 쌓인 기억 상태 zt−1에서 과제에 맞는 문맥 c^를 읽어 줍니다(Read). LLM은 과제와 그 문맥을 보고 행동 at를 냅니다. 중요한 점은 LLM 자체는 고정되어 있다는 것입니다. 바뀌는 것은 기억이 건네주는 문맥뿐입니다.
zt=Update(zt−1,xt),xt=(qt,τt,yt)
일이 끝나면 과제·실행 궤적 τt·결과 yt를 묶은 기록 xt로 기억을 갱신합니다(Update).
기존 에이전트는 z를 '과거 증거의 더미'로 두고, Read를 '과제와 관련된 항목 검색'으로 구현합니다. 논문은 여기서 남는 질문 하나를 짚습니다. 관련성은 유효성을 보장하지 않는다. 관련 있는 항목이 낡았을 수도, 나중 증거에 반박됐을 수도, 대체됐을 수도 있습니다. P-Mem은 새 증거가 반박·철회·대체한 기억을 관련이 있더라도 내주지 않습니다. 기억이 수동적인 저장소에서 능동적으로 관리되는 '결정 상태'로 바뀌는 지점입니다.
3.2 출처 그래프: 노드 네 종류, 간선 네 종류
P-Mem은 기억 전체를 유형이 있는 시간 출처 그래프Gt=(Vt,Rt)로 표현합니다.
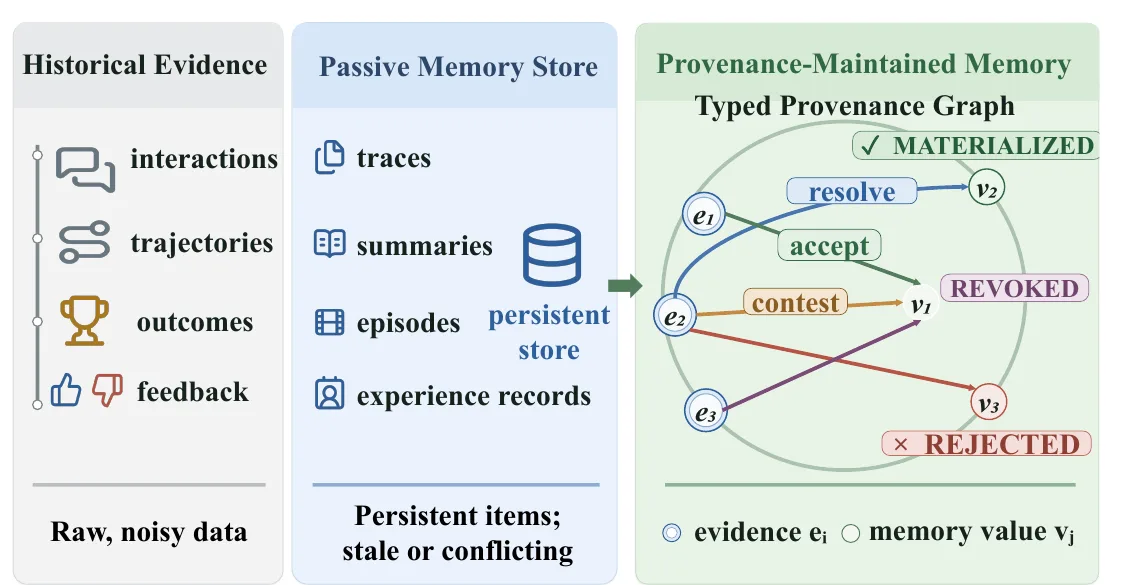
출처: Qin & Lu (2026), 그림 2. 수동적인 상호작용 기록을 유형 있는 시간 출처 그래프로 바꿔, 증거에 근거한 '현재 유효한 값의 활성 전선'을 만들고 밀려난 값은 출처로 보존한다.
그림 2를 왼쪽부터 읽으면 이렇습니다. 에이전트가 겪는 일은 원래 대화·궤적·결과·피드백 같은 날것의 잡음 많은 데이터입니다(회색). 기존 기억 시스템은 이것을 흔적·요약·에피소드·경험 기록으로 가공해 영구 저장소에 넣습니다(파랑). 하지만 그 항목들은 낡았거나 서로 충돌해도 그대로 남습니다. P-Mem(초록)은 그 위에 그래프를 얹습니다. 증거 ei(테두리 원)와 기억 값 vj(작은 원)를 연산 간선으로 잇습니다. v2는 해결(resolve)되어 물질화(MATERIALIZED), 즉 에이전트가 읽는 현재 값이 됩니다. v1은 철회(REVOKED), v3는 기각(REJECTED) 되었지만 그래프에서 사라지지 않습니다.
구성 요소를 정리하면 다음과 같습니다.
노드
담는 것
간선
의미
증거 (evidence)
날것의 관찰, 출처, 시각
근거 (supported-by)
버전 → 그 버전을 뒷받침하는 증거
버전 (version)
(키, 값) 쌍 + 상태 + 유효 구간
대체 (supersedes)
버전 → 그것이 밀어낸 앞 버전
연산 (operation)
적용된 갱신과 그 시각
대안 (alternative-of)
버전 → 경쟁 중인 형제 버전
묘비 (tombstone)
철회 표시
철회 (revokes)
묘비 → 그것이 거둔 버전
사실 하나는 이 그래프 안의 부분 그래프가 됩니다. 키 하나가 거쳐 온 버전들, 각 버전의 증거, 그리고 버전 사이에서 권위를 옮긴 연산들입니다. 그래프는 추가 전용(append-only) 입니다. 한 번 들어온 것은 지워지지 않고 유형이 바뀌거나 다시 연결될 뿐입니다. 지금 참인 것과 그것이 밀어낸 모든 것이 함께 남고, 둘은 상태와 간선 유형으로만 구별됩니다.
에이전트가 읽는 것은 점선 상자 안, 활성 전선 하나뿐입니다. "지금 PB는?"이라는 질문은 이 한 줄을 읽으면 끝납니다. "예전 PB는?"은 '대체' 간선을 한 번 거꾸로 걸으면 됩니다. "왜 25:50이라고 생각해?"는 '근거' 간선을 따라 e2를 보여 주면 됩니다. 역사·정당화·되돌리기가 모두 간선을 거꾸로 걷는 일이 됩니다. 현재 값은 싸게 읽고, 저장소는 질문마다 새로 맞춰 보는 대신 바로잡을 수 있고 감사할 수 있는 상태로 유지됩니다.
3.3 여섯 가지 연산 — 새 관찰은 기존 값과 어떤 관계인가
사실은 정해진 연산 하나를 거쳐 그래프에 들어갑니다. 연산은 새 관찰을 그 키의 현재 머리(head)와 관계 짓습니다.
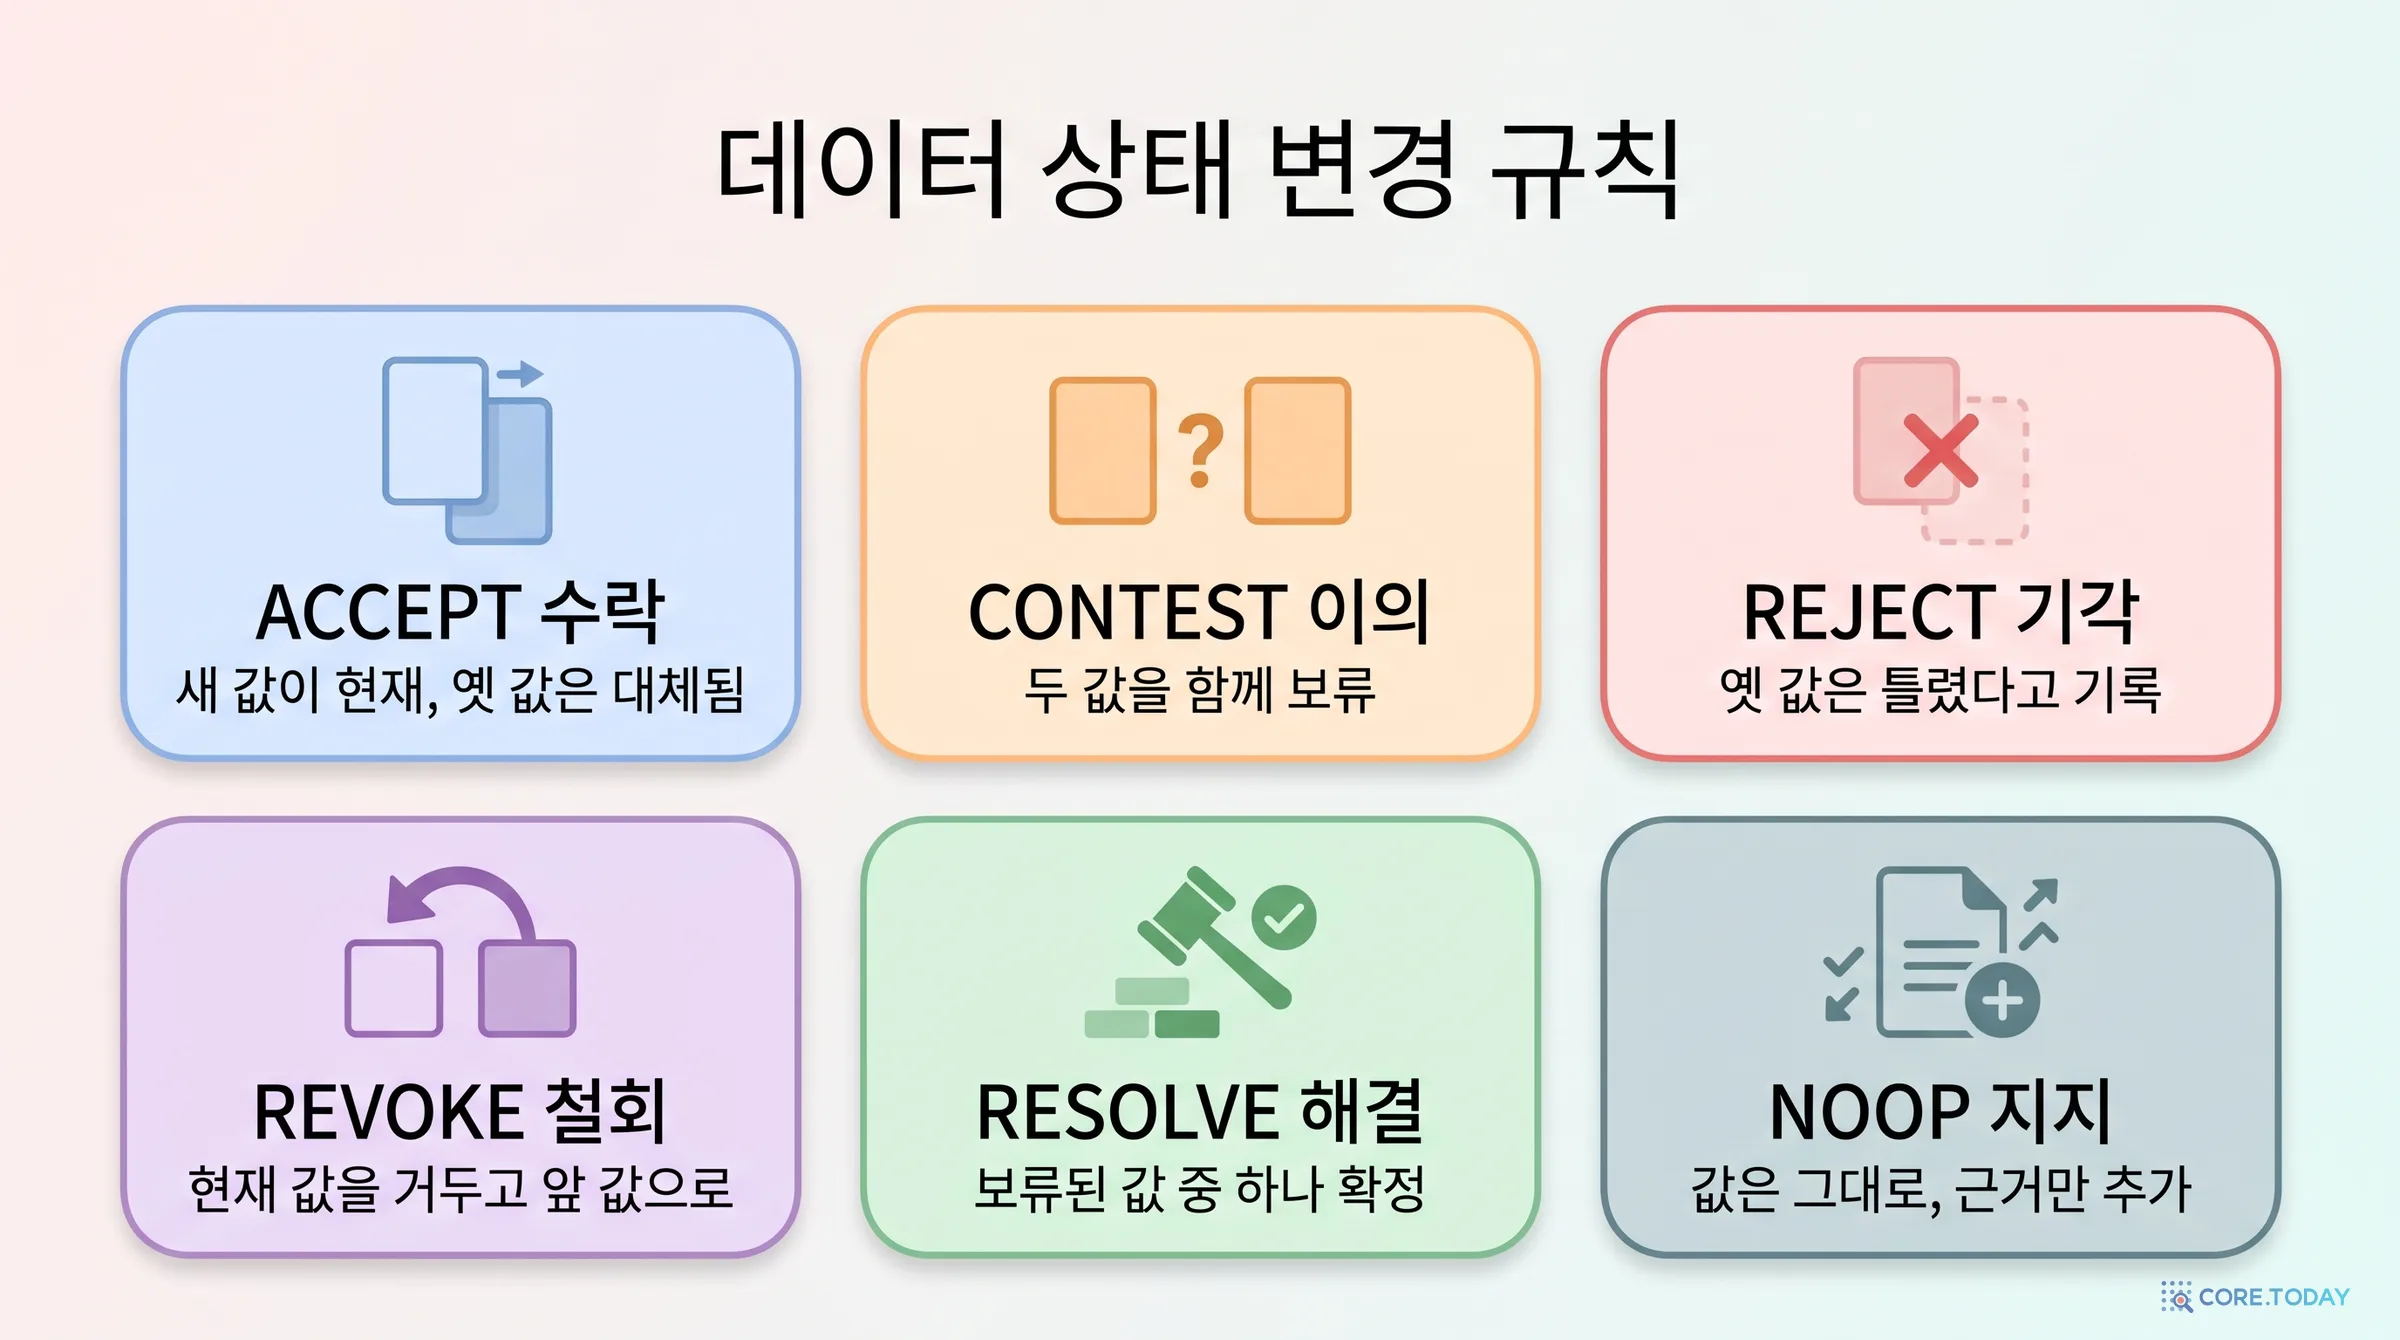
논문 표 2는 각 연산이 버전 상태를 어떻게 바꾸는지 정리합니다. '머리'는 연산 뒤 칸의 현재 값이고, 나머지 버전은 지워지지 않고 표의 상태로 바뀝니다.
연산
연산 뒤 머리(현재 값)
다른 버전
언제 쓰나 (예)
ACCEPT 수락
새 값 (active)
대체됨 (superseded)
"PB 25:50으로 깼어" — 값이 정상적으로 바뀜
REJECT 기각
새 값 (active)
틀림 (contradicted)
"27:12가 아니라 원래 28:12였어" — 옛 값이 낡은 게 아니라 처음부터 틀림
CONTEST 이의
기존 값 (contested)
새 값은 대안으로 보관
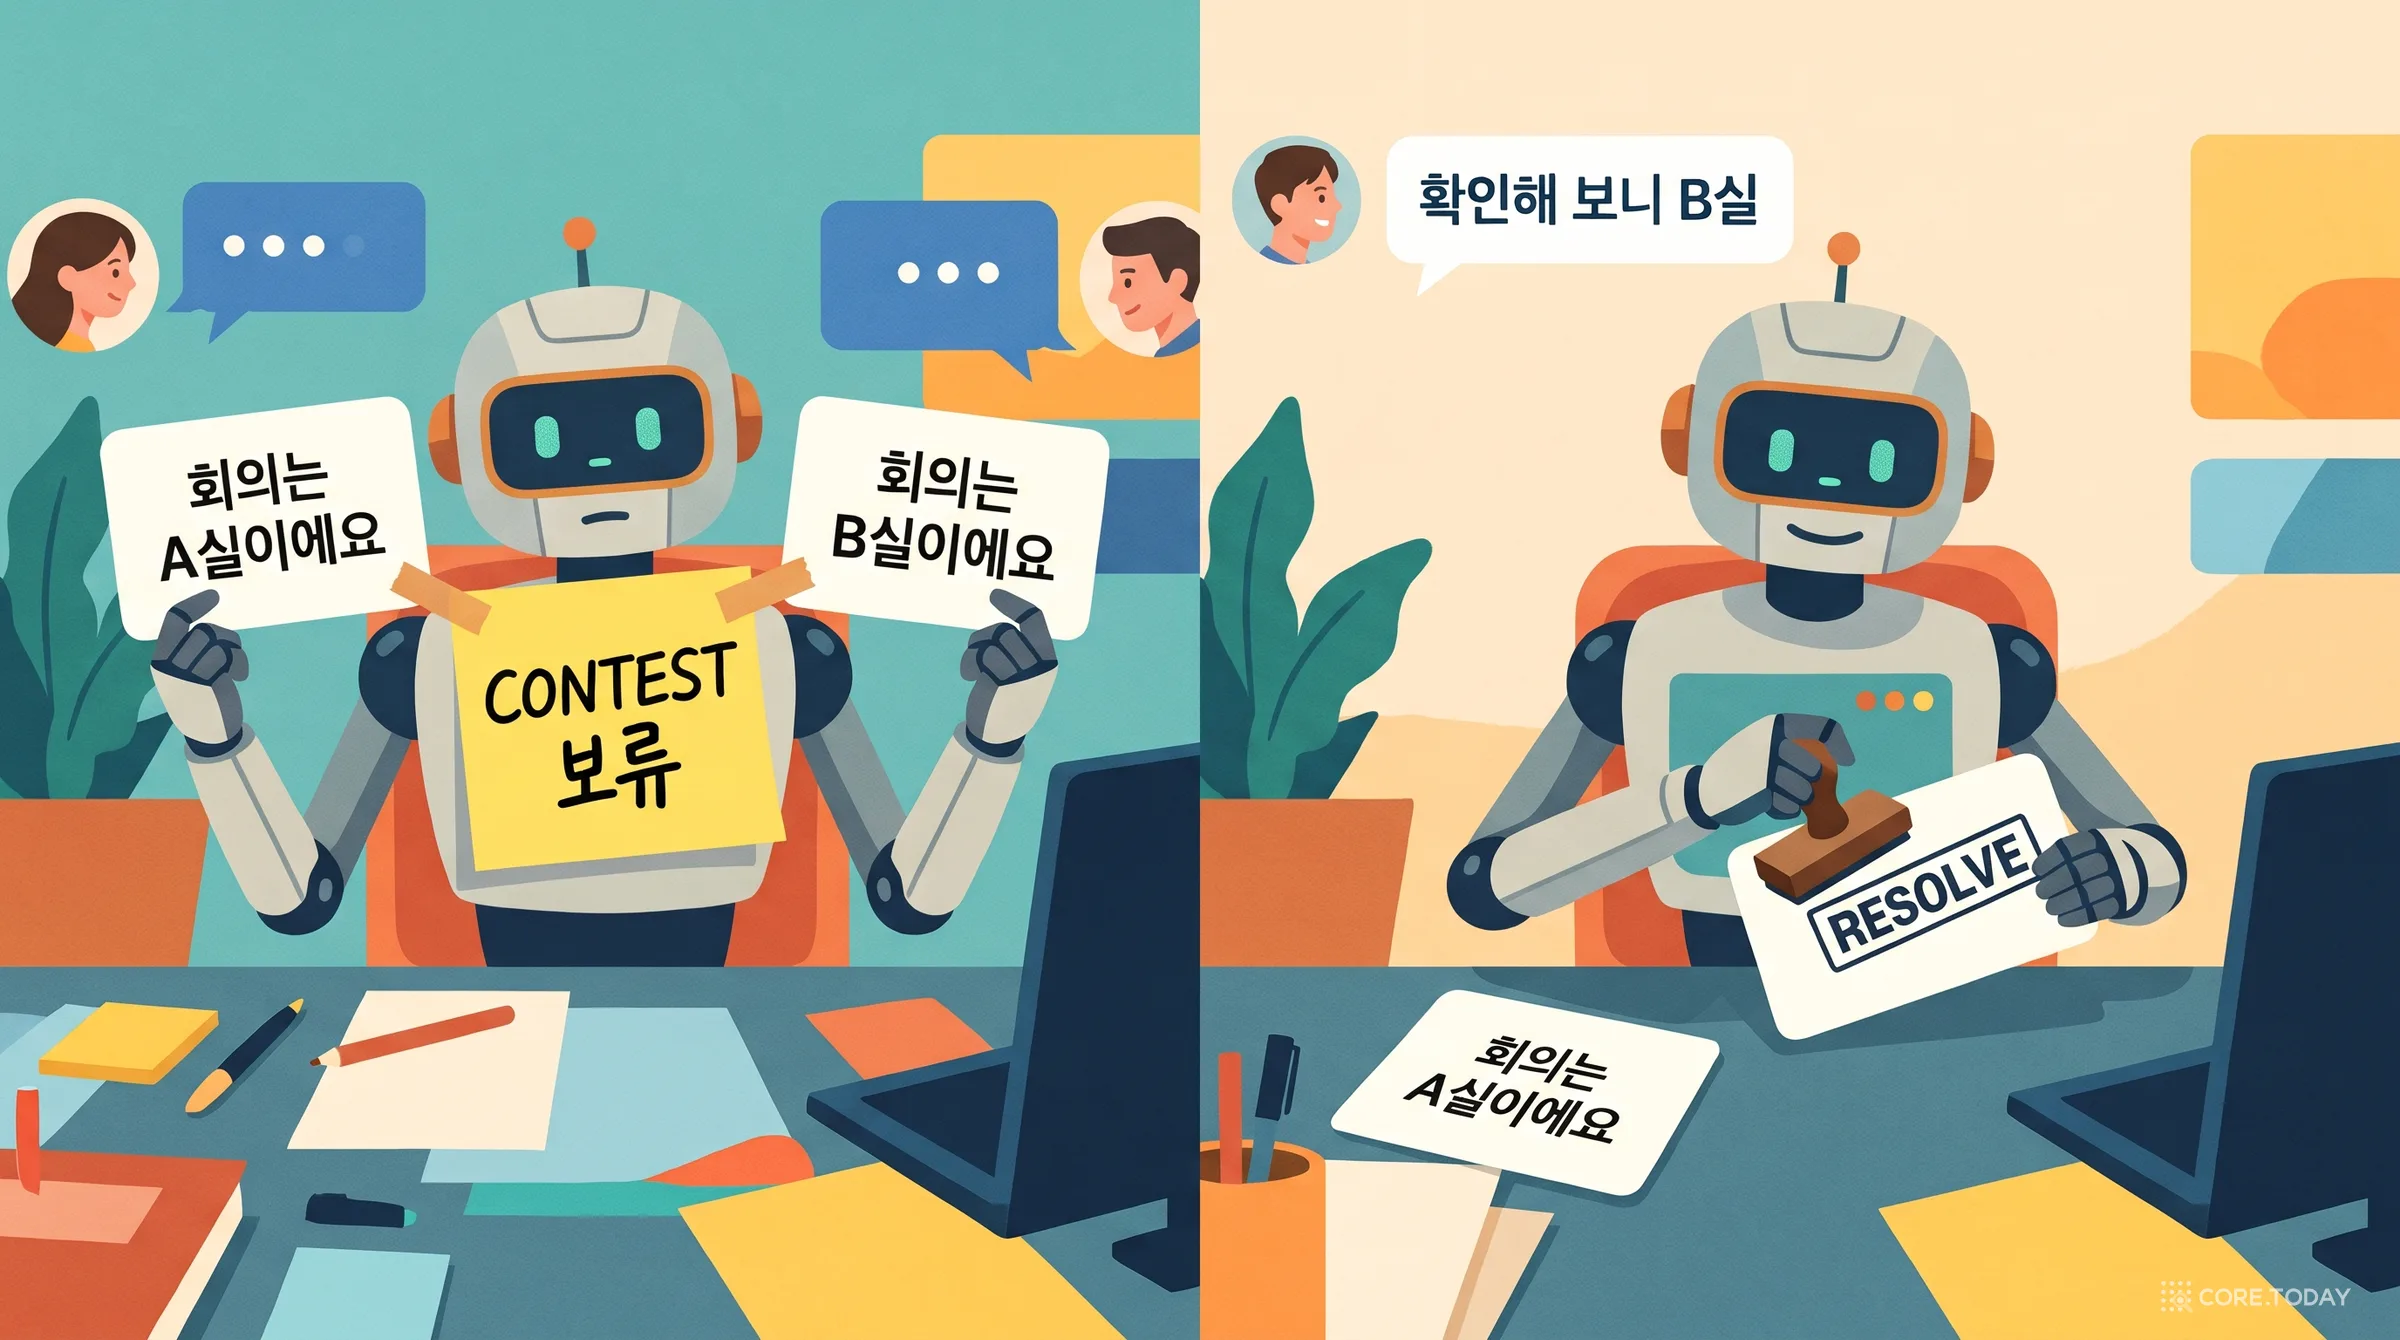
민수는 "회의는 A실", 지영은 "B실" — 우선할 단서 없음
REVOKE 철회
앞 값, 없으면 빈 칸
철회됨 (revoked, 묘비)
"5천만은 착오였어요" — 현재 값을 거둠
RESOLVE 해결
승격된 대안 (active)
나머지는 틀림 (contradicted)
"확인해 보니 B실" — 보류된 갈등을 한 번에 정리
NOOP 지지
변화 없음
변화 없음
같은 값을 다시 들음 — 근거 수만 하나 늘어남
두 가지 구별이 특히 중요합니다. 하나는 ACCEPT와 REJECT의 차이입니다. 둘 다 새 값을 현재로 만들지만, ACCEPT는 옛 값을 '한때는 맞았던 값(superseded)'으로, REJECT는 '틀렸던 값(contradicted)'으로 남깁니다. "작년 주소"와 "잘못 적은 주소"는 다른 것입니다. 앞의 것은 "예전엔 어디 살았어?"에 답이 되지만, 뒤의 것은 그래서는 안 됩니다.
다른 하나는 CONTEST입니다. 두 메시지가 서로 다른 회의실을 말하는데 어느 쪽이 우선인지 단서가 없다면, P-Mem은 추측하지 않습니다. 둘 다 들고 있다가 나중 메시지가 RESOLVE를 부를 때 한 번에 정리합니다. 이의 중에도 활성 전선은 기존 값을 보여 주지만 '이의 중' 표시를 달고, 대안은 공개 모드로 펼칠 수 있습니다.
직접 굴려 보세요. 아래 위젯은 논문 표 2와 부록 A의 규칙을 그대로 구현한 칸 하나입니다. 규칙을 어기는 연산(예: 이의가 없는 칸에 RESOLVE)은 논문처럼 NOOP으로 떨어집니다.
3.4 쓰기: 언어를 키로 바꾸고, 같은 칸을 찾고, 연산을 고른다
새 기록 xt가 그래프에 들어가는 길은 두 단계입니다.
① 추출. 고정된 추출기(논문에서는 Qwen3-4B)가 기록을 키가 붙은 사실들로 바꿉니다.
{rt,j}j=1nt=Extract(xt)
각 사실은 값과 후보 키를 가집니다. 키는 주어와 속성을 이름 짓는 스네이크 표기입니다(예: personal_best_5k_time). 부록 A.4의 추출 지시문에는 재미있는 규칙이 하나 있습니다. 키는 값과 독립이어야 한다.personal_best_27_12가 아니라 personal_best_5k_time이어야 한다는 뜻입니다. 같은 속성은 언제나 같은 키를 내야 갱신이 같은 칸으로 가기 때문입니다.
② 부드러운 키 정체성(soft key identity). 그런데 키를 언어에서 뽑으면 같은 속성이 여러 이름으로 나옵니다. 실제로 MemoryAgentBench의 6k 스트림에서 추출기는 템플릿 키 239개에 대해 칸 346개를 만들었습니다. 이걸 그대로 두면 나중 언급이 중복 칸을 새로 만들고, 옛 칸에는 낡은 값이 활성인 채로 남습니다. 대체가 일어나야 할 자리에서 분기가 일어나는 셈입니다.
P-Mem은 쓸 때 이것을 맞춥니다. 후보 키를 임베딩해 등록된 키 중 가장 비슷한 것을 찾고, 코사인 유사도가 0.72 이상이면 후보로 올립니다. 그다음 두 속성 이름만 보여 주고 "같은가, 다른가"를 한 단어로 묻는 확인 호출을 해서, SAME이면 합칩니다.
여기서 논문이 보고하는 작은 발견이 흥미롭습니다. 임베딩 후보 찾기와 확인 호출 두 단계 모두 키만 씁니다. 값까지 넣으면 합치기가 무너집니다. 값을 넣었을 때는 검증자가 135쌍 중 2쌍만 받아들였고, 키만 넣었을 때는 133쌍 중 37쌍을 받아들였습니다. 이유는 같은 값이 서로 다른 키에 자주 나오기 때문입니다. '가방 위치 = 현관'과 '우산 위치 = 현관'은 값이 같아서 서로 닮아 보이지만 다른 속성입니다. 반대로 정작 합쳐야 할 '5K PB = 27:12'와 '5km 최고 기록 = 25:50'은 값이 달라서 덜 닮아 보입니다. 값을 넣으면 후보 목록이 엉뚱한 쌍으로 채워지는 셈입니다(이 풀이는 논문의 한 줄 설명을 코어닷투데이가 예로 풀어 쓴 것입니다). 어느 칸을 갱신할지 정하는 일 자체가 추론 단계라는 것, 이것이 스키마가 고정된 고전적 출처 시스템에는 없던 문제입니다. 부드러운 키 정체성을 켜면 6k에서 낡은 답이 9.4%→4.7%로, 반복 조회 여러 단계 정답률이 42%→53%로 좋아졌습니다(부록 F).
③ 연산 적용. 사실마다 고정된 주석기(역시 4B)가 그 키의 머리와의 관계를 보고 여섯 연산 중 하나를 고릅니다. 출력은 스키마로 제약되고, 결정적 후처리로 검증합니다. CONTEST에는 활성 머리가 있어야 하고, RESOLVE에는 이의 중인 칸이 있어야 합니다. 실패한 주석은 NOOP으로 떨어집니다. 한 기록의 연산들은 도착 순서대로 그래프에 적용됩니다.
도착 순서가 쓸 때 대체의 방향을 정하므로, 읽는 쪽은 질문 때 순서를 재구성할 필요가 없습니다. 4장에서 보겠지만 이것이 수정 사슬 실험의 결정적 차이를 만듭니다.
④ 되돌리기는 그래프 걷기다. 아무것도 지우지 않으니 철회는 재추론이 아니라 걷기입니다. REVOKE는 머리의 유효 구간을 닫고, 묘비와 철회 간선을 쓰고, 머리를 revoked로 표시합니다. 새 머리는 철회된 버전의 '대체' 간선을 따라간 가장 가까운 앞 버전이고, 그 구간이 다시 열려 active가 됩니다. 연속 철회는 사슬을 한 칸씩 거슬러 올라가므로 k번 철회하면 최근 k번 커밋 이전의 값이 돌아옵니다. '대체'는 언제나 과거를 가리키므로 사슬에 순환이 없습니다. 되살린 값은 다시 만든 것이 아니라 보관된 노드에서 읽은 것이라 결정적입니다.
벤치마크 쓰기 경로에서는 사실이 하나의 '패치' 형태로 주석기에 들어갑니다(op, key, old_value, new_value, status, supersedes). 결정적 제어기가 이것을 머리와 비교해 새 키면 생성, 아니면 대체(ACCEPT)나 개정(REJECT)으로 분류합니다.
3.5 읽기: 물질화와 공개 모드, 그리고 가지치기
읽기는 두 단계입니다. 먼저 질문과 무관한 고정 절차인 물질화(materialization) 가 그래프에서 구조화된 상태 Mt=Materialize(Gt)를 만듭니다. 키마다 상태가 active나 contested인 가장 최근의 열린 버전을 머리로 고르고, '함수적 키 불변식'이 다른 열린 버전을 강등시켜 어떤 키도 현재 값을 둘 내보이지 않게 합니다.
이 물질화가 결정적이고 질문과 무관하다는 점이 P-Mem을 검색 기억과 가르는 성질입니다. 현재 값은 쓸 때 한 번 확정되고, 질문마다 다시 유도되지 않습니다. 칸 하나는 key = value 한 줄로 렌더링되고, 근거·대안·이력은 요청할 때만 덧붙습니다. 이것이 공개 모드(disclosure mode) 입니다. 등기부에 빗대면 기본은 '현재 유효사항', 필요하면 '말소사항 포함'입니다.
그다음 질문 qt가 오면 읽기가 이 상태를 문맥으로 바꿉니다. 칸마다 key: value 문자열을 임베딩해 코사인으로 상위 L개를 고르고, 공개 모드를 적용합니다. 논문은 학습된 공개 정책 πϕ를 넣을 수 있는 자리를 만들어 두었지만, 모든 실험은 학습 파라미터 없는 결정적 기본값(현재 값 먼저, 고정 깊이)을 씁니다.
LongMemEval에서는 다른 읽기 경로를 씁니다. 자연스러운 대화에서는 4B 추출기가 지나가듯 말한 갱신을 놓치기 때문에(4장에서 자세히), 사실 칸 대신 대화 턴 자체를 검색합니다. 대신 여기에 그래프의 관계를 하나 걸어 둡니다. 이것이 그래프 유도 가지치기입니다.
1모든 세션을 (날짜, 메시지) 턴으로 펼치고, 질문과 가장 비슷한 턴 12개를 가져온다
2가져온 턴 쌍 중 서로 코사인 0.55 이상이고 날짜가 다른 쌍마다 묻는다. "두 턴이 질문한 속성에 대해 다른 값을 말하나?" (예/아니오)
3'예'면 날짜가 이른 턴을 버린다. 방향은 날짜가 정한다. 모델은 어느 값이 오래됐는지 판단하지 않는다
4남은 턴만 읽는 쪽에 건넨다. 대체된 문장이 유사도만으로 다시 끼어들 수 없다
이것이 그래프 관계가 물질화되지 않은 읽기에 작용하는 유일한 지점이고, 4장의 낡은 답 비율 차이를 만듭니다.
3.6 정직한 단서: 구현은 됐지만 켜지 않은 것들
논문은 데이터 모델에 들어 있지만 실험에서 켜지 않은 장치도 밝힙니다. 사용 간선(어느 과제가 어느 버전을 읽었나), 지지 수에 따른 순위, 학습된 검색·보존 점수, 예산에 따른 축출이 그것입니다. 보고된 숫자는 모두 결정적 검색과 고정 공개 기본값에서 나왔습니다. 다시 말해 P-Mem은 "잘 튜닝된 읽기"가 아니라 유형 연산으로 쓰고, 질문과 무관하게 물질화한다는 성질로만 평가받습니다. 그리고 자연 스트림은 거의 전부 ACCEPT라서, 논문은 벤치마크 정확도의 공을 '보존이 있는 쓸 때 버전 상태'에 돌리고 나머지 연산(되돌리기·갈등)은 통제된 시험으로 따로 잽니다. 전체 노드·간선 어휘가 정확도 숫자에 필요하다고 주장하지 않는다는 점도 분명히 적습니다.
4. 실험 읽기 — 정확도가 아니라 '유효성'
4.1 여섯 가지 질문과 세 벤치마크
논문은 '보존이 있는 쓸 때 확정'을 아카이브·CRUD와 가르는 성질을 여섯 질문(RQ)으로 나눠 잽니다.
질문
무엇을 묻나
어디서 재나
RQ1 유효성 대 정확도
지식 갱신에서 가지치기(a)나 쓸 때 확정(b)이 정확도를 지키면서 낡은 답을 줄이나
LongMemEval
RQ2 읽기 비용
활성 전선을 읽으면 검색·전체 역사보다 적은 토큰으로 답하나
LongMemEval
RQ3 수정 사슬
한 사실의 수정이 쌓일 때도 쓸 때 확정이 현재 값을 지키나
ALFWorld-Revision
RQ4 되돌리기
보존이 커밋된 오류를 '영구 실패'에서 '일시 실패'로 바꾸나
ALFWorld-Revision
RQ5 갈등
추측 대신 진짜 갈등을 표현하고, 증거가 오면 한 번에 정리하나
ALFWorld-Revision
RQ6 규모와 여러 단계
역사가 길어져도 한 단계 현재성과 여러 단계 정확도를 지키나
MemoryAgentBench
세 벤치마크는 갱신의 수명 주기에서 각기 다른 부분을 누릅니다. LongMemEval은 채팅 기록에서 한 번 말하고 나중에 고친 사실을 묻습니다. 지식 갱신 78문항을 두 조건에서 씁니다. 증거 세션만 있는 oracle(문항당 평균 1.9세션)과 세션 약 48개짜리 건초더미 LongMemEval-s입니다. 전체 500문항도 따로 봅니다. ALFWorld-Revision은 저자들이 만든 변형입니다. 원래의 ALFWorld(텍스트로 된 가사 로봇 환경)는 저장된 사실을 무효로 만드는 일이 없습니다. 물건 상태는 에이전트 자신의 행동으로만 바뀌고 다시 관찰할 수도 있기 때문입니다. 그래서 물건의 위치를 한 번 이상 바꾸는 갱신을 넣고 현재 위치를 묻습니다. MemoryAgentBench FactConsolidation은 반사실 사실을 수백~수만 개 흘려보내며 나중 사실이 같은 키의 앞 값을 조용히 덮어쓰게 하는 '갈등 해결' 과제입니다.
공정성 장치도 짚어 둘 만합니다. 각 벤치마크 안에서 모든 방법은 같은 스트림, 같은 Qwen3-4B 에이전트, 같은 Qwen3-Embedding-4B 임베더, 같은 프롬프트와 검색 예산을 씁니다. 차이는 기억 설계에서만 나옵니다. 그리고 갱신은 순서대로 도착하고, 현재성은 '마지막 쓰기 승리'를 따릅니다. 즉 이 논문이 재는 것은 도착 순서대로 들어오는 수정에서의 현재성입니다. 늦게 들어온 보고, 소급 날짜, 순서가 뒤바뀐 수집, 출처끼리의 권위 충돌 같은 더 넓은 유효 시간 문제는 유형 연산으로 표현은 할 수 있지만 범위 밖입니다(6장에서 다시 다룹니다).
4.2 LongMemEval: 비슷한 정확도, 절반의 낡은 답 (RQ1·RQ2)
결과의 첫 줄은 이렇습니다. 지식 갱신 78문항에서 P-Mem은 MemoryOS 검색보다 두 지표 모두, 두 조건 모두 낫습니다. 정확도는 oracle에서 +10.2점(66.7→76.9), LongMemEval-s에서 +5.1점(60.3→65.4) 올랐고, 낡은 답 비율은 22.6%→5.4%, 19.4%→10.9%로 줄었습니다.
그런데 논문은 이 이득을 두 부품으로 분해합니다. 이 분해가 이 논문을 정직하게 만듭니다.
유효성은 가지치기가 만든다. 같은 턴 읽기에 가지치기만 더하면 낡은 답이 19.6%→5.4%(oracle), 23.6%→10.9%(_s)로 떨어집니다. 큰 건초더미에서는 아직 필요한 증거까지 쳐내 정확도를 3.8점(69.2→65.4) 내줍니다. 78문항이라 구간은 ±10점이지만, 짝지어 보면 고친 문항 8개, 망친 문항 0개입니다(맥니마 8–0, 부트스트랩 p<0.001). 같은 방향의 효과가 대체된 값 클래스(n=75), FactConsolidation(n=64~71), 철회(n=140)에서도 반복됩니다.
정확도는 검색 단위가 만든다. P-Mem의 턴 읽기는 세션 5개 대신 턴 12개를 가져옵니다. 이 입도 차이가 정확도 이득의 원천이지 그래프가 아니라고 논문 스스로 말합니다.
전체 500문항에서는 더 냉정해집니다. P-Mem 52.6%, 가장 강한 기준선인 HippoRAG-v2 50.8%로, 1.8점 차이는 통계적으로 갈리지 않습니다(짝지은 부트스트랩 95% 구간 [−2.8, +6.4]). 좋은 검색기는 정확도 대부분을 되찾습니다. 그래서 논문 초록의 문장이 "P-Mem의 결정적 이득은 정확도가 아니라 유효성"인 것입니다.
가지치기는 공짜도 아닙니다. 전체 벤치마크에 무조건 적용하면 합산 문항("영화를 몇 편 봤지?")이 반복 갱신처럼 보여 잘려 나가고, 전체 정확도가 45.6%로, 합산은 15.2%로 떨어집니다. 그래서 실제로 쓰려면 질문을 보고 '칠까 말까'를 정하는 문지기가 필요합니다. 부록 C의 35B 라우터는 정확도를 0.8점만 잃으면서 낡은 답을 27.4%→17.7%로 줄였습니다. 아래 위젯의 세 탭에서 이 숫자들을 직접 보세요.
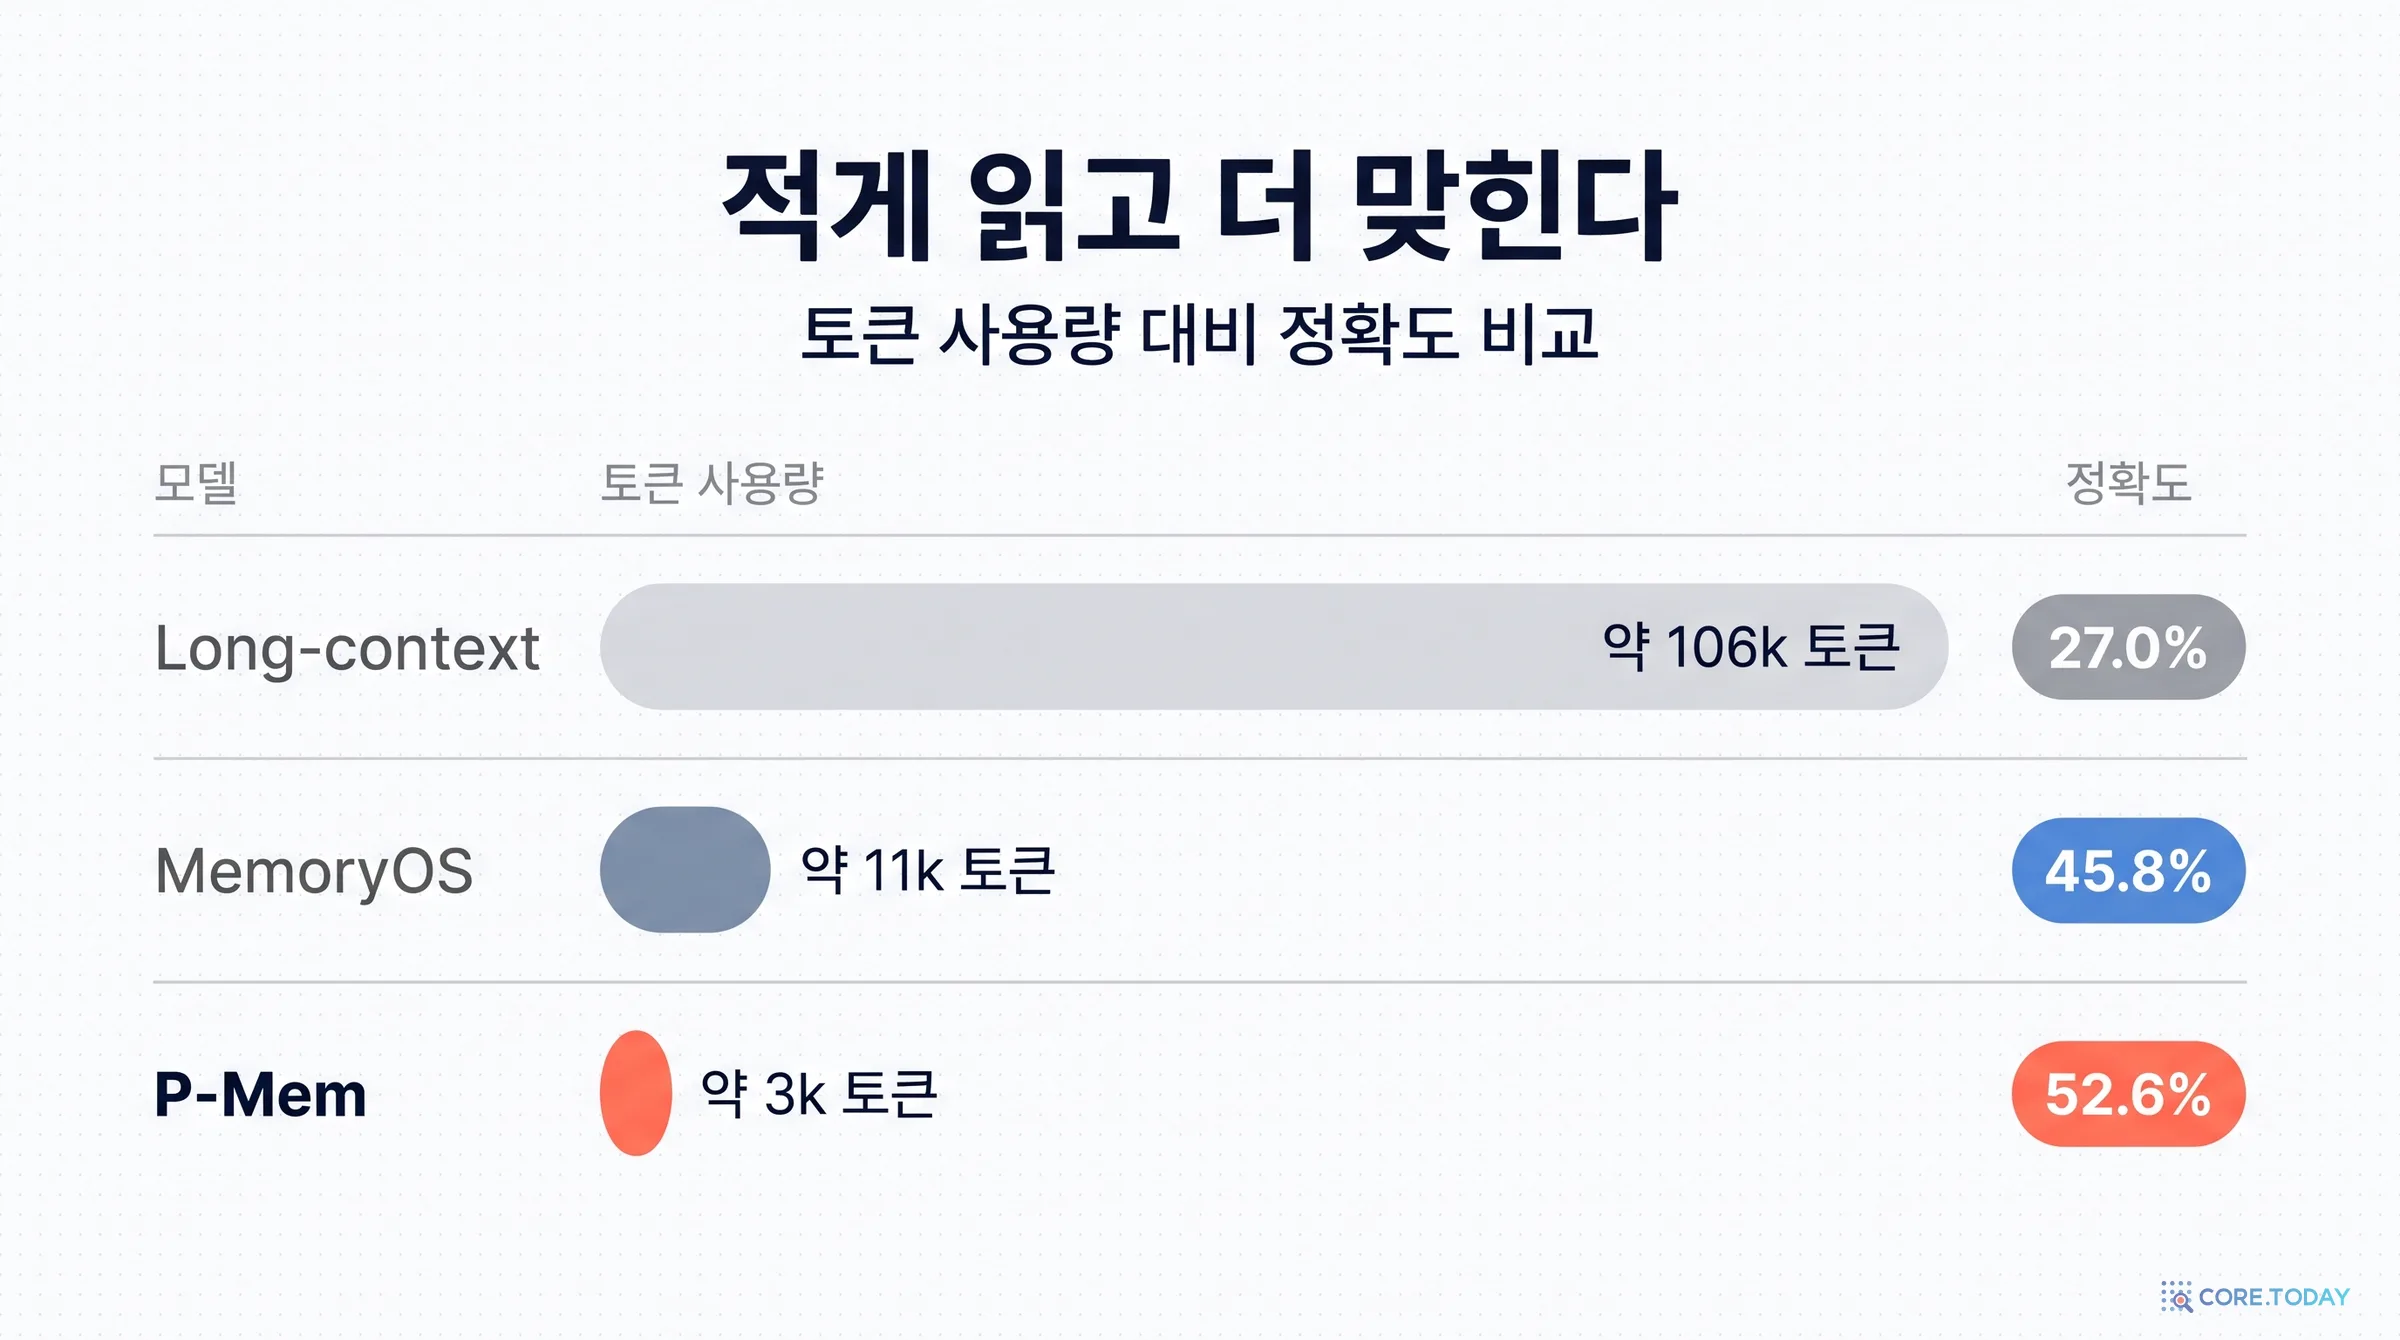
적게 읽고 더 맞힌다 (RQ2). P-Mem의 턴 읽기는 질문당 약 3k 토큰을 읽습니다. MemoryOS는 약 11k, 106k 토큰짜리 역사를 통째로 넣는 긴 문맥은 정확도 27.0%에 그칩니다. 1k 토큰당 정확도로 환산하면 P-Mem 17.5점, MemoryOS 4.2점, 긴 문맥 0.25점입니다. 다만 이것도 논문은 정직하게 적습니다. 4배의 효율은 검색 입도(턴 12개 대 세션 5개)에서 나온 것이고, 그래프의 몫은 압축이 아니라 유효성입니다. 키마다 값 하나를 담은 물질화 상태 전체를 읽는 변형은 약 1k 토큰으로 MemoryOS와 비슷한 정확도를 냅니다. 약 11배 축소입니다.
긴 문맥의 실패는 특히 곱씹을 만합니다. 106k 토큰은 모델의 262k 창에 다 들어갑니다. 그런데도 모든 기억 방식보다 낮고, 합산 문항은 5.4%입니다. 접근이 아니라 이해의 실패입니다. 예산을 1k로 묶으면 차이는 더 벌어집니다. P-Mem은 1k에서 이미 50.6점으로, 11k를 다 쓴 MemoryOS(49.2)보다 높고, MemoryOS는 같은 1k 제한에서 27.8로 떨어집니다.
4.3 쓸 때 확정이 자연 대화에서 지는 이유 (RQ1b)
여기서 의문이 생깁니다. MoM의 핵심은 '쓸 때 확정'인데, LongMemEval의 대표 결과는 왜 대화 턴을 검색하는 경로일까요? 논문은 이것을 숨기지 않습니다. 같은 대화에 쓸 때 확정(물질화 상태에서만 답하기)을 적용하면, 지금은 진다고 보고합니다.
조건 (_s 지식 갱신 78문항)
정확도 ↑
낡은 답 ↓
칸당 사실 수
턴 읽기 (그대로)
69.2
24.1
—
턴 읽기 + 출처 가지치기
65.4
9.3
—
물질화 상태, 4B 추출기
52.6
33.3
1.17
물질화 상태, 35B 추출기
61.5
20.4
1.12
35B 추출기 + 합치기 문턱 0.70
57.7
13.0
1.76
4B 추출기의 실패는 커밋이 아니라 추출 범위입니다. 지나가듯 말한 갱신이 추출기를 빠져나갑니다. 논문이 든 예가 생생합니다. 한 문항의 답이 35만 달러에서 40만 달러로 바뀌는데, 그 갱신은 "내 집을 갖게 될 날이 기대된다"는 여담 속에 있었습니다. 4B 추출기는 두 값을 모두 놓쳤고, 턴 검색기는 원문 메시지를 그대로 가져왔습니다.
35B 추출기를 쓰면 두 값을 모두 잡아 정확도가 8.9점 오릅니다. 그래도 남는 문제가 조각화입니다. 칸당 사실 수가 1.17(4B)에서 1.12(35B)로 거의 그대로입니다. FactConsolidation에서 키의 55~63%가 덮어써지는 것과 비교하면, 대부분의 칸이 사실 하나만 들고 있다는 뜻입니다. 밀려나야 할 값이 '대체된 앞 버전'이 아니라 '이름이 다른 형제 칸'으로 살아남습니다. 합치기 문턱을 0.85에서 0.70으로 낮추면 사슬이 생기고(칸당 1.76) 낡은 답이 13.0%로 떨어지지만, 잘못 합친 칸이 정확도 3.8점을 가져갑니다. 추출 범위는 쓰는 모델의 크기를 따라 늘지만, 키 정규화는 그렇지 않습니다. 결론의 한 줄도 여기서 나옵니다. "자연 대화에서 물질화는 아직 읽을 때 가지치기에 뒤진다. 병목은 상태 메커니즘이 아니라 추출과 키 정규화다."
4.4 ALFWorld-Revision: 수정이 쌓이면 누가 순서를 기억하나 (RQ3)
이제 이 논문에서 가장 극적인 표입니다. 그 전에 반대 방향의 결과부터 짚겠습니다. 수정이 한 번뿐이면, 그냥 읽는 쪽이 오히려 더 정확합니다. 두 경로는 같은 갱신 문장을 읽습니다. 쓸 때 확정은 그것을 구조화된 패치로 바꾸고, 날것 읽기는 문장에서 바로 답합니다. 갱신이 새 값을 직접 말하면 둘 다 100%입니다. 하지만 두 단계 이동 묘사에서 새 값을 추론해야 하면 날것 읽기 96.4%, 쓸 때 확정 92.9%, 질문 때 재구성 호출 87.9%입니다(n=140). 구조화된 패치가 자유 읽기가 잡는 답을 놓치는 형식 비용입니다. 고립된 사실 하나에서 물질화 상태가 사 주는 것은 정확도가 아니라 간결한 읽기(30자 대 591자)입니다.
수정 사슬은 그림을 뒤집습니다. 목표 물건 하나에 L번의 이동을 주고, 각자 L번씩 움직이는 방해 물건 넷의 사슬과 한 더미에 섞은 뒤, 임베딩 유사도로 상위 10개를 가져와 "지금 어디 있나?"를 묻습니다.
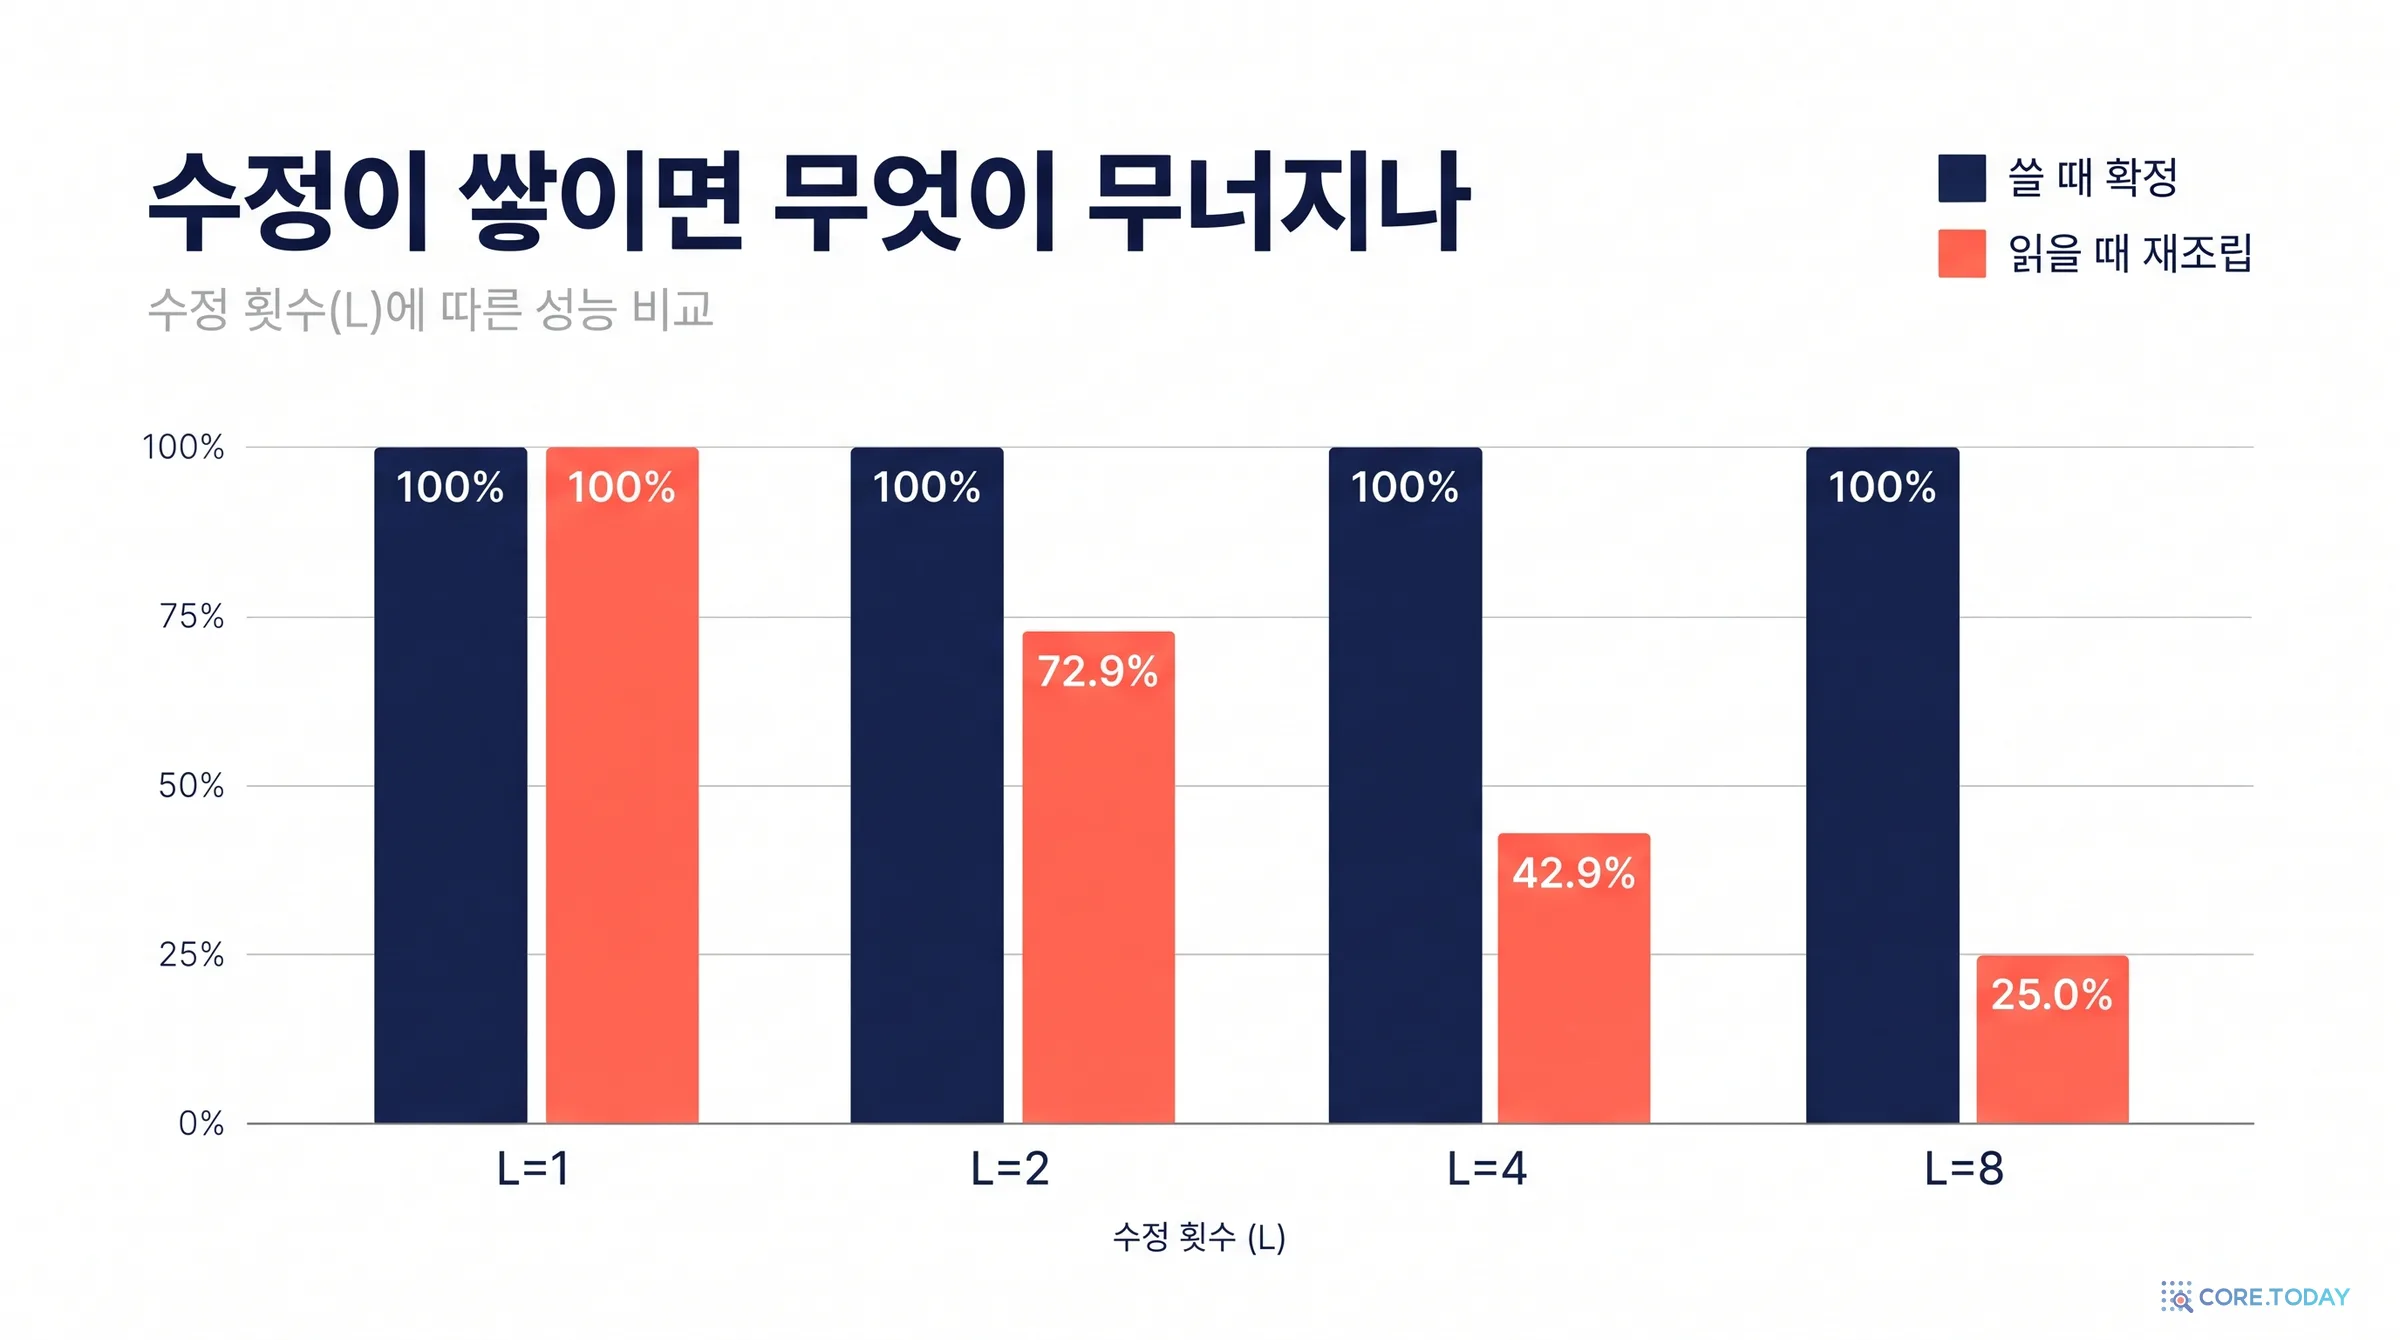
쓸 때 확정은 모든 L에서 평평하게 100%입니다. 날것 경로는 100 → 72.9 → 42.9 → 25.0%로 무너집니다. 더 중요한 것은 논문이 이 붕괴의 원인을 통제 실험 세 개로 고립시켰다는 점입니다.
검색 탓이 아니다. top-10 안에 목표 사슬이 들어 있는 비율은 모든 L에서 98.8% 이상입니다. 날것 경로가 실패할 때 증거는 문맥 안에 있습니다.
증거가 모자란 것도 아니다. 같은 사슬을 도착 순서대로 보여 주는 오라클은 94~100%를 맞힙니다.
무너지는 것은 순서 재조립이다. 유사도 순으로 늘어선 문장에서 도착 순서를 다시 맞추는 일이 깨집니다. L=8에서 날것 경로의 오답은 중간 경유지이거나 방해 물건의 위치였습니다. 문장마다 도착 번호([t=i])를 붙이고 읽는 쪽이 정렬하게 해도 97.9%→64.3%로 떨어집니다. 질문 때 재구성 호출을 한 번 더 해도 L=8에서 40.0%로, 쓸 때 확정보다 60점 낮습니다.
쓸 때 확정은 이 비용을 아예 치르지 않습니다. 도착 순서는 쓸 때 공짜로 주어지기 때문입니다. 사건이 도착하는 순간에는 무엇이 먼저 왔는지 누구나 압니다. 그 정보를 그때 써 두지 않고 문장 더미 속에 흘려보낸 뒤 나중에 유사도 순으로 다시 맞추려니 어려운 것입니다. 부록 F의 확인도 이 결론을 받칩니다. 읽는 모델을 35B로 키워도 날것 경로의 재조립은 L=2에서 72.9%→87.1%, L=8에서 25.0%→33.6%로 조금 나아질 뿐입니다. 실패는 모델 크기가 아니라 구조의 문제입니다.
아래 위젯에서 여러분이 직접 '질문 때 읽는 쪽'이 되어 보세요. L=8에서 순서표 없이 열 줄을 보고 지금 위치를 맞히기가 얼마나 어려운지 느껴질 겁니다.
4.5 되돌리기와 보류: 보존만으로는 부족하다 (RQ4·RQ5)
철회 실험(RQ4). 사슬 설정(n=140)에서 위치 v1이 한 번 진술되고, 잘못된 갱신이 v2로 옮긴 뒤, 방해 사건 d개가 지나가고 철회가 옵니다. "v2로 옮겼다는 것은 착오였다." 철회는 v2만 말하고 v1은 다시 말하지 않습니다. v1은 다른 어디에도 나오지 않으므로, 맞히려면 v1이 저장소에 아직 있어야 합니다. 잘못된 갱신은 쓸 때 정상 갱신과 구별할 수 없어서 세 방식 모두 일단 커밋합니다(철회 전 질문에는 97.9~100%가 v2라고 답함).
방식
복구 (d=0)
복구 (d=32)
틀린 v2 (d=32)
둘 다 없음 (d=32)
저장소에 v1
쓸 때 확정 + 보존
100%
100%
0%
0%
100%
쓸 때 확정, 보존 없음
0%
0%
0%
100%
0%
날것 top-10 (아카이브)
97.9%
92.0%
6.6%
1.5%
100%
Graphiti/Zep
0%
0%
93.8%
6.2%
100%
이 표에서 가장 흥미로운 줄은 맨 아래입니다. Graphiti는 v1을 무효화된 간선으로 모든 저장소에 100% 남깁니다. 그런데도 복구율은 0%입니다. 철회는 사실 하나로 더해질 뿐이고, 무효화된 간선을 다시 여는 연산이 없기 때문입니다. 보존과 되돌리기는 별개라는 것을 이보다 깔끔하게 보여 주는 숫자는 드뭅니다. 반대로 위 두 줄은 연산이 똑같고 보존 여부만 다른데, 100% 대 0%로 갈립니다. 되돌리려면 남겨 둔 값과 그 값으로 돌아가는 간선이 둘 다 있어야 합니다.
갈등 실험(RQ5). 두 보고가 한 물건에 대해 서로 다른 위치를 말합니다. 최근성 단서도 권위 단서도 없습니다. 방해 사건 여덟 개 뒤에 확인 사건이 하나를 정합니다(순서를 바꿔 균형을 맞춘 140건). 확인 전에 바람직한 행동은 한쪽을 고르는 것이 아니라 갈등을 드러내는 것입니다. 이의/해결 경로는 두 후보를 매번 기록하고(CONTEST 100%), 해결 전 질문의 100%에서 갈등을 알리며, 확인 사건이 오면 RESOLVE가 매번 들어가 해결 뒤 정답률이 97.9%입니다. '마지막 쓰기 승리' 저장소는 갈등을 표현하지 못하고 확신에 찬 값 하나를 내놓는데, 맞을 확률은 동전 던지기입니다. 날것 저장소는 갈등을 알아채지만(96.4%) 정리하지 못해 해결 뒤 정답률이 57.1%입니다. Graphiti는 도착하자마자 갈등을 중재해 없애 버립니다. 두 보고가 함께 유효로 남은 그래프는 10.7%뿐이고, 해결 뒤 정답률은 39.3%입니다. 논문의 요약이 날카롭습니다. "질문 때 읽기는 질문마다 다시 재판한다. 커밋된 해결은 한 번만 판결한다."
4.6 MemoryAgentBench: 역사가 40배로 길어질 때 (RQ6)
수정 사슬 연구는 통제된 단일 물건 실험이었습니다. MemoryAgentBench FactConsolidation은 같은 현재성 질문을 수백~수만 개의 반사실 사실 스트림으로, 그리고 발표된 기억 시스템 전부로 넓힙니다. 스트림은 455개(6k 토큰), 4,580개(64k), 18,332개(262k) 사실이고, 길이마다 한 단계·여러 단계 문항이 100개씩 있습니다. 키의 55~63%는 한 번 이상 덮어써집니다.
논문 표 7에서 읽어 낼 이야기는 다섯 가지입니다.
긴 문맥만으로는 현재를 따라가지 못합니다. 다 들어가는 6k에서도 한 단계 정답률 32%, 대체된 문항의 79.7%가 옛 값을 답합니다. 262k에서는 0%입니다.
덩어리 검색은 길어지는 역사를 못 버팁니다. MemoryOS는 한 단계 41%→16%, 여러 단계 0%로 떨어집니다. 가장 강한 아카이브 검색기인 HippoRAG-v2도 69%→39%, 낡은 답 22~36%입니다.
CRUD 커밋은 현재성이 가장 나쁩니다. Mem0는 길이가 늘수록 낡은 답이 43.8%→59.2%로 늘어나는 유일한 방법입니다. 표 1이 '보존 없는 커밋'에 대해 예측한 대로입니다. P-Mem도 커밋하지만 지우지 않고 강등하므로 낡은 답이 4~7%입니다.
한 단계 현재성은 주로 순서 정보가 정합니다. 순서 없는 평평한 저장소는 71~86%, 도착 번호만 붙이면 90~94%로 P-Mem 상태 읽기(88~95%)와 거의 같습니다. 검색은 대개 현재 값을 가져오지만, 무엇이 최신인지 알려 줄 신호가 없었을 뿐입니다.
여러 단계 추론은 쓸 때 정리가 이깁니다. 순서표를 붙인 평평한 저장소는 단계마다 현재 버전을 다시 골라야 해서 오류가 곱해집니다. 한 단계 90~94%가 여러 단계 8~14%로 무너집니다. 같은 1회 읽기(top-12)에서 P-Mem은 6k 41% 대 14%, 64k 21% 대 10%로 갈립니다. 키마다 쓸 때 한 번 정리해 두었으니 모든 단계가 현재 값 하나씩을 받기 때문입니다. 반복 조회를 더하면 53/37/29%까지 오릅니다.
두 가지 단서도 같이 읽어야 합니다. 칸당 100문항이라 95% 구간이 약 ±10점입니다. 그래서 논문은 6k·64k의 큰 여러 단계 차이(예: 41 대 14)만 확립된 것으로 보고, 한 단계 차이와 262k 여러 단계 차이(11 대 8)는 '무승부 또는 방향성'으로만 읽습니다. 또 4B로 돌린 Graphiti의 낮은 점수는 충돌 해결이 아니라 추출의 한계입니다. 4B로는 455개 사실에서 관계 간선을 110개밖에 못 만들었고, 상위 10개 간선에 정답이 들어간 문항이 100개 중 32개였습니다. 35B 추출기로 다시 돌리면 한 단계 77%(64k 86%)까지 오르지만, 그래도 P-Mem이 세 축 모두에서 앞섭니다(96% 대 77%, 낡은 답 3.1% 대 10.9%, 여러 단계 53% 대 18%). 비용도 다릅니다. Graphiti는 덩어리당 수집 시간이 15.6초에서 133초로 늘었고, 64k를 수집하는 데 12.5시간이 걸렸습니다. 262k는 손이 닿지 않았습니다.
쓰기 경로가 정말 믿을 만한지도 감사했습니다. 템플릿 스트림이라 정답 상태를 기계적으로 뽑을 수 있으니, 262k의 쓰기 18,306건을 LLM 판정 없이 대조했습니다. 정답 키 8,445개 중 99%에서 현재 값이 살아 있었고, 덮어써진 키의 13.0%에 낡은 형제 칸이 남았는데 거의 전부 '개정을 생성으로 잘못 처리한' 조각화였습니다. 그리고 본 실험의 한 단계 오답 29개 중 쓰기 경로 탓은 2개뿐이었습니다. 나머지는 답을 쥔 저장소를 잘못 읽은 경우입니다.
4.7 비용: 미리 정리하는 값은 언제 본전을 뽑나
쓸 때 확정은 공짜가 아닙니다. 부록 E는 쓰기 비용을 정직하게 셉니다. LongMemEval의 역사 하나(세션 47.5개)를 4B로 추출하는 데 LLM 호출 47.5회, 토큰 약 157k, H200 한 장에서 동시 20개 요청 기준 13.1초가 듭니다. 저장 공간은 추출된 사실(0.62MB)보다 임베딩 색인(2.8MB)이 큽니다.
손익분기는 이렇게 계산됩니다. 12칸 상태 읽기(약 0.7k)는 12턴 읽기(약 3k)보다 질문당 약 2.3k 토큰을 아낍니다. 157k를 2.3k로 나누면 약 70회입니다. 같은 역사를 70번 이상 들여다보면 미리 정리하는 쪽이 이득입니다. 전체 역사 읽기(약 106k)와 비교하면 질문 한 번이면 본전입니다. 거꾸로 LongMemEval처럼 역사 하나에 질문이 하나뿐이면 쓰기 경로는 경제적으로 회수되지 않습니다. 논문의 결론은 "같은 상태를 여러 세션에 걸쳐 들여다보는 오래 사는 비서는 이 문턱을 금방 넘는다"입니다.
5. 코어닷투데이 실측 — 한국어로 다시 만든 세 실험
논문은 코드를 공개하지 않았지만, ALFWorld-Revision의 세 실험(수정 사슬·철회·충돌)은 부록 B.2~B.3에 템플릿과 절차가 자세히 적혀 있습니다. 코어닷투데이는 이 절차를 따라 한국어 템플릿으로 실험을 새로 만들고, 논문과 거의 같은 체급의 공개 모델로 로컬에서 돌렸습니다. 질문은 두 가지였습니다. 논문의 결론이 한국어에서도 그대로 나오는가? 그리고 4B 모델이 여섯 연산을 정말 고를 수 있는가?
실험 조건
항목
논문
코어닷투데이 재현
읽기·주석 모델
Qwen3-4B-Instruct-2507 (온도 0, 사고 끔)
qwen3.5:4b (Ollama, 온도 0, 사고 끔)
임베딩
Qwen3-Embedding-4B
qwen3-embedding:4b
사실과 문장
ALFWorld 140게임의 물건-위치, 영어 템플릿
물건 20개·장소 20곳, 한국어 템플릿 ("업데이트: 열쇠를 서랍에서 선반으로 옮겼다.")
사례 수
140
40 (결정적 시드)
더미 구성
목표 1 + 방해 4개 사슬을 섞음, top-10
같음
쓸 때 확정
사건마다 패치 예측 호출 1회, 칸 한 줄 읽기
사건마다 여섯 연산 중 하나를 고르는 주석 호출 1회 + 결정적 적용, 칸 한 줄 읽기
채점
정규화 문자열 일치
정답 장소가 있고 다른 장소 이름이 없으면 정답
한 가지 사전 조정이 있었습니다. 처음 장소 목록의 '침대'를 4B가 자꾸 '침상'·'침실'로 바꿔 답해서, 동의어 채점 문제를 피하려고 '화장대'로 바꾼 뒤 처음부터 다시 돌렸습니다. 아래 숫자는 모두 다시 돌린 결과입니다.
결과 ① 수정 사슬 — 한국어에서는 더 빨리 무너진다
L
쓸 때 확정
질문 때 top-10
+ [t] 순서표
정답 순서로 제시
논문 질문 때 top-10
1
100
97.5
97.5
95.0
100.0
2
100
42.5
92.5
100
72.9
4
100
27.5
82.5
100
42.9
8
100
22.5
72.5
100
25.0
쓸 때 확정 L=8
100%
정답 순서 L=8
100%
+ 순서표 L=8
72.5%
질문 때 L=8
22.5%
모양은 논문과 똑같습니다. 쓸 때 확정은 160건 전부에서 주석기가 매번 ACCEPT를 골랐고, 네 길이 모두 100%입니다. 정답 순서로 보여 주면 4B도 95~100%를 맞힙니다. 증거가 모자란 것이 아닙니다. top-10 안에 목표 사슬이 들어 있는 비율도 L=8에서 평균 97%였습니다.
다른 점은 질문 때 읽기가 한국어에서 더 빨리 무너진다는 것입니다. 수정이 두 번뿐인 L=2에서 이미 42.5%로, 논문의 72.9%보다 30점 낮습니다. 대신 [t] 순서표의 효과는 훨씬 큽니다. L=2에서 42.5→92.5%, L=8에서 22.5→72.5%로, 논문(25.0→64.3%)보다 더 많이 회복했습니다. 4B가 한국어 문장 더미에서 '무엇이 나중인가'를 스스로 짐작하는 데 특히 약하고, 순서를 명시적으로 주면 그 약점이 대부분 사라진다는 뜻으로 읽힙니다. 그래도 순서표가 쓸 때 확정을 따라잡지는 못합니다. L=8에서 27.5점이 남습니다.
오답은 어디로 가나. 질문 때 읽기의 오답을 같은 조건으로 다시 돌려 분류했습니다.
조건
정답
중간 경유지
처음 위치
방해 물건의 위치
질문 때 L=2
17
23
0
0
질문 때 L=4
12
26
2
0
질문 때 L=8
9
28
0
3
+ 순서표 L=8
29
11
0
0
오답의 대부분은 중간 경유지입니다. 맨 처음 위치(가장 낡은 값)를 답한 경우는 드뭅니다. 모델은 "옮겼다"는 문장을 읽었고, 처음 값이 낡았다는 것도 압니다. 하지만 여러 "옮겼다" 문장 중 어느 것이 마지막인지를 잘못 고릅니다. 논문이 L=8의 오답을 "중간 경유지이거나 방해 물건의 위치"라고 설명한 것과 같습니다. 순서 재조립이 무너진다는 진단이 한국어에서도 그대로 확인됩니다. (이 분류 실행은 같은 프롬프트로 다시 돌린 것이라 L=4 정답 수가 본 실행의 11건과 1건 다릅니다.)
결과 ② 철회 — 보존 여부 하나가 100%와 0%를 가른다
방식
사이 사건 0개
사이 사건 8개
저장소에 v1
쓸 때 확정 + 보존
100%
100%
100%
쓸 때 확정, 보존 없음
0%
0%
0%
질문 때 읽기 (top-10)
85.0%
100%
100%
4B 주석기는 80건 모두에서 착오 업데이트("열쇠는 이제 선반에 있다")를 ACCEPT로, 철회 문장("열쇠가 선반에 있다는 앞의 업데이트는 착오였다")을 REVOKE로 골랐습니다. 두 쓸 때 확정 줄은 연산이 똑같은데 보존 여부만 다르고, 결과는 논문과 같이 100% 대 0%입니다. 보존이 없는 쪽은 REVOKE를 적용한 순간 칸이 비고, 읽는 모델은 정직하게 "모름"이라고 답했습니다.
질문 때 읽기는 논문(97.9%·92.0%)보다 들쭉날쭉합니다. 사이 사건 0개에서 85%, 8개에서 100%입니다. 사이 사건이 많을수록 어려워진다는 논문의 경향과는 반대입니다. 이유가 하나 있습니다. 이 조건에서는 검색된 줄을 도착 순서대로 늘어놓았는데, 논문보다 쉬운 설정입니다. 사례도 40건이라 6건의 차이는 우연일 수 있습니다. 이 칸은 '아카이브도 원문을 갖고 있으면 대체로 복구한다'는 정도로만 읽어 주세요.
결과 ③ 충돌 — 고르지 않고 들고 있기
두 사람이 같은 물건의 위치를 다르게 말하고("민수의 말: 열쇠는 서랍에 있어요." / "지영의 말: 열쇠는 선반에 있어요."), 방해 사건 8개 뒤 확인 사건("직접 확인한 결과: 열쇠는 서랍에 있었다.")이 옵니다. 정답 쪽은 사례마다 번갈아 정했습니다.
방식
충돌 기록
해결 전 '엇갈림' 알림
해결 뒤 정답률
이의/해결 경로
CONTEST 100%
100%
100% (RESOLVE 100%)
마지막 쓰기 승리
표현 못 함
0% (해결 전 답이 나중 정답과 맞은 비율 50%)
100%
질문 때 읽기 (top-10)
—
100%
72.5%
논문 질문 때 읽기
—
96.4%
57.1%
이의/해결 경로는 논문(해결 뒤 97.9%)보다도 깔끔하게 40건 모두를 맞혔습니다. 질문 때 읽기는 엇갈림은 잘 알아채지만, 확인 사건이 들어온 뒤에도 네 건 중 한 건 이상을 틀립니다. "직접 확인한 결과"라는 문장이 두 보고보다 권위가 높다는 것을 질문마다 다시 판단해야 하기 때문입니다. 쓸 때 확정은 그 판단을 확인 사건이 도착한 순간 한 번 내리고 끝냅니다.
결과 ④ 4B는 여섯 연산을 고를 수 있나 — 예시가 결정한다
마지막으로 가장 궁금했던 것을 쟀습니다. 위 결과는 모두 예시 6개가 들어간 지시문으로 얻은 것입니다. 예시를 빼고 연산의 정의만 주면 어떻게 될까요? 철회·충돌 실험의 목표 사건 네 종류에서 4B 주석기가 맞는 연산을 고른 비율입니다(각 40건).
사건
정답 연산
정의만 준 지시문
예시 6개 지시문
"이제 선반에 있다" (값 변경)
ACCEPT
100%
100%
"앞의 업데이트는 착오였다" (철회)
REVOKE
100%
100%
다른 사람이 다른 위치를 말함 (단서 없음)
CONTEST
100%
100%
"직접 확인한 결과…" (이의 중인 칸)
RESOLVE
2.5%
100%
정의만 준 지시문에서 4B는 RESOLVE를 거의 고르지 못했습니다. 40건 중 17건은 ACCEPT를, 22건은 CONTEST를 골랐습니다. 확인 결과를 '또 하나의 새 값'이나 '또 하나의 반대 의견'으로 본 것입니다. ACCEPT로 처리되면 결과적으로는 맞는 값이 머리에 올라갈 수 있지만, 이의 상태가 정리되지 않고 '대체됨' 사슬이 엉뚱하게 이어집니다. CONTEST를 고르면 갈등이 끝나지 않습니다. 예시 여섯 줄을 넣자 100%가 되었습니다.
이 결과는 6장의 첫 번째 비판과 이어집니다. 템플릿처럼 정돈된 문장과 그 모양을 그대로 닮은 예시가 있으면 4B도 여섯 연산을 완벽하게 고릅니다. 하지만 그 완벽함은 지시문 설계에 크게 기대고 있고, 실제 대화의 다양한 말투에서도 그럴지는 이 실험이 말해 주지 않습니다. 논문이 "연산 어휘의 대부분은 통제된 시험에서만 돌았다"고 스스로 밝힌 이유를 직접 확인한 셈입니다.
결과 ⑤ 읽는 모델을 9B로 키우면
논문 부록 F는 읽는 모델을 35B로 키워도 질문 때 재조립이 조금밖에 나아지지 않는다고 보고합니다(L=2 72.9→87.1%, L=8 25.0→33.6%). 같은 질문을 qwen3.5:9b로 했습니다. 주석과 읽기를 모두 9B로 바꾸고 수정 사슬 실험을 다시 돌렸습니다.
L
쓸 때 확정 (4B / 9B)
질문 때 (4B / 9B)
+ 순서표 (4B / 9B)
1
100 / 100
97.5 / 100
97.5 / 97.5
2
100 / 100
42.5 / 60.0
92.5 / 82.5
4
100 / 100
27.5 / 40.0
82.5 / 75.0
8
100 / 100
22.5 / 25.0
72.5 / 75.0
9B는 수정이 적을 때 질문 때 읽기를 꽤 끌어올립니다(L=2에서 +17.5점). 하지만 L=8에서는 25.0%로 4B와 거의 같은 바닥에 닿습니다. 순서표를 붙인 조건은 오히려 9B가 L=2·4에서 조금 낮았습니다. 모델을 두 배 넘게 키워도 쓸 때 확정과의 격차는 L=8에서 75점 그대로입니다. 논문의 말대로 이 실패는 모델 크기가 아니라 구조의 문제입니다. 사건이 도착할 때 공짜로 주어진 순서 정보를 버려 놓고, 나중에 유사도 순 문장에서 다시 추리하라고 시키는 구조입니다.
1
재현된 것
쓸 때 확정은 한국어에서도 수정 횟수와 무관하게 100%였고, 질문 때 다시 꿰기는 L=8에서 22.5%로 무너졌습니다. 보존 하나가 철회 복구 100%와 0%를 갈랐고, 이의/해결은 충돌을 한 번에 정리했습니다.
2
한국어에서 달랐던 것
질문 때 읽기가 논문보다 훨씬 빨리 무너졌고(L=2에서 42.5% 대 72.9%), 대신 도착 순서표 하나로 크게 회복했습니다(92.5%). 오답은 대부분 처음 값이 아니라 중간 경유지였습니다.
3
주의할 것
4B 주석기의 완벽한 연산 선택은 예시가 든 지시문 덕분이었습니다. 예시를 빼면 RESOLVE를 2.5%만 골랐습니다. 사례 40건의 템플릿 실험이므로 실제 대화로 일반화하지는 마세요.
6. 비판적으로 읽기 — 이 논문이 증명한 것과 아직 아닌 것
이 논문의 미덕은 자기 결과를 과장하지 않는다는 점입니다. 초록부터 "결정적 이득은 정확도가 아니라 유효성"이라고 말하고, 정확도 4배 효율이 그래프가 아니라 검색 입도에서 나왔다고 스스로 밝힙니다. 그래도 독자가 알고 읽어야 할 단서가 여럿 있습니다.
1. 연산 어휘의 대부분은 자연 데이터에서 시험되지 않았다. 자연 스트림은 거의 전부 ACCEPT입니다. CONTEST·RESOLVE는 통제된 시험에서만, REVOKE는 "v2로 옮겼다는 것은 착오였다"는 템플릿 철회 문장에서만 돌았습니다. 논문 스스로 한계 절에서 "연산 어휘의 일부만 실험했다"고 적습니다. 실제 대화에서 사람들은 "아 그거 말고"나 "아니다, 다시 생각해 보니" 같은 식으로 철회합니다. 그 다양한 말투를 4B 주석기가 얼마나 잘 연산으로 바꾸는지는 아직 모릅니다. 5장의 한국어 재현에서도 정의만 준 지시문으로는 4B가 "직접 확인한 결과…"를 RESOLVE로 거의 고르지 못했습니다(40건 중 1건). 예시를 넣자 100%가 되었지만, 그 예시는 시험 문장과 모양이 거의 같았습니다.
2. ALFWorld-Revision은 이름보다 훨씬 단순한 합성 과제다. 부록 B.2를 보면 이 벤치마크는 ALFWorld 환경을 실제로 돌리지 않습니다. 140개 게임에서 '물건-위치' 사실만 가져와 "업데이트: {물건}을 {a}에서 {b}로 옮겼다" 같은 템플릿 문장을 만든 것입니다. 수정 사슬 실험의 결론(순서 재조립이 무너진다)은 여전히 유효합니다. 다만 "가사 로봇 환경에서 100%"라는 인상과는 거리가 있습니다. 템플릿이 깔끔할수록 쓸 때 확정이 유리합니다. 키가 {object}.location으로 거의 자동으로 정해지기 때문입니다. 4.3절의 자연 대화 결과가 보여 주듯, 진짜 어려움은 그 키를 언어에서 뽑는 데 있습니다.
3. '도착 순서 = 유효 순서'라는 가정. 논문은 마지막 쓰기 승리를 전제하고, 늦게 들어온 보고·소급 날짜·순서 뒤바뀜·출처 간 권위 충돌은 범위 밖이라고 명시합니다. 하지만 현실의 기록은 자주 이 가정을 깹니다. 법령은 공포일과 시행일이 다르고, 정정공시는 원공시보다 늦게 오지만 과거 기준일을 고칩니다. "다음 달부터 부산으로 옮겨요"는 오늘 도착했지만 다음 달부터 참입니다. 코어닷투데이가 사실탐색기 v2 설계에서 '도착 순서와 무관한 키별 재생'과 권위 격자(전언 ≺ 1인칭 ≺ 공식)를 따로 둔 이유가 이것입니다.
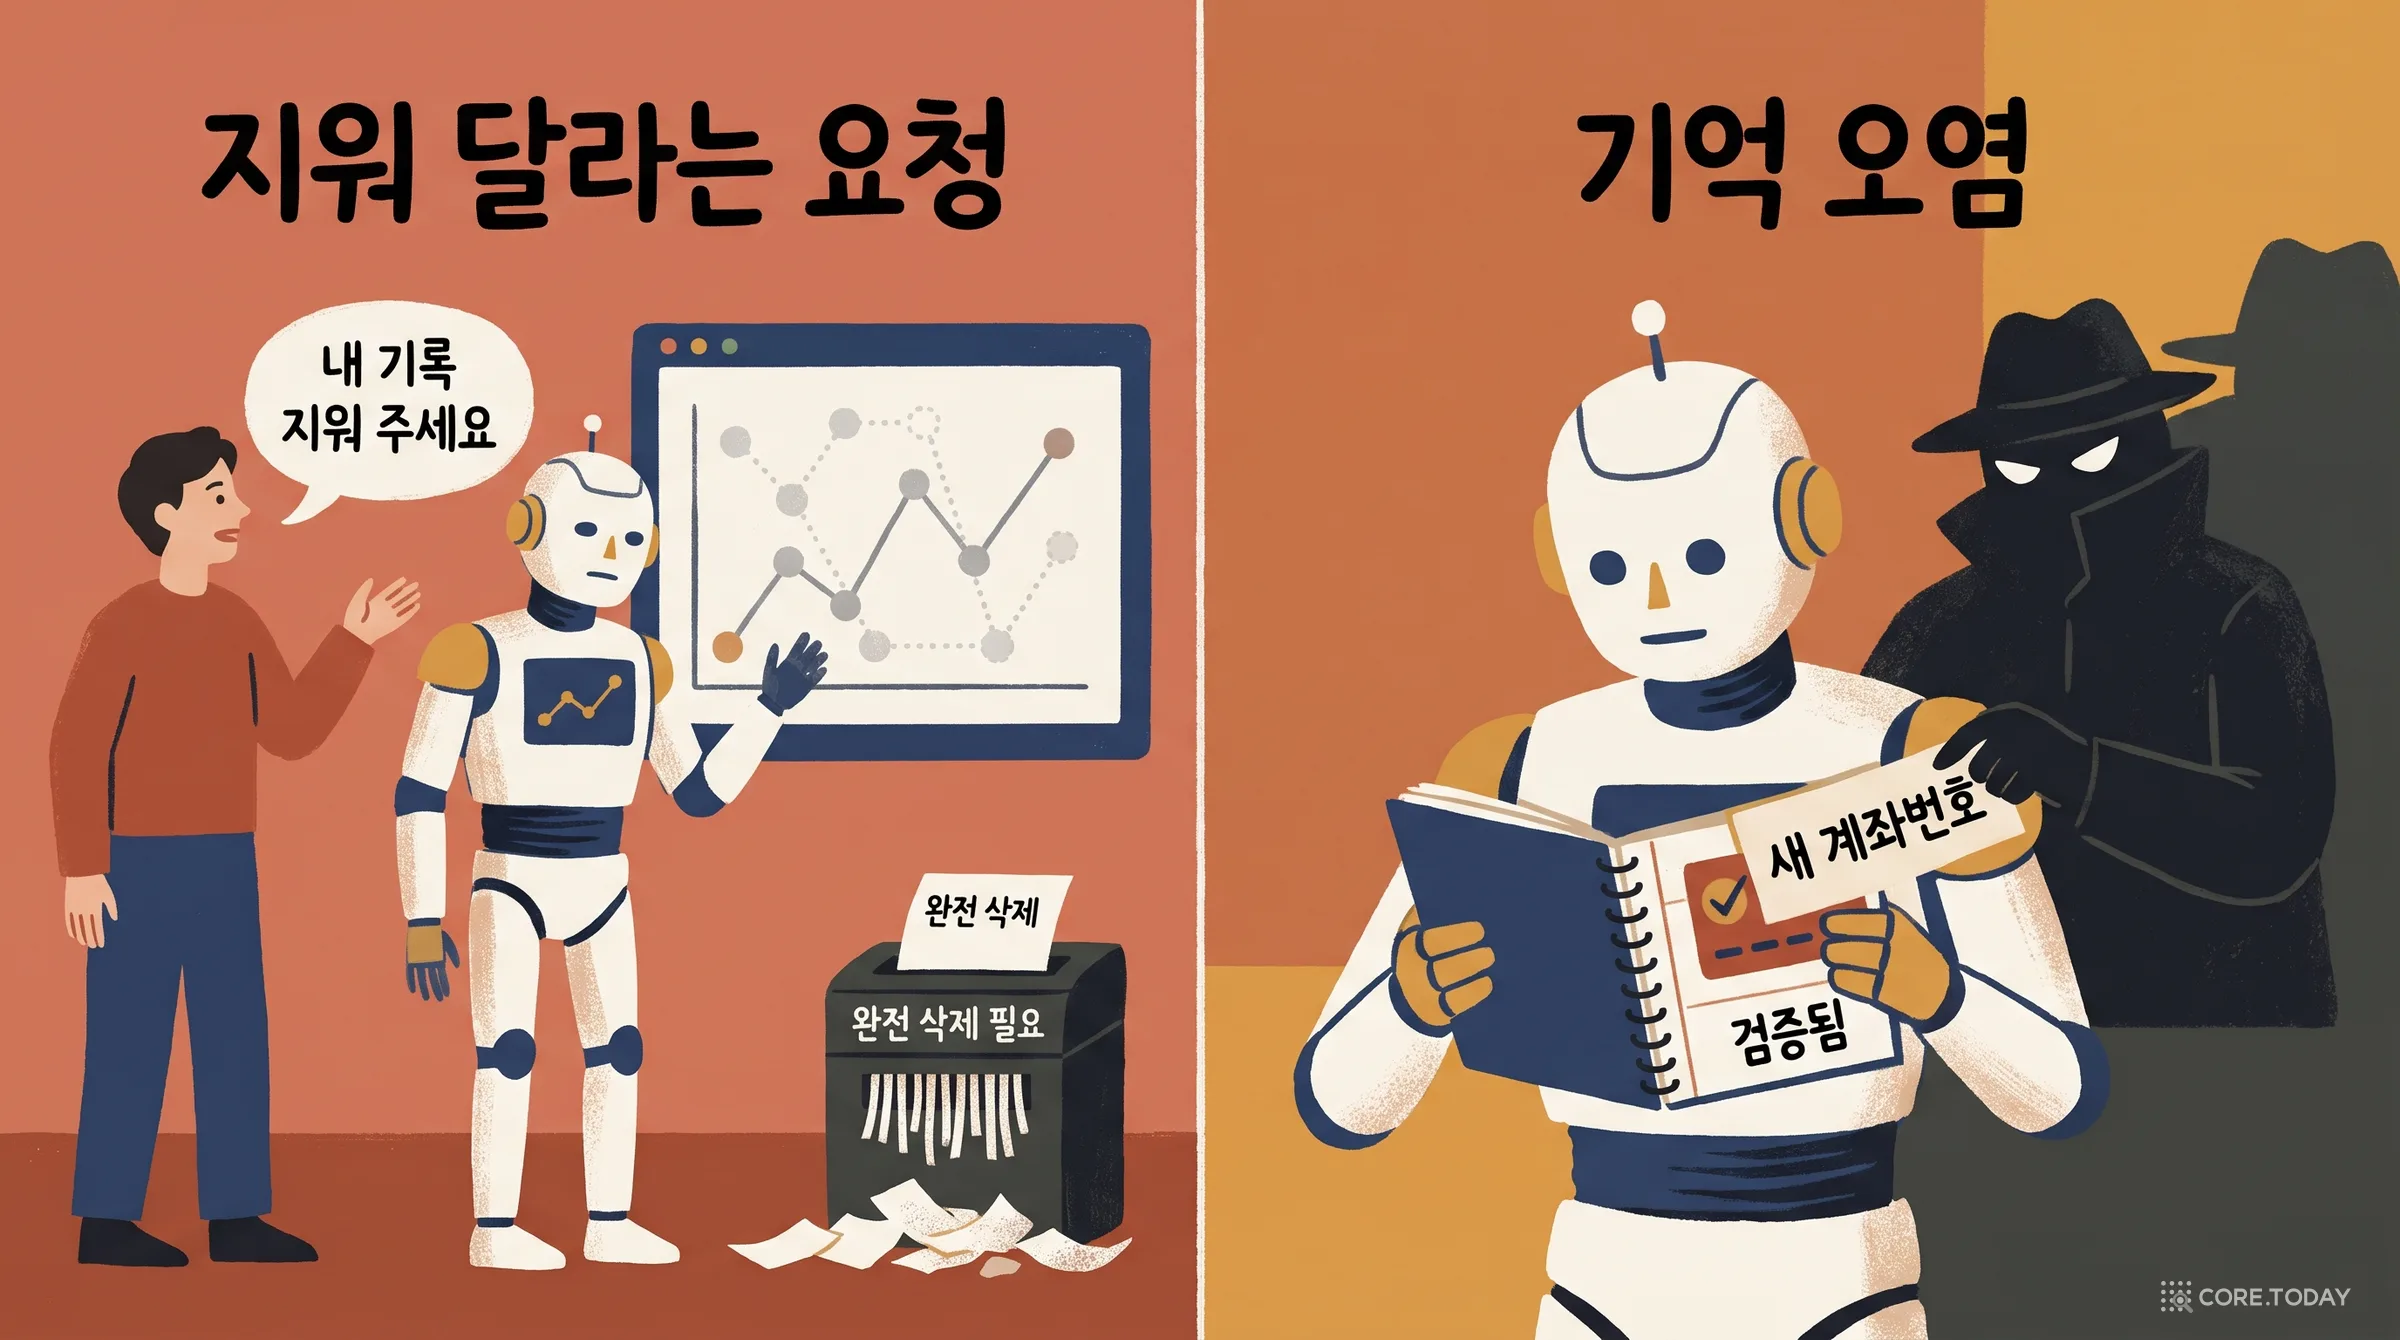
4. 권위를 따지지 않는 주석기와 기억 오염. 한계 절의 마지막 문장이 무겁습니다. "주석기는 출처의 권위를 따지지 않으므로, 믿을 수 없는 관찰이 믿을 만한 값을 대체할 수 있다. 기억 오염은 향후 과제로 남긴다." 쓸 때 확정은 양날의 칼입니다. 올바른 갱신이 즉시 반영되는 것처럼 악의적인 갱신도 즉시 반영됩니다. 메일 한 통에 숨긴 "새 계좌번호는 …"가 검증된 값을 밀어내고 활성 전선에 올라설 수 있습니다. 보존 덕분에 나중에 되돌릴 수는 있지만, 그 사이에 에이전트는 틀린 값으로 행동합니다. 코어닷투데이의 기억 오염 특집에서 Graphiti로 실측한 것과 같은 문제입니다.
5. 추가 전용은 삭제가 아니다. 논문이 스스로 짚는 두 번째 배포 공백입니다. 강등은 지우는 것이 아닙니다. 그래서 개인정보 삭제 요청을 처리하려면 노드, 임베딩, 그리고 그 값에서 파생된 값까지 실제로 지워야 합니다. 한국 개인정보 보호법의 정정·삭제 요구권, 유럽 GDPR의 삭제권(제17조)과 '아무것도 지우지 않는다'는 설계 원칙 사이에는 정면 충돌이 있습니다. 감사 가능성과 잊힐 권리를 함께 만족시키려면 '봉인'(내용은 지우고 '여기 무언가 있었다'는 묘비만 남기기) 같은 추가 설계가 필요합니다.
6. 백본 하나, 표본 크기. 모든 주 실험은 Qwen3-4B 하나입니다. 35B 읽기·쓰기 확인이 격차가 유지된다는 것을 보이긴 했지만, 더 큰 최신 모델과 다른 벤치마크는 시험하지 않았습니다. LongMemEval 지식 갱신은 78문항, FactConsolidation은 칸당 100문항이라 구간이 ±10점입니다. 논문은 이것을 알고 짝지은 검정과 '방향성'이라는 표현으로 신중하게 읽습니다. 독자도 그래야 합니다.
7. 기준선의 자리. Mem0는 이 실험에서 덮어쓰기 자체를 8.6%만 커밋했습니다. 대화형 기억을 겨냥한 시스템이라 반사실 사실 스트림은 본래 용도가 아닙니다. 논문도 Mem0를 "CRUD 모서리의 표지이지 의도된 쓰임이 아니다"라고 적습니다. Graphiti도 4B 추출기에서는 추출이 병목이었습니다. 논문이 35B 재실행으로 이것을 보완한 점은 공정하지만, 'CRUD는 이렇다', '이중 시간 KG는 이렇다'를 이 두 시스템의 특정 구성 하나로 대표하는 데는 한계가 있습니다. 거꾸로 MemoryOS는 기본 키로는 11.2%밖에 안 나와서 내용 키 변형(45.8%)을 기준선으로 썼습니다. 기준선에 유리한 선택입니다.
8. 코드는 아직 없다. 2026년 11월 14일 현재 arXiv v1 본문과 초록 페이지에 코드 저장소 링크가 없습니다. 패치 인터페이스·주석기 지시문·가지치기 질의 같은 세부는 부록의 서술로만 알 수 있습니다. 5장의 재현이 부록 설명을 따라 지시문을 새로 쓴 이유입니다.
7. 2026년, '기억의 기억'은 어디에 쓰이나
제품 기억은 이미 두 모서리에 서 있다
2026년의 AI 비서들은 모두 기억을 가졌습니다. 겉으로 드러난 동작만 놓고 보면, 이들은 표 1의 두 모서리에 걸쳐 있습니다. ChatGPT는 2024년 2월 '저장된 기억'을 내놓았습니다. 사용자가 보고 지울 수 있는 사실 목록으로, 들어올 때 정하고 고칠 때 덮어쓰는 CRUD에 가깝습니다. 2025년 4월에는 '대화 기록 참조'를 더했습니다. 지난 대화 전체에서 꺼내 쓰는 방식이라 아카이브에 가깝습니다. 2026년 6월의 'Dreaming'은 저장된 기억과 대화 기록을 백그라운드에서 정리하고 다시 씁니다. Claude의 기억도 대화 검색과 주기적으로 갱신되는 요약을 함께 씁니다(내부 구현은 공개되지 않았으므로 이 분류는 어디까지나 겉으로 보이는 동작에 기댄 비유입니다).
MoM의 관점에서 보면 질문은 하나로 모입니다. 기억을 '다시 쓸' 때, 밀려난 것은 어디로 가는가? 요약을 새로 쓰면서 옛 요약을 버린다면 CRUD의 약점(되돌릴 수 없음, "예전엔 뭐였지?"에 답 못 함)을 물려받습니다. 대화 기록을 다 들고 질문마다 다시 읽는다면 아카이브의 약점(낡은 값의 재등장, 질문마다 다른 판결)을 물려받습니다. 코어닷투데이가 Supersede 특집에서 짚었듯, OpenAI가 공개한 "시간이 지나도 정확하게" 과제 성공률(75.1%)은 업계 최고 수준의 제품도 넷 중 하나는 여전히 옛 사실을 붙든다는 뜻이기도 합니다.
사용자가 "왜?"라고 물을 수 있는 기억
출처 그래프의 가장 실용적인 가치는 정확도보다 설명 가능성일지 모릅니다. "왜 내 주소를 부산이라고 기억해?"라는 질문에, 아카이브는 비슷한 문장 몇 개를 다시 보여 주는 것이 최선입니다. CRUD는 답할 근거가 없습니다. 출처 그래프는 근거 간선 하나로 답합니다. "3월 12일 대화에서 '부산으로 이사했어요'라고 하셨고, 그 말이 서울을 대체했습니다." 그리고 바로 옆에 '되돌리기' 버튼을 달 수 있습니다.
이것은 사용자 경험의 문제이면서 규제의 문제이기도 합니다. EU AI 법은 고위험 AI 시스템에 작동 중 사건을 자동으로 기록하는 로그 기능을 요구합니다(제12조). 기업용 에이전트가 고객 예산, 계약 조건, 담당자, 권한 같은 '바뀌는 사실'을 근거로 행동한다면, "그때 에이전트가 무엇을 지금 값으로 믿었고 그 믿음은 어디서 왔나"를 재구성할 수 있어야 합니다. 질문마다 다시 판결하는 아카이브는 그 재구성이 어렵습니다. 판결 자체가 어디에도 남지 않기 때문입니다.
어디에 특히 맞나
논문의 손익분기 계산이 힌트를 줍니다. 같은 상태를 여러 번 들여다보는 오래 사는 에이전트에 맞습니다. 예를 들면 이렇습니다.
영역
바뀌는 사실의 예
MoM이 주는 것
영업·고객 관리 에이전트
고객 예산, 담당자, 계약 단계, 선호 연락 시간
현재 값 한 줄 읽기, 착오 갱신 되돌리기, 두 담당자 말이 엇갈릴 때 보류
코딩 에이전트
"이 저장소는 pnpm으로 바꿨어", 배포 대상, 금지된 API
옛 규칙이 검색으로 되살아나 잘못 실행되는 일 방지, 규칙 변경 이력
의료·돌봄 기록 보조
복용 약, 알레르기, 보호자 연락처
'낡음'(복용 중단)과 '틀림'(잘못 기록)의 구별, 근거 제시
법률·행정 문서 보조
법령 개정, 조례 변경, 담당 부서
현재 유효사항과 연혁을 함께. 다만 시행일과 도착일이 달라 유효 시간 확장이 필요
개인 비서
주소, 기록, 일정, 취향
"예전엔?"과 "지금은?"에 모두 답하기, "왜 그렇게 기억해?"에 근거로 답하기
만드는 사람을 위한 체크리스트
이 논문을 읽고 자기 에이전트 기억에 바로 적용해 볼 수 있는 것들을 정리합니다.
1기억 설계를 두 축에 놓아 보세요. 현재 값을 언제 정하나(도착 때·질문 때), 밀려난 값을 남기나(남김·지움). 지금 어느 모서리에 있는지 아는 것이 출발점입니다
2아카이브라면 최소한 도착 순서를 붙이세요. FactConsolidation에서 순서표 하나가 한 단계 정답률을 71~86%에서 90~94%로 올렸습니다. 가장 싼 개선입니다
3덮어쓰기 전에 옛 값을 '대체됨'으로 남기고, 새 값에서 옛 값으로 가는 간선을 기록하세요. 보존만 하고 간선이 없으면 Graphiti처럼 되돌리기 0%입니다
4'낡음'과 '틀림'을 구별하세요(ACCEPT 대 REJECT). "예전 주소"와 "잘못 적은 주소"는 다른 질문에 답합니다
5우선할 단서가 없는 충돌은 고르지 말고 보류(CONTEST)하세요. 사용자에게 엇갈림을 알리는 편이 동전 던지기보다 낫습니다
6키 조각화를 재세요. 칸당 사실 수가 1에 가깝다면 대체가 아니라 분기가 일어나고 있습니다. 키 합치기 확인에는 값을 보여 주지 마세요
7출처의 권위를 따지세요. 누가 말했는지 보지 않는 쓸 때 확정은 기억 오염의 지름길입니다
8'지우지 않는다'와 '지워 달라'를 함께 설계하세요. 삭제 요청은 노드·임베딩·파생값까지 실제로 지우고, 감사용 묘비만 남깁니다
사람의 기억도 출처를 잃는다
마지막으로 제목 이야기를 하겠습니다. '기억에 대한 기억'은 인지심리학에서 오래된 개념입니다. 존 플라벨은 1970년대 초 자기 기억에 대한 앎과 조절을 '메타기억(metamemory)'이라고 불렀고, 넬슨과 나렌스는 1990년에 이를 감시(monitoring)와 통제(control)의 두 흐름으로 정리했습니다. 그리고 마샤 존슨 등의 '출처 감시(source monitoring)' 연구는 사람이 내용은 기억해도 그것을 어디서 들었는지는 쉽게 잊는다는 것을 보여 주었습니다. 뉴스에서 본 것인지 친구에게 들은 것인지, 실제로 있었던 일인지 상상한 일인지가 흐려지는 것입니다.
LLM 에이전트의 기억은 이 약점을 그대로 물려받을 이유가 없습니다. 기계는 출처를 잊지 않도록 만들 수 있습니다. MoM이 제안하는 것은 결국 이것입니다. 내용만 기억하는 기억이 아니라, 자기가 무엇을 언제 왜 믿게 되었고 무엇을 밀어냈는지까지 기억하는 기억입니다.
맺으며 — 말소사항까지 기억하는 기계
등기소는 말소된 등기를 지우지 않습니다. 빨간 줄을 긋고, 언제 어떤 원인으로 말소됐는지 적고, 그 아래에 새 등기를 올립니다. 평소에는 '현재 유효사항'만 떼어 보면 되지만, 분쟁이 생기거나 이상한 점이 보이면 '말소사항 포함'을 떼어 처음부터 읽습니다. 수십 년 동안 수많은 사람이 그 기록에 재산을 걸어 왔습니다.
MoM 논문이 AI 에이전트에게 요구하는 것도 같습니다. 지금 값은 한 줄로 즉시 답하고, 밀려난 값은 빨간 줄을 그어 남기고, 왜 밀려났는지 간선으로 이어 두라는 것입니다. 그러면 낡은 값이 검색으로 슬그머니 되살아나지 않고, 잘못 고친 값은 되돌릴 수 있으며, 엇갈리는 말은 섣불리 고르지 않고 들고 있을 수 있습니다.
논문은 아직 출발점입니다. 자연 대화에서는 키를 뽑고 맞추는 일이 병목이고, 연산 대부분은 통제된 시험에서만 돌았고, 도착 순서와 유효 순서가 다른 세계와 출처의 권위는 다음 과제로 남았습니다. 하지만 이 논문이 던진 두 질문, "현재 값을 언제 정하나, 밀려난 값을 어떻게 하나" 는 모든 에이전트 기억 설계자가 한 번쯤 자기 시스템에 던져 볼 만한 질문입니다. 5K 기록을 27:12라고 답하는 비서와 "25:50이에요. 3월의 27:12를 7월에 깨셨죠"라고 답하는 비서의 차이가 거기서 나옵니다.
Prateek Chhikara 외. "Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory." arXiv:2504.19413, 2025. https://arxiv.org/abs/2504.19413
Preston Rasmussen 외. "Zep: A Temporal Knowledge Graph Architecture for Agent Memory." arXiv:2501.13956, 2025.
Charles Packer 외. "MemGPT: Towards LLMs as Operating Systems." arXiv:2310.08560, 2023.
Jiazheng Kang 외. "Memory OS of AI Agent." arXiv:2506.06326, 2025.
Bernal Jiménez Gutiérrez 외. "From RAG to Memory: Non-Parametric Continual Learning for Large Language Models (HippoRAG 2)." arXiv:2502.14802, 2025.
Shengtao Zhang 외. "MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory." arXiv:2601.03192, 2026.
Di Wu 외. "LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory." ICLR 2025.
Adyasha Maharana 외. "Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo)." ACL 2024.
Yuanzhe Hu, Yu Wang, Julian McAuley. "Evaluating Memory in LLM Agents via Incremental Multi-Turn Interactions (MemoryAgentBench)." arXiv:2507.05257, 2025.
Zexue He 외. "MemoryArena: Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks." arXiv:2602.16313, 2026.
Mohit Shridhar 외. "ALFWorld: Aligning Text and Embodied Environments for Interactive Learning." ICLR 2021.
역사·배경
Joon Sung Park 외. "Generative Agents: Interactive Simulacra of Human Behavior." UIST 2023.