에이전트 메모리벤치마크FEB-30내재 평가외재 평가평가 방법론LLM 채점메모리 연산사실 진화Mem0Hindsight실측로컬 모델
답은 맞았는데 서랍은 엉망 — 에이전트 기억을 '속까지' 채점하는 FEB-30, 그리고 한국어 미니판 실측
에이전트 기억은 지금까지 '질문에 답을 잘하나'로만 채점됐습니다. AWS와 클루지나포카 공대 연구진의 FEB-30(arXiv 2610.22209)은 문서가 하나 들어올 때마다 기억 저장소를 직접 열어 정답 상태와 비교하자고 제안합니다. 30개 궤적에서 서랍 검사(내재)와 질문 채점(외재)은 평균 16.8점 벌어졌고, 두 채점의 통과·실패 일치도는 κ=0.118로 우연을 겨우 넘었습니다. 시스템이 생성·강화·갱신·대체 중 맞는 연산을 고른 비율은 20%였습니다. 이 개념이 어디서 왔는지(1993년 스파크 존스의 내재·외재 구분, 2013년 word2vec 유추, 2016년 '내재 점수는 실전을 예측하지 못한다' 논쟁)부터, 논문의 설계·표 13개·숨은 모순(외재 점수 30개 중 16개가 11번 내내 정확히 50%), 한국어 궤적 12개로 직접 돌린 미니 실측(같은 저장소가 판정 방식만 바꿔 100%와 25%), 2026년 기억 시스템의 변화와 실무 점검표까지 정리했습니다. 인터랙티브 7개.
이 글은 코어닷투데이의 에이전트 기억 연재와 이어집니다.메모리 벤치마크 점수, 믿어도 되나에서 LoCoMo·LongMemEval의 채점기와 정답지를 의심했고, 에이전트 기억 엔진 해부에서 Hindsight·Mem0·Graphiti의 코드를 열었습니다. 이번에는 질문 하나를 더 던집니다. 채점기가 공정하고 정답지가 완벽하다면, 질문에 답하는 점수만으로 기억을 평가해도 되는가?
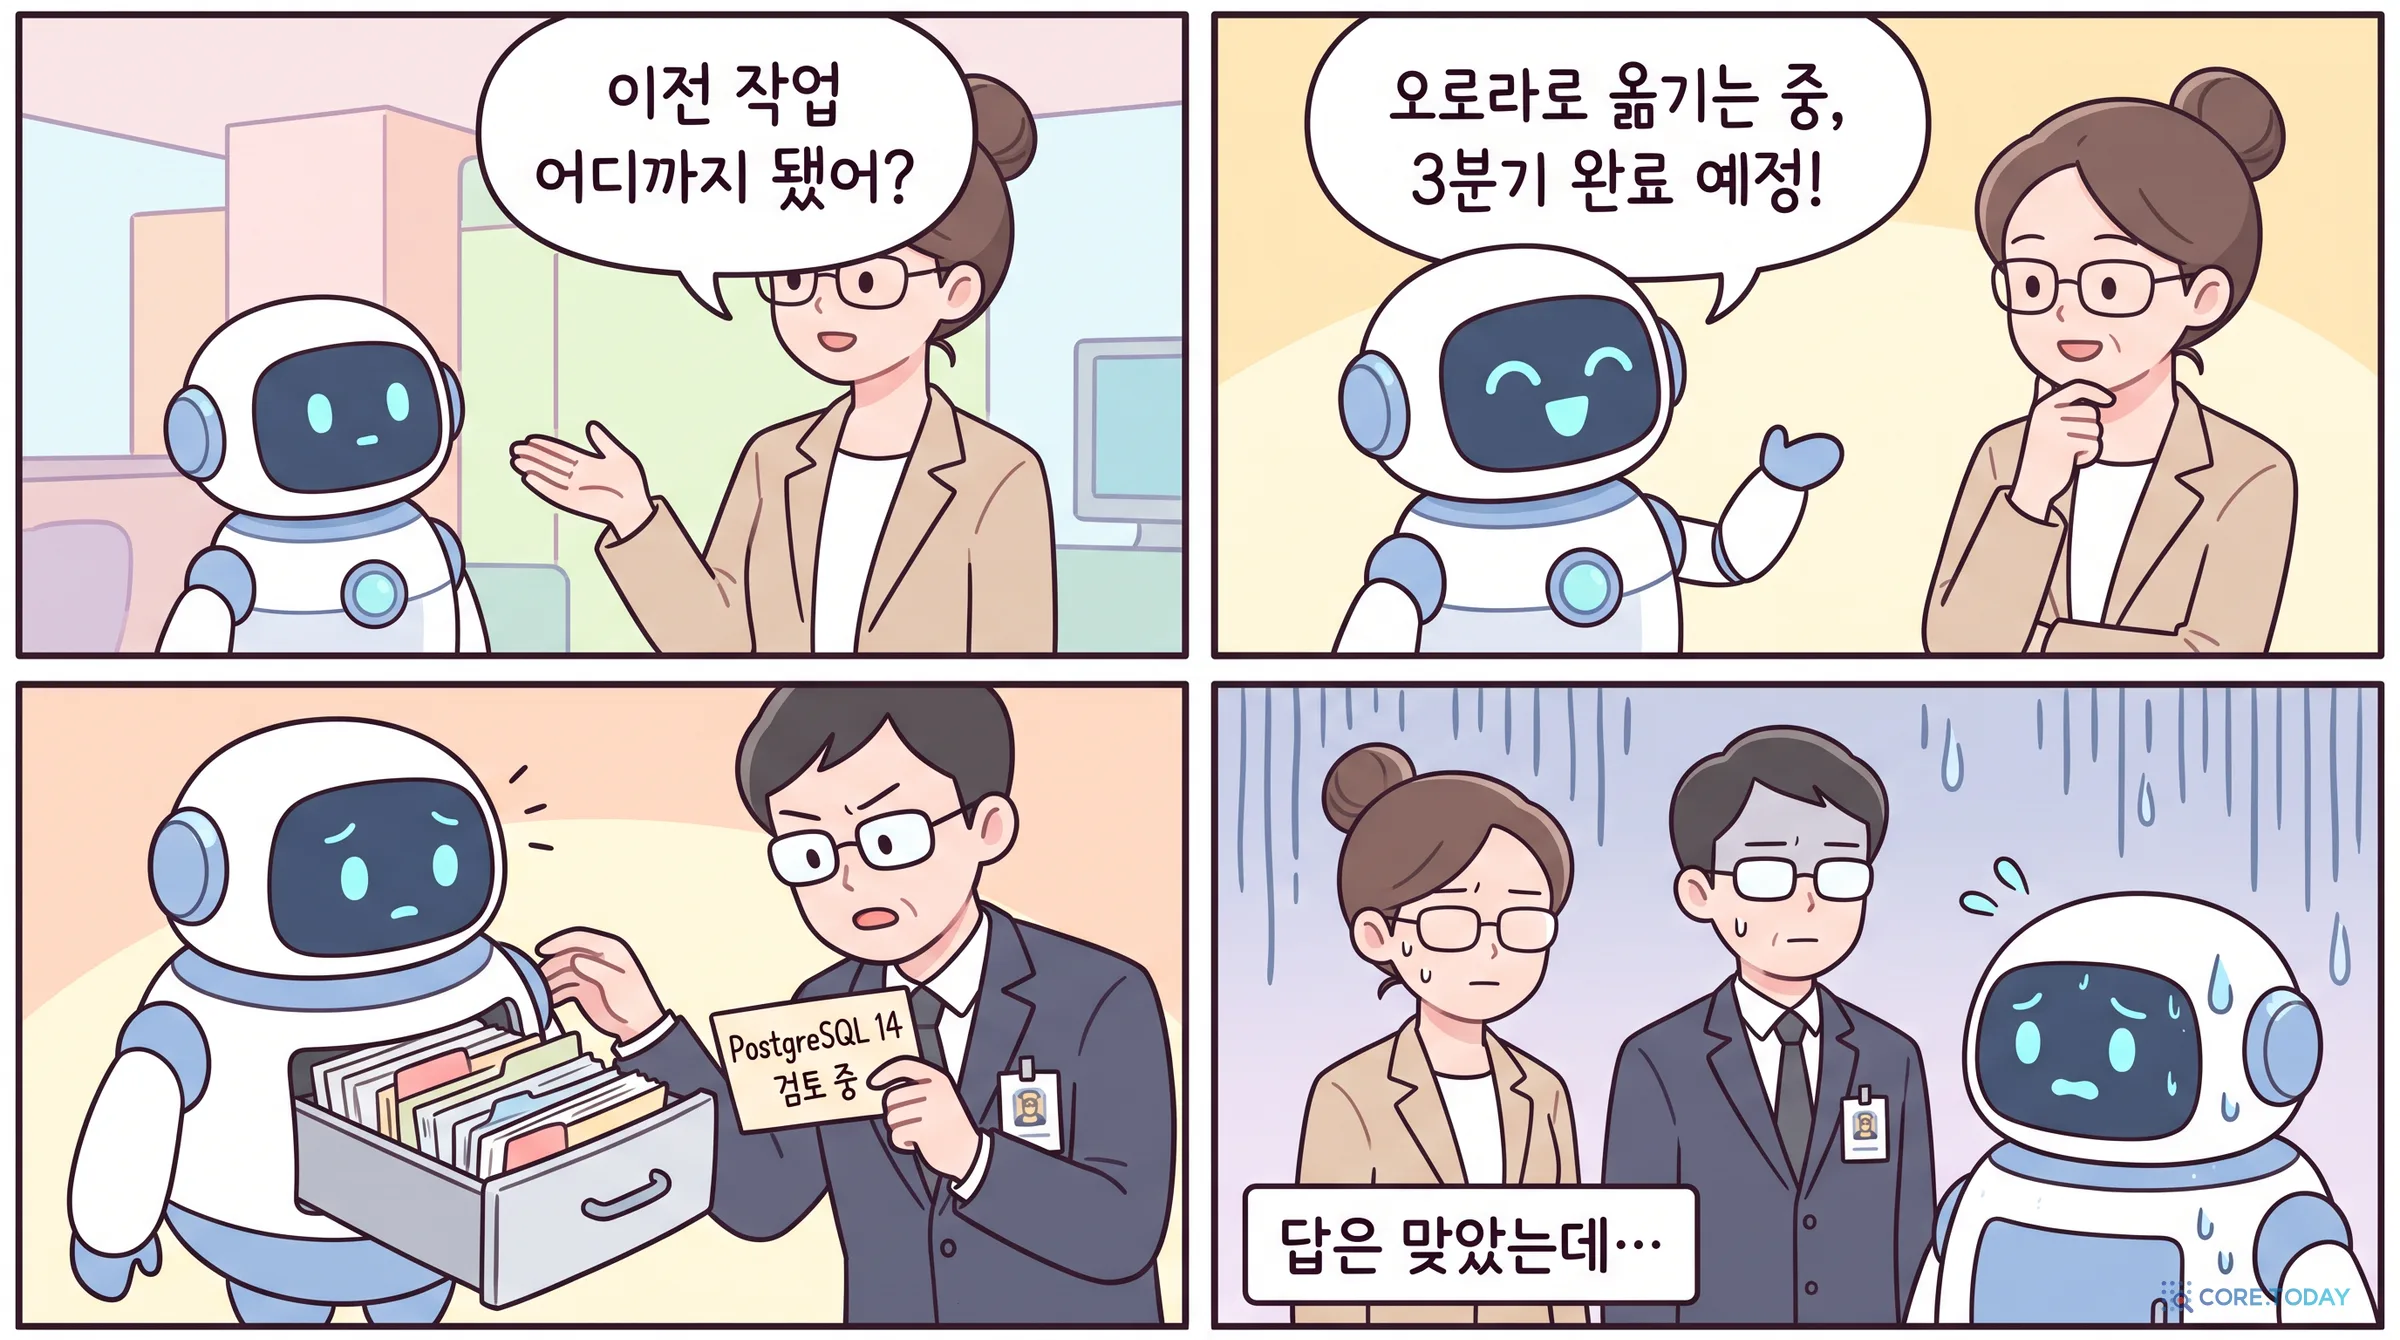
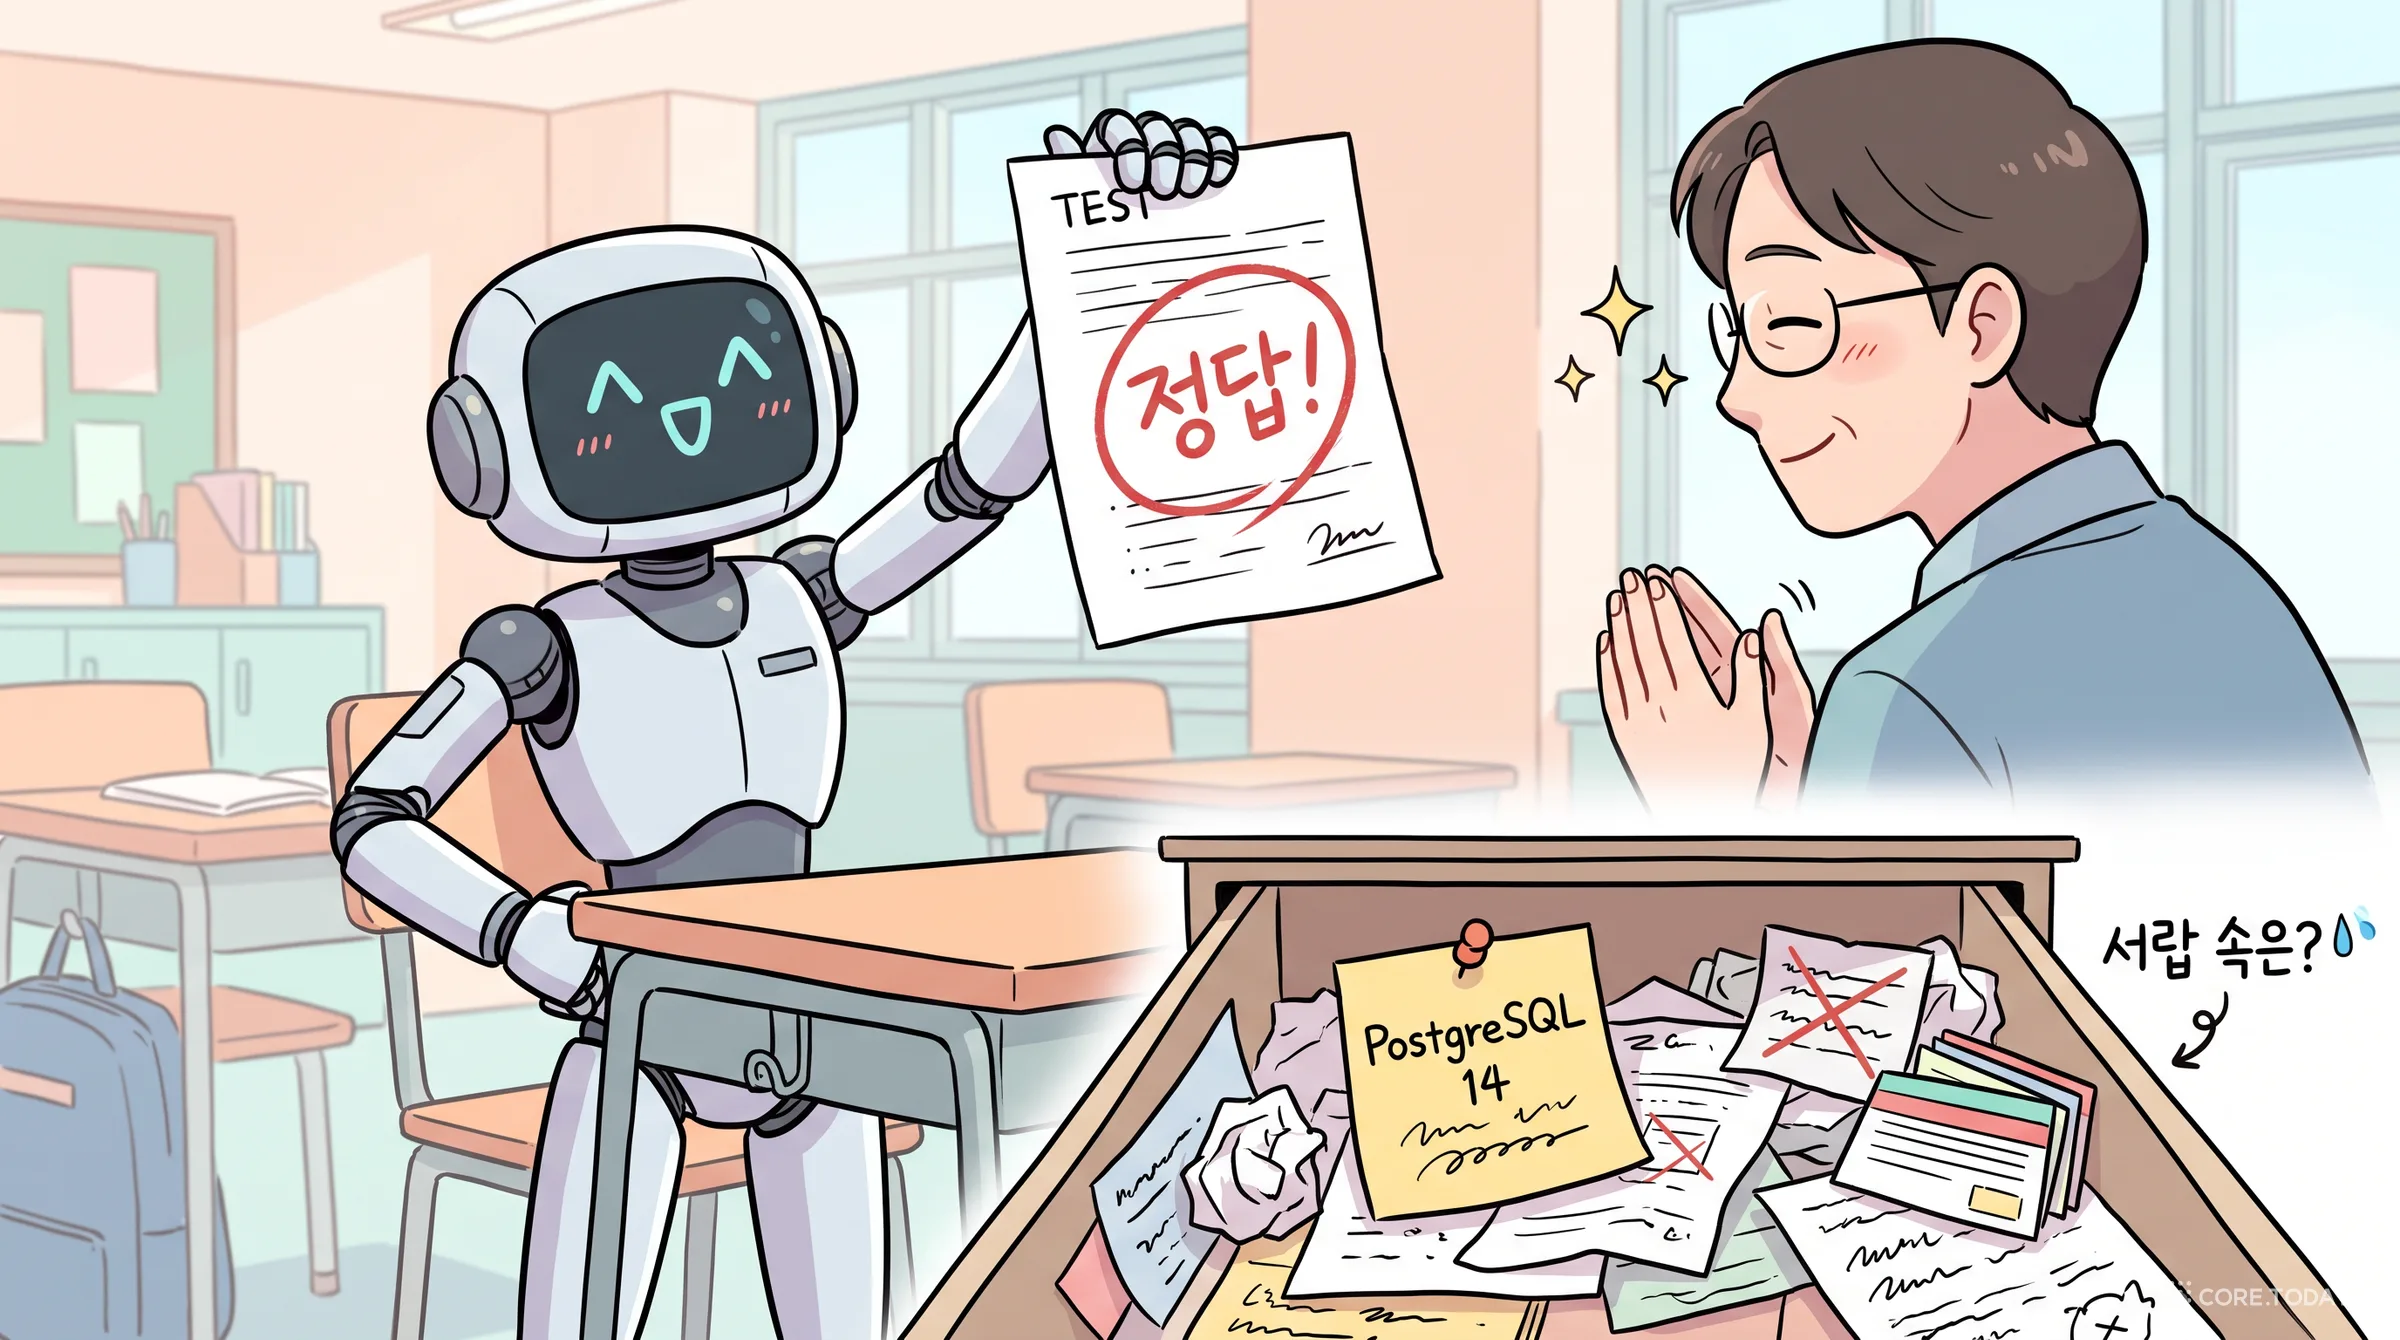
회사 업무를 돕는 AI 비서가 있다고 합시다. 지난 반년 동안 고객사 회의록, 이메일, 슬랙 메시지를 읽으며 ‘가람상사는 사내 서버의 PostgreSQL 14를 쓴다’, ‘Aurora와 AlloyDB를 검토 중이다’, ‘Aurora로 정했다’, ‘DMS 복제가 돌고 있다’ 같은 사실을 차곡차곡 기억해 왔습니다. 팀장이 묻습니다. “가람상사 이전 건, 어디까지 됐어?” 비서가 정확하게 답합니다. 시험이라면 만점입니다.
그런데 비서의 기억 저장소를 직접 열어 보면 사정이 다를 수 있습니다. 같은 고객에 대한 사실이 일곱 조각으로 흩어져 있고, 그중 하나는 석 달 전에 끝난 ‘Aurora와 AlloyDB를 검토 중’입니다. 이번 질문에는 답변 모델이 날짜를 보고 최신 조각을 골라 맞혔습니다. 하지만 다음 질문에서 검색이 하필 낡은 조각을 먼저 가져오면, 비서는 “아직 검토 중입니다”라고 답할 것입니다. 시험 점수는 이 위험을 보여 주지 않습니다.
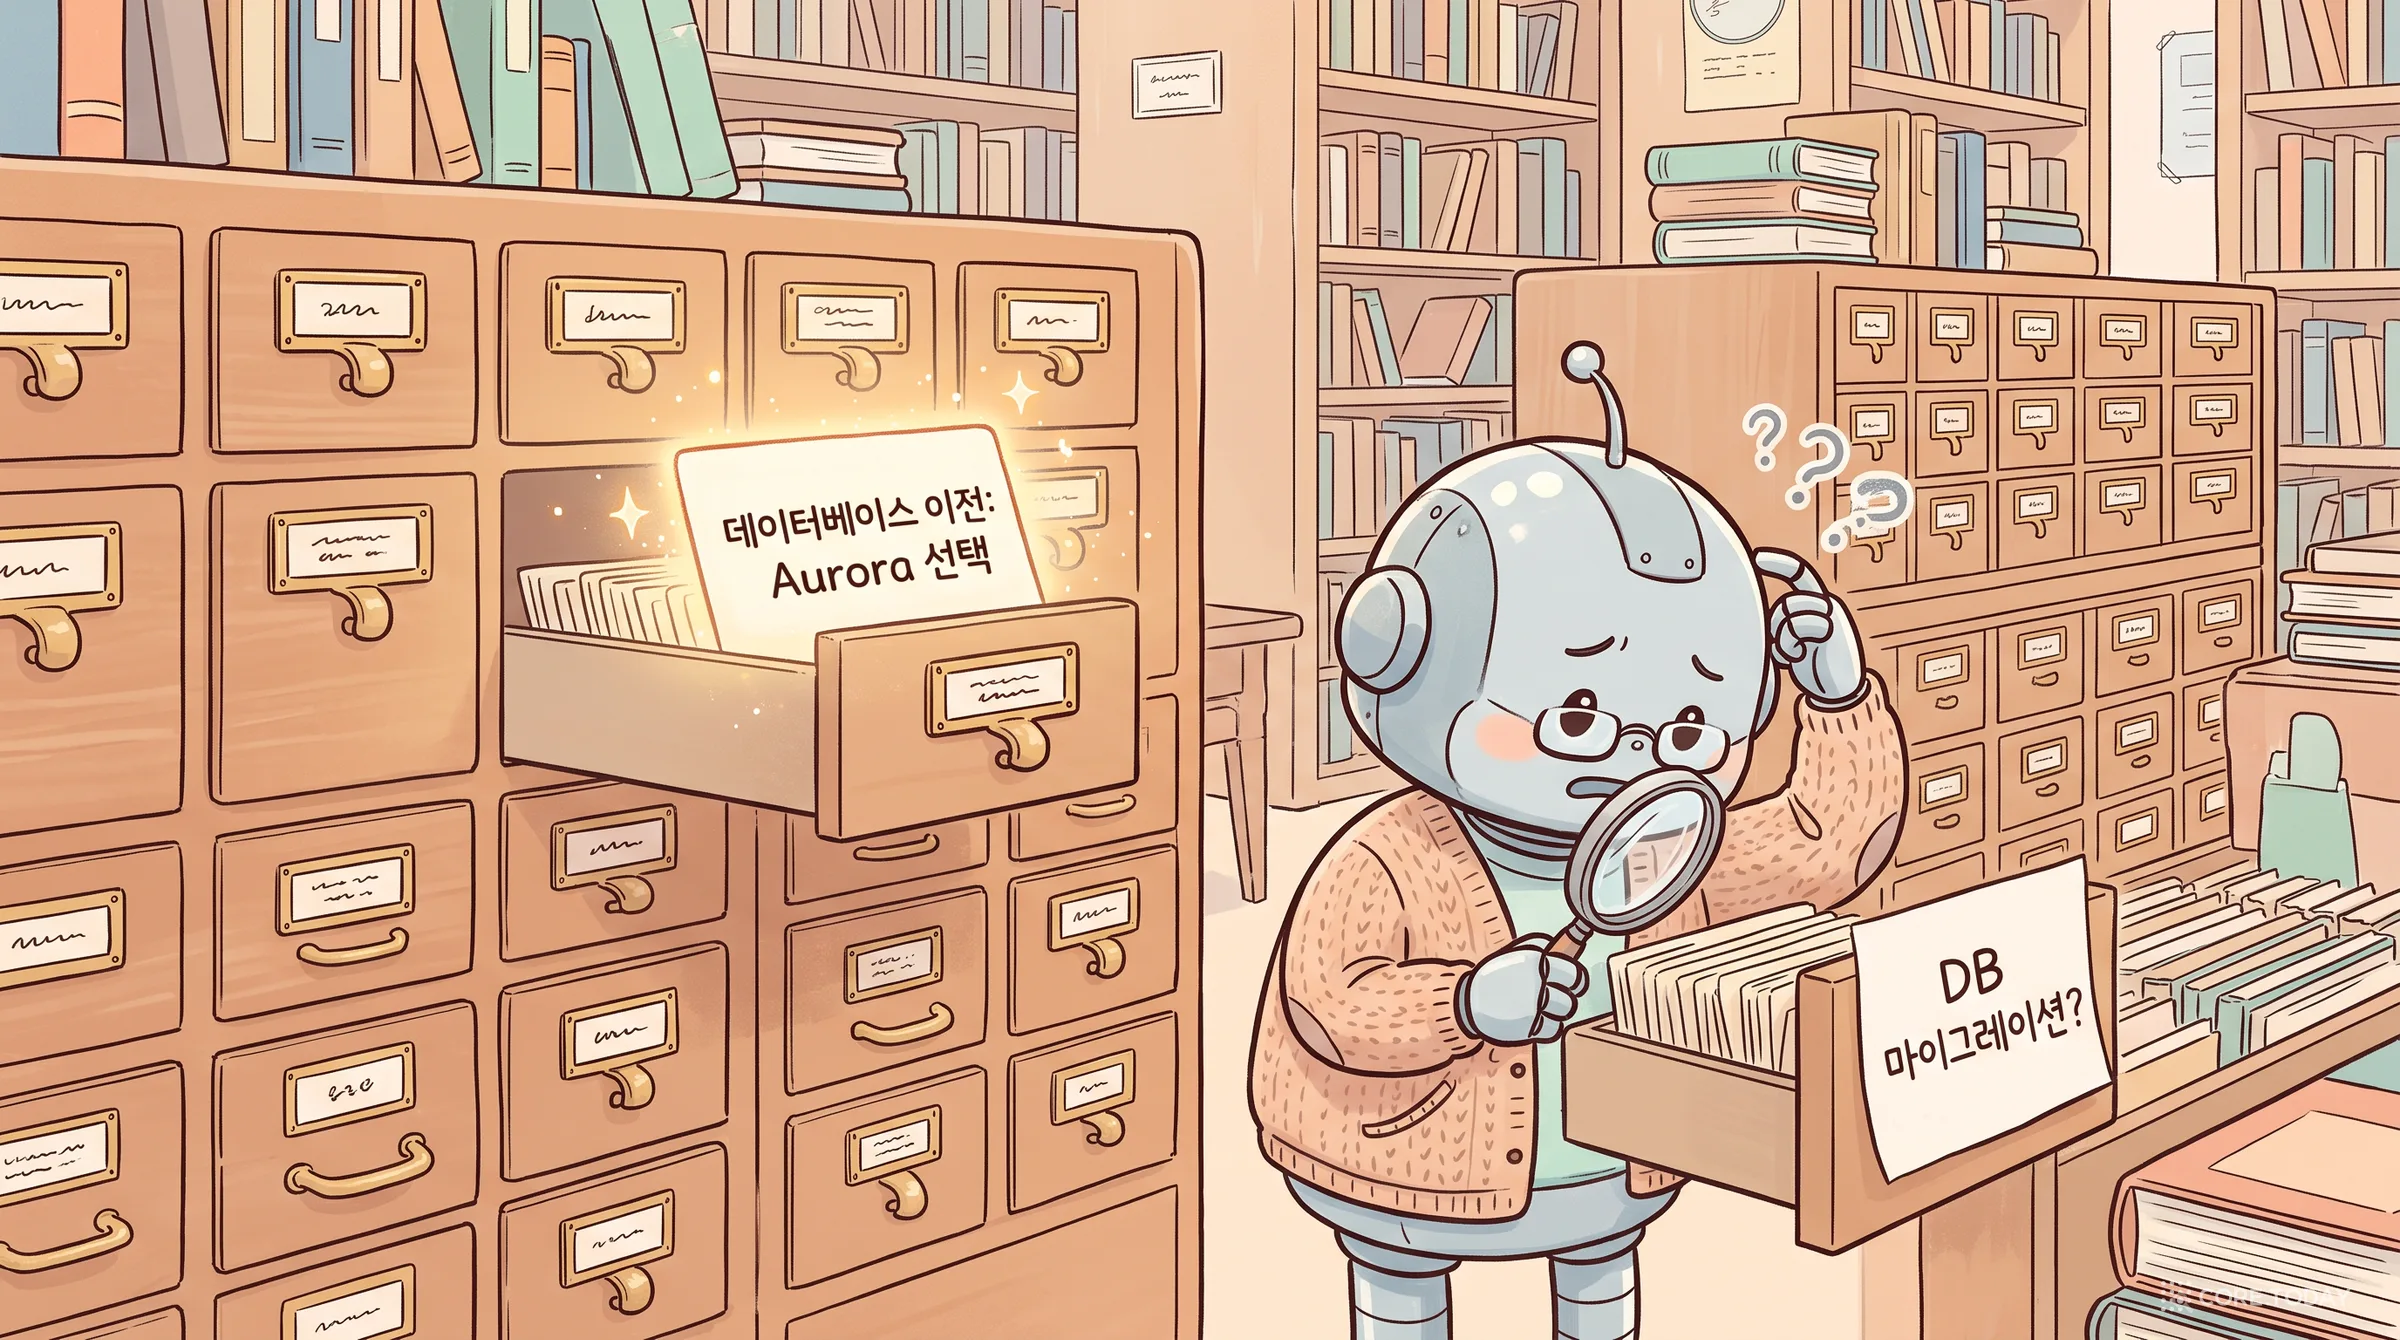
반대 경우도 있습니다. 저장소에는 ‘데이터베이스 이전: Aurora 선택’이 정확히 들어 있는데, 팀장이 “DB 마이그레이션 어떻게 됐어?”라고 다른 말로 묻는 바람에 검색이 그 사실을 찾지 못했습니다. 비서는 “정보가 없습니다”라고 답하고, 시험은 ‘기억 시스템이 틀렸다’고 채점합니다. 고쳐야 할 곳은 기억이 아니라 검색인데도 말입니다.
2026년 10월 15일 arXiv에 올라온 「Beyond Downstream QA: Rethinking How We Evaluate Agent Memory」(arXiv 2610.22209)는 이 두 상황에 이름을 붙이고, 숫자로 재 보자고 제안합니다. 저자는 AWS의 세바스티안안토니오 토마(Sebastian-Antonio Toma)·장 드 케르니에(Jean de Kernier)·마이크 플라이(Mike Ply)와 루마니아 클루지나포카 공과대학의 올리비우 마테이(Oliviu Matei)입니다. 이들이 만든 시험지 이름은 FEB-30입니다. 2월 30일이라는 뜻입니다.
?
문제
에이전트 기억 벤치마크는 모두 ‘질문을 던지고 답을 채점’한다(외재 평가). 이 점수에는 기억·검색·답변 생성의 품질이 한데 섞여 있어, 실패해도 어디가 고장인지 모르고 성공해도 기억이 맞는지 모른다.
→
제안
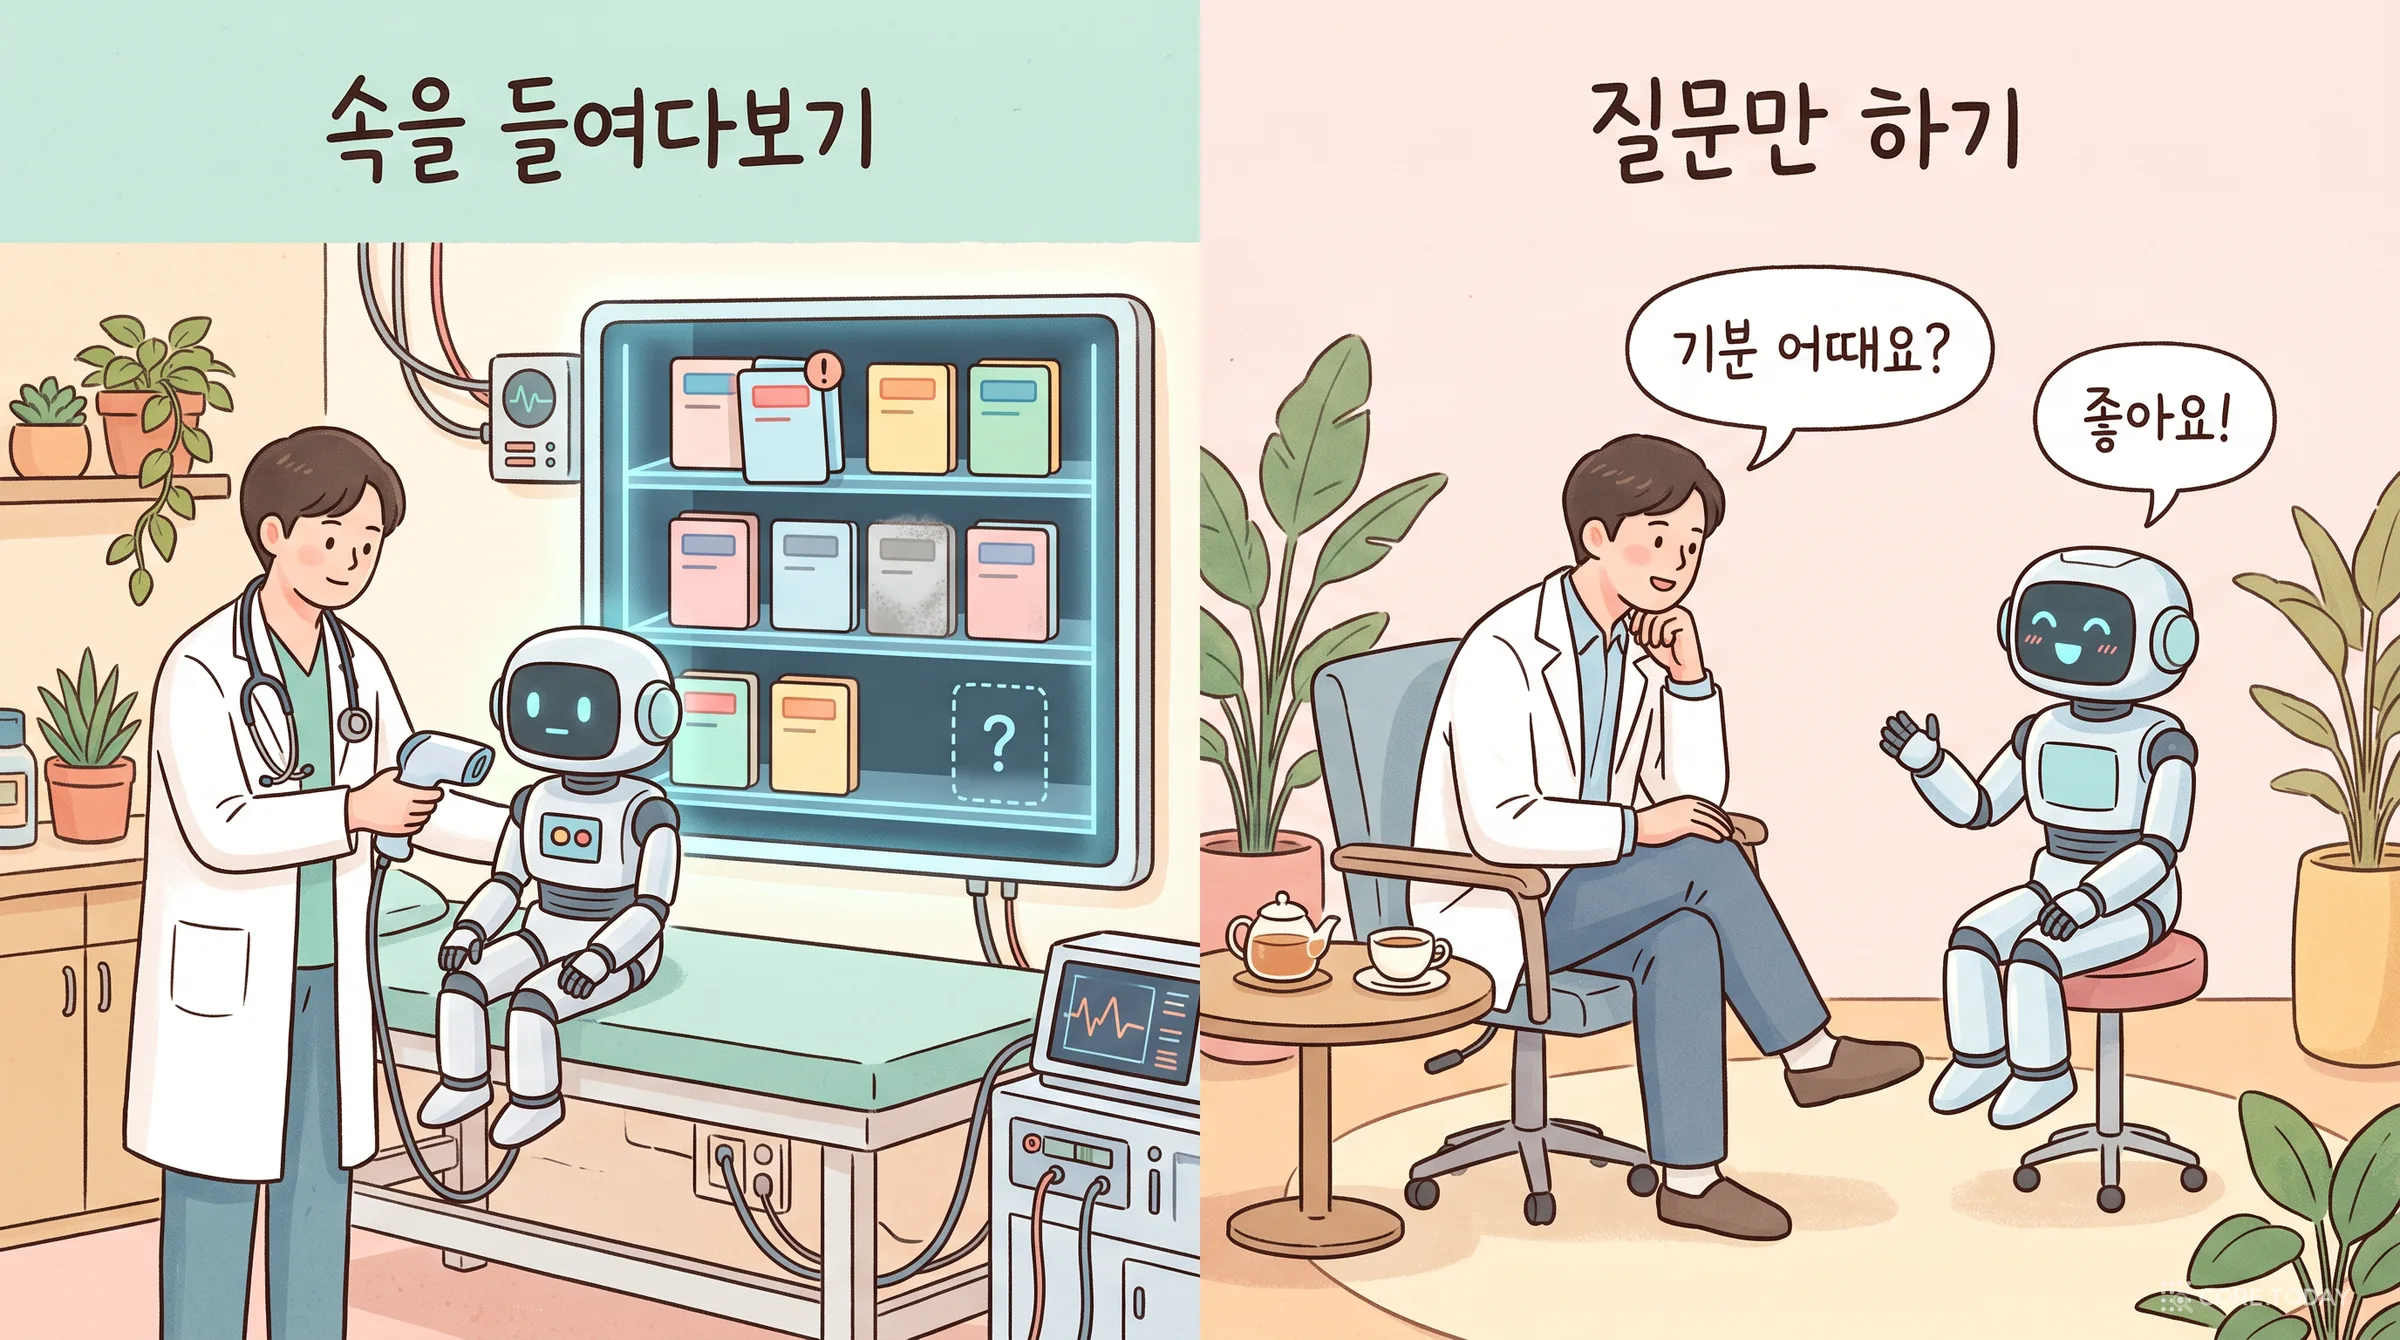
문서가 하나 들어올 때마다 기억 저장소를 직접 열어, 미리 정해 둔 ‘그 시점의 정답 상태’와 비교한다(내재 평가). 정답 상태를 먼저 쓰고 거기서 문서를 생성하는 ‘역발상 패러다임’으로 사람의 주석 없이 정답을 확보한다.
!
결과
30개 궤적에서 두 채점은 평균 16.8점 차이, 44%가 15점 넘게 벌어짐. 통과·실패 일치도 κ=0.118. 시스템이 맞는 기억 연산(생성·강화·갱신·대체)을 고른 비율 20%. 외재 점수로는 이 중 어느 것도 보이지 않는다.
이 글은 다음 순서로 갑니다. 먼저 내재·외재 평가라는 생각이 어디서 왔는지 1993년까지 거슬러 올라갑니다(1~2장). 그다음 에이전트 기억이 왜 2026년에 이 질문을 피할 수 없게 됐는지 보고(3장), FEB-30의 설계와 채점 방식을 그림과 표로 해부합니다(4~6장). 결과를 읽은 뒤(7장)에는 논문을 꼼꼼히 다시 읽으며 숫자 뒤의 모순을 짚고(8장), 한국어 궤적 12개로 직접 돌린 미니 실측을 보고합니다(9장). 마지막으로 2026년의 기억 시스템들이 이 문제를 어떻게 다루는지, 우리 팀은 무엇을 해야 하는지 정리합니다(10~11장).
1. 성적표가 둘인 이유: 내재 평가와 외재 평가
부품 검사와 주행 시험
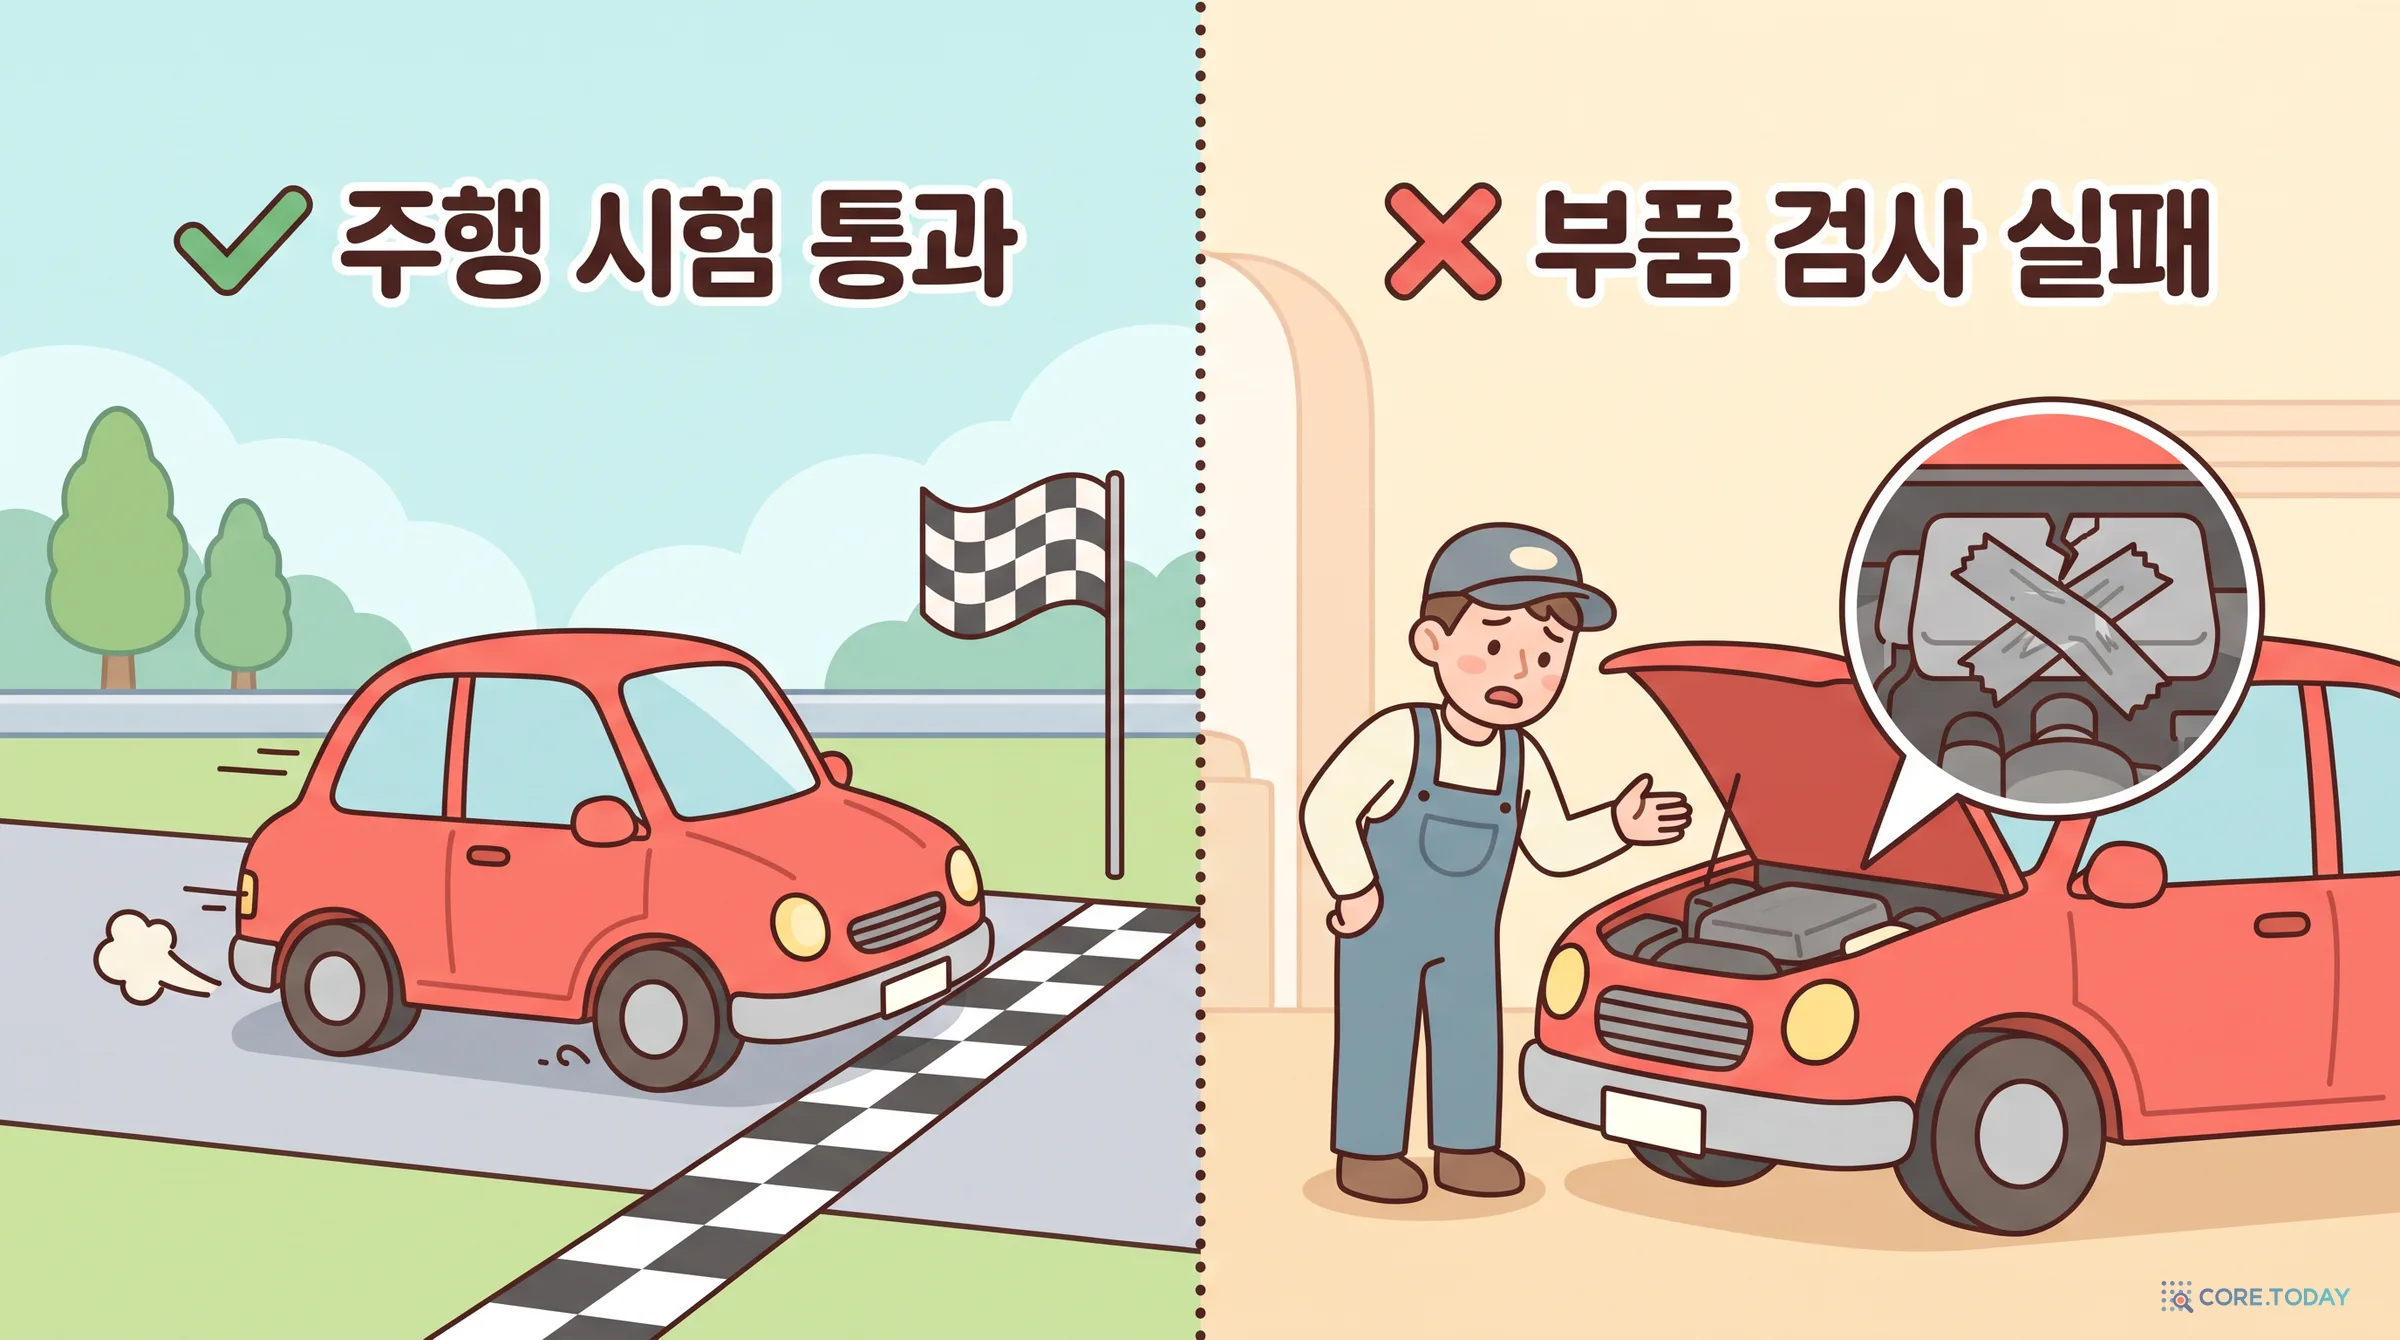
자동차 공장에는 시험이 두 종류 있습니다. 완성된 차를 시험 주행로에 올려 결승선을 통과하는지 보는 주행 시험, 그리고 보닛을 열어 엔진 부품 하나하나를 규격과 대조하는 부품 검사입니다. 주행 시험을 통과했다고 엔진이 멀쩡하다는 보장은 없습니다. 테이프로 붙여 놓은 부품이 오늘은 버텼을 수도 있습니다. 거꾸로 부품이 전부 규격대로여도 조립이 잘못되면 차는 서 버립니다.
소프트웨어 공학은 이것을 단위 테스트와 종단 간(end-to-end) 테스트로 부릅니다. 구글 테스팅 블로그는 2015년 4월 22일 「더 이상 종단 간 테스트를 늘리지 말라」(Just Say No to More End-to-End Tests)는 글에서 단위·통합·종단 간 테스트의 비율을 대략 70 : 20 : 10으로 두라고 권했습니다. 종단 간 테스트만 잔뜩 쌓은 구조를 ‘아이스크림콘’이라는 안티패턴으로 불렀습니다. 종단 간 테스트는 사용자가 실제로 겪는 일을 보여 주지만, 실패했을 때 어디가 원인인지 알려 주지 않고 느리며 불안정하기 때문입니다.
FEB-30 논문은 정확히 이 비유를 씁니다. 지금의 기억 벤치마크는 전부 종단 간 테스트, 즉 외재 평가(extrinsic evaluation)입니다. 기억 시스템을 에이전트에 붙이고, 질문을 던지고, 답을 채점합니다. 논문이 제안하는 것은 단위 테스트에 해당하는 내재 평가(intrinsic evaluation)입니다. 기억 저장소라는 부품을 직접 열어 정답과 비교합니다.
1993년: 스파크 존스가 그은 선
내재·외재라는 구분은 새로운 말이 아닙니다. 자연어 처리 평가의 틀을 세운 사람은 영국 케임브리지의 정보 검색 연구자 캐런 스파크 존스(Karen Spärck Jones)입니다. 역문서 빈도(IDF)를 고안한 바로 그 사람입니다. 그는 줄리아 갈리어스(Julia Galliers)와 함께 1993년 2월 케임브리지 컴퓨터 연구소 기술 보고서 TR-291 「자연어 처리 시스템 평가하기」를 냈고, 1994년 HLT 학회 발표와 1996년 단행본(Springer LNAI 1083)으로 정리했습니다.
이 틀에서 내재 평가는 시스템이 자기 목표를 얼마나 잘 이루는지를 재고, 외재 평가는 시스템이 놓인 환경, 즉 사람과 다른 시스템이 얽힌 ‘설정(setup)’ 안에서 제 기능을 하는지를 잽니다. 스파크 존스는 문서 분류기를 예로 들었습니다. 분류기의 결과를 독립적으로 매긴 정답 범주와 비교하면 내재 평가이고, 분류된 문서를 받은 사람들이 그 결과를 어떻게 쓰는지 보면 외재 평가입니다.
여기에 재미있는 반전이 있습니다. 스파크 존스는 1994년 발표에서 오히려 내재 평가만으로는 부족하다고 경고했습니다. 범용 시스템이라면 “내재 평가로 장점을 입증하는 것은 가치가 제한적이며, 다양한 환경에서 폭넓은 외재 평가가 필요하다”고 썼습니다. 그 뒤 30년 동안 분야는 이 두 저울 사이를 오갔습니다. FEB-30은 반대쪽 끝에서 같은 말을 합니다. 기억에 대해서는 외재 평가만으로 부족하다.
2013년: '왕 − 남자 + 여자 = 여왕'
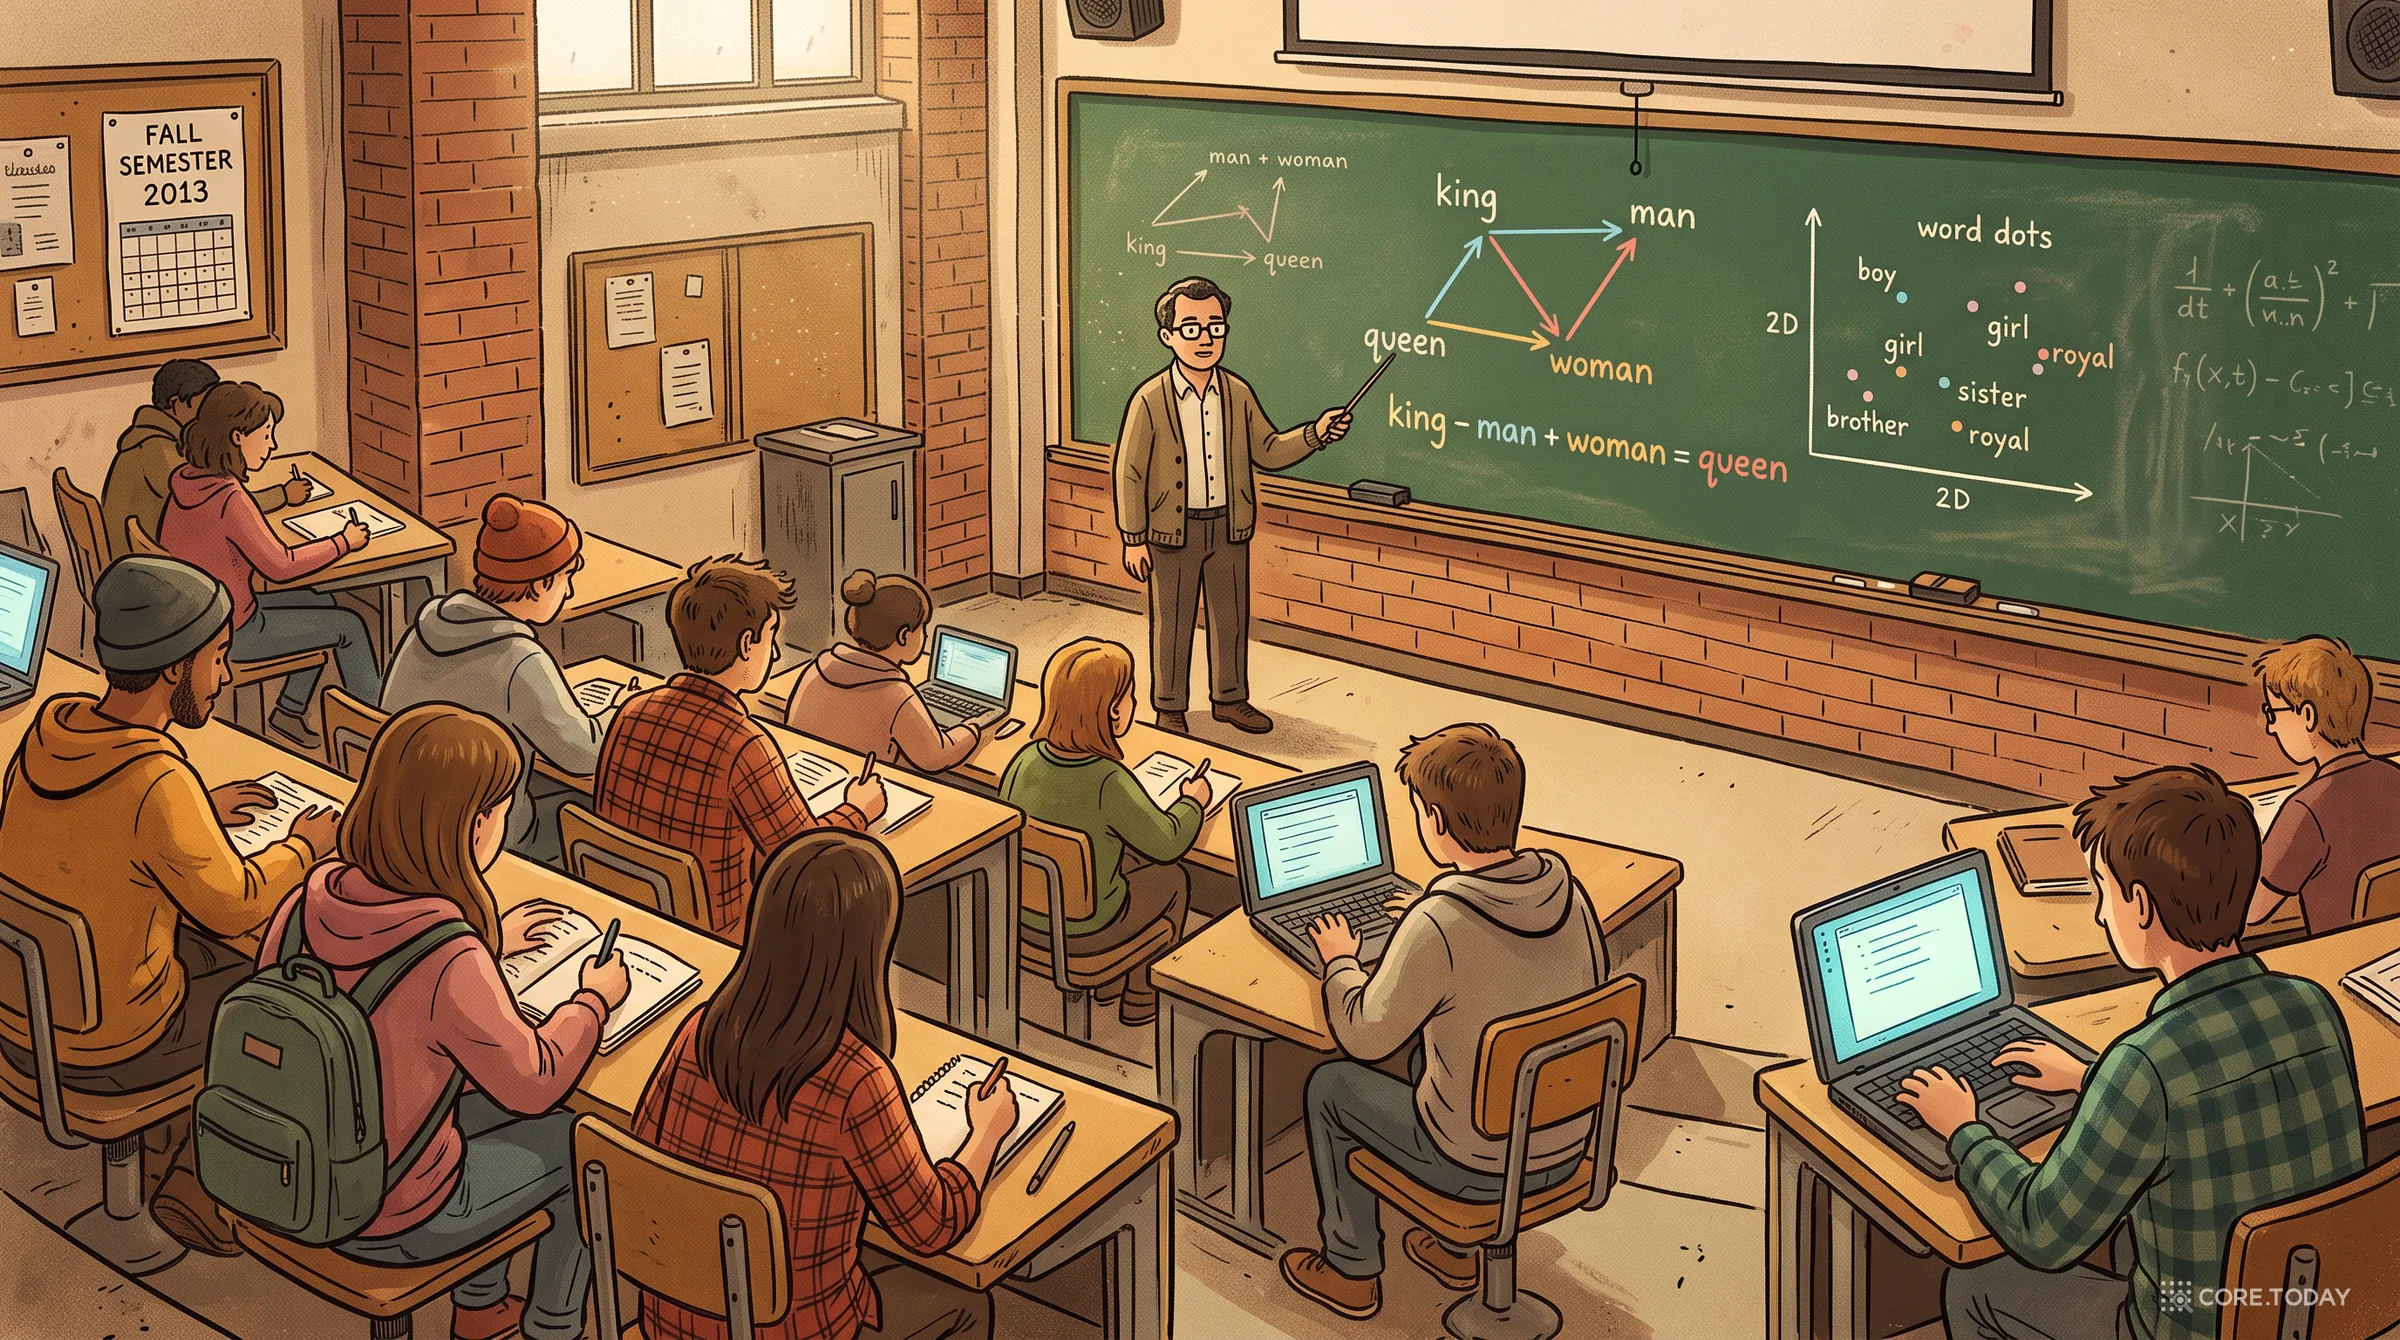
내재 평가가 가장 화려하게 주인공이 된 순간은 2013년입니다. 구글의 토마시 미콜로프(Tomáš Mikolov)와 동료들은 단어를 수백 차원의 벡터로 바꾸는 word2vec을 내놓으면서, 그 벡터가 잘 만들어졌는지를 독특한 방법으로 보였습니다. ‘왕’의 벡터에서 ‘남자’를 빼고 ‘여자’를 더하면 가장 가까운 단어가 ‘여왕’이 된다는 유추 시험이었습니다.
이 예는 2013년 NAACL에 실린 미콜로프·이(Yih)·츠바이크(Zweig)의 논문에 처음 나옵니다. 문법 유추 8,000문항이었고 벡터 덧셈만으로 “거의 40%”를 맞혔습니다. 같은 해 1월 arXiv에 올라온 word2vec 논문은 의미 유추 8,869문항과 문법 유추 10,675문항, 모두 19,544문항짜리 ‘구글 유추 세트’를 만들었고, 스킵그램 모델이 의미 55%, 문법 59%를 맞혔습니다.
유추 시험은 빠르고 쌌습니다. 번역기나 질의응답기를 통째로 다시 학습할 필요 없이, 벡터만 있으면 몇 분 안에 점수가 나왔습니다. 2014년 마르코 바로니(Marco Baroni) 등은 「세지 말고 예측하라!」(Don't count, predict!)에서 이런 내재 시험 14종으로 단어 빈도를 세는 고전 방식과 word2vec 같은 예측 방식을 비교해 예측 방식의 “철저하고 압도적인 승리”를 선언했습니다. 동의어 시험(TOEFL)에서 76점이 91점이 되는 식이었습니다. FEB-30 논문이 “내재 평가가 표현의 품질을 따로 떼어 내 더 빠른 발전을 가능하게 했다”고 쓸 때 가리키는 장면이 바로 이것입니다.
2015~2016년: 내재 점수는 실전을 예측하지 못했다
그런데 이 이야기에는 후편이 있습니다. FEB-30 논문은 전반부만 인용합니다.
2015년 레비·골드버그·다간(Levy, Goldberg, Dagan)은 예측 방식이 이긴 이유의 상당 부분이 알고리즘이 아니라 하이퍼파라미터 설정이었다고 보였습니다. 같은 설정을 고전 방식에 옮겨 주자 “대부분 국소적이거나 유의하지 않은 차이”만 남았습니다.
2015년 슈나벨 등(Schnabel et al.)은 같은 말뭉치로 학습한 임베딩 여섯 가지를 여러 시험에 넣었더니 시험마다 순위가 달랐다고 보고했습니다. 결론은 “하나의 최적 표현이 있다는 가정을 의심하게 한다”였습니다. FEB-30은 이 논문을 내재 평가를 지지하는 근거로 인용하지만, 실제 결론은 내재든 외재든 어떤 점수 하나도 범용 순위를 주지 못한다는 쪽에 가깝습니다.
2016년 8월 베를린의 RepEval 워크숍은 아예 ‘임베딩 평가를 평가하는’ 자리였습니다. 치우·코르호넨·퓌슬뢰(Chiu, Korhonen, Pyysalo)는 윈도 크기만 다르게 학습한 벡터들의 내재 점수와 실전 과제(품사 태깅·구 묶기·개체명 인식) 점수의 순위 상관을 쟀습니다. 가장 널리 쓰이던 WordSim-353은 −0.75~−0.90, MEN은 −0.83~−0.98이었습니다. 음수입니다. 내재 점수가 좋을수록 실전 점수는 나빴습니다. 양의 상관을 보인 것은 ‘유사성’과 ‘연관성’을 구분해 만든 SimLex-999 정도였습니다.
같은 워크숍에서 탈 린젠(Tal Linzen)은 유추 시험의 함정을 보였습니다. ‘왕 − 남자 + 여자’에서 입력 단어를 후보에서 빼지 않으면, 93%의 경우 가장 가까운 단어는 ‘여자’ 자신이었습니다. 유명한 데모는 입력 단어를 빼는 규칙 덕분에 성립했습니다.
교훈은 둘 중 하나가 옳다는 것이 아닙니다. 내재 시험은 빠르고 원인을 짚어 주지만, 그 자체가 검증을 받아야 하는 대리 지표입니다. 에후드 라이터(Ehud Reiter)는 2018년 기계 번역 지표 BLEU에 대한 연구 34편의 상관 284개를 모아 검토하면서, 자동 지표를 의학의 대리 종말점(surrogate endpoint)에 비유했습니다. 에이즈 약의 효과를 환자의 생존 대신 바이러스 수치로 재는 것과 같아서, 둘이 실제로 함께 움직인다는 검증이 있을 때만 쓸 수 있다는 뜻입니다.
1993~1996갈리어스·스파크 존스, 자연어 처리 평가를 내재·외재로 나눔. “범용 시스템은 내재 평가만으로 가치가 제한적”
2013word2vec과 유추 시험. ‘왕 − 남자 + 여자 ≈ 여왕’, 구글 유추 세트 19,544문항
2014바로니 등 「세지 말고 예측하라!」 내재 시험 14종으로 예측 방식의 압승 선언
2015레비 등: 승리의 상당 부분은 하이퍼파라미터. 슈나벨 등: 시험마다 순위가 다르다. 구글 테스팅 블로그: 종단 간 테스트를 줄여라
FEB-30을 읽을 때 이 역사를 기억해 두면 좋습니다. 논문은 ‘내재 평가가 단어 임베딩의 발전을 이끌었다’는 전반부를 근거로 들지만, 우리가 8장에서 볼 몇 가지 문제는 정확히 후반부, 즉 ‘내재 시험도 측정 장치로서 검증받아야 한다’는 교훈과 맞닿아 있습니다.
2. 왜 하필 지금, 왜 하필 기억인가
대화창을 넘어서는 기억
대형 언어 모델은 기본적으로 기억이 없습니다. 대화창(컨텍스트 창)에 들어온 글만 보고, 대화가 끝나면 잊습니다. 하루 이틀 대화하는 챗봇이라면 문제가 없지만, 몇 달 동안 한 고객사를 맡는 영업 비서나 한 저장소를 계속 고치는 코딩 에이전트라면 다릅니다. 지난주 회의에서 정한 것, 지난달 바뀐 가격, 석 달 전 취소된 계획을 알아야 합니다.
그래서 2023년부터 대화창 바깥에 외부 기억 장치를 붙이는 시스템이 쏟아졌습니다. 2023년 10월 MemGPT(지금의 Letta)는 운영 체제가 메모리를 페이징하듯 모델이 스스로 기억을 넣고 빼게 했습니다. 2025년에는 Mem0(추출 후 추가·갱신·삭제 판정), Zep과 그 엔진 Graphiti(유효 기간을 단 시간 그래프), 2025년 말과 2026년에는 Hindsight(사실과 의견을 나눠 담는 네 갈래 기억), AriadneMem(정보량이 낮은 메시지를 거르고 상태 전이를 시간 간선으로 남기는 구조) 등이 이어졌습니다. FEB-30 논문은 “2023년 이후 10여 종이 넘는 아키텍처가 발표됐다”고 셉니다. 코어닷투데이도 Hindsight 해부, Graphiti 시간 그래프, 에이전트 기억 엔진 해부에서 이 가운데 여럿을 코드 수준으로 열어 봤습니다.
겉모습은 달라도 이 시스템들의 속은 거의 같은 흐름을 따릅니다. 논문은 이를 추출 → 임베딩 → 분류 → 종합(extract-embed-classify-synthesize) 파이프라인이라고 부릅니다.
① 추출 문서·이메일·회의록에서 원자적 ‘관찰’을 뽑는다
→
② 임베딩 관찰을 벡터로 바꾼다
→
③ 검색 비슷한 기존 ‘사실’을 찾는다
④ 분류 LLM이 관계를 판정: 생성·강화·갱신·대체·무시
→
⑤ 종합 판정에 따라 사실을 만들거나 고쳐 쓰고 이력을 남긴다
→
사실 저장소
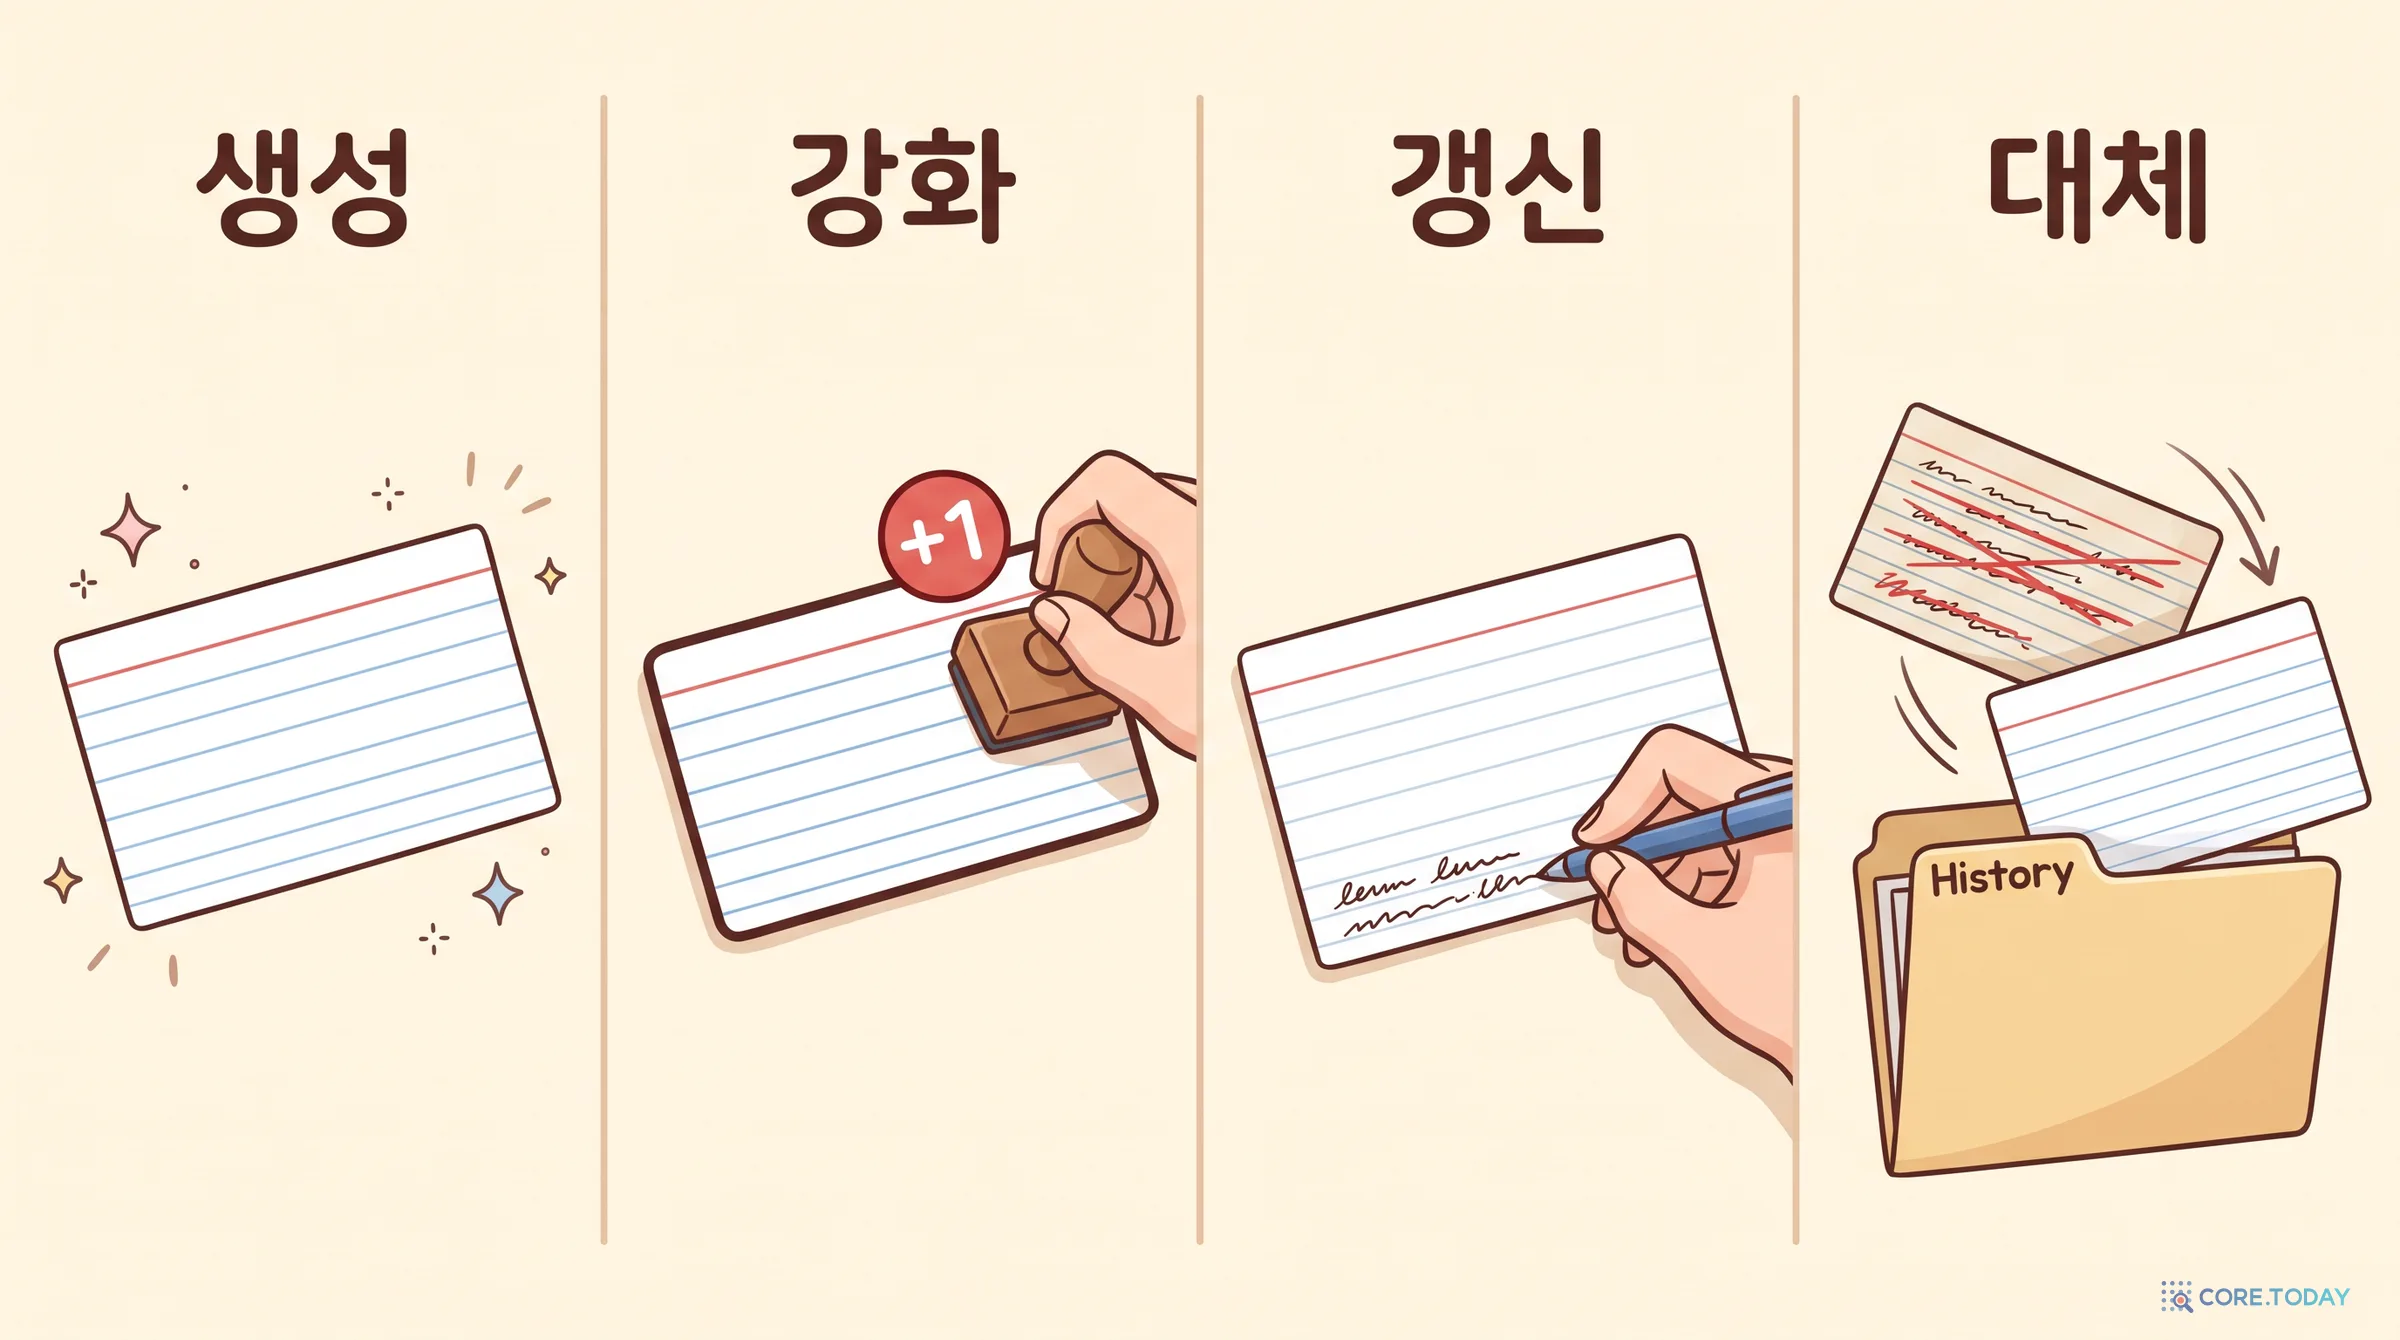
이 흐름의 핵심은 ④번입니다. 새 관찰이 들어올 때마다 LLM이 ‘이건 새로운 지식인가(생성), 이미 아는 것을 다시 확인해 주는가(강화), 기존 지식에 세부를 더하는가(갱신), 기존 지식을 뒤집는가(대체)’를 판단합니다. 사람으로 치면 새 소식을 듣고 머릿속 메모를 고쳐 쓰는 순간입니다. 기억 시스템이 틀린다면 대개 여기서 틀립니다.
기억 시스템이 늘어나자 시험지도 늘었습니다. 2024년 스냅 리서치의 LoCoMo는 수백 턴짜리 가상 대화를 만들고 그 내용을 묻는 질문 1,986개를 붙였습니다. 2025년 ICLR의 LongMemEval은 질문 500개로 정보 추출·여러 세션 추론·시간 추론·지식 갱신·답변 거부 능력을 나눠 쟀습니다. 2026년에는 더 정교한 시험지가 쏟아졌습니다.
시험지 (발표)
무엇을 재나
어떻게 채점하나
눈에 띄는 숫자
MemoryAgentBench (ICLR 2026)
정확한 검색·실시간 학습·긴 맥락 이해·선택적 망각
질문에 대한 답
여러 단계 선택적 망각에서 “모든 방법이 실패, 최고 28%”
Memora / FAMA (ACL Findings 2026)
몇 주~몇 달 대화 뒤의 기억·추론·추천, 잊어야 할 것을 잊었나
답이 낡은 기억을 썼으면 감점(FAMA)
추천 실패의 64%가 ‘잊지 못한 낡은 기억’
MEME (2026-05)
여러 개체의 상태 변화, 연쇄 갱신, 삭제, 부재
답을 채점(변화 전후 모두 맞아야 인정)
연쇄(Cascade) 평균 3%, 부재(Absence) 1%
LongMemEval-V2 (2026-05)
웹 환경 작업 기록 최대 1억 1,500만 토큰에서 상태 추적·작업 요령
고정된 읽기 모델의 답
최고 72.5%, 최고 RAG 48.5%
AMA-Bench (ICML 2026)
에이전트의 행동·관찰·도구 출력 궤적에 대한 장기 기억
질문에 대한 답
제안 시스템 57.22%
STATE-Bench (마이크로소프트, 2026-05)
고객 지원·여행·쇼핑 450개 작업에서 기억이 일을 돕나
작업 결과(환경 DB 상태)·LLM 판정
여행 분야 5회 모두 성공 약 30%
표를 보면 시험지가 점점 정교해진다는 것을 알 수 있습니다. Memora는 낡은 기억을 쓰면 감점하고, MEME는 ‘변화 전후 모두 맞아야’ 인정하며, LongMemEval-V2는 답변 모델을 고정해 생성의 변수를 줄였습니다. 그런데 하나같이 마지막 관문은 답입니다. FEB-30 논문의 표현을 빌리면, 이 시험지들은 “점점 내재 평가에 가까워지지만, 기억 저장소를 직접 들여다보지는 않는 문턱의 바깥쪽”에 머뭅니다.
시험지 이름 FEB-30이 여기서 나옵니다. 달력은 2월 28일, 가끔 29일까지 다가가지만 30일에는 결코 닿지 않습니다. 최근의 벤치마크도 기억 전용 과제(MemoryAgentBench), 기억을 고려한 점수 분해(Memora), 통제된 상태 궤적(MEME)으로 내재 평가 쪽으로 다가갔지만 문턱을 넘지는 않았다는 뜻입니다. 논문은 “FEB-30은 그 문턱을 넘는다”고 씁니다.
다만 정확히 말하면 ‘아무도 저장소를 안 봤다’는 것은 아닙니다. 조사해 보니 MEME는 실패 원인을 진단할 때 시스템 상태를 부호화·유지·검색 단계별로 추적했고, Memora는 페르소나마다 정답 기억 기록을 갖고 있습니다. 차이는 저장소 상태를 점수로 매기느냐입니다. 진단 도구로는 들여다봤지만 성적표에는 올리지 않았습니다.
2026년에 이 질문이 급해진 이유
왜 하필 지금일까요. 세 가지 흐름이 겹쳤습니다.
첫째, 질의응답 점수가 포화됐습니다.지난 실측에서 보았듯 2026년 가을 LoCoMo와 LongMemEval의 발표 점수는 90점대이고, 기억 시스템 없이 대화를 통째로 넣은 저가 모델도 80점을 넘습니다. Mem0의 공식 문서조차 이 점수가 “공격적인 검색 전략, 더 큰 컨텍스트 창, 최상위 모델로 크게 오를 수 있으며, 그것이 기억 시스템 자체가 좋아졌다는 뜻은 아니다”라고 적고 있습니다. 답변 모델이 강해질수록 답 점수는 기억의 품질에서 멀어집니다.
둘째, 쓰기 실패는 조용합니다. 2026년 「에이전트 기억의 해부」(Anatomy of Agentic Memory, arXiv 2602.19320)는 기억을 쓰는 단계에서 LLM이 형식이 깨진 JSON을 내놓는 ‘조용한 실패’를 쟀습니다. Nemori라는 시스템은 gpt-4o-mini에서 17.91%, Qwen-2.5-3B에서 30.38%의 쓰기가 형식 오류였습니다. 논문의 표현대로 “에이전트는 단기적으로 유창하게 대화하지만, 장기 기억은 실패한 쓰기 때문에 오염된다.” 질문 몇 개로는 이런 실패가 당장 드러나지 않습니다.
셋째, 기억이 업무 기록이 되고 있습니다. 개인 비서의 취향 기억이라면 틀려도 웃고 넘어가지만, 고객사의 계약 조건, 보안 점검 일정, 확정된 기술 결정을 기억하는 업무 에이전트라면 다릅니다. 이런 기억은 감사 대상이 됩니다. ‘지금 이 시점에 시스템이 무엇을 참이라고 믿고 있는가’를 답 몇 개가 아니라 저장소 그 자체로 보여 줘야 합니다.
거짓 양성(false positive)은 기억이 틀렸는데 답이 맞는 경우입니다. 논문은 이를 LLM 보상(LLM compensation)이라고 부릅니다. 저장소가 불완전하거나 낡아도, 강한 답변 모델이 검색된 조각들을 놓고 추론해 정답을 만들어 냅니다.
예를 들어 저장소에 ‘한빛물류는 스탠다드 요금제, 월 120만 원’과 ‘4월부터 엔터프라이즈, 월 310만 원’이 둘 다 살아 있다고 합시다. 앞의 사실은 대체됐어야 했는데 그대로 남았습니다. 기억 시스템으로서는 실패입니다. 그런데 “지금 요금제는?”이라는 질문에 두 사실이 함께 검색되면, 똑똑한 답변 모델은 날짜를 보고 “엔터프라이즈, 월 310만 원”이라고 답합니다. 외재 평가는 이것을 성공으로 기록합니다.
문제는 이 성공이 답변 모델 덕분이라는 점입니다. 검색 결과가 조금만 달라져도, 혹은 더 작은 답변 모델로 바꾸기만 해도 무너집니다. 논문은 이를 ‘취약성’이라고 표현합니다. 외재 점수는 높은데 내재 점수가 낮으면, 그 시스템은 LLM 보상에 기대고 있는 것입니다.
거짓 음성(false negative)은 반대입니다. 기억 시스템은 사실을 정확히 저장하고 갱신했는데, 특정 질문에서 검색이 그 사실을 꺼내지 못합니다. 임베딩 공간에서 질문과 사실의 단어가 어긋나거나(‘DB 마이그레이션’ 대 ‘데이터베이스 이전’), 추상 수준이 다르거나(‘복구 대비’ 대 ‘6시간 주기 백업’), 상위 몇 개만 가져오는 검색 한도에 걸린 경우입니다. 외재 평가는 이 실패를 기억 시스템 탓으로 돌립니다.
두 실패를 한 표로 정리하면 이렇습니다.
질문 채점: 통과
질문 채점: 실패
서랍 검사: 통과
진짜 성공 기억도 답도 맞다
거짓 음성 (검색 병목) 기억은 맞는데 검색·생성이 놓쳤다 → 검색을 고쳐라
서랍 검사: 실패
거짓 양성 (LLM 보상) 기억은 틀렸는데 답변 모델이 메웠다 → 위험하다
진짜 실패 둘 다 틀렸다 → 어디부터 고칠지 서랍 검사가 알려 준다
외재 평가만 있으면 이 표의 왼쪽 열과 오른쪽 열만 보입니다. 위아래를 가르려면 서랍을 열어야 합니다. 논문은 이 두 평가의 관계를 “서로 대체가 아니라 보완”이라고 정리합니다. 둘 다 높으면 진짜 좋은 시스템이고, 외재만 높으면 취약하고, 내재만 높으면 검색이나 생성이 병목이라는 진단이 나옵니다.
4. FEB-30은 어떻게 만들었나
정답을 먼저 쓴다: 역발상 패러다임
저장소를 정답과 비교하려면 먼저 정답 저장소가 있어야 합니다. 실제 회사 문서 수백 건을 모아 사람이 ‘이 시점에 기억해야 할 사실’을 일일이 주석하는 방법도 있지만, 비싸고 주관적입니다. 같은 회의록을 두고도 무엇이 ‘사실’인지 사람마다 다르게 적습니다.
FEB-30은 순서를 뒤집습니다. 2025년 말 JV 로이그(JV Roig)가 검색 시스템 평가를 위해 제안한 역발상 패러다임(paradigm inversion, RIKER)을 빌려 왔습니다. 문서에서 정답을 뽑는 대신, 정답을 먼저 쓰고 거기서 문서를 생성합니다. 그러면 문서가 담고 있는 사실은 처음부터 알려져 있으니 채점이 결정적이 됩니다. 로이그의 RIKER는 이 방식으로 모델 33개를 210억 토큰 넘게 시험해 ‘3만 2천 토큰을 넘으면 성능이 크게 떨어진다’ 같은 결과를 냈습니다. FEB-30은 이것을 고정된 사실 집합에서 시간에 따라 변하는 사실의 궤적으로 넓혔습니다.
FEB-30의 기본 단위는 궤적(trajectory)입니다. 한 주제의 사실이 문서 여러 건에 걸쳐 어떻게 변해야 하는지를 적은 JSON입니다. 논문 부록 A.1의 c5-linear를 한국어 가상 회사로 옮기면 이렇습니다.
json
{"id":"c5-linear","category":"C5","difficulty":"L1","trajectoryType":"linear-evolution","extrinsicQA":["가람상사 데이터베이스 이전을 설명하라: 원래 무엇이고, 어디로 가며, 일정과 진행 상황은?"],"states":[{"index":0,"timestamp":"2025-01-15","action":"create","confidence":0.9,"claims":["사내 서버에서 PostgreSQL 14 운영","운영 DB 약 3TB"]},{"index":1,"timestamp":"2025-03-20","action":"update","confidence":0.8,"claims":["사내 서버에서 PostgreSQL 14 운영","운영 DB 약 3TB","Aurora와 AlloyDB 검토 중"],"docClaims":["Aurora와 AlloyDB 검토 중","2분기 개념 검증 계획"],"changeReason":"아키텍처 리뷰"}]}
여기서 가장 중요한 설계는 claims와 docClaims의 구분입니다.
claims는 그 시점까지의 문서를 모두 처리한 뒤 저장소에 있어야 할 전체 상태입니다. 채점기가 씁니다.
docClaims는 그 시점에 도착하는 문서 한 건에 새로 담긴 정보입니다. 생성기가 씁니다.
상태 2의 문서는 ‘Aurora로 결정, 3분기 목표’만 말하고 ‘3TB’는 반복하지 않습니다. 그래도 상태 2의 claims에는 ‘3TB’가 들어 있습니다. 시스템이 앞서 배운 것을 스스로 들고 있어야 통과합니다. 문서 한 장에서 사실을 잘 뽑는 능력이 아니라, 여러 문서에 걸쳐 기억을 유지하고 고쳐 쓰는 능력을 재려는 장치입니다.
궤적은 action으로 상태 전이마다 정답 연산을 지정합니다. 생성(create), 갱신(update), 강화(reinforce), 충돌(conflict), 대체(supersede) 가운데 하나입니다. 진화 유형도 여섯 가지로 나뉩니다. 선형 진화(A→B→C), 모순, 범위 확장, 철회, 안정(변화 없음), 점진적 이동(조금씩 바뀌는 사실)입니다. 여러 작성자가 등장하는 궤적에는 작성자의 역할과 문서 유형도 붙습니다.
아래 위젯에서 이 궤적을 직접 넘겨 보세요. 시스템의 버릇을 바꾸면 같은 문서를 받고도 저장소가 얼마나 다르게 변하는지, 그리고 두 성적표가 어떻게 갈리는지 보입니다.
여섯 분야, 세 난이도
FEB-30은 궤적 30개를 여섯 진단 분야로 나눕니다. 분야마다 외재 평가가 놓치는 서로 다른 틈을 겨냥합니다.
분야
이름
설계 조건
예시
C1
LLM 보상
기억은 틀렸지만 질문에는 여전히 맞힐 수 있게
갱신 안 된 낡은 사실, 풀리지 않은 모순
C2
검색 병목
기억은 맞지만 찾기 어렵게
질문과 사실의 어휘 불일치, 긴 문서에 묻힌 사실, 방해 문서 4건
C3
연산 분류
생성·갱신·강화·충돌 판정이 맞는지
같은 말을 다시 하는 확인, 미묘한 갱신
C4
종합 품질
여러 관찰이 올바른 사실로 합쳐지는지
중복 제거, 순서가 뒤바뀐 도착, 범위 확장
C5
시간 순서
사실이 시간에 맞게 진화하는지
A→B→C, 철회, 점진적 이동
C6
여러 작성자
출처가 통합에 제대로 반영되는지
세 사람의 확인 대 한 사람의 반복, 권한자의 결정
C1과 C2는 일부러 두 평가가 엇갈리도록 만든 분야이고, C3~C6은 외재 평가로는 거칠게만 보이는 차원을 내재 평가로 잘게 보려는 분야입니다.
난이도는 문서 안에서 정답 주장이 얼마나 드러나 있느냐로 나눕니다. L1은 문서 1~2건, 상태 2~3개, 200~400단어에 주장이 거의 그대로 적혀 있고 잡음이 없습니다. L2는 문서 3~4건, 400~800단어에 관계없는 주장 2~3개가 섞입니다. L3는 문서 4~5건, 600~1,000단어에 관계없는 주장 4~5개가 섞이고, 정답 주장은 여러 문장을 조합해야 추론됩니다. 30개 궤적이 L1·L2·L3에 10개씩 들어갑니다. 분야는 인프라·보안·재무 운영·머신러닝·데이터 엔지니어링·컨테이너 여섯 기술 영역에 고루 퍼뜨렸습니다.
문서 147건을 만드는 공장
정답 궤적에서 문서를 만드는 과정에도 공을 들였습니다. 논문의 알고리즘 1을 풀어 쓰면 이렇습니다.
모델 돌려쓰기5개 회사의 생성 모델 6개를 상태 번호에 따라 돌아가며 쓴다. 한 모델이 전체의 30%를 넘게 쓰지 않는다. 여러 사람이 쓴 문서처럼 문체가 섞이게 하려는 것이다. 생성 모델은 모두 시험 대상 시스템의 추출 모델과 다른 계열이다.
문체 따라 쓰기(L1·L2)실제 문서의 말투·어휘·구조를 흉내 낸다. 참고 문서는 AMI 회의 말뭉치의 회의 요약 12건과 엔론(Enron) 이메일 말뭉치의 이메일 12건이다. 회의록·이메일·아키텍처 리뷰·현황 보고·경영진 브리핑 등으로 유형을 나눈다.
끼워 넣기(L3)관계없는 분야의 실제 사람 문서(예: 제품 디자인 회의, 에너지 파이프라인 논의)에 정답 주장을 끼워 넣는다. 결과물은 약 90%가 진짜 사람 글이다. 관련 사실은 끼워 넣은 부분에서만 나오므로 채점이 모호하지 않다.
심사관 세 명 만장일치생성기와 다른 심사 모델 3개가 ① 정답 주장이 모두 추론되는가 ② 궤적에 없는 사실을 지어내지 않았나 ③ 자연스럽게 읽히나를 본다. 셋이 모두 통과시켜야 채택, 아니면 다른 모델로 최대 3번 다시 쓴다.
사람 검토사람이 다시 읽었다. 11%는 내용 수정(앞 상태에 미래 정보가 새어 들어감, 서사 모순, 문서 간 불일치, 숫자 불일치), 28%는 껍데기 제거(코드 블록 표시, “~에 대한 이메일을 생성했습니다” 같은 LLM 머리말)가 필요했다.
이렇게 만든 말뭉치는 문서 147건입니다. 궤적 상태 문서가 127건, C2(검색 병목) 궤적마다 4건씩 넣은 방해 문서가 20건입니다. 사람 검토에서 ‘11%가 내용 수정 필요’였다는 숫자는 기억해 둘 만합니다. 심사관 세 명이 만장일치로 통과시킨 문서의 열에 하나가 여전히 사람 눈에는 틀렸다는 뜻이기 때문입니다.
5. 시험대에 오른 기억 시스템
관찰과 사실, 두 층
논문은 특정 상용 제품이 아니라 “대표적인” 기억 시스템 하나를 직접 만들어 시험합니다. 앞에서 본 추출 → 임베딩 → 분류 → 종합 흐름을 그대로 따르는 시스템이고, 저자들은 Hindsight·Mem0·AriadneMem과 상용 에이전트 기억 서비스들이 겉모습은 달라도 이 흐름을 공유한다고 말합니다. 시험의 목적은 이 ‘부류’의 시스템에서 시험지가 무엇을 드러내는지 보이는 것이지, 특정 구현을 줄 세우는 것이 아니라고 분명히 합니다.
이 시스템은 기억을 두 층으로 나눕니다.
관찰(observation)은 문서 한 건에서 뽑은 원자적이고 고정된 진술입니다. “2025년 3월 20일, 가람상사는 Aurora와 AlloyDB를 검토 중이다.” 한번 뽑히면 바뀌지 않습니다. 결정·약속·이정표 같은 범주가 붙고, 누가·무엇을·언제·왜·어디서 구조로 정리됩니다.
사실(fact)은 관찰이 쌓이며 진화하는 종합된 지식 단위입니다. “가람상사는 사내 PostgreSQL 14(약 3TB)에서 Aurora로 이전 중이며 3분기 목표다.” 새 관찰이 올 때마다 생성되고, 강화되고, 갱신되고, 대체됩니다.
모든 관찰이 사실이 되지는 않습니다. 일회성 할 일 같은 것은 관찰로만 남습니다. 논문은 내재 평가의 대상을 사실 층으로 정합니다. 관찰만 보면 추출을 얼마나 빠짐없이 했는지밖에 모르지만, 사실 층은 시스템이 실제로 무엇을 믿고 행동하는지를 결정하기 때문입니다. 용어는 시스템마다 다르다는 점도 짚어 둡니다. Hindsight는 원자적 추출을 ‘사실’, 종합된 요약을 ‘관찰’이라고 부르니 이 논문과 정반대이고, Mem0는 두 층을 구분 없이 ‘기억’이라고 부릅니다.
분류 한 번, 확신도 계단, 시간 경비
새 관찰 o가 들어오면 시스템은 그 임베딩과 가장 비슷한 기존 사실 f를 찾고, LLM에게 둘의 관계를 묻습니다.
판정에 따라 사실의 문장과 확신도가 바뀝니다. 확신도 규칙(논문 식 8)은 단순합니다. 생성·갱신·대체 때는 LLM이 새 확신도를 매기고, 강화 때는 0.1씩 올립니다(최대 1). 어떤 연산이든 관찰은 그 사실의 ‘뒷받침 관찰 목록’에 붙고, 시스템은 사실마다 서로 다른 작성자가 몇 명인지도 셉니다. 사실은 문장·확신도·변경 유형·계기가 된 관찰을 단계마다 남기는 전체 이력을 가집니다.
여기에 시간 경비(temporal guard)가 하나 붙습니다. 관찰의 날짜가 그 사실의 마지막 갱신 날짜보다 이르면, 갱신·대체 판정을 강화로 강등합니다. 늦게 도착한 옛 문서가 새 지식을 덮어쓰지 못하게 막는 장치입니다.
이 장치가 정확히 시험받는 궤적이 부록 A.2의 c4-out-of-order입니다. 3월 10일의 결정 문서(“ECS Fargate를 택했다, 100ms 이하 응답 때문”)가 먼저 들어오고, 1월 20일의 검토 메모(“람다·Fargate·EKS를 검토 중, 람다는 콜드 스타트가 걱정, EKS는 4명 팀에게 너무 복잡”)가 나중에 들어옵니다. 시스템은 결정을 지키면서도 탈락 이유는 보강해야 합니다. 그런데 논문의 시간 경비는 옛 문서의 갱신을 통째로 강화로 바꿔 버리므로, 결정은 지켜도 탈락 이유까지 함께 버릴 수 있습니다. 이 궤적의 내재 점수는 48.2%였습니다.
시스템 구성 요소도 밝혀 둡니다. 추출과 종합은 이름을 밝히지 않은 ‘최상위(frontier) LLM’ 하나가 맡고, 임베딩은 아마존 Titan Embeddings V2(1,024차원), 검색은 BM25 키워드 점수(가중치 0.3)와 벡터 유사도(0.7)를 섞은 하이브리드입니다. 채점 쪽에서는 Claude Haiku 4.5가 판정을, Amazon Nova Pro가 외재 평가의 답변 생성을 맡습니다. 모든 LLM 호출은 온도 0이고, 남는 변동은 검색 층에서 생긴다고 설명합니다. 실험은 같은 설정으로 11번 돌려 평균과 표준편차를 냅니다.
아래 위젯에서 두 규칙을 직접 만져 보세요. 왼쪽은 확신도 규칙이 ‘세 사람의 확인’과 ‘한 사람의 반복’을 구분하지 못한다는 것을, 오른쪽은 시간 경비의 세 가지 설계가 무엇을 지키고 무엇을 버리는지 보여 줍니다.
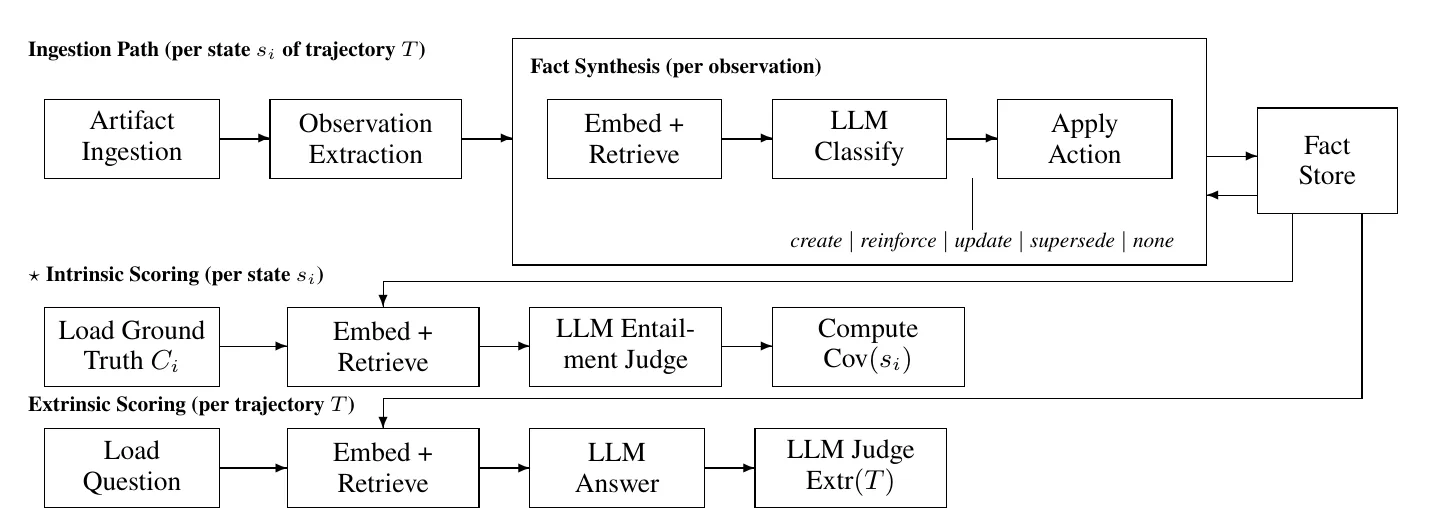
크게 보기논문 그림 1(Toma et al., arXiv 2610.22209). 위는 쓰기 경로, 아래 두 줄은 채점 경로입니다. 별표(⋆) 붙은 가운데 줄이 이 논문이 새로 제안한 내재 채점입니다. 내재 채점도 저장소를 통째로 읽는 것이 아니라 ‘임베딩+검색’ 단계를 거친다는 점을 눈여겨 두세요.
내재 지표: 서랍을 열어 보는 법
궤적 T의 문서를 처리하는 동안, 상태 si마다 저장소의 사실 집합 F를 그 시점의 정답 주장 Ci와 비교합니다. 사실 f가 주장 c를 담고 있는지(함의하는지)는 먼저 임베딩 유사도가 0.8을 넘는 사실을 고르고, LLM 판정관이 YES(1)·PARTIAL(0.5)·NO(0)로 확인해 정합니다.
주장 덮음률(claim coverage)은 정답 주장 가운데 저장소의 어떤 사실이 담고 있는 것의 비율입니다(식 1). 궤적의 사실 정확도는 모든 상태의 덮음률 평균이고(식 2), 이것이 이 글에서 말하는 ‘내재 점수’입니다.
연산이 맞았는지는 두 지표로 봅니다. 갱신 탐지 재현율(UDR, 식 3)은 갱신·대체가 필요한 상태 가운데 저장소가 실제로 바뀐 비율이고, 거짓 갱신률(FUR, 식 4)은 강화만 하면 되는 상태에서 저장소를 고쳐 버린 비율입니다. 여기에 궤적이 끝났을 때 살아 있는 사실 개수(중복이나 유실을 잡는다), 기대 확신도와 실제 확신도의 평균 절대 오차, 그리고 연산 분류 정확도를 함께 봅니다.
외재 지표와 괴리 지표
외재 평가는 익숙한 방식입니다. 궤적마다 최종 상태에 대한 진단 질문을 만들고, 시스템이 평소처럼 사실을 검색해 LLM이 답하게 한 뒤, 판정 모델이 기대 답과 비교해 YES(1)·PARTIAL(0.5)·NO(0)로 매깁니다.
MAD는 ‘외재 평가만 믿으면 정보를 얼마나 잃는가’를 임의의 기준선 없이 재려는 지표입니다. 읽기 쉽도록 보조 지표로 괴리율(DivRate)도 냅니다. 두 점수가 τ = 0.15, 즉 15점 넘게 벌어진 궤적의 비율입니다.
채점 프롬프트 요지 (논문 부록 C)
C.1 주장 함의 판정 (내재)
지식 베이스의 사실 1, 2, … 를 보여 주고 “검증할 주장: …” — 어느 사실이 이 주장과 가장 잘 맞나? FACT_NUMBER(없으면 0)와 SCORE(YES = 분명히 담고 있음, PARTIAL = 관련 있으나 불완전, NO = 맞는 사실 없음)로 답하라.
C.2 답변 생성 (외재)
주어진 사실만으로 질문에 답하라. 정보가 부족하면 “그 정보는 없습니다”라고 하라. 간결하게.
C.3 답 채점 (외재)
생성된 답이 기대 답과 같은 핵심 정보를 담았나? 다 담았으면 YES, 일부만 담았으면 PARTIAL, 어긋나거나 다 놓쳤으면 NO. 한 단어로만 답하라.
7. 결과: 두 성적표는 얼마나 다른 말을 했나
발견 1: 16.8점 차이, 우연을 겨우 넘는 일치도
30개 궤적을 11번씩 돌린 결과, 내재 점수와 외재 점수의 평균 절대 괴리는 0.168 ± 0.025, 16점이 넘습니다. 궤적의 44%가 15점 넘게 벌어졌습니다.
더 엄격하게 ‘50% 이상이면 통과’로 잘라 보면, 궤적의 21 ± 4%에서 한쪽은 통과, 다른 쪽은 실패였습니다. 외재 평가만 믿는 실무자가 다섯 번에 한 번꼴로 시스템에 대해 틀린 결론을 내린다는 뜻입니다. 두 판정의 일치도인 코헨의 카파(Cohen's κ)는 0.118이었습니다. 카파는 우연히 맞을 확률을 빼고 계산한 일치도로, 0이면 우연 수준, 1이면 완벽한 일치입니다. 흔히 0.2 이하는 ‘약간 일치’로 읽습니다.
330쌍(궤적 30개 × 11회) 전체에서 두 점수의 피어슨 상관은 r = 0.423이었습니다. 제곱하면 0.18, 한 점수의 변동 가운데 다른 점수로 설명되는 몫이 18%라는 뜻입니다. 내재에서 외재를 뺀 부호 있는 평균은 +0.118로, 내재 점수가 체계적으로 더 높았습니다. 논문은 이를 “시스템의 기억이 평균적으로 질의응답 평가가 드러내는 것보다 낫다”고 해석합니다. 거짓 음성, 즉 기억은 맞는데 질문이 놓치는 쪽이 더 흔했다는 것입니다.
분야별로는 C1(LLM 보상)의 괴리가 가장 컸습니다. 내재 82.2%, 외재 54.5%, MAD 0.295입니다. C5(시간 순서)와 C6(여러 작성자)는 내재 점수가 가장 낮았습니다(59.3%, 41.5%). 시간에 따른 진화와 출처 반영이 가장 어려운 차원이라는 진단입니다. 그런데 외재 점수는 분야를 가리지 않고 42~55%로 고만고만했습니다. 외재 점수만 보면 이 약점들이 묻혀 버립니다.
발견 2: 어려울수록 오히려 덜 갈린다
난이도별로 보면 괴리율은 L1 55%, L2 50%, L3 26%로 어려울수록 줄었습니다. L1에서는 내재(68.0%)가 외재(50.9%)를 크게 앞섰습니다. 쉬운 문서에서는 시스템이 지식을 제대로 저장했는데 검색이 질문에 맞춰 꺼내지 못했다는 뜻입니다. L3에서는 두 점수가 47% 근처에서 만났습니다. 다만 평균이 비슷할 뿐 궤적별로는 양쪽으로 벌어져, 어떤 궤적은 거짓 양성이고 어떤 궤적은 거짓 음성이었습니다.
연산 분류 정확도는 난이도를 따라 가파르게 떨어졌습니다. L1 33.8% → L2 16.5% → L3 10.1%. 신호가 미묘해질수록 시스템이 연산 이름을 제대로 붙이는 능력이 무너졌습니다.
발견 3: 분류 정확도 20%, 거짓 갱신 22%
진단 지표를 분해하면 이렇습니다. 전체 거짓 갱신률 22.2%, 강화만 해야 할 때 다섯 번에 한 번 넘게 사실을 고쳐 썼습니다. 갱신 탐지 재현율 73.6%, 바뀌어야 할 때 네 번 중 한 번은 그대로였습니다. 그리고 연산 분류 정확도는 20.1%였습니다. 생성·강화·갱신·대체 가운데 정답을 고른 비율이 다섯 번에 한 번이라는 뜻입니다. 특히 C2(4.5%)와 C5(0.4%)는 0에 가까웠습니다. 확신도의 평균 절대 오차는 0.106으로, 10점 정도 어긋났습니다.
C1과 C6은 ‘이중 실패’를 보였습니다. 갱신 탐지 재현율이 약 51%로 낮은데 거짓 갱신률은 약 39%로 높았습니다. 바꿔야 할 때는 안 바꾸고, 안 바꿔야 할 때는 바꿨습니다. 외재 점수로는 이것을 단순한 ‘낮은 정확도’와 구분할 수 없습니다.
발견 4: 어디를 고칠지가 보인다
논문은 진단을 단계별 고장 위치로 나눕니다. 문서에 있었는데 관찰로 잡히지 않은 추출 실패, 관찰은 됐는데 잘못 합쳐지거나 중복되거나 사라진 종합 실패, 상태 전이를 놓치거나 거짓 갱신을 한 갱신 실패, 모순을 잡지 못하거나 잘못 푼 충돌 실패입니다.
표 4에서 세 가지 실패가 난이도와 함께 커집니다. 기대 주장을 저장소에서 찾지 못한 놓침률이 L1 54%에서 L3 86%로, 궤적당 사실 개수가 9.6개에서 22.4개로 늘고, 분류 정확도는 33.8%에서 10.1%로 떨어집니다. 논문은 이 셋이 서로를 키운다고 해석합니다. 분류를 틀려 기존 사실을 갱신할 자리에 새 사실을 만들고, 그래서 사실 개수가 불어나며, 지식이 여러 사실로 쪼개져 주장 단위 대조에서 놓침이 늘어납니다. 그동안 외재 점수는 실패 양상과 상관없이 50% 근처에 머물렀습니다.
부록 표 8은 상태가 진행될수록 기억이 새는 모습도 보여 줍니다. 주장 덮음률이 첫 상태 64.7%에서 다섯째 상태 49.7%로 떨어졌습니다. 문서가 3건 넘게 쌓이면 앞서 배운 것을 붙들고 있기 어려워진다는 뜻입니다. 상태가 2~3개인 궤적의 정확도는 약 71%, 5~7개인 궤적은 약 49%였습니다(스피어먼 ρ = −0.45). 한편 ‘주제와 관련된 사실을 하나라도 만들었나’는 98.8%였습니다. 사실이 아예 없는 게 아니라, 있는 사실이 불완전하거나 조각나 있었습니다.
아래 탐색기로 표 3·4·9의 지표를 분야별·난이도별로 바꿔 가며 보세요. 외재 점수의 막대가 얼마나 납작한지, 내재 지표들의 막대가 얼마나 들쭉날쭉한지가 이 논문의 주장 그 자체입니다.
발견 5: 시스템·말뭉치·백본을 바꿔도 남았다
이 괴리가 특정 구현의 우연인지 확인하려고, 논문은 네 가지 구성을 비교했습니다. 정제 기능이 빠진 단순 시스템, 주 시스템(검색 관련성 필터·동시 갱신 처리·큰 문서 추출 개선 추가), 공개 전 말뭉치와 공개 말뭉치, 그리고 더 새로운 세대의 최상위 모델로 백본을 바꾼 구성입니다.
구성
내재
외재
MAD
괴리율
κ
단순 시스템 · 공개 전 말뭉치
57.6%
48.8%
0.164
43.3%
0.104
주 시스템 · 공개 전 말뭉치
61.1%
48.5%
0.181
49.4%
0.082
주 시스템 · 공개 말뭉치 (본문 결과)
60.6%
48.8%
0.168
43.6%
0.118
주 시스템 · 상위 백본
61.4%
49.2%
0.158
39.7%
0.035
네 구성 모두 내재 57.6~61.4%, 외재 48.5~49.2%로 좁은 띠 안에 있었고, 부호 있는 괴리는 늘 양수였으며, 통과·실패 일치도는 우연 수준 근처였습니다. 백본을 업그레이드하자 일치도는 오히려 0.035로 더 떨어졌습니다. 분야별 순위도 안정적이었습니다(MAD 순위의 스피어먼 상관 0.94). C1이 MAD와 분류 정확도 모두 가장 높고, C6이 내재 점수가 가장 낮고, C5가 분류 정확도가 가장 낮다는 극단은 바뀌지 않았습니다.
여기까지가 논문이 말하는 이야기입니다. 이제 표를 한 줄씩 다시 읽어 보겠습니다.
8. 꼼꼼히 다시 읽기: 숫자 뒤의 여섯 가지 의문
FEB-30의 문제 제기, 즉 ‘답 점수만으로는 기억의 상태를 알 수 없다’는 주장은 설득력이 있습니다. 하지만 논문의 표를 한 줄씩 대조하면 몇 군데가 걸립니다. 1장에서 본 역사의 후반부, 즉 ‘내재 시험도 측정 장치로서 검증받아야 한다’는 교훈을 FEB-30 자신에게 적용해 보는 셈입니다.
의문 1: C1은 거짓 양성을 만들려 했는데, 거짓 양성이 나오지 않았다
표 1은 C1(LLM 보상)의 설계 조건을 “기억은 틀렸지만 질의응답은 여전히 맞는 상황”으로 적습니다. 그렇다면 C1에서는 외재 점수가 내재 점수보다 높아야 합니다. 그런데 결과는 정반대였습니다. C1 다섯 궤적 모두 내재가 외재 이상이었고(넷은 내재 쪽으로 5점 넘게 벌어졌고, 하나는 차이 5점 미만), 분야 평균은 내재 82.2%, 외재 54.5%였습니다. 부록 표 11의 설명은 이제 이렇게 바뀌어 있습니다. “C1은 설계상 강한 양의 편향을 보인다. 기억은 맞는데 질의응답이 과소평가한다.” 같은 분야를 두고 표 1은 ‘기억이 틀린’ 분야라 하고, 표 11은 ‘기억이 맞는’ 분야라 합니다.
30개 궤적 전체에서 외재가 내재를 앞선 경우, 즉 진짜 ‘LLM 보상’ 방향의 괴리는 세 개뿐이었고(c4-compound, c6-cross-role-synthesis, c6-repetition), 모두 L3였으며 C1은 하나도 없었습니다. 초록과 서론이 두 실패를 나란히 내세우지만, 실험이 실제로 보여 준 것은 대부분 거짓 음성 쪽입니다.
왜 이렇게 됐을까요. 코어닷투데이가 보기에 가장 그럴듯한 설명은 내재 지표의 정의에 있습니다. 식 1의 덮음률은 ‘있어야 할 주장이 저장소 어딘가에 있나’만 셉니다. 재현율만 보고, ‘없어야 할 사실’이 남아 있는지는 보지 않습니다. C1이 만드는 ‘틀린 기억’의 전형은 낡은 사실이 대체되지 않고 남은 상태(c1-stale-state), 같은 사실이 중복된 상태(c1-duplicate-facts)입니다. 새 사실이 옆에 함께 생기기만 하면 덮음률은 100%가 됩니다. 낡은 사실은 덮음률에 아무 흔적도 남기지 않습니다. 오히려 질문 단계에서 낡은 사실과 새 사실이 함께 검색돼 답을 흐리게 만들 수 있으니, 외재 점수만 떨어집니다. c1-duplicate-facts가 내재 100%, 외재 50%인 것이 그런 그림과 맞습니다. 거짓 양성을 잡으려고 만든 지표가, 정작 그 거짓의 가장 흔한 형태(낡은 사실이 살아 있음)를 못 보는 셈입니다. 논문은 이 문제를 거짓 갱신률과 사실 개수 같은 별도 지표로 일부 잡지만, 헤드라인인 MAD와 κ는 덮음률로 계산됩니다.
의문 2: 외재 점수 30개 중 16개가 11번 내내 정확히 50%
부록 표 13을 보면 외재 점수에 이상한 규칙성이 있습니다. 30개 궤적 가운데 16개가 ‘50.0 ± 0.0’입니다. 11번을 돌려 11번 모두 정확히 0.5, 즉 판정관이 매번 PARTIAL을 줬다는 뜻입니다. 또 다섯 궤적은 ‘45.5 ± 14.4’, 한 궤적은 ‘54.5 ± 14.4’입니다. 0·0.5·1 세 값만 나올 수 있는 점수에서 평균 45.5%와 표준편차 14.4%가 나오는 조합은 ‘PARTIAL 10번, NO 1번’뿐입니다(54.5%는 PARTIAL 10번, YES 1번). 결국 30개 중 22개 궤적이 11번 중 10번 이상 PARTIAL을 받았습니다.
이유는 짐작할 수 있습니다. 외재 질문이 궤적당 하나이고, 대부분 “원래 무엇이고, 어디로 가며, 일정과 진행 상황은?”처럼 사실 여러 개를 한꺼번에 묻는 복합 질문입니다. 그리고 판정은 ‘다 맞으면 YES, 일부만 맞으면 PARTIAL’의 세 단계입니다. 네 가지를 묻는 질문에 하나라도 빠지면 PARTIAL이고, 하나라도 맞으면 NO가 아닙니다. 그러니 거의 모든 답이 PARTIAL에 떨어집니다.
이것이 왜 중요할까요. 논문은 “외재 평가가 대부분의 분야에서 거의 균일한 42~55%를 보고해 약점을 가린다”고 쓰는데, 그 균일함의 상당 부분은 시스템이 아니라 채점 장치의 해상도에서 나왔을 수 있습니다. 거의 상수인 변수와 다른 변수의 상관은 낮게 나올 수밖에 없고, 통과 기준이 ‘50% 이상’이라 PARTIAL은 통과로 셉니다. 외재 평가는 거의 늘 ‘통과’이고, 두 판정이 엇갈리는 경우는 대부분 내재 점수가 50% 아래로 떨어진 궤적입니다. κ = 0.118과 r = 0.423이라는 헤드라인은 ‘기억과 답이 원래 따로 논다’는 증거이기도 하지만, 동시에 ‘외재 쪽 자가 너무 거칠다’는 증거이기도 합니다. 둘을 이 데이터만으로는 가를 수 없습니다.
아래 모의실험에서 이 효과를 직접 확인할 수 있습니다. 기억의 진짜 품질과 검색 확률은 그대로 두고 외재 채점의 설계만 바꿉니다. 논문식(질문 1개 × 사실 4개 × 3단계)으로 두면 200번 모의실험의 평균이 r ≈ 0.31, κ ≈ 0.10으로 논문 값과 비슷하게 나옵니다. 사실 하나만 묻는 질문 8개로 바꾸면 r ≈ 0.54, κ ≈ 0.38로 올라갑니다. 검색이 완벽하고 LLM 보상이 전혀 없어서, 답이 오로지 기억 품질에만 달린 극단적 경우에도 논문식 설계의 κ는 약 0.15에 머뭅니다.
의문 3: 내재 채점도 '서랍을 통째로 여는 것'은 아니다
그림 1을 다시 보면 내재 채점에도 ‘임베딩+검색’ 칸이 있습니다. 5.1절에 따르면 사실이 주장을 담는지는 “임베딩 유사도 0.8 초과 뒤 LLM 판정관 확인”으로 정합니다. 즉 유사도 0.8을 넘는 사실만 판정관에게 갑니다. 그런데 기억 시스템이 사실을 잘 합칠수록 사실 문장은 길어지고, 긴 문장의 임베딩은 짧은 주장 하나와 유사도가 낮아집니다. 이 경우 잘 종합한 시스템일수록 판정 기회를 잃습니다. 9장의 실측에서 바로 이 현상이 나왔습니다. 같은 저장소가 ‘모든 사실을 판정관에게 보여 줄 때’와 ‘유사도 0.8 초과만 보여 줄 때’ 100%와 25%로 갈렸습니다. 논문도 한계 절에서 “임베딩 유사도 임계값과 LLM 판정관에 기대는 채점은 측정 잡음을 낳을 수 있다”고 인정하지만, 그 크기를 재지는 않았습니다.
의문 4: 놓침률과 내재 점수가 맞아떨어지지 않는다
표 4의 전체 놓침률은 71.4%, 표 3의 내재 점수는 60.6%입니다. 놓침률이 ‘저장소에서 찾지 못한 기대 주장의 비율’이라면 덮음률은 많아야 28.6%여야 할 것 같지만, 내재 점수가 그 두 배입니다. 판정이 PARTIAL(0.5)을 허용하니 ‘YES가 아닌 것은 모두 놓침’으로 셌다고 보면 계산상 맞출 수는 있지만, 그러면 기대 주장의 대부분이 PARTIAL을 받았다는 이야기가 됩니다. 궤적별 표에서는 더 이상한 줄도 있습니다. c1-confidence-001은 내재 100.0 ± 0.0인데 놓침률이 11 ± 21%이고, c1-duplicate-facts-001은 내재 100.0인데 놓침률이 17%입니다. 두 지표가 서로 다른 판정 경로를 쓰는 듯하지만, 논문은 놓침률의 정확한 계산법을 밝히지 않습니다.
연산 분류 정확도도 비슷합니다. C5(시간 순서)는 갱신 탐지 재현율이 90.6%, 거짓 갱신률이 0%로 거의 완벽한데, 분류 정확도는 0.4%입니다. 갱신이 필요할 때 저장소를 정확히 바꿨는데 연산 이름은 거의 다 틀렸다는 뜻입니다. 관찰이 여러 개인 상태에서 정답 연산과 무엇을 어떻게 맞췄는지 정의가 없어서, 이 숫자를 ‘시스템의 판단력’으로 읽어야 할지 ‘채점 규칙의 산물’로 읽어야 할지 알 수 없습니다.
의문 5: 분류 실패의 일부는 프롬프트가 시킨 것이다
부록 B.2에 실린 시험 대상 시스템의 종합 프롬프트에는 이런 줄이 있습니다.
논문 부록 B.2 · Fact Synthesis 프롬프트 일부
갱신 규칙
기존 문장의 모든 세부를 반드시 보존하라. 새 정보(수치·일정·사람)를 덧붙여라. 생성보다 갱신을 선호하라.
마지막 지시
기존 사실과 맞는 관찰은 거의 모두 “update”여야 한다. 애매하면 “update”를 써라.
시스템에게 ‘애매하면 갱신하라’고 지시해 놓고, 강화해야 할 때 갱신했다고 거짓 갱신률 22%를 매긴 셈입니다. 표 9에서 거짓 갱신이 가장 많은 분야는 C3(45.5%)·C1(39.4%)·C6(38.6%)으로, 모두 ‘같은 말을 다시 하는’ 강화 상태가 많은 분야입니다. 물론 이것은 논문의 결론을 약하게 만들기보다 오히려 강하게 만드는 사례일 수 있습니다. 외재 점수로는 이런 프롬프트의 편향이 전혀 보이지 않으니까요. 다만 ‘최신 기억 시스템이 연산을 20%밖에 못 맞힌다’는 헤드라인을 ‘LLM의 판단력 한계’로 일반화하기 전에, 그 20%가 이 특정 프롬프트의 산물이라는 점은 짚어야 합니다. 9장에서 이 세 줄을 뺀 프롬프트도 함께 돌렸는데, 결과는 이 가설과 달랐습니다(9장 발견 4).
의문 6: 재현할 수 있나
마지막은 재현성입니다. 2026년 10월 25일 기준으로, 논문이 공개했다고 적은 저장소(github.com/amazon-science/feb-30-benchmark)는 웹과 GitHub API 모두에서 404입니다. amazon-science 조직의 저장소 목록에도, 허깅페이스 데이터셋 검색에도 없습니다. 아마존의 오픈소스 공개 승인을 기다리는 중일 수 있지만, 지금은 궤적 30개와 문서 147건을 누구도 내려받을 수 없습니다. 시험 대상 시스템의 추출·종합 모델도 ‘최상위 LLM’이라고만 적혀 있고, 생성 모델 6개와 심사 모델 3개의 이름도 없습니다.
인용 몇 곳도 원문과 어긋납니다. 관련 연구 절은 MemoryAgentBench의 네 역량을 ‘보존·시간 추론·지식 갱신·정보 통합’이라고 적지만 원 논문의 네 역량은 ‘정확한 검색·실시간 학습·긴 맥락 이해·선택적 망각’입니다. LongMemEval-V2의 다섯 능력을 ‘시간 추론 능력’으로 묶었지만 실제로는 정적 상태 기억·동적 상태 추적·작업 흐름 지식·환경의 함정·전제 인식입니다. MEME는 NeurIPS 2026 데이터셋 트랙으로 인용됐는데, 코어닷투데이가 확인할 수 있었던 것은 ICML 2026 워크숍 포스터까지였습니다. 짝을 이루는 서베이(Toma & Matei, “What Agent Memory Benchmarks Miss”)는 ‘InnoComp 2026 발표 예정’인데, 학회는 2026년 11월 9~11일 리스본에서 열리고 원고는 아직 공개되지 않았습니다. ‘벤치마크 15개를 조사했다’는 근거는 지금 확인할 수 없습니다. 논문이 ‘저장소 직접 검사를 안티패턴이라 부른다’고 인용한 Future AGI 블로그(2026-04-07)도 실제로는 FAQ의 다섯 번째 항목에 한 줄로 그렇게 적었을 뿐, 같은 글 본문에서는 “잘못된 사실 하나의 피해 반경은 누군가 저장소를 읽거나 항목이 소멸할 때까지 끝이 없다”고 써서 저장소 읽기를 오히려 권합니다.
논문 스스로도 한계를 적어 둡니다. 생성한 문서가 실제 여러 사람의 글을 다 담지 못할 수 있고, 궤적 30개는 “진단에는 충분하지만 세밀한 통계 비교에는 부족”하며, 일화 기억·절차 기억·한 턴짜리 대화 기억은 다루지 않는다고 합니다. 여기에 코어닷투데이가 덧붙이자면, 말뭉치는 영어이고 기술·비즈니스 운영이라는 한 영역에 머뭅니다.
그래도 남는 것
여섯 가지 의문을 다 감안해도 논문의 중심 주장은 살아남는다고 봅니다. 의문 1~4는 ‘내재 평가가 필요 없다’가 아니라 ‘내재 평가의 자도 다듬어야 한다’는 이야기이고, 의문 5는 오히려 외재 평가가 얼마나 많은 것을 가리는지 보여 줍니다. 문제는 FEB-30이 그 첫 번째 자라는 것, 그리고 2016년 RepEval 워크숍이 단어 임베딩에 대해 깨달았듯 첫 번째 자는 대개 휘어 있다는 것입니다.
9. 코어닷투데이 실측: 한국어 미니 FEB
FEB-30의 궤적은 아직 내려받을 수 없습니다. 그래서 같은 방법으로 작은 한국어판을 직접 만들어 돌렸습니다. 목표는 논문의 숫자를 재현하는 것이 아니라, 8장에서 제기한 의문이 실제 시스템에서도 나타나는지 확인하는 것이었습니다. 의문은 세 가지입니다. 0.8 필터가 내재 점수를 얼마나 흔드는지, 덮음률이 낡은 사실을 정말 못 보는지, 편향된 프롬프트를 고치면 연산 분류가 나아지는지.
무엇을 만들었나
논문의 여섯 분야에서 궤적을 두 개씩, 모두 12개를 만들었습니다. 순서는 논문과 같습니다. 정답 상태(그 시점에 참인 주장 목록과 기대 연산)를 먼저 쓰고, 거기서 문서를 만들었습니다. 문서는 회의록·슬랙·이메일·티켓·위키 다섯 가지 형식으로 모두 41건(상태 문서 37건, 방해 문서 4건)이고, 기대 주장은 77개, 사실 하나만 묻는 단일 질문은 33개입니다.
분야
궤적
함정
C1 LLM 보상
한빛물류 요금제(스탠다드 120만 원 → 엔터프라이즈 310만 원), 보안 점검 일정
옛값이 남아도 답변 모델이 최신 문맥으로 바로잡을 수 있다
C2 검색 병목
사내 메신저 전환, 운영 DB 백업 정책
질문과 다른 표현으로 쓰인 사실, 방해 문서 사이에 묻힌 사실
C3 분류
모바일 앱 2.0 출시, 하반기 백엔드 채용(3명 → 한 자리 연기)
같은 말을 되풀이하는 강화, 숫자 하나만 슬쩍 바뀌는 갱신
C4 종합
누리랩스 컴퓨팅 플랫폼 결정, 상담 기록 보존 정책
결론이 먼저 오고 이유가 나중에 도착하는 순서 뒤바뀜, 적용 범위의 축소
C5 시간
가람상사 DB 이전(검토 → 결정 → 진행), 11월 고객 세미나(코엑스 → 취소, 웨비나)
단계적 진행, 철회
C6 여러 작성자
결제 API 장애 원인, 로그 저장소 선택
세 사람이 같은 원인을 확인하는 보강, 권한 있는 사람의 뒤집기
문서는 Claude Code(Opus 5.5)가 정답 궤적을 보고 썼습니다. 그 뒤의 모든 단계는 사내 맥북의 로컬 Ollama에서 돌렸습니다. 외부 API 비용은 0원입니다. 시험 대상 시스템은 논문 6.1절의 구조를 그대로 옮겼습니다. 문서마다 관찰을 뽑고(부록 B.1 프롬프트), 관찰마다 유사한 사실 3개를 찾아 생성·갱신·강화·대체 중 하나를 고르게 합니다(부록 B.2 프롬프트). 추출·종합은 qwen3.5:9b, 임베딩은 bge-m3, 답변·판정은 qwen3.8:27b가 맡았고, 검색은 논문처럼 BM25 0.3 + 밀집 검색 0.7을 섞었습니다(한국어라 BM25는 글자 두 개 단위로 잘랐습니다). 온도는 0, 궤적마다 1회 실행입니다.
종합 단계만 바꿔 시스템을 셋 만들었습니다.
A논문 프롬프트 그대로. 부록 B.2를 한 글자도 바꾸지 않았습니다. ‘생성보다 갱신을 선호하라’, ‘애매하면 update’가 들어 있습니다.
B편향 세 줄 삭제. 8장 의문 5에서 짚은 세 줄만 지웠습니다. 나머지는 A와 같습니다.
C추가 전용. 2026년 Mem0식입니다. LLM 분류 없이 관찰을 모두 새 사실로 쌓고, 거의 같은 문장(유사도 0.95 이상)만 강화로 셉니다. 정리는 읽을 때로 미룹니다.
채점은 다섯 가지로 했습니다. 논문의 두 성적표를 각각 두 방식으로 나누고, 기준선을 하나 더했습니다.
내재·전체: 상태마다 활성 사실을 전부 판정관에게 보여 주고, 기대 주장마다 YES·PARTIAL·NO를 받아 평균합니다(부록 C의 판정 프롬프트).
내재·0.8: 논문 5.1절처럼 주장과 임베딩 유사도가 0.8을 넘는 사실만 판정관에게 보여 줍니다. 나머지는 같습니다.
외재·복합: 논문처럼 궤적마다 마지막에 복합 질문 1개를 던져 하이브리드 검색 5개로 답하게 하고 채점합니다.
외재·단일: 사실 하나씩만 묻는 질문 1~5개를 같은 방식으로 채점해 평균합니다. 8장 모의실험의 ‘잘게 나눈 외재 채점’입니다.
원문 통째: 기억 시스템 없이 문서 전부를 답변 모델에 넣고 복합 질문에 답하게 합니다.
결과 한눈에
지표
A 논문 프롬프트
B 세 줄 삭제
C 추가 전용
내재·전체
91.7
89.8
89.2
내재·0.8 (논문식)
20.5
18.8
59.1
외재·복합 (논문식)
79.2
70.8
62.5
외재·단일
79.4
75.9
69.7
원문 통째 (기억 없음)
83.3
83.3
83.3
내재·전체와 외재·복합의 평균 괴리
17.7
27.3
33.0
15점 넘게 벌어진 궤적
5 / 12
8 / 12
8 / 12
궤적당 사실 수 (끝 상태)
1.8
1.8
8.9
사실 문장 평균 길이
219자
212자
42자
연산 분류 정확도
56%
56%
0% (분류 안 함)
거짓 갱신률 (강화 상태 7개 중)
7 / 7
7 / 7
7 / 7
끝까지 남은 낡은 사실
4개
3개
4개
논문의 큰 그림은 한국어에서도 그대로 나왔습니다. 세 시스템 모두 내재 점수가 외재 점수보다 높았고, 평균 18~33점 벌어졌습니다. 논문의 16.8점보다 큽니다. 아래 위젯에서 시스템을 바꿔 가며 궤적별 점수와, 끝났을 때 저장소에 무엇이 남았는지 직접 볼 수 있습니다.
발견 1: 같은 저장소가 판정 방식만 바꿔 100점과 25점
가장 먼저 눈에 띈 것은 내재·전체와 내재·0.8의 차이입니다. A의 내재 점수는 판정관에게 사실을 전부 보여 주면 91.7점, 논문처럼 유사도 0.8을 넘는 사실만 보여 주면 20.5점입니다. 저장소는 같고, 판정관에게 보여 주는 범위만 다릅니다.
원인은 A의 저장소 모양입니다. ‘애매하면 갱신하라’는 지시를 받은 9B 모델은 새 관찰을 거의 전부 기존 사실 하나에 이어 붙였습니다. 궤적이 끝났을 때 사실은 평균 1.8개, 한 문장이 평균 219자입니다. 가람상사 DB 이전(C5) 궤적은 네 번의 문서가 모두 한 사실로 합쳐졌습니다. “가람상사는 사내 서버에서 PostgreSQL 14를 운영 중이다. 용량은 약 3TB이다. 백승우가 Aurora와 AlloyDB를 비교 검토하고 있다. … 2025년 5월 8일 개념 검증을 마친 후 Aurora로…”가 계속 이어지는 식입니다. 판정관이 이 덩어리를 보면 기대 주장이 다 들어 있으니 모두 YES를 줍니다. 내재·전체는 100점입니다. 그런데 “가람상사의 운영 DB 용량은 약 3TB다”라는 짧은 주장과 219자짜리 덩어리의 임베딩 유사도는 0.8에 못 미칩니다. 판정관은 그 사실을 볼 기회조차 얻지 못하고, 내재·0.8은 25점이 됩니다.
판정관이 YES를 준 (주장, 사실) 쌍만 모아 유사도를 재 보면 A는 평균 0.705였고, 0.8을 넘는 쌍은 15%뿐이었습니다. 사실을 짧게 쪼개 쌓는 C는 평균 0.822, 0.8 초과가 64%였습니다. 그래서 내재·0.8에서는 순위가 뒤집힙니다. 판정관이 전부 보면 A가 가장 높고, 논문식으로 보면 C가 A의 세 배입니다. 0.8이라는 임계값 하나가 ‘잘 합친 시스템’과 ‘잘게 쪼갠 시스템’ 중 누구 편을 들지 정해 버립니다. 8장 의문 3에서 걱정한 일이 실제로 일어났습니다. 논문이 내재 점수 60.6을 보고할 때 이 효과가 얼마나 섞여 있는지는 알 수 없습니다.
발견 2: 덮음률은 옛 요금을 보지 못한다
C의 한빛물류 요금제(C1) 궤적을 보겠습니다. 계약 때는 ‘스탠다드, 월 120만 원’이었고, 두 달 뒤 사용량이 늘어 ‘엔터프라이즈, 월 310만 원’으로 바뀌었습니다. 추가 전용 저장소는 아무것도 지우지 않으니 끝났을 때 사실이 15개였습니다. “한빛물류의 요금제는 스탠다드이다”, “월 이용료는 120만 원이다”가 ‘엔터프라이즈로 전환하기로 합의했다’와 나란히 남아 있습니다.
내재 점수는 75점입니다. 새 요금에 대한 주장도 저장소 어딘가에 있으니 덮음률로는 꽤 잘한 셈입니다. 그런데 “한빛물류는 지금 어떤 요금제를 쓰고, 한 달에 얼마를 내나요?”라는 질문에는 “스탠다드 요금제, 월 120만 원”이라고 답했습니다. 외재 0점, 단일 질문 두 개도 모두 0점입니다. 검색 상위 5개를 옛 사실이 차지했기 때문입니다.
이것이 8장 의문 2의 실물입니다. 덮음률은 재현율만 보는 지표라 ‘있어야 할 것이 있는가’만 묻고, ‘없어야 할 것이 없는가’는 묻지 않습니다. 그래서 코어닷투데이는 지표를 하나 더했습니다. 궤적이 끝났을 때 대체·철회된 값(120만 원, 3명, ‘검토 중’, 정원 120명 등)을 아직 담은 사실의 수입니다. 세 시스템 모두 3~4개였습니다. 사실을 하나로 뭉친 A도 예외가 아니었습니다. A의 한빛물류 저장소에는 ‘스탠다드 120만 원’ 사실이 고스란히 남아 있고, ‘엔터프라이즈 전환’은 다른 사실에 이어 붙었습니다. 다만 A는 이 궤적의 질문에 “엔터프라이즈, 월 310만 원”이라고 맞게 답했습니다. 저장소에는 낡은 사실이 남아 있는데 답변 모델이 문맥으로 바로잡은 것입니다. 논문이 C1에서 보여 주려 했던 ‘LLM 보상’이 바로 이것입니다. 그런데 이 장면에서 내재 점수도 100점이라 낡은 사실을 잡지 못했습니다. 이 사례를 잡은 것은 내재 점수가 아니라 낡은 사실 수였습니다.
발견 3: 서랍에 다 있는데 답을 못 하는 두 가지 이유
거꾸로, 내재는 높은데 외재가 무너진 경우도 있었습니다. 원인은 두 가지였습니다.
하나는 덩어리 안의 모순입니다. A의 하반기 채용(C3) 궤적에서 저장소의 사실은 “2025년 하반기에 백엔드 개발자 3명이 채용될 예정이다. … 그중 백엔드 세 자리 중 한 자리는 2026년 1분기로 연기되었다”처럼 옛값과 새 소식을 한 문장에 담고 있었습니다. 답변 모델은 이 문장에서 ‘3명’을 읽고 “백엔드 3명, 8월 29일 마감”이라고 답했습니다. 정답은 2명입니다. 외재 0점이고, 내재는 67점입니다. 갱신을 ‘덮어쓰기’가 아니라 ‘덧붙이기’로 하면, 계산은 읽는 쪽 몫으로 남습니다.
다른 하나는 정리되지 않은 충돌입니다. C의 11월 세미나(C5) 궤적에서 저장소에는 ‘코엑스에서 개최 예정’, ‘정원 120명’과 ‘코엑스 대관 취소’, ‘11월 14일 온라인 웨비나, 인원 제한 없음’이 모두 남아 있었고, 검색 상위 5개에도 넷이 모두 들어왔습니다. 필요한 정보는 다 받았는데 답변 모델은 서로 부딪치는 사실 앞에서 “I don't have that information”이라고 답했습니다. 내재 100점, 외재 0점입니다. 추가 전용 방식은 정리를 ‘읽을 때’로 미루는데, 이 시험에서는 읽는 쪽이 정리를 포기했습니다.
두 경우 모두 내재 점수로는 문제가 보이지 않습니다. 기대 주장은 다 저장소에 있기 때문입니다. 실제로는 낡은 주장도 함께 있었습니다. 논문의 내재 지표에 ‘현재 상태와 맞지 않는 주장이 남아 있는가’를 보는 정밀도 쪽 지표가 빠졌다는 점이 여기서도 드러납니다.
발견 4: 세 줄을 지워도 9B 모델은 여전히 '갱신'만 했다
8장 의문 5에서 ‘연산 분류 20%의 일부는 프롬프트가 시킨 것’이라고 썼습니다. B는 그 가설을 시험하려고 만든 시스템입니다. 결과는 가설과 달랐습니다.
강화 상태(같은 내용을 다시 확인하는 문서)에 들어온 관찰은 A에서 14개, B에서 15개였습니다. 그중 ‘강화’로 분류된 것은 A·B 모두 0개였고, 거의 다 ‘갱신’이 됐습니다. 대체 상태의 관찰 17개 중 ‘대체’로 분류된 것도 둘 다 1개뿐이었습니다. 편향을 거는 세 줄을 지워도 qwen3.5:9b는 기존 사실과 비슷한 관찰이면 무조건 이어 붙였습니다. 적어도 이 크기의 모델에서는 갱신 편향이 프롬프트보다 모델 쪽에 있습니다. 그러니 의문 5는 ‘프롬프트가 원인’이 아니라 ‘프롬프트가 편향을 부추긴다’ 정도로 낮춰 읽어야 합니다. 논문의 최상위 모델에서는 결과가 다를 수 있지만, 그 모델의 이름은 공개되지 않았습니다.
연산 분류 정확도 56%라는 숫자도 조심해서 읽어야 합니다. 이 시험의 상태 25개 중 13개가 ‘갱신’이 정답이라, 무조건 갱신하는 시스템도 절반 넘게 맞힙니다. 강화·대체를 하나도 못 맞혀도 56%가 나옵니다. 논문의 20.1%도 정답 연산의 분포를 함께 보지 않으면 높은지 낮은지 판단할 수 없습니다. 논문의 표 9는 분야별 분포는 주지만 정답 연산의 분포는 주지 않습니다.
발견 5: 판정관의 PARTIAL과, 잘게 나눈 질문
결제 API 장애(C6) 궤적의 정답은 “인증서 만료”였습니다. 세 시스템 모두 “TLS 인증서 만료”라고 답했고, 기억 없이 원문을 통째로 넣었을 때도 같았습니다. 판정관(qwen3.8:27b)은 네 번 모두 PARTIAL을 줬습니다. 정답보다 자세한 답을 ‘일부만 맞음’으로 본 것입니다. 이 궤적의 외재 점수는 어떤 시스템이든 50점을 넘을 수 없습니다. 복합 질문 점수가 정확히 50점인 궤적은 A에서 3개, B·C에서 5개였습니다. 논문의 외재 점수 30개 중 16개가 11번 내내 50.0이었던 것(8장 의문 2)과 같은 현상으로 보입니다. 질문 하나를 PARTIAL 하나로 채점하면, 그 PARTIAL에는 기억의 품질만큼이나 판정관의 성향이 들어갑니다.
8장의 모의실험은 외재 채점을 단일 질문 여러 개로 나누면 두 채점의 상관이 올라간다고 예측했습니다. 실측에서도 그랬습니다. 내재·전체와의 상관계수가 복합 질문에서는 A 0.69, B 0.31, C 0.21이었고, 단일 질문에서는 각각 0.78, 0.60, 0.39로 모두 올랐습니다. 평균 괴리도 17.7·27.3·33.0점에서 13.4·17.4·24.1점으로 줄었습니다. 궤적 12개로 낸 상관계수라 크기 자체에는 큰 의미를 두기 어렵지만, 세 시스템에서 방향이 모두 같았습니다.
마지막으로 기준선입니다. 기억 시스템 없이 궤적의 문서 3~4건을 통째로 답변 모델에 넣으면 83.3점이 나옵니다. 세 시스템 중 누구도 이 점수를 넘지 못했습니다. 문서가 몇 건뿐인 궤적에서 기억 시스템은 정보를 보태지 못하고 깎기만 합니다. FEB-30도 상태 문서가 궤적당 평균 네 건 남짓(127건 ÷ 30개)이므로, 그 외재 점수는 ‘기억이 얼마나 도움이 되나’보다 ‘기억이 얼마나 덜 망치나’에 가까운 것을 잽니다.
이 실측의 한계
궤적은 12개이고 각각 1회만 돌렸습니다. 숫자 하나하나는 통계가 아니라 사례로 읽어야 합니다. 시험 대상 시스템은 9B 모델이라 논문의 ‘최상위 LLM’보다 훨씬 약하고, 답변과 판정을 같은 27B 모델이 맡았습니다. 문서는 같은 작성자(Claude Code)가 썼으므로 논문이 공들인 ‘여러 사람의 문체’는 재현하지 못했습니다. 그래도 세 가지는 이 규모에서도 분명했습니다. 0.8 필터는 내재 점수를 수십 점 흔들고, 덮음률은 낡은 사실을 보지 못하며, 갱신 편향은 프롬프트 세 줄을 지운다고 사라지지 않습니다.
10. 2026년, 기억 시스템들은 서랍을 어떻게 다루나
업계는 서랍을 열 도구를 갖고 있다, 채점에 쓰지 않을 뿐
FEB-30이 묻는 것은 ‘저장소를 볼 수 있느냐’가 아니라 ‘저장소를 점수로 매기느냐’입니다. 2026년 주요 기억 제품을 보면 대부분 저장소를 들여다볼 도구는 이미 있습니다. 그런데 스스로 발표하는 평가는 여전히 질문 채점입니다.
시스템
저장소를 여는 도구
스스로 발표하는 평가
Mem0
전체 기억 조회, 기억별 변경 이력 API(추가·갱신·삭제, 이전·이후 값), 대시보드에서 추출 결과 점검
LoCoMo 92.5, LongMemEval 94.4 등 질문 채점. 문서 스스로 “점수가 올라도 기억 시스템이 나아졌다는 뜻은 아닐 수 있다”고 적음
Letta
기억 블록이 일급 객체. 평가 도구 Letta Evals에 memory_block 추출기가 있어 “에이전트가 사용자에 대한 기억을 제대로 고쳤는지” 검사 가능
범용 평가 틀(데이터셋 → 대상 → 추출기 → 채점기). 마지막 상태만 보고 문서마다의 변화는 보지 않음
Zep / Graphiti
사실(간선)마다 생성·유효 시작·무효·만료 시각을 남기는 이중 시간 기록. 낡은 사실은 지우지 않고 무효 시각을 찍음
DMR·LongMemEval 질문 채점(2025년 논문). 정답 상태 비교 도구는 찾지 못함
AWS Bedrock AgentCore Memory
기억 기록 조회 API. 통합 단계가 추가·갱신·무시를 판정하고 대체된 기록은 INVALID로 남김
2025-10-15 블로그: LLM 판정 정답률과 압축률만 발표(LoCoMo 70.58% 등). 같은 글의 모범 사례 절은 “무엇이 생성·갱신·생략되는지 정기적으로 검토하라”고 권함
AWS의 사례는 특히 흥미롭습니다. FEB-30 저자 셋이 AWS 소속인데, AWS가 2025년 10월 발표한 자사 기억 서비스의 평가는 순수하게 외재 평가였습니다. 그러면서 같은 글은 고객에게 ‘저장소에 무엇이 생기고 바뀌는지 직접 보라’고 권합니다. 현장의 운영 감각은 이미 내재 평가를 하고 있었고, FEB-30은 그것을 벤치마크의 언어로 옮기려는 시도로 읽을 수 있습니다.
쓸 때 정리하나, 읽을 때 정리하나
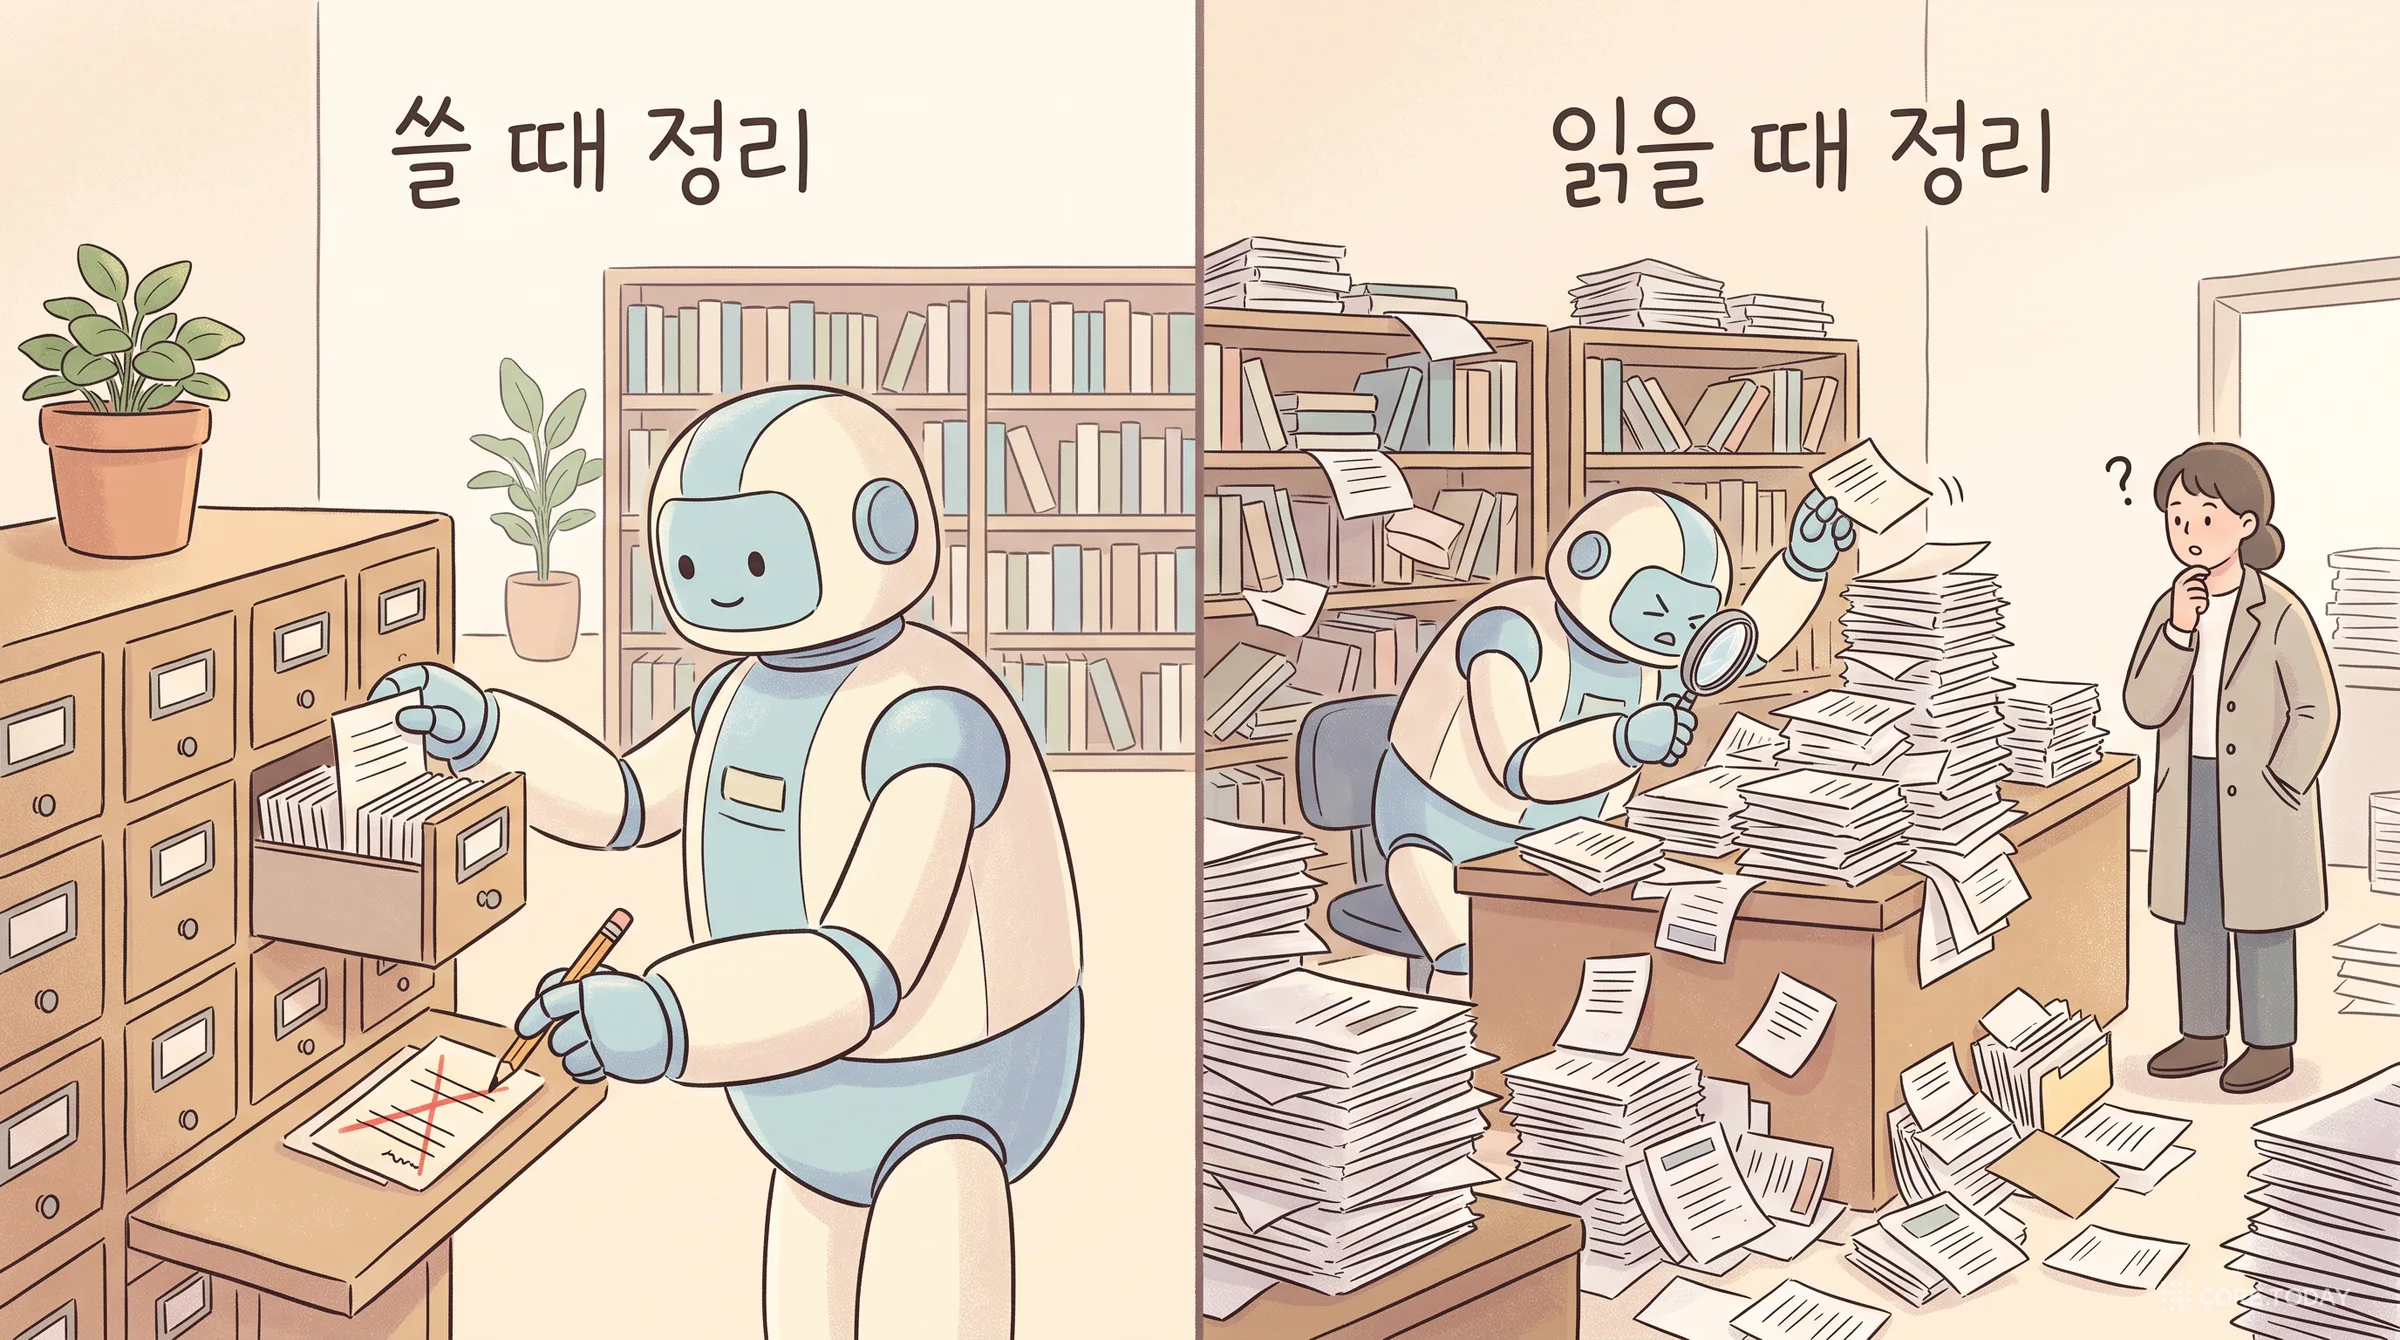
2026년에 생긴 더 근본적인 변화도 있습니다. 코어닷투데이가 에이전트 기억 엔진 해부에서 짚었듯, Mem0는 2026년 4월 쓰기 방식을 바꿨습니다. LLM 한 번으로 관찰을 뽑아 추가만(ADD-only) 하고, 기존 기억을 덮어쓰거나 지우지 않습니다. 이전 버전에서 다음 버전으로 옮기는 안내서는 기억 변경 방식을 ‘추가·갱신·삭제’에서 “추가만: 아무것도 덮어쓰거나 지우지 않는다”로 바꿨다고 적고, 상충하는 기억은 읽을 때 정리합니다. Mem0는 이 방식으로 LoCoMo와 LongMemEval 점수가 올랐다고 발표했습니다.
이 변화는 FEB-30에 곤란한 질문을 던집니다. 추가만 하는 저장소에는 ‘갱신이냐 강화냐’라는 판정이 아예 없습니다. 연산 분류 정확도, 거짓 갱신률, 갱신 탐지 재현율은 정의되지 않습니다. 덮음률은 정의되지만, 재현율만 보는 덮음률은 아무것도 지우지 않는 저장소에 가장 후합니다. 모든 것이 남아 있으니까요. 이런 시스템을 내재 평가하려면 ‘저장소의 상태’를 다시 정의해야 합니다. 예를 들어 ‘시점 t에 이 시스템이 참으로 읽어 내는 사실의 집합’이라는 읽기 시점의 상태를 만들어 정답과 비교하는 식입니다. 그러면 내재 평가와 외재 평가의 경계가 다시 흐려집니다. 읽기 시점의 상태를 만드는 데에도 검색과 LLM이 끼어들기 때문입니다.
업계는 지금 두 방향으로 동시에 움직이고 있습니다. Mem0는 진실을 판정하는 일을 읽기 쪽으로 옮겼고, AgentCore·Zep·AriadneMem은 쓰기 시점의 통합을 유지합니다. 후자는 서랍을 열어 보면 바로 채점할 수 있고, 전자는 서랍을 열어도 ‘무엇이 지금 참인지’가 적혀 있지 않습니다. FEB-30 같은 내재 평가가 표준이 되려면, 이 두 설계를 같은 자로 잴 방법부터 합의해야 합니다.
2026년에 내재 평가가 맡을 역할
그렇다면 2026년의 실무에서 내재 평가는 어떤 자리에 있어야 할까요. 코어닷투데이의 생각은 이렇습니다.
회귀 시험추출 프롬프트나 백본 모델을 바꿀 때마다 골든 궤적을 다시 돌려 저장소 상태를 비교한다. 질문 점수는 그대로인데 사실 개수가 두 배로 늘었다면, 그 변경은 조용히 기억을 쪼개고 있는 것이다.
감사 기록업무 에이전트의 기억은 ‘그때 시스템이 무엇을 참으로 믿었나’를 설명해야 한다. 사실마다 이력·출처·작성자를 남기고, 특정 시점의 저장소를 재구성할 수 있어야 한다. FEB-30의 상태별 채점은 이 능력을 시험하는 형태와 같다.
고장 위치 찾기질문 점수가 떨어졌을 때 추출·종합·갱신·검색 중 어디가 원인인지 가른다. 외재 점수가 그대로여도 내재 지표가 움직이면 미리 알 수 있다.
반대로 내재 평가가 해서는 안 되는 일도 있습니다. 내재 점수 하나로 제품 순위를 매기는 것입니다. 1장의 역사가 보여 주듯, 내재 지표는 그 자체로 대리 지표이고, 실전과 함께 움직인다는 검증이 있을 때만 의미가 있습니다. FEB-30의 r = 0.42는 그 검증이 아직 약하다는 뜻이기도 합니다.
FEB-30의 궤적은 아직 공개되지 않았지만, 방법은 바로 따라 할 수 있습니다. 9장의 미니 실측도 그렇게 만들었습니다. 우리 업무에서 사실이 변하는 이야기를 몇 개 골라 상태별 정답을 먼저 쓰고, 거기서 문서를 만들고, 문서를 넣을 때마다 저장소를 엽니다. 아래 점검표에서 항목을 골라 우리 팀의 시험 명세 초안을 만들어 보세요.
점검표를 고를 때 기억할 원칙을 다섯 줄로 줄이면 이렇습니다.
정답 상태를 먼저 쓴다. 문서에서 정답을 뽑지 말고, 정답 궤적에서 문서를 만든다. 사람의 주석 비용과 모호함이 사라진다.
재현율과 정밀도를 함께 본다. ‘있어야 할 사실이 있나’와 ‘없어야 할 사실이 없나’는 다른 질문이다. 낡은 사실이 남는 것은 덮음률에 보이지 않는다. 9장 실측에서는 세 시스템 모두 낡은 사실 3~4개를 끝까지 들고 있었다.
질문은 잘게 나눈다. 사실 네 개를 한 번에 묻는 질문 하나보다, 사실 하나씩 묻는 질문 네 개가 훨씬 많은 정보를 준다. 다른 말로 묻는 질문을 섞어 검색 병목을 가른다.
자를 검증한다. 같은 저장소를 판정 방식(후보 필터, 판정 모델)만 바꿔 다시 매겨 본다. 점수가 크게 흔들리면 시스템이 아니라 자를 먼저 고친다.
두 성적표를 같이 낸다. 내재와 외재가 엇갈리는 궤적이 가장 많은 것을 알려 준다. 그 궤적들을 사람이 직접 읽는다.
맺으며: 2월 30일에 닿으려면
FEB-30이라는 이름은 겸손한 농담입니다. 아무도 닿지 못한 날짜에 처음 닿았다는 자랑이면서, 그 날짜가 원래 달력에 없다는 고백이기도 합니다. 논문을 꼼꼼히 읽고 나면 두 번째 뜻이 더 오래 남습니다. 30개 궤적, 하나의 시험 대상 시스템, 아직 공개되지 않은 데이터, 그리고 외재 점수의 절반 이상을 PARTIAL로 채운 거친 질문 채점. FEB-30이 보여 준 16.8점의 괴리 가운데 얼마가 기억과 답의 진짜 차이이고 얼마가 자의 휘어짐인지, 이 논문만으로는 다 가를 수 없습니다.
그래도 이 논문이 던진 질문은 옳습니다. 답이 맞았다고 기억이 맞는 것은 아니고, 답이 틀렸다고 기억이 틀린 것도 아닙니다. 기억이 업무 기록이 되어 가는 2026년에는 ‘지금 이 시스템이 무엇을 참이라고 믿고 있는가’를 서랍째 보여 줄 수 있어야 합니다. 1993년 스파크 존스가 그은 선의 양쪽을 다 보는 것, 그리고 2016년의 교훈대로 양쪽의 자를 모두 의심하는 것. 그것이 2월 30일에 가장 가까이 가는 방법일 것입니다.
참고 자료
이 글의 대상 논문
Toma, de Kernier, Ply, Matei, “Beyond Downstream QA: Rethinking How We Evaluate Agent Memory”, arXiv 2610.22209 (2026-10-15). 논문이 적은 코드 저장소 github.com/amazon-science/feb-30-benchmark는 2026-10-25 기준 404
Toma, Matei, “What Agent Memory Benchmarks Miss: The Gap Between Response Quality and Knowledge State Correctness”, InnoComp 2026 발표 예정(미공개)
Mikolov, Yih, Zweig, “Linguistic Regularities in Continuous Space Word Representations”, NAACL 2013; Mikolov et al., “Efficient Estimation of Word Representations in Vector Space”, arXiv 1301.3781
Baroni, Dinu, Kruszewski, “Don't count, predict!”, ACL 2014; Levy, Goldberg, Dagan, “Improving Distributional Similarity with Lessons Learned from Word Embeddings”, TACL 2015; Schnabel et al., “Evaluation Methods for Unsupervised Word Embeddings”, EMNLP 2015
Faruqui et al., “Problems With Evaluation of Word Embeddings Using Word Similarity Tasks”, RepEval 2016; Chiu, Korhonen, Pyysalo, “Intrinsic Evaluation of Word Vectors Fails to Predict Extrinsic Performance”, RepEval 2016; Linzen, “Issues in evaluating semantic spaces using word analogies”, RepEval 2016