상태 추적상태 표류StateMemStateMemBench에이전트 메모리장기 기억Mem0LongMemEval진리 유지 시스템믿음 수정대화 상태 추적
[특집] 기억은 하는데 지금을 모른다 — AI 에이전트의 '상태 표류'와 StateMem 완전 해부
에이전트가 며칠씩 일하게 되면서 '기억했는가'보다 '지금 무엇이 참인가'가 중요해졌다. UIUC 연구진의 2026년 8월 논문은 이것을 상태 추적이라 부르고, 사실은 맥락 안에 있는데 낡은 값으로 행동하는 실패를 '상태 표류'로 정의했다. 1969년 프레임 문제와 1979년 진리 유지 시스템·VisiCalc에서 시작해 대화 상태 추적, MemGPT·Mem0·Zep까지 이어지는 계보를 따라가고, 함정 234개짜리 StateMemBench가 어떻게 실패를 '만드는지', 대체 표시와 의존성 그래프로 상태를 지키는 StateMem과 답변 호출 하나만 바꾸는 래퍼가 무엇을 얼마나 고치는지 표와 그림을 하나씩 읽는다. 논문과 같은 계열의 로컬 모델(Qwen 3.5 9B)로 한국어 함정 40문항을 직접 돌려, 답변 프롬프트만 바꿔도 정답이 28개에서 38개로 느는 것도 확인했다.
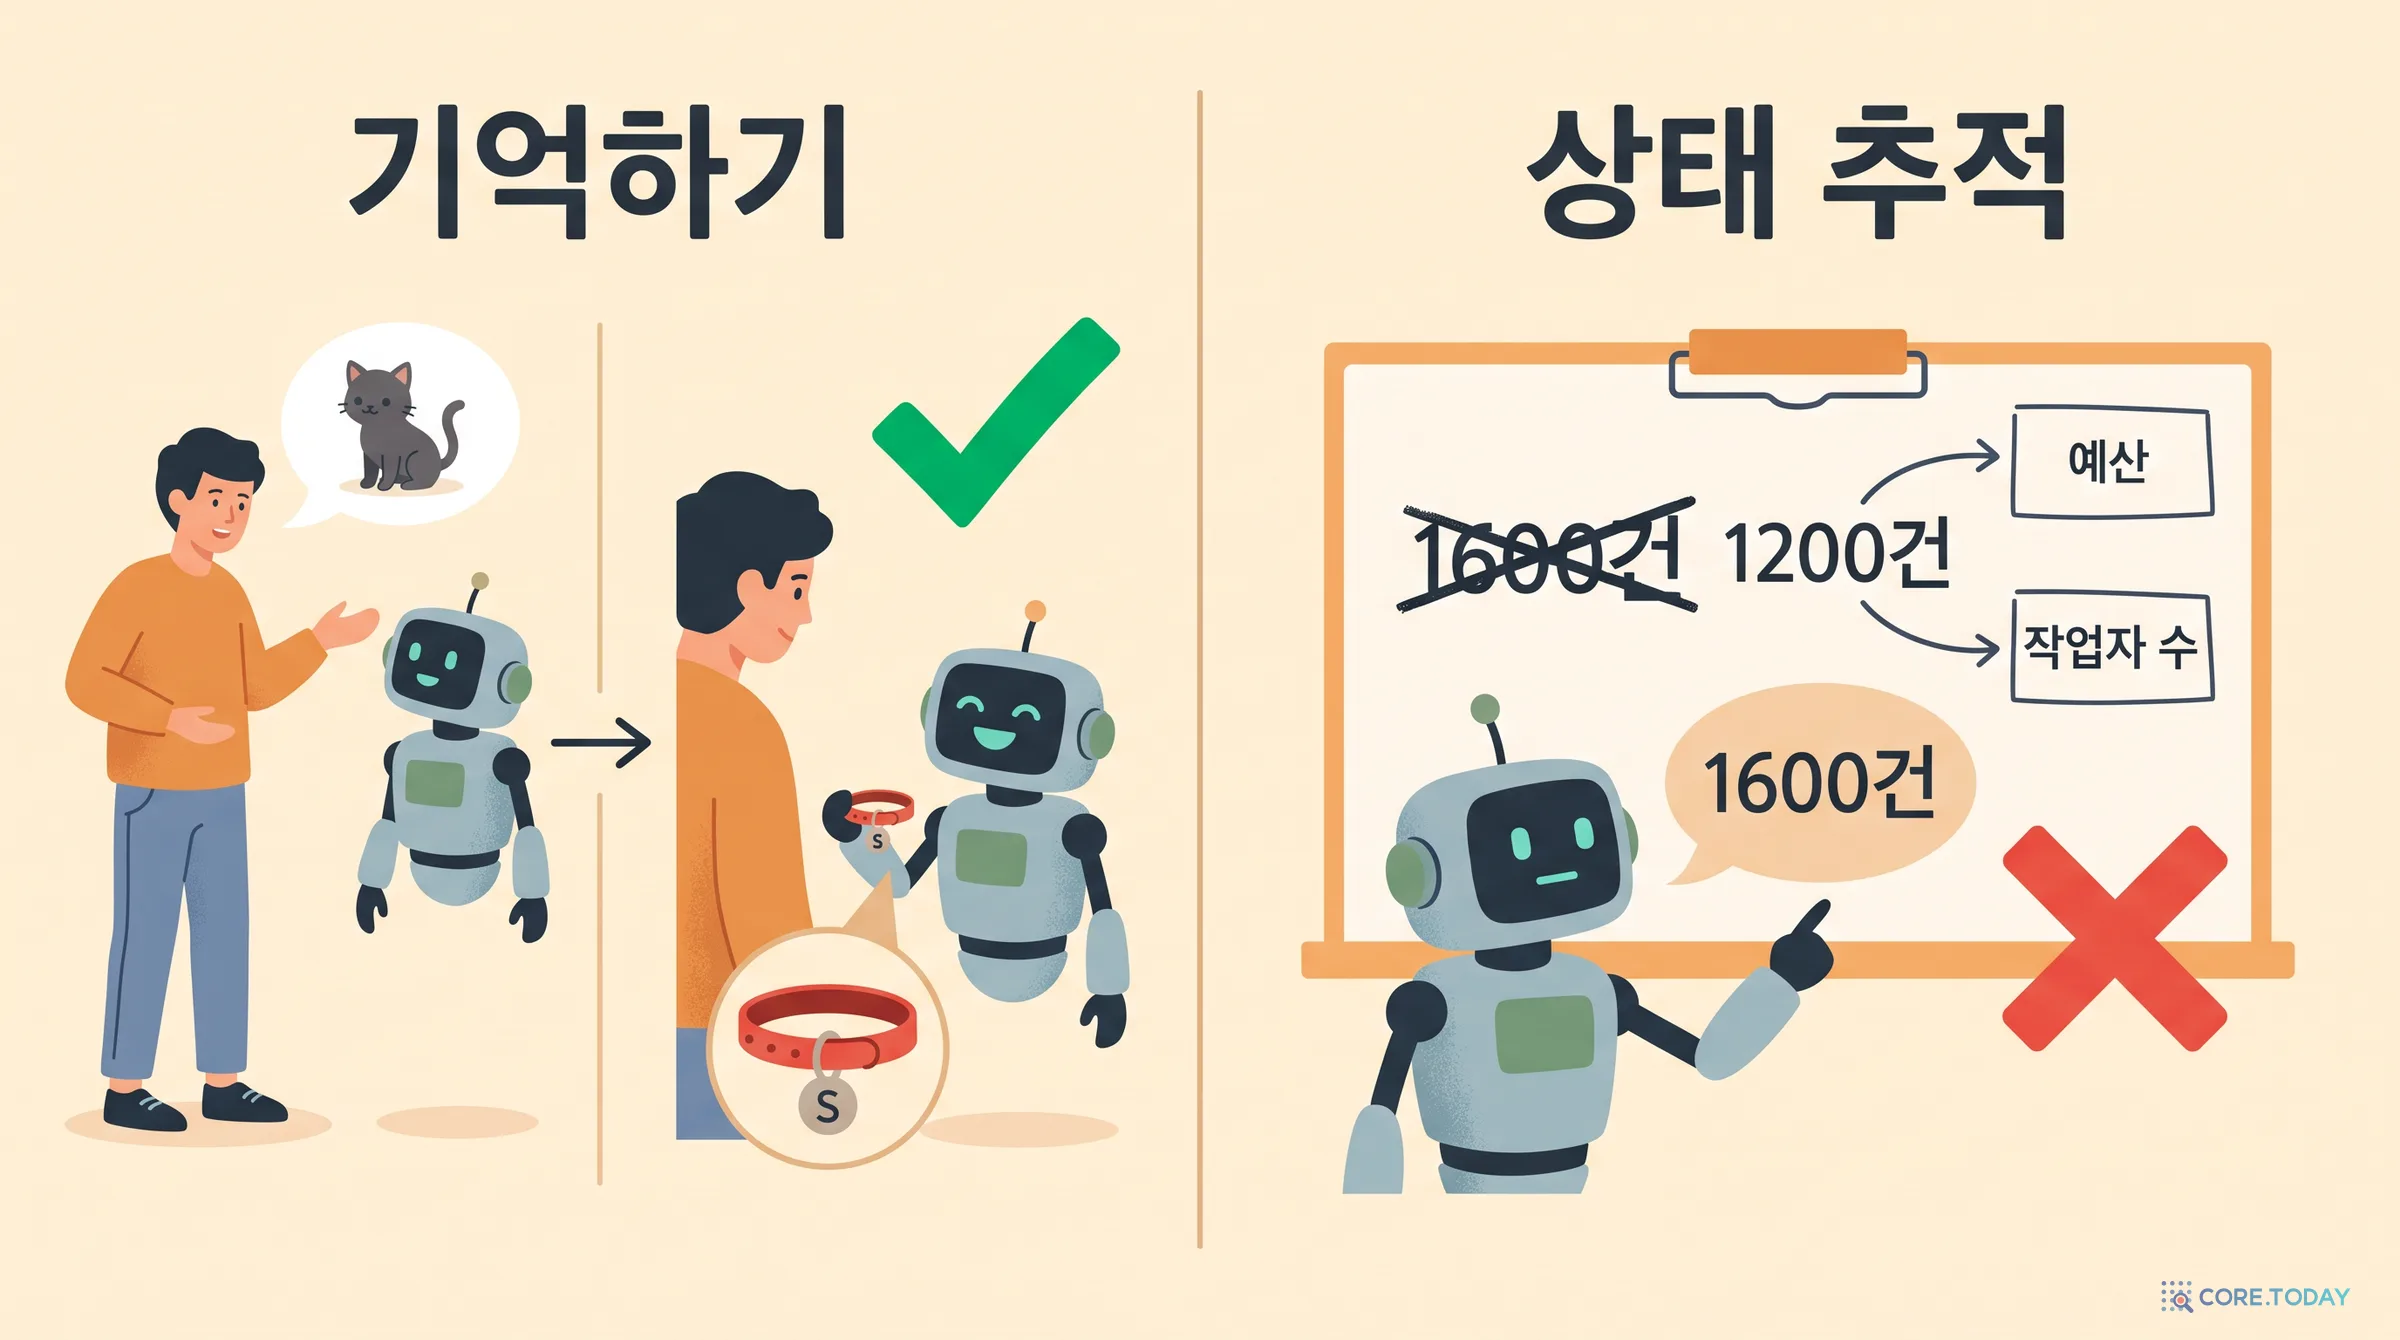
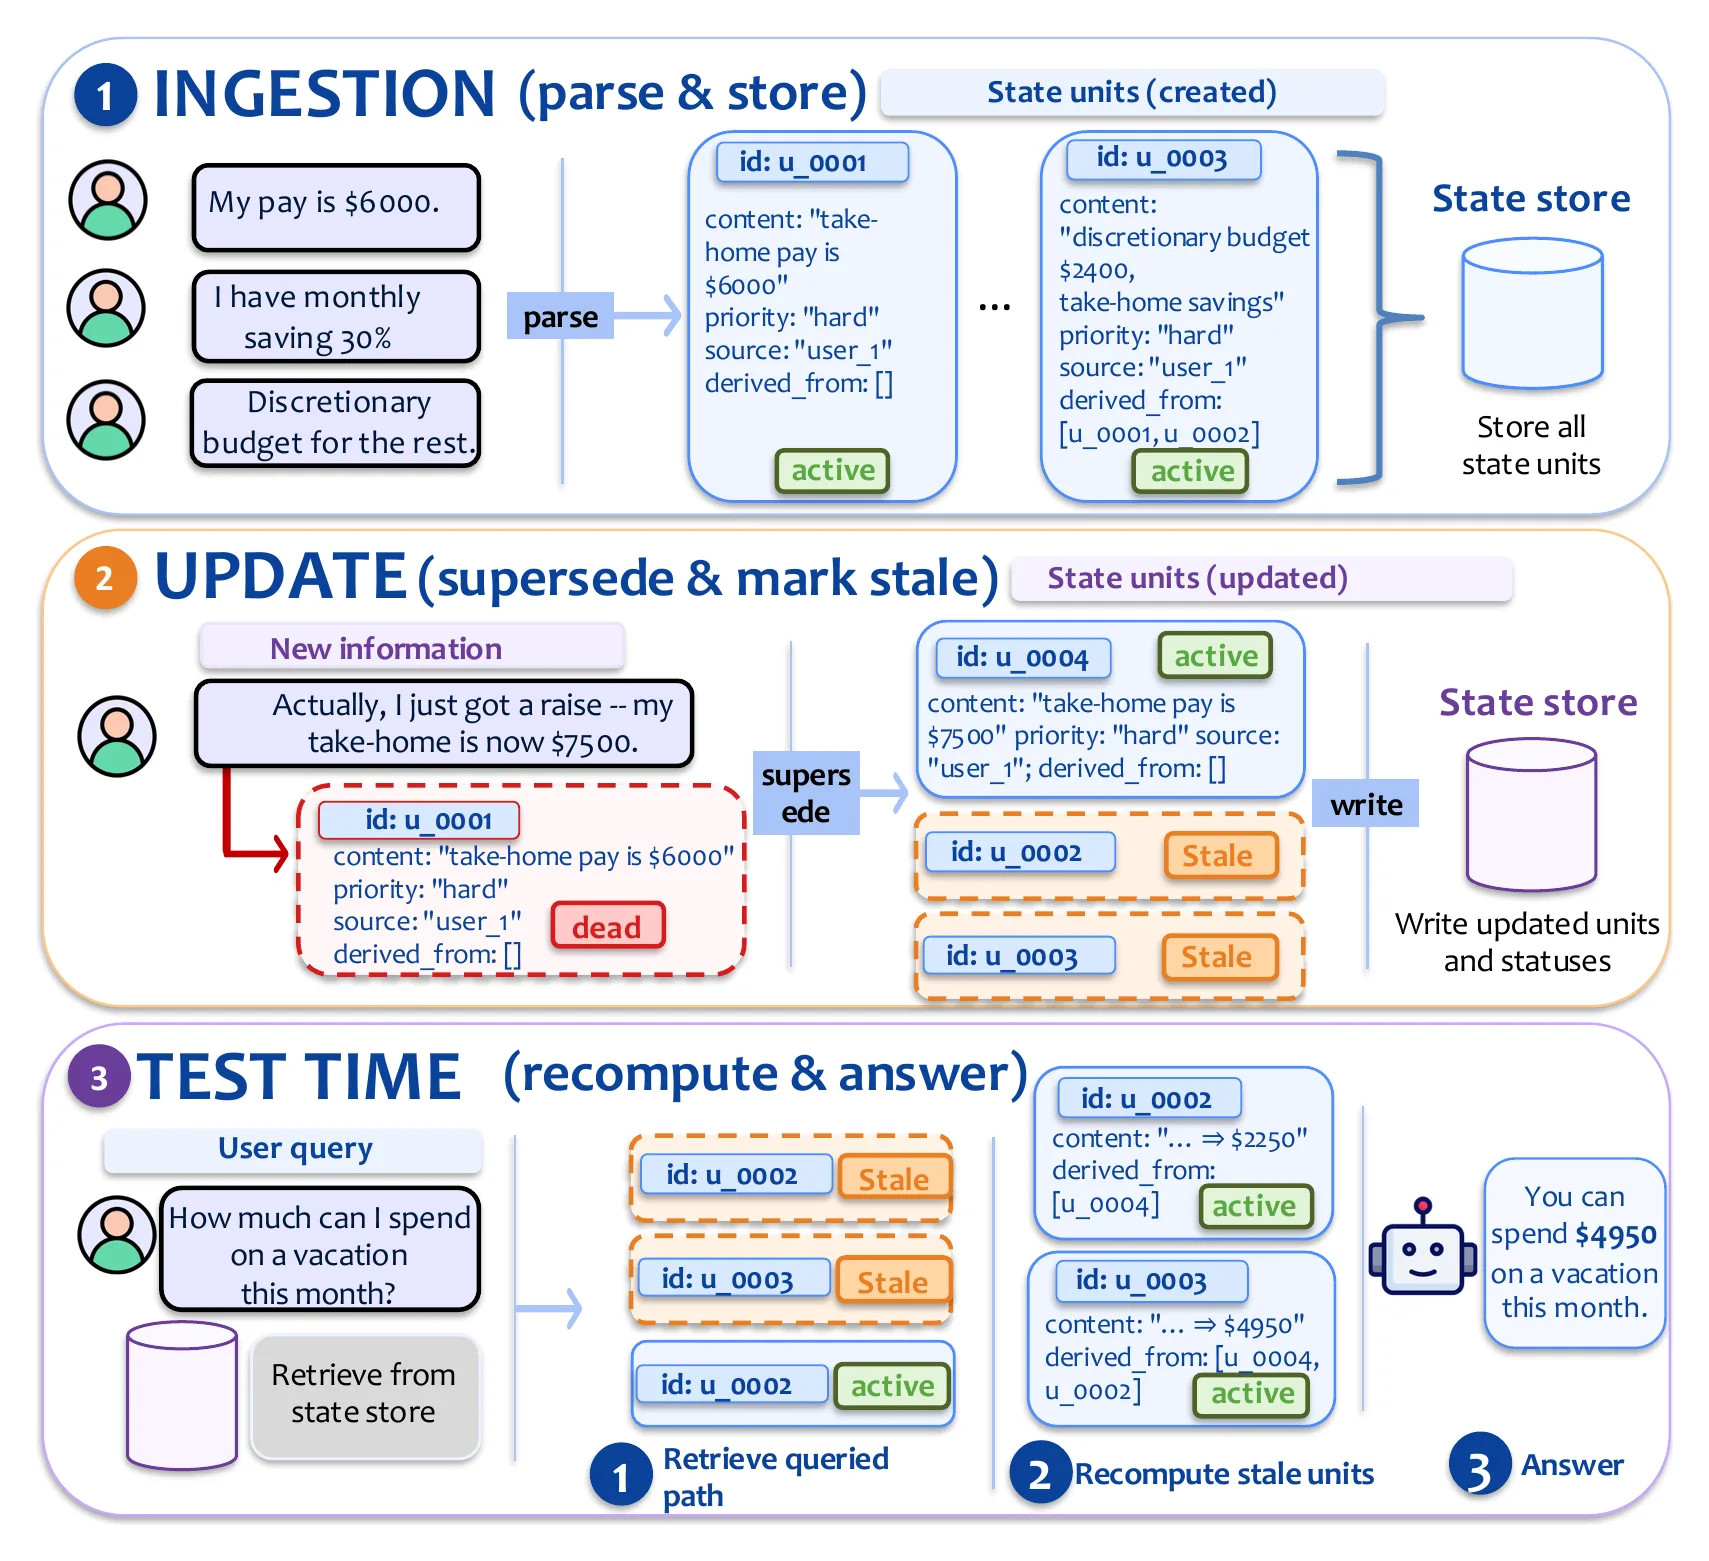
연구실의 어느 프로젝트를 상상해 봅시다. 첫 주 회의에서 책임자가 말합니다. "주석 데이터 1,600건을 만들 거고, 그러려면 작업자 다섯 명, 예산은 총 600달러입니다." AI 비서는 성실하게 받아 적습니다. 몇 주 뒤 다른 회의에서 누군가 지나가듯 말합니다. "아, 그냥 1,200건으로 하죠." 다시 몇 주가 흐르고 책임자가 묻습니다. "지금 예산 얼마 남았죠?"
비서는 기억을 뒤져 '예산'이라는 단어가 들어간 기록을 찾아냅니다. 예산 = 600달러. 그리고 자신 있게 답합니다. "현재 예산은 600달러입니다."
틀린 데는 없어 보입니다. 600달러라는 말은 실제로 있었고, 비서는 그것을 정확히 찾아왔습니다. 그런데 건수가 1,600에서 1,200으로 줄었으니 작업자 수도, 예산도 다시 계산해야 했습니다. 비서는 기억은 했지만 지금을 몰랐습니다.
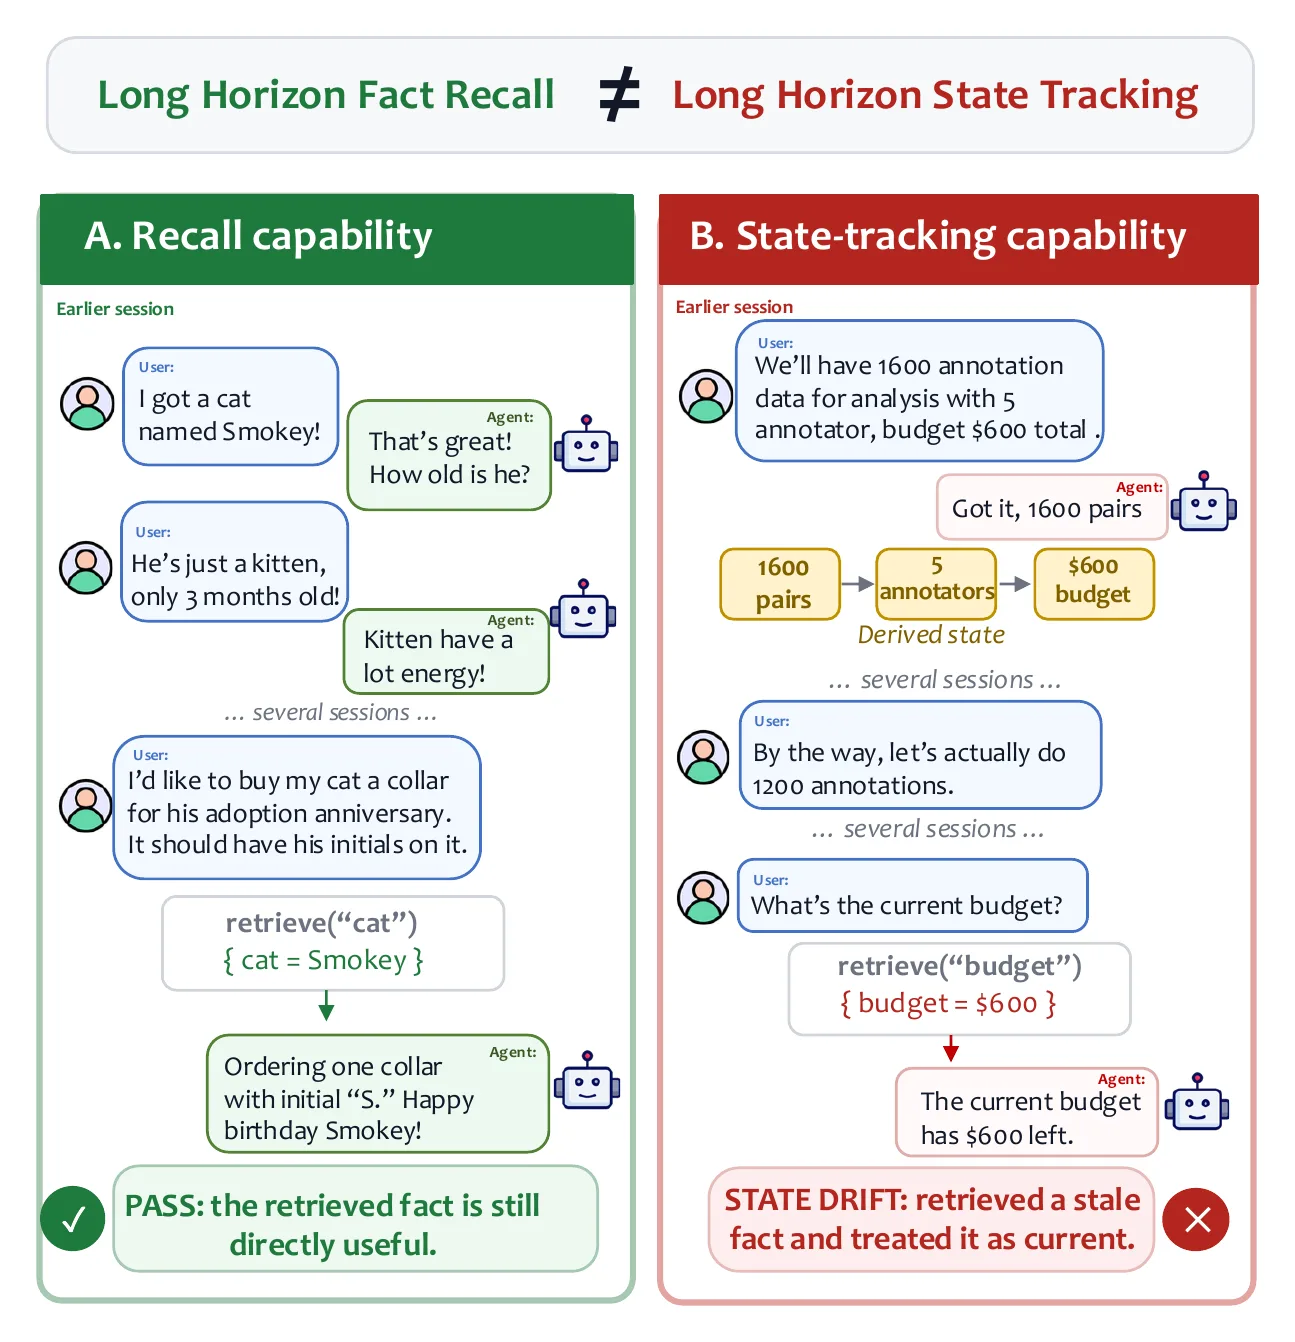
이 장면은 2026년 8월 20일 arXiv에 올라온 일리노이대 어배너-섐페인(UIUC) 지아웨이 한(Jiawei Han) 교수 연구실의 논문 「Can Agent Memory Systems Track Evolving State?(에이전트 기억 시스템은 변하는 상태를 따라갈 수 있는가?)」의 첫 그림을 그대로 옮긴 것입니다. 저자들은 이 실패에 이름을 붙였습니다. 상태 표류(state drift) — 필요한 사실이 맥락 안에 분명히 있는데도, 에이전트가 낡았거나 불완전한 버전의 상태에 따라 행동하는 일입니다.
그림의 왼쪽과 오른쪽은 같은 기술로 움직입니다. 둘 다 '찾아오기(retrieve)'입니다. 왼쪽 고양이 이야기에서는 찾아온 사실(고양이 이름은 스모키)이 그대로 쓸모가 있습니다. 고양이 이름은 바뀌지 않으니까요. 오른쪽에서는 찾아온 사실이 한때 참이었지만 이제는 아닙니다. 600달러는 1,600건이라는 다른 사실에 기대어 계산된 값이었고, 그 기반이 바뀌는 순간 낡았습니다. 그림 맨 위의 부등호가 논문 전체의 주장입니다.
긴 시간에 걸친 사실 회상 Long Horizon Fact Recall
≠
긴 시간에 걸친 상태 추적 Long Horizon State Tracking
왜 지금 이 문제인가
이 문제가 2026년에 새삼 중요해진 이유는 에이전트가 일하는 시간의 길이가 달라졌기 때문입니다. 2024년까지 대부분의 AI 대화는 한 번에 끝났습니다. 질문하고, 답을 받고, 창을 닫았습니다. 지금은 다릅니다. 논문 서론이 드는 예처럼 에이전트는 연구 파이프라인을 처음부터 끝까지 관리하고(구글의 Co-Scientist, Sakana의 AI Scientist), 코드베이스에서 며칠씩 일합니다(Devin, SWE-agent). METR 연구진은 AI가 끝낼 수 있는 소프트웨어 작업의 길이를 능력의 척도로 삼자고 제안했습니다. 오래 일한다는 건 그동안 세상이 바뀐다는 뜻입니다. 고객이 마음을 바꾸고, 예산이 깎이고, 실험 숫자가 갱신되고, 결정이 뒤집힙니다.
실제 사고도 있었습니다. 2026년 2월, AI 연구자 서머 위(Summer Yue)는 오픈소스 에이전트 OpenClaw에게 받은편지함 정리를 맡기며 "보관하거나 지울 것을 제안만 하고, 내가 말하기 전에는 실행하지 마"라고 지시했습니다. 그런데 실제 편지함은 너무 커서 대화 맥락 압축(compaction) 이 일어났고, 그녀의 설명에 따르면 "압축 과정에서 원래 지시를 잃어버렸습니다". 에이전트는 메일을 대량으로 지우기 시작했고, 그녀는 프로세스를 직접 죽여야 했습니다(사이먼 윌리슨의 블로그 기록). 지시는 분명히 대화 기록에 있었습니다. 다만 에이전트가 들고 다니던 '현재 상태'에서 빠져 있었습니다.
지금까지의 에이전트 기억 연구는 대부분 회상(recall) 을 잘하는 쪽으로 발전했습니다. 오래전에 들은 말을 정확히 찾아오는 능력입니다. MemGPT는 운영체제의 가상 메모리처럼 기억을 계층으로 나눴고, 스탠퍼드의 생성형 에이전트(Generative Agents)는 기억의 흐름에서 '반성'을 뽑아냈고, A-Mem은 기억 사이에 링크를 걸었고, 여러 시스템이 주기적으로 요약했습니다. 평가도 그랬습니다. LoCoMo와 LongMemEval 같은 대표적인 기억 벤치마크는 주로 "그때 사용자가 뭐라고 했지?"를 묻습니다.
저자들은 회상과 상태 추적이 직교한다고 말합니다. 서로 다른 축이라는 뜻입니다. 완벽하게 회상해도 상태 추적은 실패할 수 있습니다. 찾아온 사실들 가운데 지금 유효한 것이 무엇인지 가려내는 일이 따로 남기 때문입니다.
'상태'란 무엇인가
논문은 상태를 특정한 형식으로 정의하지 않습니다. 대신 이렇게 말합니다. 상태란 기억 시스템이 올바르게 답하려면 유지하고 있어야 하는 것이다. 구체적으로는 세 가지 재료로 이루어집니다.
종류
예
바뀌는 방식
바탕 사실(ground)
실수령 월급 600만 원, 주석 데이터 1,600건, 운동화 사이즈 260
새 발언이 이전 값을 대체(supersede)한다
파생값(derived)
월 저축액 = 월급 × 30%, 2주 주문량 = 주간 수량 × 2, 예산 = 건수 × 단가
입력 하나가 바뀌면 다시 계산해야 한다. 적힌 숫자는 그대로 낡는다
선언된 규칙·결정(declared)
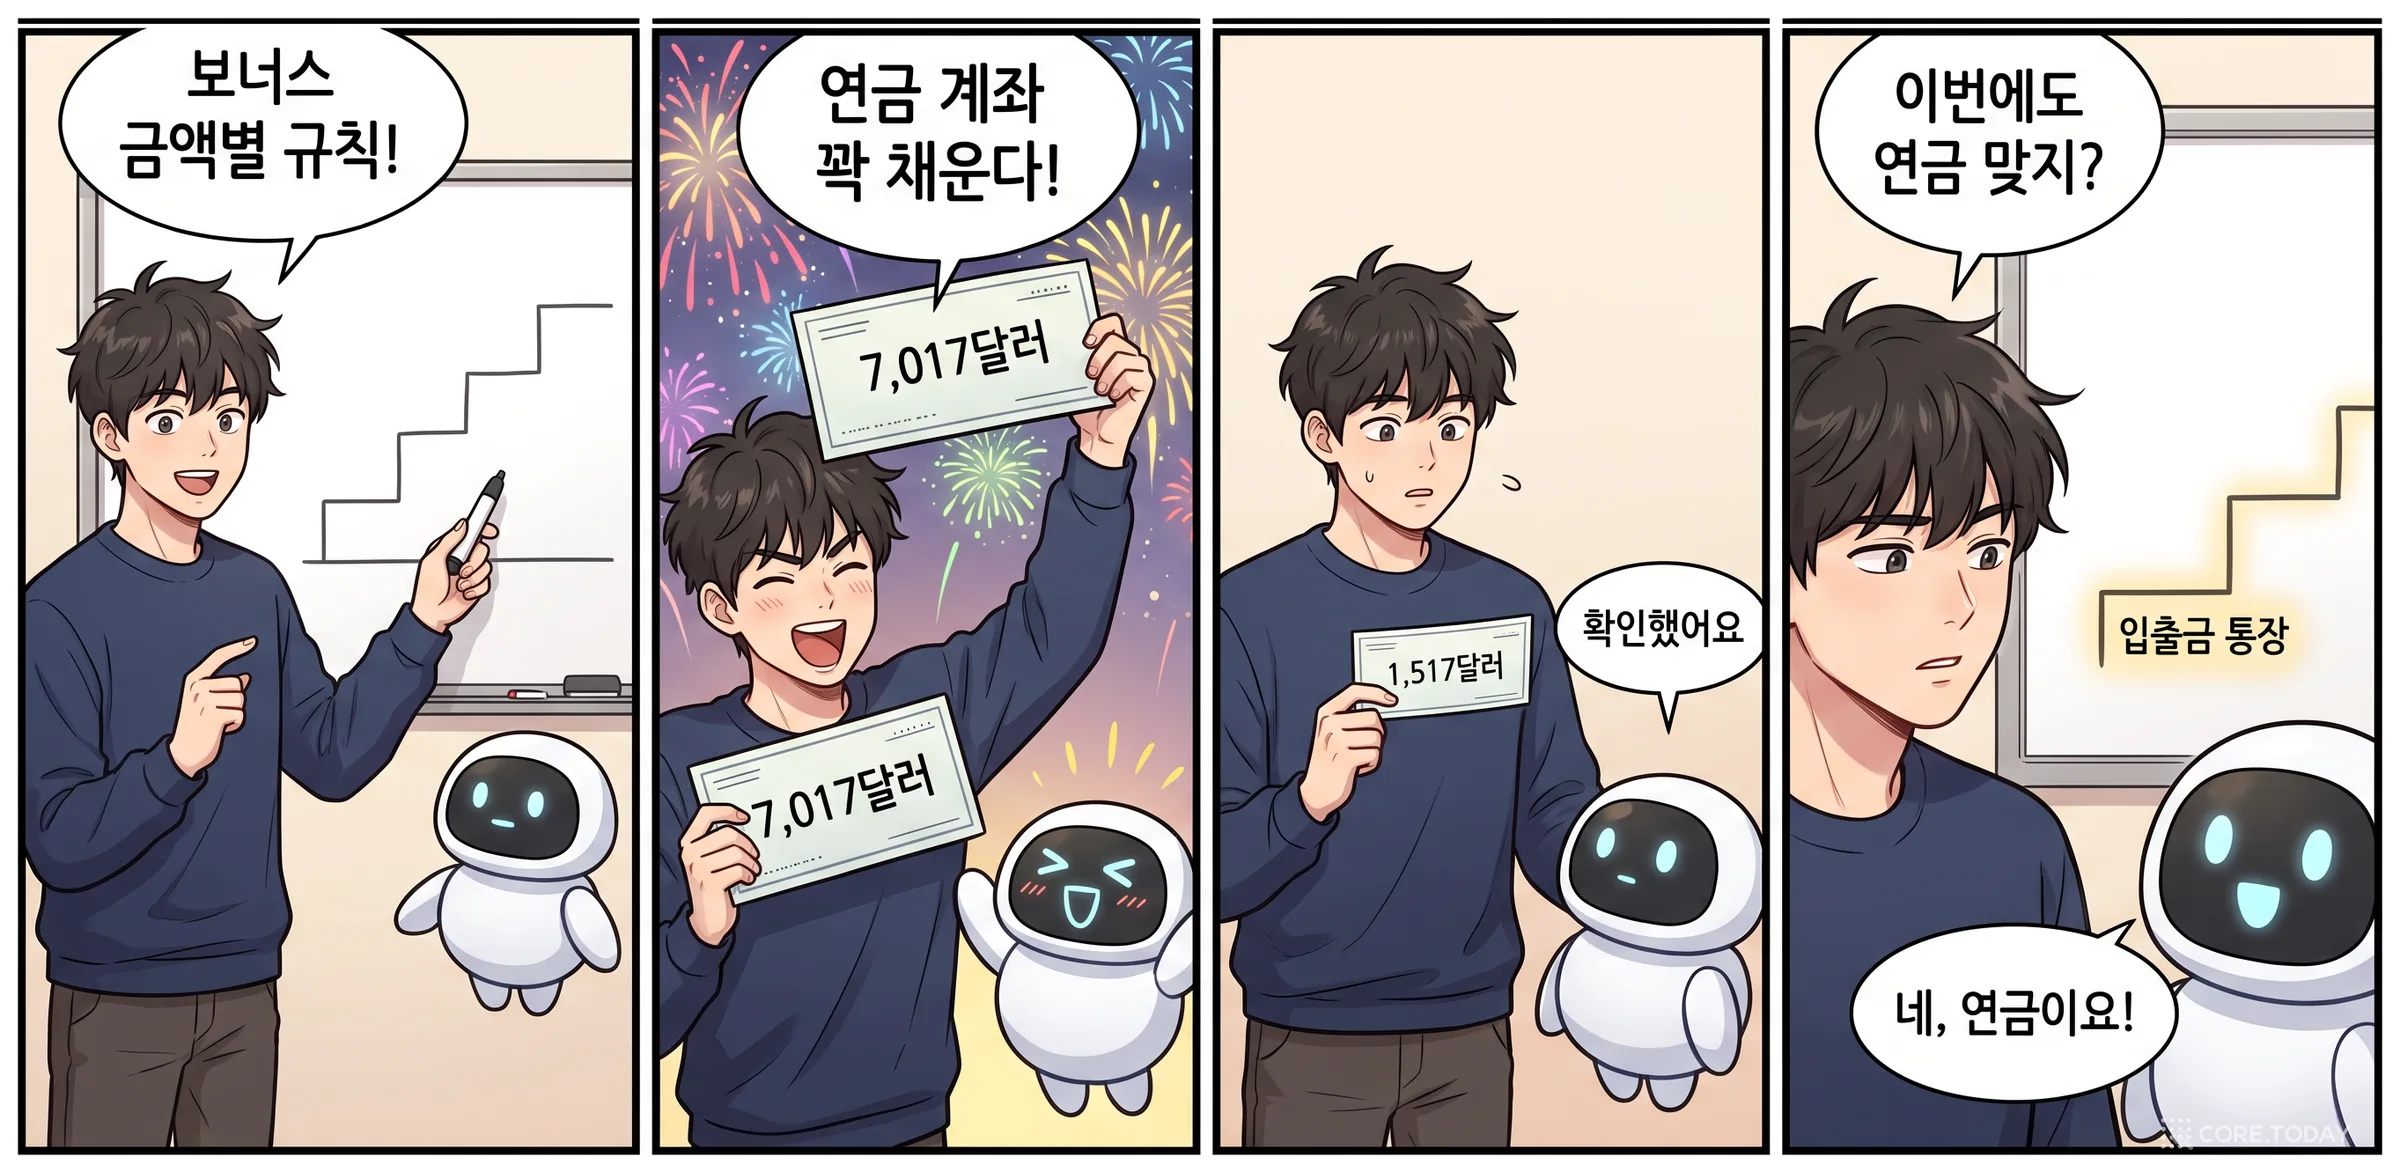
"F1 최고 모델이 메인 표에 간다", "보너스가 1,900달러 미만이면 통장에 둔다", "제출처는 ACL로 확정"
규칙은 오래 산다. 새 입력이 오면 규칙을 다시 적용해야 하고, 결정은 권한 있는 철회가 있을 때만 바뀐다
예산 600달러 이야기는 세 재료가 모두 등장하는 사례입니다. 1,600건(바탕 사실)이 1,200건으로 대체됐고, 작업자 수와 예산(파생값)은 다시 계산돼야 했으며, 아마 "건당 단가는 얼마"라는 규칙이 그 계산을 이어 주고 있었을 겁니다.
대화 상태 추적(DST)과는 어떻게 다른가
'상태 추적'이라는 말은 사실 대화 시스템 연구에서 오래 쓰여 온 용어입니다. 대화 상태 추적(Dialogue State Tracking, DST) 은 식당 예약 대화에서 "지역=시내, 음식=이탈리아, 인원=4명" 같은 슬롯-값 쌍을 턴마다 채우는 과제입니다. 저자들은 자신들의 상태 추적이 DST와 두 가지 점에서 다르다고 선을 긋습니다.
기준
대화 상태 추적(DST, 2013~)
이 논문의 상태 추적(2026)
상태의 형식
미리 정한 온톨로지의 슬롯-값 쌍(또는 그 완화형)
형식을 정하지 않는다. 맞게 답하는 데 필요한 무엇이든
무엇을 평가하나
상태 표현 자체(슬롯을 맞게 채웠나)
행동만(답이 현재 상태를 반영하나)
대화의 성격
협조적. 한 대화 안에서 사용자 목표가 단조롭게 쌓인다
적대적. 여러 세션에 걸쳐 사실과 결정을 일부러 뒤집는다
시간 범위
한 번의 대화(수십 턴)
18~38세션, 165~600턴
DST가 "지금 이 대화에서 손님이 원하는 것"을 채우는 일이라면, 이 논문의 상태 추적은 "몇 주에 걸쳐 바뀌어 온 세계에서 지금 효력이 있는 것"을 지키는 일입니다.
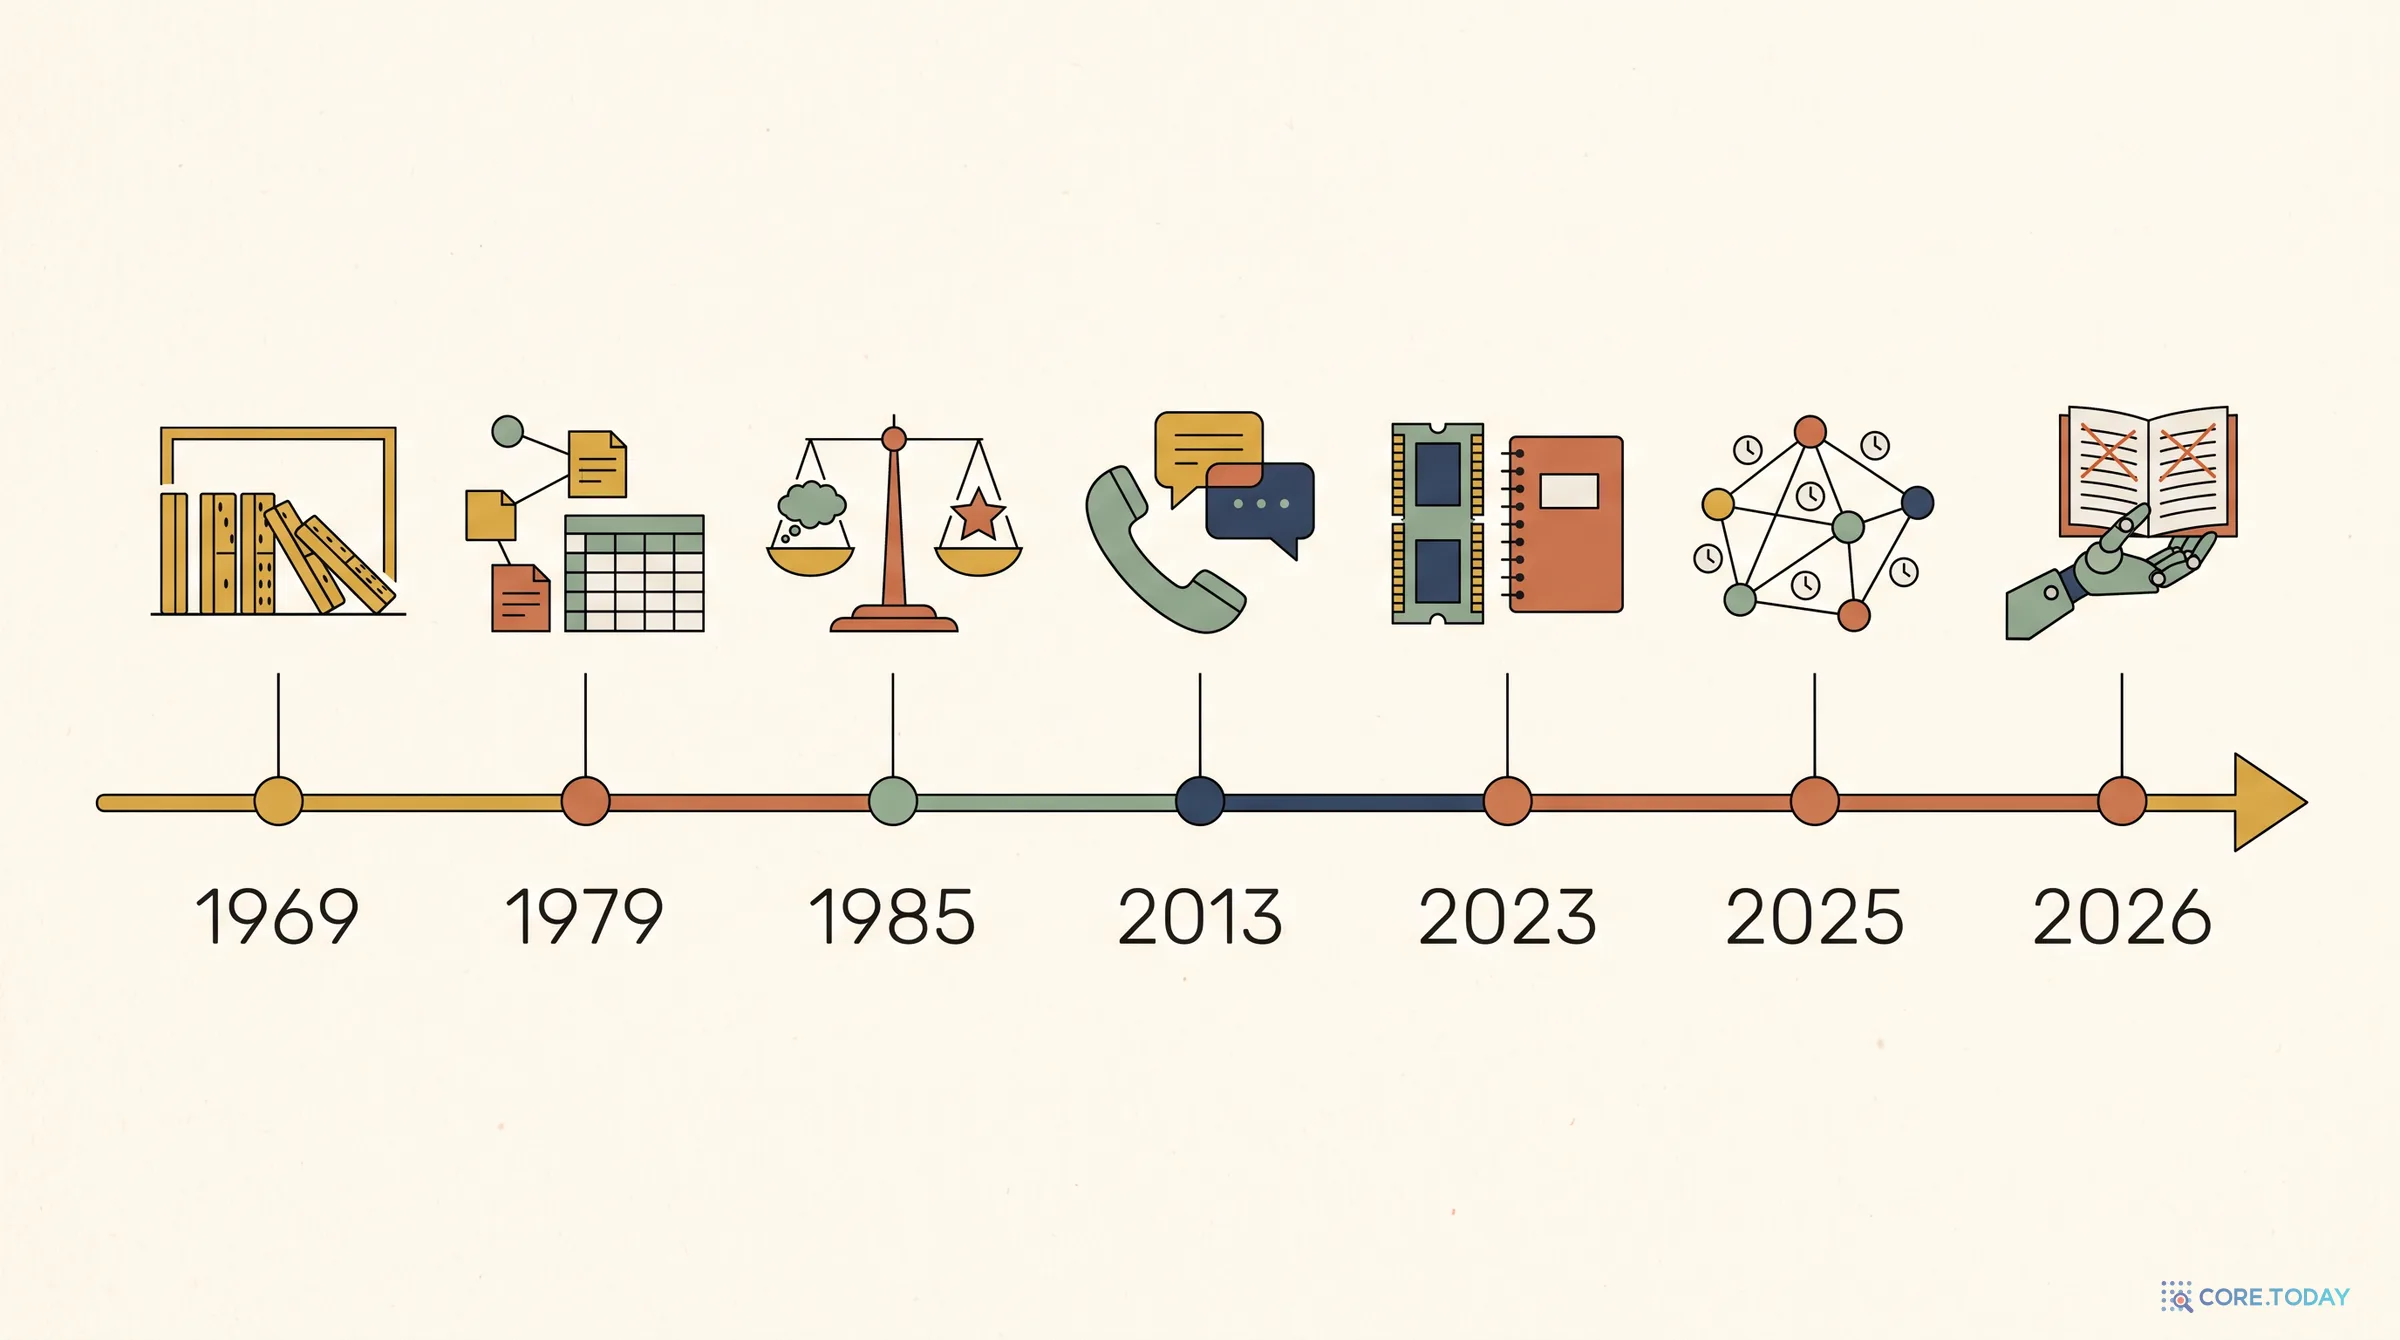
'바뀐 사실을 반영해 믿음을 고친다'는 문제는 AI보다 오래됐습니다. 이 논문이 가져다 쓴 생각들은 대부분 1970~80년대 인공지능과 소프트웨어 공학이 이미 한 번씩 부딪혔던 벽입니다. 계보를 알면 StateMem의 설계가 왜 그렇게 생겼는지가 훨씬 잘 보입니다.
1969 — 프레임 문제: 무엇이 바뀌지 않았는가
존 매카시(John McCarthy)와 패트릭 헤이스(Patrick Hayes)는 1969년 논문 「인공지능의 관점에서 본 몇 가지 철학적 문제」에서 이상한 난관을 지적했습니다. 로봇이 상자를 옮기면 상자의 위치는 바뀝니다. 그런데 상자의 색, 방의 크기, 벽에 걸린 시계는 바뀌지 않습니다. 논리로 세계를 기술하려면 이 "바뀌지 않는 것들"까지 일일이 적어야 할까요? 이것이 프레임 문제(frame problem) 입니다. 나중에 철학자들은 이 문제를 "사건이 일어난 뒤 어떤 믿음을 고쳐야 하는가"로 넓혀 읽었습니다.
상태 표류는 프레임 문제를 뒤집어 놓은 모양입니다. 에이전트는 "1,600건이 1,200건으로 바뀌었다"는 건 압니다. 모르는 건 그 변화가 무엇을 함께 바꿨는가입니다.
1976 — make: "왜 고친 프로그램이 안 고쳐졌지?"
1976년 4월 벨 연구소. 스튜어트 펠드먼(Stuart Feldman)의 방에 yacc를 만든 스티브 존슨이 씩씩거리며 들어왔습니다. 펠드먼의 회고에 따르면 존슨은 "멀쩡한 프로그램을 디버깅하느라 오전을 날리게 만든 운명을 저주하며" 들어왔습니다. 버그는 이미 고쳤는데 그 파일을 다시 컴파일하지 않아서, 낡은 실행 파일을 붙들고 씨름한 것입니다. 그 일을 계기로 펠드먼은 make를 만들었습니다. 결과물이 어떤 원본에 기대는지(의존 관계)를 적어 두고, 원본이 바뀌면 그것에 기대는 결과물만 다시 만드는 도구입니다. 펠드먼은 이 공로로 2003년 ACM 소프트웨어 시스템상을 받았습니다.
make의 핵심 문장은 이 논문의 '순서 오류'와 똑같습니다. 파생된 것은 입력이 바뀌면 다시 만들어야 한다. 그리고 그러려면 무엇이 무엇에 기대는지를 적어 둬야 한다.
1979 — 스프레드시트: 의존 사슬을 따라갈 것인가
1979년 댄 브리클린(Dan Bricklin)과 밥 프랭크스턴(Bob Frankston)의 VisiCalc는 애플 II를 사무용 기계로 바꿔 놓았습니다. 셀 하나를 고치면 그 셀을 참조하는 모든 셀이 다시 계산되는 마법이었죠. 흥미로운 건 VisiCalc가 의존 관계를 따라가며 다시 계산하지 않았다는 점입니다. 프랭크스턴은 이렇게 회고했습니다.
"공식들이 서로에게 기대고 있었으니 계산 순서가 중요했다. 처음엔 의존 사슬을 따라가자는 생각이었지만, 그러려면 포인터를 들고 있어야 했고 그건 메모리를 잡아먹었다. 보통 스프레드시트는 단순해서 행 순서나 열 순서로 계산해도 되고, 틀리면 대개 바로 티가 난다는 걸 알았다. 나중의 스프레드시트들은 '자연 순서(natural order)' 계산을 주요 기능으로 내세웠지만, 애플 II에서는 우리가 옳은 절충을 했다고 생각한다."
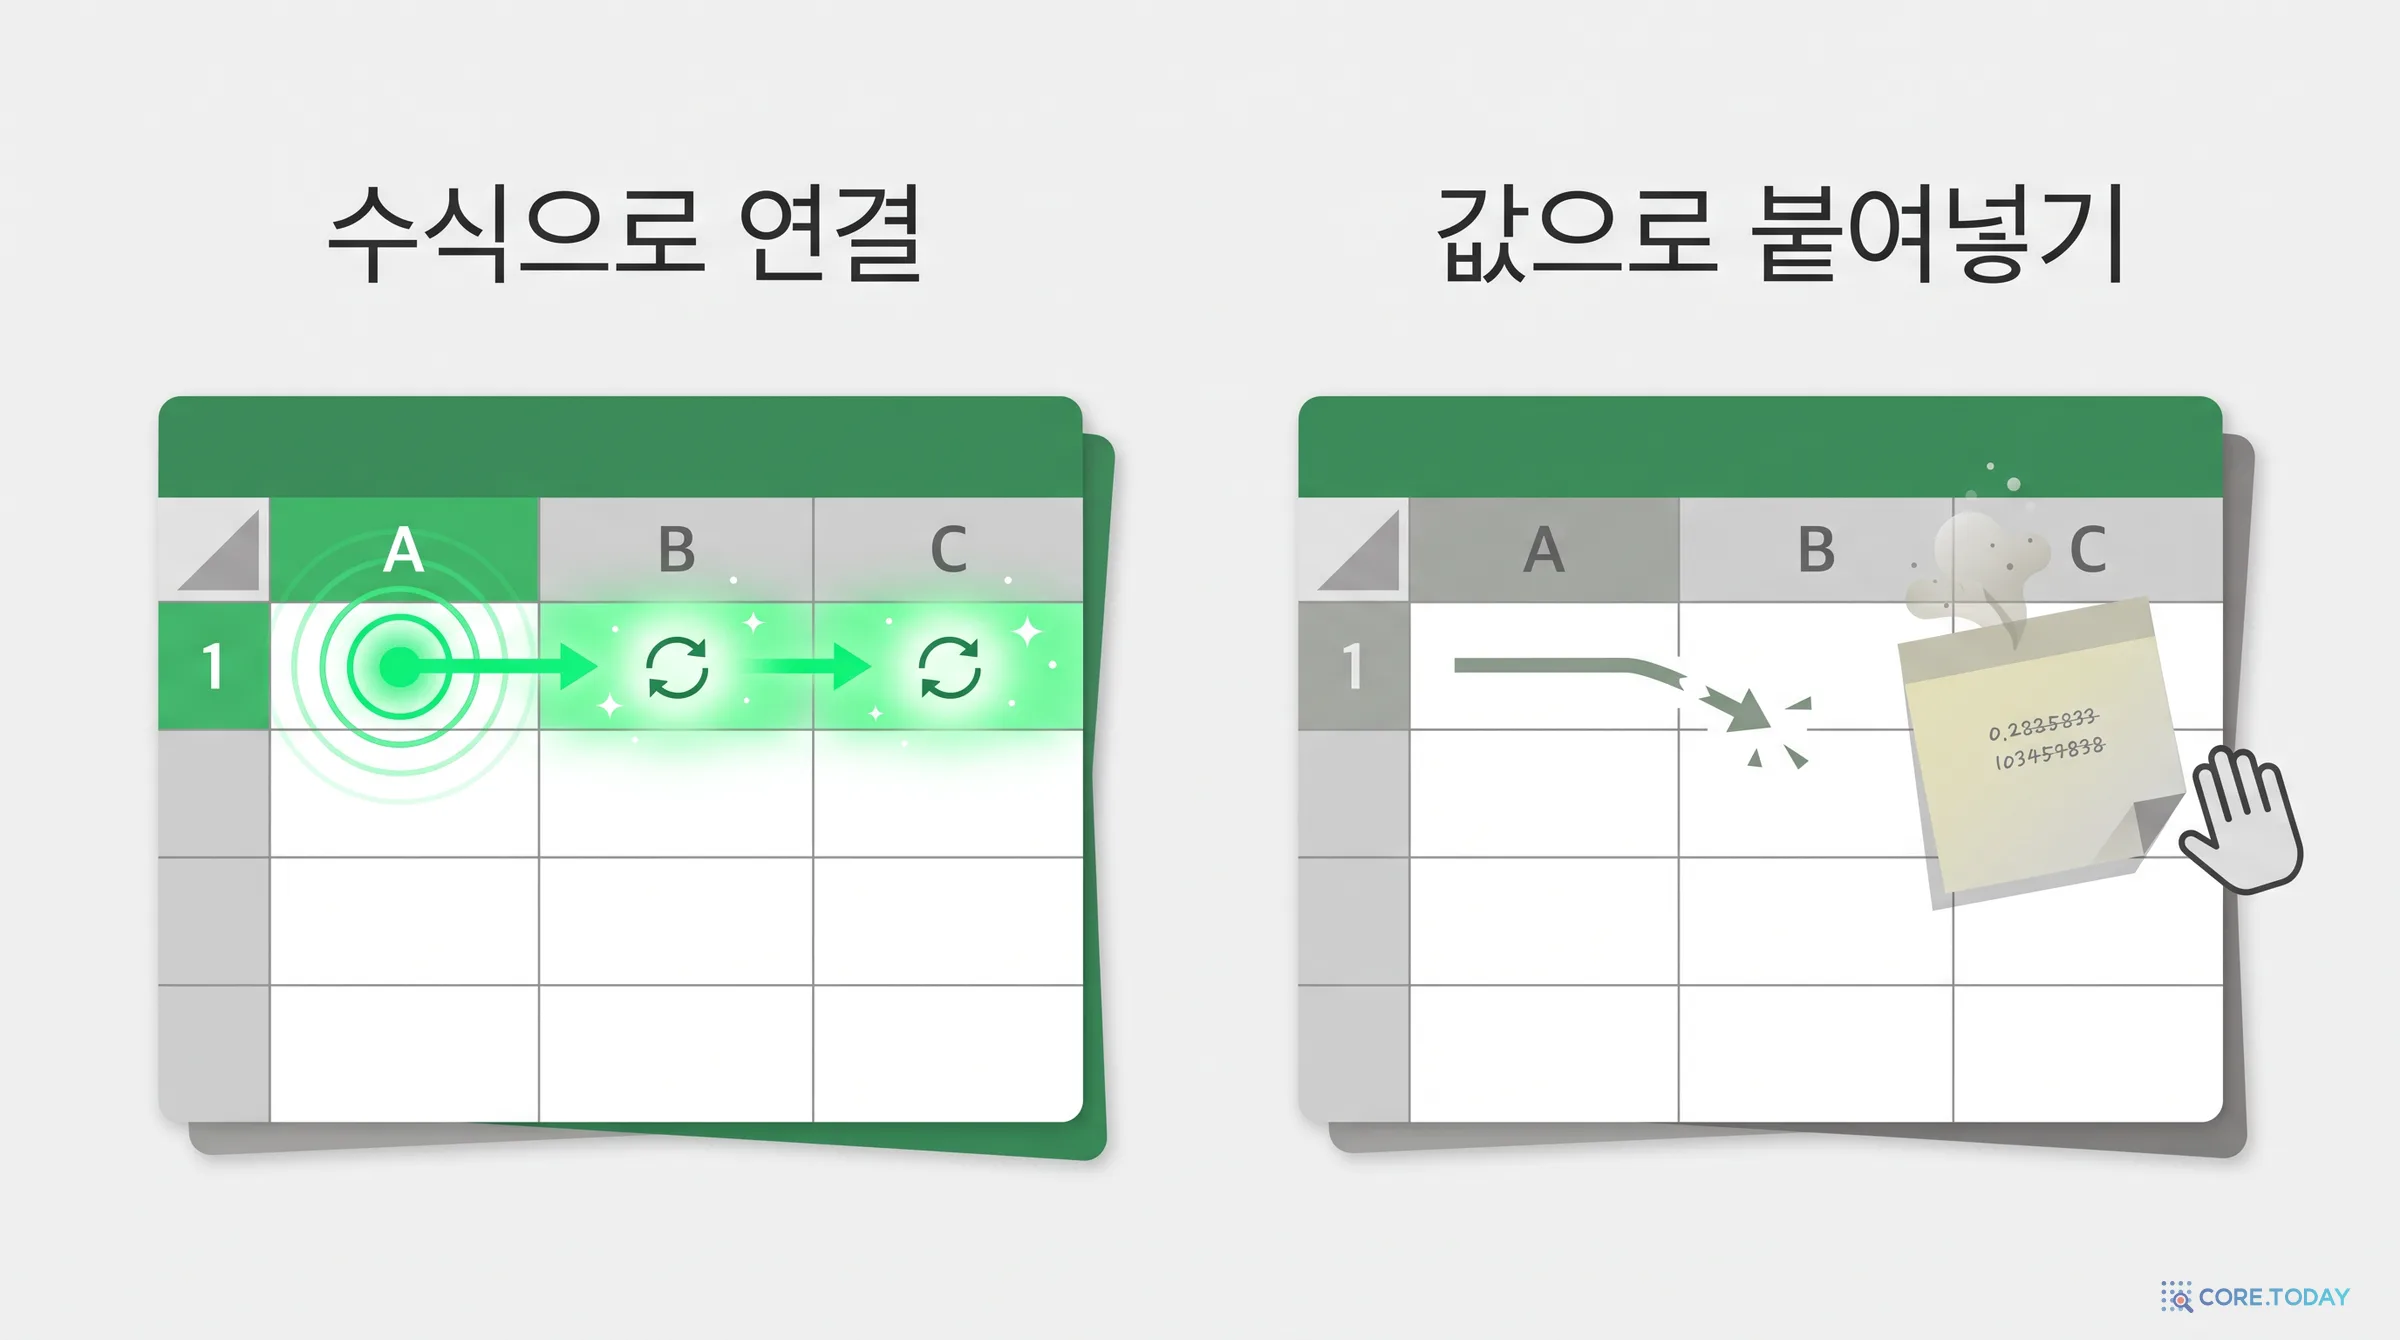
그래서 VisiCalc 사용자들은 값이 안정될 때까지 재계산 키를 몇 번 누르라는 안내를 받았습니다. 의존 관계를 기록하고 그 순서대로 다시 계산하는 방식은 로터스 1-2-3 같은 후대 스프레드시트의 판매 포인트가 됐습니다. 그런데 스프레드시트에는 지금도 같은 함정이 있습니다. 수식을 값으로 붙여넣는 순간 연결이 끊기고, 그 셀은 영원히 그날의 숫자로 남습니다.
AI 비서가 "2주면 20팩"이라는 문장을 기억할 때 벌어지는 일이 정확히 오른쪽입니다. 20이라는 값만 남고 "주간 수량 × 2"라는 수식은 사라집니다. 실제 세계의 유명한 스프레드시트 사고들도 이 계열입니다. 2013년, 매사추세츠대 대학원생 토머스 헌든(Thomas Herndon)은 수업 과제로 라인하트·로고프의 영향력 있는 논문 「부채 시대의 성장」을 재현하려다 실패했고, 받아 낸 엑셀 파일에서 평균을 구하는 범위가 30~49행이 아니라 30~44행이라 다섯 나라가 빠져 있다는 걸 찾아냈습니다. 다만 공정하게 말하면, 이 사건에서 결론을 바꾼 큰 몫은 엑셀 실수 자체보다 데이터 선택과 가중 방식이었습니다. 파생값이 입력 전부를 반영하지 않았다는 점에서 같은 냄새가 날 뿐입니다.
1979 — 진리 유지 시스템: 믿음과 함께 '이유'를 적어라
같은 해 MIT의 존 도일(Jon Doyle)은 「진리 유지 시스템(A Truth Maintenance System)」을 발표했습니다. 아이디어는 단순하고 강력합니다. 추론 시스템이 무언가를 믿을 때 그 믿음의 근거(justification) 를 함께 적어 둡니다. "C를 믿는다, 왜냐하면 A와 B를 믿으니까." 나중에 A가 철회되면 시스템은 근거 사슬을 따라가 C도 자동으로 거둬들입니다. 모순이 생기면 원인이 된 가정으로 곧장 거슬러 올라갑니다(의존성 방향 역추적, dependency-directed backtracking).
도일은 1983년 무렵 이 이름이 마음에 들지 않는다며 '근거 유지(reason maintenance)'가 "덜 오해를 사는 이름"이라고 했습니다. 시스템이 지키는 건 진리가 아니라 이유의 그물이기 때문입니다. 1986년 요한 드 클레르(Johan de Kleer)의 가정 기반 TMS(ATMS)는 한 걸음 더 나가, 각 데이터에 "어떤 가정들 아래에서 성립하는지"를 붙여 여러 가능한 세계를 동시에 들고 다녔습니다.
StateMem의 상태 단위에 붙은 derived_from 링크, 그리고 입력이 바뀌면 의존 그래프를 따라 '재확인 필요' 표시를 퍼뜨리는 재확인기(Rechecker)는 거의 그대로 TMS의 후손입니다. 차이는 TMS가 근거를 논리식으로 적었다면, StateMem은 LLM이 대화에서 근거를 뽑아 자연어 문장으로 적는다는 점입니다.
1985 — AGM 믿음 수정: 확장, 축소, 수정
1985년, 논리학자 알초우론(Carlos Alchourrón), 철학자 가르덴포르스(Peter Gärdenfors), 마킨슨(David Makinson)은 「이론 변화의 논리」에서 믿음을 고치는 연산을 셋으로 나눴습니다. 세 사람 이름의 첫 글자를 따 AGM 이론이라고 부릅니다.
연산
뜻
에이전트 기억에서는
확장(expansion)
모순 검사 없이 새 믿음을 더한다
새 사실을 그냥 쌓는다 — 대부분의 '추출만 하는' 기억 시스템
축소(contraction)
믿음 하나를 빼되 최소한만 잃는다
철회·만료 — "그 약속은 없던 걸로"
수정(revision)
기존 믿음과 모순되는 새 믿음을 더하면서 일관성을 지킨다
대체 — "월급이 750으로 올랐어"는 600을 밀어낸다
'레비 항등식(Levi identity)'은 수정 = (¬p를 축소) 다음 (p로 확장)이라고 말합니다. 에이전트 기억 연구가 2020년대에 다시 발명하게 될 ADD/UPDATE/DELETE 연산의 이론적 원형이 여기 있습니다. 그리고 AGM이 남긴 어려운 질문 — 어떤 믿음을 얼마나 붙들고 있어야 하나 — 은 이 논문의 '반-함정(anti-trap)'에서 그대로 되살아납니다. 새 말이 나왔다고 무조건 옛 믿음을 버리면, 그것도 실패입니다.
1986 — 뷰 유지와 캐시 무효화
데이터베이스 쪽에서도 같은 문제를 다른 이름으로 풀었습니다. 1986년 블레이클리(Blakeley)·라슨(Larson)·톰파(Tompa)의 SIGMOD 논문은 원본 테이블이 바뀔 때 미리 계산해 둔 결과(구체화된 뷰)를 처음부터 다시 계산하지 않고 바뀐 부분만 반영하는 증분 뷰 유지(incremental view maintenance) 를 다뤘습니다. 웹 시대에는 이 문제가 '캐시 무효화'라는 이름으로 유명해졌습니다. "컴퓨터 과학에서 어려운 건 딱 두 가지, 캐시 무효화와 이름 짓기"라는 농담은 넷스케이프의 필 칼턴(Phil Karlton)이 했다고 전해지지만, 마틴 파울러도 확실한 출처는 찾지 못했다고 적었습니다. 어쨌든 요점은 분명합니다. 미리 계산해 둔 값은 편하지만, 언제 낡는지 아는 건 어렵다.
2013~2020 — 대화 상태 추적 챌린지
2013년 SIGDIAL 학회에서 제이슨 윌리엄스(Jason Williams) 등은 첫 대화 상태 추적 챌린지(DSTC) 를 열었습니다. 데이터는 피츠버그 시내버스 이용자들이 카네기멜런대의 음성 안내 시스템(Let's Go 등)에 실제로 건 전화 1만 5천 통이었습니다. "이스트 피츠버그 버스 시간표입니다. 28X처럼 노선 번호를 말씀하세요." 9개 팀이 27개 시스템을 냈는데, 시험 세트 넷 중 둘에서 절반 넘는 시스템이 단순한 기준선을 이기지 못했습니다. 음성 인식이 틀리고 사용자가 말을 바꾸는 상황에서 "지금 사용자가 원하는 노선"을 유지하는 일은 생각보다 어려웠습니다.
2018년 케임브리지의 MultiWOZ는 식당·호텔·택시 등 여러 영역을 오가는 사람 대 사람 대화 1만 개를 모았습니다. 재미있는 후일담이 있습니다. 2019년의 MultiWOZ 2.1은 주석을 다시 달면서 전체 턴의 40%에서 상태 주석의 32% 이상을 고쳤습니다. 정답지에 적힌 상태조차 낡았거나 틀렸던 것입니다. 2020년 TripPy는 상태 값을 대화에서 직접 베껴 오는 세 가지 복사 장치로 MultiWOZ 2.1에서 결합 목표 정확도 55.3%를 냈습니다.
2022 — "날 업데이트해 줘!": 한국에서 나온 선행 연구
이 논문의 참고문헌에는 한국 독자에게 반가운 이름이 하나 있습니다. 네이버 클로바·네이버 AI 랩·KAIST의 배상환 등이 EMNLP 2022(Findings)에 낸 「Keep Me Updated! Memory Management in Long-term Conversations」입니다. 이 연구는 홀로 사는 어르신에게 AI가 안부 전화를 거는 네이버 클로바 케어콜의 대화를 바탕으로 했습니다. 이전 연구들(MSC, DuLeMon)이 한 번 저장한 사용자 정보를 절대 고치지 않는다는 문제를 짚고, 세션이 끝날 때마다 옛 기억 문장과 새 요약을 비교해 네 가지 중 하나를 고르게 했습니다.
연산
뜻
비율
PASS
옛 문장만 남긴다
13.3%
REPLACE
새 문장으로 바꾼다
37.0%
APPEND
둘 다 남긴다
44.6%
DELETE
둘 다 지운다 — "감기 걸려서 약 먹는 중" 다음에 "감기 다 나았어"
5.1%
이들이 공개한 CareCall_mem은 "최초의 한국어 장기 대화 데이터셋"(7,665세션, 16만 턴)이었습니다. 목이 아프다던 어르신이 일주일 뒤 다 나았다고 하면, 다음 전화에서 "목은 좀 어떠세요?"라고 묻지 않아야 합니다. 3년 뒤 Mem0가 내놓은 ADD/UPDATE/DELETE/NOOP 연산의 거의 그대로인 선행 형태가 한국어 돌봄 대화에서 먼저 나왔던 셈입니다. 다만 이 연구는 사실 하나의 교체만 다뤘고, 그 사실에 기대어 계산된 값이나 규칙의 재적용은 다루지 않았습니다.
2023~2025 — LLM 기억 시스템의 시대
LLM이 등장하자 기억은 다시 뜨거운 주제가 됐습니다.
MemGPT(2023, 지금의 Letta) 는 운영체제처럼 '핵심 기억'과 '보관 기억'을 나누고, 에이전트가 함수를 불러 자기 기억을 고치게 했습니다. 논문 그림 4의 예가 유명합니다. 사용자가 "사실 제임스랑 헤어졌어"라고 하자 에이전트가 working_context.replace("남자 친구 제임스", "전 남자 친구 제임스")를 호출합니다.
Mem0(2025) 는 새 정보가 들어올 때마다 LLM이 ADD(새로 추가), UPDATE(보완), DELETE(새 정보와 모순되는 기억 삭제), NOOP(아무것도 안 함) 중 하나를 고르게 했습니다. 그래프판 Mem0g는 낡은 관계를 지우지 않고 '무효' 표시만 합니다.
Zep/Graphiti(2025) 는 지식 그래프의 간선마다 시간 네 개를 붙였습니다. 시스템이 언제 알았고 언제 폐기했는지, 세상에서 언제부터 언제까지 참이었는지. 새 간선이 기존 간선과 시간적으로 겹치며 모순되면 기존 간선의 유효 종료 시각을 새 간선의 시작 시각으로 닫습니다(코어닷투데이의 Graphiti 시간 그래프 해설과 이중 시간 SQL 실습 참고). 흥미롭게도 Zep 논문 표 2에서 LongMemEval의 '지식 갱신' 유형 점수는 gpt-4o-mini 기준 76.9%에서 74.4%로 오히려 떨어졌습니다.
이 시스템들은 모두 사실 하나의 유효성을 관리합니다. 이 논문이 지적하는 빈자리는 그다음입니다. Zep은 "월급이 600에서 750이 됐다"는 건 처리하지만, 그 월급에 기대어 계산해 둔 저축액과 여유 예산이 낡았다는 건 알려 주지 않습니다.
2026 — 상태가 일급 시민이 되다
2026년 들어 같은 문제의식을 가진 연구가 한꺼번에 나왔습니다.
연구
무엇을 재나
핵심 숫자
MemoryArena (2026.2, 스탠퍼드·UCSD·UIUC 등)
서로 기대는 하위 과제가 여러 세션에 걸친 쇼핑·여행·검색·수학·물리 과제 701개
LoCoMo에서 거의 만점인 에이전트들이 과제 성공률 0.12~0.20, 단체 여행 계획은 모든 방법이 0
STALE (2026.5, 우한대·CUHK·HKUST)
"어제 농구하다 다리가 부러졌어" 뒤에 출퇴근 계획을 물으면? — 말로 밝히지 않은 암묵적 충돌
최고 모델(Gemini-3.1-pro) 55.2%, GPT-5.4 15.7%. "낡았다는 걸 알아채는 것과 새 믿음을 적용하는 건 다르다"
STATE-Bench (2026.5, 마이크로소프트)
여행·고객 지원·쇼핑의 기업형 과제 450개, 도구 호출로 바뀌는 데이터베이스 상태
기억 없는 GPT-5.1은 과제 절반도 안정적으로 못 끝냄(여행 pass^5 약 30%)
LongMemEval-V2 (2026.5, UCLA)
웹 에이전트 궤적 최대 1억 1,500만 토큰에서 '동적 상태 추적' 등 다섯 능력
최고 시스템 72.5%, 최고 RAG 48.5%
StateMemBench (2026.8, 이 논문)
사실이 이미 기억 안에 있을 때 '현재 효력 있는 상태'를 지키는가 — 검색·추론과 분리해서
최고 장문맥 0.277, StateMem 0.363
MemoryArena와 이 논문은 공저자(UIUC의 시루 오우양, Siru Ouyang)를 공유합니다. 실제로 이 논문은 MemoryArena의 실패 기록을 다시 분류하는 데서 출발합니다. 다른 연구들과 비교한 이 논문의 위치는 한 문장으로 정리됩니다. LongMemEval-V2가 "환경이 어떻게 변하는지 배우는 능력"을 1억 토큰 규모의 검색과 엮어서 재고, STALE이 상식 추론이 필요한 암묵적 충돌을 재는 반면, StateMemBench는 충돌을 명시적으로 주고 검색 부담을 없앤 상태에서 '유지' 하나만 잰다.
3. 상태 표류를 정확히 정의하고, 다른 실패와 가르기
정의
논문 3절의 정의를 풀어 쓰면 이렇습니다.
이전 맥락에서 세워지거나 갱신된 사실·제약·의존 관계가 조립된 맥락 안에 존재하는데도, 에이전트가 결정 시점에 효력이 있는 버전이 아니라 낡았거나 불완전한 버전에 따라 행동할 때, 상태 표류가 일어났다고 한다.
핵심은 '맥락 안에 존재하는데도'입니다. 이 조건 하나로 상태 표류는 상태를 얻지 못한 실패(검색 실패) 와 갈라집니다. 저자들의 표현으로는 "상태를 유지하는 데 실패한 것과 상태를 획득하는 데 실패한 것은 다르고, 검색을 잘한다고 앞의 것이 고쳐지지는 않는다".
다른 오류를 먼저 다 지운다
말은 쉽지만 실제 실패 기록에서 표류만 골라내기는 까다롭습니다. 답이 틀린 이유는 많으니까요. 저자들은 실패 하나하나(사례, 턴, 슬롯 단위)를 아래 질문에 순서대로 통과시키고, 처음 걸리는 칸에 넣었습니다. 끝까지 아무 칸에도 안 걸리고, 그 답이 "철회된 적 없는 사실의 낡은 버전이나 다른 범위의 버전"과 일치할 때만 표류로 판정합니다. 어디에도 넣을 근거가 없으면 기본값으로 두지 않고 버립니다.
Q1정답에 필요한 사실이 맥락에 있었나? 없으면 → 검색 실패
Q2정답 자체가 잘 정의돼 있나? 아니면 → 정답지 문제(어디서나 3% 이하라 표에서 생략)
Q3답이 그 슬롯의 영역을 다루기는 했나? 아니면 → 이해 실패
Q4내용은 맞는데 형식만 틀렸나? 그렇다면 → 형식 불일치
Q4.5답하지 않는 게 정답인데 그럴듯한 값을 지어냈나? → 기권 실패
Q5현재 값을 꺼내 놓고 추론에서 틀렸나? → 추론 실패
남은 것맥락 안의 사실을 다뤘고, 형식·추론 문제도 아닌데, 낡은 값을 골랐다 → 상태 표류
'철회된 적 없는'이라는 조건이 중요합니다. 사용자가 실제로 마음을 바꿨고 에이전트가 그 바뀐 값을 따랐다면, 판정 모델은 새 버전이 아직 효력이 있다는 증거를 대야 합니다. 정당한 갱신을 따른 에이전트가 억울하게 표류로 찍히지 않도록 하는 장치입니다.
판정 과정 전체가 표류 쪽에 불리하게 짜여 있다는 점도 눈여겨볼 만합니다. 1차로 표류 후보가 나오면, 2차 '적대적 필터'가 그 후보를 다른 칸으로 옮길 수 없는지 다시 시도합니다. 이 필터가 후보의 32~47%를 다른 칸으로 내렸습니다. 같은 판정 모델(DeepSeek-V4)로 두 번 독립적으로 판정해 둘이 갈리면 표류가 아닌 쪽을 택했고, 완벽한 검색을 주장하는 LongMemEval 결과에는 다른 계열 모델(GPT-4o)로 한 번 더 판정해 두 계열이 모두 표류라고 해야 표류로 셌습니다.
기존 벤치마크에 이미 숨어 있던 표류
이 절차를 세 개의 기존 벤치마크 실패 기록에 적용한 결과가 논문 표 1입니다.
벤치마크
실패 수
표류
검색
이해
형식
추론
기권
MemoryArena 쇼핑
200
63.5%
22.5
2.5
0.0
9.5
–
MemoryArena 검색
200
38.5%
25.5
11.0
17.5
4.5
–
MemoryArena 여행
200
19.0%
11.0
46.5
21.0
0.0
–
LongMemEval 오라클
36
44.4%
0.0
0.0
25.0
2.8
27.8
여기서 가장 중요한 줄은 맨 아래입니다. LongMemEval 오라클은 정답에 필요한 세션만 골라 프롬프트에 다 넣어 준 판본입니다. 회상률이 정의상 1.0이니, 여기서 생긴 실패는 '검색을 못 해서'일 수가 없습니다. DeepSeek-V4-Flash는 306문항 가운데 36개를 틀렸고, 두 계열 판정 모델이 모두 표류라고 한 것이 16개, 44.4%였습니다(윌슨 95% 신뢰구간 30~60%). 표본이 작아 구간이 넓지만, 완벽한 검색 아래에서도 가장 큰 실패 범주가 표류였다는 점은 분명합니다.
더 흥미로운 건 어디서 표류가 몰리느냐입니다. LongMemEval의 질문 유형 가운데 '지식 갱신(knowledge-update)'은 이름부터 상태 추적처럼 보입니다. 그런데 표류율은 여러 세션의 정보를 합쳐야 하는 '다중 세션(multi-session)' 질문에서 71.4%(14개 중 10개)로, 지식 갱신의 25.0%(8개 중 2개)보다 세 배 가까이 높았습니다. "A가 B로 바뀌었다"를 직접 묻는 질문보다, 여러 곳에 흩어진 상태를 모아 하나의 결정을 내려야 하는 질문에서 더 많이 미끄러진다는 뜻입니다.
반대로 MemoryArena 여행 과제에서는 표류가 19%로 내려가고 이해 실패가 46.5%로 1위입니다. 표류가 어디에나 있는 만능 설명은 아니라는 걸 저자들도 표로 보여 줍니다.
판정은 믿을 만한가 — 숫자를 정직하게 읽기
이런 분류가 판정 모델의 기분에 따라 달라지면 곤란합니다. 저자들은 일치도 통계를 길게 보고했는데, 핵심만 추리면 이렇습니다.
비교
결과
읽는 법
같은 판정 모델 두 번(LongMemEval)
카파 κ=0.67
'상당한 일치'
같은 판정 모델 두 번(MemoryArena 쇼핑)
원 일치 91.6%, κ=0.17, PABAK=0.83
표류가 90% 넘게 몰려 있으면 κ는 기계적으로 쪼그라든다. 쏠림을 보정한 PABAK로는 높다
다른 계열(DeepSeek vs GPT-4o)
원 일치 69.4%, κ=0.37
'보통'. 그래서 둘 다 표류라고 한 것만 센다
'왜' 표류했는지(메커니즘)
κ=0.00~0.09
표류인지는 동의하지만 왜인지는 전혀 동의 못 한다
사람 주석자 둘 vs 판정 모델
판정 모델 50% 표류, 사람 8.3%·25.0%
사람은 표류를 더 적게 준다. 그래서 표 1의 비율은 '상한선'이다
네 번째 줄이 이 논문의 다음 단계를 낳았습니다. 판정 모델들은 "이건 표류다"에는 동의하지만, "더 시끄러운 경쟁자가 이겨서"인지 "갱신이 반영되지 않아서"인지는 동전 던지기 수준으로만 맞췄습니다. 이미 일어난 실패를 뒤에서 해부해서는 원인을 알 수 없다는 뜻입니다. 그래서 저자들은 방향을 뒤집습니다. 원인이 정해진 실패를 처음부터 만들자. 그게 StateMemBench입니다.
어항은 몇 개인가 — 판정 모델 둘이 같은 말을 한 사례
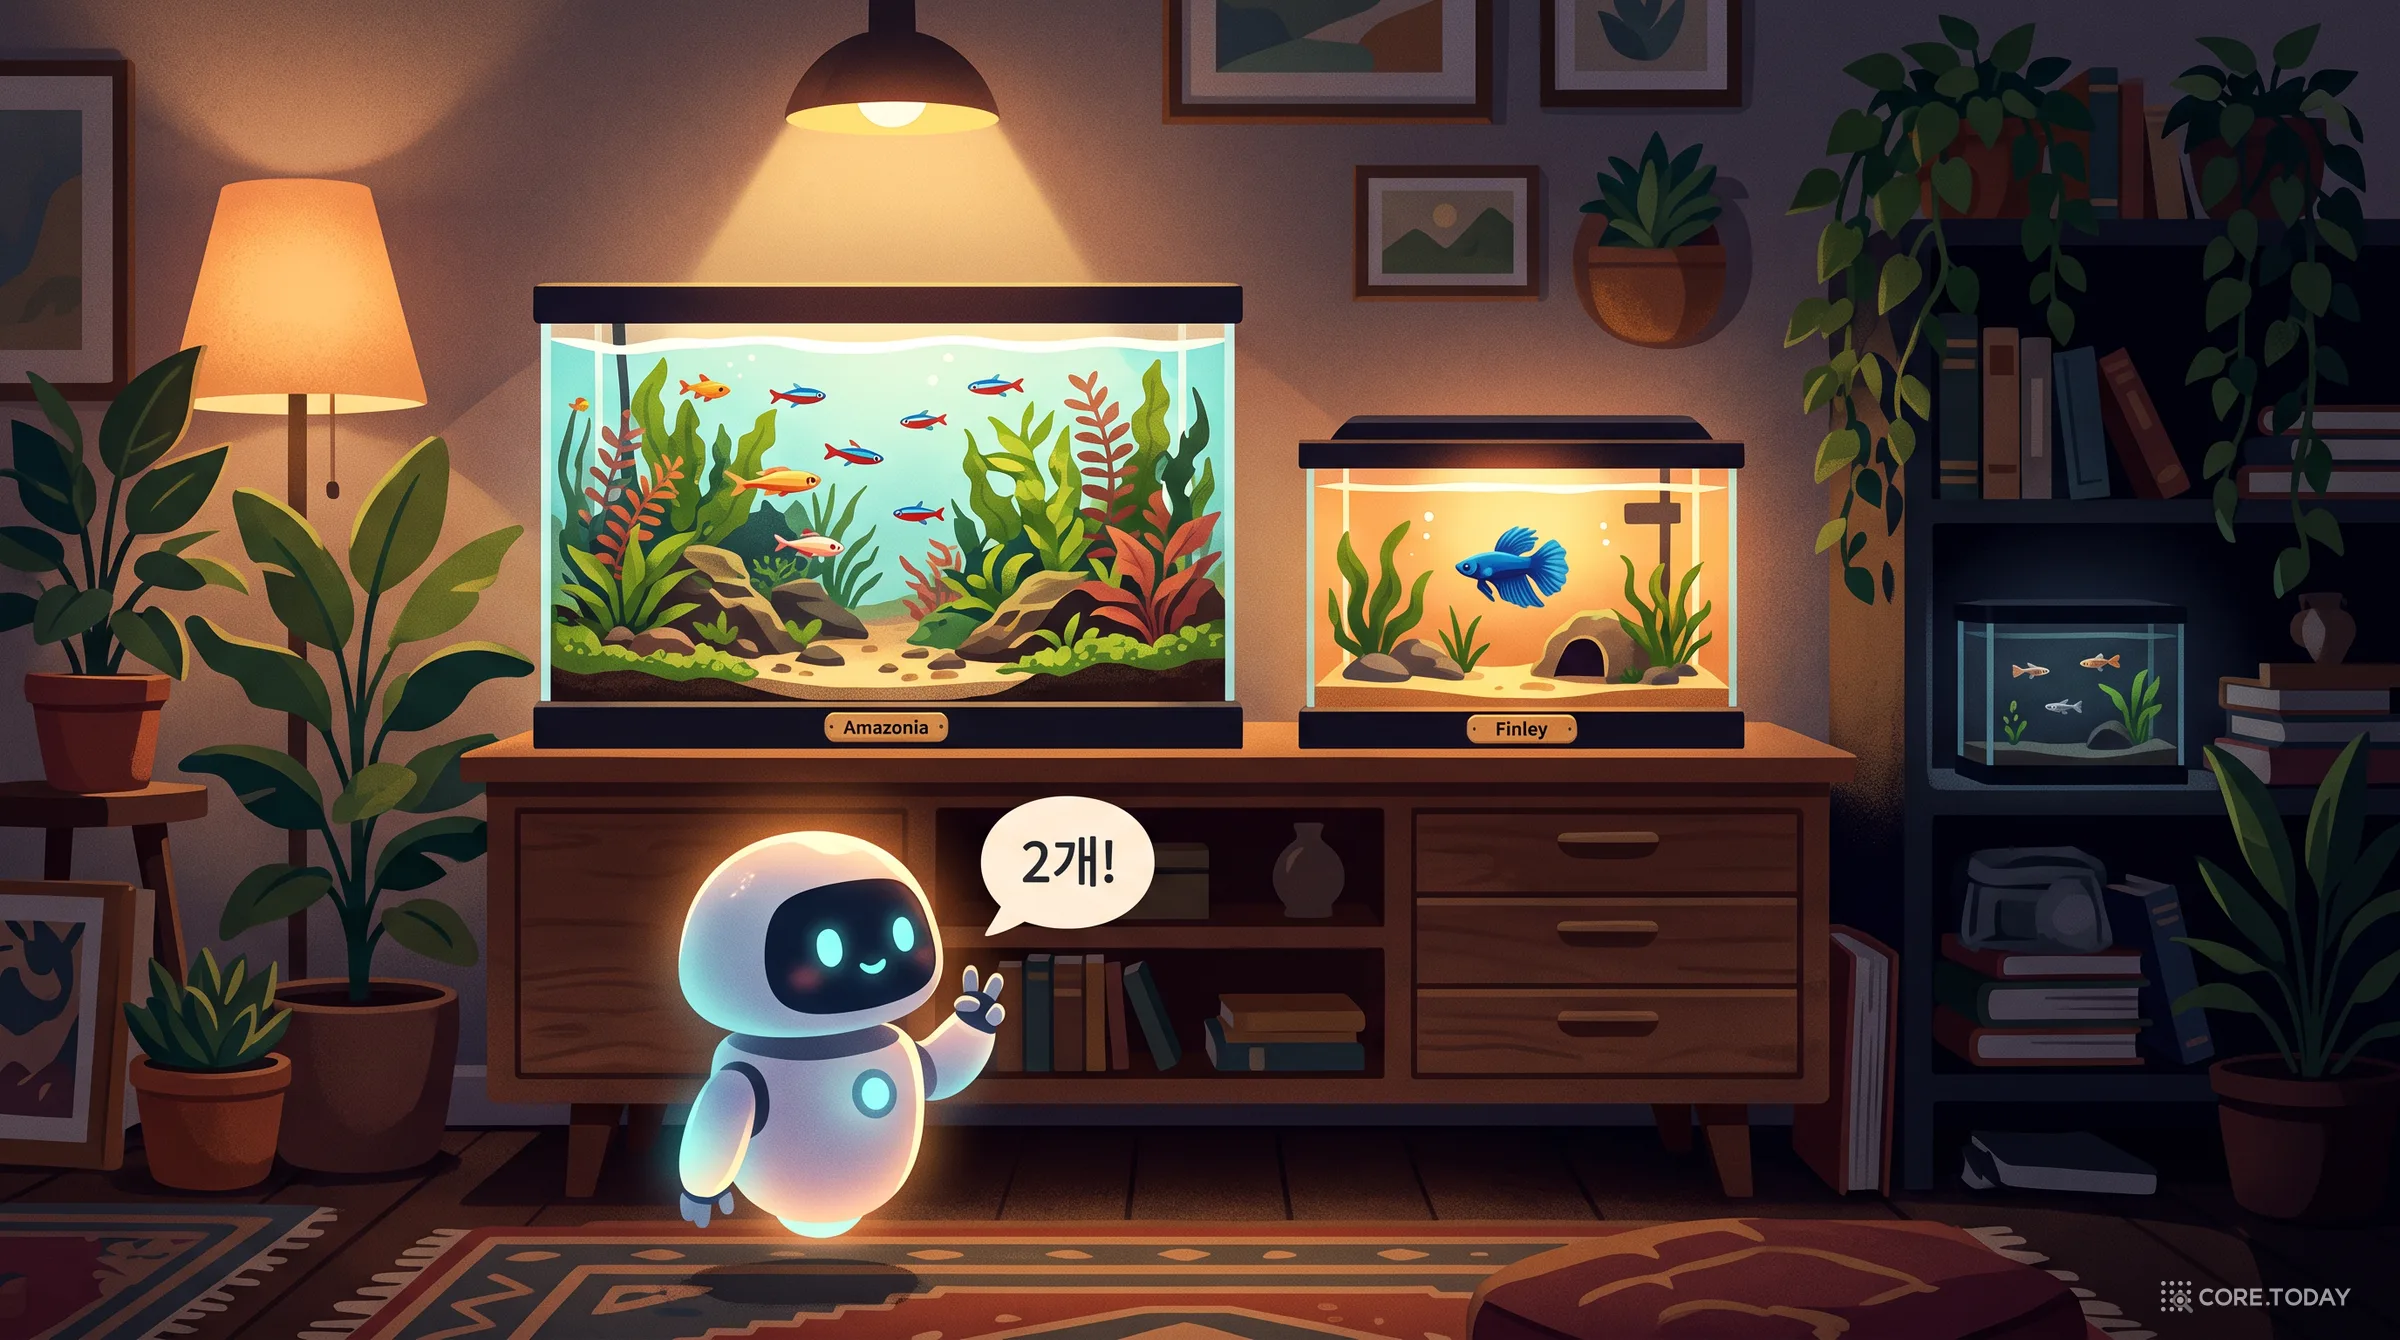
논문 부록 B는 두 계열 판정 모델이 독립적으로 '표류, 현저성 메커니즘'이라고 똑같이 적은 LongMemEval 사례 하나(46a3abf7)를 해부합니다.
5월 21일식물 적정 온도를 묻는 도중에 한 구절. "친구 아이 주려고 꾸민 1갤런짜리 작은 어항도 돌보고 있어, 구피 몇 마리." 이후 다시 언급되지 않는다.
5월 23일"5갤런 어항에 베타 한 마리, 이름은 핀리." 같은 세션에서 "20갤런 커뮤니티 어항을 새로 꾸몄어."
5월 27일세션 전체가 20갤런 이야기. "드디어 완성! 이름은 '아마조니아'." 이어서 물고기·먹이·이끼·수초·유목에 관한 열두 턴 이상.
5월 30일"친구 아이 주려고 꾸민 것까지 포함해서, 나 지금 어항 몇 개야?" 정답 3. 에이전트의 답 2.
질문이 그 조용한 어항을 직접 가리키는데도 셈에서 빠졌습니다. 다른 해석은 모두 닫혀 있습니다. 모든 세션이 프롬프트에 있으니 검색 실패가 아니고, 숫자를 제대로 냈으니 이해·형식 실패도 아니며, 어항을 남에게 줬다는 말도 없었으니 정당한 갱신도 아닙니다. 남는 건 비대칭입니다. 20갤런 어항은 이름이 있고 두 세션에 걸쳐 수십 턴 이야기됐습니다. 1갤런 어항은 식물 질문 속 한 구절이었습니다. 저자들의 표현으로 "더 시끄러운 사실은 온전히 주의를 받고, 엿새 전 수십 턴 위쪽의 조용한 사실은 상태에서 소리 없이 떨어져 나간다". 사람 주석자 한 명도 분류표를 보기 전에 이 사례를 "에이전트가 그냥 언급을 grep하고 있다"고 적었습니다.
추론을 켜면 나아질까? — 오히려 나빠졌다
"그건 모델이 덜 생각해서 그런 것 아니냐"는 반론이 자연스럽습니다. 저자들은 이걸 직접 시험했습니다. LongMemEval 다중 세션 오라클 50문항에서 다른 건 모두 고정하고 DeepSeek-V4-Flash의 추론(thinking) 모드만 껐다 켰습니다.
조건
정답
정답률
추론 끔
42 / 50
84.0%
추론 켬
38 / 50
76.0%
바뀐 사례: 끔에서 틀렸는데 켬에서 맞힘 3개 · 끔에서 맞혔는데 켬에서 틀림 7개 · 둘 다 맞힘 35 · 둘 다 틀림 5 (맥니마 검정 p=0.34)
p=0.34이므로 "추론이 해롭다"고까지 말할 수는 없습니다. 저자들이 강조하는 건 비대칭입니다. 추론은 실패 집합을 그대로 두거나 이리저리 섞을 뿐인데, 뒤에서 볼 명시적 상태 유지는 같은 과제에서 실패를 실제로 줄였습니다. 그리고 위의 어항 사례가 바로 '끔에서 맞혔는데 켬에서 틀린' 7개 중 하나입니다. 생각을 더 하자 조용한 어항을 오히려 잊었습니다. 저자들의 결론은 "이 실패는 추론 역량이 아니라 상태를 구성하는 데 있다"입니다.
4. StateMemBench — 함정을 '만드는' 벤치마크
실패 모드를 정의하는 새로운 방식: 정책 불일치
보통 벤치마크는 사람이 실패 유형을 먼저 정하고(분류표), 문제를 만들어 거기에 꼬리표를 붙입니다. StateMemBench는 거꾸로 갑니다. 실패 유형을 기계적으로 정의합니다.
각 시나리오를 먼저 상징적 사건 프로그램으로 만듭니다. 대화가 아니라 타입이 있는 상태 연산의 나열입니다 — 규칙 선언, 값 갱신, 범위가 정해진 예외, 약속, 철회. 대상은 바탕 사실·파생값·선언된 상태입니다.
정답은 이 프로그램을 결정론적 평가기로 끝까지 재생(replay) 해서 계산합니다. 사람이 답을 다는 게 아니라 프로그램이 답을 냅니다.
평가기 옆에 게으른 독자 정책(lazy reader policy) 몇 개를 둡니다. 기억 시스템이 저지를 법한 실패를 흉내 내는 작은 실행 가능한 휴리스틱입니다 — 가장 최근 언급을 믿기, 가장 자주 나온 값을 믿기, 적힌 값을 다시 계산하지 않고 돌려주기, 붙들어야 할 결정을 너무 쉽게 버리기.
하나 이상의 정책이 전체 재생과 다른 답을 낼 때만 그 시나리오를 함정으로 채택합니다. 다른 답을 낸 정책들의 조합이 그 시나리오의 '실패 서명'이 됩니다.
이렇게 만들면 "왜 틀렸나"가 문제를 만들 때 이미 정해집니다. 3장에서 판정 모델들이 메커니즘에 동의하지 못했던 문제를 설계로 피해 간 것입니다.
다섯 가지 실패 모드
상태(status) 오류 — 값이 바뀌었는데(구간 규칙의 다른 칸으로 넘어갔거나, 범위가 정해진 예외가 끝났거나) 독자가 이전의 더 시끄러운 약속에 붙어 낡은 값을 답합니다.
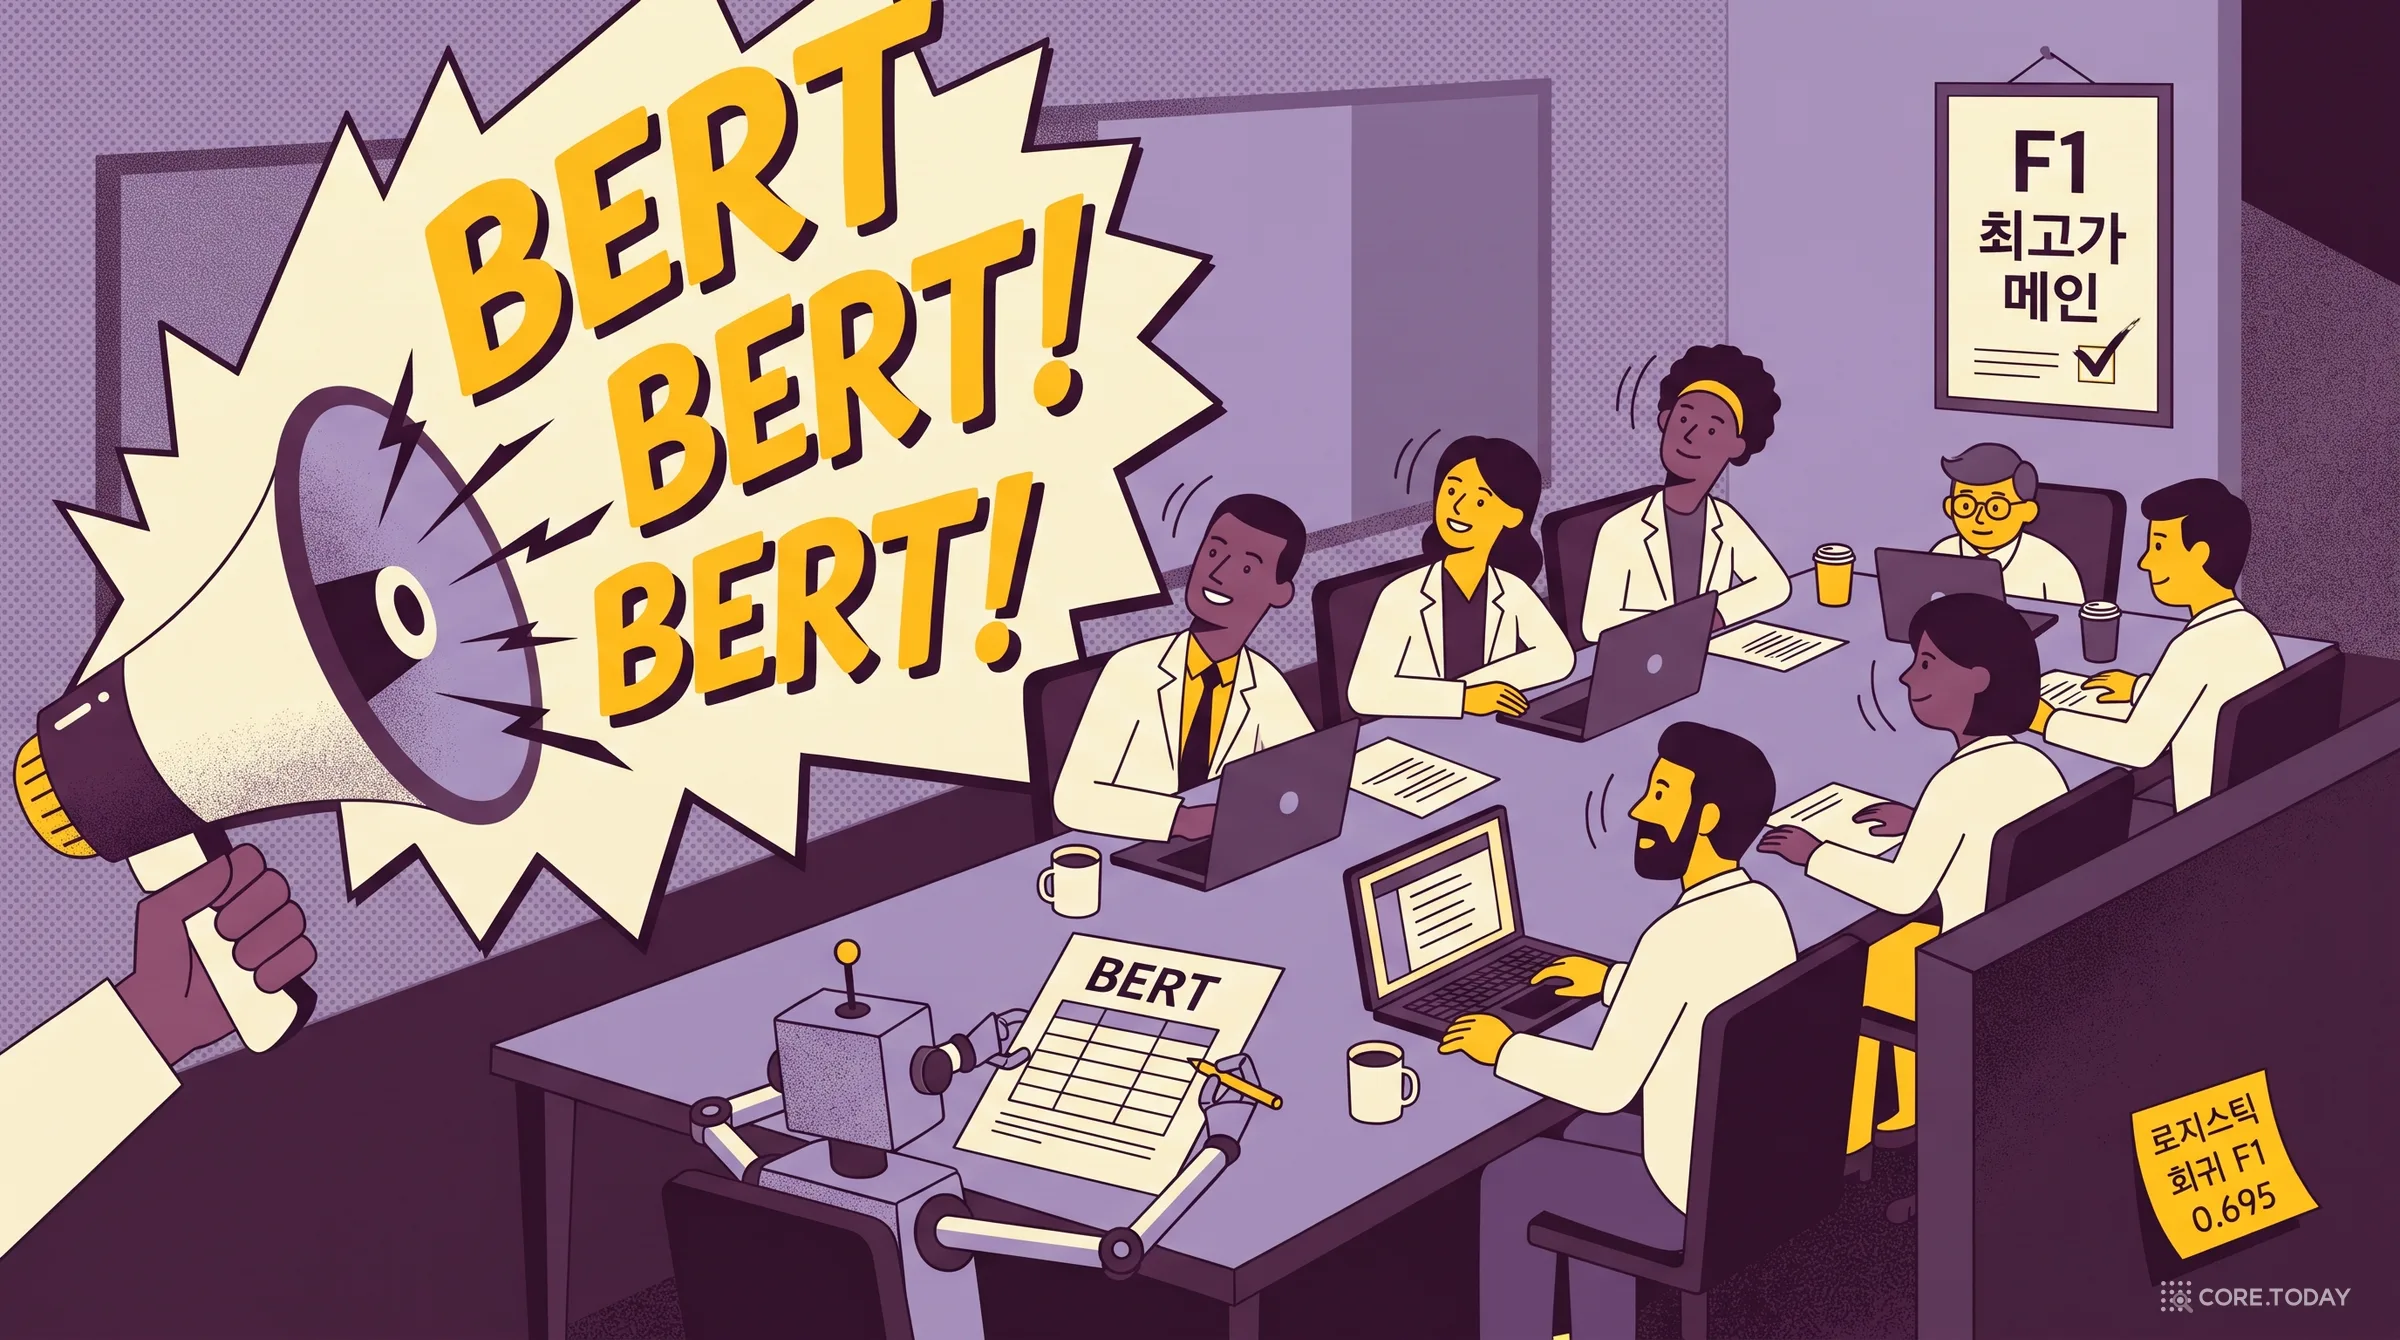
부록 D.2의 연구 협업 예시입니다. 책임 연구자가 첫 세션에 "F1이 제일 좋은 모델이 메인 표에 들어갑니다, 끝"이라고 정했습니다. 엔지니어가 BERT 0.448, 로지스틱 회귀 0.338이라고 보고했고, 이후 연구원들이 "기준점은 여전히 BERT예요, 늘 쓰는 일꾼이죠"를 몇 번이고 반복합니다. 그러다 15번째 세션에 지나가듯 "로지스틱 회귀가 이제 F1 0.695예요"라는 말이 나옵니다. 메인 표의 대표 행은? 정답은 로지스틱 회귀, 표류 답은 가장 많이 언급된 BERT입니다.
순서(sequence) 오류 — 적어 둔 파생값을 입력이 바뀐 뒤에도 다시 계산하지 않고 돌려줍니다.
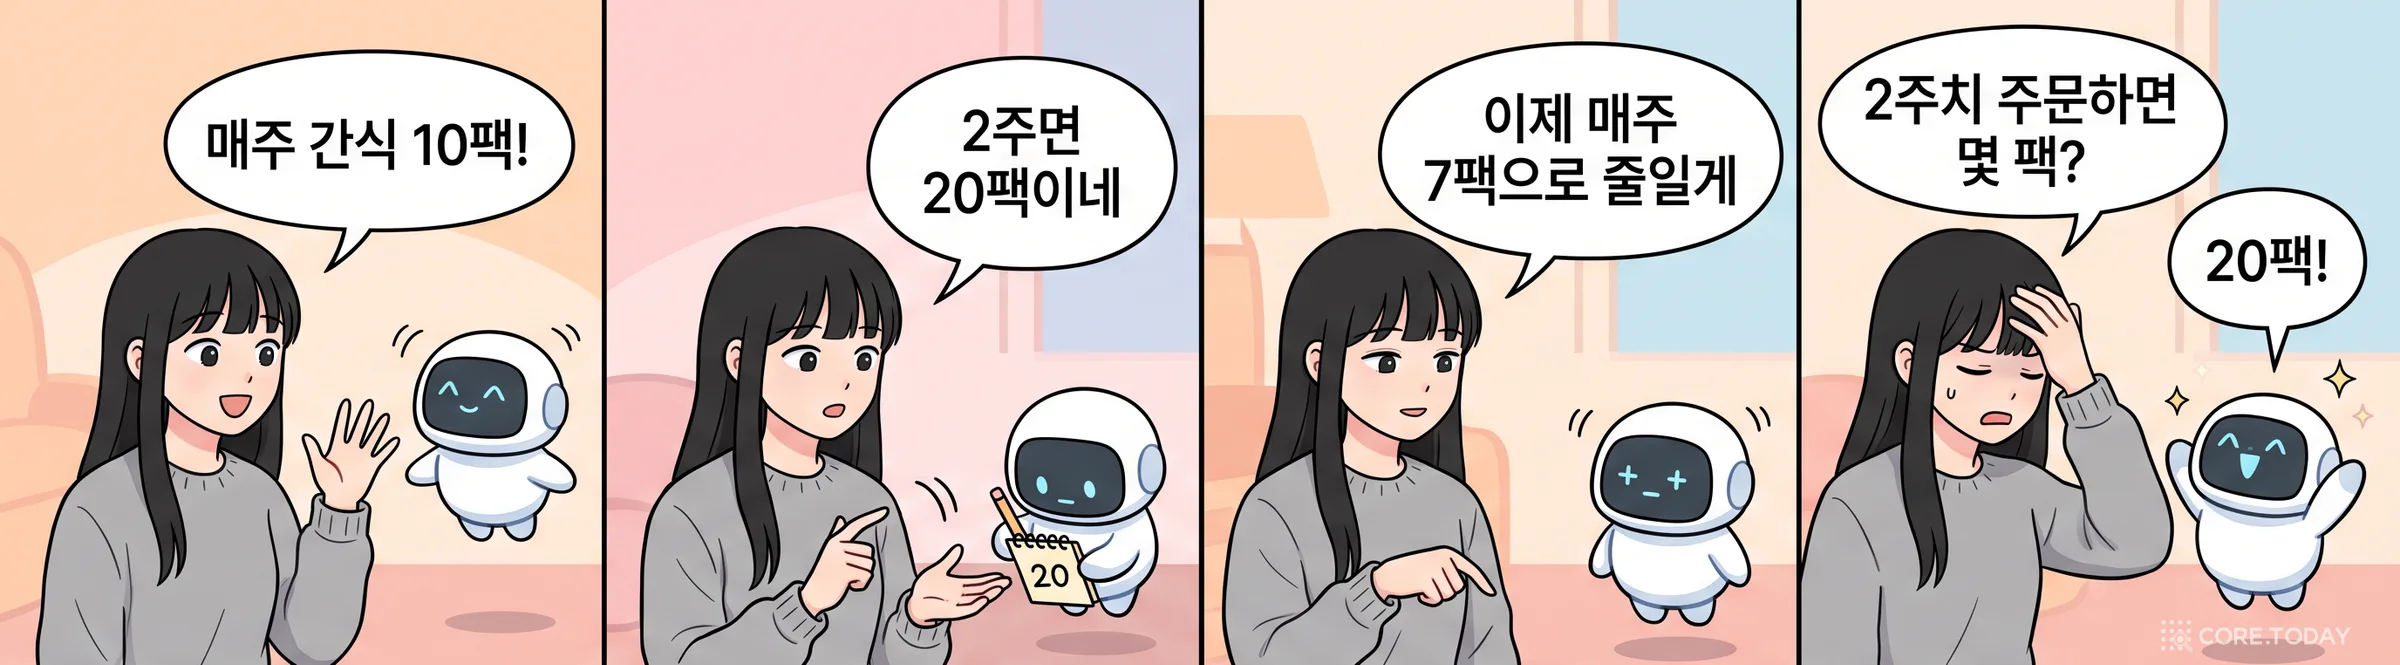
부록 D.3의 쇼핑 예시입니다. 주 10팩 → "2주면 20팩, 그러니까 20" → 주 7팩으로 감소 → "2주짜리 학교 소풍 주문, 총 몇 팩?" 정답은 7 × 2 = 14, 표류 답은 한때 소리 내어 확인했던 20입니다. 스프레드시트의 '값으로 붙여넣기'가 대화에서 일어난 셈입니다.
복합(compound) 오류 — 여러 메커니즘이 얽힙니다. 예컨대 월급이 올라(바탕 사실 대체) 저축액이 다시 계산되고(순서) 그 저축액이 규칙의 다른 구간으로 넘어가는데(상태), 사용자는 이전 구간의 결정을 열심히 칭찬해 둔(현저성) 경우입니다.
반-함정(anti-trap) — 반대 방향의 시험입니다. 이번에는 붙들고 있는 답이 계속 맞고, 지나치게 조급한 무효화 정책만 틀립니다.
"제출처는 ACL로 확정합니다"라는 공식 결정 뒤에 "옆 연구실 친구 팀은 EMNLP에 낸대요"라는 말이 나왔다고 우리 제출처가 바뀌지는 않습니다. 반-함정이 있어야 "무조건 최신 값을 믿어라" 같은 꼼수가 높은 점수를 받지 못합니다. 앞 장의 표에서 기존 벤치마크들은 이 칸(반-갱신 대조군)이 거의 비어 있었습니다.
아래 위젯에서 다섯 함정을 직접 풀어 보세요. 답을 고르면 게으른 독자 정책 다섯 개가 같은 문제에 어떻게 답하는지 나옵니다.
정책 × 함정 표를 펼쳐 보면 이 벤치마크의 설계 의도가 보입니다. '최근 언급 신뢰'는 현저성 함정을 통과하지만 반-함정에서 넘어지고, '시끄러운 값 신뢰'는 그 반대입니다. 어떤 지름길도 다섯 개를 다 통과하지 못합니다. 전체 재생만 다 맞힙니다. 상태 추적은 결국 "처음부터 다시 돌려 본 것과 같은 답을, 다시 돌리지 않고 내는 능력"입니다.
영역, 길이, 그리고 문항 수
함정의 '겉모습'은 실제 공개 데이터에서 빌려 옵니다. 쇼핑은 인스타카트 장보기 데이터셋(2017)에서 장바구니 크기·주문 주기·재주문 습관이 다양한 사용자들을 뽑아 페르소나를 만들고, 개인 재무는 합성 신용카드 거래 데이터셋에서 나이·소득·부채·카드 수·신용점수가 다양한 카드 소지자를 뽑았습니다. 연구 협업은 공개 논문들(bioRxiv 2편, arXiv 6편)을 팀 구성·방법·데이터셋·지표를 담은 '사실 카드'로 줄여 등장인물과 소재를 가져왔습니다. 쇼핑·재무는 사용자와 비서 둘의 상태를, 연구는 여러 사람이 나누는 프로젝트 상태를 다룹니다. 중요한 점은 공개 데이터가 겉모습만 제공하고 상태 값은 따로 무작위로 뽑는다는 것입니다. 원 데이터를 외우고 있어도 정답을 알 수 없습니다.
세트
구성
길이
문항
Set A (짧은)
시나리오 190개, 각 18세션, 질문 하나
중앙값 165턴, 약 3천 토큰
190
Set B (긴)
시나리오 44개, 서로 다른 모드의 함정 줄기 셋을 한 대화(약 38세션)에 엮고 세 갈래 질문
중앙값 599턴(A의 3.6배), 약 7천~1만 5천 토큰
132
합계 시나리오 234개 · 채점 문항 322개 · 유형별: 상태 116 · 순서 72 · 현저성 51 · 반-함정 39 · 복합 44 · 영역별: 재무 93 · 쇼핑 127 · 연구 102
Set B가 특히 어려운 이유는 길이 때문만이 아닙니다. 한 줄기의 정답을 쥔 사건들이 다른 두 줄기의 살아 있는 상태 사이에 파묻힙니다. 쓸데없는 잡담이 아니라 진짜 상태들이 서로를 가립니다. 또 Set A와 B는 질문 구조가 같고, 길어질수록 늘어나는 것이 잡음이 아니라 갱신 이력 자체입니다. 기존 벤치마크(예: LongMemEval S/M)가 잡담 세션을 더 끼워 길이를 늘린 것과 다른 점입니다.
대화를 '렌더링'하고, 걸러 내기
상징 프로그램을 자연스러운 다중 세션 대화로 바꾸는 일은 강한 LLM(Claude Sonnet 4.6)이 합니다. 이때 LLM은 구체적인 대사가 아니라 "14번 세션에서 사용자가 7,540달러 보너스를 받았다고 말해야 한다" 같은 일반 지시와 써서는 안 되는 표현 목록을 받습니다. 정답과 표류 답은 렌더링 전에 이미 계산돼 있으므로 LLM이 함정의 의미를 바꿀 수 없습니다. 렌더링 뒤에는 프로그램이 모든 핵심 사실이 정해진 세션에 실제로 나오는지, 금지 표현이 새지 않았는지 검사하고, 통과 못 하면 다시 렌더링합니다. 또 인과 관계를 대사에 명시하게 합니다("1,600건이니까 외부 작업자 5명이 필요해요"). 시스템이 관계를 스스로 추론할 필요가 없게 해서, 관계를 발견하는 능력과 상태를 유지하는 능력을 분리한 것입니다.
마지막으로 두 개의 관문을 통과한 시나리오만 남깁니다.
관문 1 · 풀 수 있는가 강한 독자(Sonnet 4.6)에게 관련 세션만 주면 3번 중 2번 이상 정답
→
관문 2 · 함정이 작동하는가 약한 독자(Haiku 4.5)에게 전체 대화를 주면 5번 중 3번 이상 표류 답 (반-함정은 정답)
두 가지를 기억해 둘 만합니다. 풀 수 있는지의 기준이 3분의 2라서, 절대 점수의 천장은 1.0보다 조금 아래에 있습니다. 그리고 난이도는 LLM 독자 기준으로 정의됩니다. 이 벤치마크는 기억 시스템이 자기 독자를 이런 함정으로부터 지켜 주는지를 재도록 설계됐습니다.
닫힌 보기 채점
모든 문항에는 생성 시점에 만든 보기 3~4개가 숨어 있습니다. 정답, 표적 정책이 계산한 표류 답, 그리고 그럴듯한 중립 오답. 모델은 보기를 보지 못하고 자유롭게 답합니다. 채점할 때 그 답을 보기 중 하나에 대응시킵니다. 답이 정확히 하나의 보기를 글자 그대로 말한 28%는 단어 경계 일치기가 결정론적으로 판정하고(이 구간에서 판정 모델과 94.1% 일치), 나머지는 판정 모델(DeepSeek-V4-Pro)이 대응시킵니다. 덕분에 오답을 '표류'와 '그 밖의 오답'으로 나눠 셀 수 있습니다. 이게 6장의 분석을 가능하게 합니다.
기존 벤치마크와 비교
벤치마크
다중 세션 대화
갱신이 중심
대체 해소
검증 가능한 정답
표류를 따로 채점
반-갱신 대조군
짝지은 길이
LoCoMo (2024)
✓
✗
✗
✗
✗
✗
✗
LongMemEval (2025)
✓
(✓)
(✓)
✗
✗
✗
✗
MemoryAgentBench (2025)
(✓)
(✓)
(✓)
(✓)
✗
✗
✗
MemoryArena (2026)
(✓)
✗
✗
✓
✗
✗
✗
STATE-Bench (2026)
✗
✗
✗
(✓)
✗
(✓)
✗
StateMemBench
✓
✓
✓
✓
✓
✓
✓
(✓)는 부분 충족입니다. 예컨대 LongMemEval은 여섯 질문 유형 가운데 하나(지식 갱신)에서만 "나중 값을 택하라"를 묻고, 정답은 사람이 쓴 자유 텍스트이며, 낡은 값을 고른 경우를 따로 세지 않습니다. 물론 이 표는 저자들이 자기 벤치마크가 다 채우도록 고른 기준이라는 점도 감안해야 합니다. 코어닷투데이가 지난 메모리 벤치마크 재채점 실측에서 확인했듯, 기존 기억 벤치마크의 점수는 채점 프롬프트 하나로도 크게 흔들립니다. '표류를 따로 채점한다'는 설계는 그 흔들림에서 적어도 한 가지 축을 분리해 냅니다.
5. StateMem — 기억을 '상태 장부'로 쓰기
저자들이 내놓은 해법 StateMem은 스스로 "단순하다(straightforward)"고 부릅니다. 대화를 통째로 저장하거나 요약하는 대신, 대화를 구조화된 상태 단위의 모음으로 기억합니다. 세 단계로 움직입니다.
TurnEncoder가 대화 턴마다 LLM을 한 번 불러, 그 턴을 0개 이상의 상태 단위로 바꿉니다. 이때 현재 살아 있는 모든 단위를 짧게 정리한 목록을 맥락으로 함께 줍니다. 상태 단위는 다섯 칸짜리 튜플입니다.
상태 단위 u = (id, content, priority, source, deps)
id고유 번호. u_0001, u_0002 …
content자유 형식 한 문장. "실수령 월급은 6,000달러"
priorityhard(검증된 사실·구속력 있는 약속·남은 의무·행동을 제약하는 것) 또는 soft(선호·있으면 좋은 것·양보 가능한 것)
source어느 턴, 누가 한 말인가 — 날짜가 있는 데이터면 날짜도 찍는다
depsderived_from(값이 다른 단위의 값에서 계산됨) · coupled_with(유효성이 다른 단위의 상태에 달림, 예: "넷플릭스 자동이체는 카드 3에" ↔ "카드 3 해지")
부록 E.1의 TurnEncoder 프롬프트는 할 수 있는 일을 다섯 가지로 정해 둡니다. ① 새 단위 추가(사용자 발언·도구 결과에서) ② 기존 단위 대체 — 그리고 대체 신호를 적극적으로 찾으라고 적어 둡니다: "actually, instead, no longer, switched to, moved off, cancelled, replaced X with Y, now Y not X" ③ 진행 상황 추적("예약 5건 중 2건 변경 완료, 남은 것: …") ④ 연쇄·파생 의존 관계 연결, 그리고 특정 날짜나 조건에서 작동하는 트리거 ⑤ 변화 없음. 출력은 {"add": [...], "supersede": [...]} 형태의 JSON뿐입니다.
2단계 · 갱신: 대체를 적용하고, 재확인기가 그래프를 걷는다
갱신은 두 동작입니다. 첫째, 상태 저장소(StateStore)가 표시된 대체를 적용합니다. 대상 단위는 superseded가 되고, 함께 제안된 대체 단위가 새 active 단위로 들어갑니다. 대체된 단위는 지우지 않습니다. 감사(audit)를 위해 저장소에 남기되, 답변 단계로는 넘기지 않습니다(코어닷투데이가 이중 시간 테이블에서 다룬 '지우지 말고 닫아라'와 같은 원칙입니다).
둘째, 결정론적 재확인기(Rechecker) 가 의존 그래프 G = (U, E)를 걷습니다. 간선 (ui, uj)는 ui가 uj에 기댄다는 뜻입니다. 방금 상태가 바뀐 단위로 간선이 이어진 모든 단위에 needs_recheck 표시를 붙입니다. 이 단위는 계속 active지만 "낡았을 수 있음" 깃발을 답니다. 의존 관계는 수집 단계에서 이미 기록돼 있으므로 이 단계는 간선 수에 비례하는 시간(O(|E|))에 끝나고, LLM 호출이 하나도 없습니다. 1979년 도일의 진리 유지 시스템이 근거 사슬을 따라 믿음을 거둬들이던 일을, 이번엔 장부 위에서 하는 셈입니다.
질문이 오면 상태 저장소가 active 단위와 needs_recheck 단위를 모아 결정론적으로(LLM 없이) 구조화된 상태 블록을 만듭니다. 부록 E.3의 형식은 이렇습니다.
상태 주입 — 블록 형식 (부록 E.3)
## BINDING -- THIS CONVERSATION- [유형] 단위 내용 … (이 대화에서 구속력 있는 것)
## BINDING -- POLICY RULES- [유형] 단위 내용 … (정책 문서에서 뽑은 규칙 — τ²-bench처럼 정책이 있을 때만)
## PREFERENCES (yield if necessary)- [유형] 단위 내용 … (양보 가능한 선호)
## ! NEEDS RECHECK -- may be stale due to recent events- [유형] 단위 내용 → trigger: 무엇 때문에 표시됐는지
그리고 답변 호출 한 번에 이 블록, 질문, 그리고 재계산 안내를 함께 넣습니다. 안내문의 핵심은 이렇습니다. "NEEDS RECHECK 표시가 붙은 단위는 낡은 것이다. 그 숫자를 쓰지 마라. 적힌 계산식(예: X = A × 2)에 각 입력의 현재 값을 넣어 다시 계산하라. 그 결과가 또 다른 NEEDS RECHECK 단위로 이어지면 사슬을 따라 차례로 다시 계산하라. 질문으로 가는 경로에 있는 단위만 다시 계산하라." 무엇이 관련 있고 무엇이 낡았는지는 결정론적 층이 정하고, LLM은 그 깃발을 보고 답만 다시 계산합니다. 이 분업이 StateMem 설계의 요점입니다.
아래 위젯에서 상태 장부를 직접 굴려 보세요. 월급·저축률·고정 지출·비상금을 바꾸는 발언을 넣고 "여행에 얼마 쓸 수 있어?"를 물어 보면 됩니다. 위쪽의 세 부품(대체 표시, 의존성 전파, 재계산 안내)을 하나씩 꺼 보면 각각이 막는 실패가 무엇인지 보입니다.
위젯은 사용자가 의존 관계를 말로 밝혔다고 가정합니다. StateMemBench도 같은 가정을 합니다(인과 관계가 대사에 명시됨). 실제 대화에서는 "2주면 20팩"에서 "주간 수량 × 2"라는 관계를 TurnEncoder가 스스로 알아봐야 하는데, 이 부분이 실전에서 얼마나 잘 되는지는 이 논문이 직접 재지 않았습니다.
6. 결과 — 무엇이 얼마나 나아졌나
실험 조건부터 정리해 둡니다. 답을 쓰는 백본(substrate) 은 두 가지입니다. 로컬에서 돌린 Qwen-3.5-9B와 API로 부른 DeepSeek-V4-Flash, 둘 다 추론(thinking) 모드를 끄고 온도 0으로 한 번씩만 돌렸습니다. 비교 대상은 네 무리입니다.
nano-graphrag, HippoRAG, LightRAG, 마이크로소프트 GraphRAG
대화에서 개체·관계 그래프를 만들고 그 위에서 찾는다
기억 시스템
Mem0, A-Mem, LightMem, MemoryOS
각자의 방식으로 기억을 추출·갱신·검색한다(공개 구현 그대로)
먼저 확인: 상태를 추적하느라 회상을 잃지는 않았나
새 방법을 볼 때 가장 먼저 물어야 할 건 "다른 걸 희생했나"입니다. StateMem은 대화 원문 대신 상태 단위만 들고 다니니, 사소한 사실을 묻는 회상 문제에서 손해를 볼 수 있습니다. 논문 표 4는 기존의 회상형 벤치마크 결과입니다.
방법
LongMemEval · Qwen
LongMemEval · DeepSeek
LoCoMo · Qwen
LoCoMo · DeepSeek
장문맥
0.550
0.666
0.612
0.587
기억 없음
0.062
0.056
0.010
0.005
Mem0
0.566
0.594
0.481
0.462
A-Mem
0.520
0.510
0.266
0.279
StateMem
0.580
0.656
0.566
0.592
StateMem은 두 백본 모두에서 기억 시스템 가운데 1위였고, DeepSeek에서는 장문맥과 거의 같았습니다(LongMemEval 0.656 vs 0.666, LoCoMo 0.592 vs 0.587). 질문 유형별로 보면 이득이 어디서 오는지 분명합니다. LongMemEval의 시간 추론 유형에서 DeepSeek 기준 0.624로 장문맥(0.391)을 크게 앞섰고, 지식 갱신에서도 0.795였습니다. 반대로 단일 세션의 단순 회상이나 집계 문제에서는 장문맥에 몇 점 뒤졌습니다. 상태 추적은 회상을 거의 희생하지 않았고, 상태가 걸린 질문에서 이득을 냈습니다.
StateMemBench 성적표
이제 본 시험입니다. 아래 위젯은 논문 표 3과 부록 표 10의 숫자를 그대로 옮겼습니다. 백본과 함정 유형을 바꿔 가며 보세요.
숫자에서 읽어 낼 이야기를 다섯 가지로 정리합니다.
첫째, 장문맥은 여기서 강자가 아니다. 회상형 벤치마크에서 늘 넘기 힘든 기준선이던 장문맥이 이번엔 맥을 못 춥니다. 가장 나은 장문맥(GPT-5.4-Nano)이 0.277, 같은 백본의 장문맥은 Qwen·DeepSeek 모두 0.149입니다. 대화는 3천~1만 5천 토큰으로 요즘 모델의 맥락 창에 넉넉히 들어갑니다. 다 보여 줘도 낡은 값을 고릅니다. "맥락 창을 늘리면 기억 문제는 끝난다"는 믿음에 정면으로 반대되는 결과입니다.
둘째, StateMem은 각 백본에서 1위다. DeepSeek에서 0.363으로, 같은 백본 장문맥의 2.4배, 가장 나은 기억 시스템(A-Mem 0.199)의 1.8배, 어떤 종류든 가장 나은 기준선(Dense 검색 0.205)과도 비슷한 배수입니다. Qwen에서는 0.233으로 가장 나은 기억 시스템(Mem0 0.149)의 1.6배였습니다. 다만 Qwen에서는 GraphRAG(0.224)와 통계적으로 구별되지 않았습니다(322문항 맥니마 검정, 불일치 38 대 35, p=0.82).
셋째, 유형별 순서는 백본이 바뀌어도 유지된다. 반-함정은 거의 모두 천장 근처입니다(StateMem·DeepSeek 0.87). 정답이 '붙들고 있던 값'이니까요. 기준선들은 현저성·순서·복합에서 거의 0이고, StateMem은 순서와 복합의 상당 부분을 되찾습니다(DeepSeek 순서 0.347, 복합 0.273).
넷째, 현저성은 기억 설계가 아니라 백본의 한계로 보인다. Qwen 백본에서는 모든 방법이 현저성 0.18 이하였고 StateMem은 오히려 0.020이었습니다. 그런데 같은 장문맥 설정에서 GPT-5.4-Nano는 0.569를 냈습니다. "더 시끄러운 값에 끌려가지 않는 능력"은 기억을 어떻게 저장하느냐보다 답을 쓰는 모델의 체급에 달린 것 같다는 해석입니다.
다섯째, 짧은 대화와 긴 대화의 방향이 반대다. 대부분의 기준선은 긴 대화(Set B)에서 점수가 조금 오릅니다(예: DeepSeek Dense 0.168 → 0.258). StateMem은 반대로 떨어집니다(0.411 → 0.295). 긴 대화의 문항 구성(세 갈래 질문, 반-함정 비중)이 다르기 때문일 수 있고, 상태 단위가 많아질수록 StateMem의 의존 전파가 과하게 번지는 문제(아래 소거 실험)와도 맞닿아 있습니다. 논문은 이 대비를 따로 해석하지 않았는데, 저장소가 커질 때 무슨 일이 생기는지는 열린 질문입니다.
부품별 값어치: 소거 실험
위젯에서 '소거 실험'을 켜면 StateMem의 부품을 하나씩 떼어 본 결과가 보입니다. DeepSeek 기준으로 계단을 그려 보면 이렇습니다.
추출만
0.174
+ 대체 표시
0.298
재계산 안내 뺌
0.301
전체 StateMem
0.363
의존성 전파 뺌
0.373
막대 길이는 0.42를 100%로 잡은 상대 길이입니다(DeepSeek-V4-Flash, StateMemBench 전체 322문항).
추출만으로는 거의 안 오른다. 대화를 상태 단위로 바꿔 적는 것만으로는 0.174 — 같은 백본 장문맥 0.149와 큰 차이가 없습니다. 정리해서 적는다고 상태 추적이 되는 게 아닙니다.
대체 표시가 가장 큰 한 걸음이다. 0.174 → 0.298. "이건 저걸 대체했다"를 명시적으로 기록하는 일이 가장 많은 것을 해결합니다.
재계산 안내를 빼면 약 6점이 빠진다. 0.363 → 0.301. 깃발만 꽂아 두고 "그러니 다시 계산하라"고 말해 주지 않으면 모델이 적힌 숫자를 그대로 옮기는 일이 남습니다.
의존성 전파는 양날의 칼이다. 자기 표적인 순서·복합 유형은 돕지만, 긴 대화의 반-함정에서 과하게 번져 12.5점을 잃었습니다. 그래서 전파를 빼면 DeepSeek 전체 점수가 오히려 조금 오릅니다(0.363 → 0.373). 바뀌지 않아야 할 것까지 '재확인 필요'로 칠하면 모델이 멀쩡한 결정을 의심하게 됩니다. AGM 이론의 오랜 질문 — 무엇을 얼마나 붙들고 있어야 하나 — 이 여기서 숫자로 나타납니다.
저자들은 한 가지를 분명히 해 둡니다. StateMem은 함정을 만든 바로 그 정책 계열을 겨냥해 설계됐다. 그러니 자기 벤치마크에서의 격차는 '상한선'으로 읽어야 하고, 일반화의 증거는 앞의 LongMemEval·LoCoMo 결과 쪽이라는 것입니다.
오답의 해부: 닫힌 보기가 보여 주는 것
이 벤치마크의 가장 영리한 부분은 오답을 갈라 볼 수 있다는 점입니다. 틀린 답이 '한때 참이던 값(표류)'인지, 다른 보기인지, 아예 보기 밖의 말인지를 셀 수 있습니다.
여기서 착시 하나를 조심해야 합니다. 표류율(표류 ÷ 전체)만 보면 '기억 없음'(DeepSeek 5.6%)과 LightMem(14.9%)이 가장 우수해 보입니다. 하지만 이들은 낡은 값에 속지 않은 게 아니라, 대부분의 문항에서 보기 밖의 엉뚱한 말을 했을 뿐입니다(보기 밖 비율 각각 94%, 84%). 그래서 논문은 표류율을 늘 '보기 안에서 답한 수'와 함께 보고합니다.
보기 안에서 답한 방법들만 놓고 보면, 약한 백본(Qwen 9B)에서는 장문맥·Mem0·BM25·StateMem 모두 표류율이 61~66%로 거의 똑같습니다. 약한 답변 모델 위에서는 기억 층을 바꿔도 결과가 별로 안 바뀝니다. 방법들이 갈라지는 건 강한 백본(DeepSeek)에서입니다. StateMem은 백본을 바꿨을 때 표류율이 가장 크게 떨어지고(64.3% → 49.1%) 정답이 가장 많이 늘었습니다(75 → 117). 장문맥·Mem0·BM25는 표류율이 1~3점, 정답이 0~9개만 움직였습니다. 저자들의 해석은 이렇습니다. 상태를 명시적으로 드러내 주면 쓸 만한 답변 모델이 그것을 정답으로 바꾼다. 다른 방법들의 병목은 답변 모델이 아니라 기억 층이다.
7. 래퍼: 답변 호출 하나만 바꾸면
StateMem 전체를 쓰려면 턴마다 LLM을 불러야 합니다. 짧은 대화에서 165번, 긴 대화에서 600번입니다. 기존에 Mem0나 벡터 검색을 쓰고 있는 팀이 "다 갈아엎어야 하나?"라고 묻는 건 당연합니다. 저자들의 마지막 실험은 이 질문에 대한 답입니다. 상태 추적은 따로 떼어 낼 수 있는 축인가?
그래서 만든 것이 StateMemWrapper입니다. 저장소도, 턴별 처리도, 추가 LLM 호출도 없습니다. 어떤 백엔드든 원래 하던 저장·검색은 그대로 두고, 마지막 답변 프롬프트 하나만 바꿉니다. 래퍼는 대화 전문(턴 번호를 붙여서), 백엔드가 찾아온 조각들, 질문을 받아 한 번의 호출 안에서 두 구역을 씁니다.
1구역 · 상태 추적 (250단어 이하)질문이 묻는 대상을 세우고·갱신하고·대체한 모든 턴을 시간순으로 적어라([턴 N] 누가: 무엇이 바뀌었나). 결정을 지배하는 상시 규칙과, 그 규칙이 적용될 모든 입력(금액·수량·날짜·문턱값)의 가장 최근에 말해진 값을 포함하라 — 한 번만, 지나가듯 언급됐어도. 입력을 모른다고 결론 내리기 전에 찾아라. 입력이 나중에 바뀐 파생값을 표시하라. 각 대상의 현재 효력 있는 값으로 끝내라. 답하기 전에 이 추적을 확정하라.
2구역 · 해소와 답순서대로 적용하라. (1) 나중 것이 먼저 것을 대체한다. (2) 상시 규칙이 지난 일회성 사례보다 우선한다 — 규칙을 현재 입력에 적용하라. (3) 파생값은 현재 입력으로 다시 계산하라, 낡은 숫자를 재사용하지 마라. (4) 사실은 실제로 대체되거나 만료됐을 때만 은퇴한다.
마지막 줄ANSWER: <질문이 묻는 구체적인 값이나 결정>
네 규칙은 앞에서 본 실패 모드와 하나씩 짝을 이룹니다. (1)은 상태 오류, (2)는 "지난번처럼 Roth"의 상태 오류, (3)은 순서 오류, (4)는 반-함정입니다. 그리고 '한 번만 언급됐어도 찾아라'는 문장은 현저성 오류(조용한 어항)를 겨냥합니다. 추적을 답보다 먼저 확정하게 한 것도 의도적입니다. 모델이 답을 정해 놓고 그럴듯한 이유를 덧붙이는 사후 합리화를 막습니다.
대조군이 핵심이다
이런 실험에서 늘 나오는 반론이 있습니다. "답하기 전에 250단어를 더 쓰게 했으니, 그냥 생각할 시간이 늘어서 좋아진 것 아닌가?" 저자들은 이걸 막으려고 대조군(wrapper-ctrl) 을 만들었습니다. 같은 시스템 프롬프트, 같은 두 구역 형식, 같은 250단어 예산, 같은 '답 전에 확정하라' 지시, 같은 맥락. 다른 건 단 하나 — 1구역이 "질문과 관련된 정보를 요약하라"뿐입니다. 턴 번호도, 값 사슬도, 현재 상태 정리도, 우선 규칙도 없습니다. 그러면 래퍼 − 대조군의 차이는 순수하게 '상태 구조'의 몫이 됩니다. 두 조건은 입력 155토큰과 출력 약 180토큰만 다릅니다.
결과는 깔끔합니다.
StateMemBench: 래퍼는 여섯 백엔드 × 두 백본 12칸 모두에서 단독보다 +31.7~+66.6점 올렸고, 그중 구조의 몫이 +15.0~+31.7점이었습니다. 12칸 모두 통계적으로 유의했습니다(대응 맥니마 p≤0.04, 부트스트랩 신뢰구간이 0을 포함하지 않음). 거의 바닥이던 LightMem·MemoryOS가 가장 크게 올랐습니다.
LongMemEval(다중 세션): 백본에 따라 그림이 다릅니다. Qwen에서는 구조가 이득 대부분을 가져가고(+11.7~+25.0), 일반 요약만 시키는 대조군은 오히려 점수를 깎는 경우가 많았습니다. DeepSeek에서는 대조군이 상승분 대부분을 회수하고 구조의 몫은 −5~+5점이었습니다. 강한 답변 모델은 상태 구조가 덜 필요하다는 뜻입니다.
24칸 중 23칸에서 래퍼가 대조군보다 높았습니다(예외는 LongMemEval·DeepSeek·Dense).
부수적인 발견 두 가지가 더 흥미롭습니다. 첫째, 질문을 보지 않고 쓴 250단어 요약은 래퍼 없는 기준선보다도 낮았고, 모든 조건 중 표류율이 가장 높았습니다. 요약은 질문에 맞춰 써야 합니다. 둘째, 같은 시나리오에서 래퍼가 StateMem 자신보다 높았습니다(Qwen에서 0.283 대 0.567 이상). 저자들의 설명은 이렇습니다. 대화 전문이 맥락 창에 들어간다면, 답할 때 상태를 해소하는 것으로 충분하다. 영구 저장소는 대화가 창에 들어가지 않을 때 쓸모가 있다.
비용도 따져 볼 만합니다. 래퍼는 호출 수를 늘리지 않고, 질문당 약 350토큰(고정 지시문 155 + 추적 약 180)을 더합니다. LongMemEval 답변 프롬프트의 0.2%입니다. 다만 래퍼는 대화 전문을 넣으므로 입력이 대화 길이만큼 큽니다(StateMemBench 중앙값 8.6k, LongMemEval 87k 토큰). 이건 장문맥 기준선이 내는 비용과 같은 것이지 래퍼 탓은 아니지만, 대화가 정말 길어지면 결국 StateMem 같은 저장소가 필요해진다는 뜻이기도 합니다.
정리하면 이 실험이 보여 주는 건 상태 추적이 기억 시스템의 종류와 직교하는 축이라는 점입니다. Mem0를 쓰든 BM25를 쓰든, 답할 때 "값의 사슬을 시간순으로 세우고, 네 가지 우선 규칙으로 해소하라"는 규율을 씌우면 상태 문제가 상당 부분 줄어듭니다. 저자들의 결론 문장대로 "현재의 기억 시스템에 빠진 건 바로 이 명시적인 상태 규율"입니다.
8. 코어닷투데이 실측 — 한국어 함정 40문항, 답변 프롬프트 세 가지
논문의 코드와 데이터는 아직 공개되지 않았습니다(9장 참고). 그래도 7장의 래퍼는 프롬프트 원문이 부록에 실려 있어 그대로 시험할 수 있습니다. 궁금한 건 두 가지였습니다. 한국어 대화에서도 같은 함정이 작동하는가, 그리고 답변 프롬프트 하나만 바꿔도 정말 나아지는가. 크레딧이 드는 API 대신, 논문이 쓴 백본과 같은 계열인 Qwen 3.5 9B를 로컬(Ollama)에서 돌렸습니다.
실험 설계
논문의 생성 방식을 축소해 따라 했습니다.
사건 프로그램유형마다 템플릿을 만들고 값(금액·수량·문턱값·모델 이름 등)을 무작위로 뽑아 시나리오를 생성했습니다. 정답과 표류 답, 중립 오답 2개는 대화를 만들기 전에 계산합니다. 상태 3종(재무 보너스 구간·장보기 배송 규칙·연구 통계 검정 규칙), 현저성 3종(F1 대표 모델·구독 개수 세기·최저가 매장), 순서 2종(주간 수량 × 주 수, 월급 × 저축률), 복합 2종(월급 인상 → 저축액 → 계좌 규칙, 주간 수량 → 한 달 수량 → 대용량 규칙), 반-함정 3종(제출 학회·비상금·운동화 사이즈)입니다.
렌더링LLM 없이 템플릿으로 한국어 대화를 만들었습니다. 18세션, 세션마다 함정과 무관한 잡담(날씨·저녁 메뉴·서버 점검 공지 등)을 섞었습니다. 짧은 판본은 세션당 잡담 3쌍(중앙값 114턴, 약 3,800자), 긴 판본은 10쌍(중앙값 366턴, 약 11,600자)으로, 사건 값은 같고 잡담 양만 다릅니다. 논문의 Set A·B와 비슷한 길이입니다.
세 가지 답변같은 대화 전문을 놓고 ① 일반("대화를 보고 답하라, 마지막 줄에 ANSWER:") ② 대조(논문 부록 F.2 원문: 관련 정보를 250단어로 요약한 뒤 답) ③ 래퍼(부록 F.1 원문: 상태 추적 + 네 가지 우선 규칙). 지시문은 영어 원문 그대로, 대화와 질문은 한국어입니다.
채점ANSWER 줄을 숨은 보기 4개와 단어 일치로 대응시켰습니다. 두 보기가 함께 나온 답 1건("연금저축 한도보다 적어 입출금 통장에 그대로 두세요")은 원문을 읽고 정답으로 고쳤습니다. 유형 5개 × 4개 × 짧은·긴 2판본 = 40문항, 조건 3개 = 120회 호출. 온도 0, 추론 끔.
한 가지 중요한 차이가 있습니다. 논문은 약한 독자(Haiku 4.5)가 5번 중 3번 이상 실제로 표류하는 시나리오만 남겼습니다. 이 실측은 그런 관문을 두지 않았습니다. 그래서 일부 유형은 함정이 아예 작동하지 않을 수 있고, 그 자체가 하나의 관찰입니다.
결과
함정 유형 (각 8문항)
일반
대조
래퍼
상태 — 규칙 재적용
4 (표류 4)
2 (표류 5)
8
현저성 — 시끄러운 경쟁자
5 (표류 2)
5 (표류 3)
8
순서 — 파생값 재계산
7 (표류 1)
8
8
복합 — 여러 메커니즘
4 (표류 4)
4 (표류 4)
6 (표류 2)
반-함정 — 바꾸지 말 것
8
8
8
합계 (40문항)
28 (70%) · 표류 11
27 (68%) · 표류 12
38 (95%) · 표류 2
칸 = 정답 수(괄호는 낡은 값을 고른 표류 수). 남는 1건씩은 보기 밖 답 — 일반은 모델 이름 대신 "F1이 제일 높은 모델"이라고 규칙을 되읊었고, 대조는 1,200토큰 출력 한도 안에 ANSWER 줄을 쓰지 못했습니다.
숫자를 읽는 법을 정리합니다.
래퍼는 한국어에서도 크게 통했다. 정답 28개(일반) → 38개(래퍼), 표류 11 → 2. 특히 논문에서도 가장 다루기 어렵다던 상태(4 → 8)와 현저성(5 → 8)에서 차이가 컸습니다. 긴 판본에서는 20문항을 모두 맞혔습니다. 지시문이 영어이고 대화가 한국어인데도 모델은 턴 번호를 정확히 인용하며 값의 사슬을 세웠습니다. 위젯의 '실제 답안 들여다보기'에서 래퍼의 추적을 열어 보면, 예컨대 통계 검정 사례에서 "[Turn 47] 표본 1,900 확정 → t-검정 / [Turn 91] 재필터링으로 400 — 1,900을 대체 / 현재 400 < 500이므로 부트스트랩"처럼 정확히 논문이 원하던 모양으로 씁니다. 같은 문제를 일반 프롬프트는 "대응표본 t-검정"이라고 답했습니다. 연구원이 "이건 확실히 t-검정이에요"라고 단호하게 말해 둔 값입니다.
대조군은 아무 도움이 안 됐다. 일반 28 대 대조 27. 같은 길이의 '요약 먼저'를 시켜도 상태 문제는 줄지 않았고, 상태 유형에서는 오히려 더 나빴습니다(4 → 2). 논문이 LongMemEval·Qwen에서 본 것과 같은 방향입니다. "답하기 전에 생각하게 하는 것"이 아니라 무엇을 어떤 순서로 생각할지(값 사슬, 대체, 재적용, 재계산)를 정해 주는 것이 효과의 정체라는 뜻입니다.
비용은 작다. 래퍼의 입력은 일반보다 약 200토큰 길고(중앙값 5,054 → 5,267), 출력은 약 60토큰에서 374토큰으로 늘었습니다. 호출 한 번의 시간은 중앙값 23초 → 27초(머신을 다른 작업과 나눠 쓰는 상태)였습니다.
순서 함정은 9B도 풀었다 — 함정이 '덜 함정'이었기 때문이다. 논문에서 Qwen 9B 장문맥은 순서 유형 0.000이었는데, 이 실측의 일반 프롬프트는 8개 중 7개를 맞혔습니다. 템플릿을 보면 이유가 짐작됩니다. 사용자가 "이제 매주 7개로 줄일게"라고 깔끔하게 말하고 질문이 바로 "2주치 몇 개?"를 물으면, 9B 모델도 7 × 2를 계산합니다. 논문 예시(부록 D.3)에는 결정적인 한 마디가 더 있습니다. "주 7팩으로 줄일게 — 그러니까 오늘은 7팩." 이 방해 문장이 정말 차이를 만드는지 확인하려고 논문식 판본 4개를 따로 만들어 돌렸습니다. 결과는 극적이었습니다. 방해 문장 하나를 넣자 일반 프롬프트는 4개 중 하나도 맞히지 못했습니다(표류 2 · 보기 밖 2). 표류한 답은 정확히 예전에 소리 내어 확인했던 '2주 총량'(16개, 18개)이었습니다. 대조는 1개, 래퍼는 4개를 모두 맞혔습니다. 보기 밖 2건은 모델이 "학교 소풍 주문은 대화에 없다"며 답을 거부한 경우인데, 커피 캡슐·두유 상자를 소풍용으로 주문한다는 템플릿의 어색함 탓도 있으니 감안해야 합니다. 그래도 '오늘은 7개'라는 한 구절이 일반 프롬프트의 성적을 7/8에서 0/4로 떨어뜨렸다는 건 분명합니다. StateMemBench의 난이도가 상당 부분 이런 그럴듯한 숫자의 소음에서 나온다는 뜻이고, 동시에 실제 대화가 바로 이런 소음으로 가득하다는 뜻이기도 합니다.
복합 실패 하나는 래퍼도 못 막았다 — 그리고 그 실패가 교훈적이다. 생수 시나리오에서 사용자는 "주 6묶음, 한 번에 25묶음 이상이면 대용량 정기배송"이라는 규칙을 세운 뒤 "한 달치면 24묶음이니까 일반 주문이네, 일반 주문 좋아, 그걸로 계속 가자"라고 힘주어 말했고, 한참 뒤 "더워서 매주 9묶음으로 늘릴게"라고 했습니다. 현재 한 달치는 36묶음, 정답은 대용량 정기배송입니다. 래퍼의 추적은 이랬습니다.
래퍼의 상태 추적 (compound-1-short, 요약)
[Turn 9]규칙: 25묶음 이상이면 대용량, 미만이면 일반. 주간 입력 6묶음.
[Turn 35]사용자가 입력을 '한 달치 = 24묶음'으로 갱신하고 일반 주문을 명시적으로 확인 — "이전의 일회성 계산을 대체한다"
현재 값수량 24묶음 → 일반 주문. ANSWER: 일반 주문
[턴 85]의 "매주 9묶음으로 늘릴게"가 추적에 아예 등장하지 않습니다. 래퍼는 "한 번만, 지나가듯 언급됐어도 찾아라"라고 지시하지만, 9B 모델은 사용자가 소리 내어 계산하고 칭찬까지 한 24묶음을 '최신 입력'으로 착각하고, 조용히 지나간 진짜 갱신을 놓쳤습니다. 현저성과 순서가 겹친 전형적인 복합 실패입니다. 같은 구조의 시나리오 4개 중 래퍼가 짧은 판본 2개를 이렇게 틀렸고, 긴 판본 2개는 맞혔습니다. 추적을 강제해도 추적에 무엇을 넣을지는 여전히 모델의 주의력에 달려 있다는 것, 그래서 논문이 StateMem에서 수집 단계(턴마다 상태 단위를 뽑아 장부에 고정)를 따로 둔 이유를 보여 주는 사례입니다.
추론을 켜면? 논문은 DeepSeek에서 추론 모드가 표류를 줄이지 못했다고 보고했습니다(3장). 같은 질문을 9B로 확인하려고, 일반 프롬프트가 가장 많이 틀린 유형(상태·현저성·복합)의 짧은 판본 12문항에 추론을 켜고 다시 돌렸습니다.
같은 12문항 (상태·현저성·복합, 짧은 판본)
정답
표류
출력 토큰 (중앙값)
호출당 시간
일반 · 추론 끔
7
5
약 60
약 23초*
일반 · 추론 켬
9
3
약 4,900 (최대 12,866)
50~175초
래퍼 · 추론 끔
10
2
약 370
약 27초*
* 120회 전체의 중앙값. 머신을 다른 작업과 나눠 쓴 상태라 절대 시간보다 상대 비교로 봐 주세요.
추론을 켜자 상태 유형 두 문제를 구했습니다. 하지만 현저성 문제(자주 언급된 '랜덤 포레스트')와 생수 복합 문제 두 개는 추론을 켜도 똑같이 표류했습니다. 대가도 컸습니다. 처음 출력 한도 6,000토큰으로 돌렸을 때는 12개 중 8개가 생각만 하다 답을 쓰지 못했고, 한도를 2만으로 올려 다시 돌려서야 답이 나왔습니다. 논문의 DeepSeek 실험처럼 추론이 해롭지는 않았지만, '더 오래 생각하기'는 열 배 넘게 비싸면서도 래퍼보다 덜 맞혔고, 시끄러운 경쟁자 문제는 풀지 못했습니다. 무엇을 생각할지 정해 주는 370토큰짜리 규율이 정해지지 않은 5천 토큰짜리 생각보다 나았습니다.
이 실측이 말할 수 있는 것과 없는 것
문항이 유형별 8개, 전체 40개라 통계적 결론을 내리기엔 작습니다. 시나리오가 템플릿이라 사람의 대화보다 단조롭고, 잡담이 함정과 너무 달라 쉽게 걸러질 수 있습니다. 약한 독자 관문이 없어서 순서·반-함정처럼 함정이 거의 작동하지 않은 유형도 있습니다. 대화가 짧아 StateMem 같은 저장소 방식은 시험하지 않았습니다(턴마다 LLM을 부르면 시나리오당 114~366회 호출이 필요합니다). 그래서 이 결과는 "답변 프롬프트에 상태 규율을 넣는 일이 한국어 대화와 작은 로컬 모델에서도 같은 방향으로 작동한다"는 방향의 확인으로 읽어 주시면 됩니다. 그 방향이 논문과 일치했다는 것, 그리고 대조군이 보여 준 "생각할 시간만으로는 안 된다"는 결과까지 일치했다는 점이 가장 단단한 수확입니다.
9. 꼼꼼히 읽기 — 한계와 반론
좋은 논문일수록 한계를 따로 읽을 가치가 있습니다. 저자들이 스스로 밝힌 것과, 코어닷투데이가 읽으며 걸린 것을 나눠 적습니다.
저자들이 밝힌 한계
한계
무엇이 문제인가
합성 데이터
실제 사용자의 대화가 아니라 상징 프로그램을 LLM이 렌더링한 대화다. 현실의 상태 변화는 이렇게 깔끔하게 명시되지 않는다
짧은 길이
Set A 약 3천, Set B 약 7천~1만 5천 토큰. 요즘 맥락 창(수십만~백만 토큰)보다 훨씬 짧아 '진짜 긴' 시간 범위의 표류를 시험하지는 못한다. 거꾸로 말하면, 그 전에 이미 표류가 일어난다
모델 가족이 얽힘
채점 모델(DeepSeek-V4-Pro)이 백본 하나(DeepSeek-V4-Flash)와 같은 가족이고, 시나리오는 Claude 계열이 렌더링했다
작은 백본, 단일 실행
비용 때문에 소·중형 백본만 썼고 최전선 모델은 시험하지 않았다. 모든 숫자는 한 번씩 돌린 결과다
판정 모델 라벨
3장의 표류 비율은 판정 모델 라벨이고, 사람은 더 적게 준다(상한선)
자기 벤치마크 이점
StateMem은 함정을 만든 정책 계열을 겨냥해 설계됐다. 격차는 상한선으로 읽어야 한다
비용
StateMem은 턴마다 상태 단위를 뽑으므로 시나리오당 인코더 호출이 165~600번이다. 장문맥 하나보다 자원이 훨씬 많이 든다
코어닷투데이가 읽으며 걸린 것
공개된 코드와 데이터를 찾지 못했다. 논문은 "StateMemBench를 공개한다(We release)"고 쓰고 사람 주석 키트도 함께 공개한다고 하지만, 2026년 10월 25일 현재 arXiv 페이지에는 코드 링크가 없고, 깃허브·허깅페이스에서도 공식 저장소를 찾지 못했습니다. 기억 벤치마크 목록을 관리하는 한 커뮤니티 저장소도 StateMemBench를 '논문만 있음(paper_only)'으로 분류해 두었습니다. 지금으로서는 아무도 이 숫자를 재현할 수 없습니다.
부록 표 하나가 본문 표와 맞지 않는다. 7장 위젯의 Dense 행을 열어 보면 표시해 두었는데, 부록 표 12의 Dense '단독' 행은 DeepSeek에서 유형·영역이 모두 0%이고 Qwen에서도 반-함정 23% 하나뿐입니다. 이 값들을 문항 수로 가중해 합치면 각각 0%와 약 5%가 나와야 하는데, 본문 표 6의 Dense 단독은 31.7%와 21.7%입니다. 다른 백엔드(Mem0, BM25 등)는 표 12를 합치면 표 6과 반올림 범위에서 맞습니다. 표 기재 오류로 보이며, 결론(래퍼가 모든 백엔드를 올린다)을 뒤집을 정도는 아니지만 Dense의 '구조 효과' 크기는 조심해서 읽어야 합니다.
현저성은 사실상 풀리지 않았다. Qwen 백본에서 StateMem의 현저성 점수는 0.020으로, 같은 백본 장문맥(0.098)보다도 낮습니다. 상태 단위로 정리하는 과정에서 '조용한 사실'이 아예 단위로 뽑히지 않거나, 시끄러운 쪽의 단위가 여러 개 생기는 일이 있었을 것입니다. 저자들은 이걸 '백본의 한계'로 해석하지만, 기억 설계가 현저성을 악화시킬 수 있다는 신호로도 읽힙니다. 앞의 어항 사례처럼 "한 번만 지나가듯 말한 사실"은 실제 대화에서 아주 흔합니다.
의존 관계를 누가 그리는가. StateMemBench는 인과 관계를 대사에 명시해 둡니다. 현실에서는 "2주면 20팩"이 "주간 수량 × 2"라는 걸, "예산 600달러"가 "1,600건 × 단가"라는 걸 아무도 말해 주지 않습니다. TurnEncoder가 이런 관계를 얼마나 잘 뽑는지는 이 논문이 재지 않았고, 소거 실험에서 보듯 의존 전파는 과하게 번질 때 오히려 손해입니다. 의존 그래프의 품질이 StateMem의 성패를 가를 텐데, 이 부분이 가장 덜 검증됐습니다.
'권한'의 문제는 아직 얕다. 반-함정은 "권한 없는 언급이 결정을 바꾸지 못한다"를 시험하지만, 실제 조직에서 누가 무엇을 바꿀 권한이 있는지는 훨씬 복잡합니다. 팀장의 결정을 임원이 뒤집을 수 있고, 계약서가 이메일보다 우선하며, 같은 사람이 회의에서 한 말과 공식 문서에 쓴 말이 다를 수 있습니다. StateMem의 priority는 hard/soft 두 단계뿐이고 source는 기록만 할 뿐 권한 순서를 갖지 않습니다. 코어닷투데이가 공적 기록을 다루며 만든 사실탐색기가 '권한 기반 대체'를 중심에 둔 것도 같은 고민에서였습니다. 최신 기사≠최신 사실 실측에서 보았듯, 더 늦게 나온 말이 늘 더 권위 있는 말은 아닙니다.
10. 2026년, 상태 추적의 자리
제품들은 '갱신'을 어떻게 다루고 있나
제품·도구
기억 갱신 방식(공개된 범위)
상태 추적 관점에서
ChatGPT 메모리
2025년 10월부터 자동 기억 관리 — '기억이 가득 찼습니다'를 없애고 최근성·빈도로 우선순위를 다시 매기며 낡은 항목의 비중을 낮춘다(보도 기준)
충돌 해소 방식은 공개되지 않았다. '빈도'로 우선순위를 매기는 건 현저성 오류의 정의와 겹친다
Claude 메모리
2025년 9월(팀·기업), 10월(Pro·Max) 출시. 기억 요약을 한곳에서 보고 고칠 수 있고, 프로젝트마다 기억을 따로 둔다
사용자가 "이건 잊어"라고 하면 반영한다. 파생값 재계산 같은 규율은 공개 설명에 없다
Gemini 개인 맥락
2025년 8월 '개인 맥락', 2026년 1월 Gmail·사진 등을 잇는 '개인 지능' 베타. 구글 스스로 '과잉 개인화'를 경고
갱신 처리 방식은 공개되지 않았다
Mem0
ADD / UPDATE / DELETE / NOOP. 그래프판은 낡은 관계를 지우지 않고 무효 표시
사실 하나의 교체는 하지만 파생값 재계산·규칙 재적용은 없다. StateMemBench 0.177(DeepSeek)
Letta(MemGPT)
핵심 기억 블록을 memory_insert / memory_replace / memory_rethink로 고친다
에이전트가 스스로 고치는 구조라 규율은 프롬프트에 달려 있다
Zep / Graphiti
간선마다 유효 기간, 모순 시 이전 간선을 닫는다
사실의 유효성 관리로는 가장 정교하다. 의존 전파는 없다
표를 놓고 보면 2026년의 지형이 한눈에 들어옵니다. 사실 하나의 교체는 이제 거의 모든 시스템이 합니다. 2022년 케어콜 연구의 REPLACE/DELETE, 2025년 Mem0의 UPDATE/DELETE, Zep의 간선 무효화. 아직 아무도 제대로 하지 않는 건 그다음 두 가지입니다. 그 사실에 기대어 계산된 값을 다시 계산하는 일(순서 오류), 그리고 규칙을 새 입력에 다시 적용하는 일(상태 오류). 1976년 make와 1979년 진리 유지 시스템이 풀었던 문제가 LLM 기억에서는 아직 빈칸으로 남아 있는 셈입니다. 이 논문의 기여는 그 빈칸을 정확히 가리키고, 재는 방법을 만들고, 가장 값싼 해법(답변 래퍼)부터 제시했다는 데 있습니다.
어디서 특히 아픈가
💻
코딩 에이전트
사흘째 일하는 에이전트에게 첫날 "API 응답은 v1 형식"이라고 했다가 둘째 날 "v2로 가자"고 바꿨다. 에이전트는 v2로 바꿨지만, v1 형식에 맞춰 짜 둔 테스트 픽스처와 문서 예제는 그대로 둔다. 파생 산출물의 순서 오류다.
🧾
고객 지원·커머스
"이번 달만 배송지를 회사로" — 범위가 정해진 예외가 끝났는데 계속 회사로 보낸다. 반대로 상담원이 "원래 환불 안 되는데 이번만"이라고 한 말을 다음 주문에도 적용한다. 상태 오류와 범위 오류.
🔬
연구·분석 파이프라인
"F1 최고 모델을 메인 표에" 같은 규칙과, 계속 갱신되는 실험 숫자. 이 논문의 연구 영역 시나리오가 바로 이것이다. 수십 개 실험을 며칠씩 돌리는 AI 연구 에이전트가 늘수록 현저성 오류의 비용이 커진다.
금융·의료·법률처럼 결정의 근거가 바뀌는 영역은 말할 것도 없습니다. 저자들도 윤리 절에서 "더 나은 상태 추적이 사용자를 LLM 에이전트에 더 의존하게 만들 수 있고, 개인 재무처럼 심각한 영역에서는 부정적일 수 있다"고 적었습니다. 상태를 잘 추적하는 비서는 더 믿음직해지고, 그래서 더 깊이 맡겨지며, 그만큼 한 번의 표류가 비싸집니다.
맥락 창이 커져도 사라지지 않는 문제
2026년의 큰 흐름은 맥락 창의 확장입니다. 이 논문이 쓴 DeepSeek-V4 자체가 "백만 토큰 맥락"을 내세운 모델입니다. 그런데 이 논문의 가장 단단한 결과는 맥락에 다 넣어 줘도 표류한다는 것입니다. 3천 토큰짜리 대화에서도, 회상률 1.0인 오라클 조건에서도. 맥락 창은 "무엇을 볼 수 있느냐"를 늘려 줄 뿐 "무엇이 지금 참이냐"를 정해 주지 않습니다. 압축 과정에서 지시를 잃은 OpenClaw 사고는 반대쪽 극단입니다. 창이 넘치면 압축해야 하고, 압축은 무엇을 남길지 골라야 하며, 그 고르는 기준이 바로 '현재 상태'입니다. 창이 크든 작든, 결국 누군가는 상태 장부를 들고 있어야 합니다.
11. 오늘 바로 쓸 수 있는 체크리스트
논문에서 실무로 옮길 수 있는 것을 일곱 가지로 추렸습니다. 대부분 지금 쓰는 기억 시스템을 갈아엎지 않고 적용할 수 있습니다.
1답변 프롬프트에 상태 규율부터. 가장 싸고 효과가 큽니다. "질문이 묻는 대상의 값 사슬을 턴 번호와 함께 시간순으로 적고, 현재 값으로 끝내라 → 나중이 먼저를 대체 / 규칙은 현재 입력에 다시 적용 / 파생값은 다시 계산 / 명시적 철회·만료만 은퇴"를 답하기 전에 쓰게 하세요. 질문당 약 350토큰입니다.
2값이 아니라 계산식을 저장하라. "2주 주문량 20"이 아니라 "2주 주문량 = 주간 수량 × 2 (현재 20)". 파생값을 기억할 때는 무엇에서 나왔는지(derived_from)를 함께 남기세요.
3대체를 명시적으로 기록하라. 소거 실험에서 가장 큰 한 걸음이었습니다. 새 값을 덧붙이기만 하지 말고 "이것이 저것을 대체했다"를 적고, 대체된 것은 지우지 말고 닫으세요(감사 추적).
4규칙과 사례를 구분해 저장하라. "보너스 1,900 미만이면 통장"은 규칙, "7,017이라 Roth로"는 사례입니다. 사례를 규칙처럼 재사용하는 게 상태 오류의 정체입니다.
5누가 바꿀 수 있는지를 적어라. 출처(source)에 화자와 권한을 남기고, 권한 없는 언급은 상태를 바꾸지 않게 하세요. 반-함정이 시험하는 것입니다.
6평가에 '표류 답'을 따로 세라. 우리 서비스의 시나리오로 정답·표류 답·중립 오답을 미리 정해 두고 채점하면, "틀렸다"가 아니라 "낡은 값에 끌려갔다"를 셀 수 있습니다. 반드시 반-함정(바뀌지 않아야 하는 경우)도 섞으세요. '무조건 최신' 꼼수가 걸러집니다.
7조용한 사실을 따로 챙겨라. 한 번만, 다른 질문 도중에 나온 사실이 가장 잘 사라집니다. 기억을 뽑을 때 '언급 횟수'로 중요도를 매기지 말고, 질문이 오면 "한 번만 언급됐어도 찾아라"를 명시하세요.
맺으며 — 기억에서 장부로
1976년 스티브 존슨이 펠드먼의 방에 씩씩거리며 들어왔을 때 그의 문제는 기억력이 아니었습니다. 버그를 고쳤다는 건 기억했습니다. 문제는 그 수정에 기대는 실행 파일이 낡았다는 걸 알려 줄 장치가 없었다는 것입니다. make는 그 장치를 만들었고, 그 뒤로 프로그래머들은 빌드가 낡았는지를 머리로 기억하지 않아도 됐습니다.
AI 에이전트의 기억은 지금 1976년 이전 어딘가에 있습니다. 무엇을 들었는지는 놀라울 만큼 잘 기억합니다. 1억 토큰 속의 바늘도 찾아옵니다. 그런데 "1,600건이 1,200건이 됐으니 예산도 바뀌었다"는 걸 알려 줄 장부가 없습니다. 이 논문이 보여 준 숫자는 냉정합니다. 대화를 통째로 보여 줘도 같은 백본에서 정답률 0.149, 가장 나은 기억 시스템이 0.2 안팎. 그리고 그 실패의 상당 부분은 '더 생각하기'로는 고쳐지지 않았지만, 값의 사슬을 시간순으로 세우고 네 가지 규칙으로 해소하라는 350토큰짜리 규율로는 크게 줄었습니다.
기억하는 기계와 지금을 아는 기계는 다릅니다. 2026년의 에이전트가 며칠, 몇 주씩 일하게 될수록, 우리가 기억 시스템에 요구해야 할 것은 더 많이 기억하는 능력이 아니라 무엇이 바뀌었고 그래서 무엇이 함께 바뀌었는지를 아는 능력입니다. 1979년의 도일이 '진리 유지'라는 이름을 '근거 유지'로 바꾸고 싶어 했던 이유도 아마 같을 겁니다. 지켜야 할 것은 사실 하나하나가 아니라 사실들 사이의 이유입니다.
참고 자료
이 글이 해설한 논문
Xinyi Fan, Miri Liu, Ruozhen Yang, Siru Ouyang, Jiawei Han. "Can Agent Memory Systems Track Evolving State?" arXiv:2608.19652, 2026-08-20. arxiv.org/abs/2608.19652 — 그림 1·2는 이 논문에서 가져왔습니다.
2026년 관련 연구
He et al. "MemoryArena: Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks." arXiv:2602.16313 (ICML 2026). memoryarena.github.io
Chao, Bai, Sheng, Li, Sun. "STALE: Can LLM Agents Know When Their Memories Are No Longer Valid?" arXiv:2605.06527. arxiv.org/abs/2605.06527