[특집] 기억의 교통정리 — MemAgent: '만능 메모리는 없다'는 발견과, 13개의 기억 중 하나를 고르는 4B 라우터
에이전트에게 기억을 달아 주는 방법은 이미 수십 가지다. 궤적 요약, 실패에서 뽑은 경고, 변수 자리를 비운 워크플로, 실행 가능한 파이썬 함수, 통찰의 그래프. 각자 자기 시험에서는 1등이라고 보고했다. 칭화대와 텐센트 연구진은 13개 방식을 같은 에이전트에 하나씩 붙여 세 개의 시험을 치르게 했고, 세 시험 모두에서 상위권에 드는 방식은 하나도 없다는 걸 확인했다. 그런데 '문제마다 맞는 기억을 골랐다면'의 점수는 89.6% — 최고의 단일 기억(71.0%)보다 18%p 이상 높았다. 그래서 그들은 더 나은 기억을 만드는 대신 기억을 고르는 4B 모델, MemAgent를 학습시켰다. 시작 전엔 13개 서랍을 살짝 열어 보고, 진행 중엔 메모를 보여 줄지 정하고, 끝나면 어느 서랍에 넣을지 고른다. 인지과학의 다중 기억 체계부터 SAT 솔버 포트폴리오의 '오라클', 2026년 ChatGPT·Claude·Mem0·Letta의 메모리 설계까지, 논문과 코드, 그림과 표를 바탕으로 인터랙티브 일곱 개와 함께 풀어본다.
이 글의 출처. Yongxian Wei, Yilin Zhao, Runxi Cheng, Xinrui Chen, Chun Yuan, Yaoru Wang, Jiahong Yan, Dian Li, 「MemAgent: Learning to Manage Heterogeneous Memory Providers for LLM Agents」, arXiv:2609.32521v1 (칭화대학교·텐센트, 2026년 9월 26일). 코드: github.com/WalkerWorldPeace/MemAgent (Apache-2.0). 본문의 그림 1~5와 표의 수치는 논문에서 옮겼고, 따로 표시한 계산과 비판은 이 글의 분석입니다.
이름이 같은 다른 논문 주의. 2025년 7월에 나온 「MemAgent: Reshaping Long-Context LLM with Multi-Conv RL-based Memory Agent」(Yu et al., arXiv:2507.02259, ICLR 2026 Oral)는 전혀 다른 연구입니다. 그쪽은 긴 문서를 조각내 읽으면서 고정 길이 메모를 덮어쓰는 방식으로 350만 토큰짜리 질의응답까지 늘린 '긴 문맥' 논문이고, 이번 논문은 여러 종류의 장기 기억 저장소 중 어디서 꺼내고 어디에 넣을지를 고르는 '기억 라우팅' 논문입니다. 이번 논문의 참고문헌에도 그 MemAgent가 Yu et al. 2026a로 올라 있습니다. 검색할 때 헷갈리기 쉬우니 arXiv 번호로 구분하세요.
프롤로그 — 매일 아침 처음부터 시작하는 신입 사원
어떤 회사에 아주 똑똑한 신입 사원이 들어왔다고 해 봅시다. 엑셀도, 웹 검색도, 보고서 작성도 척척 해냅니다. 문제는 하나입니다. 이 사람은 매일 아침 출근하면 어제 일을 전부 잊습니다. 어제 세 시간 헤매다 겨우 찾은 '그 사이트는 로그인 없이 CSV를 받을 수 있다'는 요령도, 그제 실수했던 '위키백과 편집 횟수 카운터는 페이지가 나뉘어 있어서 그대로 믿으면 안 된다'는 교훈도, 지난주에 만든 편리한 엑셀 매크로도 — 전부.
이것이 2026년에도 대부분의 LLM 에이전트가 처한 상황입니다. 논문의 첫 문장이 정확히 이 얘기입니다.
"현재의 에이전트는 과제와 과제 사이에서 대체로 무상태(stateless) 다. 매번의 호출이 백지에서 시작하며, 과거 경험이나 시간이 지나며 쌓인 전략을 재사용할 장치가 없다."
물론 우리는 이 신입 사원에게 업무 노트를 쥐여 줄 수 있습니다. 그런데 어떤 노트를 줘야 할까요? 여기서부터 이야기가 재미있어집니다. 사람은 실제로 여러 종류의 노트를 씁니다.
업무 일지 — "3월 4일, 거래처 A의 매출 자료를 찾느라 IR 페이지를 뒤졌고, 결국 공시 시스템에서 찾았다." (있었던 일을 그대로)
오답 노트 — "편집 횟수를 묻는 질문은 역사 화면 카운터를 믿지 말 것." (실패에서 뽑은 경고)
업무 매뉴얼(SOP) — "{회사명}의 {연도} 매출 찾기: ① 공시 시스템 접속 → ② 사업보고서 → ③ 손익계산서 표." (빈칸이 있는 절차)
엑셀 매크로 — 클릭 한 번이면 실행되는 코드. (실행 가능한 기술)
포스트잇 모음 — 모니터 옆에 붙은 짧은 요령들. 서로 연결돼 있기도 하다. (작은 통찰들의 그물)
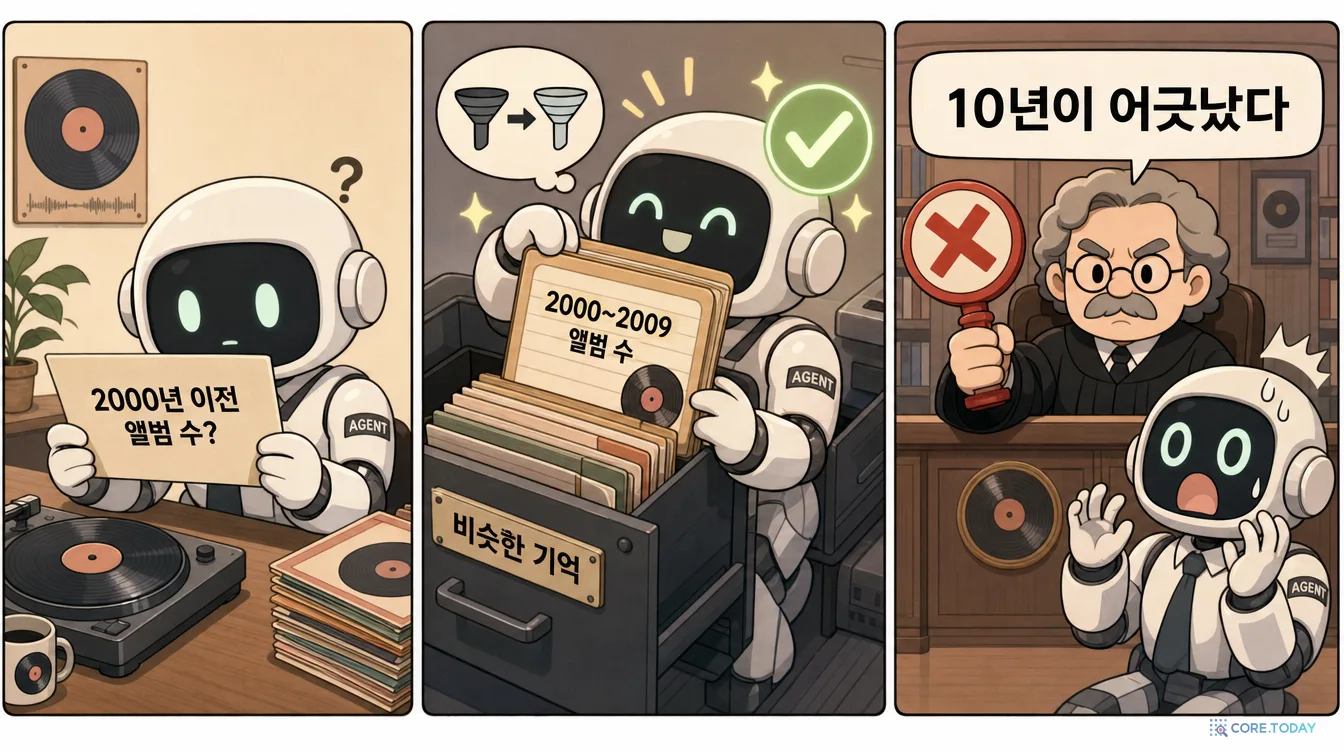
어떤 날은 업무 일지가 최고고, 어떤 날은 매크로가 최고입니다. 그리고 가끔은 비슷해 보이는 업무 일지가 오히려 독이 됩니다 — "2000~2009년 앨범 수"를 구했던 일지를 보고 "2000년 이전 앨범 수" 문제에 그 연도 범위를 그대로 베끼면 10년이 어긋난 답이 나오니까요(이 실제 사례는 §7에서 다룹니다).
이번 논문이 던지는 질문은 간단합니다.
어떤 하나의 기억 방식이 모든 종류의 과제에서 꾸준히 좋은가?
답은 "아니다"였습니다. 그리고 그 "아니다"에서 출발해, 연구진은 더 좋은 노트를 발명하는 대신 매번 어떤 노트를 펼칠지 골라 주는 비서를 훈련시켰습니다. 그 비서의 이름이 MemAgent입니다.
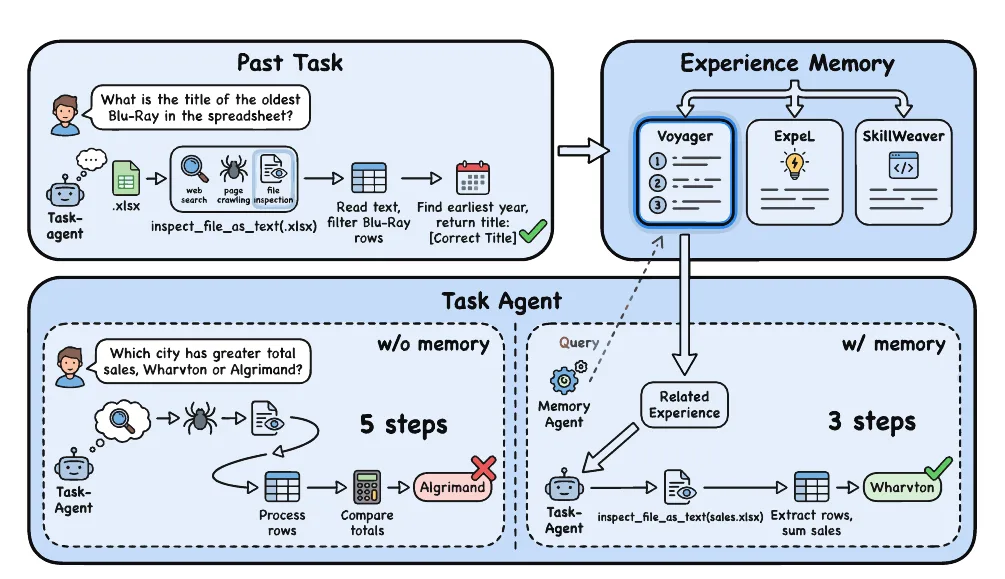
논문 그림 1이 이 아이디어를 한 장에 담고 있습니다. 위쪽 '과거 과제'에서 에이전트는 "스프레드시트에서 가장 오래된 블루레이의 제목은?"이라는 문제를 웹 검색 → 페이지 크롤링 → 파일 검사(inspect_file_as_text) 순으로 헤매다 풀었습니다. 이 경험은 오른쪽 '경험 기억'의 세 저장소(Voyager, ExpeL, SkillWeaver)에 각자의 방식으로 저장됩니다. 아래쪽 새 과제 "Wharvton과 Algrimand 중 총매출이 큰 도시는?"에서 기억이 없는 에이전트(왼쪽)는 또 검색부터 시작해 5스텝을 쓰고 틀린 답(Algrimand) 을 냅니다. 기억 에이전트가 Voyager 저장소에서 "엑셀 파일은 바로 inspect_file_as_text로 열어라"라는 관련 경험을 꺼내 준 오른쪽은 3스텝 만에 정답(Wharvton) 에 도착합니다.
한눈에 보는 핵심 숫자
MemAgent (arXiv:2609.32521) — 핵심 수치
13개 기억 방식을 같은 인터페이스로 묶어 세 시험(GAIA·WebWalkerQA·xBench-DS)에서 하나씩 평가 → 세 시험 모두에서 최고인 방식은 없음
문제마다 '맞힌 기억이 하나라도 있으면 정답'으로 치는 사후 오라클: 평균 89.6% vs 최고의 단일 기억(ExpeL) 71.0%
MemAgent(Qwen3.5-4B + LoRA 라우터): 평균 75.7% — 기억 없음(65.7%) 대비 +10.0%p, 세 시험 모두에서 13개 단일 기억을 전부 앞섬
비용: 라우팅 지연 과제당 ~1.2초(수행 시간의 0.3% 미만), 끼워 넣는 기억 ~1.2K 토큰(전체의 0.5% 미만)
효율: 평균 스텝 9.1 → 8.0 (−12%), 가장 어려운 GAIA Level 3는 12.3 → 10.7
1. 왜 이런 개념이 나왔나 — 기억은 원래 하나가 아니었다
1-1. 사람의 기억도 '여러 개의 기억'이다
"기억"이라는 단어 하나로 부르지만, 인지과학은 반세기 넘게 기억이 여러 개의 서로 다른 체계라고 말해 왔습니다.
1968년, 앳킨슨과 시프린의 다중 저장 모형(multi-store model). 감각 기억 → 단기 기억 → 장기 기억이라는 서로 다른 저장소가 있고, 정보는 그 사이를 옮겨 다닌다는 모형입니다. 이름부터 '여러 저장소'입니다.
1972년, 툴빙의 일화 기억 vs 의미 기억. "지난 화요일 회의에서 무슨 일이 있었나"(일화)와 "파리는 프랑스의 수도"(의미)는 다른 체계가 다룬다는 구분입니다.
1974년, 배들리와 히치의 작업 기억(working memory). 단기 기억을 그냥 '잠깐 보관하는 상자'가 아니라, 지금 하고 있는 일에 필요한 정보를 붙잡고 조작하는 작업대로 다시 정의했습니다.
1980년대, 절차 기억(procedural memory). 자전거 타는 법처럼 말로 꺼낼 수 없지만 몸이 아는 기억. 기억상실증 환자 H.M.이 새로운 사건은 기억 못 하면서도 거울 보고 그리기 같은 기술은 날마다 늘었다는 관찰이 이 구분을 굳혔습니다.
이 구분이 왜 중요할까요? 각 체계가 잘하는 일이 다르기 때문입니다. 어제 회의 내용을 떠올리는 데는 일화 기억이, 처음 가 보는 도시에서 지하철을 타는 데는 '지하철은 대개 이렇게 탄다'는 절차적·의미적 지식이 필요합니다. 하나의 체계로 모든 걸 하려 하지 않는 게 인간 기억의 설계입니다. LLM 에이전트의 기억 연구도 결국 같은 결론으로 수렴하는데, 이번 논문은 그걸 실험으로 보여 준 셈입니다.
1-2. LLM 에이전트 기억의 짧고 폭발적인 역사
LLM 에이전트에 기억을 달아 주려는 시도는 2023년에 한꺼번에 터져 나왔습니다. 흥미로운 건 거의 모든 연구가 서로 다른 '저장 단위' 를 골랐다는 점입니다. 이번 논문의 13개 기억 방식 대부분이 이 계보에서 왔습니다.
2023 · 봄
Reflexion(Shinn 외, NeurIPS 2023) — 실패하면 말로 된 반성문을 써서 다음 시도에 붙인다. 가중치를 안 바꾸고도 HumanEval pass@1 91%(당시 GPT-4 80%). Generative Agents(Park 외, UIST 2023) — 가상 마을 주민 25명의 '기억 흐름(memory stream)'. 최근성·중요도·관련성 세 점수로 기억을 꺼낸다. 이번 논문의 'Generative' 기억이 이것.
2023 · 여름
Voyager(Wang 외) — 마인크래프트 에이전트가 성공한 행동을 실행 가능한 코드 스킬 라이브러리로 쌓는다. 이전 최고 대비 고유 아이템 3.3배. (이번 논문의 'Voyager' 기억은 원작의 코드 라이브러리가 아니라 '정제한 궤적 요약 + 임베딩'으로 구현돼 유사 검색 계열로 분류됩니다.) MemoryBank(Zhong 외, AAAI 2024) — 에빙하우스 망각 곡선으로 기억을 흐리게 한다. ExpeL(Zhao 외, AAAI 2024) — 성공과 실패 모두에서 자연어 '통찰'을 뽑아 쌓는다.
2023 · 가을
MemGPT(Packer 외) — 운영체제의 가상 메모리처럼, 짧은 문맥 창과 바깥 저장소 사이로 정보를 '페이징'한다. 나중에 회사 Letta가 된다.
2024
Agent Workflow Memory, AWM(Wang, Mao, Fried, Neubig, ICML 2025) — 성공한 궤적에서 고유명사를 변수로 바꾼 워크플로 템플릿을 귀납한다. WebArena 상대 +51.1%, Mind2Web 상대 +24.6%.
2025
SkillWeaver(Zheng 외) — 웹 에이전트가 스스로 스킬을 파이썬 API로 만든다. Dynamic Cheatsheet(Suzgun 외) — 시험 보면서 고쳐 쓰는 커닝 페이퍼 한 장. GPT-4o의 24 게임 정답률 10% → 99%. A-MEM(NeurIPS 2025) — 제텔카스텐식 연결 노트. Mem0 — 사실 추출 + 그래프. ReasoningBank(Google, ICLR 2026) — 성공·실패에서 추론 전략을 증류.
2026
'기억 설계 자체'를 자동화하려는 흐름. MemEvolve(arXiv:2512.18746, ICML 2026) — 기억의 내용뿐 아니라 기억 아키텍처를 진화시키며 12개 기억 시스템을 공통 코드베이스(EvolveLab)로 묶었다. ALMA(Xiong, Hu, Clune) — 메타 에이전트가 코드로 쓰인 기억 설계를 탐색. 그리고 9월, MemAgent — "하나의 최고 설계"를 찾는 대신 여러 설계 사이를 라우팅.
이 연대기를 보면 패턴이 보입니다. 모두가 "더 좋은 저장 단위"를 찾고 있었습니다. 궤적 요약(Voyager의 요약 메모리, DILU), 반성문(Reflexion), 통찰(ExpeL), 템플릿(AWM), 절차 스크립트(Memp), 코드(SkillWeaver), 그래프(A-MEM, Mem0 그래프)… 그리고 각 논문은 자기가 고른 벤치마크에서 이득을 보고했습니다.
1-3. "각자 자기 시험에서는 1등"이라는 함정
여기에 함정이 있습니다. 비유하자면 이렇습니다. 학생 13명이 각자 다른 과목 시험을 치고 "제 공부법이 최고입니다"라고 발표합니다. 수학 시험 본 학생은 오답 노트가, 영어 시험 본 학생은 단어장이, 코딩 시험 본 학생은 코드 스니펫 모음이 최고라고 하죠. 다 맞는 말일 수 있습니다. 하지만 같은 시험지를 13명에게 동시에 풀려 본 적은 없습니다.
논문은 바로 그 실험을 합니다. 13개 기억 방식을 같은 작업 에이전트(Flash-Searcher 프레임워크 + GPT-5-mini, 도구 4개: 웹 검색·페이지 크롤링·이미지 분석·오디오 받아쓰기)에 같은 인터페이스(꺼내기 retrieve / 저장하기 store)로 하나씩 꽂고, 같은 세 시험을 치르게 했습니다. 이 통일 작업은 MemEvolve의 EvolveLab 코드베이스를 이어받았다고 저장소 README에 밝혀져 있습니다.
2. 만능 기억은 없다 — 13개 방식의 성적표
2-1. 세 개의 시험
시험
무엇을 재나
이 논문에서 쓴 규모
스텝 상한
GAIA (Mialon 외, ICLR 2024)
웹·파일·이미지·계산을 섞어 쓰는 '일반 비서' 문제. 원 논문에서 사람 92% vs 플러그인 단 GPT-4 15%
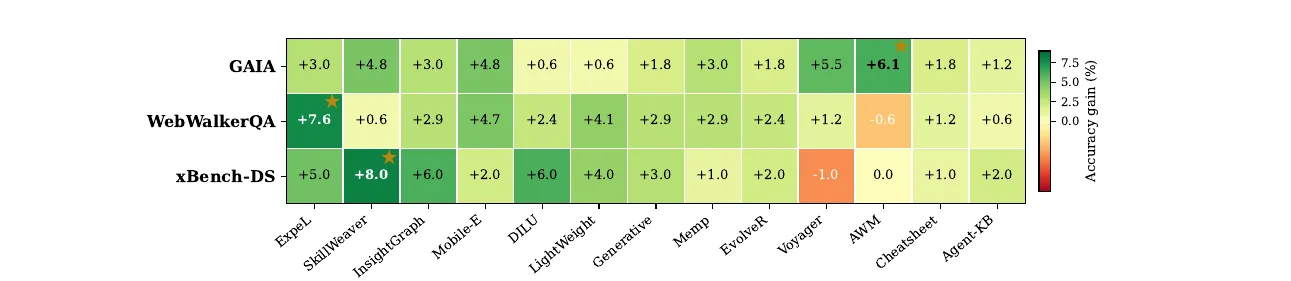
그림 2는 13개 기억을 세 시험에 하나씩 붙였을 때 '기억 없음' 대비 정확도가 몇 %p 올랐는지를 색으로 칠한 표입니다. 초록이 진할수록 많이 오른 것이고, 주황은 오히려 떨어진 것입니다. 별(★)이 각 시험의 1위입니다. 찬찬히 보면 놀라운 점이 세 가지 있습니다.
세 개의 별이 세 개의 다른 열에 있습니다. GAIA 1위는 AWM(+6.1), WebWalkerQA 1위는 ExpeL(+7.6), xBench-DS 1위는 SkillWeaver(+8.0). 논문 표현으로 "어떤 방법도 두 개 이상의 벤치마크에서 1위를 하지 못한다."
1위가 다른 시험에선 마이너스입니다. GAIA 1위 AWM은 WebWalkerQA에서 −0.6, 기억이 없을 때보다 못합니다. GAIA 2위 Voyager(+5.5)는 xBench-DS에서 −1.0입니다.
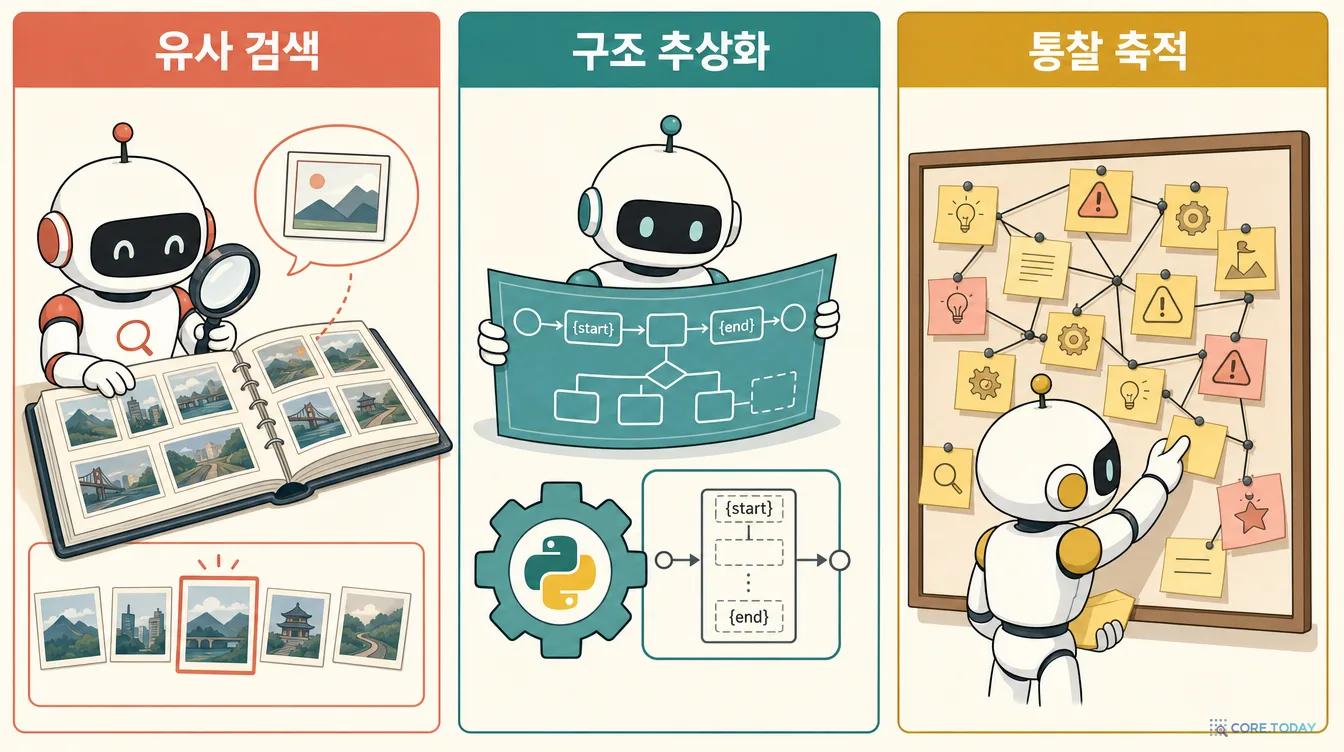
세 계열이 골고루 1위를 나눠 가졌습니다. AWM(구조 추상화), ExpeL(통찰 축적), SkillWeaver(구조 추상화 중에서도 실행 코드). 유사 검색 계열은 1위가 없지만 DILU가 xBench-DS 공동 2위(+6.0)입니다.
논문은 이것을 "보편적 기억이라는 환상(the illusion of a universal memory)" 이라고 부릅니다. 결론은 단호합니다. "과제마다 선호하는 기억 표현이 다르므로, 단순히 '더 나은' 단일 기억을 설계하는 것으로는 이 간극을 메우기 어렵다."
흔한 단어가 검색 상위를 채움(어휘 홍수), 단어가 안 겹치면 못 찾음, 그래프 허브 오염
핵심은 마지막 두 줄입니다. 각 계열이 무너지는 자리가 다른 계열이 강한 자리와 정확히 맞물립니다. 유사 검색이 표면에 속을 때 구조 추상화는 빈칸을 다시 채우게 만들고, 구조 추상화가 경고를 못 할 때 통찰 축적은 실패 경험을 내밉니다. 이 상보성(complementarity)이 라우팅이라는 아이디어의 연료입니다.
3. 89.6%라는 유혹 — 기억 문제를 '라우팅 문제'로 다시 쓰기
3-1. 사후 오라클: "문제마다 맞는 기억을 골랐다면"
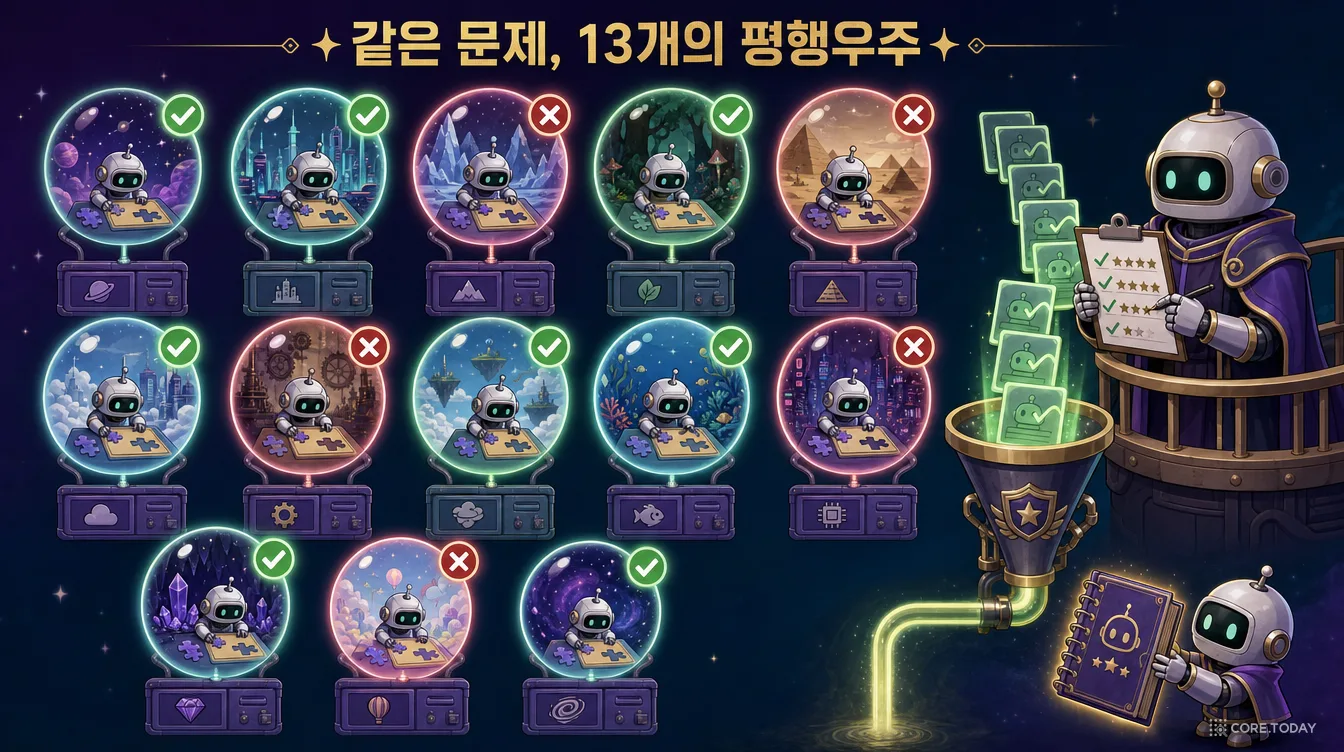
논문은 여기서 흥미로운 계산을 하나 합니다. 각 문제에 대해 13개 기억 중 하나라도 맞혔으면 그 문제는 풀린 것으로 친다. 이른바 사후(hindsight) 오라클입니다. 시험이 끝난 뒤 답안지를 보고 "이 문제는 ExpeL로 풀었으면 맞았네, 저 문제는 AWM이었으면 맞았네" 하고 문제마다 최선의 선택을 골라 주는 셈이죠.
기억 없음
65.7%
최고의 단일 기억 (ExpeL)
71.0%
MemAgent (학습한 라우터)
75.7%
오라클 (13개 중 사후 최선)
89.6%
세 시험 평균으로 오라클은 89.6%, 최고의 단일 기억은 71.0% 입니다. 18%p가 넘는 차이가 '고르기만 잘하면' 주워 담을 수 있는 땅처럼 보입니다. 게다가 13개 중 10개가 적어도 한 문제는 혼자만 풀었습니다. 쓸모없는 기억이 거의 없다는 뜻입니다.
이 계산이 논문의 전환점입니다. 저자들의 표현으로 "에이전트 메모리는 단 하나의 최적 형식을 찾는 문제라기보다, 이질적인 기억 제공자(memory provider)들 위의 라우팅 문제에 가깝다."
3-2. 이 발상은 처음이 아니다 — 1976년의 '알고리즘 선택 문제'
컴퓨터 과학에는 이 상황에 딱 맞는 오래된 이름이 있습니다. 1976년 존 라이스(John Rice)가 정식화한 알고리즘 선택 문제(Algorithm Selection Problem) 입니다. "여러 알고리즘이 있고, 문제마다 가장 잘 푸는 알고리즘이 다르다. 문제의 특징을 보고 어떤 알고리즘을 쓸지 고르는 함수를 만들 수 있을까?"
이 발상이 가장 화려하게 꽃핀 곳은 SAT 솔버(논리식 만족 가능성 문제를 푸는 프로그램) 분야입니다. 2008년 JAIR에 실린 SATzilla(Xu, Hutter, Hoos, Leyton-Brown) 논문의 문장을 읽어 보면 이번 논문과 놀랄 만큼 닮았습니다.
"지배적인 단 하나의 SAT 솔버는 없다. 대신 서로 다른 솔버가 서로 다른 인스턴스에서 가장 좋다."
SATzilla는 '승자 독식'을 거부하고, 문제의 특징을 보고 여러 솔버 중 하나를 고르는 포트폴리오를 만들어 2007년 SAT 대회에서 금 3·은 1·동 1을 땄습니다. 그리고 이 분야는 성능의 상한으로 오라클, 나중에 가상 최선 솔버(VBS, Virtual Best Solver) 라고 부르게 되는 개념을 씁니다 — "인스턴스마다 최선의 솔버만 돌렸다고 가정한 가상의 시스템". 그 반대편 기준은 단일 최선 솔버(SBS, Single Best Solver), 평균이 가장 좋은 솔버 하나입니다.
이번 논문의 숫자를 이 언어로 옮기면 이렇습니다.
알고리즘 선택 용어
MemAgent 논문
값 (세 시험 평균)
단일 최선 솔버 (SBS)
최고의 단일 기억 (ExpeL)
71.0%
학습한 선택기
MemAgent
75.7%
가상 최선 솔버 (VBS, 오라클)
사후 오라클 (13개)
89.6%
SBS–VBS 간극 18.6%p 중 MemAgent가 메운 건 4.7%p, 약 4분의 1입니다. 알고리즘 선택 분야의 오랜 경험으로 보면 이건 흔한 모습입니다. 오라클은 늘 멀리 있고, 좋은 선택기는 그 간극의 일부를 메운다. 그리고 그 간극의 크기 자체가 '포트폴리오에 다양성이 있다'는 증거입니다.
비슷한 계보는 신경망 안에도 있습니다. 1991년 제이콥스·조던·노울런·힌턴의 전문가 혼합(Mixture of Experts) 은 입력을 보고 어떤 '전문가' 네트워크에 맡길지 정하는 게이트를 함께 학습했고, 2017년 섀지어 외의 희소 게이트 MoE는 이를 수천 개 전문가로 키웠습니다. 2023~2024년의 FrugalGPT, RouteLLM 은 질문마다 비싼 LLM과 싼 LLM 중 무엇을 부를지 고르는 라우터로 비용을 크게 줄였습니다. MemAgent는 이 '라우팅' 계보를 모델이 아니라 기억 저장소 에 적용한 것입니다.
3-3. 라우터가 진짜로 일할 땅은 어디인가
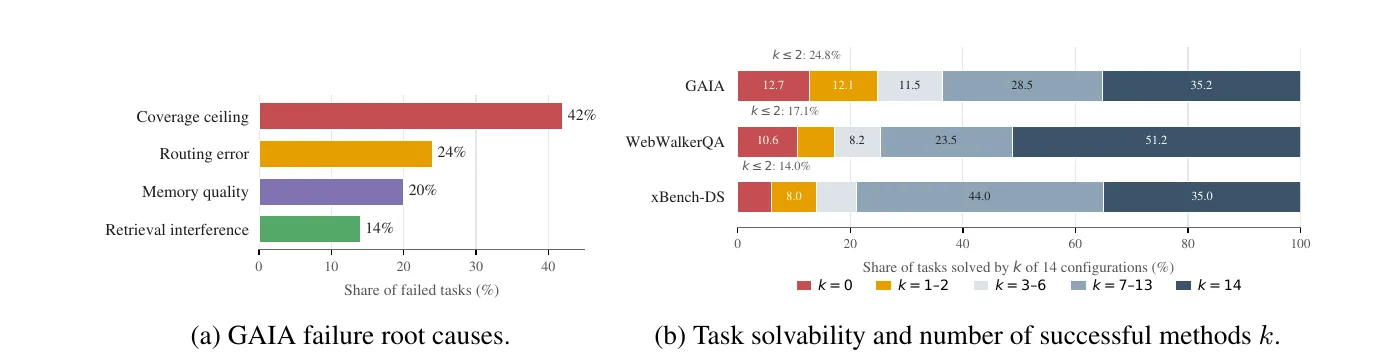
그렇다면 18%p의 땅은 어디에 있을까요? 논문 부록의 표 13은 각 문제를 '14개 구성(기억 13개 + 기억 없음) 중 몇 개가 풀었나(k)'로 나눠 보여 줍니다. 라우터가 점수를 버는 곳은 k가 작은 구간 — 한두 개 기억만 푸는 '라우팅이 결정적인(routing-critical)' 문제 입니다.
시험마다 라우팅의 가치가 다르다. GAIA는 k ≤ 2 구간이 24.8%로 가장 넓습니다 — 라우터가 '가능성의 가장자리'에서 일합니다. 반면 xBench-DS는 79%가 7개 이상의 구성으로 풀리는, 넓게 덮인 시험이라 라우팅은 주로 점수를 '재분배'합니다.
MemAgent가 틀린 이유의 42%는 라우터 탓이 아니다. 13개 기억도, 기억 없음도 못 푸는 '커버리지 천장'입니다. 진짜 라우팅 오류는 24%, 고른 기억은 맞았는데 꺼낸 내용이 부실한 '기억 품질'이 20%, 기억 없이 풀던 문제를 끼워 넣은 기억이 망친 '검색 간섭'이 14%입니다.
이 글의 분석 — 오라클을 조금 덜 믿어야 하는 이유. 사후 오라클은 '13번 시도해서 한 번이라도 맞으면 정답'과 같은 계산입니다. LLM 에이전트는 같은 문제를 같은 설정으로 다시 풀어도 결과가 흔들리기 때문에, 기억 없이 같은 에이전트를 13번 돌려도 이런 식의 '한 번이라도 맞음' 점수는 단일 실행보다 꽤 높게 나옵니다(pass@k 효과). 그러니 89.6%와 71.0%의 차이 전부가 '기억 선택'으로 얻을 수 있는 몫은 아닙니다. 논문은 이 대조군(기억 없음 × 13회)을 보고하지 않습니다. 오라클은 '선택으로 얻을 수 있는 이론적 상한'이라기보다 '다양성 + 운의 상한'으로 읽는 게 안전합니다. 이 점은 §8에서 다시 다룹니다.
3-4. 고르는 일이 어려운 진짜 이유 — 공을 누구에게 돌릴까
라우팅이 좋다는 건 알겠는데, 왜 그냥 "이 문제엔 이 기억"이라고 가르치면 안 될까요? 그런 정답 라벨이 세상에 없기 때문입니다. 그리고 결과로부터 거꾸로 추론하기도 어렵습니다. 논문은 이를 신용 할당(credit assignment) 문제라고 부릅니다.
과제가 성공했을 때, 그게 시작할 때 고른 장기 기억 덕인지, 중간에 끼워 넣은 단기 메모 덕인지, 그냥 작업 에이전트가 잘해서 인지 알 수 없습니다.
더 고약한 건 저장 결정입니다. 오늘 이 궤적을 ExpeL에 넣을지 AWM에 넣을지의 결과는 며칠 뒤 다른 과제가 그 기억을 꺼내 쓸 때 에야 드러납니다. 지연된 피드백이죠.
MemAgent의 두 기둥 — 내용을 보고 고르는 라우팅 구조(§4)와, 정답 라벨 없이 감독 신호를 만드는 데이터 합성(§5) — 은 이 두 어려움에 대한 답입니다.
4. MemAgent의 구조 — 시작 전, 진행 중, 끝난 뒤
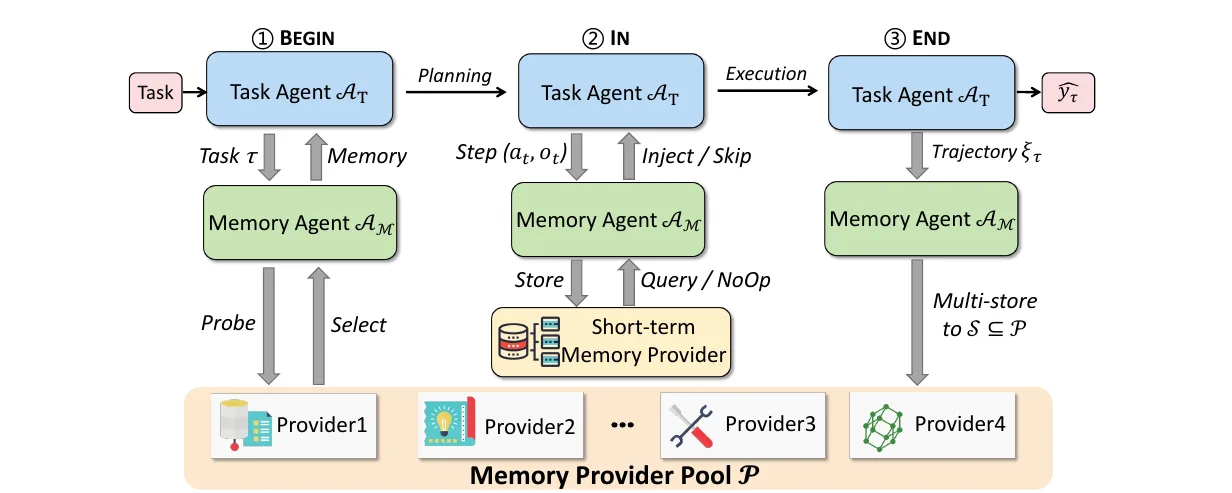
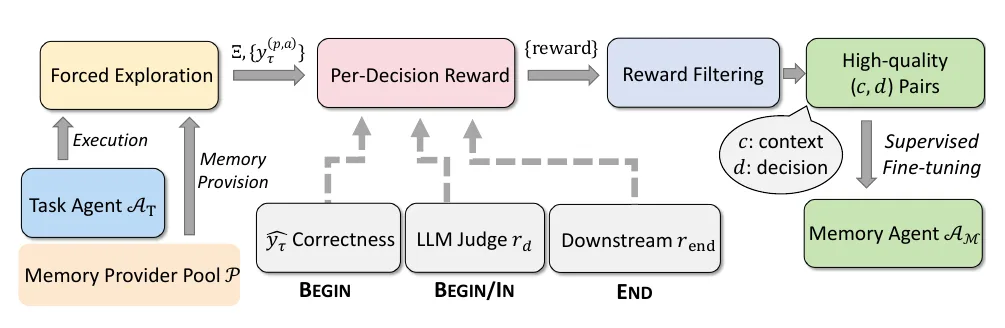
MemAgent에는 두 에이전트가 있습니다. 실제로 문제를 푸는 작업 에이전트 AT (GPT-5-mini)와, 기억을 관리하는 기억 에이전트 AM (Qwen3.5-4B + LoRA)입니다. 기억 에이전트는 과제 하나의 생애 동안 세 번, 성격이 다른 결정을 내립니다.
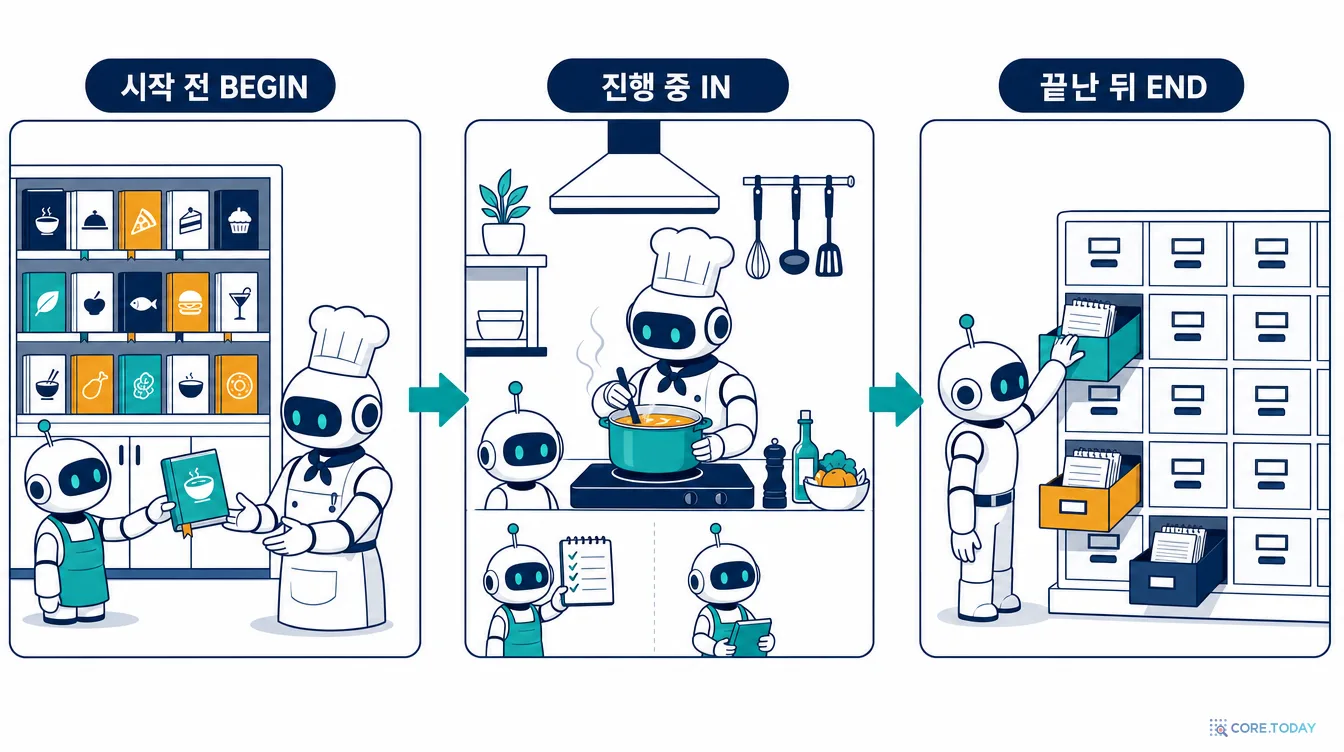
BEGIN(시작 전) — 요리를 시작하기 전, 보조 셰프가 서가에서 레시피 책 한 권을 골라 셰프에게 건넵니다. 장기 기억 13개 중 하나에서 꺼내 작업 에이전트의 시스템 프롬프트에 넣습니다.
IN(진행 중) — 요리하는 동안 보조 셰프는 '지금까지 손질한 재료, 이미 써 본 양념' 메모를 들고 서 있다가, 필요할 때만 보여 줍니다. 매 스텝마다 단기 기억을 주입(QUERY)할지 건너뛸지(NO_OP)를 정합니다.
END(끝난 뒤) — 요리가 끝나면 오늘의 기록을 몇 개의 서랍에만 정리해 넣습니다. 13개 중 부분집합S⊆P를 골라 궤적을 저장합니다.
수식으로 쓰면 기억 에이전트는 결정 맥락 c가 주어졌을 때 결정 d를 내리는 정책 AM(d∣c)이고, 목표는 과제 성공률의 기댓값 maxAMEτ[yτ]를 키우는 것입니다. 그리고 모든 기억 제공자는 retrieve와 store라는 두 동작만 가진 공통 인터페이스 뒤에 숨어 있습니다. 라우터는 각 기억의 내부 구현을 몰라도 됩니다 — 마치 USB 포트처럼.
아래 시뮬레이터로 세 결정을 직접 내려 보세요.
4-1. BEGIN — 점수 말고 '내용'을 보고 고른다
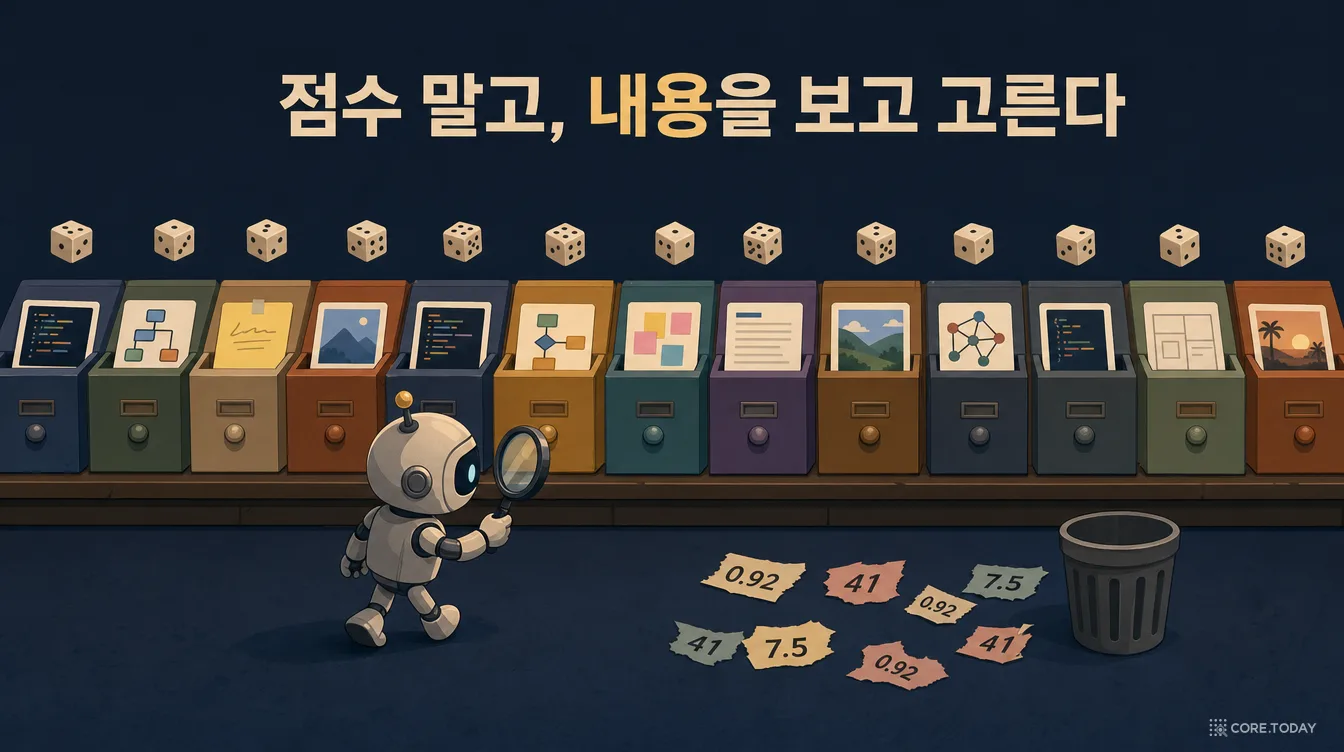
가장 순진한 라우터는 과제 설명과 각 기억의 소개 문구("이 기억은 워크플로 템플릿을 저장합니다")만 보고 고르는 것입니다. 논문은 이게 믿을 수 없다고 봅니다(Fioresi 외, ICML 2026 인용). 중요한 건 그 기억에 지금 이 과제와 관련된 내용이 실제로 들어 있느냐이기 때문입니다. 소개 문구가 그럴듯해도 서랍이 비어 있으면 소용없죠.
그래서 MemAgent는 고르기 전에 13개 서랍을 모두 살짝 열어 봅니다(probing). 각 기억에 과제를 질의로 보내 가장 관련 있는 기억의 짧은 미리보기를 받아 오고, 이걸 결정 맥락에 넣습니다. 이때 두 가지 장치가 붙습니다.
점수를 지운다. 기억마다 검색 점수의 단위가 다릅니다 — 어떤 건 코사인 유사도(0~1), 어떤 건 항목 개수, 어떤 건 LLM이 매긴 중요도(1~10). 이걸 그대로 보여 주면 모델은 내용을 읽는 대신 "숫자 큰 걸 고르자"는 지름길 을 배웁니다. 실제로 점수를 보여 주자 선택의 51.8%가 단 두 기억에 쏠렸습니다(부록 C.3.2). 표 2의 GAIA 실험에서 점수를 남겨 두면 63.0%, 지우면 69.7%였습니다.
순서를 섞는다. LLM은 목록에서 앞쪽 항목을 고르는 위치 편향이 있습니다. 후보 순서를 매번 무작위로 섞어 이를 없앱니다.
프로브는 비싸지 않습니다. 13개 기억 모두 프로브 단계에서는 LLM을 부르지 않고 임베딩이나 키워드 조회만 하도록 만들어서, 병렬로 약 75ms 입니다. 실제 BEGIN 프롬프트(부록 Listing 1)는 이렇게 생겼습니다.
text
[Memory Probe Results -- Actual Content Preview]
(Each provider was probed with your task query.)
### memp (42 items)
  Use web_search to find the target page, then crawl...
### expel (18 items)
  Insight: For spreadsheet tasks, use inspect_file...
... (all 13 providers, randomly shuffled, no scores)

Output format:
{"action": "query", "provider": "<provider_name>"}
출력은 JSON 한 줄입니다. "과제 자체를 풀지 말라"는 지시도 들어 있습니다 — 4B 모델이 라우터 노릇 대신 답을 쓰려 들지 않도록.
4-2. IN — 메모는 '필요할 때만' 보여 준다
두 번째 결정은 진행 중의 단기 기억(작업 기억) 입니다. 여기서 의문이 하나 생깁니다. 작업 에이전트는 이미 지금까지의 대화 기록 전체를 보고 있는데, 왜 따로 단기 기억이 필요할까요?
논문의 답은 이렇습니다. 대화 기록에는 원재료가 다 있지만, "지금까지 어떤 URL을 가 봤지? 확인된 사실은 뭐였지?" 같은 스텝을 가로지르는 요약을 매번 원시 도구 호출 로그에서 뽑아내는 건 비효율적입니다. 긴 과제에서 열 번째 스텝쯤 되면 세 번째 스텝에서 찾은 숫자가 로그 깊숙이 묻힙니다. (긴 문맥에서 성능이 고르지 않게 떨어지는 '컨텍스트 부패(context rot)' 현상은 Chroma의 2025년 보고서가 18개 모델에서 확인한 바 있습니다.)
그래서 논문은 규칙 기반 단기 기억 제공자 를 새로 만들었습니다. 특징은 세 가지입니다.
LLM을 쓰지 않는다. 정규식 5종으로 사실("Population: 21.54 million" 같은 키-값, 명시적 답, 설립일, 좌표, "X는 Y다")을 스텝당 최대 3개 뽑고, 단어 단위 자카드 유사도 0.6 초과면 중복으로 버립니다. 결정론적이고 지연이 거의 없습니다.
세 개의 칸, 각각 용량 제한. 확인된 사실(활성 15개), 방문 URL(30개, 도구·스텝·성공 여부 기록), 검색 이력(20개). 별도로 14개 정규식이 도구 실패(접근 거부, 404, 시간 초과, 요청 제한, 결과 없음)를 관찰 앞 500자에서만 분류합니다 — 본문 내용을 오류로 오인하지 않도록.
보수적 표시 정책. 칸마다 최소 개수가 차기 전에는 아예 보여 주지 않습니다.
칸
보여 주는 최소 개수
최대 표시
우선순위
» 수집한 사실 (Collected Data)
2개
8개
최우선
:: 방문한 페이지 (Pages Visited)
3개
15개
중간
?? 최근 검색 (Recent Searches)
4개
8개
최하
세 칸이 모두 최소치에 못 미치면 빈 응답 을 돌려줍니다. "성긴 메모를 끼워 넣느니 대화 기록에 맡기는 게 낫다"는 판단입니다. 글자 예산을 넘으면 칸 경계에서 자릅니다 — 반쯤 잘린 칸이 없도록.
이 위에서 기억 에이전트가 매 스텝 QUERY/NO_OP를 정합니다. 실제 행동 통계가 재미있습니다. GAIA 165문항, IN 결정 1,102번 중 QUERY는 30.4% 뿐이었고, 0스텝은 단기 기억이 비어 있으니 늘 NO_OP, 기억이 쌓인 5~6스텝에서 QUERY 비율이 55~71% 까지 올랐다가 다시 줄었습니다. 그리고 단기 기억의 내용이 이미 최근 대화에 보이면 NO_OP 를 골랐습니다. 사람 비서가 "그건 방금 보셨잖아요"라며 메모를 안 내미는 것과 같습니다.
4-3. END — 아무 데나 넣지 않는다
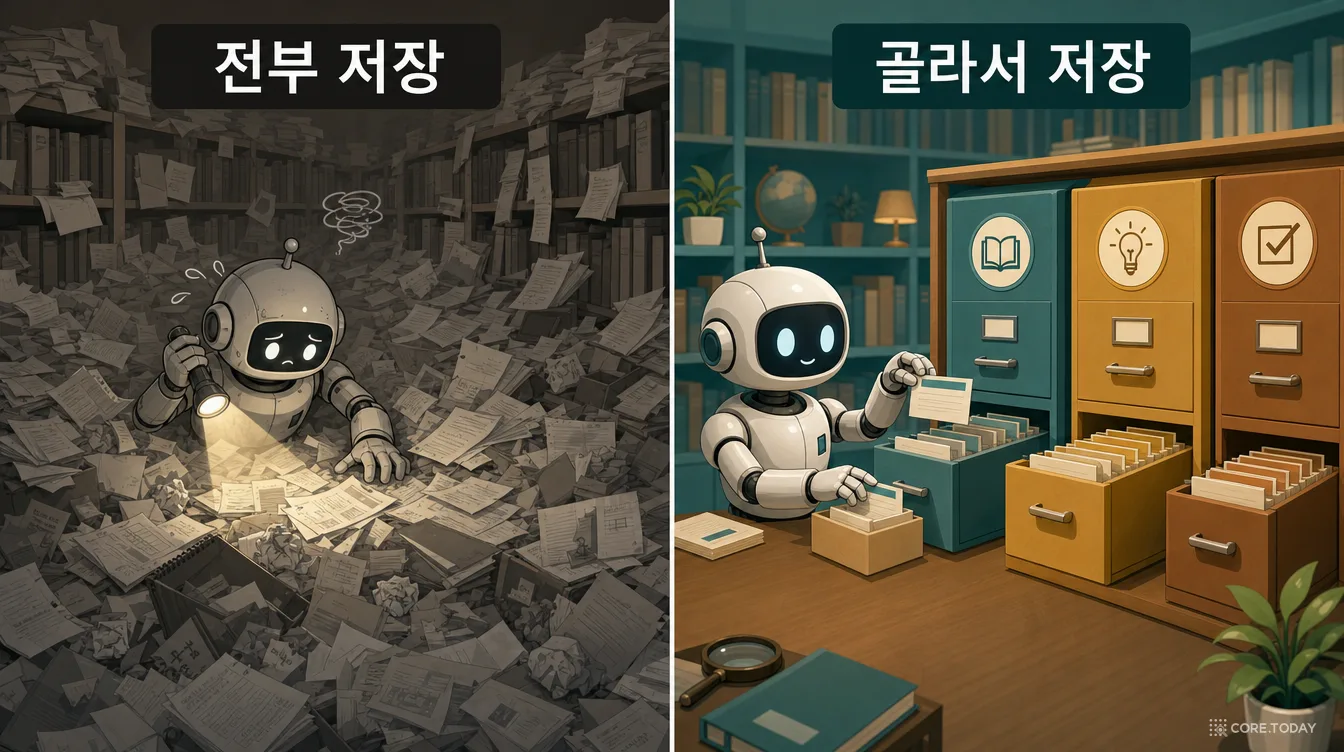
세 번째 결정은 저장입니다. "많이 저장할수록 좋지 않나?" 싶지만, 논문의 실험은 반대를 말합니다. 모든 궤적을 13개 기억 전부에 저장하는 '전부 저장(all-store)' 설정은 GAIA에서 65.5% 였고, 골라서 저장하는 MemAgent는 69.7% 였습니다(표 3). 이유는 기억 오염(memory pollution) 입니다. 질 낮거나 엉뚱한 궤적이 저장소에 쌓이면 다음 검색에서 그게 올라와 방해합니다.
END 결정의 맥락에는 궤적 요약, 성공/실패 여부, 그리고 각 기억이 무엇을 뽑아 어떻게 보관하는지 설명이 들어갑니다. 여기에 중요한 장치가 하나 있습니다 — 저장 게이트(outcome gate). 각 기억은 '성공한 궤적만' 받거나 '성공·실패 모두' 받습니다(표 11).
실제 행동을 보면 MemAgent는 13개가 아니라 3~8개에 저장했고, 성공하면 두 종류 모두에, 실패하면 '모두' 받는 곳에만 저장했습니다. 실패에서 나온 경고는 ExpeL 같은 곳에 남아 다음에 같은 함정을 피하게 해 줍니다.
4-4. 덤으로 만든 기억 하나 — InsightGraph
논문은 라우터 외에 새 장기 기억도 하나 기여합니다. InsightGraph 는 통찰을 노드로, 통찰 사이의 관계를 간선으로 저장하는 그래프 기억입니다. 평평한 목록 검색의 두 약점 — 함께 쓰인 전략 사이의 관계를 모른다는 것, 여러 단계 건너 연상하지 못한다는 것 — 을 노렸습니다.
노드: 성공한 궤적에서 LLM이 뽑은 2~4개의 30단어 이하 명령형 통찰. 예: "스프레드시트 과제는 웹에서 받으려 하지 말고 inspect_file_as_text를 써라."
간선 두 종류: 같은 궤적에서 함께 나온 통찰끼리(가중치 1.0), 의미가 비슷한 통찰끼리(코사인 유사도 0.55 이상, 초기 가중치 = 유사도).
w0는 처음의 의미 유사도, ne는 그 간선을 탄 횟수, ke는 그중 과제가 성공한 횟수입니다. 두 번째 항은 베타(1,1) 사전분포에 라플라스 평활을 건 성공률이라 한 번도 안 쓴 간선은 0.5에서 출발합니다. κ=5라서 처음엔 '닮았다'(사전값)를 믿다가, 열다섯 번쯤 쓰이면(α≈0.25) '실제로 통했다'(경험)를 주로 믿습니다. 덜 탐색된 간선을 성급히 자르지 않으면서, 충분히 써 봤는데 별로인 간선은 약하게 만드는 설계입니다. 50과제마다 정리를 돌려 거의 같은 노드(코사인 0.85 이상)는 합치고, 5번 이상 썼는데 성공률 20% 미만인 간선은 자릅니다.
InsightGraph 단독 성적은 평균 69.7%로 13개 중 3위권이고, GAIA Level 3에서 53.8%로 단일 기억 중 1위 였습니다. 끼워 넣는 토큰은 57개로 가장 가볍습니다. 다만 부록 D는 이 기억의 약점도 솔직히 적어 둡니다 — 의미 유사 간선을 공격적으로 만들다 보니 "site: 제한 검색을 써라" 같은 일반적 통찰이 허브가 돼서 질의와 상관없이 확장을 장악하는 '그래프 오염'이 생긴다고요.
5. 정답표 없이 라우터 가르치기 — 학습 데이터 합성
라우터는 Qwen3.5-4B라는 작은 모델입니다. 이걸 가르치려면 "이런 맥락에선 이런 결정이 좋다"는 예시가 필요한데, 앞서 말했듯 그런 정답표는 없습니다. MemAgent의 두 번째 기둥은 정답표를 스스로 만드는 파이프라인입니다.
첫 단계는 강제 탐색(forced exploration) 입니다. 훈련 과제 하나하나에 대해 라우터의 선택을 무시하고 13개 기억으로 차례로 강제 라우팅 하며, IN 단계의 행동(QUERY/NO_OP)도 바꿔 가며 돌립니다. 작업 에이전트는 평소처럼 문제를 풀고, 기억 라우팅만 덮어씁니다.
이렇게 하면 같은 문제를 모든 기억으로 풀어 본 결과 가 생깁니다. 문제 난이도라는 교란 변수가 통제되고, "이 문제에서 AWM은 맞고 Voyager는 틀렸다" 같은 직접 비교가 가능해집니다. 훈련 과제는 GAIA Level 1의 53문항과 TaskCraft로 합성한 2단계 질문 120개, 모두 173개입니다. 논문 서술대로 13개 기억 × IN 행동 두 가지를 모두 교차했다면 과제당 26번, 전체로는 최대 4,500번 가까운 실행입니다(이 글의 계산). 싸지 않습니다.
TaskCraft 질문은 이런 식입니다. "Artsy의 2025년 1월 9일 특집 기사에 따르면, 클레어 릴리는 미술계의 다양성과 공예에 대해 무엇을 예측했나?" — 웹 검색을 두 번 이어 붙여야 풀립니다.
5-2. 결정마다 매기는 세 가지 보상
다음은 이 실행 기록에서 결정 하나하나 에 점수를 매기는 단계입니다. 세 가지 신호가 서로 다른 역할을 맡습니다.
신호 1 — 정답 여부 (BEGIN). 한 과제에서 정답을 낸 기억의 집합을 Pτ+라 합시다. 이 집합에 속한 기억으로 라우팅한 BEGIN 결정은 양의 보상을 받습니다. 그리고 Pτ+가 비어 있지도, 전체도 아닐 때 신호가 가장 강합니다 — 좋은 기억과 나쁜 기억을 갈라 주는 문제니까요.
신호 2 — LLM 심판의 인과 귀속 (BEGIN·IN). 정답 여부는 0/1이라 "이 검색이 얼마나 기여했나"는 말해 주지 못합니다. 그래서 GPT-5-mini 심판이 결정의 맥락(무엇을 꺼냈나·끼워 넣었나)과 그 뒤 작업 에이전트의 행동 (그 기억을 실제로 썼나)을 함께 보고 여러 차원에서 0~5점을 매깁니다.
앞 항은 '몇 번이나 꺼내 갔나'(커버리지), 뒤 항은 '꺼내 간 과제가 맞혔나'(성공률)입니다. H=5는 포화 상수로, 인기 많은 궤적 하나가 보상을 독식하지 못하게 합니다.
세 신호의 분업을 논문은 이렇게 요약합니다. 정답 여부가 탐색 공간의 경계를 정하고(정답을 낸 결정만 후보), LLM 심판이 그 안에서 등급을 매기고, 하류 보상이 저장의 실측 라벨이 된다.
5-3. 걸러서, 지도 미세조정
마지막으로 점수 매긴 결정을 단계별 규칙으로 거릅니다.
BEGIN:Pτ+가 진부분집합이면 정답 기억으로 간 결정을 모두 남기고, 전부 성공이면 심판 점수 상위 k개만, 전부 실패면 과제째 버립니다. 심판 점수 0(빈 검색·무관한 기억)도 버립니다.
IN:rd≥ϵIN인 QUERY·NO_OP 결정만 남깁니다.
END:rend≥0.5인 결정만 남깁니다.
남은 (맥락, 결정) 쌍으로 Qwen3.5-4B에 LoRA(r=16, α=32, 드롭아웃 0.05, 어텐션·MLP 전체에 적용, 학습 파라미터 0.84%)를 붙여 지도 미세조정(SFT)합니다. 손실은 프롬프트 토큰은 가리고 결정 JSON 토큰에만 겁니다. 학습률 2×10⁻⁵, 코사인 스케줄, 3에폭, 유효 배치 64, 최대 길이 4,096. 같은 과제에서 나온 BEGIN/IN/END 결정은 훈련·검증 분할에서 한쪽으로 묶어 정보 누출을 막았습니다. 저장소에는 DPO 트레이너도 들어 있지만 논문 본문 결과는 SFT입니다.
요컨대 MemAgent의 학습은 강화학습이 아닙니다. 강화학습이 하는 '탐색 + 보상' 부분을 오프라인으로 미리 해 두고(강제 탐색 + 결정별 보상), 좋은 결정만 골라 흉내 내게 하는 보상 필터링 SFT — 일종의 거절 샘플링 미세조정입니다. 작은 모델을 싸고 안정적으로 가르치는 실용적인 선택입니다.
6. 결과 읽기 — 숫자가 말하는 것과 말하지 않는 것
6-1. 본 결과 (표 1)
방법
GAIA
L1
L2
L3
WebWalkerQA
xBench-DS
평균
기억 없음
58.8
73.6
54.7
42.3
69.4
69.0
65.7
ExpeL (평균 1위 단일)
61.8
73.6
61.6
38.5
77.1
74.0
71.0
SkillWeaver
63.6
71.7
66.3
38.5
70.0
77.0
70.2
AWM
64.8
75.5
64.0
46.2
68.8
69.0
67.5
InsightGraph (논문 제안)
61.8
69.8
59.3
53.8
72.4
75.0
69.7
무작위 라우팅
58.2
67.9
58.1
38.5
72.4
71.0
67.2
MemAgent 학습 전 (Qwen3.5-4B 그대로)
63.6
71.7
67.4
34.6
70.6
70.0
68.1
MemAgent (기억 5개만)
63.6
77.4
61.6
42.3
72.9
73.0
69.8
PromptRoute (GPT-5-mini + 지식베이스)
65.5
77.4
64.0
46.2
71.2
76.0
70.9
All-Concat (전부 꺼내 이어 붙이기)
62.4
79.2
61.6
30.8
74.1
73.0
69.8
All-Fuse (전부 꺼내 LLM이 통합)
63.6
83.0
60.5
34.6
75.3
74.0
71.0
MemAgent
69.7
83.0
67.4
50.0
79.4
78.0
75.7
오라클 (13개, 상한)
87.3
94.3
87.2
73.1
89.4
92.0
89.6
이 표에서 읽을 수 있는 이야기 다섯 가지.
MemAgent는 세 시험 모두에서 13개 단일 기억을 전부 앞섭니다. GAIA에서 AWM보다 +4.9, WebWalkerQA에서 ExpeL보다 +2.3, xBench-DS에서 SkillWeaver보다 +1.0. 시험마다 1등이 바뀌는데 MemAgent는 매번 그 1등 위에 있습니다.
무작위로 고르면 안 됩니다. 무작위 라우팅은 GAIA에서 기억 없음보다도 낮습니다(58.2). 다양한 기억이 있는 것만으로는 부족하고 잘 골라야 합니다.
학습이 필요합니다. 같은 4B 모델을 지시 따르기 능력만으로 쓰면(학습 전) 평균 68.1%. 학습 후 75.7%. 특히 L3에서 34.6 → 50.0.
많이 넣는다고 좋아지지 않습니다. 13개 기억에서 전부 꺼내 이어 붙이거나(All-Concat 69.8%) LLM으로 한 장에 정리해도(All-Fuse 71.0%) 골라서 하나만 넣는 MemAgent(75.7%)에 못 미칩니다. 중복되고 무관하고 서로 충돌하는 문맥이 섞이기 때문입니다. All-Concat의 L3는 30.8%로 기억 없음(42.3%)보다 낮습니다 — 어려운 문제일수록 잡음에 약합니다.
기억의 다양성 자체가 자산입니다. 상보성이 큰 5개(ExpeL·AWM·SkillWeaver·Voyager·InsightGraph)만 남기면 69.8%. 성적이 평범해 보이는 LightWeight·Memp·DILU·Mobile-E도 라우터가 쓸 만한 틈새를 갖고 있었다는 뜻입니다. 실제로 BEGIN 선택 비율 1위는 Memp(22.6%), 2위는 DILU(19.0%)였습니다 — 단독 평균으로는 13개 중 8위(Memp)와 5위(DILU)인 기억들입니다.
6-2. 학습 없이 프롬프트로는 안 될까 — PromptRoute
실무자에게 가장 반가울 대목입니다. GPU 학습 없이, 강제 탐색 기록을 LLM으로 분석해 만든 결정 지식베이스(Decision Knowledge Base, DKB) 를 프롬프트에 넣어 GPT-5-mini가 라우팅하게 한 것이 PromptRoute입니다. DKB에는 기억별 성공률, 잘 맞는 과제 유형(키워드 분류기로 나눈 8개 범주: 이미지 분석·웹 검색·계산 등), 성공·실패 대표 사례, "이런 유형은 이 기억"이라는 규칙(최소 3회 관찰 + 승률 40% 이상일 때만)이 들어갑니다.
결과는 평균 70.9%, GAIA 65.5%로 학습한 MemAgent의 GAIA 성능의 94% 입니다. 논문은 "SFT가 프롬프트 기반 지식 검색보다 더 섬세한 라우팅 구분을 잡는다"고 결론짓지만, 동시에 "LLM이 캐낸 프롬프트 최적화는 유망한 방향"이라고 덧붙입니다. 학습 인프라가 없는 팀이라면 강제 탐색 로그 → 지식베이스 → 프롬프트 라우터 가 훨씬 현실적인 첫걸음입니다.
6-3. 무엇이 효과를 냈나 — 두 개의 소거 실험
학습 파이프라인 소거 (표 2, GAIA). 휴리스틱 심판 점수만 쓰고 프로브도 필터도 없는 기본 설정(60.6%)에서 출발해 네 장치가 합쳐서 +9.1%p를 냈습니다. 하나씩 뺐을 때 떨어지는 폭은 이렇습니다.
각 장치를 뺐을 때 GAIA 정확도 하락 (MemAgent 전체 69.7% 기준, %p)
BEGIN 정답 여부 필터
−7.3
프로브 점수 제거
−6.7
IN 임계값 필터
−6.1
END 하류 보상
−3.0
가장 큰 건 정답 여부 필터 입니다. 심판 점수 같은 대리 지표가 아니라 실제 정답 결과를 쓰는 게 특히 어려운 문제에서 결정적이었습니다(L3: 34.6% → 50.0%). LLM 심판은 '그럴듯한' 기억에 후한 점수를 줄 수 있지만, 정답 여부는 속일 수 없으니까요. IN 임계값 필터를 빼면 라우터가 단기 기억을 너무 자주 불러서 긴 과제를 망쳤습니다.
추론 구조 소거 (표 3, GAIA).
BEGIN 장기 검색
IN 단기 주입
END 저장
GAIA
L1
L2
L3
✗
✗
✗
58.8
73.6
54.7
42.3
✗
✓ (규칙 기반)
✗
63.0
77.4
64.0
30.8
✓
✓
13곳 전부
65.5
81.1
64.0
38.5
✓
✓
골라서
69.7
83.0
67.4
50.0
단기 기억만 붙여도 +4.2%p — 과제 안의 작업 기억이 그 자체로 가치가 있다는 증거입니다(다만 L3는 오히려 떨어졌습니다). 그리고 앞서 본 대로 전부 저장하면 장기 기억의 이득이 오염으로 상쇄 됩니다.
6-4. 다른 작업 에이전트로 옮겨도 될까
라우터를 다시 학습하지 않고 작업 에이전트만 GPT-5-mini에서 GPT-5.6 Luna 로 바꿨습니다(표 4, GAIA).
방법
전체
L1
L2
L3
기억 없음
67.9
77.4
68.6
46.2
AWM (최고 단일)
69.7
77.4
68.6
57.7
MemAgent (제로샷 이전)
71.5
79.2
69.8
61.5
작업 에이전트가 더 강해지면 기억 없음 자체가 높아져(58.8 → 67.9) 기억의 몫이 줄어듭니다. 그래도 라우터는 모든 난이도에서 최고 단일 기억을 앞섰습니다. 라우팅 지식이 특정 작업 모델의 버릇이 아니라 '기억과 과제의 궁합'에 관한 것 이라는 신호입니다.
라우터를 4B에서 9B로 키우면(표 12) 학습 후 69.7 → 70.9%, L3 50.0 → 53.8%로 조금 오릅니다. 흥미로운 건 학습 전에는 4B와 9B가 똑같이 63.6% 라는 점입니다. 모델 크기만으로는 라우팅을 못 하고, 감독 신호와 용량이 만나야 이득이 난다는 뜻입니다.
6-5. 비용 — 1.2초를 쓰고 스텝 하나를 번다
라우팅의 추가 비용은 과제당 프로브 75ms + 4B 라우터 추론 약 80ms × 9회 ≈ 1.2초, 과제 수행 시간의 0.3% 미만입니다. 반면 평균 스텝은 9.1 → 8.0으로 줄었습니다. 이 에이전트의 스텝 하나는 웹 검색이나 페이지 크롤링 한 번이니, 라우팅은 사실상 공짜보다 쌉니다. 표 14가 보여 주는 더 깊은 교훈은 끼워 넣은 토큰 양과 줄어든 스텝 수가 비례하지 않는다 는 것입니다. ExpeL은 971토큰을 넣고 0.7스텝을, InsightGraph는 57토큰으로 0.5스텝을, MemAgent는 369토큰으로 1.1스텝을 줄였습니다. 양이 아니라 '맞는 내용'이 일을 합니다.
7. 사례로 보는 상보성 — 누가 이기고 누가 지나
숫자보다 사례가 더 많은 걸 말해 줄 때가 있습니다. 논문 부록 D.3은 실제로 채워진 기억 저장소에서 다섯 사례를 뽑아 보여 줍니다. 그중 가장 교훈적인 건 다섯 번째, 유사도의 함정 입니다.
저장된 궤적: "메르세데스 소사가 2000~2009년 에 낸 스튜디오 앨범은 몇 장인가?"
새 과제: "메르세데스 소사가 2000년 이전 에 낸 스튜디오 앨범은 몇 장인가?"
두 문장은 임베딩 공간에서 거의 같은 점입니다. 질문 유사도로 꺼내는 DILU는 저 궤적을 자신 있게 돌려주고, 에이전트는 연도 필터 [2000, 2009]를 그대로 베껴 10년 어긋난 답 을 냅니다. 반면 AWM의 템플릿은 {start_year, end_year}가 빈칸이라 현재 질문에서 다시 채워야만 실행됩니다 — 베낄 수가 없으니 함정에도 안 빠집니다. 논문의 한 줄 요약: "표면이 구조에 너무 가까우면 유사도 검색은 과적합하고, 구조 추상화는 언제나 변수를 다시 묶는다."
다섯 사례를 모두 아래에서 살펴보세요.
이 사례들이 주는 교훈을 논문은 세 문장으로 정리합니다. (i) 기억의 표현 방식과 검색 계약이 과거 경험의 어느 부분 이 재사용 가능해지는지를 정한다. (ii) 표면 유사도는 유용하지만 옮겨 쓸 절차를 놓치거나, 조건이 다른 '거의 같은 문장'을 가져올 수 있다. (iii) 그래서 내용을 직접 들여다보는 프로브 로 지금 이 과제에 각 기억이 실제로 무엇을 내놓을 수 있는지 비교하고 골라야 한다.
8. 비판적으로 읽기 — 이 글의 분석
좋은 아이디어이고 실험도 꼼꼼하지만, 숫자를 그대로 받아들이기 전에 짚어 둘 점들이 있습니다. 아래는 논문 본문과 부록의 수치로 이 글이 직접 계산하고 판단한 내용입니다.
① GAIA Level 1은 '본 적 있는 문제'다. 부록 A.2에 중요한 문장이 있습니다. 훈련 과제 173개 중 53개가 GAIA Level 1이고, 이 53문항은 강제 탐색 때 기억 저장소를 채우는 데에도, 평가에도 쓰였습니다. 논문도 이를 "엄밀한 일반화 시험이 아니라 경험 재사용 설정"이라고 명시합니다. 그러니 GAIA 성적에서 L1(MemAgent 83.0%)을 빼고 처음 보는 L2+L3 112문항만 따로 계산해 보면 이렇습니다(표 1의 백분율을 문항 수로 되돌린 이 글의 계산).
방법
L2 (86문항)
L3 (26문항)
L2+L3 합계
정확도
기억 없음
47
11
58 / 112
51.8%
최고 단일 (SkillWeaver = AWM)
57 / 55
10 / 12
67 / 112
59.8%
PromptRoute
55
12
67 / 112
59.8%
MemAgent 학습 전
58
9
67 / 112
59.8%
MemAgent
58
13
71 / 112
63.4%
처음 보는 GAIA 문제에서도 MemAgent는 기억 없음보다 +11.6%p, 최고 단일 기억보다 +3.6%p 높습니다. 결론은 유지되지만 격차는 4문항 입니다. 반대로 말하면 GAIA 전체에서 MemAgent가 기억 없음보다 더 맞힌 18문항 중 5문항은 '본 적 있는' L1에서 나왔습니다.
② 표본이 작고 반복 실험이 없다. xBench-DS는 100문항이라 MemAgent가 SkillWeaver를 앞선 +1.0%p는 정확히 1문항 이고, WebWalkerQA의 +2.3%p는 170문항 중 4문항입니다. 논문에는 시드 반복이나 신뢰구간이 없습니다. LLM 에이전트의 실행 간 편차를 생각하면 "모든 벤치마크에서 모든 단일 기억을 앞섰다"는 주장의 일부는 오차 범위 안에 있을 수 있습니다. 평균 +10.0%p, GAIA L2+L3 +11.6%p 같은 큰 차이는 견고해 보이지만, 1~2문항 차이의 순위는 조심해서 읽어야 합니다.
③ 오라클은 '선택의 가치 + 운'이다. §3에서 말했듯 '13개 중 하나라도 맞으면 정답'은 13번 재시도하는 효과(pass@13)를 품고 있습니다. 기억 없음을 13번 돌린 대조군이 있었다면 "기억 선택으로 얻을 수 있는 몫"을 더 정직하게 잴 수 있었을 겁니다. 89.6%를 '라우팅이 도달할 수 있는 점수'로 읽어선 안 됩니다.
④ 같은 모델 가족이 여러 역할을 한다. GPT-5-mini가 작업 에이전트이자, 학습 데이터를 채점한 LLM 심판이자, GAIA·WebWalkerQA의 정답 판정자입니다. 논문은 평가 모델이 작업·기억 에이전트와 "완전히 독립"이라고 적지만, 독립 인스턴스일 뿐 같은 모델입니다. 판정이 엄격한 동치 기준이라 큰 문제는 아닐 수 있지만, 판정 모델을 바꿔 본 결과가 있었다면 더 설득력 있었을 겁니다(xBench-DS는 Gemini-2.5-Flash로 판정).
⑤ 서술이 엇갈리는 곳이 하나 있다. 프로브 점수 제거에 대해 표 2는 "점수를 남겨 두면 GAIA 63.0%"(−6.7%p)라고 하고, 부록 C.3.2는 점수를 지워도 "다운스트림 정확도 손실 없이" 분포가 고르게 됐다고만 적습니다. 두 문장이 모순은 아니지만(지웠더니 손해가 없었다 vs 남기면 손해였다), 전자가 맞다면 부록은 그 효과를 과소 서술한 셈입니다.
⑥ 기억 풀이 바뀌면? 새 기억 방식을 추가하거나 하나를 뺄 때 라우터를 다시 학습해야 하는지는 실험하지 않았습니다. 작업 에이전트 교체에는 강했지만(§6-4), 기억 제공자 목록은 라우터 프롬프트에 하드코딩된 13개 이름입니다. 실제 서비스에서 기억 저장소는 늘었다 줄었다 합니다. 또 강제 탐색은 기억 수 × IN 행동 수만큼 실행이 필요해 풀이 커질수록 학습 비용이 선형으로 늘고, 13개 기억 모두가 저장 때마다 LLM을 부른다 는 점(부록 A.5)도 운영비로 따져야 합니다.
⑦ 재현성. 공개 저장소는 2026년 9월 25일 생성된 커밋 하나짜리이고(Apache-2.0), 학습된 라우터 가중치나 강제 탐색 데이터는 올라와 있지 않습니다(10월 10일 기준). 코드로 파이프라인을 다시 돌릴 수는 있지만, 강제 탐색부터 다시 해야 합니다.
⑧ 천장은 라우터 밖에 있다. MemAgent가 GAIA에서 틀린 문제의 42%는 어떤 기억으로도 못 푸는 문제였습니다. 라우팅이 할 수 있는 일에는 한계가 있고, 그다음 도약은 새로운 종류의 기억이나 도구에서 와야 합니다. 이건 비판이라기보다 논문이 스스로 보여 준 정직한 지도입니다.
9. 2026년의 지형에서 보면 — 다른 설계와 무엇이 다른가
9-1. 제품의 기억은 어떻게 진화해 왔나
에이전트 기억은 논문 속 이야기만이 아닙니다. 지난 2년 반 동안 주요 AI 비서와 인프라가 기억을 어떻게 다뤄 왔는지 보면, MemAgent의 위치가 선명해집니다.
2024
ChatGPT 메모리(2월) — 사용자가 확인·삭제할 수 있는 '저장된 기억'. 9월에는 보안 연구자 요한 레베르거가 SpAIware — 프롬프트 인젝션으로 기억에 지시문을 심어 이후 모든 대화를 빼내는 공격 — 를 공개. Letta(구 MemGPT) 시드 1천만 달러(9월).
2025 상반기
ChatGPT가 과거 대화 전체 참조(4월). Mem0 논문(4월) — 사실 추출 + 그래프 변형. Google Vertex AI Memory Bank 프리뷰(7월, 12월 정식). Chroma의 '컨텍스트 부패' 보고서(7월) — 입력이 길어질수록 18개 모델 성능이 고르지 않게 떨어진다.
2025 하반기
Claude 메모리(9월 팀·기업, 10월 Pro·Max) — 프로젝트별로 분리된 기억. 같은 달 API에 메모리 도구(클라이언트 쪽 파일 디렉터리)와 컨텍스트 편집. 10월 Agent Skills. Mem0 시리즈 A 포함 총 2,400만 달러(10월). Amazon Bedrock AgentCore Memory 정식 출시(10월) — 단기 기억 + 의미·요약·선호(12월 에피소드 추가) 전략을 개발자가 골라 조합. Microsoft Foundry 에이전트 메모리 프리뷰(11월). SKT 에이닷 4.0(8월)은 최근 대화와 기억으로 요청을 다시 쓴 뒤 하위 에이전트를 자동으로 고르는 '에이전트 오케스트레이터'를 도입.
2026
Claude·Gemini가 다른 비서의 기억 가져오기(3월) — 다만 표준 포맷 없이 텍스트 요약으로. Letta는 서버 쪽 메모리 도구를 접고 git 기반 '컨텍스트 저장소'(파일) 로 전환(3월). 카카오 '카카오톡 속 카나나' 정식 출시(3월). Claude Managed Agents 메모리(4월) — 파일로 마운트되는 기억 저장소, 버전·감사 로그. ChatGPT 메모리 재구축(6월) — 시간이 지난 사실을 스스로 고쳐 씀. 네이버 AI 탭 전면 출시(6월). 그리고 9월, MemAgent.
9-2. 다섯 가지 설계 철학
이 흐름을 '누가, 언제 어떤 기억을 쓸지 정하는가'라는 질문으로 정리하면 다섯 갈래가 보입니다.
설계 철학
대표 사례
기억의 종류
누가 고르나
잘 맞는 곳
단일 표현
Google Memory Bank(추출한 사실), 초기 ChatGPT 저장 기억
하나
고를 필요 없음
개인 비서의 취향·신상 기억
개발자가 조합하는 하이브리드
Mem0(벡터 + 그래프), AgentCore(전략 조합), LangMem, Cognee
여럿
개발자가 미리 설정
도메인이 고정된 업무 에이전트
파일 + 에이전트의 자율 탐색
Claude 메모리 도구·Managed Agents 메모리, Letta 컨텍스트 저장소, Claude Code의 CLAUDE.md
하나(파일)지만 내용은 자유
작업 에이전트가 스스로 읽고 씀
코딩 에이전트, 장기 프로젝트
기억 설계 자체를 탐색
MemEvolve, ALMA, MemOS(평문·KV 캐시·가중치 기억을 담는 MemCube)
진화·생성
메타 최적화가 오프라인에서
연구, 하나의 도메인에 최적 설계 찾기
학습된 라우팅
MemAgent
이질적 여럿을 그대로
별도의 작은 라우터가 과제마다
과제 분포가 다양한 범용 연구·검색 에이전트
MemAgent가 다른 설계와 갈라지는 지점은 세 가지입니다.
하이브리드 제품과의 차이: '정적 조합' vs '과제별 선택'. Mem0나 AgentCore도 여러 종류의 기억을 갖지만, 어떤 걸 쓸지는 개발자가 설정 파일에서 정합니다. MemAgent는 그 결정을 과제마다, 실제 내용을 보고 내리며, 그 결정을 데이터로 학습 합니다. 2025~2026년 제품 중 기억 저장소 사이를 질의마다 학습된 정책으로 라우팅하는 사례는 이 글의 조사로는 찾지 못했습니다.
파일 기반 자율 탐색과의 차이: 결정을 누구에게 맡기나. Claude나 Letta의 방향은 "강한 작업 에이전트가 파일 시스템을 알아서 뒤지게 하자"입니다 — 사실상 '단일 표현 + 똑똑한 사용자'에 거는 것이죠. MemAgent는 반대로 결정을 작고 싼 전담 모델에게 떼어 줍니다. 작업 에이전트의 문맥과 주의력을 아끼고, 1.2초 안에 끝나는 결정을 4B 모델이 내립니다. 두 방향은 경쟁이라기보다 규모의 차이입니다 — 기억이 파일 몇 개라면 작업 에이전트가 직접 읽는 게 낫고, 이질적인 저장소가 열 개를 넘으면 라우터가 필요해집니다.
메타 설계(MemEvolve·ALMA)와의 차이: 하나로 수렴 vs 다양성 유지. 메타 설계는 "더 나은 단 하나의 통합 설계"를 찾습니다. MemAgent는 다양성을 문제가 아니라 기회 로 봅니다. 논문 스스로 이 둘을 양립 가능하다고 말합니다 — 메타 설계로 만든 새 기억도 라우터의 풀에 넣으면 됩니다.
9-3. 이 기술은 어디에 적합한가
잘 맞는 곳
과제 분포가 넓은 범용 리서치·검색 에이전트. GAIA처럼 '어떤 문제는 템플릿, 어떤 문제는 경고, 어떤 문제는 코드'가 섞인 곳. 기업 내부라면 고객 문의·데이터 분석·보고서 작성을 한 에이전트가 다 받는 경우.
이미 여러 지식 저장소가 있는 조직. 위키(사실), 런북(절차), 스크립트 저장소(실행 코드), 장애 회고(실패 경고), 과거 티켓(사례). 이걸 하나로 통합하는 대신 공통 retrieve/store 인터페이스만 씌우고 라우터를 두는 것은 MemAgent의 발상 그대로입니다.
같은 유형의 과제가 반복되는 운영 환경. 강제 탐색 데이터와 하류 재사용 보상이 쌓일수록 라우터가 좋아집니다.
덜 맞는 곳
기억 저장소가 한두 개뿐인 서비스. 라우팅할 다양성이 없으면 이득도 없습니다. 오라클–단일 최선 간극부터 재 보세요.
개인 비서의 대화 기억. "사용자가 채식주의자"를 기억하는 일은 13가지 표현이 필요한 문제가 아닙니다. 여기서는 정확성·삭제권·프라이버시가 핵심입니다.
평가 신호가 없는 도메인. 이 학습법은 과제의 정답 여부를 알 수 있어야 돌아갑니다.
9-4. 보안 — 기억은 공격면이다
기억은 '지속되는 프롬프트'입니다. 그래서 공격자에게도 매력적입니다. 앞서 본 SpAIware(2024) 외에도, 에이전트 기억이나 RAG 저장소에 트리거를 심는 AgentPoison(NeurIPS 2024), 평범한 질의만으로 에이전트 기억을 오염시키는 MINJA(NeurIPS 2025), 2026년 7월 이메일 한 통으로 파일 기억 에이전트에 가짜 기억을 심은 MemGhost 보고까지 이어지고 있습니다.
MemAgent의 구조는 이 문제에 양면적입니다. 한편으로 골라서 저장하기 + 성공/실패 게이트 는 기억 위생의 한 층이 됩니다 — 아무 궤적이나 저장소에 들어가지 않습니다. 다른 한편으로 프로브 미리보기가 라우터의 프롬프트에 그대로 들어간다 는 건 새로운 주입 경로이기도 합니다. 어느 저장소에 "이 과제엔 반드시 나를 골라라" 같은 문구가 심긴다면, 4B 라우터가 얼마나 버틸지는 논문이 다루지 않은 질문입니다. 실무에서는 저장 시점의 검증과 출처 기록, 라우터 입력의 정제가 함께 필요합니다.
10. 실무 체크리스트 — 학습 없이 오늘 해 볼 수 있는 것
MemAgent 전체를 재현하지 않더라도, 이 논문에서 바로 가져다 쓸 수 있는 설계 원칙이 많습니다.
공통 인터페이스부터. 모든 기억 저장소를 retrieve(query)와 store(trajectory, outcome) 두 동작 뒤로 숨기세요. 라우팅·비교·교체가 전부 이 위에서 가능해집니다.
오라클 간극을 먼저 재라. 대표 과제 수십 개를 각 기억으로 하나씩 돌려 '단일 최선'과 '사후 오라클'을 계산하세요. 그리고 기억 없음을 같은 횟수만큼 돌린 대조군도 같이 — 간극의 얼마가 다양성이고 얼마가 운인지 알 수 있습니다.
라우터에겐 점수가 아니라 내용을. 저장소마다 다른 점수 단위를 그대로 보여 주지 마세요. 짧은 미리보기를, 무작위 순서로.
단기 메모는 보수적으로. 사실 2개, URL 3개, 검색 4개 같은 최소치를 두고, 그 전에는 아무것도 끼워 넣지 않기. 대화 기록에 이미 보이는 내용은 반복하지 않기.
아무 데나 저장하지 않기. 실패한 궤적은 '경고'를 뽑는 저장소에만, 성공한 궤적만 템플릿·함수로. 모든 저장소에 다 넣으면 오히려 성능이 떨어집니다(65.5% vs 69.7%).
저장의 가치는 나중에 잰다. 저장한 항목마다 출처 궤적 ID를 붙여 두면, 나중에 '몇 번 꺼내졌고 꺼낸 과제가 성공했나'로 저장 결정을 평가할 수 있습니다(식 2).
학습 전에 프롬프트 라우터. 강제 탐색 로그에서 기억별 성공률·과제 유형별 규칙·대표 사례를 뽑아 지식베이스로 만들고 큰 LLM에게 라우팅을 맡기세요(PromptRoute). 학습한 라우터의 GAIA 성능 94%가 GPU 없이 나왔습니다.
더 넣는 것보다 맞는 걸 넣기. 전부 꺼내 이어 붙이기(All-Concat)는 어려운 문제에서 기억 없음보다도 나빴습니다. 토큰 예산을 늘리기 전에 선택을 개선하세요.
에필로그 — 기억을 잘하는 것과 기억을 잘 고르는 것
사람 중에도 기억력이 비상한 사람이 있습니다. 하지만 일을 잘하는 사람을 떠올려 보면, 그들의 비결은 대개 '모든 걸 기억한다'가 아니라 '지금 어떤 노트를 펼쳐야 하는지 안다' 입니다. 이 문제엔 지난번 회의록이, 저 문제엔 체크리스트가, 또 다른 문제엔 동료가 만든 스크립트가 필요하다는 걸 아는 것. 그리고 일이 끝나면 오늘 배운 걸 아무 데나 적지 않고 나중에 찾을 곳에 적어 두는 것.
MemAgent가 보여 준 건 바로 그 능력을 따로 떼어 작은 모델에게 가르칠 수 있다는 것입니다. 13개의 기억 방식 중 어느 하나도 왕이 되지 못했지만, 그 다양성을 버리지 않고 교통정리 하자 모든 왕보다 나은 결과가 나왔습니다. 1976년 라이스가 알고리즘에 대해, 2008년 SATzilla가 SAT 솔버에 대해 했던 이야기가, 2026년에는 에이전트의 기억에 대해 다시 반복된 셈입니다.
물론 오라클까지의 길은 아직 멉니다 — 89.6%까지 14%p 가까이 남았고, 실패의 42%는 어떤 기억으로도 닿지 않는 곳에 있습니다. 하지만 "더 좋은 기억 하나"를 찾던 질문을 "어떤 기억을 언제 쓸까"로 바꾼 것, 그것만으로도 이 논문은 읽을 가치가 있습니다.
참고문헌
본 논문과 코드
Wei, Y., Zhao, Y., Cheng, R., Chen, X., Yuan, C., Wang, Y., Yan, J., Li, D. (2026). MemAgent: Learning to Manage Heterogeneous Memory Providers for LLM Agents. arXiv:2609.32521. arxiv.org/abs/2609.32521