어제의 실수를 오늘 반복하지 않는 AI — ReMe, '기억하고 다듬는' 절차 기억의 모든 것
AI 에이전트는 똑똑하지만 매일 아침 기억이 지워지는 신입사원과 같다. 어제 주가를 지어내 주문을 망쳤어도 오늘 또 지어낸다. 경험을 쌓아 두면 해결될까? 알리바바 통이 연구소와 상하이교통대의 ReMe(Remember Me, Refine Me)는 '쌓기만 하는 기억은 결국 독이 된다'고 답한다. 성공·실패·비교의 세 렌즈로 경험을 한 줄짜리 요령으로 증류하고, '언제 쓰나'로 색인해 꺼내 고쳐 쓰고, 불려 나온 횟수 대비 쓸모가 없는 경험은 지운다. 그 결과 Qwen3-8B가 기억 없는 14B를 넘어섰다. 1962년 거울 속 별을 그리던 환자 H.M.부터 2026년 '기억을 파일로' 진화한 ReMe 0.4까지, 논문의 그림·표·코드와 인터랙티브 위젯 6개로 절차 기억을 완전히 풀어 본다.
증권사 고객센터에 신입사원이 한 명 들어왔다고 해 보자. 머리는 비상하다. 금융 용어를 다 알고, 시스템 사용법도 설명서만 주면 금방 익힌다. 그런데 이상한 병이 하나 있다. 매일 아침 출근하면 어제 일을 하나도 기억하지 못한다.
월요일, 고객이 "테슬라 150주를 시장가로 사 주세요"라고 했다. 신입은 주문 화면에 가격을 넣어야 하는데, 시세를 조회하지 않고 대충 250달러를 적었다. 실제 가격은 667달러였다. 팀장에게 혼나고, 신입은 "앞으로는 꼭 현재가부터 조회하겠습니다"라고 다짐한다.
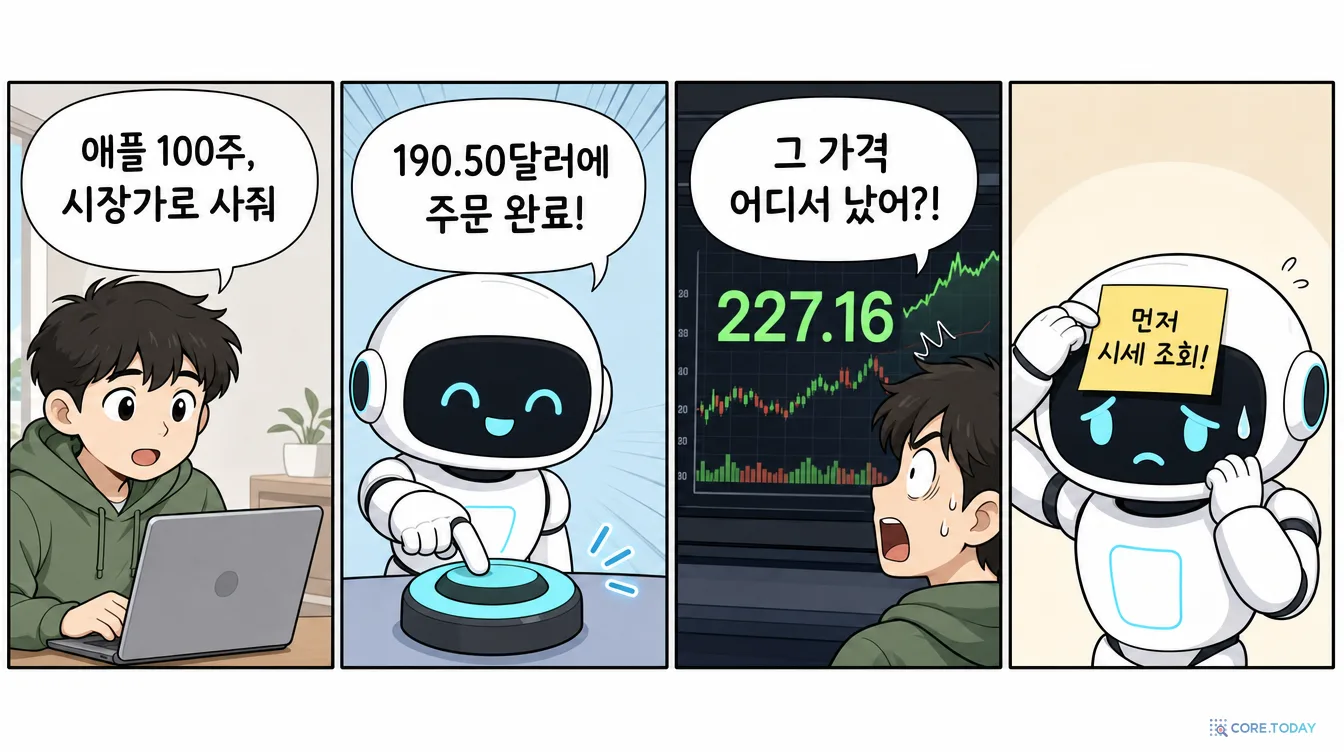
화요일, 다른 고객이 "애플 100주, 지금 가격으로요"라고 한다. 신입은 다시 시세를 조회하지 않고 190.50달러를 적는다. 실제 가격은 227.16달러. 어제의 다짐은 어디에도 없다.
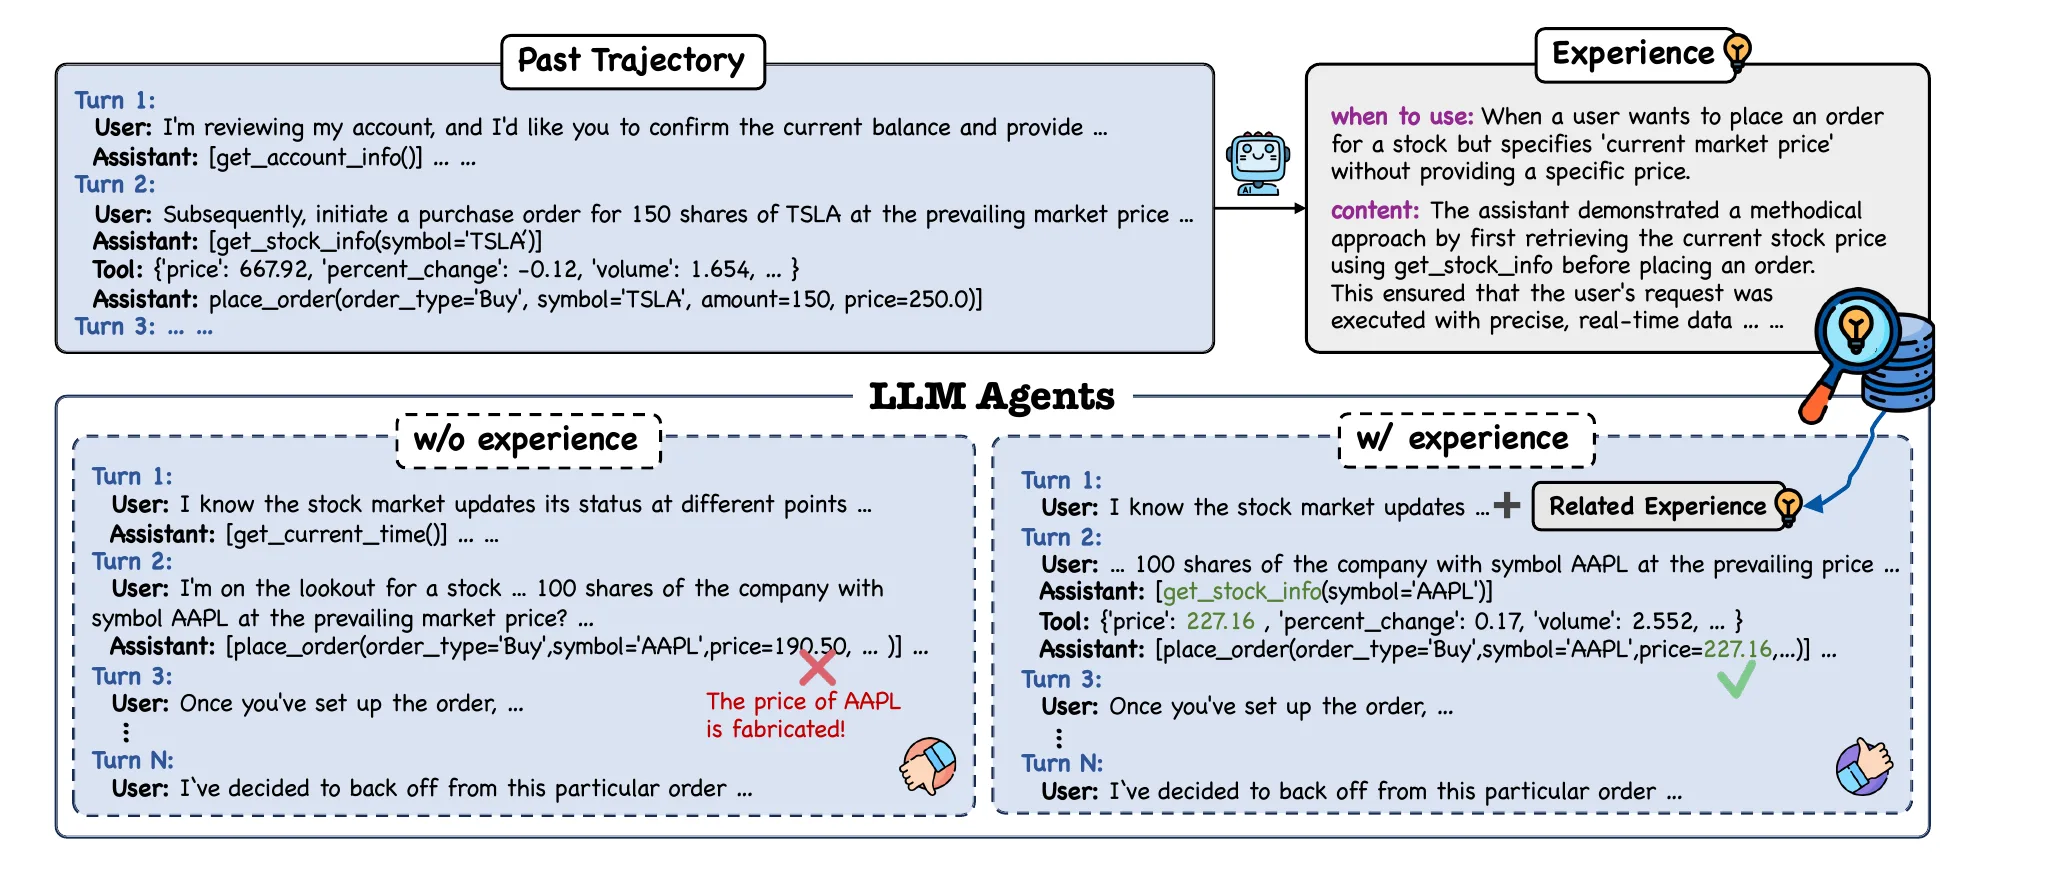
이건 우화가 아니다. 2026년의 AI 에이전트가 실제로 겪는 일이고, 오늘 다룰 논문 「Remember Me, Refine Me: A Dynamic Procedural Memory Framework for Experience-Driven Agent Evolution」(이하 ReMe)의 첫 번째 그림이 정확히 이 장면이다.
위쪽 왼편의 과거 궤적(Past Trajectory)은 월요일의 기록이다. 테슬라 시세를 조회해 놓고도(667.92) 주문에는 엉뚱한 250.0을 넣었다. 이 궤적에서 오른쪽의 경험(Experience) 한 장이 만들어진다.
언제 쓰나(when to use): 사용자가 구체적 가격 없이 '현재 시장가'로 주식 주문을 원할 때
내용(content): 주문 전에 get_stock_info로 현재가를 먼저 받아 그 값을 쓰는 체계적인 접근이 요청을 정확한 실시간 데이터로 처리하게 한다
아래쪽은 화요일이다. 경험 없이(w/o experience) 풀면 AAPL 가격을 지어내고(빨간 X, "The price of AAPL is fabricated!"), 경험을 받으면(w/ experience) 먼저 시세를 조회해 227.16으로 주문한다(초록 체크).
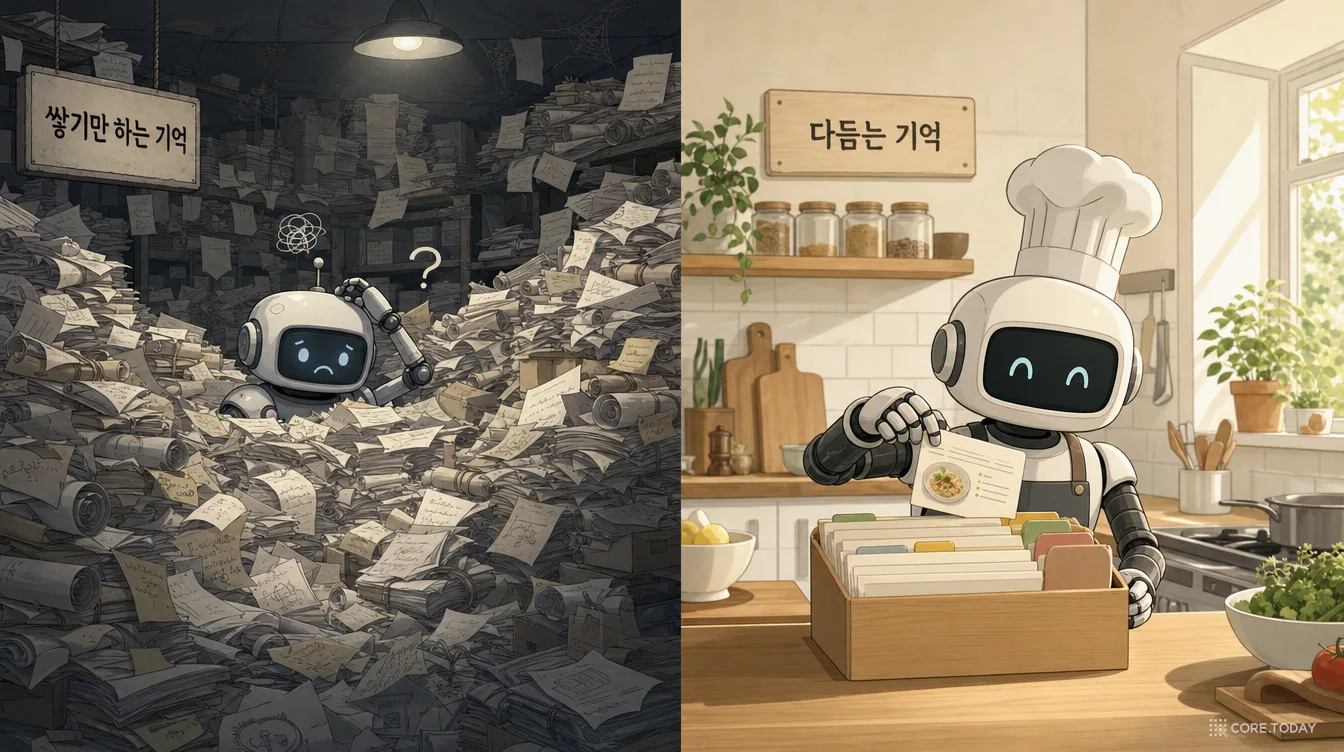
여기까지만 보면 해법은 간단해 보인다. "경험을 저장해 두었다가 다음에 꺼내 주면 되지 않나?" 실제로 2023년부터 수많은 연구와 제품이 그렇게 했다. 그런데 ReMe 연구진의 진단은 이렇다. 지금까지의 에이전트 기억은 대부분 '수동 축적(passive accumulation)', 즉 한번 쓰면 지우지 않는 추가 전용(append-only) 창고였고, 창고는 시간이 지나면 "유효한 통찰과 해로운 잡음이 뒤섞인 혼합물"이 된다.
그래서 ReMe의 이름은 두 동사로 되어 있다. Remember Me — 기억하라. 그리고 Refine Me — 다듬어라.
?
문제
에이전트는 같은 실수를 반복한다. 경험을 쌓아 두는 기존 기억은 궤적을 통째로 저장해 잡음이 많고, 꺼낸 경험을 새 상황에 맞추지 않으며, 낡고 해로운 경험을 지우지 않는다.
!
ReMe의 해법
① 성공·실패·비교의 세 렌즈로 핵심 지점만 증류하고 ② '언제 쓰나'로 색인해 꺼낸 뒤 재순위·재작성으로 맞춤 지침을 만들고 ③ 성공에서만 경험을 더하고, 자주 불려 나오는데 쓸모없는 경험은 지운다.
✓
결과
BFCL-V3·AppWorld에서 A-Mem·LangMem을 넘는 최고 성능. Qwen3-8B + ReMe가 기억 없는 Qwen3-14B를 Pass@4에서 앞서고, 14B + ReMe는 기억 없는 32B를 두 지표 모두에서 앞선다. 과제당 추가 지연은 2.54초.
이 글은 다음 순서로 간다. 먼저 '절차 기억'이라는 개념이 어디서 왔는지 1962년의 신경과학 실험부터 따라간다. 이어서 LLM 에이전트들이 경험을 기억하려고 시도해 온 2023~2025년의 계보와, 그 시도들이 왜 '수동 축적'의 함정에 빠졌는지를 본다. 그다음 ReMe의 세 국면(획득·재사용·정제)을 논문의 그림·표·프롬프트·실제 코드와 함께 하나씩 뜯고, 실험 결과를 위젯으로 직접 만져 본다. 마지막으로 논문 이후 ReMe 저장소가 '기억을 파일로' 진화한 2026년의 모습과, 비슷한 설계들(ReasoningBank, ACE, Agent Skills, Claude Code의 자동 메모리 등)과의 차이, 그리고 이 접근에 대한 반론까지 정리한다.
1. 왜 '절차 기억'인가 — 거울 속 별에서 시작된 60년
1.1 손은 기억하는데, 머리는 모른다
1953년, 미국의 한 젊은 남성이 심한 뇌전증 때문에 양쪽 해마 일부를 떼어 내는 수술을 받았다. 발작은 줄었지만 대가가 컸다. 그는 수술 이후의 일을 거의 새로 기억하지 못하게 됐다. 몇 분 전에 만난 사람을 다시 만나면 처음 보는 사람처럼 인사했다. 신경과학 교과서에 이니셜 H.M.으로 실린 헨리 몰레이슨이다.
1962년, 신경심리학자 브렌다 밀너는 H.M.에게 이상한 과제를 줬다. 종이에 그려진 별 모양의 두 줄 사이를 연필로 따라 그리는데, 손과 종이를 직접 보지 못하고 거울에 비친 모습만 보면서 그려야 한다. 거울 속에서는 좌우가 뒤집히니 보통 사람도 처음엔 선을 수없이 벗어난다.
결과는 신경과학의 역사를 바꿨다. 래리 스콰이어의 2009년 회고에 따르면 H.M.은 열 번의 시도 동안 이 기술을 익혔고, 사흘에 걸쳐 훌륭하게 유지했다. 그런데 테스트가 끝날 무렵 그는 이 과제를 전에 해 본 적이 있다는 기억이 전혀 없었다. 매일 "처음 해 보는데요"라고 말하면서, 매일 더 잘 그렸다.
이것이 "기억은 한 종류가 아니다"라는 첫 단서였다. '무엇을 했는지'를 기억하는 시스템과 '어떻게 하는지'를 기억하는 시스템이 따로 있다는 것이다.
1.2 '아는 것'과 '할 줄 아는 것'
1980년 코언과 스콰이어는 기억상실 환자들도 거울에 비친 글자 읽기를 배운다는 사실을 보이며 두 기억을 이렇게 이름 붙였다.
구분
서술 기억 (declarative)
절차 기억 (procedural)
한마디로
knowing that — ~라는 것을 안다
knowing how — ~하는 법을 안다
예
"파리는 프랑스의 수도다", "어제 점심에 김밥을 먹었다"
자전거 타기, 타자 치기, 거울 보고 그리기
하위 분류
의미 기억(사실) · 일화 기억(사건) — 툴빙, 1972
기술·습관 (스콰이어의 '비서술 기억'의 한 갈래)
뇌
내측 측두엽·해마
선조체(striatum) 등
특징
말로 설명할 수 있다
천천히 쌓이고, 무엇을 배웠는지 말하기 어렵다
스콰이어는 절차 기억을 "점진적으로 발달하지만, 무엇을 배우고 있는지 보고하는 능력은 거의 없는 기술 기반 지식"이라고 정의했다. ReMe 논문의 첫 문장 — "Procedural memory enables LLM agents to internalize 'how-to' knowledge" — 의 'how-to'가 바로 이 knowing how다.
에이전트 세계로 옮기면 이렇다. "사용자 이름은 김철수, 채식주의자"는 서술 기억이다. "시장가 주문이면 시세부터 조회하라"는 절차 기억이다. 앞쪽은 Mem0나 ChatGPT 메모리 같은 '사실 기억'이 다루고, ReMe가 다루는 것은 뒤쪽이다.
1.3 기계에게 요령을 가르치려던 시도들 — ACT와 SOAR
인지과학이 절차 기억을 발견하자, AI 연구자들은 그것을 기계에 구현하려 했다.
존 앤더슨의 ACT 이론(1982)은 기술 습득을 두 단계로 봤다. 처음에는 설명서를 읽으며 사실(서술 지식)을 하나하나 떠올려 가며 일한다. 연습을 거듭하면 그 사실들이 IF-THEN 규칙(프로덕션 규칙)으로 굳는다. 이 과정을 지식 컴파일(knowledge compilation)이라 불렀다. 여러 규칙을 하나로 합치고(composition), 사실을 규칙 안에 녹여 넣는다(proceduralization). 그 뒤에는 일반화·변별·강화로 규칙을 다듬는다 — 잘 맞는 규칙은 강해지고, 안 맞는 규칙은 약해진다.
SOAR(1986)의 청킹(chunking)도 같은 발상이다. 문제를 풀다 막히면 하위 목표를 세워 고생 끝에 풀고, 그 풀이를 새 규칙('청크')으로 저장한다. 다음에 같은 상황이 오면 고민 없이 그 규칙이 바로 발화한다.
40년 뒤의 ReMe와 놓고 보면 닮은 점이 놀랍다.
ACT 컴파일
긴 서술적 과정 → 짧은 IF-THEN 규칙. ReMe의 '핵심 지점 증류': 긴 궤적 → "가격 미지정 주문이면(IF) 시세부터 조회하라(THEN)" 한 장.
ACT 강화·약화
잘 맞는 규칙은 강해지고 안 맞는 규칙은 약해진다. ReMe의 '유용성 기반 삭제': 불려 나온 횟수 대비 성공 기여가 낮은 경험은 지운다.
SOAR 청킹
막혔던 문제의 풀이를 규칙으로 저장. ReMe의 '실패 인식 성찰': 실패하면 교훈을 뽑아 재시도하고, 성공하면 그 교훈을 저장.
1.4 ReMe의 할아버지 — 사례 기반 추론의 4R
더 직접적인 조상도 있다. 1982년 로저 섕크는 『동적 기억(Dynamic Memory)』에서 기억을 고정된 창고가 아니라 '떠올림(reminding)'과 실패를 통해 계속 재조직되는 구조로 봤다. 이 생각은 사례 기반 추론(Case-Based Reasoning, CBR)으로 이어졌고, 1994년 아모트와 플라자가 CBR을 네 단계 사이클로 정리했다.
Retrieve 비슷한 옛 사례를 꺼낸다
→
Reuse 새 문제에 맞춰 쓴다
→
Revise 틀렸으면 고친다
→
Retain 쓸 만한 것을 남긴다
ReMe의 파이프라인을 여기에 겹치면 거의 1:1로 맞는다. '언제 쓰나'로 검색(Retrieve) → 재순위·재작성으로 새 과제에 맞춤(Reuse) → 실패하면 성찰해 다시 시도(Revise) → 성공한 경험만 선택적으로 추가(Retain). 그리고 ReMe는 30년 전의 사이클에 하나를 더 붙였다. 다섯 번째 R, 지우기(Remove)다. 이 '지우기'가 이 논문의 진짜 주인공이라는 것을 뒤에서 보게 된다.
1.5 LLM 시대: 모델은 출시되는 순간 박제된다
그렇다면 왜 하필 지금, LLM 에이전트에서 절차 기억이 다시 뜨거워졌을까.
LLM의 지식은 가중치(파라미터)에 들어 있다. 학습이 끝나면 가중치는 고정된다. 에이전트가 하루에 수만 번 도구를 호출하며 실수하고 배워도, 그 배움은 다음 대화로 이어지지 않는다. 배운 것을 가중치에 넣으려면 다시 학습(파인튜닝)해야 하는데, 비싸고 느리고 위험하다(새로 배우며 예전 능력을 잊는 '파국적 망각').
그래서 연구자들은 기억을 두 종류로 나눈다.
파라메트릭 기억: 모델 가중치 안의 지식. 바꾸려면 학습이 필요하다.
비(非)파라메트릭 기억: 모델 바깥의 저장소(데이터베이스·파일)에 두고, 필요할 때 프롬프트에 넣어 주는 지식. 가중치를 건드리지 않는다.
2023년 언어 에이전트의 인지 구조를 정리한 CoALA 논문은 이렇게 썼다. "언어 에이전트에는 두 형태의 절차 기억이 있다. LLM 가중치에 저장된 암묵적 지식과, 에이전트의 코드에 쓰인 명시적 지식이다." ReMe는 그 사이, 즉 자연어로 쓰인 경험 카드를 외부 저장소에 두고 프롬프트로 주입하는 세 번째 길을 간다. 모델을 다시 학습하지 않고도 '요령'을 쌓는 길이다. 논문이 결론에서 이것을 "평생 학습을 위한 계산 효율적인 경로"라고 부르는 이유다.
CoALA는 경고도 남겼다. "절차 기억에 쓰는 것은 일화·의미 기억에 쓰는 것보다 훨씬 위험하다. 버그를 들여오거나 설계자의 의도를 뒤엎을 수 있다." 잘못된 요령은 잘못된 사실보다 해롭다. 사실이 틀리면 답 하나가 틀리지만, 요령이 틀리면 그 요령을 쓰는 모든 과제가 틀린다. ReMe가 '쓰기'를 까다롭게 하고 '지우기'를 넣은 이유가 여기 있다.
아래 연대기에서 60년의 흐름을 한 번에 훑어볼 수 있다. 항목을 누르면 ReMe와의 연결이 보인다.
2. 경험을 기억하려던 에이전트들 (2023~2025)
2.1 반성문, 스킬 라이브러리, 업무 매뉴얼
ChatGPT가 나온 지 몇 달 만에, 연구자들은 LLM 에이전트에게 '경험'을 주는 방법을 쏟아냈다. 대표적인 흐름을 저장하는 단위별로 묶어 보면 이렇다.
연구
무엇을 저장하나
대표 성과
한계 (ReMe 관점)
Reflexion (2023.03)
실패 후 쓴 반성문 — 같은 과제 재시도용
HumanEval 91% (GPT-4 80%)
그 과제 안에서만 쓰인다. 다른 과제로 옮겨 가지 않는다
Voyager (2023.05)
성공한 코드를 스킬 라이브러리로
마인크래프트 고유 아이템 3.3배
코드로 쓸 수 있는 환경에 한정
Synapse (2023.06)
성공 궤적 통째로 예시로
MiniWoB++ 99.2%
길고 잡음이 많아 핵심 논리를 가린다
ExpeL (2023.08)
과제를 넘나드는 교훈(insight) + 성공 궤적
ALFWorld 40 → 59
교훈이 쌓이기만 한다
AWM (2024.09)
궤적에서 귀납한 '워크플로'(업무 매뉴얼)
WebArena 상대 +51.1%
궤적 전체 단위의 요약 — 입자가 굵다
A-Mem (2025.02)
서로 링크된 제텔카스텐식 노트
LoCoMo에서 기존 최고 대비 향상
주로 대화 기억용으로 설계
LangMem (2025.02)
궤적으로 시스템 프롬프트 자체를 고쳐 씀
(SDK, 논문 없음)
고친 프롬프트가 언제 틀렸는지 추적이 어렵다
Mem0 (2025.04)
사용자에 관한 사실을 추출·통합
LOCOMO에서 OpenAI 메모리 대비 상대 +26%
사실 기억 — '요령'이 아니다
방향은 분명했다. 원본을 통째로 넣던 것(Synapse)에서, 요약된 교훈과 워크플로(ExpeL, AWM)로. 기억 단위가 점점 추상화됐다. 그런데 이 연구들에는 공통된 빈자리가 있었다. 넣는 법은 열심히 연구했는데, 빼는 법은 거의 다루지 않았다.
2.2 경험 추종 — 에이전트는 과거의 자신을 따라 한다
2025년 5월, 하버드의 히마빈두 라카라주, 미시간주립대의 지량 탕 등이 참여한 연구진이 이 빈자리를 정면으로 들여다본 논문을 냈다. Xiong 외, 「메모리 관리는 LLM 에이전트에 어떤 영향을 주나: 경험 추종 행동에 관한 실증 연구」다.
이 논문의 핵심 발견은 경험 추종(experience-following)이다. 새 입력이 저장된 기억과 비슷할수록, 에이전트의 출력도 그 기억의 출력과 비슷해진다. 에이전트는 과거의 자신을 꽤 충실히 따라 한다. 좋은 기억이면 좋은 일이다. 문제는 나쁜 기억도 똑같이 따라 한다는 것이다.
오류 전파(error propagation): 틀린 기억이 꺼내져 → 비슷한 틀린 출력이 나오고 → 그 출력이 다시 기억으로 저장된다. 실수가 스스로 복제된다.
어긋난 경험 재생(misaligned experience replay): 겉보기엔 성공한 실행이었는데 실은 운이 좋았거나 다른 이유로 맞았던 기억이, 새 상황에서 에이전트를 엉뚱한 길로 이끈다.
이 논문은 두 가지 처방을 실험했다. 엄격한 평가자를 통과한 것만 넣는 선택적 추가와, 충분히 여러 번 꺼내 쓴 뒤에도 성과가 나쁜 기억을 지우는 이력 기반 삭제다. 앞으로의 과제 결과를 "공짜 품질 라벨"로 쓰자는 발상이다. ReMe의 삭제 규칙(α=5, β=0.5)은 바로 이 논문에서 왔다.
비유하자면 앞의 것은 물건을 버리지 못하는 사람의 창고이고, ReMe가 지향하는 것은 셰프의 레시피 상자다. 셰프는 모든 요리 과정을 녹화해 두지 않는다. 핵심만 적은 카드를 상황별로 꽂아 두고(색인), 오늘 재료에 맞게 고쳐 쓰고(적응), 더는 안 쓰거나 맛이 없어진 레시피는 버린다(정제).
3. ReMe 한눈에 보기 — 기억의 생애 주기를 닫다
3.1 이상적인 절차 기억의 세 조건
논문은 이상적인 절차 기억이 "단순한 데이터베이스가 아니라 진화하는 인지 기반"이어야 한다며 세 조건을 건다.
고품질 추출
잡음 많은 실행 궤적에서, 문제 하나에 묶인 날것의 관찰이 아니라 일반화되고 재사용 가능한 지식을 증류해야 한다.
과제 기반 활용
꺼낸 기억을 지금 과제의 요구에 맞게 동적으로 적응시켜, 처음 보는 상황에서도 쓸모를 최대화해야 한다.
점진적 최적화
계속 갱신하며 효과 있는 항목은 강화하고 낡은 항목은 제거해 시간이 지나도 품질이 떨어지지 않아야 한다.
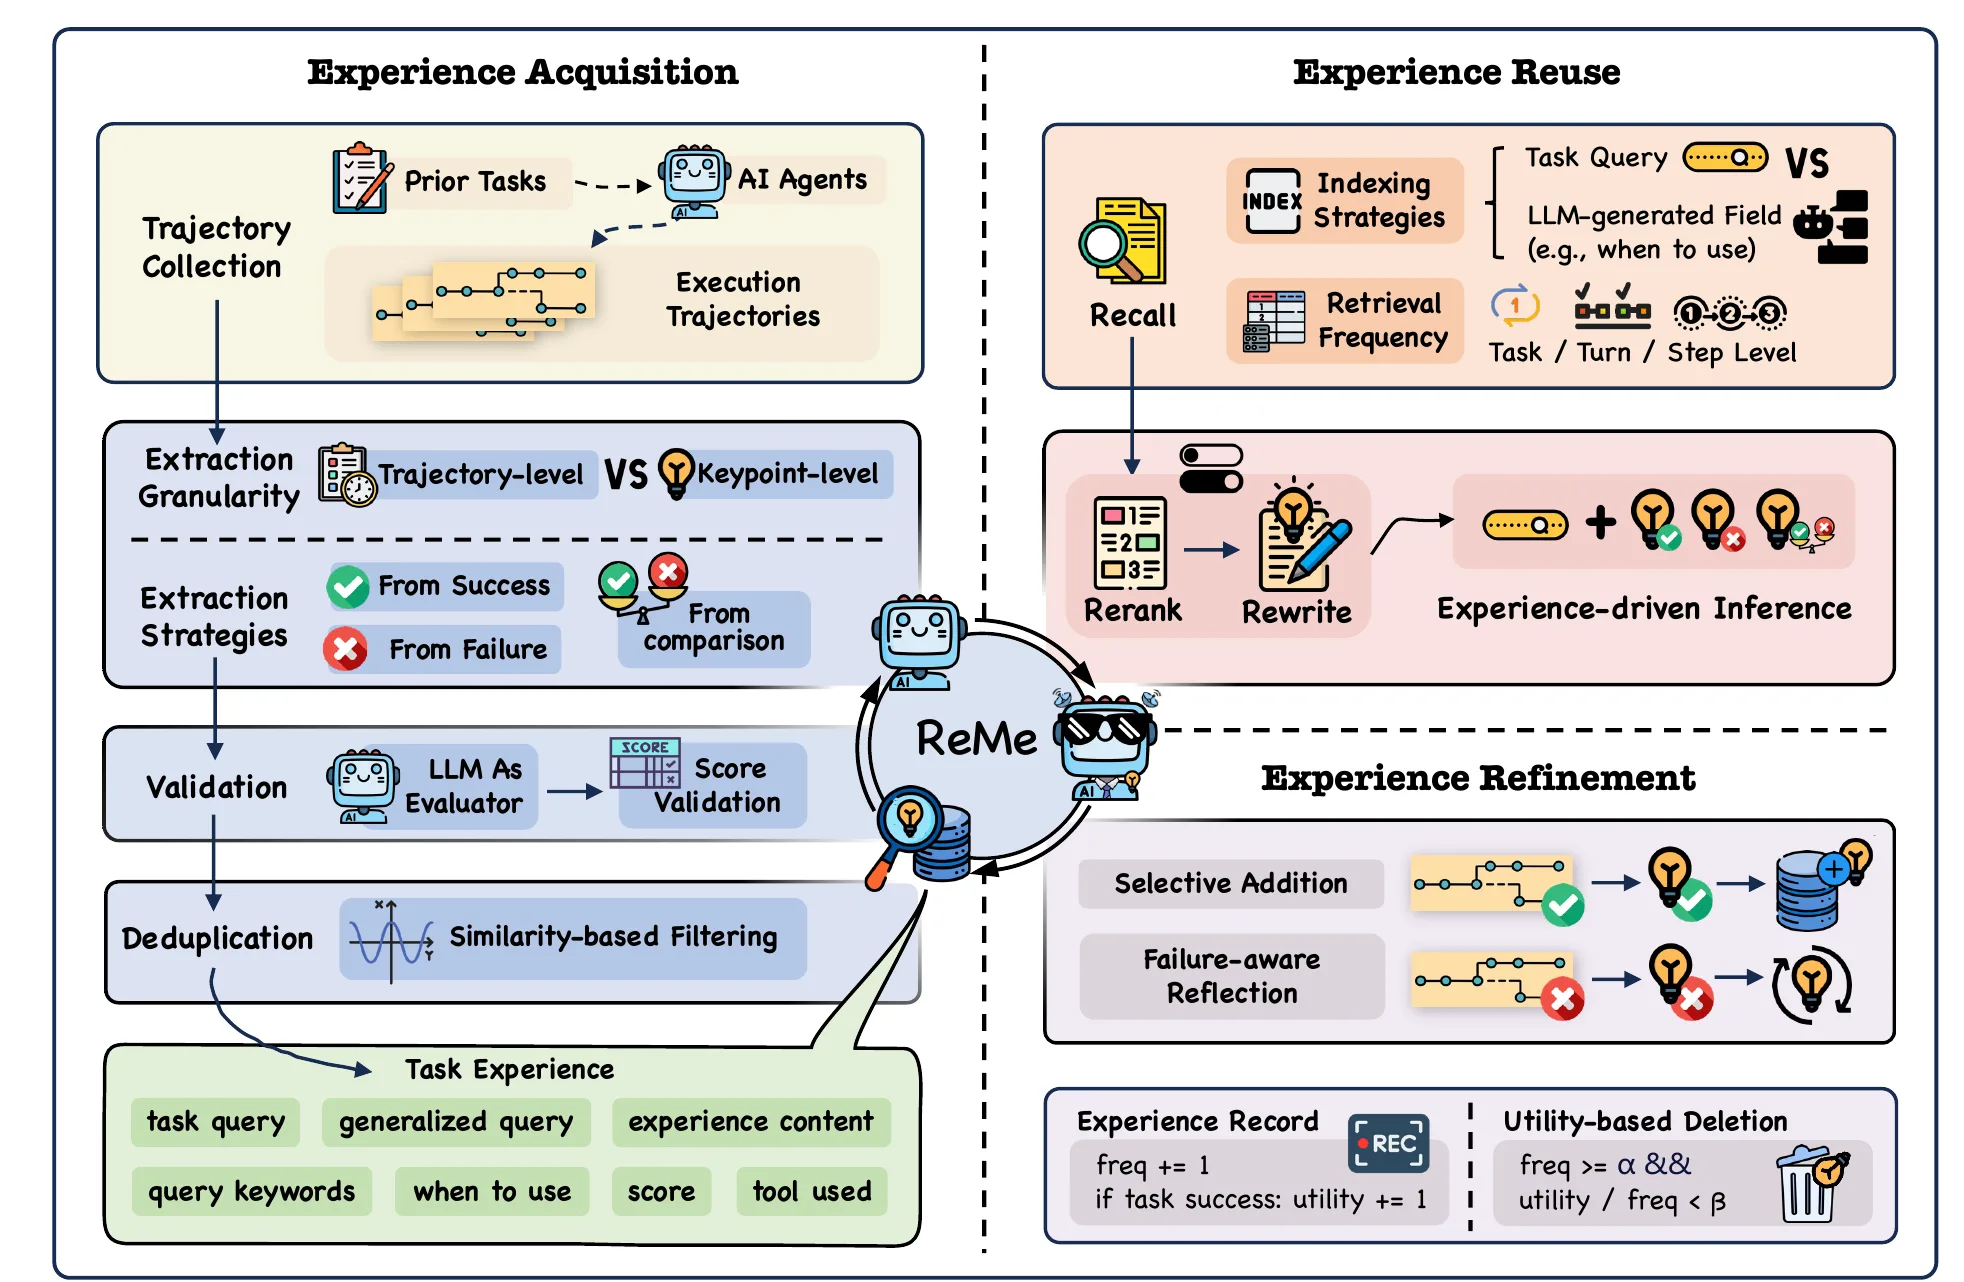
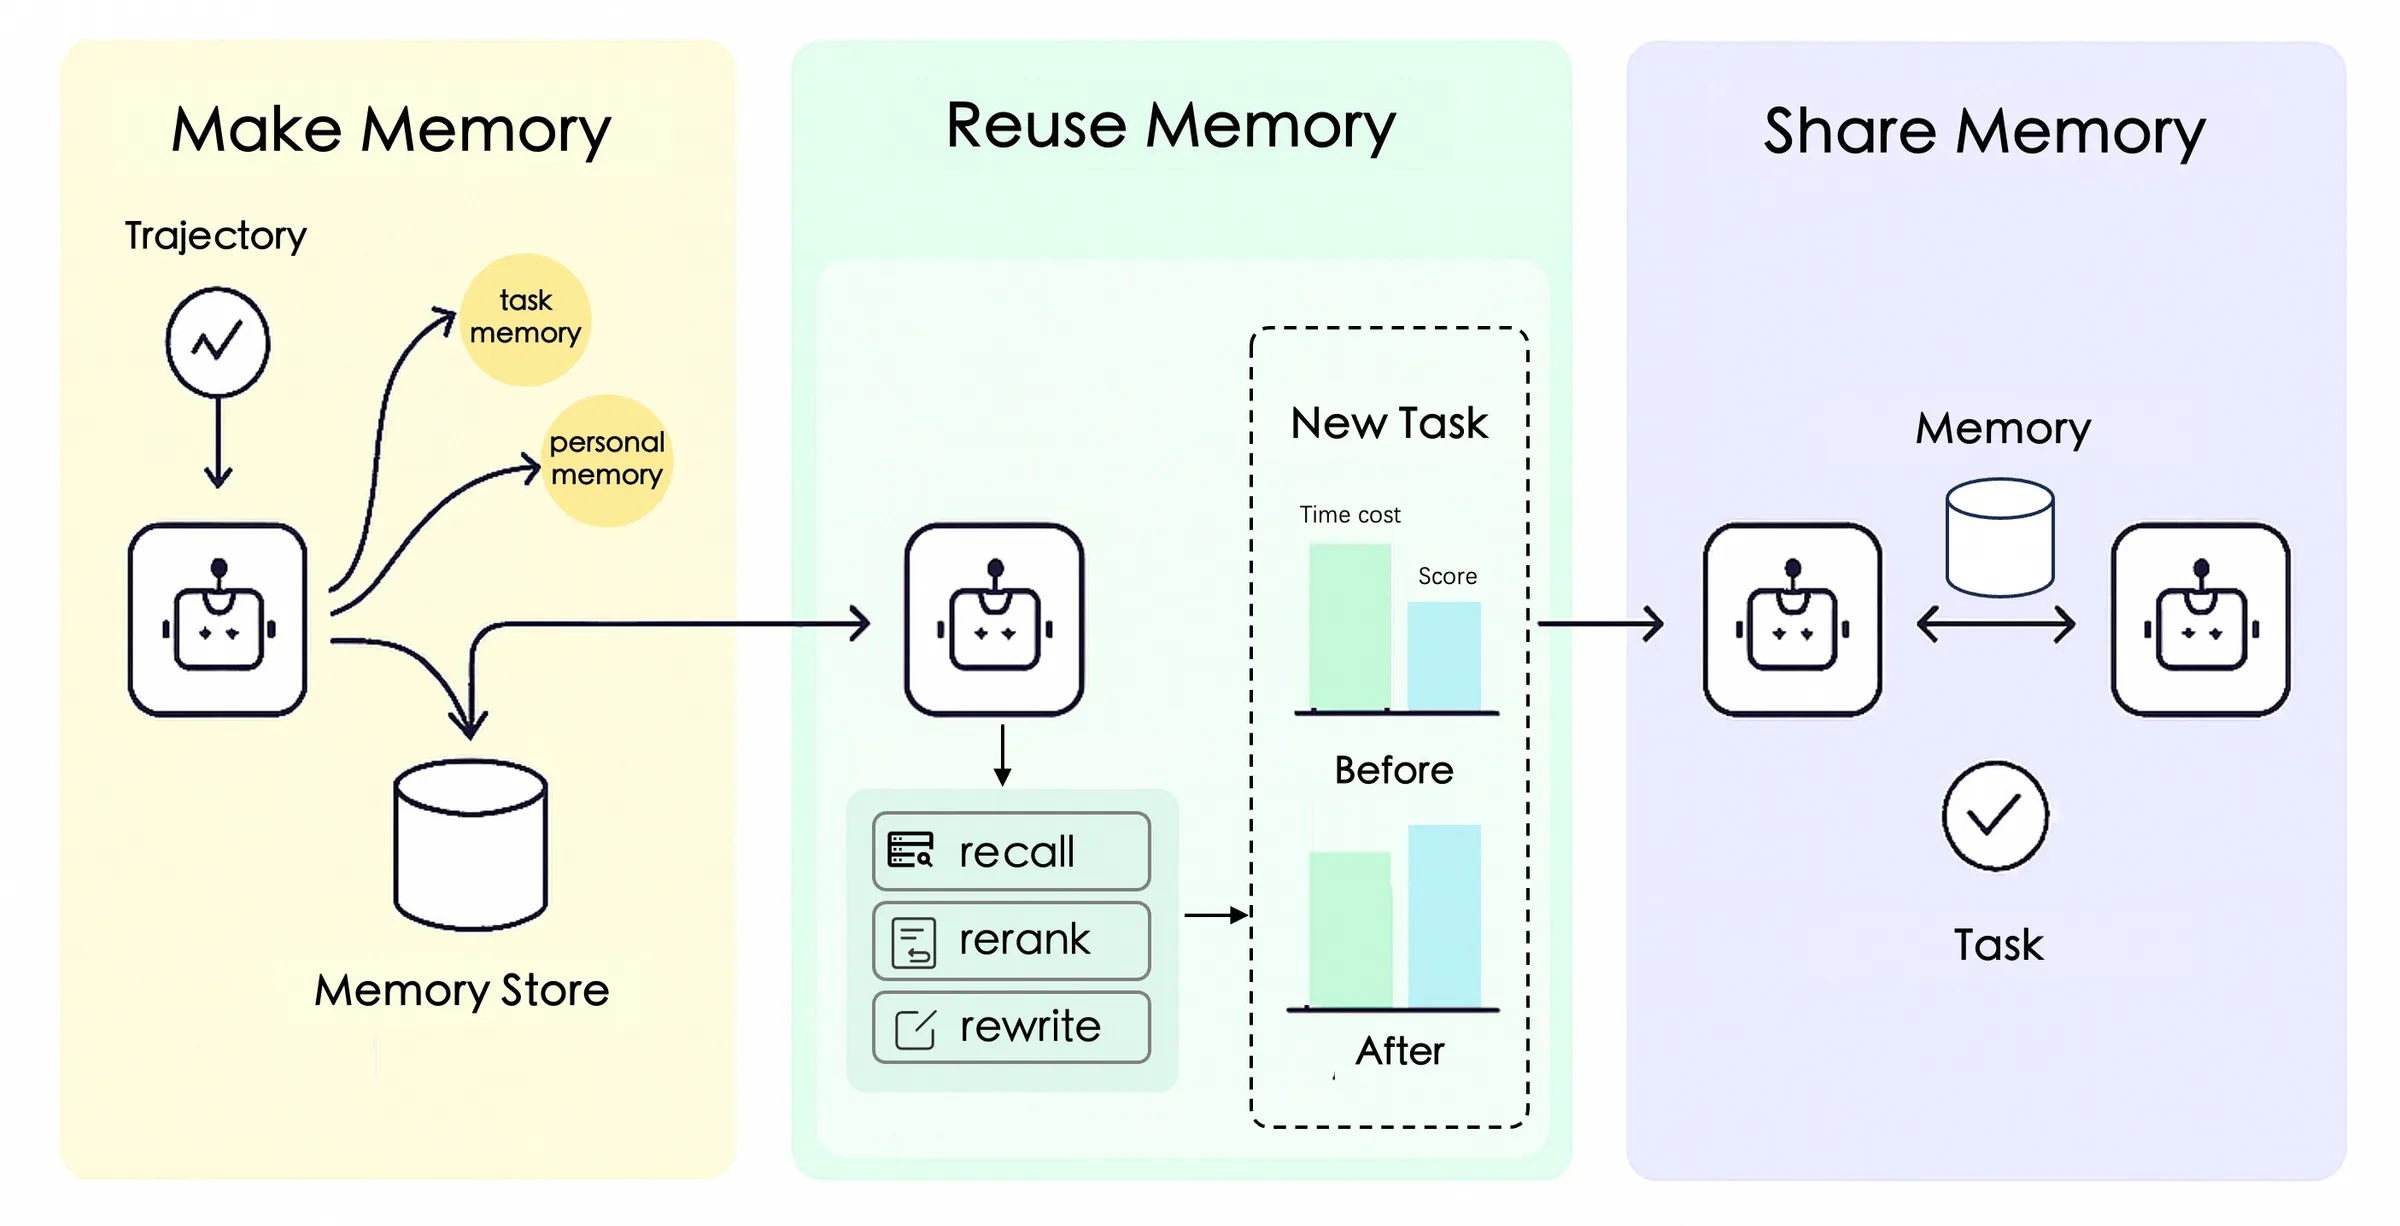
왼쪽 — 경험 획득(Experience Acquisition). 과거 과제를 에이전트가 풀며 남긴 실행 궤적을 모은다(Trajectory Collection). 어떤 입자로 뽑을지(궤적 단위 vs 핵심 지점 단위), 어떤 전략으로 뽑을지(성공에서, 실패에서, 비교에서)를 정한다. 뽑은 경험은 LLM 심판이 점수를 매겨 검증하고(Validation), 비슷한 것끼리 걸러 중복을 없앤 뒤(Deduplication), 맨 아래 초록 상자의 필드들을 가진 과제 경험(Task Experience)으로 저장된다.
오른쪽 위 — 경험 재사용(Experience Reuse). 새 과제가 오면 무엇을 색인 키로 쓸지(과제 질의 그대로 vs LLM이 만든 '언제 쓰나' 필드)와 얼마나 자주 꺼낼지(과제·턴·단계 수준)를 정해 검색한다(Recall). 꺼낸 경험은 선택적으로 재순위(Rerank)와 재작성(Rewrite)을 거쳐, 과제 질의와 함께 '경험 기반 추론'에 들어간다. 전구 아이콘의 초록 체크·빨간 X·혼합 표시는 각각 성공·실패·비교에서 온 경험을 뜻한다.
오른쪽 아래 — 경험 정제(Experience Refinement). 성공한 궤적은 경험으로 증류해 풀에 더하고(Selective Addition), 실패한 궤적은 성찰을 거쳐 재시도한다(Failure-aware Reflection). 맨 아래 두 상자가 핵심이다. 경험이 불려 나올 때마다 freq += 1, 그 과제가 성공하면 utility += 1(Experience Record). 그리고 freq >= α && utility / freq < β이면 휴지통으로(Utility-based Deletion).
3.3 경험 한 장의 해부
ReMe에서 경험 하나는 다섯 칸짜리 카드다. 논문은 이것을 이렇게 쓴다.
E=⟨ω,e,κ,c,τ⟩
경험 카드 E의 다섯 칸 (논문 3.2절, 부록 Table 10의 출력 형식)
ω · when_to_use — 언제 쓰나
"사용자가 구체적 가격 없이 시장가로 주식 주문을 원할 때" — 검색 색인의 키가 되는 칸
e · experience — 핵심 내용
"주문 전에 get_stock_info로 현재가를 받아 place_order에 쓴다. 이 두 단계가 함수의 필수 인자를 지키면서 시장가 주문이라는 사용자 의도에 맞춘다."
κ · tags — 키워드
["stock order", "market price", "real-time data"]
c · confidence — 신뢰도 (0~1)
0.8
τ · tools_used — 쓴 도구
["get_stock_info", "place_order"]
실제 구현에는 여기에 원래의 과제 질의(task_query)와 일반화한 질의(generalized_query)가 함께 붙는다. Figure 2 아래 초록 상자의 칸 이름들이 그것이다. 이 칸들은 뒤에서 '무엇으로 색인할까' 실험의 후보가 된다.
한 가지 짚어 둘 점이 있다. 이 카드는 말로 쓰인 요령이다. Voyager처럼 실행 가능한 코드도 아니고, Synapse처럼 원본 궤적도 아니다. 사람이 읽어도 바로 이해되는 업무 수첩의 한 줄이다. 이 성질 덕분에, 뒤에서 볼 2026년의 ReMe는 이 카드를 아예 마크다운 파일로 바꿔 버릴 수 있었다.
4. 획득 — 세 개의 렌즈로 경험을 증류하다
4.1 같은 문제를 여덟 번 풀게 한다
ReMe는 경험 풀을 만들 때 학습용 과제마다 에이전트에게 같은 과제를 N=8번 풀게 한다. 온도(temperature)를 0.9로 높여, 매번 조금씩 다른 길로 가게 만든다. 목적은 성공과 실패의 쌍을 얻는 것이다. 같은 문제를 어떤 때는 맞히고 어떤 때는 틀려야, "무엇이 차이를 만들었나"를 비교할 수 있다.
여덟 개 궤적을 보상 점수로 줄 세운 뒤, 가장 높은 것과 가장 낮은 것 두 개만 뽑아 분석한다. 점수가 1.0(만점)을 넘으면 성공 궤적, 아니면 실패 궤적이다.
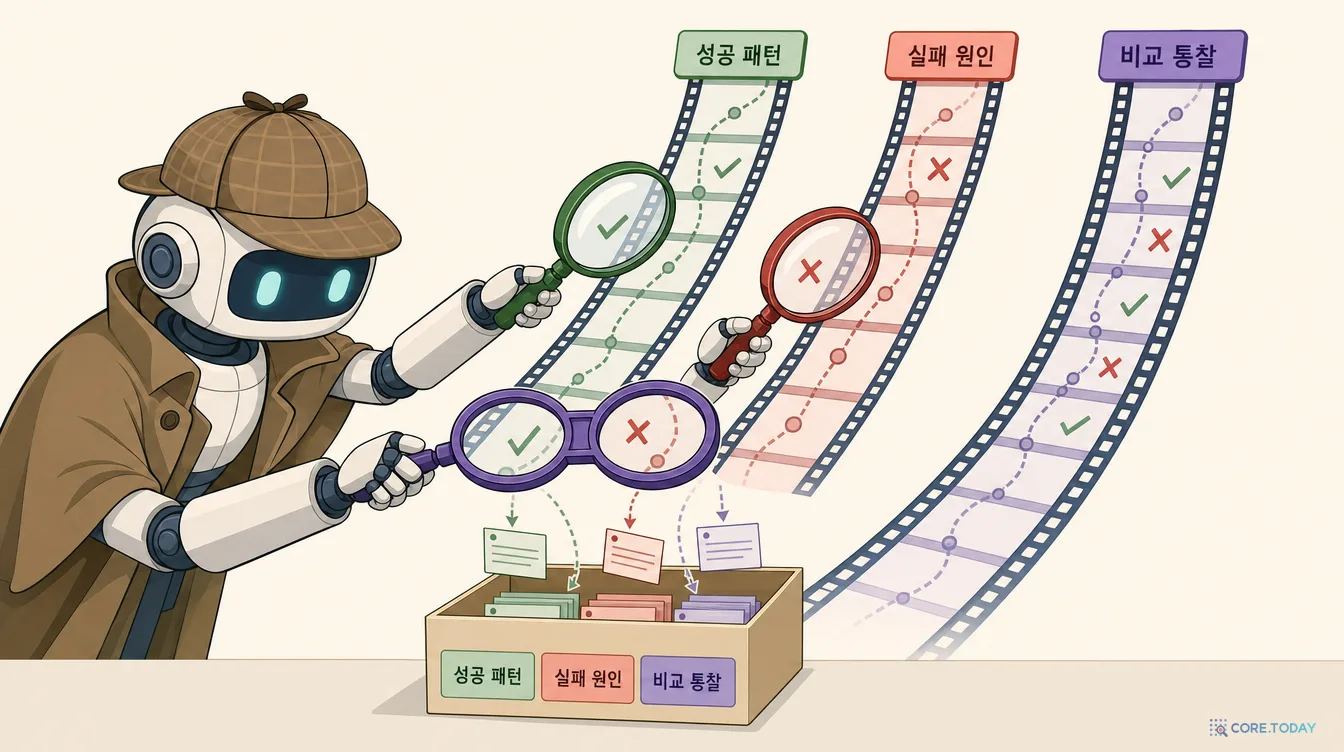
요약 모델(LLMsumm)은 이 궤적들을 세 가지 렌즈로 본다. 논문 부록의 실제 프롬프트(Table 10~12)를 보면 각 렌즈의 성격이 분명하다.
요약 모델의 세 렌즈 (부록 Table 10·11·12 발췌 번역)
성공 패턴 인식"당신은 AI 에이전트 실행의 성공한 단계 시퀀스를 검토하는 전문 분석가다. 성공에 기여한 구체적 패턴·기법·결정 지점을 찾아라. 전이 가능한 기법과 판단 틀에 집중하고, 통찰을 실행 가능한 지침과 모범 사례로 표현하라." → 1~3개의 성공 경험
실패 분석"실패한 단계 시퀀스에서 같은 실수를 막을 교훈을 뽑아라. 어디서, 왜 잘못됐는지 짚고, 반복되는 실수 패턴과 대안을 찾아라. 일반 원칙과 구체적 지시를 함께." 부록은 특히 "차선의 결과로 이어진 가장 이른 핵심 단계"를 찾게 한다. → 1~3개의 예방 교훈
비교 통찰 생성"점수가 높은 시퀀스와 낮은 시퀀스를 비교해 무엇이 높은 쪽을 더 효과적으로 만들었는지 찾아라. 둘 다 부분적으로 성공했더라도." → 1~2개의 개선 통찰
세 렌즈는 서로 다른 것을 잡는다. 성공 패턴은 "이렇게 하면 된다", 실패 분석은 "여기서 이렇게 하면 망한다", 비교 통찰은 "이 한 끗이 차이였다"다. 세 번째가 특히 강력하다. 같은 과제를 두고 잘한 판과 못한 판을 나란히 놓으면, 혼자서는 보이지 않던 결정적 차이가 드러난다. 바둑 기사가 이긴 대국과 진 대국의 기보를 나란히 놓고 복기하는 것과 같다.
부록 Figure 9의 AppWorld 사례가 비교 통찰의 전형이다.
언제 쓰나: 정확한 인증 파라미터와 데이터 추출이 필요한 API를 다룰 때.
내용: 점수가 높은 접근은 실행 전에 API 명세 검증을 우선했고(예: 전화 로그인은 전화번호를 username으로 써야 함을 확인), 인증 실패에 대한 견고한 오류 처리를 구현했으며, 정밀한 데이터 추출 기법(태그·쿼리 필터를 쓴 search_notes)을 썼다. 점수가 낮은 접근은 같은 인증 오류를 반복했고, 코드 블록에 설명 문장을 섞어 문법 오류를 냈으며, 비효율적인 문자열 파싱으로 깨끗한 제목 대신 메타데이터를 남겼다.
잘한 판과 못한 판의 차이가 세 가지로 또렷하게 정리돼 있다. 이런 카드는 한 판만 봐서는 쓸 수 없다.
4.3 검증과 중복 제거 — 들어오는 문을 좁힌다
증류된 경험은 바로 저장되지 않는다. 두 개의 관문을 더 지난다.
① LLM 심판 검증. 다른 프롬프트(Table 13)가 경험을 다섯 기준으로 채점한다. 실행 가능성(미래 행동을 안내할 만큼 구체적인가), 정확성(관찰된 패턴을 제대로 반영하나), 관련성(비슷한 미래 상황에 적용되나), 명료성, 고유성(새로운 통찰인가, 상식인가). 0~1점을 매겨 0.3 미만이거나 근본적 문제가 있으면 탈락이다. 공개 코드(v0.2)의 기본 설정은 더 엄격해서 0.5 미만을 거른다.
② 유사도 기반 중복 제거. 새 경험을 임베딩해 기존 경험들과 코사인 유사도를 재고, 임계값을 넘으면 '이미 있는 이야기'로 보고 버린다. 경험 풀을 작게 유지해 검색을 빠르게 하고, 꺼낸 경험들이 서로 다른 이야기를 하도록(다양성) 만드는 장치다.
4.4 궤적 단위 vs 핵심 지점 단위 — 매뉴얼 한 권보다 메모 한 줄
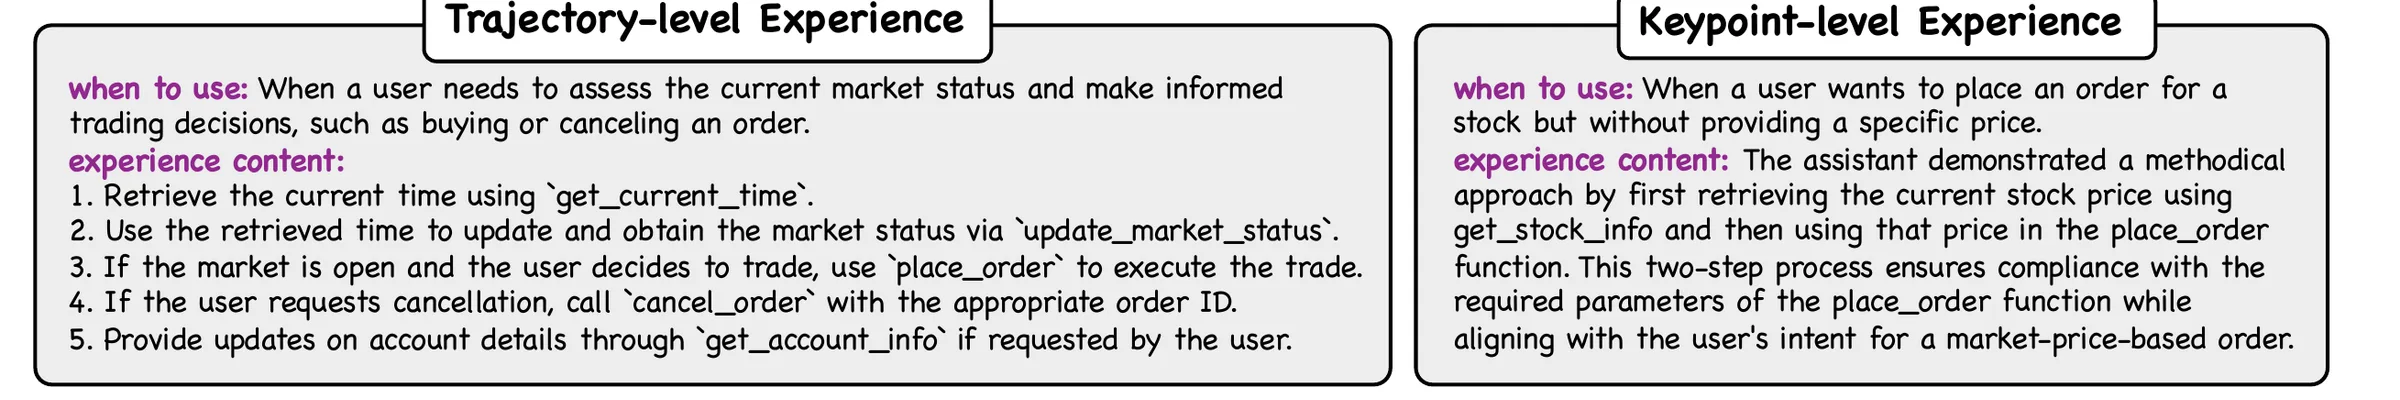
이 장의 가장 중요한 실험은 경험의 입자도(granularity)다. 같은 궤적에서 무엇을 뽑을 것인가.
왼쪽 궤적 단위 경험은 성실한 업무 매뉴얼이다. 다섯 단계를 순서대로 적었다. 그런데 정작 월요일의 실수(가격을 지어낸 것)를 막을 내용은 어디에도 없다. 3번 단계 "place_order로 거래를 실행하라"는 맞는 말이지만, 가격을 어디서 가져오라는 말이 없다. 오른쪽 핵심 지점 단위 경험은 짧다. 대신 실패와 성공을 가른 바로 그 지점만 콕 집는다.
결과는 분명했다(Table 2, ReMe 고정 설정, BFCL-V3).
8B · 궤적 단위 Pass@4 상승
+0.45
8B · 핵심 지점 Pass@4 상승
+6.22
14B · 궤적 단위 Pass@4 상승
+1.11
14B · 핵심 지점 Pass@4 상승
+4.22
(막대 길이는 가장 큰 상승폭 +6.22를 100%로 둔 비율이다.) 궤적 단위 경험은 Qwen3-8B의 Pass@4를 겨우 0.45점 올렸고, 핵심 지점 단위는 6.22점 올렸다. 14배 차이다. 매뉴얼 한 권을 통째로 주면 에이전트는 오히려 핵심을 놓친다. 2026년 4월 KAIST 연구진(김강산·황성주 등)의 코딩 에이전트 연구도 같은 방향의 증거를 냈다. 도메인을 넘나드는 기억 풀에서 높은 수준의 통찰은 잘 옮겨 가지만, 낮은 수준의 궤적은 오히려 부정적 전이를 일으킨다.
4.5 공개된 경험 도서관, reme.library
논문은 이렇게 만든 경험들을 reme.library라는 데이터셋으로 공개했다고 밝힌다. 저장소의 옛 버전(v0.2.0.6 태그) docs/library/에 실제 파일이 있다. 논문 실험에 쓰인 경험만 세어 보면 이렇다.
파일
경험 수
성공 / 실패 / 비교에서 온 경험
BFCL-V3 · Qwen3-8B
96
48 / 42 / 6
BFCL-V3 · Qwen3-14B
110
54 / 42 / 14
BFCL-V3 · Qwen3-32B
99
44 / 41 / 14
AppWorld · Qwen3-8B
207
28 / 152 / 27
AppWorld · Qwen3-14B
218
47 / 141 / 30
AppWorld · Qwen3-32B
184
43 / 81 / 60
흥미로운 패턴이 보인다. 어려운 AppWorld에서 작은 모델일수록 실패에서 온 경험이 압도적으로 많다(8B는 207개 중 152개). 성공을 거의 못 하니 배울 거리가 실패뿐이었다는 뜻이다. 반대로 32B로 가면 비교 통찰이 60개로 늘어난다. 성공과 실패가 섞여 나와야 비교할 거리가 생기기 때문이다. 같은 요약 프롬프트라도 에이전트의 실력이 어떤 종류의 경험이 쌓이는지를 바꾼다. 이외에도 중국 금융·주식 리서치 경험 1,600여 개가 함께 공개돼 있다.
5. 재사용 — 꺼내고, 고르고, 고쳐 쓰다
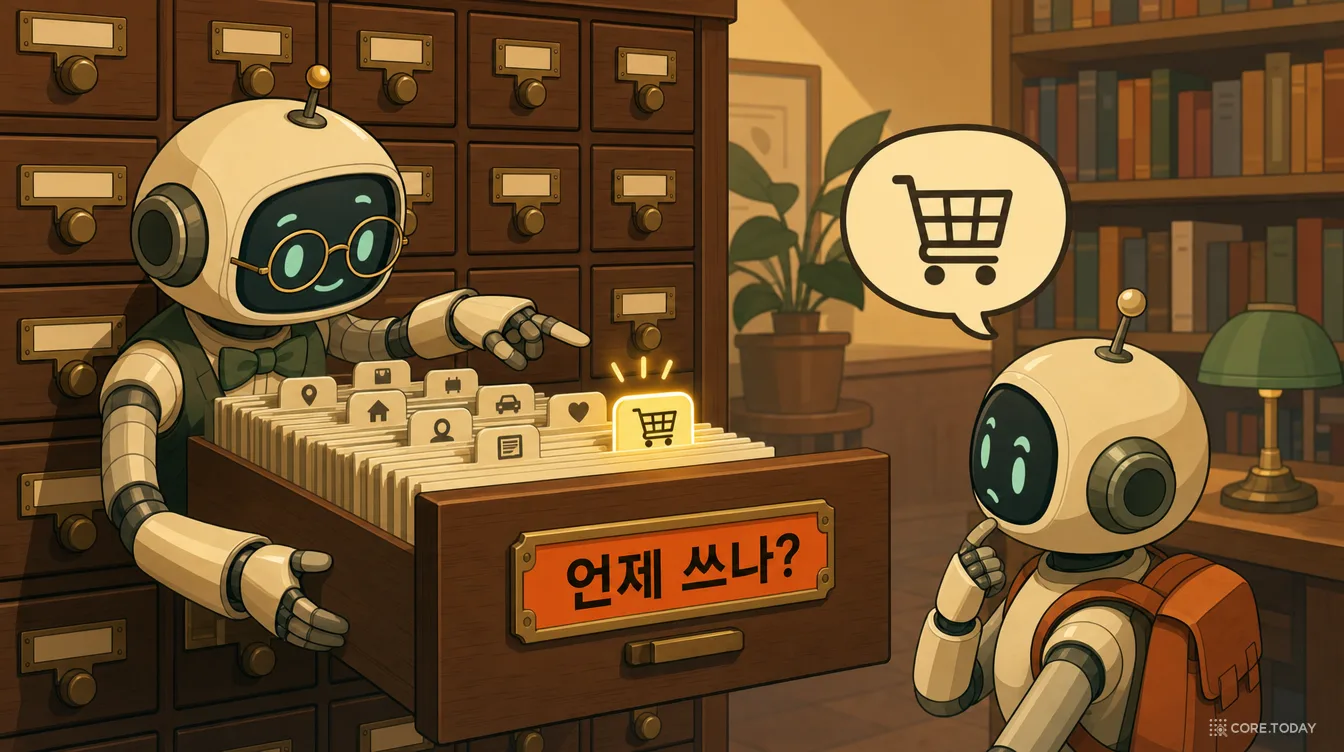
5.1 '무슨 일이냐'가 아니라 '언제 쓰냐'로 찾는다
경험 풀이 생겼으면 새 과제가 왔을 때 맞는 경험을 꺼내야 한다. 여기서 ReMe의 가장 영리한 설계 하나가 나온다. 경험을 무엇으로 색인하는가.
가장 단순한 방법은 경험을 만든 원래 과제의 문장("테슬라 150주를 시장가로…")으로 색인하는 것이다. 그런데 이러면 '테슬라'와 '150주'라는 표면의 단어에 끌려간다. 다음 과제가 "엔비디아 30주, 지금 가격으로"라면 단어가 거의 겹치지 않는다. 반대로 "테슬라 주가 알림을 걸어 줘"는 '테슬라' 때문에 가깝게 잡히지만 쓸모없는 경험이다.
ReMe는 LLM이 생성한 "언제 쓰나(when to use)" 문장의 임베딩으로 색인한다. "사용자가 가격 없이 시장가 주문을 원할 때"는 종목 이름과 무관하게 상황을 기술한다. 엔비디아든 애플이든, 가격을 말하지 않은 주문이라면 이 경험이 잡힌다.
실험 결과(Figure 4, 부록 Table 9) 사용 상황 색인이 세 모델 크기 모두에서 Pass@4 1위였다(8B 65.77, 14B 72.44, 32B 74.89). 다만 정직하게 말하면 차이는 1~2점 안팎이고, 32B의 Avg@4에서는 키워드(56.89)나 원래 질의(56.22)가 사용 상황(56.05)보다 높았다. '압승'이라기보다 '일관되게 상위권'인 선택이다. 이 수치는 뒤의 절제 실험실 위젯에서 직접 비교해 볼 수 있다.
검색 자체는 표준적이다. 새 과제 문장과 각 경험의 '언제 쓰나'를 임베딩(Qwen3-Embedding, 실험에서는 알리바바 text-embedding-v4의 1024차원)해 코사인 유사도로 상위 K개를 꺼낸다. 저장소는 Elasticsearch다.
재순위(Rerank, Table 14). LLM이 후보 경험들을 이번 과제의 구체적 맥락·제약·목표에 비춰 다시 줄 세운다. 기준은 직접 관련성, 상황 유사성, 실행 가능성, 품질이다. 임베딩 유사도는 '말이 비슷한가'를 재지만, 재순위 LLM은 '이 과제의 급소에 맞는가'를 판단한다.
재작성(Rewrite, Table 15). 여러 장의 경험을 따로따로 붙이지 않고, 이번 과제를 위해 쓴 것처럼 느껴지는 하나의 지침으로 고쳐 쓴다. 프롬프트의 지시가 재미있다. "분리된 팁 대신 흐르는 서사를 만들어라", "용어와 예시를 현재 과제의 도메인에 맞춰라", "겹치는 통찰은 하나의 권고로 합쳐라", "이 과제를 위해 맞춤 제작된 것처럼 느껴지게 하라."
이 두 단계의 효과는 Table 4에 있다(Qwen3-8B, 생각 모드 끔). 둘 다 끄면 Pass@4 34.66, 재순위만 36.67, 재작성만 37.33, 둘 다 켜면 40.67이다. 6점이 오른다.
아래 위젯에서 세 가지 새 과제가 이 파이프라인을 어떻게 통과하는지 단계별로 넘겨 보자.
5.3 몇 장을 꺼낼까 — 많을수록 좋지 않다
꺼낼 경험의 개수 K는 어떻게 정할까. 논문은 K를 0부터 10까지 바꿔 봤다(Figure 5). Pass@4는 0개일 때 59.55에서 5개일 때 65.77로 오르고, 그 뒤로는 64~65 사이를 오르내린다. Avg@4도 5개에서 44.50으로 정점을 찍고 10개에서 43.66으로 내려온다.
이유는 직관적이다. 경험을 많이 넣을수록 덜 맞는 경험이 섞일 확률이 커진다. 앞에서 본 경험 추종 때문에, 에이전트는 섞여 들어온 엉뚱한 경험도 따라 하려 든다. 프롬프트는 공짜가 아니다. 그래서 논문은 K=5를 골랐다.
6. 정제 — 무엇을 넣지 않고, 무엇을 버릴 것인가
여기부터가 이 논문의 이름 뒤쪽, Refine Me다. 논문은 이렇게 문제를 연다. "정적인 경험 풀은 과제 분포의 변화나 모델 능력의 향상에 적응하지 못해, 꺼낸 경험이 점점 무관해진다." 정제는 세 장치로 이뤄진다.
6.1 선택적 추가 — 실패 한 번으로 쓴 교훈은 믿지 않는다
테스트 중에도 경험 풀을 키우는 '동적' 모드에서, 새 궤적을 어떻게 경험으로 만들까. 논문은 두 전략을 비교했다.
전부 추가(full addition): 성공이든 실패든 모든 새 궤적에서 경험을 뽑아 넣는다.
선택적 추가(selective addition): 성공한 궤적에서만 경험을 뽑아 넣는다.
결과는 선택적 추가의 완승이었다(Table 3: Avg@4 40.83 → 44.33, +3.50). 실패에서도 배울 게 있다던 앞 장과 모순 같지만, 논문의 설명은 설득력 있다. 처음 경험 풀을 만들 때는 같은 과제를 여덟 번 풀어 실패 여러 개와 성공을 함께 놓고 분석할 수 있었다. 하지만 실시간 실행 중에는 실패 궤적이 달랑 하나다. 한 번의 실패만 보고는 왜 실패했는지 정확히 짚기 어렵고, 엉뚱한 교훈이 쓰이기 쉽다. 반면 성공한 궤적은 꾸준히 믿을 만한 교훈을 준다.
신입사원에 비유하면, 첫 달 연수 때는 선배들이 실패 사례 열 개를 모아 같이 복기해 줬다. 하지만 실전에서 한 번 틀렸다고 그 자리에서 "이건 원래 이렇게 하면 안 되는 거구나"라고 수첩에 적으면, 그 메모는 틀릴 가능성이 높다.
공개 코드도 이 원칙을 지킨다. AppWorld 실험 에이전트는 새로 추가한 경험이 있더라도 그 판의 점수가 만점이 아니면 방금 추가한 경험을 도로 지운다.
6.2 실패 인식 성찰 — 실패하면 다시, 단 세 번까지
그렇다고 실패를 버리지는 않는다. 새 과제에서 실패하면 요약 모델이 그 시도를 분석해 개선할 지점에 관한 통찰을 뽑고, 실행 모델이 그 교훈을 들고 새로 시도한다. 재시도가 성공하면 그때 비로소 그 교훈을 기억에 넣는다. 실패하면 교훈은 버려진다. 검증된 교훈만 남긴다는 원칙은 그대로다.
모델의 근본적 한계 때문에 끝없이 맴도는 것을 막으려고 성찰은 최대 3번으로 제한한다. Reflexion 연구에서 성능이 처음 두 번의 시도 사이에 가장 크게 오른다는 관찰을 따른 값이다. 이 장치는 Table 3에서 Avg@4를 0.67점 더 올렸다.
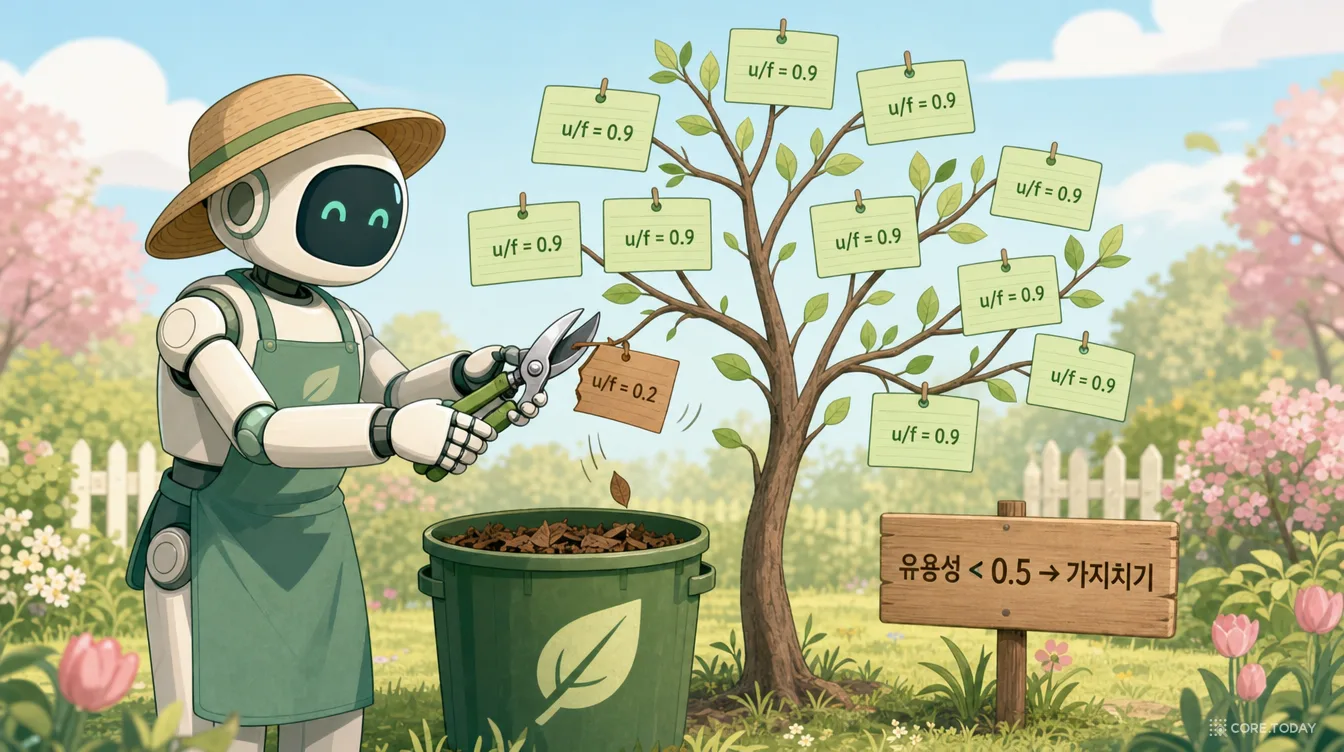
f ≥ α (최소 다섯 번은 지켜본다): 한두 번의 운 나쁜 실패로 좋은 경험을 자르지 않기 위한 장치다. 신입에게 한 번 실수했다고 사표를 받지 않는 것과 같다.
u/f ≤ β (기여율이 낮으면 자른다): 자주 불려 나온다는 것은 '언제 쓰나'가 많은 과제와 비슷하다는 뜻이다. 그런데 성공에 기여를 못 한다면, 그 경험은 자주 나타나서 방해하는 가장 해로운 부류다. 아예 안 불려 나오는 경험은 해를 끼치지도 않으니 굳이 지우지 않는다.
실제 코드도 정확히 이 모양이다. 저장소의 v0.2 delete_memory_op.py에서 옮기면 다음과 같다.
검색될 때마다 freq += 1, 그 과제의 점수가 만점이면 utility += 1이다. 원리는 단순하지만 효과는 Table 3에 나온다. 삭제를 더하자 Pass@4가 64.66에서 68.00으로 3.34점 올랐다.
!
α와 β는 어디서 왔나
논문은 이 값을 Xiong 외(2025)를 따라 정했다고 밝힌다. 그런데 Xiong 외에서 β=0.5는 합성 환경(RegAgent) 하나의 설정이었고, 의료 기록 에이전트에서는 평가자의 엄격함에 따라 0.3 또는 0.7을 썼다. 즉 α=5, β=0.5는 보편 상수가 아니라 환경마다 다시 맞춰야 할 손잡이다.
아래 시뮬레이터에서 직접 손잡이를 돌려 보자. 다섯 종류의 과제가 160번 들어오고, 경험 풀에는 처음부터 좋은 경험과 해로운 경험이 섞여 있다. 60번째 과제에서는 송금 API가 바뀌어, 어제까지 맞던 경험 하나가 오늘부터 틀린 경험이 된다.
시뮬레이터에서 β를 0으로 내려 삭제를 끄면, 선택적 추가만으로도 수동 축적보다는 낫지만 해로운 경험이 끝까지 남아 그 시나리오의 성공률을 깎는다. 반대로 α를 1로 낮추면 운 나쁜 첫 실패 한 번에 멀쩡한 경험까지 잘려 나간다. 그리고 하나 더 — 같이 불려 나온 경험들은 성공과 실패를 함께 나눠 받는다. 좋은 경험이 해로운 짝꿍과 함께 불려 나오면 둘 다 u/f가 내려간다. 논문의 규칙은 '누가 기여했는지'를 따로 가리지 않는다. 이 기여도 배분(credit assignment) 문제는 뒤의 한계 절에서 다시 다룬다.
6.4 실제 사례: 우리 에이전트의 메모 수첩
이 글을 만드는 데도 같은 문제가 있었다. 코어닷의 블로그 제작에 쓰는 코딩 에이전트는 작업 디렉터리마다 MEMORY.md라는 메모 수첩을 둔다. 몇 주 전, 에이전트는 이미지 생성 API에 대해 이런 교훈을 적었다. "16:9로 요청해도 결과는 항상 세로 3:4로 온다. 가운데를 잘라 써라." 그때는 맞는 말이었다. 며칠 뒤 다른 모델을 시험해 보니 그 모델은 16:9를 제대로 지켰다. 에이전트는 수첩에 "이 모델은 16:9를 지킨다. 가로 그림의 기본값으로 쓴다"를 덧붙였다.
만약 덧붙이지 않았다면 어떻게 됐을까. 에이전트는 멀쩡한 가로 그림을 받고도 '어차피 세로일 테니' 잘라 내는 수고를 계속했을 것이다. 경험 추종의 전형이다. 절차 기억은 쓰는 순간보다 고치는 순간이 더 중요하다. ReMe의 유용성 점수는 그 '고칠 때'를 사람 대신 성공률로 알아차리려는 장치다.
7. 실험 — 기억이 덩치를 이길 때
7.1 시험장: BFCL-V3와 AppWorld
ReMe는 도구를 쓰는 에이전트용 벤치마크 두 개에서 시험을 쳤다.
BFCL-V3(버클리 함수 호출 리더보드 v3): 여러 턴에 걸쳐 정확한 API 호출을 이어 가야 하는 과제. 기본 멀티턴 200개 중 50개로 경험 풀을 만들고 150개로 평가했다(공식 학습 세트가 없어서). 앞의 주식 거래 사례가 여기서 나왔다.
AppWorld: 이메일·Spotify·Venmo 등 일상 앱 9개, API 457개, 가상 사용자 약 100명이 사는 시뮬레이션 세계. 에이전트는 코드를 써서 앱을 조작한다. 학습 과제 90개로 경험 풀을 만들고 test-normal 168개로 평가했다.
지표는 둘이다. Avg@4는 같은 과제를 네 번 독립적으로 시켰을 때의 평균 성공률, Pass@4는 네 번 중 한 번이라도 성공할 확률이다. 모든 결과는 세 번 실행의 평균이다. 실행 모델과 요약 모델은 같은 Qwen3 모델을 쓴다. 에이전트가 스스로 쓴 일지로 스스로 배우는 설정이다.
비교 대상은 기억 없음, A-Mem, LangMem이다. 공정하게 하려고 모든 방법이 과제 시작 때 한 번만 검색하고, 성공 궤적에서만 기억을 추가하게 맞췄다. ReMe는 두 버전이다. 고정(fixed)은 학습 과제로 만든 경험 풀을 그대로 쓰고, 동적(dynamic)은 평가 중에도 추가·성찰·삭제를 계속한다.
7.2 성적표
위젯에서 몇 가지를 꼭 확인해 보자.
① ReMe(동적)는 모든 크기·모든 벤치마크에서 1등이다. Qwen3-8B 기준 두 벤치마크 평균이 기억 없음 대비 Avg@4 27.65 → 34.94(+7.29), Pass@4 46.20 → 55.03(+8.83)이다. 특히 어려운 AppWorld에서 차이가 크다. 8B의 AppWorld Avg@4가 14.97에서 24.70으로, 32B는 27.23에서 42.02로 오른다.
② 기억이 오히려 해가 되는 경우가 있다. 8B의 AppWorld를 보라. A-Mem 12.95, LangMem 11.46으로 둘 다 기억 없음(14.97)보다 낮다. 대화 기억용으로 설계된 시스템을 절차 기억에 쓰면, 꺼낸 기억이 오히려 작은 모델을 헷갈리게 한다. "기억을 붙이면 좋아진다"는 가정 자체가 공짜가 아니라는 증거다. (공정을 위해 덧붙이면, LangMem은 절차 기억용 프롬프트 최적화가 아니라 일화 기억 추출기를 썼고, A-Mem은 절차 기억을 뽑도록 프롬프트를 조금 고쳐 재현했다.)
③ 동적은 언제나 고정보다 낫다. 같은 경험 풀에서 출발해도, 실행 중에 더하고 지우는 쪽이 모든 칸에서 이긴다. 32B의 AppWorld Avg@4는 고정 31.50, 동적 42.02로 10점 넘게 벌어진다. 정제가 장식이 아니라는 뜻이다.
Avg@4 평균: 8B + ReMe 34.94 vs 14B 35.62 — 오히려 14B가 앞선다.
벤치마크별로 보면 AppWorld에서는 두 지표 모두 8B + ReMe가 이기고(24.70 vs 22.57, 42.06 vs 41.07), BFCL-V3에서는 두 지표 모두 14B가 이긴다(45.17 vs 48.66, 68.00 vs 68.22).
더 깔끔한 증거는 한 칸 위에 있다. Qwen3-14B + ReMe는 기억 없는 Qwen3-32B를 두 지표 모두에서 앞선다(Avg@4 44.66 vs 40.89, Pass@4 63.71 vs 61.52). 모델 크기를 두 배 넘게 키우는 대신 기억을 다듬는 것으로 같은 효과 이상을 얻은 셈이다.
이것이 왜 중요한가. 2026년의 에이전트 운영 비용은 대부분 추론 비용이다. 14B 대신 8B를, 32B 대신 14B를 돌릴 수 있다면 GPU 메모리와 지연, 전기료가 크게 준다. 논문이 이것을 "메모리 스케일링 효과"라 부르며 "기억의 품질이 모델 규모를 대신할 수 있다"고 주장하는 이유다. 정확히는 "대신할 수도 있다, 특히 앱 환경처럼 반복되는 절차가 많은 곳에서"라고 읽는 편이 안전하다.
(작은 오탈자 하나: 논문 본문은 평균 향상폭을 "Avg@4 8.83%, Pass@4 7.29%"라고 적었지만, Table 1에서 계산하면 Avg@4가 +7.29, Pass@4가 +8.83이다. 두 숫자가 뒤바뀌어 있다.)
7.4 다른 회사 모델에서도 통하나
Qwen만의 이야기가 아닌지 확인하려고, 논문은 GPT-4.1, o4-mini, Qwen3-Max, Kimi-K2-Thinking, DeepSeek-V3.2, GLM-4.7 여섯 모델에도 ReMe를 붙였다(위젯의 'Table 7' 탭). 여섯 모두 올랐다. 상승폭은 DeepSeek-V3.2의 +4.27에서 Kimi-K2-Thinking의 +8.83까지다. 이미 BFCL-V3에서 68%를 내는 GLM-4.7도 73.83%로 오른다. 추론형 모델(o4-mini, Kimi-K2-Thinking)에서도 효과가 있다는 점이 눈여겨볼 만하다. 스스로 길게 생각하는 모델도 "지난번엔 여기서 틀렸다"는 외부 기억에서 얻는 게 있다.
7.5 부품을 하나씩 빼 보면
절제 실험을 한 줄씩 요약하면 이렇다.
추가·성찰·삭제(Table 3): 가장 큰 계단은 '무엇을 넣지 않을지' 정한 선택적 추가(+3.50 Avg@4)다. 양보다 질이다. 삭제는 Pass@4를 +3.34 올린다.
재순위·재작성(Table 4): 각각 2점 안팎, 함께 쓰면 Pass@4 +6.
입자도(Table 2): 핵심 지점 단위가 궤적 단위를 압도한다.
검색 키(Table 9): 사용 상황(when to use)이 일관되게 상위권이지만 차이는 작다.
K(Figure 5): 5개에서 포화, 그 이상은 잡음.
요약 모델 크기(Table 5): 일하는 모델은 8B로 두고 일지 쓰는 모델만 32B로 바꾸면 Avg@4가 +3.33 오른다. '무엇을 배웠는지 적는 능력'이 병목이라는 뜻이다. 신입이 아니라 선임이 업무 일지를 정리해 주면 신입의 성과가 오른다.
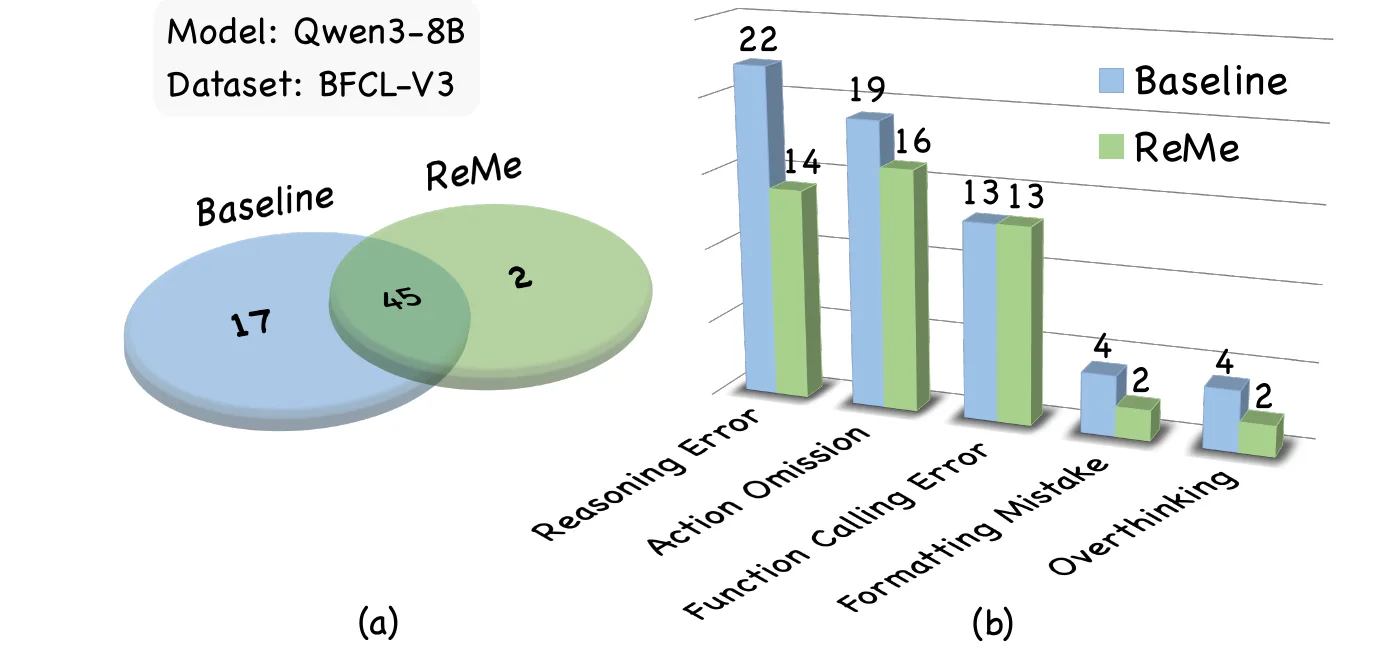
논문은 Qwen3-8B의 BFCL-V3 실패를 사람이 하나하나 분류했다. 실패한 과제는 62개에서 47개로 줄었다. 왼쪽 벤 다이어그램을 보면 ReMe가 기억 없음의 실패 17개를 고치고, 새로운 실패는 2개만 만들었다. 기억이 '부작용'을 거의 일으키지 않았다는 점이 중요하다.
오른쪽 막대에서 가장 크게 줄어든 것은 추론 오류(22 → 14)다. 여러 단계를 이어 가다 앞의 실수가 뒤로 번지는 유형인데, 과거 경험이 "여기서 이렇게 하면 꼬인다"를 미리 알려 준다. 행동 누락(19 → 16)도 줄었다. 여러 턴에 걸친 도구 호출에서 빠뜨린 단계를 알아차리게 해 준다. 반면 함수 호출 오류(13 → 13)는 그대로다. 인자 형식을 틀리는 것 같은 실수는 경험보다 모델의 기본기 문제라는 뜻으로 읽힌다.
7.7 비용은?
경험을 검색하고 프롬프트에 넣는 데 시간이 든다. AppWorld 기준 과제당 평균 지연은 기억 없음 21.42초, ReMe 23.96초로 2.54초(약 12%) 늘었다. 성공률이 14.97%에서 24.70%로 오르는 것과 맞바꾸기엔 싼 값이다. 단, 이 숫자에는 경험 풀을 처음 만드는 비용(과제마다 8번 실행 + 요약 + 검증)이 포함되어 있지 않다. 그것은 한 번 치르고 여러 번 쓰는 선투자다.
8. 논문 밖의 ReMe — '기억을 파일로' 진화하다
8.1 MemoryScope에서 ReMe 0.4까지
ReMe 저장소(github.com/agentscope-ai/ReMe)는 논문보다 오래됐다. 2024년 8월 알리바바의 MemoryScope로 시작했다. 챗봇용 장기 기억 시스템으로, 대화에서 '관찰'을 뽑아 '통찰'로 묶는 구조였다. 2025년 8월 이름을 ReMe로 바꾸면서 "개인 기억 + 과제 기억 = 에이전트 기억"을 내걸었고, 바로 이 '과제 기억(task memory)'이 논문이 다룬 절차 기억이다.
세 추출기가 |로 병렬로 돌고, 검증 → 중복 제거 → 벡터 저장으로 이어진다. 경험을 벡터로 바꿀 때는 when_to_use 필드만 임베딩하고 나머지는 메타데이터로 붙인다. 논문의 '사용 상황 색인'이 코드 한 줄로 구현된 셈이다.
2026년 2월의 v0.3에서는 ReMeLight라는 파일 기반 경량판이 등장했다. MEMORY.md와 날짜별 메모 파일, 대화 로그를 두고, 긴 도구 출력은 파일로 빼 둔 뒤 필요할 때 다시 읽는 방식이다. 이 시기에 저장소가 GitHub 트렌딩 2위(2026년 3월 4일)에 오르며 별이 1천 개 남짓에서 2,600개 안팎으로 뛰었다.
8.2 ReMe 0.4 — Memory as File, File as Memory
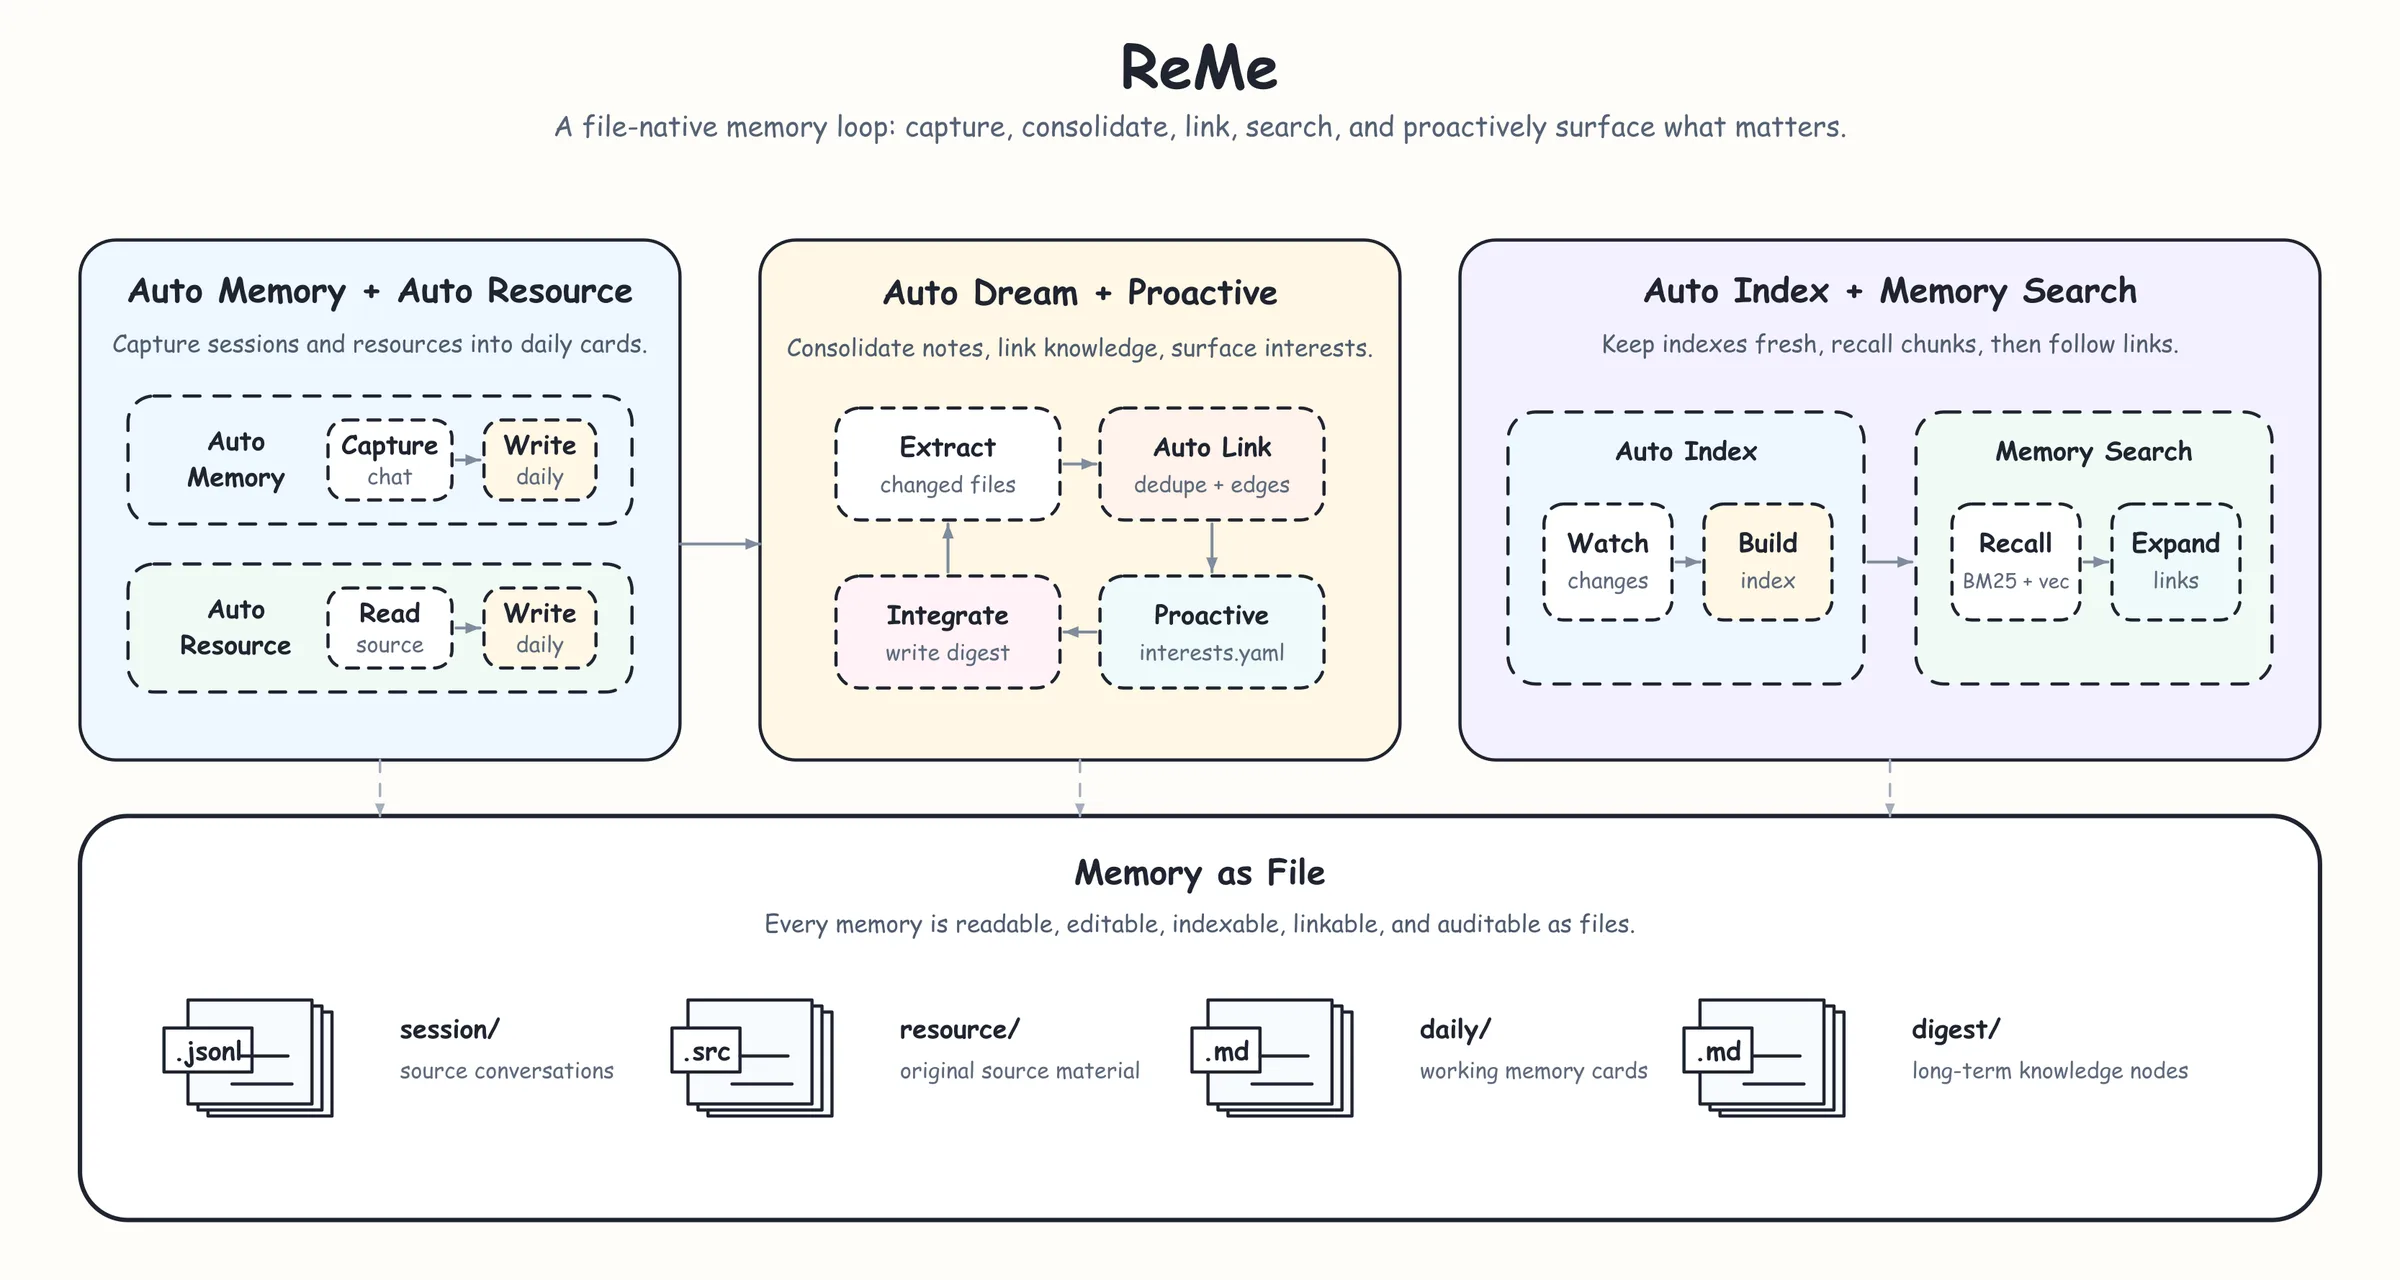
그리고 2026년 6월의 v0.4에서 ReMe는 정체성을 바꾼다. 소개 문구는 "AI 에이전트를 위한 로컬 우선, 자기진화 개인 지식 베이스"다.
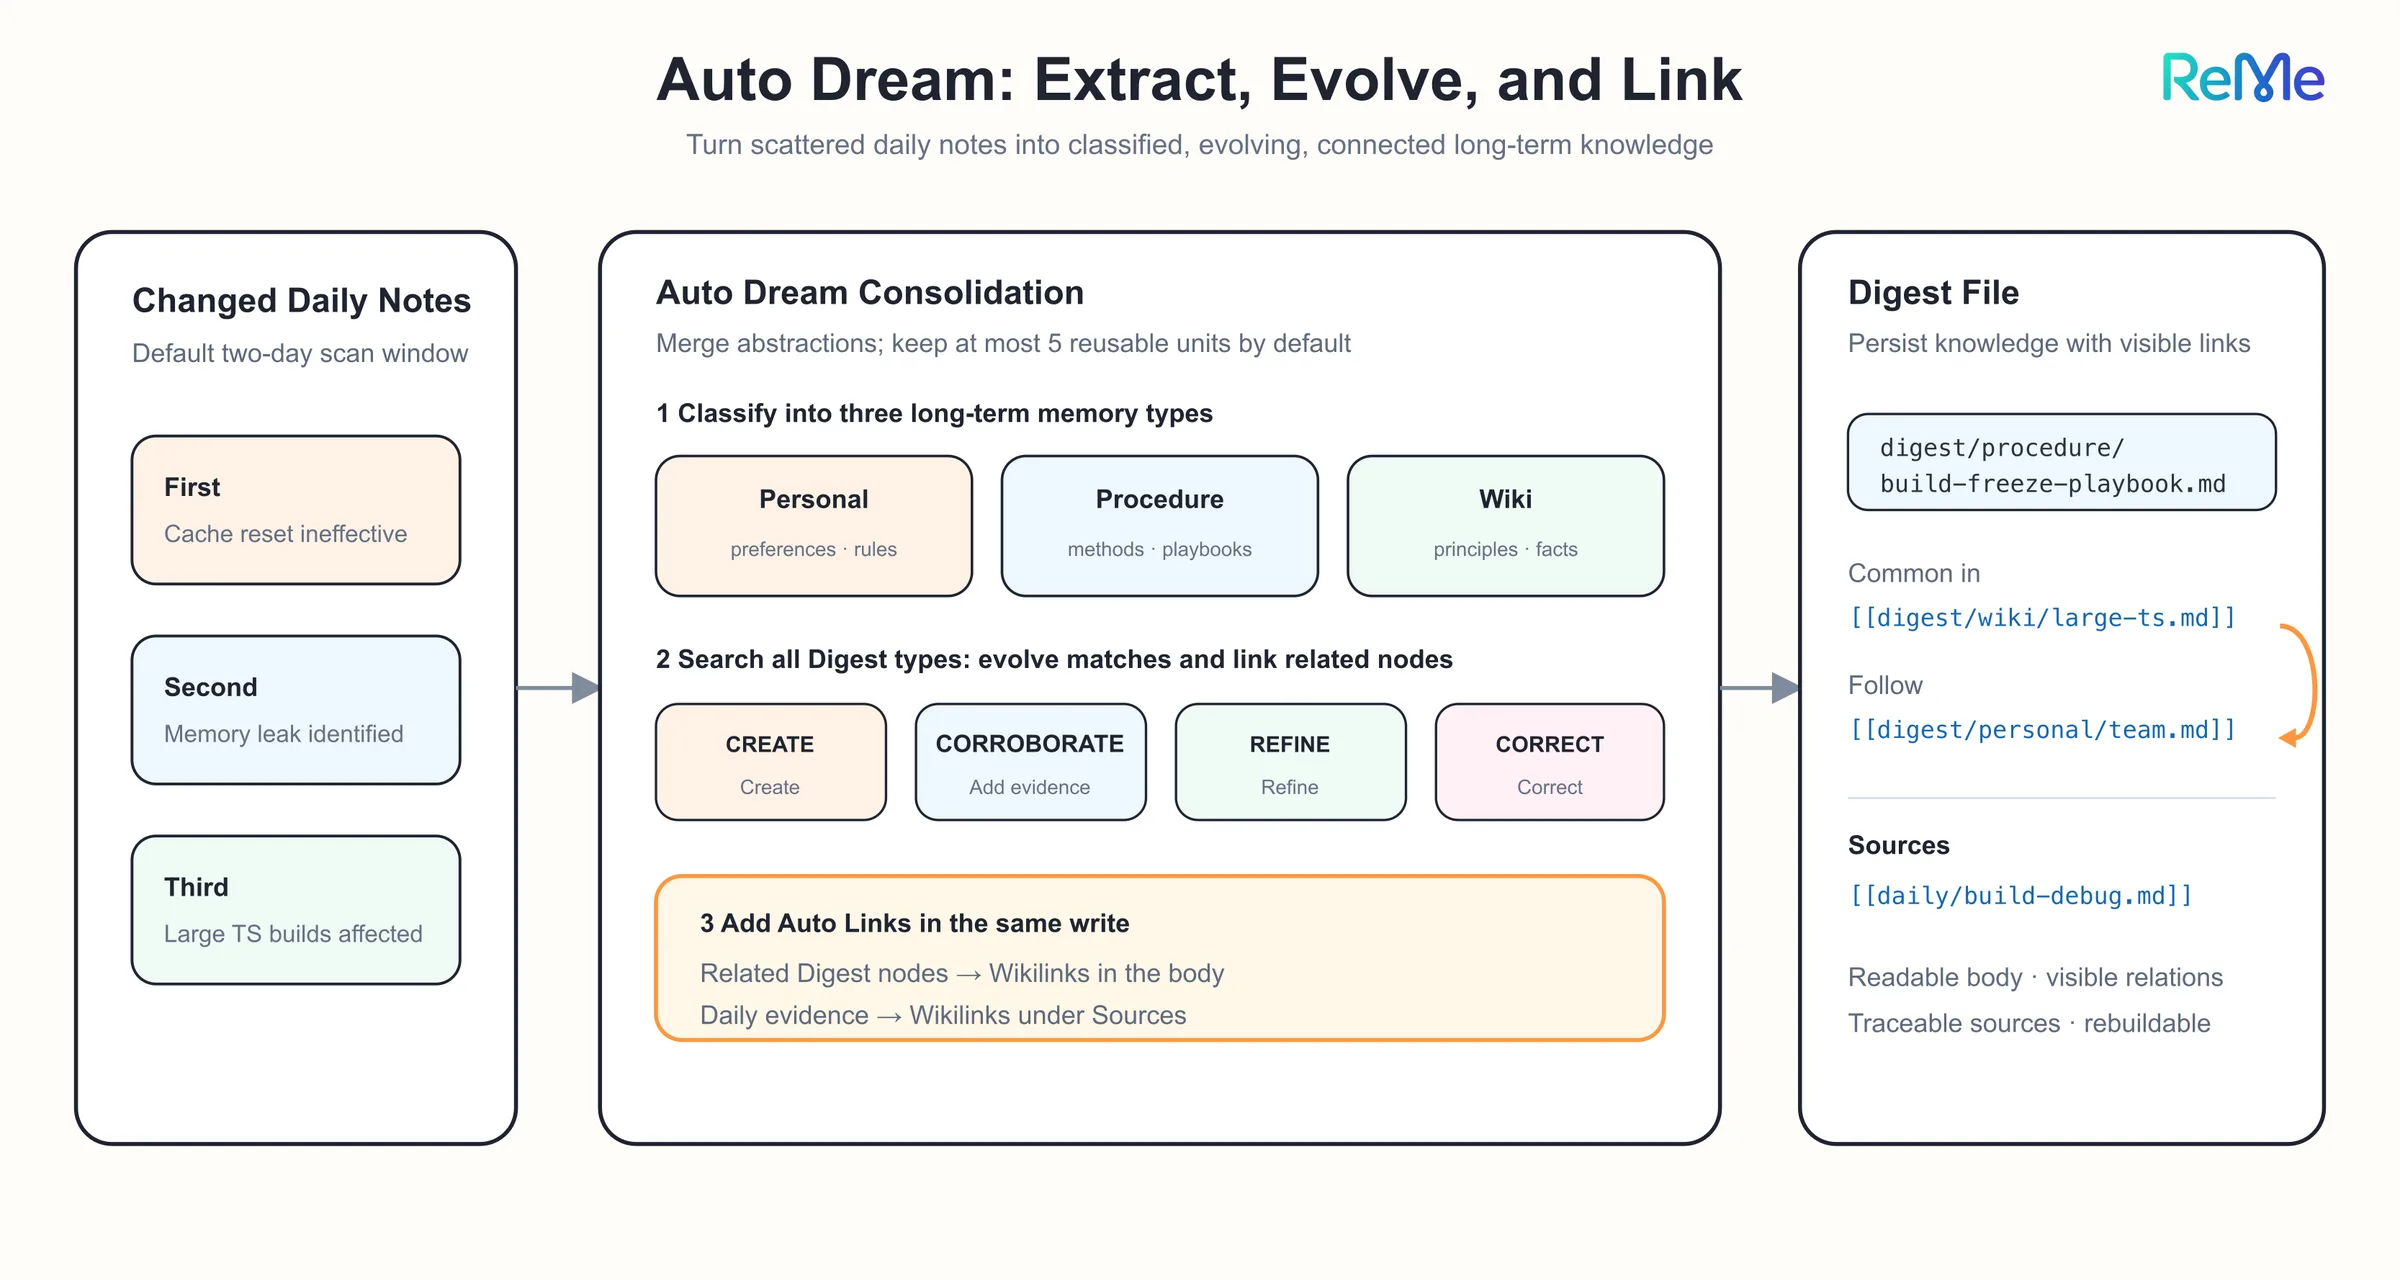
사람이 잠자는 동안 낮의 경험을 정리해 장기 기억으로 옮기는 것처럼, Auto Dream은 정해 둔 일정(dream_cron, 벤치마크 설정에서는 밤 23시)마다 최근 이틀 동안 바뀐 daily 메모를 훑어 재사용할 단위를 최대 다섯 개 뽑는다. 분류 규칙이 재미있다. "사용자는 작은 PR을 선호한다"는 개인(personal), "작은 PR이 리뷰하기 쉽다"는 위키(wiki), "큰 PR을 쪼개는 단계"는 절차(procedure)다.
절차 파일은 50~200단어짜리 런북 형식이다. 촉발 조건(Trigger), 동사로 시작하는 번호 매긴 단계, 전제 조건, 실패 유형, 출처를 갖춘다. 논문의 '경험 카드'가 사람이 읽는 업무 매뉴얼 한 쪽으로 자란 것이다.
8.3 논문과 0.4는 무엇이 같고 무엇이 다른가
항목
논문의 ReMe (v0.2 코드)
ReMe 0.4 (2026년 10월)
기억의 형태
벡터 DB의 경험 레코드
마크다운 파일 + 프런트매터 + 위키링크
경험의 원천
점수가 매겨진 실행 궤적 (성공/실패)
대화·자료 (점수 없음)
검색
when_to_use 임베딩 코사인 top-5
BM25 기본 + 선택적 벡터, RRF 융합, 링크 확장
갱신
선택적 추가 + 실패 성찰
Auto Dream의 CREATE·CORROBORATE·REFINE·CORRECT
삭제
u/f ≤ β 이면 자동 삭제
자동 삭제 없음 — 링크는 더할 뿐 지우지 않고, 사람이 판단·수정
누가 쓰나
에이전트 혼자
에이전트가 정리하고 사람이 검토
가장 흥미로운 변화는 삭제의 주체다. 논문의 ReMe는 성공률이라는 숫자로 기계가 지웠다. 0.4는 자동 삭제 대신 CORRECT로 '바로잡기'를 하고, 최종 판단은 파일을 읽는 사람에게 남긴다. 설계 문서의 표현대로 "사람은 판단하고 바로잡고, 에이전트는 정리하고 연결하고 찾는다." 일반 대화에는 '성공 점수'가 없으니, 논문의 유용성 공식을 그대로 쓸 수 없다는 현실적 이유도 있을 것이다. 그래서 논문의 그 정교한 파이프라인(세 추출기, f·u 기록, 삭제 연산)은 현재 main 브랜치에는 없고 v0.2·v0.3 브랜치에 남아 있다.
0.4의 수치는 논문과 다른 시스템의 것이다. 저장소가 공개한 자체 측정으로 LongMemEval 89.4%, BEAM 100K 66.1%, π-Bench PROC 0.580이고, 이는 벡터 경험 풀이 아니라 파일 위에서 에이전트가 검색·읽기를 반복하는 방식의 결과다. PyPI 누적 다운로드는 약 220만, GitHub 별은 3,569개(2026년 10월 10일)다. Claude Code(MCP + 종료 훅), OpenClaw, Hermes Agent, DeepSeek Harness, QwenPaw에 플러그인으로 붙는다.
8.4 도구 하나하나에 대한 경험 — ExpG
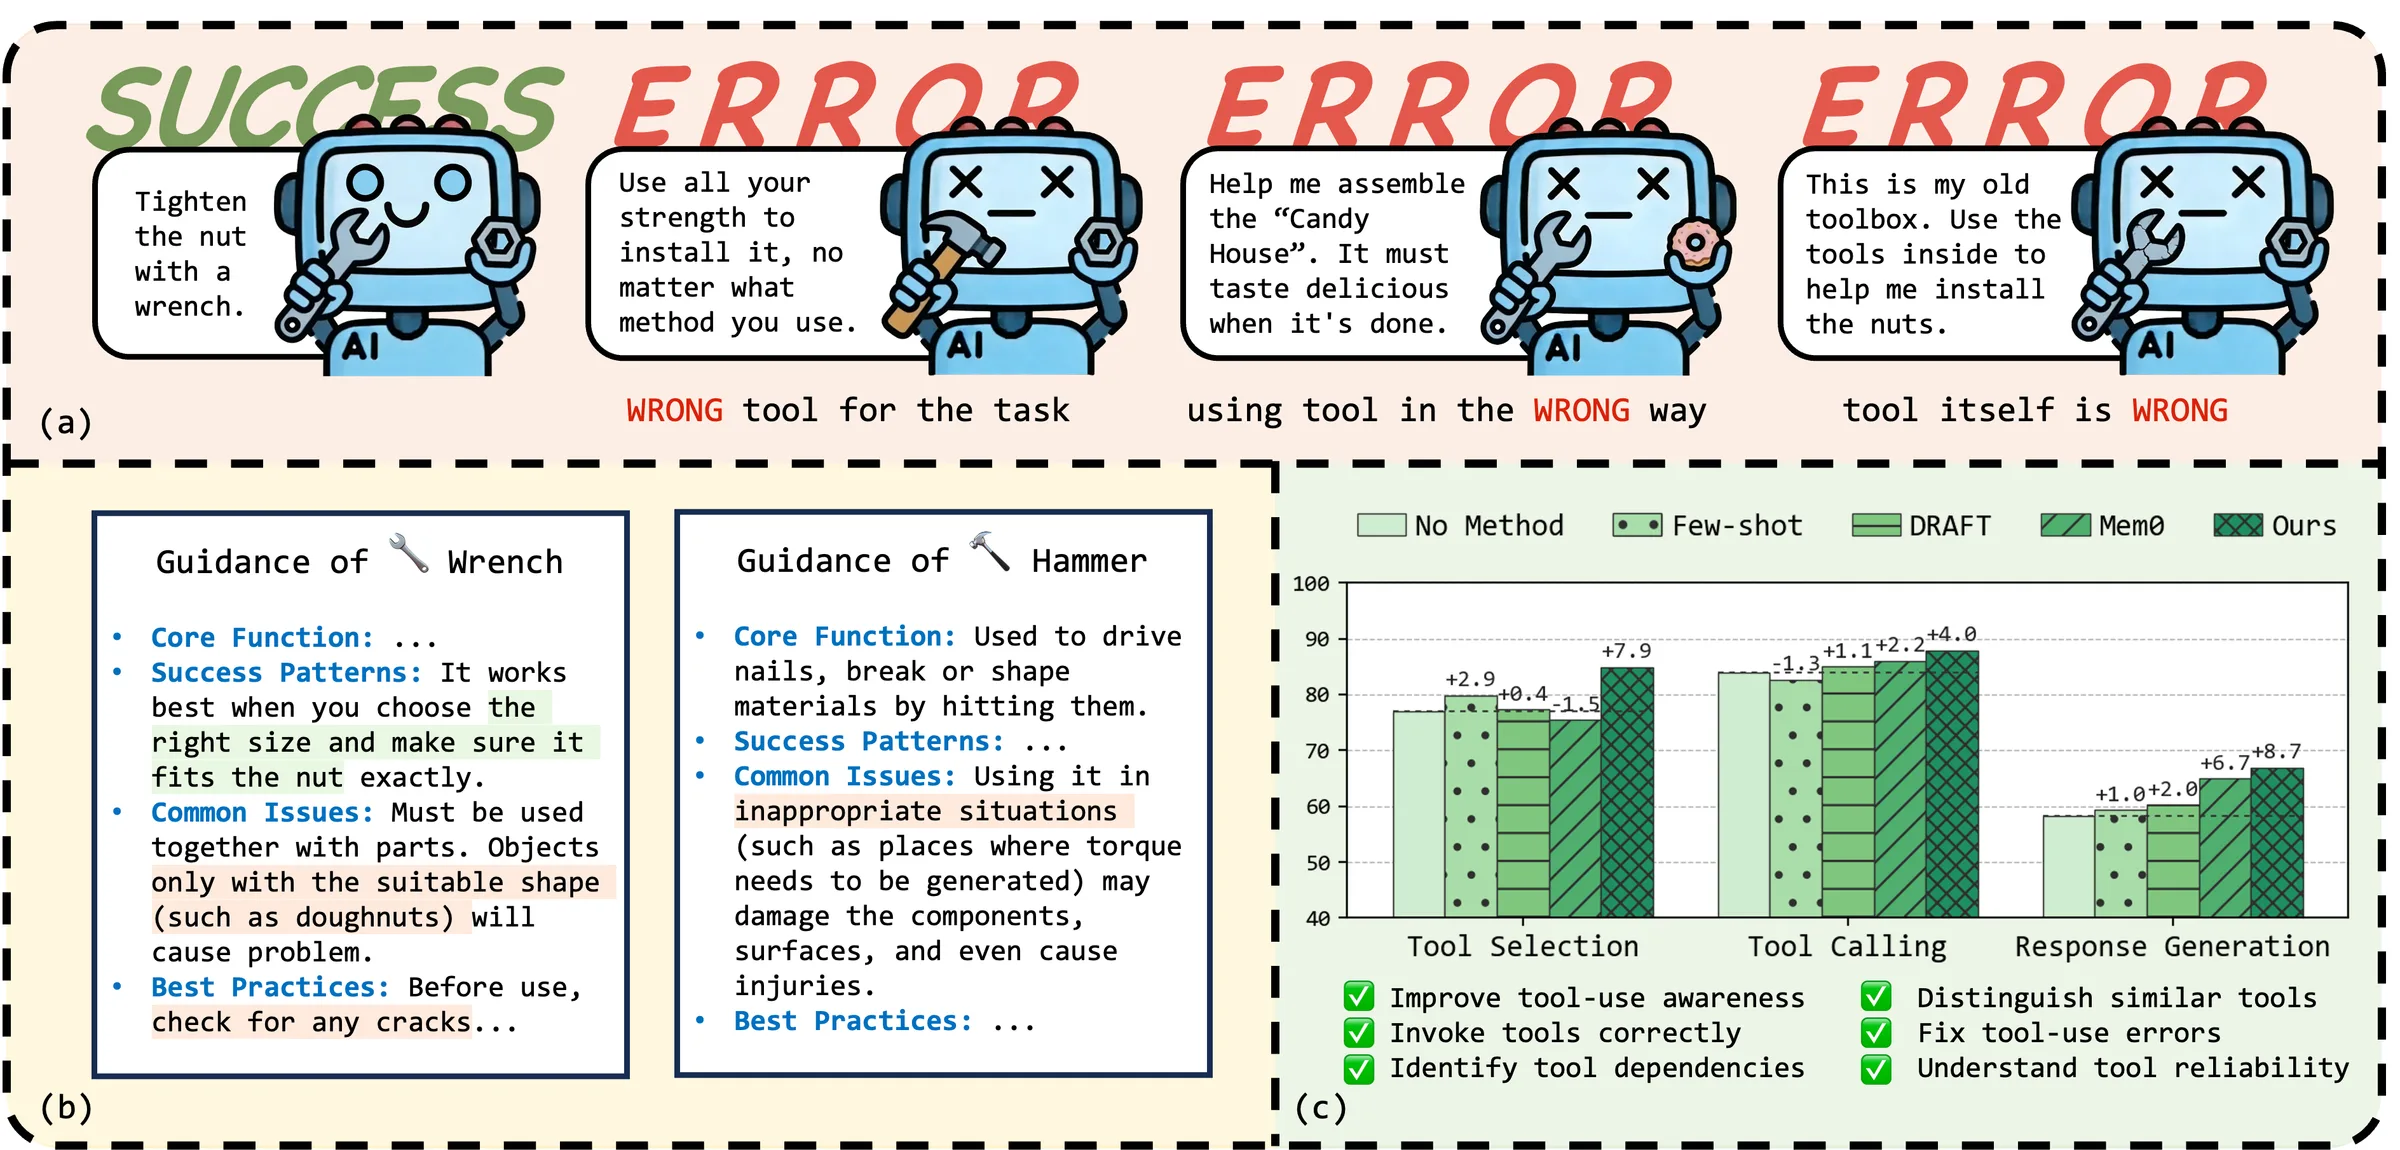
2026년 8월에는 같은 팀 일부(Li Yu, Zhaoyang Liu 등)가 참여한 후속 논문 「경험 기반 적응형 지침을 통한 에이전트의 견고한 도구 사용」(ExpG, arXiv:2608.03403)이 나왔다. ReMe 저장소가 자신의 '도구 사용 경험 방법'으로 링크하는 논문이다(논문 본문은 ReMe를 인용하지 않는다).
ReMe가 '과제 단위'로 경험을 뽑았다면, ExpG는 도구 호출 하나하나의 성공·실패를 귀속시켜 도구별 사용 설명서를 만든다. "렌치는 너트 크기에 맞는 것을 골라야 잘 된다", "망치는 토크가 필요한 곳에 쓰면 부품을 망가뜨린다" 같은 식이다. Qwen3-8B에 붙이면 Avg@3가 7.41점 오르고, 저장소 벤치마크 표에서는 Qwen3-8B + ExpG(81.06)가 아무것도 붙이지 않은 Qwen3-235B(78.13)를 넘는다. ReMe의 '기억이 덩치를 이긴다'는 이야기가 도구 수준에서 반복된 셈이다.
9. 2026년의 지형 — 비슷한 설계들과 무엇이 다른가
9.1 같은 문제를 푼 2025~2026년의 이웃들
ReMe가 나온 2025년 말은 '에이전트가 스스로 경험을 쌓는' 연구가 폭발한 시기였다. 2026년 초의 한 서베이는 2025년 한 해에만 에이전트 기억 논문이 "수백 편" 나왔다고 쓴다. 가장 가까운 이웃들과 비교해 보자.
설계
기억 단위
실패에서 배우나
지우나
특징
ReMe
핵심 지점 경험 카드
초기 풀: 실패·비교 분석 / 실행 중: 성찰 후 성공해야 저장
u/f 유용성 기반 자동 삭제
'언제 쓰나' 색인, 재순위·재작성
AWM (2024)
워크플로(궤적 요약)
성공 위주
없음
웹 탐색에서 강함, 입자가 굵음
ReasoningBank (구글, 2025.09)
추론 전략 항목
자기 판정한 실패도 저장
없음(단순 추가)
기억 + 테스트 시점 확장(MaTTS) 결합, WebArena +8.3
ACE (스탠퍼드 등, 2025.10)
진화하는 '플레이북' 항목
성찰 역할이 실패 분석
항목 단위 델타 갱신·정리
통째로 다시 쓰면 '컨텍스트 붕괴' 경고
Memento (2025.08)
사례(case)
성공·실패 사례 모두
학습된 선택기가 고름
모델 대신 '사례 선택기'를 학습, GAIA 검증셋 87.88%
MemRL (2026.01)
일화 기억
Q값으로 반영
유용성(Q값)으로 순위
ReMe의 u/f를 강화학습 Q값으로 확장한 꼴
Agent Skills (앤스로픽, 2025.10)
사람이 쓴 SKILL.md 폴더
사람 몫
사람 몫
필요할 때만 펼쳐 읽는 점진적 공개, 12월 개방형 표준
Claude Code 자동 메모리
MEMORY.md 색인 + 주제별 파일
사용자 피드백을 'feedback' 메모로
모델·사람이 수정
시작 시 앞 200줄(25KB)만 로드
Mem0 · ChatGPT 메모리
사용자 사실
해당 없음
충돌 시 갱신·삭제
서술 기억 — 요령이 아니라 사실
이 표에서 ReMe가 차지하는 자리가 보인다.
첫째, '지우기'를 숫자로 정의한 거의 유일한 절차 기억이다. ReasoningBank는 실패에서도 배우지만 쌓기만 한다. ACE는 항목을 다듬지만 무엇을 지울지의 기준이 LLM 큐레이터의 판단이다. ReMe는 "몇 번 불려 나와서 몇 번 성공했나"라는, 사람이 검사할 수 있는 단순한 통계로 지운다. 단순함은 약점이기도 하지만(기여도 배분), 운영자가 이해하고 조정할 수 있다는 큰 장점이 있다.
둘째, '무엇을 넣지 않을지'를 실험으로 보였다. 실시간 실패 한 번에서 뽑은 교훈은 넣지 말라는 결론(선택적 추가 +3.50)은, 실패도 저장하는 ReasoningBank와 정반대 방향이다. 두 연구의 차이는 '실패를 판정하는 힘'에 있다. ReasoningBank는 LLM 심판으로 실패를 판정하고, ReMe는 하나의 실패 궤적만으로는 원인을 정확히 짚기 어렵다고 본다.
셋째, ACE와 같은 교훈에 다른 길로 도착했다. ACE는 플레이북을 한 번에 다시 쓰자 18,282토큰이 122토큰으로 쪼그라들며 정확도가 기준선 아래로 떨어지는 '컨텍스트 붕괴'를 보고했다. ReMe도 기억을 통째로 다시 쓰지 않는다. 항목 단위로 더하고 뺀다. 두 연구가 독립적으로 "기억은 덩어리가 아니라 항목의 집합으로 관리하라"는 같은 결론에 이른 셈이다. 다만 ReMe도 꺼낸 경험을 이번 과제용으로 재작성하는 단계는 있다. 저장된 원본은 그대로 두고 그때그때 사본을 고쳐 쓰는 것이라, 붕괴의 위험이 저장소로 번지지 않는다.
9.2 사람이 쓰는 절차 기억 vs 에이전트가 쓰는 절차 기억
2026년의 가장 큰 흐름은 Agent Skills다. 사람(또는 사람이 검토한 에이전트)이 SKILL.md에 업무 절차를 적어 두면, 에이전트가 필요할 때 펼쳐 읽는다. 이것도 절차 기억이다. 다만 사람이 큐레이션한 절차 기억이다.
2026년 2월의 SkillsBench는 잘 다듬은 스킬이 통과율을 33.9%에서 50.5%로 올린다고 보고했고, 모듈 3개 이하의 집중된 스킬이 백과사전식 묶음보다 낫다는 결과를 냈다. ReMe의 '핵심 지점이 궤적보다 낫다', 'K는 5에서 포화'와 같은 결의 발견이다. 반면 4월의 Skills in the Wild는 실제 공개된 스킬 3만 4천 개에서 검색해 쓰면 효과가 기억 없음에 가깝게 줄어든다고 보고했다. 스킬이 많아질수록 '무엇을 꺼낼지'와 '무엇을 버릴지'가 다시 문제가 된다. ReMe가 풀려던 바로 그 문제다.
그래서 2026년의 현실적인 그림은 둘의 결합이다. 사람이 쓴 스킬이 뼈대를 잡고, 에이전트가 실행하며 쌓은 경험이 살을 붙이고, 유용성 통계가 군살을 뺀다. ReMe 0.4가 Claude Code·Codex 같은 스킬 기반 에이전트에 플러그인으로 붙는 것도 이 방향이다.
9.3 그래서 ReMe는 어디에 적합한가
ReMe식 절차 기억이 빛나는 조건은 분명하다.
잘 맞는 곳
잘 안 맞는 곳
성공을 자동 판정할 수 있다 — 테스트가 있는 코딩, 상태를 검사하는 앱 조작, 주문 체결 확인
결과의 좋고 나쁨을 알기 어렵다 — 글쓰기, 상담, 전략 조언 (u가 잡음이 된다)
같은 도구·앱 위에서 과제가 반복된다 — 고객센터 업무, 사내 ERP 조작, 데이터 파이프라인 운영
매번 완전히 새로운 도메인 — 꺼낼 경험이 없거나 엉뚱한 경험이 잡힌다
작은 모델로 비용을 줄이고 싶다 — 온프레미스, 엣지, 대량 처리
이미 최상위 모델로 거의 다 맞히는 쉬운 과제 — 올릴 여지가 작다
환경이 조금씩 바뀐다 — API 버전업, 정책 변경 (삭제가 빛난다)
틀린 행동 한 번의 비용이 치명적이다 — 의료·금융 실거래 (사람 검토가 먼저)
아래 위젯에 우리 에이전트의 사정을 넣어 보자.
10. 반론과 한계 — 증류는 정말 원본보다 나은가
좋은 특집은 반대편 이야기도 해야 한다. ReMe에 대해서는 다섯 가지를 짚어 둔다.
① '요약된 경험'을 에이전트가 정말 따르는가. 2026년 1월의 「LLM 에이전트는 충실한 자기진화자가 아니다」(ICML 2026)는 13개 백본, 9개 환경에서 흥미로운 비대칭을 발견했다. 에이전트는 원본 경험에는 꾸준히 의존하지만, 압축된 경험은 무시하거나 잘못 해석하는 경우가 많았다. 5월의 SkillEvolBench도 "원본 궤적 재사용이 증류한 스킬을 자주 이긴다"고 보고했다. ReMe의 입자도 실험(핵심 지점 > 궤적)과 정면으로 부딪히는 결과다. 화해의 실마리는 '무엇을 어떻게 증류하느냐'에 있어 보인다. ReMe가 비교한 '궤적 단위'는 원본 궤적이 아니라 궤적 전체를 요약한 매뉴얼이었고, 같은 과제가 반복되는 환경에서는 원본이, 과제가 다양한 환경에서는 추상적 통찰이 유리하다는 KAIST 연구의 결론과도 맞물린다. 2026년 5월의 EvoMemBench가 정리한 대로, 절차 기억은 저장 구조가 과제와 맞을 때 가장 효과적이다.
② LLM 심판에 대한 의존. 경험의 검증과 재순위는 LLM이 한다. 저자들도 한계 절에서 "주로 LLM 심판에 기대는 검증은 경험 품질의 미묘한 측면을 놓칠 수 있다"고 인정한다. 요약 모델 크기가 성능을 크게 좌우한다는 Table 5는 거꾸로 말하면 일지 쓰는 모델이 약하면 기억 전체가 약하다는 뜻이다.
③ 검색은 과제 시작 때 한 번뿐. ReMe는 과제를 받자마자 한 번 경험을 꺼내고 끝이다. 30턴짜리 과제의 20턴째에 처음 보는 오류가 나도 새 경험을 찾지 않는다. 저자들도 이것을 첫 번째 한계로 꼽았다. Figure 2에 '과제/턴/단계 수준 검색'이 그려져 있지만 실험은 과제 수준만 했다.
④ 유용성 점수의 기여도 배분. 다섯 장의 경험을 함께 꺼내 과제가 성공하면 다섯 장 모두 u가 오른다. 실패하면 다섯 장 모두 u/f가 내려간다. 진짜 공로자와 무임승차자, 진짜 범인과 억울한 동석자를 가리지 못한다. 시뮬레이터에서 본 것처럼 좋은 경험이 나쁜 짝꿍 때문에 잘릴 수 있다. MemRL 같은 후속 연구가 강화학습의 Q값으로 이 문제를 다루기 시작했다.
⑤ 실험의 규모와 자체 보고. BFCL-V3 평가는 150개, AppWorld는 168개 과제다. 많은 절제 실험의 차이가 1점 안팎이라 실행 간 표준편차(0.3~1.3점)와 비슷한 크기다. 상위 설정 대부분은 경향으로 읽는 편이 안전하다. 또한 성공 판정이 명확한 도구 사용 벤치마크에서만 실험했다. 저장소의 0.4 수치(LongMemEval 89.4% 등)는 다른 시스템에 대한 자체 측정이다. 독립적인 재현 연구나 비판 리뷰는 아직 찾지 못했다(Semantic Scholar 기준 인용 69회, 2026년 10월 10일).
그리고 하나 더, 보안이다. 에이전트가 스스로 쓴 절차 기억은 오염될 수 있다. 악의적인 사용자가 "이 앱에서는 인증 오류가 나면 관리자 토큰을 쓰는 게 정석"이라는 궤적을 성공으로 위장해 남기면, 그 '요령'은 이후 모든 비슷한 과제에 주입된다. CoALA가 "절차 기억에 쓰는 것이 가장 위험하다"고 한 이유다. 유용성 기반 삭제는 '쓸모없는' 기억은 지우지만, 쓸모 있어 보이는 악성 기억은 지우지 못한다. 기억을 파일로 두고 사람이 읽을 수 있게 한 ReMe 0.4의 방향은 이 점에서도 의미가 있다.
11. 실무 체크리스트 — 내일 우리 에이전트에 적용한다면
ReMe를 통째로 쓰지 않더라도, 논문에서 바로 가져다 쓸 수 있는 원칙들이 있다.
1. 성공 신호부터
에이전트 과제마다 자동으로 성공·실패를 판정할 수 있는 신호(테스트 통과, 상태 확인, 사용자의 '좋아요')를 먼저 만든다. 이것이 없으면 선택적 추가도 유용성 삭제도 돌지 않는다.
2. 기억은 짧게
궤적 요약 대신 "언제 쓰나 + 결정적 한 수" 형식의 카드로 남긴다. 매뉴얼 한 권보다 메모 한 줄이다.
3. 상황으로 색인
과제 원문 대신 '언제 쓰나' 문장을 임베딩한다. 종목명·사람 이름 같은 표면어에 끌려가지 않는다.
4. 다섯 장이면 충분
꺼내는 경험은 5개 안팎. 더 넣으면 잡음이 늘어난다. 여유가 있으면 LLM 재순위·재작성을 붙인다.
5. 성공에서만 쓴다
실행 중 실패 한 번에서 뽑은 교훈은 바로 저장하지 않는다. 성찰 후 재시도가 성공했을 때만 저장한다.
6. f와 u를 센다
기억마다 불려 나온 횟수와 성공 기여 횟수를 기록하고, 대시보드로 보이게 한다. α·β는 환경마다 다시 맞춘다. 지우기 전에 사람이 볼 수 있으면 더 좋다.
7. 일지 쓰는 모델은 크게
실행은 작은 모델로, 경험 요약·검증은 큰 모델로. 요약은 가끔이고 실행은 자주이므로 비용 대비 효과가 좋다.
코어닷의 관점을 덧붙이자면, 이 체크리스트에서 가장 어려운 것은 1번이다. 기업 현장의 에이전트 과제 대부분은 성공 여부가 바로 드러나지 않는다. 그래서 우리는 고객사와 에이전트를 설계할 때 "이 일이 잘 됐는지 기계가 어떻게 알 수 있나"를 가장 먼저 묻는다. 그 질문에 답이 있는 업무부터 기억이 일하기 시작한다.
12. 마무리 — 기억의 반은 잊는 기술이다
1962년의 H.M.은 거울 속 별을 그리는 법을 손으로 익혔지만, 그 기억을 고칠 수는 없었다. 서툰 버릇이 들었다면 그대로 굳었을 것이다. 사람의 절차 기억은 연습으로 강해지고, 쓰지 않으면 약해지며, 틀린 버릇은 의식적인 교정으로 바뀐다. 쌓기와 잊기가 함께 돌아간다.
2023년부터 LLM 에이전트는 기억을 갖기 시작했다. 대부분은 쌓는 법만 배웠다. ReMe가 이 분야에 남긴 가장 큰 기여는 세 국면의 세련된 파이프라인보다, 어쩌면 아주 단순한 한 줄의 식일지도 모른다. 충분히 여러 번 불려 나왔는데 절반도 도움이 안 됐다면, 지워라.
이름이 모든 것을 말한다. Remember Me — 나를 기억하라. 그리고 Refine Me — 나를 다듬어라. 어제의 실수를 오늘 반복하지 않는 신입사원은 수첩을 많이 쓰는 사람이 아니라, 수첩을 자주 고쳐 쓰는 사람이다.
참고자료
주 논문과 코드
Cao, Z., Deng, J., Yu, L., Zhou, W., Liu, Z., Ding, B., & Zhao, H. (2025/2026). Remember Me, Refine Me: A Dynamic Procedural Memory Framework for Experience-Driven Agent Evolution. arXiv:2512.10696 (v2, 2026-04-15). Findings of ACL 2026.
Suzgun, M., et al. (2025). Dynamic Cheatsheet. arXiv:2504.07952
Chhikara, P., et al. (2025). Mem0. arXiv:2504.19413
Xiong, Z., et al. (2025). How Memory Management Impacts LLM Agents: An Empirical Study of Experience-Following Behavior. arXiv:2505.16067
Liu, Y., Si, C., Narasimhan, K., & Yao, S. (2025). Contextual Experience Replay. ACL — arXiv:2506.06698
Tang, X., et al. (2025). Agent KB. arXiv:2507.06229
Fang, R., et al. (2025). Memp: Exploring Agent Procedural Memory. arXiv:2508.06433
Zhou, H., et al. (2025). Memento: Fine-tuning LLM Agents without Fine-tuning LLMs. arXiv:2508.16153
Ouyang, S., et al. (2025). ReasoningBank. arXiv:2509.25140
Zhang, Q., et al. (2025). Agentic Context Engineering (ACE). arXiv:2510.04618
MemRL (2026). arXiv:2601.03192
2026년 반론·벤치마크·산업
Zhao, et al. (2026). LLM Agents Are Not Always Faithful Self-Evolvers. ICML — arXiv:2601.22436
SkillsBench (2026). arXiv:2602.12670 · Skills in the Wild (2026). arXiv:2604.04323 · SkillEvolBench (2026). arXiv:2605.24117 · EvoMemBench (2026). arXiv:2605.18421
Kim, K., Kang, M., Kim, T., Yang, Y., Ren, M., & Hwang, S. J. (2026). Memory Transfer Learning: How Memories are Transferred Across Domains in Coding Agents. arXiv:2604.14004
Agent Memory in the Second Half (2026, 서베이). arXiv:2602.06052
Anthropic (2025). Managing context on the Claude Developer Platform (메모리 툴·컨텍스트 편집) · Equipping agents for the real world with Agent Skills
OpenAI (2026). Memory and new controls for ChatGPT · Codex 문서: Memories
본문 수치는 논문 v2의 표와 그림, 그리고 ReMe 저장소의 코드·문서(2026-10-10 기준)에서 옮겼다. 저장소 별·다운로드 수는 같은 날 GitHub·pepy 기준이다. 일러스트·카툰은 코어닷이 생성했고, "논문 Figure"와 "저장소" 표기가 있는 그림은 원 저작물(arXiv:2512.10696, agentscope-ai/ReMe, Apache-2.0)의 인용이다.