뉴스 클러스터링사건 코레퍼런스온라인 클러스터링스토리 스레드JevOpenAI DecisionsGemini육하원칙시간 추론
같은 사건 묶기 3편 — 나흘치 5,404건, 시간이 흐를 때 묶음은 어떻게 자라고 어디서 끊어야 하는가
1편은 하루치 한 언론사, 2편은 하루치 25개 언론사였습니다. 3편은 13개 언론사의 나흘치 정치·사회 기사 5,404건으로, 게재일이 벌어질수록 '같은 사건'이 어떻게 희귀해지는지, 판정 모델에 날짜를 주면 후속 보도를 더 잘 가르는지, 기사가 도착하는 순서대로 묶는 온라인 방식이 배치보다 사슬 합침을 막는지, 사건 묶음 위에 이야기 묶음을 어떻게 세우는지를 실측했습니다.
1편은 한 언론사 하루치 기사로 "같은 사건"을 가르는 판정 모델을 골랐고, 2편은 25개 언론사 하루치 2,766건으로 사건 레코드(누가·언제·어디서·무엇을)가 어디까지 도와주는지를 쟀습니다. 2편의 결론 하나가 마음에 걸렸습니다. 시간·장소 거부 조건이 기대보다 약했다는 것인데, 그 이유의 절반은 자료가 하루치였기 때문입니다. 하루 안에서는 "같은 사건의 후속 보도"와 "같은 이야기의 다음 사건"이 거의 같은 시각에 쓰이므로, 시간이 둘을 가를 기회 자체가 없었습니다.
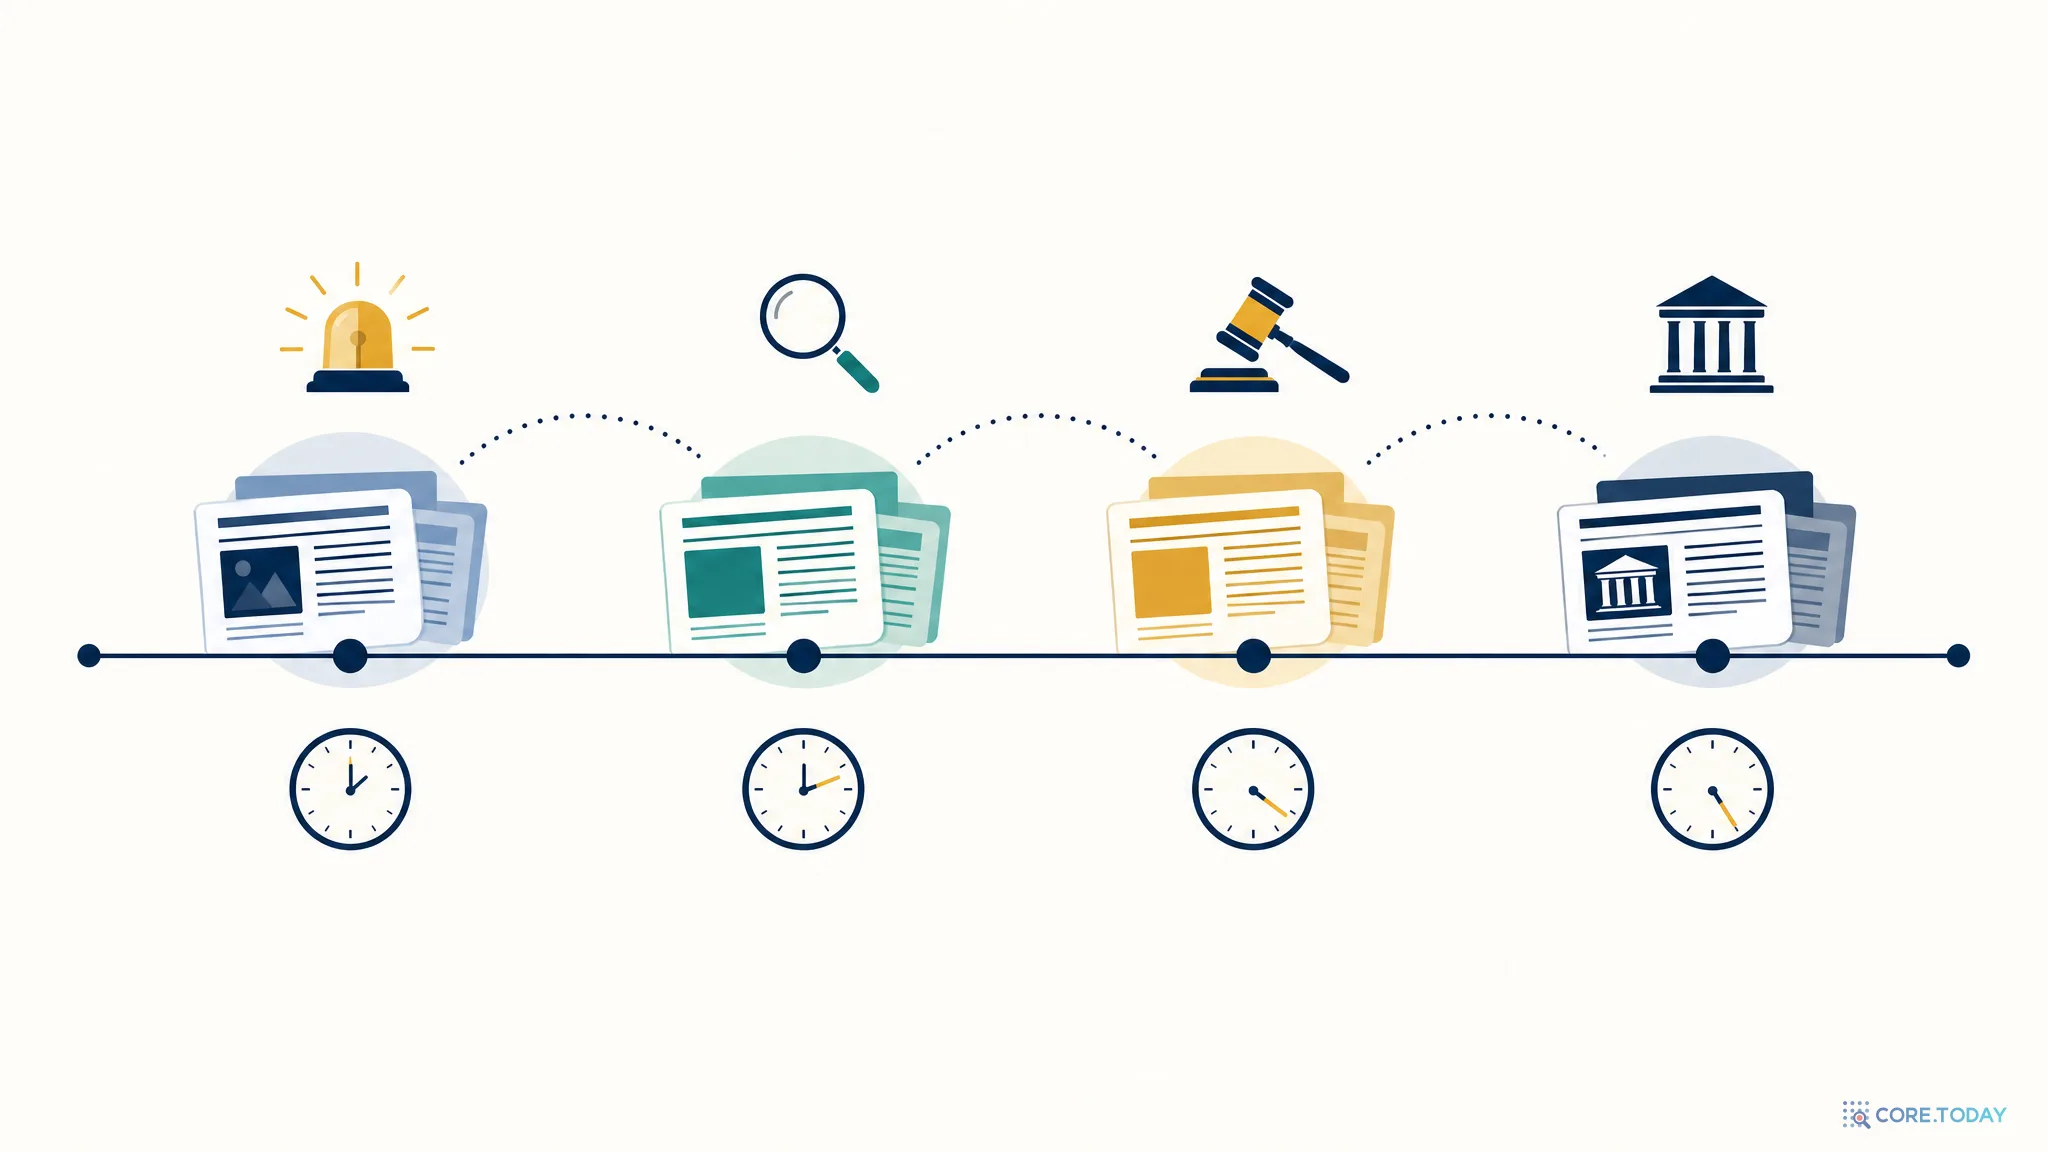
뉴스는 하루로 끝나지 않습니다. 사고가 나고, 이튿날 경찰이 원인을 발표하고, 사흘째 영장이 청구되고, 그 사이 다른 언론사가 종합 기사를 씁니다. 이 흐름 위에서 "같은 사건 묶기"는 세 가지 새 질문을 받습니다.
게재일이 하루, 이틀 벌어진 두 기사가 같은 사건일 확률은 얼마나 빨리 떨어지는가. 그리고 그때 판정 모델은 무엇을 틀리는가.
기사는 한꺼번에 오지 않고 순서대로 온다. 도착한 기사를 그때그때 기존 묶음에 붙이는 온라인 방식은, 모든 쌍을 한꺼번에 잇는 배치 방식과 무엇이 다른가. 특히 2편을 망친 사슬 합침을 막을 수 있는가.
사건 묶음 위에 "이야기 묶음"(사고 → 수사 → 영장)을 세울 수 있는가. 그것은 사건 묶음과 같은 도구로 되는가.
이 글은 그 세 질문을 나흘치 자료로 실측한 기록입니다. 모든 코드와 중간 산출물은 코어닷투데이가 2편에서 만든 파이프라인을 그대로 늘린 것이고, 바뀐 부분은 자료 수집과 시간 축에 관한 분석입니다.
1부. 재료: 13개 언론사, 나흘, 정치·사회면
네이버 언론사별 날짜 목록
2편은 RSS를 20분마다 긁어 하루치를 모았습니다. 며칠치를 뒤로 거슬러 모으려면 RSS로는 안 됩니다. 대부분 최신 50건 안팎만 내주기 때문입니다. 언론사 자체 기사 목록을 살펴봤지만 연합뉴스·뉴시스·경향·아시아경제의 목록 페이지는 자바스크립트로 그려져서 같은 HTML만 돌아왔습니다. ndsoft 기반 지역지는 날짜 범위 검색이 되고 SBS는 날짜별 속보 목록이 있었지만, 언론사마다 방식이 달라 열세 개를 맞추기 어려웠습니다.
대신 네이버 뉴스의 언론사별 날짜 목록을 썼습니다. 언론사 코드와 날짜를 주면 그날 송고된 기사를 20건씩 넘겨주는 서버 렌더링 페이지이고, 기사 본문은 네이버 기사 페이지의 본문 영역에서 같은 방식으로 뽑을 수 있습니다. 본문 추출기를 언론사마다 따로 만들던 2편의 수고가 사라진 대신, 네이버에 송고된 기사만 보게 됩니다. 스포츠·연예는 네이버에서 별도 서비스로 넘어가 본문을 못 받아 자연히 빠졌습니다.
언론사와 기간
통신사는 뺐습니다. 연합뉴스가 하루 2,705건, 뉴시스 2,920건, 뉴스1 2,470건으로 나흘이면 셋만으로 3만 건이 넘습니다. 그 대신 방송 3곳(MBC·SBS·JTBC), 전국지 5곳(경향·한겨레·동아·중앙·한국일보), 지역지 5곳(부산일보·매일신문·강원일보·대전일보·국제신문)을 골랐습니다. 2편에서 본문 추출에 실패했던 JTBC는 네이버 경유로 살아났습니다.
기간은 2026년 10월 18일 일요일부터 21일 수요일까지 나흘입니다. 일요일을 넣은 것은 주말에 생긴 사건이 월요일에 어떻게 이어지는지 보기 위해서입니다. 목록 10,006건에서 사진·영상·부고·인사·칼럼·사설·인터뷰 같은 제목 패턴 568건을 걸렀고, 본문이 300자 미만이거나 네이버 분류가 오피니언인 것을 뺀 뒤 정치·사회면만 남겨 5,404건이 됐습니다. 경제·세계·생활·IT를 뺀 이유는 두 가지입니다. 며칠에 걸쳐 전개되는 "사건"이 정치·사회면에 몰려 있고, 정답 판정 비용을 감당할 수 있는 크기여야 했기 때문입니다.
언론사
10/18(일)
10/19(월)
10/20(화)
10/21(수)
합계
강원일보
124
160
154
190
628
매일신문
107
127
159
174
567
경향신문
91
146
130
139
506
중앙일보
48
132
129
140
449
동아일보
33
111
152
137
433
SBS
39
115
128
149
431
한국일보
50
124
113
114
401
MBC
35
110
125
125
395
부산일보
48
100
102
99
349
대전일보
60
109
95
75
339
JTBC
24
95
113
107
339
한겨레
38
92
99
98
327
국제신문
53
59
63
65
240
합계
750
1,480
1,562
1,612
5,404
지역지 셋이 상위권인 것은 네이버 분류에서 지역 기사가 거의 전부 사회면으로 들어가기 때문입니다. 사회면 3,772건, 정치면 1,473건입니다.
사건 레코드와 임베딩
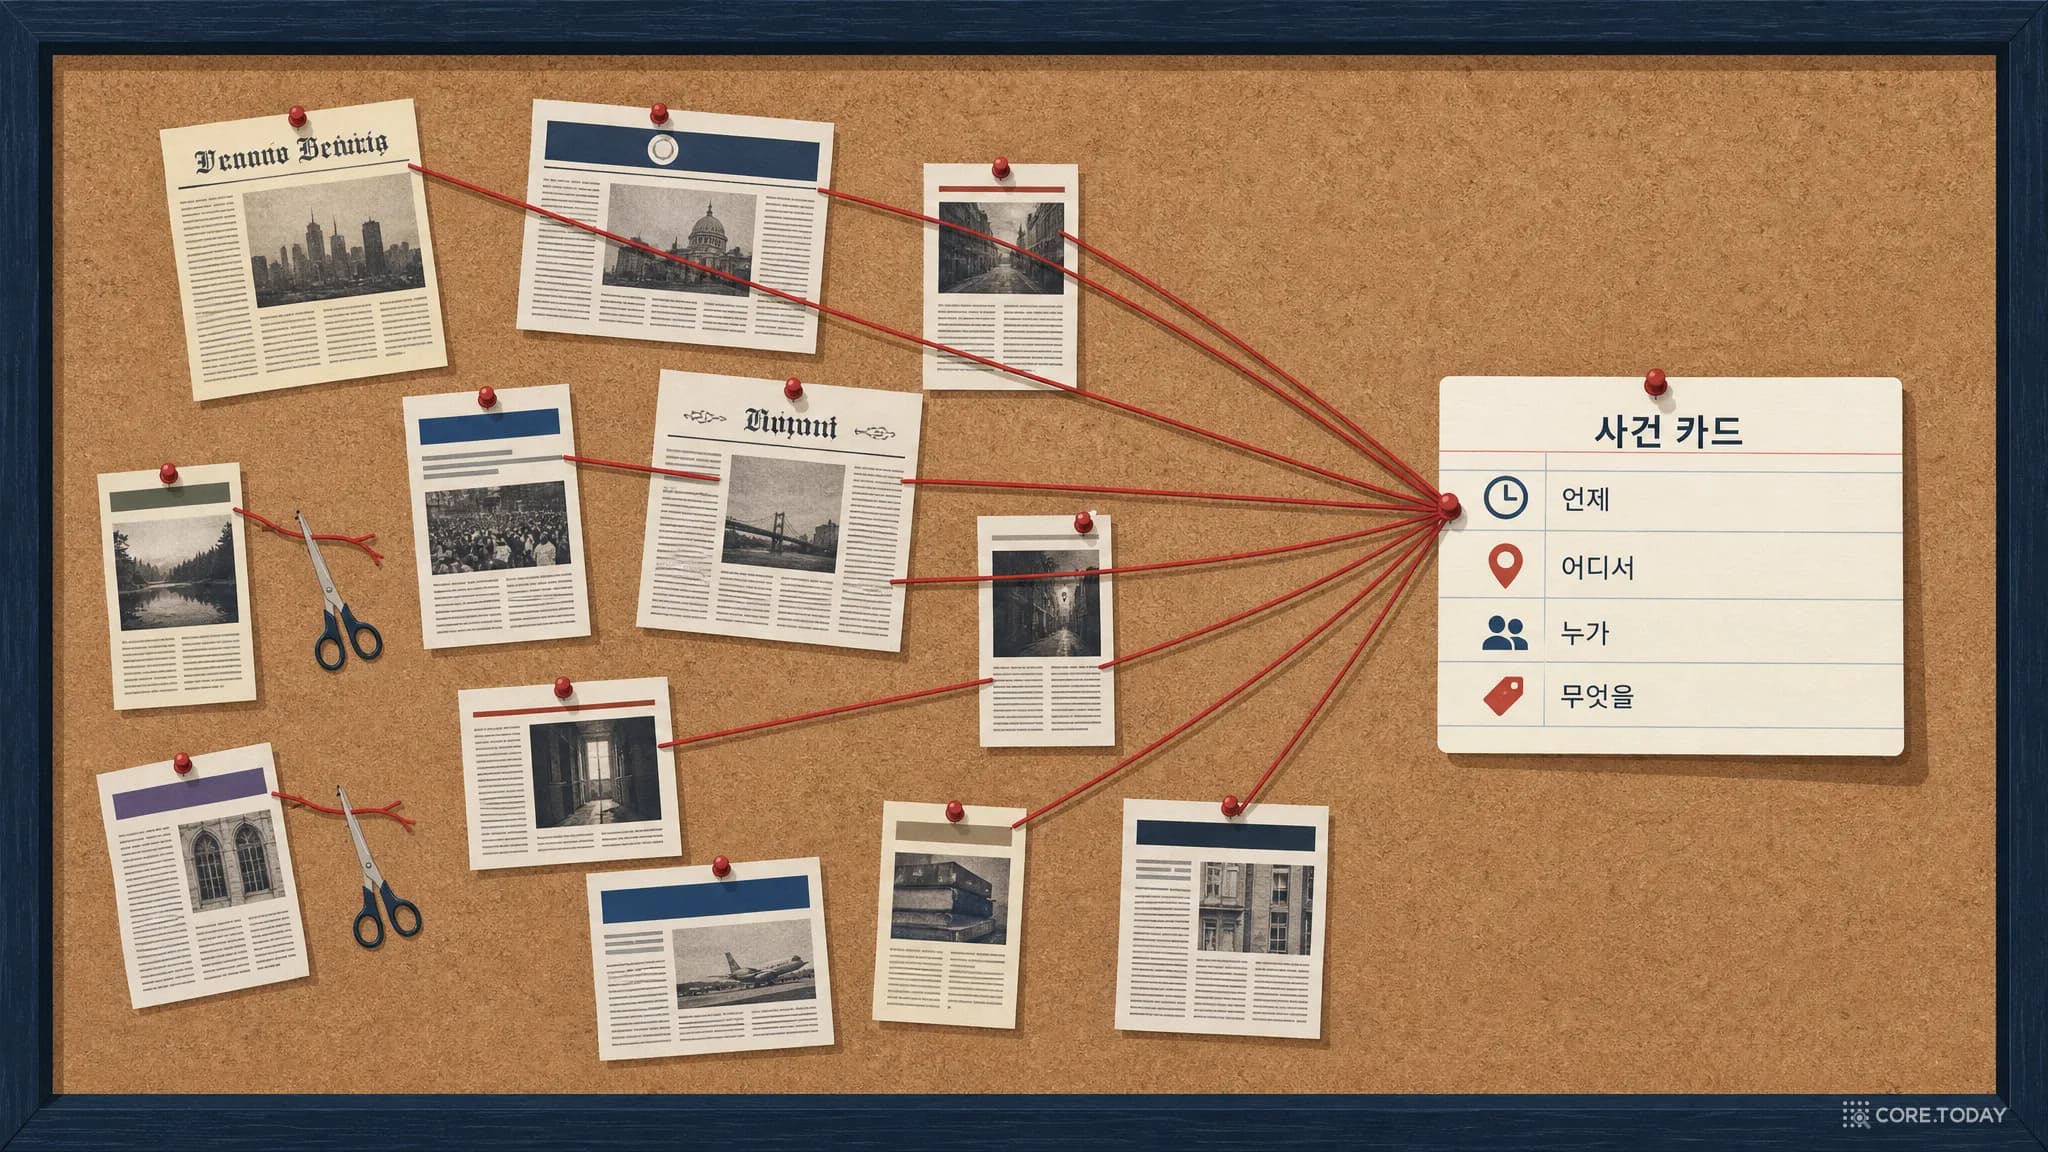
기사마다 2편과 같은 스키마로 사건 레코드를 뽑았습니다. 헤드라인 사건 하나에 배경 사건 최대 3개, 각 사건에 유형(24가지)·행위·한 문장 요약·역할 붙은 참여자·정규화한 날짜와 시각·광역/시군구/장소입니다. 기사당 사건 수는 1개 1,962건, 2개 2,051건, 3개 1,204건, 4개 186건이었습니다. 배경 사건이 있는 기사가 63%라는 뜻이고, 이 배경 사건이 뒤에서 이야기 묶음을 잇는 단서가 됩니다.
추출기는 Gemini 3.8 Flash로 시작했는데 3,816건에서 모델당 하루 1만 회 한도에 걸렸습니다(2편 작업분과 합산). 나머지 1,588건은 Gemini 3.5 Flash로 뽑았습니다. 같은 스키마와 프롬프트이고, 두 모델의 레코드를 섞어 쓴다는 점은 결과를 읽을 때 염두에 둘 만합니다. 임베딩은 Qwen3-Embedding 8B(제목+리드)와 EmbeddingGemma 300M, 그리고 요약 문장 임베딩(Qwen3 8B) 세 가지를 로컬에서 만들었습니다.
후보 쌍: 다른 날을 일부러 찾아가기
하루치와 가장 다른 설계가 여기입니다. 나흘 풀에서 임베딩 최근접 이웃 8개를 뽑으면 같은 날 기사가 이웃을 거의 다 차지합니다. 같은 사건을 다음 날 다시 쓴 기사는 그날의 비슷한 기사들에 밀려 후보에 못 들어옵니다. 그래서 다음 다섯 경로를 합쳤습니다.
전체 풀 최근접 이웃: Qwen3 8B와 EmbeddingGemma 각 8개, 유사도 0.5 이상
날짜별 교차 이웃: 기사마다 다른 날 각각에서 가장 가까운 3개(유사도 0.6 이상). 나흘이면 기사당 최대 9개
요약 임베딩 이웃 8개(0.6 이상)
참여자 이름 블로킹: 익명이 아닌 이름을 공유하고, 사건 날짜가 하루 이내이거나 이름을 둘 이상 공유
유형 + 광역 + 시군구 블로킹
경로를 다 합치면 72,779쌍이었고, 정답 판정 비용 때문에 임베딩 유사도 하한을 조금 올려 38,686쌍으로 줄였습니다. 게재일 간격은 0일 16,007쌍, 1일 13,592쌍, 2일 6,651쌍, 3일 2,341쌍으로, 전체의 58%가 다른 날 쌍입니다. 교차 이웃이 일부러 다른 날을 찾아간 결과이고, 전체 풀 이웃만 썼다면 이 비율은 훨씬 낮았을 것입니다.
정답: 날짜를 아는 판사 둘, 갈리면 셋째
정답 프로토콜은 2편과 같되 판사를 바꿨습니다. 기준 기사 하나와 후보 최대 12개를 한 번에 보여 주고 후보마다 same(같은 사건) / related(같은 이야기, 다른 사건) / different(다른 사건)를 고르게 합니다. 3편에서 달라진 점은 기사마다 게재 시각을 함께 보여 주고, related의 정의에 "같은 사건의 여파·반응·수사의 다음 단계(발생 → 영장 청구 → 영장심사 → 기소), 어제 사건과 오늘의 새로운 전개"를 명시한 것입니다. 반대로 "며칠 뒤에 다시 다룬 기사여도 그 사건 자체를 다루면 same"이라고 못 박았습니다.
판사는 gpt-6.1-sol과 Claude Sonnet 5.5, 둘이 갈리면 Gemini 3.5 Flash가 3심입니다. 2편에서 3심이던 GPT-5.4 대신 더 새롭고 싼 6.1-sol을 썼고, 평가 대상인 OpenAI Decisions의 모델(gpt-6-luna)은 자기 채점을 피하려고 판사에서 뺐습니다. Gemini 3.8 Flash는 추출에서 한도를 다 써서 3심을 3.5 Flash가 맡았습니다.
정답 38,591쌍을 두 기사의 게재일 간격으로 나누면 이 글의 첫 번째 결과가 나옵니다.
게재일 간격
쌍 수
같은 사건
같은 이야기, 다른 사건
다른 사건
0일
16,007
9,684 (60%)
3,420 (21%)
2,903 (18%)
1일
13,592
2,905 (21%)
6,216 (46%)
4,471 (33%)
2일
6,651
134 (2%)
3,528 (53%)
2,989 (45%)
3일
2,341
48 (2%)
1,207 (52%)
1,086 (46%)
후보 쌍은 임베딩이 비슷하다고 고른 것이라 어느 간격에서든 "주제가 비슷한" 쌍입니다. 그런데 같은 날에는 그 열에 여섯이 같은 사건이고, 하루만 지나면 다섯에 하나, 이틀이 지나면 쉰에 하나가 됩니다. 같은 사건 쌍 전체(12,771)에서 게재일이 다른 쌍은 3,087쌍, 24%입니다. 1편과 2편이 하루치에서 다룬 문제는 이 표의 첫 줄뿐이었습니다.
이틀 이상 벌어진 같은 사건 182쌍을 들여다보면 두 부류입니다. 하나는 날짜가 박힌 예정 사건입니다. 10월 23일 오세훈 서울시장 항소심 선고를 미리 다룬 기사들은 18일에도 21일에도 같은 사건(선고)을 가리킵니다. 다른 하나는 사건을 되짚는 기획 기사로, 부천 공장 화재 사흘 뒤의 "방폭 시설이 없었다"처럼 발생 기사와 같은 사건을 다루지만 각도가 다릅니다. 둘 다 "사건이 일어난 시각"과 "기사가 쓰인 시각"이 벌어진 경우이고, 이것이 뒤에서 시간 거부 조건을 다시 흔듭니다.
조간 효과: 하루 차 같은 사건의 정체
게재일이 하루 다른 같은 사건 2,905쌍은 대부분 "다음 날 다시 쓴 후속"이 아닙니다. 레코드에서 뽑은 사건 날짜를 보면 1,838쌍(63%)이 같은 날짜이고, 다른 날짜는 681쌍(23%)뿐입니다. 두 기사 중 먼저 나온 쪽의 게재 시각을 보면 오후 3시에서 밤 9시 사이가 1,735쌍(60%)입니다. 오후에 일어난 사건을 방송과 인터넷판이 그날 저녁에 쓰고, 신문이 이튿날 새벽 조간으로 다시 쓴 것입니다. 중앙일보와 동아일보의 "04:31", "00:10" 게재 기사가 그 자리입니다.
이 조간 효과는 설계에 바로 쓸 수 있는 사실입니다. 게재일이 하루 다른 쌍을 "다른 날 기사"로 취급해 문턱값을 올리거나 거부하면 조간을 통째로 잃습니다. 반대로 게재일 간격이 이틀 이상이면 같은 사건일 가능성이 2%로 떨어지므로, 후보 생성 단계에서 이틀 밖은 임베딩 유사도 하한을 높여도 됩니다.
정답 묶음은 나흘 동안 얼마나 자라나
같은 사건 쌍을 연결 성분으로 묶으면 585개 묶음(2건 이상)에 3,442건, 전체의 64%가 들어갑니다. 2편(53%)보다 높은 것은 통신사 없이 방송·신문만 모아 한 사건을 여러 언론사가 겹쳐 쓰는 비율이 높기 때문입니다. 같은 사건 쌍의 91%가 다른 언론사 사이입니다. 묶음의 날짜 폭은 0일 349개, 1일 182개, 2일 38개, 3일 16개입니다. 날짜를 넘기는 묶음이 40%(236개)지만 그중 182개는 하루 차이고, 대부분 조간 효과로 하루 넘어간 것입니다.
문제는 큰 묶음입니다. 가장 큰 정답 묶음은 356건으로, 2편의 최대 28건과 차원이 다릅니다. 내용은 부천 공장 화재로 순직한 소방관 이야기입니다. 18일 빈소의 딸의 편지, 19일 영결식, 추미애 경기지사의 "소방 재정 빨대" 발언과 사과, 부승찬 의원의 "쭉쭉" 발언, 대통령 조문이 한 덩어리입니다. 판사들은 쌍 단위로 "편지 기사와 영결식 기사는 같은 사건"이라고 답했고, 그 답을 이어 붙이면 나흘치 이야기 전체가 됩니다. 두 번째(167건)는 21일 이재명 대통령의 "제미나이에 물어봤다" 발언과 그 반응, 세 번째(140건)는 역삼동 연쇄 방화입니다.
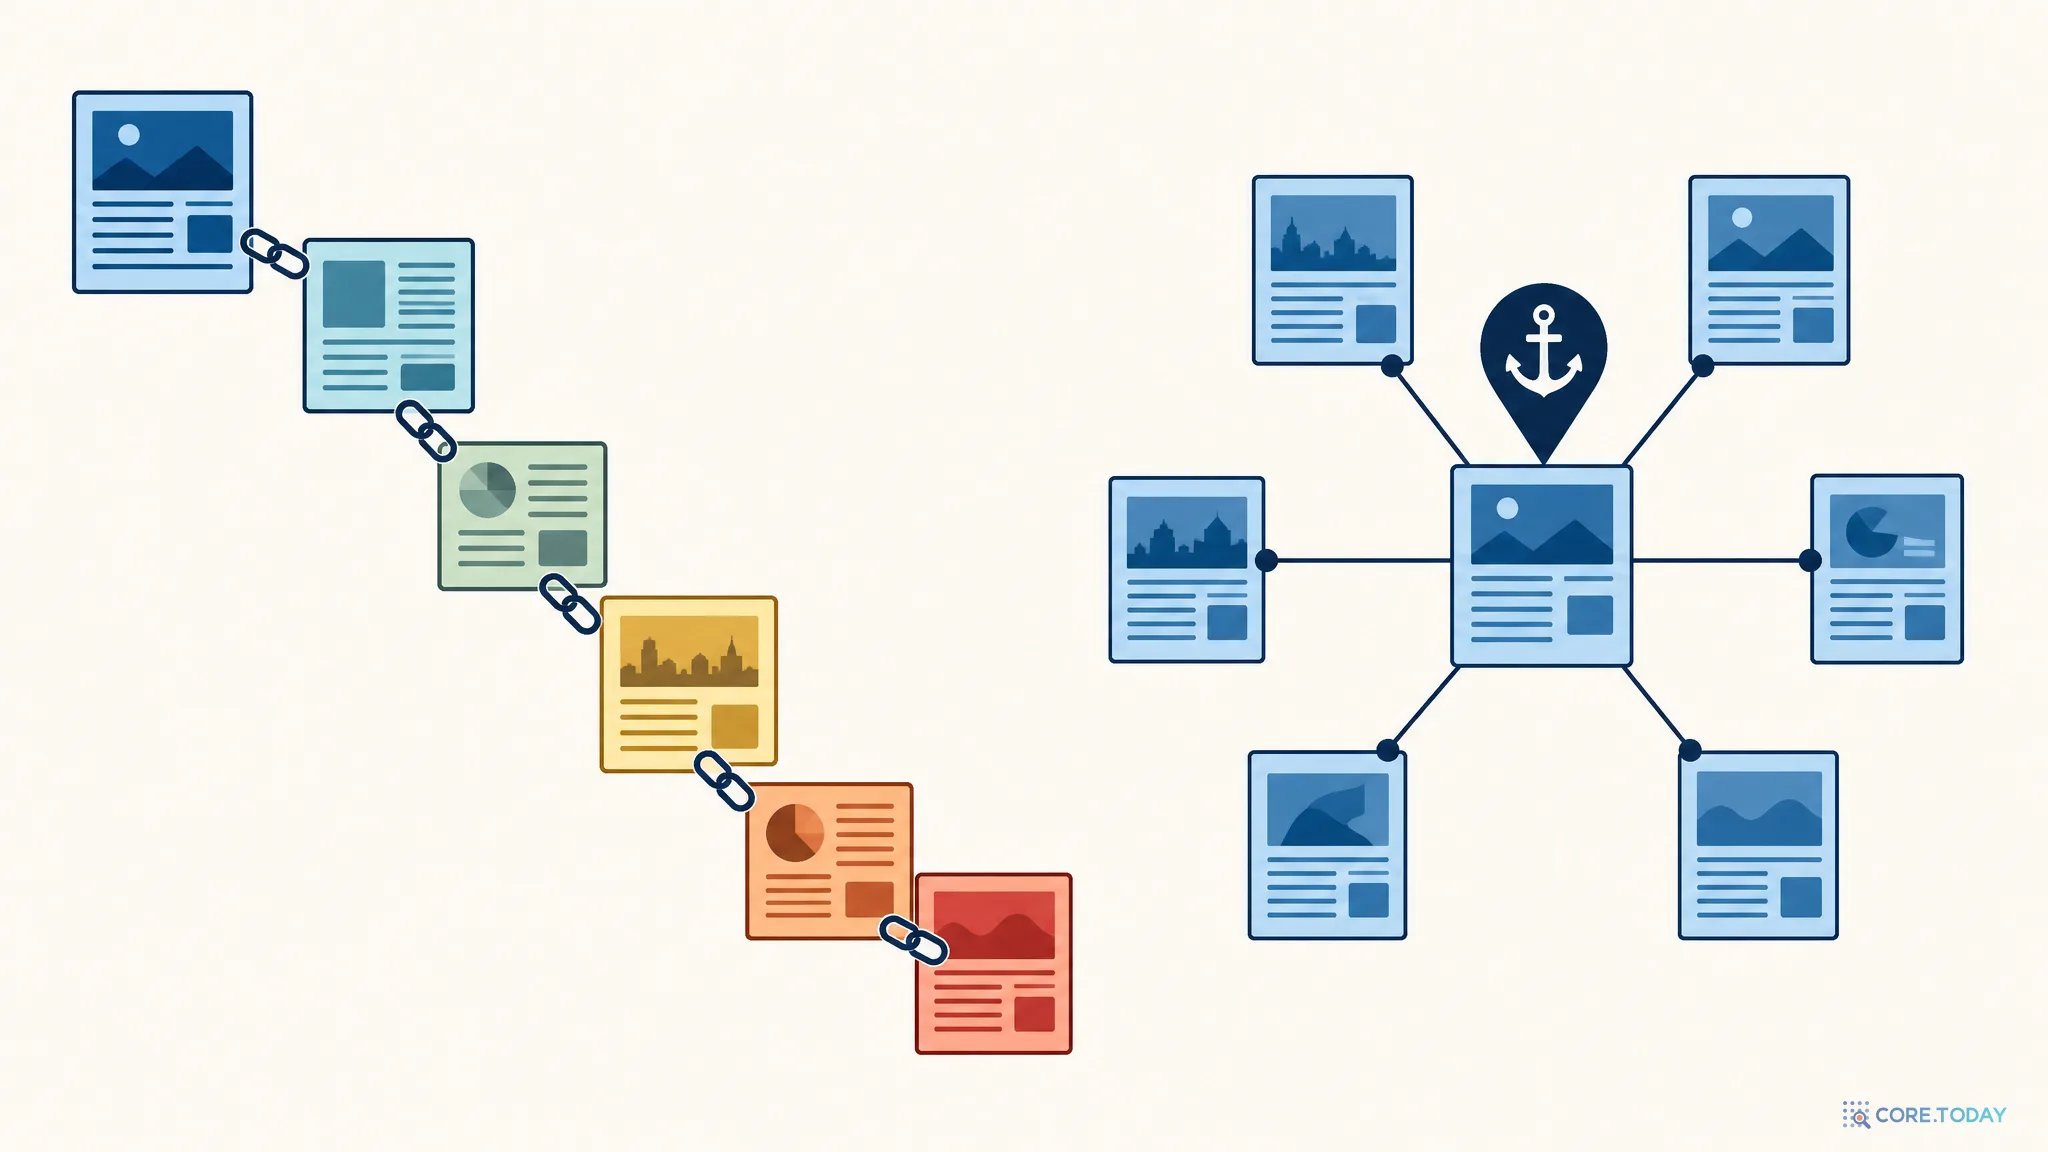
이것이 판사 한 명의 실수인지 확인하려고 두 판사가 모두 same이라고 한 11,707쌍만으로 다시 묶었습니다. 가장 큰 묶음은 318건입니다. 사슬은 다수결의 산물이 아니라 판사들의 합의입니다. 쌍 단위로 보면 하나하나는 이해할 만한 판정인데, 그 추이적 폐포는 "사건"이 아니라 "이야기"가 됩니다. 2편에서 다이제스트 기사가 허브 노릇을 했다면, 3편에서는 큰 이야기 자체가 허브입니다. 이 묶음을 어떻게 다룰지가 5부와 6부의 주제입니다.
허브의 정체도 바뀌었습니다. 토크쇼 녹취 기사(뉴스하이킥·고수다·뉴스브리핑 등 40건)는 같은 사건 차수가 평균 2.75로 전체 평균 4.74보다 낮아 허브가 아니었습니다. 대신 레코드에 사건이 몇 개 들어 있느냐가 차수를 좌우합니다. 사건 1개짜리 기사(1,954건)는 평균 2.35쌍, 2개짜리 5.51쌍, 3개짜리는 7.03쌍과 같은 사건으로 이어집니다. 2편이 설계도에 적어 둔 "레코드의 사건 수로 허브를 가려내기"가 측정으로 뒷받침된 셈입니다. 배경 사건을 셋 거느린 종합 기사가 서로 다른 묶음을 잇습니다.
3부. 판정 모델은 날짜를 어떻게 쓰나
전체 38,591쌍
2편과 같은 판정 모델 둘을 전체 쌍에 돌렸습니다. Jev(TypeSafe)와 OpenAI Decisions(gpt-6-luna)이고, 입력은 사건 레코드입니다. 3편에서는 질문을 하나 더 붙였습니다. "같은 큰 이야기에 속하는가"입니다. 한 번 호출에 두 확률이 돌아오므로 비용은 같습니다.
방법
AUROC
vs 같은 이야기
문턱
쌍 F1
묶음 F1
최대 묶음
잘못 합침
OpenAI Decisions · 레코드
0.947
0.910
0.62
0.867
0.898
380
66
Jev · 레코드
0.952
0.916
0.66
0.848
0.905
421
57
Jev · 원문+게재일
0.942
0.897
0.84
0.824
0.897
346
48
요약 임베딩 (Qwen3 8B)
0.914
0.867
0.79
0.785
0.878
353
93
EmbeddingGemma 300M
0.896
0.833
0.77
0.746
0.876
391
94
Qwen3 8B 임베딩 (제목+리드)
0.885
0.817
0.80
0.726
0.874
389
90
참여자 이름 겹침
0.775
0.704
0.23
0.636
0.727
1,500
205
순서는 2편과 같습니다. Decisions 레코드가 쌍 F1에서 1위, Jev 레코드가 순위 능력(AUROC)과 묶음 F1에서 1위입니다. 수치는 전체적으로 2편보다 0.02에서 0.05 낮습니다. 문제가 어려워져서입니다. 2편은 같은 날 쌍만 있었는데 지금은 후보의 58%가 다른 날 쌍이고, 거기서는 같은 이야기의 다른 사건이 같은 사건보다 두세 배 많습니다. 간격별로 쪼개면 분명해집니다. Decisions 레코드의 쌍 F1은 0일 0.915, 1일 0.777, 2일 0.323, 3일 0.409입니다. AUROC는 0.934, 0.928, 0.889, 0.916으로 덜 떨어집니다. 모델이 순서를 못 매기는 것이 아니라, 같은 사건이 희귀해지면서 하나의 문턱값으로는 정밀도가 무너지는 것입니다. 2일 이상에서 정밀도는 0.22에 불과합니다.
최적 문턱값도 내려왔습니다. 2편에서 0.77에서 0.92였던 것이 Decisions 레코드 0.62, Jev 레코드 0.66입니다. 같은 모델, 같은 입력 형식인데 자료가 바뀌니 문턱값이 0.15 움직였습니다. 문턱값은 모델의 상수가 아니라 자료의 함수이고, 운영에서는 주기적으로 다시 재야 합니다.
같은 3,000쌍에서: 원문, 원문+게재일, 레코드
"판정 모델에 게재일을 알려 주면 후속 보도를 더 잘 가르는가"가 3편의 두 번째 질문이었습니다. 무작위 3,000쌍을 뽑아 세 입력을 같은 쌍에서 비교했습니다.
입력
Jev 쌍 F1
Jev 1일 차 F1
Decisions 쌍 F1
Decisions 1일 차 F1
원문 (제목+400자)
0.823
0.73
0.822
0.72
원문 + 게재 시각
0.824
0.74
0.833
0.75
사건 레코드
0.851
0.79
0.864
0.79
게재 시각을 알려 주는 것은 거의 아무 효과가 없습니다. Jev는 0.001, Decisions는 0.011 올랐습니다. 반면 사건 레코드는 두 모델 모두 0.03에서 0.04를 올렸고, 하루 차 쌍에서는 0.06에서 0.07을 올렸습니다. 2편에서 Jev는 원문 입력이 레코드보다 쌍 F1에서 앞섰는데(0.834 대 0.817), 3편에서는 뒤집혔습니다. 차이는 하루 차 쌍에 있습니다. 조간 기사는 전날 기사와 같은 사건을 다른 문장으로 다시 쓰고, 종종 후속 정보(영장 신청 계획, 부상자 수 갱신)를 보탭니다. 원문을 보는 모델은 그 새 정보에 끌려 "다른 사건"으로 기울고, 레코드는 "누가 언제 어디서 무엇을"을 같은 틀로 눌러 쓰기 때문에 흔들리지 않습니다. 게재일은 그 자체로는 신호가 아닙니다. 모델이 필요로 하는 것은 "사건이 언제 일어났는가"이고, 그것은 레코드의 [시각] 칸에 있습니다.
로컬 모델 1,200쌍
GPU 한 장에서 도는 Clef-Flash 27B와 Nimble 9B를 같은 1,200쌍에서 비교했습니다. 레코드 입력 기준 Decisions 0.877, Jev 0.866, Clef 0.832, Nimble 0.821, 요약 임베딩 0.813입니다. Clef는 2편(AUROC 0.927)과 비슷한 0.937로 Jev(0.953)와 0.016 차이입니다. 하루 차 쌍에서 Clef 0.76, Jev 0.80입니다. 2편의 "로컬 27B가 붙을 만하다"는 판단은 나흘치에서도 유지됩니다.
4부. 시간·장소 거부 조건, 두 번째 재판
2편에서 레코드의 사건 날짜(이틀 이상 차이)와 시군구(다름)로 쌍을 거부하는 조건은 Jev 위에서 14쌍을 바로잡고 75쌍을 잘못 잘라 손해였습니다. 이유의 절반은 하루치라 시간이 갈라 줄 쌍이 없어서였습니다. 나흘치에서는 어떨까요.
거부 조건에 걸리는 비율을 라벨과 게재일 간격별로 보면 이렇습니다.
라벨
0일
1일
2일 이상
같은 사건
4.1% (398/9,684)
9.1% (264/2,905)
27% (49/182)
같은 이야기, 다른 사건
13%
21%
76%
다른 사건
41%
46%
76%
이틀 이상 벌어진 쌍에서 거부 조건은 같은 이야기의 다른 사건과 다른 사건의 76%를 잘라 냅니다. 2편에서 못 본 힘입니다. 그러나 같은 사건도 27%를 자릅니다. 날짜 거부가 자른 같은 사건을 보면 10월 23일 선고를 미리 쓴 기사들(한쪽 레코드는 "23일", 다른 쪽은 보도일), 사흘 전 사건을 되짚는 기획 기사, 그리고 "2026-10-02 법원 조정안"과 "10-17 조정안 확정"처럼 추출기가 사건의 다른 단계를 사건 날짜로 적은 경우입니다. 2편에서 본 것과 같은 실패 양상이고, 자료가 길어져도 바뀌지 않았습니다.
판정 모델 위에서의 손익은 2편과 같은 결론입니다. Decisions 레코드에 거부 조건을 얹으면 쌍 F1 0.867에서 0.860으로, Jev 레코드는 0.848에서 0.846으로 내려갑니다. 묶음 F1은 거의 그대로이고 잘못 합친 묶음이 66개에서 58개로 조금 줄 뿐입니다. 반면 임베딩 위에서는 뚜렷이 좋아집니다. 요약 임베딩 0.785에서 0.807, Qwen3 제목 임베딩 0.726에서 0.753, EmbeddingGemma 0.746에서 0.766입니다. 임베딩이 못 보는 것(이 사건은 이틀 전 사건이다)을 거부 조건이 대신 보고, 판정 모델이 이미 보는 것은 거부 조건이 중복해서 틀릴 뿐입니다.
그러면 거부 조건의 자리는 어디일까요. 하나는 판정 모델 앞의 후보 단계입니다. 이틀 이상 벌어진 후보 쌍 8,992개 중 같은 사건은 182쌍입니다. 여기서 거부 조건을 걸면 판정 호출의 75%(6,726쌍)를 아끼고 같은 사건 49쌍을 잃습니다. 판정 비용이 문제인 운영이라면 받아들일 만한 거래입니다. 다른 하나는 묶음 단계입니다. Jev 원문+게재일에 거부 조건을 얹으면 쌍 F1은 0.824에서 0.823으로 그대로인데 가장 큰 묶음이 346건에서 220건으로 줄었습니다. 쌍을 몇 개 끊는 것이 사슬을 자르는 데는 효과적입니다.
실제 시스템에서 기사는 한꺼번에 오지 않습니다. 도착한 기사를 그때그때 어딘가에 붙여야 하고, 붙인 뒤에는 묶음을 되돌리기 어렵습니다. 이 제약은 불편이기도 하지만 자유이기도 합니다. 배치 방식의 연결 성분은 "문턱을 넘는 쌍은 무조건 잇는다"는 규칙만 있지만, 온라인 방식은 새 기사를 무엇과 비교할지, 문턱을 넘는 묶음이 여럿일 때 합칠지 말지, 얼마나 오래된 묶음까지 볼지를 고를 수 있습니다.
5,393건을 게재 시각 순으로 하나씩 처리했습니다. 점수는 Decisions 레코드이고 문턱값은 전체 최적값 0.62입니다. 비교 대상은 세 가지입니다. 묶음 안에서 가장 비슷한 구성원(max), 묶음의 첫 기사인 앵커(anchor), 후보 쌍으로 관찰된 점수의 평균(avg)입니다. 창은 없음·2일·1일·0일(같은 날만), 합침 허용 여부를 곱해 24가지입니다.
방식
묶음 F1
정밀
재현
최대 묶음
잘못 합침
하루 지난 같은 사건을 한 묶음에
배치 · 연결 성분
0.898
0.886
0.909
380
66
0.96
온라인 max · 합침 · 창 1일
0.903
0.907
0.899
366
59
0.94
온라인 max · 합침 금지 · 창 없음
0.877
0.959
0.808
135
76
0.88
온라인 avg · 합침 · 창 없음
0.892
0.947
0.843
172
68
0.89
온라인 avg · 합침 금지
0.859
0.976
0.767
94
68
0.68
온라인 anchor · 합침 금지
0.835
0.979
0.727
28
69
0.49
온라인 max · 합침 금지 · 창 0일
0.823
0.986
0.706
68
48
0.00
세 가지가 보입니다.
창은 1일이면 충분합니다. 창을 없애도, 2일로 해도 1일과 결과가 같습니다. 같은 사건의 98%가 하루 안에 다시 쓰이기 때문입니다. 창을 0일로 좁히면 조간을 전부 잃어 재현율이 0.70으로 떨어집니다. 운영에서 "어제까지의 묶음만 열어 둔다"는 규칙은 정확도를 잃지 않으면서 비교 대상을 줄입니다.
합침을 금지하면 사슬은 줄지만 묶음 F1은 떨어집니다. max 비교에서 합침을 금지하면 가장 큰 묶음이 380건에서 135건으로 줄고 정밀도가 0.96으로 오르지만, 재현율이 0.81로 내려 묶음 F1은 0.877입니다. 정답 묶음 자체가 356건짜리 사슬이기 때문에, 사슬을 자르는 방식은 정답과 멀어집니다. 이것은 측정의 역설입니다. 정답이 "이야기"로 흘러가 있으면 사건을 깔끔하게 자르는 알고리즘이 벌점을 받습니다. 2편과 달리 3편에서는 가장 큰 묶음의 크기를 정답 대비 지표와 나란히 읽어야 합니다.
앵커 비교는 너무 보수적입니다. 첫 기사와만 비교하면 가장 큰 묶음이 28건으로 2편의 정답 수준이지만, 하루 지난 같은 사건의 절반을 놓칩니다. 조간은 전날 속보가 아니라 전날 저녁 종합 기사와 닮았기 때문입니다. 관찰된 점수의 평균(avg)은 그 중간으로, 합침을 허용하면 묶음 F1 0.892에 최대 묶음 172건입니다. 사슬을 막으면서 조간을 잃지 않는 절충이 필요하다면 이 자리입니다.
판정 모델에 함께 물은 "같은 큰 이야기에 속하는가"의 확률은 쌍 단위로 놀랄 만큼 잘 맞습니다. 정답의 same과 related를 합쳐 "같은 이야기"로 두면 AUROC 0.985, 쌍 F1 0.964입니다. 라벨별 평균 확률은 같은 사건 0.98, 같은 이야기의 다른 사건 0.80, 다른 사건 0.05로 깨끗하게 갈립니다. 같은 사건 질문(AUROC 0.947)보다 쉬운 문제입니다.
그런데 이 확률로 이야기 묶음을 만들면 무너집니다. 0.5 이상을 이으면 가장 큰 이야기가 1,860건, 0.9 이상으로 올려도 1,153건입니다. 전체 정치·사회 기사의 5분의 1이 한 이야기가 됩니다. 사건 묶음을 먼저 만들고 묶음끼리 평균 확률로 잇는 가장 보수적인 방법도 758건입니다. 그리고 정답 쪽도 같습니다. same과 related를 모두 이은 정답 이야기 묶음의 최대 크기는 2,385건입니다.
이유는 "같은 이야기"가 추이적이지 않기 때문입니다. 추미애 지사의 발언은 순직 소방관 이야기이고, 같은 발언은 경기도 국정감사 이야기이며, 국정감사는 국회의 모든 상임위 이야기로 이어집니다. 쌍마다 "같은 이야기"라는 답이 맞는데, 그것을 이으면 정치면 전체가 됩니다. 사건은 행위자·시각·장소로 경계가 닫히지만 이야기는 그렇지 않습니다. 이야기 묶음은 쌍 판정의 연결 성분으로 정의할 수 없는 개념입니다.
그래도 스레드는 있다
연결 성분 대신 "사건 묶음을 날짜 순으로 늘어놓고, 바로 앞뒤의 사건 묶음과만 잇는" 방식이면 스레드는 보입니다. 정답 이야기 묶음 가운데 6건에서 120건 사이의 중간 크기만 골라 사건 묶음으로 펼친 것이 아래 위젯입니다. 제30호 태풍 참피는 18일 발생, 20일 진로 예보, 21일 한·미·일 기상당국의 예보 비교로 이어지고, 수능 스마트 안경 단속은 18일 수험생 반발, 20일 교육부 발표, 21일 교원단체 반응으로 이어집니다. 사건 묶음은 대개 하루 안에 닫히고 다음 날 새 묶음이 열립니다.
레코드의 배경 사건도 스레드의 단서가 됩니다. 기사 5,404건에서 배경 사건 5,017개가 나왔고, 한 기사의 배경 사건 요약이 다른 기사의 헤드라인 사건 요약과 닮은(코사인 0.75 이상) 후보 쌍은 9,415개인데, 그중 98%(9,261쌍)가 같은 사건이거나 같은 이야기의 다른 사건이고 다른 사건은 154쌍뿐입니다. 후속 기사는 본문 어딘가에 "지난 16일 부천 공장 화재로..."처럼 앞 사건을 요약해 두기 때문입니다. 이야기 묶음을 쌍 확률의 성분이 아니라 "앞 사건을 배경으로 인용하는 방향 그래프"로 정의하면 사슬이 아니라 나무가 됩니다. 이것은 측정하지 못한 다음 편의 설계입니다.
7부. 설계도: 시간 축이 들어간 묶기
2편의 설계도에 시간 축을 더해 다시 그립니다.
1
수집과 정규화. 게재 시각을 분 단위로 보존한다. 조간 효과 때문에 날짜가 아니라 시각이 필요하다. 사진·영상·부고·칼럼·토크쇼 녹취를 제목 패턴으로 걸러 낸다.
2
사건 레코드 추출. 헤드라인 사건과 배경 사건을 함께 뽑는다. 사건 날짜는 보도일이 아니라 발생일로, 예정 사건은 예정일로 적게 한다. 레코드의 사건 수가 3개 이상이면 종합 기사로 표시해 둔다.
3
후보 생성. 전체 풀 최근접 이웃에 더해 다른 날 각각의 상위 후보를 일부러 넣는다. 게재일 간격이 이틀을 넘는 쌍은 임베딩 하한을 올리거나 레코드 날짜 거부로 미리 걸러 판정 호출의 4분의 3을 아낀다.
4
판정. 사건 레코드를 입력으로 "같은 사건"과 "같은 이야기"를 한 번에 묻는다. 게재일을 따로 알려 줄 필요는 없다. 문턱값은 자료마다 다시 잰다(이번 자료에서 0.6대).
5
온라인 묶기. 어제까지 열린 묶음만 비교 대상으로 둔다(창 1일). 종합 기사가 두 묶음을 이으려 하면 합치지 말고 더 비슷한 쪽에만 붙인다. 사슬이 걱정되면 가장 비슷한 구성원 대신 관찰된 점수의 평균을 쓴다.
6
이야기 스레드. "같은 이야기" 확률로 성분을 만들지 않는다. 사건 묶음을 시간 순으로 놓고 앞 묶음과만 잇거나, 배경 사건이 앞 사건을 인용하는 방향으로 나무를 만든다.
8부. 한계
정답이 LLM 다수결입니다. 두 판사가 갈린 2,997쌍 중 1,069쌍이 다수결로 같은 사건이 됐고, 그중 표본 12쌍을 직접 보니 5쌍은 같은 이야기의 다른 사건에 가까웠습니다. 반면 두 판사가 동의한 날짜 다른 같은 사건 12쌍은 모두 타당했습니다. 정답의 "같은 사건"은 큰 이야기 안에서 느슨해지는 경향이 있고, 356건짜리 정답 묶음은 그 결과입니다. 5쌍은 수동으로 바로잡았지만 나머지는 그대로입니다.
네이버 송고분, 정치·사회면만. 언론사가 자사 사이트에만 올린 기사와 경제·문화면은 없습니다. 통신사를 뺀 것은 비용 때문이고, 통신사가 들어오면 같은 날 묶음은 커지고 조간 효과의 비율은 달라질 것입니다.
추출기가 둘입니다. 레코드의 71%는 Gemini 3.8 Flash, 29%는 3.5 Flash가 뽑았습니다. 같은 프롬프트와 스키마지만 사건 날짜나 시군구를 적는 습관이 조금 다를 수 있고, 거부 조건 분석은 그 영향을 받습니다.
온라인 시뮬레이션은 점수를 미리 계산해 둔 것입니다. 실제 온라인 시스템은 후보 생성도 도착 순서대로 해야 하고, 임베딩 이웃이 바뀝니다. 이 글의 시뮬레이션은 "묶는 규칙"만 비교한 것입니다.
나흘입니다. 일주일, 한 달로 늘리면 예정 사건(선고일, 개막일)과 기념일(1주기)이 늘어나 시간 거부 조건의 실패 양상이 바뀔 수 있습니다.
맺으며
세 편에 걸쳐 같은 질문을 자료를 키우며 물었습니다. 1편은 판정 모델이 임베딩보다 낫다는 것, 2편은 사건 레코드가 블로킹·임베딩·판정 입력 세 자리에서 일한다는 것이었습니다. 3편이 보탠 것은 시간입니다.
같은 사건은 하루 안에 거의 다 쓰입니다. 하루 차 같은 사건의 정체는 조간이고, 이틀이 지나면 같은 사건은 50쌍에 하나입니다.
판정 모델에 게재일을 알려 주는 것은 소용없고, 사건 레코드는 하루 차 쌍에서 쌍 F1을 0.06 올립니다. 2편에서 원문이 앞서던 Jev도 레코드로 뒤집혔습니다.
시간·장소 거부 조건은 이틀 밖의 후보를 4분의 3 덜어 내는 비용 절감 장치이지, 판정 모델 위의 정확도 장치가 아닙니다.
온라인 묶기는 창 1일에 합침 허용이면 배치와 같거나 조금 낫고, 합침 금지는 사슬을 3분의 1로 줄이는 대신 묶음 F1을 0.02 내줍니다. 어느 쪽을 고를지는 "356건짜리 정답 묶음을 사건으로 볼 것인가"라는 질문에 달려 있고, 코어닷투데이의 답은 '아니오'입니다.
"같은 이야기"는 쌍으로는 쉽고 성분으로는 불가능합니다. 이야기는 성분이 아니라 시간 순으로 이어지는 스레드나 인용 나무로 정의해야 합니다.
다음 편이 있다면 주제는 정해져 있습니다. 배경 사건이 앞 사건을 인용하는 방향 그래프로 이야기를 나무로 세우는 것, 그리고 정답을 쌍이 아니라 스레드 단위로 만드는 것입니다.