AI 심판을 심판하다 — 육하원칙 추출을 채점하는 LLM 판사 벤치마크, 원자료로 다시 읽기
칠레 북부 가톨릭대 연구진이 2026년 2월 Electronics에 낸 논문은 GPT-4.1·Claude Sonnet 4.5·Gemini 2.5 Pro를 스페인어 뉴스의 육하원칙 추출을 채점하는 판사로 세우고, 기자 두 명에게 그 판결을 검수시켰습니다. 결론은 판사 셋 모두 98% 넘게 '수용'됐고 Claude가 99.79%로 1등이라는 것입니다. 이 글은 육하원칙이 2,000년 동안 어떻게 기사의 뼈대가 됐는지, 글자를 세던 BLEU·ROUGE가 왜 뜻을 못 보는지, LLM 판사가 어떤 구조로 채점하는지를 논문의 그림과 표로 차근차근 풀고, 이어서 논문 저장소의 검수 엑셀 5,736행을 직접 다시 셉니다. 기자는 판사가 1점을 줘도 5점을 줘도 거의 같은 비율(97~99%)로 동의했고, 같은 추출에 판사들 점수가 두 점 이상 갈린 358건 중 342건에서 세 판사 모두에게 동의했습니다. 카파 0.67은 4점과 5점 사이의 일치였고, ROUGE와의 상관 −0.53은 두 데이터셋을 섞어서 생긴 심슨의 역설이었습니다. 끝으로 한국어 기사 36건에 날짜·주체·숫자를 바꾸고 이유를 지어낸 함정 추출을 심어 판사가 실제로 오류를 잡는지 쟀습니다. Claude Sonnet은 함정 194쌍을 모두 깎았지만, 로컬 Qwen3.5 4B는 사실 함정 28건을 전부 5점으로 통과시키며 '출처와 완전히 일치한다'고 썼습니다. 자의 착시를 걷어 내면 이 논문이 남기는 교훈은 '판사는 쓸 만하다'가 아니라 '판사를 검증하는 방법을 바꿔야 한다'입니다. 위젯 6개와 삽화 10장.
2026년 2월 3일, 국제 학술지 Electronics에 짧은 제목의 논문이 실렸습니다. 「육하원칙 추출 평가를 위한 LLM 판사 모델 벤치마킹(Benchmarking LLM-as-a-Judge Models for 5W1H Extraction Evaluation)」. 칠레 안토파가스타에 있는 북부 가톨릭대(Universidad Católica del Norte)의 컴퓨터공학자 두 명과 저널리즘 연구자 두 명이 함께 썼습니다.
초록의 숫자는 눈에 확 들어옵니다. 세 판사 모두 모든 지표에서 90%를 넘었고, Claude Sonnet 4.5는 판단 수용률(JAR) 99.79%로 가장 정확한 평가자였다고 합니다. 기자 두 명 사이의 일치도는 카파 0.6739로 '상당한 일치'였습니다. 그렇다면 이제 뉴스 기사에서 누가·무엇을·언제·어디서·왜·어떻게를 뽑아내는 시스템은 사람 대신 LLM이 채점해도 된다는 뜻일까요?
코어닷투데이는 지난 10월 이 질문의 한국어판을 두 번 다뤘습니다. 「뉴스에서 육하원칙 뽑기」에서는 기사 72건에서 육하원칙을 뽑는 스무 가지가 넘는 방법을 비교했고, 「채점이 순위를 바꾸는가」에서는 같은 답 2,371개를 판사 여섯에게 다시 채점시켰습니다. 그때 배운 것은 판사에게도 버릇이 있다는 사실이었습니다. 그래서 이 논문의 99.79%를 읽으며 가장 먼저 든 질문은 이것이었습니다. 이 숫자는 정확히 무엇을 잰 것인가?
다행히 저자들은 코드와 데이터를 공개했습니다. 공개 저장소의 기본 브랜치에는 시범 실행 결과만 있지만, validation이라는 다른 브랜치에 최종 판사 출력과 기자들이 실제로 채운 검수 엑셀 5,736행이 들어 있습니다. 이 글은 세 겹으로 진행합니다.
1배경. 육하원칙은 어디서 왔고, 기계는 언제부터 그것을 뽑았으며, 왜 그 결과를 채점하기가 그렇게 어려운가. 고대 수사학에서 전신 시대 신문, BLEU·ROUGE, LLM 판사까지.
2논문 해부. 데이터 두 벌, 여섯 기준, 판사의 구조(함수 호출과 스키마 검증), 기자 검수, 표 2~8과 그림 1·5·6·7을 하나씩.
3다시 읽기와 실측. 저장소의 원자료로 98%를 뜯어 보고, 한국어 기사에 함정을 심어 판사가 오류를 잡는지 직접 잽니다.
미리 말해 두면, 이 글은 논문을 깎아내리려고 쓴 글이 아닙니다. 논문이 세운 구조(기준표, 구조화된 출력, 출처 적합도라는 메타 판단)는 2026년 현장에서 그대로 가져다 쓸 만합니다. 다만 판사가 얼마나 믿을 만한지 재는 방식에는 함정이 여럿 있고, 그 함정은 이 논문만의 것이 아니라 LLM 판사를 쓰는 거의 모든 팀이 같이 밟는 것입니다. 그래서 하나씩 짚어 봅니다.
1부. 여섯 질문의 2,000년
수사학의 '상황'에서 시작했다
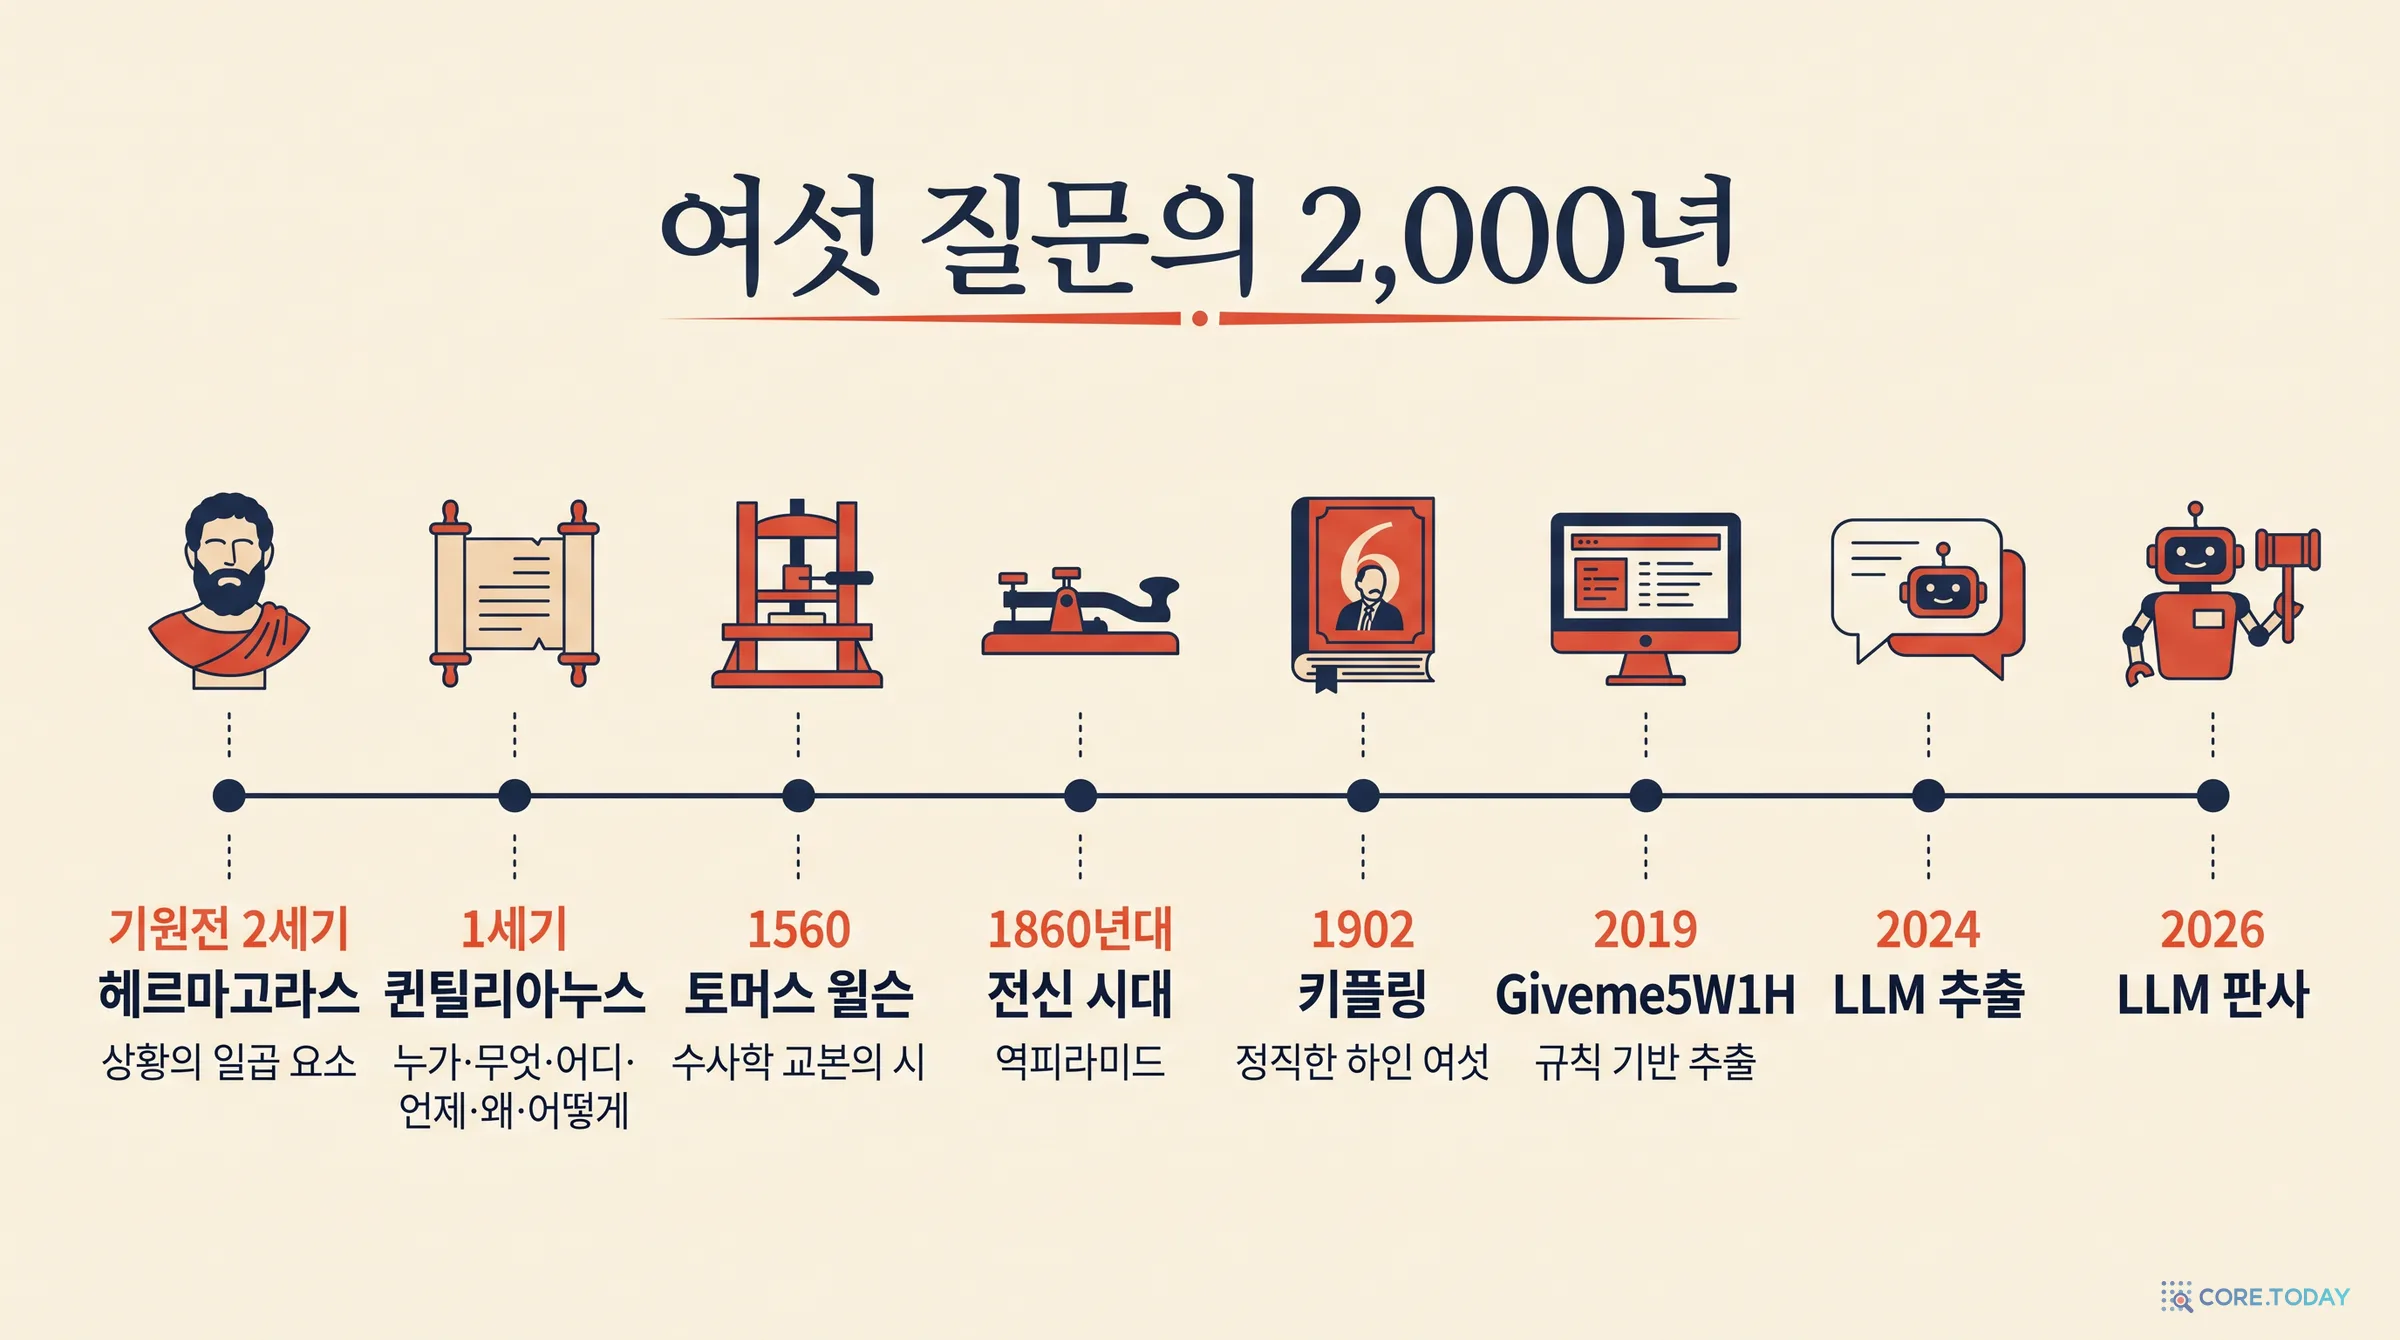
"누가, 무엇을, 언제, 어디서, 왜, 어떻게"는 신문이 만든 규칙이 아닙니다. 법정에서 사건을 따지던 고대 수사학의 도구였습니다.
기원전 2세기 그리스의 수사학자 헤르마고라스(Hermagoras of Temnos)는 하나의 사건(사안)을 이루는 '상황(페리스타시스, peristasis)'을 일곱 가지로 나눈 사람으로 전해집니다. 그의 저작은 남아 있지 않고 후대 저자의 인용으로만 전합니다. 로마의 수사학 교사 퀸틸리아누스는 1세기 말에 쓴 『웅변가 교육(Institutio Oratoria)』 5권에서 논증의 자리(loci argumentorum)를 설명하며 이렇게 씁니다. "일어난 모든 일에 대해 우리는 묻는다. 왜, 어디서, 언제, 어떻게, 무엇을 통해 그 일이 행해졌는가." 사람(누가)은 그보다 앞에서 따로 다룹니다.
흔히 인용되는 라틴어 한 줄, quis, quid, ubi, quibus auxiliis, cur, quomodo, quando(누가, 무엇을, 어디서, 무슨 도움으로, 왜, 어떻게, 언제)는 퀸틸리아누스의 문장이 아닙니다. 13세기 토마스 아퀴나스가 『신학대전』에서 키케로의 말이라며 인용한 중세식 정리이고, 그 무렵에는 고해 신부가 죄의 경중을 따질 때 묻는 질문 목록으로 쓰였습니다. 논문 2.1절은 이 범주들을 퀸틸리아누스의 것으로 소개하는데, 계보로 보면 '퀸틸리아누스와 그 이후의 정리'라고 하는 편이 정확합니다.
영어권에 이 목록을 각인시킨 것은 1560년 토머스 윌슨(Thomas Wilson)의 『수사학 기술(The Arte of Rhetorique)』 개정판입니다. 그는 일곱 상황을 늘어놓은 뒤 외우기 쉽게 운율을 붙였습니다. "누가, 무엇을, 어디서, 무슨 도움으로, 누구에 의해 / 왜, 어떻게, 언제가 많은 것을 드러낸다(Who, what, and where, by what helpe, and by whose: / Why, how, and when, doe many things disclose)." 그리고 1902년 러디어드 키플링은 『그런 이야기들(Just So Stories)』의 「코끼리 아이」 뒤에 이런 시를 붙입니다. "내게는 정직한 하인 여섯이 있다 / (내가 아는 모든 것을 그들이 가르쳐 주었다) / 그들의 이름은 무엇, 어디, 언제 / 그리고 어떻게, 왜, 누구." 키플링의 하인은 정확히 여섯, 즉 5W1H입니다.
신문이 그것을 '첫 문장'으로 옮겼다
신문 교과서에 이 질문들이 등장하는 시점은 20세기 초입니다. 위스콘신대 언론학 교수 윌러드 블라이어(W. G. Bleyer)는 1913년 『신문 기사 작성과 편집』에서 기사의 첫머리(리드)가 "무엇? 누가? 언제? 어디서? 왜? 어떻게?"에 답해야 한다고 썼습니다. 여섯 질문입니다. "다섯 개의 W(the five W's)"라는 표현이 교과 과정에 문자 그대로 나오는 것은 1917년 캔자스대 L. N. 플린트의 고교 신문 작성 교재입니다.
결론부터 쓰고 덜 중요한 것을 뒤로 미루는 역피라미드 구조도 이 무렵 자리 잡았습니다. 널리 퍼진 이야기는 "남북전쟁 때 전신선이 자주 끊겨서 가장 중요한 내용부터 보내야 했다"는 것입니다. 1865년 4월 15일 육군장관 에드윈 스탠턴이 링컨 저격 소식을 뉴욕에 보낸 전보("오늘 저녁 9시 30분께 포드 극장에서 대통령이…")가 역피라미드의 초기 사례로 자주 꼽힙니다. 그러나 미국 일간지 기사 4만 6,841건을 5년 간격으로 표본 조사한 에리코 등의 연구(1997)에 따르면, 요약형 리드를 쓴 기사는 1865년에 0%, 1890년 0.68%, 1910년에야 11.03%였습니다. 역피라미드는 전쟁의 산물이라기보다 1880~1910년 진보 시대에 교육과 '과학적 보도'의 이상과 함께 퍼진 형식에 가깝습니다. 전신 신화는 반쯤만 맞습니다.
타임라인의 '1860년대 역피라미드'는 널리 알려진 통설의 연대입니다. 위에서 본 대로 실제 확산은 1880~1910년대의 일입니다.
그리고 한국어의 '육하원칙'
한국어 사전은 육하원칙(六何原則)을 "역사 기사, 보도 기사 따위의 문장을 쓸 때에 지켜야 하는 기본적인 원칙. '누가, 언제, 어디서, 무엇을, 어떻게, 왜'의 여섯 가지"로 풀이합니다(표준국어대사전). 영어의 5W1H와 순서가 다르다는 점이 재미있습니다. 이 말이 한국 언론 교육에 언제 들어왔는지는 확인 가능한 문헌을 찾지 못했습니다. 다만 오늘날 기자 교육과 신문활용교육(NIE)에서 스트레이트 기사의 리드가 갖춰야 할 요건으로 가르친다는 점은 분명합니다.
이 역사가 이 글의 주제와 이어지는 지점은 하나입니다. '누가·언제·어디서'는 기사 첫 문장에 거의 늘 있고, '왜·어떻게'는 기사 전체에 흩어져 있거나 아예 없다. 2,000년 전 법정에서도, 2026년 기계 추출에서도 '왜'가 가장 어렵습니다.
2부. 기계가 여섯 질문에 답하기까지
규칙의 시대: 2009~2019
컴퓨터가 기사에서 5W를 뽑는 연구는 2000년대 후반 미국 정부 지원 과제에서 본격화했습니다. 2009년 ACL에 실린 파튼(Parton) 등 15명의 논문은 중국어 문장에서 영어 5W를 뽑는 교차 언어 과제를 비교했는데, 최고의 교차 언어 시스템도 단일 언어 시스템보다 19% 낮았습니다. 같은 해 야만(Yaman) 등은 DARPA 말뭉치에서 F1 0.85를 보고했고, 2010년에는 중국어 의미역 결정(SRL)으로 5W1H를 뽑는 연구도 나왔습니다.
이 계열을 정리한 것이 독일 콘스탄츠대의 Giveme5W1H(2019)입니다. 코어닷투데이는 이 시스템을 별도 글에서 자세히 해부했습니다. 문장 구조 분석, 개체명 인식, 위치 가중치 같은 규칙을 조합하는 방식이었고, BBC 기사 120건에서 평균 정밀도(MAgP)가 '누가' 0.92, '무엇을' 0.79, '언제'·'어디서' 0.78이었지만 '왜'는 0.48, '어떻게'는 0.61에 그쳤습니다. 앞의 네 질문과 뒤의 두 질문 사이에 깊은 골이 있었던 것입니다.
이 논문의 교신 저자인 브라이언 키스-노람부에나(Brian Keith-Norambuena)는 2020년 AP 통신 기사로 역피라미드를 측정하는 연구를 했습니다. 육하원칙 답이 기사 앞부분에 몰려 있을수록 역피라미드에 가깝다고 보고 점수를 매기는 방식이었고, 속보 기사일수록 역피라미드를 따른다는 결론이었습니다. 이번 논문에서 FLARES 데이터를 고를 때 '가장 먼저 나온 구절'을 정답으로 쓰는 규칙(4부)이 바로 이 생각에서 나왔습니다.
LLM의 시대: 2024~
2024년 차오(Cao) 등은 CNN/DailyMail, XSum, NYT 등에서 약 3,500건을 직접 주석해 LLaMA·Vicuna 계열을 미세 조정했습니다. 미세 조정한 7B·13B 모델이 제로샷 ChatGPT를 이겼고, GPT-4에 예시 다섯 개를 주면 '누가·왜·어디서'에서 미세 조정 모델을 앞섰습니다. 그런데 이 연구도 성능을 ROUGE와 BLEU로 쟀습니다. 논문 저자들이 "역설적으로, 추출은 발전했는데 검증은 수십 년 전 더 단순한 과제를 위해 만든 지표로 한다"고 꼬집은 대목입니다.
2026년 지금은 사정이 더 분명합니다. 범용 LLM에게 "이 기사의 육하원칙을 JSON으로 뽑아라"라고 하면 대부분 그럴듯한 답이 나옵니다. 코어닷투데이의 지난 실험에서도 사고를 끈 Gemini 3.8 Flash가 한국어 기사에서 글자 F1 0.86을 냈습니다. 추출은 거의 풀린 문제처럼 보이고, 남은 문제는 '그 답이 맞는지 누가 어떻게 확인하느냐'입니다. 이 논문이 겨냥한 곳이 바로 여기입니다.
3부. 글자를 세는 자는 왜 뜻을 못 보나
BLEU와 ROUGE가 태어난 이유
2002년 IBM 왓슨 연구소의 파피네니(Papineni) 등은 기계 번역을 평가하는 BLEU를 발표했습니다. 이름부터 '이중 언어 평가 대역(Bilingual Evaluation Understudy)', 즉 숙련된 사람 평가자의 대역이라는 뜻입니다. 사람 평가는 "끝나는 데 몇 달이 걸릴 수 있었기" 때문입니다. 아이디어는 단순했습니다. 기계 번역이 사람 번역과 단어 묶음(n-gram)을 많이 공유할수록 좋은 번역이라는 것. 논문은 시스템 다섯 개에 대해 사람 판단과의 상관 0.96~0.99를 보고했고, BLEU는 이후 20년 동안 기계 번역의 표준 자가 됐습니다.
2년 뒤 남캘리포니아대 정보과학연구소의 친-유 린(Chin-Yew Lin)은 요약 평가용 ROUGE를 냈습니다. BLEU가 '후보에 있는 단어가 정답에도 있는가'(정밀도)를 본다면, ROUGE는 '정답에 있는 내용을 후보가 얼마나 담았는가'(재현율)를 봅니다. 미국 국립표준기술원의 요약 평가 대회(DUC) 규모로 사람이 직접 평가하려면 "3,000시간이 넘는 노력"이 든다는 것이 출발점이었습니다. ROUGE-L은 그중 '가장 긴 공통 부분 수열(LCS)', 즉 순서를 지키며 겹치는 단어가 얼마나 긴지를 잽니다.
두 자 모두 '사람 평가를 싸고 빠르게 흉내 내자'는 목적으로 태어났고, 그 목적은 대체로 시스템 단위, 많은 문장을 평균한 수준에서만 달성됐습니다.
의미맹(semantic blindness)
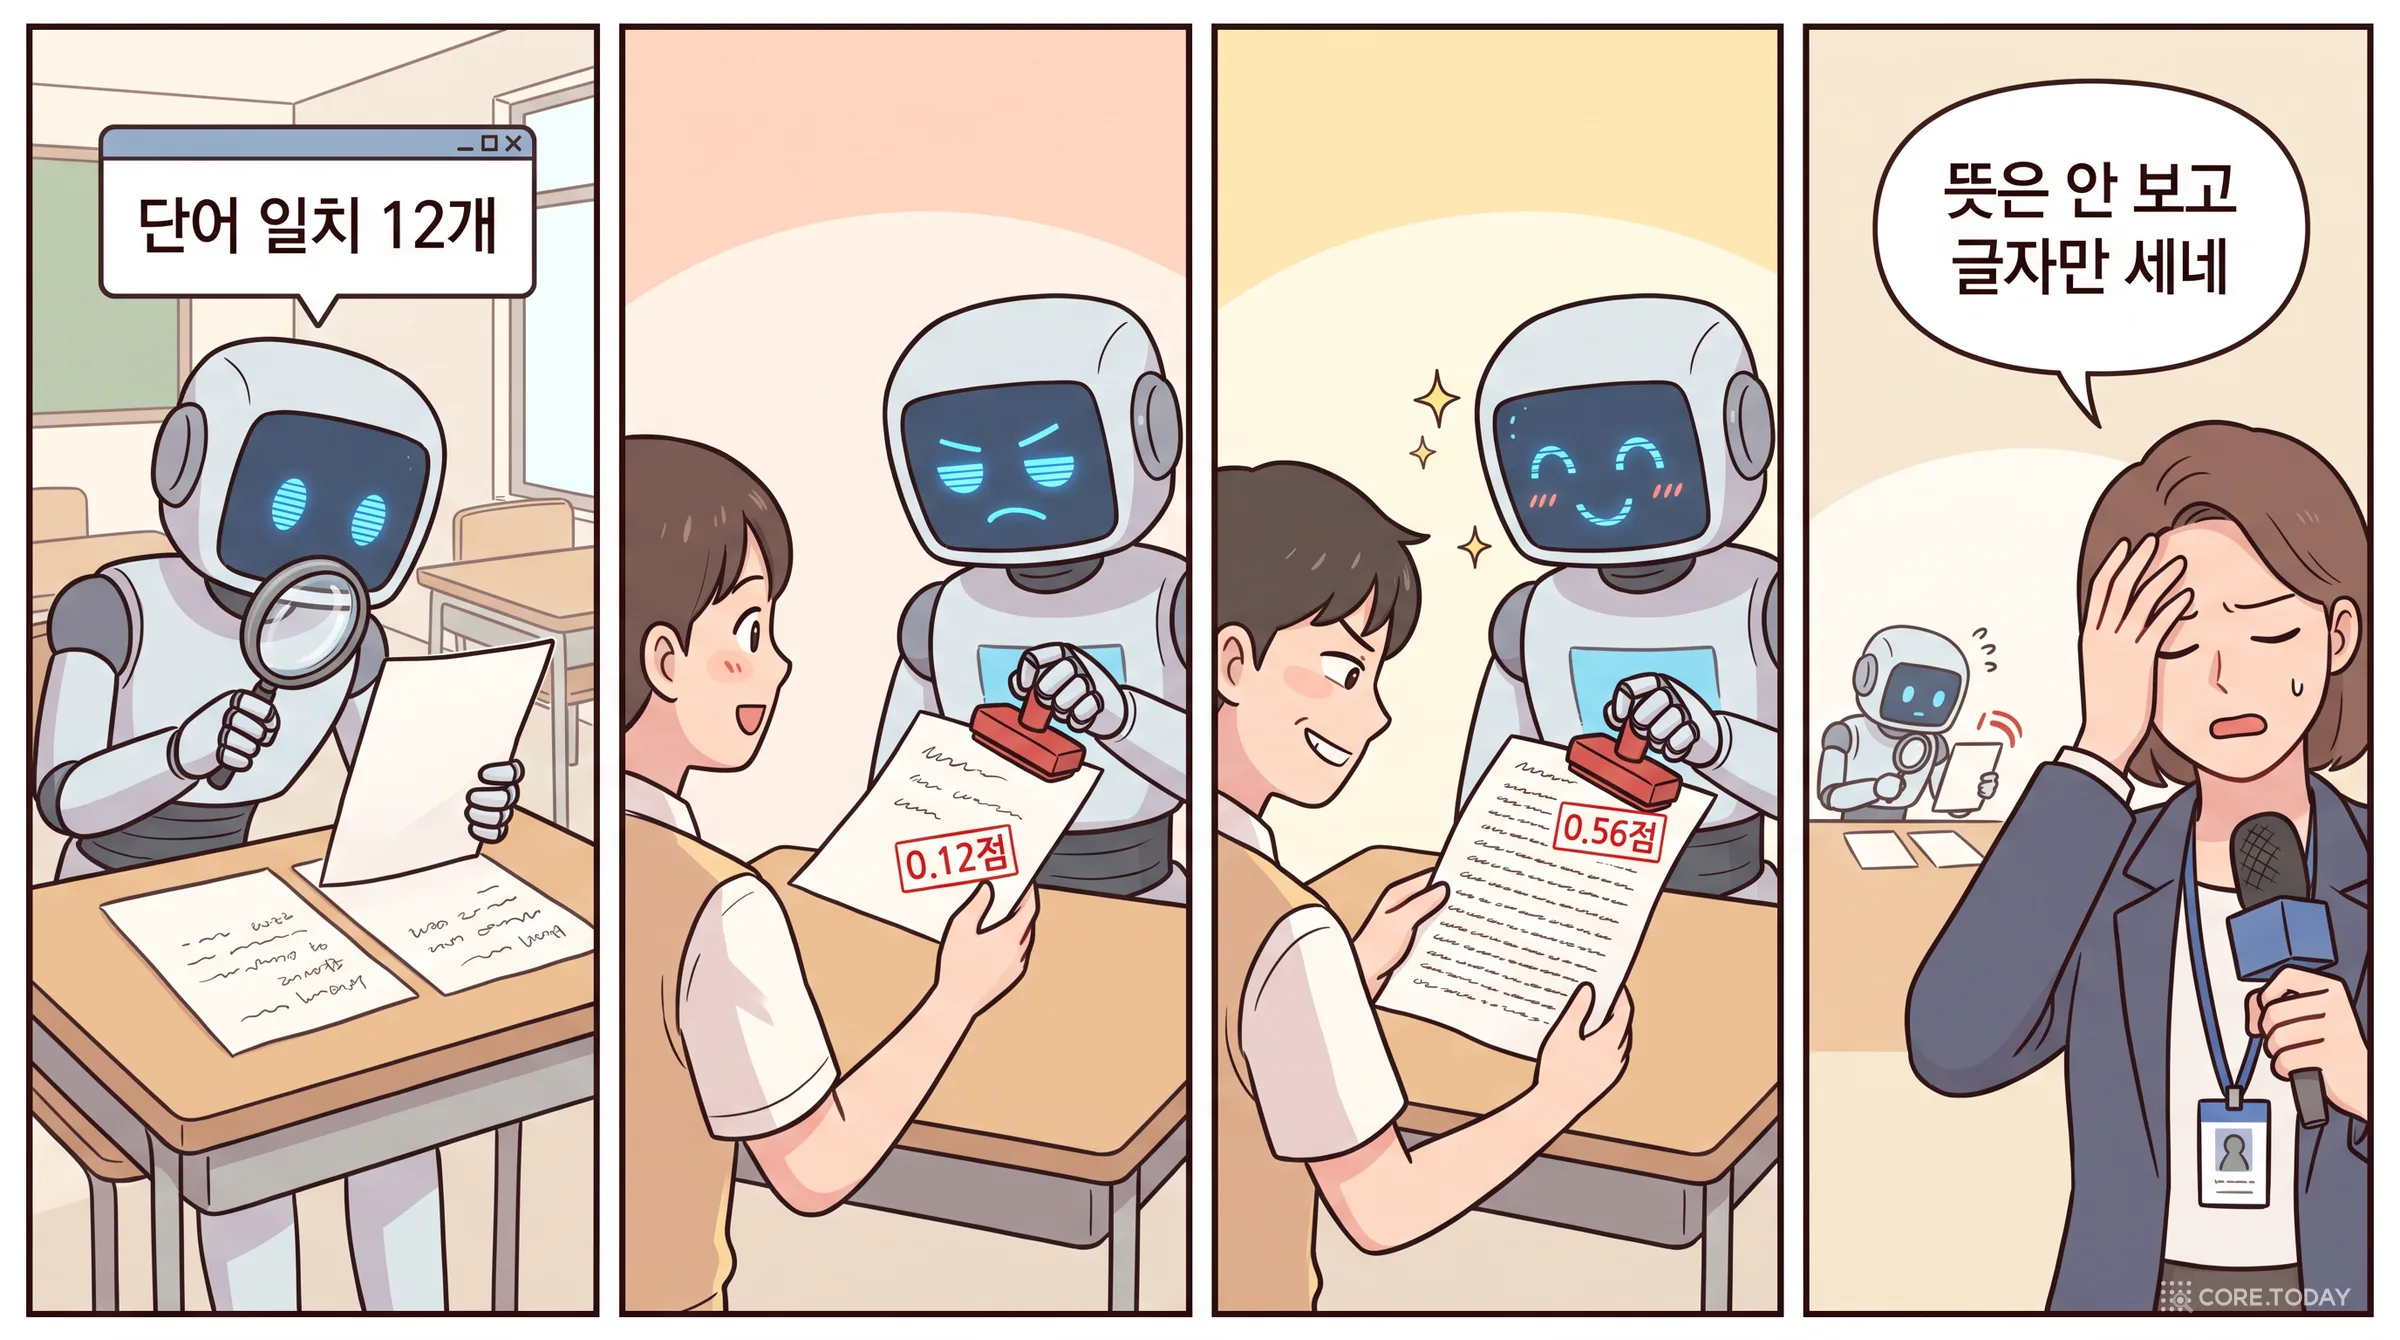
문제는 문장 하나, 답 하나 수준에서 드러납니다. 2006년 캘리슨-버치(Callison-Burch) 등은 BLEU 점수가 오르는 것은 번역 품질 향상의 "필요조건도 충분조건도 아니다"라고 썼습니다. 2005년 NIST 아랍어 번역 대회에서 사람 평가 1위였던 시스템을 BLEU는 6위로 매겼습니다. 2018년 라이터(Reiter)는 34편의 논문에서 상관 284개를 모아 검토한 뒤, BLEU는 기계 번역 시스템을 진단하는 용도 말고는 타당성 근거가 약하다고 결론 내렸습니다. 요약 쪽에서는 2021년 SummEval이 지표 14개와 모델 23개를 다시 평가했는데, ROUGE-L은 문장 간 연결성(coherence)과의 순위 상관이 0.07에 불과했습니다.
육하원칙 추출에서 이 의미맹은 특히 아픕니다. 정답이 "50대 남성"이고 모델이 "A(59)씨"라고 쓰면 같은 사람이지만 겹치는 글자가 없습니다. "이날"과 "13일"도 같은 날입니다. 반대로 원문의 단어를 잔뜩 베껴 쓰면서 칸을 엉뚱하게 채운 답은 높은 점수를 받습니다. 한국어는 조사가 붙어 어절이 쉽게 달라지므로 더 심합니다. 아래 위젯에서 직접 재 보세요.
뜻을 보려는 시도도 있었습니다. 2019년 BERTScore는 단어 대신 문맥 임베딩끼리의 유사도를 쟀고, 2020년 BLEURT는 사람 평가로 학습한 채점 모델을 만들었습니다. 사실 일관성을 따로 재는 QAGS(요약에 질문을 던져 원문과 답이 같은지 보기)와 FactCC(규칙으로 만든 오류 문장을 분류하기)도 나왔습니다. 그러나 이들은 '비슷하다'는 것은 잡아도 '어느 칸에 무엇이 들어가야 하는지', '이 이유가 원문에 있는지'처럼 과제에 특화된 판단을 하기는 어려웠습니다.
4부. 판사가 된 언어 모델
기준표를 주고 근거를 쓰게 하라
2023년 봄, 흐름이 바뀝니다. 2월의 GPTScore, 3월의 G-Eval은 GPT 계열 모델에게 평가 기준을 설명하고 점수를 매기게 했습니다. G-Eval은 GPT-4에게 단계별로 생각하게 한 뒤 점수를 매기게 해, SummEval에서 사람 판단과의 스피어만 상관 0.514를 얻었습니다. ROUGE-L의 같은 조건 상관은 0.165였습니다.
같은 해 6월 UC 버클리 등의 정(Lianmin Zheng) 연구진은 「MT-Bench와 챗봇 아레나로 LLM 판사를 판정하다」에서 'LLM-as-a-Judge'라는 이름을 대중화했습니다. 초록의 유명한 문장은 GPT-4 판사가 사람과 "80% 넘게 일치해, 사람끼리의 일치 수준과 같다"는 것입니다. 본문을 보면 이 숫자에는 조건이 붙어 있습니다. 동점을 포함하면 GPT-4와 사람의 일치는 66%, 동점을 빼면 85%이고, 사람끼리는 81%였습니다. 같은 판사라도 무엇을 일치로 세느냐에 따라 66%도 되고 85%도 됩니다. 이 감각이 이 글 내내 필요합니다.
이후 판사 전용 모델이 나왔습니다. 2023년 JudgeLM은 GPT-4의 판정을 7B~33B 모델에 가르쳤고, 2024년 Prometheus와 Prometheus 2는 사용자가 준 기준표(rubric)로 채점하도록 학습한 공개 모델이었습니다. Prometheus 연구진이 정리한 요령, 즉 기준표를 명시하고, 참조 답을 주고, 점수보다 근거(말로 된 피드백)를 먼저 쓰게 하라는 이번 논문 설계의 뼈대이기도 합니다.
판사의 버릇
판사가 된 언어 모델은 중립적인 자가 아니라 버릇이 있는 평가자입니다. 연구로 확인된 대표적인 버릇은 이렇습니다.
버릇
무엇인가
보고된 예
위치 편향
두 답을 비교할 때 먼저(또는 나중에) 놓인 답을 고른다
ChatGPT 판사에게 답 순서만 바꿔 주자 Vicuna-13B가 80문항 중 66개에서 ChatGPT를 이겼다 (Wang 외, 2023)
장황함 편향
내용과 무관하게 긴 답을 선호한다
같은 내용을 반복한 목록 공격에 Claude-v1·GPT-3.5 판사가 91.3% 속았다 (Zheng 외, 2023)
자기 선호
자기 또는 같은 가족 모델이 쓴 답을 후하게 본다
자기 글을 알아보는 능력과 자기 선호가 선형으로 비례 (Panickssery 외, 2024)
권위·외모 편향
인용이 붙거나 꾸밈이 좋은 답에 끌린다
사람 판사와 LLM 판사 모두 취약 (Chen 외, 2024)
관대함
애매하면 맞다고 해 준다
판사 13개 중 다수가 '맞음'으로 기우는 경향, 일치율 90%가 넘어도 점수는 10점 넘게 차이 (Thakur 외, 2024~25)
마지막 줄의 연구(「판사를 판정하다(Judging the Judges)」)는 이 글과 직결됩니다. 연구진은 판사 13개를 시험한 뒤 백분율 일치는 판사의 질을 가리기에 부족하다고 결론 내렸습니다. 일치율이 90%를 넘는 판사끼리도 매긴 점수가 10점 넘게 차이 날 수 있었기 때문입니다. 이 연구는 초기 판본에서 코언의 카파를 쓰다가 최신판(2025년 8월)에서 스콧의 파이(π)로 바꿨습니다. 카파에 "잘 알려진 이론적 문제"가 있다는 이유였습니다. 그 문제가 무엇인지는 7부에서 직접 만나게 됩니다.
평가에서의 환각도 따로 짚어야 합니다. 생성에서 환각은 없는 사실을 지어내는 것이지만, 평가에서 환각은 근거와 판결이 따로 노는 것입니다. "원문과 정확히 일치합니다"라고 써 놓고 틀린 날짜에 5점을 주는 식입니다. 야코비(Jacovi)와 골드버그(Goldberg)가 2020년에 지적했듯, 모델이 내놓은 설명이 그럴듯한 것(plausibility)과 실제 판단 과정을 반영하는 것(faithfulness)은 다릅니다. 이번 논문이 판사에게 기준마다 근거를 쓰게 하고 그 근거의 질(EUI)을 따로 잰 이유가 여기에 있습니다.
그런데 육하원칙은?
2023~2025년의 판사 연구는 대부분 챗봇 대화나 열린 지시 따르기를 평가했고, 대부분 영어였습니다. 육하원칙 추출처럼 구조가 정해져 있고, 원문과의 사실 대조가 핵심이며, 기자의 직업적 기준이 있는 과제에서 판사가 얼마나 믿을 만한지는 체계적으로 비교된 적이 거의 없었습니다. 스페인어는 더 그렇습니다. 논문이 꼽은 공백 세 가지는 이것입니다. 구조화된 추출에 대한 판사 검증이 없다, 영어 밖 언어가 비어 있다, 정확도·비용·안정성을 함께 놓고 판사를 고를 비교가 없다.
5부. 논문 해부 ①: 무엇을 채점했나
두 벌의 데이터: 모델이 쓴 요약과 사람이 그은 밑줄
논문은 성격이 정반대인 스페인어 데이터 두 벌을 섞었습니다. 저자들은 이것을 '하이브리드 데이터 전략'이라 부릅니다.
BASSE는 2025년 바스크 지역 연구진(Barnes 외)이 공개한 스페인어·바스크어 요약 평가 말뭉치입니다. 원래는 요약 지표와 LLM 판사가 사람 평가와 얼마나 맞는지 보려고 만든 것이고, 기사마다 여러 모델에게 여러 방식으로 요약을 시켰습니다. 그중 하나가 "다음 글을 5W1H 방법(무엇을, 누가, 언제, 어디서, 왜, 어떻게)으로 요약하라"는 프롬프트였습니다. 논문은 스페인어 기사 45건(엘 파이스, El País)에 대해 이 프롬프트로 만든 요약을 모델 다섯(Claude, Command R+, GPT-4o, Llama 3, Reka)에서 하나씩 가져와 추출 225개를 만들었습니다. 길고 매끄러운, 모델이 쓴 문장들입니다. 기사 평균 길이는 846어절입니다.
FLARES는 2024년 이베로아메리카 언어 평가 대회(IberLEF)의 과제 데이터로, 스페인어 뉴스에서 육하원칙에 해당하는 구절에 사람이 밑줄을 긋고(과제 1), 그 구절이 믿을 만한지 표시하는(과제 2) 자료입니다. 원래 목적은 허위 정보 탐지의 기초를 다지는 것이었습니다. 논문은 1,753개 기록 가운데 누가·무엇을·언제·어디서 네 칸이 모두 주석된 94건만 남겼습니다. '왜'와 '어떻게'는 주석이 드물어서 조건에 넣으면 표본이 너무 줄어들기 때문에 뺐습니다. 이쪽은 평균 49어절짜리 짧은 발췌에서 사람이 원문 그대로 따 온 구절입니다.
한 기사에 같은 칸의 밑줄이 여러 번 그어진 경우가 문제였습니다. 저자들은 역피라미드 원칙에 따라 가장 앞에 나온 구절을 고르는 규칙을 썼습니다. 가장 중요한 정보가 리드에 있다는 저널리즘 원칙에 기댄 것입니다. 저자들도 인정하듯 이 가정은 항상 맞지 않습니다. 7부에서 이 규칙이 만든 '정답'이 어떤 모습인지 볼 것입니다.
BASSE
FLARES
누가 만들었나
LLM 다섯 개 (요약 프롬프트)
사람 주석자 (구절 밑줄)
개수
기사 45건 × 모델 5 = 추출 225개
1,753건 중 네 칸이 다 있는 94건
원문 길이 (평균)
846어절
49어절
추출의 모양
문장으로 풀어 쓴 요약, 여섯 칸
원문 구절 그대로, 네 칸 + '왜·어떻게: 명시되지 않음'
판사가 본 질문
모델 요약이 원문과 맞는가
사람 정답이 원문과 맞는가
표의 마지막 줄을 기억해 두세요. FLARES 쪽에서 판사가 채점한 것은 모델의 답이 아니라 사람이 만든 정답 자체입니다. 같은 판사가 '모델의 문장'과 '사람의 밑줄'을 어떻게 다르게 대하는지 보려는 설계입니다.
여섯 기준과 한 가지 메타 판단
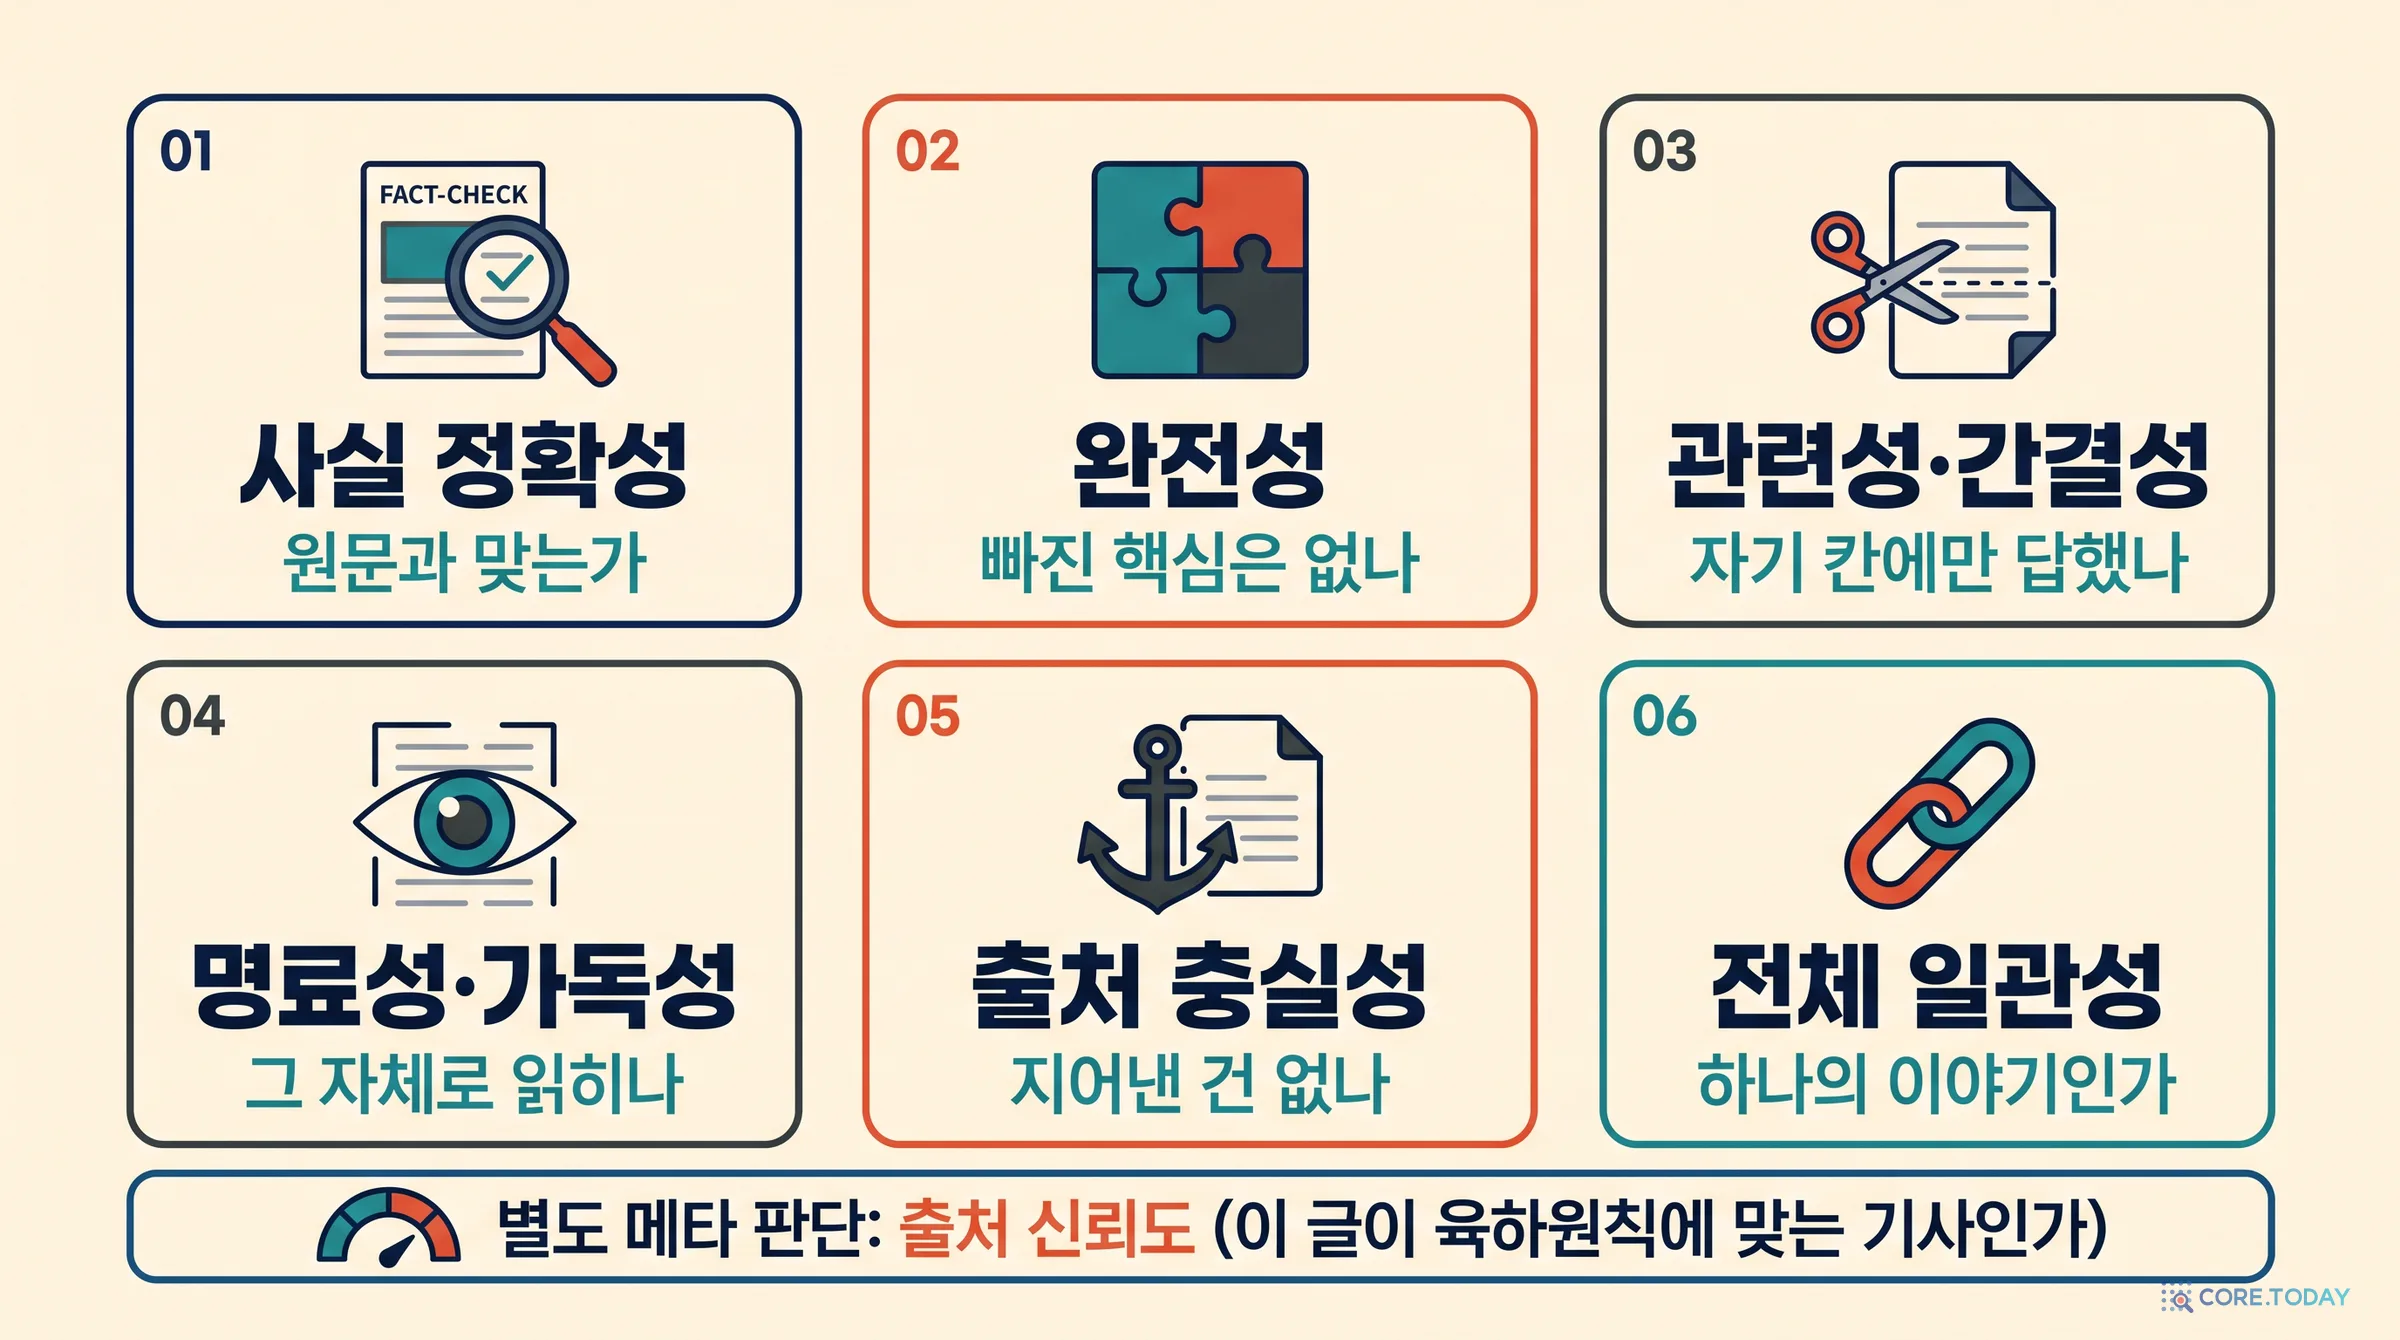
판사는 추출 하나를 여섯 기준에 대해 각각 1~5점(리커트 척도)으로 채점하고, 기준마다 짧은 근거를 씁니다. 기준은 요약 평가의 고전인 SummEval의 네 차원(연결성, 일관성, 유창성, 관련성)과 BASSE의 기준을 바탕으로, 기자들과의 보정 회의를 거쳐 육하원칙에 맞게 고쳤습니다.
여기에 출처 적합도(Confidence Level, 직역하면 신뢰도이고 아래 삽화에는 그렇게 적었습니다)라는 메타 판단이 따로 붙습니다. 추출이 아니라 원문을 보고 "이 글이 애초에 육하원칙을 뽑기에 맞는 사실 보도인가, 아니면 의견·칼럼·사설처럼 여섯 칸이 모호하거나 없는 글인가"를 1~5점으로 매기는 것입니다. 추출이 나빠서 점수가 낮은 것인지, 원문이 애초에 부적합해서 낮은 것인지를 나눠 보려는 장치입니다. 실무에서 아주 쓸모 있는 생각입니다. 칼럼에서 '누가 무엇을'을 뽑으라고 한 뒤 추출기를 탓하는 일은 생각보다 흔하기 때문입니다.
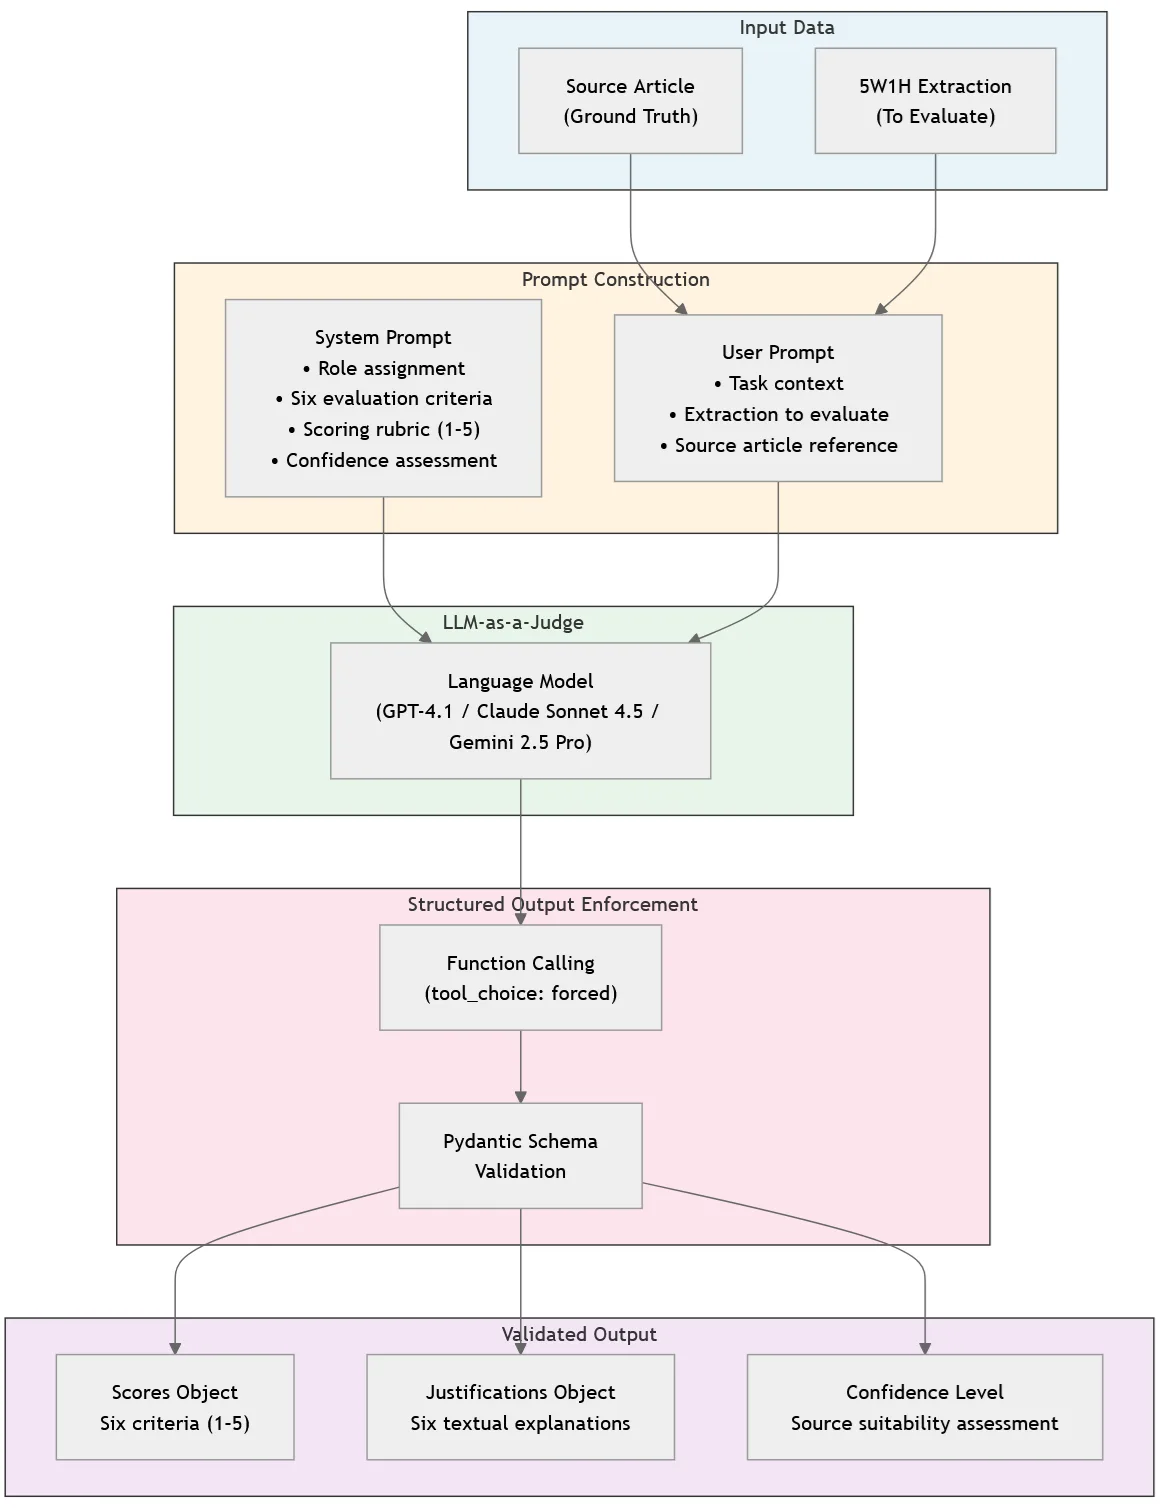
출처: Cassola-Bacallao 외(2026), Electronics 15(3):659, 그림 1. CC BY 4.0.
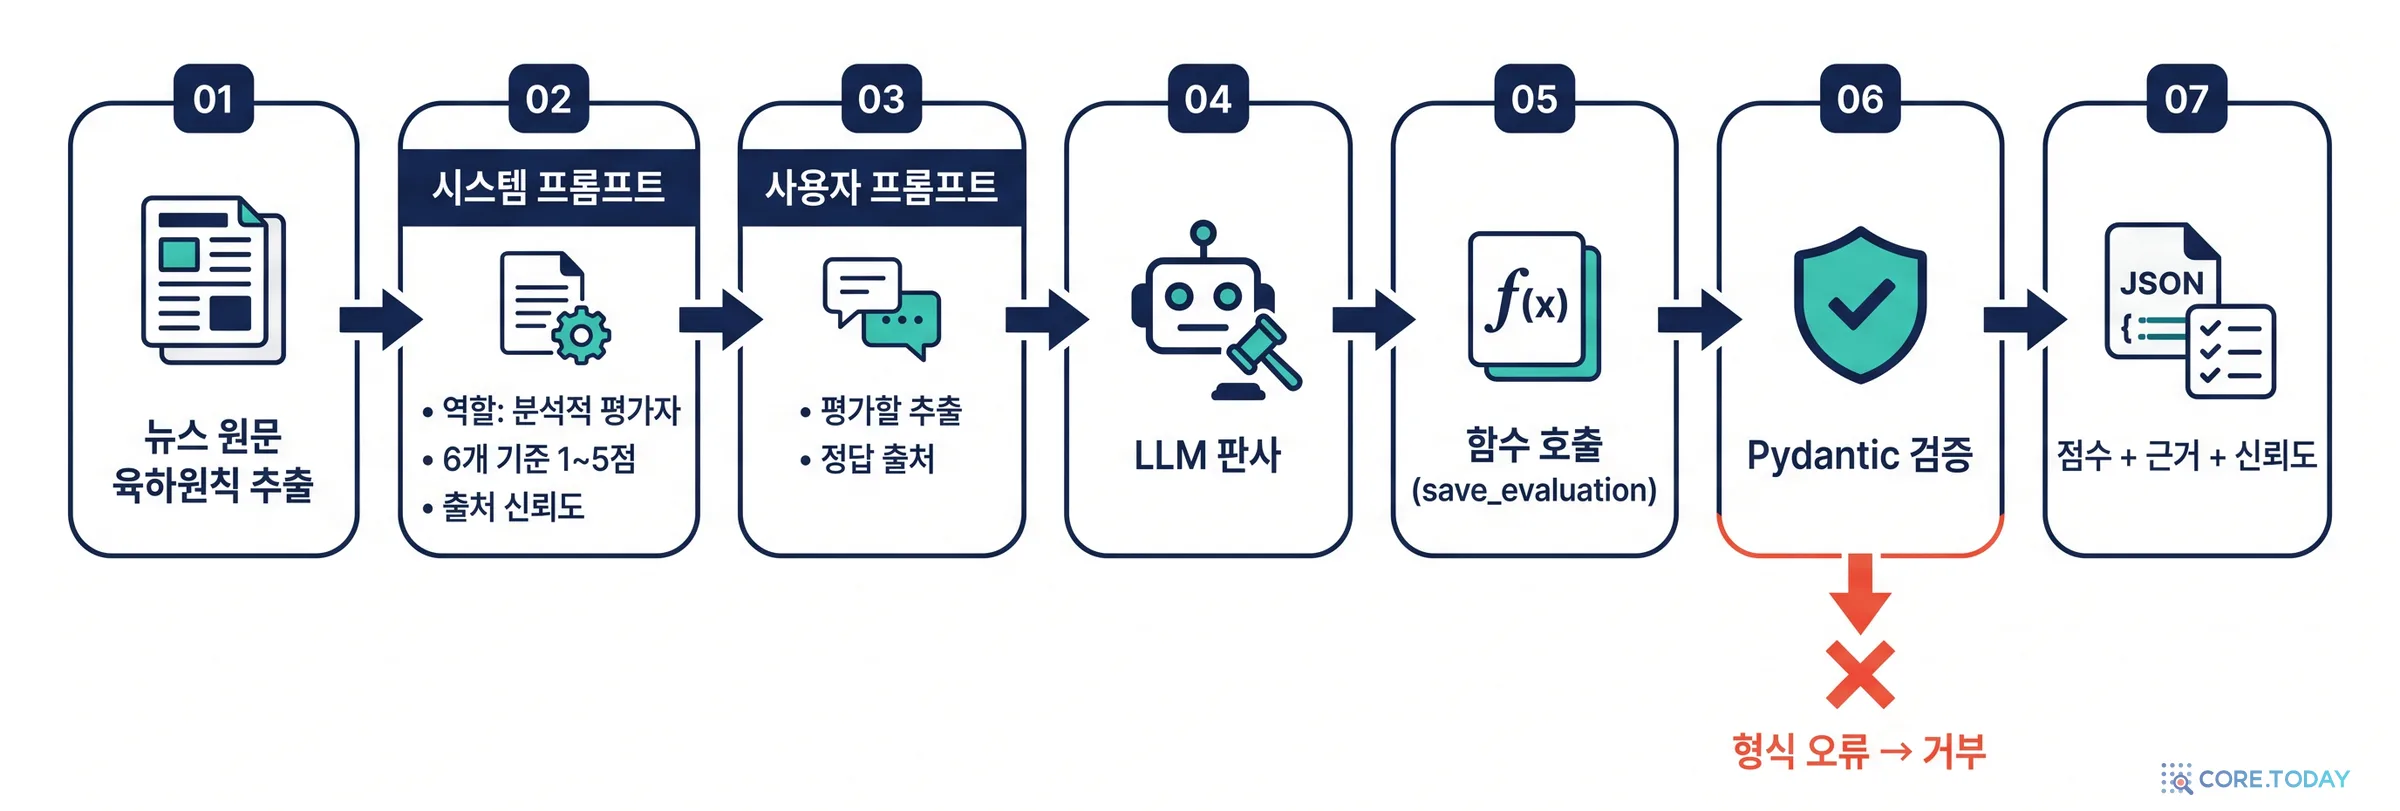
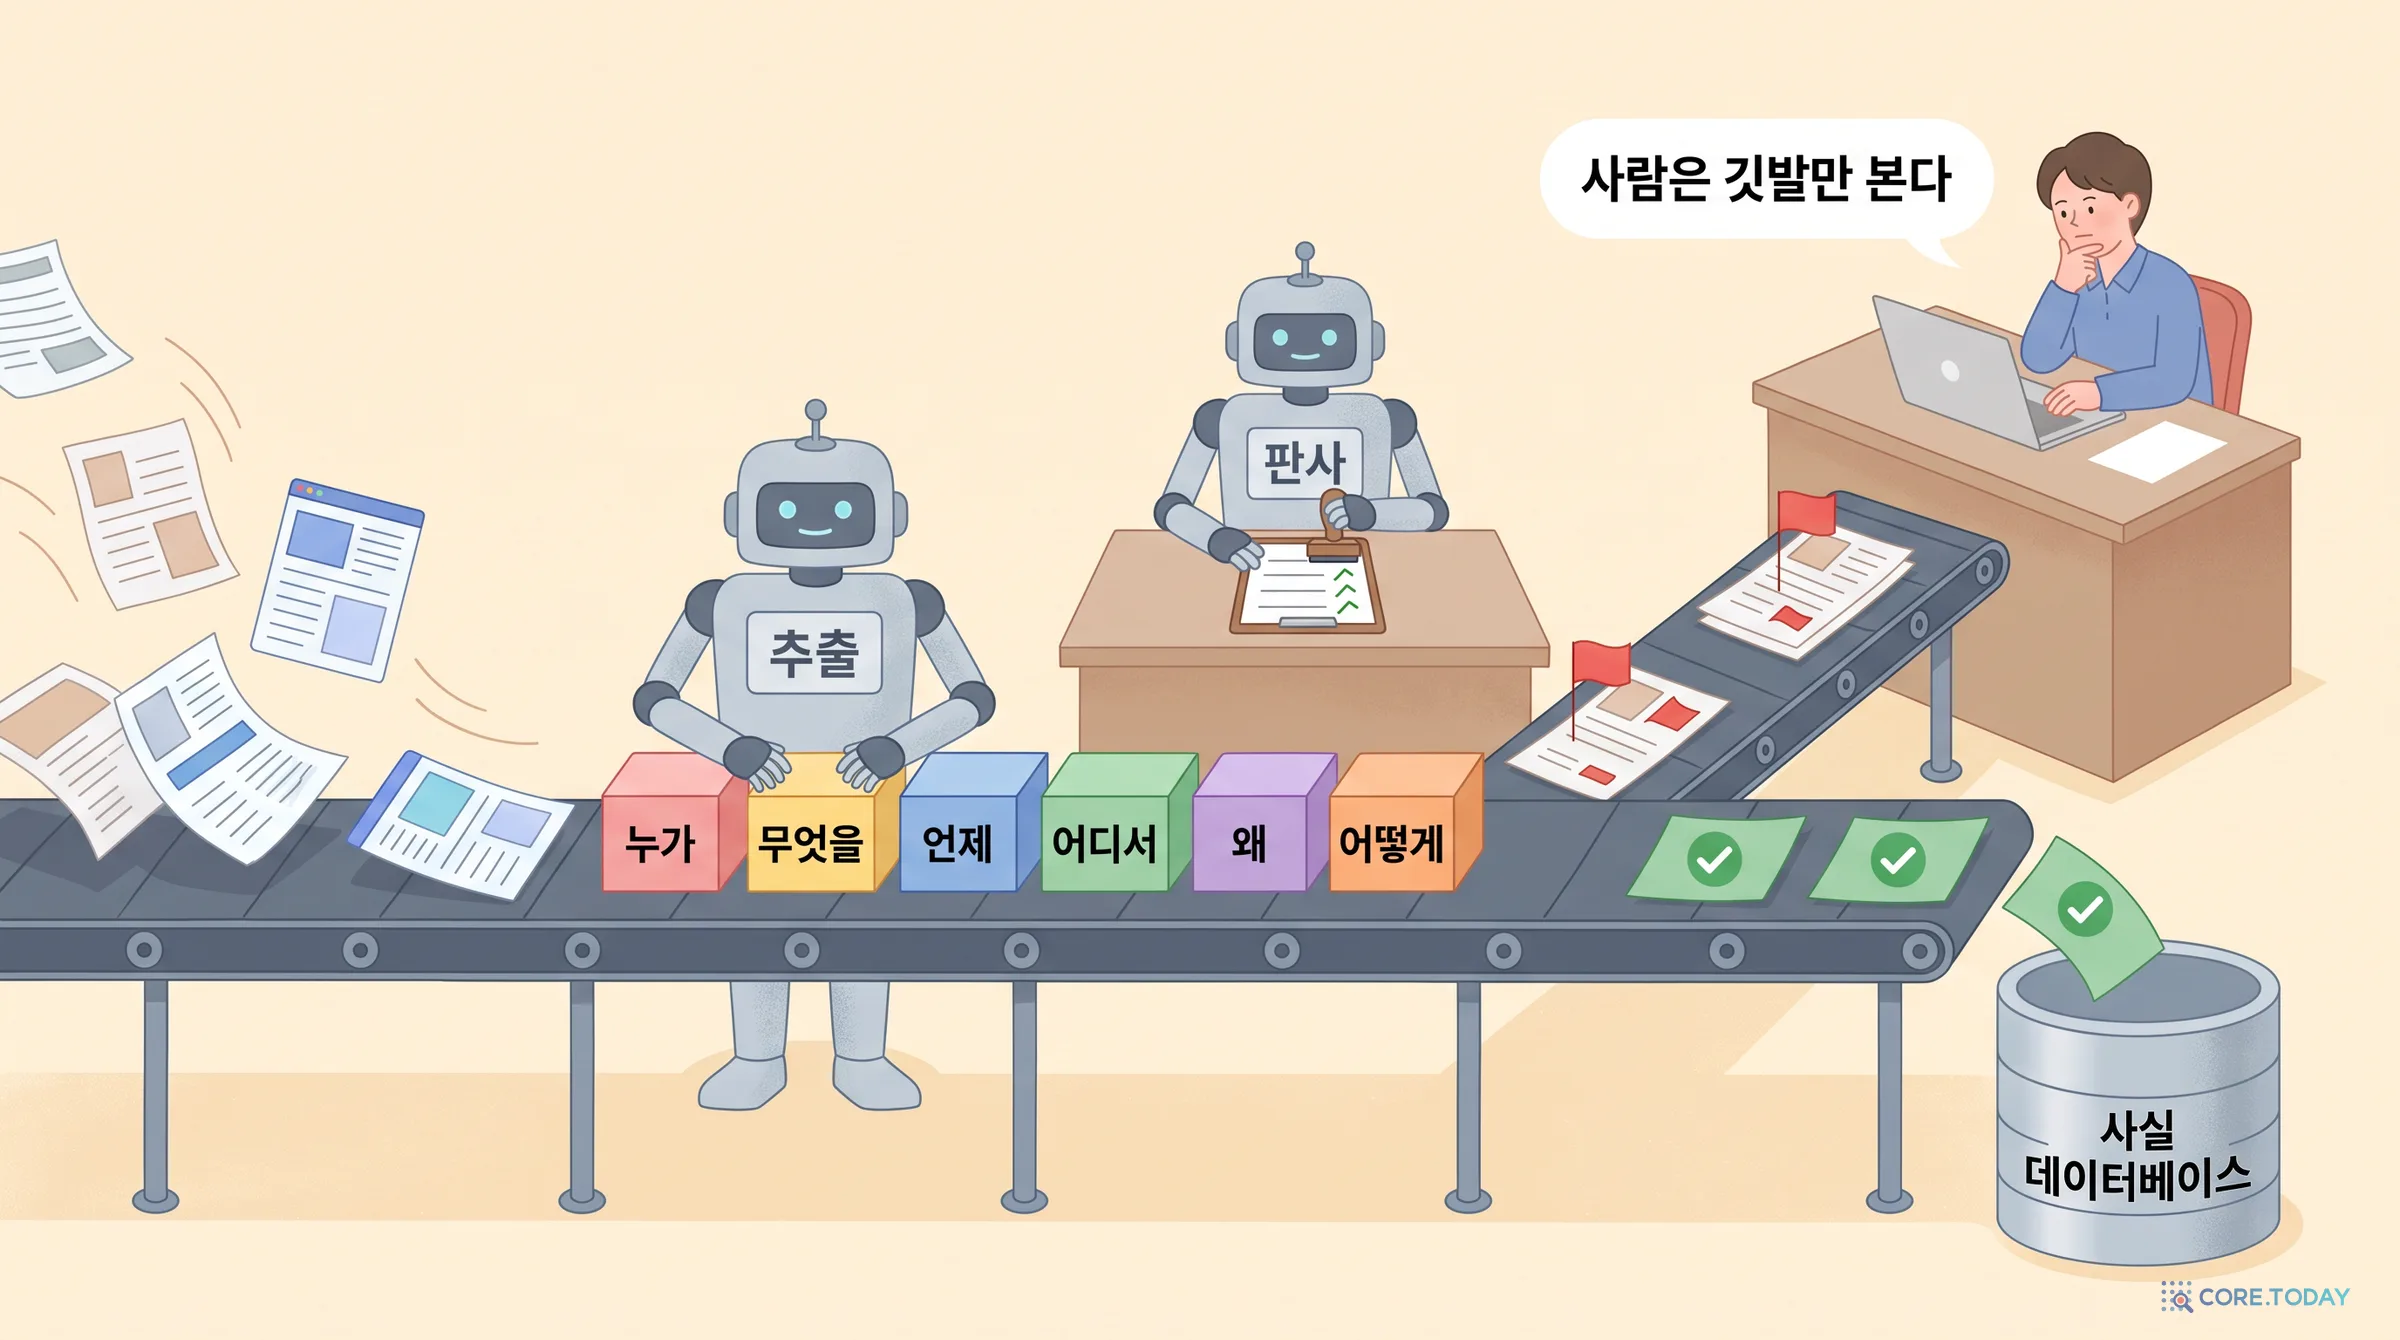
위에서 아래로 읽으면 이렇습니다. 원문과 평가할 추출(입력) → 시스템 프롬프트와 사용자 프롬프트(프롬프트 구성) → 언어 모델(판사) → 함수 호출과 Pydantic 스키마 검증(구조화된 출력 강제) → 점수 객체, 근거 객체, 출처 적합도(검증된 출력). 한국어로 다시 그리면 아래와 같습니다.
시스템 프롬프트(논문 그림 2)는 판사의 규칙입니다. 첫 줄이 "당신은 전문적이고 분석적인 평가 보조자다. 당신의 유일한 임무는 사용자가 준 정보를 분석해 save_evaluation 함수를 호출하는 것이다. 다른 방식으로 응답해서는 안 된다"입니다. 이어서 여섯 기준마다 1~5점과 근거를 요구하고, 마지막에 출처 적합도 기준을 설명합니다(1점: 순수 의견·사설, 5점: 사실 위주의 직접 보도).
사용자 프롬프트(그림 3)는 매번 바뀌는 재료를 넣습니다. 원래 과제("원문을 읽고 5W1H 형식의 정확한 구조화 요약을 만드는 것이었다"), 평가할 추출, 그리고 "정답 출처(5점짜리 기준 답)"라는 이름으로 넣은 원문 전체입니다. 별도의 정답 추출이 없고 원문 자체를 기준으로 삼는다는 점이 중요합니다. 판사는 원문을 직접 읽고 대조해야 합니다.
함수 호출(function calling)은 모델에게 자유로운 글 대신 정해진 함수의 인자를 채우게 하는 기능입니다. 논문은 tool_choice를 강제로 걸어 판사가 반드시 save_evaluation을 부르게 했고, 돌아온 인자를 Pydantic(파이썬의 데이터 검증 라이브러리) 모델로 검사했습니다. 점수가 1~5 정수가 아니거나, 근거 하나가 빠졌거나, 없는 필드가 끼어 있으면 조용히 받아들이지 않고 오류를 냅니다. 저장소 코드를 보면 세 회사 모델을 모두 OpenAI 파이썬 라이브러리 하나로 불렀습니다. Anthropic과 Google이 OpenAI 호환 주소를 열어 두었기 때문에 주소와 키만 바꾸면 됩니다. 온도는 0.2, 최대 출력은 1,500토큰이었습니다.
출력은 이렇게 생겼습니다(논문 그림 4를 줄여 옮김). 스페인 농구 대표팀이 월드컵 직전 평가전에서 러시아에 55-74로 진 엘 파이스 기사를 Claude가 요약한 것을, Claude 판사가 채점한 결과입니다.
json
{"scores":{"factual_accuracy":5,"completeness":4,"relevance_and_conciseness":5,"clarity_and_readability":5,"source_faithfulness":5,"overall_coherence":5},"justifications":{"completeness":"핵심 요소는 모두 담았다. 눈에 띄는 공백은 경기 장소(어디서)인데, 이는 원문에도 실제로 나오지 않는다.","source_faithfulness":"원문에 있는 정보만 썼다. '경기 장소가 명시되지 않았다'고 적은 것 자체가 충실성의 예다."},"confidence_level":{"score":5,"justification":"구체적인 스포츠 경기를 다룬 사실 보도로, 육하원칙에 이상적이다."}}
근거의 질이 꽤 좋아 보입니다. 다만 하나 짚어 둘 것이 있습니다. 저장소에 남은 이 추출의 원문은 "Aquí tienes un resumen…(요약해 드릴게요…)"로 시작해 "¿Te gustaría que elaborara algún punto?(더 자세히 설명해 드릴 부분이 있을까요?)"로 끝납니다. 챗봇의 인사말과 맺음말이 그대로 붙어 있는데, 판사는 관련성·간결성에 5점을 줬습니다. 8부의 '수다 포장' 함정이 여기서 나왔습니다.
기자가 판사를 채점한다: JAR와 EUI
판사가 믿을 만한지는 어떻게 아는가. 논문은 판사의 판결을 사람이 다시 채점하는 메타 평가를 했습니다. 검수자는 대학에서 저널리즘 교육을 받은 기자 두 명(논문의 공저자)입니다. 본 검수 전에 기준 해석을 맞추는 보정 회의를 했고, 기준별 정의를 적은 평가 지침서를 만들었습니다.
검수자는 원문, 추출, 그리고 판사의 점수와 근거를 함께 받아 두 가지를 적었습니다.
Q1
점수 타당성 (1~5)
판사가 이 기준에 매긴 점수에 얼마나 동의하는가. 1 = 전혀 동의하지 않음, 5 = 매우 동의함. 4나 5면 '판사의 판단을 수용'한 것으로 센다 → 판단 수용률(JAR).
Q2
설명의 질 (세 범주)
점수와 별개로 근거가 쓸모 있는가. '정확하고 유용', '그럴듯하나 부정확', '틀렸거나 쓸모없음' 중 하나. 첫째 범주의 비율 → 설명 효용 지수(EUI).
κ
검수자끼리의 일치
100건을 두 기자가 모두 검수해 코언의 카파로 일치도를 쟀다. Q1은 순서가 있는 척도라 큰 불일치를 더 벌하는 이차 가중 카파를 썼다.
정리하면 이 연구의 핵심 지표 JAR는 "판사의 점수를 본 기자가 그 점수에 동의한 비율"입니다. 판사의 점수와 기자의 독립적인 점수가 얼마나 같은가가 아닙니다. 이 차이가 7부의 출발점입니다.
6부. 논문 해부 ②: 숫자가 말하는 것
표 2: 세 판사 모두 98% 이상
전체 평가 묶음은 추출 319개(BASSE 225 + FLARES 94) × 기준 6개 = 1,914쌍입니다. Claude는 BASSE 하나가 API 시간 초과로 빠져 1,908쌍입니다.
판사
JAR (전체)
95% 신뢰구간
EUI (전체)
BASSE JAR
FLARES JAR
Claude Sonnet 4.5
99.79%
99.46~99.92
99.79%
99.85%
99.65%
Gemini 2.5 Pro
98.64%
98.02~99.07
98.43%
98.15%
99.82%
GPT-4.1
98.07%
97.35~98.60
98.01%
99.26%
95.21%
세 판사를 함께 비교하는 코크란 Q 검정(같은 항목을 세 판사가 모두 채점한 짝지은 자료용)에서 차이가 유의했고(JAR Q = 25.28, p < 0.001), 짝별 맥니마 검정에 본페로니 보정(유의 수준 0.05/3 ≈ 0.0167)을 하자 Claude는 두 판사보다 유의하게 높고, GPT와 Gemini 사이는 차이가 없었습니다(p = 0.21).
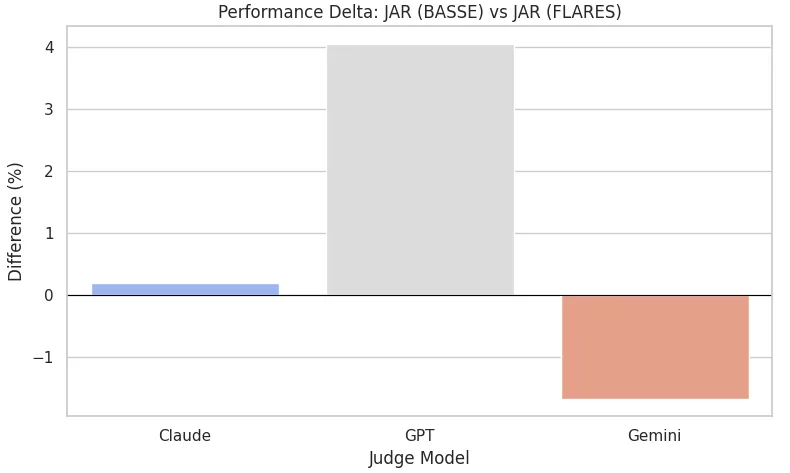
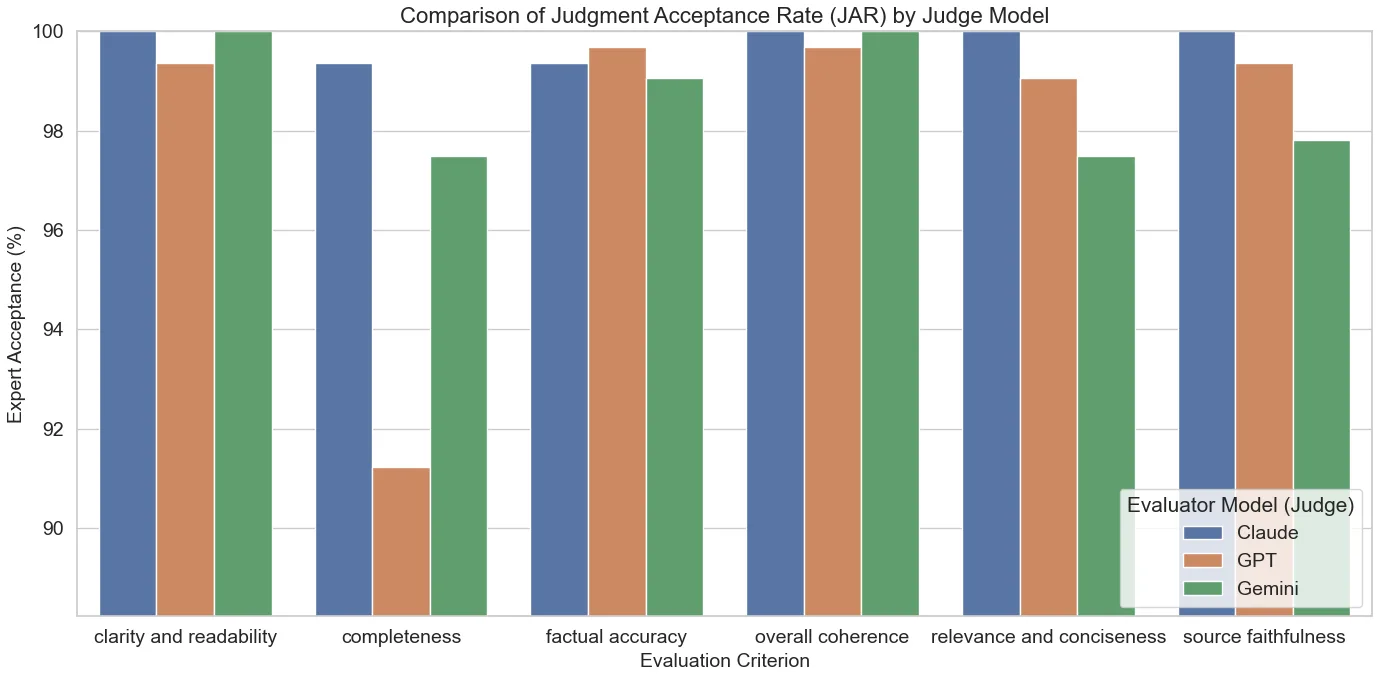
그림 5는 데이터에 따른 판사의 기울기입니다. Claude는 두 데이터 사이 차이가 +0.20%p로 거의 없고, GPT-4.1은 모델 요약(BASSE)에서 사람 구절(FLARES)로 가면 4.05%p 떨어지며, Gemini는 반대로 FLARES에서 더 높습니다(−1.67%p). 논문은 이것을 GPT의 '모델이 쓴 글에 대한 관대함·자기 선호', Gemini의 '원문 대조에 강한 엄격함'으로 해석하고, 사람이 만든 정답을 감사할 때는 Gemini, 모델들을 공정하게 비교할 때는 Claude를 권합니다.
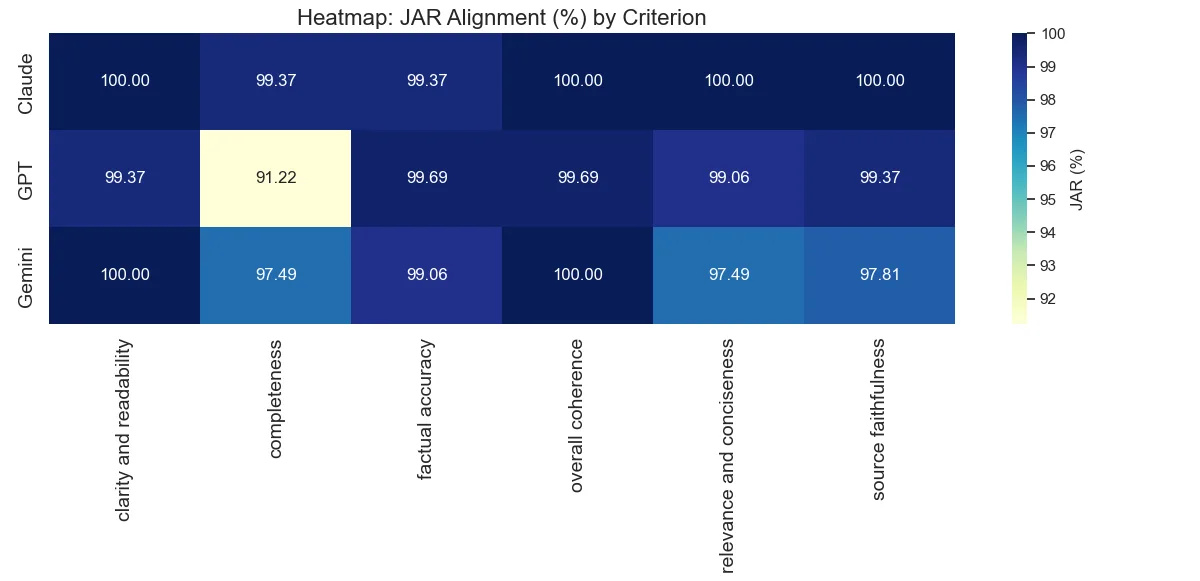
기준별로 쪼개면, 명료성·전체 일관성 같은 '형식' 기준은 100%에 붙어 있고 사실 정확성·완전성이 상대적으로 낮습니다. 가장 낮은 칸은 GPT-4.1의 완전성 91.22%입니다. 논문은 '왜'와 '어떻게'가 리드에 몰려 있지 않고 본문에 흩어져 있어서, '충분히 완전한가'를 판단하는 데 기자의 주관이 끼어든다고 설명합니다. 여러 날짜가 얽힌 사건에서 '언제 일어났나'와 '언제 보도됐나'를 헷갈리는 시간 추론 오류도 관찰됐다고 적었습니다. 검수자가 3점 이하를 준 비율은 사실 정확성 0.52%, 완전성 3.87%였습니다.
표 4: 판사끼리는 덜 맞는다
판사 쌍
스피어만 순위 상관
Claude × GPT
0.68
GPT × Gemini
0.57
Claude × Gemini
0.52
논문이 스스로 짚은 대목입니다. 수용률은 모두 98%가 넘는데 판사끼리의 점수 상관은 0.52~0.68입니다. 저자들은 "판사들이 추출이 최소 품질을 넘는지(4점 이상)에는 거의 만장일치로 동의하지만, 척도 안의 구체적인 점수에서는 더 크게 갈린다"고 해석했습니다. 이 문장이 사실 이 논문에서 가장 중요한 문장입니다. 7부에서 원자료로 확인합니다.
표 5와 카파: 일치율 97%, 카파 0.39
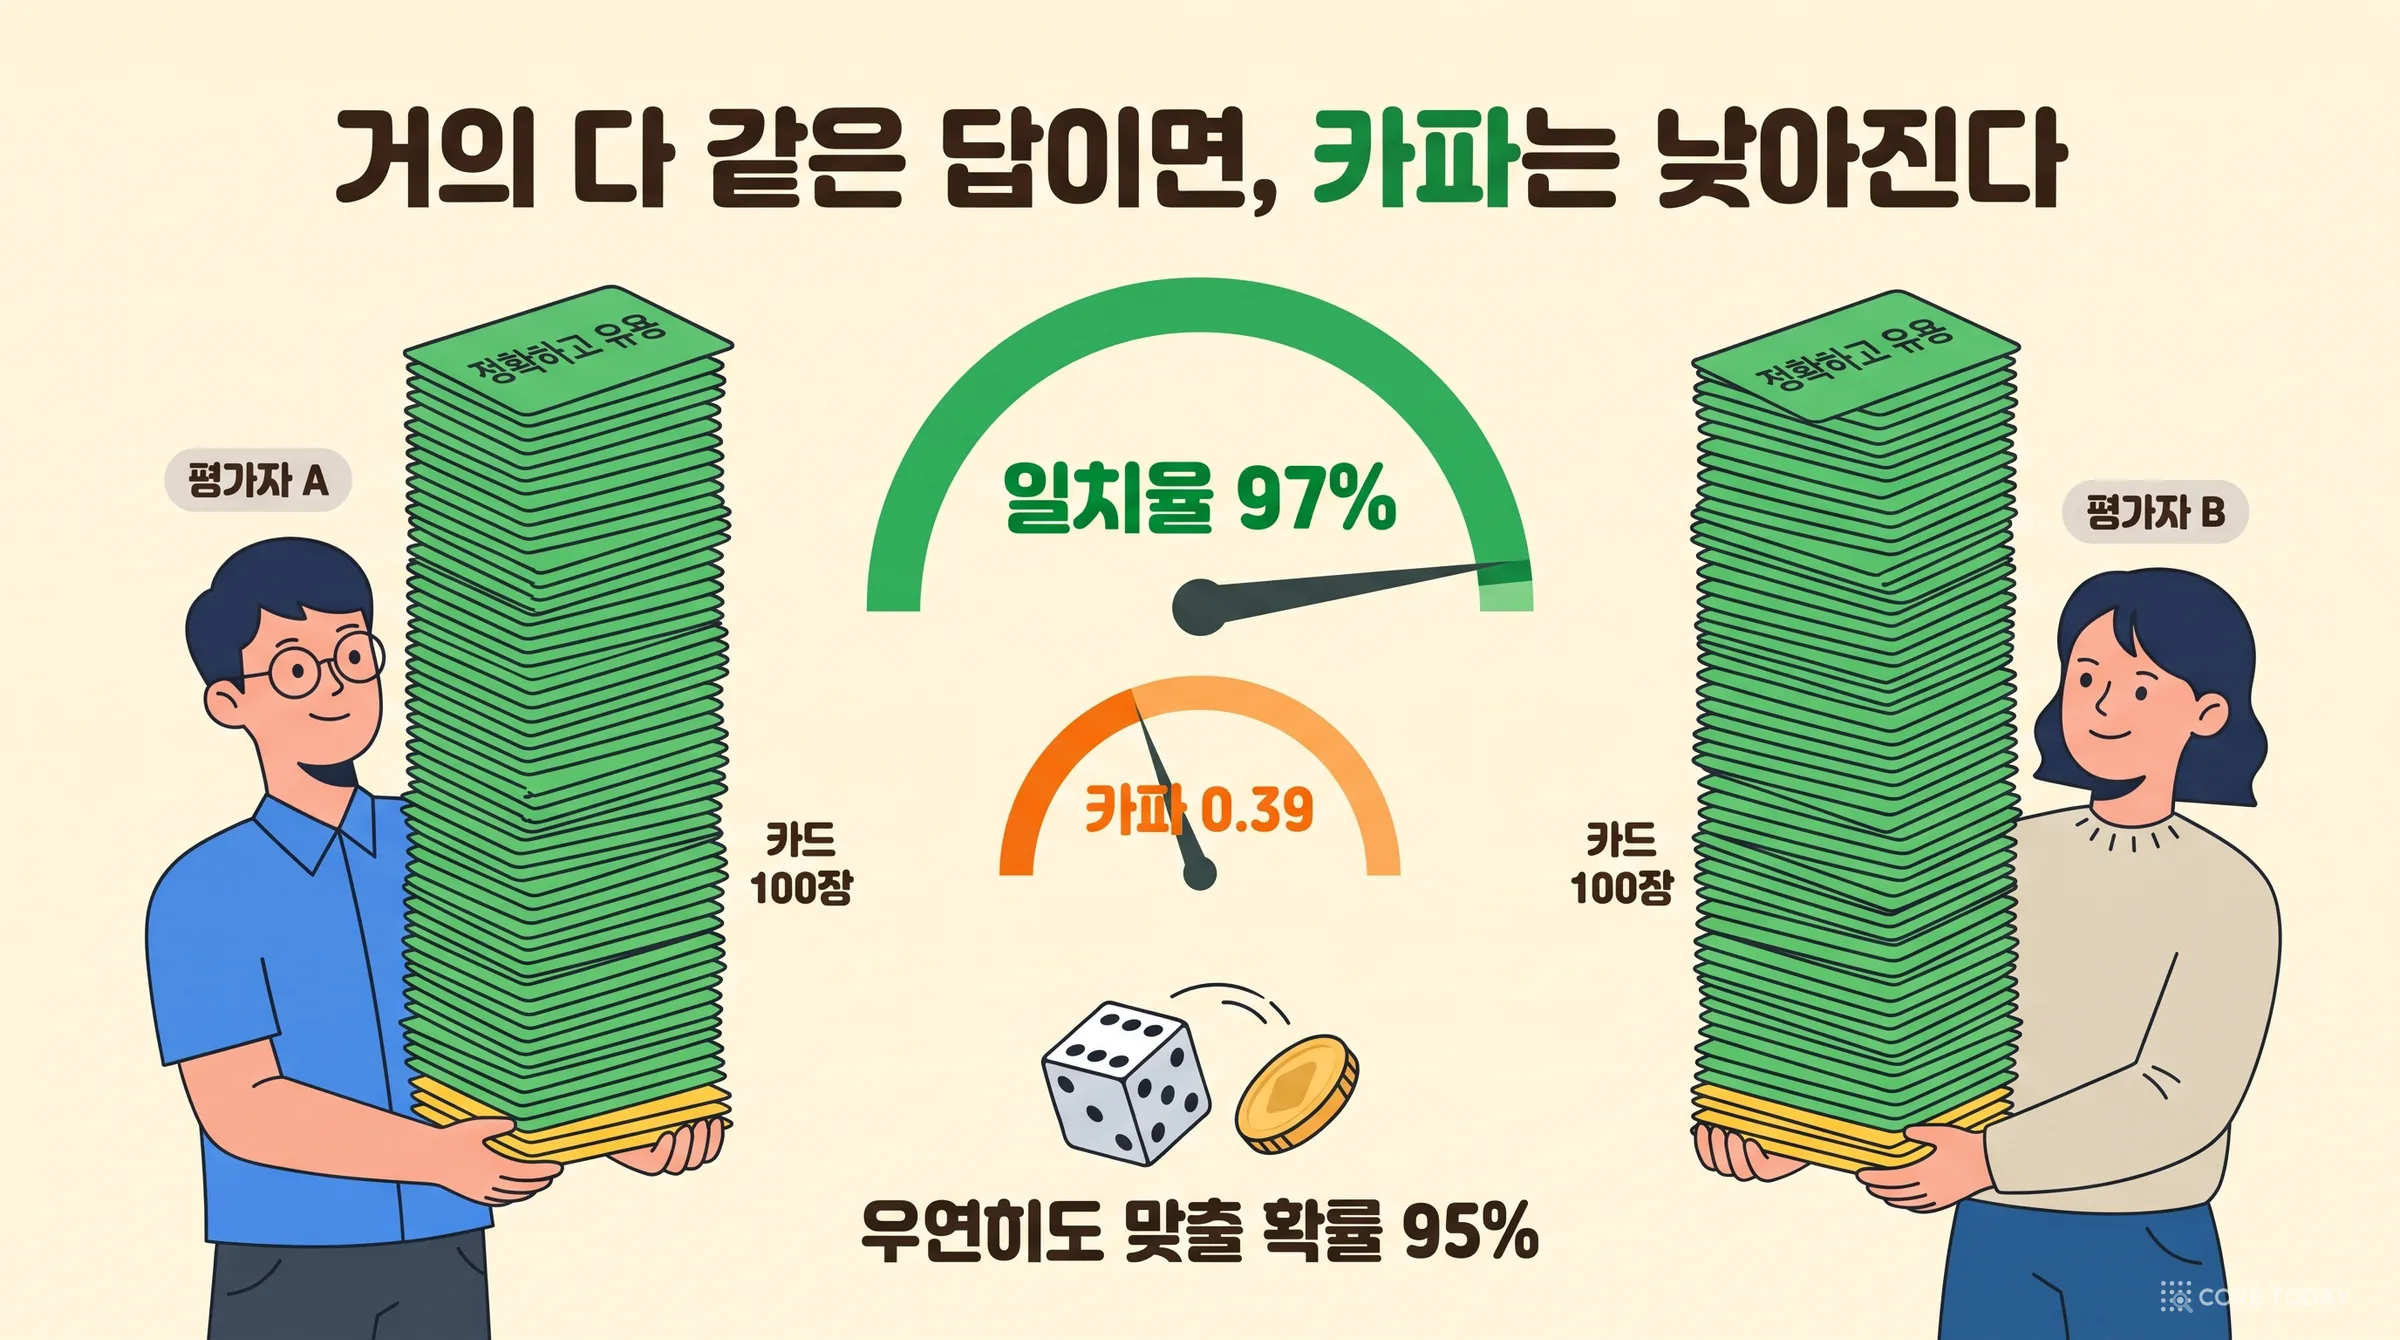
두 기자의 일치도는 Q1(점수 타당성)이 이차 가중 카파 0.6739로 랜디스·코크(1977)의 구분에서 '상당한 일치'(0.61~0.80)에 해당했습니다. Q2(설명의 질)는 카파 0.3902로 '보통 이하'였는데, 실제 일치율은 97.0%였습니다. 저자들은 이것을 카파 역설로 설명합니다. 두 사람이 거의 모든 건을 '정확하고 유용'으로 분류하면 우연히 맞을 확률(95.08%)이 너무 높아져서, 카파가 실제 일치를 과소평가한다는 것입니다. 맞는 설명입니다. 다만 그 역설이 무엇을 숨기는지는 7부에서 봅니다.
표 6과 비용: GPT는 3분의 1 값
Claude Sonnet 4.5
Gemini 2.5 Pro
GPT-4.1
토큰 (FLARES)
385,151
344,830
206,468
토큰 (BASSE)
1,282,670
1,126,937
758,030
단가 (입력/출력, 100만 토큰당)
$3 / $15
$1.25 / $10 (사고 토큰 포함)
$2 / $8
총비용 (FLARES / BASSE)
$2.03 / $6.05
$1.86 / $5.13
$0.61 / $1.98
추출 1만 개 환산
$216~270
$198~228
$65~88
Claude는 근거를 길게 써서 토큰이 가장 많고, GPT-4.1은 FLARES에서 Claude보다 46.4% 적은 토큰으로 98.07%를 냈습니다. 논문의 권고는 "예산이 빠듯하면 GPT-4.1, 정밀도가 최우선이면 1.72%p를 위해 Claude"입니다. 1만 개를 채점해도 몇백 달러라는 점은 기억해 둘 만합니다. 기자 두 명이 5,700여 개 판결을 검수하는 데 든 시간과 비교하면 더욱 그렇습니다.
표 7: ROUGE-L은 거꾸로 간다
논문은 ROUGE-L과 판사 점수를 비교한 두 사례를 듭니다.
FLARES-397, 어휘상 거짓 양성. 발렌시아 주지사 시모 푸이그가 "오늘 아침 의회 질의 시간에" 한 말을 다룬 짧은 발췌입니다. 추출의 '무엇을' 칸은 "las palabras(그 말들)"입니다. 원문 단어를 그대로 가져왔으니 ROUGE-L은 0.5588로 높지만, 판사는 핵심 사건이 빠졌다며 2/5를 줬습니다.
BASSE 농구 기사, 어휘상 거짓 음성. 846어절 기사를 몇 문장으로 압축한 요약이라 ROUGE-L은 0.1222로 낮지만, 판사는 5/5를 줬습니다.
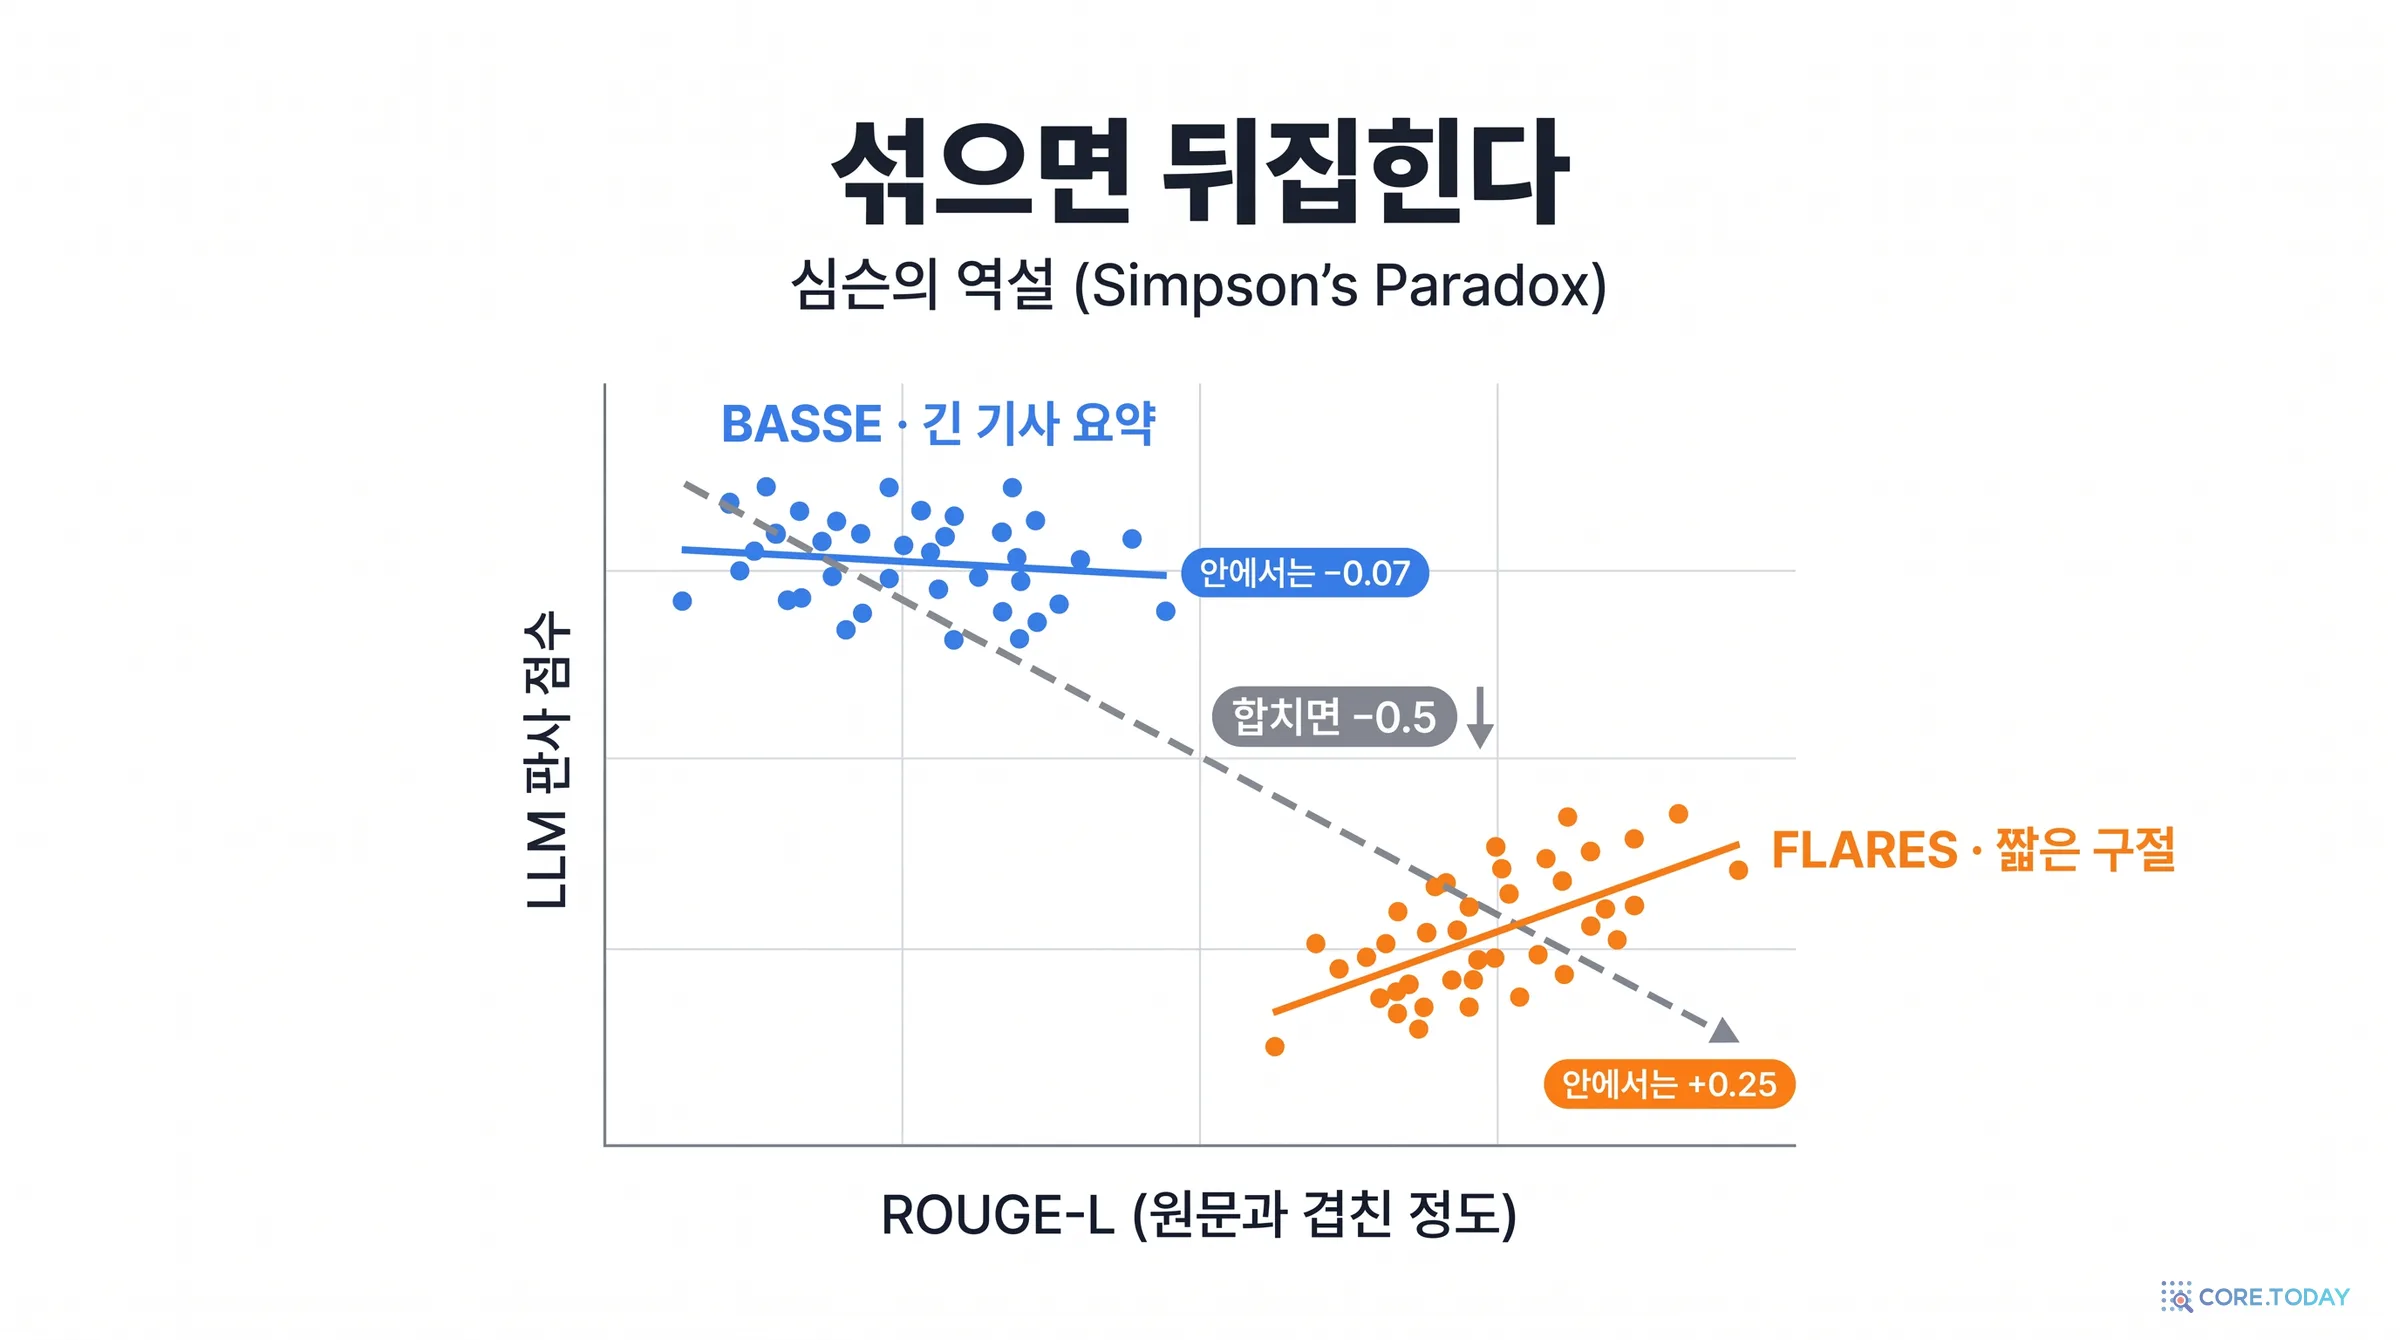
그리고 전체 319개에서 ROUGE-L과 판사 점수의 스피어만 상관이 −0.53(p < 0.001)이었다고 보고합니다. 원문과 많이 겹칠수록 오히려 점수가 낮다는 것, 그러니 ROUGE는 육하원칙 평가에 부적합하다는 결론입니다. 그런데 FLARES-397의 그 추출은 사람 주석자의 정답이었습니다. '가장 앞에 나온 밑줄' 규칙이 '무엇을'로 "그 말들"을 골라 온 것입니다. 이 사례는 ROUGE의 실패이기도 하지만, 동시에 정답을 만드는 규칙의 실패이기도 합니다.
표 8: 출처 적합도라는 안전장치
출처 적합도
건수
비율
판사 평균 점수
기자 동의율
5 (이상적)
5,280
92.1%
4.37
98.8%
4 (적합)
240
4.2%
3.00
98.8%
3 (애매)
132
2.3%
3.70
100.0%
2 (부적합)
84
1.5%
3.54
100.0%
적합도가 낮은(3 이하) 경우는 3.8%뿐이었고, 그런 원문에서는 판사 점수가 낮았으며(3.64 대 4.31), 기자 동의율은 오히려 100%였습니다. 세 판사가 같은 원문에 같은 적합도를 준 비율은 81.2%였습니다. 저자들은 판사가 원문의 한계를 알아차리고 조심스럽게 판단하며, 그 조심스러움을 기자가 인정했다고 해석합니다. 적합도 4의 평균 점수(3.00)가 적합도 3(3.70)보다 낮다는 점은 표가 깔끔한 순서를 보이지는 않는다는 뜻이고, 저자들도 낮은 적합도 표본이 작아 예비적 증거라고 적었습니다.
장황함 편향은 없었나
저자들은 판사 근거의 길이(글자 수)와 기자의 Q1 점수 사이 피어슨 상관을 구했습니다. r = −0.10(N = 5,726)으로, 긴 근거가 더 동의를 받지는 않았습니다. 기자가 장황한 설명에 끌리지 않았다는 근거입니다. 다만 이것은 기자의 장황함 편향을 본 것이고, 판사가 장황한 추출에 후한지(판사의 장황함 편향)는 재지 않았습니다. 8부에서 이것을 따로 재 봅니다.
저자들이 스스로 적은 한계
논문 6.6절은 솔직한 편입니다. 수용률이 98%를 넘으면 천장 효과로 판사 간 차이가 압축될 수 있다, 판사가 독점 모델 셋뿐이다, 검수한 기자들이 공저자라 확증 편향이 있을 수 있다(보정 회의·지침서·독립 검수로 완화했다), 프롬프트를 체계적으로 최적화하지 않았다, 온도에 따른 민감도를 보지 않았다. 앞으로 외부 전문가 검수, 공개 모델, 다국어로 넓히겠다고 합니다.
여기까지가 논문이 말한 것입니다. 이제 저장소를 엽니다.
7부. 원자료로 다시 읽기
논문의 '데이터 가용성' 절은 모든 데이터가 깃허브 저장소 jcassolaucn/5w1h_llm_evaluation에 있다고 말합니다. 기본 브랜치(master)에는 2025년 7~9월의 시범 실행 결과만 있습니다. o3-mini, Gemini 2.5 Flash, Claude 3.5 Haiku, GPT-4.1(BASSE만), OpenRouter의 정체불명 모델 horizon-beta, GPT-5 mini입니다. 논문의 세 판사 결과와 기자 검수 파일은 validation 브랜치에 따로 있습니다. 코어닷투데이는 이 브랜치의 판사 출력 6개, 검수 엑셀 8개(판사 3 × 데이터 2 + 검수자 일치도 표본 2), 집계 스크립트를 내려받아 다시 셌습니다. 저자들의 집계 결과(CSV)와 우리 재계산은 소수점 둘째 자리까지 일치했습니다. 숫자 자체는 정확합니다. 문제는 그 숫자가 무엇을 뜻하느냐입니다.
0. 먼저, 판사는 언제 누구였나
작은 것부터. 논문 4.2절은 재현을 위해 모델 식별자를 gpt-4.1-2025-04-14, gemini-2.5-pro-preview-05-06, claude-sonnet-4-5-20250514로 적고, "모든 API 호출은 2025년 7월 28일에서 9월 23일 사이에 이뤄졌다"고 씁니다. 그런데 Claude Sonnet 4.5는 2025년 9월 29일에 나왔고 공식 식별자는 claude-sonnet-4-5-20250929입니다. 20250514는 그 전 세대인 Claude Sonnet 4(claude-sonnet-4-20250514)의 날짜입니다. Gemini 2.5 Pro의 05-06 미리보기판은 2025년 6월 26일부터 정식판으로 조용히 넘겨졌습니다.
validation 브랜치의 최종 결과 파일 이름은 실제로 이렇습니다. 2025-11-26_19-20-55_..._anthropic_claude-sonnet-4-5.json부터 2025-12-02_08-50-30_..._gemini_gemini-2.5-pro.json까지. 판사 결과는 2025년 11월 26일~12월 2일에 별칭 claude-sonnet-4-5와 정식판 gemini-2.5-pro로 만들어졌습니다. 논문이 적은 7~9월은 시범 실행의 기간입니다. 연구의 결론을 바꾸는 오류는 아니지만, '재현을 위해 기록한다'고 쓴 바로 그 자리가 틀렸다는 점은 짚어 둡니다.
그리고 2026년 11월 현재, 재현은 이미 어려워지고 있습니다. GPT-4.1은 지원 중단 예고 상태이고, Claude Sonnet 4.5는 2026년 9월 30일 지원 중단이 예고돼 2026년 11월 30일 API에서 은퇴합니다. 논문이 나온 지 열 달 만에 판사 셋 중 둘이 사라지는 셈입니다. LLM 판사로 만든 평가 체계는 판사 모델의 수명만큼만 재현됩니다. 9부에서 다시 다룹니다.
1. 기자는 판사가 몇 점을 주든 동의했다
검수 엑셀 5,736행에서 기자가 Q1(점수 타당성)에 적은 값의 분포는 이렇습니다. 5점 5,188행(90.4%), 4점 481행, 3점 57행, 2점 1행, 1점 0행, 빈칸 9행. '동의하지 않는다'(3점 이하)는 전체의 1%가 조금 넘습니다.
이 자체는 '판사가 정말 잘했다'로 읽을 수도 있습니다. 그래서 판사가 준 점수별로 나눠 봤습니다. 판사가 확신에 차서 5점을 줬을 때와, 추출이 형편없다고 1~2점을 줬을 때, 기자의 동의율이 같다면 무슨 뜻일까요?
판사가 준 점수
건수
기자 동의율 (Q1 ≥ 4)
1점
114
98.2%
2점
562
97.0%
3점
486
97.5%
4점
982
98.4%
5점
3,591
99.4%
판사가 "이 추출은 1점짜리"라고 하면 기자의 98%가 동의하고, "5점짜리"라고 해도 99%가 동의합니다. 아래 위젯에서 판사와 데이터를 바꿔 보면 이 평평함이 어디서나 반복됩니다.
물론 이것만으로는 판사가 틀렸다고 할 수 없습니다. 판사가 1점을 준 추출이 실제로 1점짜리였을 수 있습니다. 그런데 다음 절의 자료를 함께 보면 그림이 달라집니다.
2. 같은 추출, 두 점 넘게 갈린 점수, 둘 다 '동의'
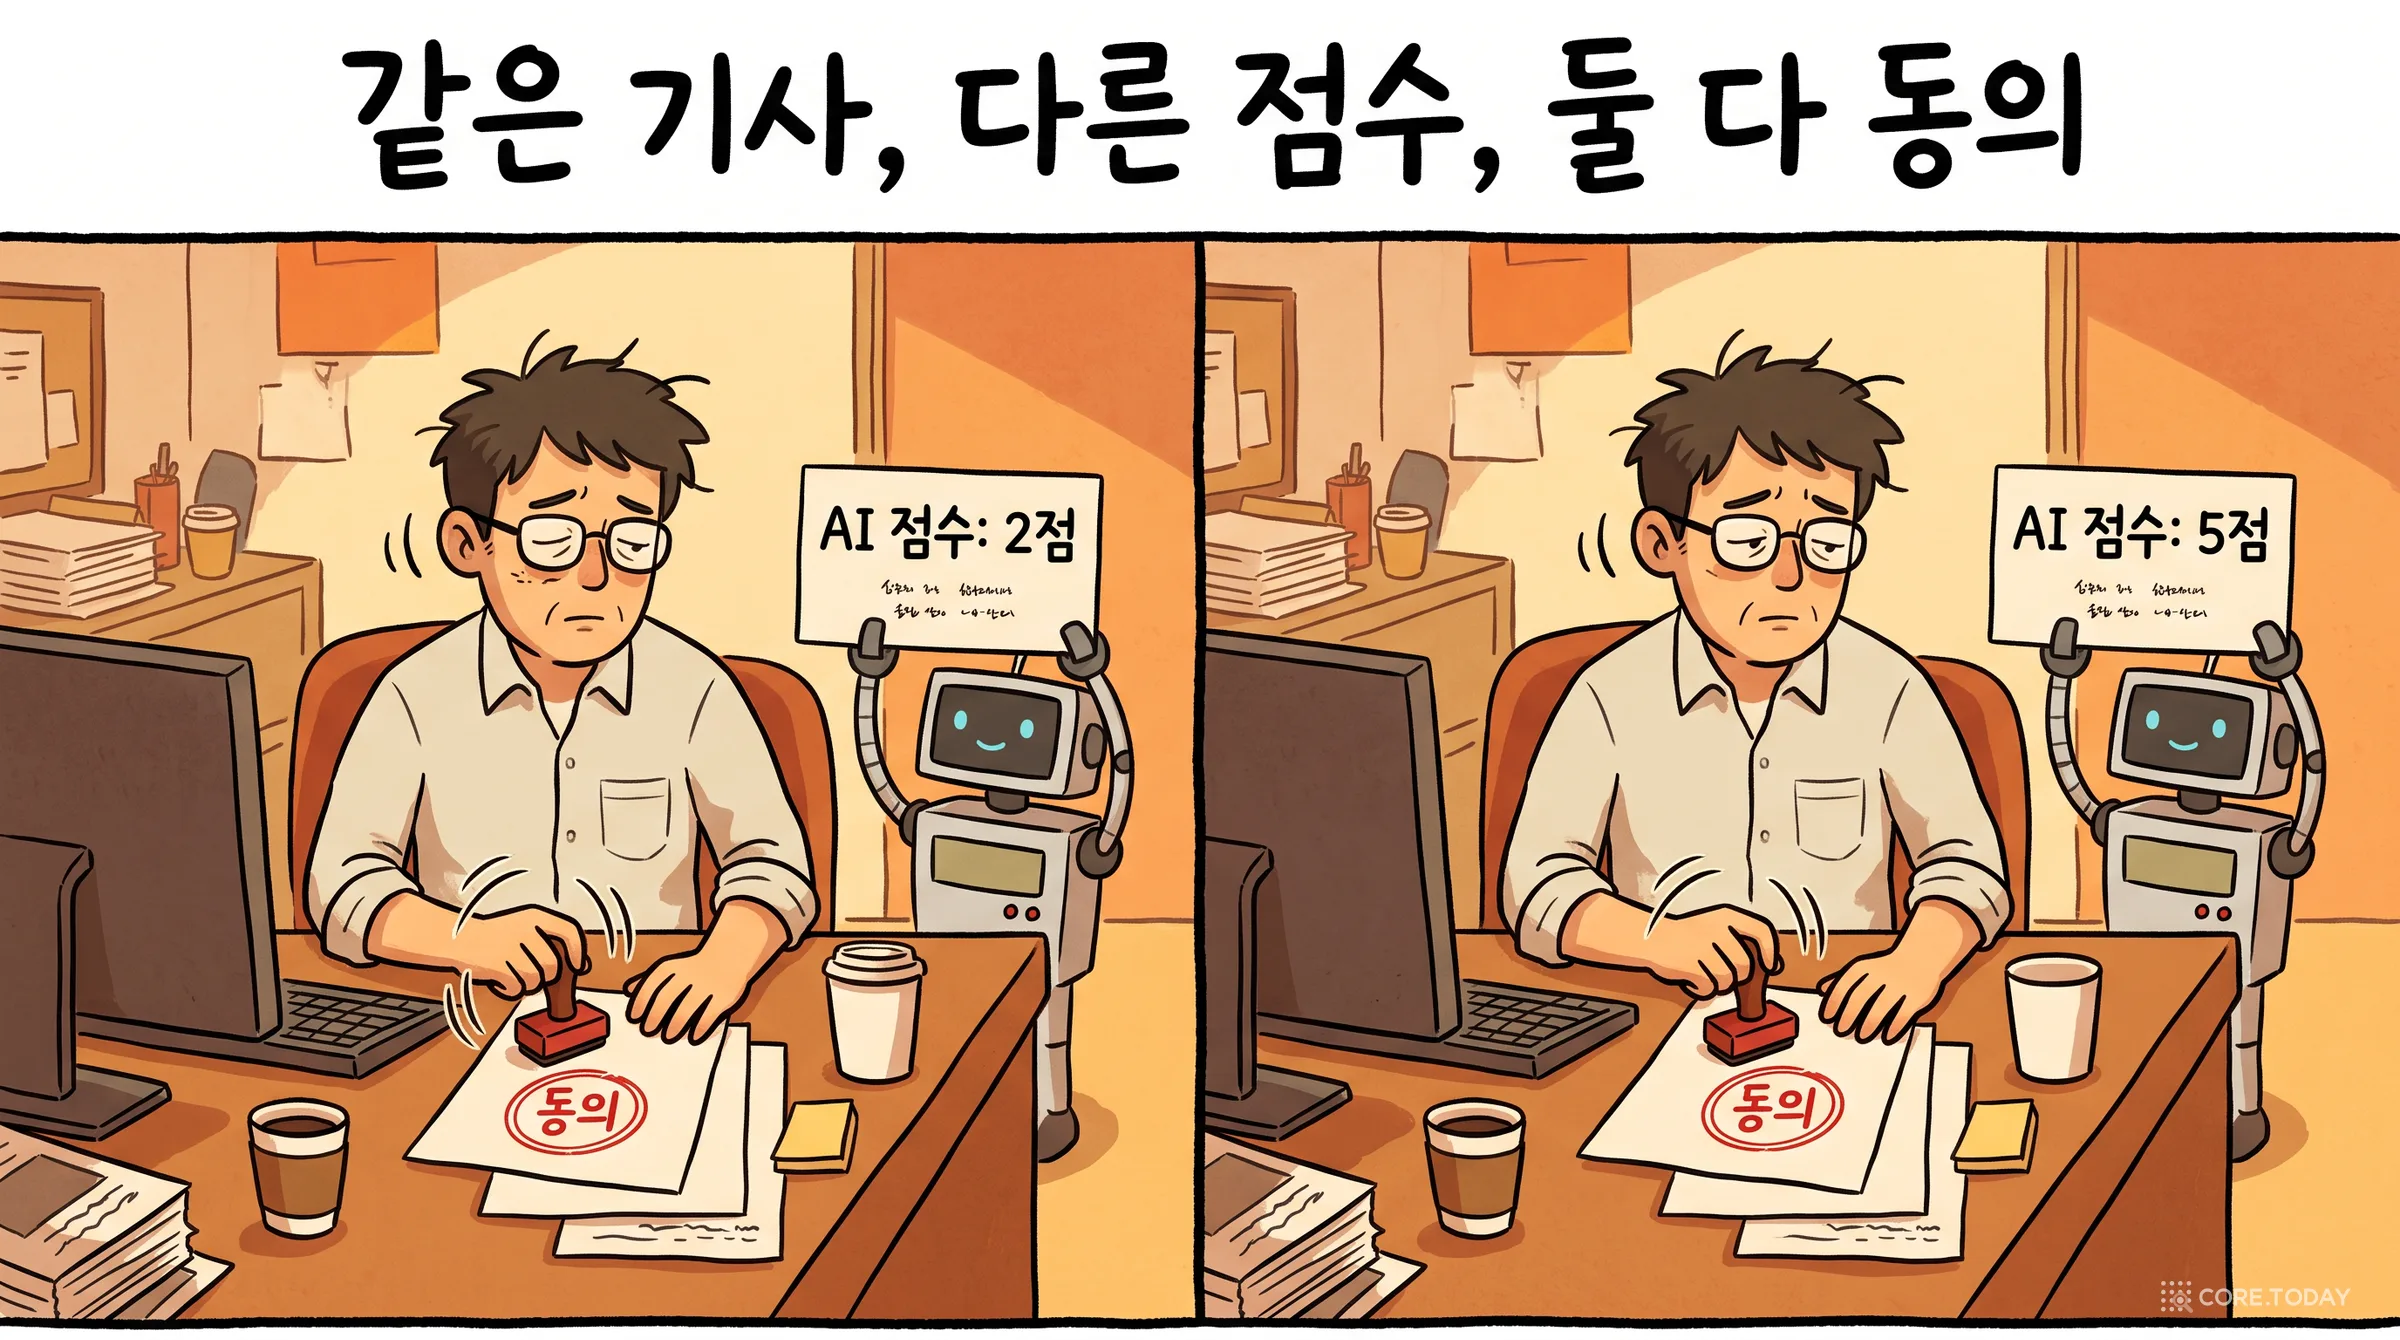
세 판사가 모두 채점한 (추출 × 기준) 1,907쌍을 짝지어 봤습니다. 세 판사가 같은 점수를 준 경우는 888쌍(46.6%)뿐입니다. 최고점과 최저점이 두 점 이상 벌어진 경우가 358쌍이고, 그중 342쌍에서 기자는 세 판사 모두의 점수에 동의했습니다. 세 점 이상 벌어진 113쌍 가운데서도 108쌍이 모두 '동의'였습니다. 예를 들어 Claude가 2점, Gemini가 5점을 준 칸이 34개 있습니다.
같은 추출의 같은 기준에 대해 "2점이 맞다"와 "5점이 맞다"를 동시에 받아들인다면, 그 검수는 판사의 점수가 맞는지를 가린 것이 아닙니다. 판사가 낸 의견이 '그럴 수 있는 의견'인지를 가린 것에 가깝습니다. 논문의 수용률(JAR)이 측정한 것은 정확도가 아니라 이 관용의 폭입니다.
왜 이런 일이 생겼을까요. 검수 양식을 만드는 저장소 코드(create_expert_review_task.py)를 보면, 기자에게 주는 각 칸은 ai_score, ai_justification, 그리고 비어 있는 expert_feedback입니다. 기자는 판사의 점수와 그럴듯한 근거를 먼저 읽고 동의 여부를 적었습니다. 사람이 기계의 답을 먼저 보면 그쪽으로 끌려가는 현상은 의학에서 오래 연구됐습니다. 2023년 영상의학 학술지 Radiology에 실린 연구에서 유방촬영 판독의 숙련자들도 'AI 제안'이 틀렸을 때 정확도가 82.3%에서 45.5%로 떨어졌고, 경험이 적은 판독자는 79.7%에서 19.8%로 떨어졌습니다. 2025년 슈뢰더(Schroeder) 등의 사전 등록 실험(주석자 410명, 7,000여 건)에서는 LLM의 제안을 보여 주자 주석자들이 그 제안을 강하게 따랐고, 그렇게 만든 라벨로 LLM을 채점하면 LLM의 성능이 유의하게 높게 나왔습니다. 이번 논문의 검수 구조가 정확히 그 모양입니다.
기자들이 성의 없이 검수했다는 뜻은 아닙니다. 판사의 근거는 대부분 실제로 그럴듯하고, 1~5점 리커트 척도에서 한 점 차이는 해석의 여지가 큽니다. 문제는 설계입니다. 판사의 정확도를 재려면 사람이 먼저 판사의 점수를 보지 않은 채로 독립적으로 채점하고, 그 점수와 판사의 점수가 얼마나 같은지를 재야 합니다. 그렇게 했다면 판사끼리 상관이 0.52~0.68이었으니, 사람과 판사의 상관도 비슷한 수준이었을 가능성이 큽니다. 98%와 0.6 사이의 거리가 이 논문을 읽을 때 가장 중요한 감각입니다.
3. 카파 0.67은 '4점이냐 5점이냐'의 일치였다
검수자 일치도를 잰 100건 표본은 판사 점수가 고르게 섞이도록(2점 28건, 3·4·5점 각 24건) 뽑았습니다. 그런데 두 기자가 이 100건에 준 Q1 점수는 4점과 5점뿐이었습니다. 3점 이하는 한 건도 없습니다. 두 사람 모두 100건 전부에 동의했으니, 이 표본에서 두 기자의 판단 수용률은 둘 다 100%입니다.
검수자 2: 4점
검수자 2: 5점
검수자 1: 4점
18
10
검수자 1: 5점
2
70
이 2×2 표에서 나오는 카파가 0.6739입니다. 범주가 두 개뿐이면 이차 가중치를 줘도 보통 카파와 값이 같습니다(직접 계산해도 둘 다 0.6739). 그러니 논문이 '상당한 일치'라고 부른 숫자는 "동의한다"와 "매우 동의한다" 사이에서 두 사람이 얼마나 같았느냐입니다. "판사가 맞았느냐"에 대해서는 두 사람이 100% 같았고, 그 100%는 판사가 2점을 준 28건에서도 마찬가지였습니다.
Q2(설명의 질)의 카파 0.39는 논문이 '카파 역설'로 설명한 그대로입니다. 두 사람이 100건 중 96건을 '정확하고 유용'으로 골랐기 때문에 우연 일치가 95%가 되고, 97% 일치가 카파 0.39로 줄어듭니다. 역설 설명 자체는 옳습니다. 다만 역설이 말해 주는 진짜 정보는 "카파가 억울하게 낮다"가 아니라 "평가 범주가 거의 한쪽으로만 쓰였다"입니다. 범주를 거의 하나만 쓴 측정은 판사들 사이의 차이를 가릴 힘이 약합니다. 직접 숫자를 바꿔 보세요.
그림 7의 가장 눈에 띄는 칸, GPT-4.1 완전성 91.22%를 따라가 봤습니다. 기자가 GPT의 판결에 동의하지 않은 칸은 FLARES의 완전성에 몰려 있습니다(26건). 이 26건에서 다른 두 판사는 어떤 점수를 받았을까요.
FLARES 문서
Claude 점수 → 기자
Gemini 점수 → 기자
GPT 점수 → 기자
109
2 → 동의(5)
2 → 동의(5)
2 → 비동의(3)
150
2 → 동의(5)
2 → 동의(5)
2 → 비동의(3)
451
2 → 동의(5)
2 → 동의(5)
2 → 비동의(3)
153
3 → 동의(5)
2 → 동의(5)
3 → 비동의(3)
50
2 → 동의(5)
1 → 동의(5)
3 → 비동의(3)
26건 중 18건에서 GPT의 점수는 '동의'를 받은 다른 판사의 점수와 똑같았습니다. 22건에서는 다른 두 판사가 GPT와 같거나 더 낮은 점수를 주고도 모두 '동의'를 받았습니다. 세 판사가 같은 점수를 준 5건에서도 GPT만 3점(비동의)을 받았습니다. 판사 파일마다 검수가 따로 이뤄졌으니 검수 시점이나 사람이 달랐을 수 있습니다. 어느 쪽이든 결론은 같습니다. GPT-4.1의 FLARES 완전성 점수가 이상했던 것이 아니라, 그 파일의 검수가 다른 파일들과 다른 기준으로 이뤄졌습니다. 논문 5.2절과 6.1절이 이 차이를 GPT의 '모델 생성 글에 대한 관대함과 자기 선호 편향'으로 해석한 것은 원자료로는 뒷받침되지 않습니다.
GPT의 BASSE '불일치' 10건 중 8건은 기자가 비워 둔 칸입니다(Gemini BASSE도 1건). 저자들의 집계 코드는 빈칸을 0으로 채워 '동의 아님'으로 셉니다. 큰 숫자는 아니지만, 판사 간 차이가 1~2%p를 다투는 표에서는 무시할 수 없는 크기입니다. 실제로 판사를 가르는 맥니마 검정은 불일치 칸 수십 개에 기대고 있습니다.
이 26건의 원문과 '정답'도 들여다볼 만합니다. 문서 50번의 FLARES 정답은 '무엇을: 실패한 사형 집행', '어디서: 그의 팔과 발목에'입니다. 문서 335번은 '언제: 등을 곧게 편 채로', '어디서: 물속에서'입니다. 첫 번째 밑줄을 정답으로 고르는 규칙이 만든 결과입니다. 기자가 남긴 메모 다섯 개 중 세 개가 바로 이런 '무엇을'의 오류를 지적하고, 그중 두 개는 판사가 그 오류를 짚지 못했다고 적었습니다(예: "AI의 평가는 '무엇을'이 틀렸다는 점을 고려하지 않았다. '무엇을'은 실패한 사형 집행이 아니라 롬멜 브룸이 코로나로 숨진 일이다"). 정답 쪽 오류를 판사가 얼마나 잡는지, 지난 「채점이 순위를 바꾸는가」에서 코어닷투데이가 판사 둘 이상이 의심한 정답 칸을 다시 봤더니 모두 정답 쪽이 틀렸던 경험과 대조되는 대목입니다.
5. −0.53은 데이터 두 벌의 위치 차이였다
이제 ROUGE와의 상관입니다. 저장소의 rouge.py를 보면 ROUGE-L을 정답 추출이 아니라 원문 전체와 비교해 계산합니다. 그러니 여기서 ROUGE-L이 재는 것은 '정답과 얼마나 같은가'가 아니라 '원문을 얼마나 베꼈는가'입니다. 같은 방식으로 319개 추출을 모두 다시 계산하면 판사 평균 점수와의 스피어만 상관은 −0.50으로, 논문 값 −0.53과 가깝습니다.
그런데 데이터셋별로 나누면 이야기가 뒤집힙니다.
추출 수
평균 ROUGE-L
판사 평균 점수
ROUGE-L × 판사 상관
합쳐서
319
-
-
−0.50
BASSE 안에서
225
0.17
4.75
−0.07 (유의하지 않음)
FLARES 안에서
94
0.34
3.18
+0.25 (p ≈ 0.015)
전형적인 심슨의 역설입니다. 1973년 UC 버클리 대학원 입학 자료에서 전체로는 여성 합격률이 낮았지만, 학과별로 나누면 오히려 여성에게 조금 유리했던 것처럼, 두 무리를 섞으면 무리 사이의 차이가 무리 안의 관계를 덮어 버립니다. 여기서 BASSE는 '긴 원문의 압축 요약'이라 겹침이 적고 점수가 높은 무리, FLARES는 '짧은 원문의 구절 복사'라 겹침이 많고 점수가 낮은 무리입니다. 음의 상관은 이 두 무리가 산점도에서 서로 다른 구석에 있다는 사실이 전부입니다. FLARES 안에서는 오히려 원문과 많이 겹칠수록 판사 점수가 조금 높습니다.
'ROUGE는 육하원칙 평가에 부적합하다'는 결론 자체는 맞습니다. 3부에서 본 대로 근거는 충분합니다. 다만 이 논문의 −0.53은 그 근거가 되지 못합니다. 원문과의 겹침을 쟀고, 성격이 다른 두 데이터를 섞었기 때문입니다.
6. 자기 선호의 흔적
BASSE의 추출 225개는 모델 다섯이 썼습니다. 판사별로 추출 모델의 평균 점수를 매겨 보면 작은 흔적이 보입니다.
추출을 쓴 모델
Claude 판사
GPT 판사
Gemini 판사
Claude
4.94 (1위)
4.87
4.88 (1위)
GPT-4o
4.76
4.90 (1위)
4.83
Reka
4.74
4.87
4.48
Llama 3
4.59
4.75
4.72
Command R+
4.63
4.69
4.54
Claude 판사는 Claude가 쓴 요약을 1위로, GPT 판사는 GPT-4o가 쓴 요약을 1위로 올렸습니다. 기사가 45건뿐이고 차이도 0.1점 안팎이라 통계적으로 단정할 수는 없습니다. 그러나 MT-Bench 연구에서 GPT-4가 자기 답에 10%, Claude-v1이 25% 높은 승률을 줬던 것과 같은 방향이고, 코어닷투데이가 지난 글에서 Gemini 판사가 Gemini 답을 +0.04, Qwen 판사가 Qwen 답을 +0.09 후하게 본 것과도 같은 방향입니다. 판사와 같은 가족 모델이 경쟁에 끼어 있다면 판사를 바꿔 가며 교차 확인해야 하는 이유입니다.
8부. 한국어 기사에 함정을 놓아 보다
7부의 결론은 '판사가 틀렸다'가 아니라 '이 검수로는 판사가 맞았는지 알 수 없다'였습니다. 그렇다면 판사가 실제로 오류를 잡는지는 어떻게 알 수 있을까요. 가장 직접적인 방법은 정답을 알고 있는 오류를 일부러 심어 보는 것입니다. 소프트웨어 테스트에서 일부러 버그를 심어 테스트가 잡는지 보는 돌연변이 시험(mutation testing)과 같은 생각입니다.
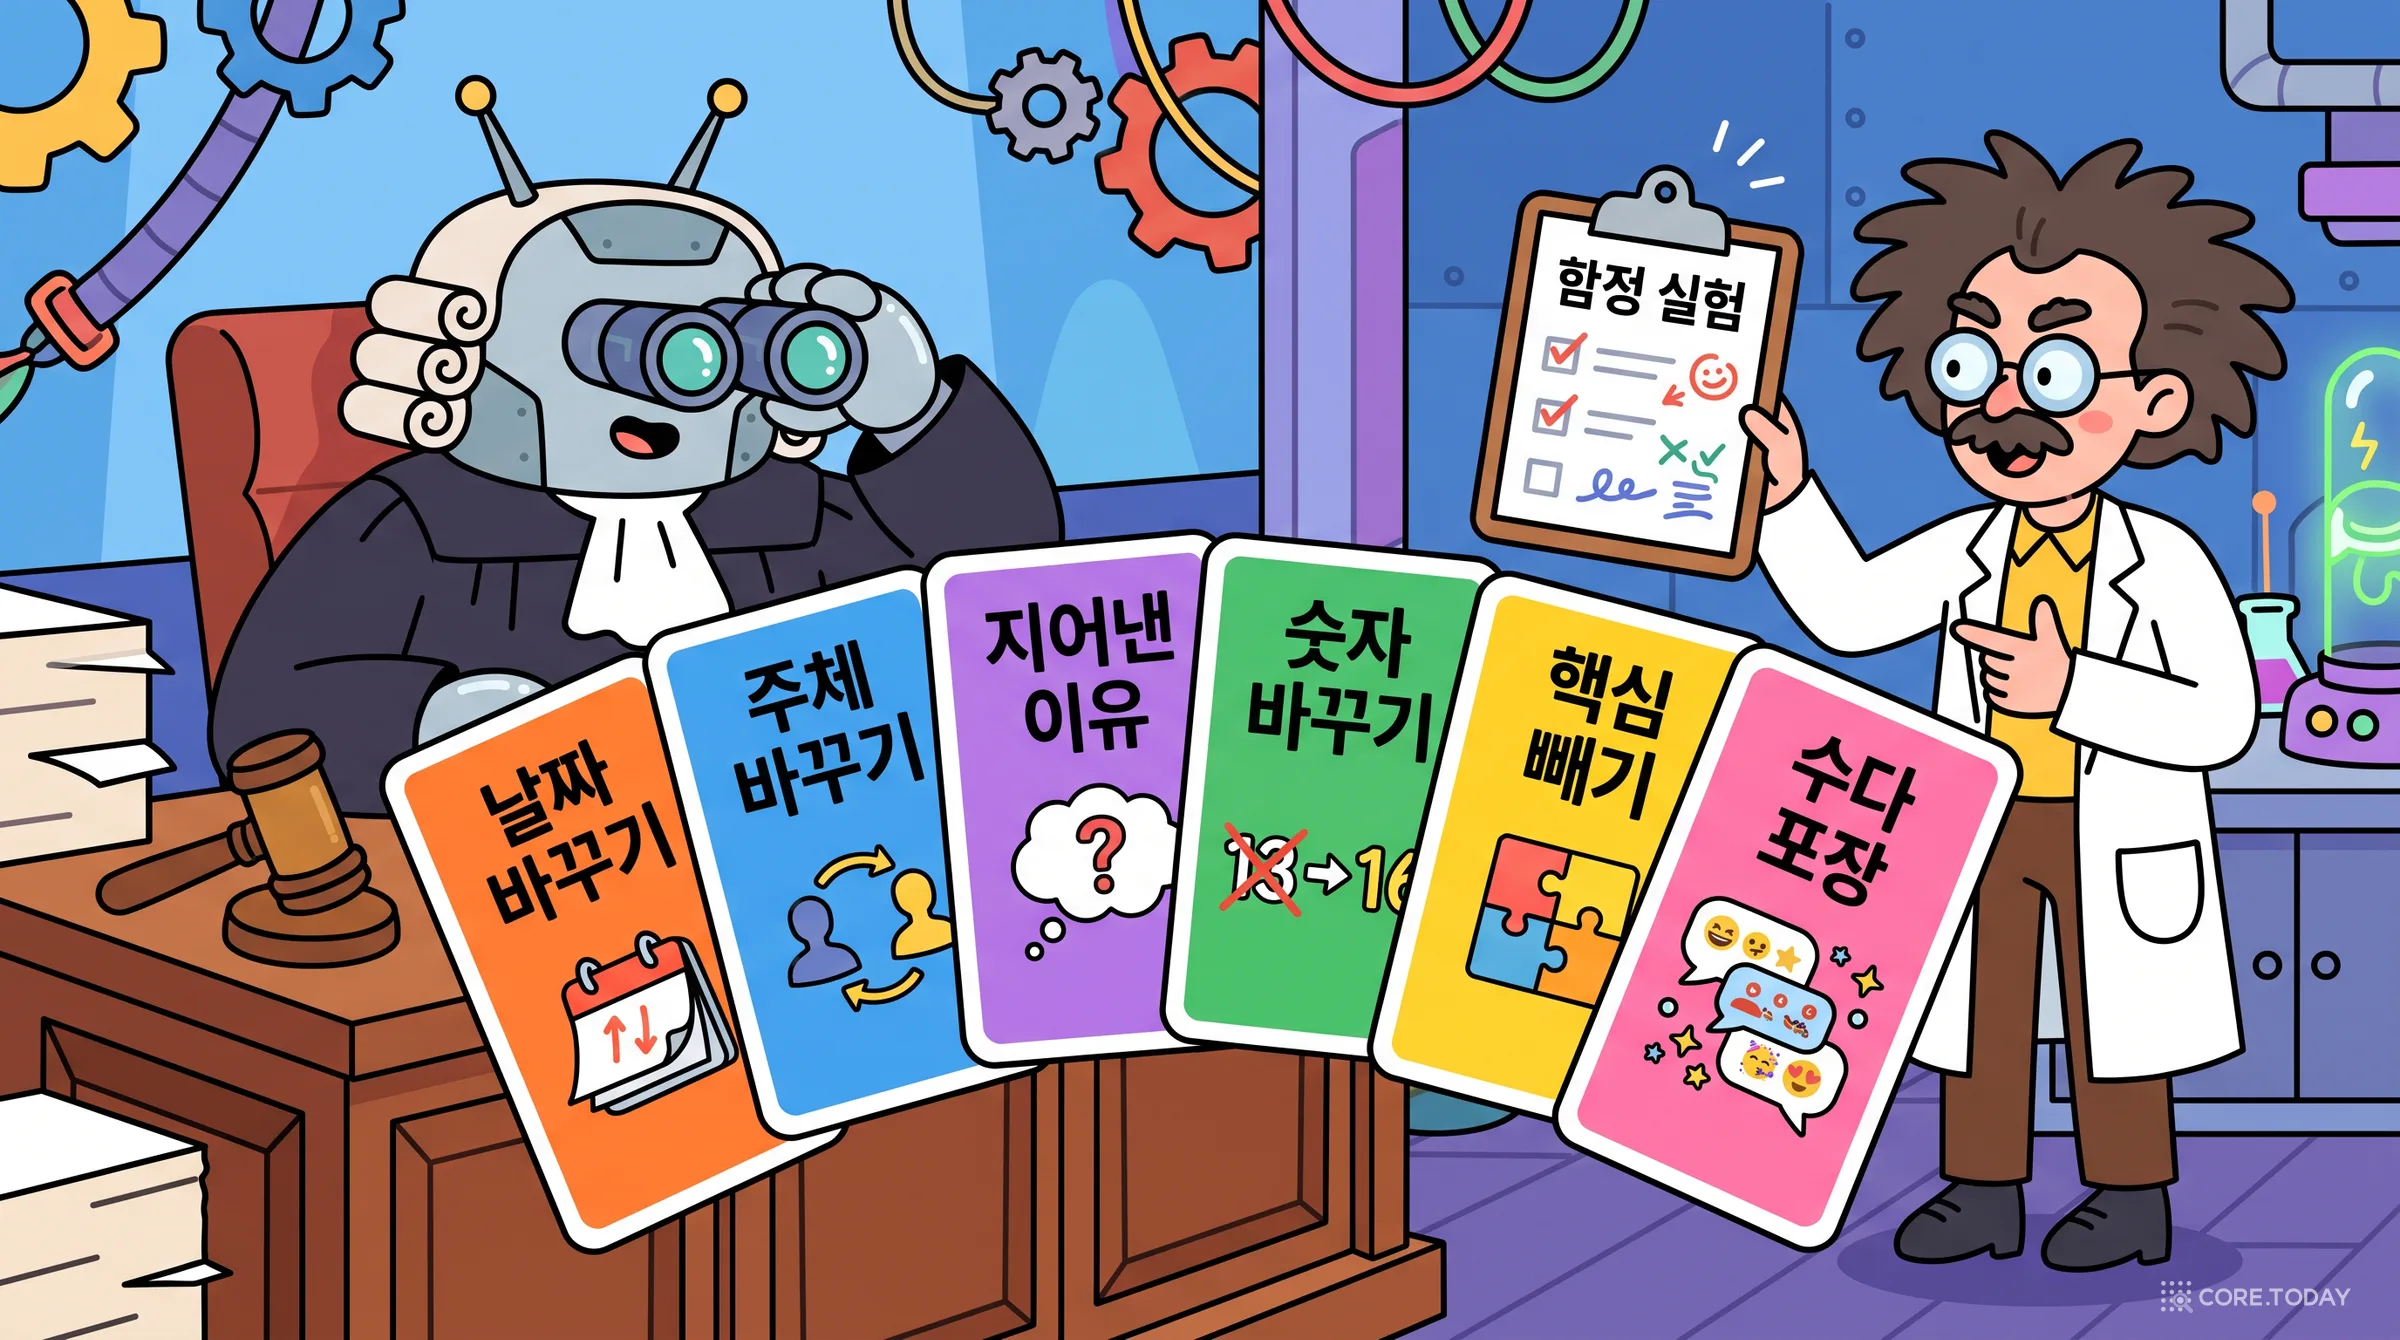
코어닷투데이가 지난 10월 육하원칙 추출 실험에서 만든 연합뉴스 기사(2026년 10월 13일자)의 정답(Gemini 초안을 원문과 한 칸씩 대조해 고친 것) 가운데, '무엇을'과 '언제'가 있는 기사 36건을 골랐습니다. 기사 본문은 원문 페이지에서 다시 받았습니다(평균 약 830자). 그리고 정답 추출 하나마다 함정 여섯 가지를 하나씩 심었습니다.
함정
무엇을 바꿨나
겨냥한 기준
기사 수
날짜 바꾸기
'언제'의 첫 숫자를 3 늘림 (13일 → 16일)
사실 정확성
36
주체 바꾸기
'누가'를 같은 분야 다른 기사의 '누가'로 교체
사실 정확성
36
숫자 바꾸기
'언제' 밖 칸의 첫 숫자를 바꿈 (2천672건 → 5천672건)
사실 정확성
16 (숫자 있는 기사만)
지어낸 이유
'왜'를 원문에 없는 그럴듯한 이유로 (사람이 직접 작성, 원문과 대조 확인)
출처 충실성
36
핵심 빼기
'누가·어디서·왜·어떻게'를 모두 '명시되지 않음'으로
완전성
34 (두 칸 이상 있는 기사만)
수다 포장
여섯 칸은 그대로, 앞뒤에 챗봇식 인사말과 맺음말
관련성·간결성
36
판사 프롬프트는 논문의 시스템·사용자 프롬프트를 한국어로 옮긴 것입니다. 판사는 둘입니다.
Claude Sonnet. Claude Code의 Sonnet 서브에이전트 7개에 나눠 맡겼습니다. 같은 기사의 정답과 함정을 나란히 보면 비교해서 깎을 수 있으므로, 서브에이전트 하나는 기사마다 변형을 하나만 보게 했습니다(라틴 방진 배치). 정답 추출과 함정 추출의 점수는 서로 다른 서브에이전트가 매긴 것입니다. 모두 230건입니다.
로컬 Qwen3.5 9B·4B. Ollama에서 논문처럼 온도 0.2, JSON 스키마 강제 출력으로 하나씩 불렀습니다. 다른 작업과 GPU를 나눠 쓰느라 한 건에 30초~4분이 걸려 앞쪽 기사 일부만 돌렸습니다. 4B는 8건(52개), 9B는 4건(26개)입니다.
결과 1: 강한 판사는 함정을 거의 다 잡는다
Claude Sonnet은 여섯 함정 모두에서 겨냥한 기준의 점수를, 같은 기사의 정답 추출보다 낮게 줬습니다(194쌍 중 194쌍). 함정 추출의 겨냥 기준 점수가 3점 이하로 떨어진 비율도 숫자 바꾸기 한 건(16건 중 15건)을 빼면 100%였습니다. 근거 문장도 정확했습니다. "기온 급하강 시점이 출처의 13일 밤이 아니라 16일 밤으로 잘못 적혔다." "문서 수를 5천672건으로 적었으나 출처는 2천672건이다." "출처의 이유(불발탄 발견 사례 지속)와 다른 사고를 환각으로 덧붙였다."
함정마다 움직인 기준도 설계 의도와 맞았습니다. 날짜·숫자·주체 바꾸기는 사실 정확성을 2~3점 깎았고, 지어낸 이유는 출처 충실성을 3.28점 깎았으며, 핵심 빼기는 완전성(−1.85)과 전체 일관성(−1.82)을, 수다 포장은 관련성·간결성(−1.89)을 가장 크게 깎았습니다. 여섯 기준으로 쪼갠 기준표가 오류의 종류를 구별해 준다는 것, 이것은 논문 설계의 강점을 직접 확인한 결과입니다.
수다 포장에서 출처 충실성도 1.53점 떨어진 데는 이유가 있습니다. 맺음말에 넣은 "이 사건은 앞으로도 많은 관심을 받을 것으로 보이며"는 원문에 없는 전망입니다. 판사는 이것을 "출처에 없는 전망 멘트를 덧붙였다"고 정확히 짚었습니다. 5부에서 본 스페인어 농구 기사의 챗봇 인사말에 논문 판사가 관련성 5점을 준 것과 대조됩니다. 그쪽 인사말은 "요약해 드릴게요"와 "더 설명해 드릴까요?"뿐이라 사실 주장이 없었다는 차이는 있습니다.
출처 적합도는 함정과 상관없이 4.82~4.94로 거의 같았습니다. 적합도는 추출이 아니라 원문을 보는 판단이라는 논문의 설계대로 움직인 것입니다.
결과 2: 그런데 정답에도 엄격하다
강한 판사가 함정을 잘 잡는다고 모든 것이 끝나지는 않습니다. 같은 판사는 검수를 거친 정답 추출 36개 중 20개(56%)에 적어도 한 기준에서 3점 이하를 줬습니다. 대부분 완전성이었습니다(3점 16건, 4점 18건, 5점 2건). 근거는 "서삼석 의원 자료, 기금 개요가 빠졌다", "재개 배경(화재, 시공사 중단)과 이후 일정이 빠졌다"처럼, 짧은 구절형 정답에 기사 맥락이 다 담기지 않았다는 지적입니다.
틀린 지적은 아닙니다. 지난 실험의 정답은 칸마다 핵심 구절만 짧게 적는 원칙으로 만들었고, 판사의 기준표는 '핵심 정보를 모두 담았나'를 묻습니다. 정답의 원칙과 판사의 기준이 다른 눈금을 쓰고 있었던 것입니다. 이 장면은 7부에서 본 FLARES와 같습니다. 사람이 일부러 '왜·어떻게'를 비워 둔 정답에 판사들은 완전성 2점대를 줬습니다. 판사의 엄격함과 관대함은 판사의 성격이 아니라 눈금의 문제이고, 눈금은 기준표 문구와 정답의 작성 원칙이 함께 정합니다. 그러니 '4점 이상이면 통과' 같은 문턱을 정하기 전에, 정답 추출이 판사에게 몇 점을 받는지부터 재야 합니다.
결과 3: 작은 판사는 '틀렸다'고 말하는 힘이 먼저 약해진다
이제 위젯에서 판사를 Qwen3.5 4B로 바꿔 보세요. 사실을 건드린 위쪽 네 줄이 하얗게 비고, 아래쪽 두 줄만 붉게 남습니다.
함정 (같은 기사 8건)
Claude Sonnet: 목표 기준을 깎은 건수
Qwen3.5 4B: 목표 기준을 깎은 건수
함정 추출의 목표 기준 평균 점수 (Sonnet → 4B)
날짜 바꾸기
8 / 8
0 / 8
2.38 → 5.00
주체 바꾸기
8 / 8
0 / 8
1.50 → 5.00
숫자 바꾸기
4 / 4
0 / 4
2.75 → 5.00
지어낸 이유
8 / 8
0 / 8
1.25 → 5.00
핵심 빼기
8 / 8
6 / 8
1.75 → 3.12
수다 포장
8 / 8
6 / 8
2.12 → 3.00
사실을 건드린 함정 28건에서 4B는 목표 기준을 한 번도 깎지 않았고, 28건 모두 5점을 줬습니다. 고용노동부 장관이 공군 폭발물처리반 대신 불발탄 교육을 했다는 추출에도, 기사에 없는 고물상 폭발 사고를 이유로 댄 추출에도 만점이었습니다.
더 눈여겨볼 것은 근거입니다. 4B는 틀린 날짜를 보고 "출처의 기온 하강 시점과 원인 설명이 추출 정보와 정확히 일치합니다"라고 썼습니다. 지어낸 이유에는 "해석이나 추론 없이 오직 출처에 명시된 사실만 객관적으로 추출했습니다"라고 썼습니다. 가장 인상적인 것은 부사관 129명을 124명으로 바꾼 함정입니다. 4B의 근거는 "출처의 숫자(129명 vs 124명)와 금액에 대한 오해 없이 정확한 정보를 추출했습니다"였습니다. 두 숫자를 나란히 적어 놓고 5점을 준 것입니다. 4부에서 말한 평가의 환각, 근거와 판결이 따로 노는 현상이 그대로 나타났습니다. 근거 문장이 있다고 해서 판사가 실제로 대조했다는 뜻은 아닙니다.
그렇다고 4B가 아무것도 못 보는 것은 아닙니다. 칸을 비운 추출과 챗봇 말투는 8건 중 6건씩 잡았습니다. 원문과 한 줄씩 대조하지 않아도 추출만 읽으면 보이는 오류이기 때문입니다. 작은 판사는 형식은 보지만 사실은 보지 못합니다. 논문이 '형식 기준은 100%에 가깝고 사실 기준이 어렵다'고 한 것과 같은 방향이고, 7부에서 판사끼리 상관이 명료성보다 출처 충실성에서 훨씬 낮았던 것과도 맞습니다.
Qwen3.5 9B는 그 사이에 있습니다. 한 건에 3분가량 걸려 기사 4건(변형 26개)까지만 돌렸으니 경향으로만 읽어 주세요. 같은 4건에서 세 판사를 나란히 놓으면 이렇습니다.
같은 기사 4건
Claude Sonnet
Qwen3.5 9B
Qwen3.5 4B
사실 함정 14건 중 목표 기준을 깎은 수 (날짜·주체·숫자·지어낸 이유)
14
4
0
형식 함정 8건 중 목표 기준을 깎은 수 (핵심 빼기·수다 포장)
8
7
6
정답 추출에 준 평균 점수
4.50
4.71
4.67
9B는 날짜 2건, 주체 1건, 숫자 1건을 잡았고 지어낸 이유는 네 건 모두 5점으로 통과시켰습니다. 잡은 네 건 중 셋은 근거도 정확했습니다("출처에 명시된 '공군 제18전투비행단'이 추출 결과의 '제21전투비행단'으로 잘못 표기"). 나머지 한 건은 판결만 맞았습니다. '오는 19일'을 '오는 22일'로 바꾼 함정에 3점을 주면서, 근거로는 19일과 22일의 차이가 아니라 "2024년 1월 22일인데 연도가 누락됐다"고 썼습니다. 기사 뒤쪽에 나오는 2024년 1월 22일 화재 날짜와 섞은 것입니다. 점수만 보면 잡은 것이지만 실제로는 오류를 찾지 못한 것입니다. 판사의 점수와 근거를 따로 검증해야 하는 이유입니다.
이 작은 표본에서 지어낸 이유가 가장 잡기 어려운 함정이었다는 점은 기억해 둘 만합니다. 틀린 값은 원문의 값과 맞대어 보면 되지만, 원문에 없다는 것을 확인하려면 원문 전체를 훑어야 합니다. 코어닷투데이의 지난 실험에서 이 과제의 절반은 '없다'고 말하는 일이라고 적었는데, 판사에게도 같은 일이 벌어집니다.
여기서 중요한 대조가 하나 있습니다. 4B는 정답 추출에도 평균 4.69점을 줬습니다. 같은 8건에서 Sonnet이 준 4.54점보다 높습니다. 함정이 없는 데이터만 보면 4B는 후하고 일관되고 근거까지 그럴듯한, 아주 훌륭한 판사처럼 보입니다. 만약 이 판사의 점수를 기자에게 보여 주고 동의 여부를 물었다면 수용률이 높게 나왔을 가능성이 큽니다. 실제 추출 대부분은 맞으니까요. 7부에서 본 측정 방식으로는 이 판사의 문제를 찾기 어렵고, 함정 몇십 개로는 바로 찾을 수 있습니다.
이 실험의 한계
정답 추출은 지난 실험에서 Gemini 초안을 원문과 대조해 고친 것이라 완벽하지 않습니다. 함정은 기계적으로 만든 것이라 실제 모델이 내는 오류보다 눈에 띄기 쉽습니다(특히 다른 기사의 '누가'로 바꾼 주체 바꾸기). Claude Sonnet은 서브에이전트 하나가 30여 건을 한 맥락에서 연달아 채점했고 온도를 정할 수 없었습니다. 로컬 판사는 기사 수가 적습니다(4B 8건, 9B 4건). 그러니 이 숫자는 '판사 X의 함정 탐지율은 몇 %'라는 측정값보다, 함정 세트가 판사를 가르는 데 쓸모 있는가에 대한 답으로 읽어 주세요. 답은 분명히 '그렇다'입니다. 98% 수용률로는 보이지 않던 판사 간 차이가, 함정 몇십 개로 바로 드러납니다.
9부. 2026년, 이 논문이 남기는 것
판사는 이미 곳곳에 있다
뉴스와 자동화의 만남은 오래됐습니다. AP 통신은 2014년 7월부터 오토메이티드 인사이츠의 워드스미스로 기업 실적 기사를 자동으로 썼고, 분기당 약 300건이던 실적 기사가 그해 말 3,000건 수준으로 늘었습니다(초기에는 사람이 검수). 로이터는 2018년 데이터에서 이상 징후를 찾아 기자에게 알려 주는 링스 인사이트를 내놨고, 뉴욕타임스는 2025년 초 사내 요약 도구 '에코'를 시험한다고 알려졌습니다. 국내에서는 연합뉴스가 2021년 1월 BERT 기반 '기사 3줄 요약'을 시작했고, 네이버 뉴스의 '요약봇'은 2017년 세 문장 추출에서 2025년 11월 생성형 요약으로 바뀌었습니다.
자동화가 늘어난 만큼 검증의 실패도 드러났습니다. BBC가 2025년 2월 AI 비서 네 종에 뉴스 질문 100개를 던졌더니 답의 51%에 중대한 문제가 있었고, 같은 해 10월 유럽방송연맹(EBU)과 BBC가 18개국 22개 공영방송과 함께 한 후속 조사에서는 45%였습니다. 사람이 일일이 볼 수 없는 규모에서 품질을 지키려면 결국 기계가 1차로 걸러야 하고, 그 기계가 LLM 판사입니다. 평가 도구 쪽에서도 OpenAI Evals(2023), Anthropic 콘솔의 평가 기능(2024), RAG 평가용 RAGAS, G-Eval 지표를 내장한 DeepEval처럼 판사를 기본 부품으로 쓰는 것이 표준이 됐습니다. 한국어에서도 LG AI연구원의 KoMT-Bench가 GPT-4를 판사로 썼고, 판사 채점 벤치마크 LogicKor는 2024년 10월 상위 모델들의 점수가 붙어 변별력이 떨어지자 저장소를 보관 처리했습니다. 판사의 천장 효과가 실제로 벤치마크 하나를 끝낸 사례입니다.
1기준을 쪼개라. '좋은 추출인가' 한 점수 대신 사실·완전·관련·명료·충실·일관을 따로 물으면, 판사가 무엇을 근거로 점수를 줬는지 보이고 오류 유형별로 대응할 수 있다. 8부에서 보듯 함정마다 다른 기준이 움직였다.
2출력을 스키마로 묶어라. 함수 호출과 Pydantic 검증은 '판사가 가끔 이상한 형식을 낸다'는 운영 문제를 없앤다. 근거를 필수 필드로 두면 나중에 사람이 왜 그 점수인지 추적할 수 있다.
3원문의 적합도를 따로 물어라. 칼럼·사설에서 육하원칙을 뽑으라고 해 놓고 추출기를 탓하는 일을 막는다. 세 판사가 81%에서 같은 적합도를 줄 만큼 안정적인 판단이었다.
4판사의 비용은 작다. 추출 1만 개에 65~270달러. 사람이 1만 개를 원문과 대조하는 비용과 비교가 되지 않는다. 판사를 1차 여과기로 쓰지 않을 이유가 없다.
그리고 바꿔야 할 것: 판사를 검증하는 방법
7부와 8부를 합치면 교훈은 하나로 모입니다. 판사는 꽤 쓸 만하지만, '사람이 판사에 동의하는 비율'로는 그것을 알 수 없다. 실무에서 판사를 검증할 때는 이렇게 바꾸는 편이 낫습니다.
논문의 방식
바꾼 방식
이유
사람이 판사의 점수를 보고 동의 여부를 적는다
사람이 판사 점수를 보지 않고 먼저 채점한 뒤 비교한다
앵커링·자동화 편향. 보여 주면 따라간다
4·5점이면 '수용'
점수 차이 분포, 가중 카파, 순위 상관을 함께 본다
2점과 5점이 동시에 '수용'되는 지표는 판사를 가르지 못한다
판사가 채점한 실제 추출만 쓴다
정답을 아는 함정 추출(날짜·주체·숫자 바꾸기, 이유 지어내기, 빠뜨리기, 수다)을 섞는다
무엇을 잡고 무엇을 놓치는지 정답이 있는 상태로 잴 수 있다
데이터를 합쳐 상관을 본다
데이터셋·출처별로 나눠서 먼저 본다
심슨의 역설
카파 하나로 신뢰도를 말한다
범주 분포를 같이 적고, 쏠림이 크면 AC1이나 스콧의 π를 병기한다
카파 역설은 '범주가 한쪽으로만 쓰였다'는 신호다
판사 모델 이름과 날짜를 적는다
스냅숏 식별자와 실행 시각을 결과 파일에 함께 저장하고, 은퇴 일정을 확인한다
판사가 은퇴하면 평가 체계가 재현되지 않는다
마지막 줄은 2026년에 특히 중요합니다. 이 논문의 Claude Sonnet 4.5는 이달 말(11월 30일) API에서 은퇴하고 GPT-4.1도 지원 중단 예고 상태입니다. 판사를 바꾸면 점수의 크기가 바뀝니다. 지난 「채점이 순위를 바꾸는가」에서 확인했듯 강한 판사끼리는 방법의 순위가 거의 같았지만(켄달 0.96~0.99) 점수의 절대값은 판사마다 달랐습니다. 그래서 판사를 교체할 때는 같은 함정 세트와 같은 사람 채점 표본으로 새 판사를 먼저 재고, 점수 눈금을 다시 맞춘 뒤 넘어가야 합니다. 함정 세트는 그 자체로 판사의 회귀 시험이 됩니다.
한국어에서 더 조심할 것
논문은 스페인어가 주어를 생략하고(pro-drop) 어순이 자유로워 영어용 방법을 그대로 옮기기 어렵다고 썼습니다. 한국어는 둘 다 해당되고, 하나가 더 있습니다. 조사와 어미가 붙어 같은 대상이 여러 표기로 나타납니다. "50대 남성"과 "A(59)씨", "이날"과 "13일"이 같은 답이라는 것을 글자 겹침은 모릅니다. 판사는 압니다. 그래서 한국어에서는 글자 지표를 버리고 판사로 가는 이점이 영어보다 큽니다. 동시에 8부의 결과처럼 판사가 작아질수록 '틀린 것을 틀렸다고 말하는 힘'이 먼저 약해집니다. 로컬 모델로 판사를 돌리고 싶다면 그 모델이 함정을 잡는지부터 재야 합니다.
실무 체크리스트: 육하원칙 판사를 들이기 전에
설계기준을 여섯 개 안팎으로 쪼개고, 기준마다 근거 필드를 필수로 둔다. 출처 적합도를 따로 묻는다. 출력은 함수 호출 + 스키마 검증으로 묶는다.
함정정답 추출 30~50개에서 날짜·주체·숫자 바꾸기, 이유 지어내기, 칸 비우기, 수다 포장 변형을 만든다. 판사가 목표 기준을 몇 % 깎는지, 정답 쪽 점수는 몇 점인지 잰다.
사람사람 채점 표본 100건은 판사 점수를 가린 채 독립적으로 채점한다. 두 명 이상이면 일치도와 함께 범주 분포를 적는다.
분석판사와 사람의 점수 차이 분포, 가중 카파, 데이터 출처별 분리 결과를 함께 본다. 합친 숫자 하나로 결론 내지 않는다.
운영판사 점수 3점 이하, 판사끼리 두 점 이상 갈림, 출처 적합도 3 이하인 항목에만 깃발을 꽂아 사람에게 보낸다. 나머지는 통과시킨다.
교체판사 모델의 스냅숏 식별자와 은퇴 일정을 기록한다. 새 판사는 함정 세트와 사람 표본으로 먼저 재고 눈금을 맞춘다.
맺으며: 판사를 판정하는 법
이 논문을 처음 읽으면 '99.79%'가 남습니다. 원자료를 열고 나면 다른 숫자들이 남습니다. 판사가 1점을 줘도 98%, 5점을 줘도 99%인 동의율. 두 점 넘게 갈린 358건 중 342건의 '모두 동의'. 4점과 5점 사이에서만 잰 카파 0.67. 섞어서 생긴 −0.53. 그리고 한국어 함정 실험의 두 숫자입니다. Claude Sonnet이 깎은 함정 194쌍 중 194쌍, Qwen3.5 4B가 5점으로 통과시킨 사실 함정 28건 중 28건.
이 숫자들은 서로 모순되지 않습니다. 강한 판사는 일을 잘했고, 그 일을 잰 자가 무뎠습니다. 그 무딘 자로는 약한 판사도 가려내지 못합니다. 2,000년 전 수사학자들이 사건을 여섯 질문으로 쪼개 따진 것처럼, 판사를 평가할 때도 질문을 쪼개야 합니다. 판사가 틀린 것을 틀렸다고 말하는가. 맞는 것을 맞다고 말하는가. 사람과 같은 눈금을 쓰는가. 그 눈금은 내년에도 남아 있는가. 논문 제목의 질문, '어떤 판사가 가장 좋은가'는 이 넷에 답한 뒤에야 의미가 생깁니다.
키플링의 하인 여섯은 정직했습니다. 그 하인들을 부리는 기계도 정직하게 만들려면, 그 기계를 감독하는 사람의 질문부터 정직해야 합니다.
출처
논문과 저장소
José Cassola-Bacallao, José Morales-Donaire, Paula Hernández-Montoya, Brian Keith-Norambuena. "Benchmarking LLM-as-a-Judge Models for 5W1H Extraction Evaluation." Electronics 2026, 15(3), 659. doi:10.3390/electronics15030659 (CC BY 4.0, 그림 1·5·6·7 인용)
저장소 jcassolaucn/5w1h_llm_evaluation — 재분석은 validation 브랜치(검수 엑셀 validation/validated_files/, 판사 출력 results/prod_results/, 집계 validation/validation_test.py·iaa_test.py·rouge.py)를 2026년 10월 31일에 내려받아 했다.
J. Barnes 외. "Summarization Metrics for Spanish and Basque: Do Automatic Scores and LLM-Judges Correlate with Humans?" arXiv:2503.17039 (BASSE, v3부터 제목 변경)
R. Sepúlveda-Torres 외. "Overview of FLARES at IberLEF 2024: Fine-grained Language-based Reliability Detection in Spanish News." Procesamiento del Lenguaje Natural 73 (2024)
육하원칙과 역피라미드
Quintilianus, Institutio Oratoria 5.10.32, 3.5.17 — The Latin Library
Thomas Aquinas, Summa Theologiae I-II q.7 a.3 — CCEL
Thomas Wilson, The Arte of Rhetorique (1560; Mair ed. 1909), p.17 — archive.org
W. G. Bleyer, Newspaper Writing and Editing (1913), p.66 — archive.org; L. N. Flint, Newspaper Writing in High Schools (1917), p.47 — archive.org
M. Errico 외. "The Evolution of the Summary News Lead." Media History Monographs 1(1), 1997–98
D. T. Z. Mindich. Just the Facts (NYU Press, 1998); H. Pöttker, "News and its communicative quality: the inverted pyramid—when and why did it appear?" Journalism Studies 4(4), 2003
표준국어대사전 '육하원칙'
5W1H 추출
K. Parton 외. "Who, What, When, Where, Why? Comparing Multiple Approaches to the Cross-Lingual 5W Task." ACL-IJCNLP 2009 — ACL Anthology
F. Hamborg, C. Breitinger, B. Gipp. "Giveme5W1H." INRA 2019 — arXiv:1909.02766, 코어닷투데이의 해설
B. Keith Norambuena, M. Horning, T. Mitra. "Evaluating the Inverted Pyramid Structure through Automatic 5W1H Extraction and Summarization." C+J 2020
Y. Cao 외. "5W1H Extraction With Large Language Models." IJCNN 2024 — arXiv:2405.16150
평가 지표와 LLM 판사
K. Papineni 외. "BLEU." ACL 2002 — P02-1040; C.-Y. Lin. "ROUGE." 2004 — W04-1013
C. Callison-Burch, M. Osborne, P. Koehn. "Re-evaluating the Role of Bleu in Machine Translation Research." EACL 2006 — E06-1032; E. Reiter. "A Structured Review of the Validity of BLEU." Computational Linguistics 44(3), 2018
A. Fabbri 외. "SummEval." TACL 2021 — arXiv:2007.12626; T. Zhang 외. "BERTScore." ICLR 2020; T. Sellam 외. "BLEURT." ACL 2020
Y. Liu 외. "G-Eval." EMNLP 2023 — arXiv:2303.16634; L. Zheng 외. "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena." NeurIPS 2023 — arXiv:2306.05685
P. Wang 외. "Large Language Models are not Fair Evaluators." ACL 2024; K. Saito 외. "Verbosity Bias in Preference Labeling by LLMs." 2023; G. H. Chen 외. "Humans or LLMs as the Judge?" EMNLP 2024; A. Panickssery 외. "LLM Evaluators Recognize and Favor Their Own Generations." NeurIPS 2024; J. Ye 외. "Justice or Prejudice?" ICLR 2025
A. S. Thakur 외. "Judging the Judges." GEM² 2025 — arXiv:2406.12624
A. Jacovi, Y. Goldberg. "Towards Faithfully Interpretable NLP Systems." ACL 2020
통계와 사람 검수
J. Cohen (1960, 1968); J. R. Landis, G. G. Koch. Biometrics 33(1), 1977; A. R. Feinstein, D. V. Cicchetti. "High agreement but low kappa." J Clin Epidemiol 43(6), 1990; K. L. Gwet. Br J Math Stat Psychol 61(1), 2008
P. J. Bickel, E. A. Hammel, J. W. O'Connell. "Sex Bias in Graduate Admissions." Science 187, 1975
T. Dratsch 외. "Automation Bias in Mammography." Radiology, 2023 — RSNA 보도
H. Schroeder, D. Roy, J. Kabbara. "Just Put a Human in the Loop?" 2025 — arXiv:2507.15821
S. Shankar 외. "Who Validates the Validators?" UIST 2024 — arXiv:2404.12272
뉴스룸과 모델 정보
BBC 뉴스 정확성 조사(2025년 2월), EBU·BBC 후속 조사(2025년 10월) — Press Gazette