뉴스 클러스터링사건 코레퍼런스스토리 트리설계 가이드JevOpenAI DecisionsGemini육하원칙비용 최적화
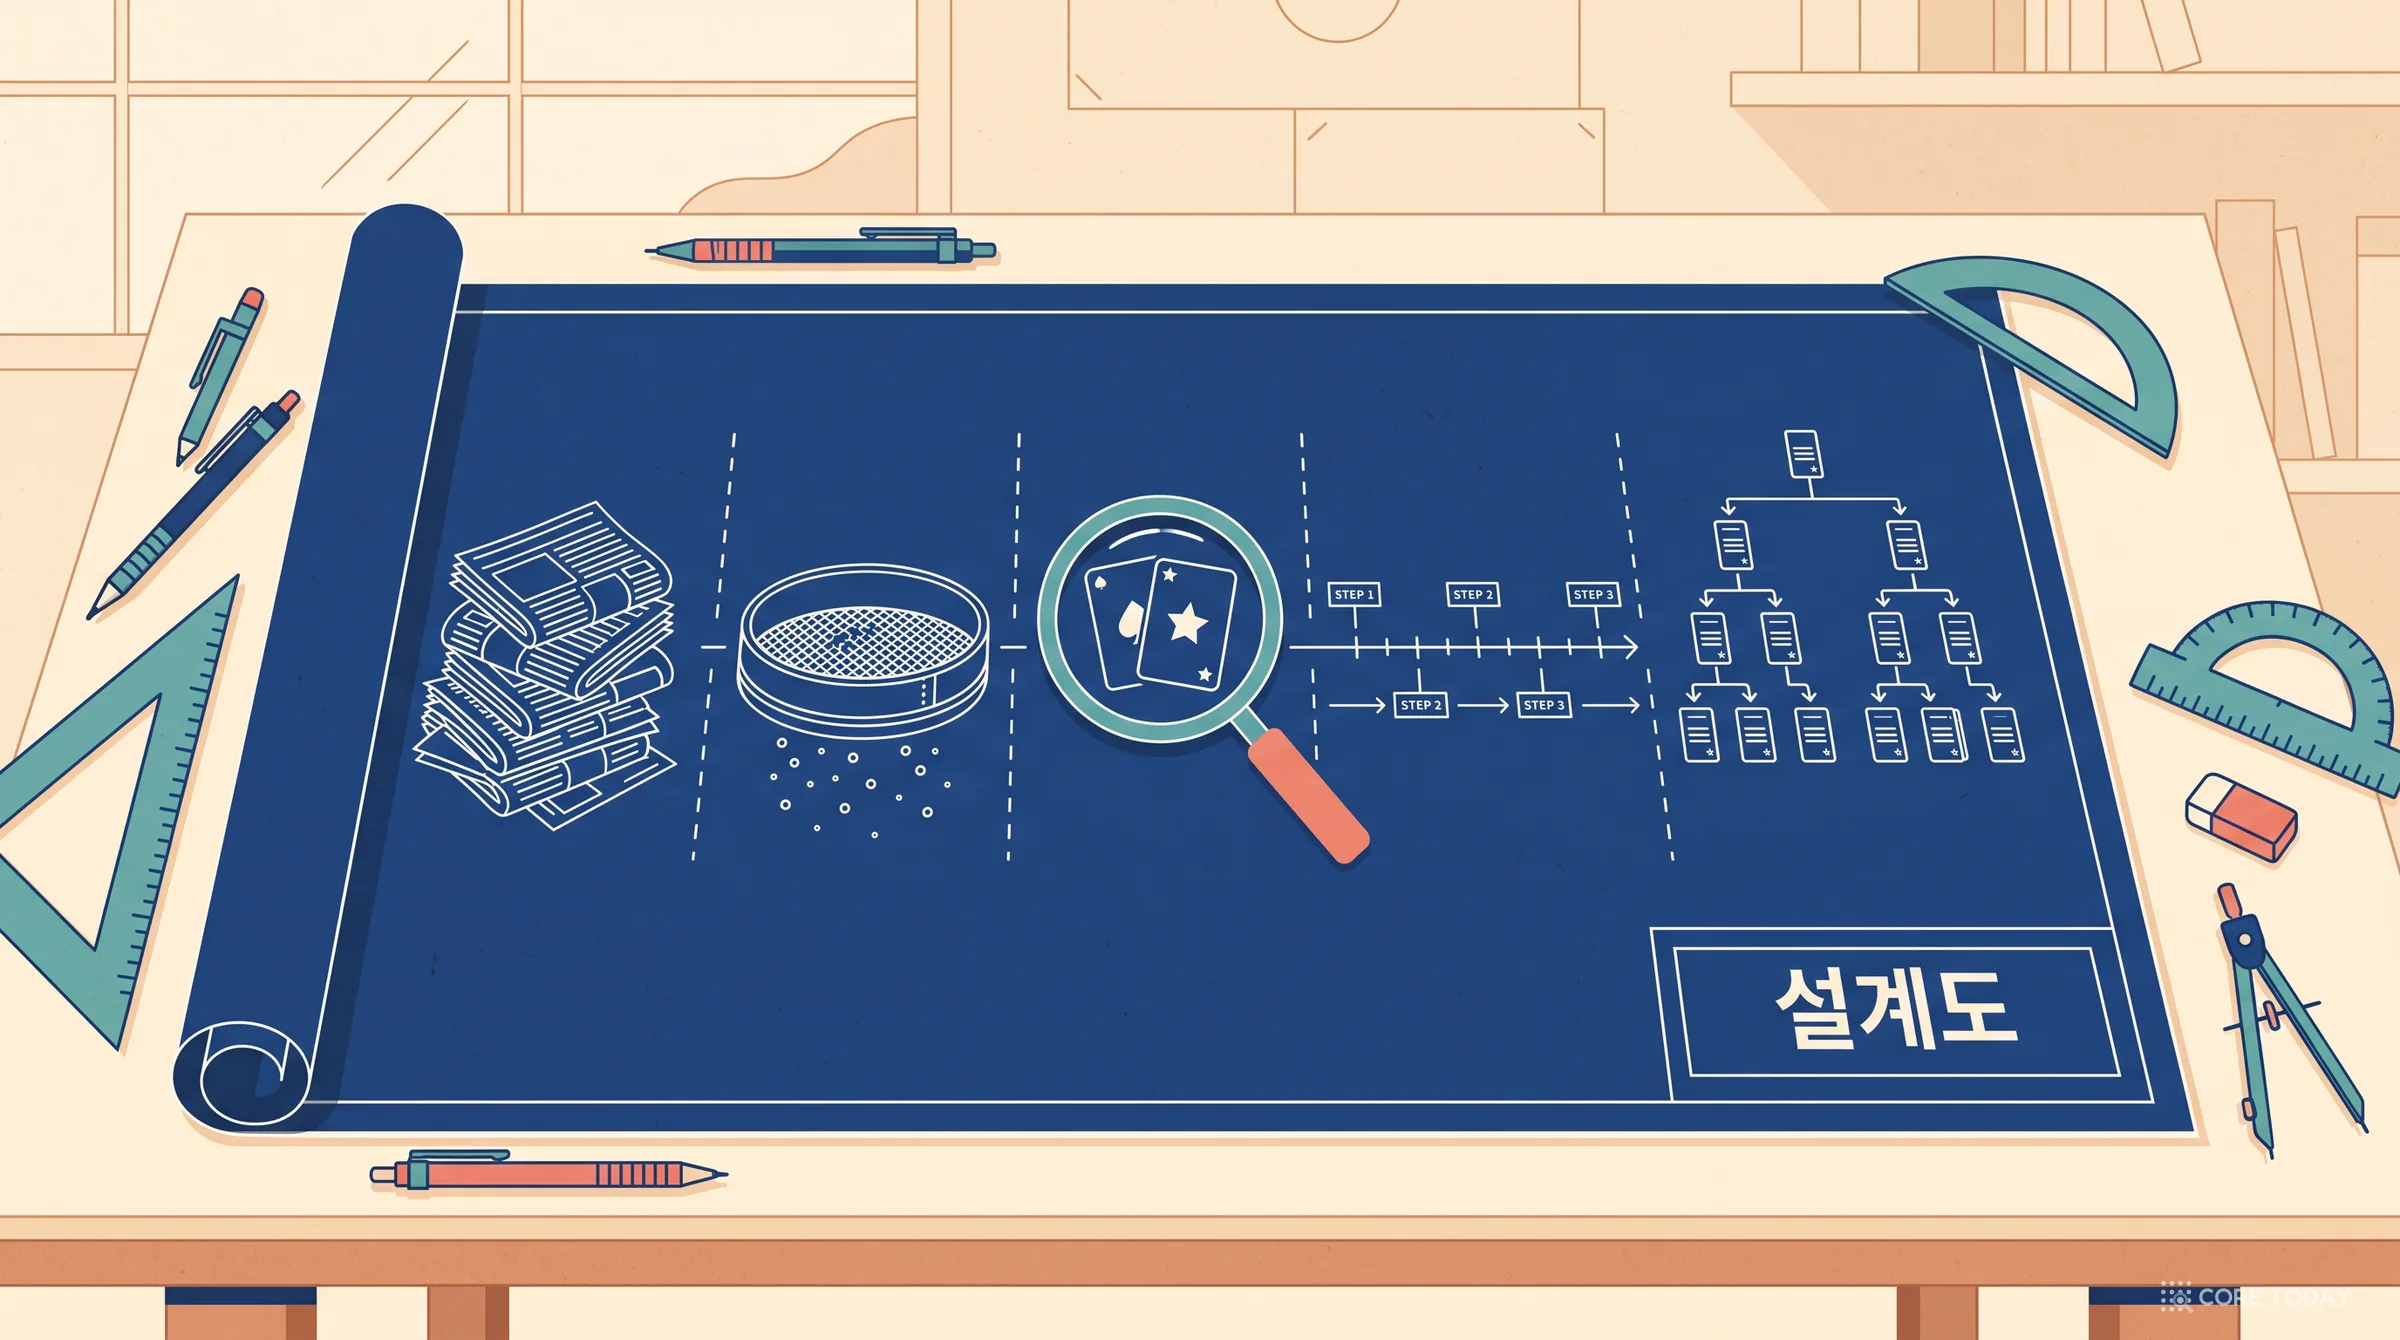
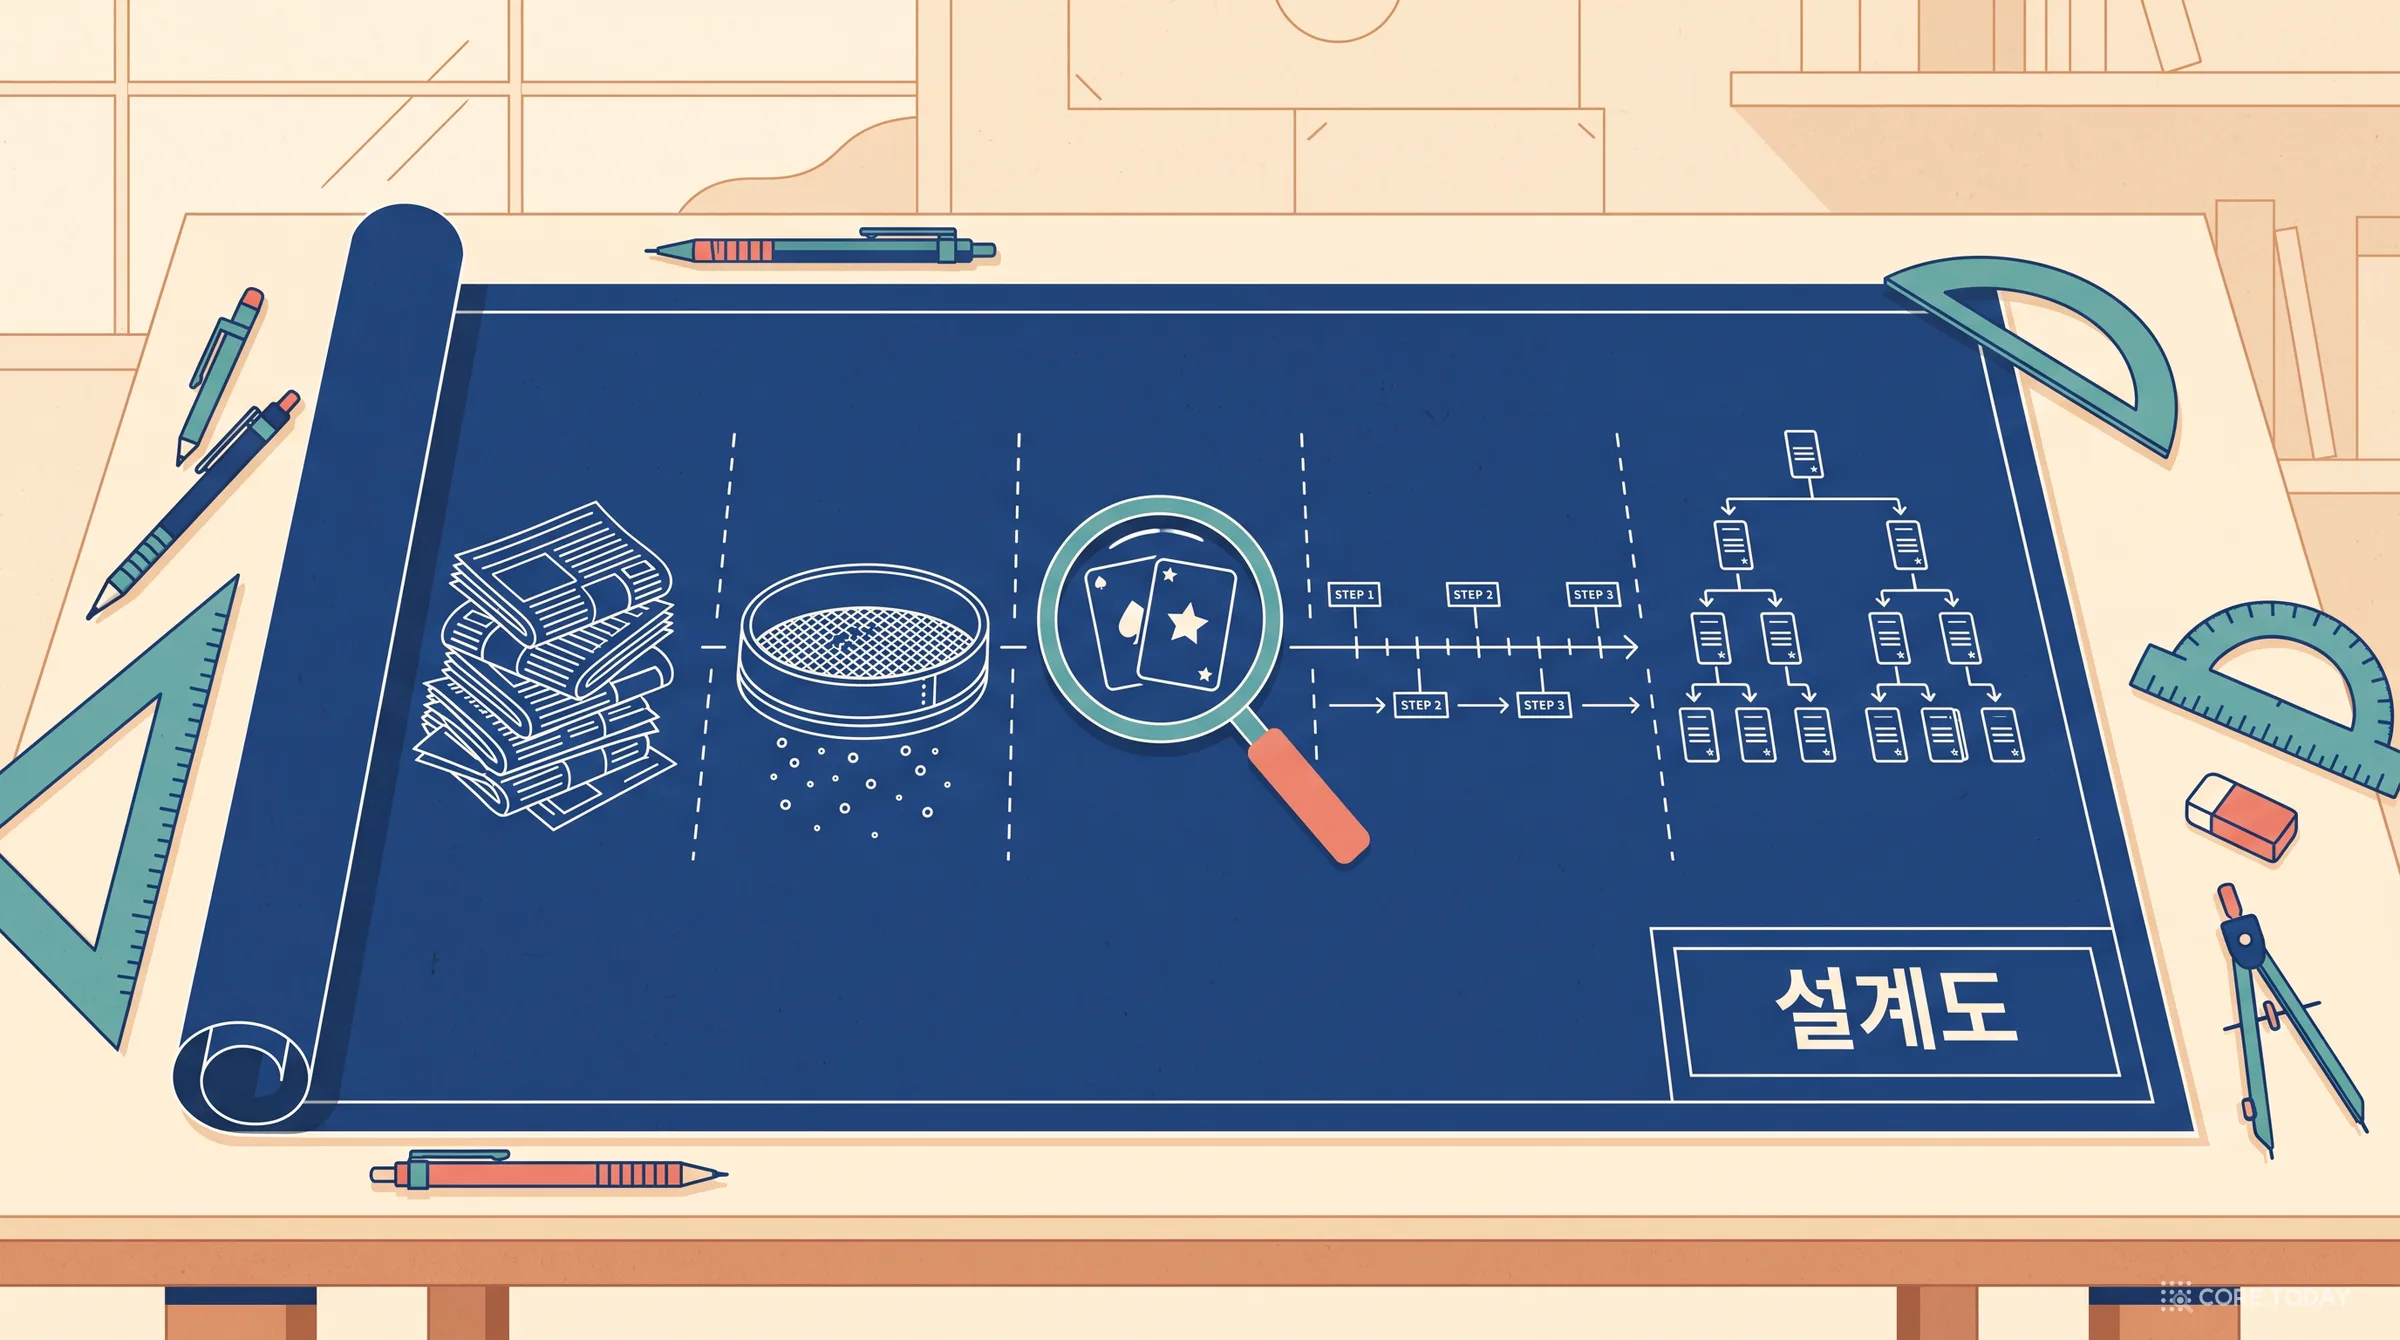
같은 사건 묶기 5편(총정리) — 뉴스 기사를 사건과 이야기로 묶는 여섯 단계 설계도
네 편에 걸쳐 하루치 603건에서 여드레치 1만 건까지 자료를 키우며 '같은 사건'과 '같은 이야기'를 묶는 법을 실측했습니다. 이 글은 그 결과를 따라 할 수 있는 한 장의 설계도로 정리합니다. 여섯 단계의 기본값과 각 값을 정한 근거, 캐시된 판정만으로 다시 돌린 기준 파이프라인의 품질, 기사 1,000건당 비용, 그리고 시도했지만 버린 열두 가지입니다. 가장 큰 교훈은 둘입니다. 판정은 싸고 레코드 추출이 비싸며, 쌍의 정확도보다 묶는 규칙이 결과를 더 크게 바꿉니다.
편마다 결론이 앞 편의 가정을 하나씩 고쳤습니다. 1편의 "육하원칙으로 묶으면 될 것"은 2편에서 "육하원칙은 규칙이 아니라 재료"가 됐고, 3편의 "이야기는 인용 나무로"는 4편에서 "인용은 소속만 알려 준다"로 바뀌었습니다. 이 글은 그 고쳐진 결론들을 한 장의 설계도로 묶습니다. 따라 하려는 사람이 앞 네 편을 읽지 않아도 되도록 쓰고, 근거는 각 편으로 링크합니다.
새 실험은 하나뿐이고 API를 새로 부르지 않았습니다. 4편까지 받아 둔 판정만으로 설계도 전체를 처음부터 끝까지 다시 돌려 품질을 쟀고, 호출 수와 프롬프트 길이로 기사 1,000건당 비용을 계산했습니다.
1부. 무엇을 묶는가: 세 층
먼저 단어를 정합니다. 시리즈 내내 가장 많이 틀린 것이 이 구분이었습니다.
단계
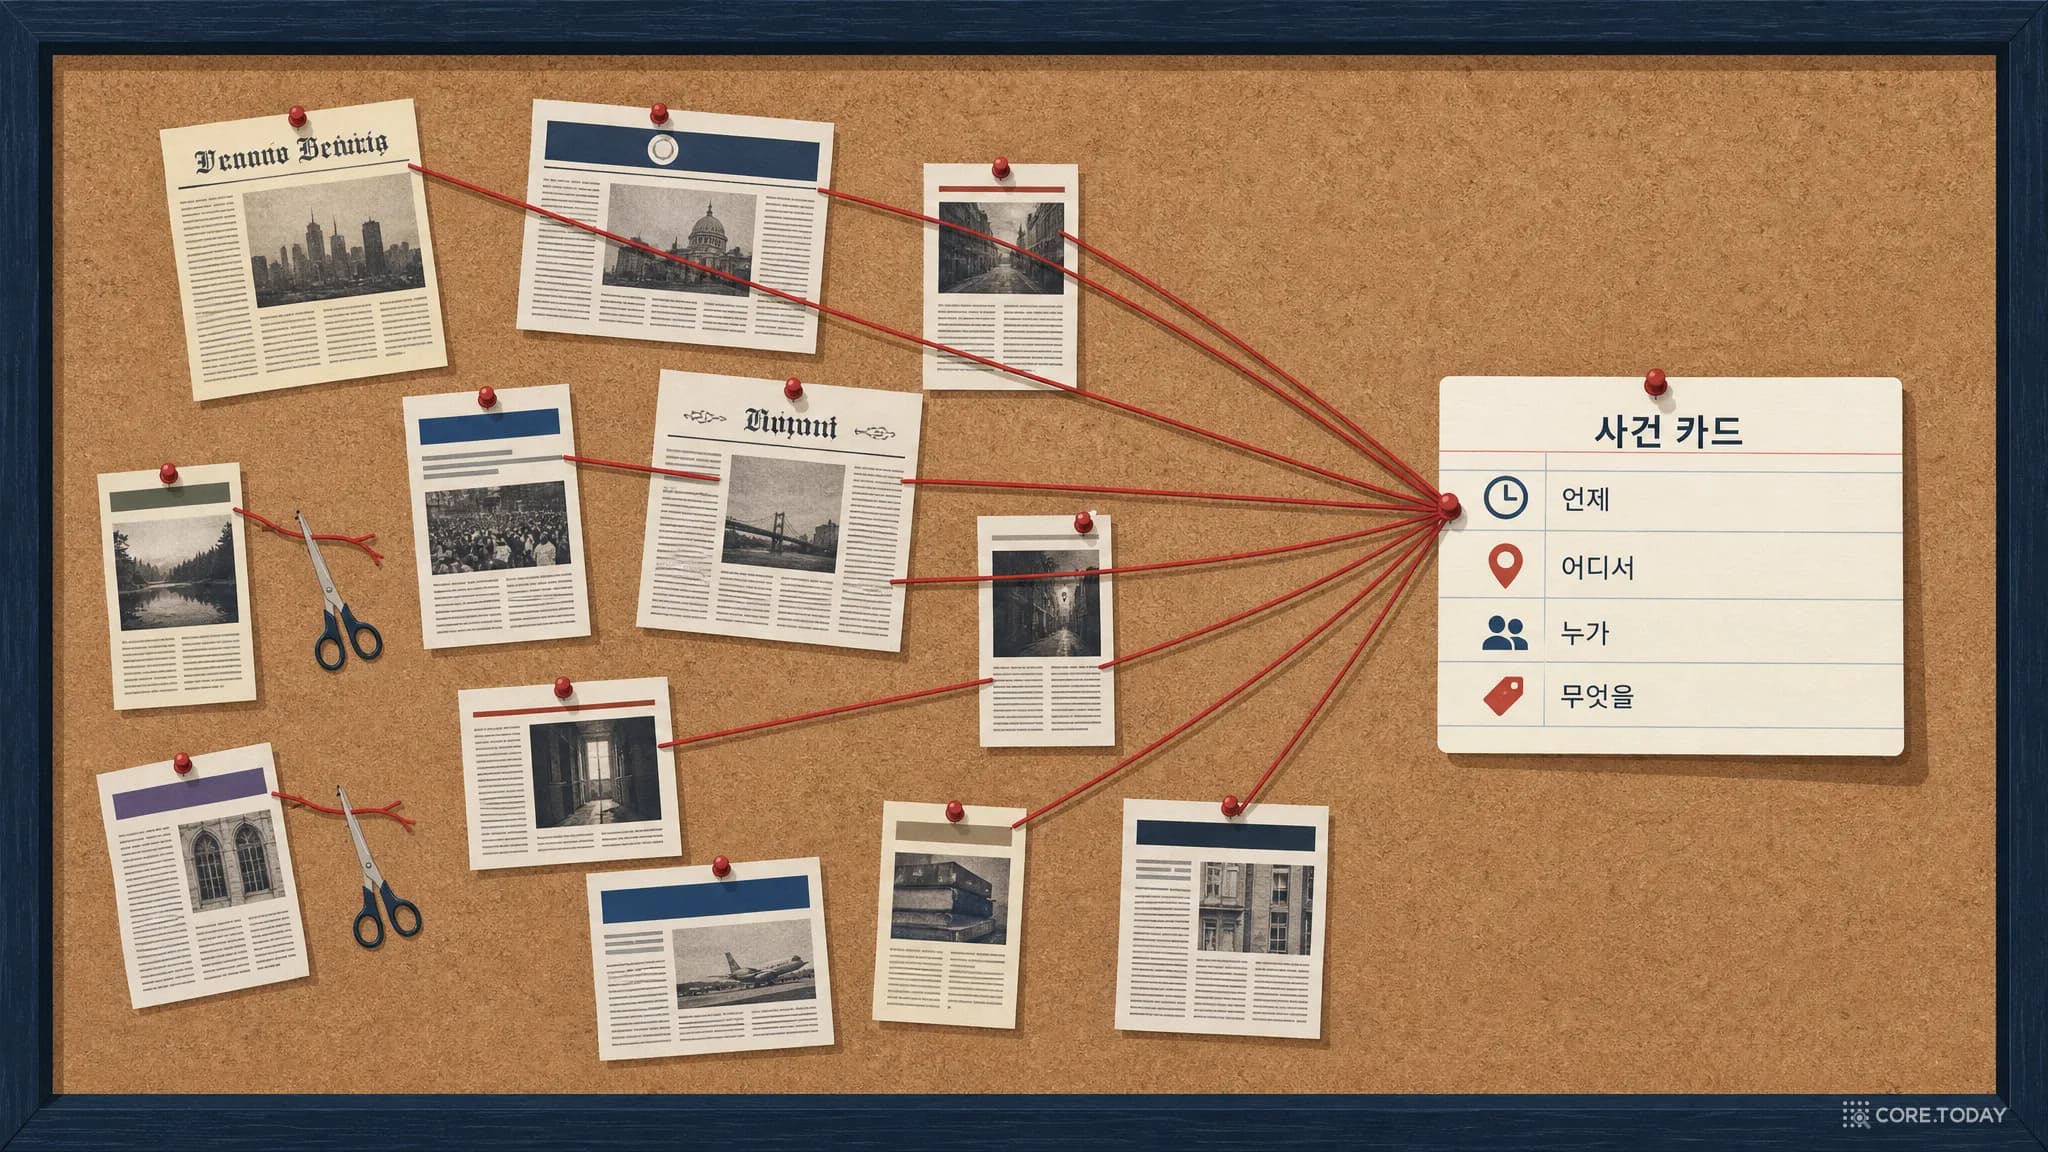
같은 행위자가 같은 때에 한 같은 일. "경찰이 방화 용의자를 체포했다"를 다룬 기사 열 건은 한 단계다. 다른 날·다른 각도의 재보도여도 같은 일이면 같은 단계다.
사건
단계들이 하나의 사건으로 이어진 것. 발생 → 수사 착수 → 체포 → 영장. 1~3편의 '같은 사건' 정답은 이 층을 겨냥했지만, 큰 사건에서는 단계 수십 개를 한데 묶은 사슬이 됐다(4편: 1,029건이 197단계).
이야기
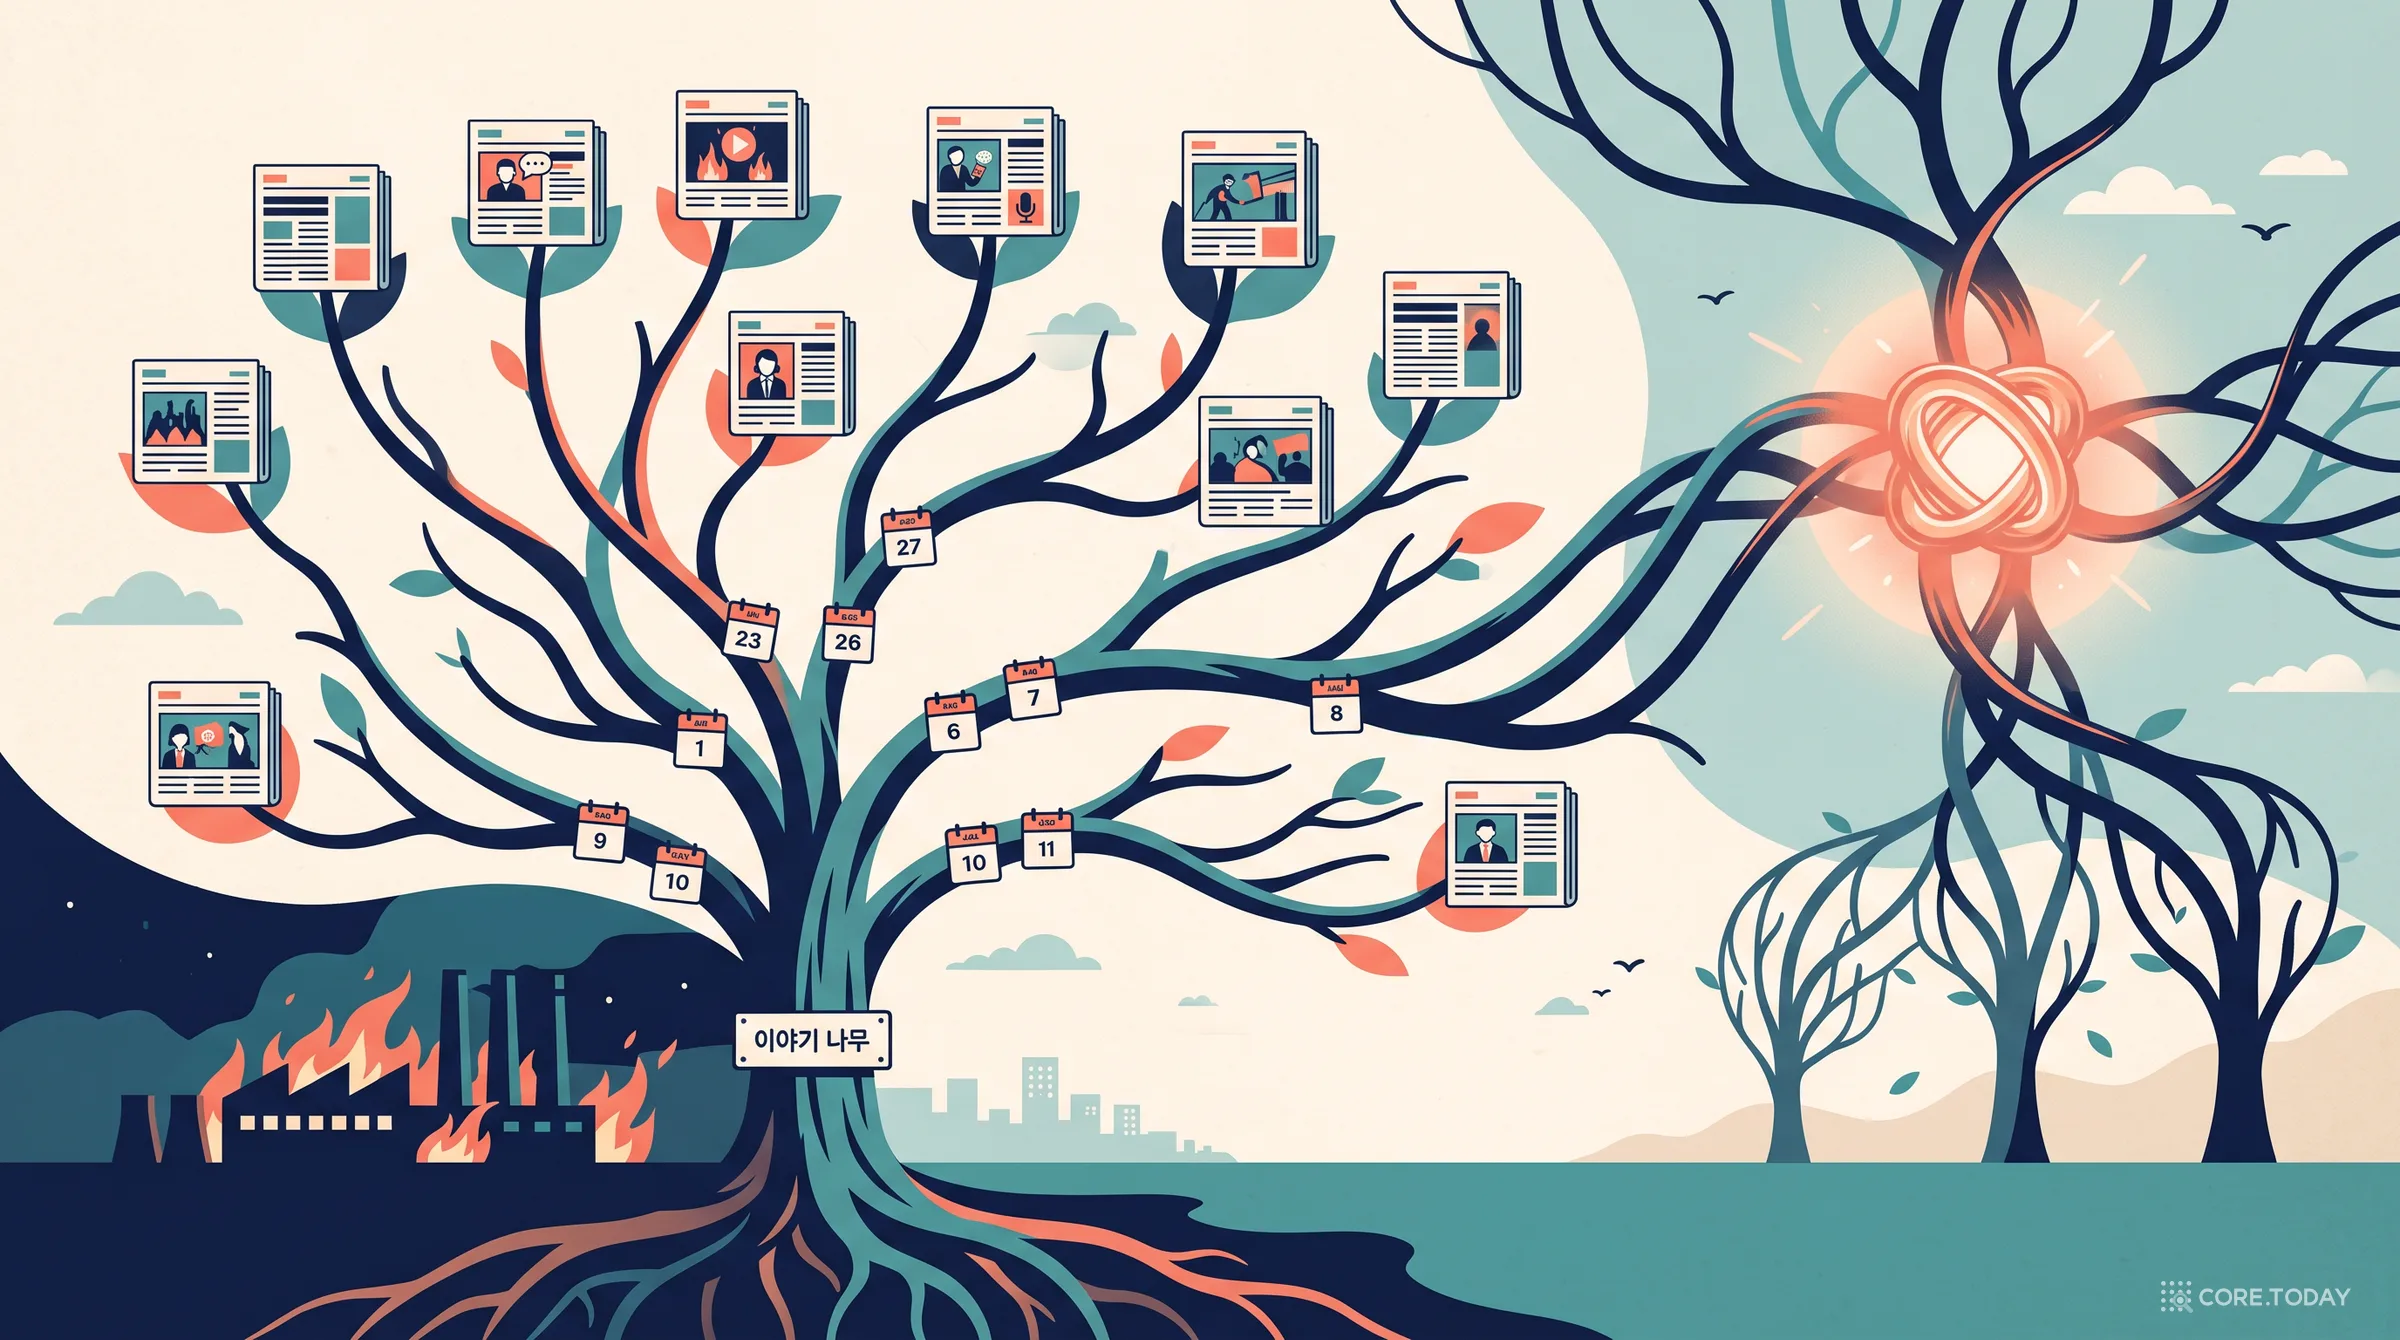
사건들이 원인과 반응으로 이어진 나무. 공장 화재 → 소방관 순직 → 지사의 소방 재정 발언 → 사과 → 당의 경고. 같은 국정감사·같은 선거처럼 한 무대에서 따로 일어난 일은 같은 이야기의 '형제'일 뿐 서로의 전개가 아니다.
설계도의 목표는 기사를 단계로 묶고, 단계를 이야기 나무의 노드로 삼아 부모를 하나씩 잇는 것입니다. '사건'은 나무의 줄기에 해당하므로 따로 만들지 않습니다.
2부. 여섯 단계
의사코드로 쓰면 이렇습니다. 숫자는 이번 자료에서 잰 기본값이고, 자기 자료로 다시 정해야 하는 것은 판정 문턱 둘뿐입니다.
python
for article in stream_by_publish_time(): # 1. 분 단위 게재 시각 순if is_digest(article) or is_photo_or_obit(article):
continue# 다이제스트·사진·부고는 묶기 전에 제외
rec = extract_record(article) # 2. 헤드라인 사건 + 배경 사건, 참여자·발생일·시군구
cands = knn(title_lead_emb, summary_emb) | name_overlap(rec)
cands = [c for c in cands if days_between(article, c) <= 3] # 3. 간격 3일 이내for c in cands:
p_stage, p_same, p_story = judge(rec, record_of(c)) # 4. 한 번에 세 질문
cache(article, c, p_stage, p_same, p_story)
stage = best_open_stage(article, window_days=1, thr=0.6) # 5. 어제까지 열린 단계 중 하나에만
attach_or_open(article, stage, merge=False) # 단계끼리는 합치지 않는다for node in closed_stages(): # 6. 이야기 나무
parents = [s for s in earlier_stages(node, window_days=3)
if story_prob(node, s) >= 0.7or cites_background(node, s)] # 후보만 모은다
scores = {s: judge_next_step(node, s) for s in parents} # 노드 쌍에 '다음 단계인가'
best = max(scores, key=scores.get, default=None)
if best and scores[best] >= 0.75:
link(parent=best, child=node) # 부모는 하나
여섯 단계 가운데 비용의 대부분은 2단계에서, 정확도의 대부분은 4단계에서 나옵니다. 5·6단계는 모델이 아니라 규칙인데, 3부에서 보듯 이 규칙이 결과를 가장 크게 바꿉니다.
3부. 처음부터 끝까지 다시 돌려 보기
여드레치 9,977건(다이제스트 제외)과 후보 쌍 102,404개에 대해, 4편까지 받아 둔 기사 쌍 판정만으로 5·6단계를 다시 돌렸습니다. 판정 모델은 셋입니다. 판정 없이 요약 임베딩의 코사인만 쓰는 경우, 사내 GPU의 로컬 모델 Clef-Flash 27B, 그리고 API 판정 모델 Jev입니다. 정답은 4편의 정답 단계와 직계 이야기 나무입니다.
기본 설정(단계 창 1일·합침 금지, 나무는 부모 하나·창 3일)의 결과입니다.
판정
단계 B³
가장 큰 단계
직계 나무 B³
가장 큰 나무
요약 임베딩만
0.858
65
0.825
226
로컬 Clef-Flash 27B
0.907
58
0.818
354
Jev (API)
0.922
76
0.869
336
Jev + 노드 쌍 판정 (정답 단계 위)
—
—
0.916
341
네 가지가 읽힙니다.
단계 묶기에서는 규칙이 모델을 구합니다. 4편에서 Clef-Flash의 '같은 단계' 확률로 연결 성분을 만들었을 때는 단계 B³가 0.816, 가장 큰 단계가 1,545건이었습니다. 같은 확률을 게재 순 온라인 묶기·합침 금지로 쓰면 0.907, 가장 큰 단계 58건입니다. 확률이 과감한 로컬 모델일수록 쌍 하나가 두 묶음을 잇는 사고가 잦고, 합침 금지가 그 사고를 막습니다. 합침을 허용하면 Jev도 가장 큰 단계가 76건에서 118건으로 커집니다.
창은 하루면 충분하고, 0일은 안 됩니다. 단계 창 0일은 Jev 0.884, 1일 0.922, 무제한 0.923입니다. 전날 저녁 사건을 다음 날 아침 신문이 쓰기 때문입니다(3편의 조간 효과).
기사 쌍 판정만으로는 나무가 0.87에서 멈춥니다. Jev 판정 위에서 부모 하나 나무는 0.869입니다. 그런데 3편식으로 '같은 사건' 확률 0.75 이상을 이은 단순 성분도 0.870, '같은 이야기' 0.95 이상 성분도 0.878입니다. 기사 쌍 판정만 쓰면 어떤 묶기 규칙도 직계 나무 B³가 0.87~0.88 언저리에 모입니다. 한 단계 위로 가는 길은 단계 노드 쌍에 "다음 단계인가"를 한 번 더 묻는 것이고, 정답 단계 위에서 잰 그 상한이 0.916입니다.
그러면 부모 하나 규칙의 값은 어디서 나오는가. 문턱에 둔감하다는 데서 나옵니다. 나무 문턱을 0.6에서 0.85까지 바꿔도 부모 하나는 직계 B³ 0.85~0.87, 가장 큰 나무 300~700건에 머뭅니다. 문턱 넘는 간선을 전부 잇는 방식은 0.79~0.88, 900~2,900건으로 출렁이고, '같은 이야기' 성분은 0.7에서 3,185건(정치면의 3분의 1)이 됩니다. 운영에서 문턱은 자료가 바뀔 때마다 어긋나므로, 최고점보다 이 둔감함이 더 쓸모 있습니다.
기사 1,000건이면 후보 쌍이 약 10,264개, 이야기 나무의 단계 쌍이 약 1,677개입니다. 게이트웨이 정가로 각 단계의 비용을 추정했습니다(토큰은 프롬프트 길이에서 글자 1.6자를 1토큰으로 환산).
단계
호출 / 1,000건
크레딧 / 1,000건
사건 레코드 추출 (Gemini 3.8 Flash)
1,000
약 15,600
기사 쌍 판정 (Jev, 세 질문)
10,264
약 610
노드 쌍 판정 (Jev)
1,677
약 150
임베딩 (로컬 Qwen3 8B)
1,000
0 (GPU)
레코드 추출이 운영 비용의 95%입니다. 출력 토큰이 비싸고 레코드가 길기 때문인데, 사고 토큰을 빼고 잡은 값이라 실제로는 더 큽니다. 반면 Jev는 입력 토큰만 받고 단가가 낮아, 기사 쌍 1만 개에 세 질문씩 물어도 추출의 4%입니다. OpenAI Decisions로 바꿔도 1,460입니다. 그러니 예산을 줄일 곳은 판정이 아니라 추출입니다. 추출을 Flash-Lite로 바꾸면 추정 4,700까지 내려가지만, 이 시리즈는 Flash-Lite 추출의 품질을 재지 않았습니다. 반대로 예산을 더 쓸 곳은 노드 쌍 판정입니다. 1,000건당 150 크레딧이 나무 품질의 마지막 0.05를 삽니다.
로컬 모델은 돈 대신 시간을 씁니다. Clef-Flash 27B는 V100 두 대에서 분당 약 270쌍을 판정해 기사 1,000건에 38분이 걸렸습니다. 단계 묶기까지는 API 모델에 0.015 뒤질 뿐이지만, 이야기 나무에서는 부모를 고르지 못해(부모 정밀 0.57) 임베딩만 쓴 경우와 비슷해집니다. 로컬만 쓸 수 있다면 단계까지는 로컬로, 이야기는 만들지 않거나 소수 노드만 API로 묻는 혼합이 맞습니다.
설계도만큼 쓸모 있는 것이 버린 목록입니다. 대부분 그럴듯했고, 몇 개는 제가 이 시리즈에서 직접 권했다가 다음 편에서 뒤집은 것입니다.
목록을 관통하는 실패는 하나입니다. 쌍으로 옳은 판단을 이으면 묶음도 옳으리라는 가정입니다. 다이제스트 기사는 쌍마다 옳게 "같은 사건"이라는 판정을 받고 하루치를 한 그물로 이었고(2편), '같은 이야기'는 쌍마다 옳은데 성분은 정치면의 5분의 1이 됐고(3편), 정답조차 성분으로 이으면 1,707건짜리 그물이었습니다(4편). 묶기는 쌍의 문제가 아니라 그래프의 문제이고, 그래프에서는 허브와 사슬이 모델의 정확도 0.01보다 큽니다.
설계도를 자기 자료에 맞추려면 문턱을 다시 정해야 하고, 그러려면 작은 정답이 필요합니다. 네 편에서 정답을 만든 방식과 거기서 배운 것을 모았습니다.
편
쌍
판사
판사 일치
배운 것
1편
5,379
Claude · GPT, 갈린 73쌍 직접 검수
—
사람이 볼 쌍은 갈린 쌍이면 충분하다
2편
20,259
LLM 판사 셋 다수결 + 직접 검수
—
다이제스트는 정답에서도 허브다
3편
38,591
gpt-6.1-sol · Claude Sonnet 5.5, 3심 Gemini 3.5 Flash
90%+
다수결 정답은 큰 이야기 안에서 느슨해진다
4편
102,365 + 간선 16,734
간선은 gpt 1심, Gemini Flash 2심, Claude 3심
70~78%
정답 정의가 점수를 0.04~0.1 움직인다
판사 일치율이 상한입니다. '같은 사건이냐 아니냐'는 두 판사가 90% 넘게 동의했지만, '후속 전개냐 같은 이야기의 다른 행위냐'는 70~78%였습니다. 관계의 종류는 관계의 유무보다 어렵고, 어떤 방법도 판사들이 서로 동의하는 것보다 정답과 더 잘 맞을 수는 없습니다.
정답 정의를 둘 이상 두고 순위를 확인합니다. 4편에서 이야기 나무의 정답을 '후속 간선의 성분'으로 두느냐 '가장 가까운 부모 하나'로 두느냐에 따라 같은 방법의 점수가 0.04 남짓 움직였습니다. 방법 사이 차이(0.03~0.06)와 비슷한 크기입니다. 그래서 두 정의 모두에서 순위를 확인하고 나무 단위 재표본으로 구간을 냈습니다. 노드 쌍 판정이 배경 인용보다 0.06 낫다는 결론은 두 정의 모두에서 95% 구간 [0.04, 0.08]이었고, Decisions와 Jev의 차이는 구간이 0을 걸쳐 구별되지 않았습니다.
예산 아래서는 판사를 배치합니다. 4편의 간선 정답은 남은 예산 10만 원 안에서 만들어야 했습니다. 후보 47,102쌍을 두 모델 API로 판정하면 넘기 때문에 세 가지를 했습니다. 후보를 노드마다 상위 몇 개로 추려 16,734쌍으로 줄였고, 2심에는 직접 키로 부르는 Gemini 3.5 Flash를 세웠고, Claude는 API 대신 서브에이전트로 돌려 둘이 갈린 2,821쌍의 3심으로만 썼습니다. 간선 정답의 비용은 gpt 1심 4만~5만 크레딧, Gemini 1만~2만 원이었습니다. 더 싼 Flash-Lite는 gpt와 일치율이 60%(Gemini Flash는 78%)라 판사로 쓰지 못했습니다.
서브에이전트는 3심 자리에만 맞습니다. Claude 판정은 API 대신 Claude Code의 서브에이전트로 돌렸습니다. 판정 프롬프트 20개를 파일로 묶어 에이전트가 읽고 JSON으로 답하게 하면 토큰 과금 없이 구독 사용량만 씁니다. 하지만 배치 하나가 11만~21만 토큰이라 열네 번째 배치에서 세션 한도에 걸렸고, 한도에 걸리면 지휘하는 세션까지 멈춥니다. 응답 형식도 흔들리고 병렬·재시도 제어도 약합니다. 수천 건의 일괄 판정 도구가 아니라, 갈린 쌍처럼 호출 수가 적고 판단이 중요한 자리의 판사입니다.
4편의 정답 비용만 게이트웨이 크레딧 기준 20만 원대(추정)였고, 그중 3분의 2 이상이 기사 쌍 10만 개 정답이었습니다. 자기 자료의 문턱을 맞추는 데는 이만큼이 필요하지 않습니다. 1편처럼 수천 쌍과 갈린 쌍 수십 개의 직접 검수면 됩니다.
7부. 아직 모르는 것
한 달. 가장 긴 후속 사슬이 23세대였는데 여드레로 잘렸습니다. 예정 사건(선고일, 개막일)과 1주기 같은 기념일이 늘면 창과 부모의 답이 달라질 수 있습니다.
예측한 단계 위의 노드 쌍 판정. 0.916은 정답 단계 위에서 잰 상한입니다. 예측 단계 위에서 노드 쌍을 다시 판정하면 그보다 낮을 것이고, 얼마나 낮은지는 재지 않았습니다.
싼 추출. 비용의 95%가 추출인데, Flash-Lite나 로컬 모델로 뽑은 레코드가 판정 품질을 얼마나 깎는지는 모릅니다. 비용을 줄이려면 가장 먼저 잴 것입니다.
통신사와 다른 면. 통신사(하루 2,500건 이상)와 경제·문화면을 넣으면 같은 날 묶음이 커지고 조간 효과의 비율이 바뀔 것입니다.
맺으며
1편의 마지막 문장은 "임베딩은 그물을 치고, 판정 모델은 같은 일인지 확인한다"였고, 2편은 "레코드는 그물코를 메우고, 허브는 묶기 전에 걷어 낸다"를 붙였습니다. 여기에 두 문장을 더해 시리즈를 닫습니다.
단계는 하루 창 안에서 합치지 않고 묶고, 이야기는 노드마다 부모 하나로 잇는다. 3편과 4편이 같은 모양의 실패를 두 층에서 보여 줬습니다. 쌍으로 옳은 판단을 성분으로 이으면 사슬이 되고, 사슬은 묶는 규칙으로만 끊을 수 있습니다.
돈은 추출에서 아끼고 판정에서 쓴다. 판정 모델은 기사 쌍 1만 개를 추출 비용의 4%로 가릅니다. 정확도를 사는 가장 싼 길은 더 좋은 묶기 규칙이고, 그다음은 노드 쌍에 한 번 더 묻는 것입니다.
자료: 연합뉴스(1편), 25개 언론사 RSS(2편), 네이버 뉴스 언론사별 날짜 목록 13개 언론사(3·4편). 기사 본문은 실험에만 썼고 재배포하지 않습니다.
기준 파이프라인: 4편 자료(2026년 10월 15일~22일, 9,977건)의 캐시된 판정으로 재실행. 비용은 core.today 게이트웨이 모델 레지스트리 정가(Gemini 3.8 Flash 입력 0.0028·출력 0.0139, Jev 입력 0.000078, gpt-6-luna 입력 0.00019 크레딧/토큰)로 추정