뉴스 클러스터링사건 코레퍼런스스토리 트리이야기 그래프JevOpenAI DecisionsGeminiClaude육하원칙시간 추론
같은 사건 묶기 4편 — 여드레치 1만 건, 이야기를 사슬이 아니라 나무로 세울 수 있는가
3편은 '같은 이야기'가 쌍으로는 쉽고 성분으로는 불가능하다는 데서 끝났습니다. 4편은 13개 언론사의 여드레치 정치·사회 기사 10,000건으로 그 다음을 실측했습니다. 같은 사건 묶음을 '단계'로 다시 쪼개고, 단계 사이에 후속·형제·참조 간선 정답 16,734개를 세 판사로 만들고, 어떤 점수가 다음 단계의 부모를 찾는지 쟀습니다. 결론은 뜻밖이었습니다. 정답 나무도 나무가 아니라 그물이었고, 그래서 이야기의 단위는 성분이 아니라 '부모 하나'여야 했습니다.
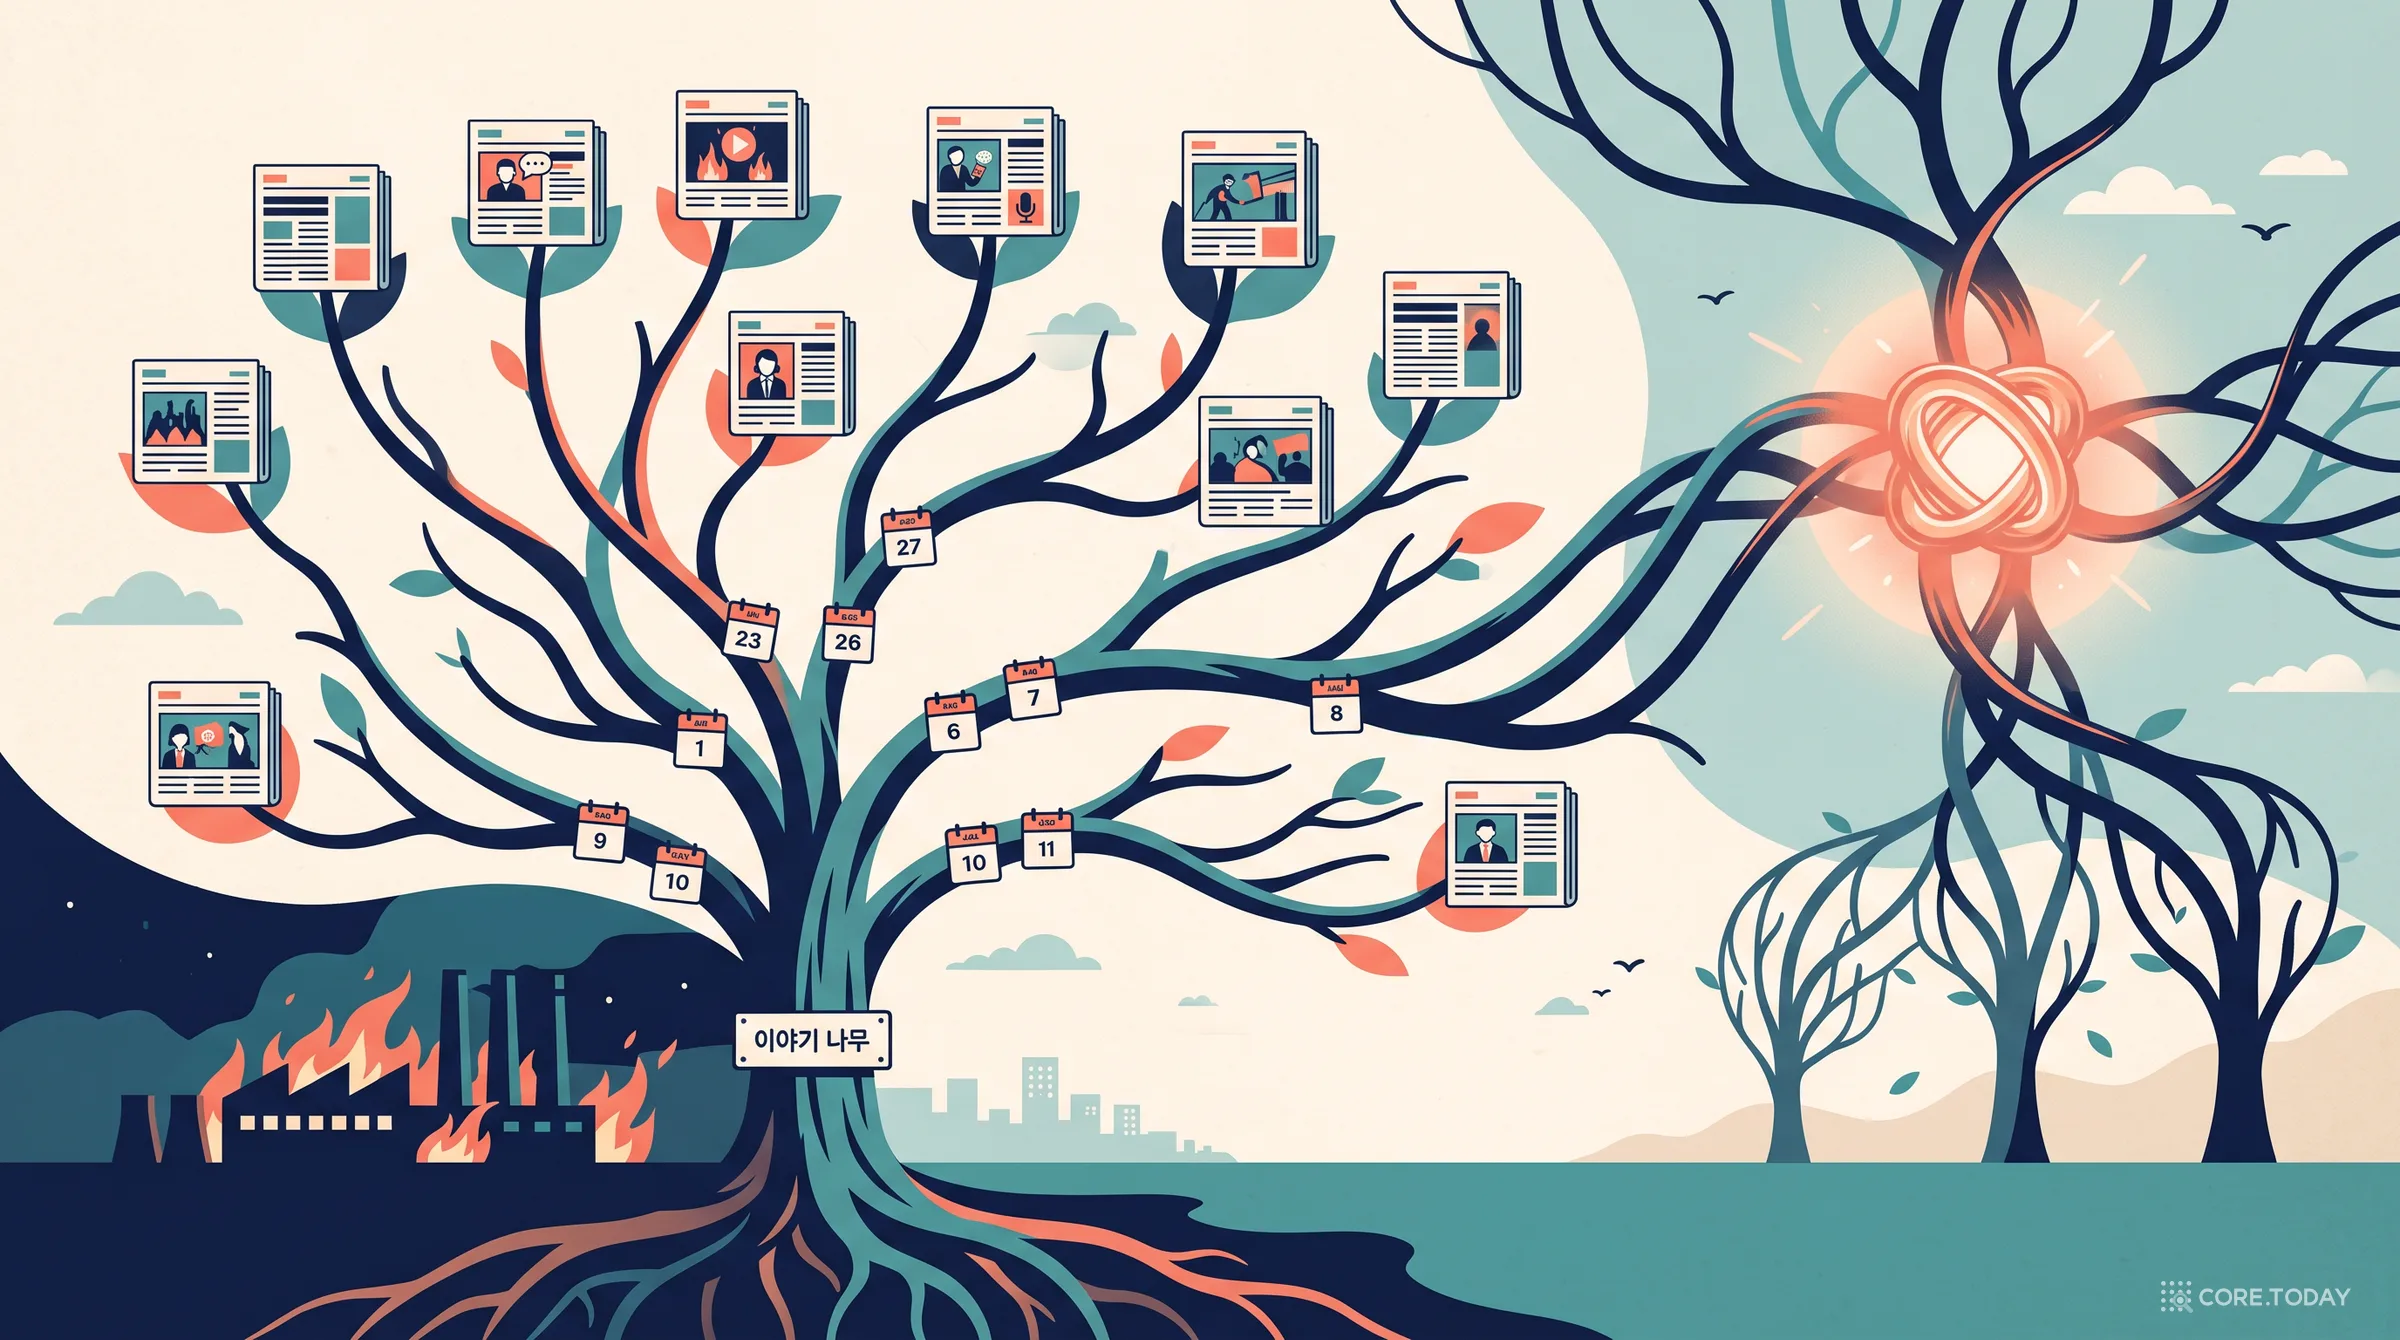
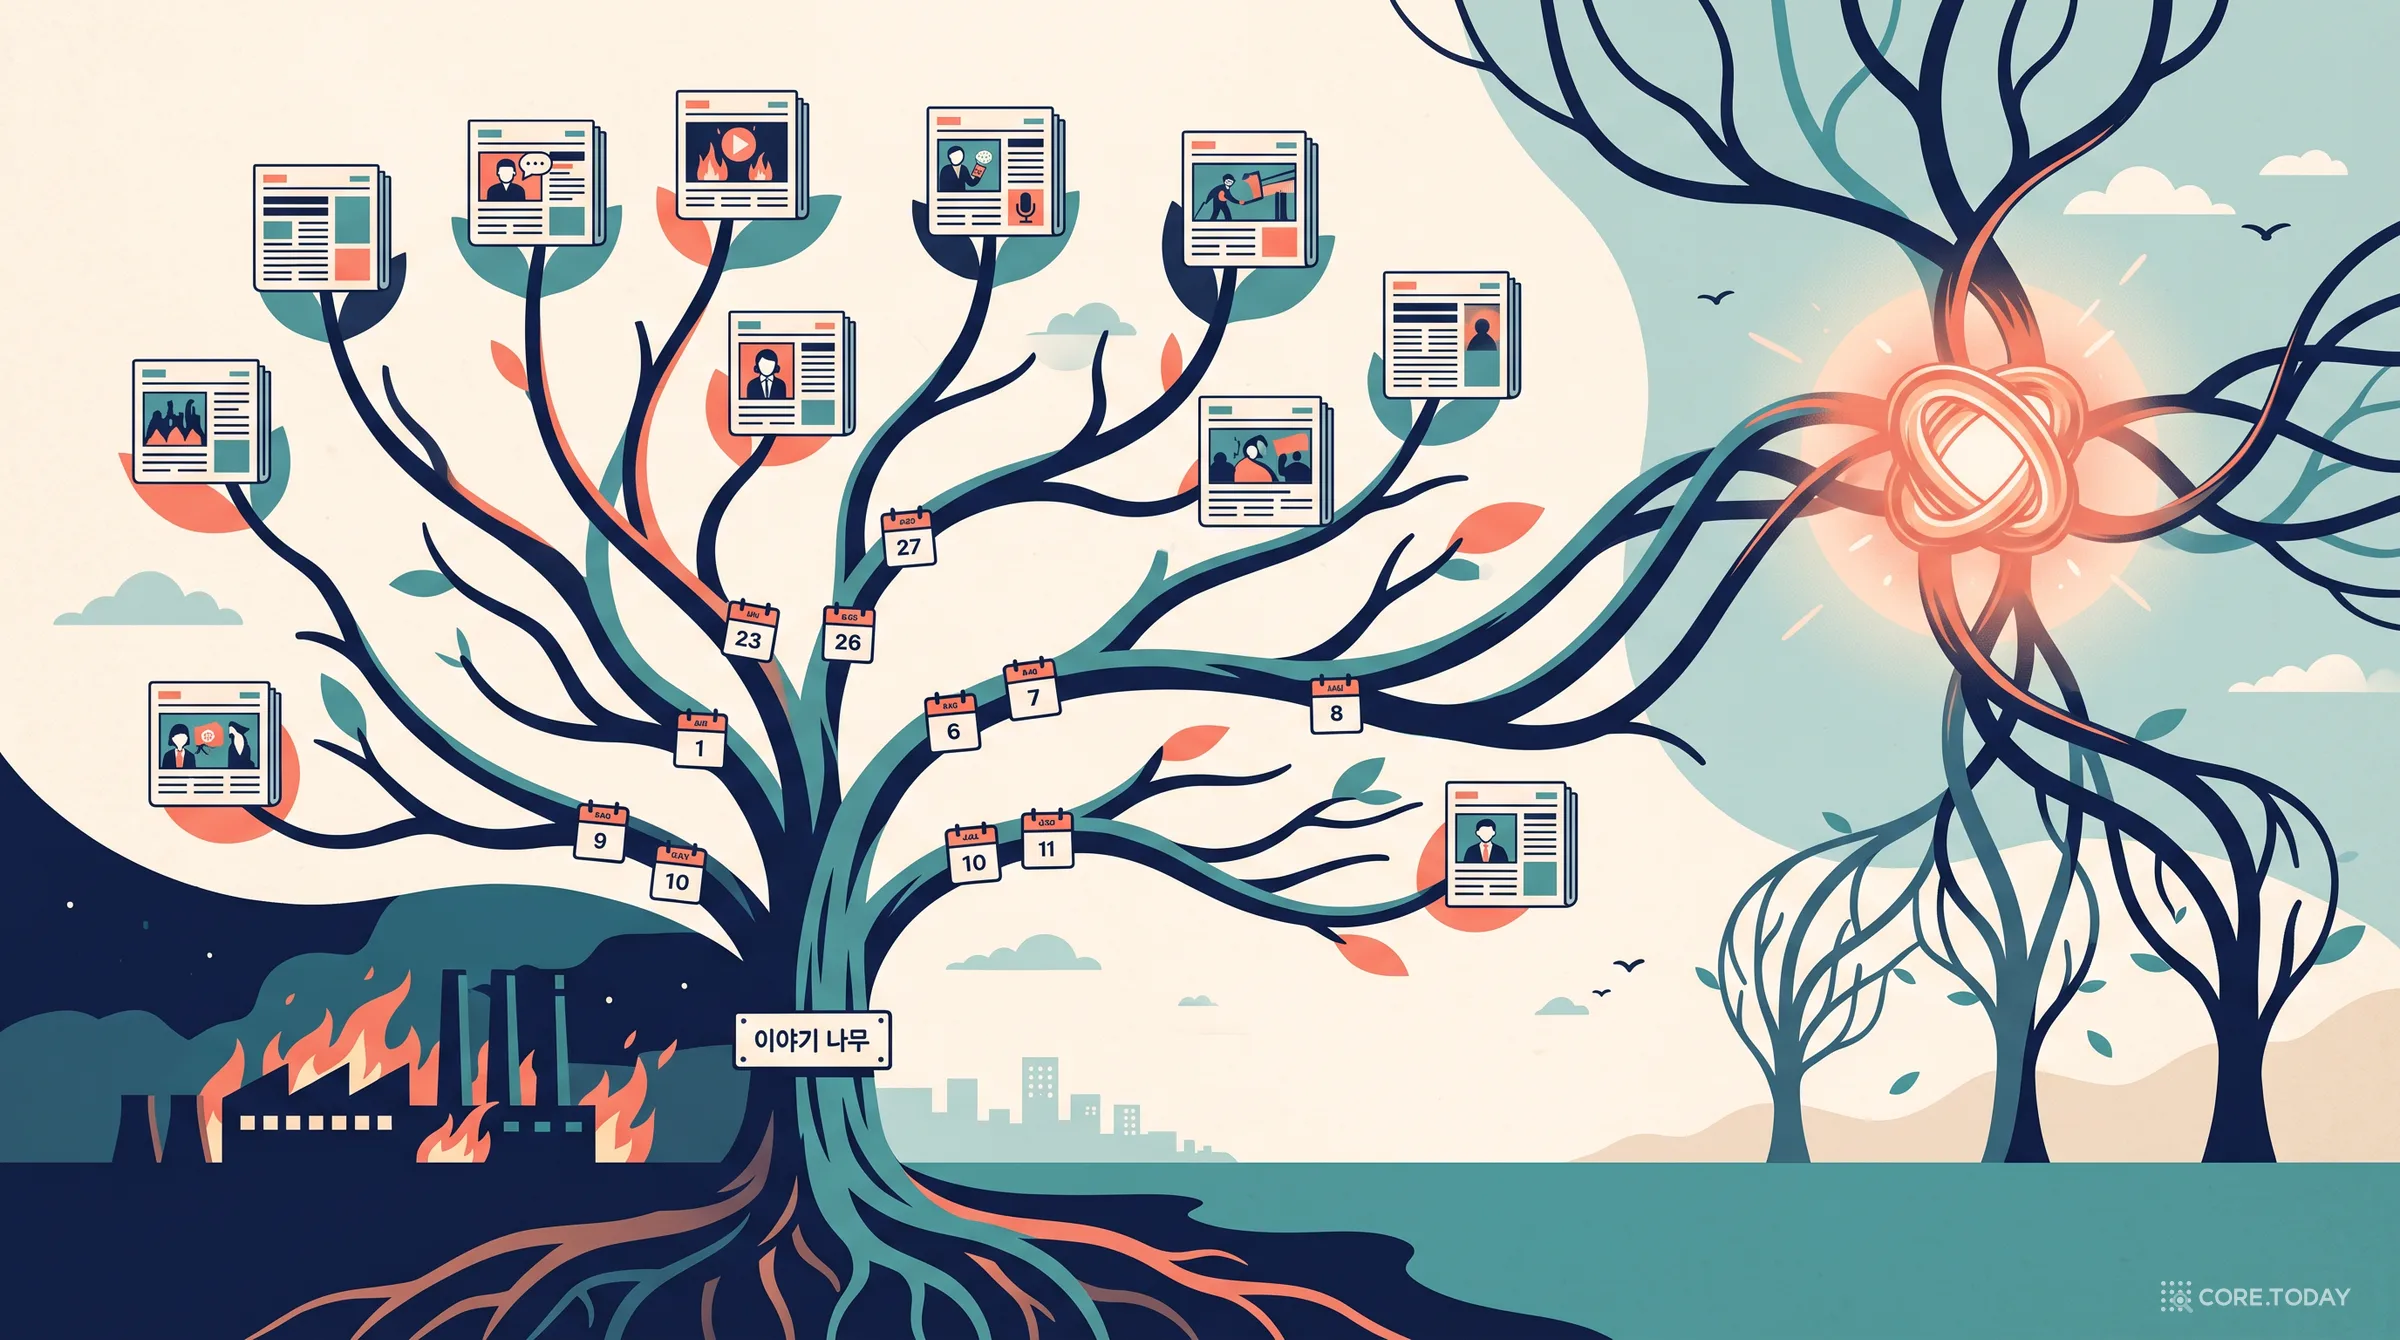
3편의 마지막 결론은 이것이었습니다. 판정 모델에 "같은 큰 이야기에 속하는가"를 물으면 쌍 단위로는 AUROC 0.985로 잘 맞는데, 그 답을 이어 성분을 만들면 정치면의 5분의 1이 한 이야기가 됩니다. 추미애 지사의 발언은 순직 소방관 이야기이자 경기도 국정감사 이야기이고, 국정감사는 국회의 모든 상임위로 이어지기 때문입니다. 이야기는 추이적이지 않으므로 쌍 판정의 연결 성분으로는 정의할 수 없고, 사건 묶음을 시간 순으로 잇는 스레드나 앞 사건을 인용하는 방향 그래프로 정의해야 한다는 것이 3편의 마지막 문장이었습니다.
그 문장은 측정하지 않은 설계였습니다. 4편은 그것을 실측합니다. 질문은 셋입니다.
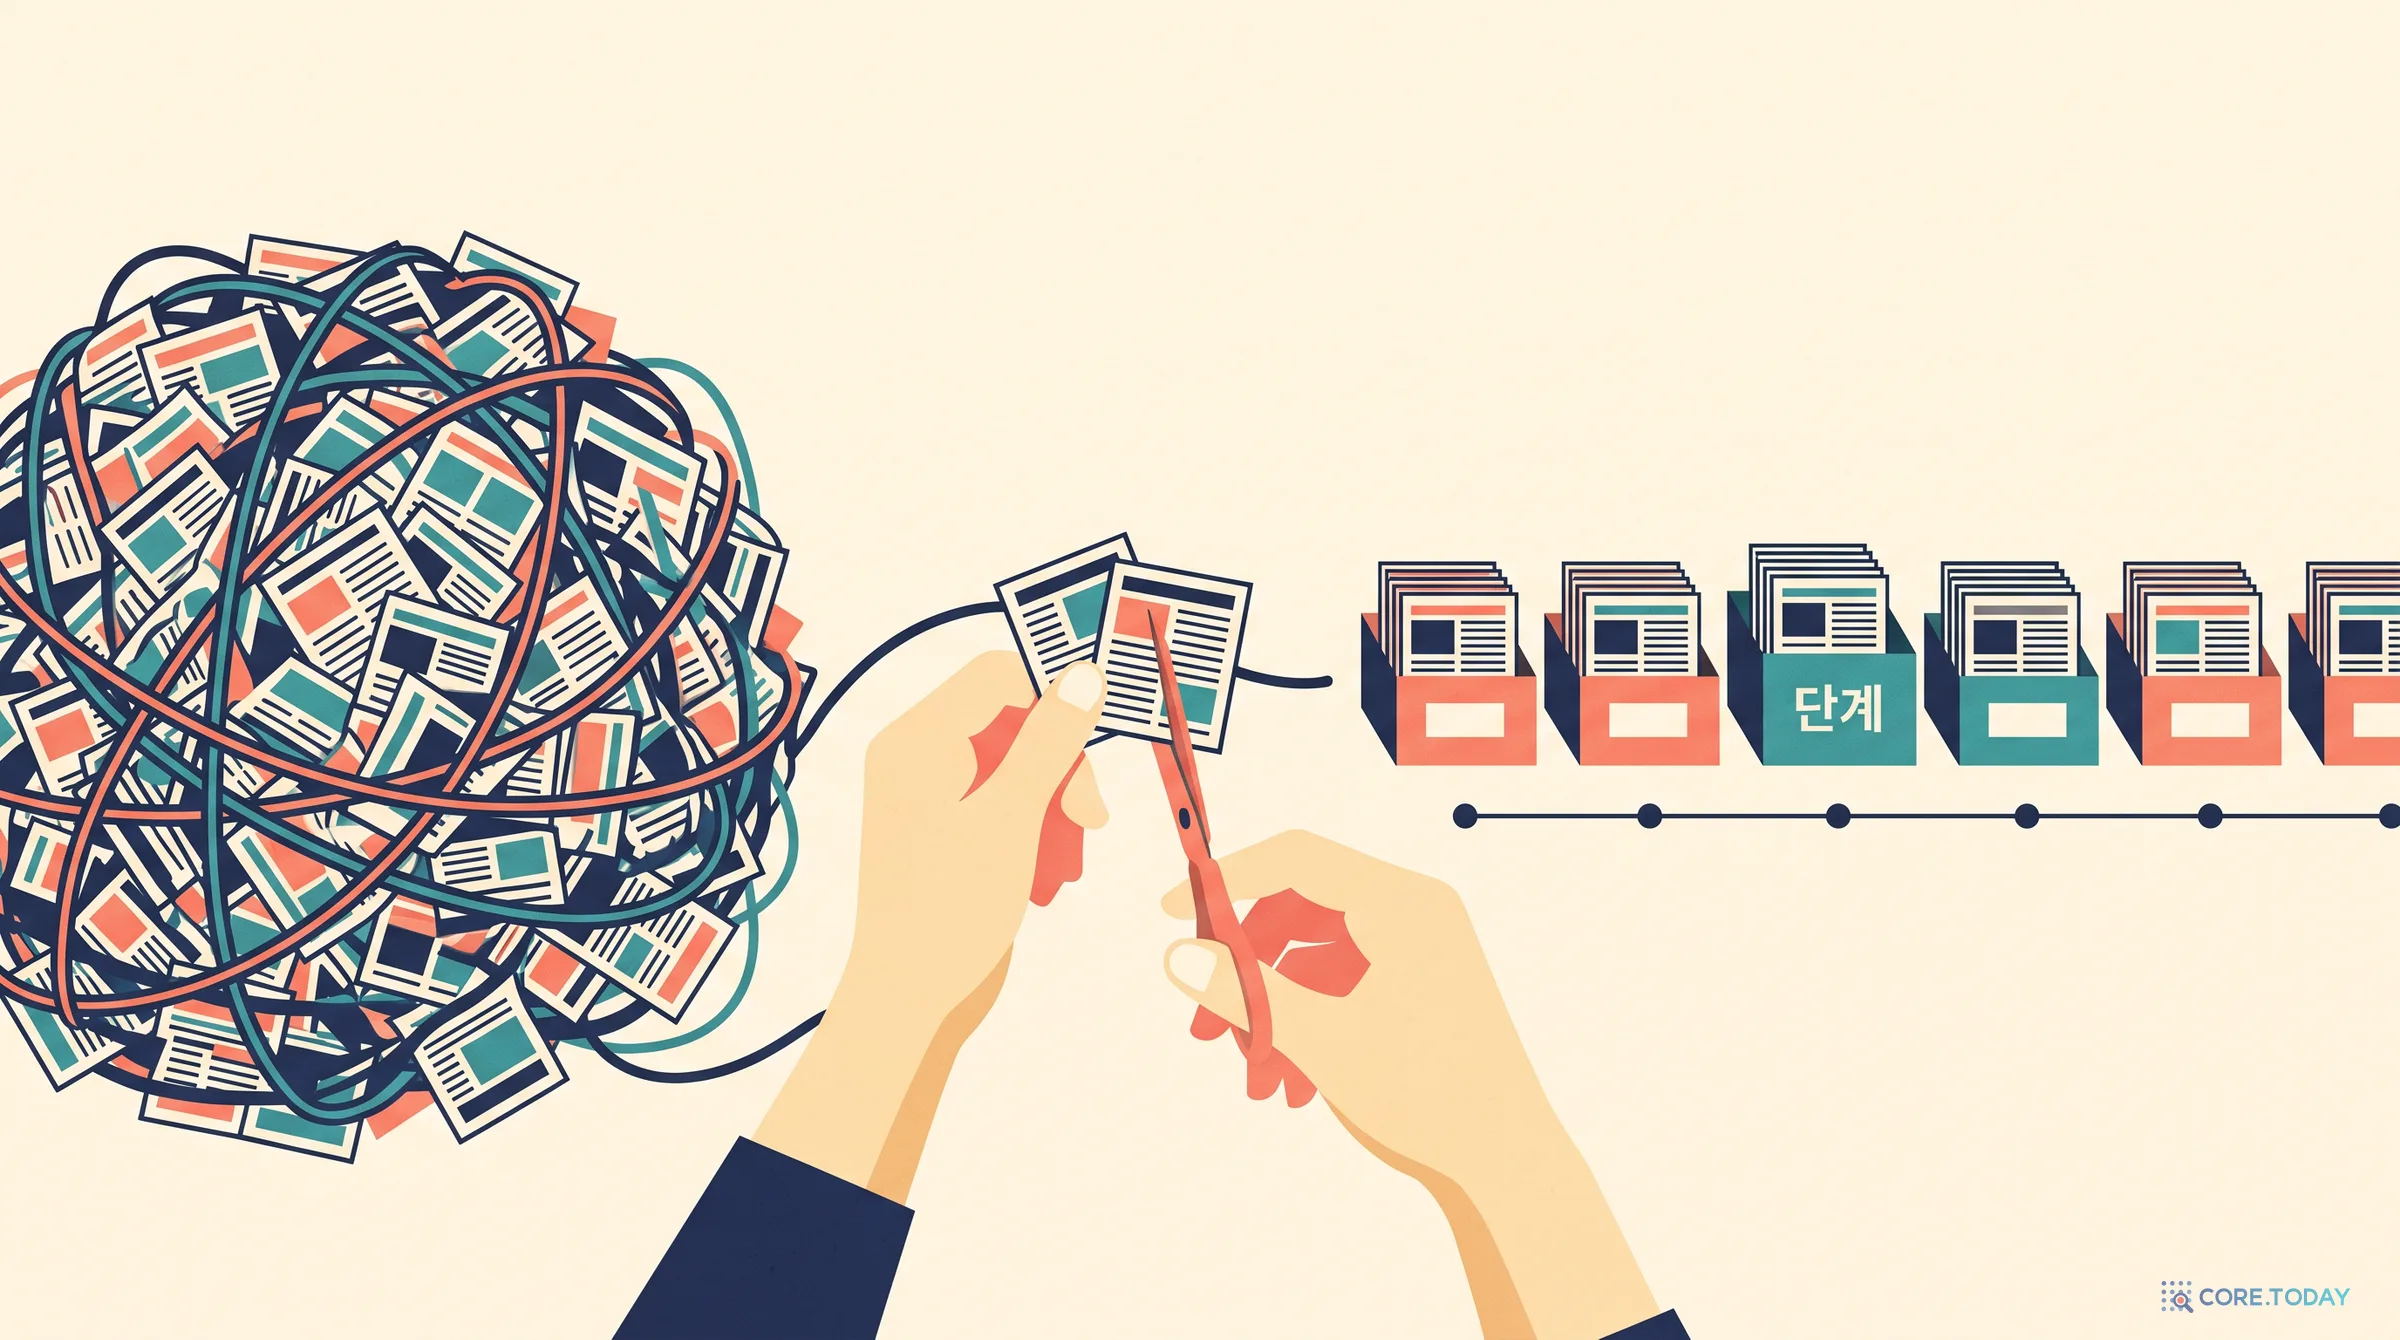
3편의 '같은 사건' 묶음은 356건, 늘리면 1,029건까지 자라는 사슬이었습니다. 그 묶음을 "같은 행위자가 같은 때에 한 같은 일"인 단계로 다시 쪼갤 수 있는가. 판정 모델에 '같은 사건' 대신 '같은 단계'를 물으면 다른 답이 나오는가.
단계 노드 사이의 관계를 후속 전개·형제·참조·같은 단계·무관의 다섯 가지로 가르는 정답을 만들 수 있는가. 판사들은 그 구분에 동의하는가.
그 정답 위에서 어떤 점수가 "다음 단계의 부모"를 찾는가. 배경 사건 인용인가, 요약 임베딩인가, 기사 쌍 판정의 집계인가, 노드 쌍을 판정 모델에 직접 묻는 것인가. 그리고 부모를 하나만 고르는 숲은 성분보다 사슬을 덜 만드는가.
자료는 3편의 나흘을 앞뒤로 늘린 여드레이고, 코드는 3편 파이프라인 위에 단계·간선·나무 층을 얹은 것입니다. 이번에는 정답을 만드는 비용에 상한이 있었습니다. 그 제약이 방법을 어떻게 바꿨는지도 적어 둡니다.
1부. 재료: 여드레치 1만 건과 두 층의 정답
13개 언론사, 10월 15일 목요일부터 22일 목요일까지
언론사는 3편과 같은 13곳(방송 3·전국지 5·지역지 5, 통신사 제외)이고, 수집은 네이버 언론사별 날짜 목록과 기사 페이지입니다. 기간을 10월 15일(목)부터 22일(목)까지 여드레로 늘려 정치·사회면 10,000건이 됐습니다. 토요일 17일이 374건으로 유난히 적은 것은 수집 오류가 아니라 그날 송고 자체가 적었던 것입니다.
날짜
15(목)
16(금)
17(토)
18(일)
19(월)
20(화)
21(수)
22(목)
기사 수
1,497
1,169
374
749
1,480
1,561
1,612
1,542
게재 시각 기준으로 14일 13건과 23일 3건이 목록에 섞여 들어와 합계는 10,000건입니다. 사건 레코드(헤드라인 사건과 배경 사건, 누가·언제·어디서·무엇을)는 3편과 같은 프롬프트로 Gemini 3.8 Flash가 뽑았고, 3편 기사 5,404건의 레코드는 그대로 다시 썼습니다.
첫째 층: 기사 쌍 정답 102,365쌍
후보 쌍은 임베딩 최근접 이웃과 레코드 참여자·장소 겹침으로 만들되, 3편의 결론대로 게재일 간격이 사흘을 넘는 쌍은 넣지 않았습니다. 131,754쌍에서 임베딩 하한으로 102,578쌍을 남겼고, 3편에서 이미 판정한 38,591쌍을 제외한 나머지를 같은 판사 구성(gpt-6.1-sol과 Claude Sonnet 5.5, 불일치는 Gemini 3.5 Flash 3심)으로 판정해 같은 사건 28,393 · 같은 이야기의 다른 사건 47,395 · 다른 사건 26,577쌍의 정답을 얻었습니다. 이것을 성분으로 묶으면 2건 이상 '같은 사건' 묶음이 1,072개이고 가장 큰 묶음은 1,029건입니다. 3편의 356건짜리 사슬이 여드레가 되자 세 배로 자랐습니다. 국정감사 주간의 정치 발언이 서로 꼬리를 물었기 때문인데, 이 묶음이 2부의 출발점입니다.
둘째 층: 단계 노드 사이의 간선 정답 16,734개
이번 편의 새 정답은 기사 쌍이 아니라 단계 노드 쌍에 매긴 관계입니다. 어떻게 만들었는지는 2부와 3부에서 따로 설명합니다. 두 층의 정답이 어떻게 맞물리는지만 먼저 그려 둡니다.
1
기사 쌍 정답 → 같은 사건 묶음. 3편과 같은 방식. 묶음 1,072개, 최대 1,029건.
2
묶음 → 단계 노드. LLM이 묶음 안의 기사를 "같은 행위자가 같은 때에 한 같은 일"로 나눈다. 노드 5,194개(단계 1,831 + 단독 기사 3,363).
3
노드 쌍 후보. 기사 쌍 정답이 이어 주는 쌍, 배경 사건 인용 유사도, 요약 중심 유사도에서 47,102쌍 → 예산에 맞춰 16,734쌍.
4
간선 정답. 이른 노드 A → 늦은 노드 B에 후속 전개·형제·참조·같은 단계·무관 중 하나. 판사 셋.
5
나무. 후속∪같은 단계 간선의 성분이 '성분 나무', 노드마다 가장 가까운 부모 하나만 남긴 것이 '직계 숲'. 방법은 둘 다에 대해 B³로 잰다.
'같은 사건' 묶음 하나를 gpt-6.1-sol에 40건씩 게재 순으로 보여 주고, 이미 만들어진 단계 목록을 함께 주며 "이 기사들을 같은 행위자가 같은 때에 한 같은 일로 나누라"고 했습니다. 결과는 묶음마다 단계 목록이고, 단계마다 이름·사건일·소속 기사가 붙습니다. 2건 이상 묶음 1,072개 가운데 249개(23%)가 둘 이상의 단계로 갈라졌고 나머지 77%는 한 단계였습니다. 작은 묶음은 애초에 한 단계였다는 뜻이고, 갈라진 것은 큰 묶음입니다.
가장 큰 묶음 1,029건은 197단계가 됐고 가장 큰 단계도 33건에 그칩니다. 역삼동 빌딩 연쇄 방화 179건은 발생 → 수사 착수 → 용의자 특정 → 체포 → 영장의 24단계로, 인천 구월동 흉기 난동 144건은 27단계로, 전시작전통제권 전환 논쟁 137건은 23단계로 풀렸습니다. 3편의 "356건짜리 정답 묶음을 사건으로 볼 것인가"라는 질문에 대한 답이 여기 있습니다. 그것은 사건이 아니라 한 사건의 단계 수십 개였습니다.
판정 모델에 '같은 단계'를 물으면
단계가 정답의 단위라면 기사 쌍 판정에도 그 질문을 던질 수 있습니다. Jev에 기사 쌍 102,578개 전부에 대해 세 질문을 한 번에 물었습니다. 같은 사건인가, 같은 큰 이야기에 속하는가, 그리고 "실제로 같은 사건의 같은 단계(같은 행위자가 같은 때에 한 같은 일)인가. 다른 날·다른 각도의 재보도여도 같은 일이면 참, 다음 절차·새 전개·반응이면 거짓"입니다.
질문
정답 '같은 사건' 대비 AUROC
쌍 F1 (문턱)
정밀 / 재현
같은 이야기의 다른 사건에 주는 평균 확률
같은 사건인가
0.945
0.815 (0.75)
0.77 / 0.86
0.36
같은 단계인가
0.955
0.846 (0.40)
0.87 / 0.83
0.15
같은 이야기인가
0.883
0.695 (0.95)
0.67 / 0.72
0.76
단계 질문이 같은 사건 질문보다 정답 '같은 사건'을 더 잘 맞힙니다. 정밀도가 0.77에서 0.87로 오르고, 같은 이야기의 다른 사건에 주는 확률이 0.36에서 0.15로 내려갑니다. 질문을 좁혔더니 3편에서 느슨하다고 했던 정답 쪽 '같은 사건'보다 깨끗한 경계가 나온 셈입니다. 정답이 '같은 사건'이라고 한 쌍 가운데 단계 확률이 0.45 미만인 비율은 게재일 간격 0일에서 16%, 1일 24%, 2일 35%, 3일 41%입니다. 날짜가 벌어진 '같은 사건' 정답의 3분의 1 이상을 모델은 다른 단계로 봅니다. 3편에서 사슬을 만든 "쌍으로는 타당한 같은 사건" 판정이 정확히 이 구간이고, 6부의 끝에서 끝까지 실험에서 이 확률로 단계를 묶습니다.
3부. 간선 정답: 다섯 가지 관계와 판사 셋
후보와 라벨
노드 쌍 후보는 세 통로로 모았습니다. 두 노드 사이에 기사 쌍 정답이 '같은 사건' 또는 '같은 이야기'인 쌍이 있으면(9,024쌍), 한 노드의 배경 사건 요약이 다른 노드의 헤드라인 요약과 코사인 0.6 이상이면, 두 노드의 요약 중심이 0.62 이상이면 후보입니다. 사건일 차이가 7일을 넘는 쌍은 뺐습니다. 이렇게 47,102쌍이 나왔는데, 뒤에 적을 예산 때문에 노드마다 배경 인용 상위 2개·요약 상위 1개와 인용 유사도 0.75 이상만 남겨 16,734쌍으로 줄였습니다. 기사 쌍 정답이 이어 주는 9,024쌍은 전부 남겼습니다.
라벨은 다섯입니다. 이른 노드 A와 늦은 노드 B에 대해,
후속 전개(successor): B는 A의 다음 절차·결과·반응이다. 발생 → 수사 → 영장 → 구속, 사고 → 장례·대책, 발표 → 반발, 질의 → 답변. A가 없었다면 B도 없다.
형제(sibling): 같은 큰 이야기(같은 국감·선거·대회·정책 논쟁)에 속하지만 B가 A의 전개는 아니다. 다른 질의, 다른 경기, 같은 인물의 다른 날 다른 행보.
3편까지 정답은 gpt-6.1-sol과 Claude Sonnet 5.5를 API로 부르고 Gemini 3.5 Flash를 3심으로 쓰는 구성이었습니다. 이번에는 남은 판정 비용의 상한이 10만 원이었고, 후보 47,102쌍을 두 모델 API로 판정하면 그 상한을 넘었습니다. 그래서 구성을 바꿨습니다.
1심 gpt-6.1-sol(게이트웨이 API): 후보를 16,734쌍으로 줄이고 기사 설명을 짧게 해 3,310회 호출, 입력 약 860만 토큰.
2심 Gemini 3.5 Flash(직접 키, 사고 예산 1,024): 같은 16,734쌍 전부. 직접 키의 단가가 게이트웨이 크레딧보다 훨씬 낮습니다.
Claude Sonnet 5.5는 API 대신 Claude Code의 서브에이전트로 돌렸습니다. 판정 프롬프트 20개를 파일로 묶어 에이전트에게 읽히고 JSON으로 답을 쓰게 하는 방식입니다. 토큰당 과금이 아니라 구독 사용량을 쓰므로 비용이 0이지만, 세션 사용량 한도에 걸립니다. 실제로 열네 번째 배치에서 한도에 걸려 7개가 멈췄고, 그 뒤로는 Claude를 gpt와 Gemini가 갈린 쌍의 3심으로만 썼습니다. 무작위 1차 4,073쌍과 3심 2,821쌍을 합쳐 Claude 판정은 6,894쌍입니다.
Gemini 3.5 Flash-Lite는 전체를 판정했지만 gpt와 일치율이 60%에 그쳐 셋이 모두 다를 때의 보조 표로만 남겼습니다.
합의 규칙은 이렇습니다. Claude 판정이 있는 쌍은 gpt와 Claude가 1·2심이고 Gemini가 3심, 없는 쌍은 gpt와 Gemini가 1·2심이고 Claude가 3심입니다. 두 판사가 같으면 확정, 다르면 세 번째 판사와 다수결, 셋이 모두 다르면 셋 다 '관계 있음'(후속·형제·같은 단계)이면 형제, 아니면 무관입니다. 결과는 gpt와 Gemini 일치 10,707 · gpt와 Claude 일치 4,132 · 다수결 1,531 · 규칙 364쌍입니다.
항목
호출
비용(추정)
gpt-6.1-sol 간선 1심
3,310회, 입력 860만 토큰
4만~5만 크레딧
Gemini 3.5 Flash 2심 + Flash-Lite
각 3,310회
직접 키 1만~2만 원
Claude Sonnet 5.5 서브에이전트
에이전트 58개, 약 780만 토큰
구독(과금 없음)
OpenAI Decisions 노드 쌍 판정
16,734회
약 3,500 크레딧
Jev 노드 쌍·기사 쌍 판정
16,734 + 102,578회
선불 크레딧
Clef-Flash 27B
사내 GPU 2대(V100S 32GB, V100 16GB)
전기세
합계는 6만~7만 원 선입니다. 서브에이전트는 비용 절감 수단이지만 재현 가능한 일괄 판정 도구는 아닙니다. 응답 형식이 흔들리고 병렬·재시도 제어가 약하며, 무엇보다 한도에 걸리면 지휘하는 세션까지 멈춥니다. 어려운 쌍의 3심처럼 호출 수가 적고 판단이 중요한 자리에 두는 것이 맞았습니다.
판사들은 얼마나 동의했나
정답 간선의 분포는 형제 8,492(51%) · 무관 4,441(27%) · 후속 전개 3,414(20%) · 참조 248 · 같은 단계 139입니다. 3편의 '같은 사건' 정답에서 90%를 넘던 두 판사 일치율이 간선에서는 gpt와 Gemini 78%, gpt와 Claude 77%(무작위 1차), Claude와 Gemini 50~67%입니다. 가장 흔한 불일치는 후속과 형제 사이입니다. 같은 국정감사에서 다른 의원이 같은 주제를 다시 묻는 것은 후속인가 형제인가. Gemini는 gpt보다 후속을 넉넉히 주고(형제 → 후속 1,477쌍), Claude는 형제를 무관으로 더 자주 내립니다(형제 → 무관 401쌍). 관계의 종류는 관계의 유무보다 어렵고, 이 흐릿함이 5부의 모든 점수의 상한입니다.
라벨별 사건일 간격도 적어 둘 만합니다. 같은 단계는 평균 0.8일, 형제는 1.6일, 후속 전개는 2.2일입니다. 다음 단계는 다음 날이 아니라 모레에 더 많이 옵니다. 5부의 창 실험이 이 숫자를 다시 만납니다.
후속 전개와 같은 단계 간선을 모두 이어 성분을 만들면 2건 이상 '나무'가 262개이고, 가장 큰 것이 408노드 1,707건입니다. 그 안에 3편의 '같은 사건' 묶음 152개가 들어 있습니다. 사슬이 또 생겼습니다. 이번에는 사슬의 원인을 간선 정답에서 직접 읽을 수 있습니다.
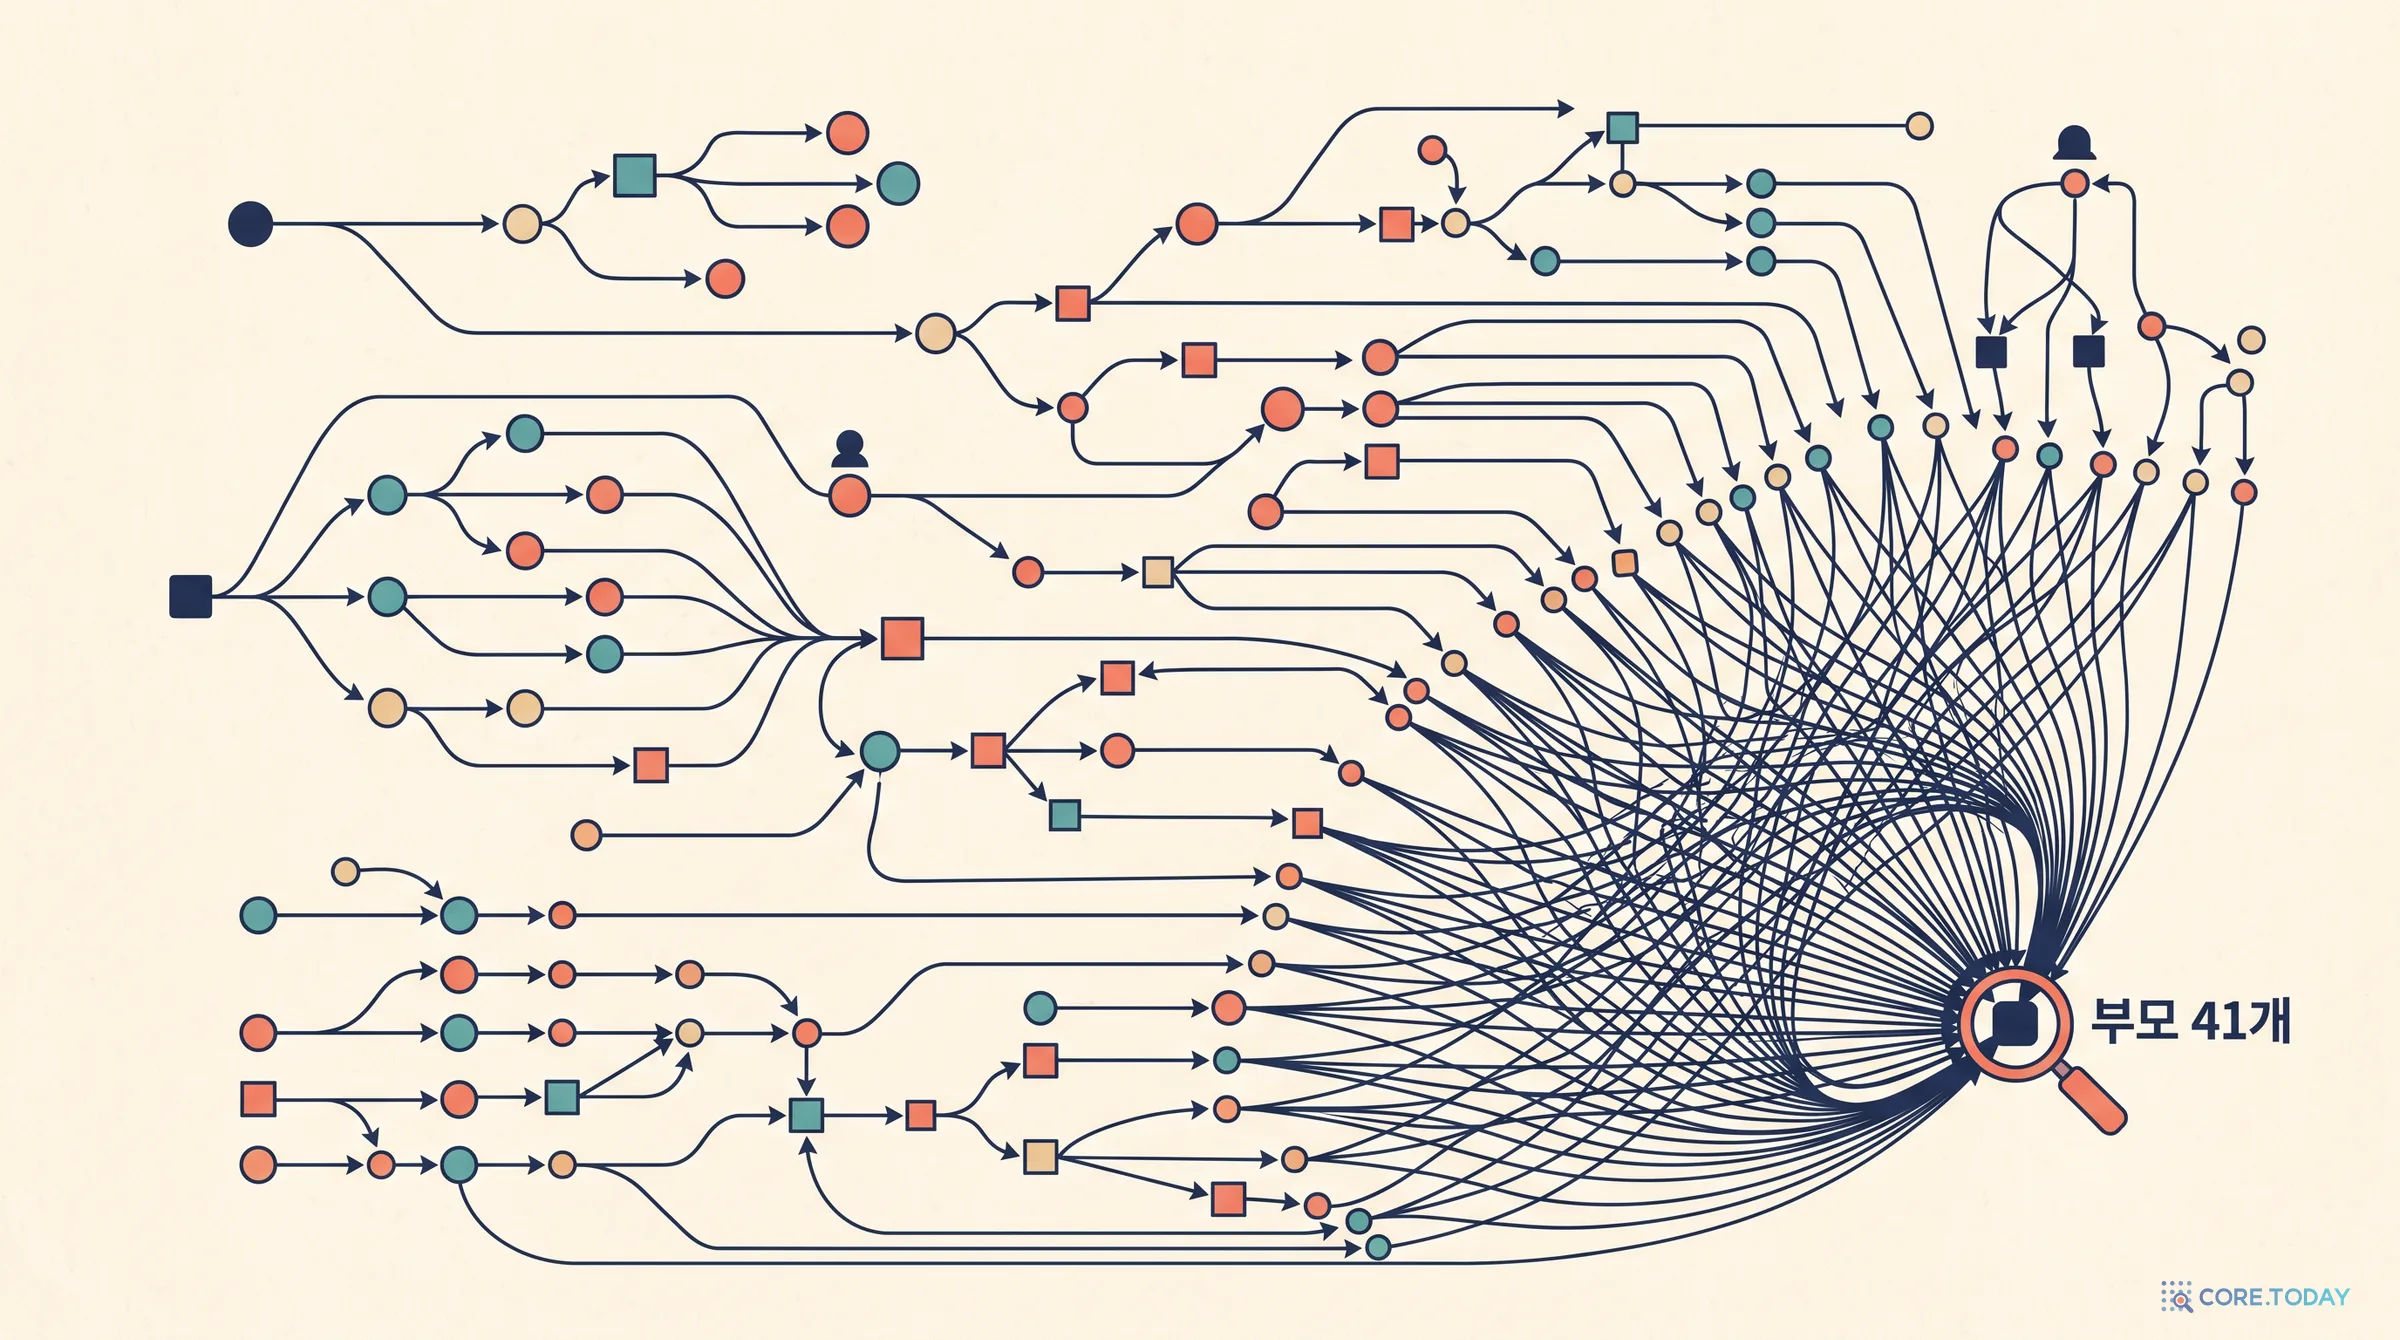
후속 부모가 하나라도 있는 노드 883개 가운데 552개(62%)는 부모가 둘 이상이고, 그중 347개는 부모가 서로 다른 3편 묶음 출신입니다. 부모가 8개 이상인 노드가 115개입니다. 가장 많은 것은 "추미애 지사, 민주당 경고 수용 및 신중한 언행 약속"으로 부모가 41개입니다. 부천 공장 화재 → 소방관 순직 → 지사의 소방 재정 발언 → 소방노조 기자회견 → 사과 → 민주당 경고 → 경고 수용으로 이어진 닷새짜리 사슬에서, 판사는 마지막 노드에 대해 조상 전부에 "후속 전개가 맞다"고 답했습니다. 질문이 "B는 A의 후속 전개인가"였으므로 틀린 답이 아닙니다. 정답 간선은 직계 부모가 아니라 조상 관계를 적고 있었고, 그래서 성분은 나무가 아니라 조상 그물입니다. 가장 긴 후속 사슬의 깊이는 23세대입니다.
그물의 두 번째 원인은 다리입니다. 가장 큰 성분에서 끊으면 양쪽이 모두 30건 이상으로 갈라지는 간선이 6개 있습니다. "임광현 비서실장 임명"에서 "라디오에서 김지용 청문회와 임광현 인선을 평가"로 가는 간선을 끊으면 164건이 떨어져 나가고, "추미애 지사 소방 재정 발언 사과"에서 "정무위 종합감사에서 한강버스 의혹·소방 재정 발언 공방"으로 가는 간선을 끊으면 64건이 떨어집니다. 다리는 전부 종합감사 공방이나 논평, 방송 브리핑처럼 두 이야기를 한 기사에서 다루는 노드입니다. 3편에서 날짜별 허브 기사가 모든 묶음을 한 그물로 엮었던 것과 같은 구조가 한 층 위에서 반복됩니다. 그 기사의 판정은 쌍마다 옳고, 그 기사를 거쳐 두 이야기가 하나가 되는 것이 틀립니다.
성분 대신 직계
해법은 3편 온라인 묶기의 '합침 금지'와 같은 생각입니다. 노드마다 후속 부모를 가장 가까운 하나만 남기면 다리 노드는 두 이야기 가운데 한쪽에만 붙고, 가장 큰 나무는 1,707건에서 714건으로 줄며 나무 수는 262개에서 310개로 늘어납니다. 이것을 '직계 숲'이라고 부르겠습니다. 직계 숲을 성분 나무에 대해 B³로 재면 0.902입니다. 즉 정답을 어느 쪽으로 정의하느냐에 따라 같은 방법의 점수가 0.1 가까이 흔들립니다. 5부는 두 정답을 모두 보여 주되 직계 숲을 기준으로 순위를 매깁니다. 이야기의 단위는 성분이 아니라 "누가 내 부모인가"라고 보기 때문입니다.
나무를 눈으로
부천 공장 화재는 16일 발생 당일에 대통령 지시·지사 방문·초진·인화물질 조사가 나란히 열리고, 17일에 순직 → 합동감식 → 수사전담팀으로 갈라지며, 20일 이후 지사의 소방 재정 발언 쪽으로 가지가 뻗어 정치 이야기와 만납니다. '정답 조상 전부'를 켜면 그물이, '정답 직계'를 켜면 나무가 보입니다. 방법별 보기에서는 Decisions와 Jev가 고른 부모가 대부분 초록(정답 조상)이고, 배경 인용이 고른 부모는 빨강이 섞입니다. 인용은 이야기 소속을 알려 줄 뿐 직계 부모를 가리키지 않기 때문입니다.
배경 사건 인용 유사도: 늦은 노드의 배경 사건 요약이 이른 노드의 헤드라인 요약과 닮은 정도(방향 보존). 3편이 제안한 '인용 그래프'입니다.
요약 중심 유사도: 두 노드의 헤드라인 요약 임베딩 중심의 코사인.
기사 쌍 판정 집계: 두 노드에 걸친 기사 쌍들의 Jev '같은 이야기' 확률의 최댓값.
노드 쌍 판정: 두 노드의 대표 기사·레코드 요약을 주고 Jev와 OpenAI Decisions(gpt-6-luna)에 "B는 A의 후속 전개인가", "같은 큰 이야기인가", "같은 단계인가"를 한 번에 물은 확률. Clef-Flash 27B는 사내 GPU 두 대(V100S 32GB, V100 16GB)의 Ollama로 같은 16,734쌍을 돌렸습니다.
정답을 '후속 전개 또는 같은 단계' 대 나머지로 두면, 노드 쌍을 직접 물은 후속 전개 확률이 Decisions 0.922, Jev 0.920으로 가장 높고, 형제만 상대로 한 어려운 구간에서도 0.89입니다. 로컬 27B인 Clef는 0.886, 기사 쌍 '같은 이야기' 집계는 0.857, 배경 인용은 0.703, 요약 중심은 0.689입니다. 3편에서 배경 인용 유사도 0.75 이상인 쌍의 98%가 같은 이야기였던 것은 사실이지만, 그것은 "같은 이야기냐"의 답이지 "누가 부모냐"의 답이 아니었습니다. 같은 이야기 안의 형제와 후속을 가르는 데 인용은 거의 쓸모가 없습니다(형제 상대 0.68).
같은 노드 쌍 판정 안에서도 질문이 갈립니다. '같은 이야기' 확률은 0.871, '같은 단계' 확률은 Jev 0.772·Decisions 0.577입니다. 후속을 찾는 데는 후속을 물어야 합니다.
부모 하나 고르기 대 전부 잇기
점수가 있으면 나무를 두 가지로 만들 수 있습니다. 문턱을 넘는 간선을 전부 이어 성분을 만드는 그래프 방식과, 노드마다 문턱을 넘는 이른 노드 가운데 점수가 가장 높은 하나만 부모로 삼는 숲 방식입니다. 직계 숲 정답에 대한 B³로 문턱을 고른 결과입니다.
점수
직계 B³ (정밀/재현)
성분 B³
최대 나무
섞임
부모 정밀
그래프 방식 B³ / 최대
Decisions 후속 전개
0.919 (0.93/0.91)
0.879
649
73
0.82
0.890 / 1,526
Jev 후속 또는 같은 단계
0.916 (0.94/0.89)
0.877
341
74
0.82
0.879 / 1,974
Jev 후속 전개
0.912 (0.92/0.91)
0.871
351
120
0.75
0.840 / 2,463
기사 쌍 Jev '같은 이야기' 최대
0.882 (0.93/0.84)
0.848
414
64
0.71
0.873 / 1,302
배경 사건 인용(방향)
0.858 (0.88/0.84)
0.818
633
90
0.59
0.822 / 2,127
요약 중심 유사도
0.856 (0.91/0.81)
0.832
265
154
0.55
0.865 / 1,089
Clef-Flash 후속 전개
0.893 (0.86/0.93)
0.856
689
221
0.57
0.792 / 3,051
3편식 '같은 이야기' 성분 ≥0.95
0.878
0.843
643
39
—
—
3편식 '같은 사건' 묶음 그대로
0.835
0.836
1,029
—
—
—
'섞임'은 서로 다른 정답 성분 나무의 기사를 한 나무에 넣은 수이고 '부모 정밀'은 고른 부모가 정답 조상인 비율입니다. 세 가지가 읽힙니다.
노드 쌍 판정이 집계·인용보다 0.04~0.06 높습니다. 기사 쌍 판정을 노드로 모은 점수(0.882)는 노드 쌍을 직접 물은 점수(0.919)에 못 미칩니다. 노드 하나를 대표 기사와 레코드 요약으로 보여 주고 "후속인가"를 묻는 호출 16,734회의 값이 그 차이입니다. 배경 인용(0.858)은 3편의 '같은 사건' 묶음(0.835)보다 조금 나은 정도입니다.
숲은 사슬을 반으로 자릅니다. 같은 점수로 그래프를 만들면 최대 나무가 1,500~3,000건으로 정답 성분의 사슬을 그대로 재현하고, 성분 정답에 대한 B³는 그쪽이 더 높아 보입니다. 숲은 최대 나무를 341~689건에서 멈추고 직계 정답에 대해 0.03~0.08 높습니다. 3편의 '합침 금지'가 한 층 위에서 같은 선택지로 돌아왔고, 이번에는 정답 정의를 직계로 바꿨기 때문에 벌점이 아니라 보상을 받습니다.
로컬 27B는 간선은 읽지만 부모는 못 고릅니다. Clef-Flash의 간선 AUROC는 0.886으로 Decisions·Jev에 0.04 뒤질 뿐인데, 숲으로 만들면 부모 정밀도가 0.57로 배경 인용 수준이고 섞임이 221로 가장 많습니다. 후속일 법한 노드 여럿에 비슷하게 높은 확률을 주어 그중 하나를 고르는 데 실패하는 것입니다. 쌍을 가르는 능력과 부모를 고르는 능력은 다릅니다.
Decisions와 Jev의 차이는 문턱의 성격입니다. Decisions는 0.82 이상에서만 부모를 고르고도 재현율 0.91을 내는 반면, Jev '후속 전개'는 문턱을 0.55까지 내려야 재현율이 같아지고 그 대가로 섞임이 120으로 늘어납니다. Jev에 '같은 단계' 확률을 보태 "후속 또는 같은 단계"로 두면 문턱 0.69에서 섞임 74, 최대 나무 341건으로 가장 작은 나무를 만듭니다.
부모를 고를 때 과거 며칠까지 볼지를 바꿔 봤습니다. 3편의 같은 사건 묶기에서는 창 1일이면 충분했습니다. 이야기 나무는 다릅니다. Decisions 후속 점수로 창 0일(같은 날만)이면 직계 B³ 0.839, 1일 0.897, 2일 0.910, 3일 0.916, 5일 0.922, 7일 0.919입니다. Jev도 같은 모양입니다(0.837 → 0.895 → 0.904 → 0.907 → 0.913 → 0.916). 창을 하루로 두면 다음 단계의 4분의 1을 놓칩니다. 3부에서 후속 전개의 평균 사건일 간격이 2.2일이었던 것과 맞습니다. 순직 → 영결식, 발언 → 당 경고는 사흘 뒤에 옵니다. 사건 묶음의 창은 하루, 이야기 나무의 창은 사흘에서 닷새입니다.
6부. 끝에서 끝까지: 기사 쌍 판정 하나로
5부는 정답 단계 노드 위에서 잰 것입니다. 실제 시스템에는 정답 노드가 없습니다. 기사 쌍에 물은 세 질문의 Jev 확률만으로 단계를 묶고, 묶인 단계 사이에 부모를 골라 나무를 만들면 어디까지 가는지가 마지막 실험입니다. 단계는 '같은 단계' 확률 0.6 이상의 성분으로 만들고, 단계 쌍의 점수는 두 단계에 걸친 기사 쌍의 '같은 이야기' 확률에 '같은 단계가 아닐' 확률을 곱한 최댓값으로 두어 "같은 이야기지만 다른 단계"인 쌍을 부모 후보로 올렸습니다.
단계는 단계 질문으로 묶는 것이 맞습니다. 정답 단계 분할에 대한 B³는 '같은 단계' 성분(0.6)이 0.904, 3편식 '같은 사건' 성분은 문턱 0.9에서 0.898, 0.75에서 0.853입니다. 같은 사건 질문은 문턱을 높여야 단계에 가까워지고, 그러면 재현을 잃습니다. 단계 질문은 문턱 0.6에서 가장 큰 단계가 130건입니다.
나무는 노드 쌍 판정이 있어야 완성됩니다. 단계 위에 부모 하나를 고른 끝에서 끝까지 나무는 직계 B³ 0.873, 최대 957건, 섞임 43, 부모 정밀 0.79입니다. 3편식 '같은 이야기' 성분을 문턱 0.95까지 올린 것(0.878, 최대 643)과 같은 수준이고, 정답 노드 위에서 노드 쌍을 직접 판정한 것(0.919)에는 0.04 못 미칩니다. 기사 쌍 판정만으로는 "같은 이야기인가"까지 알 수 있고 "누가 부모인가"는 노드를 만든 뒤 다시 물어야 합니다. 창의 효과는 정답 노드 위와 같아 0일 0.828, 3일 0.872, 5일 0.874입니다. 같은 세 질문을 Clef-Flash에 물어 끝까지 가면 단계 성분의 B³가 0.816로 떨어지고 가장 큰 단계가 1,545건까지 자랍니다. '같은 단계' 확률을 너무 넉넉히 주어 단계가 다시 사슬이 되고, 그 위의 나무도 직계 B³ 0.829에 최대 2,175건입니다. 단계 질문은 질문을 바꾼다고 되는 것이 아니라 그 질문을 가르는 모델이 있어야 합니다.
7부. 설계도: 사건 위의 이야기 나무
3편의 설계도 6단계 가운데 마지막 '이야기 스레드'를 셋으로 풉니다.
1
기사 쌍 판정에 '같은 단계'를 묻는다. '같은 사건'보다 경계가 깨끗하다(정밀 0.77 → 0.87). 단계 성분의 문턱은 0.6 안팎.
2
단계 노드를 만든다. 대표 기사, 레코드 요약 두세 개, 사건일, 기사 수. 노드가 판정 모델의 입력 단위가 된다.
3
부모 후보를 모은다. 기사 쌍 '같은 이야기' 확률이 높은 단계 쌍, 배경 사건 인용, 요약 유사도. 창은 사흘에서 닷새. 인용은 후보를 모으는 데 쓰고 부모를 고르는 데는 쓰지 않는다.
4
노드 쌍에 "후속 전개인가"를 묻는다. '같은 이야기인가'가 아니다. 노드당 후보 수가 적으므로 호출은 기사 쌍 판정의 6분의 1이었다.
5
부모는 하나. 문턱을 넘는 후보 가운데 점수가 가장 높은 이른 노드 하나. 성분을 만들지 않는다. 두 이야기를 함께 다루는 종합·논평 노드는 한쪽에만 붙는다.
6
정답도 직계로 둔다. 간선 정답은 조상 관계를 적는다. 나무를 평가할 때는 노드마다 가장 가까운 부모 하나를 남긴 직계 숲을 기준으로 삼고, 성분 B³는 참고로만 본다.
8부. 한계
간선 정답의 일치율이 70~78%입니다. 3편의 '같은 사건' 정답보다 10%포인트 넘게 낮고, 불일치의 핵심은 후속과 형제의 경계입니다. 판사 셋의 다수결은 그 경계를 안정시키지만 정의하지는 못합니다. 모든 점수의 상한은 이 흐릿함입니다.
판사 구성이 쌍마다 다릅니다. 예산 때문에 Claude는 전체의 4분의 1과 불일치 쌍만 봤고, Flash-Lite가 보조 표로 364쌍을 결정했습니다. 어느 쌍을 어느 판사가 봤는지는 정답 파일에 기록돼 있지만, 3편처럼 세 판사가 같은 자리에 선 정답은 아닙니다.
후보 추리기. 노드 쌍 후보 47,102개 중 16,734개만 판정했습니다. 기사 쌍 정답이 이어 주는 쌍은 전부 남겼으므로 정답 후속 간선의 재현에는 큰 영향이 없다고 보지만, 배경 인용 채널의 약한 후보를 잘라 낸 것은 인용 점수에 불리했을 수 있습니다.
단계 분할은 LLM 하나의 결정입니다. gpt-6.1-sol이 40건씩 보며 나눴고 다른 판사의 검증은 없습니다. '같은 단계' 간선 139개는 그 분할이 어긋난 자리입니다.
여드레입니다. 가장 긴 후속 사슬이 23세대인데 여드레로 잘렸습니다. 한 달이면 이야기 나무의 깊이와 창의 답이 달라질 수 있습니다.
맺으며
네 편에 걸쳐 같은 질문을 자료를 키우며 물었습니다. 1편은 판정 모델, 2편은 사건 레코드, 3편은 시간이었습니다. 4편이 보탠 것은 단위입니다.
'같은 사건' 묶음은 단계로 쪼개집니다. 1,029건은 197단계였고, 판정 모델에 '같은 단계'를 물으면 '같은 사건'보다 경계가 깨끗합니다.
정답 간선은 직계가 아니라 조상을 적습니다. 노드의 62%가 부모를 둘 이상 갖고, 종합·논평 노드가 다리가 되어 성분은 1,707건짜리 그물이 됩니다. 정답 쪽에서도 사슬은 성분의 성질이지 자료의 성질이 아닙니다.
"누가 부모인가"는 노드 쌍을 직접 물어야 합니다. Decisions와 Jev가 0.92, 배경 인용은 0.70입니다. 인용은 이야기 소속의 단서이지 부모의 단서가 아닙니다.
부모를 하나만 고르면 사슬이 반으로 줄고 직계 정답에 대해 0.919입니다. 창은 사흘에서 닷새입니다.
비용 상한 아래에서 정답을 만드는 방법은 있습니다. 후보를 추리고, 싼 판사를 2심에 세우고, 비싼 판사는 갈린 자리에만 세우는 것입니다. 서브에이전트는 그 마지막 자리에 맞습니다.
다음 편이 있다면 주제는 둘입니다. 하루 단위로 도착하는 기사에서 단계 노드를 온라인으로 열고 닫는 것, 그리고 한 달치 자료에서 나무의 깊이가 어디까지 가는지를 보는 것입니다.