
#Graphiti
12개의 포스트
[특집] 기억의 기억 — 바뀐 사실은 지우지 말고 '밀어내라'. AI 에이전트 기억 MoM·P-Mem 완전 해설
AI 비서에게 "5K 기록은 27:12"라고 말하고, 몇 달 뒤 "25:50으로 깼다!"고 자랑했다. 그런데 "내 최고 기록이 뭐였지?"라고 묻자 27:12라고 답한다. 싱가포르국립대의 2026년 9월 논문 「MoM: Memory of Memory」는 이 실패의 뿌리를 두 질문으로 정리한다. 현재 값을 언제 정하는가(들어올 때냐, 물을 때냐), 그리고 밀려난 값을 남기는가(남기느냐, 지우느냐)다. RAG 같은 아카이브는 물을 때 정하고 다 남긴다. 그래서 낡은 값이 다시 끼어든다. Mem0 같은 CRUD 기억은 들어올 때 정하지만 지운다. 그래서 잘못 고친 값을 되돌릴 수 없다. 논문은 비어 있던 칸, 즉 '들어올 때 확정하되 밀려난 값은 출처로 남긴다'를 고른다. 그 구현인 P-Mem은 수락·이의·기각·철회·해결·지지의 여섯 연산으로 버전을 옮기고, 간선을 따라 되돌린다. 결과는 정직하다. 정확도는 가장 강한 검색 기억과 비슷하지만(52.6% 대 50.8%), 읽는 토큰은 약 4분의 1이다. 낡은 답은 19.4%에서 10.9%로 줄었다. 수정이 여덟 번 쌓이면 물을 때 다시 꿰는 방식은 25%로 무너지지만 쓸 때 확정한 칸은 100%를 지킨다. 착오를 철회하면 100%를 되살리는데 CRUD는 0%다. 회계 장부의 역분개와 등기부의 '말소사항'부터 시간 데이터베이스, 이벤트 소싱, 2026년의 ChatGPT 'Dreaming'까지 이 생각의 계보를 따라가고, 논문의 그림과 표를 하나씩 읽는다. 논문의 실험 세 가지는 한국어로 다시 만들어 로컬 Qwen 4B로 직접 돌렸다. 수정이 여덟 번 쌓이자 질문 때 다시 꿰는 방식은 22.5%, 쓸 때 확정은 100%였고, 9B로 키워도 25%였다. 철회 복구는 보존 여부 하나로 100% 대 0%로 갈렸다. 다만 4B 주석기가 여섯 연산을 완벽히 고른 것은 예시를 넣은 지시문 덕분이었다. 예시를 빼자 '해결' 연산을 40건 중 1건만 골랐다. 인터랙티브 위젯 7개.
[특집] 영수증 있는 기억 — SodaMem으로 읽는 AI 에이전트의 '지금 참인 것': 출처·시간·대체, 그리고 92.8%의 뒷면
AI 비서가 '매운 음식 좋아하시죠?'라며 위염 환자에게 마라탕을 권한다면, 기억을 못 해서가 아니라 무엇이 지금 참인지 몰라서입니다. 2026년 8월 공개된 SodaMem은 대화에서 뽑은 사실마다 원문 영수증(출처 조각)을 붙이고, 네 개의 시계로 시간을 적고, 바뀐 사실은 지우지 않고 닫습니다. 그래프·BM25·임베딩 세 터널에서 함께 걸린 증거를 위로 올리고, 플래너가 모은 증거로 리더가 인용을 달아 답합니다. LongMemEval-S에서 92.8%, 문항당 0.16센트라는 숫자도 냈습니다. 바틀릿의 재구성 기억과 파치올리의 장부에서 시작해 이중 시간 데이터베이스, 진리 유지 시스템, BM25와 RRF, MemGPT·Mem0·Zep으로 이어지는 계보를 따라가며 논문의 개념을 하나씩 풀었습니다. 코어닷투데이는 공개된 답안 500개를 다른 모델로 다시 채점했고(88.6%, 직접 판정하면 약 90%), 같은 검색 결과를 작은 모델에 읽혔고, 코드를 열어 논문과 다른 세 곳을 찾았습니다. 92.8%를 낸 저장소는 대체를 '관찰만' 하는 모드였고, 공개 코드의 BM25는 한글을 한 글자도 토큰으로 만들지 못합니다. 작은 모델로 같은 시나리오를 넣어 보니 옛 주소는 닫히지 않았고, 영어 대화에서는 위염 환자에게 매운 김치찌개를 권했습니다. 인터랙티브 7개.
기억이 부딪칠 때 — AI 에이전트 기억의 모순 해결은 왜 '동시성 제어'인가, TOKI 논문 완전 해설
에이전트의 기억에 '담당자는 박 과장'과 '담당자는 이 대리'가 함께 들어오면 누가 이기나. 홍콩과기대의 TOKI 논문(arXiv 2606.06240)은 이 질문이 사실 50년 된 데이터베이스 문제, 즉 동시성 제어라고 말한다. 최신 우선·증거 가중·확인 대기·규칙 정책이라는 네 가지 생산 전략을 격리 수준이 붙은 연산자로 다시 쓰고, 진 사실을 지우지 않는 '감사 행'과 LLM 판정을 키로 기록하는 '판정 로그'로 세 가지 새 이상(판정 재현 불일치·믿음 표류 스큐·감사 소거)을 막는다. 이중 시간 데이터베이스, 베렌슨의 격리 수준 비판, 출처 반가환이라는 세 뿌리부터 정리 다섯 개의 쉬운 풀이, 여덟 시스템 판정표의 칸별 무게까지 읽었다. PostgreSQL 17에서 두 에이전트의 동시 쓰기를 격리 수준별로 50번씩 돌리고, 로컬 4B 모델을 판정자로 같은 모순을 반복해 물어 판정이 얼마나 뒤집히는지 직접 쟀다 — 온도 0에서도 두 기록의 제시 순서만 바꾸면 36쌍 중 13쌍에서 승자가 바뀌었다. 논문이 밝힌 코드 저장소가 404라는 점, 판정표 일부 칸이 지금 코드와 맞지 않는다는 점도 짚었다. 인터랙티브 위젯 6개.
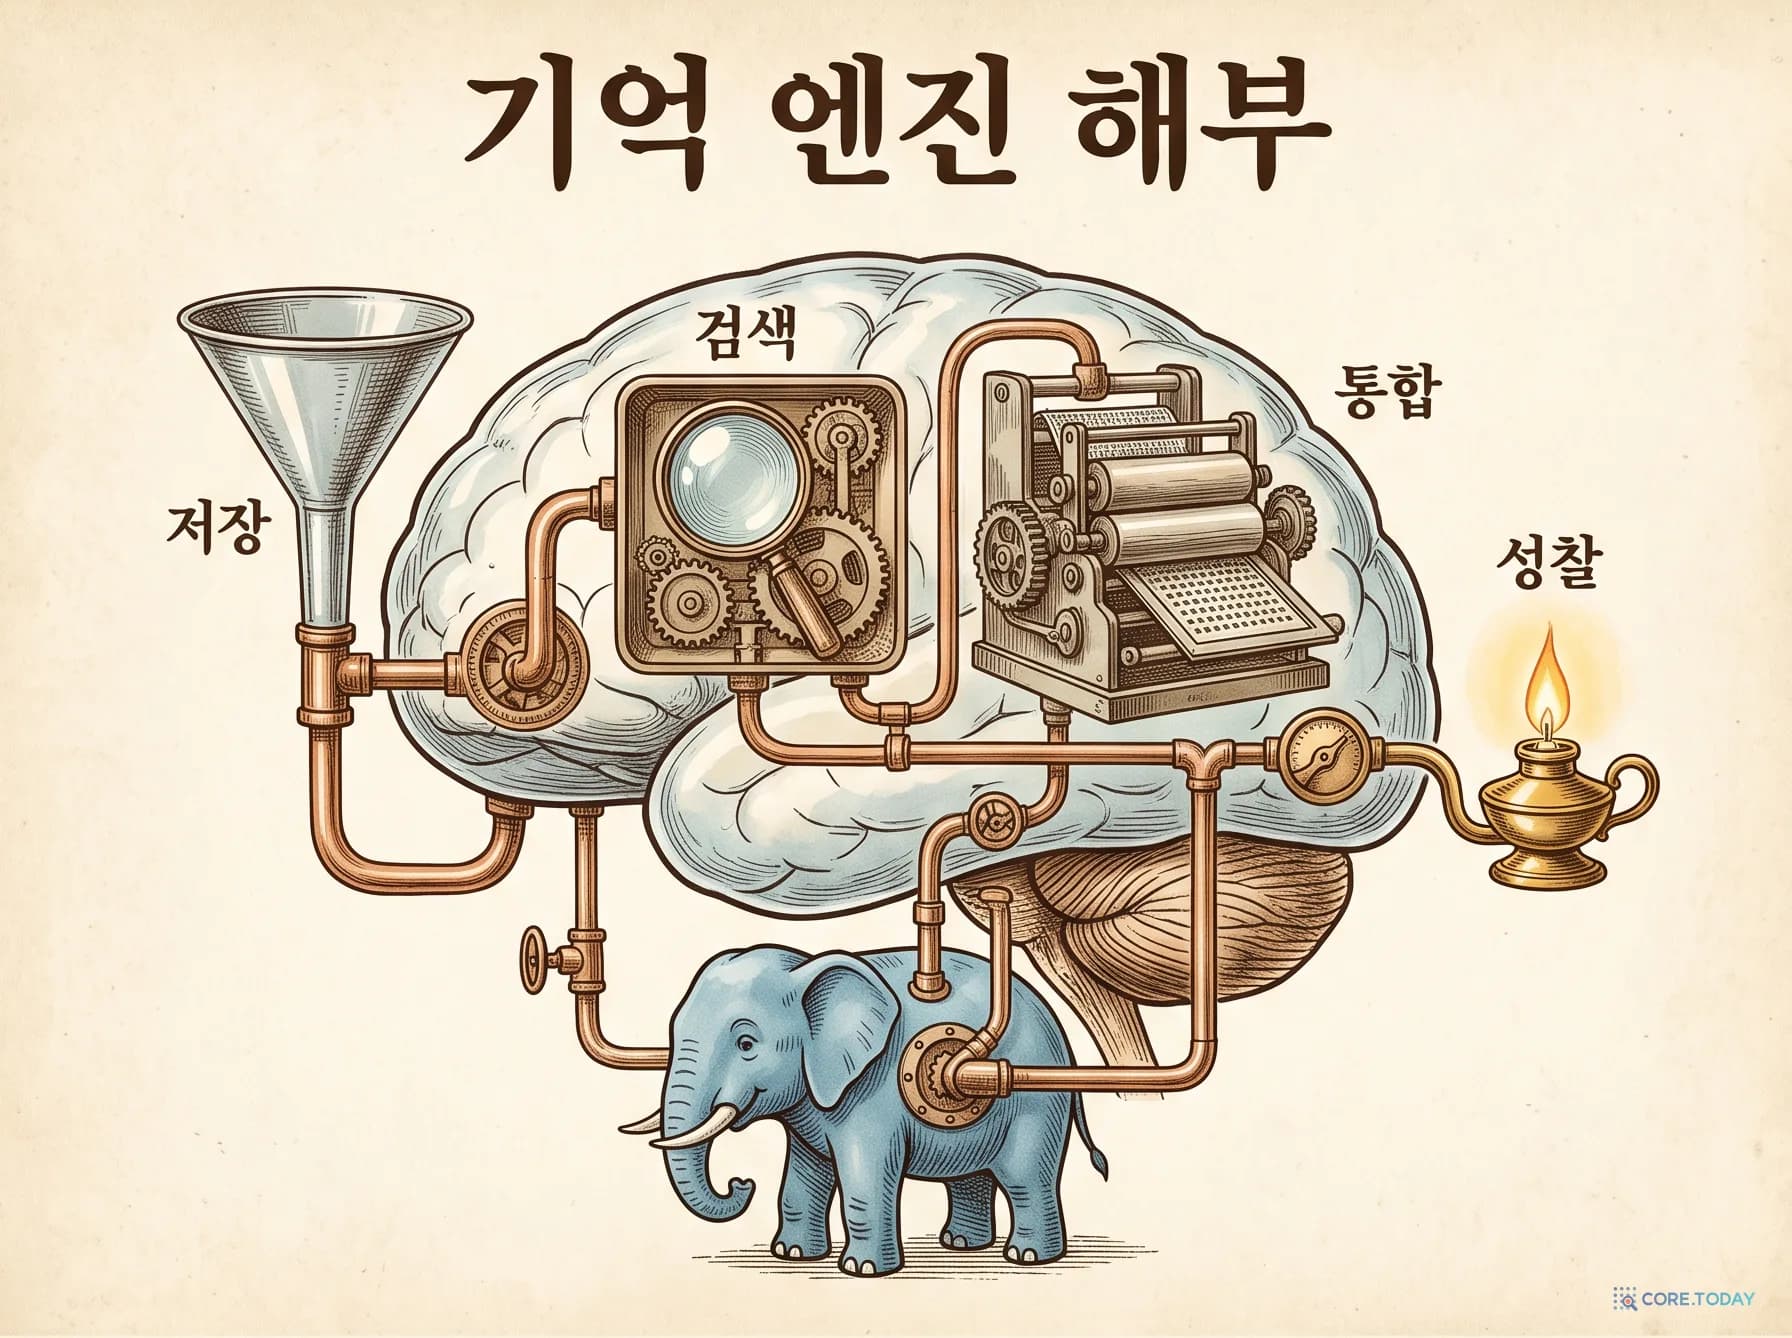
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
날짜 하나로 기억을 바꾼다 — 에이전트 기억 오염, 2023년부터 2026년까지와 Graphiti 실측
에이전트의 장기 기억에 거짓을 심는 '기억 오염'을 2023년 간접 프롬프트 인젝션 논문부터 2026년 그래프 메모리 공격(ShadowMerge)과 실제 유포 사례(마이크로소프트 AI 추천 오염)까지 따라가고, 도커 위 Graphiti 0.30.2에 위조 메일·소급 정정·제3자 주장·위조 처방전·주입 지시문을 140개 그룹으로 넣어 직접 쟀습니다. 시간 그래프는 날짜가 늦은 쪽을 믿습니다. '오늘부로 바뀌었다'는 위조 메일은 20번 중 19번 참 주소를 닫았고, '앞으로 언제부터'라고 쓰면 20번 모두 시한폭탄이 됐으며, '오래전부터'라고 소급하면 실패하는 대신 거짓 이력으로 남았습니다. 주입 지시문은 사실로 추출되는 순간 지시의 흔적을 잃었고, 판정 모델을 키워도 막지 못했으며, 오염된 에피소드를 지워도 닫힌 참 사실은 돌아오지 않았습니다. 대신 그래프에 이미 있는 출처 표시로 순위 전에 거르고 격리하자 공격 60건 모두에서 참 사실이 돌아왔습니다. 인터랙티브 5개.
시간을 기억하는 SQL — PostgreSQL 18·MariaDB·XTDB로 직접 짜 보는 이중 시간 테이블
Graphiti의 두 개의 시계는 1980년대 데이터베이스 연구에서 왔습니다. 그 뿌리가 2026년의 SQL 데이터베이스에서는 얼마나 자랐는지, PostgreSQL 18·19 베타, MariaDB 11.8·12.3, XTDB 2.1을 도커로 띄워 같은 급여·요금제 시나리오를 넣어 봤습니다. MariaDB는 표준의 이중 시간 기능을 거의 전부 갖췄고, PostgreSQL 18은 기간이 겹치지 않게 막는 키까지만 있습니다. 기간 일부만 고치는 FOR PORTION OF는 PostgreSQL 19 개발판에 들어갔다가 9월 15일에 빠졌는데, 그 이유인 '동시 수정 유실'을 직접 재현했습니다. XTDB는 과거 시각으로 기록하려는 트랜잭션을 거부했고, MariaDB는 기본 설정에서 기록 시각을 되돌리자 이력 한 줄이 조용히 사라졌습니다. 고객 1만 명 규모의 적재·질의 측정과 인터랙티브 4개를 곁들였습니다.
파일이냐 그래프냐 — 마크다운 한 장과 시간 그래프에 같은 고객 10명을 기억시켜 봤다
2026년 에이전트 업계는 CLAUDE.md·AGENTS.md·Letta MemFS처럼 마크다운 파일을 기억으로 쓰는 쪽으로 몰려왔습니다. 그렇다면 시간 지식 그래프는 왜 필요할까요. 같은 고객 10명의 한국어 상담 24마디를 같은 모델(gemini-3.5-flash-lite)로 파일 네 가지와 Graphiti에 기억시키고 같은 질문 210개를 던졌습니다. 날짜와 함께 원문을 그대로 쌓은 파일(LLM 호출 0번)이 95.2%, 이력을 남기며 통째로 다시 쓴 파일이 91.9%, Graphiti는 엣지 전체를 줘도 81.4%였습니다. 그런데 현재 상태만 남긴 파일은 47.6%로 꼴찌였습니다. 파일이 이긴 이유는 형식이 아니라 '옛 값을 기간과 함께 남겼느냐'였습니다. 150마디로 늘리자 다시 쓰기 파일의 쓰기 비용이 그래프의 두 배가 됐고, 그래프 검색은 독자가 읽는 양을 15분의 1로 줄였습니다. 지난 편의 위조 메일을 넣자 둘은 다른 곳에서 속았습니다. 과거로 소급한 위조에 그래프는 버티고 파일은 모두 속았으며, 미래 날짜 위조에는 반대였습니다. 인터랙티브 5개.
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
메모리 위의 두 그래프 DB — FalkorDB의 진화와 Memgraph의 근황, 그리고 언제 무엇을 쓸 것인가
4월에 RedisGraph의 종말과 FalkorDB의 부상을 다룬 뒤 반년, 두 인메모리 그래프 DB에 큰 변화가 있었습니다. FalkorDB는 9월 29일 엔진을 Rust로 다시 쓴 6.0을 내놨고(4.x에서 올라가는 경로는 아직 없음), 7월에는 Bolt 프로토콜을 뺐습니다. Memgraph는 3.8의 'Atomic GraphRAG'부터 3.13까지 기능을 쌓는 동안 자동 장애 조치·멀티테넌시·동적 알고리즘을 엔터프라이즈 전용으로 묶었습니다. 주변도 바뀌었습니다. PostgreSQL 19는 그래프 질의(SQL/PGQ)를 넣었다 뺐고, Kuzu는 멈췄으며, 에이전트 메모리 회사들은 범용 그래프 DB를 떠나 자기 엔진을 만들기 시작했습니다. 이 글은 2026년 10월 3일 기준으로 두 제품의 설계 차이(행렬 대 포인터), 10년 연표, 라이선스가 허락하는 쓰임새, 메모리 비용, 벤치마크를 읽는 법을 정리하고, 다섯 가지 질문으로 어느 쪽을 고를지 답합니다. 위젯 5개.
Zep 생태계 지도 — Graphiti, Konig, Context Lake는 각각 무슨 일을 하나
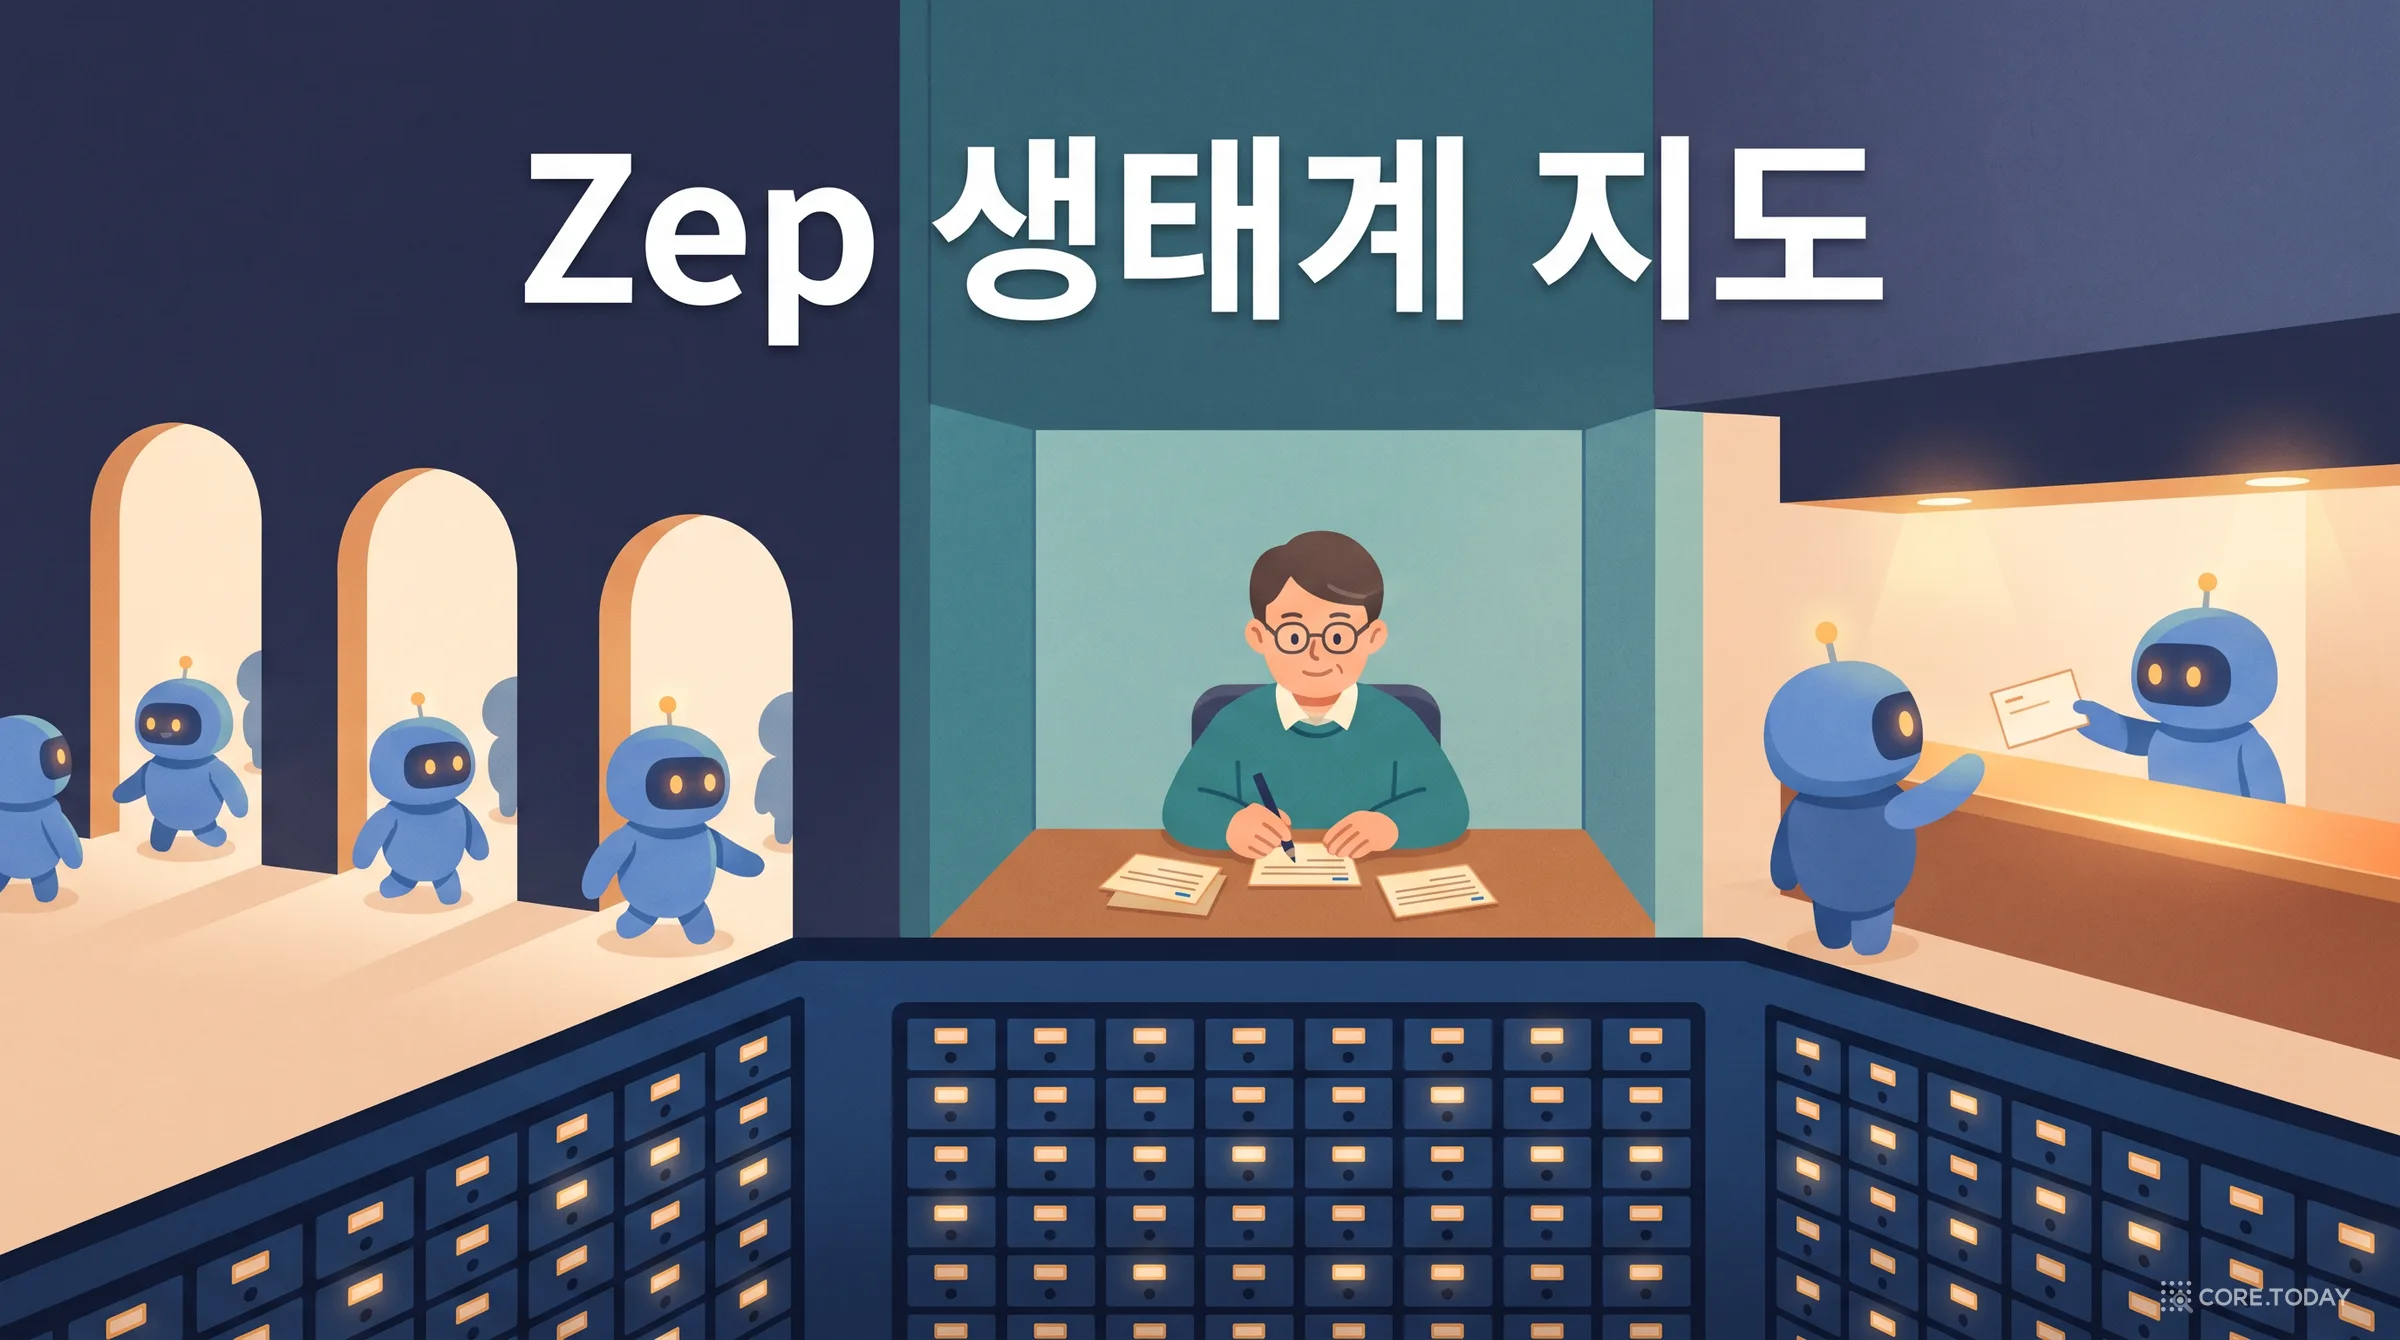
반년 전 Zep 논문을 해부할 때는 'Zep의 엔진은 Graphiti'라는 한 줄로 충분했습니다. 지금은 Konig, Context Lake, Memory MCP 서버, Graphiti MCP 서버처럼 이름이 늘어 누가 무슨 일을 하는지 헷갈립니다. 이 글은 도서관에 빗대어 문·접수대·사서·서고·대출 데스크·관리 규정 여섯 층으로 생태계를 정리하고, 문장 하나가 기억이 되기까지 어느 구성요소를 거치는지 위젯으로 따라갑니다. 열린 것과 닫힌 것, 요금과 크레딧 계산법, 직접 운영과 서비스 이용 중 무엇을 고를지도 함께 다룹니다.
Zep 논문 해부: AI 에이전트에게 '시간을 아는 기억'을 선물하다
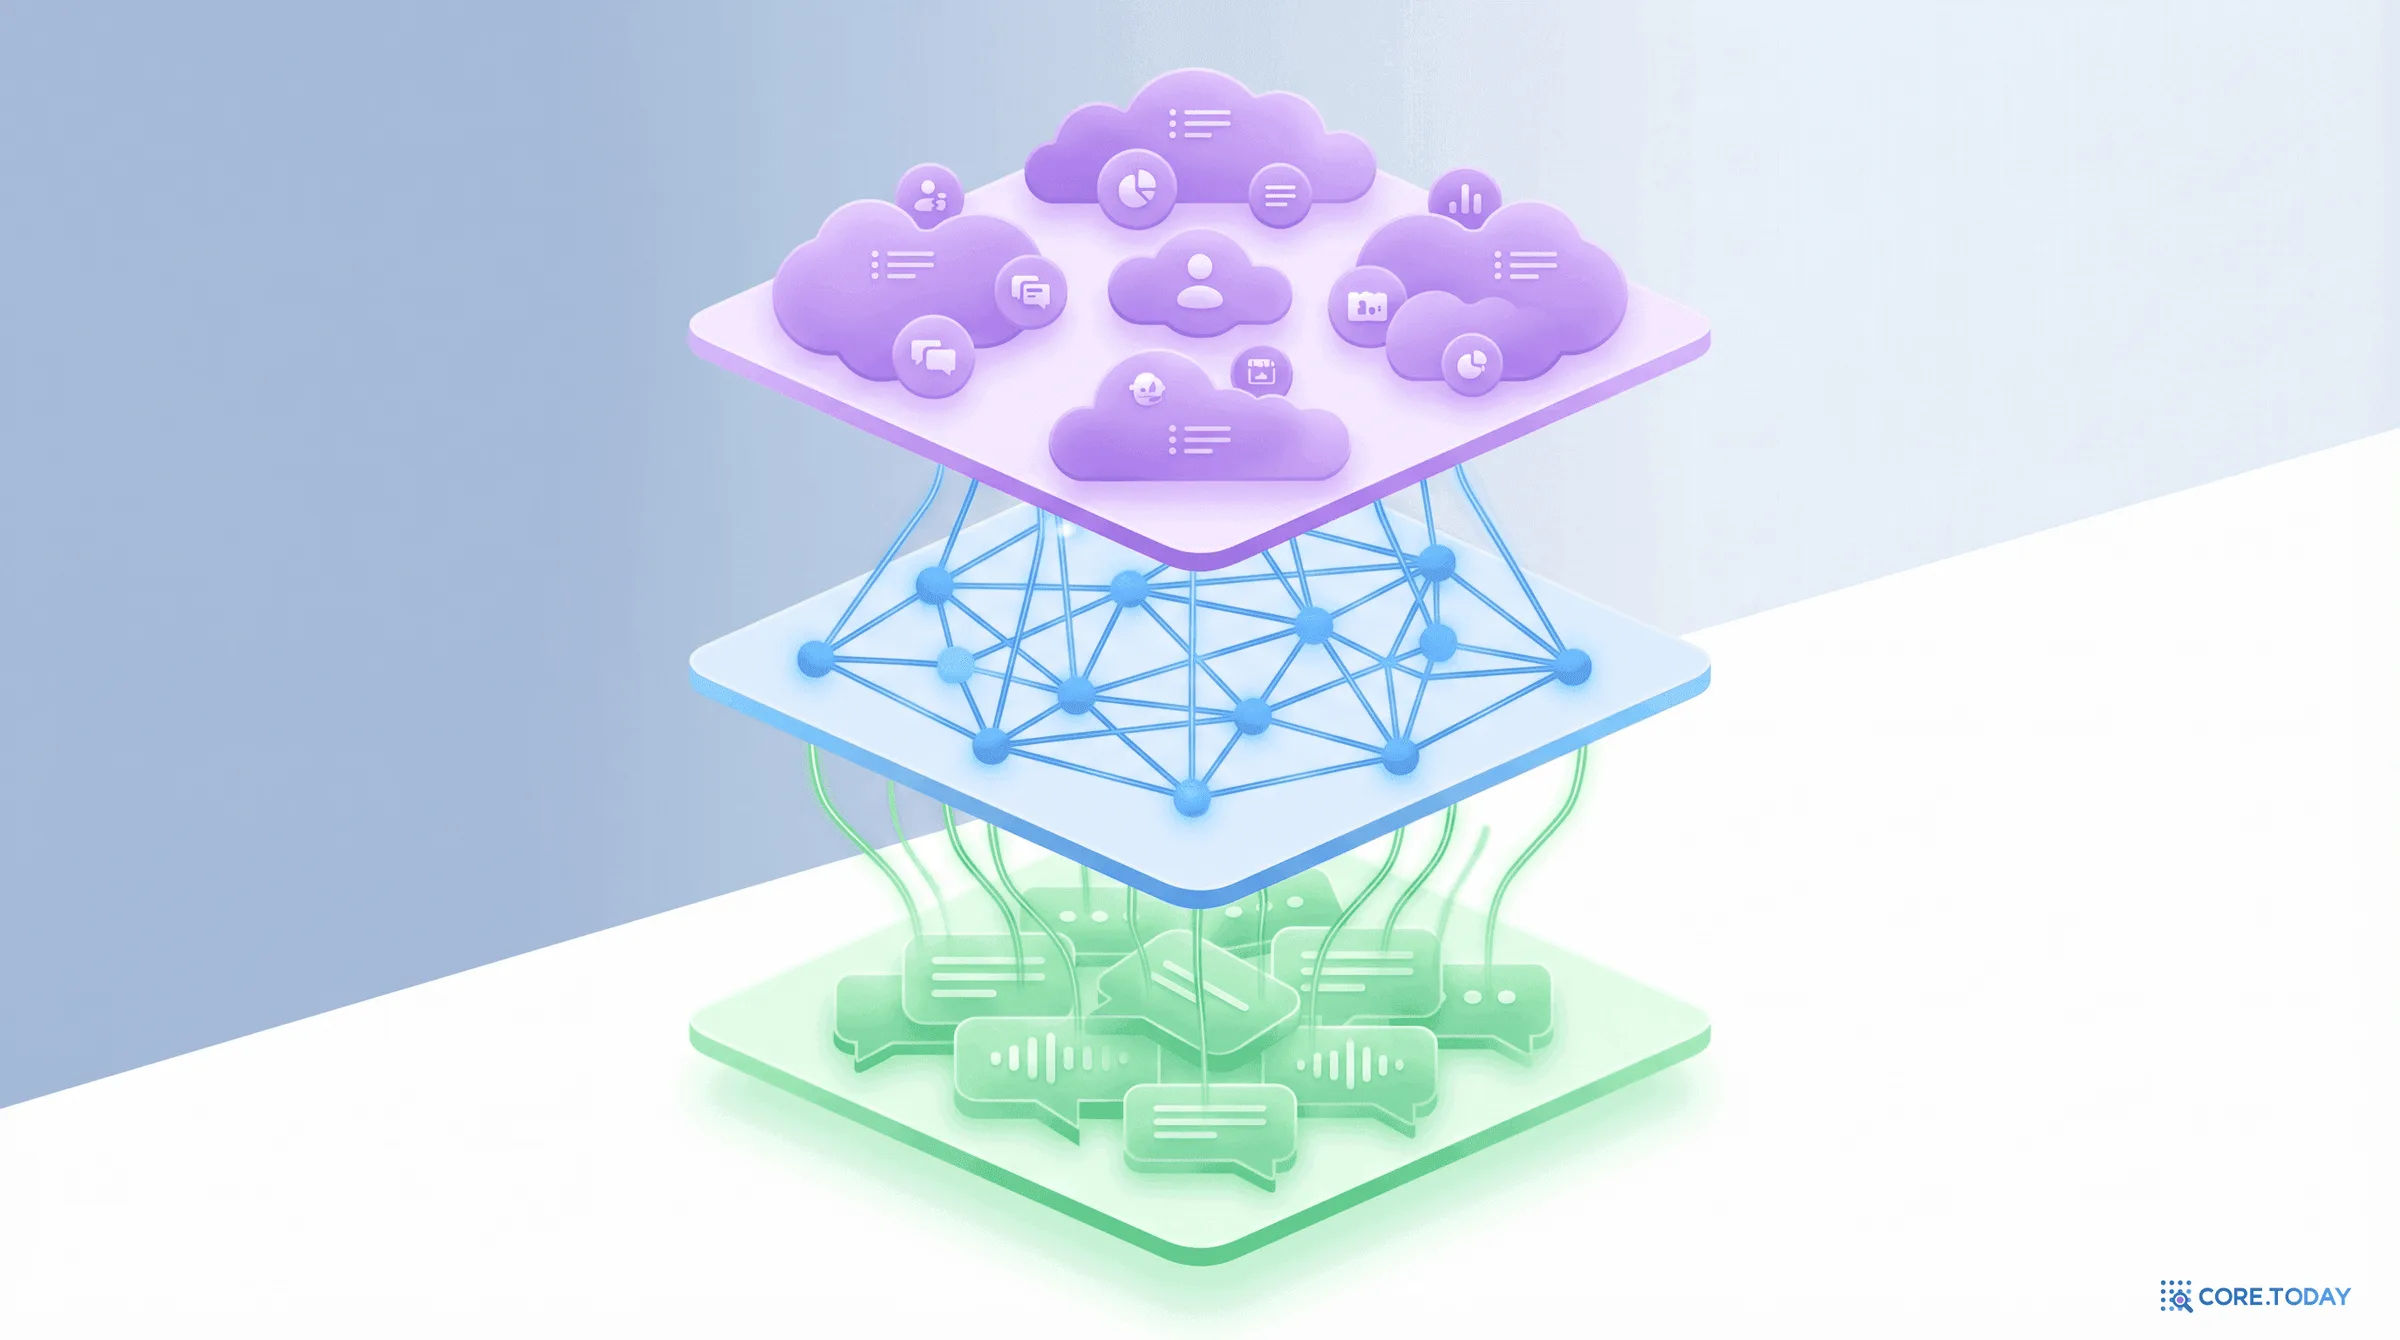
AI 에이전트가 어제 대화를 기억하지 못한다면? Zep은 시간 인식 지식 그래프(Temporal Knowledge Graph)로 이 문제를 해결한다. 3계층 그래프 구조, 이중 시간축 모델, 동적 엣지 무효화 — MemGPT를 넘어 LongMemEval에서 최대 18.5%(상대) 정확도 향상과 90% 레이턴시 감소를 달성한 Zep의 핵심을 완전 해부한다.