Zep 생태계 지도 — Graphiti, Konig, Context Lake는 각각 무슨 일을 하나
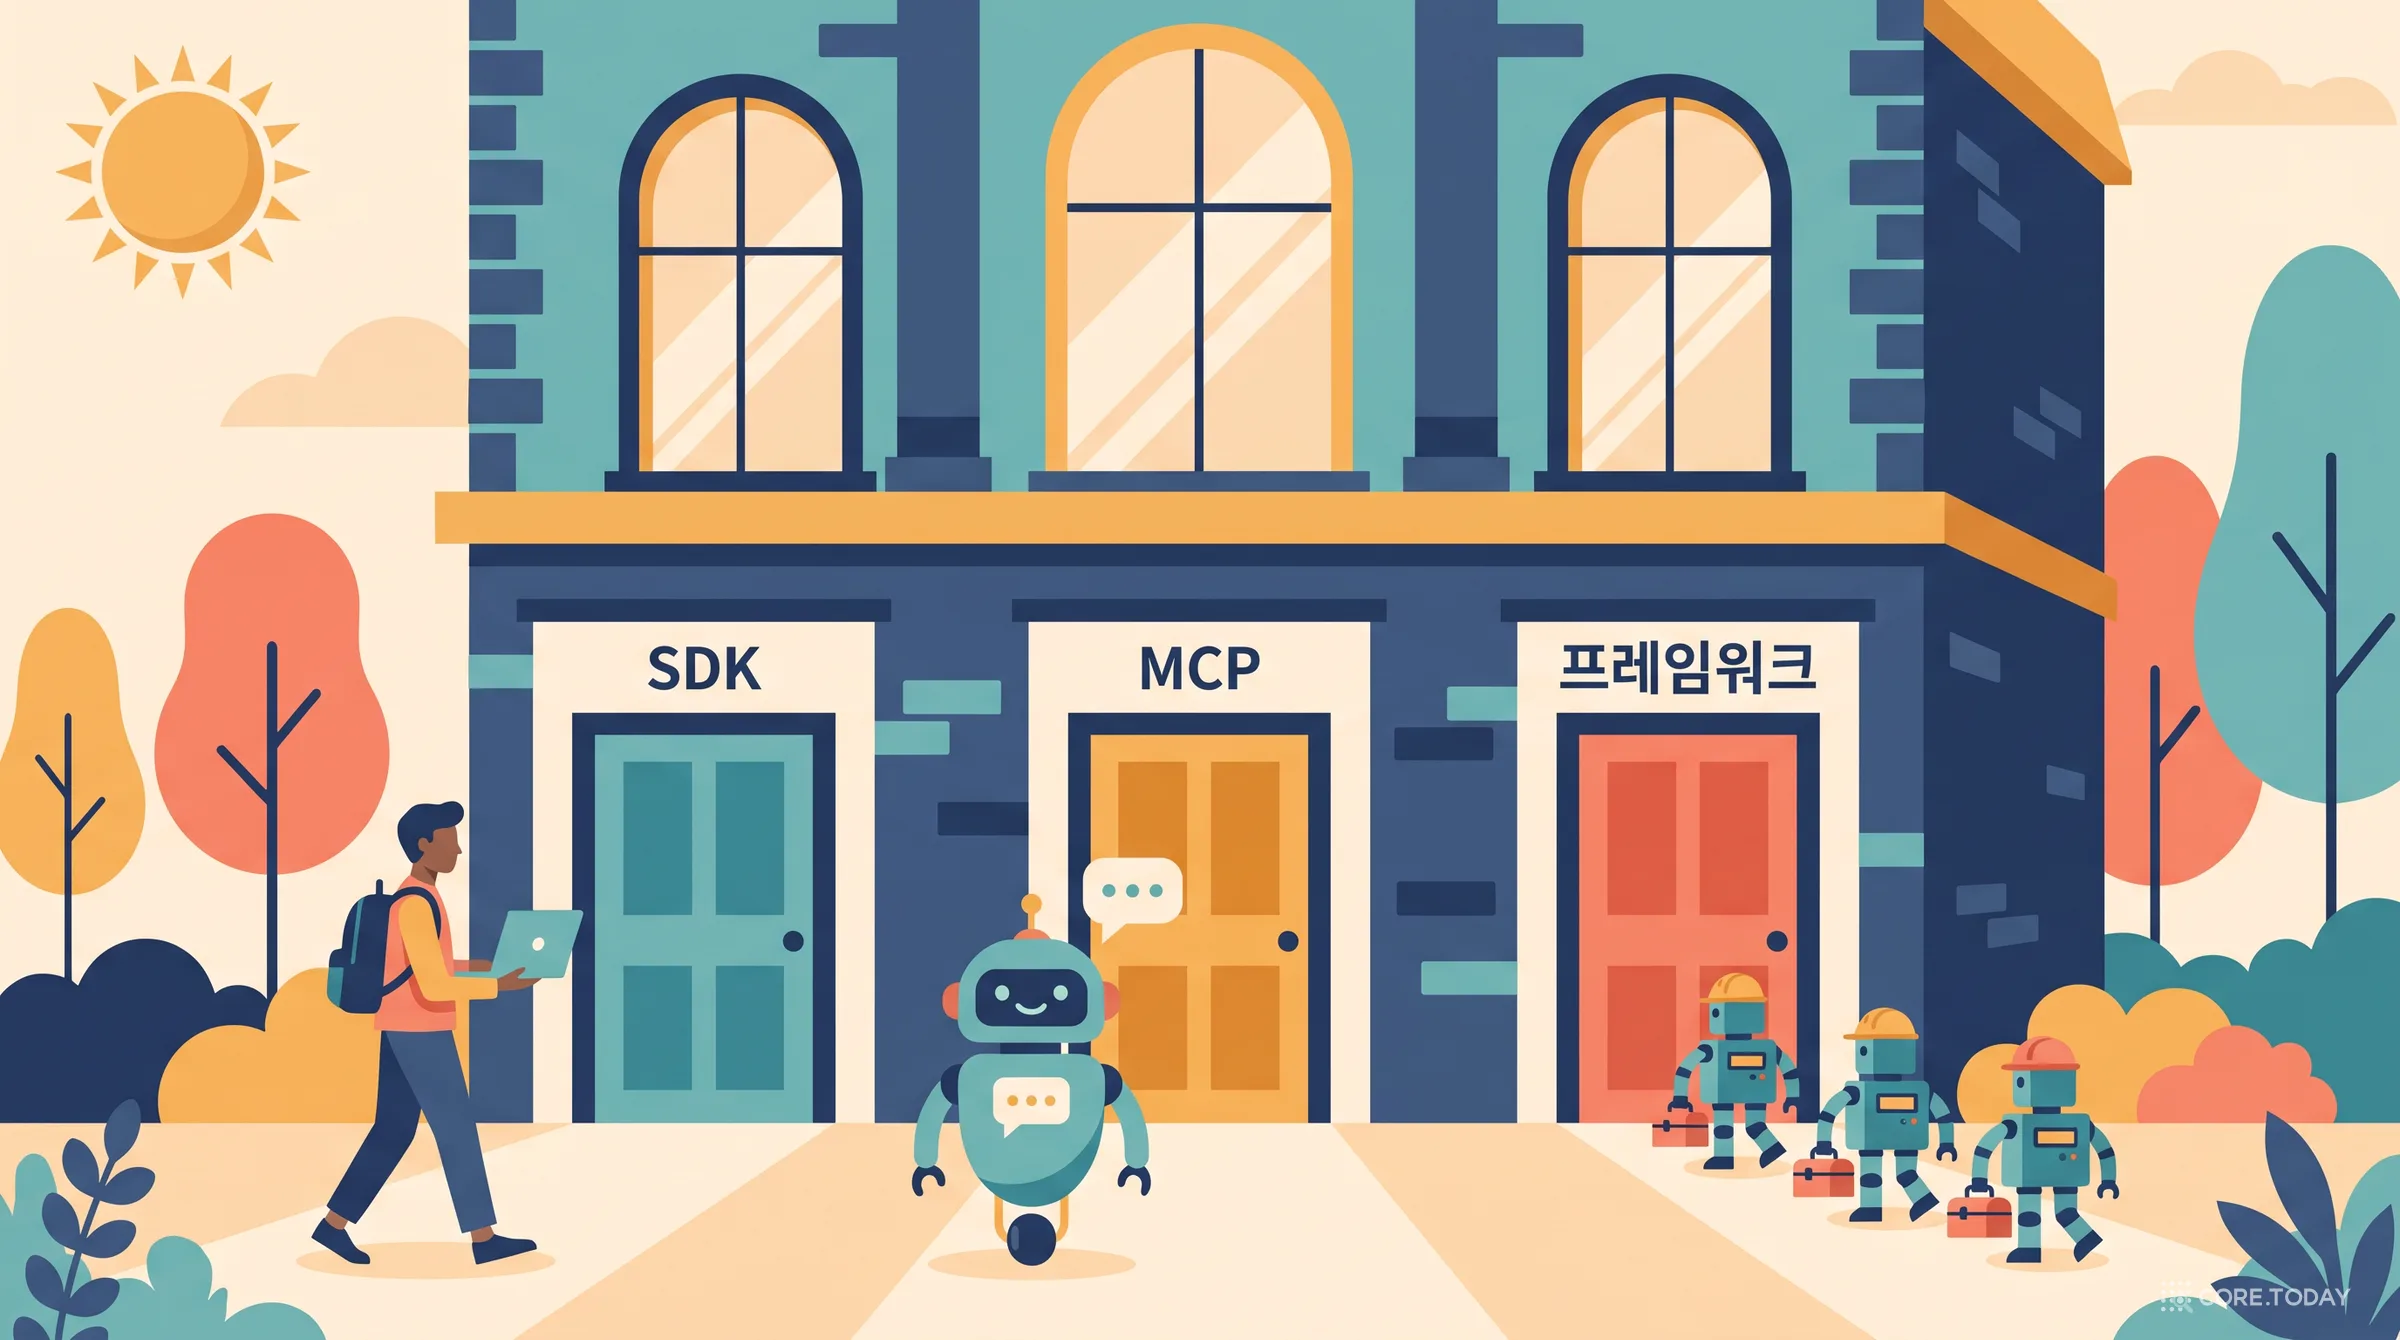
반년 전 Zep 논문을 해부할 때는 'Zep의 엔진은 Graphiti'라는 한 줄로 충분했습니다. 지금은 Konig, Context Lake, Memory MCP 서버, Graphiti MCP 서버처럼 이름이 늘어 누가 무슨 일을 하는지 헷갈립니다. 이 글은 도서관에 빗대어 문·접수대·사서·서고·대출 데스크·관리 규정 여섯 층으로 생태계를 정리하고, 문장 하나가 기억이 되기까지 어느 구성요소를 거치는지 위젯으로 따라갑니다. 열린 것과 닫힌 것, 요금과 크레딧 계산법, 직접 운영과 서비스 이용 중 무엇을 고를지도 함께 다룹니다.
지난 4월 Zep 논문 해부 글에서는 그림이 단순했습니다. Zep이라는 서비스가 있고, 그 엔진이 Graphiti라는 시간 인식 지식 그래프였습니다.
반년이 지난 지금 Zep 문서를 열면 낯선 이름이 여럿 나옵니다. Konig, Context Lake, Context Graph, Memory MCP 서버, Graphiti MCP 서버, Observations. 비슷해 보이는 이름이 서로 다른 것을 가리키기도 하고, 다른 이름이 같은 것을 가리키기도 합니다.
이 글의 목표는 하나입니다. 누가 무슨 일을 하고, 무슨 일은 하지 않는지를 지도 한 장으로 정리하는 것입니다.
✅
결론 먼저.
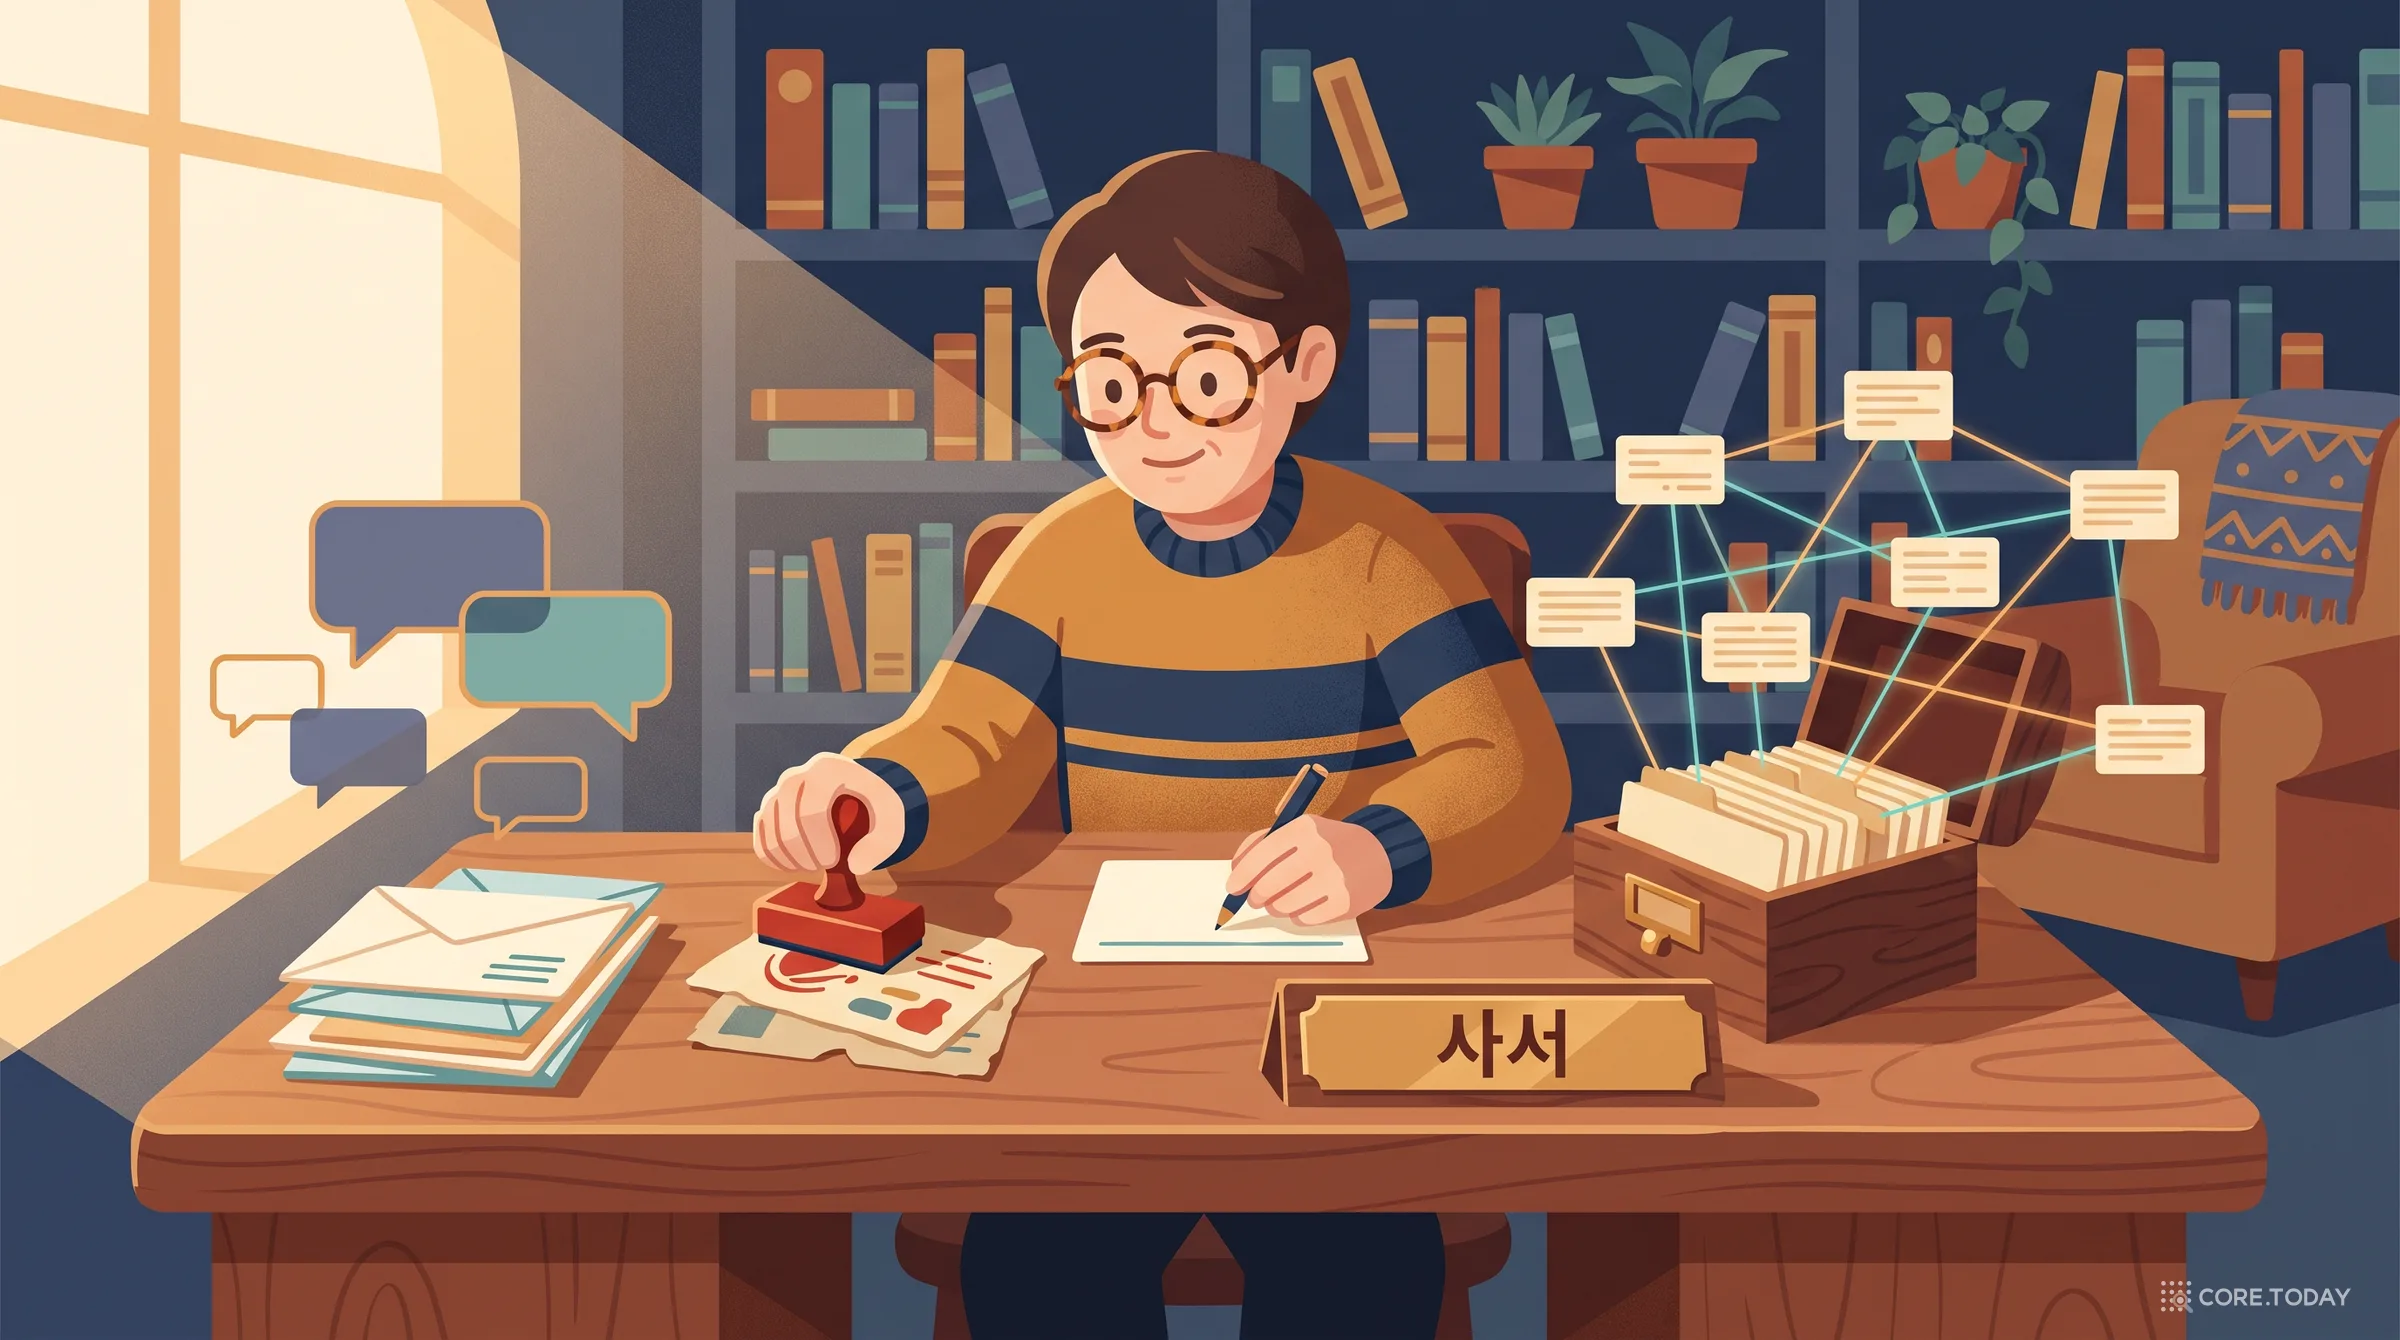
· Graphiti = 자료를 읽고 색인 카드를 쓰는 사서. 오픈소스이고, Zep 서비스 안에서도 그대로 일합니다.
· Konig = Zep이 직접 지은 서고(그래프 데이터베이스). 공개되지 않았습니다.
· Context Lake = 문부터 서고까지 묶은 도서관 전체의 이름입니다.
· MCP 서버는 두 개입니다. Zep 계정으로 들어가는 Memory MCP 서버와, 직접 띄운 Graphiti에 붙는 Graphiti MCP 서버는 다른 물건입니다.
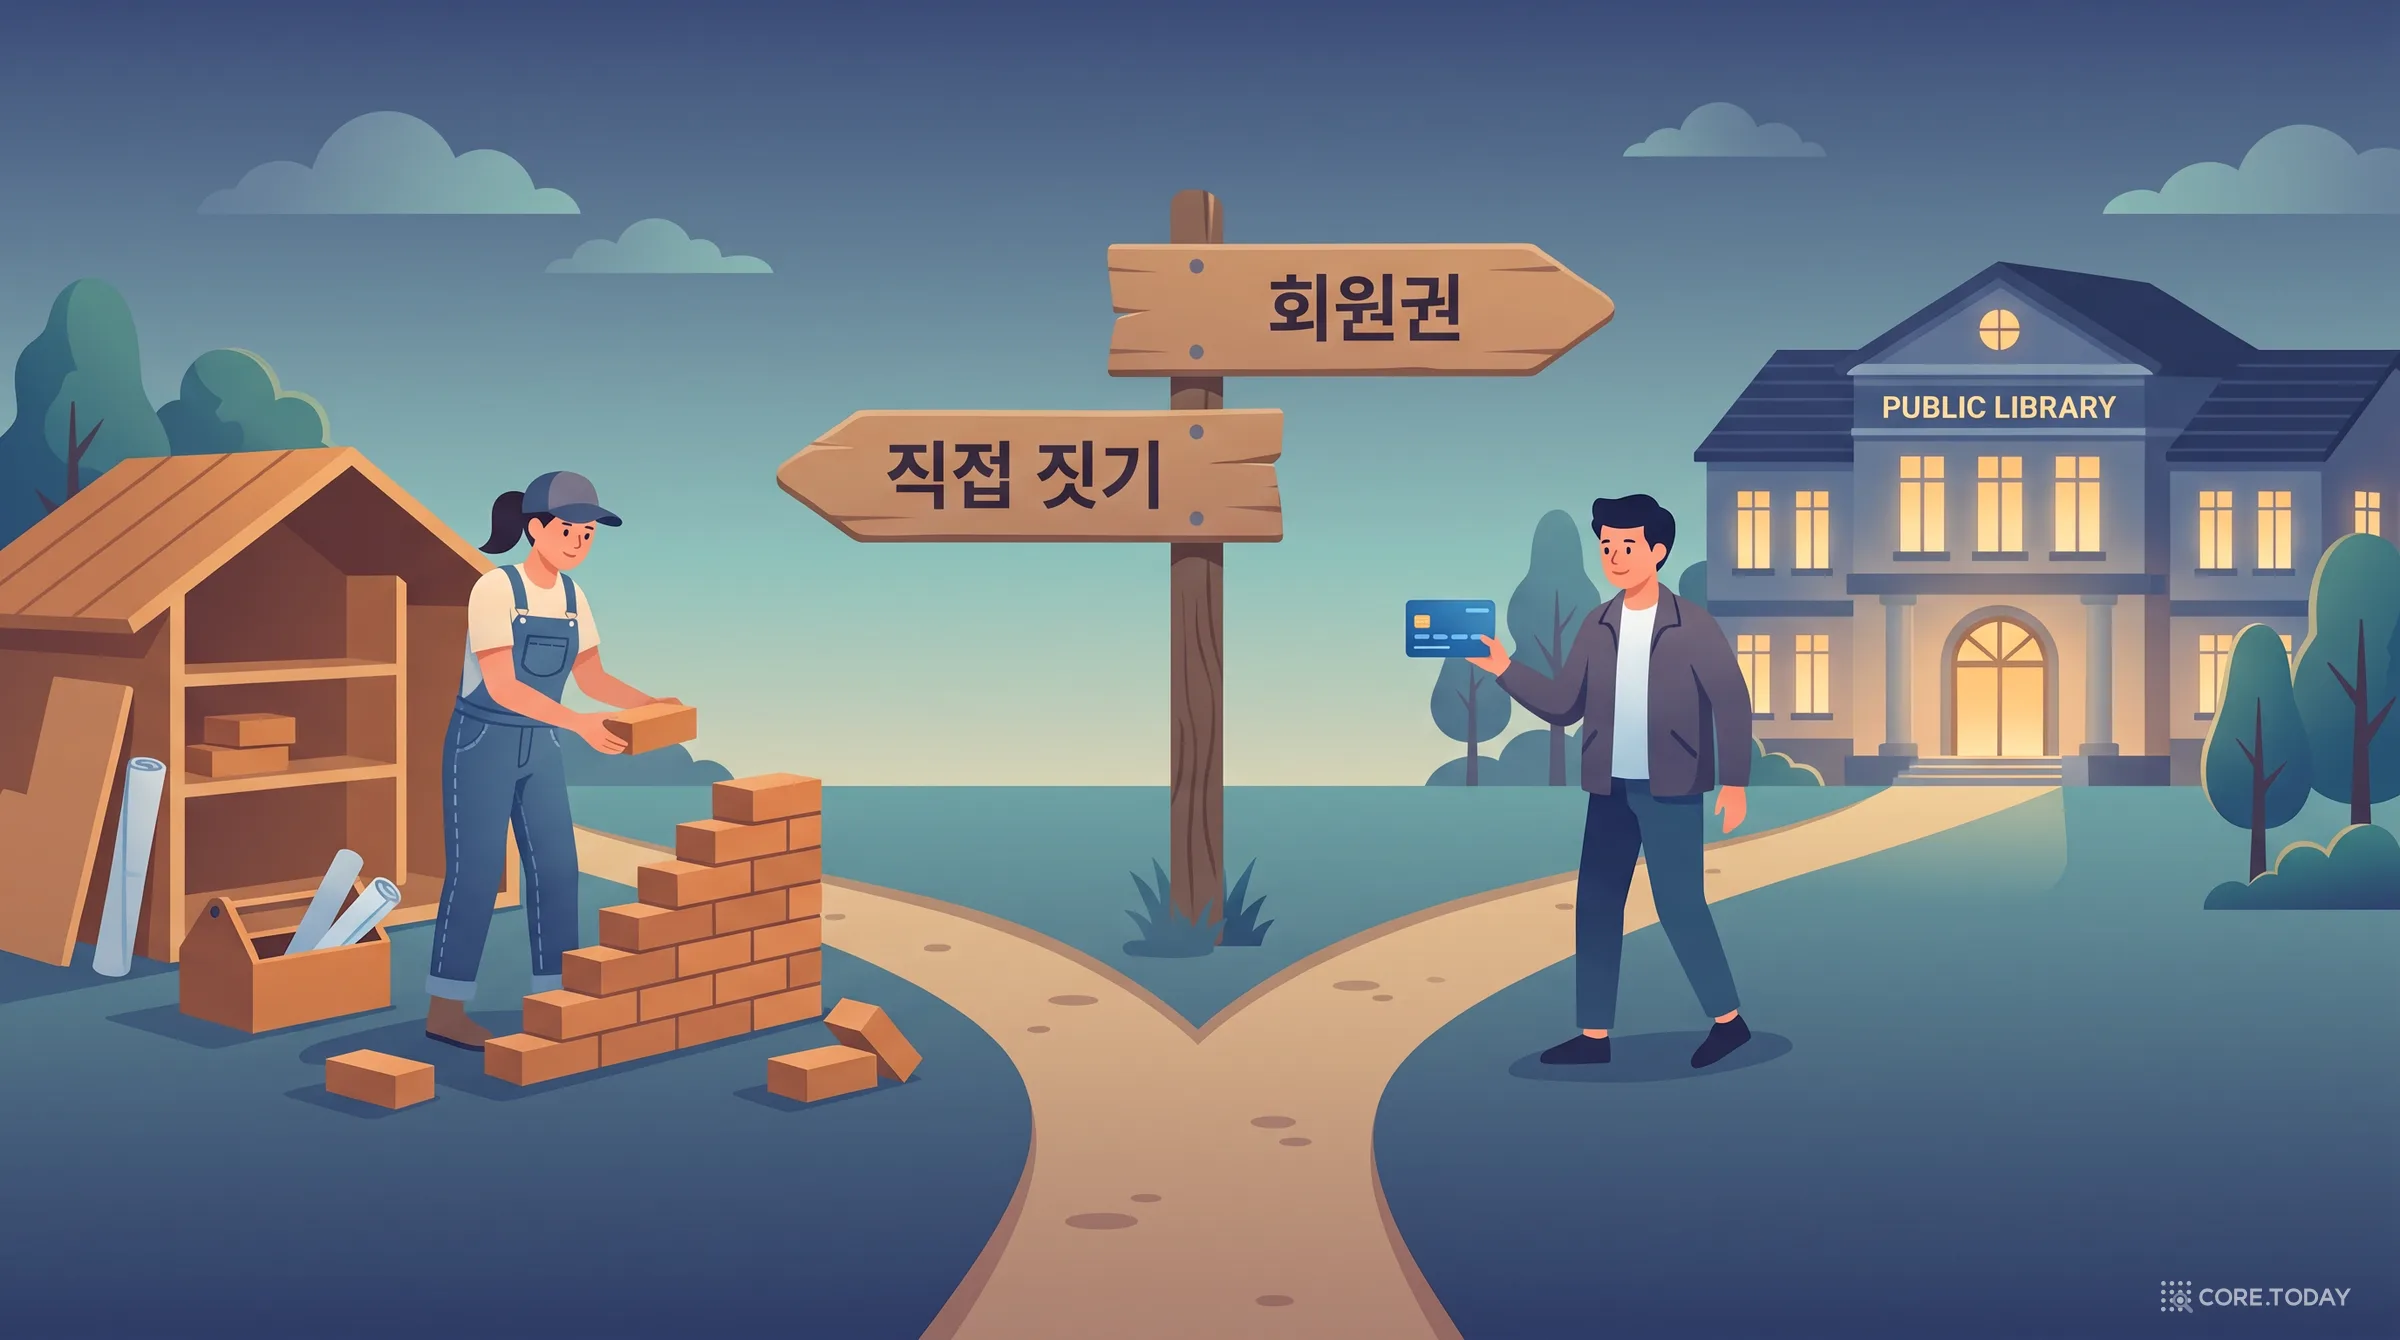
· 고를 때는 "사서만 데려와 도서관을 직접 짓느냐, 지어진 도서관의 회원이 되느냐"를 정하면 됩니다.
1. 지도 한 장 — 도서관으로 보기
에이전트의 기억 시스템은 도서관과 닮았습니다. 자료가 들어오고, 누군가 정리하고, 어딘가에 보관하고, 필요할 때 찾아서 내줍니다. Zep 생태계의 이름들은 이 여섯 자리 가운데 하나에 앉습니다.
Graphiti를 직접 쓰면 카드를 넣을 서고를 스스로 골라야 합니다. 지원되는 곳은 Neo4j, FalkorDB, Amazon Neptune입니다. FalkorDB는 별도 서버 없이 프로세스 안에 넣어 쓰는 임베디드 판도 있어 실험하기 좋습니다. Kuzu는 원 프로젝트의 관리가 멈춰 6월에 지원 종료가 예고됐으니 새로 시작한다면 피하는 편이 낫습니다.
Zep은 한동안 기성 그래프 DB 위에서 돌았습니다. 그러다 규모가 커지면서 맞지 않는 점이 드러났다고 8월 27일 글에서 밝혔습니다. 범용 그래프 DB는 큰 그래프 하나를 메모리에 올려 복잡하게 질의하는 상황을 전제합니다. Zep의 일은 정반대였습니다. 사용자마다, 고객마다 따로 있는 작은 그래프 수백만 개를 다루고, 그 대부분은 어느 순간에나 잠들어 있습니다.
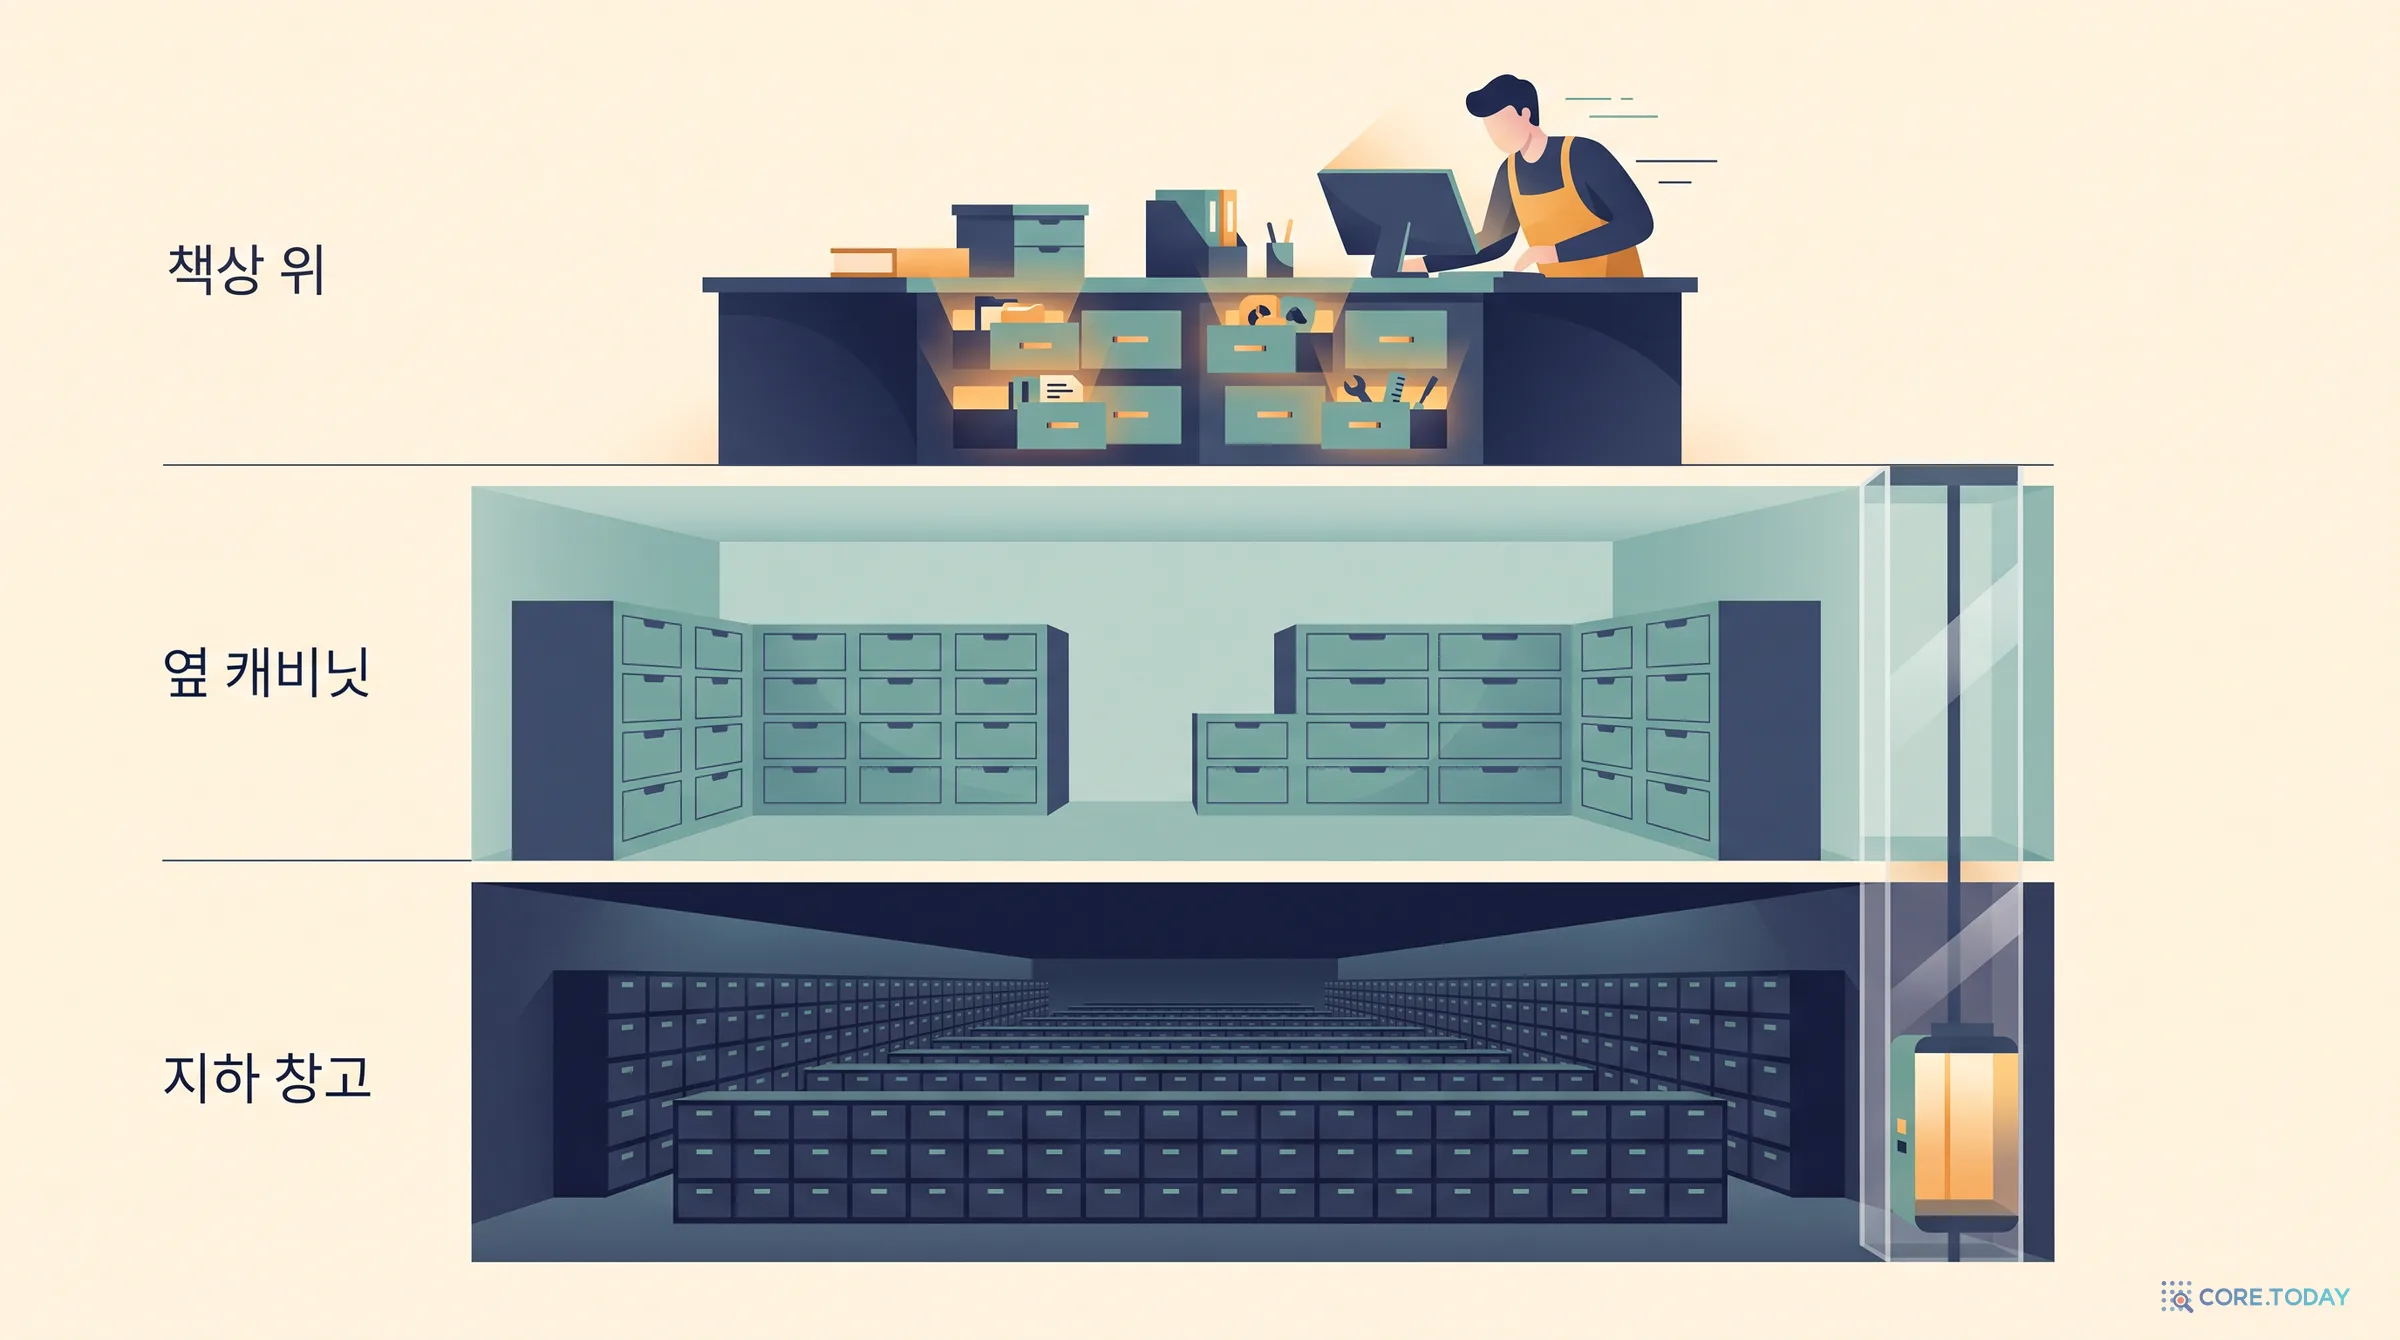
그래서 만든 것이 Konig입니다. 핵심은 세 층으로 나눈 보관입니다.
책상 위지금 쓰는 그래프는 메모리에 둡니다. 가장 빠릅니다.
옆 캐비닛조금 전까지 쓰던 그래프는 서버의 NVMe에 둡니다. 다시 여는 데 몇 밀리초가 걸립니다.
지하 창고오래 잠든 그래프는 오브젝트 스토리지에 둡니다. 다시 여는 데 수백 밀리초가 걸립니다.
이렇게 하면 비용이 전체 그래프 수가 아니라 지금 깨어 있는 그래프 수를 따라갑니다. 그래프마다 전문 검색과 벡터 색인이 함께 들어 있고, 그래프가 사용자별로 따로 있으니 남의 기억이 검색 결과에 섞일 여지가 구조적으로 없습니다.
Konig는 공개되지 않았습니다. 제품 페이지 주소는 context-graph-engine이고 Graphiti README도 "Context Graph Engine"이라고 부르는데, 둘 다 Konig를 가리킵니다.
기억은 꺼내 쓸 때 가치가 생깁니다. 대출 데스크는 의미 검색, 키워드 검색, 그래프 탐색을 섞어 지금 대화에 필요한 것을 찾습니다. 이 검색은 Graphiti에도 들어 있습니다.
Zep이 여기에 더한 것은 Context Block입니다. 사실, 엔티티, 원문, 대화 요약, 사용자 요약을 프롬프트에 바로 넣을 수 있는 문자열 하나로 묶어 줍니다. thread.get_user_context() 한 번이면 받습니다. 유료 상위 요금제에서는 여러 사실에 걸친 반복 패턴을 정리한 Observations도 함께 들어옵니다.
대출 데스크가 하지 않는 일은 답을 만드는 것입니다. 받은 덩어리를 프롬프트 어디에 넣을지, 어떤 모델을 부를지는 애플리케이션이 정합니다.
Zep의 요금은 크레딧으로 셉니다. 요금 페이지 기준으로 에피소드 350바이트까지가 1크레딧이고, 350바이트가 늘 때마다 1크레딧이 더 듭니다.
요금제
월 요금
포함 크레딧
Memory MCP 좌석
무료
0
10,000
1
Flex
125달러
50,000
5
Flex Plus
375달러
200,000
15
Enterprise
협의
협의
협의
⚠️
한글은 크레딧이 빨리 닳습니다. 한글 한 글자는 UTF-8로 3바이트입니다. 바이트를 UTF-8로 센다면 350바이트는 한글 약 116자입니다. 영문이라면 350자가 들어갈 자리입니다. 300자짜리 한글 메시지 하나는 900바이트라 3크레딧이 듭니다. 무료 요금제의 1만 크레딧은 이런 메시지 약 3,300건입니다.
Graphiti를 직접 운영하면 사용료는 없지만 공짜는 아닙니다. 3장에서 봤듯 수집 한 건마다 언어 모델을 여러 번 부르고, 그래프 DB 운영비가 듭니다. README는 구조화 출력을 지원하는 모델을 쓰라고 권하고, 작은 모델에서는 수집이 실패할 수 있다고 경고합니다.
6. 숫자를 읽을 때 주의할 점
Zep은 현재 LongMemEval 정확도 90.2%, LoCoMo 94.7%, 검색 지연 p95 162밀리초를 내세웁니다. 지난 글에서 소개한 논문 수치(LongMemEval 71.2%, 응답 2.58초)와 나란히 놓고 싶어지지만 그러면 안 됩니다.
측정 조건이 다릅니다. 새 수치는 답변 모델과 채점 모델이 모두 gpt-5.4이고, 논문은 gpt-4o였습니다.
지연의 뜻이 다릅니다. 논문의 2.58초는 답변까지 걸린 전체 시간이고, 162밀리초는 검색만 잰 시간입니다.
자체 측정입니다. 제3자가 같은 조건으로 재현한 결과는 확인하지 못했습니다.
또 하나, 이 수치는 Konig 위에서 도는 Zep 서비스의 것입니다. Graphiti를 Neo4j에 올려 직접 운영할 때 같은 속도가 난다는 뜻이 아닙니다. Zep 문서도 관리형 서비스에는 자체 추출 모델과 리랭커가 더해진다고 적고 있습니다.
마무리 — 한 장으로 다시
📇
Graphiti는 사서입니다
자료를 읽고, 사실을 뽑고, 유효 기간을 적습니다. 오픈소스이고 어디서나 같은 일을 합니다.
🗄️
Konig는 서고입니다
작은 그래프 수백만 개를 세 층에 나눠 보관합니다. Zep 안에만 있습니다.
🏛️
Context Lake는 도서관 전체입니다
문, 접수대, 사서, 서고, 대출 데스크, 관리 규정을 한 시스템으로 묶은 이름입니다.
반년 전에는 "Zep의 엔진은 Graphiti"라고 쓰면 충분했습니다. 지금은 한 줄을 더 붙여야 정확합니다. 사서는 Graphiti, 서고는 Konig입니다. 그리고 사서만 데려올지, 도서관의 회원이 될지는 운영할 사람과 데이터가 머물 곳을 보고 정하면 됩니다.