‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
코어닷투데이2026-10-2747분
?
질문
시민이 "롯데 홈구장 새로 짓는 계획 언제 시작해?"라고 물으면, 사실탐색기는 기록 속 이름 '사직야구장 재건축'을 찾아야 답할 수 있습니다. 글자가 하나도 겹치지 않을 때 그 다리를 놓는 것이 임베딩입니다. 지금 쓰는 BGE-M3가 최선일까요?
→
실험
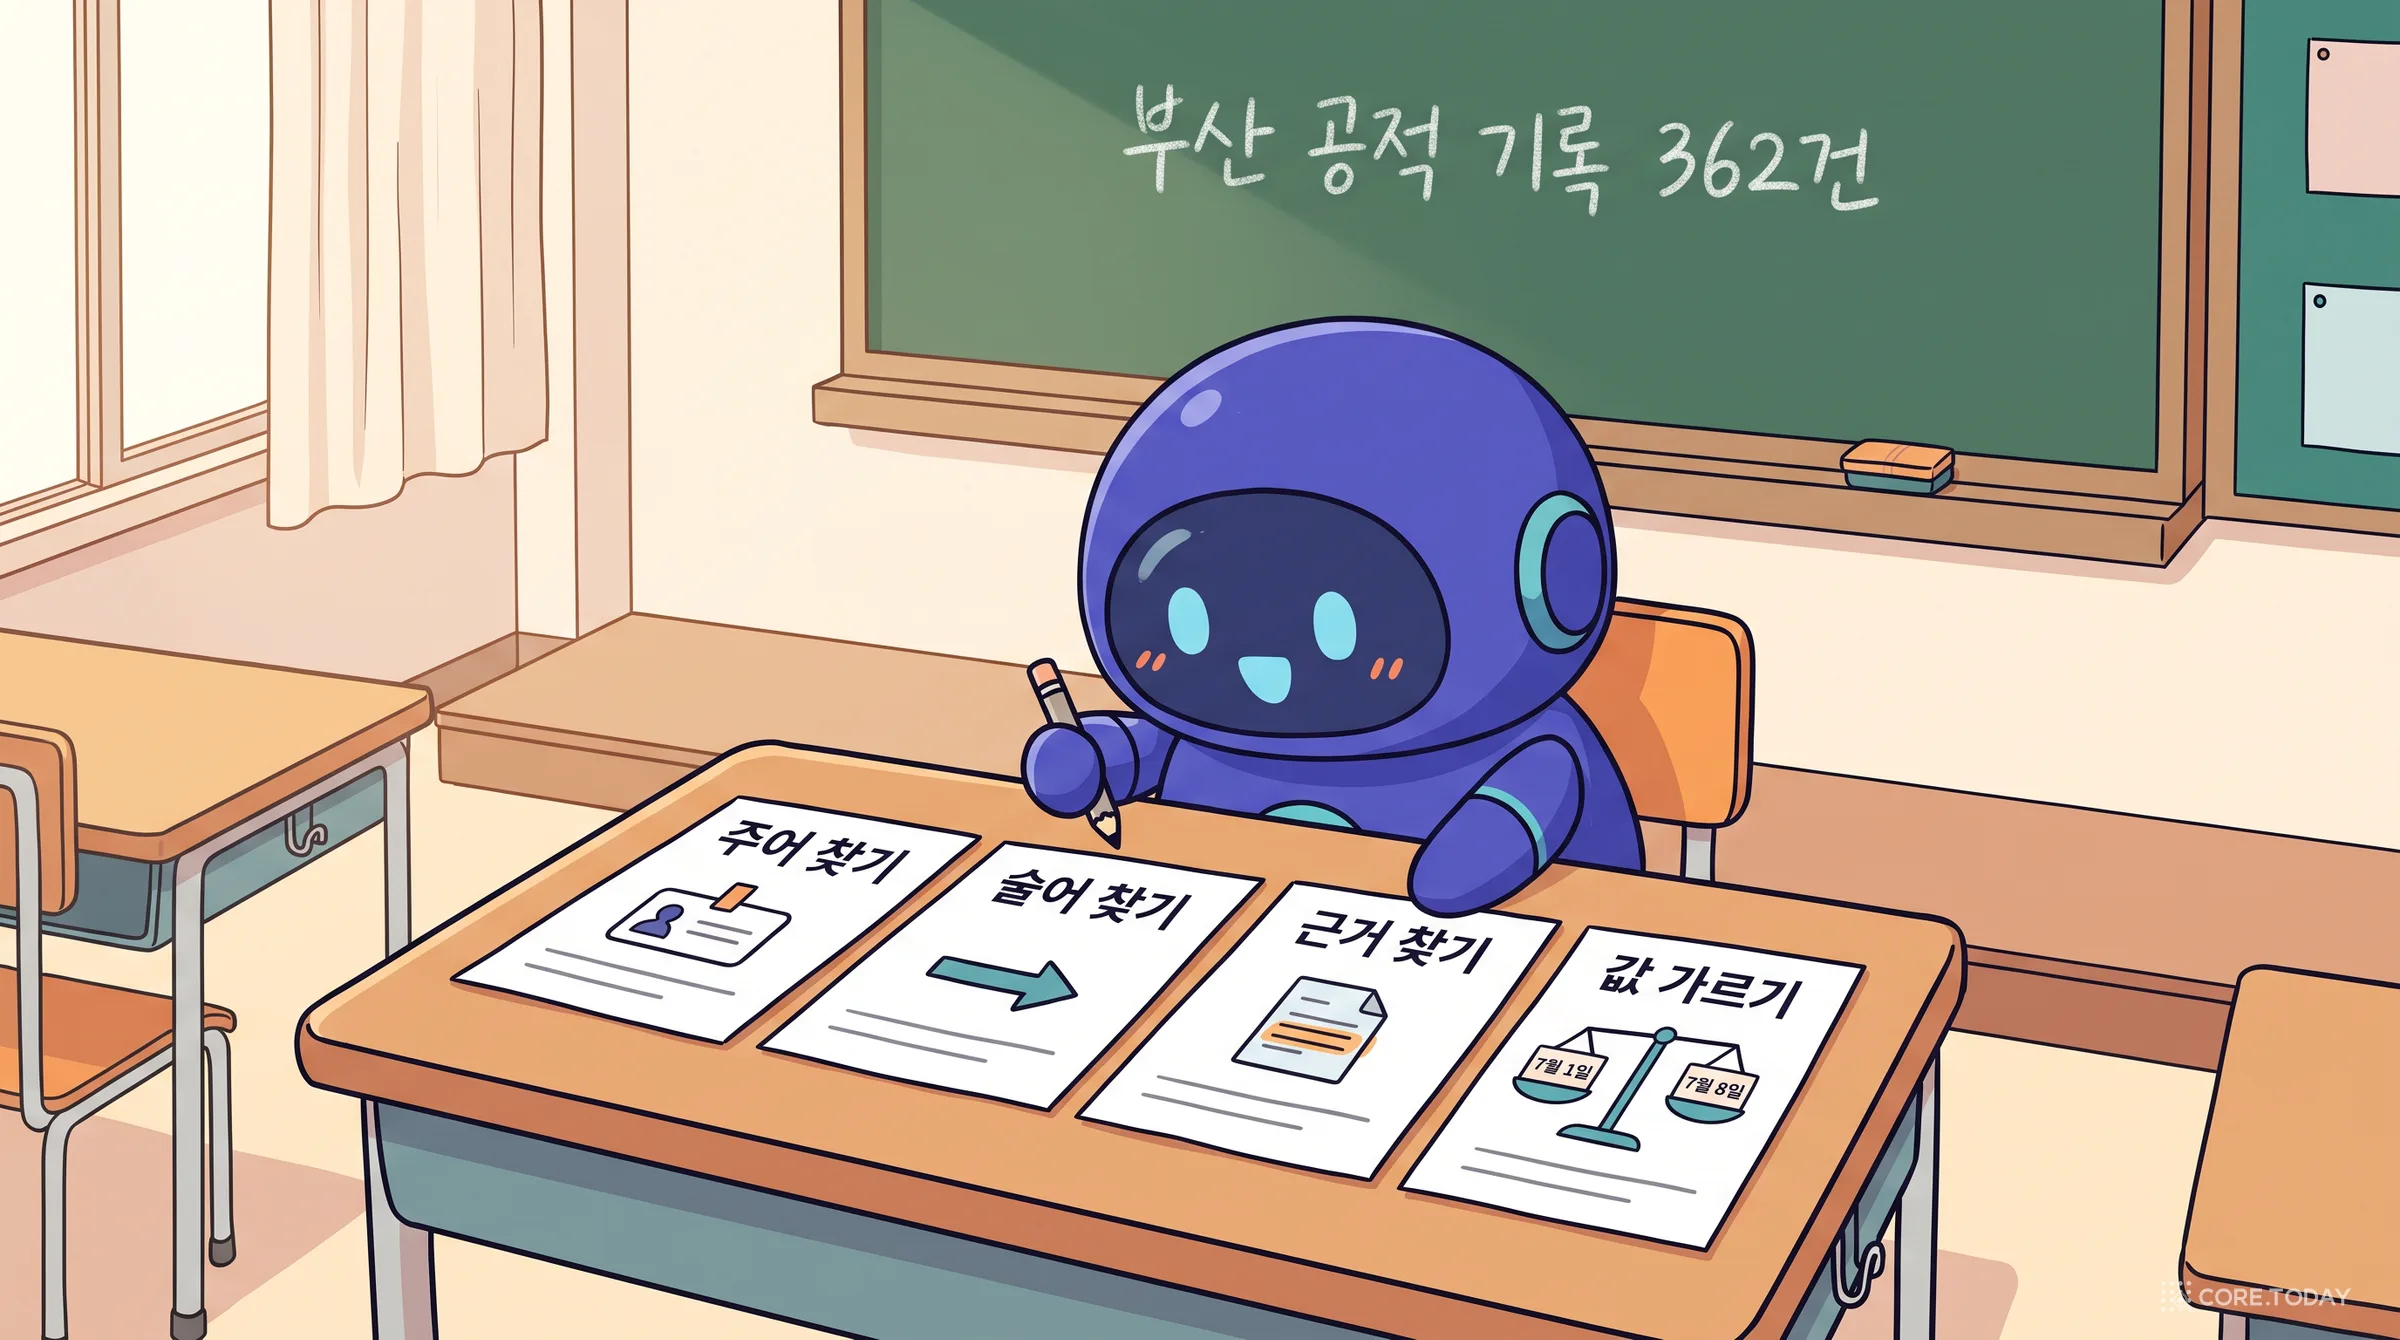
부산 공적 기록 362건으로 네 과제(주어·술어·근거 찾기, 값 가르기)를 만들고, 임베딩 14종을 맥(Ollama)과 A100(Ollama·PyTorch)에서 같은 채점기로 쟀습니다. 질의는 852개, 값 쌍은 1,365개입니다.
!
답
1위는 한국어로 다시 학습한 1.1B 모델 KURE-v3입니다(주어 찾기 69.5%, 근거 찾기 93.7%). 하지만 술어 찾기 1위는 KURE-v1·comsat이었고, KURE-v3는 권장 접두사를 빼면 31%로 무너졌습니다. 값 비교는 어떤 모델에도 맡기면 안 됩니다. 가장 잘 가르는 모델도 숫자 하나 다른 쌍의 6%를 같은 값으로 봤습니다.
들어가며: 사실탐색기에서 임베딩이 하는 일
코어닷투데이 사실탐색기는 공적 기록에서 "지금 참인 값"을 근거와 함께 답하거나, 근거가 모자라면 답하지 않는 엔진입니다(설계편, 실측편). 이 엔진에서 임베딩의 자리는 생각보다 좁습니다.
질문이 들어오면 엔진은 먼저 글자로 찾습니다. 질문에 '금정희망의집'이라고 적혀 있으면 등록부의 '금정희망의집' 엔티티를 바로 잡습니다. 임베딩은 이 글자 경로가 실패했을 때만 나섭니다. "롯데 홈구장 새로 짓는 계획"처럼 기록 속 이름 '사직야구장 재건축'과 글자가 하나도 겹치지 않는 질문입니다. 그때 임베딩이 이웃 몇 개를 후보로 내면, 엔진은 그 후보 가운데 실제로 기록이 있는 (주어, 술어) 쌍을 고르고, 값은 권위 있는 기록이 정합니다.
그러니 사실탐색기가 임베딩에 바라는 것은 두 가지입니다. 바꿔 말한 이름과 속성을 잘 찾을 것, 그리고 맡기지 않은 일(값이 같은지 판단하기)에 끼어들지 않을 것. 지금은 BGE-M3를 씁니다. 2024년 초에 나온 다국어 모델이고, 그 뒤로 한국어 특화 모델과 8B급 대형 모델이 여럿 나왔습니다. 바꿔야 할까요? 이 질문에 답하려고 열네 개 모델을 같은 시험지로 쟀습니다.
열네 개는 세 무리로 나뉩니다. 다국어 범용(BGE-M3, Nomic, Qwen3, EmbeddingGemma, Nemotron), 한국어로 다시 학습한 모델(KURE 네 종, comsat, colbert-ko-en), 그리고 벡터 모양이 다른 모델(문장 하나를 벡터 하나로 만드는 대신 토큰마다 벡터를 만드는 ColBERT, 단어 사전 크기의 희소 벡터를 만드는 SPLADE)입니다.
계보도 얽혀 있습니다. KURE-v1은 BGE-M3를 한국어로 미세 조정했고, KURE-v3는 NVIDIA Nemotron-3-Embed 1B를, comsat은 Qwen3-Embedding 8B를 바탕으로 했습니다. KURE-v2와 colbert-ko-en-v2는 SKT의 한국어 인코더 A.X-Encoder 위에 만든 ColBERT입니다. 그래서 이 비교에는 "같은 뼈대를 한국어로 더 가르치면 얼마나 오르나"를 보는 짝이 세 쌍 들어 있습니다.
2. 시험지: 부산 공적 기록으로 만든 네 과제
시험지는 사실탐색기의 실제 코퍼스인 부산 공적 기록 362건(회의록 13·입법예고 59·고시공고 106·보도자료 36·조례 공포문 68·현행 조례 56·뉴스 24)에서 만들었습니다. 엔진을 한 번 돌리면 등록부 엔티티 3,822개, 텍스트 단위 3,768개, 술어 80개(표면형 436개)가 나옵니다. 이것이 찾을 대상입니다.
질의 453개 → 엔티티 3,822개. 엔티티 151개마다 질의 세 개를 썼습니다. 쉬움(낱말은 같고 띄어쓰기·약칭만 다름: '부산시 저출산대책 출산양육 지원 조례 개정안'), 보통(핵심 낱말 하나만 남김: '부산 은둔형 외톨이 조례 왜 고쳤어'), 어려움(핵심 낱말을 하나도 쓰지 않음: '큰 건물이 차량 몰리게 해서 내는 분담금 깎아주는 규정' → 교통유발부담금 경감 조례).
술어 찾기
질문 240개 → 술어 80개. 사전에 있는 표면형을 피해서 쓴 질문 조각입니다. '효력 생기는 날' → 시행일, '최소 몇 명 찬성해야 돼' → 정족수, '우선주 한 주당 얼마씩 줘' → 종류주식주당배당금.
근거 찾기
질문 159개 → 단위 3,768개. 회의록 발언·조문·공고 문단 하나가 답하는 질문입니다. '기장군 임대주택 근로자는 어디서 온라인으로 신청하나요?', '금고지정심의위원회는 어떤 사항을 심의하나요?' 앞으로 사실탐색기가 근거 문장을 의미로 찾을 때의 과제입니다.
값 가르기
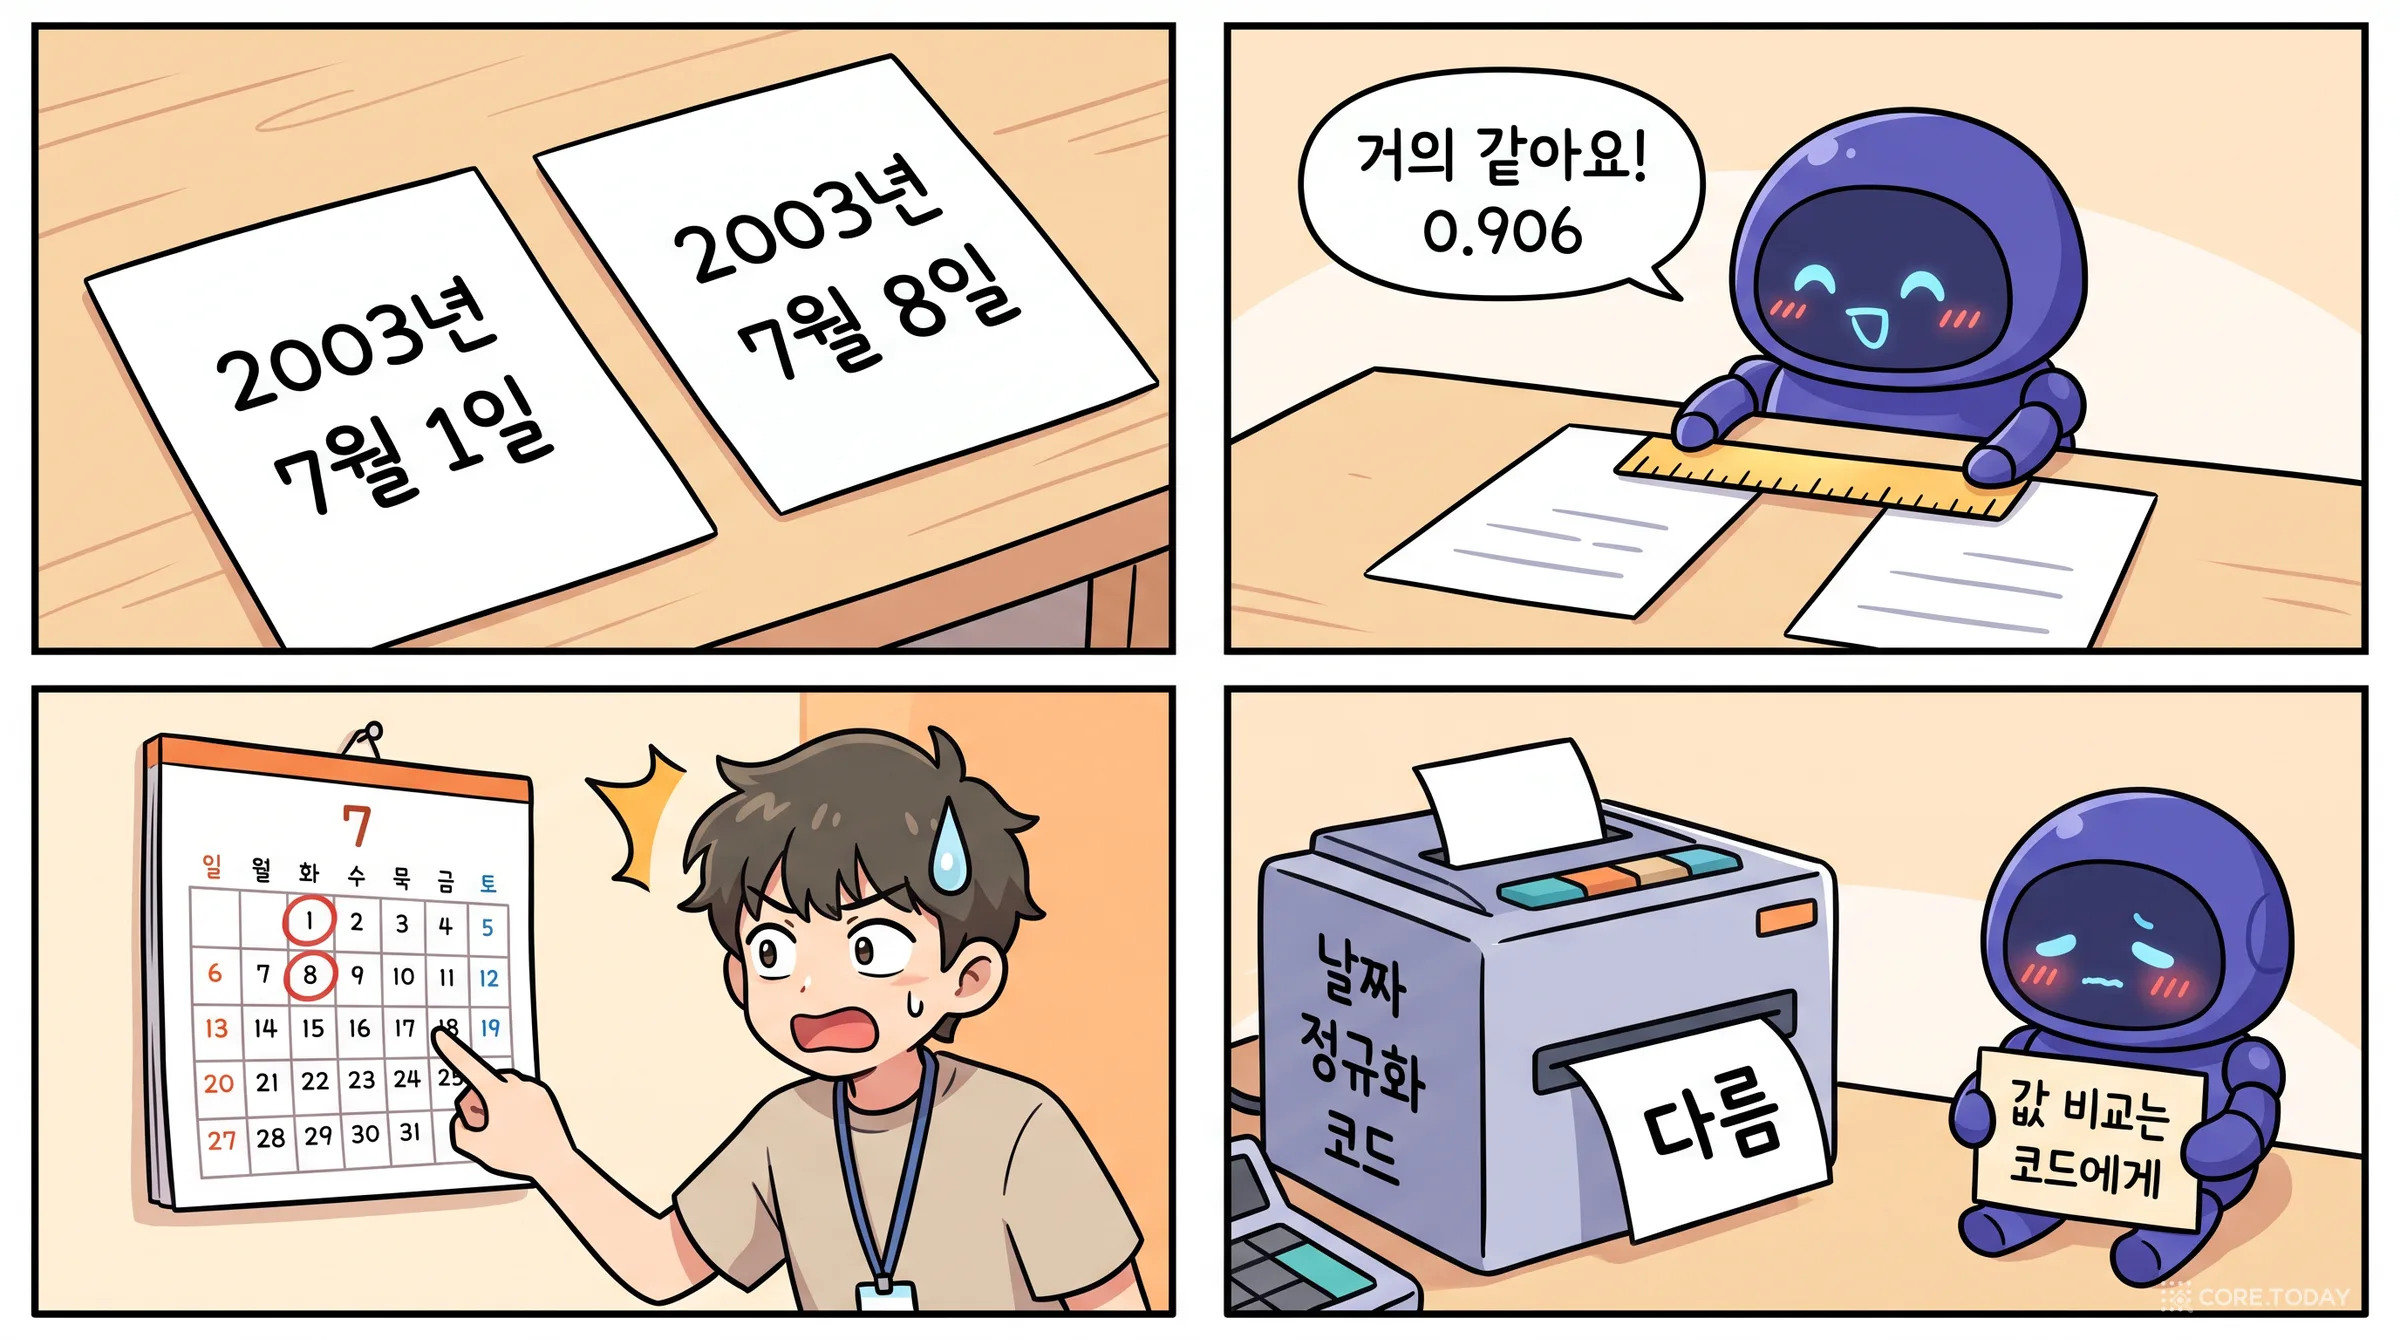
값 쌍 1,365개. 기록 속 실제 값 585개에서 규칙으로 만들었습니다. 같은 값의 다른 표기 749쌍('2026. 9. 22.' ↔ '2026-09-22', '97명' ↔ '97 명'), 숫자 하나만 바꾼 585쌍('2003년 7월 1일' ↔ '2003년 7월 8일'), 엔진이 실제로 대체한 값 31쌍. 임베딩이 이 둘을 가를 수 있는지 봅니다.
질의는 Claude Code 서브에이전트가 썼습니다(별도 비용 없음). 사람이 하나하나 검수하지는 않았으므로, 질의 몇 개는 어색하거나 두 엔티티를 함께 가리킬 수 있습니다. 그래서 정답은 넉넉하게 잡았습니다. 같은 핵심 이름을 가진 엔티티(조례와 그 일부개정조례안처럼 판본만 다른 것)는 모두 정답으로 쳤고, 근거 찾기에서는 같은 본문을 실은 다른 단위(조례 전문의 조문과 공포문의 같은 조문)도 정답입니다.
기준선은 글자입니다. 주어·술어는 문자 bigram 자카드 유사도, 근거는 bigram BM25입니다. 임베딩이 이 기준선을 얼마나 넘는지가 임베딩을 쓰는 값입니다.
모델마다 권장 접두사를 붙였습니다. EmbeddingGemma는 질의에 task: search result | query:, 문서에 title: none | text:, Nomic은 search_query:·search_document:, KURE-v3·Nemotron은 query:·passage:, Qwen3와 comsat은 질의에만 영어 지시문을 붙입니다. 값 가르기는 대칭 과제라 양쪽에 '유사도' 지시문을 붙였습니다. 접두사 없이도 한 번씩 더 쟀습니다(6절).
돌린 곳은 셋입니다. Ollama 모델은 맥 스튜디오(M1 Ultra 128GB)에서, 큰 Qwen3 두 개는 사내 쿠버네티스 클러스터의 A100 80GB 위 Ollama에서, Hugging Face 모델은 A100 40GB MIG 조각 위 PyTorch(BF16)에서 돌렸습니다. API 크레딧은 쓰지 않았습니다.
첫째, 크기보다 학습 데이터입니다. 1.1B짜리 KURE-v3가 8B 모델 셋(Nemotron 67.3%, Qwen3 65.1%, comsat 64.9%)을 모두 앞섰습니다. 뼈대가 같은 짝을 보면 더 분명합니다. BGE-M3를 한국어로 다시 가르친 KURE-v1은 59.4%에서 66.2%로 7점 올랐습니다. 반면 Qwen3-Embedding 8B를 한국어로 다시 가르친 comsat은 65.1%에서 64.9%로 그대로였습니다. 이미 큰 모델은 한국어 미세 조정으로 얻을 것이 적었습니다.
둘째, 300M짜리 EmbeddingGemma 1세대가 의외로 강합니다. 66.4%로 8B 모델들과 어깨를 나란히 했습니다. Ollama로 맥에서 바로 돌고, 메모리는 1GB가 안 됩니다.
셋째, 지금 쓰는 BGE-M3는 하위권입니다. 59.4%로 글자 기준선보다 10점 높지만, 1위와는 10점 차이입니다.
어려운 질의에서 임베딩의 값이 드러난다
평균만 보면 글자 기준선(49.2%)과 임베딩의 차이가 10~20점으로 작아 보입니다. 쉬운 질의가 평균을 끌어올리기 때문입니다. 난이도별로 나누면 그림이 달라집니다.
모델
쉬움
보통
어려움
글자 기준선
76.8%
66.2%
4.6%
BGE-M3 (현재)
85.4%
62.9%
29.8%
KURE-v3
86.8%
77.5%
44.4%
Qwen3-Embedding 8B
80.1%
68.9%
46.4%
comsat-embed-ko 8B
74.8%
74.2%
45.7%
EmbeddingGemma (308M)
79.5%
75.5%
44.4%
핵심 낱말을 하나도 쓰지 않은 질의에서 글자 기준선은 4.6%, 사실상 0입니다. 임베딩은 30~46%를 찾습니다. 사실탐색기가 임베딩을 쓰는 이유가 이 칸에 있습니다. 동시에 한계도 이 칸에 있습니다. 최고 모델도 절반을 넘지 못합니다. '큰 건물이 차량 몰리게 해서 내는 분담금 깎아주는 규정'에서 '교통유발부담금 경감 조례'까지 가려면 행정 용어를 알아야 하고, 임베딩 하나로는 반쯤만 됩니다. 그래서 벡터 이웃은 답이 아니라 후보여야 합니다.
아래에서 모델 사이에 결과가 반반쯤 갈린 질의를 직접 볼 수 있습니다.
틀린 답도 대개 엉뚱하지 않습니다. 같은 조례의 다른 조문이나 같은 분야의 다른 위원회처럼 이웃을 가져옵니다. 상위 다섯 개 안에 정답이 있는 비율(@5)은 상위 모델들이 88~93%입니다. 후보로 다섯 개를 받고 기록이 있는 쌍을 고르는 지금의 설계와 잘 맞습니다.
4. 결과 ②·③: 술어와 근거 — 과제마다 1위가 바뀐다
술어 찾기는 다른 모델이 이겼습니다. 글자 기준선은 14.6%에 그칩니다. '효력 생기는 날'과 '시행일'은 글자가 거의 안 겹치기 때문입니다. 임베딩은 32~63%입니다. 1위는 KURE-v1과 comsat(62.5%), 그다음이 KURE-v2(60.8%)와 Qwen3 8B(59.6%)였습니다. 주어 찾기 1위 KURE-v3는 50.0%로 중간이었습니다. 짧은 질문 조각을 짧은 속성 이름에 맞추는 일은 긴 이름을 찾는 일과 다른 능력입니다.
근거 찾기에서는 글자가 강합니다. BM25만으로 상위 다섯 개 안에 정답 단위가 들어온 비율이 84.9%입니다. 공적 기록의 질문은 '금고지정심의위원회', '임대주택' 같은 고유한 낱말을 담기 마련이고, 그 낱말이 단위에 그대로 있습니다. 임베딩이 더하는 것은 3~9점입니다.
모델
근거 @1
근거 @5
술어 @1
글자 기준선
61.0%
84.9%
14.6%
KURE-v3
81.1%
93.7%
50.0%
Nemotron 8B
83.7%
93.7%
56.2%
KURE-v2 (ColBERT, 149M)
79.2%
92.4%
60.8%
KURE-v1
70.4%
91.2%
62.5%
BGE-M3 (현재)
71.1%
91.2%
56.2%
Qwen3-Embedding 8B
64.1%
86.8%
59.6%
근거 찾기에서 눈여겨볼 것은 @1입니다. 다섯 개 안에 들어오는 비율은 모두 비슷하지만, 첫 결과가 맞는 비율은 BM25 61%, BGE-M3 71%, KURE-v3·Nemotron 81~84%로 벌어집니다. 질문에 답할 근거 문장 하나를 바로 보여 줘야 하는 화면이라면 이 차이가 큽니다. 149M짜리 ColBERT 모델 KURE-v2가 79%로 따라붙은 것도 눈에 띕니다. 토큰마다 벡터를 두는 방식이 긴 문단 속 한 구절을 잘 잡습니다. 다만 단위마다 벡터 수백 개를 저장해야 해서 색인이 수십 배 커집니다.
5. 값 비교의 함정: '7월 1일'과 '7월 8일'은 얼마나 가까운가
사실탐색기의 핵심 연산(AGS)은 같은 사실에 대해 값이 다른 기록이 들어오면 옛 값을 닫습니다. 값이 같으면 근거를 하나 더 붙입니다. 그래서 "두 값이 같은가"는 엔진에서 가장 위험한 판단입니다. 같은 값을 다르다고 하면 멀쩡한 사실이 닫히고, 다른 값을 같다고 하면 정정이 묻힙니다. 이 판단을 임베딩 유사도에 맡길 수 있을까요?
결과는 모델마다 극단적으로 갈렸습니다. 같은 값의 다른 표기 쌍에서 하위 5%를 문턱으로 잡았을 때(같은 값은 95% 받아들이도록), 숫자 하나만 다른 쌍이 그 문턱을 넘어 '같은 값'으로 판정되는 비율입니다.
Qwen3-Embedding 8B
6%
KURE-v3
7%
EmbeddingGemma
14%
Nemotron 8B
15%
BGE-M3 (현재)
82%
KURE-v1
81%
글자 bigram
89%
BGE-M3에서 '2003년 7월 1일'과 '2003년 7월 8일'의 유사도는 0.906입니다. 같은 날짜를 '2026.9.9.'와 '2026-09-09'로 다르게 쓴 쌍은 0.763입니다. 다른 날짜가 같은 날짜보다 더 가깝습니다. 검색에 강한 인코더 계열(BGE-M3, KURE-v1)은 문장의 겉모양을 잡도록 학습돼서, 숫자 한 자리 차이를 거의 신경 쓰지 않습니다.
지시문을 받는 디코더 계열(Qwen3, KURE-v3, EmbeddingGemma)은 훨씬 잘 가릅니다. 그래도 가장 좋은 모델이 6%를 흘립니다. 숫자 하나가 바뀐 정정 1,000건 가운데 60건이 '같은 값'으로 묻힌다는 뜻이고, 옛 값을 닫는 엔진의 연산으로는 받아들일 수 없는 숫자입니다.
글자 유사도도 다르지 않습니다. 이번 실험 데이터를 뽑다가 사실탐색기 자체의 버그를 하나 찾았습니다. 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'이 한 명제의 같은 값으로 묶여 있었습니다. 텍스트 값의 같음을 글자 bigram 유사도 0.6 이상으로 판정하는 규칙(C3)이 숫자 한 자리 차이를 놓친 것입니다. 수량과 '공포한 날부터'는 코드가 정규화하지만, 숫자가 문장 속에 섞인 값은 이 규칙을 빠져나갔습니다.
결론은 하나입니다. 값이 같은지는 수량·날짜를 풀어서 비교하는 코드가 정하고, 임베딩도 글자 유사도도 그 판단에 쓰지 않습니다. 임베딩은 '어떤 기록이 같은 것을 말하는가'를 찾는 데까지만 씁니다.
6. 접두사 한 줄이 순위를 뒤집는다
모델 카드의 권장 접두사는 장식이 아니었습니다. 같은 모델에 접두사만 빼고 다시 쟀습니다.
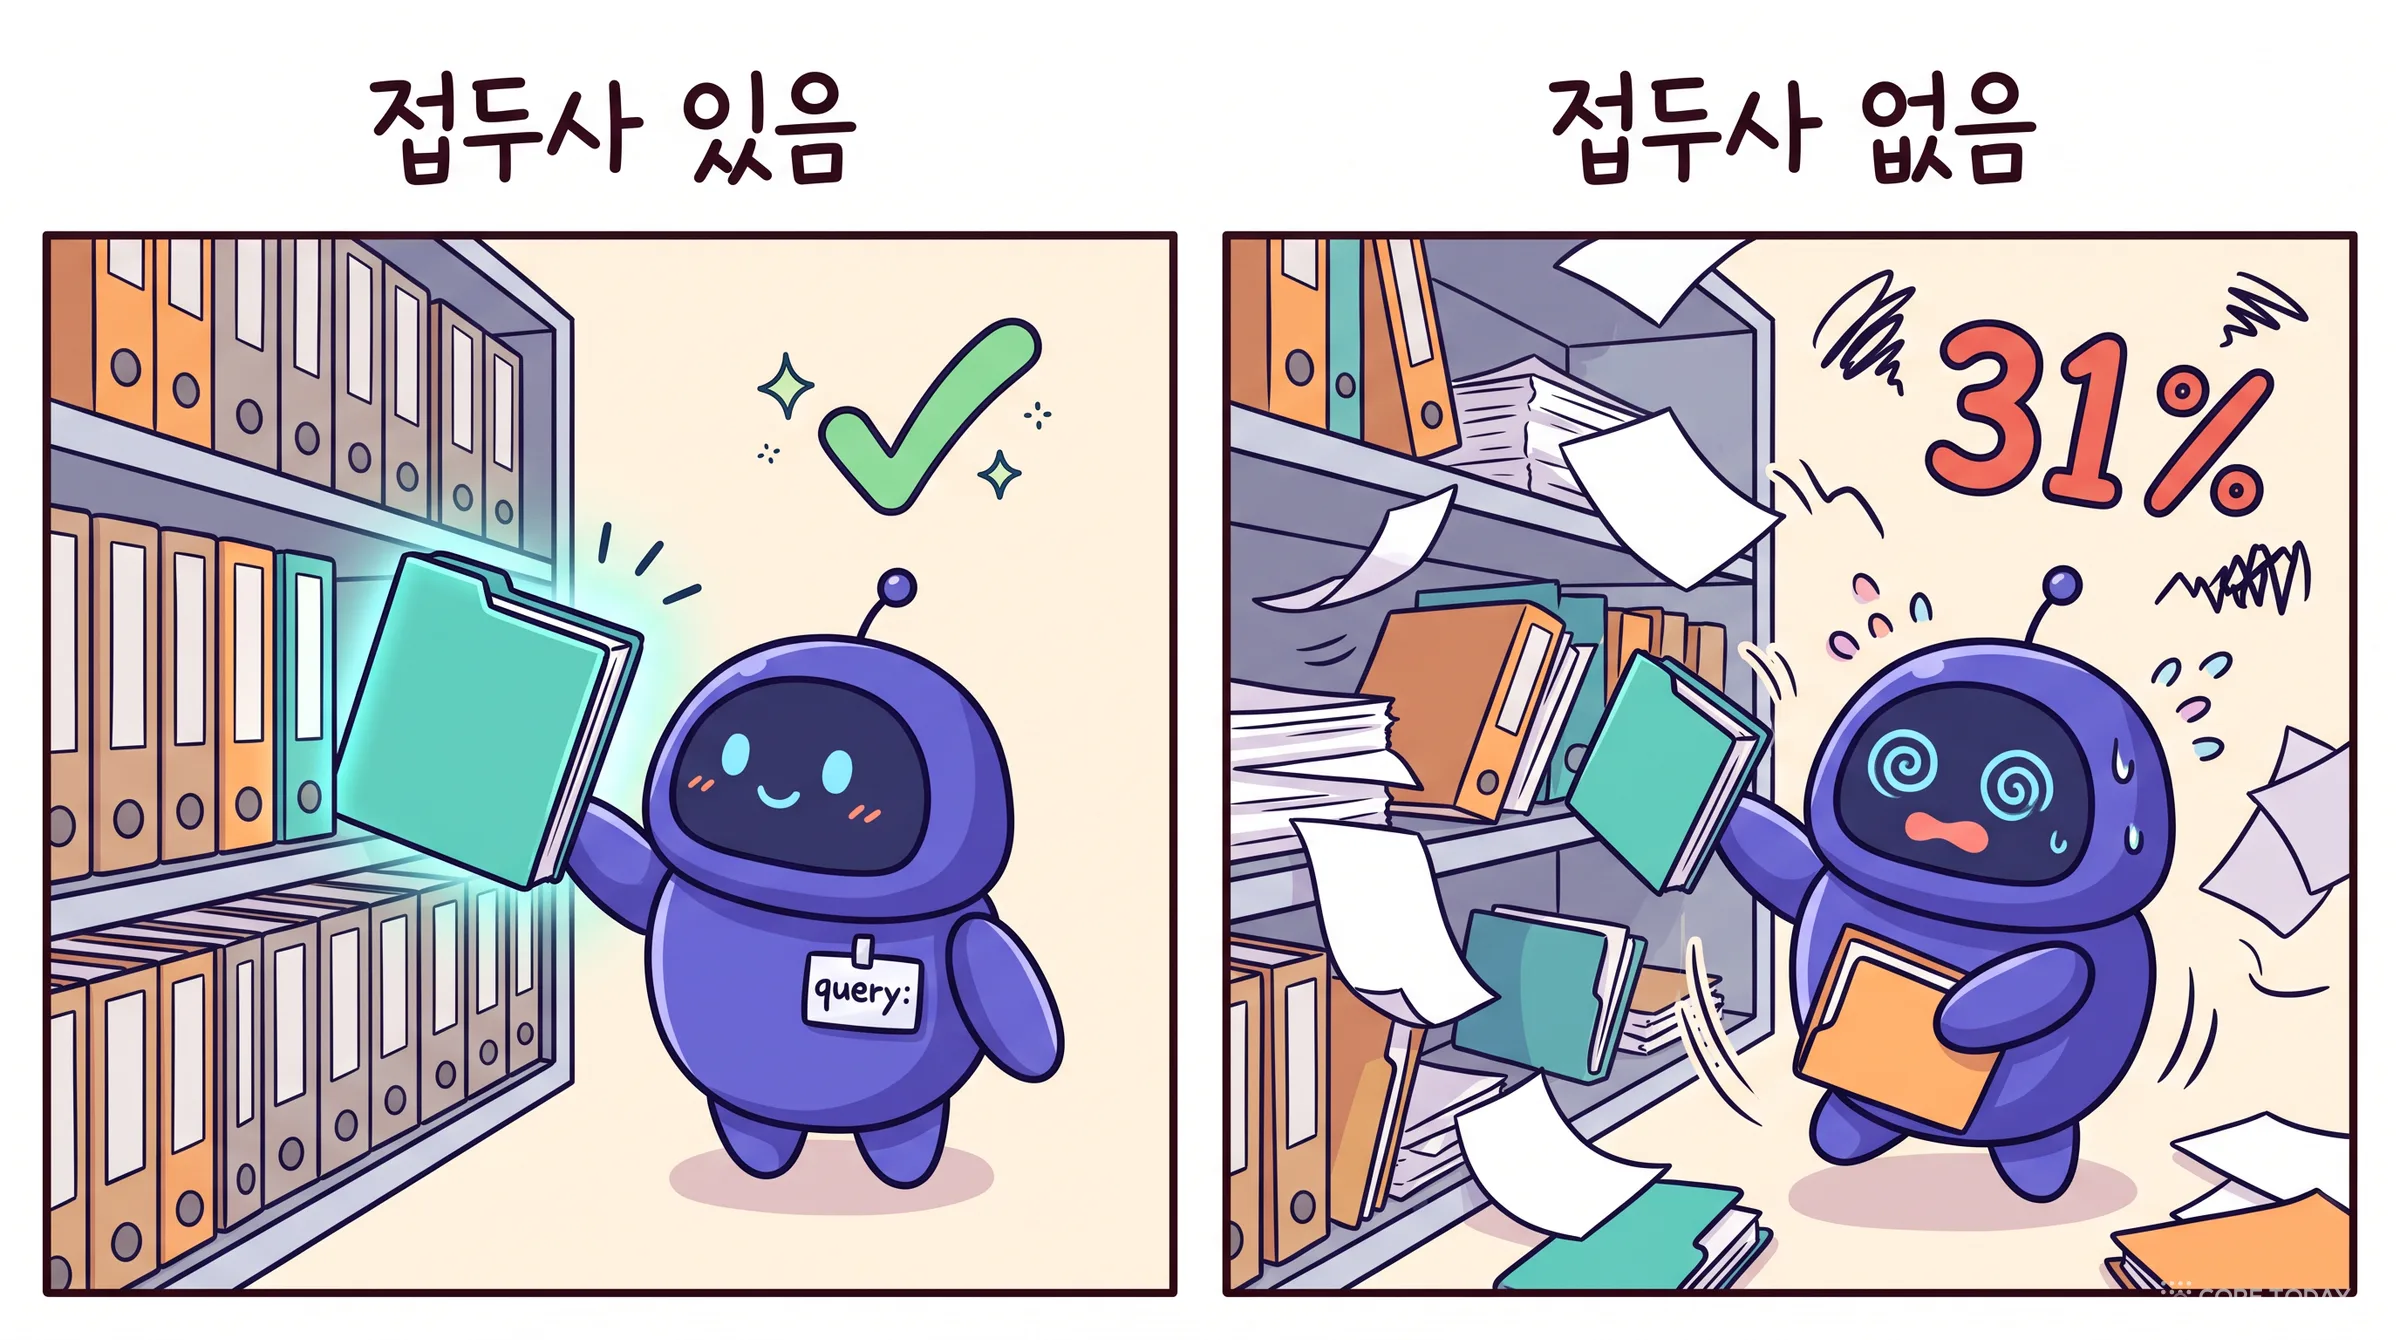
빼면 무너지는 모델. KURE-v3는 접두사 없이 넣으면 주어 찾기가 31%로, 근거 찾기가 25%로 떨어집니다. 글자 검색(85%)보다 한참 아래입니다. 질의와 문서를 늘 접두사와 함께 학습한 것으로 보이고, 접두사 없는 입력은 학습 때 거의 보지 못한 공간으로 가는 것으로 보입니다. Nemotron 8B도 접두사를 빼면 주어 찾기가 67.3%에서 49.0%로, 술어 찾기가 56.2%에서 15.8%로 떨어졌습니다. 이 모델을 고르면 접두사를 붙이는 일이 시스템의 계약이 됩니다. 색인할 때와 질문할 때 한 번이라도 어긋나면 조용히 망가집니다.
빼면 조금 나빠지는 모델. EmbeddingGemma 두 세대는 접두사가 2~8점을 보탭니다.
빼는 편이 나은 과제가 있는 모델. Qwen3 8B는 우리가 쓴 영어 지시문("Given a Korean search query about Busan city council…")을 빼자 근거 찾기가 87%에서 92%로 올랐습니다. Qwen3 8B를 바탕으로 한 comsat도 모델 카드의 기본 지시문을 빼자 주어 찾기가 64.9%에서 67.3%로, 근거 찾기가 91.2%에서 93.1%로 올랐습니다. 대신 값 가르기는 유사도 지시문을 빼면 0.975에서 0.846으로 떨어졌습니다. 지시문은 과제마다 따로 고르고, 그 효과를 재야 합니다. Nomic도 검색 접두사를 빼자 주어 찾기가 5점 올랐습니다.
권장 접두사는 기본값일 뿐입니다. 모델을 바꿀 때는 접두사를 붙인 판과 뺀 판을 우리 과제로 둘 다 재 봐야 합니다.
7. 섞으면 좋아진다는 통념
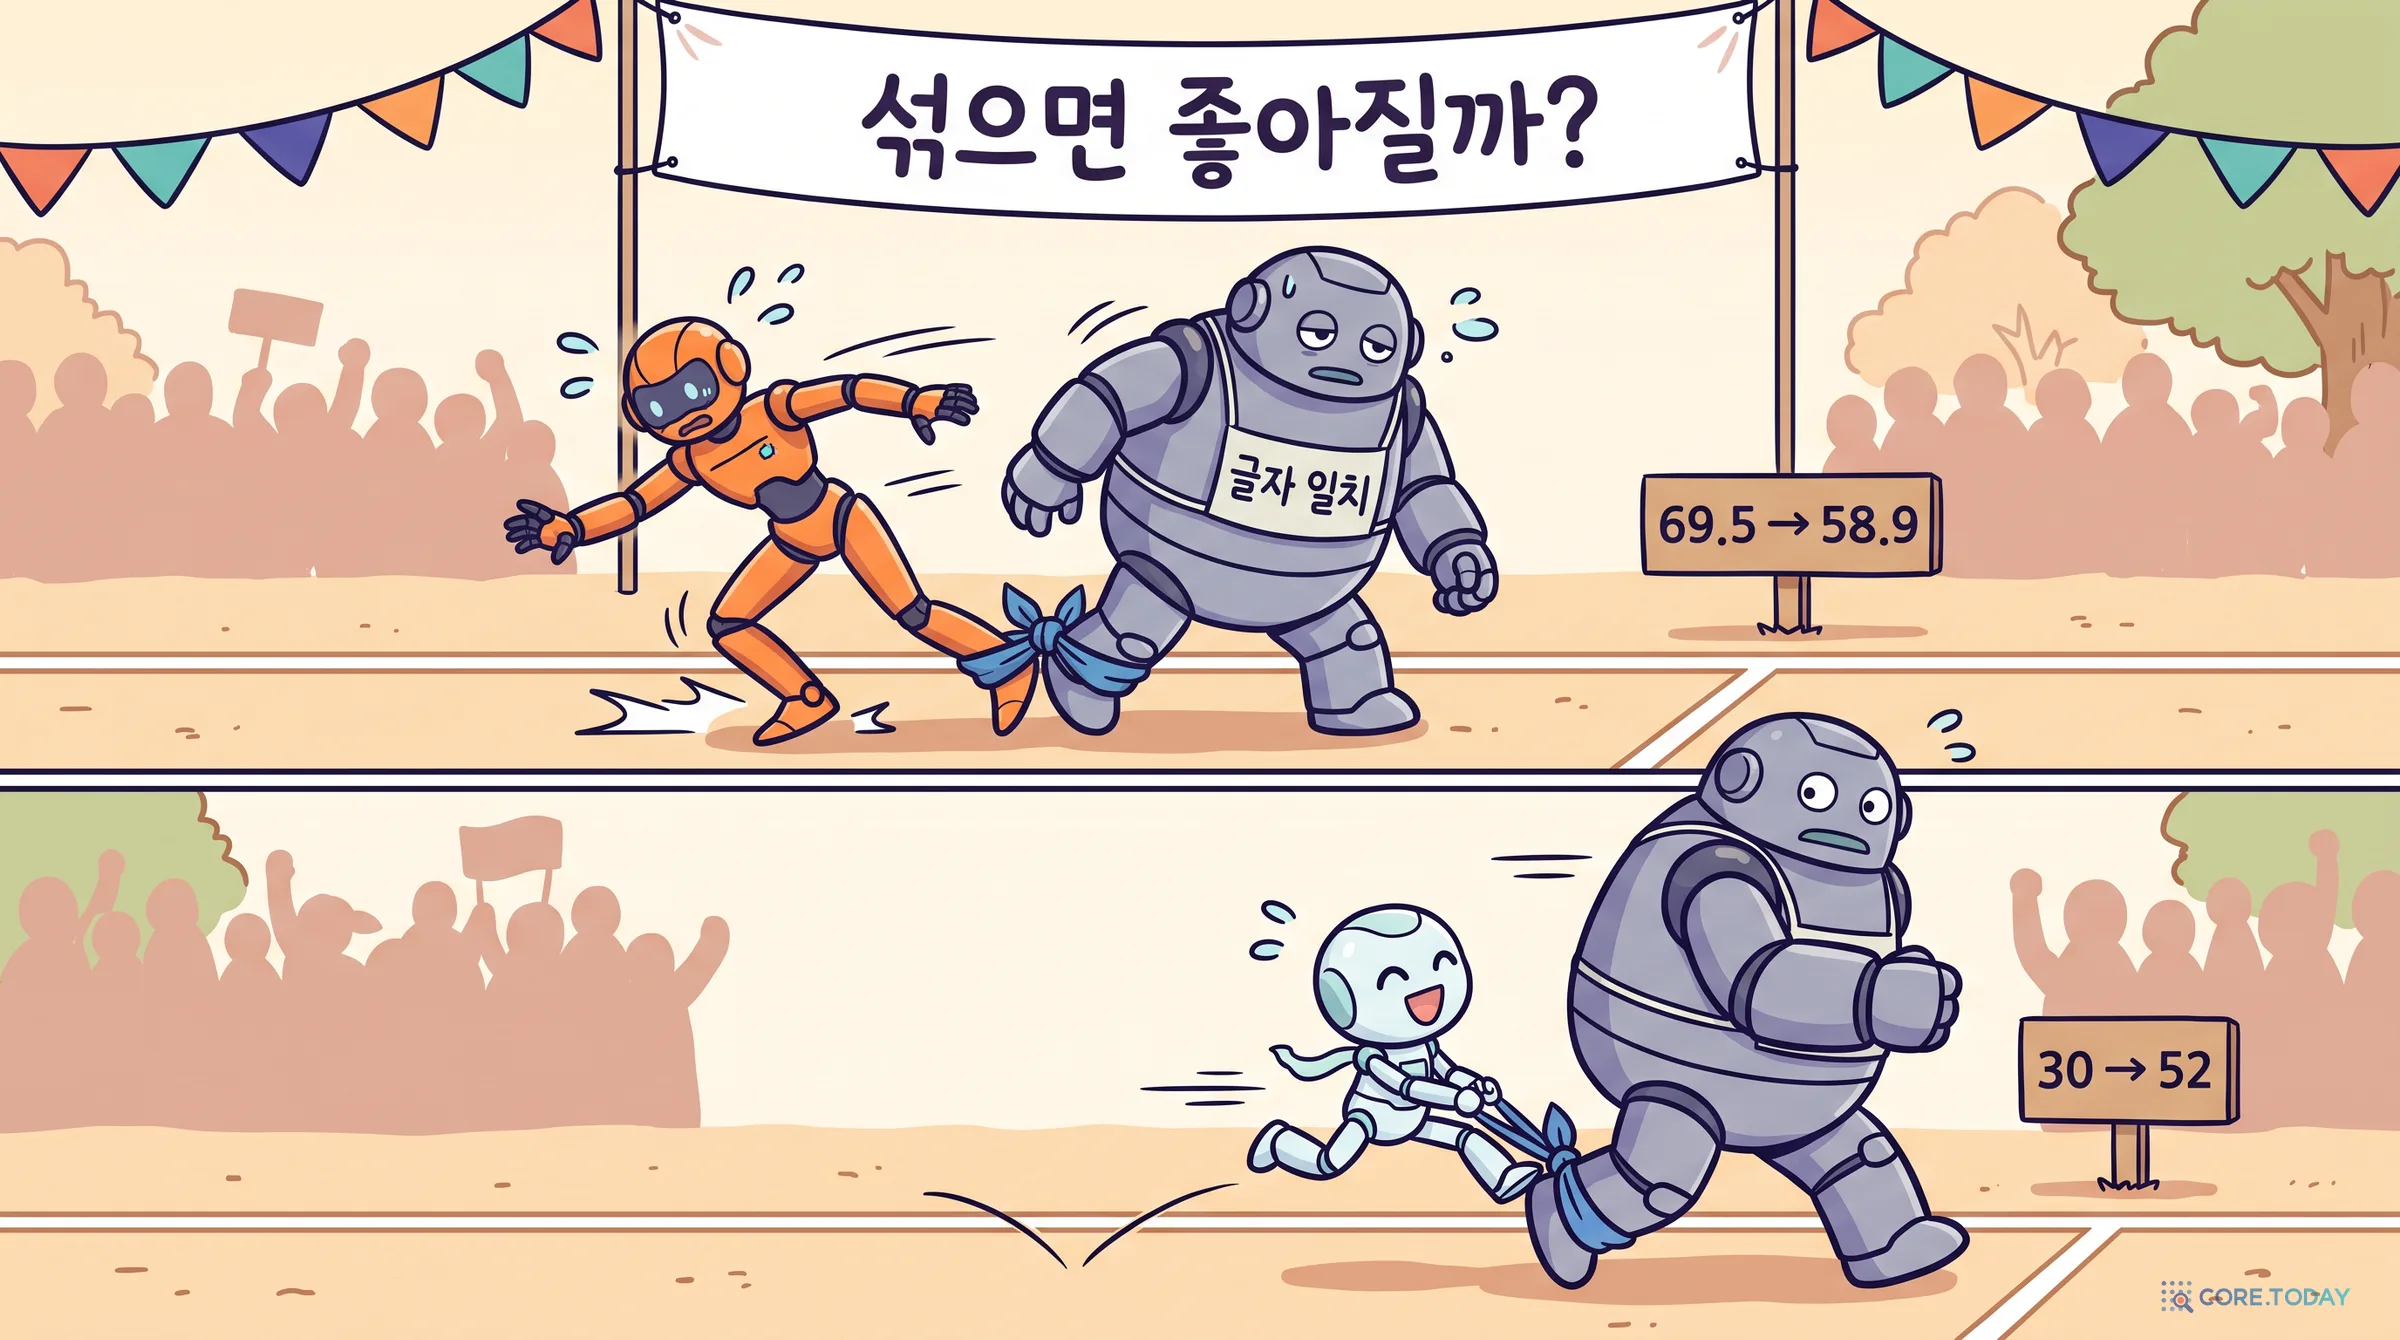
검색 시스템에서는 글자 순위와 임베딩 순위를 섞는 하이브리드(RRF)가 정석처럼 쓰입니다. 사실탐색기도 슬롯 경로가 실패하면 벡터 이웃을 글자 순위와 RRF로 섞습니다. 이번 시험지에서 섞기는 어땠을까요. 주어 찾기 @1입니다.
섞기는 약한 쪽을 끌어올리고 강한 쪽을 끌어내립니다. 강한 임베딩(KURE-v3, Nemotron)은 RRF로 7~11점을 잃었습니다. 글자 순위가 틀린 후보를 위로 올려 놓기 때문입니다. 반대로 약한 모델(희소 벡터 KURE-Sparse, 작은 ColBERT)은 섞어서 4~22점을 얻었습니다. 글자가 아주 확실할 때만(자카드 0.7 이상) 글자를 쓰는 계단식은 거의 차이가 없었습니다. 강한 임베딩이 글자로 찾을 수 있는 것도 이미 찾기 때문입니다.
사실탐색기의 실제 경로는 이 실험의 RRF와 조금 다릅니다. 글자로 정확히 포함되는 이름이 있으면 벡터를 아예 부르지 않고, 벡터 이웃은 코사인 문턱(지금 0.6)을 넘는 것만 받습니다. 그래도 교훈은 그대로입니다. 모델을 바꾸면 섞는 방식과 문턱도 다시 정해야 합니다. 코사인 0.6은 BGE-M3의 눈금이고, 모델마다 유사도의 눈금이 다릅니다(같은 값 쌍의 평균 유사도가 KURE-v2 0.69, Qwen3 8B 0.98).
8. EmbeddingGemma 2: 세 판이 똑같고, 1세대보다 낮다
EmbeddingGemma 2는 2026년 10월 6일에 나온 구글의 멀티모달 임베딩입니다(코어닷투데이 특집). Ollama에는 270m·440m·latest(744M) 세 태그가 있습니다. 이름만 보면 큰 판이 더 좋아 보입니다.
세 태그의 점수는 소수점 넷째 자리까지 똑같았습니다. 주어 찾기 54.1%, 근거 찾기 83.0%, 값 AUROC 0.886으로 모두 같습니다. 큰 판에 더 붙은 것은 이미지 인코더(170M)와 오디오 인코더(300M)이고, 글은 세 판 모두 같은 270M 텍스트 본체가 처리합니다. 글만 다룬다면 270m 태그로 충분합니다. 큰 태그는 메모리만 더 씁니다.
더 눈에 띄는 것은 1세대와의 차이입니다.
모델
주어 @1
어려운 주어 @1
근거 @1
값 AUROC
EmbeddingGemma 1세대 (Ollama BF16, 308M)
66.4%
44.4%
71.1%
0.954
EmbeddingGemma 2 (Ollama NVFP4)
54.1%
20.5%
54.1%
0.886
EmbeddingGemma 2 (HF 원본 BF16)
55.6%
21.9%
51.6%
0.891
처음에는 Ollama판의 4비트 양자화(NVFP4)를 의심했습니다. 그래서 구글이 Hugging Face에 올린 원본 가중치를 A100에서 BF16으로 따로 돌렸습니다. 원본도 55.6%로 거의 같았습니다. 양자화 탓이 아니라, 이 과제에서는 2세대가 1세대보다 실제로 약합니다. 핵심 낱말을 하나도 쓰지 않은 질의에서는 44.4% 대 21.9%로 두 배 차이입니다.
까닭을 짐작할 단서는 구조에 있습니다. 2세대의 텍스트 본체 270M 가운데 140M은 단어 조회표이고, 실제 트랜스포머는 130M, 모델 폭은 512로 1세대(768)보다 좁습니다. 구글은 이 크기로 코드와 멀티모달 점수를 크게 올렸다고 밝혔지만, 한국어 행정 용어를 바꿔 말한 질의처럼 어휘 지식이 필요한 과제에서는 폭과 깊이가 모자란 것으로 보입니다. 벤치마크 평균이 오른 새 판이 우리 과제에서도 오른다는 보장은 없습니다. 텍스트만 쓴다면 지금은 1세대가 낫습니다.
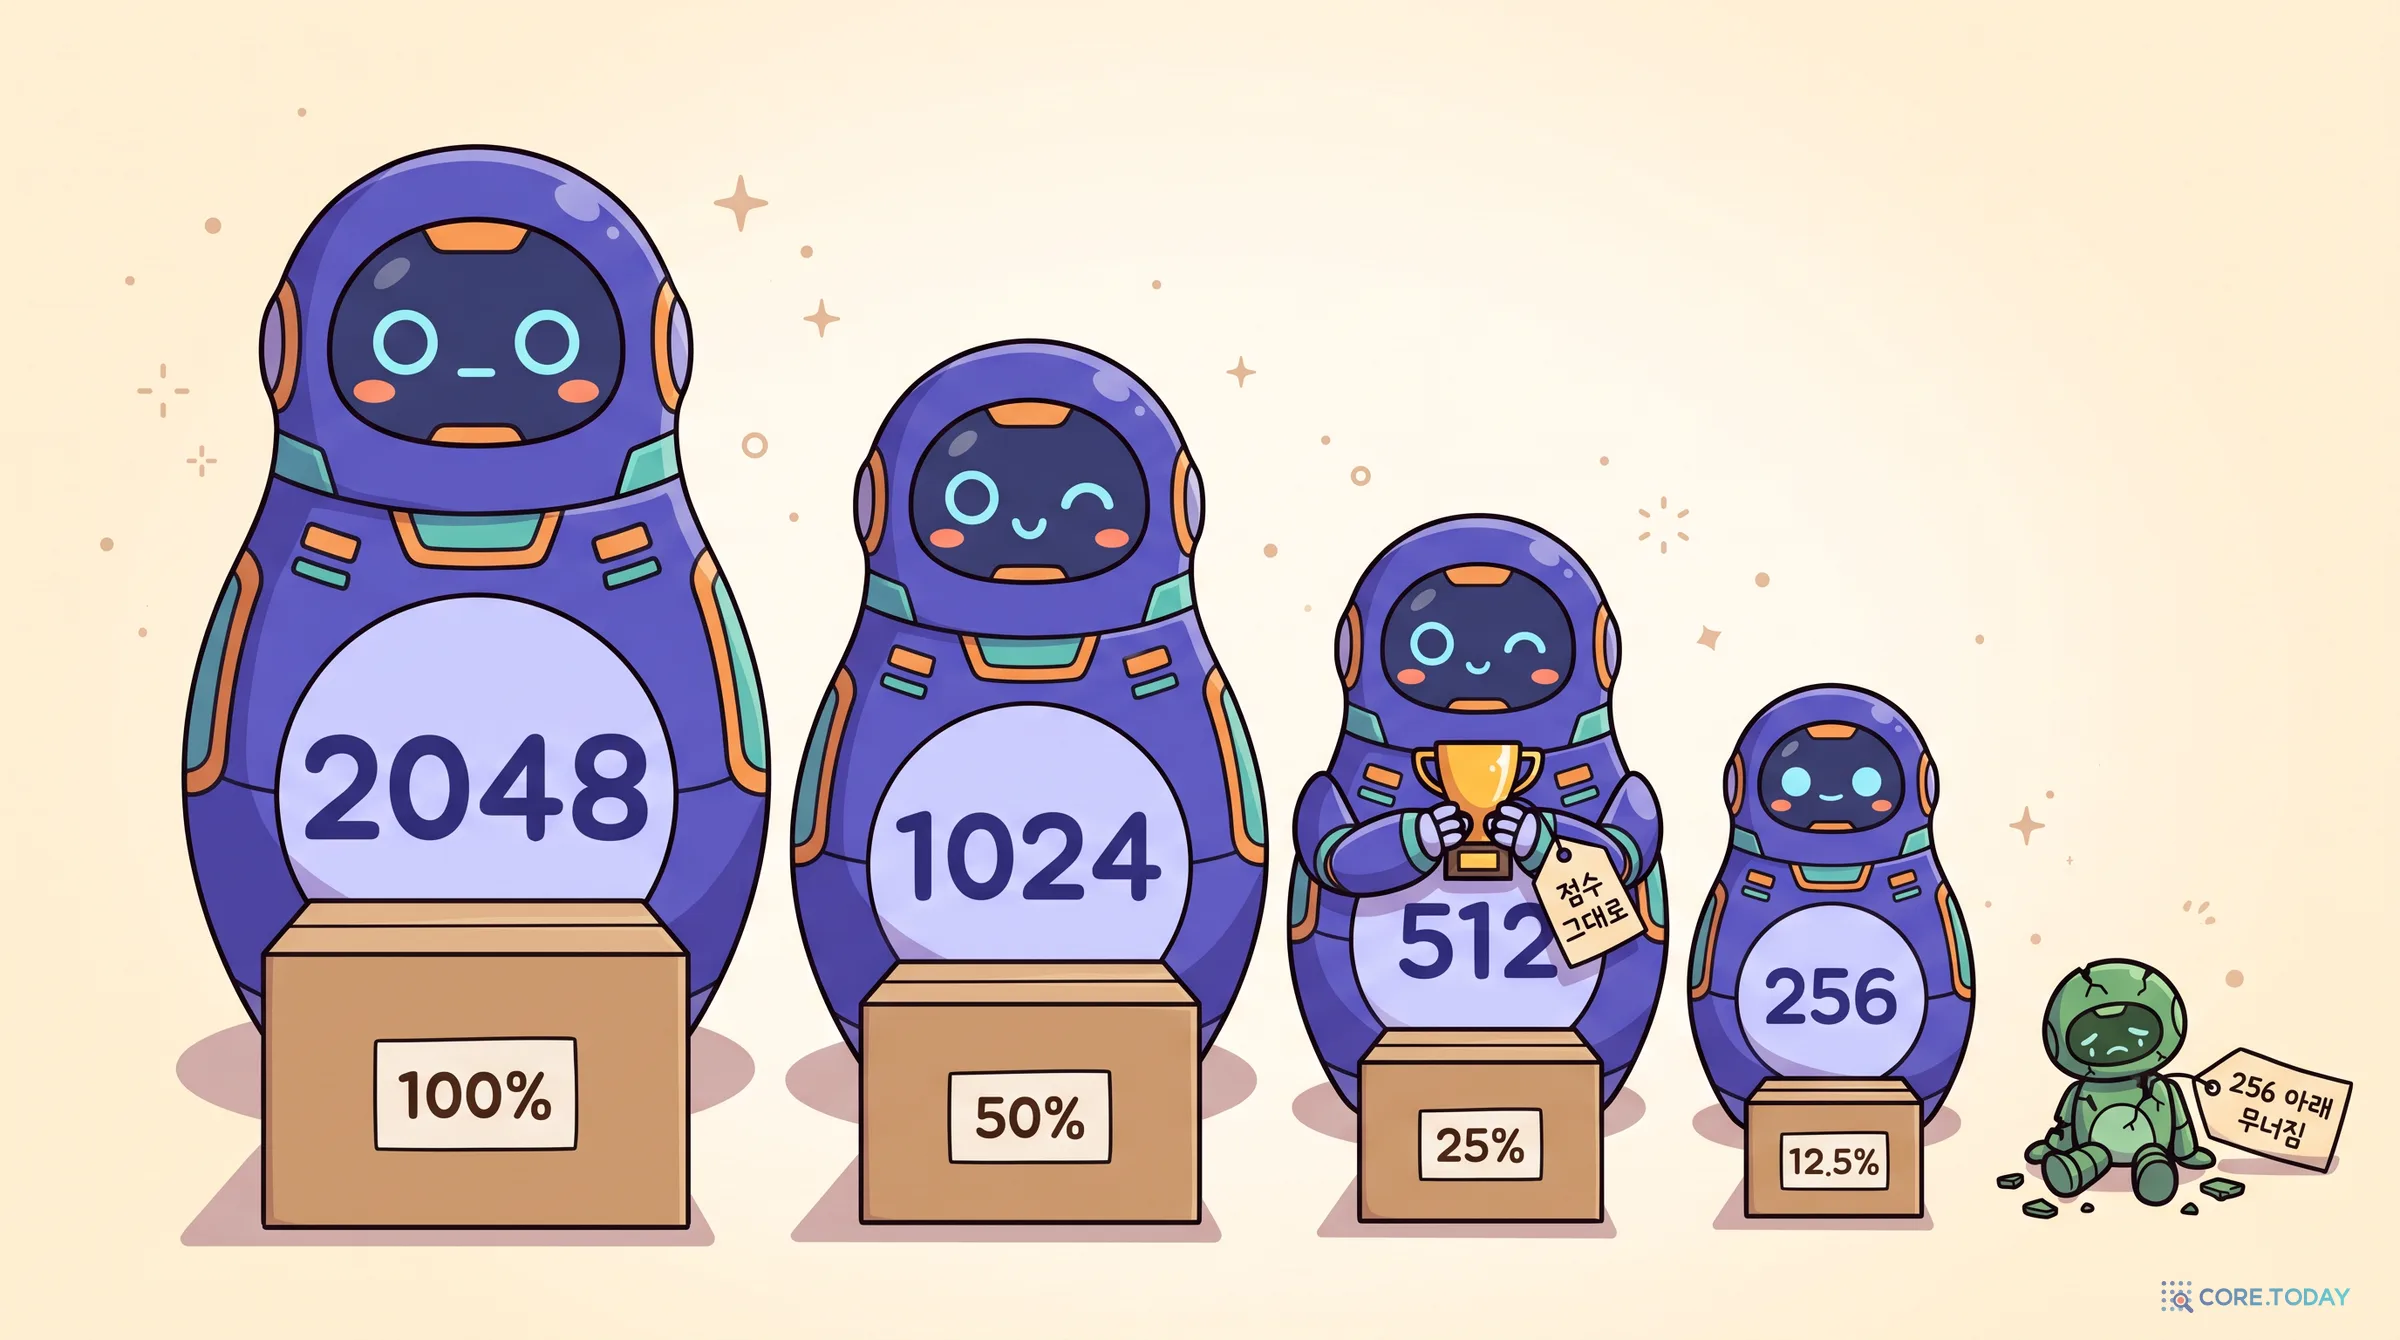
벡터가 길수록 저장과 검색이 비쌉니다. 4,096차원 float32 벡터 하나는 16KB이고, 단위 100만 개면 16GB입니다. 마트료시카 학습을 한 모델은 벡터의 앞부분만 잘라 써도 성능이 크게 줄지 않습니다.
이번 과제에서는 차이가 컸습니다. KURE-v3는 512차원으로 자르면 주어 찾기가 69.5%에서 64.2%로 줄지만 근거 찾기는 93.7% 그대로입니다. 색인은 4분의 1이 됩니다. Nemotron 8B는 근거 찾기가 512차원에서도 93.7%로 버티는 반면, 짧은 이름 찾기는 256차원에서 38%, 128차원에서 19%로 무너집니다. 마트료시카 학습을 하지 않은 BGE-M3와 KURE-v1도 512차원까지는 거의 그대로였습니다(KURE-v1은 256차원에서 오히려 68%로 올랐습니다).
Postgres의 pgvector에는 실무적인 경계도 있습니다. vector 열에 HNSW 색인을 걸 수 있는 차원은 2,000까지이고, 그보다 긴 벡터는 반정밀도 halfvec(4,000까지)으로 저장해야 합니다. 4,096차원 모델은 잘라 쓰지 않으면 색인 자체가 걸리지 않습니다.
같은 문서 단위 600개를 임베딩하는 속도를 쟀습니다. 예상과 다른 결과가 하나 있었습니다. Ollama는 A100 위에서도 맥과 속도가 같았습니다. BGE-M3는 맥에서 초당 45개, A100에서 47개입니다. Ollama는 요청 하나에 문장 32개를 넣어도 안에서 하나씩 처리하므로, 작은 모델은 연산이 아니라 처리 대기에서 시간을 씁니다.
같은 BGE-M3 뼈대를 PyTorch에서 묶어 돌린 KURE-v1은 A100 40GB에서 초당 256개였습니다. 다섯 배가 넘습니다. KURE-v3(1.1B)는 초당 296개, 8B인 Nemotron과 comsat은 초당 46~48개였습니다. GPU의 값을 하려면 문장을 묶어 넣는 서버(sentence-transformers, TEI, vLLM)가 필요합니다.
사실탐색기에 이 숫자가 뜻하는 바는 이렇습니다. 부산 코퍼스의 단위 3,768개는 어떤 모델로도 몇 분이면 끝납니다. 질문 하나의 임베딩은 수십 밀리초입니다. 속도가 선택을 가르는 것은 코퍼스가 수십만 단위를 넘거나, 기록이 매일 대량으로 들어올 때부터입니다.
사실탐색기 쪽 결론은 이렇습니다. 지금의 BGE-M3는 주어 찾기에서 10점, 근거 첫 결과에서 10점 뒤처집니다. 서버에 GPU가 있는 설치처는 KURE-v3로 바꿀 만합니다. 바꿀 때 지킬 것은 셋입니다. 접두사를 색인과 질의 양쪽에 똑같이 붙일 것, 벡터 이웃의 코사인 문턱(지금 0.6)을 새 모델의 눈금으로 다시 정할 것, 그리고 값 비교에는 어떤 경우에도 임베딩을 쓰지 않을 것.
12. 이 결과를 어디까지 믿을 수 있나
한 코퍼스입니다. 부산의 회의록·조례·공고에서 나온 결과입니다. 다른 지자체나 법령·뉴스 위주의 코퍼스에서는 순위가 달라질 수 있습니다.
질의를 Claude가 썼습니다. 사람이 실제로 친 질의가 아니고 검수도 하지 않았습니다. 어려운 질의 몇 개는 조문 번호를 '열일곱째 조'처럼 풀어 쓰는 등 실제 사용자보다 어색합니다. 모든 모델이 같은 질의를 받았으므로 순위 비교에는 영향이 작지만, 절대 수치는 실제 사용 환경과 다를 것입니다.
돌린 방식이 다릅니다. Ollama 모델은 양자화판(Q4·Q8·NVFP4)이고 HF 모델은 BF16입니다. EmbeddingGemma 2처럼 양자화가 결과를 바꾸는 경우가 있으므로(8절), 같은 모델이라도 배포 형태에 따라 다시 재야 합니다.
재정렬기(reranker)는 넣지 않았습니다. 임베딩 상위 후보를 다시 정렬하는 교차 인코더를 붙이면 순위가 바뀔 수 있습니다. 사실탐색기는 측정 결과 LLM 재정렬을 꺼 두었고, 교차 인코더는 아직 재지 않았습니다.
값 쌍은 규칙으로 만들었습니다. 실제 기록에서 엇갈린 값(31쌍)도 넣었지만 대부분은 날짜·인원·금액에서 숫자 하나를 바꾼 쌍입니다. 그래도 "임베딩에 값 비교를 맡기지 않는다"는 결론을 바꿀 만큼의 차이는 아닙니다.
맺으며
열네 개 모델을 재고 나니 "가장 좋은 임베딩"이라는 질문은 반쯤만 맞는 질문이었습니다. 1위는 과제마다 바뀌었고, 같은 모델이 접두사 한 줄에 1위에서 꼴찌로 떨어졌고, 섞기는 약한 모델만 도왔습니다.
그래도 고를 수는 있습니다. 한국어로 다시 학습한 1B급 모델이 8B 모델을 앞섰고, 300M 모델이 그 바로 뒤에 붙었습니다. 크기를 키우기 전에 한국어 데이터와 접두사부터 보라는 뜻입니다. 그리고 무엇을 고르든 지켜야 할 경계가 있습니다. 임베딩은 바꿔 말한 이름을 찾는 다리이지, 두 값이 같은지 판정하는 판사가 아닙니다. 사실탐색기에서 그 판정은 지금처럼 코드와 권위 있는 기록이 합니다.
출처
코어닷투데이 실측(2026-10-27): 부산 공적 기록 362건(사실탐색기 corpus/busan-real), 엔티티 3,822·단위 3,768·술어 80. 질의는 Claude Code 서브에이전트(Sonnet)가 작성.