KV 캐시KV cache트랜스포머어텐션추론MQAGQAMLA페이지드 어텐션vLLM프롬프트 캐싱KIVI양자화어텐션 싱크StreamingLLM슬라이딩 윈도Qwen3PythiaNLP 기초
말할수록 무거워지는 기억 — KV 캐시로 본 긴 대화의 비용, 2017년의 첫 캐시부터 GQA·페이지드 어텐션·MLA·어텐션 싱크까지 (특집)
챗봇과의 대화가 길어질수록 답이 느려지고 요금이 오르는 이유는 KV 캐시에 있다. 언어 모델은 한 토큰씩 글을 쓰는데, 앞서 읽은 모든 토큰의 ‘키(K)’와 ‘값(V)’을 메모리에 쌓아 두고 다시 꺼내 쓴다. 계산을 메모리와 맞바꾼 이 장치 덕분에 생성은 빨라졌지만, 대신 대화가 길어질수록 GPU 메모리를 정직하게 잡아먹는다. 이 글은 2017년 원조 트랜스포머 논문에는 없던 캐시가 석 달 뒤 구글 코드에 들어간 이야기에서 시작해, 헤드를 나눠 쓰는 MQA·GQA, 캐시를 압축해 담는 딥시크의 MLA, 운영체제의 가상 메모리를 빌려 온 페이지드 어텐션, 같은 앞부분을 재사용하는 프롬프트 캐싱, 캐시를 2비트로 줄이는 양자화, 그리고 모델이 첫 토큰을 ‘주의 하수구’로 쓴다는 어텐션 싱크까지 따라간다. 그리고 직접 쟀다. 사내 V100에서 Qwen3 0.6B~8B의 캐시 크기와 속도, 동시 사용자 한계, 앞부분 재사용 효과, 캐시 양자화, 창 크기 제한을 실험했고, 피티아의 학습 체크포인트를 거슬러 올라가 어텐션 싱크가 생기는 순간을 찾았다. 1.6만 토큰짜리 앞부분의 캐시를 재사용하자 Qwen3-8B의 첫 토큰이 54배 빨리 나왔다. 캐시를 4비트로 줄일 때 Qwen3는 키를 토큰별로 자르자 무너졌지만, 채널별로 자르면 멀쩡했다. 최근 토큰만 남기자 흔들리던 모델은 첫 토큰 하나를 붙잡아 두자 되살아났다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
챗봇과 오래 대화하다 보면 이상한 일을 겪는다. 처음에는 빠르던 답이 점점 늦게 나온다. 긴 계약서를 붙여 넣고 질문하면 첫 글자가 나오기까지 한참 걸린다. API 요금표를 보면 더 이상하다. 같은 문서를 두 번째 보낼 때는 입력 요금을 10분의 1, 심지어 40분의 1만 받겠다고 한다. 똑같은 글자를 똑같이 읽는데 왜 값이 다를까?
답은 하나의 장치에 있다. KV 캐시(KV cache)다. 언어 모델은 글을 한 토큰씩 쓴다. 다음 토큰을 고를 때마다 앞에 있는 모든 토큰을 돌아봐야 하는데, 매번 처음부터 다시 읽으면 너무 느리다. 그래서 모델은 한 번 읽은 토큰마다 ‘키(K)’와 ‘값(V)’이라는 메모 두 장을 만들어 GPU 메모리에 쌓아 두고, 다음 걸음에서 그 메모를 꺼내 쓴다. 계산을 메모리와 맞바꾼 것이다.
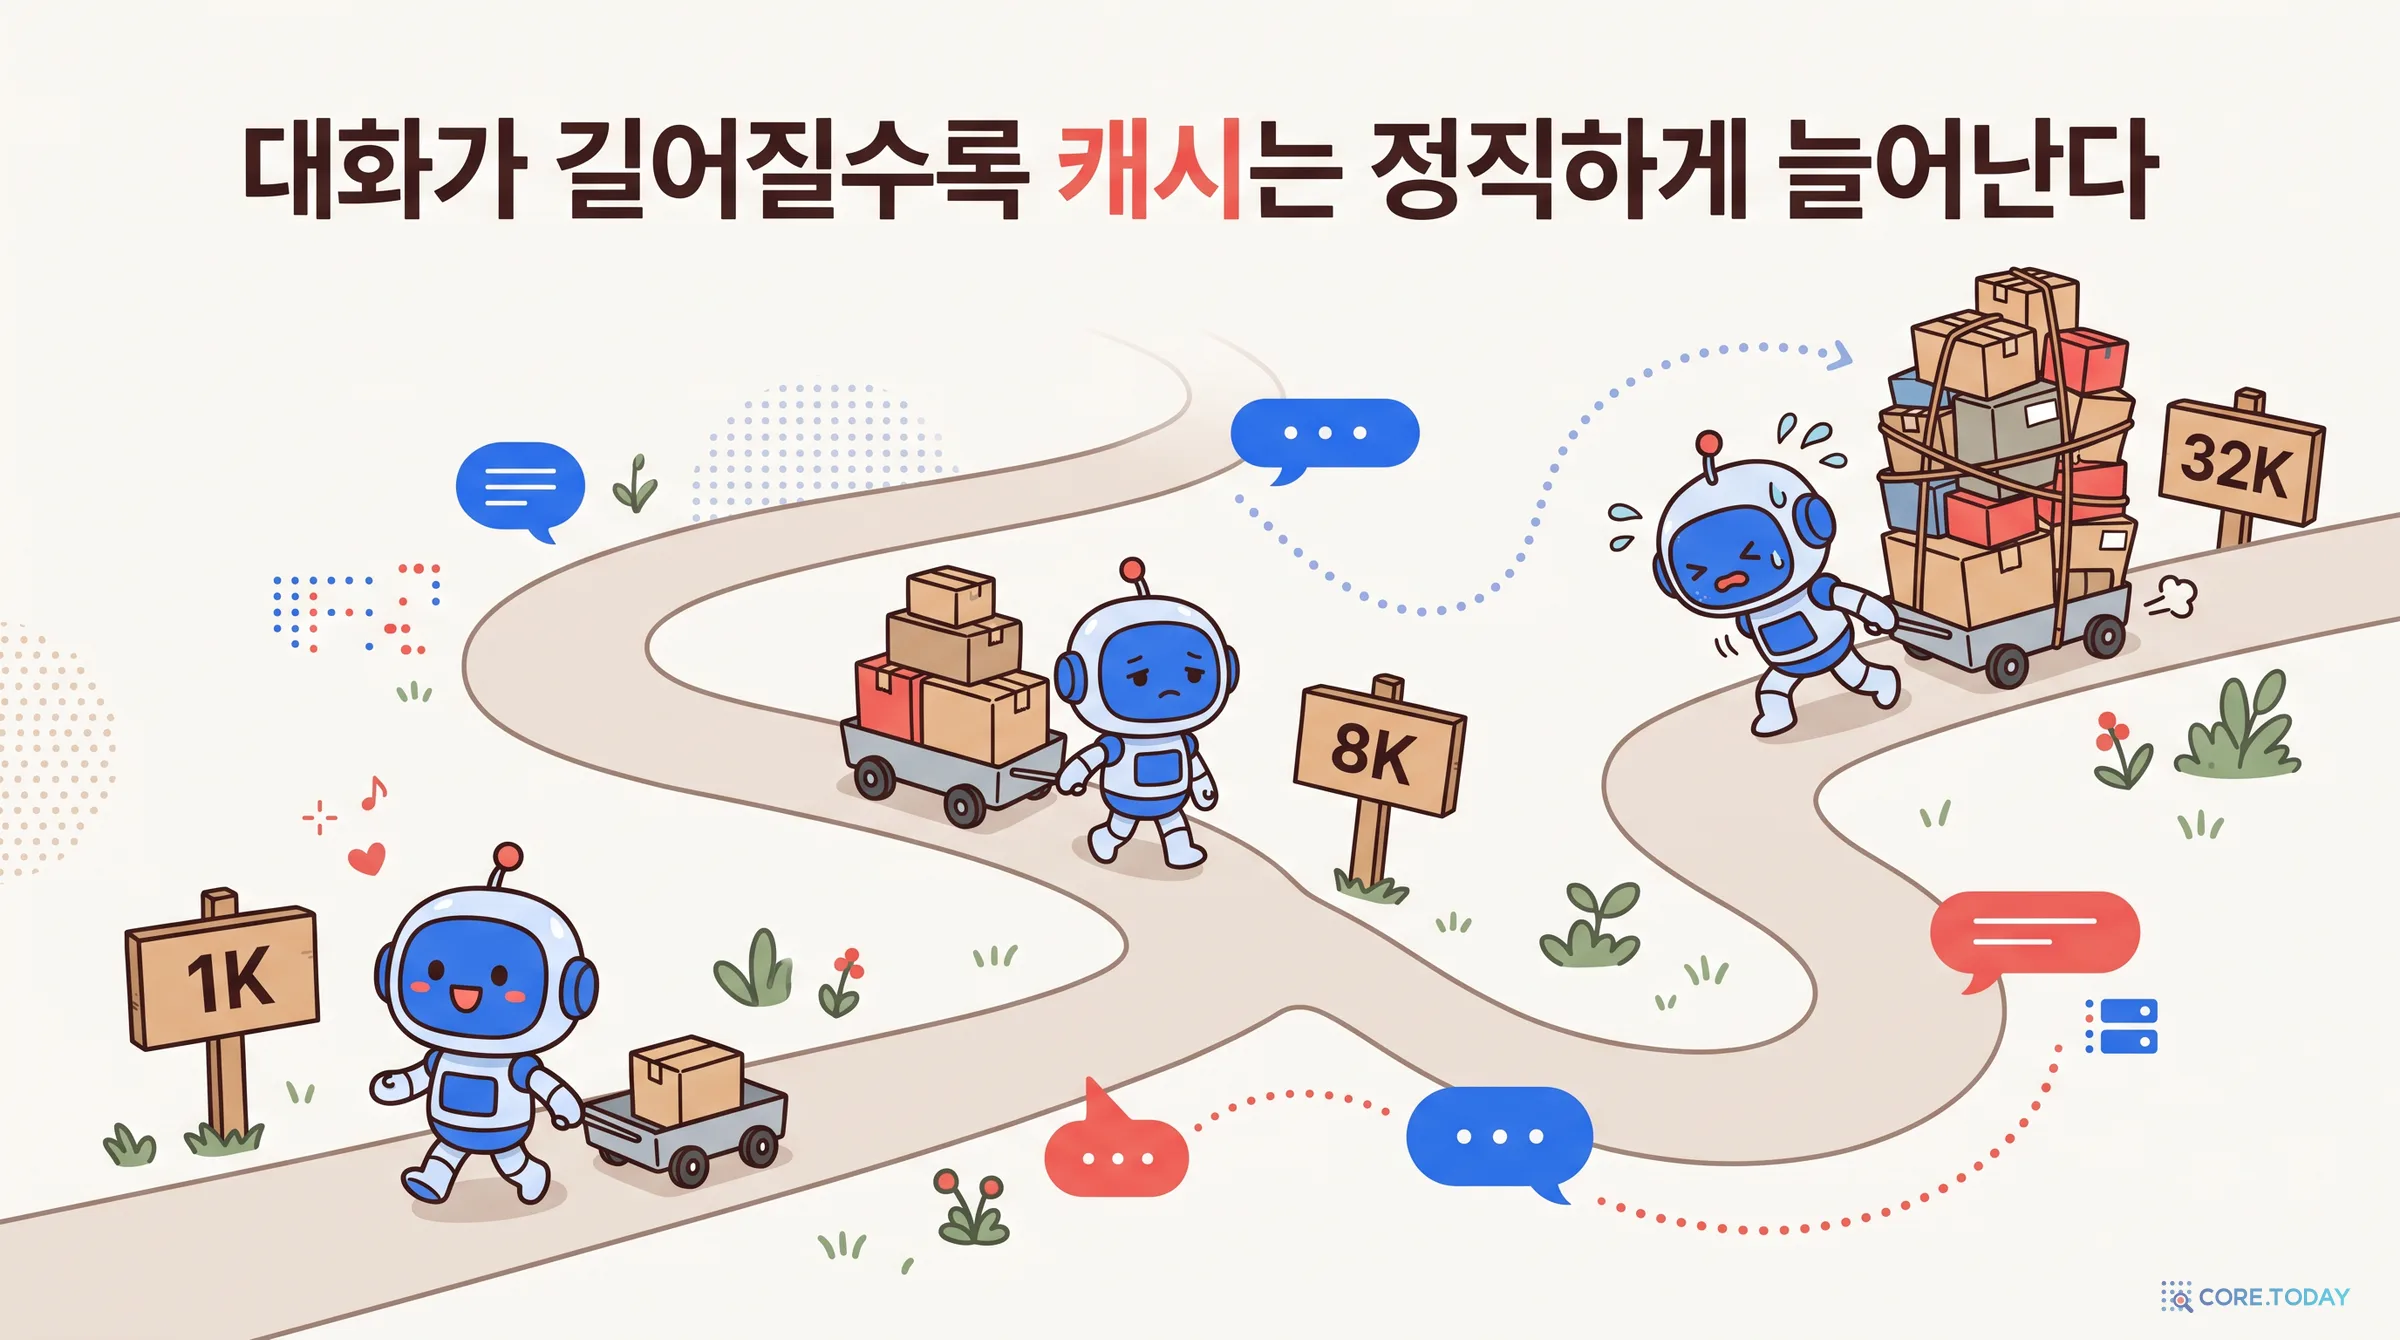
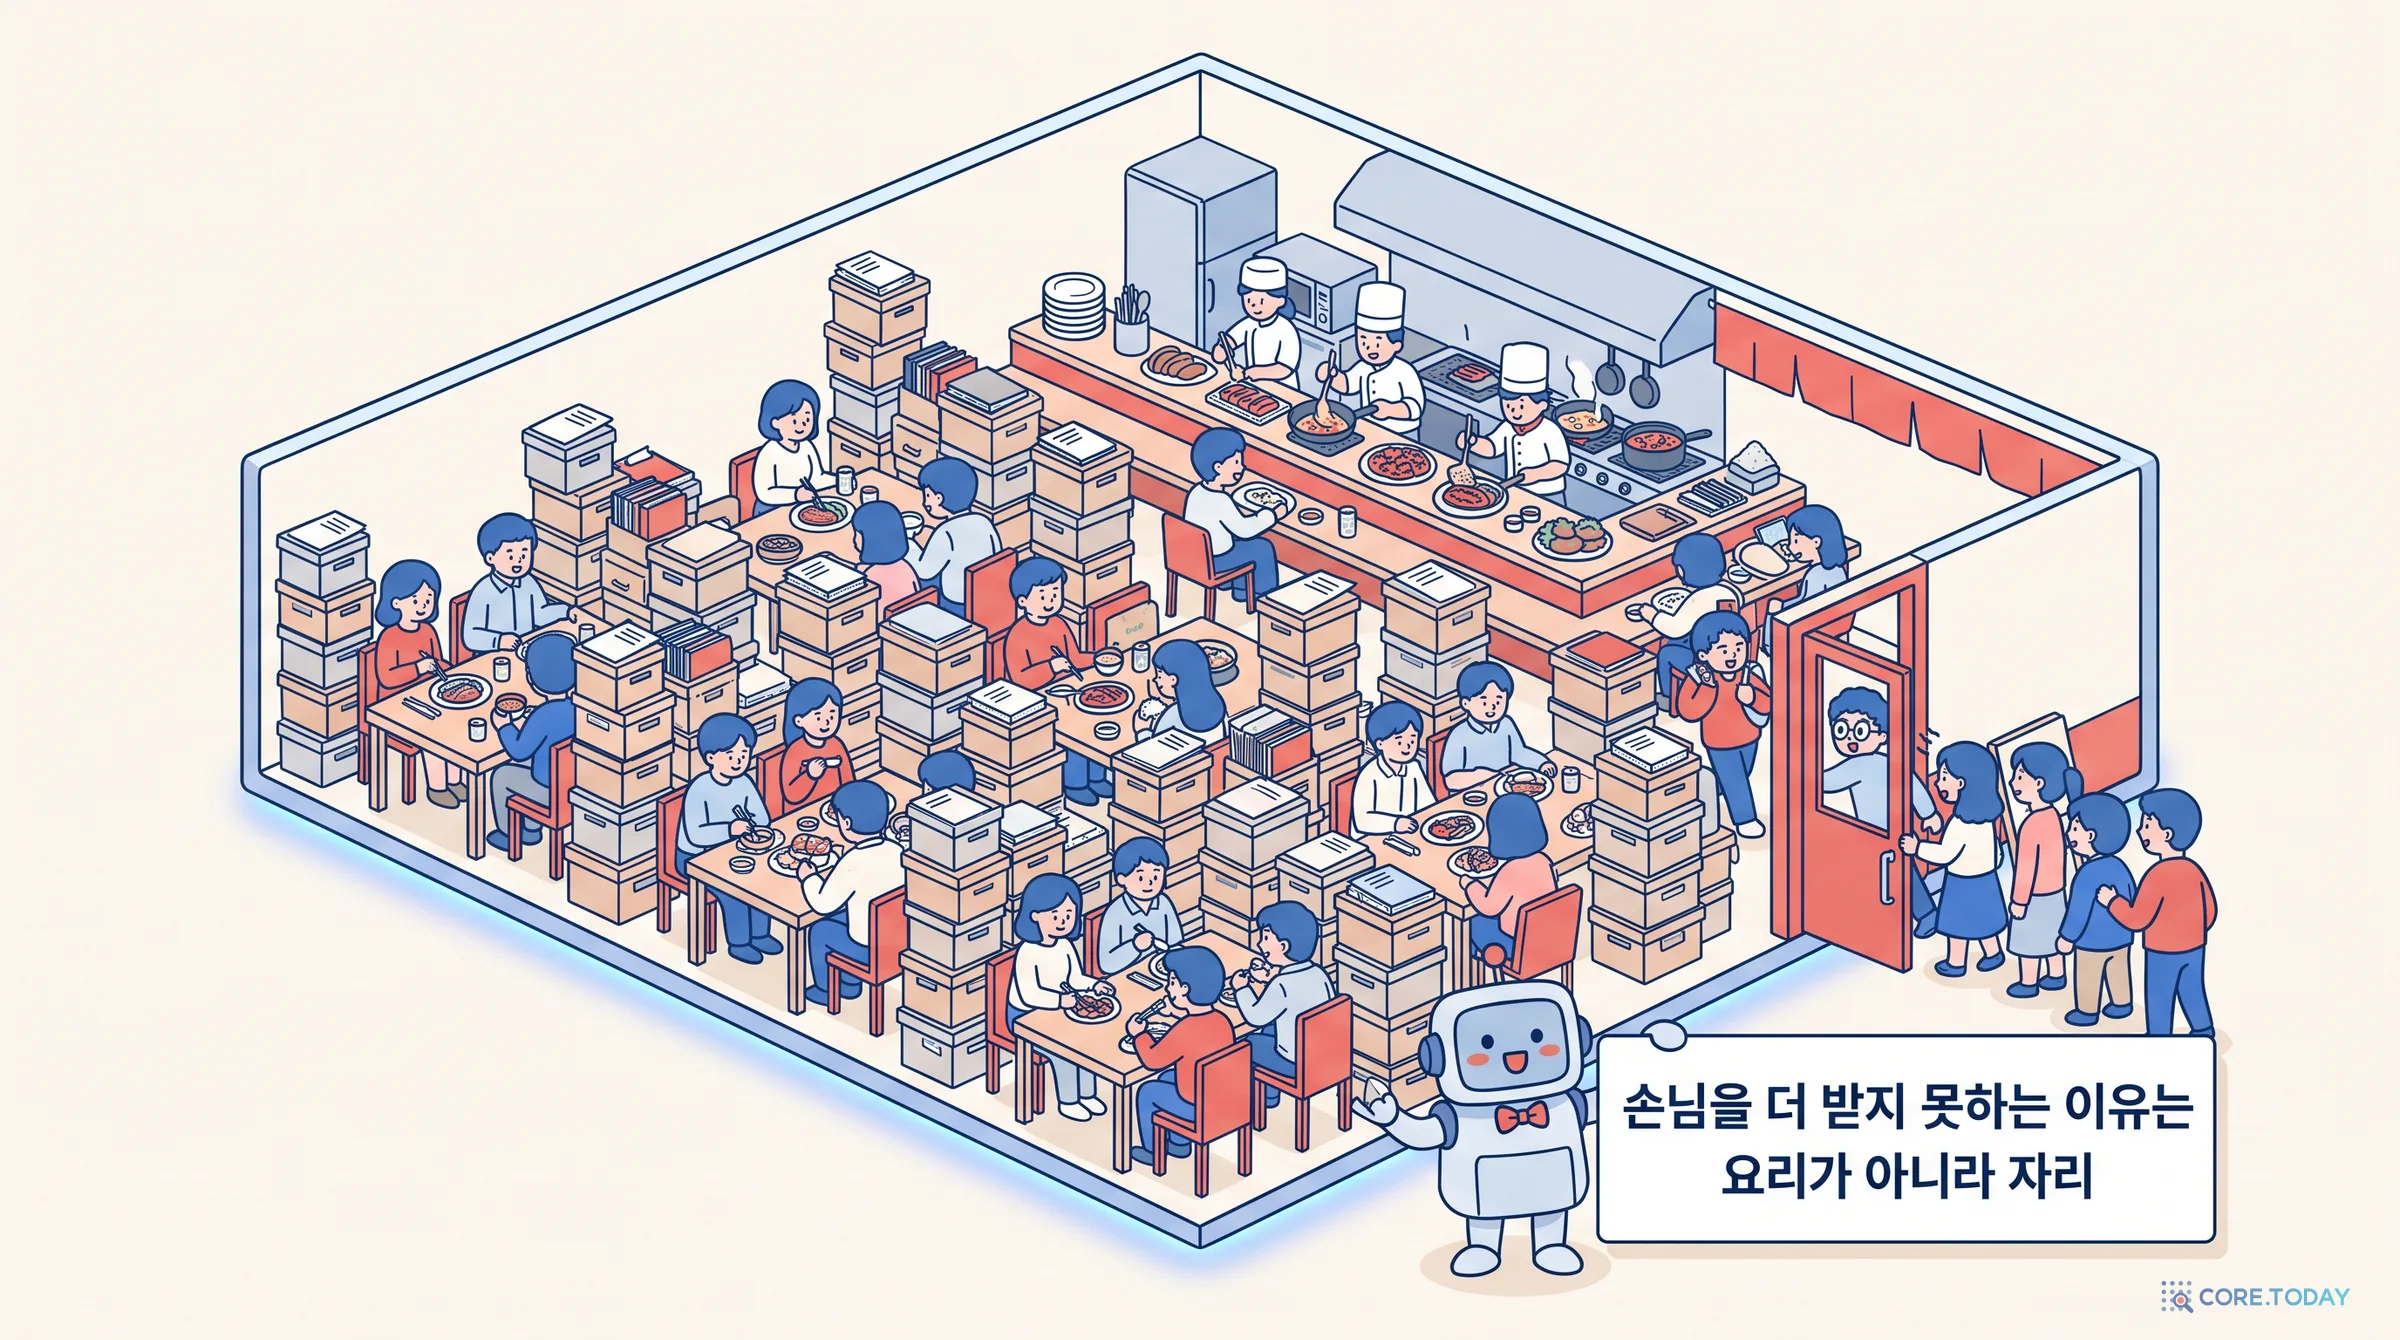
이 맞바꿈은 공짜가 아니다. 메모는 대화가 끝날 때까지 버릴 수 없고, 대화가 길어질수록 정직하게 늘어난다. 우리가 사내 GPU에서 잰 바로는, 6억 개 파라미터짜리 Qwen3-0.6B가 3.2만 토큰을 읽으면 메모 더미가 모델 자신보다 세 배 무거워졌다. 대화 하나가 GPU 하나를 차지하면 다른 손님을 받을 수 없다. 긴 대화가 비싼 진짜 이유는 계산이 아니라 자리다.
이번에도 직접 쟀다. 사내 V100 GPU와 쿠버네티스 클러스터에서 알리바바의 Qwen3 0.6B~8B를 돌려 캐시의 크기와 속도, 한 GPU가 받을 수 있는 동시 사용자 수, 같은 앞부분을 재사용할 때 아끼는 시간을 쟀다. 캐시를 4비트·2비트로 줄여 보고, 오래된 토큰을 버려 보고, 공개된 학습 체크포인트를 거슬러 올라가며 모델 안의 이상한 습관 하나가 생기는 순간을 찾았다.
3배
Qwen3-0.6B가 3.2만 토큰을 읽었을 때 KV 캐시(3.5GiB)와 모델 가중치(1.1GiB)의 비. 약 1만 토큰부터 캐시가 모델보다 크다
54배
1.6만 토큰짜리 앞부분의 캐시를 재사용했을 때 Qwen3-8B의 첫 토큰이 빨라진 정도. 8.4초 → 0.16초
12.6 → 2,853
캐시를 4비트로 줄일 때 키를 ‘토큰별’로 자르자 Qwen3-0.6B의 퍼플렉서티가 폭발한 정도. ‘채널별’로 자르면 12.6 그대로였다
57%
Qwen3-8B의 8층부터 위쪽 층에서 맨 첫 토큰 하나가 받은 주의의 평균 몫(한국어). 최근 1,024토큰만 남기는 캐시에서 이 토큰 하나를 버리면 퍼플렉서티 9.3, 남기면 5.9였다
Qwen3·Pythia로 잰 코어닷투데이 실측. 2·3·6·7부에서 자세히 다룬다.
이 시리즈는 그동안 언어 모델을 이루는 기본 개념을 하나씩 다뤘다. 글자를 토큰으로 자르는 BPE, 토큰의 위치를 알려 주는 RoPE, 다음 토큰을 고르는 디코딩, 프롬프트 속 예시로 배우는 문맥 내 학습이다. 이번에는 그 모든 일이 실제로 돌아가는 바닥, 메모리를 들여다본다. 순서는 이렇다.
한 토큰씩 쓰는 기계 — 캐시는 왜 생겼나.
캐시는 얼마나 큰가 — 곱셈 한 줄과 실측.
계산보다 기억이 문제다 — 속도와 동시 사용자의 한계.
기억하는 헤드만 줄이기 — MQA, GQA, MLA.
자리를 아껴 쓰기 — 페이지드 어텐션과 프롬프트 캐싱.
줄여서 담기 — 캐시 양자화.
버리고 가기 — 슬라이딩 윈도와 어텐션 싱크.
1부. 한 토큰씩 쓰는 기계
1.1 다음 한 토큰을 위해 전부 다시 읽는다면
GPT 같은 언어 모델은 자기회귀(autoregressive) 방식으로 글을 쓴다. 지금까지의 글을 보고 다음 토큰 하나를 고른 뒤, 그 토큰을 글 끝에 붙여 다시 다음 토큰을 고른다. 2017년 트랜스포머 논문은 이렇게 적었다. “매 걸음 모델은 자기회귀적이며, 앞서 생성한 기호를 추가 입력으로 받는다.”
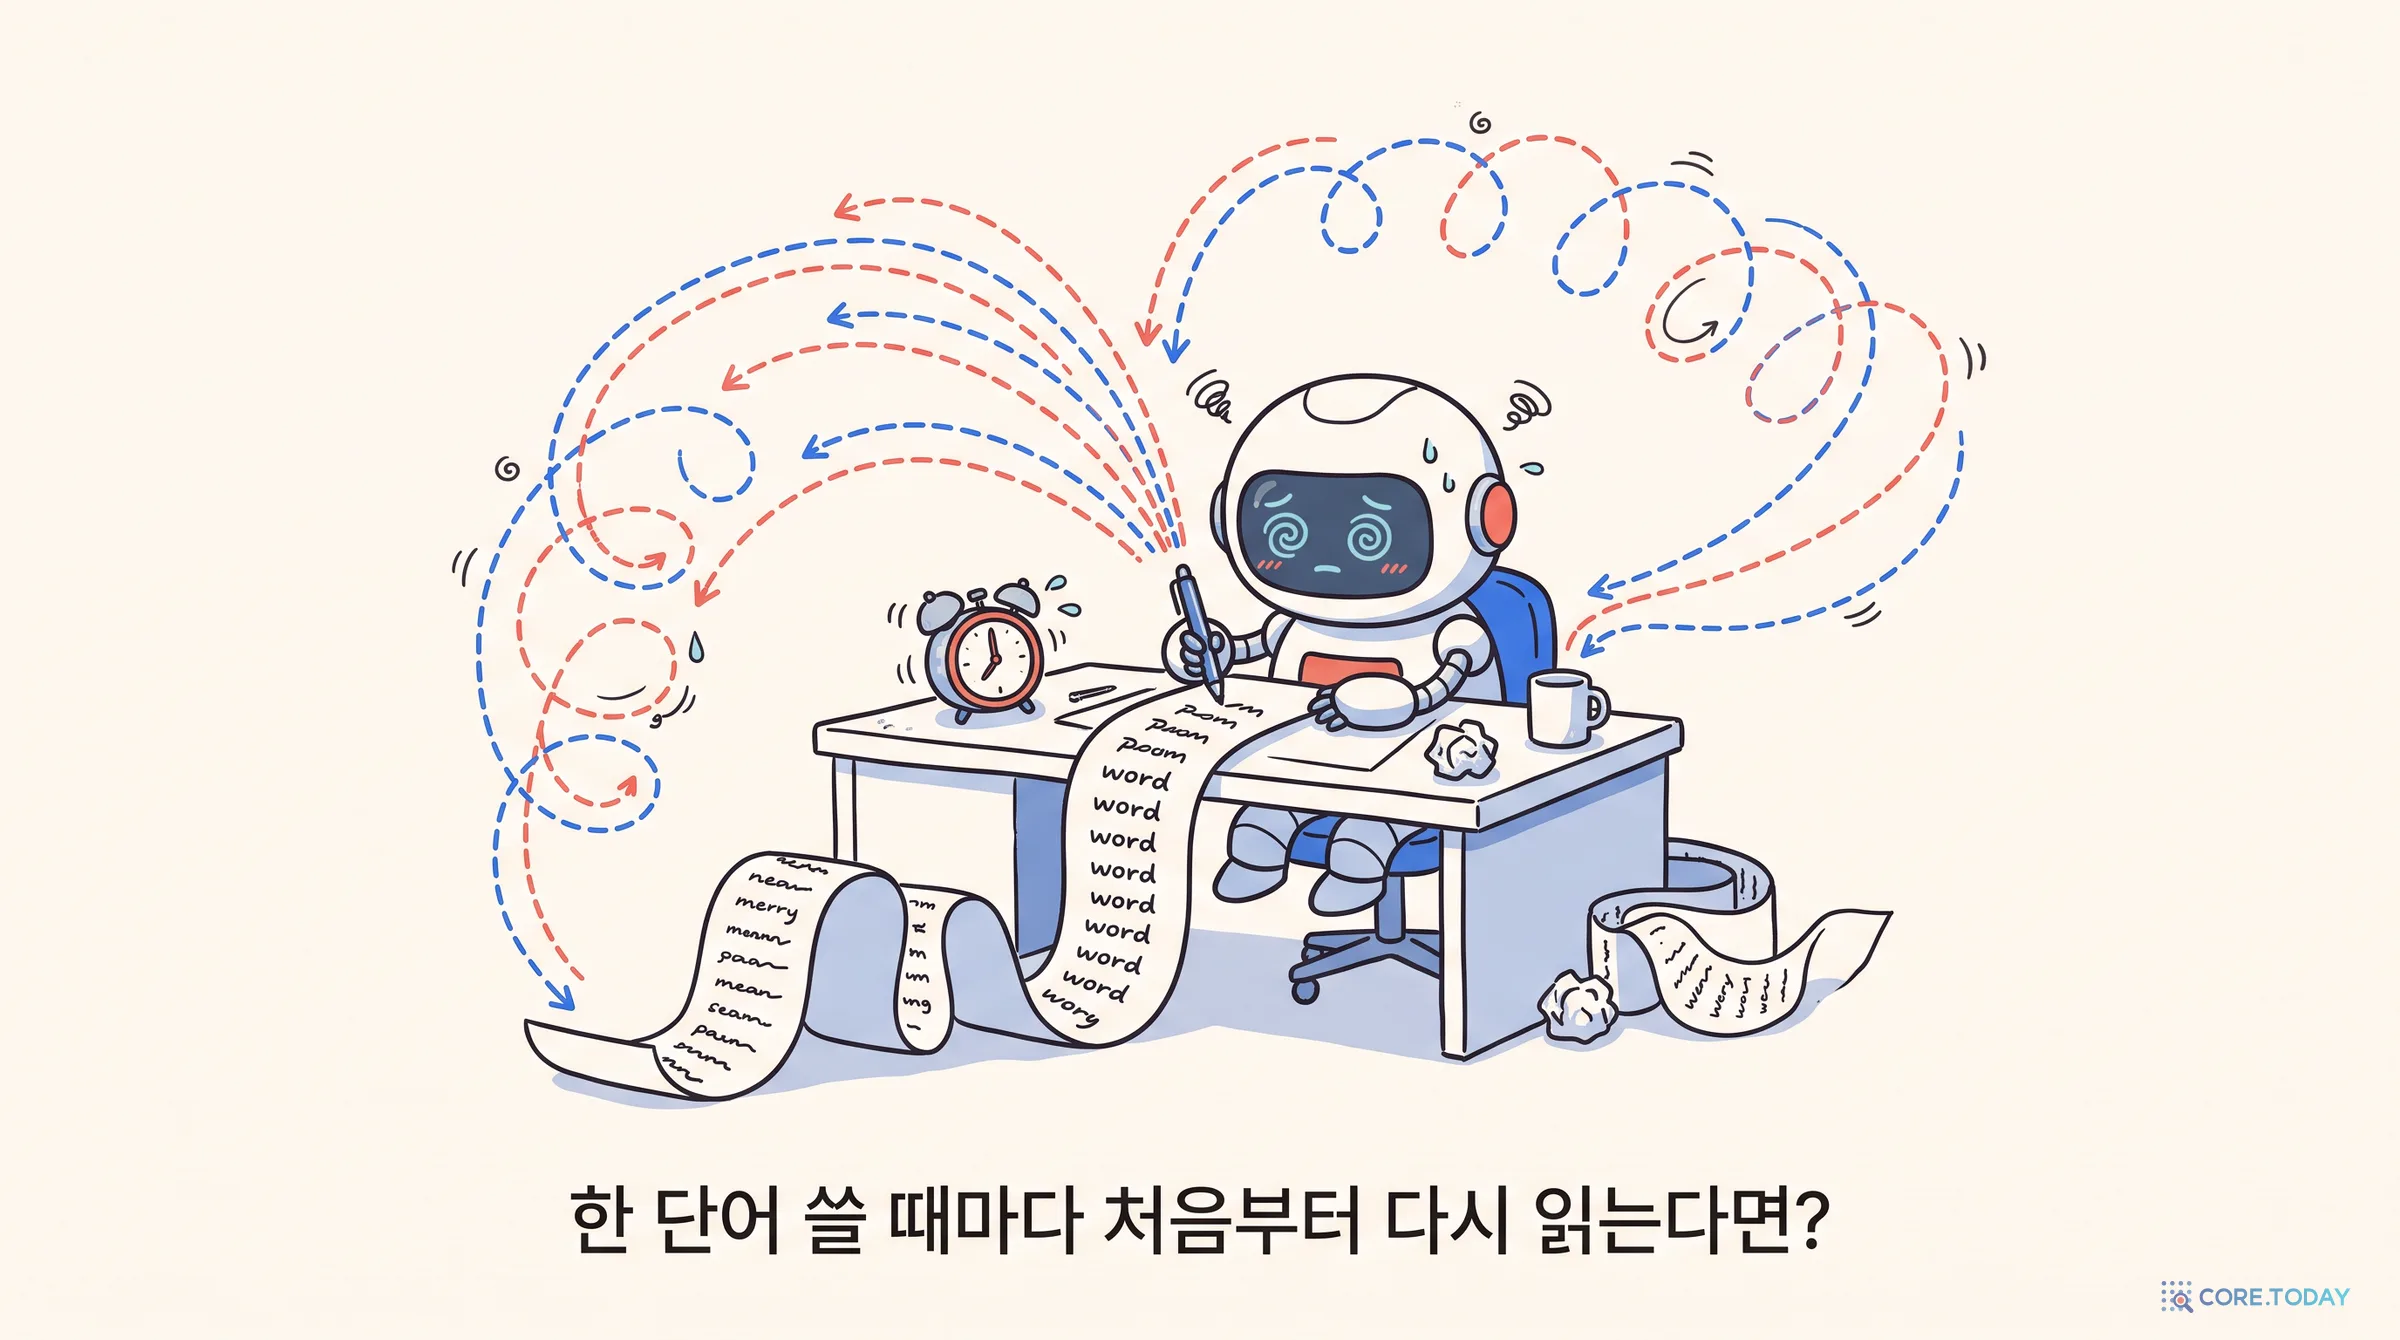
문자 그대로 하면 낭비가 심하다. 답변 500토큰을 쓰려면 모델을 500번 돌려야 하고, 매번 그때까지의 글 전체를 입력으로 넣는다. 4,000토큰짜리 문서를 읽고 답을 쓰는 중이라면 첫 걸음에 4,000토큰, 다음 걸음에 4,001토큰, 그다음에 4,002토큰을 처리한다. 같은 4,000토큰을 500번 반복해서 읽는 셈이다.
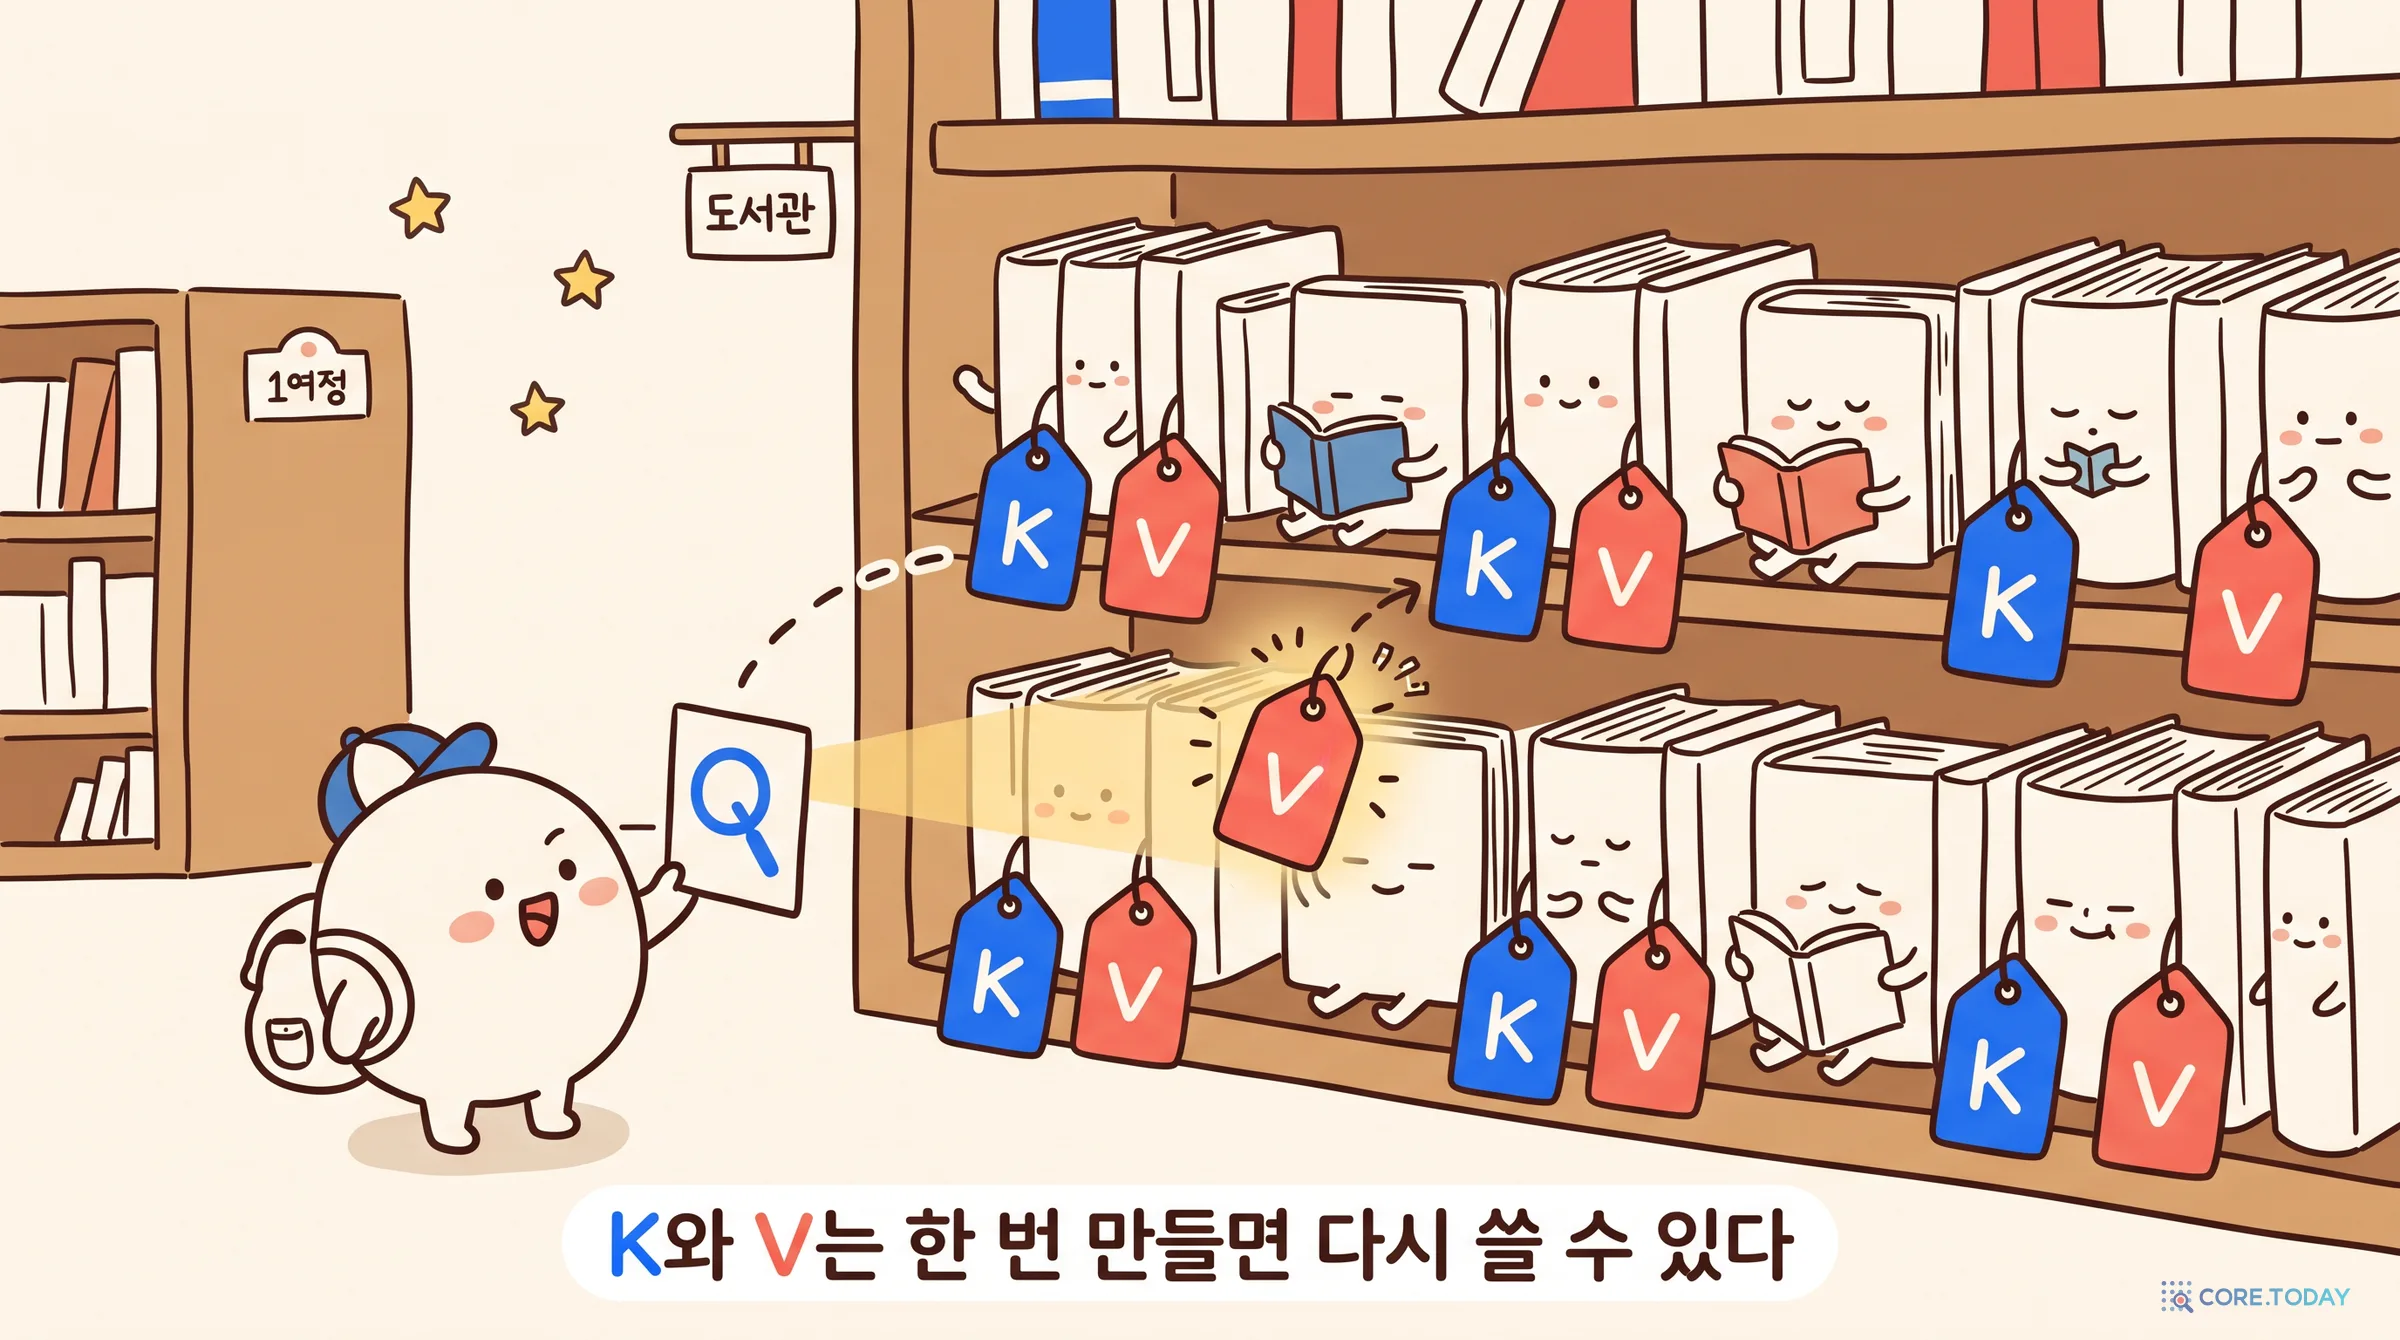
1.2 키, 값, 질의 — 도서관의 색인 카드
반복해서 읽지 않아도 되는 이유는 어텐션의 구조에 있다. 트랜스포머의 각 층에서 토큰은 세 가지 벡터를 만든다.
질의(Query, Q) — “나는 지금 무엇을 찾고 있나.”
키(Key, K) — “나는 이런 내용을 갖고 있다”는 색인 카드.
값(Value, V) — 실제로 건네줄 내용.
새 토큰은 자기 질의를 앞선 모든 토큰의 키와 비교해 점수를 매기고, 점수가 높은 토큰의 값을 많이 섞어 가져간다. 어텐션의 모든 것에서 다룬 그 계산이다.
핵심은 GPT 같은 디코더가 앞만 본다는 점이다. 토큰은 자기보다 앞에 있는 토큰만 볼 수 있고, 뒤에 무엇이 오든 영향을 받지 않는다. 그러니 이미 지나간 토큰의 키와 값은 뒤에 어떤 토큰이 붙든 바뀌지 않는다. 한 번 계산해 두면 끝까지 그대로 쓸 수 있다. 반면 질의는 새 토큰이 ‘지금’ 무엇을 찾는지를 나타내므로, 쓰고 나면 버려도 된다.
그래서 각 층마다, 지나간 모든 토큰의 K와 V를 보관해 두는 것이다. 이것이 KV 캐시다. 새 걸음에서는 새 토큰 하나의 Q·K·V만 계산하고, K·V는 캐시에 덧붙인 뒤, 캐시 전체와 어텐션을 계산한다.
위젯 아래쪽에서 실제 크기로 늘려 보면 차이가 극적이다. 4,000토큰 프롬프트에 500토큰을 생성하면, 캐시 없이는 K·V를 약 212만 번 계산하지만 캐시가 있으면 4,500번이면 된다. 470배쯤이다.
1.3 원조 논문에는 없던 캐시
흥미롭게도 2017년 6월의 트랜스포머 논문 「Attention Is All You Need」 어디에도 ‘캐시’라는 말은 없다. 논문은 디코더가 앞서 만든 기호를 다시 입력으로 받는다고만 썼다.
공개 기록으로 확인되는 가장 이른 트랜스포머 KV 캐시는 석 달 뒤에 나온다. 구글의 트랜스포머 구현체 텐서투텐서(tensor2tensor)가 2017년 9월 22일 v1.2.3을 내며 릴리스 노트에 이렇게 적었다. “트랜스포머가 이제 빠른 디코딩을 지원합니다! 디코딩 경로가 매 걸음 시퀀스 전체를 다시 계산했는데, 이제는 진행하면서 캐시합니다.” 공식 구현조차 석 달 동안은 매번 처음부터 다시 읽었던 것이다. 비공개 코드에서 이보다 먼저 쓰였을 가능성은 있다. 다만 그 뒤로 캐시는 너무 당연한 구현 기법이 되어, 2019년 샤지어(Noam Shazeer)의 논문은 캐시를 이어 붙이는 코드를 따로 설명 없이 적어 둘 정도였다.
2부. 캐시는 얼마나 큰가
2.1 곱셈 한 줄
캐시의 크기는 모델 설계도만 있으면 계산된다. 토큰 하나를 읽을 때마다 모든 층에 K 벡터와 V 벡터를 하나씩, 헤드마다 쌓는다.
토큰당캐시=2×층수×KV 헤드수×헤드차원×바이트수
맨 앞의 2는 K와 V 두 장이다. 바이트 수는 16비트(fp16, bf16)면 2다. 여기에 문맥 길이와 동시 사용자 수를 곱하면 전체 캐시가 나온다.
Qwen3-8B로 계산해 보자. 36층, KV 헤드 8개, 헤드 차원 128이다. 2 × 36 × 8 × 128 × 2바이트 = 147,456바이트, 토큰 하나에 144KiB다. 3.2만 토큰이면 4.5GiB, 동시 사용자 열 명이면 45GiB다. 모델 가중치(15.3GiB)의 세 배다.
2023년 페이지드 어텐션 논문은 OPT-13B를 예로 들었다. 토큰 하나에 800KB, 요청 하나에 최대 1.6GB다. A100 40GB에 13B 모델을 올리면 메모리의 약 65%를 가중치가, 약 30%를 KV 캐시가 차지한다고 했다.
2.2 코어닷투데이 실측 — 계산대로, 정확히
공식이 실제와 맞는지 확인했다. 사내 V100에서 Qwen3 모델에 한국어 위키백과 문서를 1,024토큰부터 3.2만 토큰까지 읽히고, 캐시 텐서의 크기를 직접 더했다.
모델
구조(층 · KV 헤드/질의 헤드 · 헤드 차원)
토큰당 캐시
가장 긴 문맥에서 잰 캐시
가중치(16비트)
캐시가 가중치와 같아지는 길이
Qwen3-0.6B
28층 · KV 헤드 8/16 · 128
112KiB
3.50GiB (32K)
1.11GiB
10.4K 토큰
Qwen3-1.7B
28층 · KV 헤드 8/16 · 128
112KiB
3.50GiB (32K)
3.20GiB
30.0K 토큰
Qwen3-4B
36층 · KV 헤드 8/32 · 128
144KiB
4.50GiB (32K)
7.49GiB
54.5K 토큰
Qwen3-8B
36층 · KV 헤드 8/32 · 128
144KiB
4.50GiB (32K)
15.26GiB
111.1K 토큰
Pythia-1B
16층 · KV 헤드 8/8 · 256
128KiB
0.25GiB (2K)
1.88GiB
15.4K 토큰
가장 긴 문맥은 Qwen3 3.2만 토큰, Pythia-1B는 최대 길이 2,048토큰. 마지막 열은 가중치 크기 ÷ 토큰당 캐시. 사내 V100·V100S, fp16.
캐시 크기는 공식과 바이트 단위까지 같았고, 문맥에 정확히 비례했다. 눈여겨볼 점이 두 가지다.
첫째, 작은 모델일수록 캐시가 상대적으로 무겁다. Qwen3-0.6B의 가중치는 1.1GiB인데 캐시는 토큰당 112KiB다. 약 1만 토큰부터 캐시가 모델보다 커지고, 3.2만 토큰에서는 세 배가 된다. 휴대폰이나 노트북에서 작은 모델을 돌릴 때 긴 문맥이 금방 메모리를 채우는 이유다.
둘째, Qwen3-0.6B와 1.7B의 캐시는 토큰당 크기가 똑같다. 둘 다 28층, KV 헤드 8개, 헤드 차원 128이기 때문이다. 4B와 8B도 36층으로 같다. 모델을 키울 때 층 수와 헤드 차원을 그대로 두고 각 층의 폭(은닉 차원과 피드포워드 층)을 넓혔기 때문에, 모델이 커지는 만큼 캐시가 커지지 않았다. 애초에 캐시가 이만큼 작은 것은 4부에서 다룰 ‘KV 헤드 공유’ 덕분이다.
아래 계산기에서 모델과 GPU를 고르고 문맥 길이와 동시 사용자 수를 바꿔 보자. 2020년의 GPT-3 175B는 토큰 하나에 4.5MiB를 썼다. 같은 일을 하는 2024년의 Llama 3.1 70B는 320KiB, 딥시크-V3는 69KiB다.
Llama 3.1 70B로 12.8만 토큰짜리 대화 하나를 하려면 캐시만 40GiB다. H100 한 장(80GB)에는 16비트 가중치(141GB)도 들어가지 않는다. 128K, 1M 같은 긴 문맥 창이 광고 문구가 되기까지, 캐시를 줄이려는 노력이 그만큼 많았다는 뜻이다.
3부. 계산보다 기억이 문제다
3.1 읽기는 빠르고, 쓰기는 느리다
모델이 하는 일은 두 단계로 나뉜다.
프리필(prefill) — 프롬프트 전체를 한꺼번에 읽어 캐시를 채운다. 수천 토큰을 동시에 처리하므로 GPU의 계산 능력을 꽉 채워 쓴다.
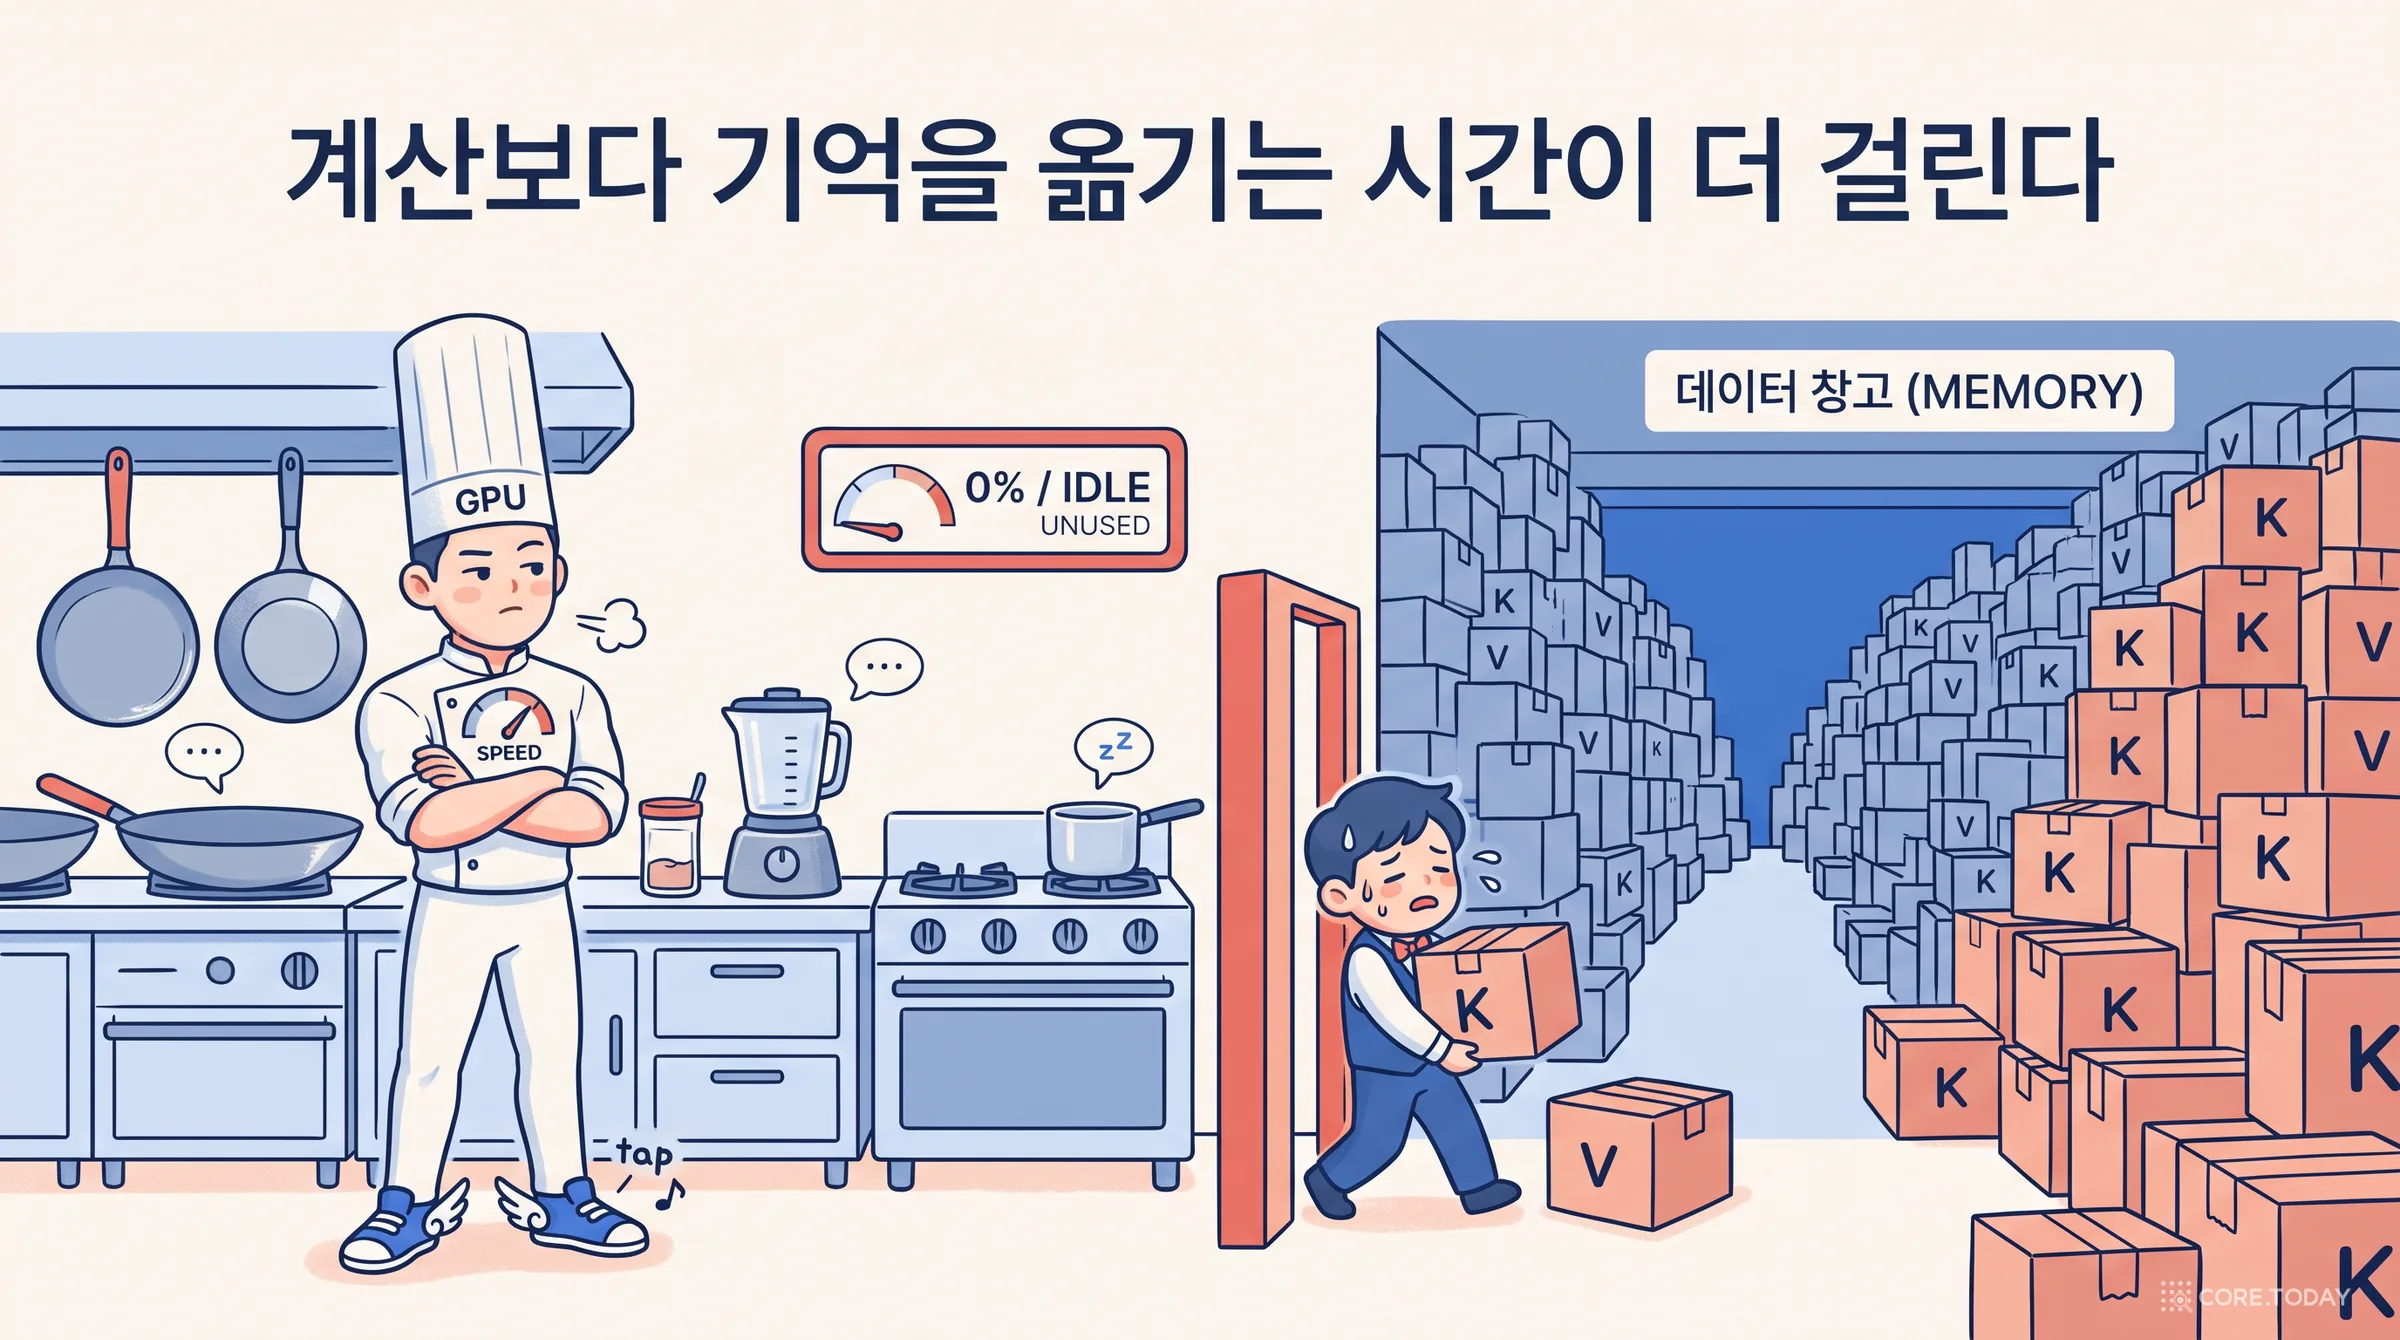
디코드(decode) — 답을 한 토큰씩 쓴다. 걸음마다 새 토큰은 하나뿐인데, 그 하나를 위해 모델 가중치 전체와 캐시 전체를 메모리에서 읽어 와야 한다.
디코드에서 GPU는 대부분의 시간을 계산이 아니라 메모리에서 데이터를 가져오는 데 쓴다. 샤지어는 2019년 논문 첫머리에 이렇게 적었다. 점진적 추론은 “큰 ‘키’와 ‘값’ 텐서를 반복해서 불러오는 메모리 대역폭 비용 때문에 종종 느리다.” 2022년 구글의 포프(Reiner Pope) 등은 더 구체적으로 썼다(이듬해 MLSys 발표). 배치와 문맥이 작을 때는 가중치를 읽는 시간이 지배하지만, “문맥 2,048토큰 이상, 배치 512 이상처럼 커지면 KV 캐시를 읽는 시간이 지배한다.” 그들의 계산으로 500B급 모델에서 그 캐시는 3TB, 모델의 세 배였다. 그동안 “칩의 계산 코어는 사실상 놀고 있다.”
사내 V100(Qwen3-0.6B·1.7B·4B)과 V100S(Qwen3-8B)에서, 이미 L토큰이 쌓인 상태로 토큰 하나를 더 쓰는 데 걸리는 시간을 쟀다. 캐시를 쓸 때와, 캐시 없이 매번 전체를 다시 계산할 때를 비교했다.
모델
1K 토큰
4K
8K
16K
Qwen3-0.6B
66ms / 84ms
66ms / 829ms
66ms / 3.66초
61ms / 메모리 부족
Qwen3-1.7B
50ms / 116ms
51ms / 950ms
52ms / 3.94초
64ms / 메모리 부족
Qwen3-4B
43ms / 262ms
43ms / 2.25초
68ms / 9.71초
117ms / –
Qwen3-8B
44ms / 355ms
48ms / 2.65초
75ms / 메모리 부족
123ms / –
칸마다 ‘캐시 사용 / 캐시 없음’, 토큰 하나를 더 쓰는 데 걸린 시간(중앙값). 0.6B·1.7B는 V100 16GB, 4B·8B는 V100S 32GB, fp16.
캐시를 쓰면 4,096토큰까지는 토큰 하나의 시간이 거의 일정했다. 그보다 길어지면 캐시를 읽고 어텐션을 계산하는 비용이 드러나, 4B·8B에서는 1.6만 토큰에서 짧은 문맥의 약 2.6배(117~123ms)가 됐다. 그래도 캐시가 없을 때와는 비교가 되지 않는다. 캐시가 없으면 문맥 길이에 따라 가파르게 늘었다. Qwen3-8B에서 4,096토큰 문맥이면 캐시 없이 2.6초, 캐시를 쓰면 0.05초였다. 캐시 없이 8,192토큰을 다시 계산하려 하자 V100S의 32GB가 모자랐다. V100 계열은 플래시 어텐션을 지원하지 않아, 어텐션 점수 행렬을 통째로 메모리에 펼치는 방식으로 계산했을 가능성이 크다(직접 확인하지는 않았다).
다만 실험 환경을 정직하게 밝혀 두자. 우리는 허깅페이스 transformers의 기본 구현을 그대로 썼다. 이 구현은 GPU 연산을 하나씩 띄우는 고정 비용이 커서, 짧은 문맥에서 걸음당 시간이 모델 크기와 별 상관없이 44~68ms였다(V100의 0.6B가 V100S의 8B보다 오히려 느렸다). vLLM 같은 서빙 엔진은 이 부가 비용을 크게 줄인다. 절대 시간보다 비율과 모양을 보자.
3.3 코어닷투데이 실측 — 한 GPU에 몇 명까지
캐시가 서비스 비용을 결정하는 진짜 이유는 동시 사용자 수다. 같은 GPU로 여러 사용자의 요청을 한꺼번에 처리(배치)하면 가중치를 한 번 읽어 여러 명에게 쓸 수 있어 효율이 오른다. 그런데 사용자마다 자기 캐시가 따로 필요하다.
동시 사용자 수를 1명에서 2배씩 늘리며, 모두 같은 길이의 문맥을 가진 상태로 토큰을 생성했다. 사용자가 적을 때는 걸음당 시간이 거의 그대로라 처리량이 사용자 수에 비례해 늘었다. 가중치를 한 번 읽어 여러 명에게 나눠 쓰기 때문이다. 그러다 어느 지점부터 걸음당 시간이 사용자 수만큼 늘기 시작하며 처리량이 평평해졌고, 결국 메모리가 바닥났다.
모델(GPU)
문맥 1,024토큰: 최대 처리량
받을 수 있던 사용자
문맥 4,096토큰: 최대 처리량
받을 수 있던 사용자
Qwen3-0.6B (V100 16GB)
초당 312토큰
64명
초당 78토큰
16명
Qwen3-1.7B (V100 16GB)
초당 288토큰
32명
초당 77토큰
16명
Qwen3-4B (V100S 32GB)
초당 171토큰
64명
초당 43토큰
16명
Qwen3-8B (V100S 32GB)
초당 157토큰
64명
초당 42토큰
16명
사용자 수는 1·2·4·…·128명으로 늘렸고, ‘받을 수 있던 사용자’는 메모리가 부족해지기 직전 값이다.
문맥이 4배 길어지자 최대 처리량은 네 모델 모두 약 4분의 1로 줄었다. 받을 수 있던 사용자는 0.6B·4B·8B에서 64명에서 16명으로 줄었다. Qwen3-8B는 64명 × 1,024토큰에서 캐시만 9.1GiB, 16명 × 4,096토큰에서도 9.0GiB였다. 사용자 수 × 문맥 길이가 같으면 캐시도 같다. 결국 GPU 한 장이 감당하는 것은 ‘사용자 수’도 ‘문맥 길이’도 아닌, 그 둘을 곱한 토큰 총량이다. 긴 대화가 비싼 이유가 바로 이것이다. 대화가 길어지면 같은 GPU로 받을 수 있는 손님이 그만큼 줄어든다.
3.4 같은 앞부분은 한 번만
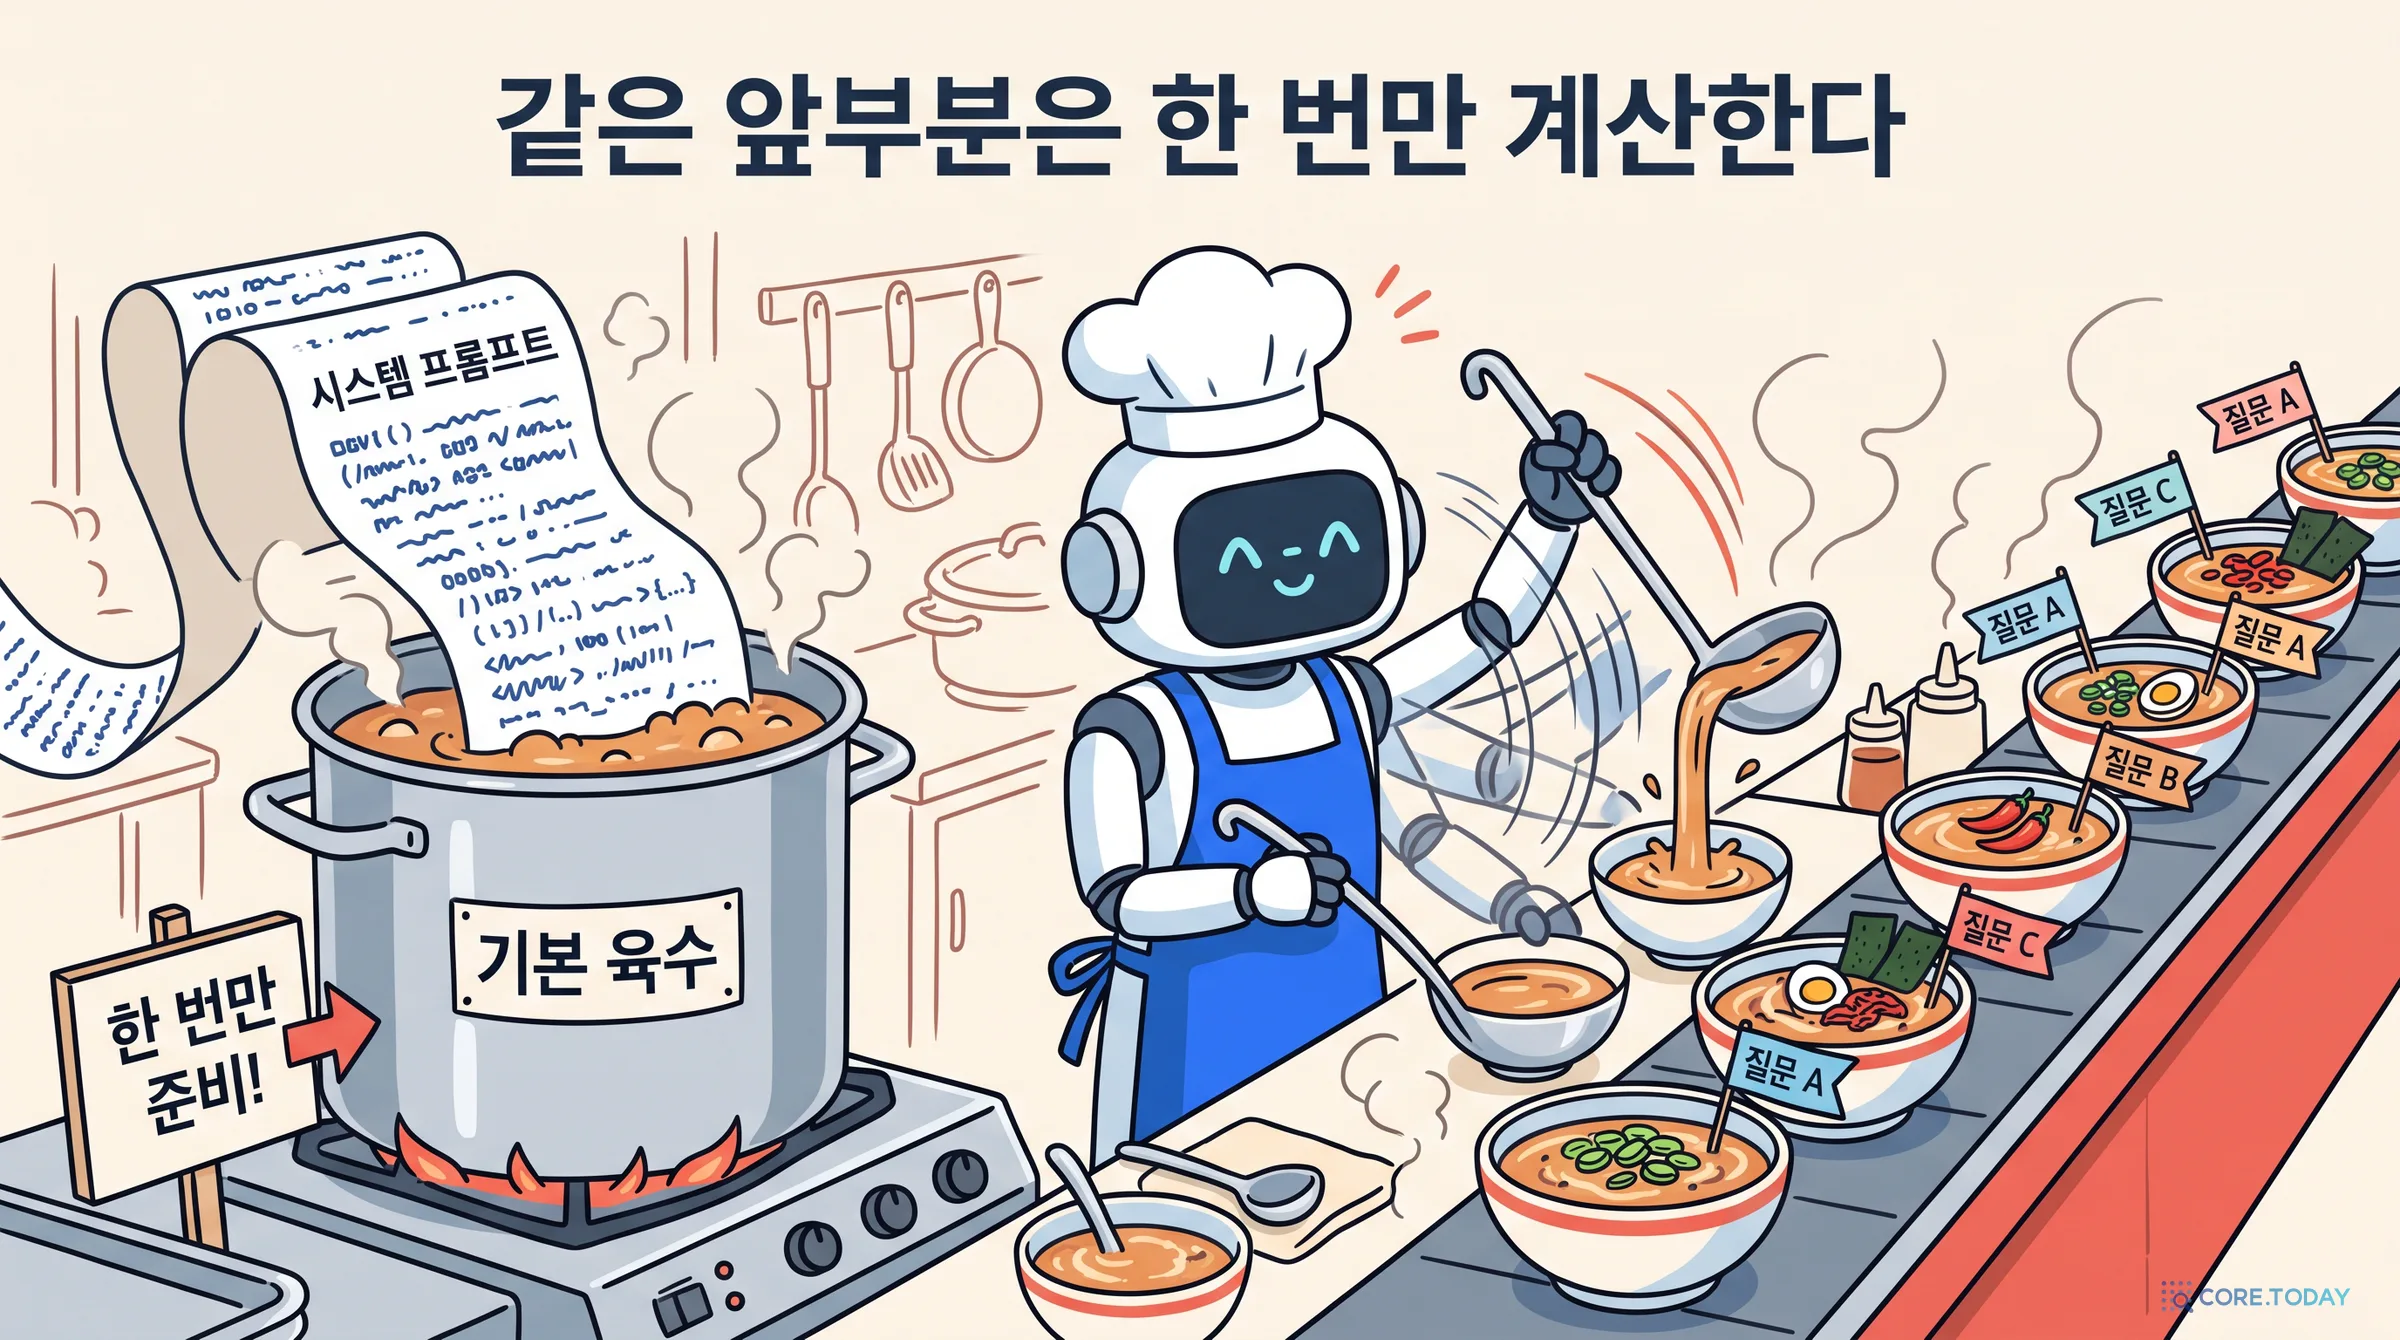
여러 요청이 같은 앞부분을 공유하는 경우가 많다. 모든 대화에 붙는 시스템 프롬프트, 여러 질문을 던지는 하나의 긴 문서, 같은 예시 묶음이 그렇다. 앞부분의 캐시를 보관해 두면 새 요청은 뒤에 붙은 질문만 계산하면 된다.
위젯의 ③번 탭이 그 실측이다. Qwen3-8B에 1.6만 토큰짜리 앞부분을 주고 64토큰짜리 질문을 붙였을 때, 매번 처음부터 계산하면 첫 토큰까지 8.44초가 걸렸다. 앞부분의 캐시를 재사용하면 0.16초, 54배 빨랐다. 앞부분이 4,096토큰이면 2.58초 → 0.08초(33배), 1,024토큰이면 0.37초 → 0.06초(6.5배)였다. 재사용할 때도 질문이 앞부분 전체를 돌아봐야 하므로 시간이 조금씩 늘지만(0.06초 → 0.16초), 처음부터 계산하는 시간이 훨씬 가파르게 늘기 때문에 앞부분이 길수록 이득이 커진다. 0.6B·1.7B·4B도 1.6만 토큰에서 27~50배였다.
4부. 기억하는 헤드만 줄이기
4.1 2019년, 헤드 하나로 — MQA
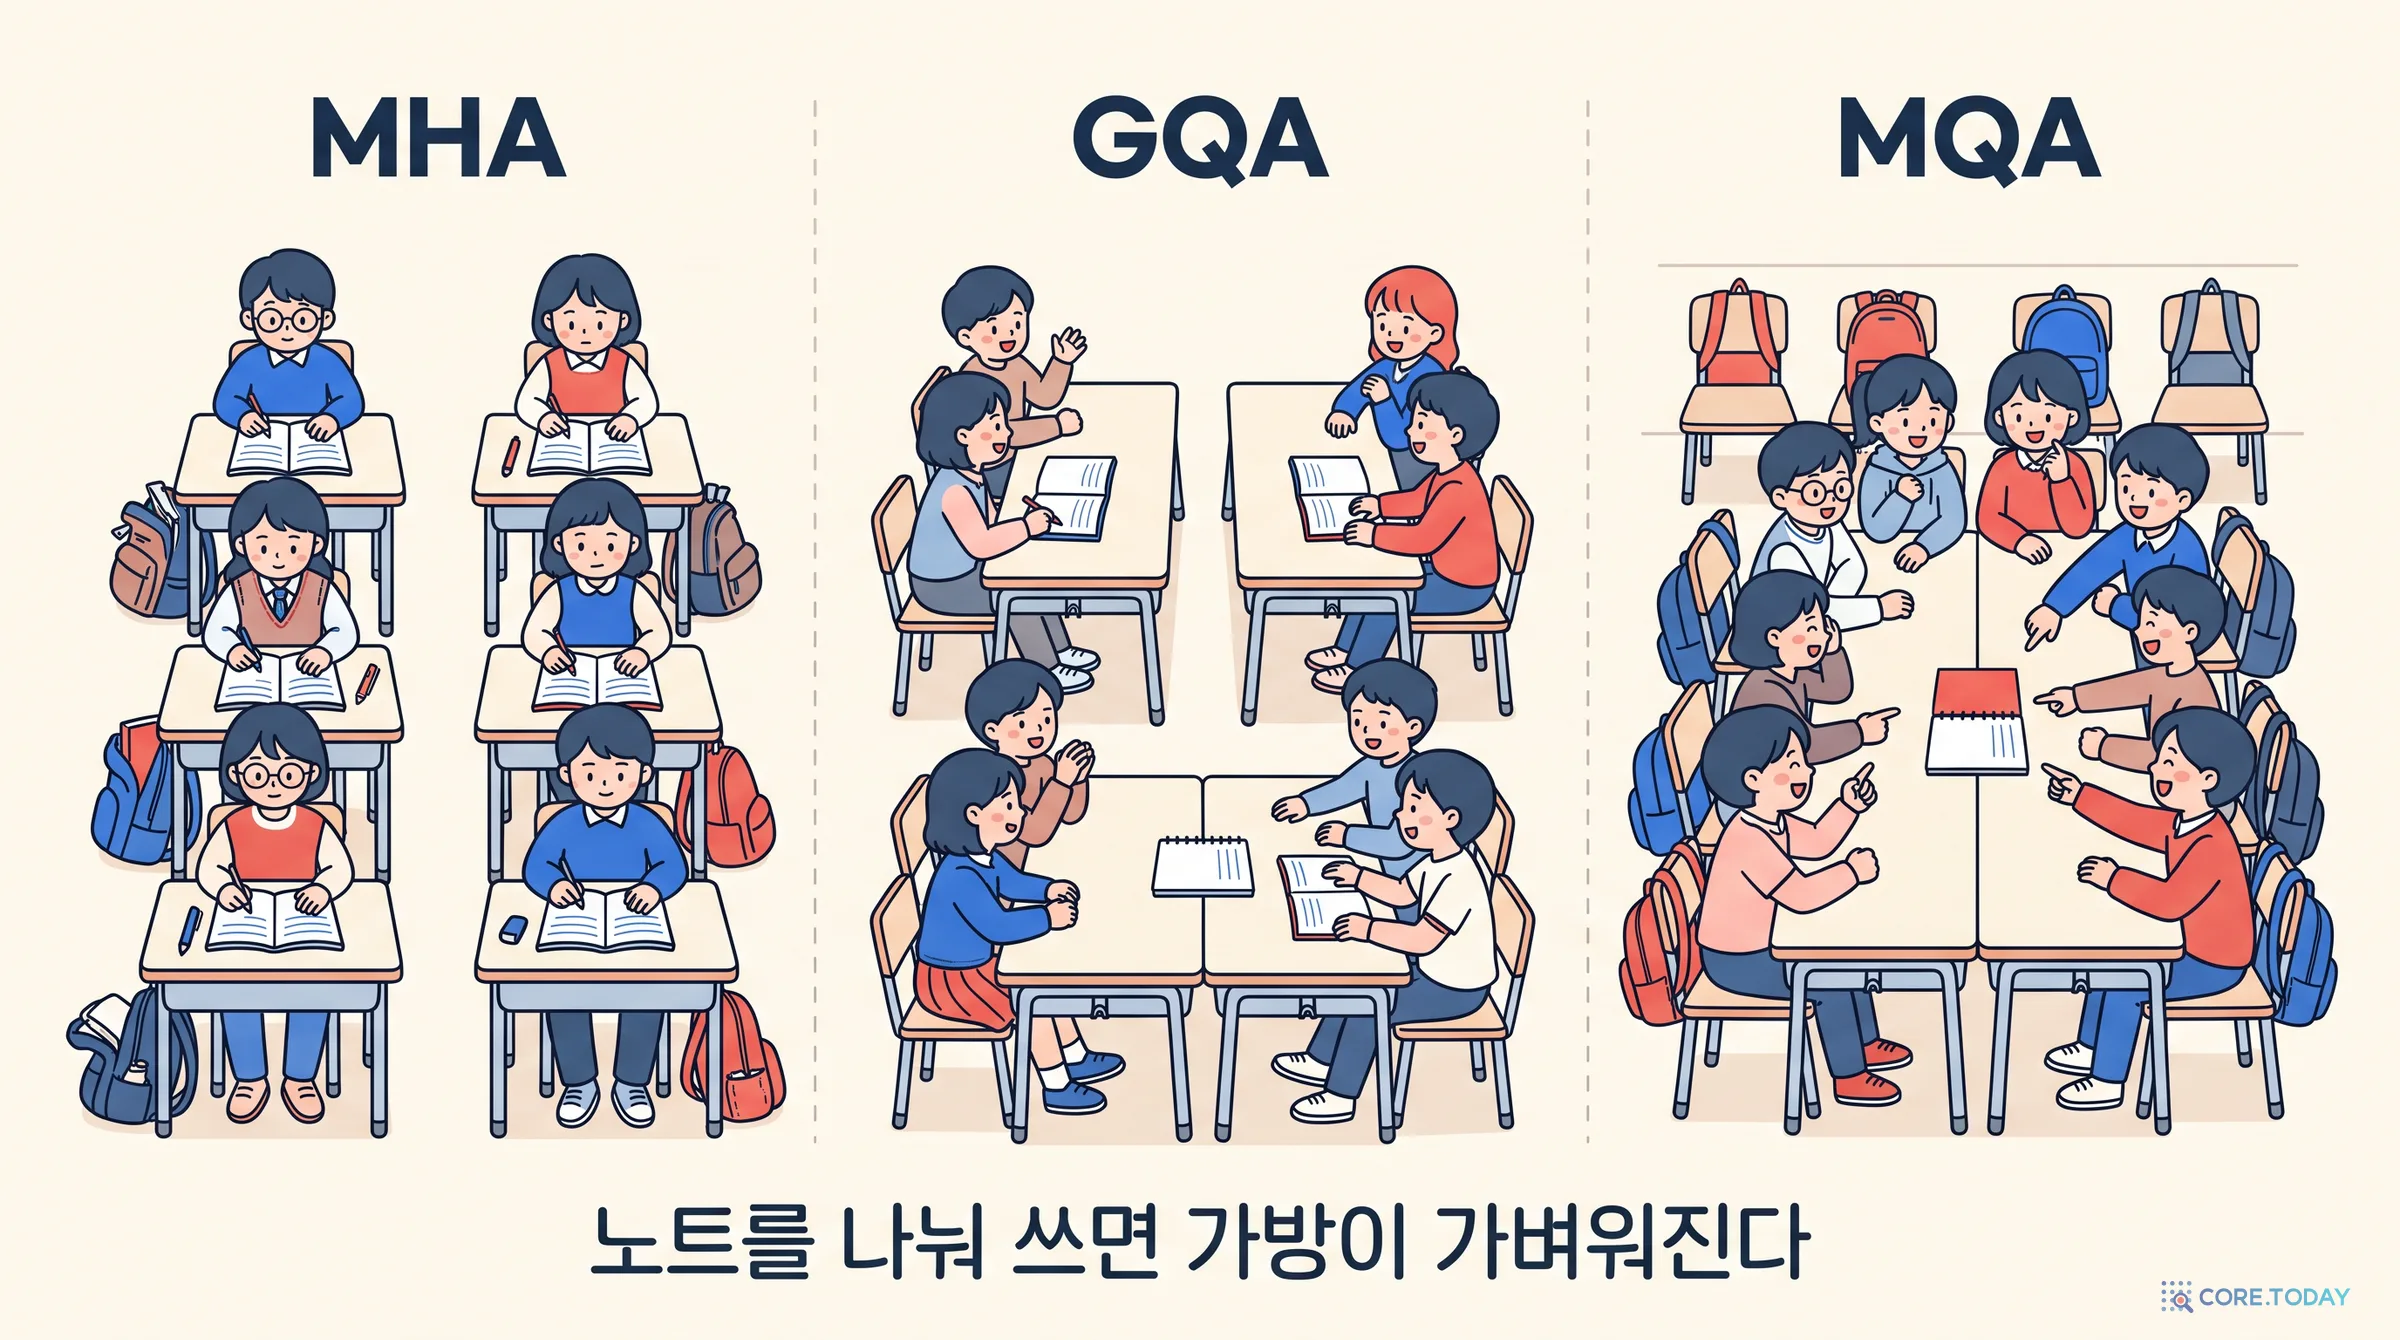
트랜스포머의 어텐션은 여러 개의 헤드로 나뉜다. 헤드마다 자기 Q·K·V를 갖고 서로 다른 관계를 본다. 원조 방식인 멀티헤드 어텐션(MHA)에서는 헤드 수만큼 K·V를 캐시에 쌓아야 한다.
샤지어는 2019년 「빠른 트랜스포머 디코딩: 쓰기 헤드 하나면 충분하다」에서 과감한 제안을 했다. 질의 헤드는 여러 개 두되, K·V 헤드는 하나만 두고 모든 질의 헤드가 나눠 쓰자. 이것이 다중 질의 어텐션(MQA)이다. 캐시가 헤드 수만큼 줄어든다. 번역 실험(배치 1,024개를 동시에 생성)에서 토큰 하나당 생성 시간이 46마이크로초에서 3.8마이크로초로 약 12배 빨라졌고, BLEU는 27.7에서 27.5로 거의 그대로였다.
MQA는 빠르지만 품질이 떨어지고 학습이 불안정할 수 있다는 우려가 남았다. 2023년 구글의 에인슬리(Joshua Ainslie) 등은 중간을 택했다. 질의 헤드를 몇 개의 그룹으로 묶고, 그룹마다 K·V 헤드 하나를 두는 그룹 질의 어텐션(GQA)이다. 그룹이 하나면 MQA, 헤드 수만큼이면 MHA다.
논문은 이미 학습된 MHA 모델을 원래 사전 학습 계산량의 5%만 더 들여 GQA로 바꾸는 방법도 보였다. T5-XXL에서 MHA는 샘플당 1.51초에 평균 47.2점, MQA는 0.24초에 46.6점, 8그룹 GQA는 0.28초에 47.1점이었다. 품질은 MHA에 가깝고, 속도는 MQA에 가까웠다.
GQA는 곧 표준이 됐다. Llama 2는 34B·70B에, Llama 3는 전 모델에 KV 헤드 8개짜리 GQA를 썼다. Qwen3도 0.6B부터 32B까지 KV 헤드가 8개다. 질의 헤드는 0.6B의 16개에서 32B의 64개까지 늘리면서도 KV 헤드는 8개로 묶어 두었다. Qwen3-32B는 질의 헤드 64개가 KV 헤드 8개를 나눠 쓴다. 멀티헤드였다면 캐시가 8배였을 것이다.
4.3 2024년, 압축해서 담기 — MLA
딥시크는 2024년 5월 딥시크-V2에서 다른 길을 냈다. K·V를 헤드별로 저장하는 대신, 그 둘을 만들어 낼 수 있는 작은 잠재 벡터 하나만 저장한다. 어텐션을 계산할 때 그 벡터에 행렬을 곱해 헤드별 K·V로 펼친다. 다중 헤드 잠재 어텐션(MLA)이다. 딥시크-V3 기준으로 층마다 잠재 벡터 512차원과 위치 정보용 64차원, 합쳐 576개 숫자만 저장한다. 토큰당 69KiB로, 비슷한 규모의 Llama 3.1 405B(504KiB)의 7분의 1이다. 논문은 이것이 GQA로 치면 그룹 2.25개에 해당하는 캐시 크기라고 했다.
자주 인용되는 숫자에는 주의가 필요하다. 딥시크-V2 논문은 이전 모델 딥시크 67B보다 “KV 캐시를 93.3% 줄이고 최대 생성 처리량을 5.76배로 높였다”고 썼다. 그런데 같은 논문은 배포 모델의 캐시를 원소당 평균 6비트로 양자화했다고 밝힌다. 우리가 두 모델의 설정값으로 계산해 보니, 93.3%는 6비트 양자화까지 더했을 때 정확히 나오는 숫자였다. MLA만으로(16비트) 줄어드는 몫은 약 82%다. 그래도 대단한 압축이지만, ‘MLA = 93.3%’는 정확한 표현이 아니다.
이 밖에도 이웃한 층끼리 K·V를 나눠 쓰는 교차 층 어텐션(CLA, 2024)이 MQA 위에서 캐시를 다시 절반으로 줄였고, 캐시를 한 번만 만들어 모든 층이 재사용하는 YOCO(2024) 같은 설계도 나왔다.
5부. 자리를 아껴 쓰기
5.1 2023년, 운영체제에서 빌려 온 생각 — 페이지드 어텐션
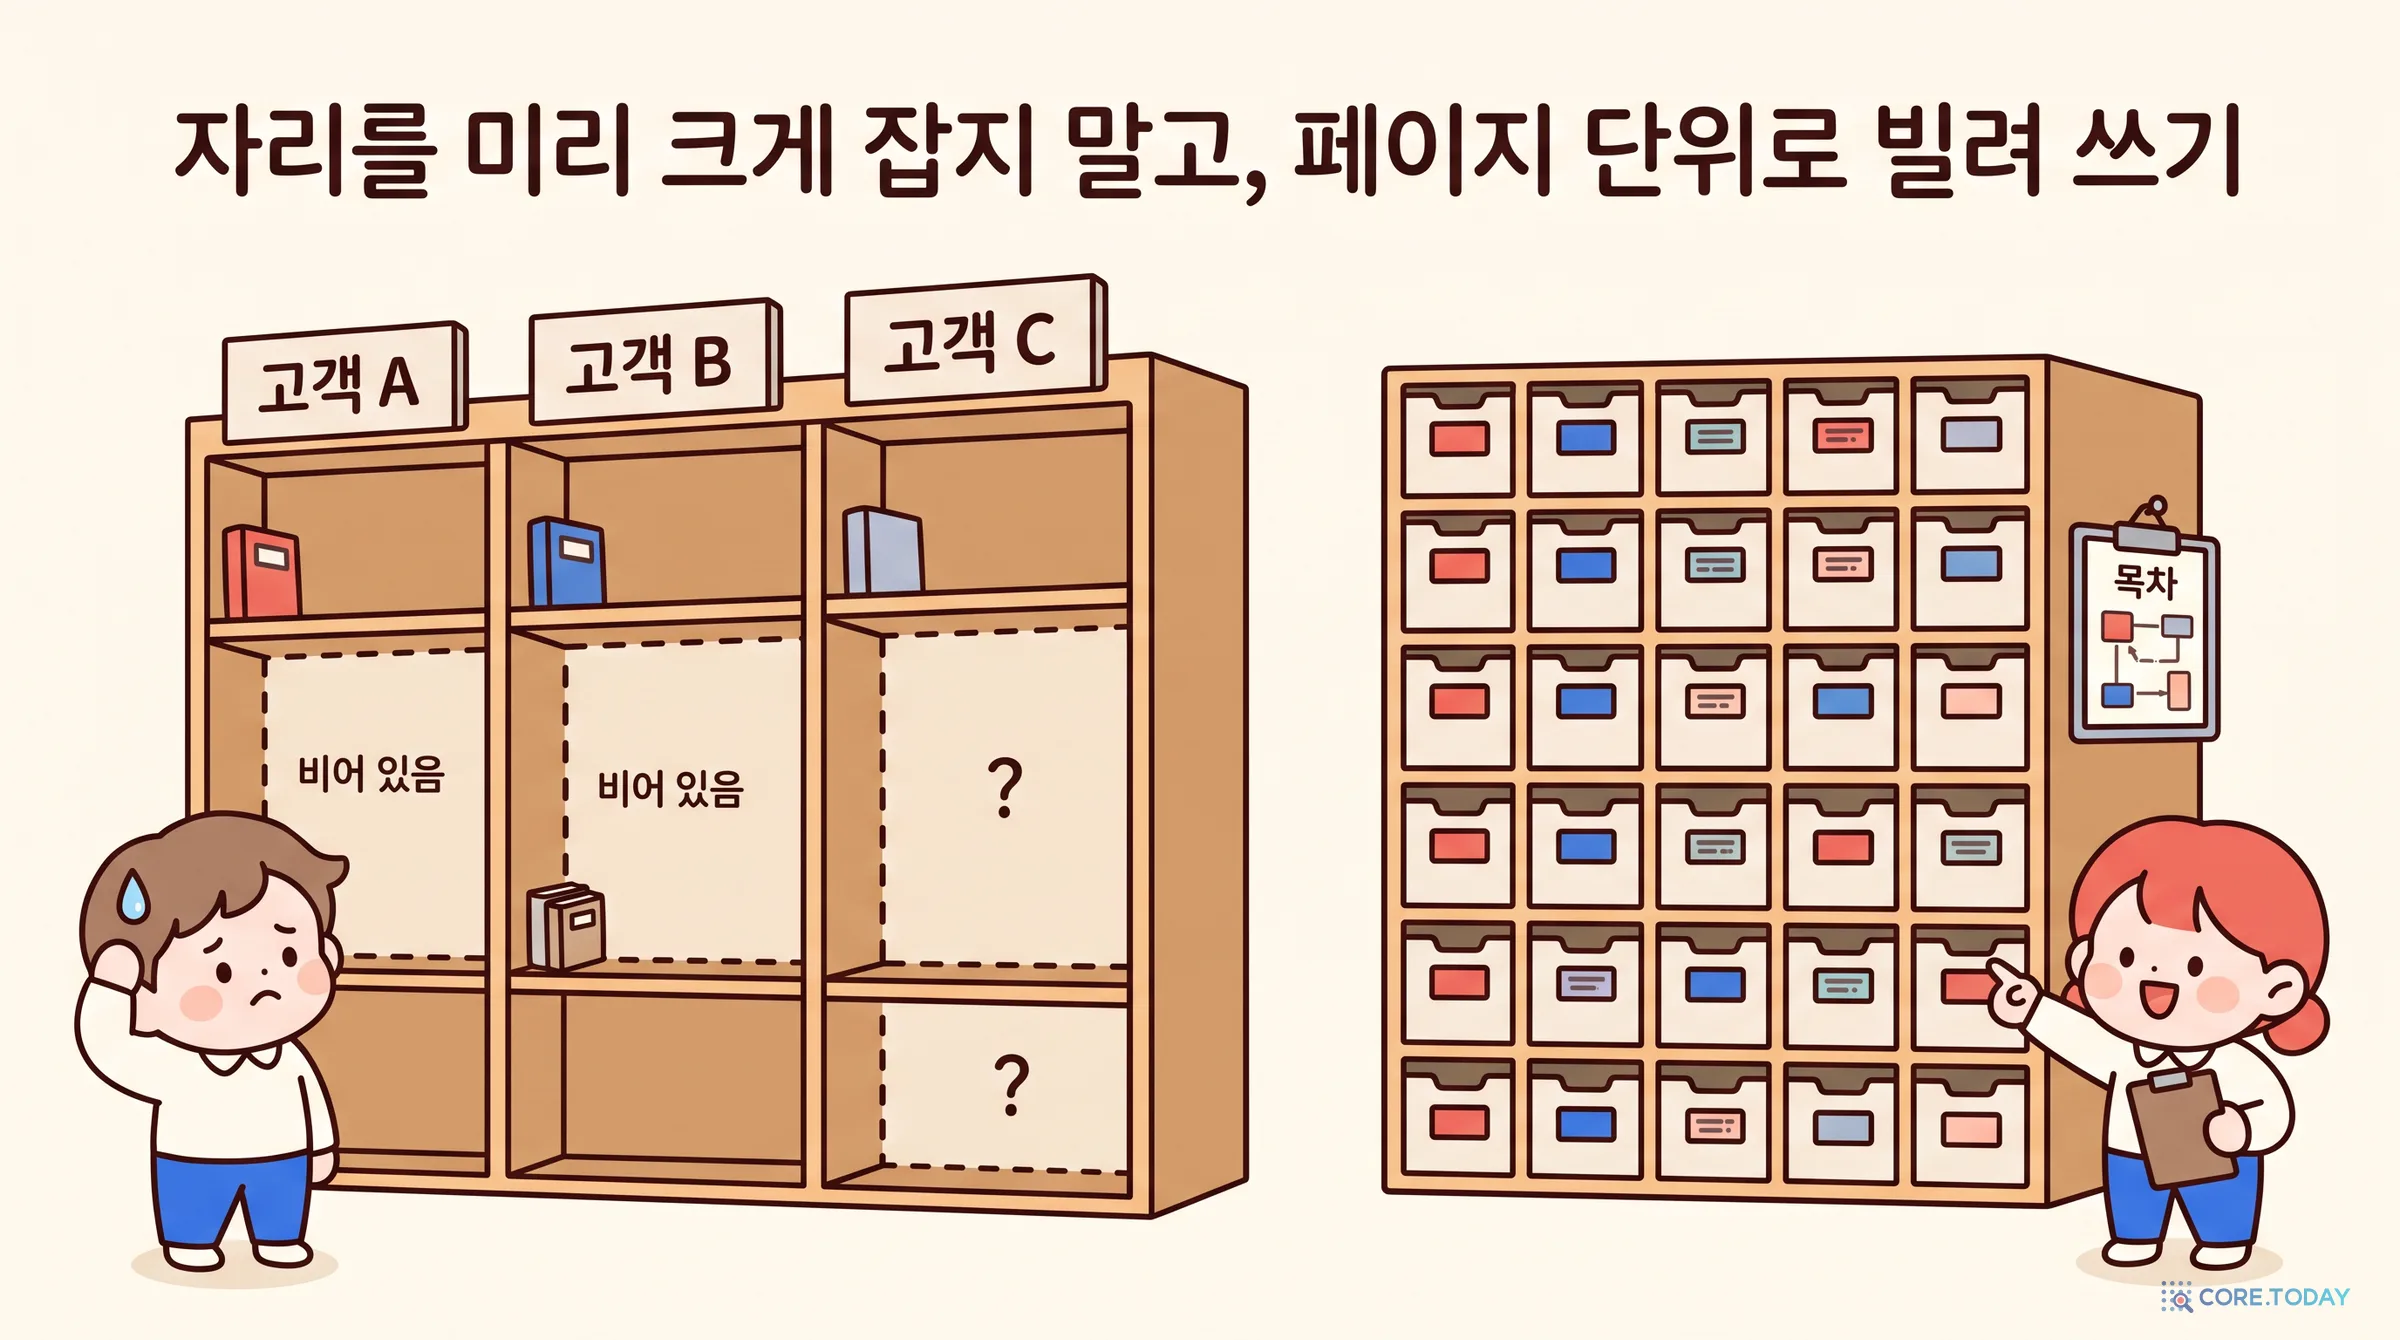
캐시를 줄이는 것만큼 중요한 것이 캐시를 잘 배치하는 일이다. 초기 서빙 시스템은 요청마다 최대 길이만큼의 연속된 메모리를 미리 잡아 두었다. 답이 몇 토큰이 될지 모르기 때문이다. 짧게 끝나면 나머지는 놀고, 그 틈은 다른 요청이 쓰지 못한다.
UC 버클리의 권(Woosuk Kwon) 등은 2023년 SOSP에서 발표한 vLLM 논문에서 이 낭비를 쟀다. 기존 시스템에서는 KV 캐시 메모리의 20.4~38.2%만 실제 토큰을 담는 데 쓰였다. 해법은 운영체제의 가상 메모리였다. 캐시를 작은 고정 크기 블록(페이지)으로 쪼개고, 요청이 필요할 때마다 한 블록씩 빌려 준다. 블록들은 메모리 여기저기 흩어져 있어도 되고, 표 하나가 순서를 기억한다. 이것이 페이지드 어텐션(PagedAttention)이다. vLLM의 실제 사용률은 96.3%였고, 같은 지연 시간에서 처리량이 기존 시스템보다 2~4배 높았다. 흔히 인용되는 “기존 시스템은 메모리의 60~80%를 낭비, vLLM은 4% 미만”은 논문이 아니라 같은 해 6월 vLLM 블로그의 표현이다.
블록 단위로 캐시를 관리하면 덤이 생긴다. 앞부분이 같은 요청들이 같은 블록을 가리키게 할 수 있다. vLLM은 블록마다 그 블록과 앞선 모든 토큰의 해시를 매겨, 같은 해시가 나오면 계산하지 않고 재사용한다. 현재 vLLM은 이 기능이 기본으로 켜져 있다. 스탠퍼드·버클리의 LMSYS 팀이 만든 SGLang은 2023년 12월 요청들의 공유 앞부분을 트리(래딕스 트리)로 관리하는 래딕스 어텐션을 내놓았고, 논문에서 처리량을 최대 6.4배 높였다고 보고했다.
2024년 8월, KV 캐시가 API 요금표에 등장했다. 8월 2일 딥시크가 ‘디스크 위의 문맥 캐싱’을 내놓으며 캐시에 적중한 입력을 정가의 10%에 받았다. 8월 14일 앤트로픽이 프롬프트 캐싱을 공개 베타로 열었고, 10월 1일 오픈AI가 1,024토큰 이상의 프롬프트에 자동으로 50% 할인을 적용했다. 들어가며의 질문, “같은 문서를 두 번째 보낼 때는 왜 싼가”의 답이 이것이다. 두 번째 요청은 앞부분을 다시 계산하지 않고, 보관해 둔 KV 캐시를 꺼내 쓰기 때문이다.
2026년 11월 현재, 할인 폭은 더 커졌다.
제공자
출시
캐시 적중 입력 요금(정가 대비)
비고
딥시크
2024.08.02
약 2~3%(V4 세대)
출시 때 10%. 기본 적용, 64토큰 단위
앤트로픽
2024.08.14
10%(기본), 최신 모델 5% 또는 2.5%
캐시 쓰기는 5분 보관 1.25배, 1시간 보관 2배
오픈AI
2024.10.01
10%(GPT-5.6 이후)
출시 때 50%, 쓰기 요금 없음. 지금은 30분 보관 쓰기 1.25배
구글 제미나이
2024.06(명시적), 2025.05(자동)
약 10%
2.5 이후 모델은 자동 캐싱 기본 적용
각 사 공식 문서·요금표, 2026-11-08 조회. 모델마다 다르며 자주 바뀐다.
보관 시간에도 KV 캐시의 성질이 드러난다. 기본값은 대개 몇 분에서 한 시간 정도로 짧고, 더 오래 보관하려면 쓰기 요금을 더 받는다(앤트로픽 1시간 2배, 오픈AI 12시간 2.5배). 딥시크처럼 캐시를 디스크에 내려 몇 시간에서 며칠씩 보관하는 곳도 있다. 비싼 GPU 메모리에 언제까지 둘지, 값싼 저장소로 옮길지의 문제다. 긴 대화의 비용은 이제 ‘얼마나 길게 말하느냐’만큼 ‘앞부분을 얼마나 그대로 유지하느냐’에 달려 있다. 시스템 프롬프트를 자주 바꾸거나 대화 앞쪽을 고쳐 쓰면 캐시가 깨진다.
6부. 줄여서 담기 — 캐시 양자화
6.1 숫자를 거칠게
가중치를 4비트로 줄이는 양자화는 양자화 완전 해부에서 다뤘다. 캐시도 같은 방법으로 줄일 수 있다. 16비트를 8비트로 줄이면 캐시가 절반, 2비트면 8분의 1이다. 2부의 계산기에서 KV 캐시 비트를 바꿔 보면, 같은 GPU에 들어가는 문맥이 몇 배로 늘어난다.
문제는 어느 방향으로 묶어 자르느냐다. 양자화는 숫자 묶음의 최솟값과 최댓값 사이를 몇 칸으로 나눠, 각 숫자를 가장 가까운 칸에 붙인다. 캐시 텐서는 ‘토큰 × 채널’ 모양이라, 한 토큰의 모든 채널을 한 묶음으로 자를 수도(토큰별) 있고, 한 채널의 여러 토큰을 한 묶음으로 자를 수도(채널별) 있다.
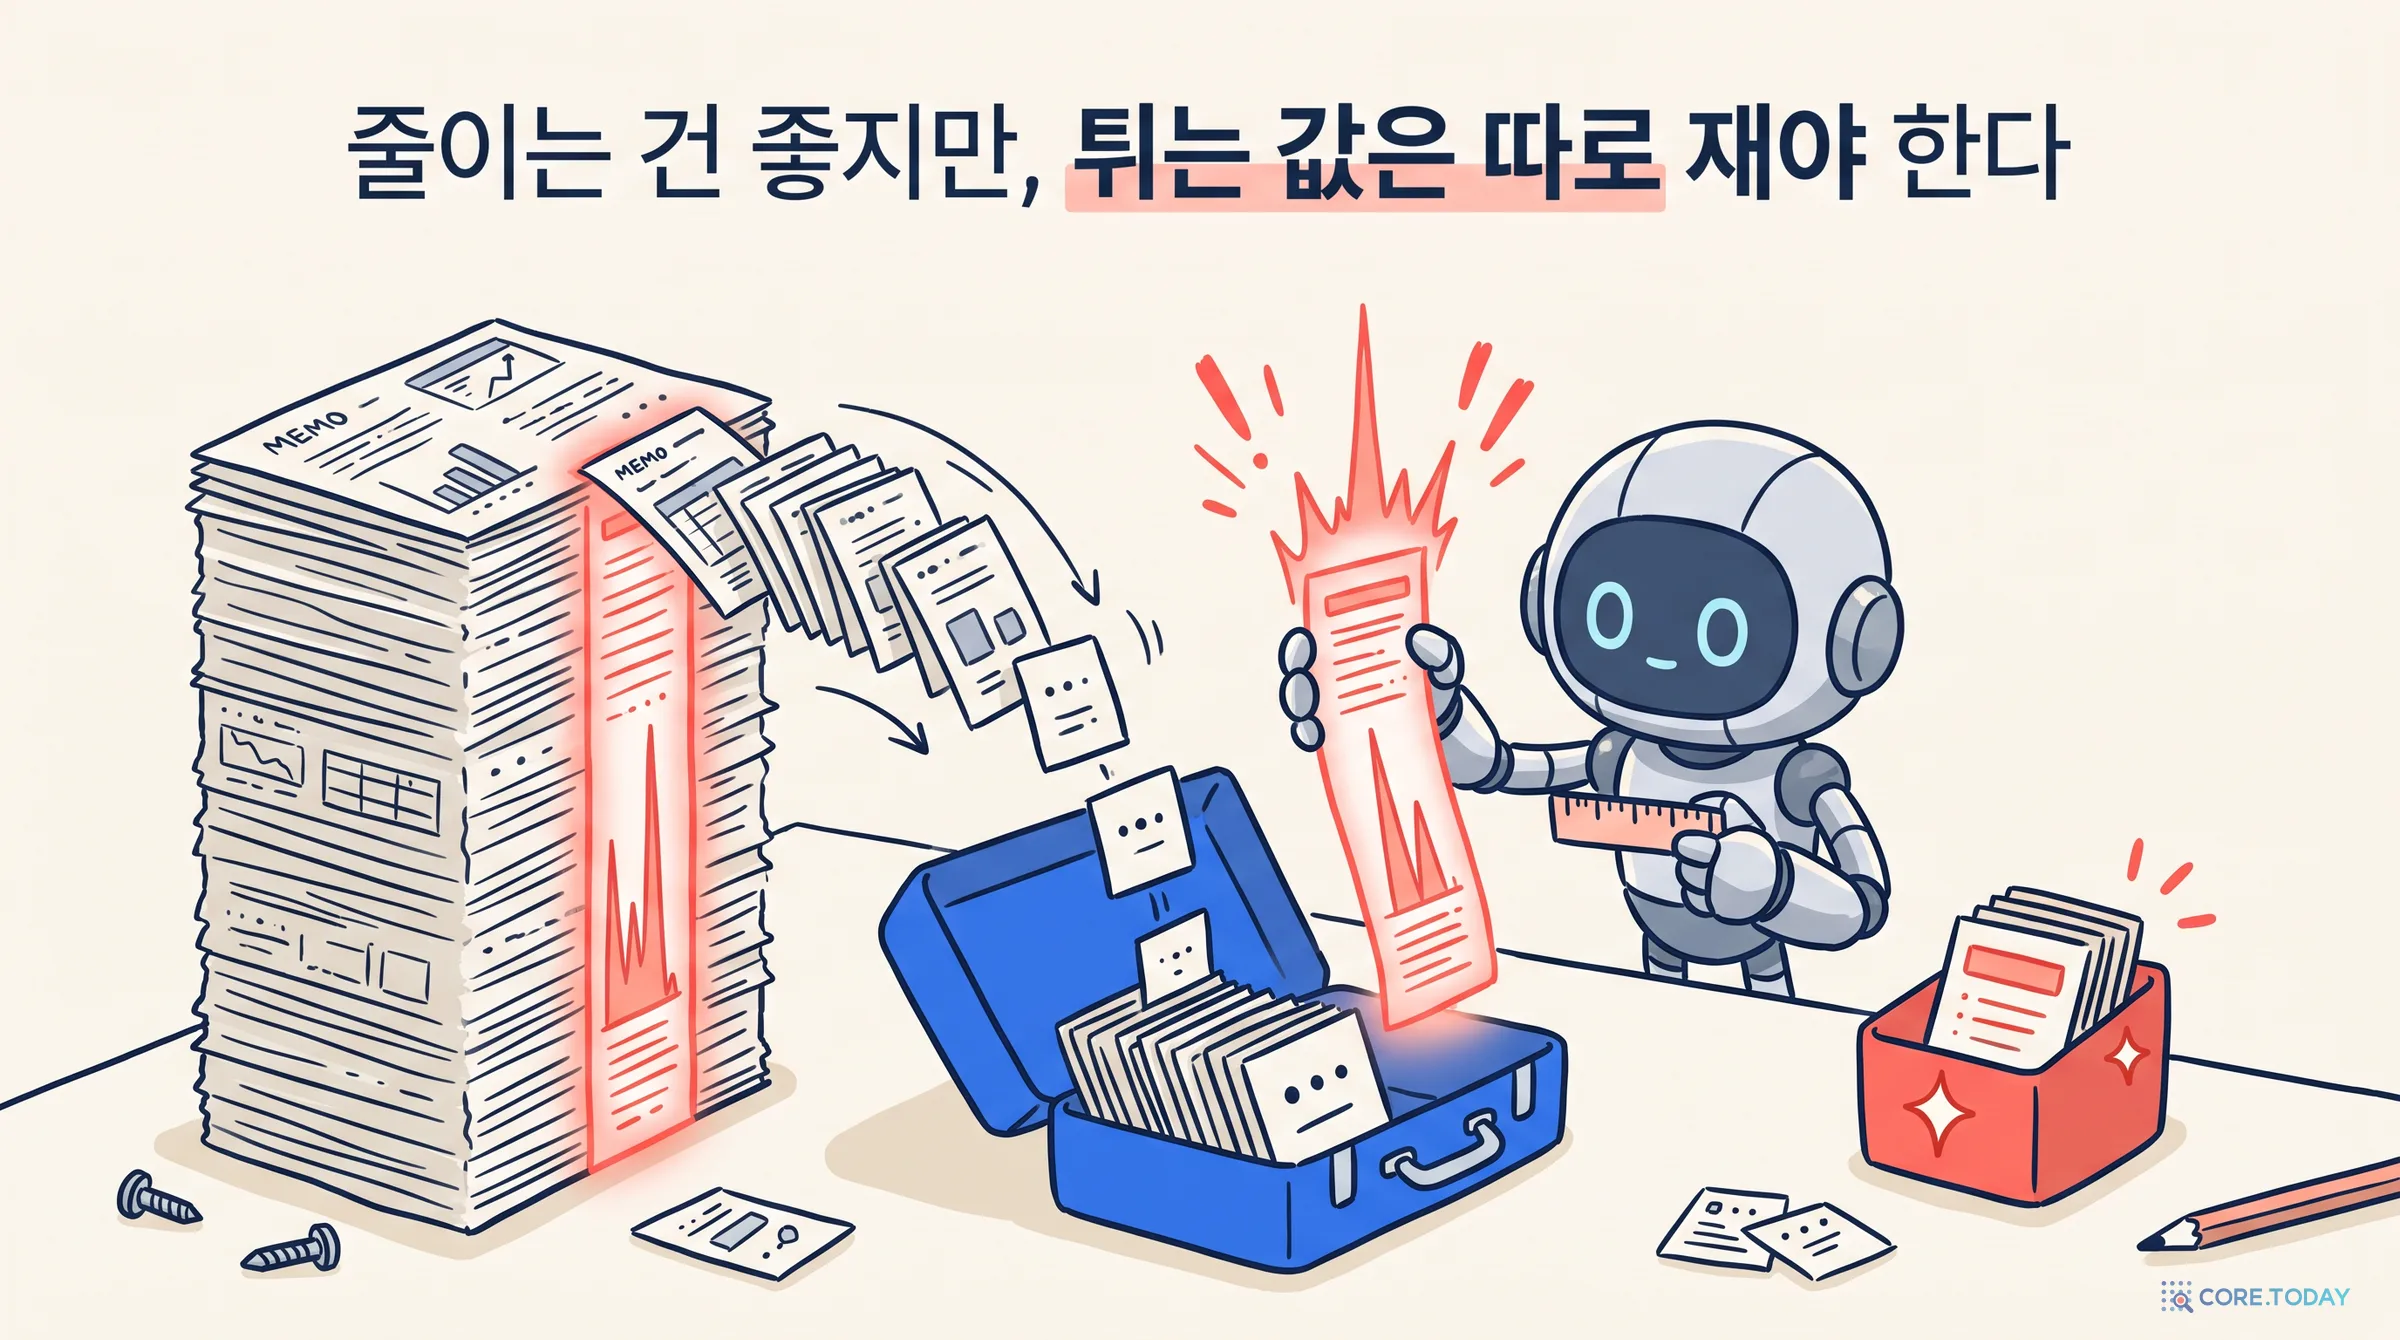
2024년 KIVI 논문(ICML 2024)은 키와 값을 살펴보다가 차이를 발견했다. 키에는 유독 값이 큰 채널이 몇 개 있다. 토큰별로 자르면 그 큰 채널 때문에 칸이 너무 넓어져, 나머지 채널의 섬세한 차이가 뭉개진다. 그래서 KIVI는 “키는 채널별로, 값은 토큰별로” 자르자고 했고, 2비트로도 품질을 지키며 최대 메모리를 2.6배 줄였다(모델 가중치 포함). 같은 해 KVQuant(NeurIPS 2024)는 3비트에서 퍼플렉서티 손실 0.1 미만, A100 한 장에서 Llama-7B로 100만 토큰 문맥을 보였다.
Qwen3 캐시로 직접 확인했다. 위키백과 문서(한국어 6개, 영어 6개)의 앞 4,096토큰을 읽혀 캐시를 만든 뒤, 캐시만 양자화했다가 복원하고, 이어지는 512토큰을 얼마나 잘 예측하는지 퍼플렉서티로 쟀다. 또 약 4,000토큰짜리 글의 앞쪽(10%)·가운데(50%)·뒤쪽(90%)에 다섯 자리 비밀번호를 숨겨 두고, 양자화된 캐시만으로 그 번호를 찾게 했다(언어마다 24회).
모델 · 언어
16비트(원본)
8비트 토큰별
4비트 토큰별
4비트 키 채널별
2비트 토큰별
2비트 키 채널별
Qwen3-0.6B · 한국어
12.55
12.59
2,853
12.60
13,320
17.01
Qwen3-0.6B · 영어
9.35
9.36
2,037
9.43
30,638
11.76
Qwen3-1.7B · 한국어
8.85
8.85
1,703
8.88
9,330
10.41
Qwen3-1.7B · 영어
7.32
7.32
906
7.34
15,979
8.16
Qwen3-4B · 한국어
7.17
7.17
903
7.18
767
8.04
Qwen3-4B · 영어
6.26
6.26
403
6.28
1,980
6.87
Qwen3-8B · 한국어
6.23
6.22
144
6.25
362
6.67
Qwen3-8B · 영어
5.66
5.66
172
5.66
428
6.03
Pythia-1B · 한국어
4.90
4.90
4.92
4.93
8.20
5.46
Pythia-1B · 영어
12.85
12.85
12.85
12.87
20.97
13.61
퍼플렉서티(낮을수록 좋음). ‘키 채널별’은 KIVI 방식: 키는 채널마다 128토큰 묶음으로, 값은 토큰마다 자른다. ‘토큰별’은 키와 값 모두 토큰마다(헤드 차원 128개 묶음) 자른다. 비대칭 최솟값-최댓값 균일 양자화.
모델
16비트
8비트 토큰별
4비트 토큰별
4비트 키 채널별
2비트 토큰별
2비트 키 채널별
Qwen3-0.6B
96 / 100
100 / 100
0 / 0
96 / 100
0 / 0
71 / 83
Qwen3-1.7B
100 / 100
100 / 100
0 / 0
100 / 100
0 / 0
75 / 92
Qwen3-4B
100 / 100
100 / 100
0 / 4
100 / 100
0 / 0
92 / 96
Qwen3-8B
100 / 100
100 / 100
8 / 100
100 / 100
0 / 0
79 / 96
Pythia-1B
0 / 100
0 / 100
0 / 100
0 / 100
0 / 12
0 / 100
숨긴 비밀번호를 맞힌 비율(%), ‘한국어 / 영어’, 각 24회.
Pythia-1B는 한국어를 거의 배우지 않은 모델이라 한국어 비밀번호는 16비트에서도 0%였다.
결과는 극적이었다. 8비트는 어떻게 잘라도 원본과 같았다. 4비트에서 길이 갈렸다. Qwen3 네 모델 모두, 키를 토큰별로 자르자 퍼플렉서티가 백 단위에서 천 단위로 치솟았다. Qwen3-0.6B의 한국어는 12.6에서 2,853, 8B는 6.2에서 144였다. 모델이 사실상 글을 이어 쓰지 못한다는 뜻이다. 한국어 비밀번호는 거의 하나도 찾지 못했다(0~8%). 반면 키를 채널별로 자르면 4비트는 원본과 소수점 둘째 자리까지 거의 같았고(0.6B 12.60, 8B 6.25), 3비트도 0.6B의 한국어(+5%)를 빼면 약 2% 안쪽이었다. 2비트에서는 퍼플렉서티가 6~36% 나빠지고 비밀번호도 일부 놓쳤지만(71~96%), 토큰별 2비트처럼 무너지지는 않았다.
차이는 키의 모양과 맞아떨어졌다. 채널마다 평균 크기를 재 보니, Qwen3 키에서 가장 큰 채널은 중간 채널보다 18~39배 컸다. 값(V)은 3배 정도였다. 비교를 위해 잰 Pythia-1B는 키의 쏠림이 8.7배로 작았고, 토큰별 4비트에서도 퍼플렉서티가 그대로였다. KIVI 논문의 설명과 일치하는 결과다. 다만 Pythia는 학습 데이터·어텐션 구조·문맥 길이도 Qwen3와 달라, 다섯 모델만으로 원인을 단정할 수는 없다. 분명한 것은 같은 ‘토큰별 4비트’가 어떤 모델에서는 멀쩡하고 어떤 모델에서는 치명적이라는 점이다. 캐시를 줄이기 전에 그 모델의 키부터 들여다봐야 하는 이유다.
이상한 점도 하나 있었다. Qwen3-8B의 영어는 토큰별 4비트에서 퍼플렉서티가 172로 무너졌는데도 비밀번호는 24번 모두 찾았다. 다섯 자리 숫자를 ‘베껴 오는’ 일은 글을 자연스럽게 잇는 일보다 덜 섬세한 모양이다. 하나의 시험만으로 양자화를 판단하면 안 된다.
실제 서비스에서는 이렇게 단순하지 않다. 최근 토큰 몇십 개는 원본 정밀도로 두고, 쌓일 때마다 묶어서 양자화하며, 양자화된 캐시를 바로 계산하는 전용 커널이 있어야 속도 이득도 생긴다. 우리 실험은 ‘양자화했다가 복원한’ 값으로 정확도만 본 것이다.
7부. 버리고 가기 — 슬라이딩 윈도와 어텐션 싱크
7.1 최근 것만 기억하기
캐시를 아예 버리는 방법도 있다. 가장 단순한 것은 슬라이딩 윈도다. 최근 W개 토큰의 캐시만 남기고 오래된 것은 버린다. 메모리는 문맥이 아무리 길어져도 W개 분량으로 고정된다. 2023년 10월의 미스트랄 7B는 창 4,096토큰짜리 ‘롤링 버퍼 캐시’를 써서, 3.2만 토큰에서 캐시 메모리를 8배 줄였다. 층이 32개이므로 정보가 층을 타고 넘어가며 이론상 약 13만 토큰까지 닿는다고 설명했다. 구글의 젬마 3(2025)는 창 1,024토큰짜리 지역 층 5개마다 전체를 보는 전역 층 1개를 두었다.
어텐션 점수를 기준으로 고르는 방법도 있다. 2023년 H2O는 어텐션을 많이 받는 ‘무거운’ 토큰 20%만 남겨도 품질이 유지된다며, 처리량을 딥스피드 제로 추론·허깅페이스 액셀러레이트보다 최대 29배 높였다. 2024년 SnapKV는 질문이 주목하는 토큰을 골라, 1.6만 토큰 입력에서 생성 속도 3.6배, 메모리 효율 8.2배를 보고했다.
7.2 2023년, 창이 무너지는 이유 — 어텐션 싱크
그런데 순수한 슬라이딩 윈도를 이미 학습된 모델에 그냥 적용하면 이상한 일이 생긴다. MIT와 메타의 샤오(Guangxuan Xiao) 등은 2023년 9월 「어텐션 싱크를 가진 효율적인 스트리밍 언어 모델」에서, 글이 창보다 길어져 맨 처음 토큰이 창 밖으로 밀려나는 순간 모델이 무너진다는 것을 보였다.
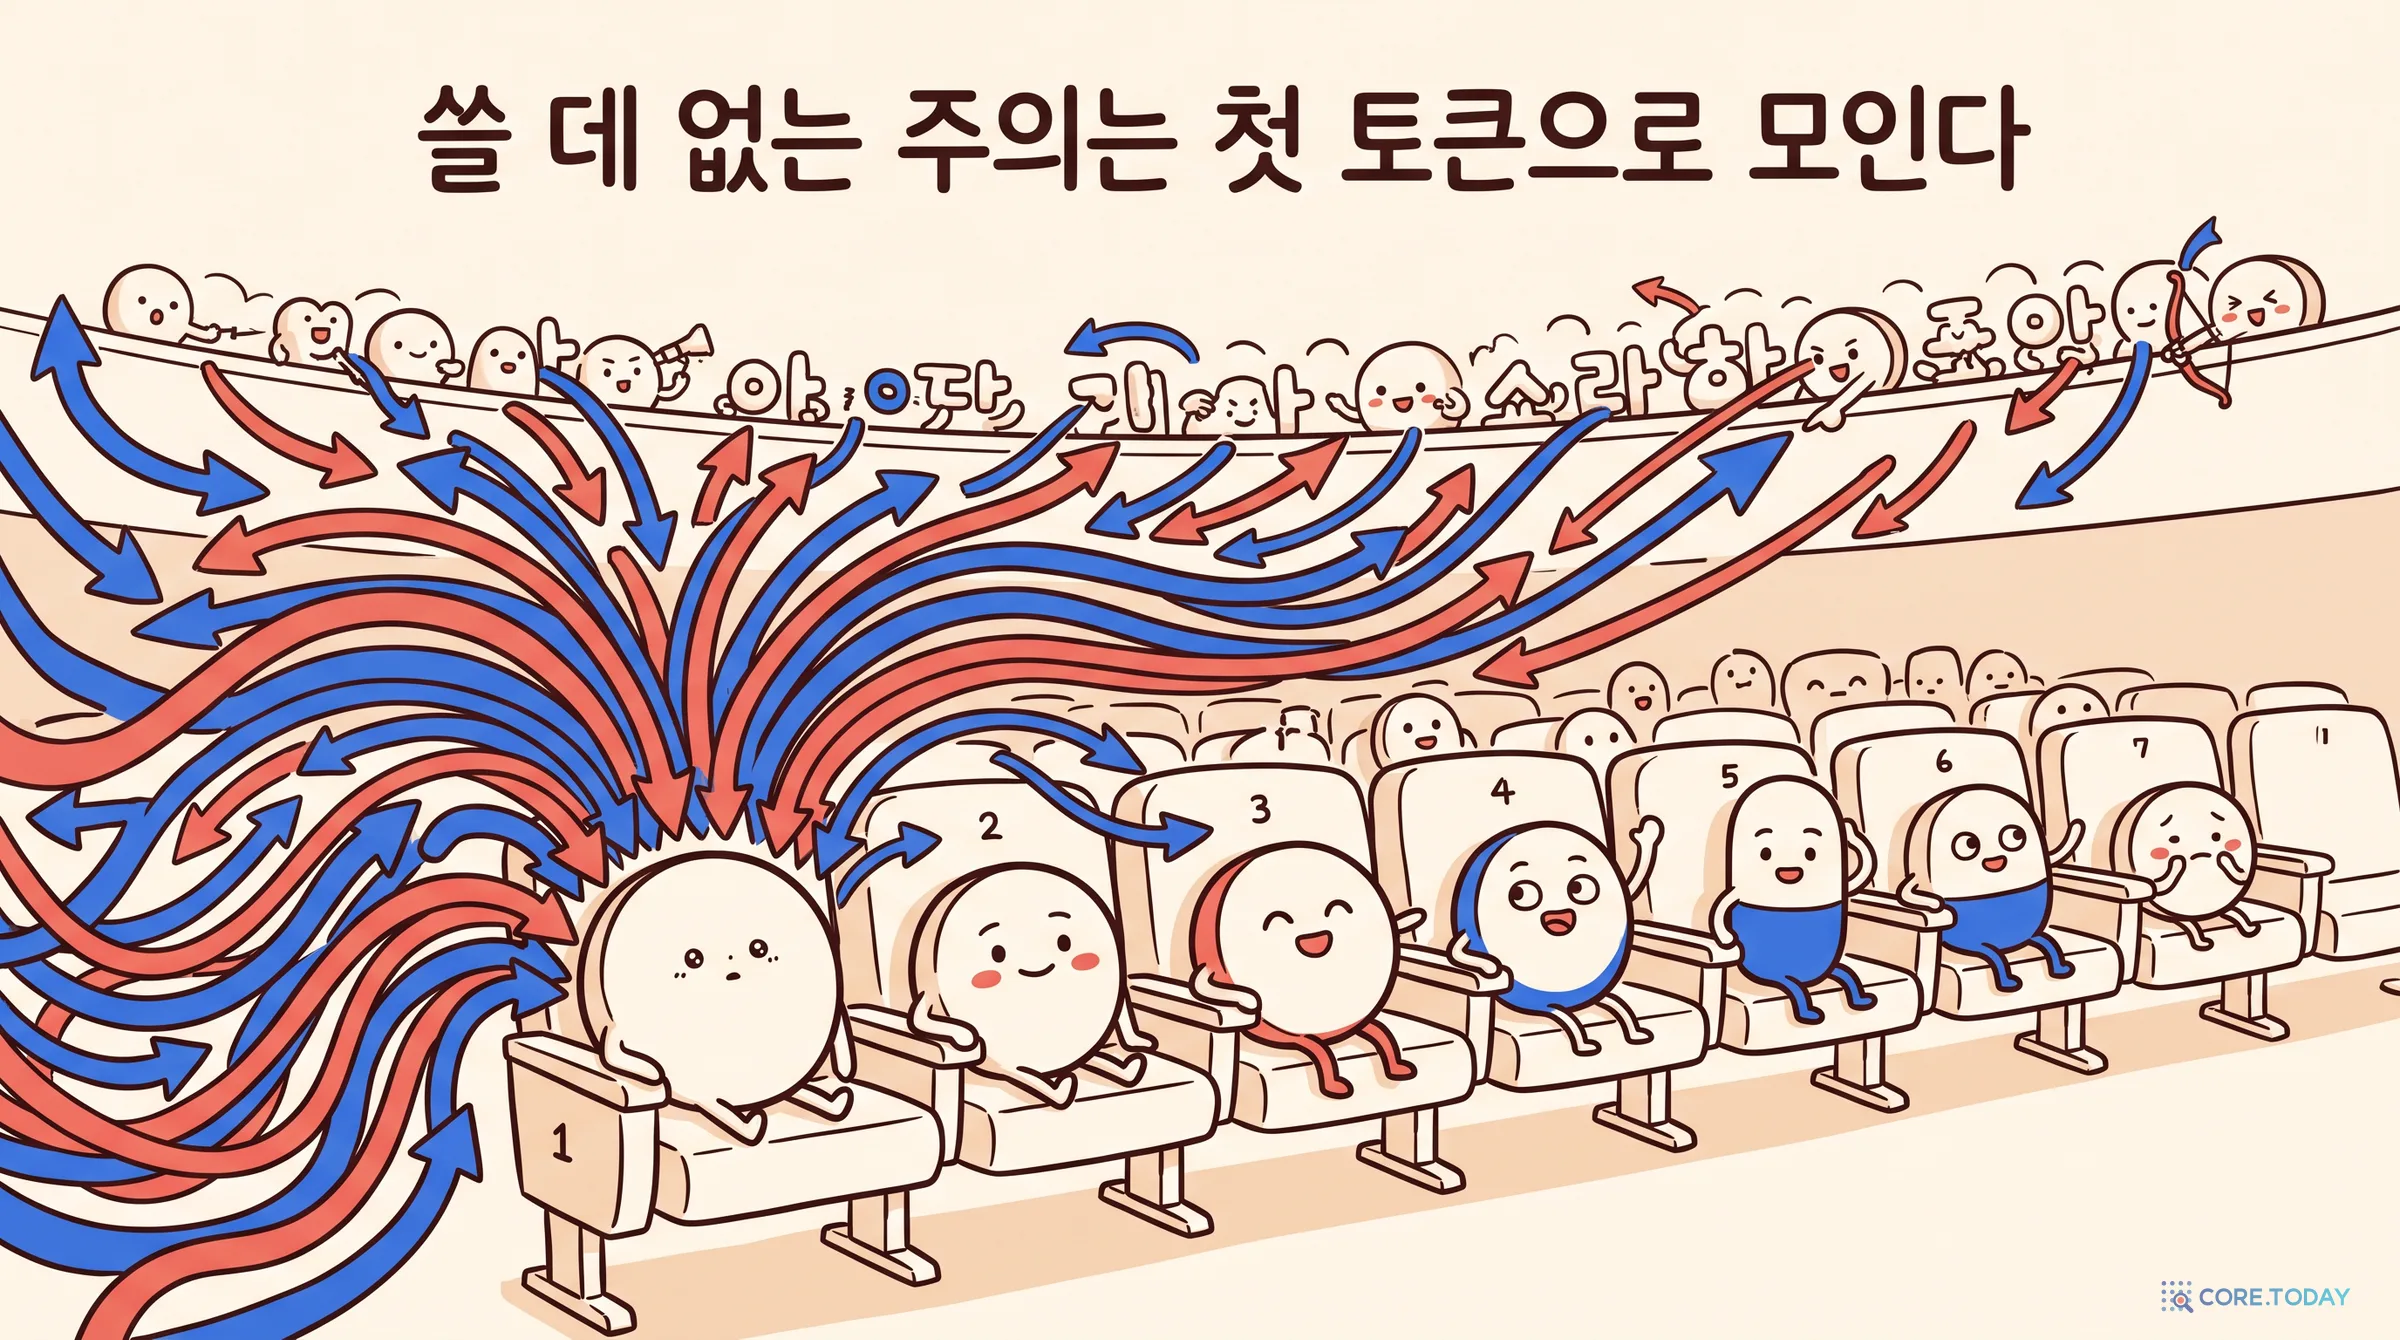
이유를 찾아보니, 모델은 내용과 상관없이 맨 앞 토큰들에 엄청난 양의 어텐션을 주고 있었다. 소프트맥스는 어텐션 점수를 모두 합쳐 1이 되도록 나눠야 한다. 지금 토큰이 딱히 볼 것이 없을 때도 어딘가에 점수를 줘야 하고, 모델은 모든 토큰이 언제나 볼 수 있는 첫 토큰을 그 남는 점수를 버리는 곳으로 쓰도록 배운다. 논문은 이것을 어텐션 싱크(attention sink), 말하자면 ‘주의 하수구’라 불렀다. 하수구를 치워 버리니 남는 주의가 엉뚱한 토큰으로 흘러가 계산이 엉망이 된 것이다.
해법은 싱거울 만큼 간단했다. 맨 앞 토큰 4개의 캐시를 버리지 말고 창과 함께 들고 다니면 된다. 이 ‘스트리밍LLM’으로 Llama 2, MPT, 팰컨, 피티아가 400만 토큰 넘게 안정적으로 글을 이어 썼고, 창을 매번 다시 계산하는 방식보다 최대 22.2배 빨랐다. 단, 이것은 퍼플렉서티가 안정적이라는 뜻이지 400만 토큰을 기억한다는 뜻은 아니다. 창 밖으로 나간 토큰은 그대로 잊힌다.
① 첫 토큰이 받는 주의. 위키백과 문서를 읽히고 층마다 모든 헤드의 어텐션을 평균해, 맨 첫 토큰 하나가 받은 몫을 쟀다. Qwen3는 네 크기 모두 비슷한 모양이었다. 아래쪽 층에서는 첫 토큰이 거의 주목받지 못하다가(3% 미만), 어느 층에서 갑자기 주의의 절반 이상을 가져갔다. 그 층은 0.6B·1.7B에서 4층, 4B·8B에서 8층이었다. 그 층부터 위쪽 평균은 0.6B 59%, 1.7B 55%, 4B 57%, 8B 57%(한국어)였고, 가장 심한 층은 80% 안팎이었다(4B·8B는 앞 1,024토큰, 나머지는 2,048토큰으로 쟀다). 수천 개 토큰 가운데 하나가 주의의 절반을 받는 것이다. 멀티헤드 모델인 Pythia-1B는 그보다 적어 한국어 24%, 영어 14%였다.
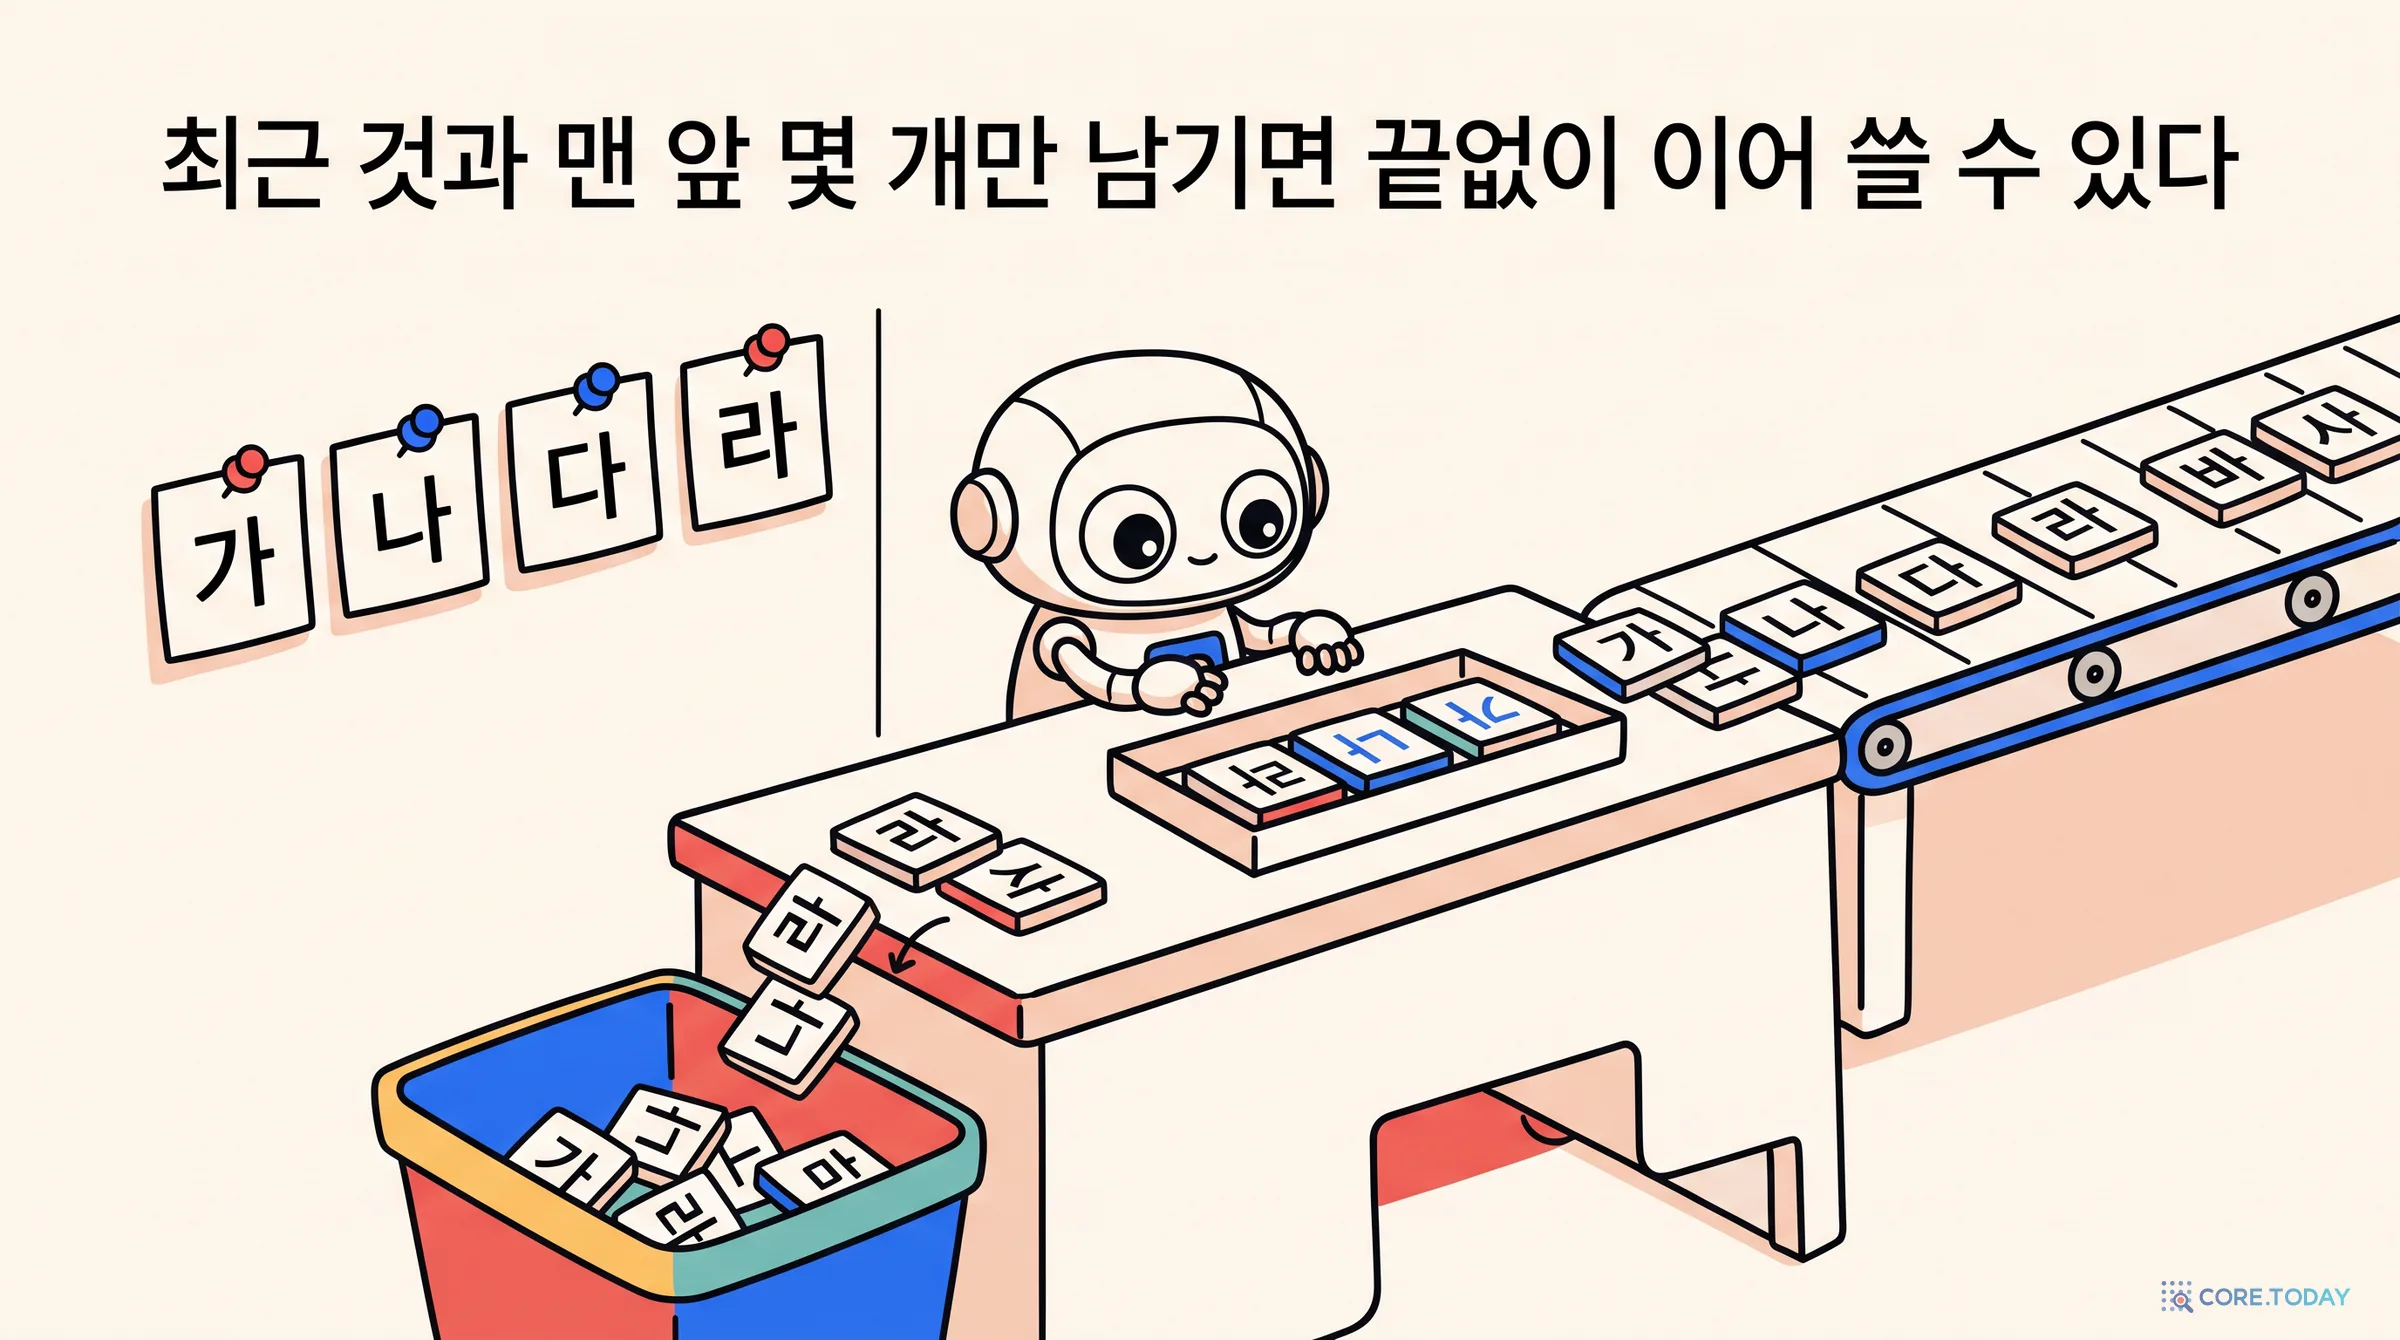
② 창만 남기면. 한국어·영어 위키백과 문서 3개씩, 8,192토큰을 64토큰씩 끊어 읽히면서 캐시 예산을 256토큰 또는 1,024토큰으로 묶었다. 예산을 넘으면 (가) 최근 토큰만 남기거나 (나) 맨 앞 4개 + 최근 토큰을 남겼다. 위치 번호는 원래 위치를 그대로 썼다. 결과는 스트리밍LLM 논문 그대로였다. 예산 1,024토큰으로 최근 토큰만 남기자 Qwen3-0.6B의 한국어 퍼플렉서티가 전부 보관할 때의 11.5에서 89로 뛰었다. 맨 앞 토큰을 함께 남기자 12.2로, 기준과 거의 같아졌다. Qwen3-8B도 5.7 → 9.3(창만) → 5.9(앞 토큰 포함)였다. 예산을 256토큰으로 줄여도 앞 토큰을 남기면 대부분 회복됐다. 덧붙여, Qwen3에서는 맨 앞 4개 대신 첫 토큰 하나만 남겨도 결과가 똑같았다. 이 모델의 하수구는 첫 토큰 하나다.
③ 언제 생기나.문맥 내 학습 특집에서 썼던 피티아-410M의 학습 체크포인트 13개(0~143,000단계)를 다시 꺼내, 같은 방식으로 첫 토큰이 받는 몫을 쟀다. 512단계(학습 토큰 약 11억 개)까지는 0.1~0.2%로, 하수구가 없었다. 1,000단계에서 0.5%, 2,000단계 2%, 4,000단계 8%, 8,000단계 13%, 1만6,000단계 17%로 자라, 학습이 끝날 때는 층 평균 20%, 가장 큰 층은 34%가 됐다. 문맥 내 학습 글에서 ‘앞에서 본 것을 베끼는’ 유도 헤드가 512~1,000단계 사이에 갑자기 나타났던 것과 비교하면, 하수구는 그 무렵 생기기 시작해 수백억 토큰에 걸쳐 천천히 깊어졌다. 맨 아래 6개 층은 끝까지 하수구를 쓰지 않았다.
어텐션 싱크는 캐시 너머로도 의미가 있다. 이 하수구 토큰에는 유독 큰 활성값이 몰리는데, 그것이 6부에서 본 ‘튀는 채널’과 양자화의 어려움으로 이어진다는 연구도 있다. 최근에는 학습할 때부터 하수구 역할을 할 전용 토큰이나 장치를 넣는 모델들도 나왔다.
KV 캐시는 트랜스포머 논문에 한 줄도 없던 구현 요령으로 시작했다. 석 달 뒤 구글 코드에 “이제는 진행하면서 캐시한다”는 한 줄로 들어왔고, 9년이 지난 지금은 모델 설계와 서빙 시스템과 API 요금표를 함께 결정하는 변수가 됐다.
그동안의 노력은 세 갈래였다. 줄이기 — 헤드를 나눠 쓰고(MQA·GQA), 압축해 담고(MLA), 거칠게 담았다(양자화). 관리하기 — 페이지로 쪼개 빌려 주고, 같은 앞부분은 나눠 썼다. 버리기 — 최근 것만 남기되, 하수구 노릇을 하는 맨 앞 몇 개는 붙잡아 두었다.
우리 실측이 보여 준 것도 같다. 캐시는 공식대로, 바이트 하나 틀리지 않고 문맥에 비례해 자랐다. 작은 모델일수록 캐시가 모델보다 먼저 메모리를 채웠다. 캐시는 생성 시간이 문맥 길이에 따라 크게 늘지 않게 해 주었지만, 그 대가로 한 GPU가 받을 수 있는 사용자를 문맥 길이에 반비례해 줄였다. 같은 앞부분을 재사용하면 첫 토큰이 수십 배 빨라졌다. 캐시를 4비트로 줄이는 일은 방향 하나에 성패가 갈렸고, 오래된 토큰을 버리는 일은 맨 앞 토큰을 남기느냐에 성패가 갈렸다. Qwen3에서는 첫 토큰 하나면 충분했다.
실무자에게 남는 교훈도 단순하다. 긴 대화의 비용은 길이가 아니라 메모리다. 시스템 프롬프트와 문서처럼 변하지 않는 부분은 앞에 두고 그대로 유지하자. 그래야 캐시가 맞는다. 모델을 고를 때는 파라미터 수만큼 KV 헤드 수와 층 수를 보자. 그리고 긴 문맥 창이 광고될 때, 그 창을 다 채웠을 때 내 GPU에 몇 명이 들어가는지 곱셈 한 줄로 계산해 보자.
Brandon, W. et al. (2024). Reducing Transformer Key-Value Cache Size with Cross-Layer Attention. arXiv:2405.12981.
Sun, Y. et al. (2024). You Only Cache Once: Decoder-Decoder Architectures for Language Models. arXiv:2405.05254.
메모리 관리와 프롬프트 캐싱
Kwon, W. et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023. arXiv:2309.06180, §3·그림 1·2.
vLLM 팀 (2023-06-20). vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention. vllm.ai 블로그.
vLLM. Automatic Prefix Caching 설계 문서. docs.vllm.ai (2026-11-08 조회).
Zheng, L. et al. (2024). SGLang: Efficient Execution of Structured Language Model Programs. NeurIPS 2024. arXiv:2312.07104.
DeepSeek (2024-08-02). DeepSeek API introduces Context Caching on Disk. api-docs.deepseek.com.
Anthropic. Prompt caching 문서·요금표; OpenAI. Prompt caching 가이드; Google. Gemini API context caching 문서 (모두 2026-11-08 조회).
양자화와 버리기
Liu, Z. et al. (2024). KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache. ICML 2024. arXiv:2402.02750.
Hooper, C. et al. (2024). KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization. NeurIPS 2024. arXiv:2401.18079.
Zhang, Z. et al. (2023). H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models. NeurIPS 2023. arXiv:2306.14048.
Li, Y. et al. (2024). SnapKV: LLM Knows What You are Looking for Before Generation. arXiv:2404.14469.
Xiao, G. et al. (2024). Efficient Streaming Language Models with Attention Sinks. ICLR 2024. arXiv:2309.17453.
Jiang, A. Q. et al. (2023). Mistral 7B. arXiv:2310.06825.
Gemma Team (2025). Gemma 3 Technical Report. arXiv:2503.19786.
Biderman, S. et al. (2023). Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling. ICML 2023. arXiv:2304.01373.
코어닷투데이 실측 조건
모델: Qwen3-0.6B-Base·1.7B-Base·4B-Base·8B-Base(알리바바), Pythia-1B(멀티헤드 비교용), Pythia-410M의 학습 체크포인트 13개(0~143,000단계).
하드웨어: 0.6B·1.7B·Pythia-1B는 사내 V100 16GB, 4B·8B는 사내 쿠버네티스 클러스터의 V100S 32GB. 모두 fp16, 허깅페이스 transformers 5.22, SDPA 어텐션(V100 계열은 플래시 어텐션 미지원). Pythia-410M 체크포인트는 클러스터의 CPU 노드에서 fp32로 계산했다.
데이터: 한국어 위키백과(2023-11-01 덤프)에서 3만 자 이상인 문서 12개, 영어 위키텍스트-103 테스트 세트에서 가장 긴 문서 12개(문서당 앞 6만 자).
캐시 크기: 문맥을 1,024토큰씩 나눠 채운 뒤, 모든 층의 K·V 텐서 바이트를 더했다.
속도: 문맥 L토큰을 채운 뒤 토큰 32개를 그리디로 생성하며 걸음마다 시간을 재 중앙값을 썼다. ‘캐시 없음’은 매 걸음 전체 시퀀스를 다시 넣어 계산(6걸음 중 뒤 5걸음의 중앙값). 동시 사용자 실험은 같은 문맥의 캐시를 사용자 수만큼 복제해 12걸음을 쟀다.
앞부분 재사용: 앞부분 P토큰 + 질문 64토큰. ‘처음부터’는 전체를 다시 계산, ‘재사용’은 미리 만든 앞부분 캐시를 복사한 뒤 질문만 계산했다(각 4회 중 뒤 3회 중앙값).
양자화: 비대칭 최솟값-최댓값 균일 양자화 후 복원(가짜 양자화). ‘토큰별’은 토큰·헤드마다 헤드 차원 128개를 한 묶음, ‘채널별’은 채널마다 128토큰을 한 묶음으로 잘랐다. 퍼플렉서티는 문서 12개(언어별 6개)의 앞 4,096토큰(Pythia-1B는 1,536토큰)을 캐시에 넣고 양자화한 뒤 다음 512토큰으로 쟀다. 비밀번호 찾기는 약 4,000토큰(Pythia-1B는 1,400토큰) 글의 10%·50%·90% 위치에 다섯 자리 숫자를 넣고, 양자화한 캐시로 8토큰을 생성해 숫자가 들어 있는지 봤다(언어별 24회).
어텐션 싱크: 문서 앞 2,048토큰(4B·8B는 1,024토큰)을 eager 어텐션으로 계산해, 65번째 이후 질의가 첫 토큰에 준 어텐션을 헤드 전체로 평균했다. 창 실험은 문서 8,192토큰을 64토큰씩 읽으며 예산을 넘으면 캐시를 잘랐고, 위치 번호는 원래 위치를 그대로 썼다(스트리밍LLM은 캐시 안의 위치를 다시 매긴다는 점이 다르다).
한계: 서빙 엔진(vLLM 등)이 아닌 기본 구현이라 절대 시간은 느리다. 양자화는 정확도만 봤고 속도 이득은 재지 않았다.