SemiAnalysis미드필KV 캐시HBMHBM4E4단 HBMRubin Ultra에이전트 추론Claude Code프리픽스 캐시vLLMDeepSeek V4.1Kimi K3SK하이닉스삼성전자메모리 반도체
[특집] 에이전트의 추론은 '미드필'이다 — 캐시 대 새 입력, 그리고 HBM 4단의 역습
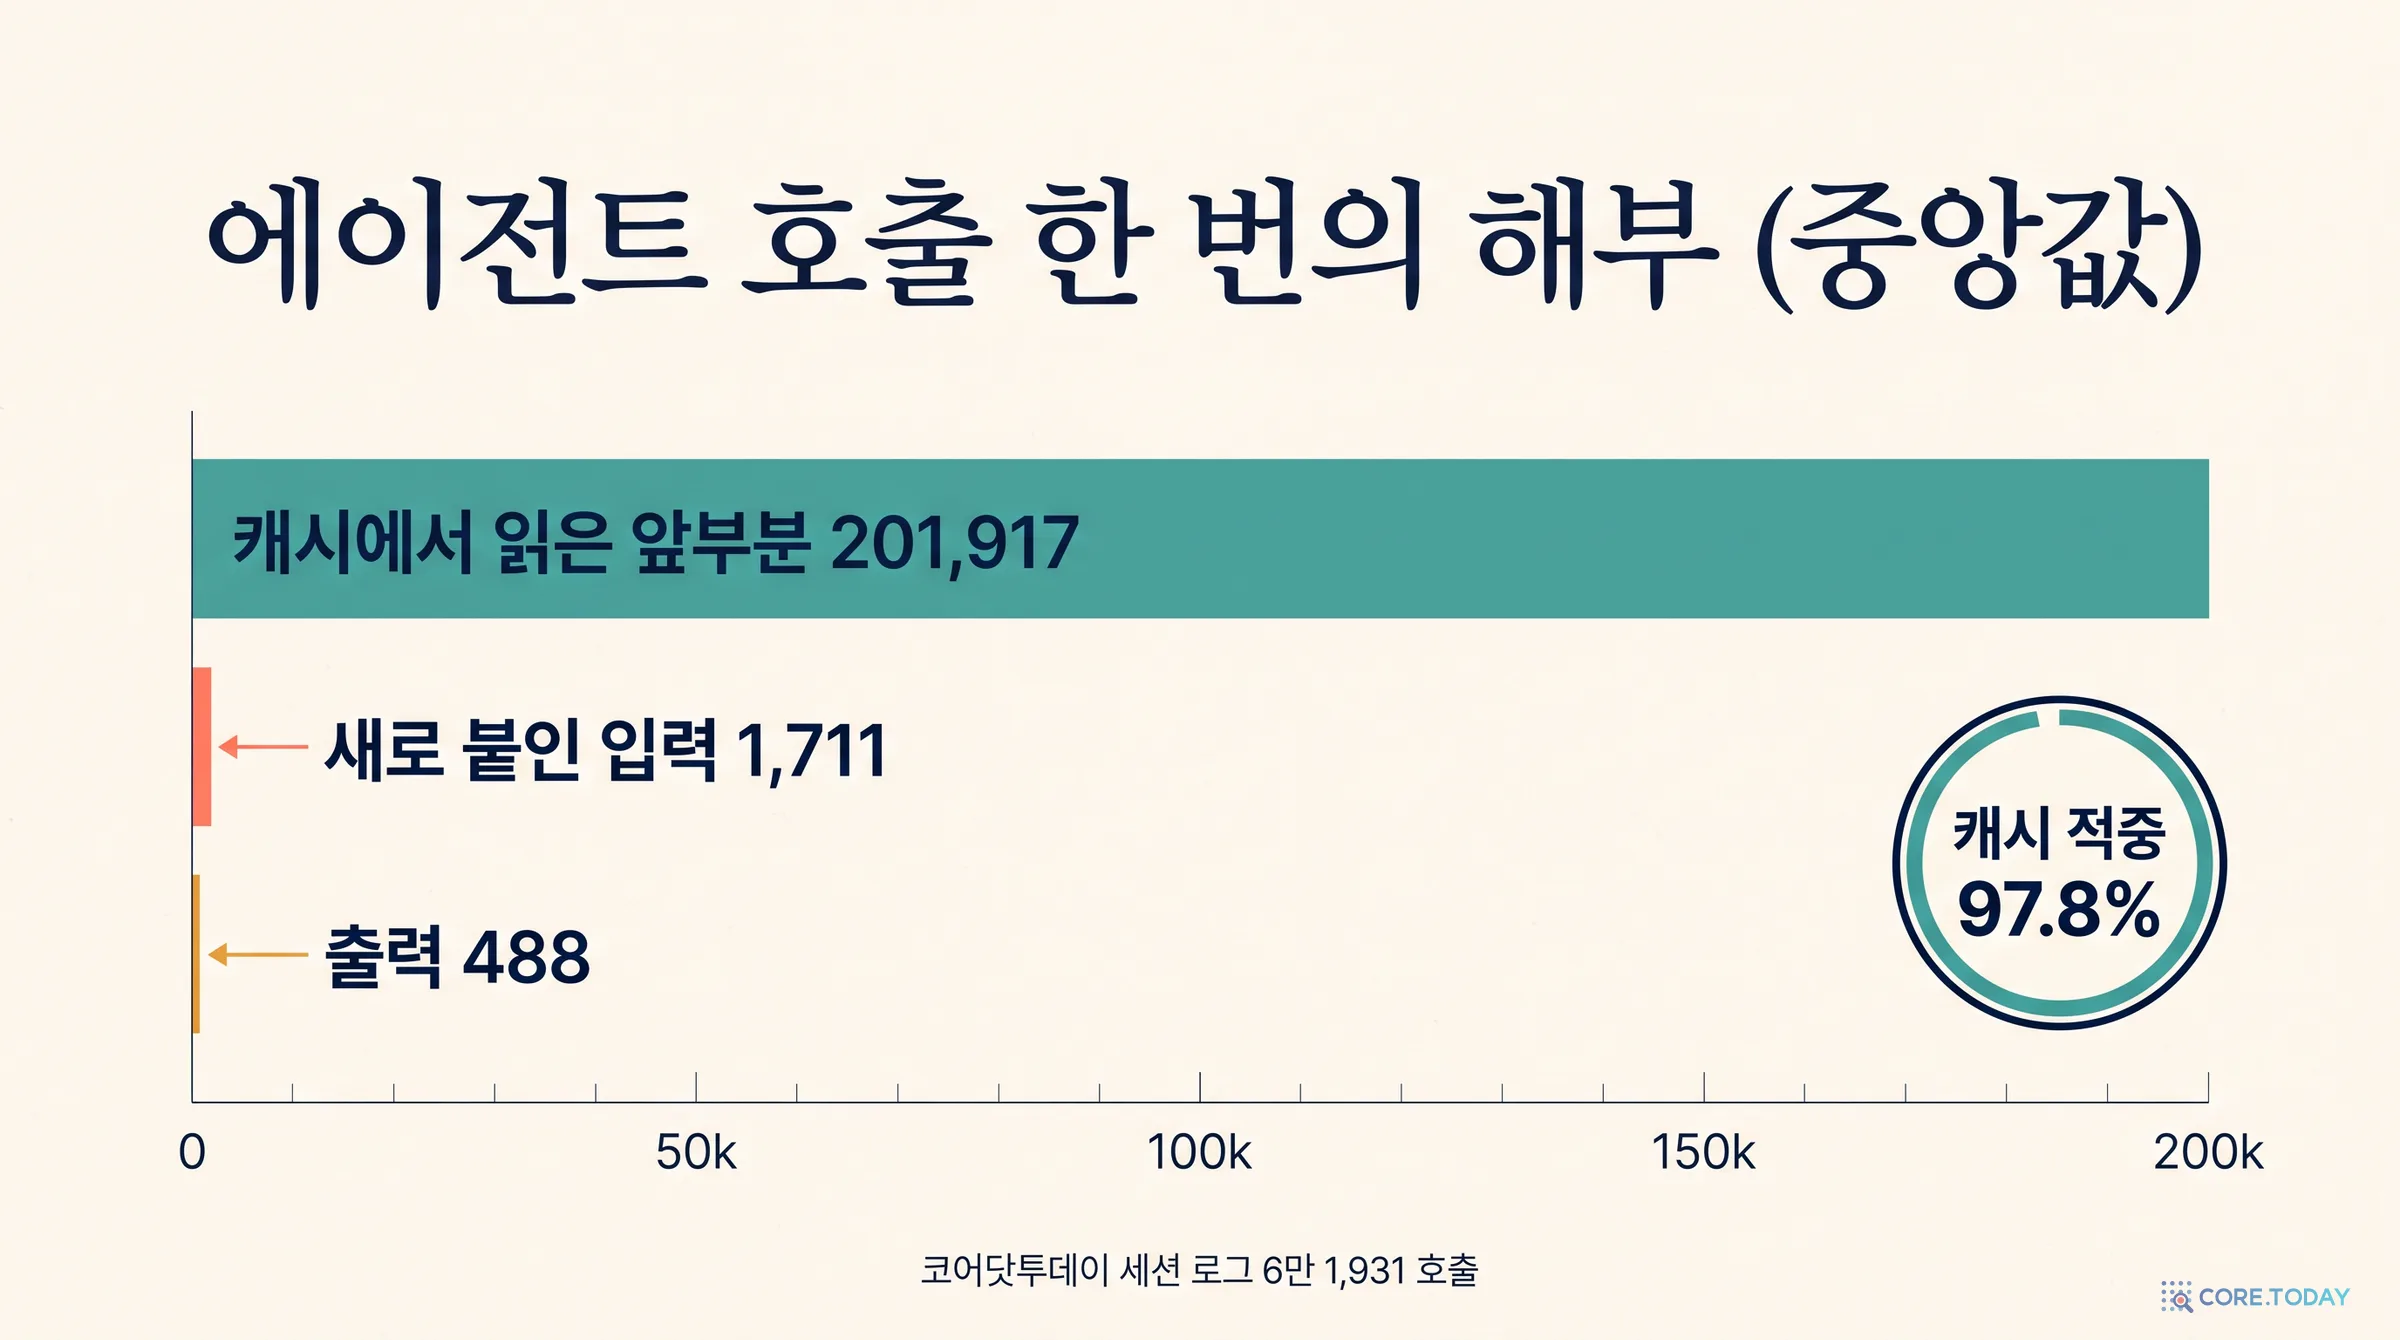
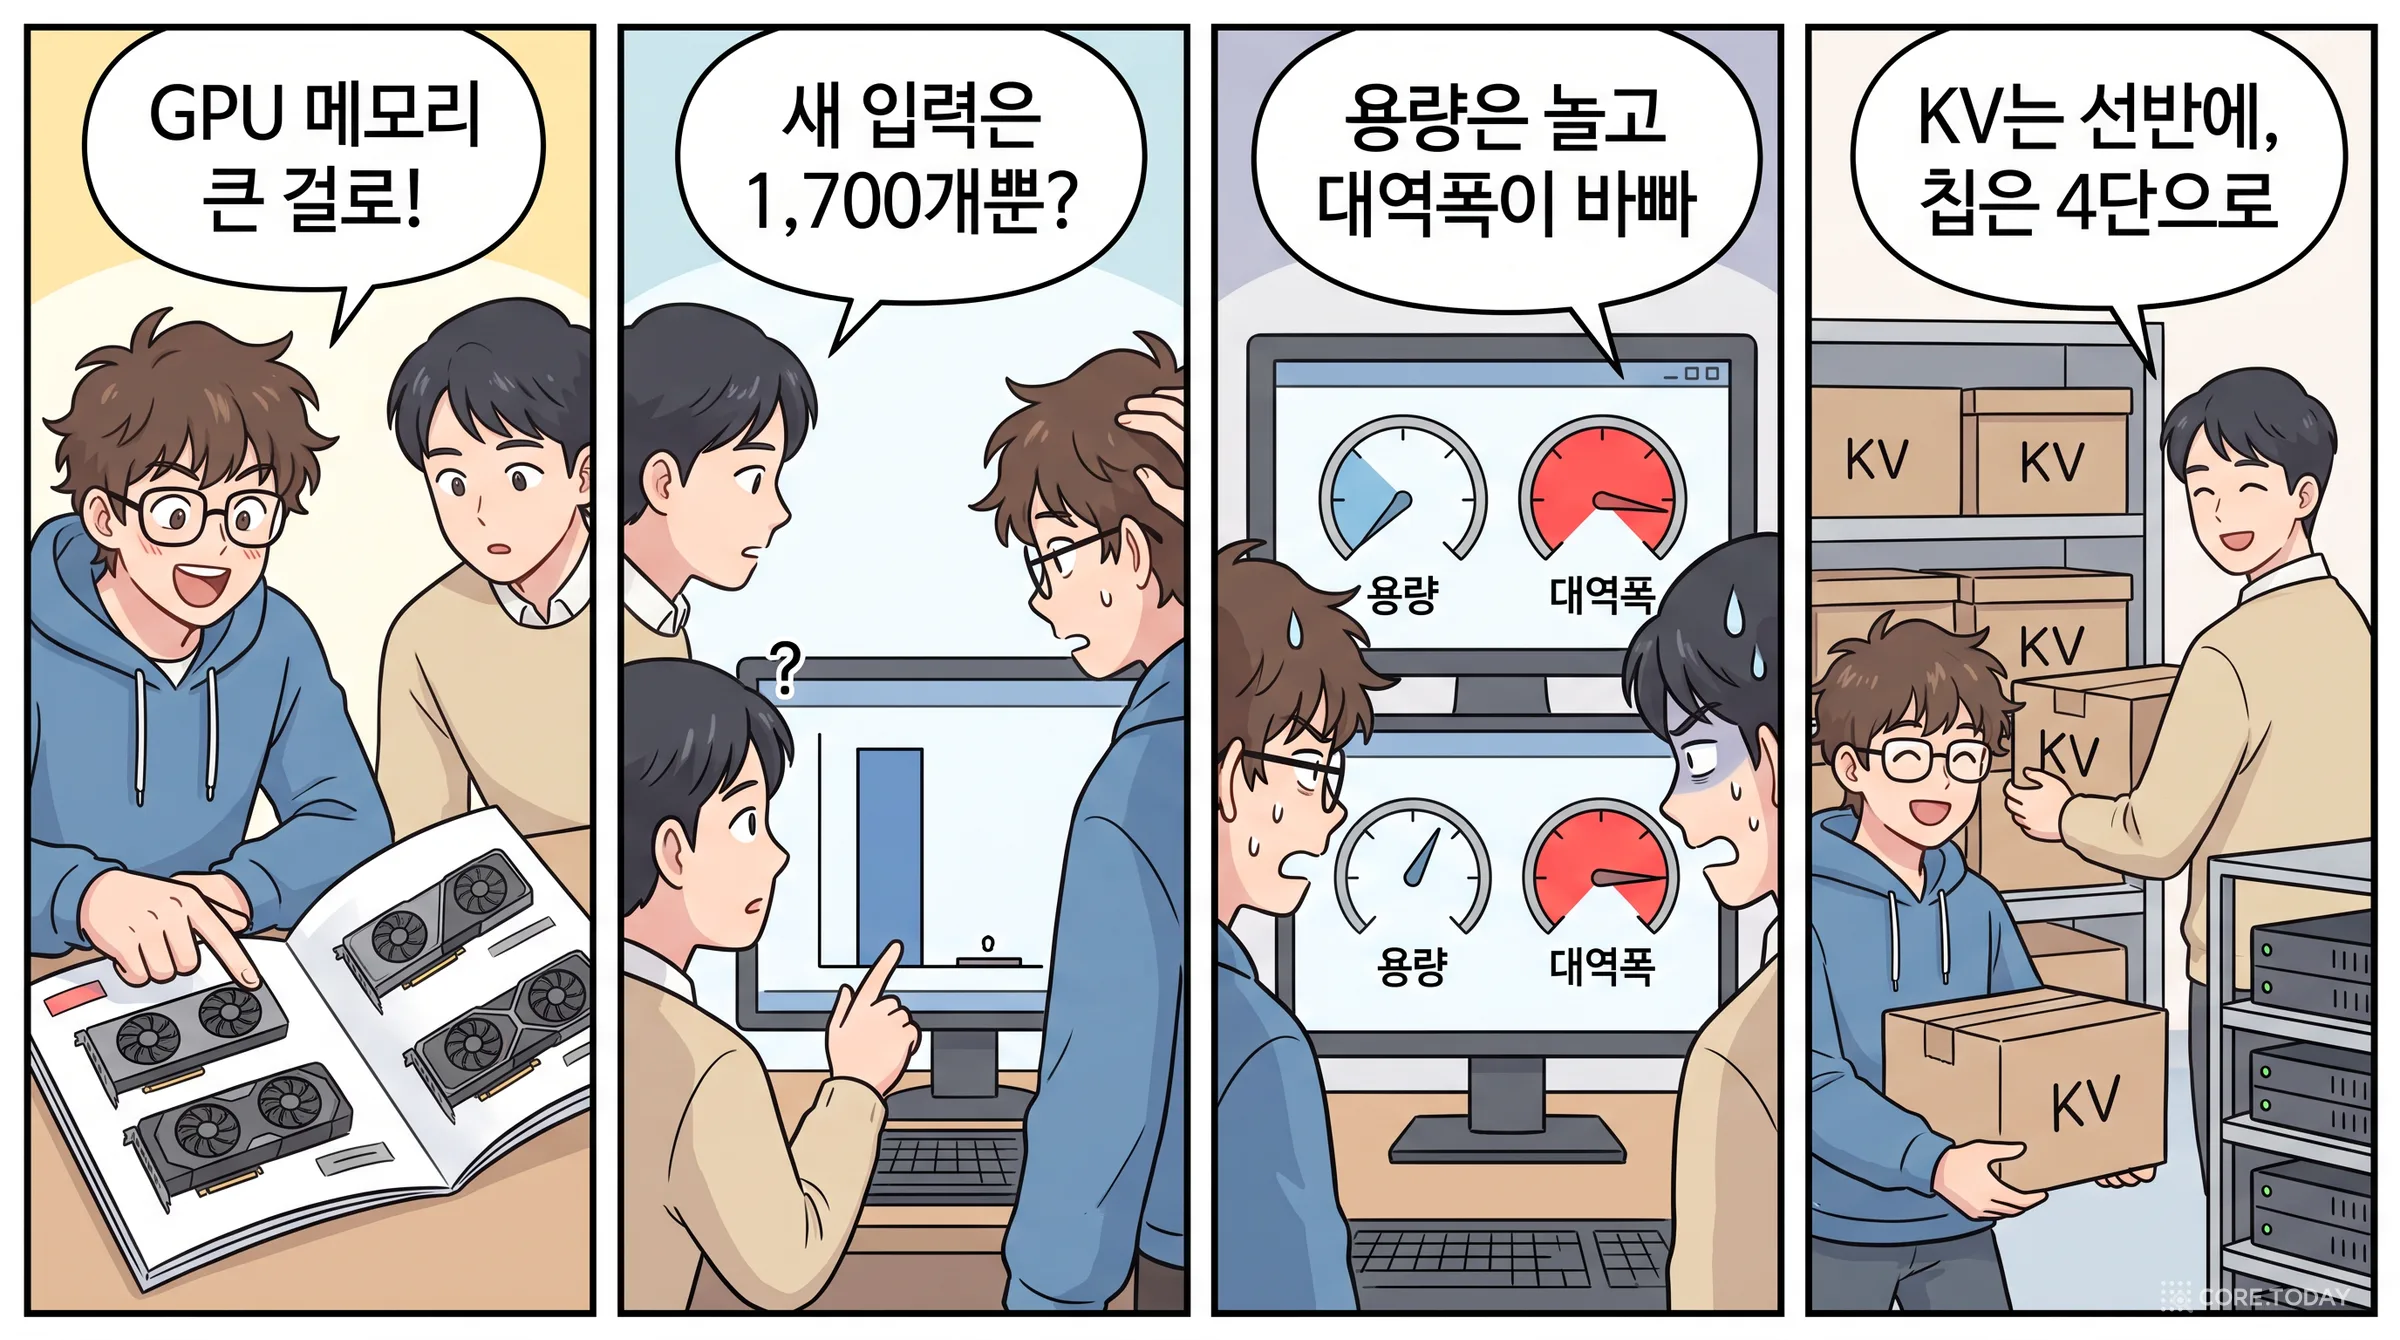
코딩 에이전트의 추론은 '프리필 다음 디코드'가 아니라, 이미 캐시된 긴 앞부분에 짧은 새 입력을 붙이는 '미드필'의 반복입니다. 코어닷투데이 Claude Code 로그 6만 1,931번 호출을 세어 보니 입력의 97.8%가 캐시에서 왔고, 새 입력은 중앙값 1,711개로 캐시된 앞부분(중앙값 20만 1,917개)의 119분의 1이었습니다. 이런 일감에서는 HBM의 용량보다 대역폭과 KV를 옮기는 능력이 값을 정한다는 것이 SemiAnalysis의 주장이고, 그래서 Rubin Ultra는 GPU당 HBM을 288GB에서 192GB로 줄였으며 프런티어 연구소들은 4단 HBM을 원합니다. 공개 설정 파일과 공식 자료로 계산한 토큰당 KV는 모델마다 0.9kB에서 389kB까지 400배 넘게 벌어졌고, A100에서 vLLM으로 KV 예산을 줄여 본 실험은 '동시 사용자가 일정 수를 넘기 전까지는 아무 일도 없다'는 모양을 재현했습니다. 메모리 회사 입장의 계산은 유료 구간이라 추정하지 않고, 산수와 열린 질문만 정리했습니다.
코어닷투데이2026-10-3081분
?
질문
에이전트가 AI 연산의 주인이 된 지금, GPU 한 장에 HBM을 더 많이 쌓는 것이 여전히 정답일까요? 엔비디아는 다음 세대에서 오히려 HBM을 줄였습니다.
→
방법
SemiAnalysis의 9월 두 글(미드필, 4단 HBM)을 축으로 관련 글 다섯 편을 읽고, 세 가지를 직접 쟀습니다. 코어닷투데이 Claude Code 로그 6만 건의 토큰 구성, 공개 모델 21종의 토큰당 KV 바이트, A100에서 KV 예산을 줄인 vLLM 실험입니다.
✓
결론
에이전트 일감은 '거대한 캐시 + 작은 새 입력'이고, 그 캐시는 대부분 HBM에 앉아 있을 필요가 없습니다. 값은 용량이 아니라 대역폭과 KV를 계층 사이로 옮기는 설계에서 나옵니다. 그 산수가 '더 낮게 쌓은 HBM'을 가리킵니다.
2026년 9월, 반도체 업계에서 오래 당연하던 그래프 하나가 꺾였습니다. 엔비디아의 다음 세대 가속기 Rubin Ultra는 GPU 한 장에 HBM을 192GB 싣습니다. 지금의 Blackwell Ultra(B300)와 표준 Rubin이 싣는 288GB보다 적습니다. 불과 1년 전 업계가 기대한 숫자는 GPU당 1TB였습니다. 그때는 Rubin Ultra가 연산 다이 4개를 묶는다고 봤고 지금은 2개라서 단순 비교는 불공평하지만, 다이당으로 맞춰도 256GB가 96GB로 줄었습니다. 반도체·AI 인프라 분석 회사 SemiAnalysis가 9월 13일 낸 글 「키 작은 왕이여 영원하라: 4단 HBM이 이기는 이유(Long Live the Short King: Why 4-hi HBM Wins)」는 이 변화를 이렇게 정리합니다.
"HBM 함량이 늘기만 하던 흐름이 깨졌다(The HBM Content Trend is Broken)."
HBM(High Bandwidth Memory)은 D램 다이를 여러 층 쌓아 GPU 옆에 붙인 메모리입니다. 가속기는 세대마다 스택 수와 다이 용량, 쌓는 높이를 늘려 왔고, 그 결과 HBM이 D램 웨이퍼를 점점 더 먹어 2026년의 극심한 D램 부족이 생겼습니다. 그런데 엔비디아는 이번에 12단 대신 8단을 표준으로 골랐고, SemiAnalysis는 한 걸음 더 나가 추론에는 4단이 가장 싸다고 주장합니다. 그리고 그것이 프런티어 연구소의 하드웨어 팀들이 다음 세대 자체 칩(ASIC)에 원하는 사양이라고 전합니다.
엿새 뒤인 9월 21일, SemiAnalysis는 또 한 편의 긴 글 「추론의 계산과 데이터 이동(Computation and Data Movement for Inference)」을 냈습니다. 여기서 낯선 단어 하나가 나옵니다. 미드필(midfill). 우리는 보통 LLM 추론을 두 단계로 배웁니다. 입력을 한꺼번에 처리하는 프리필(prefill), 그리고 한 토큰씩 출력을 만드는 디코드(decode). 그런데 에이전트의 추론은 그렇게 생기지 않았다는 것입니다. 에이전트는 이미 처리해 둔 긴 대화 기록(캐시된 앞부분) 위에 도구 실행 결과나 사용자 한 줄 같은 짧은 새 입력을 붙이고, 조금 출력하고, 다시 붙이기를 수천 번 되풀이합니다. 처음부터 다시 읽는 것도 아니고 한 토큰씩 읽는 것도 아닌 이 가운데 작업이 미드필입니다.
두 글은 따로 나왔지만 같은 이야기를 합니다. 에이전트의 일감은 '거대한 캐시 + 작은 새 입력'이고, 그런 일감에서는 메모리의 용량보다 대역폭과 '옮기는 능력'이 값을 정한다. 이것은 한국 독자에게 남의 이야기가 아닙니다. GPU 한 장에 실리는 HBM의 양은 SK하이닉스와 삼성전자의 물량과 이익을 정하는 숫자이고, 사내에서 에이전트용 모델을 직접 돌리려는 팀은 대개 'GPU 메모리가 몇 GB냐'부터 따지기 때문입니다.
코어닷투데이는 어제 SemiAnalysis 스물한 편으로 모델의 값어치를 정리한 「토큰의 값어치」를 냈습니다. 그 글이 '토큰이 얼마에 팔리나'를 다뤘다면, 이 글은 그 토큰이 어떤 메모리 위에서, 어떤 모양으로 만들어지는지를 다룹니다. 그리고 남의 숫자만 옮기지 않으려고 세 가지를 직접 쟀습니다.
실측 ①코어닷투데이 맥 한 대에 쌓인 26일치 Claude Code 로그에서 API 호출 6만 1,931번의 토큰 구성(캐시 읽기·새 입력·출력)을 셌습니다. 내용은 읽지 않고 숫자만 모았습니다.
계산 ②Hugging Face에 공개된 설정 파일(config.json)로 DeepSeek·GLM·Kimi·Qwen·MiniMax와 한국 모델(A.X·K-EXAONE·EXAONE·Solar·HyperCLOVA X·kanana·Mi:dm)의 토큰당 KV 캐시 바이트를 계산했습니다.
실측 ③코어닷투데이 GPU 클러스터의 A100 40GB에서 vLLM으로 KV 예산을 줄여 가며, 미드필 모양의 부하를 동시 세션 수별로 걸었습니다.
글은 두 부분입니다. 앞부분(1~3장)은 일감, 곧 에이전트 추론이 메모리에 무엇을 요구하는지를 봅니다. 뒷부분(4~6장)은 메모리 산업, 곧 그 요구가 HBM을 몇 단으로 쌓을지, 웨이퍼를 어디에 쓸지를 어떻게 바꾸는지를 봅니다. 숫자마다 출처를 달았고, 코어닷투데이가 직접 계산하거나 잰 값은 그렇다고 밝혔습니다. SemiAnalysis 글은 대부분 결론부가 유료라서, 특히 "그래서 SK하이닉스와 삼성전자 중 누가 이득인가"라는 부분(「Memory Supplier Impact」 절)은 읽지 못했습니다. 그 답은 지어내지 않고, 산수와 열린 질문만 남깁니다.
SemiAnalysis의 9월 21일 글은 추론 서비스 전체에서 출발합니다. 사용자(또는 그의 에이전트)가 요청을 보내고 답을 받는 한 번이 '턴(turn)'입니다. 요즘 AI는 대개 클라이언트 프로그램 안에서 돌고, 답의 일부는 그 프로그램이 가로채 실행합니다. 코드를 고치거나, 파일을 찾거나, 테스트를 돌리는 식입니다. 그 결과는 다시 요청이 되어 모델에게 돌아가고, 또 한 턴이 됩니다. 글의 표현으로 "사용자가 에이전트에게 긴 일을 맡기면 한 시간에 수천 턴"이 생기고, 대화는 몇 시간, 며칠 쉬었다가 다시 이어지기도 합니다.
서버는 그동안 대화를 '압축한 상태'를 들고 있습니다. 이것이 KV 캐시입니다. 트랜스포머는 토큰을 읽을 때 층마다 그 토큰의 키(K)와 값(V) 벡터를 만들고, 다음 토큰은 앞선 모든 토큰의 K·V를 보면서 계산합니다. 한 번 계산한 K·V를 저장해 두면 다음 턴에서 처음부터 다시 계산하지 않아도 됩니다. 문제는 이 저장물이 크다는 점입니다. 토큰 하나당 수십 kB에서 수백 kB, 대화 하나면 수 GB에서 수십 GB가 됩니다.
네 가지 운영 영역
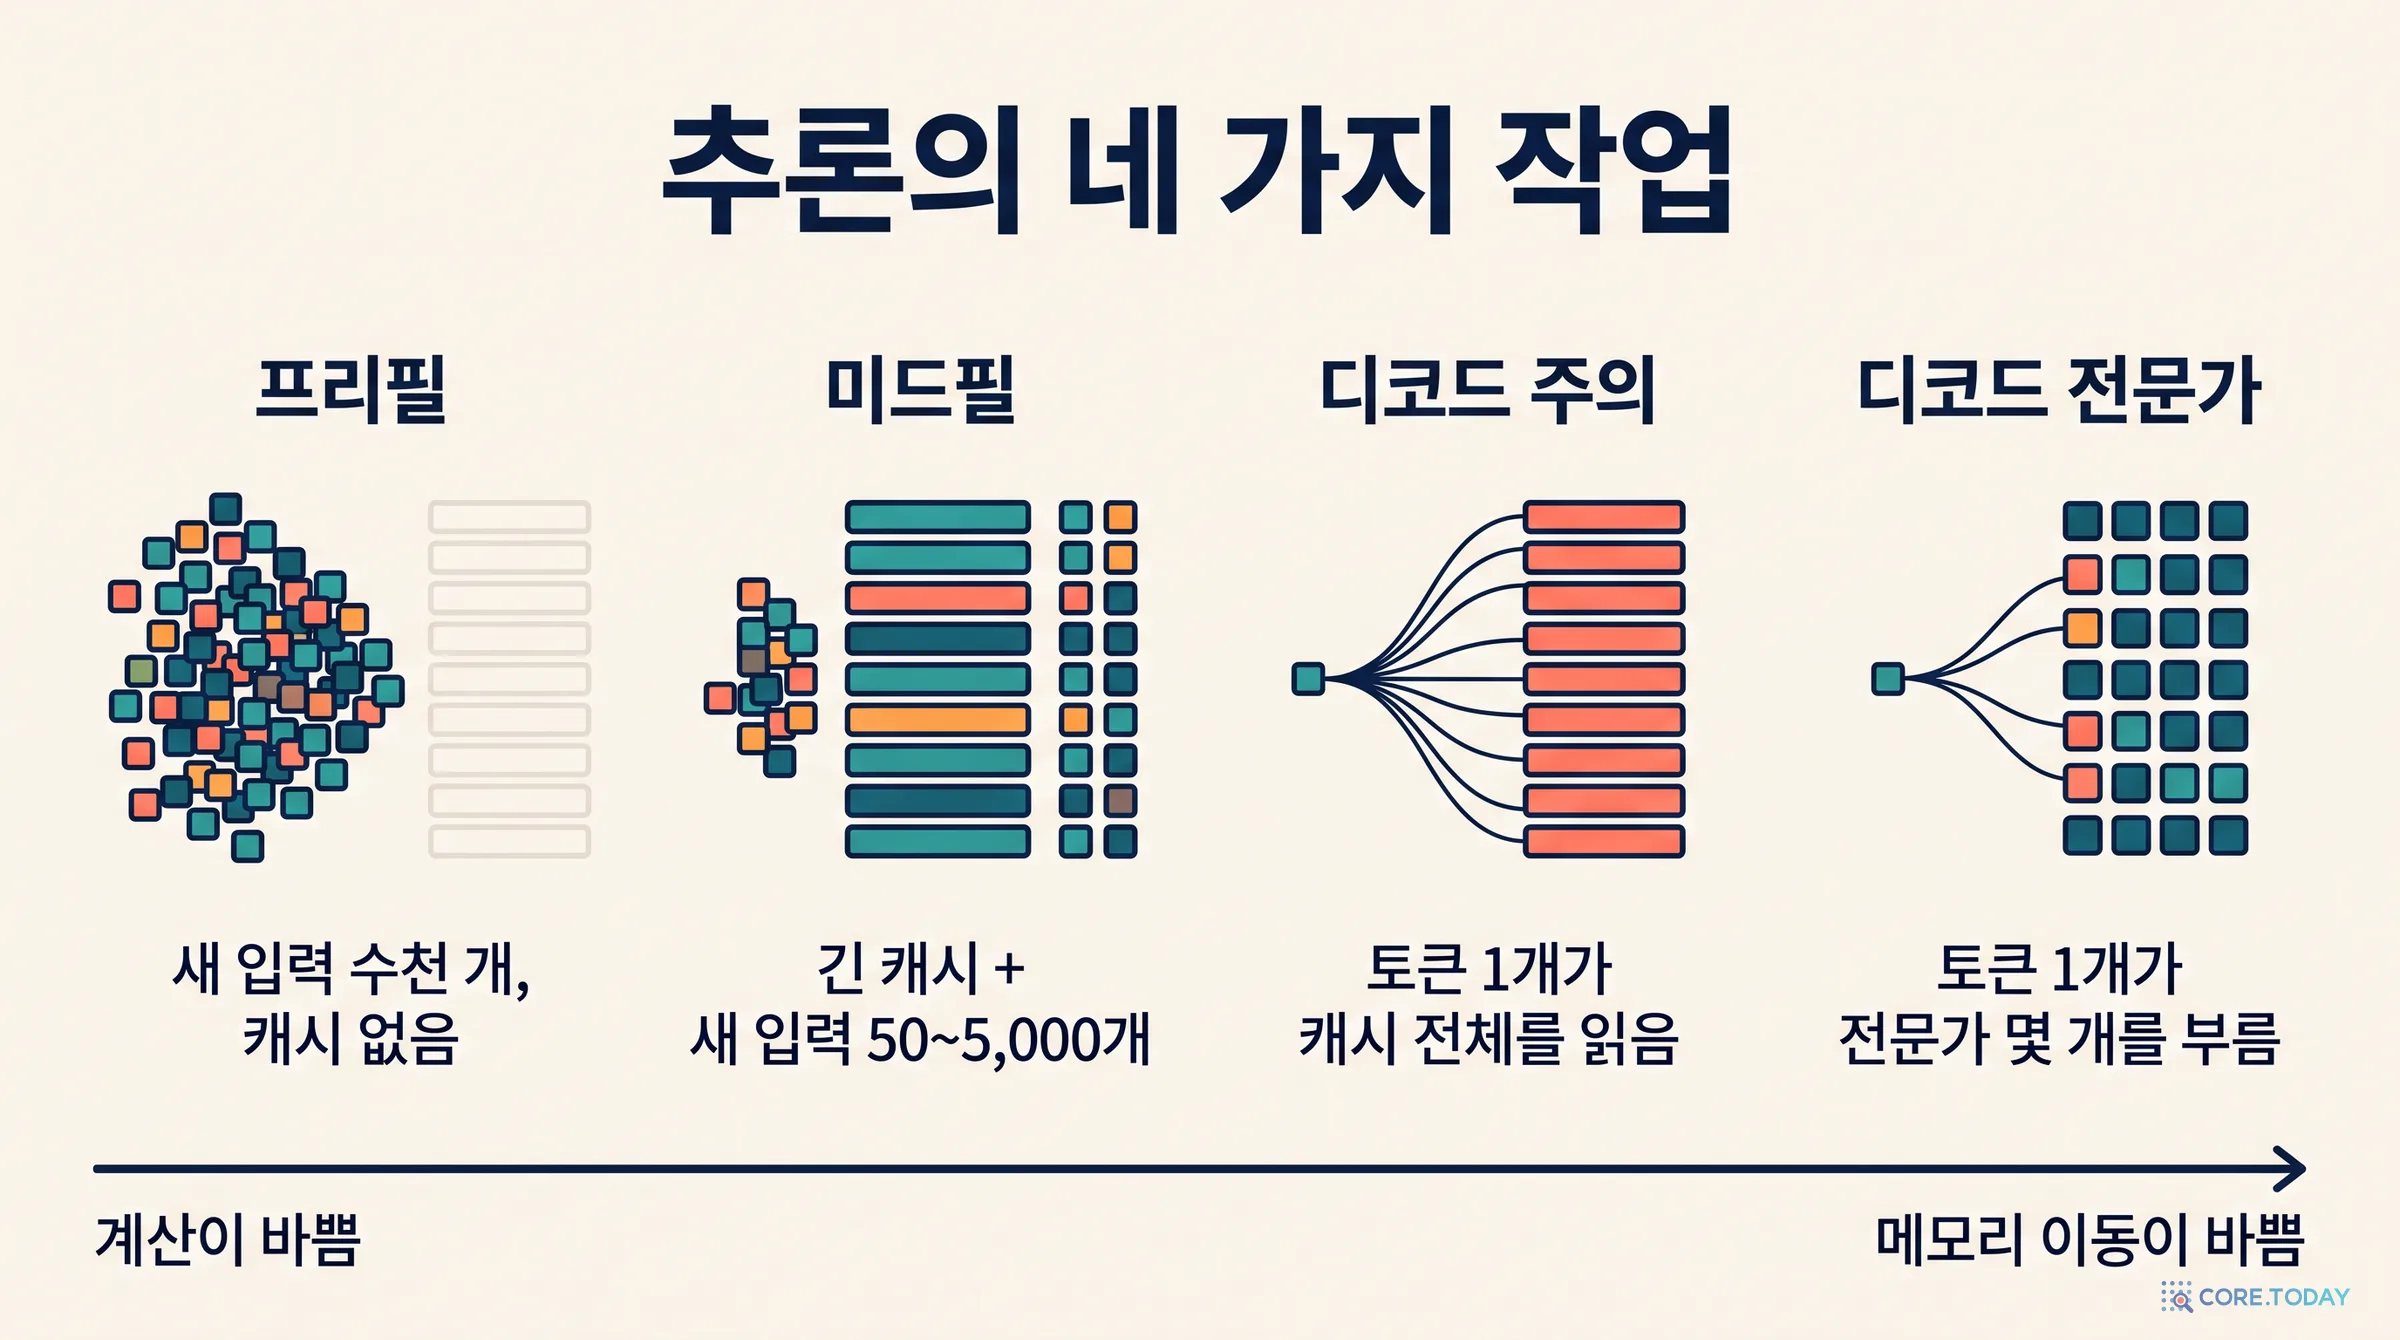
SemiAnalysis는 GPU 안에서 벌어지는 일을 네 가지로 나눕니다.
작업
무엇을 하나
새 입력
읽어야 할 기존 상태
병목
프리필
처음 들어온 입력 덩어리를 한꺼번에 처리
수천~수만 토큰
거의 없음
계산
미드필
캐시된 긴 앞부분 위에 새 입력을 붙여 처리
50~5,000 토큰
수십만 토큰의 KV(수십 GB)
계산 + KV 읽기 (섞임)
디코드 주의
새 토큰 하나가 앞선 문맥 전체를 훑음
1개(또는 MTP로 몇 개)
문맥 전체의 KV
메모리 대역폭
디코드 전문가
새 토큰 하나가 MoE 전문가 몇 개를 거침
1개
선택된 전문가 가중치
메모리 대역폭·네트워크
이 구분의 열쇠는 산술 강도(arithmetic intensity), 곧 메모리에서 1바이트를 읽어 올 때마다 몇 번 계산하느냐입니다. 프리필은 수천 개 토큰이 같은 가중치를 함께 쓰므로 가중치 한 번 읽고 수천 번 계산합니다. 강도가 높아 GPU의 연산기가 바쁩니다. 디코드는 토큰 하나를 위해 거대한 KV와 가중치를 읽어야 하므로 강도가 낮고, 연산기는 메모리를 기다리며 놉니다.
미드필은 그 사이에 있습니다. SemiAnalysis의 설명을 옮기면, 미드필의 새 입력 블록은 "수백에서 수천 개의 활성화를 공유 가중치와 전문가 재사용에 제공해 산술 강도를 바이트당 수천 연산까지 올릴 수 있다". 동시에 "어텐션은 수십 GB가 될 수 있는 기존 KV 상태를 읽어야 한다". 그래서 미드필은 "작은 프리필도, 큰 디코드도 아니며", "산술 강도는 토큰 하나짜리 디코드보다 수백 배 높을 수 있지만, 캐시된 상태의 이동량은 같은 크기의 첫 프리필보다 수십 배 클 수 있다".
사용자 · 도구 결과
→
미드필 캐시 + 새 입력
→
디코드 짧은 출력
→
도구 실행
↺ 한 시간에 수천 번 반복
SemiAnalysis는 그래서 미드필을 따로 다뤄야 한다고 봅니다. 디코드 파이프라인에 미드필이 끼면 그 단계만 오래 붙잡혀 옆 단계들이 놀고, 최적의 병렬화 조합도 다릅니다(글 끝의 Kimi K3 예측에서 캐시 12.7만 + 새 입력 1천 토큰짜리 미드필의 최적 설정은 디코드와 달랐습니다). 같은 하드웨어라도 "미드필에 최적화된 노드 풀"을 따로 두는 것이 이득일 수 있다는 것입니다.
데이터는 놀 때 비용이고, 움직일 때 매출이다
이 글에서 가장 많이 인용될 문장은 아마 이것입니다.
"메모리에 가만히 앉아 있는 데이터는 비용이고, 처리되려고 움직이는 데이터는 매출이다(Data sitting idle in memory is an expense, data moving to be processed is revenue)."
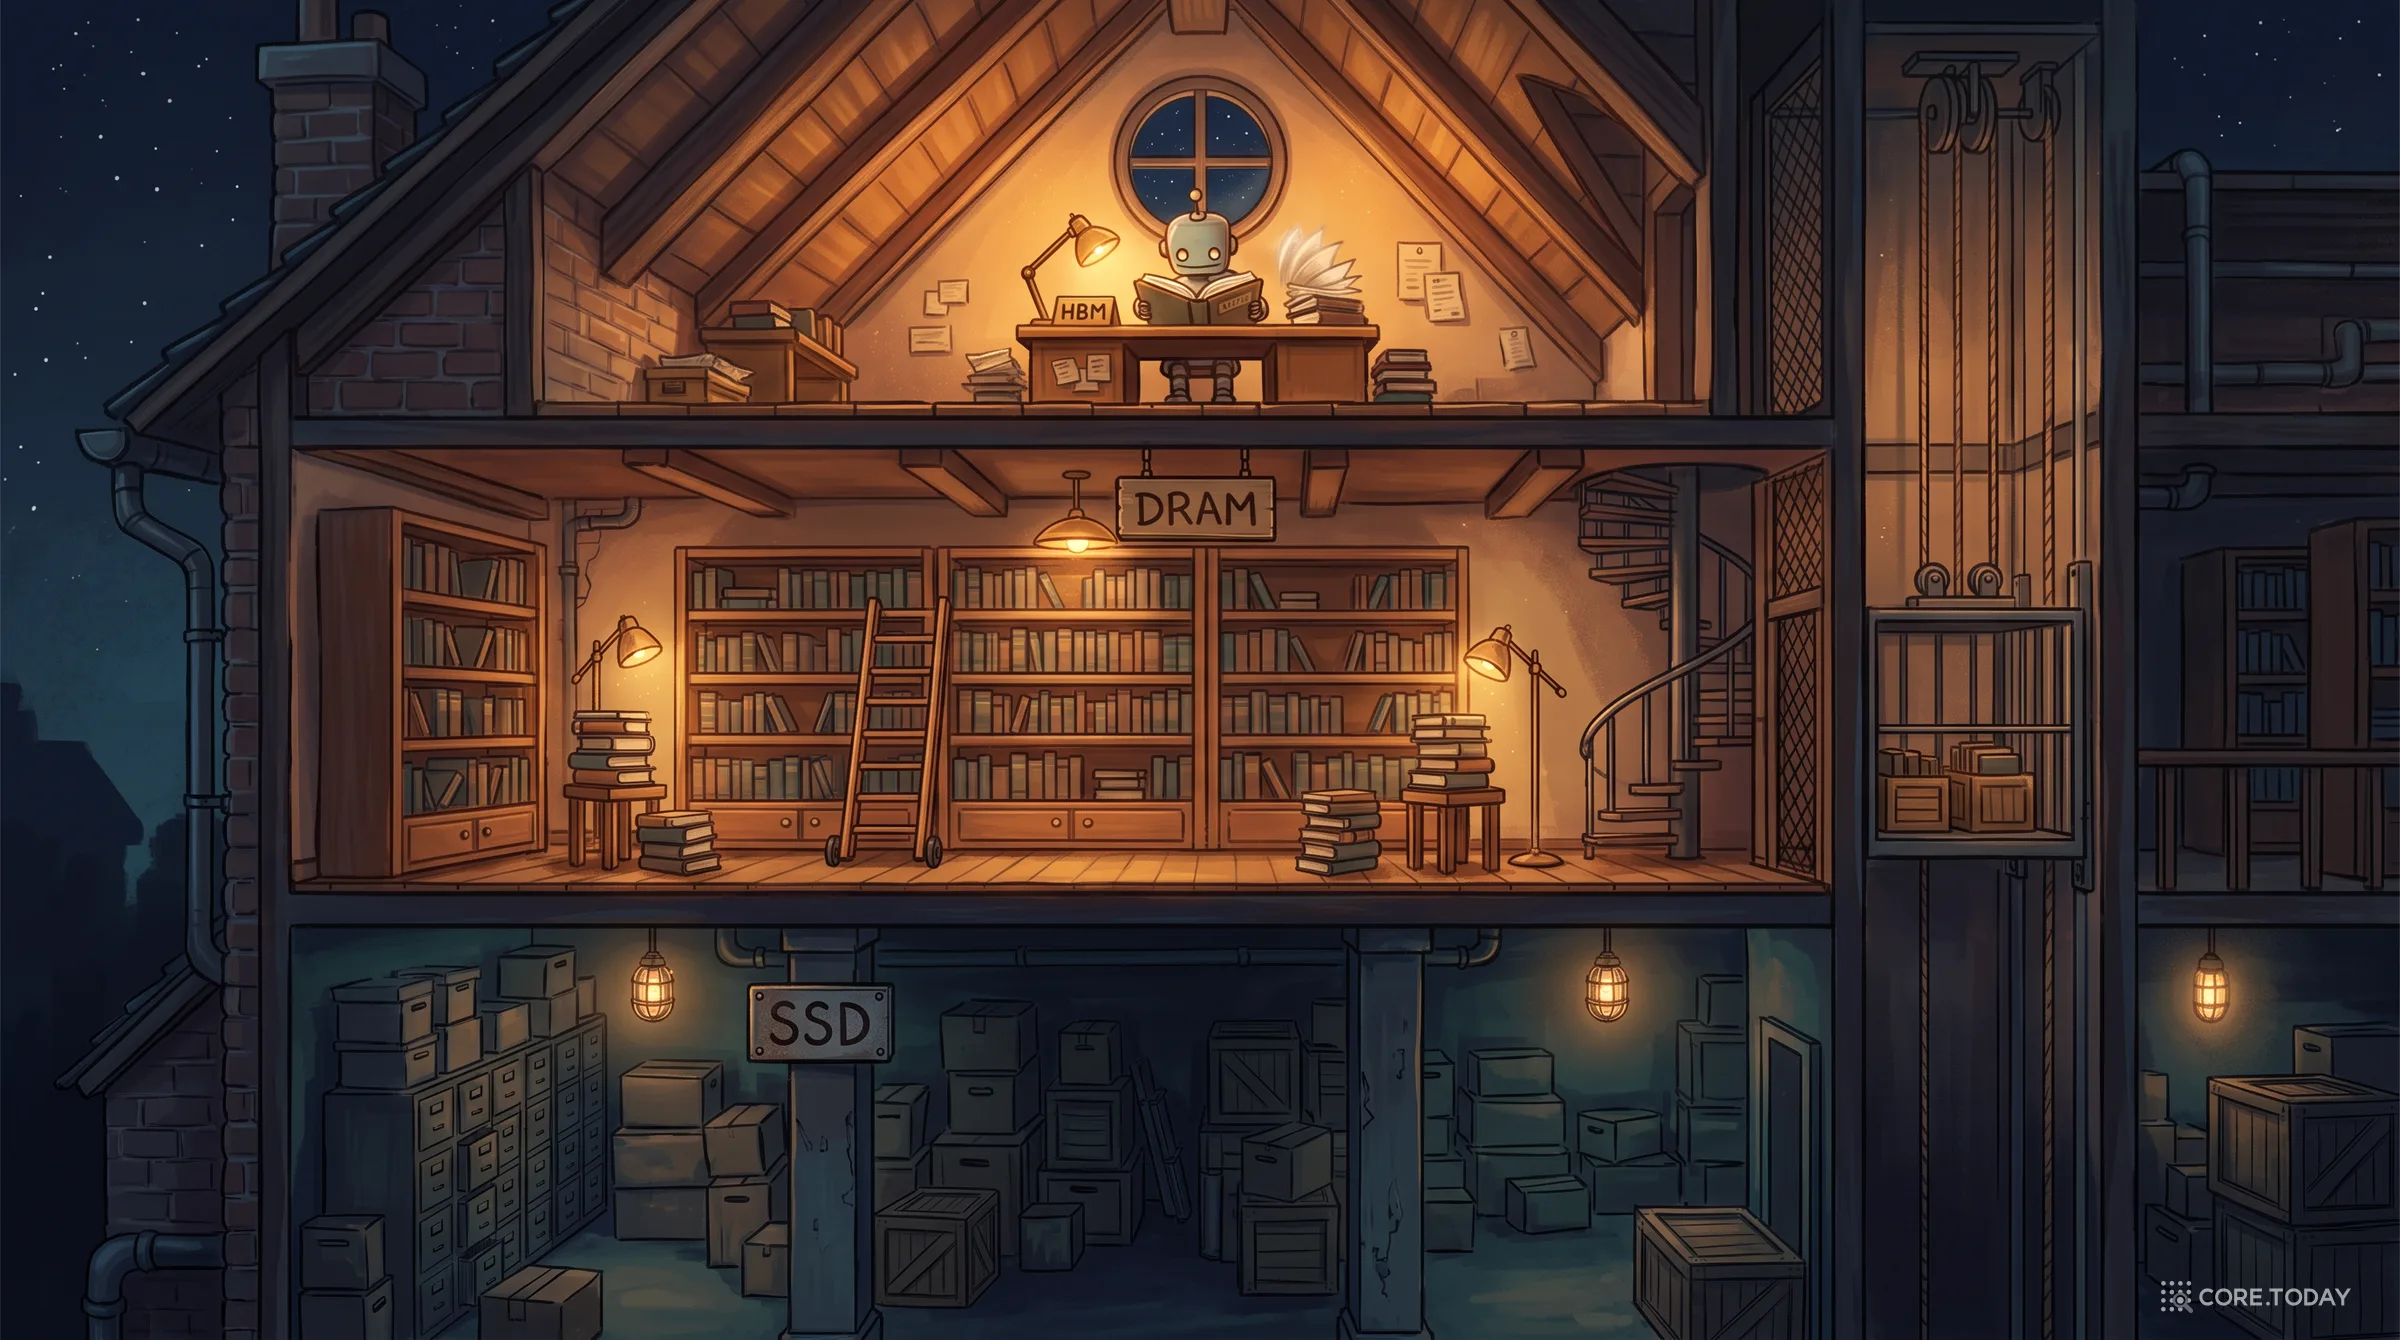
에이전트 대화는 몇 분, 몇 시간씩 멈춥니다. 그동안 그 대화의 KV가 HBM에 앉아 있으면 가장 비싸고 귀한 메모리가 아무 매출도 내지 않습니다. SemiAnalysis의 처방은 KV를 불변(immutable) 블롭으로 다루는 것입니다. 시스템 프롬프트, 프로젝트 문맥, 이전 턴, 도구 출력, 생성 토큰이 각각 블롭이 되고, 새 작업은 필요한 블롭을 읽고 새 블롭을 덧붙입니다. 턴이 끝나면 블롭은 CPU에 달린 D램(DDR), 네트워크로 묶인 메모리 장비, 더 오래 쓸 것이면 SSD로 내려갑니다. 그리고 다시 필요할 때 HBM으로 올라옵니다. "HBM의 가장 좋은 쓰임은 지금 매출을 내고 있는 활성 배치의 데이터"라는 것입니다.
Claude Code는 세션마다 대화 기록을 로컬 JSONL 파일로 남기고, 모델이 답한 메시지마다 API가 돌려준 토큰 사용량(usage)을 함께 적습니다. cache_read_input_tokens(이미 캐시된 앞부분을 다시 읽은 토큰, 이 글의 캐시), cache_creation_input_tokens와 input_tokens(이번에 새로 처리한 토큰, 이 글의 새 입력), output_tokens(생각·도구 호출을 포함한 출력)입니다.
코어닷투데이 맥 한 대의 ~/.claude/projects/ 아래에 2026년 10월 4일부터 30일까지 쌓인 파일 1,080개를 읽기 전용으로 훑었습니다. 메인 세션 287개와 서브에이전트 스레드 790개, 모두 1,077개 스레드에서 API 호출 6만 1,931번이 나왔습니다(같은 메시지가 여러 줄로 기록되므로 메시지 id로 중복을 지웠습니다). 모델 구성은 Opus 5.5가 5만 1,483번, Fable 5.1이 9,036번, Sonnet 5.5가 1,355번입니다. 대화 내용, 파일 경로, 프로젝트 이름은 읽지도 저장하지도 않았고, 아래 숫자는 모두 합계와 분포입니다.
한 가지 미리 밝혀 둡니다. 이 숫자는 클라이언트가 받은 청구 단위입니다. Anthropic 서버 안에서 그 캐시가 HBM에 있었는지, D램이나 SSD에서 올라왔는지는 알 수 없습니다. 그래도 일감의 모양, 곧 '새로 처리할 것'과 '다시 읽을 것'의 비율은 서버 구조와 상관없이 그대로입니다. SemiAnalysis의 에이전트 벤치마크 AgentX도 자사 직원들의 Claude Code 기록 393개를 익명화해 만든 것이니, 같은 종류의 재료입니다.
결과: 거대한 캐시, 작은 새 입력
세션의 첫 호출(1,077번)을 빼면 나머지 6만 854번이 모두 '이미 캐시된 앞부분 위에 무언가를 붙이는' 호출입니다. 숫자는 이렇습니다.
지표 (첫 호출 제외)
중앙값
하위 10%
상위 10%
캐시에서 읽은 앞부분
201,917
86,707
435,273
새로 붙인 입력
1,711
509
7,269
출력
488
185
2,618
캐시 ÷ 새 입력 (호출별)
119배
–
–
전체 입력 토큰 가운데 캐시에서 읽은 몫은 97.8% 입니다(146억 384만 토큰 대 3억 3,576만 토큰). SemiAnalysis가 AgentX를 소개하며 쓴 "KV 캐시 적중률 95% 이상"과 같은 영역입니다. 새 입력이 50~5,000개 사이인 호출은 83% 였습니다. SemiAnalysis가 미드필을 정의하며 쓴 "증분 질의는 대개 50에서 5,000개 새 입력 토큰" 범위와 거의 겹칩니다. 출력은 입력 전체의 0.48% 에 불과했습니다. 입력 대 출력이 약 200 대 1입니다.
호출 하나를 그림으로 그리면, 20만 토큰짜리 긴 띠 끝에 1,700토큰짜리 조각이 붙고, 500토큰쯤 나옵니다. 모델이 이 호출에서 '하는 일'의 대부분은 20만 토큰의 문맥을 다시 훑는 것입니다. 아래 위젯에서 분포를 직접 넘겨 볼 수 있습니다.
출력이 짧은 이유, 그리고 그것이 뜻하는 것
출력 중앙값이 488토큰으로 짧은 것은 코딩 에이전트가 '말'보다 '도구 호출'을 많이 내기 때문입니다. 그래서 일의 리듬은 "거대한 문맥을 HBM으로 끌어올림 → 1,700토큰 미드필 → 500토큰 디코드 → 도구가 도는 동안 대기"가 됩니다. 디코드가 짧으니, 비싸게 끌어올린 문맥은 짧게 일하고 다시 쉽니다. SemiAnalysis가 "HBM은 활성 배치에만"이라고 말하는 근거가 바로 이 리듬입니다.
세션의 첫 호출은 다른 모양입니다. 메인 세션이든 서브에이전트든 첫 호출의 새 입력은 중앙값 4만 1,310개 였습니다. 시스템 프롬프트, 도구 정의, 프로젝트 지침(CLAUDE.md), 메모리 같은 '출발 짐'입니다. 이것은 고전적인 프리필에 가깝지만, 같은 짐을 여러 세션이 공유하므로 서버 쪽에서는 공용 블롭으로 캐시될 후보입니다. SemiAnalysis가 "시스템 프롬프트 같은 아주 흔한 객체는 랙 단위 공용 캐시의 자연스러운 후보"라고 쓴 부분입니다.
미드필의 '앞부분'은 고정돼 있지 않습니다. 메인 세션의 호출 순서별 문맥 길이(캐시 + 새 입력) 중앙값은 첫 호출 6.9만, 10번째 10.7만, 50번째 22.5만, 100번째 30.2만 토큰이었습니다. 한 호출마다 늘어나는 양의 중앙값은 1,701토큰으로, 새 입력 중앙값과 거의 같습니다. 붙인 것이 그대로 앞부분이 됩니다.
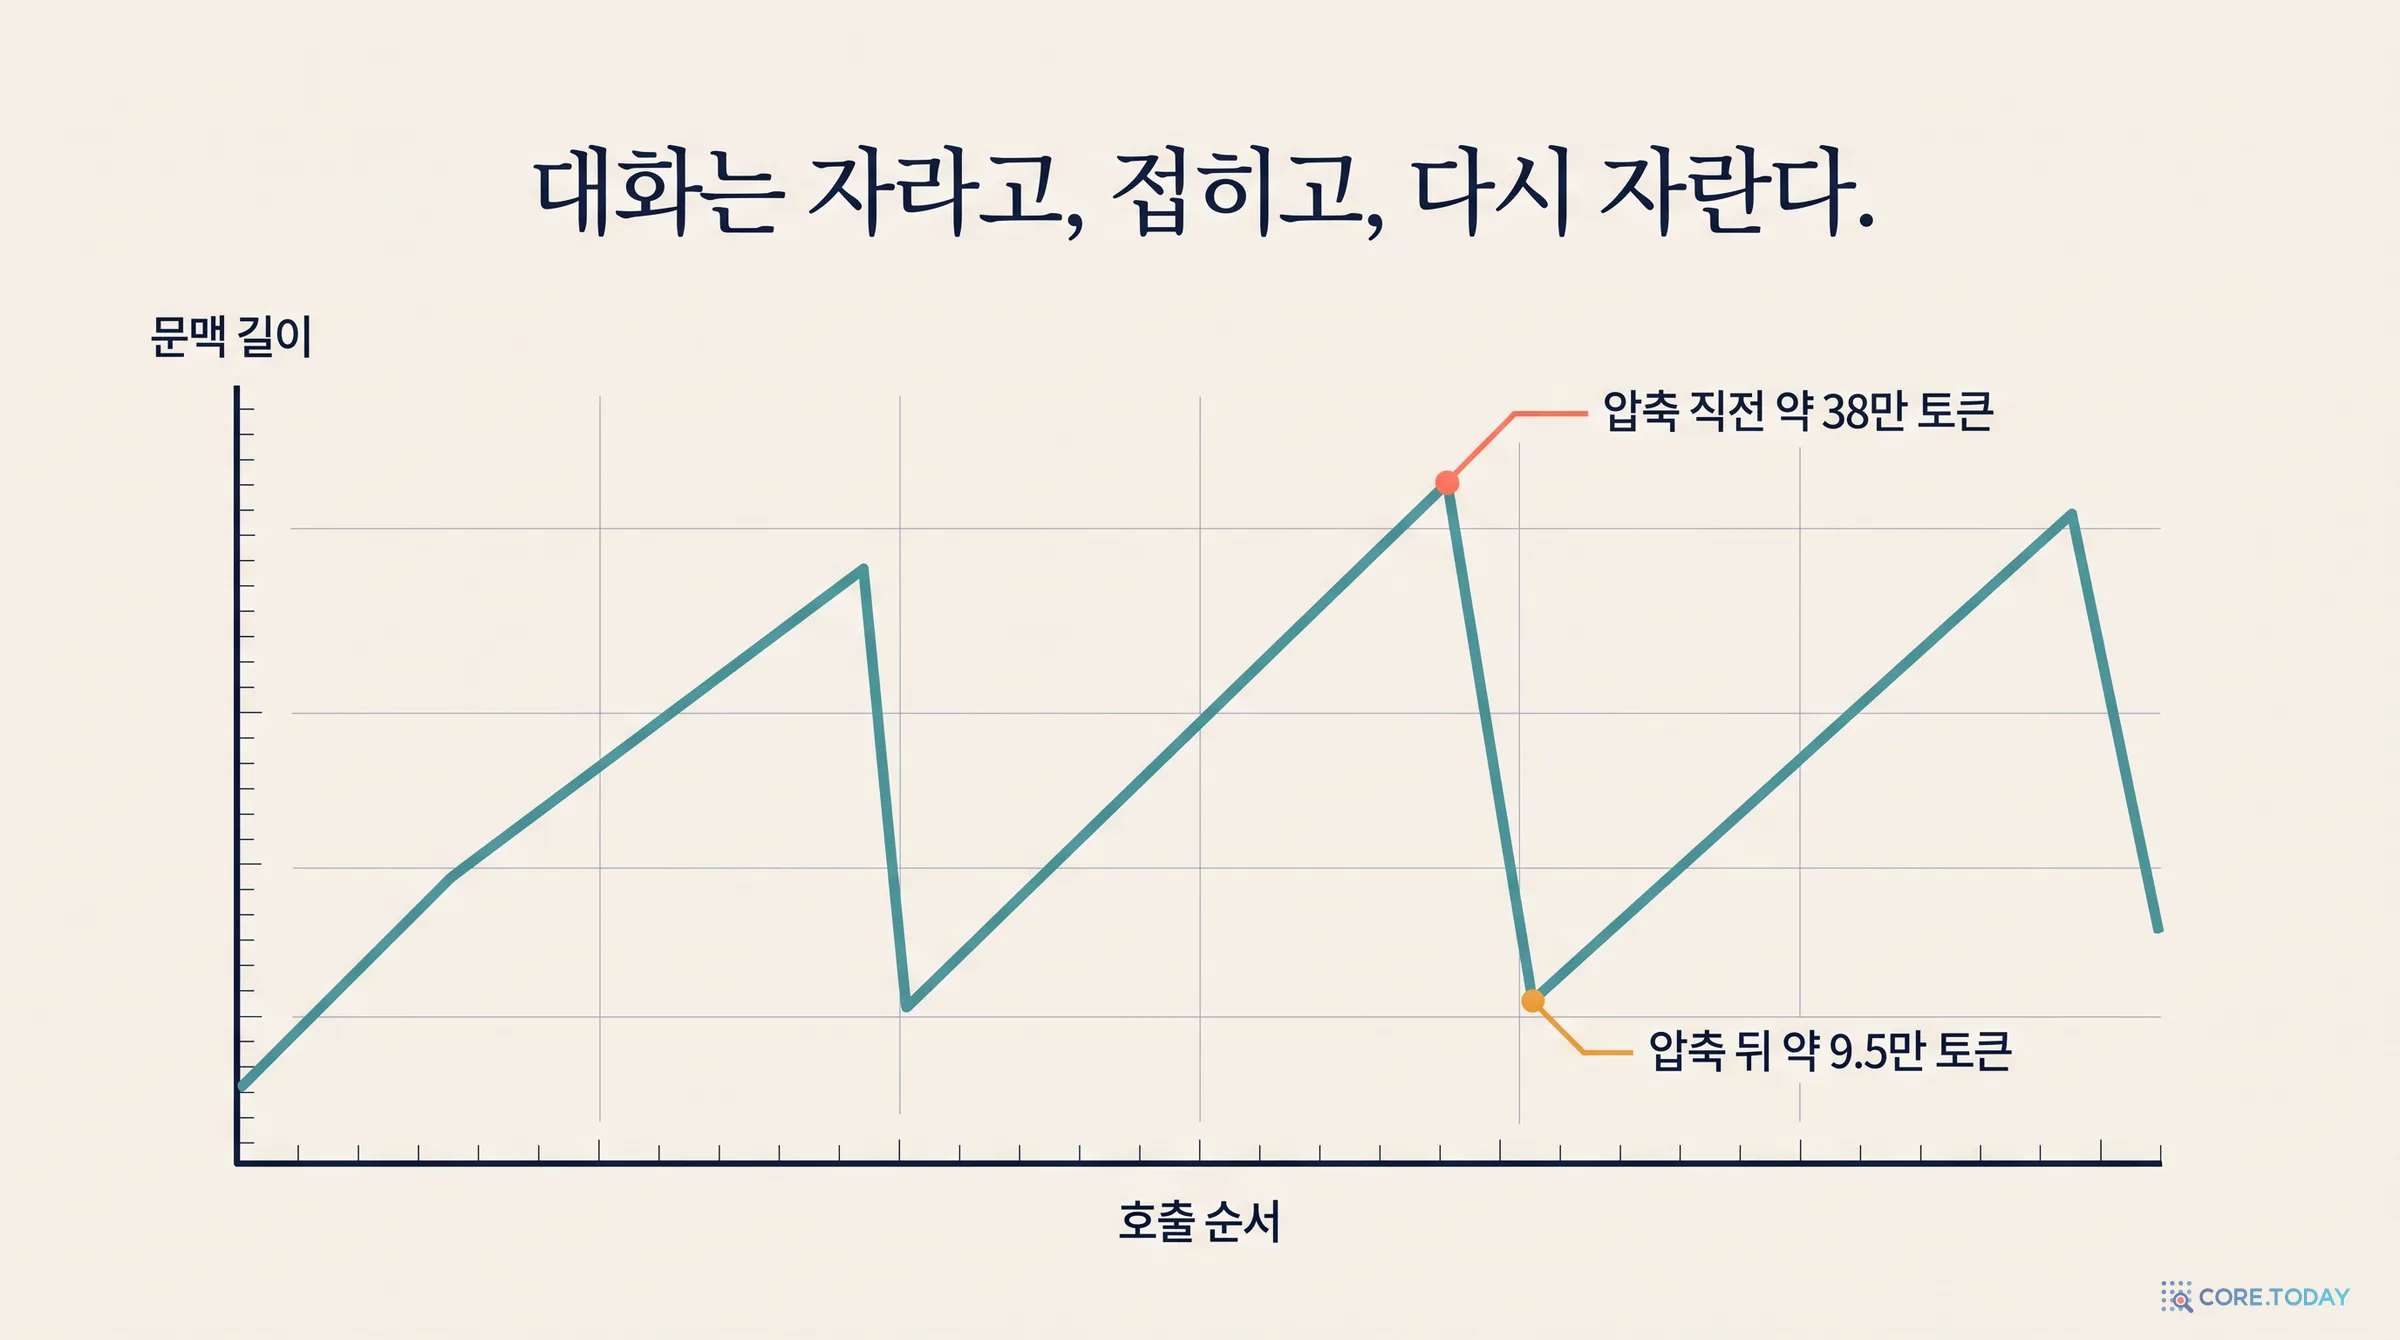
그러다 한계에 가까워지면 압축(compaction) 이 일어납니다. 코어닷투데이 기준(직전 문맥 6만 토큰 이상에서 다음 호출 문맥이 40% 넘게 줄어든 경우)으로 26일 동안 124번이었고, 압축 직전 문맥의 중앙값은 약 38만 토큰, 직후는 약 9.5만 토큰 이었습니다. 가장 긴 세션은 1,840번 호출하는 동안 11번 접혔습니다. SemiAnalysis는 AgentX 기록에서 "Opus 4.8은 25만, Fable은 100만 토큰"을 실질 한계로 적었는데, 코어닷투데이 로그에서는 Opus 5.5·Fable 5.1 모두 96만 토큰을 넘긴 호출이 있었습니다(모델 세대·설정이 달라 직접 비교할 숫자는 아닙니다).
압축은 메모리 관점에서 중요한 사건입니다. 접히기 전의 KV 블롭 수십 GB가 한순간에 쓸모를 잃고, 9.5만 토큰짜리 새 앞부분이 프리필처럼 다시 만들어집니다. SemiAnalysis는 "압축 뒤에는 버려진 이전 블롭이 많이 생기고 그 공간은 아마 새 일에 재활용될 것"이라고 썼습니다.
쉬는 시간과 '캐시 재계산'
호출 사이 간격의 중앙값은 8.8초, 90%가 55초 안에 다음 호출로 이어졌습니다. 5분 넘게 쉰 간격은 2.4%, 한 시간 넘게 쉰 간격은 0.5%였습니다. 대부분의 시간 동안 대화는 '살아' 있고, 도구가 도는 몇 초 동안만 쉽니다.
그런데 드물게 쉬었다 돌아온 세션이 비쌉니다. 새 입력이 2만 토큰을 넘고, 캐시 읽기가 직전 문맥의 절반에 못 미치는데 문맥은 줄지 않은 호출, 곧 캐시가 사라져 앞부분을 다시 계산한 호출 은 336번으로 전체의 0.55% 였습니다. 그 직전에 쉰 시간의 중앙값은 77분 이었습니다. 그리고 이 0.55%의 호출이 26일 동안의 새 입력 토큰 29% 를 만들었습니다. 캐시 적중률 97.8%라는 숫자 뒤에, 쉬었다 돌아온 세션 몇 개가 새 계산의 3분의 1 가까이를 차지한 것입니다.
이 결과는 코어닷투데이가 예전에 「클로드 코드 세션 경제학」에서 "캐시는 왜 1시간 뒤에 증발하는가"로 다룬 요금 구조(캐시 유지 시간 5분·1시간)의 하드웨어 쪽 얼굴입니다. 서비스 회사가 쉬는 KV를 HBM에 계속 두지 않는 것은 당연하고, 그것을 버릴지 D램·SSD로 내려 둘지가 비용을 가릅니다. SemiAnalysis가 인용한 수치로, LMCache는 3.2만 토큰 앞부분을 CPU 메모리에서 다시 올리는 데 약 0.32초, 처음부터 다시 계산하는 데 약 2.5초가 걸렸습니다. 여덟 배 차이입니다.
한 사람이 동시에 들고 있는 문맥
마지막으로 하나 더 셌습니다. 1분 간격으로, 최근 5분 안에 호출이 있었던 스레드의 마지막 문맥 길이를 모두 더하면 '이 맥 한 대가 동시에 살려 두고 있는 문맥'이 됩니다. 활동한 1만 131분 가운데 중앙값은 63만 토큰, 90번째 백분위는 194만 토큰, 최대는 642만 토큰(동시 스레드 최대 55개)이었습니다. 서브에이전트를 여러 개 띄우는 작업 방식 탓에 한 사람이 동시에 수십 개 대화를 굴립니다.
이 194만이라는 숫자는 우연히도 SemiAnalysis가 2027년 설계 기준으로 제시한 "한 파이프라인 단계에 배정되는 살아 있는 문맥 200만 토큰"과 거의 같습니다. 다음 장에서 이 토큰들이 실제로 몇 GB인지 계산합니다.
2장의 '앞부분 20만 토큰'이 메모리로는 얼마일까요? 그것은 모델이 토큰 하나를 기억하는 데 몇 바이트를 쓰느냐에 달렸습니다. SemiAnalysis는 9월 21일 글에서 세 가지 기준점을 줍니다.
고전적인 완전 주의(full attention)는 "모든 층을 합쳐 토큰당 수백 kB"가 필요할 수 있다.
MLA(Multi-head Latent Attention) 같은 설계는 "보통 수십 kB".
"토큰당 약 70kB는 검증된 압축 주의 설계의 보수적 기준점", "약 25kB는 일부 새 하이브리드에 합리적인 평균".
그리고 이것으로 2027년의 설계 목표를 계산합니다. 토큰당 70kB에 한 파이프라인 단계가 맡는 살아 있는 문맥 200만 토큰을 곱하면 약 140GB. 한 묶음이 일하는 동안 다른 묶음을 옮길 수 있게 두 벌(double buffering)을 두면 280GB. 여기에 모델 가중치, 활성화, 임시 버퍼, 라우팅 표, 단편화, 운영 여유를 더하면 단계당 400~500GB의 빠른 메모리가 "2027년의 쓸모 있는 기준"이라는 것입니다. 이 메모리는 GPU 한 장이 아니라 스케일업 패브릭(NVLink 등)으로 묶인 여러 소켓에 나눠 실을 수 있고, 대형 MoE 모델의 가중치는 95% 넘게 라우팅 전문가에 있어 소켓 사이에 자연스럽게 나뉩니다.
그런데 같은 글 끝의 Kimi K3 예측(B200·B300·GB200, 16~64 GPU)에서는 반대 방향의 결론도 나옵니다. "대부분의 최적 설정은 KV 전송 버퍼를 감안해도 GPU당 약 80GB 아래에 머문다." 랙 전체로 보면 수백 GB가 필요하지만, 그것을 넓게 나누면 GPU 한 장이 들고 있어야 할 양은 생각보다 작다는 뜻입니다. 이 두 숫자는 모순이 아니라 같은 이야기의 양면입니다. 용량은 시스템 전체에서 채우고, 칩 하나에는 대역폭이 중요하다는 것.
계산 방법
코어닷투데이는 이 '토큰당 바이트'를 공개 모델마다 직접 계산했습니다. Hugging Face에 공개된 설정 파일(config.json)을 인증 없이 받아, 층 수·KV 헤드 수·헤드 차원 같은 값을 읽었습니다. 공식은 주의 방식마다 다릅니다.
토큰당 KV 바이트 — 코어닷투데이가 쓴 공식
일반 GQA (그룹 질의 주의)
층 수 × KV 헤드 수 × 헤드 차원 × 2(K와 V) × 2바이트(BF16)
MLA (DeepSeek·Kimi·GLM·A.X·kanana)
층 수 × (잠재 벡터 512 + 위치(RoPE) 64) × 2바이트 — K와 V를 따로 두지 않고 압축한 잠재 벡터 한 벌만 저장
DSA 인덱서 (희소 주의용 색인)
색인 키가 있는 층마다 + 132바이트(FP8 128 + 스케일 4)
문맥에 비례하지 않는 것 (따로 셈)
슬라이딩 창 층 = 창 크기만큼만 / 선형 주의(GDN·KDA) 층 = 헤드 × 키 차원 × 값 차원 × 4바이트(fp32 가정)의 고정 상태
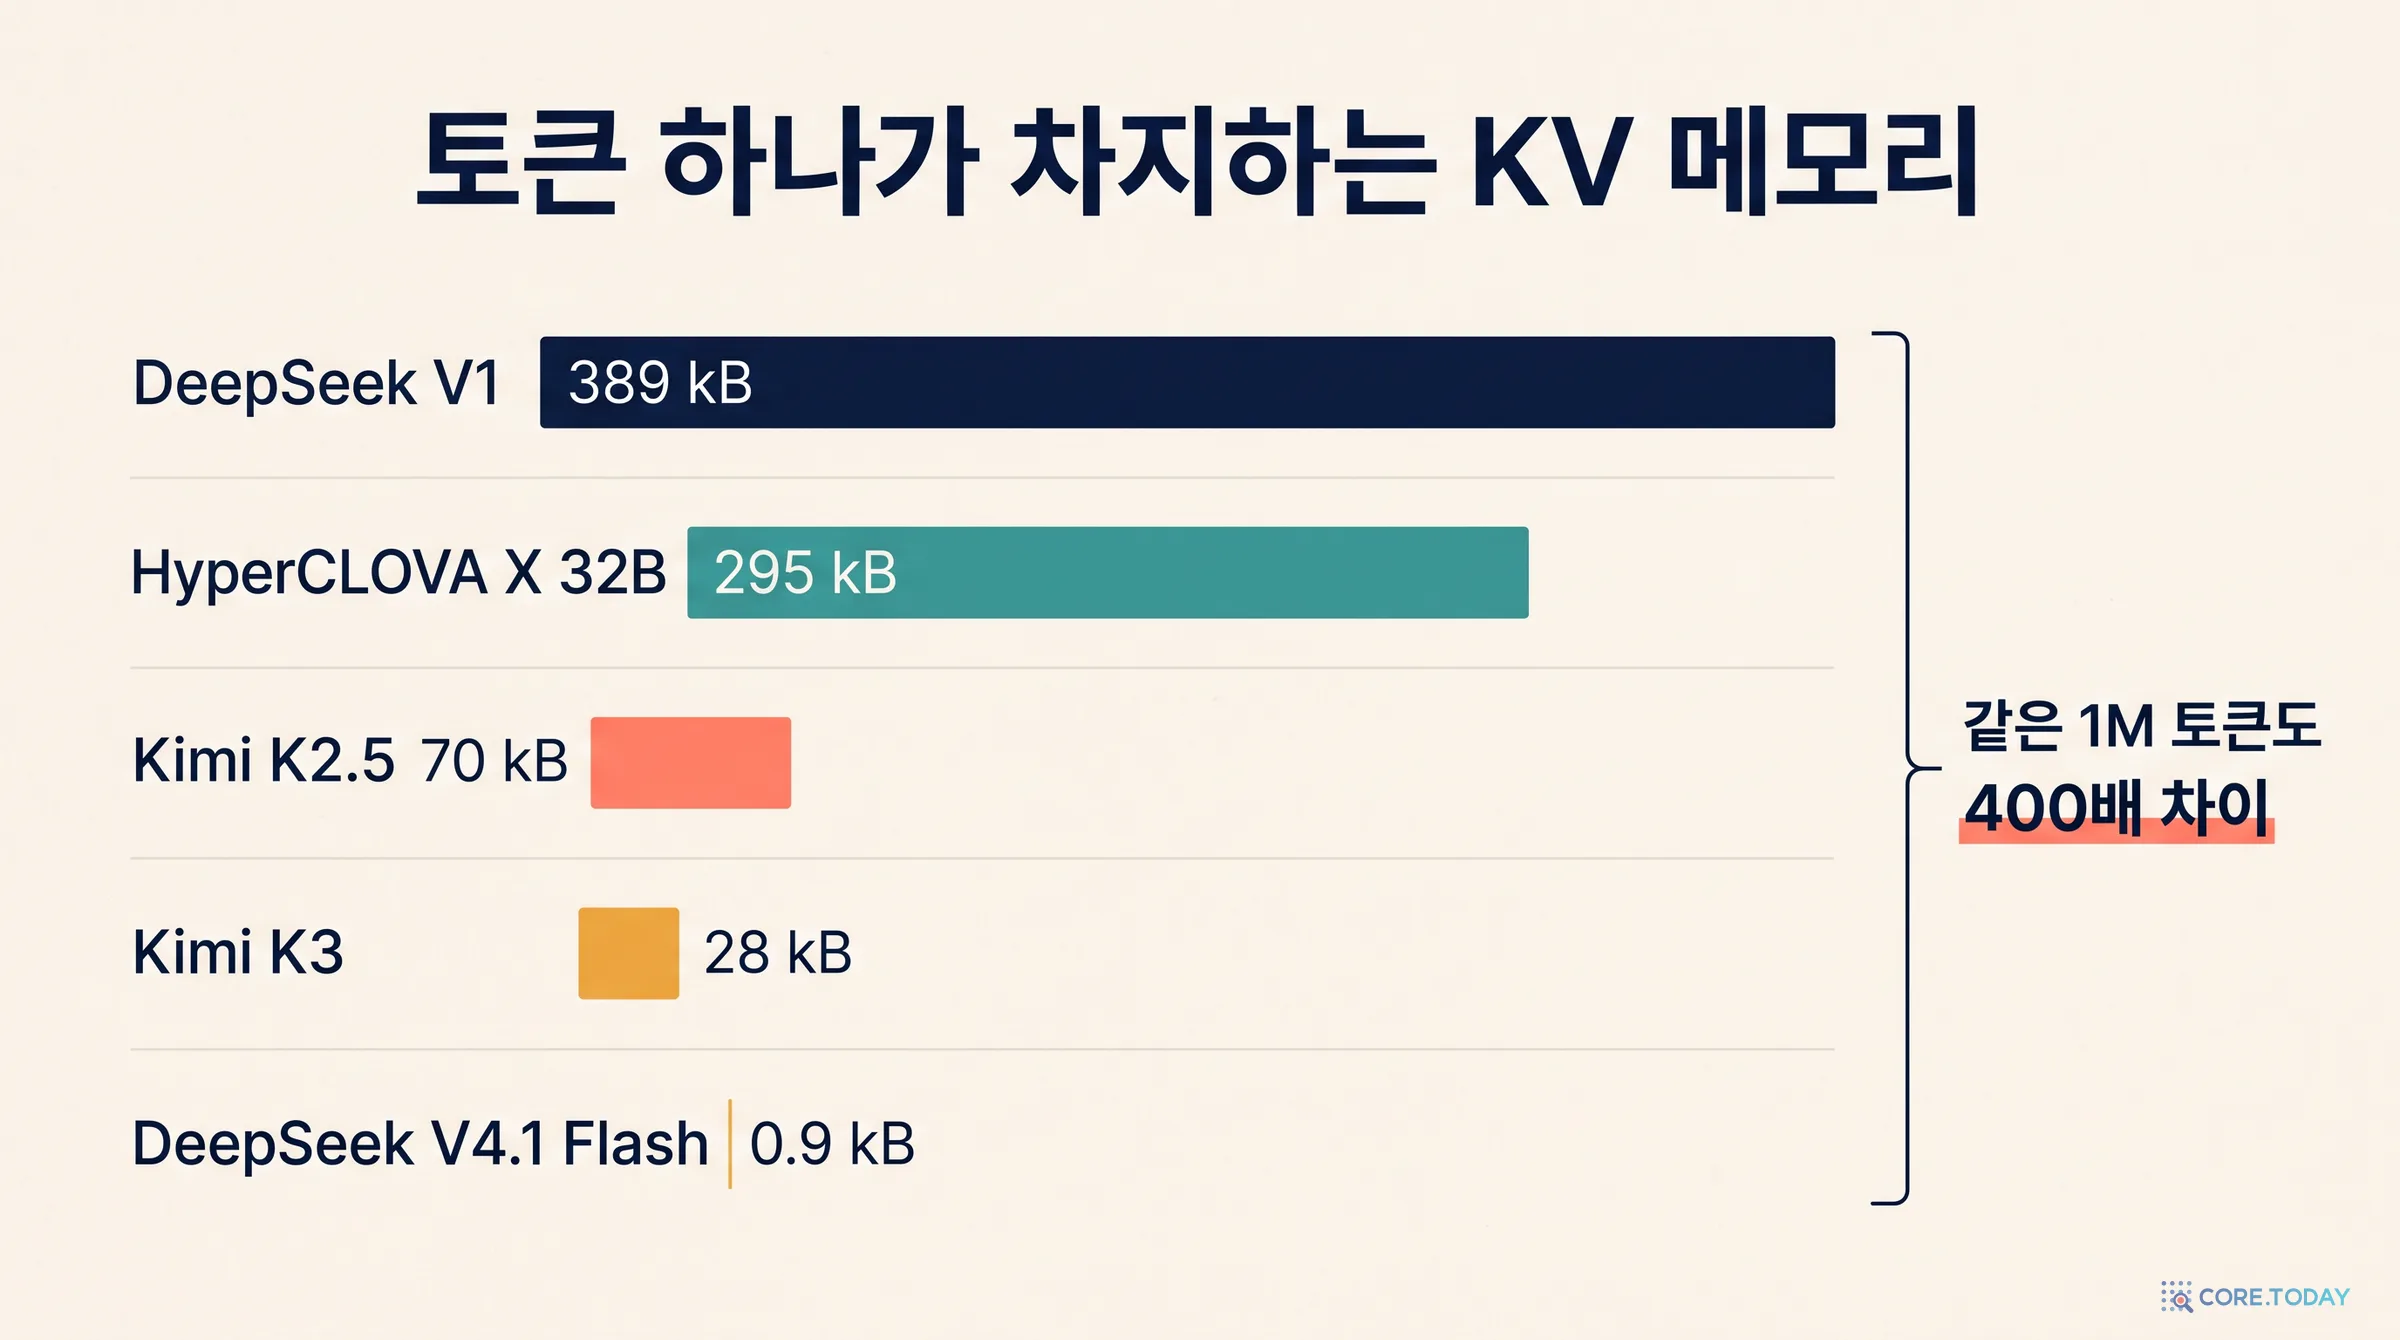
이 공식이 맞는지 검산할 수단이 하나 있었습니다. DeepSeek이 9월에 낸 DeepSeek-V4.1-Flash의 모델 카드에는 세대별 "토큰당 전역 KV 캐시(바이트)" 그림이 실려 있습니다. DeepSeek V1 389,120바이트, V3.2 48,068바이트, V4-Flash 3,514바이트, V4.1-Flash 890바이트. 코어닷투데이 공식으로 V3.2(61층, FP8로 저장한 MLA 656바이트 + 인덱서 132바이트)를 계산하면 61 × 788 = 48,068바이트, 공식 값과 한 자리까지 같았습니다. V1(67B, 95층, KV 헤드 8개, 헤드 차원 128)도 95 × 8 × 128 × 2 × 2 = 389,120바이트 로 정확히 맞습니다. V4와 V4.1은 압축 비율이 층마다 다르고(CSA·HCA, 층 사이 공유, FP4 저장) 설정 파일만으로 정확히 재현하기 어려워 공식 값을 그대로 썼습니다.
결과: 0.9kB에서 389kB까지
모델
토큰당 KV
구조
20만 토큰 한 세션
DeepSeek V1 (67B, 2023)
389.1 kB
GQA 95층 (공식 값)
77.8 GB
HyperCLOVA X SEED Think 32B (네이버)
294.9 kB
GQA 72층
59.0 GB
Solar Open 100B (업스테이지)
196.6 kB
GQA 48층
39.3 GB
MiniMax M3
122.9 kB
GQA 60층, 희소 주의(저장은 전부)
24.6 GB
GLM-5.3
92.6 kB
MLA 78층 + 인덱서
18.5 GB
K-EXAONE 2.0 750B (LG AI연구원)
81.9 kB
전체 주의 20층 + 슬라이딩 58층
16.4 GB
A.X K2 (SK텔레콤)
78.3 kB
MLA 61층 + 인덱서
15.7 GB
Kimi K2.5
70.3 kB
MLA 61층
14.1 GB
Qwen3.5 27B / Qwen3.8 27B
65.5 kB
전체 주의 16층 + 선형 48층
13.1 GB (+151 MB)
kanana-2 30B-A3B (카카오)
55.3 kB
MLA 48층
11.1 GB
Solar Open2 250B (업스테이지)
49.2 kB
GQA 12층 + 선형 36층
9.8 GB (+151 MB)
DeepSeek V3.2
48.1 kB
MLA + DSA, FP8 (공식 값)
9.6 GB
Kimi K3
27.6 kB
MLA 24층 + KDA 69층
5.5 GB (+434 MB)
GLM-5.3 Flash
11.6 kB
MLA 11층 + KDA 34층
2.3 GB (+143 MB)
DeepSeek V4.1 Flash
0.9 kB
CSA2·층 간 공유·FP4 (공식 값)
0.18 GB
(BF16 저장 기준, 괄호 안은 문맥 길이와 무관한 고정 상태. FP8로 저장하면 대략 절반입니다. 표에서 뺀 모델 — Mi:dm 2.0 Base 196.6kB, EXAONE 4.5 33B 65.5kB, gpt-oss-120b 36.9kB, Qwen3.8 Flash Next 24.6kB, Qwen3.5 35B-A3B 20.5kB, DeepSeek V4 Flash 3.5kB — 은 아래 계산기에 있습니다.)
몇 가지가 눈에 띕니다.
첫째, SemiAnalysis의 두 기준점이 실제 모델과 맞아떨어집니다. '검증된 압축 주의 70kB'는 MLA를 BF16으로 저장한 61층 모델, 곧 DeepSeek V3 계열과 Kimi K2.5의 70,272바이트와 같습니다. '새 하이브리드 25kB'는 Kimi K3의 27.6kB와 비슷합니다. Kimi K3는 93층 가운데 24층만 MLA이고 나머지 69층은 KDA라는 선형 주의라서, 문맥에 비례해 커지는 KV가 그만큼 작습니다.
둘째, 설계에 따라 400배 넘게 차이 납니다. 같은 20만 토큰 세션 하나가 DeepSeek V1에서는 78GB, HyperCLOVA X 32B에서는 59GB, Kimi K2.5에서는 14GB, DeepSeek V4.1 Flash에서는 0.18GB입니다. HyperCLOVA X 32B는 BF16 가중치만 약 64GB라서, H100 80GB 한 장에는 이 20만 토큰 세션 하나도 들어가지 않습니다. 반대로 DeepSeek V4.1 Flash로는 같은 문맥 수백 개가 한 장에 들어갑니다. 2장의 '한 사람이 동시에 들고 있는 194만 토큰'을 넣으면, Kimi K2.5 기준 136GB(SemiAnalysis의 140GB와 거의 같습니다), HyperCLOVA X 32B 기준 572GB, DeepSeek V4.1 Flash 기준 1.7GB입니다.
셋째, 한국 모델 사이의 폭도 큽니다. 일반 GQA로 만든 HyperCLOVA X SEED Think 32B(295kB), Solar Open 100B·Mi:dm 2.0 Base(197kB)와, MLA·희소 주의·선형 주의를 받아들인 A.X K2(78kB), K-EXAONE 2.0(82kB), kanana-2(55kB), Solar Open2(49kB) 사이에 4~6배 차이가 있습니다. 같은 업스테이지 안에서도 Solar Open 100B에서 Solar Open2 250B로 가며 모델은 커졌는데 토큰당 KV는 4분의 1이 됐습니다. 에이전트처럼 긴 문맥을 오래 들고 있는 일에서는 이 숫자가 같은 GPU로 몇 명을 동시에 받을 수 있는지를 정합니다.
넷째, 선형 주의의 '고정 상태'는 공짜가 아닙니다. Qwen3.5·3.8의 Gated DeltaNet이나 Kimi K3·GLM-5.3 Flash의 KDA 같은 선형 주의 층은 문맥이 아무리 길어도 크기가 같은 상태를 들고 다닙니다. 대신 그 크기가 작지 않습니다. fp32로 저장한다고 보면 Kimi K3는 시퀀스 하나에 약 434MB로, MLA KV로 치면 1.6만 토큰 분량입니다. 짧은 대화에서는 손해, 긴 대화에서는 이득인 구조입니다. 그리고 SemiAnalysis의 AgentX 글이 지적하듯, 이 상태는 "주변 토큰으로 다시 만들 수 없다". 앞부분을 버리면 처음부터 다시 돌려야 합니다. 캐시 관리가 더 까다로워집니다.
그래서 HBM은 얼마나 필요한가
이 계산을 2장의 로그와 겹치면 답의 모양이 보입니다. KV는 동시 세션 수 × 문맥 길이 × 토큰당 바이트로 불어나지만, 그 대부분은 "지금 이 순간에는" 쉬고 있습니다. 나머지 시간에 KV를 어디 둘지가 설계의 핵심입니다.
SemiAnalysis의 AgentX 측정이 그 실제 모습을 보여 줍니다. DeepSeek V4를 B300 8장(vLLM)에 올리고 D램 3TB를 KV 오프로드용으로 붙여 동시 384개의 에이전트 기록을 재생했을 때, HBM 캐시 적중이 91%, D램 캐시 적중이 추가로 1.36% 였습니다. HBM에 담을 수 있는 KV 작업 집합이 약 4,300만 토큰이고 부하가 이를 겨우 넘었기 때문입니다. HBM이 B300의 3분의 2인 B200으로 동시 196개를 돌리자 HBM 적중은 73% 로 떨어지고 D램 적중이 20% 가까이로 올라갔습니다. 작업 집합은 약 2,200만 토큰으로 절반이었습니다. 그리고 SemiAnalysis는 D램 오프로드가 대개 '모두 함께 쓰는(write-through)' 캐시라서, D램 용량이 HBM KV 용량의 1.5~3배는 돼야 효과적이라고 덧붙였습니다.
GLM-5.3을 B200에서 돌린 9월 28일 글도 같은 방향입니다. 동시 요청을 8개에서 16개로 늘리자 GPU 메모리 재사용은 90.3%에서 54.8%로 떨어졌지만 호스트 메모리 재사용이 6.0%에서 40.3%로 올라, 전체 캐시 적중은 95% 위를 지켰습니다.
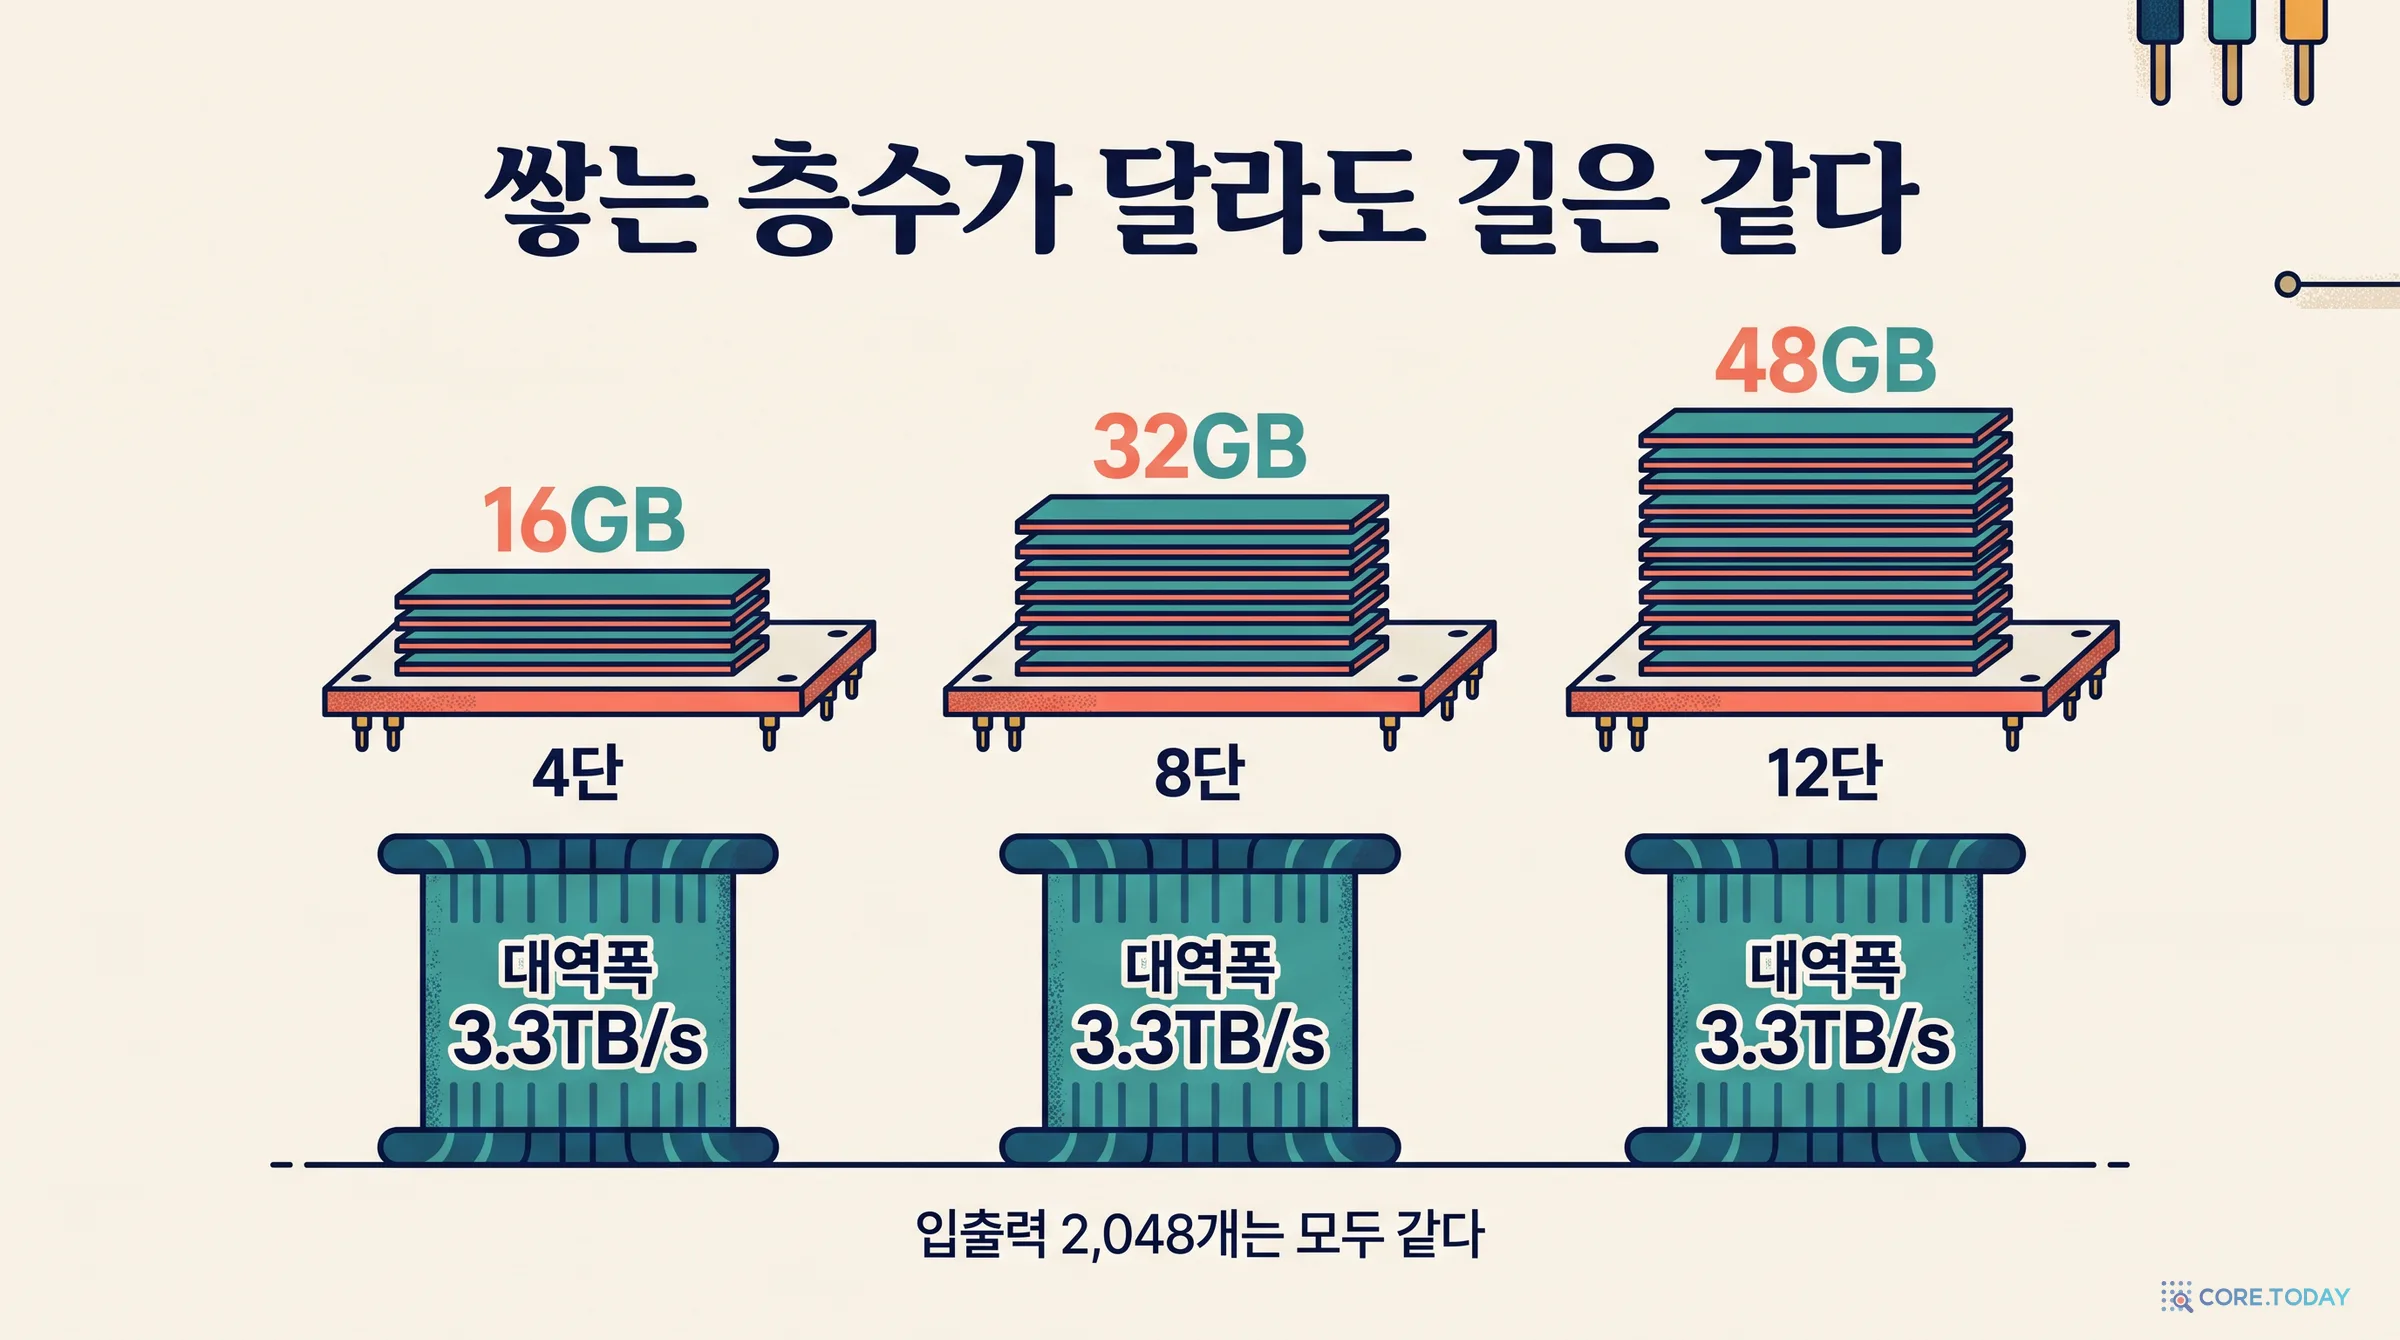
이제 메모리 쪽으로 건너갑니다. SemiAnalysis의 9월 13일 글이 먼저 상기시키는 사실은 이것입니다. HBM4와 HBM4E 스택은 바깥(GPU)과 데이터를 주고받는 I/O가 2,048개 입니다. 이 2,048개는 스택 안의 D램 코어 다이들에 고르게 나뉘는데, 다이 하나가 맡을 수 있는 최대치가 512개 입니다. 그래서 4단이 2,048개를 모두 쓸 수 있는 가장 낮은 높이이고, 4단·8단·12단 어느 쪽이든 스택 하나의 대역폭은 같습니다.
그런데 값은 그렇지 않습니다. "공급자와 최종 고객의 원가는 주로 스택당 D램 함량, 곧 GB로 정해진다." 고객이 HBM에서 얻는 가치는 대개 대역폭인데 가격은 용량을 따라가니, 낮게 쌓을수록 대역폭 1달러당 값이 싸집니다. SemiAnalysis는 이것을 "거의 공짜 점심"이라고 불렀습니다.
숫자로 보면 이렇습니다. HBM4E가 핀당 13Gbps라고 가정하면 스택 하나의 대역폭은 2,048 × 13 ÷ 8 = 3,328GB/s. 코어 다이 하나가 32Gb(4GB)이므로 4단·8단·12단은 각각 16GB·32GB·48GB 입니다.
'토큰당 스택 읽기 횟수'
SemiAnalysis는 여기에 간단한 지표 하나를 붙입니다. 시퀀스 하나를 초당 100토큰으로 만든다면, 토큰 하나에 쓸 수 있는 대역폭은 3,328 ÷ 100 = 33.28GB입니다. 이것을 스택 용량으로 나누면 '토큰 하나가 스택 전체를 몇 번 읽을 수 있나'가 나옵니다.
4단 (16GB)
2.08회
8단 (32GB)
1.04회
12단 (48GB)
0.69회
(초당 100토큰, 스택 하나 기준. 막대는 4단의 2.08회를 100으로 맞춘 값입니다.)
1회면 용량과 대역폭이 딱 맞습니다. 토큰 하나를 만드는 동안 메모리에 담긴 작업 데이터를 정확히 한 번 다 읽을 수 있습니다. 1보다 크면 대역폭이 남는데, 그 남는 대역폭은 초당 토큰을 늘리는 데 쓰일 수 있으니 버려지지 않습니다. 1보다 작으면 문제입니다. 그 속도로는 담긴 데이터를 다 읽을 수 없으니, 작업 데이터를 용량보다 작게 둬야 하고 나머지 용량은 놉니다. 속도를 높일수록(사용자가 빠른 응답을 원할수록) 이 숫자는 작아지고, 높게 쌓은 스택의 용량은 더 많이 남아돕니다. SemiAnalysis의 결론은 이 비대칭입니다. "대역폭은 대개 다 쓸 수 있지만, 남는 용량은 늘 다 쓸 수 있는 게 아니면서 갈수록 비싸진다."
물론 실제 서빙은 여러 사용자를 묶어(batching) 가중치 한 번 읽기를 나눠 씁니다. 이때 용량이 크면 더 많은 사용자의 KV를 담아 배치를 키울 수 있으니, 용량에도 값이 생깁니다. 그래서 SemiAnalysis는 배치까지 넣은 곡선을 그렸고, 결론은 "더 높이 쌓은 HBM은 일정한 사용자당 속도까지만 처리량을 더 준다"는 것이었습니다.
Kimi K3로 계산한 숫자
SemiAnalysis는 지금 가장 큰 공개 모델인 Kimi K3(2.8조 파라미터)를 Rubin Ultra NVL576(GPU 576개를 한 스케일업 도메인으로 묶은 시스템, HBM4E 13Gbps 가정)에 올려 디코드 풀만 루프라인으로 계산했습니다. GPU당 스택 8개라서 4단·8단·12단은 GPU당 128GB·256GB·384GB입니다. MXFP4로 저장한 Kimi K3 가중치는 576개 GPU에 나누면 GPU당 16.8GB, 스택 하나에 2.1GB밖에 되지 않습니다.
사용자당 105 tok/s를 요구하면 12단은 8단보다 처리량이 나을 게 없고, 213 tok/s까지 올리면 4단보다 높은 어떤 스택도 도움이 안 됩니다. 그리고 4단이 낼 수 있는 최대 처리량 지점에서는 사용자당 속도가 두 배 넘게 빠릅니다. 시스템 비용(SemiAnalysis는 총소유비용의 대부분이라 이것을 TCO 대용으로 썼습니다)의 증가가 처리량 증가보다 커서, "이 메모리 가격과 엔비디아의 마진 구조에서 12단과 8단은 4단보다 토큰당 비용이 높다". 아직 KV를 더 싼 메모리로 내리는 오프로드조차 넣지 않은 계산입니다.
이 계산은 이론적 최대 대역폭을 쓴 루프라인입니다. 실제 달성 대역폭은 훨씬 낮고, SemiAnalysis는 그 경우 곡선이 왼쪽(더 느린 속도)으로 옮겨 "더 큰 용량이 손익분기를 넘는 지점이 사용자가 받아들이기 어려울 만큼 느린 속도로 밀릴 수 있다"고 썼습니다. 결론의 방향은 같다는 것입니다.
모델이 세 배 커지면
이 결론의 가장 큰 약점은 SemiAnalysis 스스로 짚었습니다. "현재의 일감을 미래의 시스템에 올려 4단이면 충분하다고 보이는 것"이라는 점입니다. AI 서버는 5년 넘게 쓰고, 그동안 모델은 커질 것입니다. 그래서 그들은 Kimi K3의 3배 크기 모델(사용자당 KV도 3배)을 넣어 다시 계산했습니다. 이번에는 12단이 4단보다 처리량을 47%, 8단이 36% 더 냈습니다(사용자당 속도는 절반 수준에서). 비용까지 넣으면 8단은 사용자당 180 tok/s 아래에서 비용 증가보다 처리량 증가가 컸습니다. 다만 12단을 8단과 비교하면, 곡선 어디에서도 12단의 처리량 이득이 비용 증가를 넘지 못했습니다.
SemiAnalysis는 그래도 4단 쪽에 무게를 둡니다. 파라미터 키우기가 예전만큼 중요하지 않고(강화학습, 추론 시간, 같은 층을 여러 번 도는 루프 트랜스포머), 4단이 설치 기반의 큰 몫이 되면 연구자들이 모델을 거기에 맞출 것이며, 4단을 가장 원하는 쪽이 하드웨어·소프트웨어 공동 설계에 집착하는 프런티어 연구소의 하드웨어 팀이라는 사실 자체가 신호라는 것입니다. 마지막 근거는 해석의 영역입니다.
5장. KV 자리를 줄이면 언제 아픈가 — SemiAnalysis의 실험과 코어닷투데이의 재현
SemiAnalysis: HBM 8%를 줄였더니
루프라인만으로는 설득이 부족하다고 봤는지, SemiAnalysis는 실제 시스템에서 HBM을 줄여 보는 실험을 했습니다. GB300 16장에 Kimi K3를 올리고, 8장은 프리필, 8장은 디코드로 나눈 분리 서빙 구성입니다. 평소처럼 HBM의 92%를 쓰게 한 경우와, 85%로 제한한 경우를 InferenceX 벤치마크로 비교했습니다.
HBM 8% 감소는 8단에서 4단으로 갈 때의 50% 감소에 비하면 작습니다. 하지만 Kimi K3를 8장에만 올렸으니 가중치가 메모리의 큰 몫을 차지하고, 그래서 KV 자리는 크게 줄었습니다. GPU당 KV 저장 공간이 약 20GB 줄어, 합친 서빙 기준 KV 예산이 53GB에서 34GB(−36%), 분리 서빙 쌍 기준 44GB에서 24GB(−44%) 가 됐습니다.
결과는 이랬습니다. 곡선의 대부분에서 HBM을 줄인 쪽의 처리량은 거의 같았습니다. 그러다 동시 사용자가 70을 넘자 처리량이 30% 가까이 떨어졌습니다. 그 지점이 줄인 쪽의 KV 점유율이 100%에 닿은 곳이었고, 이후 선점(preemption), 반복 적재, 대기열이 처리량을 갉아먹었습니다. 같은 동시성에서 HBM을 줄인 쪽은 D램 KV 읽기가 10배 넘게 많았습니다. SemiAnalysis는 이 붕괴가 "동시성은 높지만 상호작용성(사용자당 속도)은 아주 낮은 구간"에서 일어난다는 점도 짚었습니다. 사람과 대화하는 에이전트라면 애초에 잘 가지 않는 구간입니다.
코어닷투데이: A100 한 장에서 같은 모양을 찾아서
같은 모양이 작은 규모에서도 나오는지 확인하려고, 코어닷투데이 GPU 클러스터(kubecore)의 A100-PCIE-40GB 한 장(MIG 7g.40gb, 카드 전체)에 vLLM 0.11.0으로 Llama 3.1 8B Instruct를 올렸습니다. 고전적인 GQA 모델이라 토큰당 KV가 131kB로 크고, 가중치(약 15GiB)가 40GB의 큰 몫을 차지해 SemiAnalysis 실험과 사정이 비슷합니다. 크레딧이 드는 API는 쓰지 않았습니다.
부하는 2장의 로그를 흉내 냈습니다. 세션마다 무작위 토큰 6,000개짜리 앞부분으로 시작해, 턴마다 새 입력 1,000개를 붙이고 100개를 생성합니다(실제 출력 대신 무작위 토큰 100개를 다음 턴에 붙여 문맥을 키웁니다). 20턴이 지나면 새 세션을 엽니다. 세션 하나의 문맥은 6천에서 2.8만 토큰까지 자랍니다. 동시 세션을 2·4·8·12·16·24·32로 바꾸며 각각 75초씩 돌리고 앞 25초를 버렸습니다. vLLM이 쓸 GPU 메모리 몫은 SemiAnalysis와 같은 92%·85%에, 더 줄인 75%를 더했습니다.
동시 세션
92% (KV 21.0GiB, 17.2만 토큰)
85% (KV 18.3GiB, 15.0만 토큰)
75% (KV 14.3GiB, 11.8만 토큰)
2
96
96
96
4
144
144
144
8
156
124 (−21%)
80 (−49%)
12
132
100 (−24%)
66 (−50%)
16
106
84 (−21%)
86 (−19%)
(출력 토큰/초. 괄호는 92% 대비. 한 번씩 잰 값이라 ±10% 안팎은 잡음으로 보세요.)
동시 4세션까지는 세 설정의 처리량이 똑같았습니다. 네 세션의 문맥 합은 KV 자리 어디에나 들어가니, 줄인 메모리는 그냥 비어 있던 자리였습니다. 8세션부터 갈라졌습니다. 92%에서는 8세션이 가장 많은 토큰을 냈지만, 85%에서는 21%, 75%에서는 절반이 줄었습니다. 이유는 프리픽스 캐시 적중률에 그대로 보입니다. 8세션에서 92%는 토큰 기준 76%를 캐시에서 읽었는데, 85%는 56%, 75%는 53%였습니다. KV 자리가 모자라 앞부분이 밀려나면 다음 턴에 그 앞부분 전체를 다시 프리필해야 하고, 그 계산이 디코드를 밀어냅니다. 75%에서는 12세션에서 요청 지연 중앙값이 5초에서 17초로 뛰었습니다.
16세션을 넘으면 세 설정이 모두 무너져 비슷해집니다. 어느 쪽이든 문맥 합이 KV 자리를 크게 넘어, 세션들이 캐시 없이 서로를 밀어내는 상태가 됩니다(24·32세션에서 처리량이 오히려 조금 오르는 것은 세션들이 첫 턴의 캐시 없는 프리필에 머무는 비중이 커져 일감의 모양이 바뀌었기 때문입니다).
정리하면 SemiAnalysis의 실험과 같은 모양입니다. KV 자리를 줄여도 동시 세션들의 살아 있는 문맥이 그 자리 안에 들어가는 동안에는 아무 일도 없고, 넘는 순간부터 캐시 재계산이 처리량을 갉아먹습니다. 다른 점은 우리 실험에 D램 오프로드가 없었다는 것입니다. 밀려난 KV를 D램에 받아 줬다면 8~12세션의 낙폭은 더 작았을 것입니다. 그 차이가 바로 SemiAnalysis가 동시 70까지 손실이 거의 없었던 이유 가운데 하나입니다.
여기서 실무 교훈 하나가 나옵니다. 'HBM이 얼마나 필요한가'의 답은 가중치 크기가 아니라 동시에 살아 있는 문맥의 합 × 토큰당 KV 이고, 그 합을 넘는 메모리는 놀고, 모자라는 메모리는 재계산으로 값을 치릅니다. 그 경계는 일감(세션 수·문맥 길이)과 모델(토큰당 KV)과 KV 계층 설계(D램 오프로드)가 함께 정합니다.
지금까지는 쓰는 쪽(연구소·클라우드)의 계산이었습니다. 이번에는 만드는 쪽에서 봅니다. SemiAnalysis는 엔비디아가 Rubin Ultra에서 HBM을 줄인 이유가 "상당 부분 공급 때문"이라고 씁니다. "HBM 웨이퍼가 모자란다. 엔비디아가 내년에 확보한 N3 로직과 CoWoS를 받쳐 줄 만큼의 12단 큐브를 만들 웨이퍼가 없다. 8단으로 가면 한정된 웨이퍼에서 큐브를 훨씬 많이 만들어 차이를 메울 수 있다." 게다가 HBM 값이 내년에 크게 오르면서, GPU 수요가 공급을 한참 넘는 지금도 엔비디아가 마진 일부를 내줘야 하는 상황이고, 부품 원가 가운데 가장 큰 것이 메모리라는 것입니다.
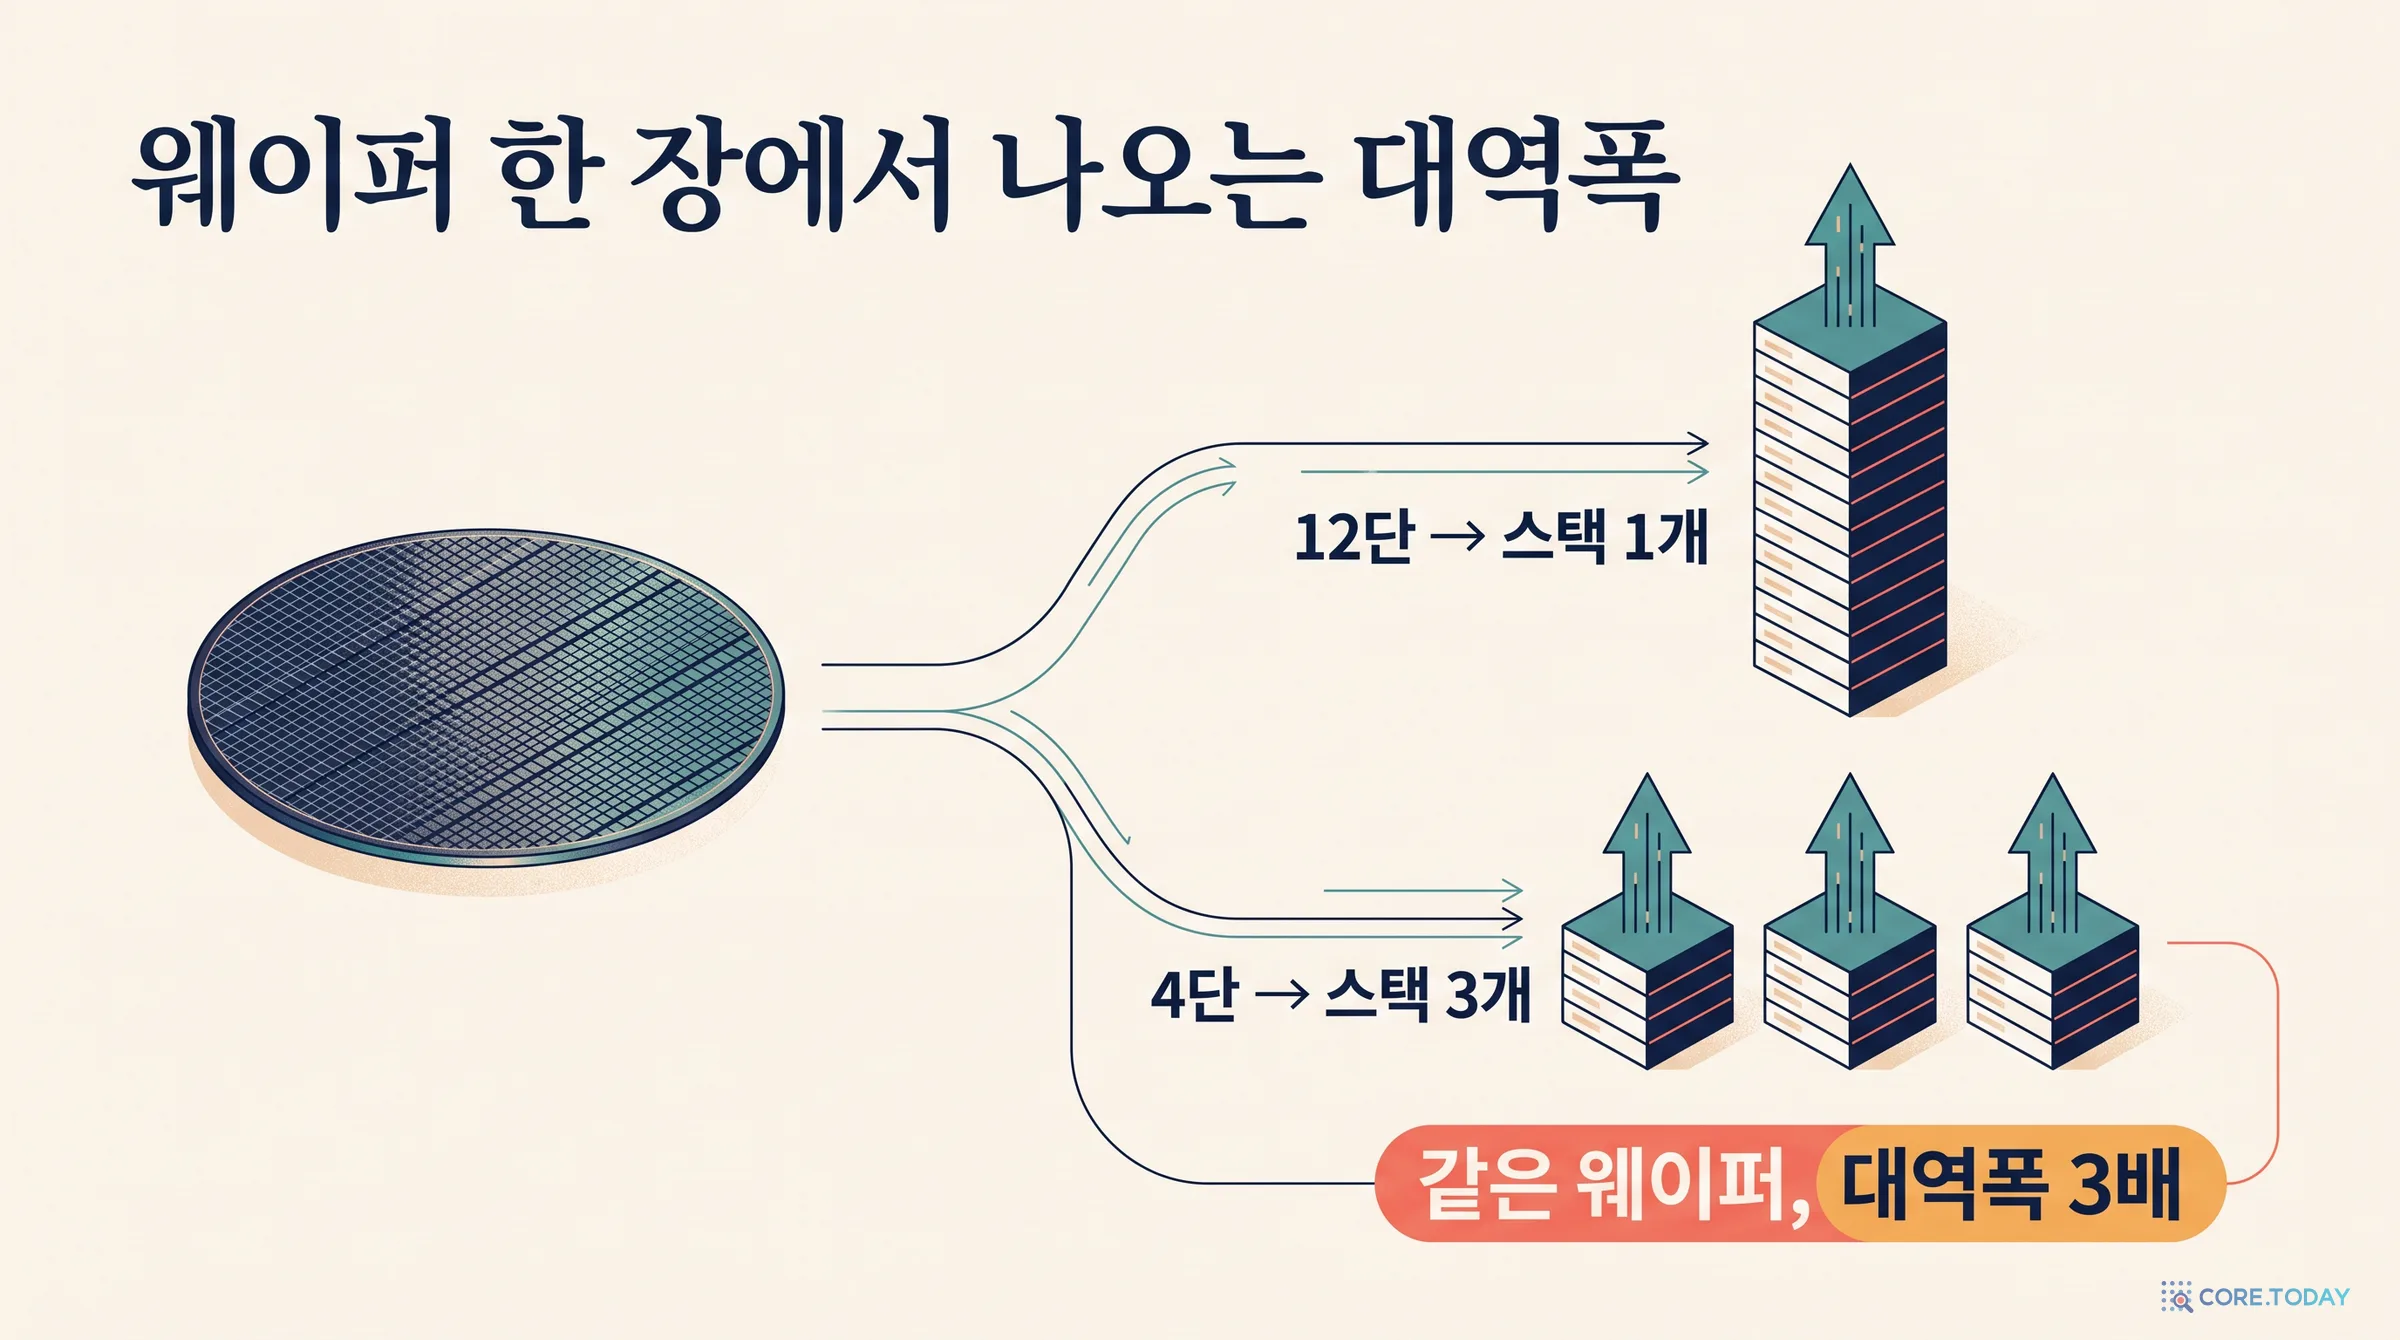
그러면서 SemiAnalysis는 새 잣대를 제안합니다. 전력이 모자라면 토큰/와트를, 돈이 모자라면 토큰/총소유비용을 최적화하듯, HBM 웨이퍼가 모자라면 토큰/HBM 웨이퍼를 최적화해야 한다는 것입니다. 방법은 단순합니다. 같은 대역폭을 4단 스택에서도 얻을 수 있으니, 웨이퍼 한 장을 4단으로 쌓으면 12단으로 쌓을 때보다 3배, 8단보다 2배의 대역폭이 나옵니다. 4단의 패키징 수율이 더 높으니 실제 차이는 그보다 큽니다. 그리고 디코드 처리량은 대개 메모리 대역폭에 비례합니다.
웨이퍼D램 코어 다이 D개 (용량은 층수와 무관하게 D × 4GB)
쌓기h단으로 묶으면 스택 D/h개. 스택마다 베이스(로직) 다이 1개와 패키징이 하나씩 필요
물론 공짜는 아닙니다. 4단으로 큐브 수가 두 배, 세 배가 되면 그 큐브를 붙일 가속기·베이스 다이용 로직 웨이퍼·기판·PCB·조립 능력과 전력이 그만큼 더 필요합니다. SemiAnalysis는 "병목이 HBM 웨이퍼에서 공급망의 다른 곳으로 옮겨 간다"고 인정하면서도, "앞으로 몇 년 동안 나머지 공급망은 D램 공급보다 빨리 늘릴 수 있다"고 봅니다. 그리고 설령 AI 서버 쪽이 큐브를 다 소화하지 못해도, 남는 웨이퍼는 HBM에 잡아먹혀 부족해진 일반 D램, 특히 서버 D램으로 돌아갈 수 있다고 덧붙입니다. 소켓당 D램을 크게 깎고 있는 지금의 서버 D램 부족은 에이전트와도 이어집니다. 에이전트는 GPU가 토큰을 디코드하는 시간보다 CPU 쪽 실행을 기다리는 시간이 길 때가 많기 때문입니다.
D램은 왜 이렇게 귀해졌나
'웨이퍼가 모자라다'는 전제는 SemiAnalysis의 2월 글 「메모리 광풍(Memory Mania)」에 배경이 있습니다. 이 글의 가장 중요한 숫자는 이것입니다. 지난 10년 동안 D램 밀도는 모두 합쳐 약 2배밖에 늘지 않았다. 업계 전성기에는 10년에 약 100배였습니다. D램 셀이라는 '전하 양동이'가 종횡비 100 대 1에 가까운 빨대 모양이 되어 전자 수만 개만 담고, 신호가 약해 비트라인과 센스 앰프가 병목이 됐기 때문입니다.
밀도가 안 늘면 비트당 원가도 예전처럼 떨어지지 않고, 가격은 기술보다 증설과 수급 주기에 더 휘둘립니다. 공급을 늘리는 길은 두 가지입니다. 새 팹을 짓거나(수년이 걸립니다), 더 앞선 공정으로 옮겨 웨이퍼당 비트를 늘리는 것입니다. 글에 따르면 삼성전자의 1c 공정은 1a 공정보다 웨이퍼당 비트가 약 70% 많습니다. 팹 가동률은 호황에 약 95%, 깊은 불황에 약 50%까지 오르내리고, 1990년대 중반 20곳 넘던 의미 있는 D램 공급사는 이제 3~4곳 입니다.
이 맥락에서 '높이 쌓기'는 밀도가 안 늘어나는 D램으로 용량을 늘리는 거의 유일한 방법이었습니다. 다이를 더 촘촘하게 못 만드니 더 많이 쌓은 것입니다. 4단 이야기는 그 방향을 거꾸로 돌리자는 제안입니다. 용량을 다이 수로 채우지 말고, 필요한 만큼만 채운 뒤 남는 웨이퍼를 대역폭(스택 수)으로 바꾸자는 것입니다.
한 가지 시점 차이를 짚어 둡니다. 「메모리 광풍」은 2월 글이고, 4단 주장은 9월 글입니다. 2월 글은 HBM과 D램의 수급·가격·공급사별 HBM4 점유율 전망을 2027년까지 담았다고 소개하지만 그 부분은 유료이고, 그 전망에 4단 전환이 반영돼 있었는지는 알 수 없습니다.
하이브리드 본딩은 2029년 전에는 오지 않는다
높이 쌓기와 관련된 또 하나의 기술 축이 하이브리드 본딩(HB) 입니다. 다이 사이를 범프 없이 구리 패드끼리 직접 붙이는 방식으로, 층을 더 얇고 촘촘하게 쌓을 수 있어 16단 이상 HBM의 열쇠로 꼽혀 왔습니다. SemiAnalysis의 10월 15일 글은 ASML이 다이-웨이퍼(D2W) 하이브리드 본딩 장비를 만들고 있다는 분석(2022년 12월~2024년 11월 본딩 특허 27건)을 다루면서 이렇게 씁니다.
"우리는 HBM이 2029년 전에는, 어쩌면 영영 D2W 하이브리드 본딩을 쓰지 않을 것이라고 본다."
지금 D2W 장비의 처리량 상한은 시간당 웨이퍼 약 1장입니다. 4단이 주류가 된다면 '더 높이 쌓기 위한 본딩'의 시급함은 그만큼 줄어든다는 해석이 자연스럽지만, 이것은 코어닷투데이의 추론이고 원문이 두 주장을 직접 잇지는 않았습니다. 같은 글은 HBM 본딩 장비에서 "한국 도전자들이 따라잡고 있다"고 쓰고, ASML의 유력 협력사 Prodrive가 한화세미텍의 본더 SHB2 Nano를 만들었다고 적었습니다.
모델 설계도 HBM을 덜 쓰는 쪽으로
하드웨어만 움직이는 것이 아닙니다. 모델 설계가 같은 방향으로 가고 있습니다. 3장에서 본 KV 압축의 흐름(DeepSeek V3.2 48kB → V4 Flash 3.5kB → V4.1 Flash 0.9kB)이 그 하나입니다. SemiAnalysis는 4단 글에서 V4.1 Flash가 V4 Flash보다 활성 KV를 약 75% 줄였다며, "이 정도로 줄면 HBM 용량을 다 채우려고 동시성을 올릴 때 일감이 용량보다 계산과 네트워크에 묶이게 되고, 그만큼 높은 스택의 가치도 줄어든다"고 썼습니다.
다른 하나는 9월 18일 글이 다룬 엔그램(Engram) 입니다. 자주 나오는 토큰 묶음(n-gram)의 벡터를 큰 표에서 찾아 쓰는 구조로, DeepSeek V4.1 Flash는 이 표만 약 189GiB입니다. 토큰 하나가 읽는 행은 몇 개뿐이고 주소가 토큰 id로 정해지니, 호스트 D램에서 미리 가져올 수 있습니다. SemiAnalysis의 측정에서 B300에서는 이 표를 HBM으로 옮겨도 성능이 나아지지 않았고(측정 오차 안), 오히려 D램에 두어 GPU 수를 줄인 설정(TP4 → TP2)이 파레토 곡선을 최대 1.6배 끌어올렸습니다. SSD까지 내리는 것은 아직 손해였습니다. B200에서 사용자당 약 125 tok/s일 때 D램은 1달러당 1억 2,100만 토큰, SSD는 5,200만 토큰이었습니다. 이 글의 결론 문장은 4단 글과 똑같습니다. "그래서 HBM 대역폭이 HBM 용량보다 훨씬 중요하다."
메모리 회사에 대한 열린 질문
SemiAnalysis는 4단 글을 이렇게 끝냅니다. "유료 구간에서는 이것이 메모리 공급사에 어떤 영향을 주는지, 4단이 그들에게 어떻게 이득이 될 수 있는지, 그들이 어떻게 대응하고 있는지를 다룬다." 글의 부제는 "연구소의 총소유비용과 메모리 공급사의 수익성 모두에 윈윈"입니다. 그러나 그 근거는 잠겨 있습니다. 코어닷투데이는 SK하이닉스와 삼성전자 가운데 누가 유리한지 추정하지 않습니다. 대신 공개된 산수에서 바로 나오는 질문을 정리합니다.
질문 1가격이 GB를 따라간다면, 같은 웨이퍼를 4단으로 팔든 12단으로 팔든 웨이퍼당 매출은 비슷합니다. 그런데 스택 수가 3배면 베이스 다이·TSV·적층·검사 비용도 늘어납니다. 그 비용은 GB당 가격에 얹힐까요, 아니면 '대역폭 프리미엄'으로 따로 매겨질까요?
질문 2SemiAnalysis는 4단으로 늘어날 수요 목록에 'HBM 베이스 다이용 로직 웨이퍼'를 넣었습니다. 스택 수가 늘면 베이스 다이 수요도 같은 비율로 늡니다. 그 몫은 메모리 회사 안에 남을까요, 파운드리로 갈까요?
질문 312단·16단 적층 수율과 본딩 기술은 지금까지 공급사 사이의 차별점이었습니다. 4단이 표준이 되면 그 차별점의 값은 줄고, 대역폭(핀 속도)과 원가가 경쟁의 축이 됩니다. 이 변화는 누구에게 유리할까요?
질문 4남는 웨이퍼가 서버 D램으로 돌아간다면 일반 D램 가격과 이익률은 어떻게 될까요? 에이전트 KV 오프로드는 바로 그 서버 D램을 'HBM KV의 1.5~3배'만큼 원합니다.
참고로 SemiAnalysis의 다른 공개 구간에는 공급사 이름이 나오는 대목이 몇 군데 있습니다. OpenAI의 추론 칩 'Jalapeño'의 HBM4(핀당 10Gbps)는 "아마 삼성전자가 공급"하고(8월 25일 글), 엔비디아가 인수한 Groq 계열의 차세대 LP40은 SK하이닉스의 하이브리드 본딩 D램을 쓴다고 했습니다(3월 24일 글). 이런 개별 공급 소식은 4단 전환의 손익과는 별개의 이야기입니다.
7장. 반론과 한계 — 어디까지 믿을까
이 글의 논리는 "에이전트 일감은 미드필 → KV는 대부분 쉰다 → 용량보다 대역폭과 계층 이동 → 낮게 쌓은 HBM"으로 이어집니다. 고리마다 약한 곳이 있습니다.
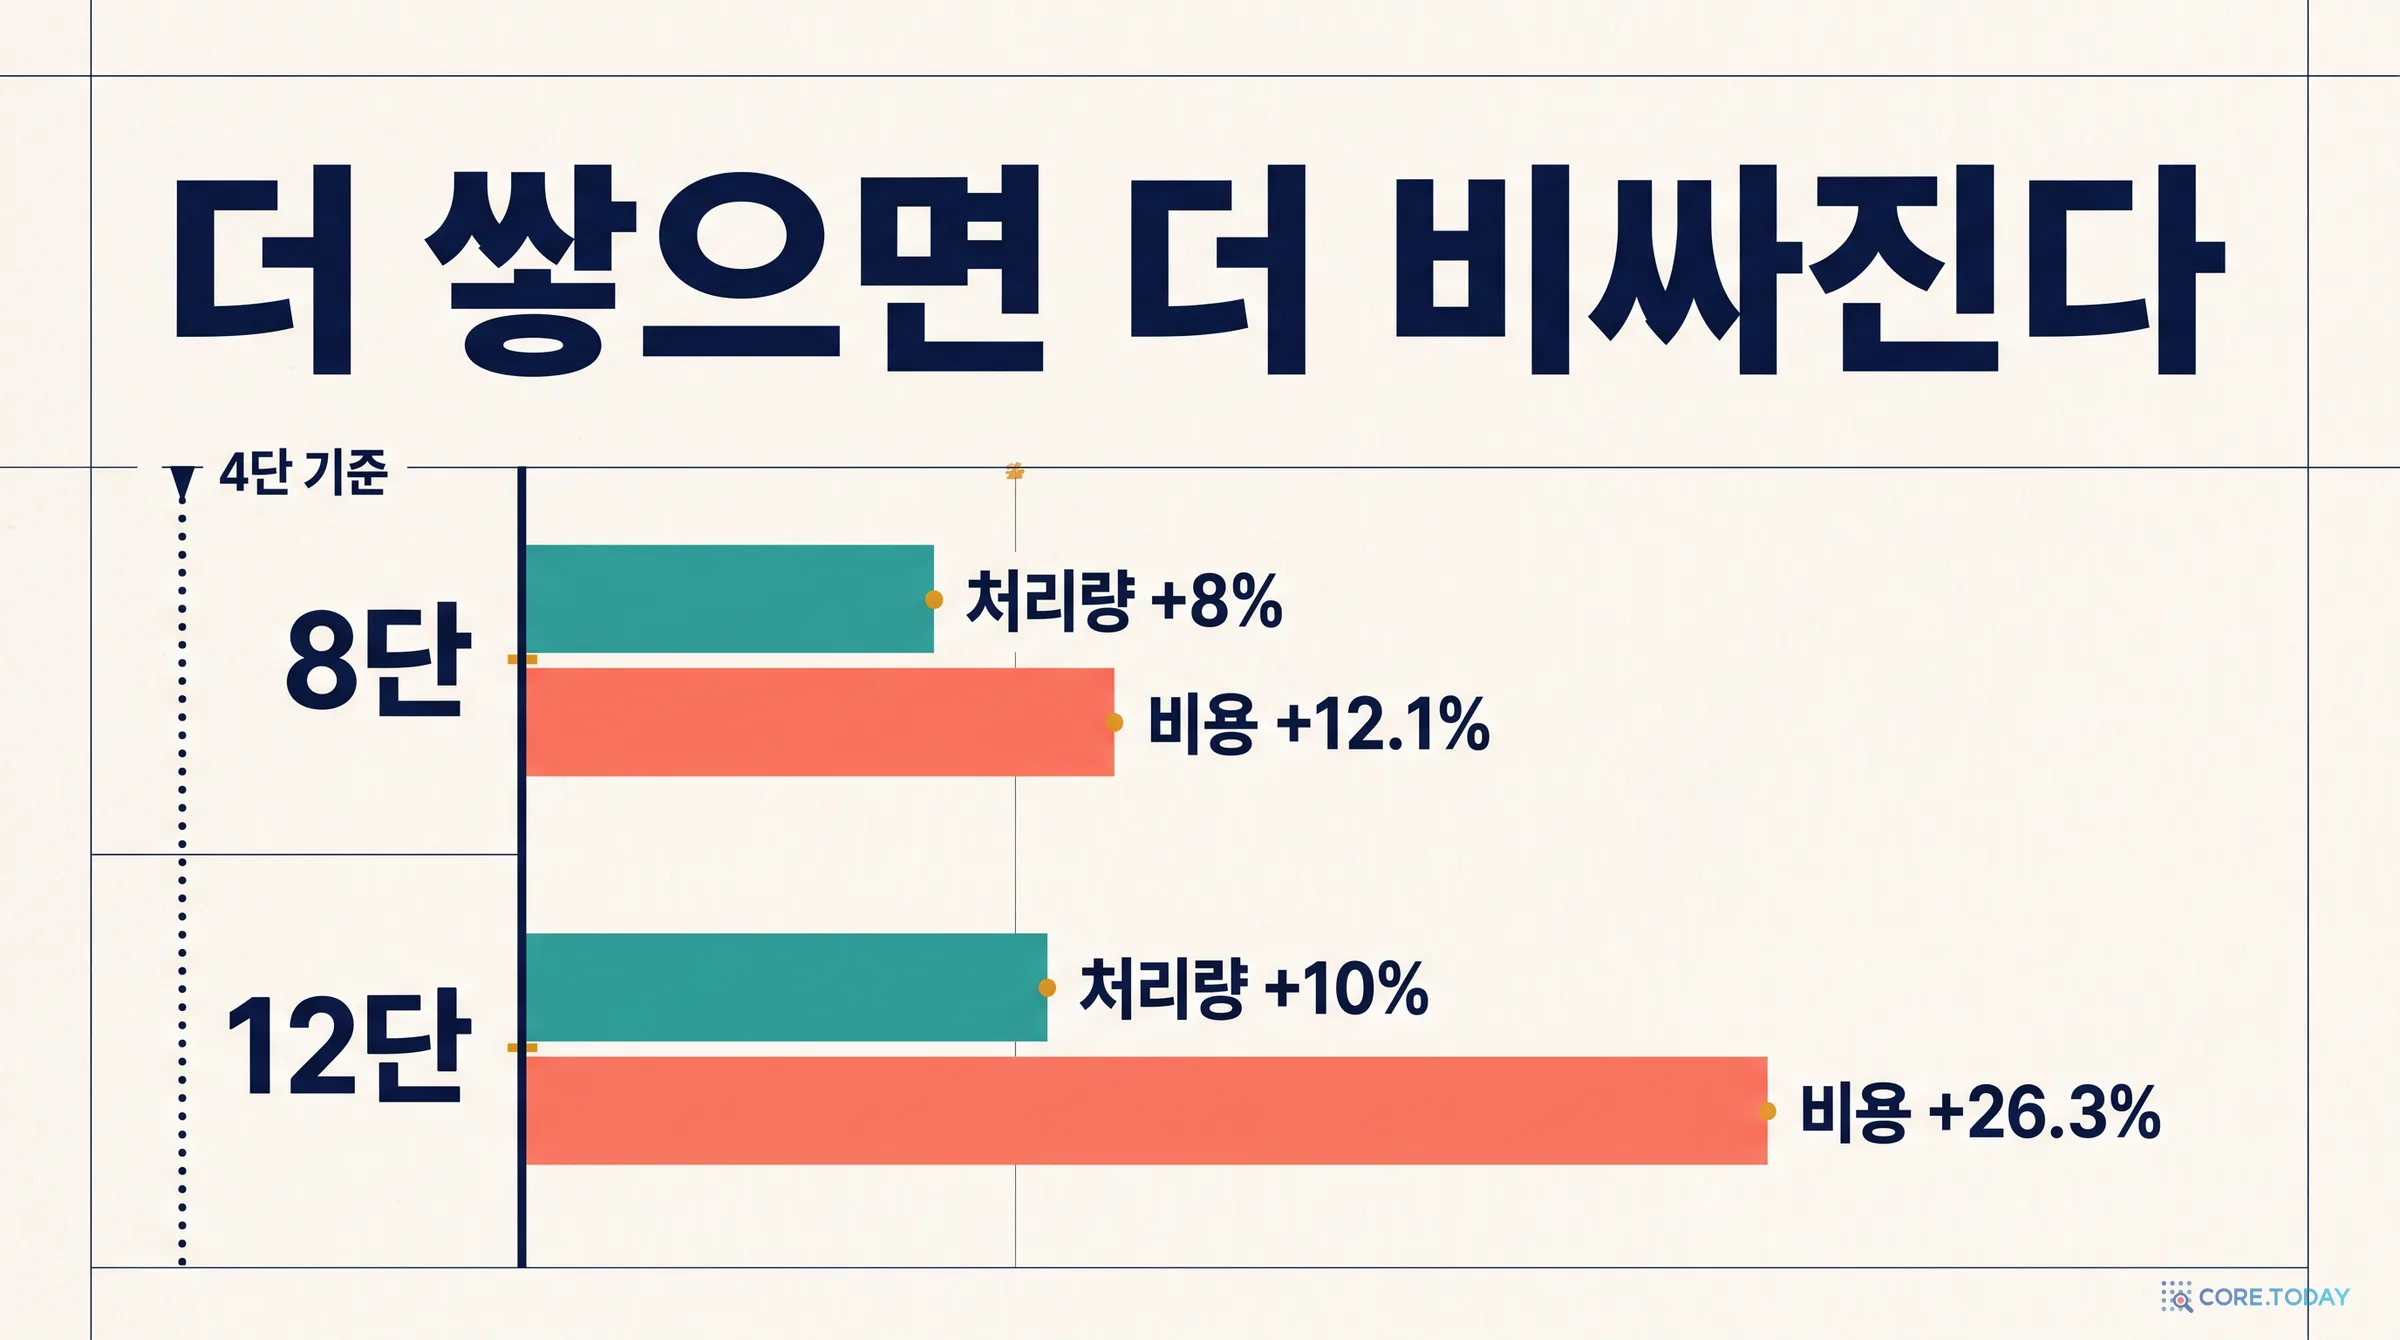
루프라인과 예측이다. 4단의 손익 계산(8단 +8%/+12.1%, 12단 +10%/+26.3%)은 Rubin Ultra NVL576과 HBM4E라는 아직 나오지 않은 시스템 위에서 이론 최대 대역폭으로 계산한 값입니다. 9월 21일 글의 'GPU당 80GB 아래'도 SemiAnalysis 스스로 "측정한 벤치마크 결과가 아니라 일감·하드웨어 예측"이라고 적었습니다. 실제로 측정한 것은 GB300 16장에서 HBM 한도를 92%에서 85%로 줄인 실험 하나입니다(5장).
미래 모델이 커지면 결론이 뒤집힌다. SemiAnalysis가 직접 보였듯, 모델이 3배가 되면 8단이 사용자당 180 tok/s 아래에서 비용 대비 이득입니다. 서버는 5년 넘게 쓰입니다. 4단을 고른 시스템은 그 5년 동안 더 큰 모델이 나오지 않는다는 데 거는 셈입니다. "루프 트랜스포머로 가중치 없이 깊이를 키운다", "연구소 하드웨어 팀이 4단을 원한다는 것 자체가 신호다"는 근거는 설득력이 있지만 검증된 사실은 아닙니다.
메모리 회사 쪽 계산은 비어 있다. 부제의 '윈윈'을 뒷받침할 공급사 분석은 유료 구간입니다. 4단이 연구소의 토큰 원가를 낮춘다는 계산과, 그것이 메모리 회사의 이익에 좋다는 주장은 다른 문제입니다. 이 글은 후자를 판단하지 않았습니다.
코어닷투데이 로그는 한 사람, 한 도구, 클라이언트 쪽이다. 6만 1,931번 호출은 한 사람의 맥 한 대, Claude Code 한 가지 도구에서 나온 26일치입니다. 다른 에이전트(고객 상담, 검색)는 분포가 다를 수 있습니다. cache_read는 요금 단위이지 서버 HBM 적중이 아니고, Anthropic 서버의 캐시 계층과 모델 구조는 공개되지 않았습니다. 압축·캐시 재계산은 숫자 패턴으로 정한 기준이라, 대화 되감기나 큰 파일 읽기가 섞였을 수 있습니다.
KV 계산은 이론값이다. 실제 엔진은 페이지 할당·버퍼 때문에 조금 더 씁니다. 선형 주의 상태 fp32, MiniMax M3 색인 키 제외는 가정이고, DeepSeek V4·V4.1은 공식 값을 썼습니다.
vLLM 실험은 작은 모델, 작은 GPU, 짧은 시간이다. Llama 3.1 8B를 A100 40GB 한 장에서 조건마다 50초씩 한 번 잰 것입니다. SemiAnalysis의 GB300 16장 분리 서빙, Kimi K3, D램 오프로드가 켜진 환경과는 규모가 다르고, 우리 실험에는 D램 오프로드가 없습니다. 같은 '모양'을 확인한 것이지 같은 '숫자'를 재현한 것이 아닙니다.
SemiAnalysis의 입장. SemiAnalysis는 메모리 수급 모델을 기관 고객에게 팔고 엔비디아·AMD·프런티어 연구소들과 긴밀히 일하는 회사입니다. 측정값과 의견을 구분해 적으려 했지만, 그들의 결론이 고객 관계와 무관하다고 볼 수는 없습니다.
HBM 이야기는 한국 경제 기사에서 늘 '몇 단을 누가 먼저 양산하나'의 경쟁으로 그려졌습니다. 12단 다음은 16단, 그다음은 하이브리드 본딩이라는 사다리입니다. SemiAnalysis의 두 글은 그 사다리가 추론의 시대에 꼭 위로만 뻗지는 않을 수 있다는 가능성을 제기합니다. GPU당 HBM이 줄면 물량(GB)의 성장은 둔해질 수 있고, 반대로 같은 GB에서 더 많은 스택(=더 많은 대역폭, 더 많은 가속기)이 나오면 다른 방식의 성장이 생길 수 있습니다. 어느 쪽이 우세할지는 공개 자료로 판단할 수 없습니다. 볼 만한 지표는 이런 것입니다.
지표 1다음 세대 가속기의 GPU당 HBM 용량과 스택 높이. Rubin Ultra의 192GB(8단)가 첫 신호였습니다.
지표 2HBM 값이 GB당으로 남는지, 대역폭·스택 단위로 바뀌는지.
지표 3새 모델의 토큰당 KV. DeepSeek은 3년 사이(V1 → V4.1 Flash) 437분의 1로 줄였습니다.
지표 4서버 D램 수요. KV·엔그램 오프로드와 에이전트의 CPU 작업이 키웁니다.
에이전트를 직접 서빙하려는 팀에게 — 실무 체크리스트
사내 문서 검색 에이전트든, 코딩 에이전트든, 공공기관용 상담 에이전트든, 한국에서 모델을 직접 올리려는 팀은 대개 "모델 가중치가 몇 GB니까 GPU 몇 장"으로 시작합니다. 에이전트 일감에서는 그것만으로 부족합니다. 이 글의 숫자로 정리한 점검표입니다.
우리 일감의 미드필 분포부터 잰다. 첫 호출의 '출발 짐'(우리 로그 중앙값 4.1만 토큰), 호출당 새 입력(1,711), 캐시된 앞부분(20만), 출력(488), 호출 간격(8.8초). 이 다섯 숫자가 용량 계획의 입력입니다.
모델을 고를 때 '토큰당 KV'를 성능표 옆에 둔다. 같은 능력이라면 토큰당 KV가 4배 작은 모델은 같은 GPU에서 동시 세션을 4배 받습니다. 한국 모델 사이에서도 49kB에서 295kB까지 차이 납니다. 위의 계산기에 우리 문맥 길이와 동시 세션 수를 넣어 보세요.
용량은 '가중치 + 동시에 디코드 중인 세션의 KV'로만 잡는다. 쉬고 있는 세션의 KV까지 HBM에 담으려 하면 GPU가 끝없이 필요합니다. 프리픽스 캐시를 켜고, 쉬는 KV는 CPU D램(가능하면 HBM KV의 1.5~3배)으로 내립니다. vLLM의 CPU 오프로드, LMCache, SGLang HiCache 같은 선택지가 있습니다.
세션을 같은 워커로 보낸다. AgentX에서 MiniMax M3는 데이터 병렬 랭크마다 KV를 따로 들고 있는데 세션이 엉뚱한 랭크로 가서, 이론상 96.0%였을 캐시 적중이 28.8%로 떨어졌습니다. 세션 id 기반 고정 라우팅이 기본입니다.
'쉬었다 돌아오는 세션'의 비용을 따로 본다. 우리 로그에서 0.55%의 호출이 새 계산의 29%를 만들었습니다. KV 보관 시간(몇 분인지 몇 시간인지)과 보관 계층을 정하는 것이 GPU 증설보다 싼 경우가 많습니다.
압축 정책을 메모리 정책으로 본다. 에이전트가 언제, 얼마로 문맥을 접는지가 KV 작업 집합의 상한을 정합니다. 우리 로그에서는 약 38만 토큰에서 9.5만 토큰으로 접혔습니다.
처리량보다 '사용자당 속도'를 먼저 정한다. 4단·8단·12단의 손익은 요구하는 tok/s/user에 따라 뒤집힙니다. 에이전트는 사람이 기다리는 시간이 곧 비용이라, 큰 배치로 처리량을 짜내는 것보다 작은 배치로 빨리 도는 편이 나을 때가 많습니다. SemiAnalysis는 긴 문맥 디코드의 최적 배치가 "큰 처리량 지향 배치보다 1이나 5에 훨씬 가까울 수 있다"고 썼습니다.
GPU를 고를 때 GB보다 TB/s를 본다. 같은 예산이면 대역폭이 높은 쪽이 디코드 토큰을 더 냅니다. 용량은 문턱만 넘으면 됩니다. 문턱은 2번과 3번으로 계산합니다.
맺음말 — 놀고 있는 바이트, 움직이는 바이트
코어닷투데이의 코딩 에이전트는 26일 동안 146억 토큰을 '다시 읽고', 3억 4천만 토큰을 새로 처리하고, 7,200만 토큰을 썼습니다. 다시 읽은 것이 새로 처리한 것의 43배, 쓴 것의 200배입니다. 에이전트가 하는 일의 대부분은 이미 아는 것을 다시 펼쳐 보는 일입니다. 그 펼쳐 보기를 어디서, 얼마나 빨리 하느냐가 에이전트 시대의 메모리 문제입니다.
SemiAnalysis는 그 문제를 두 문장으로 요약했습니다. "메모리에 가만히 앉아 있는 데이터는 비용이고, 움직이는 데이터는 매출이다." 그리고 "4단 HBM은 대역폭 1달러당 값이 가장 싸서 토큰당 비용이 가장 낮다." 앞 문장은 코어닷투데이의 로그와 실험이 뒷받침합니다. 대화는 짧게 일하고 길게 쉬며, KV 자리를 줄여도 동시 사용자가 일정 수를 넘기 전까지는 아무 일도 일어나지 않았습니다. 뒷 문장은 아직 미래의 시스템에 대한 계산이고, 모델이 커지면 뒤집힐 수 있으며, 그것이 메모리 회사에 어떤 의미인지는 공개된 글만으로는 알 수 없습니다.
그래도 방향 하나는 분명해 보입니다. HBM의 경쟁이 '얼마나 높이 쌓나'에서 '얼마나 빨리, 얼마나 싸게 읽어 주나'로 옮겨 가고 있고, 그 옆에서 D램과 SSD, 네트워크와 스케줄러가 KV를 옮기는 일을 나눠 맡기 시작했습니다. 메모리를 만드는 나라의 독자에게도, 그 메모리 위에서 에이전트를 돌리려는 팀에게도, 물어야 할 질문이 '몇 GB'에서 '몇 TB/s, 그리고 쉬는 바이트는 어디에'로 바뀌고 있습니다.
참고문헌
SemiAnalysis 뉴스레터 (newsletter.semianalysis.com, 각 글의 무료 공개 구간)